Améliorez la Gestion des incidents
Optimisez la résolution des incidents grâce à notre guide en 6 étapes.
Améliorez la Gestion des incidents
Gestion des incidents
ServiceNow

Sélectionnez un processus

Choisissez un processus pour continuer à travailler dans votre espace de travail connecté.

Processus disponibles
Systèmes disponibles

Optimisez la résolution des incidents dans la Gestion des problèmes de ServiceNow

La plateforme vous aide à repérer les goulots d’étranglement qui retardent la résolution des incidents. Elle met en évidence les flux de travail inefficaces et les étapes qui entraînent des dépassements des accords de niveau de service. Vous pouvez alors cibler les améliorations, optimiser les processus, gagner en efficacité et améliorer la satisfaction générale. Les incidents sont ainsi résolus plus rapidement et les exigences de conformité mieux respectées.

Téléchargez notre modèle de données préconfiguré et découvrez les défis courants pour atteindre vos objectifs d’efficacité. Suivez notre plan d’amélioration en six étapes et consultez le guide du modèle de données pour transformer vos opérations.

Afficher la description détaillée

Pourquoi l’optimisation de la Gestion des incidents est essentielle

Une Gestion des incidents efficace est indispensable à la fiabilité des services informatiques. Dans un environnement numérique qui évolue rapidement, chaque minute pendant laquelle un incident reste sans solution peut avoir des conséquences importantes pour l’activité : baisse de la productivité des utilisateurs, insatisfaction des clients et, parfois, perte de revenus. Dans ServiceNow, la présence d’outils performants ne suffit pas à garantir l’efficacité. De nombreuses organisations font face à des délais de résolution, à des réaffectations fréquentes et à un manque de visibilité sur les raisons pour lesquelles certains incidents prennent plus de temps que d’autres à résoudre. Ces inefficacités augmentent les coûts opérationnels, mobilisent des ressources d’assistance précieuses et peuvent entraîner le non-respect des accords de niveau de service, nuire à la réputation de votre organisation et donner lieu à des pénalités. Comprendre le déroulement réel de votre processus de Gestion des incidents est la première étape vers l’excellence opérationnelle.

Comment le Process Mining révèle le déroulement des incidents dans ServiceNow

Le Process Mining s’appuie sur les données pour examiner et comprendre l’exécution réelle de votre processus de Gestion des incidents dans ServiceNow. Plutôt que de vous fier à des suppositions ou à des témoignages isolés, il extrait les journaux d’événements directement de vos données ServiceNow, en particulier de la table incident et de ses liens avec les tables problem, problem_task et known_error. Il reconstitue le parcours de chaque incident, du signalement initial à la clôture, et présente visuellement toutes les variantes du processus. Cette vue de bout en bout vous permet de voir précisément où les incidents passent le plus de temps, de repérer les détours inattendus et de découvrir les causes profondes des retards. Vous pouvez suivre des activités importantes comme « Incident signalé », « Diagnostic lancé », « Transféré à une équipe spécialisée » et « Résolution appliquée/testée » pour comprendre comment elles se déroulent réellement. Cette capacité d’analyse est essentielle pour optimiser les processus à partir des données et transformer votre approche de la résolution des incidents.

Repérer les principaux axes d’amélioration de la résolution des incidents

Le Process Mining vous donne une vision claire des aspects du processus qui peuvent être optimisés. Vous pouvez notamment examiner les points suivants :

  • Repérage des goulots d’étranglement : repérez facilement les étapes, les groupes ou les agents où les incidents restent régulièrement bloqués ou subissent des retards prolongés, ce qui ralentit leur résolution. La phase de catégorisation initiale prend-elle trop de temps ? Les transferts entre niveaux d’assistance entraînent-ils des attentes importantes ?
  • Analyse des variantes du processus : découvrez et analysez les parcours non standard des incidents. Comprenez pourquoi certains s’écartent du déroulement prévu et mesurez les conséquences de ces écarts sur le temps de cycle et la consommation de ressources. Vous pourrez ainsi généraliser les pratiques efficaces.
  • Boucles de reprise et réaffectations : visualisez les cas où les incidents sont souvent réaffectés ou renvoyés à une étape précédente. Ces situations peuvent révéler des problèmes de diagnostic initial, des lacunes dans les articles de la base de connaissances ou des compétences à renforcer au sein des équipes. Ces données peuvent orienter vos efforts de Gestion des problèmes dans ServiceNow en mettant en évidence les problèmes récurrents à analyser plus en détail et à prévenir.
  • Suivi du respect des SLA : mesurez les résultats par rapport aux SLA définis, non seulement dans une vue d’ensemble, mais aussi en examinant les parcours d’incidents précis pour comprendre pourquoi les SLA ne sont pas respectés et déterminer les mesures préventives à prendre.
  • Possibilités d’automatisation : repérez les tâches manuelles répétitives ou les décisions prévisibles qui pourraient être automatisées dans ServiceNow afin d’accélérer la résolution et de réduire les erreurs humaines, tout en améliorant l’efficacité globale et en raccourcissant le temps de cycle des incidents.

Des résultats concrets : résolution plus rapide et satisfaction accrue

L’application du Process Mining à la Gestion des incidents dans ServiceNow peut apporter des améliorations mesurables à l’échelle de votre organisation. En traitant les goulots d’étranglement repérés et en optimisant les processus, vous pouvez vous attendre à :

  • Réduire le temps de cycle des incidents : diminuez sensiblement le délai moyen de résolution (MTTR) pour que vos utilisateurs retrouvent plus rapidement leur capacité à travailler.
  • Mieux respecter les SLA : respectez systématiquement vos accords de niveau de service, voire dépassez les objectifs fixés, afin de renforcer la confiance et la conformité.
  • Réduire les coûts opérationnels : optimisez la répartition des ressources et limitez les efforts inutiles pour rendre les opérations d’assistance plus économiques.
  • Améliorer la satisfaction des utilisateurs : une résolution plus rapide et plus efficace des incidents améliore directement l’expérience des utilisateurs finaux et des clients.
  • Gérer les problèmes de manière préventive : les analyses des tendances liées aux incidents peuvent alimenter directement la Gestion des problèmes dans ServiceNow et vous aider à repérer et à prévenir les problèmes récurrents avant qu’ils ne touchent davantage d’utilisateurs.
  • Prendre des décisions fondées sur les données : passez du dépannage réactif à l’amélioration préventive et éclairée des processus, et inscrivez l’optimisation continue dans les pratiques de vos équipes.

Engagez votre démarche d’excellence en Gestion des incidents

L’optimisation de la Gestion des incidents est une démarche continue qui commence par une compréhension de votre situation actuelle. En appliquant le Process Mining à vos données ServiceNow, vous donnez à vos équipes les éléments nécessaires pour apporter des changements qui comptent. Vous pourrez ainsi résoudre les incidents plus rapidement, réduire les interruptions de service et améliorer la satisfaction des utilisateurs, tout en transformant en profondeur la prestation de vos services informatiques. Appuyez-vous sur les données pour tirer le meilleur parti de votre processus de Gestion des incidents.

Gestion des incidents Centre de services Opérations informatiques Respect des SLA Analyse des causes profondes Résolution des problèmes Processus ITIL Amélioration des services Gestion des tickets Gestion des tickets Assistance informatique Délai moyen de résolution MTTR Rétablissement du service Résolution des incidents Assistance informatique

Problèmes et difficultés courants

Repérez les difficultés qui vous concernent

Les retards de résolution des incidents nuisent directement à la productivité et à la satisfaction des utilisateurs, entraînant davantage d’interruptions de service et des pertes financières potentielles. Des délais prolongés peuvent aussi conduire au non-respect des accords de niveau de service, entraîner des pénalités et porter atteinte à la réputation de l’organisation. ProcessMind analyse l’ensemble du processus de Gestion des incidents dans la Gestion des problèmes de ServiceNow et repère les étapes, les équipes ou les agents à l’origine des goulots d’étranglement. La visualisation du déroulement du processus montre où les incidents restent souvent bloqués et permet de cibler les améliorations pour accélérer leur résolution.

Le non-respect répété des accords de niveau de service pour la résolution des incidents provoque la frustration des utilisateurs, nuit à la réputation de l’organisation et peut entraîner des pénalités contractuelles. Il révèle des problèmes systémiques dans le processus de Gestion des incidents qui empêchent de traiter les incidents critiques dans les délais. ProcessMind repère précisément les types d’incidents, les services ou les groupes d’affectation les plus susceptibles de ne pas respecter les SLA dans la Gestion des problèmes de ServiceNow. La visualisation des parcours réels des incidents met en évidence les écarts par rapport aux procédures standard qui contribuent au non-respect des engagements.

Une catégorisation ou une définition des priorités incorrecte peut entraîner une mauvaise affectation, retarder la résolution des incidents critiques et conduire à une répartition inefficace des ressources. Les équipes finissent souvent par gérer les urgences au coup par coup plutôt que de résoudre les problèmes de manière structurée, ce qui augmente les coûts opérationnels et l’insatisfaction des utilisateurs. ProcessMind retrace la catégorisation et la définition des priorités des incidents, et révèle les changements de catégorie ou de priorité après l’affectation initiale dans la Gestion des problèmes de ServiceNow. Ces tendances peuvent signaler des besoins de formation ou des consignes peu claires, afin d’améliorer le traitement initial des incidents.

Les réaffectations fréquentes d’incidents entre équipes ou agents allongent les délais de résolution, entraînent des efforts répétés et nuisent à l’expérience des utilisateurs. Chaque transfert peut provoquer un retard et une perte de contexte, ce qui réduit sensiblement l’efficacité et la productivité des équipes. ProcessMind cartographie le parcours complet des incidents entre les différents groupes d’affectation et agents dans la Gestion des problèmes de ServiceNow. La visualisation des transferts fréquents permet de mesurer leur effet sur le délai global de résolution et de repérer les boucles dans le processus.

Un volume élevé d’incidents récurrents indique que les problèmes sous-jacents ne sont pas repérés et résolus efficacement. Les mêmes incidents se reproduisent, les équipes perdent du temps et le processus de Gestion des incidents peine à transmettre les problèmes à la Gestion des problèmes pour qu’ils soient traités à la source. ProcessMind repère, dans la Gestion des problèmes de ServiceNow, les groupes d’incidents similaires qui suivent des parcours de résolution identiques ou très proches, souvent sans que leur cause profonde soit déterminée. Il montre où des solutions temporaires sont régulièrement appliquées au lieu de rechercher et de résoudre le problème de fond, afin d’orienter les efforts d’amélioration.

L’application systématique de solutions temporaires peut soulager immédiatement les utilisateurs, mais elle ne règle pas les problèmes sous-jacents. Elle crée une dette technique et risque de provoquer de nouvelles interruptions de service. Cette pratique peut augmenter le nombre d’incidents et masquer des problèmes systémiques plus profonds dans les opérations informatiques. ProcessMind compare, pour des incidents similaires dans la Gestion des problèmes de ServiceNow, la fréquence et la durée des solutions temporaires à celles des résolutions définitives. Il repère les services ou les catégories d’incidents pour lesquels les solutions temporaires sont utilisées de manière disproportionnée, ce qui indique où approfondir la Gestion des problèmes.

Une répartition inefficace des incidents peut surcharger certains agents tandis que d’autres sont sous-utilisés. Elle risque alors d’entraîner de l’épuisement professionnel, une baisse du moral et un allongement des files d’attente de l’assistance. L’efficacité de l’équipe et la rapidité de résolution des incidents s’en trouvent affectées. ProcessMind analyse les schémas d’affectation des incidents et l’activité des agents dans le temps au sein de la Gestion des problèmes de ServiceNow. La visualisation de leur charge de travail met en évidence les déséquilibres et les possibilités de mieux répartir les ressources, d’améliorer l’efficacité de l’équipe et de réduire les délais de réponse.

Lorsque les incidents s’écartent des parcours de résolution établis, des incohérences, des erreurs et des risques de non-conformité peuvent apparaître. Il devient alors plus difficile de prévoir les résultats et de garantir la qualité du service. Ces écarts peuvent aussi accroître le travail manuel et réduire la maîtrise du processus. ProcessMind compare les parcours réels des incidents dans la Gestion des problèmes de ServiceNow aux processus cibles ou aux bonnes pratiques définies. Il met en évidence les variantes et leur fréquence, et précise où et pourquoi les écarts se produisent, afin d’adapter les procédures et la formation.

Une communication insuffisante avec les utilisateurs concernés pendant la résolution d’un incident peut susciter de la frustration et des demandes répétées, et donner l’impression que la qualité du service est médiocre, même si l’incident est résolu dans les délais. La satisfaction des utilisateurs et la réputation du centre de services en pâtissent. ProcessMind suit le moment et la fréquence des notifications envoyées aux utilisateurs dans le processus de Gestion des incidents de la Gestion des problèmes de ServiceNow. Il repère les notifications tardives ou manquantes afin de vous aider à améliorer les échanges avec les utilisateurs.

Les retards répétés à certaines étapes du cycle de vie d’un incident, comme le diagnostic ou le transfert à une équipe spécialisée, peuvent allonger considérablement le délai global de résolution. Ces goulots d’étranglement ralentissent le processus et empêchent la prestation efficace des services, tout en créant des retards inutiles. ProcessMind mesure précisément la durée de chaque activité et transition dans le processus de Gestion des incidents de la Gestion des problèmes de ServiceNow. La visualisation met en évidence les étapes où les incidents passent le plus de temps et repère les goulots d’étranglement à traiter en priorité.

Lorsque les accords de niveau de service ne sont pas appliqués de manière cohérente ou suivis avec précision, il devient difficile de mesurer les résultats, de déterminer les responsabilités ou de définir les priorités des incidents. La réputation du service peut en pâtir et les indicateurs de performance manquer d’objectivité. ProcessMind compare les délais réels aux objectifs des SLA pour tous les incidents de la Gestion des problèmes de ServiceNow, selon leur catégorie et leur priorité. Il révèle les éventuelles erreurs de calcul des SLA et les types d’incidents qui dépassent régulièrement les objectifs, afin de préciser les règles ou les étapes du processus à revoir.

Objectifs habituels

Définissez les critères de réussite

Cet objectif consiste à réduire le délai moyen de résolution des incidents, du signalement initial à la clôture. Une résolution plus rapide réduit directement les interruptions de service, améliore la disponibilité et accroît la satisfaction des utilisateurs, autant d’éléments essentiels à l’efficacité des opérations informatiques et de la Gestion des incidents.
ProcessMind cartographie précisément le cycle de vie complet des incidents et repère les étapes ou les transferts à l’origine des retards. La visualisation des parcours réels permet aux organisations de repérer les goulots d’étranglement, de supprimer les étapes inutiles et de réduire les délais de résolution de 20 à 30 % dans la Gestion des problèmes de ServiceNow.

Atteindre cet objectif signifie respecter systématiquement les accords de niveau de service pour les incidents critiques, voire dépasser les objectifs fixés. Les manquements fréquents aux SLA révèlent des inefficacités opérationnelles et peuvent entraîner des pénalités et une perte de confiance. Un meilleur respect des engagements garantit le traitement rapide des incidents prioritaires et le maintien de la qualité du service.
ProcessMind repère tous les écarts par rapport aux objectifs des SLA en comparant la durée des incidents aux délais convenus. Il met en évidence les catégories d’incidents ou les groupes d’assistance où les manquements sont les plus fréquents, afin de cibler les mesures à prendre et d’augmenter de 15 à 25 % le taux de respect des SLA dans la Gestion des problèmes de ServiceNow.

Une catégorisation et une définition des priorités précises sont indispensables à un traitement efficace des incidents. Elles permettent de les orienter vers les bonnes équipes et de leur accorder l’attention nécessaire. Une mauvaise classification entraîne des retards, des affectations incorrectes et un gaspillage de ressources dans la Gestion des incidents.
ProcessMind analyse les attributs des incidents, comme la catégorie, la priorité et le groupe d’affectation, pour repérer les erreurs de catégorisation et les reclassements fréquents. En déterminant les causes profondes de ces erreurs, les organisations peuvent revoir leur système de catégorisation et la formation, et réduire de 10 à 15 % les incidents mal catégorisés dans la Gestion des problèmes de ServiceNow.

Des réaffectations et des transferts trop fréquents entre les groupes d’assistance ou les agents peuvent révéler un manque de clarté dans la répartition des responsabilités, des lacunes de compétences ou des règles d’orientation inefficaces. Réduire ces transferts simplifie la résolution, évite les retards et améliore l’efficacité globale de la Gestion des incidents.
ProcessMind cartographie le parcours complet d’un incident et met en évidence chaque réaffectation ainsi que le temps passé à chaque étape. Vous pouvez ainsi repérer les pratiques d’orientation inefficaces et les points où les incidents sont renvoyés d’une équipe à l’autre, puis réduire de 15 à 20 % les transferts dans la Gestion des problèmes de ServiceNow.

Cet objectif vise à réduire le nombre d’incidents qui se reproduisent parce que les problèmes sous-jacents ne sont pas résolus durablement. Un volume élevé d’incidents récurrents mobilise les ressources, augmente les coûts opérationnels et frustre les utilisateurs. Il signale également la nécessité de mieux intégrer la Gestion des problèmes.
ProcessMind repère les groupes d’incidents similaires qui renvoient à une cause profonde commune, même si les incidents semblent différents au premier abord. En reliant les incidents aux problèmes sous-jacents et aux erreurs connues, il aide les équipes à définir des priorités et à mettre en place des solutions définitives, avec une réduction potentielle de 20 à 30 % des incidents récurrents dans la Gestion des problèmes de ServiceNow.

Pour assurer la stabilité et l’efficacité à long terme de la Gestion des incidents, il est essentiel de remplacer les solutions temporaires par des solutions définitives. Cet objectif consiste à augmenter la part des incidents résolus en traitant leur cause profonde plutôt qu’en appliquant des mesures provisoires, qui entraînent souvent leur réapparition.
ProcessMind distingue les incidents résolus au moyen de solutions temporaires de ceux qui bénéficient d’une solution définitive, en analysant les codes de résolution et les liens avec les enregistrements de problèmes. Il repère les cas où les solutions définitives sont retardées ou négligées, afin d’augmenter de 10 à 15 % leur adoption dans la Gestion des problèmes de ServiceNow.

Une charge de travail inégalement répartie entre les agents peut entraîner l’épuisement de certains, la sous-utilisation d’autres et des retards dans la résolution des incidents. Cet objectif vise à affecter les incidents efficacement, en tenant compte de la capacité des agents et en améliorant les délais de réponse.
ProcessMind analyse les schémas d’affectation et le temps passé par les incidents auprès de chaque agent ou groupe, afin de mettre en évidence les déséquilibres. Il repère les agents régulièrement surchargés ou sous-utilisés, ce qui permet de mieux répartir les files d’attente et d’améliorer potentiellement de 5 à 10 % l’affectation des ressources dans la Gestion des problèmes de ServiceNow.

Les écarts par rapport aux procédures opérationnelles standard peuvent entraîner des inefficacités, des erreurs et des différences dans la qualité de résolution des incidents. Cet objectif consiste à faire respecter les bonnes pratiques et les flux de travail définis pour garantir un traitement prévisible et fiable des incidents.
ProcessMind visualise tous les parcours réels des incidents et les compare aux parcours prévus ou recommandés. Il repère les raccourcis non autorisés et les détours prolongés, afin d’aider les organisations à faire respecter les processus standard et à atteindre un taux de conformité supérieur à 90 % pour les parcours de résolution dans la Gestion des problèmes de ServiceNow.

Une communication efficace et rapide avec les utilisateurs concernés tout au long du cycle de vie d’un incident est essentielle pour gérer leurs attentes et améliorer leur satisfaction. Les lacunes de communication peuvent susciter de la frustration et entraîner des demandes supplémentaires, ce qui accroît la charge de travail des équipes d’assistance.
ProcessMind suit les événements liés aux notifications et aux confirmations des utilisateurs dans le processus de traitement des incidents. Il met en évidence les étapes où les mises à jour sont souvent retardées ou omises, afin d’améliorer les protocoles de communication et d’augmenter de 10 à 15 % la rapidité des notifications dans la Gestion des problèmes de ServiceNow.

Certaines étapes du processus de résolution des incidents peuvent devenir des points de blocage, où les incidents s’accumulent et où les délais globaux de résolution s’allongent considérablement. Cet objectif consiste à repérer et à éliminer ces goulots d’étranglement pour assurer un déroulement continu des incidents.
ProcessMind met automatiquement en évidence les étapes dont la durée est anormalement longue ou les files d’attente particulièrement importantes. La visualisation du débit et des temps d’attente à chaque étape permet de cibler les mesures à prendre et de réduire de 20 à 30 % les temps d’attente aux points critiques dans la Gestion des problèmes de ServiceNow.

Une application ou un suivi incohérent des accords de niveau de service peut conduire à des évaluations inéquitables, à une mauvaise définition des priorités et à des difficultés pour rendre compte des résultats réels. Cet objectif vise à gérer les SLA de manière uniforme et précise pour tous les incidents concernés.
ProcessMind analyse l’application et le suivi des SLA selon les types d’incidents, les priorités et les groupes d’affectation. Il révèle les différences dans le déclenchement, la suspension ou le non-respect des SLA, afin de garantir une application cohérente et équitable des règles dans la Gestion des problèmes de ServiceNow.

Les 6 étapes pour améliorer la Gestion des incidents

1

Télécharger le modèle

Que faire

Obtenez le modèle Excel conçu spécialement pour extraire les données de Gestion des incidents. Il vous aide à structurer correctement vos données en vue de leur analyse.

Pourquoi est-ce important ?

Un modèle standardisé évite les incohérences et les erreurs dans les données. Il constitue une base solide pour analyser les processus avec précision et obtenir des résultats fiables.

Résultat attendu

Un modèle Excel prêt à l’emploi, avec les colonnes adaptées aux données de Gestion des incidents.

CE QUE VOUS OBTIENDREZ

Découvrez le parcours réel de résolution de vos incidents

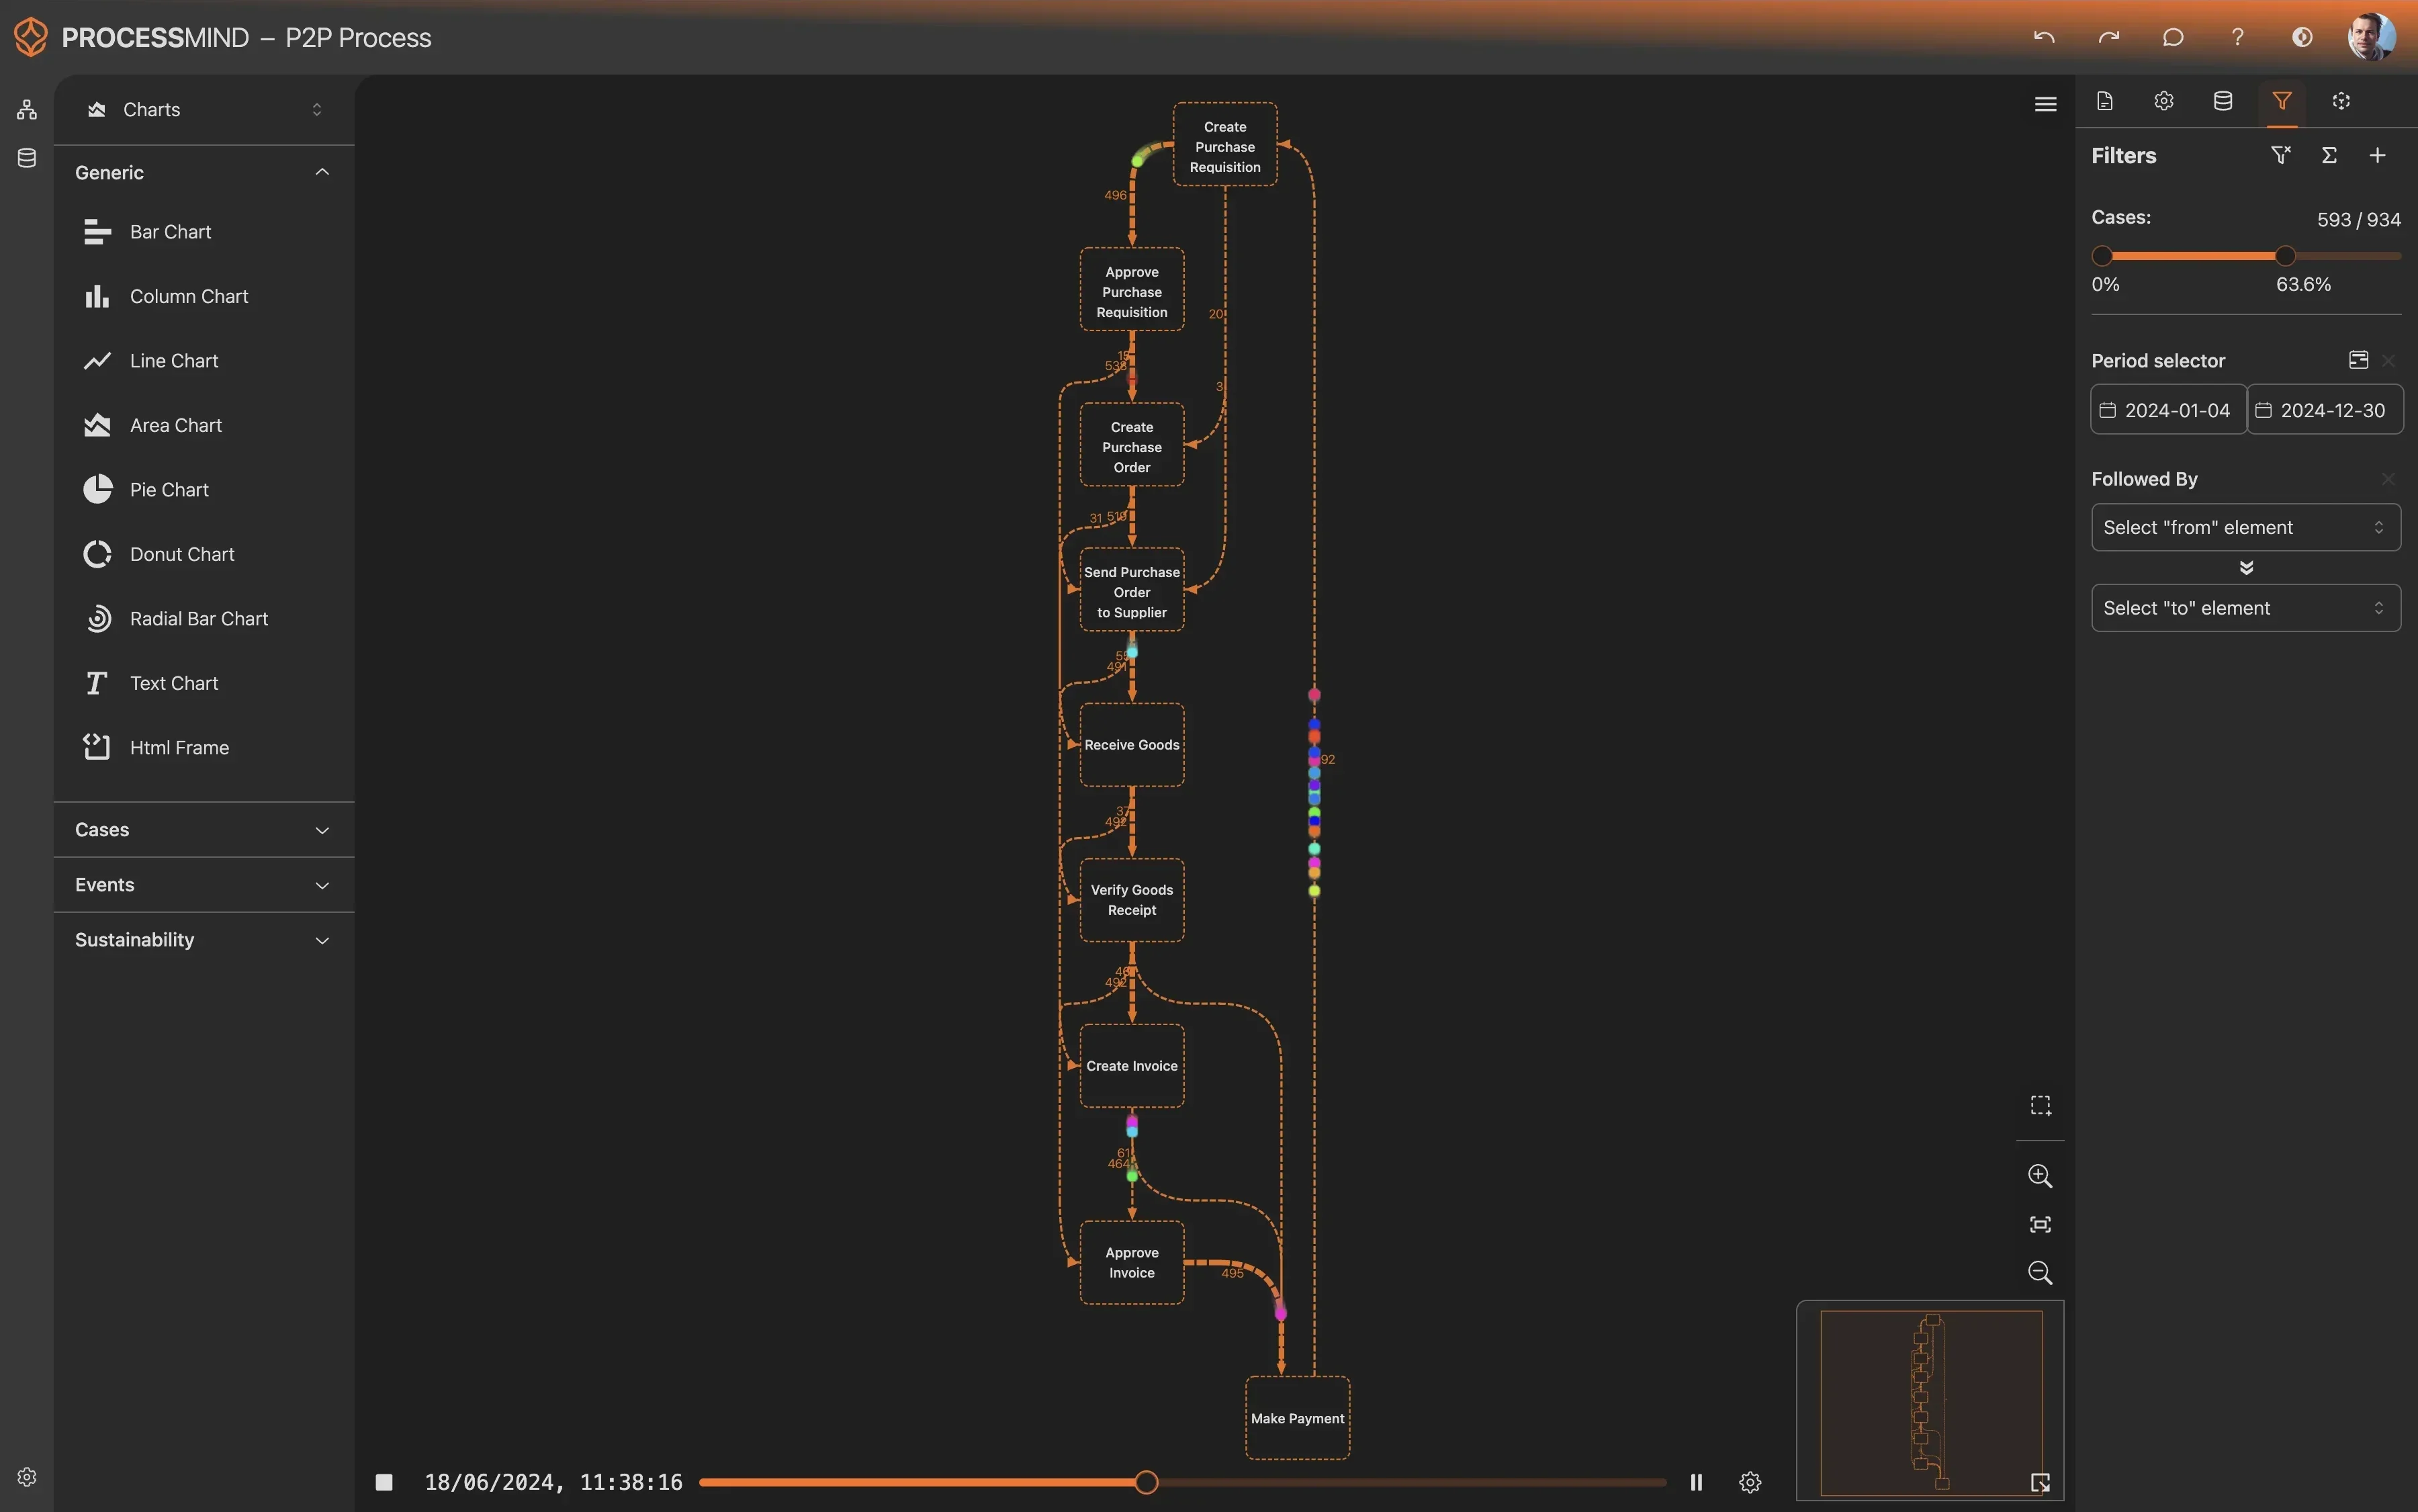
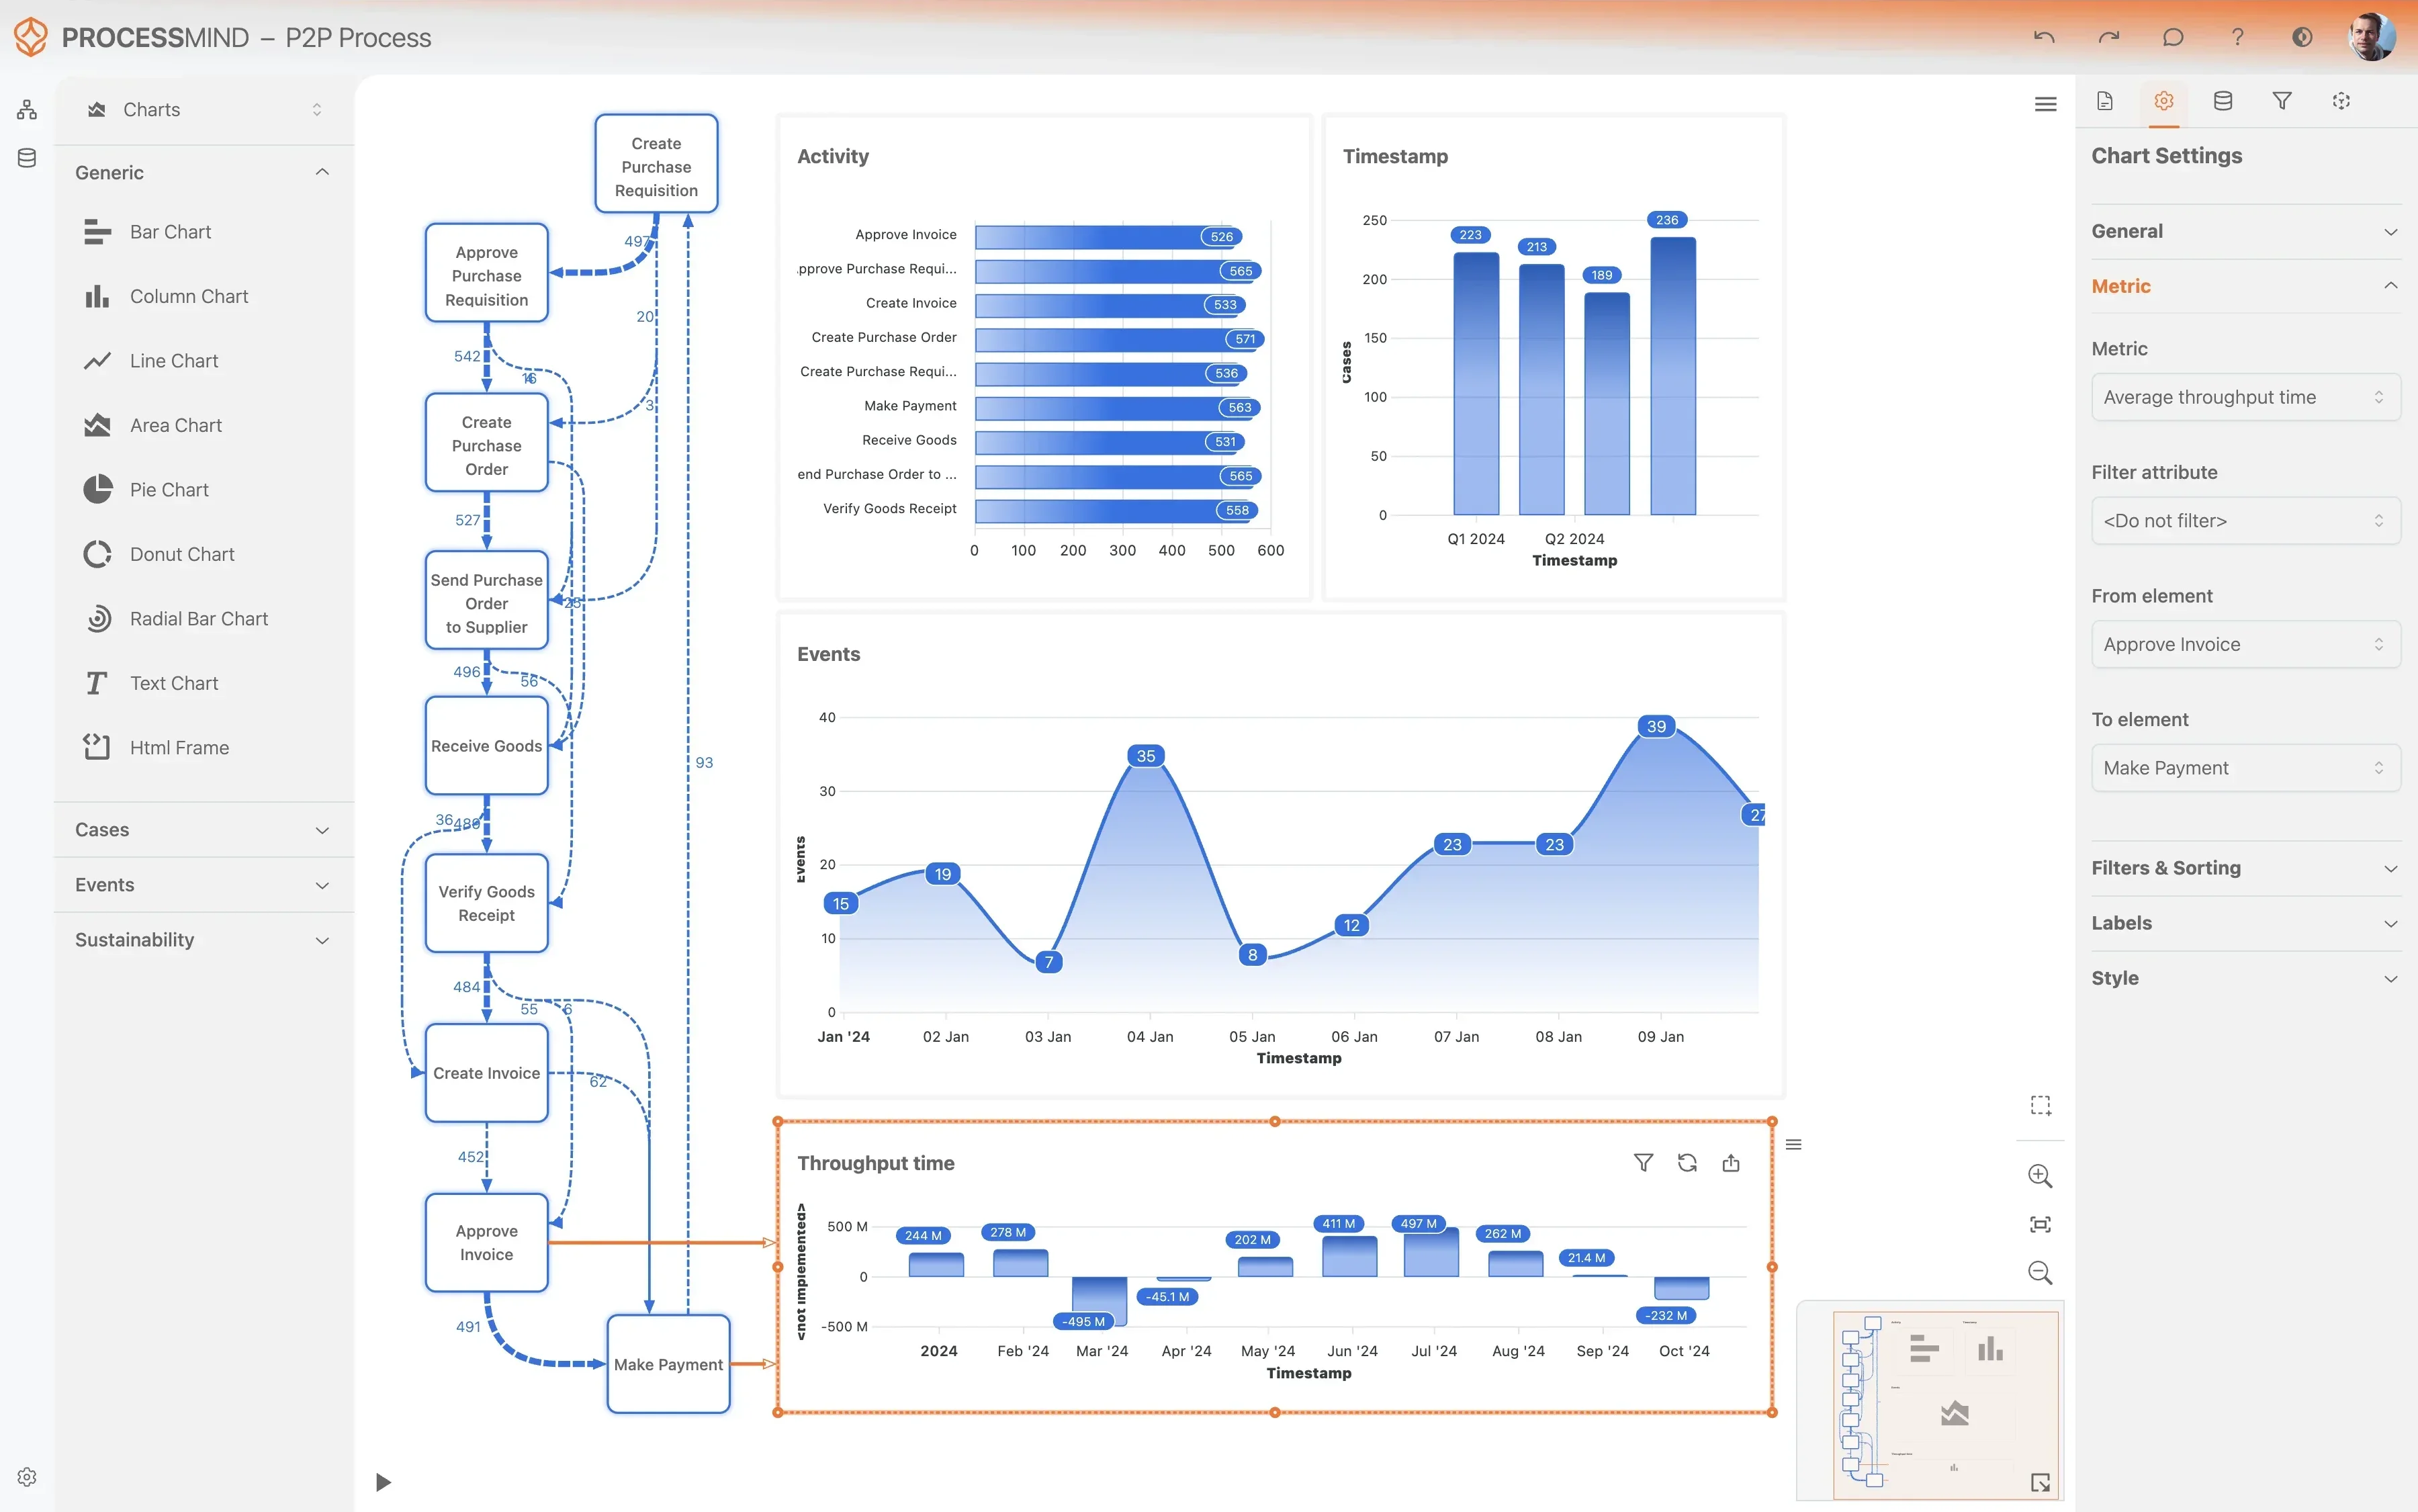
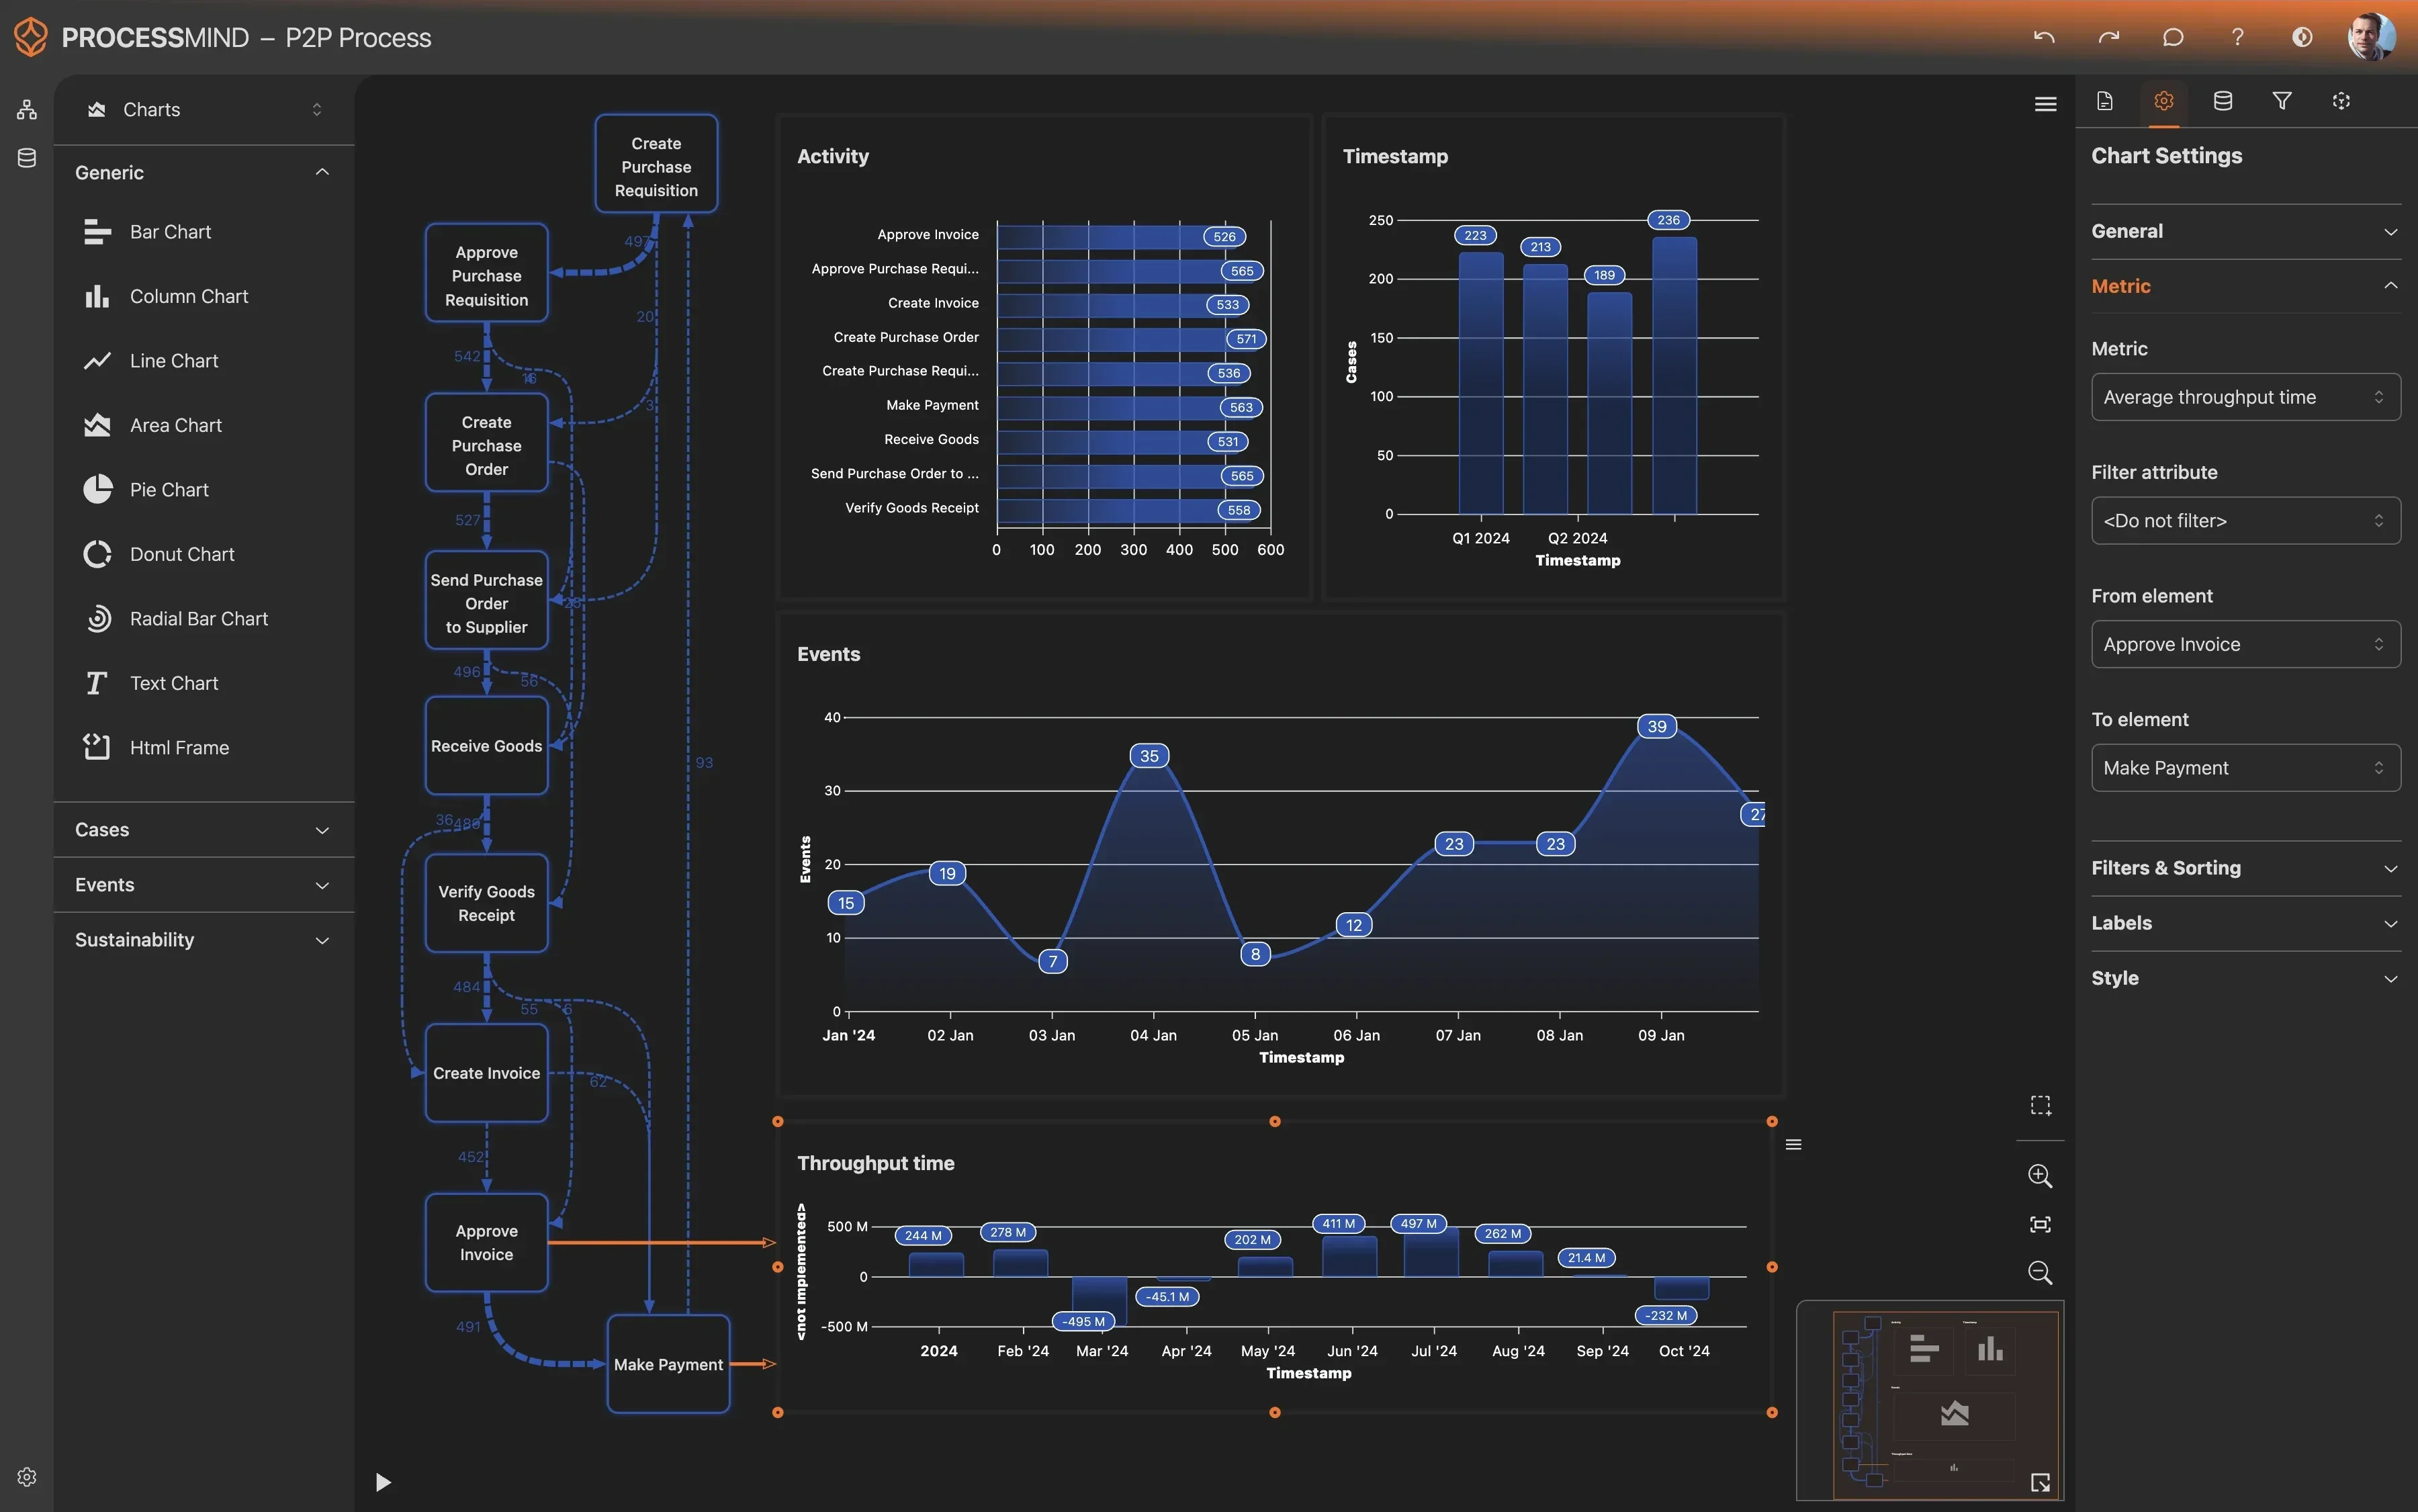
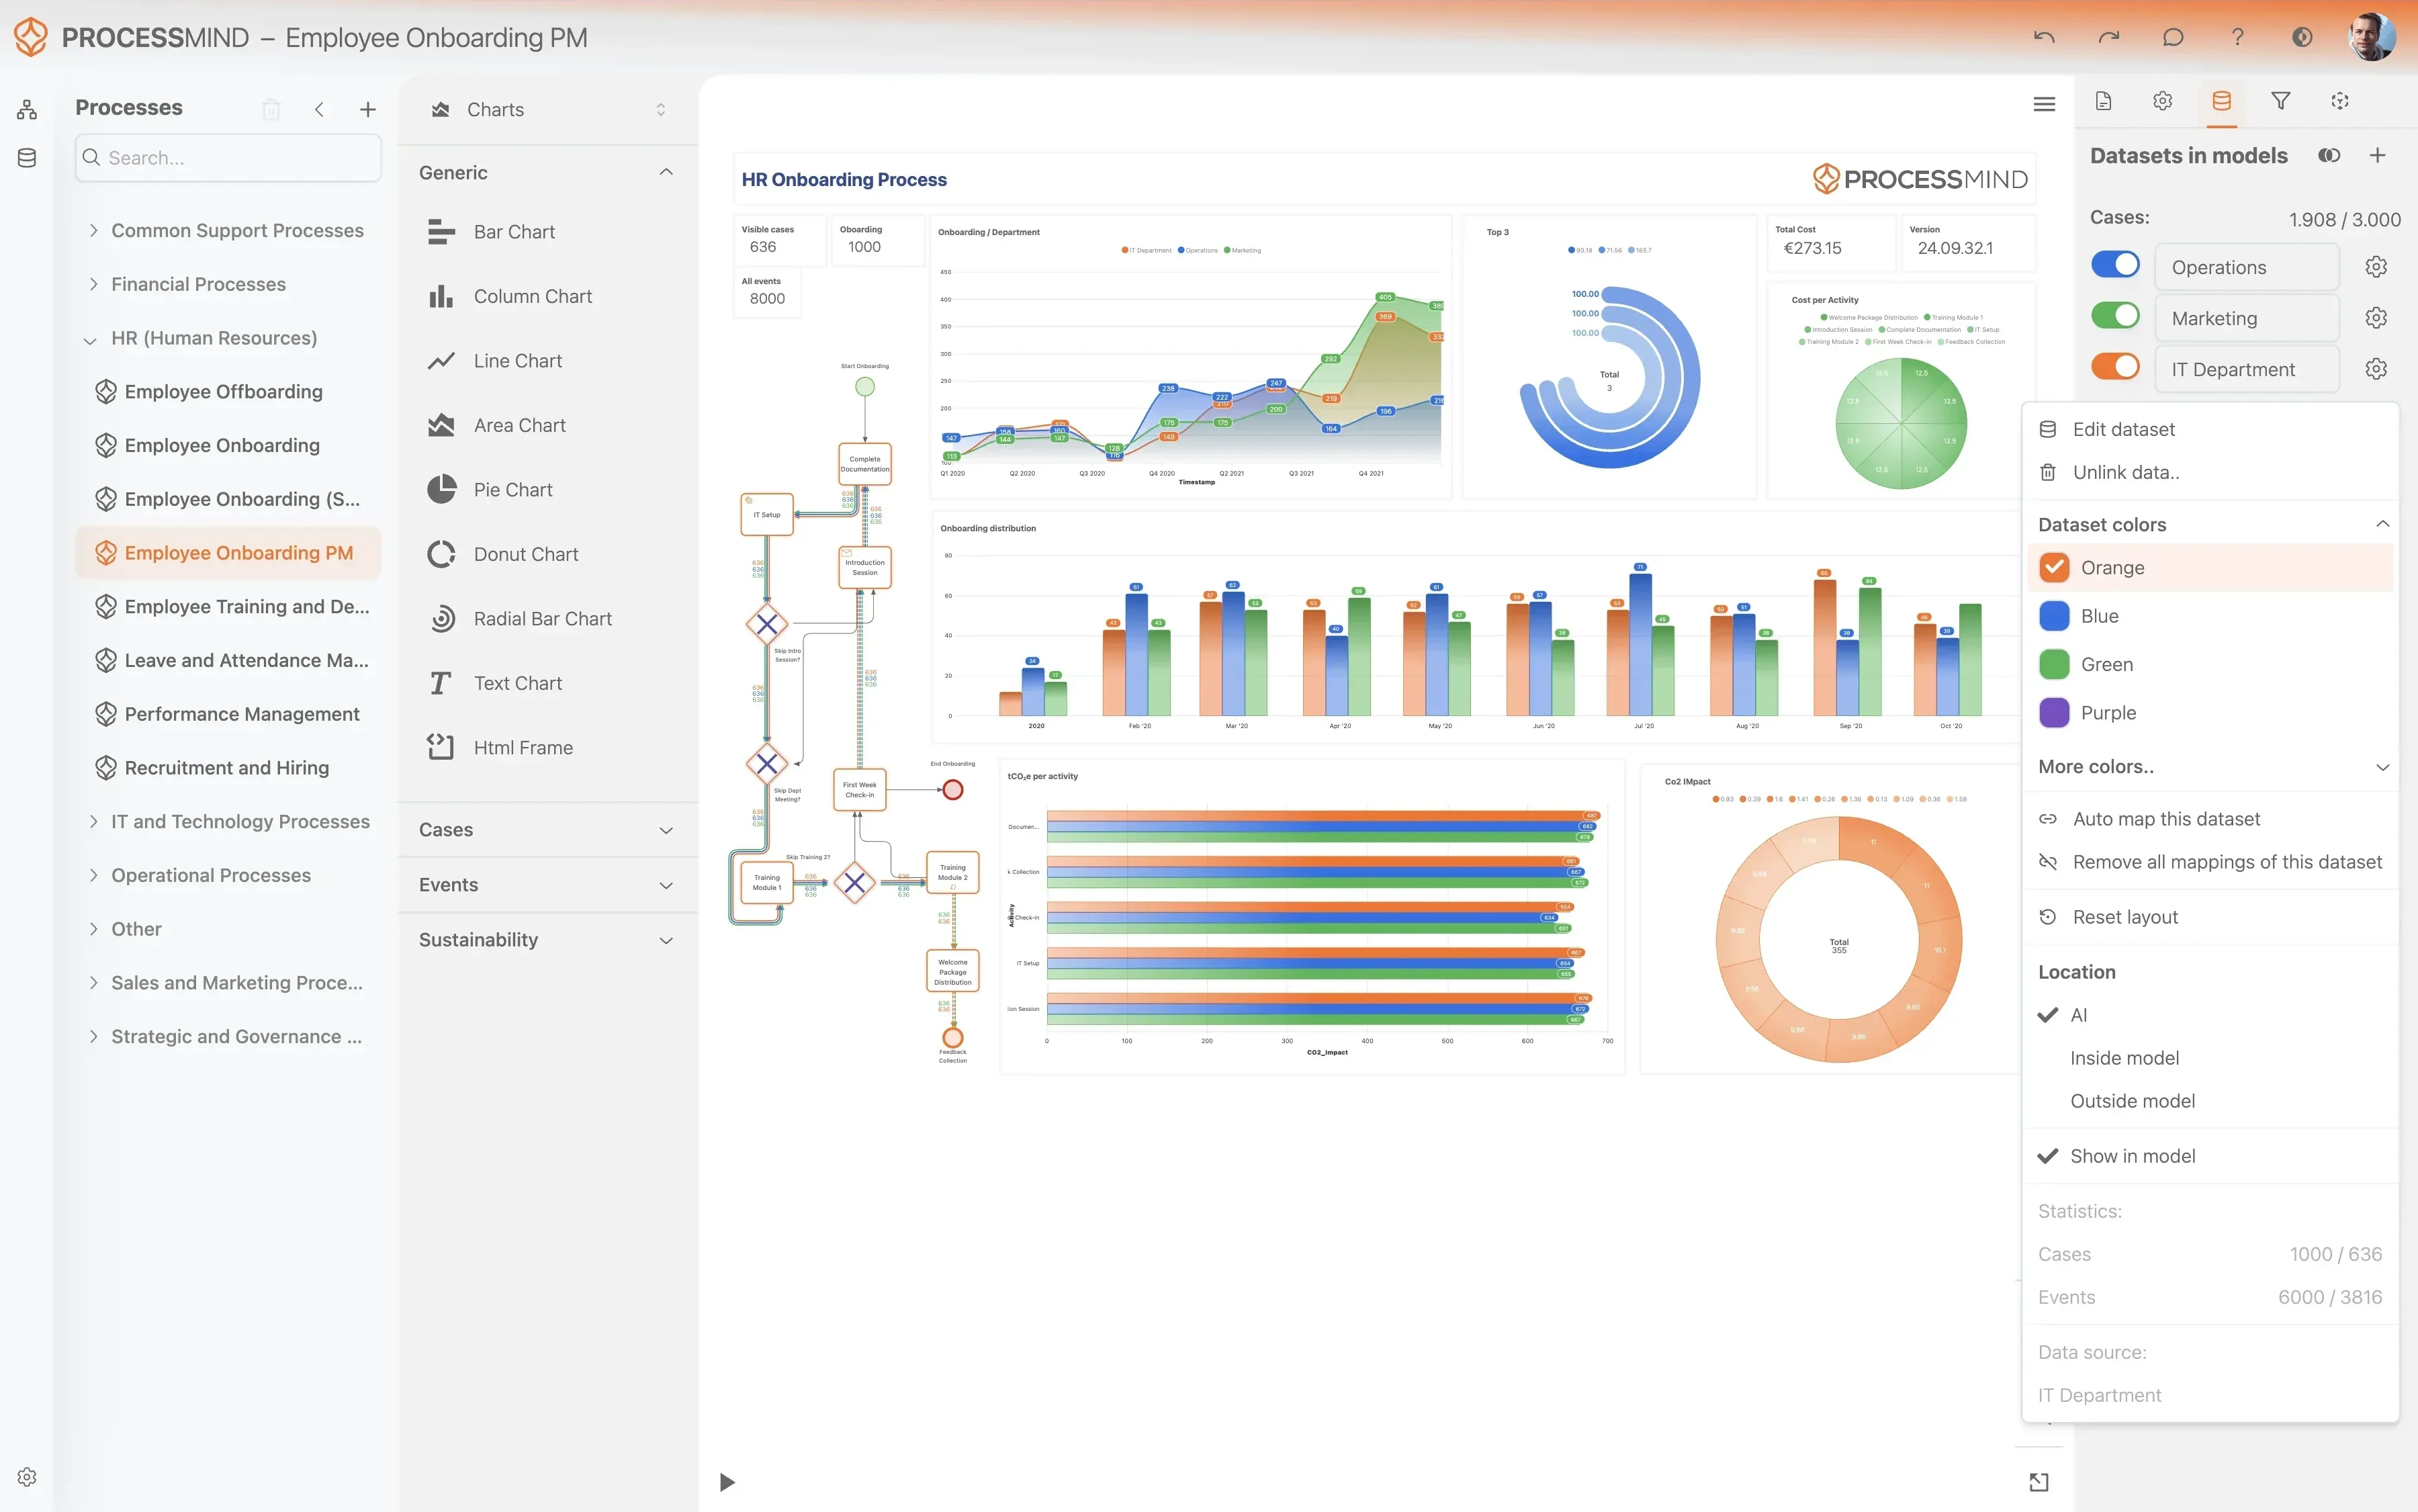
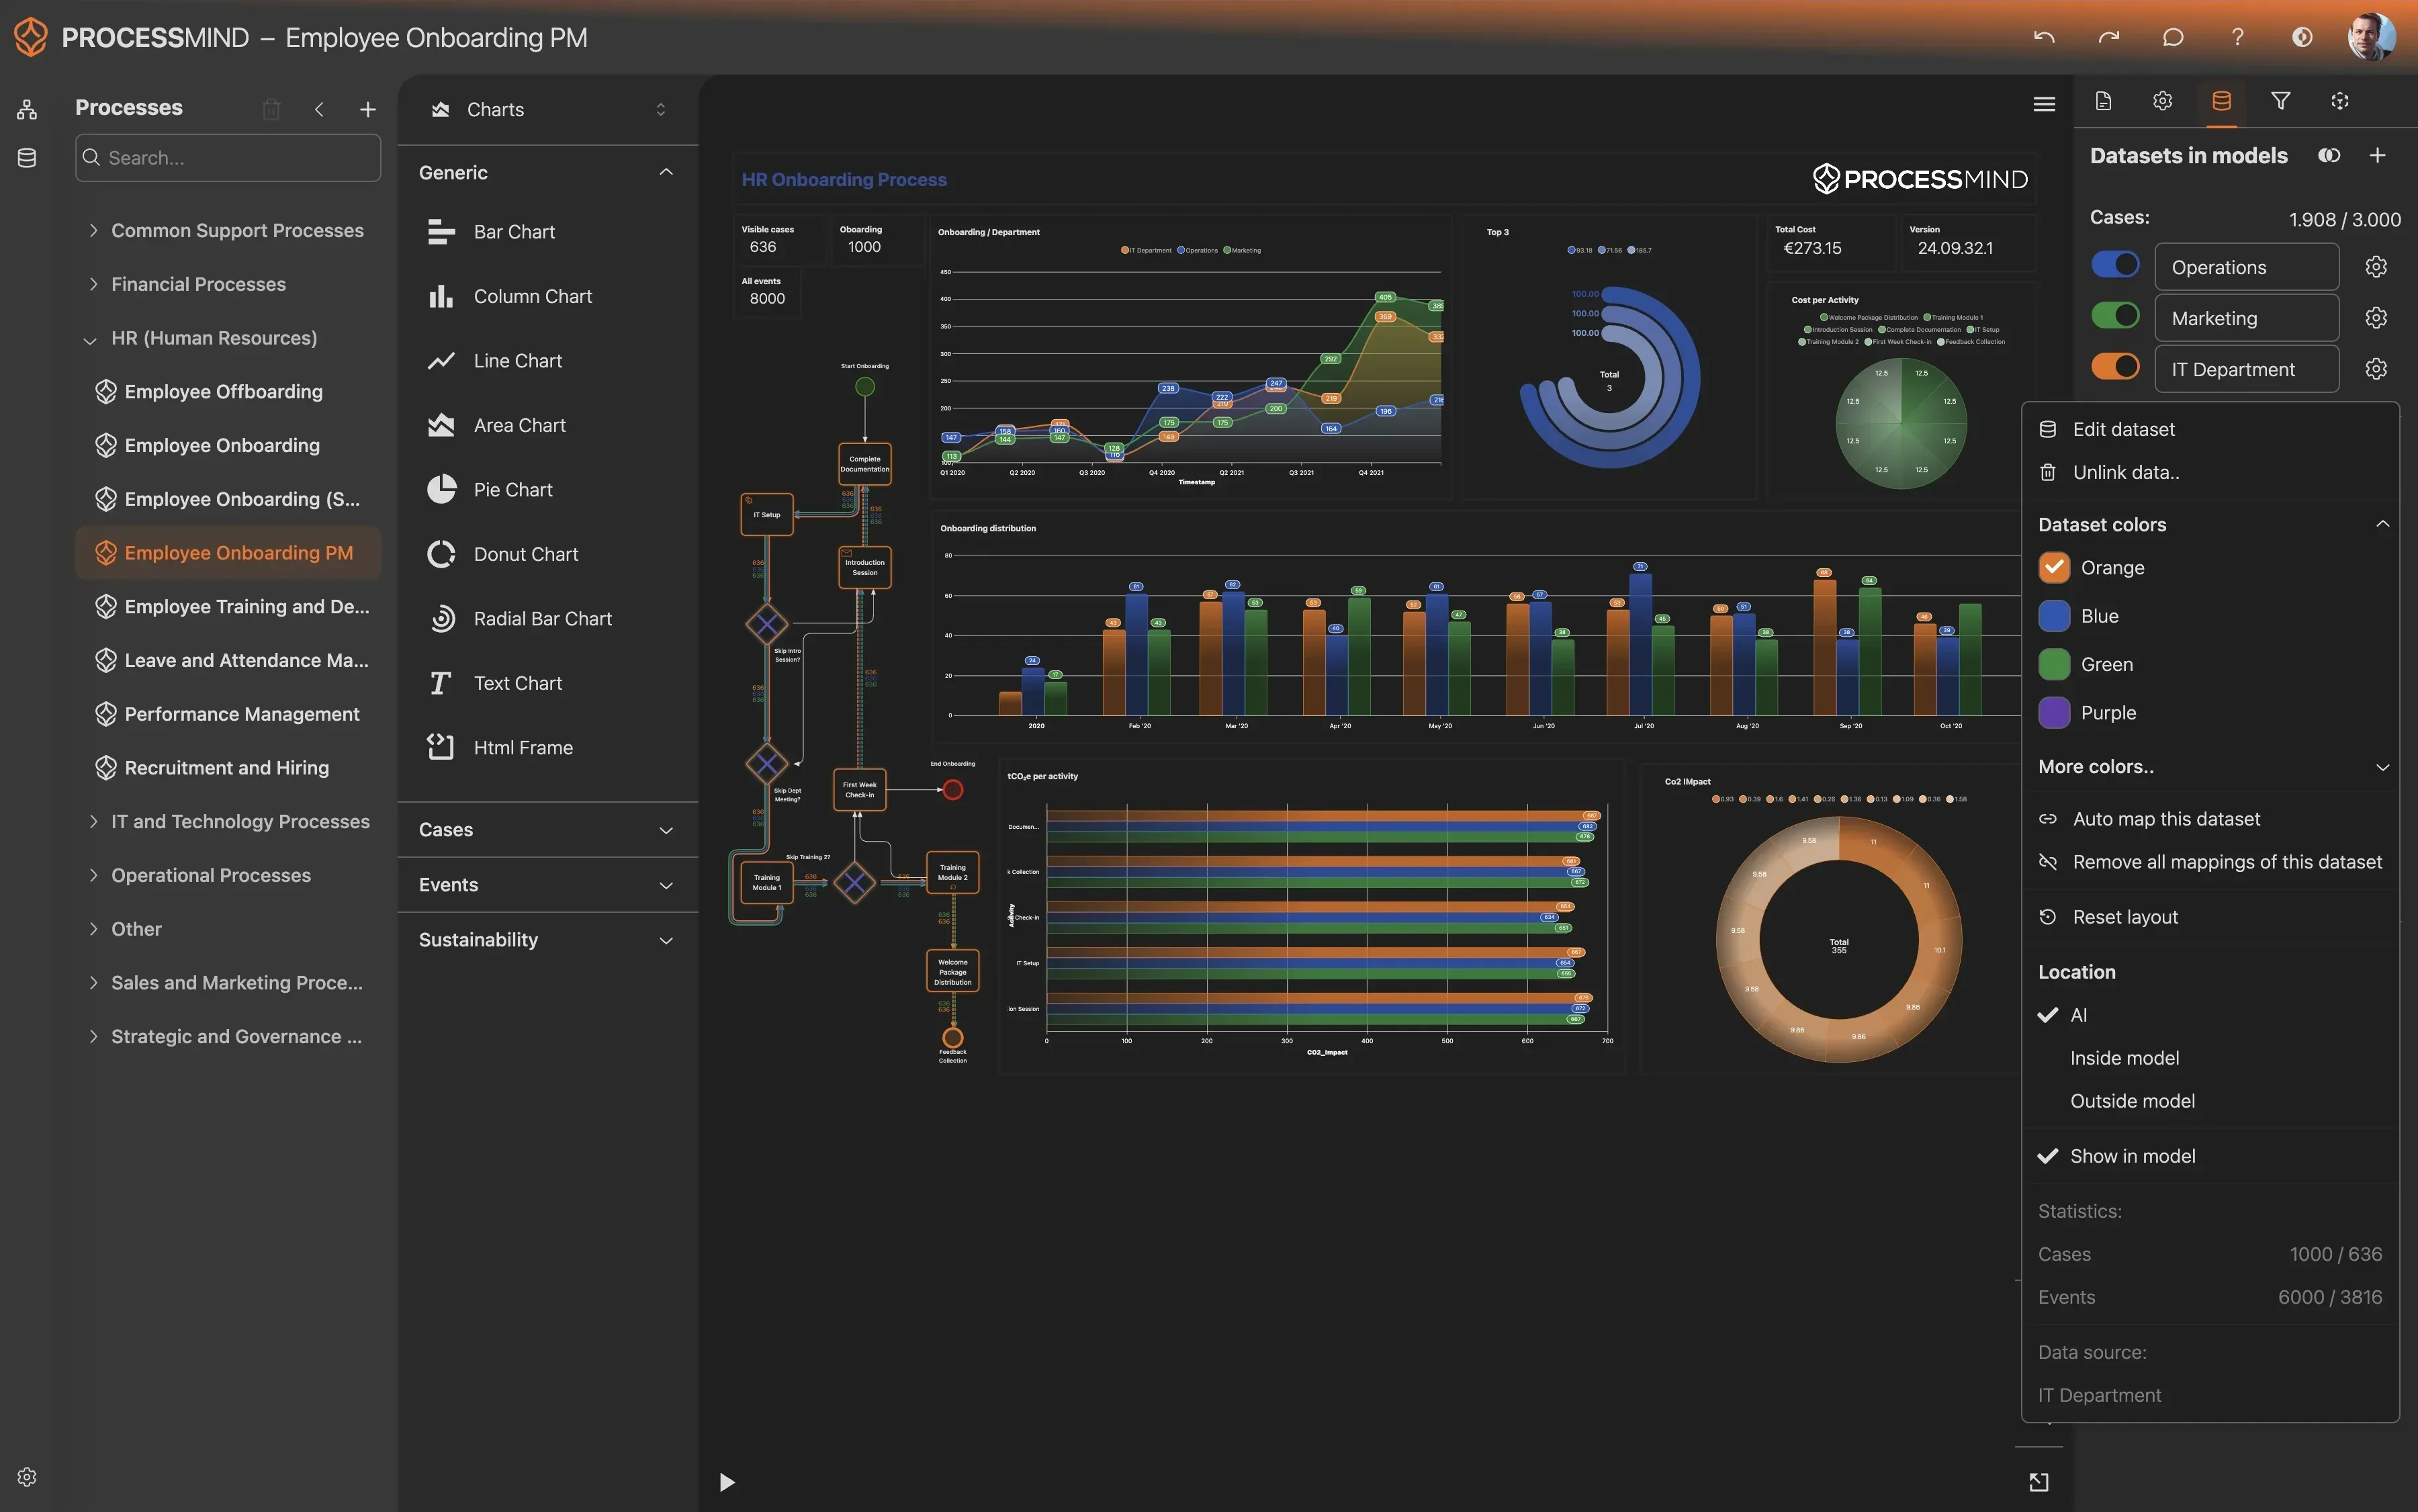
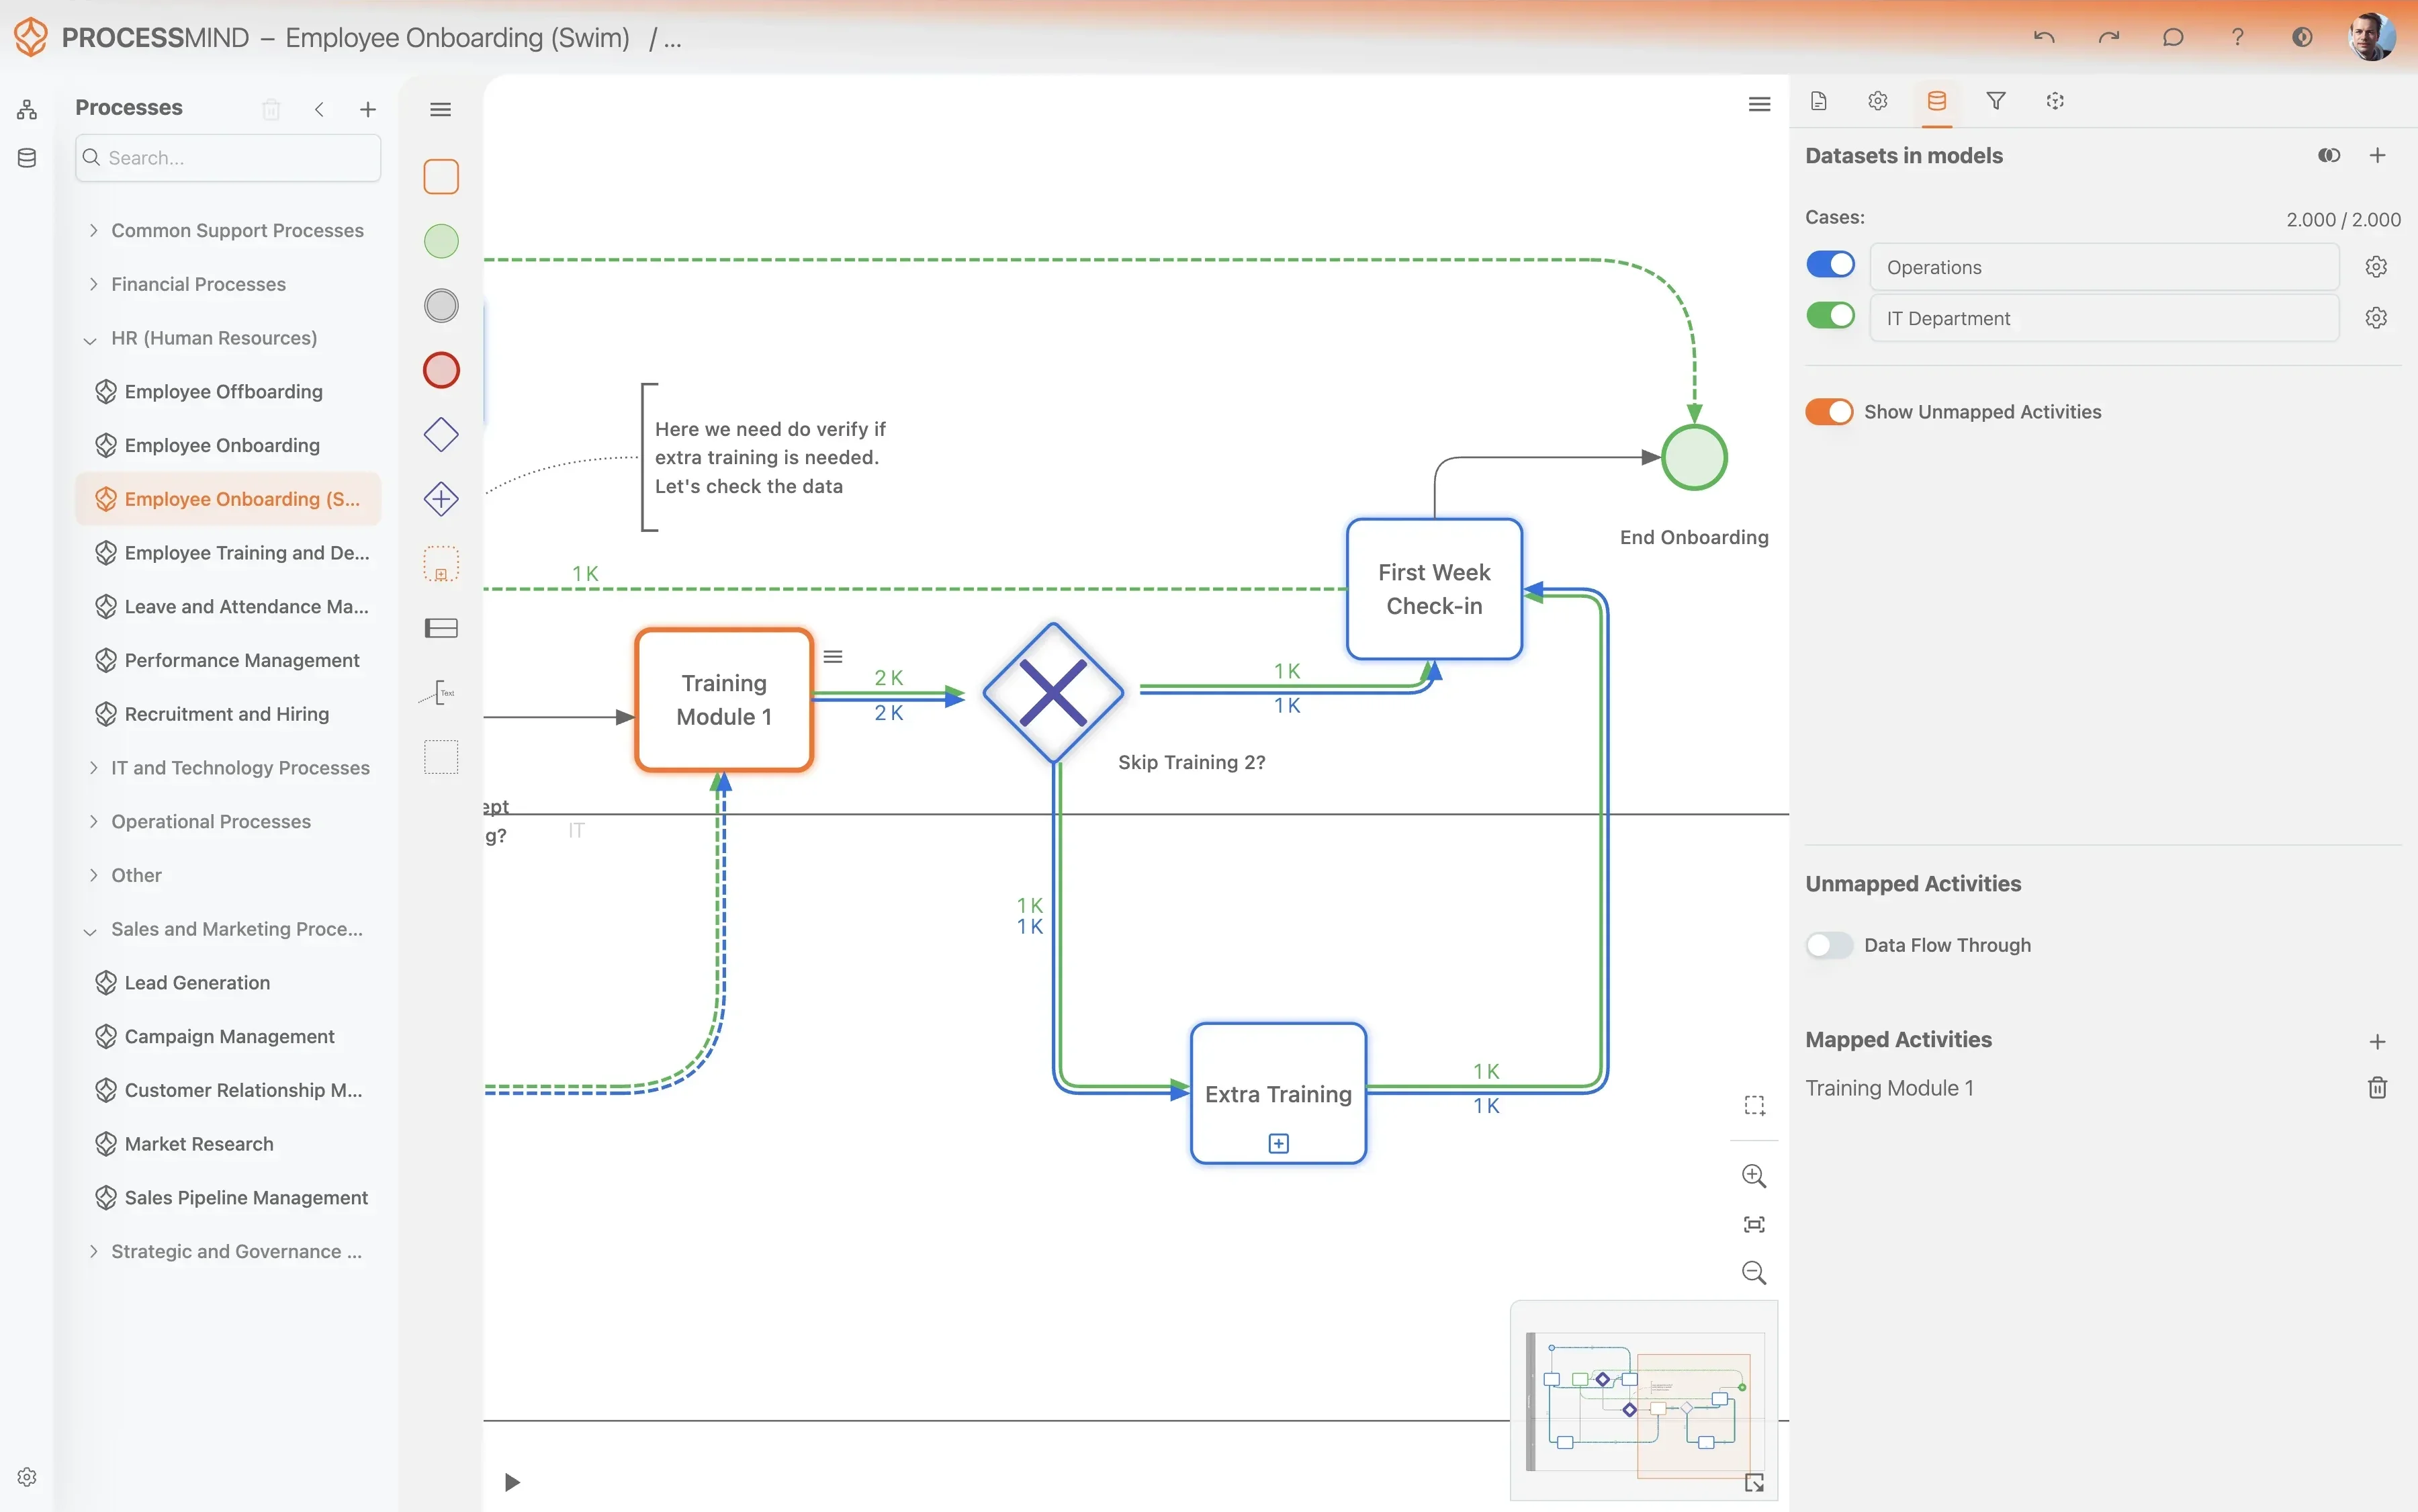
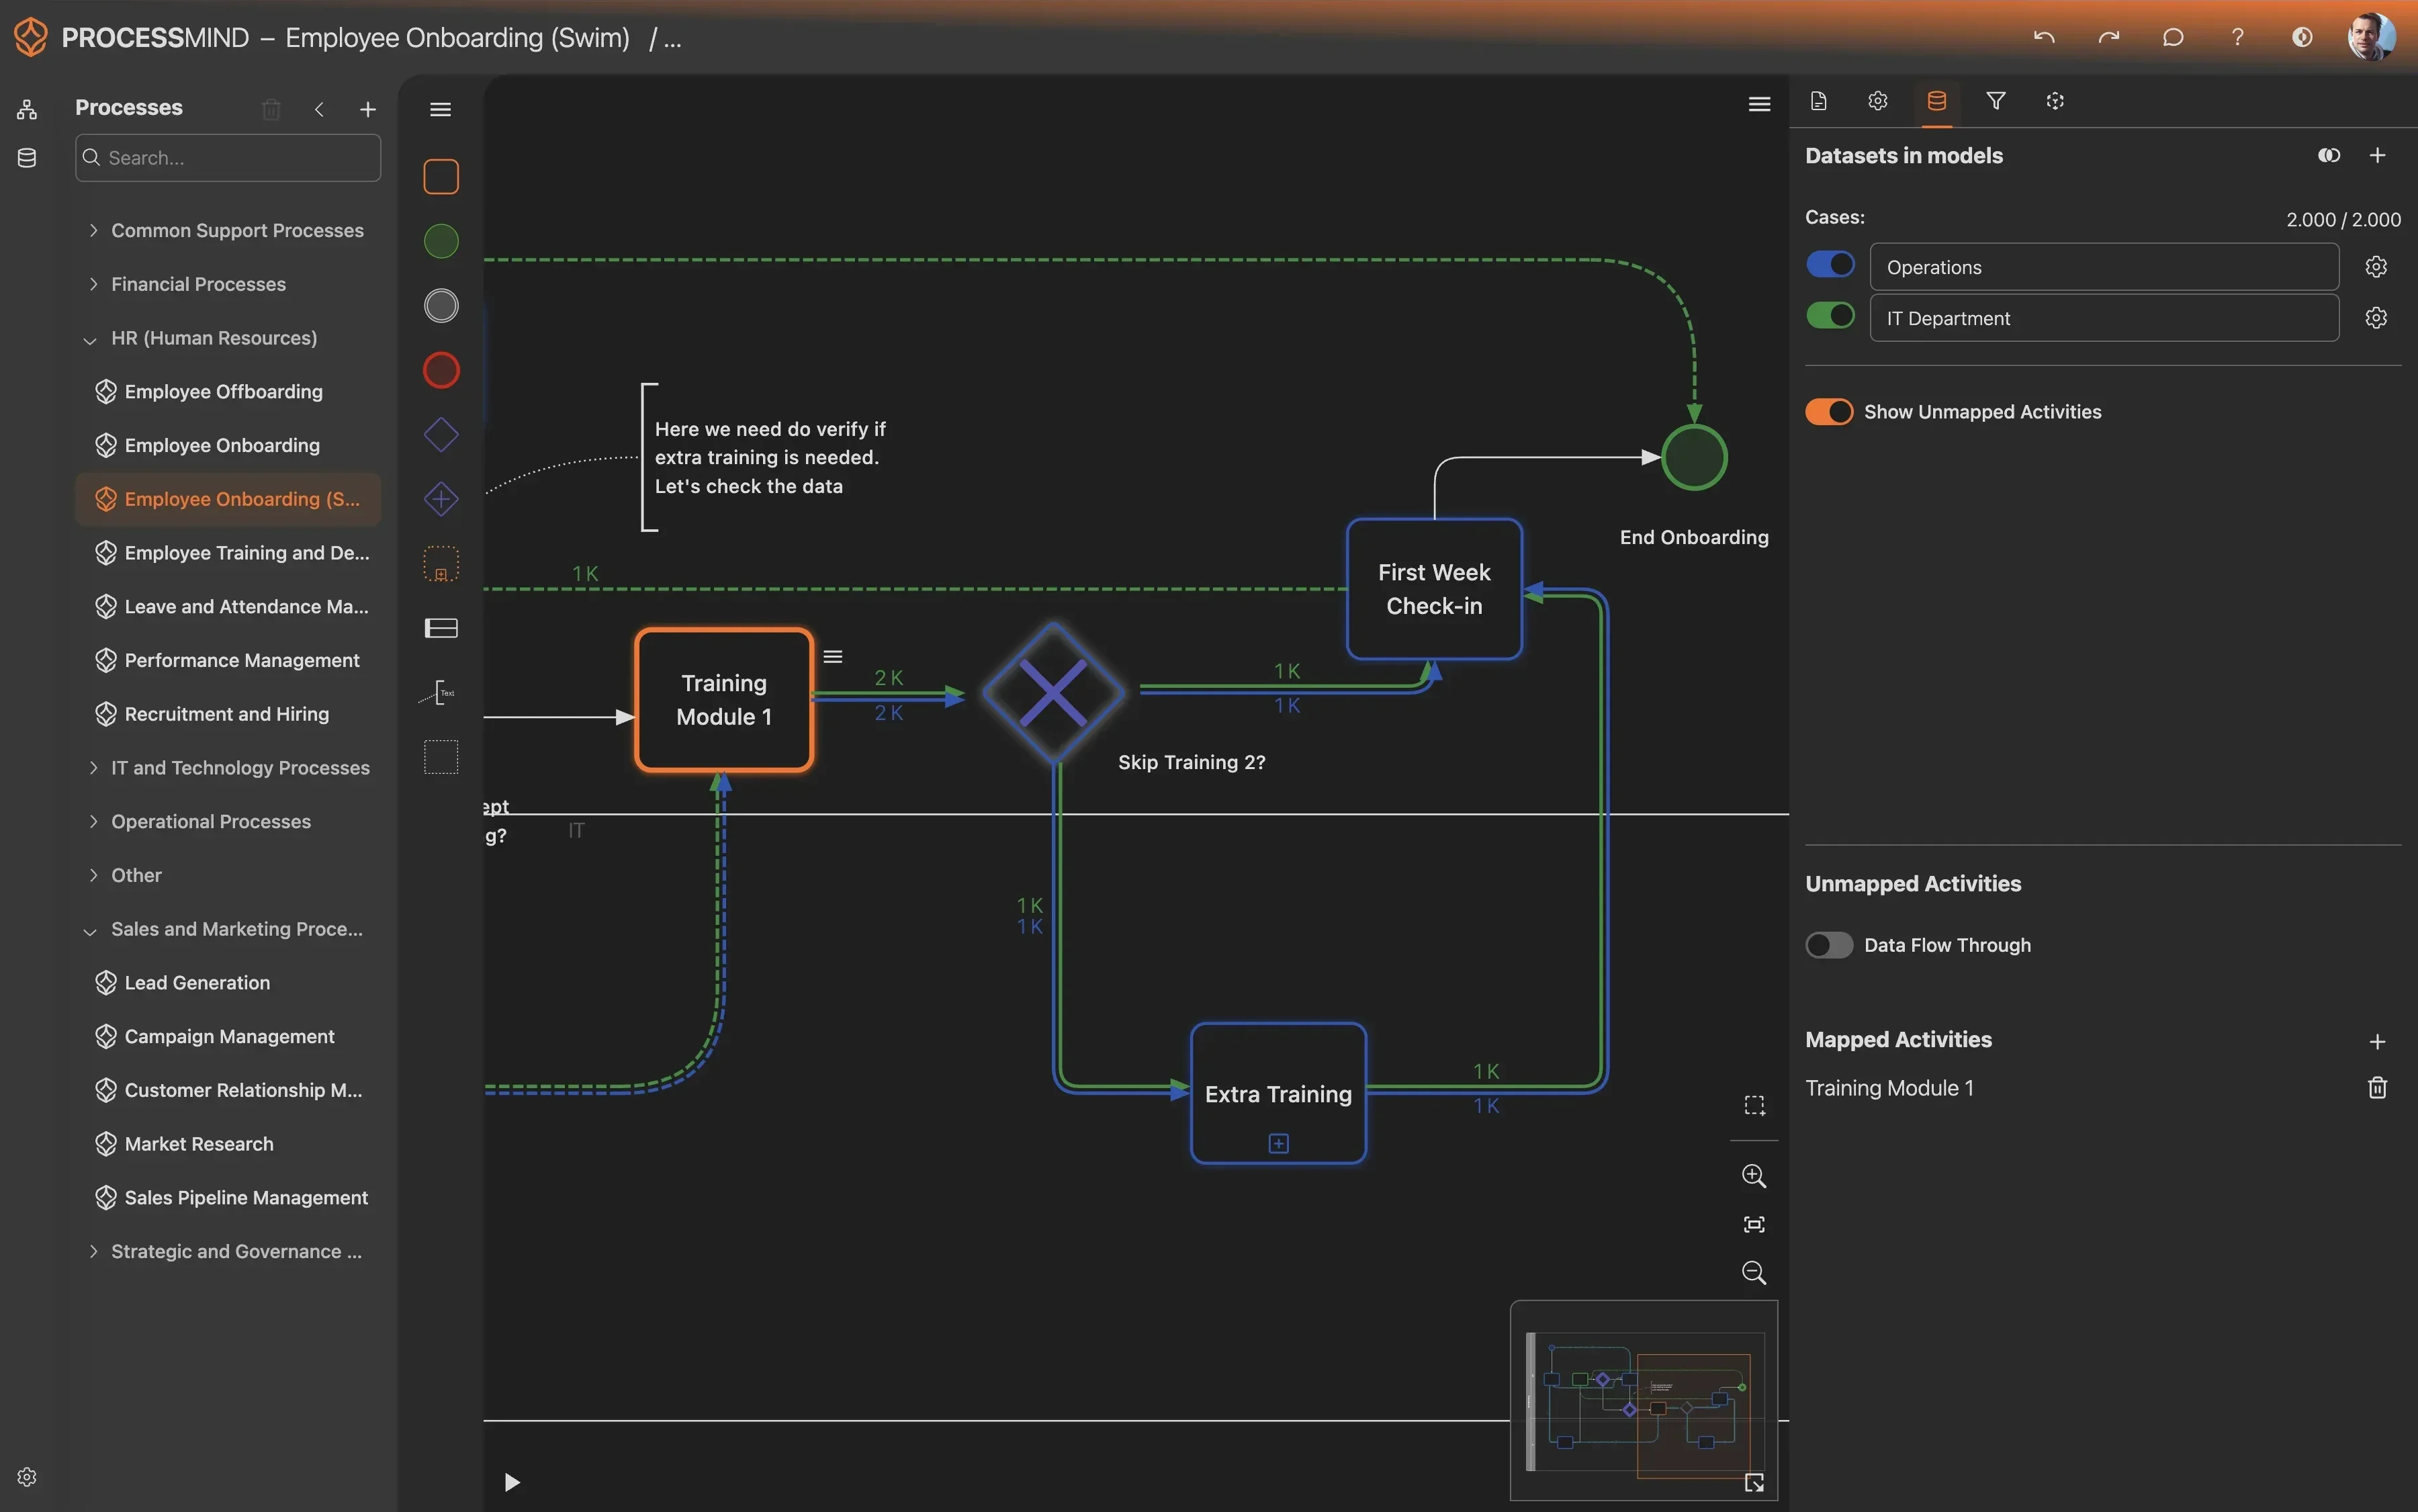
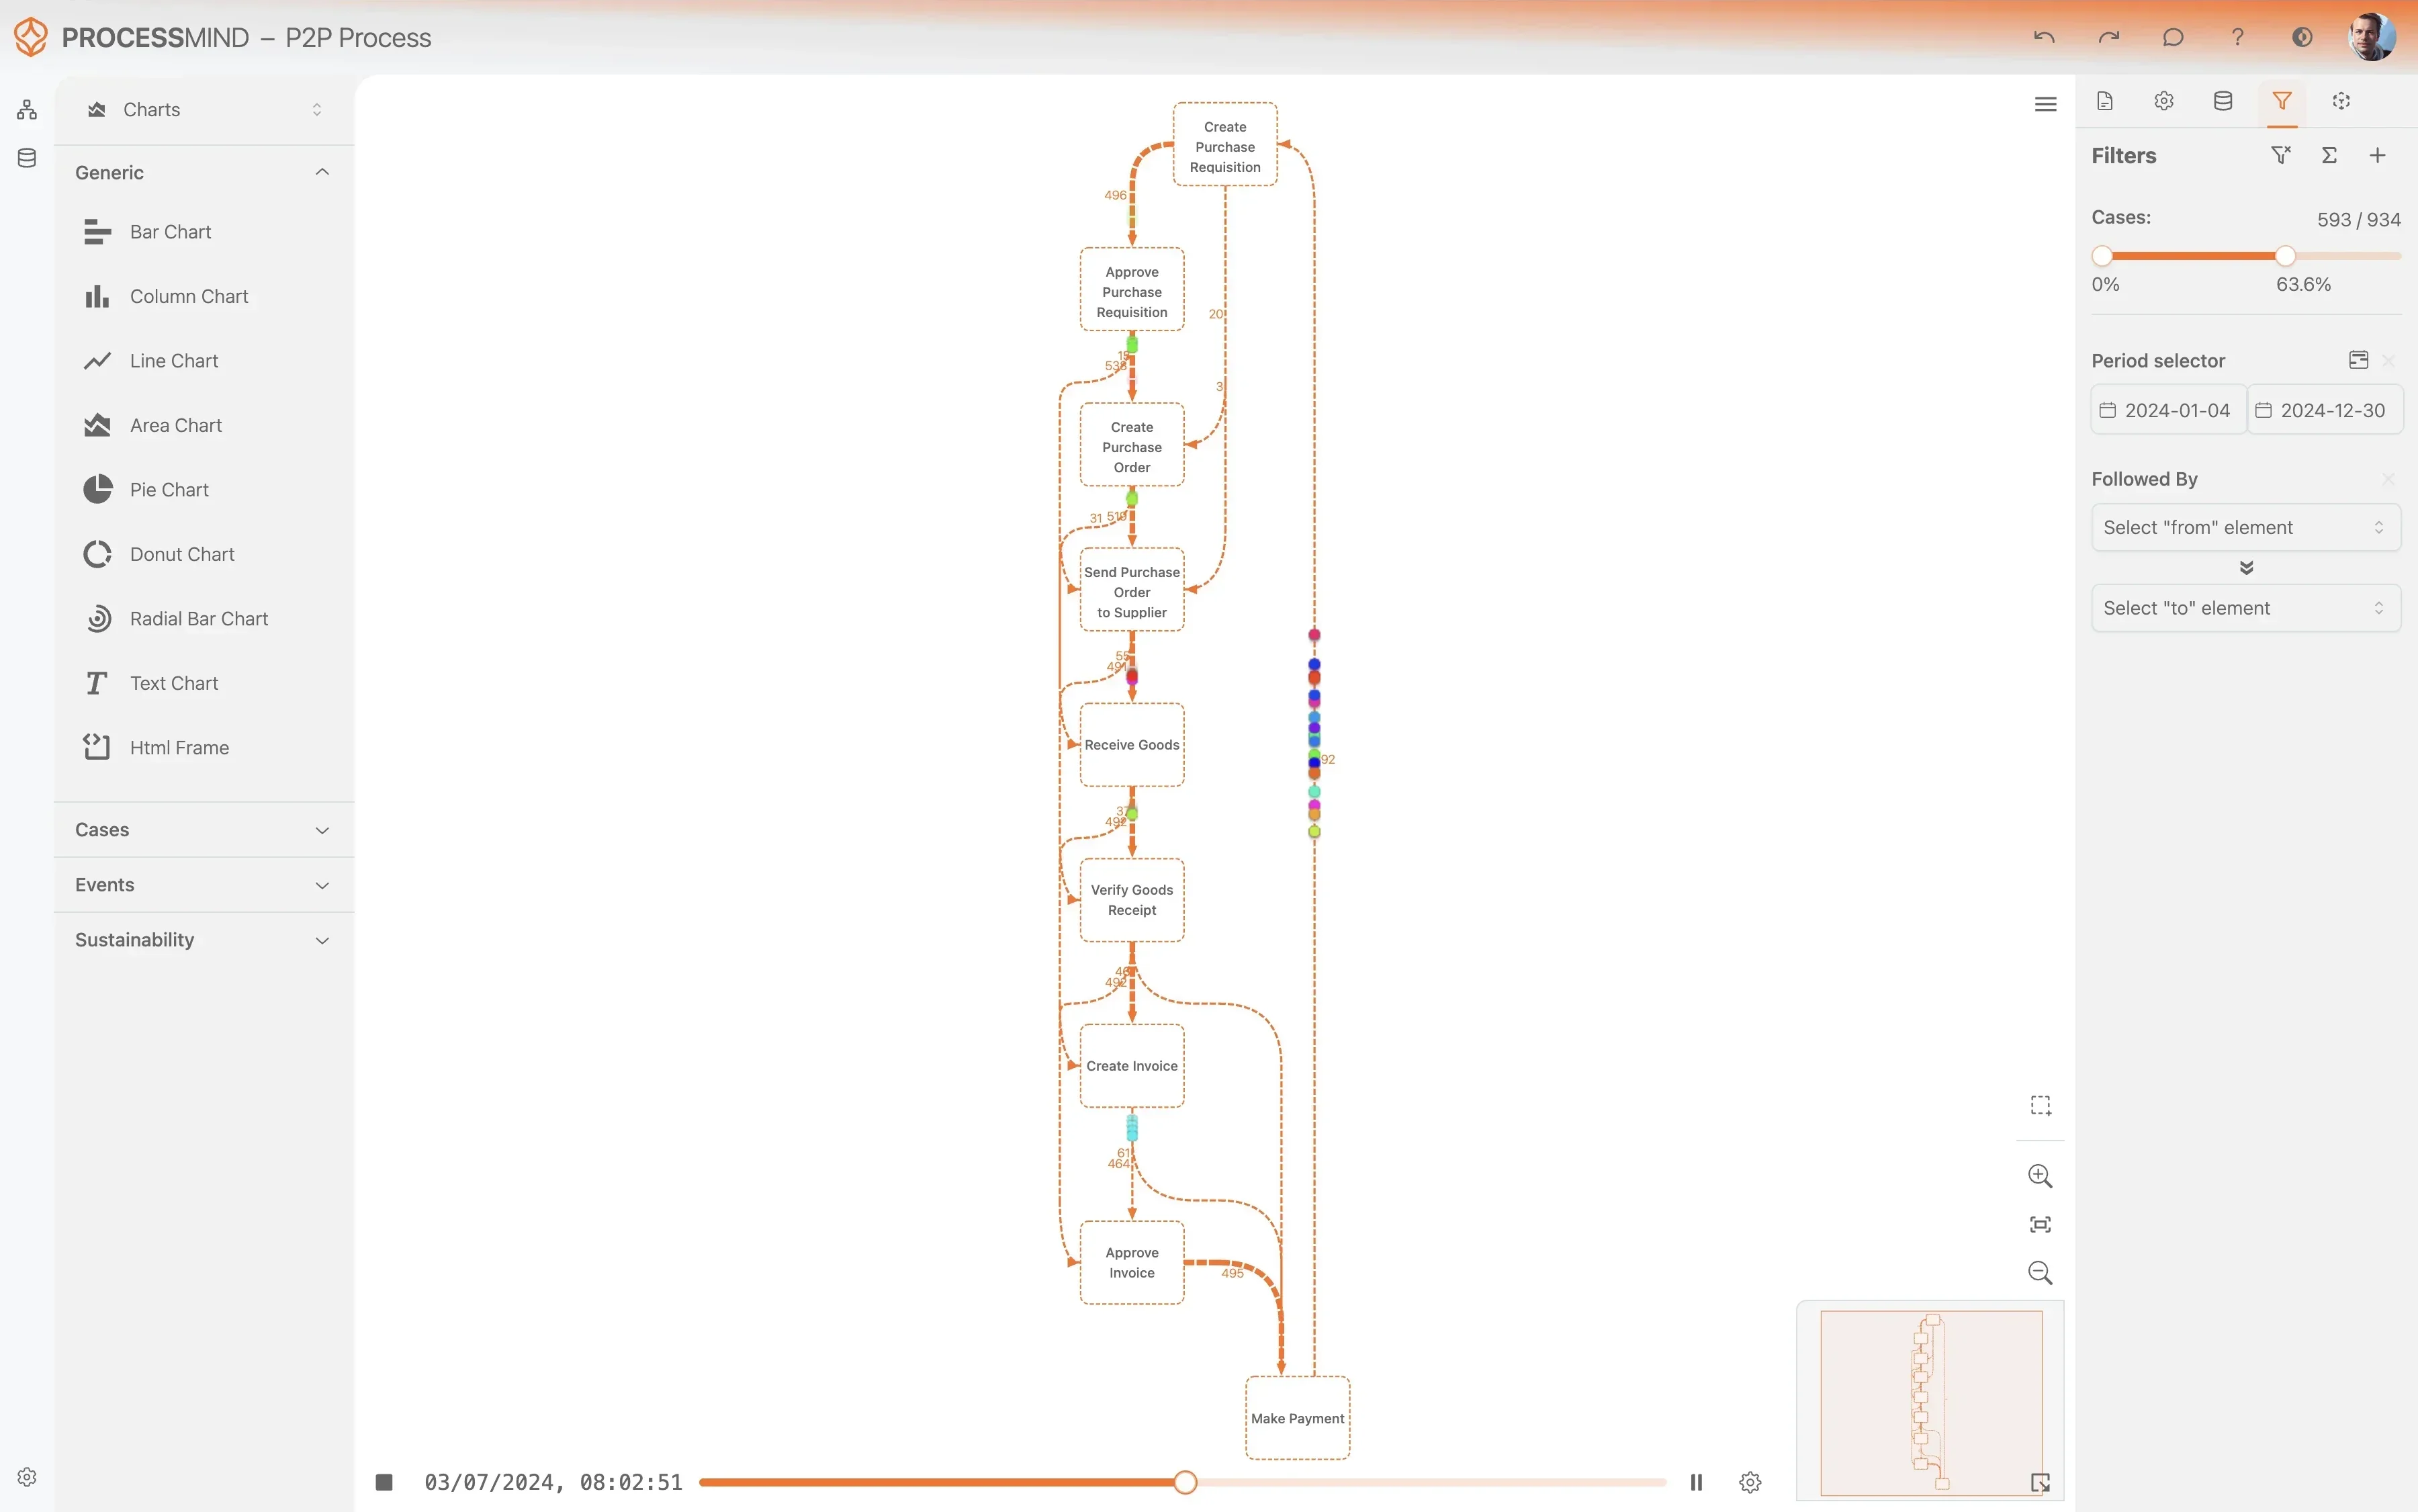
ProcessMind révèle le déroulement réel de la résolution de vos incidents et représente clairement chaque étape. Repérez les écarts et les goulots d’étranglement dans votre processus de Gestion des problèmes dans ServiceNow.
  • Visualisez les flux réels de résolution des incidents
  • Identifiez les causes profondes des retards et des reprises
  • Suivez la conformité aux SLA et les écarts
  • Comparez les performances des équipes et des processus
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

RÉSULTATS TYPES

Gagner en efficacité dans la Gestion des incidents

L’analyse des données de Gestion des problèmes ServiceNow avec le Process Mining permet aux organisations de mieux comprendre leurs flux de travail de Gestion des incidents. Elles peuvent ainsi repérer les inefficacités et apporter des améliorations ciblées, avec des bénéfices concrets à la clé.

0 % faster
Résolution plus rapide des incidents

Réduction moyenne du délai de résolution

Le Process Mining repère les goulots d’étranglement et les reprises. Les équipes peuvent ainsi simplifier les parcours de résolution et accélérer le traitement des problèmes, ce qui réduit le temps de cycle global des incidents.

0 % fewer breaches
Meilleure conformité aux SLA

Réduction des manquements aux SLA pour les incidents critiques

En repérant les parcours non conformes et les retards, les organisations peuvent traiter de manière proactive les problèmes qui touchent les incidents critiques et réduire sensiblement les manquements aux SLA.

0 % fewer handoffs
Moins de transferts d’incidents

Réaffectations d’incidents simplifiées

L’analyse des processus met en évidence les réaffectations excessives. Les équipes peuvent alors optimiser les règles d’acheminement et améliorer la résolution dès le premier contact, limitant les transferts et accélérant la résolution.

0 % reduction
Moins de problèmes récurrents

Baisse du nombre d’incidents répétés

Le Process Mining aide à identifier les causes profondes des incidents récurrents. Les équipes peuvent ainsi mettre en place des corrections durables et réduire le nombre total de problèmes qui se répètent.

0 % faster communication
Satisfaction accrue des utilisateurs

Des échanges et des mises à jour plus rapides

En réduisant les délais de communication et en transmettant les mises à jour au bon moment, les organisations améliorent l’expérience des utilisateurs pendant la résolution des incidents et leur niveau de satisfaction.

Les résultats varient considérablement selon la complexité de votre processus de Gestion des incidents et la qualité de vos données opérationnelles. Les résultats présentés correspondent aux améliorations couramment observées par les organisations qui utilisent des solutions de Process Mining.

Données recommandées

Commencez par les attributs et les activités les plus importants, puis ajoutez des données au fil de votre analyse.
Vous découvrez les journaux d’événements ? Découvrez comment créer un journal d’événements pour le Process Mining.

Attributs

Les principales données à recueillir pour l’analyse

Identifiant unique de chaque enregistrement d’incident, utilisé comme clé principale pour suivre l’ensemble de son cycle de vie.

Pourquoi est-ce important ?

Cet ID de cas essentiel relie tous les événements du cycle de vie d’un incident et rend possible l’analyse du processus de bout en bout.

Nom de l’événement ou de la tâche qui s’est produit à un moment donné du cycle de vie de l’incident.

Pourquoi est-ce important ?

Il définit les étapes de la carte du processus, qui sert de base à l’analyse et à la visualisation en Process Mining.

Horodatage précis indiquant le moment où l’activité a eu lieu.

Pourquoi est-ce important ?

Cet horodatage ordonne les activités dans le temps et permet de calculer tous les indicateurs fondés sur la durée, comme les temps de cycle et les goulots d’étranglement.

Utilisateur ou agent actuellement chargé de traiter l’incident.

Pourquoi est-ce important ?

Il permet d’analyser la charge de travail et les résultats des agents, ainsi que les transferts entre personnes, pour mieux comprendre l’efficacité de l’utilisation des ressources.

Équipe ou groupe d’assistance chargé de traiter l’incident.

Pourquoi est-ce important ?

Il indique quelle équipe est responsable et permet d’analyser ses résultats, sa charge de travail et les transferts entre groupes.

Niveau de priorité de l’incident, qui détermine le degré d’urgence de la réponse requise.

Pourquoi est-ce important ?

Il permet de classer les incidents selon leur importance pour l’activité, un élément essentiel au suivi de la conformité aux SLA et à la répartition des ressources.

État actuel de l’incident dans son cycle de vie.

Pourquoi est-ce important ?

Il permet de suivre l’avancement de l’incident, d’analyser le temps passé à chaque étape et de repérer les goulots d’étranglement du processus.

Activités

Étapes du processus à suivre et à optimiser

Marque le début du cycle de vie de l’incident, au moment où un nouvel incident est officiellement enregistré dans ServiceNow. Cet événement est identifié à partir de l’horodatage de création de l’enregistrement.

Pourquoi est-ce important ?

Il s’agit de l’événement de début principal du processus. Mesurer le temps écoulé entre cette activité et la résolution est essentiel pour calculer le temps de cycle global et évaluer la conformité aux SLA.

Cette activité a lieu lorsqu’un incident est affecté à un groupe d’assistance chargé de le traiter. Étape importante de l’acheminement, elle est repérée en observant les modifications du champ du groupe d’affectation.

Pourquoi est-ce important ?

Le suivi des affectations est essentiel pour analyser les transferts, les temps d’attente dans chaque groupe et les inefficacités ou goulots d’étranglement liés à l’acheminement.

Indique qu’un agent a commencé à examiner activement l’incident ou à le traiter. Cet événement est généralement déduit du passage de l’état de l’incident de « New » ou « Assigned » à un état actif tel que « In Progress ».

Pourquoi est-ce important ?

Cette étape marque la fin du temps d’attente initial et le début du traitement actif. Mesurer le délai avant le début du travail est essentiel pour analyser les goulots d’étranglement.

Correspond au transfert d’un incident d’un groupe d’assistance à un autre. Il est repéré en observant les modifications ultérieures du champ « assignment_group », après son premier renseignement.

Pourquoi est-ce important ?

Des réaffectations fréquentes peuvent révéler une erreur d’acheminement initiale, un processus complexe ou des lacunes dans les connaissances. Cette activité est essentielle au calcul de l’indicateur « Nombre moyen de transferts par incident ».

Marque le moment où un agent d’assistance a appliqué une correction et fait passer l’incident à l’état « Resolved ». Cette étape importante précède la clôture définitive.

Pourquoi est-ce important ?

Cette activité marque la fin du traitement actif et le début de la phase de confirmation. Le temps écoulé jusqu’à « Incident Closed » peut révéler des retards dans la confirmation de l’utilisateur ou la vérification de la résolution.

Il s’agit de la dernière activité du cycle de vie : l’incident est entièrement résolu et confirmé, et aucune autre intervention n’est nécessaire. Cet événement est enregistré explicitement à l’aide de l’horodatage de clôture.

Pourquoi est-ce important ?

En tant qu’événement de fin définitif, cette activité est essentielle pour calculer la durée totale du cycle de vie de l’incident et analyser le temps consacré aux opérations après résolution.

FAQ

Foire aux questions

Le Process Mining analyse les données de Gestion des incidents de ServiceNow pour révéler le déroulement réel du processus. Il repère les goulots d’étranglement, les écarts par rapport aux parcours standard et les facteurs qui allongent les délais de résolution ou entraînent le non-respect des SLA. Vous disposez ainsi d’analyses fondées sur les données pour optimiser le processus.

Pour commencer, vous avez généralement besoin de journaux d’incidents contenant au minimum l’identifiant de l’incident, la description de l’activité, son horodatage et l’agent ou le système responsable de chaque activité. Des champs supplémentaires, comme la catégorie de l’incident, sa priorité et son groupe d’affectation, peuvent enrichir l’analyse. Ces données sont généralement extraites de la table incident et des tables associées dans ServiceNow.

Les premières analyses peuvent souvent être produites quelques semaines après l’extraction et la préparation des données. Elles révèlent rapidement les goulots d’étranglement et les écarts. Une analyse plus approfondie et la mise en œuvre des changements prennent naturellement plus de temps, selon la complexité des problèmes repérés et la capacité de l’organisation à évoluer.

Vous pouvez vous attendre à une réduction des délais de résolution des incidents, à une meilleure conformité aux SLA pour les incidents critiques et à moins de réaffectations. Le Process Mining aide également à uniformiser les parcours de résolution et à mieux répartir la charge de travail des agents, pour un service plus efficace et plus cohérent.

Le principal prérequis technique est de pouvoir accéder à votre instance ServiceNow afin d’en extraire les données, généralement par API ou directement depuis la base de données, selon votre configuration et vos règles de sécurité. Vous aurez également besoin d’un outil de Process Mining capable d’ingérer, de traiter et de visualiser les données du journal d’événements.

Oui. Le Process Mining permet de repérer les récurrences et de mettre en évidence les processus qui conduisent souvent aux mêmes problèmes. La visualisation des parcours et des activités les plus fréquents aide à cerner les causes profondes possibles de ces incidents répétés et à mettre en place des corrections durables.

Le Process Mining est particulièrement utile pour les processus complexes, mais il peut aussi apporter une réelle valeur aux flux de travail de Gestion des incidents plus modestes ou moins complexes. La méthode s’adapte à différentes tailles de processus, même si le niveau de détail des résultats peut varier.

Oui. En général, l’extraction sécurisée et efficace des données nécessite une certaine assistance informatique ou l’intervention d’un administrateur ServiceNow. Celui-ci peut configurer les droits d’accès nécessaires, créer les rapports adaptés ou mettre en place des intégrations API pour récupérer les données requises du journal des incidents.

Résolvez les incidents plus rapidement : améliorez dès maintenant l’efficacité de ServiceNow

Réduisez de 35 % le temps moyen de résolution dans ServiceNow. Repérez les problèmes et améliorez la satisfaction.

Démarrez l’essai gratuit

Aucune carte bancaire requise. Commencez à optimiser vos processus en quelques minutes.