Journal d’événements pour le Process Mining : comment en créer un
Créez un journal d’événements pour le Process Mining : découvrez les colonnes à inclure, téléchargez un exemple de restaurant et suivez nos méthodes pas à pas pour Excel et SQL.

Le Process Mining à partir d’un journal d’événements repose sur une table simple : des activités horodatées, regroupées par identifiant de cas. Ce guide vous explique comment la créer à partir des données de vos systèmes, à l’aide d’un exemple fictif de commandes de restaurant. Vous découvrirez deux méthodes : saisir quelques lignes dans Excel ou utiliser une requête SQL qui rassemble les activités avec UNION ALL. Comparez votre travail à l’journal d’événements final au fil du guide.
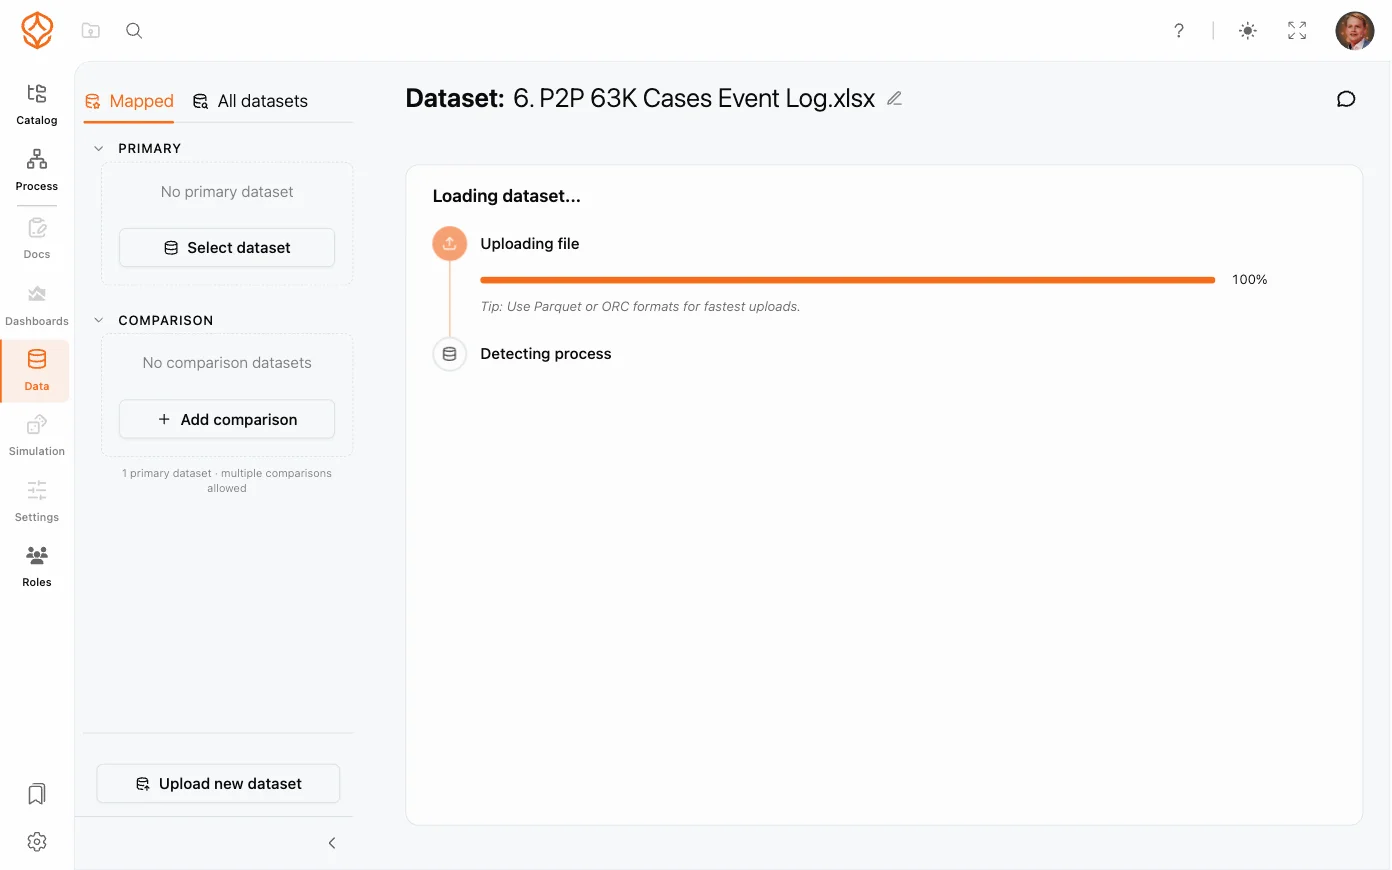
Créer un journal d’événements peut sembler intimidant. Pourtant, rien ne vous oblige à tout faire d’un coup. Commencez dès aujourd’hui avec un modèle ou quelques lignes dans Excel, puis développez votre démarche une fois vos besoins clarifiés.
Journal d’événements pour le Process Mining : les trois colonnes nécessaires
Un journal d’événements décrit de façon structurée ce qui s’est passé dans un processus. Chaque ligne correspond à un événement, par exemple la création d’une commande ou la réception d’un paiement. L’ID de cas relie les événements associés, l’horodatage situe chacun d’eux dans le temps et, ensemble, ces éléments permettent à un outil de reconstituer le parcours des cas dans le processus.
Une activité désigne un type, un événement une occurrence. Une activité correspond à un type d’action, comme « Commande expédiée ». Un événement en est une occurrence précise : la commande 12345 a été expédiée le 15 janvier à 14 h 30. Votre journal consigne les événements, chacun étant associé à un nom d’activité. Les deux termes sont souvent employés indifféremment, mais la distinction compte lors de la préparation des données : l’activité indique ce qui s’est passé, tandis que l’événement précise que cela s’est produit pour ce cas, à ce moment-là.
Un journal d’événements de base pour le Process Mining nécessite trois colonnes :
| Colonne | Contenu | Exemple |
|---|---|---|
| ID de cas | Identifiant qui regroupe les événements d’un même cas | 1001 |
| Horodatage | Moment où l’événement s’est produit | 2025-01-15 18:30:00 |
| Activité | Ce qui s’est passé | Order Placed |
Avant d’aller plus loin, vérifiez ces trois champs :
| Vérification | Points à confirmer |
|---|---|
| ID de cas | Les événements associés ont le même ID ; les cas distincts ont des ID différents |
| Horodatage | Chaque événement comporte une date et une heure utilisables |
| Activité | Les noms sont clairs et cohérents dans tout l’extrait |
Ces trois champs constituent la base du journal. Si l’un d’eux est manquant ou incohérent, la représentation du processus donnera une image erronée de l’ordre des tâches. Tout le reste est facultatif : les outils de Process Mining lisent un journal d’événements sous la forme d’une table unique regroupant cas et événements. Les trois colonnes nécessaires à son utilisation ne changent pas. Pour connaître les formats pris en charge et les étapes de préparation, consultez la documentation sur les données pour le Process Mining.
Exemple détaillé : le système de commande de Pizza Palace
Pour illustrer les étapes, prenons l’exemple fictif d’un restaurant appelé Pizza Palace. Les clients passent commande en ligne, le personnel prépare les plats et les livreurs les apportent. Cet exemple ne contient aucune donnée client.
Imaginons que le système stocke les informations dans les tables suivantes :
- orders : ID de commande, client et heure de commande
- order_items : pizzas, accompagnements et boissons de chaque commande
- kitchen_queue : heures d’entrée et de sortie des commandes en cuisine
- delivery_assignments : affectation des livreurs et suivi des livraisons
- payments : enregistrements du traitement des paiements
L’objectif est de créer un journal d’événements unique qui suit chaque commande, de sa création à sa livraison. L’ID de commande servira d’ID de cas. Chaque horodatage et chaque action pertinents formeront une ligne. Téléchargez l’exemple de journal Pizza Palace pour disposer d’un modèle de journal d’événements pour le Process Mining, puis comparez ses colonnes à celles de votre propre extrait.
Déterminez les activités à inclure avant l’extraction. Pour Pizza Palace, le parcours d’une commande comporte six étapes :
- Commande passée : le client envoie sa commande.
- Paiement reçu : le paiement est traité avec succès.
- Commande envoyée en cuisine : la commande entre dans la file de préparation.
- Commande prête : la cuisine indique que la commande est terminée.
- Commande attribuée à un livreur : un livreur est affecté à la commande.
- Livraison effectuée : la commande est livrée.
Pour chaque activité, identifiez la table source, le champ d’horodatage et le champ d’ID de cas. Vérifiez que l’ID de cas relie bien l’événement à la bonne commande.
| Activité | Table source | Champ d’horodatage | Champ d’ID de cas |
|---|---|---|---|
| Commande passée | orders | created_at | id |
| Paiement reçu | payments | payment_time | order_id |
| Commande envoyée en cuisine | kitchen_queue | queue_entry_time | order_id |
| Commande prête | kitchen_queue | completed_time | order_id |
| Commande attribuée à un livreur | delivery_assignments | assigned_at | order_id |
| Livraison effectuée | delivery_assignments | delivered_at | order_id |
Distinguez les événements directs des événements déduits. Un événement direct dispose d’un enregistrement et d’un horodatage explicites dans un système source : l’activité « Commande passée » provient de l’horodatage de la ligne orders, « Paiement reçu » de payments et « Livraison effectuée » de delivery_assignments. Leur extraction est généralement simple, à condition que l’horodatage corresponde bien à l’événement que vous souhaitez analyser.
Un événement déduit ne possède pas d’enregistrement propre : son heure est calculée à partir d’un autre champ. L’activité « Commande attribuée à un livreur » peut n’être enregistrée qu’à la création de l’affectation de livraison, tandis que l’activité « Commande prête » peut correspondre uniquement au moment où le statut de la file d’attente en cuisine est passé à « completed ». Les événements déduits peuvent être utiles, mais consignez la méthode utilisée : un changement de statut ou la création d’un enregistrement ne signifie pas toujours exactement ce que suggère le nom de l’activité. Avant d’utiliser ce champ comme horodatage d’événement, vérifiez sa signification auprès des personnes qui connaissent le système source.
Cette association constitue un plan, pas la preuve que chaque champ convient. Vérifiez que les horodatages sont renseignés et que chaque table peut être jointe à l’ID de commande sans créer de doublons.
Attributs de cas et d’événement
Les attributs apportent du contexte à votre analyse. Ce sont les colonnes qui s’ajoutent à l’ID de cas, à l’horodatage et à l’activité. N’ajoutez que ceux dont le sens est clair et qui peuvent être associés au bon cas ou au bon événement.
Les attributs de cas décrivent l’ensemble du cas et restent généralement identiques d’un événement à l’autre : nom du client, montant total de la commande, adresse de livraison, nombre d’articles commandés. Dans un journal d’événements à plat, la valeur est répétée sur chaque ligne du cas. Vous pouvez ainsi filtrer ou comparer les événements à partir des informations relatives au cas.
Les attributs d’événement décrivent un événement précis : le livreur pour un événement de livraison, le mode de paiement pour un événement de paiement, le poste de cuisine pour un événement en cuisine. Une telle colonne ne concerne pas toutes les lignes. Laissez-la vide lorsqu’elle ne s’applique pas, mais conservez-la dans la table afin que toutes les lignes gardent la même structure.
Votre journal d’événements final doit tenir dans une table à plat, avec un événement par ligne. Voici celui de Pizza Palace :
| ID de cas | Horodatage | Activité | Client | Montant de la commande | Livreur | Mode de paiement |
|---|---|---|---|---|---|---|
| 1001 | 2025-01-15 18:30:00 | Commande passée | John Smith | 45,99 | ||
| 1001 | 2025-01-15 18:30:15 | Paiement reçu | John Smith | 45,99 | Carte bancaire | |
| 1001 | 2025-01-15 18:31:00 | Commande envoyée en cuisine | John Smith | 45,99 | ||
| 1001 | 2025-01-15 18:45:00 | Commande prête | John Smith | 45,99 | ||
| 1001 | 2025-01-15 18:46:00 | Commande attribuée à un livreur | John Smith | 45,99 | Maria Garcia | |
| 1001 | 2025-01-15 19:05:00 | Livraison effectuée | John Smith | 45,99 | Maria Garcia | |
| 1002 | 2025-01-15 18:35:00 | Commande passée | Jane Doe | 28,50 | ||
| 1002 | 2025-01-15 18:35:20 | Paiement reçu | Jane Doe | 28,50 | PayPal | |
| … | … | … | … | … | … | … |
Le nom du client et le montant de la commande sont répétés pour chaque événement d’un même cas. Cette répétition est intentionnelle : elle permet de conserver une table simple, lisible par les outils de Process Mining.
Méthode 1 : créez le journal dans Excel
Excel convient bien à un petit extrait ou à un premier exercice. Exportez chaque type d’événement, uniformisez les colonnes, puis rassemblez les lignes dans une seule feuille. Les cinq étapes ci-dessous prennent environ une heure avec les données de Pizza Palace.
Étape 1 : exportez chaque type d’événement dans une feuille distincte. Créez une feuille de calcul pour chaque type d’activité. Par exemple :
Feuille 1 : Commande passée
| ID de cas | Horodatage | Activité | Client | Montant de la commande |
|---|---|---|---|---|
| 1001 | 2025-01-15 18:30:00 | Commande passée | John Smith | 45,99 |
| 1002 | 2025-01-15 18:35:00 | Commande passée | Jane Doe | 28,50 |
Feuille 2 : Paiement reçu
| ID de cas | Horodatage | Activité | Client | Montant de la commande | Mode de paiement |
|---|---|---|---|---|---|
| 1001 | 2025-01-15 18:30:15 | Paiement reçu | John Smith | 45,99 | Carte bancaire |
| 1002 | 2025-01-15 18:35:20 | Paiement reçu | Jane Doe | 28,50 | PayPal |
Créez des feuilles supplémentaires pour les événements en cuisine et en livraison en suivant la même méthode.
Étape 2 : uniformisez les colonnes. Utilisez les mêmes noms de colonnes, dans le même ordre, sur chaque feuille. Ajoutez des colonnes vides lorsqu’un attribut ne s’applique pas. Par exemple, la feuille Commande passée peut reprendre l’ensemble des colonnes :
| ID de cas | Horodatage | Activité | Client | Montant de la commande | Livreur | Mode de paiement |
|---|---|---|---|---|---|---|
| 1001 | 2025-01-15 18:30:00 | Commande passée | John Smith | 45,99 |
Vérifiez que les valeurs utilisent des formats compatibles. Assurez-vous notamment que les horodatages sont enregistrés comme des dates et des heures, et non comme du texte qui leur ressemble.
Étape 3 : rassemblez les feuilles. Créez une nouvelle feuille appelée Journal d’événements, puis copiez-y les lignes d’événements de chaque feuille d’activité. Conservez une seule ligne d’en-tête et une ligne par événement.
Étape 4 : triez par cas et par horodatage. Triez les données regroupées par ID de cas croissant, puis par horodatage croissant. Vous pourrez ainsi examiner plus facilement la séquence de chaque cas. Le tri ne corrige pas les horodatages inexacts : vérifiez les événements qui ont la même heure ou une heure inattendue avant de vous fier à leur ordre.
Étape 5 : exportez au format CSV. Enregistrez la feuille regroupée au format CSV pour journal d’événements de Process Mining, dans un format lisible par votre outil. Ouvrez le fichier exporté pour vérifier que les en-têtes, les séparateurs, le format des dates et les valeurs vides sont conformes à vos attentes.
Conseils pour Excel :
- Utilisez RECHERCHEV ou RECHERCHEX pour ajouter des attributs de cas, comme le nom du client, depuis la feuille des commandes.
- Utilisez un format de date et d’heure cohérent, par exemple
YYYY-MM-DD HH:MM:SS. - Vérifiez l’absence de lignes en double avant l’exportation.
- Conservez une copie intacte des extraits d’origine afin de pouvoir retracer les corrections.
Méthode 2 : créez le journal avec SQL
SQL est une bonne option lorsque vos données se trouvent dans une base de données, que l’extrait est volumineux ou que vous devez répéter la même extraction le mois suivant. En général, on utilise une requête SELECT par activité, puis on rassemble les résultats avec UNION ALL.
Fonctionnement de UNION ALL. Cette instruction rassemble les lignes renvoyées par plusieurs requêtes SELECT. Chaque requête doit renvoyer le même nombre de colonnes, dans le même ordre, avec des types de données compatibles et des alias cohérents afin que les colonnes finales portent des noms clairs.
La requête. L’exemple ci-dessous utilise les tables fictives de Pizza Palace. Avant de l’adapter, vérifiez les noms de vos tables et de vos champs, la signification des horodatages et le dialecte SQL utilisé.
-- Event Log Extraction for Pizza Palace
-- This query combines multiple event types into a single event log
-- Each SELECT block represents one activity type

-- Event 1: Order Placed
-- Source: orders table
-- This captures when customers submit their orders
SELECT
    o.id AS case_id,                          -- The order ID is our case identifier
    o.created_at AS timestamp,                -- When the order was placed
    'Order Placed' AS activity,               -- The activity name (hardcoded)
    o.customer_name AS customer,              -- Case attribute: who ordered
    o.total_amount AS order_value,            -- Case attribute: order value
    NULL AS driver,                           -- Not applicable for this event
    NULL AS payment_method                    -- Not applicable for this event
FROM orders o
WHERE o.created_at >= '2025-01-01'            -- Filter to your desired date range

UNION ALL

-- Event 2: Payment Received
-- Source: payments table
-- This captures successful payment processing
SELECT
    p.order_id AS case_id,
    p.payment_time AS timestamp,
    'Payment Received' AS activity,
    o.customer_name AS customer,              -- Join to get case attributes
    o.total_amount AS order_value,
    NULL AS driver,
    p.payment_method AS payment_method        -- Event-specific attribute
FROM payments p
JOIN orders o ON p.order_id = o.id            -- Join to get order details
WHERE p.payment_time >= '2025-01-01'
  AND p.status = 'successful'                 -- Only include successful payments

UNION ALL

-- Event 3: Order Sent to Kitchen
-- Source: kitchen_queue table
-- This captures when the kitchen starts working on the order
SELECT
    k.order_id AS case_id,
    k.queue_entry_time AS timestamp,
    'Order Sent to Kitchen' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    NULL AS driver,
    NULL AS payment_method
FROM kitchen_queue k
JOIN orders o ON k.order_id = o.id
WHERE k.queue_entry_time >= '2025-01-01'

UNION ALL

-- Event 4: Order Ready
-- Source: kitchen_queue table (different timestamp field)
-- This is an inferred event based on when the kitchen marked it complete
SELECT
    k.order_id AS case_id,
    k.completed_time AS timestamp,            -- Different timestamp than entry
    'Order Ready' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    NULL AS driver,
    NULL AS payment_method
FROM kitchen_queue k
JOIN orders o ON k.order_id = o.id
WHERE k.completed_time >= '2025-01-01'
  AND k.completed_time IS NOT NULL            -- Only include completed orders

UNION ALL

-- Event 5: Assigned to Driver
-- Source: delivery_assignments table
-- This captures when a driver is assigned to deliver the order
SELECT
    d.order_id AS case_id,
    d.assigned_at AS timestamp,
    'Assigned to Driver' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    d.driver_name AS driver,                  -- Event-specific attribute
    NULL AS payment_method
FROM delivery_assignments d
JOIN orders o ON d.order_id = o.id
WHERE d.assigned_at >= '2025-01-01'

UNION ALL

-- Event 6: Delivery Completed
-- Source: delivery_assignments table (different timestamp field)
-- This captures when the order was delivered to the customer
SELECT
    d.order_id AS case_id,
    d.delivered_at AS timestamp,
    'Delivery Completed' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    d.driver_name AS driver,
    NULL AS payment_method
FROM delivery_assignments d
JOIN orders o ON d.order_id = o.id
WHERE d.delivered_at >= '2025-01-01'
  AND d.delivered_at IS NOT NULL              -- Only include completed deliveries

-- Final ordering: by case, then by time
-- This makes the event log easy to read and follow
ORDER BY case_id, timestamp;
La requête utilise l’ID de commande comme ID de cas et renvoie les mêmes sept colonnes pour chaque activité. Les valeurs NULL garantissent une structure de colonnes cohérente lorsqu’un attribut ne s’applique pas. Le filtre de date et la condition de paiement réussi ne sont que des exemples : choisissez des filtres adaptés au processus et à la période que vous souhaitez analyser.
Pour compléter la requête. Pour ajouter une activité :
- Copiez un bloc
SELECTpour vous en servir de point de départ. - Utilisez la table source qui enregistre l’événement.
- Sélectionnez le champ qui correspond à son horodatage.
- Choisissez un nom d’activité cohérent avec les autres lignes.
- Incluez l’ID de cas et les attributs pertinents.
- Ajoutez des filtres adaptés à votre analyse.
Par exemple, vous pouvez ajouter une tentative de livraison de la manière suivante, si votre système comporte la table et les champs nécessaires :
UNION ALL

-- Event 7: Delivery Attempted
-- Add this to track failed delivery attempts
SELECT
    d.order_id AS case_id,
    d.attempt_time AS timestamp,
    'Delivery Attempted' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    d.driver_name AS driver,
    NULL AS payment_method
FROM delivery_attempts d
JOIN orders o ON d.order_id = o.id
WHERE d.attempt_time >= '2025-01-01'
Vérifications à effectuer avant d’analyser le journal
Effectuez ces vérifications avant d’analyser le journal. Ensemble, elles couvrent les problèmes courants des journaux d’événements qui faussent le plus les résultats du Process Mining : doublons, horodatages manquants, ID de cas instables et champs de statut pris à tort pour des activités.
- Commencez par les colonnes obligatoires. Créez un journal de petite taille avec l’ID de cas, l’horodatage et l’activité avant d’ajouter d’autres événements ou attributs.
- Utilisez des ID de cas stables. Tous les événements d’un même cas doivent utiliser le même identifiant. N’utilisez pas une valeur qui change au cours du processus.
- Gardez des noms d’activité cohérents. Choisissez un seul libellé, comme « Commande passée », au lieu de le mélanger avec « Commande créée » et « Nouvelle commande ».
- Vérifiez les horodatages. Confirmez qu’ils correspondent au moment de l’événement, qu’ils utilisent un fuseau horaire cohérent et qu’ils peuvent être triés comme des dates et des heures.
- Recherchez les doublons et les valeurs manquantes. Examinez les événements répétés et les lignes où l’ID de cas, l’horodatage ou l’activité manque.
- Consignez les détails de votre extraction. Notez les tables sources, les champs, les filtres, la date d’extraction et les hypothèses retenues. Le journal sera ainsi plus facile à mettre à jour et à dépanner.
- Ajoutez les attributs avec discernement. Incluez les champs utiles pour répondre à une question et vérifiez que les jointures ne multiplient pas les lignes d’événements.
La FAQ à la fin de cette page répond à sept problèmes courants liés aux données, des événements en double aux ID de cas manquants. Le guide sur l’ETL pour le Process Mining présente la même démarche pour les extractions récurrentes.
Que faire si vous ne disposez pas des données nécessaires
Vous n’avez pas besoin d’un connecteur prêt à l’emploi pour préparer un journal d’événements. Commencez par vérifier les données que votre système peut exporter et s’il fournit les trois champs obligatoires.
- Identifiez le processus et l’ID de cas que vous souhaitez suivre.
- Vérifiez si le système peut exporter l’historique des événements, les pistes d’audit ou les changements de statut horodatés.
- Utilisez un modèle de données pour associer les champs disponibles à l’ID de cas, à l’horodatage et à l’activité.
- Si vous ne pouvez pas exporter une table d’événements prête à l’emploi, demandez à votre équipe de données un extrait de la base ou un rapport comportant une ligne par événement.
Un export système peut contenir plusieurs tables ou utiliser des noms différents pour un même champ. Vous pouvez regrouper et renommer les données dans Excel ou SQL, à condition de préserver le sens de chaque champ et de pouvoir le retracer jusqu’à sa source. La page Où trouver les données pour le Process Mining présente d’autres sources de données utilisables. Nos guides d’amélioration des processus ont déjà réalisé les étapes 1 à 3 pour votre système et proposent un modèle de données pour chaque processus.
Pour comparer différents formats avec un autre exemple de journal d’événements pour le Process Mining, consultez la collection de fichiers d’exemple et de modèles de journaux d’événements, qui comprend un tableur prêt à l’emploi. La page consacrée au modèle de journal d’événements répertorie les colonnes obligatoires et facultatives. Pour découvrir comment charger votre premier jeu de données, consultez Chargez votre premier jeu de données.
Chargez le journal que vous avez créé
Une fois le journal prêt, chargez le fichier et associez ses trois colonnes obligatoires. ProcessMind lit directement les fichiers Excel, CSV et les extraits de bases de données.
- Importez votre fichier ou sélectionnez l’extrait de votre base de données.
- Associez les colonnes ID de cas, horodatage et activité.
- Vérifiez les autres attributs éventuels.
- Générez la représentation du processus et vérifiez que les cas et l’ordre des événements sont cohérents.
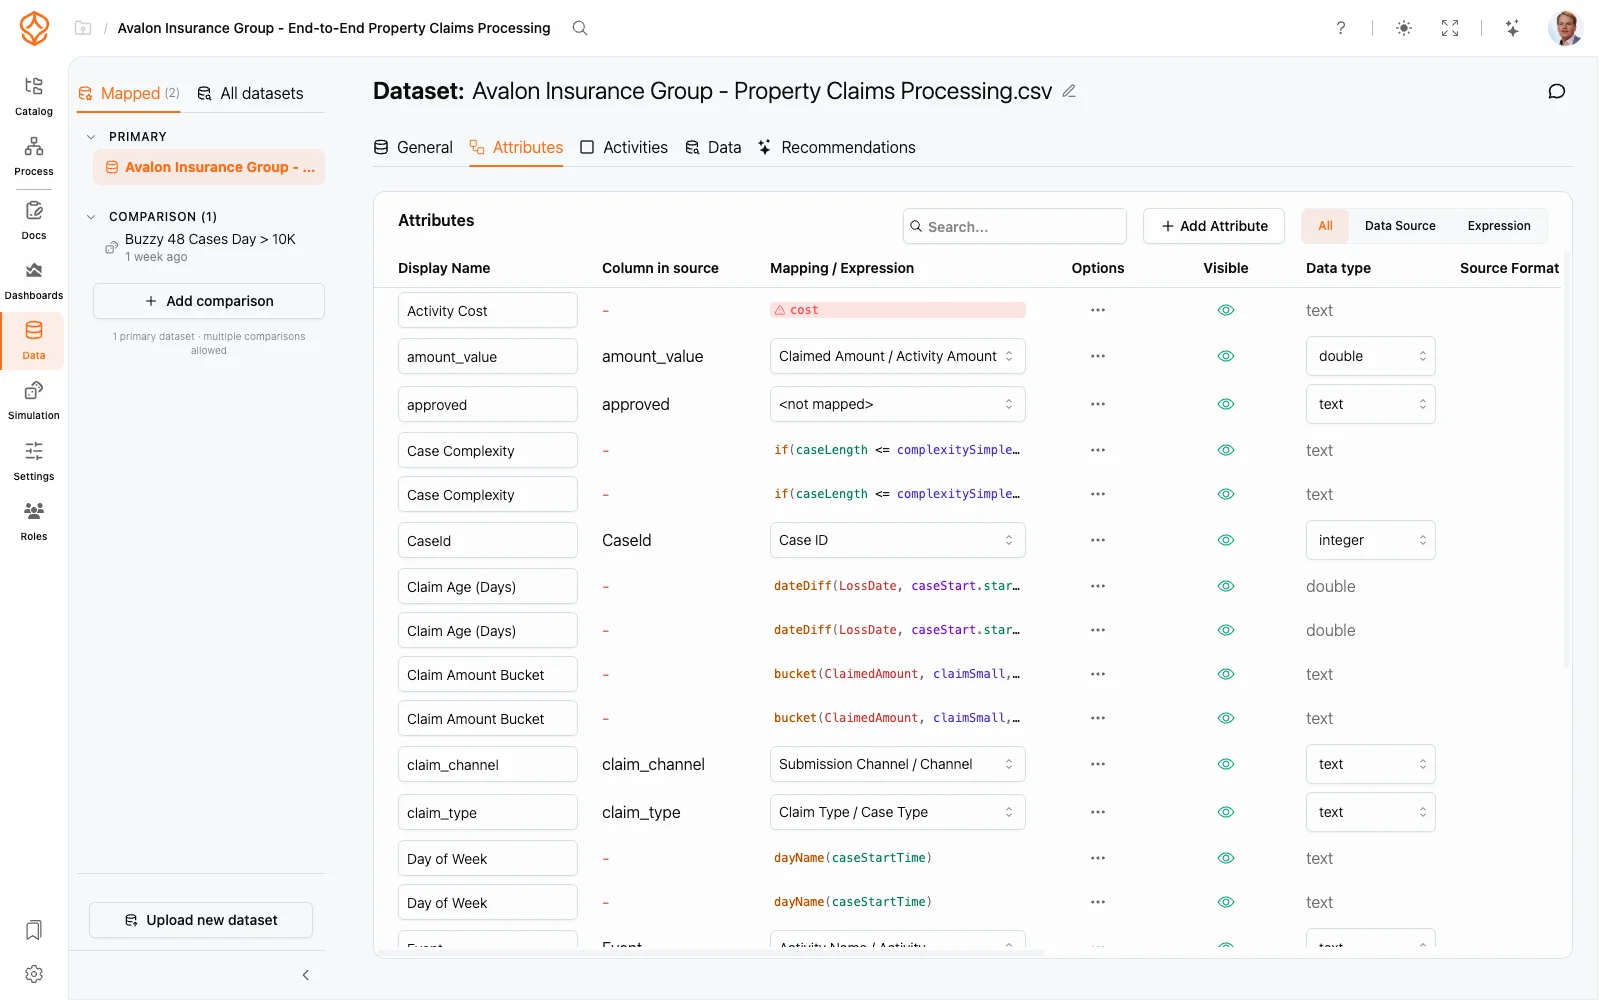
La représentation du processus peut vous aider à repérer des activités manquantes, des séquences inattendues et des points à examiner. Elle ne corrige pas les données sources et ne modifie pas la façon dont le travail est effectué. Si le premier résultat révèle un problème de données, mettez à jour l’extrait et chargez-le de nouveau. La page Chargez votre premier jeu de données détaille l’importation et l’association des colonnes.
Where to Go From Here
Vous disposez d’un journal d’événements, ou des trois colonnes nécessaires pour en créer un. Il ne vous reste qu’à examiner le fonctionnement réel du processus.