Mejore la gestión de problemas
Guía de 6 pasos para optimizar la gestión de problemas en ServiceNow
Mejore la gestión de problemas
Gestión de problemas
ServiceNow

Seleccione un proceso

Elija un proceso para seguir trabajando en su espacio de trabajo conectado.

Procesos disponibles
Sistemas disponibles

Optimice la gestión de problemas de ServiceNow para resolverlos más rápido

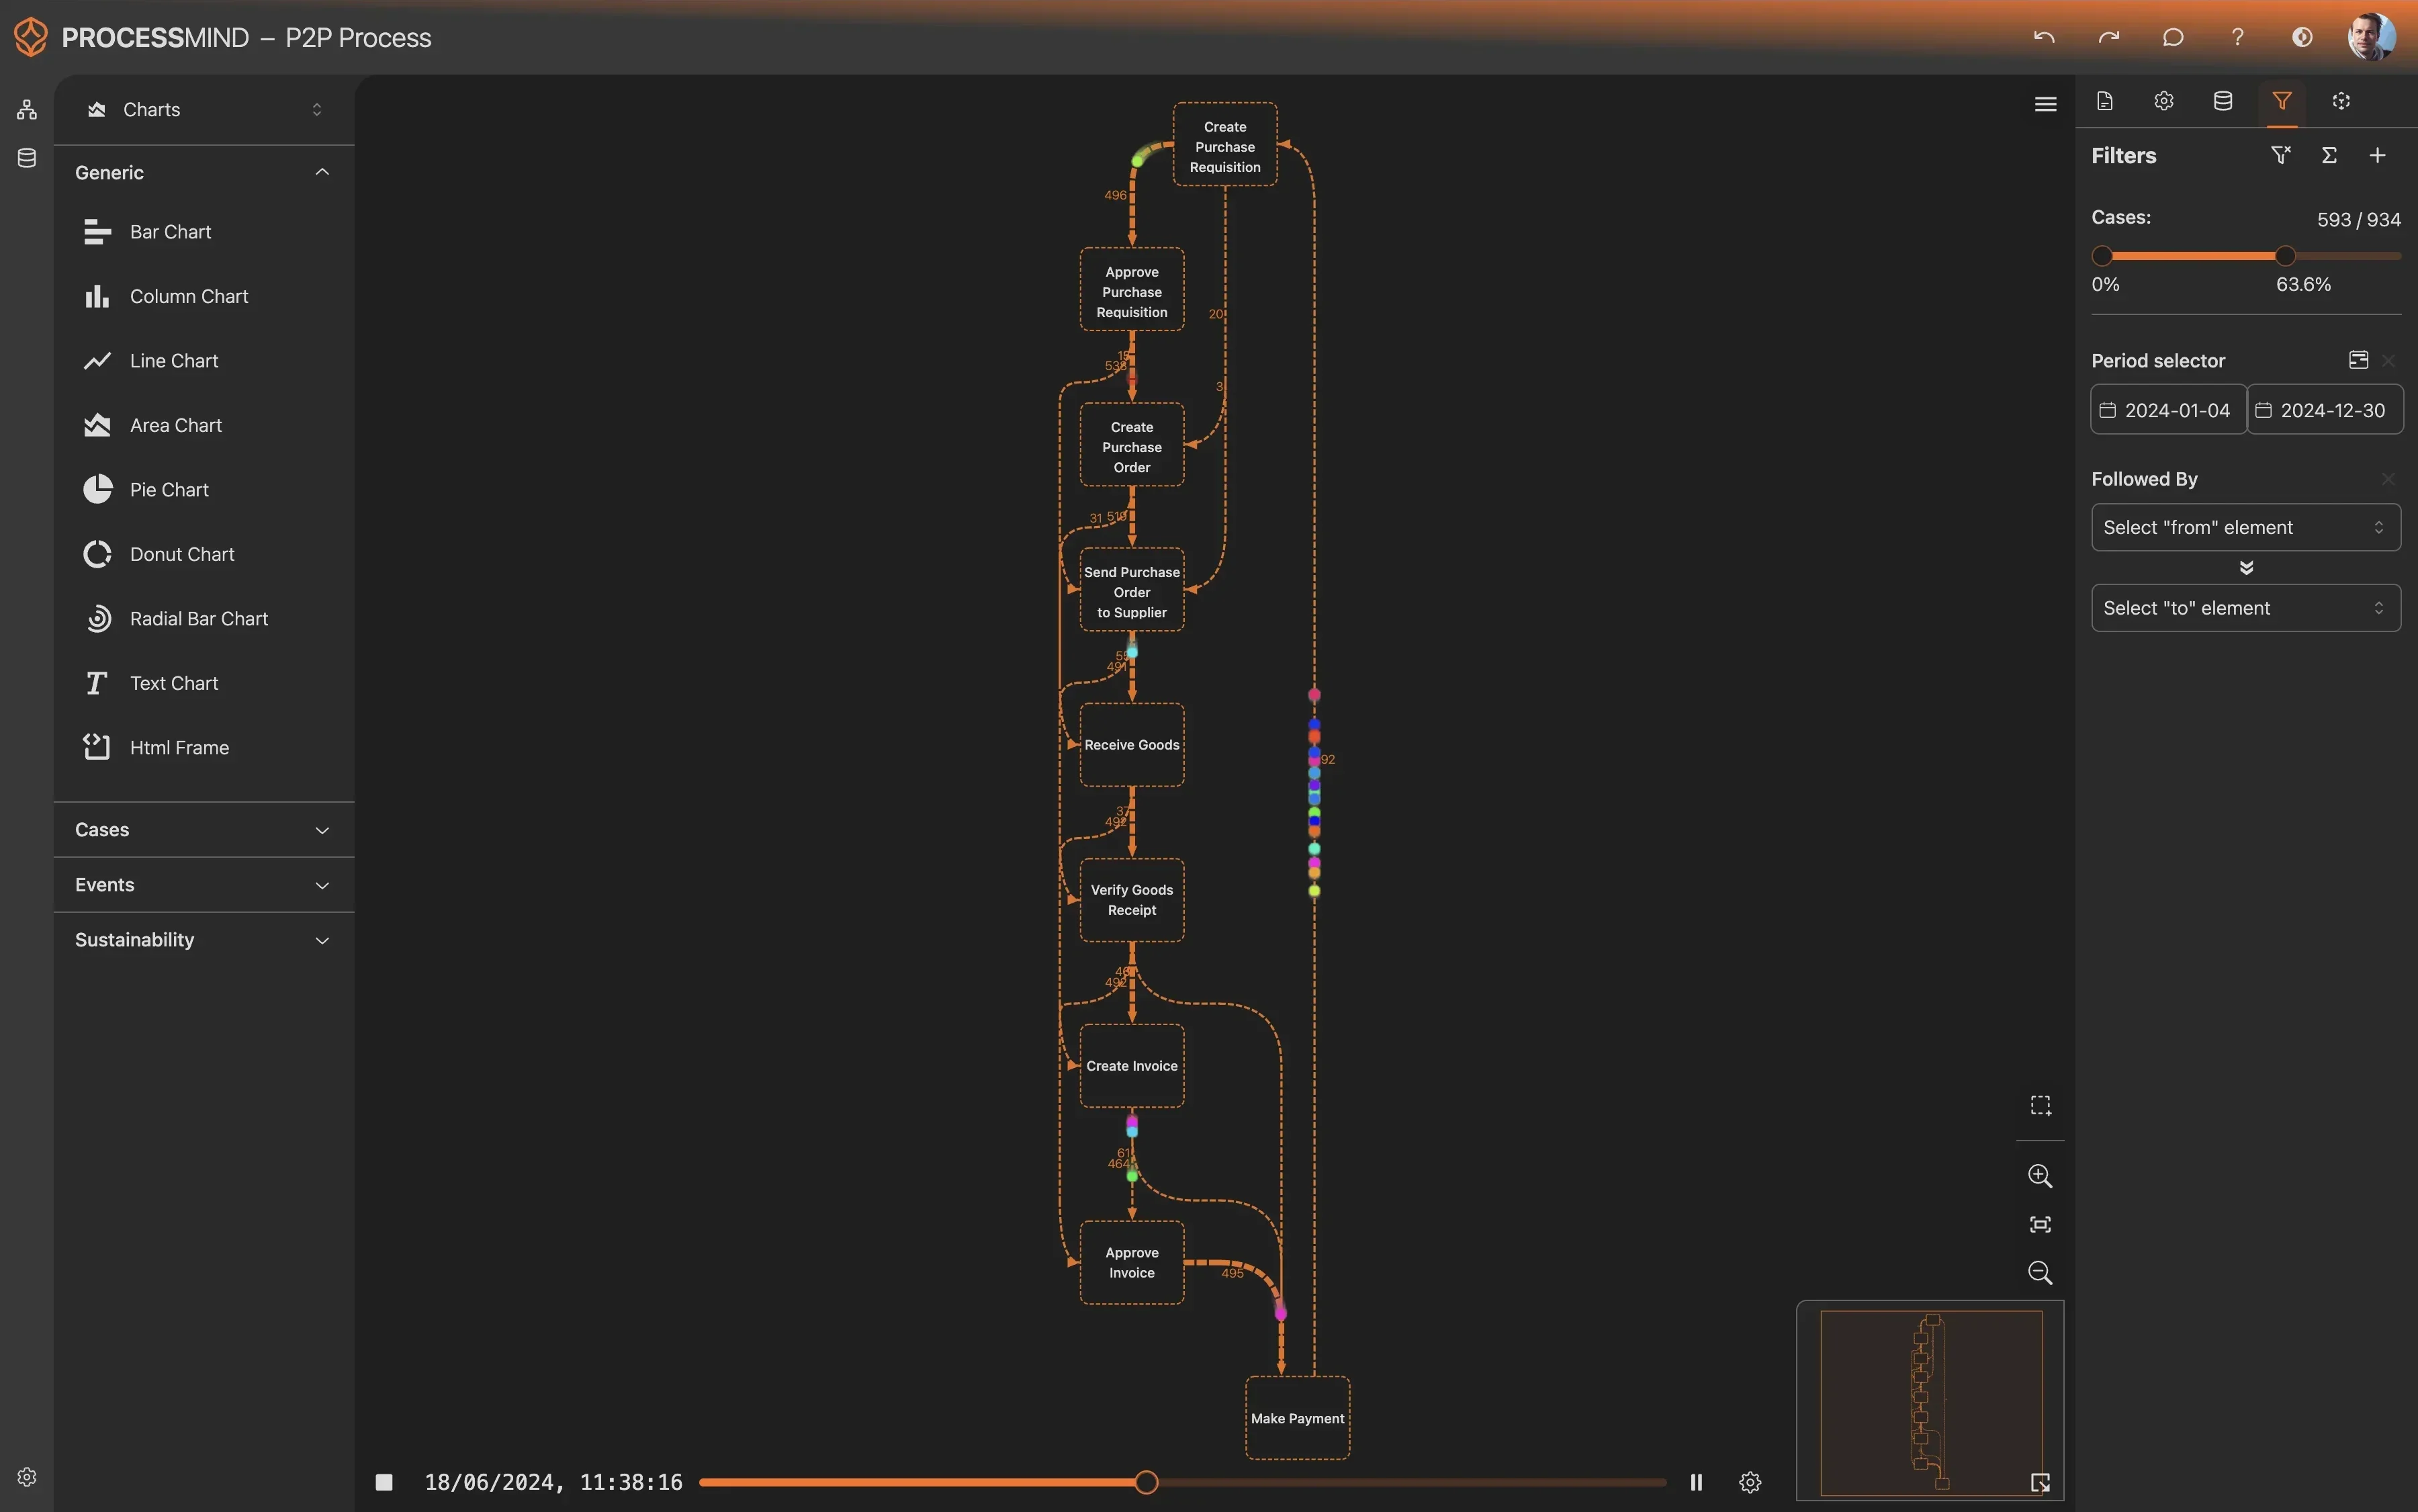
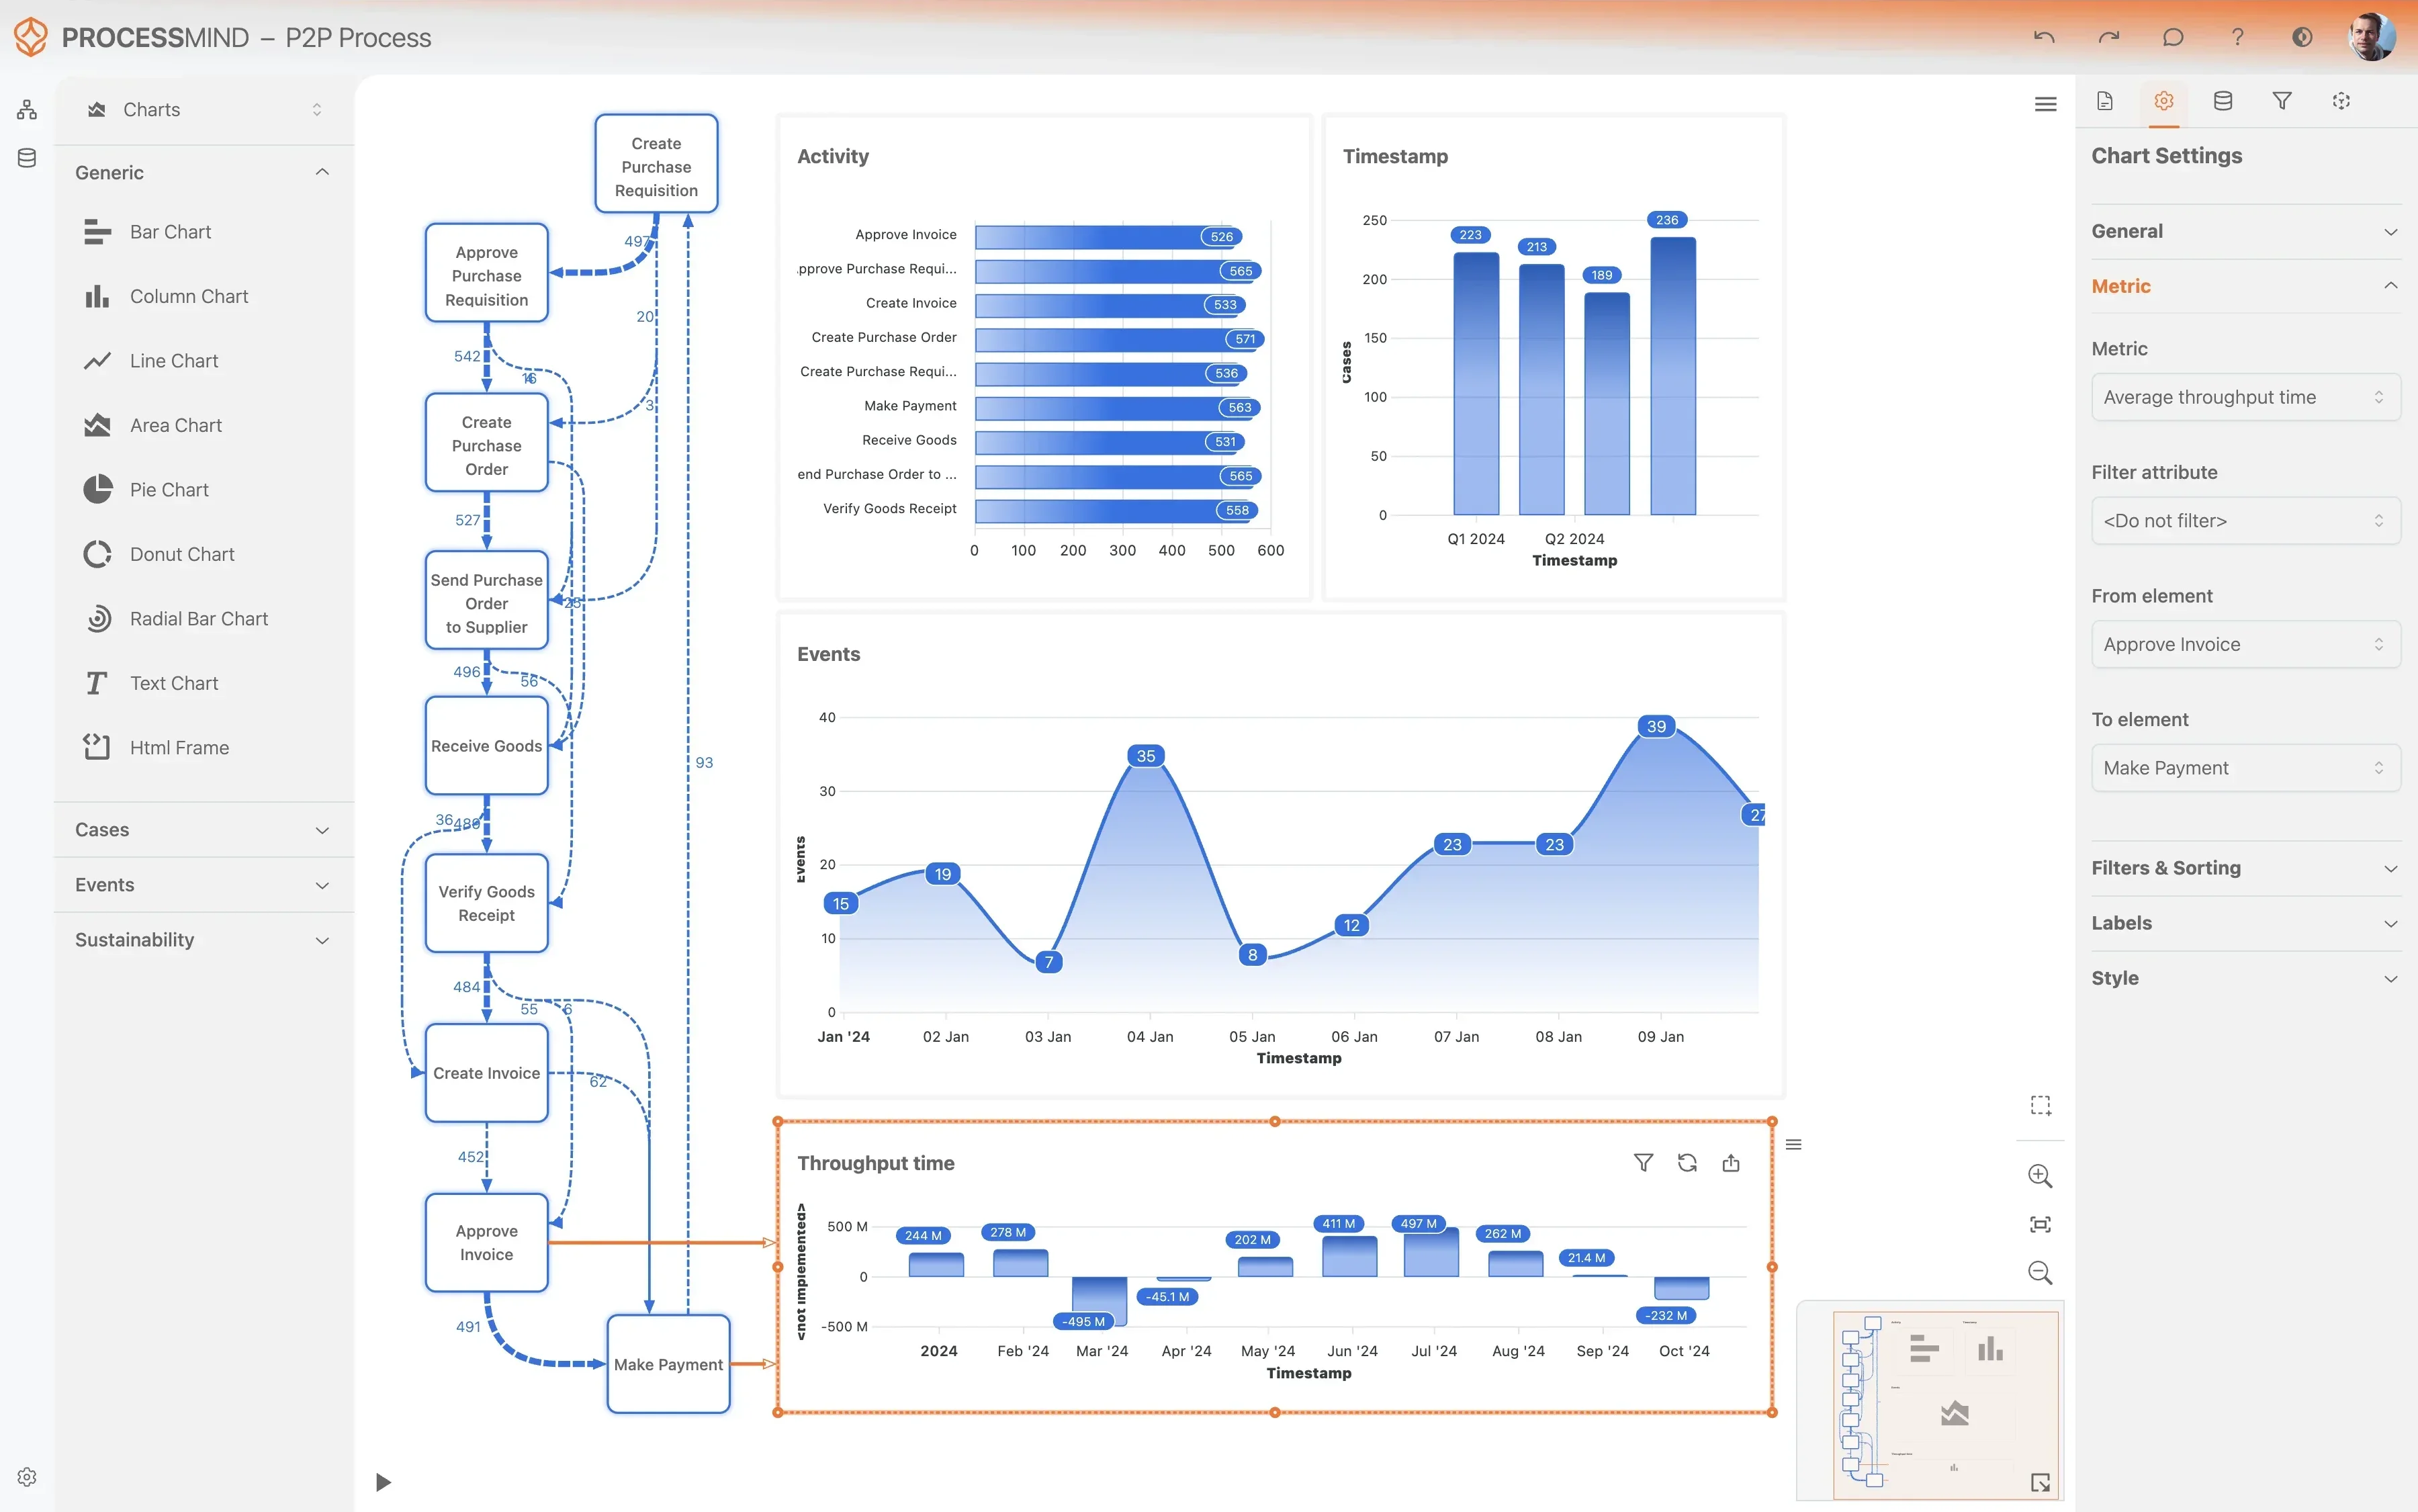
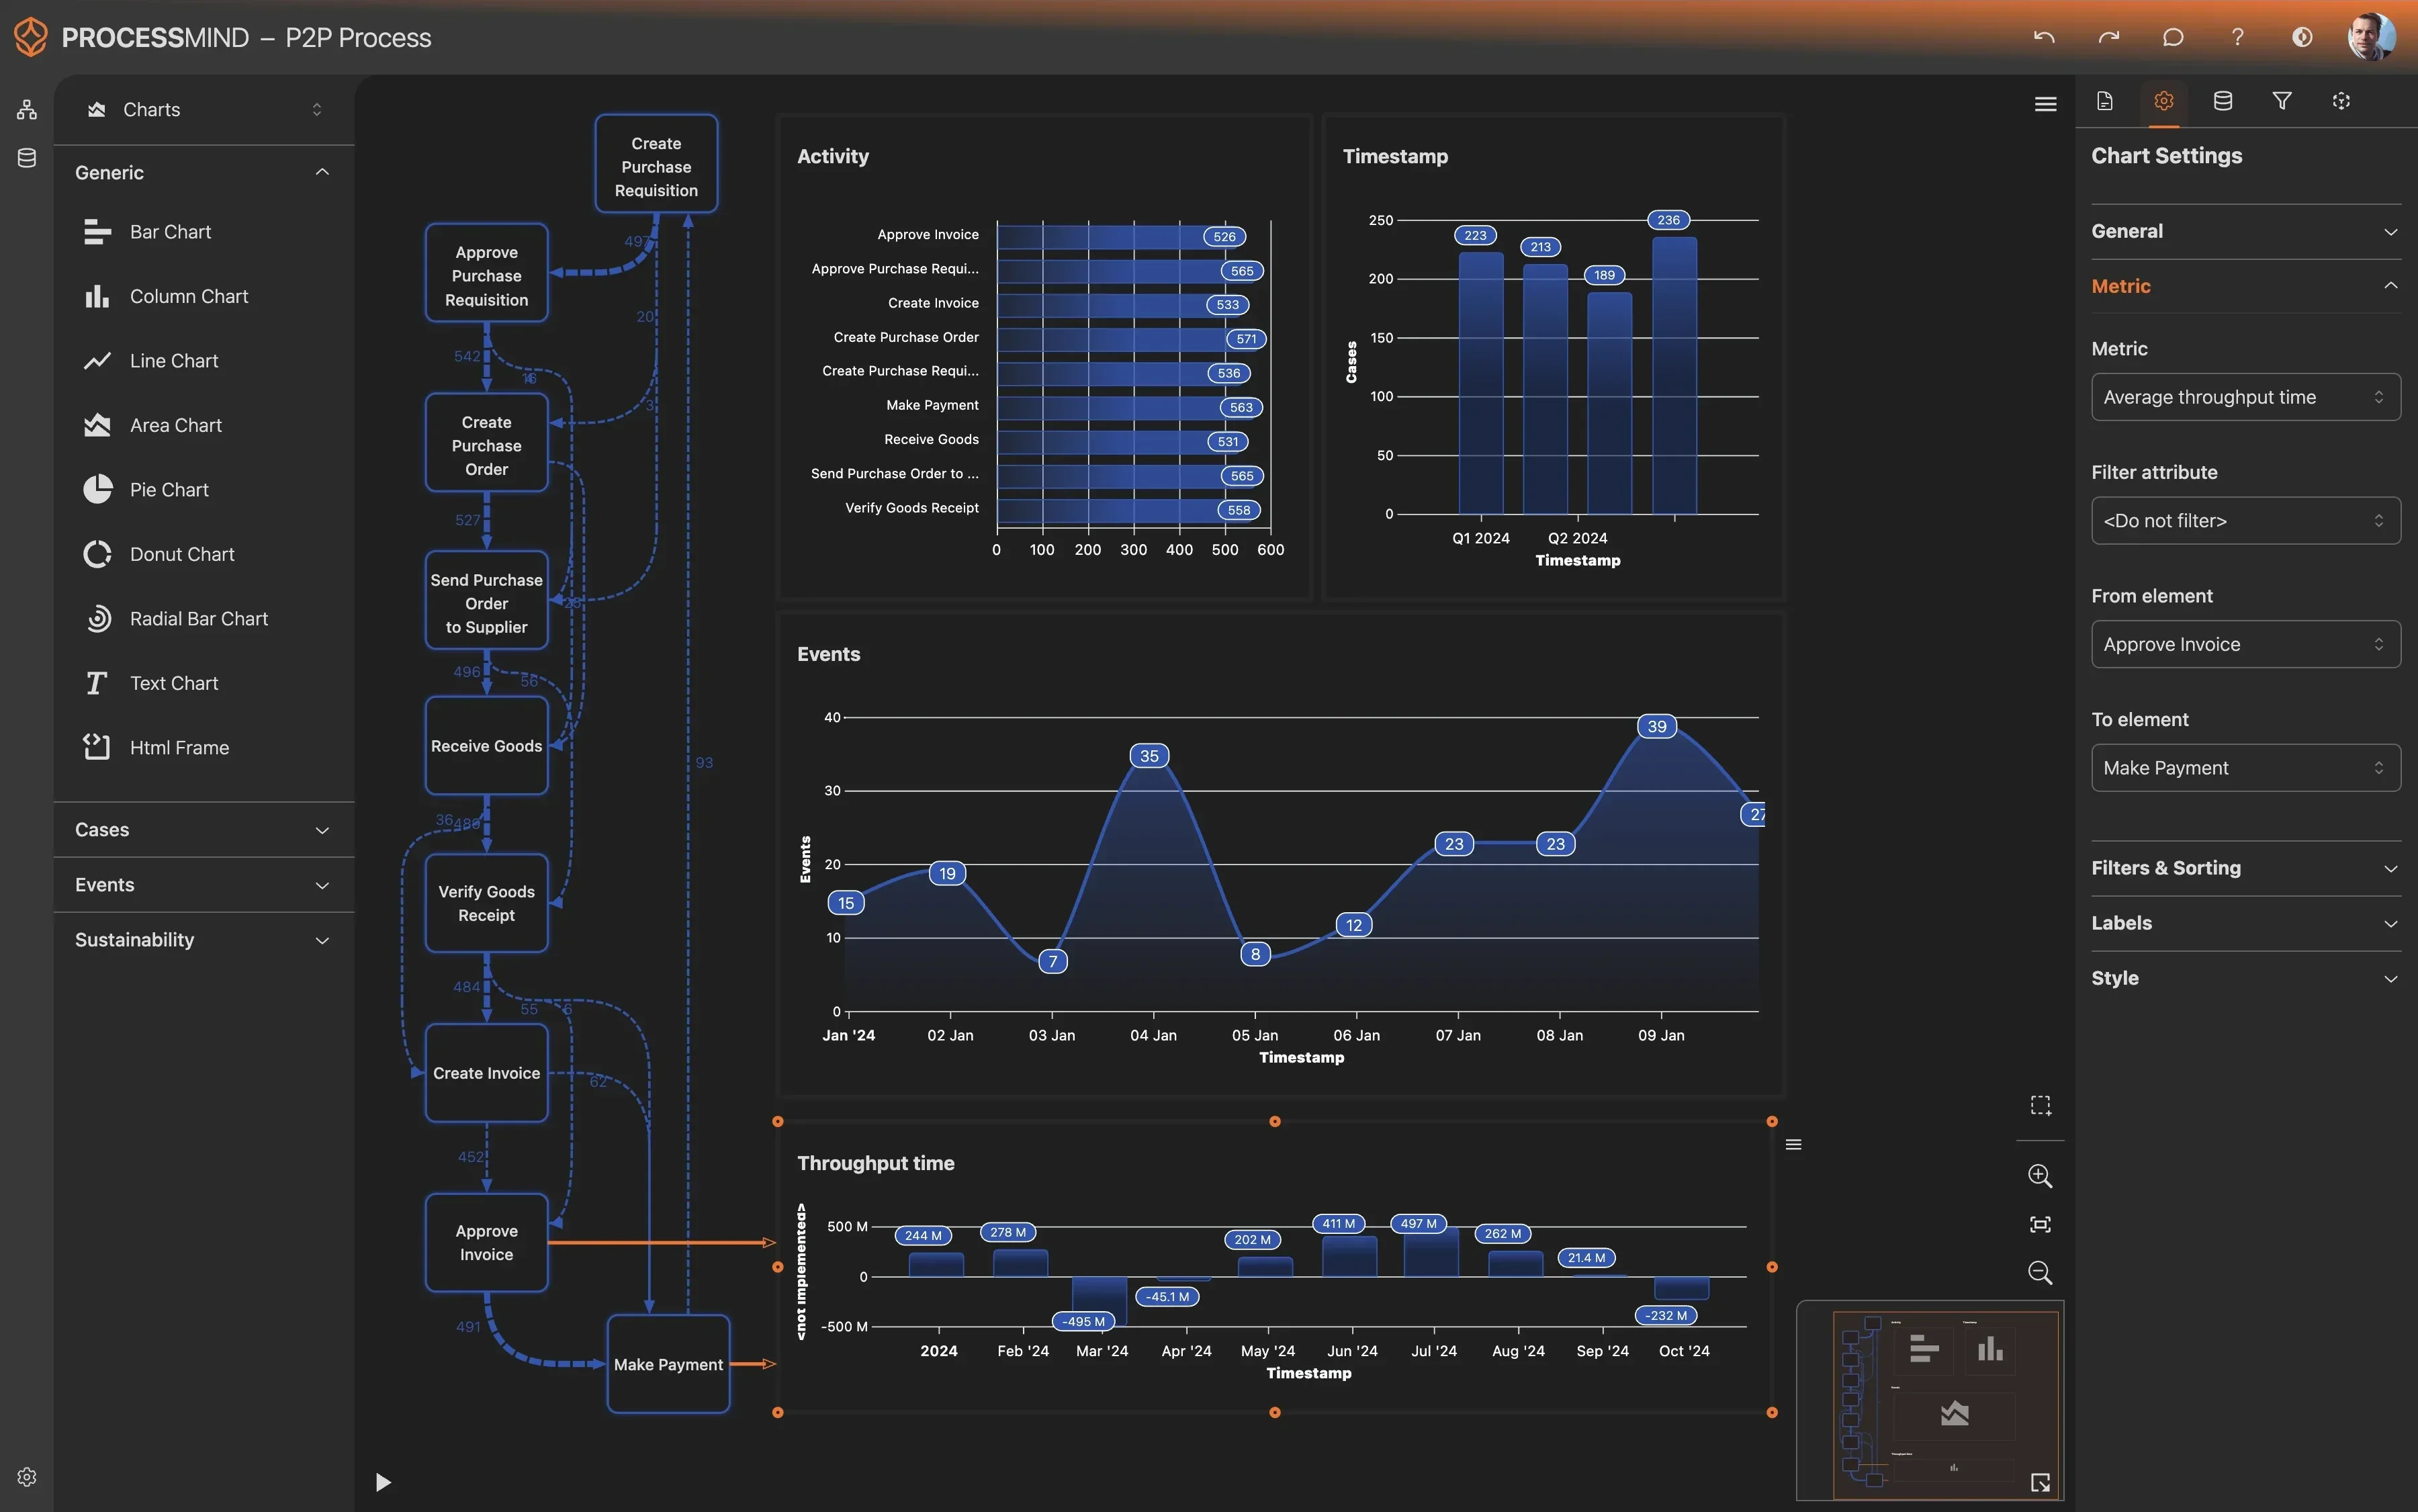
Nuestra plataforma de Process Mining revela los cuellos de botella ocultos y los ciclos de retrabajo que alargan los tiempos de resolución. Identificamos dónde se estancan las investigaciones y por qué se producen fallos de comunicación, para que pueda tomar decisiones con mayor claridad y agilizar las operaciones. Al visualizar el flujo de trabajo real, podrá reducir las demoras manuales y ofrecer un entorno más estable a sus usuarios.

Descargue nuestro Template de datos preconfigurado y aborde los desafíos habituales para alcanzar sus objetivos de eficiencia. Siga nuestro plan de mejora de seis pasos y consulte la guía del Template de datos para transformar sus operaciones.

Mostrar descripción detallada

Por qué es esencial optimizar la gestión de problemas

Hoy en día, muchas organizaciones de TI quedan atrapadas en un ciclo de respuesta reactiva a las crisis. Cuando se producen incidentes graves, la prioridad inmediata es restablecer el servicio, pero a menudo no se aborda la causa raíz. Esto provoca interrupciones recurrentes y aumenta los costes operativos. Optimizar la gestión de problemas es la única forma de romper este ciclo. Si mejora la manera en que su organización identifica, investiga y resuelve los problemas de fondo del entorno de TI, puede reducir considerablemente el volumen de incidentes y mejorar la estabilidad general del servicio. Una gestión de problemas ineficiente no solo hace perder tiempo: también debilita la confianza de los usuarios e impide que los equipos técnicos altamente cualificados se centren en innovar.

Cómo obtener una visión detallada con Process Mining

La gestión de problemas de ServiceNow registra una gran cantidad de datos en tablas como problem y problem_task, pero los informes tradicionales no suelen mostrar el flujo de trabajo real. Process Mining convierte estos datos en un mapa dinámico de los procesos tal como se ejecutan. En lugar de limitarse a KPI estáticos, como la antigüedad media de los problemas abiertos, puede visualizar todo el ciclo de vida, desde la identificación del problema hasta su cierre. Así puede ver cómo pasa el trabajo de un grupo de soporte a otro y dónde se desvía el proceso de los procedimientos operativos estándar. Al representar la huella digital que dejan los procesos en ServiceNow, obtiene una visión objetiva de las operaciones, sin sesgos departamentales.

Detección de ineficiencias en el ciclo de investigación

Uno de los principales retos de la gestión de problemas es la duración de la fase de investigación. Process Mining ayuda a identificar por qué se estancan algunas investigaciones. Por ejemplo, puede descubrir que los registros de problemas pasan con frecuencia de un equipo técnico aislado a otro, en un ciclo de reasignaciones, porque la clasificación inicial fue insuficiente. También puede detectar cuellos de botella concretos, donde los registros permanecen pendientes durante semanas a la espera de información de proveedores o de aprobaciones internas de cambios. Al sacar a la luz estos retrasos, puede aplicar mejoras específicas, como mejores protocolos de traspaso o vías de escalamiento automatizadas, para acelerar la implementación de una corrección permanente.

Mejora del análisis de causas raíz y el cumplimiento

Las investigaciones de calidad son la base de una gestión de problemas eficaz. Process Mining permite auditar la coherencia del proceso de análisis de causas raíz (RCA). Puede comprobar si se omiten o se realizan con demasiada rapidez pasos importantes, como publicar una solución provisional o llevar a cabo una revisión posterior a la implementación. Es esencial que cada registro de problema siga un proceso conforme a los requisitos, sobre todo en sectores muy regulados. Además, al analizar la relación entre incidentes y problemas en ServiceNow, puede determinar si los equipos identifican correctamente los problemas de gran impacto o dedican demasiado tiempo a investigaciones de baja prioridad que aportan poco valor al negocio.

Medición de resultados y mejora continua

El objetivo final de optimizar la gestión de problemas es crear una infraestructura de TI más resiliente. Process Mining proporciona información detallada para medir los resultados de las iniciativas de optimización a lo largo del tiempo. Puede hacer un seguimiento de la proporción entre correcciones permanentes y soluciones provisionales, y observar cómo se reduce el tiempo total del ciclo de vida de los registros de problemas. Al eliminar obstáculos en los flujos de trabajo de ServiceNow, el equipo puede prevenir incidentes con mayor eficacia. Este cambio de una gestión reactiva a una proactiva no solo ahorra dinero, sino que también permite que los servicios de TI crezcan al ritmo de las necesidades del negocio. Empezar con un Template de Process Mining permite obtener esta información desde el primer momento y convertir los datos existentes de ServiceNow en una hoja de ruta para mejorar las operaciones.

Gestión de problemas Análisis de causas raíz Gestión de servicios de TI Prevención de incidentes Mesa de ayuda Soporte técnico Operaciones de TI Gestión de cambios Gestión de tickets Gestión de tickets Error conocido Incidentes recurrentes Solución provisional Mesa de ayuda de TI

Problemas y desafíos frecuentes

Identifique los desafíos que le afectan

Los problemas suelen permanecer pendientes durante mucho tiempo mientras los equipos esperan la retroalimentación de los proveedores o información interna adicional. Esto paraliza la investigación de la causa raíz, alarga los tiempos de resolución y aumenta el volumen de problemas técnicos sin resolver que siguen afectando al negocio.

ProcessMind hace un seguimiento de las transiciones de estado en la gestión de problemas de ServiceNow para mostrar dónde y por qué se estancan los registros. Al visualizar el tiempo que pasan en cada estado, puede identificar los grupos de soporte o proveedores externos que provocan retrasos importantes en el ciclo de investigación.

Cuando los registros de problemas no se resuelven con eficacia, los mismos incidentes vuelven a producirse, lo que sobrecarga la mesa de ayuda y frustra a los usuarios finales. Esta recurrencia suele indicar que las soluciones provisionales no se publican correctamente o no logran mitigar el problema subyacente mientras se encuentra una corrección permanente.

Al analizar los vínculos entre los incidentes y los registros de problemas en la gestión de problemas de ServiceNow, ProcessMind detecta patrones de recurrencia que apuntan a investigaciones fallidas o incompletas. Estos datos permiten a los equipos priorizar los problemas de mayor impacto, que generan más incidencias y consumen más recursos.

No cumplir los objetivos de nivel de servicio para identificar las causas raíz suele prolongar la inestabilidad del servicio y debilitar la confianza de las partes interesadas en las operaciones de TI. Es posible que los equipos técnicos estén sobrecargados o no tengan suficiente visibilidad para priorizar las investigaciones según el impacto real del problema en el negocio.

Nuestra plataforma supervisa el tiempo transcurrido entre el registro del problema y la identificación de la causa raíz en su entorno de ServiceNow. Señala los registros que se acercan al límite del SLA para que los coordinadores de problemas puedan reasignar recursos y mantener las investigaciones críticas en curso antes de que incumplan sus objetivos.

Los registros de problemas suelen pasar de un equipo técnico a otro antes de que comience una investigación formal. Este ciclo de reasignaciones hace perder tiempo valioso, genera confusión sobre quién es responsable y retrasa considerablemente la resolución final, porque ningún grupo asume la responsabilidad de encontrar la causa raíz.

ProcessMind representa el flujo de asignaciones entre los grupos de soporte para detectar obstáculos en los traspasos y vacíos de responsabilidad. Al descubrir los ciclos de reasignación habituales en la gestión de problemas de ServiceNow, puede mejorar la lógica de asignación inicial y lograr que los problemas lleguen antes a los especialistas técnicos adecuados.

Incluso después de identificar correctamente la causa raíz, a menudo se tarda mucho en iniciar una solicitud de cambio para corregirla. Esta demora expone a la organización a nuevos incidentes, ya que la solución permanente aún no se ha programado ni implementado, aunque ya se conozca.

Hacemos un seguimiento del traspaso entre la gestión de problemas de ServiceNow y el módulo de gestión de cambios. Al medir el tiempo entre la identificación de la causa raíz y la redacción de una propuesta de solución, ProcessMind ayuda a reducir la demora hasta la resolución permanente y a que las correcciones pasen a producción sin retrasos.

Muchas organizaciones cierran los registros de problemas sin realizar una revisión adecuada después de aplicar una corrección. Sin este cierre, no se extraen lecciones valiosas ni se verifica formalmente que se haya eliminado la causa raíz, lo que puede provocar fallos en el futuro.

ProcessMind destaca los casos en que el proceso pasa directamente de la resolución al cierre, sin realizar la revisión obligatoria. Así, los equipos pueden seguir el ciclo completo de gestión de problemas de ServiceNow, mejorar la estabilidad del servicio y compartir conocimientos en toda la organización de TI.

Si las soluciones provisionales no se documentan y publican en la base de datos de errores conocidos, el personal de la mesa de ayuda no puede atender eficazmente a los usuarios mientras se investiga el problema. Esto genera trabajo duplicado, aumenta el volumen de llamadas y alarga el tiempo medio de resolución de todos los incidentes relacionados.

Al analizar los registros de actividad de publicación de soluciones provisionales, ProcessMind identifica las investigaciones que no ofrecen una solución temporal al negocio. Esta visibilidad ayuda a los responsables a aplicar los estándares de documentación en el flujo de trabajo de gestión de problemas de ServiceNow y a mejorar la eficiencia general de la mesa de ayuda.

A veces, los equipos técnicos se centran en tareas de baja prioridad mientras los problemas de gran impacto que afectan a servicios empresariales críticos siguen sin atenderse en la lista de pendientes. Este desajuste en la asignación de esfuerzos provoca interrupciones importantes en el negocio y reduce el rendimiento de la inversión de tiempo de los recursos técnicos más costosos.

Nuestro análisis relaciona los niveles de prioridad de los problemas con el esfuerzo y el tiempo reales de resolución en todos los registros. ProcessMind permite comprobar si los registros más críticos de ServiceNow reciben la atención adecuada o quedan relegados frente a tareas menos urgentes y más fáciles de resolver.

El paso de identificar una causa raíz a proponer una solución técnica concreta suele convertirse en un cuello de botella importante. A menudo se debe a la falta de recursos o de documentación clara durante la investigación, lo que dificulta que el personal de arquitectura diseñe una corrección adecuada.

ProcessMind visualiza el ciclo de vida de cada registro de problema para identificar dónde se estanca el diseño de la solución. Al localizar estos retrasos en la gestión de problemas de ServiceNow, puede mejorar la colaboración entre el personal de arquitectura e ingeniería para pasar de la teoría a una solución práctica.

Los registros de problemas suelen quedar abiertos indefinidamente, sin una investigación activa, lo que genera una acumulación desordenada y difícil de gestionar. Estos registros abandonados ocultan problemas reales y dificultan que la dirección de TI evalúe el estado real de la estabilidad operativa y el desempeño de los equipos.

Identificamos los registros que permanecen inactivos durante largos periodos entre cambios de estado en Problem Management de ServiceNow. ProcessMind le ayuda a depurar la acumulación al señalar las investigaciones estancadas que deben cerrarse oficialmente o reactivarse con nuevos recursos.

Cuando los equipos utilizan categorías genéricas o imprecisas para las causas raíz, resulta imposible identificar tendencias a largo plazo o problemas sistémicos en la infraestructura. Esta falta de calidad de los datos impide que la organización tome decisiones de inversión fundamentadas para prevenir futuras interrupciones.

ProcessMind analiza la relación entre la resolución final y las categorías asignadas en Problem Management de ServiceNow. Le ayudamos a identificar patrones de uso incorrecto de las categorías para que pueda mejorar la integridad de los datos y conocer mejor las principales fuentes de deuda técnica.

Tardar demasiado en encontrar una solución temporal deja a los usuarios sin servicio y aumenta el impacto negativo de un problema en curso. Si la investigación comienza con lentitud, la empresa sufre durante más tiempo del necesario, aunque finalmente se encuentre una solución permanente.

Nuestra plataforma mide el tiempo transcurrido desde la identificación del problema hasta la publicación de la primera solución temporal. Al analizar este segmento específico del proceso de Problem Management de ServiceNow, le ayudamos a detectar los equipos que tienen dificultades para ofrecer alivio rápidamente y a orientar la formación sobre mitigación de incidentes.

Objetivos habituales

Defina cómo se ve el éxito

Un análisis más rápido de la causa raíz evita que se repitan los incidentes y reduce al mínimo el tiempo de inactividad de la infraestructura. Al acelerar la fase de investigación, los equipos técnicos pueden dejar atrás la atención repetitiva de incidentes y centrarse en implementar soluciones permanentes que mejoren la fiabilidad general del servicio. Este objetivo influye directamente en la eficiencia de los recursos de ingeniería sénior y reduce el tiempo durante el cual las vulnerabilidades críticas quedan sin resolver en el entorno.

ProcessMind visualiza todo el flujo de investigación en Problem Management de ServiceNow para identificar con precisión dónde se estancan los equipos. Al localizar cuellos de botella en grupos de soporte o áreas técnicas específicas, la plataforma ofrece información útil para la acción que permite reducir el tiempo de investigación hasta un 30 %. Puede supervisar el recorrido desde la identificación del problema hasta la determinación de la causa raíz y comprobar que cada investigación avance según lo previsto.

Cada traspaso entre grupos de soporte aumenta el tiempo total de resolución y genera trabajo administrativo adicional. Reducir estos traspasos permite que los especialistas adecuados se ocupen del problema de inmediato y evita el habitual ir y venir que se produce cuando la responsabilidad no está bien definida. Menos reasignaciones agilizan el proceso y refuerzan la rendición de cuentas de los equipos técnicos.

Nuestra plataforma registra el historial del atributo del grupo de soporte asignado a cada registro de problema en ServiceNow. Al detectar patrones de asignación incorrecta o de traspasos frecuentes entre equipos, ProcessMind le ayuda a optimizar las reglas de asignación a grupos y a reducir a la mitad las reasignaciones innecesarias. Así, la investigación puede avanzar sin perder impulso durante los traspasos.

Cumplir los plazos de investigación es fundamental para mantener los niveles de servicio y la estabilidad operativa en toda la organización de TI. El cumplimiento constante garantiza que los problemas de alta prioridad no se descuiden y que la empresa esté protegida frente a riesgos conocidos. Cuando los equipos alcanzan sistemáticamente sus objetivos de nivel de servicio, generan confianza entre las partes interesadas y ofrecen un servicio predecible.

ProcessMind supervisa en tiempo real el desempeño real frente a los objetivos de los SLA mediante el análisis de las tablas de problemas y tareas de problemas. Al identificar las etapas específicas del proceso en las que es más probable que se incumplan los SLA, ayudamos a sus equipos a mantener un cumplimiento superior al 95 % en todos los niveles de prioridad. Puede ver qué categorías o servicios corren más riesgo de retrasarse e intervenir antes de que se produzca un incumplimiento.

Ofrecer rápidamente una solución temporal reduce el impacto de un problema activo en los usuarios finales y en la Mesa de ayuda. Permite que el personal de soporte resuelva incidentes antes de que esté lista una solución permanente, lo que reduce considerablemente el volumen de tickets abiertos y mejora la satisfacción de los usuarios. Resolver con rapidez la publicación de soluciones temporales suele ser la forma más eficaz de gestionar el impacto inmediato de una interrupción importante.

Analizamos el tiempo transcurrido entre la identificación del problema y la publicación de una solución temporal en la base de datos de errores conocidos. La información de ProcessMind le ayuda a estandarizar este paso fundamental y a poner a disposición la documentación de errores conocidos un 40 % más rápido. Esta visibilidad permite exigir a los equipos que comuniquen rápidamente las soluciones provisionales mientras se investiga la causa raíz.

Un traspaso fluido de un registro de problema a una solicitud de cambio es esencial para implementar soluciones permanentes de forma controlada. Las demoras en esta transición prolongan innecesariamente la presencia de vulnerabilidades identificadas en el entorno de producción. Una integración eficaz entre ambos procesos garantiza que el trabajo de investigación se traduzca en medidas correctivas concretas.

Al mapear la huella digital entre las tablas de problemas y solicitudes de cambio de ServiceNow, identificamos fricciones en el ciclo de aprobación y traspaso. Esto le ayuda a conectar la identificación de la causa raíz con el inicio de una solución y a reducir el tiempo perdido en trámites administrativos. Puede ver exactamente dónde se atascan las soluciones propuestas durante la redacción o la aprobación.

El principal indicador de éxito de cualquier equipo de gestión de problemas es la reducción de los incidentes recurrentes. Identificar y corregir las causas raíz reduce el coste total de propiedad de los servicios de TI y la carga diaria de la Mesa de ayuda. Evitar que los incidentes se repitan demuestra el valor concreto del proceso de gestión de problemas para el resto de la empresa.

ProcessMind relaciona el volumen de incidentes con registros de problemas específicos para evaluar la eficacia a largo plazo de sus soluciones permanentes. Así puede comprobar si las soluciones eliminan realmente la causa raíz prevista, en lugar de limitarse a tratar los síntomas. Puede hacer un seguimiento del éxito de los cambios implementados y verificar que reduzcan el volumen de incidentes según lo esperado.

Los registros obsoletos y abandonados saturan el entorno de ServiceNow y ocultan las prioridades reales de los equipos técnicos. Depurar la acumulación permite asignar los recursos limitados a los problemas actuales más críticos. Una cola de problemas activa y ordenada mejora la visibilidad para la dirección y facilita mucho el trabajo diario de quienes coordinan los problemas.

Señalamos los registros inactivos o estancados que llevan mucho tiempo sin cambios de estado ni actividad. Esta visibilidad permite a los equipos eliminar las investigaciones abandonadas y centrarse en las tareas de corrección activas. Al establecer un proceso periódico de depuración de registros, puede mantener una cola de gestión de problemas ágil y centrada en las investigaciones de mayor valor.

Clasificar correctamente las causas raíz es fundamental para analizar tendencias a largo plazo y mejorar los servicios de forma estratégica. Esto ayuda a la dirección de TI a entender dónde se acumula la deuda técnica y dónde se necesitan más inversiones en infraestructura. Los datos de calidad permiten que la organización aprenda de los fallos anteriores y evite problemas similares en otras áreas de la empresa.

ProcessMind detecta incoherencias en el registro y la clasificación de las causas raíz entre distintos grupos de soporte. Al identificar patrones de clasificación errónea o un uso excesivo de categorías genéricas, le ayudamos a mejorar la calidad de los datos operativos. Esto permite generar informes más fiables y tomar mejores decisiones para mantener la estabilidad de los servicios a largo plazo.

Aprender de los problemas anteriores es la única forma de evitar errores futuros y mejorar continuamente el ciclo de vida de los servicios de TI. Las revisiones posteriores a la implementación permiten que el equipo evalúe la investigación y la resolución para encontrar nuevas oportunidades de eficiencia. Esta fase formal de revisión es esencial para desarrollar el proceso de gestión de problemas y fomentar una cultura de aprendizaje continuo.

Supervisamos las tasas de finalización y el tiempo dedicado a las actividades posteriores a la implementación una vez resuelto un problema. Así, cada registro de un problema importante concluye con un análisis verificado del desempeño del proceso. ProcessMind le ayuda a comprobar si estas revisiones se realizan de forma sistemática y si generan mejoras medibles en los procesos con el tiempo.

Los problemas de alta prioridad requieren atención inmediata del personal más experimentado para reducir al mínimo el impacto en la empresa. Asignar los mejores recursos a los problemas más críticos contribuye a mantener la estabilidad del entorno de TI. Cuando la asignación de recursos está optimizada, la organización puede gestionar incidentes importantes sin descuidar el análisis de las causas raíz.

ProcessMind analiza el rendimiento del proceso según el nivel de prioridad y el grupo asignado en ServiceNow. Esto le permite equilibrar las cargas de trabajo y evitar que las investigaciones críticas esperen en las mismas colas que las tareas de bajo impacto. Puede visualizar la capacidad de sus grupos de soporte y ajustar las asignaciones para que los problemas más importantes reciban la atención necesaria.

A menudo, los problemas quedan inactivos mientras esperan información de proveedores, retroalimentación de usuarios o datos de terceros, lo que prolonga el periodo de riesgo. Reducir estos tiempos de inactividad acelera la resolución general y evita que las dependencias externas pongan en peligro sus SLA internos. Gestionar eficazmente los estados pendientes es clave para mantener un ritmo ágil durante el ciclo de vida del problema.

Cuantificamos exactamente cuánto tiempo se pierde en estados de espera mediante el análisis del historial de estados de los registros de problemas. Al visualizar estas demoras, puede identificar qué proveedores o equipos externos generan más fricción. Estos datos le permiten renegociar las condiciones de los acuerdos con proveedores o mejorar los procedimientos internos de seguimiento para que el proceso siga avanzando.

Una vez identificada la causa raíz, la solución propuesta debe documentarse y revisarse rápidamente para avanzar hacia su implementación. Las demoras en esta fase aplazan la solución efectiva y dejan a la empresa expuesta a que el mismo problema vuelva a producirse. Un proceso ágil de redacción y aprobación permite pasar de la teoría a la acción lo antes posible.

ProcessMind registra la duración de las etapas de redacción y aprobación en el flujo de trabajo de ServiceNow. Esta visibilidad le ayuda a eliminar trabas burocráticas y a detectar cuándo una solución propuesta lleva demasiado tiempo estancada. Puede agilizar el proceso de revisión interna y pasar de la investigación a la corrección en muchos menos pasos.

Cómo mejorar Problem Management de ServiceNow en 6 pasos

1

Descargue el Template

Qué hacer

Obtenga el Template de Excel diseñado para Problem Management de ServiceNow y asegúrese de que el mapeo de datos se ajuste a los estándares de ITIL y a las tablas de ServiceNow.

Por qué es importante

Empezar con un formato estructurado evita problemas de calidad de los datos y garantiza que los registros y las tareas de problemas estén listos para el análisis.

Resultado esperado

Un Template de datos estandarizado, listo para exportar desde ServiceNow.

INFORMACIÓN SOBRE LOS PROCESOS

Obtenga una visión completa de las investigaciones de problemas

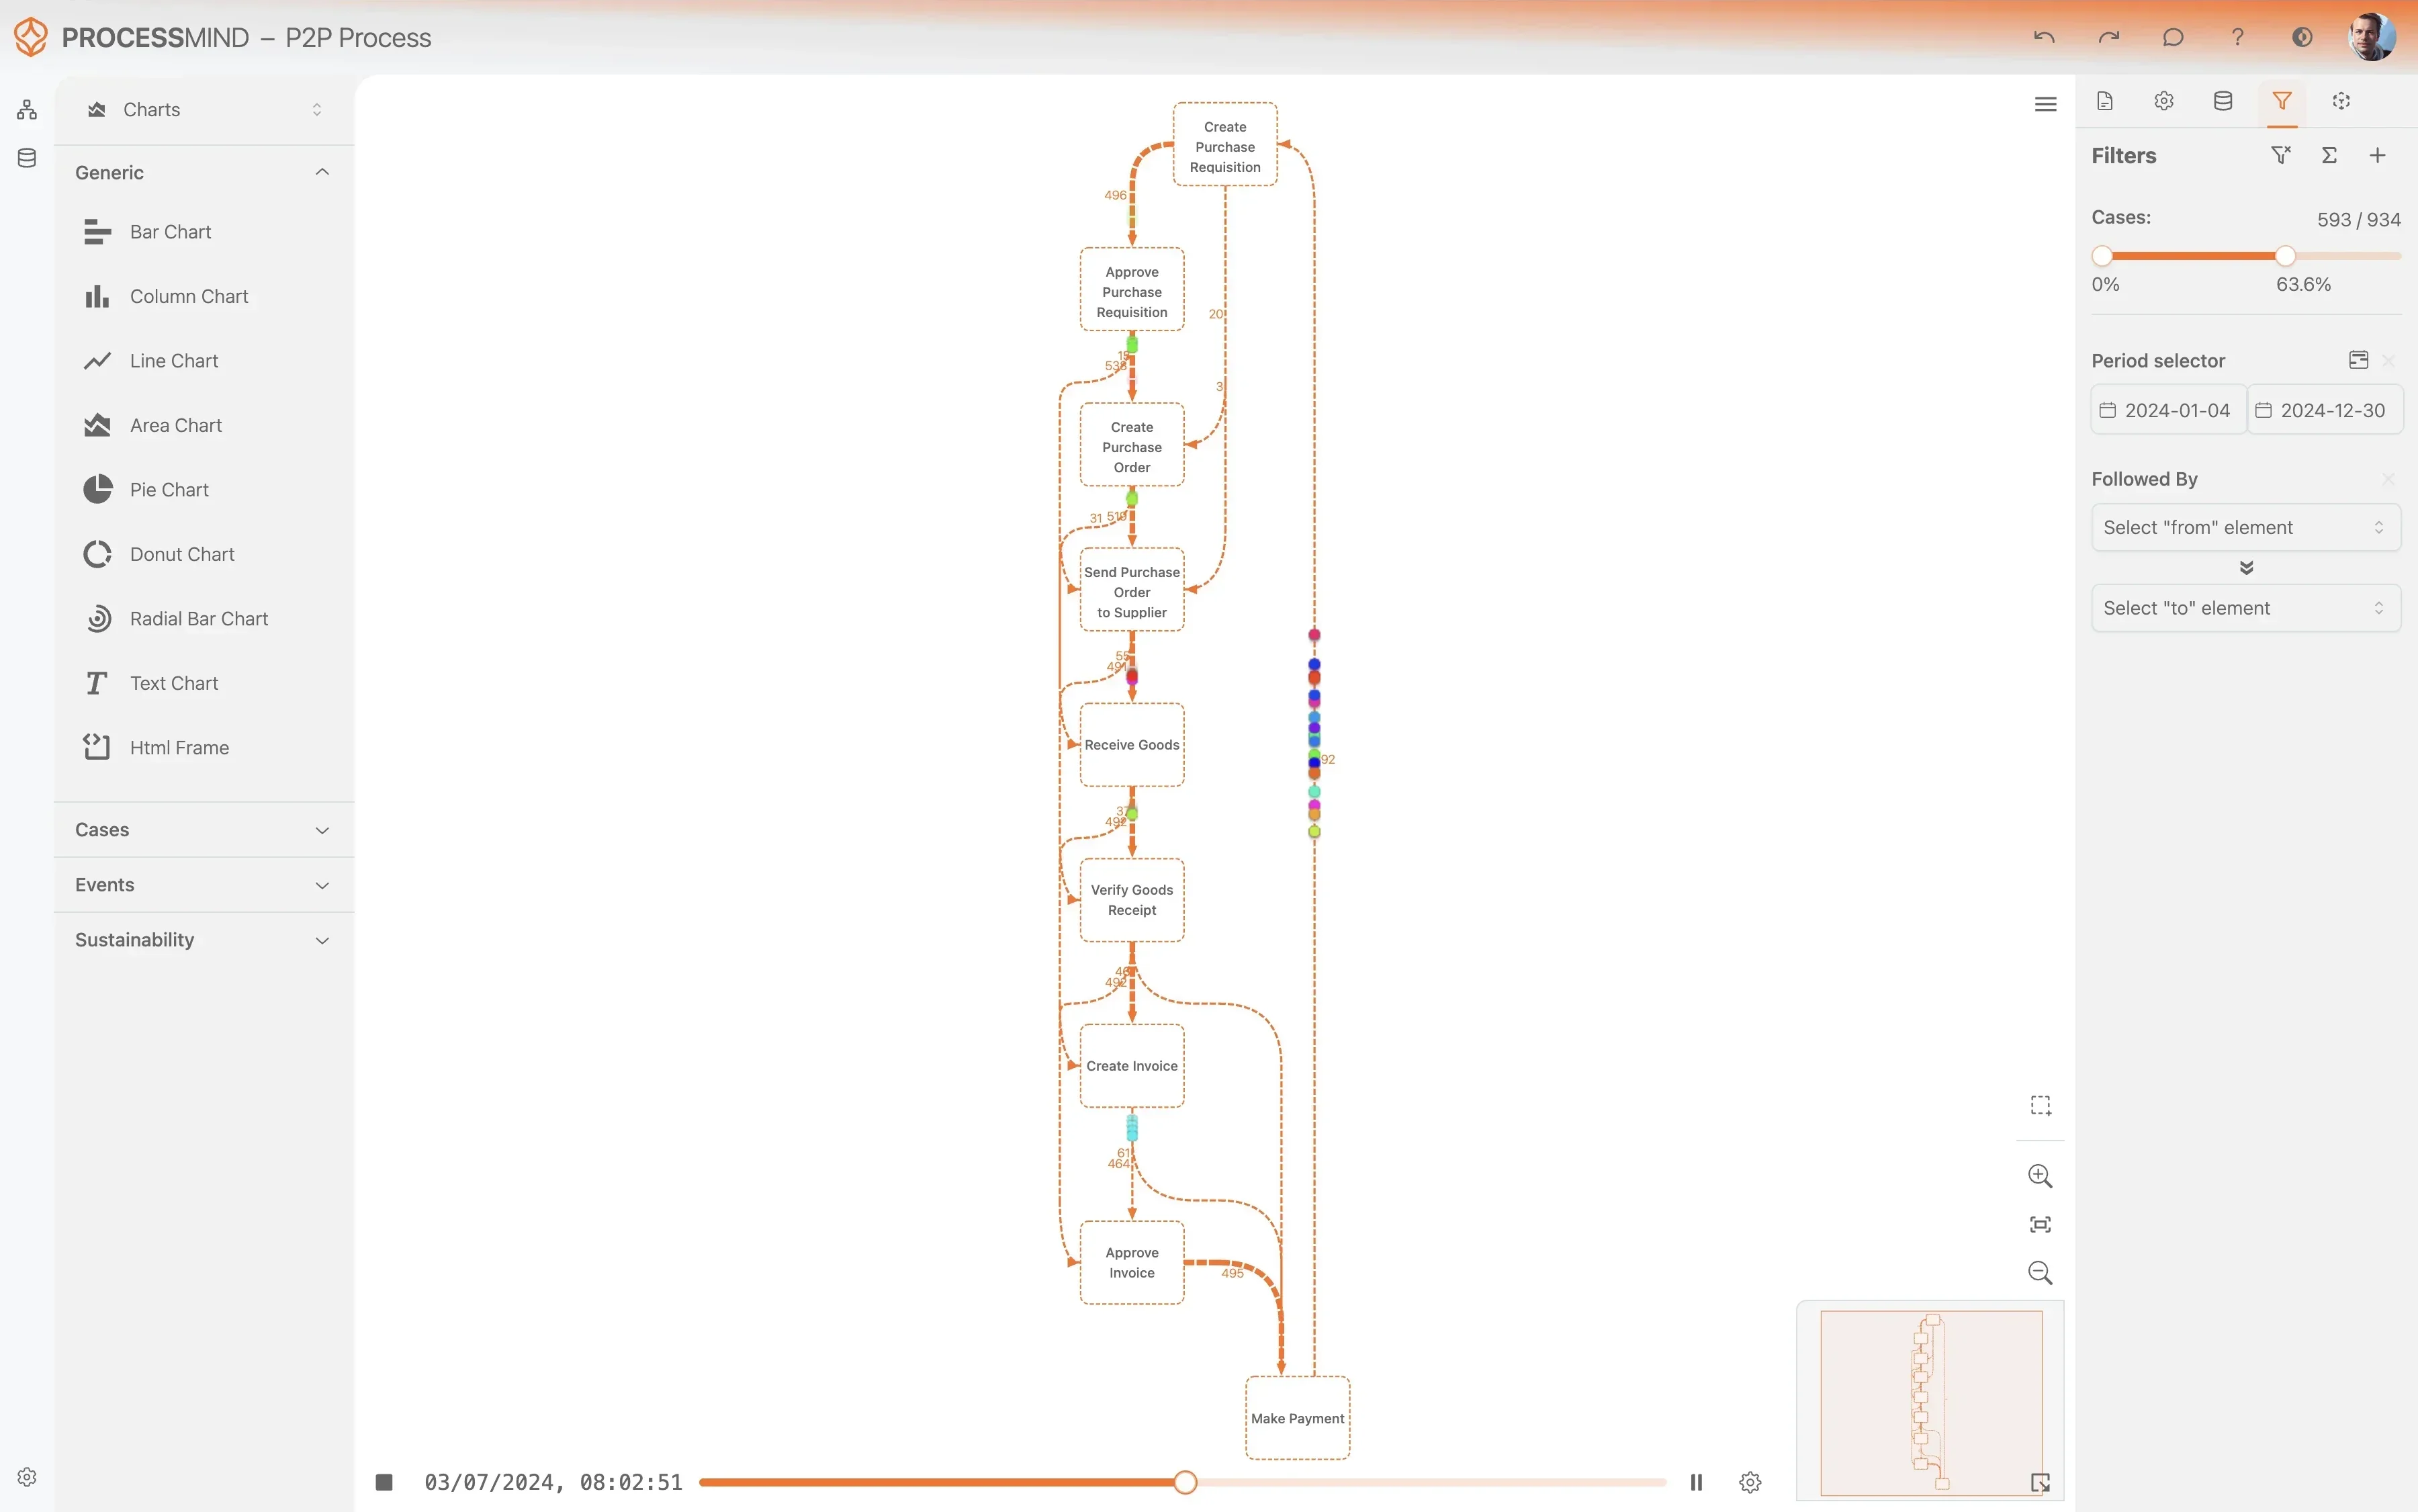
ProcessMind analiza sus datos de ServiceNow para mostrar las rutas reales que siguen las investigaciones de problemas. Podrá ver dónde fallan los traspasos y qué análisis de causa raíz tardan más en completarse.
  • Mapee todo el ciclo de vida de las investigaciones
  • Identifique los silos de comunicación entre los equipos de TI
  • Localice los cuellos de botella que frenan el análisis de causa raíz
  • Realice un seguimiento del tiempo medio de resolución de todos los casos
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

RESULTADOS COMPROBADOS

Mejore la eficiencia de Problem Management

Al descubrir ineficiencias ocultas en los flujos de trabajo de Problem Management de ServiceNow, los equipos pueden acelerar el análisis de las causas raíz y reducir el volumen de incidentes recurrentes. Estos resultados reflejan el impacto de optimizar los procesos a partir de datos de los registros estándar de problemas.

0 %
Análisis más rápido de la causa raíz

Reducción del tiempo de investigación

Agilizar la fase de investigación ayuda a los equipos a identificar mucho más rápido el origen de los incidentes importantes, lo que reduce considerablemente el impacto de las interrupciones recurrentes del servicio.

0 %
Menos reasignaciones

Reducción de los traspasos de registros

Eliminar los traspasos innecesarios entre equipos de soporte evita que los registros de problemas vayan de un grupo a otro, aclara quién es responsable y acelera la resolución.

+ 0 %
Mayor cumplimiento de los SLA

Aumento del cumplimiento de los análisis de causas raíz

Una mayor visibilidad de los estados pendientes y los cuellos de botella permite completar el análisis de la causa raíz dentro de los plazos acordados para el nivel de servicio.

0 %
Menos incidentes recurrentes

Reducción del volumen de errores conocidos

Publicar eficazmente soluciones temporales y permanentes en la base de datos de errores conocidos ayuda a evitar que nuevos incidentes saturen la Mesa de ayuda.

0 %
Acumulación de problemas depurada

Reducción de los registros antiguos

Identificar y cerrar los registros abandonados permite que los equipos centren sus esfuerzos en los problemas actuales de alta prioridad, en lugar de ocuparse de tickets antiguos.

Los resultados varían según la complejidad del proceso y la calidad de los datos. Estas cifras representan mejoras habituales observadas en distintas implementaciones.

Datos recomendados

Para empezar, seleccione los atributos y las actividades clave que determinan el proceso de investigación.
¿Es nuevo en los registros de eventos? Aprenda a crear un Registro de eventos para Process Mining.

Atributos

Datos clave que debe recopilar para el análisis

Identificador único del registro de problema.

Por qué es importante

Es la clave principal para distinguir los casos únicos y agrupar los eventos relacionados en el grafo del proceso.

El evento o la acción específicos realizados en el registro del problema.

Por qué es importante

Define los nodos del mapa del proceso y permite visualizar el flujo de trabajo y sus variantes.

La fecha y hora exactas en que se produjo una actividad.

Por qué es importante

Esencial para ordenar los eventos y calcular todos los KPI basados en el tiempo.

La persona específica asignada para trabajar en el problema.

Por qué es importante

Clave para analizar la eficiencia de los recursos y la carga de trabajo individual.

El equipo técnico responsable de resolver el problema.

Por qué es importante

Es fundamental para identificar cuellos de botella entre departamentos y analizar la eficiencia de los traspasos.

El estado del ciclo de vida del registro del problema.

Por qué es importante

El indicador de estado principal para filtrar los casos abiertos y cerrados.

El nivel de prioridad asignado al registro del problema.

Por qué es importante

Permite segmentar el desempeño del proceso según la criticidad para el negocio.

La clasificación de la causa raíz identificada.

Por qué es importante

Permite analizar patrones de fallas para impulsar mejoras estratégicas.

El número de veces que el problema se reasignó entre grupos.

Por qué es importante

Indicador directo de fricciones en el proceso y de falta de una responsabilidad claramente definida.

El número de incidentes vinculados a este registro del problema.

Por qué es importante

Mide la magnitud del impacto del problema en los usuarios.

Actividades

Pasos del proceso que debe supervisar y optimizar

Creación inicial de un registro de problema en el sistema ServiceNow. Marca el inicio del ciclo de vida de la gestión de problemas y establece la marca de tiempo de referencia para las métricas de antigüedad.

Por qué es importante

Establece la hora de inicio para todos los cálculos del tiempo de ciclo y las mediciones de los SLA. Es la referencia principal para identificar el volumen de nuevas investigaciones de problemas.

Asignación del registro de problema a un equipo técnico específico para su investigación. Esta actividad registra el flujo de responsabilidad y es fundamental para analizar los traspasos.

Por qué es importante

Esencial para el Dashboard de análisis de reasignaciones entre grupos de soporte, que permite detectar traspasos repetidos y cuellos de botella entre equipos.

Cambio del estado del registro de problema de 'New' a 'Assess' o 'Root Cause Analysis'. Indica que un analista ha comenzado a trabajar activamente en el problema.

Por qué es importante

Marca el final del tiempo de espera inicial en la cola y el comienzo de la fase de investigación activa, y sirve de apoyo para analizar los estados pendientes.

Introducción de texto en el campo 'Workaround' del registro de problema. Registra el momento en que el analista documenta una solución temporal.

Por qué es importante

Permite que el Dashboard de rendimiento de publicación de soluciones temporales determine cuándo se conoció por primera vez la solución técnica.

Momento en que se completan los códigos de 'Root Cause' o el estado cambia a 'Fix in Progress'. Representa el diagnóstico satisfactorio del problema.

Por qué es importante

Calcula el tiempo medio hasta identificar la causa raíz y sirve de apoyo para el Dashboard de tiempo de ciclo de investigación de causas raíz. Es un hito importante del proceso.

Asociación de una solicitud de cambio (RFC) con el registro de problema. Indica el traspaso de Problem Management a Change Management para la implementación.

Por qué es importante

Es fundamental para el Dashboard de eficiencia de las transiciones de solicitudes de cambio. Permite detectar demoras entre la identificación de una solución y el inicio del proceso de cambio.

Momento en que el problema se marca como Resolved, a menudo al cerrarse la solicitud de cambio asociada. Indica que el trabajo técnico ha concluido.

Por qué es importante

Determina el final del ciclo de corrección activa. Se utiliza para calcular el tiempo total de resolución en relación con el SLA.

Evento final del ciclo de vida en el que el registro queda inactivo. No se espera que se realicen más tareas.

Por qué es importante

Punto final definitivo de la instancia del proceso. Es necesario para calcular el tiempo de ciclo total.

Preguntas frecuentes

Preguntas frecuentes

Process Mining visualiza el recorrido real de cada registro de problema, desde su creación hasta su cierre. Permite a los equipos ver exactamente dónde se producen las demoras, por ejemplo, en estados pendientes prolongados o en reasignaciones excesivas entre grupos de soporte, que suelen pasar inadvertidas en los informes estándar.

Principalmente, necesita datos de las tablas de problemas y tareas de problemas, junto con los registros de auditoría del sistema o las instancias de métricas. Estos datos deben incluir un ID único del problema, nombres de actividades como cambios de estado o actualizaciones de asignación, y las marcas de tiempo correspondientes a cada evento.

Sí. Detecta cuellos de botella en la fase de investigación al medir la duración entre cambios de estado específicos. Al analizar estos recorridos, puede determinar si las demoras se deben a la falta de recursos, a documentación insuficiente o a dependencias de proveedores externos.

La información inicial suele estar disponible pocos días después de conectar y mapear los datos. Muchas organizaciones empiezan a detectar ineficiencias importantes, como registros antiguos o abandonados, durante el primer recorrido por el mapa del proceso.

Al analizar la relación entre los registros de incidentes y los de problemas, Process Mining muestra con qué eficacia se comunican los errores conocidos. Detecta casos en los que las soluciones temporales no se publican con suficiente rapidez o las causas raíz se clasifican incorrectamente, lo que provoca que los problemas se repitan.

No. Por lo general, las herramientas de Process Mining utilizan los datos existentes y no requieren cambios en los formularios ni en los flujos de trabajo de ServiceNow. Si el sistema registra el historial en los registros de auditoría, la herramienta puede reconstruir el proceso sin interferir en las operaciones actuales.

La tecnología registra específicamente los cambios en el campo del grupo de asignación en los registros de auditoría para visualizar los traspasos. Esto revela los casos en que un registro de problema va de un equipo a otro, lo que permite optimizar la asignación de recursos y la formación de esos grupos.

Los informes estándar muestran instantáneas o métricas sencillas, como el tiempo medio de resolución, pero no reflejan la complejidad del recorrido. Process Mining revela las transiciones y los bucles que se producen entre esas métricas. Así, muestra no solo que un proceso es lento, sino también dónde y por qué se estanca.

Optimice ahora la gestión de problemas para resolverlos más rápido

Reduzca un 30 % el tiempo de ciclo de sus investigaciones con Process Mining

Comience su prueba gratuita

No se requiere tarjeta de crédito. Configuración en minutos.