Mejore la gestión de incidentes
Guía de 6 pasos para optimizar la gestión de incidentes en BMC Helix ITSM.
Mejore la gestión de incidentes
Gestión de incidentes
BMC Helix ITSM

Seleccione un proceso

Elija un proceso para seguir trabajando en su espacio de trabajo conectado.

Procesos disponibles
Sistemas disponibles
259 Procesos

Optimice la gestión de incidentes en BMC Helix ITSM

Los procesos complejos suelen generar ineficiencias y demoras. Nuestra plataforma le ayuda a identificar cuellos de botella, ciclos de retrabajo y pasos que no cumplen con los estándares de su proceso. Al localizar exactamente dónde surgen los problemas, podrá aplicar mejoras específicas. Así reducirá los costes operativos y aumentará la satisfacción de los usuarios.

Descargue nuestro Template de datos preconfigurado y aborde los desafíos habituales para alcanzar sus objetivos de eficiencia. Siga nuestro plan de mejora de seis pasos y consulte la guía del Template de datos para transformar sus operaciones.

Mostrar descripción detallada

La importancia de gestionar los incidentes con eficiencia

Una gestión eficaz de incidentes es fundamental para ofrecer servicios de TI fiables. Influye directamente en la satisfacción de los usuarios, los costes operativos y la continuidad del negocio. En el entorno actual, marcado por un ritmo acelerado, las organizaciones que utilizan sistemas sólidos como BMC Helix ITSM dependen de sus procesos de gestión de incidentes para restablecer rápidamente el funcionamiento normal de los servicios y reducir las interrupciones. Sin embargo, la complejidad propia de estos procesos, que suelen implicar a varios equipos, traspasos y dependencias externas, puede generar ineficiencias sin que nadie lo advierta. Los cuellos de botella ocultos alargan el tiempo de ciclo y pueden provocar incumplimientos de los acuerdos de nivel de servicio, frustración entre los usuarios y un aumento de los gastos operativos. Para dejar atrás una gestión reactiva de los incidentes, es necesario comprender a fondo cómo se desarrolla realmente el proceso, no solo cómo se diseñó. Esta información detallada permite abordar los problemas sistémicos de forma proactiva y convertir la gestión de incidentes en una ventaja competitiva.

Descubra cómo Process Mining ayuda a resolver incidentes

Process Mining permite observar cómo se ejecuta realmente el proceso de gestión de incidentes en BMC Helix ITSM. Al analizar los registros de eventos, que identifican cada incidente mediante un identificador único de caso, Incident ID, Process Mining crea un mapa visual y objetivo, basado en datos, de cada paso, desde que se notifica el incidente hasta que se cierra. Esta visión completa permite:

  • Descubrir los flujos reales del proceso: Detecte las diferencias respecto de los procedimientos operativos estándar e identifique los casos en que los incidentes siguen rutas inesperadas o ineficientes. Puede ver exactamente cuántas veces se transfiere un incidente a un equipo especializado o si se implementa una solución temporal antes de iniciar el diagnóstico. Así podrá detectar ciclos de retrabajo y pasos innecesarios.
  • Localizar cuellos de botella y demoras: Identifique exactamente dónde se estancan los incidentes, ya sea durante la asignación inicial a un grupo de soporte, la investigación o la aplicación y prueba de la solución. Esto le ayuda a conocer el tiempo de ciclo real de cada tipo de incidente y a detectar los puntos críticos que afectan al objetivo de tiempo de resolución.
  • Analizar el rendimiento y el cumplimiento: Evalúe el cumplimiento del estado del SLA mediante el seguimiento de la duración de cada actividad y del recorrido completo del incidente. Identifique las categorías de incidentes o los grupos asignados que incumplen sus objetivos de forma recurrente y aplique mejoras específicas.
  • Cuantificar el retrabajo y las ineficiencias: Compruebe con qué frecuencia se reabren o se cambia la prioridad de los incidentes, o cuántas veces pasan de un equipo a otro. Así podrá cuantificar los costes ocultos de las ineficiencias en BMC Helix ITSM. Estos datos respaldan las iniciativas para reducir el tiempo de ciclo de la gestión de incidentes mediante la eliminación de acciones redundantes.

Áreas clave para mejorar los procesos en BMC Helix ITSM

El análisis de los datos de gestión de incidentes de BMC Helix ITSM con Process Mining revela oportunidades concretas para optimizar los procesos. Estas son algunas áreas habituales de mejora:

  • Agilizar la clasificación inicial y la categorización: Analice el flujo desde que se notifica un incidente hasta que se categoriza y se asigna una prioridad. ¿Se categorizan mal los incidentes con frecuencia y esto retrasa su asignación inicial a un grupo de soporte? Optimizar esta primera fase puede reducir considerablemente los tiempos de resolución.
  • Optimizar los traspasos y las transferencias: Examine los cambios entre grupos asignados. Un gran número de transferencias a equipos especializados, sobre todo en periodos breves, suele indicar falta de conocimientos iniciales o rutas de escalamiento poco claras. Process Mining pone estos patrones en evidencia para que los agentes asignados trabajen de forma más eficiente.
  • Acelerar el diagnóstico y la resolución: Examine la duración y la secuencia de las actividades de inicio del diagnóstico, investigación, implementación de soluciones temporales e identificación de la solución. ¿Hay tipos de incidentes o servicios afectados cuyo diagnóstico suele tardar más? Esta información puede orientar la formación y la creación de artículos para la base de conocimientos.
  • Mejorar la comunicación con los usuarios y la confirmación: Analice los pasos de envío de la notificación al usuario y recepción de su confirmación. Las demoras en esta etapa pueden alargar innecesariamente el ciclo de vida del incidente y afectar al objetivo de tiempo de resolución informado. Agilizar estas interacciones puede acelerar la verificación y el cierre del incidente.
  • Abordar las causas raíz de forma sistémica: Aunque la gestión de incidentes es reactiva, identificar las rutas habituales de los incidentes graves o frecuentes puede revelar problemas en la categoría de causa raíz que requieren una gestión proactiva de problemas. Así se reduce la cantidad de incidentes futuros.

Beneficios concretos de optimizar la gestión de incidentes

Las mejoras de procesos identificadas mediante Process Mining generan beneficios importantes y cuantificables para su organización. Si se centra en mejorar la gestión de incidentes, puede esperar lo siguiente:

  • Resolver los incidentes más rápido: Reduzca directamente el tiempo objetivo de resolución al eliminar cuellos de botella y acortar el tiempo de ciclo. Así podrá restablecer los servicios con mayor rapidez.
  • Mejorar el cumplimiento de los niveles de servicio: Mejore el rendimiento de los SLA al abordar de forma proactiva las causas raíz de las demoras y facilitar el avance de los incidentes.
  • Reducir los costes operativos: Minimice el retrabajo, optimice la asignación de recursos a los grupos asignados y reduzca el esfuerzo total dedicado a cada incidente para lograr ahorros importantes.
  • Aumentar la satisfacción de usuarios y clientes: Las resoluciones más rápidas y una comunicación más transparente mejoran la experiencia de los departamentos de usuarios afectados y de los clientes externos, y contribuyen a generar confianza y fidelidad.
  • Aprovechar mejor los recursos: Asegúrese de que los agentes y grupos asignados se centren en actividades que aportan valor, en lugar de dedicar tiempo a tareas administrativas o repetitivas.
  • Prevenir problemas de forma proactiva: Aproveche la información sobre patrones recurrentes para orientar la estrategia de gestión de problemas, prevenir futuros incidentes y mejorar aún más la estabilidad del servicio.

Cómo empezar a optimizar la gestión de incidentes

Optimizar la gestión de incidentes en BMC Helix ITSM con Process Mining es una inversión estratégica en la eficiencia y eficacia de sus operaciones de TI. Le proporciona la claridad y los datos necesarios para dejar atrás las suposiciones y localizar exactamente dónde y por qué falla el proceso. Con este enfoque, sus equipos pueden aplicar cambios específicos y de gran impacto que mejoran la prestación de servicios y contribuyen a crear un entorno de TI más resiliente y ágil. Comience hoy a optimizar de verdad el proceso de resolución de incidentes y convierta los desafíos en oportunidades de mejora continua.

Gestión de incidentes Mesa de ayuda Soporte de TI Resolución de tickets Cumplimiento de los SLA Operaciones de TI Resolución de problemas Reducción del tiempo de inactividad Gestión de tickets Gestión de tickets Mesa de ayuda de TI Tiempo medio de resolución MTTR Restablecimiento del servicio Resolución de incidentes

Problemas y desafíos frecuentes

Identifique los desafíos que le afectan

Los incidentes pasan con frecuencia de un grupo de soporte o agente a otro, lo que provoca demoras importantes y frustración. Cada transferencia alarga el tiempo de resolución, aumenta los costes operativos y perjudica la satisfacción de los usuarios. Este ir y venir suele indicar que no hay una persona o equipo claramente responsable, o que el diagnóstico inicial del proceso de gestión de incidentes es insuficiente. ProcessMind analiza todo el recorrido de los incidentes en BMC Helix ITSM e identifica patrones de reasignaciones excesivas. Señala los puntos de transferencia y los grupos o agentes implicados, revela las causas raíz de los traspasos ineficientes y sugiere mejoras para agilizar el flujo de los incidentes y reducir el retrabajo.

Los incidentes críticos incumplen los acuerdos de nivel de servicio de forma recurrente, lo que prolonga las interrupciones y puede acarrear sanciones. No cumplir los SLA, es decir, los acuerdos de nivel de servicio, debilita la confianza de los usuarios, perjudica la reputación de la organización y puede generar pérdidas económicas importantes debido al tiempo de inactividad prolongado. Es un desafío habitual en entornos complejos de gestión de incidentes. ProcessMind ofrece una visión detallada de todo el ciclo de vida de los incidentes y destaca cada punto de incumplimiento de los SLA en BMC Helix ITSM. Relaciona los incumplimientos con actividades, cuellos de botella y limitaciones de recursos concretos, para que pueda aplicar medidas específicas, mejorar el cumplimiento y prestar los servicios con mayor eficacia.

Los incidentes tardan demasiado en resolverse y provocan periodos prolongados de degradación o interrupción del servicio. Estos tiempos de resolución reducen la productividad de los usuarios finales, aumentan los gastos operativos y pueden revelar ineficiencias o carencias de conocimientos en el proceso de gestión de incidentes. ProcessMind traza el flujo real de los incidentes en BMC Helix ITSM e identifica las actividades o etapas en las que se estancan. Revela cuellos de botella ocultos y desviaciones de la ruta óptima, y proporciona información basada en datos para acelerar la resolución y restablecer el servicio más rápido.

A menudo, los incidentes se categorizan de forma incorrecta o reciben una prioridad equivocada. Esto provoca asignaciones erróneas y retrasa la atención de los equipos de soporte adecuados. Este error inicial puede repercutir en todo el proceso de gestión de incidentes, alargar los tiempos de resolución y frustrar tanto a los usuarios como al personal de soporte. ProcessMind analiza atributos de los incidentes, como la categoría, la prioridad y la gravedad, y los compara con la ruta y el tiempo reales de resolución en BMC Helix ITSM. Detecta discrepancias y patrones de clasificación incorrecta para que pueda ajustar las reglas de categorización y mejorar la gestión inicial de los incidentes.

Los equipos de soporte dedican demasiado tiempo al retrabajo, ya sea porque vuelven a atender problemas similares o porque realizan pasos innecesarios. Esta ineficiencia desperdicia recursos valiosos, eleva los costes operativos e impide que los agentes se centren en incidentes más complejos o críticos, lo que reduce la eficacia general de la gestión de incidentes. ProcessMind visualiza todo el recorrido de los incidentes y revela ciclos repetitivos, actividades redundantes y patrones habituales de retrabajo en BMC Helix ITSM. Al comprender estas ineficiencias, las organizaciones pueden optimizar sus procesos, automatizar tareas repetitivas y aplicar soluciones más sostenibles.

Con frecuencia, quienes gestionan los incidentes omiten los procedimientos establecidos o toman atajos no aprobados. Esto genera incoherencias, riesgos de incumplimiento y resultados impredecibles. La falta de cumplimiento puede reducir la calidad del servicio, dificultar las auditorías y debilitar la fiabilidad de todo el marco de gestión de incidentes. ProcessMind ofrece una visión objetiva de cada ruta que siguen los incidentes en BMC Helix ITSM y la compara con el proceso estándar previsto. Identifica todas las desviaciones y señala dónde, cuándo y quién realiza actividades no estándar, lo que permite orientar la formación y mejorar la gobernanza.

Los incidentes suelen estancarse durante el diagnóstico o la investigación, a menudo por falta de recursos, carencias de conocimientos o problemas técnicos complejos. Este estancamiento prolonga directamente los tiempos de resolución y eleva el MTTR, por lo que los servicios permanecen afectados durante más tiempo. ProcessMind examina la duración de las actividades «Inicio del diagnóstico» e «Investigación realizada» en BMC Helix ITSM. Identifica los equipos, agentes o categorías de incidentes que sufren estas demoras para que pueda asignar recursos, ofrecer formación o ajustar los procesos de forma específica.

Las soluciones temporales se implementan con lentitud o no son eficaces, por lo que los usuarios siguen afectados mientras se busca una solución definitiva. Una gestión deficiente de esta etapa puede aumentar la frustración de los usuarios y prolongar el tiempo de inactividad percibido, lo que reduce el valor de las iniciativas de gestión de incidentes. ProcessMind hace un seguimiento de la actividad «Solución temporal implementada» en BMC Helix ITSM y de su efecto posterior en el estado y el tiempo de resolución del incidente. Ayuda a detectar si las soluciones temporales se aplican tarde de forma recurrente o si no ofrecen un alivio provisional, lo que permite identificar oportunidades de mejora.

Una vez aplicada la solución, pueden producirse demoras importantes antes de recibir la confirmación del usuario o verificar la resolución, lo que retrasa el cierre del incidente. Esta espera prolonga el ciclo de vida oficial del incidente, infla artificialmente las métricas de resolución y puede generar una acumulación de tickets «resueltos pero no cerrados» en BMC Helix ITSM. ProcessMind analiza el tiempo transcurrido entre las actividades «Notificación enviada al usuario», «Confirmación recibida del usuario» e «Incidente verificado/cerrado». Identifica patrones de demora para ayudarle a agilizar la comunicación o automatizar los recordatorios y acelerar las últimas etapas de la resolución.

Muchos incidentes se resuelven sin identificar ni documentar claramente la causa raíz, lo que hace que los problemas se repitan. Este enfoque reactivo sobrecarga a los equipos de soporte con incidentes recurrentes e impide gestionar los problemas de forma proactiva y mejorar continuamente el servicio. ProcessMind relaciona los códigos de resolución y los patrones de recurrencia de incidentes en BMC Helix ITSM con el atributo «Categoría de causa raíz». Destaca los casos que se resuelven sin un análisis adecuado de la causa raíz y aquellos en que los incidentes recurrentes comparten una resolución imprecisa, lo que indica la necesidad de integrar mejor la gestión de problemas.

Una parte importante de los incidentes corresponde a problemas que vuelven a aparecer después de haberse «resuelto». Esto indica que no se han abordado eficazmente las causas subyacentes. Además de sobrecargar los recursos de soporte, estos incidentes frustran a los usuarios, que sufren interrupciones repetidas por el mismo motivo. ProcessMind relaciona los ID de los incidentes para identificar grupos de casos idénticos o muy similares y analiza su ciclo de vida completo y sus patrones de resolución en BMC Helix ITSM. Detecta qué tipos de incidentes se repiten con mayor frecuencia y ayuda a localizar las etapas del proceso en las que faltan soluciones definitivas.

Los incidentes transferidos a equipos especializados suelen sufrir demoras adicionales o requieren más información antes de poder atenderse, lo que anula el propósito del escalamiento. Esto puede indicar problemas en el intercambio de información o falta de claridad sobre las responsabilidades al transferir los incidentes. ProcessMind analiza el tiempo y las actividades posteriores a la transferencia de un incidente a un equipo especializado en BMC Helix ITSM. Detecta si estas transferencias alargan sistemáticamente los tiempos de resolución o generan investigaciones repetidas, lo que puede revelar ineficiencias en los traspasos entre equipos.

Objetivos habituales

Defina cómo se ve el éxito

Las reasignaciones frecuentes de incidentes entre grupos de soporte o agentes alargan considerablemente los tiempos de resolución y aumentan los costes operativos. Alcanzar este objetivo significa que los incidentes llegan antes al equipo adecuado, lo que permite resolverlos más rápido y mejorar la satisfacción de los usuarios. ProcessMind visualiza todos los ciclos de reasignación e identifica exactamente dónde se estancan los incidentes o se asignan al equipo equivocado en BMC Helix ITSM. El análisis de datos históricos revela patrones de transferencias ineficientes y permite aplicar formación o ajustes específicos en los procesos. Así, las organizaciones pueden reducir las reasignaciones entre un 20 % y un 30 %.

Cumplir sistemáticamente los acuerdos de nivel de servicio es fundamental para mantener la calidad del servicio y la confianza de los usuarios. Alcanzar este objetivo implica reducir los incumplimientos, restablecer los servicios críticos dentro de los plazos acordados y minimizar el impacto en el negocio. ProcessMind revela las rutas y actividades concretas que provocan incumplimientos de los SLA en la gestión de incidentes y muestra dónde se acumulan las demoras en los flujos de trabajo de BMC Helix ITSM. Destaca los cuellos de botella y las variaciones del proceso que no cumplen los requisitos, para que los equipos puedan perfeccionar sus procesos y aumentar el cumplimiento de los SLA entre un 15 % y un 25 %.

La resolución prolongada de incidentes afecta directamente a la continuidad del negocio y a la productividad de los usuarios. Alcanzar este objetivo permite resolver los problemas más rápido, reducir el tiempo de inactividad y mejorar la eficiencia de las operaciones de TI, así como la experiencia de los usuarios. ProcessMind ofrece una visión integral de los ciclos de vida de los incidentes en BMC Helix ITSM e identifica las rutas y actividades que más contribuyen a las demoras. Al localizar los pasos que consumen más tiempo, las organizaciones pueden optimizar los flujos de trabajo, automatizar tareas rutinarias y reducir el tiempo medio de resolución entre un 10 % y un 20 %.

Una categorización incorrecta de los incidentes provoca asignaciones erróneas, demoras en la resolución y un uso ineficiente de los recursos. Alcanzar este objetivo permite clasificar correctamente los incidentes desde el principio, asignarlos más rápido al equipo adecuado y acelerar su resolución. ProcessMind analiza la categorización inicial y las recategorizaciones o reasignaciones posteriores en BMC Helix ITSM, y revela errores habituales y patrones de clasificación incorrecta. Esta información permite orientar la formación o mejorar las reglas de categorización, lo que puede aumentar entre un 15 % y un 20 % la precisión de la clasificación en el primer intento.

Un alto nivel de retrabajo y escalamientos innecesarios revela ineficiencias, desperdicio de recursos y frustración entre los usuarios. Alcanzar este objetivo significa que las soluciones funcionan desde el primer intento, se reducen los esfuerzos repetidos y mejora la calidad general del servicio. ProcessMind traza el ciclo de vida completo de los incidentes en BMC Helix ITSM y destaca los casos que vuelven a etapas anteriores o se escalan porque la resolución inicial fue insuficiente. Al identificar las causas raíz del retrabajo, como un diagnóstico insuficiente o soluciones incompletas, las organizaciones pueden reducir los ciclos de retrabajo entre un 10 % y un 15 %.

La gestión incoherente de los incidentes genera resultados impredecibles, riesgos de incumplimiento y una calidad de servicio desigual. Alcanzar este objetivo permite que todos los incidentes sigan las prácticas recomendadas establecidas, lo que mejora la previsibilidad, la calidad y el cumplimiento de las normativas. ProcessMind visualiza todas las variantes reales del proceso en BMC Helix ITSM y las compara con el proceso estándar diseñado. Así se identifican las desviaciones habituales y las actividades que no cumplen los requisitos, lo que permite reforzar las prácticas recomendadas de forma específica y aumentar el cumplimiento del proceso entre un 20 % y un 30 %.

Las demoras en las fases de diagnóstico e investigación alargan considerablemente el tiempo total de resolución de los incidentes, frustran a los usuarios y prolongan las interrupciones del servicio. Alcanzar este objetivo permite identificar antes la causa raíz del problema, encontrar soluciones más rápido y mejorar el flujo operativo. ProcessMind identifica con precisión las actividades y los recursos que provocan demoras importantes durante el diagnóstico y la investigación de incidentes en BMC Helix ITSM. Al analizar estos cuellos de botella, las organizaciones pueden reasignar recursos, ofrecer formación adicional o agilizar los pasos de diagnóstico, y reducir entre un 15 % y un 20 % el tiempo dedicado a estas fases críticas.

La aplicación ineficiente de soluciones temporales puede prolongar el impacto de los incidentes o incluso generar nuevos problemas, anulando el beneficio previsto. Alcanzar este objetivo permite implementar soluciones temporales con rapidez y eficacia para reducir las interrupciones mientras se desarrolla una solución definitiva. ProcessMind analiza los plazos y la eficacia de las actividades de aplicación de soluciones temporales en BMC Helix ITSM e identifica patrones de demora o fallos. Ayuda a comprender por qué algunas soluciones temporales funcionan mejor o se implementan más rápido, para introducir mejoras que pueden reducir entre un 10 % y un 15 % el tiempo de implementación.

Las demoras en la confirmación del usuario o en la verificación de la resolución pueden mantener abiertos los incidentes innecesariamente y afectar a las métricas y a la asignación de recursos. Alcanzar este objetivo permite cerrar rápidamente los incidentes una vez aplicada la solución, lo que mejora la eficiencia y la precisión de los datos. ProcessMind traza el tiempo que los incidentes permanecen en las etapas «Confirmación recibida del usuario» e «Incidente verificado» en BMC Helix ITSM, y revela dónde se ralentizan la comunicación o el seguimiento. Al identificar estas demoras, las organizaciones pueden implementar notificaciones automáticas o protocolos más claros y reducir entre un 10 % y un 20 % el tiempo hasta el cierre.

No identificar la verdadera causa raíz de los incidentes provoca problemas recurrentes, más carga de trabajo y fallos persistentes en los servicios. Alcanzar este objetivo implica realizar análisis más exhaustivos para prevenir incidentes similares y mejorar la estabilidad del sistema a largo plazo. ProcessMind destaca los incidentes que se repiten con frecuencia y aquellos que omiten el proceso formal de análisis de causas raíz en BMC Helix ITSM. Al examinar las rutas de los incidentes resueltos y relacionarlas con problemas posteriores, ayuda a detectar carencias en la gestión de problemas y puede mejorar entre un 10 % y un 15 % la eficacia del análisis de causas raíz.

Un volumen elevado de incidentes recurrentes indica que hay problemas sistémicos que no se han resuelto por completo. Esto obliga a repetir tareas y reduce la satisfacción de los usuarios. Alcanzar este objetivo significa que habrá menos problemas repetidos, se liberarán recursos y mejorará la fiabilidad general del servicio. ProcessMind detecta patrones de recurrencia al analizar las características de los incidentes y sus rutas de resolución en BMC Helix ITSM. Ayuda a identificar los incidentes que se reabren con frecuencia o se parecen a otros ya cerrados, para que las organizaciones puedan centrarse en la gestión proactiva de problemas y reducir entre un 10 % y un 20 % la tasa de recurrencia.

Las transferencias ineficaces o tardías a equipos especializados en resolución estancan los incidentes y retrasan la intervención de especialistas y la resolución general. Alcanzar este objetivo permite escalar los incidentes de forma eficiente al equipo experto adecuado y aprovechar sus conocimientos para resolver los problemas más rápido. ProcessMind traza el flujo de los incidentes cuando pasan de un grupo de soporte a otro o a equipos especializados en BMC Helix ITSM, e identifica las demoras y las asignaciones incorrectas. Al analizar los puntos de traspaso y la duración habitual de las transferencias, las organizaciones pueden ajustar sus matrices de escalamiento y mejorar entre un 15 % y un 25 % la eficiencia de las transferencias.

Los 6 pasos para mejorar la gestión de incidentes

1

Descargar la plantilla

Qué hacer

Obtenga la plantilla de Excel con formato predefinido para los datos de gestión de incidentes. Esta plantilla garantiza que los datos tengan la estructura adecuada para el análisis.

Por qué es importante

Usar la plantilla adecuada agiliza la preparación de los datos, evita errores y permite obtener información precisa de los registros de incidentes de BMC Helix ITSM.

Resultado esperado

Una plantilla de Excel estructurada, lista para recibir los datos de gestión de incidentes de BMC Helix ITSM.

SUS DESCUBRIMIENTOS

Descubra cuellos de botella ocultos en la gestión de incidentes

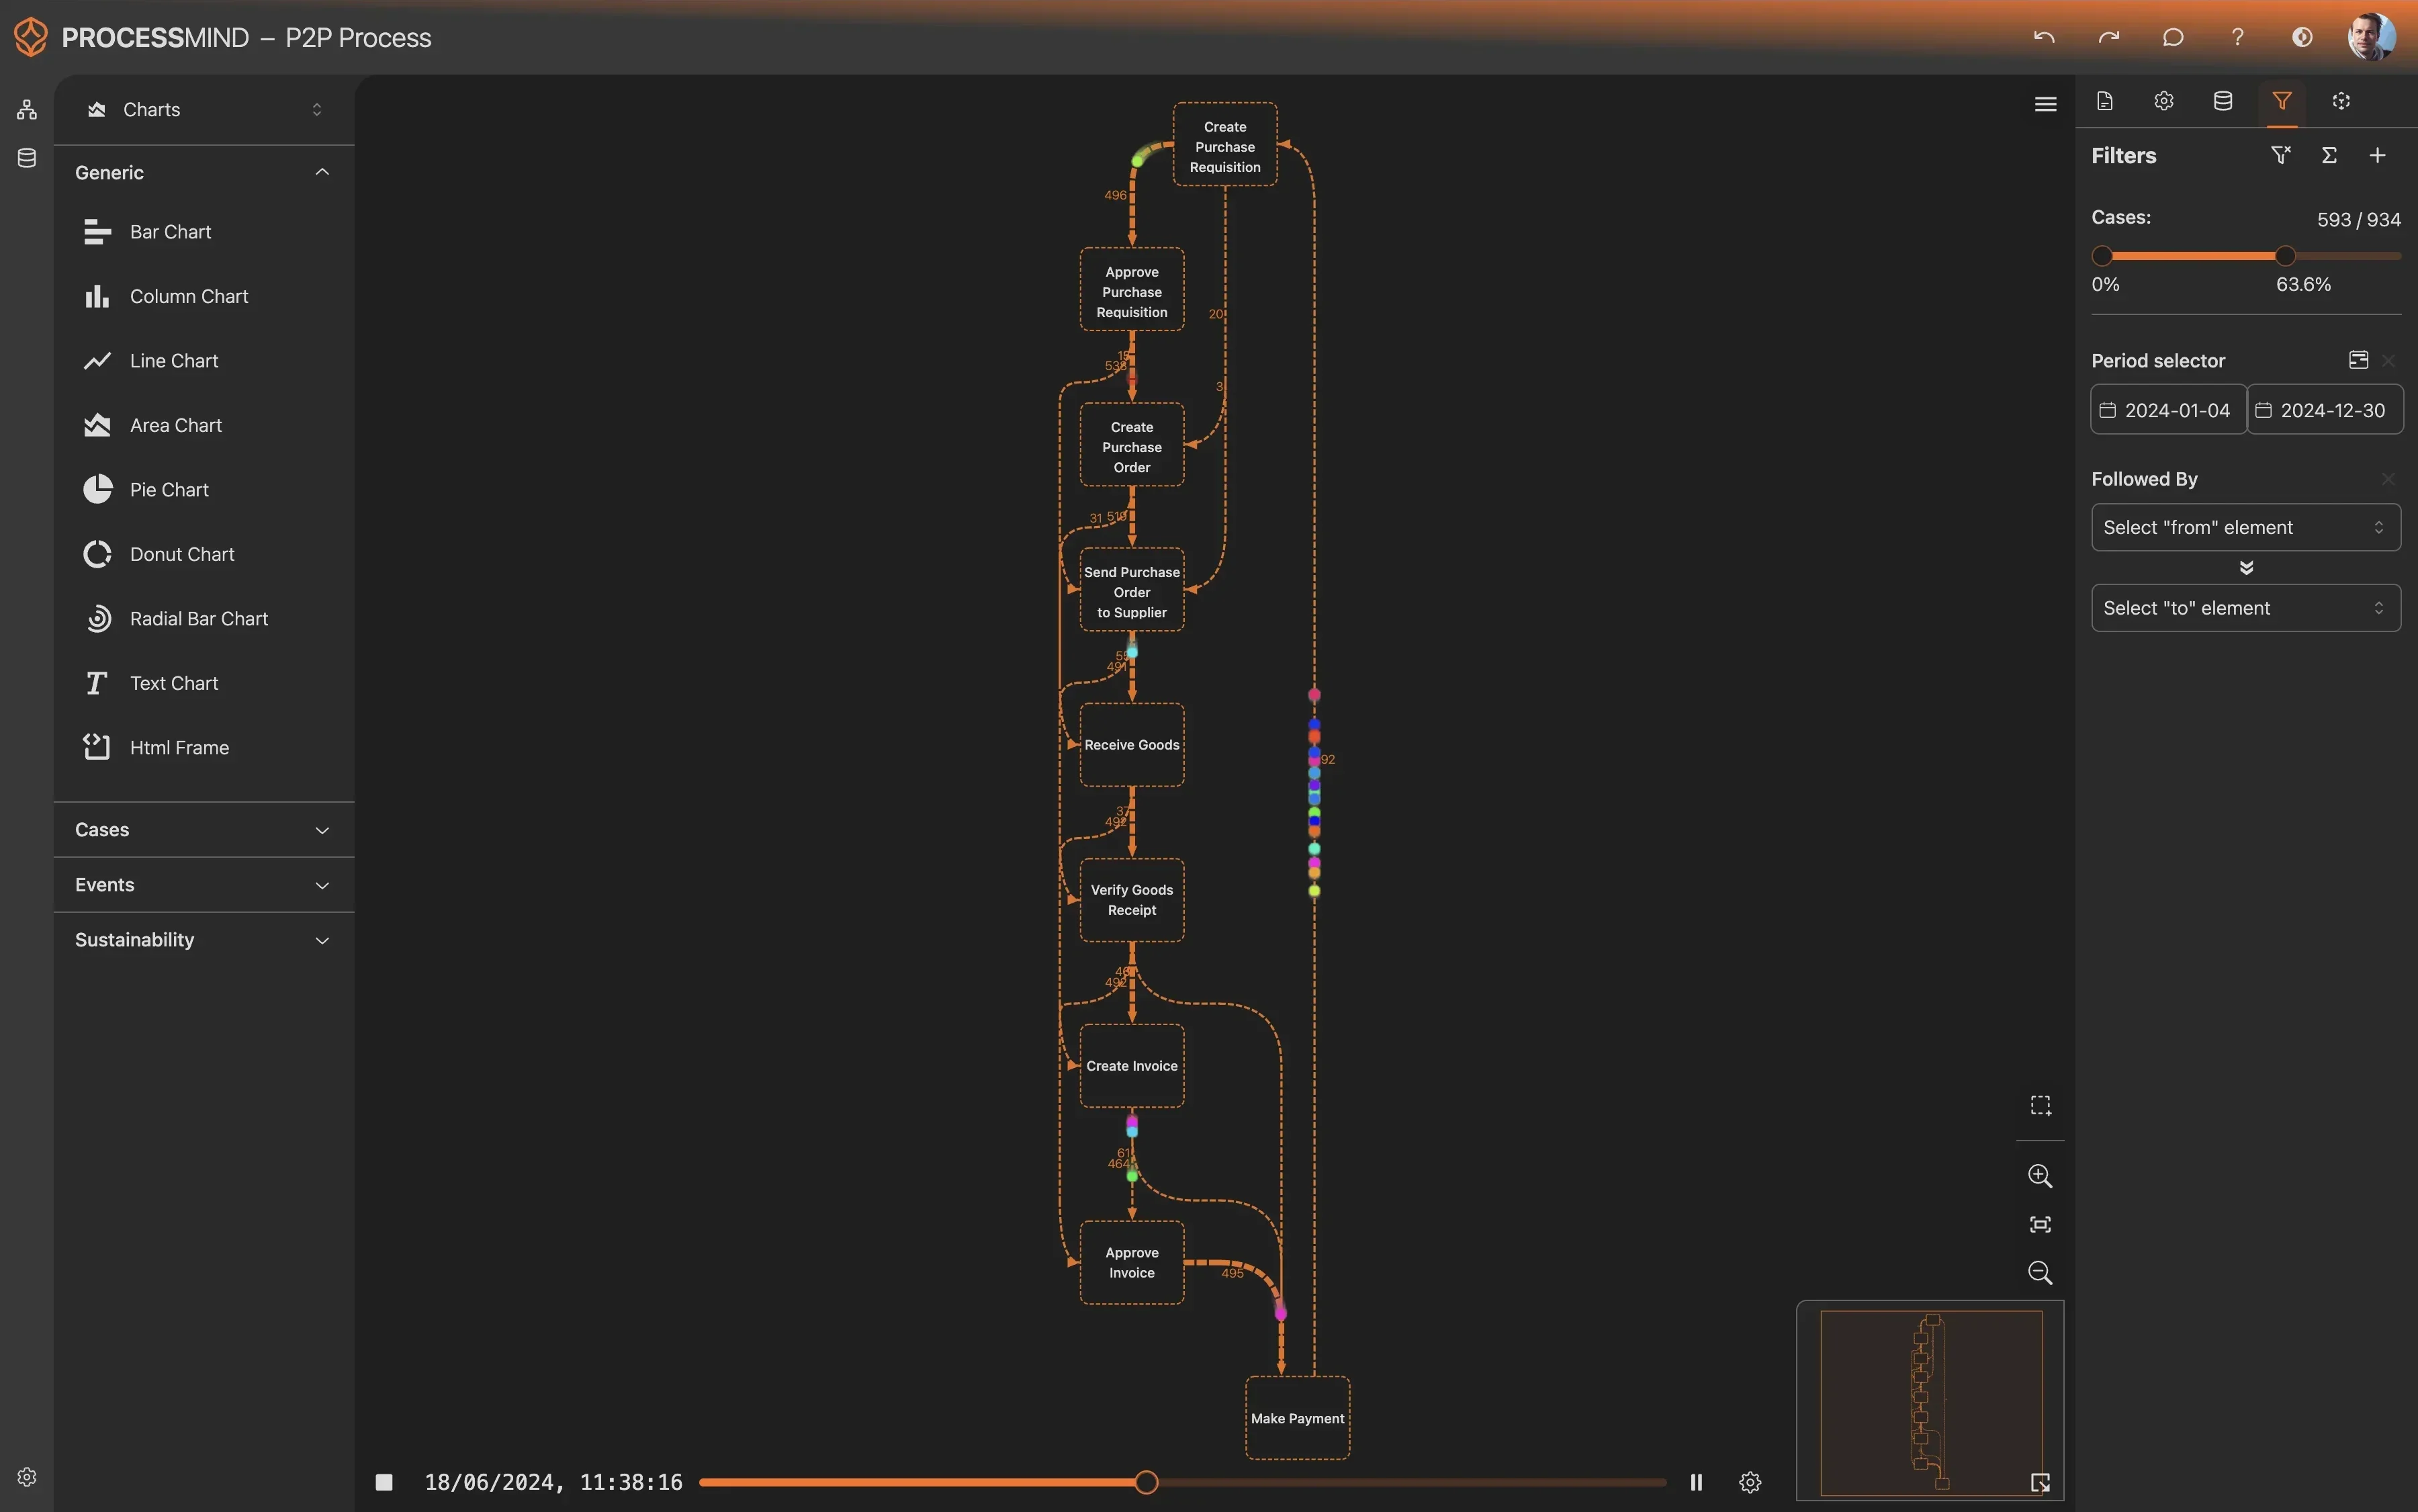
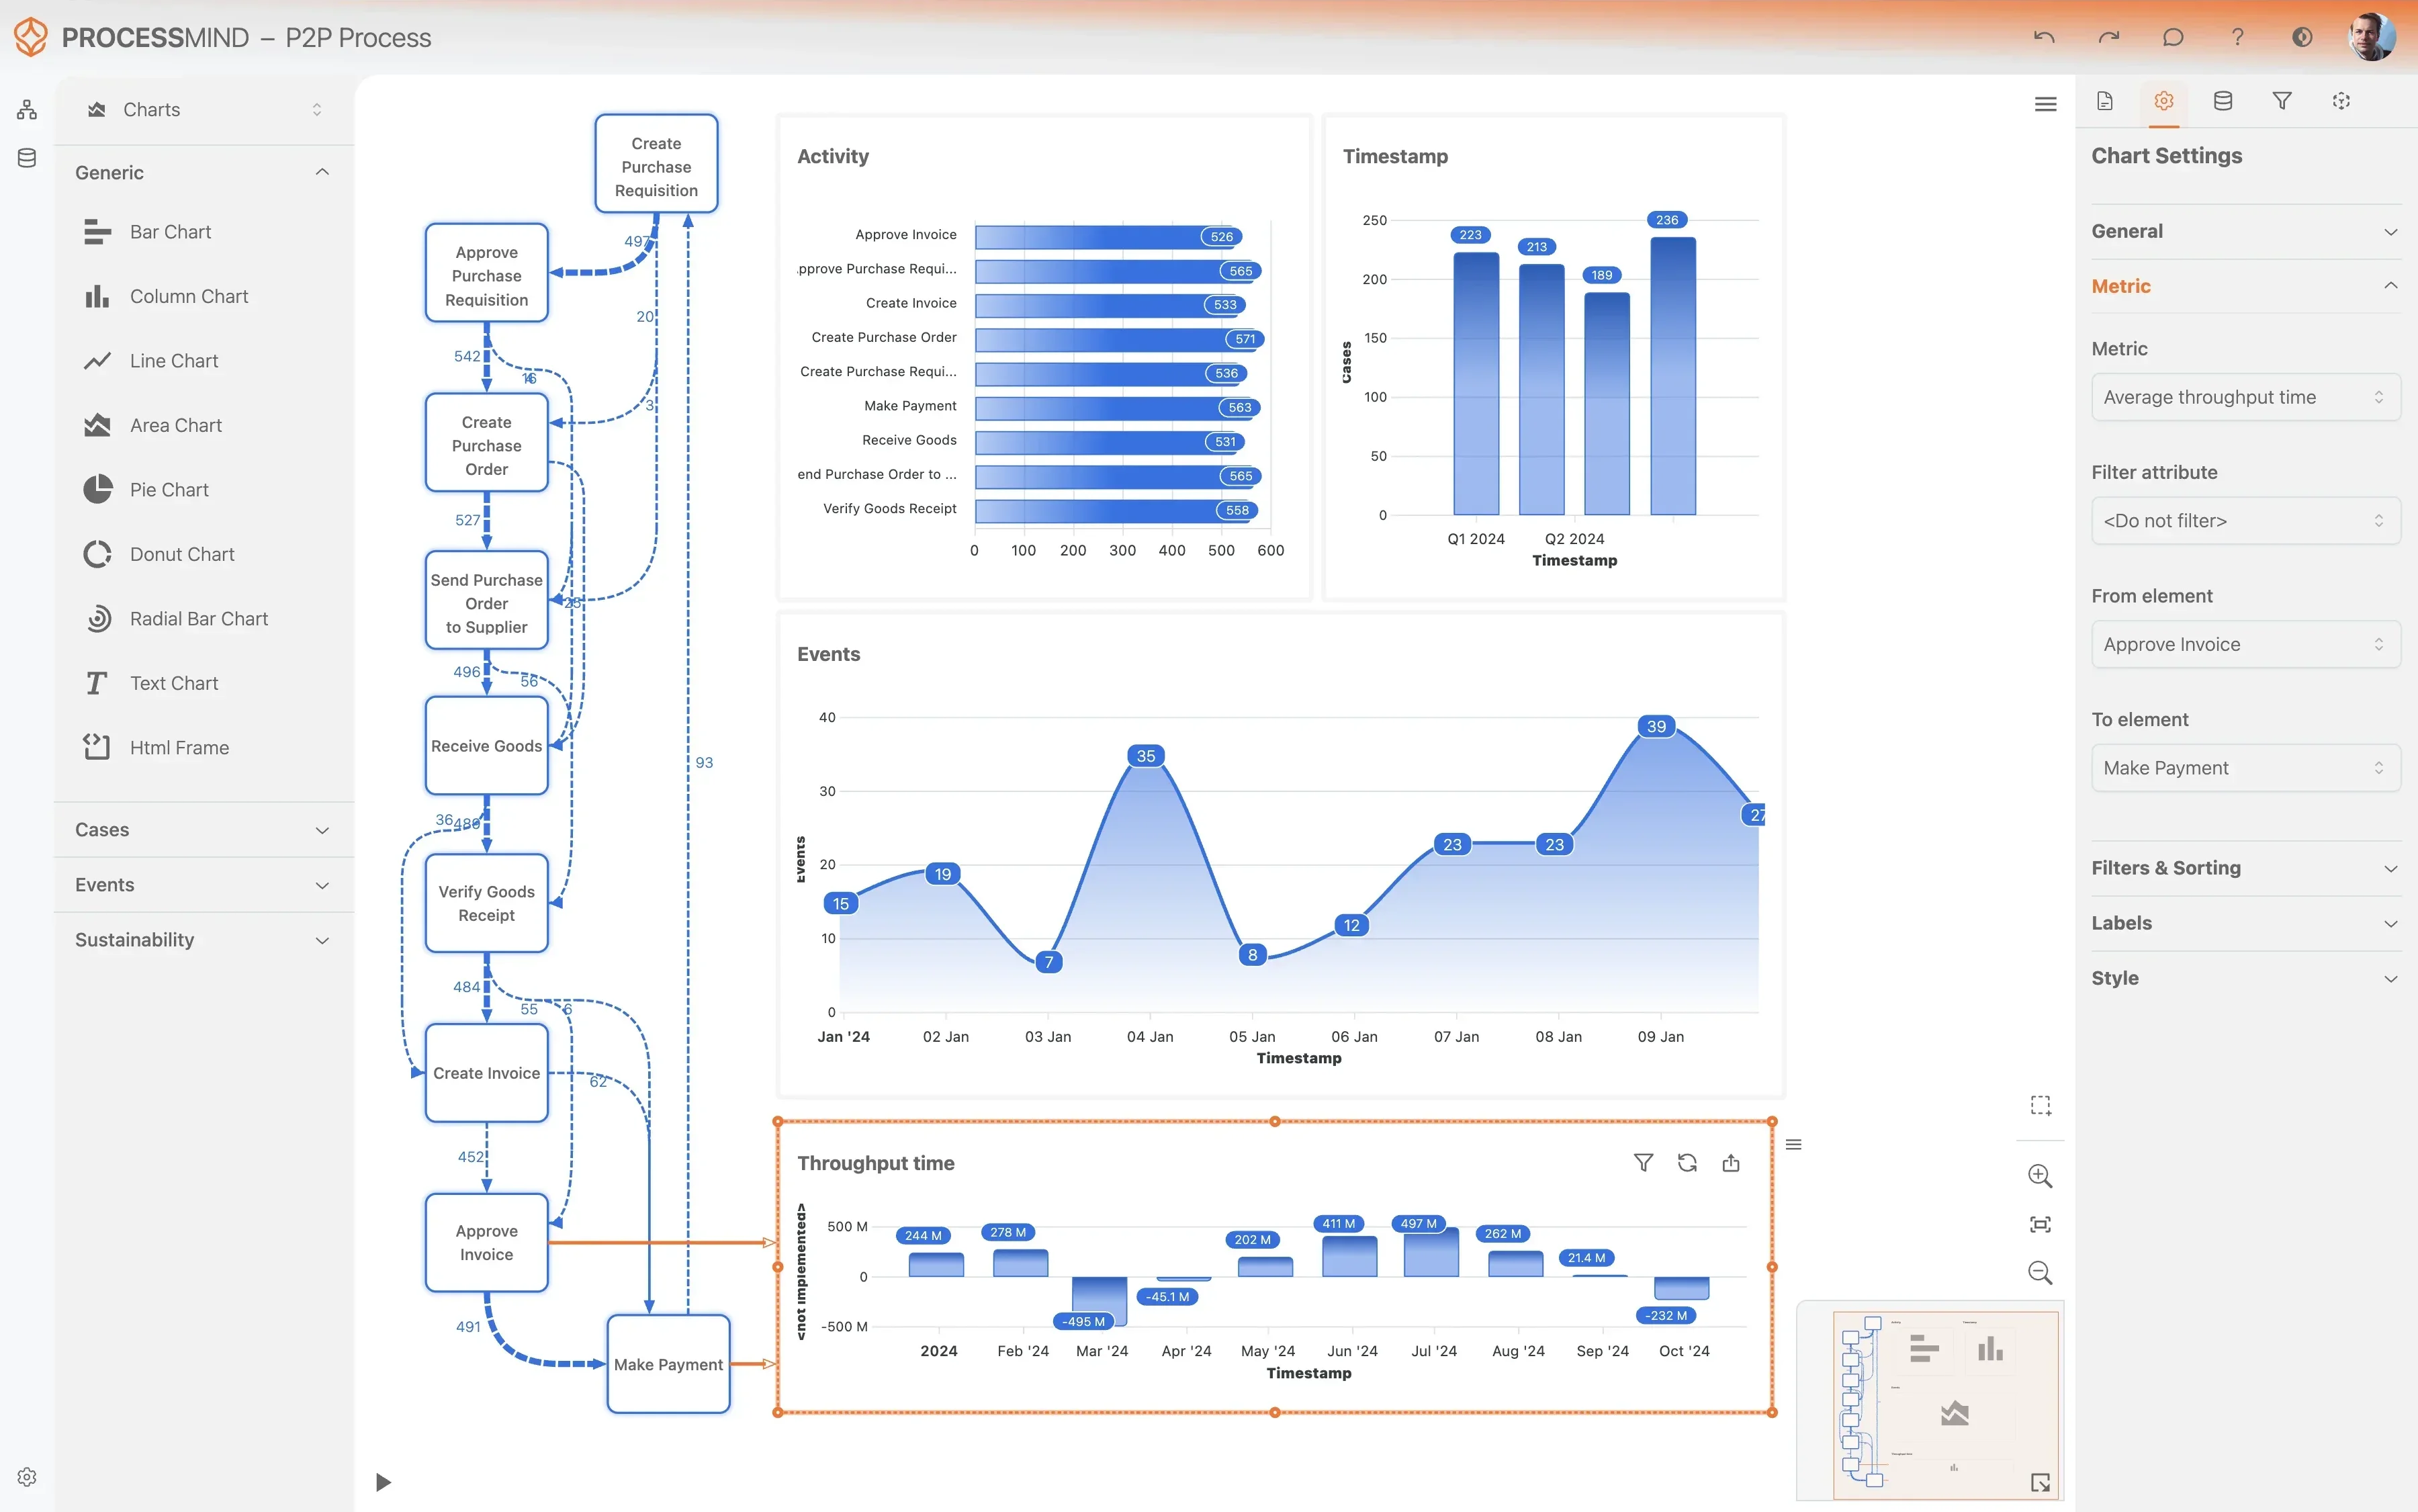
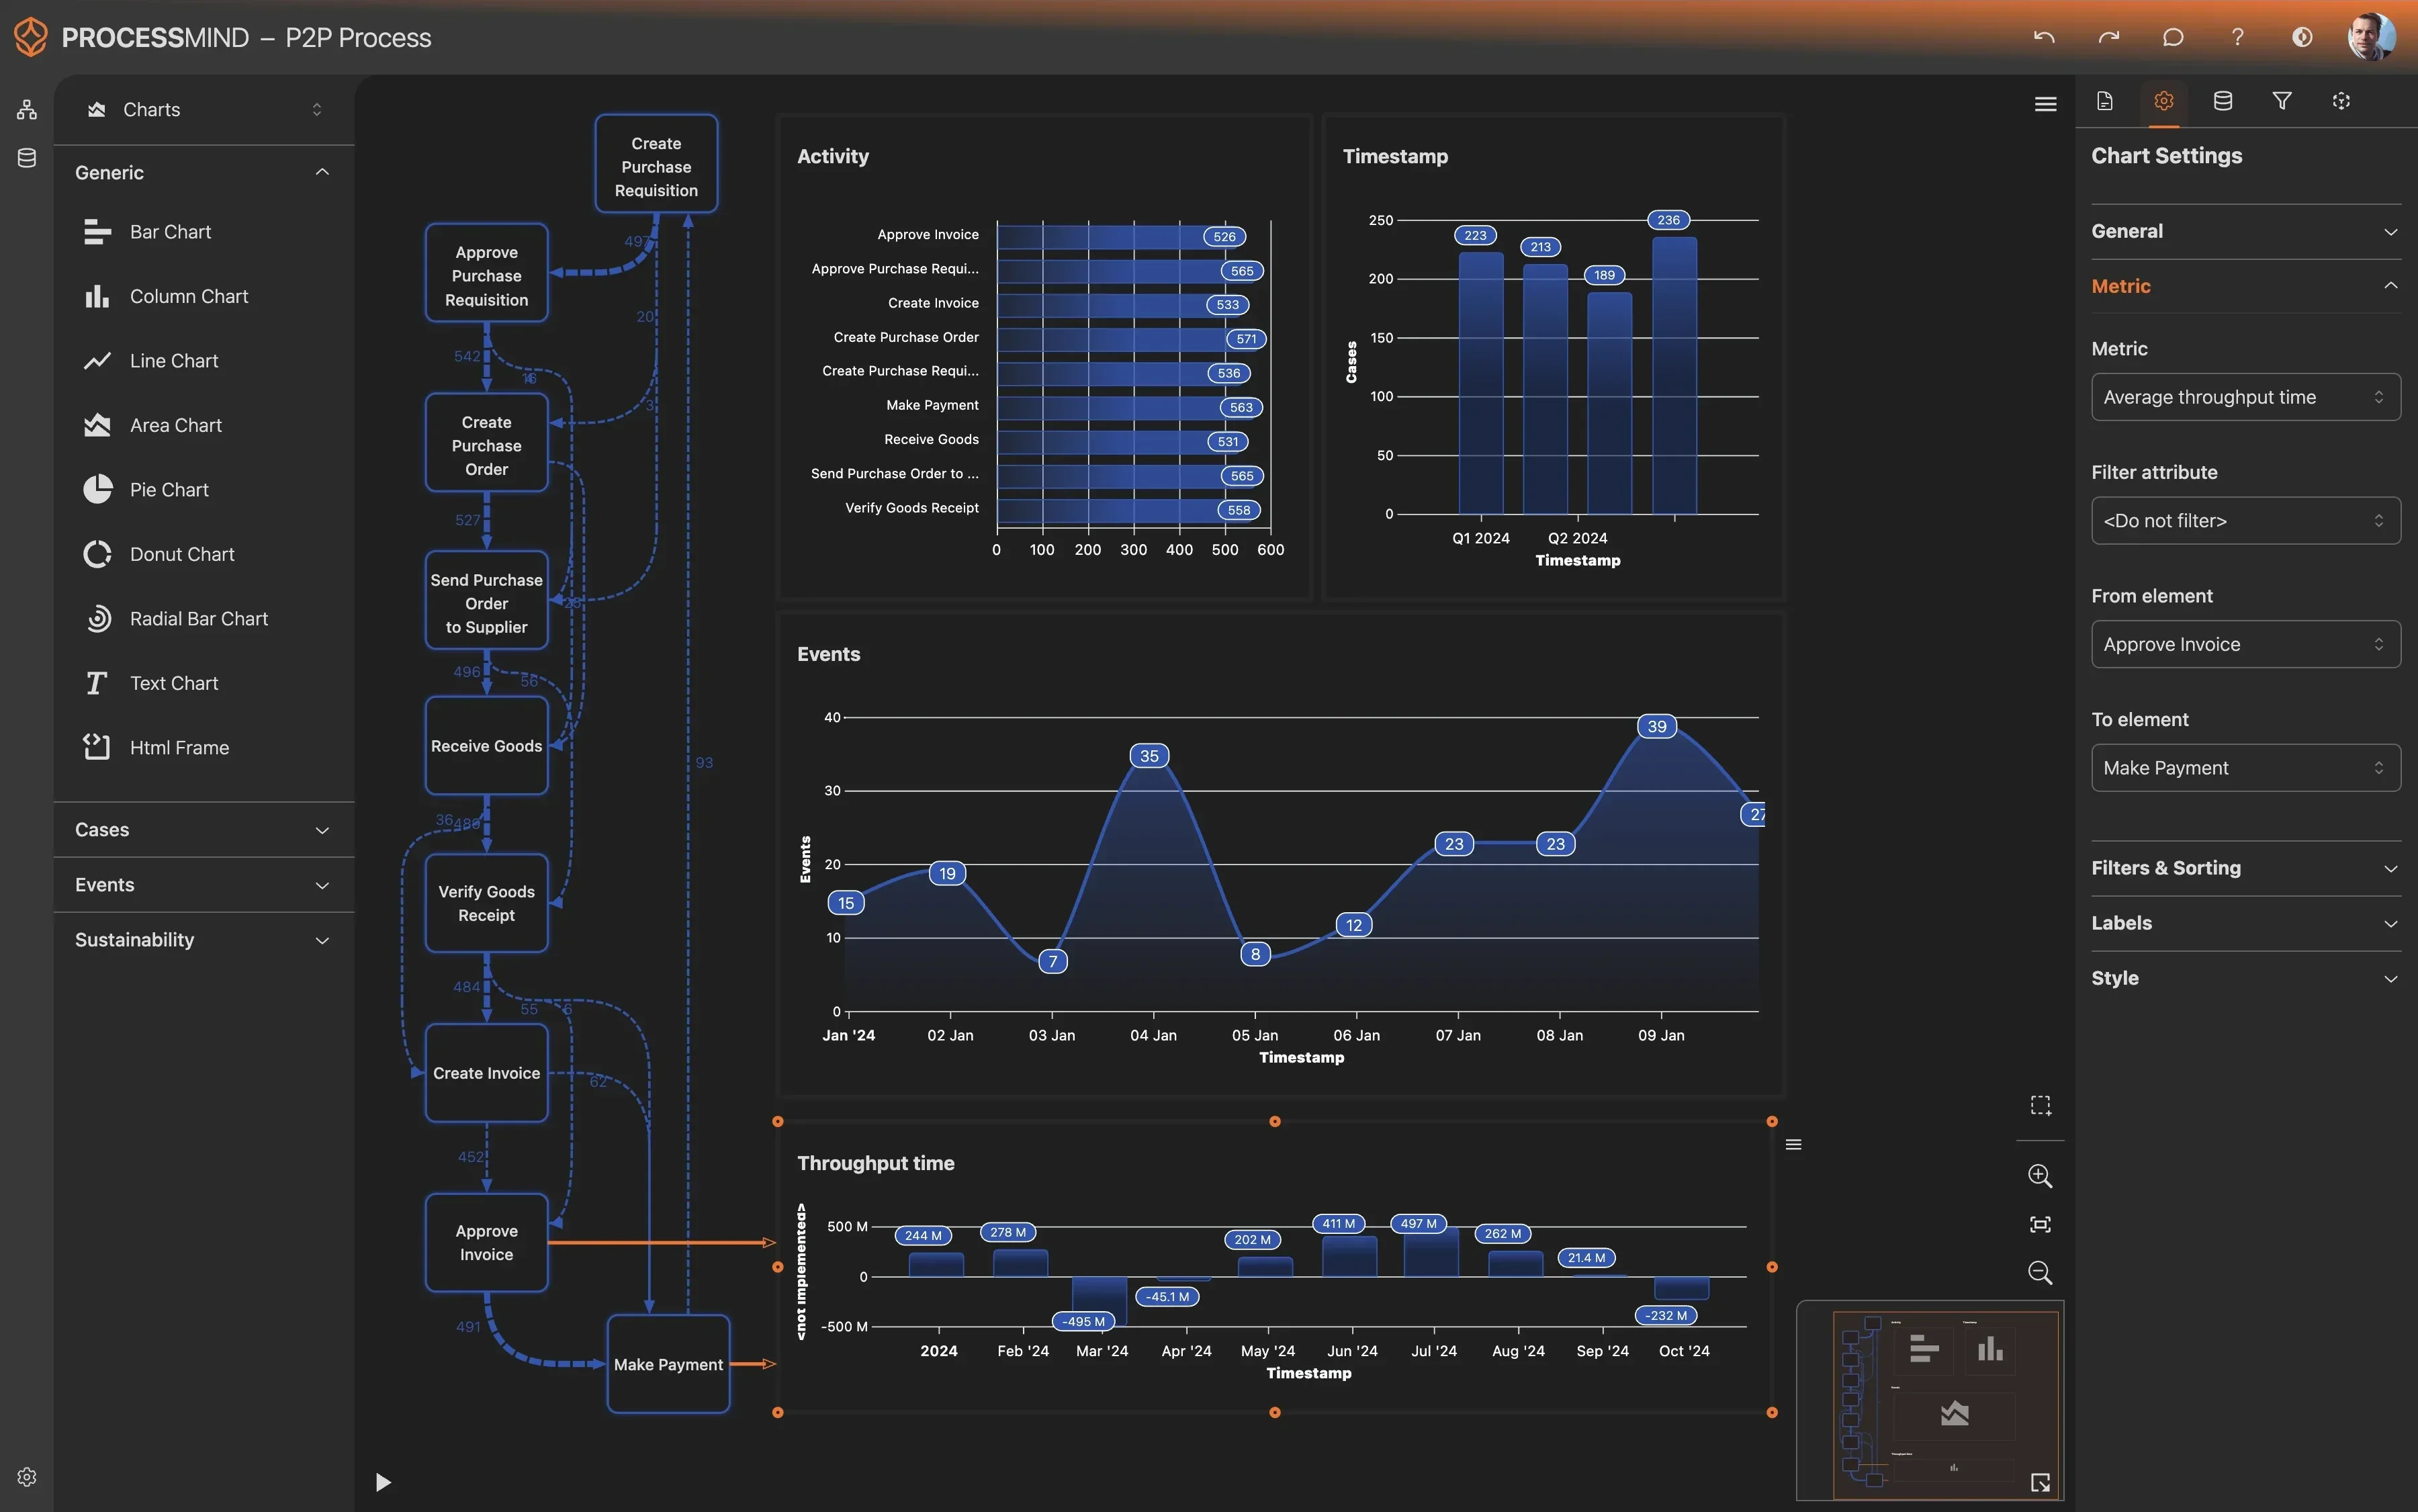
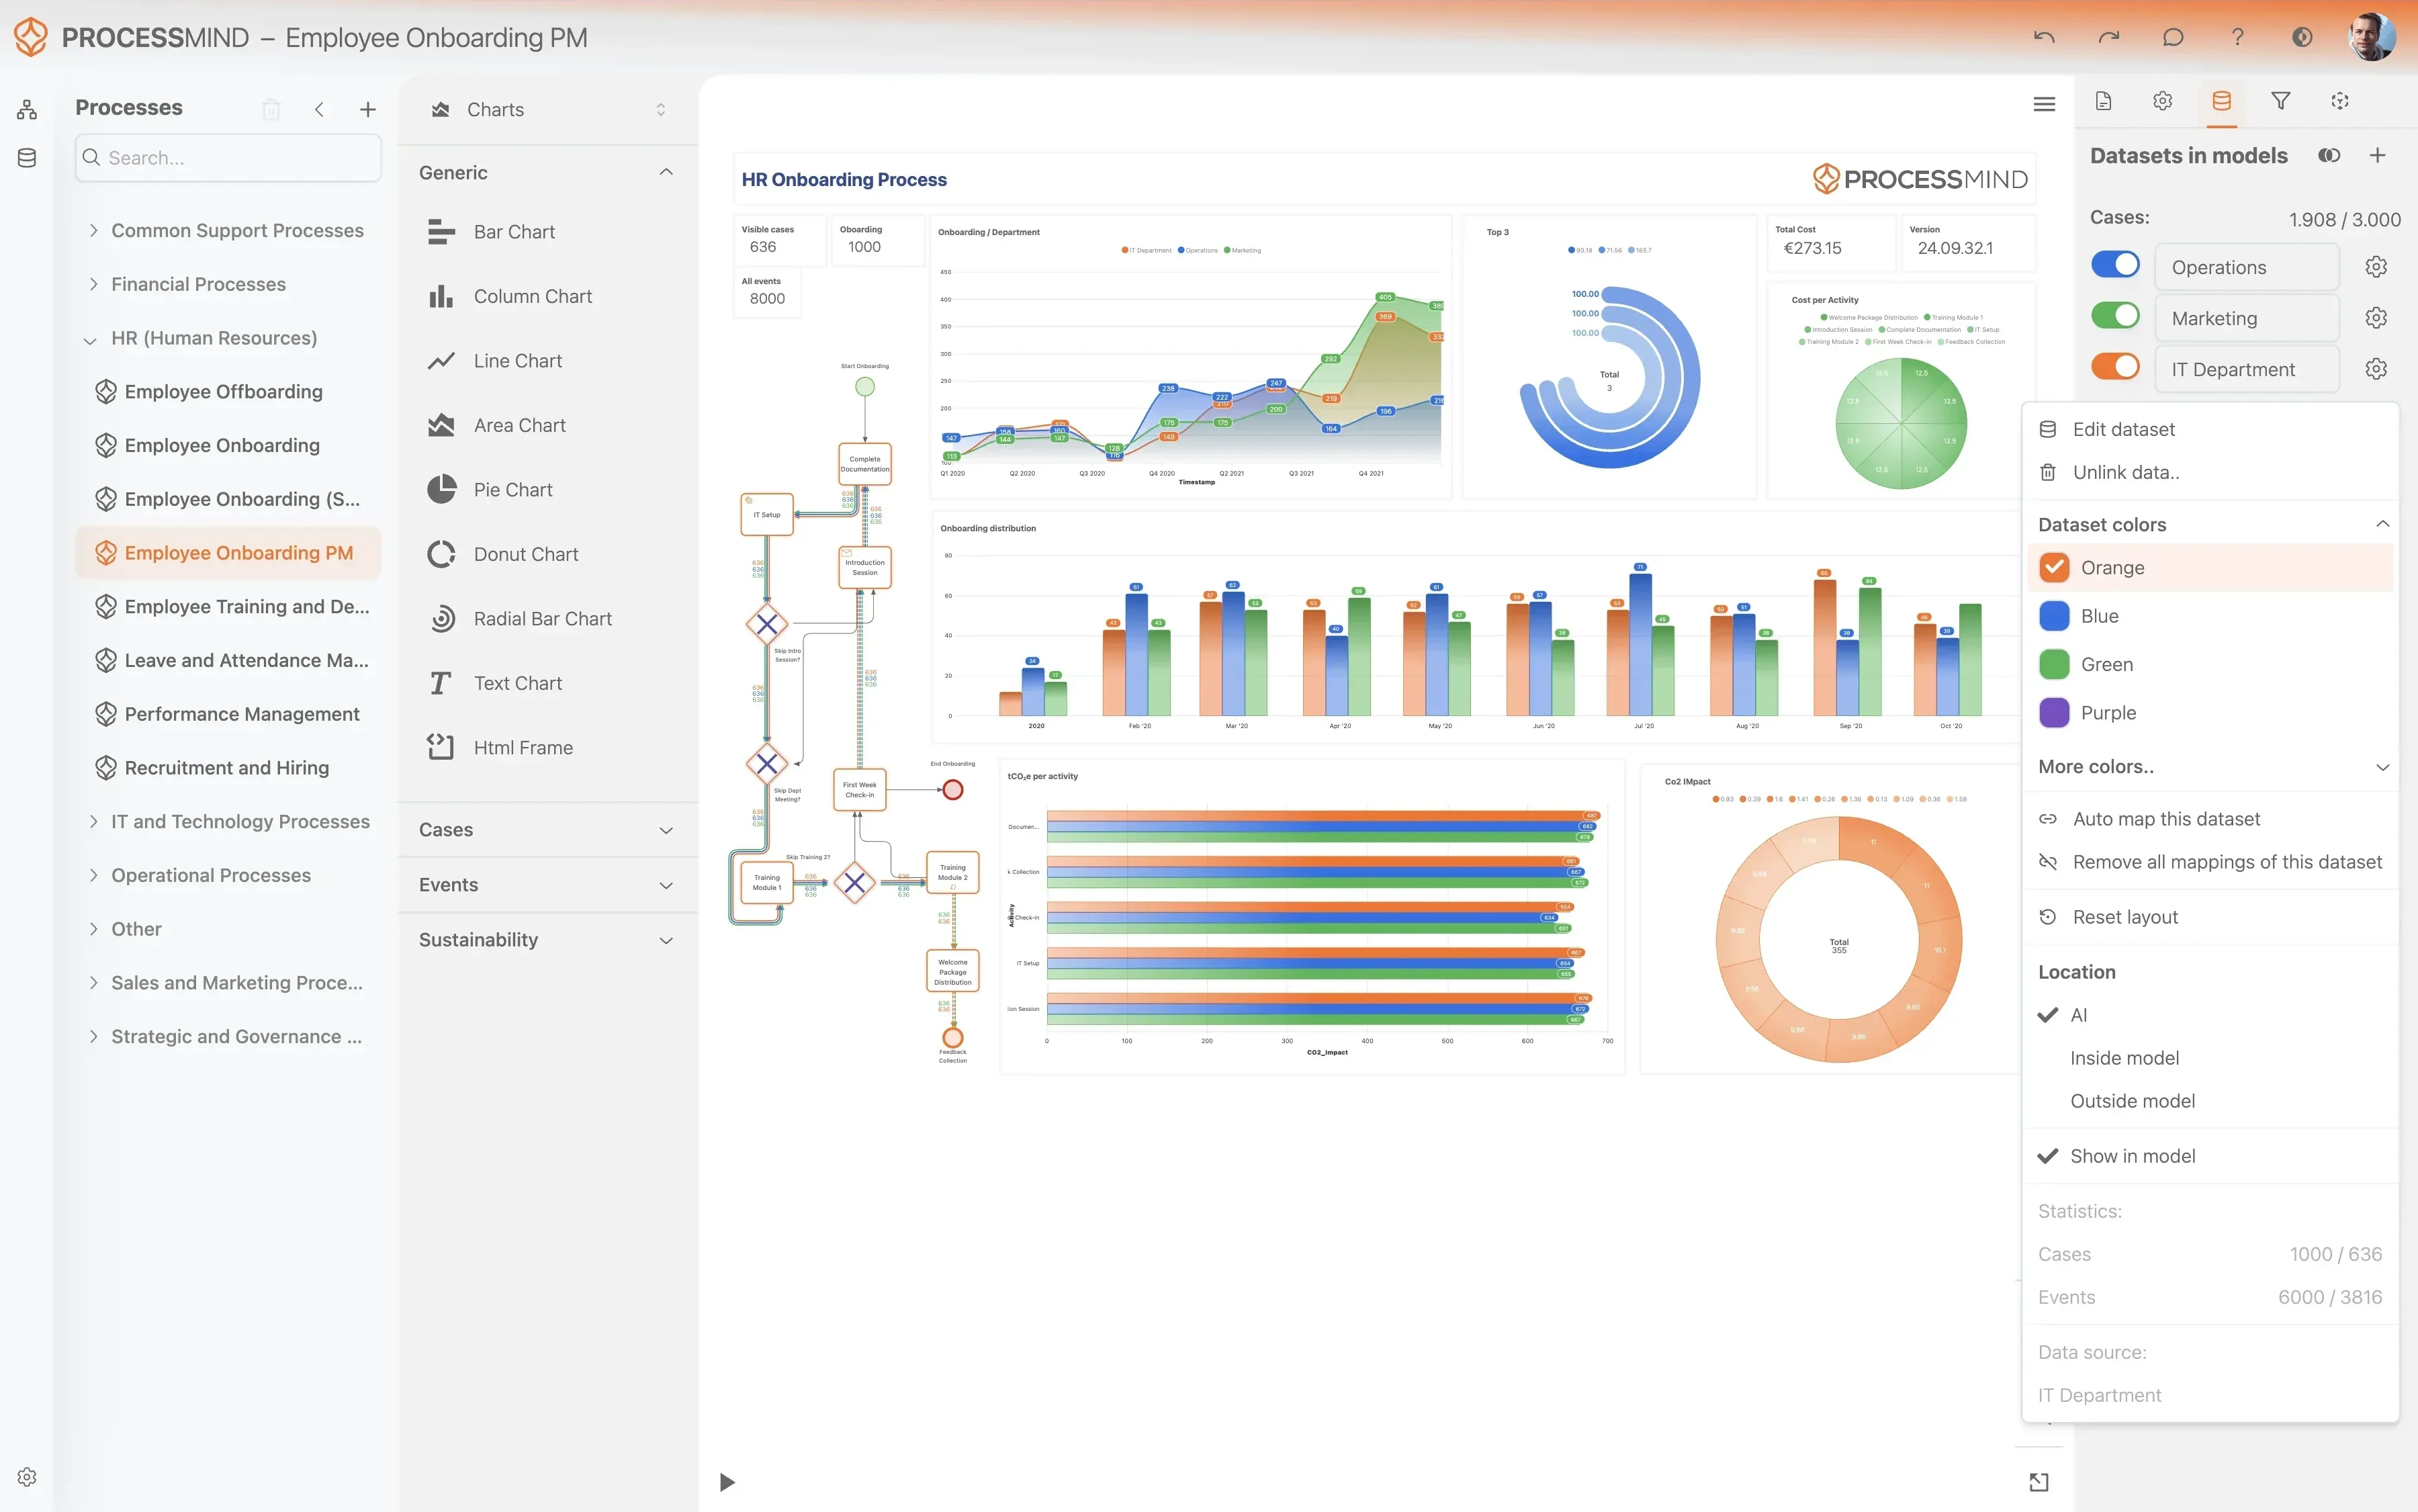
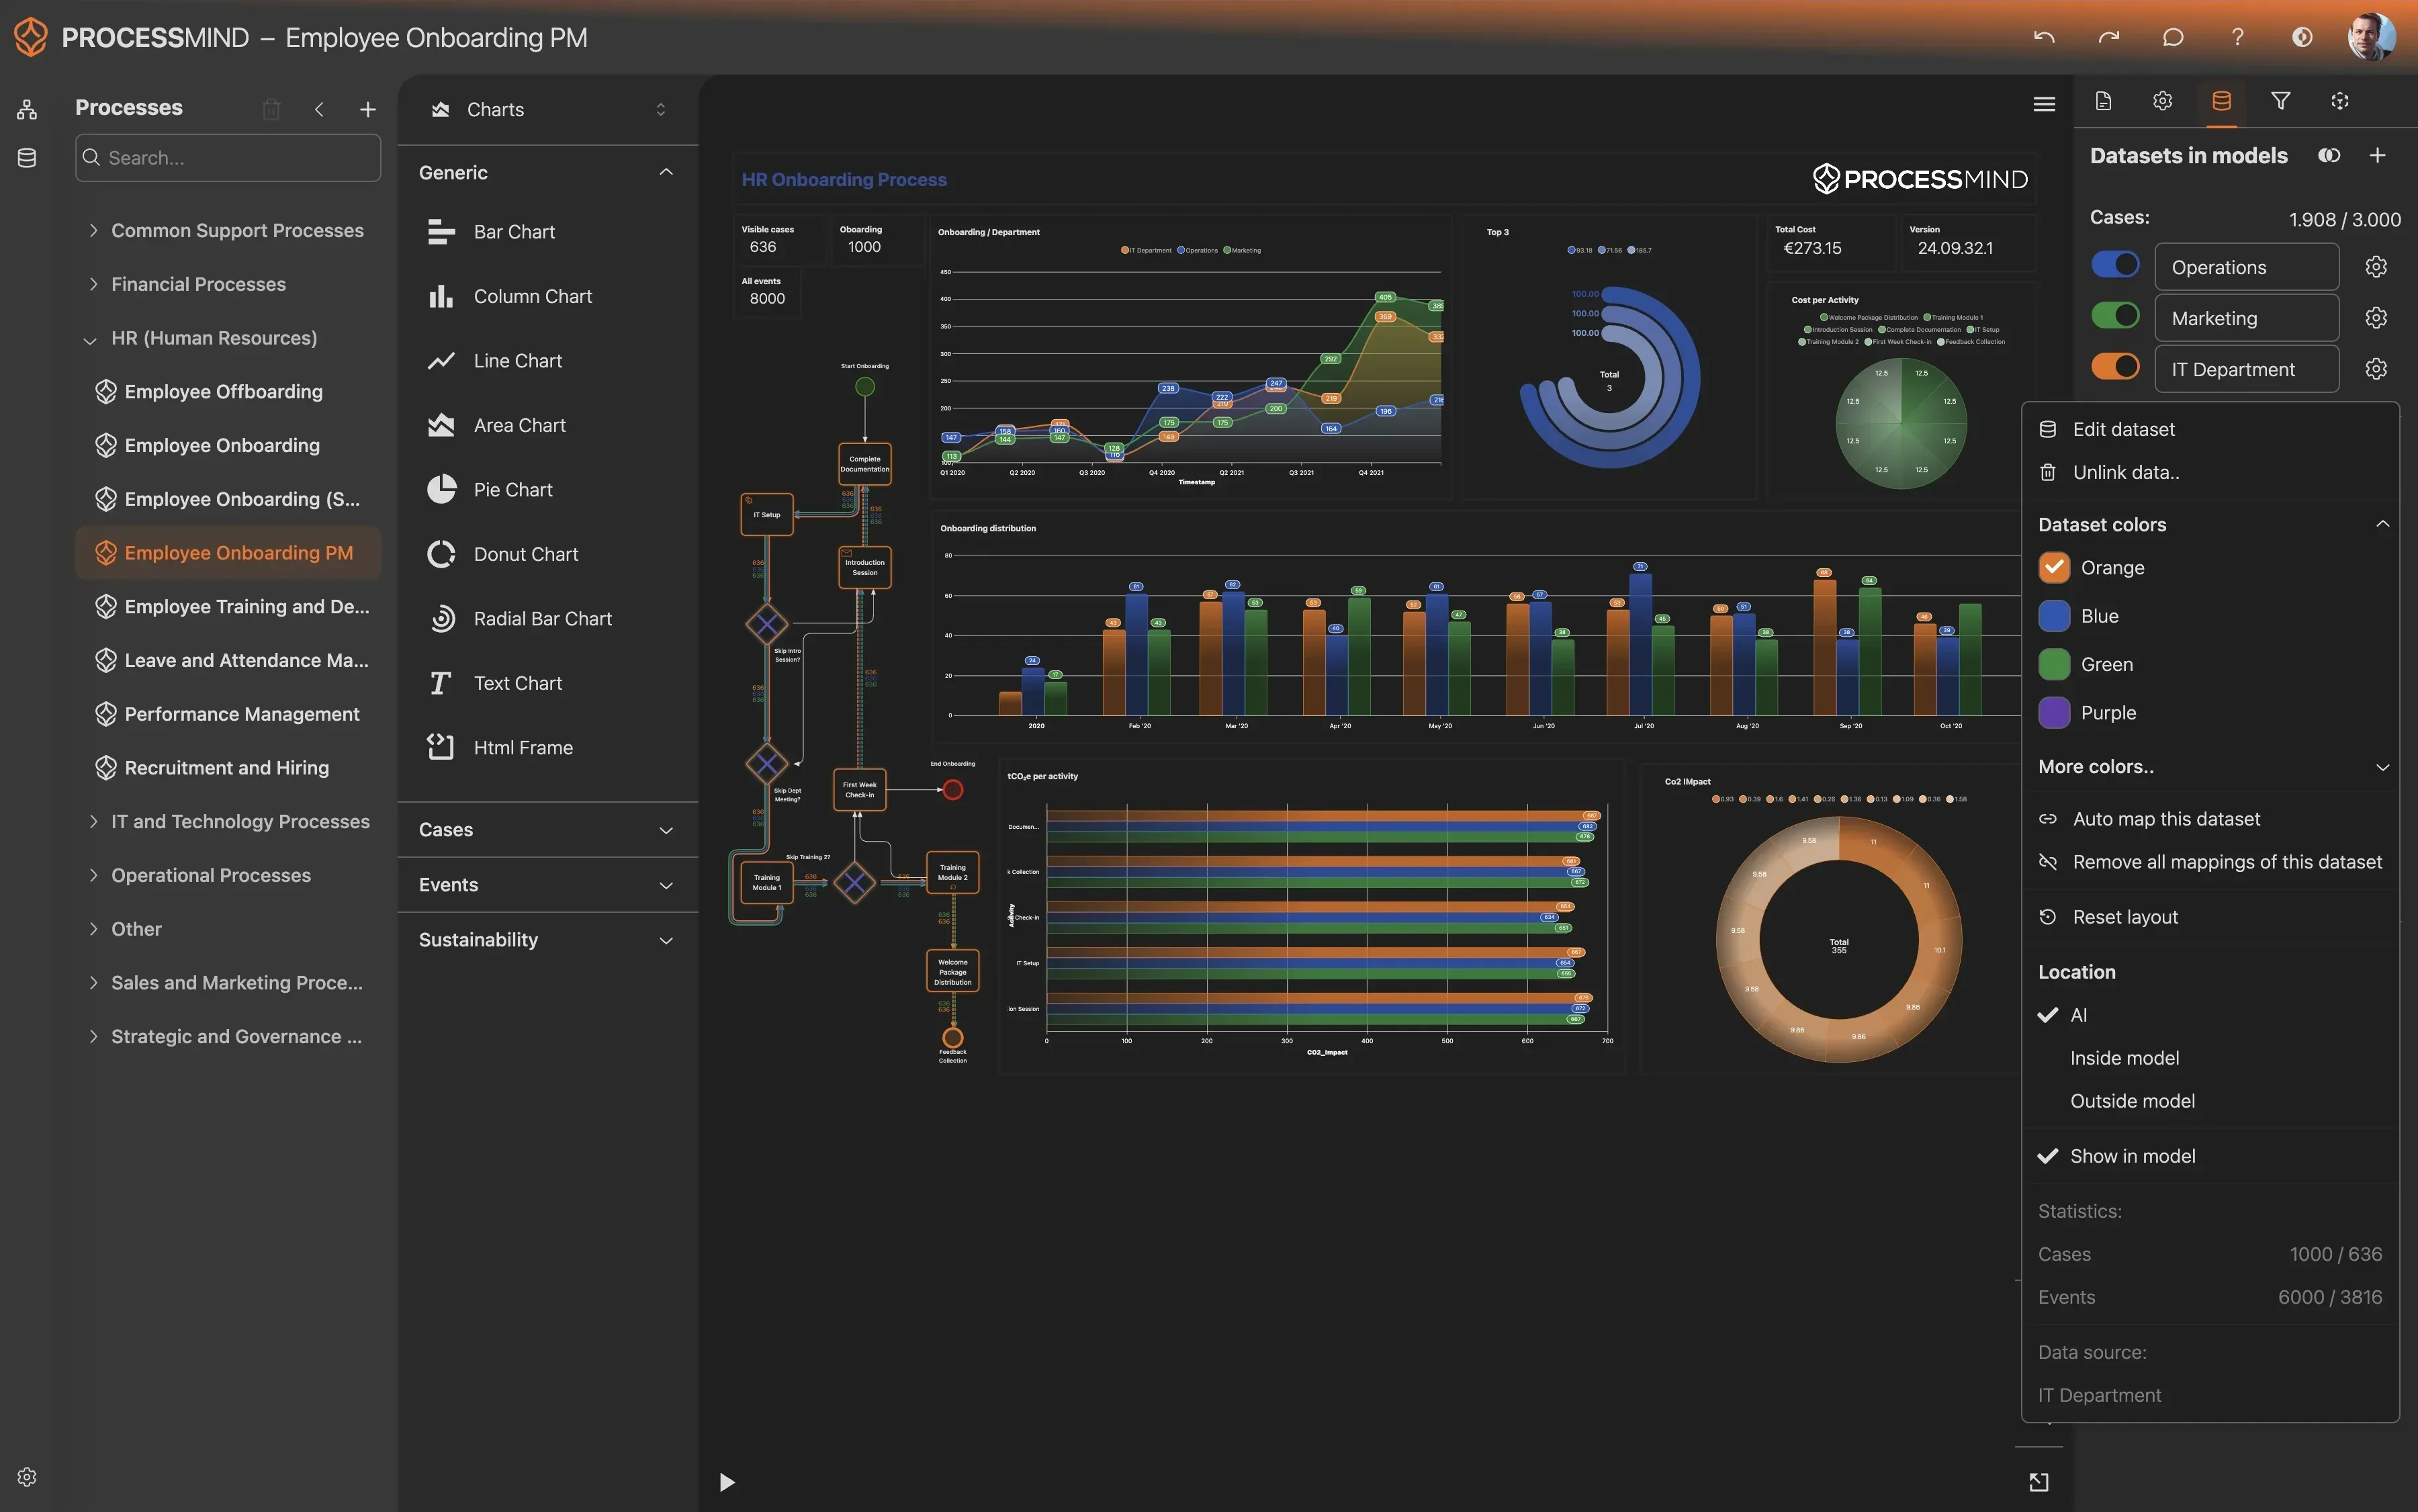
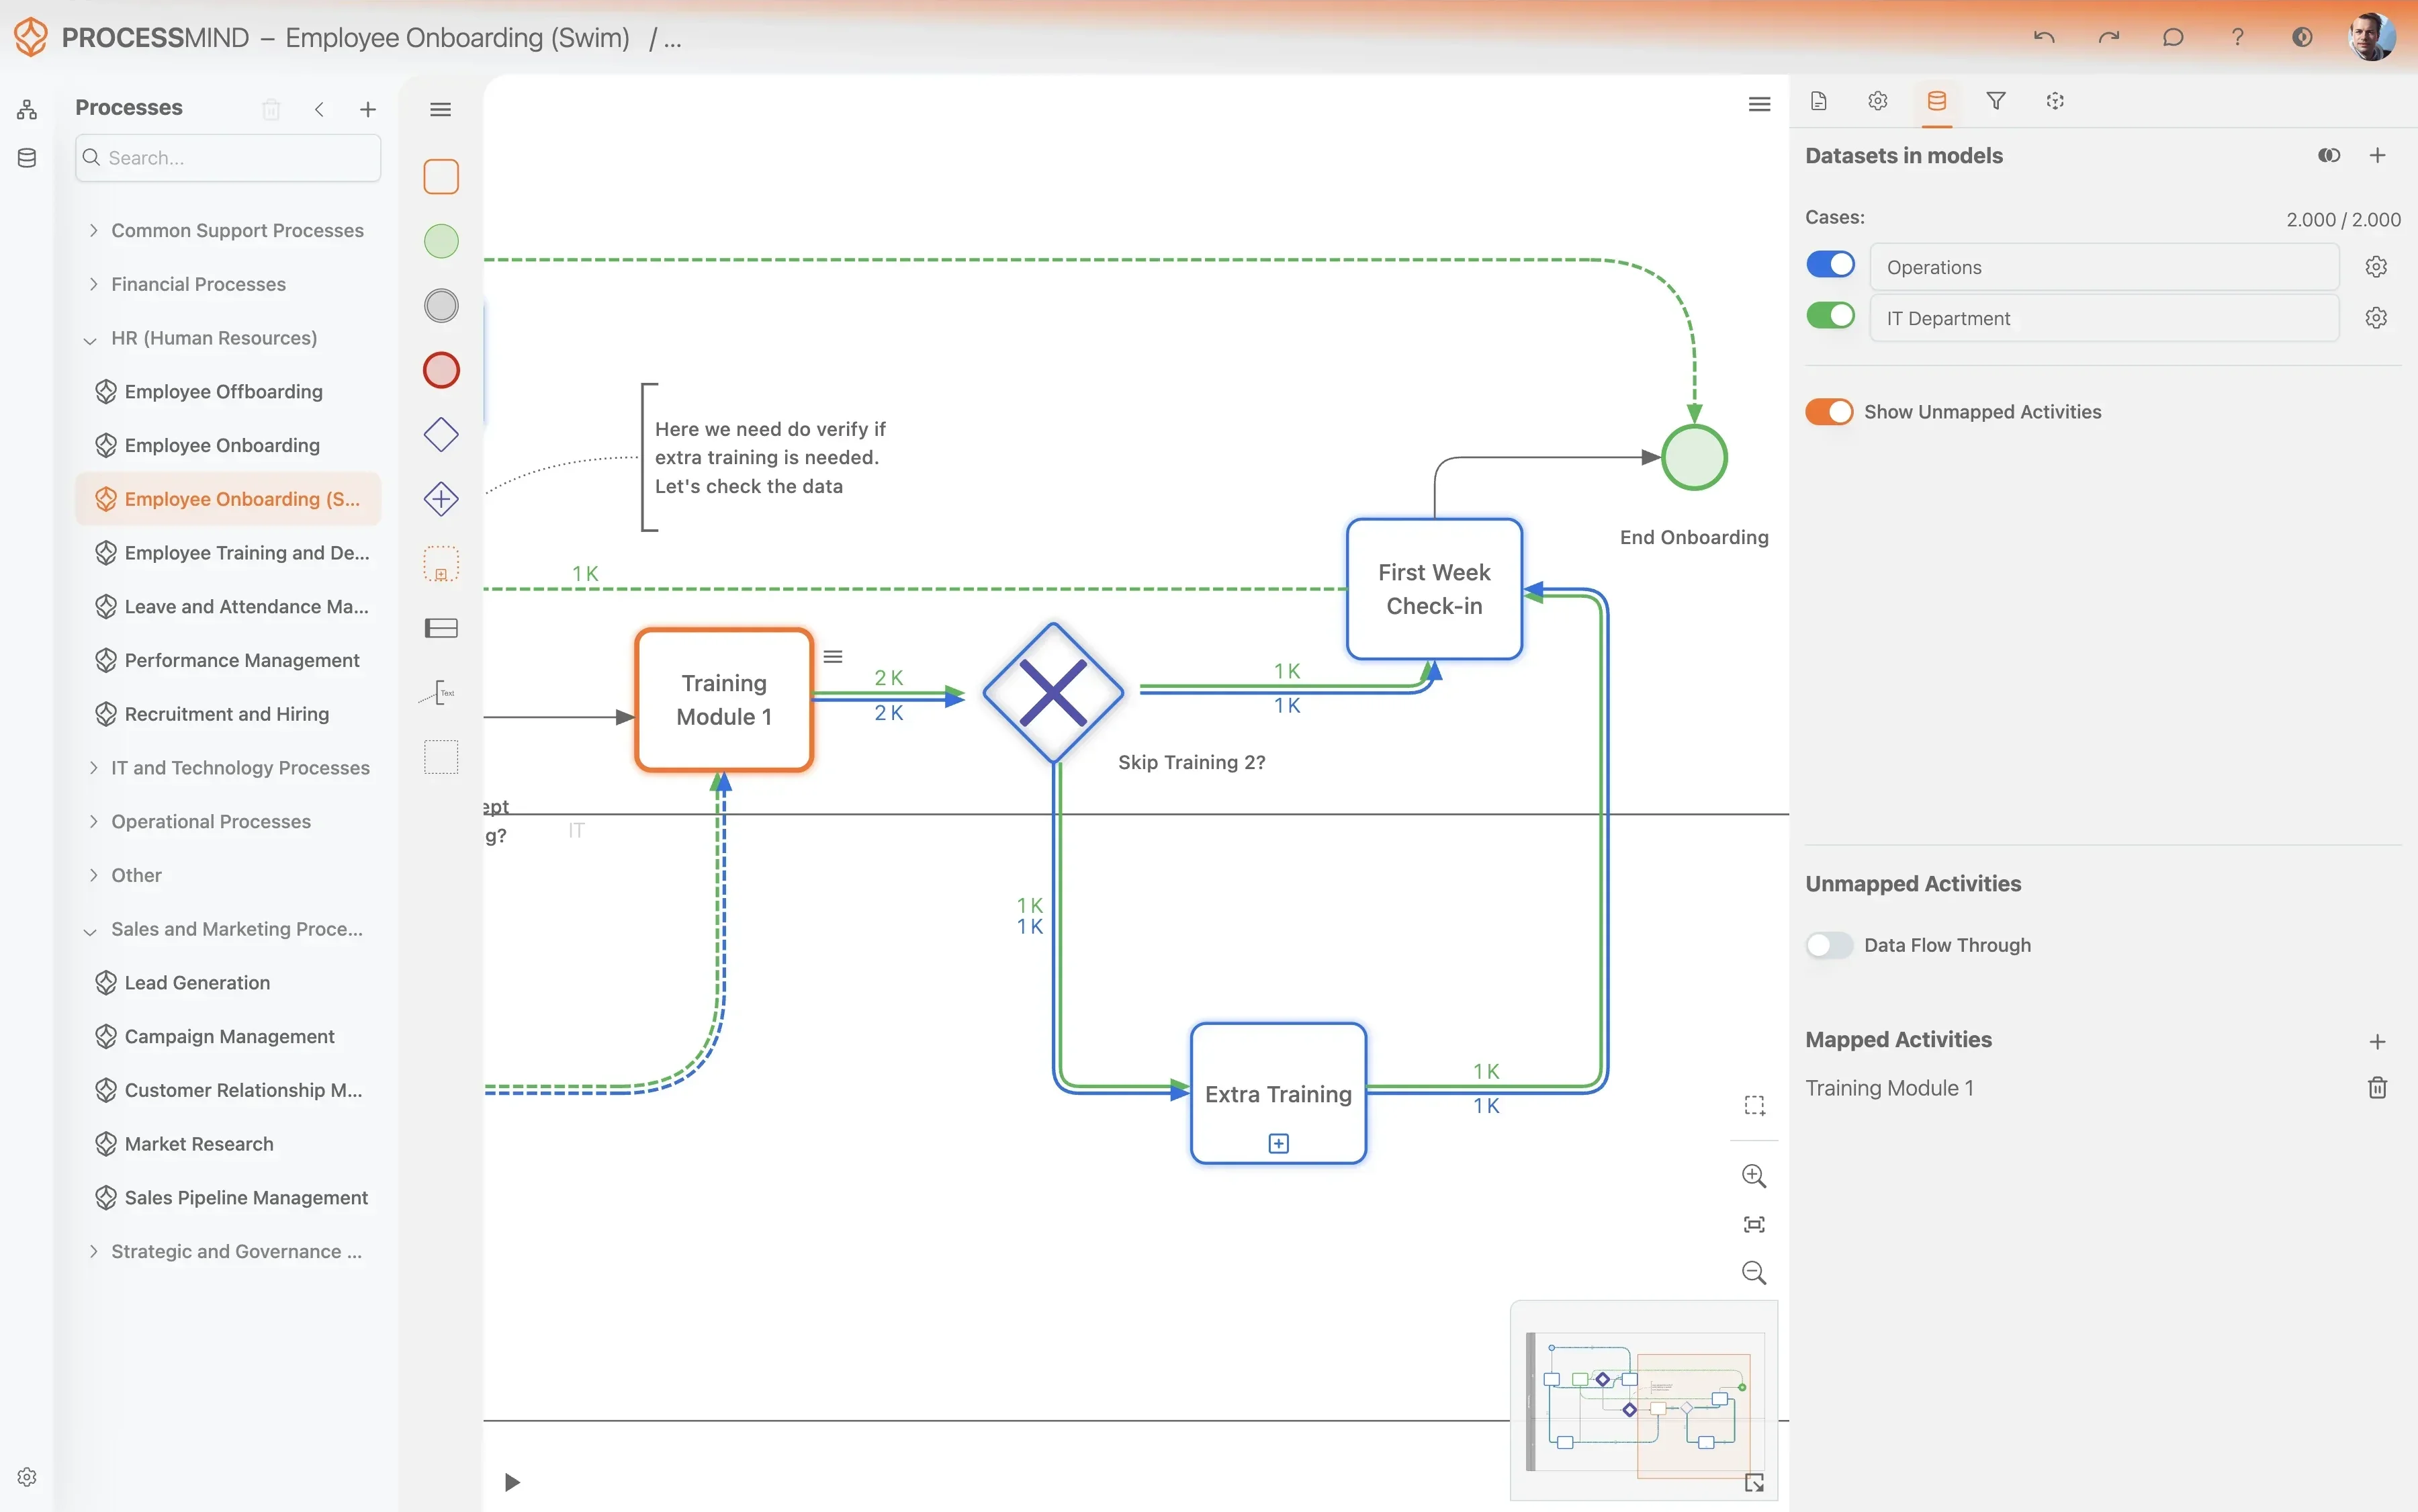
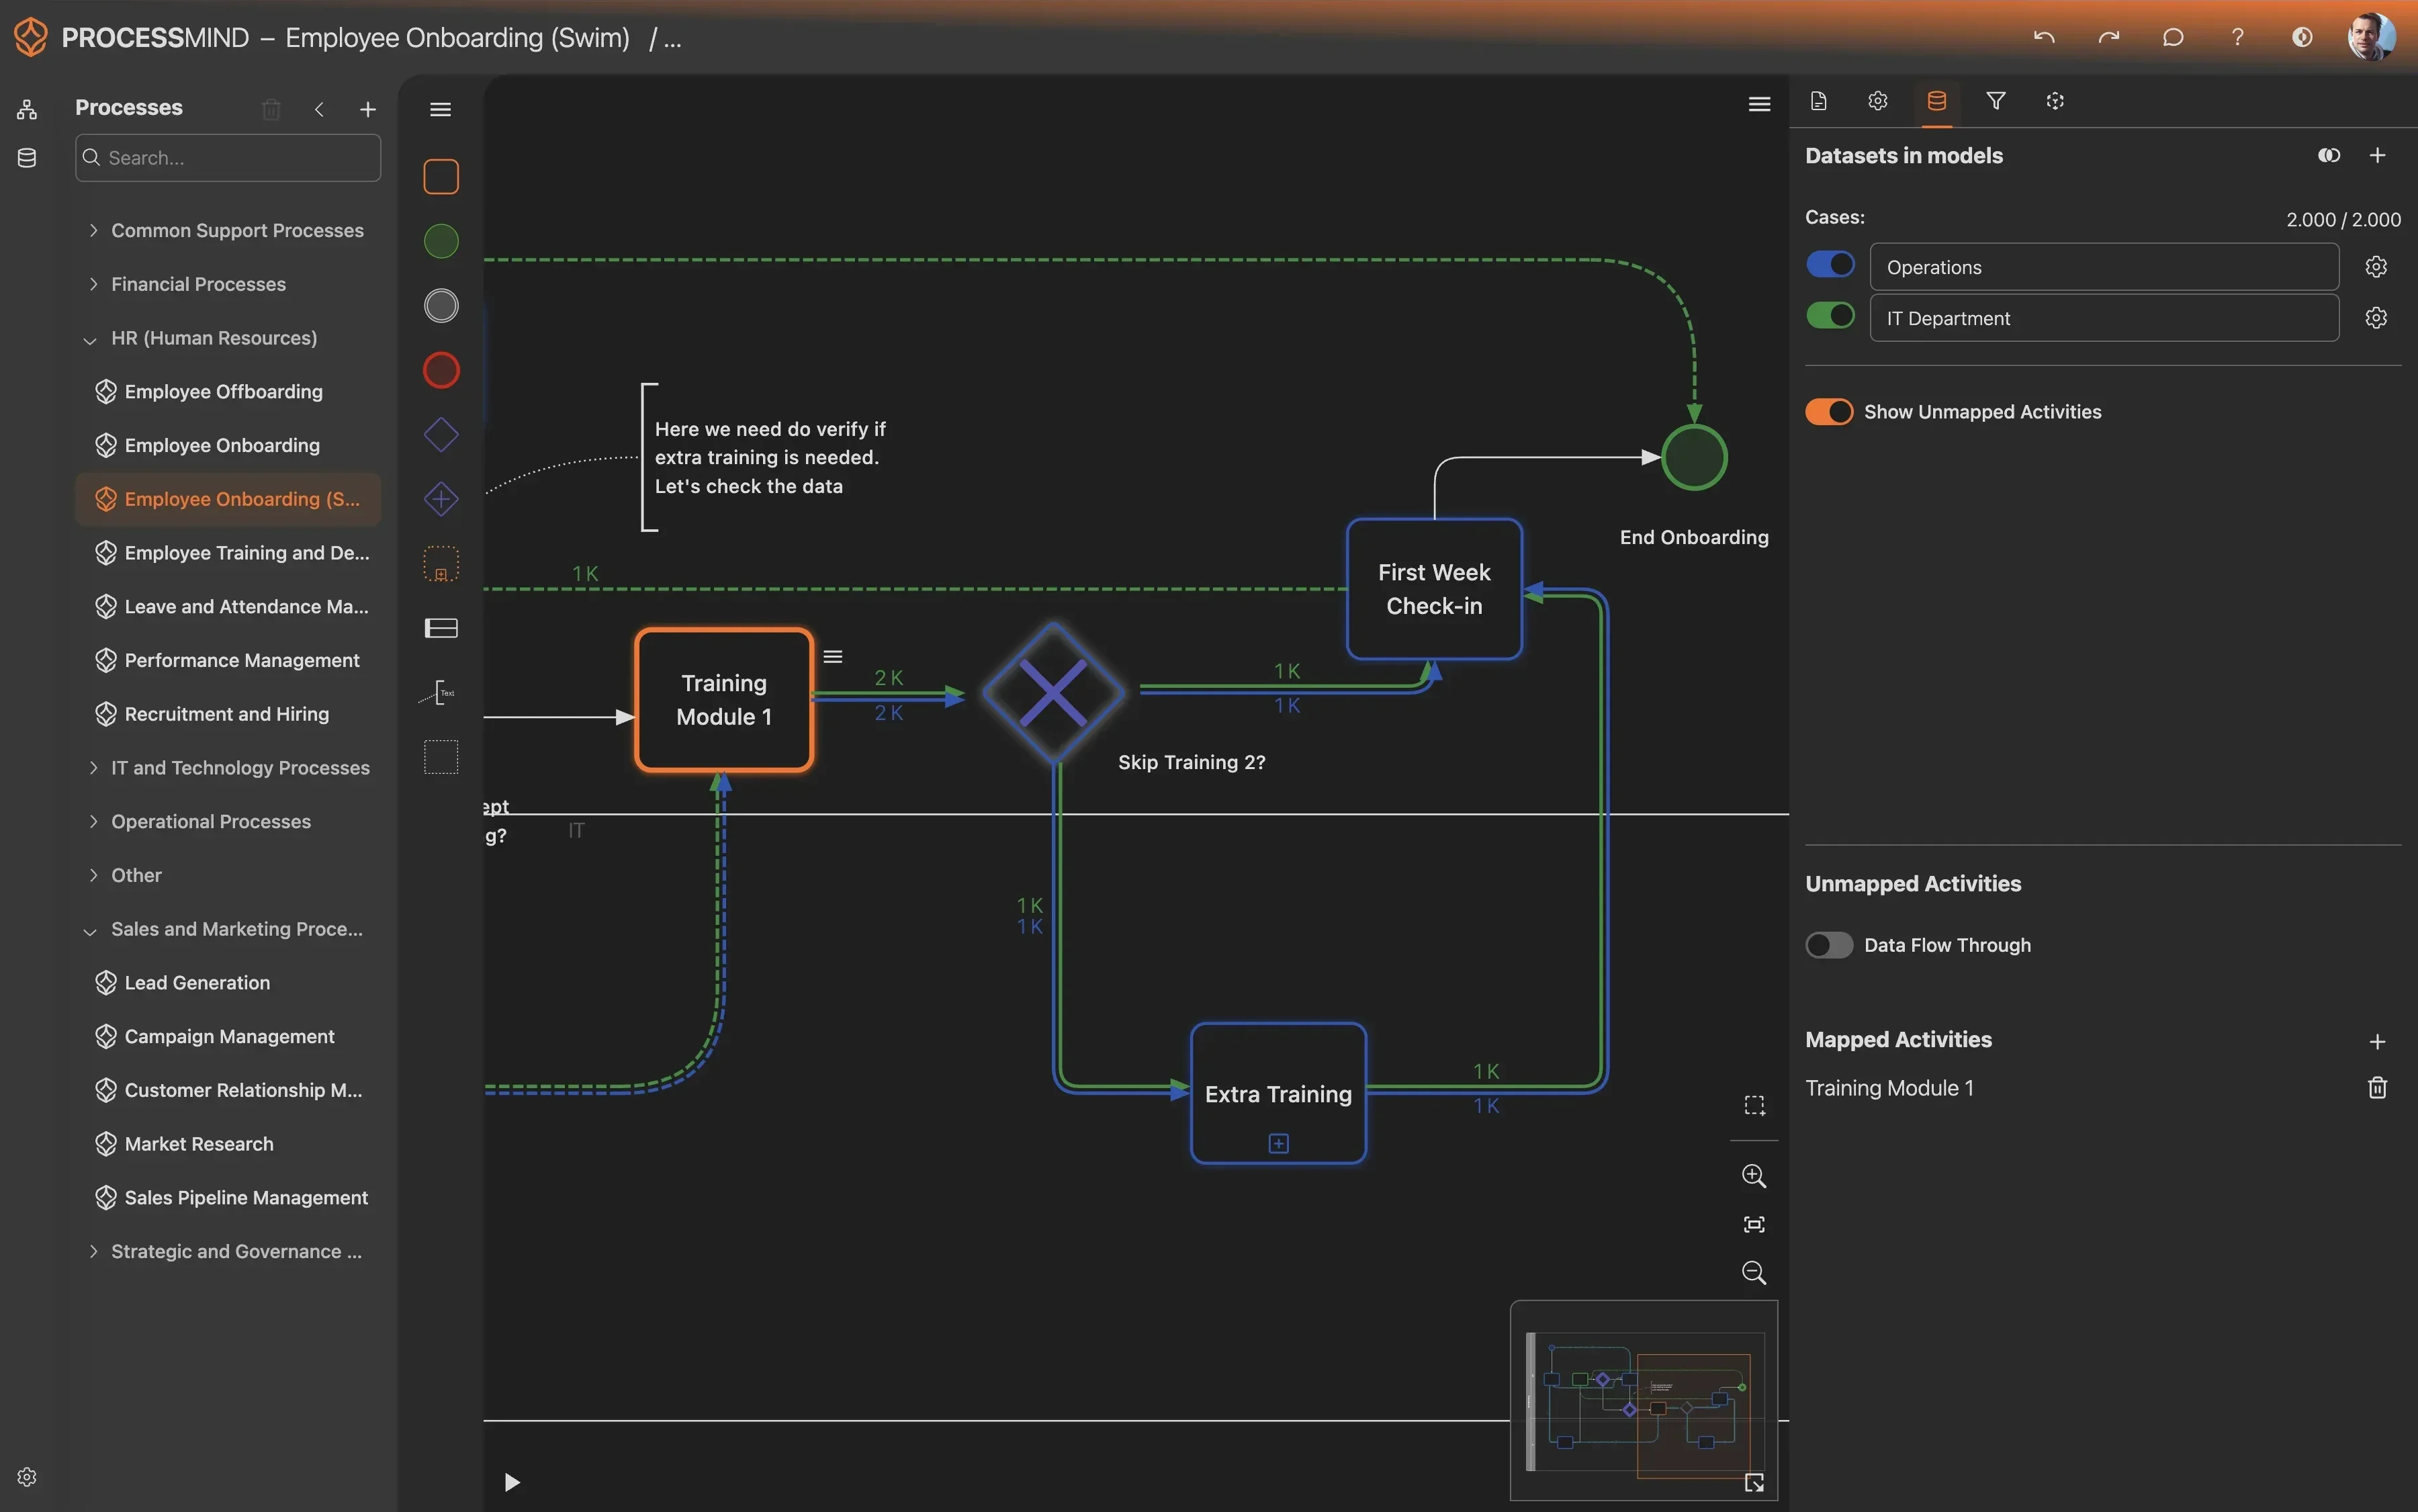
ProcessMind muestra el flujo real del proceso de gestión de incidentes y ofrece visualizaciones claras e información basada en datos. Descubra exactamente dónde se producen las ineficiencias y cómo optimizar el proceso para resolver los incidentes más rápido.
  • Visualice los flujos reales de resolución de incidentes
  • Localice los cuellos de botella y las demoras en la resolución
  • Identifique las causas raíz de las interrupciones del servicio
  • Optimice la asignación de recursos para agilizar el servicio
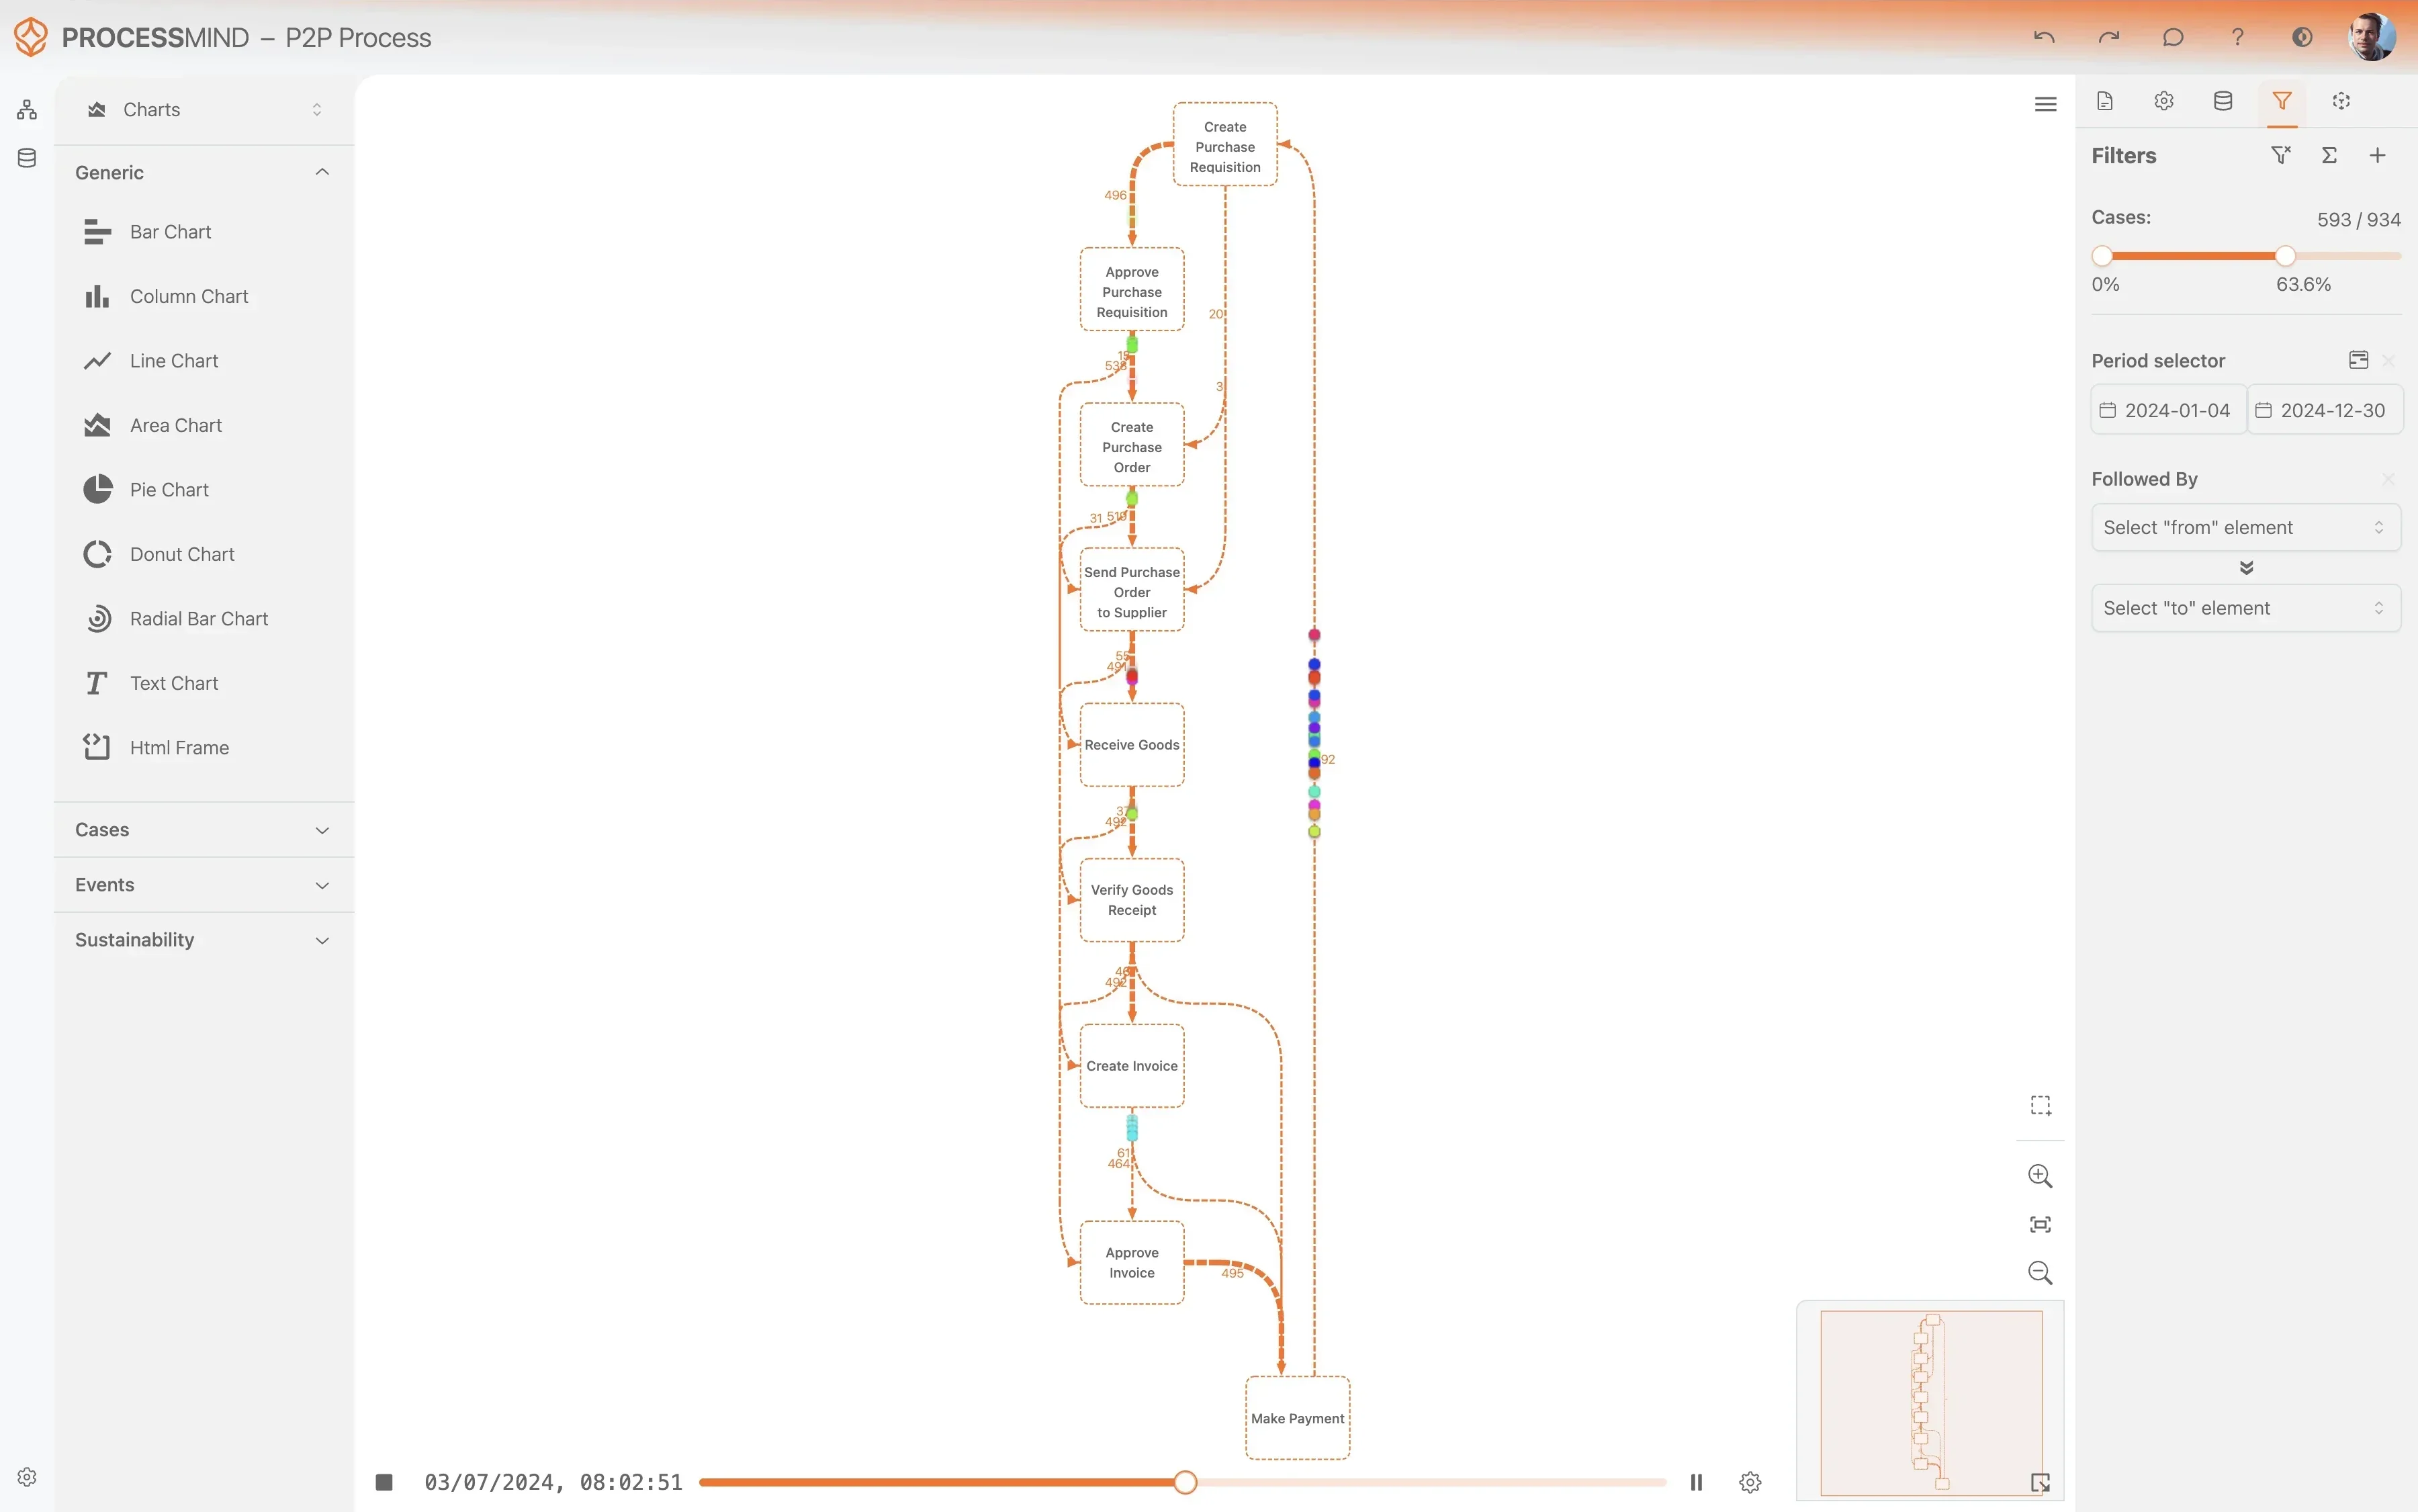
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

RESULTADOS HABITUALES

Qué consiguen las organizaciones al optimizar la gestión de incidentes

Al analizar con Process Mining los flujos de trabajo de gestión de incidentes en BMC Helix ITSM, las organizaciones obtienen información sobre los cuellos de botella y las ineficiencias. Estos resultados reflejan las mejoras habituales en los tiempos de resolución, la calidad del servicio y los costes operativos que pueden lograrse.

0 %
Menor tiempo de resolución

Menos tiempo para cerrar los incidentes

Agilice los flujos de trabajo al identificar cuellos de botella en las etapas de diagnóstico, investigación o aprobación, y reduzca considerablemente el tiempo total de resolución de los incidentes.

0 %
Mejor cumplimiento de los SLA

Mayor cumplimiento de los objetivos de servicio

Detecte y corrija las desviaciones o demoras del proceso que provocan incumplimientos de SLA para resolver más incidentes dentro de los niveles de servicio acordados.

0 %
Menos reasignaciones

Menos transferencias entre equipos

Identifique y elimine las rutas ineficientes que hacen que los incidentes pasen de un grupo de soporte a otro, para acelerar la resolución inicial y reducir el esfuerzo.

0 %
Menos retrabajo en los incidentes

Menos incidentes reabiertos o recurrentes

Descubra las causas raíz de las soluciones iniciales ineficaces o los diagnósticos incompletos para reducir la necesidad de reabrir o escalar incidentes después de los primeros intentos de resolución.

0 %
Mejor cumplimiento del proceso

Mayor cumplimiento de los pasos estándar

Visualice las rutas reales de los incidentes para detectar desviaciones de los procedimientos estándar y mejorar la coherencia y la previsibilidad de su gestión.

Los resultados varían según la complejidad del proceso de gestión de incidentes, la calidad de los datos y el contexto de cada organización. Estas cifras ilustran las mejoras habituales observadas en distintas implementaciones.

Datos recomendados

Empiece por los atributos y las actividades más importantes y amplíe el análisis según sea necesario.
¿Es nuevo en los registros de eventos? Aprenda a crear un Registro de eventos para Process Mining.

Atributos

Datos clave que debe recopilar para el análisis

Identificador único de cada registro de incidente.

Por qué es importante

Este es el identificador esencial del caso, que conecta todos los eventos del ciclo de vida de un incidente y permite analizar el proceso de principio a fin.

Estado actual o histórico del incidente en el momento del evento.

Por qué es importante

Registrar los cambios de estado es fundamental para comprender el avance del incidente y medir cuánto tiempo permanece en estados específicos, como 'Pending' o 'In Progress'.

Nivel de prioridad asignado al incidente, que determina la urgencia con la que debe gestionarse.

Por qué es importante

Este atributo es esencial para segmentar el análisis, agilizar la atención de los incidentes de alta prioridad y cumplir sus objetivos de nivel de servicio específicos.

El grupo de soporte responsable de atender el incidente.

Por qué es importante

Registrar qué grupo tiene asignado el incidente ayuda a analizar los traspasos, detectar ciclos de reasignación e identificar cuellos de botella en equipos específicos.

La persona asignada para atender el incidente.

Por qué es importante

Ofrece una visión detallada de la distribución de la carga de trabajo y del rendimiento individual, y ayuda a identificar a quienes obtienen mejores resultados o necesitan apoyo.

El servicio empresarial o técnico afectado por el incidente.

Por qué es importante

Vincular los incidentes con los servicios empresariales es fundamental para analizar su impacto e identificar qué servicios presentan más problemas.

La clasificación del incidente, que suele organizarse en varios niveles.

Por qué es importante

La categorización permite mejorar el enrutamiento, analizar tendencias y comparar el rendimiento de distintos tipos de incidentes.

Indicador que señala si el incidente se resolvió después de la fecha objetivo del SLA.

Por qué es importante

Este indicador simplifica el análisis del cumplimiento del SLA: permite filtrar fácilmente todos los incidentes con incumplimientos e investigar sus causas raíz.

Indicador que señala si un incidente se reabrió después de pasar al estado 'Resuelto'.

Por qué es importante

Mide directamente el retrabajo y la calidad de las resoluciones. Una tasa elevada de reapertura apunta a soluciones ineficaces y debilidades en el proceso.

Actividades

Pasos del proceso que debe supervisar y optimizar

Esta actividad marca la creación inicial del registro del incidente en el sistema. Se obtiene directamente de la marca de tiempo de creación del incidente en el formulario principal de gestión de incidentes.

Por qué es importante

Este es el evento de inicio principal del ciclo de vida del incidente. Es esencial para calcular los tiempos totales de resolución y comprender la frecuencia de llegada de incidentes.

Esta actividad marca la asignación inicial del incidente a un grupo de soporte específico para su investigación. Se infiere a partir de la primera vez que se completa el campo 'Assigned Group' después de crear el incidente.

Por qué es importante

Este es un hito clave que señala el inicio del trabajo activo. Registrar el tiempo hasta la primera asignación es fundamental para evaluar los tiempos de respuesta y la eficiencia de la asignación inicial.

Indica que una persona del equipo de soporte ha empezado a trabajar activamente en el incidente. Suele inferirse a partir del cambio de estado de 'Assigned' a 'In Progress'.

Por qué es importante

Este hito marca el paso de la espera en una cola al diagnóstico activo. Analizar el tiempo de espera hasta el inicio de la investigación ayuda a detectar cuellos de botella de recursos y contribuye al Dashboard «Cuellos de botella en el diagnóstico y la investigación».

Esta actividad marca la resolución oficial del incidente desde la perspectiva de la mesa de ayuda, antes del cierre definitivo. Se registra cuando el estado del incidente se establece en 'Resolved'.

Por qué es importante

Este es el hito más importante para medir el cumplimiento de los SLA y el tiempo de resolución. Indica que se ha restablecido el servicio para la persona usuaria.

Esta es la actividad final, que marca el cierre formal del registro del incidente una vez confirmada la resolución o transcurrido el periodo de confirmación. Se registra cuando el estado se establece en 'Closed'.

Por qué es importante

Este es el evento de fin definitivo del ciclo de vida del incidente. El tiempo entre 'Resolved' y 'Closed' corresponde al periodo de confirmación de la persona usuaria y a las tareas administrativas de cierre.

Preguntas frecuentes

Preguntas frecuentes

Process Mining analiza los datos reales de incidentes de BMC Helix ITSM para visualizar el flujo real de cada incidente. Detecta cuellos de botella ocultos, desviaciones de los procedimientos estándar y ciclos de retrabajo que afectan los tiempos de resolución y los niveles de servicio. Así podrá ver exactamente dónde se pierde eficiencia.

Para empezar, normalmente se necesitan registros de eventos que incluyan el ID del incidente, el nombre de la actividad y una marca de tiempo para cada paso. Otros atributos, como la persona asignada, el tipo de incidente, la prioridad y los códigos de resolución, son muy útiles para profundizar en el análisis. Estos datos permiten reconstruir el recorrido completo de cada incidente.

Los datos de BMC Helix ITSM se pueden extraer de varias formas, por ejemplo, mediante consultas directas a la base de datos, integraciones de API o las funciones de generación de informes disponibles. El objetivo es obtener un conjunto completo de registros de eventos que recoja todas las actividades pertinentes y sus marcas de tiempo. En esta fase inicial, siempre se priorizan los métodos seguros y conformes con los requisitos de cumplimiento.

Una vez extraídos y preparados los datos, a menudo es posible obtener información útil para la acción en unas semanas e incluso en unos días, según el grado de preparación de los datos y el alcance del proyecto. El análisis inicial permite detectar rápidamente las principales desviaciones y los problemas de rendimiento, para que los equipos puedan priorizar las mejoras. La supervisión continua ayuda a mantener los esfuerzos de optimización.

Sí. Process Mining traza cada reasignación y señala exactamente dónde se atascan los incidentes o se envían al equipo equivocado, lo que provoca demoras y posibles incumplimientos de SLA. Al visualizar estas ineficiencias, podrá identificar sus causas, como funciones poco claras, falta de conocimientos o rutas de escalamiento inadecuadas. Así podrá aplicar medidas específicas para agilizar el proceso.

Process Mining suele utilizar plataformas de software especializadas para incorporar, transformar y visualizar datos de eventos. Algunas herramientas ofrecen soluciones en la nube, mientras que otras pueden requerir una instalación local. Entre los requisitos habituales se incluyen capacidad de procesamiento y almacenamiento suficientes para los datos históricos de incidentes, además de una conexión segura a los datos.

No. Process Mining va mucho más allá de los informes tradicionales. Los informes muestran «qué» ocurrió; Process Mining revela «cómo» y «por qué» ocurrió al trazar el flujo real del proceso de principio a fin, en lugar de limitarse a métricas agregadas. Ofrece una visión visual y basada en datos de las variaciones del proceso y su impacto, con más capacidad para diagnosticar problemas.

Process Mining identifica los puntos exactos del ciclo de vida del incidente en los que se aplican soluciones provisionales con frecuencia o se omiten los pasos de análisis de causas raíz, o estos resultan ineficaces. Al trazar las rutas de los incidentes, revela patrones de problemas recurrentes y señala las etapas en las que se pasan por alto los pasos de diagnóstico adecuados. Esta visibilidad permite orientar la formación y ajustar los procesos para mejorar la resolución de problemas.

¡Resuelva hoy los incidentes recurrentes en BMC Helix ITSM!

Reduzca el MTTR un 35 % y elimine los incumplimientos de SLA para aumentar la satisfacción de los usuarios.

Comience su prueba gratuita

No se requiere tarjeta de crédito. Prueba gratuita de 14 días.