Verbeter je probleembeheer
Een gids in 6 stappen om probleembeheer in ServiceNow te optimaliseren
Verbeter je probleembeheer
Probleembeheer
ServiceNow

Selecteer een proces

Kies een proces om verder te werken in de gekoppelde workspace.

259 Processen

Optimaliseer ServiceNow-probleembeheer voor snellere oplossingen

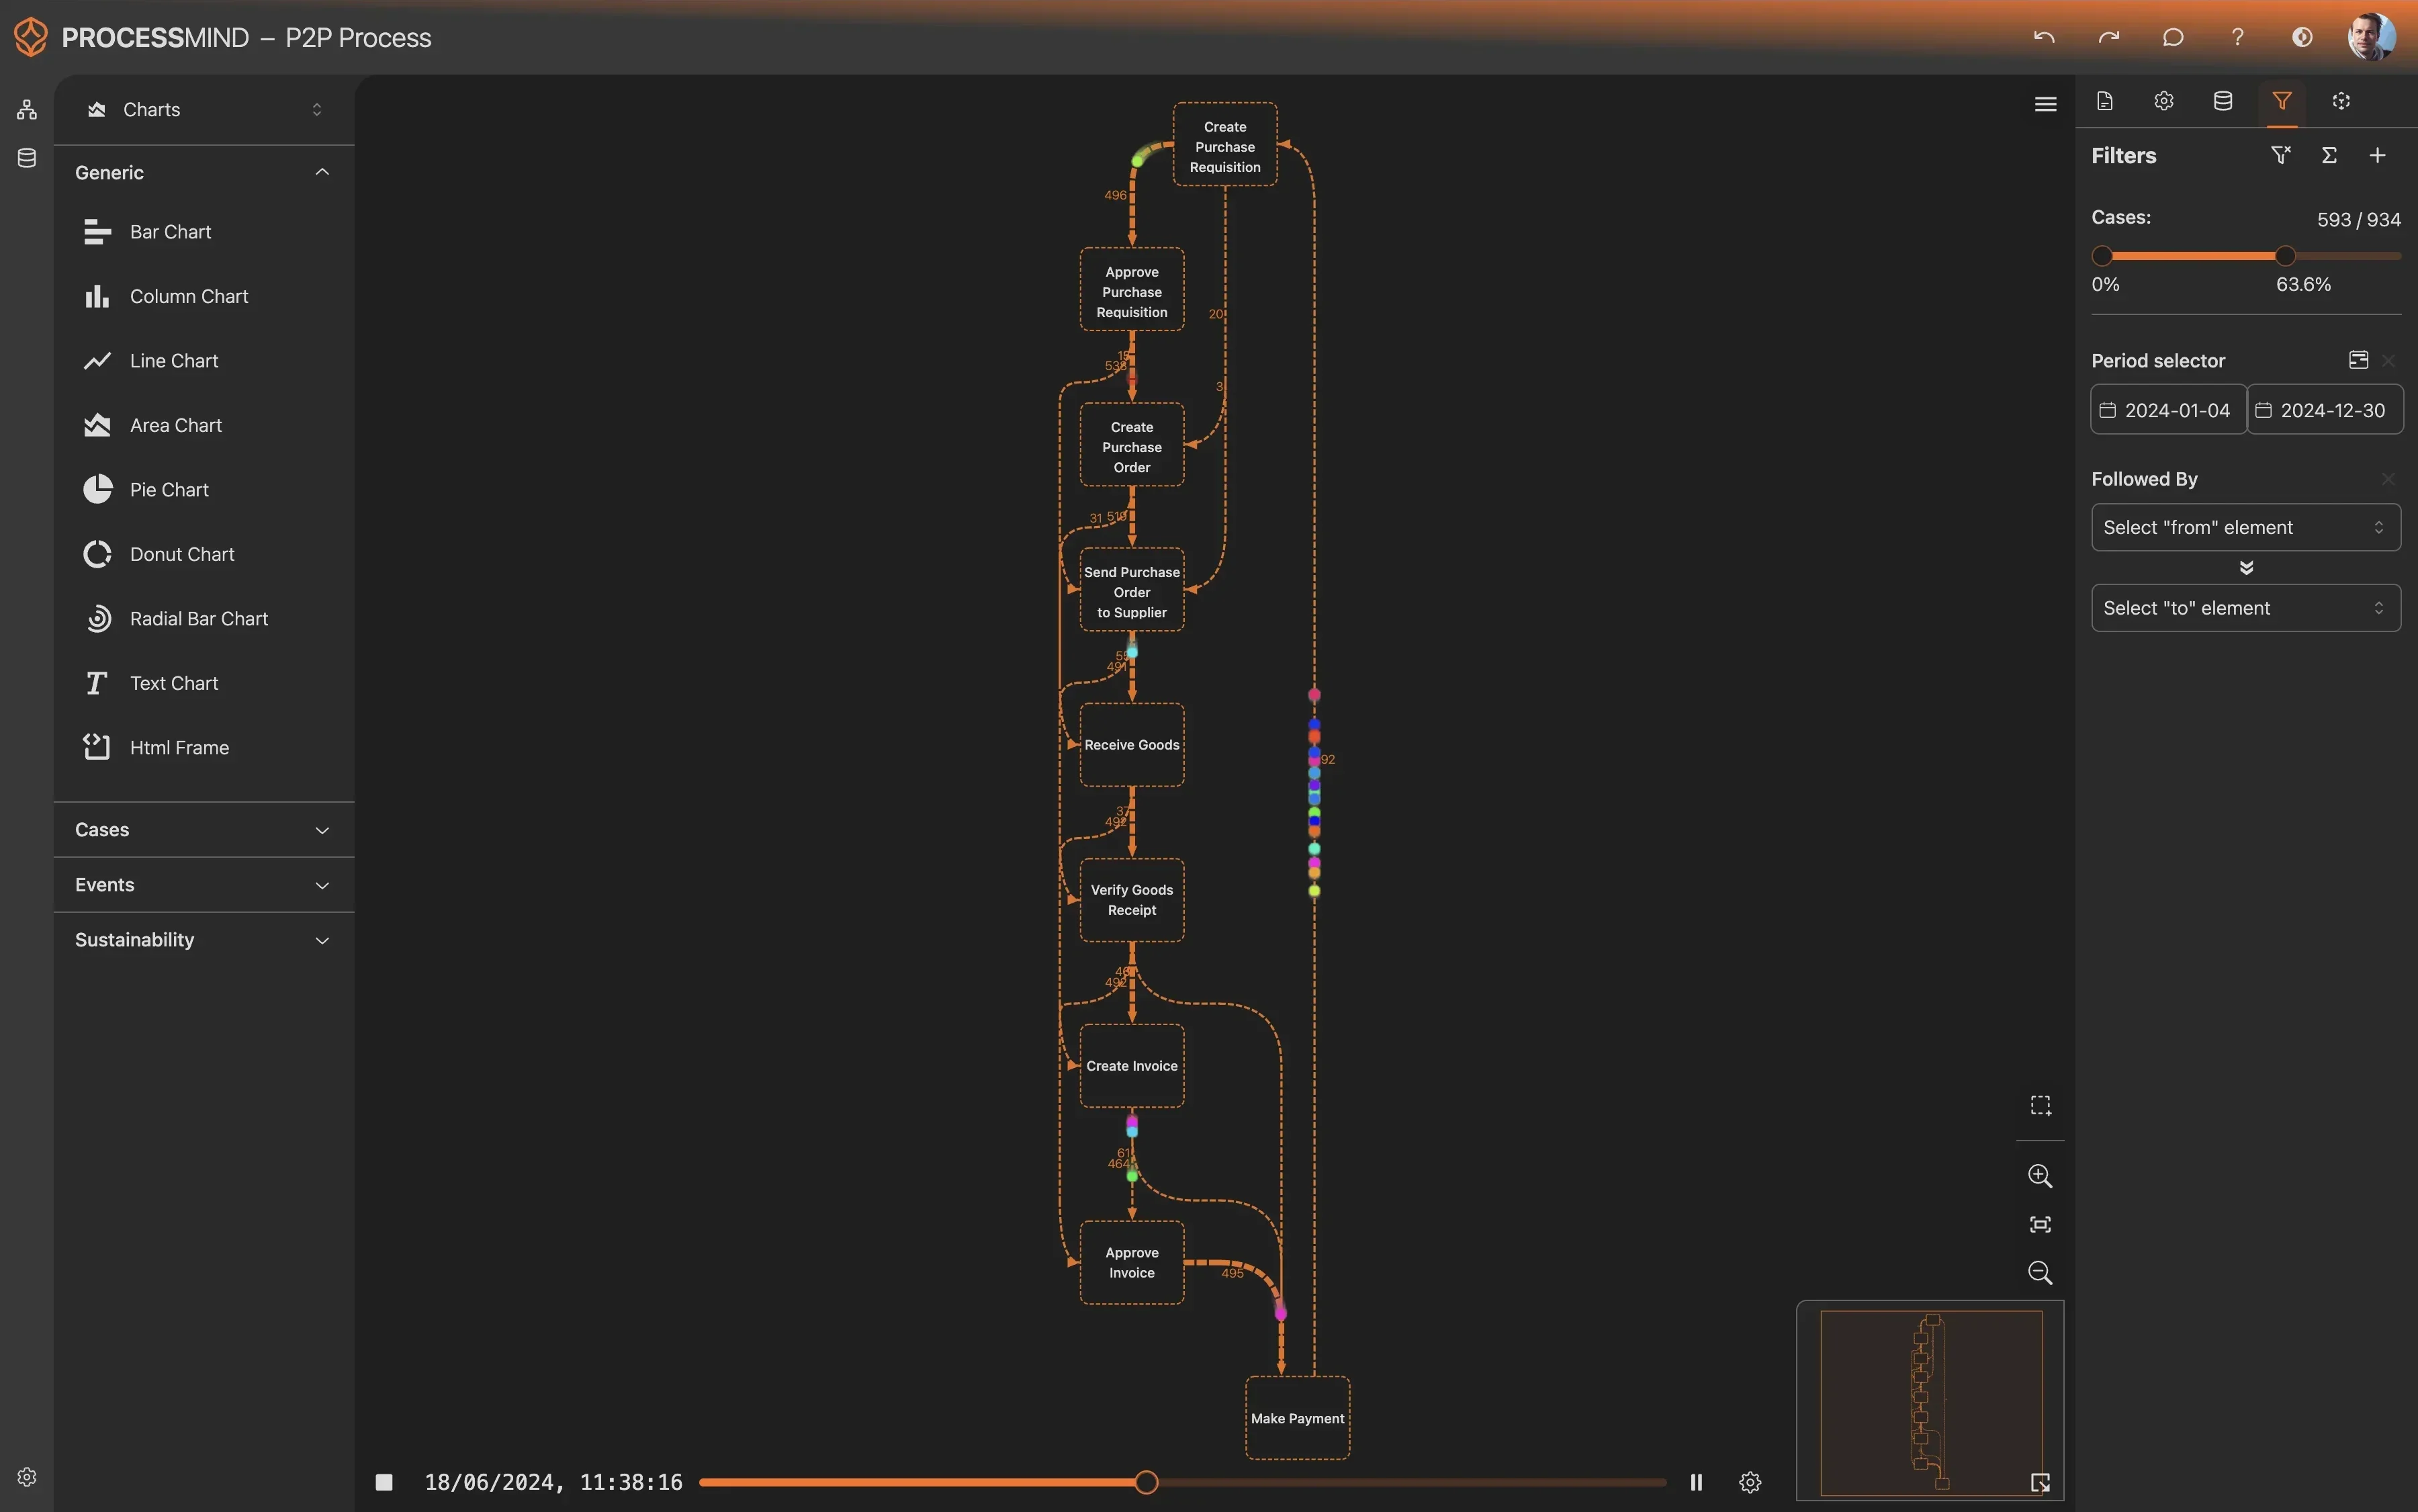
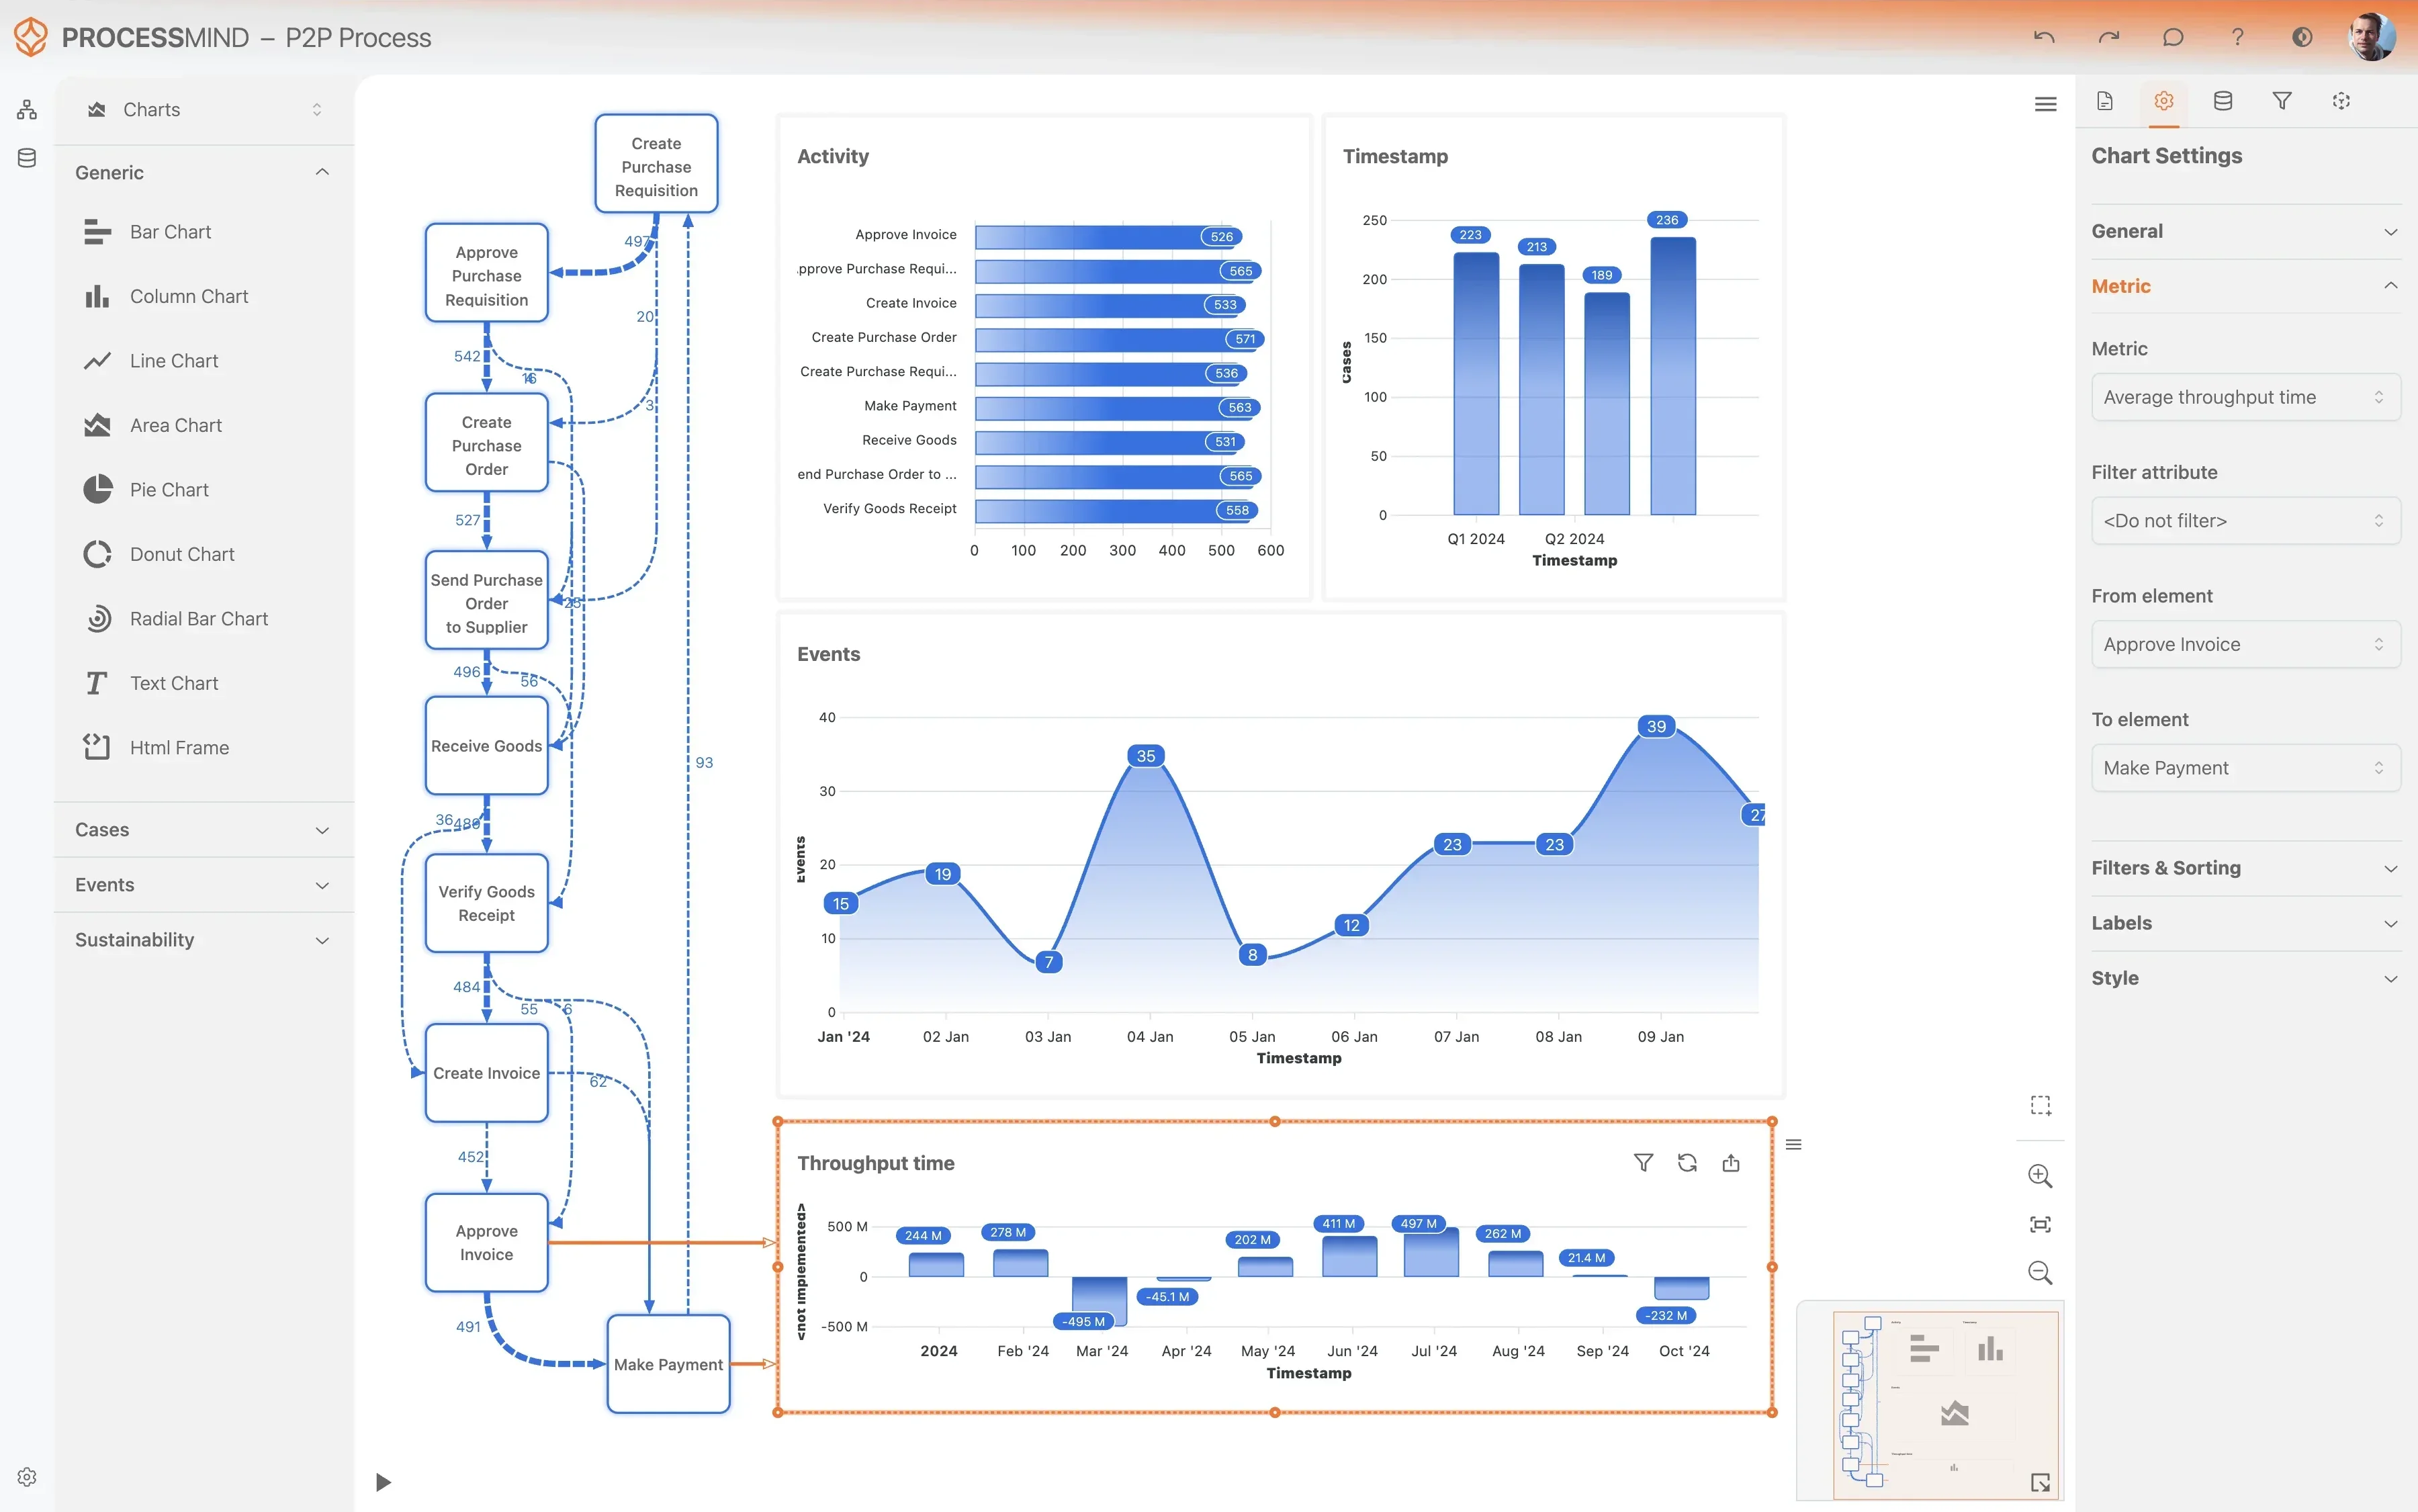
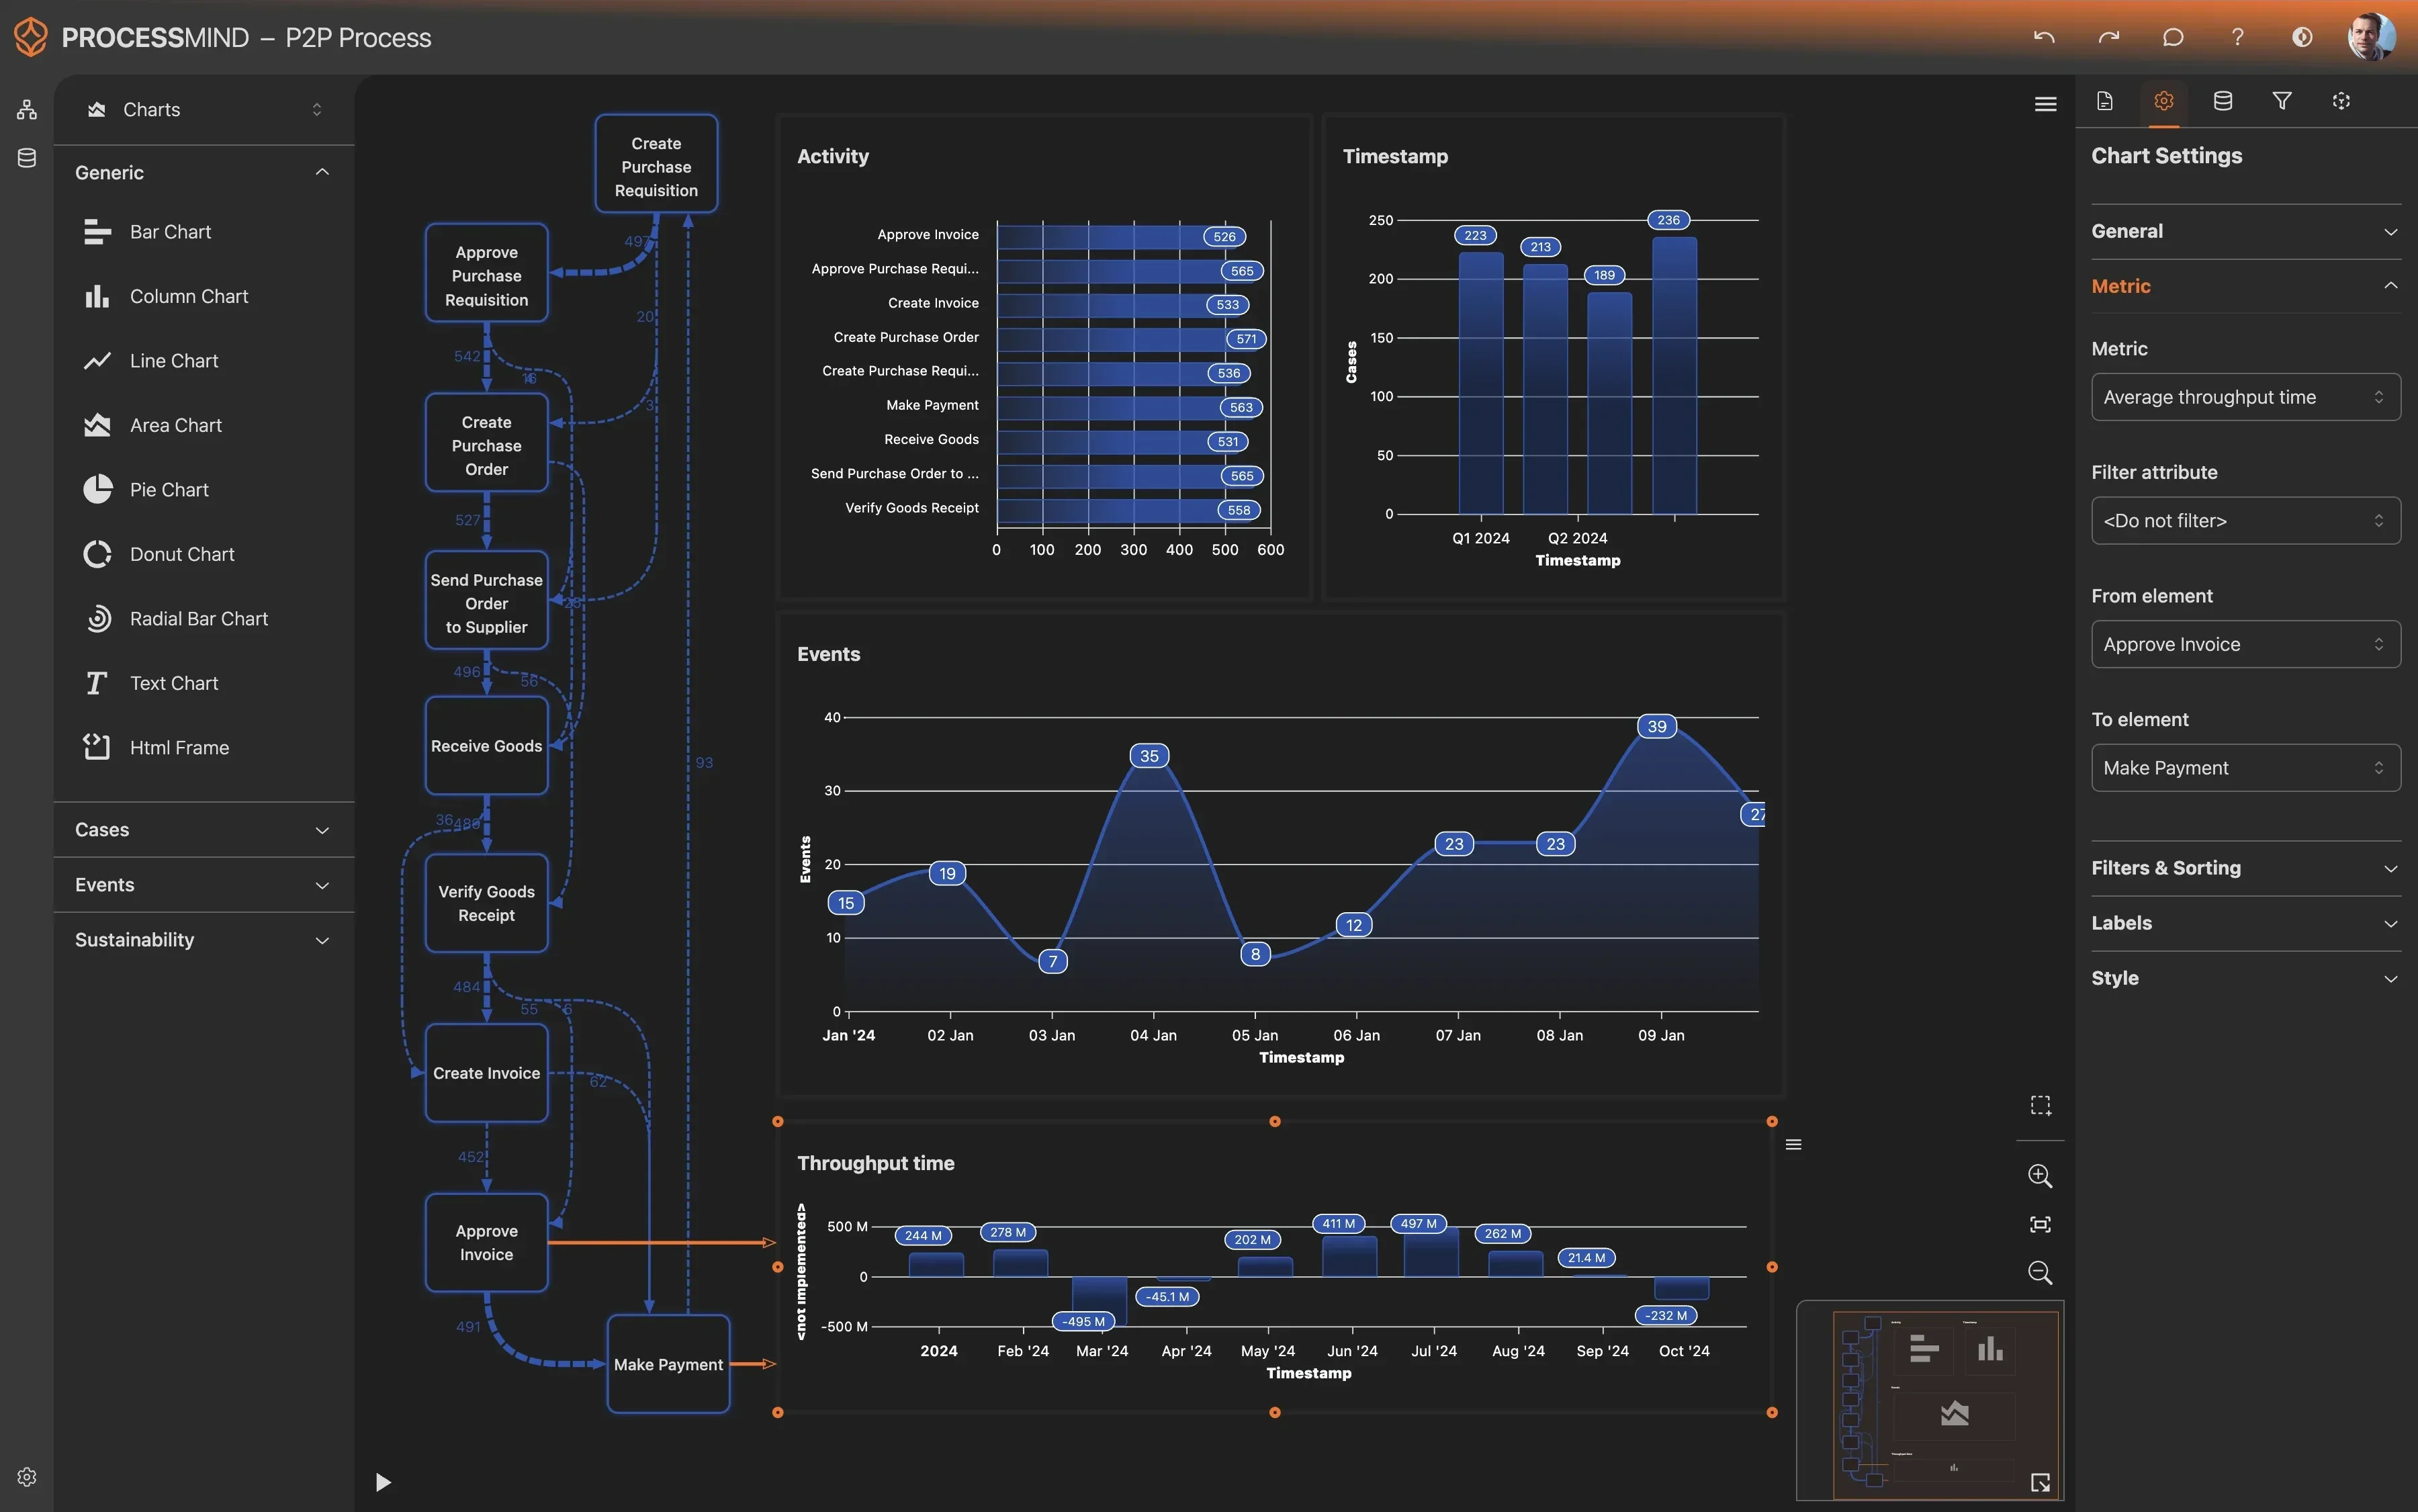
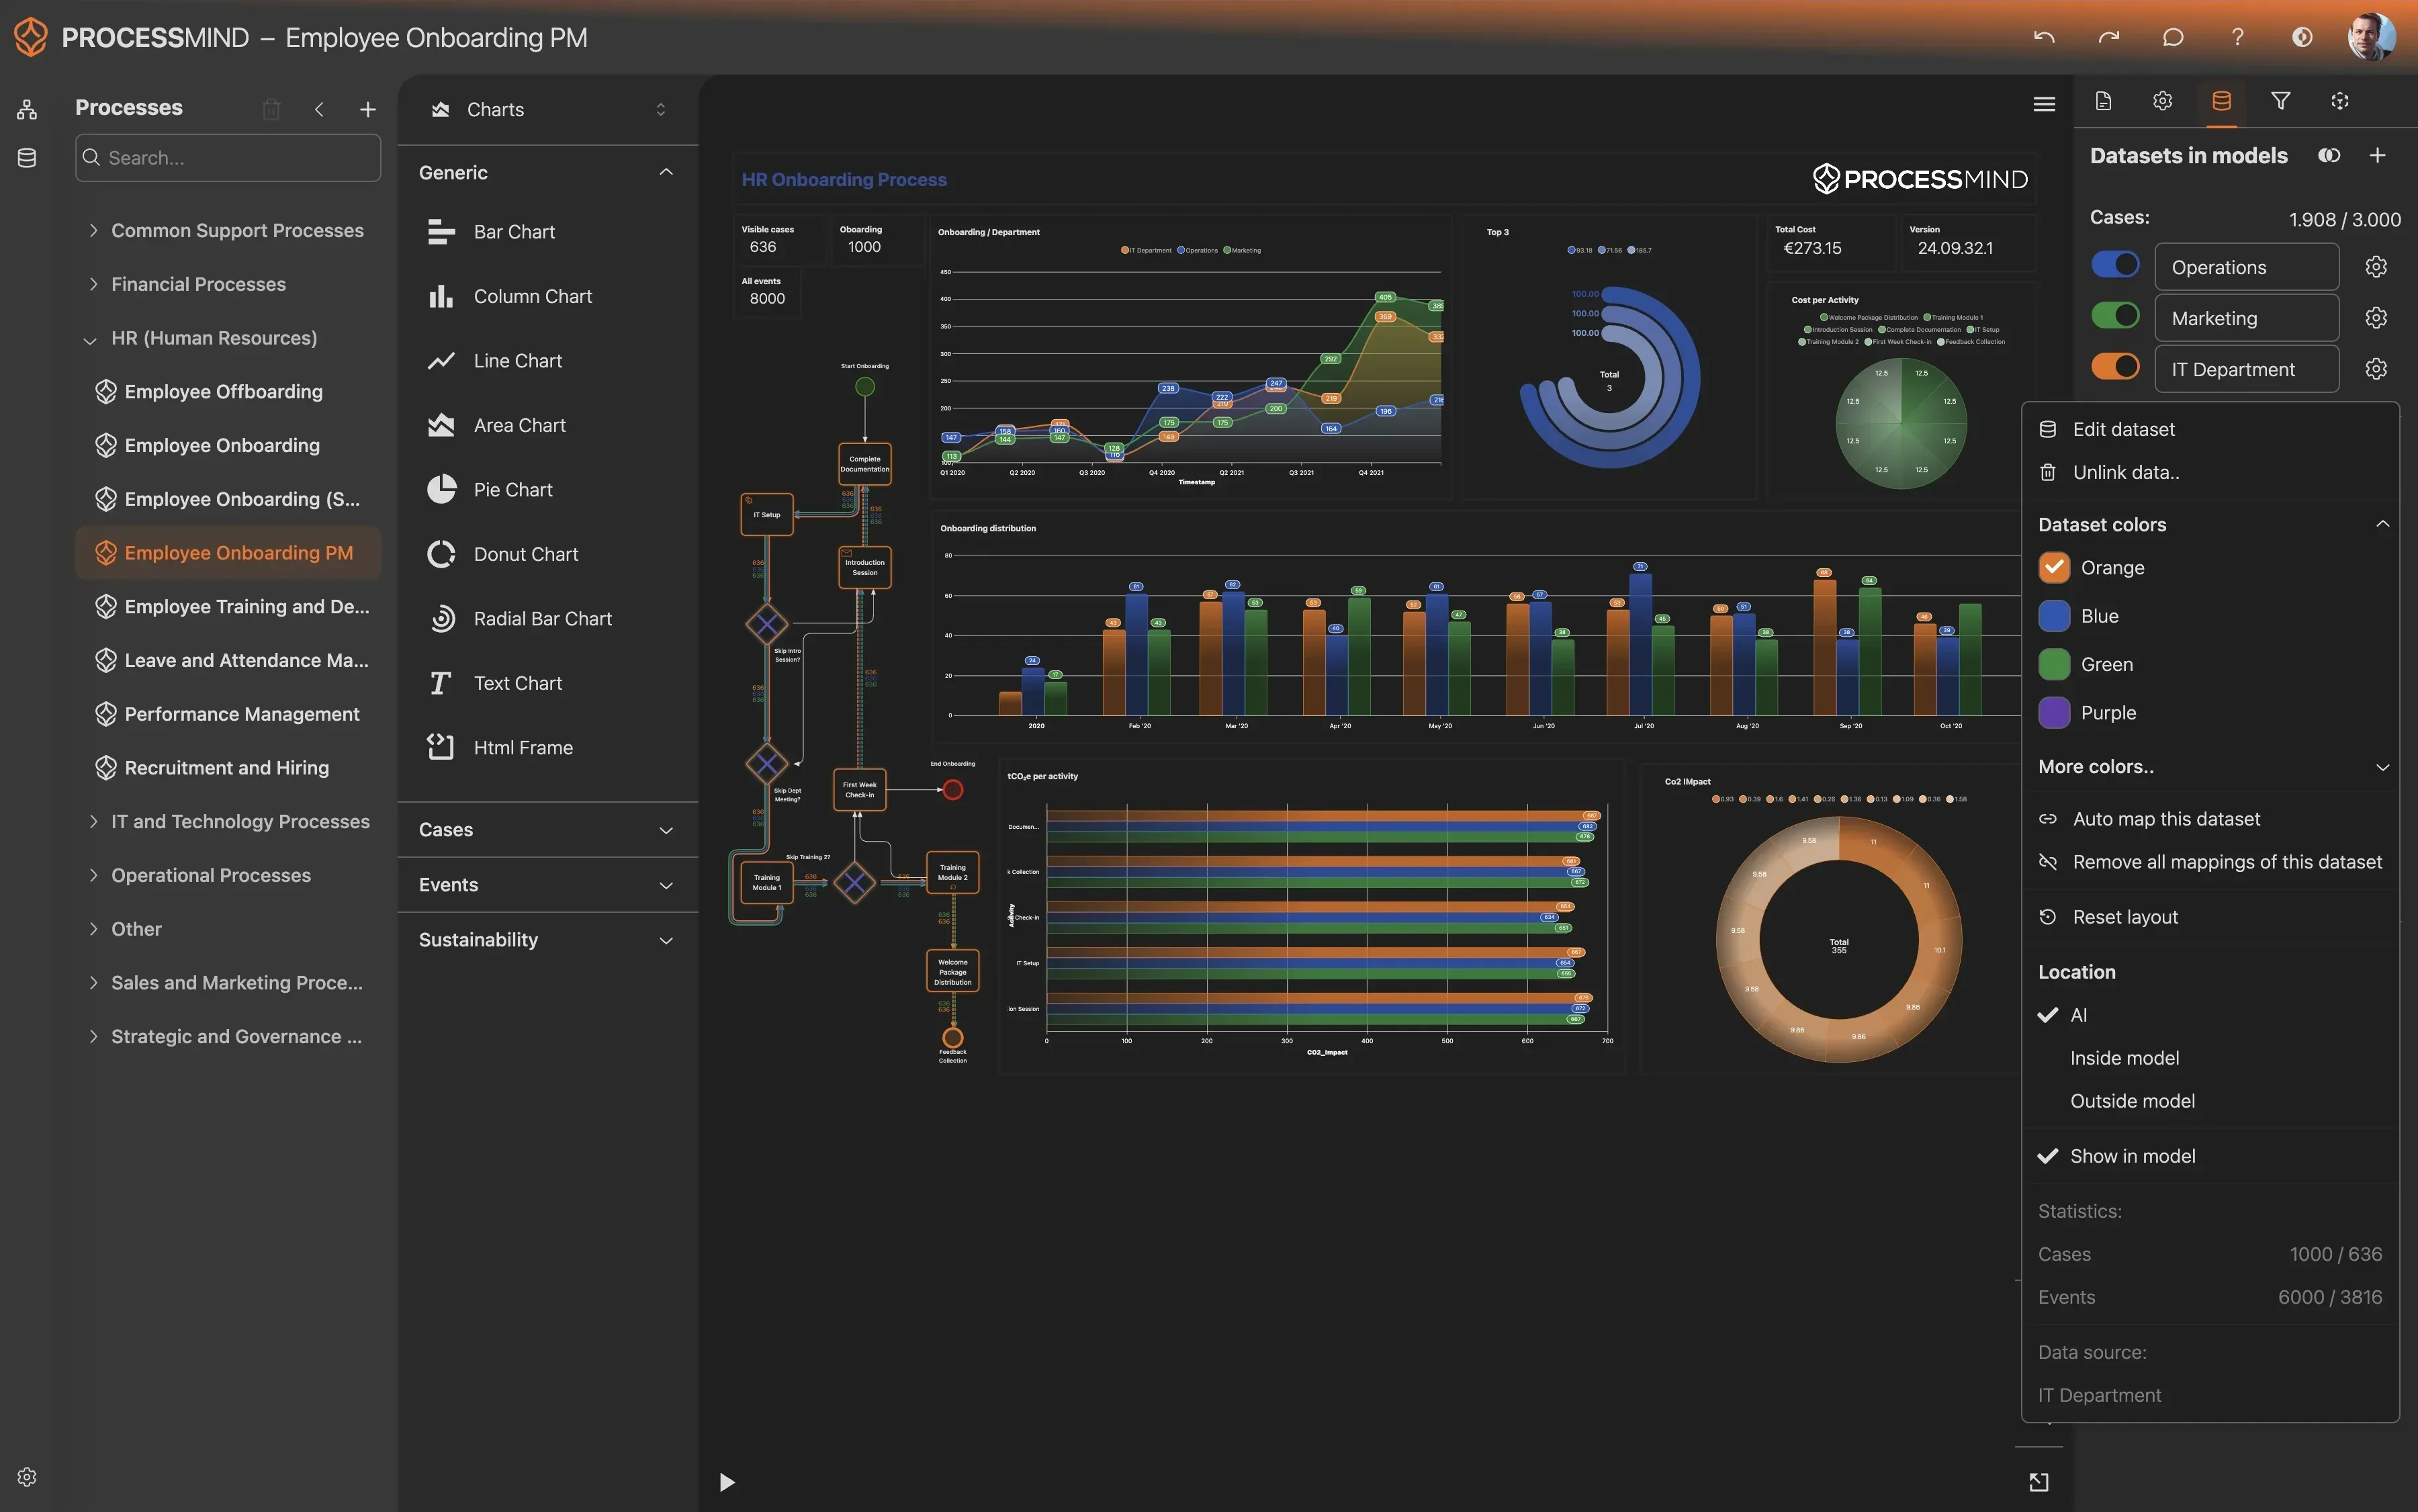
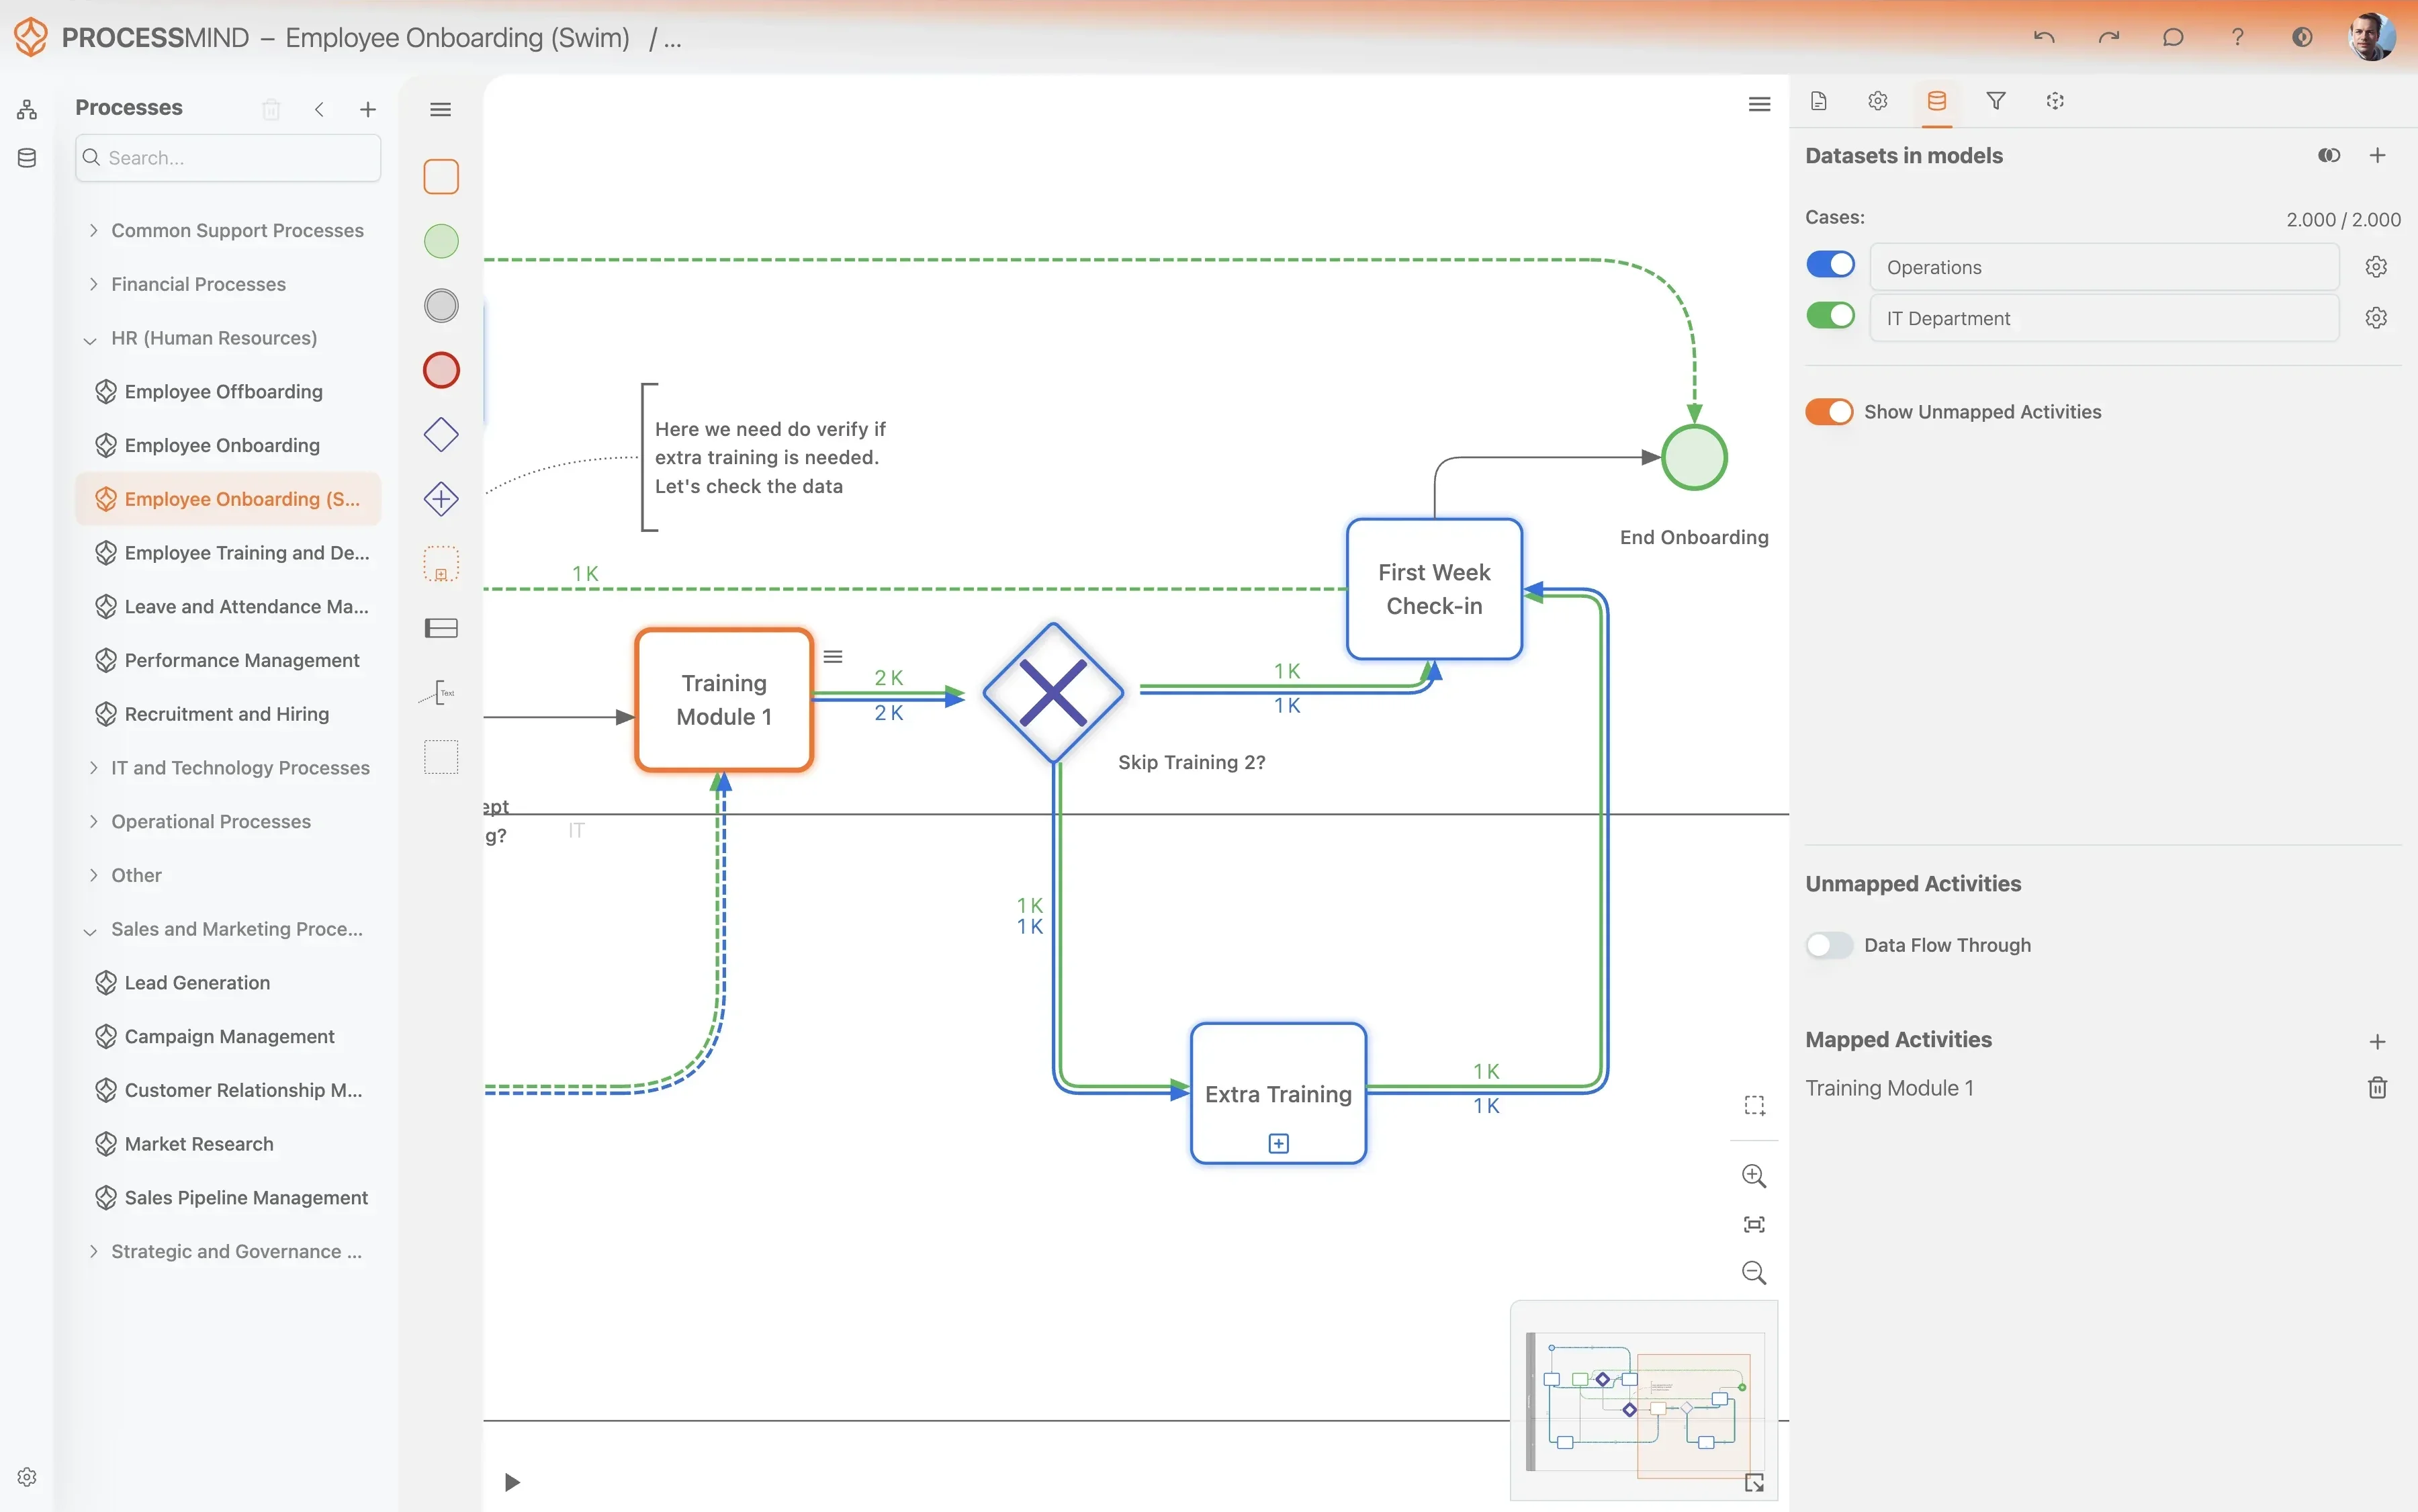
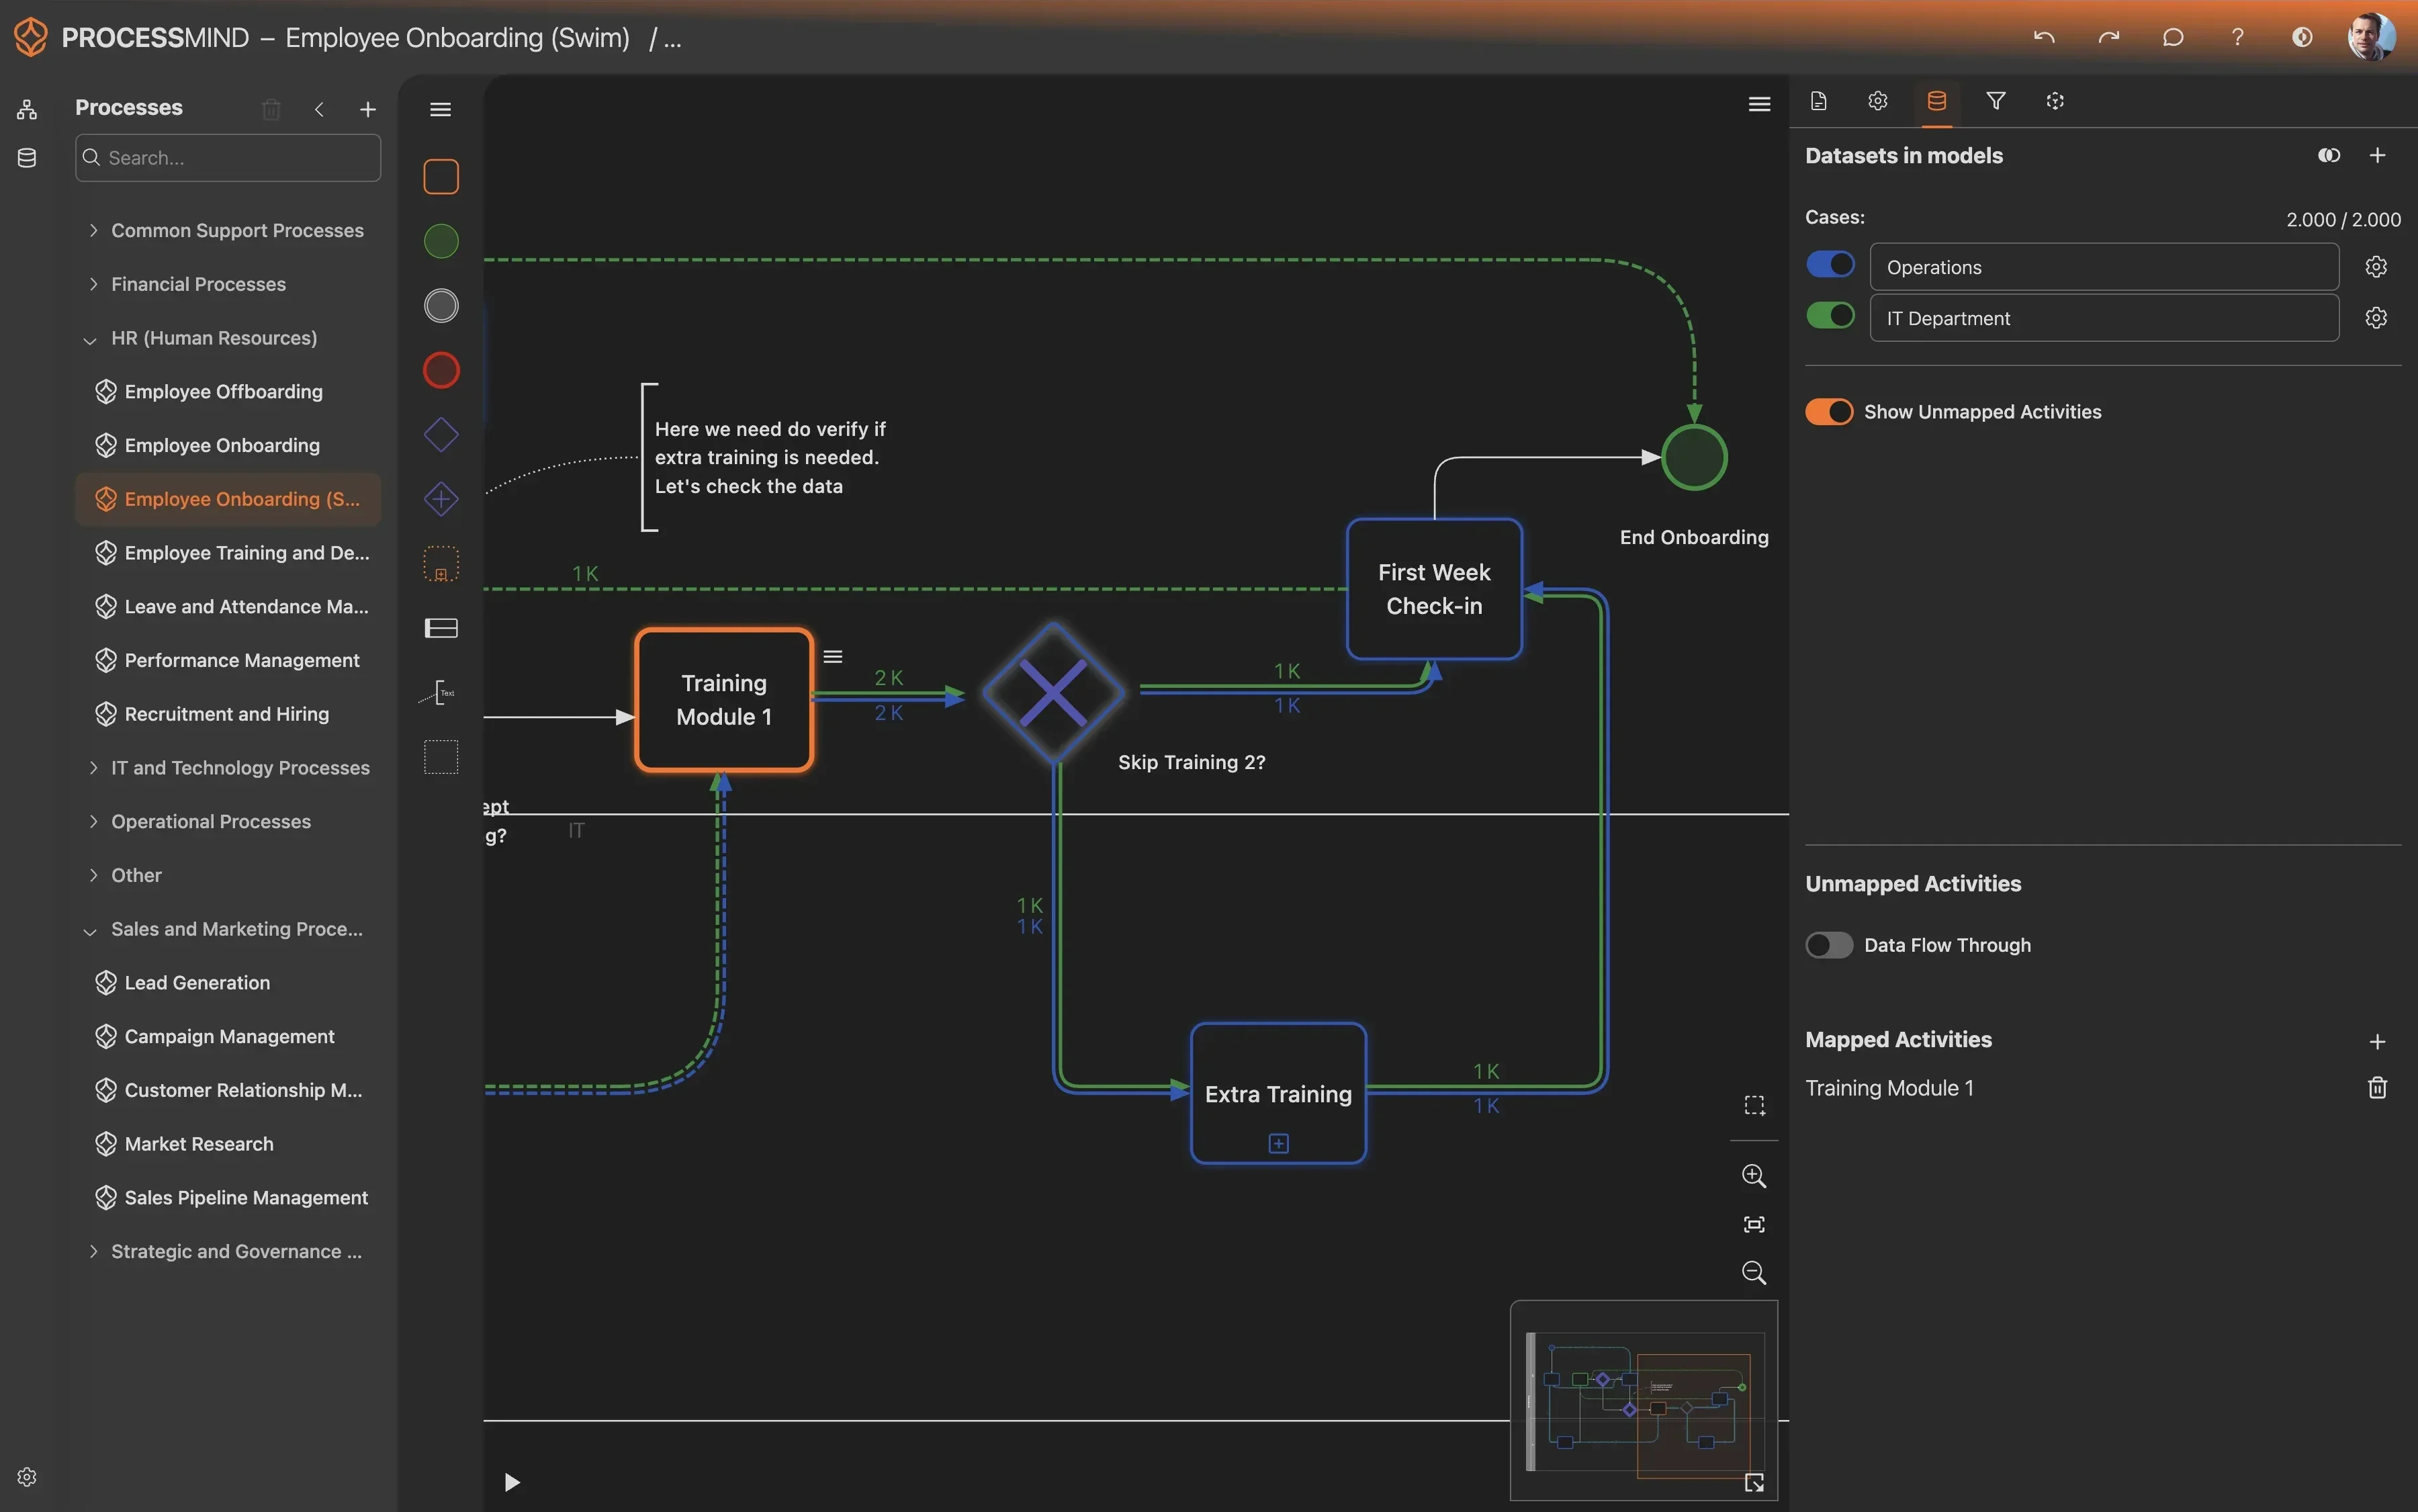
Ons process mining-platform brengt verborgen bottlenecks en herstelwerk aan het licht die de doorlooptijd van oplossingen verlengen. We laten zien waar onderzoeken vastlopen en waardoor communicatieproblemen ontstaan. Zo zie je waar processen efficiënter kunnen. Met een visualisatie van de werkelijke procesgang kun je handmatige vertragingen opsporen en zorgen voor een stabielere omgeving voor gebruikers.

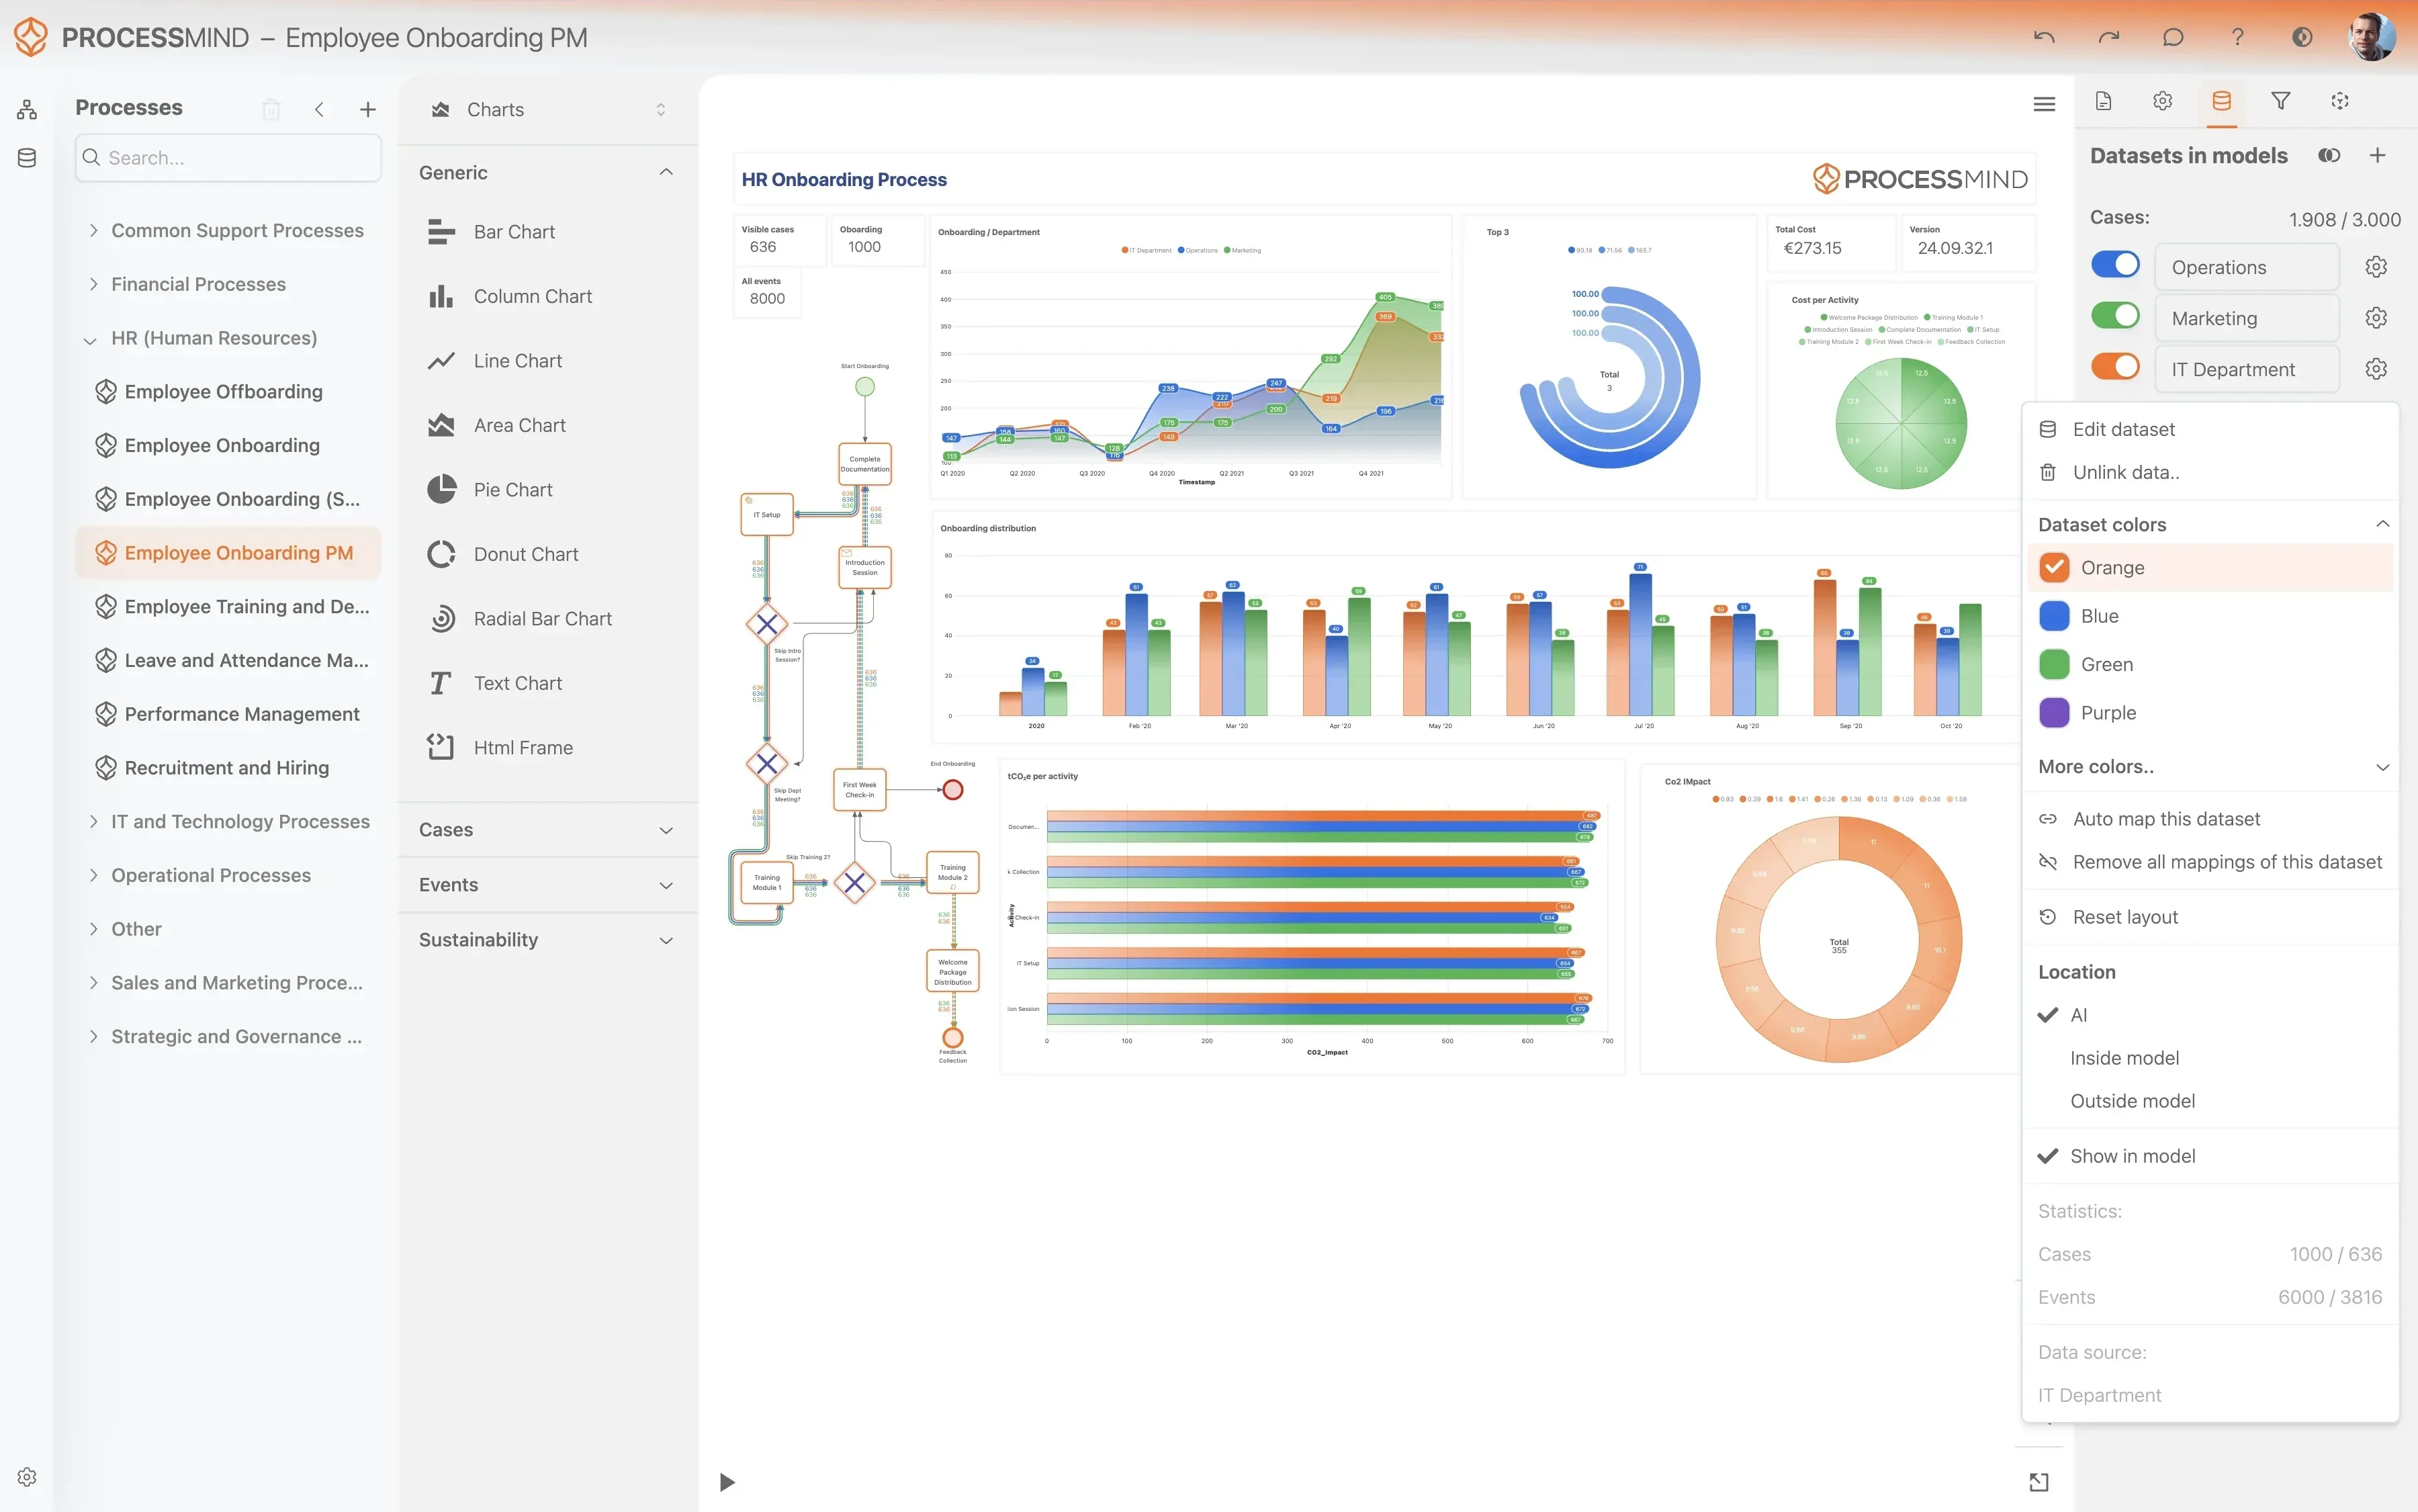
Download onze vooraf ingestelde datatemplate en pak veelvoorkomende uitdagingen aan om je efficiëntie-doelen te bereiken. Volg ons verbeterplan in zes stappen en raadpleeg de gids voor de datatemplate om je bedrijfsvoering te verbeteren.

Gedetailleerde beschrijving tonen

Waarom goed probleembeheer belangrijk is

IT-organisaties zijn vaak bezig met het oplossen van incidenten zodra die zich voordoen. Bij een groot incident ligt de nadruk eerst op het herstellen van de dienstverlening. De onderliggende oorzaak blijft echter vaak bestaan, waardoor storingen terugkeren en de bedrijfskosten oplopen. Goed probleembeheer doorbreekt deze cyclus. Door problemen in de IT-omgeving beter te herkennen, onderzoeken en op te lossen, kun je het aantal nieuwe incidenten flink terugdringen en de dienstverlening stabieler maken. Inefficiënt probleembeheer kost niet alleen tijd, maar schaadt ook het vertrouwen van gebruikers en houdt technische teams af van innovatiewerk.

Meer inzicht met process mining

ServiceNow-probleembeheer bevat veel data in tabellen zoals problem en problem_task. Standaardrapportages laten echter vaak niet zien hoe het werk werkelijk verloopt. Process mining zet deze data om in een dynamische kaart van de processen in de praktijk. In plaats van alleen statische KPI's te bekijken, zoals de gemiddelde ouderdom van openstaande problemen, kun je de volledige levenscyclus volgen: van het vaststellen van een probleem tot de afsluiting ervan. Zo zie je hoe werk tussen supportgroepen wordt overgedragen en waar het proces afwijkt van de standaardwerkwijze. De digitale sporen in ServiceNow geven een objectief beeld van de bedrijfsvoering, zonder de blik van één afdeling.

Inefficiënties in het onderzoeksproces opsporen

Een van de grootste uitdagingen in probleembeheer is de duur van de onderzoeksfase. Process mining laat zien waarom bepaalde onderzoeken vastlopen. Zo ontdek je misschien dat probleemrecords vaak tussen technische teams heen en weer worden gestuurd, omdat de eerste beoordeling niet grondig genoeg was. Ook kun je bottlenecks vinden waar records wekenlang op een wachtstatus blijven staan, bijvoorbeeld in afwachting van informatie van een leverancier of interne goedkeuring voor een wijziging. Met deze inzichten kun je gerichte verbeteringen doorvoeren, zoals betere afspraken over overdrachten of automatische escalaties, zodat een permanente oplossing sneller dichterbij komt.

Oorzaakanalyse en compliance verbeteren

Goed onderzoek vormt de basis van effectief probleembeheer. Met process mining kun je controleren of de oorzaakanalyse (RCA) steeds op dezelfde manier wordt uitgevoerd. Je ziet of belangrijke stappen worden overgeslagen of afgeraffeld, zoals het publiceren van een tijdelijke oplossing of het uitvoeren van een evaluatie na implementatie. Voor organisaties in sterk gereguleerde sectoren is het belangrijk dat elk probleemrecord volgens de regels wordt afgehandeld. Door ook de relatie tussen incidenten en problemen in ServiceNow te analyseren, zie je of teams problemen met grote gevolgen goed herkennen, of juist te veel tijd besteden aan onderzoeken met lage prioriteit en weinig bedrijfswaarde.

Resultaten meten en blijven verbeteren

Het doel van beter probleembeheer is een IT-infrastructuur die verstoringen beter opvangt. Process mining geeft je de details om de resultaten van verbeteringen in de loop van de tijd te meten. Volg bijvoorbeeld de verhouding tussen permanente en tijdelijke oplossingen en meet hoe lang probleemrecords in totaal openstaan. Door knelpunten in ServiceNow-workflows weg te nemen, kan het team incidenten beter voorkomen. Zo bespaar je niet alleen kosten, maar kan de IT-dienstverlening ook meegroeien met de behoeften van de organisatie. Met een process mining-template kun je meteen aan de slag en bestaande ServiceNow-data gebruiken om de bedrijfsvoering te verbeteren.

Probleembeheer Oorzaakanalyse IT-servicemanagement Incidentpreventie Servicedesk Technische ondersteuning IT-bedrijfsvoering Verandermanagement Ticketregistratie Ticketbeheer Bekende fout Terugkerende incidenten Tijdelijke oplossing IT-helpdesk

Veelvoorkomende problemen en uitdagingen

Bekijk welke uitdagingen voor jou spelen

Problemen blijven soms lange tijd op een wachtstatus staan terwijl teams wachten op feedback van leveranciers of aanvullende interne informatie. Daardoor loopt het onderzoek naar de grondoorzaak vertraging op, duurt het langer om problemen op te lossen en groeit de achterstand met technische problemen die de bedrijfsvoering blijven raken.

ProcessMind volgt statusovergangen in ServiceNow-probleembeheer en laat zien waar en waarom records vastlopen. Door de tijd per status in beeld te brengen, kun je precies zien welke supportgroepen of externe leveranciers het onderzoek vertragen.

Als probleemrecords niet efficiënt worden opgelost, blijven dezelfde incidenten terugkomen. Dat overbelast de servicedesk en frustreert eindgebruikers. Vaak betekent dit dat tijdelijke oplossingen niet goed worden gepubliceerd of de onderliggende oorzaak onvoldoende ondervangen totdat er een permanente oplossing is.

Door de koppeling tussen incidenten en probleemrecords in ServiceNow-probleembeheer te analyseren, vindt ProcessMind patronen die wijzen op mislukte of onvolledige onderzoeken. Zo kunnen teams voorrang geven aan problemen die de meeste incidenten en extra werk veroorzaken.

Als doelen voor het vaststellen van grondoorzaken niet worden gehaald, blijft de dienstverlening langer instabiel en neemt het vertrouwen in de IT-bedrijfsvoering af. Technische teams kunnen overbelast zijn of onvoldoende zicht hebben op de bedrijfsimpact om onderzoeken goed te prioriteren.

Ons platform meet in ServiceNow hoe lang het duurt vanaf de registratie van een probleem tot het vaststellen van de grondoorzaak. Het markeert records die de SLA-limiet naderen. Zo kunnen probleemcoördinatoren de inzet van mensen aanpassen en zorgen dat belangrijke onderzoeken op koers blijven.

Probleemrecords gaan vaak langs meerdere technische teams voordat het onderzoek echt begint. Dat heen-en-weer kost tijd, maakt onduidelijk wie verantwoordelijk is en vertraagt de oplossing, omdat geen enkele groep de verantwoordelijkheid voor de grondoorzaak op zich neemt.

ProcessMind brengt de toewijzingen tussen supportgroepen in kaart en laat zien waar overdrachten stroef verlopen en verantwoordelijkheden onduidelijk zijn. Door terugkerende overdrachtslussen in ServiceNow-probleembeheer op te sporen, kun je de eerste routering verbeteren en problemen sneller bij de juiste experts krijgen.

Zelfs nadat de grondoorzaak is vastgesteld, kan het lang duren voordat een wijzigingsverzoek wordt gestart om het probleem op te lossen. De organisatie blijft daardoor kwetsbaar voor nieuwe incidenten: de permanente oplossing is bekend, maar nog niet ingepland of uitgevoerd.

We volgen de overdracht tussen ServiceNow-probleembeheer en de module Change Management. Door de tijd te meten tussen het vaststellen van de grondoorzaak en het opstellen van een oplossingsvoorstel, helpt ProcessMind de stap naar een permanente oplossing te verkorten en wijzigingen zonder onnodige vertraging naar productie te brengen.

Veel organisaties sluiten probleemrecords zonder na het doorvoeren van een oplossing een goede evaluatie uit te voeren. Daardoor blijven waardevolle lessen onbenut en wordt niet formeel gecontroleerd of de grondoorzaak echt is weggenomen. Dat kan later opnieuw tot problemen leiden.

ProcessMind laat zien wanneer cases rechtstreeks van oplossing naar afsluiting gaan en de verplichte evaluatie overslaan. Zo kunnen teams de volledige levenscyclus van ServiceNow-probleembeheer volgen, de dienstverlening stabieler maken en kennis beter delen binnen de IT-organisatie.

Als tijdelijke oplossingen niet worden vastgelegd en gepubliceerd in de database met bekende fouten, kunnen servicedeskmedewerkers gebruikers niet goed helpen zolang een probleem nog wordt onderzocht. Dat leidt tot dubbel werk, meer telefoontjes en een langere gemiddelde oplostijd voor alle gerelateerde incidenten.

Door activiteiten rond het publiceren van tijdelijke oplossingen te analyseren, laat ProcessMind zien bij welke onderzoeken een tijdelijke oplossing voor de organisatie ontbreekt. Dit inzicht helpt managers om de documentatieafspraken in de ServiceNow-workflow voor probleembeheer te bewaken en de servicedesk efficiënter te laten werken.

Technische teams richten zich soms op taken met lage prioriteit, terwijl problemen met grote gevolgen voor belangrijke bedrijfsdiensten in de achterstand blijven staan. Die verkeerde verdeling leidt tot verstoringen en levert weinig op voor de tijd die dure technische specialisten erin steken.

Onze analyse vergelijkt de prioriteit van problemen met de tijd en inspanning die nodig zijn om ze op te lossen. ProcessMind laat zien of de belangrijkste ServiceNow-records voldoende aandacht krijgen of opzij worden geschoven voor minder urgente, eenvoudigere taken.

De stap van het vaststellen van een grondoorzaak naar het voorstellen van een concrete technische oplossing loopt vaak vast. Dat komt geregeld door beperkte capaciteit of gebrekkige documentatie tijdens het onderzoek. Architecten hebben daardoor moeite om een passende oplossing te ontwerpen.

ProcessMind brengt de levenscyclus van afzonderlijke probleemrecords in beeld en laat zien waar het ontwerpen van een oplossing vastloopt. Door deze vertragingen in ServiceNow-probleembeheer op te sporen, kun je de samenwerking tussen architecten en engineers verbeteren en sneller van analyse naar een praktische oplossing gaan.

Probleemrecords blijven vaak voor onbepaalde tijd openstaan zonder dat er actief onderzoek naar wordt gedaan. Zo ontstaat een rommelige, onbeheersbare achterstand. Deze verlaten records verhullen echte problemen en maken het voor IT-leidinggevenden lastig om de werkelijke stabiliteit van de bedrijfsvoering en de prestaties van teams te beoordelen.

We signaleren records met lange perioden zonder activiteit tussen statuswijzigingen in ServiceNow Problem Management. ProcessMind helpt je de achterstand op te schonen door onderzoeken te markeren die stilliggen en officieel moeten worden afgesloten of met nieuwe bronnen weer op gang moeten worden gebracht.

Als teams generieke of onjuiste categorieën voor hoofdoorzaken gebruiken, zijn langetermijntrends en structurele problemen in de infrastructuur niet meer te herkennen. Door deze gebrekkige datakwaliteit kan de organisatie geen goed onderbouwde investeringsbeslissingen nemen om toekomstige uitval te voorkomen.

ProcessMind analyseert het verband tussen de uiteindelijke oplossing en de categorieën die in ServiceNow Problem Management zijn toegewezen. Zo herken je patronen van onjuist categoriegebruik en kun je de datakwaliteit verbeteren en beter zien waar de technische schuld vooral ontstaat.

Als het te lang duurt om een tijdelijke oplossing te vinden, kunnen gebruikers niet werken en neemt de impact van het probleem toe. Begint het onderzoek traag, dan ondervindt de bedrijfsvoering langer dan nodig hinder, ook als er uiteindelijk een permanente oplossing komt.

Ons platform meet de tijd tussen het vaststellen van een probleem en het publiceren van de eerste tijdelijke oplossing. Door dit deel van het ServiceNow Problem Management-proces te analyseren, zie je welke teams moeite hebben om snel verlichting te bieden. Zo kun je gericht trainen in het beperken van de impact van incidenten.

Veelvoorkomende doelen

Bepaal hoe succes eruitziet

Een snellere oorzaakanalyse voorkomt terugkerende incidenten en beperkt de uitval van de infrastructuur. Als de onderzoeksfase sneller verloopt, kunnen technische teams stoppen met steeds dezelfde brandjes blussen en zich richten op permanente oplossingen die de betrouwbaarheid van de dienstverlening verbeteren. Dit maakt senior engineers efficiënter inzetbaar en verkort de tijd waarin kritieke kwetsbaarheden onopgelost blijven.

ProcessMind brengt het volledige onderzoeksproces in ServiceNow Problem Management in beeld, zodat je precies ziet waar teams vastlopen. Door bottlenecks in specifieke supportgroepen of technische domeinen aan te wijzen, geeft het platform concrete aanknopingspunten om de onderzoekstijd met maximaal 30 procent te verkorten. Volg het traject van probleemidentificatie tot het vaststellen van de hoofdoorzaak en zie of elk onderzoek op koers ligt.

Elke overdracht tussen supportgroepen verlengt de totale oplostijd en zorgt voor extra administratief werk. Minder overdrachten betekent dat de juiste experts meteen aan de slag kunnen. Zo voorkom je dat records heen en weer worden gestuurd doordat onduidelijk is wie verantwoordelijk is. Minder herverdelingen maken het proces eenvoudiger en vergroten de verantwoordelijkheid van technische teams.

Ons platform volgt de geschiedenis van het attribuut voor de toegewezen supportgroep bij elk probleemrecord in ServiceNow. ProcessMind brengt patronen aan het licht waarbij records verkeerd worden gerouteerd of vaak tussen teams heen en weer gaan. Zo kun je routeringsregels voor groepen verbeteren en onnodige herverdelingen halveren. Het onderzoek kan dan zonder vertraging door overdrachten verdergaan.

Onderzoekstermijnen halen is belangrijk voor het serviceniveau en de stabiliteit van de IT-bedrijfsvoering. Consequente naleving voorkomt dat problemen met hoge prioriteit blijven liggen en beschermt de organisatie tegen bekende risico’s. Als teams hun serviceniveaudoelen steeds halen, weten belanghebbenden waar ze aan toe zijn en blijft de dienstverlening voorspelbaar.

ProcessMind vergelijkt de werkelijke prestaties realtime met de SLA-doelen door de tabellen met problemen en probleemtaken te analyseren. Je ziet in welke processtappen SLA-overschrijdingen het vaakst voorkomen, zodat teams bij alle prioriteitsniveaus een naleving van meer dan 95 procent kunnen behouden. Bekijk welke categorieën of diensten het risico lopen achter te raken en grijp in voordat een SLA wordt overschreden.

Een tijdelijke oplossing beperkt de impact van een actief probleem op eindgebruikers en de Servicedesk. Supportmedewerkers kunnen incidenten ermee afhandelen voordat er een permanente oplossing is. Dat vermindert het aantal openstaande tickets en verhoogt de tevredenheid van gebruikers. Bij een grote storing is een tijdelijke oplossing vaak de effectiefste manier om de directe impact te beperken.

We analyseren de tijd tussen het vaststellen van een probleem en het publiceren van een tijdelijke oplossing in de database met bekende fouten. Met de inzichten van ProcessMind kun je deze belangrijke stap standaardiseren, zodat documentatie over bekende fouten 40 procent sneller beschikbaar is. Zo kun je teams aanspreken op het snel delen van tijdelijke oplossingen terwijl de hoofdoorzaak wordt onderzocht.

Een goede overdracht van een probleemrecord naar een wijzigingsverzoek is belangrijk om permanente oplossingen gecontroleerd door te voeren. Vertraging in deze overgang betekent dat vastgestelde kwetsbaarheden langer dan nodig in de productieomgeving blijven bestaan. Een goede aansluiting tussen beide processen zorgt ervoor dat onderzoek ook daadwerkelijk tot herstel leidt.

Door de digitale sporen tussen de tabellen voor problemen en wijzigingsverzoeken in ServiceNow in kaart te brengen, zien we waar de goedkeuring en overdracht vertraging oplopen. Zo verklein je de afstand tussen het vaststellen van de hoofdoorzaak en het starten van een oplossing en voorkom je onnodig wachten op administratieve afhandeling. Je ziet precies waar voorgestelde oplossingen vastlopen tijdens het opstellen of goedkeuren.

Het succes van een team voor probleembeheer blijkt uiteindelijk uit een afname van terugkerende incidenten. Door hoofdoorzaken vast te stellen en op te lossen, verlaag je de totale eigendomskosten van IT-diensten en neemt de dagelijkse druk op de Servicedesk af. Als incidenten niet terugkeren, ziet de rest van de organisatie wat probleembeheer oplevert.

ProcessMind koppelt het aantal incidenten aan specifieke probleemrecords om te beoordelen hoe effectief permanente oplossingen op de lange termijn zijn. Zo controleer je of oplossingen de hoofdoorzaak echt wegnemen, in plaats van alleen de symptomen te behandelen. Volg het succespercentage van doorgevoerde wijzigingen en controleer of het aantal incidenten daardoor afneemt zoals verwacht.

Verouderde en verlaten records maken de ServiceNow-omgeving onoverzichtelijk en verhullen de actuele prioriteiten van technische teams. Door de achterstand op te schonen, kunnen schaarse bronnen naar de belangrijkste actuele problemen gaan. Een actuele wachtrij met problemen geeft leidinggevenden beter zicht op de situatie en maakt het dagelijkse werk van probleemcoördinatoren beter beheersbaar.

We markeren records die al langere tijd inactief zijn of stilliggen, zonder statuswijzigingen of andere activiteit. Zo kunnen teams verlaten onderzoeken verwijderen en zich richten op actieve herstelwerkzaamheden. Met een vaste aanpak voor het opschonen van records blijft de wachtrij voor probleembeheer beperkt en gericht op onderzoeken die ertoe doen.

Een juiste classificatie van hoofdoorzaken is belangrijk voor trendanalyse op de lange termijn en voor het verbeteren van de dienstverlening. Zo ziet IT-leiding waar technische schuld ontstaat en waar investeringen in de infrastructuur het hardst nodig zijn. Met data van goede kwaliteit kan de organisatie leren van eerdere problemen en vergelijkbare problemen elders voorkomen.

ProcessMind brengt verschillen aan het licht in de manier waarop supportgroepen hoofdoorzaken registreren en classificeren. Door patronen van verkeerde classificaties en overmatig gebruik van generieke categorieën te herkennen, kun je de kwaliteit van operationele data verbeteren. Dat levert betrouwbaardere rapportages en betere beslissingen op voor een stabiele dienstverlening op de lange termijn.

Leren van eerdere problemen is de enige manier om herhaling te voorkomen en de levenscyclus van IT-diensten steeds te verbeteren. Met evaluaties na implementatie kijkt het team terug op het onderzoek en de oplossing om te bepalen waar het efficiënter kan. Deze formele evaluatie is belangrijk om probleembeheer verder te ontwikkelen en een cultuur van continu leren op te bouwen.

We volgen hoe vaak activiteiten na de oplossing van een probleem worden afgerond en hoeveel tijd ze kosten. Zo eindigt elk belangrijk probleemrecord met een gecontroleerde analyse van de procesprestaties. ProcessMind laat zien of deze evaluaties consequent plaatsvinden en of ze na verloop van tijd tot meetbare procesverbeteringen leiden.

Problemen met hoge prioriteit vragen om directe aandacht van de meest ervaren medewerkers, zodat de impact op de bedrijfsvoering beperkt blijft. Door de beste mensen aan de belangrijkste problemen te koppelen, blijft de IT-omgeving stabieler. Als bronnen goed worden verdeeld, kan de organisatie grote incidenten aanpakken zonder het belangrijke werk aan oorzaakanalyses te verwaarlozen.

ProcessMind analyseert de doorvoer van het proces op basis van de prioriteit en toegewezen groep in ServiceNow. Zo kun je de werklast opnieuw verdelen en voorkomen dat kritieke onderzoeken in dezelfde wachtrij belanden als taken met weinig impact. Bekijk de capaciteit van supportgroepen en pas de toewijzingen aan, zodat de belangrijkste problemen de aandacht krijgen die ze nodig hebben.

Problemen liggen vaak stil terwijl teams wachten op informatie van leveranciers, feedback van gebruikers of gegevens van derden. Daardoor blijft het risico langer bestaan. Door deze wachttijd te verkorten, neemt de totale oplostijd af en brengen externe afhankelijkheden de interne SLA’s minder snel in gevaar. Goed beheer van statussen in afwachting is belangrijk om het probleemproces op gang te houden.

We berekenen precies hoeveel tijd verloren gaat in wachtstatussen door de statusgeschiedenis van probleemrecords te analyseren. Door deze vertragingen zichtbaar te maken, zie je welke leveranciers of externe teams de meeste vertraging veroorzaken. Met deze data kun je afspraken met leveranciers herzien of interne opvolgprocedures verbeteren, zodat het proces verdergaat.

Zodra de hoofdoorzaak bekend is, moet de voorgestelde oplossing snel worden vastgelegd en beoordeeld om de uitvoering te starten. Vertraging in deze fase stelt de oplossing uit en laat de organisatie kwetsbaar voor hetzelfde probleem. Een vlot proces voor het opstellen en goedkeuren zorgt ervoor dat de stap van plan naar uitvoering zo weinig mogelijk tijd kost.

ProcessMind volgt de doorlooptijd van de stappen voor het opstellen en goedkeuren in de ServiceNow-workflow. Zo zie je waar bureaucratische obstakels zitten en waar een voorgestelde oplossing onredelijk lang blijft liggen. Je kunt de interne beoordeling vereenvoudigen en met minder stappen van onderzoek naar herstel gaan.

ServiceNow Problem Management verbeteren in 6 stappen

1

Download de template

Wat je moet doen

Download de Excel-template voor ServiceNow Problem Management. Zo sluit de datamapping aan op de ITIL-standaarden en ServiceNow-tabellen.

Waarom dit belangrijk is

Met een vaste structuur voorkom je problemen met de datakwaliteit en zorg je dat probleemrecords en taken klaar zijn voor process mining.

Verwacht resultaat

Een gestandaardiseerde datatemplate, klaar voor je ServiceNow-export.

PROCESINZICHTEN

Krijg volledig zicht op onderzoeken naar problemen

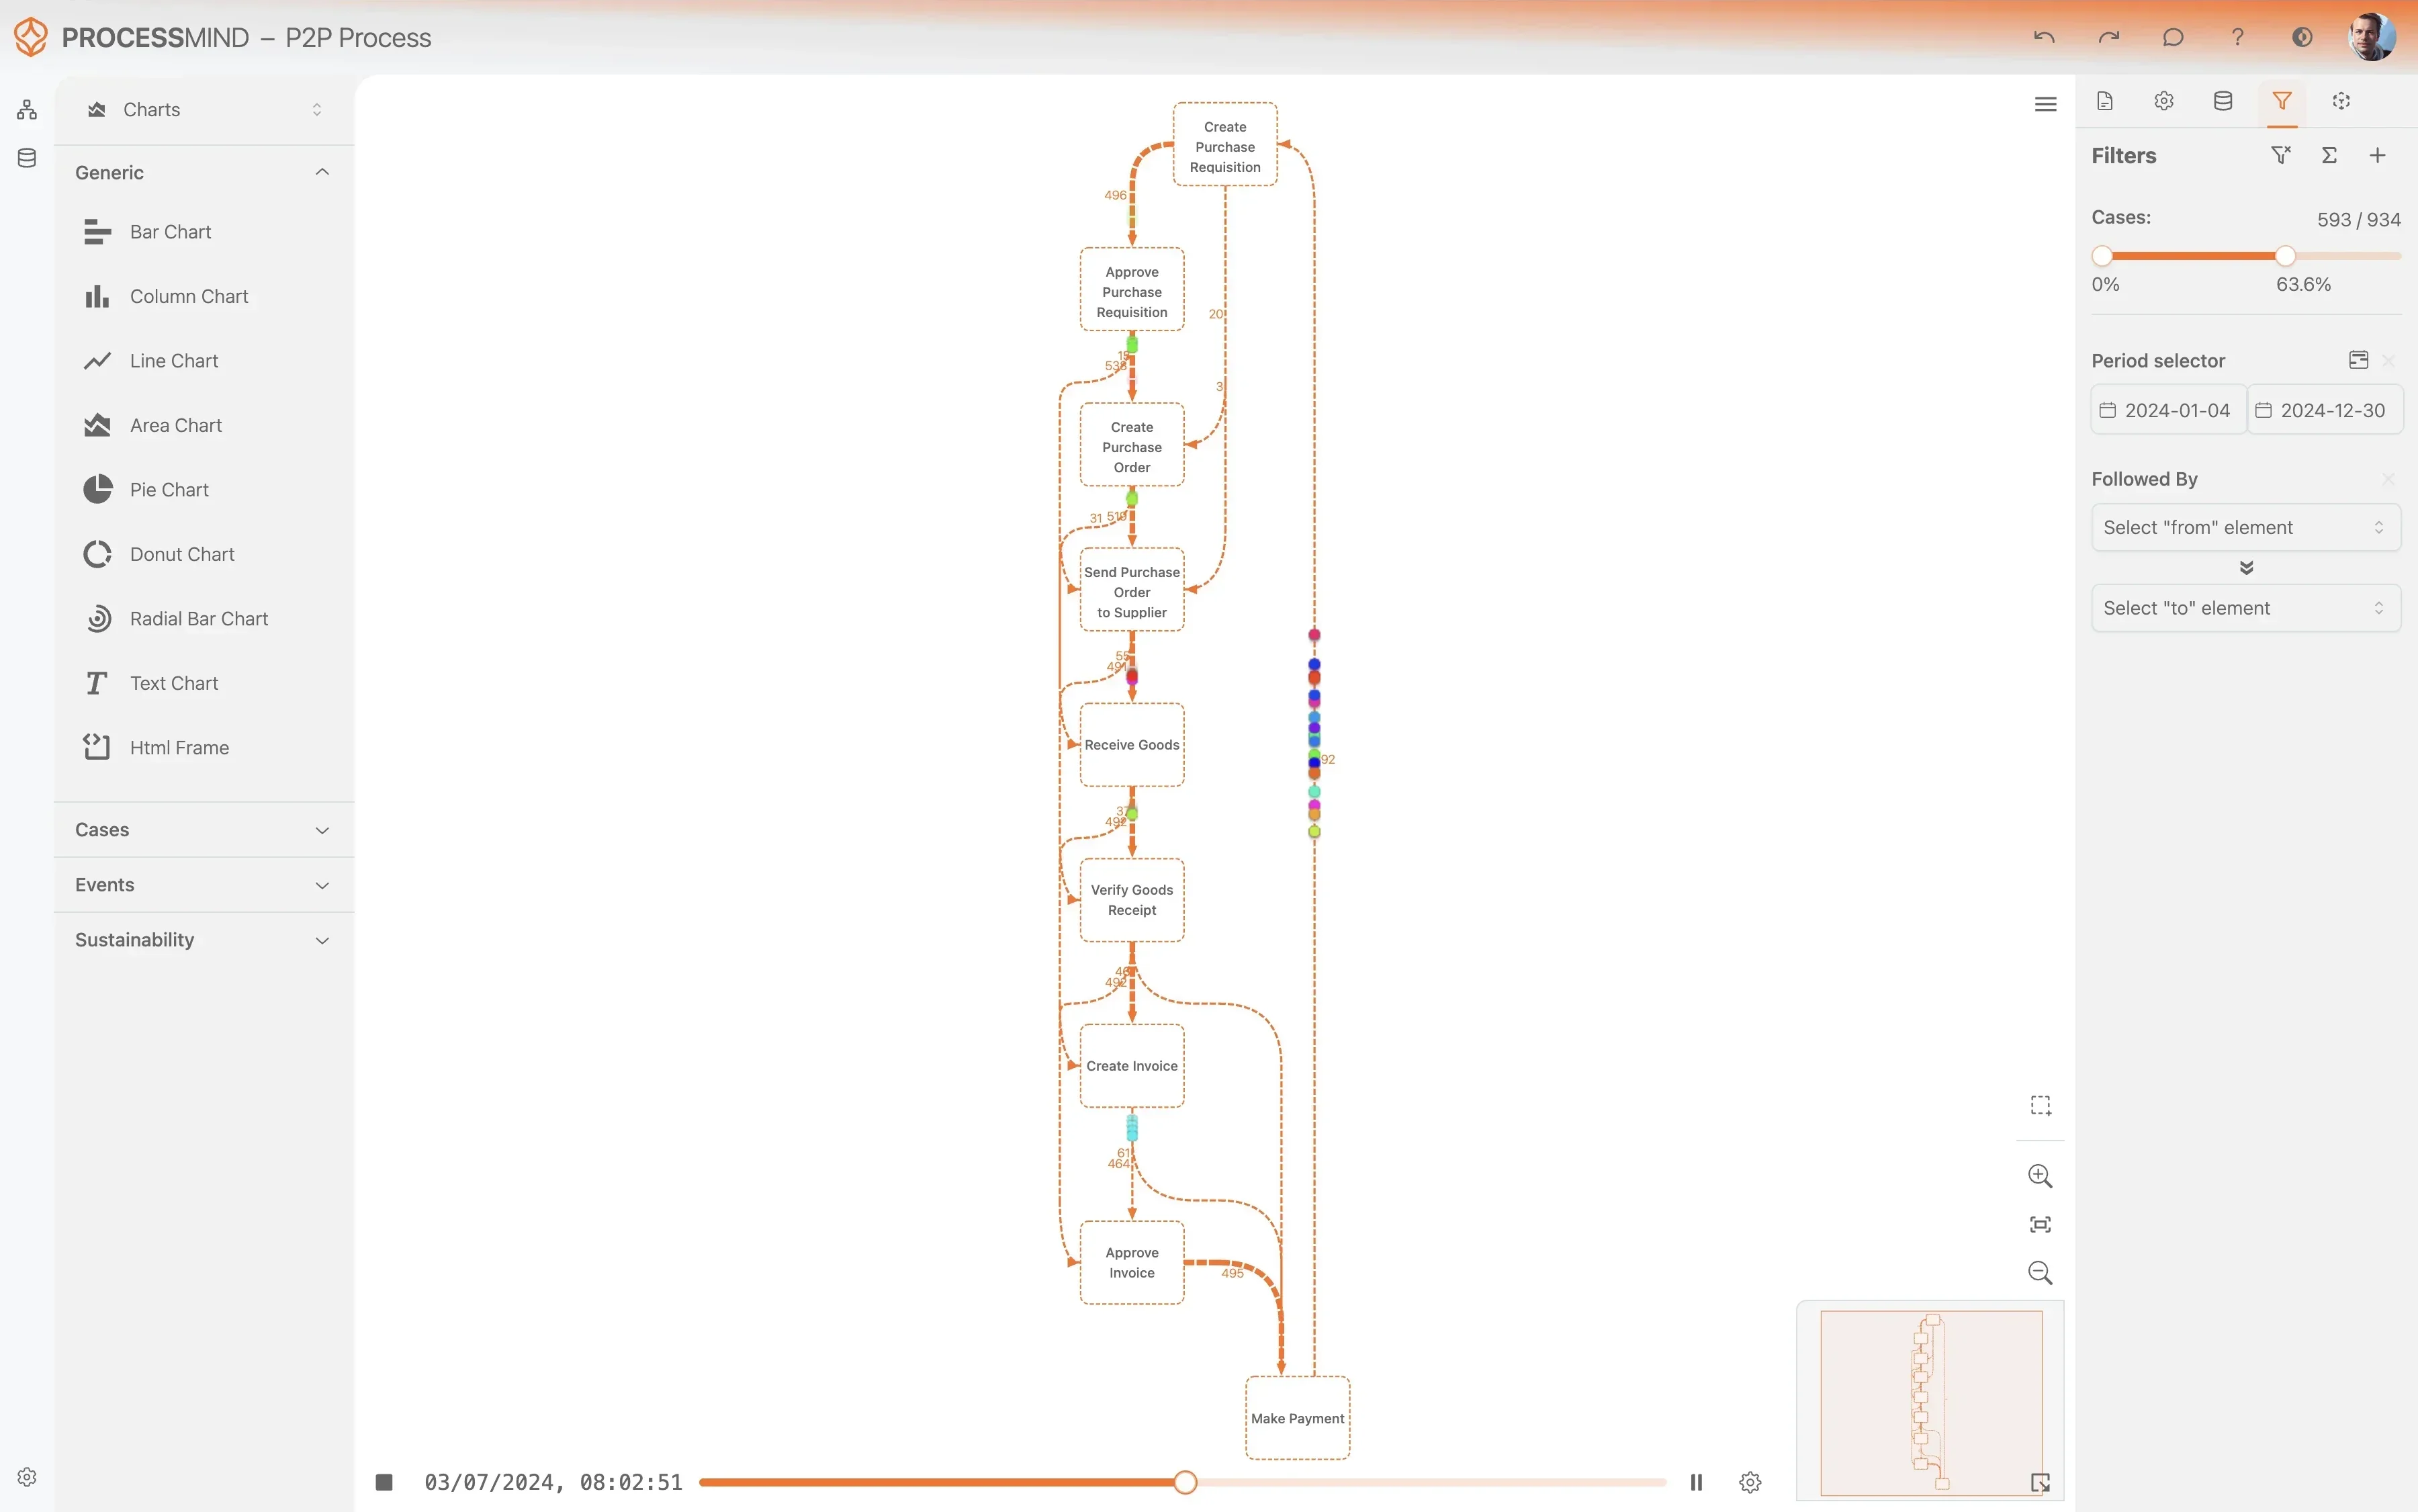
ProcessMind brengt je ServiceNow-data in kaart en laat zien hoe onderzoeken naar problemen in de praktijk verlopen. Je ziet precies waar overdrachten misgaan en welke oorzaakanalyses de meeste tijd kosten.
  • Breng de volledige levenscyclus van onderzoeken in kaart
  • Spoor communicatieproblemen tussen IT-teams op
  • Vind bottlenecks die oorzaakanalyses vertragen
  • Volg de gemiddelde oplostijd voor alle cases
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

BEWEZEN RESULTATEN

Verbeter de efficiëntie van probleembeheer

Door verborgen inefficiënties in ServiceNow-workflows voor probleembeheer zichtbaar te maken, kunnen teams oorzaakanalyses versnellen en het aantal terugkerende incidenten verminderen. Deze resultaten laten zien wat procesoptimalisatie op basis van data kan opleveren voor standaardprobleemrecords.

0 %
Snellere oorzaakanalyse

Kortere onderzoekstijd

Als de onderzoeksfase sneller verloopt, vinden teams de oorzaak van grote incidenten eerder. Dat beperkt de impact van terugkerende verstoringen van de dienstverlening.

0 %
Minder herverdelingen

Minder overdrachten van records

Door onnodige overdrachten tussen supportteams te voorkomen, gaan probleemrecords niet meer van groep naar groep. Zo is duidelijker wie verantwoordelijk is en worden problemen sneller opgelost.

+ 0 %
Betere naleving van SLA’s

Meer naleving van de afspraken voor oorzaakanalyse

Beter zicht op wachtstatussen en bottlenecks zorgt ervoor dat oorzaakanalyses binnen de afgesproken serviceniveautermijnen worden afgerond.

0 %
Minder terugkerende incidenten

Minder bekende fouten

Door tijdelijke en permanente oplossingen snel in de database met bekende fouten te publiceren, voorkom je dat nieuwe incidenten de Servicedesk overbelasten.

0 %
Opgeschoonde achterstand in probleemrecords

Minder oude records

Door verlaten records te vinden en af te sluiten, richten teams zich op actuele problemen met hoge prioriteit in plaats van oude tickets.

Resultaten verschillen per procescomplexiteit en datakwaliteit. De cijfers geven verbeteringen weer die bij implementaties vaak worden gezien.

Aanbevolen data

Begin met het selecteren van de belangrijkste attributen en activiteiten die het onderzoeksproces bepalen.

Attributen

Belangrijke datapunten voor de analyse

De unieke identificatiecode van het probleemrecord.

Waarom dit belangrijk is

Dit is de primaire sleutel om cases van elkaar te onderscheiden en bijbehorende events in de procesgrafiek te groeperen.

De specifieke gebeurtenis of actie op het probleemrecord.

Waarom dit belangrijk is

Dit attribuut bepaalt de knooppunten in de proceskaart en maakt workflows en procesvarianten zichtbaar.

De exacte datum en tijd waarop een activiteit plaatsvond.

Waarom dit belangrijk is

Nodig om events te ordenen en alle tijdgebonden KPI’s te berekenen.

De persoon die aan het probleem is toegewezen.

Waarom dit belangrijk is

Handig om de efficiëntie en werkbelasting per gebruiker te analyseren.

Het technische team dat verantwoordelijk is voor het oplossen van het probleem.

Waarom dit belangrijk is

Helpt bottlenecks tussen afdelingen op te sporen en de efficiëntie van overdrachten te analyseren.

De status van het probleemrecord in de levenscyclus.

Waarom dit belangrijk is

De belangrijkste statusindicator om open en gesloten cases van elkaar te onderscheiden.

De prioriteit die aan het probleemrecord is toegekend.

Waarom dit belangrijk is

Hiermee kun je de procesprestaties uitsplitsen naar het belang voor de bedrijfsvoering.

De classificatie van de vastgestelde hoofdoorzaak.

Waarom dit belangrijk is

Maakt analyse van foutpatronen mogelijk, zodat je gerichte verbeteringen kunt doorvoeren.

Het aantal keren dat het probleem tussen groepen is herverdeeld.

Waarom dit belangrijk is

Een directe aanwijzing voor procesfrictie en onduidelijk eigenaarschap.

Het aantal incidenten dat aan dit probleemrecord is gekoppeld.

Waarom dit belangrijk is

Meet hoe groot de impact van het probleem op gebruikers is.

Activiteiten

Processtappen om te volgen en te optimaliseren

Het probleemrecord wordt aangemaakt in ServiceNow. Dit is het begin van de levenscyclus van probleembeheer en het startpunt voor metingen van de ouderdom van records.

Waarom dit belangrijk is

Bepaalt de starttijd voor alle berekeningen van doorlooptijden en SLA-metingen. Dit is het belangrijkste uitgangspunt om het aantal binnenkomende onderzoeken te bepalen.

Het probleemrecord wordt voor onderzoek naar een specifiek technisch team gerouteerd. Deze activiteit volgt de overdracht van verantwoordelijkheid en is belangrijk voor het analyseren van overdrachten.

Waarom dit belangrijk is

Nodig voor het dashboard voor analyse van herverdelingen tussen supportgroepen. Hiermee herken je dat records tussen teams heen en weer gaan en zie je bottlenecks.

De status van het probleemrecord verandert van 'New' naar 'Assess' of 'Root Cause Analysis'. Dit betekent dat een analist actief aan het probleem is begonnen.

Waarom dit belangrijk is

Markeert het einde van de eerste wachttijd en het begin van het actieve onderzoek. Dit ondersteunt de analyse van wachtstatussen.

Er wordt tekst ingevuld in het veld 'Workaround' van het probleemrecord. Hiermee wordt vastgelegd wanneer de analist een tijdelijke oplossing documenteert.

Waarom dit belangrijk is

Ondersteunt het dashboard voor de prestaties van het publiceren van tijdelijke oplossingen door vast te leggen wanneer de technische oplossing voor het eerst bekend was.

De codes voor 'Root Cause' worden ingevuld of de status verandert in 'Fix in Progress'. Dit betekent dat het probleem met succes is gediagnosticeerd.

Waarom dit belangrijk is

Berekent de gemiddelde tijd tot het vaststellen van de hoofdoorzaak en ondersteunt het dashboard voor de doorlooptijd van oorzaakanalyses. Dit is een belangrijke mijlpaal in het proces.

Een wijzigingsverzoek (RFC) wordt gekoppeld aan het probleemrecord. Dit markeert de overdracht van probleembeheer naar verandermanagement voor de uitvoering.

Waarom dit belangrijk is

Belangrijk voor het dashboard over de efficiëntie van de overgang naar wijzigingsverzoeken. Hiermee zie je hoeveel tijd er zit tussen het vinden van een oplossing en het starten van het wijzigingsproces.

Het probleem wordt als opgelost gemarkeerd, vaak nadat het bijbehorende wijzigingsverzoek is afgesloten. Dit betekent dat het technische werk is afgerond.

Waarom dit belangrijk is

Bepaalt het einde van de actieve oplossingsfase. Wordt gebruikt om de totale oplostijd ten opzichte van de SLA te berekenen.

De laatste gebeurtenis in de levenscyclus: het record wordt inactief en er wordt geen verder werk verwacht.

Waarom dit belangrijk is

Het definitieve eindpunt van het proces. Nodig om de totale doorlooptijd te berekenen.

Veelgestelde vragen

Veelgestelde vragen

Process mining brengt het werkelijke traject van elk probleemrecord van aanmaak tot afsluiting in beeld. Teams zien precies waar vertraging ontstaat, bijvoorbeeld door lange wachtstatussen of veel herverdelingen tussen supportgroepen. Zulke vertragingen zijn vaak niet zichtbaar in standaardrapportages.

Je hebt vooral data nodig uit de tabellen problem en problem task, aangevuld met systeemlogboeken voor controles of metriekinstanties. De data moet een uniek probleem-ID bevatten, activiteitsnamen zoals statuswijzigingen of aanpassingen van toewijzingen, en de bijbehorende timestamps van elke gebeurtenis.

Ja. Het brengt bottlenecks in de onderzoeksfase aan het licht door de tijd tussen specifieke statuswijzigingen te meten. Door deze trajecten te analyseren, zie je of vertraging komt door een tekort aan bronnen, ontbrekende documentatie of afhankelijkheid van externe leveranciers.

De eerste inzichten zijn meestal binnen enkele dagen beschikbaar nadat de data is gekoppeld en gemapt. Tijdens de eerste verkenning van de proceskaart zien de meeste organisaties al grote inefficiënties, zoals oude of verlaten records.

Door het verband tussen incidentrecords en probleemrecords te analyseren, laat process mining zien hoe goed bekende fouten worden gedeeld. Het brengt tekortkomingen aan het licht, bijvoorbeeld wanneer tijdelijke oplossingen niet snel genoeg worden gepubliceerd of hoofdoorzaken verkeerd worden geclassificeerd. Daardoor kunnen problemen terugkeren.

Nee. Process mining-tools werken doorgaans met de bestaande data en vereisen geen wijzigingen aan ServiceNow-formulieren of workflows. Als het systeem de geschiedenis in auditlogboeken vastlegt, kan de tool het proces reconstrueren zonder de huidige bedrijfsvoering te verstoren.

De technologie volgt wijzigingen in het veld voor de toewijzingsgroep in de auditlogboeken en brengt zo overdrachten in beeld. Dit laat zien wanneer een probleemrecord tussen teams heen en weer gaat. Je kunt vervolgens de verdeling van bronnen en de training voor die groepen verbeteren.

Standaardrapportages tonen momentopnamen of eenvoudige metrieken, zoals de gemiddelde oplostijd, maar missen het verloop van het proces. Process mining laat de overgangen en lussen tussen die metrieken zien. Zo zie je niet alleen dát een proces traag is, maar ook waar en waarom het vastloopt.

Verbeter probleembeheer en los problemen sneller op

Verkort met process mining de doorlooptijd van onderzoeken met 30%

Start je gratis proefperiode

Geen creditcard nodig. Binnen enkele minuten ingesteld.