Mejore la gestión de incidencias
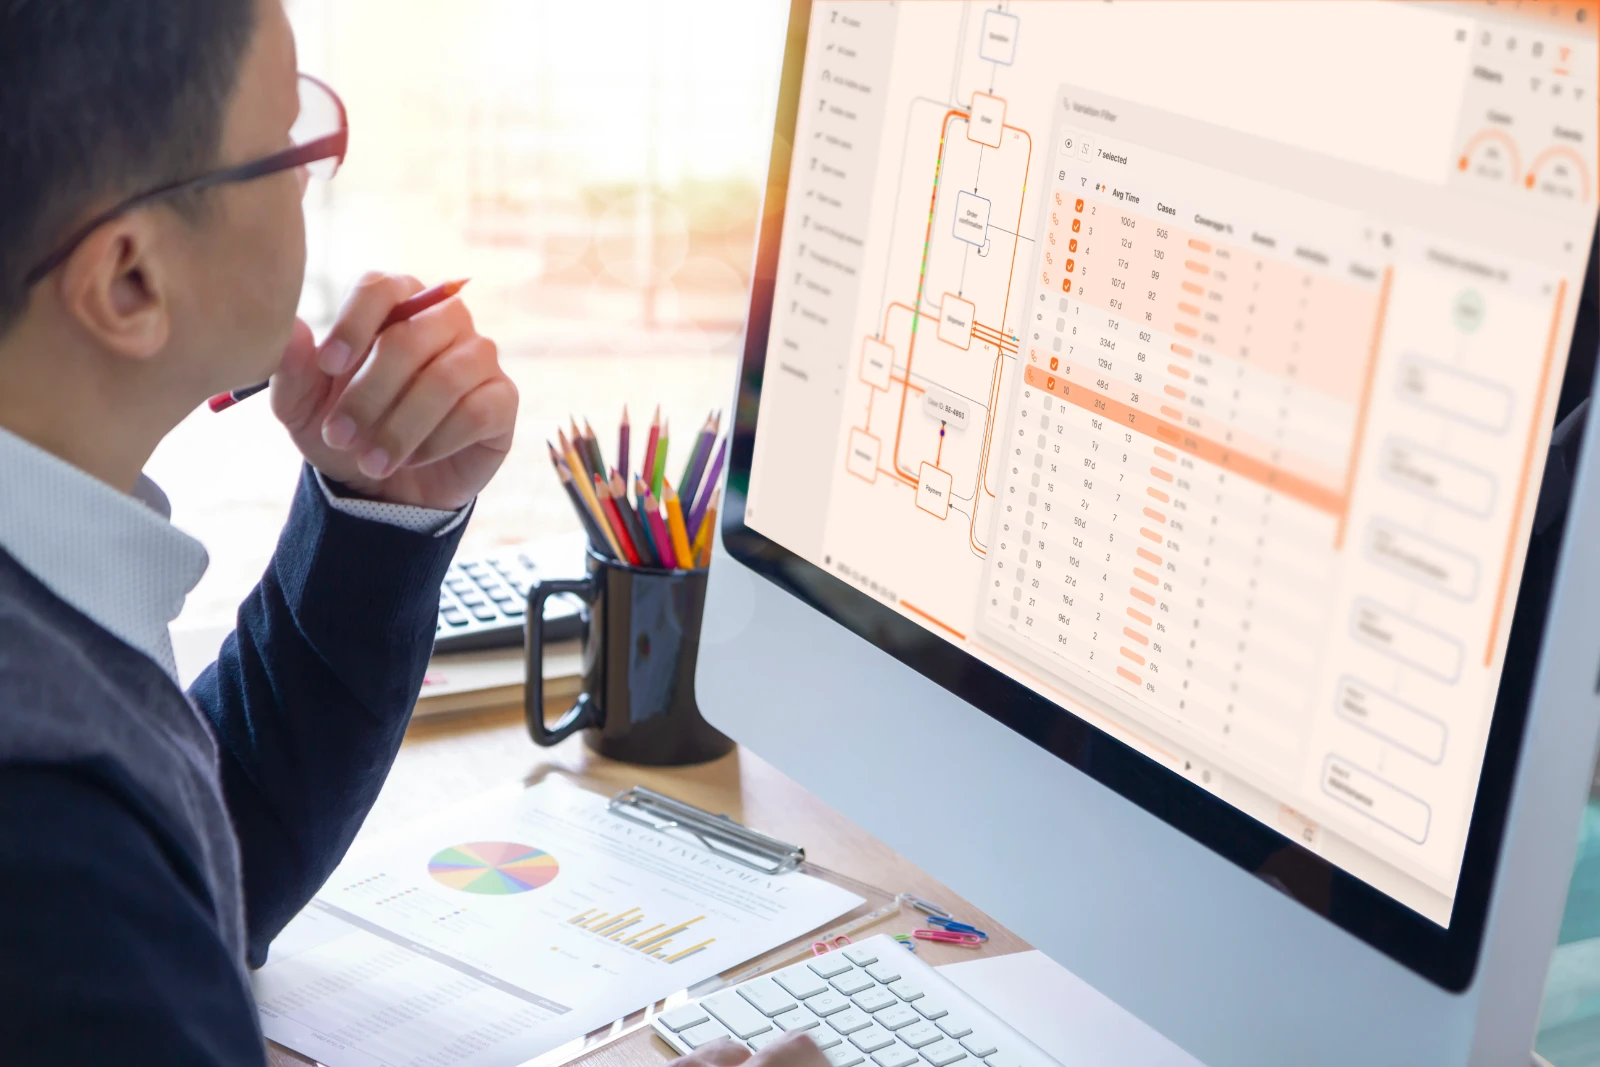
Seleccione un proceso
Elija un proceso para seguir trabajando en su espacio de trabajo conectado.
Optimice la gestión de incidentes en Zendesk Support para resolverlos más rápido
Gestionar las incidencias de forma eficaz es fundamental para la satisfacción de los usuarios y la eficiencia operativa. Nuestra plataforma le ayuda a detectar retrasos y cuellos de botella que dificultan una resolución rápida. Identifique con precisión dónde se producen las ineficiencias y obtenga recomendaciones prácticas para agilizar los procesos y resolver las incidencias más rápido.
Descargue nuestro Template de datos preconfigurado y aborde los desafíos habituales para alcanzar sus objetivos de eficiencia. Siga nuestro plan de mejora de seis pasos y consulte la guía del Template de datos para transformar sus operaciones.
Mostrar descripción detallada
Por qué es fundamental optimizar la gestión de incidentes
Una gestión eficaz de incidentes es la base de un servicio fiable y de la satisfacción de los usuarios. En el entorno digital actual, cualquier interrupción, por pequeña que sea, puede agravarse rápidamente y afectar las operaciones, la confianza de los clientes e incluso el cumplimiento de la normativa. Aunque Zendesk Support ofrece una plataforma sólida para registrar y seguir incidentes, el verdadero reto consiste en resolverlos de forma eficiente. Sin una visión clara del trabajo tal como se realiza, las organizaciones suelen enfrentarse a retrasos ocultos, retrabajo frecuente e incumplimientos de los acuerdos de nivel de servicio (SLA). Estas ineficiencias frustran tanto a los usuarios como al personal de soporte, aumentan los costes operativos y pueden perjudicar la reputación de la marca. Comprender el rendimiento real del proceso de gestión de incidentes no consiste solo en solucionar problemas: también permite proteger el negocio de forma proactiva y mejorar el servicio continuamente.
Cómo Process Mining permite ver el flujo de incidentes en Zendesk Support
Process Mining ayuda a entender la complejidad de los datos de gestión de incidentes en Zendesk Support. Al analizar los registros de eventos, que recogen cada interacción y cambio de estado de cada incidente, reconstruye el recorrido real desde el informe inicial hasta el cierre. Esta visión integral revela mucho más que los informes habituales. Muestra todas las rutas, incluidas las desviaciones del proceso previsto, y señala dónde se producen cuellos de botella, reasignaciones excesivas o reaperturas frecuentes. Puede visualizar el tiempo de ciclo completo de distintos tipos de incidentes y comparar el rendimiento real con los objetivos de los SLA. Así, los datos de Zendesk se convierten en información útil para la acción: muestran cómo avanzan los incidentes por los equipos de soporte, qué pasos consumen más tiempo y dónde las intervenciones manuales o las ineficiencias prolongan la resolución.
Cómo localizar oportunidades clave para mejorar la resolución de incidentes
Process Mining le permite descubrir aspectos concretos de la gestión de incidentes en Zendesk que conviene mejorar. Por ejemplo, puede detectar:
- Demasiados traspasos: ¿Se transfieren los incidentes entre grupos de soporte, por ejemplo, del equipo inicial a uno especializado, más veces de las necesarias? Estos traspasos pueden alargar el tiempo de ciclo. Process Mining muestra su frecuencia y su impacto.
- Retrasos en la resolución: Identifique las etapas en las que los incidentes suelen quedar detenidos, como los periodos prolongados entre «Diagnóstico iniciado» y «Resolución identificada». Esto puede indicar la necesidad de mejorar la formación o la asignación de recursos.
- Ciclos de retrabajo: Detecte patrones en los que los incidentes se reabren con frecuencia después de marcarse como «Resueltos». Esto puede indicar problemas en la calidad de la resolución inicial o en el proceso de confirmación del usuario.
- Incumplimientos de los SLA: Visualice con claridad qué categorías o prioridades de incidentes incumplen sistemáticamente los objetivos de los SLA y centre las mejoras donde más se necesitan.
- Análisis de causa raíz: Relacione los patrones del proceso con los atributos habituales de categoría de causa raíz para tomar medidas proactivas y evitar incidentes recurrentes.
Este nivel de detalle va más allá de las impresiones y aporta información basada en datos para optimizar de verdad la gestión de incidentes en Zendesk Support.
Beneficios concretos de optimizar el proceso de gestión de incidentes
La información obtenida con Process Mining se traduce directamente en beneficios importantes y medibles para su organización. Al abordar las ineficiencias y los cuellos de botella detectados, puede:
- Reducir el tiempo de ciclo de la gestión de incidentes: Acelerar la resolución, restablecer los servicios antes y reducir el tiempo de inactividad de los usuarios afectados.
- Mejorar el cumplimiento de los SLA: Cumplir o superar sistemáticamente los acuerdos de nivel de servicio, mejorar la satisfacción de los clientes y evitar posibles sanciones.
- Reducir los costes operativos: Simplificar los flujos de trabajo, reducir el retrabajo y optimizar la asignación de recursos para aprovechar mejor el tiempo y los recursos del equipo de soporte.
- Mejorar la satisfacción de usuarios y agentes: Los usuarios reciben soluciones más rápidas y una comunicación más clara, mientras que los agentes trabajan con procesos más ágiles y menos frustraciones.
- Impulsar la mejora continua: Fomentar una cultura basada en datos que permita supervisar y mejorar continuamente el rendimiento de los procesos, para que la gestión de incidentes evolucione con las necesidades del negocio.
En definitiva, optimizar la gestión de incidentes ayuda a pasar de una respuesta reactiva a los problemas a una prestación de servicios eficiente y proactiva.
Tome las riendas de la gestión de incidentes en Zendesk
Mejorar los procesos de gestión de incidentes en Zendesk Support no exige renovar todo el sistema. El primer paso es comprender la situación actual con la perspectiva objetiva de Process Mining. Este enfoque permite tomar decisiones fundamentadas en datos reales, no en suposiciones. Con información detallada sobre los procesos, puede ir más allá del simple seguimiento de incidentes y crear una operación de soporte más ágil, eficiente y centrada en los usuarios. Dé el primer paso para transformar la gestión de incidentes con un enfoque basado en datos que muestre exactamente cómo reducir el tiempo de ciclo y mejorar la calidad general del servicio.
La ruta de mejora en 6 pasos para la gestión de incidentes
Descargue la plantilla
Qué hacer
Obtenga la plantilla de Excel preestructurada para los datos de gestión de incidentes. Así, los datos de Zendesk Support se ajustarán a los requisitos de análisis de ProcessMind.
Por qué es importante
Una plantilla estandarizada agiliza la preparación de los datos, reduce los errores y garantiza que se registren todos los detalles importantes de cada incidente para analizarlos con precisión.
Resultado esperado
Dispondrá de una plantilla de Excel lista para completar y adaptada a los datos de incidentes de Zendesk Support.
Exporte los datos de Zendesk
Qué hacer
Extraiga entre 3 y 6 meses de datos históricos de incidentes de Zendesk Support. Utilice las funciones de informes o la API para recopilar información sobre tickets, usuarios y políticas de SLA; después, complete la plantilla.
Por qué es importante
Un conjunto completo de datos históricos ofrece una base sólida para detectar problemas recurrentes, variaciones en los procesos y tendencias de rendimiento a lo largo del tiempo.
Resultado esperado
Los datos de incidentes de Zendesk Support se incorporarán correctamente a la plantilla de Excel proporcionada.
Cargue el conjunto de datos
Qué hacer
Cargue la plantilla de Excel completada en la plataforma segura de ProcessMind. El sistema procesará y validará automáticamente los datos de gestión de incidentes.
Por qué es importante
La carga sencilla permite disponer rápidamente de los datos para el análisis, reduce el tiempo de configuración y le permite centrarse en obtener conclusiones cuanto antes.
Resultado esperado
Los datos de incidentes de Zendesk se cargarán de forma segura y estarán listos para el análisis automatizado de Process Mining.
Analice el proceso de gestión de incidentes
Qué hacer
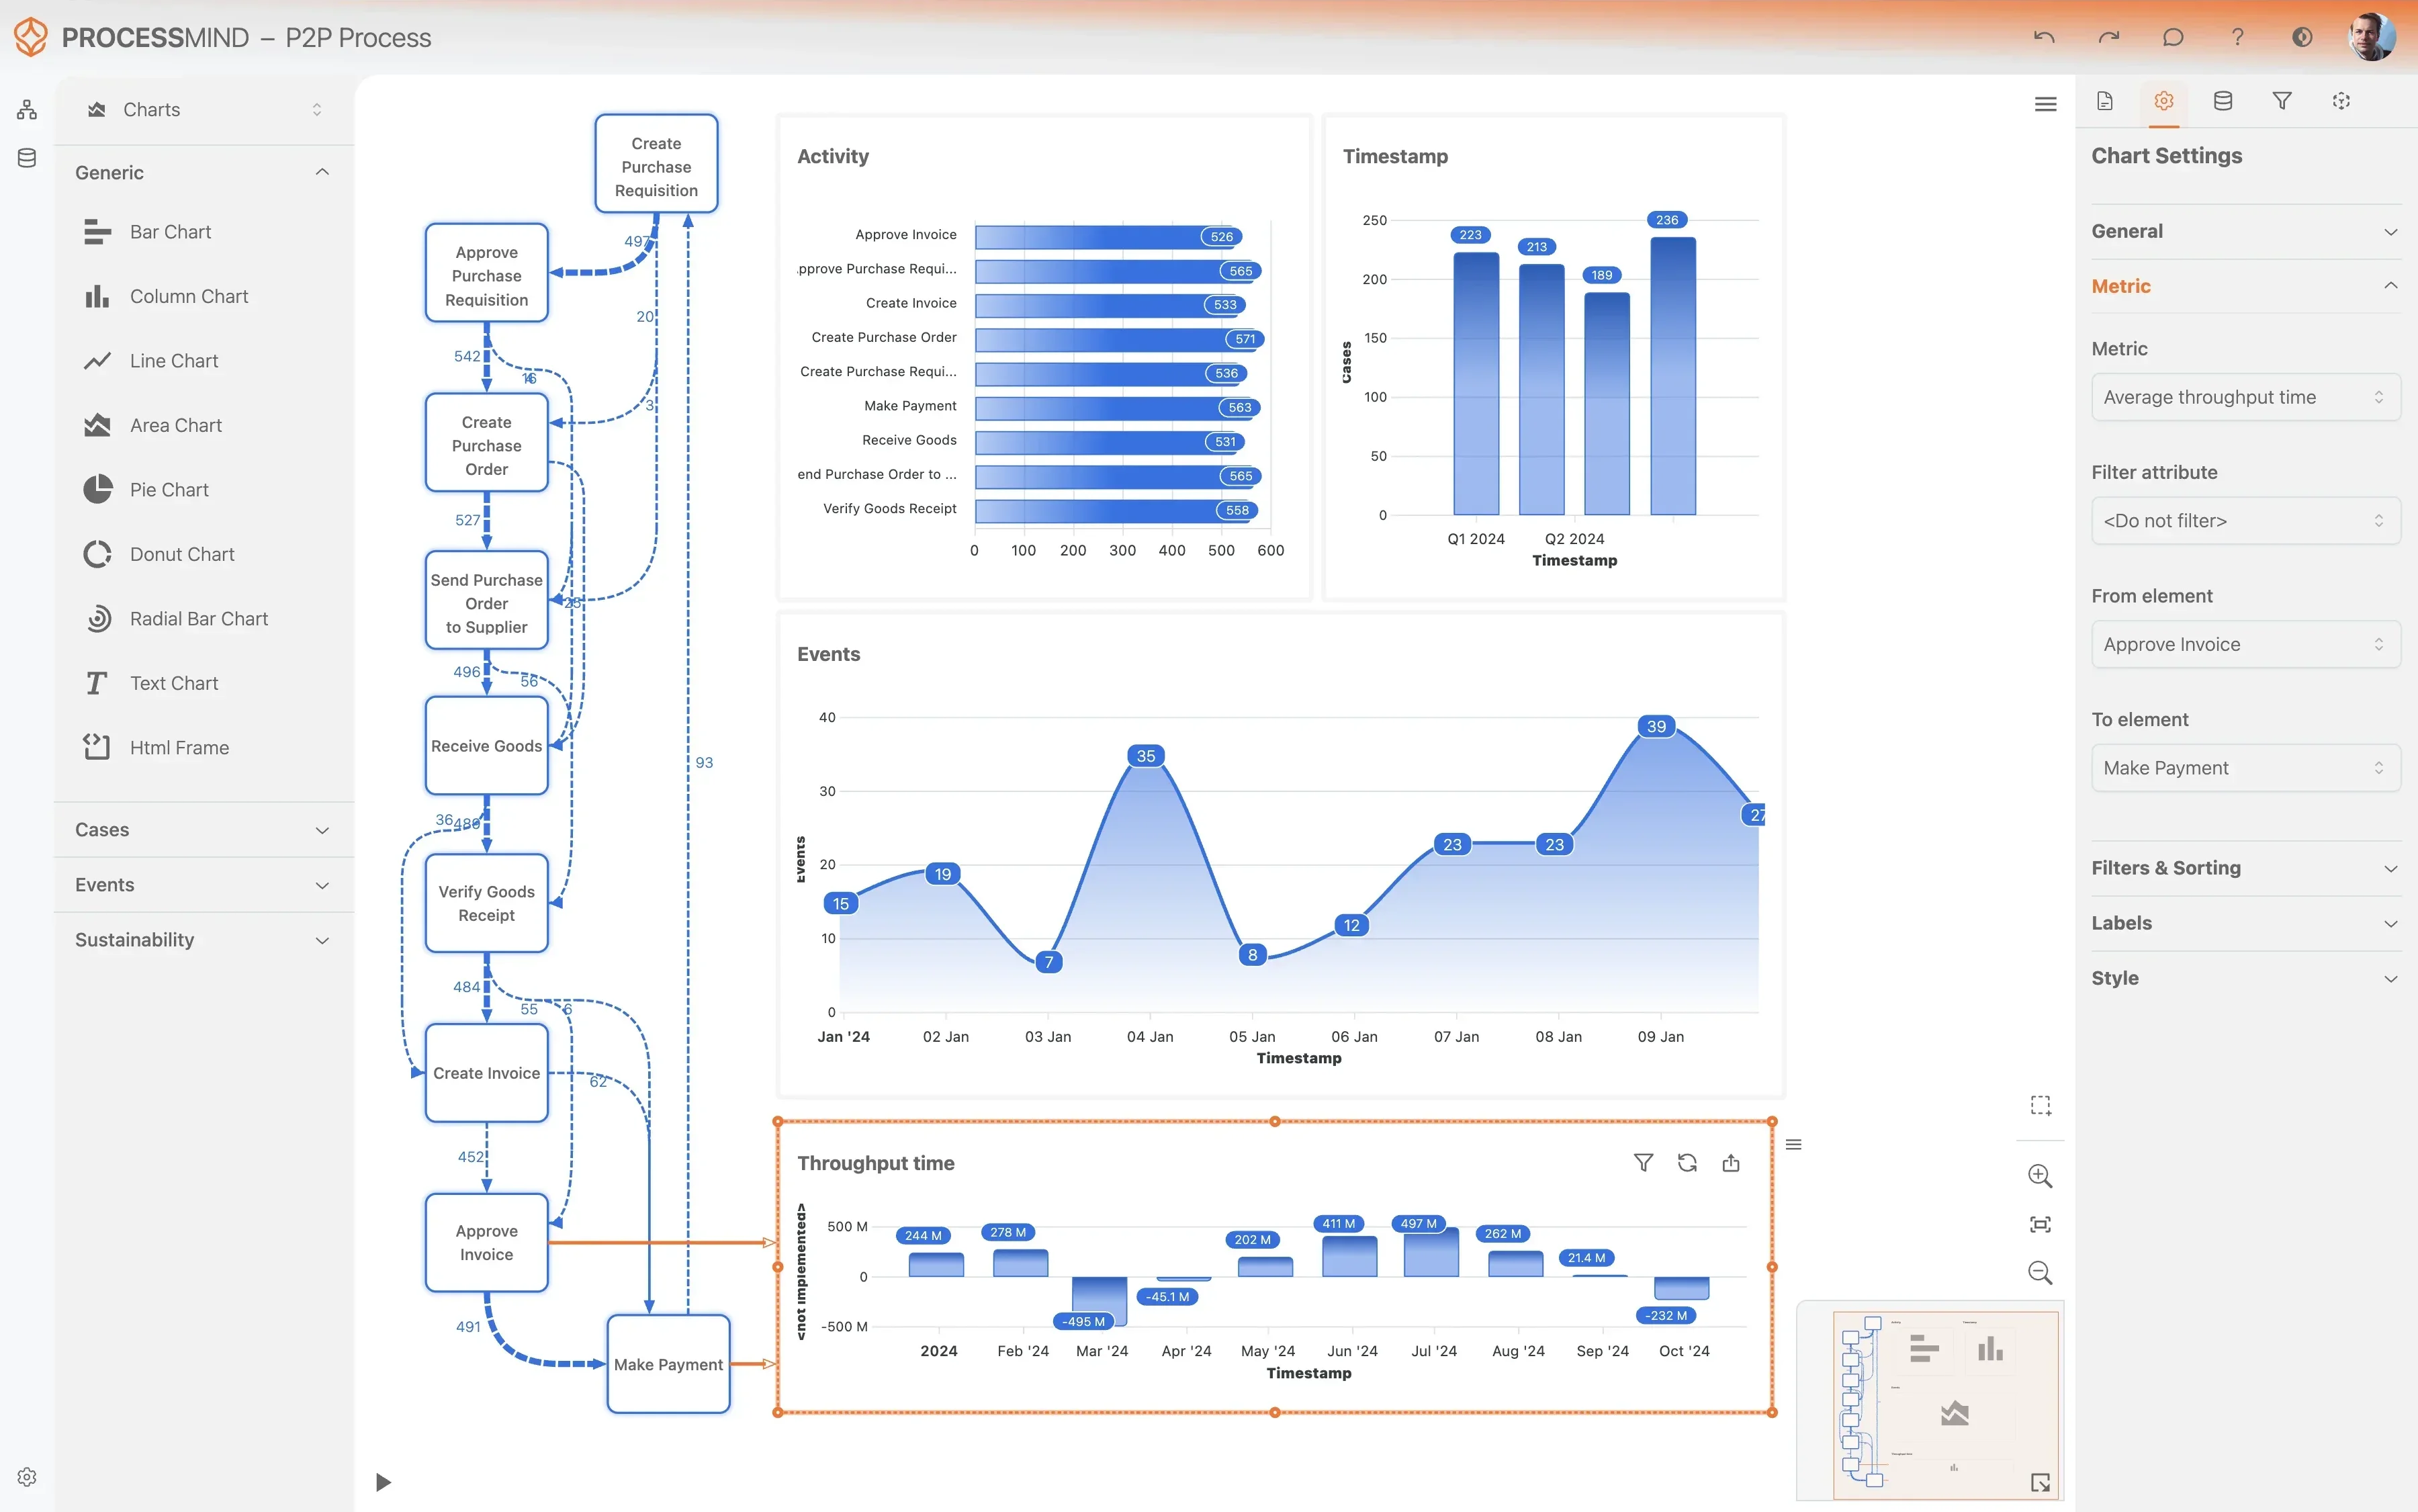
Explore los Dashboards generados automáticamente y los mapas visuales de su proceso de gestión de incidentes. Aproveche las recomendaciones basadas en IA para localizar cuellos de botella y rutas que no cumplen los requisitos.
Por qué es importante
Obtenga información detallada sobre los tiempos de resolución, el cumplimiento de los SLA y la carga de trabajo de los agentes. Así podrá detectar ineficiencias ocultas y brechas de cumplimiento que afectan a la calidad del servicio.
Resultado esperado
Tendrá una visión clara de su proceso de gestión de incidentes basada en datos, además de una lista priorizada de oportunidades de mejora.
Implemente mejoras
Qué hacer
Priorice las oportunidades de mejora detectadas, como optimizar las reglas de asignación de tickets o perfeccionar los flujos de resolución en Zendesk Support, y actúe.
Por qué es importante
Convertir la información obtenida en medidas concretas permite abordar directamente las causas de las demoras y las ineficiencias, mejorar las operaciones de inmediato y ofrecer un mejor servicio.
Resultado esperado
El proceso de gestión de incidentes se optimizará, lo que permitirá resolverlos más rápido y asignar mejor los recursos.
Supervise y mantenga el progreso
Qué hacer
Vuelva a cargar periódicamente en ProcessMind datos actualizados de incidentes de Zendesk Support. Realice un seguimiento continuo de los KPI clave para medir el impacto de los cambios implementados.
Por qué es importante
La supervisión continua ayuda a mantener las mejoras, detectar nuevos problemas a tiempo y conservar la eficiencia del proceso de gestión de incidentes.
Resultado esperado
Mantendrá optimizado el proceso de gestión de incidentes, cumplirá los SLA de forma constante y mejorará la satisfacción de los usuarios.
QUÉ OBTENDRÁ
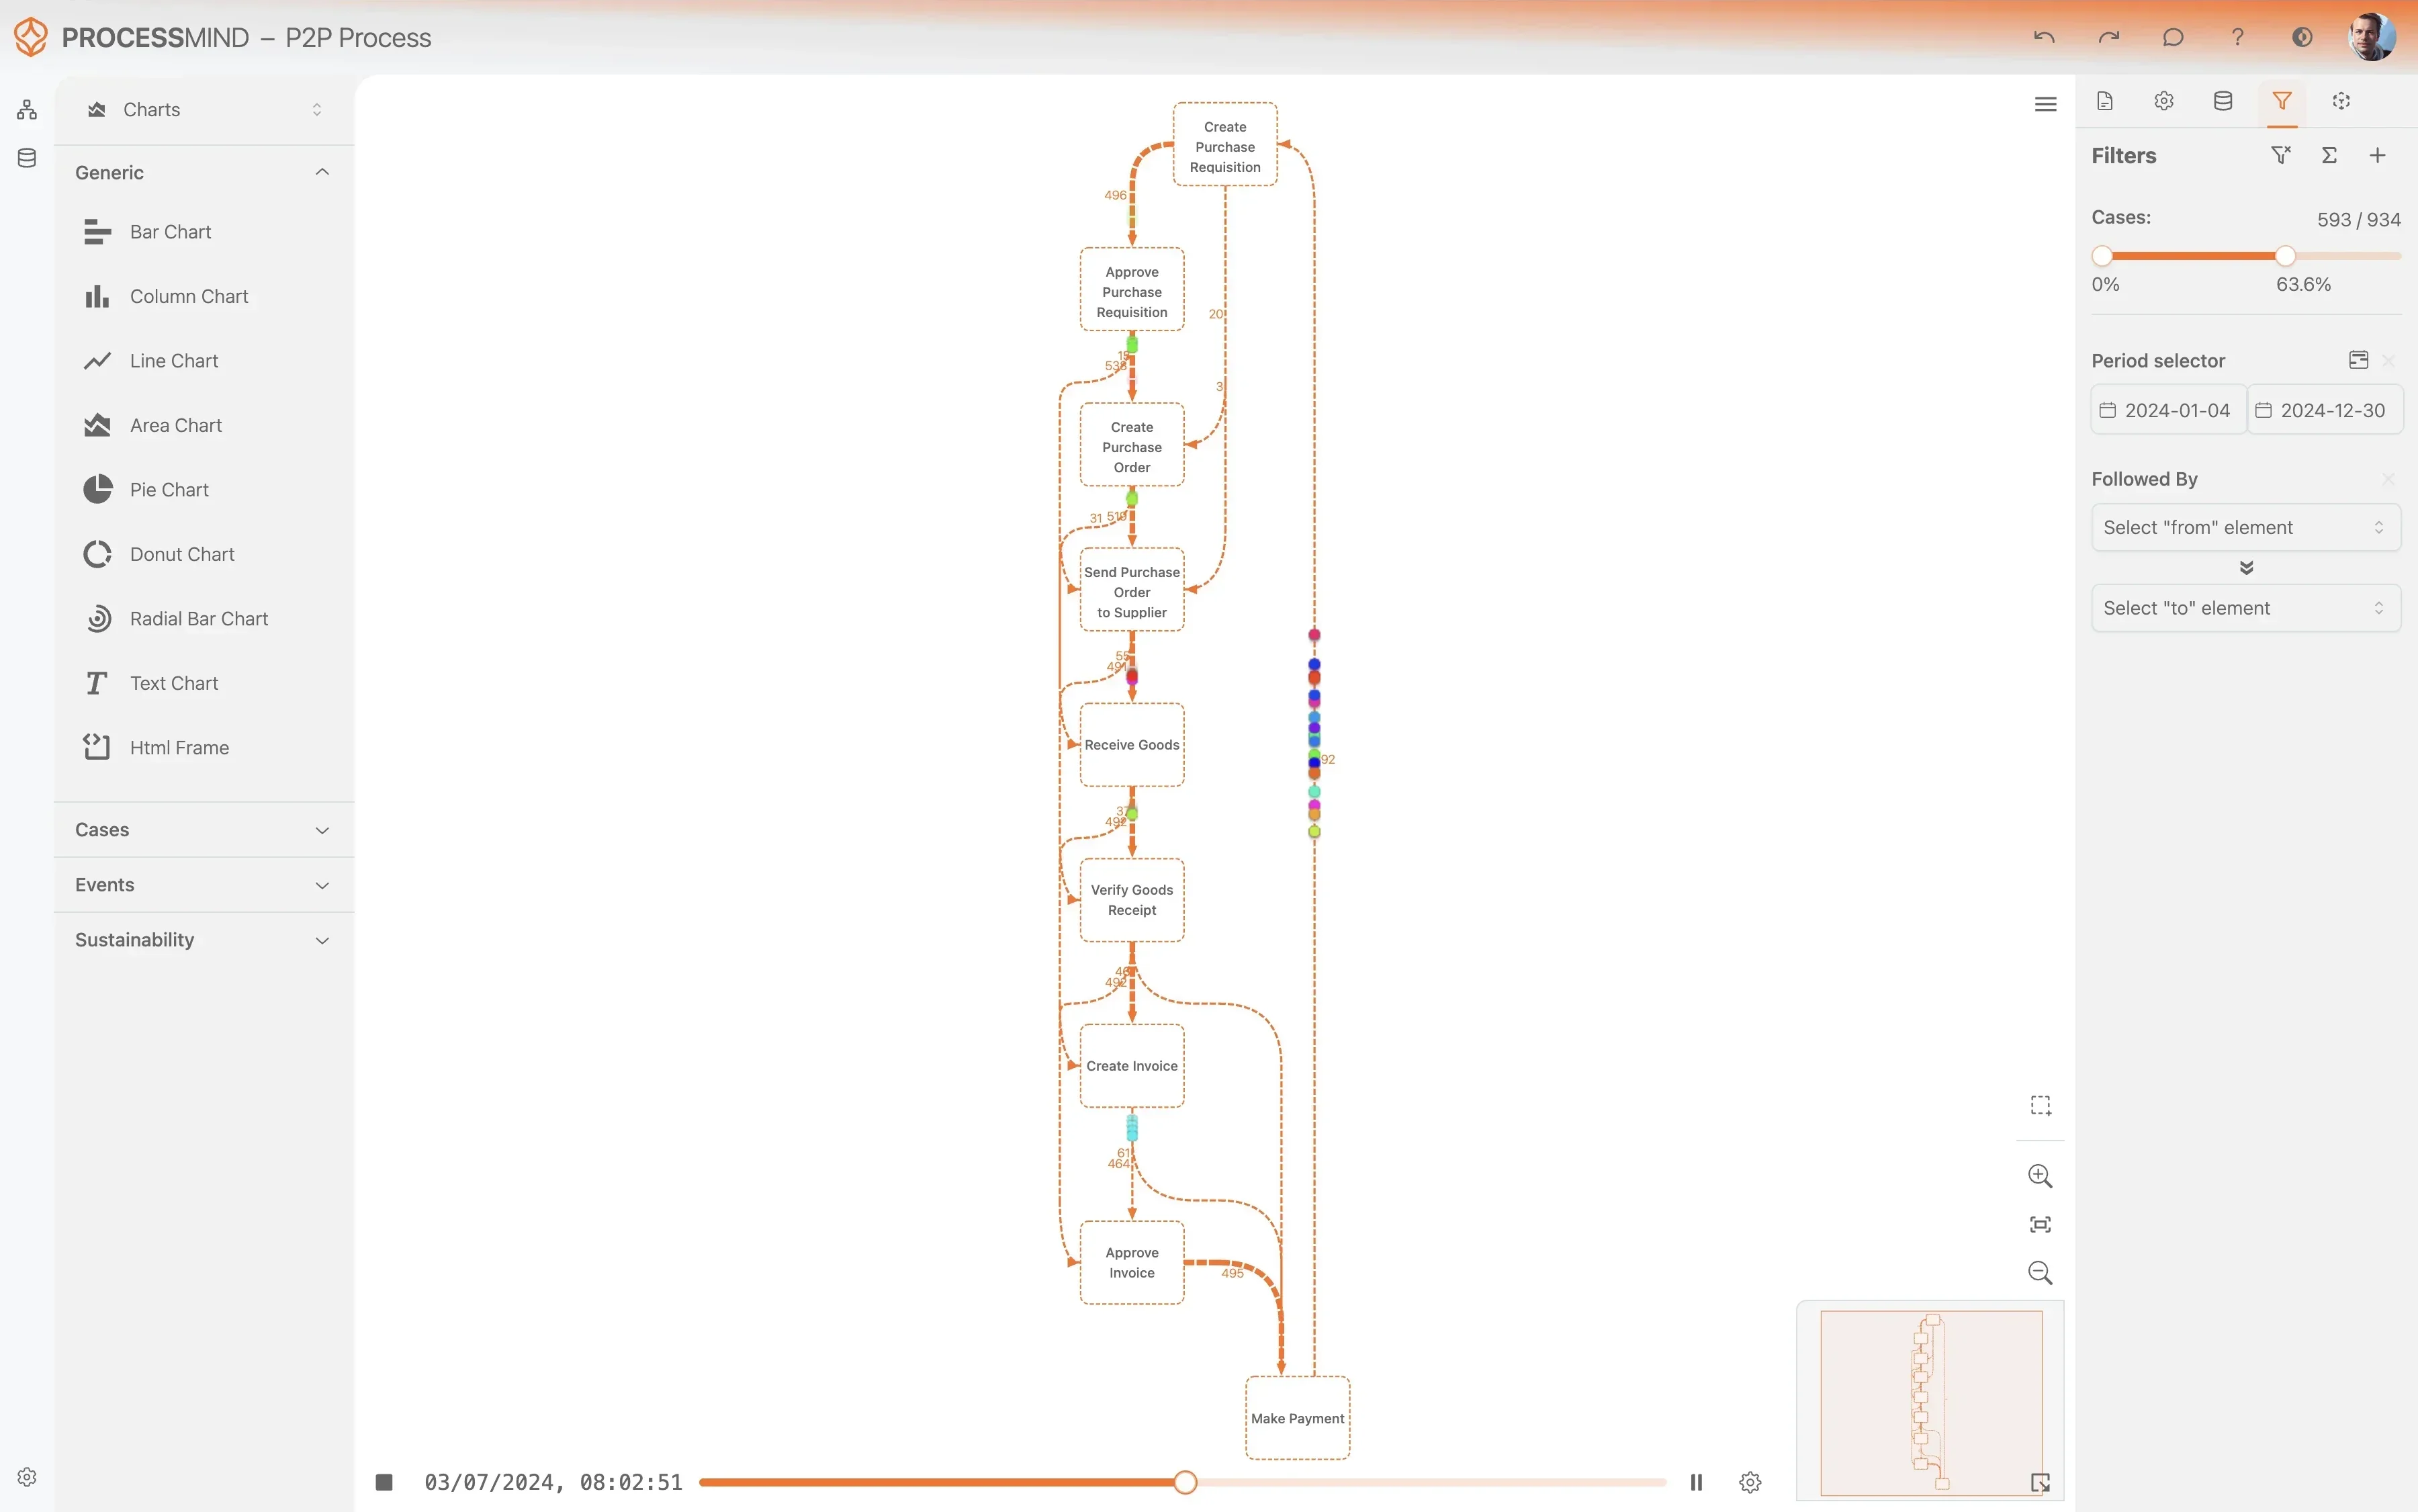
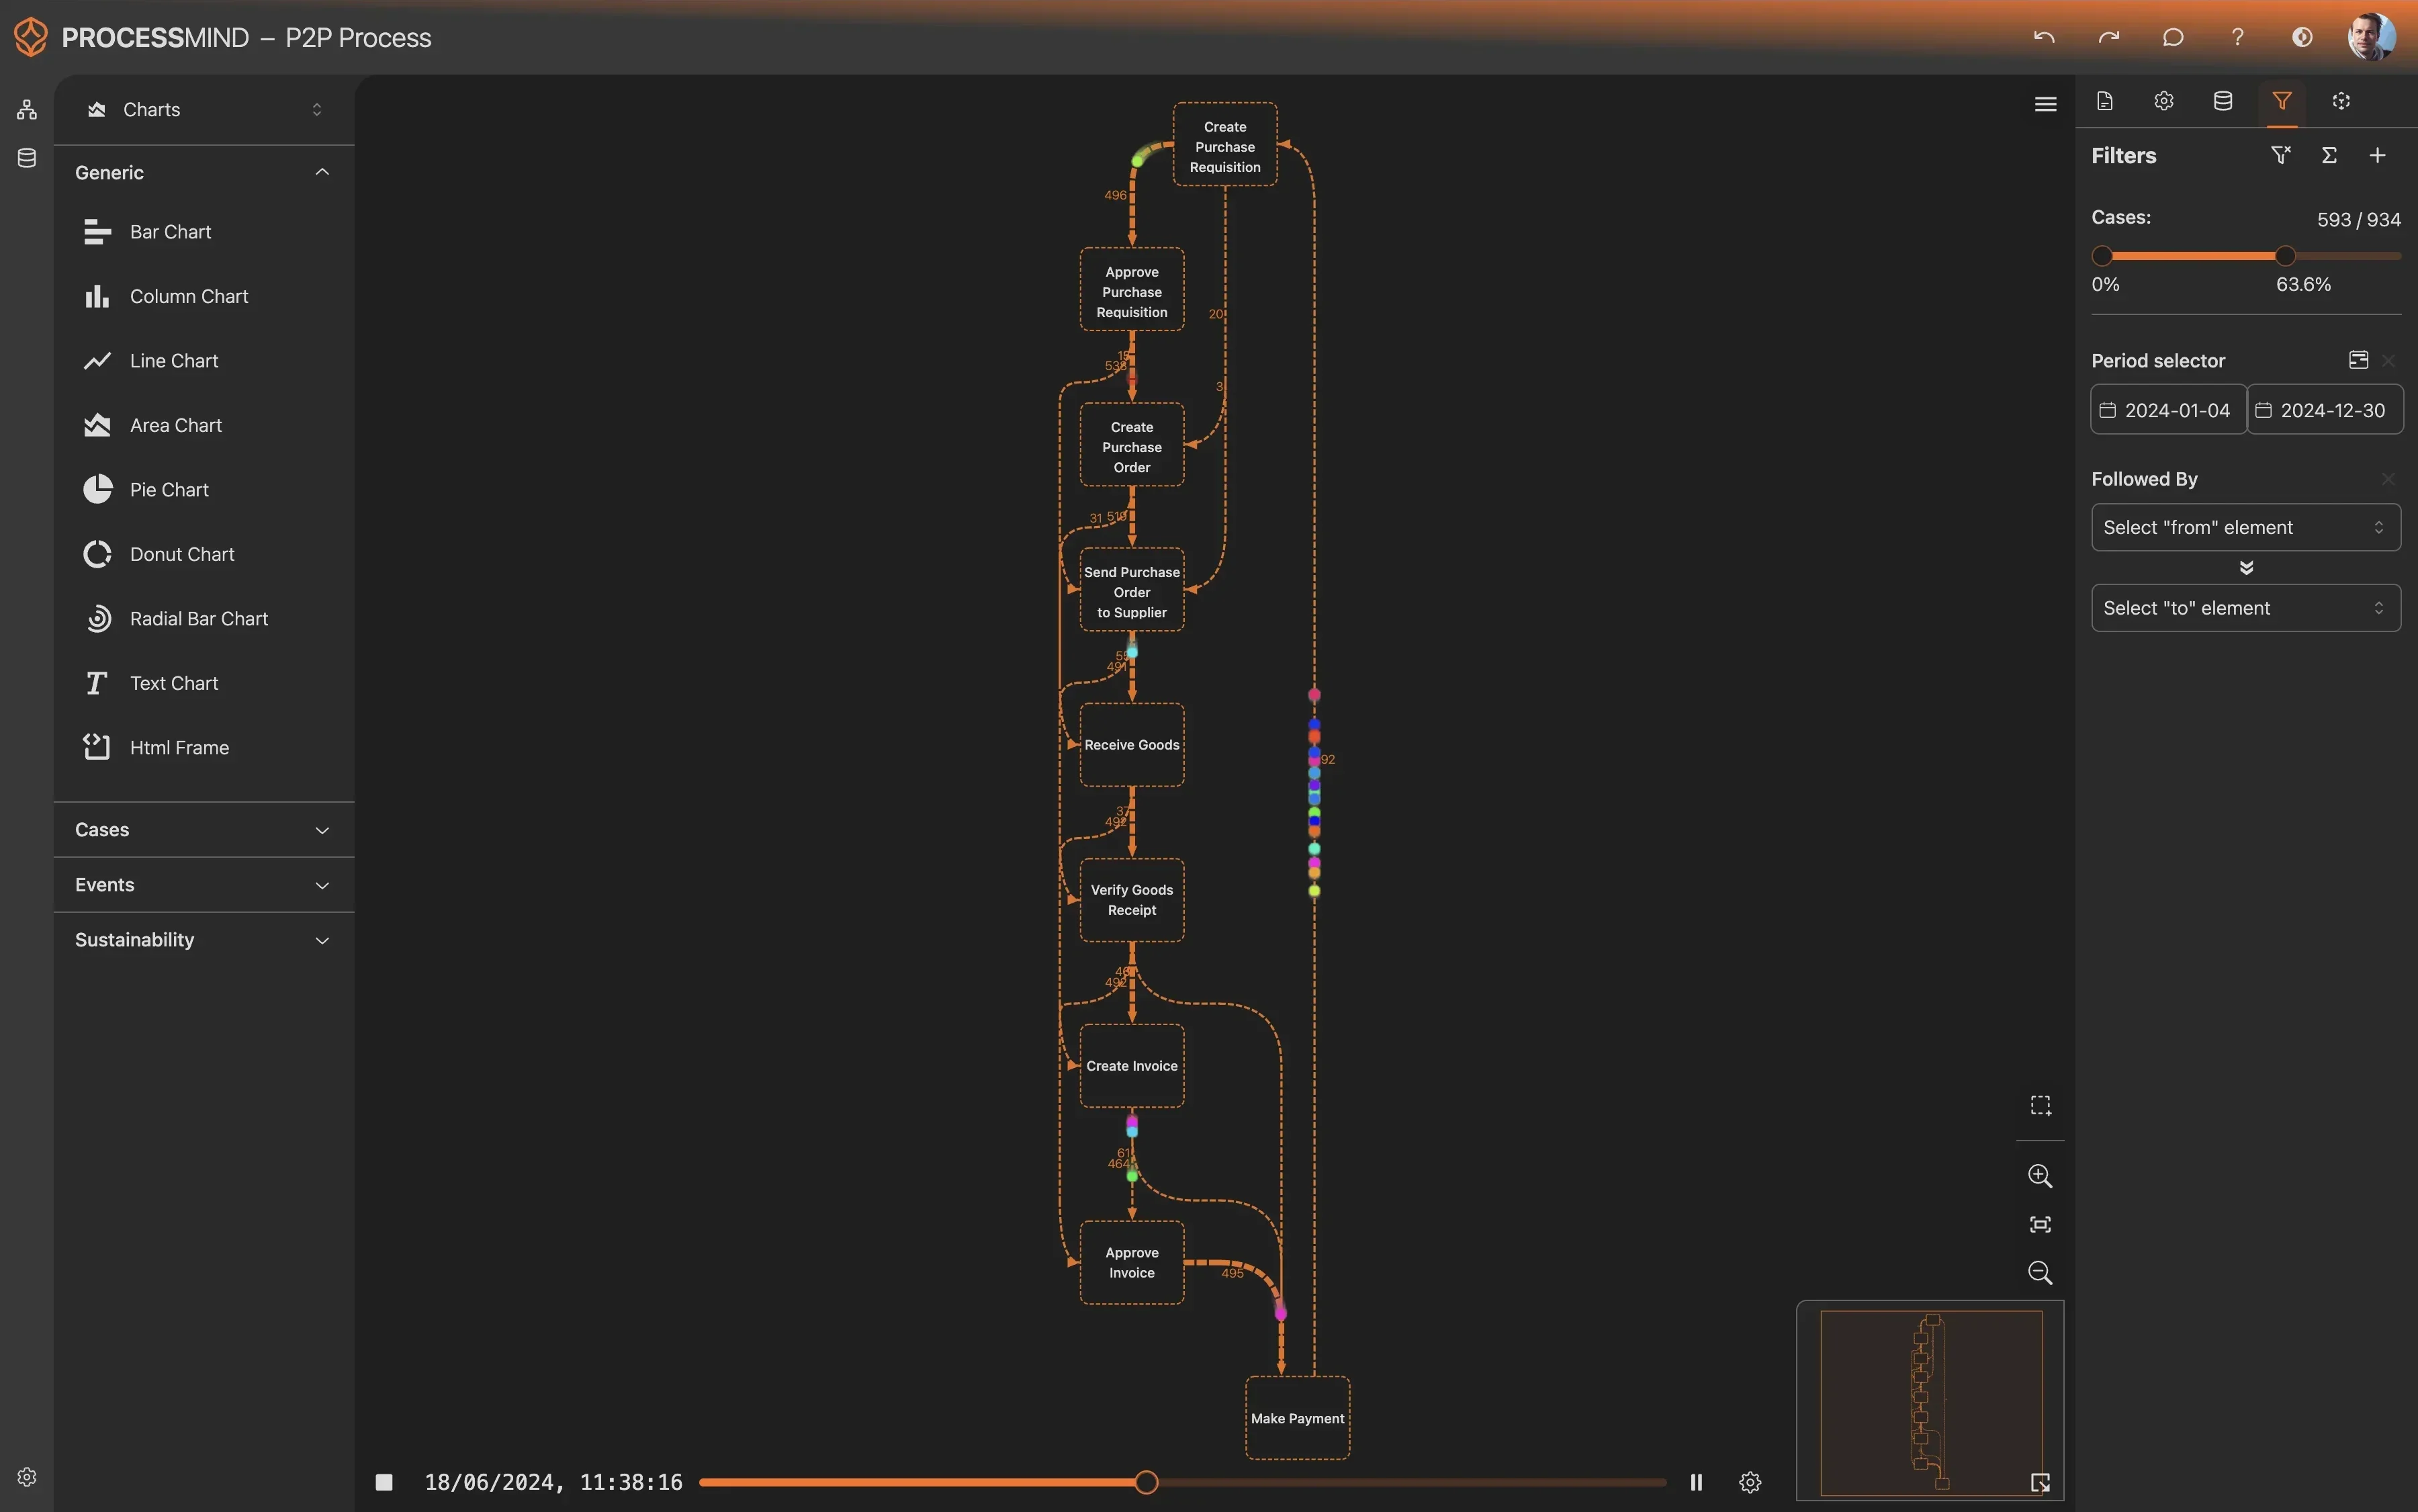
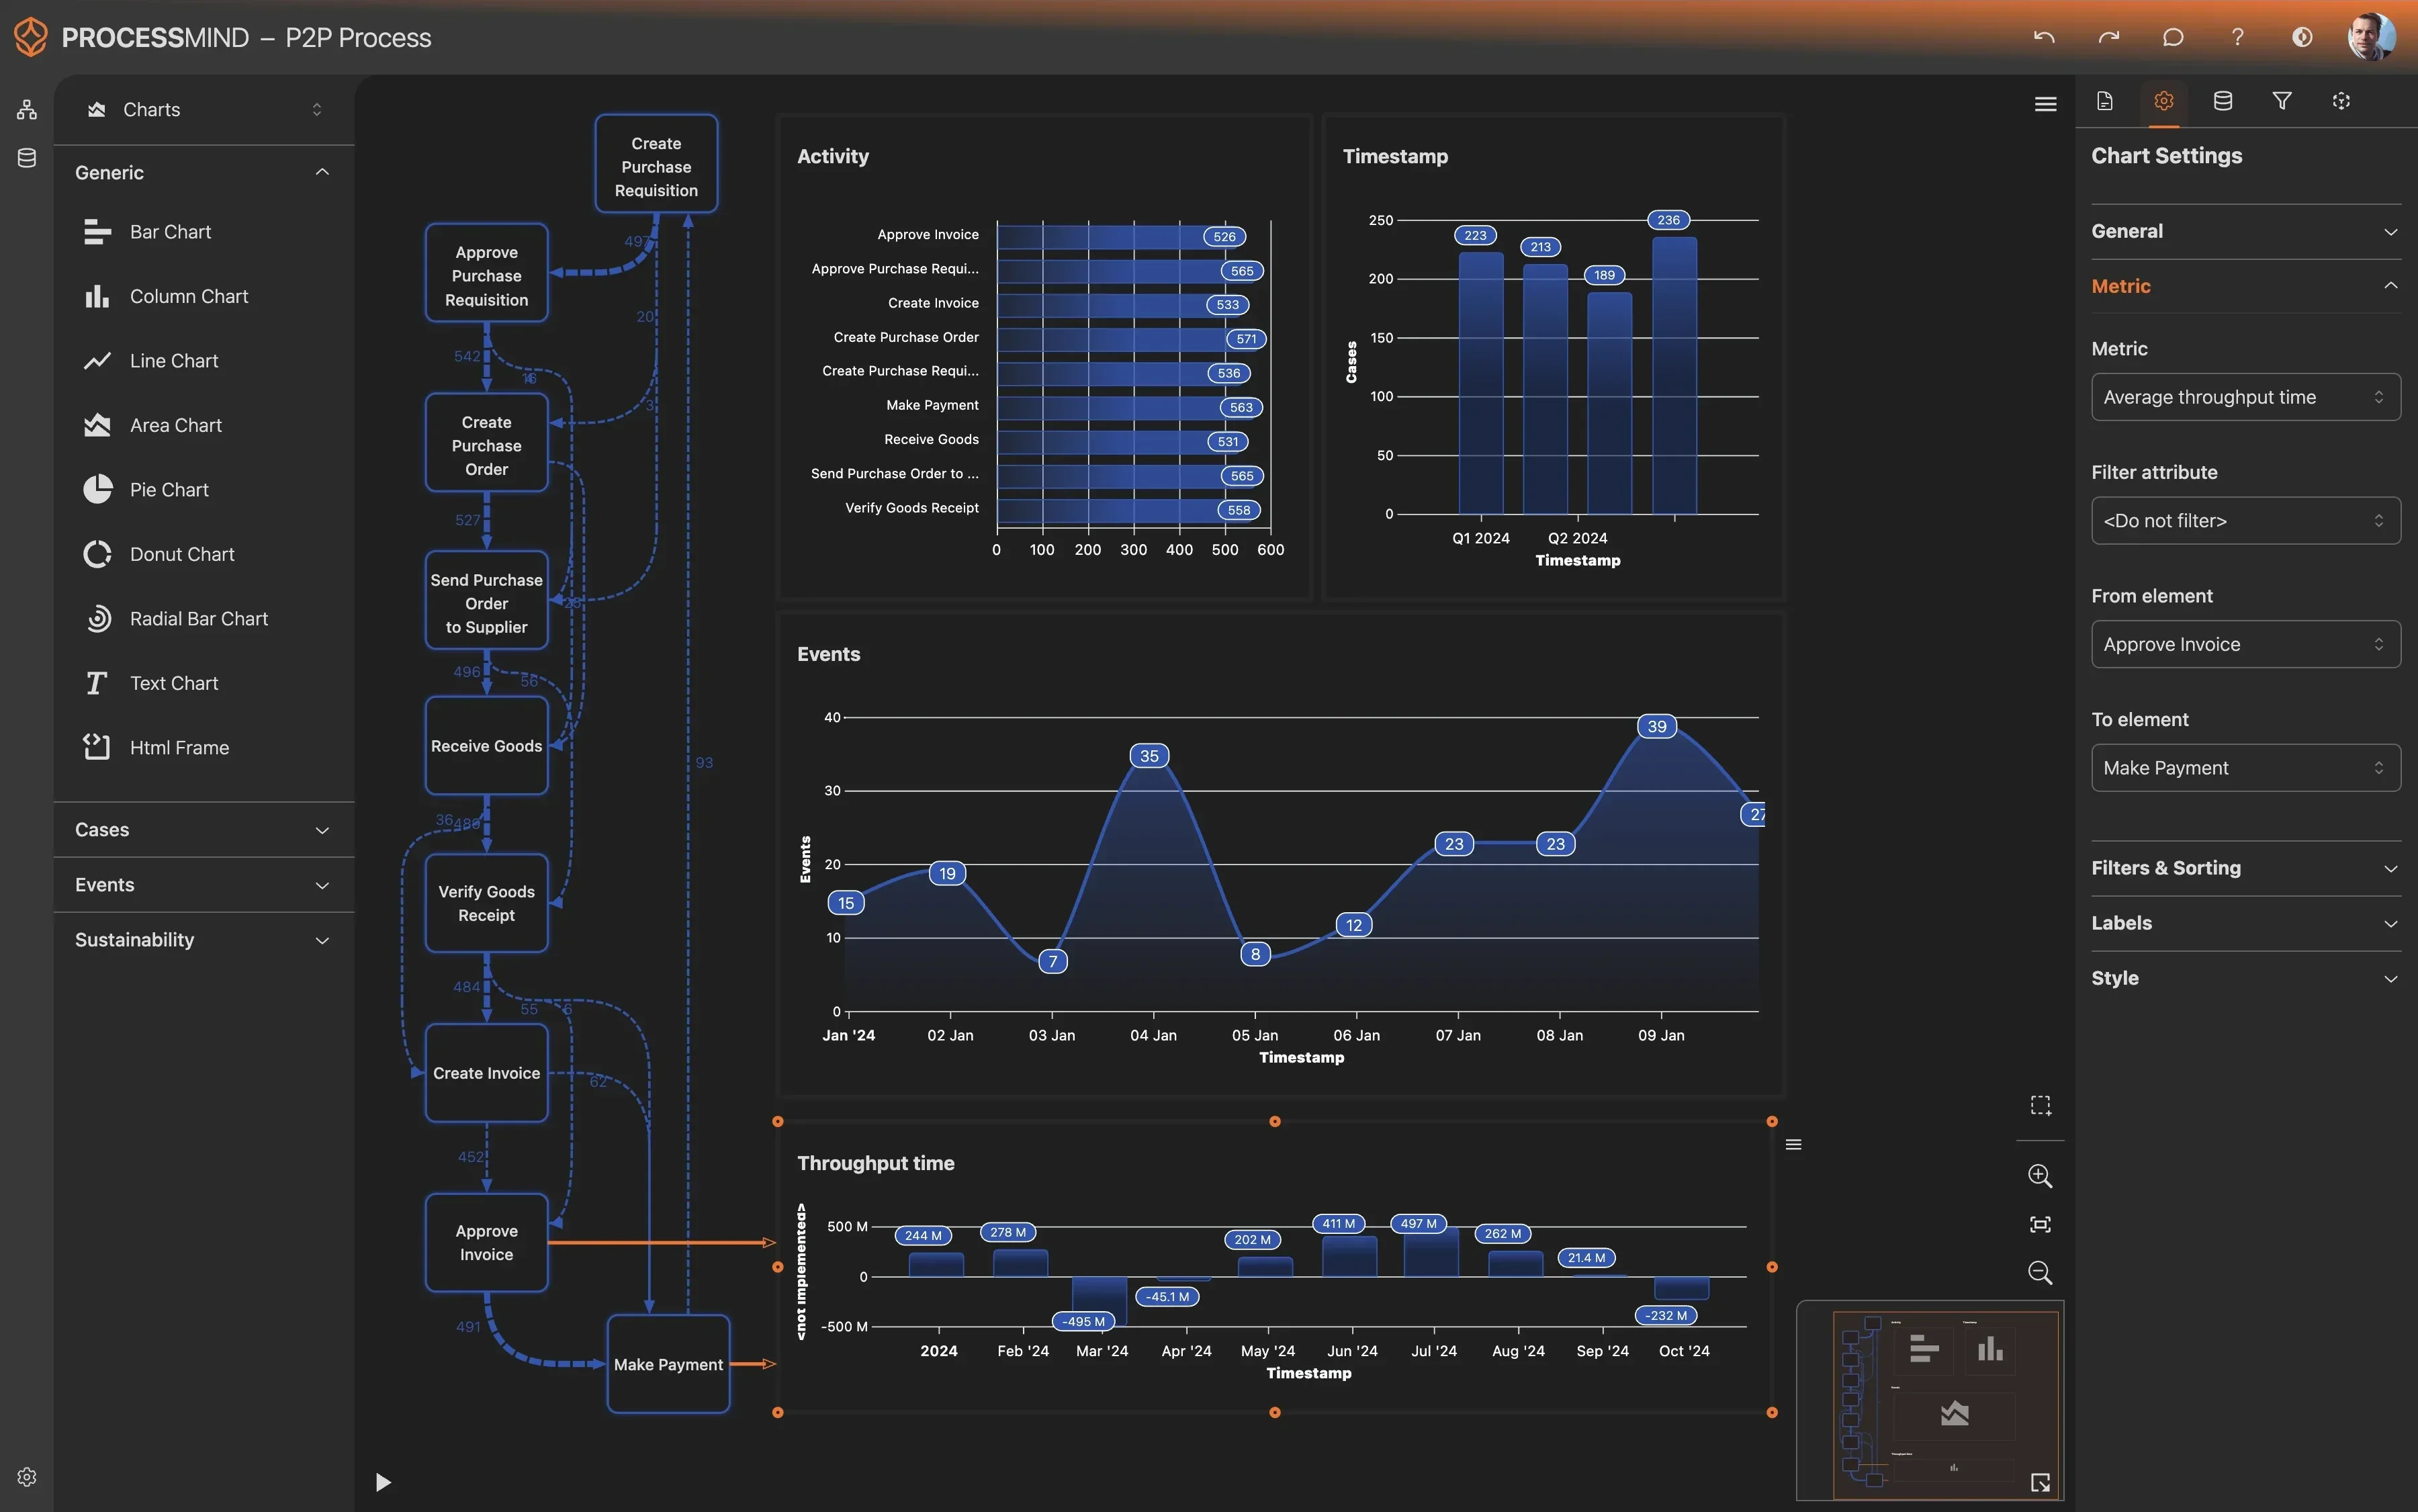
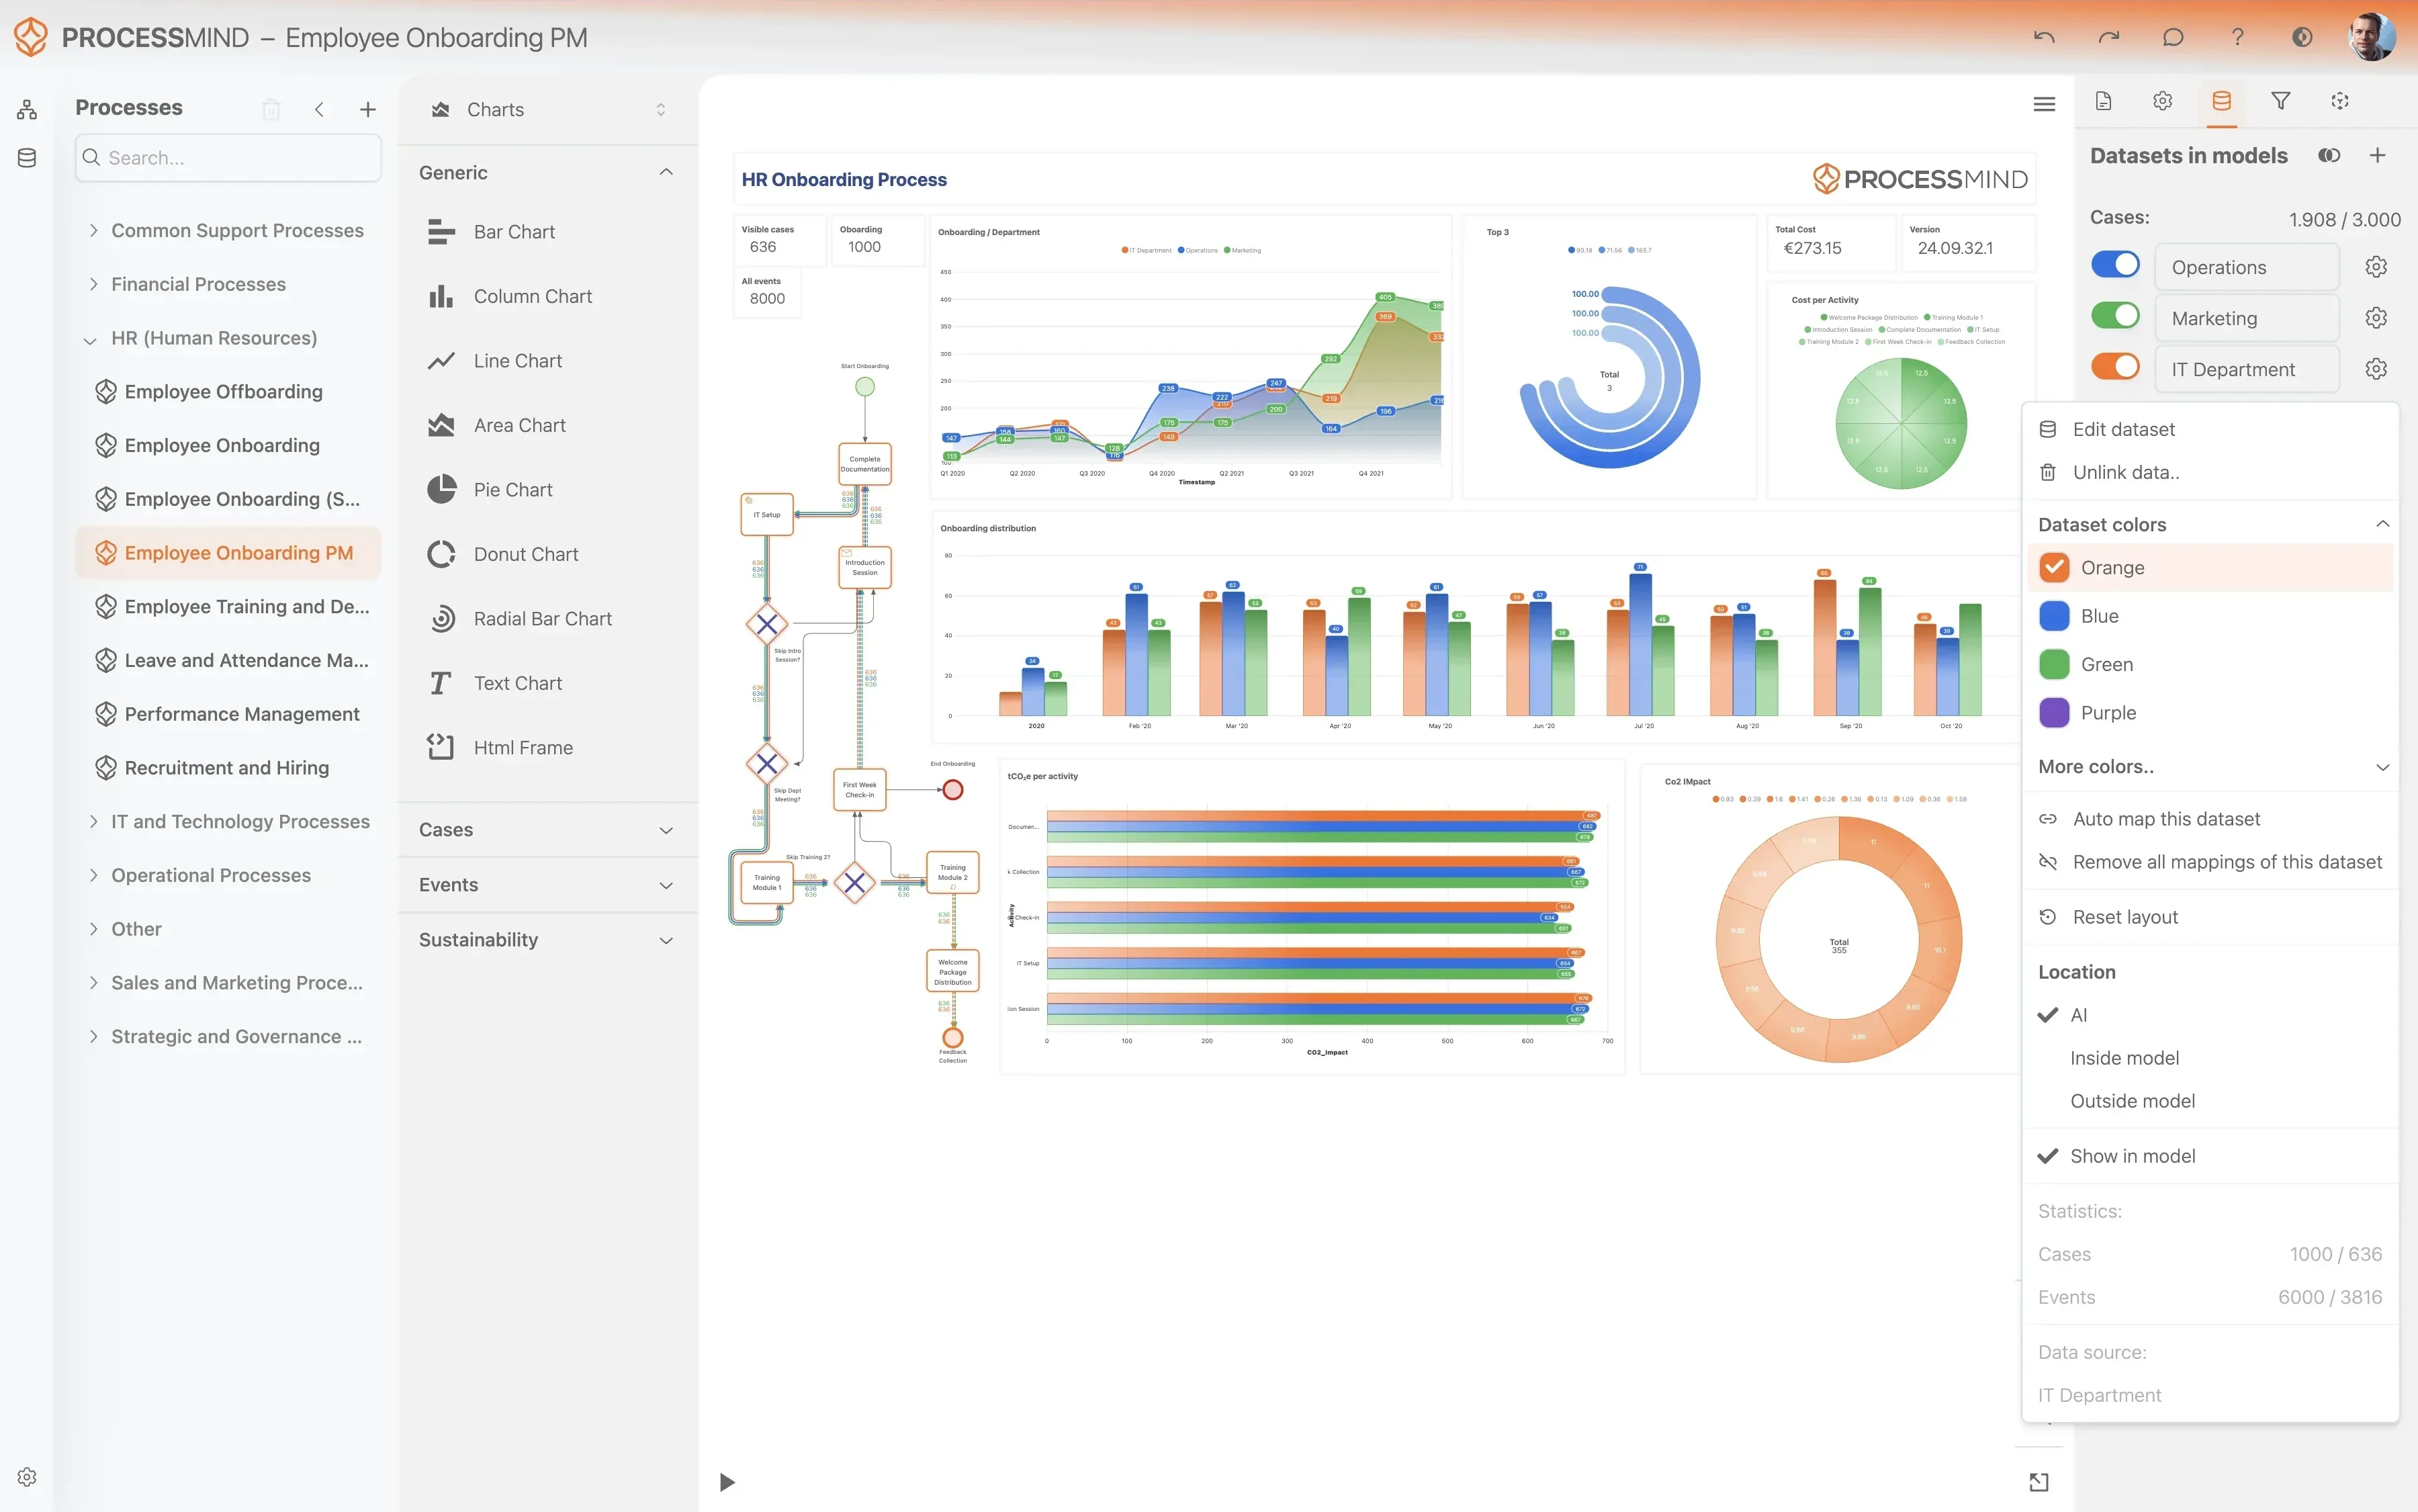
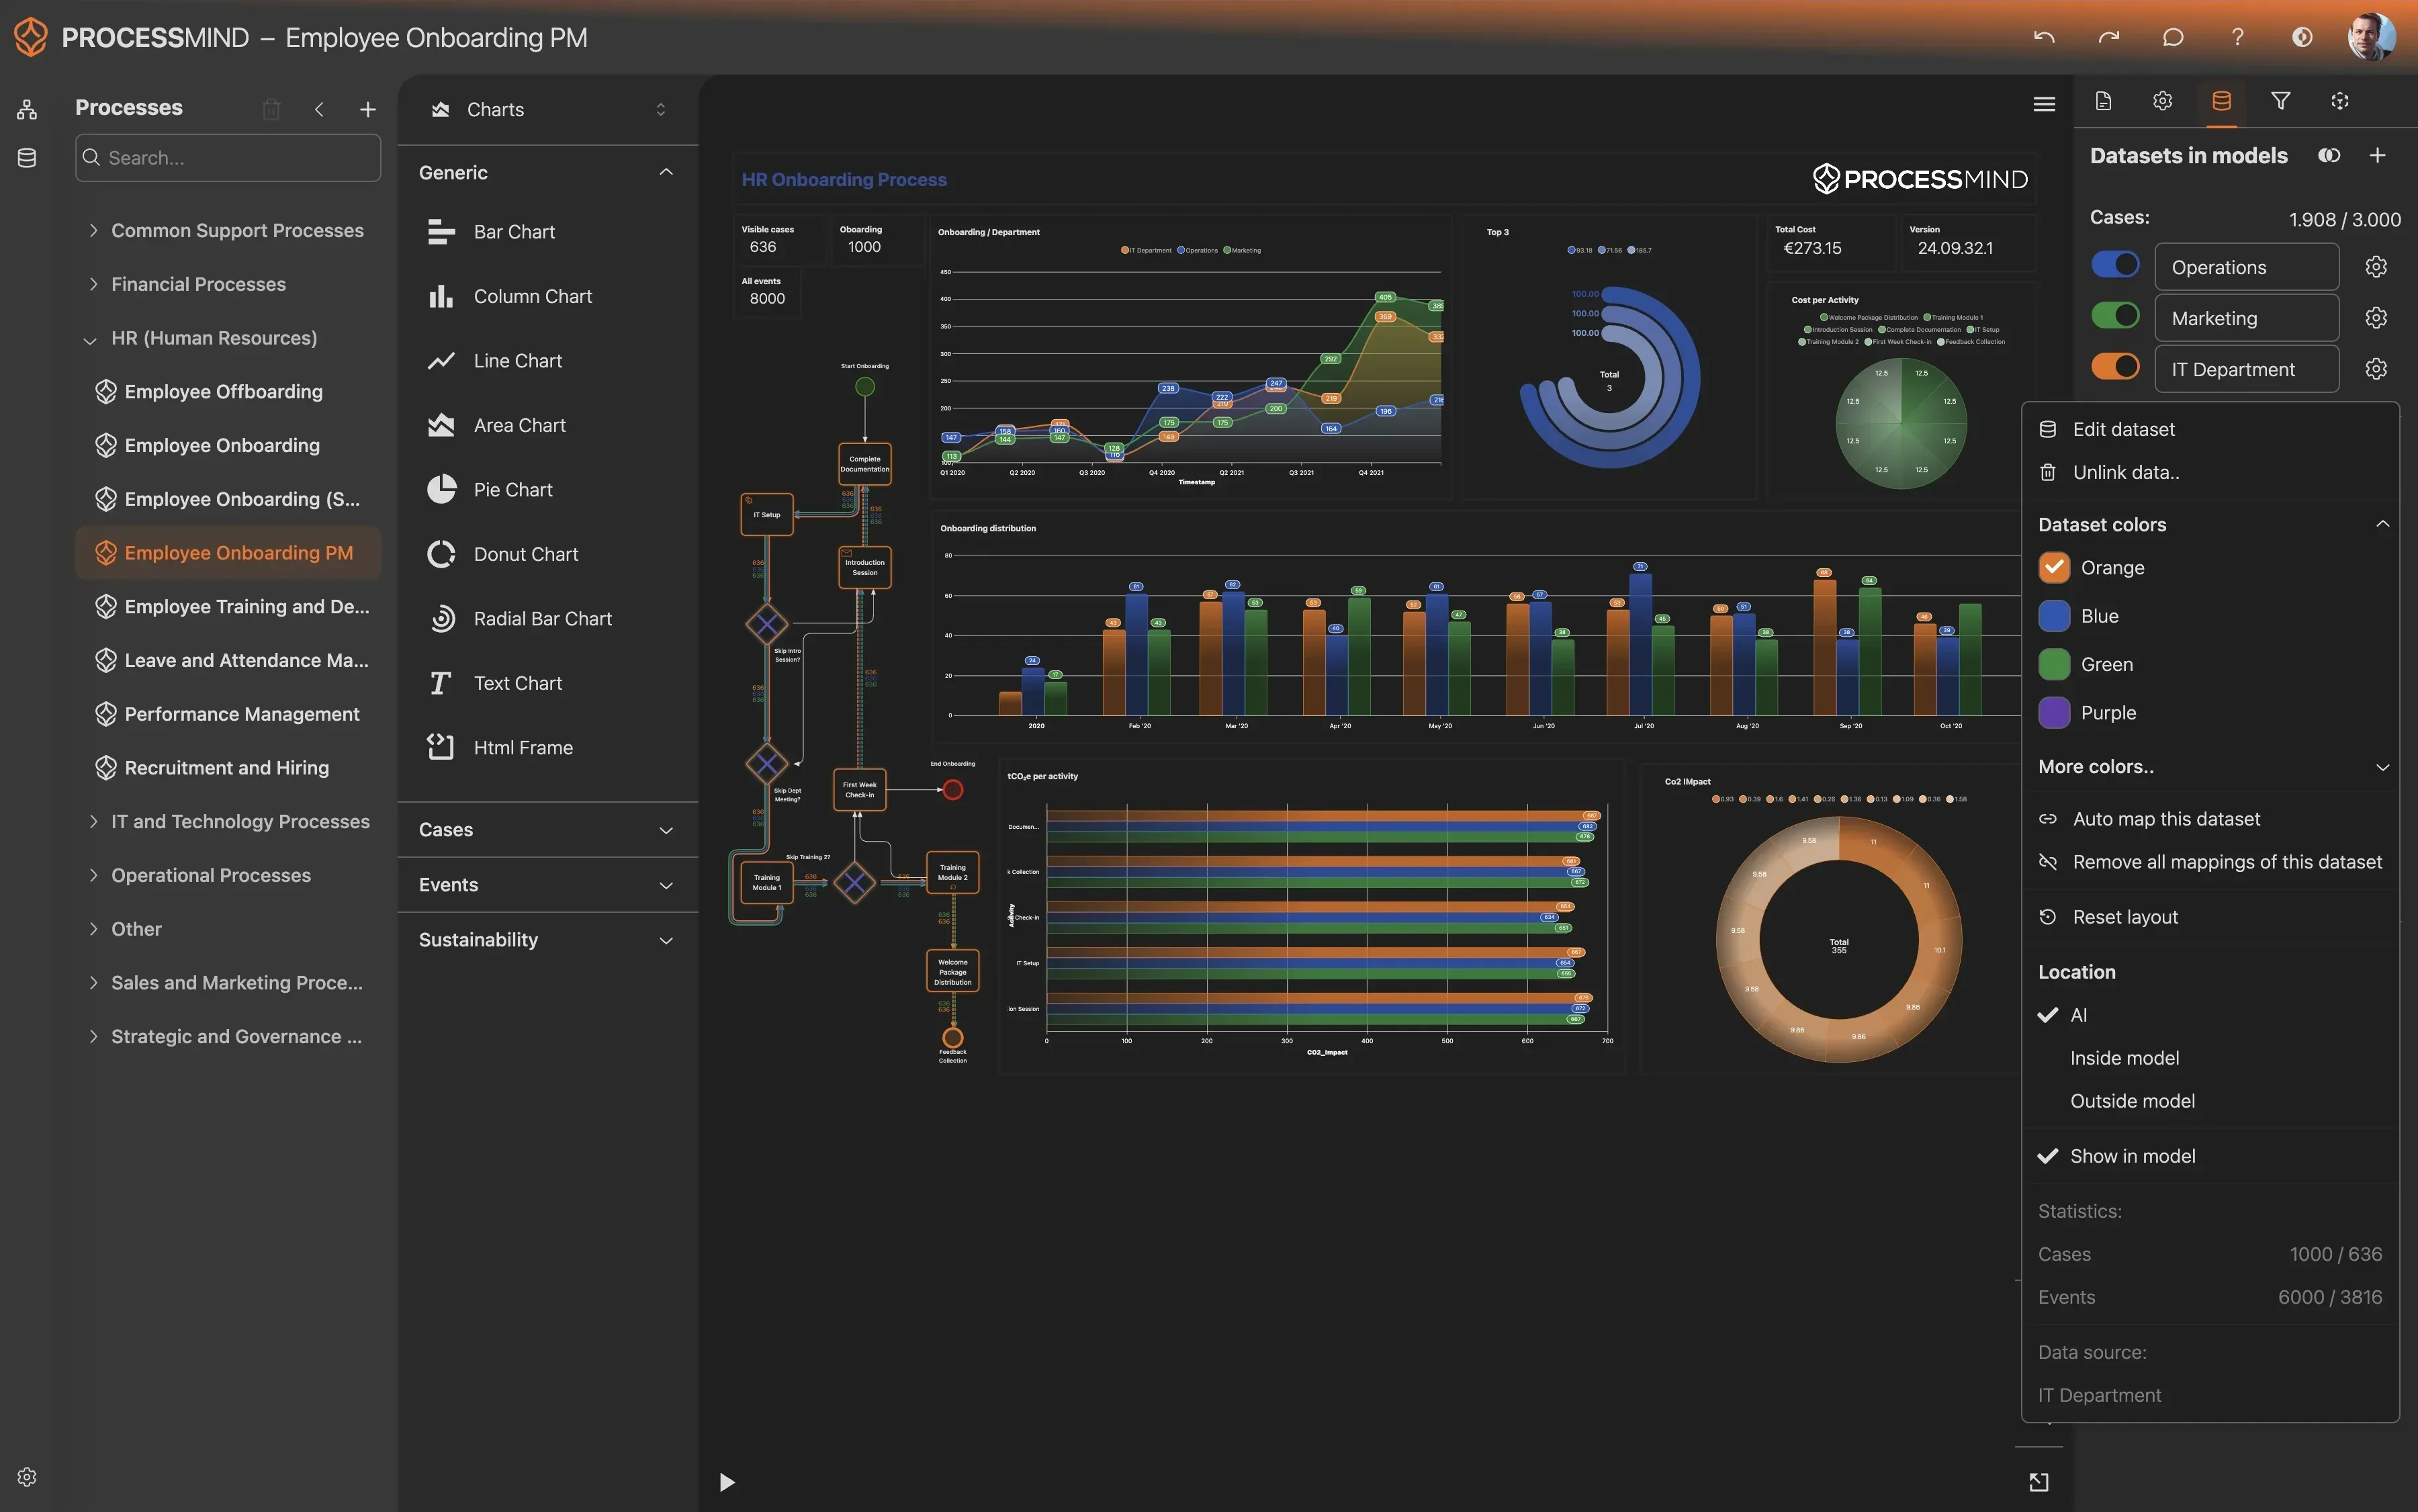
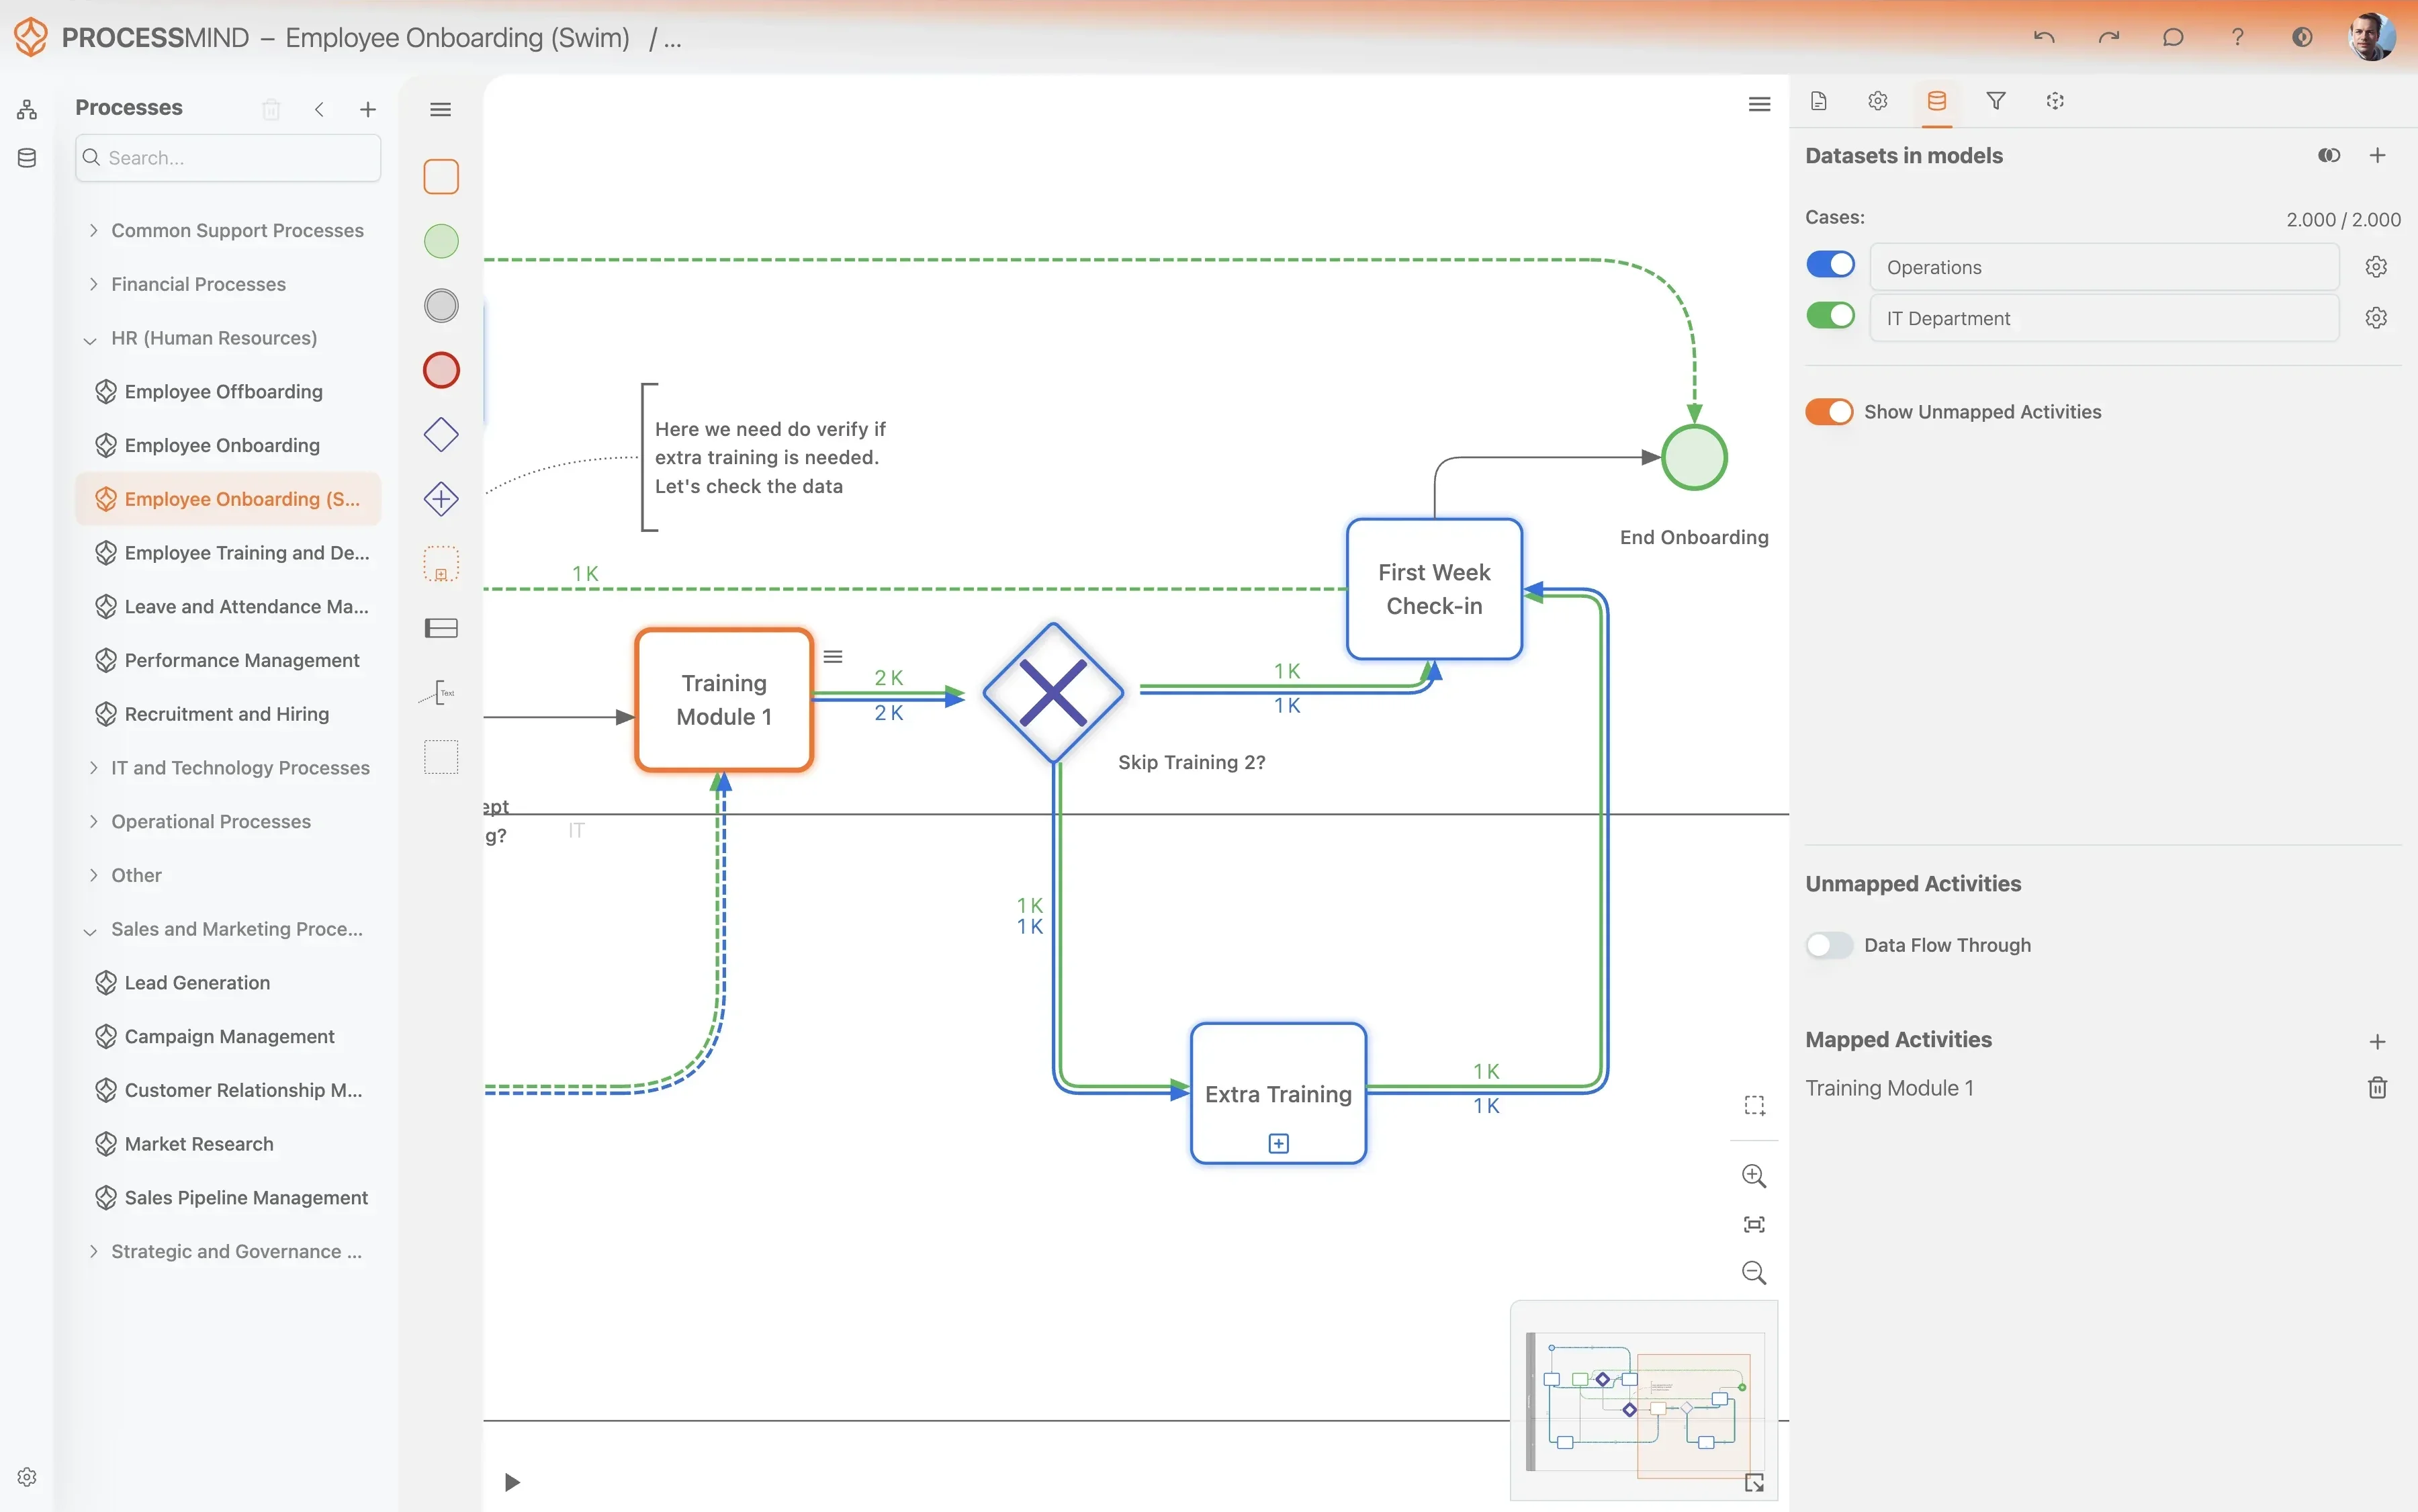
Detecte retrasos ocultos en el flujo de incidencias de Zendesk
- Visualice el flujo real de incidencias en Zendesk
- Identifique los cuellos de botella exactos en la resolución
- Reduzca el tiempo de resolución de las incidencias
- Asegure el cumplimiento de los SLA y mejore la satisfacción
RESULTADOS HABITUALES
Mejore la gestión de incidentes
Estos resultados muestran las mejoras medibles que suelen lograr las organizaciones al aplicar Process Mining a los flujos de gestión de incidentes de Zendesk Support. El análisis de cada "ID del incidente", desde su creación hasta su resolución, permite localizar cuellos de botella e ineficiencias importantes, reducir considerablemente los tiempos de resolución y mejorar la fiabilidad del servicio.
Reducción del tiempo de ciclo promedio
Agilice el proceso de resolución de incidentes: detecte y elimine cuellos de botella para reducir considerablemente el tiempo entre la notificación y el cierre del incidente. Así mejorará la satisfacción de los usuarios y la eficiencia operativa.
Mejora del índice de cumplimiento de los SLA
Identifique las causas de los incumplimientos de los SLA y aplique mejoras específicas para resolver más incidentes dentro de los acuerdos de nivel de servicio establecidos. Así fortalecerá la confianza y cumplirá los compromisos de servicio.
Reducción de las transferencias por incidente
Optimice las rutas de asignación y transferencia de conocimientos para reducir las transferencias innecesarias de incidentes entre equipos o agentes. Esto acelera la resolución y reduce el riesgo de errores.
Aumento del índice de resolución en el primer contacto
Detecte y resuelva los problemas durante la primera interacción con el usuario, proporcionando a los agentes mejores herramientas e información. Esto mejora notablemente la satisfacción de los clientes y reduce la carga operativa general.
Reducción de las actividades repetidas
Detecte y elimine los ciclos recurrentes de retrabajo en los que se vuelve a tratar un incidente después de intentar resolverlo. Así evitará esfuerzos innecesarios, reducirá los costes y acelerará el cierre definitivo.
Los resultados varían según las características del proceso de gestión de incidentes, la calidad de los datos disponibles y el contexto de cada organización. Las cifras que se muestran aquí ilustran las mejoras habituales observadas en distintas implementaciones.
Datos recomendados
Preguntas frecuentes
Preguntas frecuentes
Process Mining utiliza los datos de Zendesk para visualizar el flujo real de los incidentes y revelar desviaciones, cuellos de botella y ciclos de retrabajo. Esto ayuda a identificar las causas de las demoras y las ineficiencias, reducir los tiempos de resolución y mejorar la calidad del servicio. Además, ofrece una visión objetiva de las operaciones basada en datos.
Principalmente, necesita registros de eventos que detallen cada paso del incidente, incluidos el ID del incidente, la descripción de la actividad, la marca de tiempo y la persona que intervino. Entre los campos clave de Zendesk Support suelen estar el ID del ticket, los cambios de estado y de persona asignada, los comentarios y las marcas de tiempo de creación, actualización y resolución. Estos datos permiten que la herramienta de Process Mining reconstruya todo el recorrido del incidente.
Puede reducir los tiempos de resolución y mejorar el cumplimiento de los SLA al detectar y eliminar ineficiencias del proceso. Process Mining ayuda a reducir las transferencias innecesarias, minimizar los ciclos de retrabajo y estandarizar la priorización, para gestionar los incidentes con mayor eficiencia. En última instancia, esto mejora la satisfacción de los usuarios y la coherencia de las operaciones.
La configuración inicial y la extracción de datos suelen completarse en unos días o hasta dos semanas, según el volumen y la accesibilidad de los datos. Las primeras conclusiones suelen aparecer poco después de incorporar y modelar los datos en la herramienta de Process Mining. El análisis completo y la identificación de mejoras útiles para la acción pueden llevar algunas semanas.
Para obtener los registros de eventos, resulta útil tener conocimientos básicos de extracción de datos, por ejemplo, de SQL o de las API de informes de Zendesk. La mayoría de las plataformas de Process Mining ofrecen interfaces fáciles de usar para el análisis, aunque conviene conocer los conceptos de procesos. Es posible que se necesite cierta asistencia técnica para conectar y transformar los datos al inicio.
Sí. Process Mining permite detectar procesos informales, es decir, formas no oficiales de gestionar incidentes al margen de los procedimientos estándar. Al visualizar todas las rutas reales del proceso a partir de los datos de Zendesk, muestra las desviaciones respecto del modelo de proceso previsto. Esto ayuda a aportar transparencia y mejorar el cumplimiento en la gestión de incidentes.
Process Mining identifica con precisión dónde y por qué se incumplen los SLA en el flujo de trabajo de gestión de incidentes. Señala las actividades, demoras o transferencias concretas que impiden alcanzar los objetivos. Al destacar los cuellos de botella de las rutas críticas, permite tomar medidas específicas para mejorar el cumplimiento de los SLA.
La seguridad de los datos es fundamental. Las herramientas de Process Mining suelen ofrecer funciones de seguridad sólidas, como opciones para anonimizar los datos y almacenarlos de forma segura. Usted mantiene el control de sus datos y la mayoría de las soluciones cumple los estándares y las normativas del sector para proteger la privacidad durante todo el análisis.
Al detectar y eliminar ineficiencias como el retrabajo, las transferencias excesivas y los tiempos de resolución prolongados, Process Mining reduce directamente el trabajo manual y los recursos dedicados a cada incidente. Esta optimización disminuye los costes operativos y permite que los equipos gestionen más incidentes con eficacia o reasignen recursos.
Detectar cuellos de botella es una de sus principales ventajas, pero Process Mining abarca mucho más. Permite analizar el uso de los recursos, detectar incumplimientos, medir las variaciones del proceso y predecir resultados futuros. Ofrece una visión integral del proceso de gestión de incidentes, mucho más allá de localizar demoras.
Optimice la gestión de incidencias y resuélvalas más rápido desde hoy
Reduzca el MTTR un 35 %, elimine las incidencias recurrentes y mejore la satisfacción.
No se requiere tarjeta de crédito. Empiece a mejorar en cuestión de minutos.