Usprawnij zarządzanie problemami
6 kroków do optymalizacji zarządzania problemami w ServiceNow
Usprawnij zarządzanie problemami
Zarządzanie problemami
ServiceNow

Wybierz proces

Wybierz proces, aby kontynuować pracę w połączonym obszarze roboczym.

Usprawnij zarządzanie problemami w ServiceNow i szybciej je rozwiązuj

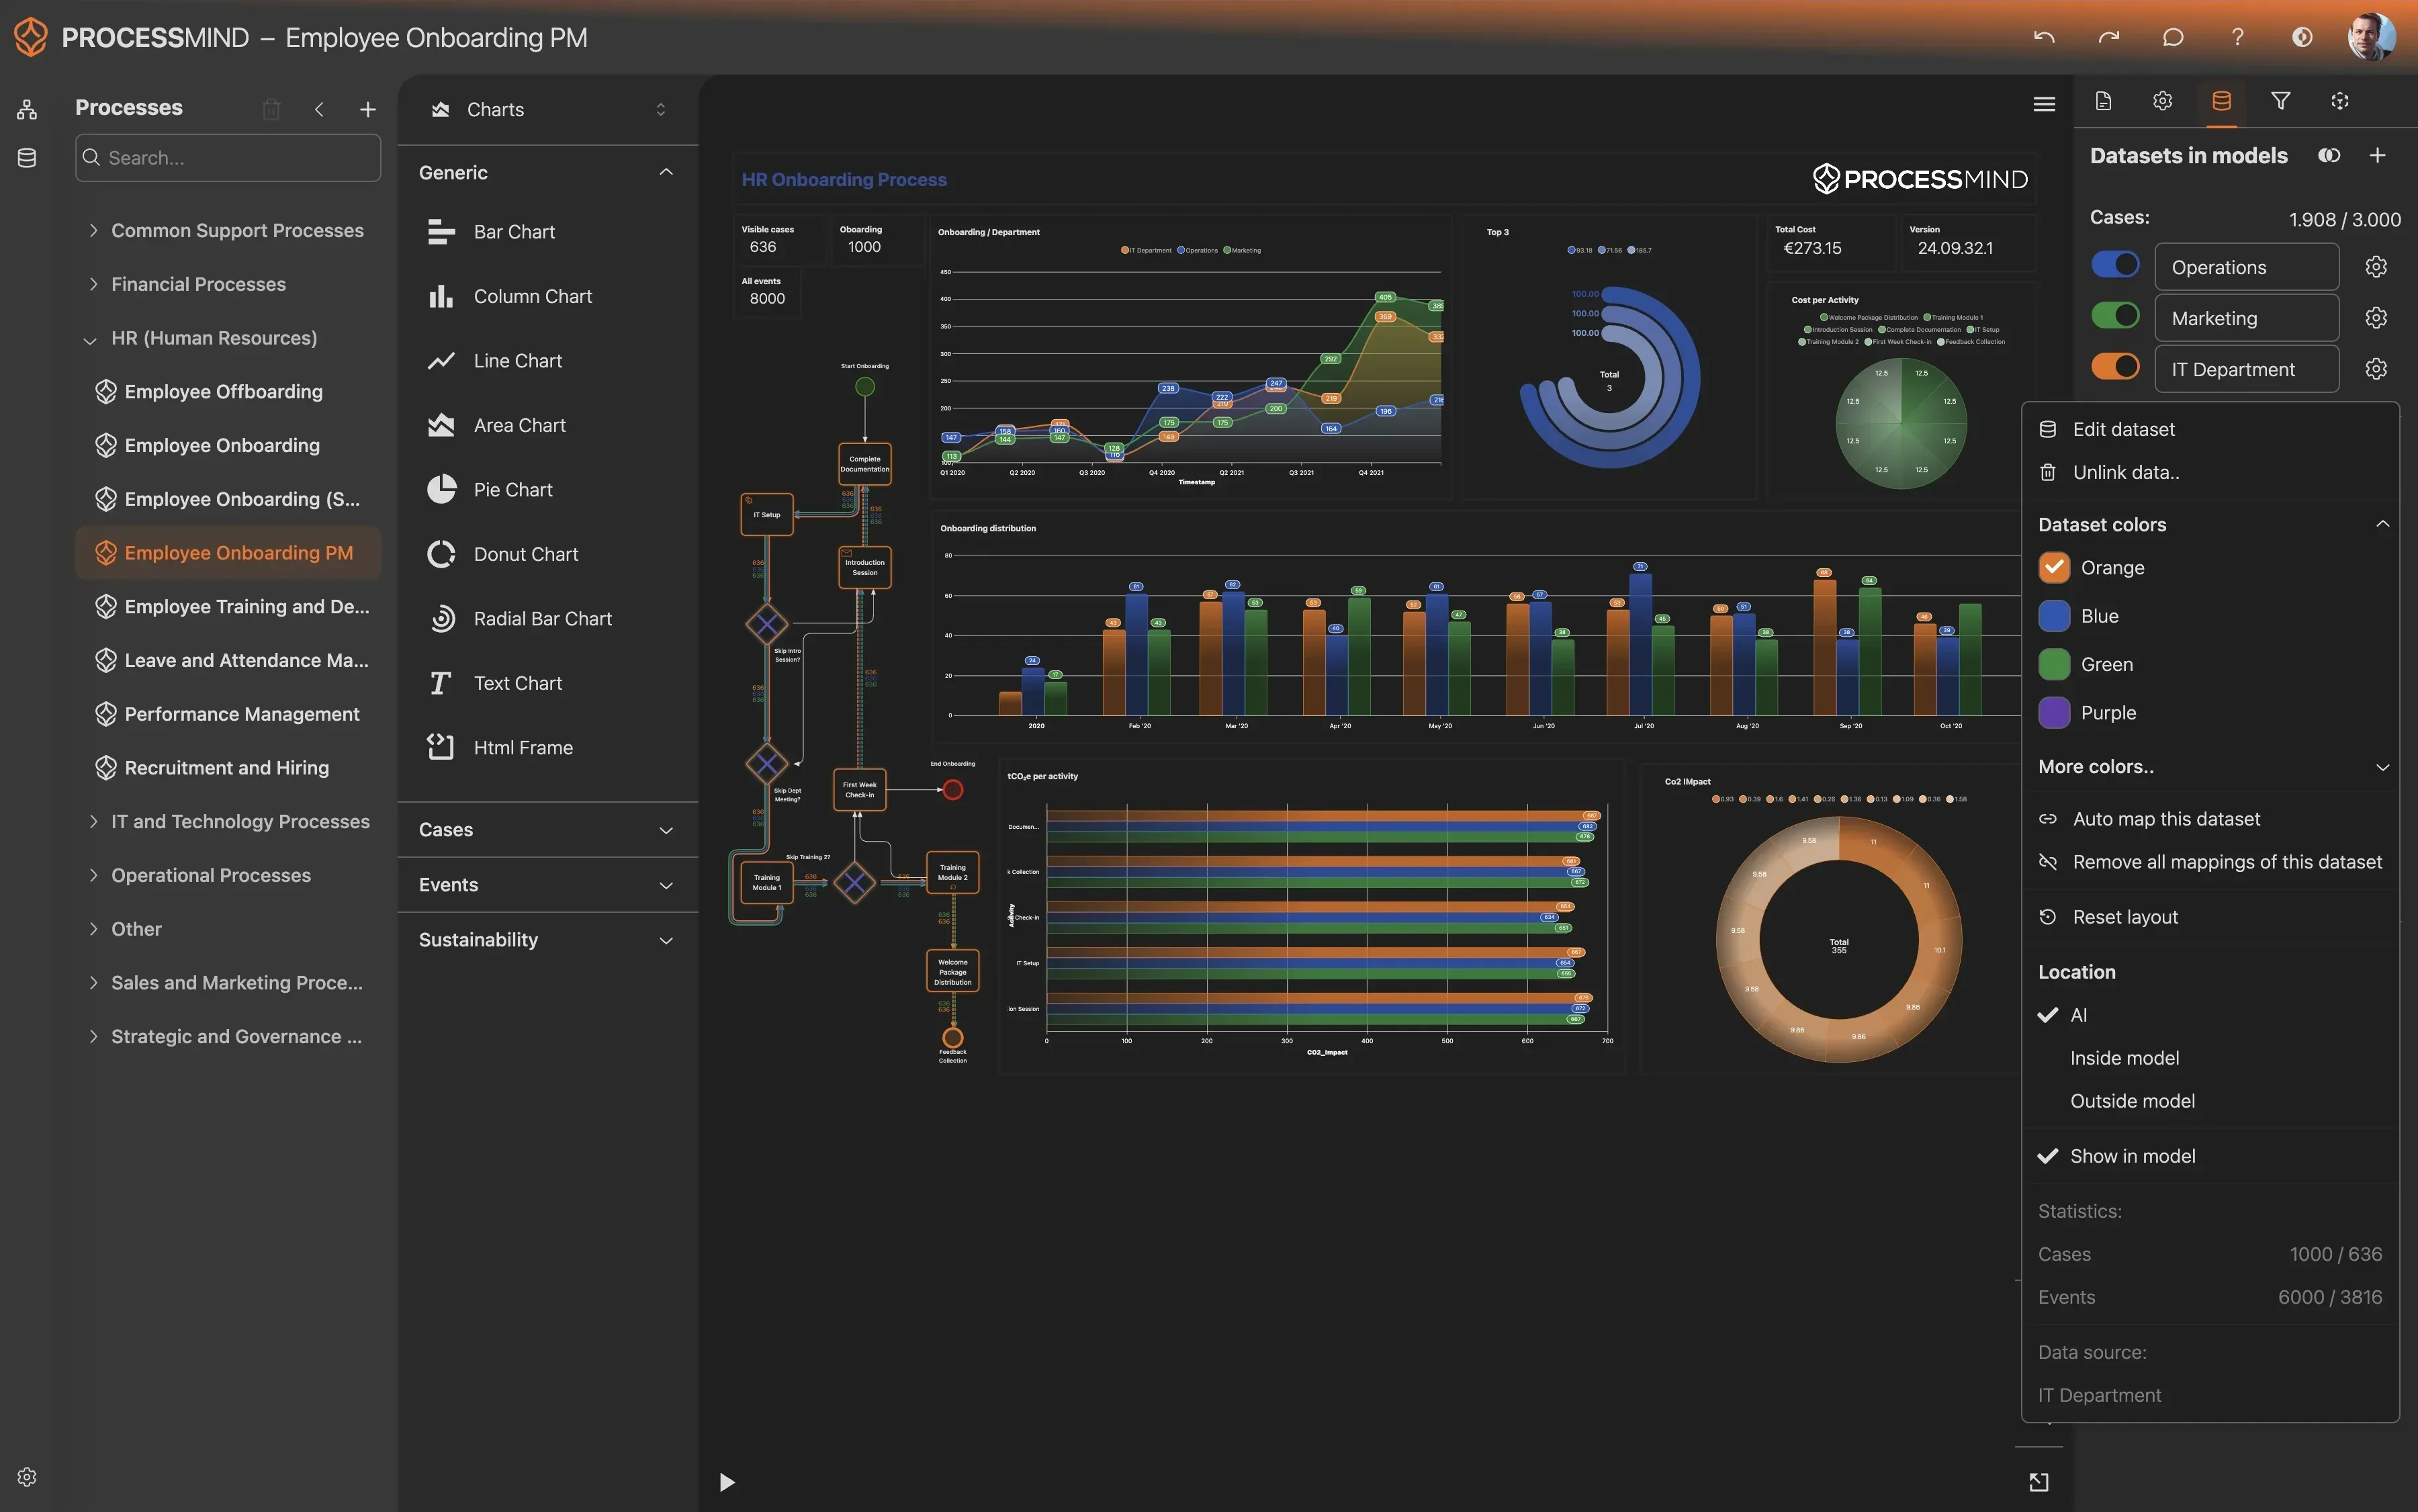
Nasza platforma process mining pokazuje ukryte wąskie gardła i pętle poprawek, które wydłużają czas rozwiązania problemu. Wskazuje, na jakim etapie zatrzymują się analizy i skąd biorą się luki w komunikacji. Dzięki temu można usprawnić operacje. Wizualizacja rzeczywistego przebiegu pracy pomaga ograniczyć ręczne opóźnienia i zapewnić użytkownikom stabilniejsze środowisko.

Pobierz gotowy szablon danych i poznaj częste wyzwania, które utrudniają osiągnięcie celów efektywnościowych. Skorzystaj z planu doskonalenia w sześciu krokach oraz przewodnika po szablonie danych, aby usprawnić operacje.

Pokaż szczegółowy opis

Dlaczego warto usprawnić zarządzanie problemami

Wiele organizacji IT działa w trybie ciągłego reagowania na awarie. Gdy dochodzi do poważnego incydentu, priorytetem jest przywrócenie usługi, ale jego przyczyna źródłowa często pozostaje nierozwiązana. Skutkiem są kolejne awarie i wyższe koszty operacyjne. Usprawnienie zarządzania problemami pozwala przerwać ten cykl. Lepsze metody identyfikowania, analizowania i usuwania problemów w środowisku IT mogą znacząco ograniczyć liczbę nowych incydentów i poprawić stabilność usług. Nieefektywne zarządzanie problemami to nie tylko strata czasu. Osłabia zaufanie użytkowników i odciąga wykwalifikowane zespoły techniczne od innych zadań.

Pełniejszy obraz dzięki process mining

ServiceNow Problem Management gromadzi wiele danych w tabelach takich jak problem i problem_task, ale standardowe raporty często nie pokazują rzeczywistego przebiegu pracy. process mining przekształca te dane w dynamiczną mapę faktycznych procesów. Zamiast ograniczać się do statycznych KPI, takich jak średni wiek otwartych problemów, można prześledzić cały cykl, od wykrycia problemu po jego zamknięcie. Widać wtedy, jak praca przechodzi między grupami wsparcia i gdzie proces odbiega od standardowych procedur. Mapowanie śladów cyfrowych pozostawionych w ServiceNow daje obiektywny obraz operacji, niezależny od perspektywy poszczególnych działów.

Wykrywanie nieefektywności w cyklu dochodzenia

Jednym z głównych wyzwań w zarządzaniu problemami jest czas trwania dochodzenia. process mining pomaga ustalić, dlaczego niektóre dochodzenia się przeciągają. Może się na przykład okazać, że rekordy problemów krążą między zespołami technicznymi, ponieważ wstępna ocena była niewystarczająca. Można też wykryć wąskie gardła, w których zgłoszenia tygodniami czekają na odpowiedź dostawcy lub wewnętrzną zgodę na zmianę. Po zidentyfikowaniu tych opóźnień można wprowadzić ukierunkowane usprawnienia, takie jak lepsze zasady przekazywania spraw lub automatyczne ścieżki eskalacji, aby szybciej wdrażać trwałe poprawki.

Lepsza analiza przyczyn źródłowych i zgodność

Rzetelne dochodzenia są podstawą skutecznego zarządzania problemami. process mining pozwala sprawdzić, czy analiza przyczyn źródłowych (RCA) przebiega zgodnie z ustalonymi zasadami. Można ustalić, czy pomijane lub przyspieszane są ważne kroki, takie jak publikacja obejścia problemu lub przeprowadzenie przeglądu po wdrożeniu. W organizacjach działających w branżach podlegających ścisłym regulacjom każdy rekord problemu powinien przechodzić zgodną z wymaganiami ścieżkę. Analiza powiązań między incydentami a problemami w ServiceNow pomaga też ocenić, czy zespoły prawidłowo identyfikują problemy o dużym wpływie, czy poświęcają zbyt wiele czasu na dochodzenia o niskim priorytecie i niewielkim znaczeniu biznesowym.

Pomiar efektów i ciągłe usprawnianie

Celem usprawniania zarządzania problemami jest zwiększenie odporności infrastruktury IT. process mining dostarcza szczegółowych danych, które pozwalają mierzyć efekty wprowadzanych zmian. Można śledzić, jak zmienia się stosunek trwałych poprawek do tymczasowych obejść, oraz monitorować skracanie całego cyklu obsługi rekordów problemów. Gdy z workflow ServiceNow znikają zbędne utrudnienia, zespół skuteczniej zapobiega incydentom. Przejście od reagowania na problemy do zapobiegania im ogranicza koszty i ułatwia rozwój usług IT wraz z potrzebami firmy. Szablon process mining pozwala szybko uzyskać te informacje i wykorzystać istniejące dane ServiceNow do planowania usprawnień operacyjnych.

Zarządzanie problemami Analiza przyczyn źródłowych Zarządzanie usługami IT Zapobieganie incydentom Service desk Wsparcie techniczne Operacje IT Zarządzanie zmianami Obsługa zgłoszeń Zarządzanie zgłoszeniami Znany błąd Powtarzające się incydenty Obejście problemu Dział pomocy IT

Typowe problemy i wyzwania

Wskaż wyzwania, które Państwa dotyczą

Problemy często przez długi czas pozostają w statusie oczekującym, gdy zespoły czekają na odpowiedź dostawcy lub dodatkowe informacje wewnętrzne. Wstrzymuje to analizę przyczyny źródłowej, wydłuża czas rozwiązania i zwiększa zaległości nierozwiązanych problemów technicznych, które nadal wpływają na działalność firmy.

ProcessMind śledzi zmiany statusów w zarządzaniu problemami w ServiceNow i wskazuje, gdzie oraz dlaczego zatrzymują się rekordy. Wizualizacja czasu spędzonego w każdym statusie pomaga ustalić, które grupy wsparcia lub dostawcy powodują znaczne opóźnienia w cyklu dochodzenia.

Gdy rekordy problemów nie są sprawnie rozwiązywane, te same incydenty powracają, przeciążając service desk i frustrując użytkowników końcowych. Może to oznaczać, że obejścia problemu nie są prawidłowo publikowane albo nie ograniczają skutków problemu do czasu wdrożenia trwałej poprawki.

Analizując powiązania między incydentami a rekordami problemów w ServiceNow Problem Management, ProcessMind wykrywa wzorce nawrotów wskazujące na nieudane lub niepełne dochodzenia. Dzięki tym danym zespoły mogą nadać priorytet problemom o dużym wpływie, które generują najwięcej zgłoszeń i pochłaniają najwięcej zasobów.

Nieosiągnięcie celów SLA dotyczących ustalenia przyczyny źródłowej może prowadzić do długotrwałej niestabilności usług i utraty zaufania interesariuszy do operacji IT. Zespoły techniczne mogą być przeciążone lub nie mieć wystarczających informacji, by ustalać priorytety dochodzeń na podstawie rzeczywistego wpływu problemu na działalność firmy.

Nasza platforma mierzy czas od rejestracji problemu do ustalenia jego przyczyny źródłowej w środowisku ServiceNow. Oznacza rekordy zbliżające się do limitów SLA, dzięki czemu koordynatorzy problemów mogą przesunąć zasoby i dopilnować, aby ważne dochodzenia przebiegały zgodnie z planem i nie przekroczyły wyznaczonych terminów.

Rekordy problemów często przechodzą między zespołami technicznymi, zanim rozpocznie się właściwe dochodzenie. Takie przekazywanie spraw w kółko marnuje czas, utrudnia ustalenie odpowiedzialności i opóźnia rozwiązanie, ponieważ żadna grupa nie bierze odpowiedzialności za przyczynę źródłową.

ProcessMind mapuje przepływ przypisań między grupami wsparcia, aby wykryć problemy z przekazywaniem spraw i luki w odpowiedzialności. Identyfikacja częstych pętli ponownych przypisań w ServiceNow Problem Management pozwala usprawnić początkowe kierowanie zgłoszeń i szybciej przekazywać problemy właściwym ekspertom technicznym.

Nawet po ustaleniu przyczyny źródłowej często mija dużo czasu, zanim zostanie zainicjowane zgłoszenie zmiany potrzebnej do jej usunięcia. W tym czasie organizacja pozostaje narażona na kolejne incydenty, ponieważ trwałe rozwiązanie nie zostało zaplanowane ani wdrożone, mimo że jest już znane.

Śledzimy przekazywanie spraw między ServiceNow Problem Management a modułem Change Management. Mierząc czas od ustalenia przyczyny źródłowej do przygotowania projektu rozwiązania, ProcessMind pomaga skrócić drogę do trwałego rozwiązania i dopilnować, aby poprawki trafiały do środowiska produkcyjnego bez zbędnej zwłoki.

Wiele organizacji zamyka rekordy problemów bez przeprowadzenia właściwego przeglądu po wdrożeniu poprawki. W efekcie nie wyciąga się wniosków i nie potwierdza formalnie, czy przyczyna źródłowa została usunięta, co może prowadzić do kolejnych awarii.

ProcessMind wskazuje przypadki, w których proces przechodzi bezpośrednio od rozwiązania do zamknięcia, z pominięciem wymaganego przeglądu. Dzięki temu zespoły mogą realizować pełny cykl zarządzania problemami w ServiceNow, zwiększać stabilność usług i lepiej dzielić się wiedzą w organizacji IT.

Jeśli obejścia problemów nie są dokumentowane i publikowane w bazie znanych błędów, pracownicy service desk nie mogą skutecznie pomagać użytkownikom w trakcie dochodzenia. Prowadzi to do powielania pracy, większej liczby połączeń i wydłużenia średniego czasu rozwiązania powiązanych incydentów.

Analizując dzienniki działań związanych z publikowaniem obejść, ProcessMind wskazuje dochodzenia, które nie zapewniają firmie tymczasowej ulgi. Te informacje pomagają menedżerom egzekwować standardy dokumentacji w workflow ServiceNow Problem Management i zwiększać efektywność service desk.

Zdarza się, że zespoły techniczne zajmują się zadaniami o niskim priorytecie, podczas gdy problemy o dużym wpływie na krytyczne usługi biznesowe pozostają w kolejce. Takie rozłożenie pracy powoduje poważne zakłócenia w działalności firmy i oznacza niewłaściwe wykorzystanie czasu wysoko wykwalifikowanych, kosztownych zasobów technicznych.

Nasza analiza zestawia priorytety problemów z nakładem pracy i czasem potrzebnym na ich rozwiązanie. ProcessMind pomaga sprawdzić, czy najważniejsze rekordy w ServiceNow otrzymują należytą uwagę, czy też ustępują miejsca mniej pilnym, łatwiejszym do rozwiązania zadaniom.

Przejście od ustalenia przyczyny źródłowej do zaproponowania konkretnego rozwiązania technicznego często staje się wąskim gardłem. Przyczyną bywają ograniczone zasoby lub niepełna dokumentacja z etapu dochodzenia, przez co architektom trudno zaprojektować odpowiednią poprawkę.

ProcessMind wizualizuje cykl obsługi poszczególnych rekordów problemów i wskazuje, na którym etapie zatrzymuje się projektowanie rozwiązania. Ustalenie przyczyn opóźnień w ServiceNow Problem Management pozwala usprawnić współpracę architektów i inżynierów oraz szybciej przejść od analizy do praktycznej poprawki.

Rekordy problemów często pozostają otwarte bezterminowo, mimo że nikt aktywnie się nimi nie zajmuje. W efekcie zaległości rosną i trudno nad nimi zapanować. Porzucone rekordy przesłaniają rzeczywiste problemy i utrudniają kierownictwu IT ocenę stabilności operacyjnej oraz wyników zespołów.

Wykrywamy rekordy, w których przez długi czas nie zmienia się stan, analizując historię ServiceNow Problem Management. ProcessMind pomaga uporządkować zaległości, wskazując nierozpatrywane zgłoszenia, które należy oficjalnie zamknąć albo ponownie skierować do analizy, przydzielając do niej zasoby.

Jeśli zespoły stosują ogólne lub nieprawidłowe kategorie przyczyn źródłowych, trudno wykryć długoterminowe trendy i problemy systemowe w infrastrukturze. Niska jakość danych utrudnia podejmowanie świadomych decyzji inwestycyjnych, które mogłyby zapobiec przyszłym awariom.

ProcessMind analizuje zależność między sposobem rozwiązania problemu a kategoriami przypisanymi w ServiceNow Problem Management. Pomaga wykryć przypadki nieprawidłowego stosowania kategorii, poprawić jakość danych i lepiej rozpoznać główne źródła długu technicznego.

Zbyt długie poszukiwanie obejścia problemu sprawia, że użytkownicy nie mogą pracować, a skutki problemu się nasilają. Jeśli analiza rozpoczyna się z opóźnieniem, firma odczuwa jego konsekwencje dłużej, nawet gdy ostatecznie udaje się znaleźć trwałe rozwiązanie.

Nasza platforma mierzy czas od zidentyfikowania problemu do opublikowania pierwszego obejścia. Analiza tego etapu procesu ServiceNow Problem Management pozwala wskazać zespoły, które mają trudności z szybkim ograniczeniem skutków problemu. Dzięki temu można zaplanować szkolenia dotyczące łagodzenia skutków incydentów.

Typowe cele

Określ, jak wygląda sukces

Szybsza analiza przyczyn źródłowych zapobiega powtarzającym się incydentom i ogranicza przestoje infrastruktury. Sprawniejsza analiza pozwala zespołom technicznym odejść od ciągłego gaszenia pożarów i skupić się na trwałych poprawkach, które zwiększają niezawodność usług. Wpływa to bezpośrednio na efektywność pracy doświadczonych inżynierów i skraca czas, przez który krytyczne podatności pozostają nierozwiązane.

ProcessMind przedstawia cały przebieg analizy w ServiceNow Problem Management i wskazuje, na których etapach zespoły tracą czas. Pozwala wykryć wąskie gardła w konkretnych grupach wsparcia lub obszarach technicznych. Platforma dostarcza informacji, które pomagają skrócić czas analizy nawet o 30%. Można śledzić drogę od identyfikacji problemu do ustalenia jego przyczyny źródłowej i sprawdzać, czy analiza przebiega zgodnie z planem.

Każde przekazanie sprawy między grupami wsparcia wydłuża czas rozwiązania i zwiększa nakład pracy administracyjnej. Ograniczenie liczby przekazań pomaga od razu skierować problem do właściwych ekspertów i zapobiega przerzucaniu go między zespołami, gdy odpowiedzialność za jego rozwiązanie nie jest jasno określona. Mniej zmian przypisania usprawnia proces i zwiększa odpowiedzialność zespołów technicznych.

Nasza platforma śledzi historię zmian pola przypisanej grupy wsparcia w każdym rekordzie problemu w ServiceNow. ProcessMind wykrywa przypadki błędnego kierowania rekordów i częstego przekazywania ich między zespołami. Dzięki temu można poprawić reguły kierowania spraw i ograniczyć liczbę zbędnych zmian przypisania o połowę. Analiza może wtedy przebiegać bez utraty tempa podczas przekazywania sprawy.

Dotrzymywanie terminów analizy jest niezbędne do utrzymania poziomu usług i stabilności operacyjnej w całej organizacji IT. Stałe przestrzeganie ustaleń SLA sprawia, że pilne problemy nie zostają bez reakcji, a firma jest chroniona przed znanymi zagrożeniami. Gdy zespoły regularnie osiągają wyznaczone cele dotyczące poziomu usług, rośnie zaufanie interesariuszy, a realizacja usług staje się bardziej przewidywalna.

ProcessMind analizuje tabele problemów i zadań związanych z problemami, aby na bieżąco porównywać rzeczywiste wyniki z celami SLA. Wskazuje etapy procesu, na których najczęściej dochodzi do przekroczenia terminów, i pomaga zespołom utrzymać zgodność na poziomie powyżej 95% dla wszystkich priorytetów. Można sprawdzić, którym kategoriom lub usługom najbardziej grozi opóźnienie, i zareagować, zanim dojdzie do naruszenia SLA.

Szybkie udostępnienie obejścia ogranicza wpływ aktywnego problemu na użytkowników końcowych i Service Desk. Pracownicy wsparcia mogą rozwiązywać incydenty jeszcze przed wdrożeniem trwałej poprawki, co znacznie zmniejsza liczbę otwartych zgłoszeń i poprawia zadowolenie użytkowników. Szybkie przygotowanie obejścia często najskuteczniej ogranicza bezpośrednie skutki poważnej awarii.

Analizujemy czas od zidentyfikowania problemu do opublikowania obejścia w bazie znanych błędów. Informacje z ProcessMind pomagają ujednolicić ten etap, dzięki czemu dokumentacja znanych błędów może być dostępna o 40% szybciej. Widać, czy zespoły szybko przekazują informacje o rozwiązaniach tymczasowych, gdy trwa analiza przyczyny źródłowej.

Sprawne przekazanie rekordu problemu do wniosku o zmianę jest niezbędne, aby wdrażać trwałe poprawki w kontrolowany sposób. Opóźnienia na tym etapie sprawiają, że wykryte podatności pozostają w środowisku produkcyjnym dłużej, niż to konieczne. Dobra współpraca między tymi procesami pozwala przełożyć pracę analityczną na rzeczywiste usunięcie problemu.

ProcessMind mapuje ślady działań w tabelach problemów i wniosków o zmianę w ServiceNow, aby wykryć utrudnienia na etapach zatwierdzania i przekazywania spraw. Pomaga skrócić czas między ustaleniem przyczyny źródłowej a rozpoczęciem prac nad poprawką oraz ograniczyć przestoje administracyjne. Można dokładnie sprawdzić, na którym etapie przygotowania lub zatwierdzania zatrzymują się proponowane rozwiązania.

Najważniejszą miarą skuteczności zespołu zarządzania problemami jest spadek liczby powtarzających się incydentów. Ustalenie i usunięcie przyczyn źródłowych obniża całkowity koszt utrzymania usług IT i zmniejsza codzienne obciążenie Service Desk. Zapobieganie nawrotom incydentów pokazuje, jaką wymierną korzyść dla całej firmy przynosi proces zarządzania problemami.

ProcessMind łączy dane o liczbie incydentów z konkretnymi rekordami problemów, aby ocenić długoterminową skuteczność trwałych poprawek. Pozwala sprawdzić, czy rozwiązania rzeczywiście usuwają przyczynę źródłową, zamiast jedynie łagodzić objawy. Można śledzić skuteczność wdrożonych zmian i sprawdzać, czy przynoszą oczekiwany spadek liczby incydentów.

Nieaktualne i porzucone rekordy zaśmiecają środowisko ServiceNow i utrudniają zespołom technicznym rozpoznanie bieżących priorytetów. Uporządkowanie zaległości pomaga kierować ograniczone zasoby do najpilniejszych, aktualnych problemów. Aktywna i uporządkowana kolejka problemów ułatwia kierownictwu ocenę sytuacji, a koordynatorom codzienną pracę.

Wskazujemy nieaktywne lub nierozpatrywane rekordy, w których od dłuższego czasu nie zmienił się stan ani nie odnotowano żadnych działań. Dzięki temu zespoły mogą zamknąć porzucone analizy i skupić się na bieżących zadaniach naprawczych. Regularne porządkowanie rekordów pozwala utrzymać kolejkę problemów w ryzach i skoncentrować się na analizach przynoszących największe korzyści.

Prawidłowa klasyfikacja przyczyn źródłowych jest niezbędna do analizy długoterminowych trendów i planowania ulepszeń usług. Pomaga kierownictwu IT zrozumieć, gdzie narasta dług techniczny i które obszary infrastruktury najbardziej potrzebują inwestycji. Dane dobrej jakości pozwalają wyciągać wnioski z wcześniejszych awarii i zapobiegać podobnym problemom w innych częściach firmy.

ProcessMind wykrywa niespójności w rejestrowaniu i klasyfikowaniu przyczyn źródłowych w różnych grupach wsparcia. Wskazuje błędne klasyfikacje i nadużywanie ogólnych kategorii, co pomaga poprawić jakość danych operacyjnych. Dzięki temu raporty są bardziej wiarygodne, a decyzje dotyczące długoterminowej stabilności usług można podejmować na podstawie lepszych informacji.

Analiza wcześniejszych problemów pozwala zapobiegać kolejnym błędom i stale ulepszać cykl życia usług IT. Przeglądy po wdrożeniu pomagają zespołom ocenić przebieg analizy i rozwiązania problemu oraz znaleźć sposoby na usprawnienie pracy. Ten formalny etap jest niezbędny, aby rozwijać proces zarządzania problemami i budować kulturę ciągłego uczenia się.

Monitorujemy odsetek ukończonych działań po wdrożeniu oraz czas ich realizacji po rozwiązaniu problemu. Dzięki temu każdy poważny problem może zakończyć się oceną przebiegu procesu. ProcessMind pomaga sprawdzić, czy przeglądy odbywają się regularnie i czy z czasem prowadzą do mierzalnych usprawnień.

Problemy o wysokim priorytecie wymagają natychmiastowego zaangażowania najbardziej doświadczonych pracowników, aby ograniczyć skutki dla firmy. Skierowanie najlepszych zasobów do najpilniejszych spraw zwiększa stabilność środowiska IT. Dobrze zaplanowany przydział zasobów pozwala obsługiwać poważne incydenty bez zaniedbywania analizy ich przyczyn źródłowych.

ProcessMind analizuje przepustowość procesu według priorytetu i przypisanej grupy w ServiceNow. Pozwala równoważyć obciążenie pracą i zapobiegać oczekiwaniu krytycznych analiz w tych samych kolejkach co zadania o niewielkim wpływie. Można sprawdzić możliwości grup wsparcia i zmienić przydział zadań, aby najważniejsze problemy otrzymały należytą uwagę.

Rozwiązanie problemu często czeka na informacje od dostawcy, opinię użytkownika lub dane od strony trzeciej, co wydłuża okres ryzyka. Skrócenie przestojów przyspiesza rozwiązanie problemu i ogranicza wpływ zewnętrznych zależności na wewnętrzne SLA. Sprawne zarządzanie stanami oczekiwania pomaga utrzymać tempo pracy nad problemem.

Analizujemy historię stanów rekordów problemów, aby dokładnie zmierzyć czas stracony na oczekiwanie. Wizualizacja opóźnień pozwala wskazać dostawców lub zespoły zewnętrzne, które najczęściej utrudniają postęp. Na tej podstawie można renegocjować warunki umów z dostawcami lub usprawnić wewnętrzne procedury monitorowania spraw, aby proces nie stawał w miejscu.

Po ustaleniu przyczyny źródłowej proponowane rozwiązanie trzeba szybko opisać i poddać ocenie, aby można było przejść do wdrożenia. Opóźnienia na tym etapie odsuwają naprawę i narażają firmę na ponowne wystąpienie tego samego problemu. Sprawne przygotowanie i zatwierdzenie rozwiązania przyspiesza przejście od analizy do działania.

ProcessMind mierzy czas przygotowania i zatwierdzania rozwiązań w workflow ServiceNow. Dzięki temu można ograniczyć zbędne formalności i wykryć przypadki, w których proponowane rozwiązanie zbyt długo czeka na dalsze działania. Usprawnienie wewnętrznego procesu oceny pozwala przejść od analizy do naprawy przy mniejszej liczbie etapów.

Usprawnienie ServiceNow Problem Management w 6 krokach

1

Pobierz szablon

Co zrobić

Pobierz szablon Excel przygotowany dla ServiceNow Problem Management, aby mapowanie danych było zgodne ze standardami ITIL i strukturą tabel ServiceNow.

Dlaczego to ważne

Ustrukturyzowany format pomaga zapobiegać problemom z jakością danych i przygotować rekordy problemów oraz zadania do analizy process mining.

Oczekiwany rezultat

Ustandaryzowany szablon danych gotowy do uzupełnienia danymi wyeksportowanymi z ServiceNow.

WNIOSKI O PROCESACH

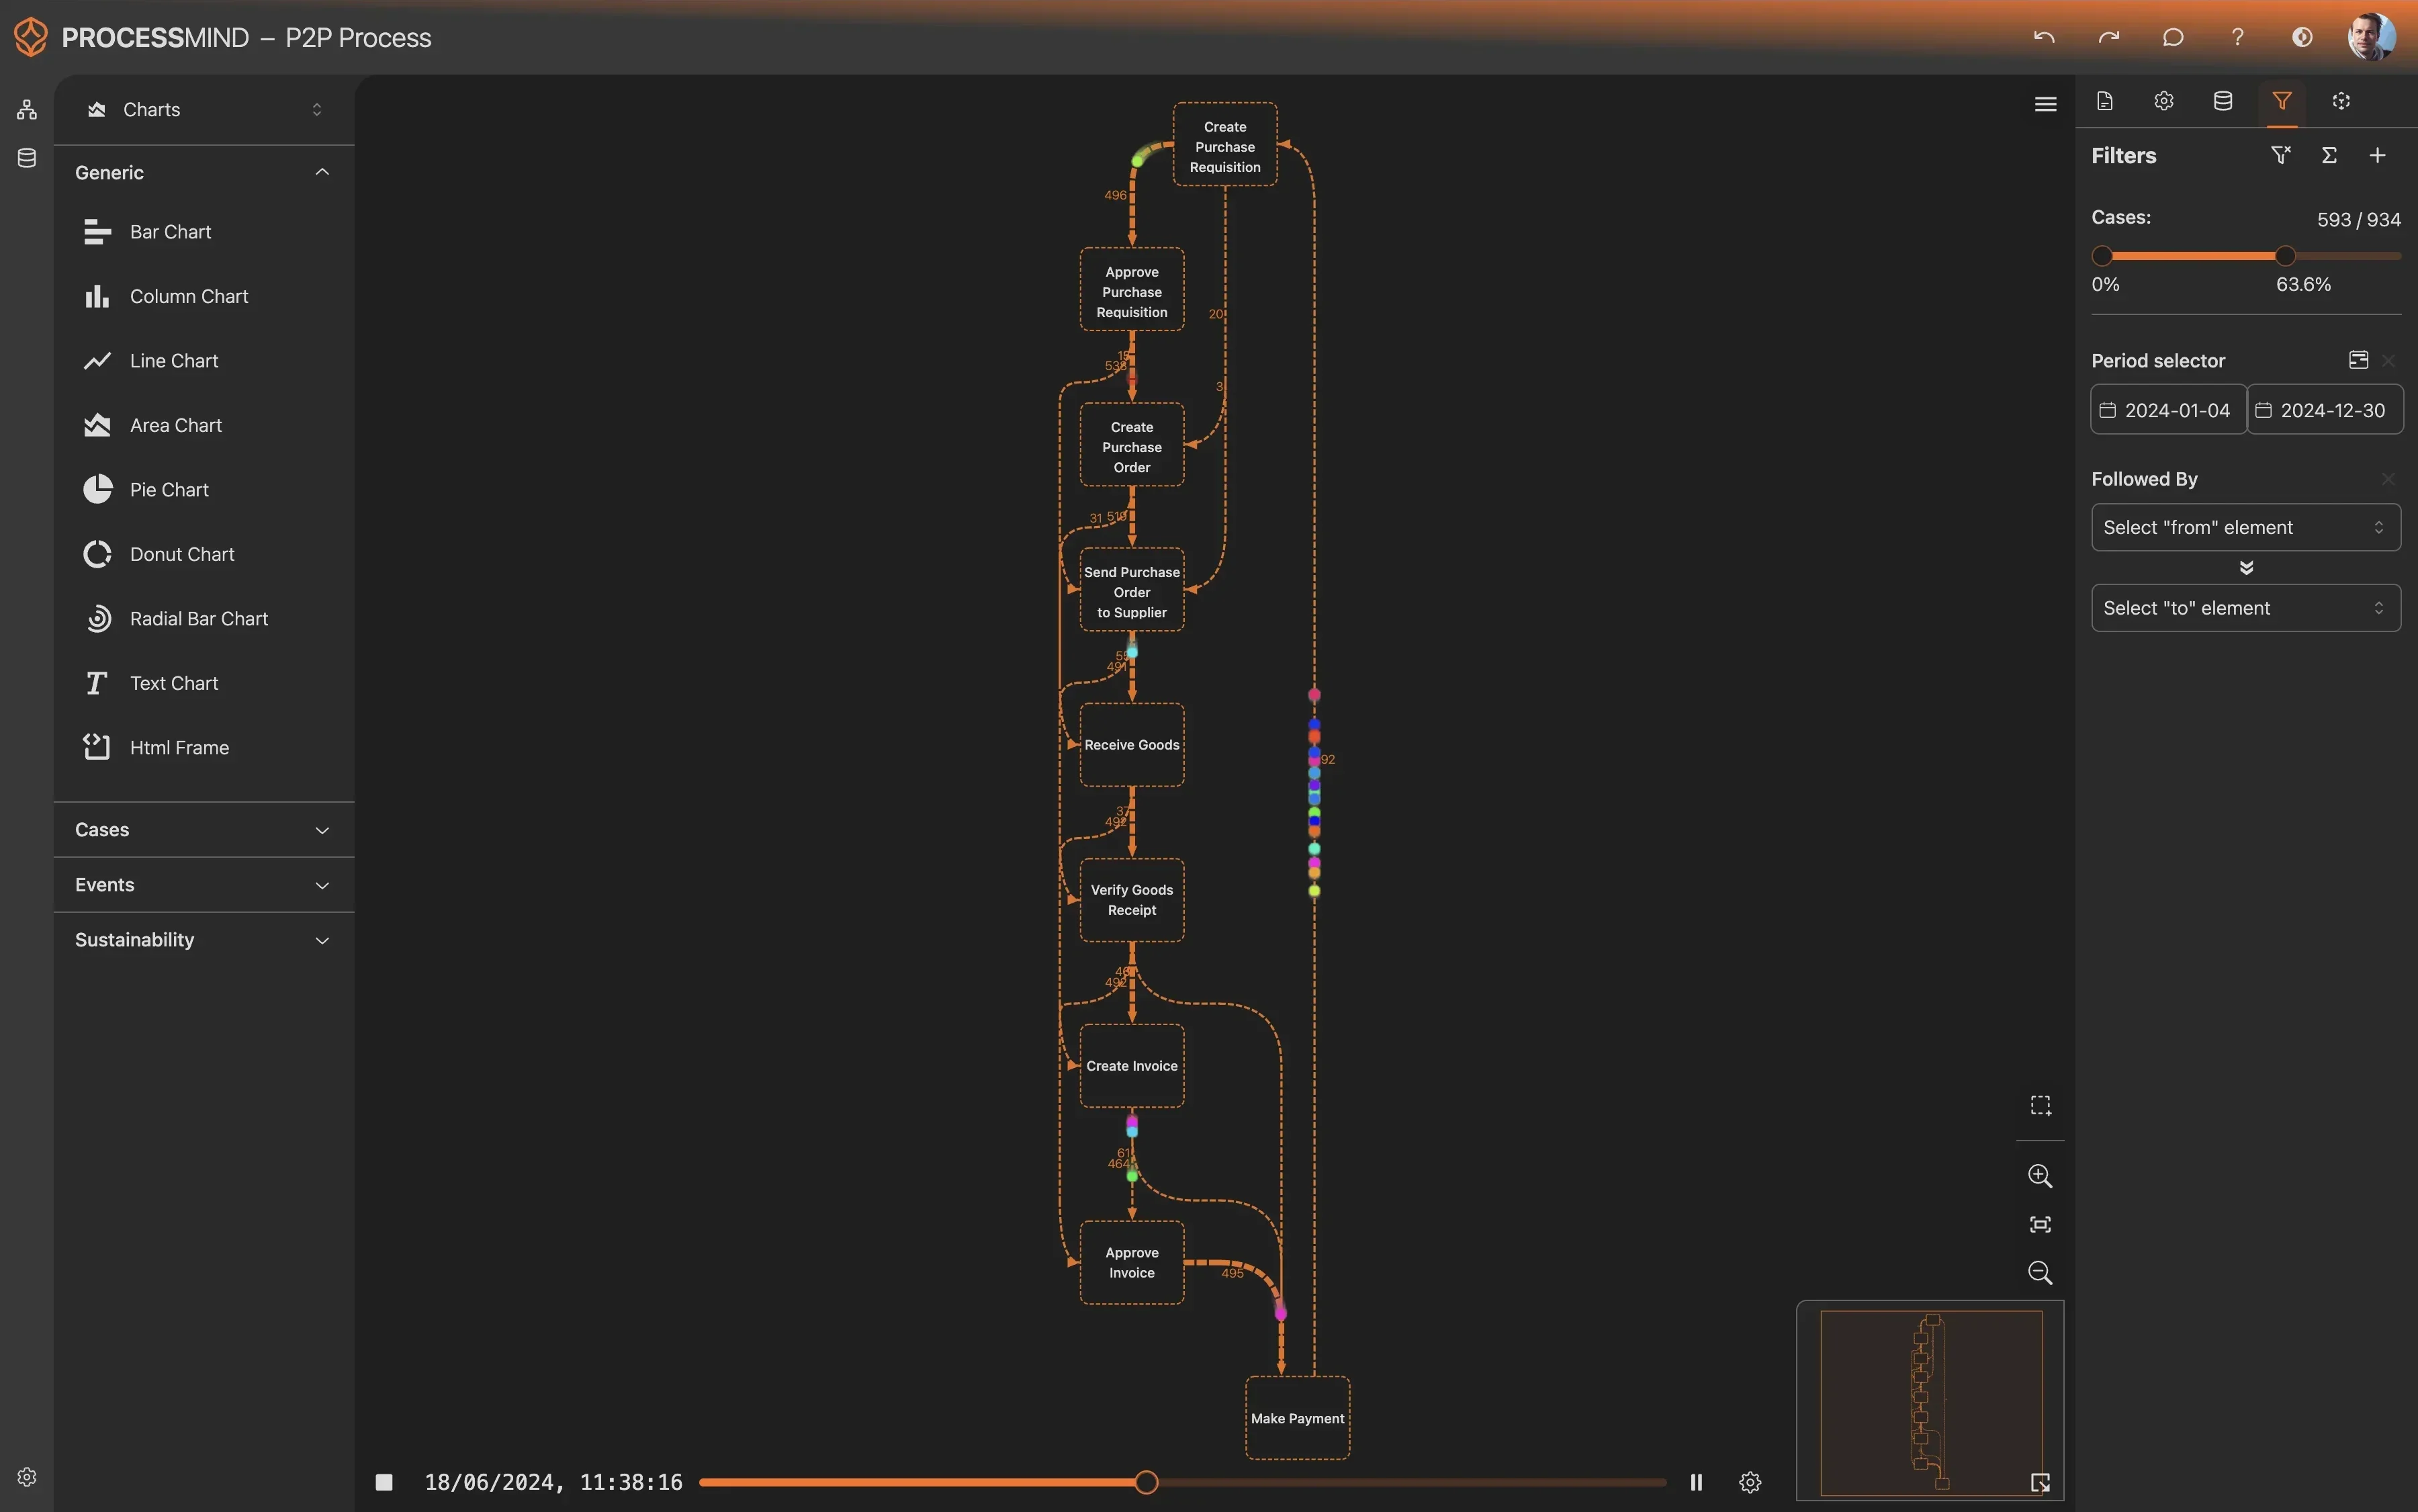
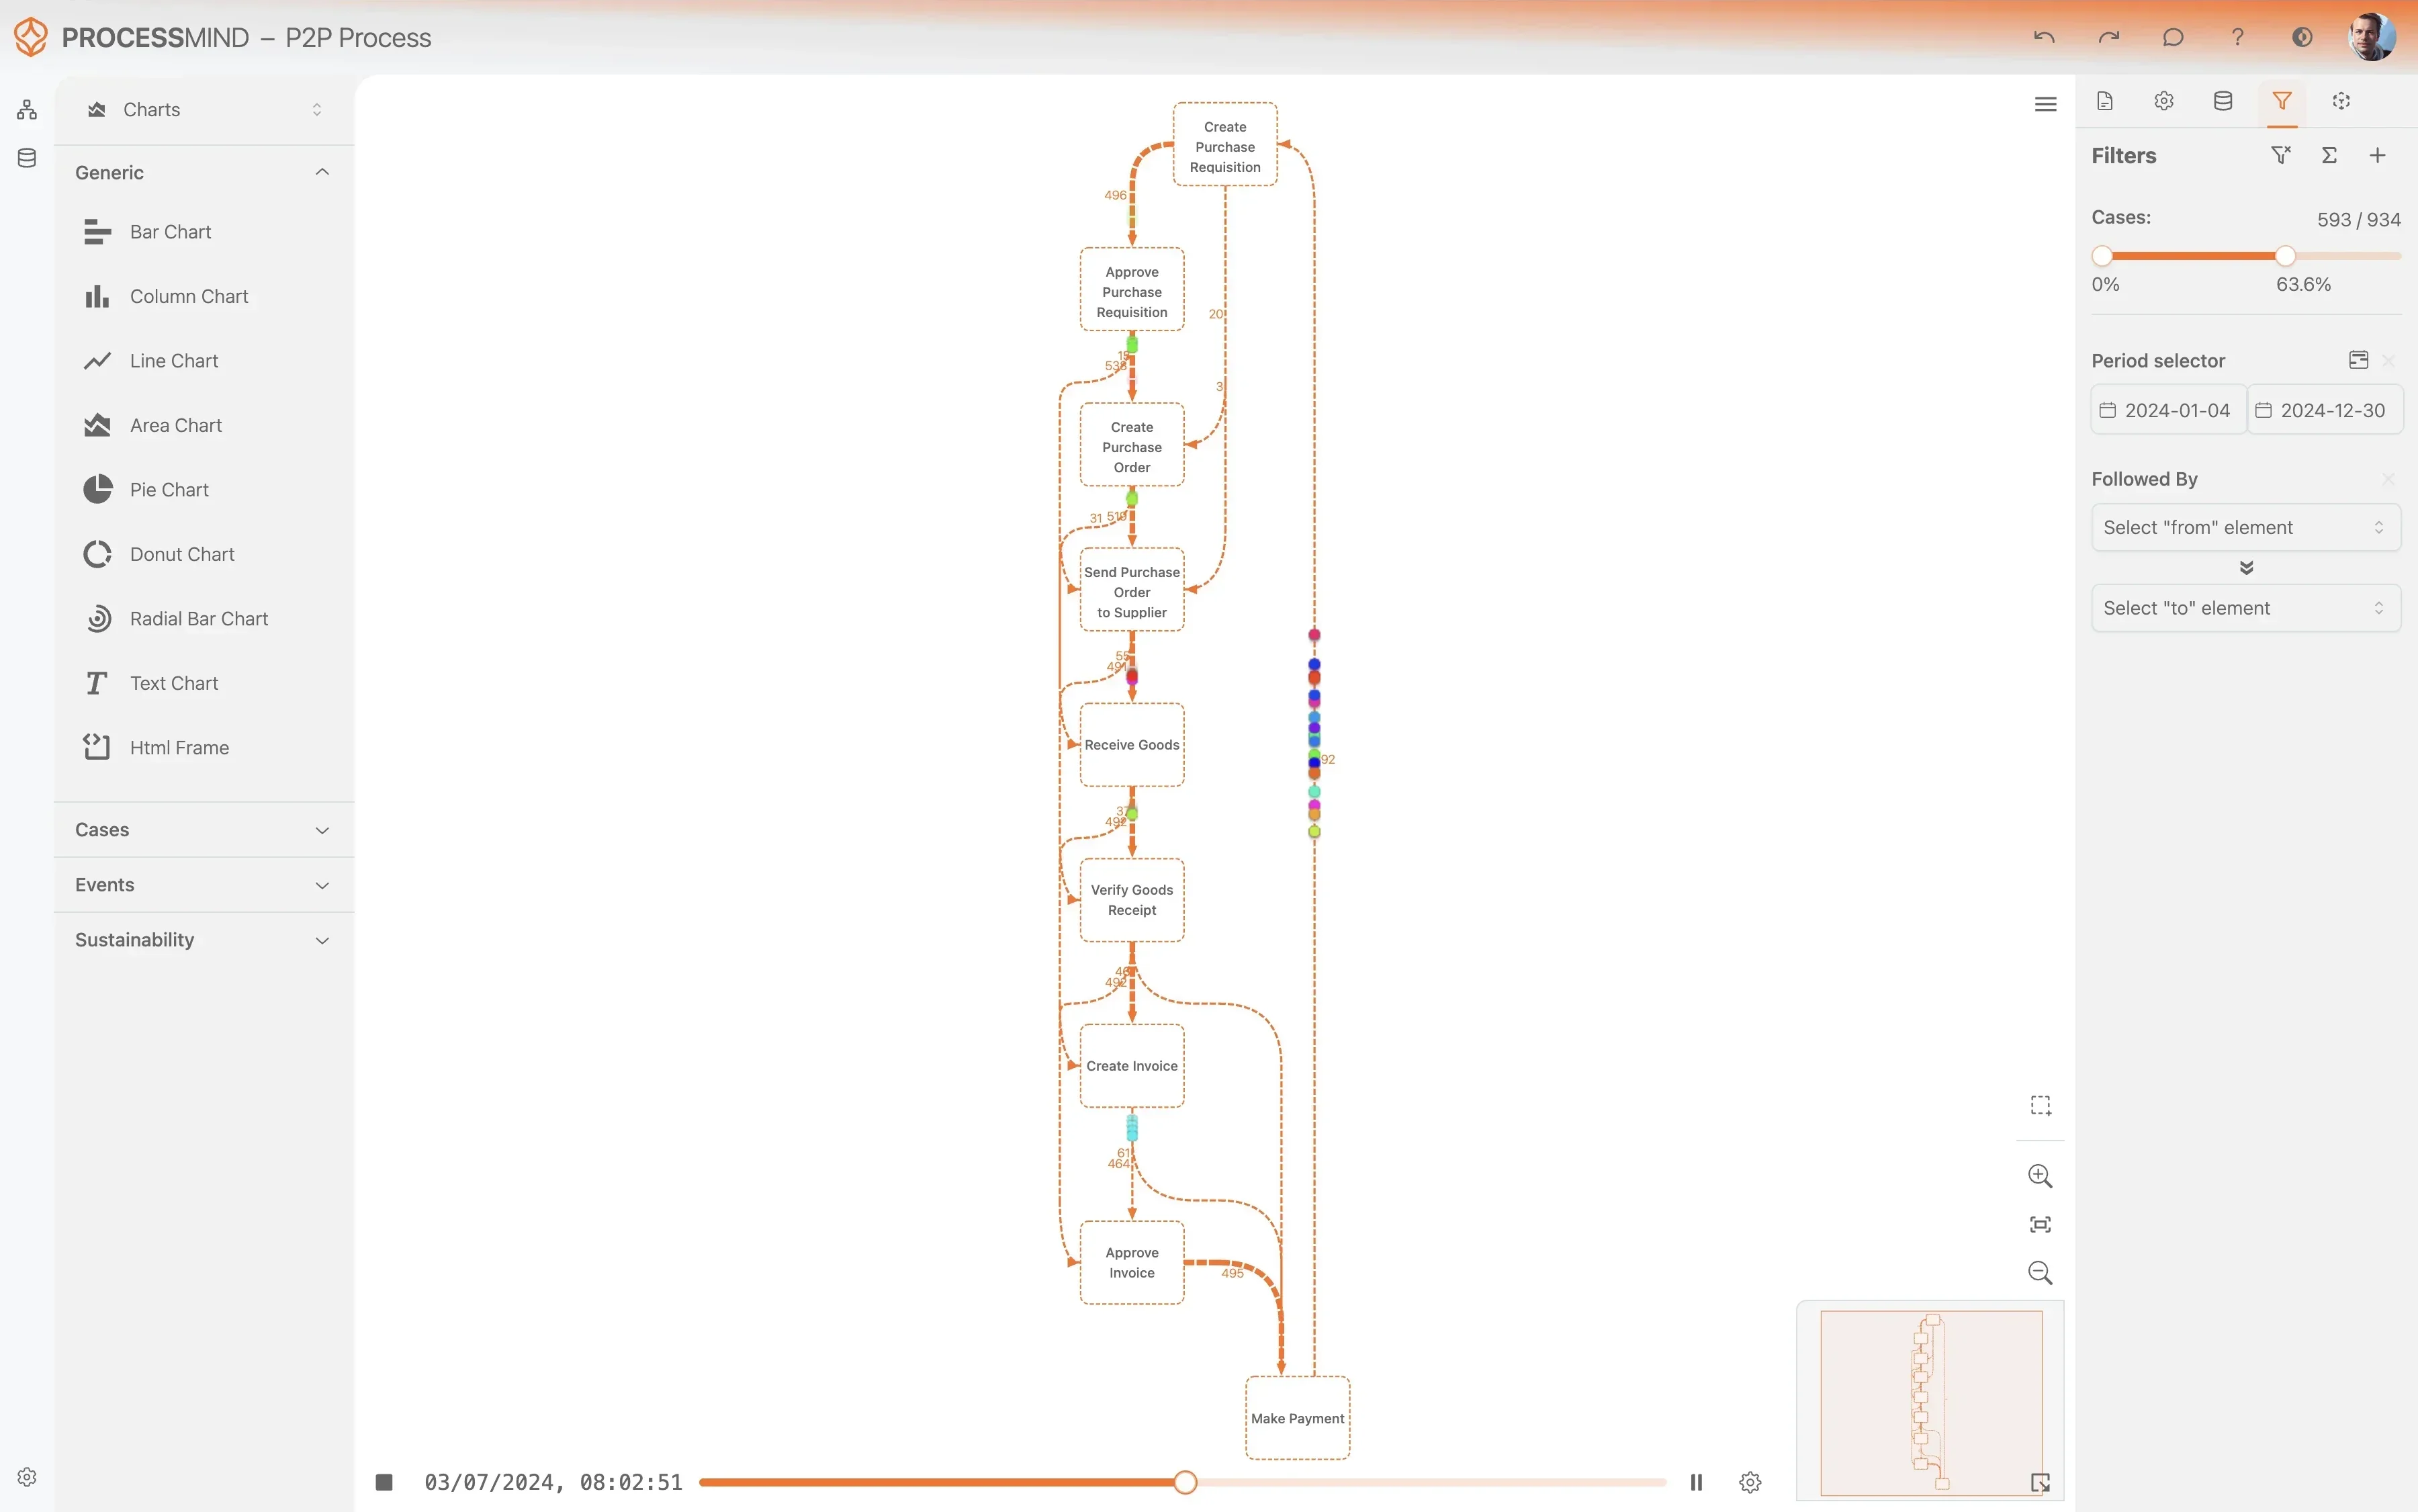
Zobacz cały przebieg analizy problemów

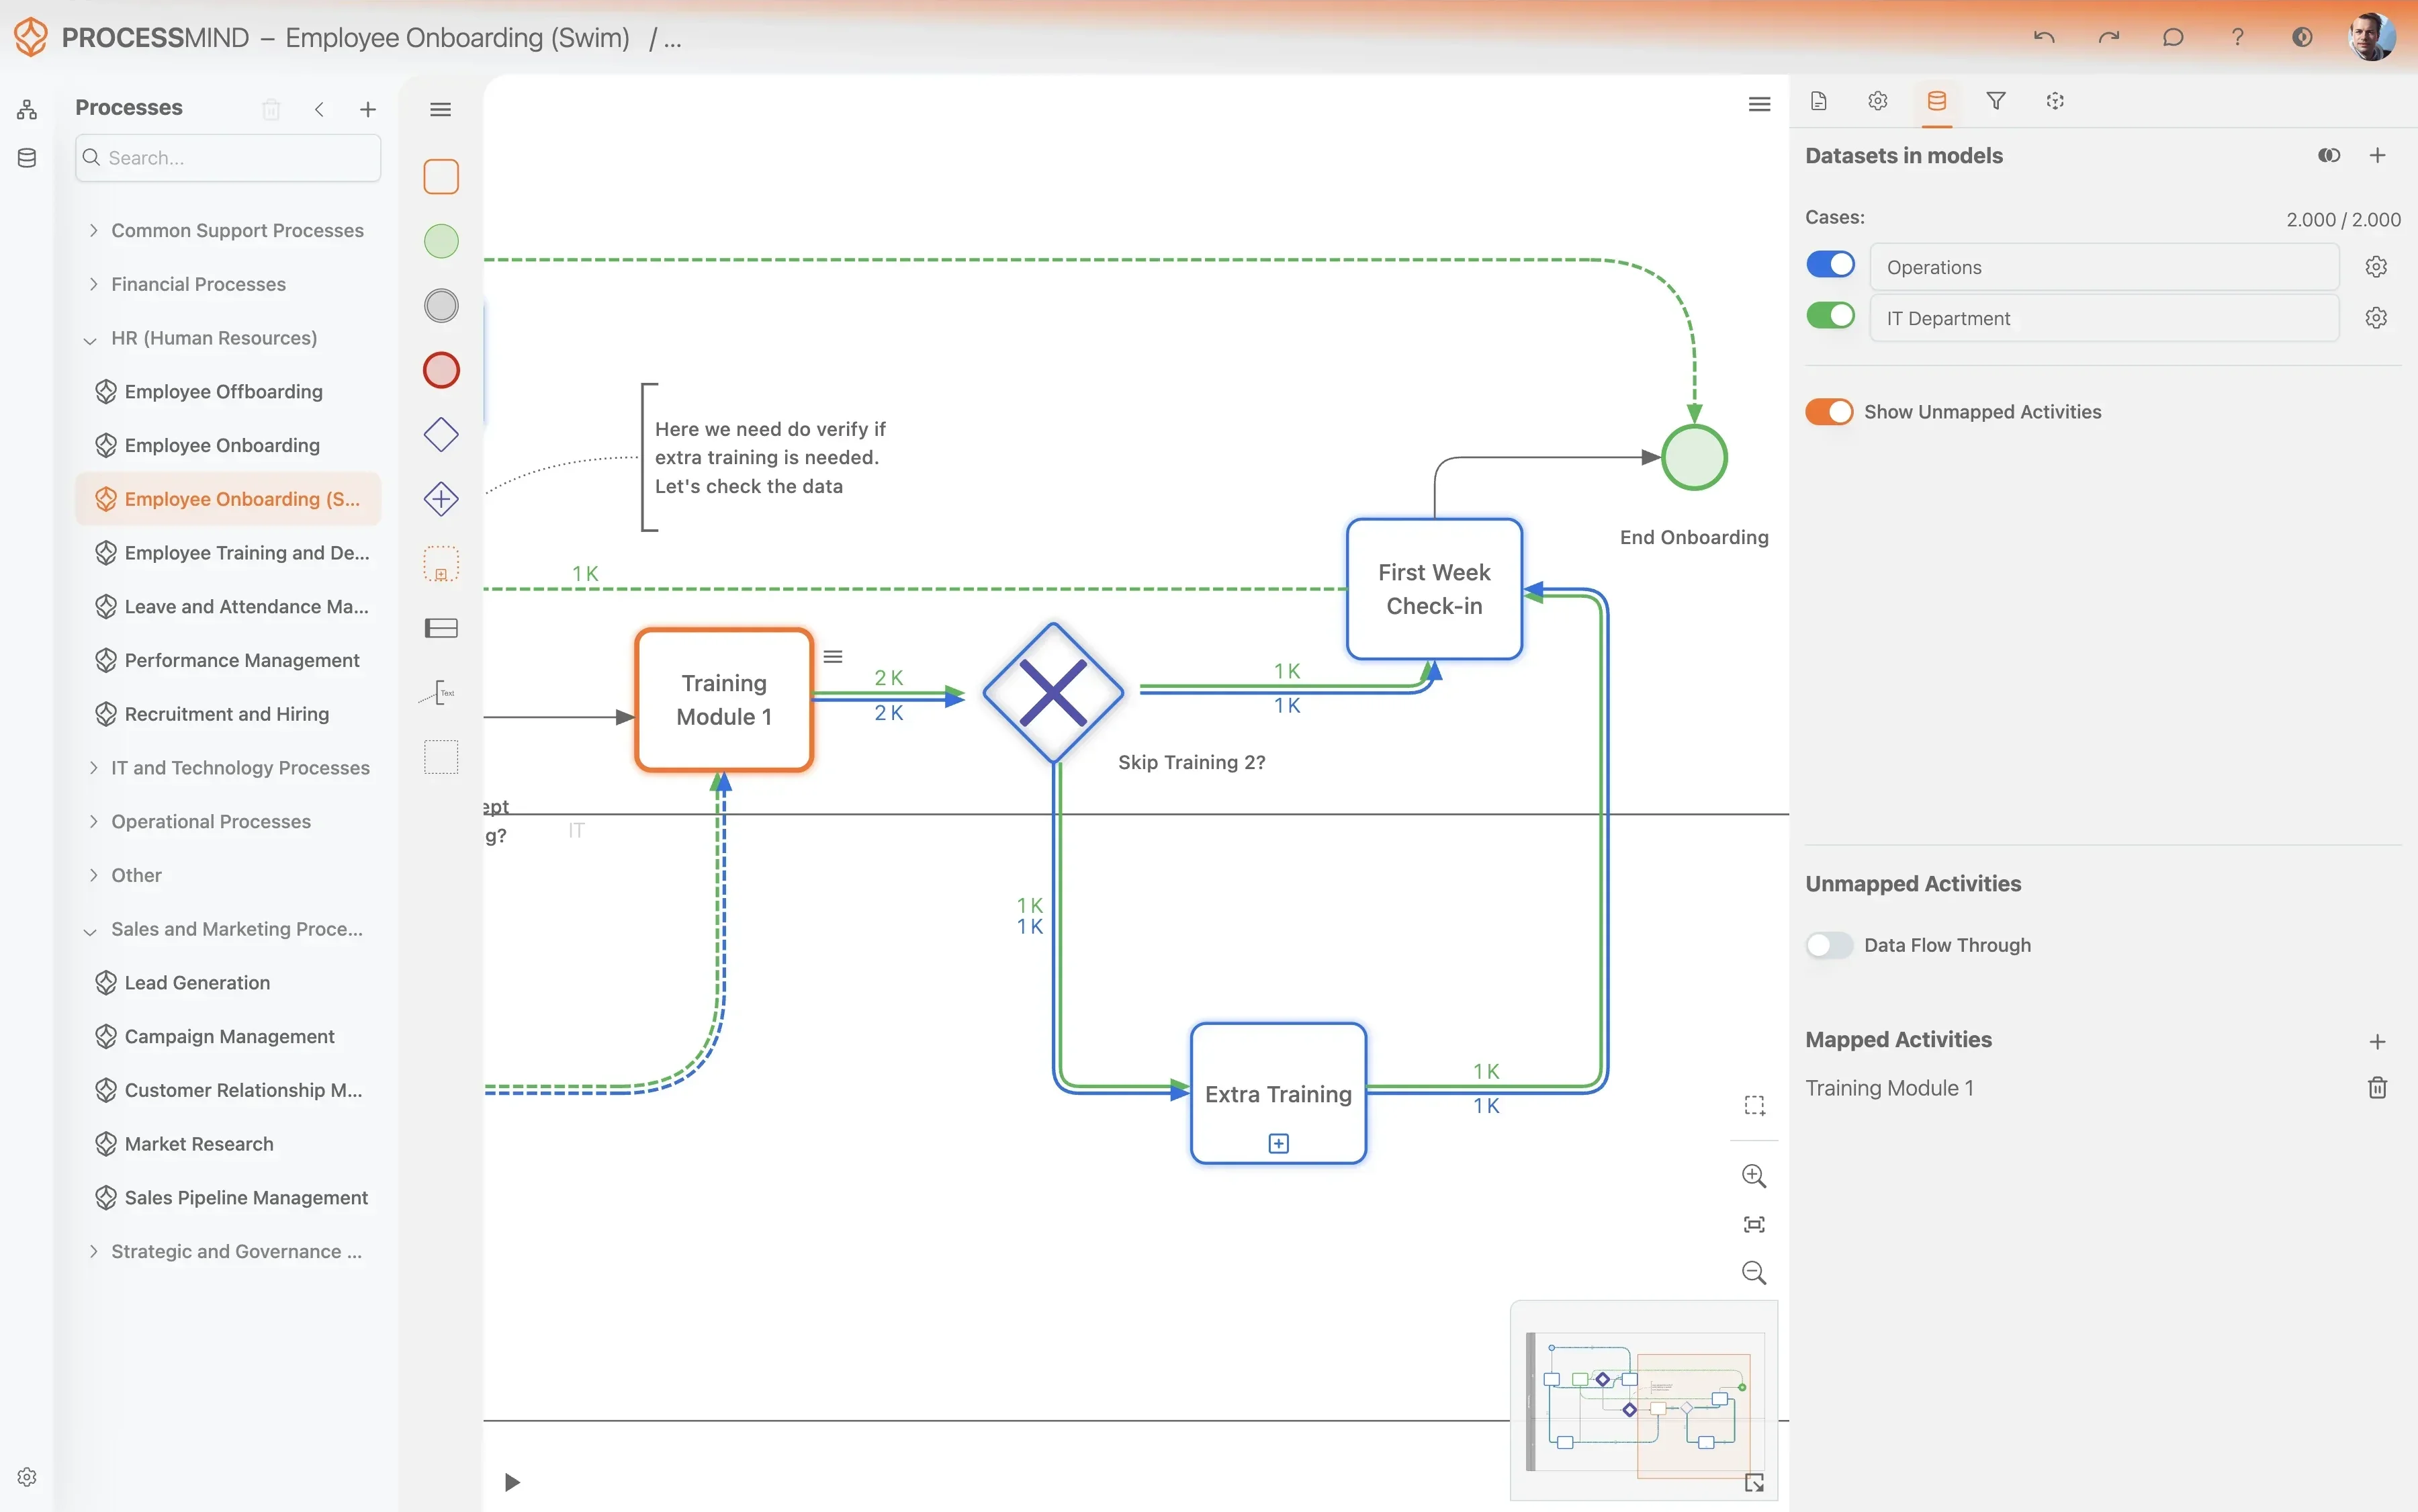
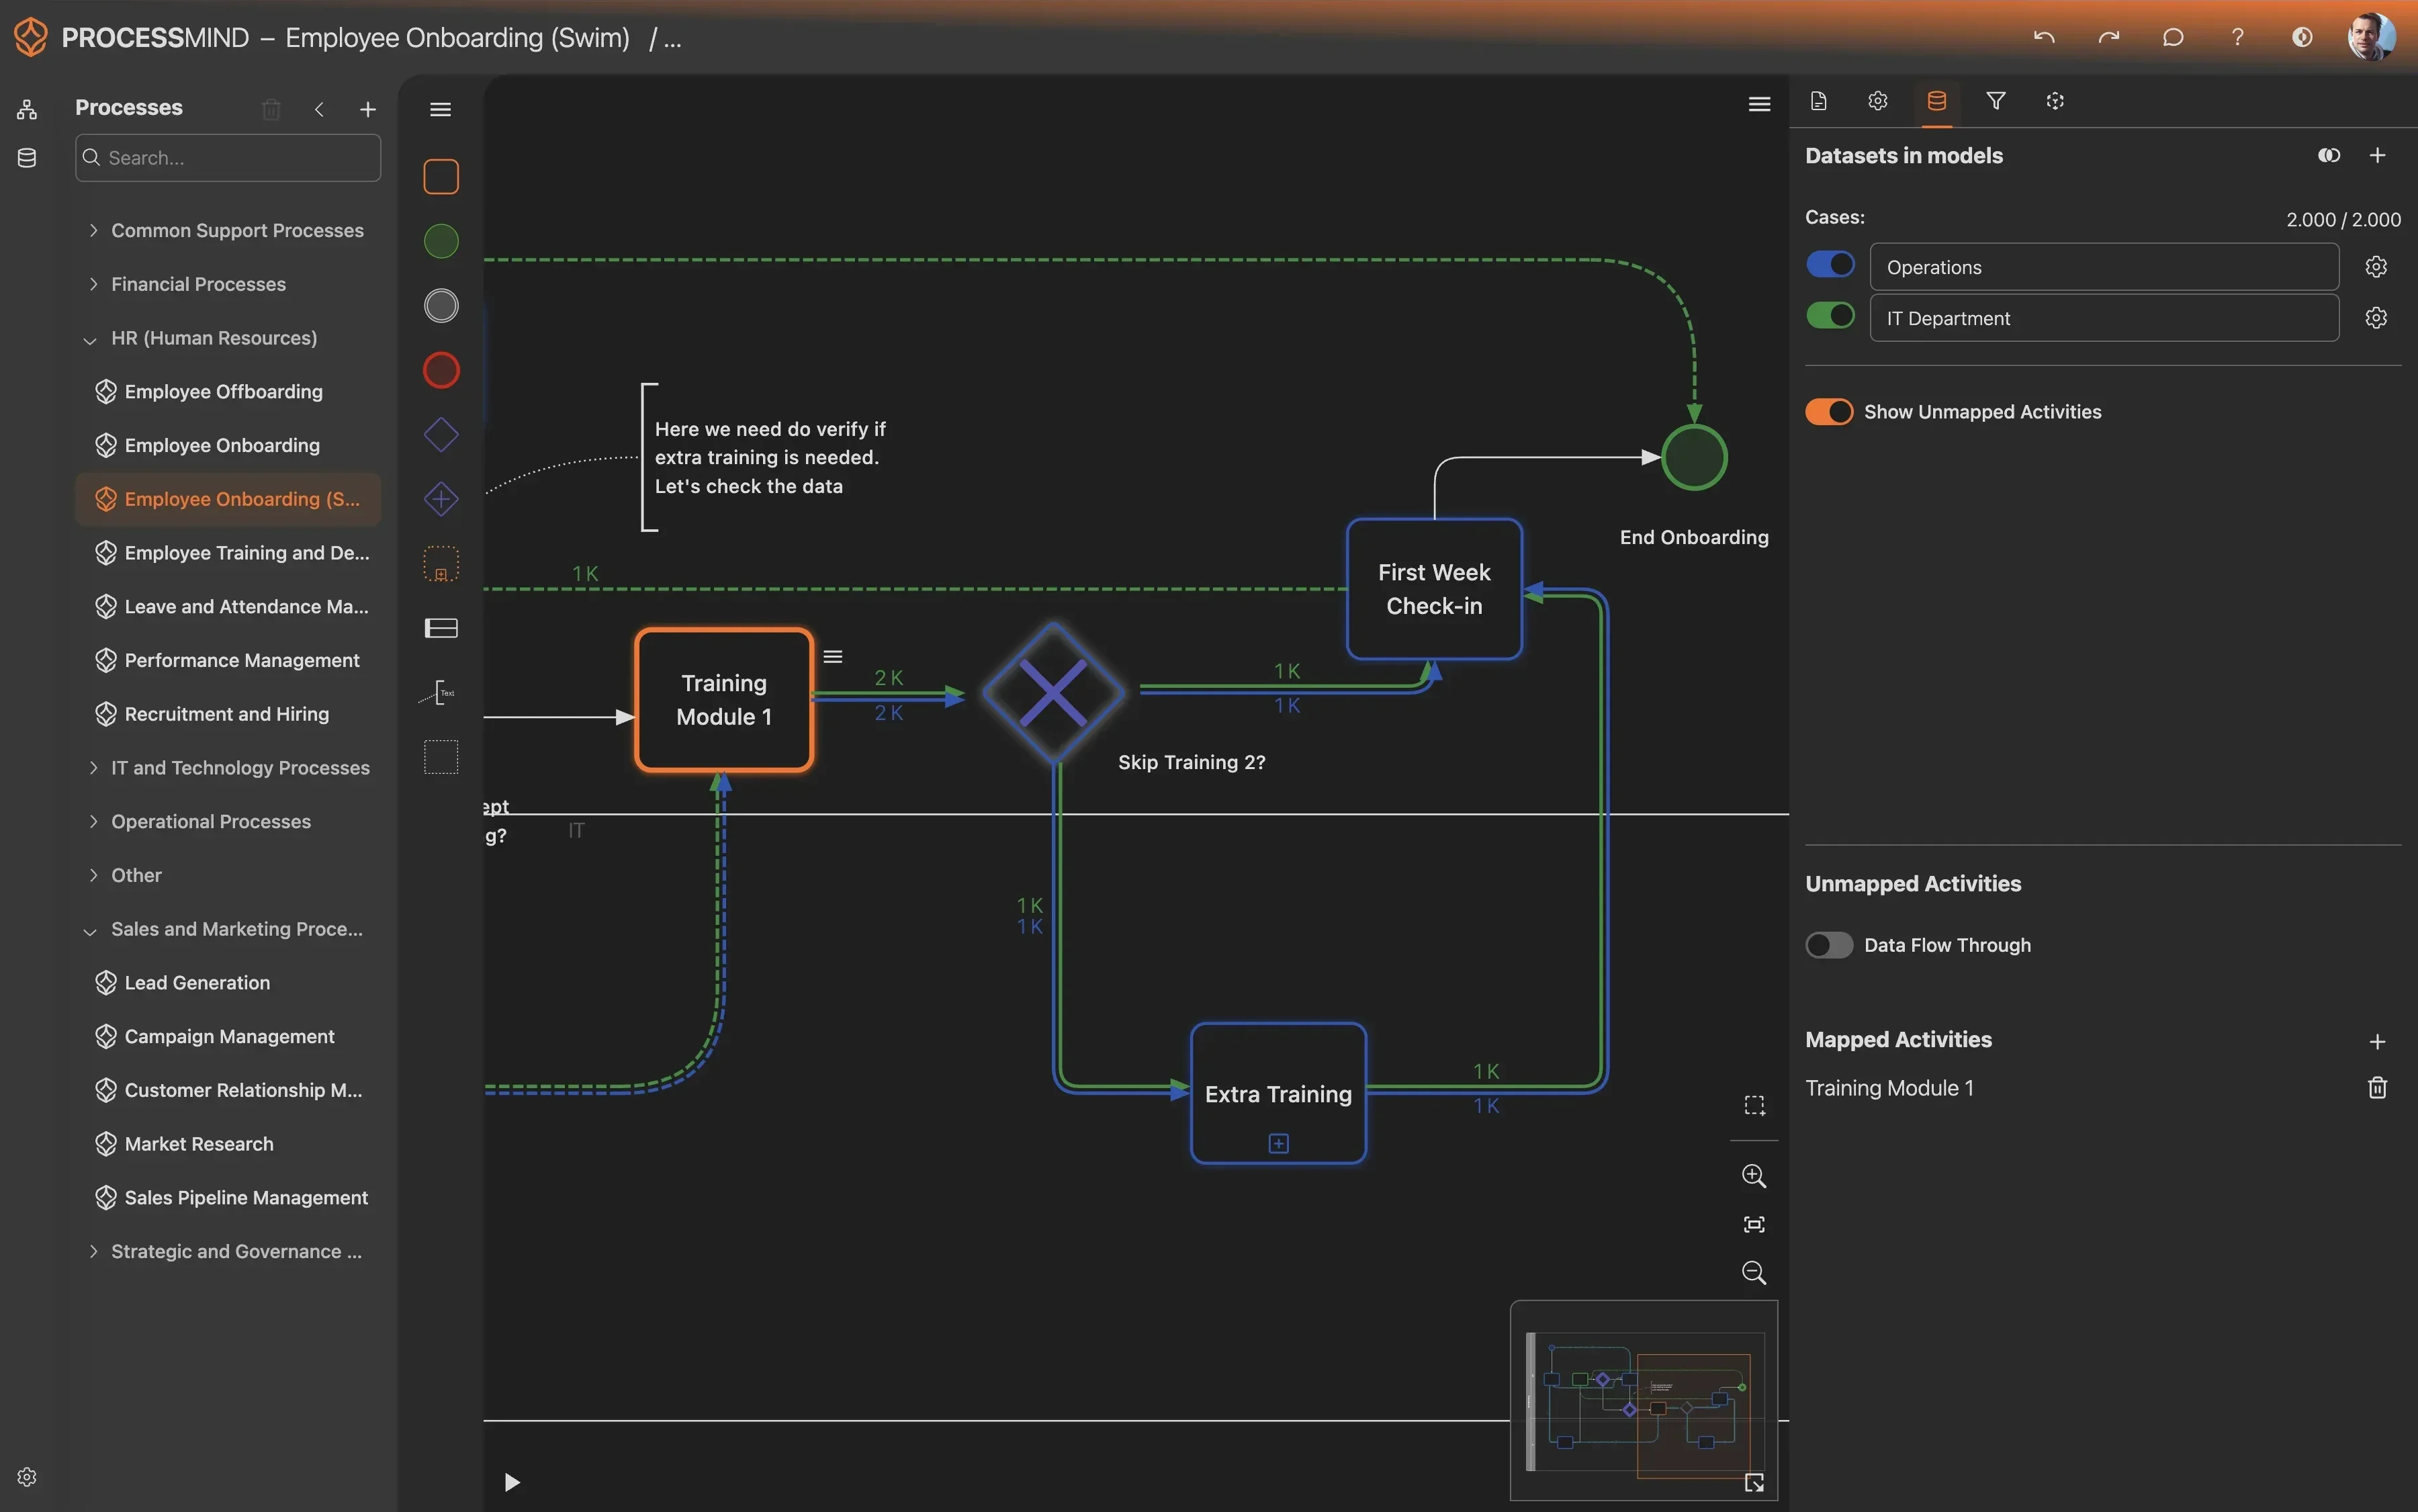
ProcessMind mapuje dane z ServiceNow i pokazuje rzeczywisty przebieg analizy problemów. Można sprawdzić, gdzie zawodzą przekazania i które analizy przyczyn źródłowych trwają najdłużej.
  • Mapuj pełny cykl analizy, od początku do końca
  • Wykrywaj bariery komunikacyjne między zespołami IT
  • Znajduj wąskie gardła opóźniające analizę przyczyn źródłowych
  • Śledź średni czas rozwiązania we wszystkich sprawach
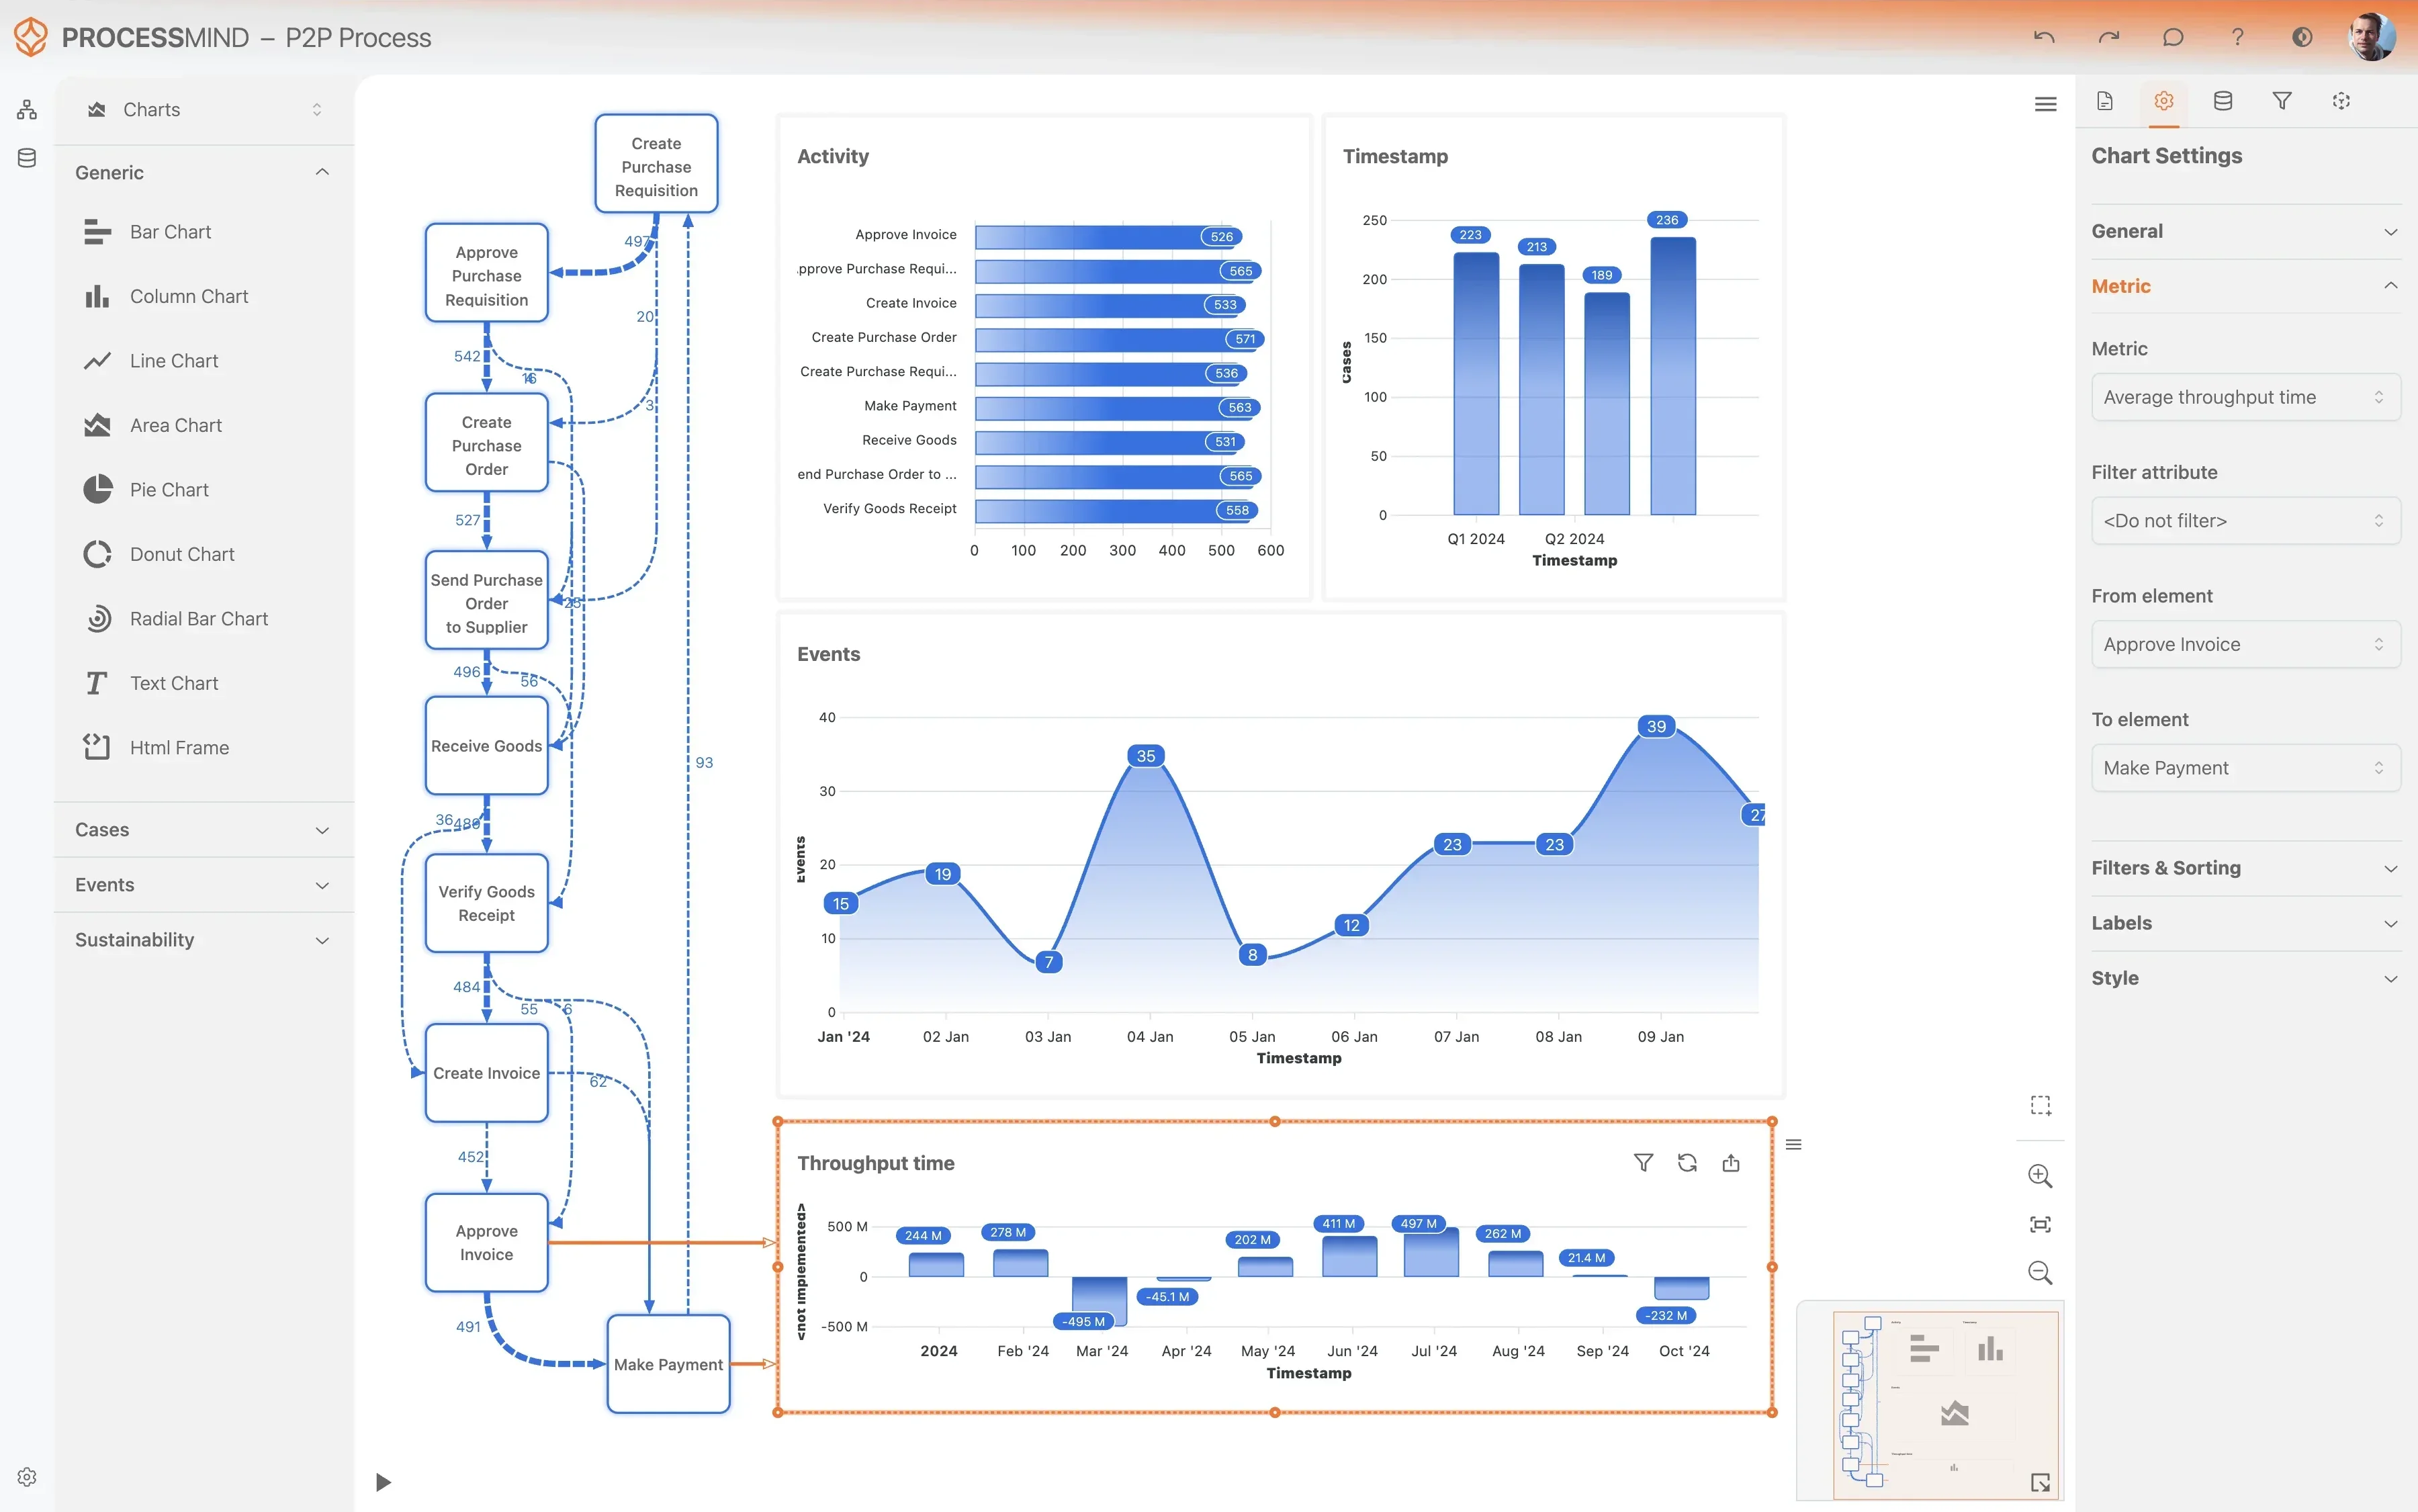
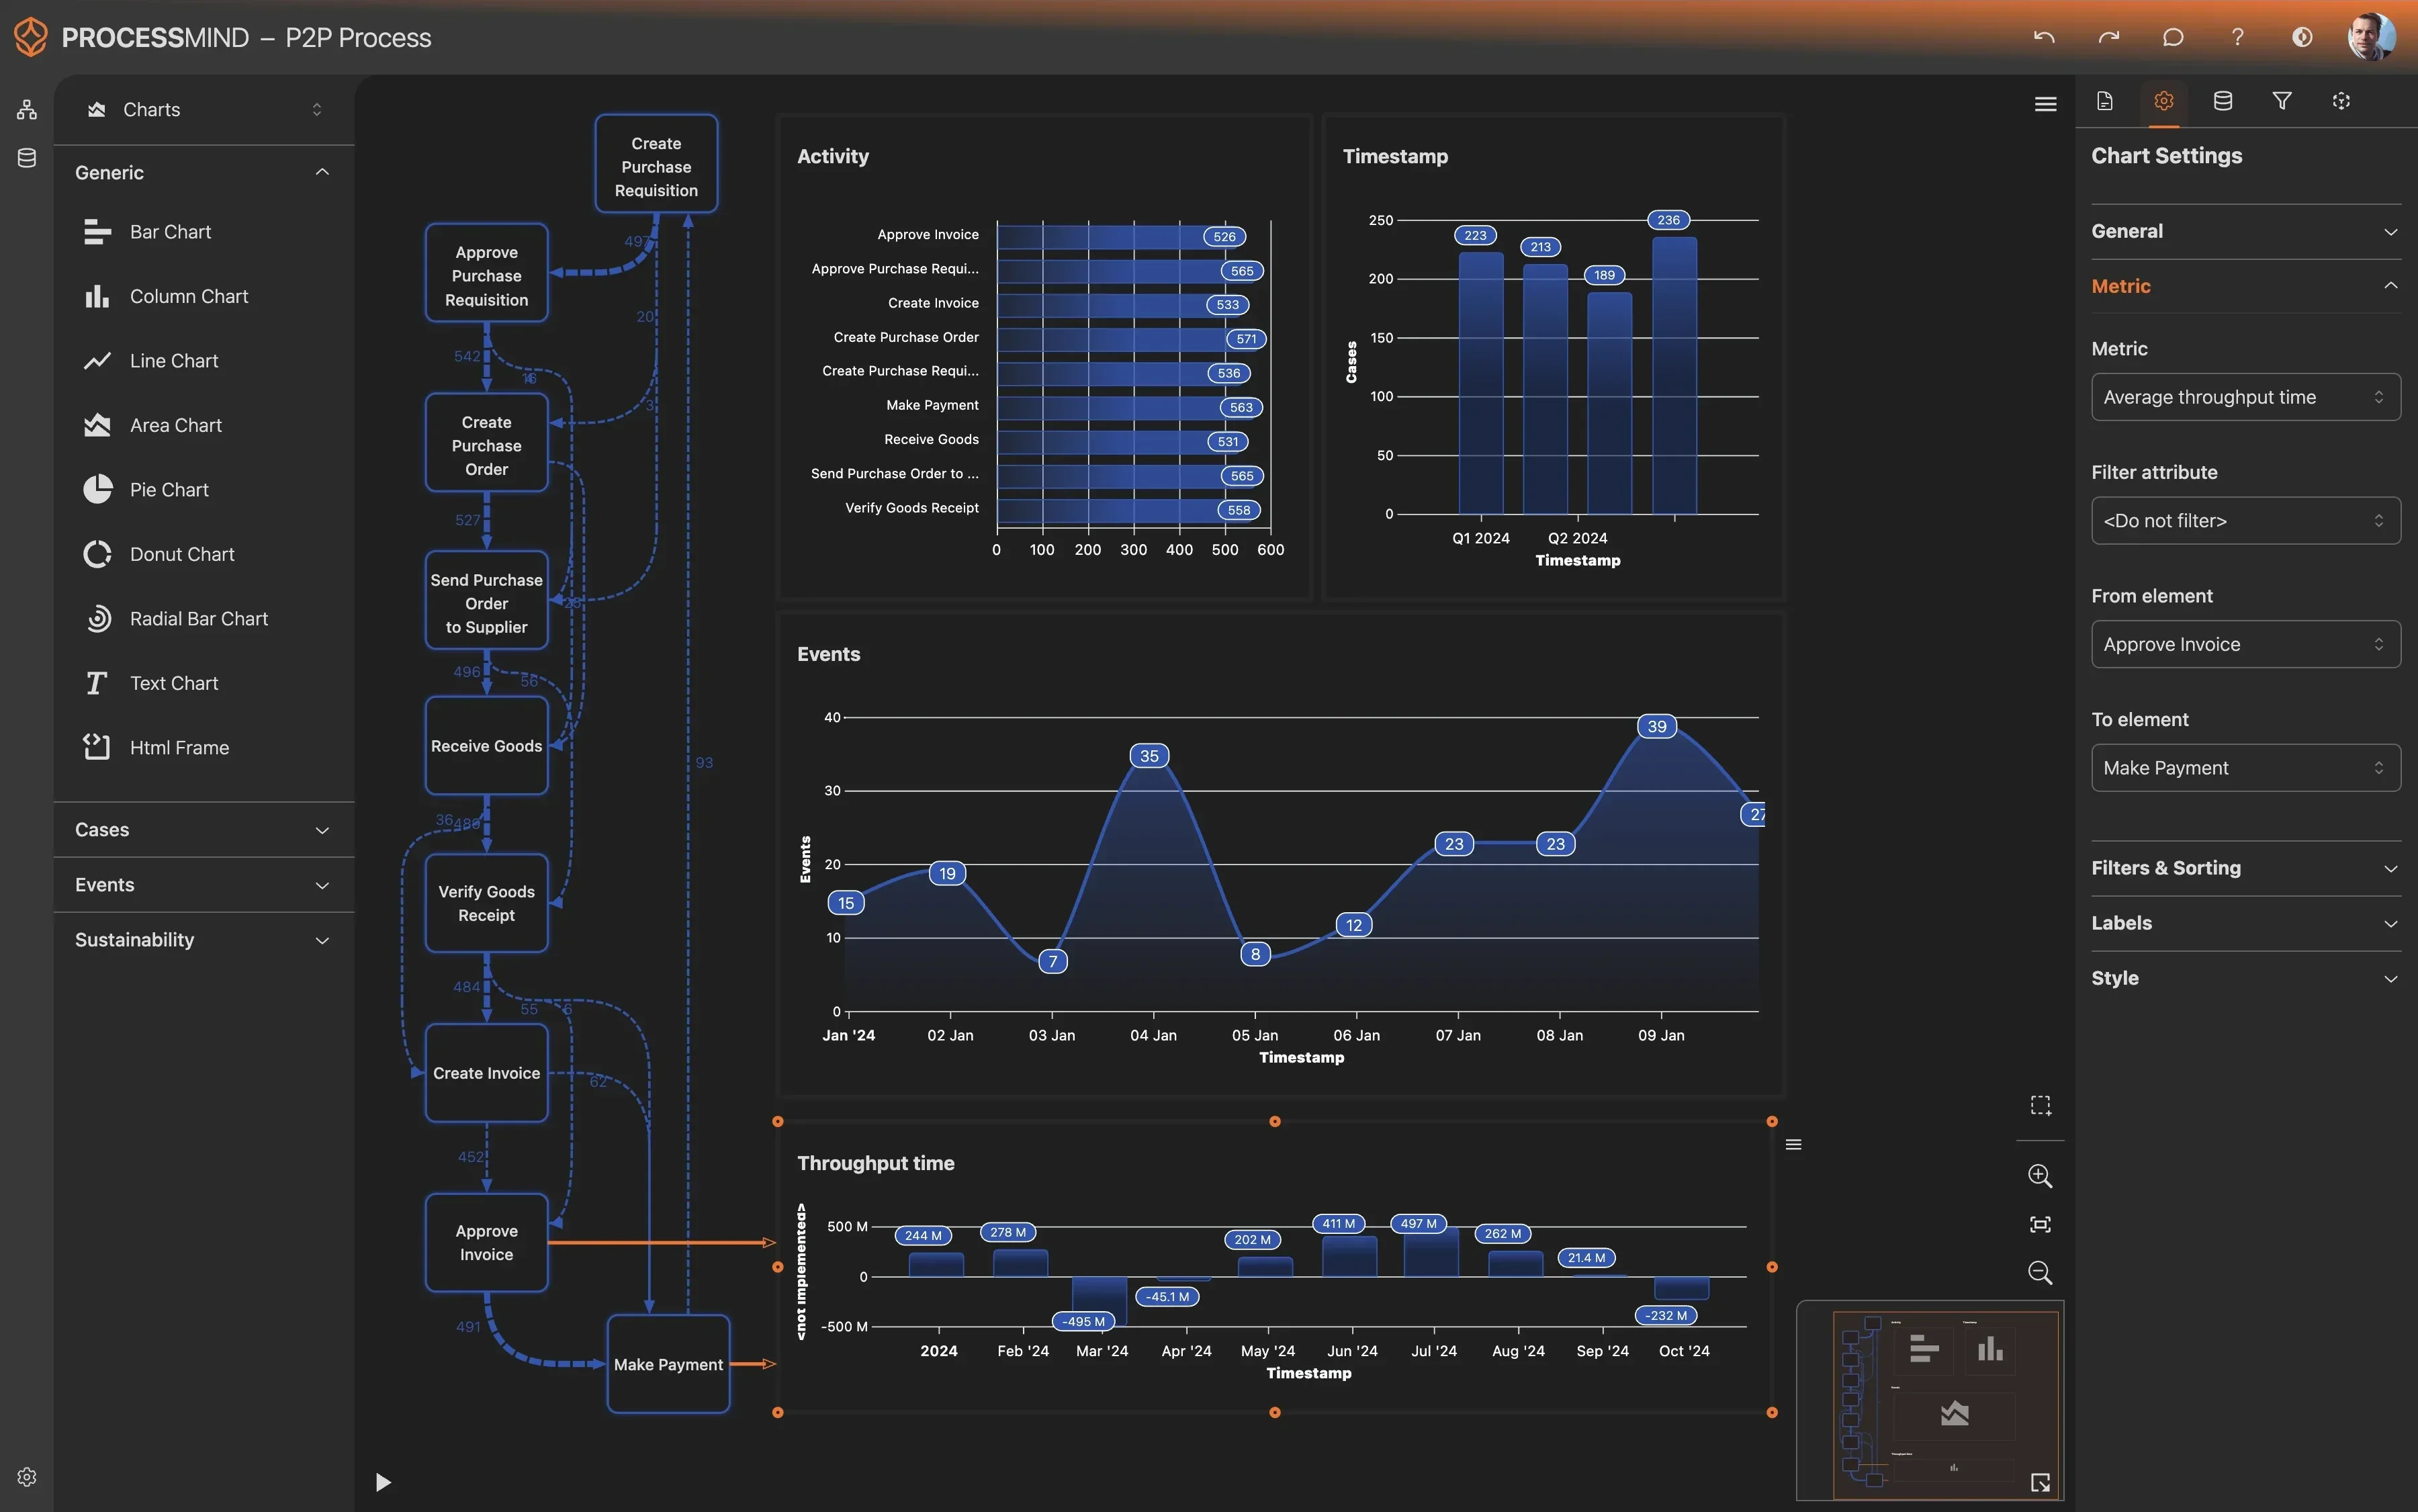
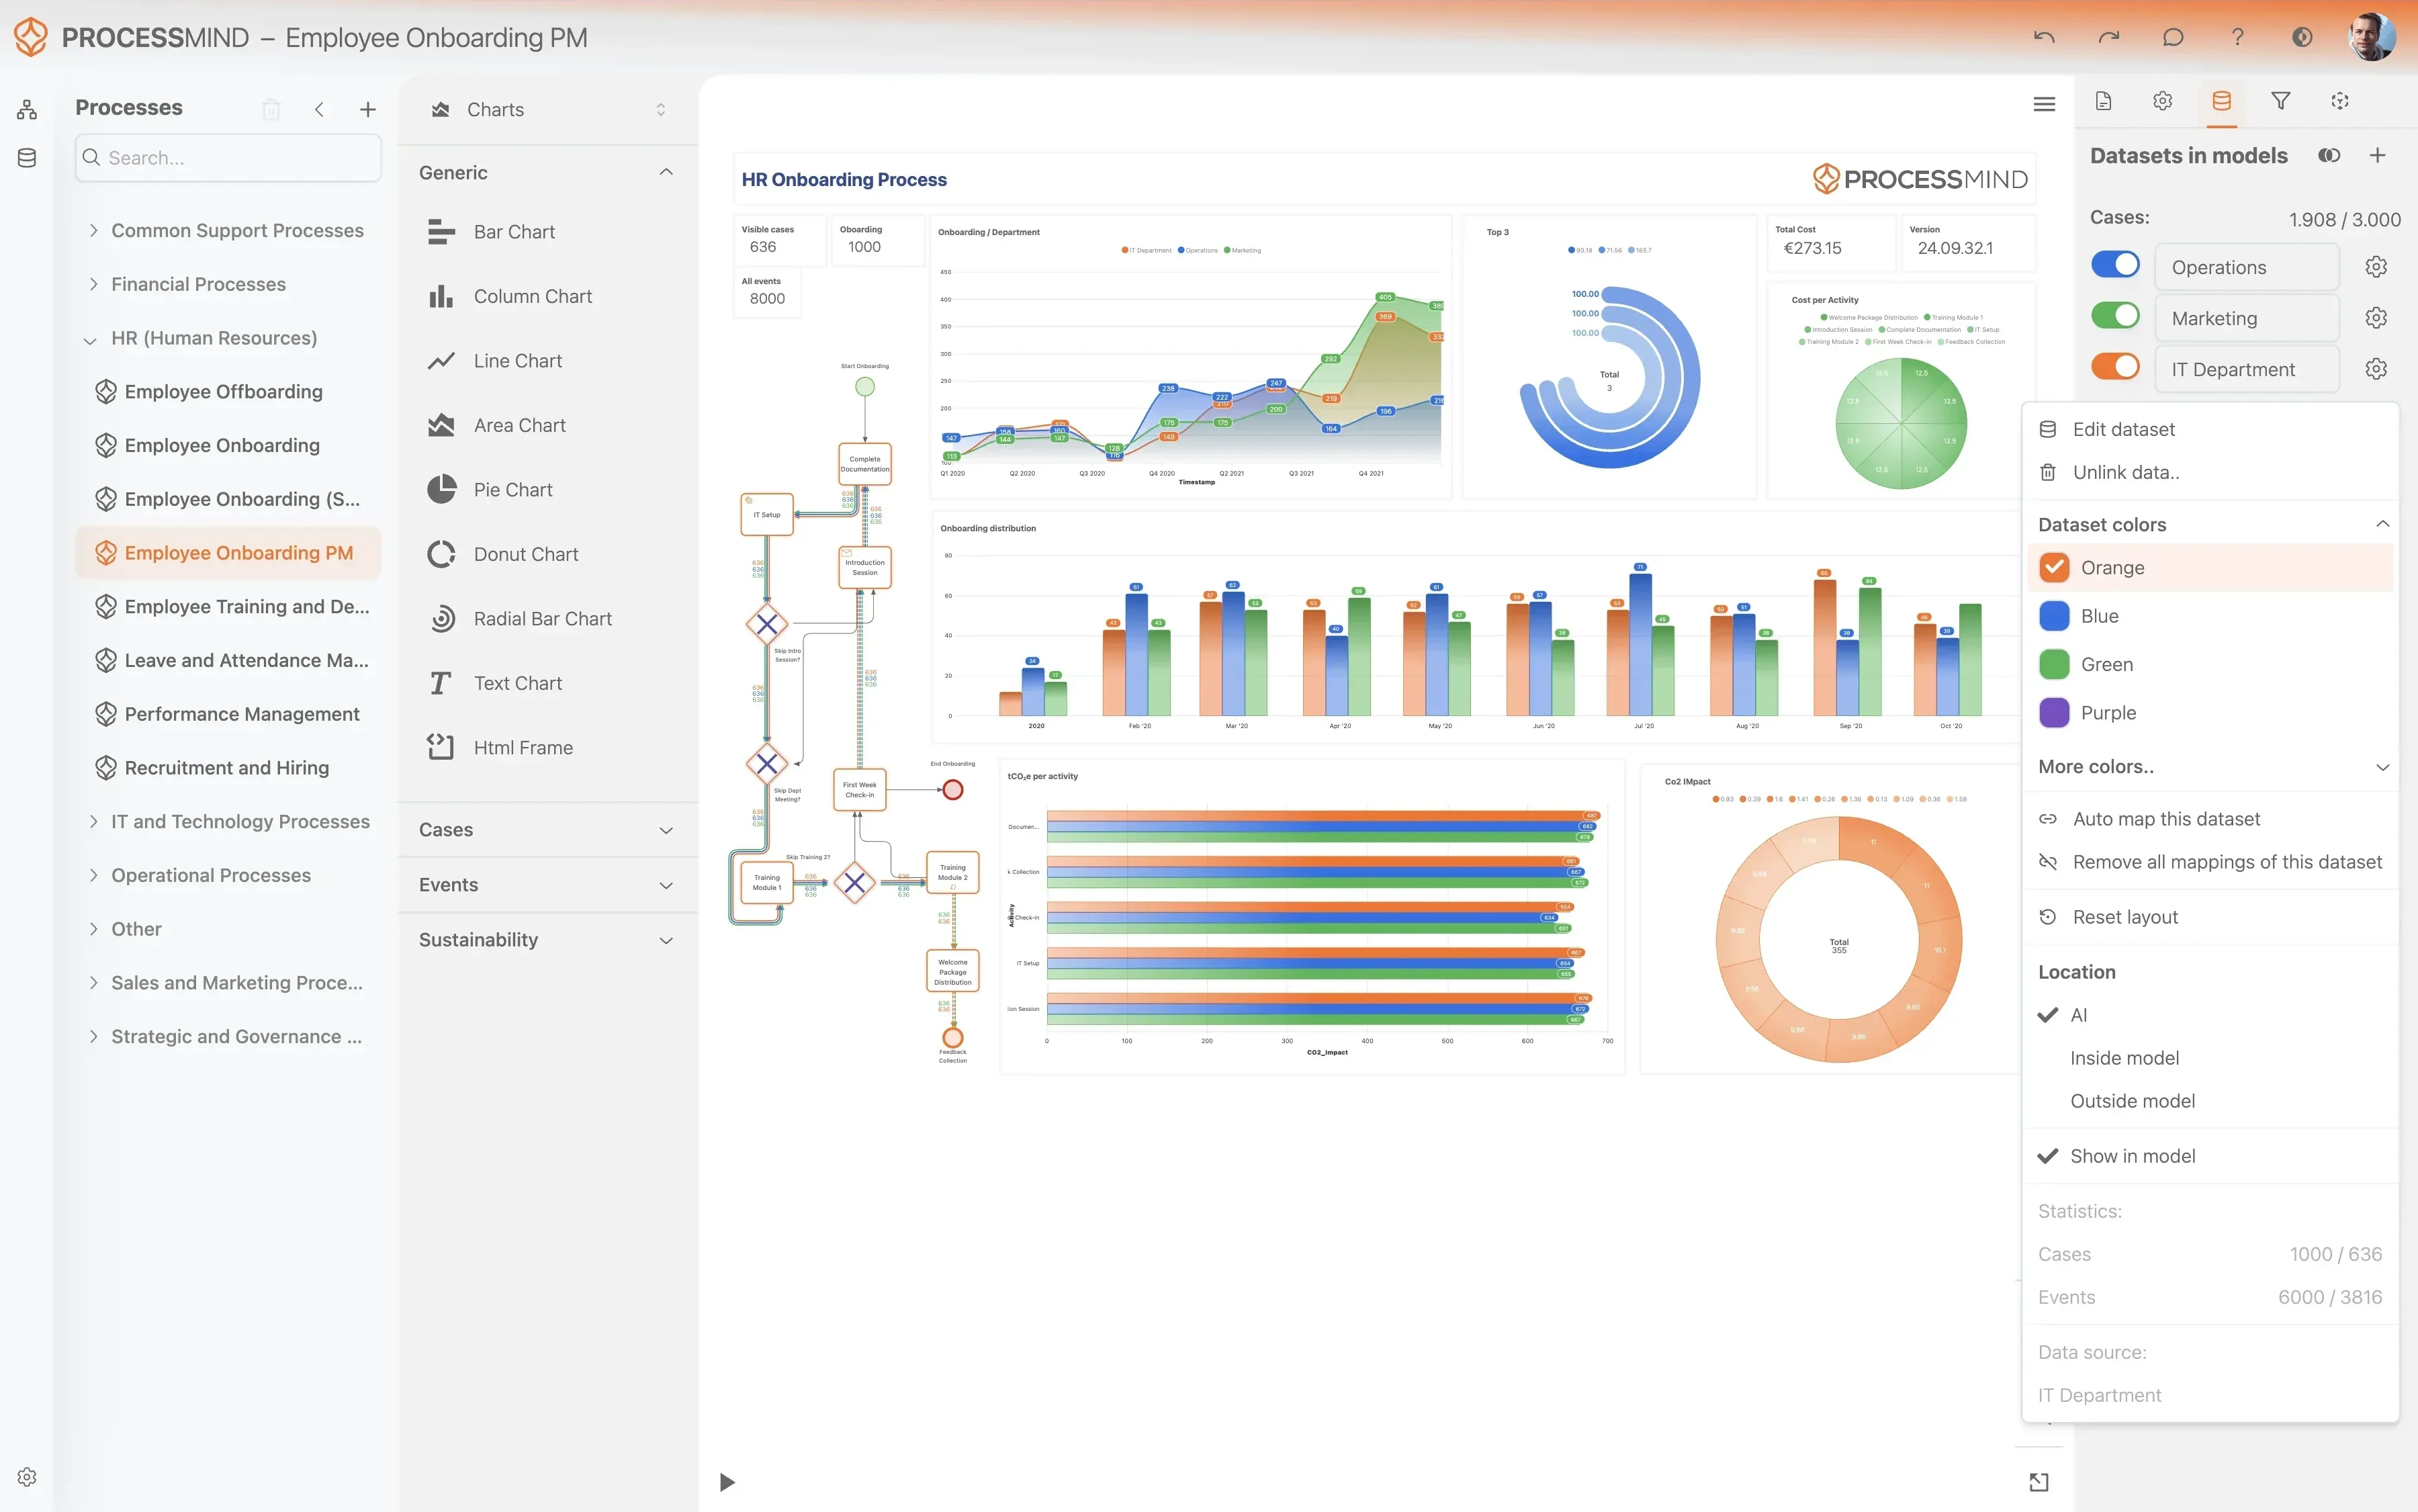
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

POTWIERDZONE WYNIKI

Większa efektywność zarządzania problemami

Wykrycie ukrytych nieefektywności w workflow ServiceNow Problem Management pomaga zespołom przyspieszyć analizę przyczyn źródłowych i ograniczyć liczbę powtarzających się incydentów. Wyniki te pokazują wpływ optymalizacji procesów opartej na danych na standardową obsługę rekordów problemów.

0 %
Szybsza analiza przyczyn źródłowych

Skrócenie czasu analizy

Usprawnienie etapu analizy pomaga zespołom szybciej ustalić przyczyny poważnych incydentów, co znacznie ogranicza skutki powtarzających się przerw w działaniu usług.

0 %
Mniej zmian przypisania

Mniej przekazań rekordów

Ograniczenie zbędnego przekazywania spraw między zespołami wsparcia zapobiega przerzucaniu rekordów problemów między grupami, ułatwia ustalenie odpowiedzialności i przyspiesza rozwiązanie.

+ 0 %
Lepsza zgodność z SLA

Większa zgodność z terminami analizy przyczyn źródłowych

Lepsza widoczność okresów oczekiwania i wąskich gardeł pomaga zakończyć analizę przyczyn źródłowych w uzgodnionym terminie SLA.

0 %
Mniej powtarzających się incydentów

Spadek liczby znanych błędów

Sprawne publikowanie obejść i trwałych poprawek w bazie znanych błędów pomaga zapobiegać nowym incydentom, które zwiększają obciążenie Service Desk.

0 %
Uporządkowana kolejka problemów

Mniej starych rekordów

Wykrywanie i zamykanie porzuconych rekordów pozwala zespołom skupić się na bieżących problemach o wysokim priorytecie, zamiast na starych zgłoszeniach.

Wyniki zależą od złożoności procesu i jakości danych. Podane wartości przedstawiają typowe usprawnienia zaobserwowane podczas wdrożeń.

Zalecane dane

Najpierw wybierz atrybuty i działania, które mają największy wpływ na przebieg analizy.
Pierwszy raz spotykają się Państwo z dziennikiem zdarzeń? Dowiedz się jak utworzyć dziennik zdarzeń na potrzeby process mining.

Atrybuty

Najważniejsze dane do zebrania na potrzeby analizy

Unikalny identyfikator rekordu problemu.

Dlaczego to ważne

To podstawowy klucz, który pozwala rozróżniać poszczególne sprawy i grupować powiązane zdarzenia na grafie procesu.

Zdarzenie lub czynność wykonana w ramach rekordu problemu.

Dlaczego to ważne

Określa węzły na mapie procesu, dzięki czemu można wizualizować przebieg workflow i warianty procesu.

Dokładna data i godzina wystąpienia działania.

Dlaczego to ważne

Niezbędny do uporządkowania zdarzeń i obliczania wszystkich KPI opartych na czasie.

Osoba przypisana do obsługi problemu.

Dlaczego to ważne

Przydatny do analizy efektywności zasobów i obciążenia poszczególnych osób.

Zespół techniczny odpowiedzialny za rozwiązanie problemu.

Dlaczego to ważne

Pomaga wykrywać wąskie gardła między działami i analizować sprawność przekazywania spraw.

Status cyklu życia rekordu problemu.

Dlaczego to ważne

Podstawowy wskaźnik statusu, który pozwala filtrować sprawy otwarte i zamknięte.

Poziom priorytetu przypisany do rekordu problemu.

Dlaczego to ważne

Pozwala analizować wyniki procesu z uwzględnieniem znaczenia problemu dla działalności.

Klasyfikacja ustalonej przyczyny źródłowej.

Dlaczego to ważne

Pozwala analizować wzorce awarii i planować usprawnienia.

Liczba zmian grupy przypisanej do problemu.

Dlaczego to ważne

Bezpośredni wskaźnik tarć w procesie i niejasnego podziału odpowiedzialności.

Liczba incydentów powiązanych z tym rekordem problemu.

Dlaczego to ważne

Mierzy skalę wpływu problemu na użytkowników.

Działania

Kroki procesu do monitorowania i optymalizacji

Utworzenie rekordu problemu w systemie ServiceNow. To początek cyklu zarządzania problemem i punkt odniesienia dla pomiaru wieku rekordu.

Dlaczego to ważne

Wyznacza początek pomiaru czasu cyklu i SLA. Jest podstawą do określenia liczby nowych analiz problemów.

Skierowanie rekordu problemu do konkretnego zespołu technicznego w celu przeprowadzenia analizy. To działanie pokazuje, jak zmienia się odpowiedzialność za sprawę, i ma zasadnicze znaczenie przy analizie przekazań.

Dlaczego to ważne

Niezbędne do analizy zmian przypisania do grup wsparcia w dashboardzie, który pomaga wykrywać przerzucanie spraw i wąskie gardła między zespołami.

Zmiana stanu rekordu problemu z 'New' na 'Assess' lub 'Root Cause Analysis'. Oznacza, że analityk rozpoczął pracę nad problemem.

Dlaczego to ważne

Wyznacza koniec początkowego oczekiwania w kolejce i początek aktywnej analizy. Umożliwia analizę okresów oczekiwania.

Wprowadzenie tekstu w polu 'Workaround' rekordu problemu. Rejestruje moment udokumentowania rozwiązania tymczasowego przez analityka.

Dlaczego to ważne

Umożliwia pomiar skuteczności publikowania obejść w dashboardzie, wskazując, kiedy po raz pierwszy znane było rozwiązanie techniczne.

Moment uzupełnienia kodów 'Root Cause' lub zmiany stanu na 'Fix in Progress'. Oznacza pomyślne zdiagnozowanie problemu.

Dlaczego to ważne

Pozwala obliczyć średni czas ustalenia przyczyny źródłowej i zasila dashboard czasu analizy przyczyny źródłowej. To ważny etap procesu.

Powiązanie wniosku o zmianę (RFC) z rekordem problemu. Oznacza przekazanie sprawy z zarządzania problemami do zarządzania zmianą w celu wdrożenia poprawki.

Dlaczego to ważne

Niezbędne do dashboardu efektywności przekazywania wniosków o zmianę. Pozwala wykryć opóźnienia między ustaleniem poprawki a rozpoczęciem procesu zmiany.

Moment oznaczenia problemu jako Resolved, często po zamknięciu powiązanego wniosku o zmianę. Oznacza zakończenie prac technicznych.

Dlaczego to ważne

Wyznacza koniec aktywnego cyklu wdrażania poprawki. Służy do obliczenia całkowitego czasu rozwiązania w odniesieniu do SLA.

Końcowe zdarzenie cyklu życia, po którym rekord staje się nieaktywny. Nie przewiduje się dalszych działań.

Dlaczego to ważne

Ostateczny koniec instancji procesu. Niezbędny do obliczenia całkowitego czasu cyklu.

FAQ

Często zadawane pytania

Process mining przedstawia rzeczywistą ścieżkę każdego rekordu problemu, od utworzenia do zamknięcia. Zespoły mogą dokładnie sprawdzić, gdzie pojawiają się opóźnienia, na przykład długie okresy oczekiwania lub częste przekazywanie spraw między grupami wsparcia. Takich problemów często nie widać w standardowych raportach.

Potrzebne są przede wszystkim dane z tabel problemów i zadań związanych z problemami, a także dzienniki audytu systemu lub instancje metryk. Zbiór danych powinien zawierać unikalny identyfikator problemu, nazwy działań, takie jak zmiana stanu lub aktualizacja przypisania, oraz znaczniki czasu dla każdego zdarzenia.

Tak. Process mining mierzy czas między określonymi zmianami stanu i wskazuje wąskie gardła na etapie analizy. Dzięki temu można ustalić, czy opóźnienia wynikają z braku zasobów, niekompletnej dokumentacji czy zależności od zewnętrznych dostawców.

Pierwsze wnioski są zazwyczaj dostępne w ciągu kilku dni od podłączenia i zmapowania danych. Już podczas pierwszego przeglądu mapy procesu większość organizacji zaczyna wykrywać poważne nieefektywności, takie jak stare lub porzucone rekordy.

Analizując powiązania między rekordami incydentów i problemów, process mining pokazuje, jak skutecznie przekazywane są informacje o znanych błędach. Wykrywa przypadki, w których obejścia nie są publikowane wystarczająco szybko lub przyczyny źródłowe są błędnie klasyfikowane, co prowadzi do powtarzających się problemów.

Nie. Narzędzia process mining zazwyczaj korzystają z istniejących danych i nie wymagają zmian w formularzach ani workflow ServiceNow. Jeśli system zapisuje historię w dziennikach audytu, narzędzie może odtworzyć przebieg procesu bez ingerowania w bieżące operacje.

Technologia śledzi zmiany pola grupy przypisania w dziennikach audytu, aby pokazać przekazywanie spraw. Ujawnia przypadki przerzucania rekordu problemu między zespołami, co pozwala usprawnić przydział zasobów i zaplanować szkolenia dla konkretnych grup.

Standardowe raporty pokazują migawki lub proste miary, takie jak średni czas rozwiązania, ale nie przedstawiają całego przebiegu procesu. Process mining pokazuje zmiany i pętle między poszczególnymi etapami. Dzięki temu można ustalić nie tylko, że proces trwa zbyt długo, lecz także gdzie i dlaczego się zatrzymuje.

Usprawnij zarządzanie problemami, aby szybciej je rozwiązywać

Skróć cykl analizy o 30% dzięki process mining

Rozpocznij bezpłatny okres próbny

Karta kredytowa nie jest wymagana. Konfiguracja zajmuje kilka minut.