Migliori la gestione dei problemi
Guida in 6 passaggi per ottimizzare la gestione dei problemi in ServiceNow
Migliori la gestione dei problemi
Gestione dei problemi
Gestione dei problemi in ServiceNow

Selezioni un processo

Scelga un processo per continuare a lavorare nell’area di lavoro collegata.

Processi disponibili
Sistemi disponibili
259 Processi

Ottimizzi la gestione dei problemi in ServiceNow per risolverli più rapidamente

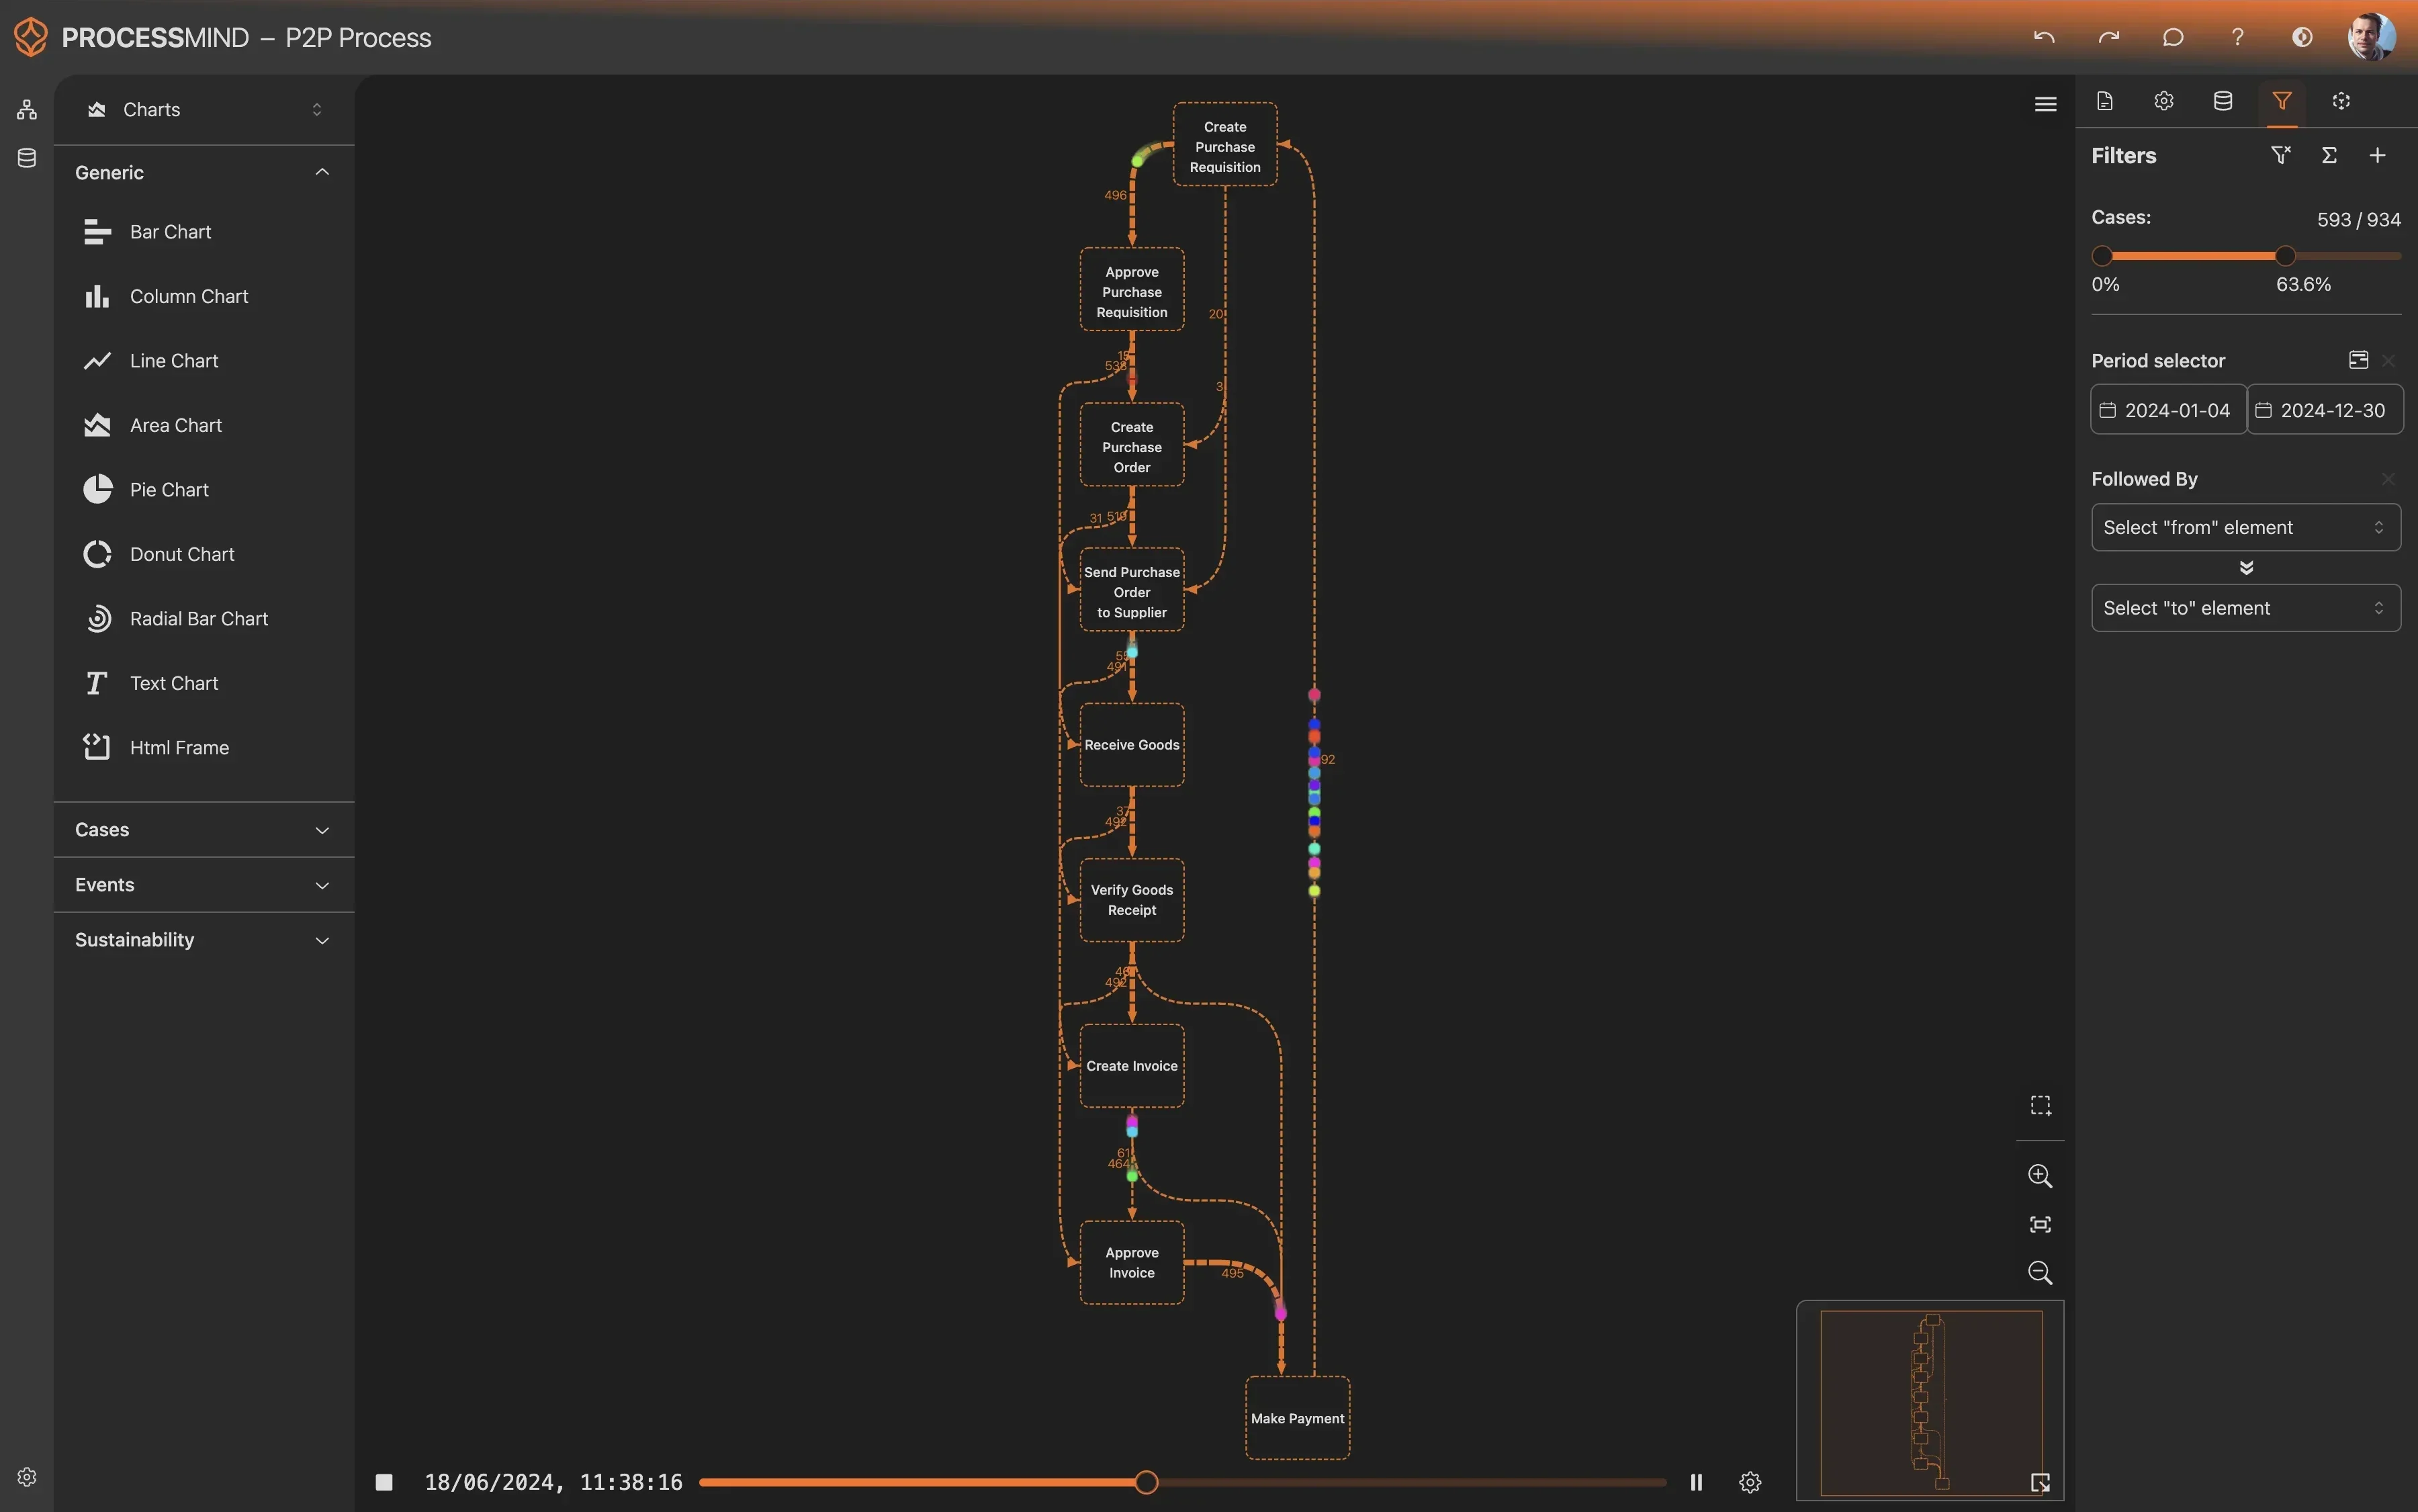
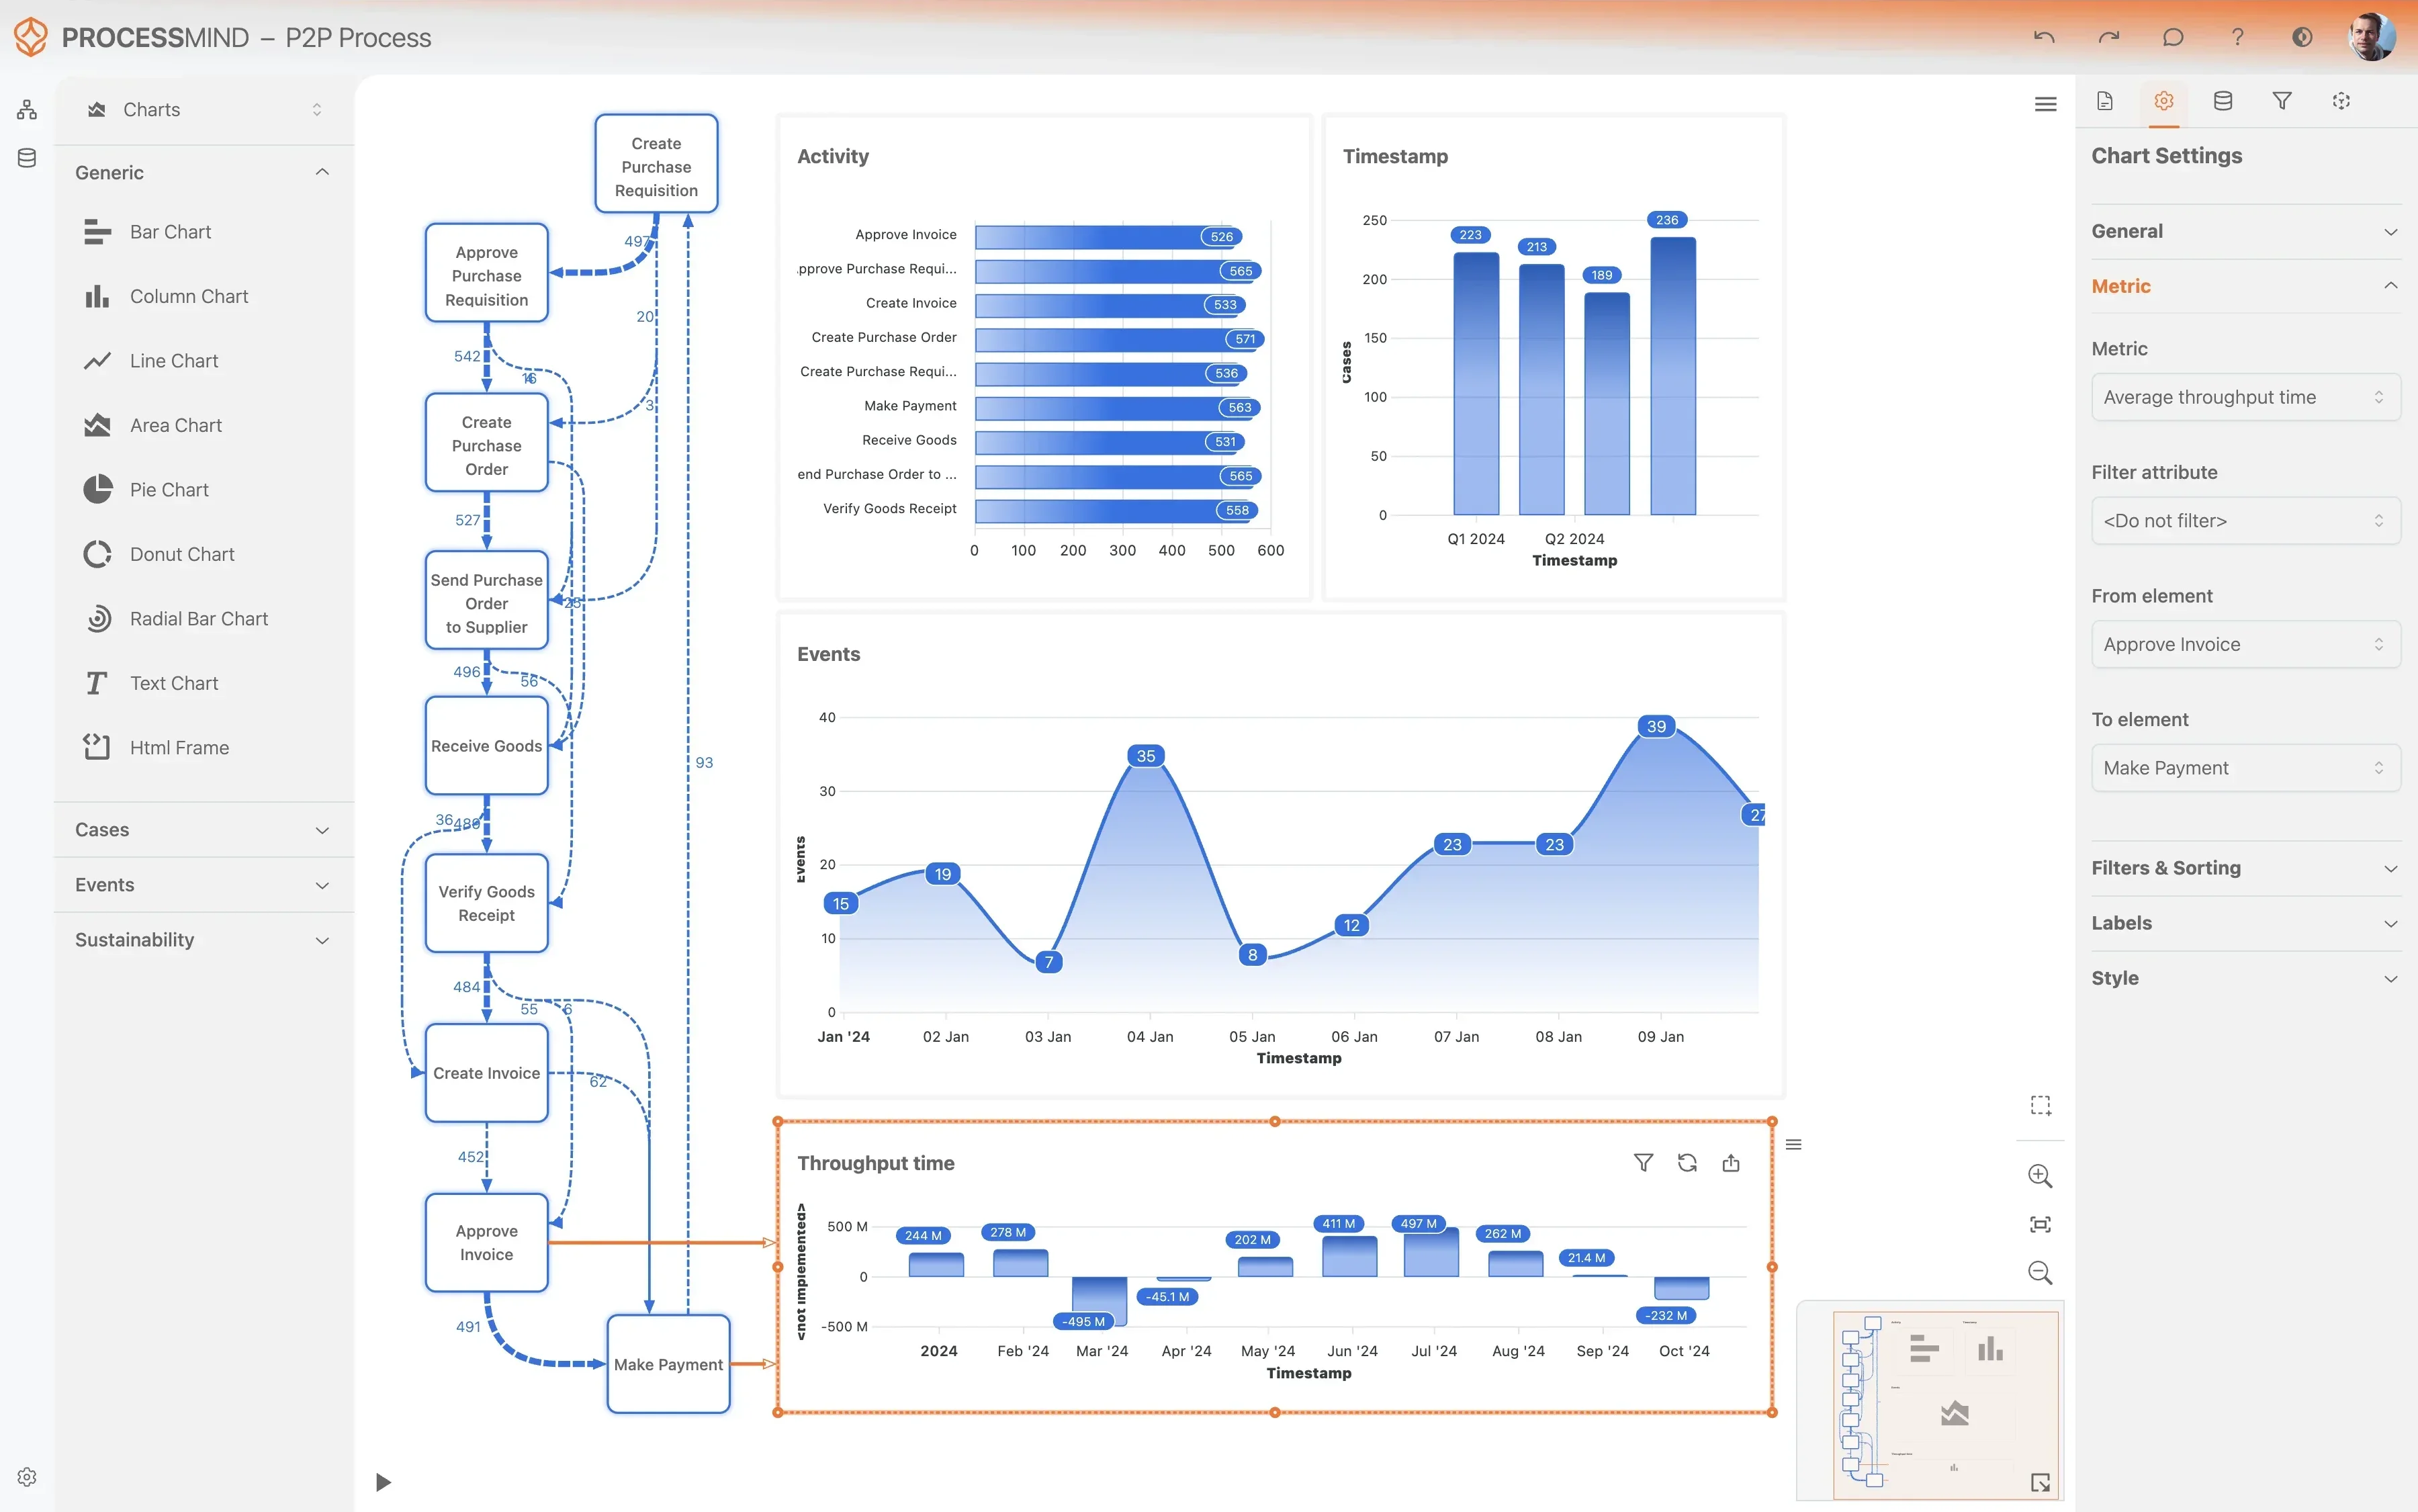
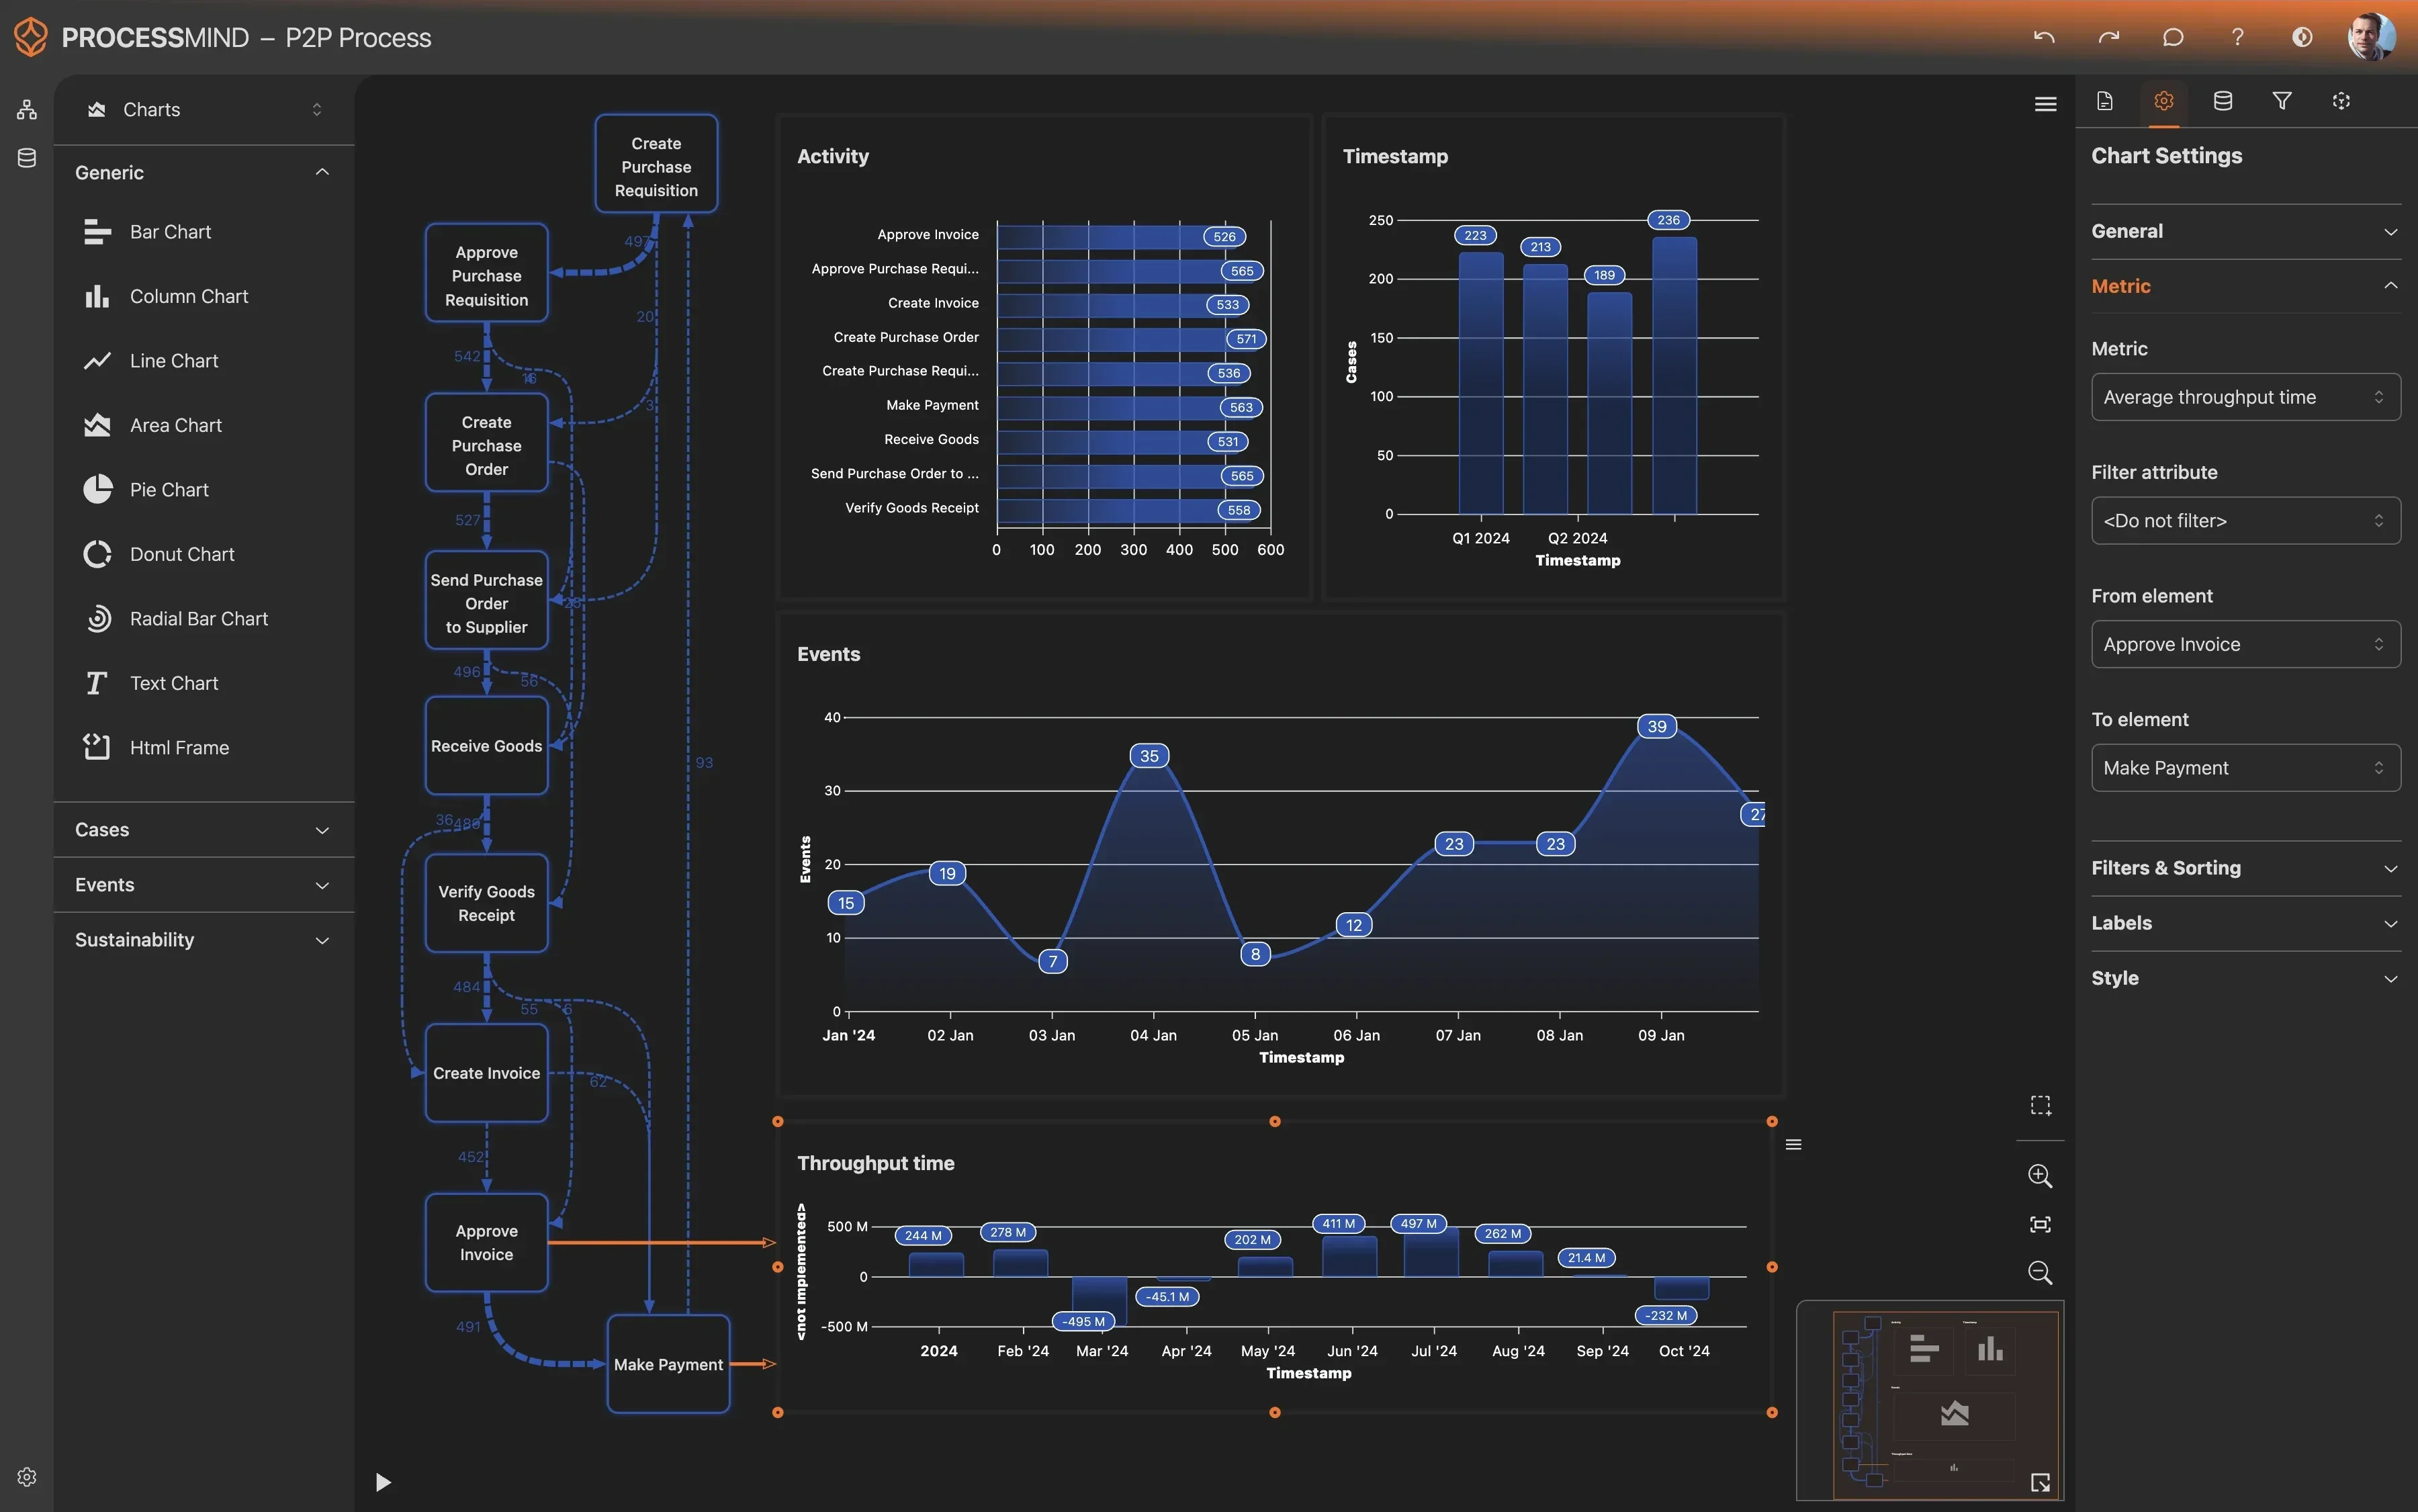
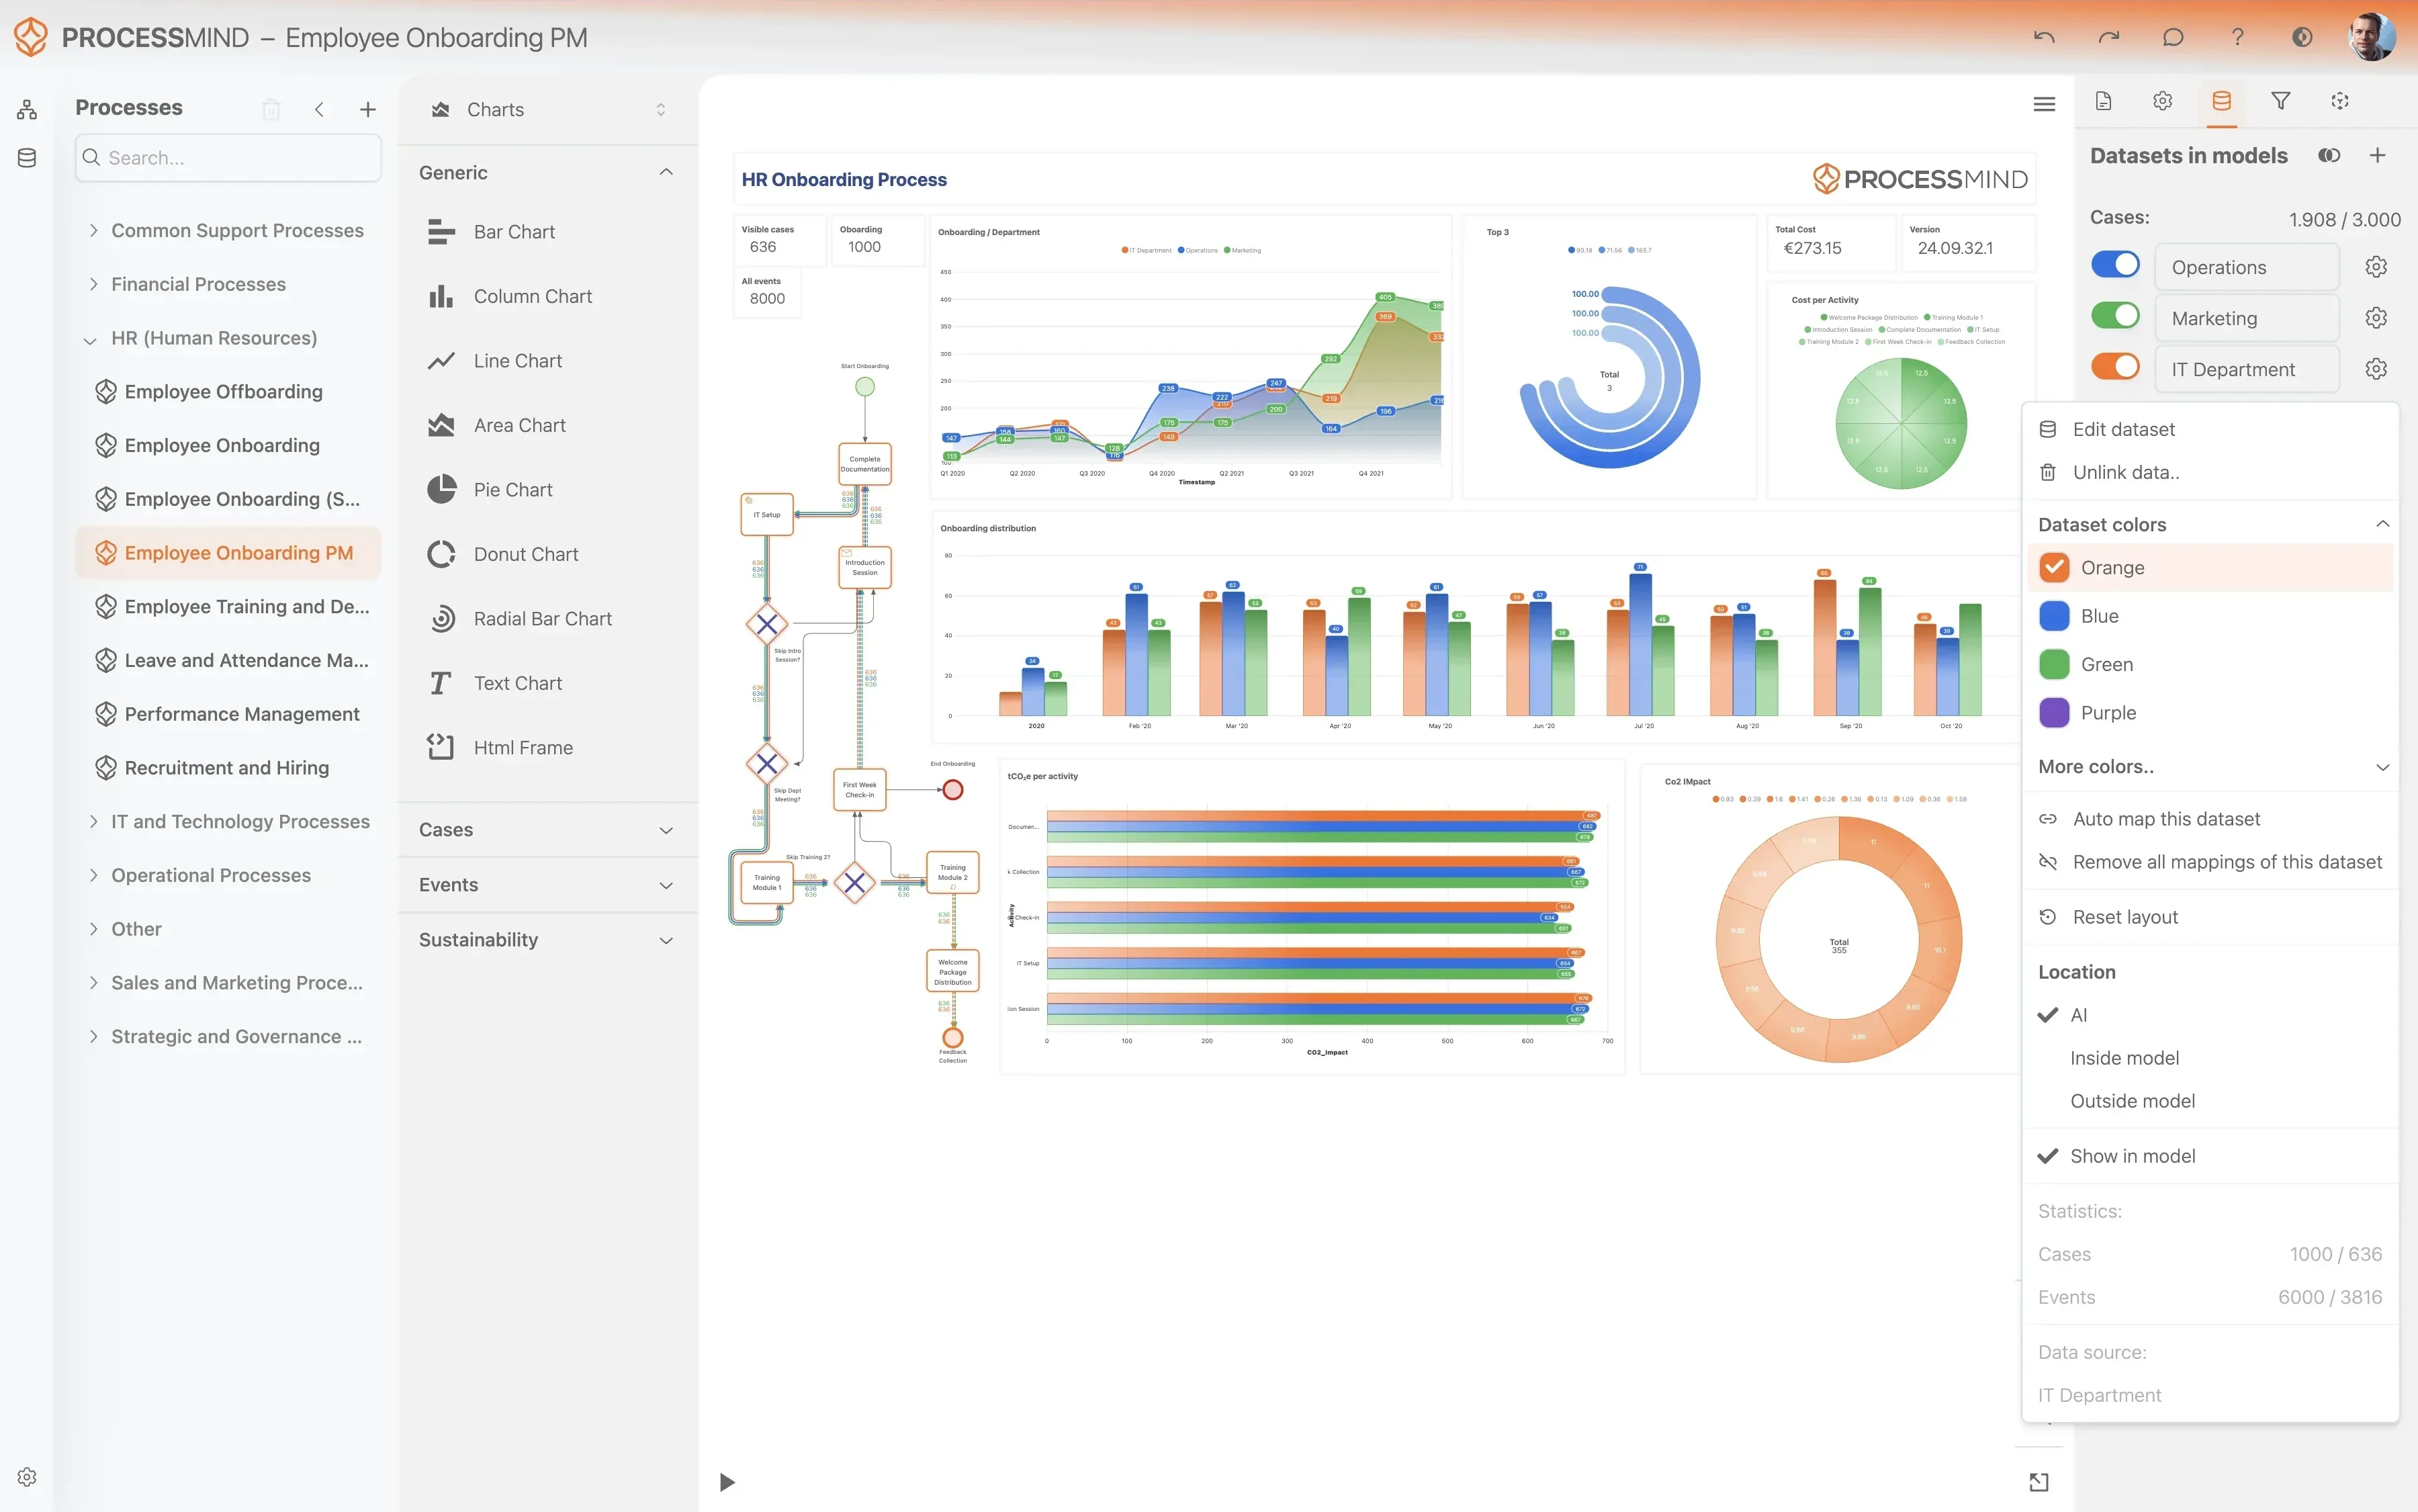
La nostra piattaforma di Process Mining individua i colli di bottiglia nascosti e i cicli di rilavorazione che allungano i tempi di risoluzione. Mostra in quali punti le indagini si bloccano e perché si verificano lacune nella comunicazione, offrendo gli elementi necessari per rendere più efficienti le operazioni. Visualizzando il flusso effettivo del lavoro, può individuare i ritardi dovuti alle attività manuali e favorire un ambiente più stabile per gli utenti.

Scarichi il nostro template dei dati preconfigurato e affronti le sfide più comuni per raggiungere i Suoi obiettivi di efficienza. Segua il nostro piano di miglioramento in sei fasi e consulti la guida al template dei dati per trasformare le Sue attività.

Mostra la descrizione dettagliata

Perché è essenziale ottimizzare la gestione dei problemi

Oggi le organizzazioni IT si trovano spesso intrappolate in un ciclo di interventi reattivi e urgenti. Quando si verificano incident gravi, l’obiettivo immediato è ripristinare il servizio, ma spesso la causa profonda resta irrisolta, provocando nuove interruzioni e un aumento dei costi operativi. Ottimizzare la gestione dei problemi è l’unico modo per interrompere questo ciclo. Migliorando il modo in cui l’organizzazione individua, analizza e risolve i problemi alla radice nell’ambiente IT, può ridurre sensibilmente il numero di incident in ingresso e aumentare la stabilità complessiva dei servizi. Una gestione inefficiente dei problemi non fa solo perdere tempo: mina la fiducia degli utenti e impedisce ai team tecnici altamente qualificati di concentrarsi sull’innovazione.

Usare il Process Mining per ottenere una visione approfondita

La gestione dei problemi in ServiceNow acquisisce una grande quantità di dati tramite tabelle come problem e problem_task, ma i report tradizionali spesso non mostrano il flusso effettivo del lavoro. Il Process Mining trasforma questi dati in una mappa dinamica dei processi reali. Anziché limitarsi a KPI statici, come l’età media dei problemi aperti, può visualizzare l’intero ciclo di vita, dal momento in cui un problema viene individuato fino alla sua chiusura. Questa prospettiva mostra come il lavoro passa da un gruppo di assistenza all’altro e individua con precisione i punti in cui il processo si discosta dalle procedure operative standard. Mappando le tracce digitali lasciate in ServiceNow, ottiene una visione oggettiva delle operazioni, libera da pregiudizi legati ai reparti.

Individuare le inefficienze nel ciclo di indagine

Una delle principali difficoltà nella gestione dei problemi è la durata della fase di indagine. Il Process Mining aiuta a capire con precisione perché alcune indagini si bloccano. Per esempio, può emergere che i record dei problemi passano spesso da un gruppo tecnico all’altro, in un continuo rimpallo dovuto a una valutazione iniziale insufficiente. È inoltre possibile individuare colli di bottiglia specifici, dove i record restano in sospeso per settimane in attesa di informazioni dai fornitori o di approvazioni interne per le modifiche. Una volta individuati questi ritardi nascosti, è possibile introdurre miglioramenti mirati, come procedure di passaggio più efficaci o percorsi di escalation automatizzati, per accelerare l’applicazione di una correzione permanente.

Rafforzare l’analisi delle cause profonde e la conformità

Indagini di qualità sono alla base di una gestione efficace dei problemi. Il Process Mining consente di verificare la coerenza del processo di analisi delle cause profonde (RCA). Può verificare se passaggi fondamentali, come la pubblicazione di una soluzione alternativa o lo svolgimento di una revisione post-implementazione, vengono saltati o svolti troppo in fretta. Per le organizzazioni che operano in settori altamente regolamentati è essenziale che ogni record del problema segua un percorso conforme. Inoltre, analizzando la relazione tra incident e problemi in ServiceNow, può determinare se i team individuano correttamente i problemi ad alto impatto o dedicano troppo tempo a indagini a bassa priorità, con scarso valore per l’azienda.

Misurare i risultati e promuovere il miglioramento continuo

L’obiettivo finale dell’ottimizzazione della gestione dei problemi è creare un’infrastruttura IT più resiliente. Il Process Mining fornisce informazioni dettagliate per misurare nel tempo i risultati degli interventi di ottimizzazione. Può monitorare l’aumento del rapporto tra correzioni permanenti e soluzioni temporanee e la riduzione del tempo complessivo del ciclo di vita dei record dei problemi. Eliminando gli ostacoli nei flussi di lavoro di ServiceNow, il team diventa più efficace nel prevenire gli incident prima che si verifichino. Questo passaggio da una gestione reattiva a una proattiva non solo riduce i costi, ma consente anche ai servizi IT di adeguarsi alle esigenze crescenti dell’azienda. Partendo da un template di Process Mining, può ottenere subito queste informazioni e trasformare i dati già presenti in ServiceNow in una guida per migliorare le operazioni.

Gestione dei problemi Analisi delle cause profonde Gestione dei servizi IT Prevenzione degli incident Service Desk Assistenza tecnica Operazioni IT Gestione delle modifiche Gestione dei ticket Gestione dei ticket Errore noto Incident ricorrenti Soluzione alternativa Help desk IT

Problemi e sfide comuni

Individui le sfide che La riguardano

I problemi restano spesso in sospeso per periodi prolungati mentre i team attendono riscontri dai fornitori o ulteriori informazioni interne. Questo blocca l’indagine sulle cause profonde, allunga i tempi di risoluzione e fa accumulare problemi tecnici irrisolti che continuano a incidere sull’attività aziendale.

ProcessMind monitora le transizioni di stato nella gestione dei problemi in ServiceNow per evidenziare con precisione dove e perché i record si bloccano. Visualizzando il tempo trascorso in ogni stato, può individuare i gruppi di assistenza o i fornitori esterni che causano ritardi significativi nel ciclo di indagine.

Quando i record dei problemi non vengono risolti in modo efficiente, gli stessi incident continuano a ripetersi, sovraccaricando il Service Desk e frustrando gli utenti finali. Spesso ciò indica che le soluzioni alternative non vengono pubblicate correttamente o non riescono a mitigare il problema sottostante mentre si attende una correzione permanente.

Analizzando i collegamenti tra incident e record dei problemi nella gestione dei problemi in ServiceNow, ProcessMind individua gli schemi di ricorrenza che segnalano indagini incomplete o non riuscite. Questi dati consentono ai team di dare priorità ai problemi ad alto impatto che generano più richieste e assorbono più risorse.

Il mancato rispetto degli obiettivi di livello di servizio per l’individuazione delle cause profonde spesso prolunga l’instabilità dei servizi e riduce la fiducia degli stakeholder nelle operazioni IT. I team tecnici possono essere sovraccarichi o non disporre della visibilità necessaria per stabilire le priorità delle indagini in base all’effettivo impatto aziendale del problema.

La nostra piattaforma monitora il tempo che intercorre tra la registrazione del problema e l’individuazione della causa profonda nell’ambiente ServiceNow. Segnala i record prossimi ai limiti SLA, consentendo ai coordinatori dei problemi di riallocare le risorse e mantenere le indagini critiche in linea con gli obiettivi, prima che vengano superati.

I record dei problemi passano spesso da un team tecnico all’altro prima che l’indagine vera e propria abbia inizio. Questo continuo rimpallo fa perdere tempo prezioso, crea confusione sulle responsabilità e ritarda sensibilmente la risoluzione finale, perché nessun gruppo si assume la responsabilità della causa profonda.

ProcessMind mappa il flusso delle assegnazioni tra i gruppi di assistenza per individuare gli ostacoli nei passaggi di consegne e le lacune nelle responsabilità. Individuando i cicli di riassegnazione ricorrenti nella gestione dei problemi in ServiceNow, può perfezionare la logica di assegnazione iniziale e fare in modo che i problemi arrivino più rapidamente agli esperti tecnici competenti.

Anche dopo aver individuato la causa profonda, spesso passa molto tempo prima che venga avviata una richiesta di modifica per risolverla. Questa attesa espone l’organizzazione a ulteriori incident, perché la soluzione permanente non è stata pianificata né applicata, anche se è già nota.

Monitoriamo il passaggio tra la gestione dei problemi in ServiceNow e il modulo Change Management. Misurando il tempo che intercorre tra l’individuazione della causa profonda e la stesura della soluzione proposta, ProcessMind aiuta a colmare il divario verso una risoluzione permanente e a portare le correzioni in produzione senza ritardi.

Molte organizzazioni chiudono i record dei problemi senza svolgere una revisione post-implementazione adeguata dopo aver applicato una correzione. Senza questa fase conclusiva, non si traggono insegnamenti utili e manca una verifica formale che confermi l’effettiva eliminazione della causa profonda, con il rischio di nuovi problemi.

ProcessMind evidenzia i casi in cui il processo passa direttamente dalla risoluzione alla chiusura, saltando la revisione obbligatoria. In questo modo i team possono seguire l’intero ciclo di vita della gestione dei problemi in ServiceNow, migliorando la stabilità dei servizi e la condivisione delle conoscenze nell’organizzazione IT.

Se le soluzioni alternative non vengono documentate e pubblicate nel database degli errori noti, gli operatori del Service Desk non possono assistere efficacemente gli utenti mentre il problema è ancora in fase di indagine. Ne derivano attività duplicate, un aumento delle chiamate e tempi medi di risoluzione più lunghi per tutti gli incident correlati.

Analizzando i log delle attività relative alla pubblicazione delle soluzioni alternative, ProcessMind individua le indagini che non forniscono un rimedio provvisorio all’azienda. Questa visibilità aiuta i responsabili a far rispettare gli standard di documentazione nei flussi di lavoro di gestione dei problemi in ServiceNow e a migliorare l’efficienza complessiva del Service Desk.

A volte i team tecnici si concentrano su attività a bassa priorità, mentre problemi ad alto impatto che coinvolgono servizi aziendali critici restano inevasi nel backlog. Questo squilibrio causa notevoli disagi all’attività aziendale e riduce il valore del tempo dedicato dai tecnici più qualificati e costosi.

La nostra analisi mette in relazione i livelli di priorità dei problemi con l’impegno effettivo e i tempi di risoluzione registrati. ProcessMind aiuta a capire se i record ServiceNow più critici ricevono l’attenzione necessaria o vengono trascurati a favore di attività meno urgenti e più semplici da risolvere.

Il passaggio dall’individuazione di una causa profonda alla proposta di una soluzione tecnica specifica diventa spesso un importante collo di bottiglia. Le cause sono spesso la scarsità di risorse o la documentazione insufficiente durante l’indagine, che rende difficile per gli architetti progettare una correzione adeguata.

ProcessMind visualizza il ciclo di vita dei singoli record dei problemi per individuare con precisione dove si blocca la progettazione della soluzione. Individuando questi ritardi nella gestione dei problemi in ServiceNow, può migliorare la collaborazione tra architetti e ingegneri e trasformare le ipotesi in una soluzione concreta.

Le segnalazioni di problema restano spesso aperte a tempo indeterminato, senza che sia in corso un’indagine, e finiscono per creare un arretrato disordinato e difficile da gestire. Queste segnalazioni abbandonate nascondono problemi reali e rendono difficile ai responsabili IT valutare l’effettiva stabilità operativa e le prestazioni dei team.

Individuiamo i record che presentano lunghi periodi di inattività tra un cambio di stato e l’altro in ServiceNow Problem Management. ProcessMind aiuta a riordinare l’arretrato mettendo in evidenza le indagini ferme, che devono essere chiuse ufficialmente oppure riprese con nuove risorse.

Quando i team utilizzano categorie generiche o imprecise per indicare le cause profonde, diventa impossibile individuare tendenze di lungo periodo o problemi sistemici nell’infrastruttura. La scarsa qualità dei dati impedisce all’organizzazione di prendere decisioni informate sugli investimenti necessari a prevenire future interruzioni.

ProcessMind analizza la relazione tra la risoluzione finale e le categorie assegnate in ServiceNow Problem Management. Aiutiamo a individuare i casi in cui le categorie vengono utilizzate in modo errato, così da migliorare l’integrità dei dati e ottenere indicazioni più precise sulle principali fonti di debito tecnico.

Se occorre troppo tempo per individuare una soluzione temporanea, gli utenti restano senza servizio e l’impatto del problema aumenta. Se l’indagine parte in ritardo, l’attività aziendale subisce disagi più a lungo del necessario, anche quando alla fine si trova una soluzione definitiva.

La nostra piattaforma misura il tempo che intercorre tra l’identificazione del problema e la pubblicazione della prima soluzione temporanea. Analizzando questa fase specifica del processo ServiceNow Problem Management, aiutiamo a individuare i team che faticano a fornire un sollievo tempestivo, così da poter pianificare interventi mirati di formazione sulla mitigazione degli incidenti.

Obiettivi tipici

Definisca i criteri di successo

Un’analisi più rapida delle cause profonde previene il ripetersi degli incidenti e riduce al minimo i tempi di inattività dell’infrastruttura. Accelerando la fase d’indagine, i team tecnici possono dedicarsi meno alla gestione ripetitiva delle emergenze e concentrarsi sull’attuazione di soluzioni definitive che migliorano l’affidabilità complessiva dei servizi. Questo obiettivo incide direttamente sull’efficienza delle risorse tecniche senior e riduce il tempo in cui le vulnerabilità critiche restano senza risposta nell’ambiente IT.

ProcessMind visualizza l’intero flusso d’indagine in ServiceNow Problem Management, così da individuare con precisione i punti in cui i team si bloccano. Evidenziando i colli di bottiglia nei gruppi di supporto o negli ambiti tecnici specifici, la piattaforma fornisce indicazioni concrete per ridurre i tempi d’indagine fino al 30%. È possibile monitorare il percorso dall’identificazione del problema alla determinazione della causa profonda e verificare che ogni indagine proceda regolarmente.

Ogni passaggio tra gruppi di supporto allunga i tempi complessivi di risoluzione e aumenta il carico amministrativo. Ridurre questi passaggi permette agli esperti più adatti di occuparsi subito del problema, evitando il frequente rimpallo dovuto a responsabilità poco chiare. Limitare le riassegnazioni rende il processo più lineare e rafforza la responsabilità dei team tecnici.

La nostra piattaforma tiene traccia della cronologia dell’attributo del gruppo di supporto assegnato a ogni segnalazione di problema in ServiceNow. Individuando i casi in cui le segnalazioni vengono indirizzate al gruppo sbagliato o passano ripetutamente da un team all’altro, ProcessMind aiuta a ottimizzare le regole di assegnazione e a dimezzare le riassegnazioni non necessarie. In questo modo, le indagini possono proseguire senza perdere slancio durante i passaggi di consegne.

Rispettare le scadenze delle indagini è essenziale per mantenere i livelli di servizio e la stabilità operativa dell’organizzazione IT. Il rispetto costante degli SLA assicura che i problemi ad alta priorità non vengano trascurati e che l’azienda sia protetta dai rischi noti. Quando i team raggiungono regolarmente gli obiettivi di servizio, cresce la fiducia degli stakeholder e l’erogazione dei servizi diventa più prevedibile.

ProcessMind monitora in tempo reale le prestazioni effettive rispetto agli obiettivi SLA, analizzando le tabelle problem e problem task. Individuando le fasi del processo in cui è più probabile che gli SLA non vengano rispettati, aiutiamo i team a mantenere un tasso di conformità superiore al 95% per tutti i livelli di priorità. È possibile vedere quali categorie o servizi rischiano maggiormente di accumulare ritardi e intervenire prima che si verifichi una violazione.

Fornire rapidamente una soluzione temporanea riduce l’impatto di un problema in corso sugli utenti finali e sul Service Desk. Il personale di supporto può così risolvere gli incidenti prima che sia pronta una soluzione definitiva, riducendo sensibilmente il numero di ticket aperti e migliorando la soddisfazione degli utenti. Pubblicare tempestivamente le soluzioni temporanee è spesso il modo più efficace per gestire l’impatto immediato di una grave interruzione.

Analizziamo il tempo che intercorre tra l’identificazione del problema e la pubblicazione di una soluzione temporanea nella banca dati degli errori noti. Le indicazioni di ProcessMind aiutano a rendere uniforme questa fase fondamentale, rendendo disponibile la documentazione degli errori noti il 40% più rapidamente. Questa visibilità permette di attribuire ai team la responsabilità di comunicare tempestivamente le soluzioni provvisorie mentre si indaga sulla causa profonda.

Un passaggio fluido dalla segnalazione di un problema a una richiesta di modifica è essenziale per attuare soluzioni definitive in modo controllato. I ritardi in questa fase lasciano le vulnerabilità individuate nell’ambiente di produzione più a lungo del necessario. Un’integrazione efficace tra i due processi assicura che il lavoro d’indagine porti a un’effettiva correzione.

Mappando le tracce digitali tra le tabelle problem e change request di ServiceNow, individuiamo gli ostacoli nelle fasi di approvazione e passaggio di consegne. Questo aiuta a colmare la distanza tra l’identificazione della causa profonda e l’avvio della correzione, riducendo il tempo trascorso in attesa di attività amministrative. È possibile vedere con precisione in quale fase di stesura o approvazione si bloccano le soluzioni proposte.

Il risultato più importante per un team di gestione dei problemi è ridurre il ripetersi degli incidenti. Individuando e correggendo le cause profonde, si abbassa il costo totale di gestione dei servizi IT e si riduce il carico quotidiano sul Service Desk. Prevenire con successo il ripetersi degli incidenti dimostra il valore concreto del processo di gestione dei problemi per l’intera azienda.

ProcessMind mette in relazione il volume degli incidenti con specifiche segnalazioni di problema per valutare nel tempo l’efficacia delle soluzioni definitive. In questo modo è possibile verificare che le soluzioni eliminino davvero la causa profonda, anziché limitarsi a trattarne i sintomi. È possibile monitorare il tasso di successo delle modifiche attuate e verificare che riducano il volume degli incidenti come previsto.

Le segnalazioni obsolete e abbandonate appesantiscono l’ambiente ServiceNow e rendono meno visibili le priorità effettive dei team tecnici. Riordinare l’arretrato assicura che le risorse limitate siano destinate ai problemi attuali più critici. Una coda di problemi aggiornata e attiva offre ai responsabili una visione più chiara e rende molto più gestibile il lavoro quotidiano dei coordinatori.

Mettiamo in evidenza le segnalazioni inattive o ferme, senza cambi di stato né attività da molto tempo. Questa visibilità permette ai team di eliminare le indagini abbandonate e concentrarsi sulle attività di correzione in corso. Definendo una procedura per la revisione periodica dei record, è possibile mantenere la coda di gestione dei problemi snella e focalizzata sulle indagini di maggior valore.

Classificare correttamente le cause profonde è fondamentale per analizzare le tendenze nel tempo e migliorare strategicamente i servizi. Aiuta i responsabili IT a capire dove si accumula il debito tecnico e dove sono più necessari gli investimenti nell’infrastruttura. Dati di qualità consentono all’organizzazione di imparare dagli errori passati e prevenire problemi analoghi in altre aree aziendali.

ProcessMind individua le incoerenze nella registrazione e classificazione delle cause profonde tra i diversi gruppi di supporto. Rilevando i casi di classificazione errata o l’uso eccessivo di categorie generiche, aiutiamo a migliorare la qualità dei dati operativi. Ne derivano report più affidabili e decisioni migliori per garantire la stabilità dei servizi nel lungo periodo.

Imparare dai problemi passati è l’unico modo per evitare errori futuri e migliorare continuamente il ciclo di vita dei servizi IT. Le revisioni successive all’implementazione permettono al team di riflettere sulle indagini e sulle risoluzioni per individuare ulteriori margini di efficienza. Questa fase formale di revisione è essenziale per far maturare il processo di gestione dei problemi e promuovere una cultura di apprendimento continuo.

Monitoriamo il tasso di completamento e i tempi delle attività successive all’implementazione, una volta risolto un problema. In questo modo, ogni segnalazione di problema importante si conclude con un’analisi verificata delle prestazioni del processo. ProcessMind aiuta a monitorare la regolarità di queste revisioni e a verificare se, nel tempo, portano a miglioramenti misurabili del processo.

I problemi ad alta priorità richiedono l’intervento immediato del personale più esperto per ridurre al minimo l’impatto sull’attività aziendale. Assegnare le risorse più qualificate ai problemi più critici contribuisce a mantenere stabile l’ambiente IT. Quando le risorse sono distribuite in modo ottimale, l’organizzazione può gestire gli incidenti gravi senza trascurare le attività importanti di analisi delle cause profonde.

ProcessMind analizza il flusso del processo in base al livello di priorità e al gruppo assegnato in ServiceNow. È così possibile riequilibrare i carichi di lavoro e assicurarsi che le indagini critiche non attendano nelle stesse code delle attività a basso impatto. È possibile visualizzare la capacità dei gruppi di supporto e modificare le assegnazioni, affinché i problemi più importanti ricevano l’attenzione necessaria.

I problemi restano spesso fermi in attesa di informazioni da un fornitore, di un riscontro dell’utente o di dati da terzi, prolungando il periodo di esposizione al rischio. Ridurre queste attese accelera i tempi complessivi di risoluzione e impedisce che le dipendenze esterne compromettano gli SLA interni. Gestire efficacemente gli stati in attesa è fondamentale per mantenere un ritmo sostenuto durante il ciclo di vita del problema.

Misuriamo con precisione il tempo perso negli stati di attesa analizzando la cronologia degli stati delle segnalazioni di problema. Visualizzando questi ritardi, è possibile individuare i fornitori o i team esterni che creano i maggiori ostacoli. Questi dati consentono di rinegoziare le condizioni degli accordi con i fornitori o migliorare le procedure interne di sollecito, così da mantenere il processo in movimento.

Una volta individuata la causa profonda, la soluzione proposta deve essere documentata e rivista rapidamente per poter passare all’attuazione. I ritardi in questa fase rimandano la correzione effettiva ed espongono l’azienda al rischio che il problema si ripresenti. Una stesura e un’approvazione rapide consentono di passare dalla teoria all’azione nel minor tempo possibile.

ProcessMind monitora la durata delle fasi di stesura e approvazione nel flusso di lavoro di ServiceNow. Questa visibilità aiuta a rimuovere gli ostacoli burocratici e a individuare i casi in cui la soluzione proposta resta bloccata troppo a lungo. È possibile semplificare il processo di revisione interno e passare dall’indagine alla correzione con molti meno passaggi.

Migliorare ServiceNow Problem Management in 6 passaggi

1

Scarichi il template

Cosa fare

Scarichi il template Excel per ServiceNow Problem Management, progettato per allineare la mappatura dei dati agli standard ITIL e alle tabelle di ServiceNow.

Perché è importante

Partire da un formato strutturato previene i problemi di qualità dei dati e assicura che le segnalazioni di problema e le attività siano pronte per il Process Mining.

Risultato atteso

Un template dati standardizzato, pronto per l’esportazione da ServiceNow.

ANALISI DEI PROCESSI

Ottenga una visione completa delle indagini sui problemi

ProcessMind mappa i dati di ServiceNow per mostrare i percorsi effettivi delle indagini sui problemi. Può vedere con precisione dove si interrompono i passaggi di consegne e quali analisi delle cause profonde richiedono più tempo.
  • Mappi l’intero ciclo di vita delle indagini, dall’inizio alla fine
  • Individui i silos di comunicazione tra i team IT
  • Individui i colli di bottiglia che rallentano l’analisi delle cause profonde
  • Monitori il tempo medio di risoluzione di tutti i casi
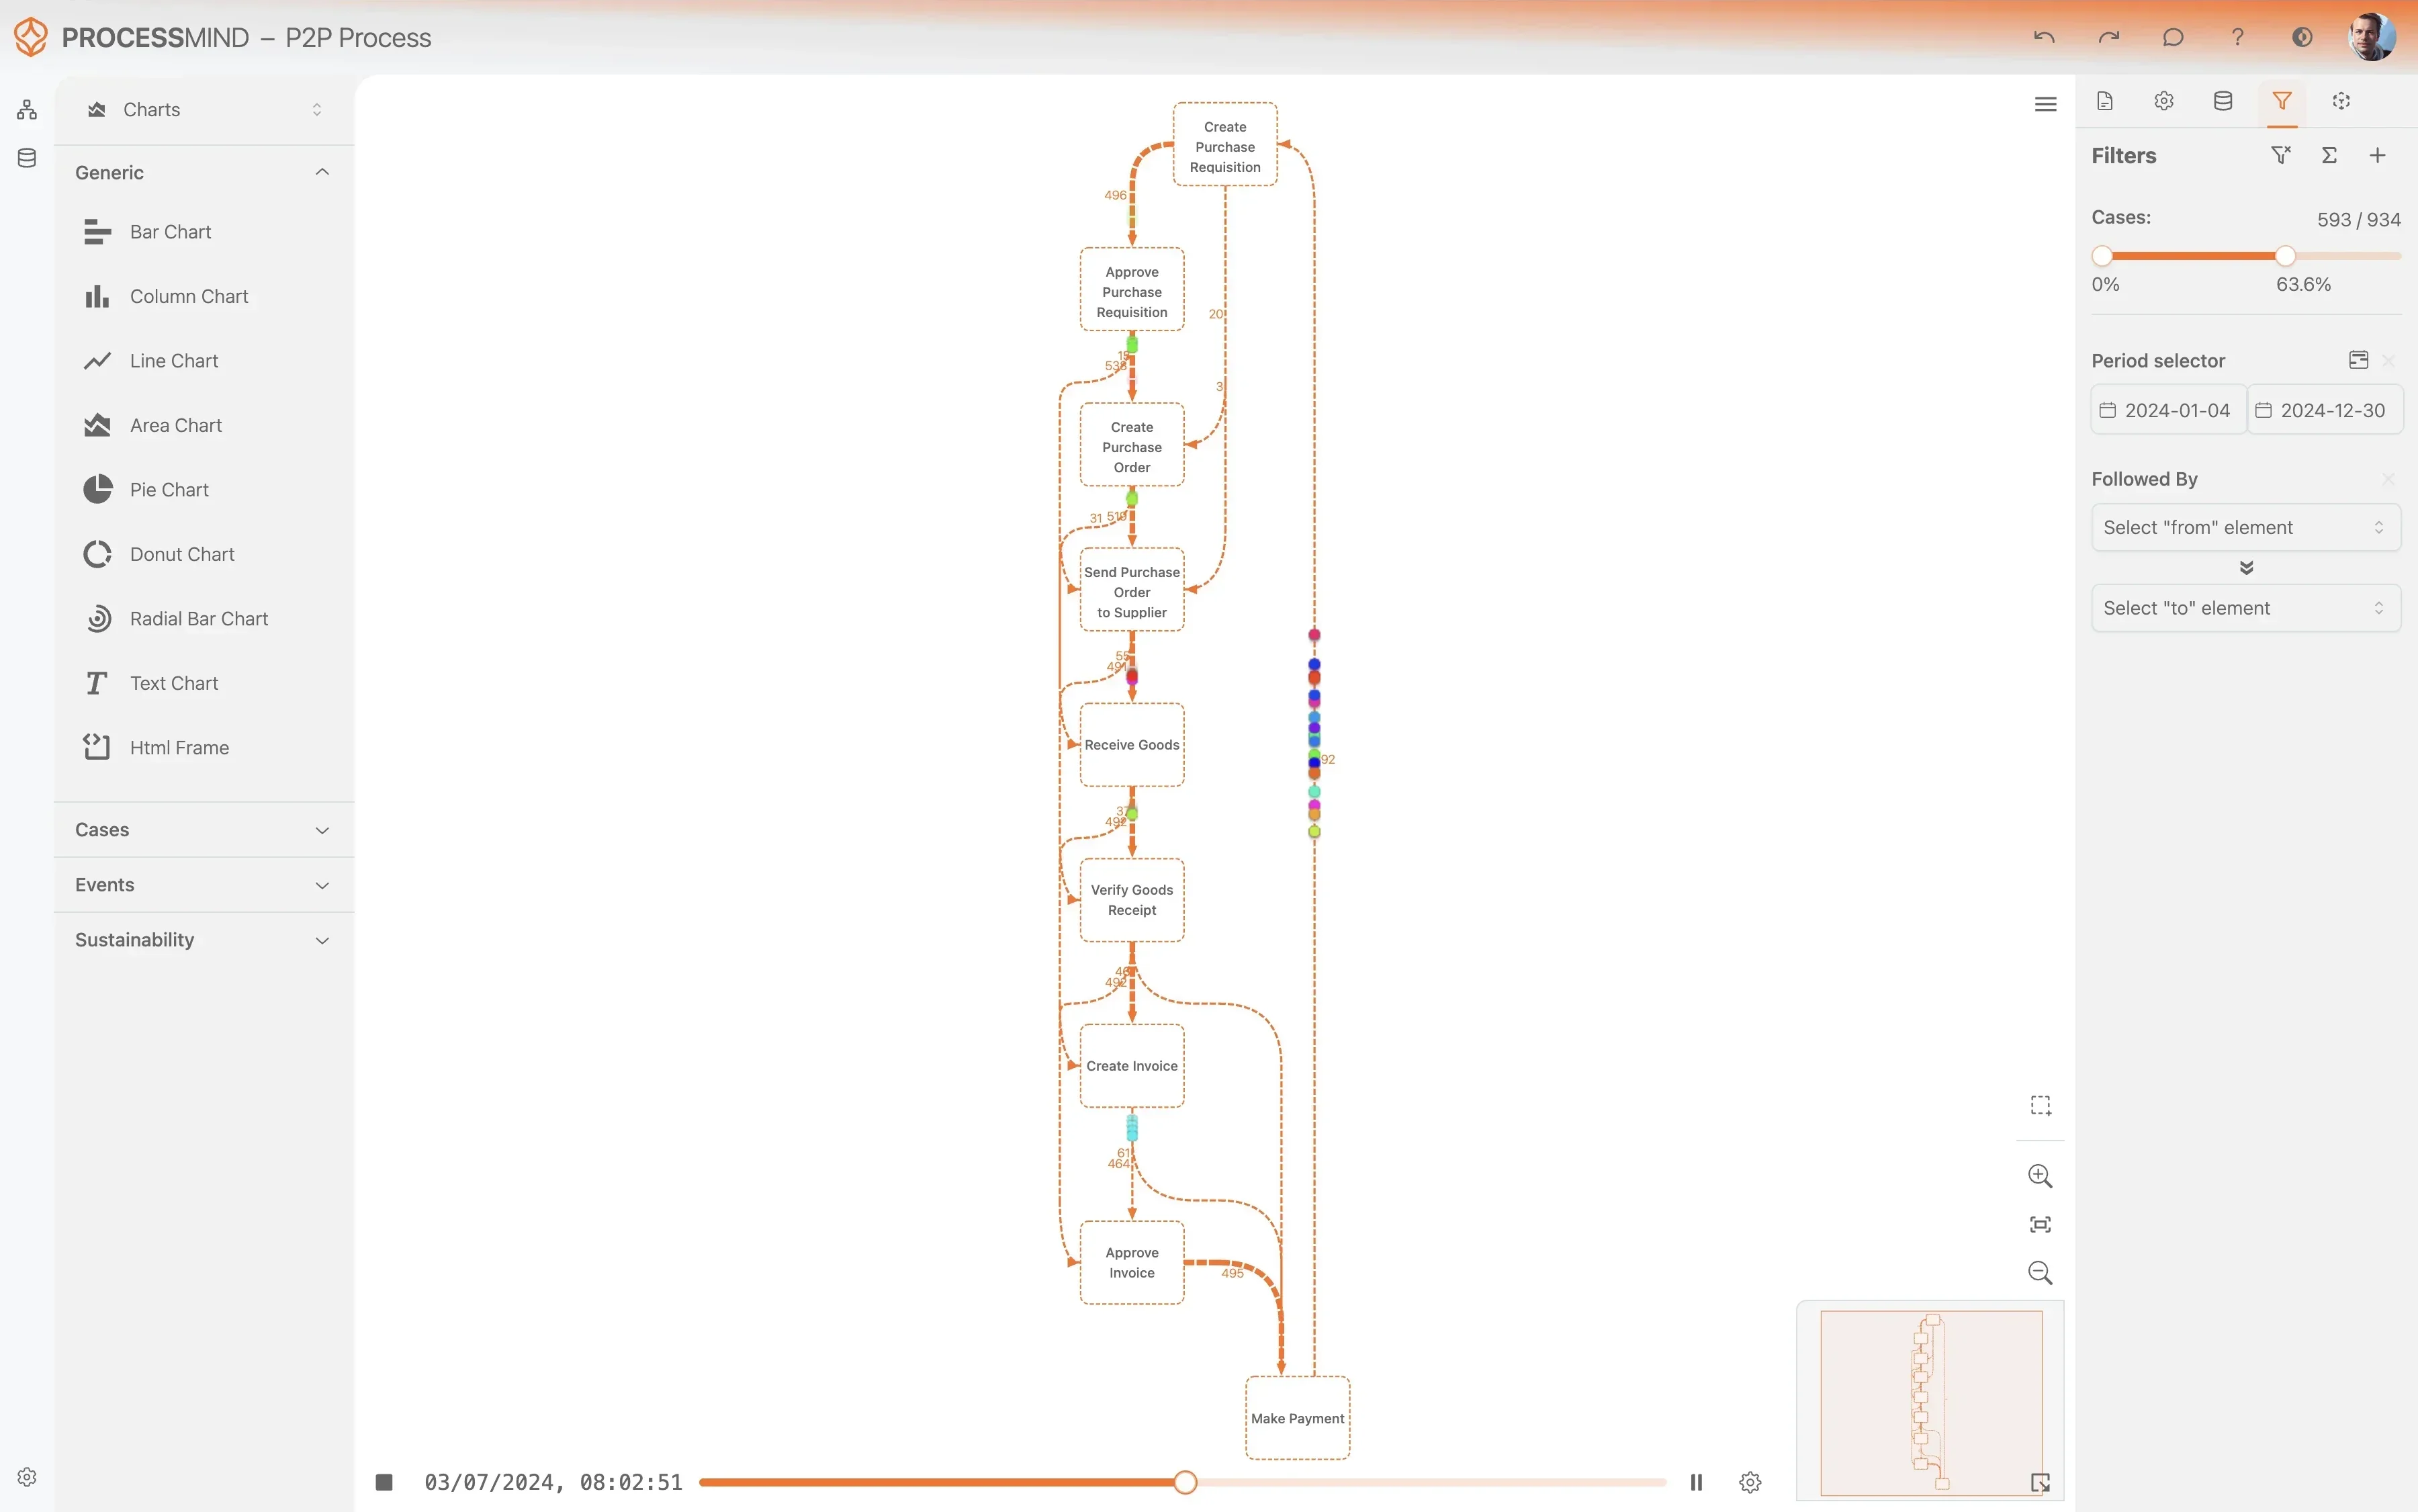
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

RISULTATI DIMOSTRATI

Aumentare l’efficienza nella gestione dei problemi

Individuando le inefficienze nascoste nei flussi di lavoro di ServiceNow Problem Management, i team possono accelerare l’analisi delle cause profonde e ridurre il numero di incidenti ricorrenti. Questi risultati mostrano l’impatto dell’ottimizzazione dei processi basata sui dati sulle segnalazioni di problema standard.

0 %
Analisi più rapida delle cause profonde

Riduzione dei tempi d’indagine

Semplificare la fase d’indagine aiuta i team a individuare molto più rapidamente l’origine degli incidenti gravi, riducendo sensibilmente l’impatto delle interruzioni ricorrenti dei servizi.

0 %
Meno riassegnazioni

Riduzione dei trasferimenti delle segnalazioni

Eliminare i passaggi non necessari tra i team di supporto evita che le segnalazioni di problema rimbalzino da un gruppo all’altro, chiarisce le responsabilità e accelera la risoluzione.

+ 0 %
Migliore rispetto degli SLA

Aumento del rispetto degli obiettivi di analisi delle cause profonde

Una maggiore visibilità sugli stati in attesa e sui colli di bottiglia assicura che l’analisi delle cause profonde si concluda entro i tempi di servizio concordati.

0 %
Meno incidenti ricorrenti

Riduzione degli errori noti

Pubblicare in modo efficiente soluzioni temporanee e correzioni definitive nella banca dati degli errori noti aiuta a evitare che nuovi incidenti intasino il Service Desk.

0 %
Arretrato di problemi sotto controllo

Riduzione delle segnalazioni obsolete

Individuare e chiudere le segnalazioni abbandonate permette ai team di concentrarsi sui problemi attuali ad alta priorità, anziché sui ticket ormai superati.

I risultati variano in base alla complessità del processo e alla qualità dei dati. Le cifre indicano i miglioramenti tipici osservati nelle implementazioni.

Dati consigliati

Inizi selezionando gli attributi e le attività principali che caratterizzano il processo di indagine.
Non conosce ancora gli Event Log? Scopra come creare un Event Log per il Process Mining.

Attributi

Dati chiave da acquisire per l’analisi

Identificatore univoco della segnalazione di problema.

Perché è importante

È la chiave primaria che consente di distinguere i singoli casi e raggruppare gli eventi correlati nel grafo del processo.

Evento o azione specifica eseguita sul record di problema.

Perché è importante

Definisce i nodi della mappa del processo e permette di visualizzare il flusso di lavoro e le varianti del processo.

Data e ora esatte in cui si è verificata un’attività.

Perché è importante

È essenziale per ordinare gli eventi e calcolare tutti i KPI basati sul tempo.

Persona specifica incaricata di gestire il problema.

Perché è importante

È fondamentale per analizzare l’efficienza delle risorse e il carico di lavoro individuale.

Team tecnico responsabile della risoluzione del problema.

Perché è importante

È fondamentale per individuare i colli di bottiglia tra i reparti e analizzare l’efficienza dei passaggi di consegne.

Stato del ciclo di vita del record di problema.

Perché è importante

È il principale indicatore di stato utilizzato per filtrare i casi aperti e quelli chiusi.

Livello di priorità assegnato al record di problema.

Perché è importante

Consente di segmentare le prestazioni del processo in base alla criticità per l’azienda.

Classificazione della causa profonda individuata.

Perché è importante

Consente di analizzare gli schemi di malfunzionamento per orientare i miglioramenti strategici.

Numero di volte in cui il problema è stato riassegnato tra gruppi.

Perché è importante

È un indicatore diretto degli attriti nel processo e della mancanza di responsabilità chiare.

Numero di incidenti collegati a questo record di problema.

Perché è importante

Misura l’entità dell’impatto del problema sugli utenti.

Attività

Fasi del processo da monitorare e ottimizzare

Creazione iniziale di una segnalazione di problema nel sistema ServiceNow. Segna l’inizio del ciclo di vita della gestione dei problemi e definisce il timestamp di riferimento per le metriche di anzianità.

Perché è importante

Definisce l’ora di inizio per tutti i calcoli del tempo di ciclo e le misurazioni degli SLA. È il riferimento principale per individuare il volume delle nuove indagini sui problemi.

Assegnazione della segnalazione di problema a un team tecnico specifico per l’indagine. Questa attività tiene traccia dei passaggi di responsabilità ed è fondamentale per analizzare i passaggi di consegne.

Perché è importante

Essenziale per la Dashboard di analisi delle riassegnazioni ai gruppi di supporto, che permette di individuare rimpalli e colli di bottiglia tra i team.

Passaggio della segnalazione di problema dallo stato 'New' a 'Assess' o 'Root Cause Analysis'. Indica che un analista ha iniziato a occuparsi attivamente del problema.

Perché è importante

Segna la fine dell’attesa iniziale in coda e l’inizio della fase d’indagine attiva, fornendo dati utili per l’analisi degli stati in attesa.

Inserimento di testo nel campo 'Workaround' della segnalazione di problema. Registra il momento in cui l’analista documenta una soluzione temporanea.

Perché è importante

Fornisce alla Dashboard sulle prestazioni di pubblicazione delle soluzioni temporanee il momento in cui la soluzione tecnica è stata individuata per la prima volta.

Momento in cui vengono compilati i codici 'Root Cause' o lo stato passa a 'Fix in Progress'. Indica che il problema è stato diagnosticato.

Perché è importante

Calcola il tempo medio necessario per individuare la causa profonda e fornisce dati utili alla Dashboard sul tempo di ciclo delle indagini sulle cause profonde. È una tappa fondamentale del processo.

Associazione di una richiesta di modifica (RFC) alla segnalazione di problema. Segna il passaggio dalla gestione dei problemi alla gestione delle modifiche per l’attuazione.

Perché è importante

Fondamentale per la Dashboard sull’efficienza del passaggio alle richieste di modifica. Individua i ritardi tra l’individuazione di una correzione e l’avvio del processo di modifica.

Momento in cui il problema viene contrassegnato come risolto, spesso in seguito alla chiusura della richiesta di modifica associata. Indica che il lavoro tecnico è terminato.

Perché è importante

Determina la fine del ciclo di correzione attiva. Serve a calcolare il tempo totale di risoluzione rispetto allo SLA.

Evento finale del ciclo di vita, in cui il record diventa inattivo. Non sono previste altre attività.

Perché è importante

Punto finale definitivo dell’istanza di processo. È necessario per calcolare il tempo di ciclo totale.

Domande frequenti

Domande frequenti

Il Process Mining visualizza il percorso effettivo di ogni segnalazione di problema, dalla creazione alla chiusura. Permette ai team di vedere con precisione dove si verificano i ritardi, ad esempio negli stati di attesa prolungati o nelle riassegnazioni frequenti tra gruppi di supporto, spesso invisibili nei report standard.

Servono principalmente i dati delle tabelle problem e problem task, insieme ai registri di controllo del sistema o alle istanze delle metriche. I dati devono includere un ID univoco del problema, i nomi delle attività, come i cambi di stato o gli aggiornamenti delle assegnazioni, e i relativi timestamp per ogni evento.

Sì. Misurando la durata tra specifici cambi di stato, mette in evidenza i colli di bottiglia nella fase d’indagine. Analizzando questi percorsi, è possibile capire se i ritardi dipendono dalla carenza di risorse, dalla mancanza di documentazione o dalle dipendenze da fornitori esterni.

Le prime indicazioni sono in genere disponibili entro pochi giorni dal collegamento e dalla mappatura dei dati. Già durante la prima analisi della mappa del processo, la maggior parte delle organizzazioni inizia a individuare inefficienze importanti, come le segnalazioni obsolete o abbandonate.

Analizzando il collegamento tra le segnalazioni di incidente e quelle di problema, il Process Mining mostra quanto efficacemente vengono comunicati gli errori noti. Individua le lacune nei casi in cui le soluzioni temporanee non vengono pubblicate abbastanza rapidamente o le cause profonde sono classificate in modo errato, favorendo il ripetersi dei problemi.

No. In genere, gli strumenti di Process Mining utilizzano i dati esistenti e non richiedono modifiche ai moduli o ai flussi di lavoro di ServiceNow. Se il sistema registra la cronologia nei registri di controllo, lo strumento può ricostruire il processo senza interferire con le attività in corso.

La tecnologia tiene traccia delle modifiche al campo del gruppo di assegnazione nei registri di controllo per visualizzare i passaggi di consegne. In questo modo emergono i rimpalli tra team, permettendo di ottimizzare l’assegnazione delle risorse e la formazione dei gruppi coinvolti.

I report standard mostrano istantanee o metriche semplici, come il tempo medio di risoluzione, ma non descrivono la complessità del percorso. Il Process Mining rivela i passaggi e i cicli che si verificano tra una metrica e l’altra, mostrando non solo che un processo è lento, ma anche dove e perché si blocca.

Ottimizzi subito la gestione dei problemi per risolverli più rapidamente

Riduca del 30% il tempo del ciclo di indagine con il Process Mining

Inizi la prova gratuita

Non è richiesta alcuna carta di credito. La configurazione richiede pochi minuti.