Migliori la gestione degli incidenti
Guida in 6 passaggi per ottimizzare la gestione degli incidenti in BMC Helix ITSM.
Migliori la gestione degli incidenti
Gestione degli incidenti
BMC Helix ITSM

Selezioni un processo

Scelga un processo per continuare a lavorare nell’area di lavoro collegata.

Processi disponibili
Sistemi disponibili

Ottimizzi la gestione degli incidenti in BMC Helix ITSM

I processi complessi spesso causano inefficienze e ritardi. La nostra piattaforma La aiuta a individuare i colli di bottiglia, i cicli di rilavorazione e i passaggi non conformi nel flusso del processo. Individuando con precisione i punti in cui si verificano i problemi, può introdurre miglioramenti mirati, riducendo i costi operativi e aumentando la soddisfazione degli utenti.

Scarichi il nostro template dei dati preconfigurato e affronti le sfide più comuni per raggiungere i Suoi obiettivi di efficienza. Segua il nostro piano di miglioramento in sei fasi e consulti la guida al template dei dati per trasformare le Sue attività.

Mostra la descrizione dettagliata

L’importanza di una gestione efficiente degli incidenti

Una gestione efficace degli incidenti è alla base di servizi IT affidabili e incide direttamente sulla soddisfazione degli utenti, sui costi operativi e sulla continuità aziendale. Nell’attuale contesto, caratterizzato da ritmi serrati, le organizzazioni che utilizzano sistemi evoluti come BMC Helix ITSM fanno affidamento sui processi di gestione degli incidenti per ripristinare rapidamente la normale operatività dei servizi e ridurre al minimo le interruzioni. Tuttavia, la complessità intrinseca di questi processi, che spesso coinvolgono più team, passaggi di consegne e dipendenze esterne, può introdurre inefficienze. I colli di bottiglia non rilevati allungano i tempi di ciclo e possono causare il mancato rispetto degli accordi sui livelli di servizio, insoddisfazione degli utenti e un aumento dei costi operativi. Per superare un approccio reattivo alla risoluzione degli incidenti, è necessario comprendere a fondo il flusso effettivo del processo, non soltanto quello previsto. Questa visione dettagliata consente alle organizzazioni di affrontare in modo proattivo i problemi sistemici e di trasformare la gestione degli incidenti da una criticità in un vantaggio competitivo.

Individuare opportunità di miglioramento con il Process Mining

Il Process Mining consente di osservare come viene realmente eseguito il processo di gestione degli incidenti in BMC Helix ITSM. Analizzando gli Event Log, in cui ogni incidente è identificato dal relativo identificativo univoco, Incident ID, il Process Mining ricostruisce una mappa visiva, oggettiva e basata sui dati di tutte le fasi che portano dalla segnalazione alla chiusura dell’incidente. Questa visione completa consente di:

  • Individuare i flussi effettivi del processo: rilevare gli scostamenti dalle procedure operative standard e capire quando gli incidenti seguono percorsi imprevisti o inefficienti. È possibile verificare quante volte un incidente viene trasferito a un team specializzato o se viene implementata una soluzione temporanea prima dell’avvio della diagnosi, individuando cicli di rilavorazione e passaggi superflui.
  • Individuare colli di bottiglia e ritardi: identificare con precisione le fasi in cui gli incidenti si bloccano, dall’assegnazione iniziale al gruppo di supporto alle attività di indagine, fino all’applicazione e al collaudo della soluzione. In questo modo è possibile comprendere i tempi di ciclo effettivi per i diversi tipi di incidente e individuare i punti critici che incidono sul tempo previsto per la risoluzione.
  • Analizzare prestazioni e conformità: valutare il rispetto degli SLA monitorando la durata di ogni attività e l’intero percorso dell’incidente. È possibile individuare le categorie di incidenti o i gruppi assegnatari che non raggiungono regolarmente gli obiettivi e intervenire in modo mirato.
  • Quantificare rilavorazioni e inefficienze: vedere con chiarezza con quale frequenza gli incidenti vengono riaperti, ricevono una nuova priorità o passano ripetutamente da un team all’altro, quantificando i costi nascosti delle inefficienze in BMC Helix ITSM. Questi dati aiutano a ridurre i tempi di ciclo della gestione degli incidenti eliminando le attività ridondanti.

Aree prioritarie per migliorare i processi in BMC Helix ITSM

Applicando il Process Mining ai dati di gestione degli incidenti in BMC Helix ITSM, è possibile individuare opportunità concrete di ottimizzazione. Tra le aree di intervento più comuni:

  • Semplificare la valutazione iniziale e la categorizzazione: analizzare il percorso dalla segnalazione alla categorizzazione e all’assegnazione della priorità. Gli incidenti vengono classificati in modo errato con una certa frequenza, causando ritardi nell’assegnazione iniziale al gruppo di supporto? Ottimizzare questa fase può ridurre sensibilmente i tempi di risoluzione.
  • Ottimizzare i passaggi di consegne e i trasferimenti: esaminare i passaggi tra i gruppi assegnatari. Un numero elevato di trasferimenti a team specializzati, soprattutto in un breve intervallo di tempo, può indicare una carenza di competenze nella fase iniziale o percorsi di escalation poco chiari. Il Process Mining mette in evidenza questi schemi e aiuta a rendere più efficiente il flusso di lavoro degli agenti assegnatari.
  • Accelerare la diagnosi e la risoluzione: esaminare durata e sequenza dell’avvio della diagnosi, delle indagini, dell’implementazione di soluzioni temporanee e dell’individuazione della soluzione. Alcuni tipi di incidente o servizi interessati richiedono regolarmente più tempo per la diagnosi? Queste informazioni possono orientare la formazione e la creazione di articoli per la base di conoscenza.
  • Migliorare le comunicazioni con gli utenti e la conferma della risoluzione: analizzare le fasi di invio della notifica all’utente e di ricezione della conferma. I ritardi in queste fasi possono prolungare inutilmente il ciclo di vita dell’incidente e incidere sul tempo di risoluzione previsto. Semplificare queste interazioni può accelerare la verifica e la chiusura dell’incidente.
  • Affrontare sistematicamente le cause profonde: sebbene la gestione degli incidenti sia reattiva, individuare i percorsi ricorrenti degli incidenti più gravi o frequenti può far emergere problemi sottostanti nella categoria della causa principale, che richiedono una gestione proattiva dei problemi e possono ridurre il numero di incidenti futuri.

Benefici concreti di una gestione degli incidenti ottimizzata

I miglioramenti individuati con il Process Mining possono produrre benefici significativi e misurabili per la Sua organizzazione. Intervenendo sulla gestione degli incidenti, può ottenere:

  • Risoluzione più rapida degli incidenti: ridurre direttamente il tempo previsto per la risoluzione eliminando i colli di bottiglia e accorciando i tempi di ciclo, così da ripristinare i servizi più rapidamente.
  • Maggiore rispetto degli accordi sui livelli di servizio: migliorare il rispetto degli SLA affrontando in modo proattivo le cause profonde dei ritardi e assicurando che gli incidenti avanzino senza intoppi.
  • Riduzione dei costi operativi: limitare le rilavorazioni, ottimizzare l’allocazione delle risorse ai gruppi assegnatari e ridurre l’impegno complessivo richiesto per ogni incidente, ottenendo risparmi significativi.
  • Maggiore soddisfazione di utenti e clienti: risoluzioni più rapide e comunicazioni più trasparenti migliorano l’esperienza dei reparti degli utenti interessati e dei clienti esterni, rafforzando fiducia e fidelizzazione.
  • Migliore utilizzo delle risorse: fare in modo che gli agenti e i gruppi assegnatari si concentrino sulle attività che generano valore, anziché sulle incombenze amministrative o sulle attività ripetitive.
  • Prevenzione proattiva dei problemi: utilizzare le informazioni sugli schemi ricorrenti per orientare la strategia di gestione dei problemi, prevenire nuovi incidenti e migliorare ulteriormente la stabilità dei servizi.

Avviare il percorso di ottimizzazione della gestione degli incidenti

Ottimizzare la gestione degli incidenti in BMC Helix ITSM con il Process Mining è un investimento strategico per migliorare l’efficienza e l’efficacia delle operazioni IT. Offre la chiarezza e le evidenze basate sui dati necessarie per superare le supposizioni e individuare con precisione dove e perché il processo presenta criticità. Adottando questo approccio, i team possono introdurre cambiamenti mirati e incisivi, migliorare l’erogazione dei servizi e creare un ambiente IT più resiliente e reattivo. Inizi oggi il percorso verso un processo di risoluzione degli incidenti davvero ottimizzato, trasformando le criticità in opportunità di miglioramento continuo.

Gestione degli incidenti Service Desk Assistenza IT Risoluzione dei ticket Conformità agli SLA Operazioni IT Risoluzione dei problemi Riduzione dei tempi di inattività Gestione dei ticket Gestione dei ticket Help desk IT Tempo medio di risoluzione MTTR Ripristino del servizio Risoluzione degli incidenti

Problemi e sfide comuni

Individui le sfide che La riguardano

Gli incidenti passano spesso da un gruppo di supporto o da un agente all’altro, causando ritardi significativi e frustrazione. Ogni trasferimento allunga i tempi di risoluzione, aumenta i costi operativi e incide negativamente sulla soddisfazione degli utenti. Questo continuo passaggio può indicare responsabilità poco chiare o una diagnosi iniziale insufficiente nel processo di gestione degli incidenti. ProcessMind analizza l’intero percorso degli incidenti in BMC Helix ITSM e individua gli schemi di riassegnazione eccessiva. Evidenzia i punti di trasferimento, i gruppi o gli agenti coinvolti, facendo emergere le cause profonde dei passaggi di consegne inefficienti e suggerendo miglioramenti per semplificare il flusso degli incidenti e ridurre le rilavorazioni.

Gli incidenti critici superano regolarmente i tempi previsti dagli accordi sui livelli di servizio, causando interruzioni prolungate e possibili penali. Il mancato rispetto degli SLA riduce la fiducia degli utenti, danneggia la reputazione dell’organizzazione e può comportare perdite finanziarie significative a causa dei tempi di inattività prolungati. È una criticità comune negli ambienti complessi di gestione degli incidenti. ProcessMind offre una visione completa dell’intero ciclo di vita degli incidenti e mette in evidenza ogni violazione degli SLA in BMC Helix ITSM. Collega le violazioni alle attività, ai colli di bottiglia e ai vincoli di risorse specifici, consentendo interventi mirati per garantire la conformità e migliorare l’efficacia dei servizi.

Gli incidenti richiedono troppo tempo per essere risolti e causano periodi prolungati di degrado o interruzione dei servizi. Tempi di risoluzione così lunghi riducono la produttività degli utenti finali, aumentano i costi operativi e possono segnalare inefficienze o carenze di competenze nel processo di gestione degli incidenti. ProcessMind ricostruisce il flusso effettivo degli incidenti in BMC Helix ITSM e individua le attività o le fasi in cui si verificano blocchi. Fa emergere colli di bottiglia nascosti e scostamenti dal percorso ottimale, fornendo informazioni basate sui dati per accelerare la risoluzione e ripristinare più rapidamente i servizi.

Spesso gli incidenti vengono categorizzati in modo errato o ricevono una priorità non corretta, con conseguenti instradamenti sbagliati e ritardi nell’intervento dei team di supporto più adatti. Questo errore iniziale può ripercuotersi sull’intero processo di gestione degli incidenti, allungando i tempi di risoluzione e creando frustrazione sia negli utenti sia nel personale di supporto. ProcessMind analizza attributi degli incidenti come categoria, priorità e gravità e li confronta con il percorso e i tempi effettivi di risoluzione in BMC Helix ITSM. Individua discrepanze e schemi di classificazione errata, consentendo di perfezionare le regole di categorizzazione e migliorare la gestione iniziale degli incidenti.

I team di supporto dedicano troppo tempo alle rilavorazioni, affrontando ripetutamente problemi simili o svolgendo attività superflue. Questa inefficienza spreca risorse preziose, aumenta i costi operativi e impedisce agli agenti di concentrarsi sugli incidenti più complessi o critici, riducendo l’efficacia complessiva della gestione degli incidenti. ProcessMind visualizza l’intero percorso degli incidenti e mette in evidenza cicli ripetitivi, attività ridondanti e schemi ricorrenti di rilavorazione in BMC Helix ITSM. Comprendendo queste inefficienze, le organizzazioni possono ottimizzare i processi, automatizzare le attività ripetitive e adottare soluzioni più durature.

Chi gestisce gli incidenti spesso ignora le procedure stabilite o ricorre a scorciatoie non approvate, con conseguenti incoerenze, rischi di conformità e risultati imprevedibili. Il mancato rispetto delle procedure può compromettere la qualità del servizio, complicare gli audit e ridurre l’affidabilità dell’intero sistema di gestione degli incidenti. ProcessMind offre una visione oggettiva di ogni percorso seguito dagli incidenti in BMC Helix ITSM e lo confronta con il processo standard previsto. Individua tutti gli scostamenti e mostra dove, quando e da chi vengono svolte attività non standard, consentendo interventi mirati di formazione e miglioramenti nella governance.

Gli incidenti si bloccano spesso durante la diagnosi o le indagini, a causa di risorse limitate, carenze di competenze o problemi tecnici complessi. Questi blocchi prolungati allungano direttamente i tempi di risoluzione e aumentano l’MTTR, lasciando i servizi compromessi più a lungo. ProcessMind analizza la durata delle attività di avvio della diagnosi e svolgimento delle indagini in BMC Helix ITSM. Individua i team, gli agenti o le categorie di incidenti interessati dai ritardi, consentendo di intervenire sull’allocazione delle risorse, sulla formazione o sui processi.

Le soluzioni temporanee vengono implementate lentamente o non sono efficaci, prolungando l’impatto sugli utenti anche prima che venga individuata una soluzione definitiva. Una gestione inadeguata di questa fase può aumentare la frustrazione degli utenti e prolungare la percezione dei tempi di inattività, riducendo il valore degli interventi di gestione degli incidenti. ProcessMind monitora il ciclo di vita dell’attività di implementazione delle soluzioni temporanee in BMC Helix ITSM e il suo impatto successivo sullo stato e sui tempi di risoluzione degli incidenti. Aiuta a capire se le soluzioni temporanee vengono applicate sistematicamente in ritardo o se spesso non offrono un sollievo immediato, segnalando le aree in cui migliorare gli interventi provvisori.

Dopo l’applicazione di una soluzione, possono verificarsi ritardi significativi prima di ricevere la conferma o la verifica da parte dell’utente, impedendo la chiusura dell’incidente. Questa attesa prolunga il ciclo di vita ufficiale dell’incidente, altera le metriche di risoluzione e può creare in BMC Helix ITSM un arretrato di ticket «risolti ma non chiusi». ProcessMind analizza il tempo che intercorre tra l’invio della notifica all’utente, la ricezione della conferma e la verifica o chiusura dell’incidente. Individua gli schemi di ritardo e aiuta a semplificare le comunicazioni o ad automatizzare i promemoria, accelerando le fasi finali della risoluzione.

Molti incidenti vengono risolti senza individuare o documentare chiaramente la causa profonda, favorendo il ripetersi di problemi simili. Questo approccio reattivo grava sui team di supporto con incidenti ricorrenti e impedisce una gestione proattiva dei problemi e il miglioramento continuo dei servizi. ProcessMind mette in relazione i codici di risoluzione e gli schemi di ricorrenza degli incidenti in BMC Helix ITSM con l’attributo della categoria della causa principale. Evidenzia i casi risolti senza un’analisi adeguata delle cause profonde e gli incidenti ricorrenti associati alla stessa risoluzione generica, segnalando la necessità di integrare meglio la gestione dei problemi.

Una parte significativa degli incidenti è costituita da problemi già «risolti» che si ripresentano, segnalando che le cause sottostanti non sono state affrontate in modo efficace. Questo sovraccarica i team di supporto e crea frustrazione negli utenti, che subiscono ripetute interruzioni del servizio per lo stesso motivo. ProcessMind collega gli ID degli incidenti per individuare gruppi di casi identici o molto simili e ne analizza l’intero ciclo di vita e gli schemi di risoluzione in BMC Helix ITSM. Fa emergere i tipi di incidente che si ripresentano più spesso e aiuta a individuare le fasi del processo in cui mancano soluzioni definitive.

Gli incidenti trasferiti ai team specializzati subiscono spesso ulteriori ritardi o richiedono altre verifiche, vanificando lo scopo dell’escalation. Questo può indicare problemi nello scambio di informazioni o nella definizione delle responsabilità al momento del passaggio di consegne. ProcessMind analizza il tempo e le attività successive al trasferimento di un incidente a un team specializzato in BMC Helix ITSM. Individua i casi in cui questi trasferimenti comportano regolarmente tempi di risoluzione più lunghi o indagini ripetute, segnalando inefficienze nei passaggi tra team.

Obiettivi tipici

Definisca i criteri di successo

Le frequenti riassegnazioni degli incidenti tra gruppi di supporto o agenti allungano notevolmente i tempi di risoluzione e aumentano i costi operativi. Raggiungere questo obiettivo significa indirizzare più rapidamente gli incidenti al team corretto, risolverli prima e migliorare la soddisfazione degli utenti. ProcessMind visualizza tutti i cicli di riassegnazione e individua i punti esatti in cui gli incidenti si bloccano o vengono instradati in modo errato in BMC Helix ITSM. Analizzando i dati storici, fa emergere gli schemi di trasferimento inefficiente e consente alle organizzazioni di introdurre formazione o modifiche mirate ai processi, riducendo infine le riassegnazioni del 20-30%.

Rispettare con regolarità gli accordi sui livelli di servizio è fondamentale per mantenere la qualità del servizio e la fiducia degli utenti. Raggiungere questo obiettivo significa ridurre le violazioni, ripristinare i servizi critici entro i tempi concordati e limitare l’impatto sull’attività aziendale. ProcessMind individua i percorsi e le attività che causano violazioni degli SLA nella gestione degli incidenti e mostra dove si accumulano i ritardi nei flussi di lavoro di BMC Helix ITSM. Evidenzia i colli di bottiglia e le varianti di processo non conformi, consentendo ai team di perfezionare i processi e migliorare il rispetto degli SLA del 15-25%.

Tempi di risoluzione prolungati compromettono direttamente la continuità aziendale e la produttività degli utenti. Raggiungere questo obiettivo significa risolvere i problemi più rapidamente, ridurre i tempi di inattività e rendere più efficienti le operazioni IT, migliorando l’esperienza degli utenti e l’efficienza operativa. ProcessMind offre una visione completa del ciclo di vita degli incidenti in BMC Helix ITSM e individua i percorsi più lunghi e le attività che causano ritardi. Identificando le fasi che richiedono più tempo, le organizzazioni possono ottimizzare i flussi di lavoro, automatizzare le attività di routine e ridurre del 10-20% il tempo medio di risoluzione.

Una categorizzazione imprecisa degli incidenti causa instradamenti errati, ritardi nella risoluzione e un’allocazione inefficiente delle risorse. Raggiungere questo obiettivo significa classificare correttamente gli incidenti fin dall’inizio, assegnarli più rapidamente al team giusto e accelerarne la risoluzione. ProcessMind analizza la categorizzazione iniziale e le successive ricategorizzazioni o riassegnazioni in BMC Helix ITSM, facendo emergere gli errori più comuni e gli schemi di classificazione errata. Queste informazioni consentono di introdurre formazione mirata o migliorare le regole di categorizzazione, aumentando del 15-20% la precisione della classificazione al primo tentativo.

Un numero elevato di rilavorazioni ed escalation non necessarie segnala inefficienze, spreco di risorse e frustrazione degli utenti. Raggiungere questo obiettivo significa risolvere gli incidenti in modo più efficace al primo tentativo, riducendo le attività ripetute e migliorando la qualità complessiva del servizio. ProcessMind ricostruisce l’intero ciclo di vita degli incidenti in BMC Helix ITSM e mette in evidenza i casi che tornano alle fasi precedenti o vengono sottoposti a escalation a causa di una risoluzione iniziale inadeguata. Individuando le cause profonde delle rilavorazioni, come diagnosi insufficienti o soluzioni incomplete, le organizzazioni possono ridurre del 10-15% i cicli di rilavorazione.

Una gestione incoerente degli incidenti produce risultati imprevedibili, rischi di conformità e livelli di servizio variabili. Raggiungere questo obiettivo significa fare in modo che tutti gli incidenti seguano le buone pratiche definite, migliorando prevedibilità, qualità e rispetto delle normative. ProcessMind visualizza tutte le varianti effettive del processo in BMC Helix ITSM e le confronta con il processo standard previsto. In questo modo è possibile individuare gli scostamenti più comuni e le attività non conformi, applicare interventi mirati per promuovere le buone pratiche e aumentare del 20-30% il rispetto del processo.

I ritardi nelle fasi di diagnosi e indagine allungano notevolmente i tempi complessivi di risoluzione degli incidenti, creando frustrazione negli utenti e prolungando le interruzioni del servizio. Raggiungere questo obiettivo significa individuare più rapidamente la causa profonda del problema, trovare soluzioni in tempi brevi e migliorare il flusso operativo. ProcessMind individua con precisione le attività e le risorse che causano ritardi significativi durante la diagnosi e le indagini in BMC Helix ITSM. Analizzando questi colli di bottiglia, le organizzazioni possono riallocare le risorse, offrire ulteriore formazione o semplificare le fasi diagnostiche, riducendo del 15-20% il tempo dedicato a queste fasi critiche.

Le soluzioni temporanee applicate in modo inefficiente possono prolungare l’impatto degli incidenti o persino introdurre nuovi problemi, vanificando il beneficio previsto. Raggiungere questo obiettivo significa implementare soluzioni temporanee in modo rapido ed efficace, limitando le interruzioni mentre si sviluppa una soluzione definitiva. ProcessMind analizza i tempi e l’efficacia delle attività di implementazione delle soluzioni temporanee in BMC Helix ITSM e individua schemi di ritardo o insuccesso. Aiuta a capire perché alcune soluzioni temporanee sono più efficaci o rapide da implementare, così da introdurre miglioramenti che possono ridurre del 10-15% i tempi di attuazione.

I ritardi nella conferma degli utenti o nella verifica della risoluzione possono mantenere inutilmente aperti gli incidenti, incidendo sulle metriche e sull’allocazione delle risorse. Raggiungere questo obiettivo significa chiudere rapidamente gli incidenti una volta applicata la soluzione, migliorando l’efficienza e l’accuratezza dei dati. ProcessMind ricostruisce il tempo trascorso nelle fasi di ricezione della conferma dell’utente e verifica dell’incidente in BMC Helix ITSM, facendo emergere i punti in cui le comunicazioni o le attività di follow-up sono lente. Individuando questi ritardi, le organizzazioni possono introdurre notifiche automatiche o procedure più chiare e ridurre del 10-20% i tempi di chiusura.

Non individuare la vera causa profonda degli incidenti porta al ripetersi dei problemi, a un aumento del carico di lavoro e a criticità persistenti nei servizi. Raggiungere questo obiettivo significa condurre analisi più approfondite, prevenire il ripetersi di incidenti simili e migliorare la stabilità dei sistemi nel lungo periodo. ProcessMind può mettere in evidenza gli incidenti che si ripresentano frequentemente o che non seguono il processo formale di analisi delle cause profonde in BMC Helix ITSM. Esaminando i percorsi degli incidenti risolti e collegandoli ai problemi correlati successivi, aiuta a individuare le lacune nella gestione dei problemi e a migliorare del 10-15% l’efficacia dell’analisi delle cause profonde.

Un numero elevato di incidenti ricorrenti segnala problemi sistemici non affrontati completamente, con conseguenti attività ripetute e insoddisfazione degli utenti. Raggiungere questo obiettivo significa ridurre il ripetersi dei problemi, liberare risorse e migliorare l’affidabilità complessiva dei servizi. ProcessMind rileva gli schemi degli incidenti ricorrenti analizzandone le caratteristiche e i percorsi di risoluzione in BMC Helix ITSM. Aiuta a individuare gli incidenti riaperti di frequente o simili a quelli già chiusi, consentendo alle organizzazioni di concentrarsi sulla gestione proattiva dei problemi e ridurre del 10-20% il tasso di ricorrenza.

I trasferimenti inefficaci o tardivi ai team specializzati nella risoluzione bloccano gli incidenti e ritardano l’intervento degli esperti e la risoluzione complessiva. Raggiungere questo obiettivo significa sottoporre gli incidenti a escalation in modo efficiente verso il gruppo di esperti corretto, sfruttando competenze specialistiche per risolvere i problemi più rapidamente. ProcessMind ricostruisce il flusso degli incidenti trasferiti tra i diversi gruppi di supporto e i team specializzati in BMC Helix ITSM, individuando ritardi e instradamenti errati. Analizzando i passaggi di consegne e la durata tipica dei trasferimenti, le organizzazioni possono perfezionare le matrici di escalation e migliorare del 15-25% l’efficienza dei trasferimenti.

Il percorso in 6 passaggi per migliorare la gestione degli incidenti

1

Scarichi il template

Cosa fare

Scarichi il template Excel già formattato per i dati di gestione degli incidenti. Il template assicura che i dati siano strutturati correttamente per l’analisi.

Perché è importante

Utilizzare il template corretto semplifica la preparazione dei dati, previene gli errori e assicura risultati accurati dall’analisi dei record degli incidenti in BMC Helix ITSM.

Risultato atteso

Un template Excel strutturato, pronto per ricevere i dati di gestione degli incidenti di BMC Helix ITSM.

LE SUE SCOPERTE

Individui i colli di bottiglia nascosti nella gestione degli incidenti

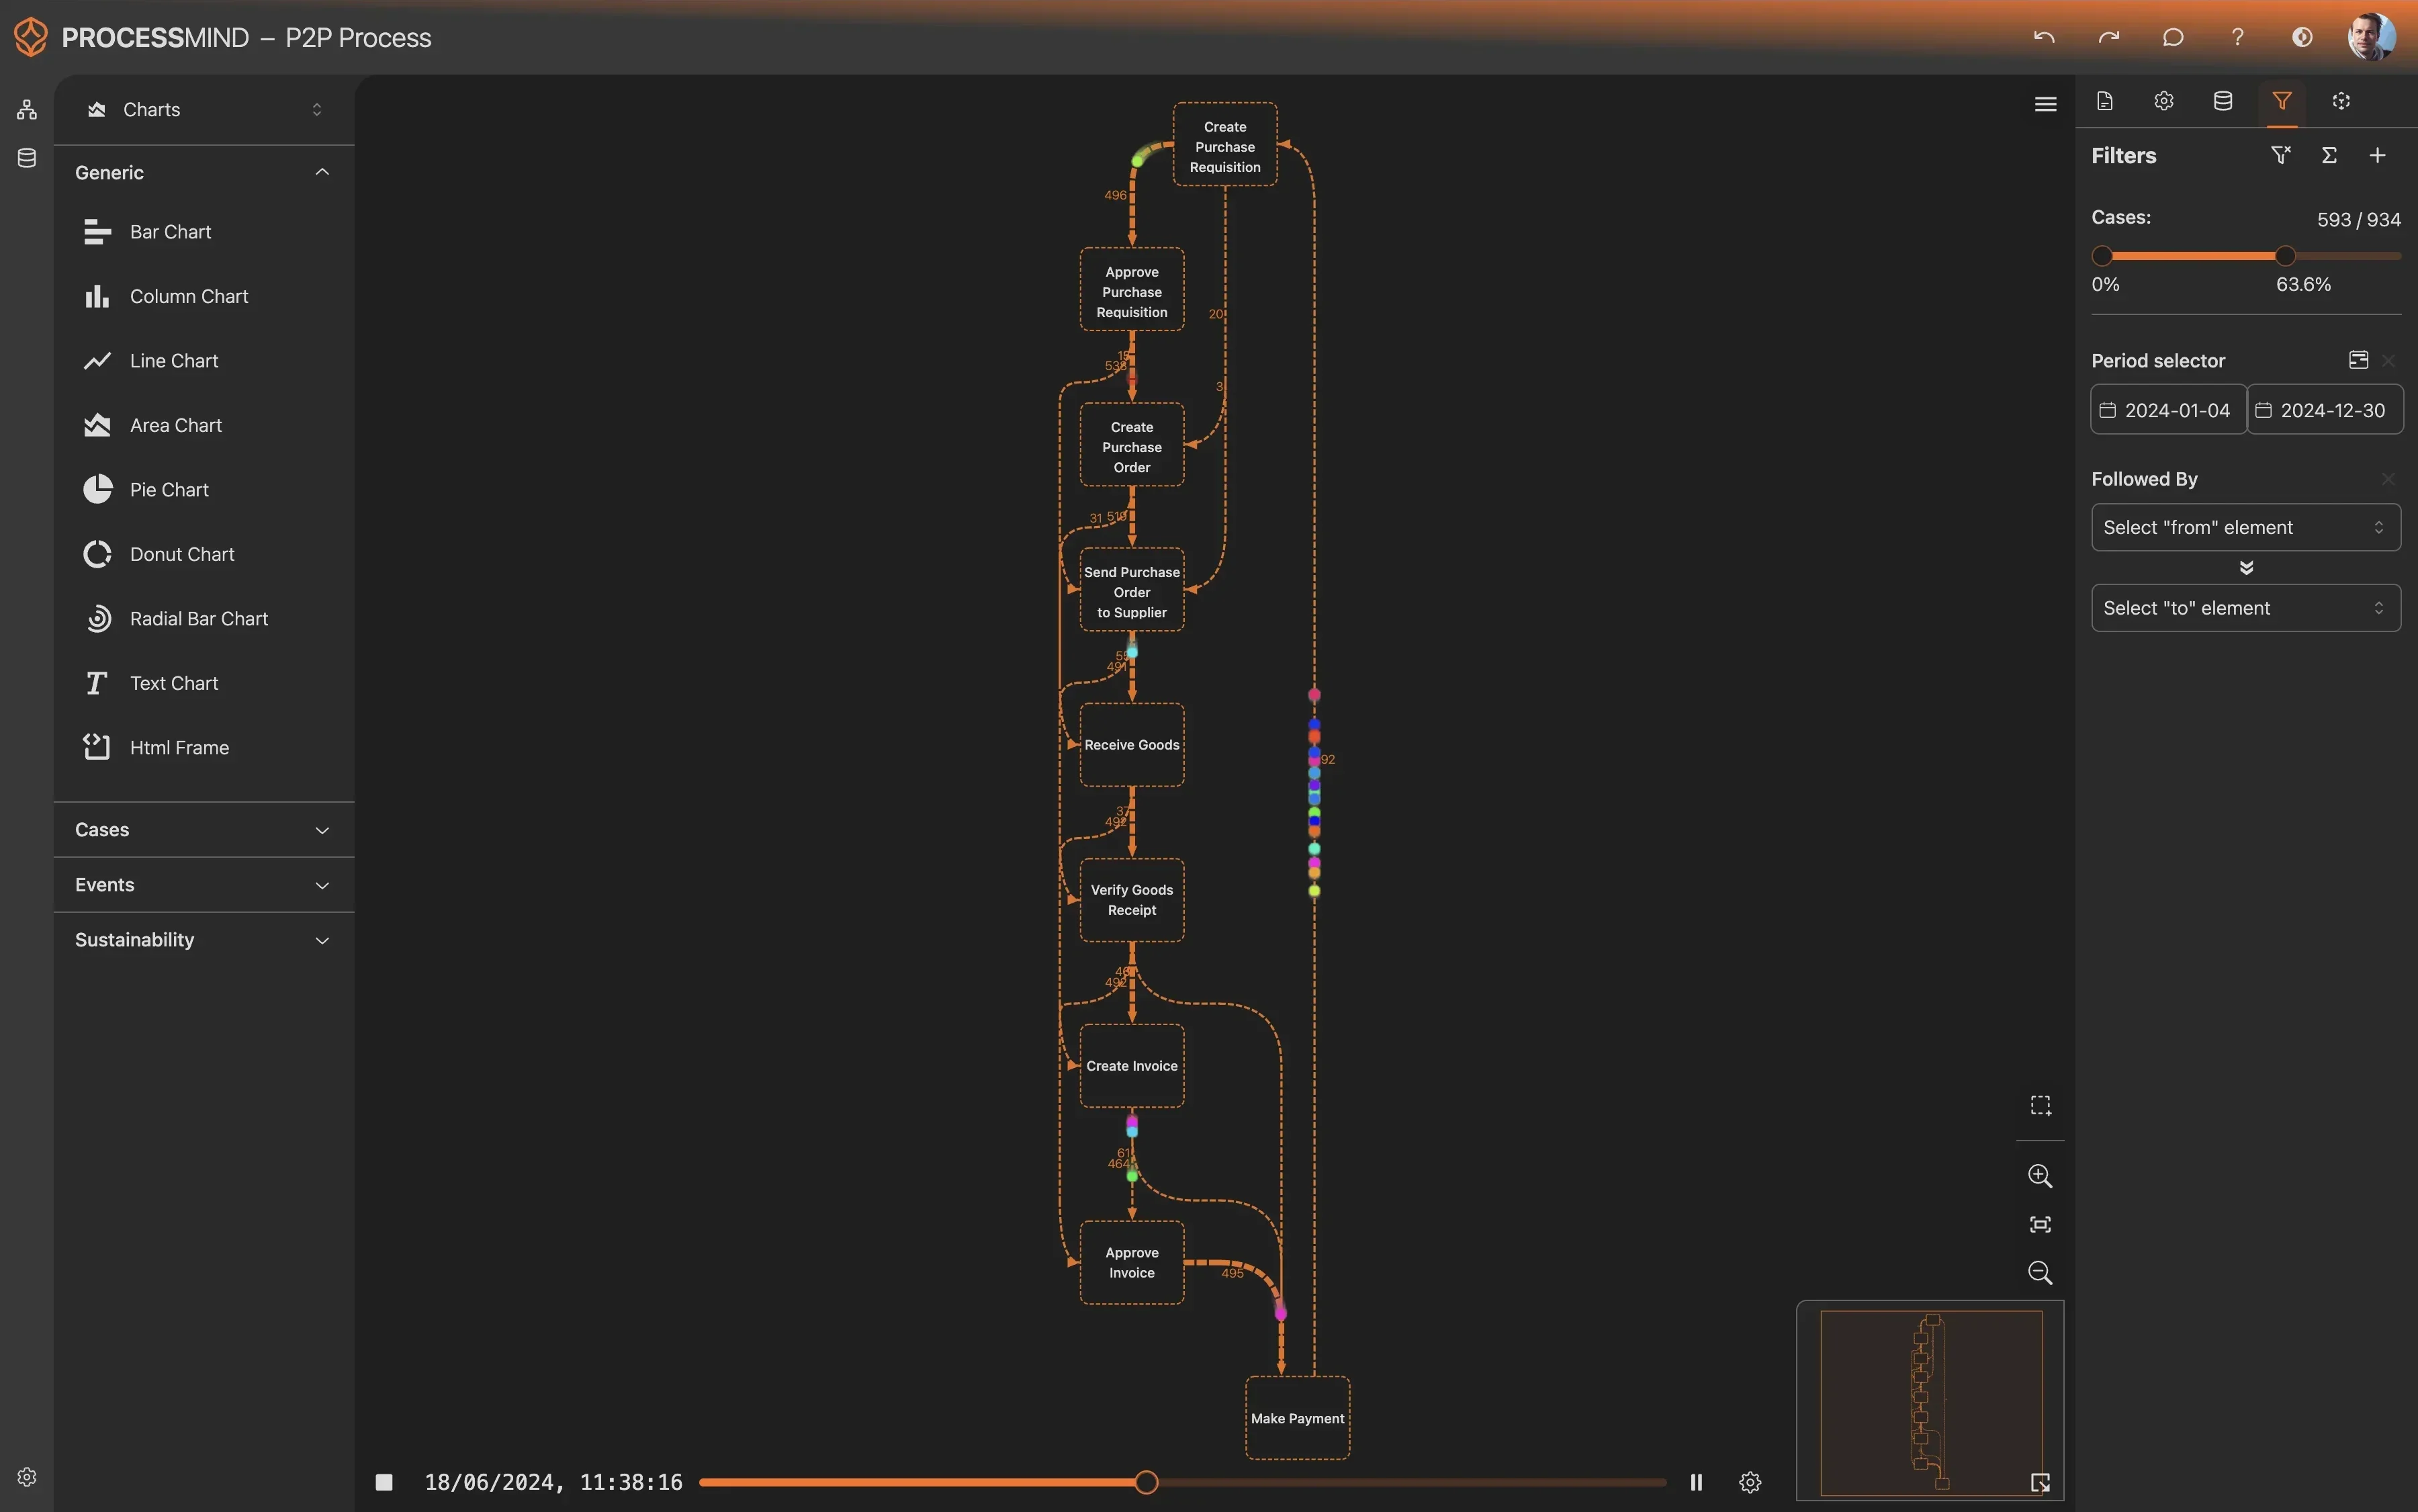
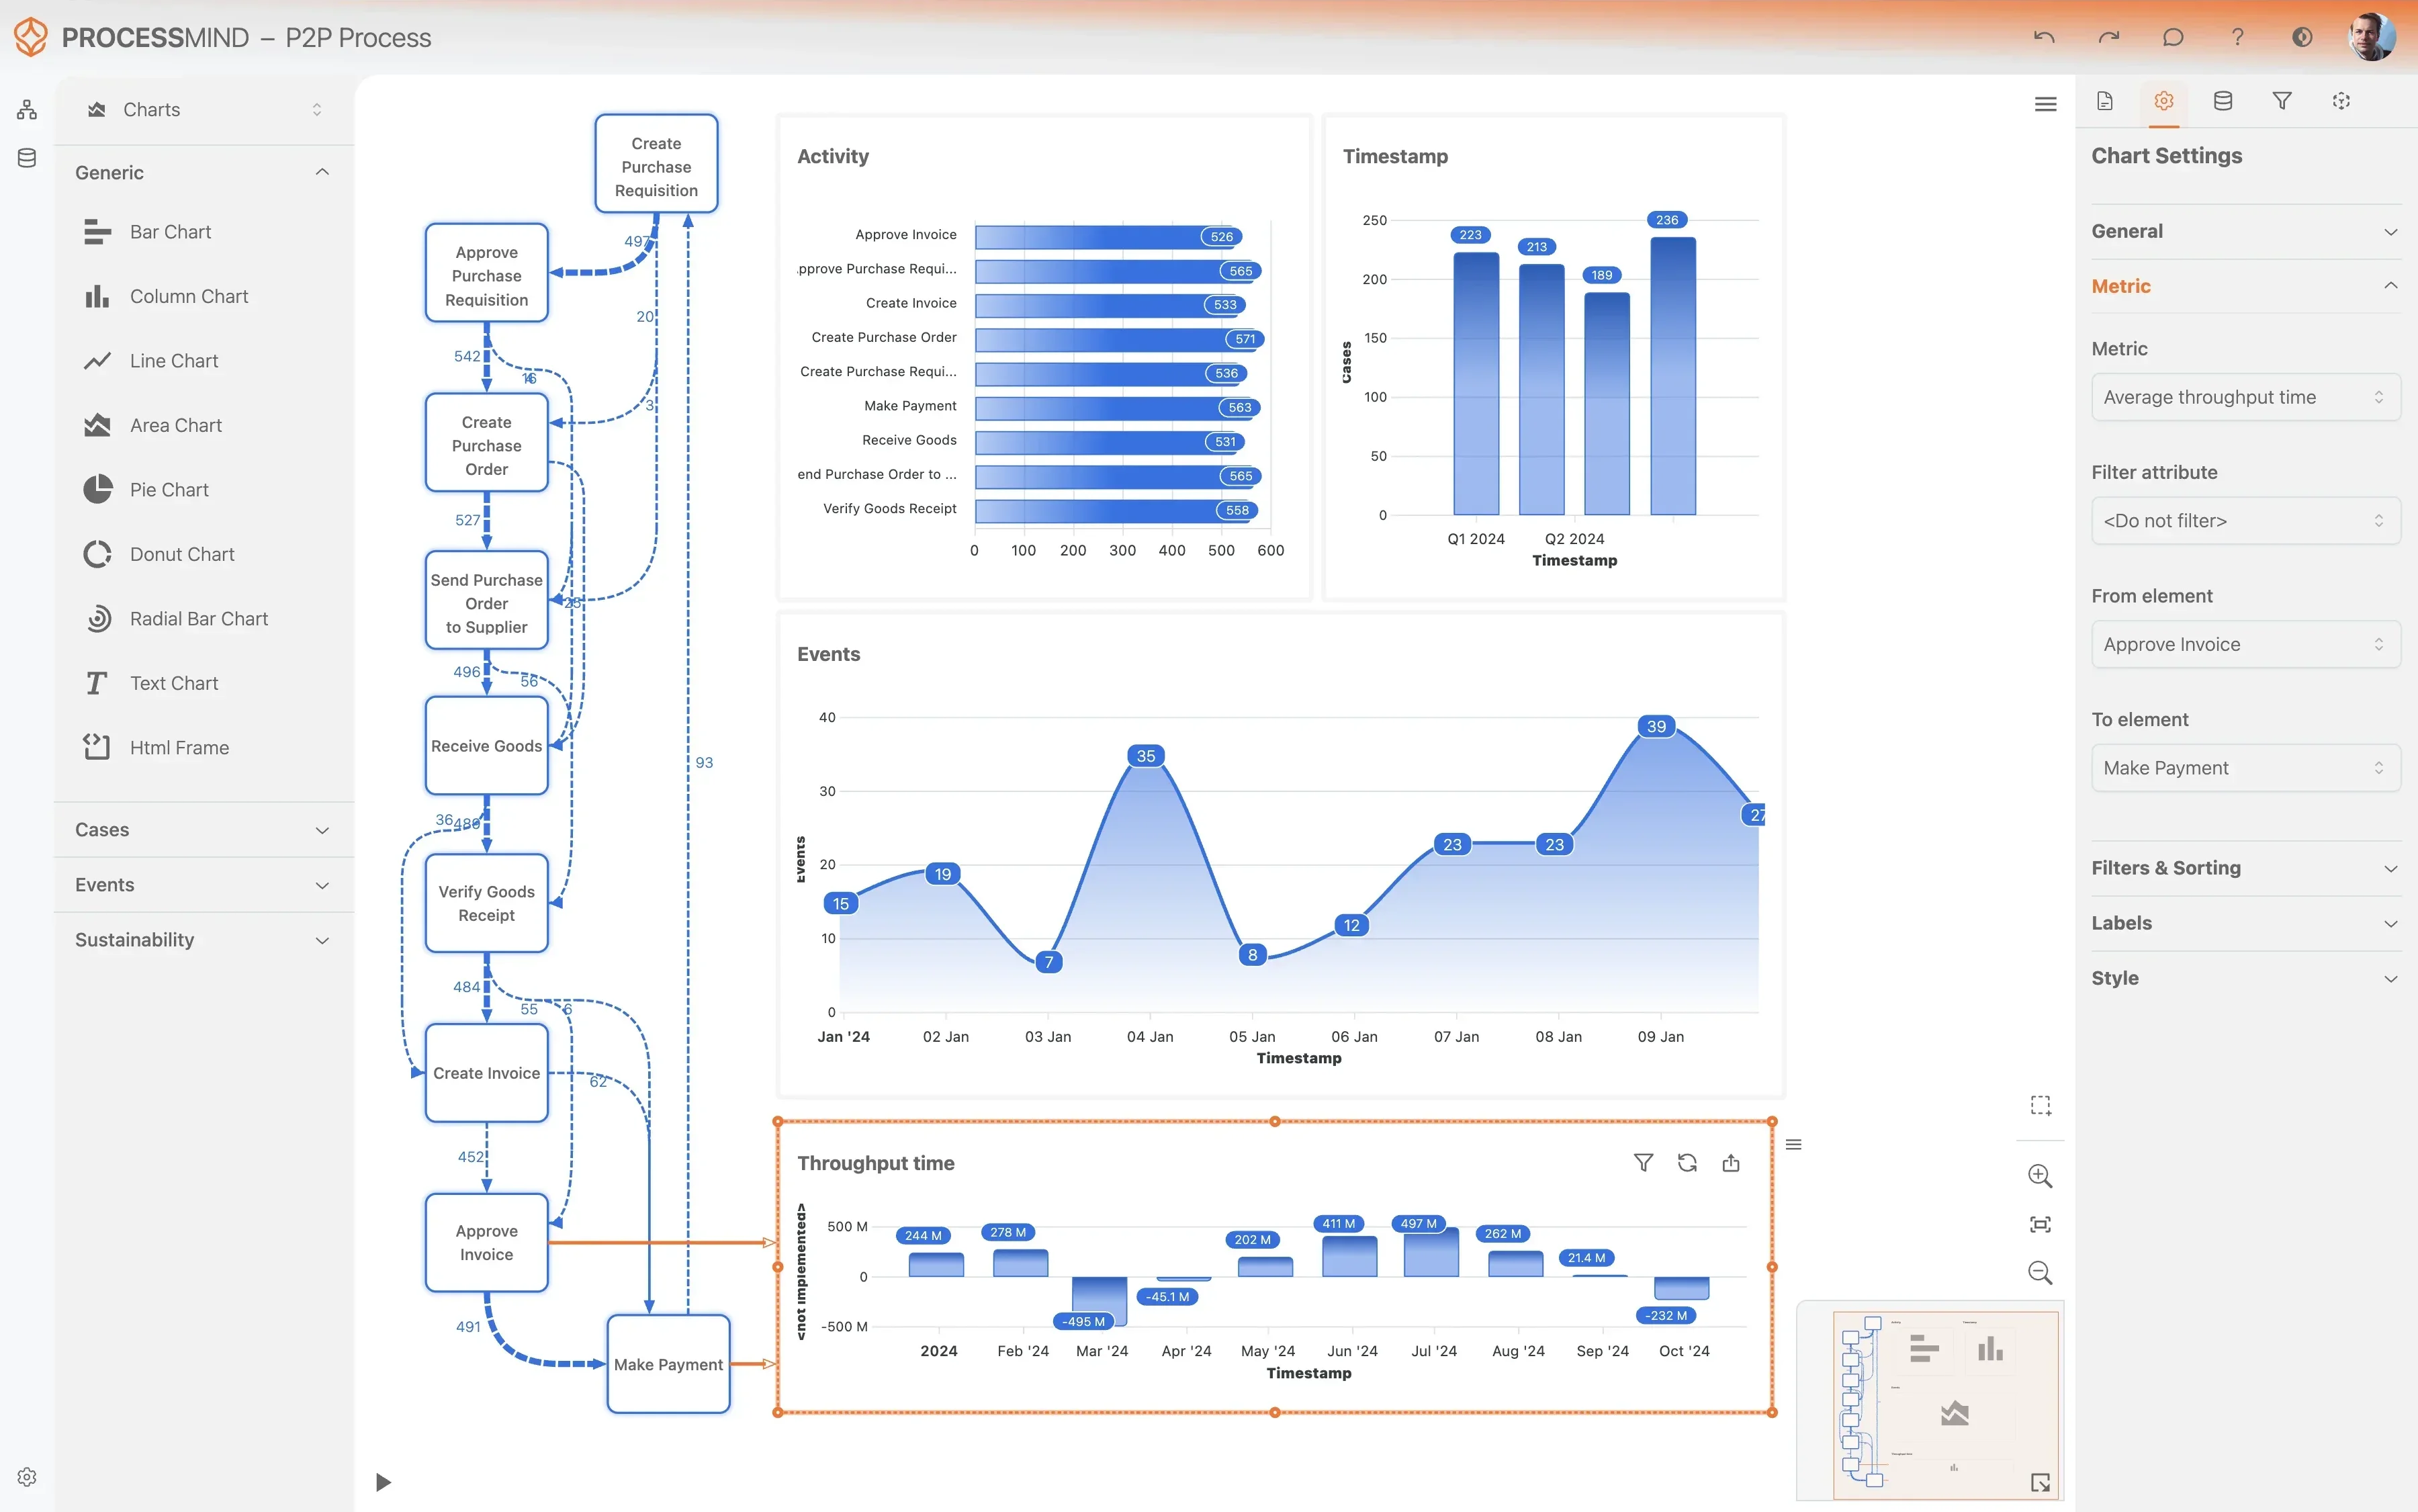
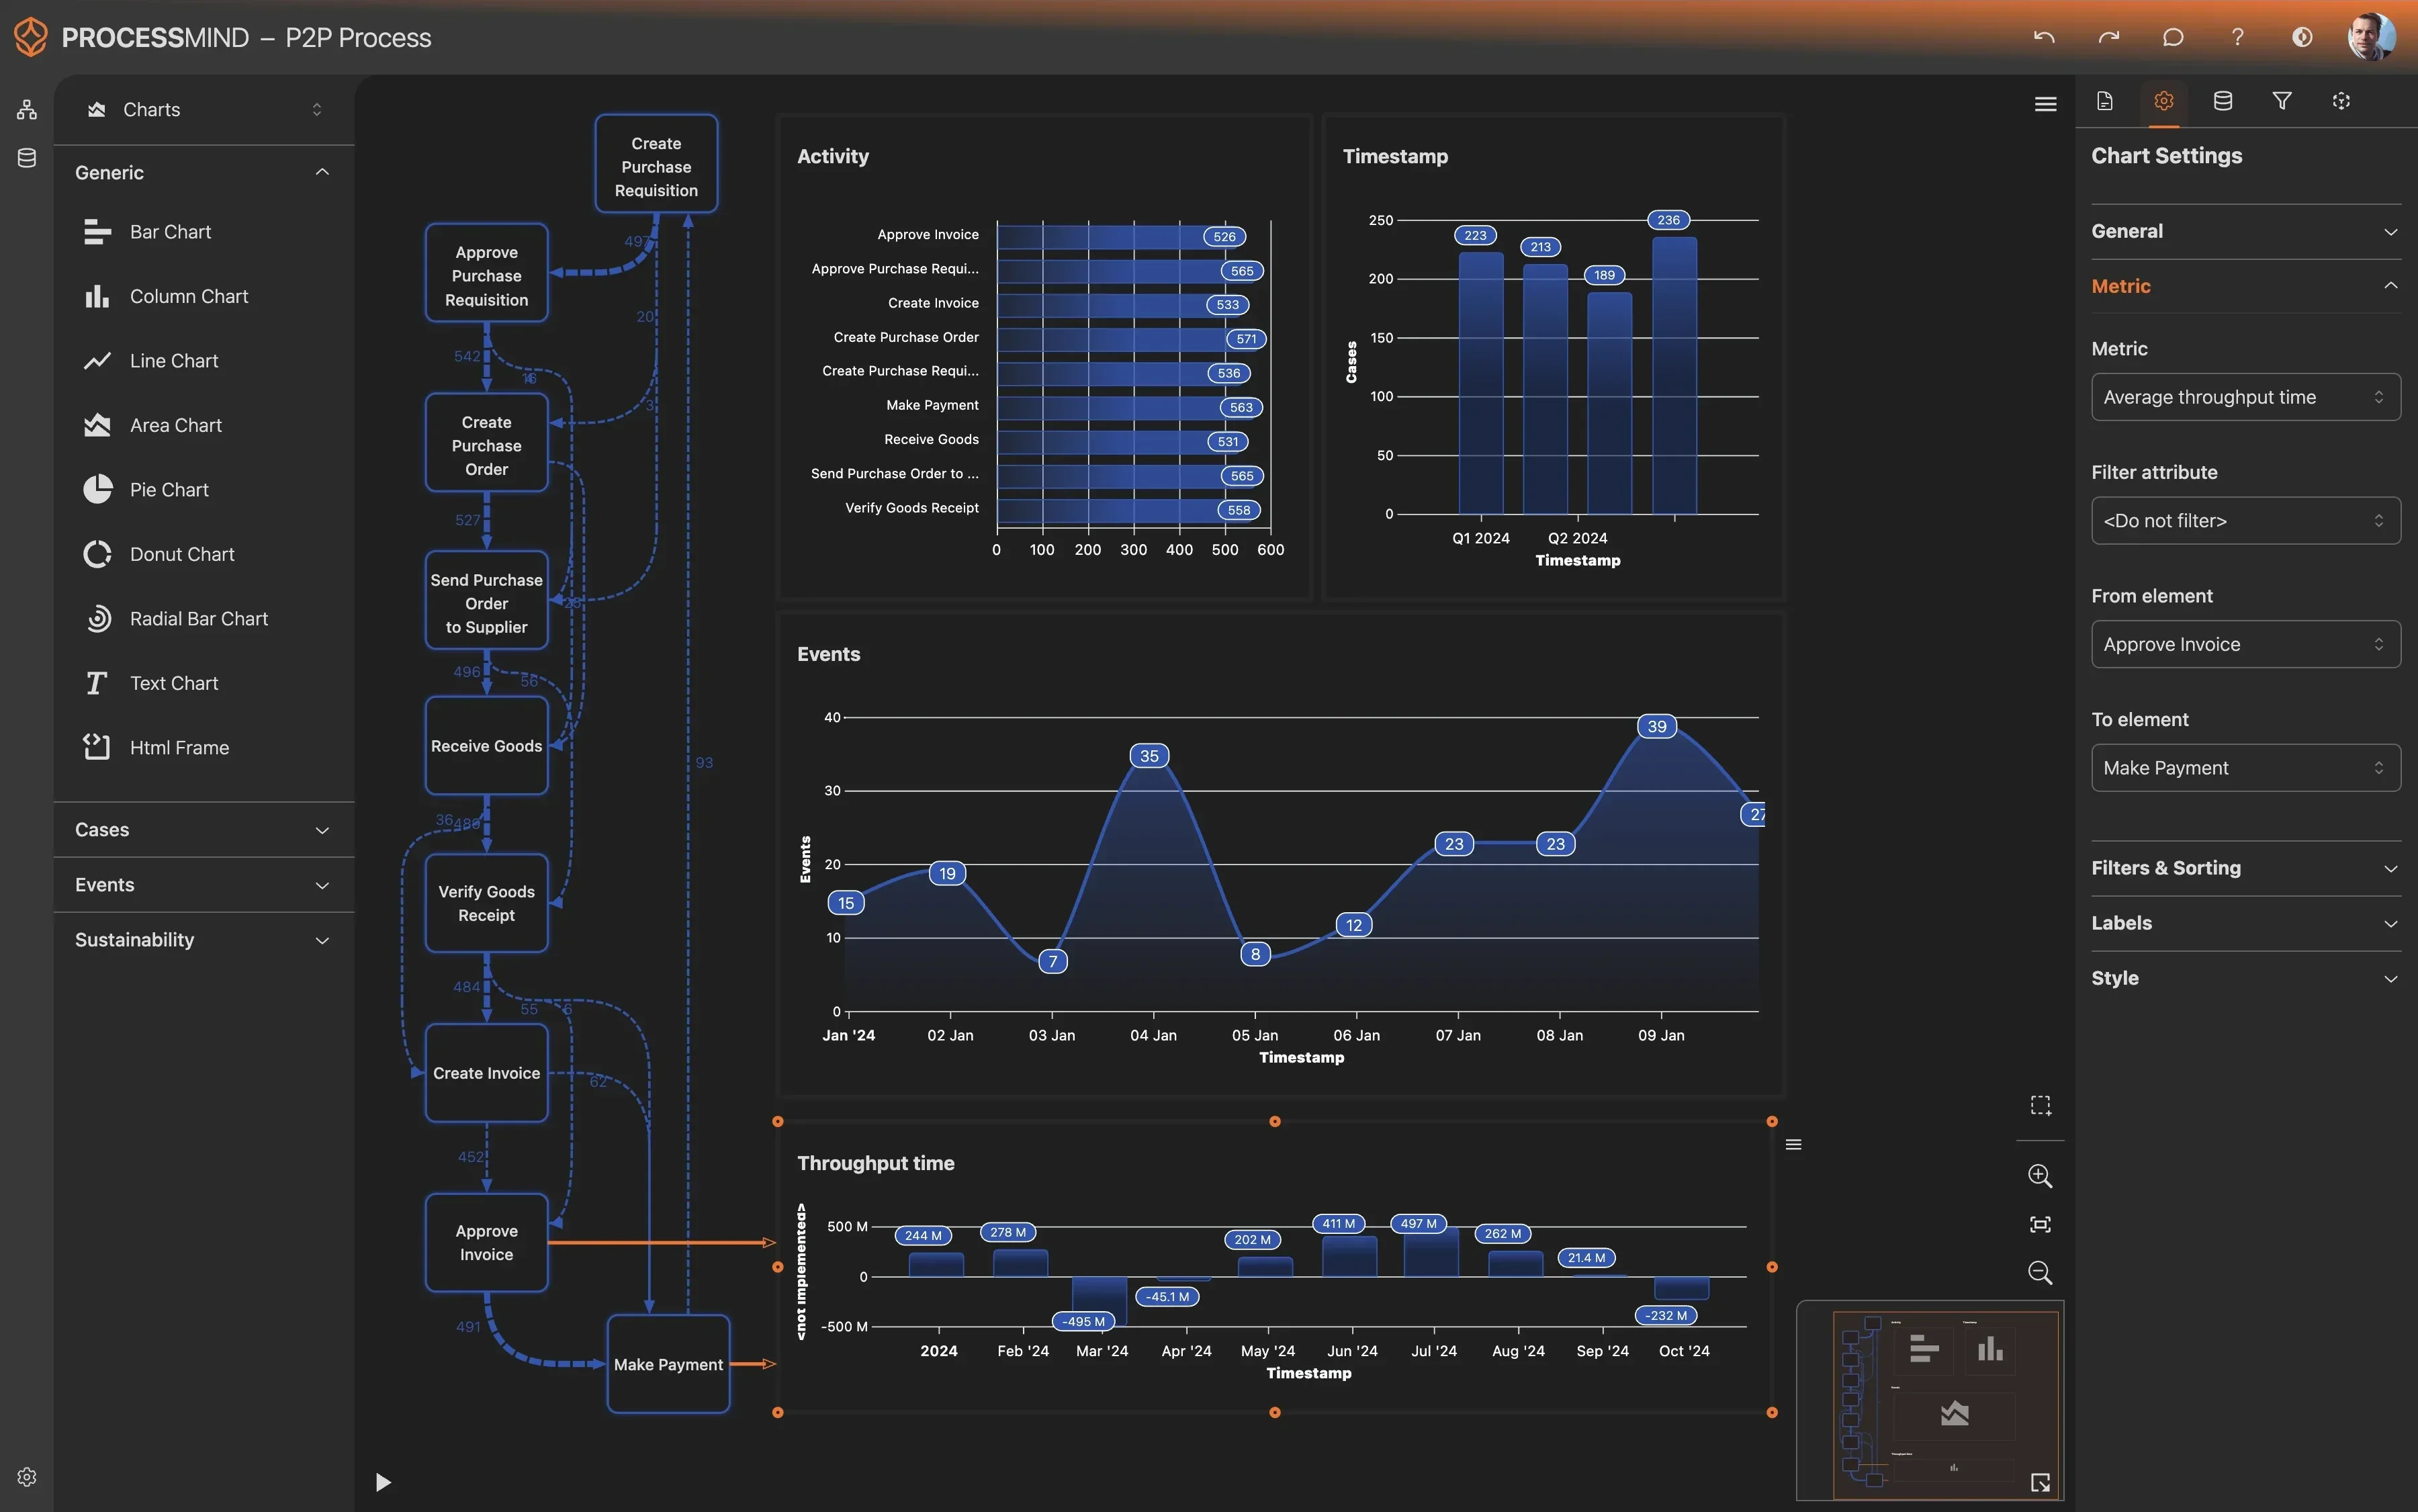
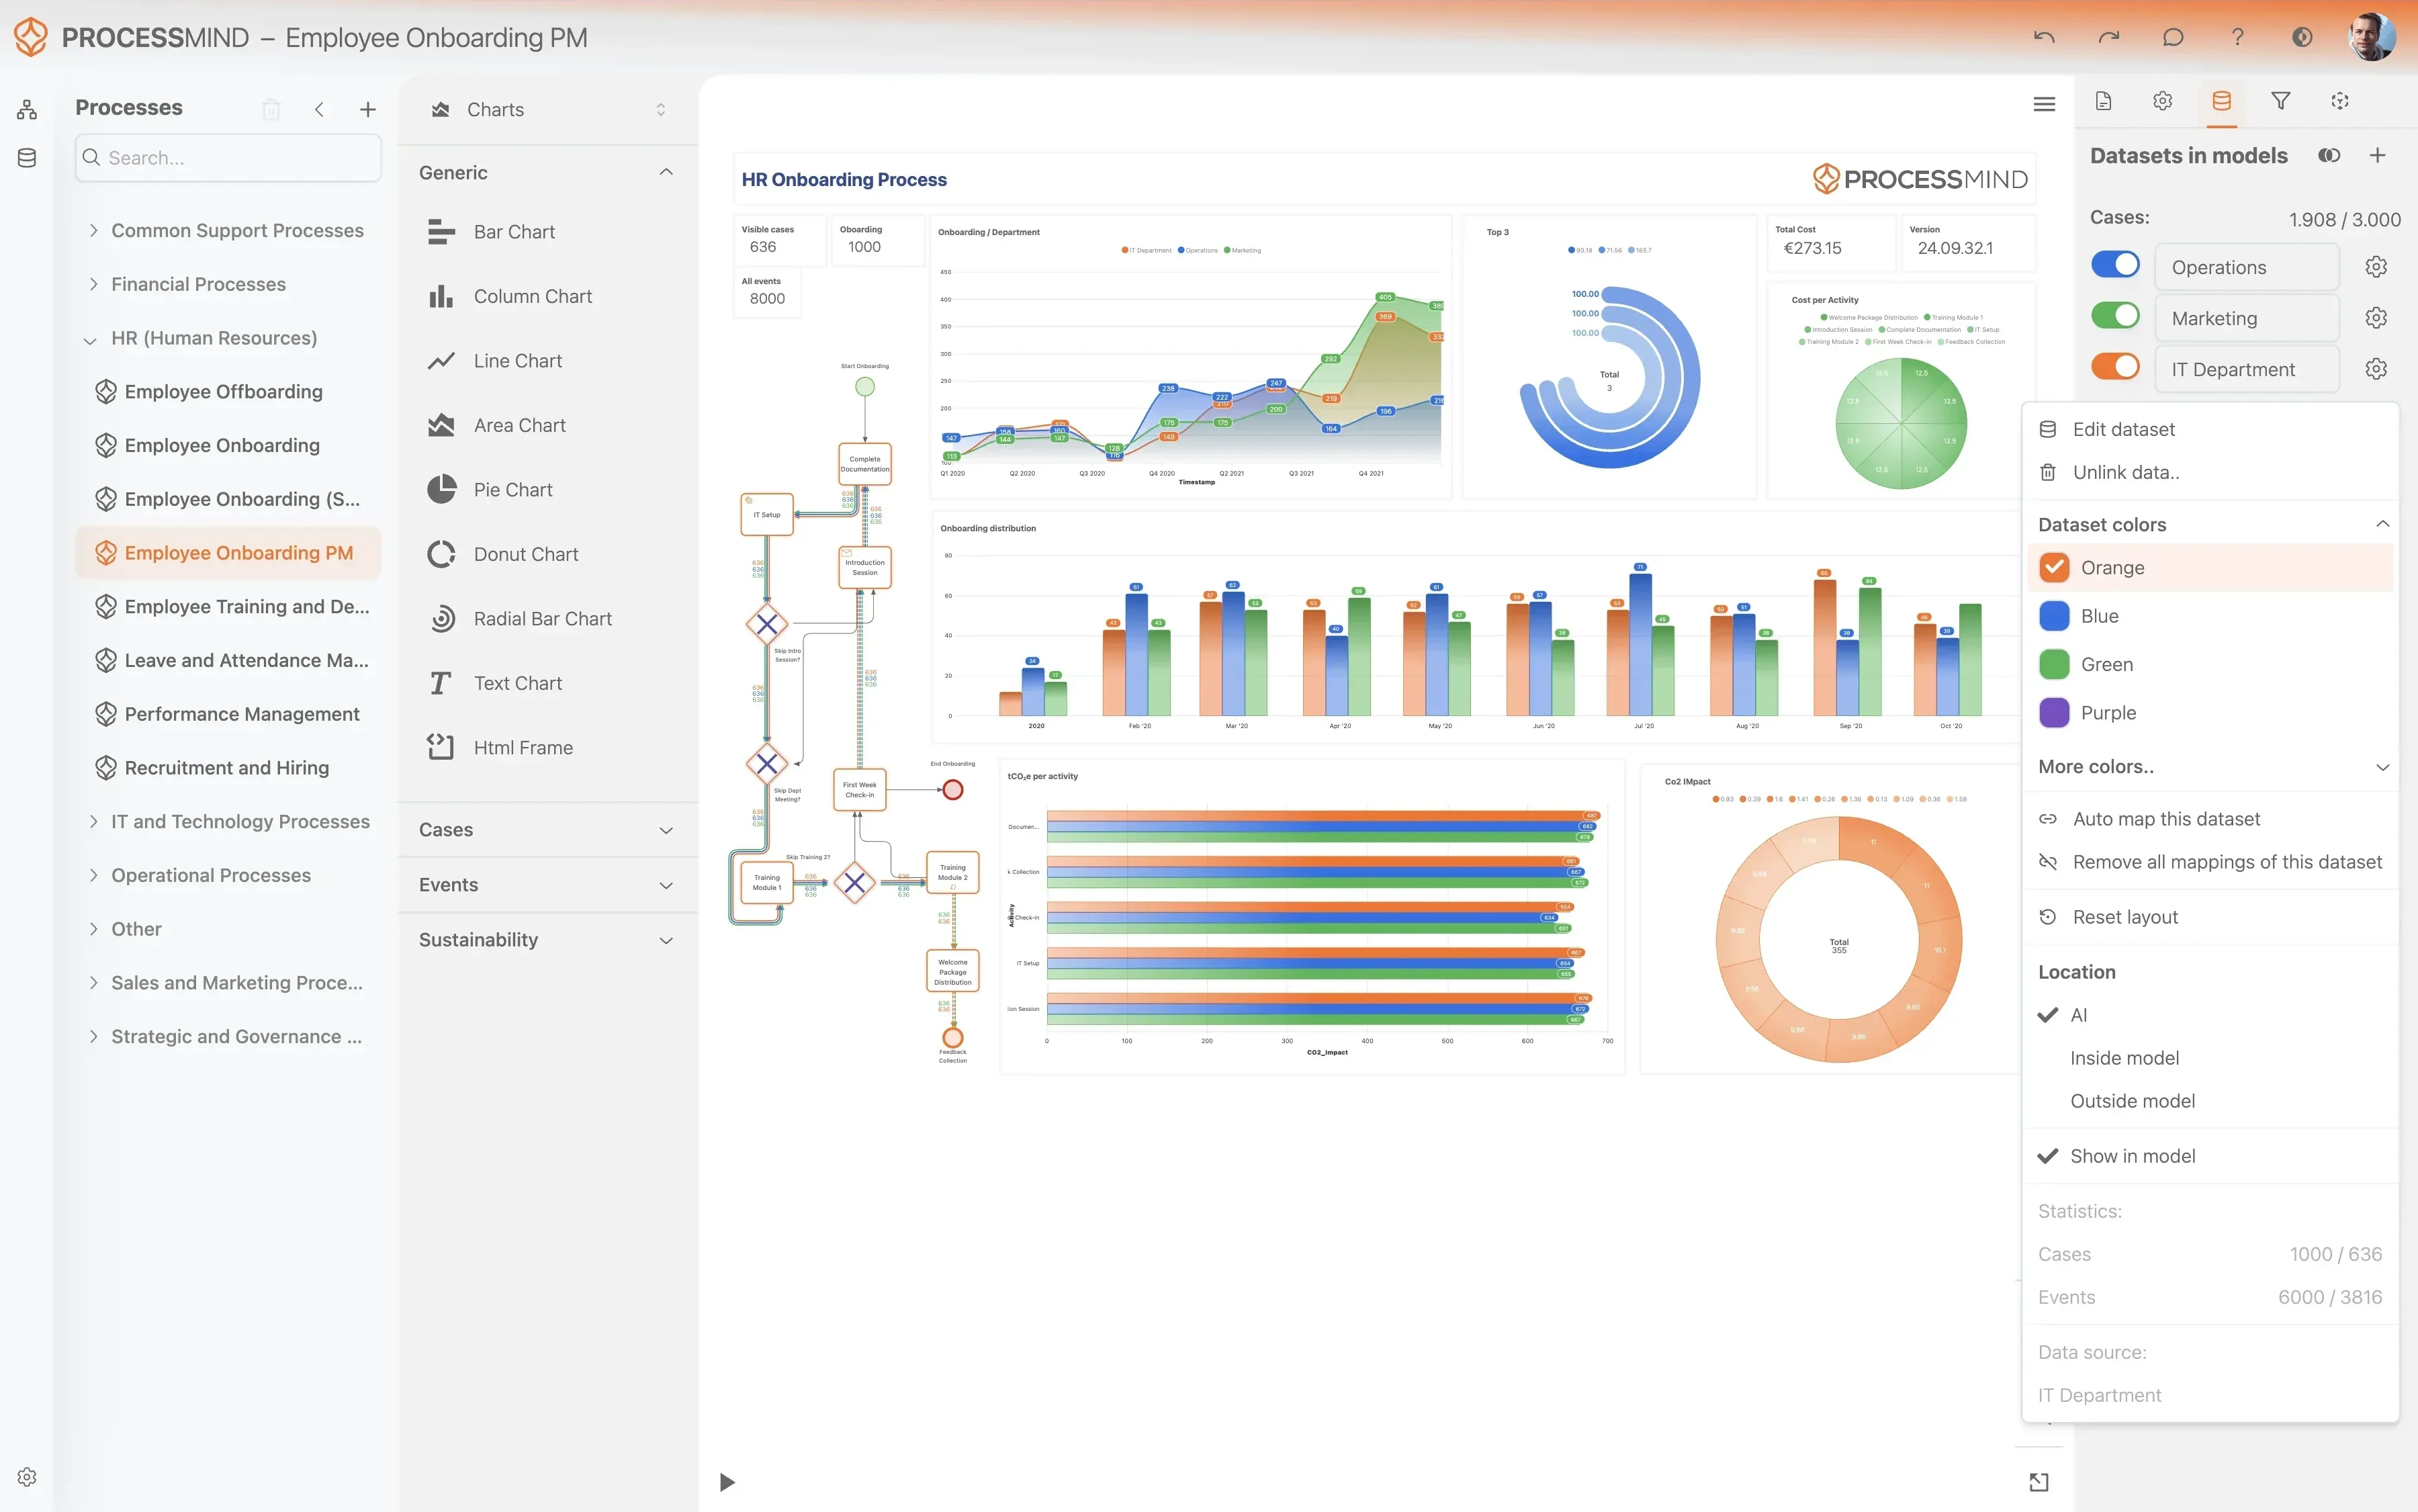
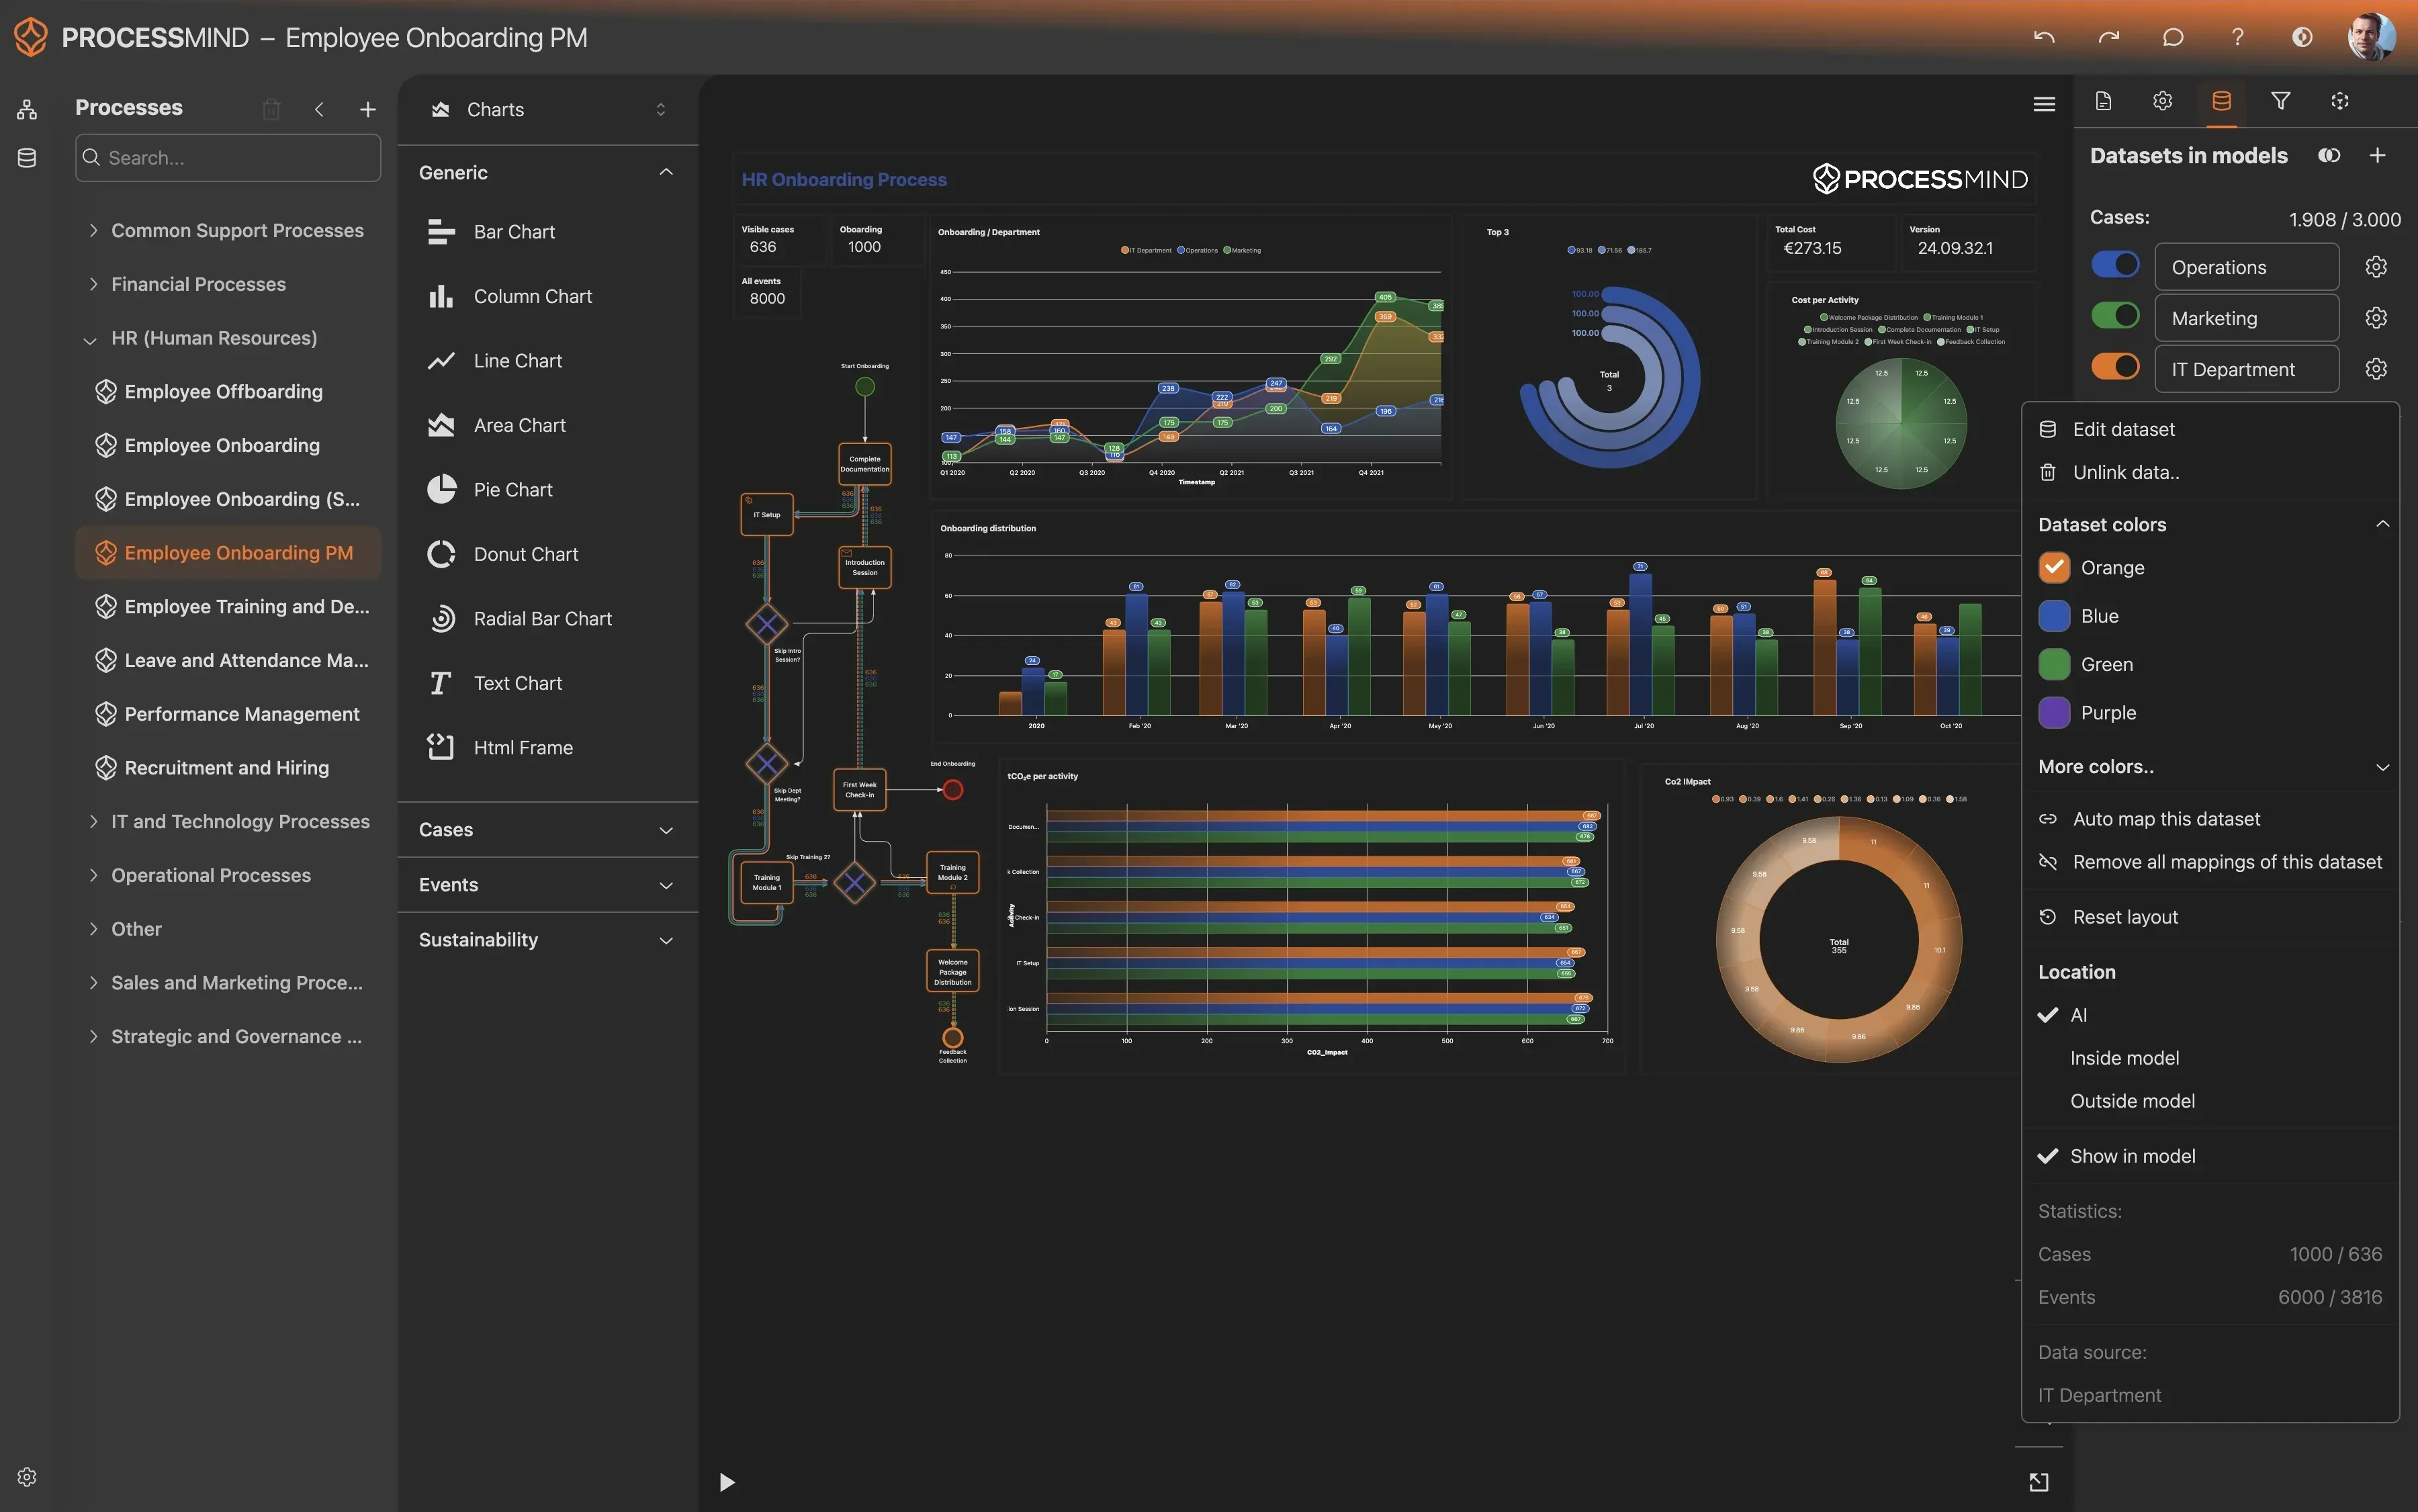
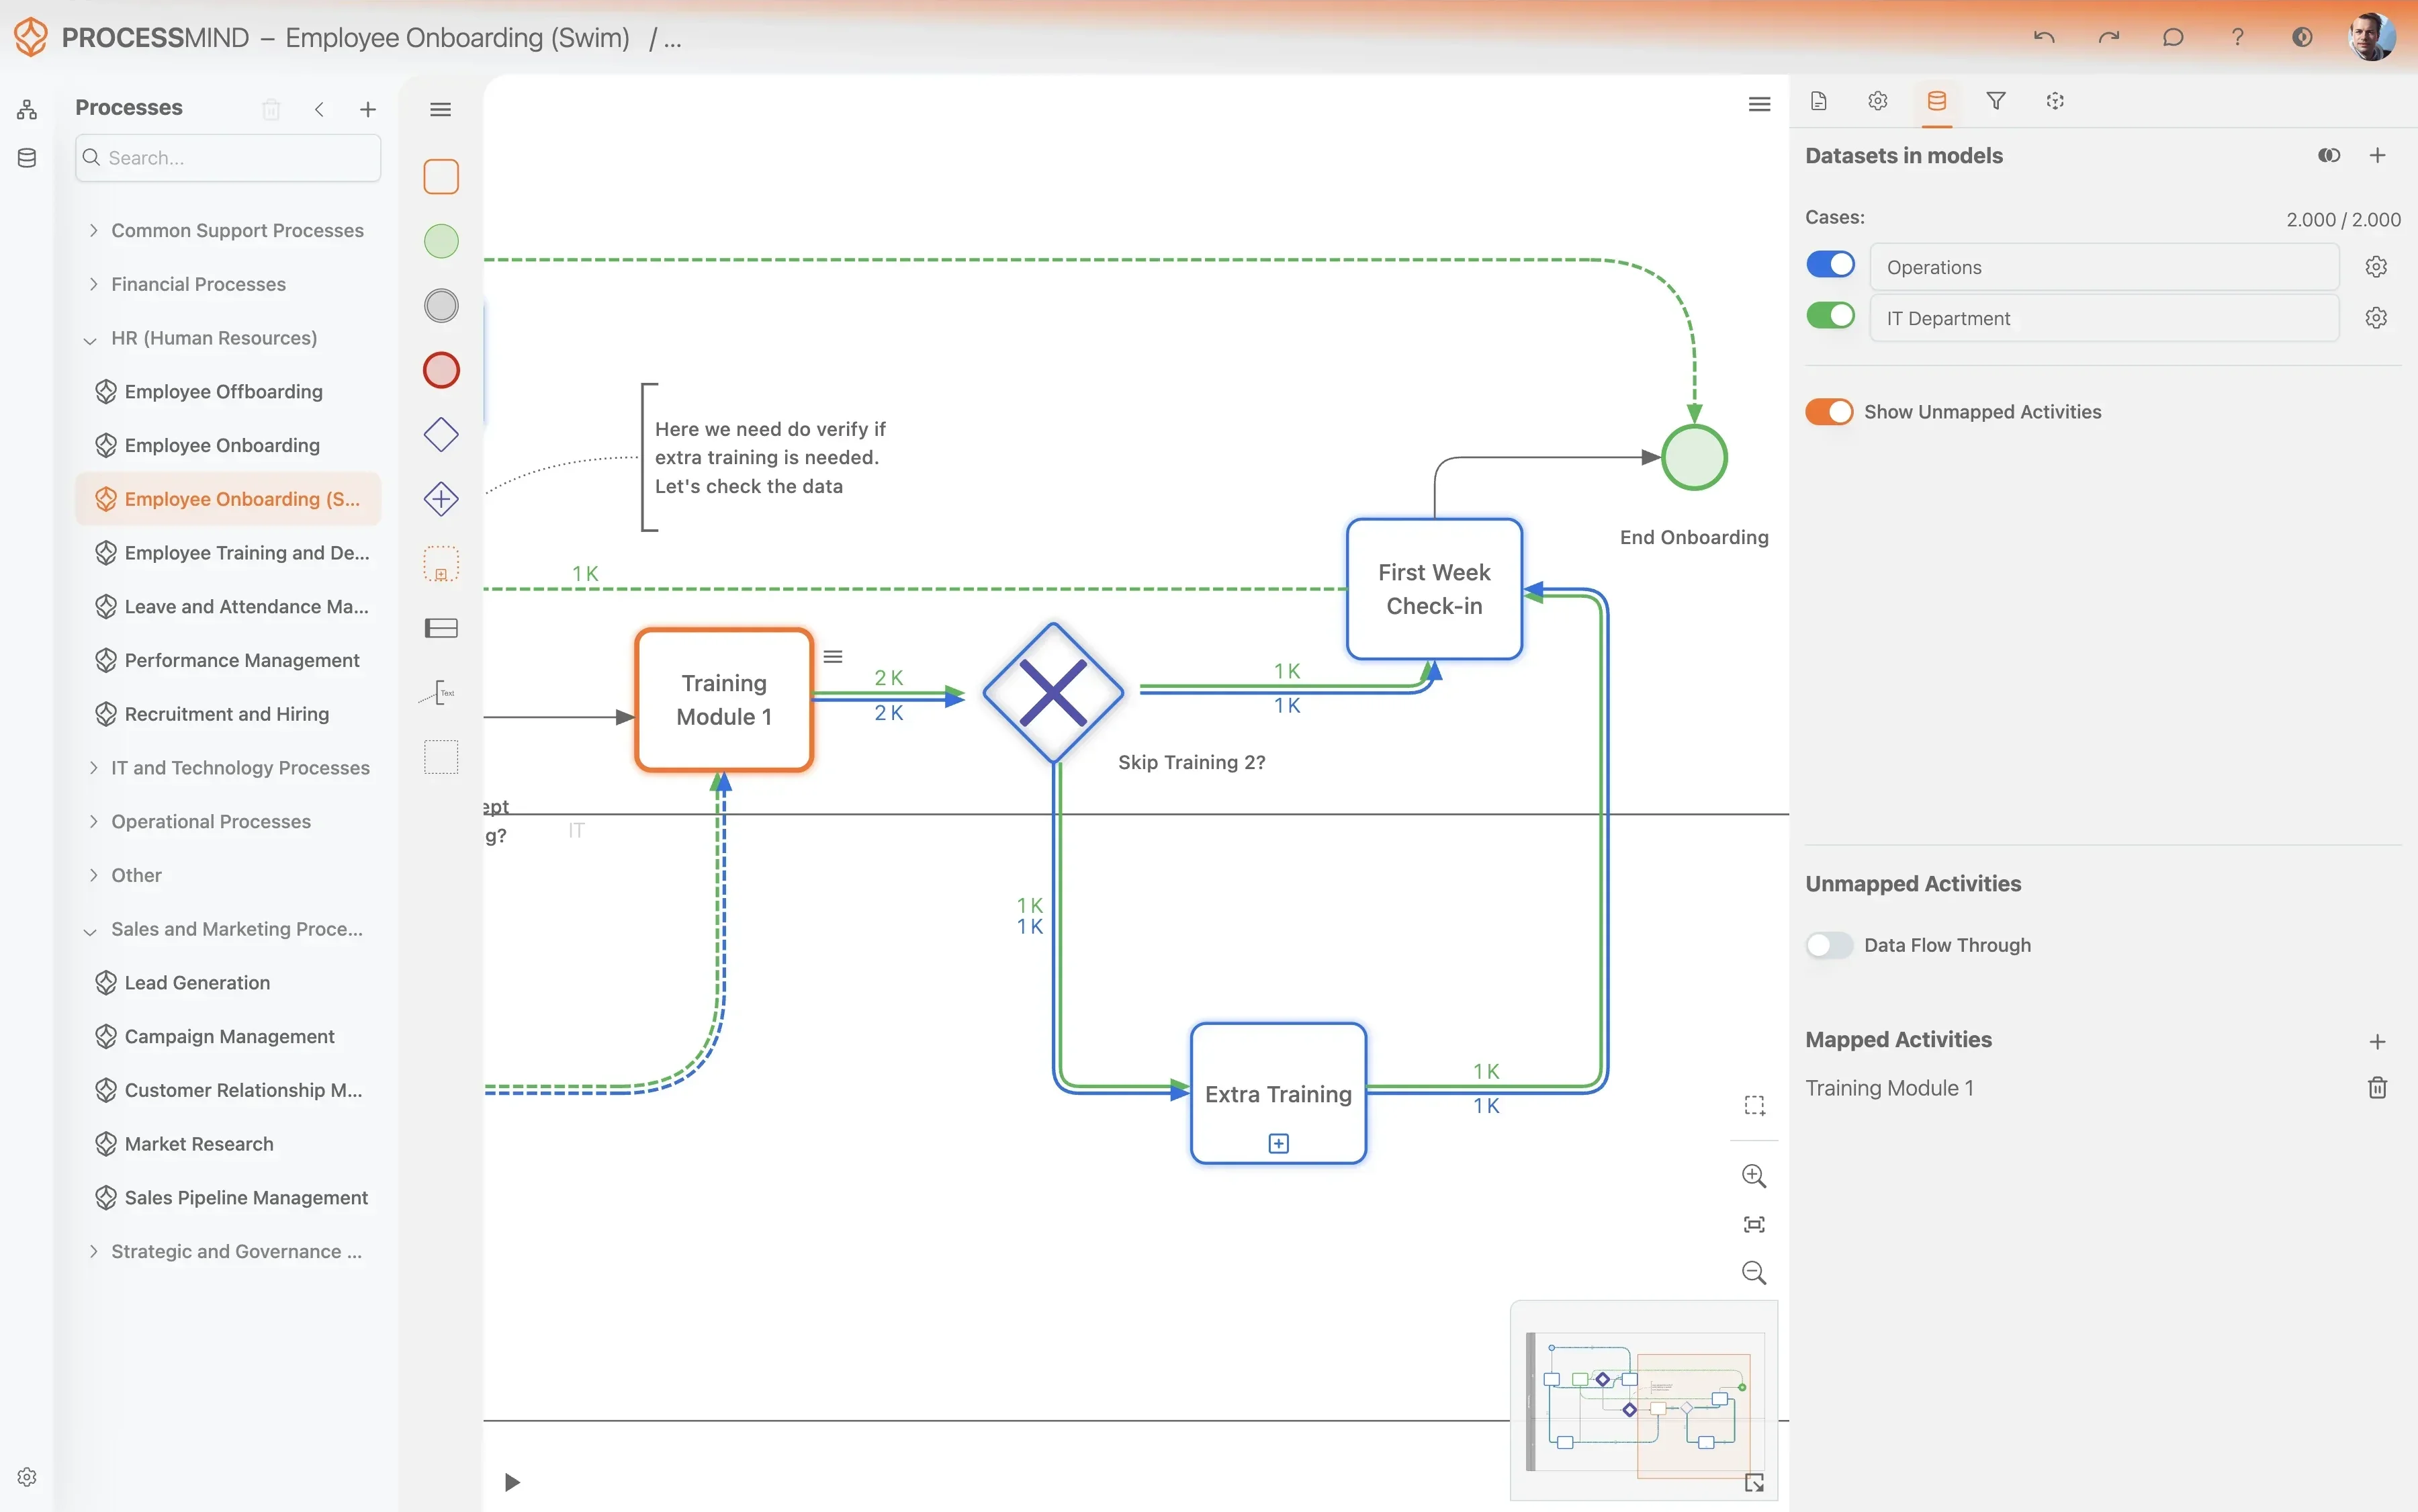
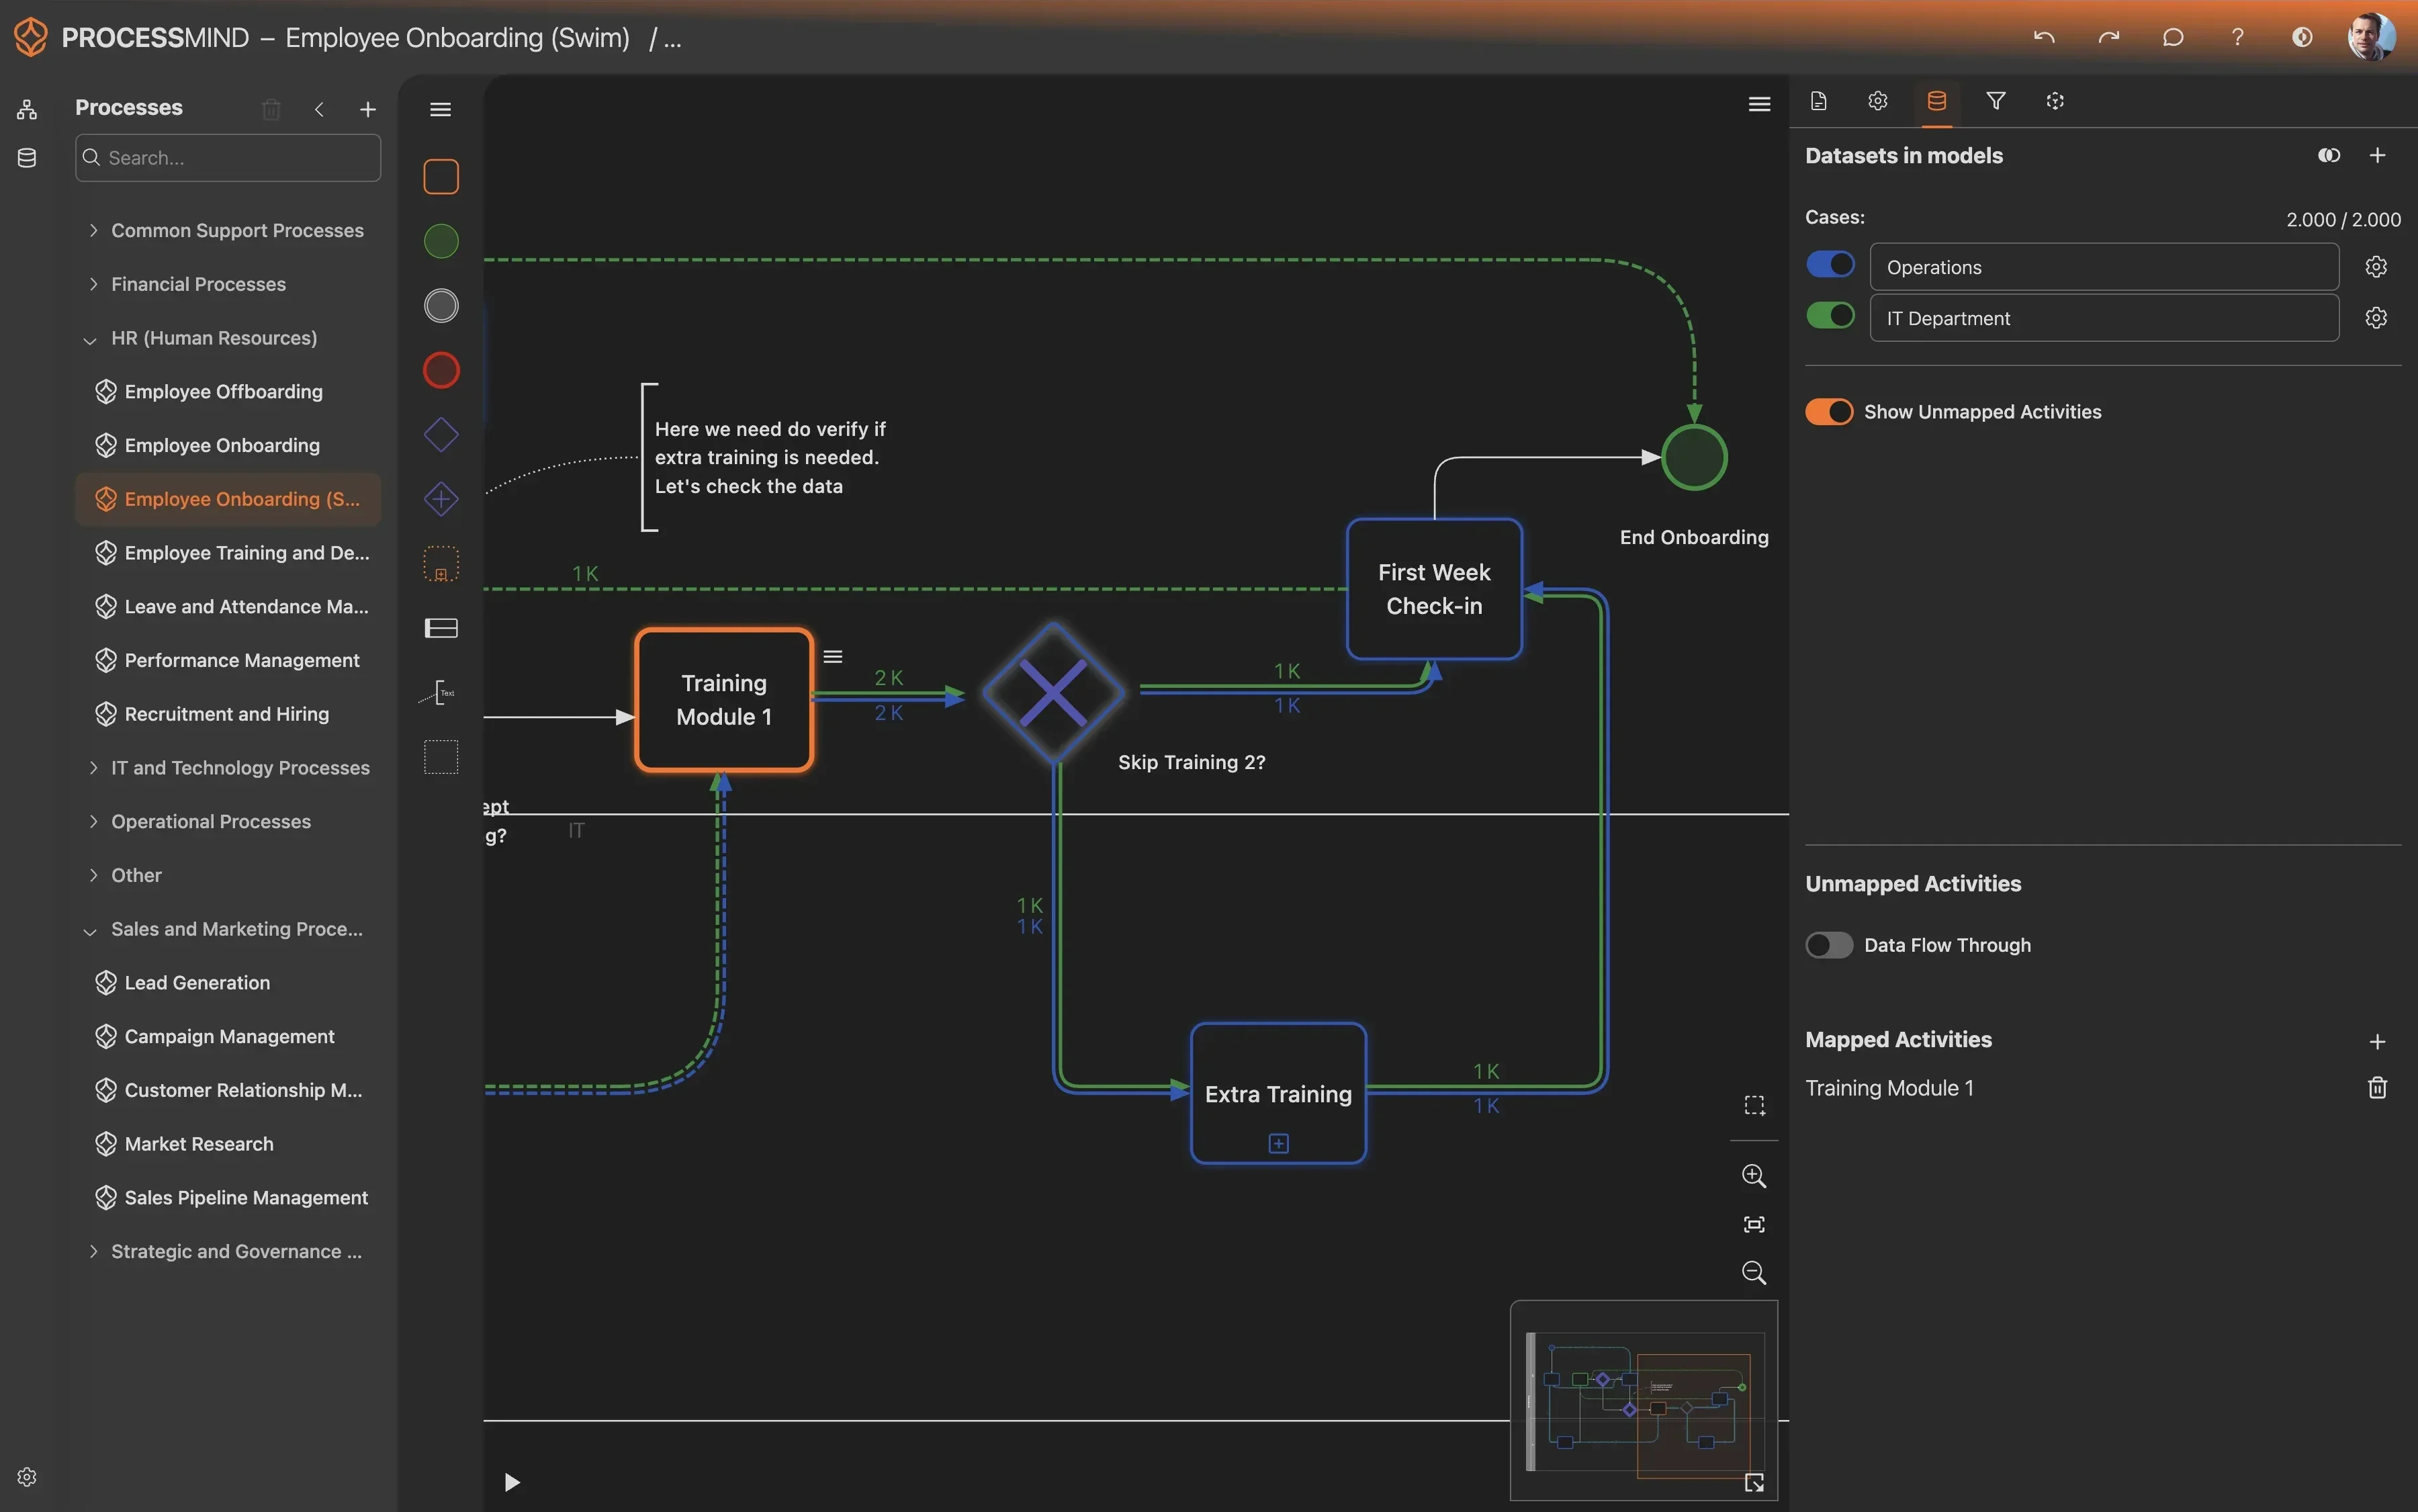
ProcessMind mostra il flusso effettivo del processo di gestione degli incidenti, con visualizzazioni chiare e informazioni basate sui dati. Individui con precisione le inefficienze e come intervenire per accelerare la risoluzione.
  • Visualizzi i flussi effettivi di risoluzione degli incidenti
  • Individui con precisione i colli di bottiglia e i ritardi nella risoluzione
  • Individui le cause profonde delle interruzioni del servizio
  • Ottimizzi l’allocazione delle risorse per accelerare il servizio
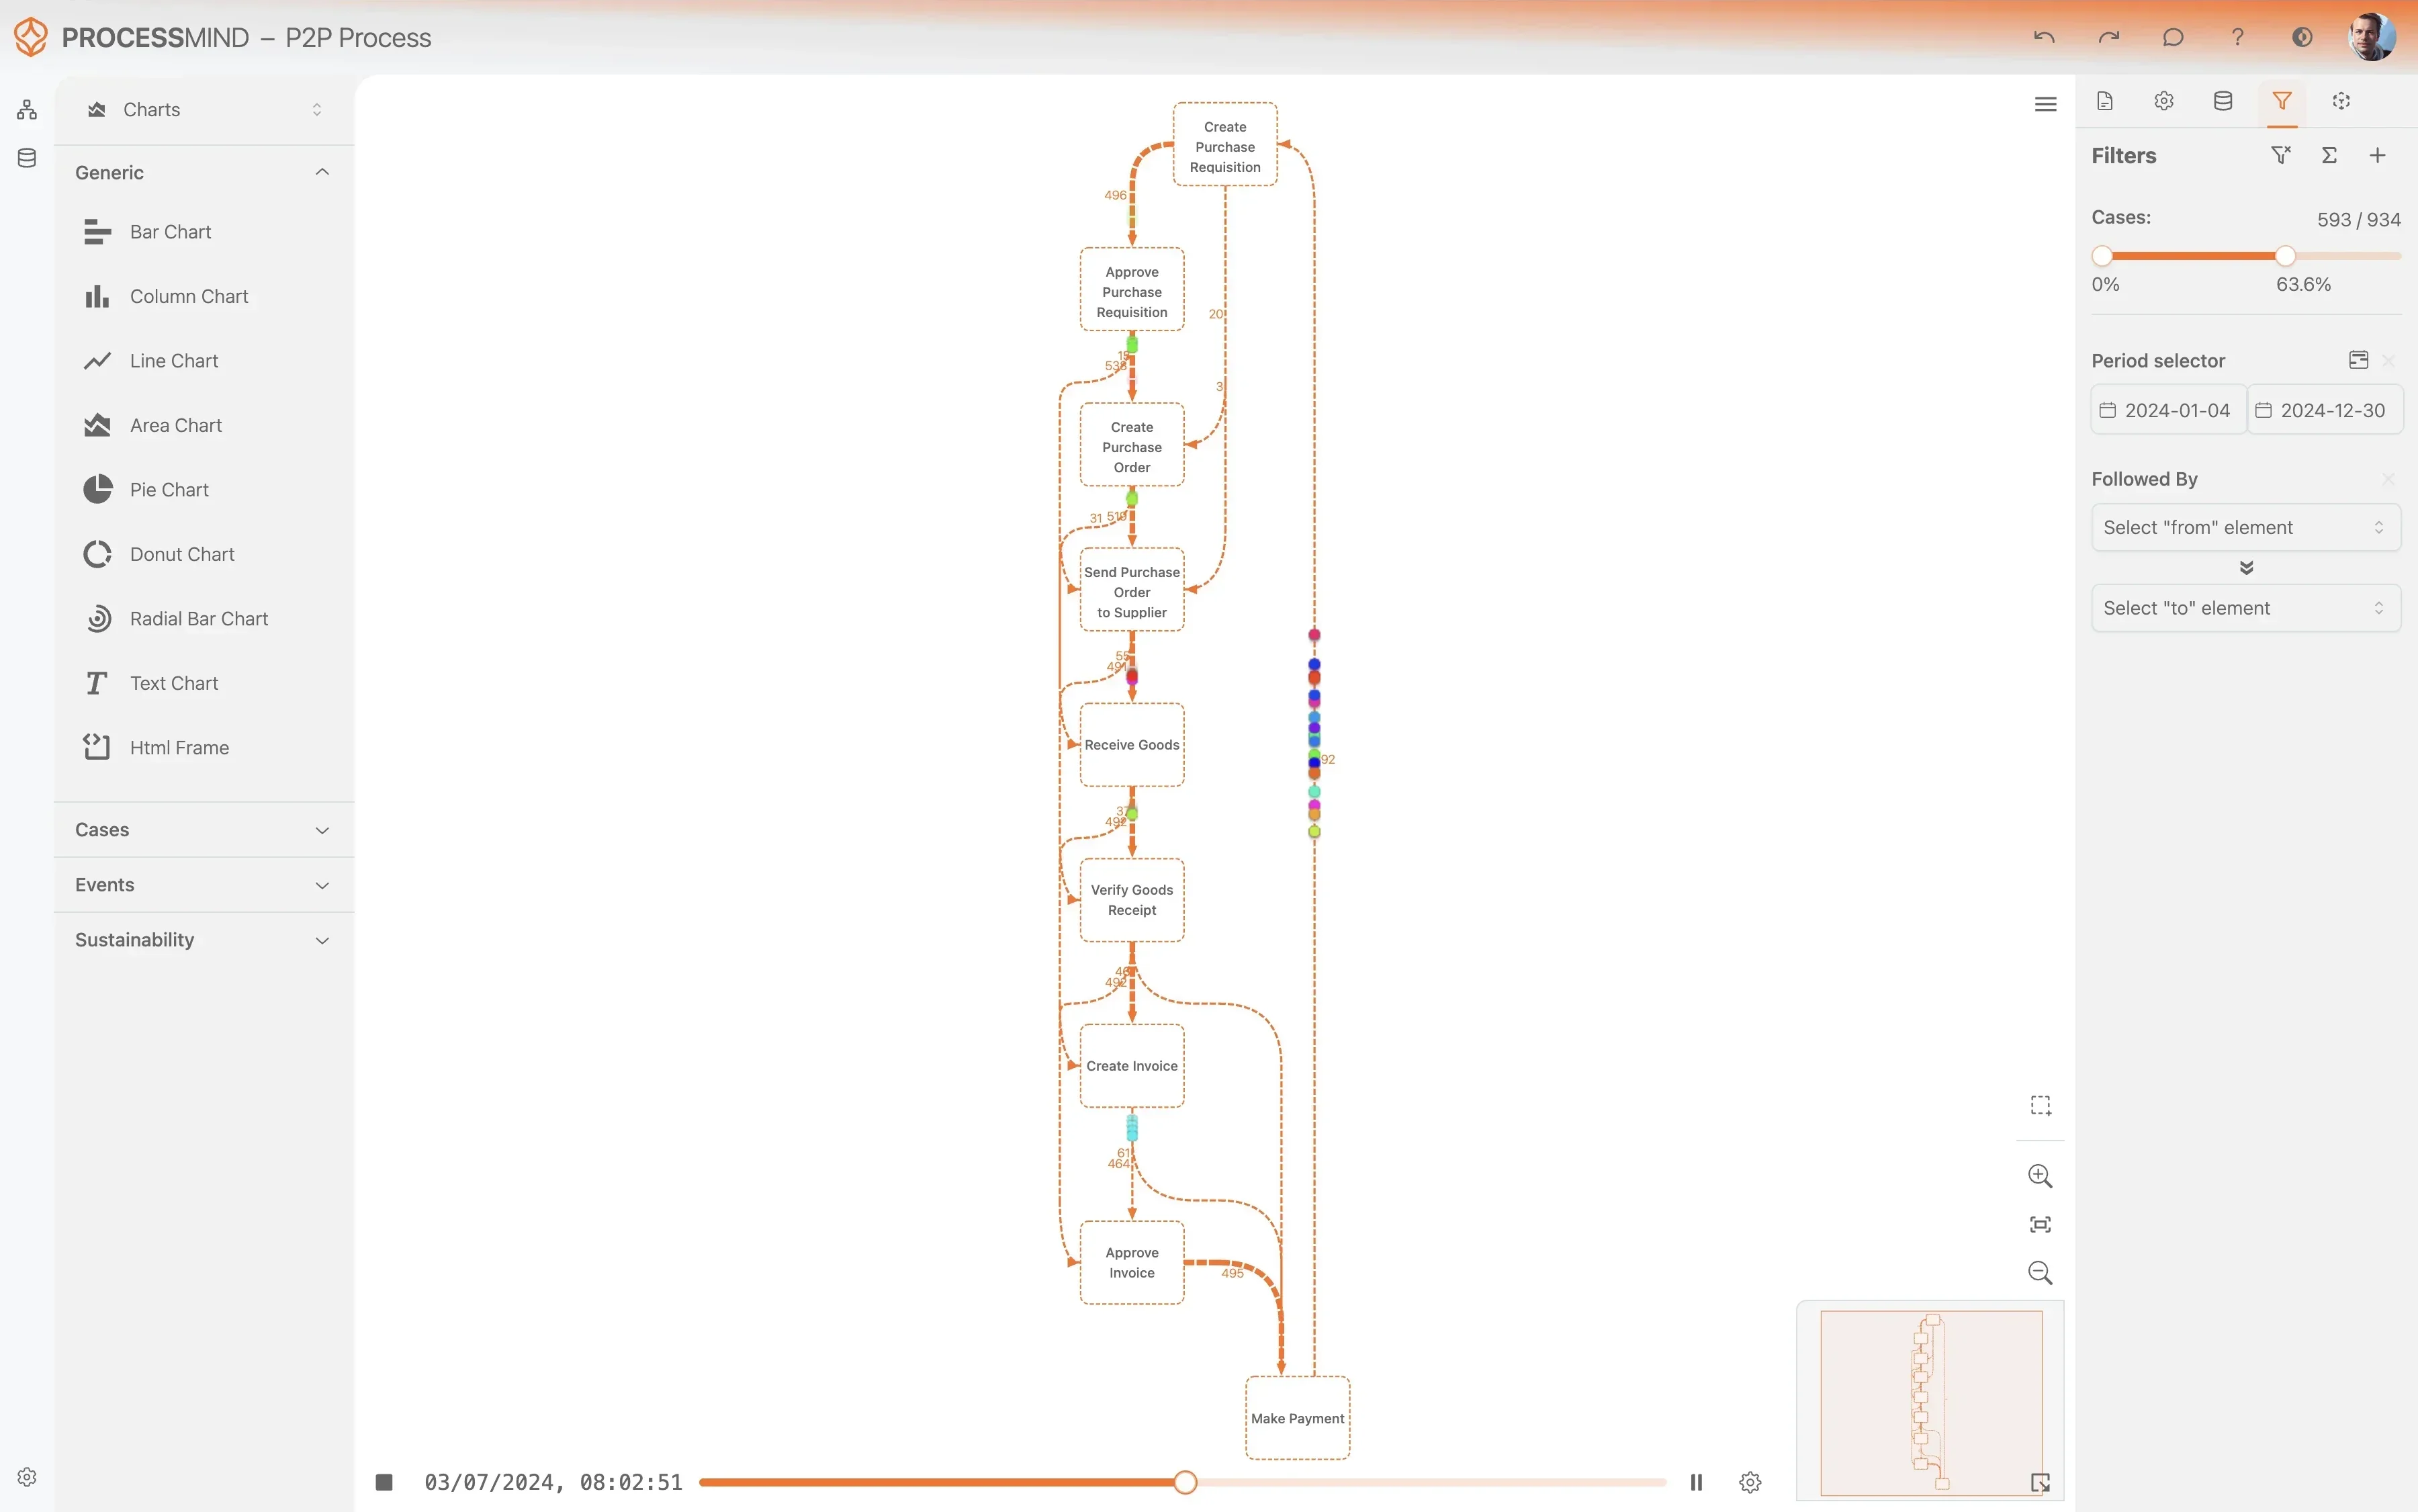
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

RISULTATI TIPICI

I risultati ottenuti dalle organizzazioni con una gestione degli incidenti ottimizzata

Analizzando con il Process Mining i flussi di lavoro degli incidenti in BMC Helix ITSM, le organizzazioni ottengono informazioni sui colli di bottiglia e sulle inefficienze. Questi risultati rappresentano i miglioramenti tipici che è possibile ottenere nei tempi di risoluzione, nella qualità del servizio e nei costi operativi.

0 %
Tempi di risoluzione più brevi

Riduzione del tempo necessario per chiudere gli incidenti

Renda più efficienti i flussi di lavoro individuando i colli di bottiglia nelle fasi di diagnosi, indagine o approvazione, così da ridurre sensibilmente il tempo complessivo necessario per risolvere gli incidenti.

0 %
Migliorare il rispetto degli SLA

Maggiore rispetto degli obiettivi di servizio

Individui e affronti gli scostamenti dal processo o i ritardi che causano violazioni degli SLA, così da risolvere un numero maggiore di incidenti entro i livelli di servizio concordati.

0 %
Ridurre le riassegnazioni

Meno trasferimenti tra team

Individui ed elimini gli instradamenti inefficienti che fanno rimbalzare gli incidenti tra i gruppi di supporto, per accelerare la prima risoluzione e ridurre il lavoro necessario.

0 %
Ridurre le rilavorazioni sugli incidenti

Meno incidenti riaperti o ricorrenti

Individui le cause profonde delle correzioni iniziali inefficaci o delle diagnosi incomplete, riducendo la necessità di riaprire o inoltrare gli incidenti dopo i primi tentativi di risoluzione.

0 %
Migliorare la conformità del processo

Maggiore rispetto dei passaggi standard

Visualizzi i percorsi effettivi degli incidenti per individuare gli scostamenti dalle procedure standard e migliorare la coerenza e la prevedibilità della gestione.

I risultati variano in base alla complessità del processo di gestione degli incidenti, alla qualità dei dati e al contesto organizzativo. Queste cifre illustrano i miglioramenti tipici osservati in diverse implementazioni.

Dati consigliati

Inizi dagli attributi e dalle attività più importanti, poi aggiunga altri elementi secondo necessità.
Non conosce ancora gli Event Log? Scopra come creare un Event Log per il Process Mining.

Attributi

Dati chiave da acquisire per l’analisi

Identificativo univoco di ogni record di incidente.

Perché è importante

È l’identificativo essenziale del caso, che collega tutti gli eventi del ciclo di vita di un incidente e rende possibile l’analisi del processo da un capo all’altro.

Stato corrente o storico dell’incidente al momento dell’evento.

Perché è importante

Monitorare le modifiche di stato è essenziale per comprendere l’avanzamento dell’incidente e misurare quanto tempo trascorre in stati specifici, come 'In attesa' o 'In corso'.

Livello di priorità assegnato all’incidente, che ne determina l’urgenza di gestione.

Perché è importante

Questo attributo è essenziale per segmentare l’analisi, così da gestire più rapidamente gli incidenti ad alta priorità e rispettare i relativi obiettivi di livello di servizio.

Il gruppo di supporto responsabile della gestione dell’incidente.

Perché è importante

Sapere a quale gruppo è assegnato un incidente aiuta ad analizzare i passaggi di consegne, individuare i cicli di riassegnazione e localizzare i colli di bottiglia all’interno di team specifici.

La persona incaricata di gestire l’incidente.

Perché è importante

Offre una visione dettagliata della distribuzione del carico di lavoro e dei risultati individuali, aiutando a individuare chi ottiene i risultati migliori e gli agenti che necessitano di supporto.

Il servizio aziendale o tecnico interessato dall’incidente.

Perché è importante

Collegare gli incidenti ai servizi aziendali è fondamentale per analizzarne l’impatto e individuare quelli più soggetti a problemi.

La classificazione dell’incidente, spesso organizzata su più livelli.

Perché è importante

La categorizzazione consente di instradare correttamente gli incidenti, analizzare l’andamento e confrontare i risultati tra le diverse tipologie.

Indicatore che segnala se l’incidente è stato risolto dopo la data obiettivo SLA.

Perché è importante

Questo indicatore semplifica l’analisi della conformità agli SLA: consente di filtrare facilmente tutti gli incidenti che hanno superato la scadenza e di indagarne le cause profonde.

Indicatore che segnala se un incidente è stato riaperto dopo essere passato allo stato 'Resolved'.

Perché è importante

Misura direttamente il lavoro da rifare e la qualità delle risoluzioni. Un tasso elevato di riapertura segnala correzioni inefficaci e debolezze nel processo.

Attività

Fasi del processo da monitorare e ottimizzare

Questa attività indica la creazione iniziale del record dell’incidente nel sistema. Viene rilevata direttamente dalla data e ora di creazione dell’incidente nel modulo principale di gestione degli incidenti.

Perché è importante

È l’evento iniziale principale del ciclo di vita dell’incidente. È essenziale per calcolare i tempi complessivi di risoluzione e comprendere la frequenza di arrivo degli incidenti.

Questa attività indica la prima assegnazione dell’incidente a un gruppo di supporto specifico per l’indagine. Si deduce dal momento in cui il campo 'Assigned Group' viene compilato per la prima volta dopo la creazione dell’incidente.

Perché è importante

È una tappa fondamentale che segna l’inizio del lavoro effettivo. Monitorare il tempo necessario per la prima assegnazione è essenziale per valutare i tempi di risposta e l’efficienza dell’instradamento iniziale.

Indica che un addetto al supporto ha iniziato a lavorare attivamente sull’incidente. In genere si deduce dal passaggio di stato da 'Assigned' a 'In Progress'.

Perché è importante

Questa tappa segna il passaggio dall’attesa in coda alla diagnosi attiva. Analizzare il tempo trascorso in attesa dell’avvio dell’indagine aiuta a individuare i colli di bottiglia legati alle risorse e supporta la Dashboard 'Diagnosis & Investigation Bottlenecks'.

Questa attività indica la risoluzione ufficiale dell’incidente dal punto di vista del Service Desk, prima della chiusura definitiva. Viene registrata quando lo stato dell’incidente è impostato su 'Resolved'.

Perché è importante

È la tappa più importante per misurare il rispetto degli SLA e i tempi di risoluzione. Indica che il servizio è stato ripristinato per l’utente.

È l’attività finale, che segna la chiusura formale del record dell’incidente dopo la conferma della risoluzione o il termine del periodo previsto per la conferma. Viene registrata quando lo stato è impostato su 'Closed'.

Perché è importante

È l’evento finale definitivo del ciclo di vita dell’incidente. Il tempo tra 'Resolved' e 'Closed' corrisponde al periodo necessario per la conferma dell’utente e per le attività amministrative di chiusura.

Domande frequenti

Domande frequenti

Il Process Mining analizza i dati effettivi degli incidenti in BMC Helix ITSM per visualizzare il percorso reale di ogni incidente. Fa emergere colli di bottiglia nascosti, scostamenti dalle procedure standard e cicli di rilavorazione che incidono sui tempi di risoluzione e sui livelli di servizio. In questo modo è possibile vedere con precisione dove si perde efficienza.

In genere, per iniziare servono Event Log che contengano l’ID dell’incidente, il nome dell’attività e la data e l’ora di ogni passaggio. Altri attributi, come l’assegnatario, il tipo di incidente, la priorità e i codici di risoluzione, sono molto utili per approfondire l’analisi. Questi dati consentono di ricostruire l’intero percorso di ogni incidente.

I dati di BMC Helix ITSM possono essere estratti in diversi modi, ad esempio tramite query dirette al database, integrazioni API o funzionalità di reportistica già disponibili. L’obiettivo è ottenere un insieme completo di Event Log che registri tutte le attività pertinenti e i relativi orari. In questa fase iniziale si privilegiano sempre metodi sicuri e conformi.

Dopo l’estrazione e la preparazione iniziale dei dati, spesso è possibile ottenere informazioni utili nel giro di poche settimane, talvolta anche di pochi giorni, a seconda della disponibilità dei dati e dell’ambito del progetto. L’analisi iniziale mette rapidamente in evidenza gli scostamenti più rilevanti e i problemi di prestazione, aiutando i team a stabilire le priorità di intervento. Il monitoraggio continuo sostiene poi le attività di ottimizzazione nel tempo.

Sì. Il Process Mining ricostruisce con precisione ogni riassegnazione e individua i punti in cui gli incidenti si bloccano o vengono indirizzati in modo errato, causando ritardi e possibili violazioni degli SLA. Visualizzando queste inefficienze, è possibile risalire alle cause profonde, come responsabilità poco chiare, carenze di competenze o percorsi di escalation inadeguati. Ciò consente di intervenire in modo mirato per rendere il processo più efficiente.

Il Process Mining si avvale in genere di piattaforme software specializzate per acquisire, trasformare e visualizzare i dati degli eventi. Alcuni strumenti sono disponibili in cloud, mentre altri possono richiedere l’installazione in sede. Tra i requisiti principali rientrano spesso una capacità di elaborazione e uno spazio di archiviazione adeguati ai dati storici sugli incidenti, oltre a una connettività sicura ai dati.

No, il Process Mining va ben oltre la reportistica tradizionale. I report mostrano «che cosa» è successo, mentre il Process Mining rivela «come» e «perché», ricostruendo il flusso effettivo del processo da un capo all’altro, anziché limitarsi a metriche aggregate. Offre una visione visiva e basata sui dati delle variazioni del processo e del loro impatto, consentendo analisi diagnostiche più approfondite.

Il Process Mining individua i punti esatti del ciclo di vita degli incidenti in cui si ricorre spesso a soluzioni alternative o in cui le fasi di analisi delle cause profonde vengono saltate o risultano inefficaci. Ricostruendo i percorsi degli incidenti, mette in luce gli schemi ricorrenti e le fasi in cui non vengono svolte le verifiche diagnostiche necessarie. Questa visibilità consente di concentrare la formazione e adeguare il processo per migliorare la risoluzione dei problemi.

Risolva oggi gli incidenti ricorrenti in BMC Helix ITSM!

Riduca del 35% il tempo medio di risoluzione (MTTR) ed elimini le violazioni degli SLA, aumentando la soddisfazione degli utenti.

Inizi la prova gratuita

Non è richiesta alcuna carta di credito. Prova gratuita di 14 giorni.