Usprawnij zarządzanie incydentami
6 kroków do optymalizacji zarządzania incydentami w BMC Helix ITSM.
Usprawnij zarządzanie incydentami
Zarządzanie incydentami
BMC Helix ITSM

Wybierz proces

Wybierz proces, aby kontynuować pracę w połączonym obszarze roboczym.

Usprawnij zarządzanie incydentami w BMC Helix ITSM

Złożone procesy często prowadzą do nieefektywności i opóźnień. Nasza platforma pomaga znaleźć wąskie gardła, pętle ponownej pracy i kroki niezgodne z procedurami. Dzięki wskazaniu miejsc, w których pojawiają się problemy, można wprowadzić ukierunkowane usprawnienia. Pozwala to obniżyć koszty operacyjne i zwiększyć zadowolenie użytkowników.

Pobierz gotowy szablon danych i poznaj częste wyzwania, które utrudniają osiągnięcie celów efektywnościowych. Skorzystaj z planu doskonalenia w sześciu krokach oraz przewodnika po szablonie danych, aby usprawnić operacje.

Pokaż szczegółowy opis

Dlaczego sprawne zarządzanie incydentami ma znaczenie

Sprawne zarządzanie incydentami stanowi podstawę niezawodnych usług IT. Bezpośrednio wpływa na satysfakcję użytkowników, koszty operacyjne i ciągłość działania firmy. W dynamicznym środowisku organizacje korzystające z zaawansowanych systemów, takich jak BMC Helix ITSM, polegają na procesach obsługi incydentów, aby szybko przywracać normalne działanie usług i ograniczać zakłócenia. Jednak złożoność tych procesów, w których uczestniczy wiele zespołów, dochodzi do przekazywania spraw i występują zależności zewnętrzne, może niepostrzeżenie prowadzić do nieefektywności. Niewidoczne wąskie gardła wydłużają czas realizacji, co skutkuje niedotrzymaniem uzgodnionych poziomów usług, frustracją użytkowników i rosnącymi kosztami operacyjnymi. Aby odejść od reaktywnego rozwiązywania incydentów, trzeba dobrze poznać rzeczywisty przebieg procesu, a nie tylko jego zaprojektowany wariant. Taka wiedza pozwala zawczasu usuwać problemy systemowe i zmienić zarządzanie incydentami z wyzwania w źródło przewagi konkurencyjnej.

Wykorzystanie process mining do usprawnienia obsługi incydentów

Process mining pozwala przyjrzeć się rzeczywistemu przebiegowi procesu zarządzania incydentami w BMC Helix ITSM. Analizując dzienniki zdarzeń, w których każdy incydent jest identyfikowany za pomocą unikalnego identyfikatora sprawy: Incident ID, process mining tworzy obiektywną, opartą na danych mapę kolejnych etapów, od zgłoszenia incydentu do jego zamknięcia. Dzięki temu można:

  • Poznać rzeczywisty przebieg procesu: Wykryć odstępstwa od standardowych procedur i ustalić, w których miejscach incydenty przebiegają nieoczekiwaną lub nieefektywną ścieżką. Można sprawdzić, ile razy incydent przekazano do wyspecjalizowanego zespołu albo czy przed rozpoczęciem diagnozy wdrożono obejście problemu. Pozwala to wykryć powtarzanie pracy i zbędne kroki.
  • Wskazać wąskie gardła i opóźnienia: Ustalić, na którym etapie incydenty utknęły, czy podczas początkowego przypisania do grupy wsparcia, prowadzenia dochodzenia, czy wdrażania i testowania rozwiązania. Dzięki temu można poznać rzeczywisty czas realizacji dla różnych typów incydentów i wskazać miejsca, które opóźniają osiągnięcie docelowego czasu rozwiązania.
  • Analizować wyniki i zgodność: Oceniać przestrzeganie SLA, śledząc czas trwania poszczególnych działań i cały przebieg obsługi incydentu. Można wskazać kategorie incydentów lub przypisane grupy, które regularnie nie osiągają wyznaczonych celów, i zaplanować odpowiednie usprawnienia.
  • Mierzyć skalę powtarzania pracy i nieefektywności: Sprawdzić, jak często incydenty są ponownie otwierane, zmienia się ich priorytet lub są przekazywane między zespołami. Pozwala to określić ukryte koszty nieefektywności w środowisku BMC Helix ITSM. Takie dane pomagają ograniczyć czas obsługi incydentów przez eliminację zbędnych działań.

Obszary usprawnień w BMC Helix ITSM

Process mining zastosowany do danych o incydentach w BMC Helix ITSM wskazuje konkretne możliwości usprawnienia procesu. Typowe obszary do poprawy to:

  • Usprawnienie wstępnej oceny i kategoryzacji: Przeanalizować przebieg od zgłoszenia incydentu do jego skategoryzowania i ustalenia priorytetu. Czy incydenty są regularnie błędnie kategoryzowane, co opóźnia ich początkowe przypisanie do grupy wsparcia? Usprawnienie tego etapu może znacznie skrócić czas rozwiązania.
  • Usprawnienie przekazywania spraw: Zbadać przejścia między przypisanymi grupami. Częste przekazywanie do wyspecjalizowanego zespołu, zwłaszcza w krótkich odstępach czasu, może wskazywać na brak odpowiedniej wiedzy na początku procesu lub niejasne zasady eskalacji. Process mining ujawnia takie schematy i pomaga usprawnić workflow przypisywania agentów.
  • Przyspieszenie diagnozy i rozwiązania: Sprawdzić czas trwania i kolejność działań: rozpoczęcia diagnozy, prowadzenia dochodzenia, wdrożenia obejścia problemu i ustalenia rozwiązania. Czy diagnoza określonych typów incydentów lub usług, których dotyczą, regularnie trwa dłużej? Ta wiedza może pomóc zaplanować szkolenia lub przygotować lepsze artykuły w bazie wiedzy.
  • Usprawnienie komunikacji z użytkownikami i potwierdzania rozwiązania: Przeanalizować etapy wysłania powiadomienia do użytkownika i otrzymania jego potwierdzenia. Opóźnienia na tym etapie niepotrzebnie wydłużają obsługę incydentu i wpływają na raportowany docelowy czas rozwiązania. Usprawnienie komunikacji może przyspieszyć weryfikację i zamknięcie incydentu.
  • Systemowe usuwanie przyczyn źródłowych: Zarządzanie incydentami ma charakter reaktywny, ale powtarzające się ścieżki obsługi incydentów o wysokim priorytecie lub dużej częstotliwości mogą wskazywać na problemy z kategorią przyczyny źródłowej. Wymagają one proaktywnego zarządzania problemami, które ograniczy liczbę przyszłych incydentów.

Wymierne efekty usprawnienia zarządzania incydentami

Usprawnienia procesu wskazane dzięki process mining przynoszą organizacji wymierne korzyści. Skupienie się na poprawie zarządzania incydentami może przynieść:

  • Szybsze rozwiązywanie incydentów: Ograniczenie wąskich gardeł i skrócenie czasu realizacji pozwala osiągać docelowy czas rozwiązania i szybciej przywracać działanie usług.
  • Lepsze dotrzymywanie poziomów usług: Można poprawić wyniki dotyczące SLA, usuwając przyczyny opóźnień i zapewniając sprawny przebieg obsługi incydentów.
  • Niższe koszty operacyjne: Ograniczenie powtarzania pracy, lepsze wykorzystanie zasobów przypisanych grup i zmniejszenie nakładu pracy przy obsłudze każdego incydentu pozwalają obniżyć koszty.
  • Większa satysfakcja użytkowników i klientów: Szybsze rozwiązywanie problemów i bardziej przejrzysta komunikacja poprawiają doświadczenia działów użytkowników, których dotyczy incydent, oraz klientów zewnętrznych. Pomaga to budować zaufanie i lojalność.
  • Lepsze wykorzystanie zasobów: Przypisani agenci i grupy mogą skupić się na działaniach przynoszących wartość, zamiast na pracy administracyjnej i powtarzalnych zadaniach.
  • Zapobieganie problemom: Wiedza o powtarzających się schematach pomaga rozwijać strategię zarządzania problemami, zapobiegać kolejnym incydentom i zwiększać stabilność usług.

Jak rozpocząć usprawnianie zarządzania incydentami

Usprawnienie zarządzania incydentami w BMC Helix ITSM z wykorzystaniem process mining to inwestycja w wydajność i skuteczność operacji IT. Dostarcza jasnych informacji i danych, które pozwalają odejść od przypuszczeń i dokładnie ustalić, gdzie oraz dlaczego proces napotyka problemy. Dzięki temu zespoły mogą wprowadzać ukierunkowane zmiany, które poprawiają jakość usług i pomagają budować bardziej odporną oraz sprawniej reagującą organizację IT. Warto rozpocząć usprawnianie procesu rozwiązywania incydentów już dziś i zamienić problemy w możliwości ciągłego doskonalenia.

Zarządzanie incydentami Service Desk Wsparcie IT Rozwiązywanie zgłoszeń Zgodność z SLA Operacje IT Rozwiązywanie problemów Ograniczanie przestojów Obsługa zgłoszeń Zarządzanie zgłoszeniami Help desk IT Średni czas rozwiązania MTTR Przywracanie usług Rozwiązywanie incydentów

Typowe problemy i wyzwania

Wskaż wyzwania, które Państwa dotyczą

Incydenty często krążą między grupami wsparcia lub agentami, co powoduje znaczne opóźnienia i frustrację. Każde przekazanie wydłuża czas rozwiązania, zwiększa koszty operacyjne i obniża satysfakcję użytkowników. Taka sytuacja często wskazuje na brak jasnej odpowiedzialności lub niewystarczającą wstępną diagnozę w procesie zarządzania incydentami. ProcessMind analizuje pełny przebieg obsługi incydentów w BMC Helix ITSM i wykrywa schematy nadmiernego ponownego przypisywania. Wskazuje konkretne miejsca przekazania spraw, grupy i zaangażowanych agentów, ujawniając przyczyny nieefektywnej współpracy. Na tej podstawie można usprawnić proces, ograniczyć liczbę przekazań i zmniejszyć ilość powtarzanej pracy.

Incydenty krytyczne regularnie prowadzą do niedotrzymania uzgodnionych poziomów usług, co wydłuża przerwy w działaniu usług i może wiązać się z karami. Niedotrzymywanie SLA, czyli uzgodnionych poziomów usług, osłabia zaufanie użytkowników, szkodzi reputacji organizacji i może powodować znaczne straty finansowe z powodu długich przestojów. To częsty problem w złożonych środowiskach zarządzania incydentami. ProcessMind pokazuje pełny przebieg obsługi incydentów i wskazuje każde miejsce naruszenia SLA w BMC Helix ITSM. Łączy naruszenia z konkretnymi działaniami, wąskimi gardłami i ograniczeniami zasobów, co pozwala podjąć ukierunkowane działania, poprawić zgodność i zwiększyć skuteczność świadczenia usług.

Rozwiązywanie incydentów trwa zbyt długo, powodując długotrwałe pogorszenie jakości usług lub ich niedostępność. Długie czasy rozwiązania obniżają produktywność użytkowników końcowych, zwiększają koszty operacyjne i mogą wskazywać na nieefektywność lub braki kompetencyjne w procesie zarządzania incydentami. ProcessMind mapuje rzeczywisty przebieg obsługi incydentów w BMC Helix ITSM i wskazuje działania lub etapy, na których sprawy utknęły. Ujawnia ukryte wąskie gardła i odstępstwa od optymalnej ścieżki, dostarczając danych, które pomagają przyspieszyć rozwiązanie i szybciej przywrócić działanie usług.

Incydenty są często błędnie kategoryzowane lub otrzymują niewłaściwy priorytet. W efekcie trafiają do nieodpowiednich zespołów wsparcia, a właściwe zespoły zajmują się nimi z opóźnieniem. Ten błąd na początku może wpłynąć na cały proces zarządzania incydentami, wydłużając czas rozwiązania i frustrując zarówno użytkowników, jak i pracowników wsparcia. ProcessMind analizuje atrybuty incydentów, takie jak kategoria, priorytet i ważność, w zestawieniu z rzeczywistą ścieżką i czasem rozwiązania w BMC Helix ITSM. Wykrywa rozbieżności i powtarzające się błędy klasyfikacji, dzięki czemu można dopracować zasady kategoryzacji i poprawić jakość wstępnej obsługi incydentów.

Zespoły wsparcia poświęcają zbyt dużo czasu na ponowne rozwiązywanie podobnych problemów i wykonywanie zbędnych czynności. To marnuje cenne zasoby, zwiększa koszty operacyjne i odciąga agentów od bardziej złożonych lub krytycznych incydentów, obniżając skuteczność zarządzania incydentami. ProcessMind przedstawia pełny przebieg obsługi incydentów, ujawniając powtarzające się pętle, zbędne działania i typowe przypadki ponownego wykonywania pracy w BMC Helix ITSM. Znając te nieefektywności, organizacje mogą usprawnić procesy, zautomatyzować powtarzalne zadania i wdrożyć trwalsze rozwiązania.

Osoby obsługujące incydenty często pomijają ustalone procedury lub stosują niezatwierdzone skróty. Prowadzi to do niespójności, ryzyka naruszenia zgodności i nieprzewidywalnych wyników. Nieprzestrzeganie procedur może obniżać jakość usług, utrudniać audyty i podważać niezawodność całego procesu zarządzania incydentami. ProcessMind pokazuje obiektywny obraz ścieżek obsługi incydentów w BMC Helix ITSM i porównuje je z przyjętym standardem. Wskazuje wszystkie odstępstwa oraz miejsca, czas i osoby związane z niestandardowymi działaniami. Dzięki temu można zaplanować ukierunkowane szkolenia i usprawnić nadzór.

Incydenty często zatrzymują się na etapie diagnozy lub dochodzenia z powodu ograniczonych zasobów, braków kompetencyjnych albo złożonych problemów technicznych. Takie przestoje bezpośrednio wydłużają czas rozwiązania i zwiększają MTTR, przez co usługi pozostają niedostępne dłużej. ProcessMind analizuje czas trwania działań „Rozpoczęcie diagnozy” i „Prowadzenie dochodzenia” w BMC Helix ITSM. Wskazuje zespoły, agentów lub kategorie incydentów, których dotyczą opóźnienia, co pozwala lepiej przydzielić zasoby, zaplanować szkolenia lub zmienić proces.

Obejścia problemu są wdrażane z opóźnieniem lub nie przynoszą efektu, przez co użytkownicy odczuwają skutki incydentu aż do wprowadzenia trwałego rozwiązania. Źle zarządzany etap wdrażania obejścia może zwiększać frustrację użytkowników i wydłużać odczuwany czas przestoju, ograniczając skuteczność zarządzania incydentami. ProcessMind śledzi przebieg działania „Wdrożenie obejścia problemu” w BMC Helix ITSM oraz jego wpływ na status i czas rozwiązania incydentu. Pomaga ustalić, czy obejścia są regularnie wdrażane z opóźnieniem lub nie zapewniają tymczasowej poprawy, wskazując obszary wymagające usprawnienia.

Po wdrożeniu rozwiązania uzyskanie potwierdzenia lub weryfikacji od użytkownika często trwa zbyt długo, co opóźnia zamknięcie incydentu. Czas oczekiwania wydłuża oficjalny cykl obsługi, sztucznie zawyża wskaźniki czasu rozwiązania i może powodować gromadzenie się zgłoszeń o statusie „rozwiązane, ale niezamknięte” w BMC Helix ITSM. ProcessMind analizuje odstępy między działaniami „Wysłanie powiadomienia do użytkownika”, „Otrzymanie potwierdzenia od użytkownika” oraz „Weryfikacja/zamknięcie incydentu”. Wykrywa schematy opóźnień, co pomaga usprawnić komunikację lub zautomatyzować przypomnienia i przyspieszyć końcowe etapy obsługi incydentu.

Wiele incydentów jest rozwiązywanych bez ustalenia lub udokumentowania jasnej przyczyny źródłowej, co prowadzi do powtarzania się podobnych problemów. Takie reaktywne podejście obciąża zespoły wsparcia kolejnymi incydentami i utrudnia proaktywne zarządzanie problemami oraz ciągłe doskonalenie usług. ProcessMind może zestawić kody rozwiązania i schematy nawrotów incydentów w BMC Helix ITSM z atrybutem „Kategoria przyczyny źródłowej”. Wskazuje przypadki, w których incydenty rozwiązano bez właściwej analizy przyczyny źródłowej, oraz powracające incydenty z tak samo ogólnym opisem rozwiązania. Może to wskazywać na potrzebę lepszej integracji z zarządzaniem problemami.

Znaczna część incydentów to ponowne wystąpienia problemów, które wcześniej uznano za rozwiązane. Wskazuje to, że ich przyczyny nie zostały skutecznie usunięte. Obciąża to zasoby wsparcia i frustruje użytkowników, którzy wielokrotnie doświadczają przerw w działaniu usług z tego samego powodu. ProcessMind łączy identyfikatory incydentów, aby wykrywać grupy identycznych lub bardzo podobnych spraw, a następnie analizuje ich pełny przebieg i sposób rozwiązania w BMC Helix ITSM. Wskazuje typy incydentów, które powracają najczęściej, i pomaga ustalić, na których etapach procesu brakuje trwałych rozwiązań.

Incydenty przekazane do wyspecjalizowanych zespołów często są obsługiwane z opóźnieniem lub wymagają dodatkowego doprecyzowania, co niweczy cel eskalacji. Może to wskazywać na problemy z wymianą informacji lub niejasny podział odpowiedzialności przy przekazywaniu spraw. ProcessMind analizuje czas i działania po przekazaniu incydentu do wyspecjalizowanego zespołu w BMC Helix ITSM. Wykrywa, czy takie przekazania regularnie wydłużają czas rozwiązania lub prowadzą do ponownego dochodzenia, co może świadczyć o nieefektywnej współpracy między zespołami.

Typowe cele

Określ, jak wygląda sukces

Częste przekazywanie incydentów między grupami wsparcia lub agentami znacznie wydłuża czas rozwiązania i zwiększa koszty operacyjne. Ograniczenie takich sytuacji pozwala szybciej kierować incydenty do właściwych zespołów, sprawniej je rozwiązywać i zwiększać satysfakcję użytkowników. ProcessMind przedstawia wszystkie pętle ponownych przypisań i wskazuje miejsca, w których incydenty utknęły lub zostały błędnie skierowane w BMC Helix ITSM. Analiza danych historycznych ujawnia nieefektywne przekazania, co pozwala wprowadzić ukierunkowane szkolenia lub zmiany w procesie i ograniczyć liczbę ponownych przypisań o 20–30%.

Regularne dotrzymywanie uzgodnionych poziomów usług ma zasadnicze znaczenie dla jakości usług i zaufania użytkowników. Osiągnięcie tego celu oznacza mniej naruszeń SLA, szybsze przywracanie krytycznych usług w uzgodnionym czasie i mniejszy wpływ incydentów na działalność firmy. ProcessMind wskazuje ścieżki i działania prowadzące do naruszeń SLA w procesie zarządzania incydentami oraz pokazuje, gdzie w workflow BMC Helix ITSM narastają opóźnienia. Ujawnia wąskie gardła i odstępstwa od wymogów, dzięki czemu zespoły mogą usprawnić procesy i poprawić zgodność z SLA o 15–25%.

Długi czas rozwiązywania incydentów bezpośrednio wpływa na ciągłość działania firmy i produktywność użytkowników. Osiągnięcie tego celu oznacza szybsze rozwiązywanie problemów, krótsze przestoje i sprawniejsze operacje IT, a w efekcie lepsze doświadczenia użytkowników i większą wydajność operacyjną. ProcessMind pokazuje pełny przebieg obsługi incydentów w BMC Helix ITSM i wskazuje najdłuższe ścieżki oraz działania powodujące opóźnienia. Dzięki identyfikacji czasochłonnych etapów organizacje mogą usprawnić workflow, zautomatyzować rutynowe zadania i skrócić średni czas rozwiązania o 10–20%.

Błędna kategoryzacja incydentów prowadzi do kierowania ich do niewłaściwych zespołów, opóźnień w rozwiązaniu i nieefektywnego przydzielania zasobów. Prawidłowa klasyfikacja od początku pozwala szybciej przypisać incydent do właściwego zespołu i sprawniej go rozwiązać. ProcessMind analizuje początkową kategoryzację oraz późniejsze zmiany kategorii i ponowne przypisania w BMC Helix ITSM, ujawniając częste błędy i schematy błędnej klasyfikacji. Ta wiedza pozwala zaplanować ukierunkowane szkolenia lub poprawić zasady kategoryzacji, zwiększając dokładność klasyfikacji za pierwszym razem o 15–20%.

Częste powtarzanie pracy i niepotrzebne eskalacje wskazują na nieefektywność, marnowanie zasobów i frustrację użytkowników. Osiągnięcie tego celu oznacza skuteczniejsze rozwiązywanie incydentów za pierwszym razem, mniej powtórnych działań i lepszą jakość usług. ProcessMind mapuje pełny przebieg obsługi incydentów w BMC Helix ITSM i wskazuje przypadki, w których sprawy wracają do wcześniejszych etapów lub są eskalowane z powodu nieskutecznego rozwiązania. Ustalenie przyczyn, takich jak niewystarczająca diagnoza lub niepełna naprawa, pozwala ograniczyć powtarzanie pracy o 10–15%.

Niespójna obsługa incydentów prowadzi do nieprzewidywalnych wyników, ryzyka naruszenia zgodności i zróżnicowanej jakości usług. Stosowanie określonych dobrych praktyk przy każdym incydencie zwiększa przewidywalność i jakość oraz pomaga przestrzegać przepisów. ProcessMind przedstawia rzeczywiste warianty procesu w BMC Helix ITSM i porównuje je z zaprojektowanym standardem. Pozwala wykryć częste odstępstwa i działania niezgodne z wymaganiami, a następnie ukierunkować działania na stosowanie dobrych praktyk i zwiększyć zgodność procesu o 20–30%.

Opóźnienia na etapie diagnozy i dochodzenia znacznie wydłużają czas rozwiązywania incydentów, frustrują użytkowników i przedłużają zakłócenia w działaniu usług. Osiągnięcie tego celu oznacza szybsze ustalenie przyczyny źródłowej problemu, sprawniejsze rozwiązanie i płynniejszy przebieg operacji. ProcessMind dokładnie wskazuje działania i zasoby powodujące znaczne opóźnienia podczas diagnozy i dochodzenia w BMC Helix ITSM. Analiza tych wąskich gardeł pozwala lepiej przydzielić zasoby, zapewnić dodatkowe szkolenia lub uprościć czynności diagnostyczne, skracając czas spędzany na tych etapach o 15–20%.

Nieefektywne wdrażanie obejść może przedłużać skutki incydentu, a nawet powodować nowe problemy, niwecząc oczekiwane korzyści. Sprawne i skuteczne wdrożenie obejścia ogranicza zakłócenia do czasu przygotowania trwałego rozwiązania. ProcessMind analizuje czas i skuteczność wdrażania obejść w BMC Helix ITSM, wykrywając opóźnienia i niepowodzenia. Pomaga ustalić, dlaczego niektóre obejścia działają lepiej lub można je wdrożyć szybciej, co pozwala skrócić czas ich wdrażania o 10–15%.

Opóźnienia w uzyskaniu potwierdzenia od użytkownika lub weryfikacji rozwiązania niepotrzebnie utrzymują incydenty w stanie otwartym, wpływając na wskaźniki i przydział zasobów. Szybkie zamykanie incydentów po wdrożeniu rozwiązania zwiększa wydajność i poprawia dokładność danych. ProcessMind mapuje czas spędzony na etapach „Otrzymanie potwierdzenia od użytkownika” i „Weryfikacja incydentu” w BMC Helix ITSM, wskazując opóźnienia w komunikacji i działaniach następczych. Dzięki temu można wdrożyć automatyczne powiadomienia lub jaśniejsze procedury i skrócić czas zamknięcia o 10–20%.

Nieustalenie rzeczywistej przyczyny źródłowej incydentu prowadzi do powracających problemów, większego obciążenia pracą i utrzymujących się zakłóceń w działaniu usług. Dokładniejsza analiza pomaga zapobiegać podobnym incydentom i zwiększa długoterminową stabilność systemów. ProcessMind wskazuje incydenty, które często powracają lub omijają formalną analizę przyczyny źródłowej w BMC Helix ITSM. Analizując ścieżki rozwiązanych incydentów i zestawiając je z późniejszymi powiązanymi problemami, pomaga wykryć luki w zarządzaniu problemami i poprawić skuteczność analizy przyczyn źródłowych o 10–15%.

Duża liczba powracających incydentów wskazuje na nierozwiązane problemy systemowe, które prowadzą do ponownego wykonywania pracy i niezadowolenia użytkowników. Ograniczenie liczby takich przypadków uwalnia zasoby i zwiększa niezawodność usług. ProcessMind wykrywa schematy powracających incydentów, analizując ich cechy i ścieżki rozwiązania w BMC Helix ITSM. Pomaga wskazać incydenty, które są często ponownie otwierane lub przypominają wcześniej zamknięte sprawy, dzięki czemu organizacje mogą skupić się na proaktywnym zarządzaniu problemami i ograniczyć liczbę powracających incydentów o 10–20%.

Nieefektywne lub opóźnione przekazywanie spraw do wyspecjalizowanych zespołów wydłuża obsługę incydentów, opóźniając zaangażowanie ekspertów i rozwiązanie problemu. Sprawna eskalacja do właściwego zespołu pozwala wykorzystać specjalistyczną wiedzę i szybciej rozwiązywać problemy. ProcessMind mapuje przepływ incydentów między grupami wsparcia i wyspecjalizowanymi zespołami w BMC Helix ITSM, wskazując opóźnienia i błędne przypisania. Analiza miejsc przekazania spraw i typowego czasu ich obsługi pozwala dopracować zasady eskalacji i zwiększyć sprawność przekazywania o 15–25%.

6 kroków do usprawnienia zarządzania incydentami

1

Pobierz szablon

Co zrobić

Pobierz przygotowany szablon Excel do analizy danych dotyczących zarządzania incydentami. Dzięki niemu dane będą miały odpowiednią strukturę.

Dlaczego to ważne

Właściwy szablon ułatwia przygotowanie danych, ogranicza ryzyko błędów i pomaga uzyskać dokładne wyniki analizy zgłoszeń incydentów z BMC Helix ITSM.

Oczekiwany rezultat

Przygotowany szablon Excel do wprowadzenia danych dotyczących zarządzania incydentami w BMC Helix ITSM.

WASZE ODKRYCIA

Znajdź ukryte wąskie gardła w zarządzaniu incydentami

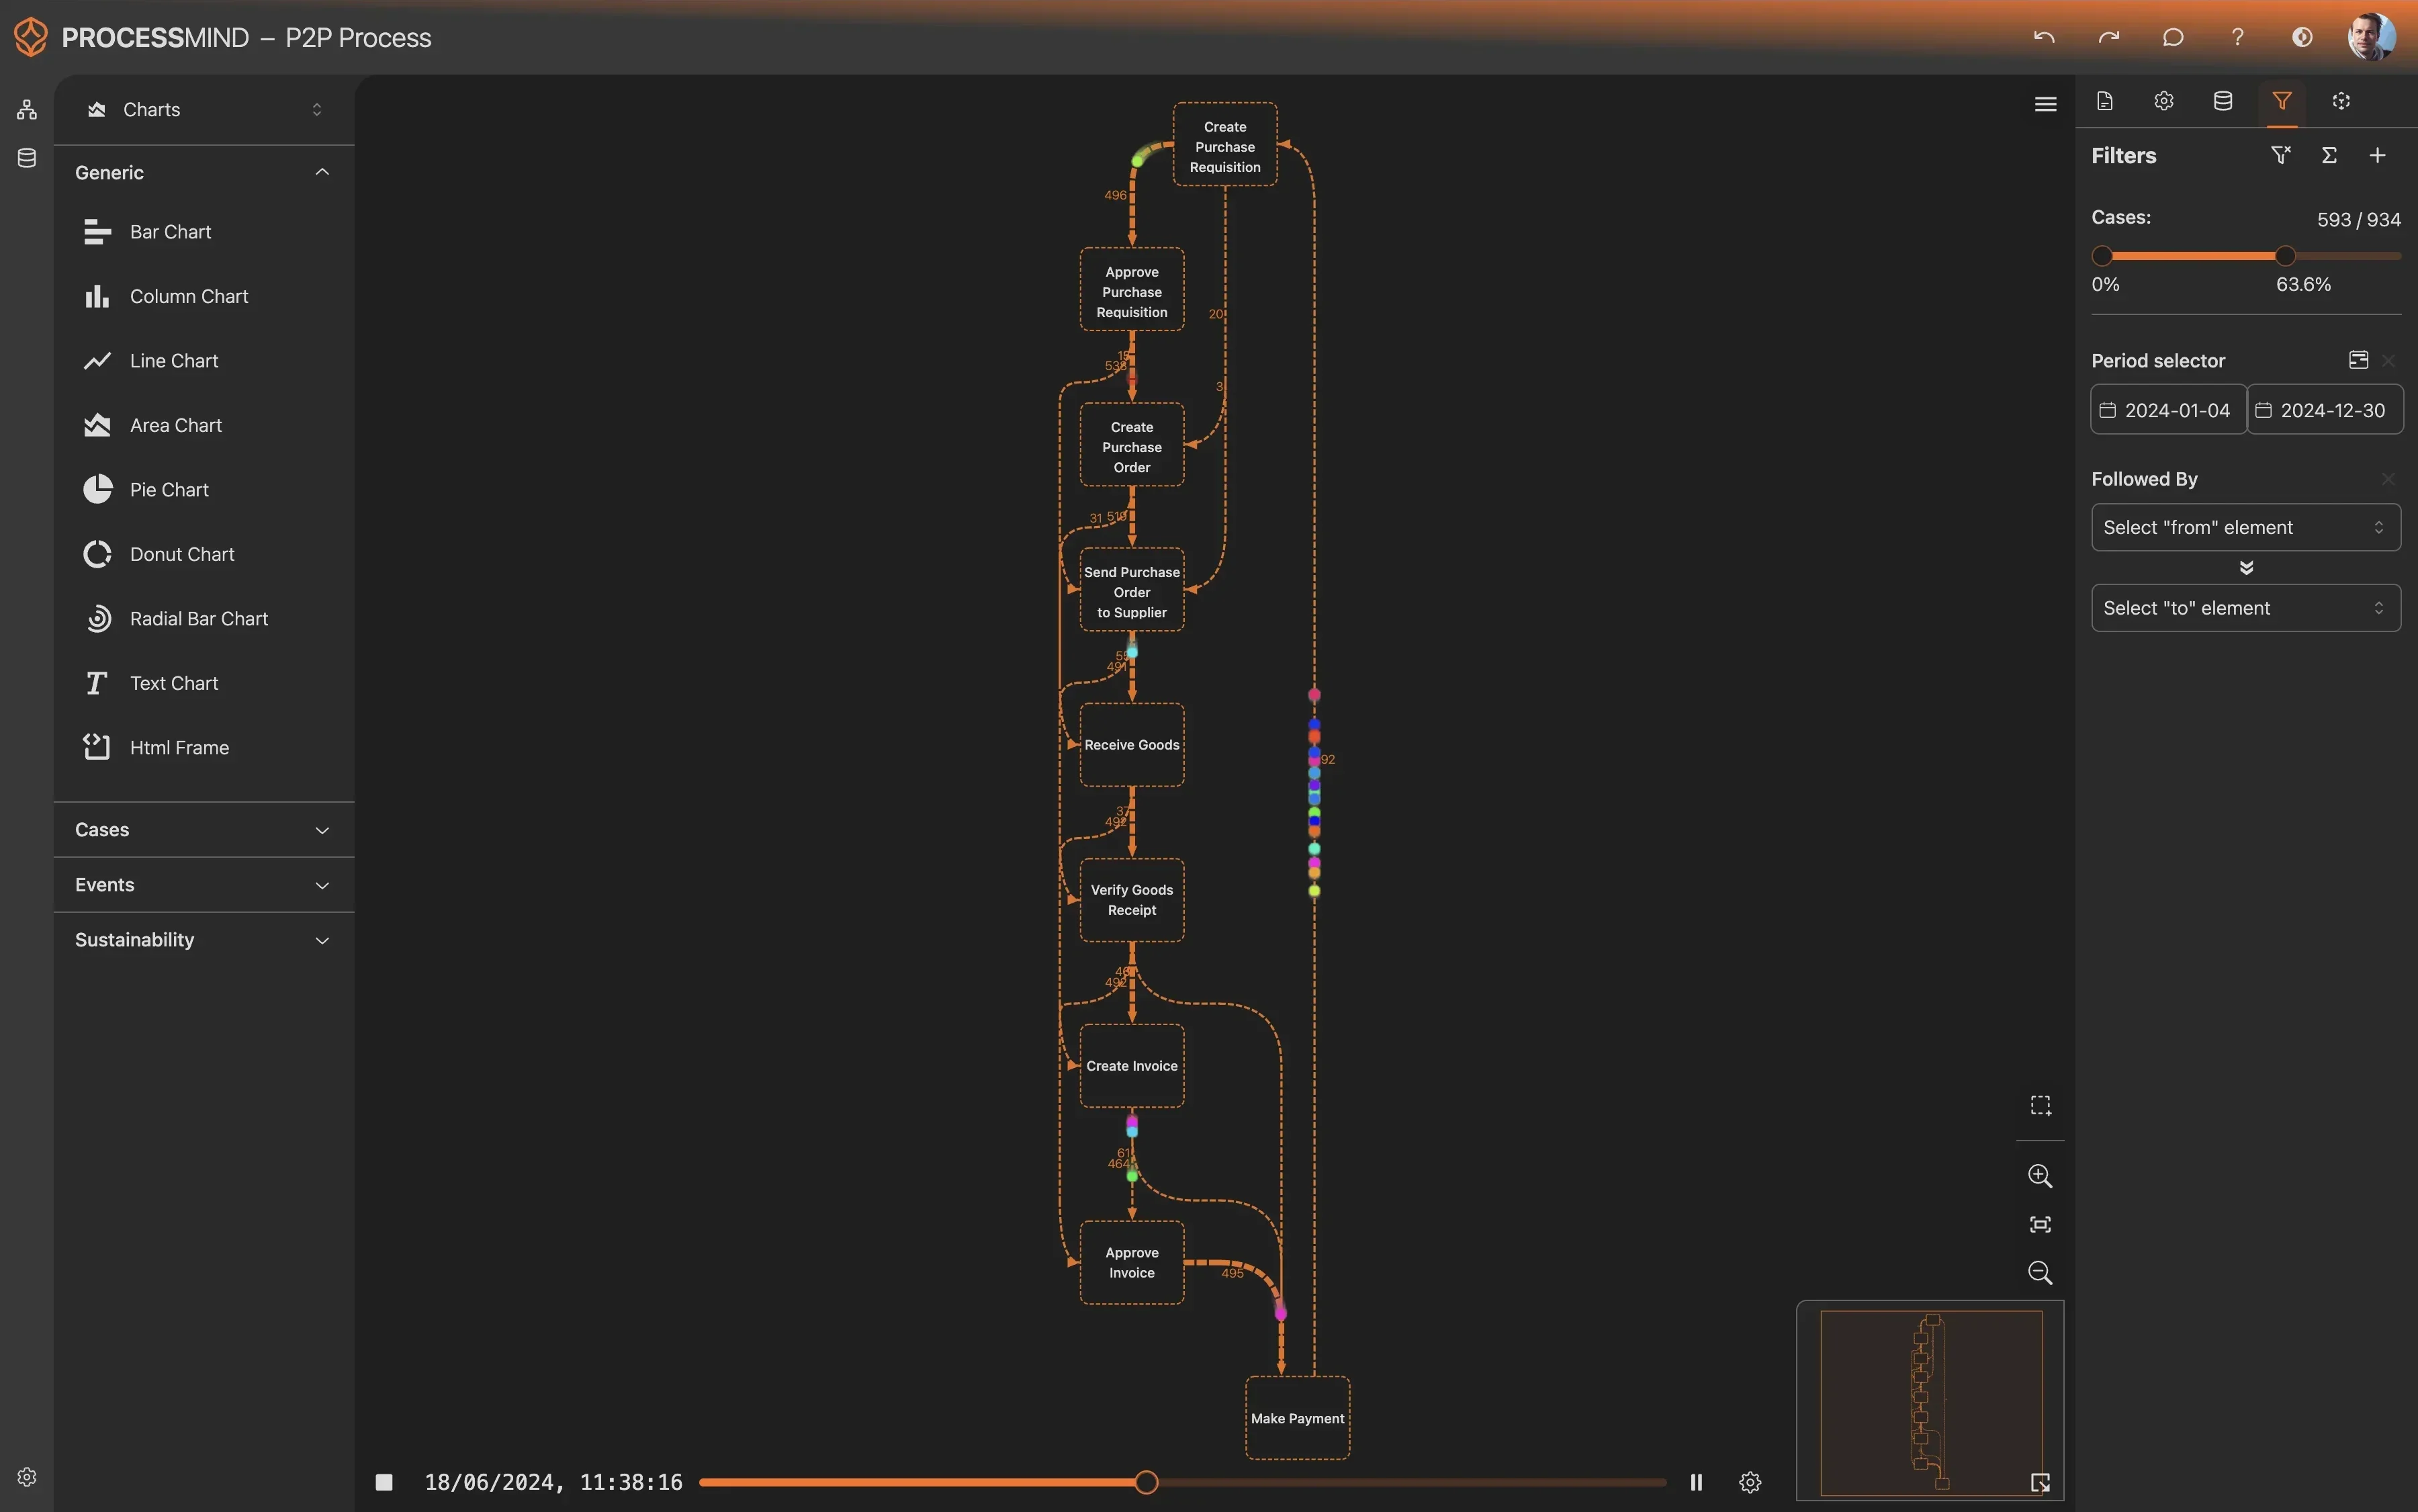
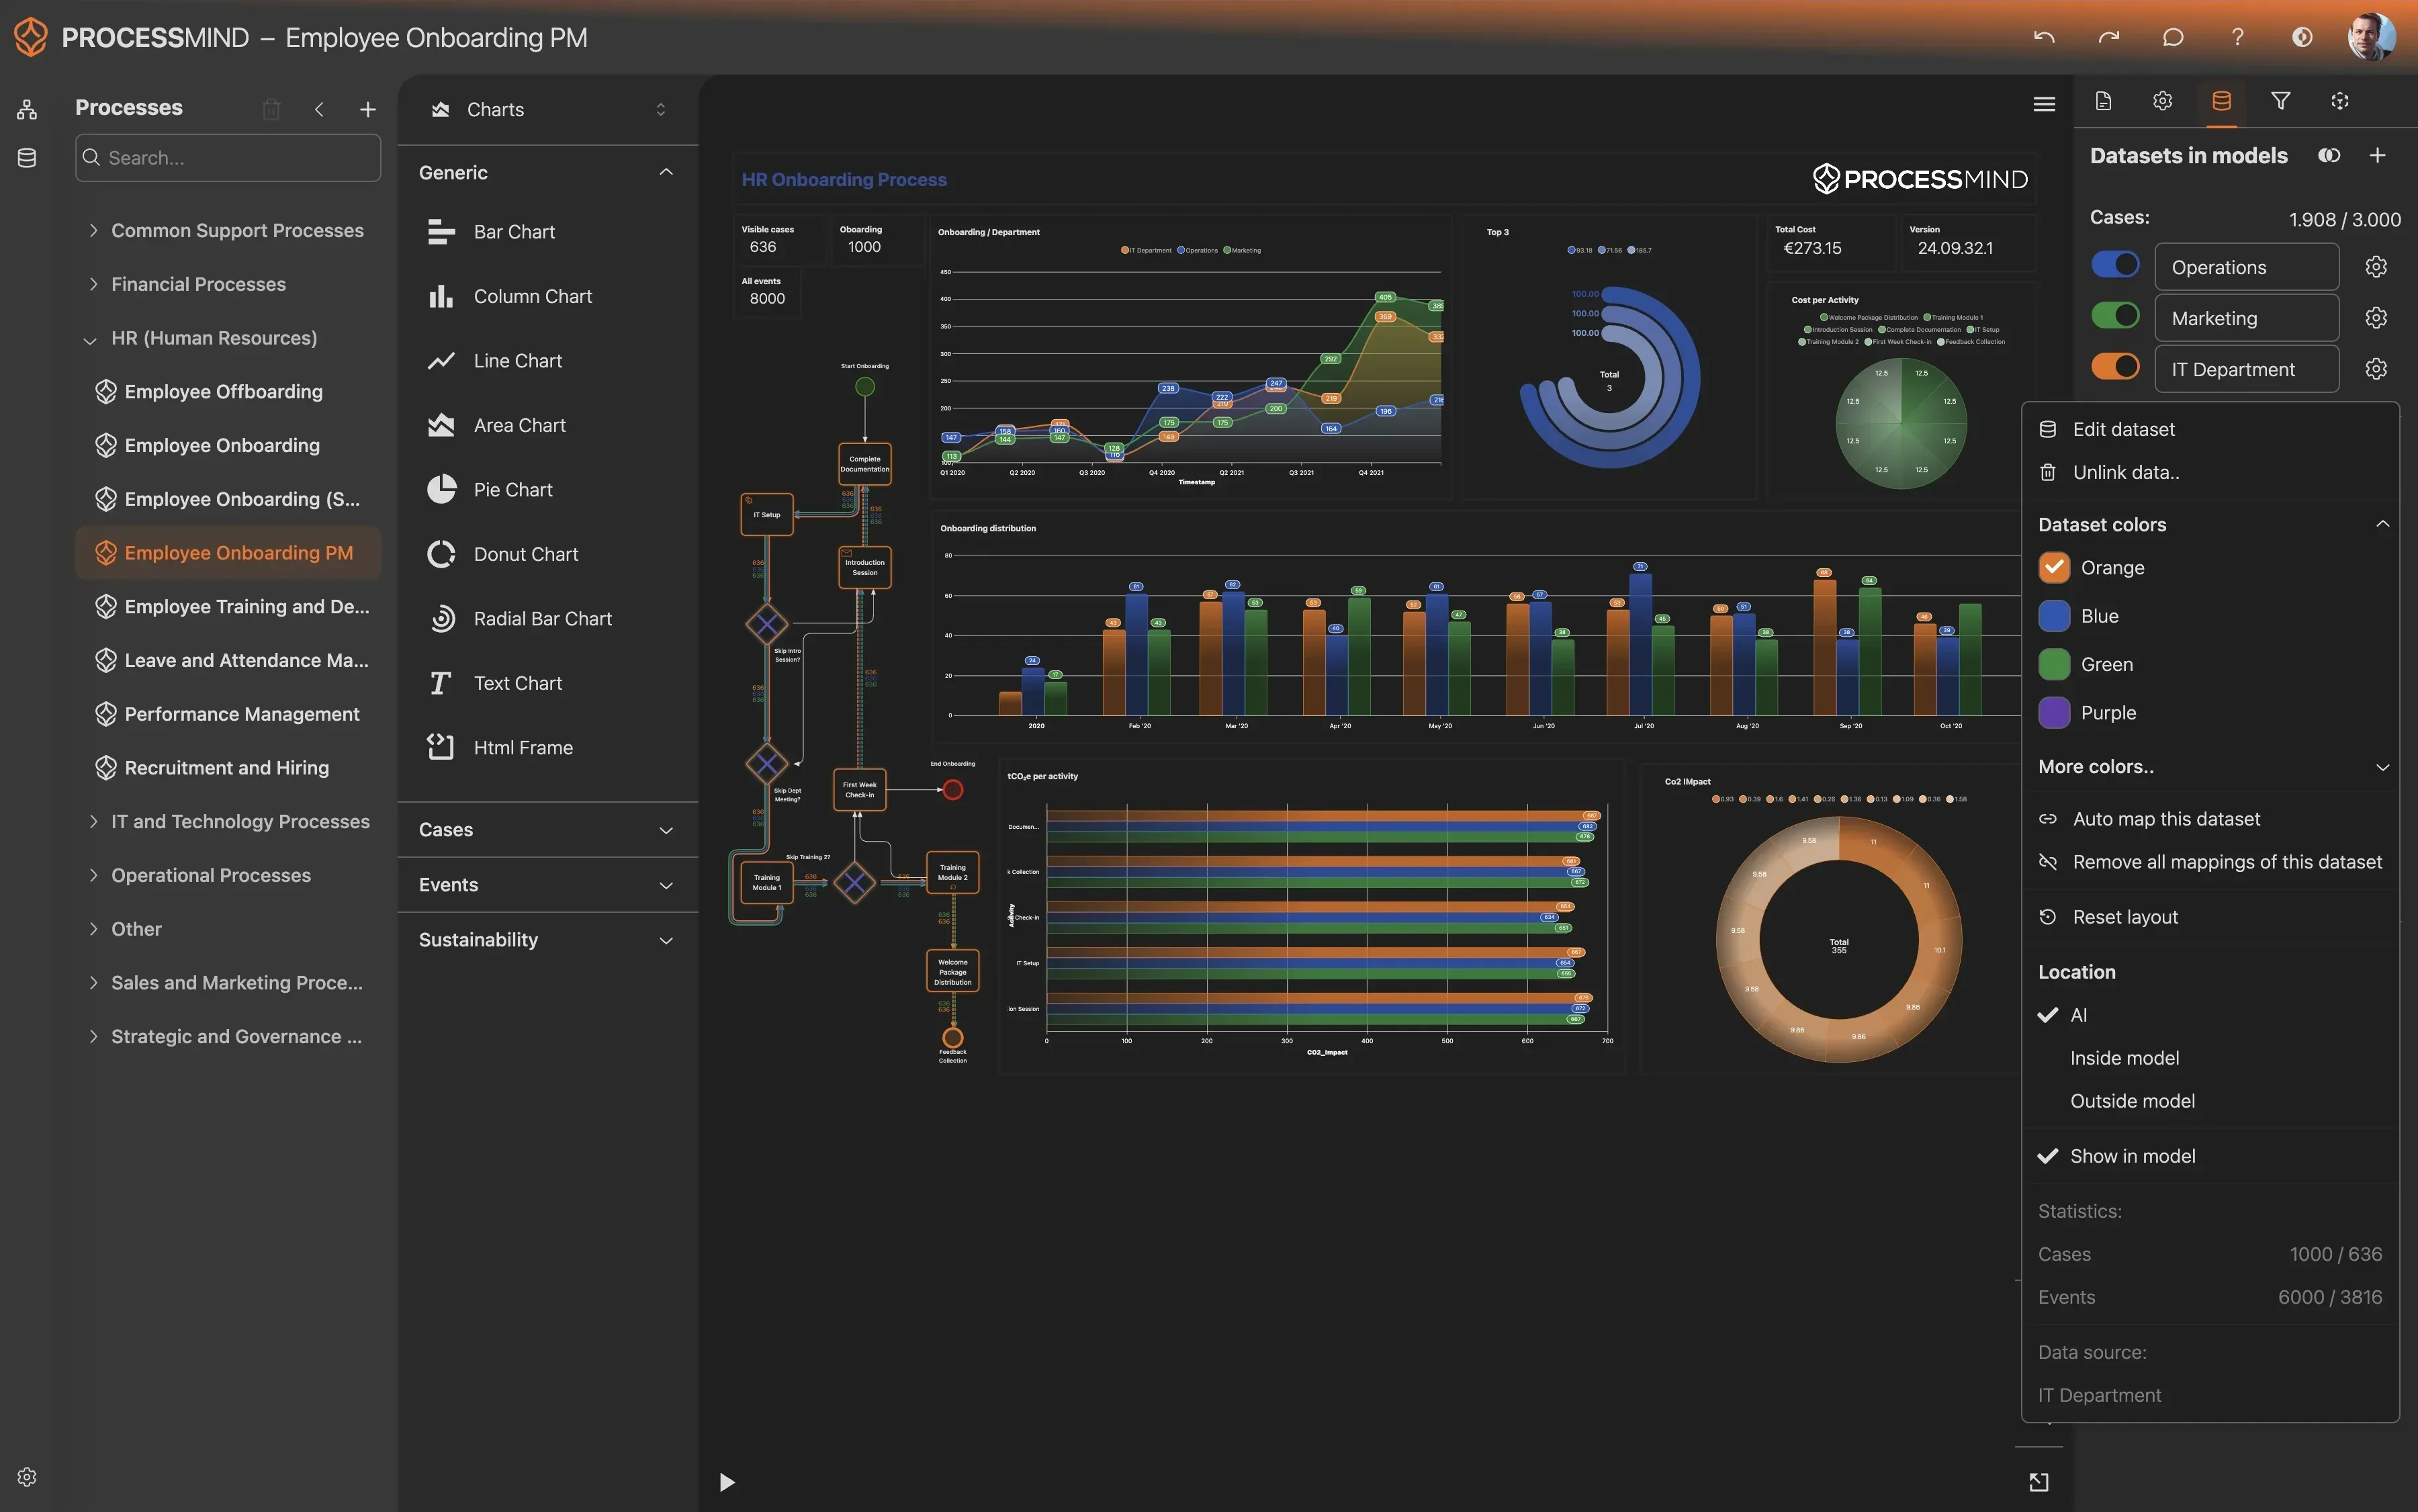
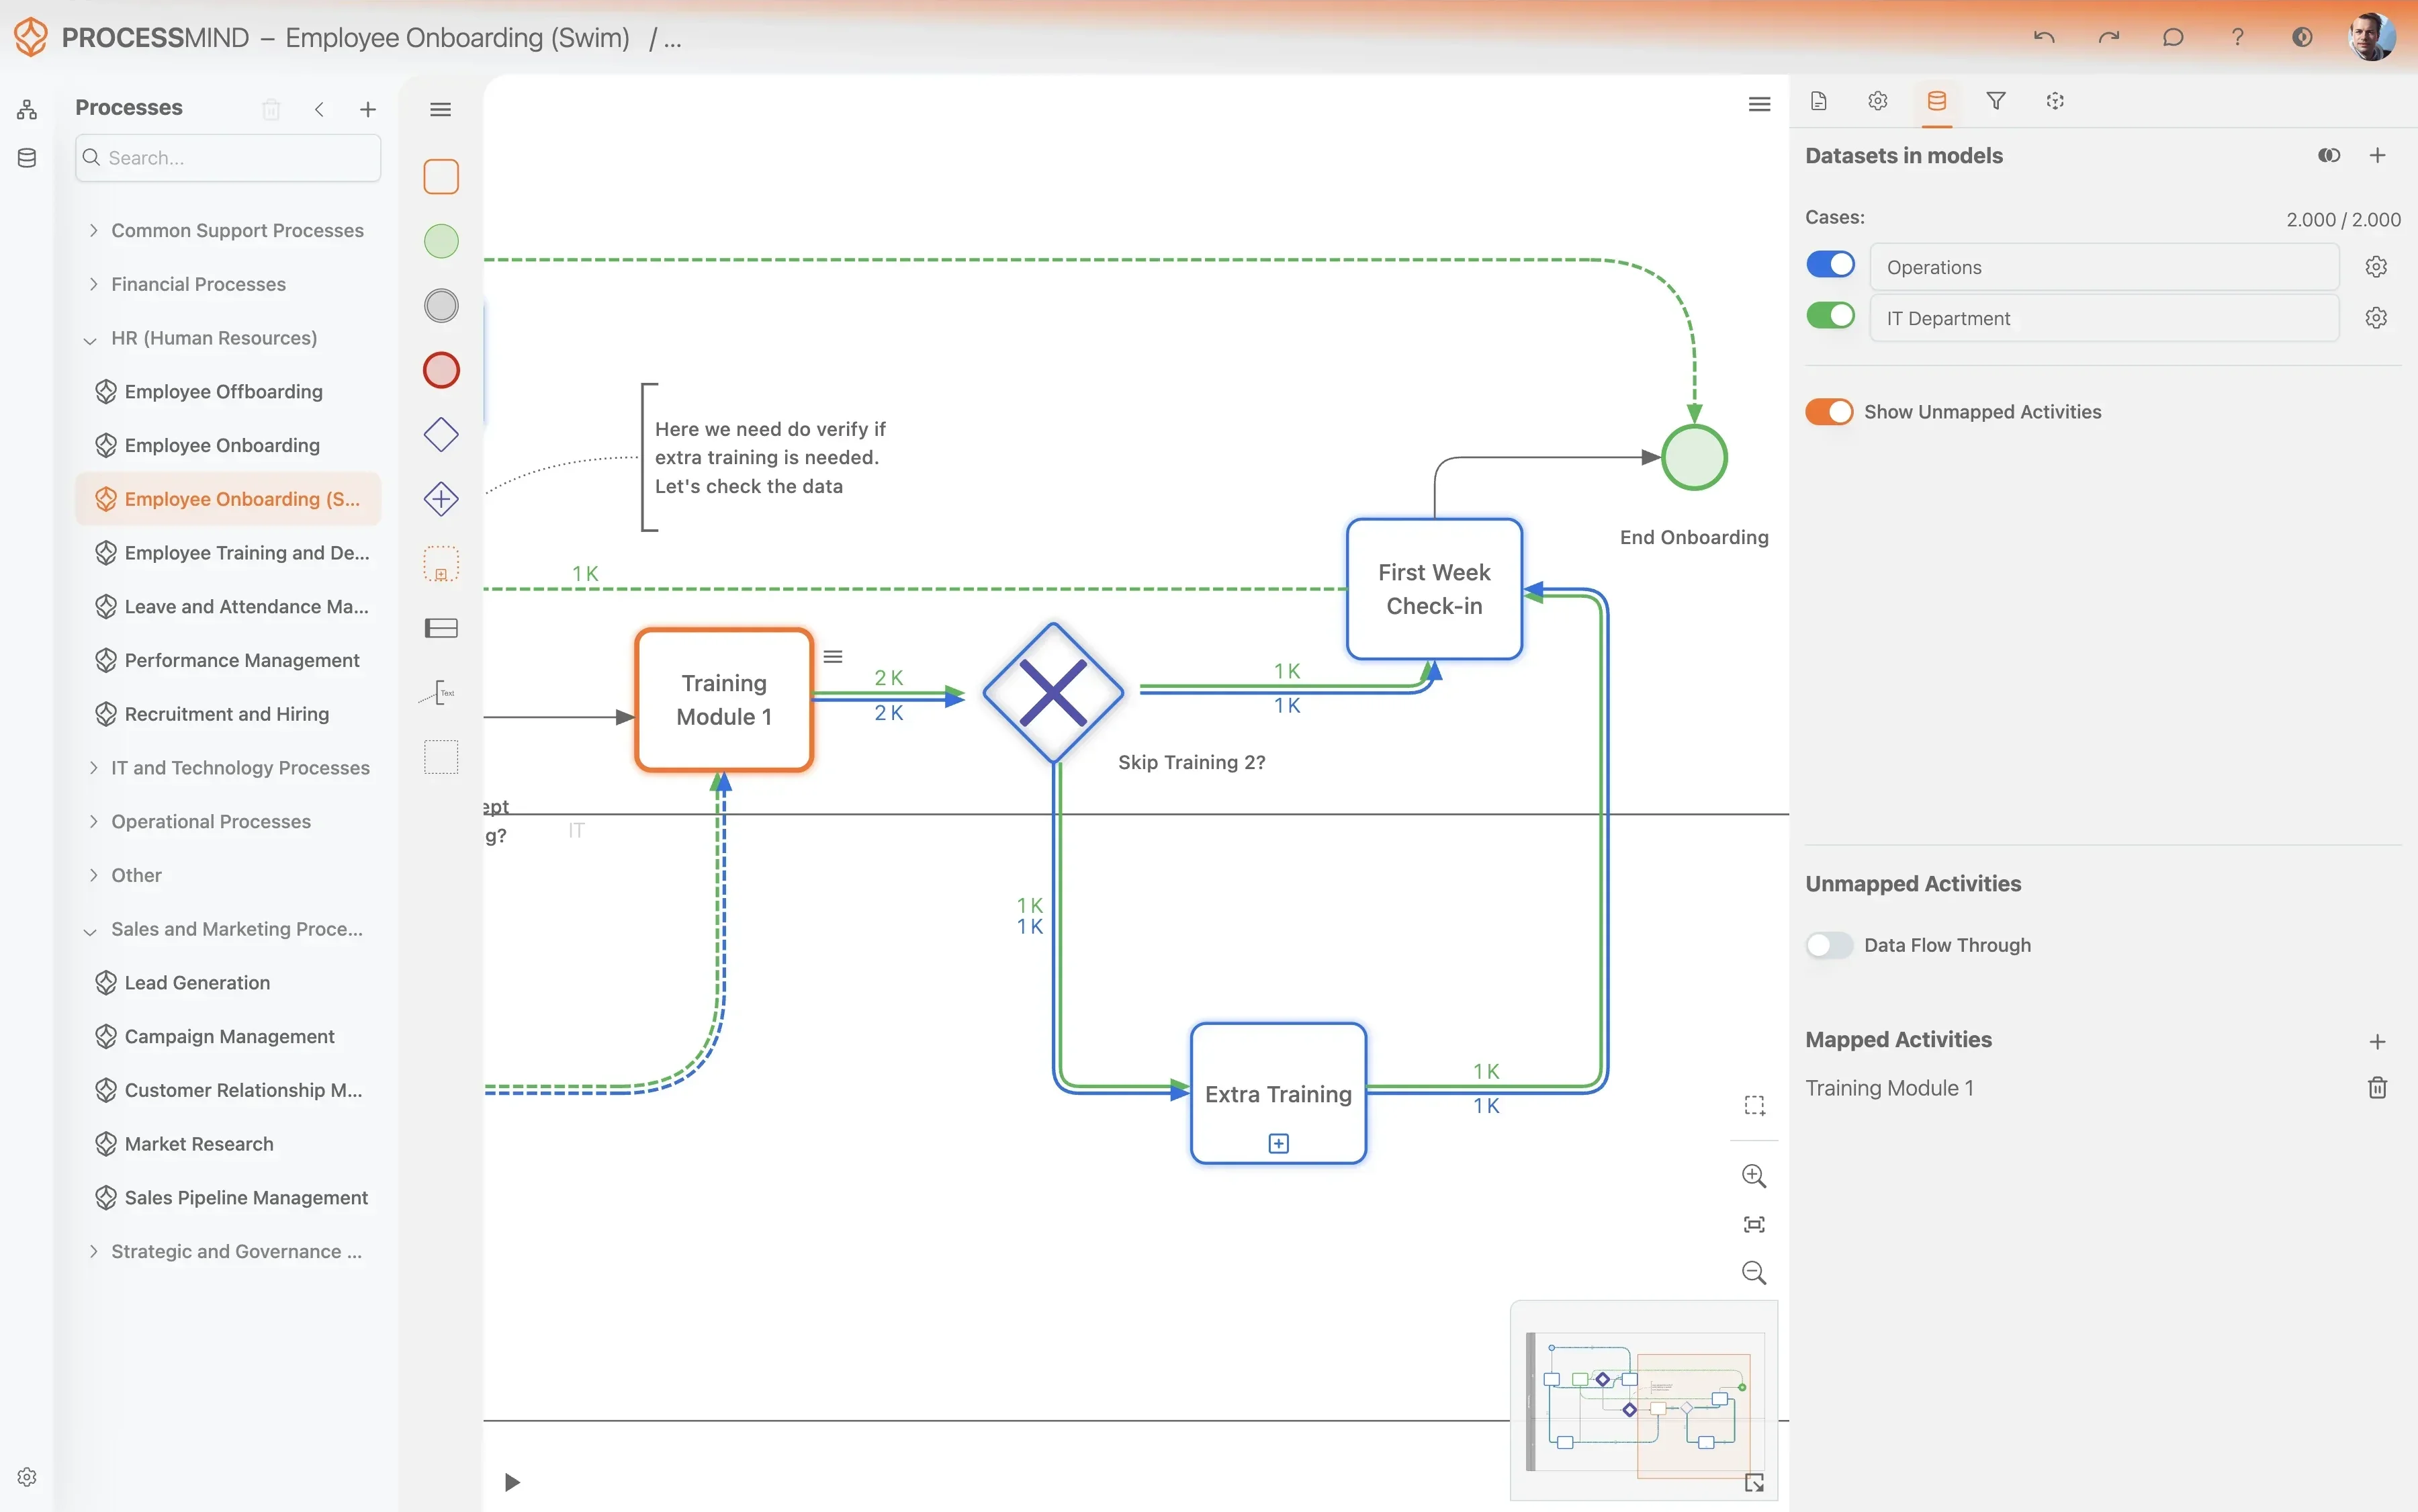
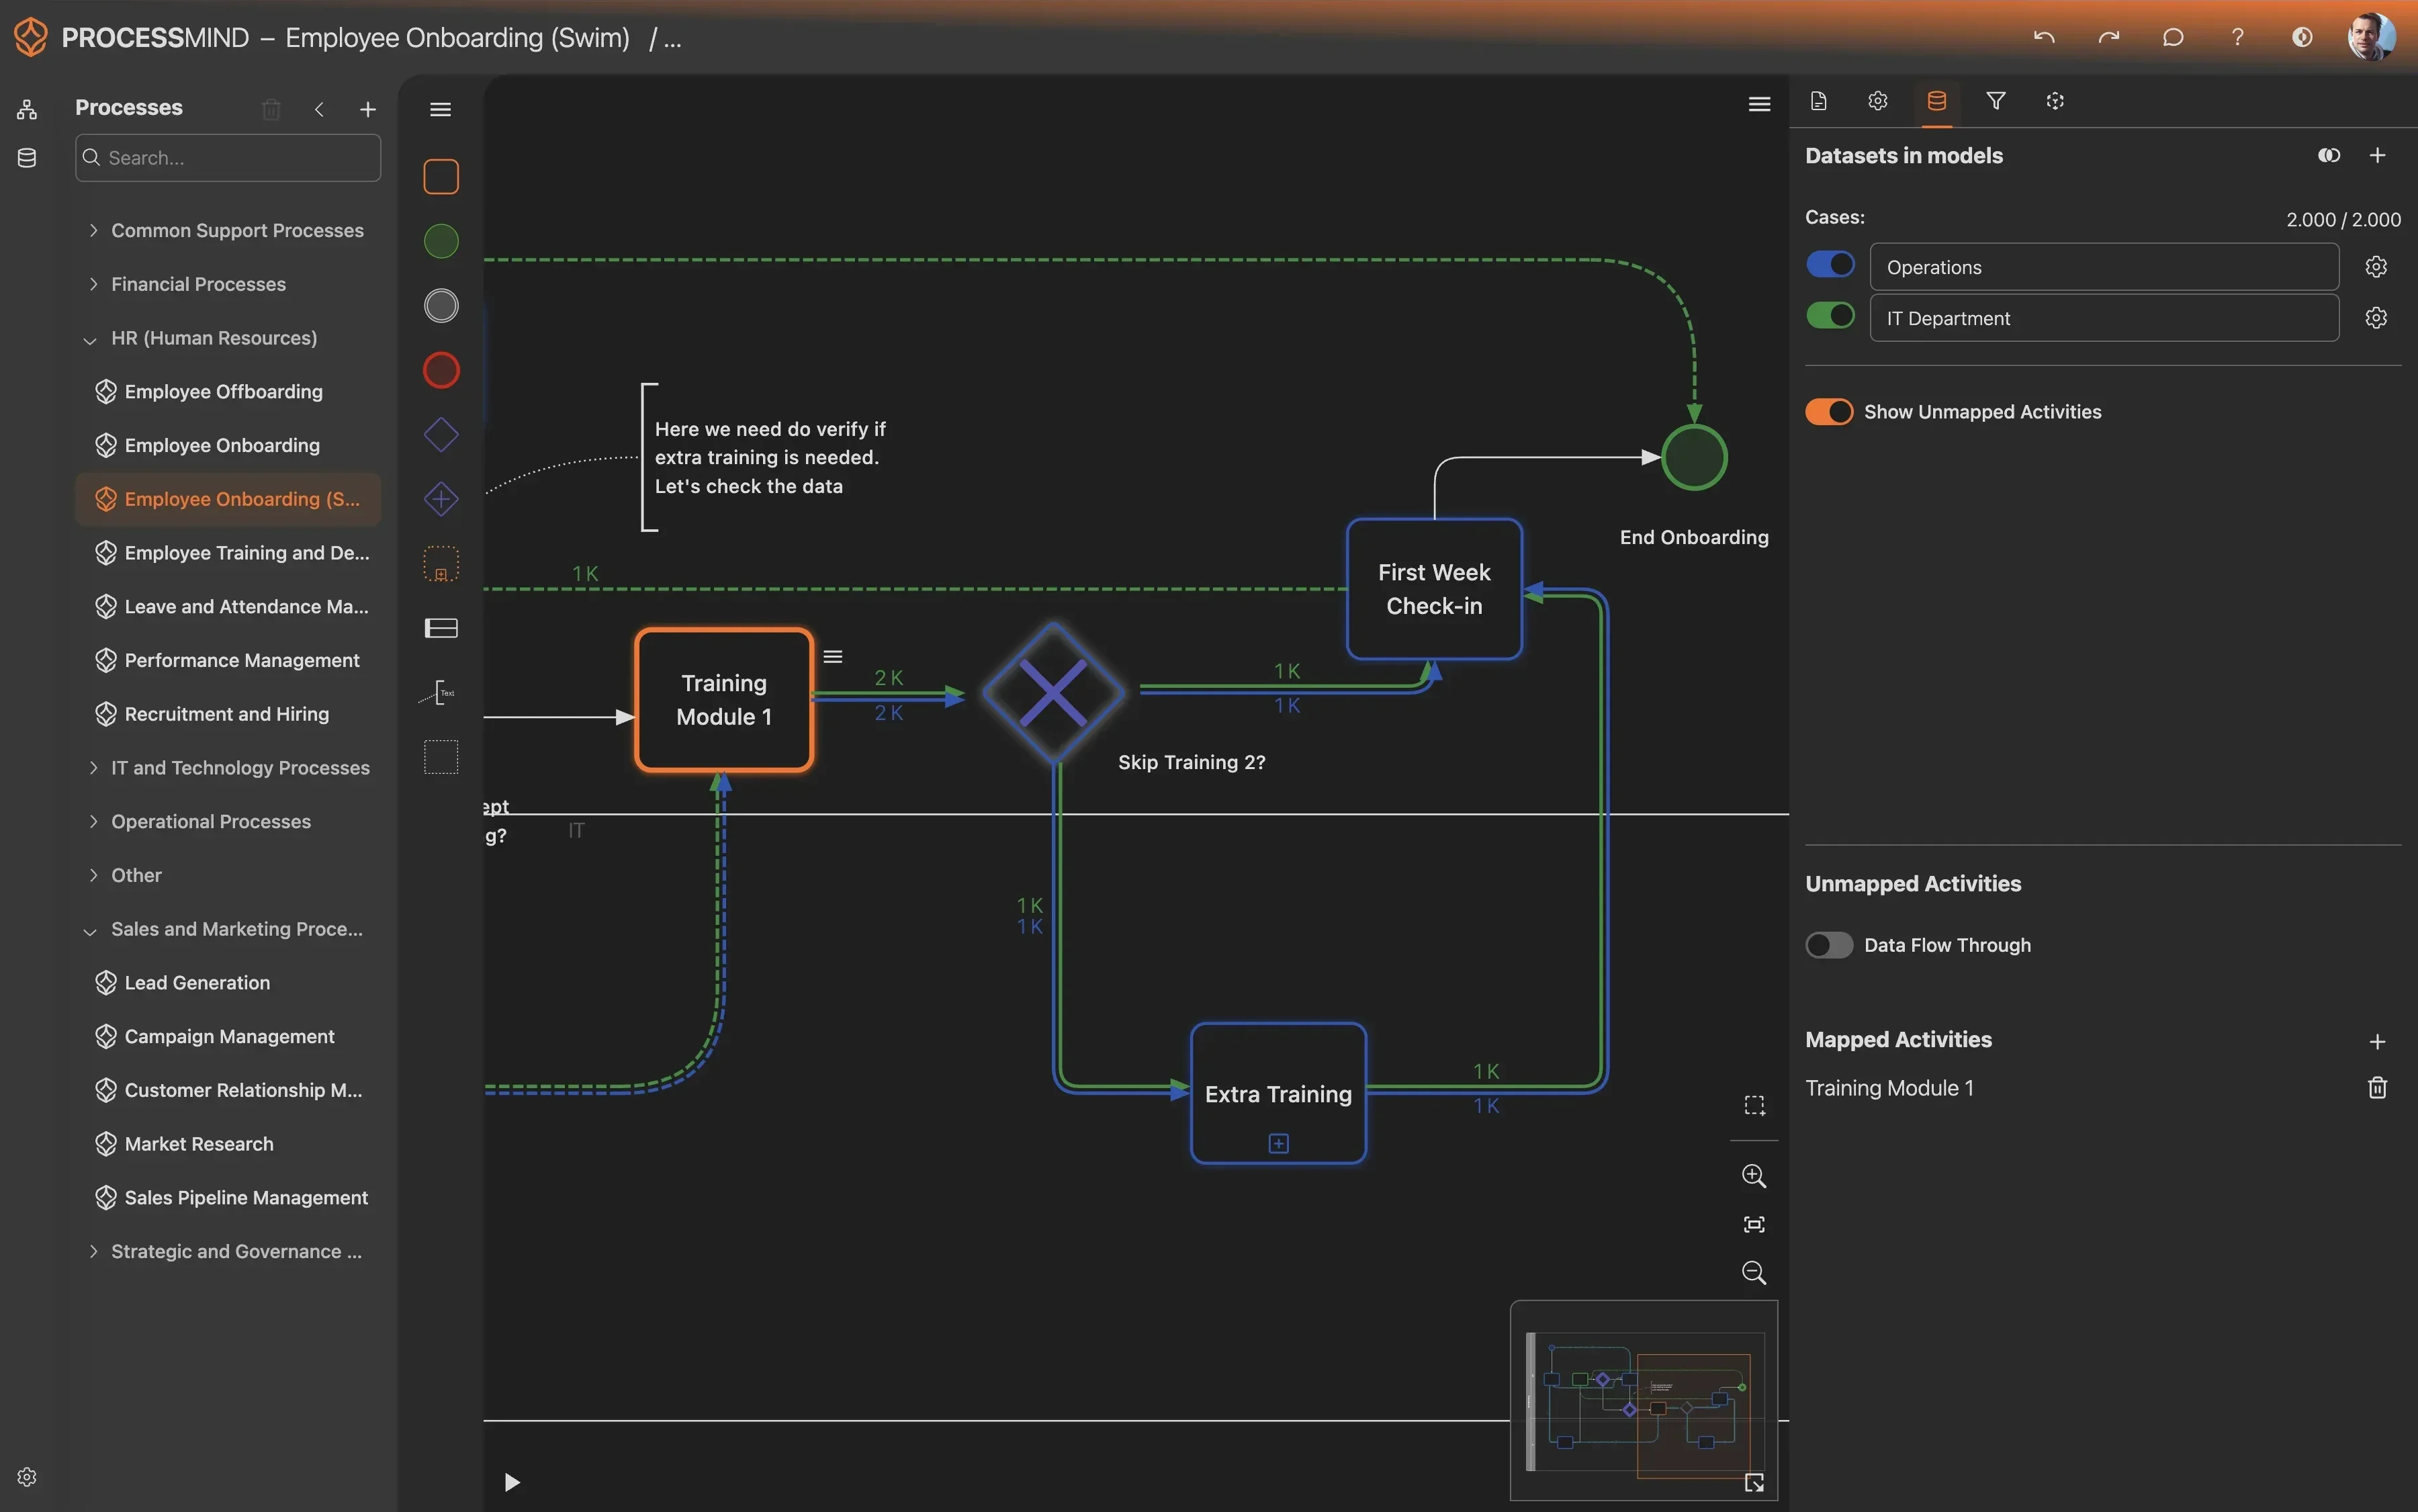
ProcessMind pokazuje rzeczywisty przebieg procesu zarządzania incydentami za pomocą czytelnych wizualizacji i analiz opartych na danych. Sprawdźcie, gdzie pojawiają się nieefektywności i co można usprawnić, aby szybciej rozwiązywać incydenty.
  • Zobrazuj rzeczywisty przebieg rozwiązywania incydentów
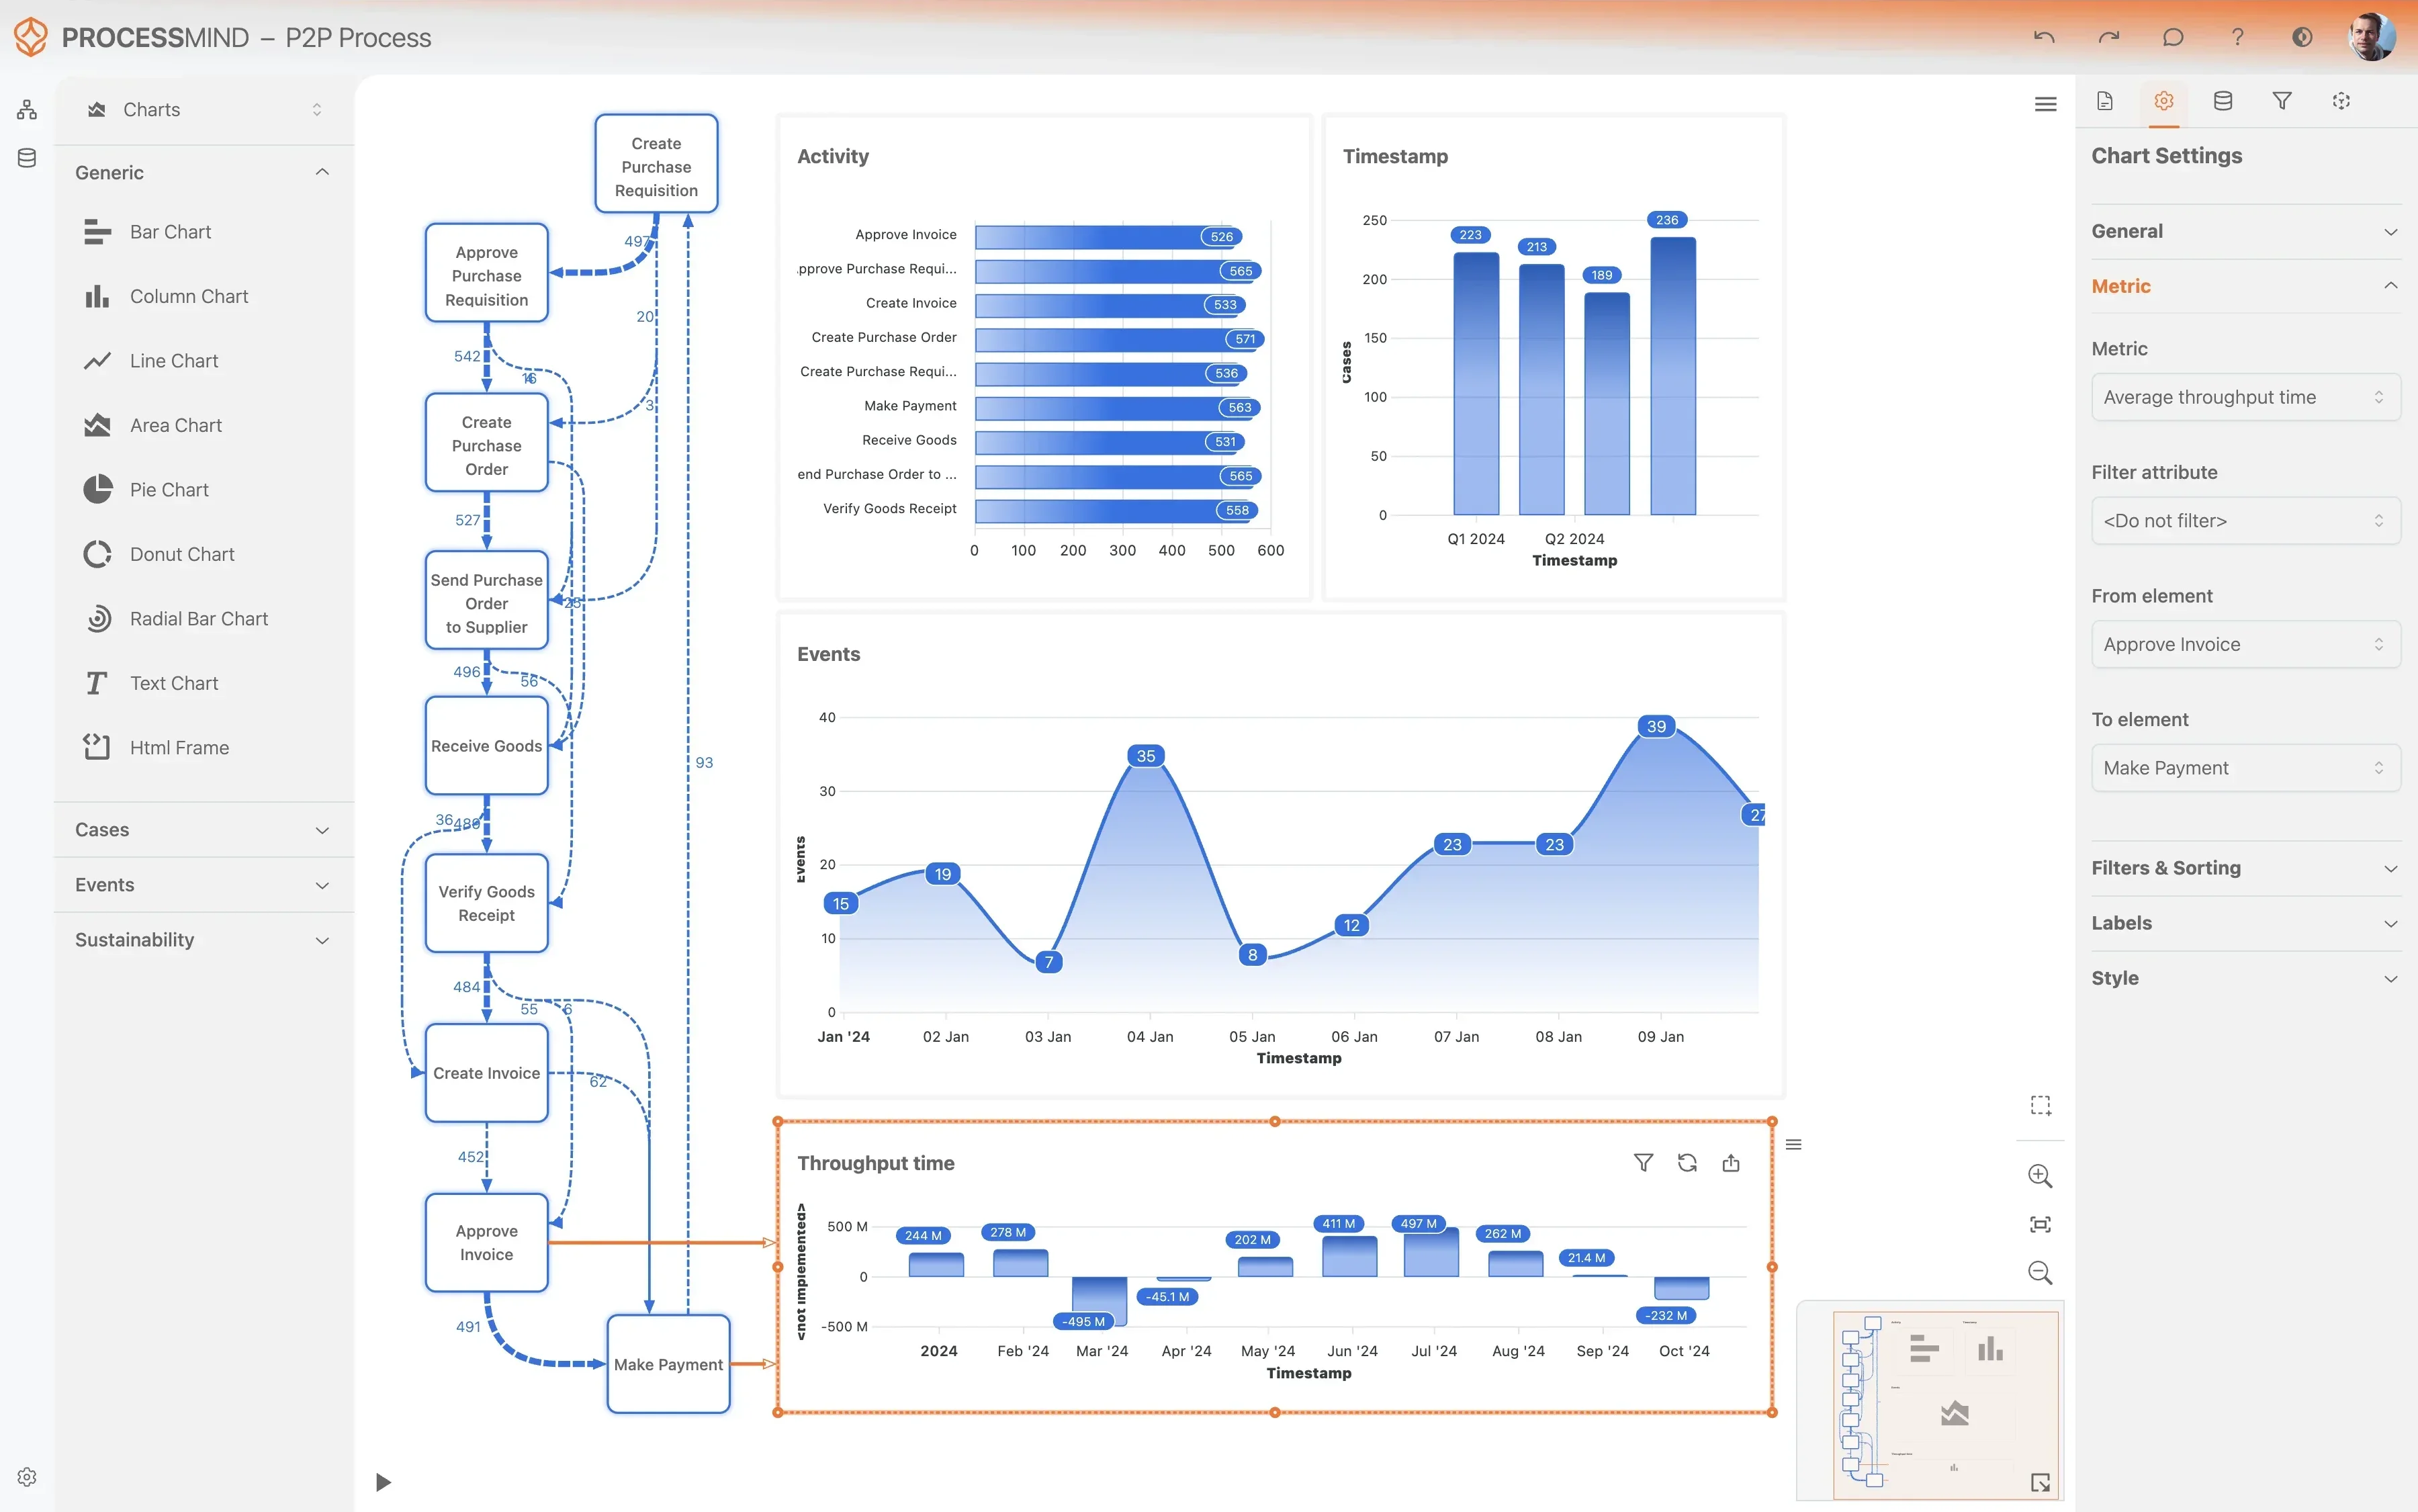
  • Wskaż dokładne miejsca powstawania wąskich gardeł i opóźnień w rozwiązywaniu incydentów
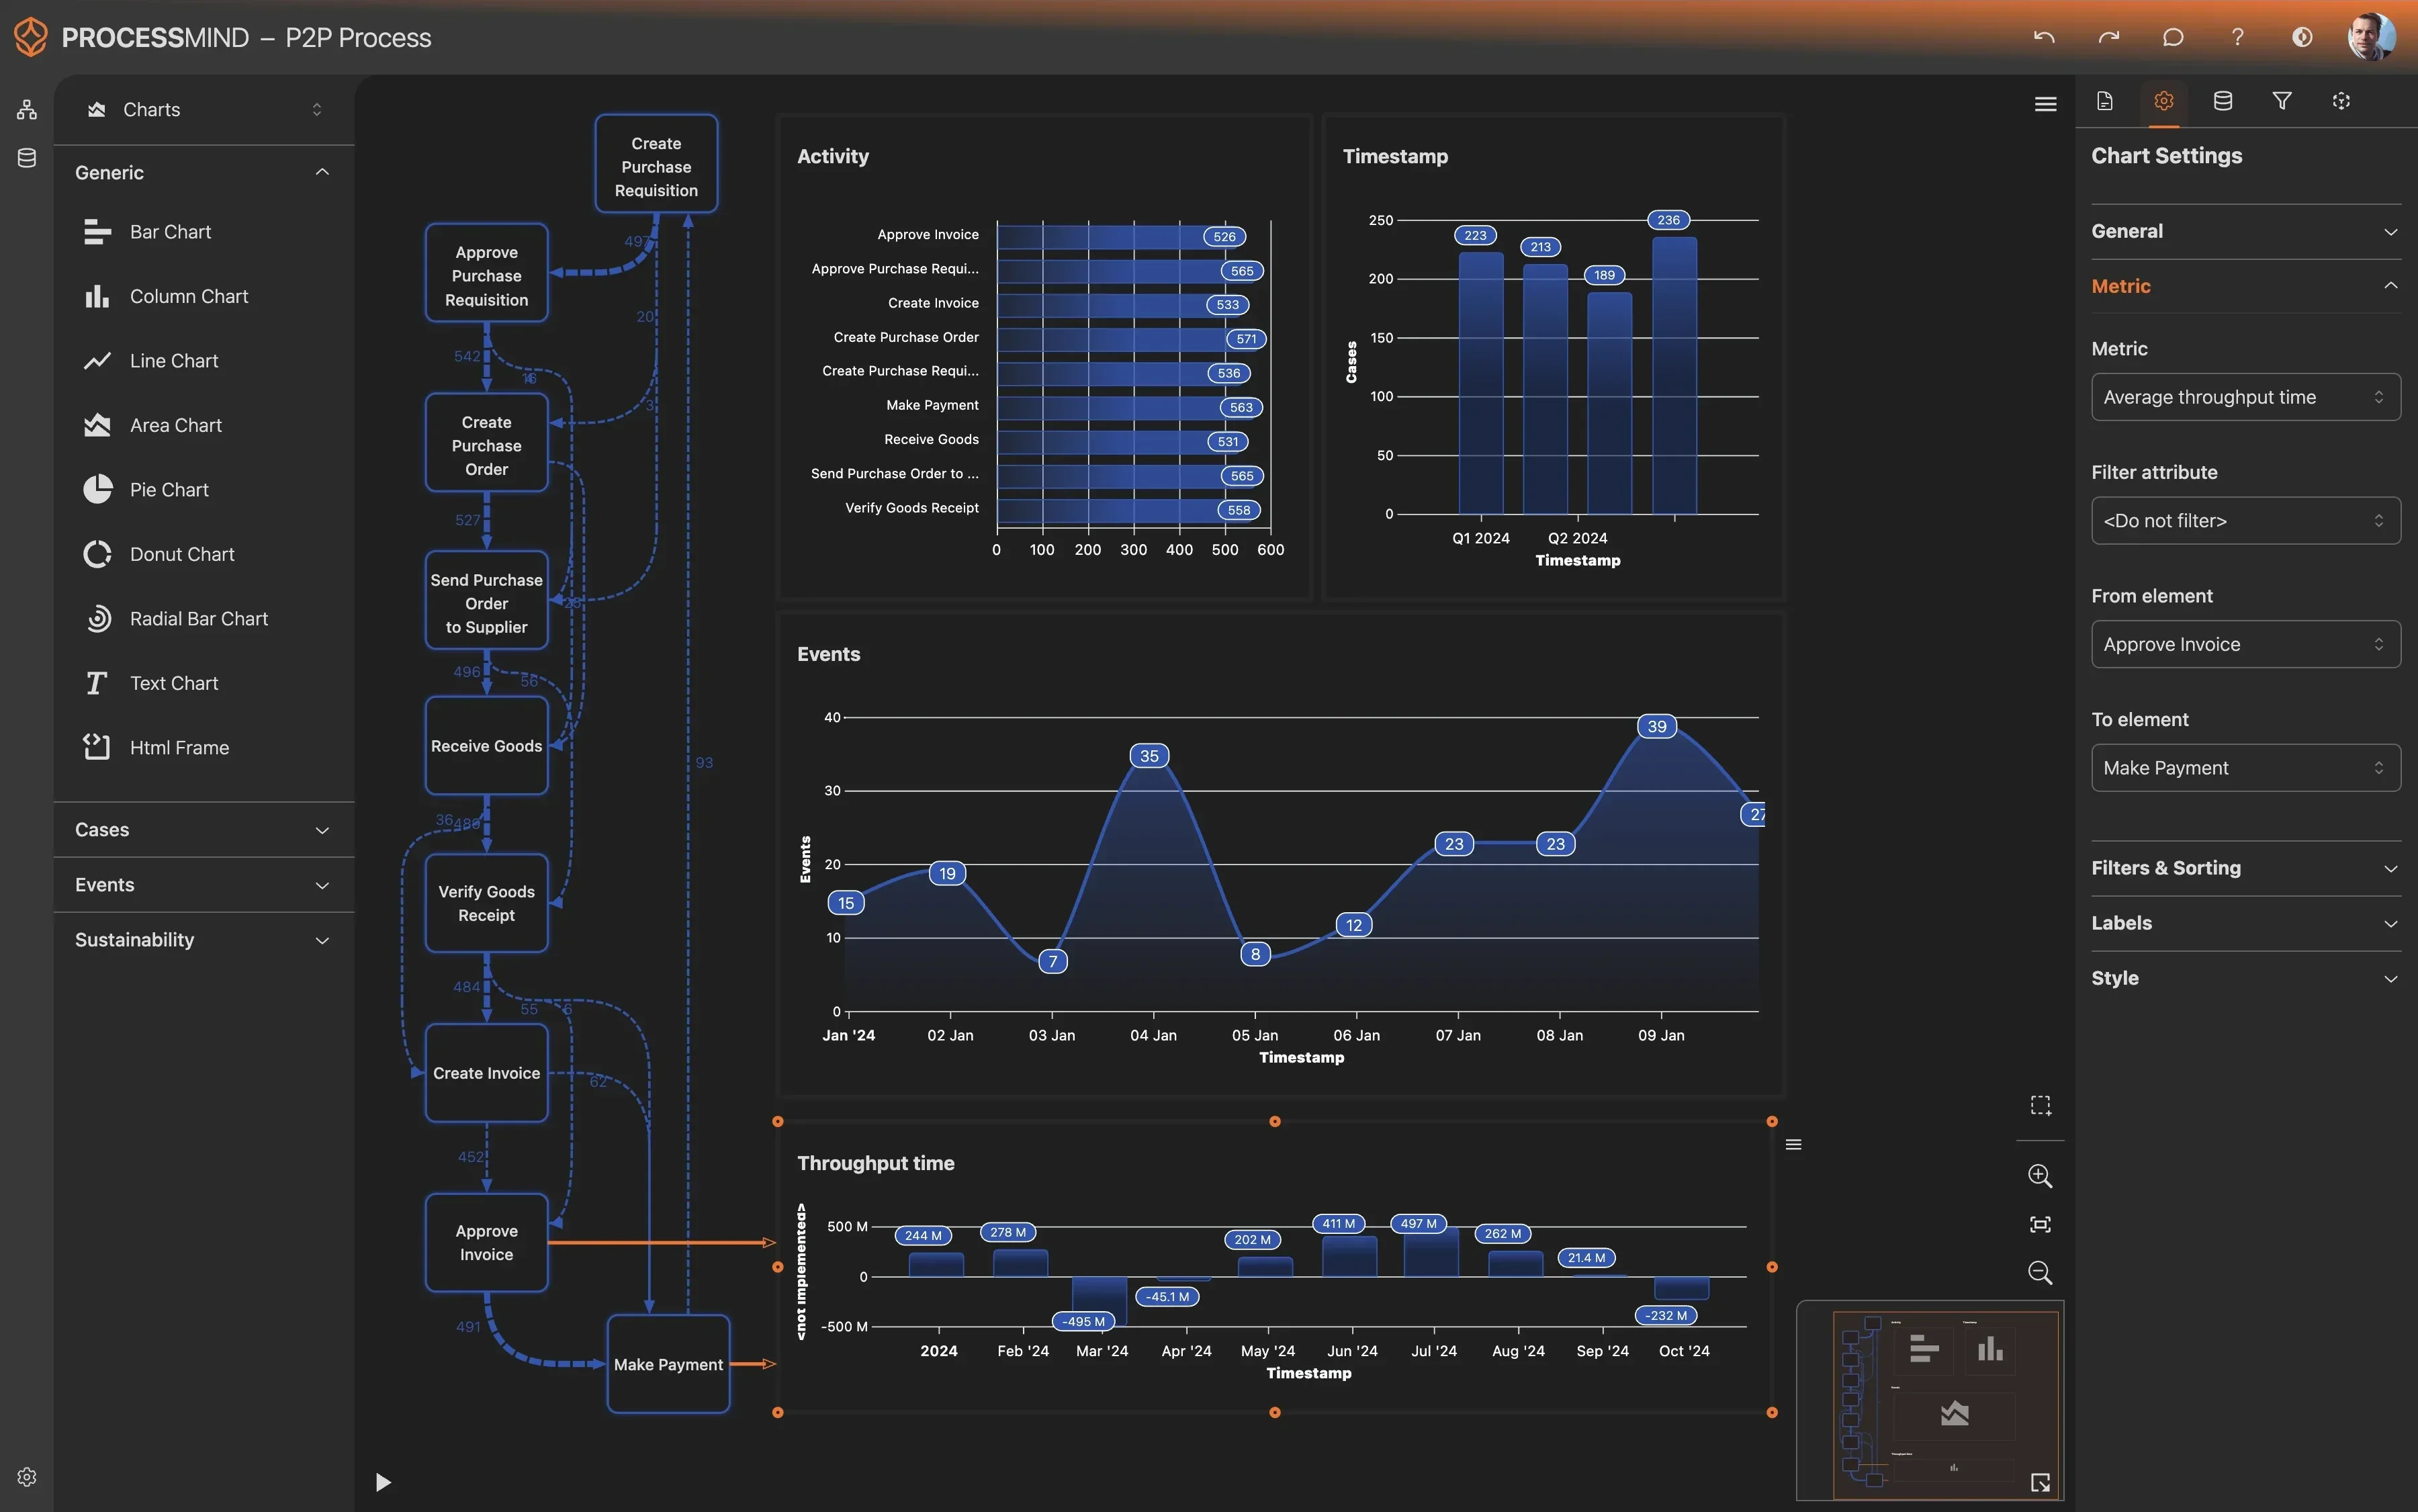
  • Ustal przyczyny źródłowe zakłóceń w świadczeniu usług
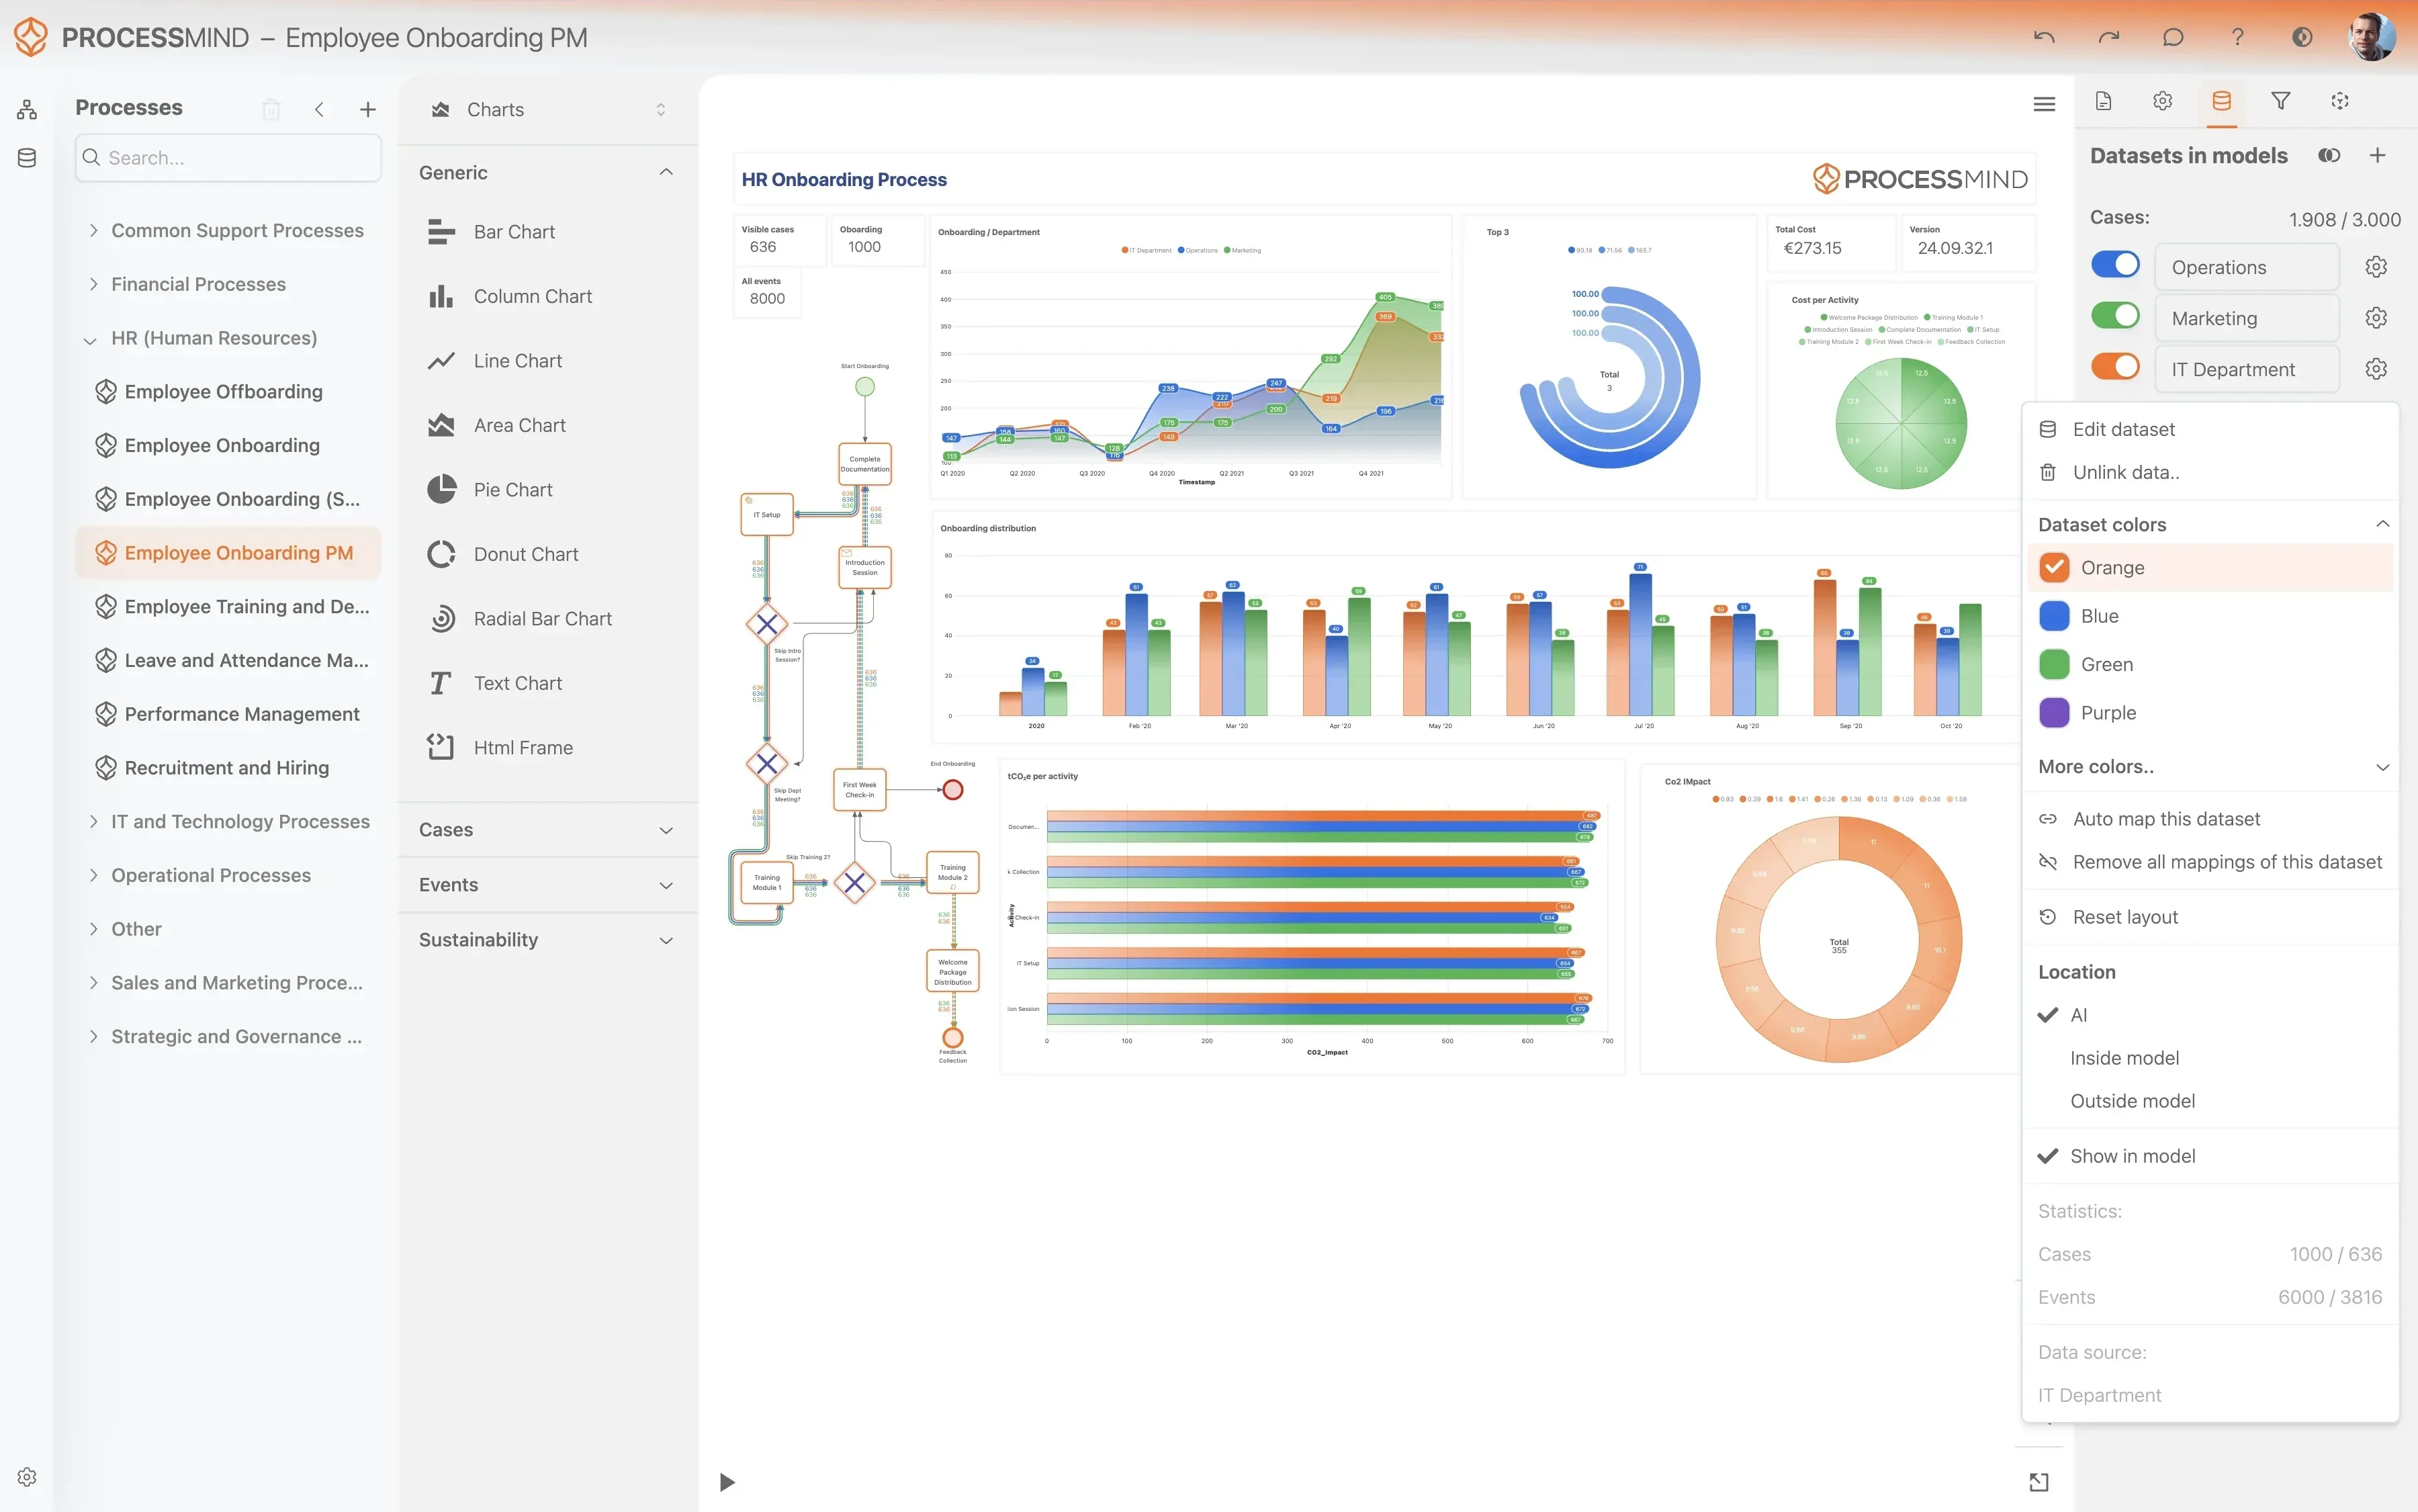
  • Lepiej przydzielaj zasoby, aby szybciej świadczyć usługi
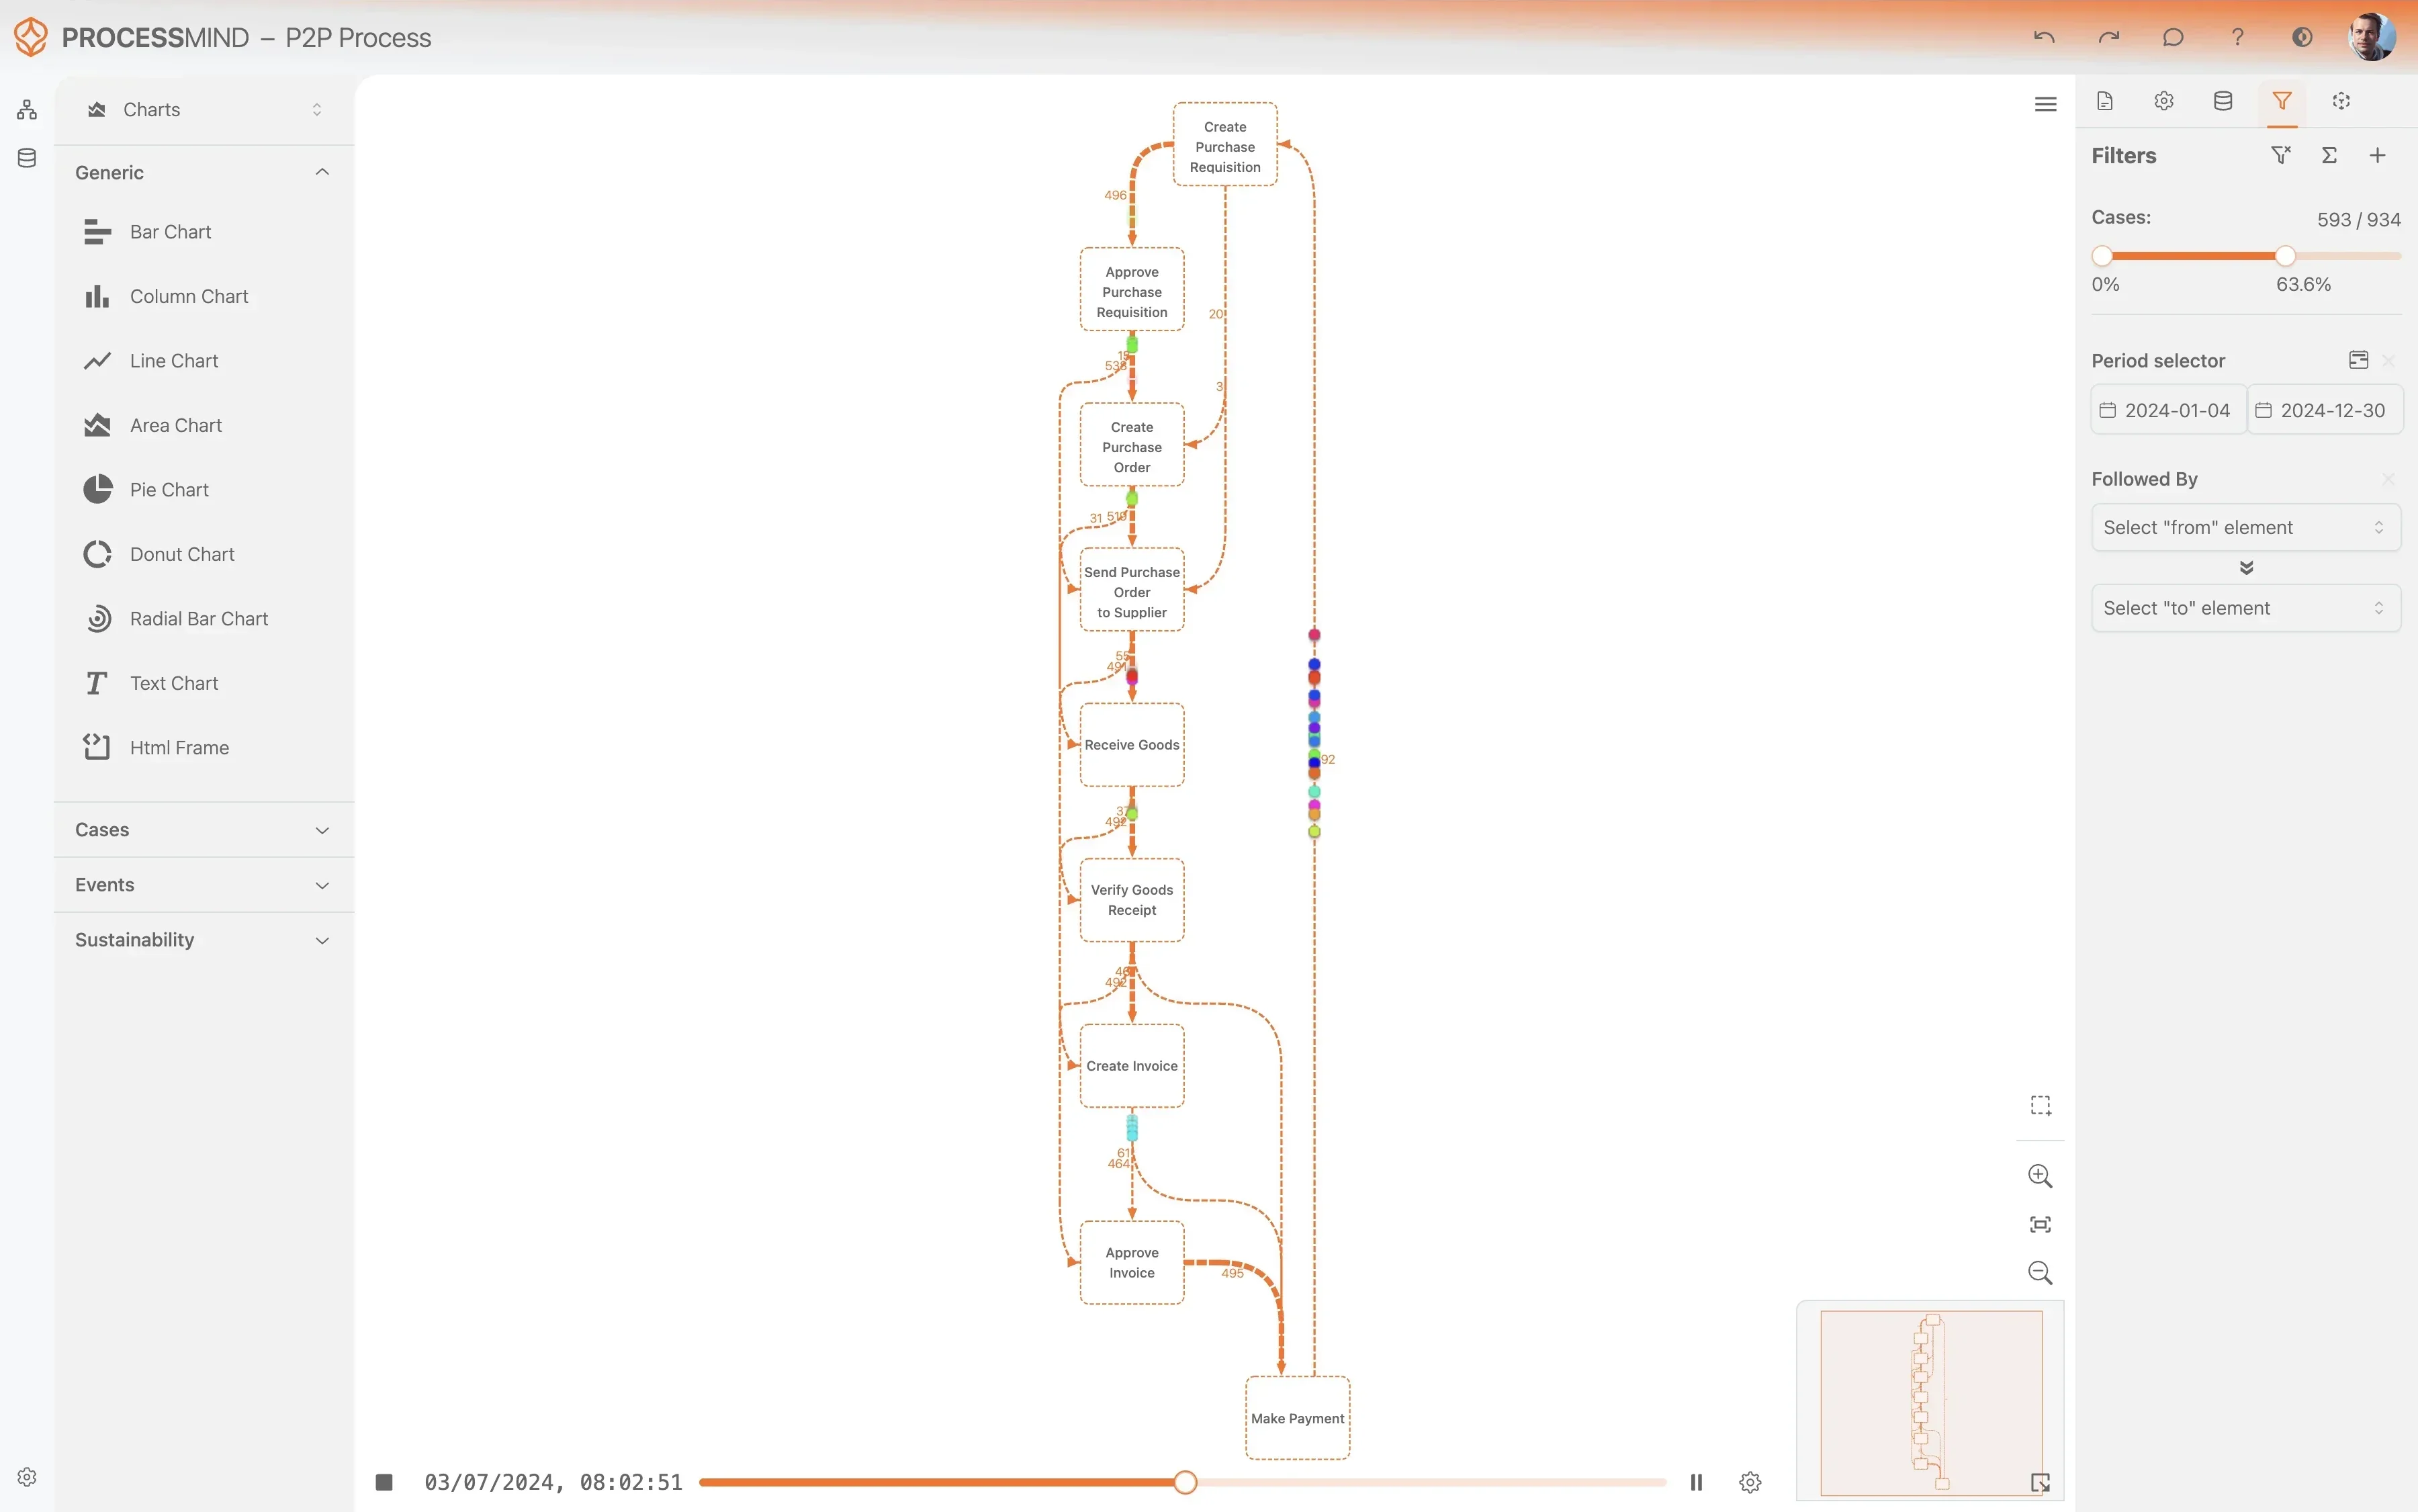
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

TYPOWE REZULTATY

Efekty usprawnienia zarządzania incydentami

Analiza workflow obsługi incydentów w BMC Helix ITSM za pomocą process mining pozwala organizacjom wykrywać wąskie gardła i nieefektywności. Typowe efekty to krótszy czas rozwiązywania incydentów, lepsza jakość usług i niższe koszty operacyjne.

0 %
Szybsze rozwiązywanie incydentów

Krótszy czas zamykania incydentów

Usprawnienie workflow przez wykrywanie wąskich gardeł na etapach diagnozy, analizy i zatwierdzania pozwala znacząco skrócić całkowity czas rozwiązywania incydentów.

0 %
Lepsza zgodność z SLA

Większa realizacja celów usługowych

Wskazanie i usunięcie odstępstw od procesu lub opóźnień prowadzących do naruszeń SLA pozwala rozwiązywać więcej incydentów w uzgodnionym czasie.

0 %
Mniej ponownych przypisań

Mniej przekazań między zespołami

Wykrycie i wyeliminowanie nieefektywnego kierowania incydentów między grupami wsparcia pozwala szybciej rozpocząć ich rozwiązywanie i ograniczyć nakład pracy.

0 %
Mniej ponownej pracy przy incydentach

Mniej ponownie otwieranych i powracających incydentów

Ustalenie przyczyn nieskutecznych napraw lub niepełnej diagnozy ogranicza konieczność ponownego otwierania incydentów i eskalowania ich po pierwszej próbie rozwiązania.

0 %
Większa zgodność z procesem

Lepsze przestrzeganie standardowych kroków

Wizualizacja rzeczywistych ścieżek obsługi incydentów pozwala wykrywać odstępstwa od standardowych procedur i zwiększać spójność oraz przewidywalność procesu.

Wyniki zależą od złożoności procesu zarządzania incydentami, jakości danych i specyfiki organizacji. Podane wartości pokazują typowe usprawnienia zaobserwowane w różnych wdrożeniach.

Zalecane dane

Zacznijcie od najważniejszych atrybutów i działań, a następnie w razie potrzeby rozszerzcie ich zakres.
Pierwszy raz spotykają się Państwo z dziennikiem zdarzeń? Dowiedz się jak utworzyć dziennik zdarzeń na potrzeby process mining.

Atrybuty

Najważniejsze dane do zebrania na potrzeby analizy

Unikalny identyfikator rekordu incydentu.

Dlaczego to ważne

To podstawowy identyfikator case, który łączy wszystkie zdarzenia w cyklu życia incydentu i umożliwia analizę procesu od początku do końca.

Bieżący lub historyczny status incydentu w chwili wystąpienia zdarzenia.

Dlaczego to ważne

Śledzenie zmian statusu pozwala zrozumieć przebieg obsługi incydentu i zmierzyć czas spędzony w określonych stanach, takich jak 'Pending' lub 'In Progress'.

Poziom priorytetu przypisany do incydentu, który określa pilność jego obsługi.

Dlaczego to ważne

Ten atrybut pozwala dzielić analizę na segmenty, aby incydenty o wysokim priorytecie były obsługiwane szybciej i zgodnie z przypisanymi im celami SLA.

Grupa wsparcia odpowiedzialna za obsługę incydentu.

Dlaczego to ważne

Informacja o przypisanej grupie pozwala analizować przekazywanie spraw, wykrywać pętle ponownych przypisań i wskazywać wąskie gardła w poszczególnych zespołach.

Użytkownik przypisany do obsługi incydentu.

Dlaczego to ważne

Pozwala szczegółowo analizować podział obciążenia i wyniki pracy poszczególnych osób, a także wskazać najlepszych pracowników i osoby potrzebujące wsparcia.

Usługa biznesowa lub techniczna, której dotyczy incydent.

Dlaczego to ważne

Powiązanie incydentów z usługami biznesowymi ułatwia analizę ich wpływu i wskazanie usług najczęściej dotkniętych problemami.

Klasyfikacja incydentu, często oparta na hierarchii wielopoziomowej.

Dlaczego to ważne

Kategoryzacja ułatwia prawidłowe kierowanie zgłoszeń, analizę trendów i porównywanie wyników dla różnych rodzajów incydentów.

Flaga wskazująca, czy incydent rozwiązano po upływie terminu SLA.

Dlaczego to ważne

Flaga ułatwia analizę zgodności z SLA. Można szybko odfiltrować incydenty z przekroczonym terminem i zbadać ich przyczyny źródłowe.

Flaga wskazująca, czy incydent ponownie otwarto po zmianie jego statusu na „Resolved”.

Dlaczego to ważne

Bezpośrednio mierzy ponowną pracę i jakość rozwiązań. Wysoki odsetek ponownie otwartych incydentów wskazuje na nieskuteczne poprawki i słabości procesu.

Działania

Kroki procesu do monitorowania i optymalizacji

Ta czynność oznacza utworzenie rekordu incydentu w systemie. Jest rejestrowana na podstawie znacznika czasu utworzenia incydentu w głównym formularzu zarządzania incydentami.

Dlaczego to ważne

To główne zdarzenie rozpoczynające cykl życia incydentu. Jest niezbędne do obliczania całkowitego czasu rozwiązania i analizy liczby napływających incydentów.

Ta czynność oznacza pierwsze przypisanie incydentu do konkretnej grupy wsparcia w celu jego zbadania. Jest ustalana na podstawie pierwszego wypełnienia pola 'Assigned Group' po utworzeniu incydentu.

Dlaczego to ważne

To ważny etap oznaczający rozpoczęcie aktywnej pracy nad incydentem. Czas do pierwszego przypisania ma zasadnicze znaczenie przy ocenie czasu reakcji i skuteczności wstępnego kierowania zgłoszeń.

Oznacza, że pracownik wsparcia rozpoczął aktywną pracę nad incydentem. Zdarzenie jest zwykle ustalane na podstawie zmiany statusu z 'Assigned' na 'In Progress'.

Dlaczego to ważne

Ten etap oznacza przejście od oczekiwania w kolejce do aktywnej diagnozy. Analiza czasu oczekiwania na rozpoczęcie pracy pomaga wykrywać wąskie gardła związane z zasobami i wspiera dashboard „Wąskie gardła w diagnozie i analizie”.

Ta czynność oznacza formalne rozwiązanie incydentu z perspektywy service desku, przed jego ostatecznym zamknięciem. Jest rejestrowana, gdy status incydentu zostaje ustawiony na 'Resolved'.

Dlaczego to ważne

To najważniejszy etap przy pomiarze zgodności z SLA i czasu rozwiązania incydentu. Oznacza przywrócenie użytkownikowi dostępu do usługi.

To ostatnia czynność, która oznacza formalne zamknięcie rekordu incydentu po potwierdzeniu rozwiązania lub upływie okresu oczekiwania na potwierdzenie. Jest rejestrowana, gdy status zostaje ustawiony na 'Closed'.

Dlaczego to ważne

To końcowe zdarzenie w cyklu życia incydentu. Czas między zmianą statusu na 'Resolved' i 'Closed' obejmuje oczekiwanie na potwierdzenie użytkownika oraz czynności administracyjne.

FAQ

Często zadawane pytania

Process mining analizuje rzeczywiste dane o incydentach z BMC Helix ITSM i przedstawia faktyczny przebieg każdego z nich. Ujawnia ukryte wąskie gardła, odstępstwa od standardowych procedur oraz powtarzające się etapy pracy, które wydłużają czas rozwiązania i obniżają poziom usług. Dzięki temu można dokładnie ustalić, gdzie proces traci efektywność.

Na początek potrzebny jest zwykle dziennik zdarzeń zawierający identyfikator incydentu, nazwę czynności i znacznik czasu dla każdego kroku. Przydatne są też dodatkowe atrybuty, takie jak osoba przypisana, typ incydentu, priorytet i kody rozwiązania. Pozwalają one dokładniej odtworzyć pełny przebieg każdego incydentu.

Dane z BMC Helix ITSM można wyodrębnić na kilka sposobów, na przykład za pomocą bezpośrednich zapytań do bazy danych, integracji API lub dostępnych funkcji raportowania. Celem jest uzyskanie pełnego dziennika zdarzeń, który obejmuje wszystkie istotne czynności i ich znaczniki czasu. Na tym etapie priorytetem są bezpieczne metody zgodne z obowiązującymi wymaganiami.

Po wyodrębnieniu i wstępnym przygotowaniu danych praktyczne wnioski można często uzyskać w ciągu kilku tygodni, a czasem nawet dni. Zależy to od gotowości danych i zakresu projektu. Wstępna analiza szybko wskazuje istotne odstępstwa i problemy z wynikami, co ułatwia ustalenie priorytetów usprawnień. Dalsze monitorowanie wspiera ciągłe doskonalenie.

Tak. Process mining dokładnie odwzorowuje każde ponowne przypisanie i wskazuje, gdzie incydenty utknęły lub zostały skierowane do niewłaściwego zespołu, co powoduje opóźnienia i może prowadzić do naruszeń SLA. Wizualizacja tych nieefektywności pomaga ustalić ich przyczyny, takie jak niejasny podział ról, braki kompetencyjne czy nieprawidłowe ścieżki eskalacji. Na tej podstawie można zaplanować ukierunkowane działania usprawniające proces.

Process mining wykorzystuje zwykle specjalistyczne platformy do pobierania, przekształcania i wizualizacji danych o zdarzeniach. Niektóre narzędzia działają w chmurze, inne mogą wymagać instalacji lokalnej. Zazwyczaj potrzebne są odpowiednia moc obliczeniowa i miejsce na przechowywanie historycznych danych o incydentach, a także bezpieczne połączenie z danymi.

Nie. Process mining wykracza poza tradycyjne raportowanie. Raporty pokazują, „co” się wydarzyło, a process mining wyjaśnia, „jak” i „dlaczego”, odwzorowując rzeczywisty przebieg procesu od początku do końca, a nie tylko zagregowane wskaźniki. Pokazuje różnice w przebiegu procesu i ich wpływ, dostarczając bardziej szczegółowych informacji diagnostycznych.

Process mining wskazuje dokładne etapy obsługi incydentu, na których często stosuje się obejścia albo pomija lub nieskutecznie przeprowadza analizę przyczyn źródłowych. Śledzenie ścieżek incydentów ujawnia powtarzające się problemy i etapy, na których pominięto właściwą diagnostykę. Dzięki temu można lepiej ukierunkować szkolenia i dostosować proces, aby skuteczniej rozwiązywać problemy.

Ogranicz powtarzające się incydenty w BMC Helix ITSM już dziś!

Skróć MTTR o 35% i wyeliminuj przekroczenia SLA, zwiększając zadowolenie użytkowników.

Rozpocznij okres próbny

Nie trzeba podawać danych karty płatniczej. Okres próbny trwa 14 dni.