Migliori la gestione degli incidenti
Selezioni un processo
Scelga un processo per continuare a lavorare nell’area di lavoro collegata.
Ottimizzi la gestione degli incidenti in Zendesk Support per risolverli più rapidamente
Gestire gli incidenti in modo efficace è fondamentale per la soddisfazione degli utenti e l’efficienza operativa. La nostra piattaforma Le consente di individuare ritardi e colli di bottiglia nascosti che rallentano la risoluzione. Scopra dove si concentrano le inefficienze e riceva indicazioni concrete per semplificare i processi e risolvere gli incidenti più rapidamente.
Scarichi il nostro template dei dati preconfigurato e affronti le sfide più comuni per raggiungere i Suoi obiettivi di efficienza. Segua il nostro piano di miglioramento in sei fasi e consulti la guida al template dei dati per trasformare le Sue attività.
Mostra la descrizione dettagliata
Perché è fondamentale ottimizzare la gestione degli incidenti
Una gestione efficace degli incidenti è alla base di servizi affidabili e della soddisfazione degli utenti. Nell’attuale contesto digitale, in cui tutto cambia rapidamente, qualsiasi interruzione, anche minima, può aggravarsi in poco tempo, compromettendo le attività aziendali, la fiducia dei clienti e persino la conformità normativa. Zendesk Support offre una piattaforma completa per registrare e monitorare gli incidenti, ma la vera sfida consiste nel risolverli in modo efficiente ed efficace. Senza una visione chiara del flusso di lavoro effettivo, le organizzazioni faticano spesso a individuare ritardi nascosti, rilavorazioni frequenti e accordi sui livelli di servizio (SLA) non rispettati. Queste inefficienze frustrano utenti e agenti dell’assistenza, aumentano i costi operativi e danneggiano la reputazione del marchio. Comprendere le prestazioni effettive del processo di gestione degli incidenti non significa soltanto risolvere i problemi: significa proteggere l’azienda in modo proattivo e migliorare continuamente il servizio.
Come il Process Mining fa luce sul flusso degli incidenti in Zendesk Support
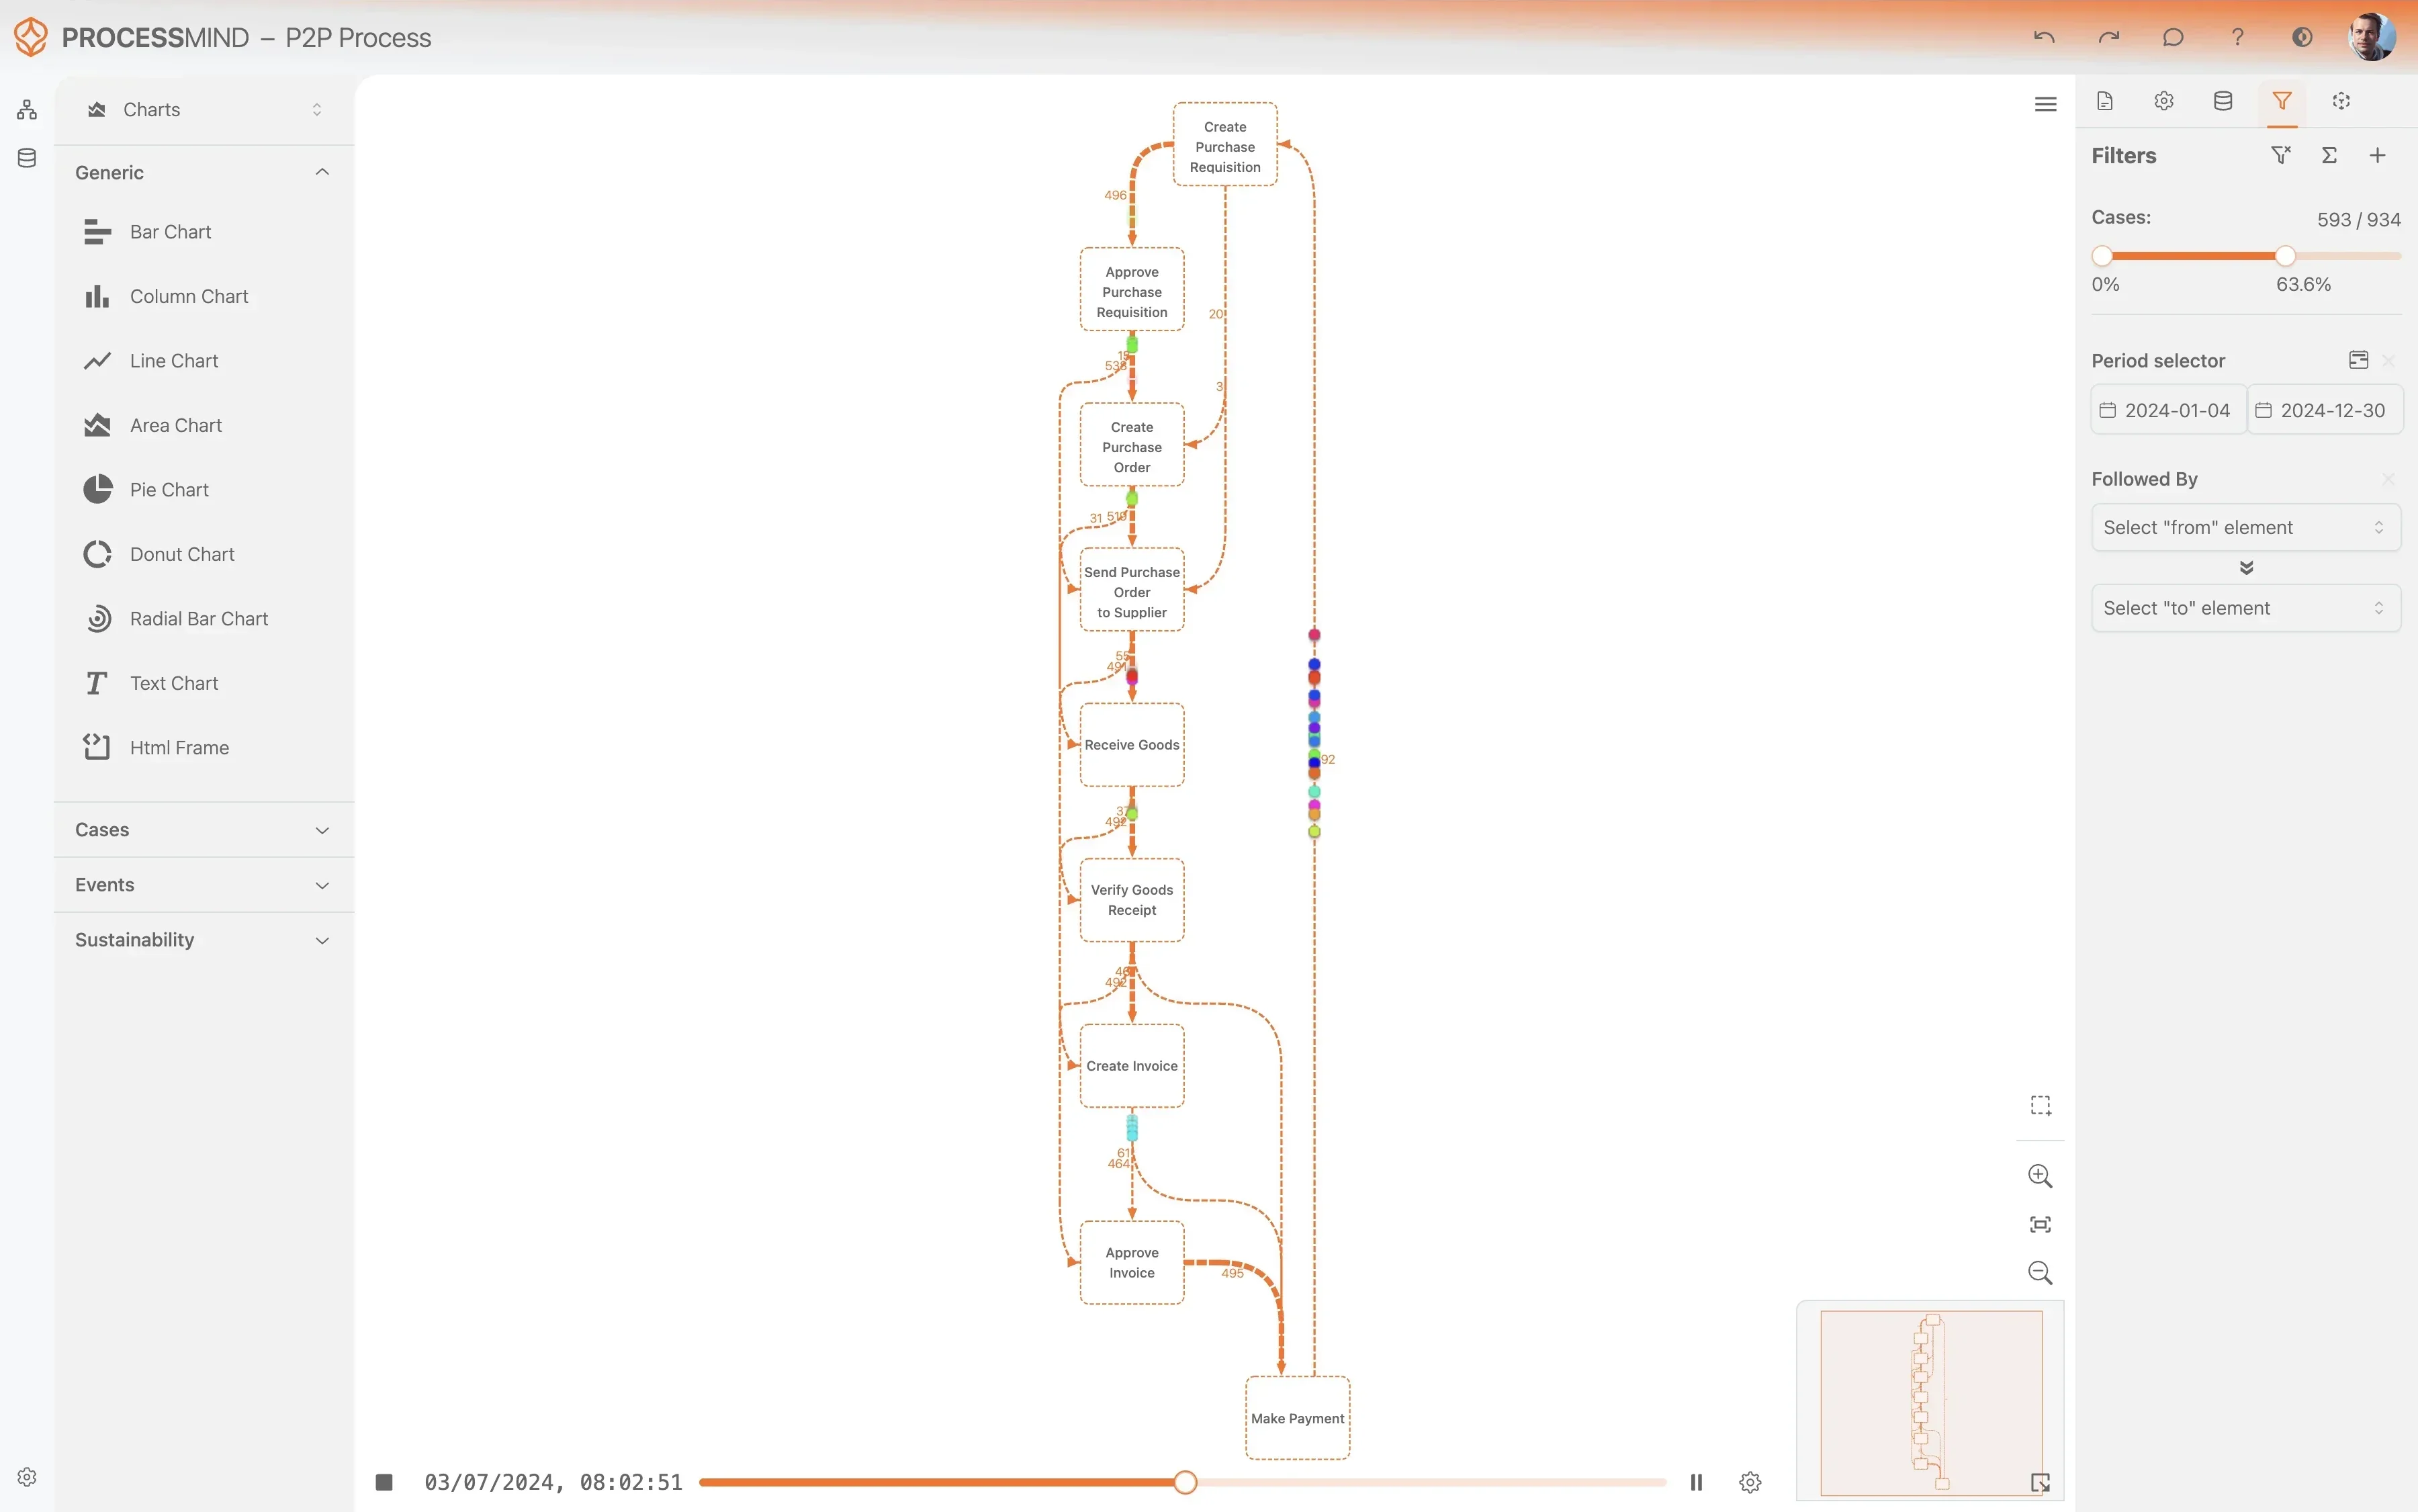
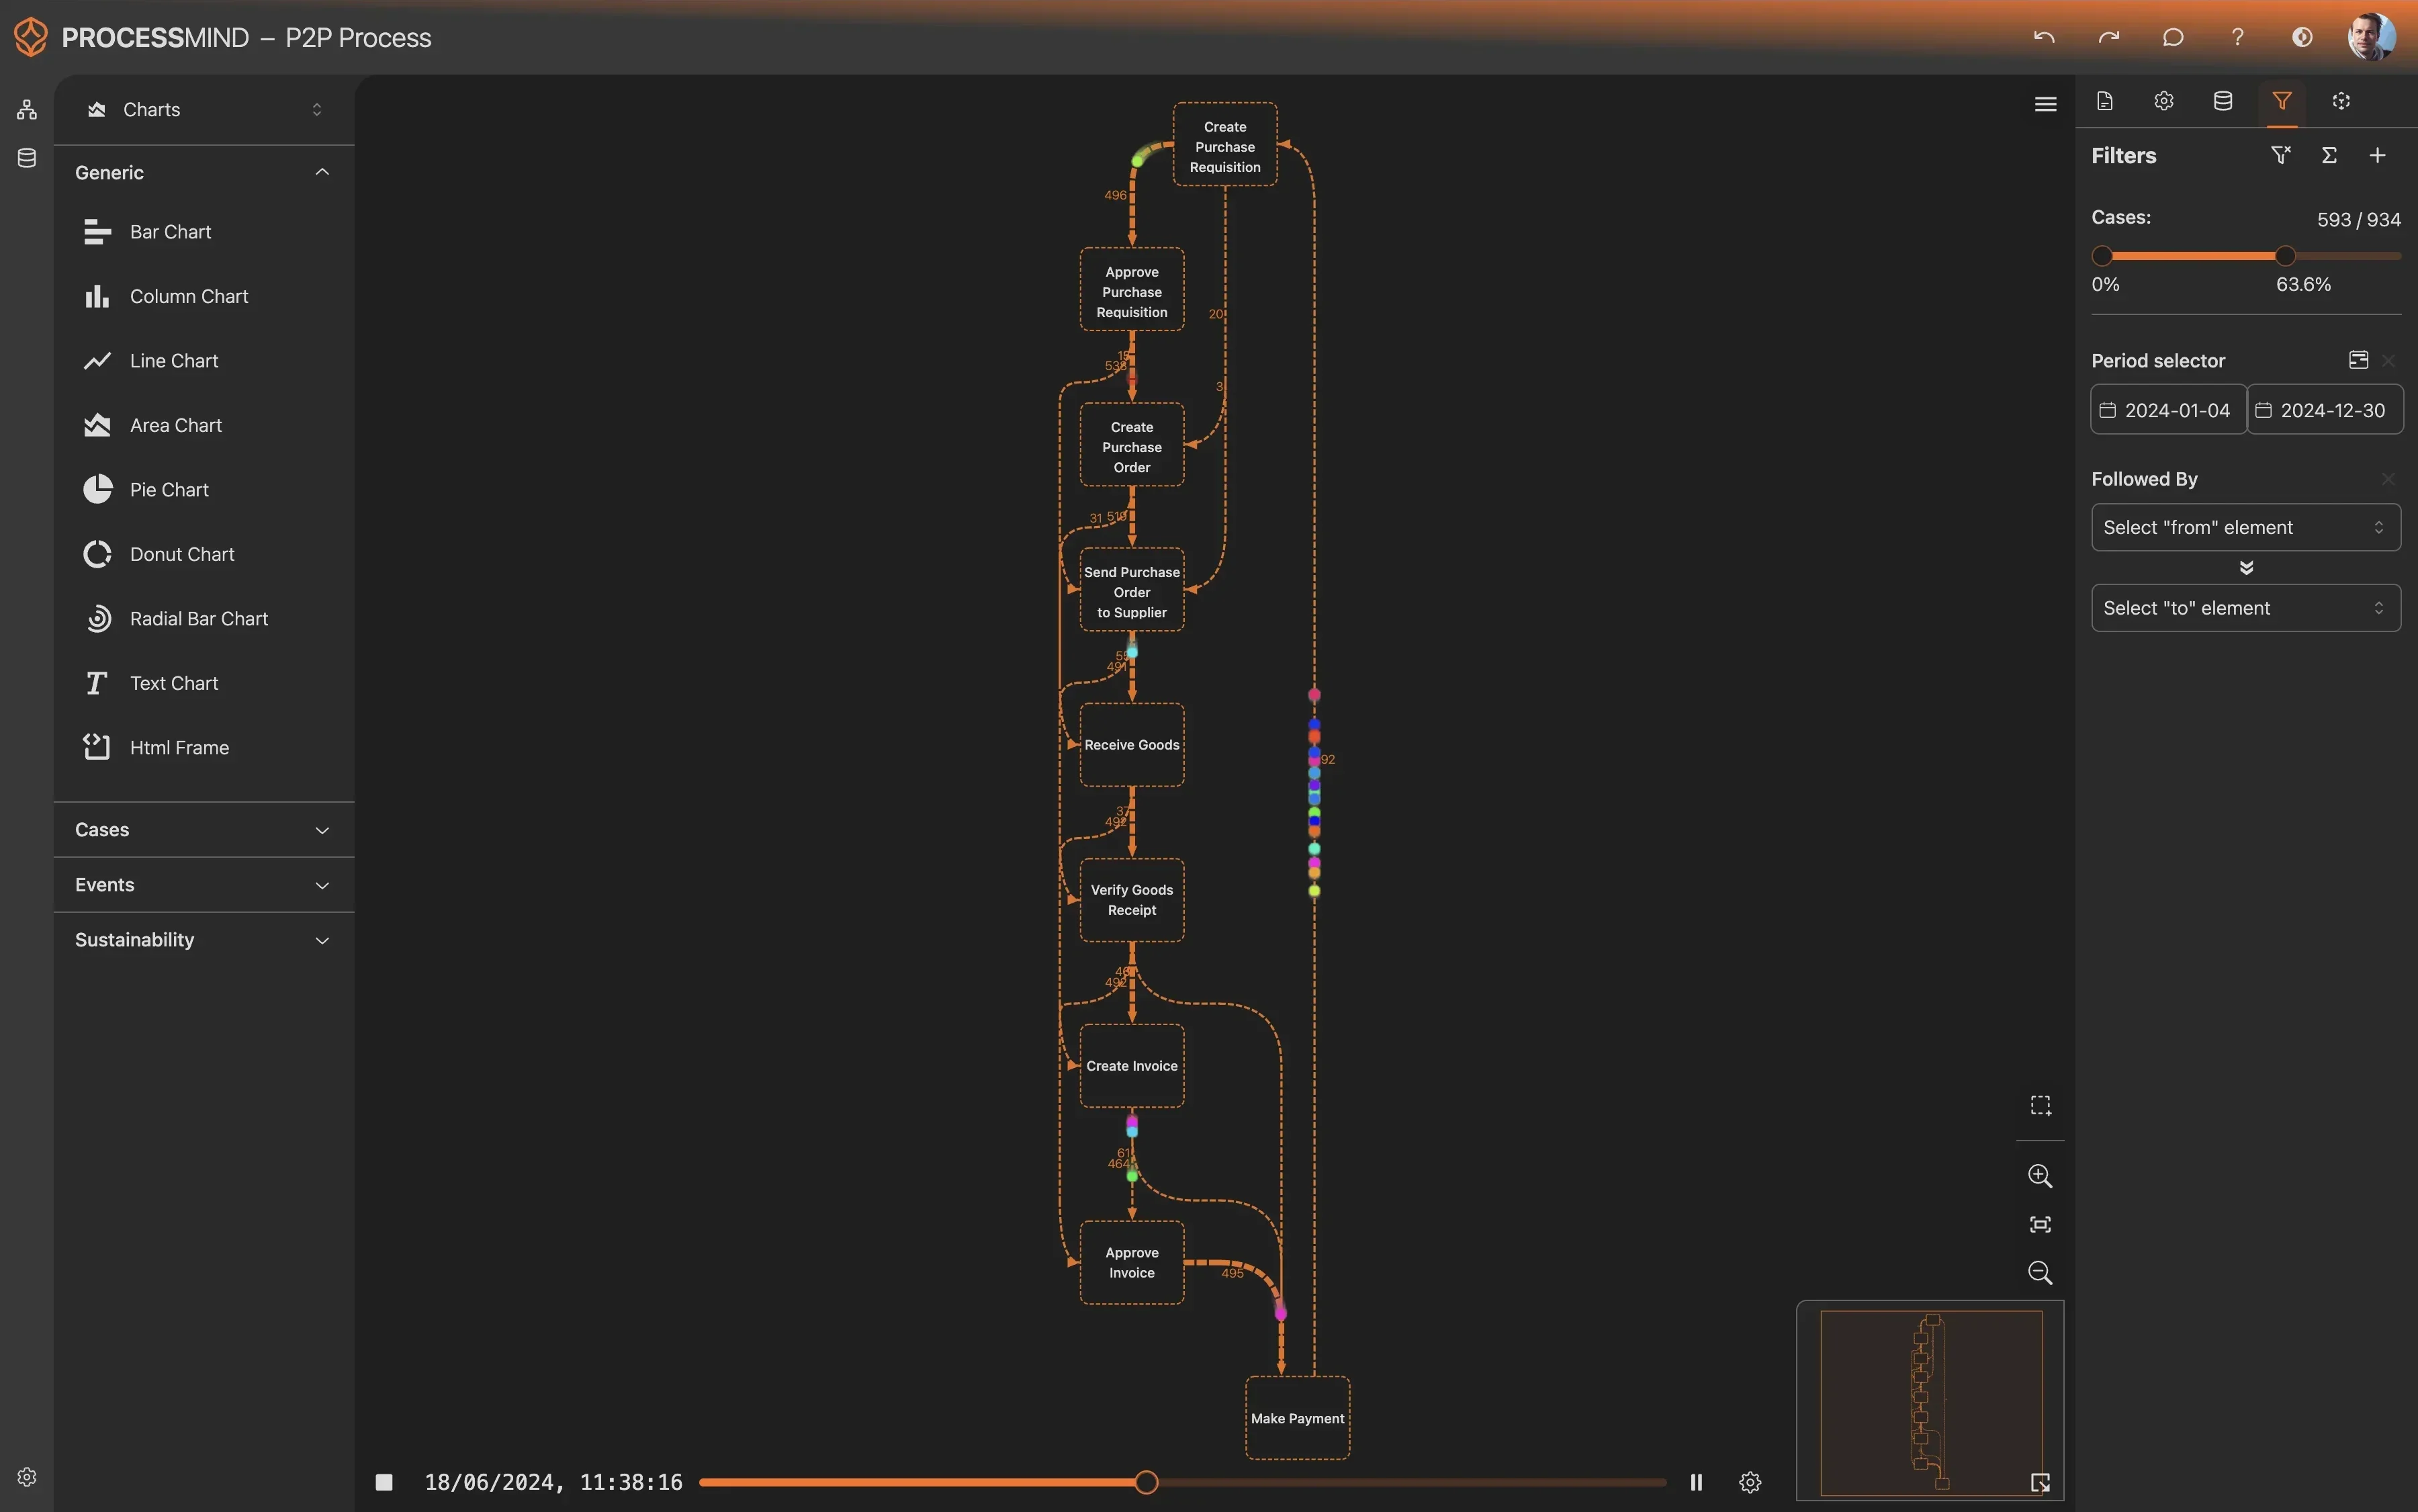
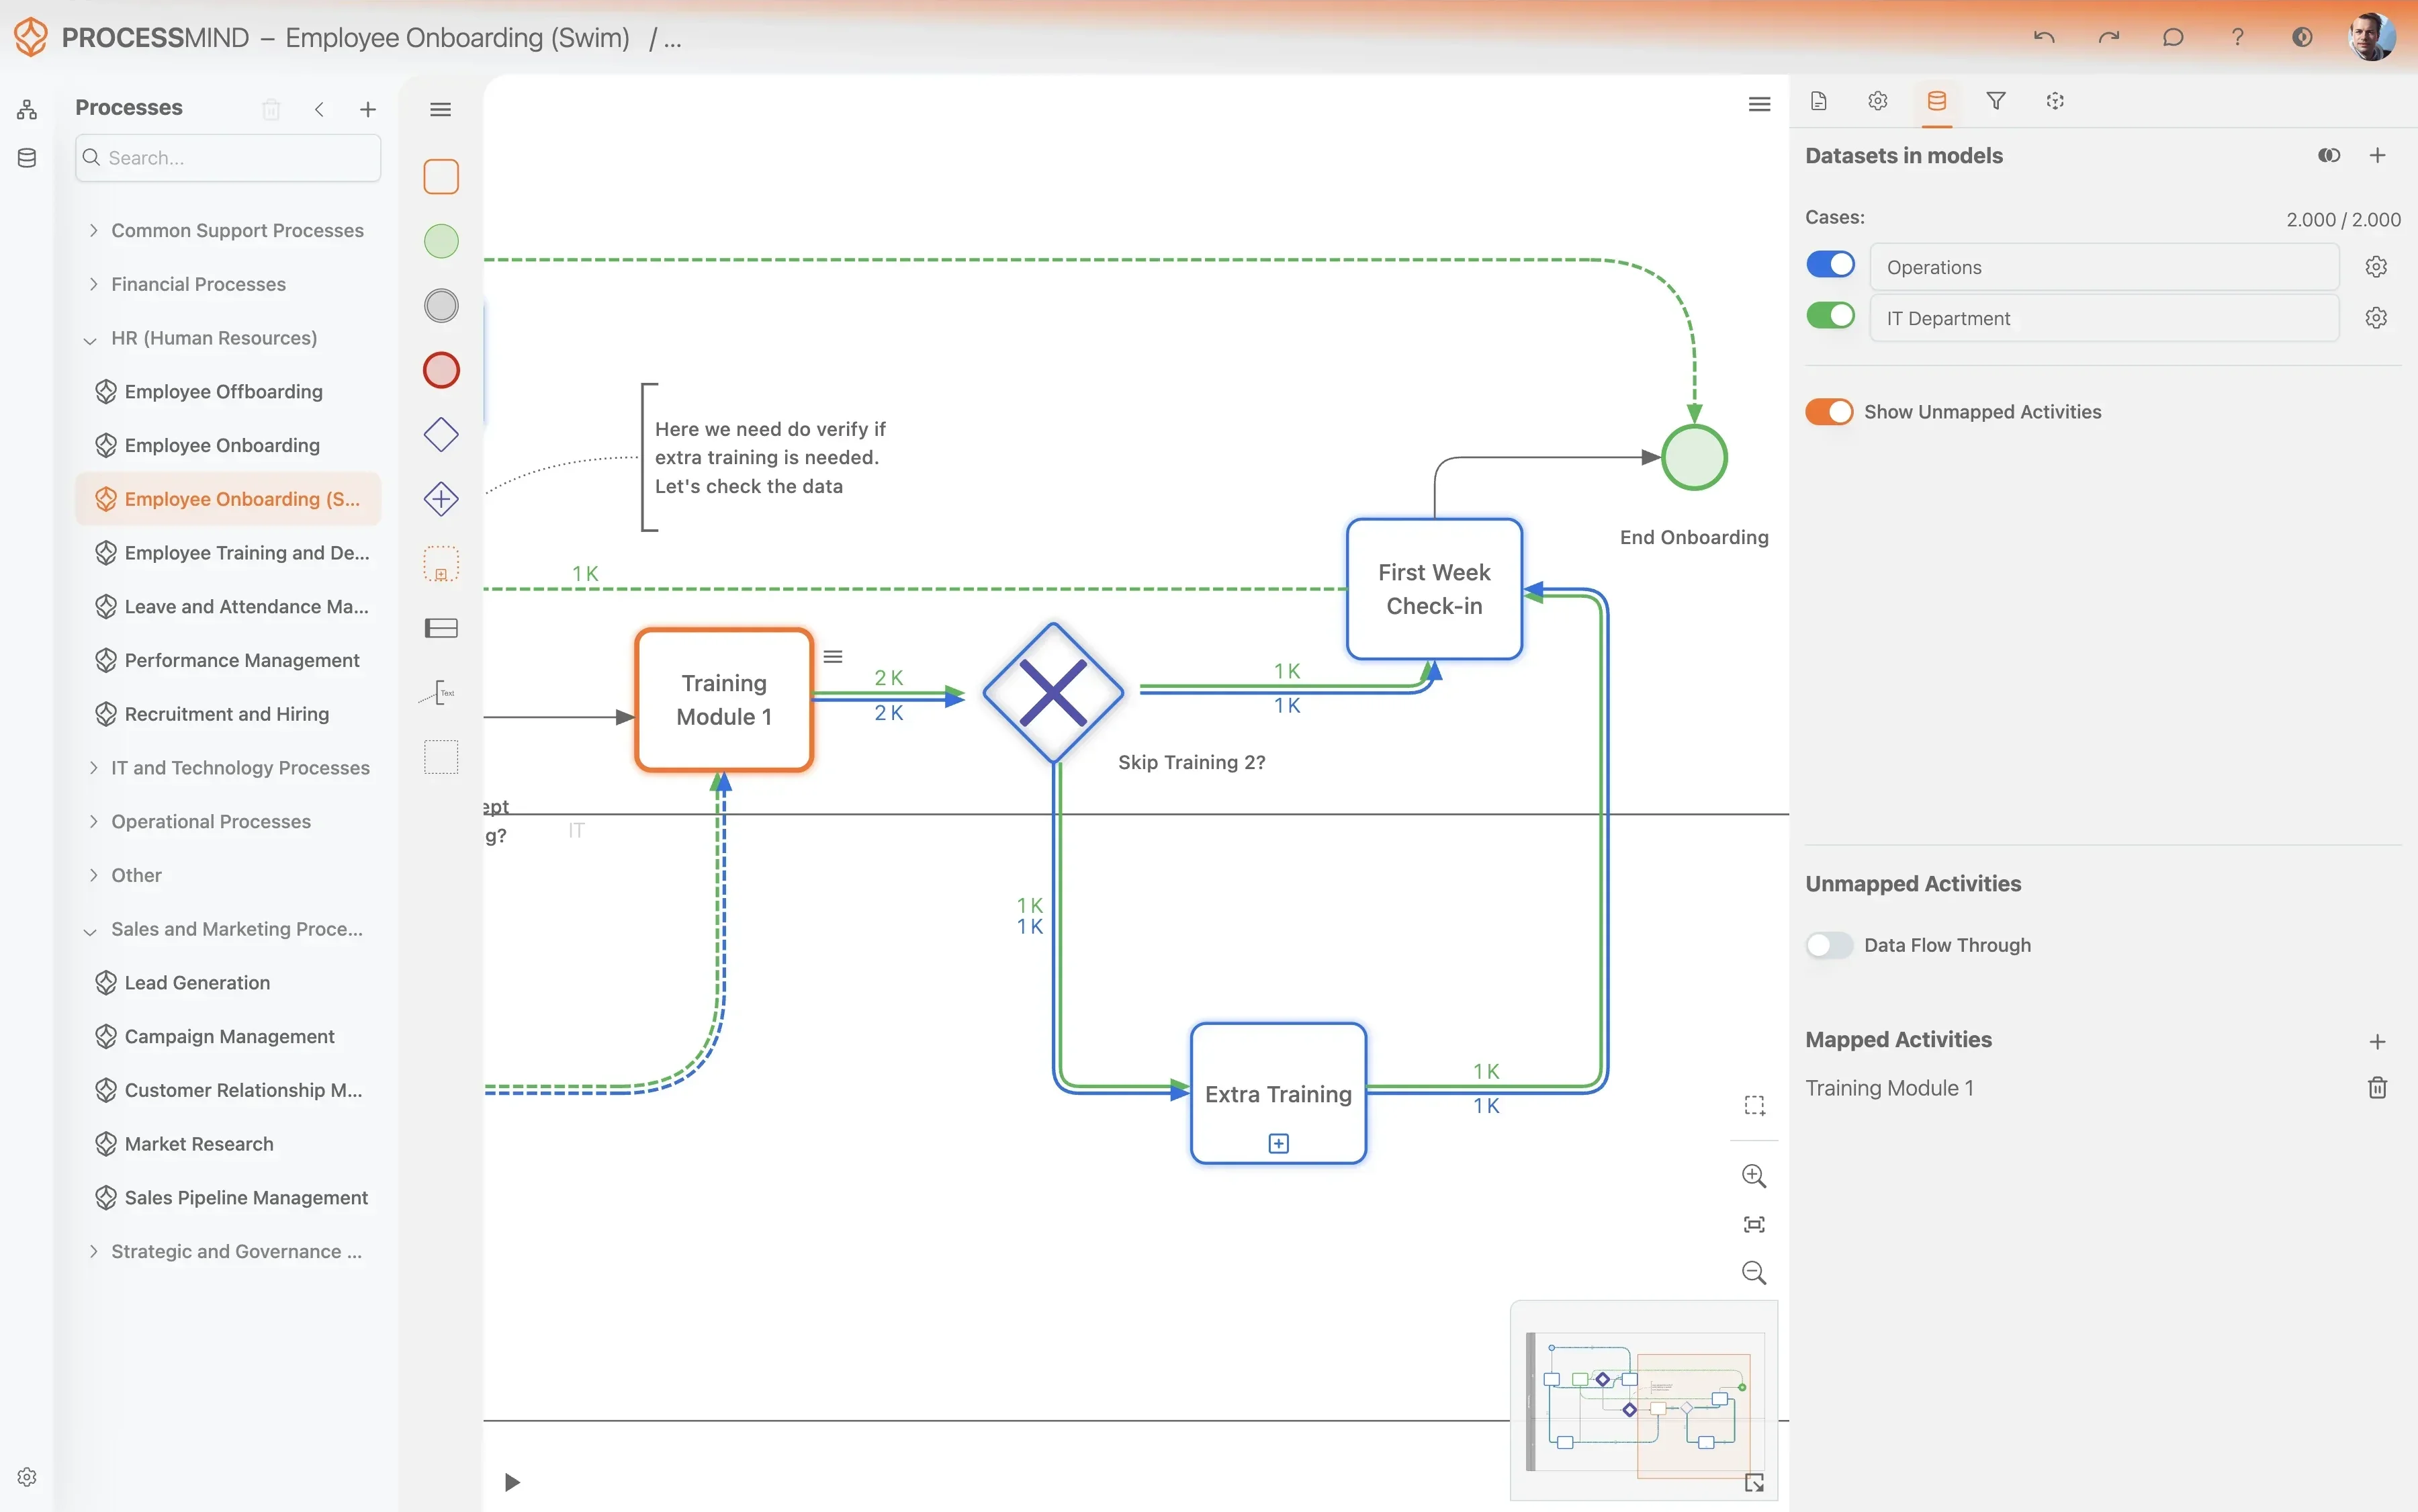
Il Process Mining consente di analizzare in modo approfondito i dati di gestione degli incidenti in Zendesk Support. Esaminando gli Event Log, che registrano ogni interazione e cambiamento di stato per ciascun incidente, ricostruisce il percorso effettivo dall’apertura alla chiusura. Questa visione completa, dall’inizio alla fine, offre molto più dei report standard: mostra tutti i percorsi, comprese le deviazioni dal processo previsto, e individua con precisione i colli di bottiglia, le riassegnazioni eccessive e gli incidenti riaperti di frequente. Può visualizzare il tempo di ciclo completo per i diversi tipi di incidente e confrontare i risultati effettivi con gli SLA previsti. In questo modo, i dati grezzi di Zendesk diventano informazioni utili: mostrano come gli incidenti passano tra i team di assistenza, quali fasi richiedono più tempo e dove gli interventi manuali o le inefficienze prolungano la risoluzione.
Individuare le principali opportunità di miglioramento nella risoluzione degli incidenti
Con il Process Mining può individuare aree specifiche in cui migliorare la gestione degli incidenti in Zendesk. Per esempio, potrebbe rilevare:
- Passaggi di consegne eccessivi: gli incidenti vengono trasferiti tra gruppi di assistenza, ad esempio dal supporto iniziale a un team specializzato, più spesso del necessario, allungando i tempi di ciclo? Il Process Mining evidenzia questi trasferimenti frequenti e il loro impatto.
- Ritardi nella risoluzione: individui le fasi in cui gli incidenti tendono a bloccarsi, ad esempio lunghi intervalli tra “Diagnosis Initiated” e “Resolution Identified”, che possono indicare la necessità di una formazione più adeguata o di una diversa allocazione delle risorse.
- Cicli di rilavorazione: individui gli schemi in cui gli incidenti vengono riaperti spesso dopo essere stati contrassegnati come “Resolved”, segnalando possibili problemi nella qualità della risoluzione iniziale o nel processo di conferma da parte dell’utente.
- Mancato rispetto degli SLA: visualizzi con chiarezza le categorie o le priorità di incidenti che non raggiungono regolarmente gli obiettivi SLA, così da concentrare gli interventi sulle aree più importanti.
- Analisi delle cause profonde: colleghi gli schemi di processo ai comuni attributi Root Cause Category, per adottare misure proattive e prevenire il ripetersi degli incidenti.
Questo livello di dettaglio supera le impressioni aneddotiche e offre informazioni basate sui dati per ottimizzare davvero la gestione degli incidenti in Zendesk Support.
Benefici concreti grazie all’ottimizzazione del processo di gestione degli incidenti
Le informazioni ottenute con il Process Mining si traducono direttamente in benefici significativi e misurabili per la Sua organizzazione. Intervenendo sulle inefficienze e sui colli di bottiglia individuati, può:
- Ridurre il tempo di ciclo della gestione degli incidenti: accelerare la risoluzione, ripristinare più rapidamente i servizi e ridurre i tempi di inattività per gli utenti interessati.
- Migliorare il rispetto degli SLA: rispettare o superare con regolarità gli accordi sui livelli di servizio, aumentando la soddisfazione dei clienti ed evitando possibili penali.
- Ridurre i costi operativi: semplificare i flussi di lavoro, limitare le rilavorazioni e ottimizzare l’allocazione delle risorse, utilizzando in modo più efficiente il tempo e le risorse del team di assistenza.
- Aumentare la soddisfazione di utenti e agenti: gli utenti ottengono risposte più rapide e comunicazioni più chiare, mentre gli agenti lavorano con processi più lineari e meno frustranti.
- Promuovere il miglioramento continuo: creare una cultura basata sui dati, in cui le prestazioni dei processi vengono monitorate e migliorate costantemente, così che la gestione degli incidenti si evolva insieme alle esigenze aziendali.
In definitiva, ottimizzare la gestione degli incidenti aiuta a passare da un’assistenza reattiva, impegnata a spegnere le emergenze, a un’erogazione del servizio efficiente e proattiva.
Prenda il controllo della gestione degli incidenti in Zendesk
Per migliorare i processi di gestione degli incidenti in Zendesk Support non è necessario rinnovare l’intero sistema. Il primo passo è comprendere la situazione attuale attraverso un’analisi imparziale con il Process Mining. Questo approccio consente di prendere decisioni informate sulla base di dati concreti, anziché di supposizioni. Grazie a informazioni dettagliate sui processi, può andare oltre il semplice monitoraggio degli incidenti e contribuire attivamente a rendere l’assistenza più reattiva, efficiente e attenta alle esigenze degli utenti. Inizi a migliorare la gestione degli incidenti con un approccio basato sui dati, che individua con precisione come ridurre il tempo di ciclo e aumentare la qualità complessiva del servizio.
Il percorso di miglioramento in 6 passaggi per la gestione degli incidenti
Scarichi il template
Cosa fare
Scarichi il template Excel già strutturato per i dati relativi alla gestione degli incidenti. In questo modo, i dati di Zendesk Support saranno conformi ai requisiti di analisi di ProcessMind.
Perché è importante
Un template standardizzato semplifica la preparazione dei dati, riduce gli errori e consente di acquisire tutti i dettagli essenziali sugli incidenti per un’analisi accurata.
Risultato atteso
Avrà a disposizione un template Excel pronto da compilare, predisposto per i dati sugli incidenti di Zendesk Support.
Esporti i dati da Zendesk
Cosa fare
Estragga da Zendesk Support i dati storici sugli incidenti relativi a un periodo di 3-6 mesi. Utilizzi le funzioni di reportistica o l’API per raccogliere informazioni su ticket, utenti e policy SLA, quindi inserisca i dati nel template.
Perché è importante
Un insieme completo di dati storici offre una base solida per individuare problemi ricorrenti, variazioni del processo e tendenze delle prestazioni nel tempo.
Risultato atteso
I dati sugli incidenti di Zendesk Support saranno inseriti accuratamente nel template Excel fornito.
Carichi il dataset
Cosa fare
Carichi il template Excel compilato sulla piattaforma sicura ProcessMind. Il sistema elaborerà e convaliderà automaticamente i dati relativi alla gestione degli incidenti.
Perché è importante
Il caricamento semplice rende rapidamente disponibili i dati per l’analisi, riduce i tempi di configurazione e Le consente di concentrarsi subito sui risultati.
Risultato atteso
I dati sugli incidenti di Zendesk saranno caricati in modo sicuro e saranno pronti per l’analisi automatizzata con Process Mining.
Analizzi il processo di gestione degli incidenti
Cosa fare
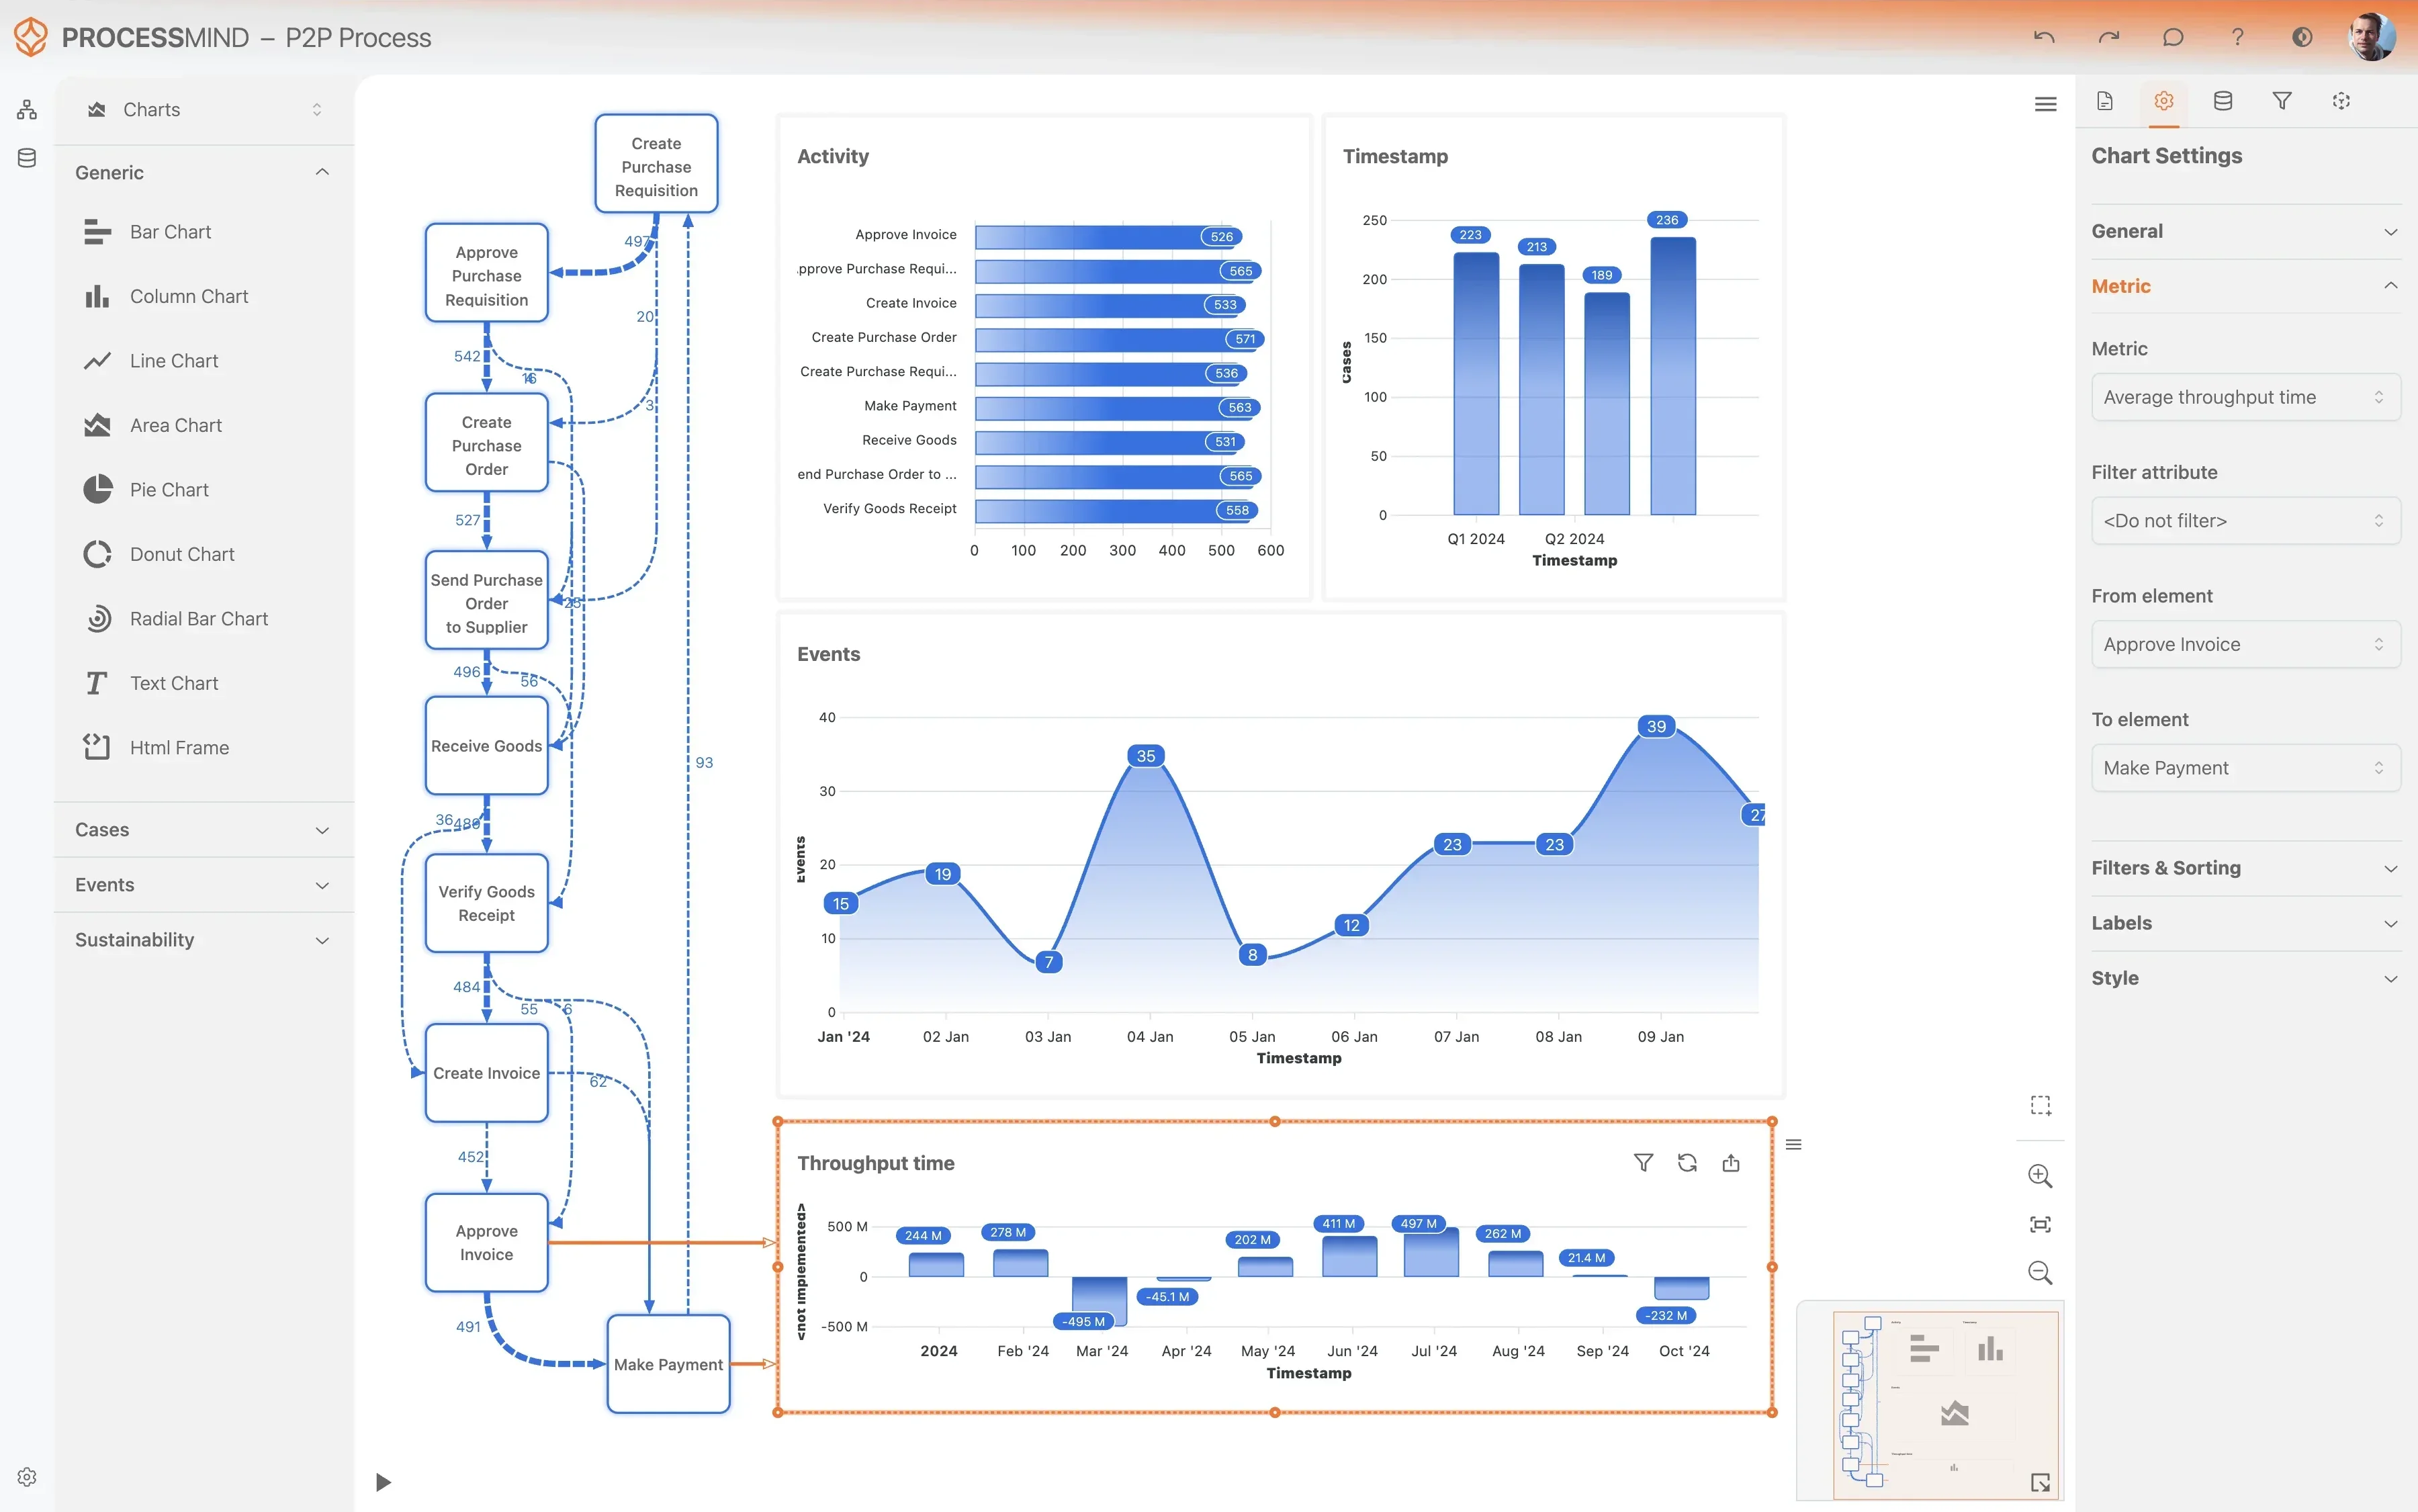
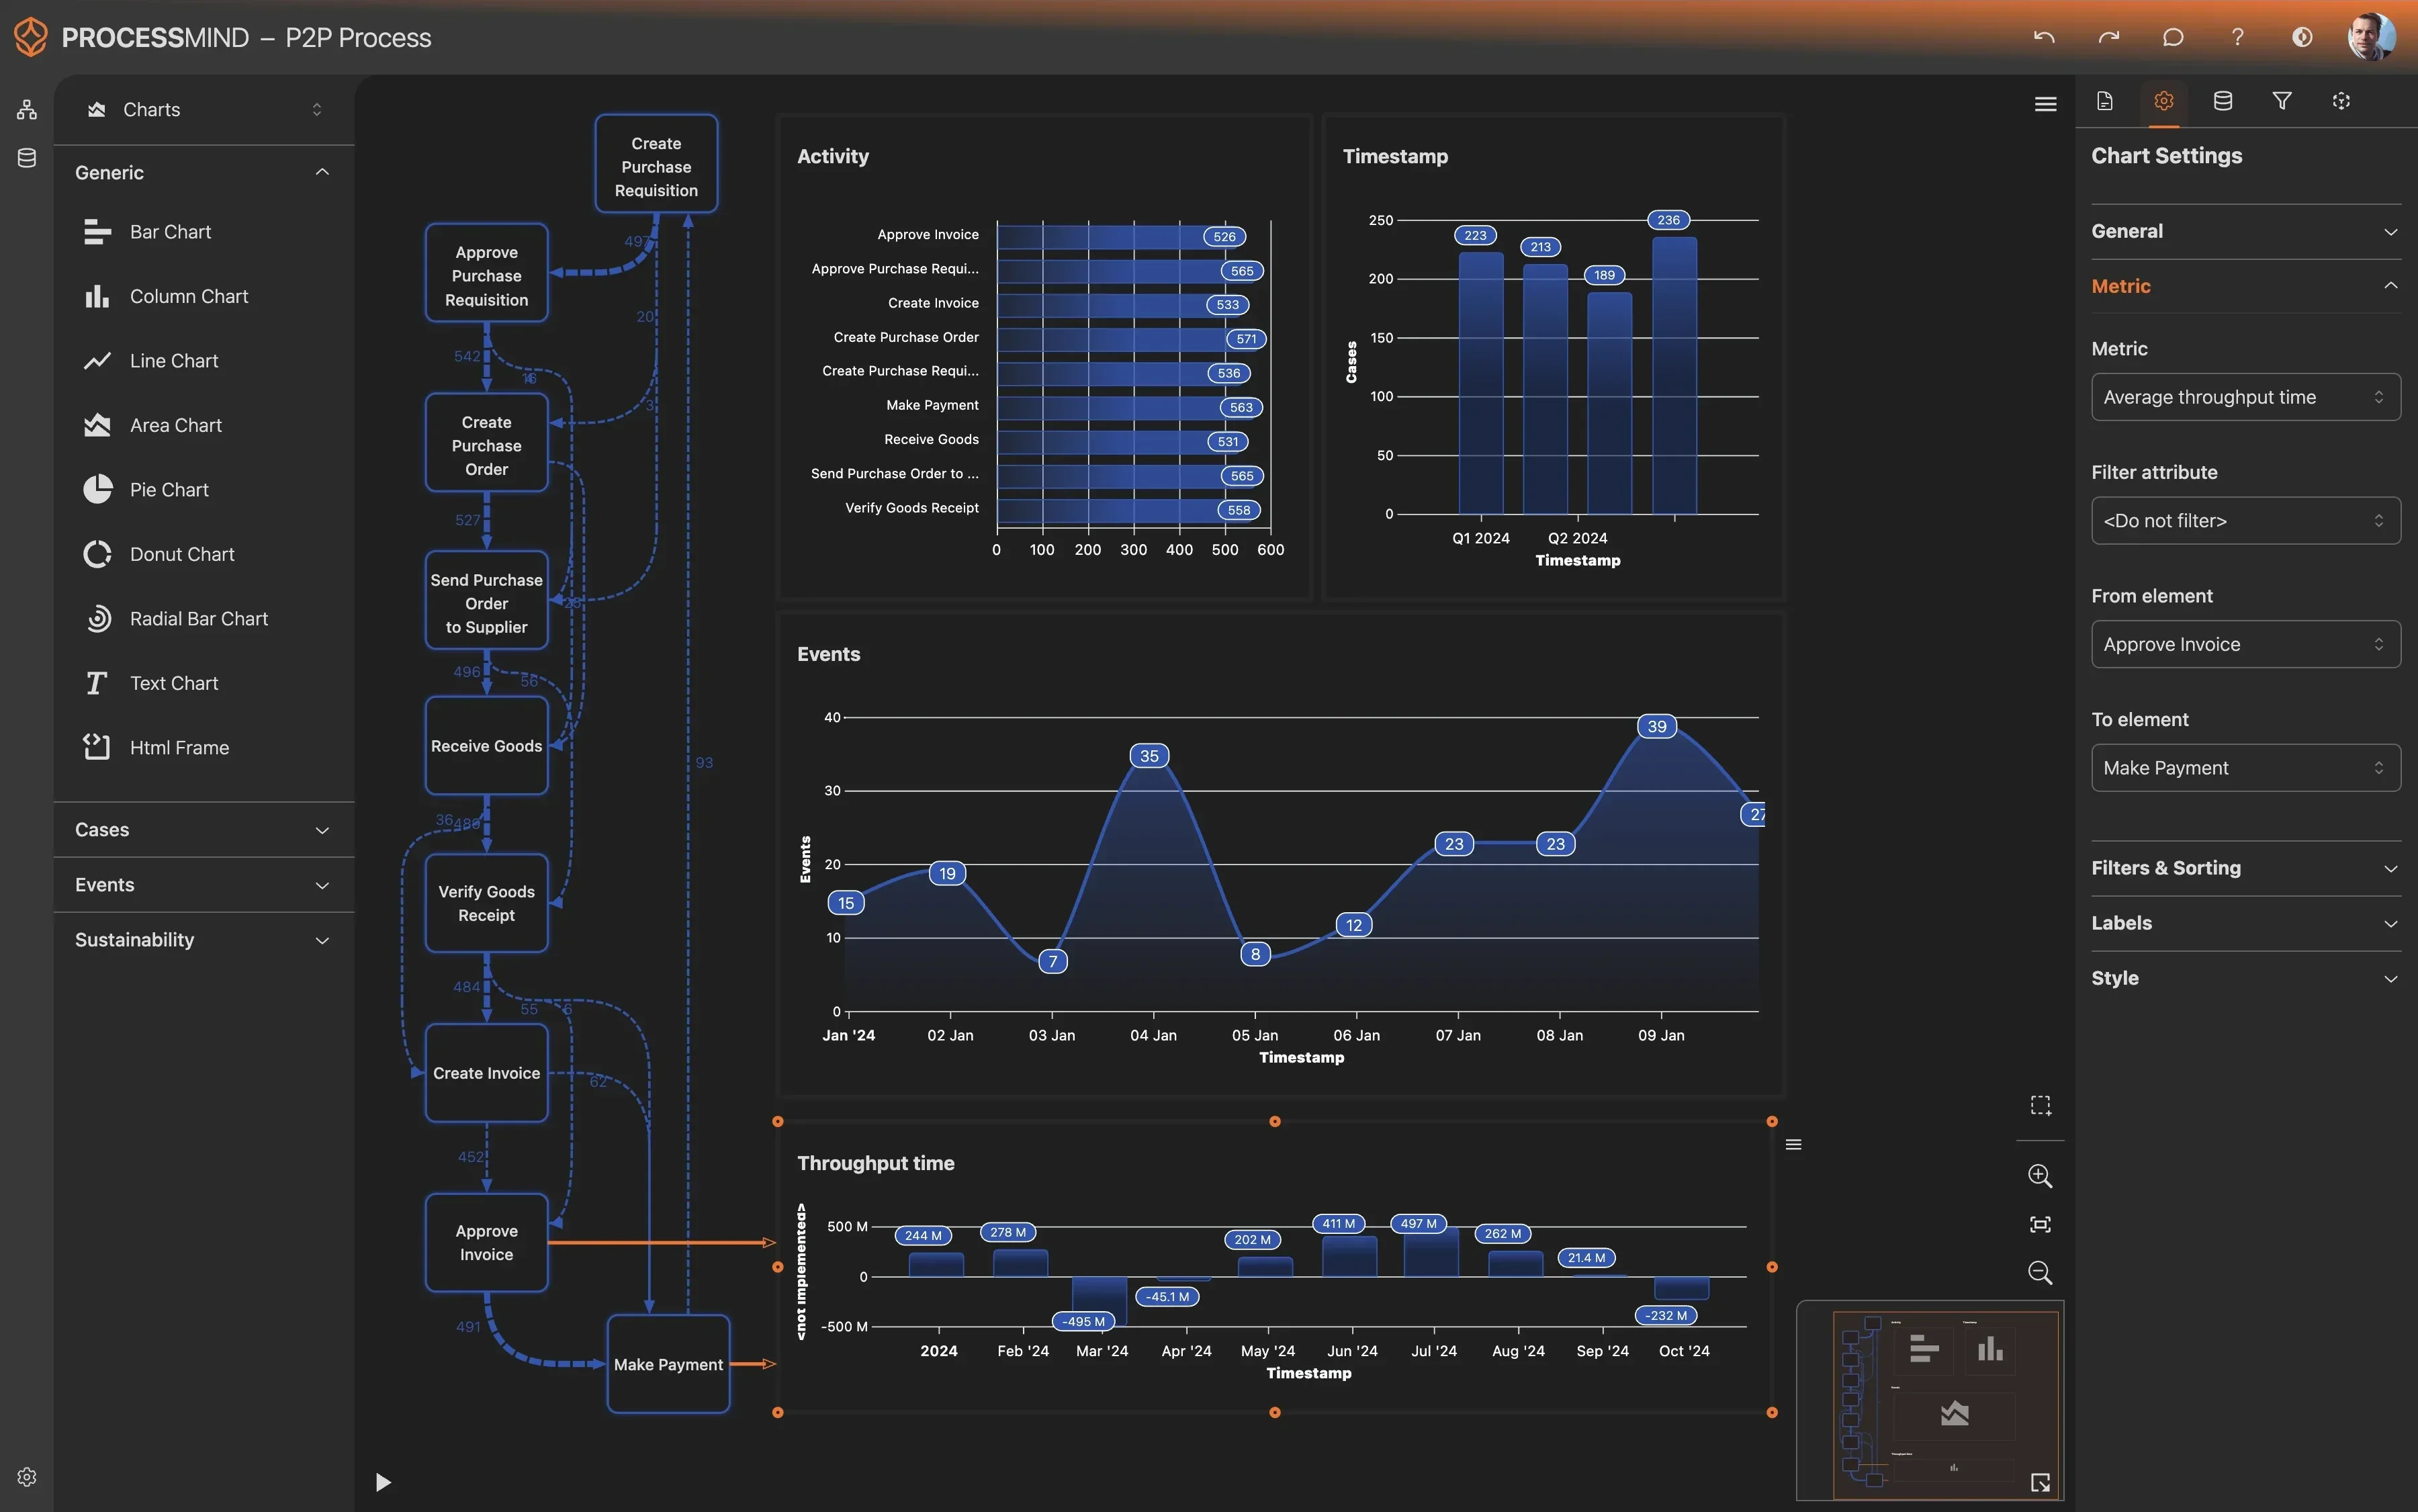
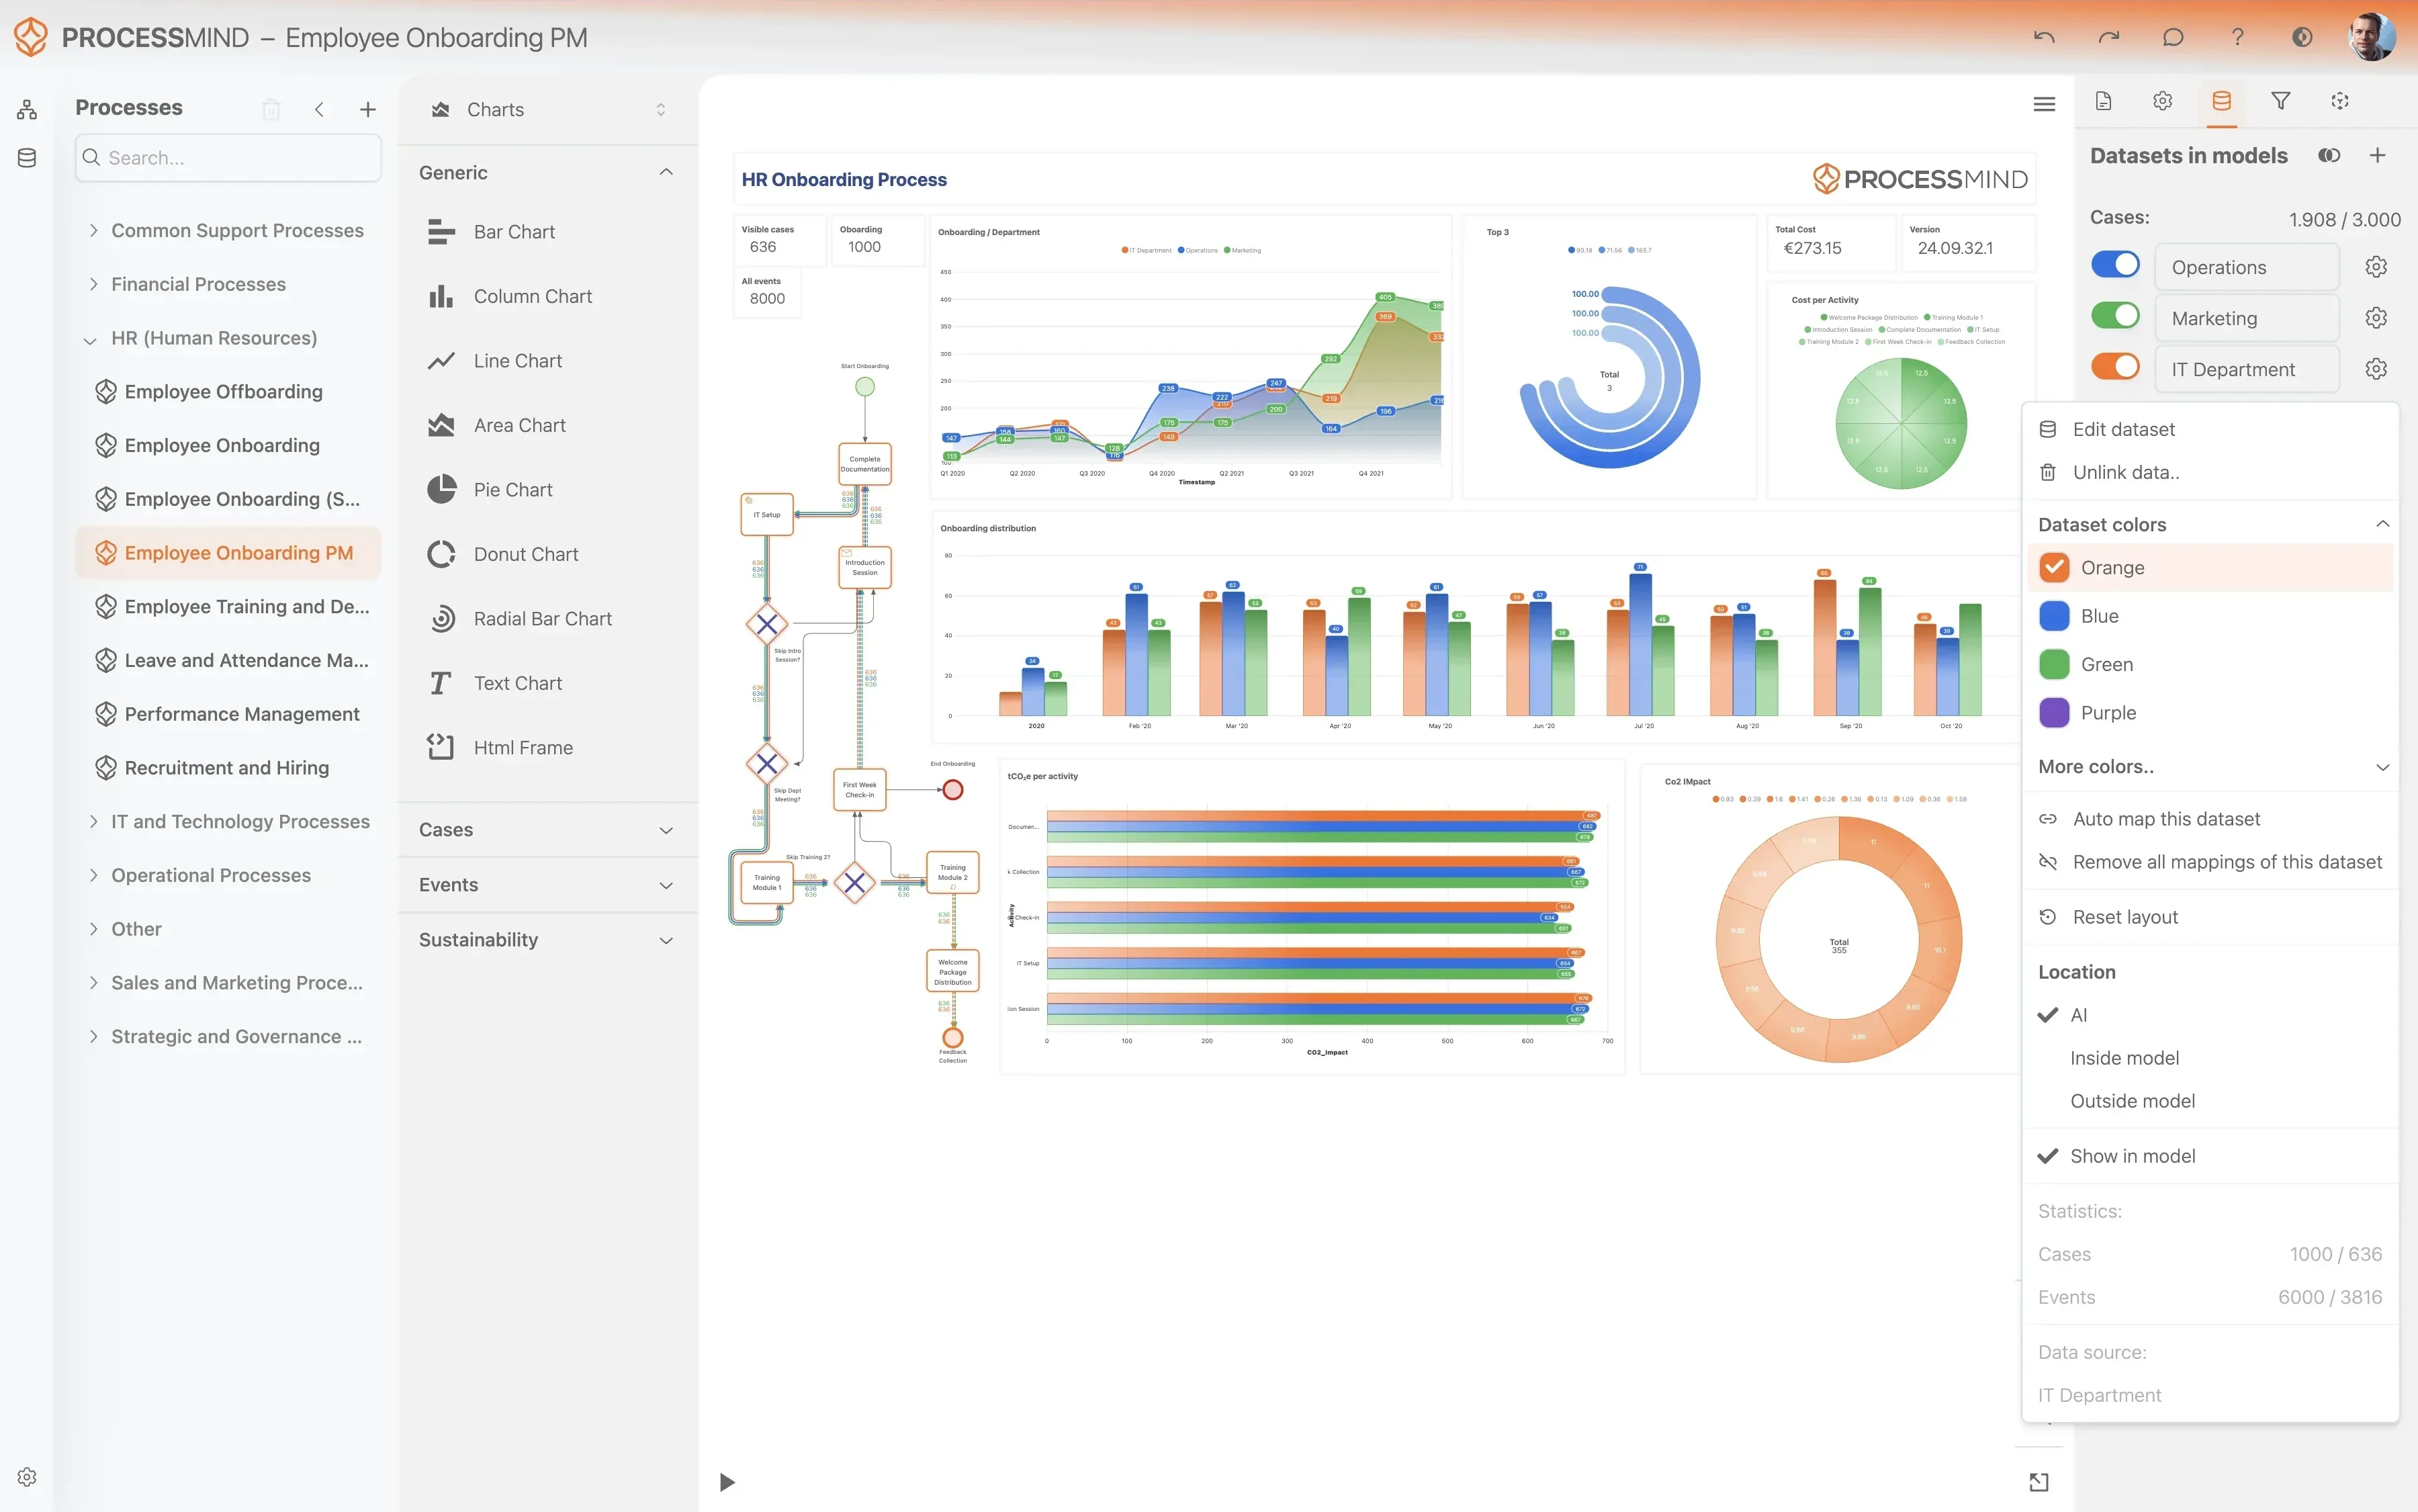
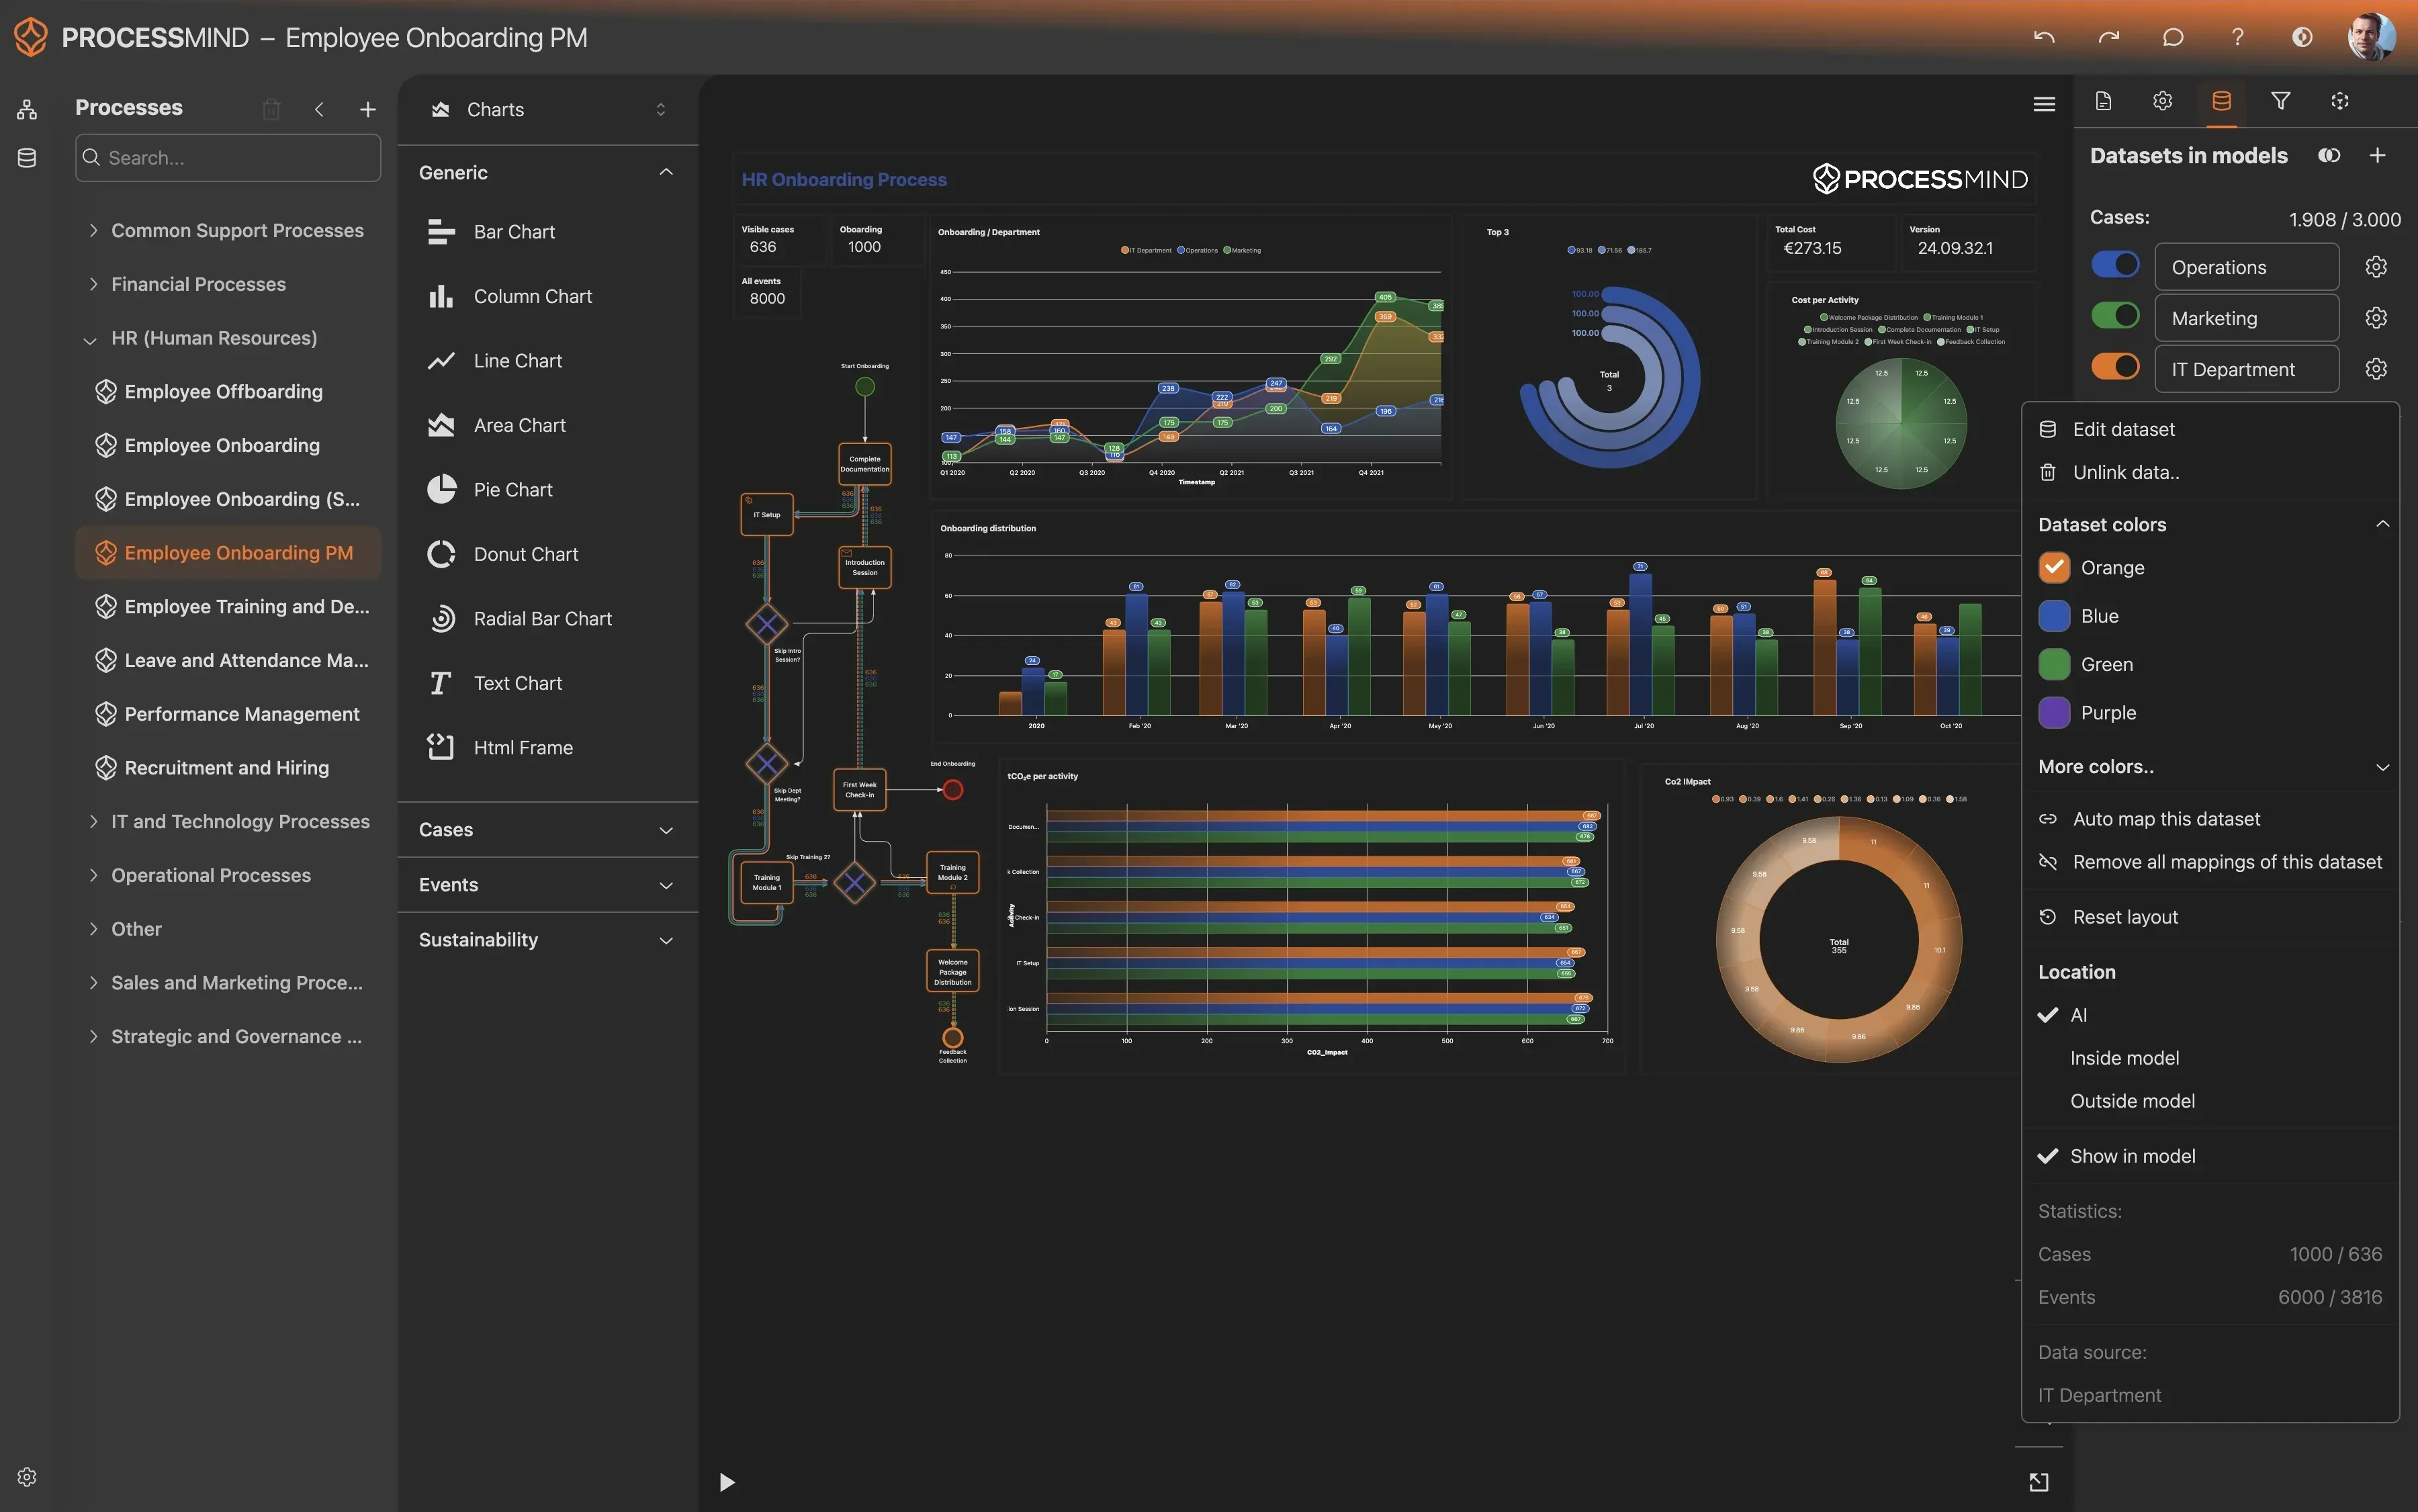
Esplori le Dashboard generate automaticamente e le mappe visive del processo di gestione degli incidenti. Utilizzi i suggerimenti basati sull’AI per individuare colli di bottiglia e percorsi non conformi.
Perché è importante
Ottenga informazioni dettagliate sui tempi di risoluzione, sul rispetto degli SLA e sul carico di lavoro degli agenti, facendo emergere inefficienze nascoste e lacune di conformità che incidono sulla qualità del servizio.
Risultato atteso
Avrà una visione chiara del processo di gestione degli incidenti, basata sui dati, e potrà individuare le aree di miglioramento in ordine di priorità.
Apporti i miglioramenti
Cosa fare
Definisca le priorità tra le opportunità di miglioramento individuate, ad esempio ottimizzando le regole di assegnazione dei ticket o perfezionando i flussi di lavoro di risoluzione in Zendesk Support, e intervenga di conseguenza.
Perché è importante
Tradurre i risultati dell’analisi in azioni concrete permette di intervenire direttamente sulle cause profonde dei ritardi e delle inefficienze, migliorando subito le attività operative e la qualità del servizio.
Risultato atteso
Il processo di gestione degli incidenti sarà ottimizzato, con tempi di risoluzione più brevi e una migliore allocazione delle risorse.
Monitori e consolidi i progressi
Cosa fare
Carichi regolarmente in ProcessMind dati aggiornati sugli incidenti provenienti da Zendesk Support. Tenga sotto controllo gli indicatori chiave di prestazione per misurare l’impatto delle modifiche introdotte.
Perché è importante
Il monitoraggio continuo aiuta a consolidare i miglioramenti, individuare tempestivamente nuovi problemi e mantenere efficiente ed efficace nel tempo il processo di gestione degli incidenti.
Risultato atteso
Potrà mantenere ottimizzato il processo di gestione degli incidenti, rispettare con regolarità gli SLA e migliorare la soddisfazione degli utenti.
COSA OTTERRÀ
Individui i ritardi nascosti nel flusso degli incidenti di Zendesk
- Visualizzi il flusso effettivo degli incidenti in Zendesk
- Individui i colli di bottiglia nella risoluzione
- Riduca i tempi di risoluzione degli incidenti
- Verifichi la conformità agli SLA e migliori la soddisfazione
RISULTATI TIPICI
Migliori la gestione degli incidenti
Questi risultati illustrano i miglioramenti misurabili che le organizzazioni ottengono in genere applicando il Process Mining ai flussi di gestione degli incidenti in Zendesk Support. Analizzando ogni "ID incidente" dalla creazione alla risoluzione, è possibile individuare colli di bottiglia e inefficienze critiche, ridurre sensibilmente i tempi di risoluzione e migliorare l’affidabilità del servizio.
Riduzione del tempo medio di ciclo
Semplifichi il processo di risoluzione degli incidenti individuando ed eliminando i colli di bottiglia, così da ridurre sensibilmente il tempo che intercorre tra la segnalazione e la chiusura dell’incidente. Migliorerà così la soddisfazione degli utenti e l’efficienza operativa.
Aumento del tasso di rispetto degli SLA
Individui le cause profonde delle violazioni degli SLA e introduca miglioramenti mirati, affinché un numero maggiore di incidenti venga risolto entro i livelli di servizio concordati. In questo modo, rafforzerà la fiducia e rispetterà gli impegni di servizio.
Riduzione dei trasferimenti per incidente
Ottimizzi i percorsi di assegnazione e trasferimento delle conoscenze per ridurre i passaggi di consegne non necessari tra team o agenti. La risoluzione sarà più rapida e diminuirà il rischio di errori.
Aumento del tasso di risoluzione al primo contatto
Individui e risolva i problemi già al primo contatto con l’utente, fornendo agli agenti strumenti e conoscenze più adeguati. Questo migliora sensibilmente la soddisfazione degli utenti e riduce il carico operativo complessivo.
Riduzione delle attività ripetute
Individui ed elimini i cicli di rilavorazione ricorrenti, in cui gli incidenti vengono ripresi dopo un tentativo di risoluzione. Eviterà così sprechi di lavoro, ridurrà i costi e accelererà la chiusura definitiva degli incidenti.
I risultati variano in base alle caratteristiche del processo di gestione degli incidenti, alla qualità dei dati disponibili e al contesto organizzativo. I valori riportati illustrano i miglioramenti tipici osservati in diverse implementazioni.
Dati consigliati
Domande frequenti
Domande frequenti
Il Process Mining utilizza i dati di Zendesk per visualizzare il flusso effettivo degli incidenti e far emergere deviazioni, colli di bottiglia e cicli di rilavorazione. Aiuta così a individuare le cause profonde dei ritardi e delle inefficienze, riducendo i tempi di risoluzione e migliorando la qualità del servizio. Offre una visione oggettiva delle attività, basata sui dati.
Servono principalmente log degli eventi che descrivano ogni passaggio dell’incidente, compresi l’ID dell’incidente, la descrizione dell’attività, la data e l’ora e l’autore dell’azione. Tra i campi più utili di Zendesk Support rientrano in genere l’ID del ticket, le modifiche di stato e di assegnatario, i commenti e le date e ore di creazione, aggiornamento e risoluzione. Questi dati consentono allo strumento di Process Mining di ricostruire l’intero percorso dell’incidente.
Individuando ed eliminando le inefficienze del processo, è possibile ridurre i tempi di risoluzione degli incidenti e migliorare il rispetto degli SLA. Il Process Mining aiuta a limitare i passaggi di consegne superflui, ridurre i cicli di rilavorazione e uniformare la definizione delle priorità, rendendo la gestione più efficiente. In definitiva, migliora la soddisfazione degli utenti e la coerenza delle attività operative.
La configurazione iniziale e l’estrazione dei dati richiedono in genere da pochi giorni a due settimane, a seconda del volume e dell’accessibilità dei dati. I primi risultati emergono spesso rapidamente dopo l’importazione e la modellazione dei dati nello strumento di Process Mining. L’analisi completa e l’individuazione di miglioramenti attuabili possono richiedere alcune settimane.
Per estrarre i log degli eventi necessari sono utili competenze di base nell’estrazione dei dati, ad esempio con SQL o con le API di reportistica di Zendesk. La maggior parte delle piattaforme di Process Mining offre interfacce intuitive per l’analisi, ma conoscere i concetti di processo è un vantaggio. Per collegare e trasformare i dati inizialmente potrebbe essere necessario un supporto tecnico.
Sì. Il Process Mining è particolarmente efficace nell’individuare i processi informali, ovvero le modalità non ufficiali con cui vengono gestiti gli incidenti al di fuori delle procedure standard. Visualizzando tutti i percorsi effettivi ricavati dai dati di Zendesk, mette in evidenza le deviazioni dal modello di processo previsto. In questo modo, favorisce la trasparenza e la conformità nella gestione degli incidenti.
Il Process Mining individua con precisione dove e perché si verificano violazioni degli SLA nel flusso di lavoro di gestione degli incidenti. Evidenzia le attività, i ritardi o i passaggi di consegne che impediscono di raggiungere gli obiettivi. Facendo emergere i colli di bottiglia nei passaggi critici, consente di intervenire in modo mirato e migliorare il rispetto degli SLA.
La sicurezza dei dati è fondamentale. Gli strumenti di Process Mining offrono in genere solide misure di sicurezza, tra cui opzioni di anonimizzazione e archiviazione protetta dei dati. Lei mantiene il controllo sui Suoi dati e la maggior parte delle soluzioni rispetta gli standard e le normative di settore per tutelare la riservatezza e la protezione dei dati durante l’intero processo di analisi.
Individuando ed eliminando inefficienze come le rilavorazioni, i passaggi di consegne superflui e i tempi di risoluzione prolungati, il Process Mining riduce direttamente il lavoro manuale e le risorse impiegate per ogni incidente. Questa ottimizzazione abbassa i costi operativi e consente ai team di gestire più incidenti in modo efficace o di riallocare le risorse.
Individuare i colli di bottiglia è uno dei suoi punti di forza, ma le possibilità del Process Mining sono più ampie. Può analizzare l’utilizzo delle risorse, far emergere violazioni della conformità, misurare le variazioni del processo e prevedere i risultati futuri. Offre una visione completa del processo di gestione degli incidenti, che va ben oltre l’individuazione dei ritardi.
Ottimizzi la gestione degli incidenti e li risolva più rapidamente
Riduca del 35% il tempo medio di risoluzione (MTTR), elimini gli incidenti ricorrenti e migliori la soddisfazione.
Non è richiesta la carta di credito. Inizi a migliorare in pochi minuti.