Zlepšete správu problémů
Jak optimalizovat BMC Helix ITSM v 6 krocích
Zlepšete správu problémů
Řízení problémů
BMC Helix ITSM

Vyberte proces

Vyberte proces a pokračujte v práci v připojeném pracovním prostoru.

Zlepšete řízení problémů v BMC Helix ITSM

Naše platforma odhalí skrytá úzká místa a problémy v procesu, které snižují efektivitu vašich služeb. Snadno si zobrazíte, kde ruční kroky nebo předávání práce zdržují řešení problémů. Díky tomu můžete zjednodušit workflow a odstranit příčiny opakujících se provozních potíží.

Stáhněte si naši předpřipravenou datovou šablonu a řešte běžné problémy, abyste dosáhli svých cílů v oblasti efektivity. Postupujte podle našeho plánu zlepšování v šesti krocích a při změnách provozu využijte průvodce datovou šablonou.

Zobrazit podrobný popis

Strategický přínos zlepšování správy problémů

Efektivní správa problémů je základem stabilního IT prostředí. Správa incidentů se zaměřuje na co nejrychlejší obnovení služby, zatímco správa problémů hledá a odstraňuje příčiny těchto výpadků. Pokud proces nefunguje dobře, IT tým zůstává v reaktivním režimu a opakovaně řeší stejné potíže. To zvyšuje provozní náklady, snižuje spokojenost uživatelů a zbytečně zatěžuje technické pracovníky. Zlepšením tohoto procesu v BMC Helix ITSM přejdete od reaktivního řešení k aktivnímu předcházení problémům. Zvýšíte tak spolehlivost firemních služeb a omezíte riziko nákladných výpadků.

Jak z dat BMC Helix ITSM získat užitečné poznatky

Standardní reporty v BMC Helix ITSM obvykle nabízejí statický pohled na data, například počet otevřených problémů nebo průměrnou dobu do uzavření. Tyto ukazatele ale málokdy vysvětlí, proč se konkrétní šetření zastavilo. Process mining skládá celý průběh každého záznamu o problému z digitálních stop v tabulkách, jako jsou PBM:Problem Investigation a PBM:Known Error. Ukáže skutečné pořadí událostí a odhalí, kde selhává předávání, váznou schválení nebo vzniká práce navíc. Místo odhadů, proč proces trvá příliš dlouho, uvidíte konkrétní cesty vedoucí ke zpoždění. Zlepšení pak můžete zaměřit na doložené příčiny, ne na jednotlivé zkušenosti.

Odhalení systémových nedostatků při hledání příčin

Jednou z největších výzev při správě problémů je přechod od zaznamenání problému k zahájení šetření. V mnoha organizacích zůstává záznam několik dní ve stavu zaznamenáno nebo přiřazeno, než se jím začne zabývat specialista. Process mining pomáhá najít tato skrytá úzká místa. Můžete zjistit, že některé skupiny podpory jsou přetížené a hromadí se jim nevyřízené záznamy, nebo že nejsou jasná pravidla pro předání problému k analýze příčiny. Analýzou průchodu mezi aktivitami Investigation Commenced a Root Cause Identified ověříte, zda mají technické týmy potřebné informace, nebo zda tráví příliš mnoho času administrativou místo diagnostiky. Zkrácení této doby je nejrychlejší cestou ke stabilnějšímu IT prostředí.

Rychlejší zveřejňování náhradních řešení a známých chyb

Rychlost zveřejnění náhradního řešení je důležitou, ale často přehlíženou součástí procesu. Pokud je řešení nalezeno, ale nezapíše se do formuláře PBM:Known Error, pracovníci Service Desku dál obtížně řeší opakující se incidenty. To vede ke zbytečné práci napříč organizací. Process mining měří dobu mezi aktivitami Workaround Identified a Workaround Published. Příliš dlouhá prodleva ukazuje na problém v komunikaci, který přímo ovlivňuje počet incidentů. Zlepšením této části workflow zajistíte, že organizace může využívat dočasná řešení, zatímco se připravuje trvalá oprava. Specialisté tak získají čas na důkladnou analýzu a nemusí pracovat pod tlakem narůstající fronty incidentů.

Měření výsledků a rozvoj vyspělosti procesu

Cílem zlepšování procesů je omezit četnost incidentů a jejich dopad na provoz. Pomocí process mining můžete stanovit jasné výchozí hodnoty pro celý průběh správy problémů. Změříte účinnost aktivit Change Request Initiated a ověříte, zda se trvalé opravy zavádějí v dohodnutých lhůtách služby. Po zavedení změn vám process mining průběžně ukazuje, zda přinášejí očekávaný výsledek. Přístup založený na datech podporuje transparentnost a odpovědnost. Týmy mohou upravovat své workflow podle skutečných zjištění. Postupně tak ubývá opakujících se problémů a IT infrastruktura je odolnější.

Jak začít se zlepšováním procesů na základě dat

Zlepšení správy problémů nevyžaduje kompletní přestavbu vašeho ITSM. Začněte tím, že získáte přehled o současném stavu. Analytické postupy můžete použít na data z BMC Helix ITSM a začít v malém, například u konkrétní důležité služby nebo často se opakující kategorie problémů. Jakmile odhalíte a odstraníte úzká místa, nižší počet incidentů uvolní kapacitu týmu pro další systémová zlepšení. Pomocí tohoto průvodce a přiložených šablon můžete začít budovat stabilnější, efektivnější a proaktivnější IT služby.

Řízení problémů Analýza hlavní příčiny Řízení IT služeb Servisní středisko Provoz ITSM Snižování počtu incidentů Koordinátor problémů Správa požadavků Správa požadavků Známá chyba Opakované incidenty Náhradní řešení Prevence incidentů IT helpdesk

Časté problémy a výzvy

Zjistěte, které výzvy se vás týkají

Mnoho záznamů o problémech zůstává několik dní nepřiřazených, protože není jasné, kdo za ně odpovídá, nebo pracovníci nevědí o oznámení. Prodleva zvyšuje riziko opakování závažných incidentů a snižuje schopnost IT oddělení rychle reagovat. Zásadní příčiny zůstávají nevyřešené, zatímco čas běží.

ProcessMind zobrazuje dobu od zaznamenání problému po jeho první přiřazení v BMC Helix ITSM. Odhalí skupiny podpory nebo kategorie problémů, u kterých se převzetí odpovědnosti pravidelně zpožďuje. Na základě těchto zjištění můžete upravit rozdělení zdrojů nebo zpřesnit pravidla přiřazování.

Šetření problému často přejde do fáze investigation commenced, ale pak v ní zůstane bez smysluplného pokroku. Takové záznamy brání trvalému odstranění příčin a vytvářejí rostoucí dluh v IT, který může vést k dalším výpadkům služeb.

Naše řešení sleduje dobu trvání fáze šetření a přesně ukáže, kde se proces zastavuje. V BMC Helix ITSM odhalí záznamy, jejichž doba řešení překročila obvyklou délku. Koordinátoři problémů tak mohou zasáhnout a přerozdělit zdroje dřív, než šetření ztratí smysl.

Pokud se náhradní řešení po nalezení rychle nezveřejní v systému správy znalostí, pracovníci Service Desku nemohou incidenty rychle vyřešit. Nedostatečné sdílení dočasných řešení prodlužuje průměrnou dobu opravy souvisejících incidentů a zvyšuje nespokojenost uživatelů, zatímco se připravuje trvalá oprava.

ProcessMind měří prodlevu mezi nalezením náhradního řešení a aktivitou Workaround Published. Díky tomuto přehledu se dočasná řešení rychleji šíří prostřednictvím BMC Helix ITSM. Omezíte tak dopad přetrvávajících problémů, zatímco technické týmy pracují na odstranění jejich příčiny.

Záznamy o problémech často putují mezi různými technickými týmy. Skupiny se mohou snažit vyhnout odpovědnosti nebo nesprávně chápat technický rozsah problému. Takové přeposílání výrazně prodlužuje řešení a oddaluje analýzu příčiny. Výsledkem je zbytečná práce a přetížení zdrojů.

Naše analytické nástroje mapují pořadí přiřazování a odhalují opakované přeposílání záznamů v BMC Helix ITSM. Uvidíte, které skupiny podpory záznamy často přesměrovávají. Můžete pak upravit školení nebo přesněji vymezit odpovědnosti skupin a přerušit tento koloběh.

Problémy s vysokou prioritou často nesplní dohodnuté lhůty služby kvůli skrytým nedostatkům při šetření a opravě. Nedodržení termínů ohrožuje stabilitu IT služeb a může vyvolat napětí uvnitř organizace nebo oslabit důvěru v podnikání, pokud kritická infrastruktura zůstává nestabilní déle, než bylo dohodnuto.

ProcessMind porovnává termíny SLA se skutečnými časovými údaji v procesu a určuje, které aktivity vedou k jejich nedodržení. V BMC Helix ITSM tak můžete průběžně sledovat plnění SLA a upravit priority nebo workflow dříve, než dojde k překročení termínu a ohrožení stability služeb.

Po určení příčiny často trvá dlouho, než se zahájí požadavek na změnu, který umožní zavést trvalou opravu. Organizace je tak vystavena opakovaným incidentům, přestože technické řešení už zná. Jeho zavedení uvízne v administrativním procesu.

Analyzujeme dobu mezi aktivitou Root Cause Identified a událostí Change Request Initiated. Odhalíme tak překážky při přechodu od správy problémů ke správě změn v BMC Helix ITSM a pomůžeme posunout trvalé opravy dál bez zbytečných administrativních prodlev.

Týmy v rušných obdobích často vynechávají kontrolu po zavedení změny, aby záznamy rychle uzavřely a zmenšily nevyřízenou frontu. Bez této kontroly organizace neověří, zda oprava funguje podle očekávání, ani nezaznamená získané poznatky. V budoucnu se tak mohou opakovat podobné problémy.

ProcessMind sleduje, zda se u každého uzavřeného záznamu o problému provedla aktivita Post-Implementation Review Conducted. V BMC Helix ITSM upozorní na odchylky od standardního procesu a pomůže zajistit dodržení všech kroků řešení, dlouhodobé zlepšování služeb i požadavků na shodu.

Záznamy o problémech se někdy uzavřou dřív, než vedoucí z obchodního nebo technického týmu ověří řešení. Krátce po uzavření se pak může stejný problém objevit znovu. Záznam je nutné znovu otevřít nebo založit nový, což komplikuje reporting a snižuje přesnost ukazatelů.

Naše analýza porovnává aktivitu Resolution Verified s konečným uzavřením záznamu v BMC Helix ITSM. Odhalí případy, kdy se ověření vynechalo nebo uspěchalo. Týmy tak mohou lépe kontrolovat kvalitu a před oficiálním vyřešením problému ověřit, že byla odstraněna jeho příčina.

Pokud technici nesprávně zařazují příčiny problémů, nelze spolehlivě sledovat dlouhodobé trendy ani systémové slabiny infrastruktury. Nedostatek údajů brání vedení v informovaném rozhodování o investicích do infrastruktury a potřebných změnách procesů, které by zvýšily stabilitu.

ProcessMind vyhledá záznamy, u kterých chybí kategorie příčiny nebo je nastavena obecná hodnota. Upozorněním na tyto nedostatky v BMC Helix ITSM pomáháme zlepšit kvalitu dat a lépe porozumět skutečným příčinám nestability IT. Na základě těchto poznatků můžete účinněji předcházet problémům.

Některé specializované technické týmy bývají zahlcené velkým počtem přiřazených problémů. Hromadí se jim nevyřízené záznamy a opravy se zpožďují. Nerovnoměrné rozložení práce vytváří jediné místo selhání, které brzdí celý proces správy problémů a ohrožuje důležité služby.

Analýzou počtu aktivních záznamů přiřazených jednotlivým skupinám podpory naše řešení odhalí nedostatečnou kapacitu. Vedoucí IT pak mohou v BMC Helix ITSM upravit rozložení práce nebo posílit důležité týmy. Rozhodují se přitom podle skutečného objemu zpracování, ne podle jednotlivých zkušeností.

Pokud správa problémů trvá příliš dlouho, stejné incidenty dál zahlcují Service Desk a spotřebovávají cenné zdroje na opakující se úkoly. Tato práce snižuje efektivitu a odvádí tým od strategických projektů i složitější diagnostiky.

ProcessMind porovnává počet souvisejících incidentů s délkou šetření a opravy. Ukáže, jak pomalé řešení problémů přímo zvyšuje počet incidentů v BMC Helix ITSM. Tato data vám pomohou zdůvodnit urychlení trvalých oprav a snížit zátěž Service Desku.

Typické cíle

Určete, jak vypadá úspěch

Rychlé přiřazení zajistí, že se důležitými problémy začnou hned zabývat správní odborníci. Zkrácením doby, po kterou záznam zůstává ve stavu zaznamenáno, mohou organizace dříve zahájit šetření a zkrátit dobu, po kterou jsou vystaveny riziku přetrvávajících výpadků IT. Zlepší se tak i rychlost obnovy služeb.

ProcessMind měří dobu mezi aktivitami Logged a Assigned v BMC Helix ITSM. Upozorní na kategorie nebo úrovně priority, u kterých přiřazení trvá déle než obvykle. Vedoucí mohou stanovit cílové hodnoty a sledovat, jak se doba odezvy průběžně mění.

Hledání příčiny problému je nejnáročnější částí procesu. Její zkrácení přímo urychlí přípravu trvalých oprav, zabrání hromadění technického dluhu a sníží zátěž technických týmů, které by jinak řešily opakované incidenty.

Naše platforma sleduje aktivitu Investigation Commenced a měří čas věnovaný analýze příčiny. Odhalí skrytá úzká místa, kde se šetření zastavuje. Koordinátoři tak mohou zasáhnout a přerozdělit zdroje dřív, než složité problémy překročí lhůty SLA.

Rychlé poskytnutí náhradního řešení je důležité pro obnovení služby, zatímco se hledá trvalá oprava. Včasné zveřejnění známých chyb omezuje provozní dopad incidentů a zlepšuje zkušenost uživatelů. Pracovníci Service Desku tak mají ihned k dispozici řešení běžných problémů a služby jsou dostupnější.

Pomocí process mining můžete zobrazit dobu mezi prvním zaznamenáním problému a aktivitou Workaround Published. Zjistíte, které skupiny podpory poskytují dočasnou pomoc nejrychleji, a jejich efektivní workflow můžete uplatnit v celé IT organizaci.

Pokaždé, když záznam o problému putuje mezi skupinami podpory, ztrácí se čas i kontext. Omezením tohoto přeposílání zajistíte přímější cestu k řešení, snížíte frustraci technických pracovníků a zkrátíte celkovou dobu zpracování. Záznam zůstane u správných odborníků.

ProcessMind mapuje pohyb záznamů mezi skupinami podpory v BMC Helix ITSM. Odhalí opakující se smyčky a častá přeřazení. Můžete tak určit, kde chybějí znalosti nebo kde je třeba zlepšit prvotní třídění, aby se záznam hned napoprvé dostal ke správnému týmu.

Dodržování dohodnutých lhůt služby u problémů s vysokou prioritou je důležité pro zachování kontinuity provozu. Pravidelné plnění SLA posiluje důvěru obchodních partnerů a zajišťuje, že nejzávažnější problémy dostanou potřebnou pozornost. Zkracuje se tak doba výpadků důležitých služeb.

Platforma porovnává termín SLA se skutečným časem dokončení každého záznamu o problému. Včas upozorní na záznamy, které se blíží k limitu. Koordinátoři tak mohou určit priority práce a udržet plnění SLA u důležitých služeb.

Po určení příčiny by měl následovat plynulý přechod k formálnímu požadavku na změnu. Rychlejší předání umožní co nejdříve zavést trvalou opravu, odstranit rizika v IT prostředí a zkrátit dobu čekání na navržené řešení.

Analyzujeme pořadí událostí od Root Cause Identified po Change Request Initiated. Zviditelníme administrativní prodlevy a úzká místa při schvalování. Týmy pak mohou automatizovat vytváření záznamů o změnách a zkrátit čekání mezi určením příčiny a nápravou.

Poučení z minulých problémů je důležité pro průběžné zlepšování služeb. Kontrola každého závažného problému zajistí zaznamenání získaných poznatků, pomáhá předcházet podobným potížím a postupně zvyšuje vyspělost IT organizace díky lepšímu sdílení znalostí.

ProcessMind sleduje, zda se před uzavřením záznamu provedla aktivita Post-Implementation Review Conducted. Odhalí, kde se tento krok často vynechává. Můžete tak zajistit dodržování postupu a zaznamenání i sdílení znalostí napříč Service Deskem.

Uzavření záznamu o problému bez ověření opravy často vede k tomu, že se stejný problém znovu objeví. Formální ověření pomáhá zajistit, že byla skutečně odstraněna příčina. Snižuje tak počet budoucích incidentů a chrání stabilitu služeb v celé organizaci.

Analýzou pořadí aktivit Resolution Verified a Record Closed naše platforma odhalí případy předčasného uzavření. Tato data pomáhají důsledně dbát na kvalitu a ověřit účinnost každé opravy před konečným uzavřením případu.

Kvalitní data jsou základem účinné správy problémů. Přesnější zařazování příčin umožňuje lépe sledovat trendy a cíleněji investovat do technologií nebo školení, které řeší systémové nedostatky IT infrastruktury. Výsledkem je dlouhodobě vyšší stabilita.

Platforma analyzuje kategorii příčiny napříč tisíci záznamy a hledá nesrovnalosti i nadměrné používání obecných kategorií. Vedoucí mohou na základě těchto poznatků upravit pravidla pro zadávání dat a zvýšit spolehlivost reportů v prostředí BMC Helix ITSM.

Rovnoměrné rozložení práce mezi technickými týmy brání tomu, aby se jednotlivé skupiny staly úzkým místem. Správné přidělení zdrojů zajistí, že se všem problémům bez ohledu na kategorii dostane potřebné pozornosti a procesem procházejí předvídatelným tempem.

ProcessMind zobrazuje počet otevřených záznamů o problémech, které zpracovává každá přiřazená skupina podpory. Odhalí týmy s nepřiměřeně vysokým objemem práce nebo delší dobou zpracování. Můžete tak rozhodovat o počtu pracovníků, školení a rozdělení práce na základě dat.

Hlavním cílem správy problémů je zabránit opakování incidentů. Nižší počet opakovaných incidentů výrazně snižuje náklady na IT podporu a zvyšuje dostupnost důležitých firemních aplikací. Pracovníci IT se tak mohou věnovat rozvoji místo rutinní údržby.

Pro měření skutečného dopadu jednotlivých problémů porovnáváme záznamy o problémech s počtem souvisejících incidentů. Sledujte, jak rychle po zavedení trvalé opravy počet incidentů klesá. Můžete tak vyčíslit přínos správy problémů a zjistit, které opravy měly největší účinek.

Proaktivní správa problémů pomáhá předcházet potížím dřív, než zasáhnou uživatele. Včasné rozpoznání trendů umožňuje řešit zranitelná místa při plánované údržbě, ne až během nouzového zásahu. IT prostředí je tak stabilnější.

ProcessMind analyzuje dobu mezi shluky incidentů a vytvořením záznamu o problému. Sledováním těchto vzorců zjistíte, kde lze zahájit šetření dříve. Tým se tak může místo hašení problémů soustředit na prevenci a omezit jejich celkový dopad na organizaci.

Šest kroků ke zlepšení správy problémů

1

Získejte šablonu pro data

Co dělat

Získejte standardizovanou šablonu Excelu pro pole BMC Helix Problem Management, včetně formulářů Problem Investigation a Known Error.

Proč je to důležité

Předpřipravená struktura zajistí, že data o průběhu procesu budou odpovídat analytickým modelům. Díky tomu rychleji získáte diagnostické poznatky.

Očekávaný výsledek

Šablona připravená k mapování dat ITSM.

POZNATKY O VAŠEM PROCESU

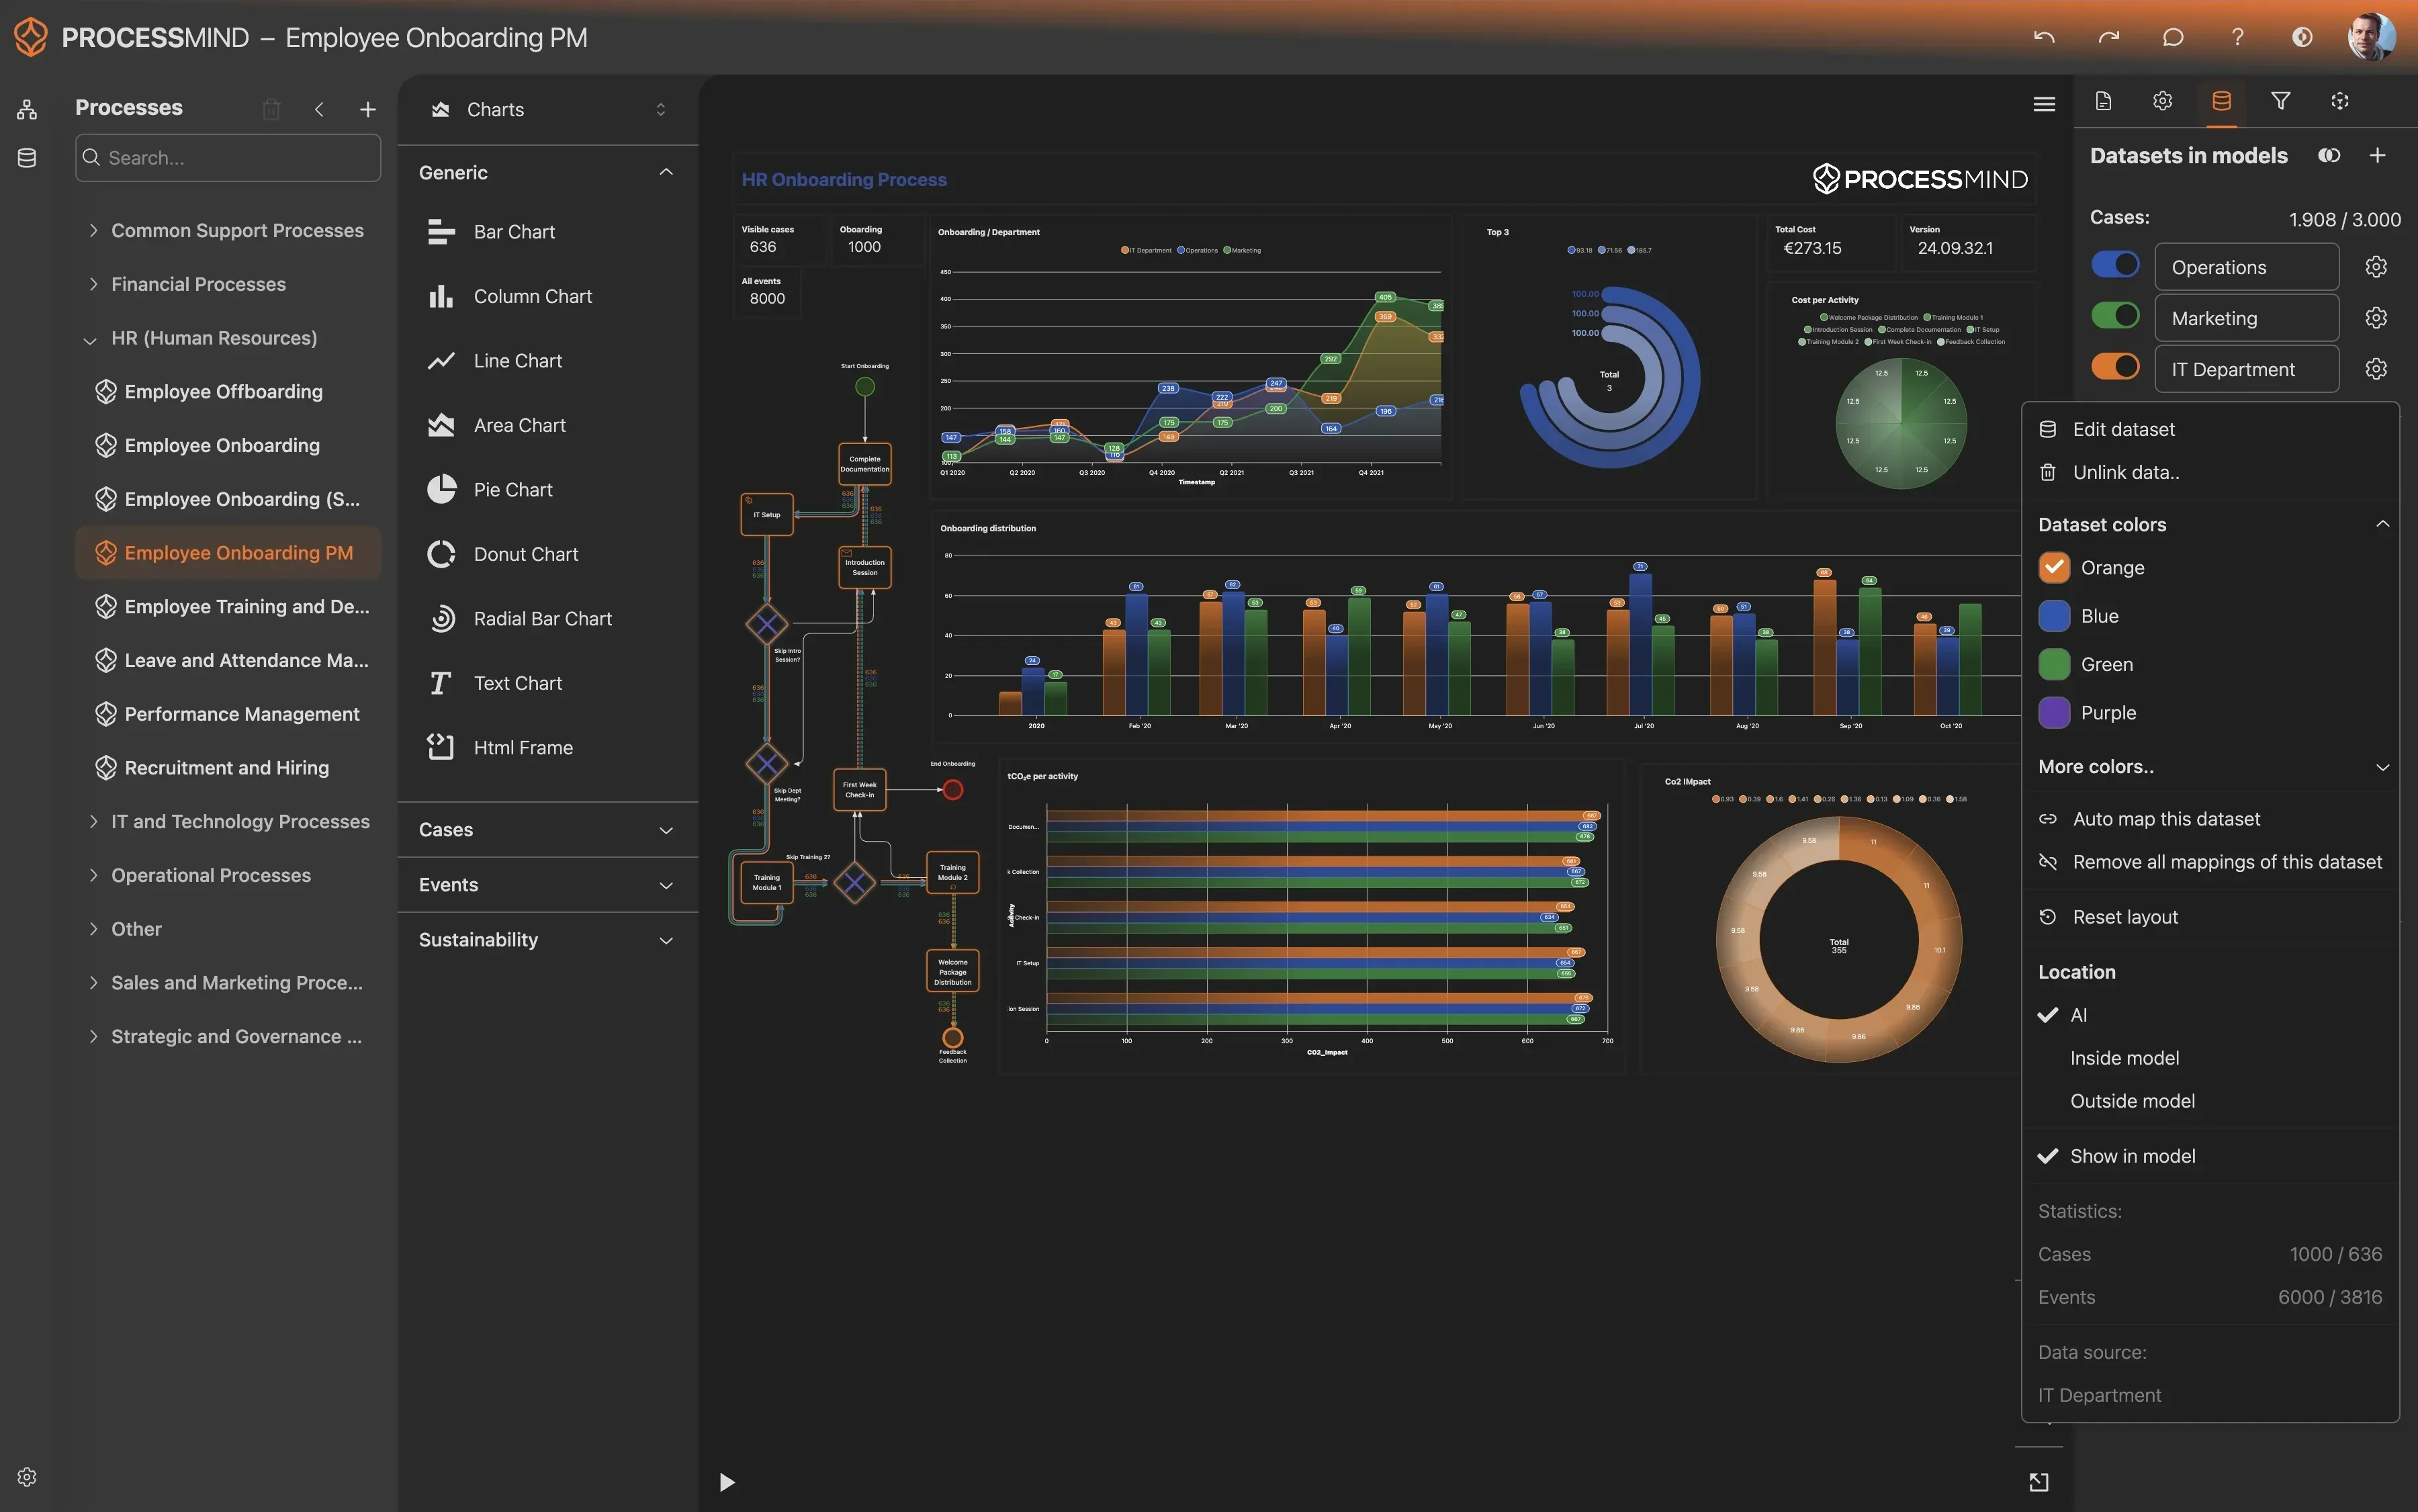
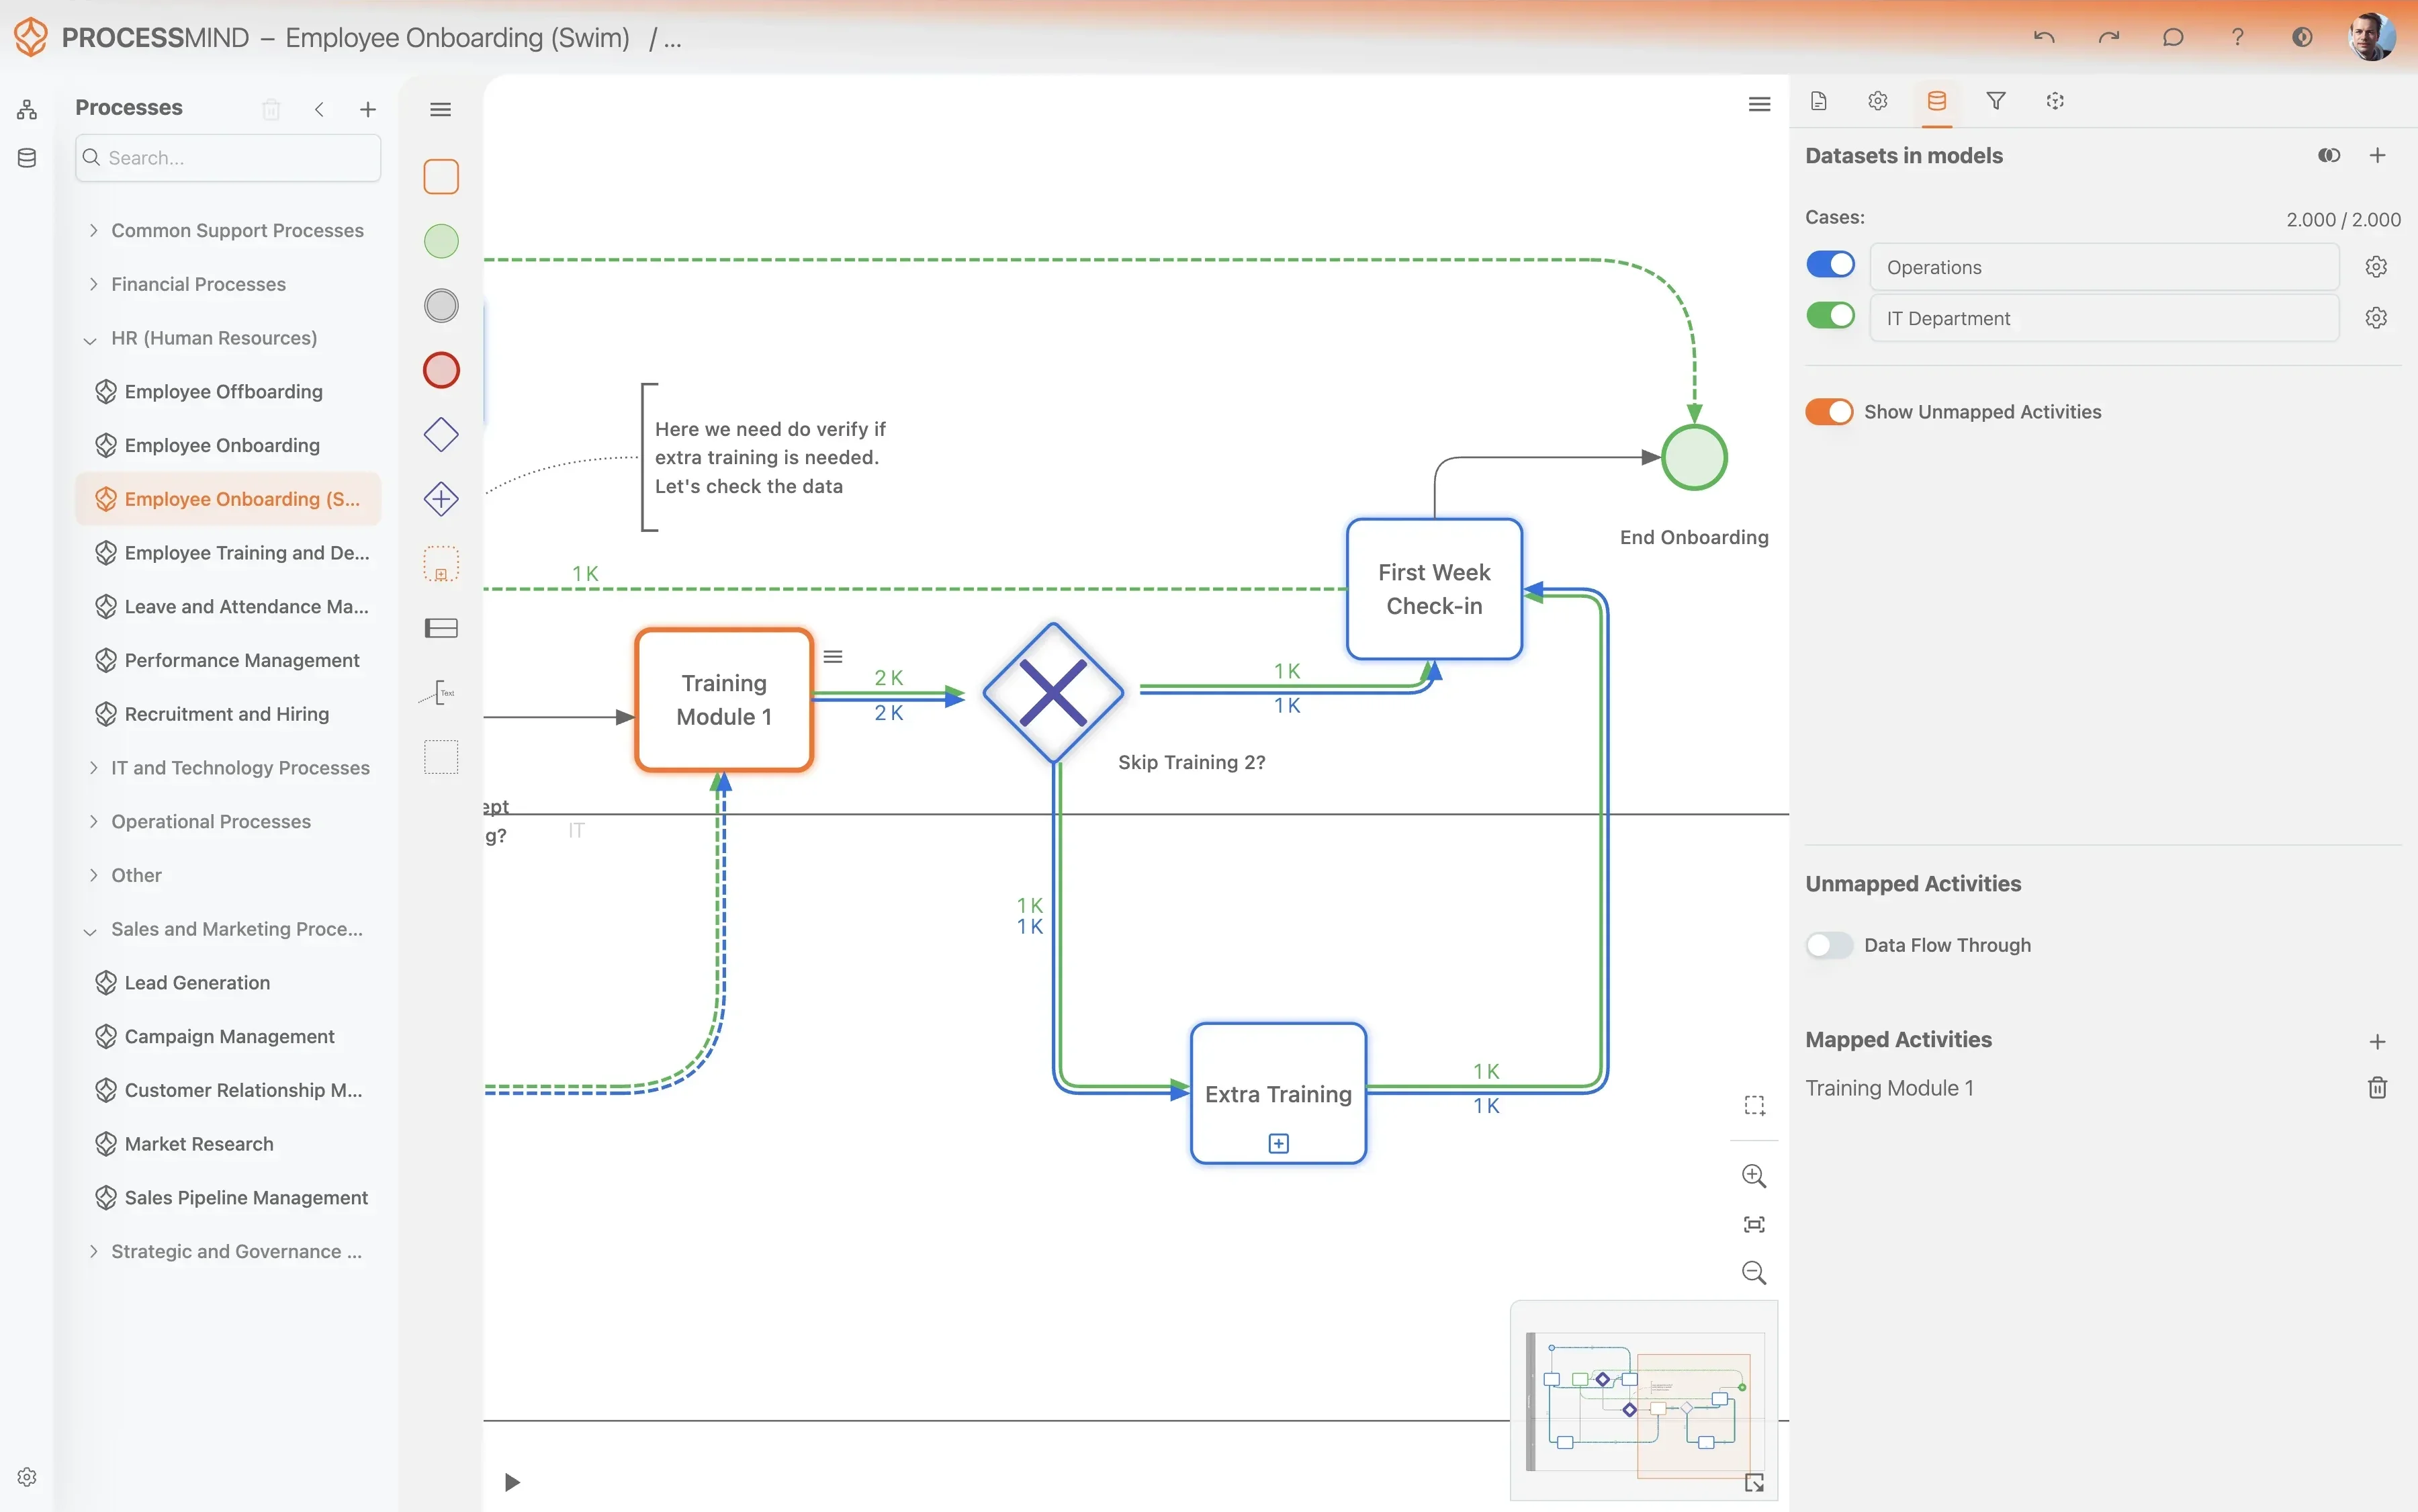
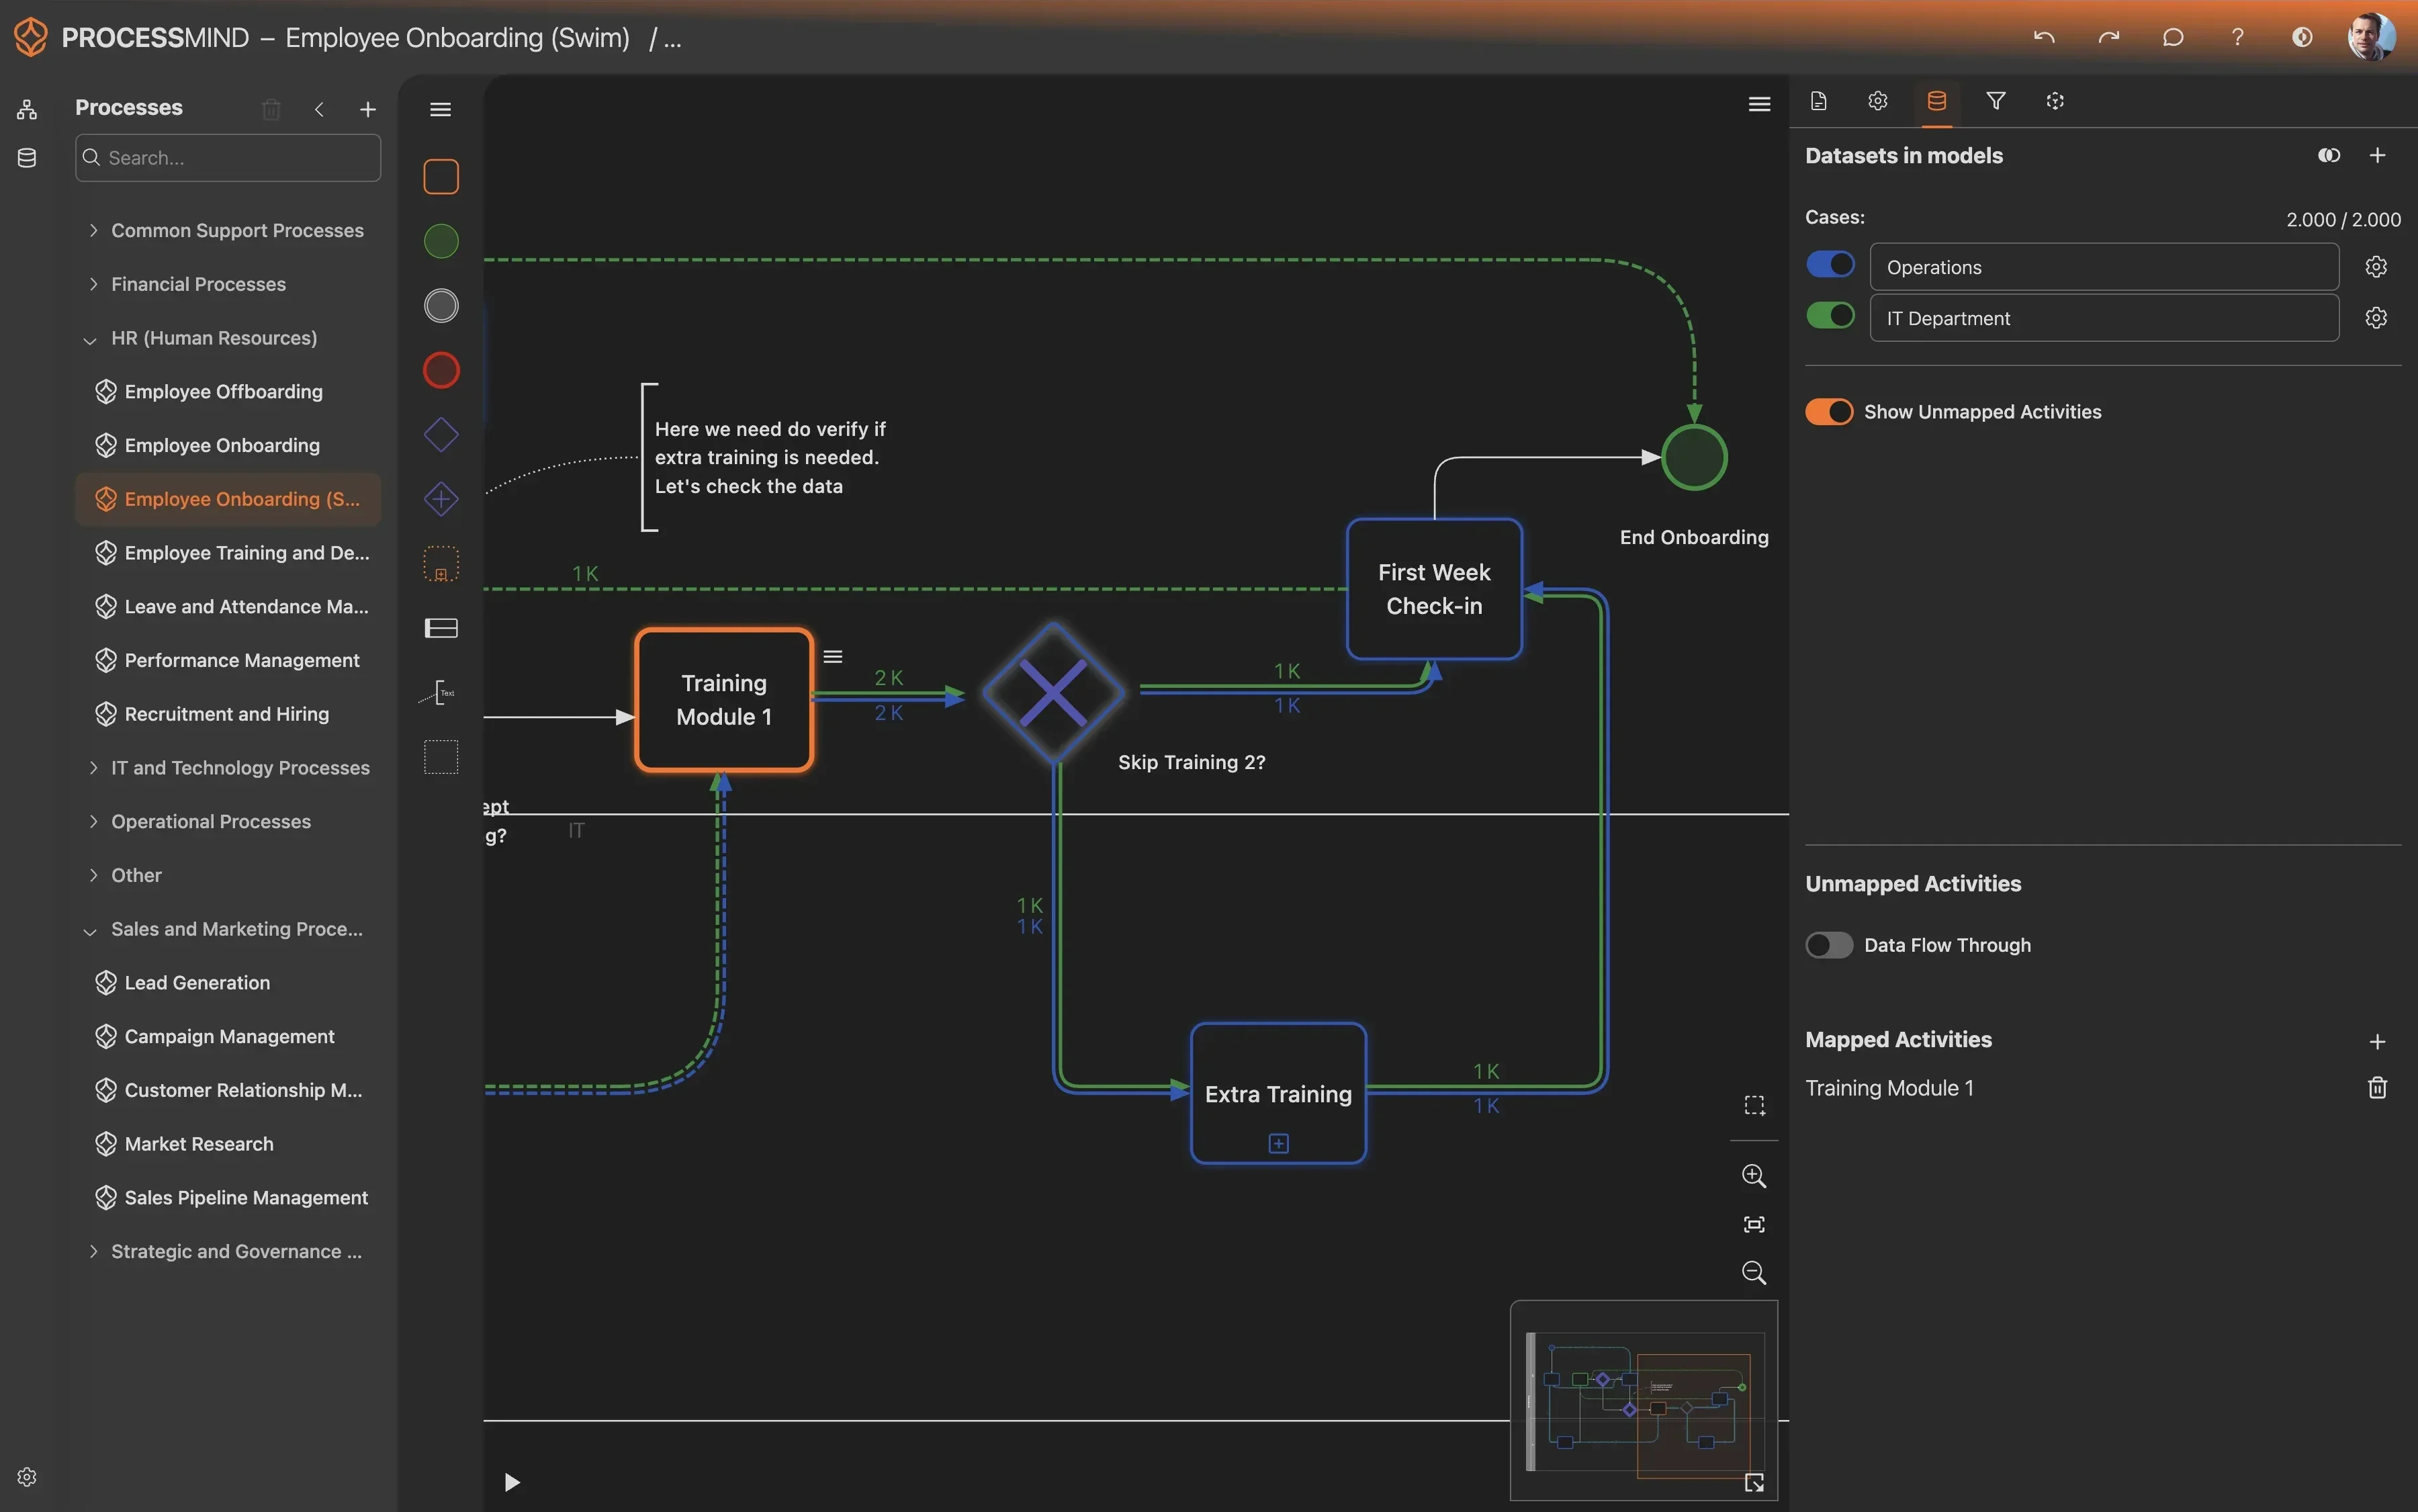
Odhalte skutečná úzká místa při řešení problémů v Helix

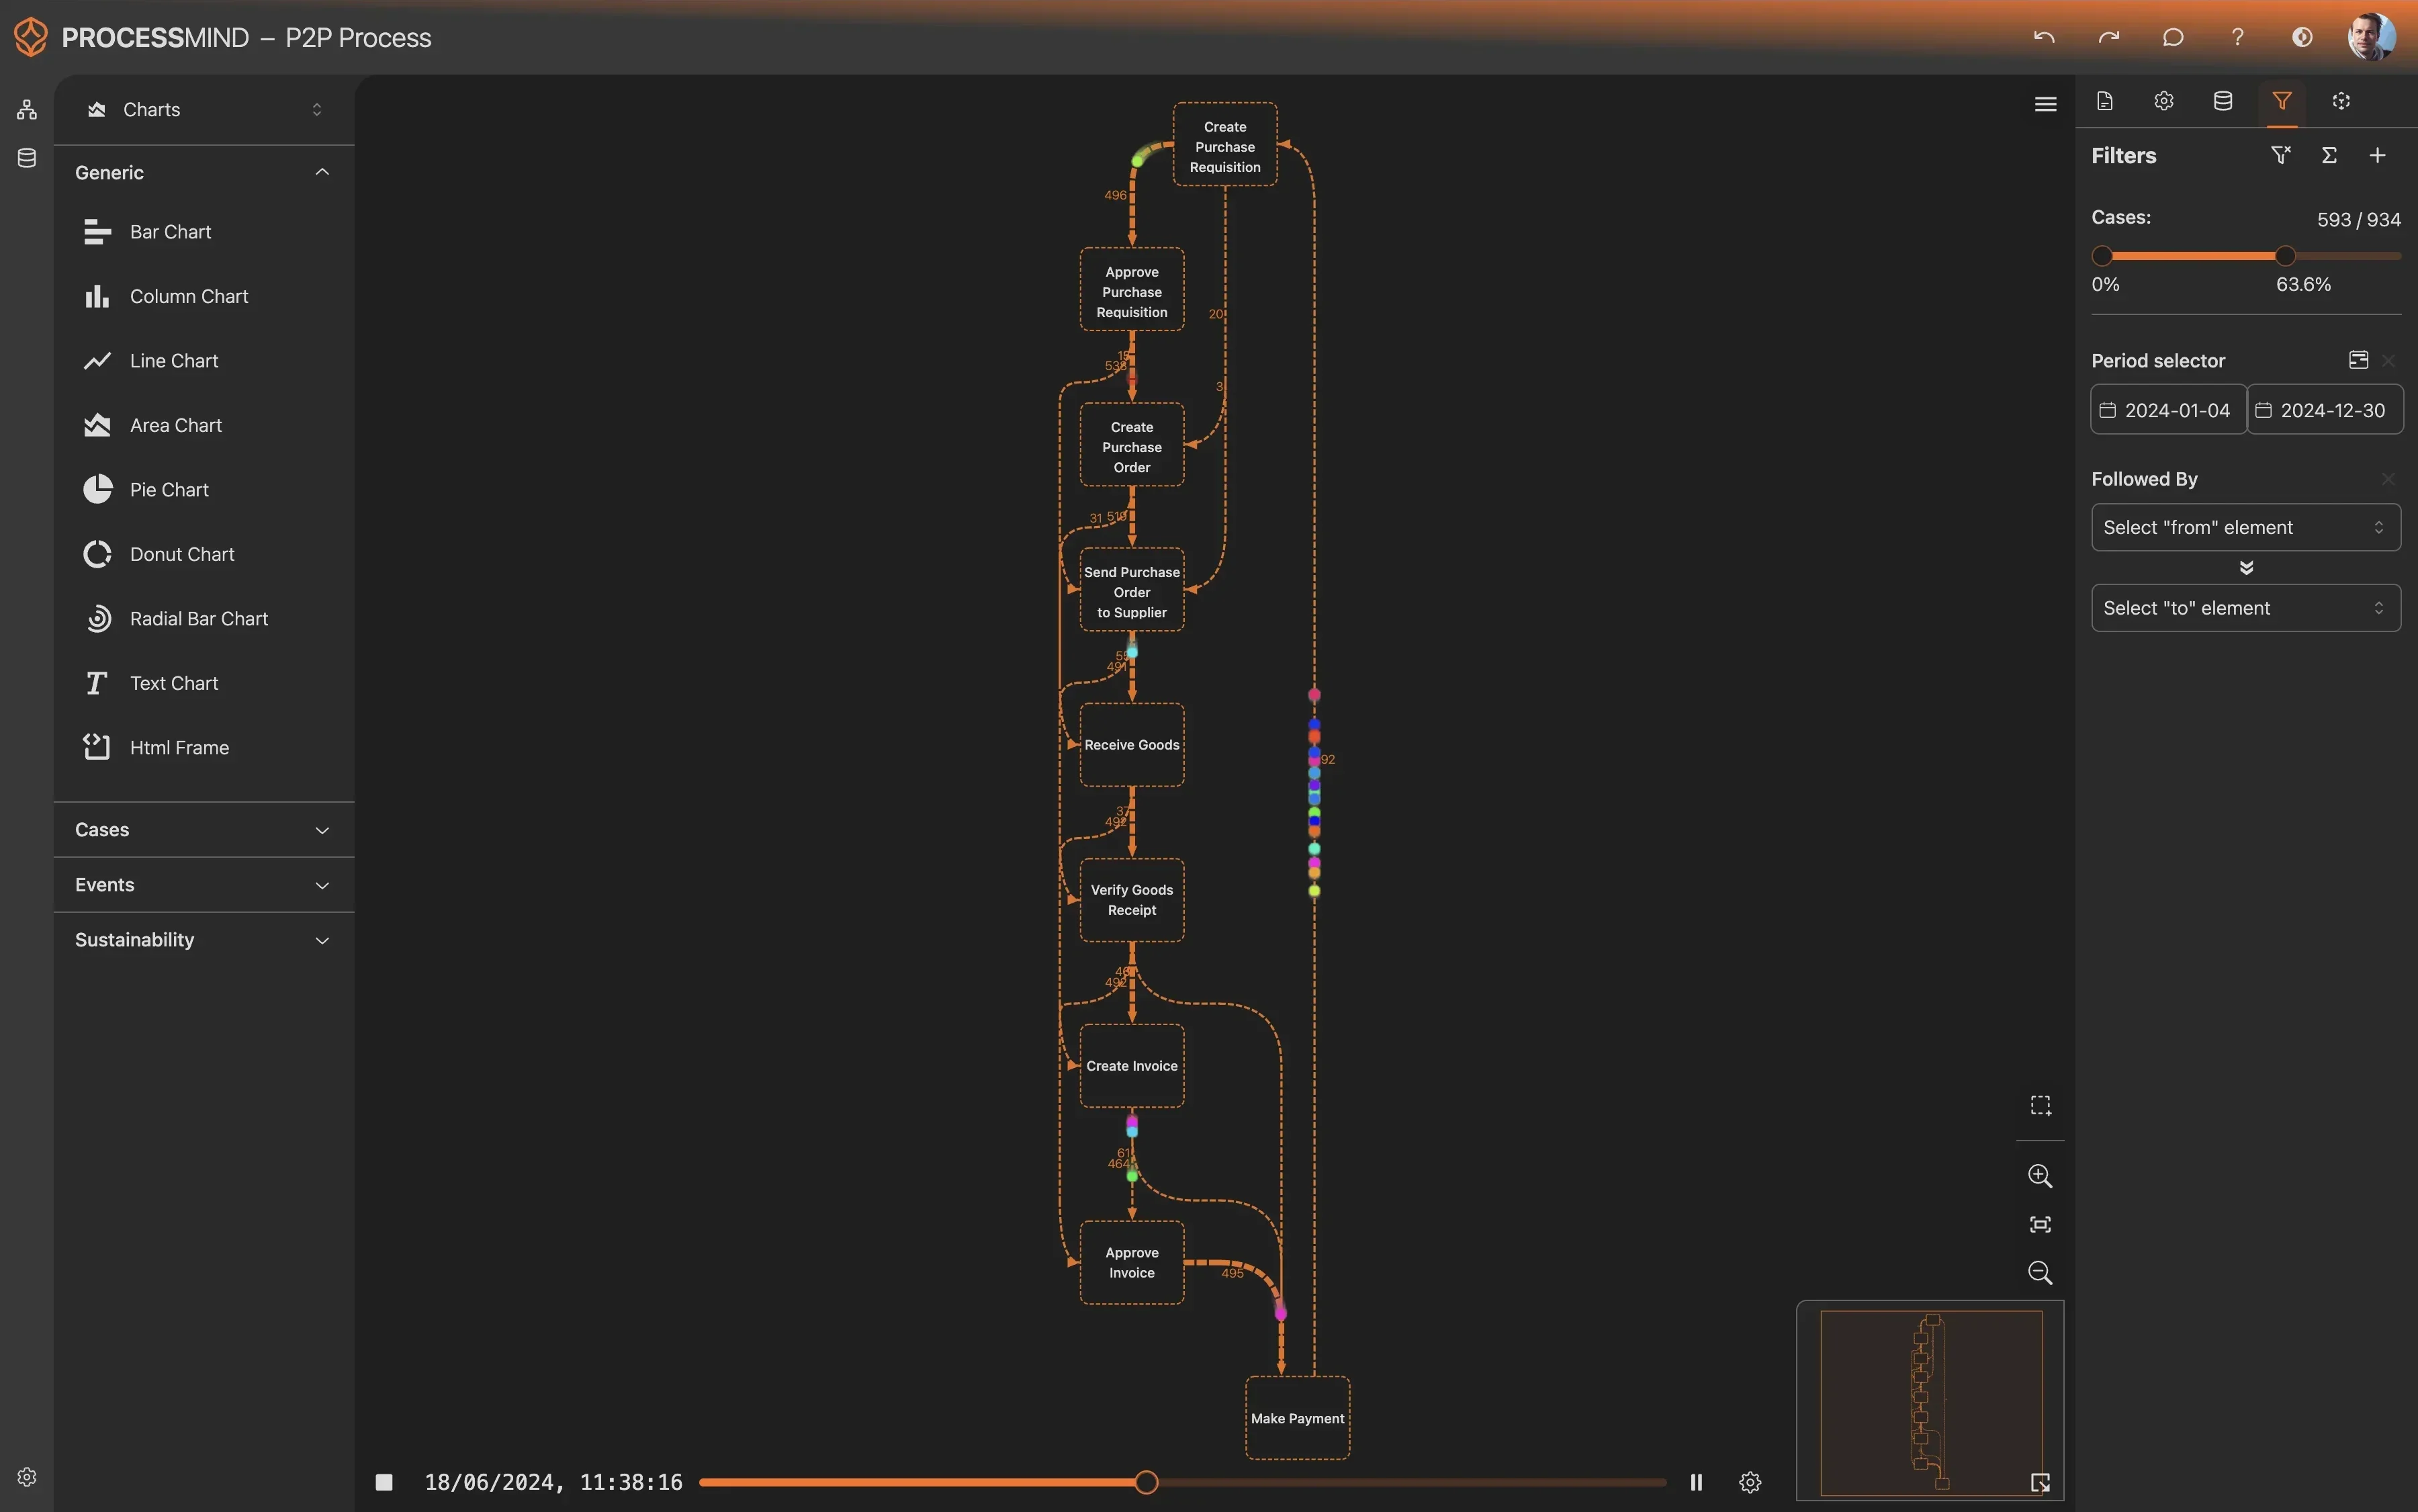
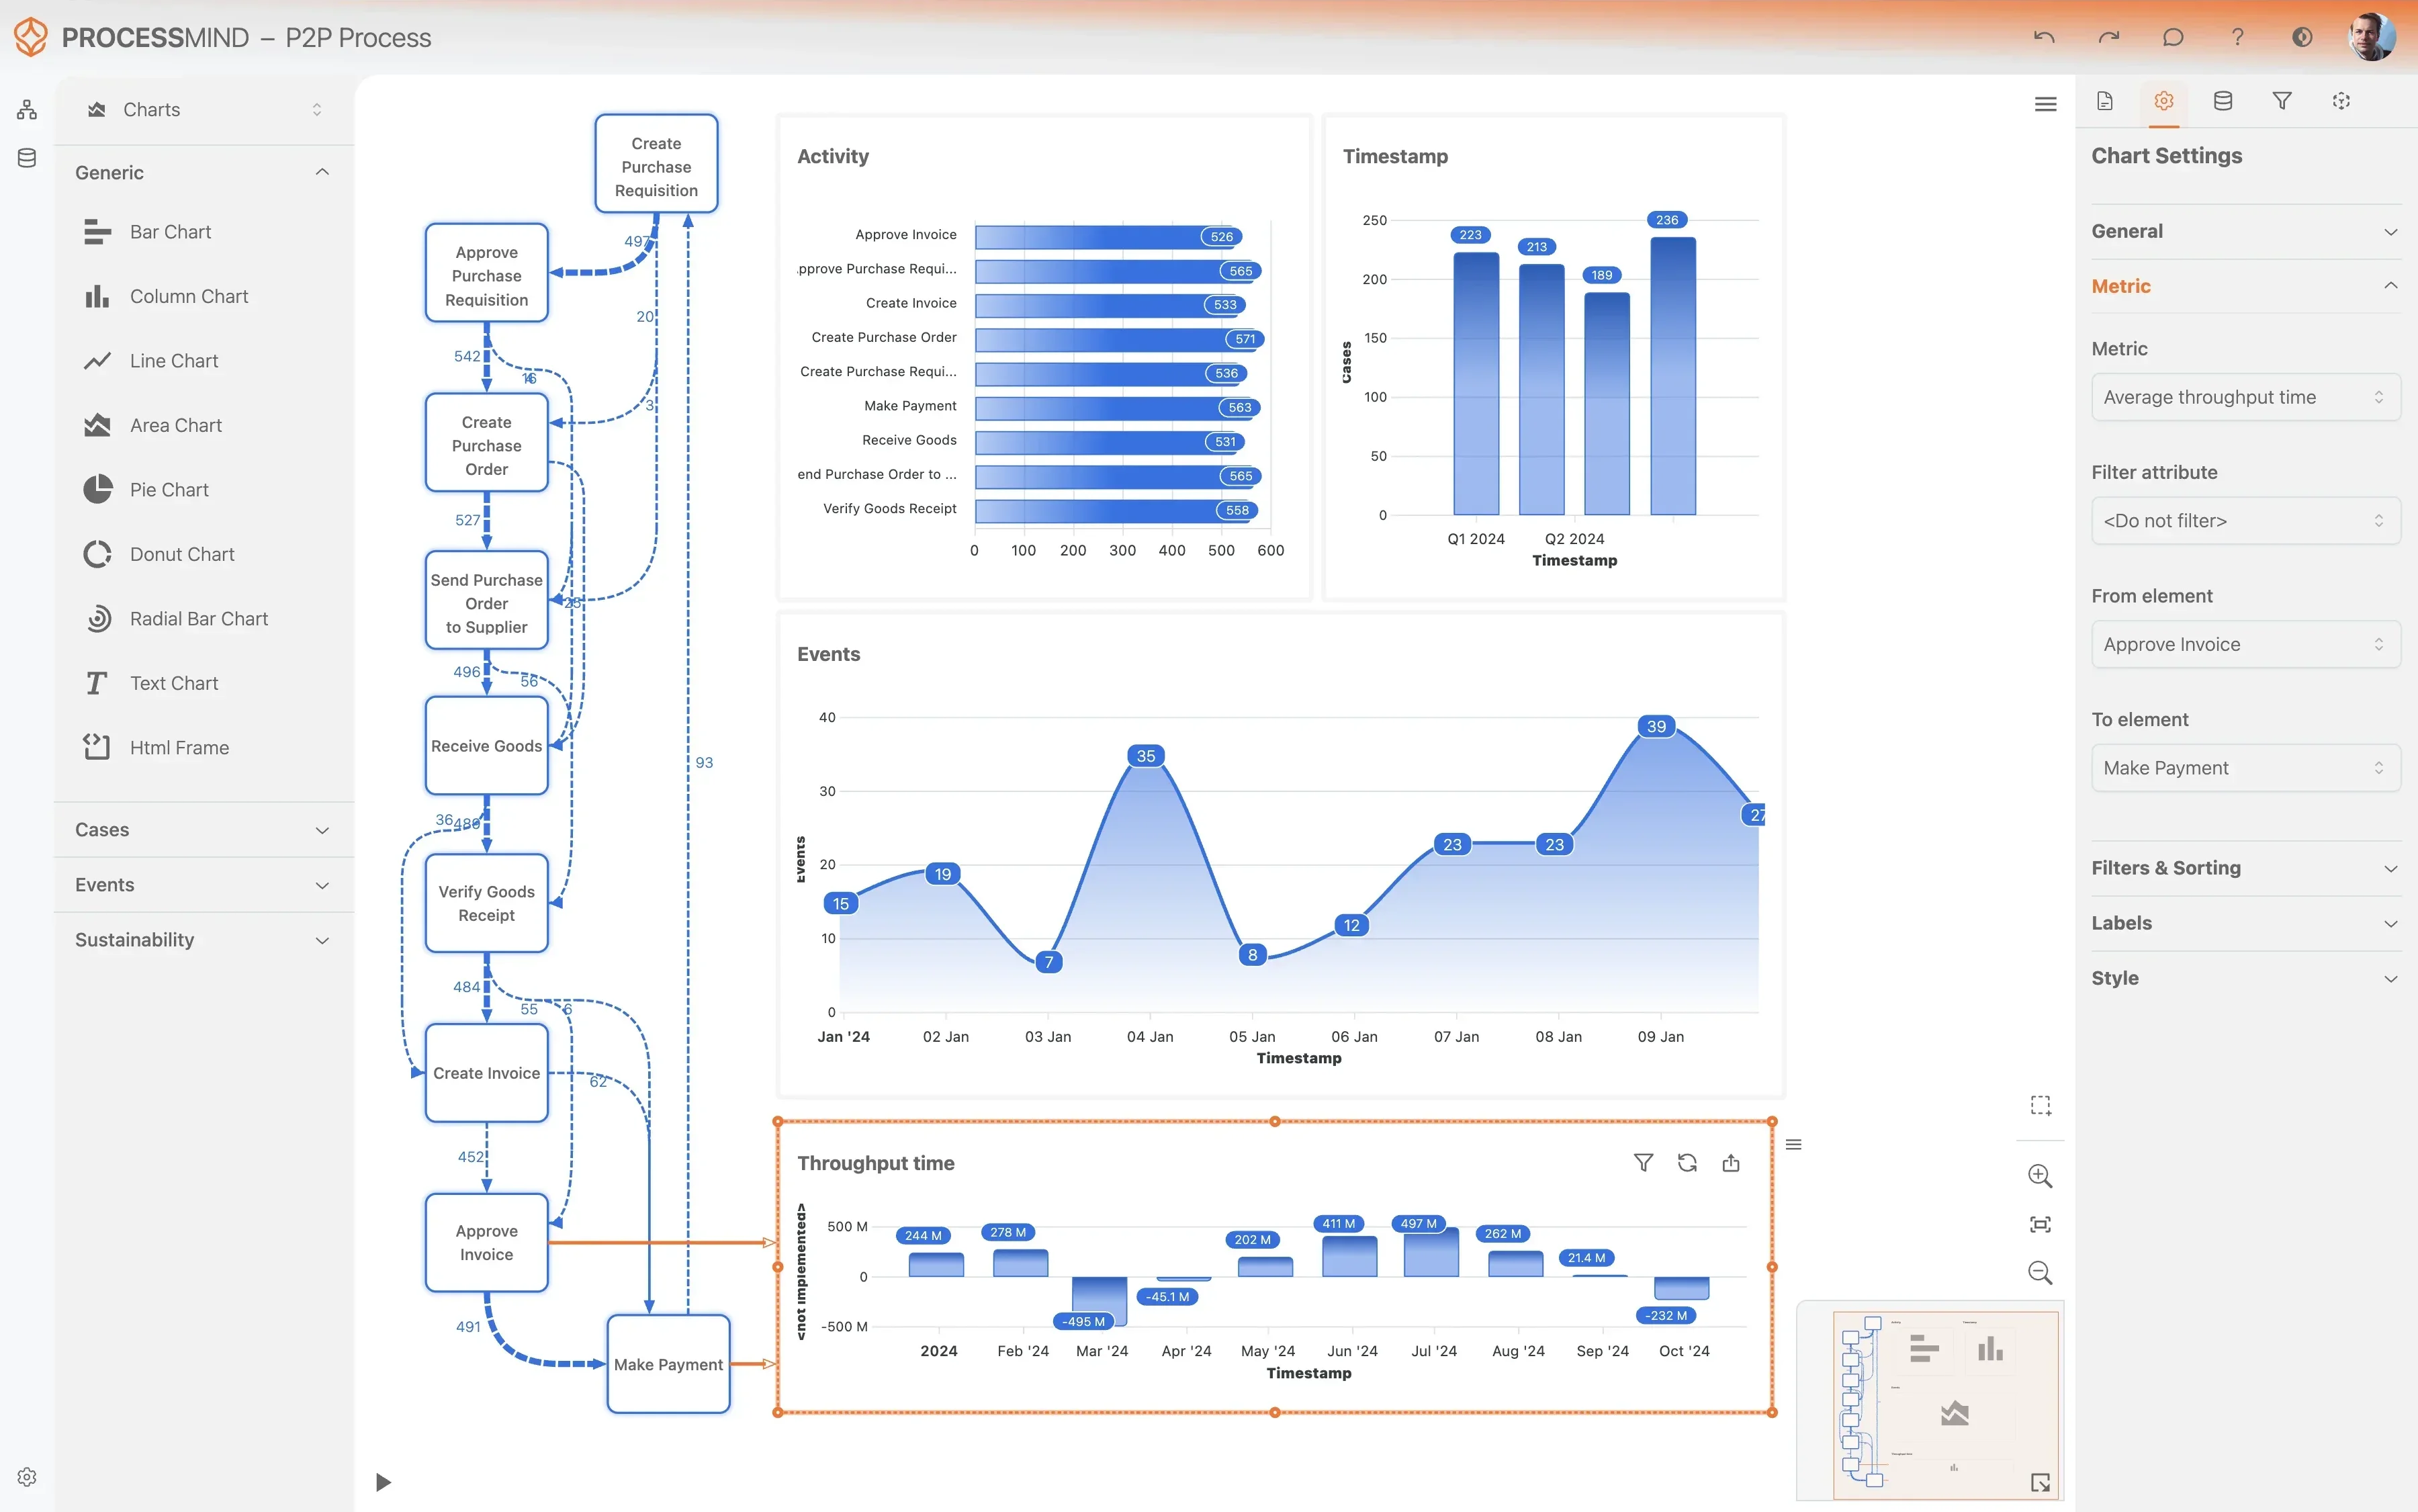
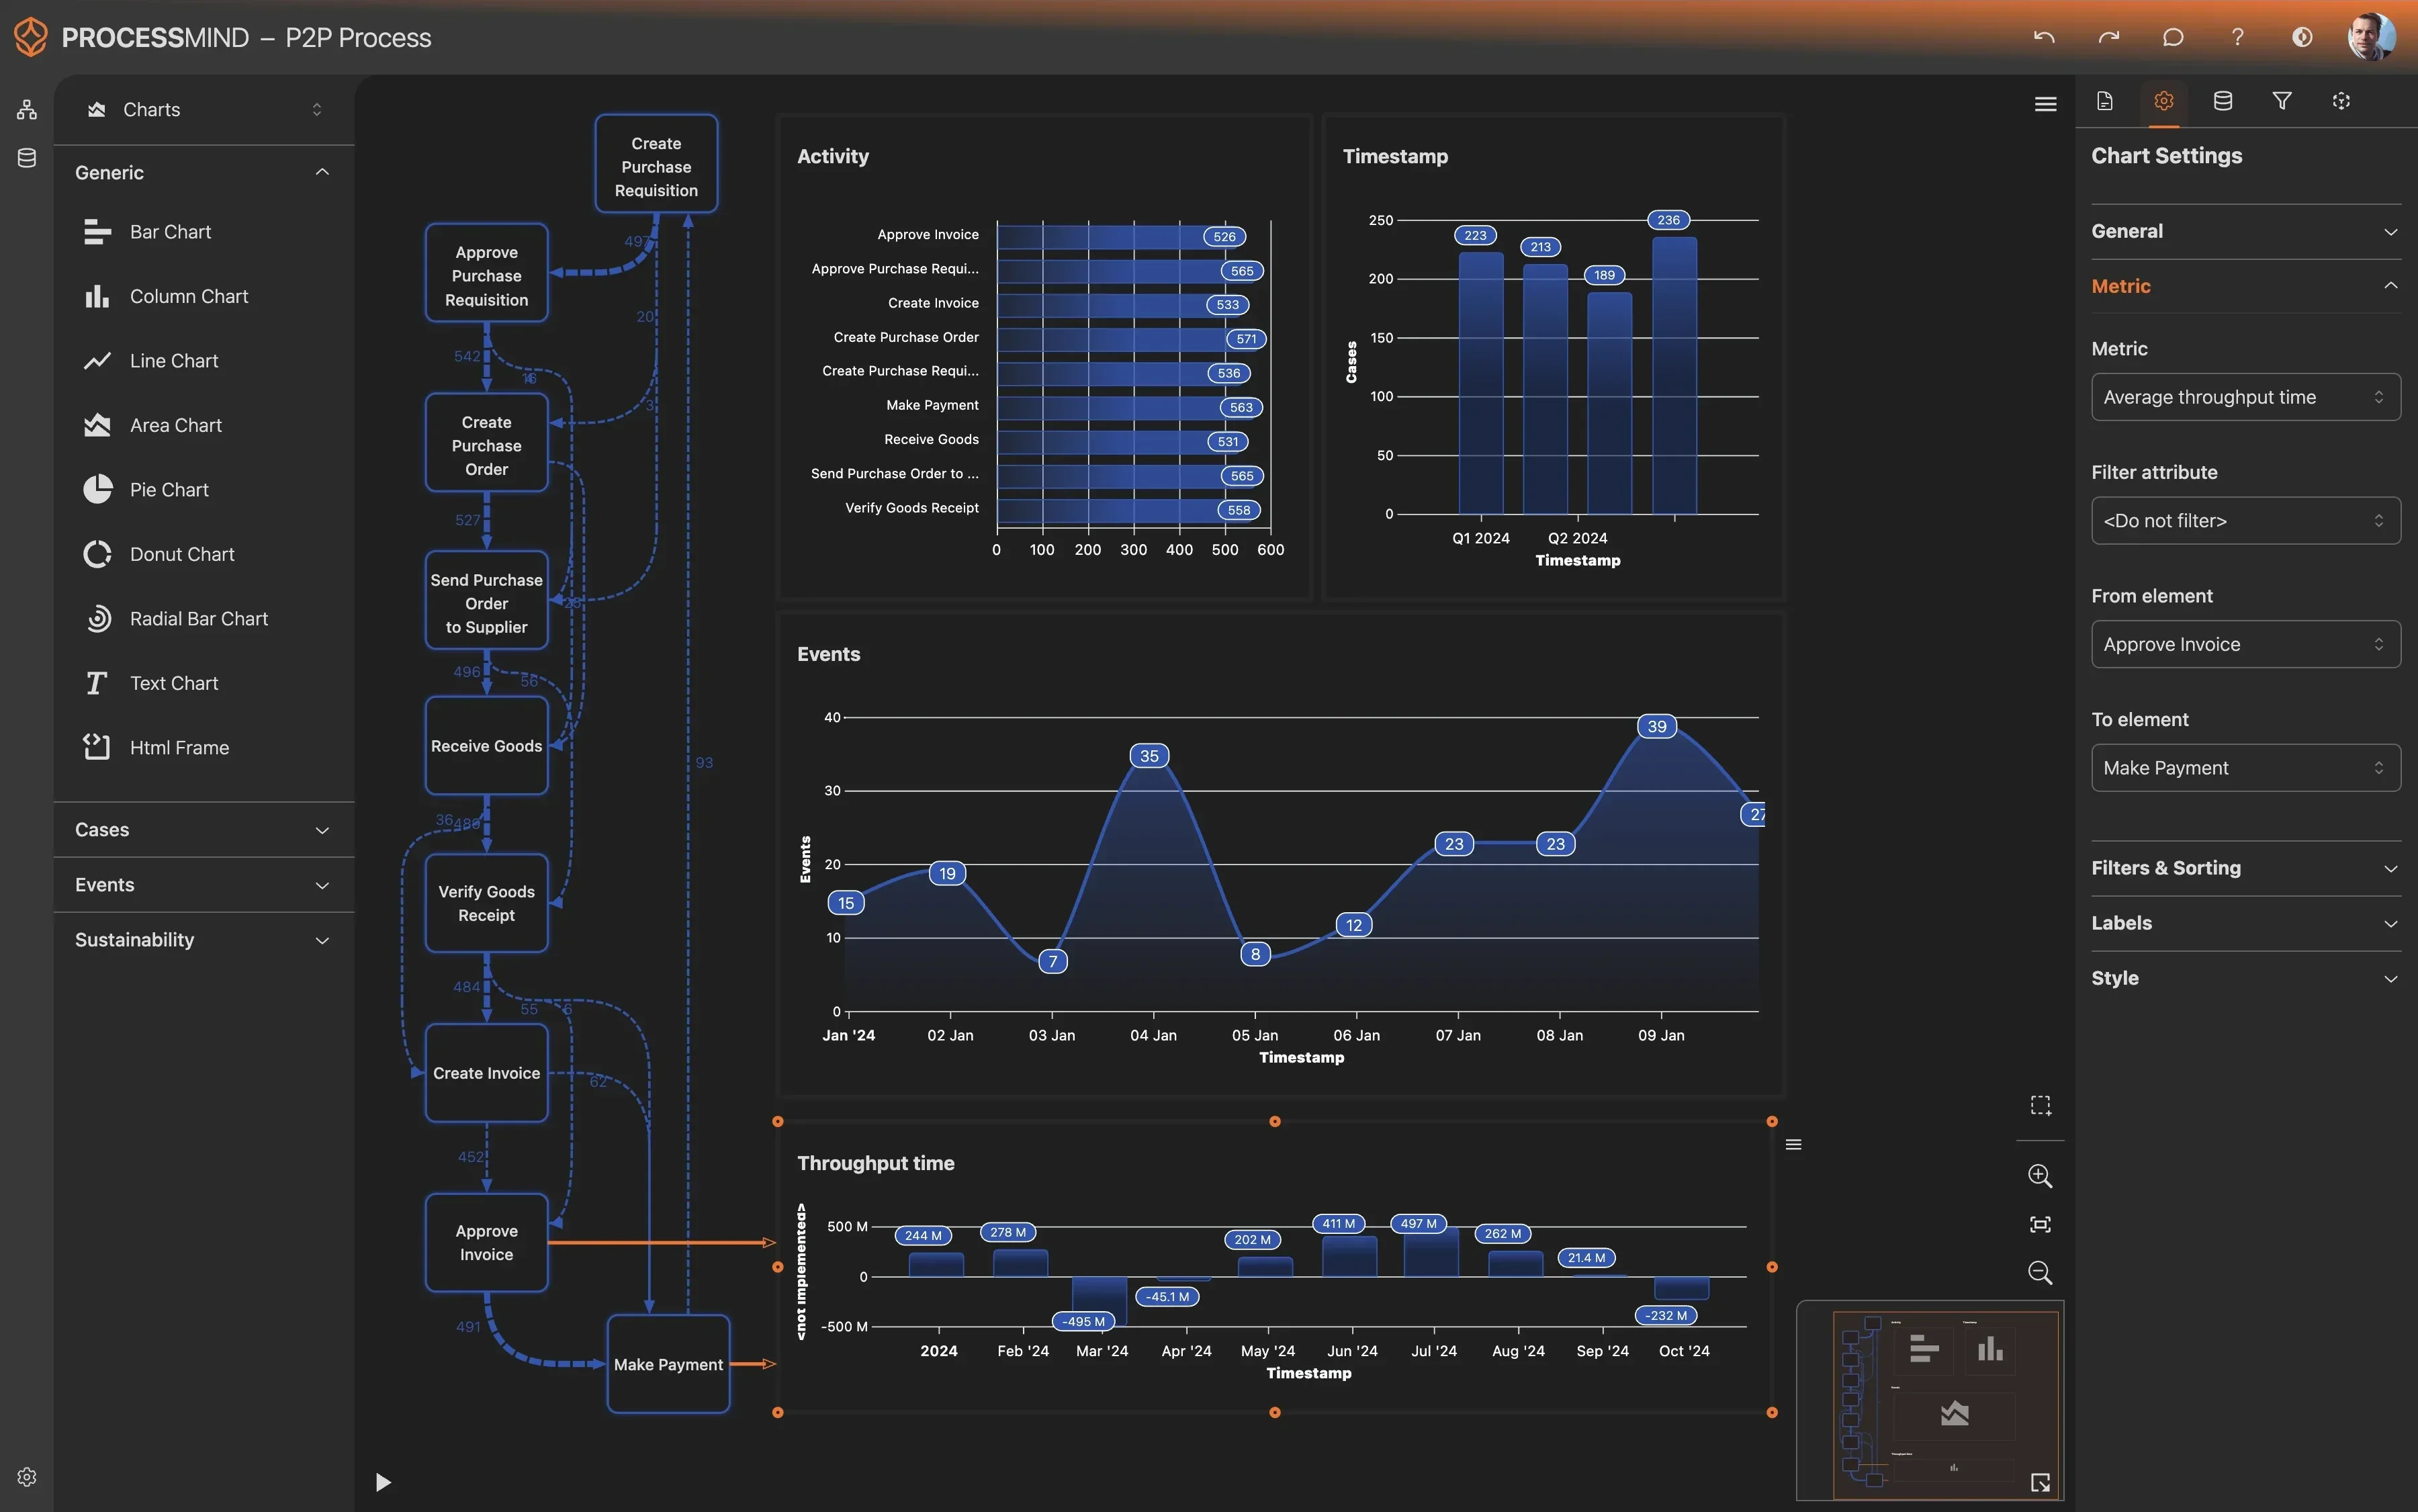
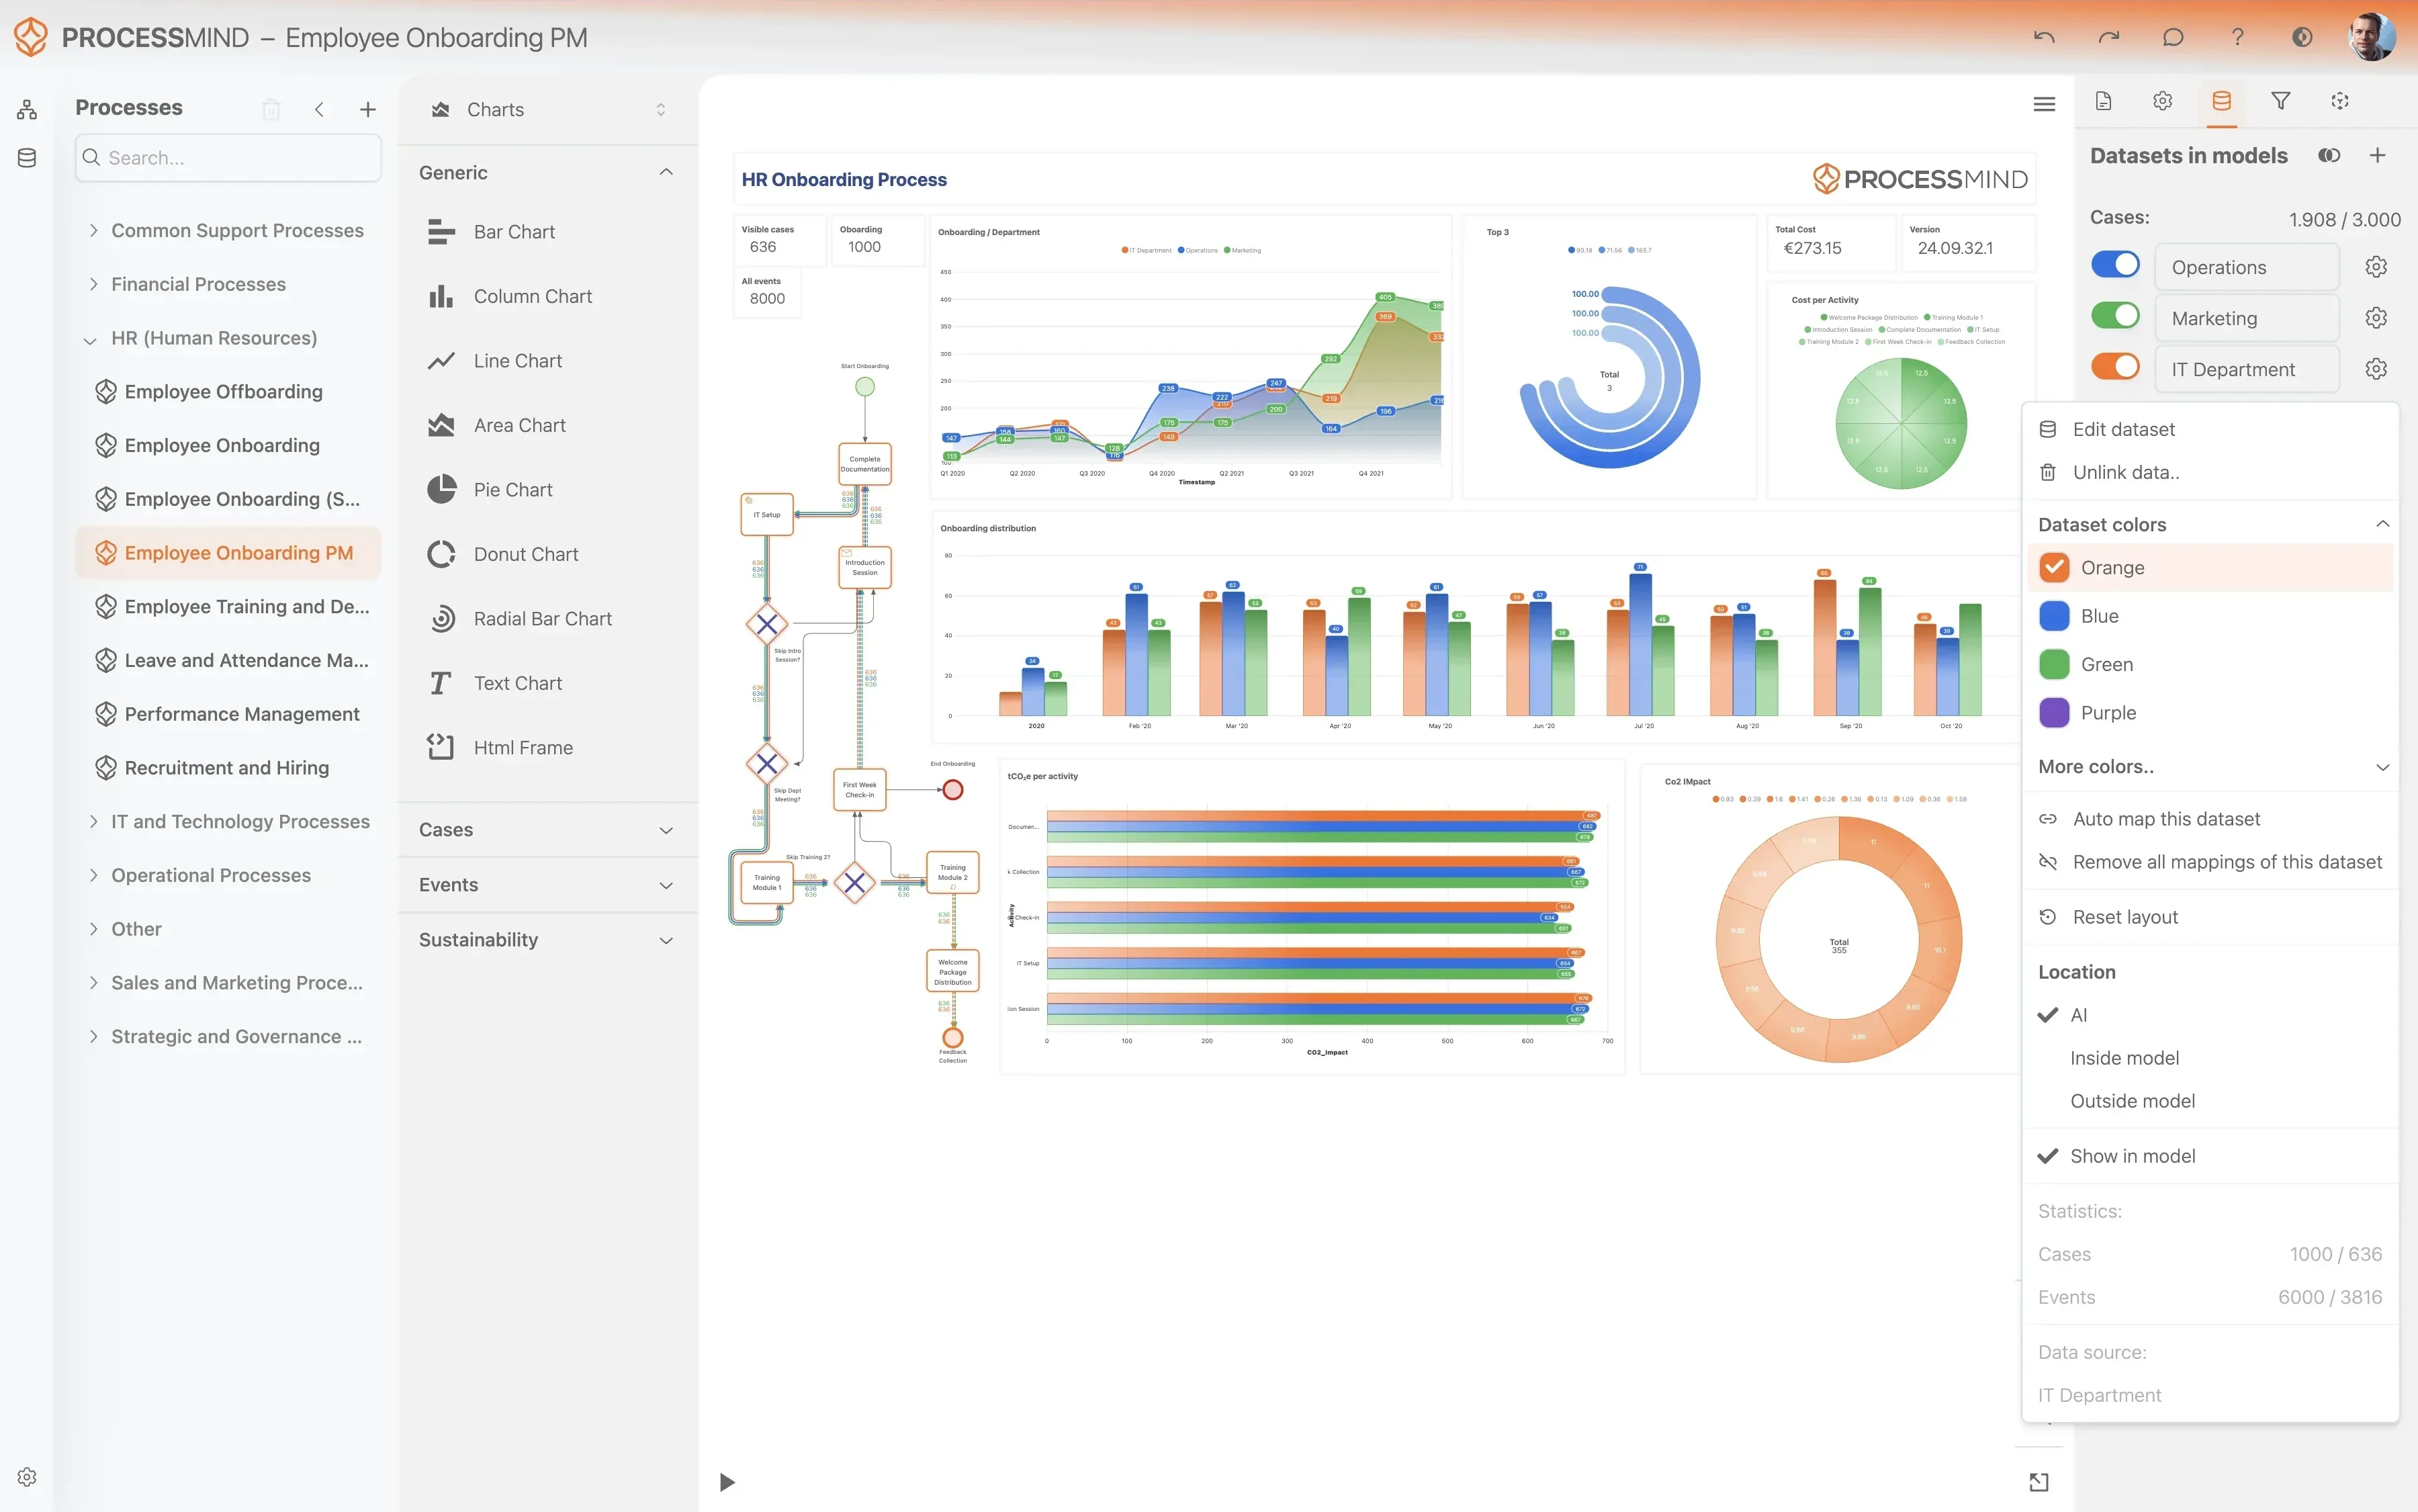
ProcessMind přehledně zobrazí data z BMC Helix ITSM a ukáže, kde se šetření zastavují a jak urychlit trvalé řešení.
  • Zobrazte si všechny kroky šetření
  • Zjistěte přesné příčiny prodlev při přidělování
  • Zkraťte dobu potřebnou k dokumentaci náhradního řešení
  • Změřte, jak řešení ovlivňují počet incidentů
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

DOLOŽENÉ VÝSLEDKY

Měřitelný dopad na řešení problémů

Organizace získají podrobný přehled o záznamech problémů, mohou zefektivnit analýzu hlavních příčin a omezit opakované incidenty napříč firmou. Tyto výsledky ukazují, jak lze díky poznatkům založeným na datech zefektivnit workflow BMC Helix ITSM.

0 % reduction
Rychlejší odhalení hlavní příčiny

Zkrácení doby vyšetřování

Když zkrátíte dobu od zahájení vyšetřování po určení hlavní příčiny, mohou se technické týmy soustředit na trvalé opravy místo zdlouhavé diagnostiky.

0 x fewer moves
Méně přehazování záznamů

Méně změn přiřazení podpory

Odhalením úzkých míst při prvotním směrování zajistíte, že se záznamy o problémech dostanou hned ke správným odborníkům a nebudou zbytečně putovat mezi několika skupinami podpory.

+ 0 % improvement
Lepší dodržování SLA

Procentní nárůst shody

Díky přehledu o záznamech problémů, které se zastavily, může vedení zasáhnout dříve, než dojde k nesplnění cílů SLA. Tím pomáhá zajistit stabilní úroveň služeb pro firmu.

0 % less rework
Méně opakované práce při řešení

Méně znovuotevřených problémů

Ověření řešení před uzavřením záznamu pomáhá zajistit, že je příčina skutečně odstraněna. Předejdete tak nákladnému opakování vyšetřování po opravě, která problém nevyřešila.

0 hours saved
Rychlejší zpřístupnění náhradního řešení

Rychlejší zveřejnění oprav

Rychlejší zveřejnění dočasných náhradních řešení výrazně omezuje dopad probíhajících incidentů na koncové uživatele, zatímco se připravuje dlouhodobé řešení.

Skutečné zlepšení výkonu závisí na složitosti procesu a kvalitě dat. Uvedené hodnoty odpovídají obvyklým výsledkům pozorovaným v různých podnikových prostředích.

Doporučená data

Začněte s těmito základními atributy a aktivitami. Analýzu pak podle potřeby rozšiřte.
Pracujete se záznamy událostí poprvé? Přečtěte si, jak vytvořit záznam událostí pro process mining.

Atributy

Důležité údaje pro analýzu

Jedinečný identifikátor případu vyšetřování problému.

Proč je to důležité

Jde o základní klíč potřebný k vytvoření pohledu na proces a sledování životního cyklu konkrétních problémů.

Konkrétní úkol nebo událost změny stavu, ke které došlo.

Proč je to důležité

Určuje uzly v mapě procesu a umožňuje vizualizovat workflow.

Časové razítko udávající, kdy konkrétní aktivita proběhla.

Proč je to důležité

Umožňuje vypočítat všechny KPI založené na době trvání a seřadit události.

Technický tým, kterému je aktuálně přiřazeno vyšetřování problému.

Proč je to důležité

Umožňuje analyzovat organizaci práce a odhalovat úzká místa na úrovni týmů.

Vypočítaná priorita problému podle dopadu a naléhavosti.

Proč je to důležité

Rozděluje analýzu podle důležitosti pro firmu a slouží k analýze SLA.

Uživatel pověřený koordinací vyšetřování.

Proč je to důležité

Umožňuje analyzovat zdroje a vyrovnávat pracovní zátěž jednotlivců.

Klasifikace příčiny problému.

Proč je to důležité

Umožňuje sledovat vývoj systémových problémů a podporuje proaktivní správu problémů.

Hlavní obchodní služba nebo konfigurační položka, které se problém týká.

Proč je to důležité

Propojuje výkonnost procesu s konkrétními produkty nebo službami firmy.

Důvod zahájení vyšetřování problému.

Proč je to důležité

Rozlišuje reaktivní a proaktivní práci, což je důležitý ukazatel vyspělosti.

Datum a čas, do kdy musí být problém vyřešen.

Proč je to důležité

Slouží jako referenční bod pro výpočet ukazatelů shody a včasnosti.

Počet incidentů propojených se záznamem tohoto problému.

Proč je to důležité

Vyjadřuje provozní dopad problému a potíže, které způsobuje uživatelům.

Příznak udávající, zda řešení problému překročilo povolenou dobu.

Proč je to důležité

Usnadňuje vykazování shody a analýzu selhání.

Aktivity

Kroky procesu ke sledování a optimalizaci

První vytvoření záznamu Problem Investigation v systému. Tato událost se zaznamená při uložení nového záznamu ve formuláři PBM:Problem Investigation.

Proč je to důležité

Označuje začátek instance procesu. Je nezbytný pro výpočet celkové doby průchodu a metrik počáteční reakce.

Přiřazení záznamu problému konkrétnímu technickému týmu. Zachytí se sledováním změn pole „Assigned Group“.

Proč je to důležité

Nezbytné pro měření předání, opakovaného přehazování a KPI „Mean Time to Initial Assignment“.

Přechod záznamu problému do aktivní fáze analýzy. Událost se odvozuje ze změny pole Status na „Under Investigation“.

Proč je to důležité

Označuje začátek vlastní práce a slouží k výpočtu KPI „Investigation Cycle Time“.

Zadání nebo aktualizace textu v poli Workaround záznamu problému. Událost znamená, že bylo zdokumentováno dočasné řešení.

Proč je to důležité

Slouží ke sledování KPI „Workaround Publication Lead Time“. Ukazuje, že se zmírňuje dopad incidentu.

Okamžik, kdy záznam problému přejde do stavu označujícího, že je příčina známa. Událost se odvozuje ze změny pole Status na „Root Cause Identified“.

Proč je to důležité

Důležitý milník pro dashboard „Root Cause Investigation Cycle Time“. Označuje přechod od analýzy k hledání řešení.

Propojení požadavku Infrastructure Change Request s vyšetřováním problému. Označuje začátek fáze zavádění.

Proč je to důležité

Nezbytné pro KPI „Root Cause to Change Lead Time“ a odhalení oddělených postupů mezi procesy Problem a Change.

Okamžik, kdy je potvrzeno, že trvalá oprava funguje. Událost se odvozuje ze změny pole Status na „Solution Implemented“ nebo „Completed“.

Proč je to důležité

Používá se pro výpočet „Problem SLA Adherence Rate“. Potvrzuje dokončení technické práce.

Konečné administrativní uzavření záznamu problému. Tato událost ukončuje instanci procesu.

Proč je to důležité

Standardní koncová událost. Je nutná pro analýzu celkové doby průchodu a výpočet „Incident Linkage Density“.

Ukončení záznamu problému před vyřešením. Zachytí se při změně stavu na „Cancelled“ nebo „Rejected“.

Proč je to důležité

Pomáhá odhalit zbytečně vynaloženou práci nebo oprávněné duplicity. Představuje alternativní konec procesu.

Časté dotazy

Nejčastější otázky

Process mining zobrazuje všechny cesty, kterými záznam o problému prochází, a ukazuje skutečný průběh místo toho plánovaného. Analýzou historických záznamů událostí zjistíte, kde se záznamy přesouvají mezi skupinami podpory nebo zůstávají ve stavu čekání. Díky tomuto přehledu mohou týmy odstranit systémové nedostatky a zaměřit se na analýzu příčin problémů s velkým dopadem.

Potřebujete základní záznam událostí s jedinečným ID záznamu o problému, časovým razítkem a popisem aktivity, například změna stavu nebo přiřazená skupina. Tyto údaje se obvykle exportují z tabulek PBM:Problem Investigation v databázi BMC Helix. Většina nástrojů process mining se může k těmto tabulkám připojit přímo nebo načíst exporty CSV a zmapovat průběh procesu.

Ukáže konkrétní fáze, ve kterých se šetření zastavuje, například při čekání na informace od dodavatele nebo na zpětnou vazbu od jiného oddělení. Měřením doby jednotlivých přechodů mohou vedoucí odhalit nedostatek zdrojů nebo chybějící dokumentaci, které šetření zpomalují. Přístup založený na datech nahrazuje jednotlivé zkušenosti konkrétními důkazy o tom, kde ke zpožděním skutečně dochází.

První poznatky lze často získat během dvou až čtyř týdnů od zprovoznění exportu dat z BMC Helix. V první fázi se tým připojí k systému a zmapuje hlavní změny stavu, aby vytvořil výchozí model. V dalších týdnech se analýza zpřesňuje a hledají se konkrétní možnosti zlepšení, například omezení přeřazování záznamů.

Process mining pomáhá odhalovat problémy s kvalitou dat, například chybějící časová razítka nebo nesprávné zařazení. Nekvalitní data mohou některé poznatky zakrýt, vizualizace však často ukáže, kde pracovníci podpory vynechávají kroky procesu nebo je zadávají nesprávně. Odstranění těchto nedostatků se pak stává jedním z prvních cílů zlepšování, aby byly budoucí reporty přesné.

Process mining za vás proces neopraví, ale ukáže přesnou cestu záznamů, které nesplnily cílové lhůty, a pomůže určit příčiny nedodržení SLA. Porovnáním záznamů, které SLA splnily, s těmi, které je nesplnily, zjistíte, zda se zpoždění častěji týká konkrétních skupin podpory nebo typů problémů. Na základě těchto zjištění můžete cíleně upravit školení nebo přerozdělit zdroje, aby se problémy s vysokou prioritou řešily v požadovaných lhůtách.

Sleduje předání mezi moduly Problem Management a Change Management a ukazuje, zda při něm vzniká výrazné zpoždění. Díky vizualizaci tohoto přechodu zjistíte, zda se požadavky na změnu vytvářejí krátce po určení hlavní příčiny, nebo zda se zasekávají v administrativním kolečku. Pomáhá tak zefektivnit celý proces od identifikace problému až po zavedení trvalé opravy.

Doplňuje standardní reporty o dlouhodobý pohled na proces, zatímco běžné reporty zachycují jen aktuální stav. Tradiční reporty ukazují, kolik problémů je otevřených. Process mining ukáže, jak se tyto problémy v průběhu času pohybovaly systémem. Tento podrobnější pohled je nutný pro skutečné zlepšování procesů a odhalení skrytých úzkých míst, která standardní dashboardy nemusí zachytit.

Odstraňte úzká místa ve správě problémů

Zkraťte dobu řešení o 30 % a zlepšete stabilitu služeb.

Spusťte zkušební verzi zdarma

Bez platební karty. Nastavení zvládnete za několik minut.