Verbeter het probleembeheer
Een 6-stappengids voor het optimaliseren van BMC Helix ITSM
Verbeter het probleembeheer
Probleembeheer
BMC Helix ITSM

Selecteer een proces

Kies een proces om verder te werken in de gekoppelde workspace.

259 Processen

Verbeter probleembeheer in BMC Helix ITSM

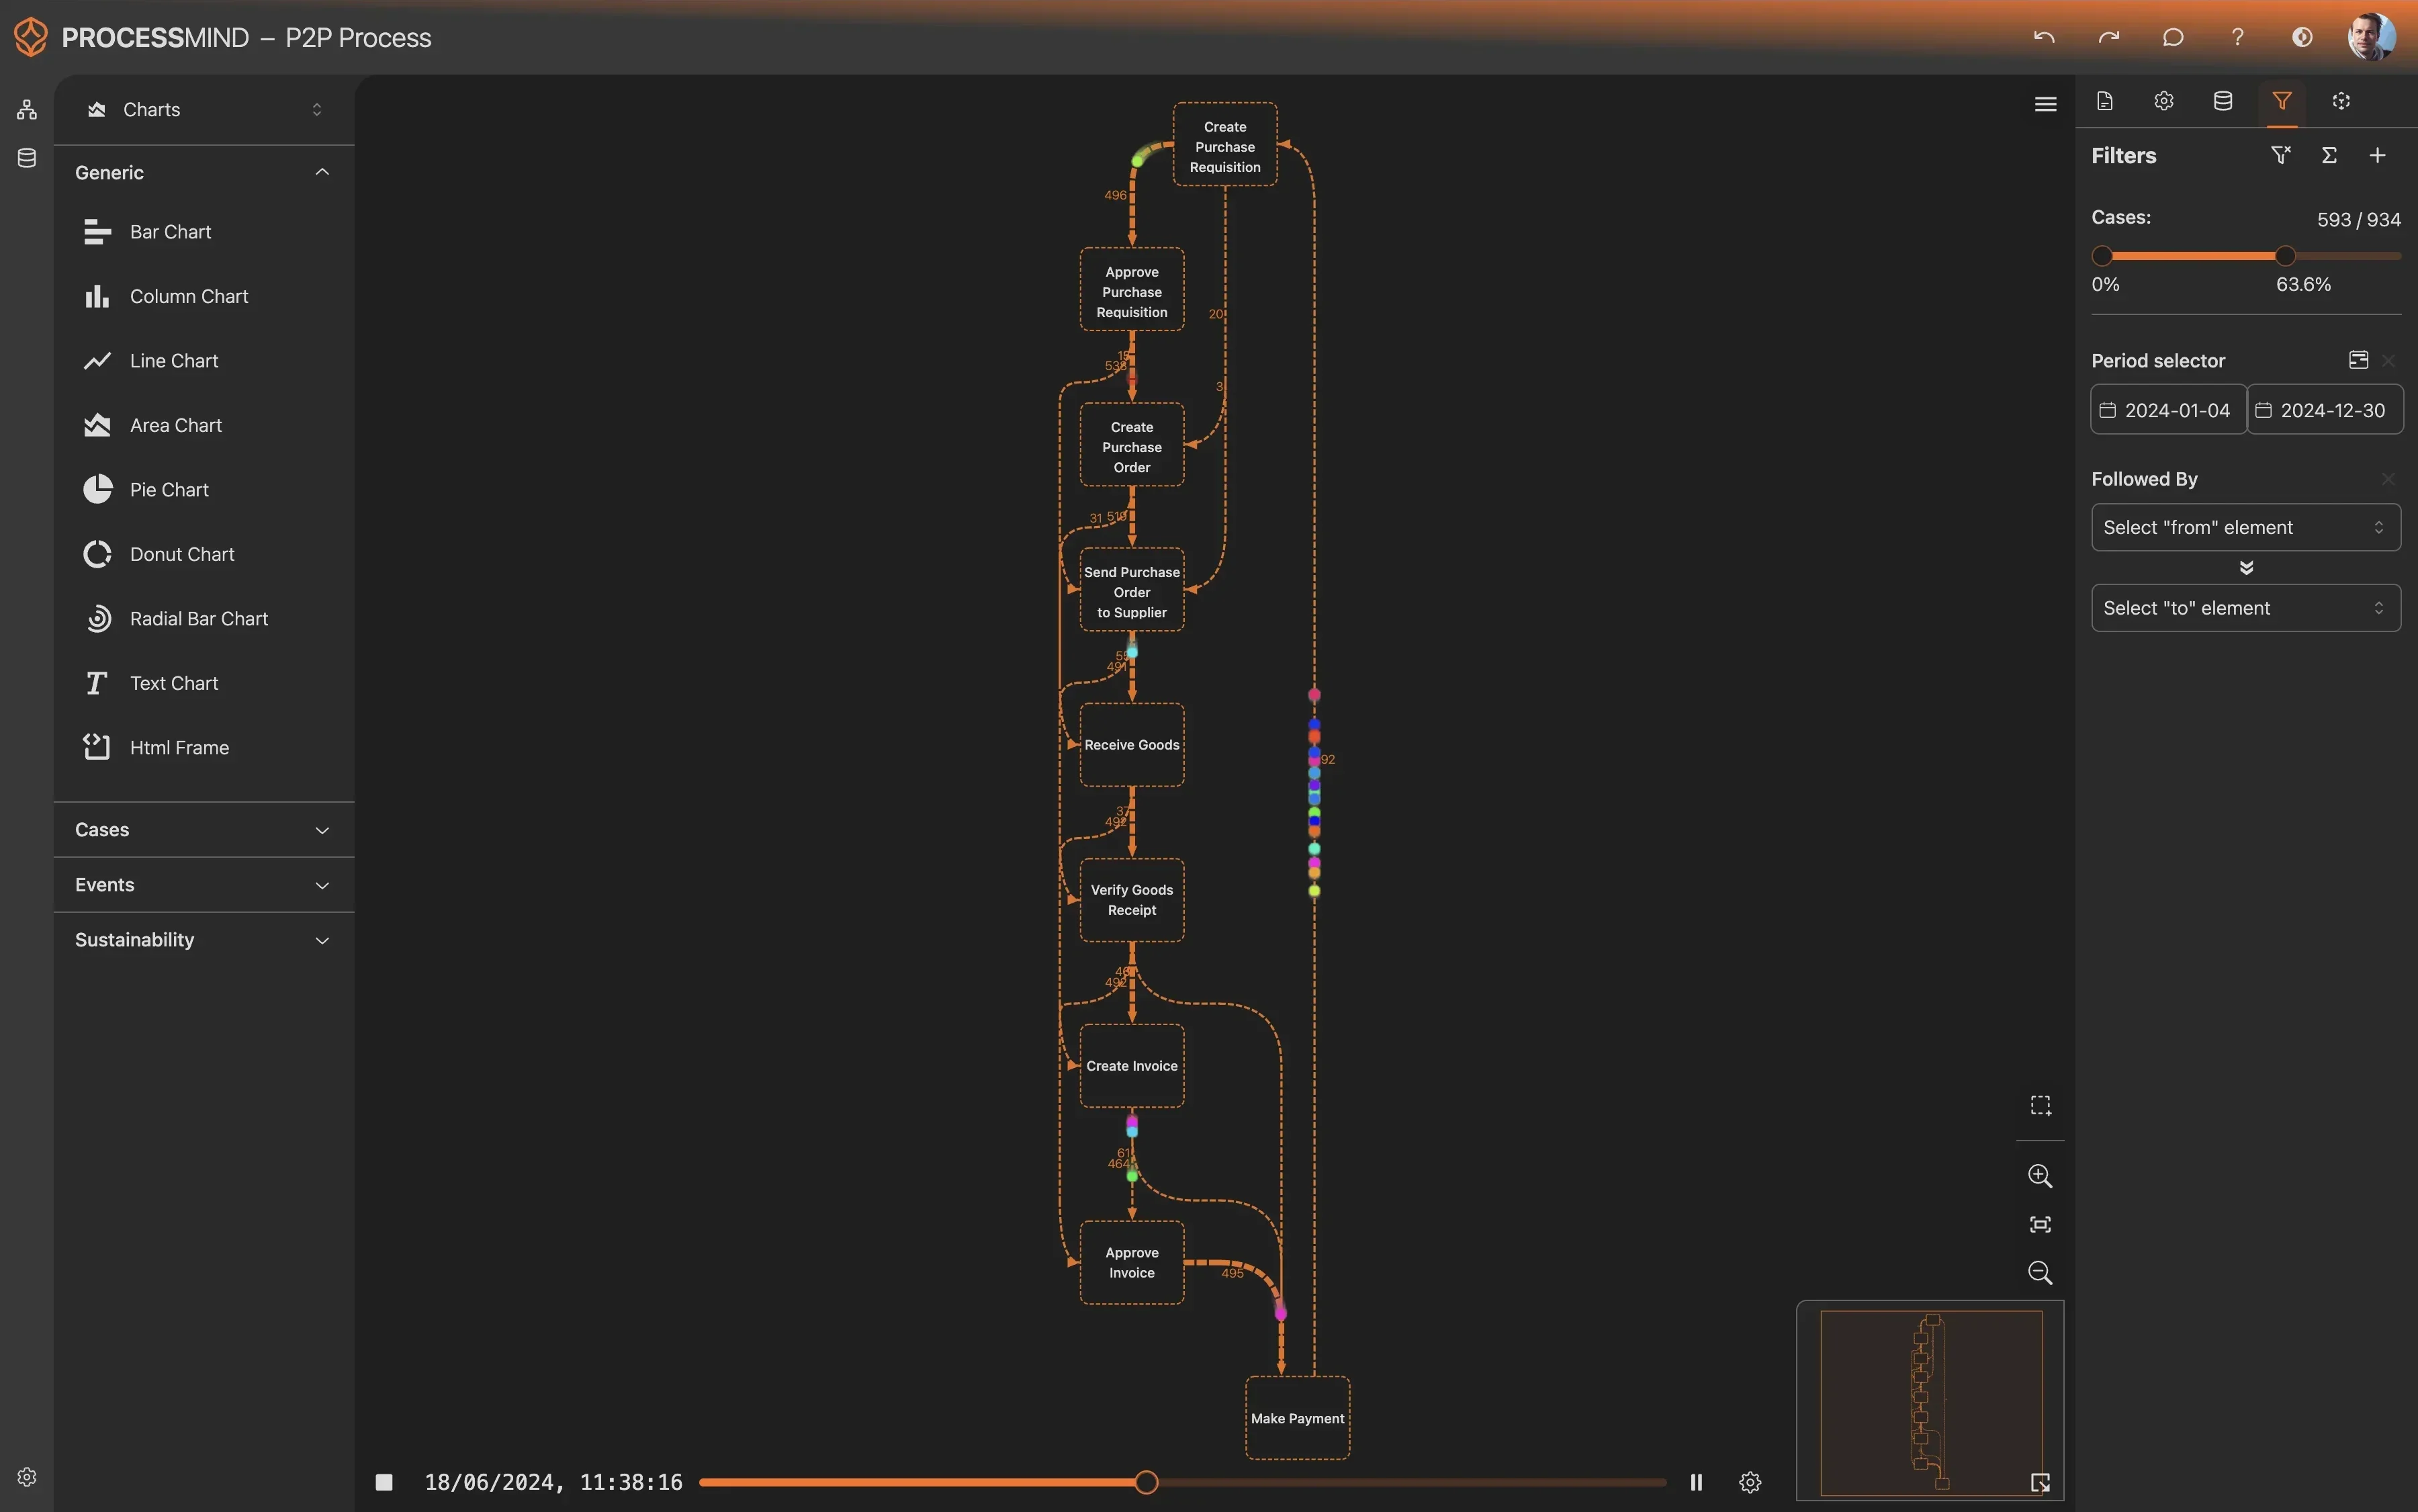
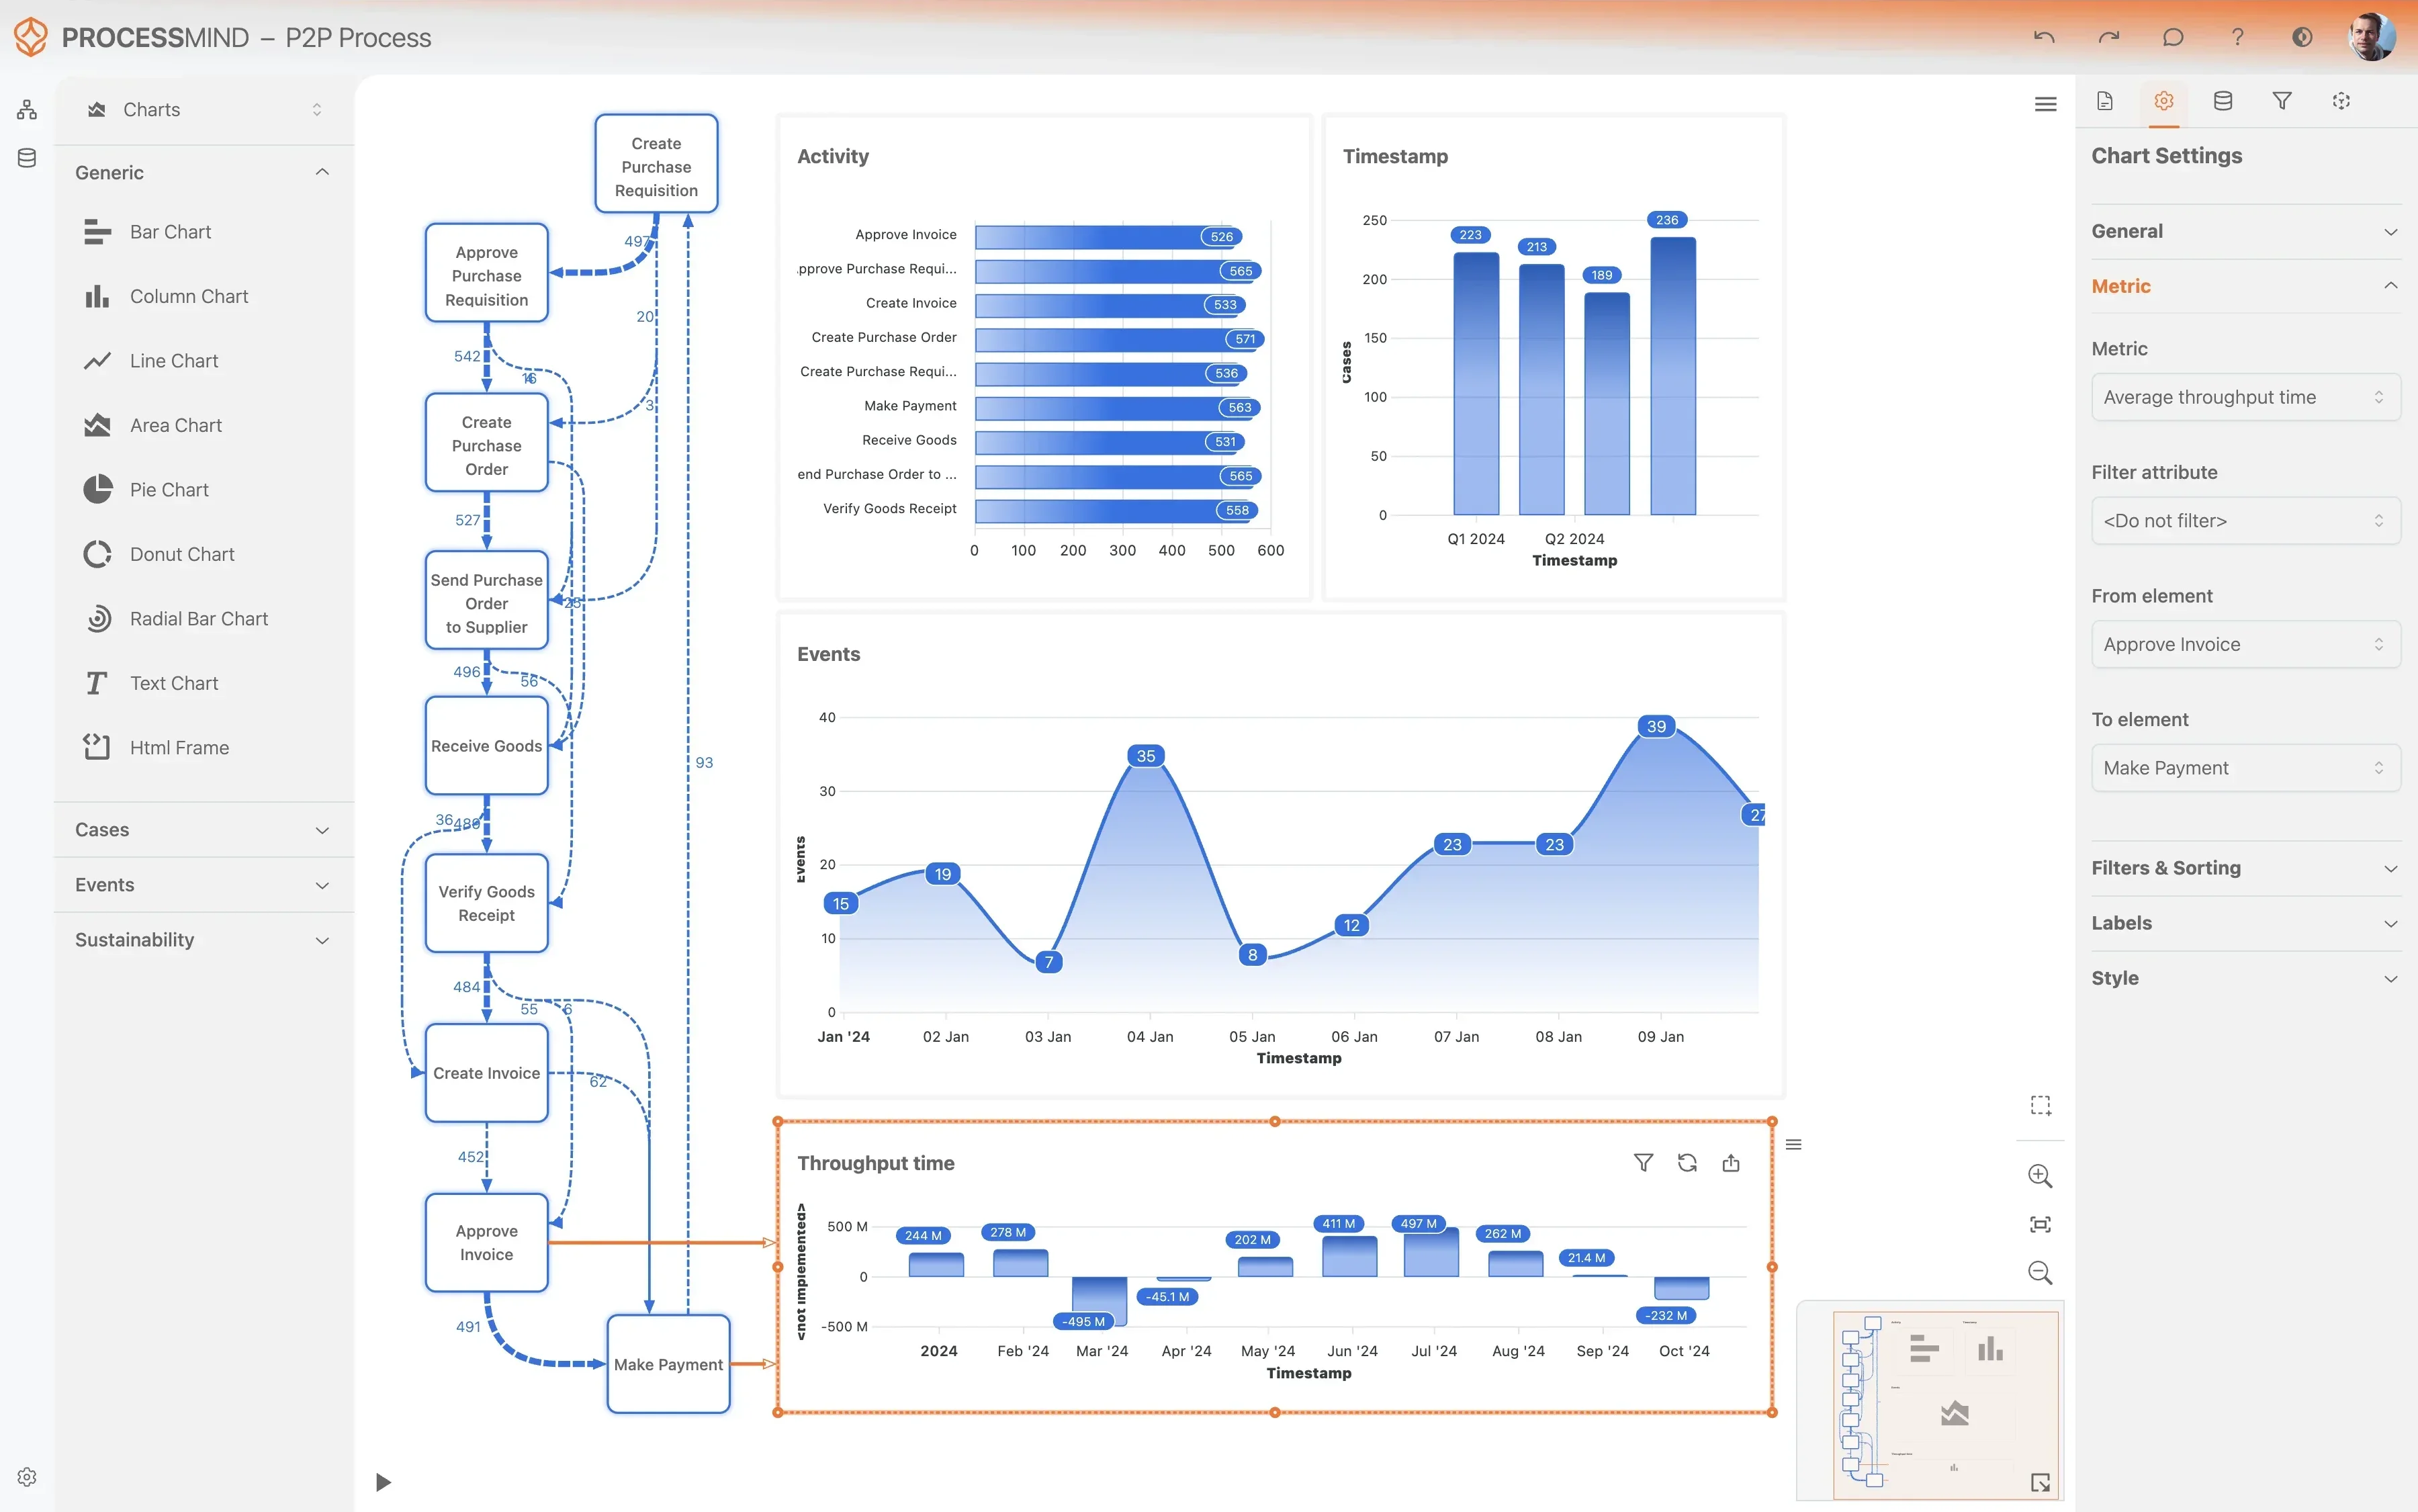
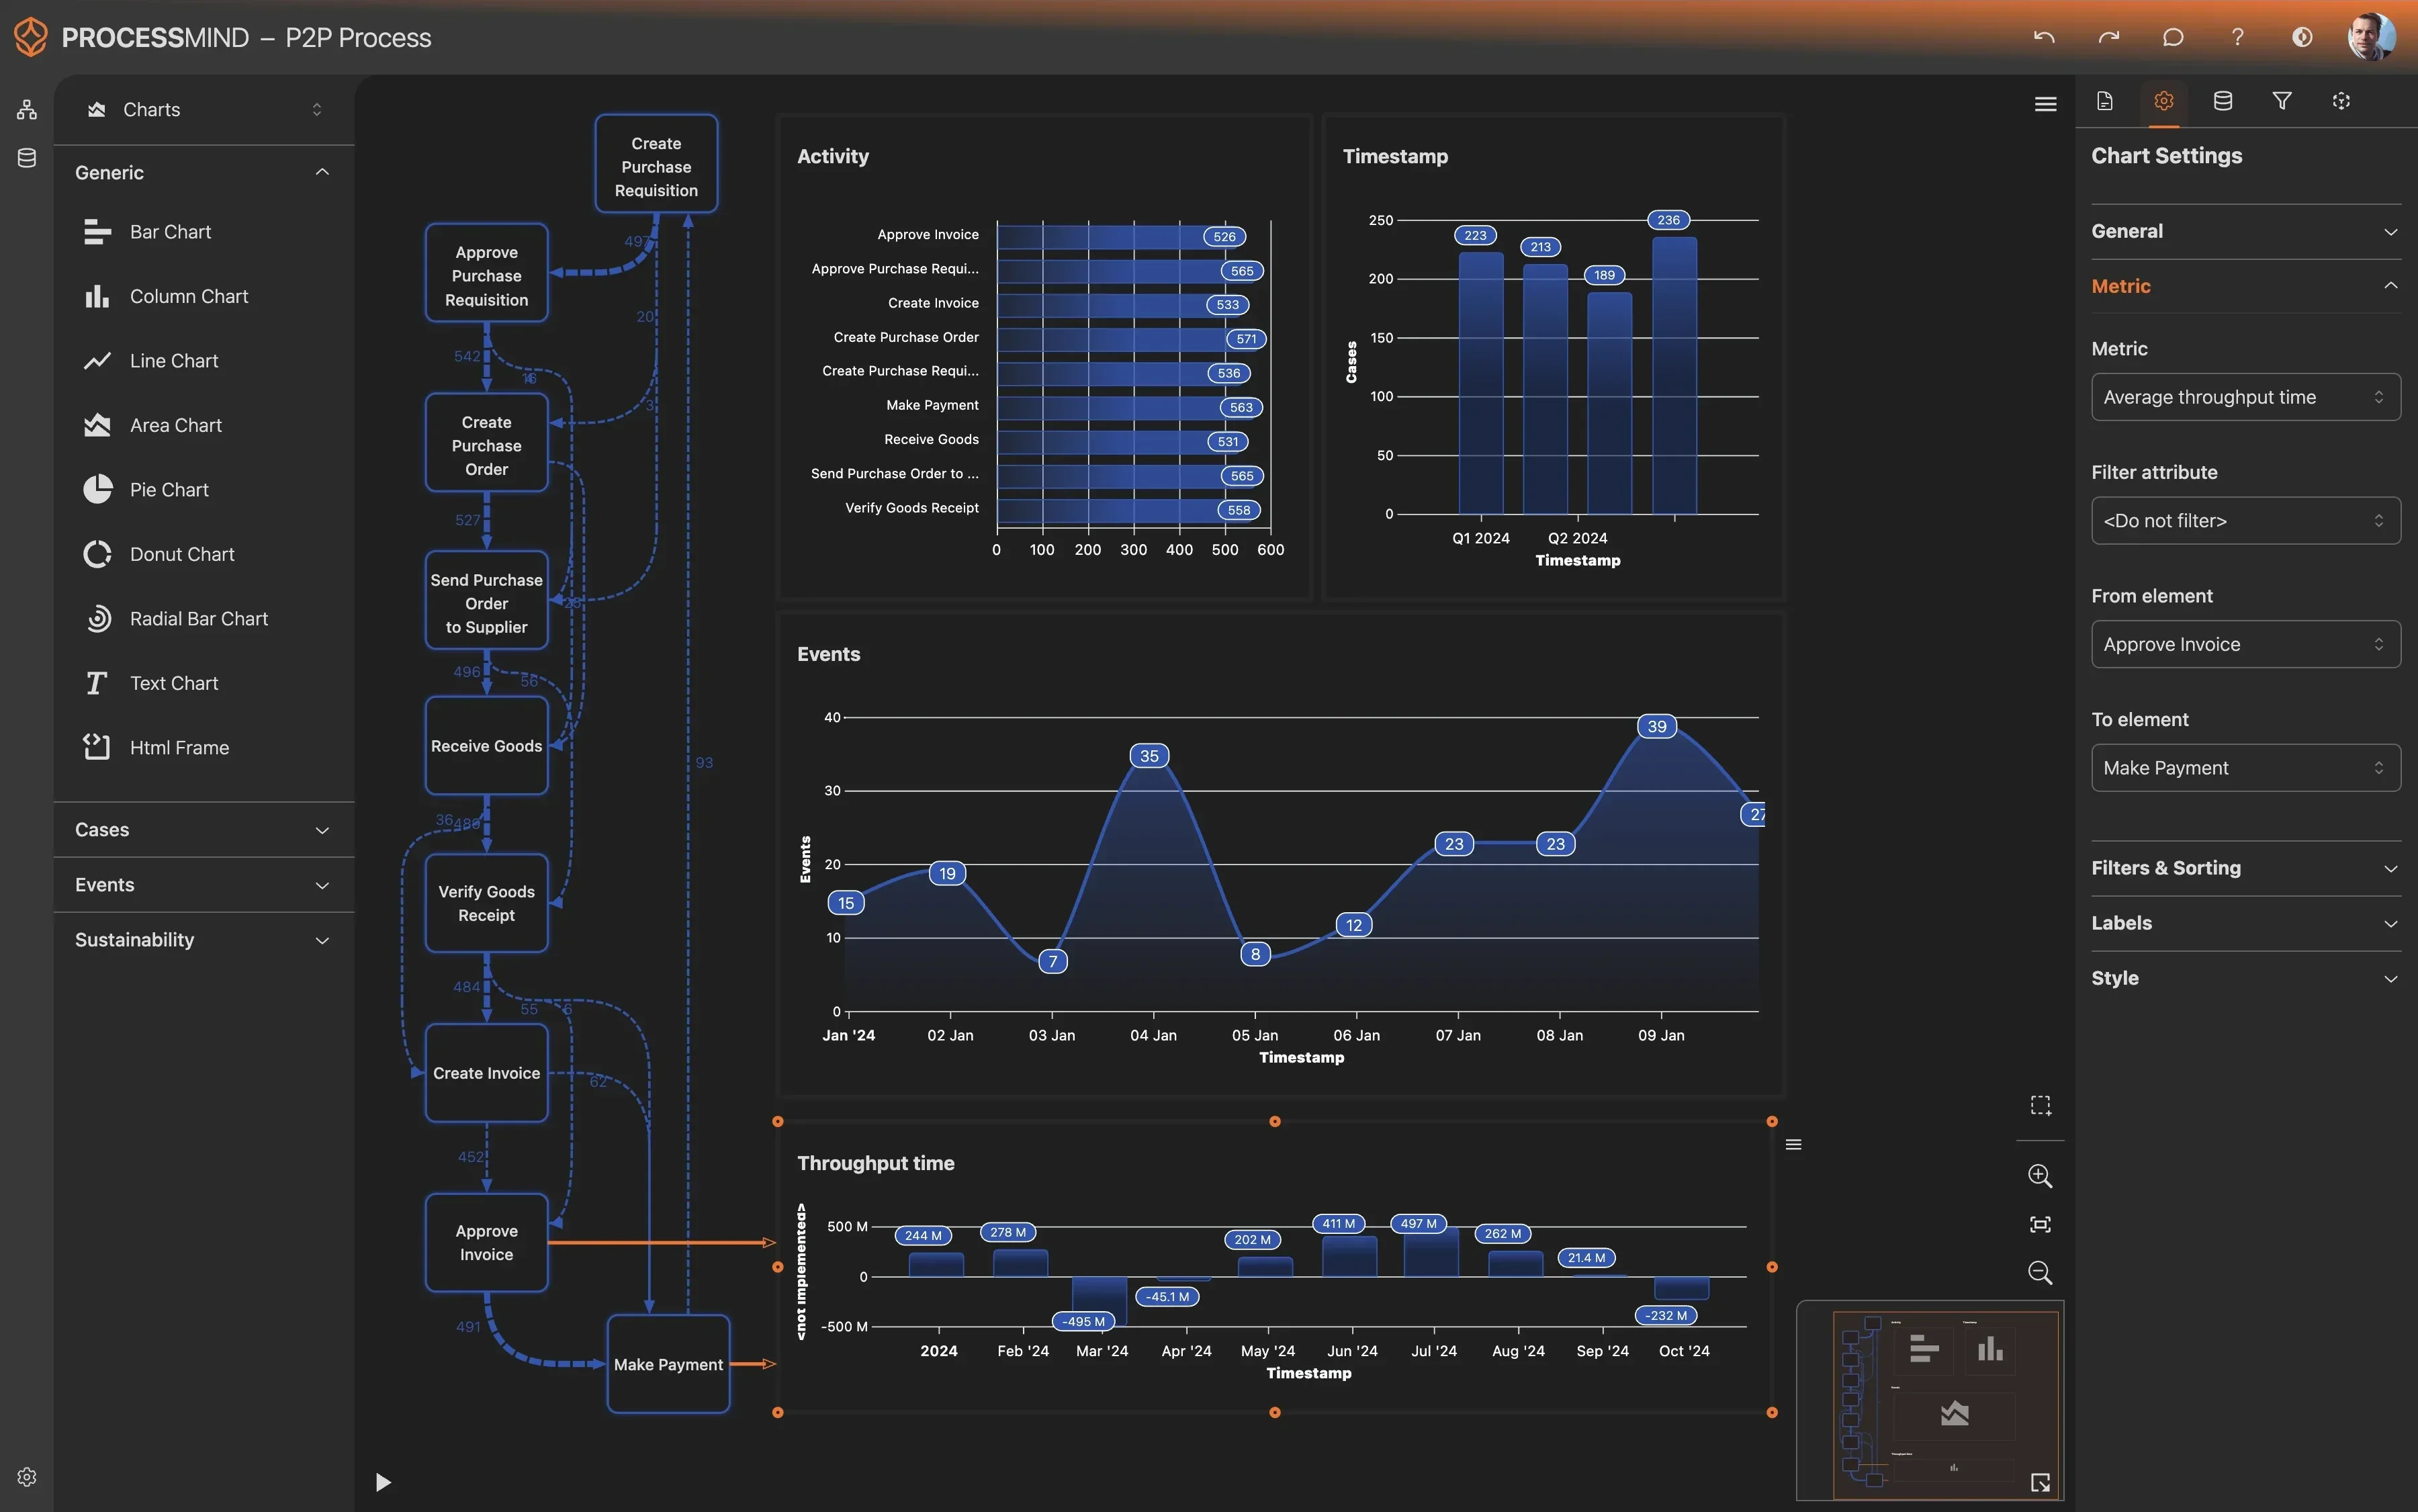
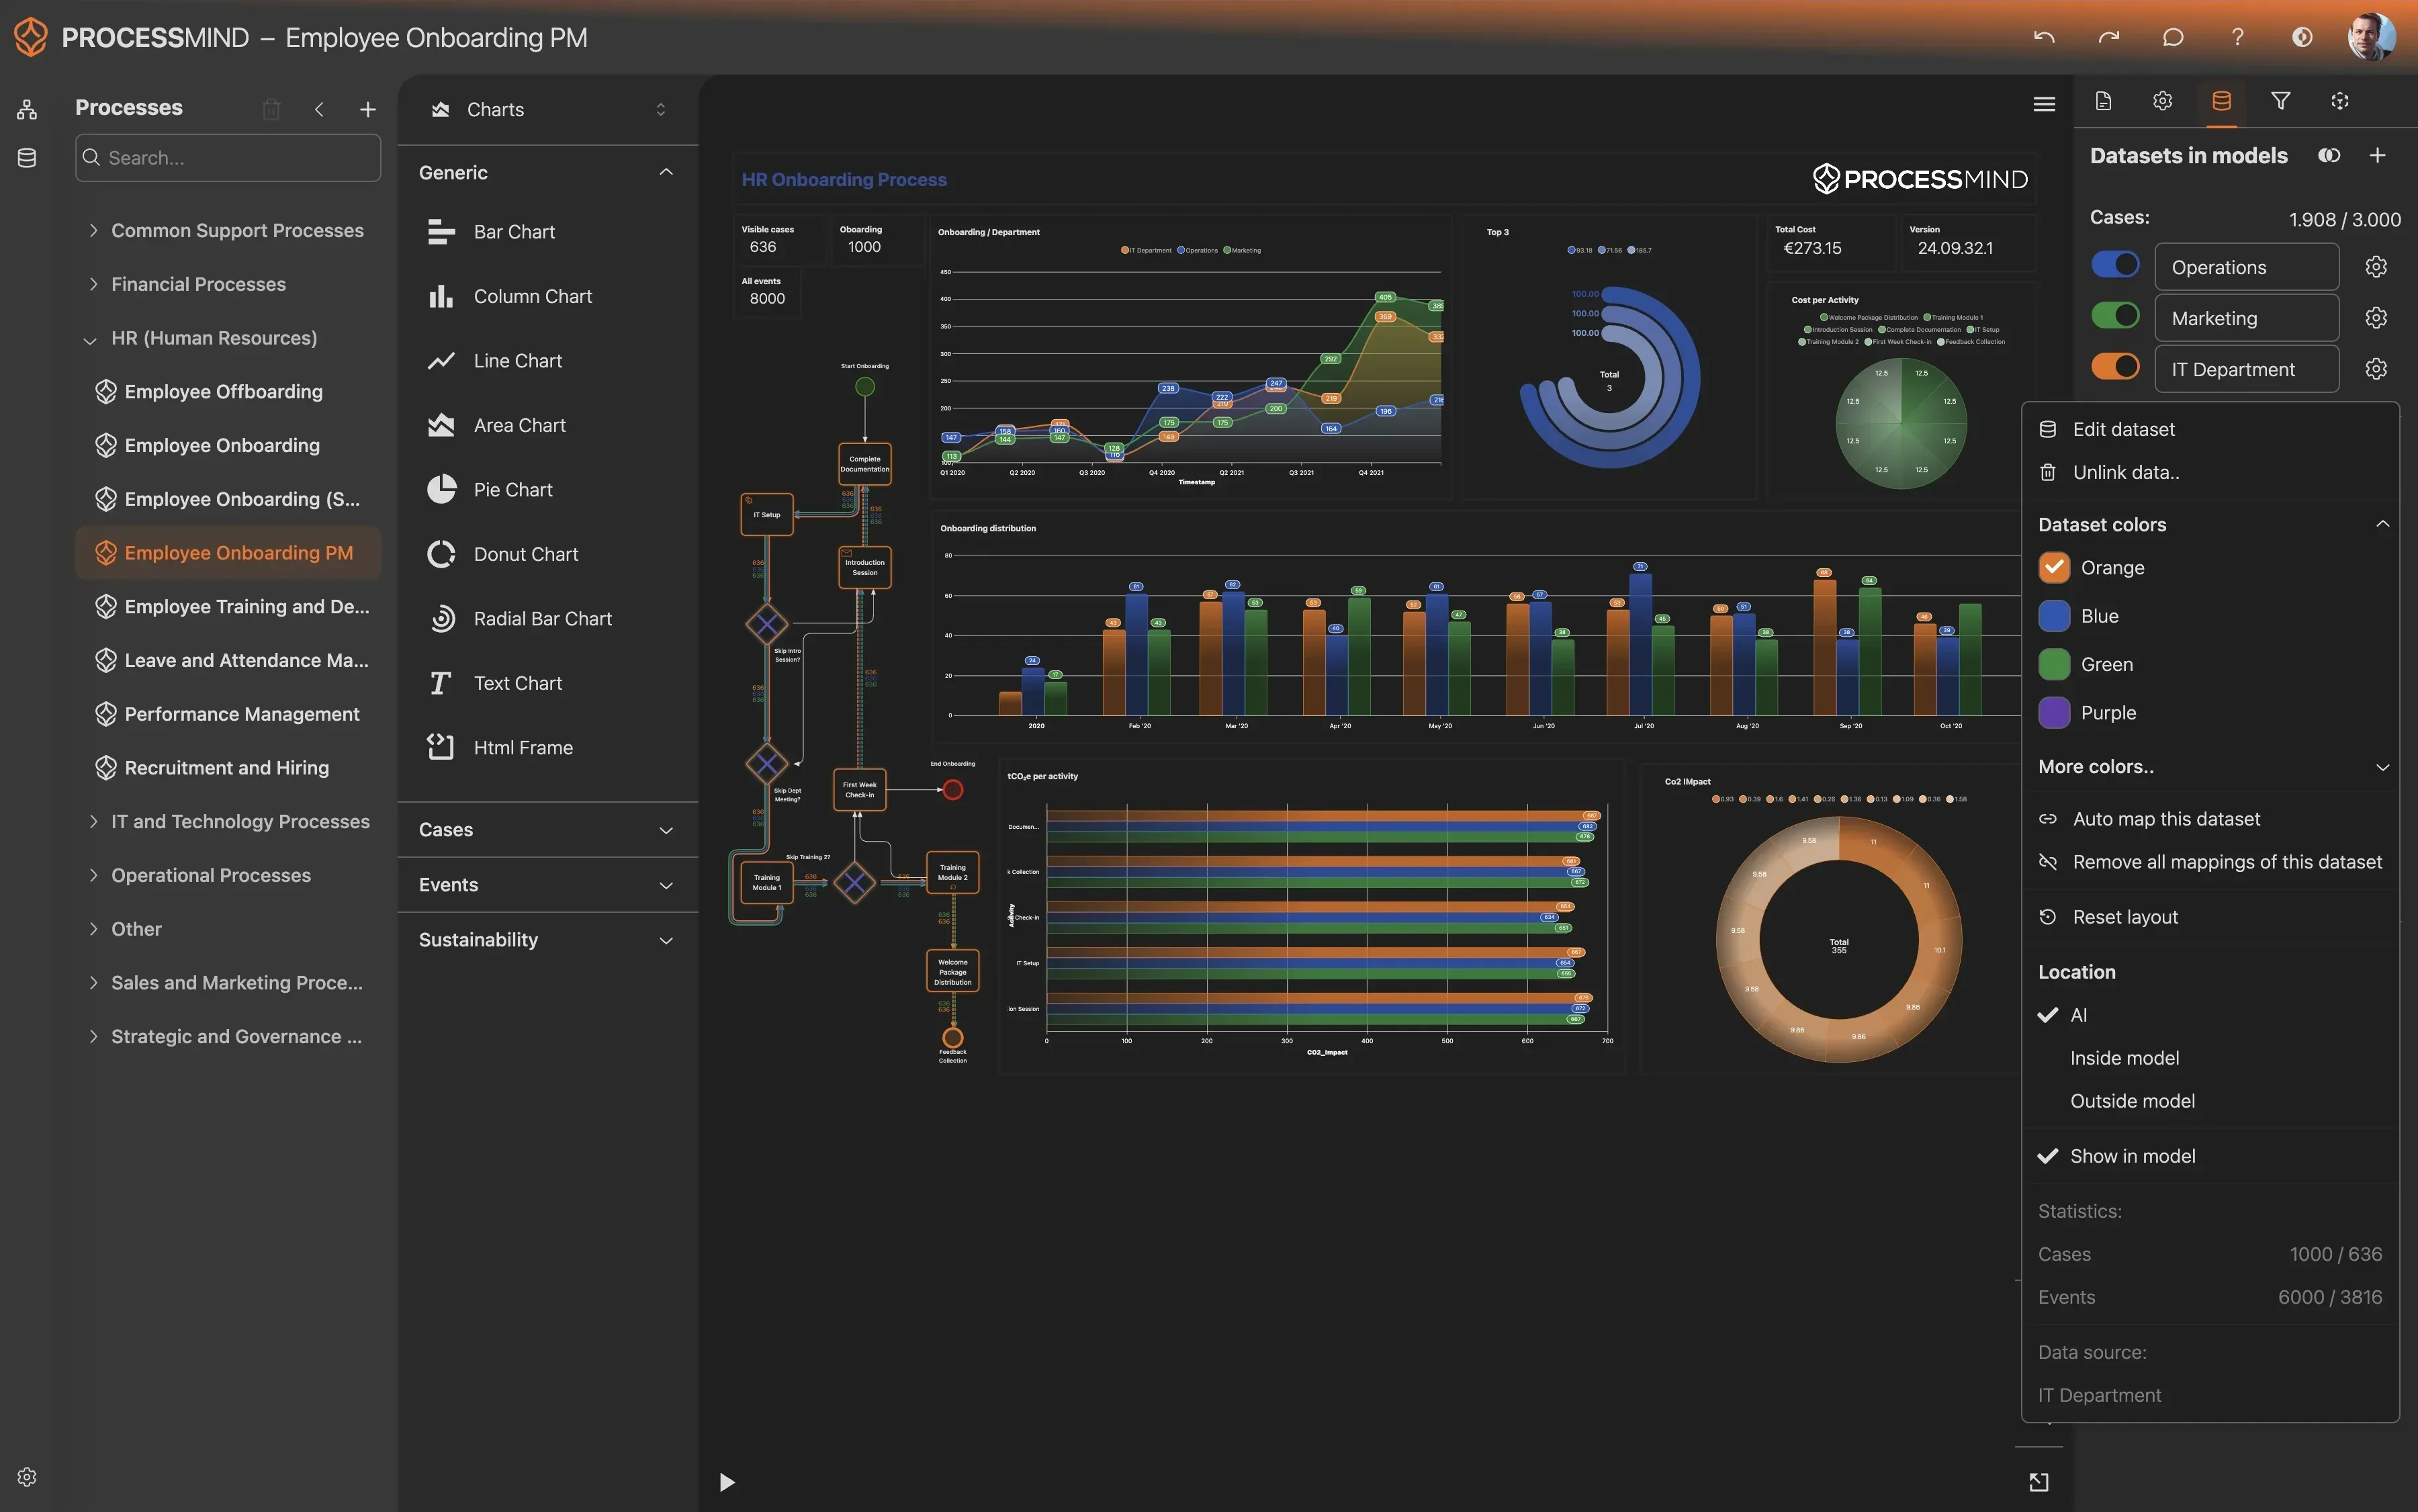
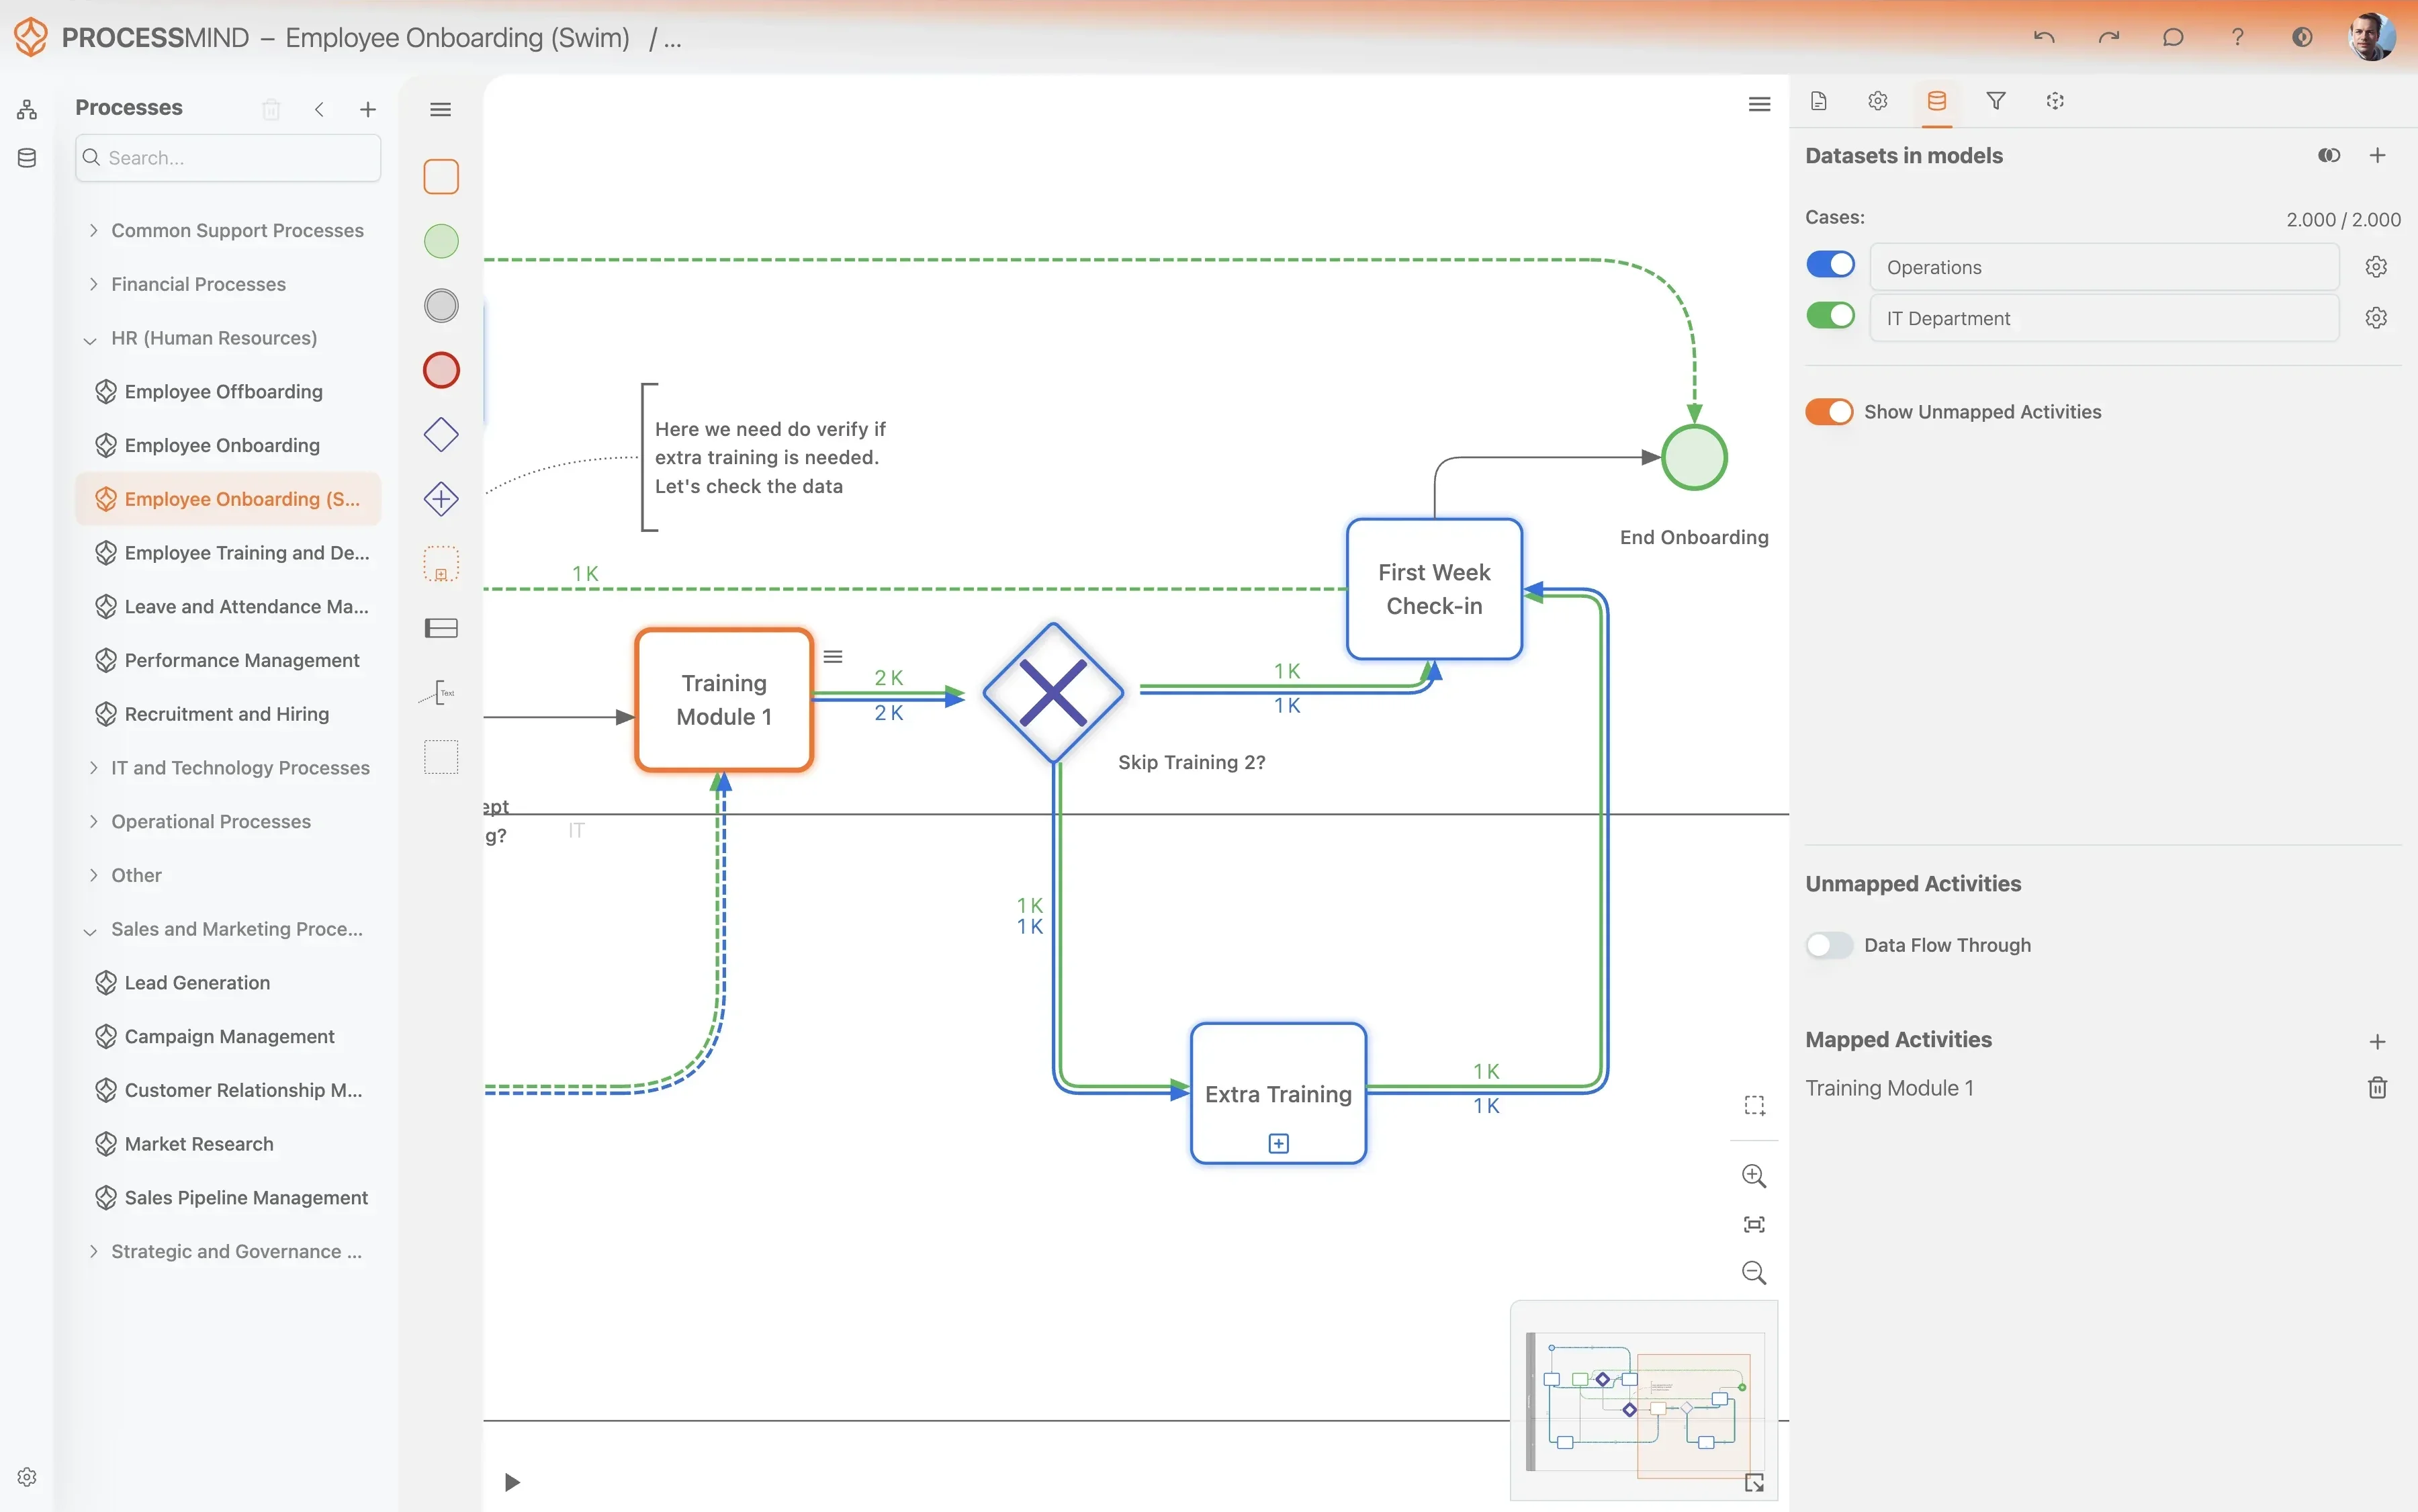
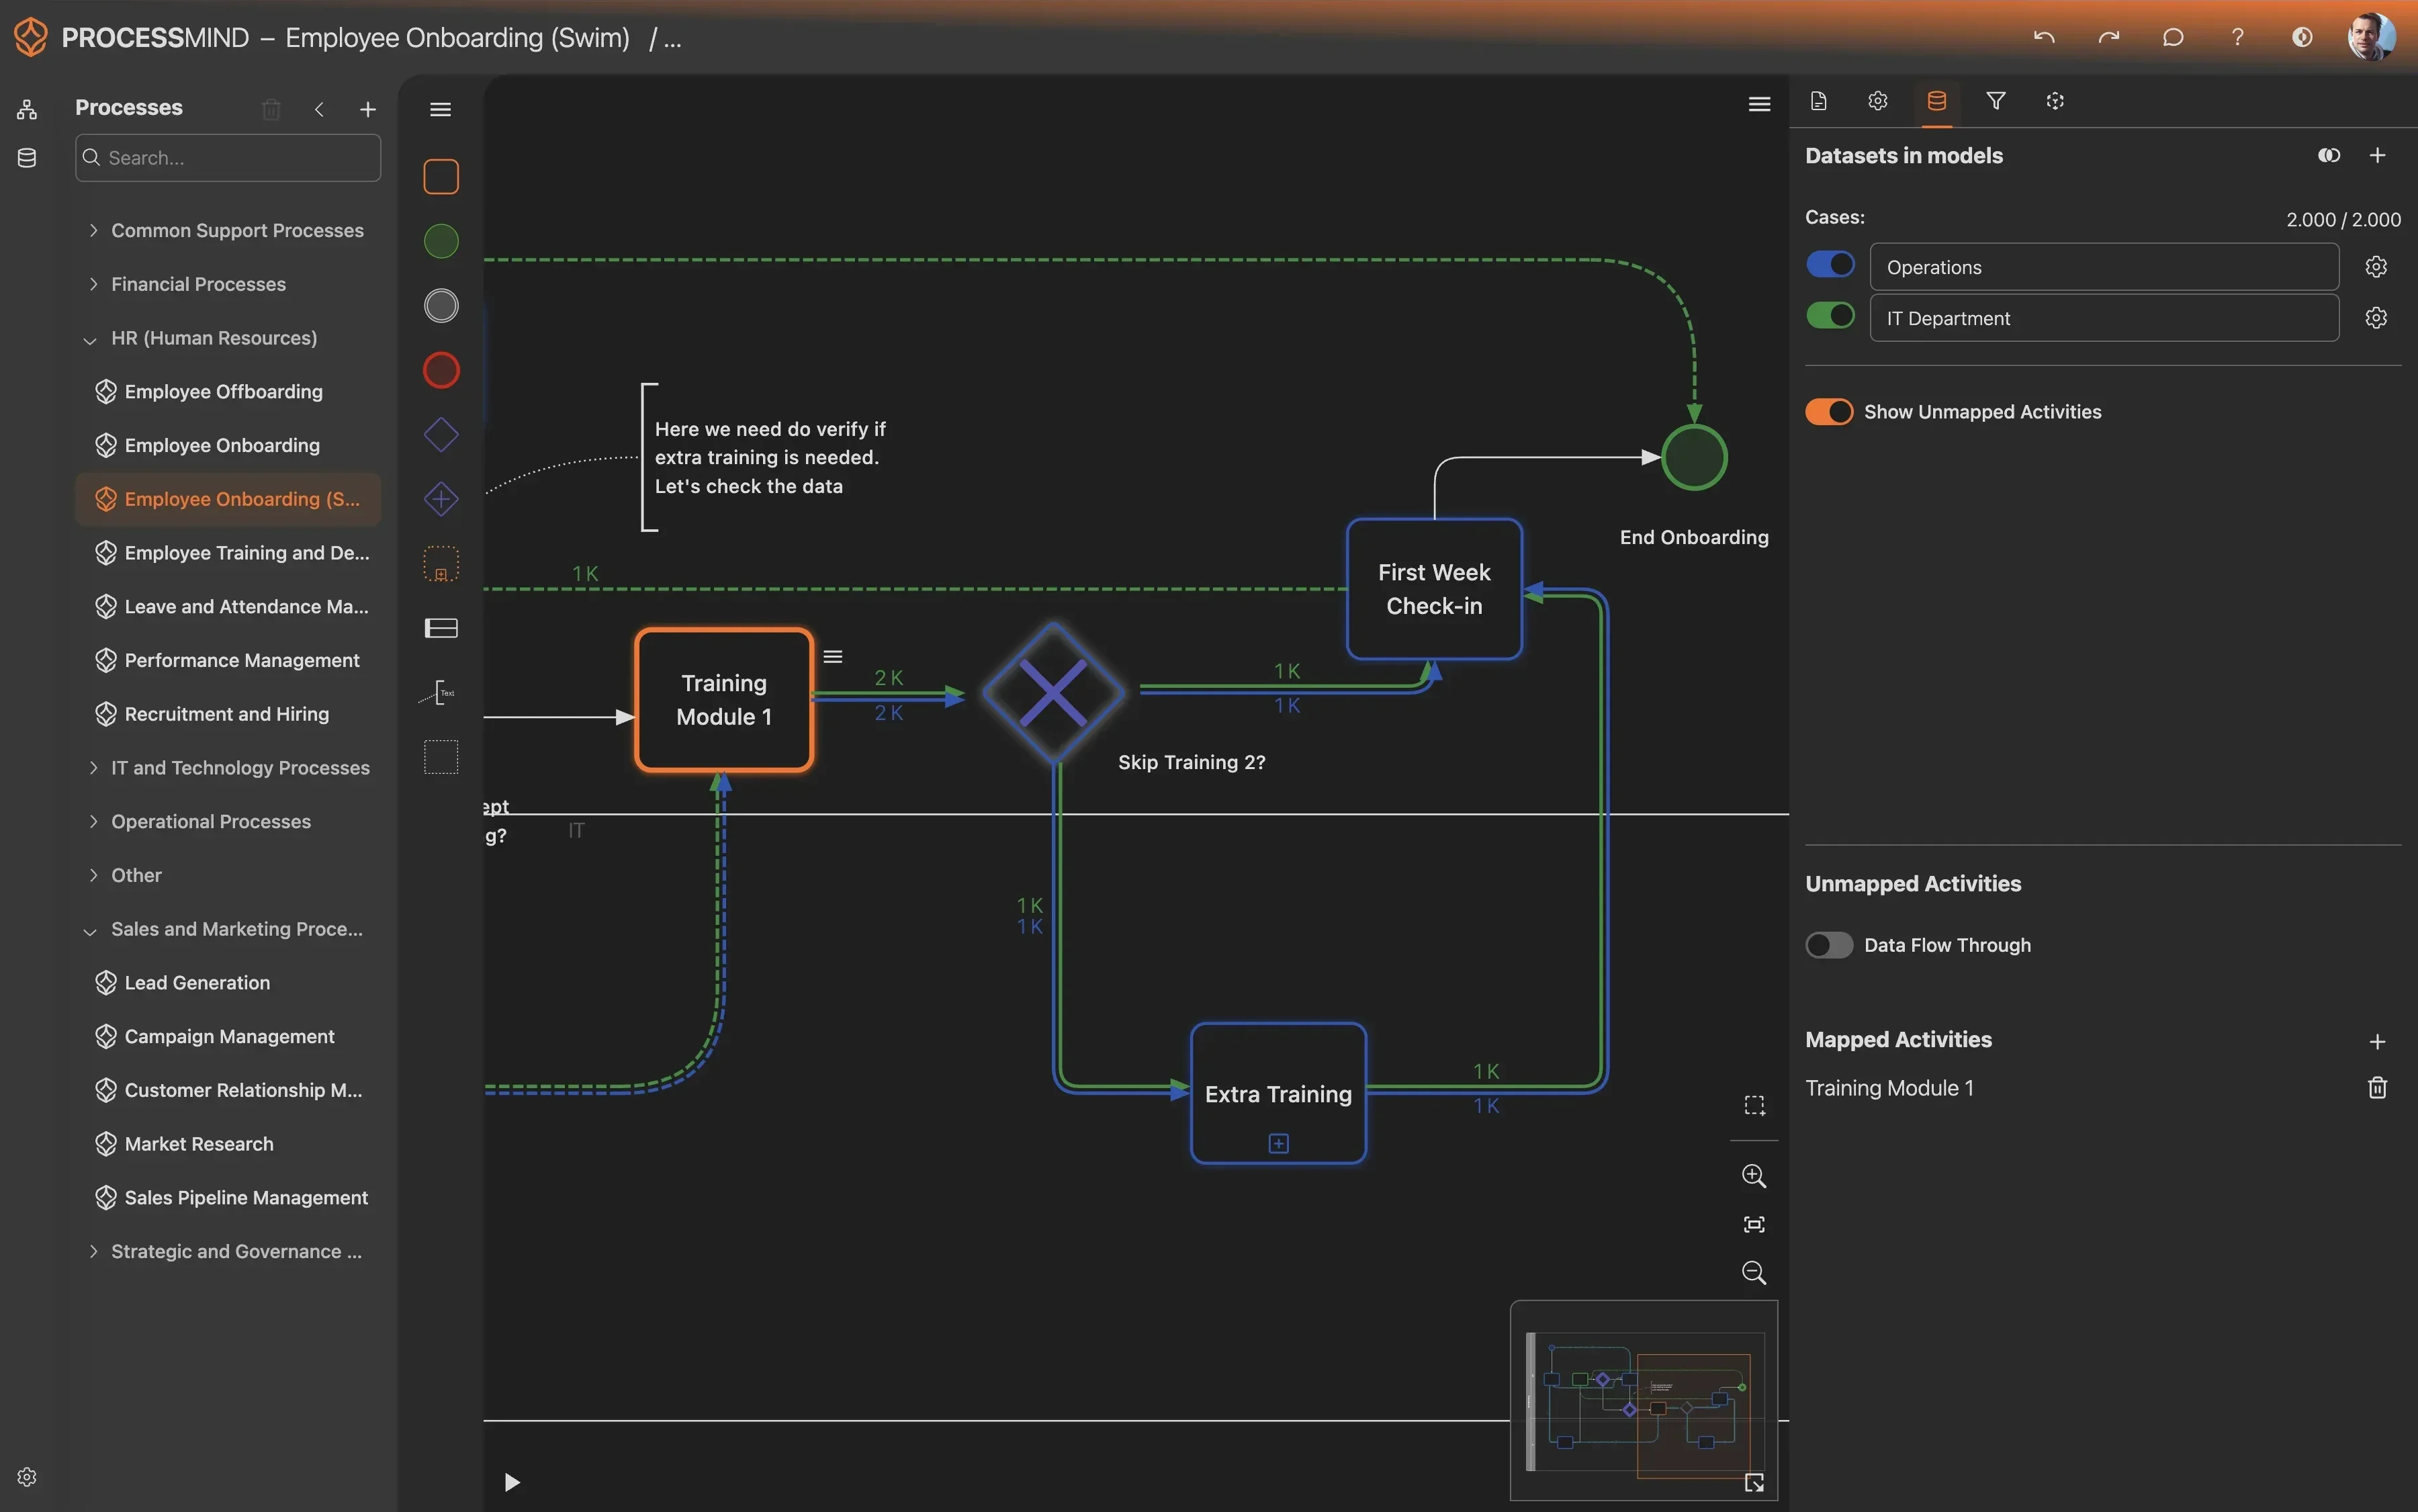
Ons platform brengt verborgen bottlenecks en procesfrictie aan het licht die de efficiëntie van je servicedesk beïnvloeden. Je ziet eenvoudig waar handmatige stappen of overdrachten vertraging veroorzaken in onderzoeken. Zo krijg je zicht op manieren om workflows te vereenvoudigen en de oorzaken van terugkerende operationele problemen aan te pakken.

Download onze vooraf ingestelde datatemplate en pak veelvoorkomende uitdagingen aan om je efficiëntie-doelen te bereiken. Volg ons verbeterplan in zes stappen en raadpleeg de gids voor de datatemplate om je bedrijfsvoering te verbeteren.

Gedetailleerde beschrijving tonen

De strategische waarde van beter Probleembeheer

Efficiënt Probleembeheer is de basis voor een stabiele IT-omgeving. Incidentbeheer richt zich op het zo snel mogelijk herstellen van de dienstverlening. Probleembeheer zoekt naar de onderliggende oorzaken van verstoringen en wil die wegnemen. Als dit proces niet goed is ingericht, blijft het IT-team vooral reageren op problemen en dezelfde brandjes blussen. Dat leidt tot hogere bedrijfskosten, lagere gebruikerstevredenheid en onnodige druk op technische medewerkers. Door dit proces in BMC Helix ITSM te verbeteren, verruil je een reactieve aanpak voor een proactieve strategie. Zo worden je bedrijfsdiensten betrouwbaarder en voorkom je kostbare serviceonderbrekingen.

Van BMC Helix ITSM-data naar bruikbare inzichten

Standaardrapportages in BMC Helix ITSM geven vaak een statisch beeld van de data, bijvoorbeeld het aantal openstaande problemen of de gemiddelde tijd tot afsluiting. Maar zulke cijfers verklaren zelden waarom een onderzoek stilligt. Process mining brengt daar verandering in. Het reconstrueert de volledige levenscyclus van elk probleemrecord aan de hand van digitale sporen uit tabellen zoals PBM:Problem Investigation en PBM:Known Error. Zo zie je welke gebeurtenissen daadwerkelijk plaatsvinden en waar overdrachten misgaan, goedkeuringen blijven liggen of herstelwerk ontstaat. In plaats van te gissen naar de oorzaak van lange doorlooptijden, zie je welke routes tot vertraging leiden. Daardoor kun je verbeteringen richten op feiten in plaats van op losse ervaringen.

Structurele inefficiëntie in oorzaakanalyses opsporen

Een van de grootste uitdagingen in Probleembeheer is de overgang van het vaststellen van een probleem naar het starten van een onderzoek. In veel organisaties blijft een record dagenlang op geregistreerd of toegewezen staan voordat een specialist ermee aan de slag gaat. Process mining laat zien waar zulke verborgen bottlenecks zitten. Misschien zijn bepaalde supportgroepen overbelast en loopt het werk op. Of het is onduidelijk wanneer een probleem moet worden opgeschaald naar een oorzaakanalyse. Door de activiteiten Investigation Commenced en Root Cause Identified met elkaar te vergelijken, zie je of technische teams over de benodigde informatie beschikken en of ze te veel tijd kwijt zijn aan administratie in plaats van diagnose. Een kortere doorlooptijd helpt de stabiliteit van je IT snel te verbeteren.

Workarounds en bekende fouten beter opvolgen

Een belangrijk, maar vaak vergeten onderdeel van het proces is hoe snel workarounds worden gepubliceerd. Als een workaround is gevonden maar niet wordt vastgelegd in het formulier PBM:Known Error, kunnen medewerkers van de servicedesk terugkerende incidenten niet goed oplossen. Dat kost de hele organisatie tijd en moeite. Met process mining meet je de tijd tussen Workaround Identified en Workaround Published. Een lange tussenpoos wijst op gebrekkige communicatie en heeft direct invloed op het aantal incidenten. Door dit deel van de workflow te verbeteren, kan de organisatie tijdelijke oplossingen gebruiken terwijl aan een definitieve oplossing wordt gewerkt. Zo krijgen specialisten tijd voor een grondige analyse, zonder dat de incidentenvoorraad steeds verder oploopt.

Resultaten meten en het proces verder ontwikkelen

Het uiteindelijke doel van procesoptimalisatie is het aantal incidenten en de impact ervan op de organisatie terug te dringen. Met process mining stel je duidelijke meetpunten vast voor de levenscyclus van Probleembeheer. Je kunt meten hoe effectief de activiteiten rond Change Request Initiated zijn en nagaan of definitieve oplossingen binnen de afgesproken servicenormen worden doorgevoerd. Na wijzigingen laat process mining doorlopend zien of ze effect hebben. Deze aanpak op basis van data maakt resultaten en verantwoordelijkheden inzichtelijk. Teams kunnen hun workflows verbeteren op basis van feiten. Na verloop van tijd leidt dat tot minder terugkerende problemen en een IT-infrastructuur die beter tegen verstoringen kan.

Aan de slag met procesverbetering

Je hoeft je ITSM-suite niet volledig te vervangen om het proces voor Probleembeheer te verbeteren. Begin met inzicht in de huidige situatie. Pas deze analysetechnieken toe op de data uit BMC Helix ITSM en start klein, bijvoorbeeld met een specifieke dienst met hoge prioriteit of een probleemcategorie die vaak voorkomt. Door bottlenecks op te sporen en aan te pakken, daalt het aantal incidenten en krijgt het team ruimte om ook grotere structurele verbeteringen aan te pakken. Gebruik deze gids en de bijbehorende templates om te werken aan een stabielere, efficiëntere en proactievere IT-dienstverlening.

Probleembeheer Oorzaakanalyse IT-servicemanagement Servicedesk ITSM-bedrijfsvoering Incidenten verminderen Probleemcoördinator Ticketsysteem Ticketbeheer Bekende fout Terugkerende incidenten Workaround Incidentpreventie IT-helpdesk

Veelvoorkomende problemen en uitdagingen

Bekijk welke uitdagingen voor jou spelen

Veel probleemrecords blijven dagenlang niet toegewezen doordat onduidelijk is wie verantwoordelijk is of meldingen niet worden opgemerkt. Door deze vertraging neemt de kans toe dat grote incidenten terugkeren. Ook reageert de IT-afdeling trager, omdat onderliggende problemen blijven liggen.

ProcessMind brengt in BMC Helix ITSM de tijd in beeld tussen het registreren van een record en de eerste toewijzing. Zo zie je welke supportgroepen of probleemcategorieën structureel achterlopen met het oppakken van werk. Vervolgens kun je gericht capaciteit aanpassen of duidelijkere toewijzingsregels invoeren.

Probleemonderzoeken bereiken vaak de fase investigation commenced, maar blijven daar vervolgens staan zonder betekenisvolle voortgangsupdates. Daardoor worden onderliggende problemen niet definitief opgelost en groeit de achterstand met onopgeloste IT-problemen. Uiteindelijk leidt dat tot meer serviceonderbrekingen.

Door de duur van de onderzoeksfase te meten, laat onze oplossing precies zien waar het proces stilvalt. We brengen records in BMC Helix ITSM aan het licht die langer openstaan dan gebruikelijk. Probleemcoördinatoren kunnen dan ingrijpen en capaciteit anders verdelen voordat het onderzoek achterhaald raakt.

Als een workaround is gevonden maar niet snel wordt gepubliceerd in het Knowledge Management-systeem, kunnen medewerkers van de servicedesk incidenten niet snel oplossen. Doordat tijdelijke oplossingen niet worden gedeeld, duurt het gemiddeld langer om gerelateerde incidenten te herstellen en raken gebruikers gefrustreerd terwijl aan een definitieve oplossing wordt gewerkt.

ProcessMind meet de tijd tussen het vinden van een workaround en de activiteit Workaround Published. Zo zie je of tijdelijke oplossingen snel via BMC Helix ITSM worden gedeeld. Dat beperkt de impact van lopende problemen terwijl technische teams aan een definitieve oplossing werken.

Probleemrecords gaan vaak heen en weer tussen technische teams. Groepen proberen verantwoordelijkheid te vermijden of begrijpen de technische reikwijdte verkeerd. Door deze omwegen duurt het veel langer voordat het probleem is opgelost en begint de oorzaakanalyse later. Dat kost tijd en capaciteit.

Onze analysetool brengt de volgorde van toewijzingsactiviteiten in kaart en laat zien waar records in BMC Helix ITSM heen en weer worden gestuurd. Je ziet welke supportgroepen records vaak doorsturen. Zo kun je gerichte training geven of verantwoordelijkheden duidelijker afbakenen.

Problemen met hoge prioriteit halen hun servicenormen vaak niet door verborgen inefficiëntie tijdens het onderzoek of de oplossing. Het missen van deadlines bedreigt de stabiliteit van IT-diensten. Ook kan het leiden tot spanningen binnen de organisatie of verlies van vertrouwen wanneer kritieke infrastructuur langer dan afgesproken instabiel blijft.

ProcessMind vergelijkt SLA-deadlines met de daadwerkelijke timestamps in het proces en laat zien welke activiteiten tot overschrijdingen leiden. Zo kun je servicenormen in BMC Helix ITSM realtime volgen en prioriteiten of workflows aanpassen voordat deadlines worden gemist en de stabiliteit van diensten in gevaar komt.

Na het vaststellen van de oorzaak duurt het vaak lang voordat een wijzigingsverzoek wordt gestart om het probleem definitief op te lossen. In die periode blijft de organisatie kwetsbaar voor terugkerende incidenten, ook al is de technische oplossing bekend. De uitvoering blijft steken in administratieve afhandeling.

We meten de tijd tussen de activiteit Root Cause Identified en de gebeurtenis Change Request Initiated. Zo worden knelpunten zichtbaar bij de overgang van Probleembeheer naar Verandermanagement in BMC Helix ITSM. Definitieve oplossingen kunnen daardoor verder zonder onnodige administratieve vertraging.

Teams slaan de evaluatie na implementatie regelmatig over om records snel af te sluiten en de achterstand tijdens drukke periodes te verkleinen. Zonder deze stap controleren organisaties niet of de oplossing naar verwachting werkt en leggen ze geleerde lessen niet vast. Daardoor kunnen vergelijkbare problemen later opnieuw optreden.

ProcessMind controleert voor elk afgesloten probleemrecord of de activiteit Post-Implementation Review Conducted is uitgevoerd. Afwijkingen van het standaardproces in BMC Helix ITSM worden zichtbaar. Zo kun je zorgen dat alle stappen voor een oplossing worden gevolgd en voldoen aan eisen voor dienstverlening en compliance.

Soms worden probleemrecords afgesloten voordat de oplossing door de bedrijfsverantwoordelijke of technische leidinggevende is gecontroleerd. Kort daarna kan hetzelfde probleem terugkeren. Dan moet het record opnieuw worden geopend of moet er een nieuw record worden aangemaakt, wat rapportages en meetgegevens minder betrouwbaar maakt.

Onze analyse vergelijkt de activiteit Resolution Verified met de laatste afsluitgebeurtenis in BMC Helix ITSM. We laten zien wanneer de controle wordt overgeslagen of te snel wordt uitgevoerd. Zo kunnen teams de kwaliteitscontrole aanscherpen en nagaan of de onderliggende oorzaak echt is weggenomen voordat een probleem als opgelost wordt gemarkeerd.

Als technici de oorzaak van een probleem niet goed categoriseren, zijn langetermijntrends en structurele zwakke plekken in de infrastructuur moeilijk te herkennen. Door ontbrekende of onjuiste data kan het management geen goed onderbouwde beslissingen nemen over investeringen in infrastructuur of proceswijzigingen die de stabiliteit verbeteren.

ProcessMind vindt records waarin het attribuut voor de oorzaak ontbreekt of een generieke waarde heeft. Door deze hiaten in BMC Helix ITSM zichtbaar te maken, helpen we organisaties de datakwaliteit te verbeteren en beter te begrijpen waardoor IT-instabiliteit ontstaat. Dat vormt de basis voor effectievere preventie.

Gespecialiseerde technische teams krijgen soms zoveel probleemtoewijzingen dat de achterstand snel oploopt en oplossingen op zich laten wachten. Door deze ongelijke werkverdeling wordt één team een zwakke schakel. Dat vertraagt het hele proces van Probleembeheer en brengt kritieke diensten in gevaar.

Onze oplossing analyseert hoeveel actieve records aan elke supportgroep zijn toegewezen en brengt capaciteitsknelpunten in beeld. IT-managers kunnen de werkdruk anders verdelen of extra medewerkers inzetten op kritieke onderdelen van BMC Helix ITSM. Zo baseren ze hun beslissingen op daadwerkelijke doorvoerdata in plaats van op losse ervaringen.

Als de levenscyclus van Probleembeheer te lang duurt, blijven dezelfde incidenten binnenkomen bij de servicedesk. Medewerkers besteden dan veel tijd aan terugkerend werk. Dat gaat ten koste van de efficiëntie en leidt af van strategische projecten en complexere diagnoses.

ProcessMind vergelijkt het aantal gerelateerde incidenten met de duur van de onderzoeks- en oplossingsfasen. Je ziet hoe een trage oplossing van problemen het aantal incidenten in BMC Helix ITSM verhoogt. Daarmee kun je onderbouwen waarom definitieve oplossingen sneller moeten worden doorgevoerd en de servicedesk minder wordt belast.

Veelvoorkomende doelen

Bepaal hoe succes eruitziet

Door problemen snel toe te wijzen, kunnen de juiste experts er meteen mee aan de slag. Als een record minder lang op geregistreerd blijft staan, kan het onderzoek eerder beginnen en wordt de periode waarin IT-verstoringen risico vormen korter. Ook herstelt de dienstverlening sneller.

ProcessMind meet in BMC Helix ITSM de tijd tussen de activiteiten Logged en Assigned. Je ziet bij welke categorieën of prioriteiten de toewijzing langer duurt dan gemiddeld. Managers kunnen vervolgens meetpunten vaststellen en verbeteringen in responstijden realtime volgen.

De onderliggende oorzaak van een probleem vinden is het meest arbeidsintensieve deel van het proces. Een kortere onderzoeksfase betekent dat definitieve oplossingen sneller worden ontwikkeld. Zo voorkom je dat technische problemen zich opstapelen en verlaag je de druk op teams die anders steeds terugkerende incidenten moeten afhandelen.

Ons platform analyseert de activiteit Investigation Commenced en meet hoeveel tijd actief aan de oorzaakanalyse wordt besteed. Het laat zien waar onderzoeken vastlopen. Coördinatoren kunnen ingrijpen en capaciteit toewijzen aan complexe problemen voordat de servicenormen worden overschreden.

Een workaround snel beschikbaar maken is belangrijk om de dienstverlening te herstellen terwijl aan een definitieve oplossing wordt gewerkt. Door bekende fouten snel te publiceren, beperk je de impact van incidenten. Medewerkers van de servicedesk kunnen veelvoorkomende problemen meteen oplossen, wat de beschikbaarheid van diensten verbetert.

Met process mining zie je hoeveel tijd er zit tussen het registreren van een probleem en de activiteit Workaround Published. Zo ontdek je welke supportgroepen het snelst tijdelijke oplossingen bieden. Hun werkwijze kan vervolgens binnen de hele IT-organisatie worden toegepast.

Elke keer dat een probleemrecord tussen supportgroepen heen en weer gaat, gaat tijd verloren en raakt informatie versnipperd. Door dit te voorkomen, kan het record rechtstreeks naar een oplossing. Dat vermindert frustratie bij technische medewerkers en verkort de totale doorlooptijd, doordat het record bij de juiste experts blijft.

ProcessMind brengt de route van records tussen supportgroepen in BMC Helix ITSM in kaart. Je ziet waar records vaak in een lus terechtkomen of opnieuw worden toegewezen. Zo kun je achterhalen waar kennis ontbreekt of de eerste beoordeling beter moet, zodat het record meteen bij het juiste team terechtkomt.

Afspraken over serviceniveaus nakomen bij problemen met hoge prioriteit is belangrijk voor de continuïteit van de organisatie. Consequente compliance versterkt het vertrouwen van belanghebbenden en zorgt dat problemen met de grootste impact snel aandacht krijgen. Zo worden kritieke serviceonderbrekingen korter.

Het platform vergelijkt het attribuut SLA Due Date met de daadwerkelijke afrondingstijden van elk probleemrecord. Records die hun deadline naderen, komen vroeg in beeld. Coördinatoren kunnen het werk prioriteren en de compliance voor kritieke diensten op peil houden.

Na het vaststellen van de oorzaak moet een formeel wijzigingsverzoek snel volgen. Door deze overdracht te versnellen, kunnen definitieve oplossingen eerder in productie worden genomen. Zo verdwijnen risico’s uit de IT-omgeving en duurt de fase waarin een oplossing wordt voorgesteld korter.

We analyseren de gebeurtenissen vanaf Root Cause Identified tot Change Request Initiated. Zo worden administratieve vertragingen en knelpunten bij goedkeuringen zichtbaar. Teams kunnen de aanmaak van wijzigingsrecords automatiseren en de wachttijd tussen het vaststellen van de oorzaak en het oplossen ervan verkorten.

Leren van eerdere problemen is belangrijk om de dienstverlening voortdurend te verbeteren. Door elk groot probleem te evalueren, worden lessen vastgelegd. Dat helpt vergelijkbare problemen voorkomen en vergroot op termijn de volwassenheid van de IT-organisatie doordat kennis beter wordt gedeeld.

ProcessMind controleert of de activiteit Post-Implementation Review Conducted is uitgevoerd voordat een record wordt afgesloten. Je ziet waar deze stap vaak wordt overgeslagen. Zo kun je compliance bewaken en zorgen dat kennis wordt vastgelegd en gedeeld binnen de servicedesk.

Een probleemrecord afsluiten zonder de oplossing te controleren, leidt er vaak toe dat hetzelfde probleem terugkomt. Met een formele controle kun je nagaan of de onderliggende oorzaak echt is weggenomen. Dat vermindert het aantal toekomstige incidenten en beschermt de stabiliteit van diensten in de hele organisatie.

Ons platform analyseert de volgorde van de activiteiten Resolution Verified en Record Closed en laat zien wanneer records te vroeg worden afgesloten. Met deze data kun je de kwaliteitscontrole aanscherpen en controleren of elke oplossing werkt voordat de case wordt afgerond.

Betrouwbare data vormen de basis voor goed Probleembeheer. Betere categorieën voor oorzaken maken trendanalyses nauwkeuriger en helpen investeringen in technologie of training te richten op structurele problemen in de IT-infrastructuur. Dat draagt bij aan stabiliteit op de lange termijn.

Het platform analyseert het attribuut voor de oorzaak in duizenden records en vindt inconsistenties en categorieën die te vaak generiek worden ingevuld. Managers kunnen deze informatie gebruiken om de invoerregels aan te scherpen en rapportages in BMC Helix ITSM betrouwbaarder te maken.

Een evenwichtige werkverdeling voorkomt dat afzonderlijke technische teams bottlenecks worden. Met een goede verdeling van capaciteit krijgen alle problemen de aandacht die ze nodig hebben, ongeacht de categorie. Ook verloopt de afhandeling gelijkmatiger en voorspelbaarder.

ProcessMind laat zien hoeveel open probleemrecords elke toegewezen supportgroep afhandelt. Je ziet welke teams een onevenredig hoge werkdruk of langere verwerkingstijden hebben. Zo kun je beslissingen over bezetting, training en werkverdeling baseren op data.

Het belangrijkste doel van Probleembeheer is voorkomen dat incidenten terugkeren. Minder terugkerende incidenten verlagen de kosten van IT-ondersteuning en vergroten de beschikbaarheid van bedrijfskritieke applicaties. IT-medewerkers kunnen zich dan richten op vernieuwing in plaats van onderhoud.

We vergelijken probleemrecords met het aantal gerelateerde incidenten om de werkelijke impact van elk probleem te meten. Door te volgen hoe snel het aantal incidenten daalt nadat een definitieve oplossing is doorgevoerd, kun je het rendement van Probleembeheer berekenen en zien welke oplossingen het meeste effect hadden.

Met proactief Probleembeheer voorkom je problemen voordat gebruikers er last van krijgen. Door trends vroeg te herkennen, kan de organisatie kwetsbaarheden tijdens gepland onderhoud aanpakken in plaats van tijdens een noodsituatie. Dat zorgt voor een stabielere IT-omgeving.

ProcessMind analyseert de tijd tussen groepen incidenten en het aanmaken van een probleemrecord. Door deze patronen te volgen, zie je wanneer een onderzoek eerder kan beginnen. Zo verschuift de aandacht van brandjes blussen naar preventie en neemt de impact op de organisatie af.

Het verbetertraject in 6 stappen voor Probleembeheer

1

Download de datatemplate

Wat je moet doen

Gebruik de gestandaardiseerde Excel-template voor BMC Helix Probleembeheer. Deze bevat velden voor Problem Investigation en Known Error-formulieren.

Waarom dit belangrijk is

Met een voorgebouwde structuur sluit de data over de levenscyclus goed aan op analytische modellen. Zo krijg je sneller inzicht in de oorzaken van problemen.

Verwacht resultaat

Een kant-en-klare template voor datamapping van ITSM-data.

INZICHT IN PROCESSEN

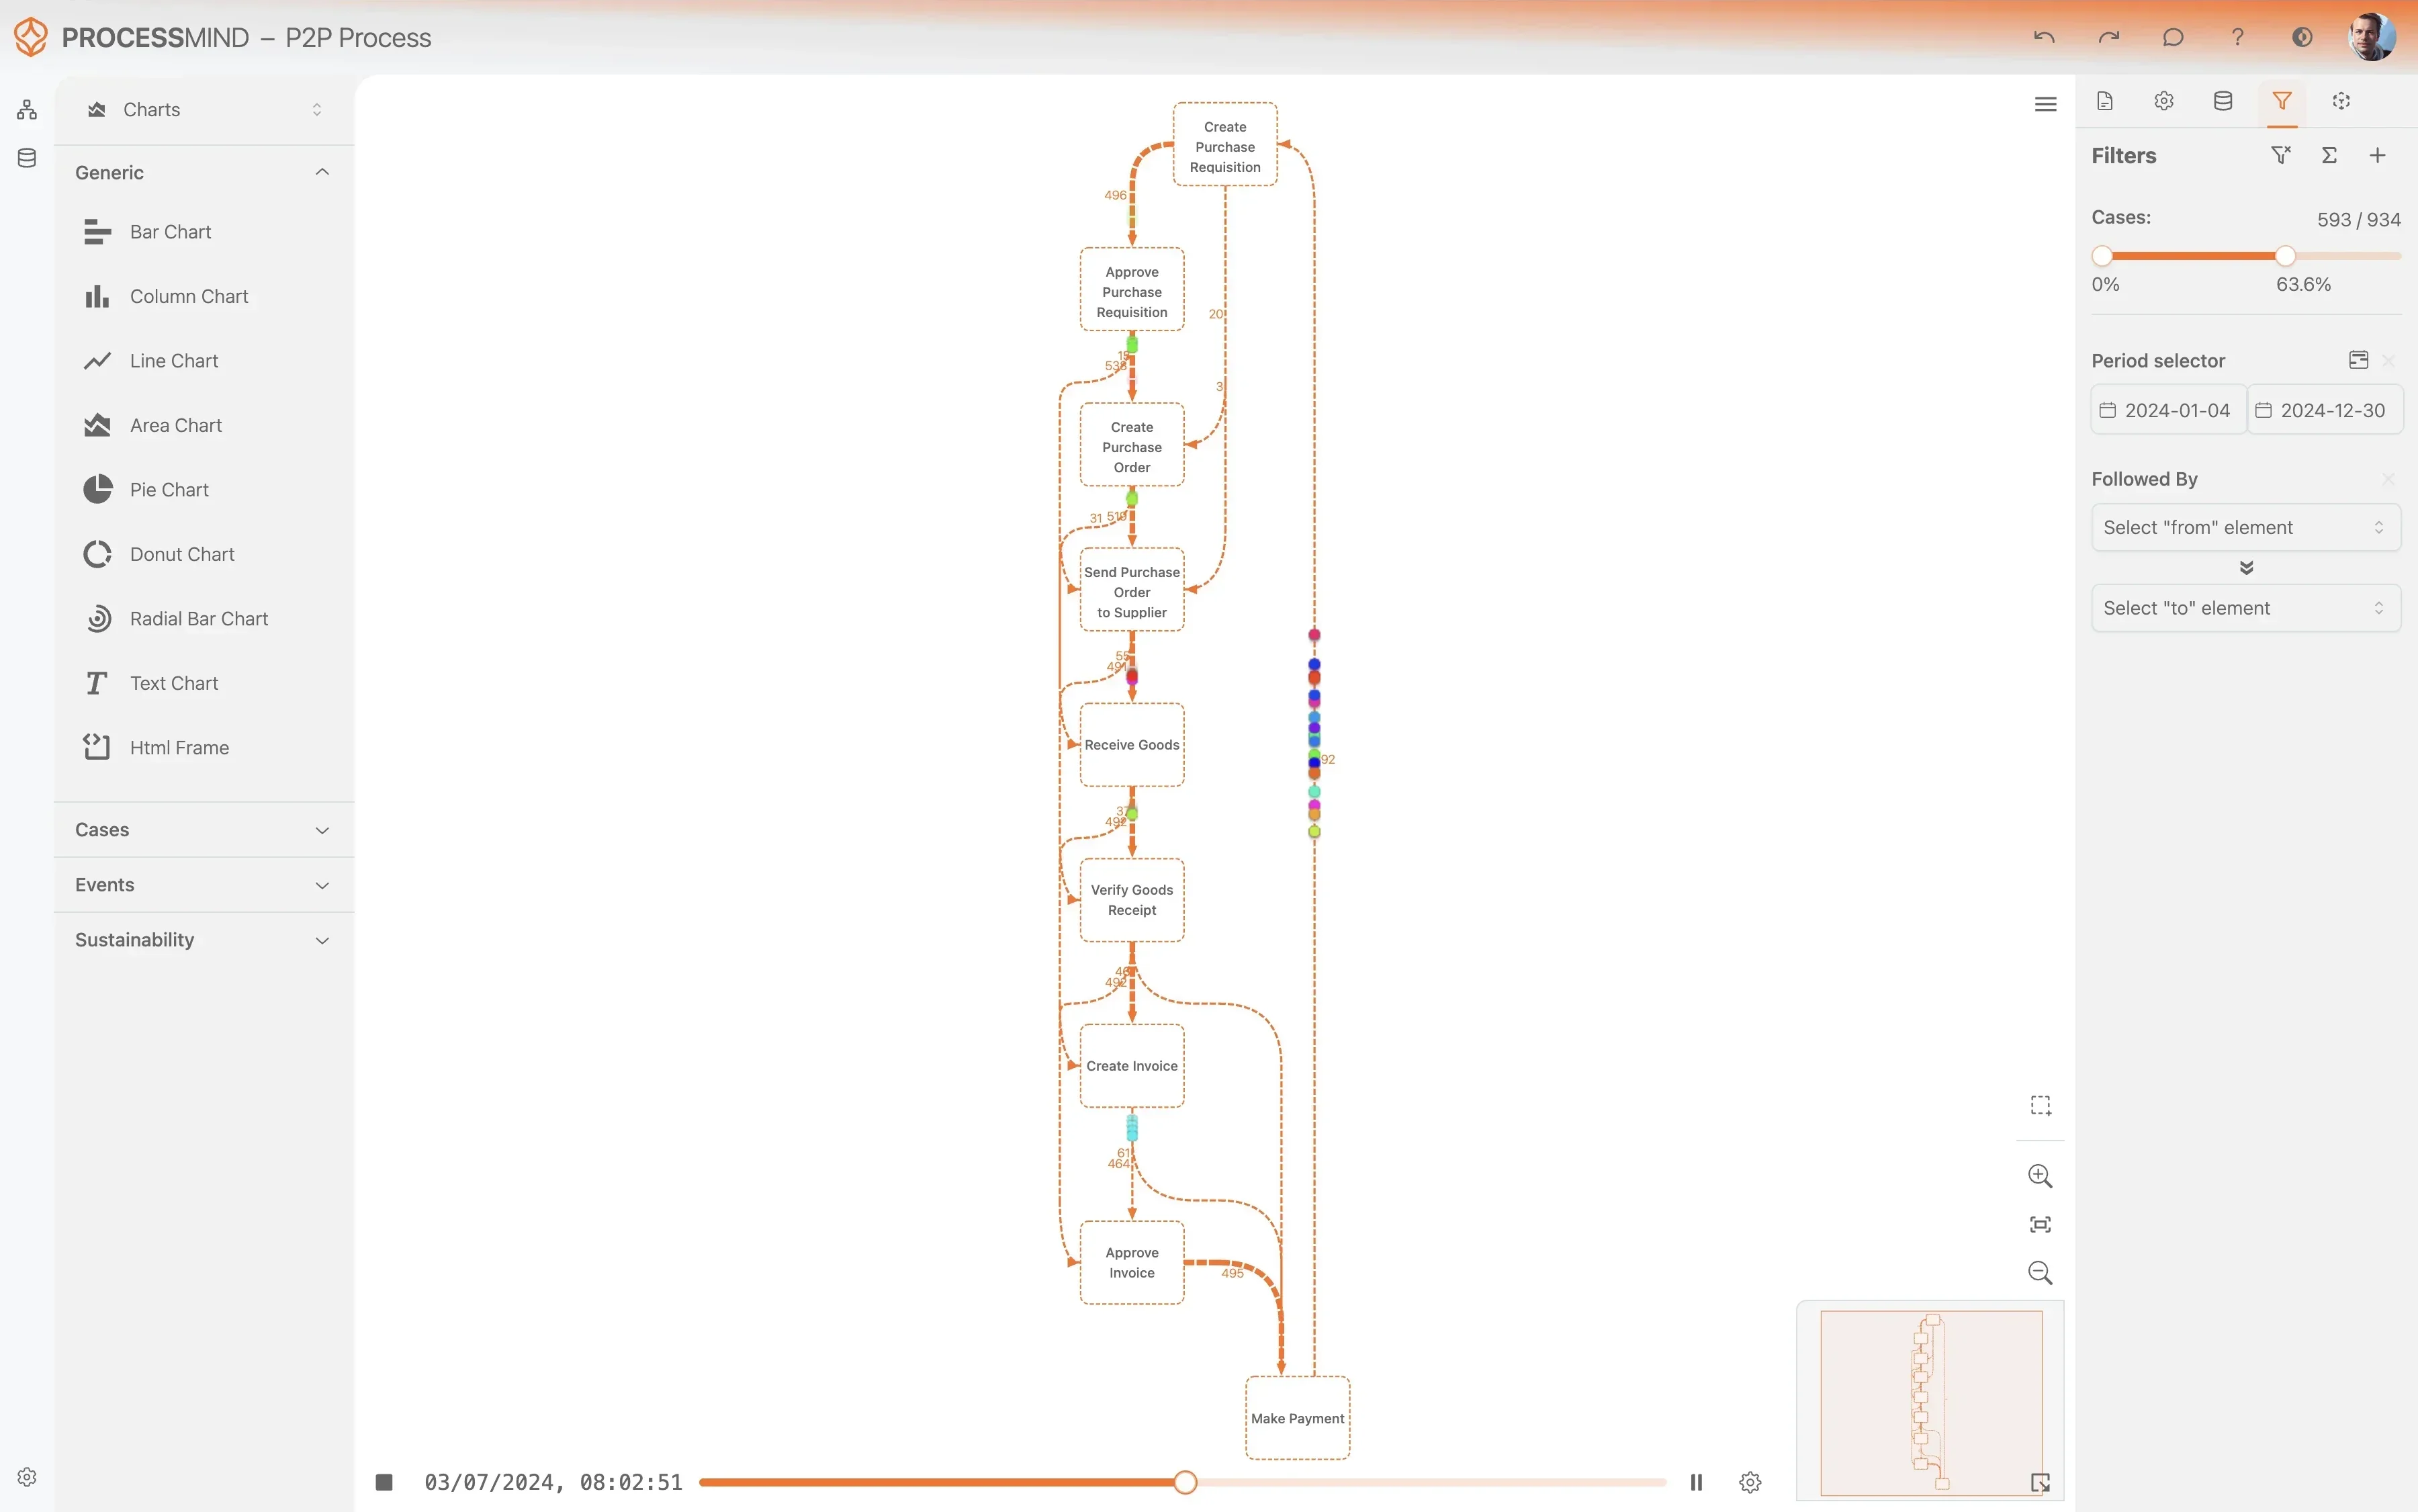
Ontdek waar onderzoeken naar problemen in Helix vastlopen

ProcessMind geeft een helder beeld van BMC Helix ITSM-data. Je ziet precies waar onderzoeken stilvallen en hoe je blijvende oplossingen sneller kunt realiseren.
  • Breng elke stap in de onderzoekscyclus in beeld
  • Achterhaal precies waardoor toewijzingen vertraging oplopen
  • Verbeter de snelheid waarmee workarounds worden vastgelegd
  • Meet wat oplossingen doen met het aantal incidenten
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

AANGETOONDE RESULTATEN

Meetbare impact op probleemoplossing

Organisaties krijgen helder inzicht in probleemrecords. Zo kunnen ze de oorzaakanalyse verbeteren en het aantal terugkerende incidenten binnen de organisatie terugdringen. Deze resultaten laten zien welke efficiëntiewinst mogelijk is wanneer teams inzichten uit data toepassen op workflows in BMC Helix ITSM.

0 % reduction
Hoofdoorzaken sneller vinden

Kortere onderzoekstijd

Als het traject van de start van een onderzoek tot het vaststellen van de hoofdoorzaak korter wordt, kunnen technische teams zich richten op permanente oplossingen in plaats van langdurige diagnoses.

0 x fewer moves
Minder heen-en-weer met probleemrecords

Minder herverdelingen naar supportteams

Door bottlenecks in de eerste routering op te sporen, komen probleemrecords meteen bij de juiste experts terecht. Zo voorkom je onnodig werk bij meerdere supportteams.

+ 0 % improvement
Betere naleving van SLA’s

Procentuele stijging van compliance

Realtime inzicht in probleemrecords die vastlopen helpt het management om in te grijpen voordat SLA-doelen worden gemist. Zo blijft de dienstverlening aan de organisatie op peil.

0 % less rework
Minder herstelwerk na oplossingen

Minder heropende probleemcases

Door oplossingen te controleren voordat een probleem wordt gesloten, weet je zeker dat de onderliggende oorzaak is verholpen. Zo voorkom je dat onderzoeken opnieuw beginnen nadat een oplossing al was doorgevoerd.

0 hours saved
Sneller tijdelijke oplossingen beschikbaar

Oplossingen sneller publiceren

Door tijdelijke oplossingen sneller te publiceren, beperk je de gevolgen van lopende incidenten voor eindgebruikers terwijl aan een oplossing voor de lange termijn wordt gewerkt.

De daadwerkelijke prestatieverbetering hangt af van de complexiteit van het proces en de kwaliteit van de data. Deze cijfers zijn gebaseerd op resultaten die doorgaans in verschillende grote organisaties worden waargenomen.

Aanbevolen data

Begin met deze essentiële attributen en activiteiten. Breid de analyse daarna uit als dat nodig is.

Attributen

Belangrijke datapunten voor de analyse

De unieke identificatiecode van de case voor het probleemonderzoek.

Waarom dit belangrijk is

Deze sleutel is nodig om het procesoverzicht op te bouwen en het verloop van specifieke problemen te volgen.

De specifieke taak of statuswijziging die heeft plaatsgevonden.

Waarom dit belangrijk is

Dit attribuut bepaalt de knooppunten op de proceskaart en maakt de workflow zichtbaar.

De timestamp waarop de activiteit plaatsvond.

Waarom dit belangrijk is

Hiermee kun je alle KPI’s op basis van tijdsduur berekenen en gebeurtenissen op volgorde zetten.

Het technische team dat op dit moment aan het probleemonderzoek is toegewezen.

Waarom dit belangrijk is

Hiermee kun je de organisatie analyseren en bottlenecks op teamniveau opsporen.

De berekende prioriteit van het probleem op basis van impact en urgentie.

Waarom dit belangrijk is

Hiermee kun je analyses uitsplitsen naar belang voor de bedrijfsvoering en SLA’s analyseren.

De medewerker die is aangewezen om het onderzoek te coördineren.

Waarom dit belangrijk is

Hiermee kun je de werkverdeling en werkdruk per medewerker analyseren.

De classificatie van de onderliggende oorzaak van het probleem.

Waarom dit belangrijk is

Hiermee kun je trends in structurele problemen analyseren en proactief probleembeheer ondersteunen.

De belangrijkste bedrijfsservice of het configuratie-item waarop het probleem invloed heeft.

Waarom dit belangrijk is

Dit attribuut koppelt de procesprestaties aan specifieke producten of services van de organisatie.

De reden waarom het probleemonderzoek is gestart.

Waarom dit belangrijk is

Dit maakt onderscheid tussen reactief en proactief werk, een belangrijke maatstaf voor de volwassenheid van het proces.

De datum en tijd waarop het probleem uiterlijk moet zijn opgelost.

Waarom dit belangrijk is

Dit is het referentiepunt voor alle metingen van compliance en tijdigheid.

Het aantal incidenten dat aan deze probleemregistratie is gekoppeld.

Waarom dit belangrijk is

Dit geeft de operationele impact van het probleem en de hinder voor gebruikers weer.

Een indicator die aangeeft of de toegestane oplostijd is overschreden.

Waarom dit belangrijk is

Dit maakt rapportages over compliance en analyses van procesfouten eenvoudiger.

Activiteiten

Processtappen om te volgen en te optimaliseren

Het moment waarop een Problem Investigation-record voor het eerst in het systeem wordt aangemaakt. Deze gebeurtenis wordt vastgelegd wanneer een nieuwe invoer wordt opgeslagen in het formulier PBM:Problem Investigation.

Waarom dit belangrijk is

Dit markeert het begin van de procesinstantie. Nodig om de totale doorlooptijden en de eerste responstijden te berekenen.

De toewijzing van het probleemrecord aan een specifiek technisch team. Vastgelegd door wijzigingen in het veld 'Assigned Group' te volgen.

Waarom dit belangrijk is

Nodig om overdrachten, heen-en-weerbewegingen en de KPI 'Mean Time to Initial Assignment' te meten.

De overgang van het probleemrecord naar een actieve analysefase. Dit wordt afgeleid uit een wijziging van het veld Status naar 'Under Investigation'.

Waarom dit belangrijk is

Dit markeert het begin van het daadwerkelijke werk en ondersteunt de KPI 'Investigation Cycle Time'.

Tekst invoeren in of wijzigen van het veld Workaround van het probleemrecord. Deze gebeurtenis geeft aan dat een tijdelijke oplossing is gedocumenteerd.

Waarom dit belangrijk is

Ondersteunt de KPI 'Workaround Publication Lead Time' en geeft aan dat de impact van het incident wordt beperkt.

Het moment waarop de status van het probleemrecord aangeeft dat de oorzaak bekend is. Dit wordt afgeleid uit een wijziging van Status naar 'Root Cause Identified'.

Waarom dit belangrijk is

Een belangrijk moment voor het dashboard 'Root Cause Investigation Cycle Time'. Dit markeert de overgang van analyse naar het uitwerken van een oplossing.

Een Infrastructure Change Request koppelen aan het probleemonderzoek. Dit markeert het begin van de invoeringsfase.

Waarom dit belangrijk is

Nodig voor de KPI 'Root Cause to Change Lead Time' en om silo’s tussen Problem Management en Change Management op te sporen.

Het moment waarop is bevestigd dat de permanente oplossing werkt. Dit wordt afgeleid uit een wijziging van Status naar 'Solution Implemented' of 'Completed'.

Waarom dit belangrijk is

Wordt gebruikt voor 'Problem SLA Adherence Rate'. Bevestigt dat het technische werk is afgerond.

De definitieve administratieve afsluiting van het probleemrecord. Deze gebeurtenis beëindigt de procesinstantie.

Waarom dit belangrijk is

De standaardgebeurtenis aan het einde van het proces. Nodig voor een volledige analyse van de doorlooptijd en de berekening van 'Incident Linkage Density'.

Een probleemrecord beëindigen voordat het is opgelost. Vastgelegd wanneer de status 'Cancelled' of 'Rejected' wordt.

Waarom dit belangrijk is

Spoor onnodig werk of terechte duplicaten op. Dit is een alternatieve eindstatus.

Veelgestelde vragen

Veelgestelde vragen

Process mining brengt alle routes van een probleemrecord in beeld. Zo zie je hoe het proces echt verloopt, niet alleen hoe het bedoeld is. Door historische event logs te analyseren, ontdek je waar records tussen supportgroepen heen en weer gaan of in een wachtstatus blijven staan. Met dat inzicht kunnen teams structurele inefficiëntie aanpakken en zich richten op oorzaakanalyses met grote impact.

Je hebt een eenvoudig event log nodig met een uniek ID voor het probleemrecord, een timestamp en een omschrijving van de activiteit, zoals Status Change of Assigned Group. Deze informatie komt meestal uit de tabellen PBM:Problem Investigation in de BMC Helix-database. De meeste process mining-tools kunnen rechtstreeks verbinding maken met deze tabellen of CSV-bestanden importeren om het procesverloop in kaart te brengen.

Process mining laat zien in welke fasen onderzoeken vastlopen, bijvoorbeeld wanneer teams wachten op informatie van een leverancier of feedback van een andere afdeling. Door de duur van elke overgang te meten, kunnen managers ontbrekende capaciteit of documentatie opsporen die het onderzoek vertraagt. Zo vervangen feiten de losse ervaringen en wordt duidelijk waar vertraging ontstaat.

De eerste inzichten zijn vaak binnen twee tot vier weken beschikbaar, zodra de data-extractie uit BMC Helix is ingericht. In de eerste fase wordt verbinding gemaakt met het systeem en worden de belangrijkste statuswijzigingen in kaart gebracht voor een basismodel. In de weken daarna wordt de analyse verfijnd en worden concrete verbeterkansen opgespoord, zoals minder vaak records opnieuw toewijzen.

Process mining is geschikt om problemen met datakwaliteit op te sporen, zoals ontbrekende timestamps of onjuiste categorieën. Slechte data kunnen sommige inzichten verhullen, maar de visualisatie laat vaak zien waar supportmedewerkers processtappen overslaan of verkeerd registreren. Het verbeteren van deze data is een van de eerste doelen, zodat toekomstige rapportages kloppen.

Process mining lost het proces niet voor je op, maar laat wel zien waardoor SLA’s worden overschreden. Je ziet precies welke routes records volgen die hun doelen niet halen. Vergelijk records die wel en niet aan de afspraken voldoen om te ontdekken of bepaalde supportgroepen of probleemtypen vaker vertraging oplopen. Zo kun je gerichte training geven of capaciteit anders verdelen, zodat problemen met prioriteit binnen de afgesproken tijd worden afgehandeld.

Hiermee volg je de overdracht tussen de modules Problem Management en Change Management om te zien of er veel tijd verloren gaat. Door deze overgang zichtbaar te maken, zie je of wijzigingsverzoeken snel worden aangemaakt nadat de hoofdoorzaak is vastgesteld, of dat ze blijven hangen in administratieve stappen. Zo wordt duidelijk hoe lang het duurt vanaf het vaststellen van een probleem tot de invoering van een permanente oplossing.

Process mining is een aanvulling op standaardrapportages. Je ziet het verloop van het proces over een langere periode, in plaats van alleen momentopnames van de huidige status. Een traditioneel rapport laat zien hoeveel problemen openstaan. Process mining laat zien hoe die problemen in de loop van de tijd door het systeem zijn gegaan. Dat detailniveau is nodig om processen echt te optimaliseren en verborgen bottlenecks te vinden die standaarddashboards mogelijk niet laten zien.

Pak bottlenecks in Probleembeheer vandaag aan

Verkort doorlooptijden met 30% en verbeter de stabiliteit van de dienstverlening.

Start je gratis proefperiode

Geen creditcard nodig. Binnen enkele minuten ingesteld.