Migliori la gestione dei problemi
Guida in 6 passaggi per ottimizzare BMC Helix ITSM
Migliori la gestione dei problemi
Gestione dei problemi
BMC Helix ITSM

Selezioni un processo

Scelga un processo per continuare a lavorare nell’area di lavoro collegata.

Processi disponibili
Sistemi disponibili
259 Processi

Ottimizzi la gestione dei problemi in BMC Helix ITSM

La nostra piattaforma individua i colli di bottiglia nascosti e gli ostacoli nei processi che riducono l’efficienza dei servizi. Può visualizzare facilmente i punti in cui le attività manuali o i passaggi di consegne rallentano le indagini. Questa visibilità Le consente di semplificare i flussi di lavoro ed eliminare le cause profonde dei problemi operativi ricorrenti.

Scarichi il nostro template dei dati preconfigurato e affronti le sfide più comuni per raggiungere i Suoi obiettivi di efficienza. Segua il nostro piano di miglioramento in sei fasi e consulti la guida al template dei dati per trasformare le Sue attività.

Mostra la descrizione dettagliata

Il valore strategico di una gestione dei problemi più efficace

Una gestione efficace dei problemi è alla base di un ambiente IT stabile. Mentre la gestione degli incidenti punta a ripristinare il servizio nel minor tempo possibile, la gestione dei problemi mira a eliminare le cause profonde delle interruzioni. Se il processo non è ottimizzato, il team IT resta in modalità reattiva e si trova a gestire ripetutamente gli stessi problemi. Questo circolo vizioso aumenta i costi operativi, riduce la soddisfazione degli utenti e sottopone il personale tecnico a una pressione inutile. Ottimizzando il processo in BMC Helix ITSM, si passa da un approccio reattivo a una strategia proattiva, che migliora l’affidabilità complessiva dei servizi aziendali e protegge l’organizzazione da costose interruzioni.

Dai dati di BMC Helix ITSM a indicazioni concrete

I report standard di BMC Helix ITSM offrono spesso una fotografia statica dei dati, per esempio il numero di problemi aperti o il tempo medio di chiusura. Queste metriche, però, raramente spiegano perché una determinata indagine sia ferma. Il Process Mining ricostruisce l’intero ciclo di vita di ogni record di problema a partire dalle tracce digitali presenti in tabelle come PBM:Problem Investigation e PBM:Known Error. In questo modo emerge la sequenza effettiva degli eventi e si vede con precisione dove si interrompono i passaggi di consegne, si accumulano le approvazioni e si ripetono attività già svolte. Invece di ipotizzare perché il tempo di ciclo sia elevato, è possibile individuare i percorsi che causano i ritardi e intervenire in modo mirato, sulla base di dati oggettivi anziché di segnalazioni aneddotiche.

Individuare le inefficienze strutturali nell’analisi delle cause profonde

Una delle sfide più rilevanti nella gestione dei problemi è il passaggio dall’identificazione di un problema all’avvio dell’indagine. In molte organizzazioni, un record può restare nello stato registrato o assegnato per giorni prima che uno specialista inizi a lavorarci. Il Process Mining aiuta a individuare questi colli di bottiglia poco visibili. Può emergere, per esempio, che alcuni gruppi di supporto sono sovraccarichi e accumulano arretrati, oppure che i criteri per avviare l’analisi delle cause profonde non sono chiari. Analizzando il flusso tra attività come Indagine avviata e Causa profonda identificata, è possibile capire se i team tecnici dispongono delle informazioni necessarie o se dedicano troppo tempo ad attività amministrative invece che alla diagnosi. Ridurre il tempo di ciclo è il modo più rapido per migliorare la stabilità complessiva dell’IT.

Rendere più efficaci le soluzioni temporanee e la gestione degli errori noti

Un aspetto fondamentale, ma spesso trascurato, del processo è la rapidità con cui vengono pubblicate le soluzioni temporanee. Se una soluzione viene individuata ma non documentata nel modulo PBM:Known Error, gli operatori del Service Desk continuano ad avere difficoltà a gestire gli incidenti ricorrenti, con uno spreco di risorse per tutta l’organizzazione. Il Process Mining consente di misurare il tempo che intercorre tra Soluzione temporanea individuata e Soluzione temporanea pubblicata. Se l’intervallo è troppo lungo, può indicare un problema di comunicazione che incide direttamente sul volume degli incidenti. Semplificando questa parte del flusso di lavoro, l’organizzazione può beneficiare delle soluzioni temporanee mentre si sviluppa quella definitiva, dando agli specialisti il tempo necessario per un’analisi approfondita senza la pressione di una coda di incidenti in crescita.

Misurare i risultati e far maturare il processo

L’obiettivo ultimo dell’ottimizzazione dei processi è ridurre la frequenza e l’impatto degli incidenti sull’attività aziendale. Con il Process Mining è possibile definire valori di riferimento chiari per il ciclo di vita della gestione dei problemi. Si può misurare l’efficacia delle attività Avvio richiesta di modifica e verificare se le soluzioni definitive vengono applicate entro gli obiettivi di livello di servizio concordati. Man mano che si introducono cambiamenti, il Process Mining fornisce riscontri continui e mostra in tempo reale se le ottimizzazioni stanno dando risultati. Questo approccio basato sui dati favorisce una cultura di trasparenza e responsabilità chiare, in cui i team possono migliorare i propri flussi di lavoro sulla base dei fatti. Nel tempo, una maggiore maturità riduce sensibilmente il ripetersi dei problemi e rende più resiliente l’infrastruttura IT.

Da dove iniziare per ottimizzare i processi

Per migliorare la gestione dei problemi non è necessario rivedere da cima a fondo la suite ITSM. Il primo passo è ottenere visibilità sullo stato attuale. Applicando queste tecniche di analisi ai dati di BMC Helix ITSM, è possibile iniziare in piccolo, per esempio concentrandosi su un servizio prioritario o su una categoria di problemi frequente. Man mano che si individuano e si risolvono i colli di bottiglia, la conseguente riduzione degli incidenti libera capacità e permette al team di affrontare miglioramenti strutturali più complessi. Utilizzi questa guida e i template allegati per avviare il percorso verso servizi IT più stabili, efficienti e proattivi.

Gestione dei problemi Analisi delle cause profonde Gestione dei servizi IT Service Desk Operazioni ITSM Riduzione degli incidenti Coordinatore dei problemi Gestione dei ticket Gestione dei ticket Errore noto Incidenti ricorrenti Soluzione temporanea Prevenzione degli incidenti Help Desk IT

Problemi e sfide comuni

Individui le sfide che La riguardano

Molti record di problema restano senza assegnazione per giorni a causa di responsabilità poco chiare o della mancata consapevolezza delle notifiche. Il ritardo aumenta il rischio che si ripetano incidenti gravi e riduce la capacità di risposta complessiva del reparto IT, mentre le cause profonde restano irrisolte e il tempo continua a passare.

ProcessMind visualizza il tempo che intercorre tra la registrazione del record e la prima assegnazione in BMC Helix ITSM. In questo modo individua i gruppi di supporto o le categorie di problemi che tardano sistematicamente a farsene carico, consentendo di adeguare le risorse o definire regole di assegnazione più chiare.

Le indagini sui problemi entrano spesso nella fase di indagine avviata, ma vi restano a tempo indeterminato senza aggiornamenti significativi. Questi record fermi impediscono di risolvere definitivamente le cause profonde e alimentano un arretrato crescente di debito tecnico irrisolto, che finisce per provocare altre interruzioni del servizio.

Monitorando la durata della fase di indagine, la nostra soluzione mostra con precisione dove il processo si arresta. Evidenzia i record che in BMC Helix ITSM hanno superato i tempi di risoluzione abituali, così i coordinatori dei problemi possono intervenire e riallocare le risorse prima che l’indagine perda rilevanza.

Se una soluzione temporanea viene individuata ma non pubblicata tempestivamente nel sistema di gestione delle conoscenze, gli operatori del Service Desk non riescono a risolvere rapidamente gli incidenti. La mancata comunicazione delle soluzioni provvisorie allunga il tempo medio di riparazione degli incidenti correlati e aumenta la frustrazione degli utenti, mentre si sviluppa la soluzione definitiva.

ProcessMind misura il tempo che intercorre tra l’individuazione di una soluzione temporanea e la relativa attività di pubblicazione. Questa visibilità permette di diffondere rapidamente le soluzioni provvisorie tramite BMC Helix ITSM, limitando l’impatto dei problemi ancora in corso mentre i team tecnici lavorano alla risoluzione definitiva della causa profonda.

I record di problema passano spesso da un team tecnico all’altro, perché i gruppi cercano di evitare di farsene carico o interpretano in modo diverso l’ambito tecnico. Questi passaggi circolari allungano notevolmente il ciclo di vita del problema e ritardano l’avvio dell’analisi delle cause profonde, sprecando risorse e affaticando i team.

Il motore di analisi mappa la sequenza delle attività di assegnazione e individua i passaggi ripetuti tra gruppi in BMC Helix ITSM. È possibile vedere quali gruppi reindirizzano spesso i record e intervenire con una formazione mirata o una definizione più chiara delle responsabilità, interrompendo il ciclo di rimpalli.

Spesso i problemi ad alta priorità non rispettano gli obiettivi di livello di servizio a causa di inefficienze nascoste nelle fasi di indagine e risoluzione. Il mancato rispetto delle scadenze compromette la stabilità dei servizi IT e può generare tensioni interne o minare la fiducia nell’azienda, quando le infrastrutture critiche restano instabili più a lungo del previsto.

Confrontando le scadenze degli SLA con le date e gli orari effettivi delle attività, ProcessMind individua quelle che causano le violazioni. È così possibile monitorare in tempo reale gli obiettivi di livello di servizio in BMC Helix ITSM e adeguare le priorità o i flussi di lavoro prima che le scadenze vengano superate e la stabilità del servizio sia compromessa.

Dopo aver individuato una causa profonda, spesso passa molto tempo prima che venga avviata una richiesta di modifica per applicare una soluzione definitiva. Questo intervallo espone l’organizzazione al rischio di nuovi incidenti, anche quando la soluzione tecnica è nota, perché l’implementazione resta bloccata in un limbo amministrativo.

Analizziamo il tempo trascorso tra l’attività Causa profonda identificata e l’evento Richiesta di modifica avviata. In questo modo emergono gli ostacoli nel passaggio dalla gestione dei problemi alla gestione delle modifiche in BMC Helix ITSM e si può procedere con le soluzioni definitive senza ritardi amministrativi inutili.

Nei periodi di intenso lavoro, i team saltano spesso la fase di revisione successiva all’implementazione per chiudere rapidamente i record e ridurre gli arretrati. Senza questo passaggio, l’organizzazione non verifica che la soluzione abbia funzionato come previsto né raccoglie gli insegnamenti utili, con il rischio che in futuro si ripetano problemi simili.

ProcessMind monitora l’attività Revisione successiva all’implementazione completata per ogni record di problema chiuso. Evidenzia le deviazioni dal processo standard in BMC Helix ITSM, così da garantire che vengano seguiti tutti i passaggi di risoluzione e rispettati i requisiti di miglioramento del servizio e di conformità.

A volte i record di problema vengono chiusi prima che la risoluzione sia stata verificata dai responsabili aziendali o tecnici. Di conseguenza, lo stesso problema può ripresentarsi poco dopo la chiusura e richiedere la riapertura del record o la creazione di uno nuovo, complicando la reportistica e riducendo l’accuratezza delle metriche.

La nostra analisi confronta l’attività Risoluzione verificata con l’evento di chiusura finale in BMC Helix ITSM. Individuiamo i casi in cui la verifica viene omessa o svolta in fretta, aiutando i team a garantire la qualità e ad accertarsi che la causa profonda sia stata davvero eliminata prima di dichiarare risolto il problema.

Se i tecnici non classificano correttamente la causa profonda di un problema, diventa impossibile individuare tendenze di lungo periodo o debolezze sistemiche dell’infrastruttura. La mancanza di dati impedisce alla direzione di prendere decisioni informate sugli investimenti infrastrutturali o sulle modifiche ai processi necessarie per migliorare la stabilità.

ProcessMind individua i record in cui l’attributo della categoria della causa profonda è assente o contiene valori generici. Evidenziando queste lacune in BMC Helix ITSM, aiutiamo le organizzazioni a migliorare l’integrità dei dati e a comprendere meglio le cause effettive dell’instabilità IT, così da definire strategie di prevenzione più efficaci.

Alcuni team tecnici specializzati sono spesso sopraffatti dall’elevato numero di problemi assegnati, con conseguenti arretrati consistenti e ritardi nelle risoluzioni. Questo squilibrio nei carichi di lavoro crea un singolo punto di criticità che blocca l’intero processo di gestione dei problemi e mette a rischio i servizi essenziali.

Analizzando il numero di record attivi assegnati a ciascun gruppo di supporto, la nostra soluzione individua i colli di bottiglia legati alle risorse. I responsabili IT possono così riequilibrare i carichi di lavoro o aumentare il personale nelle aree critiche di BMC Helix ITSM, basandosi sui dati effettivi di gestione e non su impressioni aneddotiche.

Quando il ciclo di gestione dei problemi è troppo lento, gli stessi incidenti continuano ad arrivare al Service Desk e assorbono risorse preziose in attività ripetitive. Questo circolo vizioso riduce l’efficienza e distoglie il team dai progetti strategici e dalla risoluzione di problemi più complessi.

ProcessMind mette in relazione il numero di incidenti correlati con la durata delle fasi di indagine e risoluzione. Mostrando come la lentezza nella risoluzione dei problemi faccia aumentare direttamente il volume degli incidenti in BMC Helix ITSM, aiutiamo a motivare l’accelerazione delle soluzioni definitive e a ridurre il carico complessivo sul Service Desk.

Obiettivi tipici

Definisca i criteri di successo

Un’assegnazione rapida permette agli esperti più adatti di occuparsi subito dei problemi critici. Riducendo il tempo in cui un record resta nello stato registrato, l’organizzazione può avviare prima le indagini e limitare il periodo di esposizione ai disservizi IT, accelerando il ripristino del servizio.

ProcessMind individua il tempo esatto che intercorre tra le attività Registrato e Assegnato in BMC Helix ITSM. Evidenzia le categorie o i livelli di priorità per cui l’assegnazione richiede più tempo della media, consentendo ai responsabili di definire valori di riferimento e monitorare in tempo reale i miglioramenti nei tempi di risposta.

Individuare la causa profonda di un problema è la fase più impegnativa in termini di lavoro. Ridurne la durata accelera direttamente lo sviluppo di soluzioni definitive, evita l’accumulo di debito tecnico e alleggerisce il carico dei team tecnici, che altrimenti dovrebbero continuare a gestire incidenti ricorrenti.

La nostra piattaforma analizza l’attività Indagine avviata per misurare il tempo effettivamente dedicato all’analisi delle cause profonde. Fa emergere i colli di bottiglia nascosti che bloccano le indagini, consentendo ai coordinatori di intervenire e riallocare le risorse per i problemi complessi prima che vengano superati gli obiettivi di livello di servizio.

Fornire rapidamente una soluzione temporanea è essenziale per ripristinare il servizio mentre si cerca una soluzione definitiva. Pubblicare tempestivamente gli errori noti riduce l’impatto operativo degli incidenti e migliora l’esperienza degli utenti, offrendo agli operatori del Service Desk soluzioni immediate ai problemi più comuni e aumentando così la disponibilità del servizio.

Con il Process Mining è possibile visualizzare l’intervallo tra la registrazione iniziale del problema e l’attività Soluzione temporanea pubblicata. Questi dati aiutano a individuare i gruppi di supporto che forniscono più rapidamente soluzioni provvisorie, così da estendere i loro flussi di lavoro efficaci a tutta l’organizzazione IT.

Ogni volta che un record di problema passa da un gruppo di supporto all’altro, si perde tempo e si disperdono informazioni. Eliminare questi rimpalli crea un percorso diretto verso la risoluzione, riduce la frustrazione del personale tecnico e accelera il ciclo di vita del record, che resta così in carico agli esperti più adatti.

ProcessMind mappa il flusso dei record tra i diversi gruppi di supporto in BMC Helix ITSM. Individuando i cicli ricorrenti e le riassegnazioni frequenti, è possibile capire dove mancano conoscenze o dove occorre migliorare la valutazione iniziale, affinché il record raggiunga il team giusto fin dal primo passaggio.

Rispettare gli accordi sul livello di servizio per i problemi ad alta priorità è fondamentale per garantire la continuità operativa. Una conformità costante rafforza la fiducia degli stakeholder aziendali e assicura che i problemi con il maggiore impatto ricevano l’attenzione urgente necessaria, riducendo la durata complessiva delle interruzioni dei servizi critici.

La piattaforma confronta l’attributo della scadenza SLA con i tempi effettivi di completamento di ogni record di problema. Segnala in anticipo i record prossimi alla scadenza, aiutando i coordinatori a stabilire le priorità dei carichi di lavoro e a mantenere la conformità per i servizi critici.

Una volta individuata la causa profonda, il passaggio a una richiesta formale di modifica dovrebbe essere lineare. Accelerare questo passaggio consente di portare le soluzioni definitive in produzione il prima possibile, eliminando i rischi dall’ambiente IT e riducendo il tempo trascorso nella fase di proposta della soluzione.

Analizziamo la sequenza di eventi dall’attività Causa profonda identificata all’evento Richiesta di modifica avviata. Questa visibilità fa emergere ritardi amministrativi o colli di bottiglia nelle approvazioni, consentendo ai team di automatizzare la creazione dei record di modifica e ridurre i tempi di inattività tra l’individuazione del problema e la sua risoluzione.

Imparare dai problemi passati è essenziale per migliorare continuamente il servizio. Completare una revisione per ogni problema grave permette di documentare gli insegnamenti, prevenire il ripetersi di problemi simili e accrescere nel tempo la maturità dell’organizzazione IT attraverso una migliore condivisione delle conoscenze.

ProcessMind verifica che l’attività Revisione successiva all’implementazione completata sia presente prima della chiusura di un record. Individuando i casi in cui questo passaggio viene spesso saltato, è possibile garantire la conformità e assicurarsi che le conoscenze vengano raccolte e condivise in tutto il Service Desk.

Chiudere un record di problema senza verificare la soluzione porta spesso al ripresentarsi dello stesso problema. Introdurre una fase formale di verifica permette di accertare che la causa profonda sia stata davvero eliminata, riducendo il volume complessivo degli incidenti futuri e proteggendo la stabilità dei servizi aziendali.

Analizzando la sequenza di attività tra Risoluzione verificata e Record chiuso, la nostra piattaforma evidenzia i casi in cui i record vengono chiusi prematuramente. Questi dati aiutano a dare priorità alla qualità e a verificare l’efficacia di ogni soluzione prima di chiudere definitivamente il caso.

Dati accurati sono alla base di una gestione efficace dei problemi. Migliorare la qualità delle categorie delle cause profonde consente di analizzare meglio le tendenze e di indirizzare gli investimenti in tecnologia o formazione verso i problemi sistemici dell’infrastruttura IT, favorendo la stabilità nel lungo periodo.

La piattaforma analizza l’attributo della categoria della causa profonda in migliaia di record per individuare incoerenze o un uso eccessivo di categorie generiche. Queste informazioni consentono ai responsabili di perfezionare gli standard di inserimento dei dati e migliorare l’affidabilità dei report in BMC Helix ITSM.

Distribuire il carico di lavoro tra i diversi team tecnici evita che singoli gruppi diventino colli di bottiglia. Un’allocazione adeguata delle risorse assicura che tutti i problemi, indipendentemente dalla categoria, ricevano l’attenzione necessaria e attraversino il ciclo di vita con tempi regolari e prevedibili.

ProcessMind mostra il volume dei record di problema aperti gestiti da ciascun gruppo di supporto assegnatario. Individuando i team con carichi di lavoro sproporzionati o tempi di elaborazione più lunghi, è possibile prendere decisioni basate sui dati in materia di personale, formazione e distribuzione del lavoro.

L’obiettivo principale della gestione dei problemi è impedire che gli incidenti si ripetano. Ridurne il volume abbassa sensibilmente i costi del supporto IT e aumenta la disponibilità delle applicazioni aziendali critiche, consentendo al personale IT di concentrarsi sull’innovazione anziché sulla manutenzione.

Mettiamo in relazione i record di problema con il numero di incidenti correlati per misurare l’impatto effettivo di ciascun problema. Monitorando la rapidità con cui il volume degli incidenti diminuisce dopo l’applicazione di una soluzione definitiva, è possibile quantificare il ritorno sugli investimenti nella gestione dei problemi e individuare le soluzioni più efficaci.

Passare da una gestione reattiva a una proattiva permette di prevenire i problemi prima che abbiano conseguenze per gli utenti. Individuare tempestivamente le tendenze consente all’organizzazione di affrontare le vulnerabilità durante gli interventi di manutenzione programmati, anziché durante le emergenze, e di mantenere un ambiente IT più stabile.

ProcessMind analizza il tempo che intercorre tra i gruppi di incidenti e la creazione di un record di problema. Monitorando questi andamenti, è possibile individuare le occasioni per avviare prima le indagini e spostare l’attenzione del team dalla gestione delle emergenze alla prevenzione, riducendo l’impatto complessivo sull’azienda.

Il percorso di miglioramento in 6 passaggi per la gestione dei problemi

1

Scaricare il template dei dati

Cosa fare

Ottenga il template Excel standardizzato, progettato per i campi di BMC Helix Problem Management, inclusi i moduli Problem Investigation e Known Error.

Perché è importante

Una struttura predefinita assicura che i dati del ciclo di vita siano allineati ai modelli di analisi e permette di ottenere indicazioni utili per la diagnosi molto più rapidamente.

Risultato atteso

Un template pronto all’uso per mappare i dati ITSM.

I SUOI DATI SUI PROCESSI

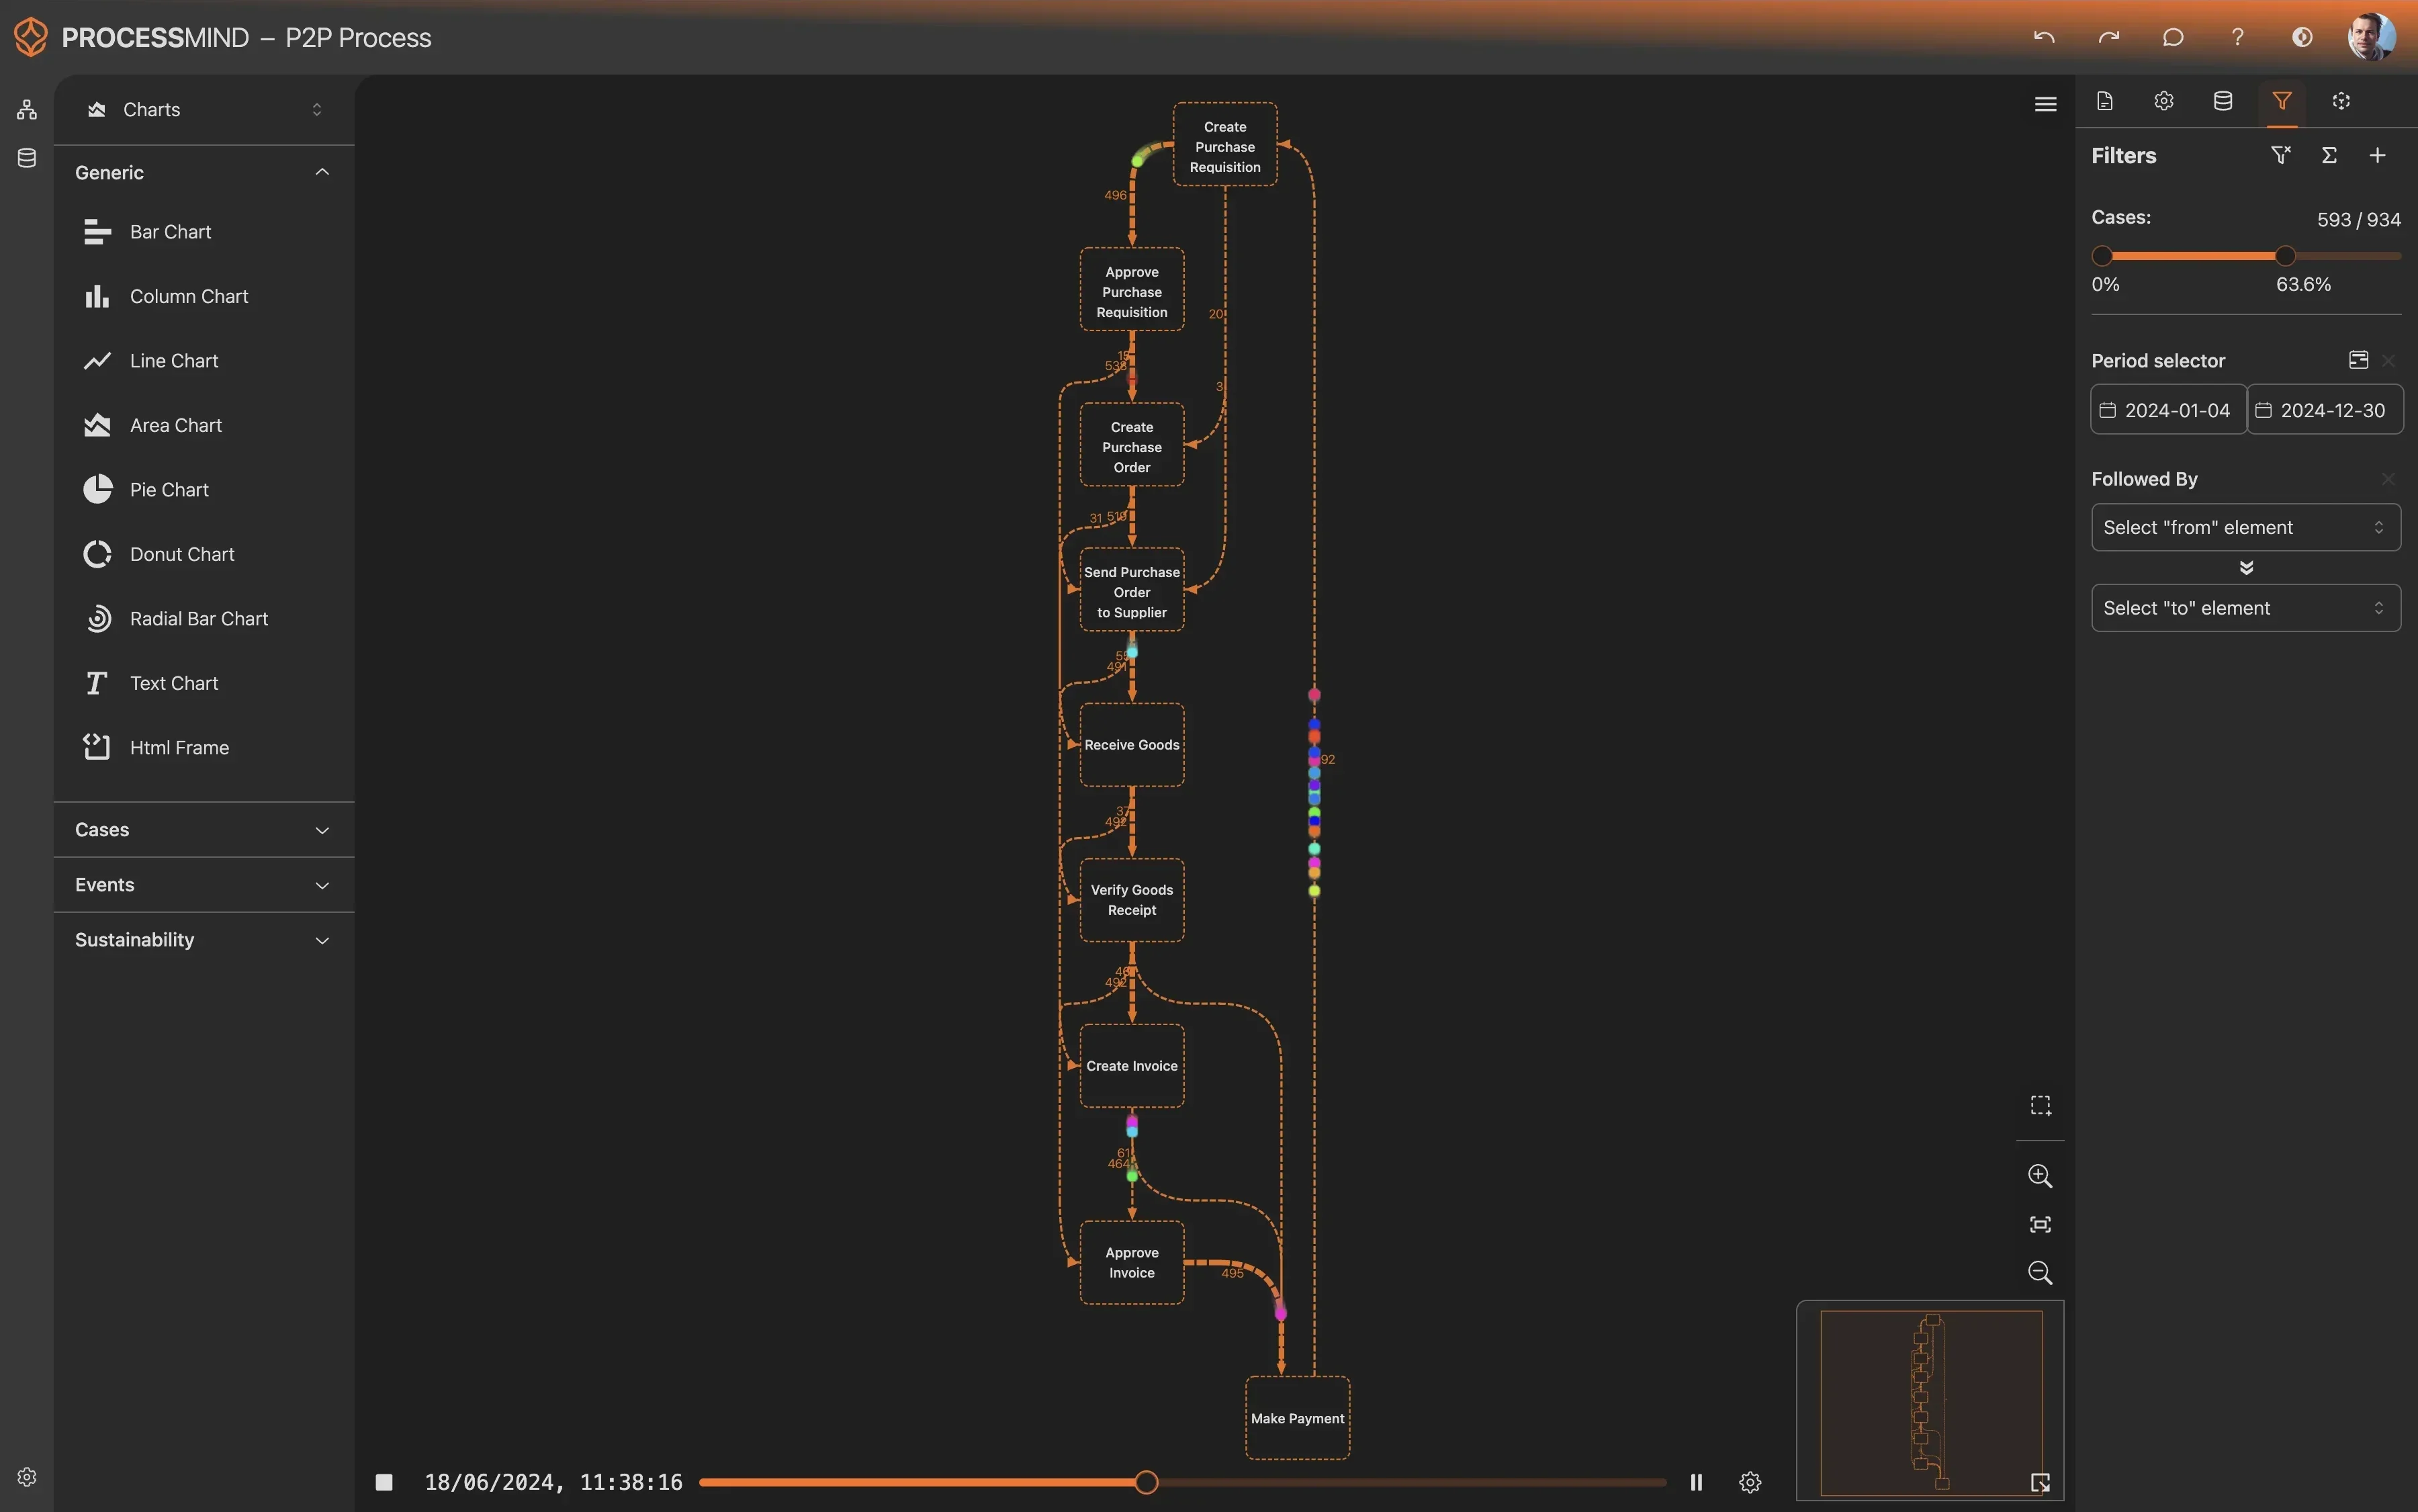
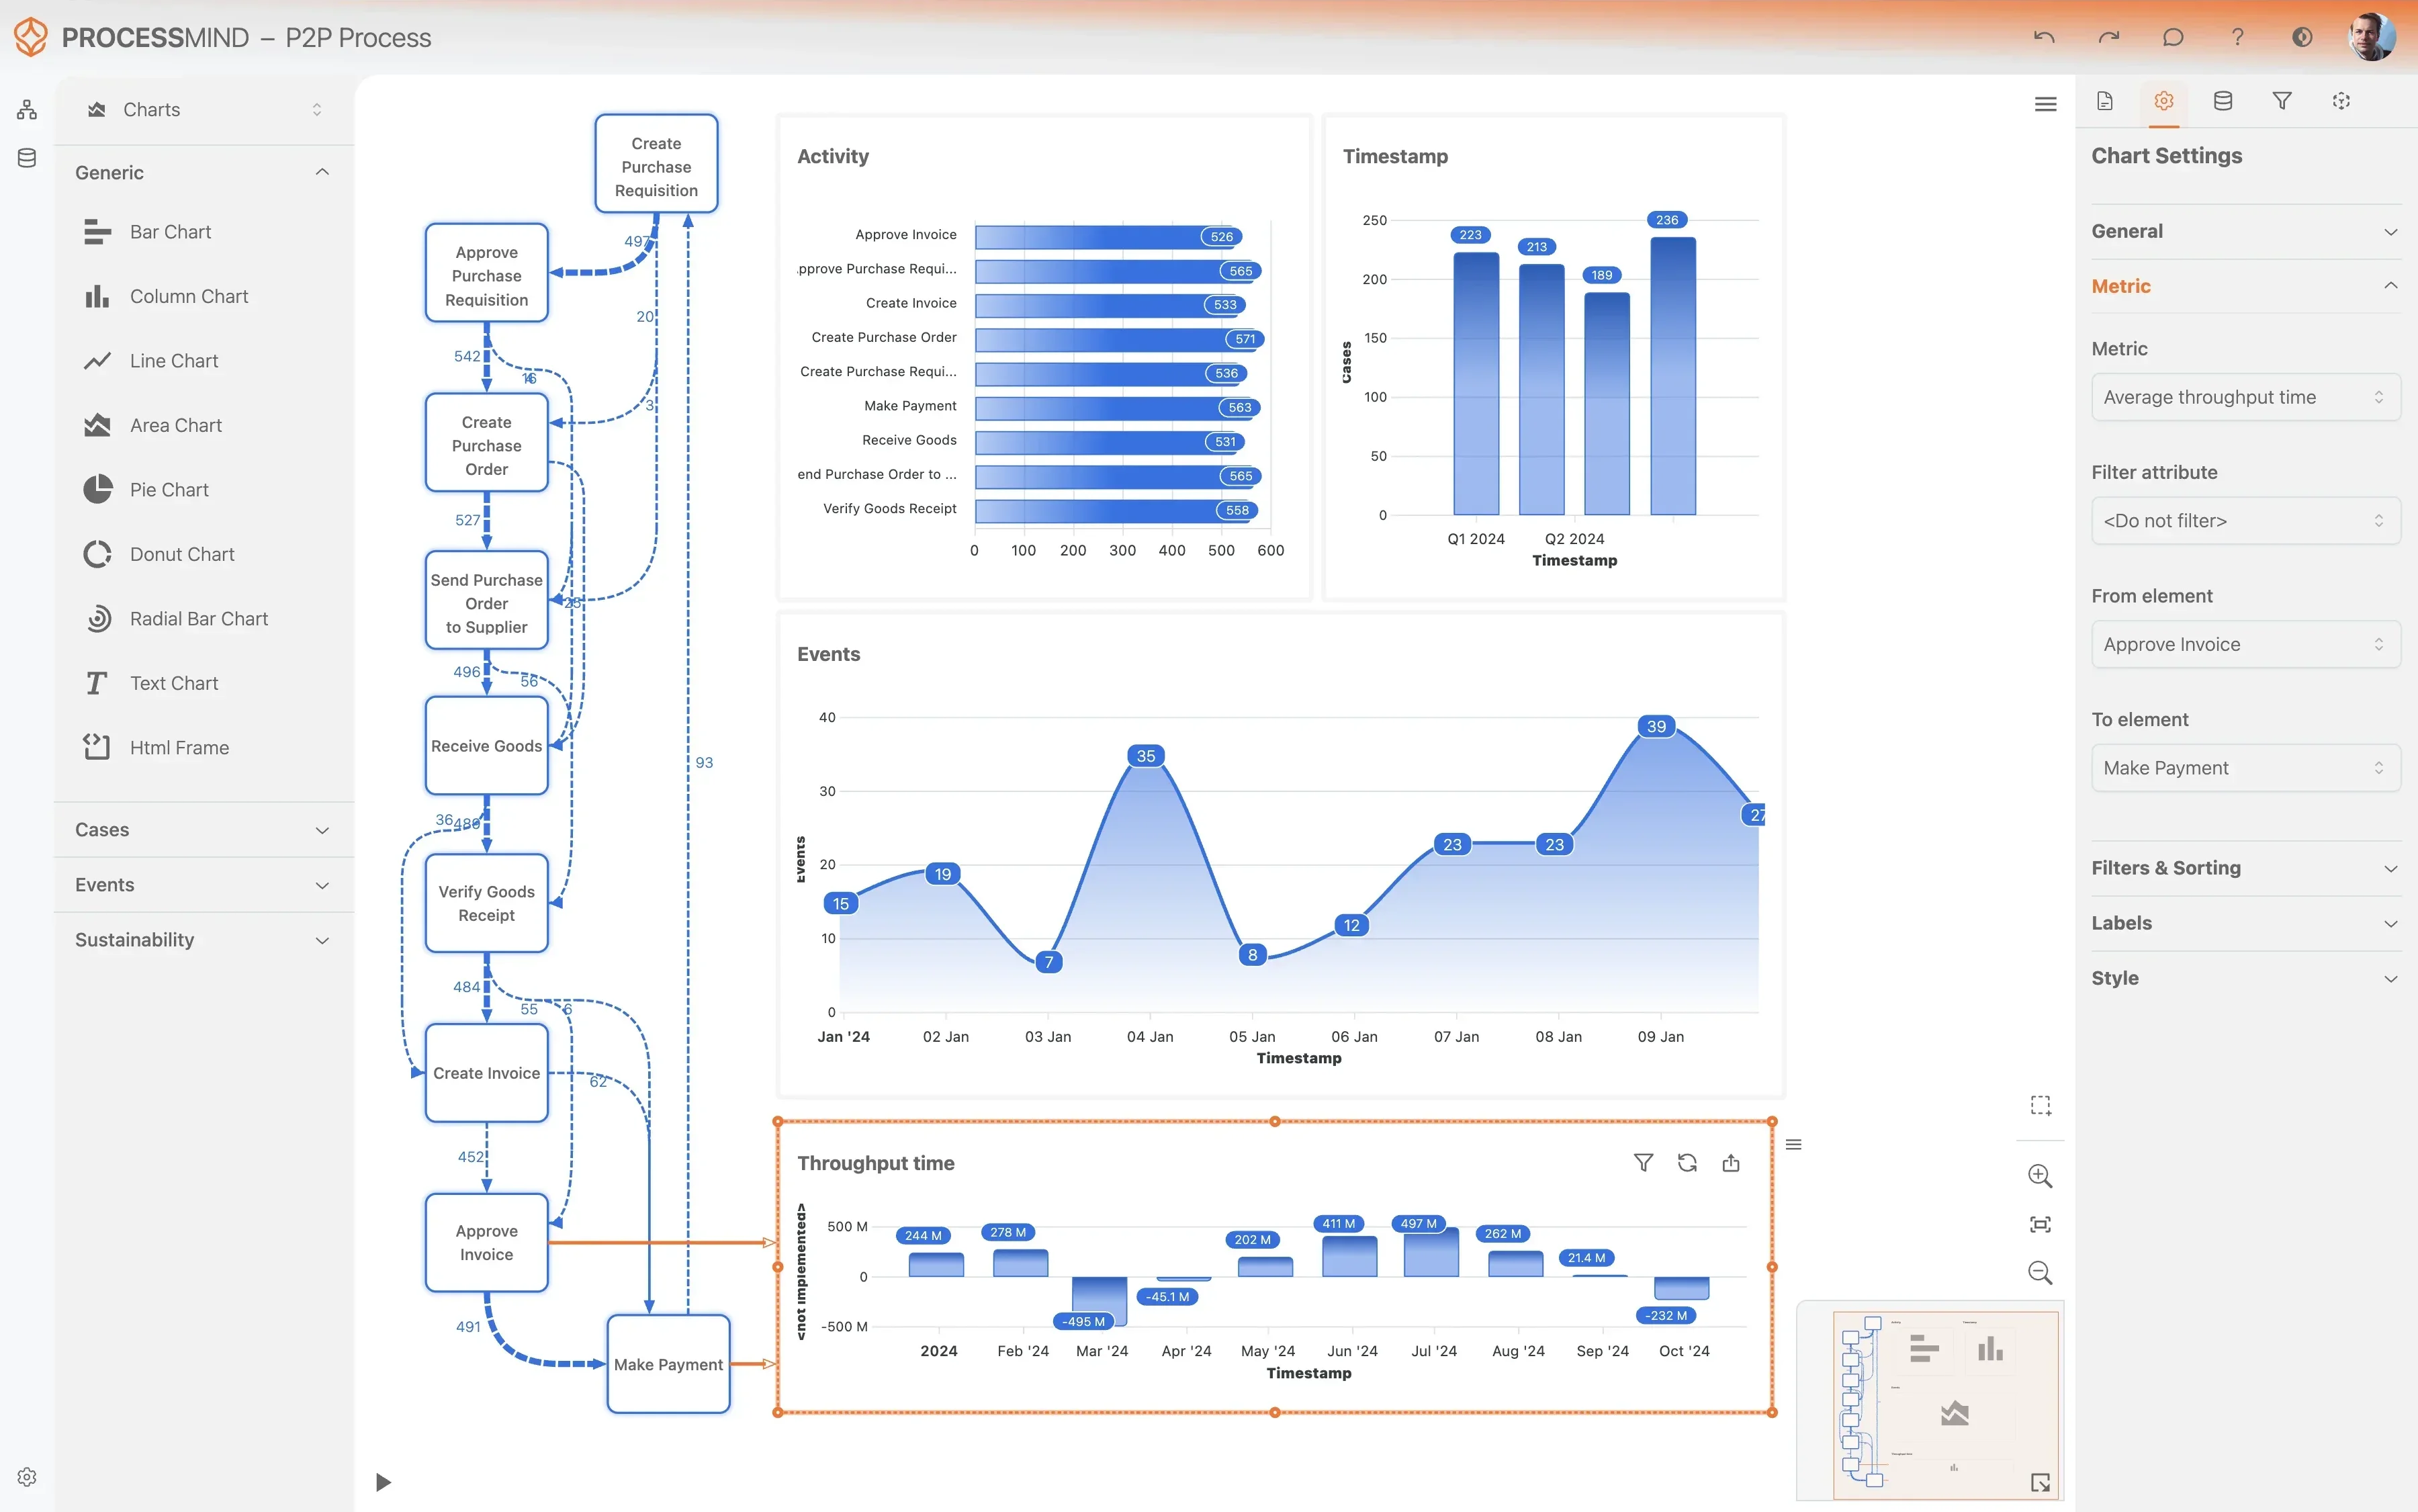
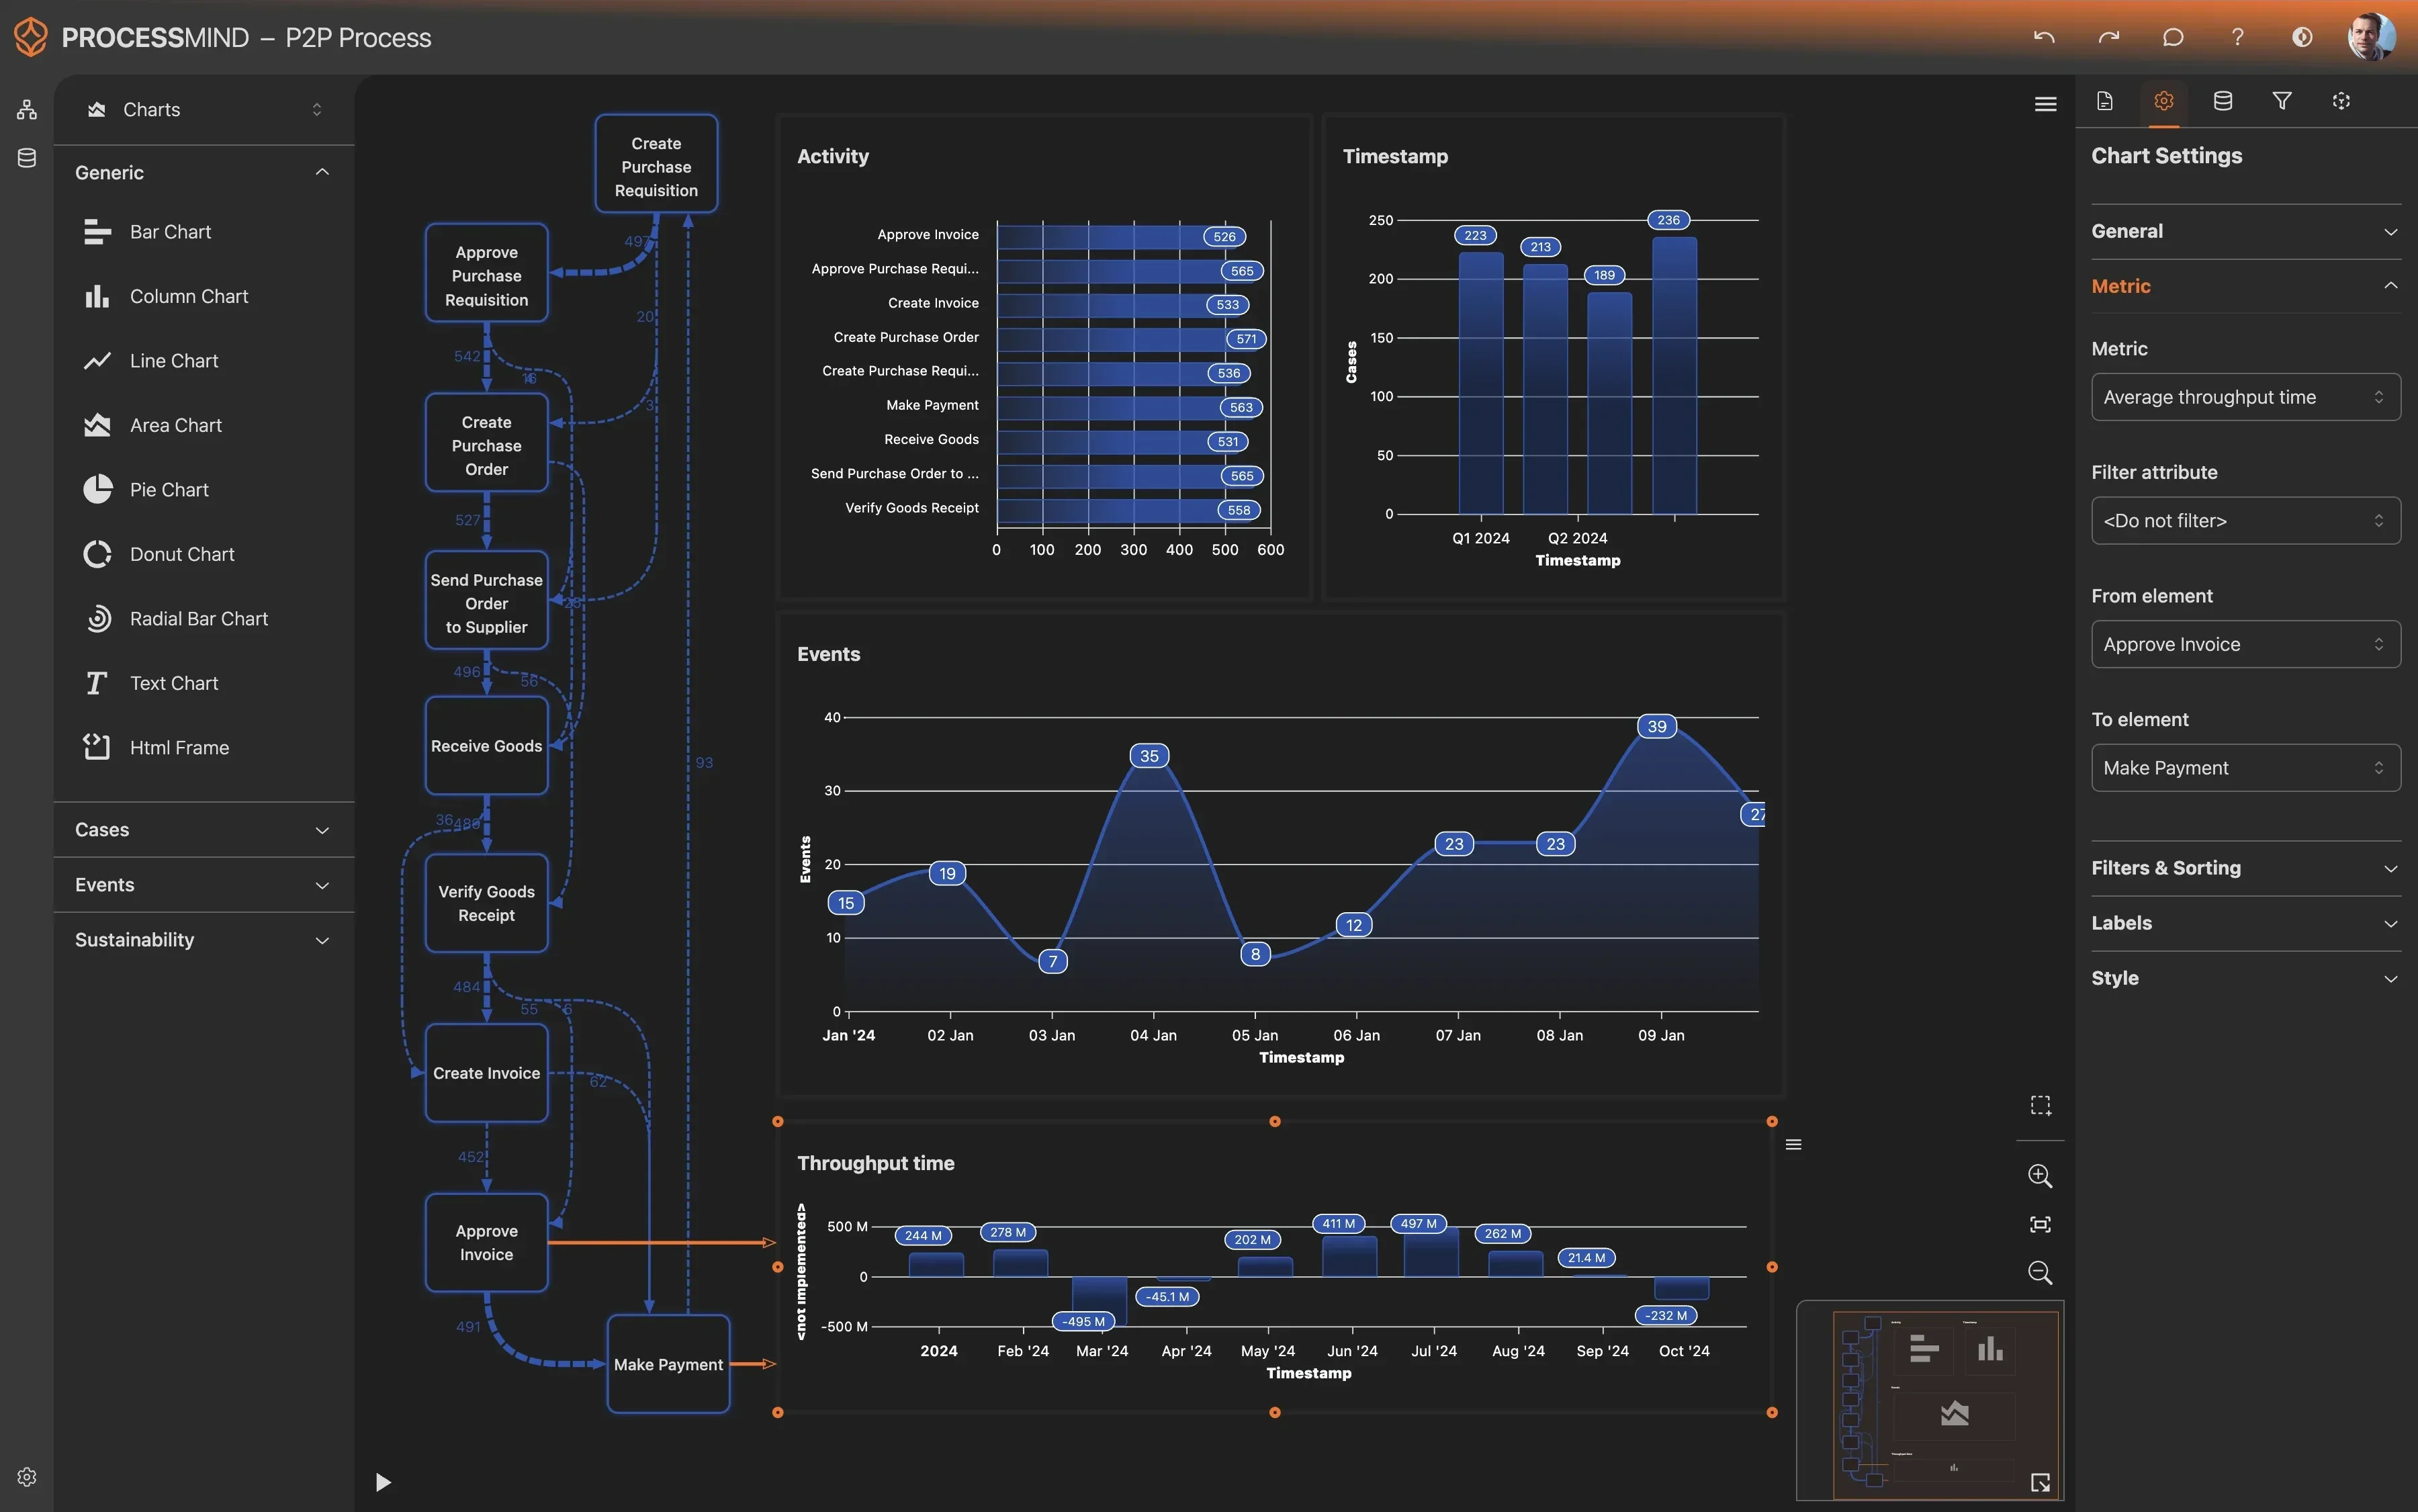
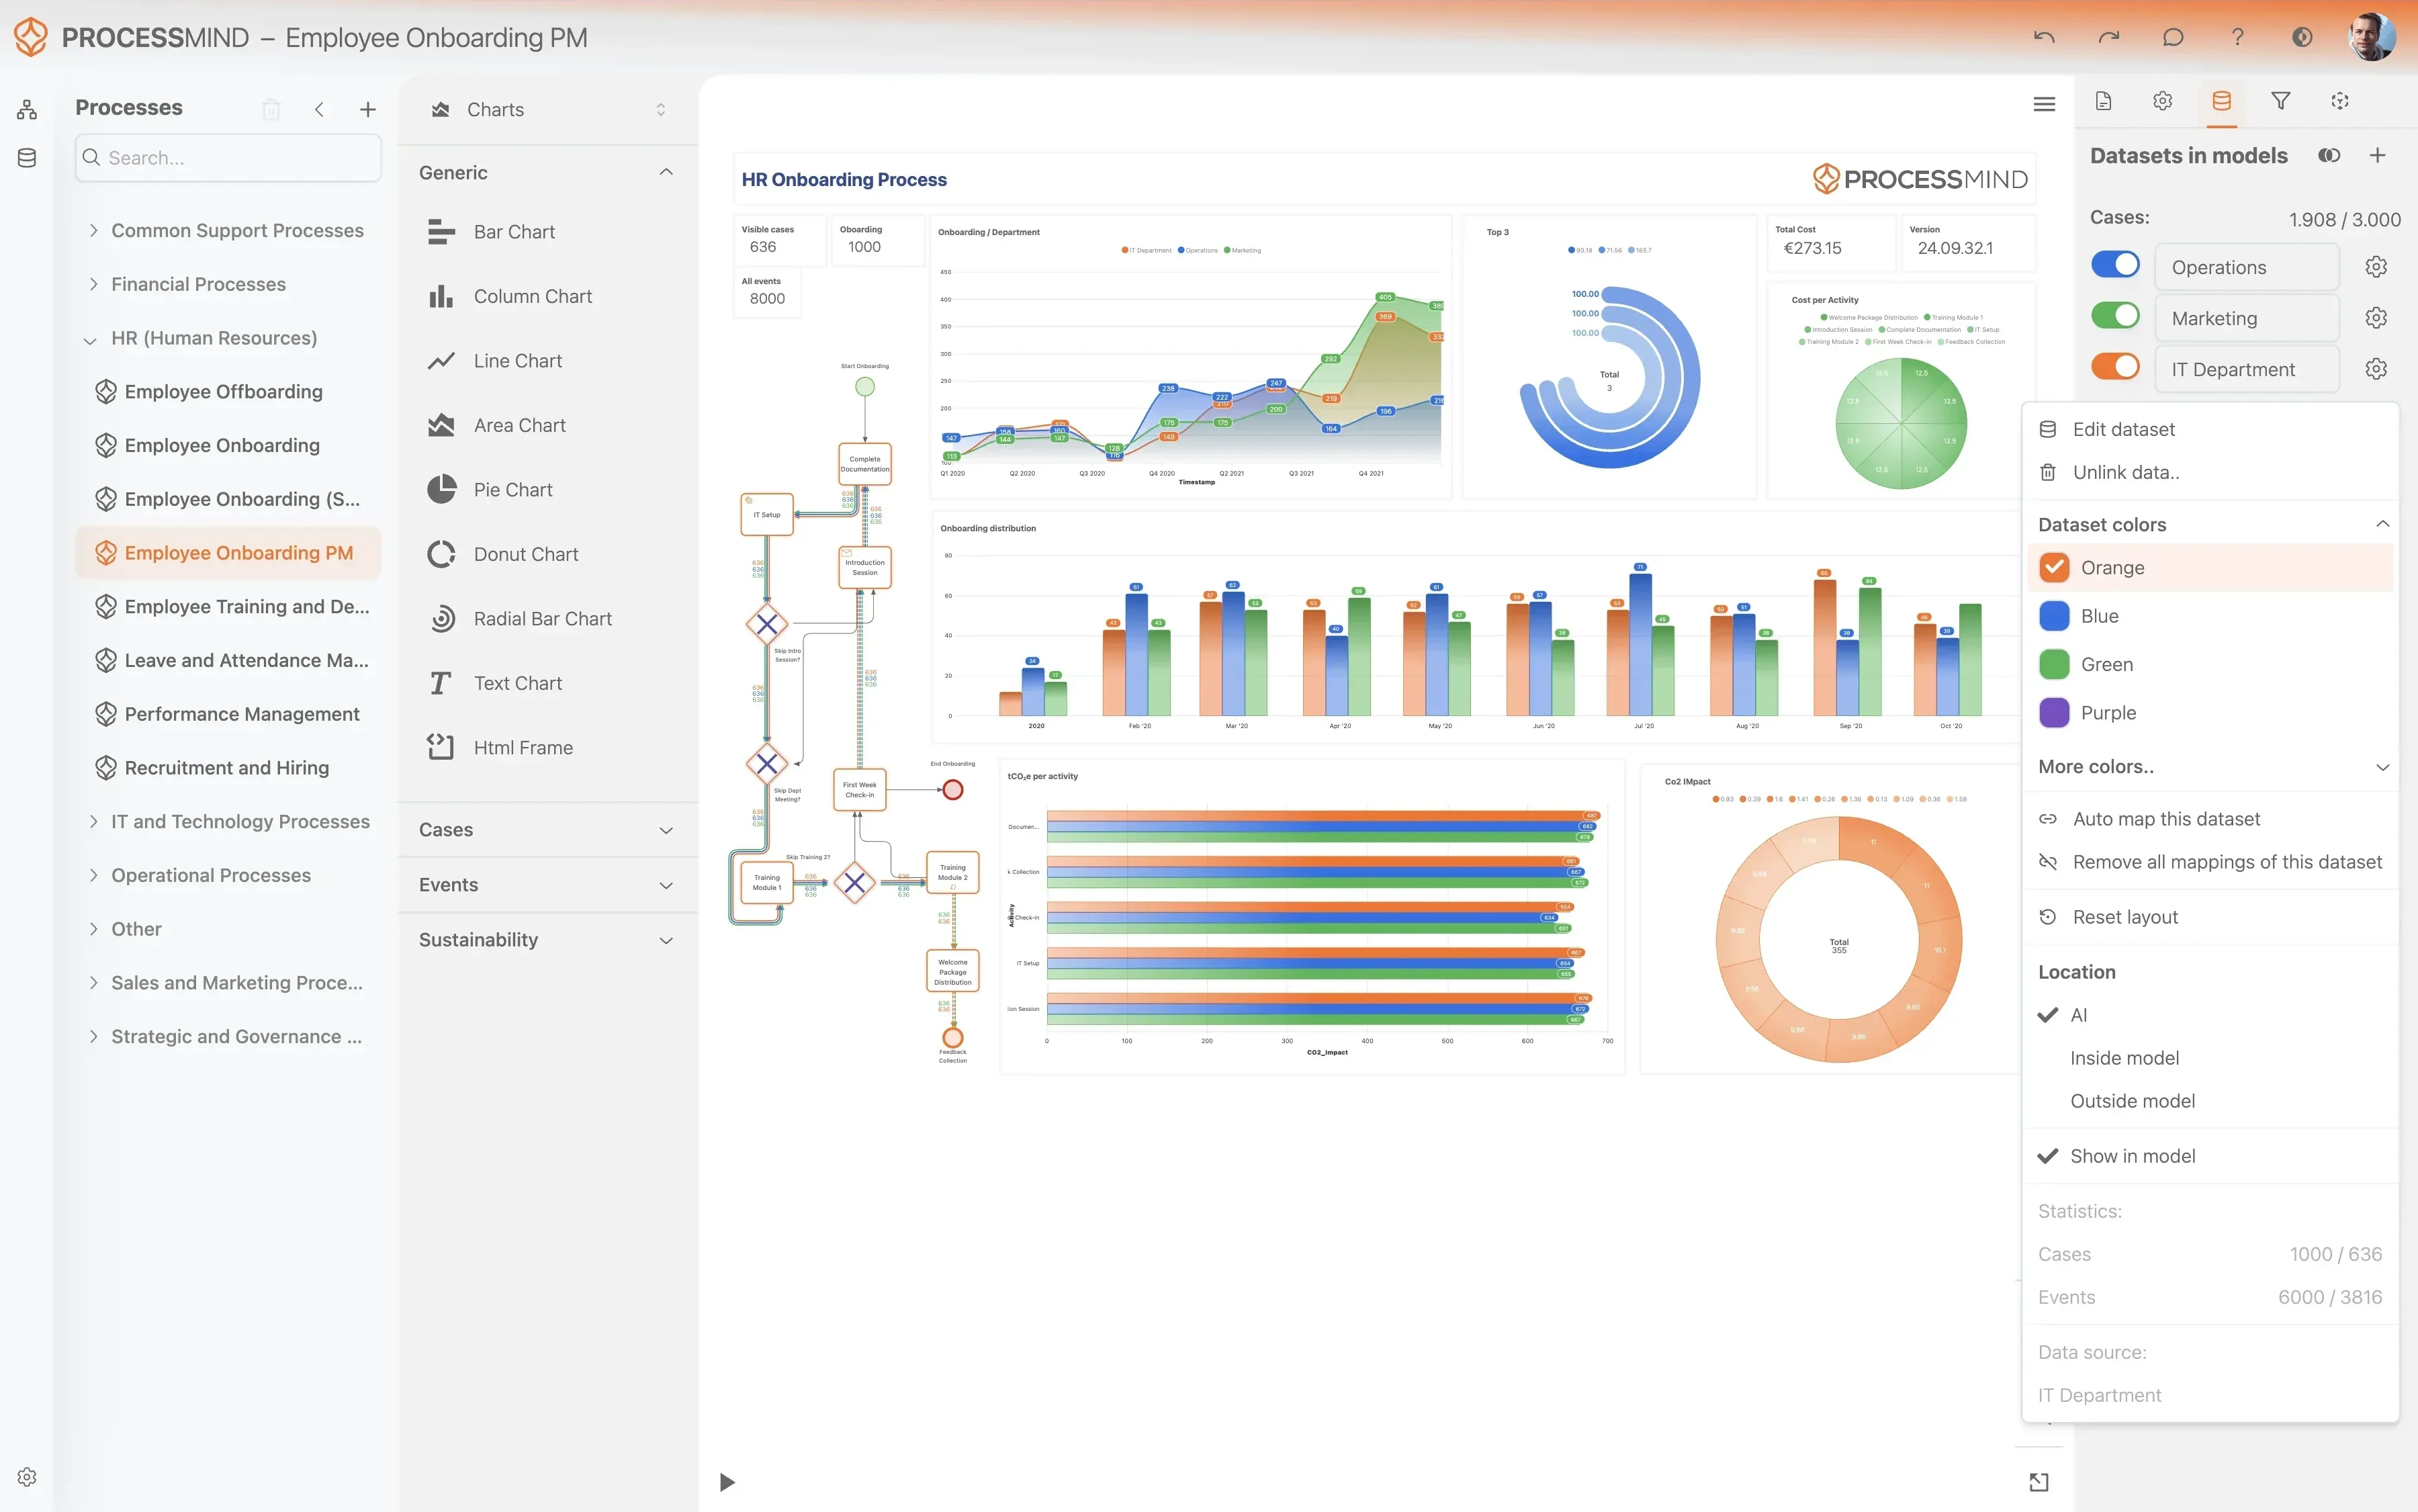
Individui i veri colli di bottiglia nel flusso di gestione dei problemi di Helix

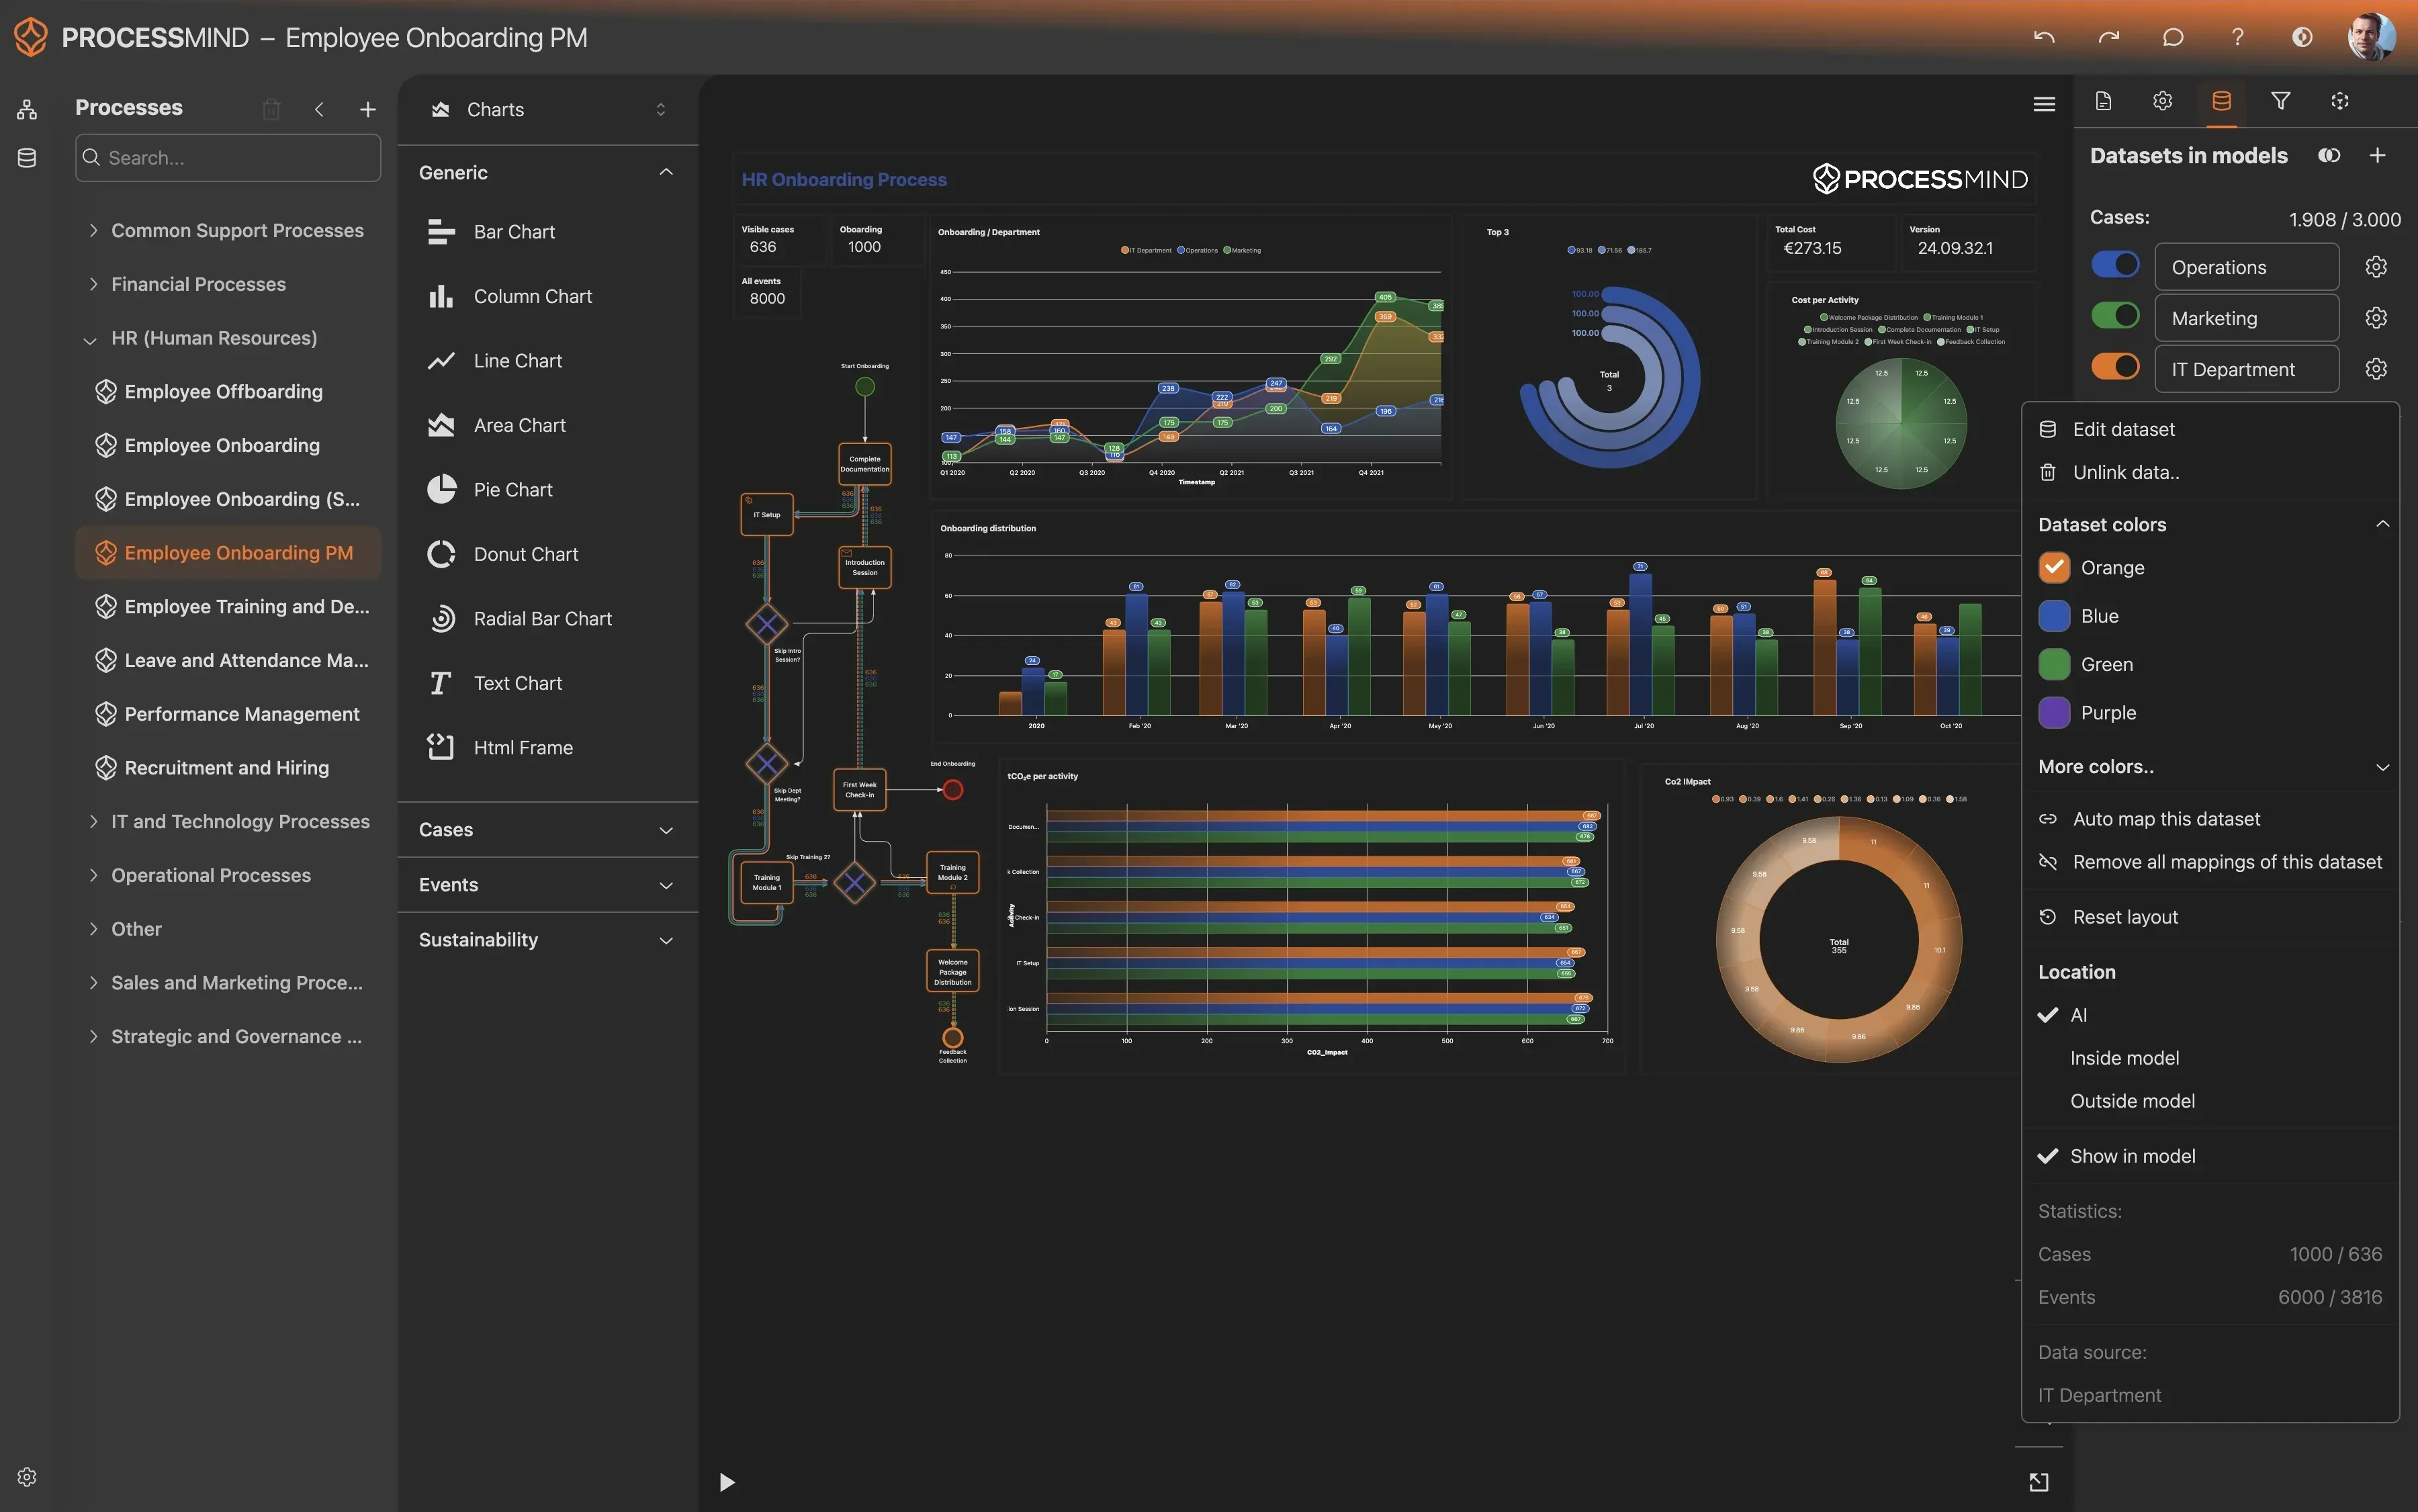
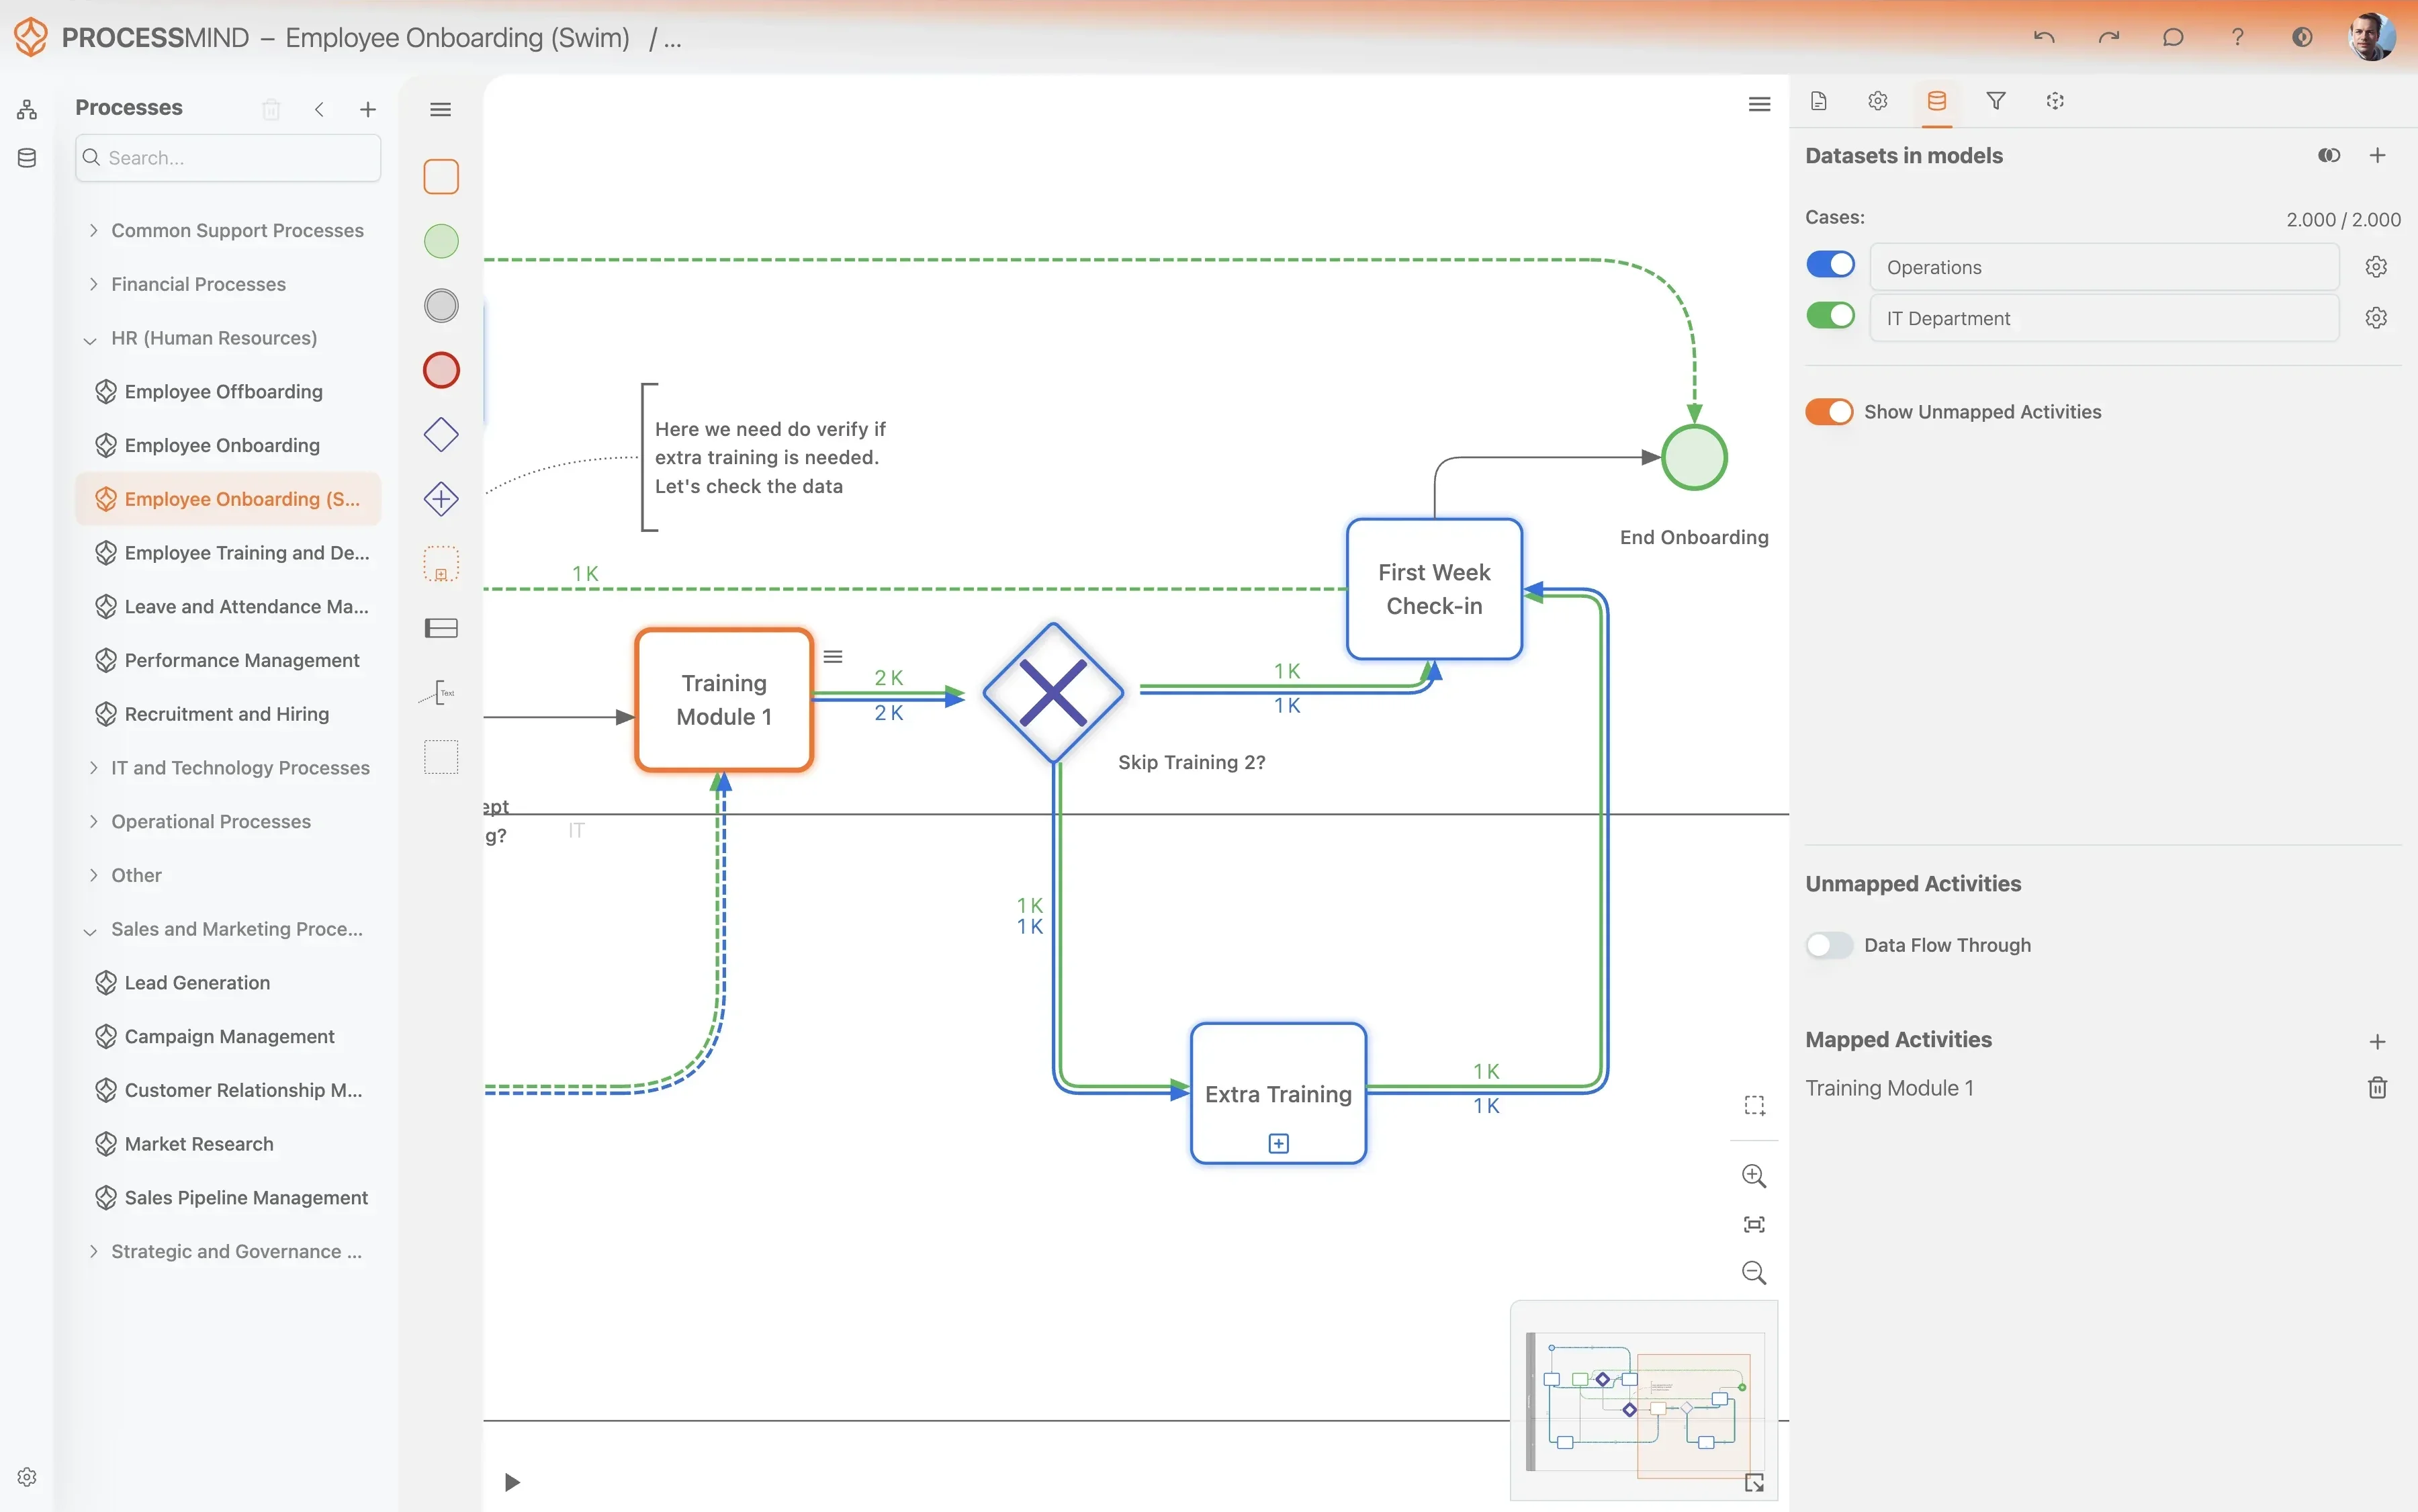
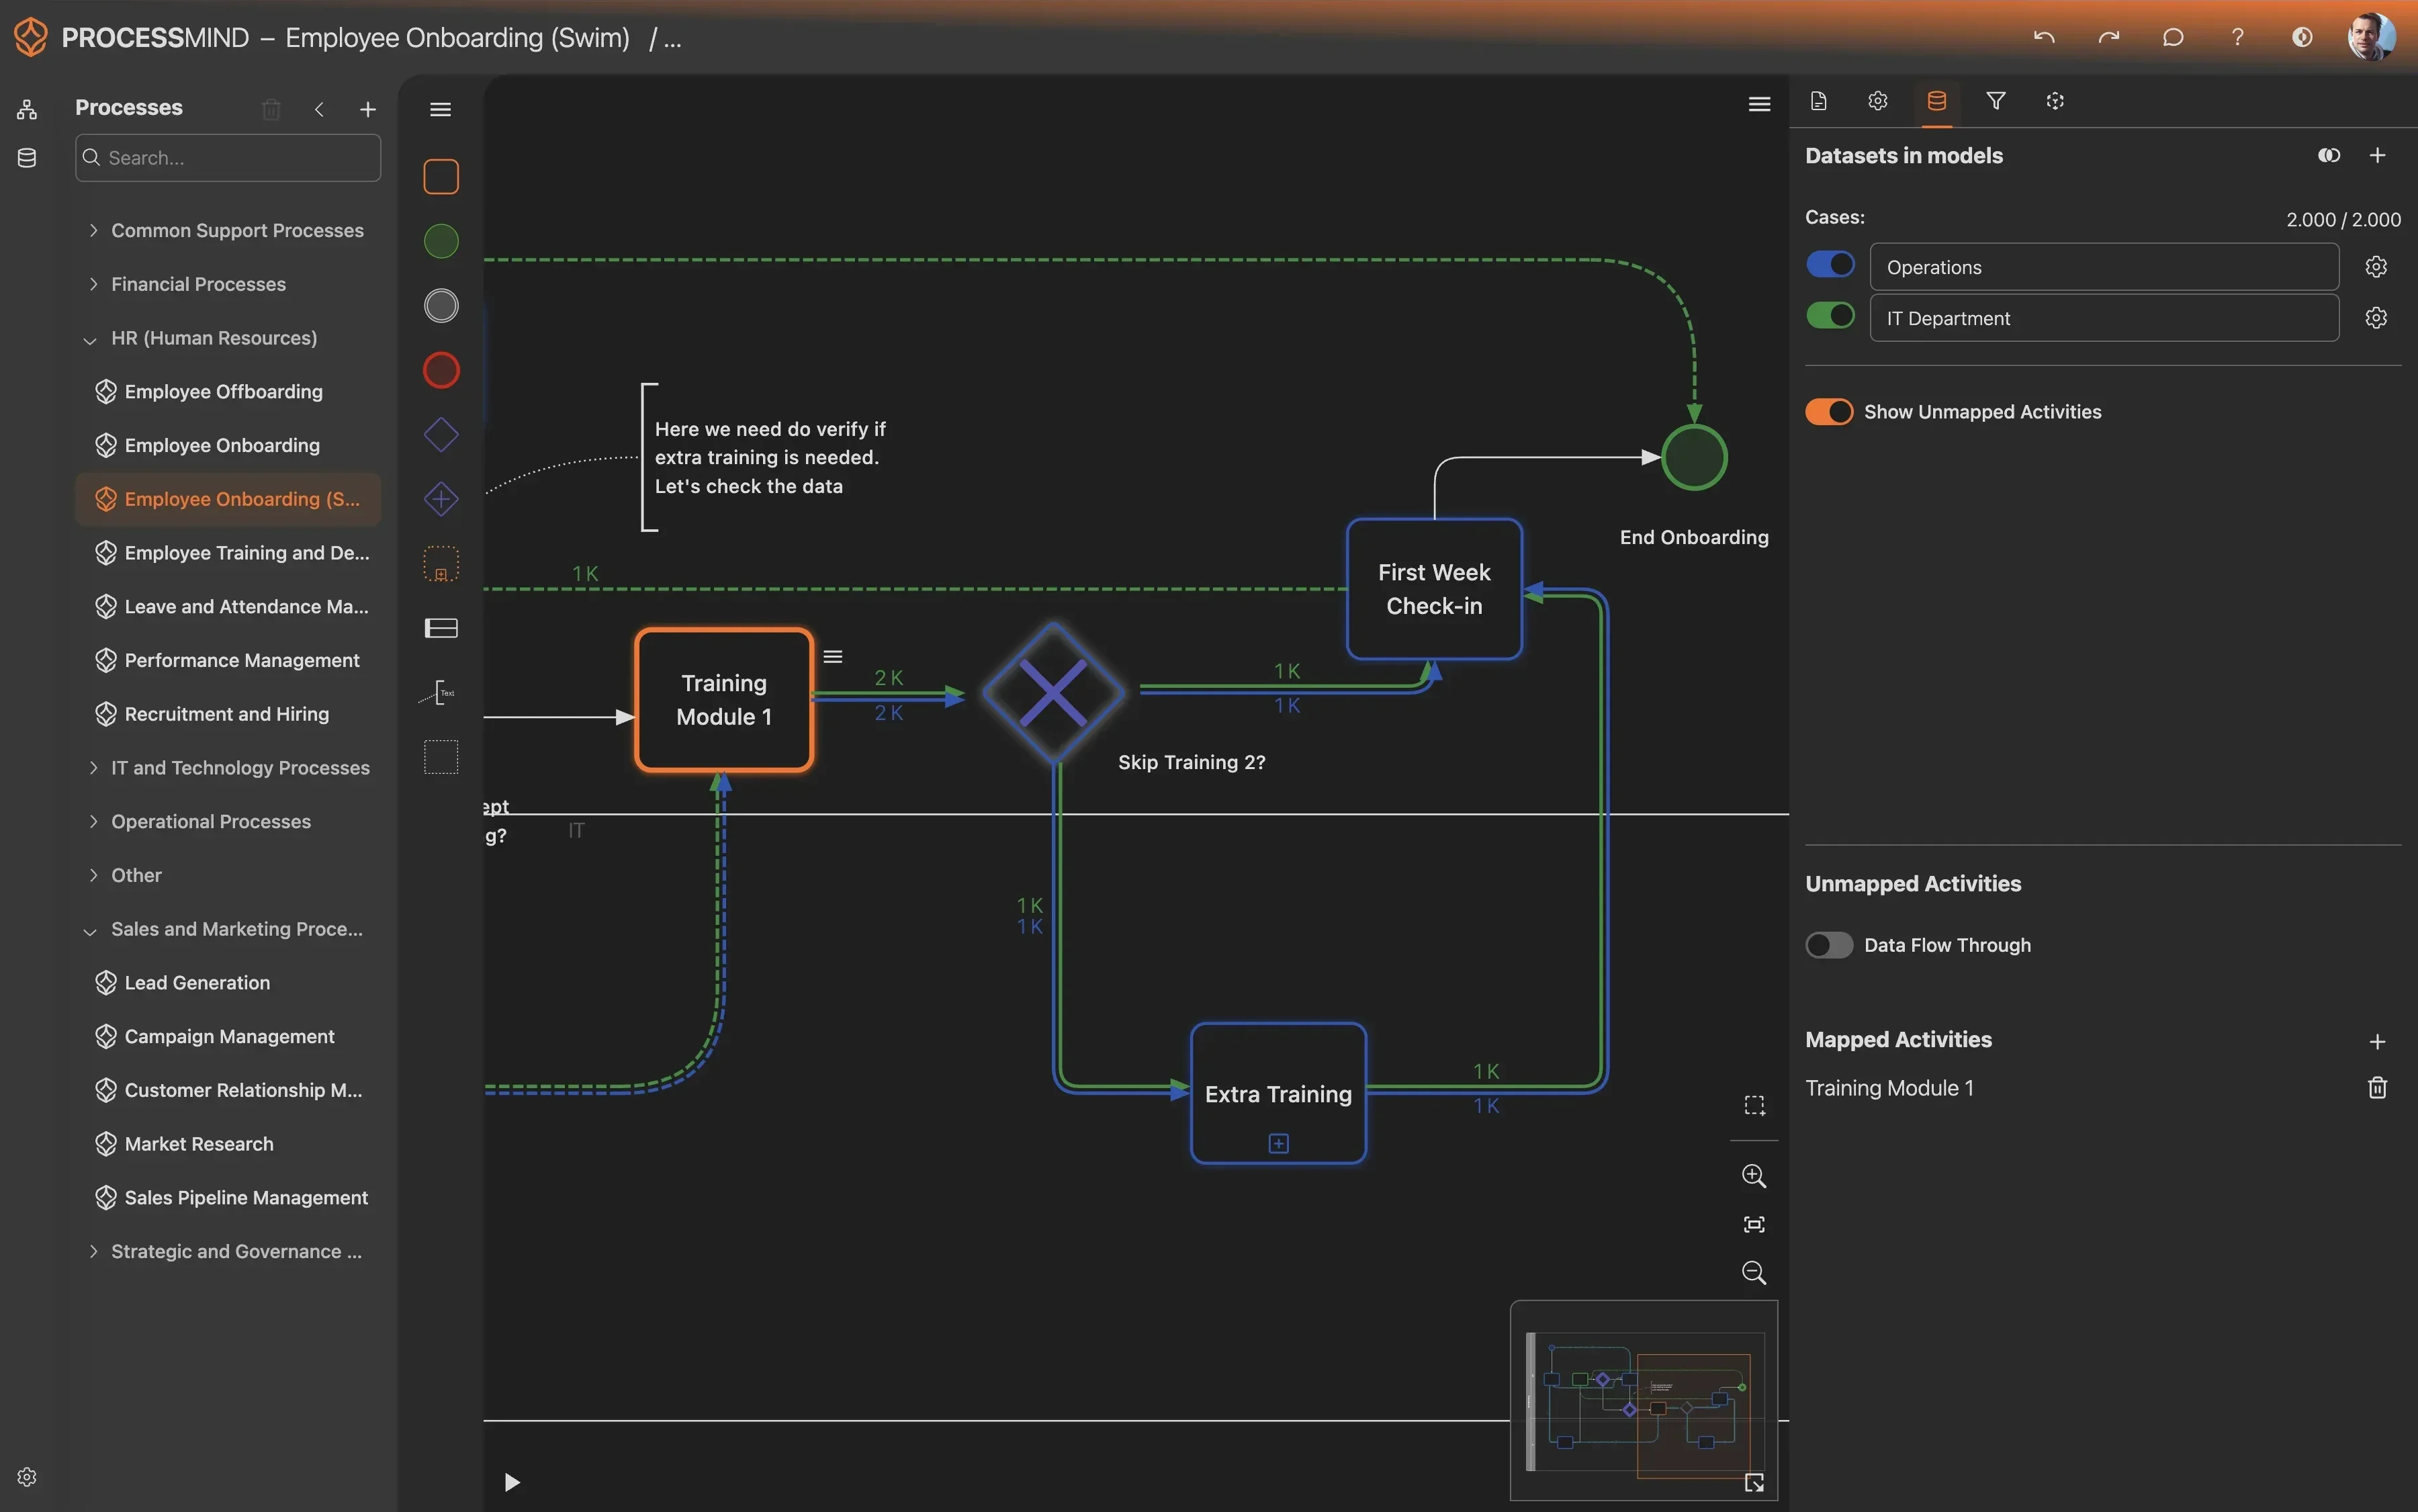
ProcessMind offre una visione trasparente dei dati di BMC Helix ITSM, mostrando con precisione dove si bloccano le indagini e come accelerare le correzioni definitive.
  • Visualizzi ogni passaggio del ciclo di indagine
  • Individui con precisione le cause dei ritardi nelle assegnazioni
  • Ottimizzi i tempi di documentazione delle soluzioni temporanee
  • Misuri l’impatto delle correzioni sul volume degli incidenti
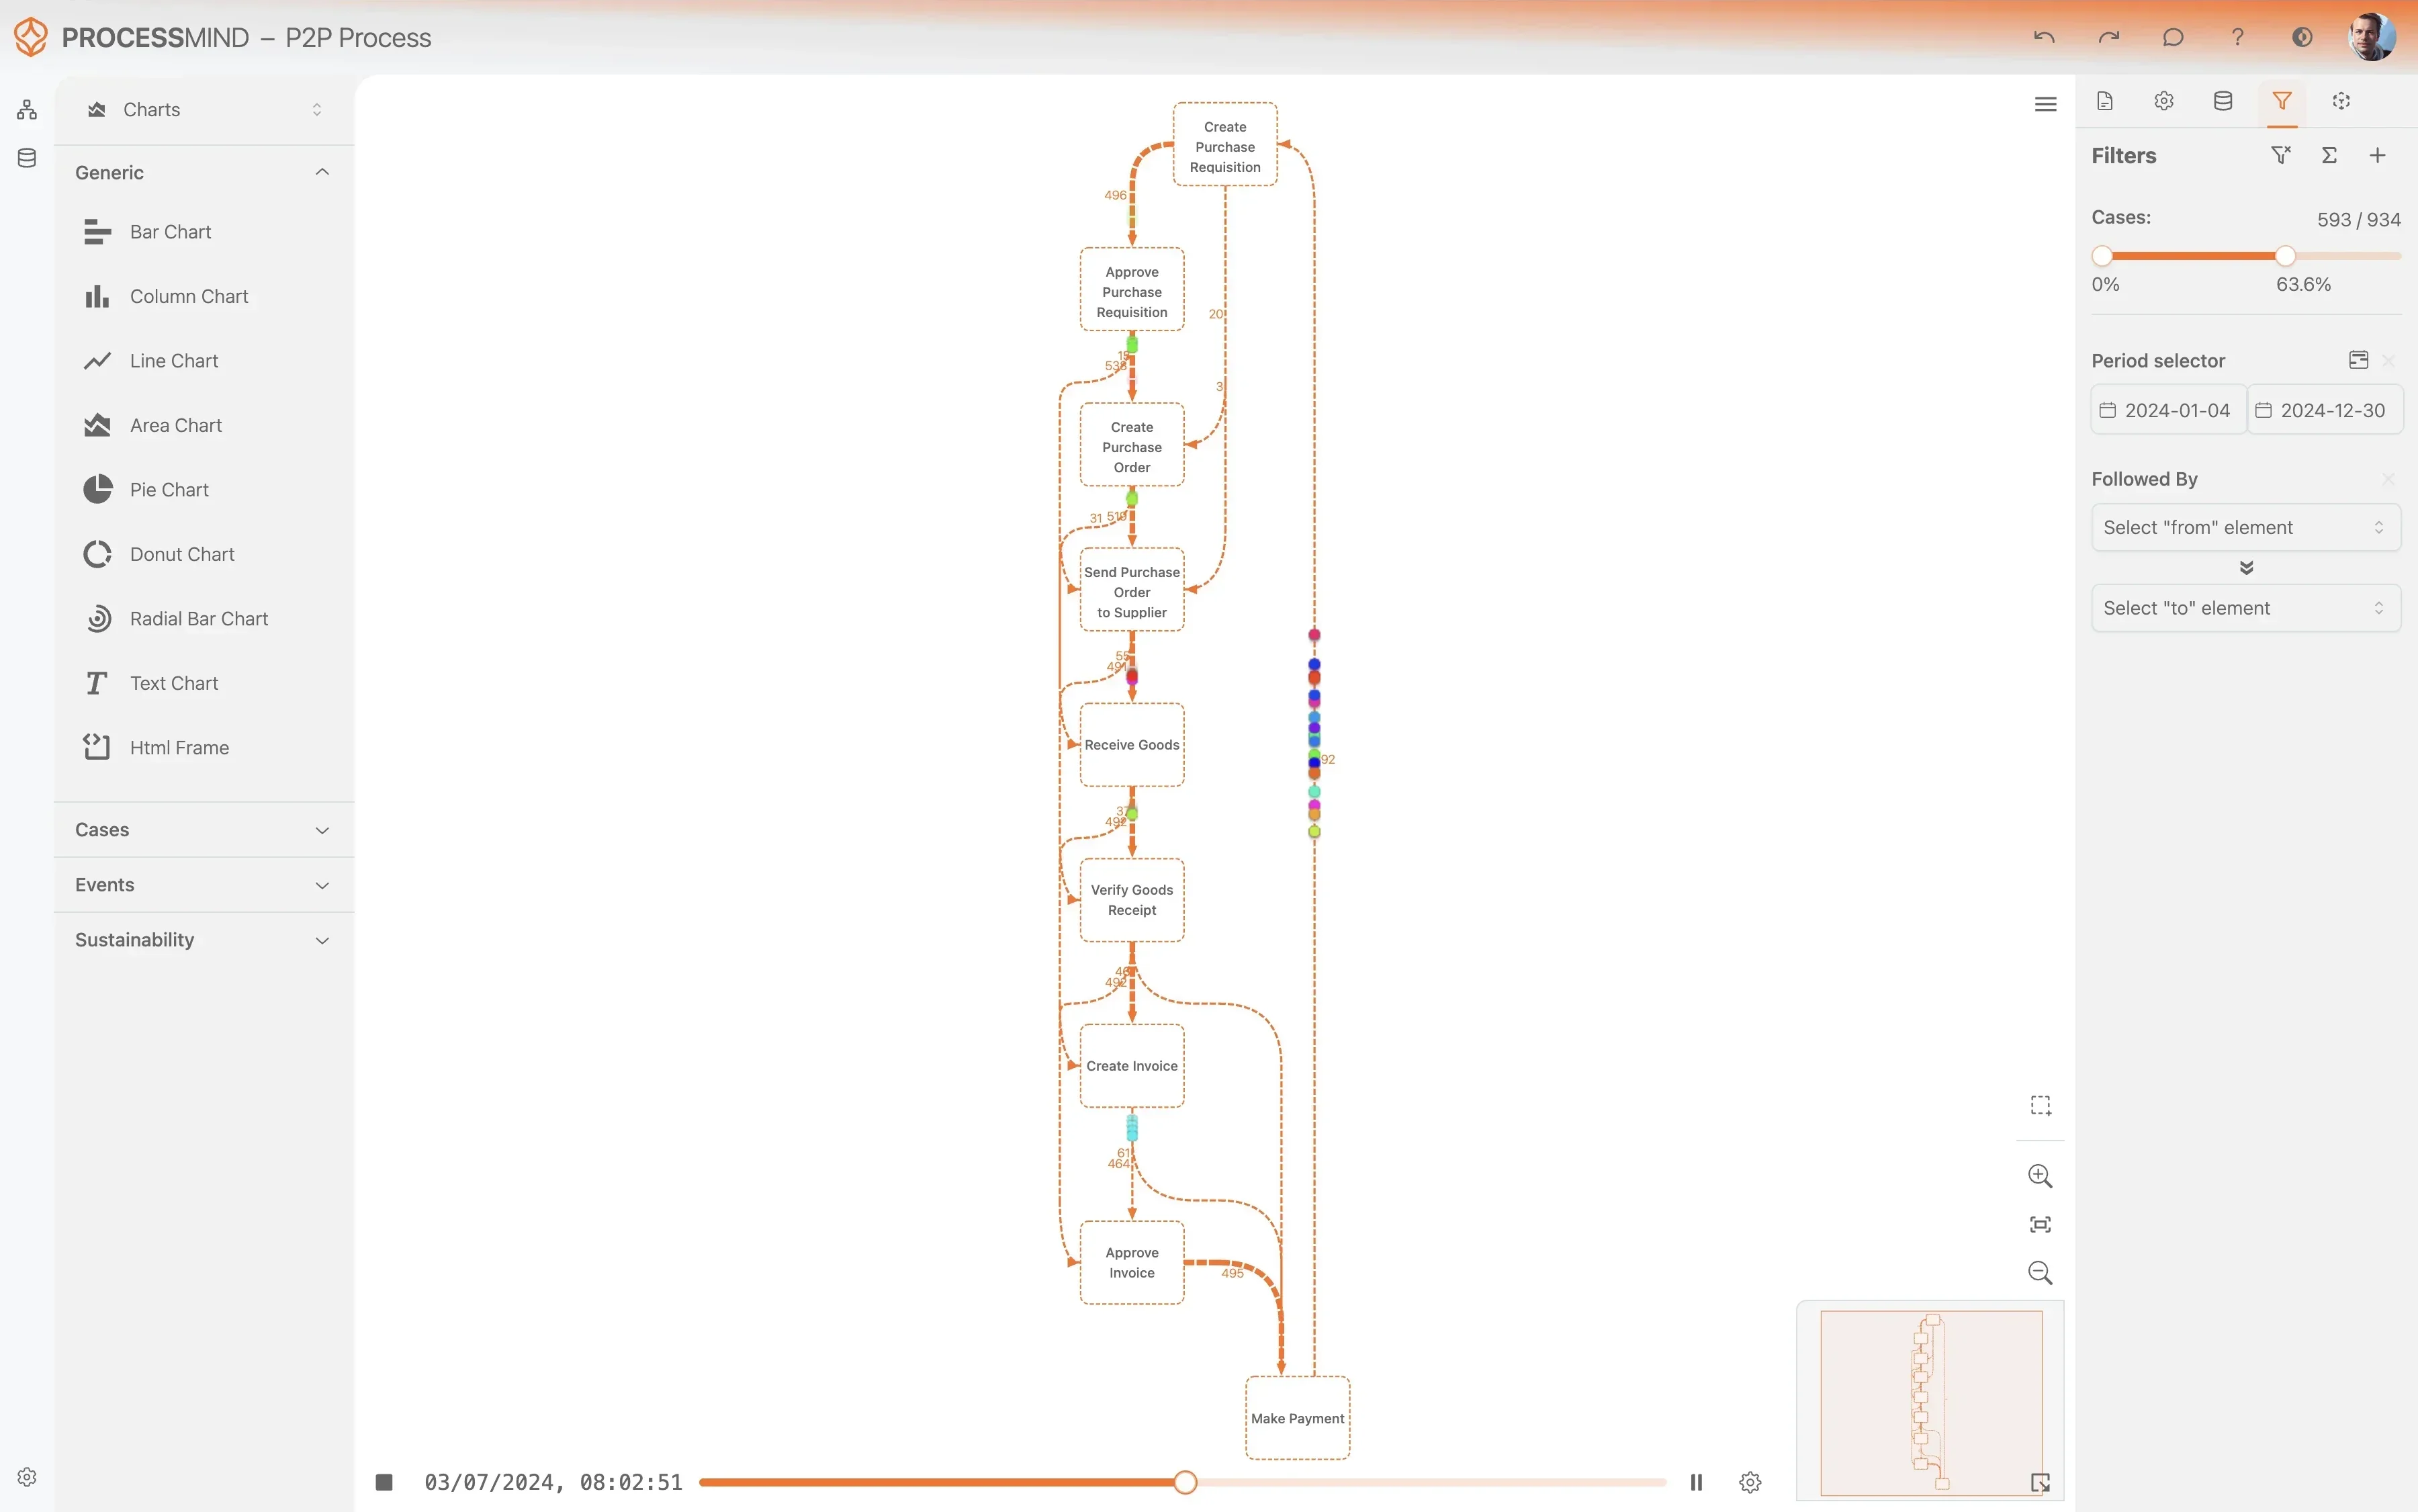
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

RISULTATI DIMOSTRATI

Impatto misurabile sulla risoluzione dei problemi

Le organizzazioni ottengono una visione approfondita dei record dei problemi, così da rendere più efficiente l’analisi delle cause profonde e ridurre il numero di incidenti ricorrenti in tutta l’azienda. Questi risultati mostrano i guadagni di efficienza possibili applicando agli Workflow di BMC Helix ITSM informazioni basate sui dati.

0 % reduction
Individuazione più rapida della causa profonda

Riduzione del tempo di ciclo delle indagini

Ridurre il tempo che intercorre tra l’avvio dell’indagine e l’individuazione della causa profonda consente ai team tecnici di concentrarsi sulle soluzioni definitive, anziché prolungare la fase diagnostica.

0 x fewer moves
Meno passaggi ripetuti tra i team

Riduzione delle riassegnazioni al supporto

Individuare i colli di bottiglia nell’assegnazione iniziale consente di indirizzare subito i record dei problemi agli esperti più adatti, evitando sprechi di tempo tra più gruppi di supporto.

+ 0 % improvement
Migliore rispetto degli SLA

Aumento percentuale della conformità

La visibilità in tempo reale sui record dei problemi bloccati consente alla direzione di intervenire prima che vengano superati gli obiettivi SLA, garantendo un servizio costante all’azienda.

0 % less rework
Meno rilavorazioni per la risoluzione

Meno casi di problemi riaperti

Verificare le soluzioni prima della chiusura permette di accertare che i problemi alla base siano stati davvero risolti, evitando il costoso ciclo di riavvio delle indagini dopo una soluzione solo apparente.

0 hours saved
Distribuzione più rapida delle soluzioni temporanee

Pubblicazione più rapida delle soluzioni

Pubblicare più rapidamente le soluzioni temporanee riduce in modo significativo l’impatto degli incidenti in corso sugli utenti finali, mentre si sviluppa la soluzione a lungo termine.

I miglioramenti effettivi dipendono dalla complessità del processo e dall’integrità dei dati. Queste cifre rappresentano risultati tipici osservati in diversi contesti aziendali.

Dati consigliati

Inizi dagli attributi e dalle attività essenziali indicati qui, poi ampli l’analisi secondo necessità.
Non conosce ancora gli Event Log? Scopra come creare un Event Log per il Process Mining.

Attributi

Dati chiave da acquisire per l’analisi

Identificativo univoco del caso di indagine del problema.

Perché è importante

È la chiave fondamentale per costruire la vista del processo e monitorare il ciclo di vita di problemi specifici.

L’attività specifica o la modifica di stato che si è verificata.

Perché è importante

Definisce i nodi della mappa del processo e consente di visualizzare il flusso di lavoro.

Timestamp in cui si è verificata l’attività specifica.

Perché è importante

Consente di calcolare tutti i KPI basati sulla durata e di ordinare gli eventi.

Il team tecnico attualmente assegnato all’indagine del problema.

Perché è importante

Consente di analizzare l’organizzazione e individuare i colli di bottiglia a livello di team.

Priorità del problema calcolata in base all’impatto e all’urgenza.

Perché è importante

Segmenta l’analisi in base alla criticità aziendale e supporta l’analisi degli SLA.

La persona assegnata al coordinamento dell’indagine.

Perché è importante

Consente di analizzare le risorse e bilanciare il carico di lavoro a livello individuale.

Classificazione della causa alla base del problema.

Perché è importante

Consente di analizzare l’andamento dei problemi sistemici e supporta una gestione proattiva dei problemi.

Servizio aziendale principale o elemento di configurazione interessato.

Perché è importante

Collega le prestazioni del processo a specifici prodotti o servizi aziendali.

Motivo per cui è stata avviata l’indagine del problema.

Perché è importante

Distingue il lavoro reattivo da quello proattivo, un indicatore fondamentale del livello di maturità.

La data e l’ora entro cui il problema deve essere risolto.

Perché è importante

È il riferimento per calcolare tutte le metriche di conformità e puntualità.

Il numero di incidenti collegati a questo record del problema.

Perché è importante

Quantifica l’impatto operativo del problema e i disagi per gli utenti.

Indicatore che segnala se la risoluzione del problema ha superato il tempo consentito.

Perché è importante

Semplifica la rendicontazione sulla conformità e l’analisi degli errori.

Attività

Fasi del processo da monitorare e ottimizzare

Creazione iniziale nel sistema di un record di indagine del problema. L’evento viene registrato esplicitamente quando si salva una nuova voce nel modulo PBM:Problem Investigation.

Perché è importante

Segna l’inizio dell’istanza di processo. È essenziale per calcolare i tempi di ciclo complessivi e le metriche di risposta iniziale.

Assegnazione del record del problema a un team tecnico specifico. Rilevata monitorando le modifiche al campo 'Assigned Group'.

Perché è importante

Essenziale per misurare i passaggi di consegne, i rimbalzi tra i team e il KPI 'Tempo medio alla prima assegnazione'.

Passaggio del record del problema alla fase di analisi attiva. Si deduce quando il campo Status cambia in 'Under Investigation'.

Perché è importante

Segna l’inizio dell’attività effettiva e consente di calcolare il KPI 'Tempo di ciclo dell’indagine'.

Inserimento o aggiornamento di testo nel campo Workaround del record del problema. L’evento indica che è stata documentata una soluzione temporanea.

Perché è importante

Consente di calcolare il KPI 'Tempo di pubblicazione della soluzione temporanea' e indica la mitigazione dell’impatto dell’incidente.

Momento in cui il record del problema passa a uno stato che indica che la causa è nota. Si deduce quando lo stato cambia in 'Root Cause Identified'.

Perché è importante

Traguardo fondamentale per la Dashboard 'Tempo di ciclo dell’indagine della causa profonda'. Segna il passaggio dall’analisi alla definizione della soluzione.

Collegamento di una richiesta di modifica dell’infrastruttura all’indagine del problema. Segna l’inizio della fase di implementazione.

Perché è importante

Essenziale per il KPI 'Tempo dalla causa profonda alla modifica' e per individuare i silos tra i processi di gestione dei problemi e delle modifiche.

Momento in cui viene confermata l’efficacia della soluzione definitiva. Si deduce quando lo stato cambia in 'Solution Implemented' o 'Completed'.

Perché è importante

Utilizzato per il KPI 'Tasso di rispetto degli SLA dei problemi'. Conferma che il lavoro tecnico è terminato.

Chiusura amministrativa definitiva del record del problema. Questo evento termina l’istanza di processo.

Perché è importante

È l’evento finale standard. Necessario per analizzare l’intero tempo di ciclo e calcolare la 'Densità dei collegamenti agli incidenti'.

Interruzione del record del problema prima della risoluzione. Rilevata quando lo stato diventa 'Cancelled' o 'Rejected'.

Perché è importante

Consente di individuare attività inutili o duplicati legittimi. Rappresenta un punto finale alternativo.

Domande frequenti

Domande frequenti

Il Process Mining visualizza tutti i percorsi seguiti da un record di problema, mostrando il flusso effettivo anziché quello previsto. Analizzando gli Event Log storici, è possibile individuare i record che passano da un gruppo di supporto all’altro o restano bloccati in attesa. Questa visibilità aiuta i team a rimuovere le inefficienze strutturali e a concentrarsi sull’analisi delle cause profonde dei problemi a maggiore impatto.

Serve un Event Log di base con un ID univoco del record di problema, una data e un’ora e la descrizione di un’attività, per esempio Modifica dello stato o Gruppo assegnato. Queste informazioni vengono in genere estratte dalle tabelle PBM:Problem Investigation del database BMC Helix. La maggior parte degli strumenti di Process Mining può collegarsi direttamente a queste tabelle o importare esportazioni CSV per mappare il flusso del processo.

Evidenzia le fasi in cui le indagini si bloccano, per esempio in attesa di informazioni da un fornitore o di riscontri da altri reparti. Misurando la durata di ogni passaggio, i responsabili possono individuare carenze di risorse o documentazione mancante che rallentano la fase di indagine. Questo approccio basato sui dati sostituisce le impressioni aneddotiche con riscontri oggettivi sui punti in cui si verificano davvero i ritardi.

Spesso è possibile ottenere le prime indicazioni entro due-quattro settimane dall’attivazione dell’estrazione dei dati da BMC Helix. La prima fase consiste nel collegarsi al sistema e mappare le principali modifiche di stato per creare un modello di base di riferimento. Nelle settimane successive si perfeziona l’analisi e si individuano opportunità di ottimizzazione specifiche, come la riduzione delle riassegnazioni dei record.

Il Process Mining è uno strumento efficace per individuare problemi di qualità dei dati, come date e orari mancanti o classificazioni errate. Anche se dati di scarsa qualità possono limitare alcune analisi, la visualizzazione spesso mostra i passaggi del processo saltati o registrati in modo errato dal personale di supporto. Colmare queste lacune nei dati diventa uno dei primi obiettivi di miglioramento, per garantire l’accuratezza dei report futuri.

Il Process Mining non può correggere il processo al posto Suo, ma individua le cause profonde delle violazioni degli SLA mostrando il percorso esatto dei record che non hanno rispettato gli obiettivi. Può confrontare i record conformi con quelli non conformi per verificare se alcuni gruppi di supporto o tipi di problema sono più soggetti a ritardi. Queste informazioni consentono di intervenire con formazione mirata o una diversa distribuzione delle risorse, affinché i problemi prioritari vengano gestiti entro i tempi previsti.

Tiene traccia del passaggio tra i moduli Problem Management e Change Management per verificare se si verificano ritardi significativi. Visualizzando questa transizione, è possibile capire se le richieste di modifica vengono create tempestivamente dopo l’individuazione della causa profonda o se restano bloccate in un ciclo amministrativo. Questo consente di rendere più fluido l’intero percorso, dall’individuazione del problema all’implementazione di una soluzione definitiva.

Il Process Mining integra i report standard offrendo una visione del processo nel tempo, anziché limitarsi a mostrare istantanee statiche dello stato corrente. I report tradizionali indicano quanti problemi sono aperti, mentre il Process Mining mostra come questi si sono evoluti nel sistema. Questo livello di dettaglio è necessario per ottimizzare davvero il processo e individuare i colli di bottiglia nascosti che potrebbero sfuggire alle Dashboard standard.

Elimini oggi i colli di bottiglia nella gestione dei problemi

Riduca del 30% i tempi di ciclo e migliori la stabilità dei servizi.

Inizi ora la prova gratuita.

Non è richiesta la carta di credito. La configurazione richiede pochi minuti.