Verbessern Sie Ihr Problemmanagement
BMC Helix ITSM optimieren: Anleitung in 6 Schritten
Verbessern Sie Ihr Problemmanagement
Problemmanagement
BMC Helix ITSM

Prozess auswählen

Wählen Sie einen Prozess aus, um in Ihrem verbundenen Arbeitsbereich weiterzuarbeiten.

259 Prozesse

Optimieren Sie das Problemmanagement in BMC Helix ITSM

Unsere Plattform macht verborgene Engpässe und Reibungsverluste sichtbar, die die Effizienz Ihres Service beeinträchtigen. Sie erkennen auf einen Blick, wo manuelle Schritte oder Übergaben Ihre Untersuchungen verzögern. Diese Transparenz hilft Ihnen, Workflows zu verbessern und die Ursachen wiederkehrender betrieblicher Probleme zu beseitigen.

Laden Sie unser vorkonfiguriertes Daten-Template herunter und gehen Sie typische Herausforderungen an, um Ihre Effizienz-Ziele zu erreichen. Folgen Sie unserem Verbesserungsplan in sechs Schritten und lesen Sie den Leitfaden zum Daten-Template, um Ihre Abläufe zu verbessern.

Ausführliche Beschreibung anzeigen

Der strategische Nutzen eines optimierten Problem Managements

Ein effizientes Problem Management ist die Grundlage für eine stabile IT-Umgebung. Während das Incident Management darauf abzielt, den Service so schnell wie möglich wiederherzustellen, beseitigt das Problem Management die Ursachen der Störungen. Ist der Prozess nicht optimiert, bleibt Ihr IT-Team im reaktiven Modus und muss dieselben Probleme immer wieder lösen. Das erhöht die Betriebskosten, senkt die Zufriedenheit der Benutzer und belastet Ihre technischen Mitarbeitenden unnötig. Wenn Sie diesen Prozess in BMC Helix ITSM optimieren, wechseln Sie von einer reaktiven zu einer proaktiven Vorgehensweise. So erhöhen Sie die Zuverlässigkeit Ihrer Business-Services und schützen Ihr Unternehmen vor kostspieligen Serviceausfällen.

Aus Daten aus BMC Helix ITSM konkrete Erkenntnisse gewinnen

Die Standardberichte in BMC Helix ITSM zeigen Ihre Daten oft nur statisch, etwa die Zahl offener Probleme oder die durchschnittliche Zeit bis zum Abschluss. Sie erklären jedoch selten, warum eine bestimmte Untersuchung ins Stocken gerät. Process Mining zeichnet den gesamten Lebenszyklus jedes Problem-Datensatzes nach und nutzt dafür digitale Spuren aus Tabellen wie PBM:Problem Investigation und PBM:Known Error. So wird die tatsächliche Abfolge der Ereignisse sichtbar: Sie sehen, wo Übergaben scheitern, Freigaben ausstehen und Nacharbeit anfällt. Statt über die Gründe für eine lange Zykluszeit zu spekulieren, erkennen Sie die konkreten Abläufe, die zu Verzögerungen führen. Damit können Sie gezielt Verbesserungen auf Basis objektiver Daten statt einzelner Erfahrungsberichte umsetzen.

Strukturelle Ineffizienzen bei der Ursachenanalyse erkennen

Eine der größten Herausforderungen im Problem Management ist der Übergang von der Erfassung eines Problems zum Beginn der Untersuchung. In vielen Unternehmen bleibt ein Datensatz tagelang im Status „Erfasst“ oder „Zugewiesen“, bevor eine Fachkraft mit der Arbeit beginnt. Process Mining macht diese verborgenen Engpässe sichtbar. Vielleicht sind bestimmte Supportgruppen überlastet und es entsteht ein Rückstand. Oder die Kriterien für die Eskalation eines Problems zur Ursachenanalyse sind unklar. Wenn Sie den Ablauf zwischen den Aktivitäten „Untersuchung begonnen“ und „Ursache ermittelt“ analysieren, sehen Sie, ob den technischen Teams die nötigen Informationen vorliegen oder ob sie zu viel Zeit mit Verwaltungsaufgaben statt mit der Diagnose verbringen. Eine kürzere Zykluszeit ist der schnellste Weg zu einer stabileren IT.

Workarounds und bekannte Fehler wirksamer einsetzen

Ein wichtiger, aber oft übersehener Teil des Prozesses ist die Zeit bis zur Veröffentlichung eines Workarounds. Wird ein Workaround gefunden, aber nicht im Formular PBM:Known Error dokumentiert, können Service-Desk-Mitarbeitende wiederkehrende Incidents weiterhin nur schwer lösen. Das führt im gesamten Unternehmen zu unnötigem Aufwand. Mit Process Mining messen Sie die Zeit zwischen den Aktivitäten „Workaround ermittelt“ und „Workaround veröffentlicht“. Ist der Abstand zu groß, deutet das auf Probleme bei der Kommunikation hin, die sich direkt auf die Zahl der Incidents auswirken. Wenn Sie diesen Abschnitt des Workflows verbessern, können Mitarbeitende im Unternehmen von vorläufigen Lösungen profitieren, während die dauerhafte Behebung entwickelt wird. So gewinnen Ihre Fachkräfte Zeit für eine gründliche Analyse, ohne dass der Rückstand an Incidents weiter wächst.

Erfolg messen und die Prozessreife steigern

Ziel der Prozessoptimierung ist es, Häufigkeit und Auswirkungen von Incidents auf das Unternehmen zu verringern. Mit Process Mining legen Sie klare Vergleichswerte für den Lebenszyklus des Problem Managements fest. Sie messen, wie wirksam die Aktivitäten zur Einleitung von Change Requests sind, und prüfen, ob dauerhafte Lösungen innerhalb der vereinbarten Service-Level-Ziele umgesetzt werden. Während Sie Änderungen einführen, liefert Process Mining kontinuierlich Rückmeldungen dazu, ob die Optimierungen greifen. Dieser datengetriebene Ansatz fördert Transparenz und Verantwortlichkeit. Teams können ihre Workflows anhand konkreter Fakten verbessern. Mit der Zeit sinkt dadurch die Zahl wiederkehrender Probleme deutlich, und die IT-Infrastruktur wird widerstandsfähiger.

Prozessoptimierung mit Process Mining starten

Um Ihr Problem Management zu verbessern, müssen Sie Ihre ITSM-Suite nicht vollständig umbauen. Der erste Schritt ist, den aktuellen Status sichtbar zu machen. Wenden Sie diese Analysemethoden auf Ihre Daten aus BMC Helix ITSM an und beginnen Sie in einem überschaubaren Bereich, etwa bei einem besonders wichtigen Service oder einer häufig auftretenden Problemkategorie. Wenn Sie Engpässe aufdecken und beseitigen, sinkt die Zahl der Incidents. Dadurch gewinnt Ihr Team Kapazität, um weitere strukturelle Verbesserungen anzugehen. Nutzen Sie diesen Leitfaden und die zugehörigen Templates, um Ihre IT-Services stabiler, effizienter und proaktiver zu gestalten.

Problemmanagement Ursachenanalyse IT-Service-Management Service Desk ITSM-Betrieb Incidents reduzieren Problemkoordinator Ticketverwaltung Ticketmanagement Bekannter Fehler Wiederkehrende Incidents Workaround Incidents verhindern IT-Helpdesk

Häufige Probleme und Herausforderungen

Ermitteln Sie, welche Herausforderungen Sie betreffen

Viele Problem-Datensätze bleiben tagelang ohne Zuweisung, weil die Zuständigkeit unklar ist oder Benachrichtigungen übersehen werden. Dadurch steigt das Risiko, dass schwerwiegende Incidents erneut auftreten. Zugleich reagiert die IT-Abteilung langsamer, weil kritische Ursachen ungelöst bleiben.

ProcessMind visualisiert in BMC Helix ITSM die Zeit zwischen der Erfassung eines Datensatzes und seiner ersten Zuweisung. So erkennen Sie Supportgruppen oder Problemkategorien, bei denen die Zuständigkeit regelmäßig verspätet übernommen wird. Anschließend können Sie Ressourcen gezielt anpassen oder klarere Zuweisungsregeln festlegen.

Problem-Untersuchungen erreichen häufig die Phase „Untersuchung begonnen“, kommen dort aber ohne aussagekräftige Fortschrittsmeldungen nicht weiter. Diese stagnierenden Datensätze verhindern, dass die zugrunde liegenden Probleme dauerhaft gelöst werden. Gleichzeitig wächst der Rückstand ungelöster IT-Probleme, der später zu weiteren Serviceausfällen führen kann.

Wenn Sie die Dauer der Untersuchungsphase verfolgen, zeigt unsere Lösung genau, wo der Prozess ins Stocken gerät. Sie macht Datensätze in BMC Helix ITSM sichtbar, deren Bearbeitungszeit die üblichen Werte überschreitet. So können Problemkoordinatoren eingreifen und Ressourcen neu zuweisen, bevor die Untersuchung überholt ist.

Wird ein Workaround ermittelt, aber nicht zeitnah im Knowledge-Management-System veröffentlicht, können Mitarbeitende am Service Desk Incidents nicht schnell lösen. Werden vorläufige Lösungen nicht kommuniziert, verlängert sich die durchschnittliche Reparaturzeit bei den betroffenen Incidents. Zugleich wächst der Frust der Benutzer, während die dauerhafte Lösung noch entwickelt wird.

ProcessMind misst die Zeit zwischen dem Ermitteln eines Workarounds und der Aktivität „Workaround veröffentlicht“. So sehen Sie, ob vorläufige Lösungen über BMC Helix ITSM schnell verbreitet werden. Das begrenzt die Auswirkungen ungelöster Probleme, während sich die technischen Teams auf die dauerhafte Ursachenbehebung konzentrieren.

Problem-Datensätze wechseln häufig zwischen technischen Teams, weil Gruppen die Zuständigkeit vermeiden oder den technischen Umfang falsch einschätzen. Dieses Hin und Her verlängert den Lebenszyklus des Problems erheblich und verzögert den Beginn der eigentlichen Ursachenanalyse. Das kostet Zeit und belastet die verfügbaren Ressourcen.

Unsere Analysefunktion bildet die Abfolge der Zuweisungsaktivitäten ab und macht solche Muster in BMC Helix ITSM sichtbar. Sie sehen, welche Supportgruppen Datensätze häufig weiterleiten. So können Sie gezielte Schulungen anbieten oder die Zuständigkeiten der Gruppen klarer festlegen, um das Hin und Her zu beenden.

Probleme mit hoher Priorität verfehlen häufig ihre Service-Level-Ziele, weil es in den Untersuchungs- und Behebungsphasen verborgene Ineffizienzen gibt. Werden Fristen nicht eingehalten, leidet die Stabilität der IT-Services. Bleibt kritische Infrastruktur länger als vereinbart instabil, kann das zudem zu internen Konflikten führen und das Vertrauen in den IT-Bereich beeinträchtigen.

ProcessMind vergleicht SLA-Fälligkeitstermine mit den tatsächlichen Zeitstempeln im Prozess und zeigt, welche Aktivitäten zu Verstößen führen. So können Sie Service-Level-Ziele in BMC Helix ITSM in Echtzeit überwachen und Prioritäten oder Workflows anpassen, bevor Fristen verstreichen und die Stabilität der Services gefährdet ist.

Nach der Ermittlung einer Ursache dauert es oft lange, bis ein Change Request zur Umsetzung einer dauerhaften Lösung eingeleitet wird. Solange die Umsetzung in administrativen Abläufen feststeckt, bleibt das Unternehmen trotz bekannter technischer Lösung anfällig für wiederkehrende Incidents.

Wir analysieren die Zeit zwischen der Aktivität „Ursache ermittelt“ und dem Ereignis „Change Request eingeleitet“. So werden Reibungspunkte beim Übergang vom Problem Management zum Change Management in BMC Helix ITSM sichtbar. Dauerhafte Lösungen können dadurch ohne unnötige administrative Verzögerungen vorangebracht werden.

In arbeitsintensiven Phasen überspringen Teams häufig die Prüfung nach der Umsetzung, um Datensätze schneller abzuschließen und Rückstände abzubauen. Ohne diese Prüfung lässt sich nicht feststellen, ob die Lösung wie vorgesehen funktioniert hat. Auch wichtige Erkenntnisse gehen verloren. Dadurch können ähnliche Probleme später erneut auftreten.

ProcessMind verfolgt bei jedem abgeschlossenen Problem-Datensatz, ob die Aktivität „Prüfung nach der Umsetzung durchgeführt“ erfolgt ist. Abweichungen vom Standardprozess in BMC Helix ITSM werden sichtbar. So stellen Sie sicher, dass alle Lösungsschritte eingehalten werden und langfristige Verbesserungen sowie Compliance-Anforderungen berücksichtigt sind.

Manchmal werden Problem-Datensätze geschlossen, bevor die Fachverantwortlichen oder technischen Verantwortlichen die Lösung bestätigt haben. Kurz darauf tritt dasselbe Problem erneut auf. Der Datensatz muss wieder geöffnet oder ein neuer angelegt werden, was die Berichterstattung erschwert und die Aussagekraft von Kennzahlen beeinträchtigt.

Unsere Analyse vergleicht die Aktivität „Lösung bestätigt“ mit dem abschließenden Ereignis „Datensatz geschlossen“ in BMC Helix ITSM. Sie zeigt Fälle, in denen die Bestätigung ausgelassen oder zu schnell durchgeführt wurde. So können Teams die Qualitätskontrolle stärken und sicherstellen, dass die Ursache tatsächlich beseitigt ist, bevor ein Problem als gelöst gilt.

Wenn Techniker die Ursache eines Problems nicht korrekt kategorisieren, lassen sich langfristige Trends und systemische Schwachstellen der Infrastruktur kaum erkennen. Ohne diese Daten kann das Management fundierte Entscheidungen über Investitionen in die Infrastruktur oder notwendige Prozessänderungen zur Verbesserung der Stabilität nur schwer treffen.

ProcessMind erkennt Datensätze, bei denen das Attribut für die Ursachen-Kategorie fehlt oder einen generischen Wert enthält. Diese Lücken werden in BMC Helix ITSM sichtbar. So können Unternehmen die Datenqualität verbessern und besser nachvollziehen, welche Faktoren die Instabilität der IT tatsächlich verursachen. Das schafft die Grundlage für wirksamere Präventionsmaßnahmen.

Einige spezialisierte technische Teams sind häufig mit einer großen Zahl von Problemzuweisungen überlastet. Dadurch entstehen erhebliche Rückstände und Lösungen verzögern sich. Die ungleiche Arbeitsverteilung schafft einen einzelnen kritischen Engpass, der den gesamten Problem-Management-Prozess aufhält und wichtige Services gefährdet.

Unsere Lösung analysiert die Zahl der aktiven Datensätze, die jeder Supportgruppe zugewiesen sind, und macht Ressourcenengpässe sichtbar. IT-Leiter können die Arbeitslast neu verteilen oder die Besetzung kritischer Bereiche in BMC Helix ITSM anpassen. Grundlage dafür sind tatsächliche Durchsatzdaten statt einzelner Erfahrungsberichte.

Dauert der Lebenszyklus des Problem Managements zu lange, gehen beim Service Desk weiterhin Incidents zum selben Thema ein. Wertvolle Ressourcen fließen dann in wiederkehrende Aufgaben. Das beeinträchtigt die Effizienz und hält das Team von strategischen Projekten und anspruchsvollen Fehleranalysen ab.

ProcessMind setzt die Zahl der zugehörigen Incidents mit der Dauer der Untersuchungs- und Behebungsphasen in Beziehung. So sehen Sie, wie eine langsame Problemlösung die Zahl der Incidents in BMC Helix ITSM erhöht. Damit können Sie begründen, warum dauerhafte Lösungen schneller umgesetzt werden sollten, um den Service Desk zu entlasten.

Typische Ziele

Definieren Sie, woran Sie den Erfolg erkennen

Eine schnelle Zuweisung stellt sicher, dass sich die richtigen Fachkräfte sofort um kritische Probleme kümmern. Wenn ein Datensatz weniger Zeit im Status „Erfasst“ verbringt, können Untersuchungen früher beginnen. Das verkürzt den Zeitraum, in dem laufende IT-Störungen ein Risiko darstellen, und beschleunigt die Wiederherstellung der Services.

ProcessMind ermittelt in BMC Helix ITSM die genaue Zeit zwischen den Aktivitäten „Erfasst“ und „Zugewiesen“. Die Analyse zeigt Problemkategorien und Prioritätsstufen, bei denen die Zuweisung länger als üblich dauert. So können Verantwortliche Vergleichswerte festlegen und Verbesserungen der Reaktionszeiten in Echtzeit verfolgen.

Die zugrunde liegende Ursache eines Problems zu finden, ist der arbeitsintensivste Teil des Prozesses. Wird diese Phase verkürzt, können dauerhafte Lösungen schneller entwickelt werden. Das verhindert, dass sich technische Altlasten ansammeln, und entlastet technische Teams, die sich sonst mit wiederkehrenden Incidents befassen müssten.

Unsere Plattform analysiert die Aktivität „Untersuchung begonnen“, um den tatsächlichen Aufwand für die Ursachenanalyse nachzuverfolgen. Sie macht verborgene Engpässe sichtbar, an denen Untersuchungen ins Stocken geraten. Koordinatoren können eingreifen und Ressourcen für komplexe Probleme neu zuweisen, bevor Service-Level-Ziele überschritten werden.

Ein Workaround hilft, den Service wiederherzustellen, während eine dauerhafte Lösung untersucht wird. Werden bekannte Fehler schnell veröffentlicht, sinken die betrieblichen Auswirkungen von Incidents. Mitarbeitende am Service Desk erhalten sofort Lösungen für häufige Probleme, was die Customer Experience und die Verfügbarkeit der Services verbessert.

Mit Process Mining visualisieren Sie die Zeit zwischen der Erfassung des Problems und der Aktivität „Workaround veröffentlicht“. So erkennen Sie, welche Supportgruppen am schnellsten vorläufige Lösungen bereitstellen. Deren effiziente Workflows können Sie anschließend auf die gesamte IT-Organisation übertragen.

Jeder Wechsel eines Problem-Datensatzes zwischen Supportgruppen kostet Zeit und lässt Kontext verloren gehen. Wenn Sie dieses Hin und Her vermeiden, führt ein direkterer Weg zur Lösung. Das entlastet die technischen Mitarbeitenden und verkürzt den Lebenszyklus des Datensatzes, weil die zuständigen Fachkräfte ihn bearbeiten.

ProcessMind bildet den Ablauf der Datensätze zwischen den Supportgruppen in BMC Helix ITSM ab. Wenn Sie häufige Schleifen und Neuzuweisungen erkennen, können Sie Wissenslücken aufdecken oder die erste Triage verbessern. So gelangt der Datensatz gleich beim ersten Mal zum richtigen Team.

Die Einhaltung von Service-Level-Vereinbarungen bei Problemen mit hoher Priorität ist entscheidend für die Geschäftskontinuität. Eine konsequente Einhaltung stärkt das Vertrauen der Fachbereiche und stellt sicher, dass die Probleme mit den größten Auswirkungen die nötige Aufmerksamkeit erhalten. So verkürzt sich die Dauer kritischer Serviceausfälle.

Die Plattform vergleicht das Attribut „SLA-Fälligkeitstermin“ mit den tatsächlichen Abschlusszeiten aller Problem-Datensätze. Sie warnt frühzeitig, wenn Datensätze ihre Frist bald erreichen. So können Koordinatoren die Arbeitslast priorisieren und die SLA-Konformität bei kritischen Services sicherstellen.

Sobald eine Ursache ermittelt ist, sollte der formelle Change Request zügig folgen. Eine schnellere Übergabe sorgt dafür, dass dauerhafte Lösungen möglichst bald in die Produktion gelangen. So werden Risiken in der IT-Umgebung dauerhaft beseitigt und die Zeit in der Phase „Lösung vorgeschlagen“ verkürzt.

Wir analysieren die Abfolge der Ereignisse von „Ursache ermittelt“ bis „Change Request eingeleitet“. So werden administrative Verzögerungen und Engpässe bei Freigaben sichtbar. Teams können die Erstellung von Change-Datensätzen automatisieren und die Wartezeit zwischen Ermittlung und Behebung verringern.

Aus früheren Problemen zu lernen, ist entscheidend für die kontinuierliche Verbesserung der Services. Werden alle schwerwiegenden Probleme geprüft, lassen sich Erkenntnisse dokumentieren und ähnliche Probleme künftig vermeiden. Ein besserer Wissensaustausch steigert zudem langfristig die Prozessreife der IT-Organisation.

ProcessMind überwacht, ob die Aktivität „Prüfung nach der Umsetzung durchgeführt“ erfolgt ist, bevor ein Datensatz geschlossen wird. Wenn Sie erkennen, wo dieser Schritt häufig übersprungen wird, können Sie die Einhaltung des Prozesses sicherstellen und dafür sorgen, dass Erkenntnisse dokumentiert und im Service Desk geteilt werden.

Wird ein Problem-Datensatz geschlossen, ohne die Lösung zu überprüfen, tritt dasselbe Problem häufig erneut auf. Ein verbindlicher Prüfschritt stellt sicher, dass die Ursache tatsächlich beseitigt wurde. So sinkt die Zahl künftiger Incidents und die Stabilität der Services im gesamten Unternehmen bleibt erhalten.

Unsere Plattform analysiert die Abfolge der Aktivitäten „Lösung bestätigt“ und „Datensatz geschlossen“ und zeigt Fälle, in denen Datensätze vorzeitig geschlossen wurden. Diese Daten helfen Ihnen, Qualität konsequent in den Vordergrund zu stellen und die Wirksamkeit jeder Lösung zu bestätigen, bevor der Fall abgeschlossen wird.

Genaue Daten sind die Grundlage für ein wirksames Problem Management. Bessere Ursachen-Kategorien ermöglichen aussagekräftigere Trendanalysen und gezieltere Investitionen in Technologie oder Schulungen, um systemische Probleme der IT-Infrastruktur zu beheben und langfristig für Stabilität zu sorgen.

Die Plattform analysiert das Attribut für die Ursachen-Kategorie in Tausenden von Datensätzen und erkennt Unstimmigkeiten sowie die übermäßige Verwendung generischer Kategorien. Diese Erkenntnisse helfen Verantwortlichen, Standards für die Dateneingabe zu verbessern und die Zuverlässigkeit der Berichte in BMC Helix ITSM zu erhöhen.

Eine ausgewogene Arbeitslast verhindert, dass einzelne technische Teams zu Engpässen werden. Eine angemessene Ressourcenverteilung stellt sicher, dass alle Probleme unabhängig von ihrer Kategorie die nötige Aufmerksamkeit erhalten und den Lebenszyklus gleichmäßig und planbar durchlaufen.

ProcessMind zeigt, wie viele offene Problem-Datensätze die einzelnen Supportgruppen bearbeiten. Wenn Sie Teams mit einer überproportional hohen Arbeitslast oder längeren Bearbeitungszeiten erkennen, können Sie datengetrieben über Personalbesetzung, Schulungen und die Verteilung der Arbeit entscheiden.

Das wichtigste Ziel des Problem Managements ist, ein erneutes Auftreten von Incidents zu verhindern. Weniger wiederkehrende Incidents senken die Kosten des IT-Supports und erhöhen die Verfügbarkeit geschäftskritischer Anwendungen. So können sich IT-Mitarbeitende auf Innovation statt auf Wartungsaufgaben konzentrieren.

Wir setzen Problem-Datensätze mit der Zahl der zugehörigen Incidents in Beziehung, um die tatsächlichen Auswirkungen jedes Problems zu messen. Wenn Sie verfolgen, wie schnell die Zahl der Incidents nach der Umsetzung einer dauerhaften Lösung sinkt, können Sie den Nutzen Ihrer Maßnahmen im Problem Management beziffern und die wirksamsten Lösungen erkennen.

Ein proaktives statt reaktives Problem Management verhindert, dass Probleme die Benutzer beeinträchtigen. Wenn Sie Trends früh erkennen, kann das Unternehmen Schwachstellen bei geplanten Wartungsarbeiten beheben, statt erst im Ausnahmezustand zu reagieren. Das trägt zu einer stabileren IT-Umgebung bei.

ProcessMind analysiert die Zeit zwischen Häufungen von Incidents und der Erstellung eines Problem-Datensatzes. Wenn Sie diese Muster überwachen, erkennen Sie, wann Untersuchungen früher beginnen sollten. So kann sich Ihr Team stärker auf Prävention statt auf die Behebung akuter Störungen konzentrieren und die Auswirkungen auf das Unternehmen verringern.

Der Verbesserungsprozess für das Problem Management in 6 Schritten

1

Daten-Template herunterladen

Was zu tun ist

Laden Sie das standardisierte Excel-Template für die Felder des BMC Helix Problem Management herunter. Es umfasst die Formulare „Problem Investigation“ und „Known Error“.

Warum das wichtig ist

Mit einer vorgefertigten Struktur stimmen Ihre Daten zum Prozesslebenszyklus genau mit den Analysemodellen überein. So erhalten Sie deutlich schneller Erkenntnisse für die Ursachenanalyse.

Erwartetes Ergebnis

Ein sofort einsetzbares Template für die Datenzuordnung Ihrer ITSM-Daten.

IHRE PROZESSERKENNTNISSE

Entdecken Sie die tatsächlichen Engpässe in Ihrem Helix-Problemprozess

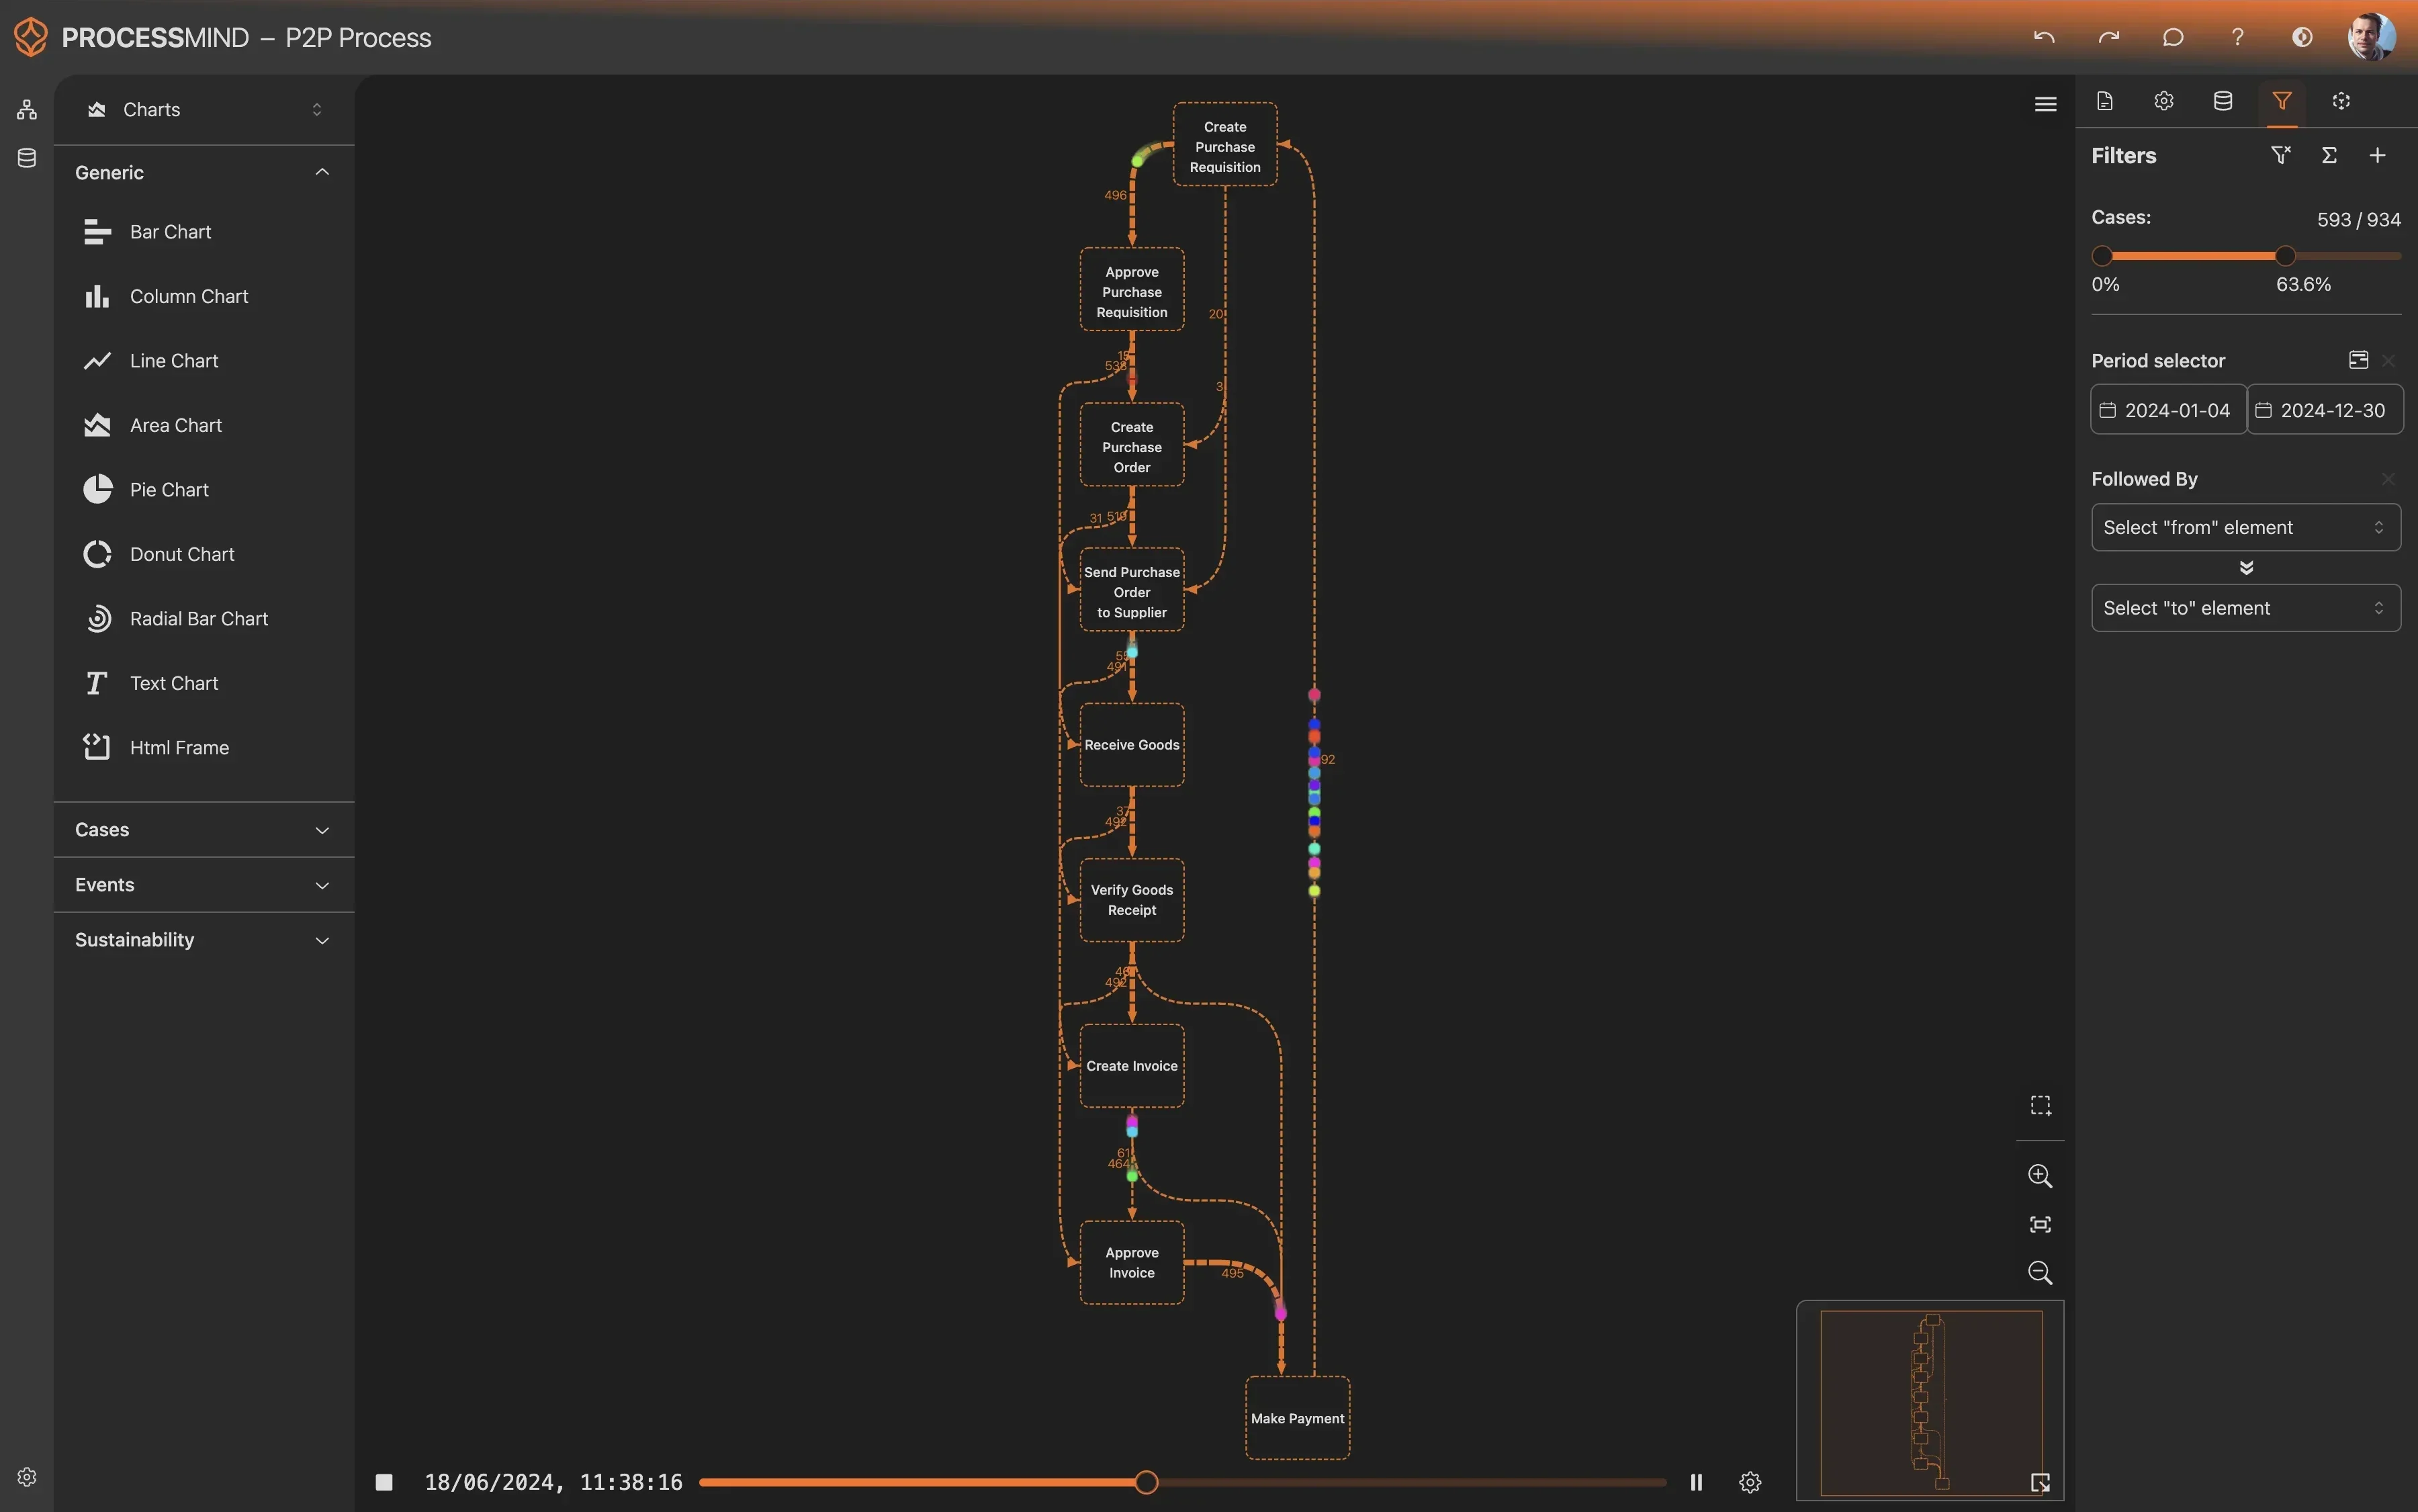
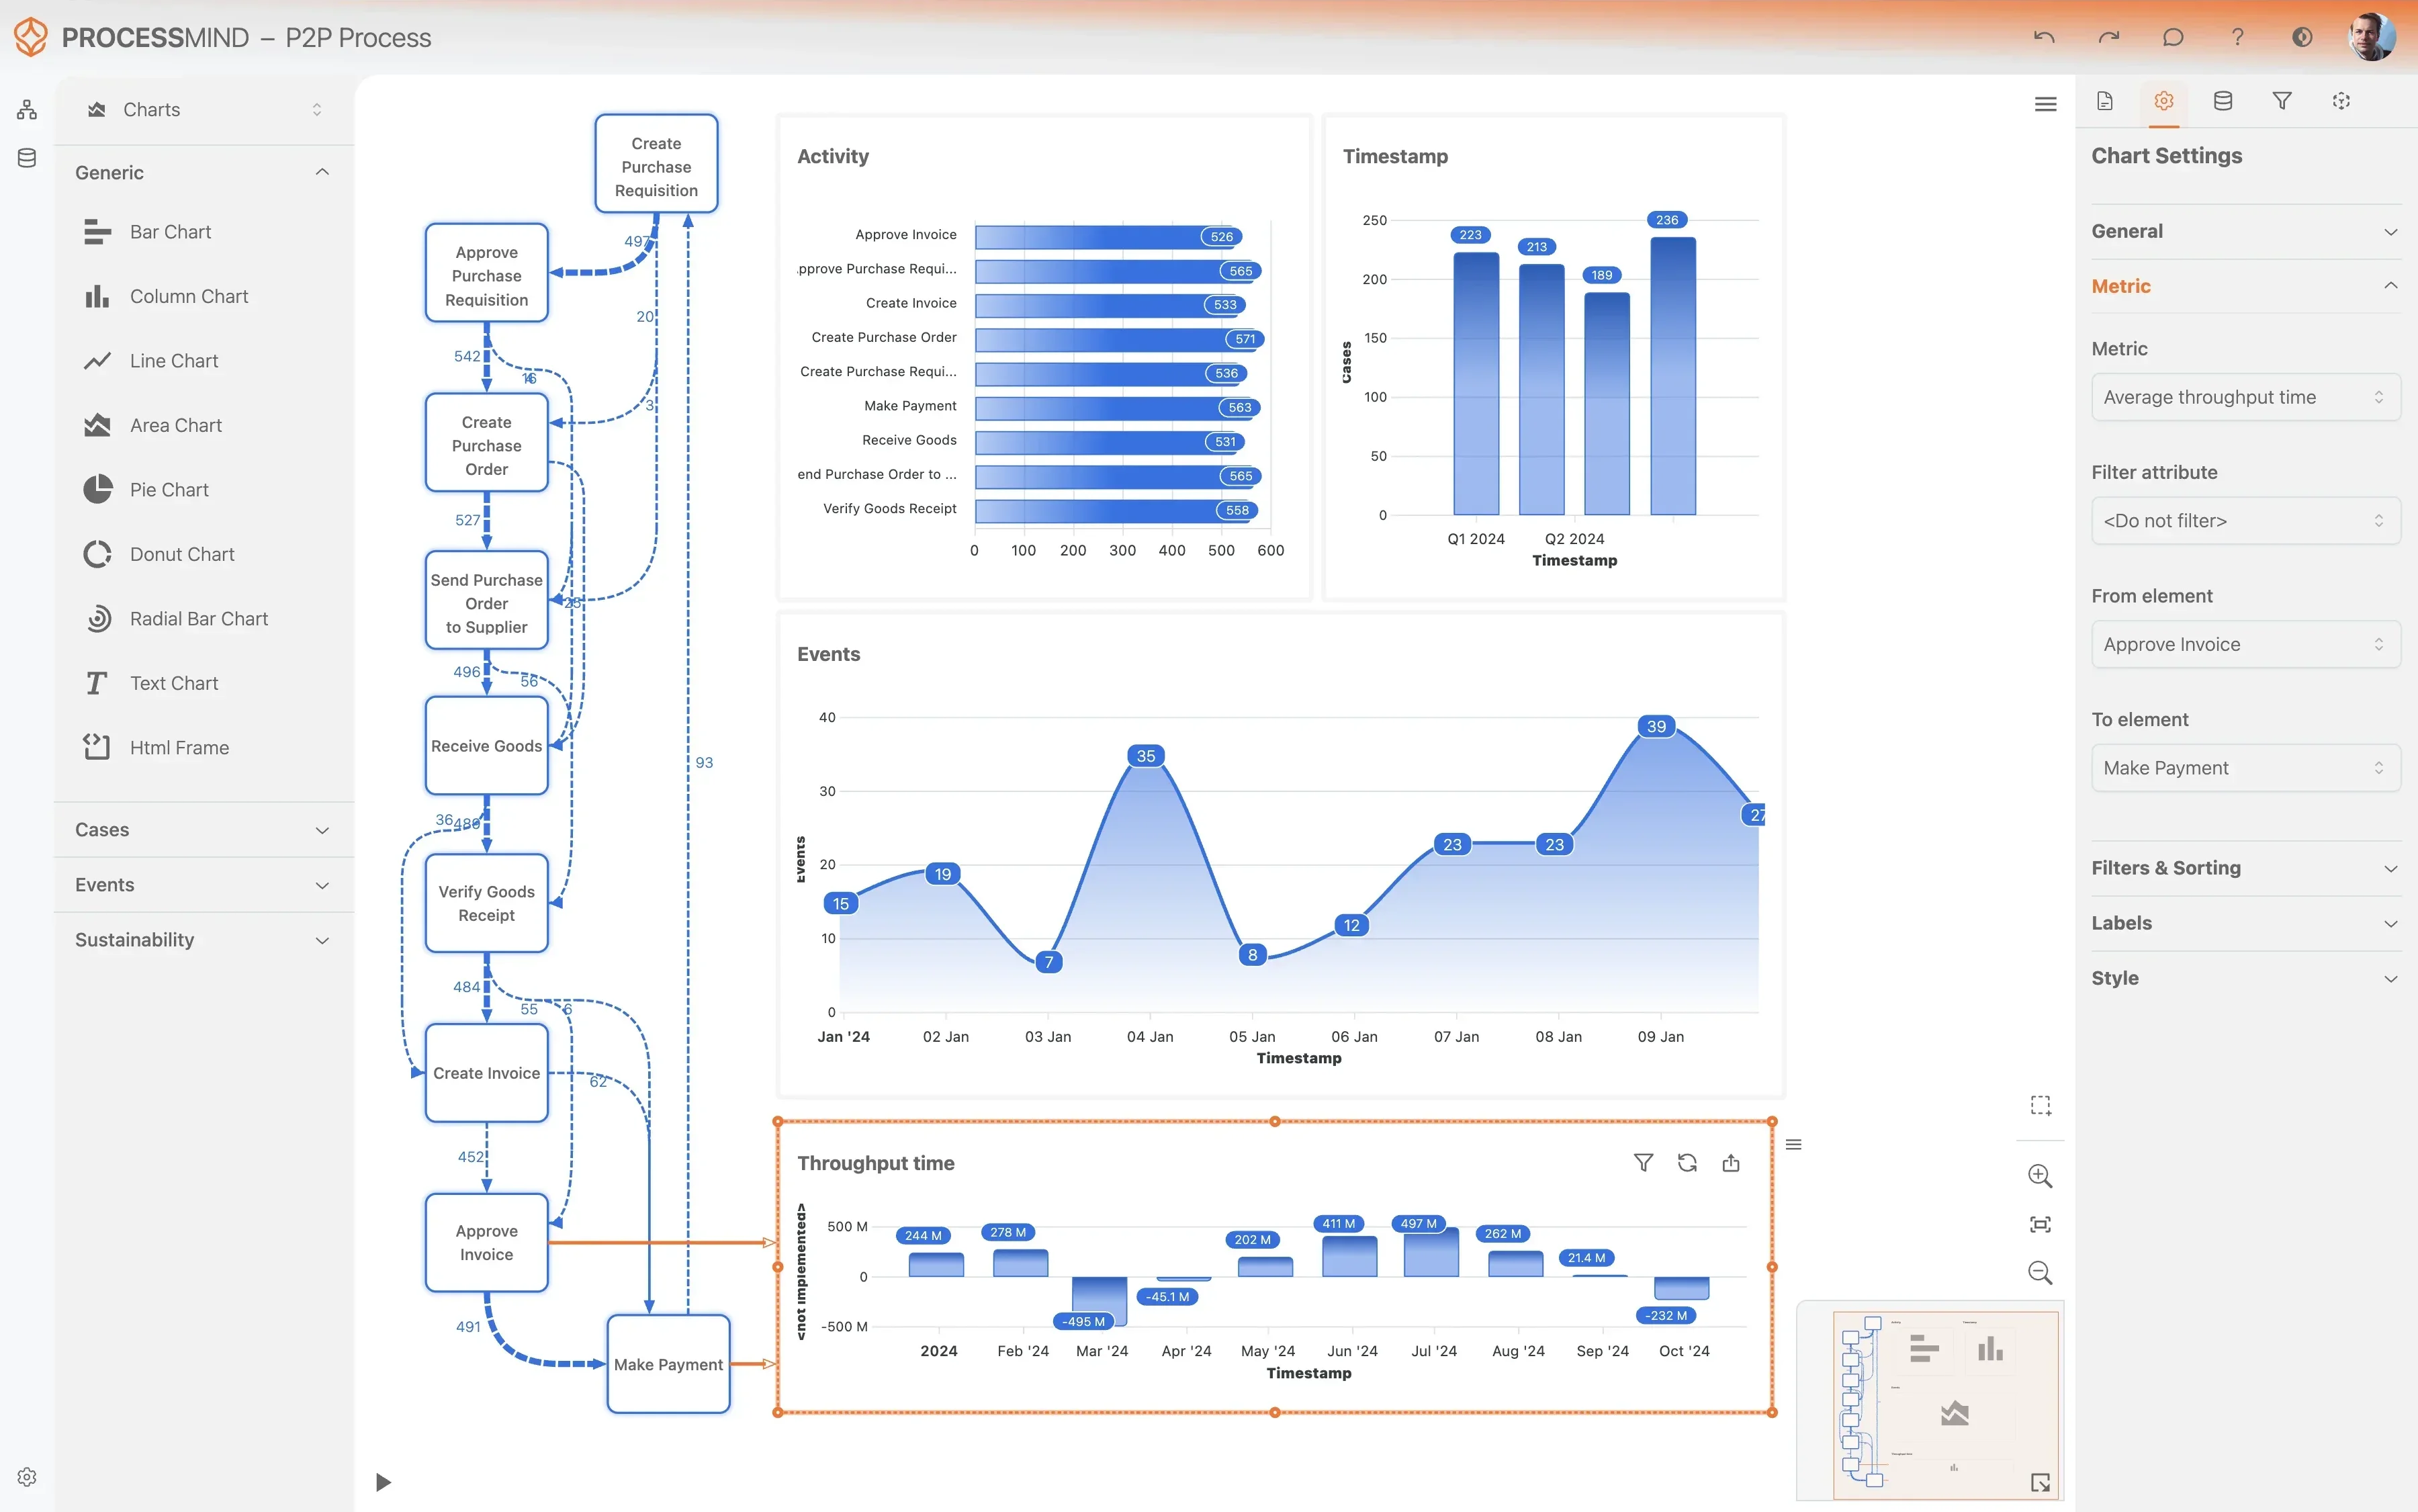
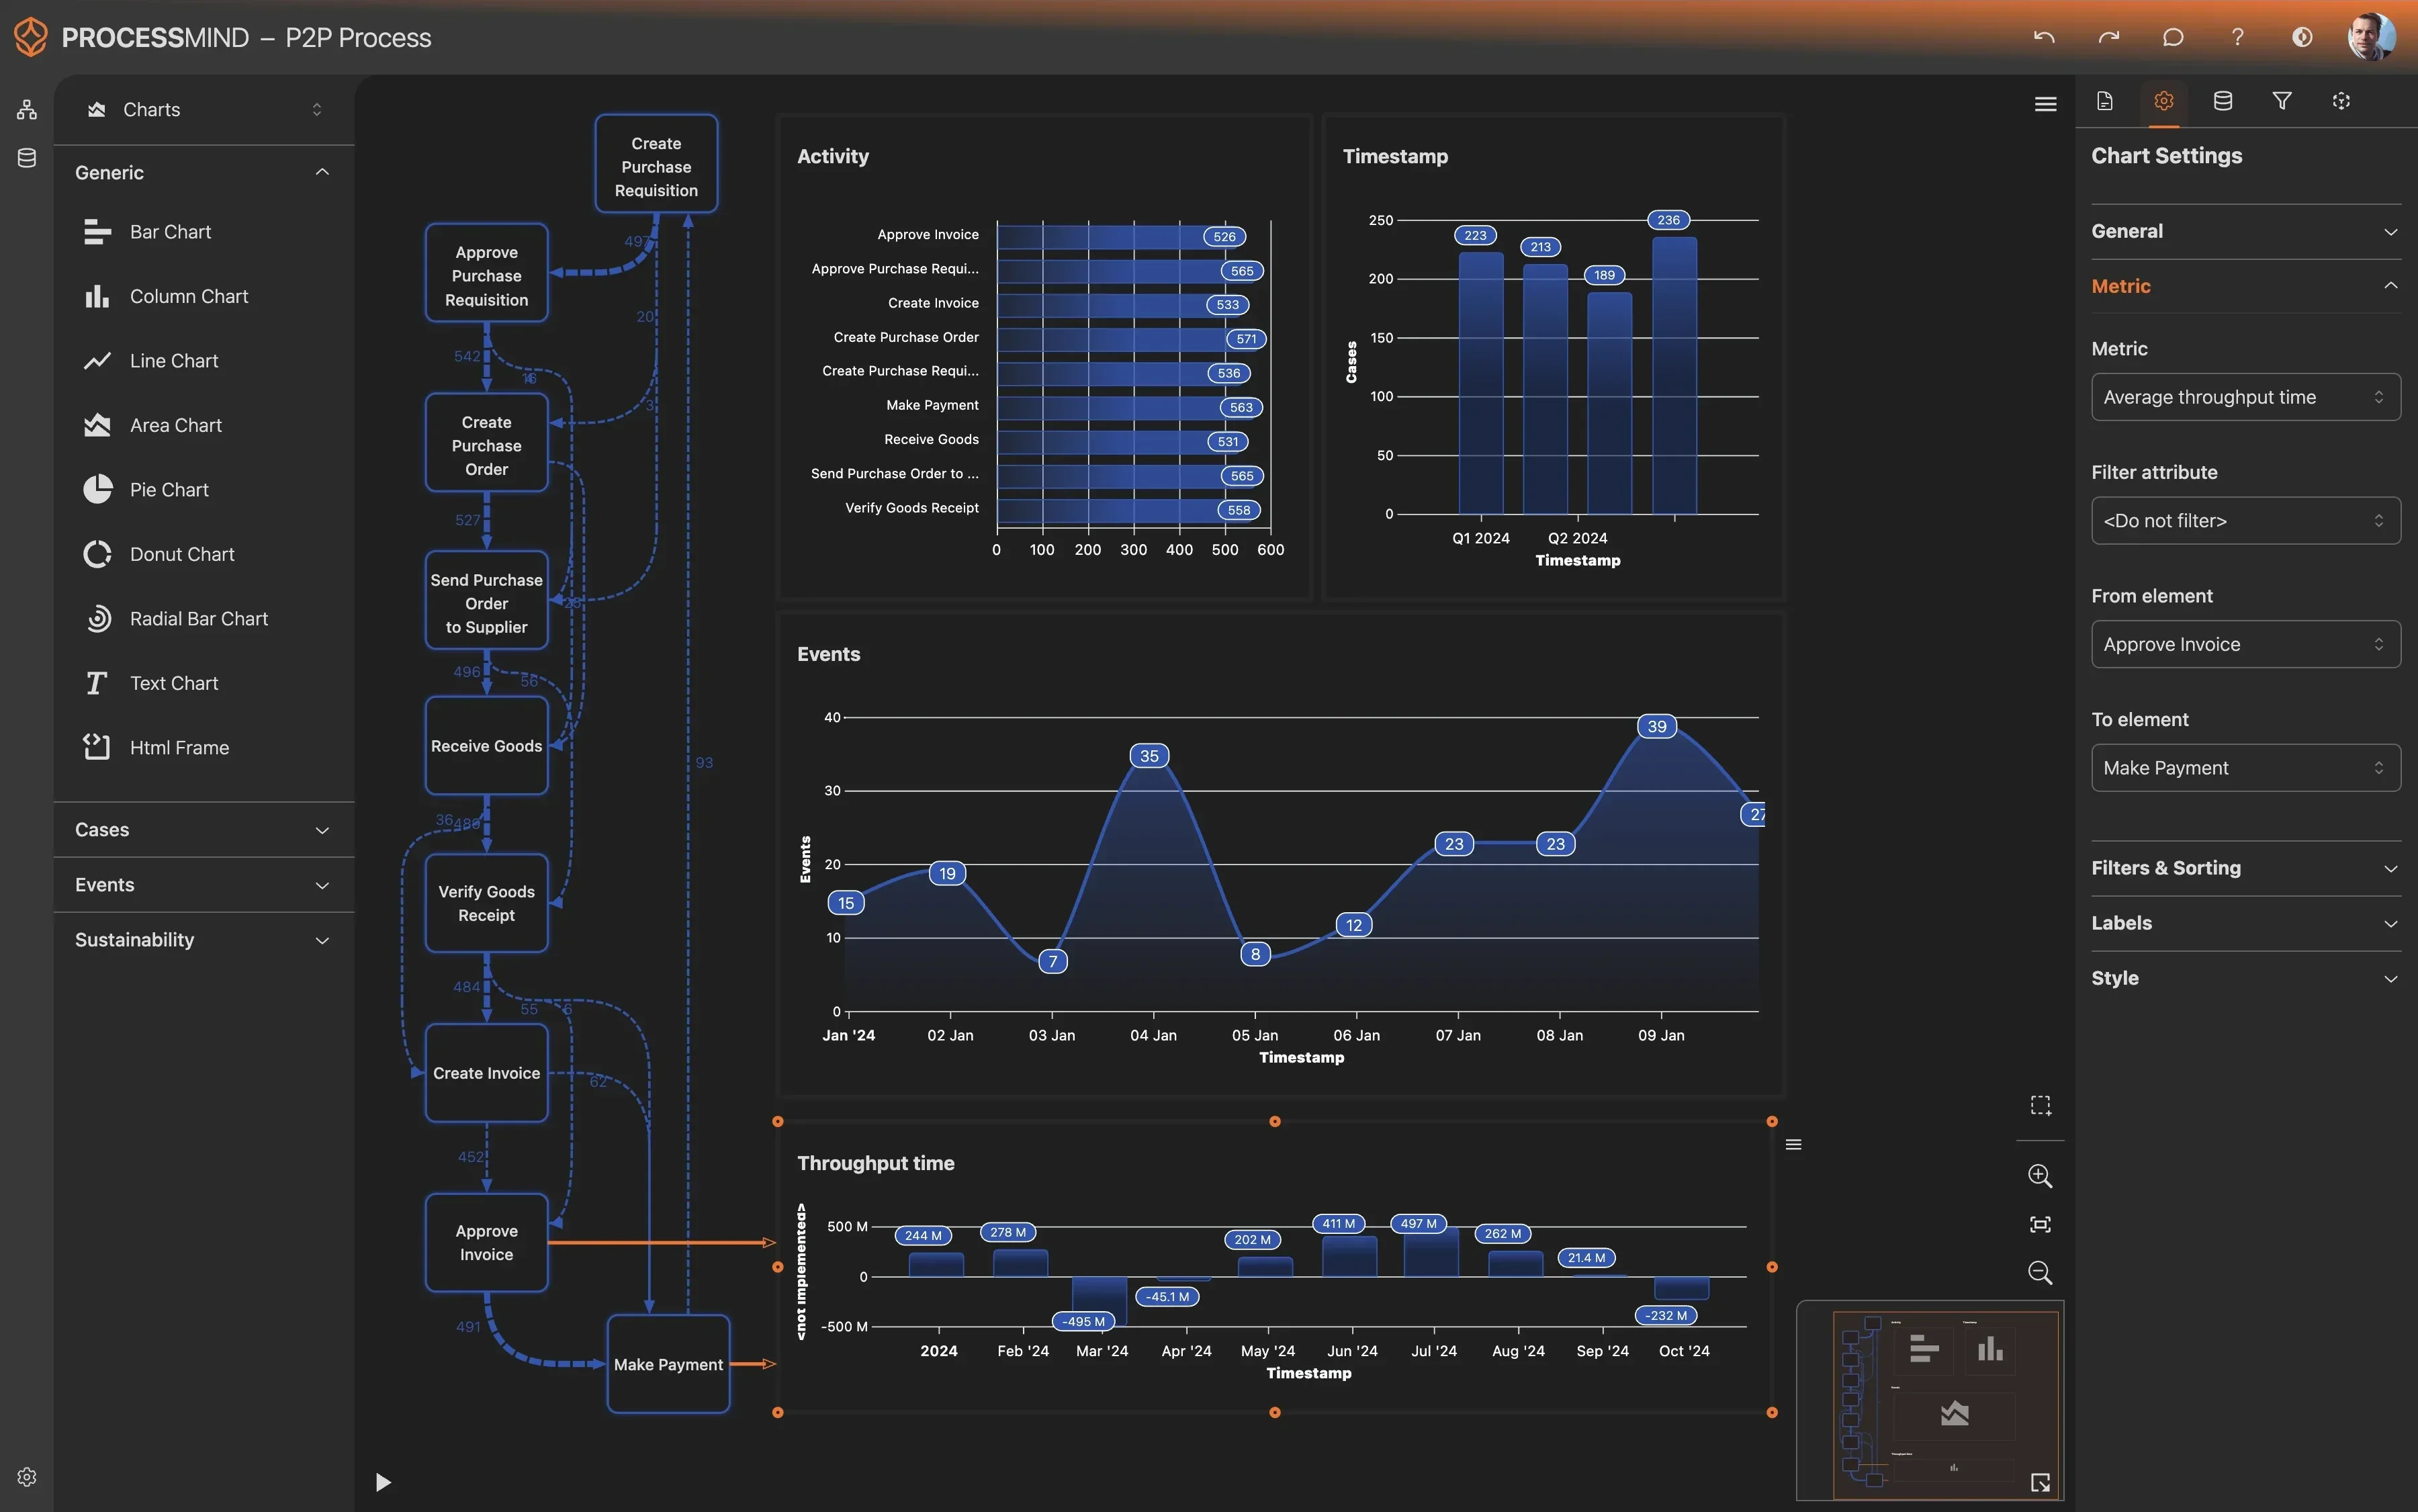
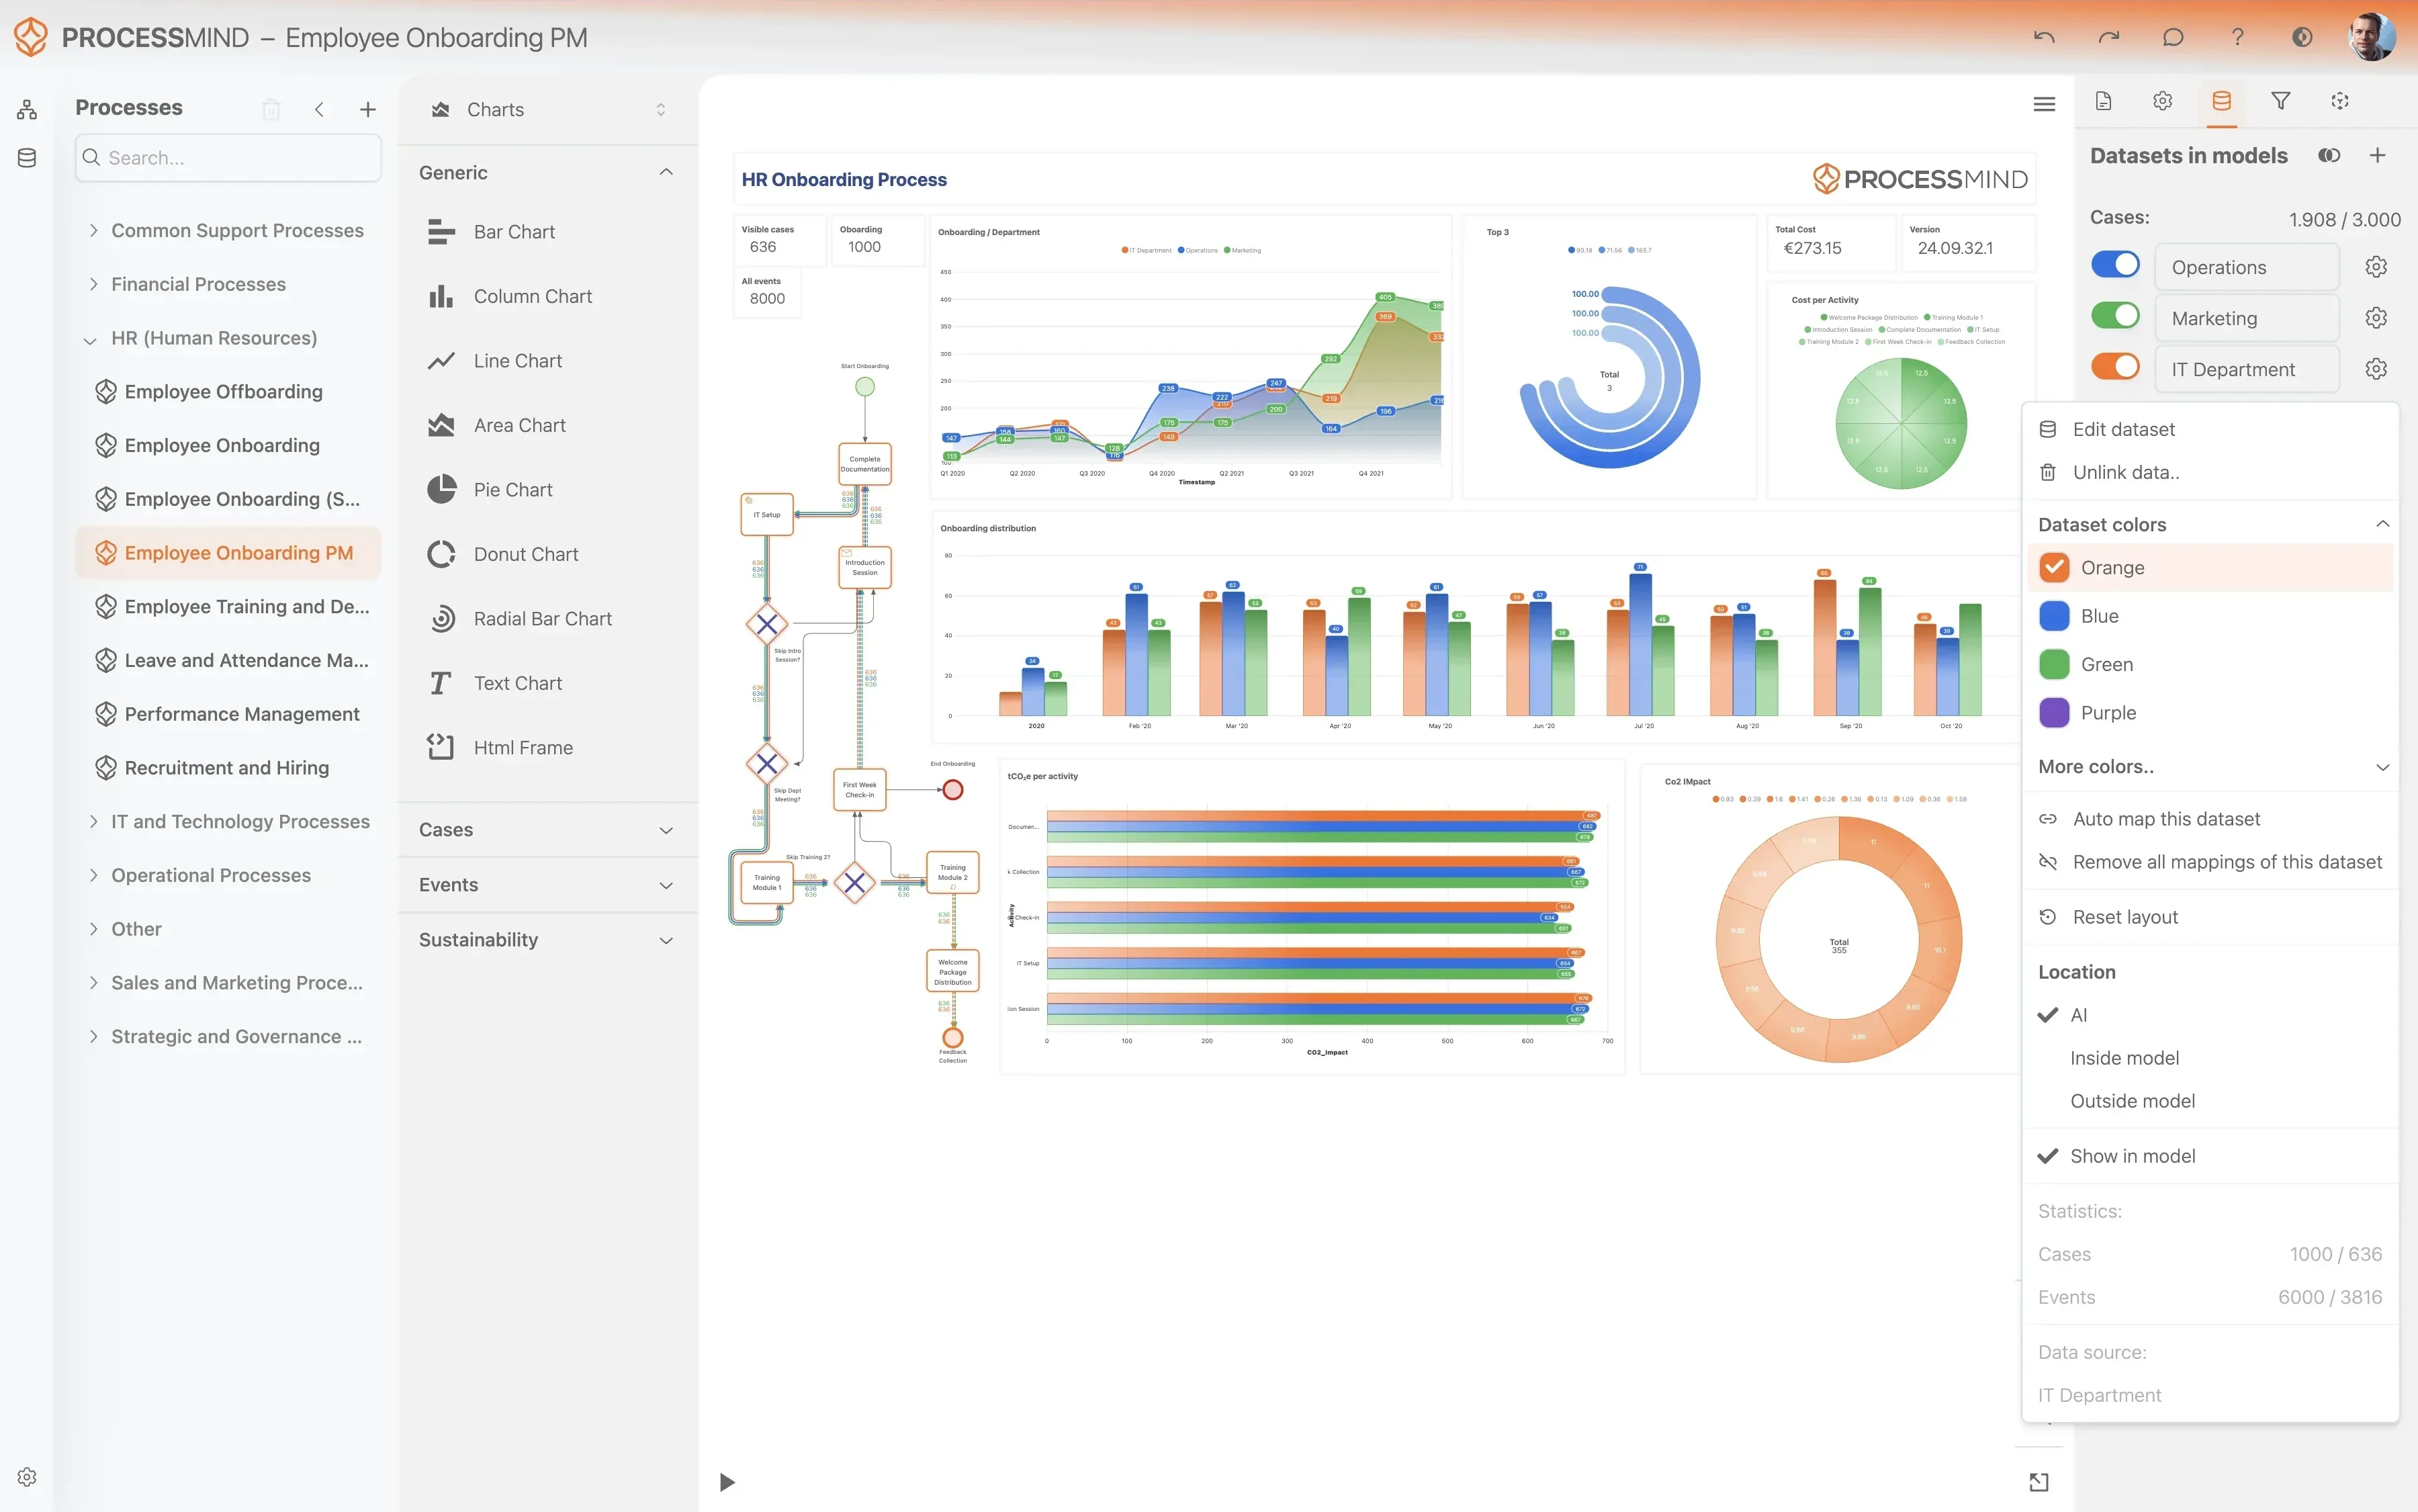
ProcessMind schafft Transparenz in Ihren BMC Helix ITSM-Daten. Sie sehen genau, wo Untersuchungen ins Stocken geraten und wie sich dauerhafte Lösungen schneller umsetzen lassen.
  • Machen Sie jeden Schritt Ihres Untersuchungszyklus sichtbar
  • Ermitteln Sie die genauen Ursachen für Verzögerungen bei Zuweisungen
  • Verkürzen Sie die Dokumentation von Workarounds
  • Messen Sie, wie sich Lösungen auf das Vorfallaufkommen auswirken
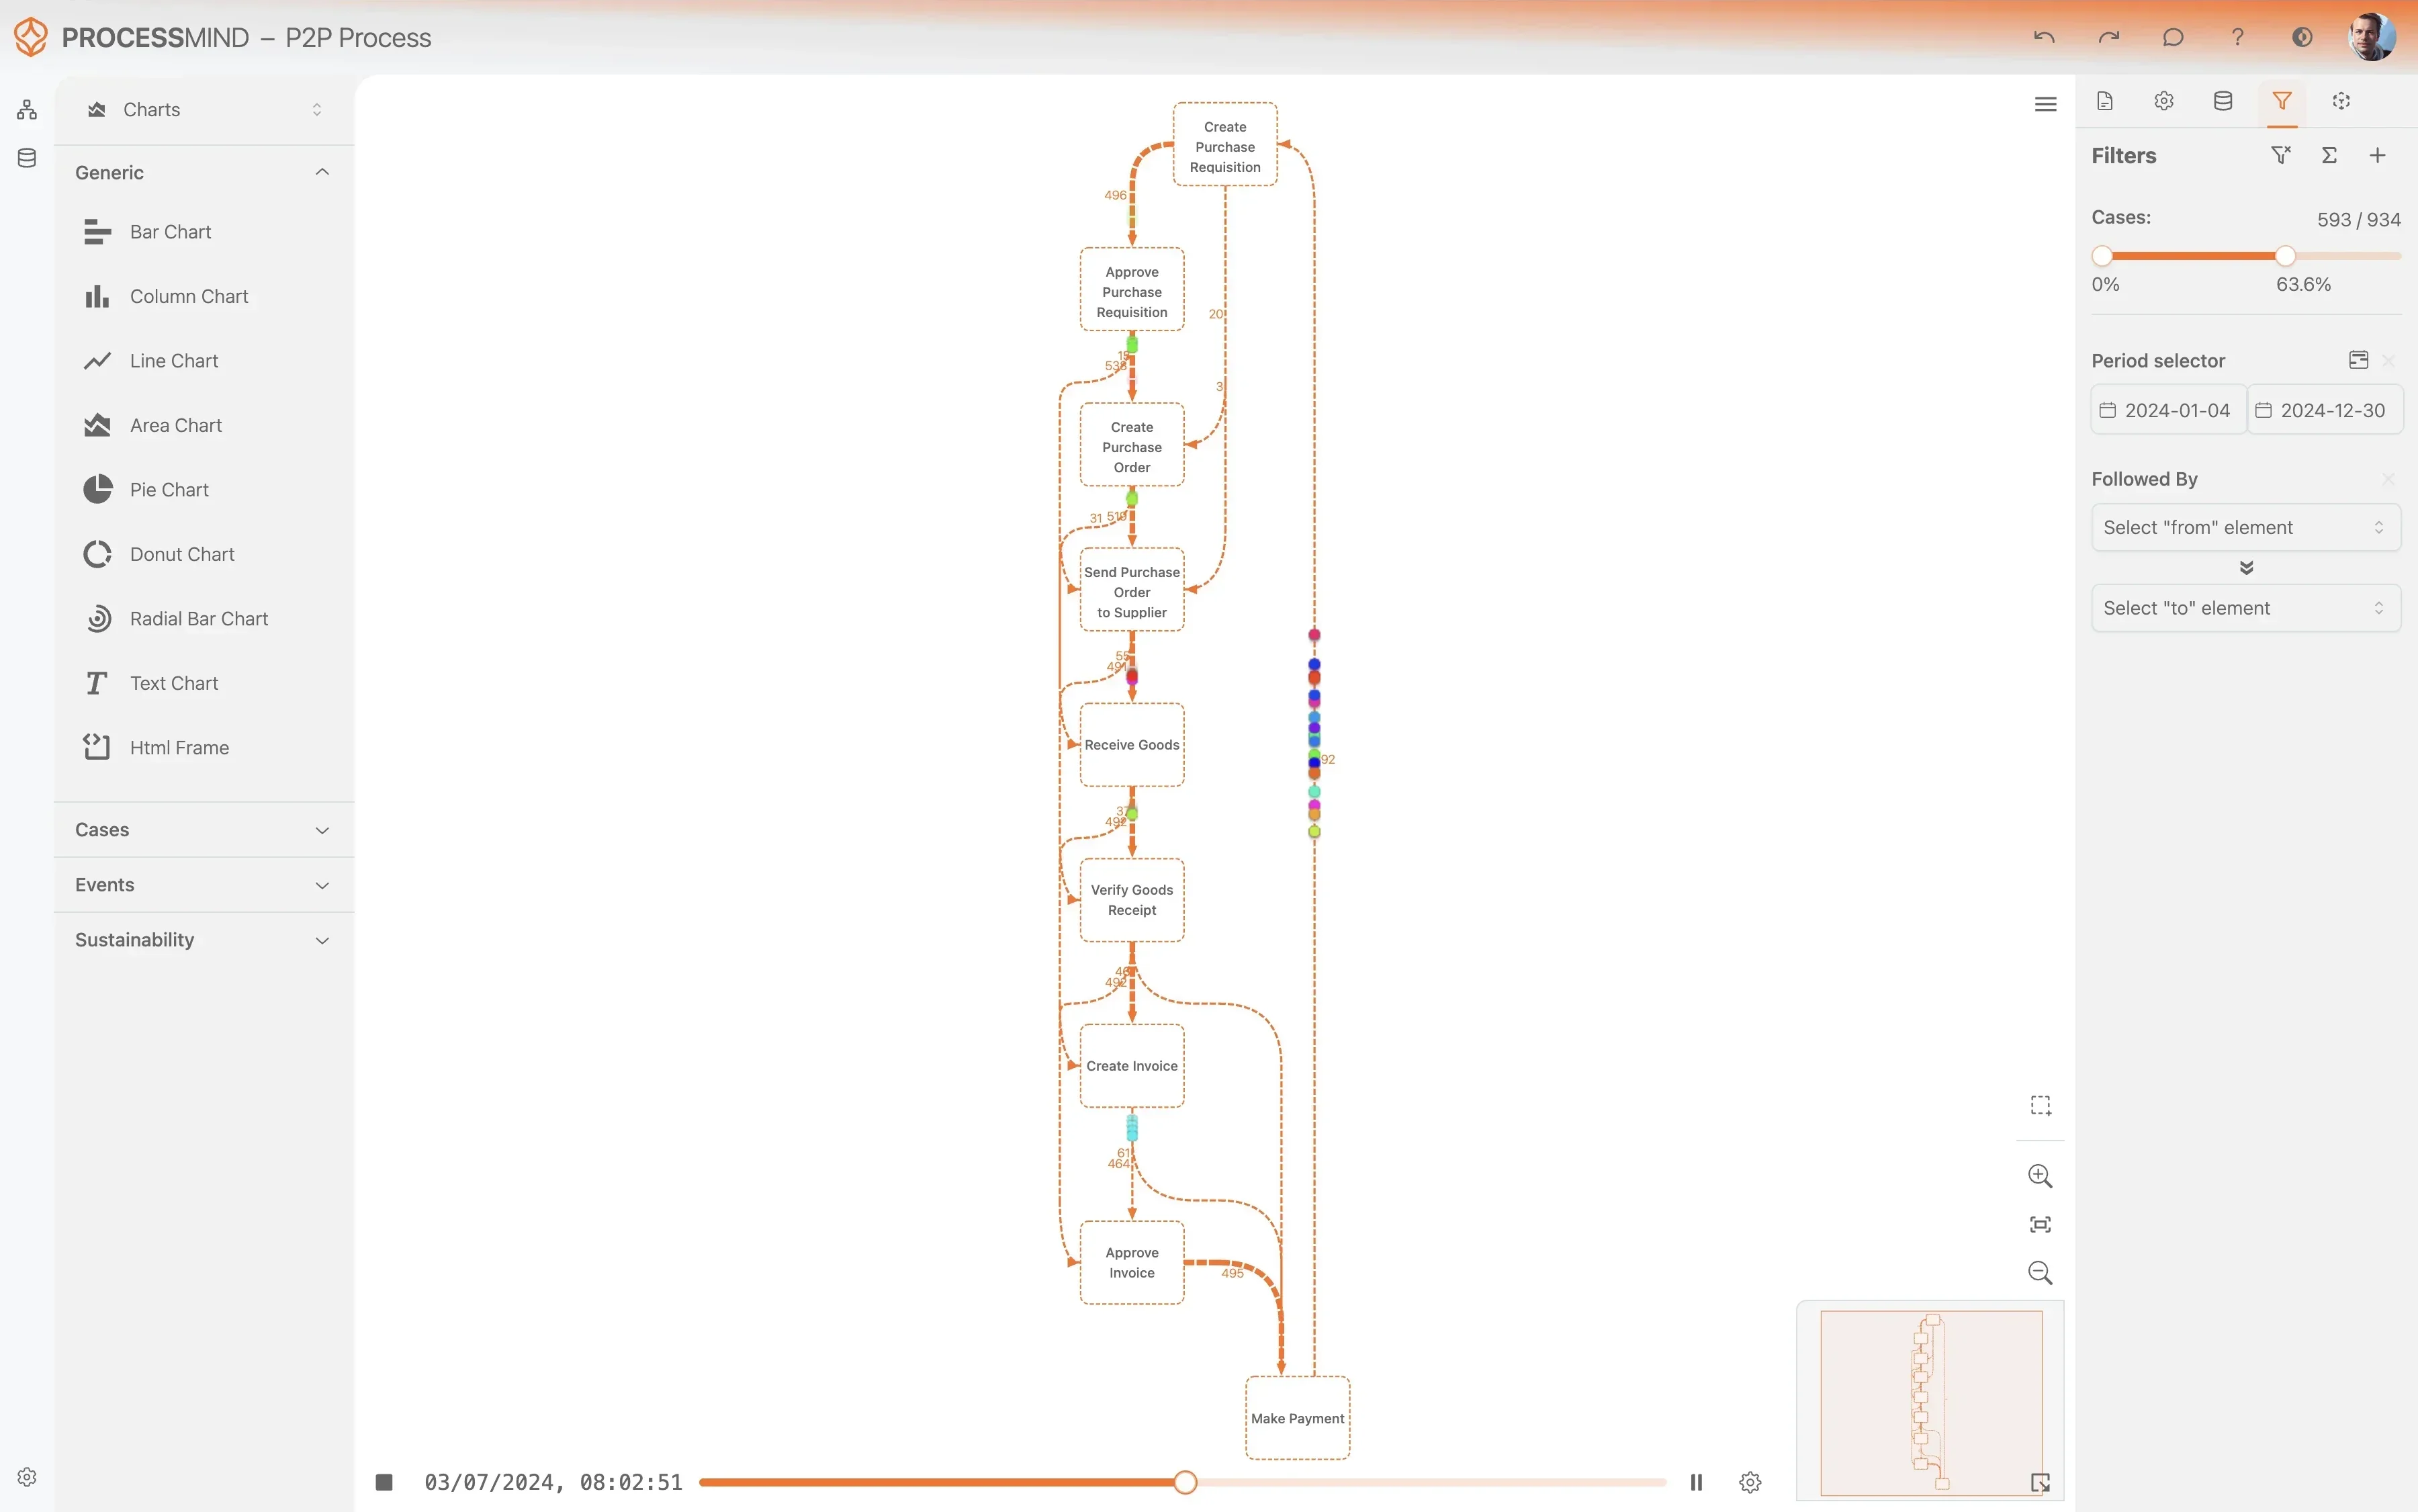
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

NACHGEWIESENE ERGEBNISSE

Messbare Verbesserungen bei der Problemlösung

Unternehmen erhalten einen detaillierten Einblick in Problem Records. So können sie die Ursachenanalyse verbessern und die Zahl wiederkehrender Vorfälle im gesamten Unternehmen senken. Die Ergebnisse zeigen, welche Effizienzgewinne datengetriebene Erkenntnisse in BMC Helix ITSM-Workflows ermöglichen.

0 % reduction
Ursachen schneller erkennen

Kürzere Untersuchungsdauer

Wenn der Weg vom Beginn der Untersuchung bis zur Identifizierung der Ursache kürzer wird, können sich technische Teams auf dauerhafte Lösungen konzentrieren, statt lange nach der Ursache zu suchen.

0 x fewer moves
Weniger Weiterreichen von Problemfällen

Weniger Neuzuweisungen im Support

Werden Engpässe bei der anfänglichen Zuweisung erkannt, erreichen Problemfälle sofort die zuständigen Fachleute. So vermeiden Sie unnötigen Aufwand in mehreren Supportgruppen.

+ 0 % improvement
Bessere SLA-Einhaltung

Prozentuale Steigerung der Compliance

Die Echtzeitübersicht über festgefahrene Problemfälle ermöglicht es der Leitung, einzugreifen, bevor SLA-Ziele verfehlt werden. So bleibt die Servicebereitstellung für das Unternehmen verlässlich.

0 % less rework
Weniger Nacharbeit bei der Lösung

Weniger erneut geöffnete Problemfälle

Werden Lösungen vor dem Abschluss überprüft, ist sichergestellt, dass die zugrunde liegenden Probleme tatsächlich behoben sind. So vermeiden Sie kostspielige erneute Untersuchungen, nachdem ein Problem vermeintlich gelöst wurde.

0 hours saved
Workarounds schneller bereitstellen

Lösungen schneller veröffentlichen

Werden vorläufige Workarounds schneller veröffentlicht, sinkt die Belastung der Endbenutzer durch laufende Vorfälle deutlich, während die langfristige Lösung entwickelt wird.

Die tatsächlichen Verbesserungen hängen von der Prozesskomplexität und der Datenqualität ab. Die Zahlen zeigen typische Ergebnisse aus verschiedenen Unternehmensumgebungen.

Empfohlene Daten

Beginnen Sie mit diesen wichtigen Attributen und Aktivitäten. Erweitern Sie Ihre Analyse bei Bedarf.
Neu bei Event Logs? Erfahren Sie, wie Sie ein Event Log für Process Mining erstellen.

Attribute

Wichtige Datenpunkte für die Analyse

Die eindeutige Kennung des Problem Investigation Case.

Warum das wichtig ist

Diese grundlegende Kennung ist erforderlich, um die Prozessansicht zu erstellen und den Ablauf einzelner Probleme nachzuverfolgen.

Die konkrete Task oder Statusänderung, die stattgefunden hat.

Warum das wichtig ist

Das Attribut legt die Knoten in der Prozessübersicht fest und ermöglicht die Visualisierung des Workflows.

Der Timestamp, zu dem die jeweilige Aktivität stattgefunden hat.

Warum das wichtig ist

Ermöglicht die Berechnung aller zeitbasierten KPIs und die chronologische Anordnung der Ereignisse.

Das technische Team, dem die Problem Investigation derzeit zugewiesen ist.

Warum das wichtig ist

Ermöglicht die Analyse der Organisation und das Erkennen von Engpässen auf Teamebene.

Die anhand von Auswirkungen und Dringlichkeit berechnete Priorität des Problems.

Warum das wichtig ist

Gliedert die Analyse nach geschäftlicher Kritikalität und unterstützt die SLA-Analyse.

Die Person, die mit der Koordination der Untersuchung betraut ist.

Warum das wichtig ist

Ermöglicht die Ressourcenanalyse und den Ausgleich der Arbeitslast auf individueller Ebene.

Die Klassifizierung der zugrunde liegenden Ursache des Problems.

Warum das wichtig ist

Ermöglicht die Trendanalyse systemischer Probleme und unterstützt ein vorausschauendes Problem Management.

Der betroffene geschäftliche Service oder das betroffene Konfigurationselement.

Warum das wichtig ist

Verknüpft die Prozessleistung mit bestimmten Produkten oder Services des Unternehmens.

Der Grund für den Start der Problem Investigation.

Warum das wichtig ist

Unterscheidet zwischen reaktiver und proaktiver Arbeit, einem wichtigen Indikator für den Reifegrad.

Datum und Uhrzeit, bis zu denen das Problem gelöst sein muss.

Warum das wichtig ist

Dient als Referenz für die Berechnung aller Kennzahlen zur Compliance und Termintreue.

Anzahl der Incidents, die mit diesem Problem-Datensatz verknüpft sind.

Warum das wichtig ist

Beziffert die betrieblichen Auswirkungen des Problems und die Belastung der Benutzer.

Kennzeichen dafür, ob die Problemlösung die zulässige Zeit überschritten hat.

Warum das wichtig ist

Vereinfacht die Compliance-Berichterstattung und die Analyse von Fehlern.

Aktivitäten

Prozessschritte, die Sie verfolgen und optimieren sollten

Ein Problem Investigation Record wird erstmals im System angelegt. Dieses Ereignis wird ausdrücklich erfasst, wenn ein neuer Eintrag im Formular PBM:Problem Investigation gespeichert wird.

Warum das wichtig ist

Kennzeichnet den Beginn der Prozessinstanz. Wichtig für die Berechnung der gesamten Zykluszeit und der Kennzahlen zur ersten Reaktion.

Der Problem Record wird einem bestimmten technischen Team zugewiesen. Erfasst durch die Überwachung von Änderungen am Feld „Assigned Group“.

Warum das wichtig ist

Wichtig für die Messung von Übergaben, wiederholten Weiterleitungen und der KPI „Mean Time to Initial Assignment“.

Der Problem Record wechselt in eine aktive Analysephase. Dies wird abgeleitet, wenn sich das Feld „Status“ zu „Under Investigation“ ändert.

Warum das wichtig ist

Kennzeichnet den Beginn der eigentlichen Arbeit und unterstützt die KPI „Investigation Cycle Time“.

Im Feld „Workaround“ des Problem Records wird Text eingetragen oder aktualisiert. Dieses Ereignis zeigt an, dass eine vorläufige Lösung dokumentiert wurde.

Warum das wichtig ist

Unterstützt die KPI „Workaround Publication Lead Time“ und zeigt, dass Maßnahmen zur Begrenzung der Auswirkungen eines Vorfalls ergriffen wurden.

Der Problem Record wechselt in einen Status, der anzeigt, dass die Ursache bekannt ist. Dies wird abgeleitet, wenn sich der Status zu „Root Cause Identified“ ändert.

Warum das wichtig ist

Ein wichtiger Meilenstein für das Dashboard „Root Cause Investigation Cycle Time“. Er kennzeichnet den Übergang von der Analyse zur Lösungsfindung.

Ein Infrastructure Change Request wird mit der Problem Investigation verknüpft. Damit beginnt die Umsetzungsphase.

Warum das wichtig ist

Wichtig für die KPI „Root Cause to Change Lead Time“ und zum Erkennen von Silos zwischen Problem- und Change-Prozessen.

Die dauerhafte Lösung wird als erfolgreich bestätigt. Dies wird abgeleitet, wenn sich der Status zu „Solution Implemented“ oder „Completed“ ändert.

Warum das wichtig ist

Wird für die „Problem SLA Adherence Rate“ verwendet und bestätigt den Abschluss der technischen Arbeit.

Der Problem Record wird abschließend administrativ geschlossen. Dieses Ereignis beendet die Prozessinstanz.

Warum das wichtig ist

Das reguläre Endereignis. Erforderlich für die vollständige Analyse der Zykluszeit und die Berechnung der „Incident Linkage Density“.

Ein Problem Record wird vor der Lösung beendet. Erfasst, wenn der Status zu „Cancelled“ oder „Rejected“ wechselt.

Warum das wichtig ist

Hilft, unnötigen Aufwand oder berechtigte Duplikate zu erkennen. Stellt einen alternativen Endpunkt dar.

Häufig gestellte Fragen

Häufig gestellte Fragen

Process Mining visualisiert jeden Ablauf eines Problem-Datensatzes. So sehen Sie, wie der Prozess tatsächlich verläuft, statt nur den vorgesehenen Ablauf. Anhand historischer Event Logs erkennen Sie, wo Datensätze zwischen Supportgruppen hin- und hergeschoben werden oder in ausstehenden Status stecken bleiben. Diese Transparenz hilft Teams, strukturelle Ineffizienzen zu beseitigen und sich auf die Ursachenanalyse von Problemen mit großen Auswirkungen zu konzentrieren.

Sie benötigen ein einfaches Event Log mit einer eindeutigen Problem-Datensatz-ID, einem Timestamp und einer Aktivitätsbeschreibung wie „Statusänderung“ oder „Zugewiesene Gruppe“. Diese Informationen stammen in der Regel aus den Tabellen PBM:Problem Investigation in der BMC-Helix-Datenbank. Die meisten Process-Mining-Tools können direkt auf diese Tabellen zugreifen oder CSV-Exporte importieren, um den Prozessablauf abzubilden.

Process Mining zeigt bestimmte Phasen, in denen Untersuchungen ins Stocken geraten, etwa wenn Rückmeldungen von Anbietern oder anderen Fachabteilungen ausstehen. Wenn Verantwortliche die Dauer der einzelnen Übergänge messen, können sie fehlende Ressourcen oder Dokumentation erkennen, die die Untersuchung verzögern. Dieser datengetriebene Ansatz ersetzt einzelne Erfahrungsberichte durch konkrete Belege dafür, wo Verzögerungen tatsächlich auftreten.

Erste Erkenntnisse liegen häufig innerhalb von zwei bis vier Wochen vor, sobald der Datenexport aus BMC Helix eingerichtet ist. In der ersten Phase wird die Verbindung zum System hergestellt und die wichtigsten Statusänderungen werden zu einem Basismodell zusammengeführt. In den folgenden Wochen wird die Analyse verfeinert und es werden konkrete Optimierungsmöglichkeiten ermittelt, etwa weniger Neuzuweisungen von Datensätzen.

Process Mining eignet sich gut, um Probleme mit der Datenqualität zu erkennen, etwa fehlende Zeitstempel oder falsche Kategorisierungen. Eine schlechte Datenqualität kann zwar manche Erkenntnisse verdecken, doch die Visualisierung zeigt häufig, wo Supportmitarbeitende Prozessschritte überspringen oder falsch erfassen. Die Behebung dieser Datenlücken gehört zu den ersten Verbesserungszielen und schafft die Grundlage für zuverlässige künftige Berichte.

Process Mining behebt den Prozess nicht für Sie, zeigt aber die Ursachen von SLA-Verstößen. Dazu bildet es den genauen Ablauf der Datensätze ab, die ihre Ziele verfehlt haben. Sie können Datensätze mit und ohne SLA-Verstoß vergleichen und feststellen, ob bestimmte Supportgruppen oder Problemtypen häufiger von Verzögerungen betroffen sind. Auf dieser Grundlage lassen sich gezielte Schulungen oder eine andere Ressourcenverteilung planen, damit Probleme mit hoher Priorität innerhalb der vorgegebenen Fristen bearbeitet werden.

Der Übergang zwischen den Modulen Problem Management und Change Management wird nachverfolgt, um festzustellen, ob es zu erheblichen Verzögerungen kommt. Die Visualisierung dieses Übergangs zeigt, ob Änderungsanträge zeitnah erstellt werden, nachdem eine Ursache identifiziert wurde, oder ob sie in administrativen Abläufen stecken bleiben. So lässt sich der gesamte Ablauf von der Problemerkennung bis zur Umsetzung einer dauerhaften Lösung verbessern.

Process Mining ergänzt die Standardberichte um eine langfristige Prozesssicht, statt nur eine Momentaufnahme des aktuellen Status zu liefern. Herkömmliche Berichte zeigen, wie viele Probleme offen sind. Process Mining macht sichtbar, wie sich diese Probleme im Laufe der Zeit durch das System bewegt haben. Diese Detailtiefe ist notwendig, um Prozesse gezielt zu optimieren und verborgene Engpässe zu erkennen, die in Standard-Dashboards möglicherweise nicht auffallen.

Beseitigen Sie noch heute Engpässe im Problem Management

Verkürzen Sie die Zykluszeiten um 30 % und verbessern Sie die Stabilität Ihres Service.

Starten Sie Ihre kostenlose Testphase

Keine Kreditkarte erforderlich. In wenigen Minuten eingerichtet.