Migliori la gestione degli incidenti
La guida in 6 passaggi per ottimizzare gli incidenti in Freshservice
Migliori la gestione degli incidenti
Gestione degli incidenti
Freshservice

Selezioni un processo

Scelga un processo per continuare a lavorare nell’area di lavoro collegata.

Processi disponibili
Sistemi disponibili

Ottimizzi la gestione degli incidenti in Freshservice per risolverli più rapidamente

La gestione degli incidenti deve spesso fare i conti con tempi di risoluzione lunghi e problemi che si ripresentano. La nostra piattaforma Le consente di individuare rapidamente dove si verificano i ritardi e da cosa dipendono, facendo emergere i colli di bottiglia nascosti nei processi. Individui le cause profonde delle inefficienze e capisca come rendere più efficaci i flussi di lavoro. Potrà così migliorare l’erogazione dei servizi e aumentare la soddisfazione degli utenti.

Scarichi il nostro template dei dati preconfigurato e affronti le sfide più comuni per raggiungere i Suoi obiettivi di efficienza. Segua il nostro piano di miglioramento in sei fasi e consulti la guida al template dei dati per trasformare le Sue attività.

Mostra la descrizione dettagliata

Perché è fondamentale ottimizzare la gestione degli incidenti

Una gestione efficace degli incidenti è alla base di servizi IT affidabili e incide direttamente sulla produttività degli utenti, sui costi operativi e sulla soddisfazione dei clienti. Nell’attuale contesto digitale, caratterizzato da ritmi serrati, qualsiasi ritardo nella risoluzione degli incidenti, anche di quelli minori, può causare gravi ripercussioni sull’attività aziendale. I tempi di inattività prolungati, il ripetersi di attività manuali e le conseguenti perdite di produttività sono effetti diretti di processi di gestione degli incidenti inefficienti. Quando gli incidenti in Freshservice o in qualsiasi altro sistema non vengono gestiti in modo efficiente, aumentano i costi operativi e il rischio di violazioni degli SLA, mentre diminuisce la fiducia degli utenti. Comprendere il flusso effettivo del processo di gestione degli incidenti in Freshservice è il primo passo per ridurre questi rischi e garantire servizi solidi e affidabili.

Come il Process Mining migliora la risoluzione degli incidenti in Freshservice

Il Process Mining offre una prospettiva concreta, basata sui dati, sui flussi di lavoro esistenti per la gestione degli incidenti in Freshservice, mostrando il processo effettivo anziché una situazione ideale teorica. Analizzando gli Event Log di Freshservice, ricostruisce l’intero percorso di ogni incidente, dalla segnalazione iniziale alla chiusura. Questa visione completa permette di individuare con precisione i punti in cui gli incidenti si bloccano, si ripetono attività non necessarie e si creano colli di bottiglia che allungano il tempo di ciclo della risoluzione.

Ad esempio, può ricostruire visivamente le modalità di classificazione e assegnazione delle priorità degli incidenti, osservare il numero effettivo di trasferimenti tra i gruppi di assistenza e individuare se alcune fasi di diagnosi vengono ripetute senza progressi. Queste informazioni sono preziose per far emergere inefficienze nascoste, come riassegnazioni frequenti, attese prolungate per la conferma degli utenti o scostamenti dalle procedure operative standard. Il Process Mining aiuta a rispondere a domande importanti, come: "Quali sono le cause dei tempi di risoluzione particolarmente lunghi per gli incidenti ad alta priorità in Freshservice?" oppure "Perché gli incidenti relativi a determinati servizi superano regolarmente gli obiettivi SLA?" Queste informazioni dettagliate consentono di superare le supposizioni e basare gli interventi di miglioramento su dati concreti e verificabili, ricavati direttamente da Freshservice.

Aree principali di miglioramento nella gestione degli incidenti

Le informazioni ricavate dal Process Mining consentono di intervenire su aree specifiche della gestione degli incidenti in Freshservice. Tra le opportunità di miglioramento più comuni rientrano:

  • Semplificare la classificazione e l’assegnazione delle priorità degli incidenti: individuare se la classificazione iniziale è spesso errata e causa riclassificazioni e ritardi.
  • Ridurre trasferimenti ed escalation non necessari: individuare gli incidenti che passano frequentemente da un team all’altro, segnalando la necessità di una formazione migliore, di una maggiore condivisione delle conoscenze o di regole di assegnazione riviste.
  • Ottimizzare i flussi di lavoro di diagnosi e risoluzione: far emergere i passaggi che richiedono troppo tempo o in cui gli addetti ripetono le procedure diagnostiche, segnalando lacune nelle basi di conoscenza o nelle procedure standardizzate.
  • Migliorare l’utilizzo della base di conoscenza: individuare gli incidenti in cui le soluzioni vengono ripetutamente
Gestione degli incidenti Service Desk ITIL Ripristino del servizio Rispetto degli SLA Help Desk Analisi delle cause profonde Risoluzione dei ticket Gestione dei ticket Gestione dei ticket Help Desk IT Tempo medio di risoluzione MTTR Risoluzione degli incidenti Assistenza IT

Problemi e sfide comuni

Individui le sfide che La riguardano

I ritardi nella risoluzione degli incidenti incidono direttamente sulla produttività degli utenti e sulla disponibilità dei servizi, riducendo la soddisfazione e causando potenziali perdite per l’azienda. Spesso dipendono da passaggi di consegne inefficienti, fasi diagnostiche prolungate o attese legate a dipendenze esterne, con un impatto significativo sulle prestazioni della gestione degli incidenti.

ProcessMind ricostruisce il flusso effettivo della gestione degli incidenti in Freshservice e mostra con precisione dove si accumulano attese eccessive, ad esempio tra l’assegnazione e la diagnosi o durante l’indagine. Individua i colli di bottiglia e le variazioni rispetto al percorso previsto, evidenziando dove intervenire per semplificare il processo e accelerare la risoluzione.

Le violazioni ripetute degli accordi sui livelli di servizio (SLA) compromettono la fiducia, comportano penali e segnalano inefficienze strutturali nel processo di gestione degli incidenti. Capire perché gli SLA non vengono rispettati è fondamentale per mantenere la qualità del servizio ed evitare conseguenze negative sull’esperienza degli utenti e sulla conformità.

Correlando i percorsi degli incidenti con lo stato degli SLA, ProcessMind individua le attività o le sequenze di eventi in Freshservice che portano regolarmente a violazioni. Visualizza gli scostamenti dalle procedure operative standard che contribuiscono al mancato raggiungimento degli obiettivi, consentendo di introdurre miglioramenti mirati e rispettare meglio gli SLA.

Gli incidenti passano spesso da un gruppo di assistenza o da un addetto all’altro, causando ritardi e rilavorazioni. Procedure di passaggio poco chiare o responsabilità non definite possono allungare notevolmente i tempi di risoluzione e creare frustrazione negli utenti, aumentando il costo complessivo della gestione degli incidenti.

ProcessMind visualizza tutti i trasferimenti e le riassegnazioni in Freshservice, mostrando la frequenza e la durata dei passaggi tra i diversi gruppi di assistenza e gli addetti. Individua i frequenti rimbalzi tra team e i percorsi di assegnazione inefficienti che ostacolano una risoluzione rapida, indicando dove intervenire sulla progettazione dei flussi di lavoro.

Gli incidenti classificati in modo errato o con un livello di priorità non adeguato possono essere assegnati ai team sbagliati o ricevere un’attenzione insufficiente, ritardando la risoluzione e aggravando potenzialmente l’impatto. Ne derivano uno spreco di risorse e il mancato raggiungimento degli obiettivi nell’istanza Freshservice.

Analizzando la classificazione iniziale e le successive riclassificazioni o modifiche delle priorità in Freshservice, ProcessMind individua gli schemi ricorrenti di classificazione errata. Mostra dove e perché gli incidenti vengono riclassificati spesso, segnalando la necessità di linee guida più chiare o di una formazione degli addetti per migliorare la precisione della classificazione iniziale e l’assegnazione.

Senza un’analisi efficace delle cause profonde (RCA), le organizzazioni rischiano di risolvere più volte gli stessi problemi, aumentando il numero di incidenti e sprecando risorse. Questo ostacola la stabilità a lungo termine e il miglioramento continuo dell’erogazione dei servizi.

ProcessMind può individuare gli incidenti risolti senza un’analisi delle cause profonde associata e quelli caratterizzati da codici di risoluzione che ricorrono spesso senza un ticket di problema corrispondente in Freshservice. Mostra quanto spesso si omette l’RCA e segnala le opportunità per integrare meglio la gestione dei problemi nel flusso di lavoro della gestione degli incidenti.

Quando i percorsi di escalation non sono chiari o non vengono seguiti con regolarità, gli incidenti possono bloccarsi oppure essere inoltrati manualmente senza un criterio preciso. Ne derivano un servizio discontinuo e tempi di risoluzione più lunghi, soprattutto per i problemi critici, con conseguenze sull’efficienza dei team e sulla fiducia degli utenti.

ProcessMind visualizza i percorsi di escalation effettivi in Freshservice e fa emergere quelli non autorizzati o inefficienti, che si discostano dalle procedure definite. Mostra come vengono inoltrati gli incidenti, da chi e in quale fase, individuando incoerenze e colli di bottiglia nel processo di escalation su cui intervenire.

Le soluzioni temporanee sono fondamentali per ripristinare rapidamente il servizio, ma se vengono applicate in ritardo o non attenuano davvero il problema, gli incidenti possono restare aperti più a lungo o ripresentarsi, frustrando utenti e team di assistenza. Questo riduce l’efficacia della strategia di gestione degli incidenti.

ProcessMind monitora l’attività 'Workaround Implemented' in Freshservice e il suo impatto sui tempi di risoluzione successivi o sulla riapertura degli incidenti. Può individuare se le soluzioni temporanee vengono applicate regolarmente in ritardo o se causano ulteriori ritardi o nuovi incidenti, mettendo in luce le inefficienze del processo.

Gli incidenti riassegnati spesso tra addetti o gruppi, oppure riaperti ripetutamente dopo la risoluzione, segnalano problemi di diagnosi, qualità della risoluzione o comunicazione. Questo aumenta i costi operativi e riduce notevolmente la soddisfazione degli utenti.

Ricostruendo l’intero ciclo di vita di un incidente in Freshservice, ProcessMind quantifica le riassegnazioni e le riaperture. Individua le fasi in cui si verificano più spesso e le mette in relazione con specifici addetti o gruppi, facendo emergere problemi di qualità o lacune nelle conoscenze su cui intervenire.

Differenze significative nel modo in cui i singoli agenti o gruppi di supporto gestiscono incidenti simili possono causare una qualità del servizio disomogenea, tempi di risoluzione imprevedibili e una distribuzione iniqua del carico di lavoro. Individuare queste differenze è fondamentale per migliorare i risultati e gestire i team.

In Freshservice, ProcessMind consente di confrontare i tempi di risoluzione, il rispetto delle fasi del processo e il ricorso a soluzioni alternative tra agenti o gruppi di supporto. Mette in evidenza le buone pratiche e gli ambiti in cui occorre intervenire con formazione o procedure più rigorose, così da rendere i risultati più uniformi e migliorare l’efficienza complessiva.

Le fasi finali della gestione degli incidenti, come l’attesa della conferma dell’utente o di una verifica interna prima della chiusura, possono trasformarsi in colli di bottiglia imprevisti. Il ciclo dell’incidente si prolunga anche dopo la risoluzione tecnica, con ripercussioni sui report e sulle metriche di ripristino del servizio.

In Freshservice, ProcessMind analizza il tempo che intercorre tra le attività «Notifica all’utente inviata», «Conferma dell’utente ricevuta», «Incidente verificato» e «Incidente chiuso». Individua le fasi finali che si protraggono eccessivamente e segnala le opportunità per semplificare le comunicazioni o automatizzare i solleciti, accelerando la chiusura.

Se gli utenti segnalano regolarmente gli incidenti tramite canali non adatti a una gestione rapida, i tempi della prima risposta possono allungarsi e il lavoro manuale dei team di supporto aumentare. Capire come vengono utilizzati i diversi canali è essenziale per rendere più efficiente la raccolta delle segnalazioni e allocare meglio le risorse.

In Freshservice, ProcessMind mette a confronto l’attributo «Canale di segnalazione» con i tempi delle fasi successive e l’efficienza della risoluzione, mostrando quali canali causano ritardi o richiedono più rilavorazioni. Queste informazioni aiutano a ottimizzare la gestione delle segnalazioni e a indirizzare gli utenti verso modalità più efficienti.

Obiettivi tipici

Definisca i criteri di successo

Ridurre il tempo necessario per risolvere gli incidenti critici è essenziale per limitare le interruzioni delle attività aziendali e garantire la continuità operativa. Una risoluzione più rapida migliora direttamente la soddisfazione degli utenti e aiuta a evitare le penali legate alle interruzioni del servizio in Freshservice. L’obiettivo è abbreviare il tempo che va dalla segnalazione dell’incidente al pieno ripristino del servizio. ProcessMind individua i colli di bottiglia e le attività che non aggiungono valore nel percorso di risoluzione degli incidenti critici, indicando le attività o i passaggi di consegne che causano ritardi. La visualizzazione dei flussi effettivi mette in luce le deviazioni dai percorsi più efficienti e suggerisce dove intervenire con l’automazione o una diversa allocazione delle risorse per ridurre sensibilmente i tempi di risoluzione.

Rispettare con regolarità gli obiettivi degli accordi sui livelli di servizio (SLA) è fondamentale per mantenere la fiducia dei clienti, garantire la conformità ed evitare penali contrattuali. L’obiettivo è rispettare i tempi concordati di risposta e risoluzione per tutti gli incidenti gestiti in Freshservice, migliorando la qualità complessiva del servizio. ProcessMind mostra quali incidenti rischiano di non rispettare gli SLA e in quale punto del processo si verificano i ritardi. Fa emergere le cause profonde del mancato rispetto degli SLA, come assegnazioni iniziali tardive o fasi di diagnosi troppo lunghe, consentendo interventi mirati per garantire la conformità e migliorare l’affidabilità del servizio.

I passaggi di consegne non necessari o tardivi tra team o agenti possono allungare notevolmente i tempi di risoluzione e ridurre l’efficienza in Freshservice. Semplificarli significa ridurre il numero di trasferimenti e i tempi di inattività tra le fasi del processo, per gestire gli incidenti in modo più fluido e rapido. ProcessMind visualizza l’intero percorso di un incidente, evidenziando ogni passaggio di consegne e riassegnazione. Individua i trasferimenti inefficienti e i continui rimbalzi tra gruppi, mostrando dove ottimizzare le regole di instradamento, migliorare la precisione dell’assegnazione iniziale e ridurre il numero complessivo di passaggi necessari per risolvere un incidente.

Una categorizzazione precisa degli incidenti è alla base di una gestione efficiente: permette di assegnare i ticket ai team corretti e risolverli tempestivamente. In Freshservice, una categorizzazione errata causa instradamenti sbagliati, ritardi e spreco di risorse. L’obiettivo è rendere più precisa la classificazione iniziale degli incidenti. ProcessMind analizza i percorsi degli incidenti a partire dalle diverse categorie e individua dove e perché si verificano errori di classificazione. Mostra le conseguenze a valle, come tempi di risoluzione più lunghi, aiutando le organizzazioni a perfezionare gli schemi di categorizzazione, migliorare la formazione degli agenti o introdurre strumenti di classificazione automatica per instradare meglio gli incidenti.

In Freshservice, rendere più efficace l’analisi delle cause profonde (RCA) è essenziale per prevenire il ripetersi degli incidenti, ridurne il numero e migliorare la stabilità dei sistemi nel lungo periodo. L’obiettivo è verificare che le cause profonde individuate affrontino davvero i problemi sottostanti e portino a soluzioni durature. ProcessMind collega gli schemi ricorrenti degli incidenti ai processi di gestione dei problemi e valuta se gli incidenti con sintomi simili vengono risolti in modo definitivo dopo l’RCA. Aiuta a individuare le inefficienze nel flusso di lavoro dell’RCA, mostrando se i problemi vengono chiusi troppo presto o se l’analisi trascura sistematicamente questioni sottostanti importanti, così da migliorare le azioni preventive.

In Freshservice, procedure di escalation degli incidenti incoerenti o improvvisate possono generare confusione, coinvolgere interlocutori non necessari e allungare i tempi di risoluzione degli incidenti critici. Standardizzare l’escalation significa inoltrare gli incidenti in modo appropriato e prevedibile, seguendo percorsi e criteri definiti. ProcessMind mostra tutti i percorsi di escalation effettivamente seguiti dagli incidenti e li confronta con le procedure previste o documentate. Individua le deviazioni, i colli di bottiglia nella matrice di escalation e le condizioni che innescano spesso escalation non pianificate, aiutando a definire flussi di lavoro chiari, coerenti ed efficienti.

Le soluzioni alternative sono essenziali per ripristinare rapidamente il servizio, ma la loro efficacia nel limitare davvero l’impatto e prevenire il ripetersi degli incidenti può variare. In Freshservice, l’obiettivo è assicurarsi che le soluzioni adottate riducano effettivamente l’impatto degli incidenti, senza limitarsi a rimandare o complicare la risoluzione definitiva. ProcessMind analizza il ciclo degli incidenti per i quali sono state applicate soluzioni alternative e mette in relazione il loro utilizzo con i tempi di risoluzione successivi, le riaperture e i problemi collegati. Aiuta a distinguere le soluzioni davvero efficaci da quelle che aggiungono complessità o non funzionano, orientando il miglioramento delle strategie temporanee.

In Freshservice, differenze nei risultati degli agenti che gestiscono gli incidenti possono tradursi in tempi di risoluzione, qualità del servizio e soddisfazione degli utenti disomogenei in tutta l’organizzazione. L’obiettivo è individuare e condividere le buone pratiche per rendere più uniformi l’efficienza e l’efficacia degli agenti. ProcessMind confronta i percorsi del processo e le metriche dei diversi agenti o gruppi di supporto, mettendo in evidenza i flussi di lavoro più efficienti e gli scostamenti. Consente alle organizzazioni di riconoscere gli schemi più efficaci, offrire formazione mirata e adottare flussi di lavoro coerenti per migliorare i risultati complessivi degli agenti.

I ritardi nella conferma o nella verifica della risoluzione da parte dell’utente possono prolungare inutilmente il ciclo dei ticket, con ripercussioni sulle metriche e sull’allocazione delle risorse in Freshservice. L’obiettivo è accelerare le fasi finali della chiusura degli incidenti semplificando le interazioni con gli utenti. ProcessMind individua le fasi o gli eventi che causano attese prolungate per ricevere una risposta, ad esempio dopo l’applicazione della soluzione. Mostra dove ottimizzare le notifiche, automatizzare i solleciti o perfezionare le comunicazioni per favorire una verifica tempestiva da parte dell’utente e accelerare la chiusura dell’incidente.

In Freshservice, canali di segnalazione degli incidenti inefficienti o poco utilizzati possono creare colli di bottiglia, frustrare gli utenti e ritardare la gestione iniziale degli incidenti. Ottimizzarli significa consentire agli utenti di segnalare facilmente gli incidenti e instradare le segnalazioni in modo efficiente, per risolverli più rapidamente. ProcessMind analizza il percorso degli incidenti provenienti da canali diversi, come e-mail, portale o telefono. Individua i canali che portano a una risoluzione più rapida e i punti in cui si introducono inefficienze, come ulteriori passaggi di categorizzazione o attività manuali, orientando gli interventi per rendere più semplice la segnalazione.

In Freshservice, costi operativi elevati per la gestione degli incidenti possono mettere sotto pressione i budget IT, spesso a causa di processi inefficienti, rilavorazioni eccessive e tempi di risoluzione prolungati. Ridurre questi costi significa individuare ed eliminare le inefficienze che assorbono risorse preziose. ProcessMind quantifica l’impatto economico delle diverse deviazioni dal processo, come riassegnazioni frequenti, escalation non necessarie o tempi di risoluzione troppo lunghi. Mostrando le conseguenze economiche delle inefficienze, aiuta le organizzazioni a individuare ed eliminare le attività che generano costi, ottimizzando l’allocazione delle risorse e l’impiego del budget.

Il percorso di miglioramento in 6 fasi per la gestione degli incidenti

1

Scarichi il template

Cosa fare

Acceda al template Excel preconfigurato per la gestione degli incidenti. Il template Le consente di raccogliere tutti i dati necessari per mappare con precisione i flussi degli incidenti in Freshservice.

Perché è importante

Disporre fin dall’inizio della struttura dati corretta è fondamentale per ottenere un’analisi precisa e prevenire rilavorazioni, così da poter contare su risultati affidabili.

Risultato atteso

Un template dati pronto all’uso, strutturato appositamente per il processo di gestione degli incidenti.

COSA OTTERRÀ

Scopra informazioni decisive sulla gestione degli incidenti

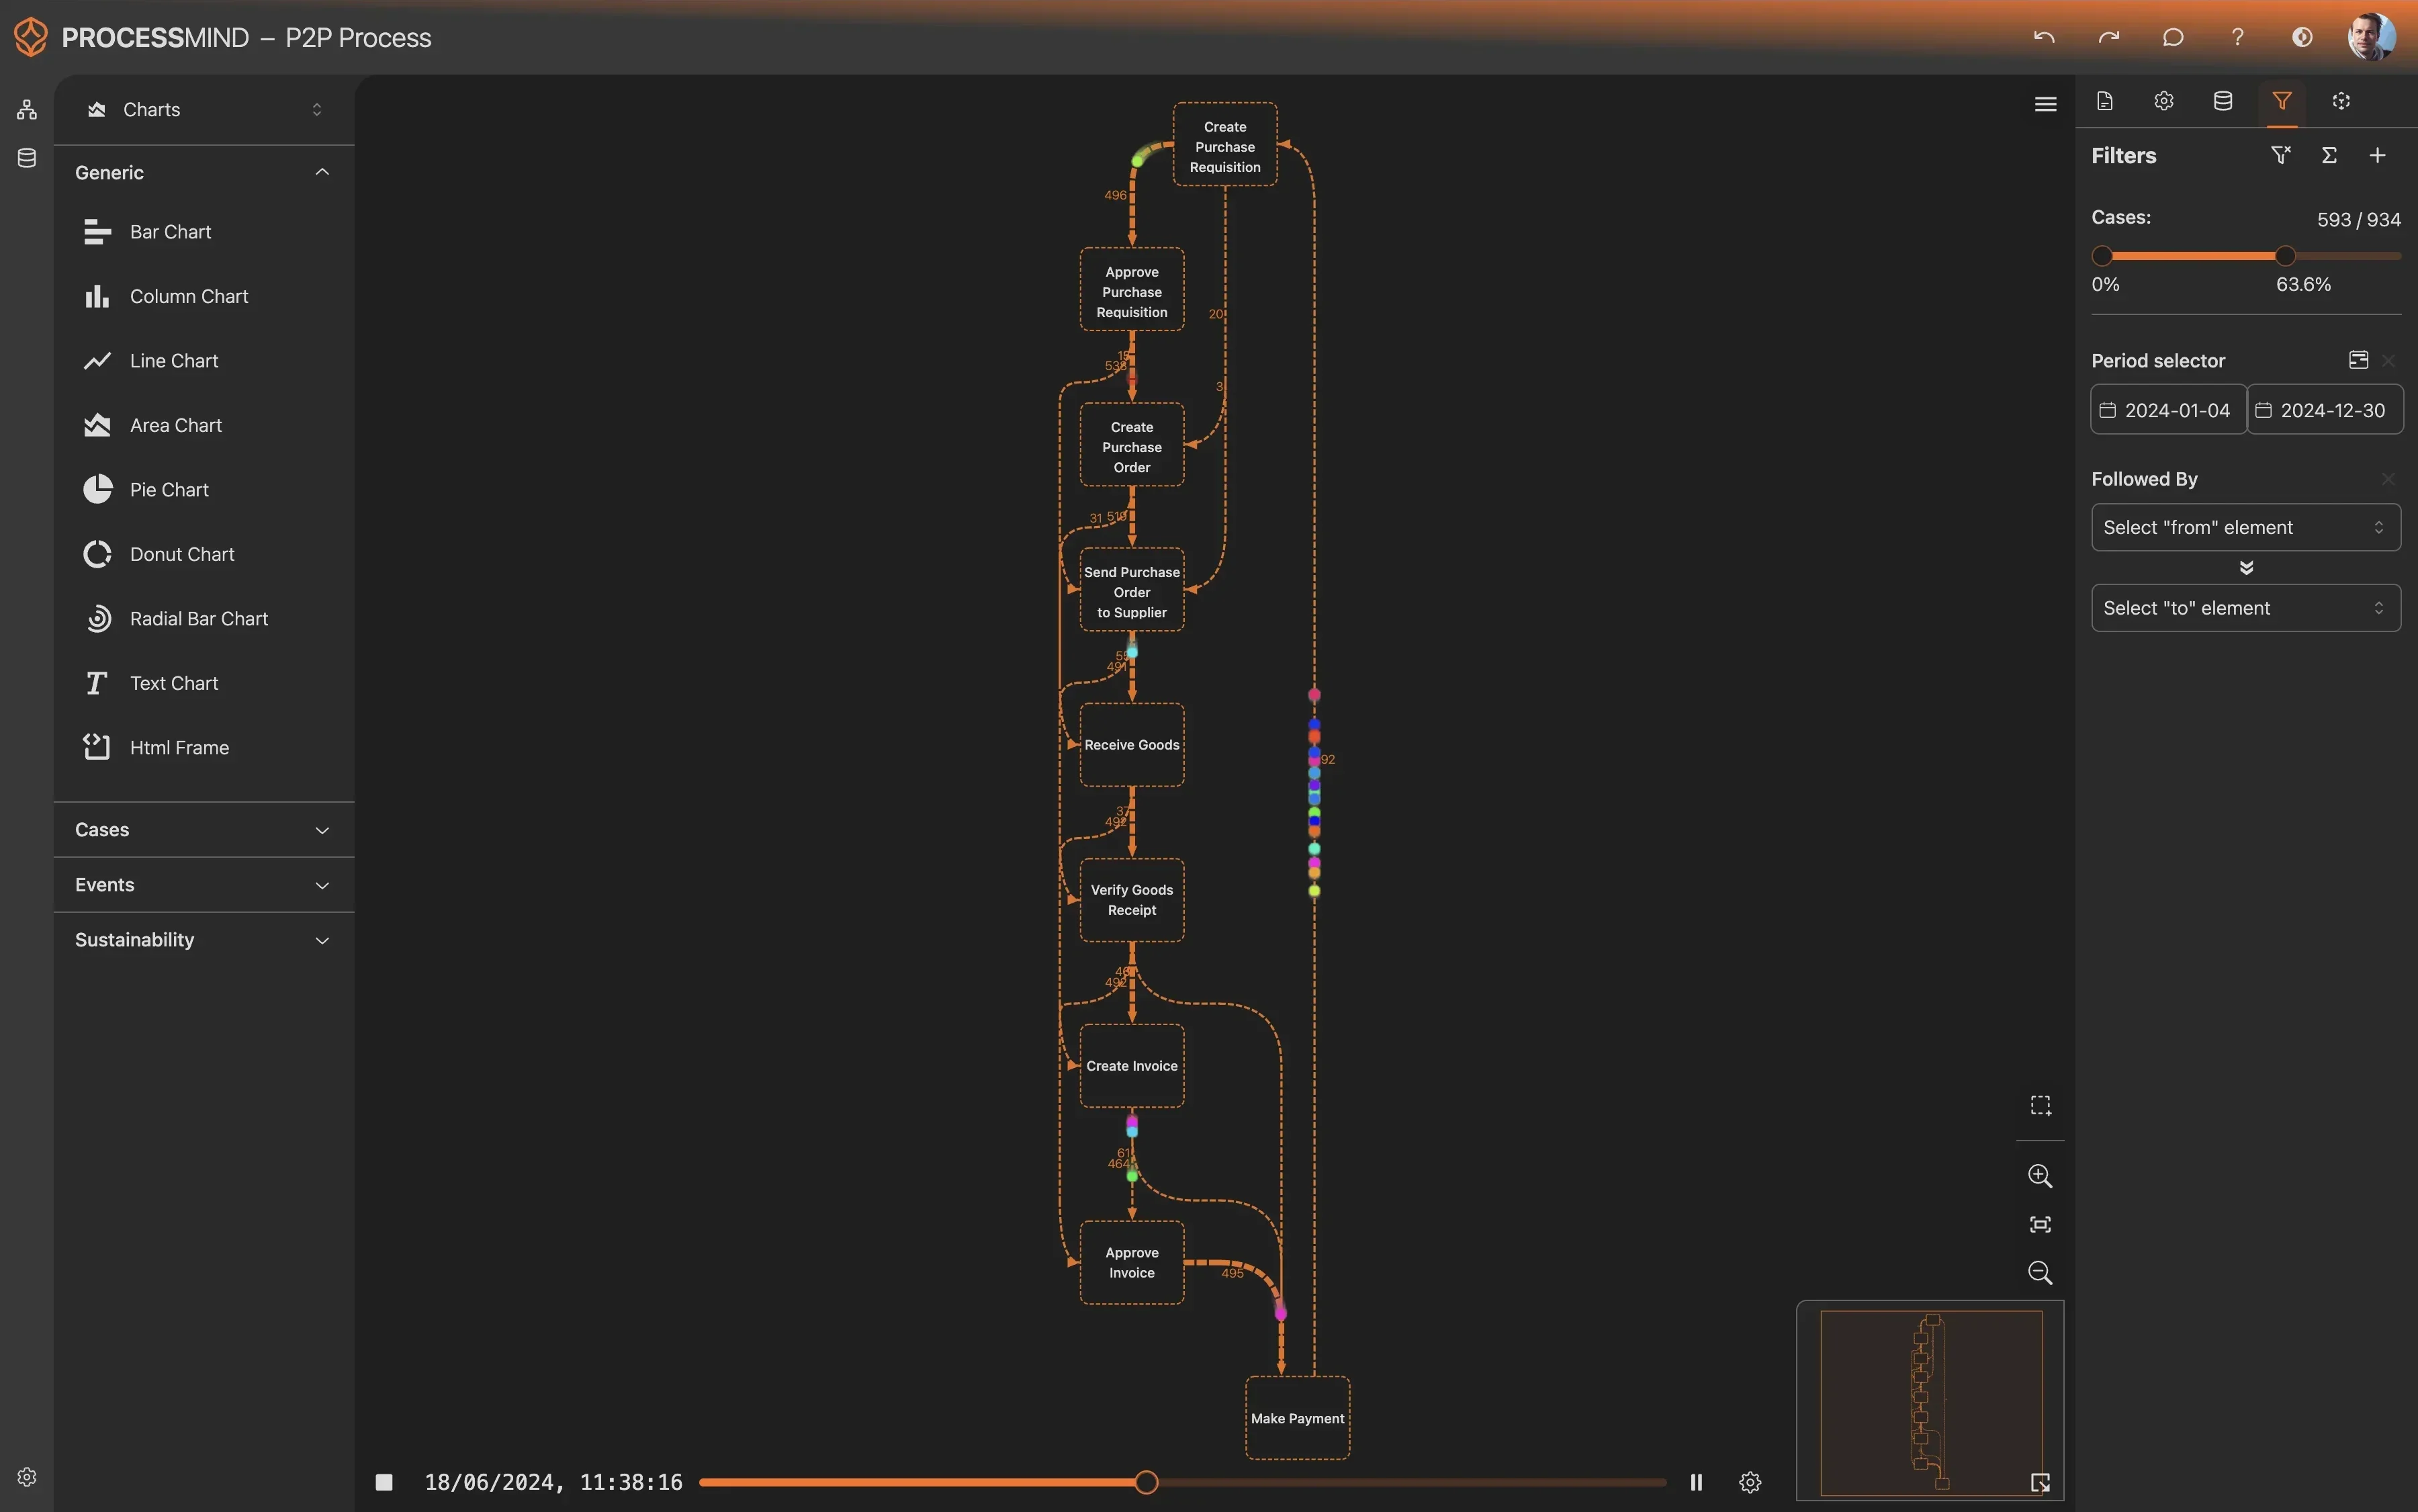
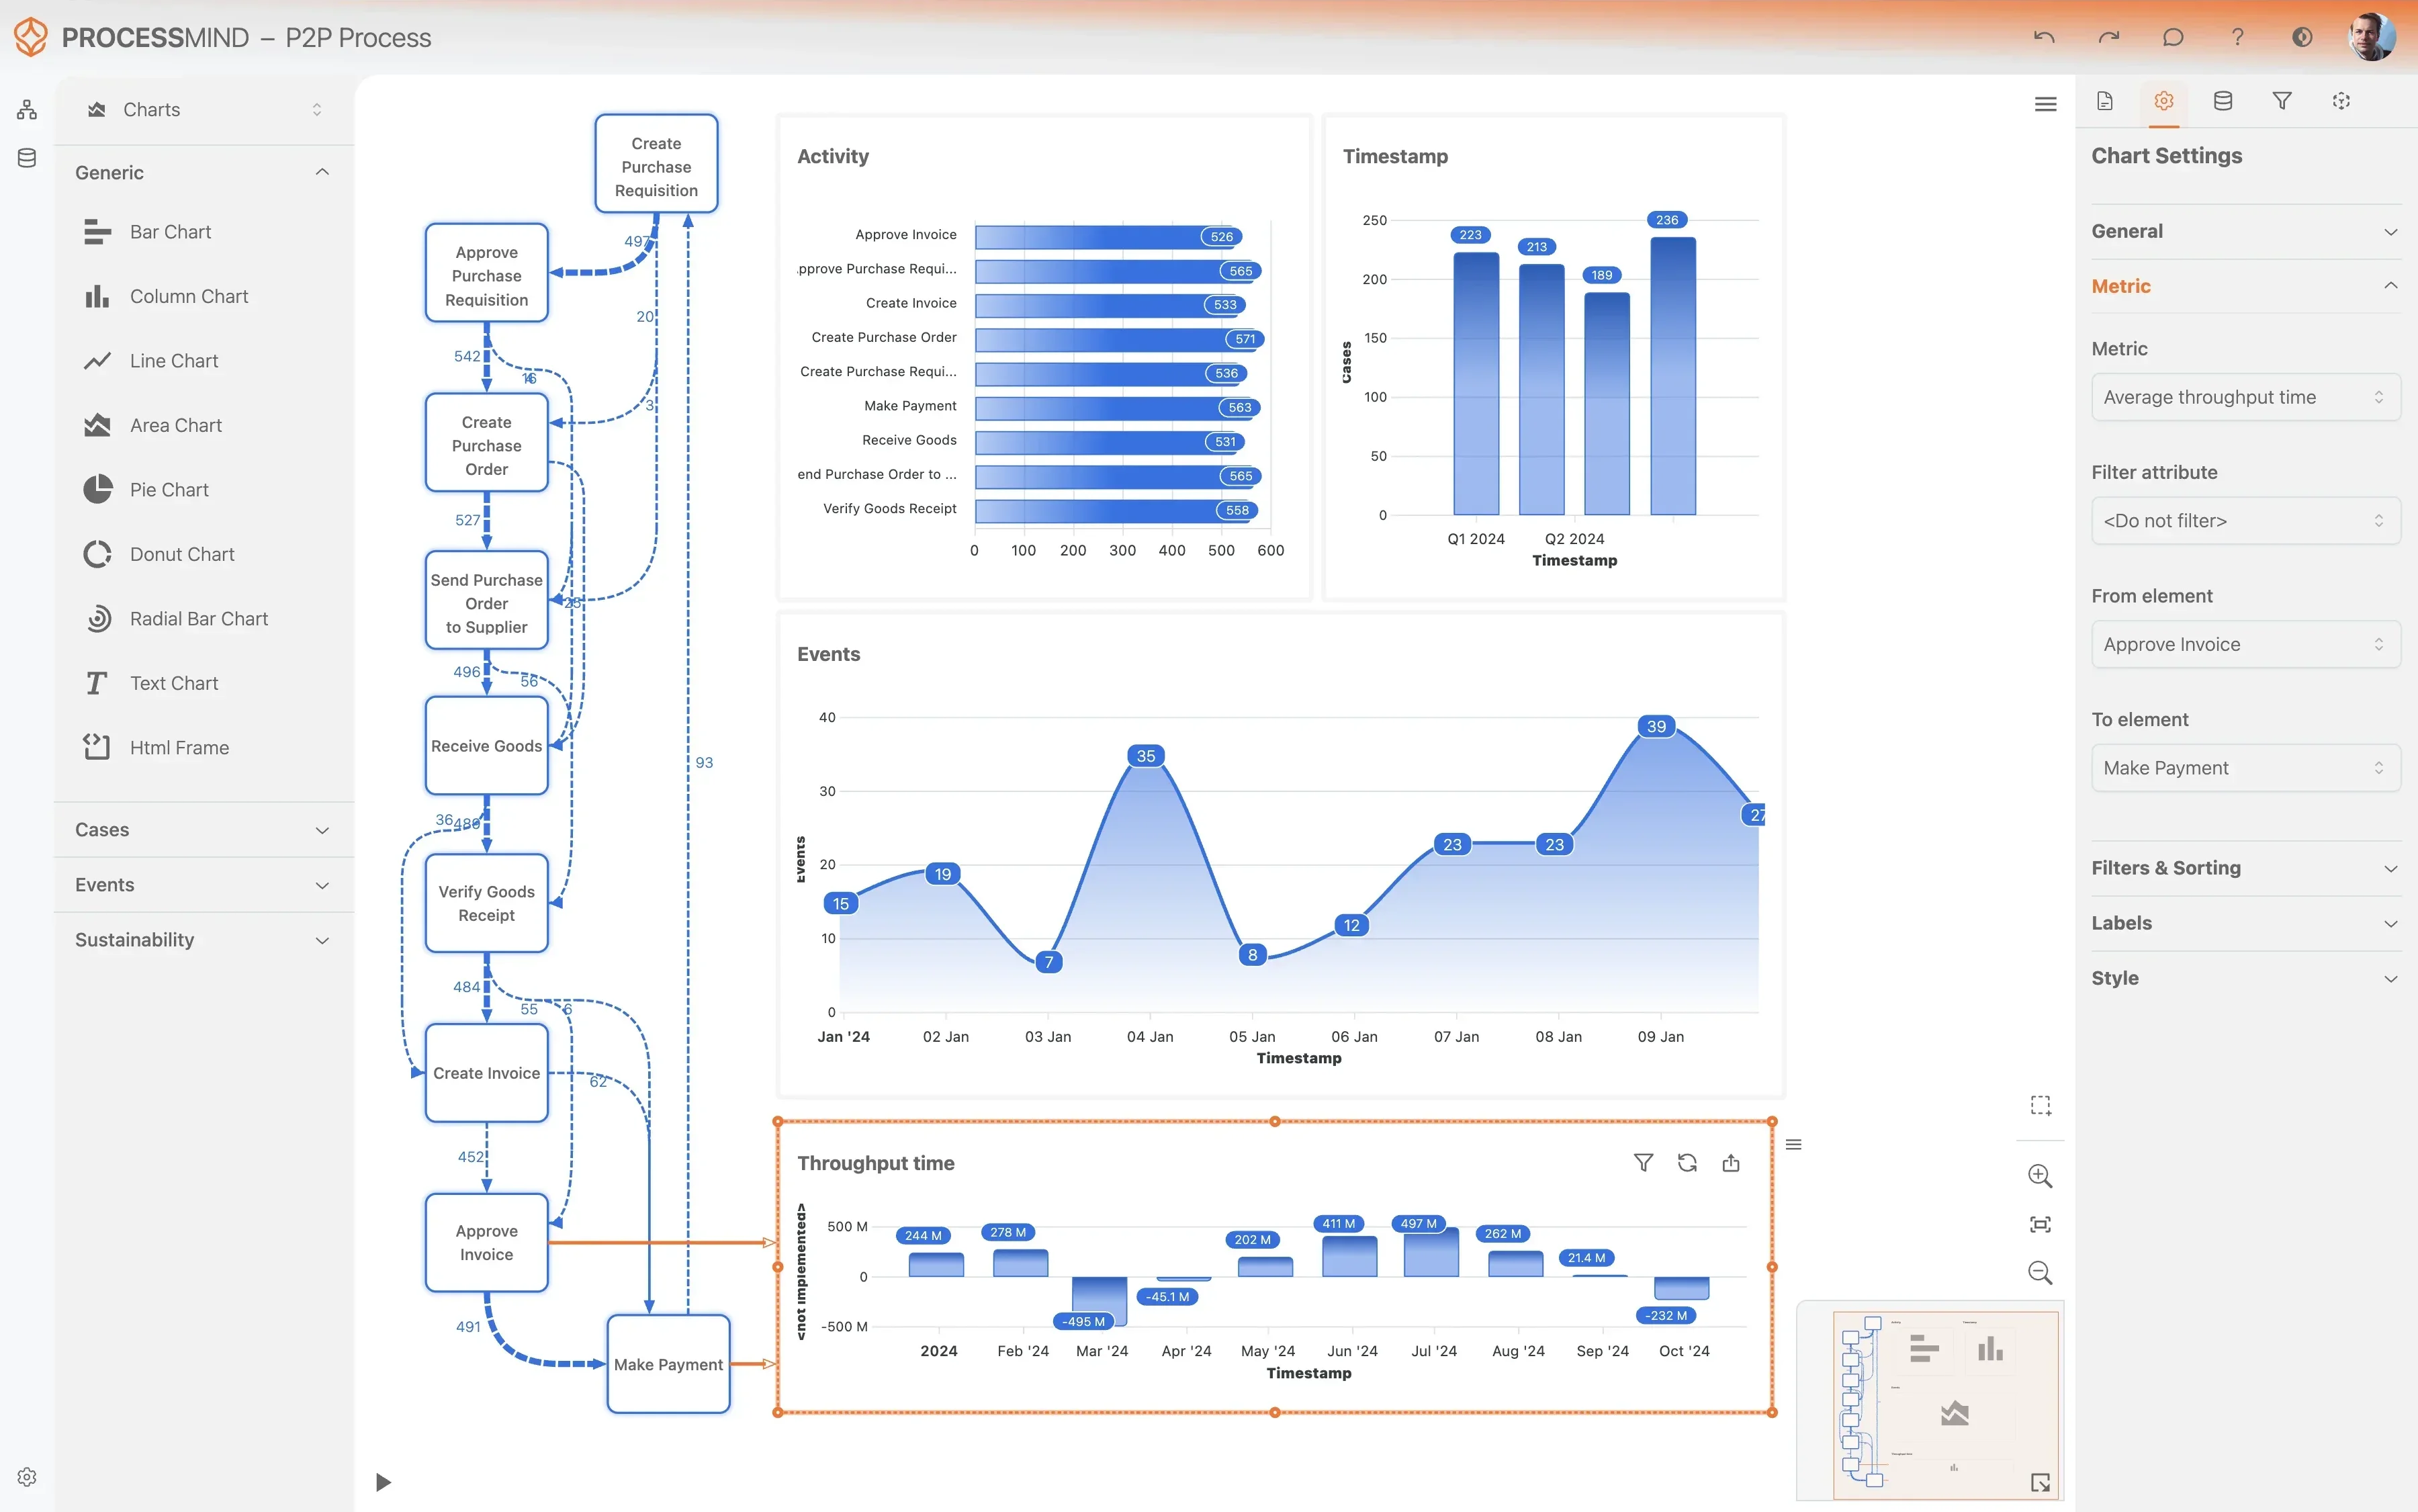
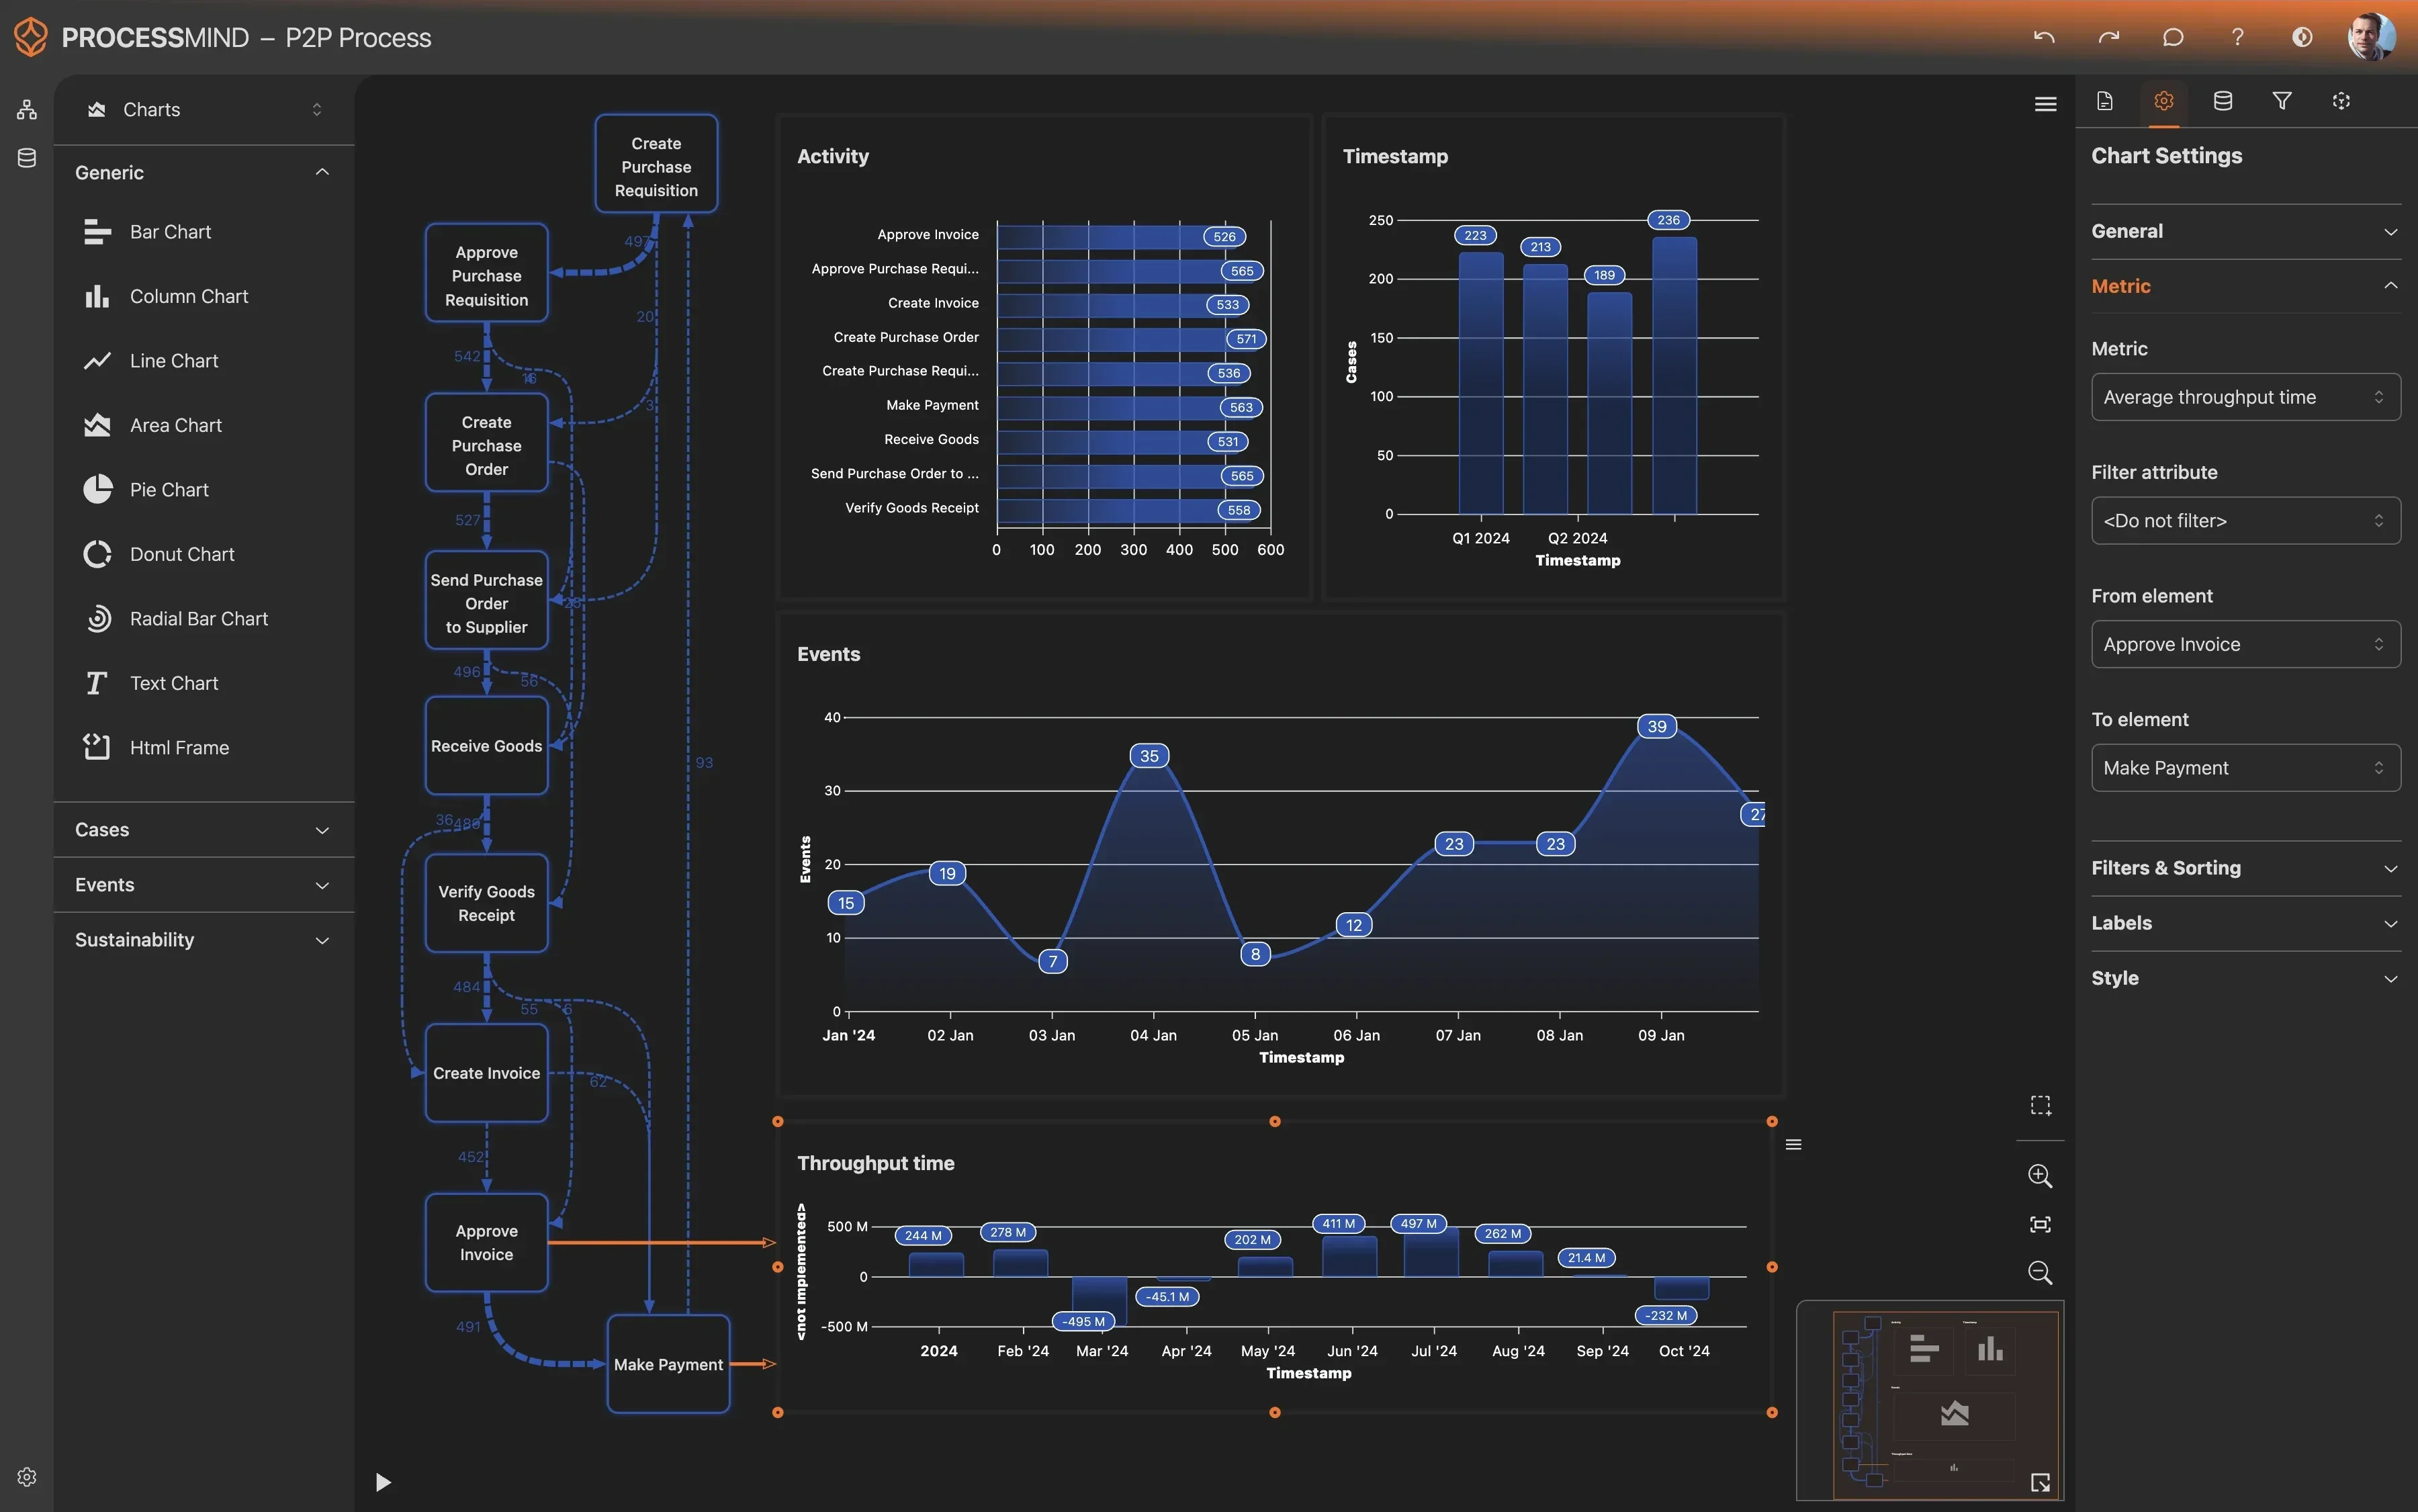
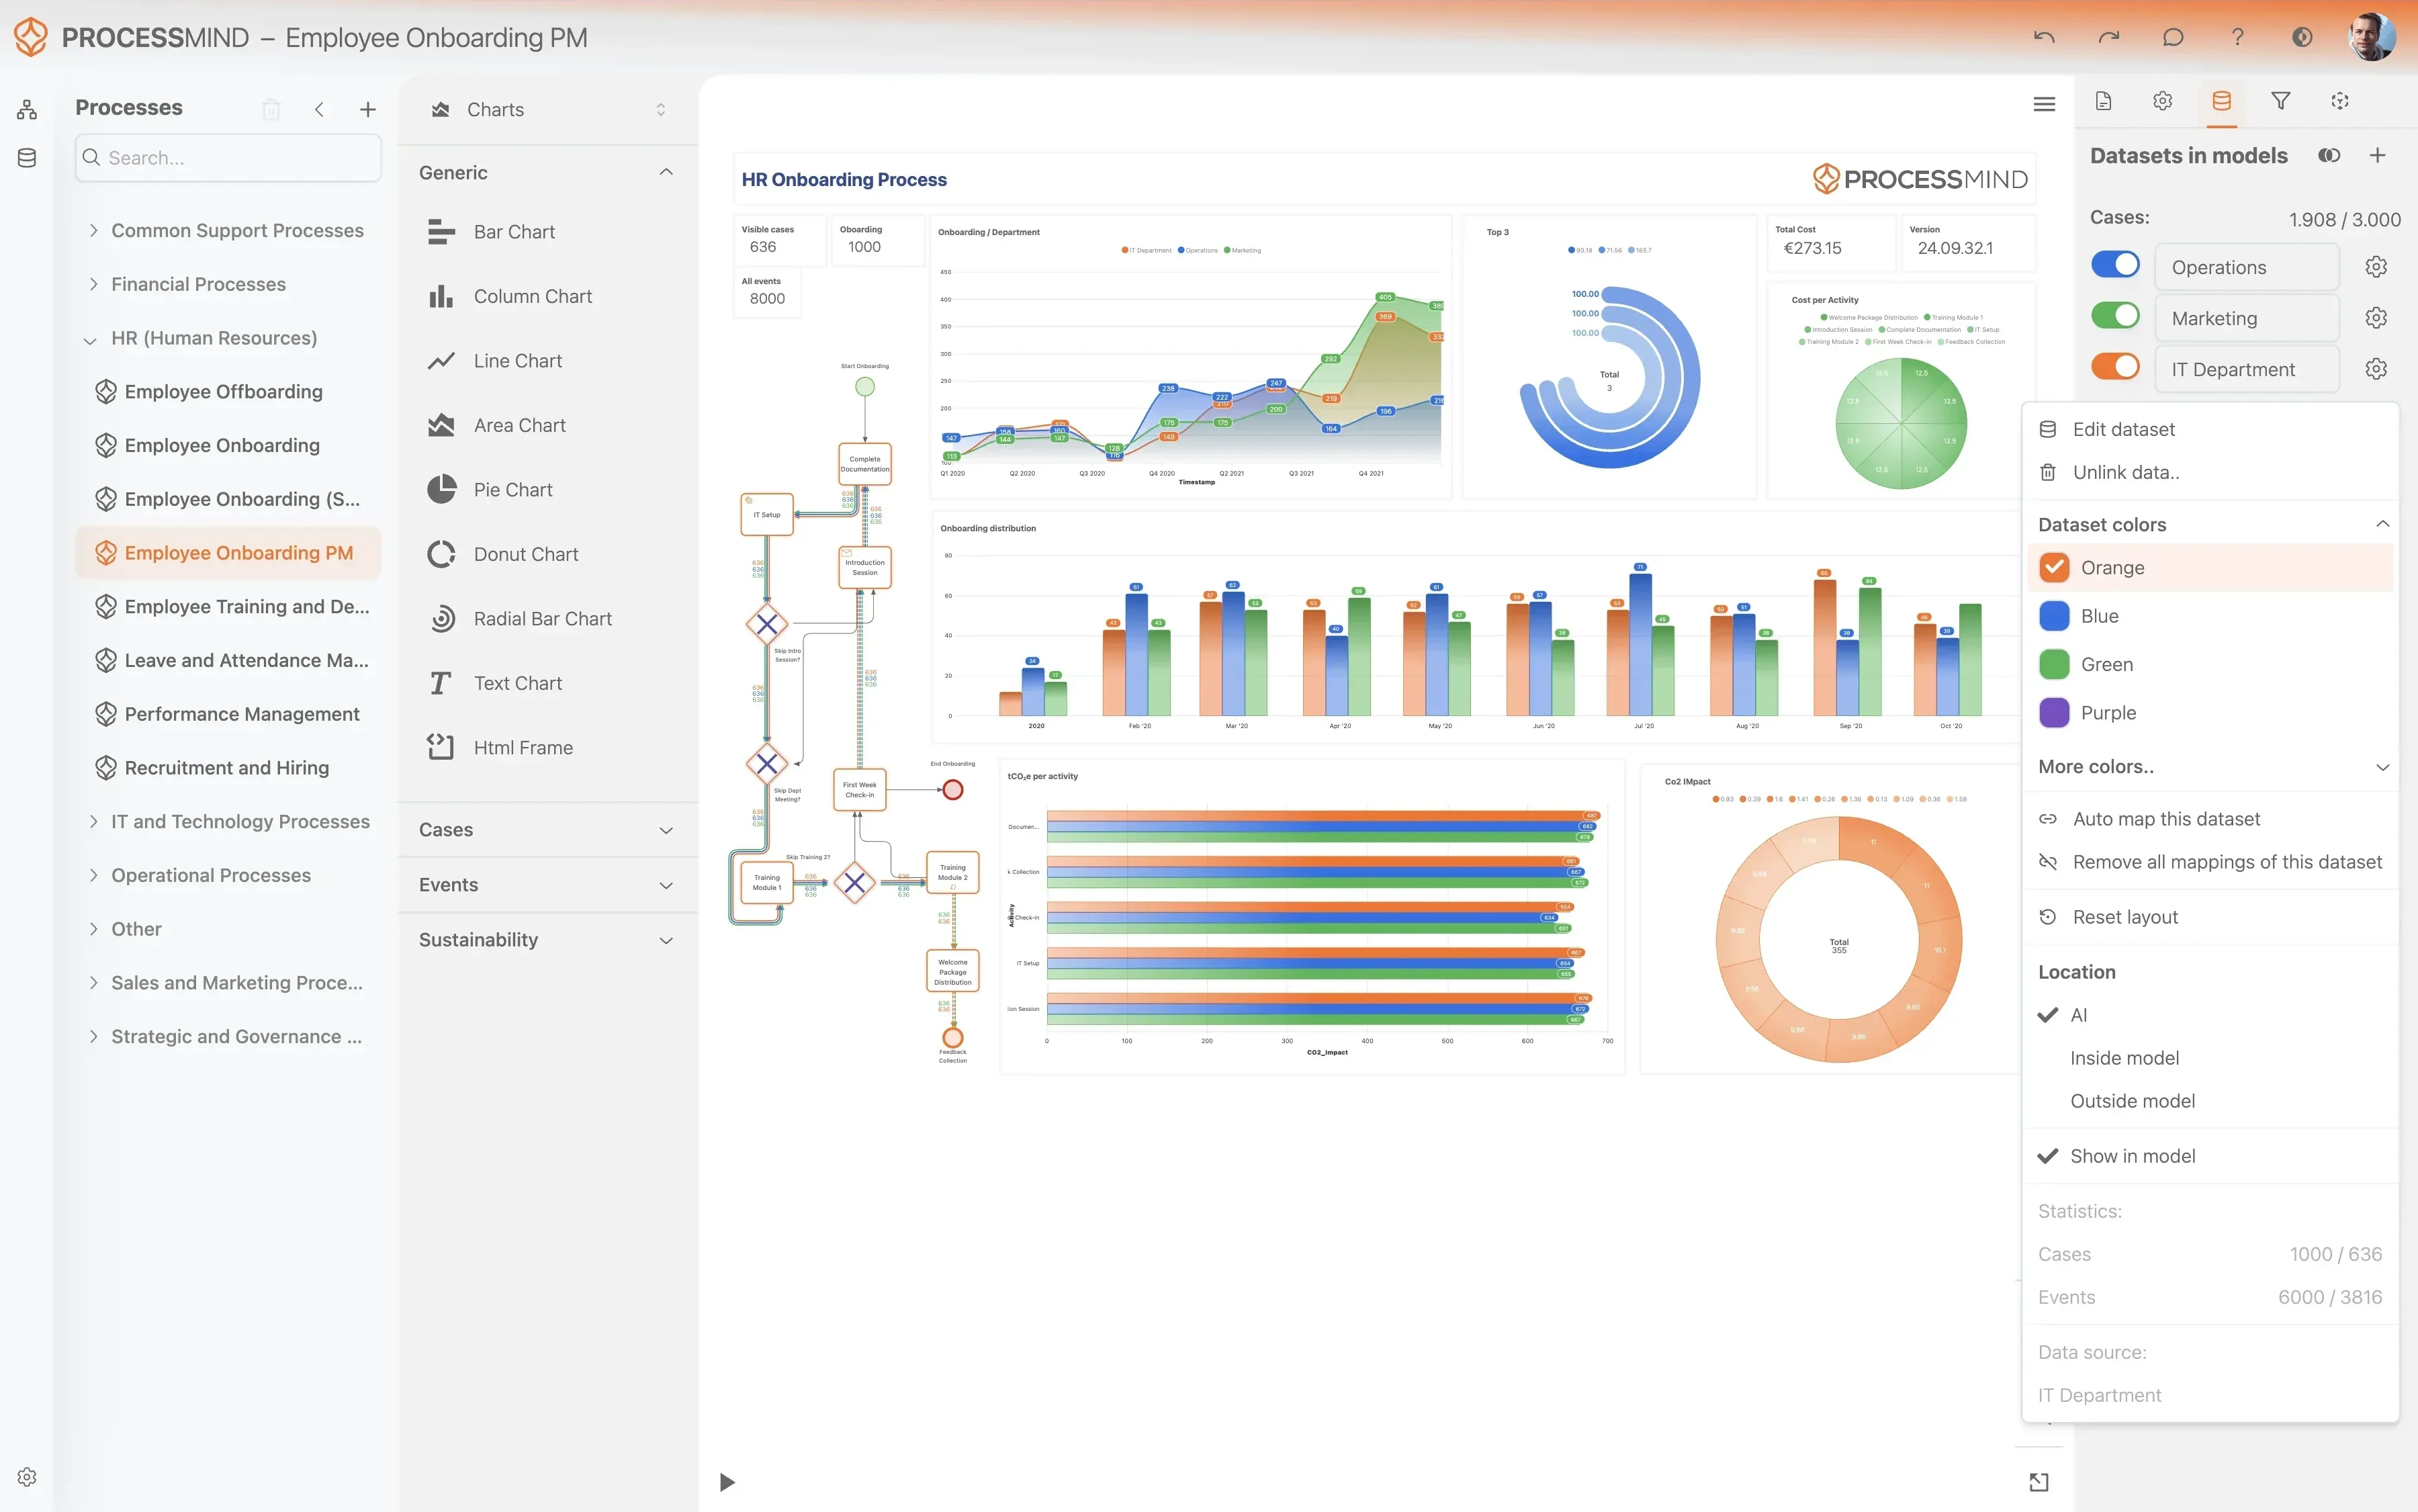
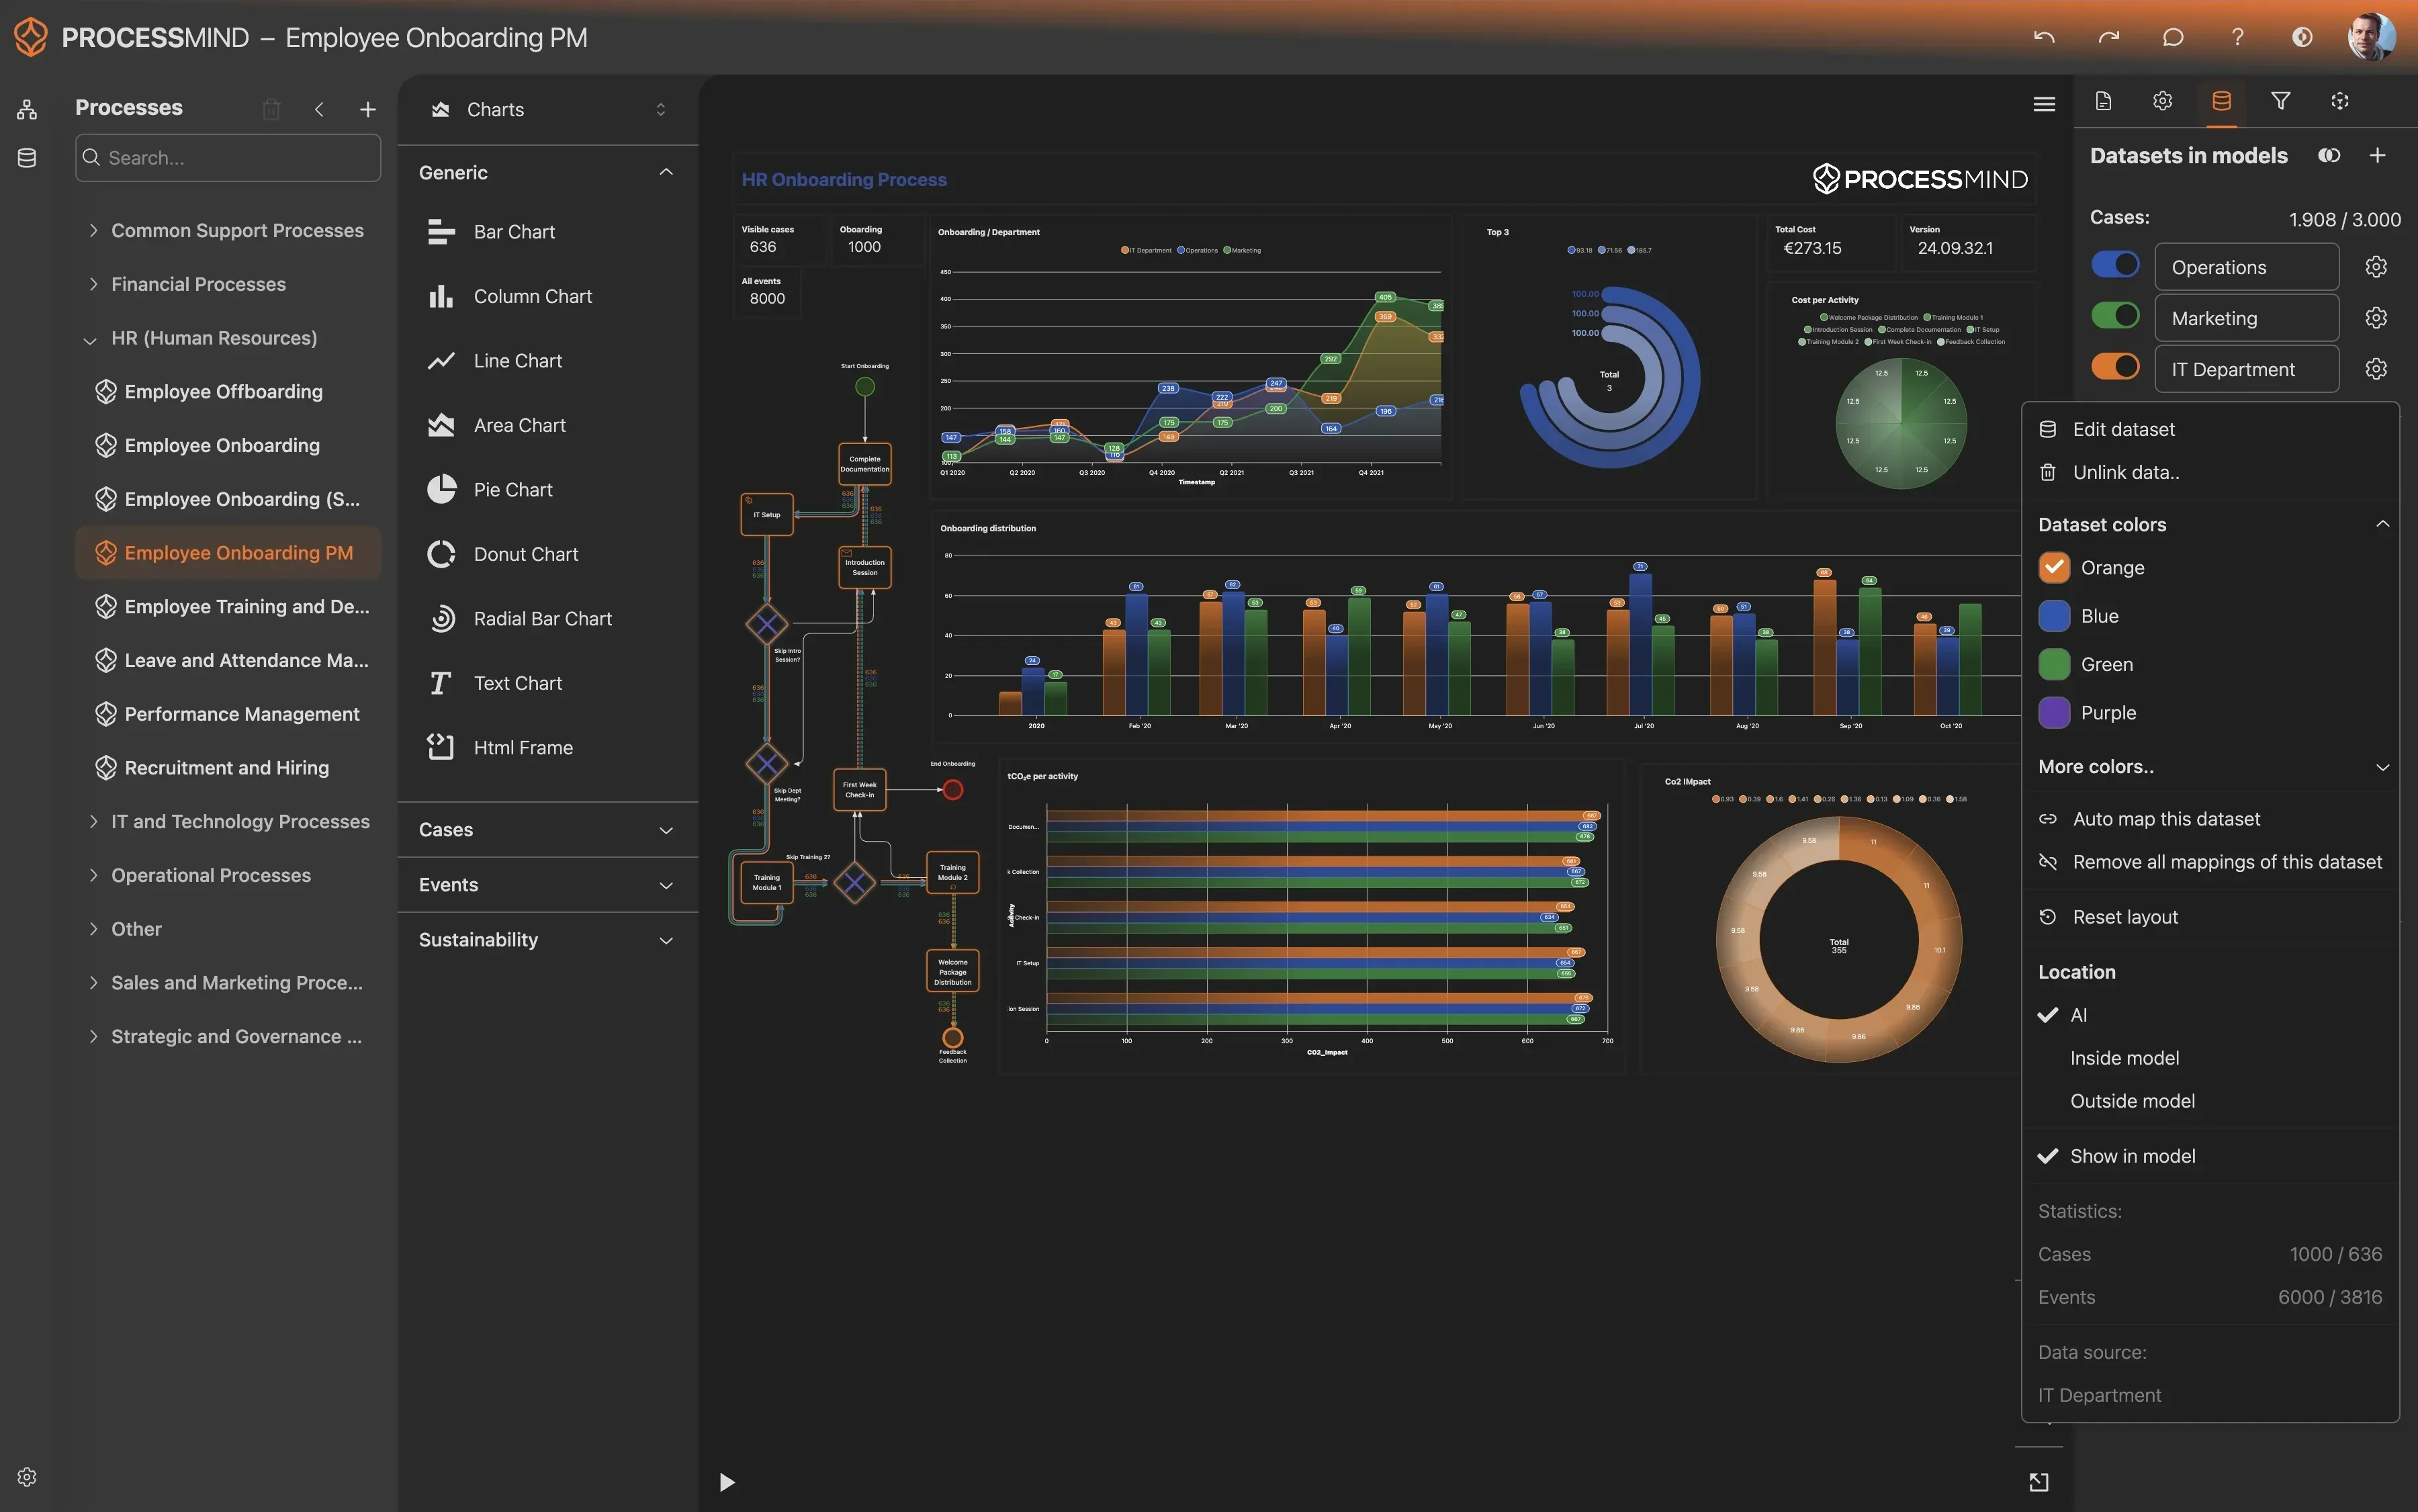
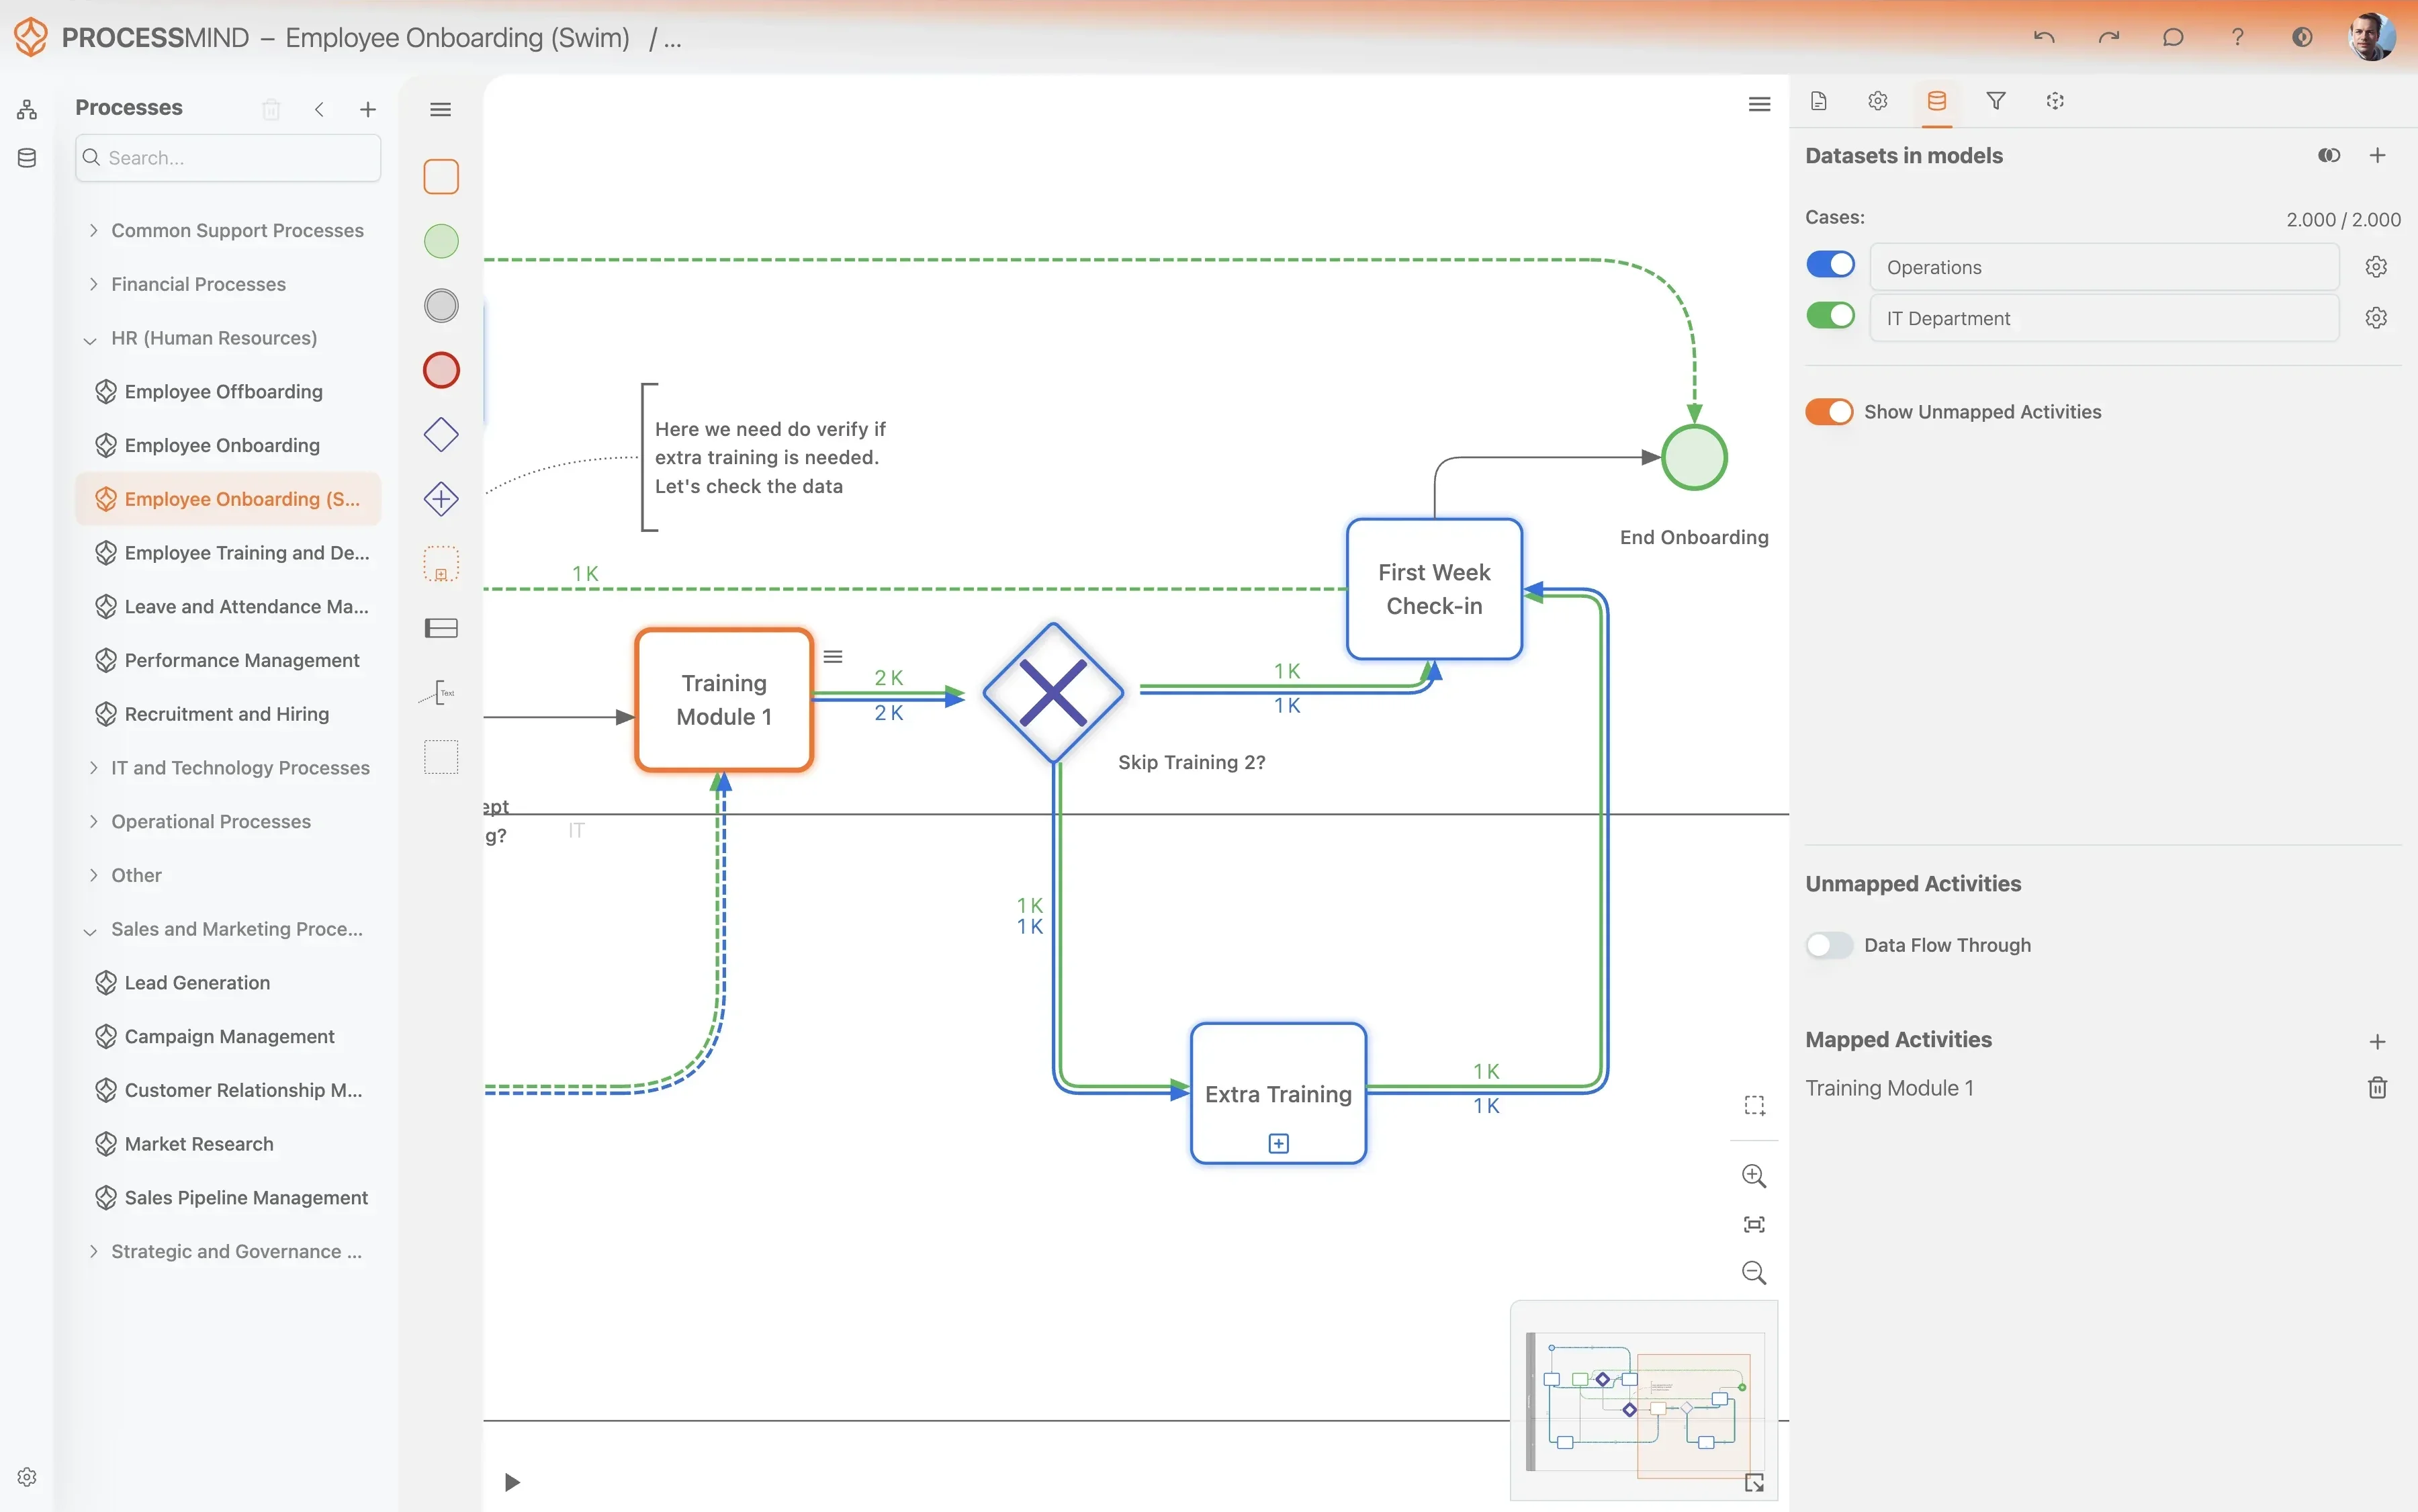
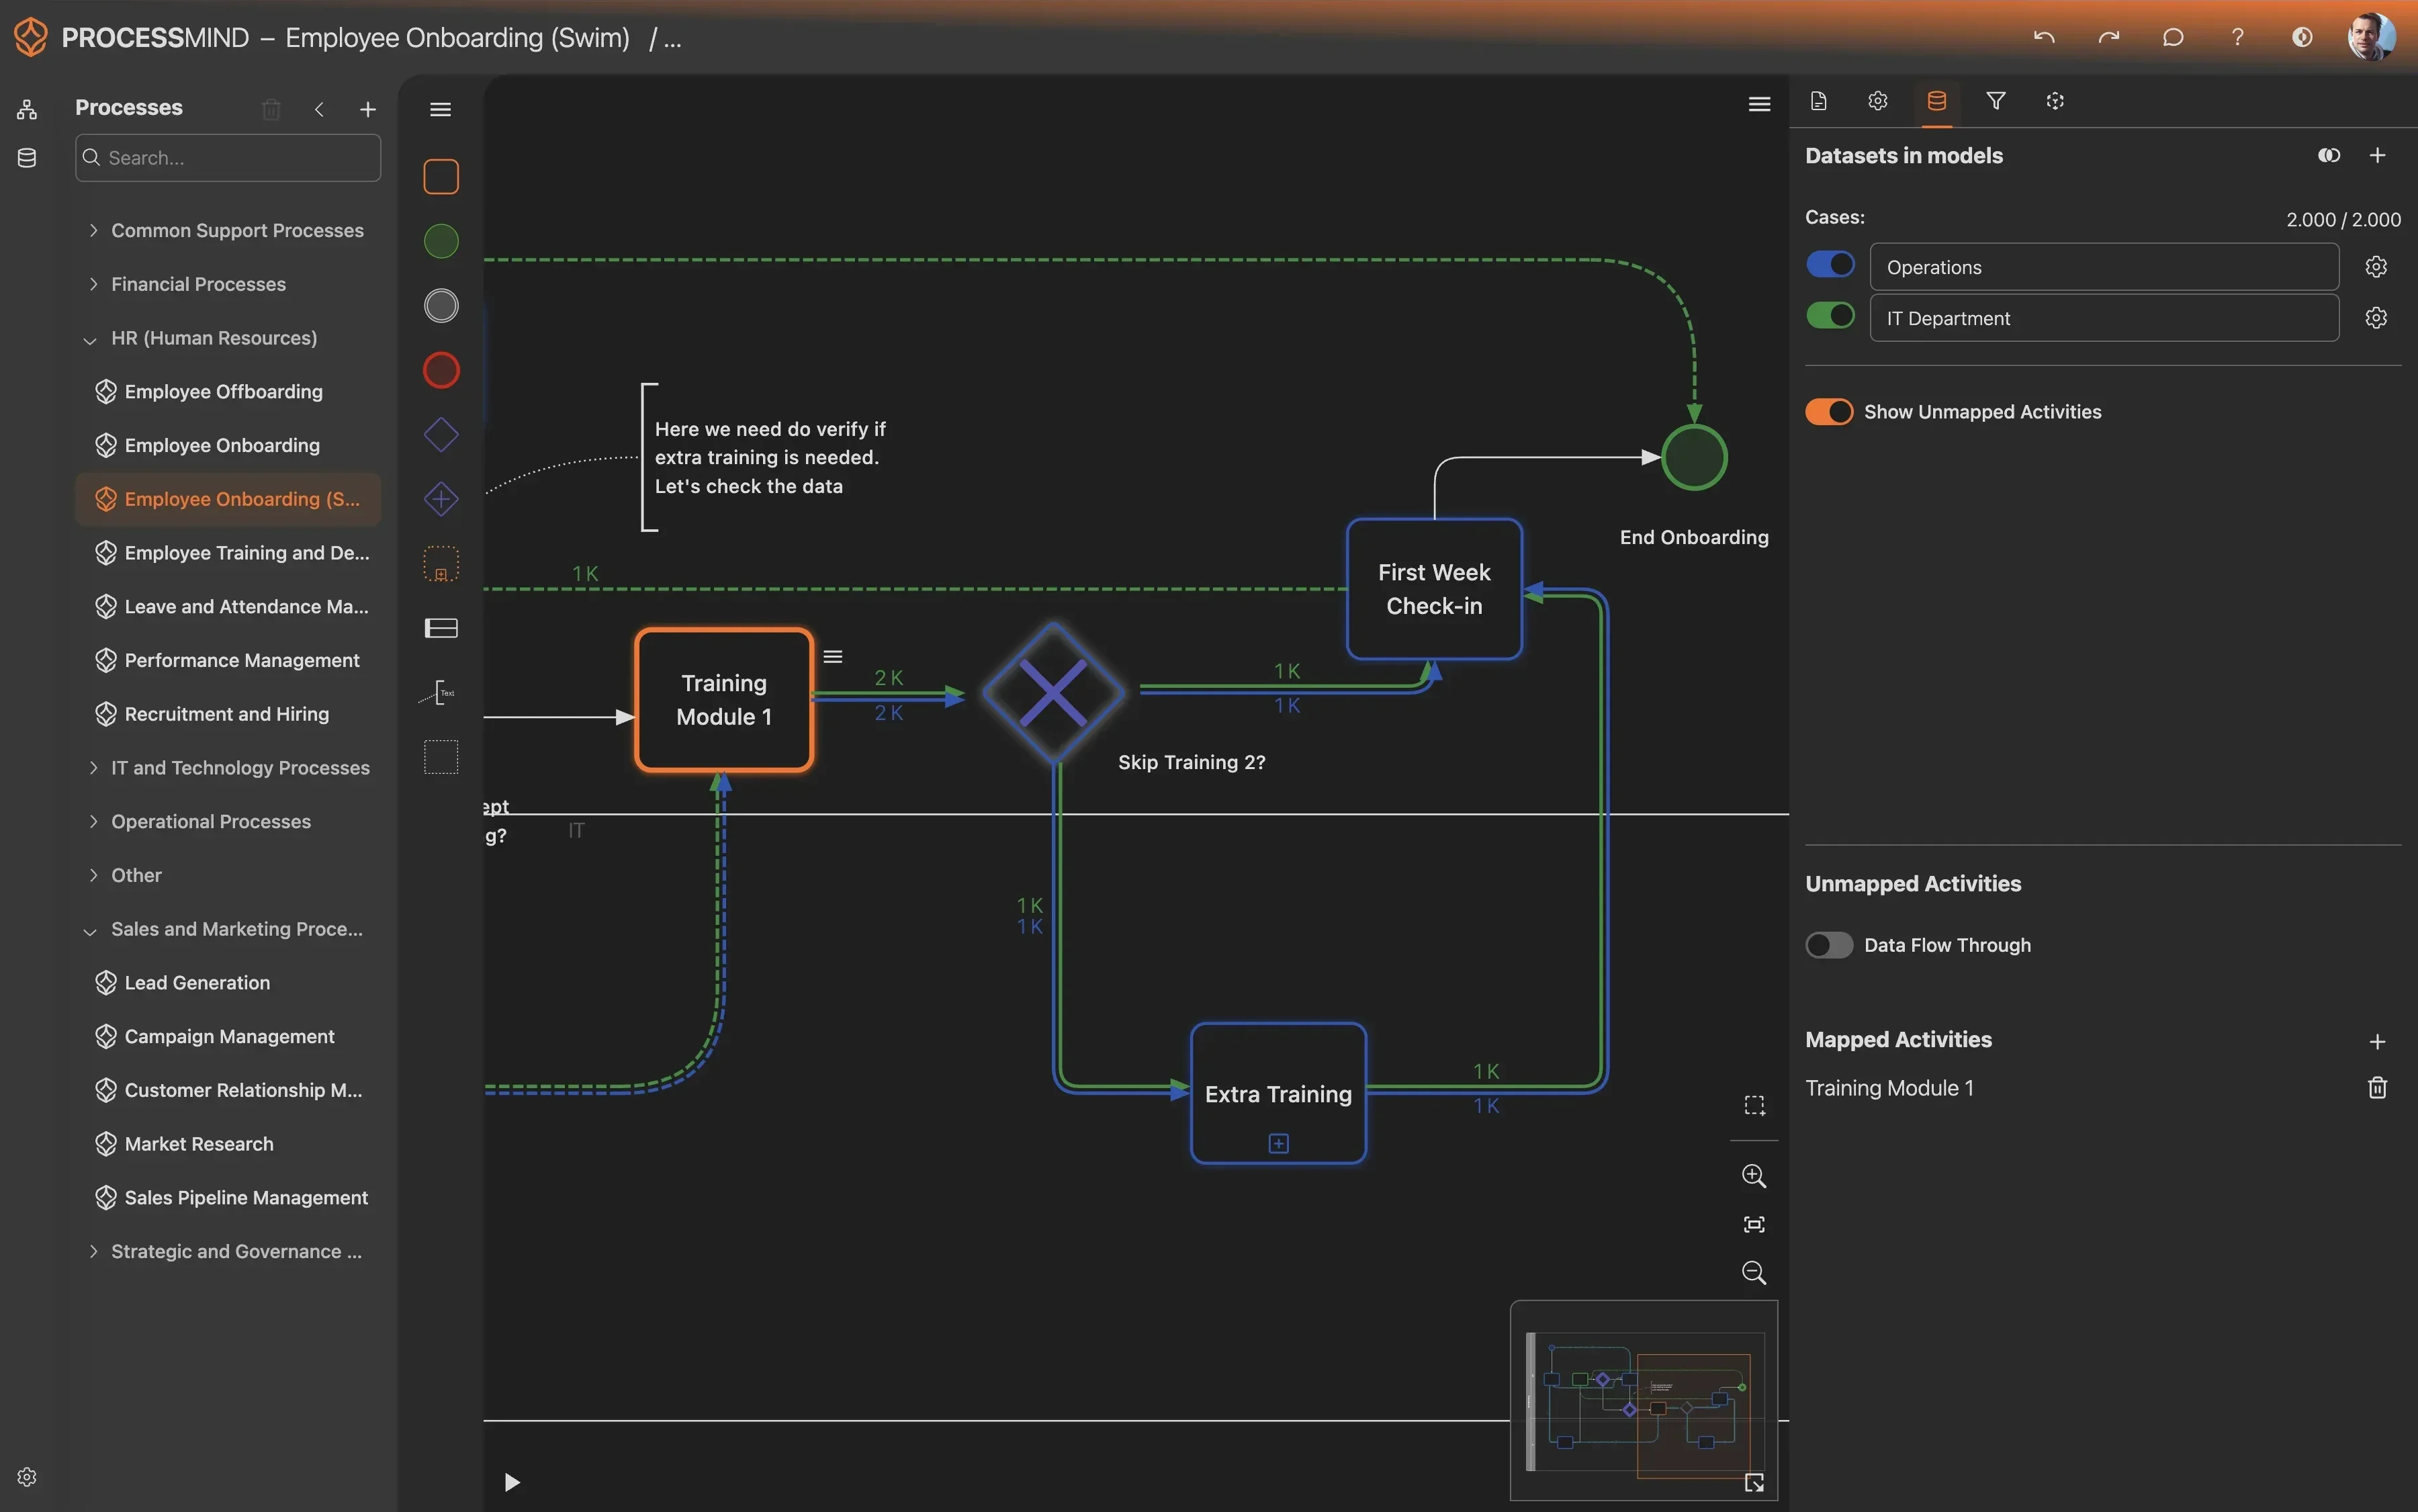
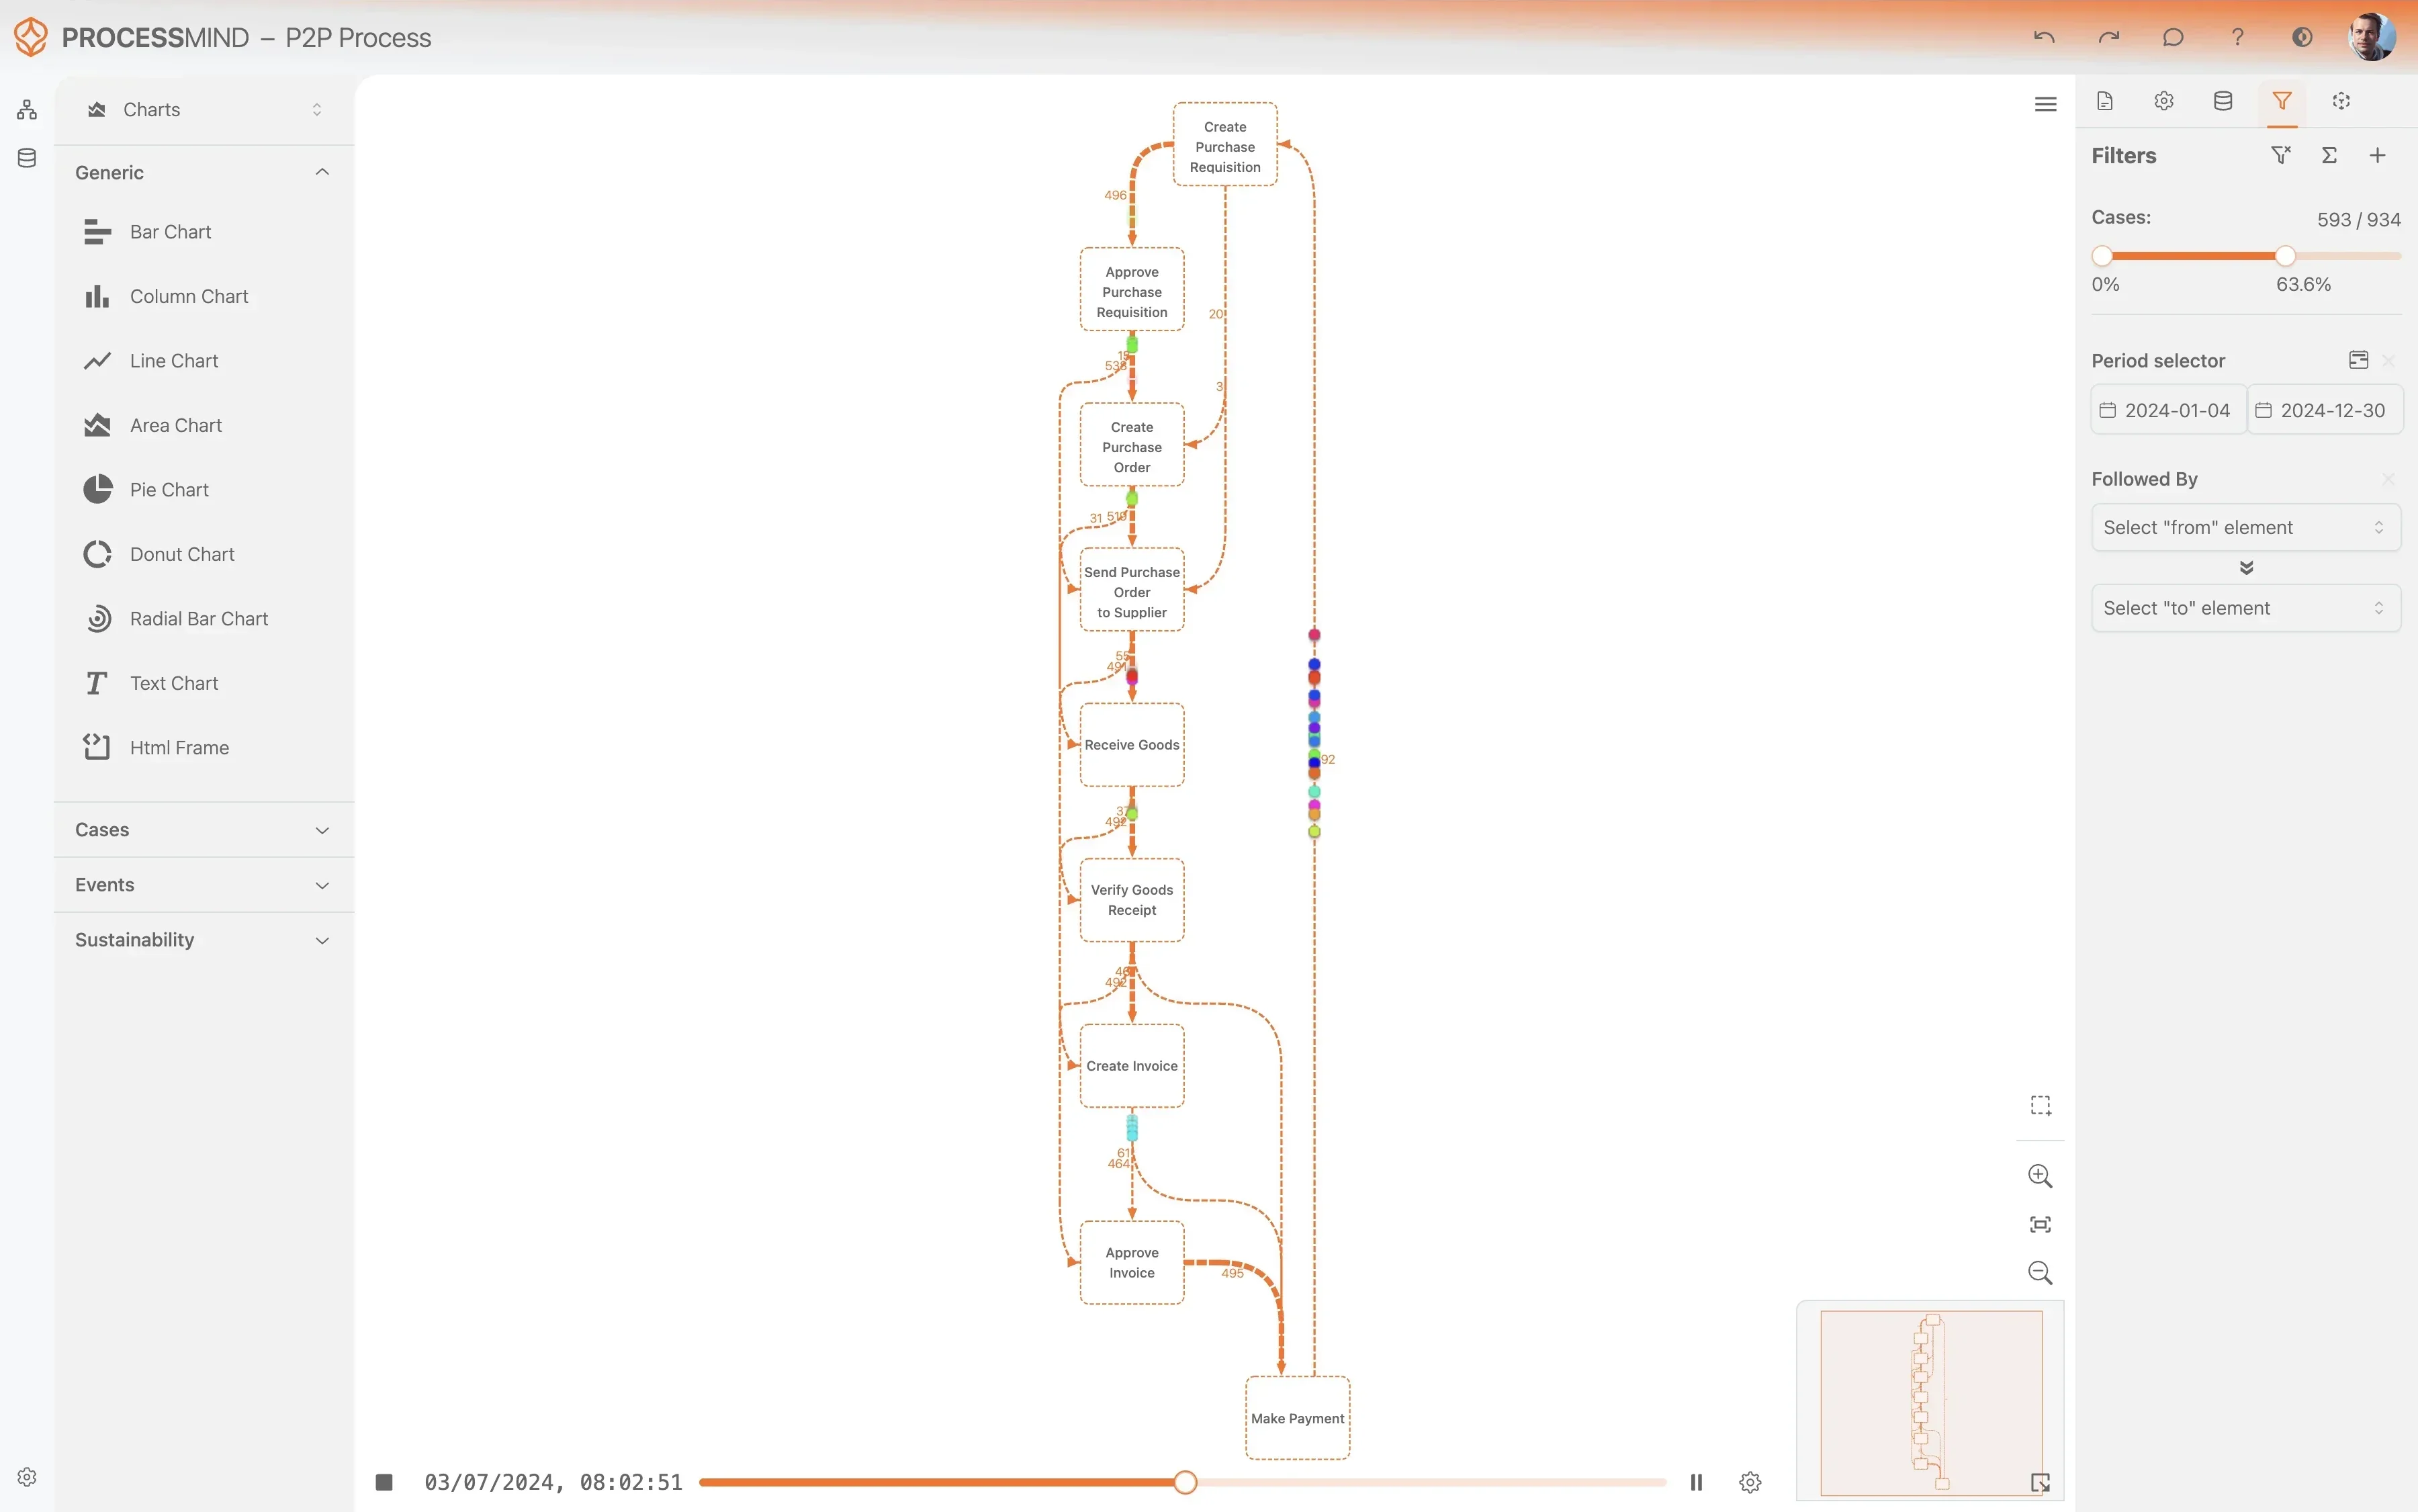
ProcessMind mostra l’intero percorso degli incidenti in Freshservice attraverso visualizzazioni interattive. Individui con precisione i ritardi, riconosca i passaggi di consegne problematici e scopra come ripristinare il servizio più rapidamente.
  • Visualizzi i flussi di lavoro degli incidenti dall’inizio alla fine
  • Individui i colli di bottiglia in Freshservice
  • Individui le cause profonde delle violazioni degli SLA
  • Scopra come risolvere gli incidenti più rapidamente
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

RISULTATI TIPICI

Migliorare la gestione degli incidenti con il Process Mining

Applicato ai dati di gestione degli incidenti di Freshservice, il Process Mining fa emergere colli di bottiglia e inefficienze, offrendo nuovi strumenti per risolvere i problemi. Questi risultati illustrano i miglioramenti concreti che le organizzazioni ottengono comunemente.

0 %
Risoluzione più rapida degli incidenti critici

Tempo medio per gli incidenti ad alta priorità

Riduca il tempo medio necessario per risolvere gli incidenti critici, limitando le interruzioni delle attività e dei servizi aziendali. In questo modo migliora la soddisfazione dei clienti e aumenta il tempo di disponibilità dei sistemi.

0 %
Migliorare il rispetto degli SLA

Miglioramento nel raggiungimento degli obiettivi di servizio

Aumenti il rispetto degli accordi sui livelli di servizio individuando ed eliminando i colli di bottiglia che causano il mancato rispetto delle scadenze. Così rafforza la fiducia dei clienti ed evita le penali.

0 %
Ridurre i passaggi di consegne degli incidenti

Meno trasferimenti tra team o agenti

Riduca il numero di trasferimenti degli incidenti tra i gruppi di supporto per accelerare la risoluzione e contenere i costi operativi. In questo modo migliora l’efficienza e l’uniformità del lavoro degli agenti.

0 %
Migliorare la categorizzazione

Riduzione degli errori di categorizzazione iniziale

Migliori la precisione della categorizzazione iniziale degli incidenti, così da instradarli correttamente fin dall’inizio e ridurre i ritardi nella risoluzione. Ne derivano indicazioni più utili e una migliore allocazione delle risorse.

0 %
Ridurre il tasso di riapertura

Meno incidenti riaperti dopo la risoluzione

Riduca la percentuale di incidenti riaperti dopo la chiusura iniziale, segno di risoluzioni più solide e corrette al primo tentativo. In questo modo migliora la soddisfazione degli utenti e riduce le rilavorazioni degli agenti.

0 %
Ridurre i costi di gestione

Riduzione complessiva della spesa operativa

Ottimizzi l’impiego delle risorse e riduca le attività manuali non necessarie durante tutto il ciclo di gestione degli incidenti. Questo si traduce direttamente in risparmi significativi per la Sua organizzazione.

I risultati variano in base alla complessità dei processi, alla qualità dei dati e all’efficienza operativa già raggiunta da ciascuna organizzazione. Le cifre presentate riflettono miglioramenti comuni osservati in diverse implementazioni.

Dati consigliati

Inizi dagli attributi e dalle attività essenziali, poi ne aggiunga altri man mano che procede.
Non conosce ancora gli Event Log? Scopra come creare un Event Log per il Process Mining.

Attributi

Dati chiave da acquisire per l’analisi

Identificativo univoco di ciascun record di incidente, utilizzato come chiave primaria per tracciare l’intero ciclo di vita dell’incidente.

Perché è importante

Identifica in modo univoco ogni incidente e ne consente il monitoraggio e l’analisi dall’inizio alla fine, dalla creazione alla chiusura.

Il nome o l’ID dell’agente di supporto attualmente incaricato di risolvere l’incidente.

Perché è importante

Consente di analizzare le prestazioni degli agenti, la distribuzione del carico di lavoro e l’impatto dei passaggi di consegne sui tempi di risoluzione.

Il gruppo o il team di supporto attualmente incaricato dell’incidente.

Perché è importante

Indica quale team è responsabile, un’informazione essenziale per analizzare i passaggi di consegne, le escalation e i ritardi tra team.

Il livello di priorità dell’incidente, che determina l’urgenza della risposta e della risoluzione.

Perché è importante

Aiuta a concentrare l’analisi sugli incidenti più critici ed è essenziale per valutare le prestazioni SLA e l’allocazione delle risorse.

Il livello di gravità dell’incidente, che ne indica l’impatto sull’attività aziendale.

Perché è importante

Misura l’impatto di un incidente sull’attività aziendale e consente di concentrare l’analisi sulla riduzione dei problemi più dannosi.

Lo stato attuale dell’incidente nel suo ciclo di vita, ad esempio Open, Pending, Resolved o Closed.

Perché è importante

Tiene traccia dell’avanzamento dell’incidente durante il suo ciclo di vita e aiuta a individuare le fasi in cui si verificano spesso ritardi.

La categoria utilizzata per classificare l’incidente, ad esempio Hardware, Software o Rete.

Perché è importante

Consente di analizzare l’andamento degli incidenti e di verificare se una classificazione errata causa ritardi nella risoluzione.

La data e l’ora entro cui l’incidente dovrebbe essere risolto secondo la relativa politica SLA.

Perché è importante

Fornisce la scadenza per la risoluzione, necessaria per calcolare il rispetto degli SLA e individuare gli incidenti a rischio.

Attività

Fasi del processo da monitorare e ottimizzare

Indica la creazione di un nuovo record di incidente in Freshservice. È il punto di partenza del ciclo dell’incidente, in genere attivato da un utente finale tramite il portale o e-mail, oppure da un agente del Service Desk che crea un ticket per suo conto. L’evento viene registrato esplicitamente con la data e l’ora di creazione.

Perché è importante

Questa attività è l’evento di inizio principale dell’intero processo. Analizzare il tempo che intercorre tra questo evento e la risoluzione è fondamentale per misurare i tempi di ciclo complessivi e il rispetto degli SLA.

Indica l’assegnazione iniziale di un incidente a un gruppo di supporto. Può avvenire automaticamente tramite regole di instradamento oppure manualmente da parte di un addetto al coordinamento. L’attività viene rilevata registrando il primo inserimento del valore nel campo «Group» nel registro di controllo dell’incidente.

Perché è importante

Monitorare le assegnazioni è essenziale per misurare i tempi della prima risposta e individuare i colli di bottiglia nel processo di smistamento. Aiuta a valutare l’efficienza con cui gli incidenti vengono instradati al team corretto.

Si verifica quando la priorità dell’incidente viene impostata o aggiornata. Il livello di priorità determina l’urgenza e gli obiettivi SLA per la risoluzione. L’attività viene rilevata monitorando le modifiche al campo «Priority» nella cronologia dell’incidente.

Perché è importante

Un’impostazione errata o tardiva della priorità può causare il mancato rispetto degli SLA e un’allocazione inefficiente delle risorse. Analizzare questa attività aiuta a garantire che gli incidenti critici ricevano attenzione immediata.

Questa attività segna l’inizio ufficiale dell’analisi e del lavoro attivo sull’incidente. Viene rilevata quando un agente modifica lo stato dell’incidente in «In Progress». Si tratta di una modifica di stato standard, registrata nella cronologia delle attività del ticket.

Perché è importante

Questa tappa consente di distinguere il tempo di attesa dal tempo di lavoro effettivo. Analizzare quanto a lungo un incidente rimane «In Progress» è fondamentale per capire l’impegno richiesto per risolverlo.

Si verifica quando un agente documenta la soluzione dell’incidente aggiungendo una nota di risoluzione. In Freshservice è un’azione distinta, che precede la modifica dello stato in «Resolved». L’azione e il relativo contenuto vengono registrati esplicitamente.

Perché è importante

Segna il momento in cui viene individuata una soluzione. Il tempo che intercorre tra questa attività e lo stato «Incident Resolved» può indicare tempi aggiuntivi dovuti a verifiche interne o alla documentazione.

Indica il momento in cui l’agente ha applicato una correzione e considera risolto l’incidente. Viene rilevato quando lo stato dell’incidente passa a «Resolved». In Freshservice, questa tappa fondamentale arresta il conteggio del tempo SLA.

Perché è importante

È una tappa fondamentale per misurare il tempo di risoluzione (TTR). Il periodo tra «Resolved» e «Closed» è importante per analizzare i ritardi nella conferma dell’utente e le regole di chiusura automatica.

Indica la chiusura definitiva e formale del record dell’incidente. In genere avviene automaticamente dopo un periodo prestabilito nello stato 'Resolved', ma può anche essere eseguita manualmente da un agente. Questo evento segna la fine del ciclo di vita dell’incidente.

Perché è importante

Questa attività rappresenta il punto finale del processo. Il tempo totale fino a questo evento corrisponde all’intero ciclo di vita dell’incidente, compresi gli eventuali periodi di attesa della conferma dell’utente.

Domande frequenti

Domande frequenti

Il Process Mining individua colli di bottiglia, mancato rispetto delle procedure e inefficienze nel ciclo degli incidenti, dalla creazione alla risoluzione. Aiuta a visualizzare il flusso effettivo del processo e a individuare gli ambiti su cui intervenire, come tempi di risoluzione lunghi, riassegnazioni frequenti o ritardi. Ne deriva una comprensione più chiara di come vengono gestiti gli incidenti. Facendo emergere le deviazioni dai percorsi previsti, consente di apportare miglioramenti mirati e offrire un servizio migliore.

In genere servono i log degli incidenti con un identificativo del caso, ad esempio l’ID dell’incidente, le descrizioni delle attività e le relative date e ore. Anche attributi come agente, gruppo di assegnazione, categoria e priorità dell’incidente possono arricchire notevolmente l’analisi. Per ottenere indicazioni significative, è fondamentale che i dati siano completi e accurati.

Può aspettarsi una risoluzione più rapida degli incidenti critici, un maggiore rispetto degli accordi sui livelli di servizio e passaggi di consegne più fluidi. Il Process Mining aiuta a migliorare la precisione della categorizzazione, l’analisi delle cause profonde e la standardizzazione delle escalation. Nel complesso, questi miglioramenti riducono i costi di gestione degli incidenti e migliorano l’esperienza degli utenti.

Sì. Il Process Mining ricostruisce con precisione i percorsi seguiti dagli incidenti e individua le attività o sequenze che portano al mancato rispetto degli SLA. Evidenzia i punti in cui si verificano ritardi, ad esempio a causa di riassegnazioni multiple, attese prolungate o soluzioni alternative non approvate. In questo modo può individuare le cause profonde del mancato rispetto degli SLA e attuare interventi mirati.

Il primo passo consiste nell’individuare ed estrarre i dati pertinenti dell’Event Log dalla propria istanza di Freshservice. In genere includono gli ID degli incidenti, le date e ore delle attività corrispondenti e descrizioni chiare di ogni fase. Per ottenere un’analisi accurata e utile, è fondamentale che i dati estratti siano completi e di qualità.

No. Il Process Mining è utile alle organizzazioni di qualsiasi dimensione che desiderano ottimizzare i propri processi, indipendentemente dal livello di complessità. Anche i team più piccoli possono ottenere indicazioni concrete e utili sui risultati della gestione degli incidenti. Aiuta a individuare opportunità per aumentare l’efficienza e migliorare il rispetto delle procedure, che altrimenti potrebbero passare inosservate.

Dopo aver estratto i dati e configurato il modello, è spesso possibile ottenere le prime indicazioni e individuare i colli di bottiglia del processo nel giro di poche settimane. Un’analisi più approfondita, l’attuazione dei miglioramenti e la misurazione del loro impatto possono richiedere alcuni mesi. I tempi dipendono soprattutto dalla complessità del processo di gestione degli incidenti e dalle risorse disponibili.

Oltre ai dati di Freshservice, serve uno strumento di Process Mining, disponibile in cloud oppure come soluzione installata localmente. La maggior parte degli strumenti moderni offre interfacce intuitive, quindi in genere non sono necessarie competenze specifiche di programmazione. Potrebbe tuttavia essere necessario trasformare inizialmente i dati grezzi di Freshservice o preparare script per renderli pronti per l’analisi.

Analizzando le modalità con cui vengono gestiti i singoli incidenti, il Process Mining mette in evidenza le differenze nei risultati degli agenti e nel rispetto delle procedure operative standard. Aiuta a individuare le buone pratiche degli agenti con i risultati migliori e gli ambiti in cui altri potrebbero aver bisogno di formazione o indicazioni più chiare. In questo modo è possibile offrire supporto mirato e garantire un servizio più uniforme.

Prevenga le violazioni degli SLA: ottimizzi oggi la gestione degli incidenti

Si unisca alle aziende che hanno ridotto del 35% il tempo medio di risoluzione (MTTR) e prevenuto costose violazioni degli SLA.

Inizi la prova gratuita

Prova gratuita di 14 giorni, senza carta di credito.