Migliori la gestione dei problemi
Segua questa guida in 6 passaggi per ottimizzare il flusso di lavoro.
Migliori la gestione dei problemi
Gestione dei problemi
Zendesk Support

Selezioni un processo

Scelga un processo per continuare a lavorare nell’area di lavoro collegata.

Processi disponibili
Sistemi disponibili
259 Processi

Ottimizzi la gestione dei problemi in Zendesk Support per garantire la stabilità IT

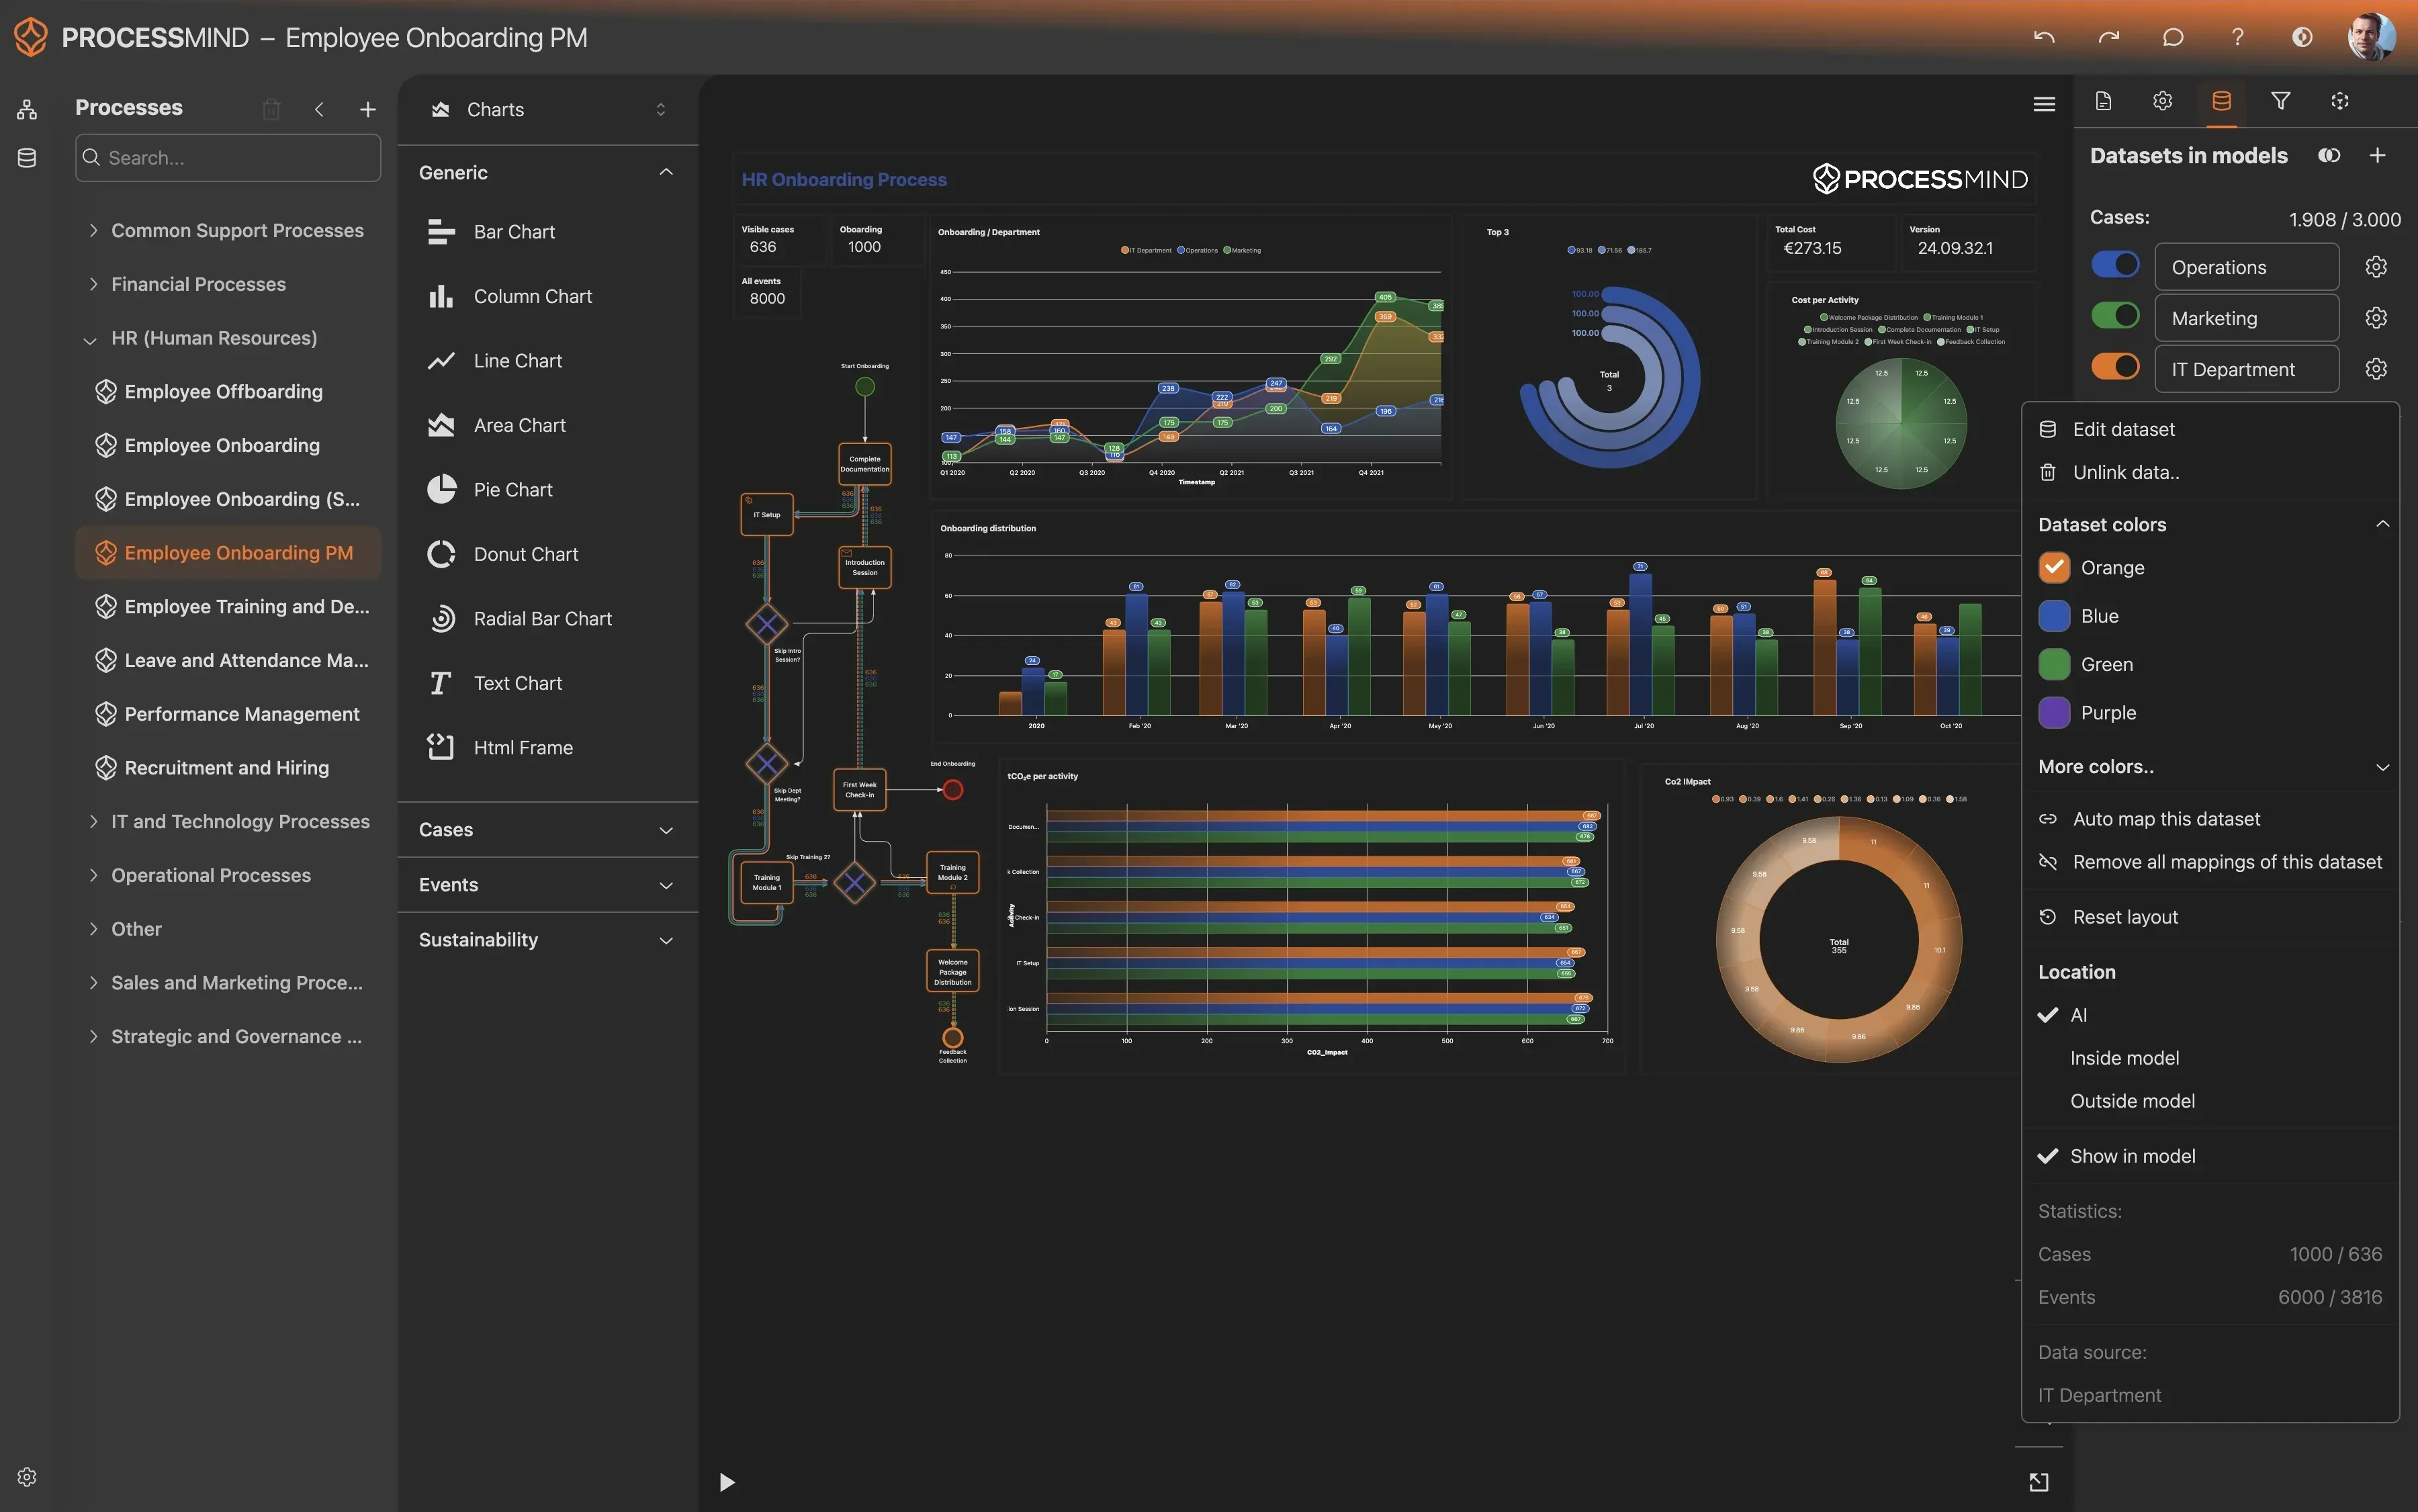
Il Process Mining fa emergere colli di bottiglia nascosti e ritardi strutturali che spesso sfuggono alle revisioni manuali. La nostra piattaforma individua i punti in cui i ticket si bloccano o passano ripetutamente da un team all’altro, aiutando a rendere più fluide tutte le fasi del percorso di risoluzione. Questa visibilità consente al team di concentrarsi sulle correzioni con il maggiore impatto, anziché dedicare tempo alle attività amministrative.

Scarichi il nostro template dei dati preconfigurato e affronti le sfide più comuni per raggiungere i Suoi obiettivi di efficienza. Segua il nostro piano di miglioramento in sei fasi e consulti la guida al template dei dati per trasformare le Sue attività.

Mostra la descrizione dettagliata

Perché ottimizzare la gestione dei problemi è fondamentale per la stabilità IT

La gestione dei problemi è alla base di un’infrastruttura IT stabile. Mentre la gestione degli incidenti si concentra sul ripristino del servizio nel minor tempo possibile, la gestione dei problemi mira a individuare ed eliminare le cause profonde degli incidenti. In un ambiente Zendesk Support, molte organizzazioni si ritrovano a intervenire continuamente in modo reattivo: gli stessi problemi si ripresentano settimana dopo settimana perché la causa profonda non è mai stata affrontata adeguatamente. Questa inefficienza ha costi elevati: aumenta le spese operative, riduce la disponibilità dei servizi e mette a dura prova il team di assistenza, che ha la sensazione di non riuscire a fare progressi.

Ottimizzare questo processo non significa soltanto lavorare più rapidamente, ma anche intervenire con precisione e prevenire i problemi. Perfezionando il flusso di lavoro di gestione dei problemi, nel tempo si riduce il numero complessivo di incidenti in ingresso. Il passaggio da un’assistenza reattiva a una proattiva consente alle risorse tecniche più esperte di dedicarsi meno alle correzioni ripetitive e più a iniziative di valore che fanno progredire l’organizzazione. Senza una visione chiara del percorso seguito dai problemi nei sistemi, è quasi impossibile capire in quale fase le indagini si bloccano o perché le soluzioni tardano ad arrivare.

Come il Process Mining fa luce sul ciclo di vita in Zendesk

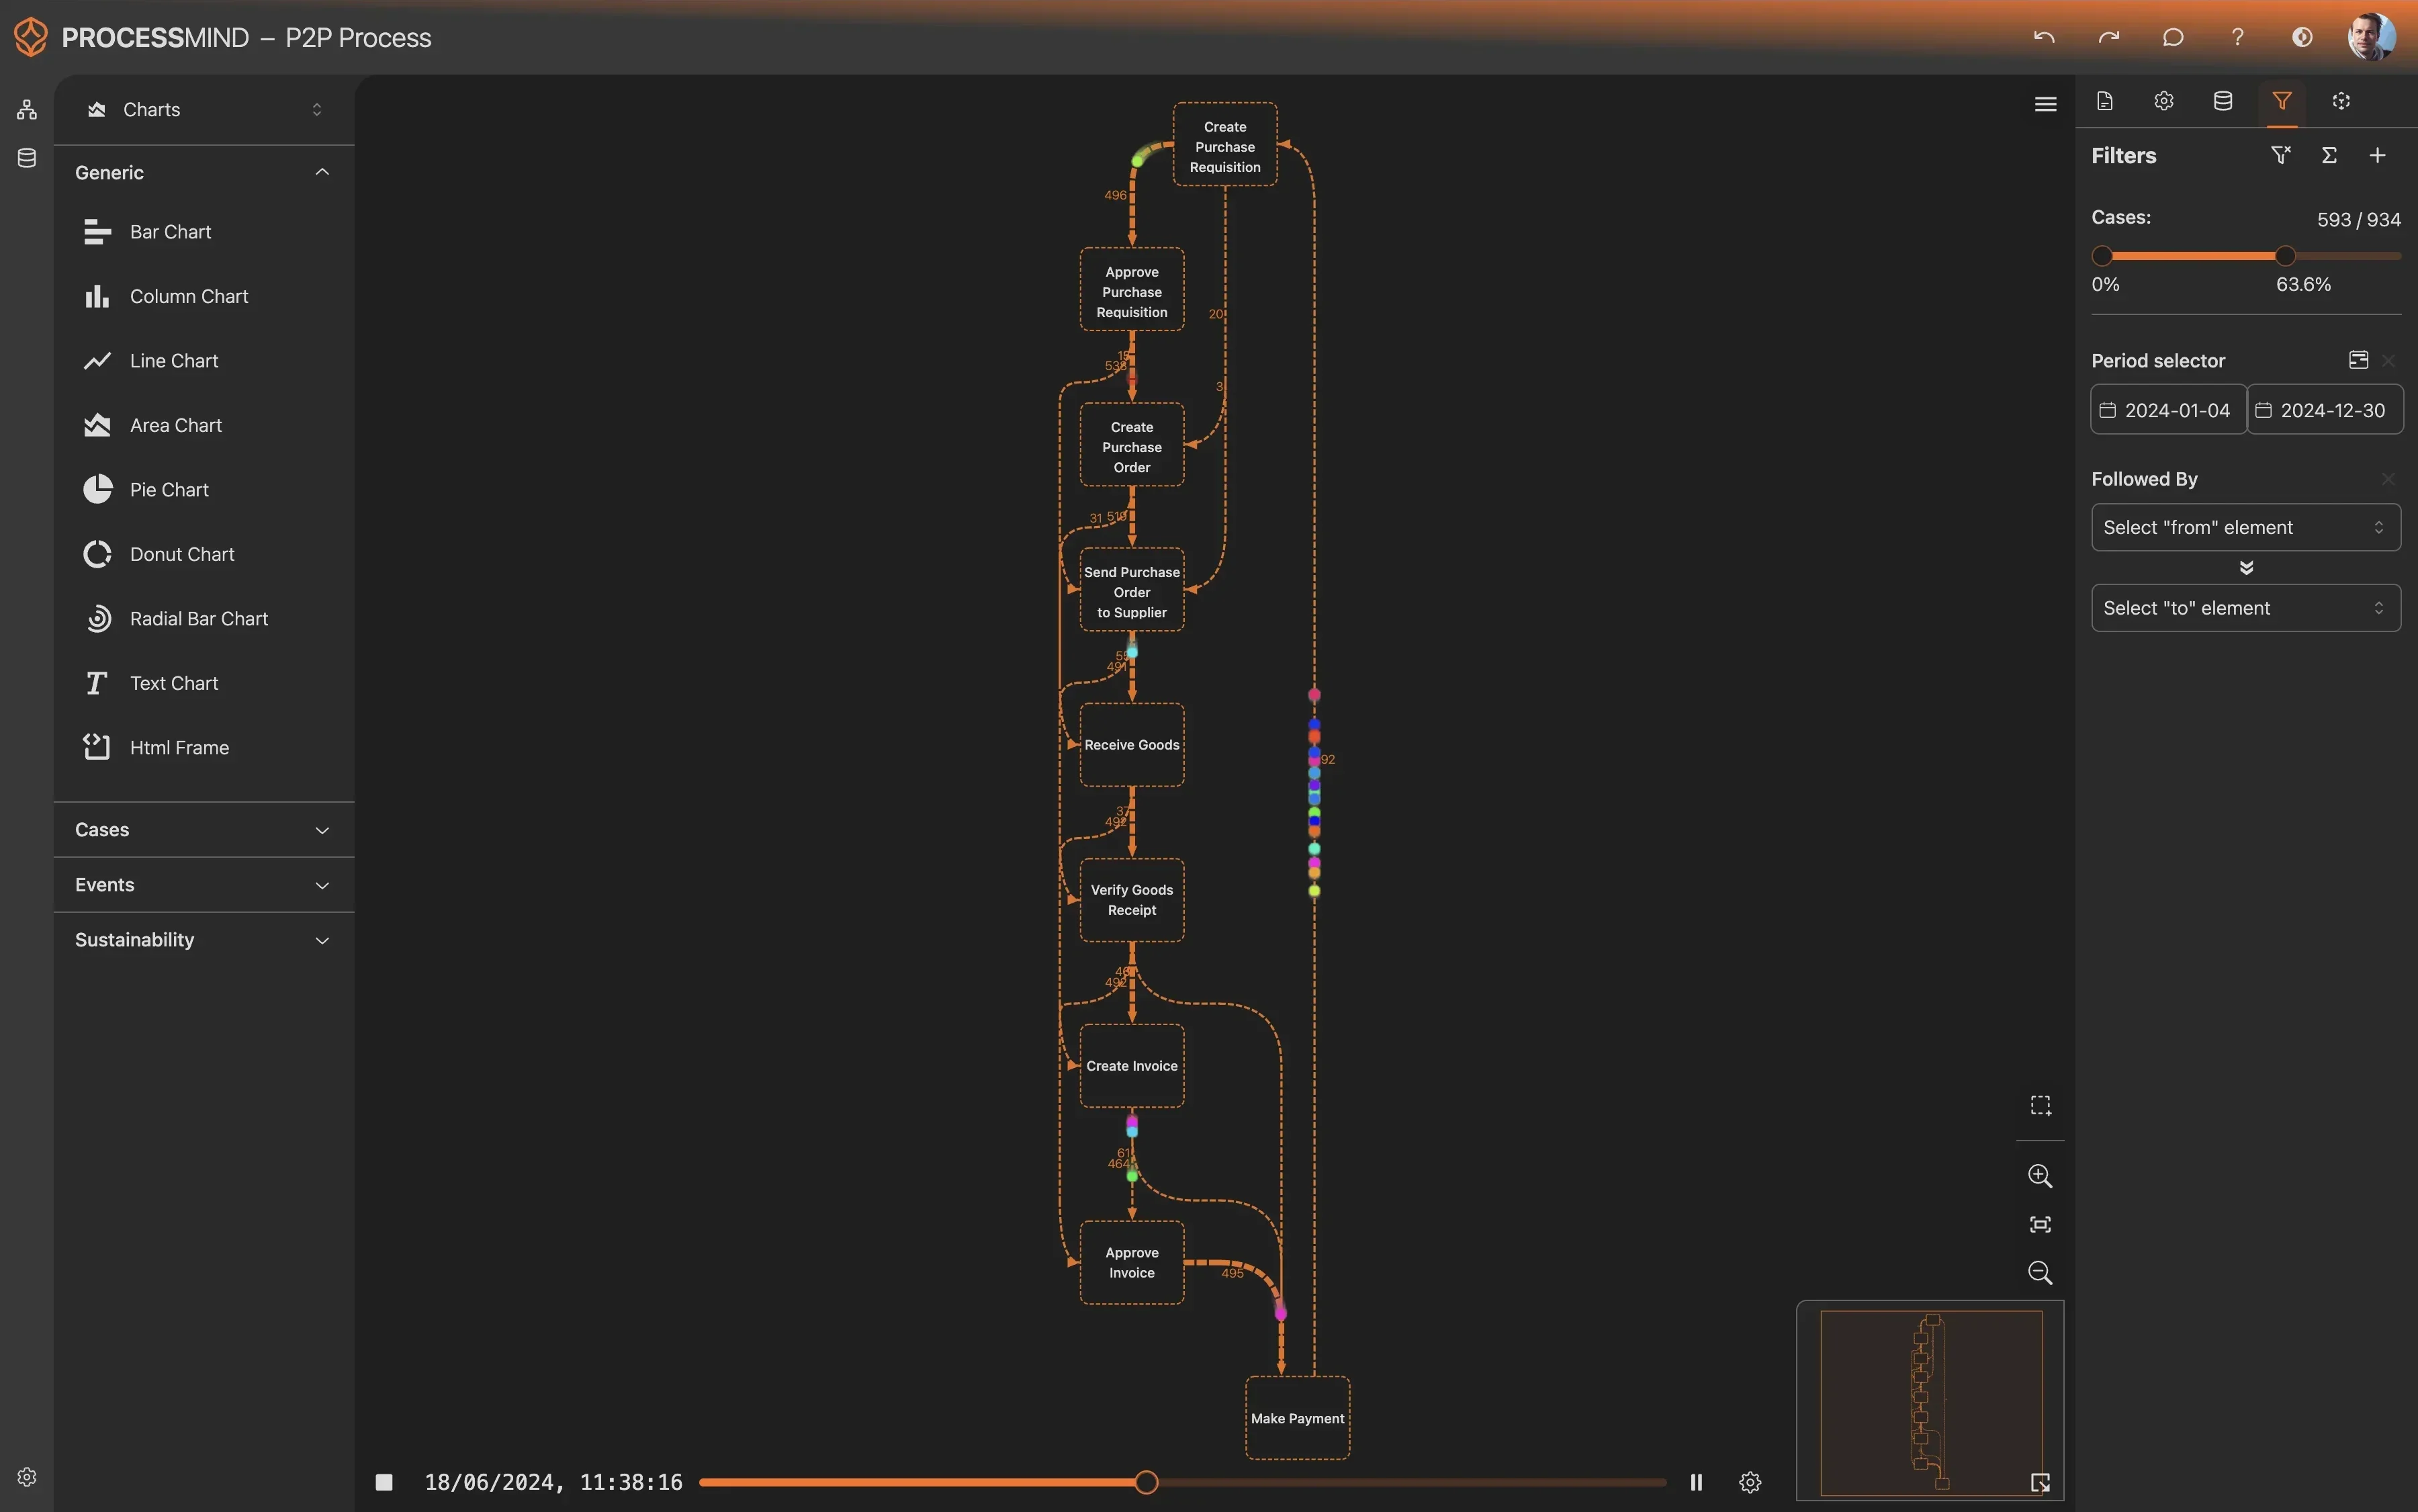
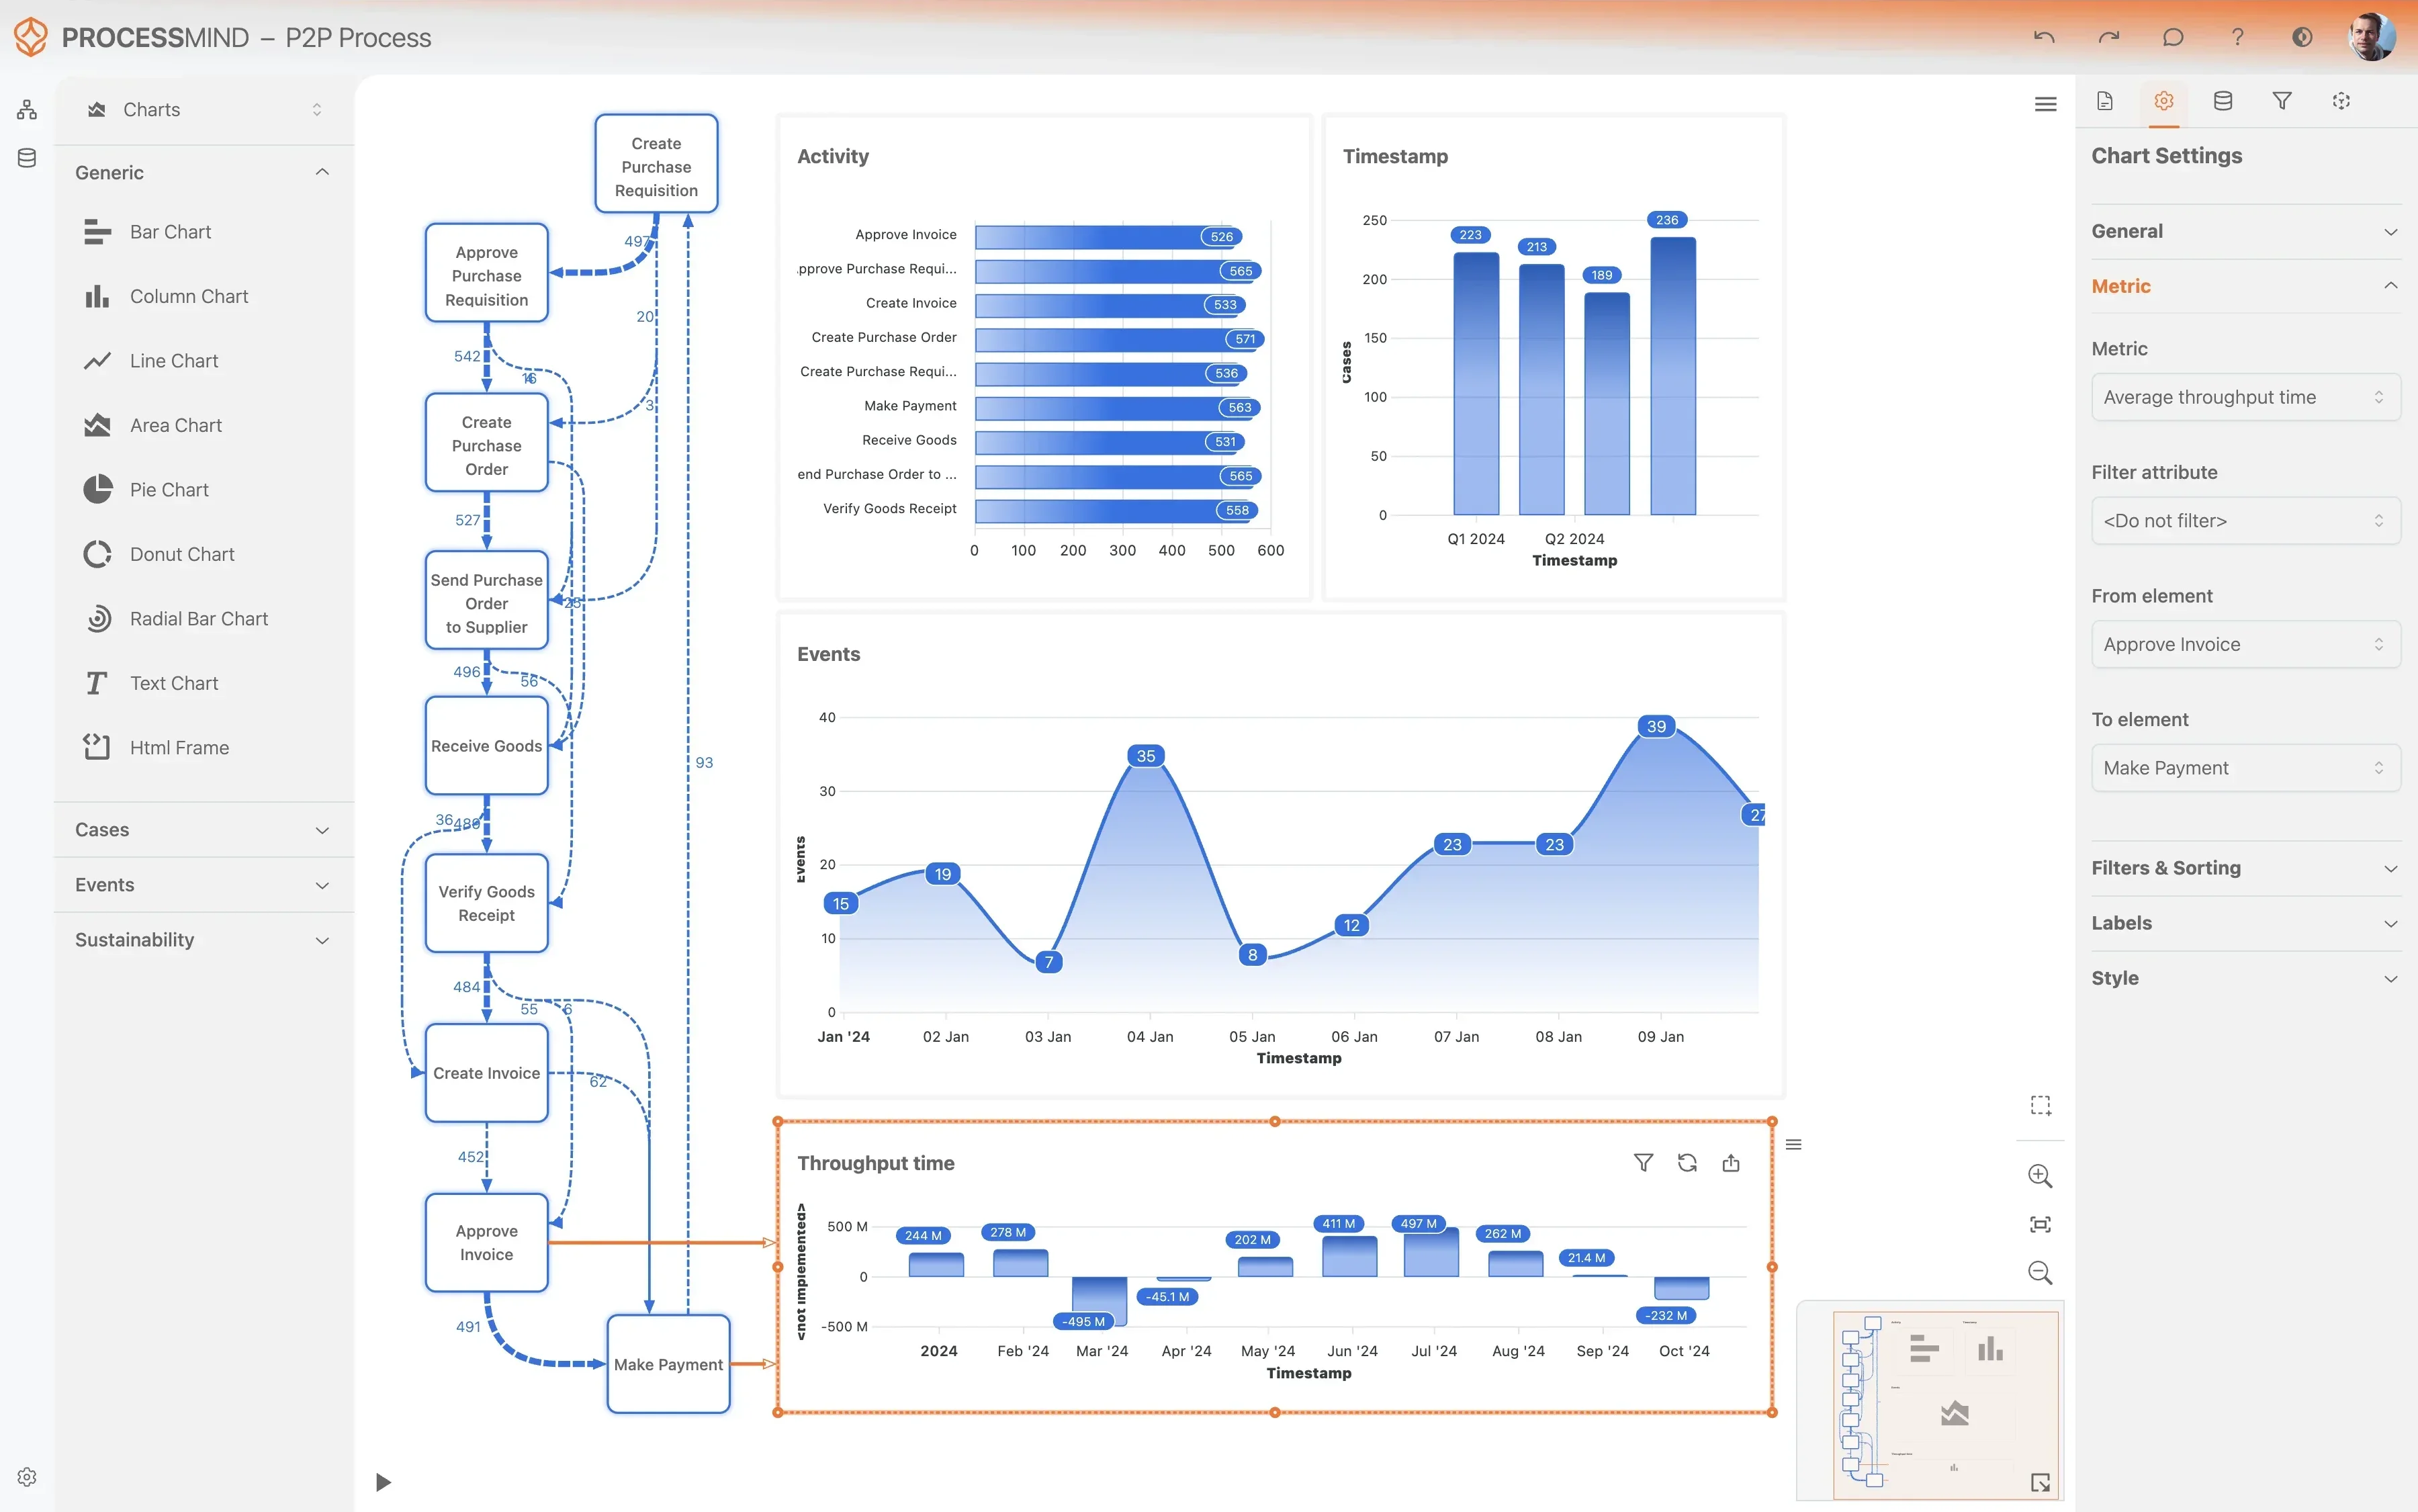
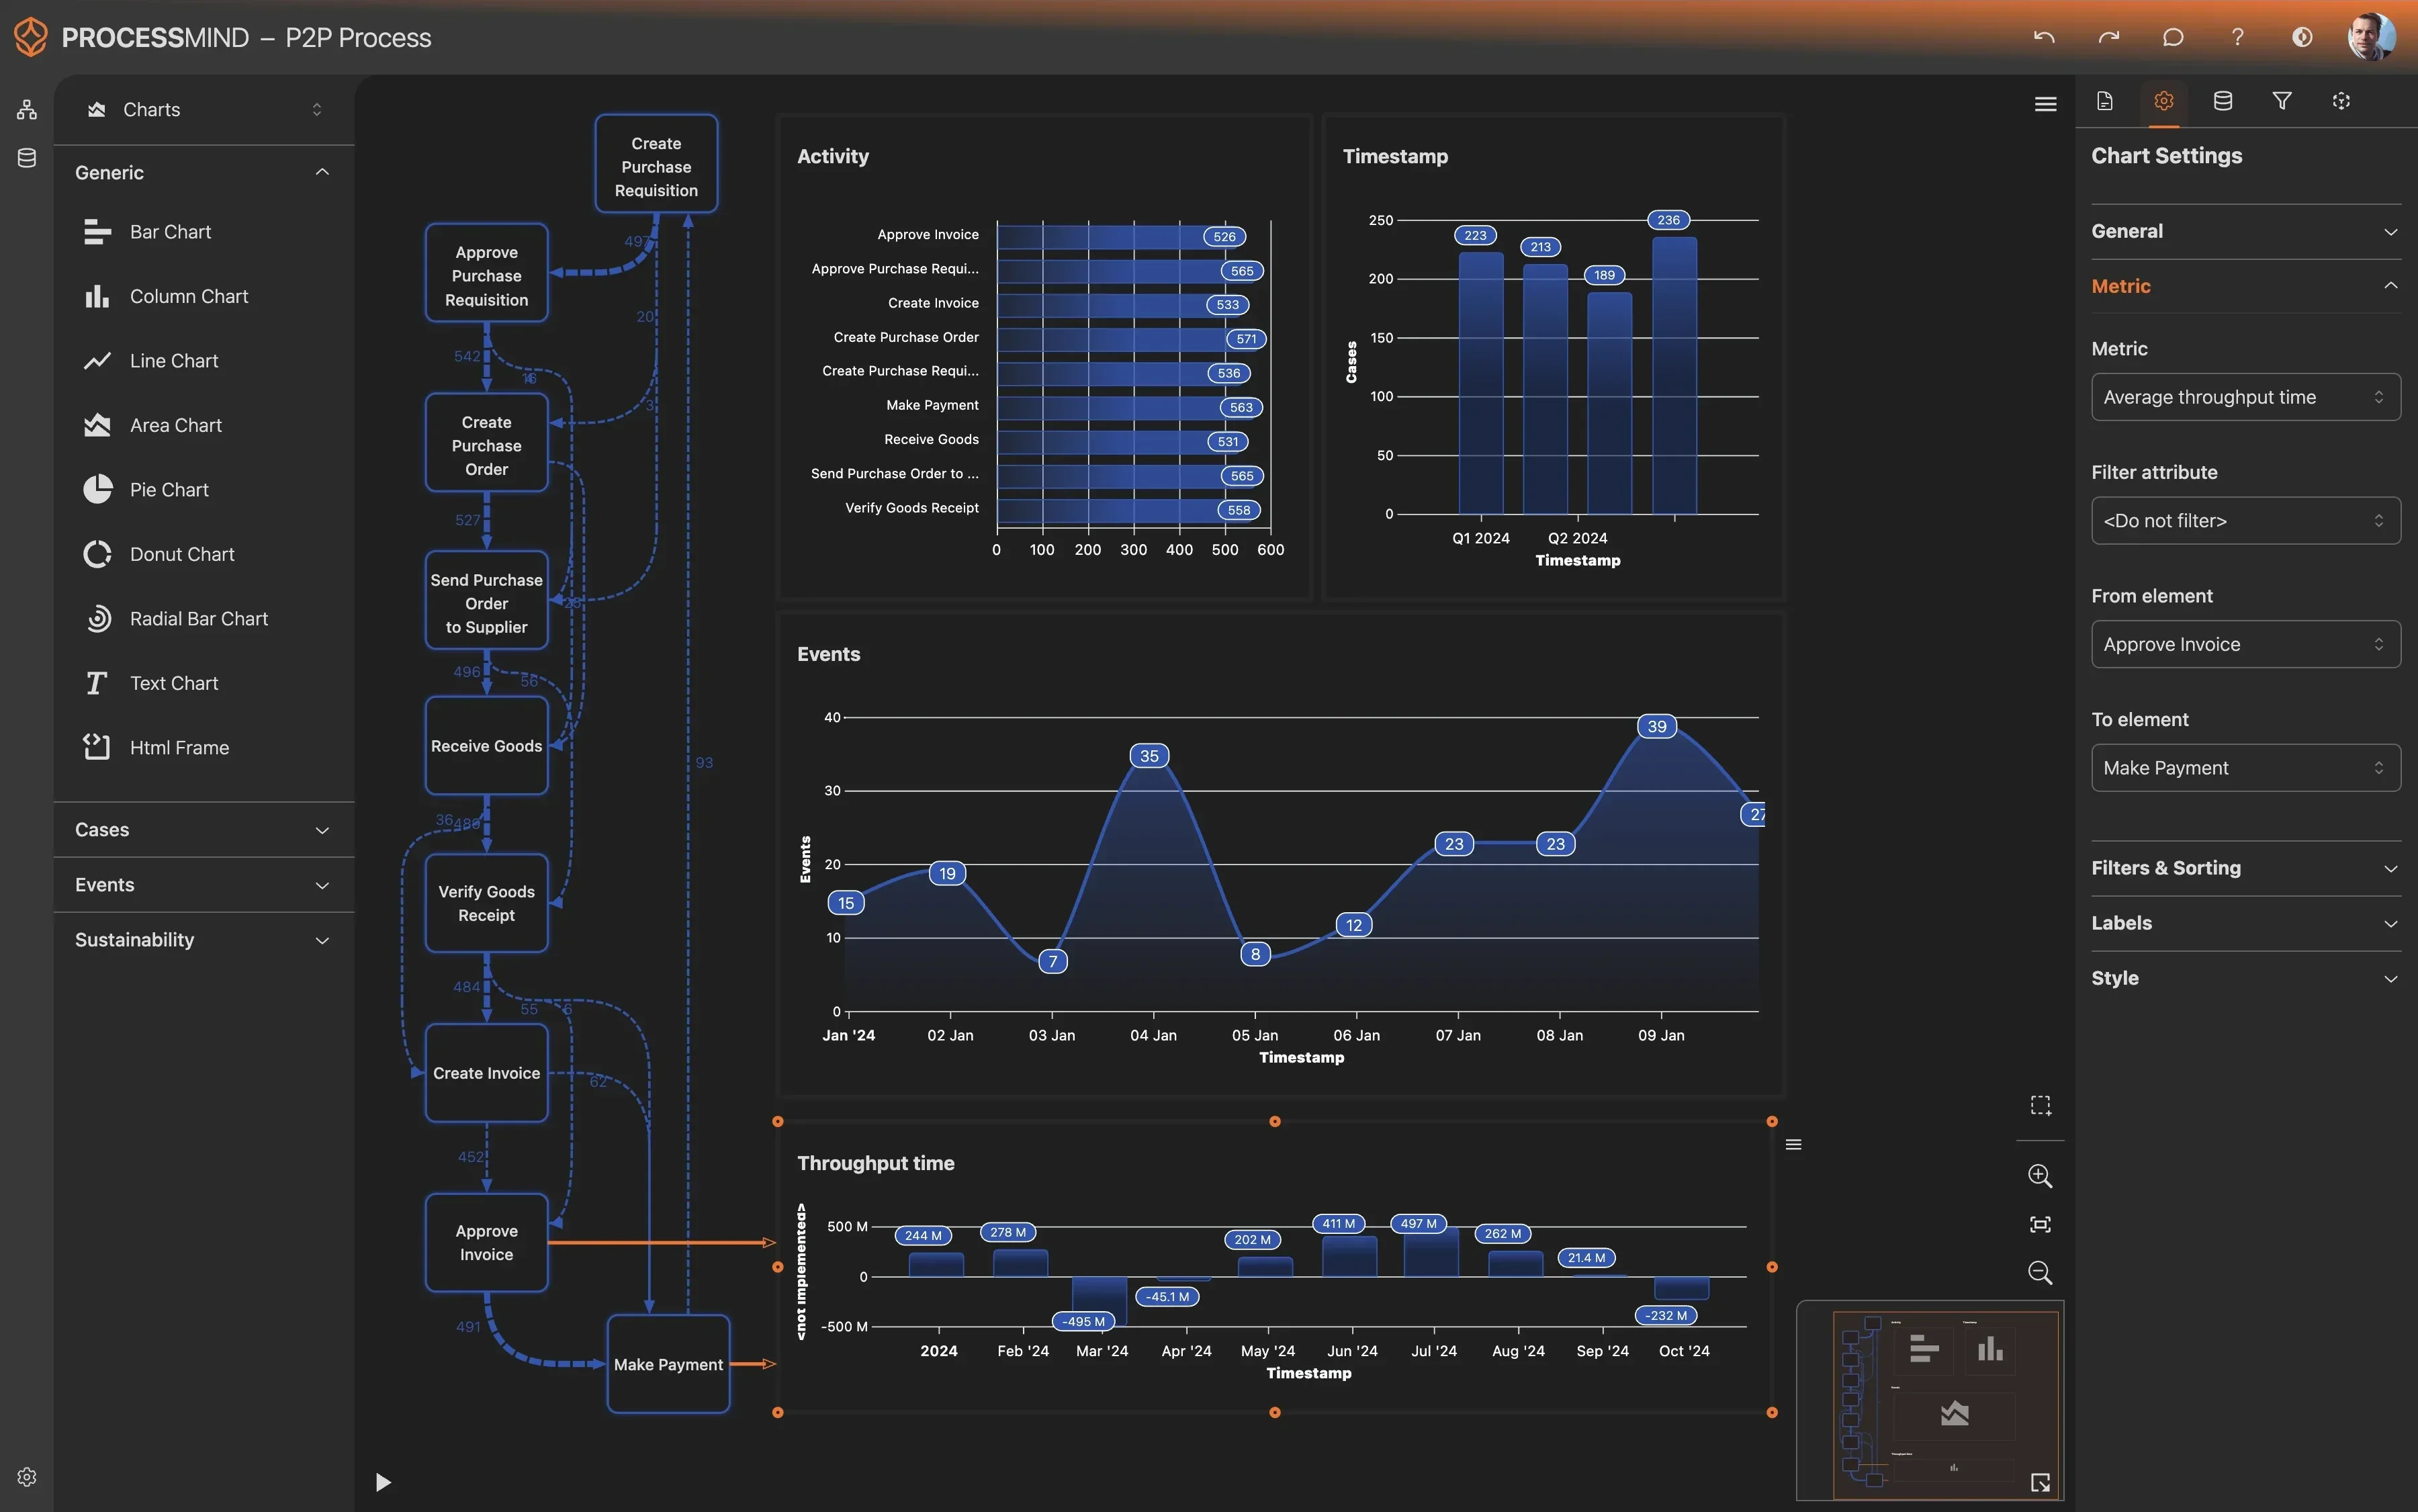
Il Process Mining cambia il modo di analizzare i dati di Zendesk, ricostruendo il percorso effettivo di ogni record di problema. Invece di affidarsi a report statici che mostrano i tempi medi di risoluzione, consente di osservare la sequenza reale degli eventi. È possibile visualizzare ogni passaggio, dall’individuazione del problema alla revisione successiva all’implementazione. Questa trasparenza è essenziale per comprendere la differenza tra il processo documentato e il modo in cui il lavoro viene svolto davvero.

Analizzando le tracce digitali lasciate dai team tecnici, il Process Mining individua con precisione i punti in cui il processo perde slancio. Per esempio, può emergere che i record di problema si bloccano spesso dopo l’individuazione di una soluzione temporanea, perché viene meno l’urgenza di implementare una correzione definitiva. Il Process Mining mette in evidenza schemi nascosti e colli di bottiglia, come i passaggi eccessivi tra gruppi di assistenza o le lunghe attese per l’approvazione delle richieste di modifica. Questo approccio basato sui dati elimina le supposizioni dall’ottimizzazione dei processi e permette di concentrare gli interventi sulle fasi con il maggiore potenziale di miglioramento.

Individuare le aree prioritarie da migliorare nel flusso di indagine

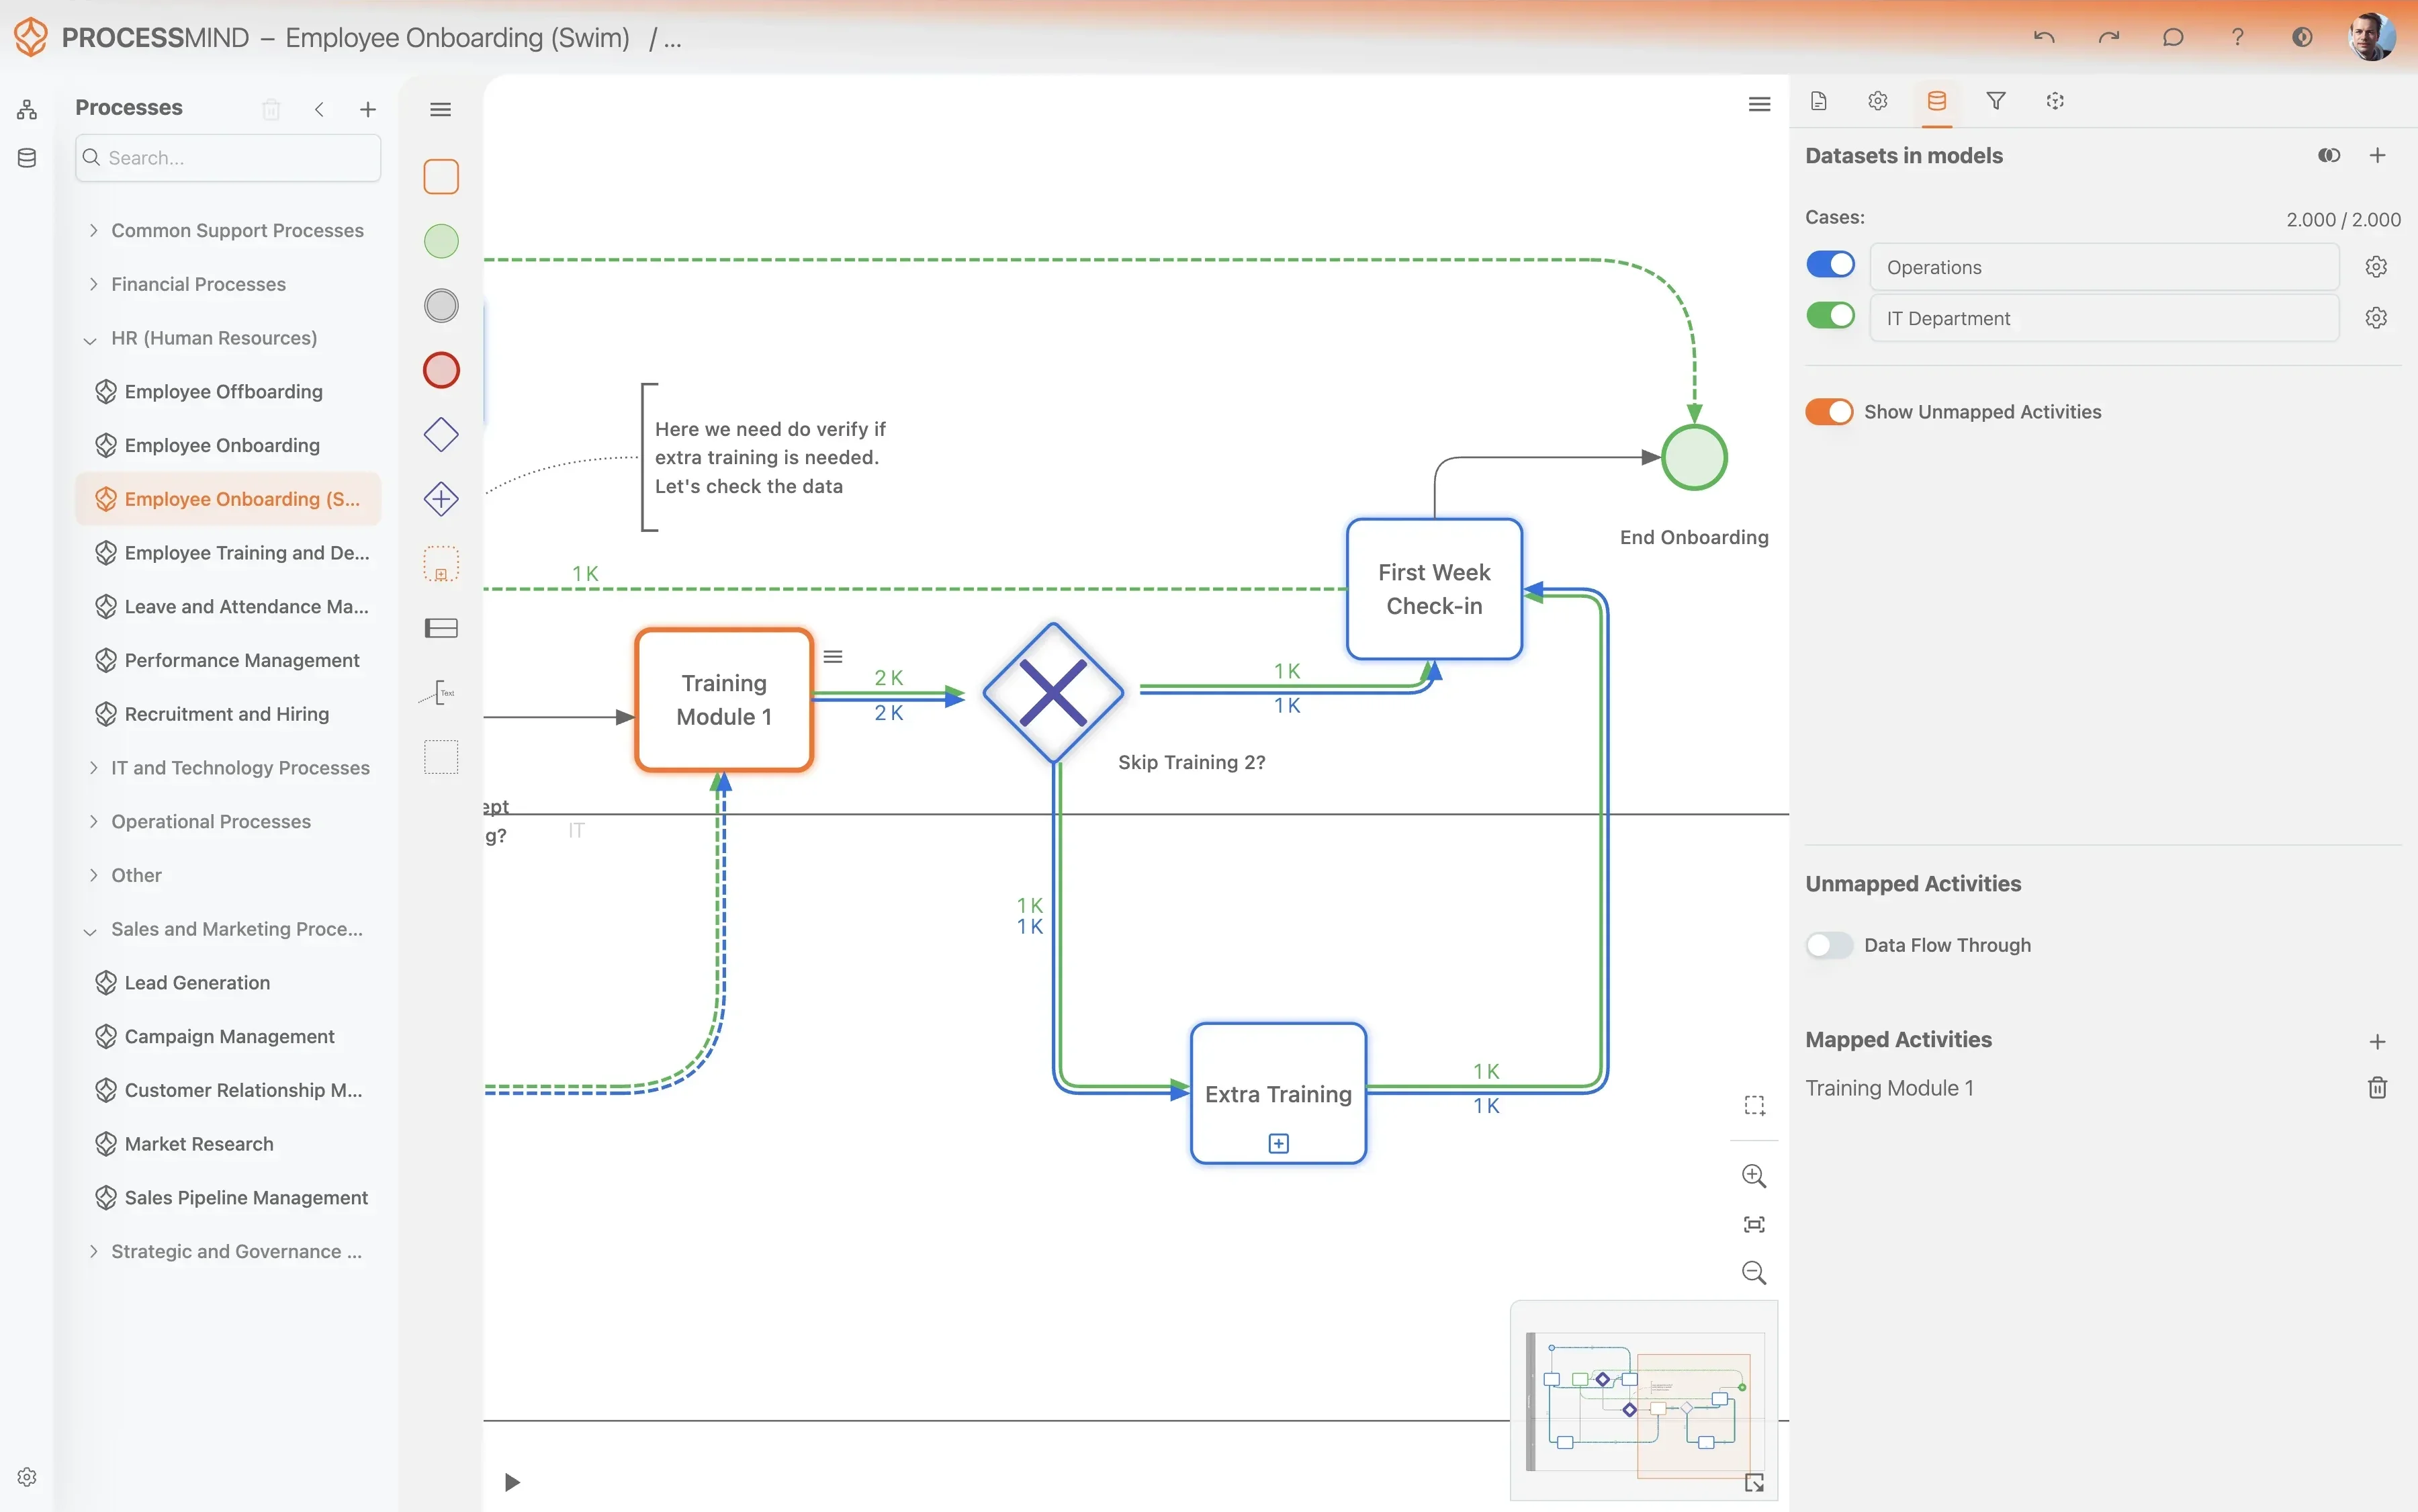
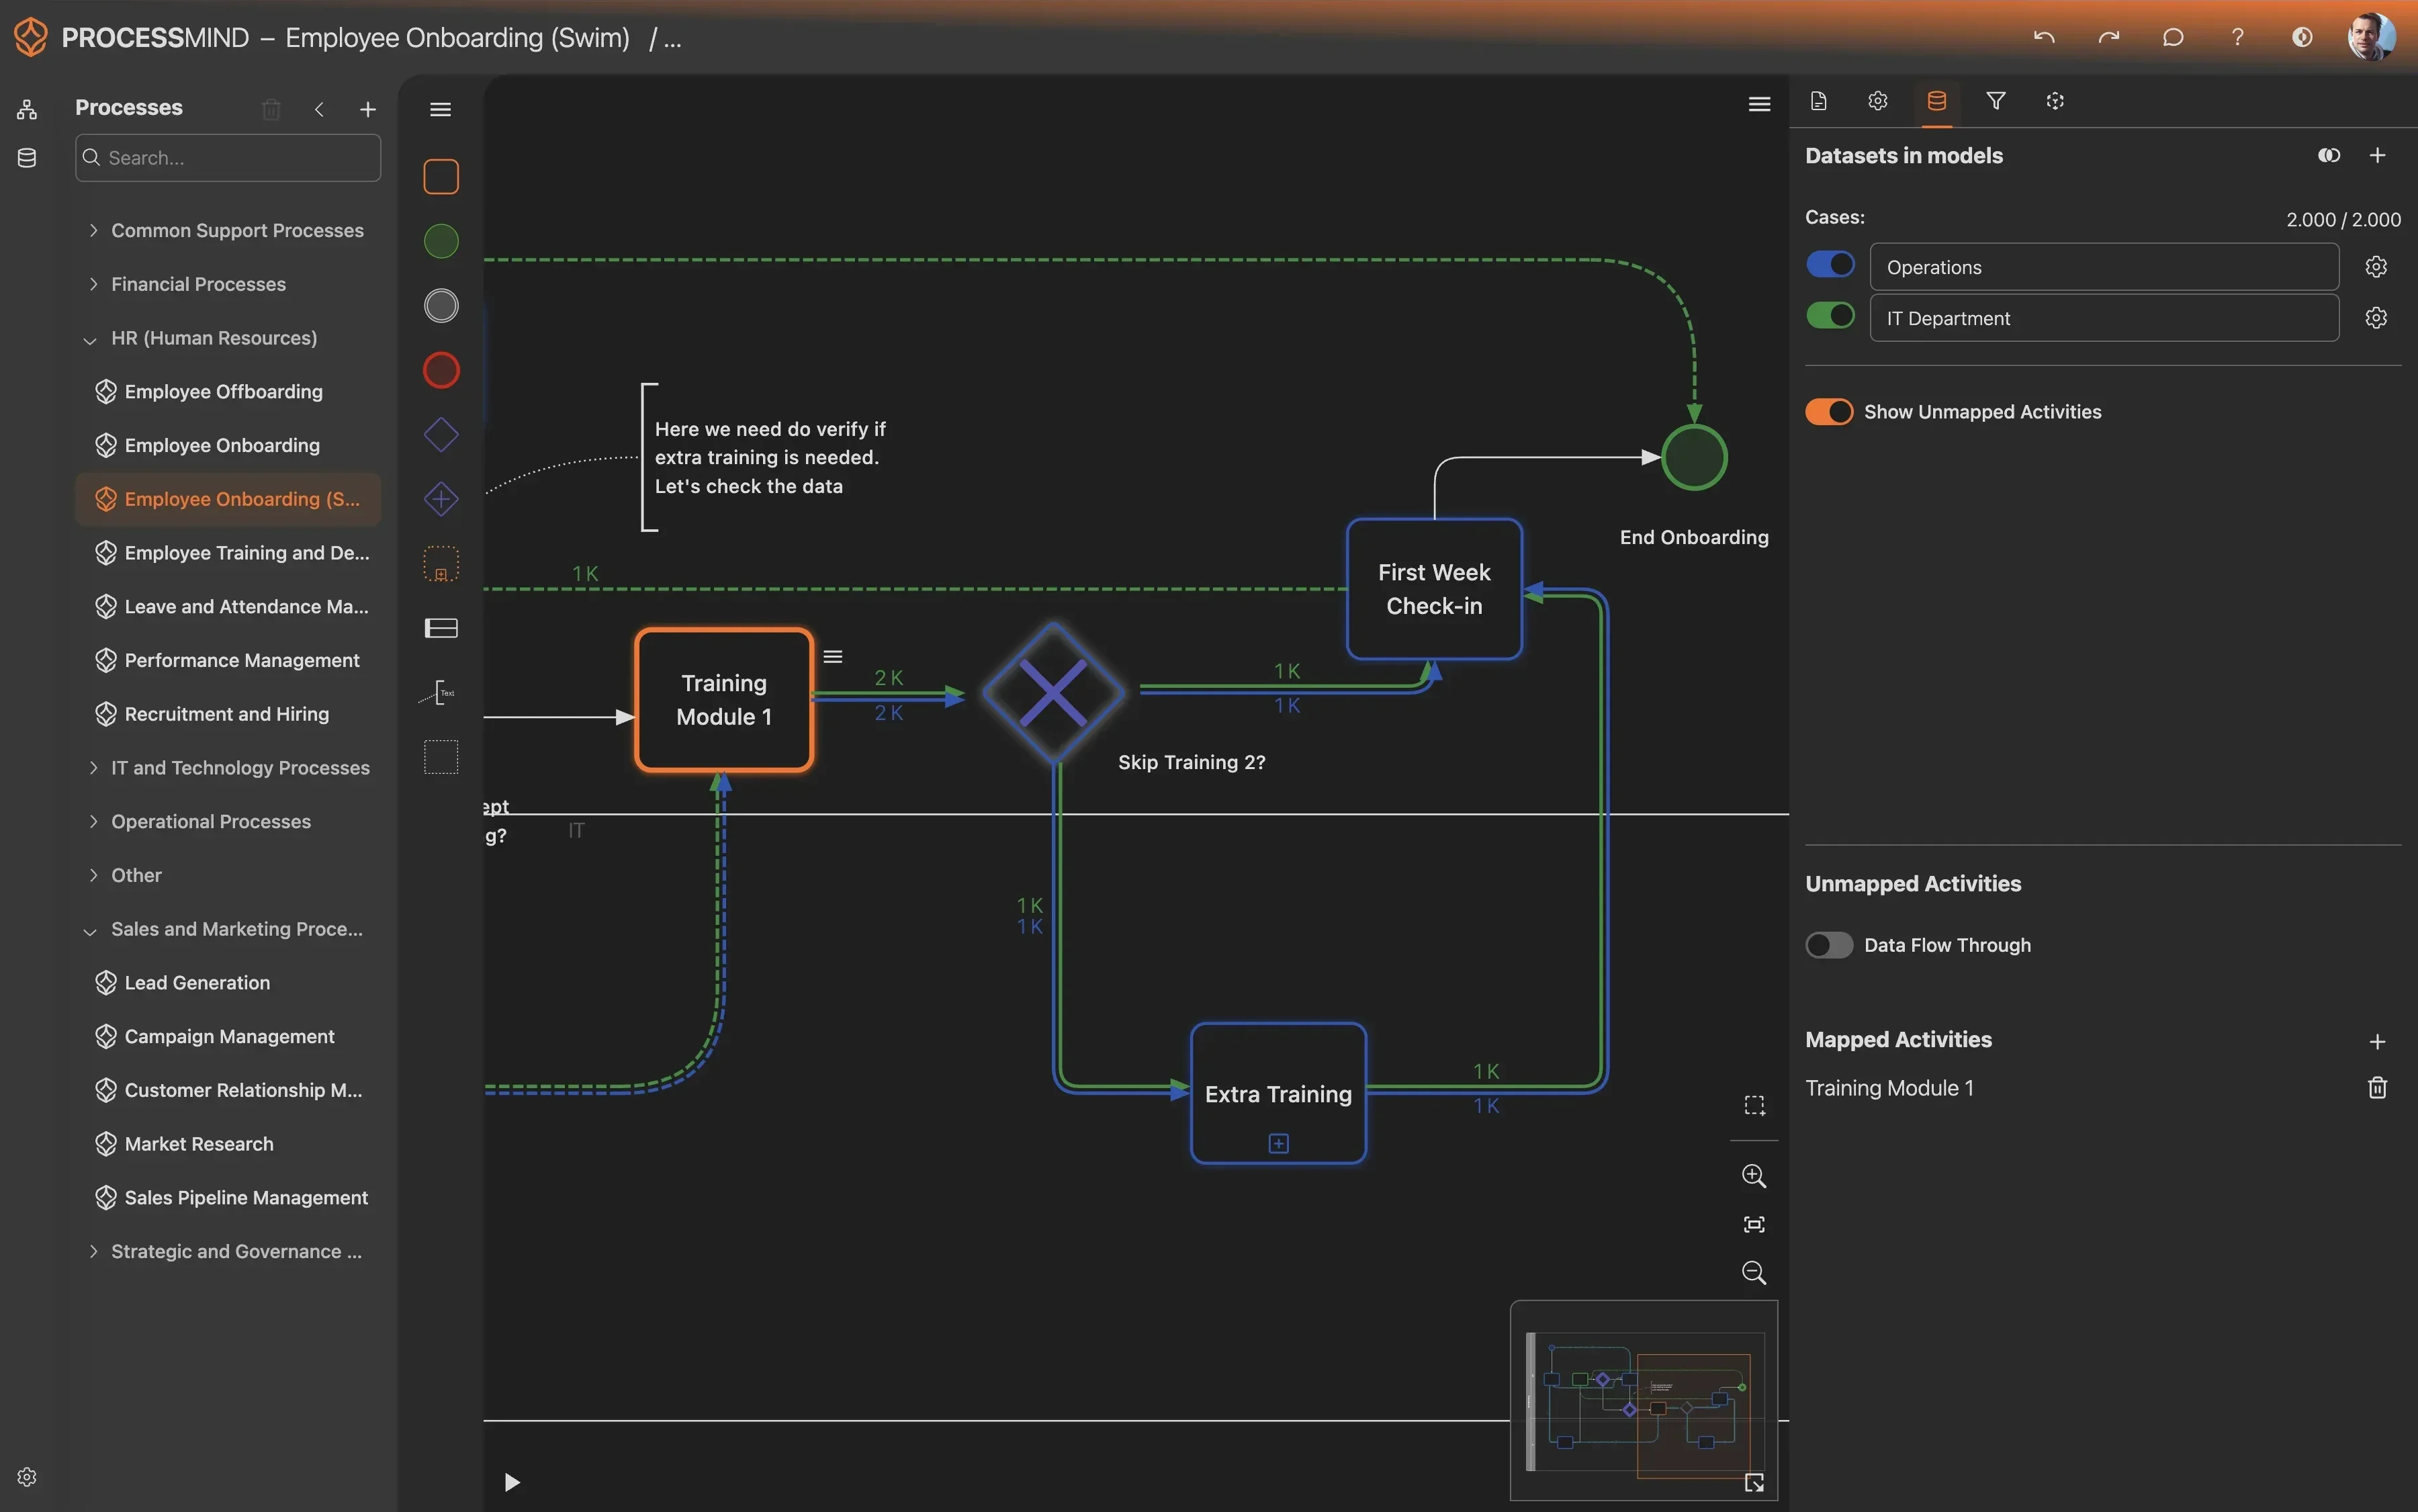
In Zendesk Support, uno degli aspetti che più spesso richiedono un miglioramento è il passaggio tra il supporto di secondo livello e i team di ingegneria specializzati. Il Process Mining può mostrare se queste transizioni avvengono senza intoppi o se i problemi finiscono in code senza assegnatario, dove rischiano di essere dimenticati. Analizzando il tempo trascorso nella fase Investigation Commenced, è possibile capire se i team dispongono degli strumenti e delle informazioni necessari per individuare efficacemente le cause profonde. Se la fase di indagine si prolunga con regolarità, potrebbe essere necessario integrare meglio la base di conoscenze o standardizzare le procedure diagnostiche.

Un’altra area critica è il divario tra una soluzione proposta e l’effettiva implementazione di una correzione definitiva. In molte organizzazioni, una soluzione viene definita ma resta in arretrato perché il processo di gestione delle modifiche è scollegato o eccessivamente burocratico. Il Process Mining aiuta a colmare questo divario mostrando la durata esatta dei ritardi. Consente inoltre di monitorare l’efficacia delle soluzioni temporanee. Se una soluzione temporanea viene pubblicata ma gli incidenti continuano ad aumentare allo stesso ritmo, è possibile che sia difficile da trovare o inefficace: occorre quindi rivedere subito l’approccio.

I vantaggi di un processo di risoluzione più snello

Ottimizzare con successo la gestione dei problemi porta benefici a tutta l’organizzazione. Il risultato più immediato è una riduzione misurabile del tempo di ciclo delle indagini sulle cause profonde. Indagini più rapide consentono di implementare prima le correzioni definitive, riducendo direttamente il numero di incidenti ricorrenti. Ne conseguono un maggiore rispetto degli accordi sui livelli di servizio e una maggiore fiducia da parte degli stakeholder aziendali.

Oltre a velocizzare il processo, un flusso di lavoro perfezionato migliora la qualità dei risultati tecnici. Verificando accuratamente la risoluzione di ogni problema e svolgendo una revisione dopo l’implementazione, si evita di introdurre nuovi problemi nell’ambiente. Si crea così un ciclo di miglioramento continuo, in cui ogni problema risolto rende i sistemi più resilienti. Inoltre, il personale tecnico è meno esposto al rischio di esaurimento professionale, perché dedica meno tempo ai problemi ripetitivi e più ad attività complesse e gratificanti.

Come iniziare a gestire i problemi basandosi sui dati

Per migliorare la gestione dei problemi in Zendesk Support, occorre andare oltre le impressioni e basarsi sui dati effettivi dei processi. Inizi mappando lo stato attuale per individuare gli interventi più semplici, per esempio le fasi con lunghi tempi di inattività o i gruppi di assistenza costantemente sovraccarichi. Utilizzi queste informazioni per definire obiettivi realistici per i team tecnici e motivare le risorse necessarie per le indagini più complesse sulle cause profonde. Man mano che introduce le modifiche, continui a monitorare i flussi di processo per verificare che i miglioramenti durino nel tempo e che non emergano nuovi colli di bottiglia. Trasformare il team di assistenza in una funzione proattiva richiede un impegno costante, ma con una visione chiara dei flussi di lavoro in Zendesk è un obiettivo raggiungibile.

Gestione dei problemi Gestione dei servizi IT Analisi delle cause profonde Riduzione degli incidenti Responsabile del Service Desk Gestione delle richieste di modifica Conformità agli SLA Gestione dei ticket Gestione dei ticket Errore noto Incidenti ricorrenti Soluzione temporanea Prevenzione degli incidenti Help desk IT

Problemi e sfide comuni

Individui le sfide che La riguardano

Le indagini che si protraggono a lungo lasciano spesso irrisolti per settimane problemi critici, con un conseguente accumulo di debito tecnico e il ripetersi degli incidenti. Quando l’analisi delle cause profonde richiede troppo tempo, il team di assistenza continua a intervenire in modo reattivo, compromettendo la stabilità dei servizi IT e aumentando il carico operativo degli agenti di Zendesk Support. I ritardi sono spesso dovuti a percorsi di indagine poco chiari o alla difficoltà di accedere ai dati storici durante la diagnosi.

La nostra soluzione mappa il percorso dall’individuazione del problema all’identificazione della causa profonda, indicando con precisione dove le indagini si bloccano. Visualizzando il flusso tra i diversi gruppi di assistenza, è possibile individuare i colli di bottiglia legati alle risorse e rendere più efficaci i passaggi di consegne, accelerando così le correzioni definitive. In questo modo, i team tecnici possono concentrarsi sulle indagini a maggiore impatto, senza perdere tempo in ritardi amministrativi legati al processo.

Se i problemi non vengono affrontati alla radice, gli stessi incidenti continuano a intasare il service desk, sottraendo tempo e risorse preziosi. Questo ciclo di interventi urgenti impedisce al team di concentrarsi sui miglioramenti strategici e frustra gli utenti finali, costretti a subire ripetutamente le stesse interruzioni. Senza un collegamento chiaro tra gli incidenti e le relative cause profonde, l’organizzazione continua a pagare per gli stessi errori.

Analizziamo la correlazione tra i record di problema e il numero di incidenti in Zendesk Support, per mettere in evidenza i problemi che causano le maggiori interruzioni. Il Process Mining mostra se le soluzioni temporanee vengono usate come rimedi permanenti invece di risolvere il problema alla radice tramite una richiesta formale di modifica. È così possibile dare priorità alla risoluzione dei problemi in base alla riduzione effettiva degli incidenti e del carico di lavoro del service desk.

Se i team tecnici individuano soluzioni temporanee ma non le pubblicano nella base di conoscenze, gli agenti di prima linea non possono assistere rapidamente gli utenti. Questa mancanza di comunicazione allunga i tempi di risoluzione degli incidenti, mentre il record formale del problema resta in fase di indagine. Spesso, conoscenze preziose sull’organizzazione rimangono confinate in note private o scambi di e-mail individuali, invece di essere condivise sulla piattaforma Zendesk Support.

ProcessMind monitora il passaggio da Workaround Identified a Workaround Published, affinché la condivisione delle conoscenze diventi una parte integrante del flusso di lavoro. Individuiamo i casi in cui le soluzioni temporanee vengono trovate ma non documentate, così da poter migliorare le pratiche di gestione delle conoscenze. In questo modo, ogni soluzione temporanea nota è subito a disposizione di chi gestisce gli incidenti e gli utenti devono attendere meno per ricevere assistenza.

Il mancato rispetto degli obiettivi di risoluzione per i record di problema ad alta priorità può causare gravi interruzioni delle attività e perdite di produttività. Senza una visione chiara dell’avanzamento di questi record, è difficile assegnare le risorse in modo efficace per rispettare i livelli di servizio concordati. Spesso le organizzazioni faticano a capire quale fase del ciclo di vita del problema provochi più frequentemente il mancato rispetto degli SLA.

Confrontando l’attributo SLA Due Date con l’avanzamento del processo in tempo reale, la nostra piattaforma segnala i record a rischio prima che si verifichi una violazione. È possibile vedere quali gruppi di assistenza faticano a mantenere il ritmo nella gestione dei problemi critici e ridistribuire di conseguenza i carichi di lavoro in Zendesk Support. Questo monitoraggio proattivo aiuta a rispettare gli accordi sui livelli di servizio e garantisce che i problemi ad alto impatto ricevano l’attenzione necessaria.

I record di problema passano spesso da un gruppo di assistenza all’altro senza progressi concreti, causando ritardi evitabili. Questi passaggi sono spesso dovuti a responsabilità poco chiare, a informazioni insufficienti condivise tra i team o alla mancanza di responsabilità durante la fase di indagine. Questo continuo rimbalzo aumenta l’età complessiva del record senza avvicinarlo a una soluzione definitiva.

Il nostro strumento di Process Mining visualizza il flusso dei problemi tra i gruppi di assistenza assegnati, per individuare i passaggi circolari e i tempi di inattività. Questa trasparenza aiuta a definire con maggiore chiarezza le responsabilità e a migliorare la qualità delle informazioni condivise nei passaggi di consegne. Individuando i gruppi in cui i problemi tendono a bloccarsi, è possibile introdurre interventi formativi mirati o modifiche al processo in Zendesk Support, migliorando la collaborazione tra i team.

Individuare la causa profonda è solo metà del lavoro: molte organizzazioni faticano a passare da una soluzione identificata a una correzione definitiva completata. I ritardi nell’avvio delle richieste di modifica o nell’applicazione delle correzioni lasciano i sistemi esposti a nuovi incidenti, anche quando la causa è nota. Questo divario tra conoscenza e intervento è spesso dovuto alla scarsa integrazione tra i team che gestiscono i problemi e quelli che gestiscono le modifiche.

Monitoriamo il ciclo di vita da Proposed Solution Drafted a Permanent Fix Applied per individuare gli ostacoli nella fase di implementazione. In questo modo è possibile misurare l’efficacia dell’integrazione con la gestione delle modifiche e verificare che le correzioni individuate vengano applicate tempestivamente. Evidenziando il tempo trascorso in attesa delle approvazioni, è possibile rendere più efficiente il flusso di lavoro che porta dall’individuazione tecnica alla risoluzione concreta.

Saltare la fase di revisione successiva all’implementazione impedisce all’organizzazione di imparare dai problemi complessi e di prevenirne il ripetersi. Senza un ciclo di feedback strutturato, è probabile che le stesse inefficienze di processo si ripresentino nelle indagini successive. Questa mancanza di chiusura formale ostacola il miglioramento continuo dei servizi e frena la maturità IT.

ProcessMind individua i record di problema che passano direttamente da Resolution Verified a Closed senza una revisione. Evidenziando queste lacune, è possibile verificare che il team segua l’intero ciclo di vita in Zendesk Support e raccolga informazioni utili al miglioramento continuo. Questo approccio basato sui dati fa sì che ogni problema rilevante contribuisca ad arricchire le conoscenze dell’organizzazione e a migliorare le misure preventive.

Se i record di problema sono classificati in modo errato o non includono attributi specifici relativi alle cause profonde, diventa quasi impossibile analizzare le tendenze in modo significativo. Questa carenza nella qualità dei dati nasconde le vere cause dell’instabilità IT e impedisce alla direzione di prendere decisioni informate sugli investimenti infrastrutturali. Se la categoria del problema non corrisponde alla causa profonda effettiva, la pianificazione strategica a lungo termine si basa su presupposti errati.

Analizziamo l’uso di attributi come Problem Category e Root Cause Category lungo il flusso di processo in Zendesk Support. Individuando i punti in cui mancano dati o vengono modificati in una fase avanzata del ciclo di vita, è possibile migliorare gli standard di inserimento e ottenere informazioni più accurate sui problemi. Questo aiuta a capire quali servizi aziendali o elementi di configurazione richiedono maggiori investimenti e attenzione.

A volte i team si affidano a soluzioni temporanee a tempo indeterminato per evitare la complessità di una correzione definitiva. Anche se possono risolvere il sintomo nell’immediato, lasciano instabile l’infrastruttura sottostante e aumentano il carico di manutenzione a lungo termine per il reparto IT. Con il tempo, l’accumulo di misure temporanee crea un ambiente fragile, in cui anche modifiche minime possono causare gravi interruzioni.

La nostra piattaforma rileva i record di problema che restano aperti a lungo dopo la pubblicazione di una soluzione temporanea, senza che venga avviata una richiesta di modifica. Questa visibilità aiuta a dare priorità al passaggio dalla mitigazione temporanea alla risoluzione definitiva, riducendo il debito tecnico complessivo. Monitorando il tempo trascorso dalla pubblicazione della soluzione temporanea, è possibile sollecitare il team a individuare una soluzione più stabile e duratura.

Molti record di problema vengono aperti ma non arrivano mai a una conclusione: restano attivi per mesi senza aggiornamenti. Questi record ingombrano la coda, alterano le metriche di prestazione e rappresentano rischi irrisolti per l’organizzazione. Spesso vengono dimenticati quando i team passano a incidenti più urgenti, lasciando che il problema sottostante provochi un’altra crisi.

Individuiamo automaticamente i record con lunghi periodi di inattività tra attività come Investigation Commenced e Proposed Solution Drafted. In questo modo, i responsabili possono verificare l’arretrato e riavviare le indagini bloccate oppure chiudere formalmente i record che non sono più pertinenti in Zendesk Support. Eliminare i record inattivi offre un quadro molto più accurato della capacità effettiva e del carico di lavoro della gestione dei problemi.

Obiettivi tipici

Definisca i criteri di successo

Concentrarsi sulla rapidità dell’individuazione è essenziale, perché le indagini prolungate lasciano i sistemi esposti ai rischi. Ridurre il tempo necessario per trovare la causa profonda limita le possibili interruzioni delle attività e tutela la continuità dei servizi in tutta l’organizzazione. Quando le indagini sono più rapide, i team IT possono passare dalla diagnosi reattiva al miglioramento proattivo della stabilità.

ProcessMind mappa il flusso dall’individuazione del problema alla scoperta della causa profonda in Zendesk Support. Individua le fasi in cui le indagini si bloccano, consentendo ai responsabili di riassegnare gli esperti tecnici e semplificare le attività diagnostiche. Identificando questi colli di bottiglia, le organizzazioni possono ridurre fino al 30% la durata della fase di indagine.

Il ripetersi frequente degli incidenti indica che i problemi sistemici non vengono risolti alla radice. Affrontando le cause profonde invece dei soli sintomi, i team IT possono ridurre il costo complessivo dell’assistenza e migliorare la soddisfazione degli utenti. Una gestione efficace dei problemi si traduce direttamente in un minor numero di ticket nella coda di Zendesk Support nel tempo.

Con il Process Mining, i team possono mettere in relazione i record di problema con gli schemi degli incidenti più frequenti. ProcessMind evidenzia quali risoluzioni prevengono efficacemente il ripetersi degli incidenti e quali non affrontano il problema sottostante. Queste informazioni consentono di ridurre del 20% il volume dei ticket ricorrenti, dando priorità ai problemi che causano gli incidenti più frequenti.

Le soluzioni temporanee efficaci offrono un sollievo immediato mentre si sviluppa una correzione definitiva. Documentarle e pubblicarle rapidamente riduce i tempi di inattività per gli utenti finali e permette agli agenti del service desk di risolvere più velocemente gli incidenti correlati. Un approccio standardizzato evita che le conoscenze tecniche restino confinate in singoli team.

ProcessMind monitora il tempo che intercorre tra l’individuazione di una soluzione temporanea e la sua pubblicazione nella base di conoscenze di Zendesk Support. Segnala i casi in cui le soluzioni temporanee sono note ma non vengono condivise, favorendo una circolazione più fluida delle informazioni. Questa visibilità aiuta a rendere disponibili più soluzioni temporanee e a ridurre il tempo medio necessario per ripristinare il servizio in caso di problemi noti.

Rispettare gli accordi sui livelli di servizio per i problemi ad alta priorità è fondamentale per mantenere la stabilità delle attività aziendali. Raggiungere questi obiettivi con regolarità rafforza la fiducia degli stakeholder e garantisce che i problemi più gravi ricevano l’attenzione necessaria. Il mancato rispetto degli obiettivi può innescare una serie di guasti e perdite di produttività.

ProcessMind offre una visione in tempo reale dello stato degli SLA per tutti i record di problema attivi. Individua i percorsi di processo che portano al mancato rispetto delle scadenze, consentendo ai responsabili di intervenire prima che si verifichi una violazione. Grazie a queste informazioni, le organizzazioni possono raggiungere il 100% di conformità nella risoluzione dei problemi critici, eliminando gli ostacoli nel percorso di escalation.

Per risolvere i problemi è spesso necessaria la collaborazione tra diversi team tecnici specializzati. Passaggi di consegne fluidi tra i gruppi evitano la perdita di informazioni e riducono i tempi di inattività che spesso caratterizzano la risoluzione dei problemi complessi. Quando i passaggi sono ottimizzati, l’intero ciclo di vita procede più rapidamente e gli errori di comunicazione diminuiscono in modo significativo.

La piattaforma visualizza i passaggi tra i diversi gruppi di assistenza in Zendesk Support. Misurando i tempi di attesa a ogni transizione, ProcessMind aiuta a individuare i compartimenti stagni e a rendere più efficiente il flusso di comunicazione. I responsabili possono così perfezionare le procedure di passaggio, riducendo il tempo in cui un record di problema resta in sospeso durante il trasferimento tra gruppi.

Una volta individuata la causa profonda, l’attenzione dovrebbe spostarsi subito sull’implementazione. Ridurre il tempo tra la conclusione dell’indagine e l’avvio di una richiesta di modifica permette di riportare i sistemi a uno stato stabile il più rapidamente possibile. I ritardi in questa fase sono spesso dovuti a ostacoli amministrativi o a uno scarso coordinamento tra i reparti.

ProcessMind analizza il tempo che intercorre tra l’identificazione della causa profonda e la creazione di una richiesta di modifica o l’applicazione di una correzione. Mette in evidenza gli ostacoli amministrativi che rallentano il passaggio dalla diagnosi alla risoluzione. Rendendo più efficiente questo passaggio, le organizzazioni possono ridurre il tempo complessivo necessario per risolvere i problemi IT complessi.

Le revisioni successive all’implementazione sono fondamentali per il miglioramento continuo dei processi e per l’apprendimento dell’organizzazione. Sottoporre ogni problema rilevante a una revisione formale aiuta a imparare dagli errori passati e a impedire che problemi simili si presentino altrove. Senza queste revisioni, è probabile che gli stessi errori di processo si ripetano all’infinito.

Il Process Mining monitora il tasso di completamento delle revisioni dopo la chiusura di un record di problema in Zendesk Support. Evidenzia i team o le categorie che saltano spesso questo passaggio, consentendo di intervenire in modo mirato per far rispettare gli standard di processo. Una maggiore conformità alle revisioni fa sì che ogni problema rilevante contribuisca ad arricchire le conoscenze dell’organizzazione.

Una classificazione corretta è alla base di un’analisi significativa delle tendenze e della pianificazione delle risorse. Dati accurati consentono di destinare le risorse alle aree che incidono maggiormente sulla qualità dei servizi IT e sui risultati aziendali. Se le categorie sono errate, i report direzionali diventano inaffidabili e individuare le cause profonde è più difficile.

ProcessMind individua gli schemi di riclassificazione lungo il ciclo di vita dei problemi. Capendo dove le classificazioni iniziali sono spesso errate, i responsabili possono migliorare la formazione e le procedure di inserimento dei dati. Migliorare la qualità dei dati all’origine permette di ottenere report più accurati e di prendere decisioni strategiche più efficaci sugli investimenti nell’infrastruttura IT.

Affidarsi troppo alle soluzioni temporanee crea debito tecnico e instabilità a lungo termine per l’organizzazione. L’obiettivo della gestione dei problemi è passare da correzioni provvisorie a soluzioni definitive che eliminino del tutto la vulnerabilità sottostante. Ridurre il numero di problemi che restano indefinitamente in uno stato di soluzione temporanea è un indicatore chiave del successo.

La piattaforma monitora il numero di problemi che restano in uno stato di soluzione temporanea per periodi prolungati. Fornisce i dati necessari per motivare l’impegno tecnico richiesto dalle correzioni definitive, invece di continuare a intervenire in modo reattivo. Questo passaggio riduce il carico di manutenzione a lungo termine per i team tecnici e aumenta l’affidabilità complessiva dei sistemi.

I record di problema aperti che non mostrano alcuna attività rappresentano rischi trascurati per l’organizzazione. Mantenere l’arretrato aggiornato e attivo permette al team IT di concentrarsi sulle priorità attuali, anziché gestire un elenco sempre più lungo di elementi fermi. I record inattivi spesso nascondono problemi irrisolti che potrebbero causare gravi interruzioni in futuro.

ProcessMind rileva i record di problema inattivi in base al tempo trascorso dall’ultima attività o modifica dello stato in Zendesk Support. Consente ai responsabili di automatizzare gli avvisi o riassegnare i record che non avanzano entro un intervallo di tempo stabilito. Questo monitoraggio proattivo evita che i problemi vengano dimenticati e mantiene gestibile l’arretrato.

I problemi ad alta priorità hanno l’impatto maggiore sulle attività e sui ricavi dell’organizzazione. Risolverli più rapidamente e con maggiore regolarità protegge i servizi e le risorse aziendali più importanti. Un tasso elevato di risoluzione dei problemi critici è un indicatore fondamentale dell’efficacia del processo di gestione dei problemi.

ProcessMind consente di analizzare in dettaglio il ciclo di vita dei record ad alta priorità e confrontarlo con quello dei record standard. Mostra se i problemi critici vengono gestiti con la dovuta urgenza e in quali punti si incontrano ostacoli procedurali. Queste informazioni aiutano i team a dare priorità alle attività più importanti e ad aumentare la percentuale di problemi critici risolti entro i tempi previsti.

Indagare sui problemi può richiedere molte risorse, spesso diverse ore di lavoro da parte di ingegneri esperti. Rendere più efficiente il processo di analisi permette a questi specialisti di dedicare meno tempo alle attività amministrative e più alla diagnosi tecnica complessa e all’innovazione. Ridurre il costo delle analisi rende più sostenibile l’intera funzione di gestione dei problemi.

Quantificando le ore di lavoro e la durata delle diverse indagini, ProcessMind individua i percorsi di risoluzione più efficienti. Questi dati aiutano a standardizzare le buone pratiche in tutti i team di assistenza tecnica. Le organizzazioni possono usare queste informazioni per ridurre il costo medio di risoluzione di ogni problema, mantenendo standard qualitativi elevati.

Il percorso in 6 passaggi per la gestione dei problemi in Zendesk

1

Scarichi il template

Cosa fare

Scarichi il template Excel preconfigurato per le strutture dei dati di gestione dei problemi in Zendesk.

Perché è importante

Un formato standard garantisce che i record di problema e i collegamenti ai ticket siano perfettamente compatibili con il motore di analisi.

Risultato atteso

Un template di dati pronto all’uso per monitorare i problemi in Zendesk.

LE SUE SCOPERTE

Individui le cause profonde dei ritardi nella gestione dei problemi

ProcessMind mappa i flussi di lavoro di Zendesk per mostrare con precisione dove si bloccano le indagini e perché le soluzioni tardano. Potrà osservare chiaramente il ciclo di risoluzione effettivo, dal ticket iniziale alla soluzione definitiva.
  • Mappi ogni passaggio del percorso di risoluzione
  • Individui i ritardi nell’analisi delle cause profonde
  • Individui i colli di bottiglia nell’implementazione delle soluzioni
  • Misuri la coerenza tra i team di supporto
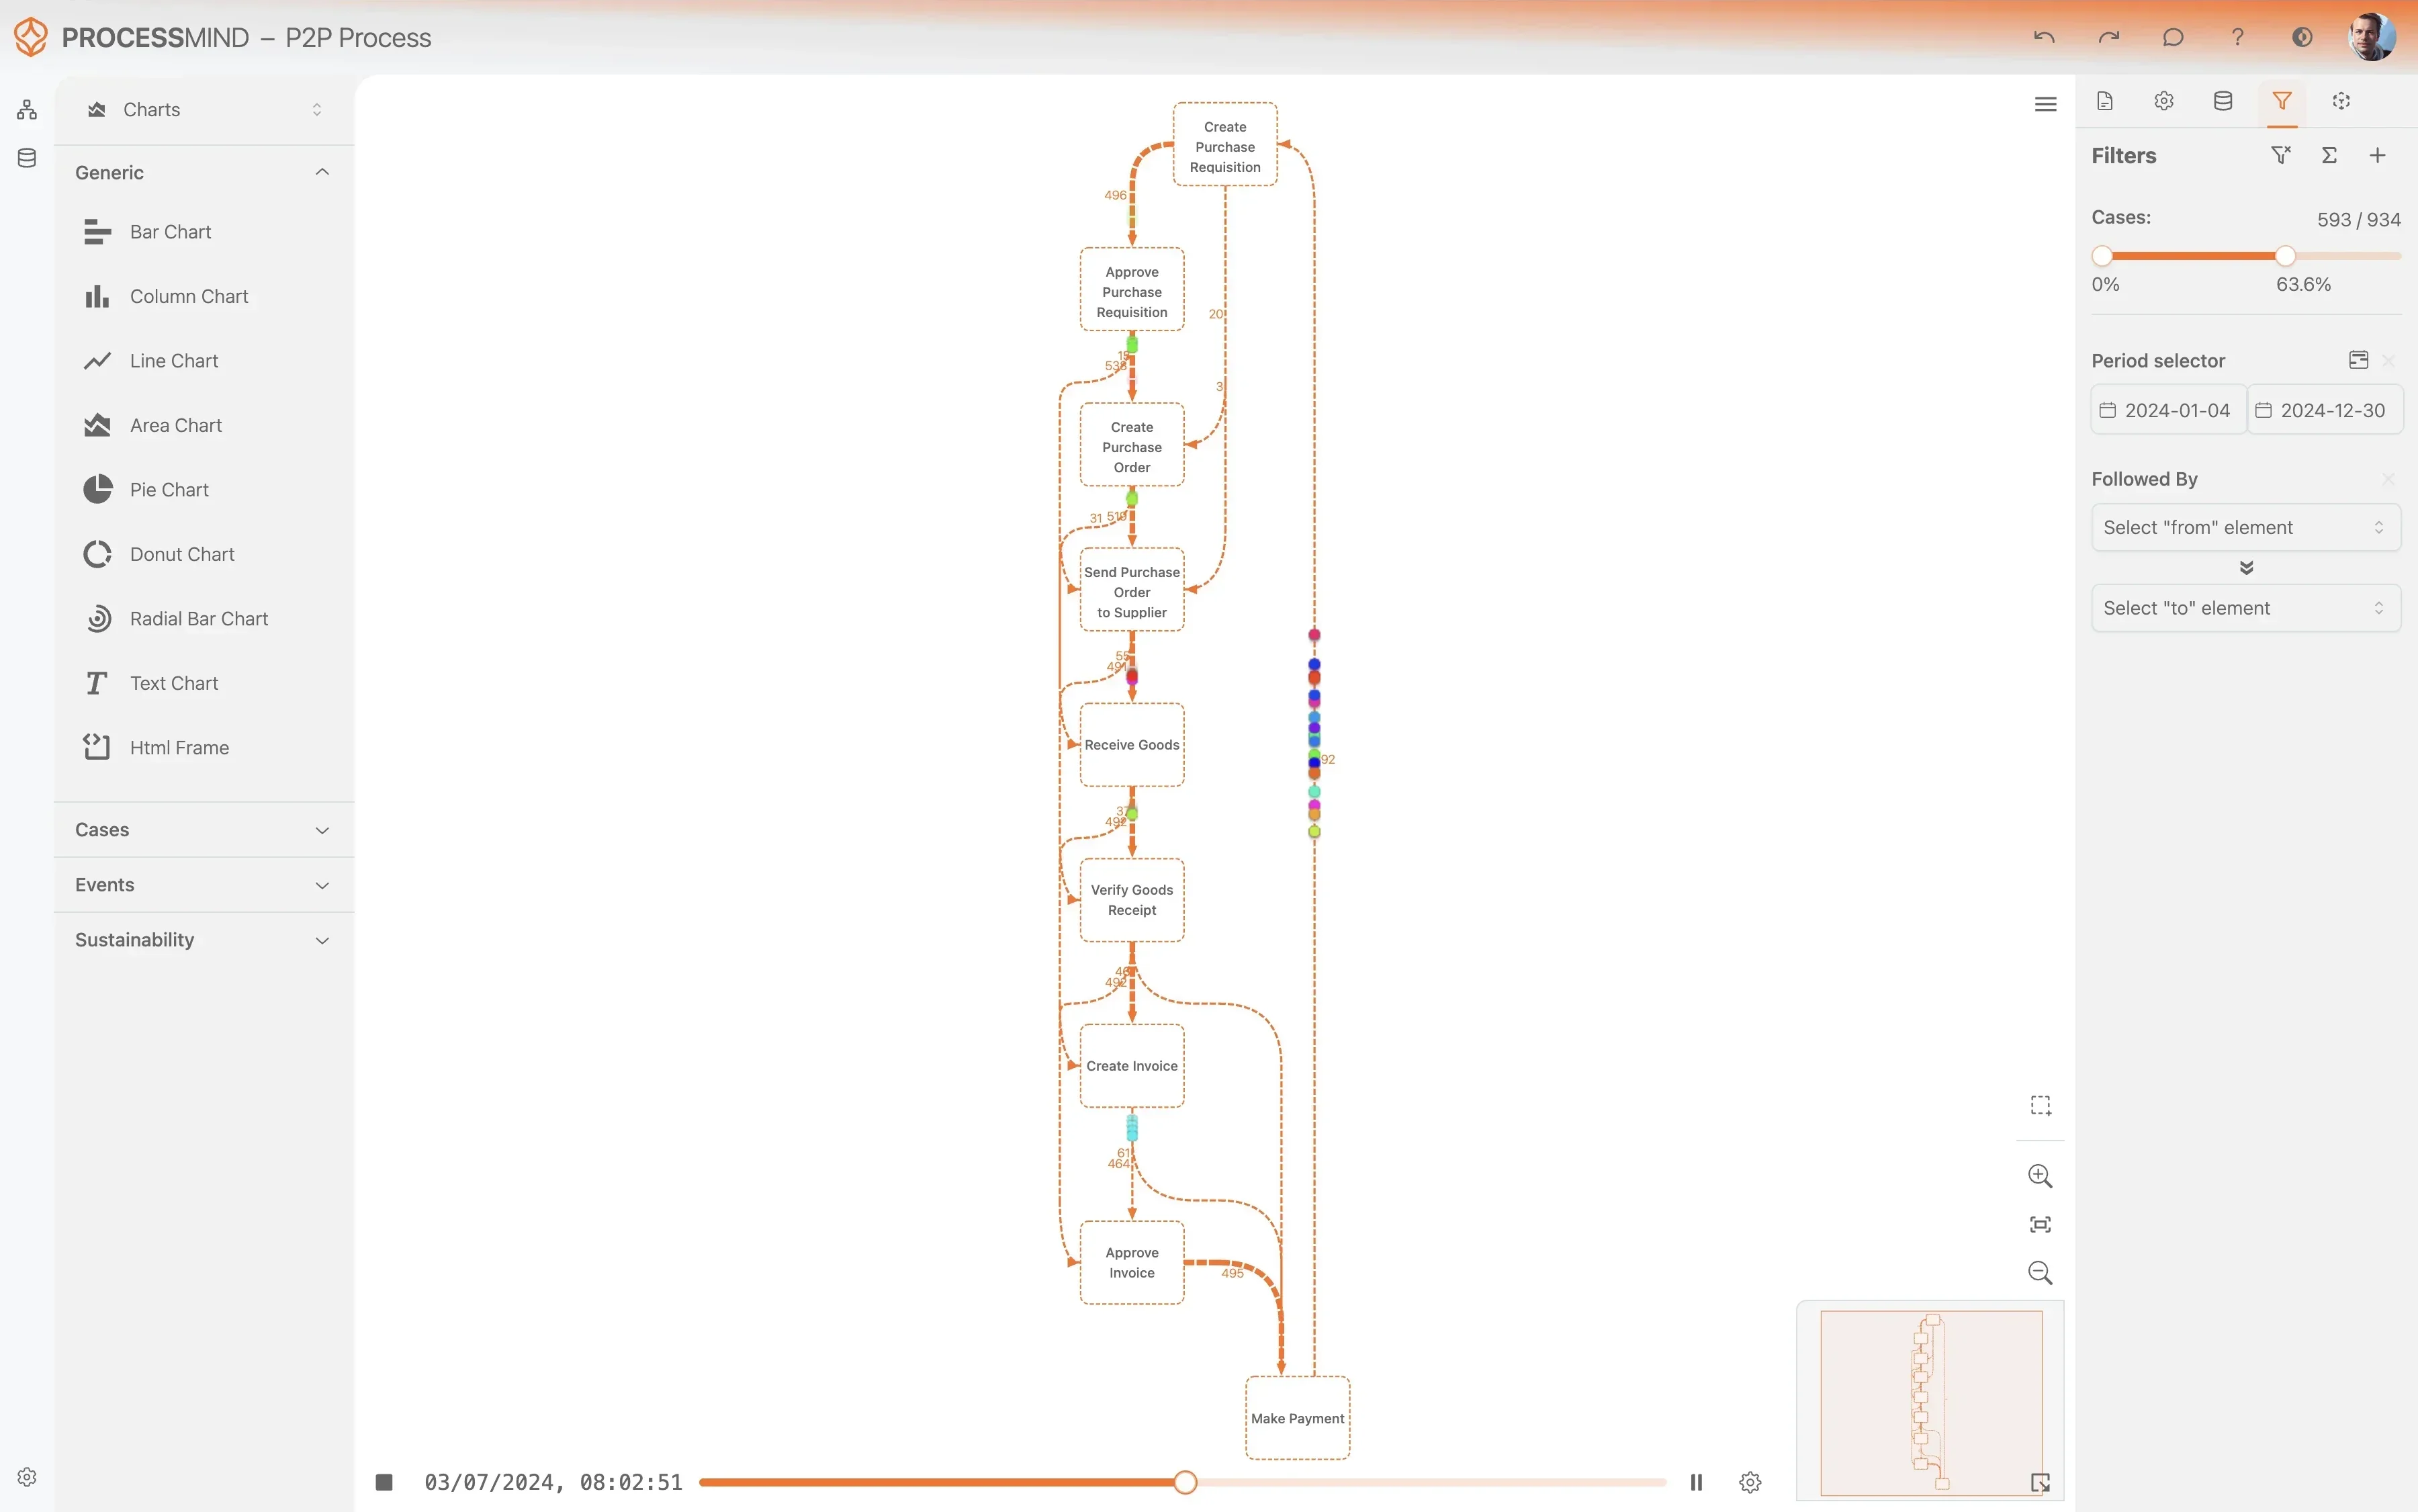
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

RISULTATI DIMOSTRATI

Ottimizzare il ciclo di vita della gestione dei problemi

Analizzando i dati di Zendesk Support con il Process Mining, le organizzazioni individuano i colli di bottiglia nella risoluzione dei problemi ed eliminano gli incidenti ricorrenti attraverso un’analisi mirata delle cause profonde.

0 %
Analisi più rapida delle cause profonde

Riduzione dei tempi di diagnosi

Individuare i colli di bottiglia nella diagnosi consente ai team di accelerare la ricerca delle cause profonde e risolvere con maggiore efficienza i problemi sottostanti.

0 %
Meno incidenti

Riduzione degli incidenti correlati

Aumentare la percentuale di risoluzioni definitive riduce direttamente il numero di incidenti conseguenti e abbassa in modo significativo il costo complessivo delle attività di assistenza.

+ 0 %
Maggiore utilizzo delle soluzioni temporanee

Aumento della percentuale di documentazione

Pubblicare con regolarità le soluzioni temporanee aiuta gli agenti del Service Desk a ripristinare il servizio più rapidamente, mentre vengono sviluppate soluzioni definitive.

0 days
Passaggi di consegne più efficienti tra i gruppi

Riduzione dei tempi di attesa

Visualizzare i trasferimenti tra reparti consente alle organizzazioni di eliminare i tempi di inattività durante il passaggio dei record tra diversi gruppi di assistenza tecnica.

0 %
Più risoluzioni al primo intervento

Riduzione dei casi riaperti

Verificare l’efficacia delle soluzioni definitive consente di accertare che le cause profonde siano state realmente affrontate, prevenendo il ripetersi di interruzioni critiche del servizio.

0 %
Meno record bloccati

Pulizia dei casi di problema inattivi

Il monitoraggio automatico dei record aperti assicura che nessuna indagine venga dimenticata e mantiene l’arretrato concentrato sui casi attivi e prioritari.

I risultati variano in base alla complessità dei processi e alla qualità dei dati. Questi valori rappresentano i miglioramenti tipici osservati in diverse implementazioni di Zendesk.

Dati consigliati

Inizi dagli attributi e dalle attività essenziali per creare una mappa chiara del processo.
Non conosce ancora gli Event Log? Scopra come creare un Event Log per il Process Mining.

Attributi

Dati chiave da acquisire per l’analisi

Livello di urgenza assegnato al record del problema.

Perché è importante

È essenziale per segmentare i casi e analizzare il rispetto degli SLA e la definizione delle priorità nell’allocazione delle risorse.

Team o reparto a cui è attualmente assegnato il record del problema.

Perché è importante

Consente di analizzare l’organizzazione e individuare i colli di bottiglia tra i reparti.

Agente specifico incaricato di gestire il problema.

Perché è importante

Consente di analizzare le risorse a livello individuale.

Stato corrente del record del problema nel suo ciclo di vita.

Perché è importante

Consente di filtrare i casi in base al loro stato di completamento.

Numero di ticket di incidente collegati a questo record del problema.

Perché è importante

Indica la portata del problema e il suo impatto sugli utenti.

Data e ora entro cui il problema dovrebbe essere risolto.

Perché è importante

È fondamentale per misurare il rispetto degli accordi e le prestazioni contrattuali.

Classificazione del problema (ad es. software, hardware, rete).

Perché è importante

Consente di segmentare i dati in base alla tecnologia o al servizio aziendale.

La causa profonda individuata del problema (ad es. difetto del codice, errore di configurazione).

Perché è importante

Consente di analizzare gli schemi ricorrenti dei guasti e orienta le iniziative di miglioramento a lungo termine.

Attività

Fasi del processo da monitorare e ottimizzare

Creazione iniziale del ticket del problema in Zendesk Support. Questo evento registra il timestamp in cui il problema è stato inserito per la prima volta nel sistema e di norma avvia l’istanza del processo.

Perché è importante

Definisce l’ora di inizio del ciclo di risoluzione end-to-end e costituisce la base di riferimento per tutte le successive metriche del tempo di attraversamento.

Instradamento del record del problema a uno specifico team tecnico o reparto. Viene rilevato quando si aggiorna il campo Group ID del ticket.

Perché è importante

È essenziale per la Dashboard di analisi dei passaggi tra gruppi di assistenza, che misura i tempi di attesa tra i reparti.

Segna il passaggio dallo stato passivo 'New' a uno stato di lavoro attivo. Indica che un agente ha preso in carico il problema e ha avviato la diagnosi.

Perché è importante

Viene utilizzato per calcolare le metriche dei record dei problemi non aggiornati e costituisce il punto di partenza del KPI sulla durata media dell’analisi delle cause profonde.

Documentazione e condivisione di una soluzione temporanea al problema. In Zendesk, l’evento viene spesso registrato tramite un tag specifico o un campo casella di controllo personalizzato che indica la disponibilità di una soluzione temporanea.

Perché è importante

Supporta la Dashboard di conformità alla pubblicazione delle soluzioni temporanee, assicurando agli utenti un rimedio provvisorio durante le indagini più lunghe.

Momento in cui viene determinata la causa sottostante del problema. In genere, l’evento viene registrato quando l’agente compila un campo di testo personalizzato 'Root Cause' o seleziona una categoria da un menu a discesa.

Perché è importante

È una tappa fondamentale per la Dashboard sulla velocità delle indagini sulle cause profonde e per misurare l’efficienza della diagnosi.

Indica che la soluzione tecnica è stata distribuita nell’ambiente. Di solito viene rilevata tramite una transizione di stato personalizzata o un tag specifico, prima che il ticket venga risolto completamente.

Perché è importante

È essenziale per la Dashboard sull’efficienza dell’implementazione delle correzioni, che misura il tempo dalla diagnosi alla distribuzione.

Registrazione formale del problema come risolto. In Zendesk, avviene quando lo stato standard del sistema viene impostato su 'Solved', a indicare che la correzione è stata verificata e il caso è concluso.

Perché è importante

È il punto finale di riferimento per il calcolo delle prestazioni e del rischio SLA e del tasso di rispetto degli SLA dei problemi.

Evento finale del ciclo di vita, in cui il ticket viene bloccato e non può più essere modificato. In Zendesk, di solito avviene automaticamente 4 giorni dopo il passaggio allo stato Solved.

Perché è importante

Segna la fine definitiva del ciclo di vita del record e viene utilizzato per la conservazione dei dati e la reportistica storica.

Domande frequenti

Domande frequenti

Il Process Mining utilizza gli Event Log già presenti in Zendesk per creare una mappa visiva del percorso effettivo dei record dei problemi nel sistema. Individua i colli di bottiglia nascosti e gli scostamenti dalle procedure operative standard, mostrando con precisione in quali punti le indagini si bloccano.

Per iniziare, servono in genere l’ID del record del problema, un timestamp per ogni modifica di stato e il nome dell’attività, ad esempio gli aggiornamenti di stato o le modifiche di assegnazione. Altri campi, come priorità, categoria o gruppo assegnatario, sono utili per applicare filtri più approfonditi e analizzare le cause profonde.

Mappando la relazione tra incidenti e record dei problemi, è possibile individuare situazioni in cui determinati problemi vengono affrontati ripetutamente con soluzioni temporanee anziché essere risolti in modo definitivo. Questa visibilità aiuta a dare priorità agli interventi ad alto impatto, capaci di eliminare interi gruppi di ticket di assistenza ricorrenti.

La maggior parte dei team visualizza le prime mappe dei processi entro pochi giorni dal collegamento dei dati di Zendesk. Poiché il sistema utilizza i log storici, non è necessario attendere l’accumulo di nuovi dati per individuare colli di bottiglia significativi o problemi di conformità.

Sì, lo strumento monitora il trasferimento dei record dei problemi tra i diversi gruppi di assistenza e i team tecnici. In questo modo è possibile individuare con precisione i punti in cui i passaggi di consegne non vanno a buon fine o i record restano inattivi troppo a lungo, così da allocare meglio le risorse.

No, il Process Mining analizza i log di audit che Zendesk genera già in background. Per ottenere risultati accurati, non è necessario modificare i flussi di lavoro, aggiungere campi personalizzati o cambiare il modo in cui operano gli agenti.

Il sistema monitora il tempo trascorso in ogni fase del processo e lo confronta con gli obiettivi di livello di servizio definiti. Può segnalare i percorsi che portano spesso al mancato rispetto degli SLA, ad esempio quando si verificano ritardi nel passaggio dalla diagnosi alla riparazione.

Analizzando la sequenza delle attività, lo strumento può segnalare i record che passano direttamente allo stato di chiusura senza completare passaggi obbligatori, come l’analisi delle cause profonde o la revisione successiva all’implementazione. In questo modo il team può attenersi agli standard di qualità richiesti per ogni problema rilevante.

Ottimizzi la gestione dei problemi per risolvere più rapidamente le criticità IT

Riduca del 30% i cicli di risoluzione e rimuova i colli di bottiglia IT.

Inizi la prova gratuita

Non è richiesta alcuna carta di credito. Configurazione in pochi minuti.