Migliori la gestione dei problemi
Guida in 6 passaggi all’ottimizzazione dei processi in Freshservice
Migliori la gestione dei problemi
Gestione dei problemi
Freshservice

Selezioni un processo

Scelga un processo per continuare a lavorare nell’area di lavoro collegata.

Processi disponibili
Sistemi disponibili
259 Processi

Ottimizzi la gestione dei problemi in Freshservice con il Process Mining

La nostra piattaforma individua i colli di bottiglia nascosti e mostra in quali punti le indagini sulle cause profonde subiscono più spesso rallentamenti. Visualizzando ogni fase, può capire dove si verificano i ritardi e in che modo i percorsi non standard incidono sull’erogazione dei servizi. Queste informazioni aiutano il Suo team a semplificare i flussi di lavoro e a ridurre il tempo dedicato agli incidenti ricorrenti.

Scarichi il nostro template dei dati preconfigurato e affronti le sfide più comuni per raggiungere i Suoi obiettivi di efficienza. Segua il nostro piano di miglioramento in sei fasi e consulti la guida al template dei dati per trasformare le Sue attività.

Mostra la descrizione dettagliata

Il valore strategico di una gestione dei problemi efficace

La gestione dei problemi è spesso il motore silenzioso dell’eccellenza nei servizi IT. Mentre la gestione degli incidenti punta alla rapidità e al ripristino del servizio, la gestione dei problemi si concentra sulla qualità e sulla risoluzione definitiva. Nell’ambiente Freshservice, i team possono registrare e classificare facilmente i ticket, ma la vera difficoltà sta nei complessi passaggi di consegne tra i diversi livelli di supporto e nel passaggio da una soluzione temporanea alla sua sostituzione con una correzione definitiva. Se il processo è lento o inefficiente, l’organizzazione si trova a gestire numerosi problemi ricorrenti, che assorbono risorse tecniche e frustrano gli utenti finali.

Ottimizzare questo flusso non significa soltanto chiudere i ticket più rapidamente, ma anche fare in modo che ogni analisi delle cause profonde porti a una riduzione misurabile delle interruzioni del servizio. Concentrandosi su come e perché si sviluppa il ciclo di gestione dei problemi, è possibile passare da una gestione reattiva delle emergenze a una strategia proattiva, che previene i tempi di inattività prima che si verifichino. Per riuscirci, occorre comprendere a fondo come circolano le informazioni in Freshservice e in quali punti le indagini tendono a bloccarsi.

Trasformare i dati di Freshservice in informazioni visive

Il Process Mining offre una prospettiva unica sull’ambiente Freshservice, ricostruendo ogni singolo passaggio di un record di problema. Invece di basarsi su medie statiche o semplici grafici a barre, può osservare i percorsi effettivamente seguiti dai team tecnici. Può individuare con precisione i record che restano inattivi per giorni o che passano ripetutamente da un gruppo di supporto all’altro, in un continuo rimpallo.

Questa visibilità consente di distinguere le indagini complesse, che richiedono naturalmente tempi più lunghi, dai semplici ritardi amministrativi che si possono eliminare. Visualizzando la sequenza delle attività, non occorre più affidarsi a supposizioni sui colli di bottiglia: si dispone di dati oggettivi su cui basare i miglioramenti del processo. Per esempio, potrebbe emergere che il passaggio da «Problema individuato» ad «Assegnato al gruppo di supporto» è la fase più lunga del ciclo, segnalando la necessità di migliorare il triage iniziale o introdurre automazioni nella piattaforma Freshservice.

Individuare gli ostacoli nel ciclo di indagine

Un’area che spesso offre margini di miglioramento è il tempo che intercorre tra l’individuazione di una soluzione temporanea e l’avvio dell’indagine completa. In molte organizzazioni, una volta attenuata la pressione causata dall’incidente grazie a una soluzione provvisoria, diminuisce l’urgenza di individuarne la causa profonda. Il Process Mining consente di verificare se il team è bloccato in un ciclo di soluzioni temporanee, in cui la stessa misura provvisoria viene applicata più volte senza procedere verso una soluzione definitiva.

Analizzando i passaggi in Freshservice, per esempio il tempo tra «Soluzione temporanea pubblicata» e «Richiesta di modifica avviata», è possibile verificare che le risorse siano dedicate a modifiche architetturali di grande impatto anziché a continue correzioni temporanee. Inoltre, si può individuare se determinate categorie di problemi vengono riaperte spesso, segno che la causa profonda inizialmente individuata potrebbe essere errata o che è stato saltato il passaggio di verifica. Queste informazioni consentono di rafforzare la conformità e di verificare che il processo venga seguito come previsto.

Accelerare il percorso verso una risoluzione definitiva

Per migliorare la gestione dei problemi è necessario anche analizzare a fondo le interazioni tra i team. Quando un record di problema passa da un gruppo di supporto generico a un team specializzato di ingegneri, spesso si perdono informazioni importanti. Potrebbe emergere che i record vengono restituiti più volte per richiedere ulteriori informazioni, con un conseguente aumento significativo del tempo di ciclo complessivo. Il Process Mining permette di individuare questi cicli e definire standard di documentazione più efficaci fin dall’inizio dell’indagine.

In questo modo, il passaggio di consegne è più fluido e gli specialisti possono iniziare l’analisi disponendo fin da subito di tutti i dati necessari. Inoltre, monitorando l’integrazione con la gestione delle modifiche, è possibile verificare se le soluzioni proposte vengono implementate tempestivamente o restano in attesa nell’arretrato delle modifiche da approvare. Ridurre questi ritardi è fondamentale per mantenere lo slancio delle iniziative di miglioramento dei servizi.

Costruire un ambiente IT più resiliente

L’obiettivo finale dell’ottimizzazione della gestione dei problemi in Freshservice è rendere più resilienti i servizi IT. Riducendo la durata delle indagini e aumentando il tasso di successo delle correzioni definitive, si riduce direttamente il costo complessivo delle attività IT. Il personale dedica meno tempo alla gestione delle emergenze ricorrenti e più tempo all’innovazione e al miglioramento dell’infrastruttura.

Adottare il Process Mining significa scegliere un percorso di maturità basato sui dati. Seguendo le tracce digitali lasciate nei registri di Freshservice, è possibile trasformare un reparto IT reattivo in un centro di eccellenza proattivo, capace di anticipare e prevenire i problemi prima che abbiano un impatto sull’attività aziendale. Questo approccio migliora l’efficienza interna e aumenta l’affidabilità complessiva dei servizi da cui l’azienda dipende ogni giorno.

Gestione dei problemi Analisi delle cause profonde Gestione dei servizi IT Responsabile del Service Desk Riduzione degli incidenti Coordinatore dei problemi Conformità ITIL Gestione dei ticket Gestione dei ticket Errore noto Incidenti ricorrenti Soluzione temporanea Prevenzione degli incidenti Help desk IT

Problemi e sfide comuni

Individui le sfide che La riguardano

I record dei problemi restano spesso nella fase di indagine per settimane senza progressi evidenti, facendo aumentare l’arretrato e lasciando irrisolte le cause sottostanti. Questi ritardi impediscono ai team di affrontare l’origine degli incidenti ricorrenti, aumentano il carico di lavoro del Service Desk e riducono l’affidabilità complessiva dei servizi per gli utenti aziendali.

Quando un record di problema passa da un team tecnico all’altro, spesso si perde il contesto e i tempi di risoluzione si allungano notevolmente. La mancanza di responsabilità chiare comporta lavoro sprecato, frustrazione per il personale tecnico e il mancato raggiungimento degli obiettivi di livello del servizio relativi alla stabilità e alle prestazioni delle infrastrutture critiche.

Se una soluzione temporanea non viene pubblicata rapidamente, gli addetti alla gestione degli incidenti continuano a dover affrontare problemi ripetitivi e aumenta il tempo medio di risoluzione per gli utenti finali. Quando il tempo tra l’individuazione di un problema e la pubblicazione di una soluzione temporanea è eccessivo, l’azienda subisce tempi di inattività evitabili, nonostante sia già disponibile una soluzione provvisoria.

Anche dopo aver individuato una causa profonda, il percorso verso una correzione definitiva spesso si blocca quando viene avviata una richiesta di modifica. La mancata integrazione tra i flussi di lavoro della gestione dei problemi e della gestione delle modifiche lascia irrisolti errori noti che potrebbero essere corretti, esponendo l’ambiente IT a interruzioni ricorrenti dei servizi e a rischi per la sicurezza.

Saltare la fase di revisione successiva all’implementazione impedisce ai team IT di trarre insegnamenti dagli incidenti gravi e migliorare le strategie di risposta future. Se queste revisioni vengono omesse o svolte in fretta, l’organizzazione non riesce a raccogliere informazioni essenziali e finisce per ripetere gli stessi errori di processo nelle indagini successive.

Spesso i team dedicano molto tempo all’indagine di record di problemi a bassa priorità mentre quelli ad alto impatto restano irrisolti. Senza stabilire le priorità in base ai rischi effettivi per l’azienda, le risorse tecniche specializzate vengono utilizzate in modo inefficiente e i servizi aziendali più critici non vengono stabilizzati nell’ambiente Freshservice.

Il mancato rispetto degli obiettivi di livello del servizio per i problemi ad alta priorità può avere gravi conseguenze finanziarie e reputazionali per i reparti IT. Se le scadenze per l’analisi delle cause profonde o l’implementazione delle correzioni definitive vengono ripetutamente mancate, il flusso del processo potrebbe non funzionare correttamente oppure potrebbe mancare la visibilità sulle scadenze imminenti.

Se un record di problema viene chiuso e poi riaperto perché gli incidenti si ripresentano, è probabile che la causa profonda non sia stata individuata correttamente o che la correzione non sia adeguata. Questa rilavorazione raddoppia i costi dell’indagine e riduce la fiducia nel processo di gestione dei problemi, mentre la criticità di fondo resta irrisolta.

Una classificazione imprecisa o generica delle cause profonde impedisce di analizzare in modo significativo le tendenze o pianificare la manutenzione preventiva. Quando i team tecnici scelgono categorie vaghe in Freshservice, l’organizzazione perde la possibilità di individuare nel tempo le debolezze sistemiche di specifiche infrastrutture o componenti software.

Se gli incidenti non vengono collegati correttamente a un record di problema attivo, la direzione non riesce a valutare il reale impatto della criticità. I team finiscono per duplicare le indagini e diventa difficile giustificare le risorse necessarie per una correzione definitiva, perché il volume degli incidenti appare inferiore a quello reale.

Obiettivi tipici

Definisca i criteri di successo

Accelerare la fase di indagine è fondamentale per prevenire future interruzioni dei servizi. Se l’analisi delle cause profonde subisce ritardi, l’organizzazione resta esposta a incidenti ricorrenti che assorbono risorse IT e frustrano gli utenti finali. Riducendo i tempi di questa fase, i team possono passare più efficacemente dalla gestione reattiva delle emergenze alla prevenzione proattiva.

ProcessMind individua in Freshservice le fasi esatte in cui le indagini si bloccano, per esempio in attesa di informazioni da fornitori esterni o di documentazione interna. Visualizzando il tempo trascorso in ciascuno stato, i team possono definire valori di riferimento realistici e rimuovere i colli di bottiglia che impediscono una diagnosi rapida, riducendo potenzialmente i cicli di indagine del 30% o più.

I frequenti passaggi di consegne dei record dei problemi spesso comportano la perdita di informazioni e l’allungamento dei tempi di risoluzione. Ridurre questi passaggi permette al team più qualificato di mantenere la responsabilità dall’inizio alla fine, favorendo risultati tecnici più coerenti e affidabili. Migliora inoltre la chiarezza delle responsabilità all’interno della struttura di supporto tecnico.

La nostra piattaforma di Process Mining mappa il flusso dei record dei problemi tra i diversi gruppi di supporto, evidenziando percorsi circolari e riassegnazioni eccessive. Queste informazioni consentono ai responsabili di perfezionare le regole di assegnazione e di indirizzare subito i problemi agli esperti più adatti, riducendo sensibilmente il numero medio di passaggi per record.

Fornire tempestivamente soluzioni temporanee è essenziale per ripristinare il servizio mentre si sviluppa una correzione definitiva. In questo modo si limita l’impatto dei problemi in corso sull’attività aziendale e si riduce la pressione sul Service Desk durante le indagini complesse. Pubblicare più rapidamente le soluzioni temporanee migliora direttamente l’esperienza degli utenti finali interessati dagli incidenti ricorrenti.

ProcessMind monitora in Freshservice il tempo che intercorre tra l’individuazione di un problema e la pubblicazione della relativa soluzione temporanea. Individuando i ritardi nel flusso di pubblicazione, può semplificare il processo di revisione e rendere le soluzioni disponibili molto prima al personale a contatto con gli utenti, riducendo il volume degli incidenti legati a errori noti.

Individuare una causa profonda serve a poco se la soluzione definitiva resta bloccata nel flusso di gestione delle modifiche. Coordinare questi due processi consente di implementare rapidamente le correzioni individuate, risolvere definitivamente gli errori noti e ridurre il periodo di esposizione al rischio per l’organizzazione.

Visualizziamo i passaggi di consegne tra il modulo di gestione dei problemi e quello di gestione delle modifiche in Freshservice. In questo modo può individuare i punti in cui le soluzioni proposte si bloccano nelle code di approvazione e migliorare il coordinamento tra i coordinatori dei problemi e i responsabili delle modifiche, accelerando la risoluzione definitiva.

I problemi ad alta priorità richiedono il rispetto rigoroso degli obiettivi dei livelli di servizio, per proteggere i servizi essenziali per l’attività aziendale. Migliorare la conformità consente di riservare ai problemi più gravi l’attenzione urgente necessaria a mantenere la stabilità operativa. In questo modo, il reparto IT può rispettare gli impegni assunti nei confronti dell’intera azienda.

Analizzando i dati storici sulle prestazioni, ProcessMind individua gli schemi che portano al mancato rispetto degli SLA. È possibile identificare le categorie o i livelli di priorità che più spesso non raggiungono gli obiettivi, così da gestire le scadenze in modo proattivo e distribuire meglio le risorse, assicurando il rispetto costante degli obiettivi critici.

La riapertura dei record dei problemi indica spesso che la soluzione iniziale era incompleta o che la causa profonda è stata individuata in modo errato. Ridurre queste riaperture rende più affidabile il processo di gestione dei problemi ed evita di sprecare risorse su questioni che si ritenevano risolte. In questo modo, quando un problema viene contrassegnato come chiuso, la minaccia è stata davvero eliminata.

La nostra piattaforma analizza le tracce digitali dei casi riaperti per verificare se, durante il primo tentativo di risoluzione, siano state omesse attività specifiche. Ciò consente di applicare standard qualitativi più elevati e di chiudere un problema solo quando è effettivamente risolto, riducendo le rilavorazioni fino al 20%.

Spesso i team IT dedicano una quantità sproporzionata di tempo a problemi di scarso impatto, mentre quelli critici restano in attesa. Riequilibrare le priorità permette al personale tecnico senior di occuparsi dei problemi che offrono il maggior ritorno in termini di stabilità dei servizi, valorizzando al meglio le competenze tecniche specialistiche.

ProcessMind mette in relazione il volume degli incidenti correlati con il tempo dedicato ai record dei problemi. In questo modo, i responsabili possono individuare le attività di scarso valore da automatizzare o a cui assegnare una priorità inferiore, liberando gli esperti tecnici per le indagini sulle cause profonde ad alto impatto, che possono prevenire centinaia di incidenti futuri.

Una classificazione accurata è alla base di un’analisi efficace dell’andamento e del miglioramento dei servizi nel lungo periodo. Se le cause profonde sono documentate in modo inadeguato, diventa quasi impossibile individuare problemi sistemici nell’infrastruttura IT. Dati di qualità uniforme favoriscono decisioni strategiche migliori.

La nostra soluzione di Process Mining monitora l’uniformità dei dati inseriti alla chiusura del ciclo di vita del problema. Individuando i record con dati generici o mancanti sulle cause profonde, è possibile organizzare interventi formativi mirati e migliorare la qualità dei report nel lungo periodo, rendendo più semplice riconoscere le nuove tendenze tecnologiche.

Collegare tutti gli incidenti correlati a un unico record del problema offre una visione chiara dell’impatto complessivo e aiuta a stabilire le priorità degli interventi. Questo collegamento consente di avvisare tutti gli utenti interessati quando è disponibile una soluzione temporanea o definitiva, migliorando la comunicazione e l’efficienza del Service Desk.

ProcessMind aiuta a individuare in Freshservice gruppi di incidenti simili che non sono collegati a un record del problema. Evidenziando queste lacune, è possibile attivare con maggiore regolarità la gestione proattiva dei problemi, prevenire picchi nel volume degli incidenti e valutare con maggiore precisione l’impatto dei problemi.

Le revisioni successive all’implementazione sono fondamentali per favorire l’apprendimento continuo e prevenire futuri problemi di processo. Saltarle significa perdere opportunità di ottimizzazione e rischiare di ripetere gli stessi errori nei cicli successivi. Revisioni regolari promuovono una cultura del miglioramento continuo.

Verifichiamo che l’attività di revisione sia presente in ogni record del problema chiuso, così da individuare le lacune di conformità. Questa visibilità consente ai responsabili di rendere obbligatoria la fase di revisione per i problemi più gravi, assicurando che ogni problema significativo contribuisca con informazioni utili alla base di conoscenze dell’organizzazione.

Percorso di miglioramento in 6 passaggi per la gestione dei problemi

1

Scarichi il template

Cosa fare

Scarichi il template Excel specifico, progettato per le strutture dati di Problem Management di Freshservice.

Perché è importante

Partire da una struttura predefinita assicura che i dati siano mappati correttamente nel motore di Process Mining, per ottenere un’analisi accurata.

Risultato atteso

Un documento di mappatura dei dati pronto all’uso

LE INFORMAZIONI SUI SUOI PROBLEMI

Gestisca al meglio il flusso di gestione dei problemi in Freshservice

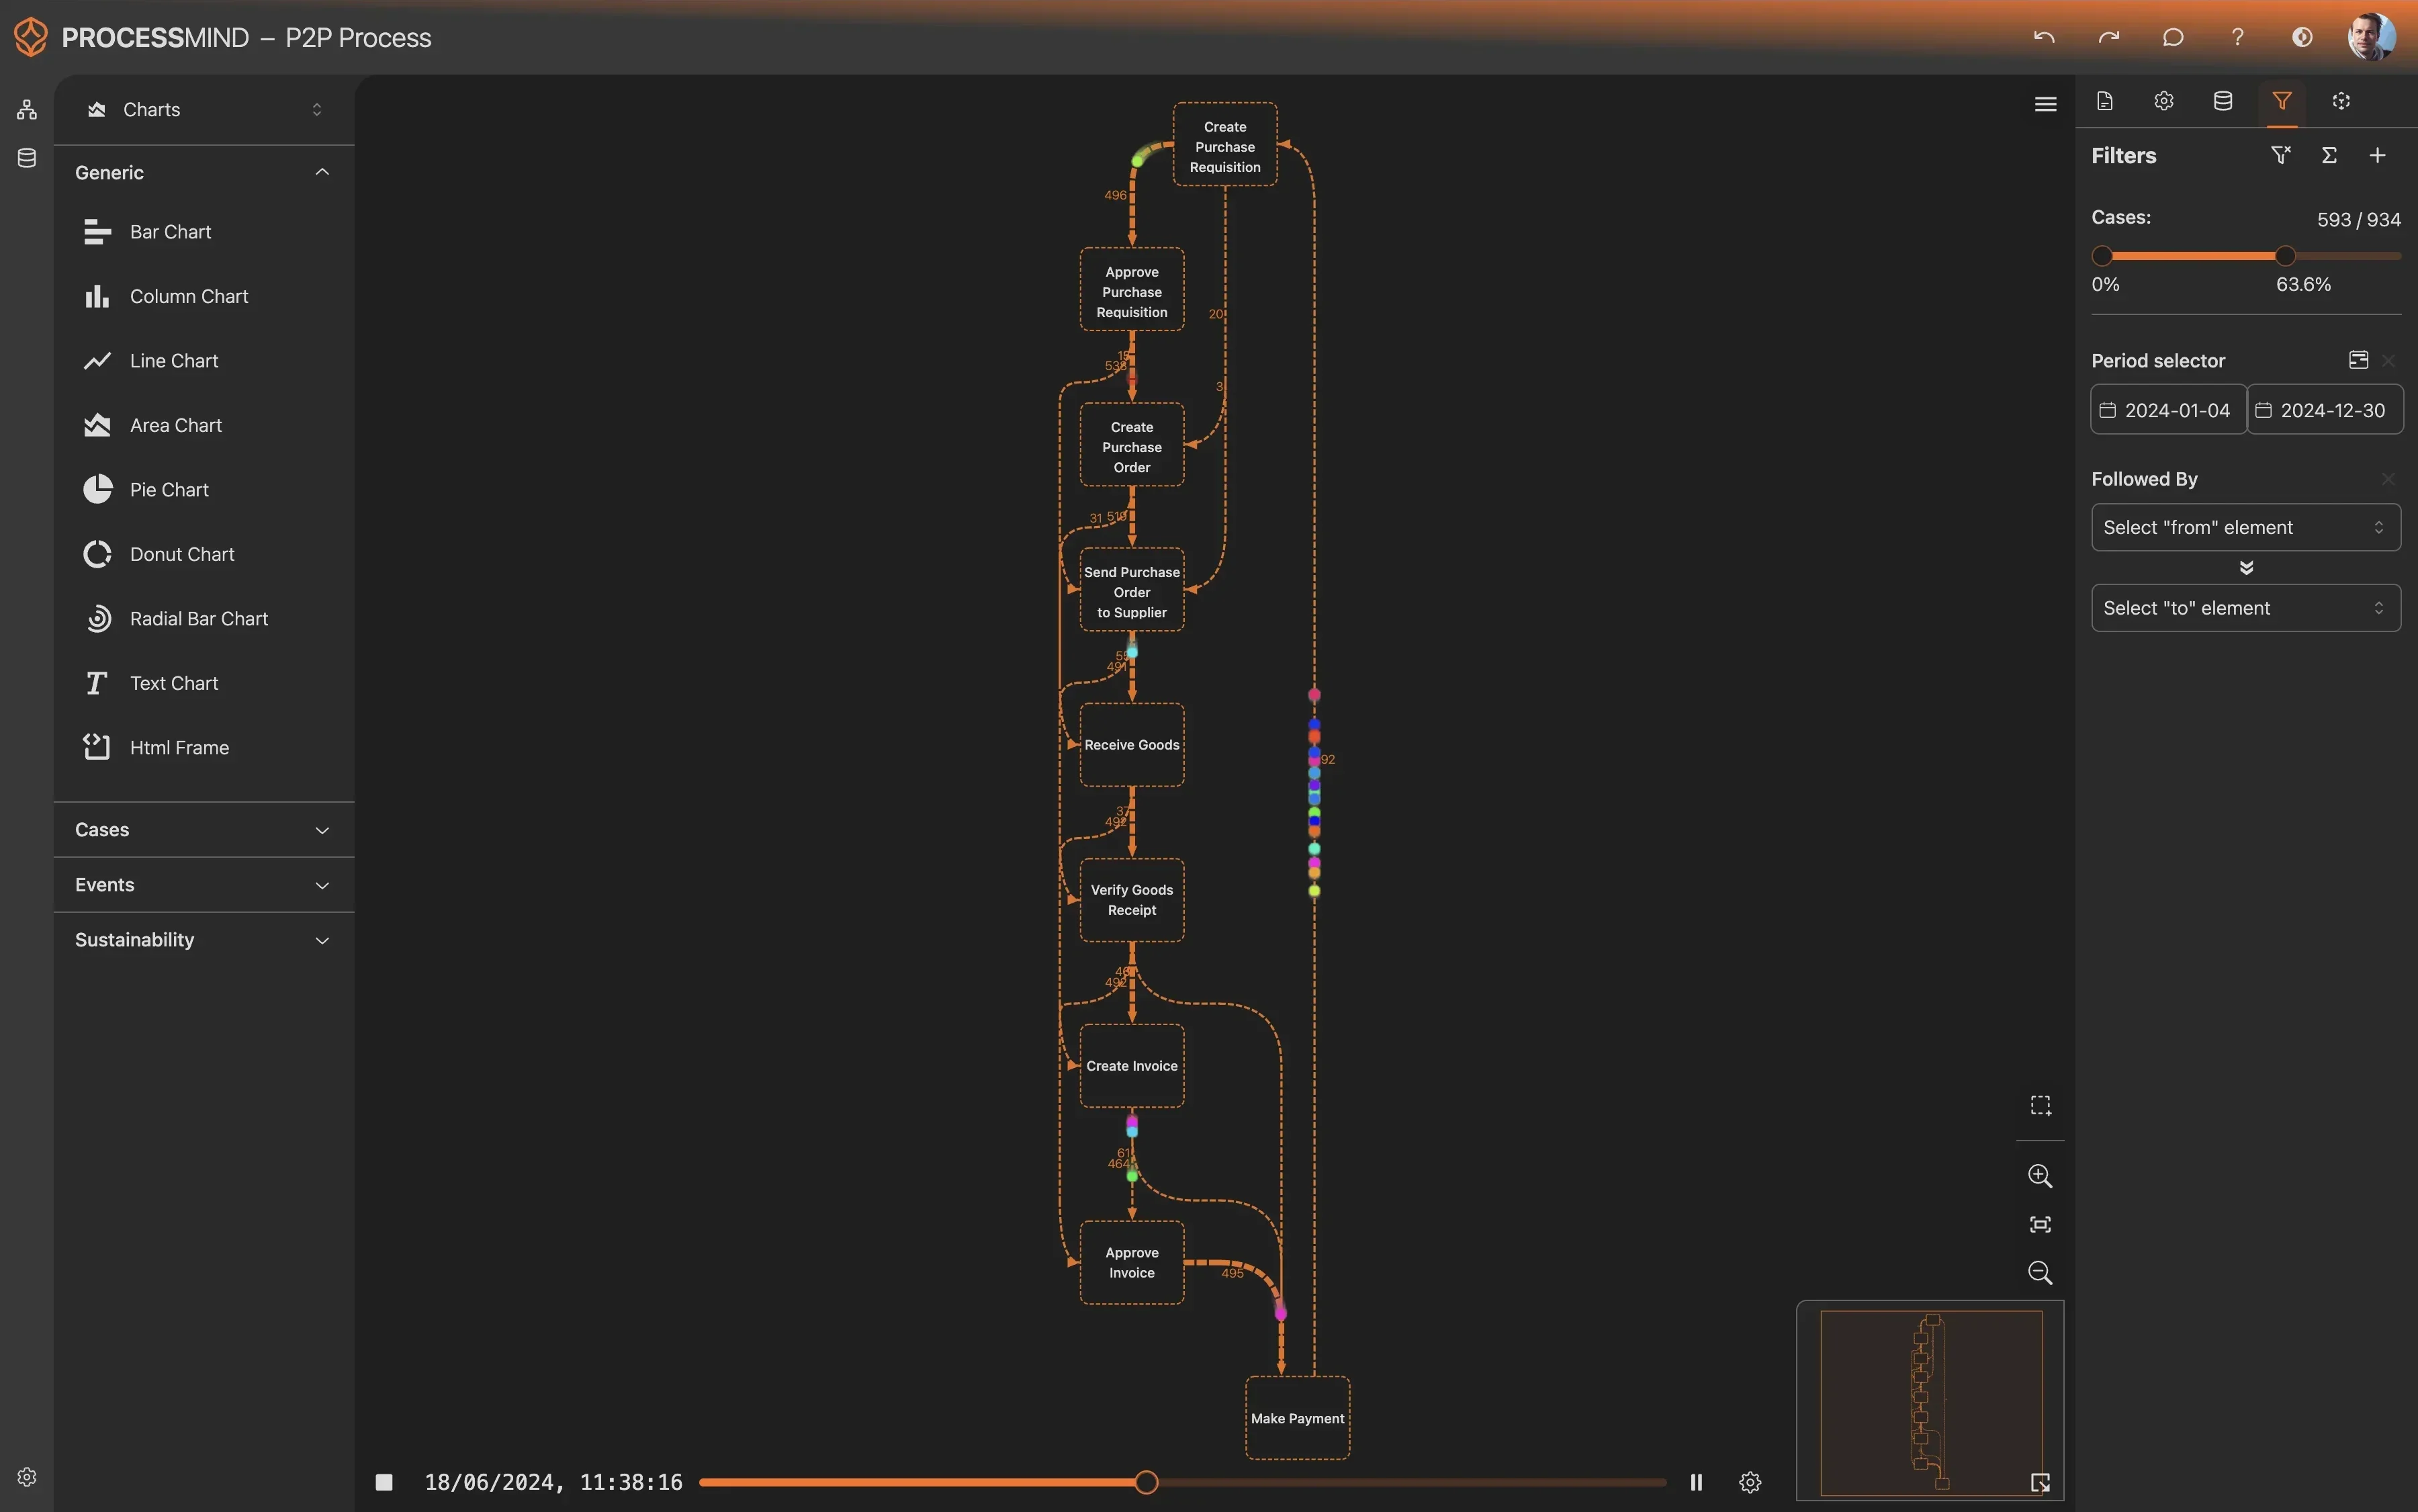
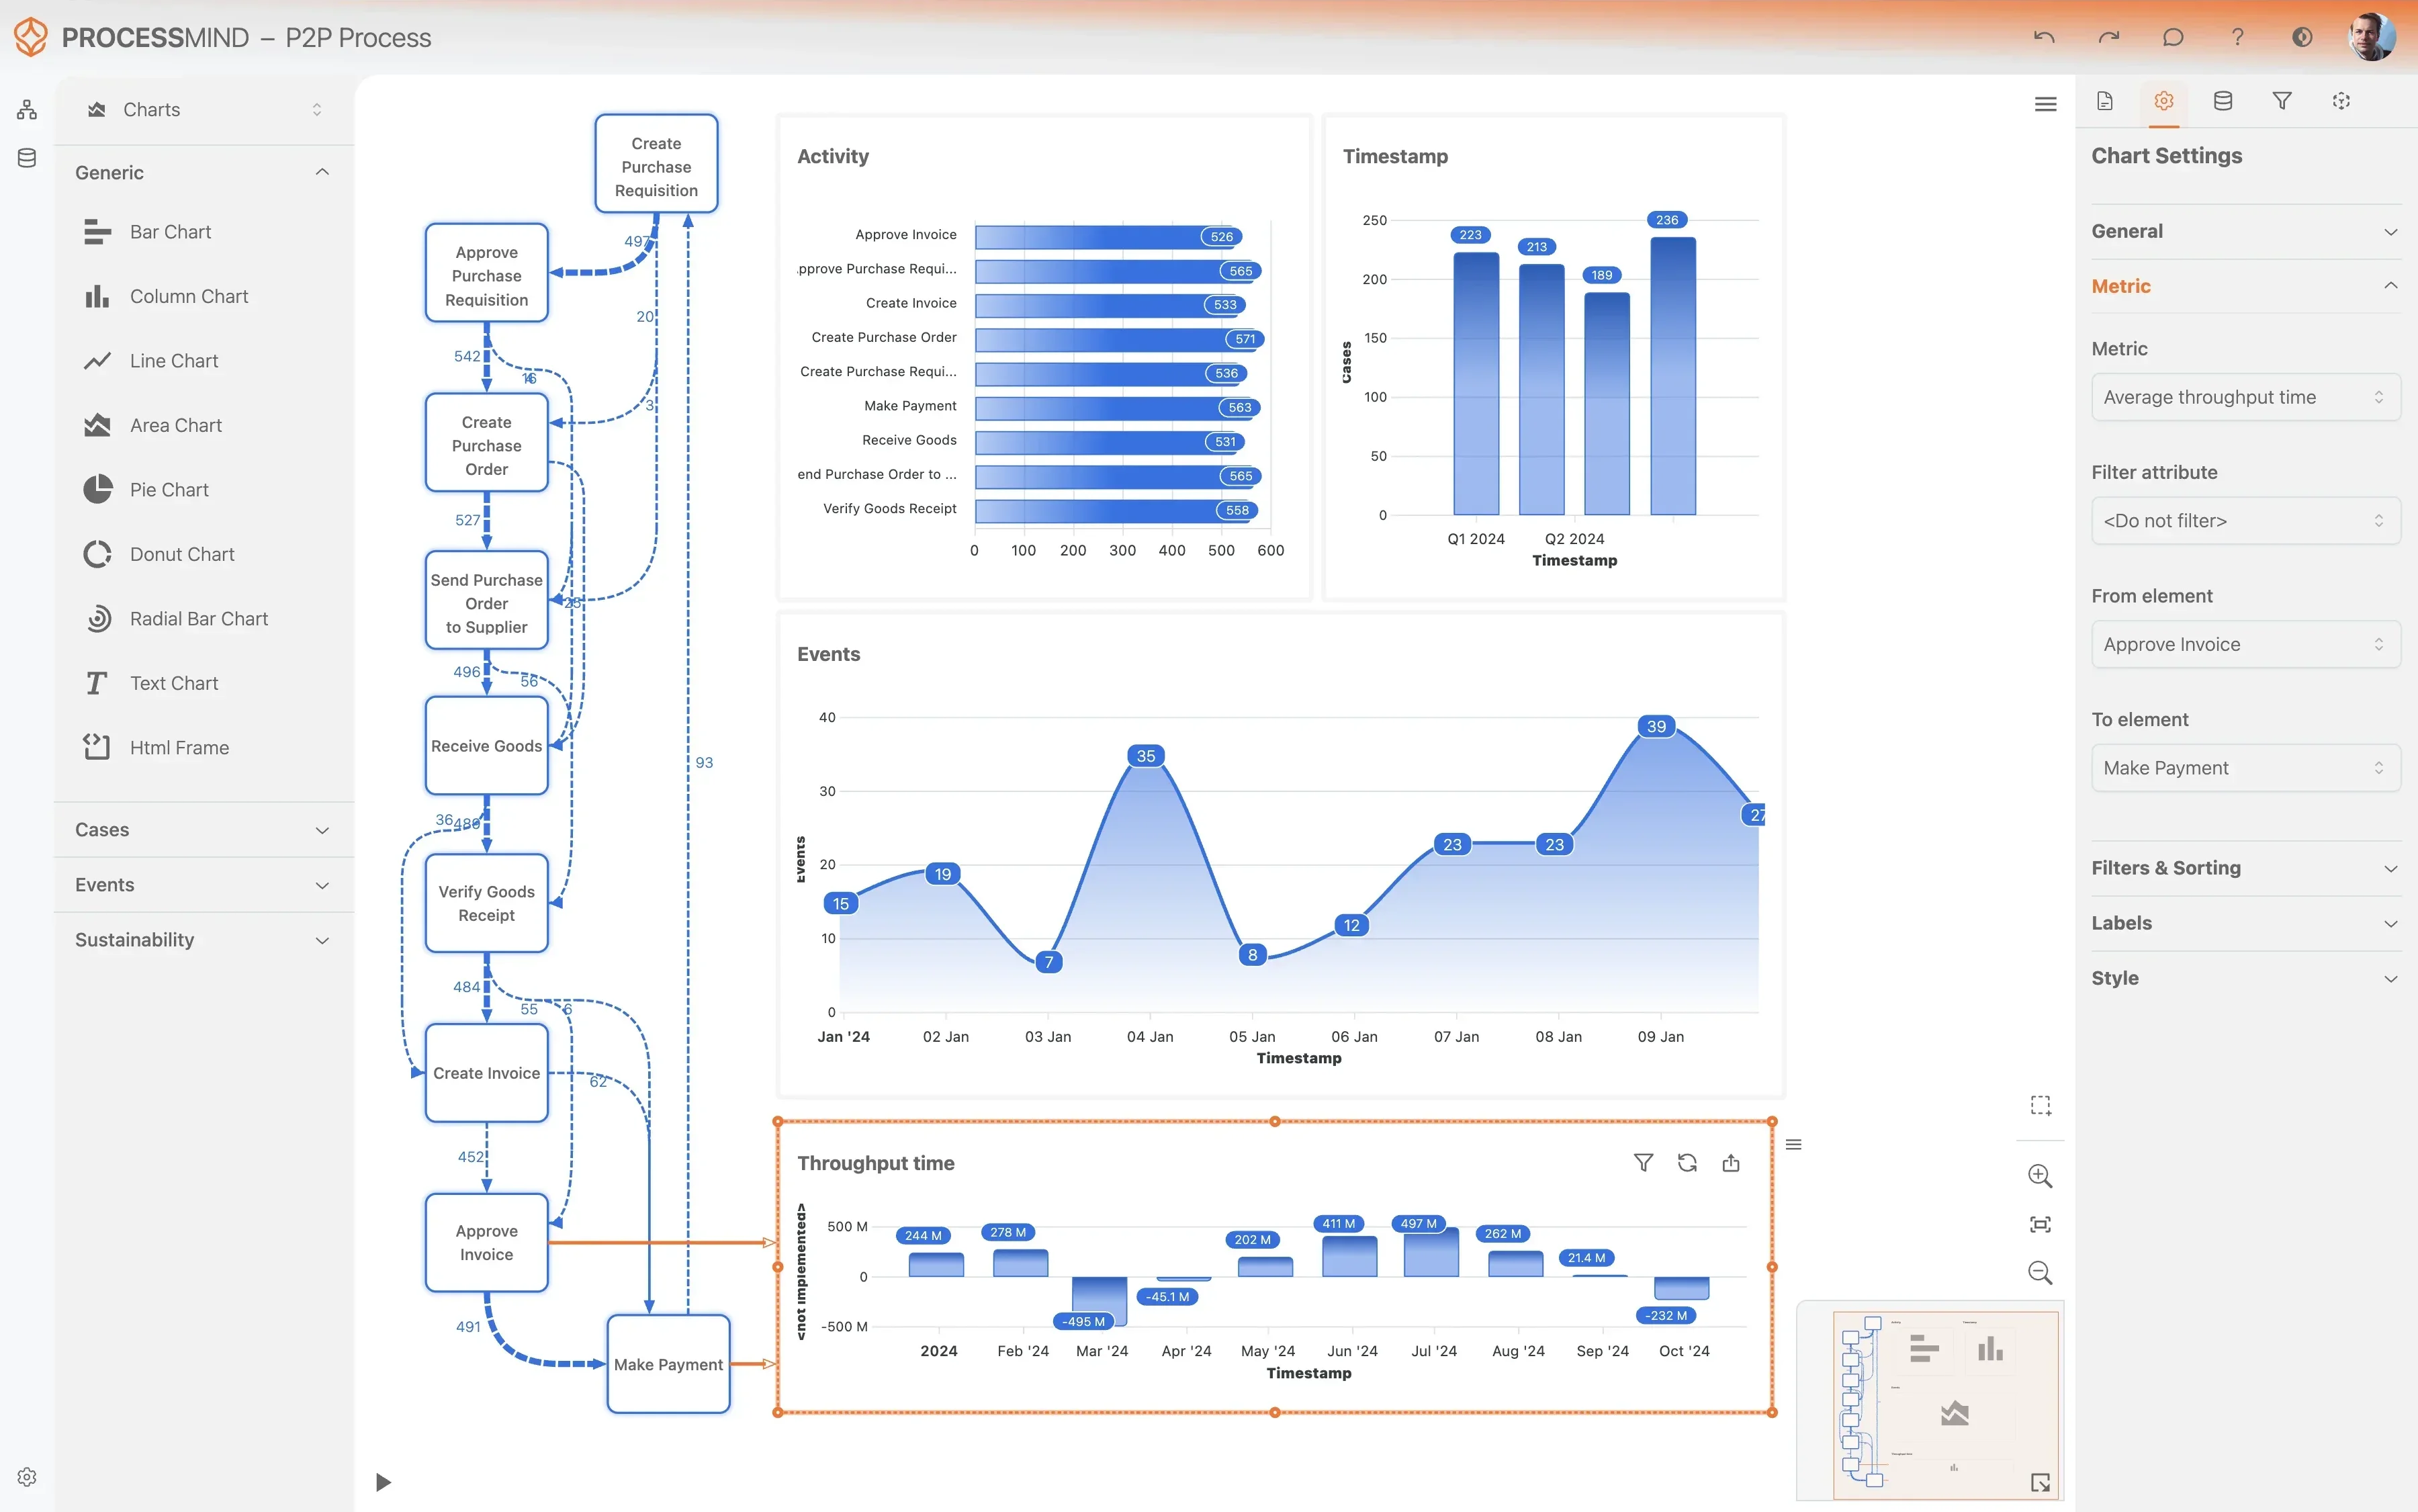
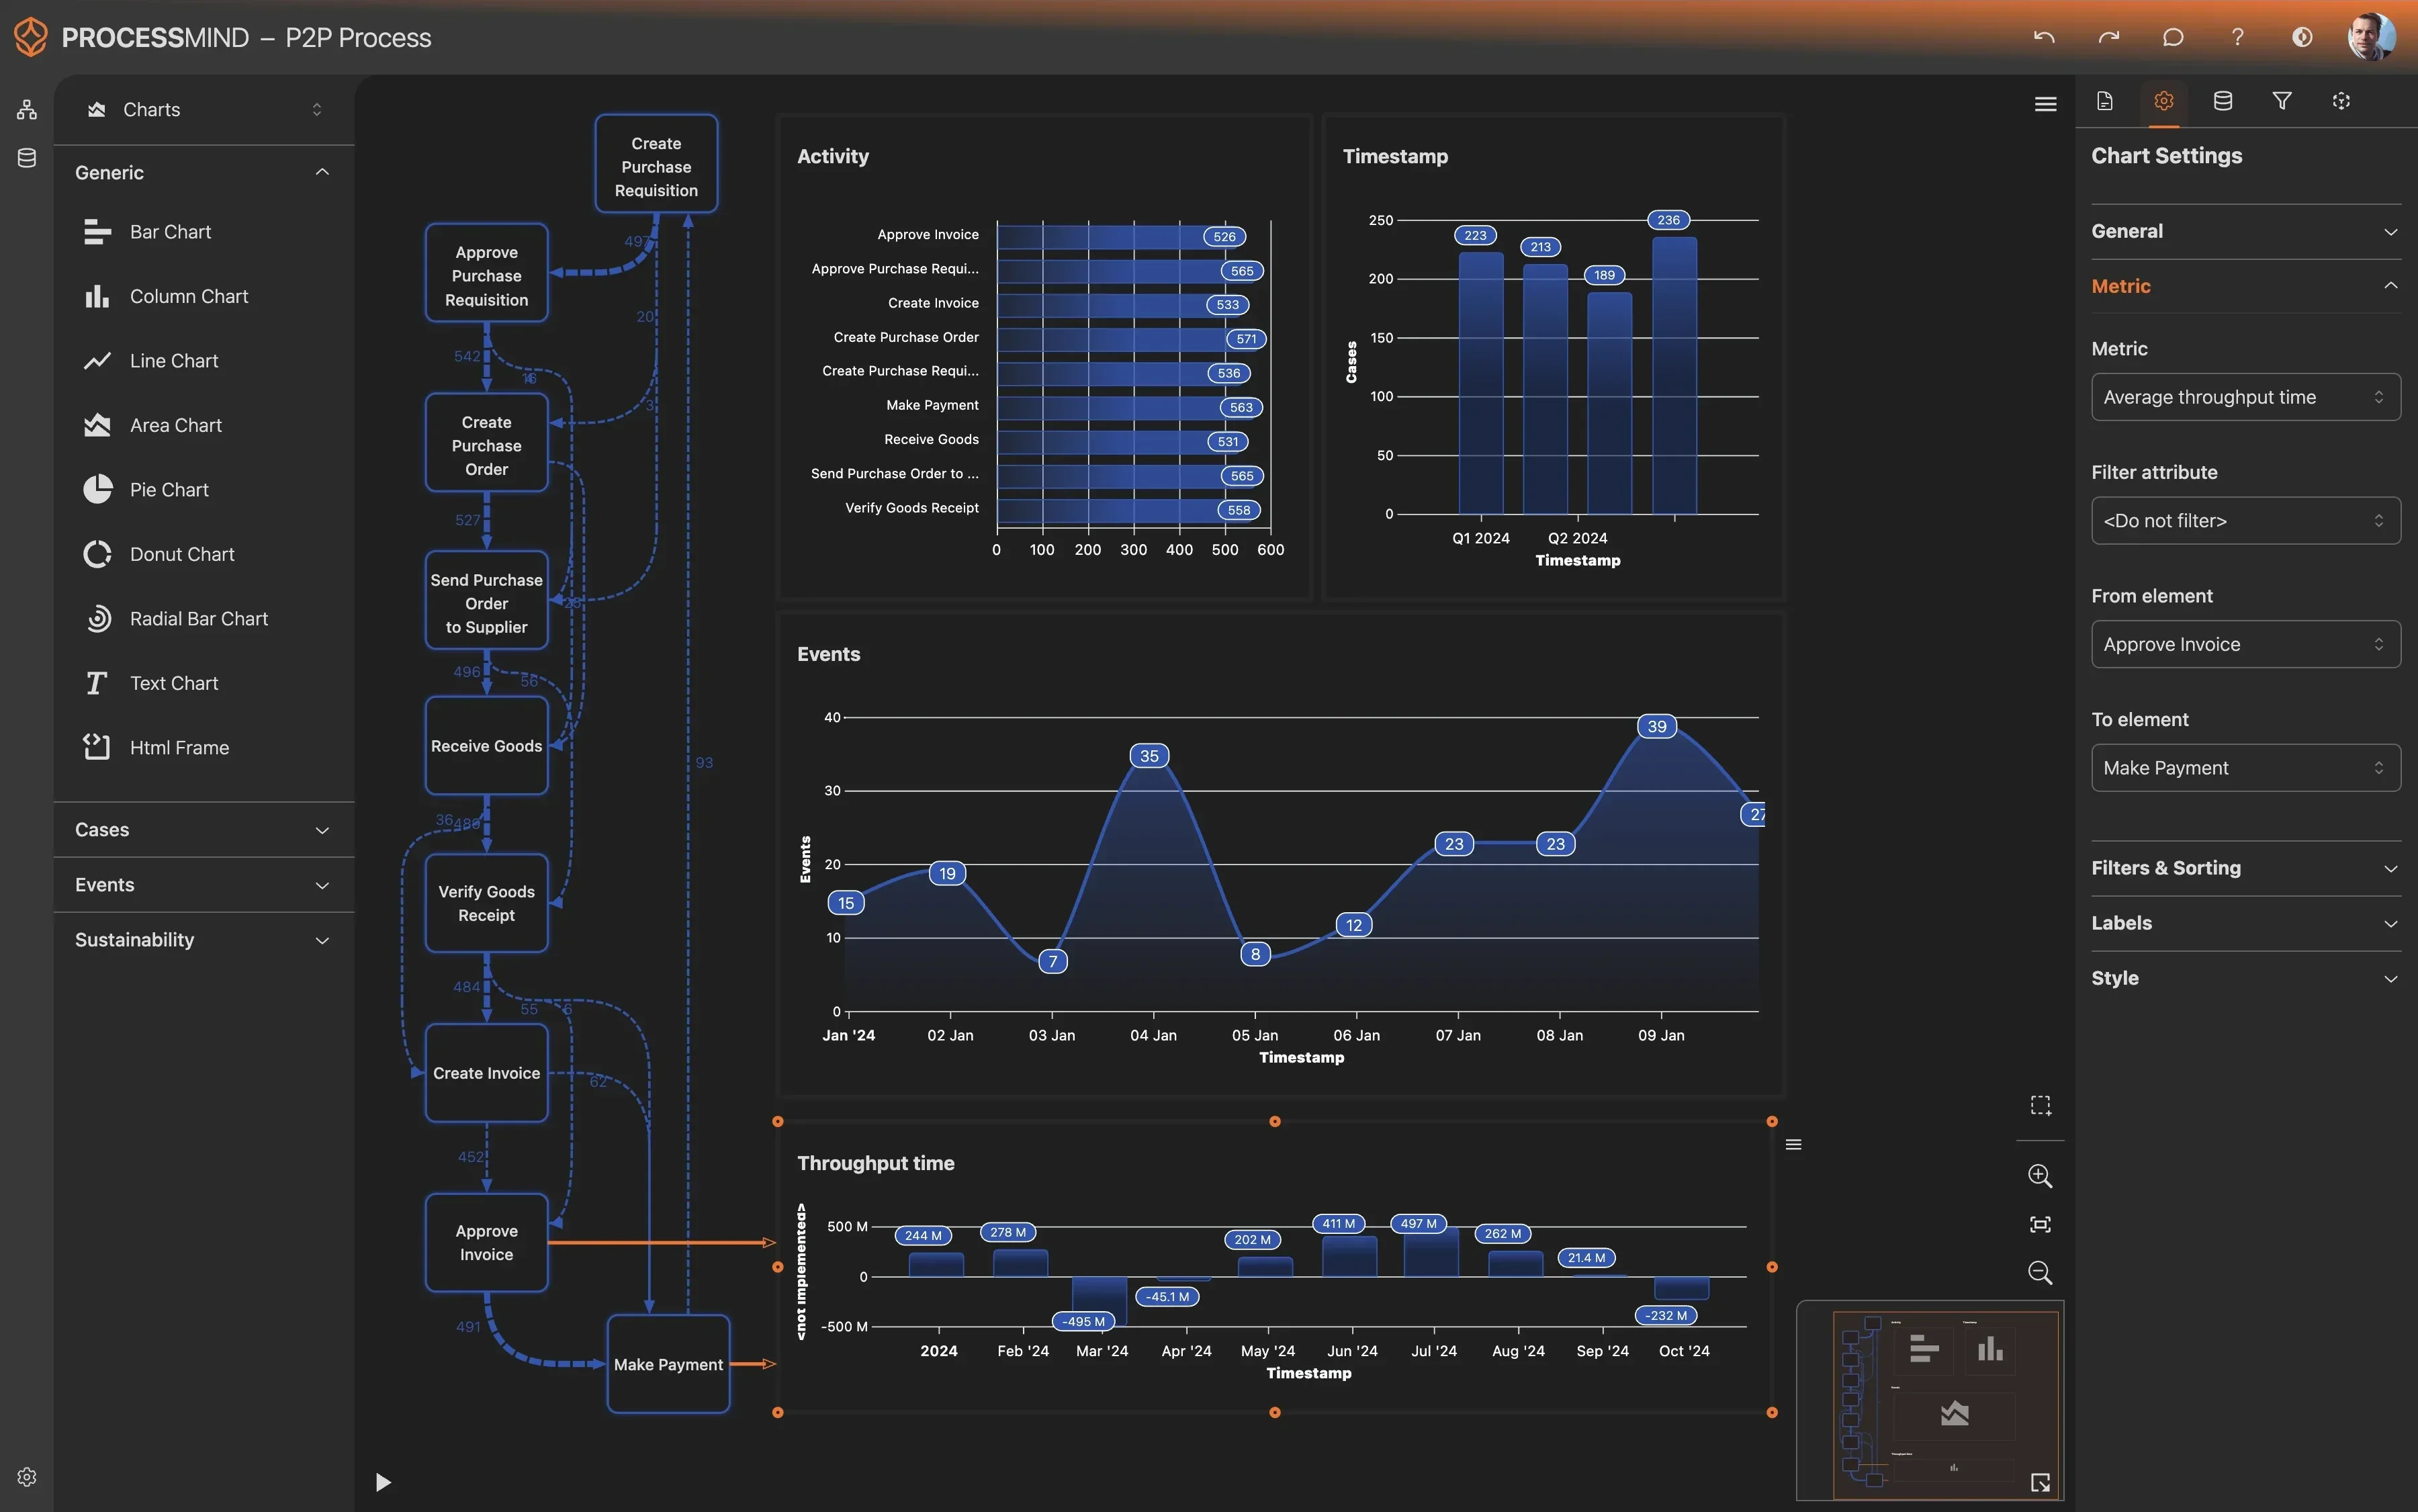
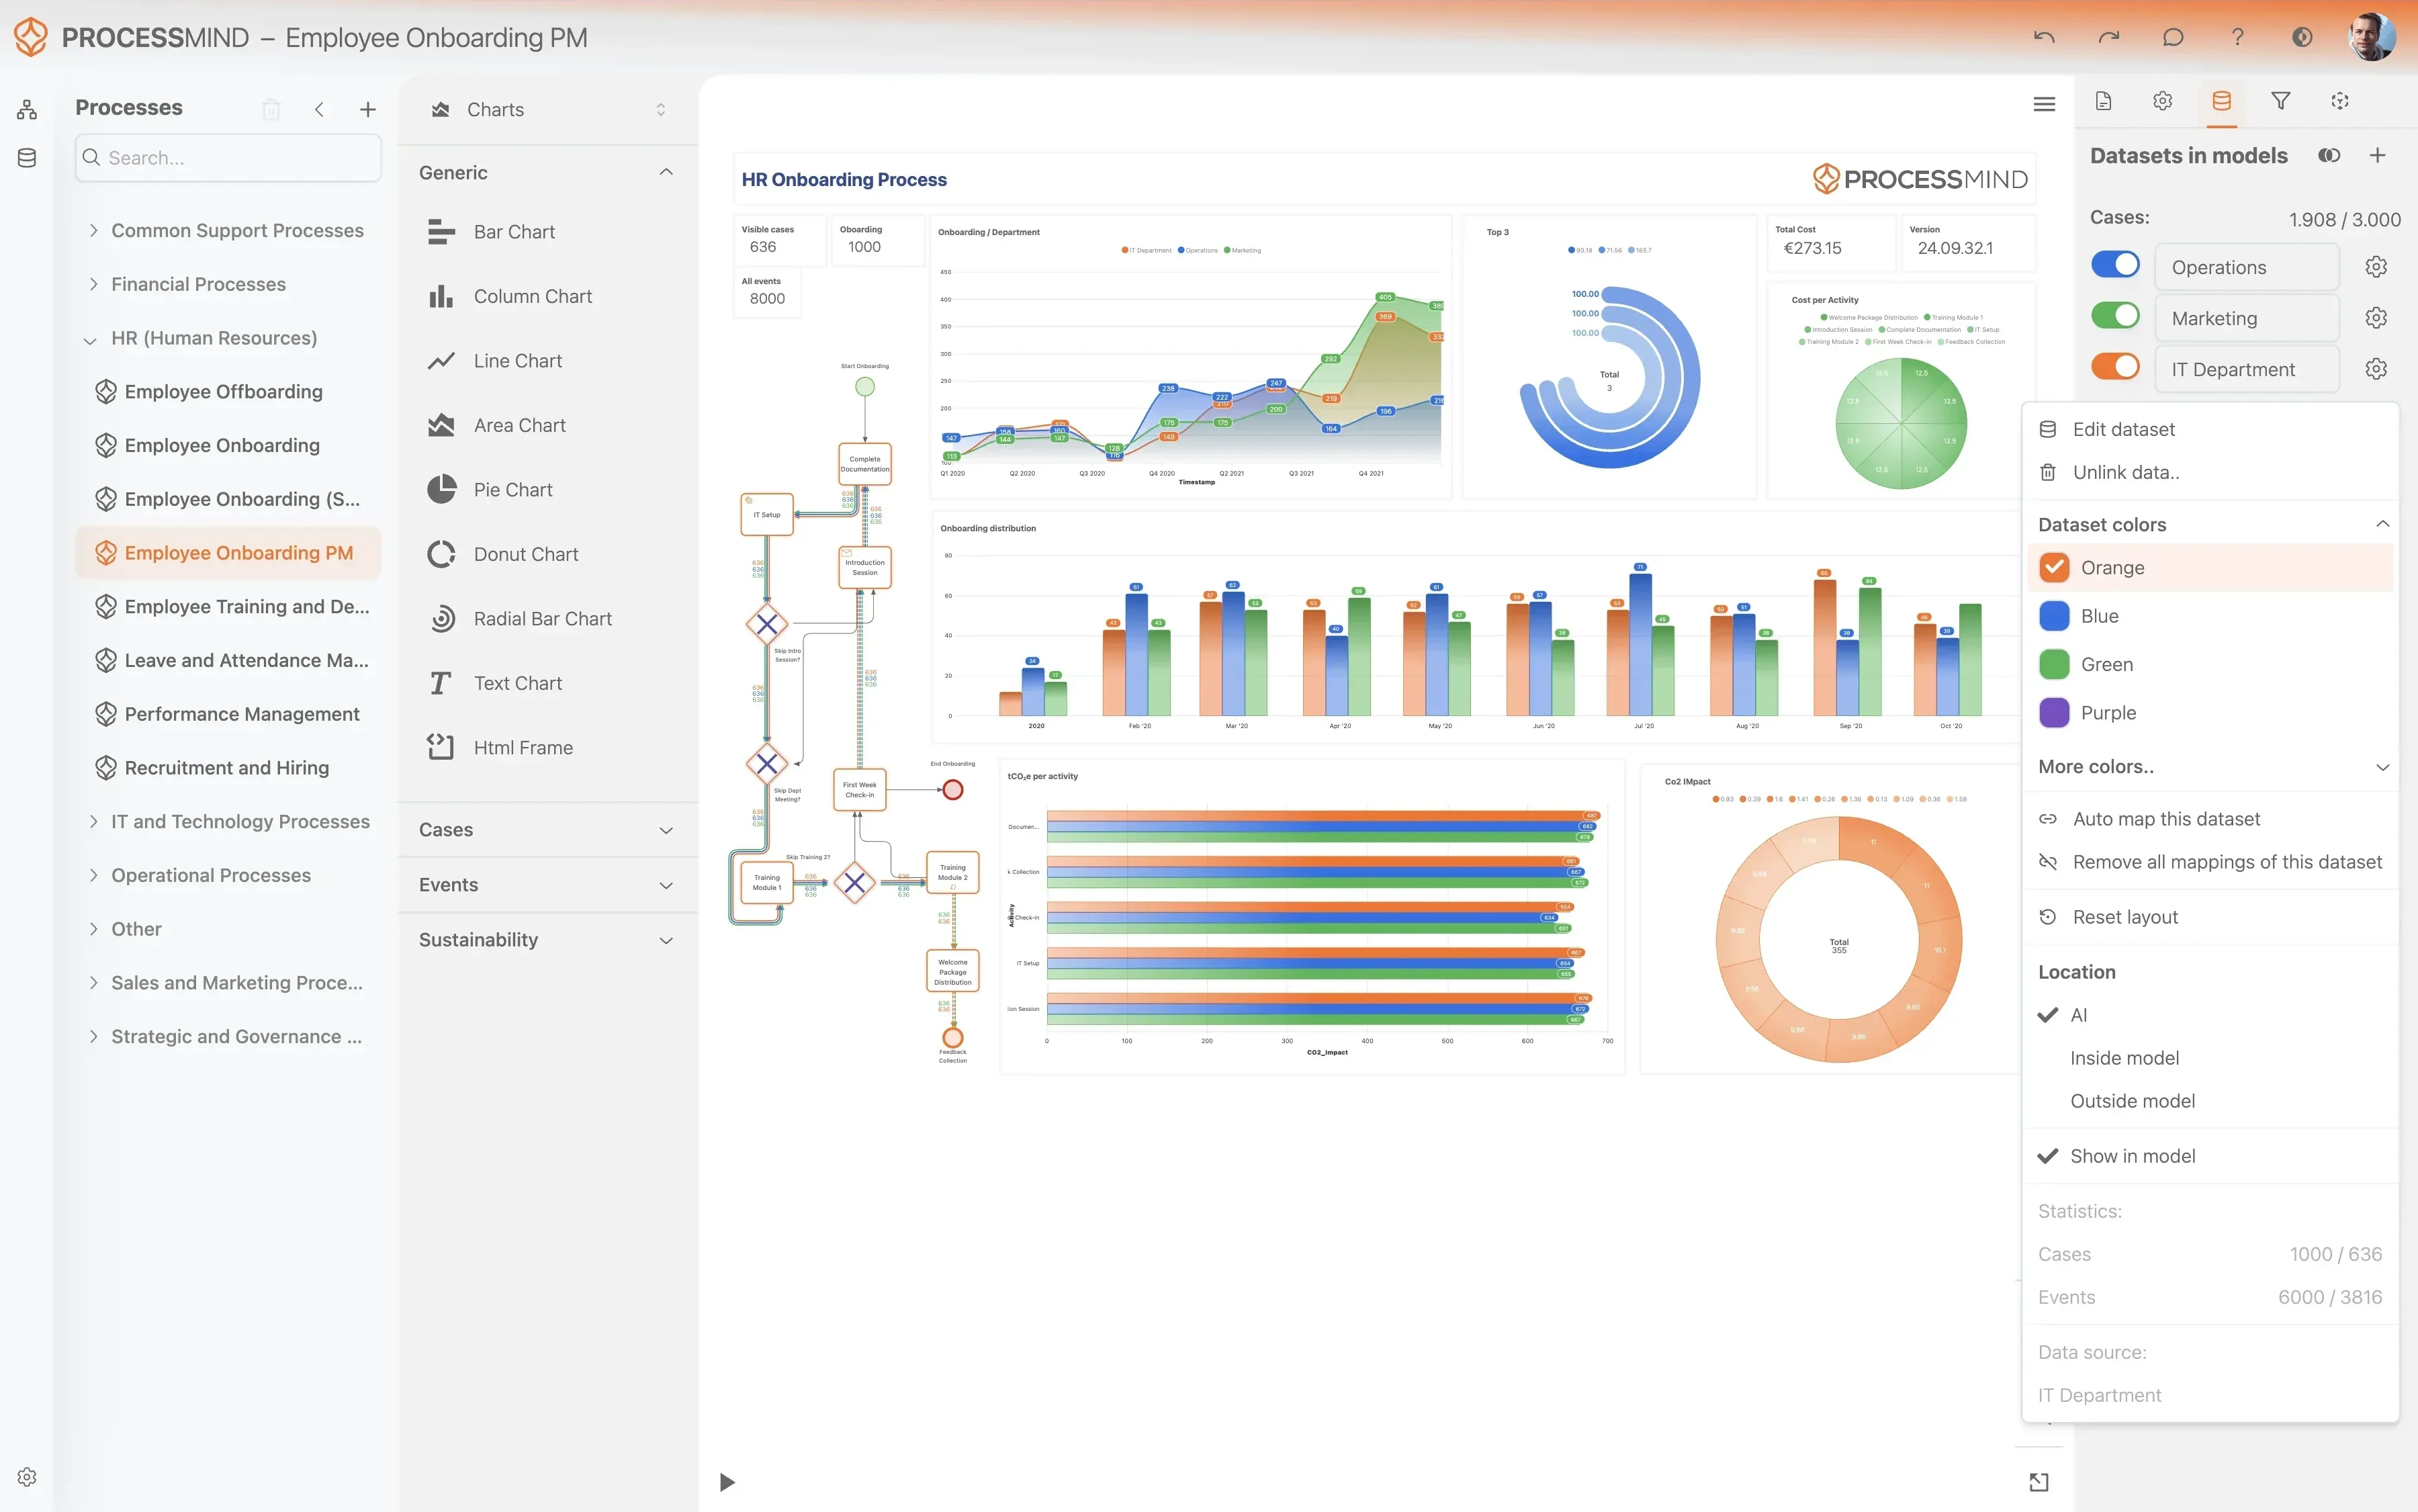
Ottenga una visione completa del ciclo di vita dei problemi e individui con precisione i punti in cui le indagini si bloccano. Le nostre visualizzazioni mettono in evidenza gli ostacoli tra l’identificazione del problema e la sua risoluzione definitiva.
  • Mappi visivamente l’intero ciclo di vita dell’analisi delle cause profonde
  • Individui le fasi specifiche che ritardano la risoluzione
  • Faccia emergere i cicli nascosti nelle indagini sui problemi
  • Misuri l’impatto dei workaround sulla stabilità
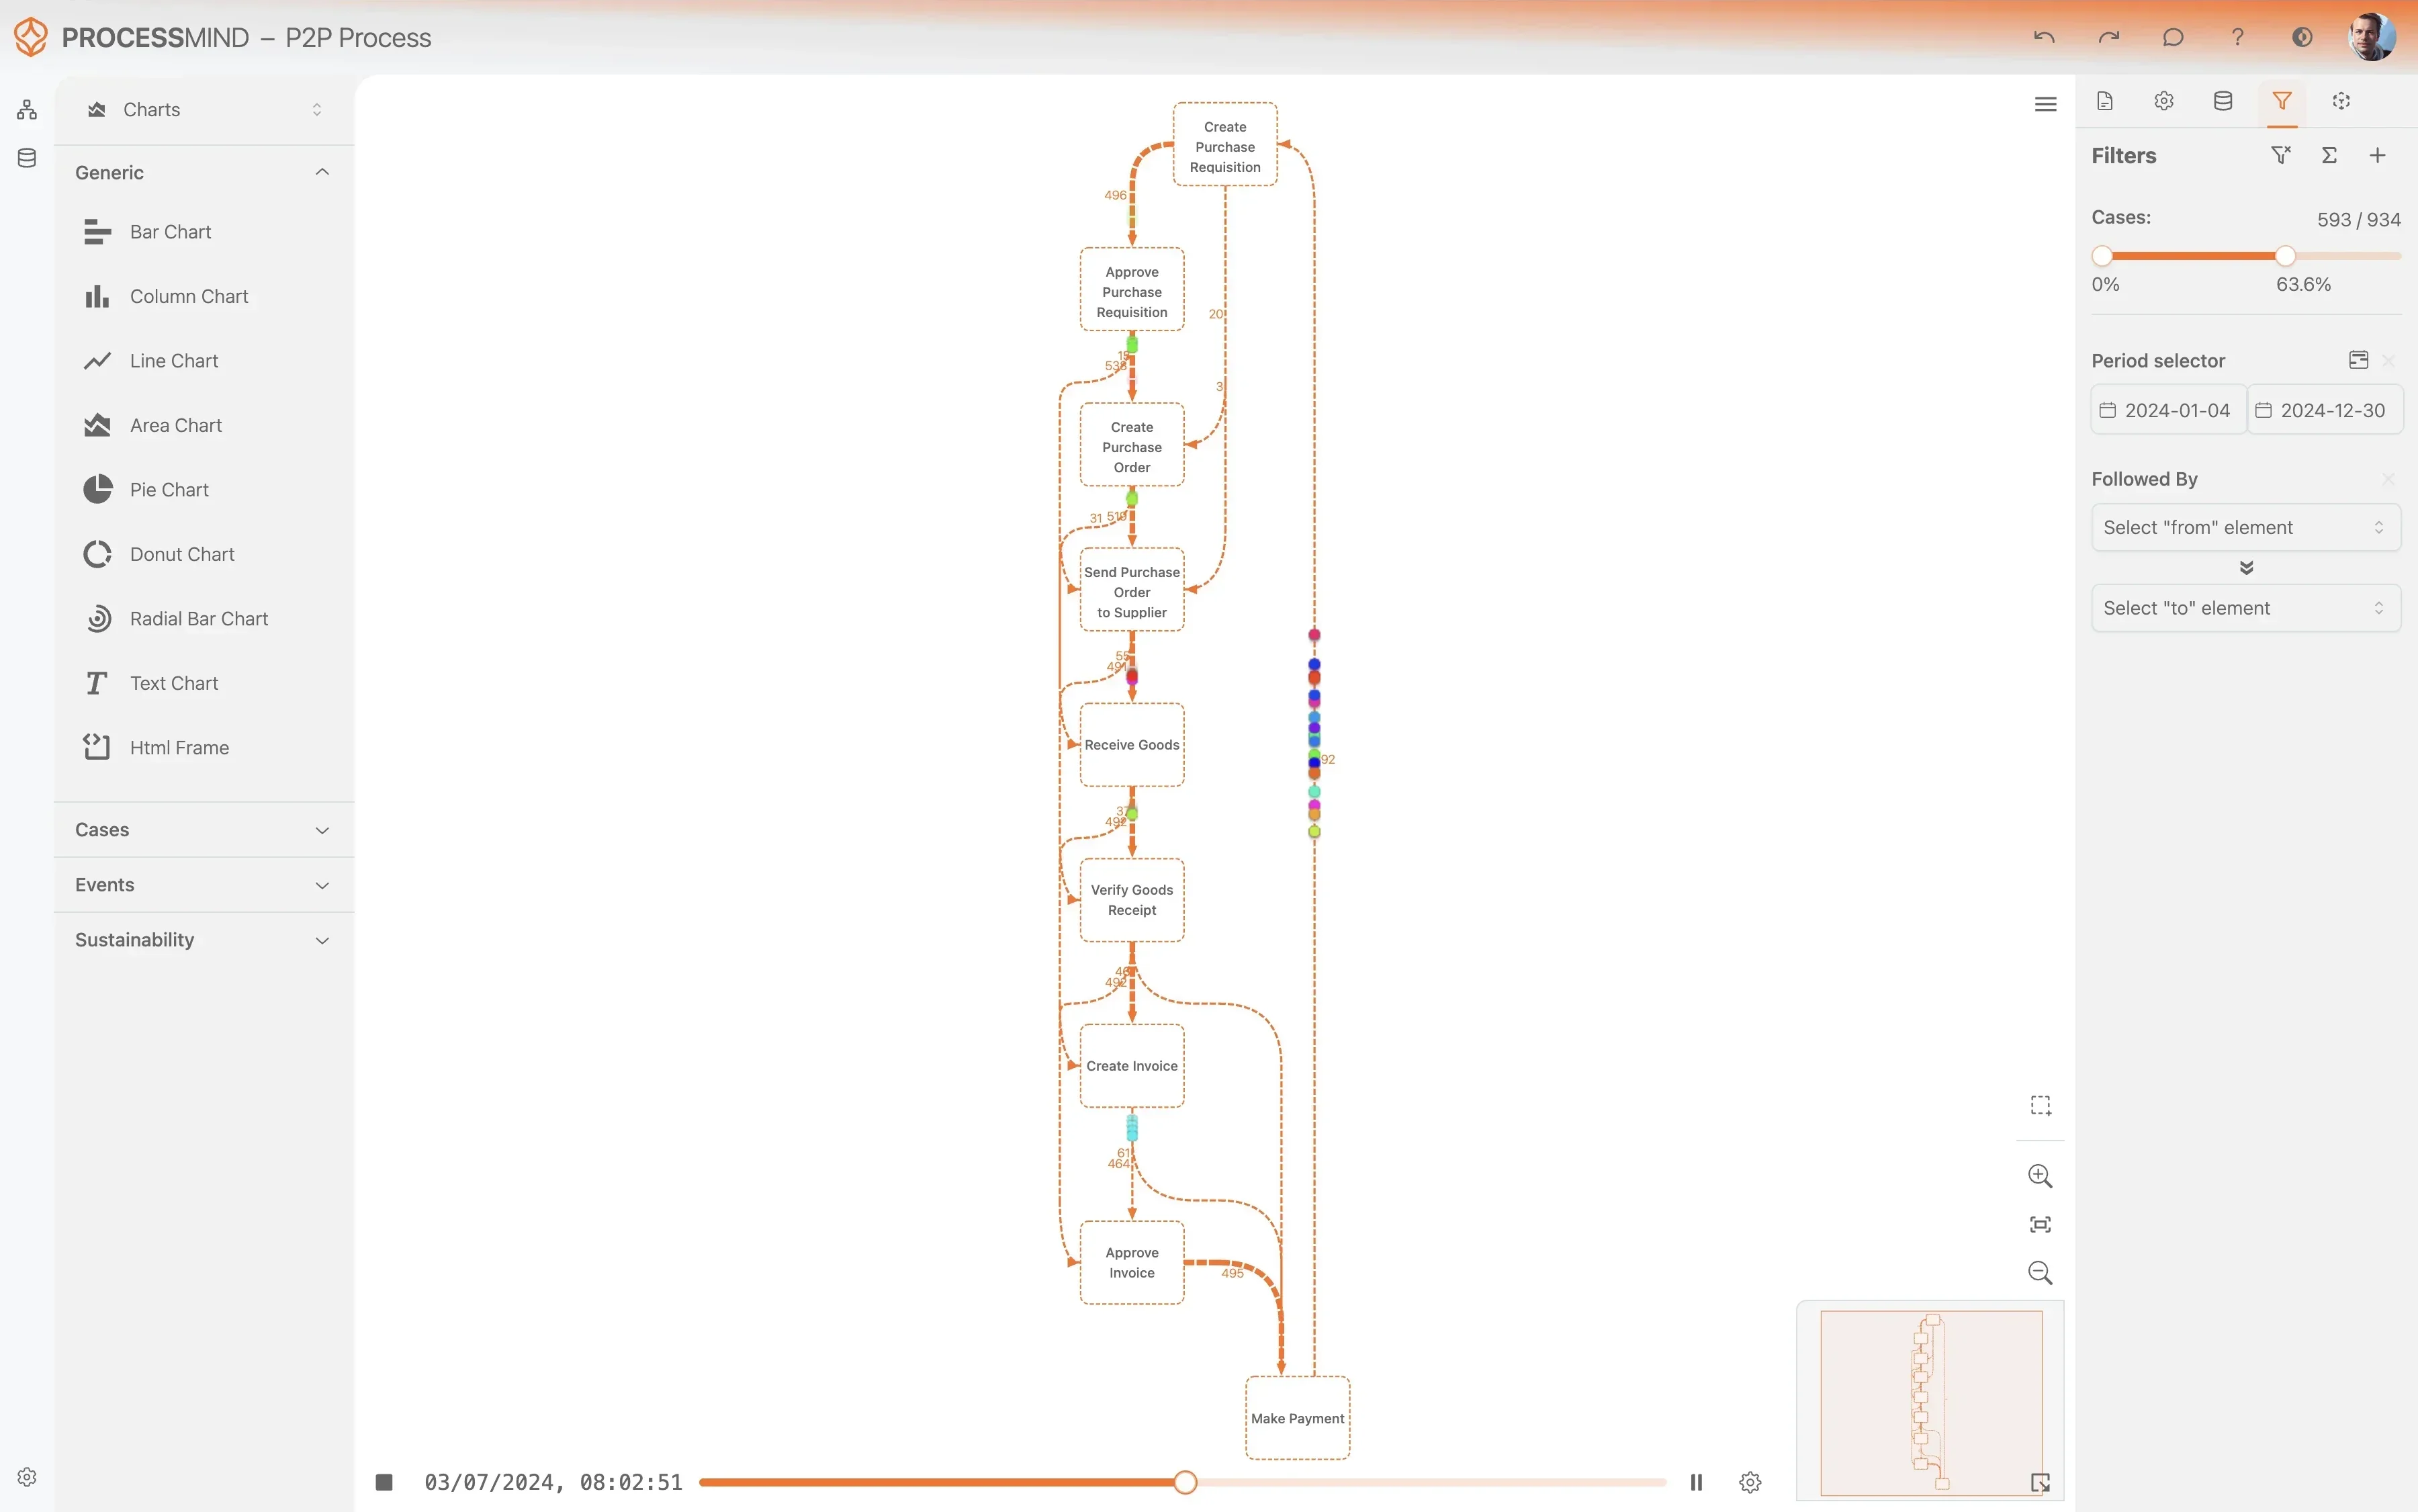
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

RISULTATI DIMOSTRATI

Maggiore efficienza nella gestione dei problemi

Le organizzazioni che applicano il Process Mining ai dati di Freshservice individuano in genere colli di bottiglia significativi nel ciclo di vita dei record dei problemi, ottenendo analisi delle cause profonde più rapide e riducendo gli incidenti ricorrenti.

0 %
Analisi più rapida delle cause profonde

Riduzione del tempo di ciclo dell’analisi delle cause profonde

Semplificare le fasi di indagine e individuare i colli di bottiglia nella diagnosi consente di identificare le cause profonde molto più rapidamente.

0 %
Meno passaggi di consegne tra i team

Riduzione delle riassegnazioni tra gruppi

Eliminare i trasferimenti tecnici non necessari permette agli esperti giusti di occuparsi prima dei problemi, riducendo i costi complessivi del lavoro e i ritardi.

+ 0 %
Migliore conformità agli SLA

Risoluzione puntuale dei problemi critici

Il monitoraggio in tempo reale dei record ad alta priorità assicura che i problemi critici siano gestiti entro i tempi concordati, mantenendo la stabilità dei servizi.

0 %
Meno riaperture

Riduzione delle rilavorazioni sui record

Migliorare la qualità delle indagini iniziali e delle soluzioni definitive evita la riapertura dei record dei problemi e assicura che le questioni siano davvero risolte.

+ 0 %
Più revisioni successive all’implementazione completate

Aumento delle revisioni successive alla correzione

Assicurare lo svolgimento regolare delle revisioni successive all’implementazione aiuta a raccogliere gli insegnamenti emersi e a verificare l’efficacia delle soluzioni definitive.

0 %
Distribuzione più rapida delle soluzioni temporanee

Tempo di attraversamento per le soluzioni temporanee

Pubblicare più rapidamente soluzioni temporanee efficaci riduce l’impatto sull’attività aziendale mentre sono ancora in corso gli interventi di correzione a lungo termine.

I risultati variano in base alla maturità dei processi, alle dimensioni del team e alla qualità dei dati in Freshservice. Questi valori rappresentano i miglioramenti medi osservati nelle implementazioni aziendali.

Dati consigliati

Per iniziare a ottimizzare il processo, parta da questi attributi e attività essenziali.
Non conosce ancora gli Event Log? Scopra come creare un Event Log per il Process Mining.

Attributi

Dati chiave da acquisire per l’analisi

Identificativo alfanumerico univoco assegnato al record del problema (ad esempio, PRB-10234).

Perché è importante

È la chiave fondamentale per ricostruire il flusso del processo ed è necessaria per identificare in modo univoco ogni caso.

Evento o azione specifica eseguita sul record del problema.

Perché è importante

Definisce il 'che cosa' dell’esecuzione del processo ed è obbligatorio per generare la mappa del processo.

Data e ora esatte in cui si è verificata l’attività.

Perché è importante

Definisce la cronologia degli eventi, consentendo di calcolare il tempo di ciclo e ordinare le fasi del processo.

Livello di priorità assegnato al problema (ad esempio, bassa, media, alta, urgente).

Perché è importante

Essenziale per filtrare e dare priorità all’analisi dei problemi ad alto impatto.

Nome dell’agente del Service Desk attualmente assegnato al problema.

Perché è importante

Fondamentale per l’analisi delle risorse e l’analisi organizzativa.

Team o gruppo tecnico incaricato di gestire il problema.

Perché è importante

Essenziale per analizzare i passaggi di consegne e individuare i colli di bottiglia dovuti alla frammentazione tra team.

Stato attuale del ciclo di vita del problema (ad esempio, aperto, modifica richiesta, risolto).

Perché è importante

Definisce lo stato del caso e viene usato per calcolare le statistiche sui flussi.

Classificazione della causa sottostante individuata per il problema.

Perché è importante

Essenziale per analizzare le tendenze e individuare le aree in cui intervenire in modo proattivo.

Numero di record di incidente collegati a questo problema.

Perché è importante

Indica l’entità degli effetti del problema sul Service Desk.

Indicatore che segnala se il record del problema non ha rispettato l’obiettivo previsto dall’accordo sul livello del servizio.

Perché è importante

Misura diretta della conformità e delle prestazioni del processo.

Reparto dell’utente che ha segnalato il problema o che ne subisce principalmente gli effetti.

Perché è importante

Fornisce il contesto organizzativo necessario per valutare l’impatto dei problemi.

Indicatore che segnala se il record del problema è mai passato dallo stato chiuso a quello aperto.

Perché è importante

Indicatore principale delle risoluzioni errate e delle rilavorazioni.

Attività

Fasi del processo da monitorare e ottimizzare

Creazione iniziale del record del problema nel sistema. Questo evento viene registrato esplicitamente nel log di audit di Freshservice quando si salva un nuovo ticket relativo a un problema.

Perché è importante

Segna l’inizio dell’istanza del processo. È il punto di riferimento per calcolare tutti i tempi di attraversamento e i tempi di ciclo.

Assegnazione del record del problema a un team tecnico o a un gruppo specifico. L’evento viene rilevato monitorando le modifiche al campo 'Group' nella cronologia del ticket.

Perché è importante

Essenziale per la mappa di calore dei trasferimenti tra gruppi di supporto. Il monitoraggio permette di individuare i rimbalzi e gli eccessivi passaggi di consegne tra i team.

Momento in cui viene compilato il campo di testo della causa profonda o la sezione di analisi. L’evento viene rilevato individuando il primo aggiornamento del campo 'Root Cause' da uno stato nullo.

Perché è importante

È la tappa principale per l’analisi del tempo di attraversamento dell’analisi delle cause profonde. Segna il passaggio dall’indagine alla progettazione della soluzione.

Aggiunta di una soluzione temporanea al record del problema, spesso indicata in una nota o in un campo 'Workaround'. Serve a calcolare la velocità di pubblicazione delle soluzioni temporanee.

Perché è importante

Misura la rapidità con cui il team riduce l’impatto. È essenziale per il KPI del tempo medio di attraversamento delle soluzioni temporanee.

Collegamento di un record di modifica al record del problema, che segnala l’inizio della fase di correzione. L’evento viene rilevato tramite l’evento di sistema 'Association with Change'.

Perché è importante

Essenziale per il monitoraggio dei colli di bottiglia nelle richieste di modifica. Misura il passaggio dalla gestione dei problemi alla gestione delle modifiche.

Indica l’implementazione della soluzione definitiva. In Freshservice, in genere si deduce dal passaggio dello stato a 'Solved' o 'Resolved'.

Perché è importante

Calcola il ritardo nell’implementazione della correzione definitiva. Segna la fine dell’intervento tecnico di correzione.

Evento finale del ciclo di vita, in cui il record viene bloccato e considerato inattivo. Viene rilevato dal passaggio dello stato a 'Closed'.

Perché è importante

Definisce la fine effettiva dell’istanza del processo. È necessario per calcolare il tempo di ciclo totale.

Domande frequenti

Domande frequenti

Il Process Mining visualizza ogni passaggio del ciclo di vita della gestione dei problemi utilizzando i log degli eventi già presenti in Freshservice. Evidenzia i colli di bottiglia, come le lunghe fasi di indagine o gli eccessivi trasferimenti tra gruppi, aiutando i team a individuare i punti in cui il processo si discosta dal flusso di lavoro standard.

In genere servono l’ID del record del problema, le date e gli orari delle attività e la cronologia delle modifiche ai campi in Freshservice. Si esportano anche attributi chiave come la priorità, la categoria e il gruppo assegnatario, per fornire il contesto necessario ad analisi e filtri più approfonditi.

Di solito è possibile generare le prime analisi entro pochi giorni dall’esportazione dei dati storici da Freshservice. I tempi dipendono dal volume dei dati e dalla complessità dei campi personalizzati, ma la maggior parte delle organizzazioni individua schemi utili su cui intervenire in meno di due settimane.

No, in genere il Process Mining utilizza un’integrazione tramite API o l’esportazione dei dati, senza richiedere l’installazione di software. È sufficiente fornire accesso ai log di audit e alla cronologia dei ticket archiviati nell’ambiente Freshservice.

Sì, l’analisi mostra la durata esatta della fase di analisi delle cause profonde per ogni record. È quindi possibile scendere di livello per verificare se i ritardi maggiori riguardano categorie, livelli di priorità o team tecnici specifici.

Mappando ogni passaggio, lo strumento individua i ticket che rimbalzano ripetutamente da un gruppo all’altro senza essere risolti. I responsabili possono così capire se la titolarità dei gruppi non è chiara o se alcuni team tecnici non dispongono delle risorse necessarie per gestire determinati tipi di problema.

Sì, può monitorare il collegamento tra i ticket degli incidenti e i relativi record principali dei problemi, offrendo la visibilità necessaria. Ciò aiuta a verificare che le soluzioni temporanee siano comunicate ai responsabili degli incidenti e che le fasi di risoluzione siano applicate in modo uniforme a tutti i problemi correlati.

L’analisi si concentra principalmente sui dati storici, ma molte piattaforme offrono aggiornamenti frequenti per monitorare la conformità in corso. In questo modo è possibile verificare se i record dei problemi aperti si stanno avvicinando alla scadenza SLA, prima che venga effettivamente superata.

Elimini oggi i colli di bottiglia nella gestione dei problemi

Riduca del 30% il tempo di ciclo e migliori la stabilità dei servizi IT

Inizi la prova gratuita

Non è richiesta la carta di credito. Configurazione in 5 minuti.