Migliori la gestione dei problemi
La guida in 6 passaggi per ottimizzare la gestione dei problemi.
Migliori la gestione dei problemi
Gestione dei problemi
Qualsiasi sistema

Selezioni un processo

Scelga un processo per continuare a lavorare nell’area di lavoro collegata.

Processi disponibili
Sistemi disponibili
259 Processi

Migliori la gestione dei problemi con il Process Mining

ProcessMind La aiuta a individuare le inefficienze nascoste nel processo di gestione dei problemi. Identifichi facilmente i colli di bottiglia, le attività ripetitive e i tempi di risoluzione prolungati che incidono sulla qualità del servizio. La nostra piattaforma offre una visione chiara delle deviazioni del processo e delle aree da migliorare, per consentirLe di ottimizzare le attività sulla base dei dati. Comprenda l’intero ciclo di vita della risoluzione dei problemi, dall’identificazione alla chiusura, indipendentemente dal sistema di origine.

Scarichi il nostro template dei dati preconfigurato e affronti le sfide più comuni per raggiungere i Suoi obiettivi di efficienza. Segua il nostro piano di miglioramento in sei fasi e consulti la guida al template dei dati per trasformare le Sue attività.

Mostra la descrizione dettagliata

Gestire al meglio i problemi è fondamentale per mantenere la stabilità operativa e offrire un servizio di qualità. Il Process Mining applicato alla gestione dei problemi fornisce una visione completa di come questi vengono effettivamente identificati, analizzati e risolti all’interno dell’organizzazione. Consente di andare oltre le testimonianze aneddotiche e di ricostruire i percorsi realmente seguiti dai record dei problemi, dal rilevamento iniziale fino alla risoluzione e alla verifica finali. L’analisi mette in luce i colli di bottiglia che ritardano la risoluzione, individua le deviazioni non conformi e segnala le opportunità di automazione lungo l’intero flusso di lavoro. Indipendentemente dal sistema ERP, ITSM o da qualsiasi altro sistema di origine, ProcessMind estrae i dati degli eventi per ricostruire il funzionamento effettivo delle attività e offrire una comprensione oggettiva, basata sui dati e applicabile al processo di gestione dei problemi specifico dell’organizzazione.

La gestione dei problemi presenta spesso alcune difficoltà ricorrenti, a prescindere dal sistema utilizzato: analisi delle cause profonde che si prolungano, ricomparsa frequente di problemi noti, passaggi di consegne inefficienti tra i team e scarsa visibilità sul tempo di ciclo effettivo della risoluzione. Le organizzazioni faticano a capire perché alcuni problemi richiedano più tempo per essere risolti, dove vengano impiegate male le risorse e se le procedure operative standard vengano davvero seguite. ProcessMind affronta queste difficoltà con mappe di processo dettagliate e metriche ricavate direttamente dai dati operativi. Può individuare con precisione i punti in cui si verificano i ritardi, riconoscere le fasi che non aggiungono valore e mettere in luce le variazioni che portano a risultati non ottimali. Questa chiarezza consente di semplificare le attività, ridurre il tempo medio di risoluzione (MTTR), utilizzare meglio le risorse e fare in modo che la gestione dei problemi contribuisca attivamente alla stabilità dei servizi, anziché limitarsi a reagire agli incidenti.

Analizzare con ProcessMind il processo di gestione dei problemi porta vantaggi concreti: maggiore efficienza, costi ridotti e migliore qualità del servizio. Comprendendo il processo sulla base dei dati, può prendere decisioni informate per ottimizzare i flussi di lavoro, eliminare le fasi ridondanti e dare priorità alle iniziative di automazione con il maggiore impatto. Ne derivano meno problemi ricorrenti, meno interruzioni dei servizi e, in definitiva, una maggiore soddisfazione dei clienti. Inoltre, individuare e affrontare in modo proattivo le lacune di conformità riduce i rischi e favorisce il rispetto delle politiche interne e delle normative esterne. Per iniziare a ottenere queste informazioni, la nostra piattaforma è progettata per integrarsi agevolmente con i dati già disponibili. Può partire dal nostro template completo, che La guida nell’estrazione degli Event Log necessari dal Suo sistema e rende più semplice e rapido l’avvio. ProcessMind La aiuta a trasformare la gestione dei problemi da attività reattiva a processo proattivo, ottimizzato ed efficiente.

Gestione dei problemi Process Mining Gestione dei servizi ITSM Analisi delle cause profonde Ottimizzazione dei processi Efficienza Compliance Gestione dei ticket Gestione dei ticket Errore noto Incidenti ricorrenti Workaround Prevenzione degli incidenti Service Desk IT

Problemi e sfide comuni

Individui le sfide che La riguardano

I record dei problemi restano spesso nella fase di indagine per settimane, senza progressi evidenti. Si accumulano così le pratiche arretrate e i problemi sottostanti restano irrisolti. Il ritardo impedisce ai team di affrontare la causa degli incidenti ricorrenti, aumentando il carico sul Service Desk e riducendo l’affidabilità complessiva del servizio.

ProcessMind misura la durata della fase di indagine e mostra con precisione dove il processo si arresta. Fa emergere i record che hanno superato i tempi di risoluzione abituali, così i coordinatori dei problemi possono intervenire e riallocare le risorse prima che l’indagine perda utilità.

Quando un record di problema passa da un team tecnico all’altro, spesso si perde il contesto e i tempi di risoluzione si allungano notevolmente. La mancanza di responsabilità chiare comporta sprechi di lavoro, frustrazione tra il personale tecnico e il mancato raggiungimento degli obiettivi di livello di servizio per la stabilità delle infrastrutture critiche.

Il nostro motore di analisi mappa la sequenza delle assegnazioni e mette in evidenza questi passaggi ripetuti da un gruppo all’altro. Può vedere quali gruppi di supporto reindirizzano spesso i record e intervenire con una formazione mirata o una definizione più chiara delle responsabilità, interrompendo questo ciclo.

Se un workaround non viene pubblicato rapidamente, gli agenti che gestiscono gli incidenti continuano ad affrontare problemi ripetitivi e aumenta il tempo medio di risoluzione per gli utenti finali. Quando l’intervallo tra l’identificazione del problema e la pubblicazione del workaround è troppo ampio, l’azienda subisce interruzioni evitabili, nonostante sia già disponibile una soluzione temporanea.

ProcessMind misura il tempo che intercorre tra l’identificazione del workaround e l’attività di pubblicazione. Questa visibilità aiuta a diffondere rapidamente le soluzioni temporanee, limitando l’impatto dei problemi ancora in corso mentre i team tecnici lavorano alla risoluzione definitiva della causa profonda.

Anche dopo aver individuato la causa profonda, il percorso verso una soluzione definitiva spesso si interrompe prima dell’avvio di una richiesta di modifica. Questa discontinuità tra i flussi di lavoro di gestione dei problemi e di gestione delle modifiche lascia irrisolti errori noti che potrebbero essere eliminati, esponendo l’ambiente IT a interruzioni ricorrenti dei servizi.

Analizziamo il tempo che intercorre tra l’attività di individuazione della causa profonda e l’evento di avvio della richiesta di modifica. In questo modo emergono gli ostacoli nel passaggio dalla gestione dei problemi alla gestione delle modifiche e si può procedere con le soluzioni definitive senza ritardi amministrativi superflui.

Quando il ciclo di gestione dei problemi è troppo lento, gli stessi incidenti continuano ad accumularsi nel Service Desk, assorbendo risorse preziose in attività ripetitive. Questo circolo vizioso riduce l’efficienza, distoglie i team dai progetti strategici e indebolisce la fiducia degli utenti nella capacità dell’IT di mantenere un ambiente stabile.

ProcessMind mette in relazione il numero di incidenti correlati con la durata delle fasi di indagine e risoluzione. Mostrando come la lentezza nella risoluzione dei problemi faccia aumentare direttamente il volume degli incidenti, aiuta a costruire un business case per accelerare le soluzioni definitive e alleggerire il carico complessivo sul Service Desk.

Per chiudere rapidamente le registrazioni e ridurre gli arretrati, i team spesso saltano la fase di revisione successiva all’implementazione. Senza questo passaggio fondamentale, le organizzazioni non verificano che la soluzione abbia funzionato come previsto né raccolgono le lezioni apprese. Aumenta così il rischio che problemi simili si ripresentino e si ostacola il miglioramento dei servizi nel lungo periodo.

ProcessMind monitora il rispetto del passaggio di revisione successivo all’implementazione per ogni registrazione di problema chiusa. Evidenzia gli scostamenti dal processo standard, aiutando a verificare che tutte le fasi di risoluzione siano completate e a sostenere il miglioramento dei servizi e i requisiti di conformità.

Spesso i problemi critici non rispettano gli obiettivi dei livelli di servizio a causa di inefficienze nascoste nelle fasi di indagine e risoluzione. Il mancato rispetto delle scadenze compromette la stabilità dei servizi IT e può minare la fiducia dell’azienda quando le infrastrutture critiche restano instabili più a lungo del previsto.

Mettendo in relazione le scadenze degli SLA con le date e gli orari effettivi registrati nel sistema di origine, ProcessMind individua le attività che causano le violazioni. È così possibile monitorare in tempo reale gli obiettivi dei livelli di servizio e adeguare priorità o flussi di lavoro prima che le scadenze vengano superate.

Se i tecnici non classificano correttamente la causa profonda di un problema, diventa impossibile individuare tendenze di lungo periodo o debolezze sistemiche dell’infrastruttura. Senza dati adeguati, la direzione non può prendere decisioni informate sugli investimenti infrastrutturali o sulle modifiche ai processi necessarie per migliorare la stabilità.

ProcessMind individua le registrazioni in cui manca l’attributo della categoria della causa profonda o in cui è impostato su valori generici. Evidenziando queste lacune nella qualità dei dati, aiuta le organizzazioni a migliorarne l’integrità e a comprendere meglio le cause effettive dell’instabilità IT.

Obiettivi tipici

Definisca i criteri di successo

Un’analisi più rapida delle cause profonde previene gli incidenti ricorrenti e riduce al minimo i tempi di inattività dell’infrastruttura. Accelerando la fase di indagine, i team tecnici possono dedicarsi meno alla gestione ripetitiva delle emergenze e concentrarsi sulle soluzioni definitive, migliorando l’affidabilità complessiva dei servizi e riducendo il tempo in cui le vulnerabilità critiche restano irrisolte.

Il Process Mining visualizza l’intero flusso di indagine nel sistema e individua con precisione i punti in cui il lavoro si blocca. Identificando i colli di bottiglia nei gruppi di supporto o negli ambiti tecnici, la piattaforma fornisce indicazioni utili per ridurre i tempi di indagine. È inoltre possibile monitorare il percorso dall’apertura del problema all’individuazione della causa profonda e verificare che ogni indagine proceda regolarmente.

Ogni passaggio tra gruppi di supporto allunga i tempi complessivi di risoluzione e aumenta il carico amministrativo. Ridurre questi passaggi permette agli esperti più adatti di occuparsi subito del problema, evitando il continuo rimpallo che si verifica quando le responsabilità non sono chiare. Ne deriva un processo più lineare e una maggiore responsabilizzazione.

La piattaforma monitora la cronologia dei campi di assegnazione per ogni registrazione di problema nel sistema di origine. Individuando gli schemi di instradamento errato o i frequenti passaggi da un team all’altro, è possibile ottimizzare le regole di assegnazione ai gruppi e ridurre i riassegnamenti superflui, così che l’indagine prosegua senza perdere slancio nei passaggi di consegne.

Fornire rapidamente una soluzione temporanea riduce l’impatto di un problema attivo sugli utenti finali e sul Service Desk. Il personale di supporto può così risolvere gli incidenti prima che sia pronta una soluzione definitiva, riducendo sensibilmente il numero di ticket aperti e migliorando la soddisfazione degli utenti durante lo sviluppo della soluzione permanente.

Il Process Mining analizza il tempo che intercorre tra l’individuazione del problema e la pubblicazione di una soluzione temporanea nella banca dati degli errori noti. Queste informazioni aiutano a standardizzare questo passaggio fondamentale e a rendere disponibile prima la documentazione sugli errori noti. La visibilità sul processo consente inoltre di attribuire ai team la responsabilità di comunicare tempestivamente le soluzioni provvisorie.

Il risultato più importante per un team di gestione dei problemi è la riduzione degli incidenti ricorrenti. Individuando ed eliminando le cause profonde, si riduce il costo totale di gestione dei servizi IT e si alleggerisce il carico quotidiano sul Service Desk, dimostrando il valore concreto del processo all’intera azienda.

La piattaforma mette in relazione il volume degli incidenti con specifiche registrazioni di problema per valutare nel tempo l’efficacia delle soluzioni definitive. In questo modo è possibile verificare che le soluzioni eliminino davvero la causa profonda, anziché limitarsi a trattare i sintomi. È inoltre possibile monitorare il tasso di successo delle modifiche implementate e verificare che riducano il volume degli incidenti come previsto.

Un passaggio fluido dalla registrazione di un problema alla richiesta di modifica è essenziale per implementare soluzioni definitive in modo controllato. I ritardi in questa fase lasciano le vulnerabilità individuate nell’ambiente di produzione più a lungo del necessario, aumentando i rischi e vanificando parte del lavoro di indagine.

Mappando le tracce digitali dei processi di gestione dei problemi e delle modifiche nel sistema, il Process Mining individua gli ostacoli nelle fasi di approvazione e passaggio di consegne. Aiuta così a colmare la distanza tra l’individuazione della causa profonda e l’avvio della soluzione, riducendo il tempo in cui le proposte restano bloccate tra procedure amministrative e code di approvazione.

Rispettare gli accordi sui livelli di servizio per i problemi ad alta priorità è fondamentale per garantire la continuità aziendale e la stabilità operativa. Una conformità costante rafforza la fiducia degli interlocutori aziendali e assicura che i problemi più gravi ricevano l’attenzione urgente necessaria, riducendo la durata complessiva delle interruzioni dei servizi critici.

Il Process Mining confronta i risultati effettivi con gli obiettivi degli SLA analizzando le date e gli orari registrati durante l’intero ciclo di vita delle registrazioni. Individuando le fasi del processo o i gruppi di supporto in cui è più probabile che si verifichino violazioni degli SLA, fornisce avvisi tempestivi e aiuta i team a rispettare gli obiettivi per ogni livello di priorità, intervenendo prima che si verifichi una violazione.

Imparare dai problemi passati è essenziale per migliorare continuamente i servizi ed evitare errori futuri. Completare una revisione per ogni problema rilevante permette di documentare e condividere le lezioni apprese, prevenire il ripetersi di problemi simili e accrescere nel tempo la maturità dell’organizzazione IT.

La piattaforma verifica che le attività di revisione successive all’implementazione siano presenti prima della chiusura di una registrazione. Individuando i casi in cui questo passaggio viene spesso saltato o ritardato, è possibile far rispettare il processo definito e assicurarsi che le conoscenze utili vengano raccolte e condivise nel Service Desk per ogni problema rilevante.

Dati accurati sono alla base di una gestione efficace dei problemi e dell’analisi delle tendenze nel lungo periodo. Migliorare la qualità delle categorie delle cause profonde consente di prendere decisioni strategiche più efficaci e di indirizzare gli investimenti in tecnologia o formazione verso i problemi sistemici dell’infrastruttura IT, favorendo una stabilità duratura.

Il Process Mining analizza i campi relativi alle cause profonde e alle categorie in migliaia di registrazioni per individuare incoerenze, riclassificazioni o un uso eccessivo di categorie generiche come «altro». Queste informazioni aiutano i responsabili a perfezionare gli standard di inserimento dei dati e ad aumentare l’affidabilità dei report, facilitando l’individuazione delle nuove tendenze tecnologiche nei dati del sistema di origine.

La guida in 6 passaggi per migliorare la gestione dei problemi

1

Collegare e individuare i dati

Cosa fare

Colleghi la fonte dei dati, ad esempio il sistema ERP o di gestione dei servizi, per estrarre i log delle attività pertinenti alle registrazioni dei problemi. Verifichi che vengano importati tutti i dati degli eventi necessari, comprese le date e gli orari e gli ID dei casi, per poterli analizzare.

Perché è importante

Questo passaggio fondamentale consente di disporre di un insieme di dati completo e accurato, necessario per comprendere il flusso effettivo e i risultati del processo di gestione dei problemi.

Risultato atteso

È disponibile per l’analisi un insieme completo e accurato di dati sulle attività di gestione dei problemi.

COSA OTTERRÀ

Faccia emergere oggi ciò che i Suoi processi nascondono

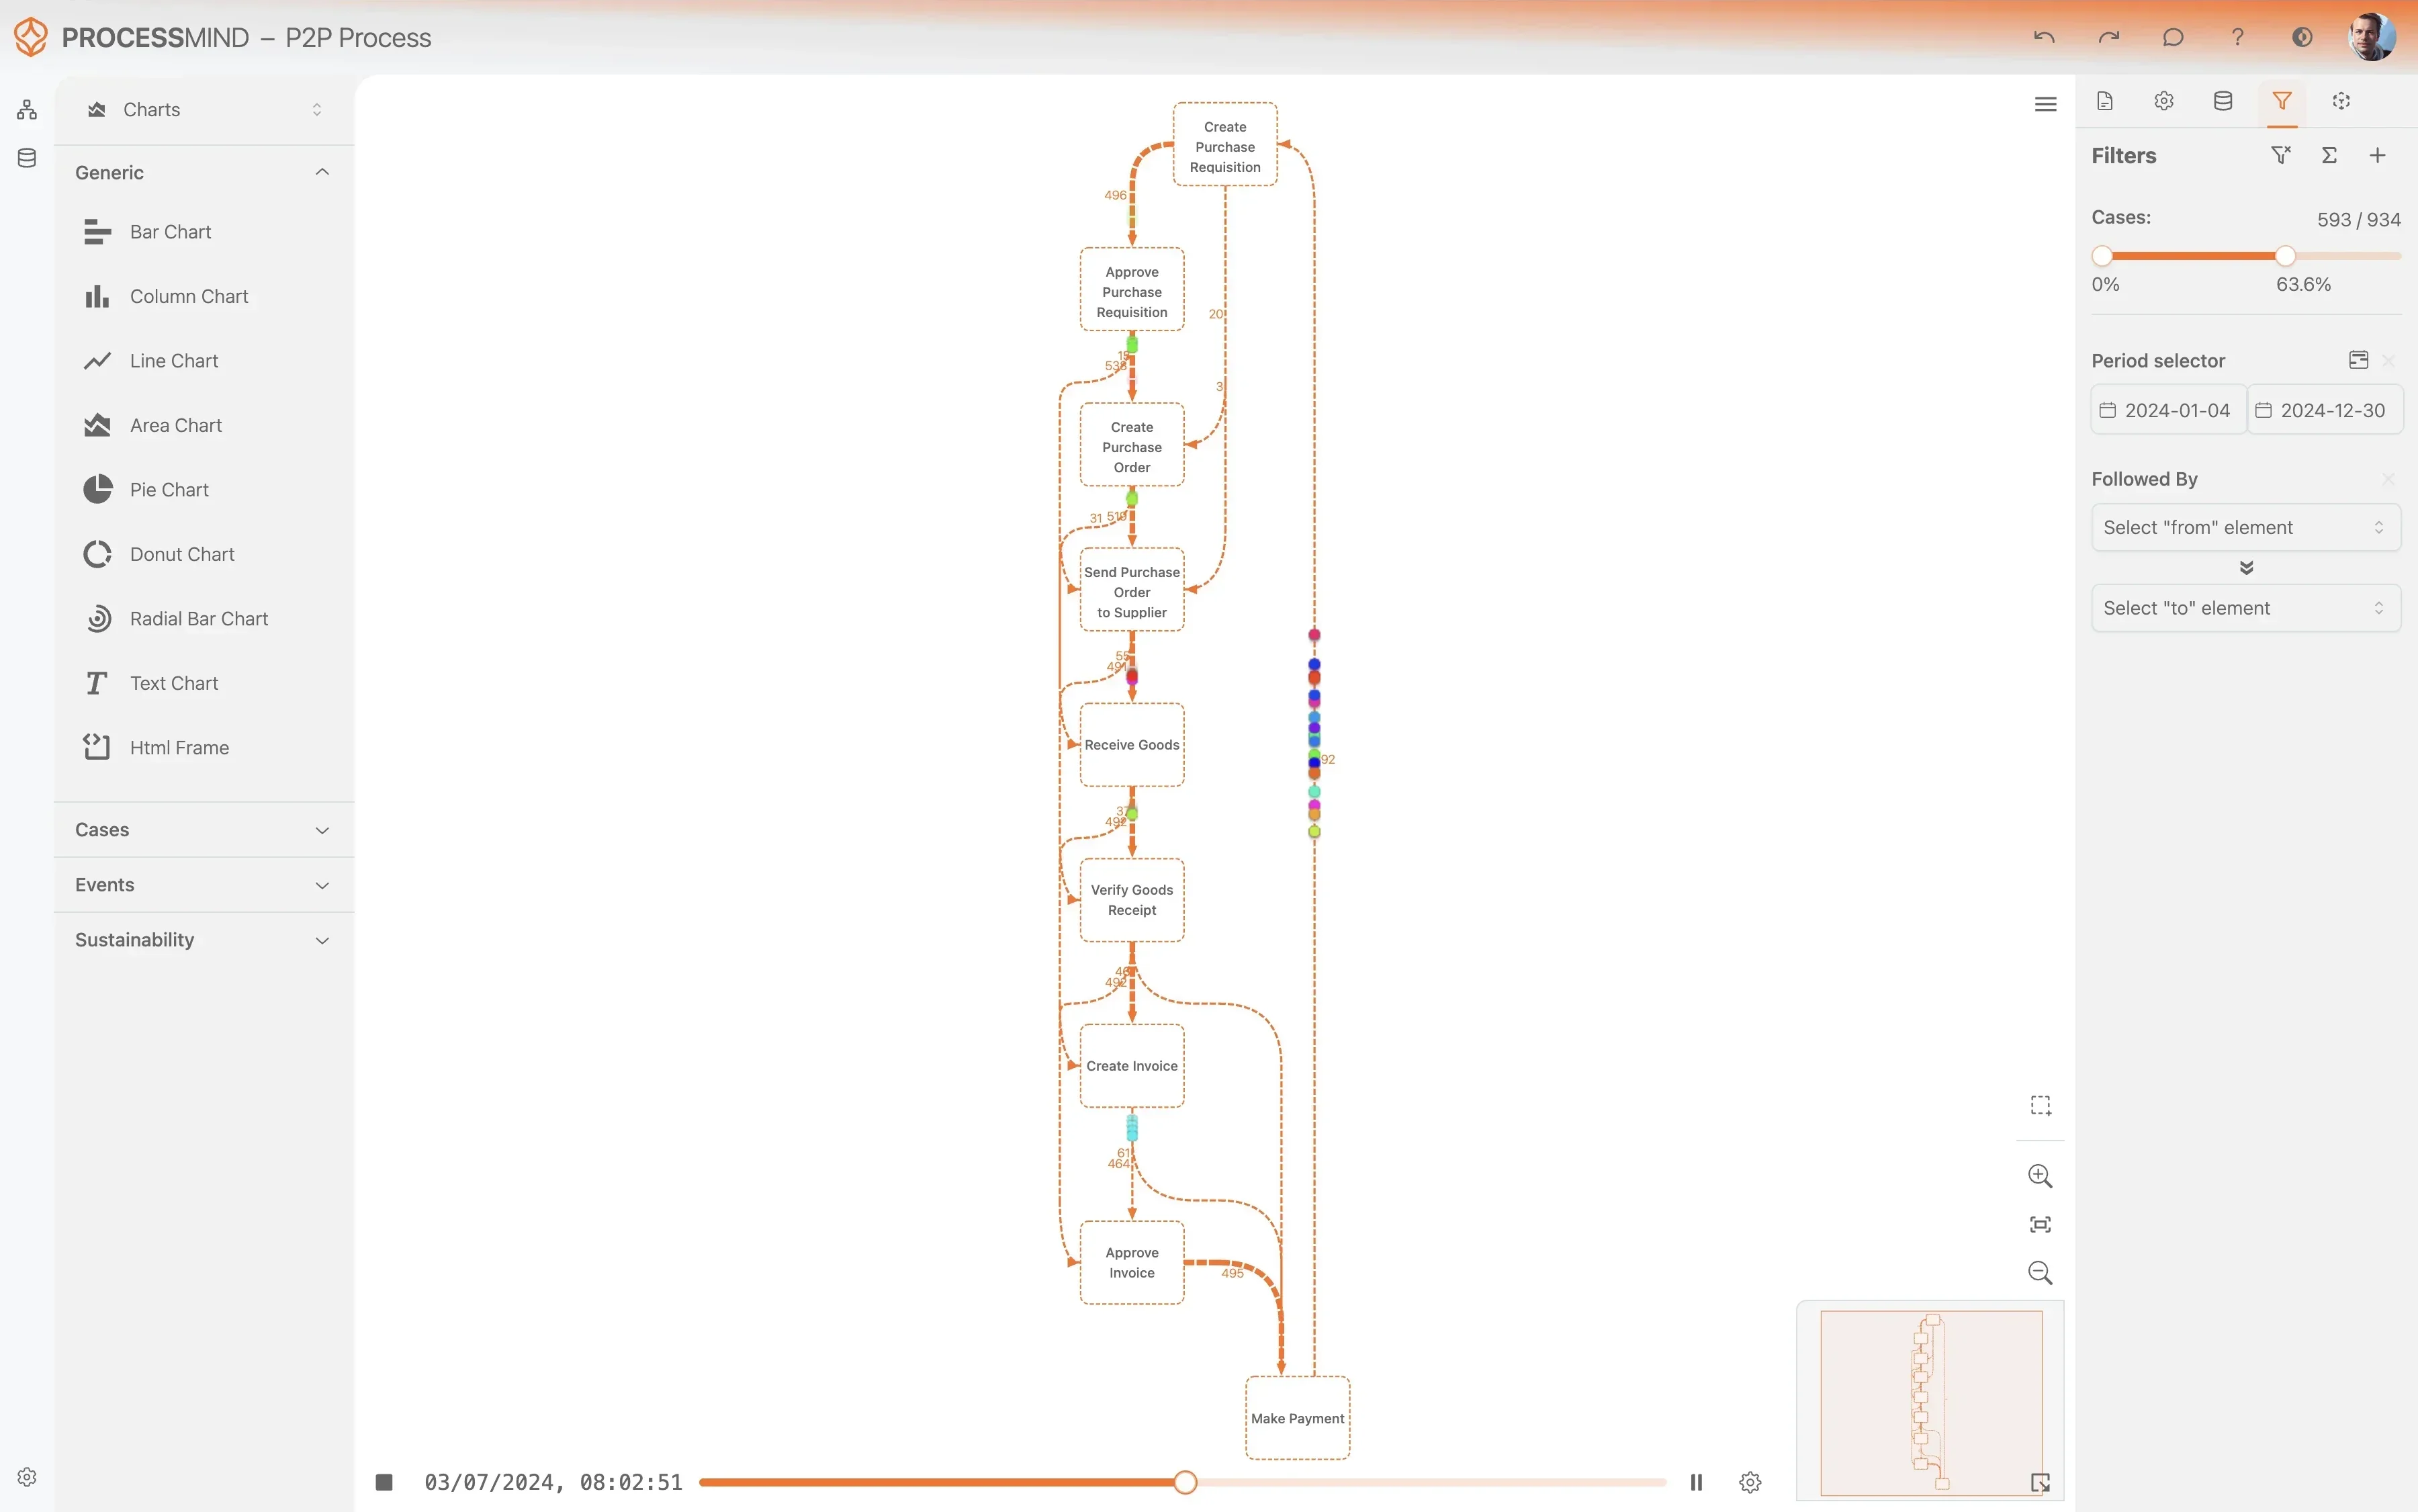
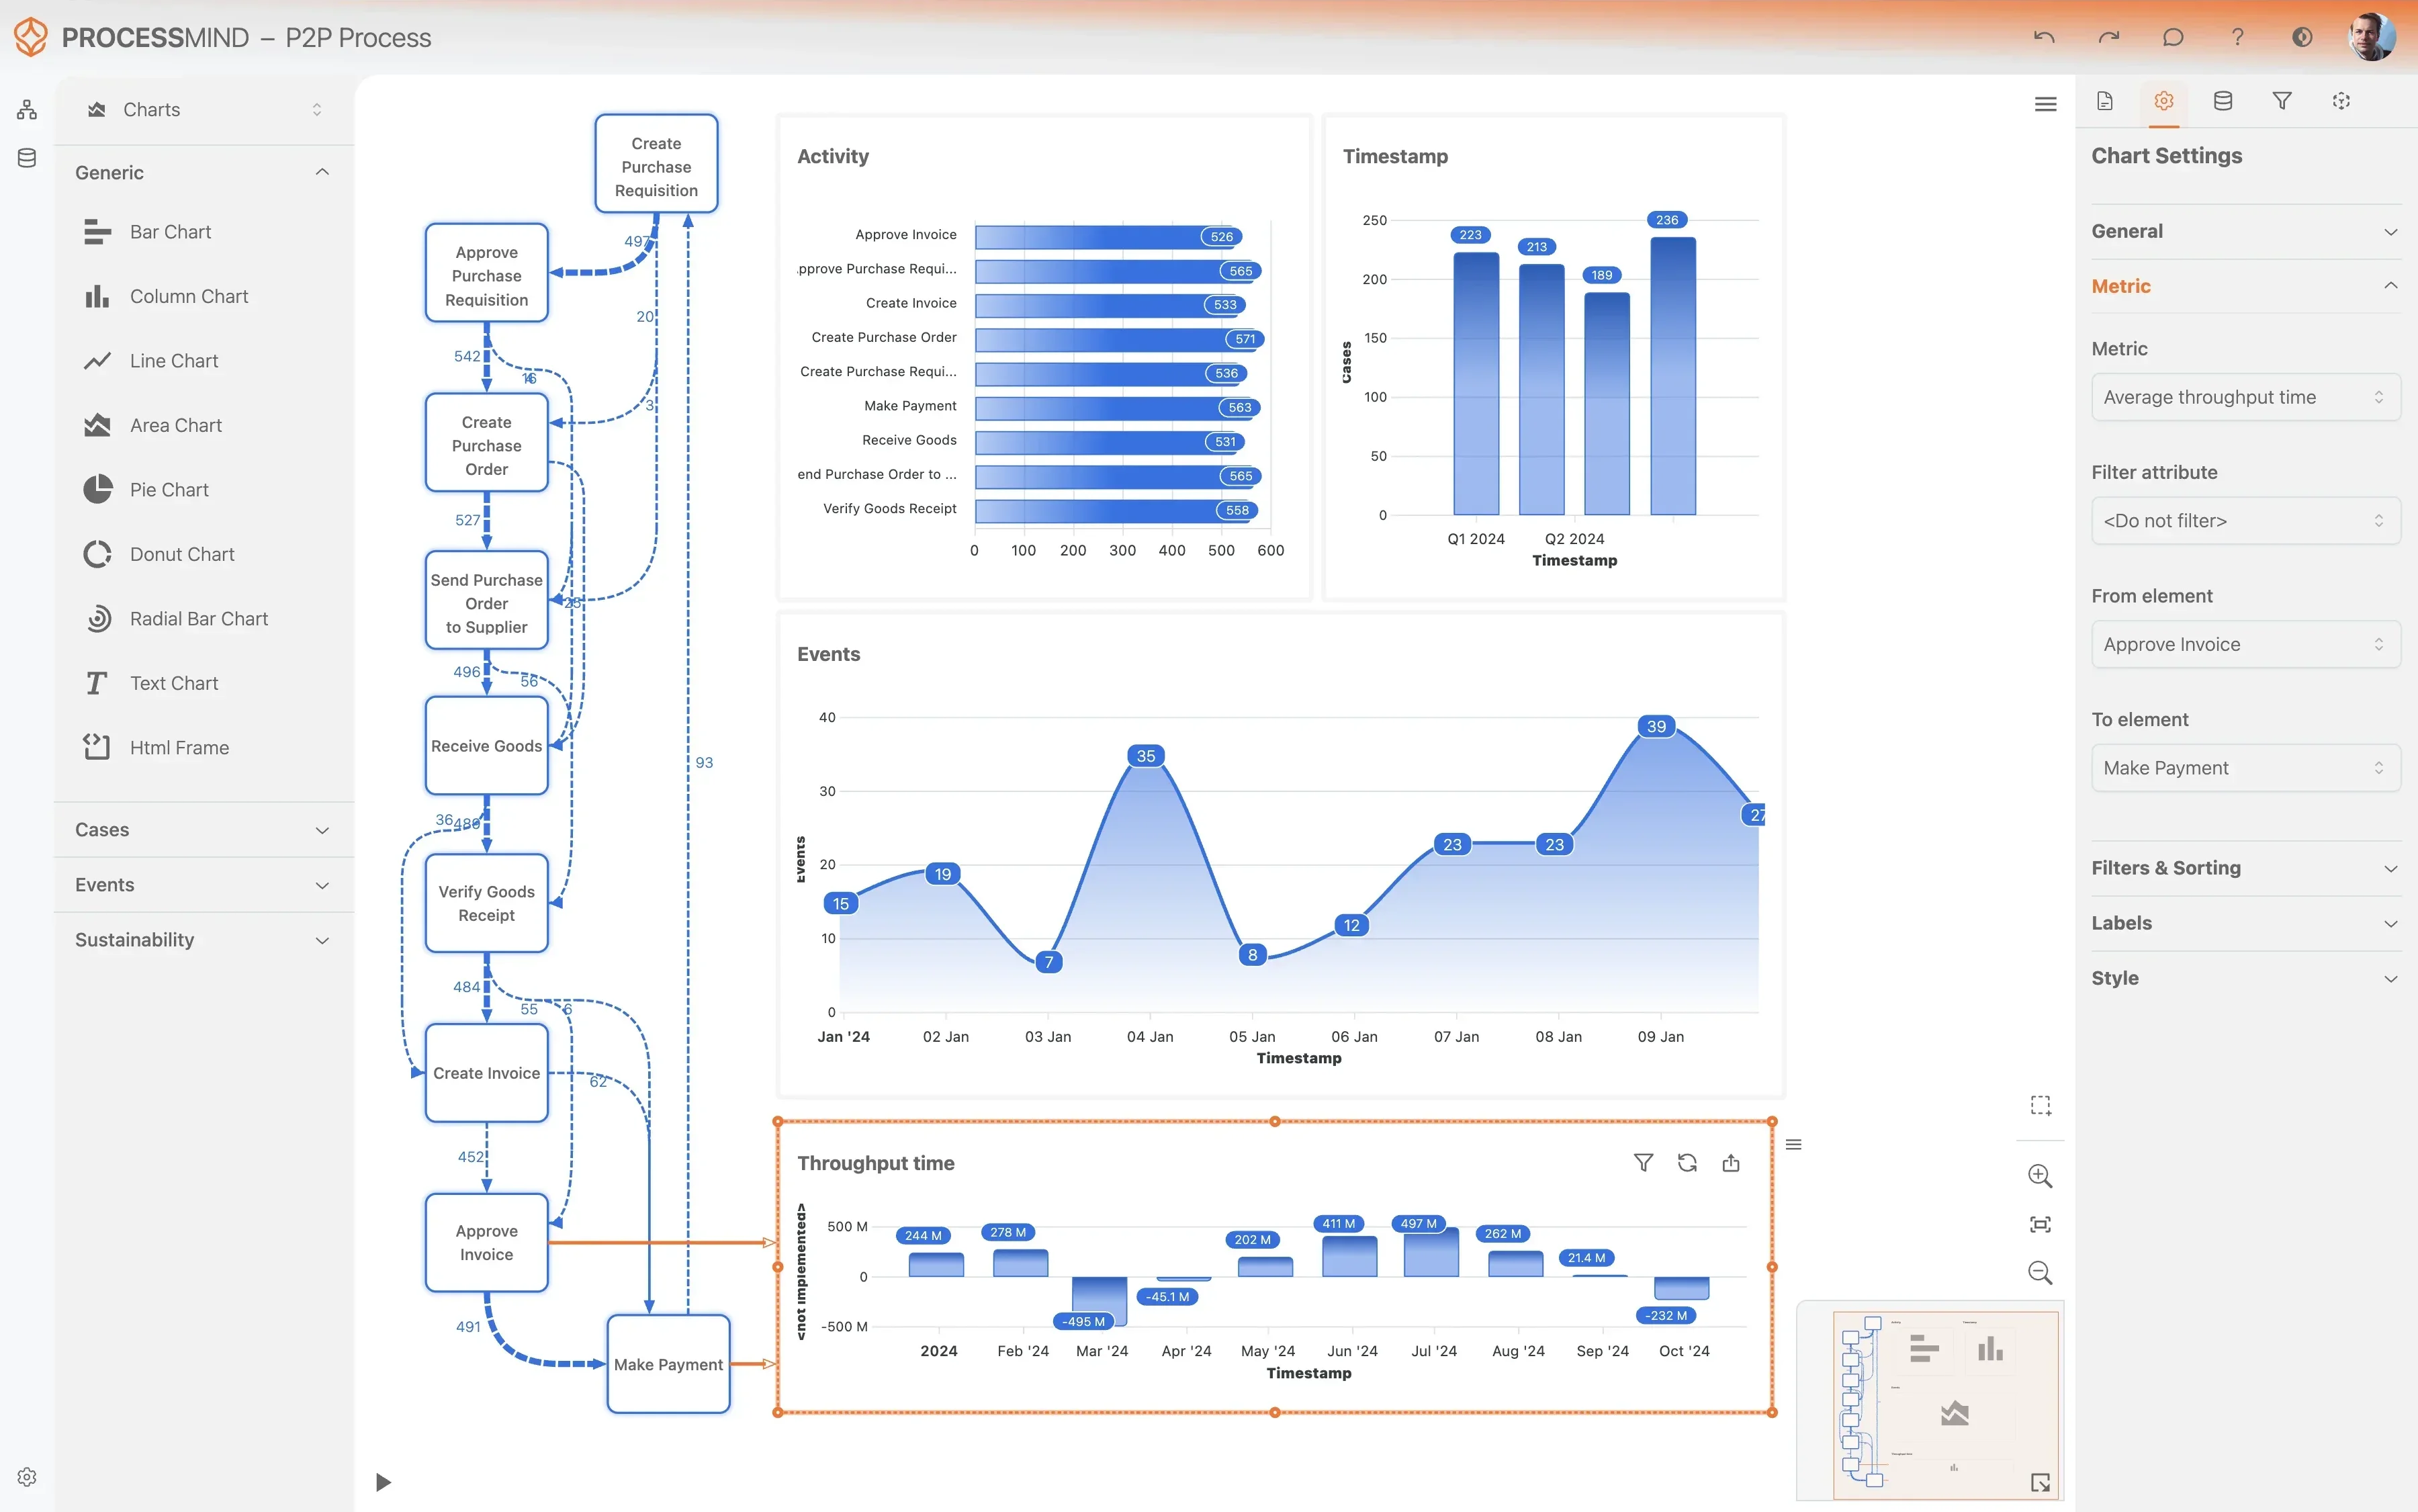
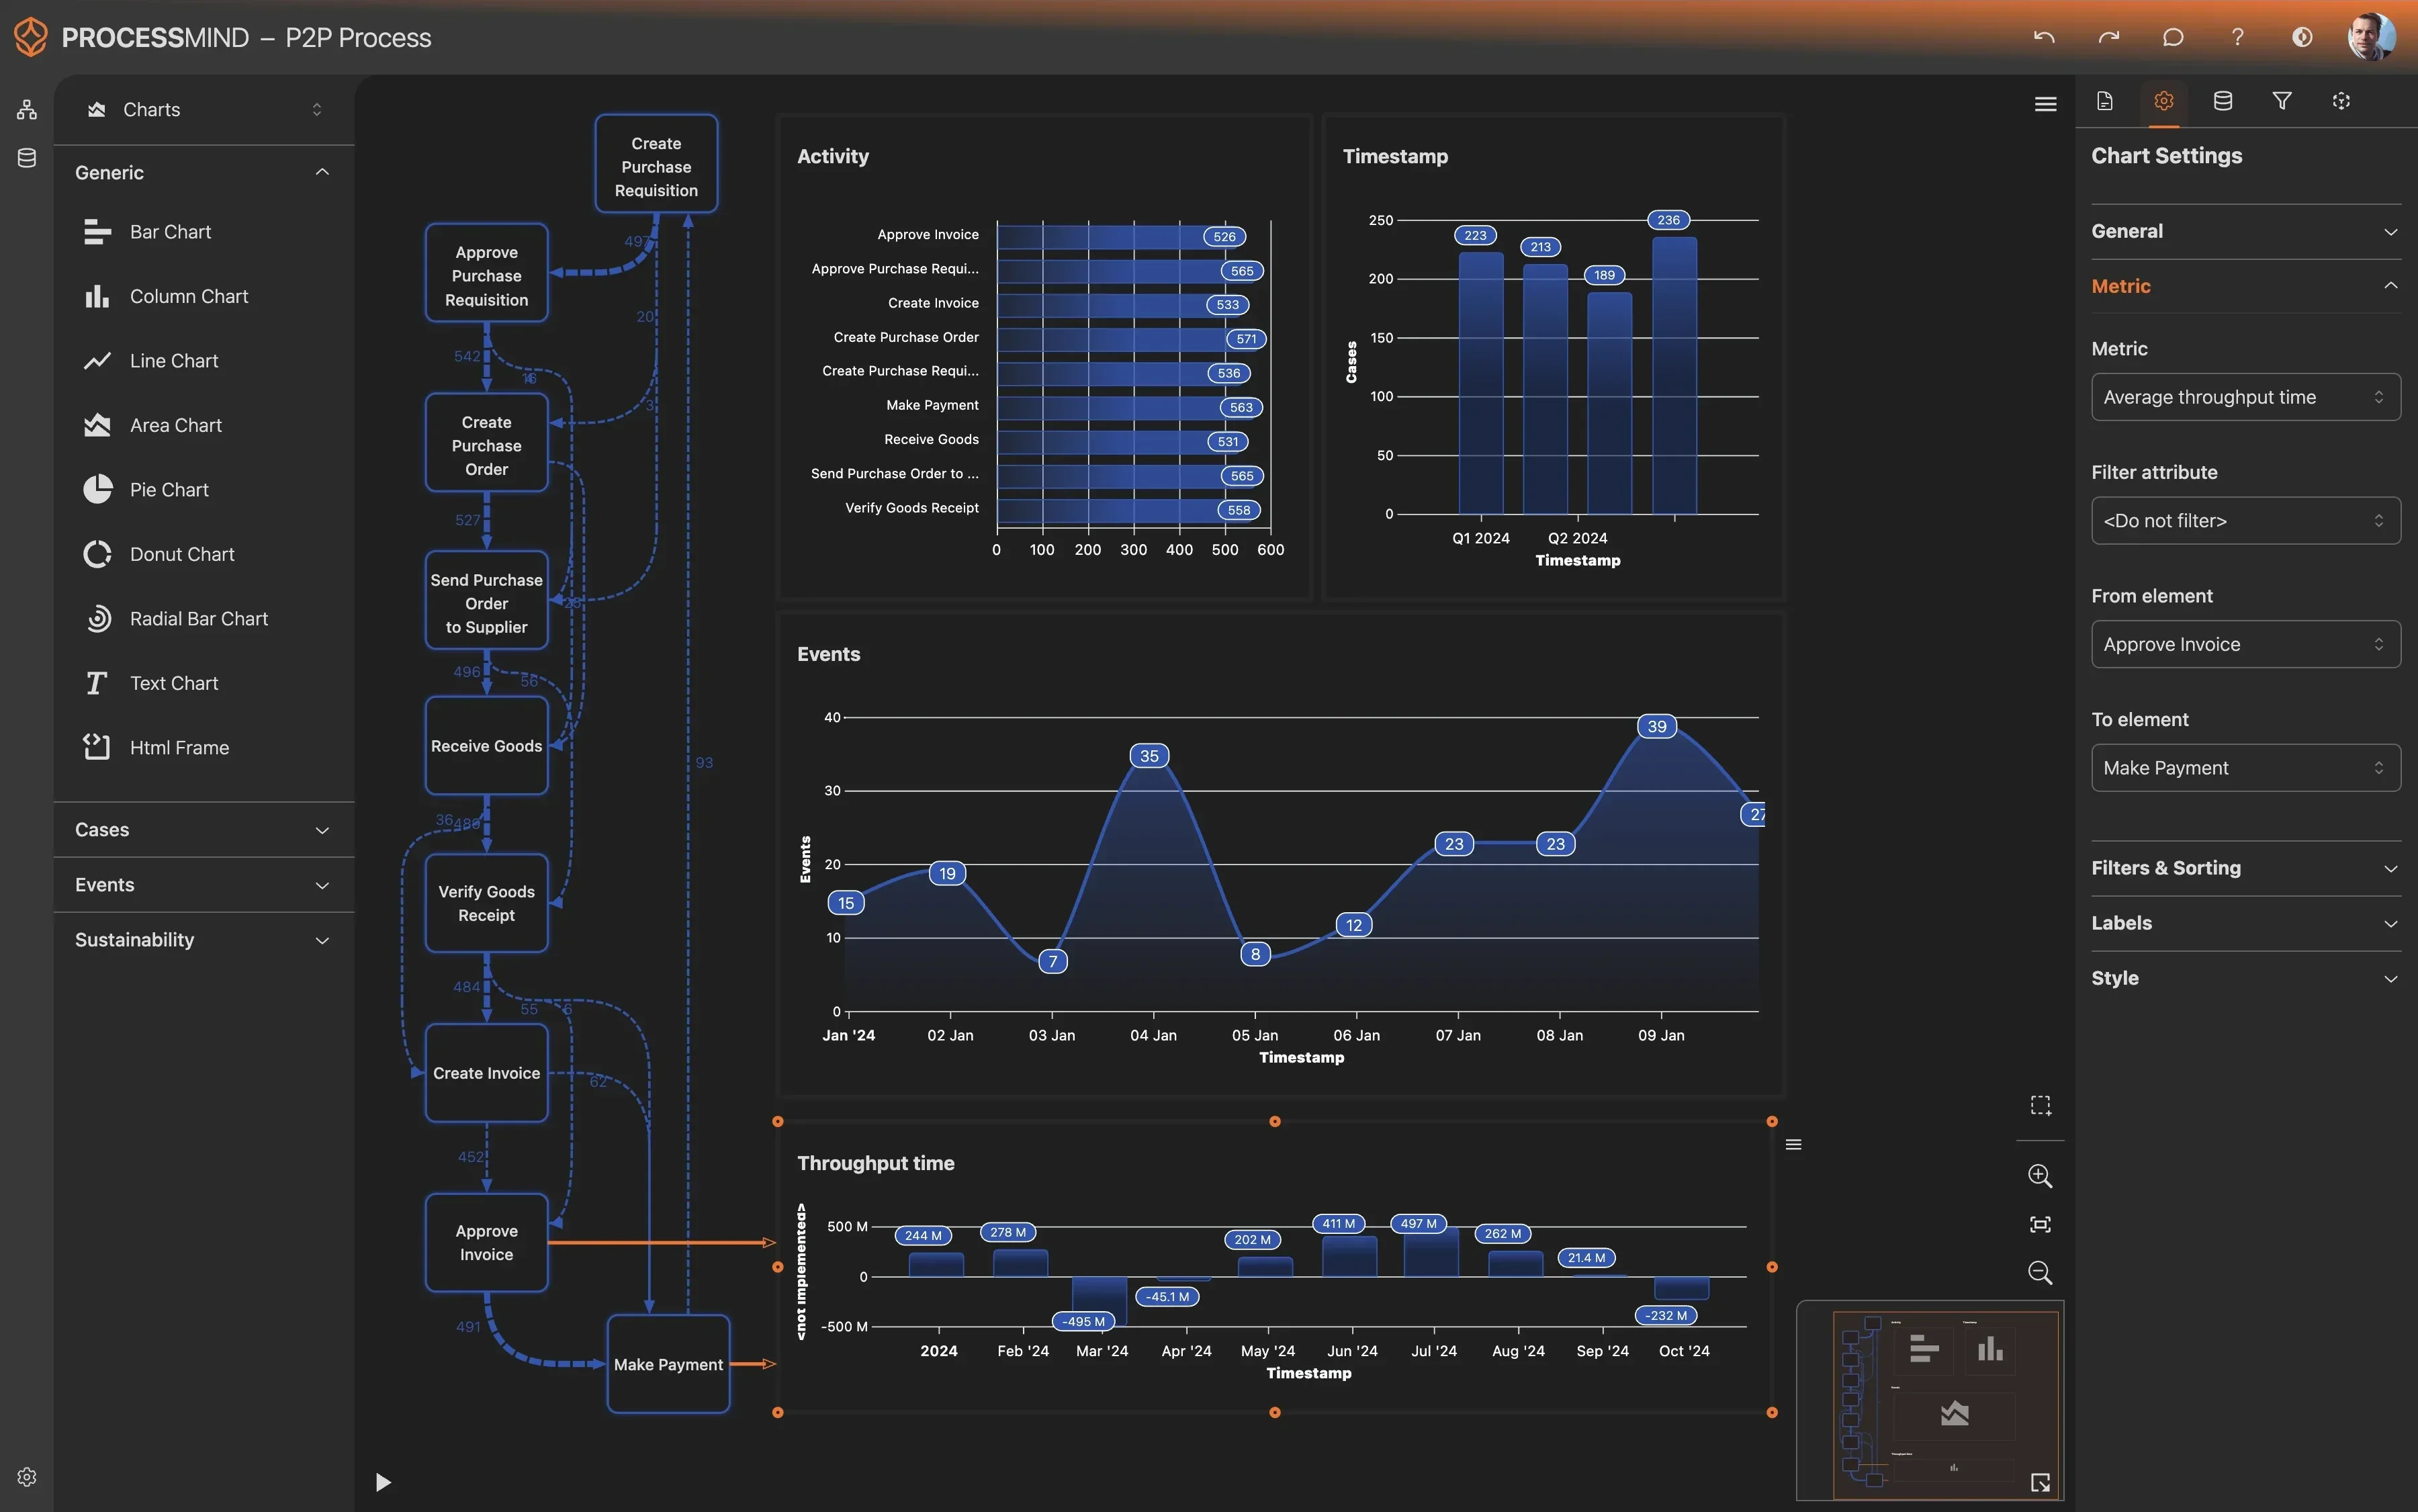
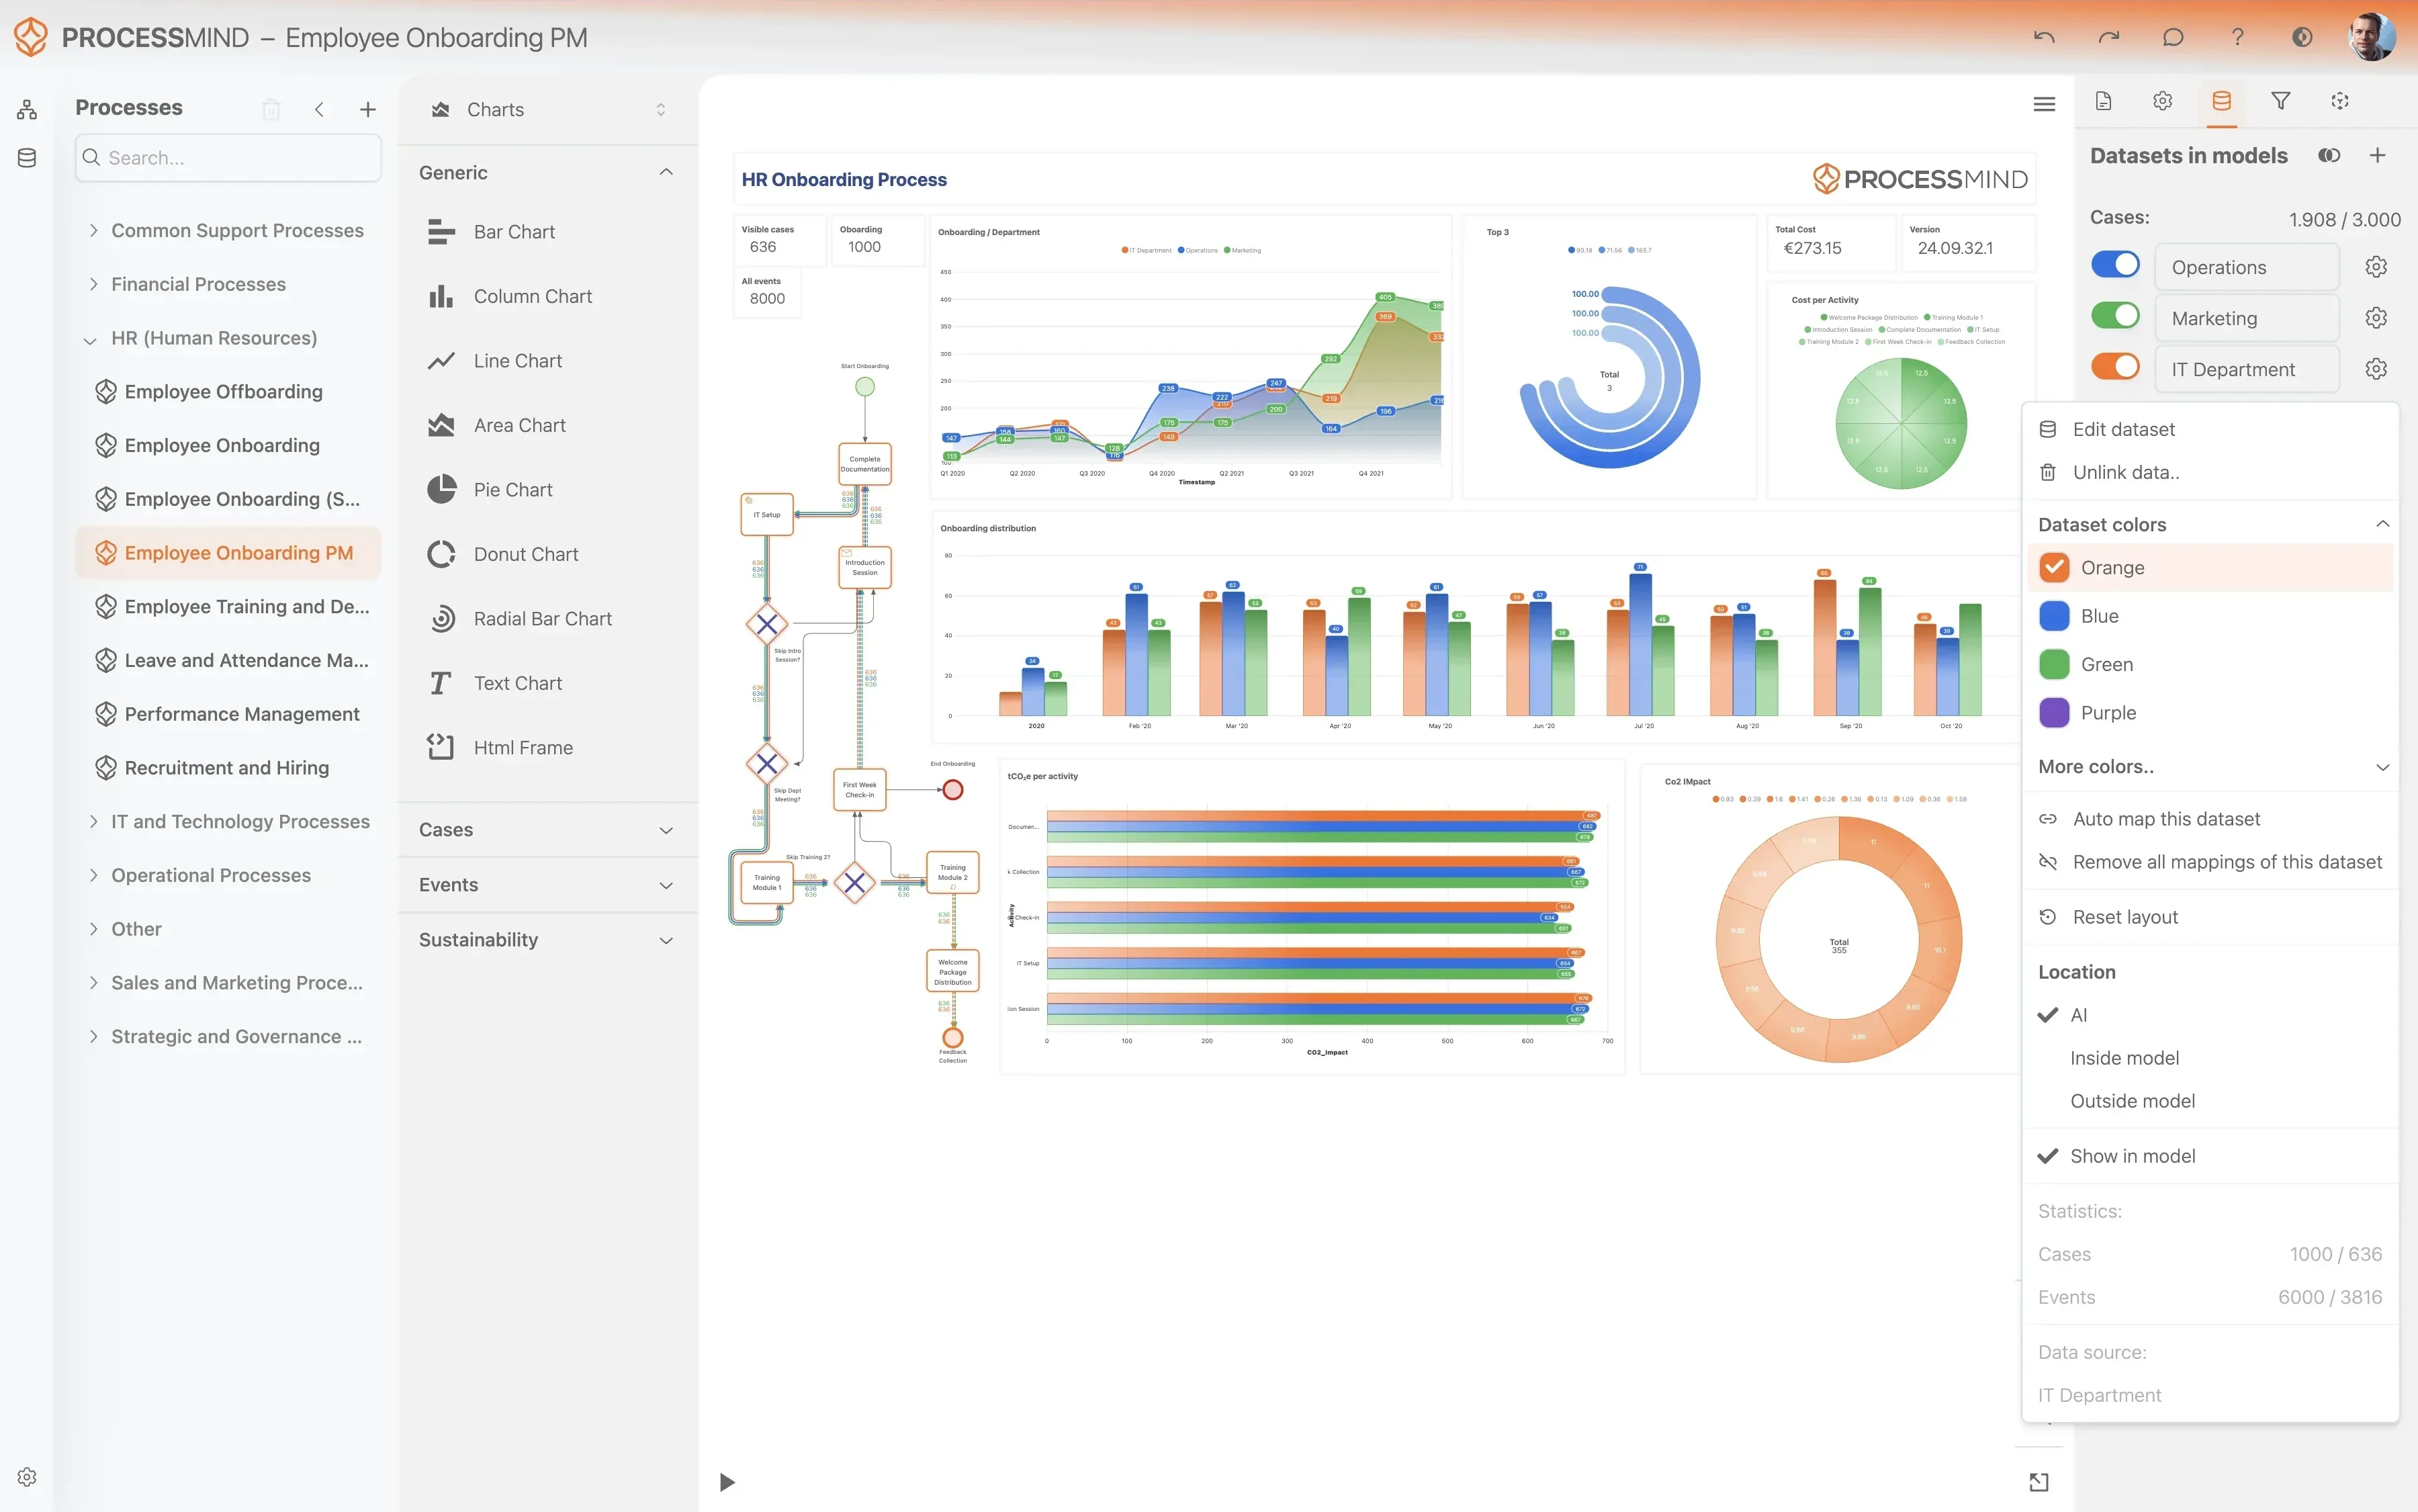
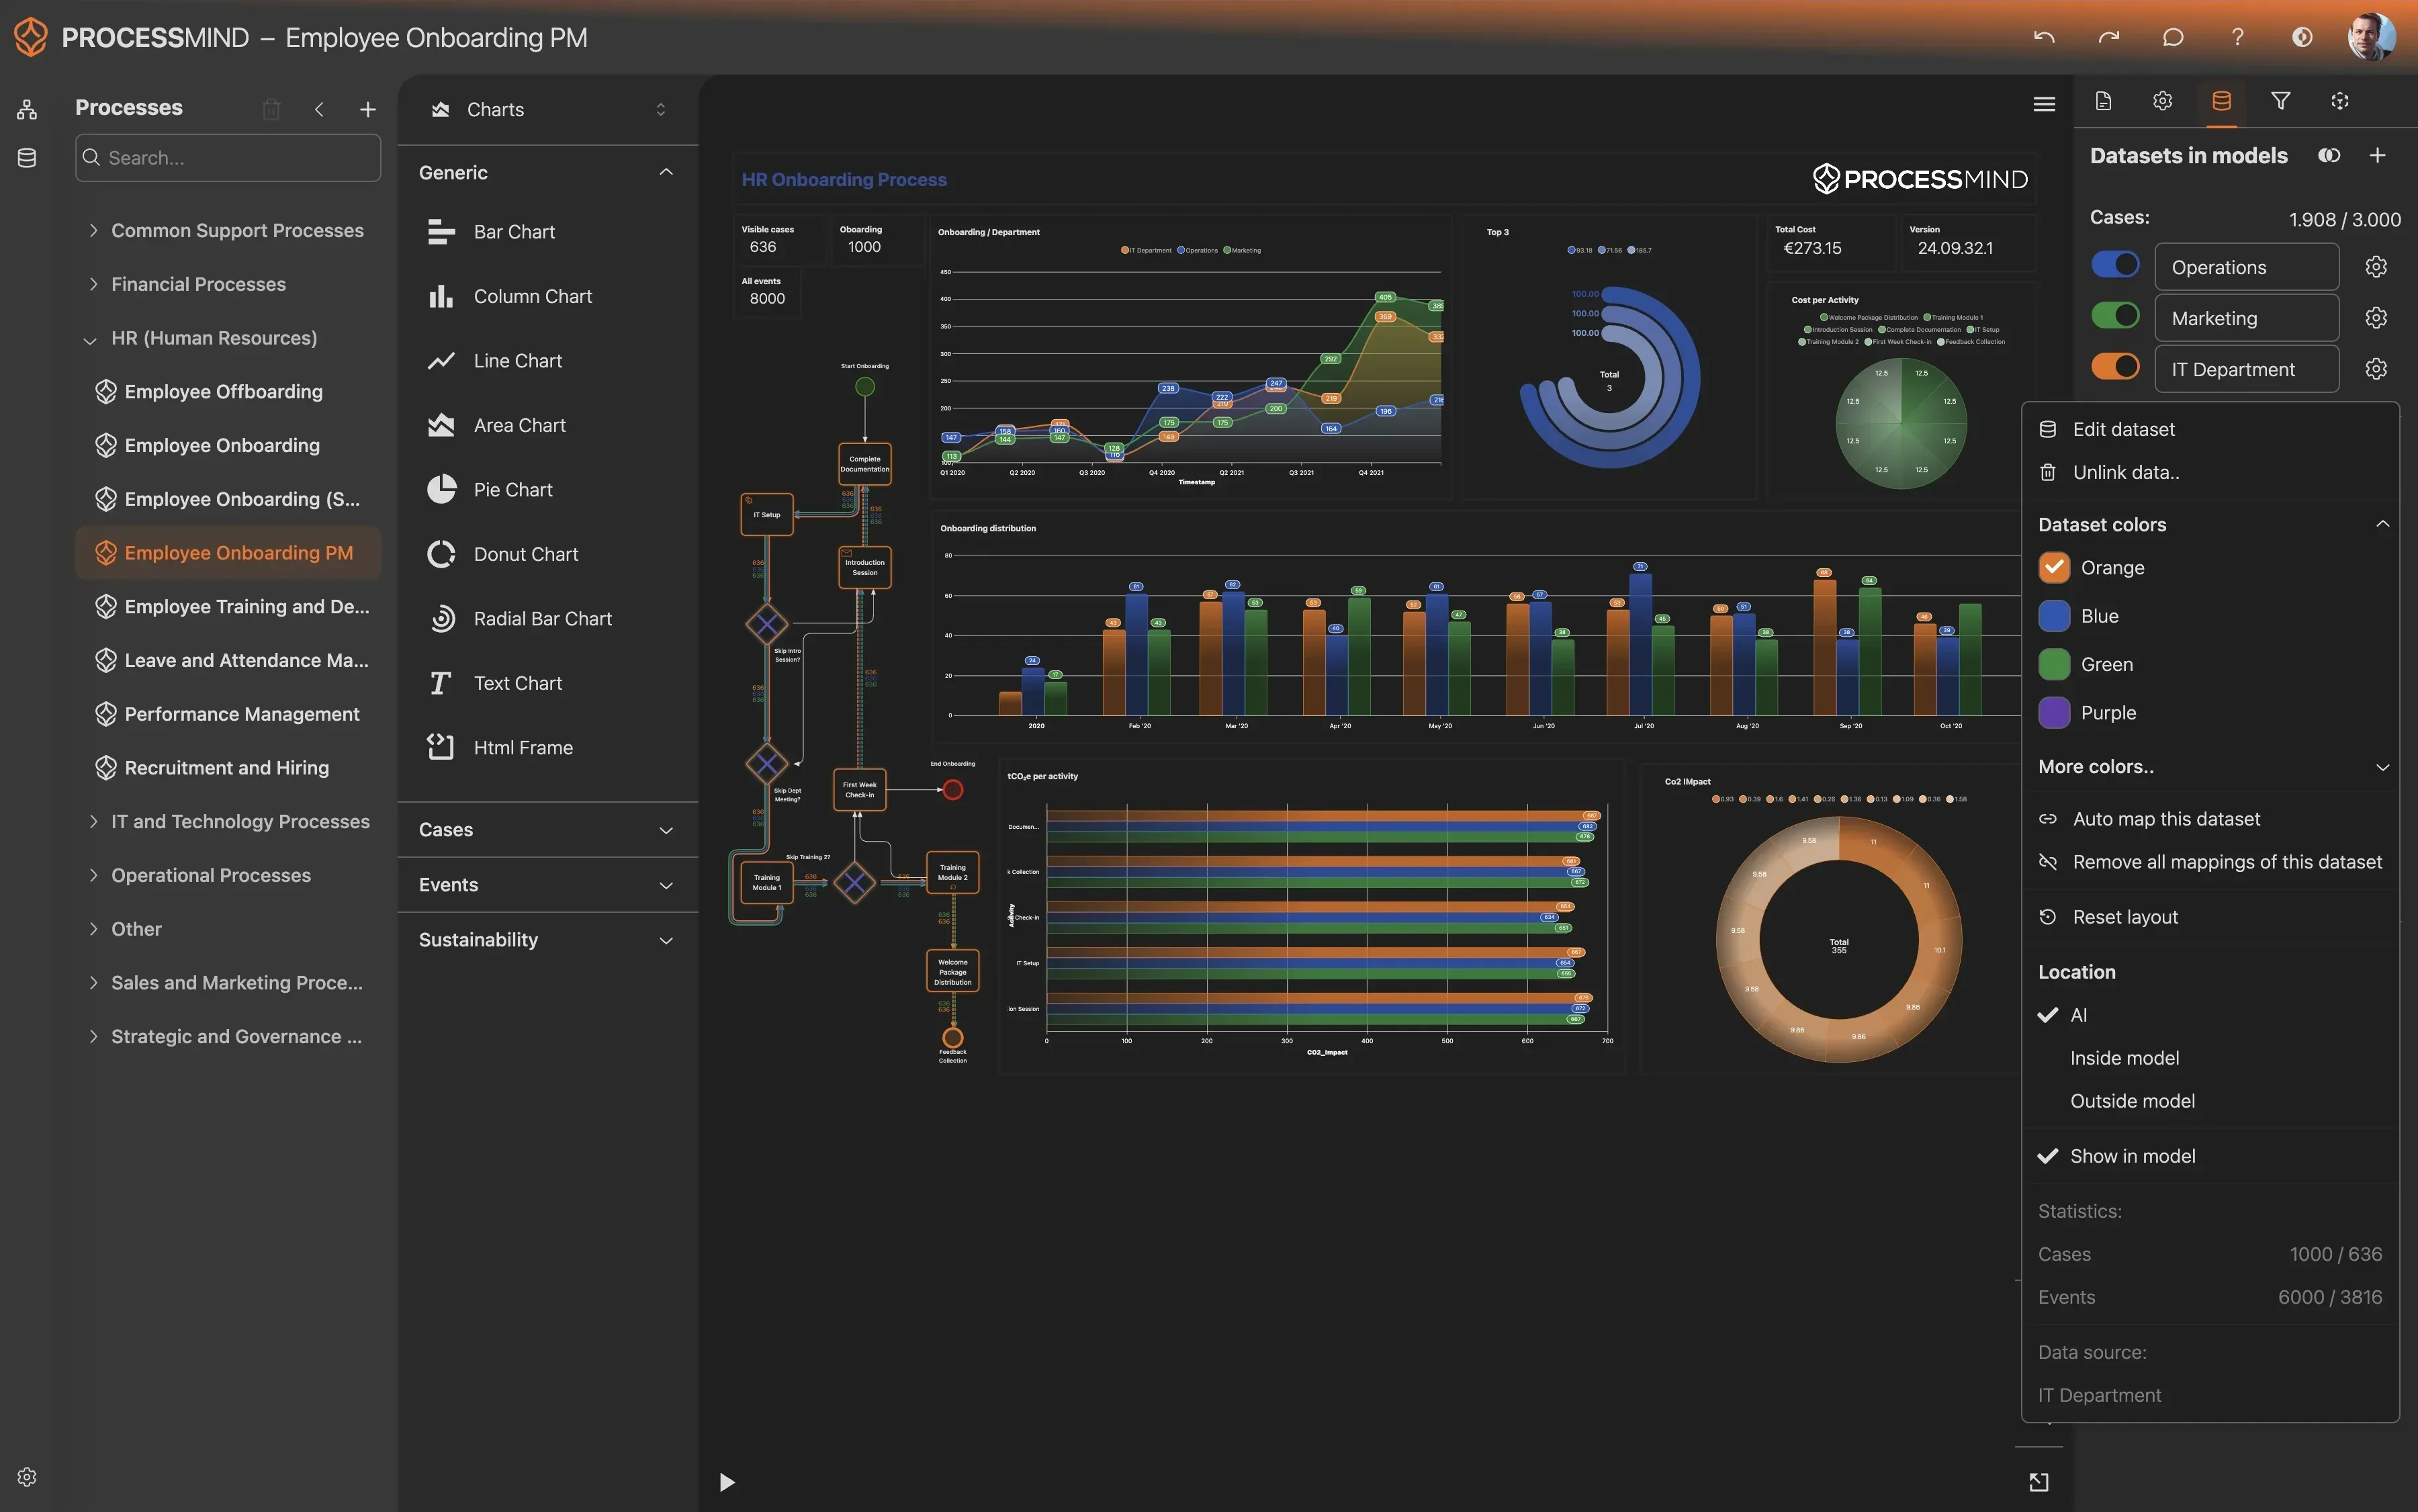
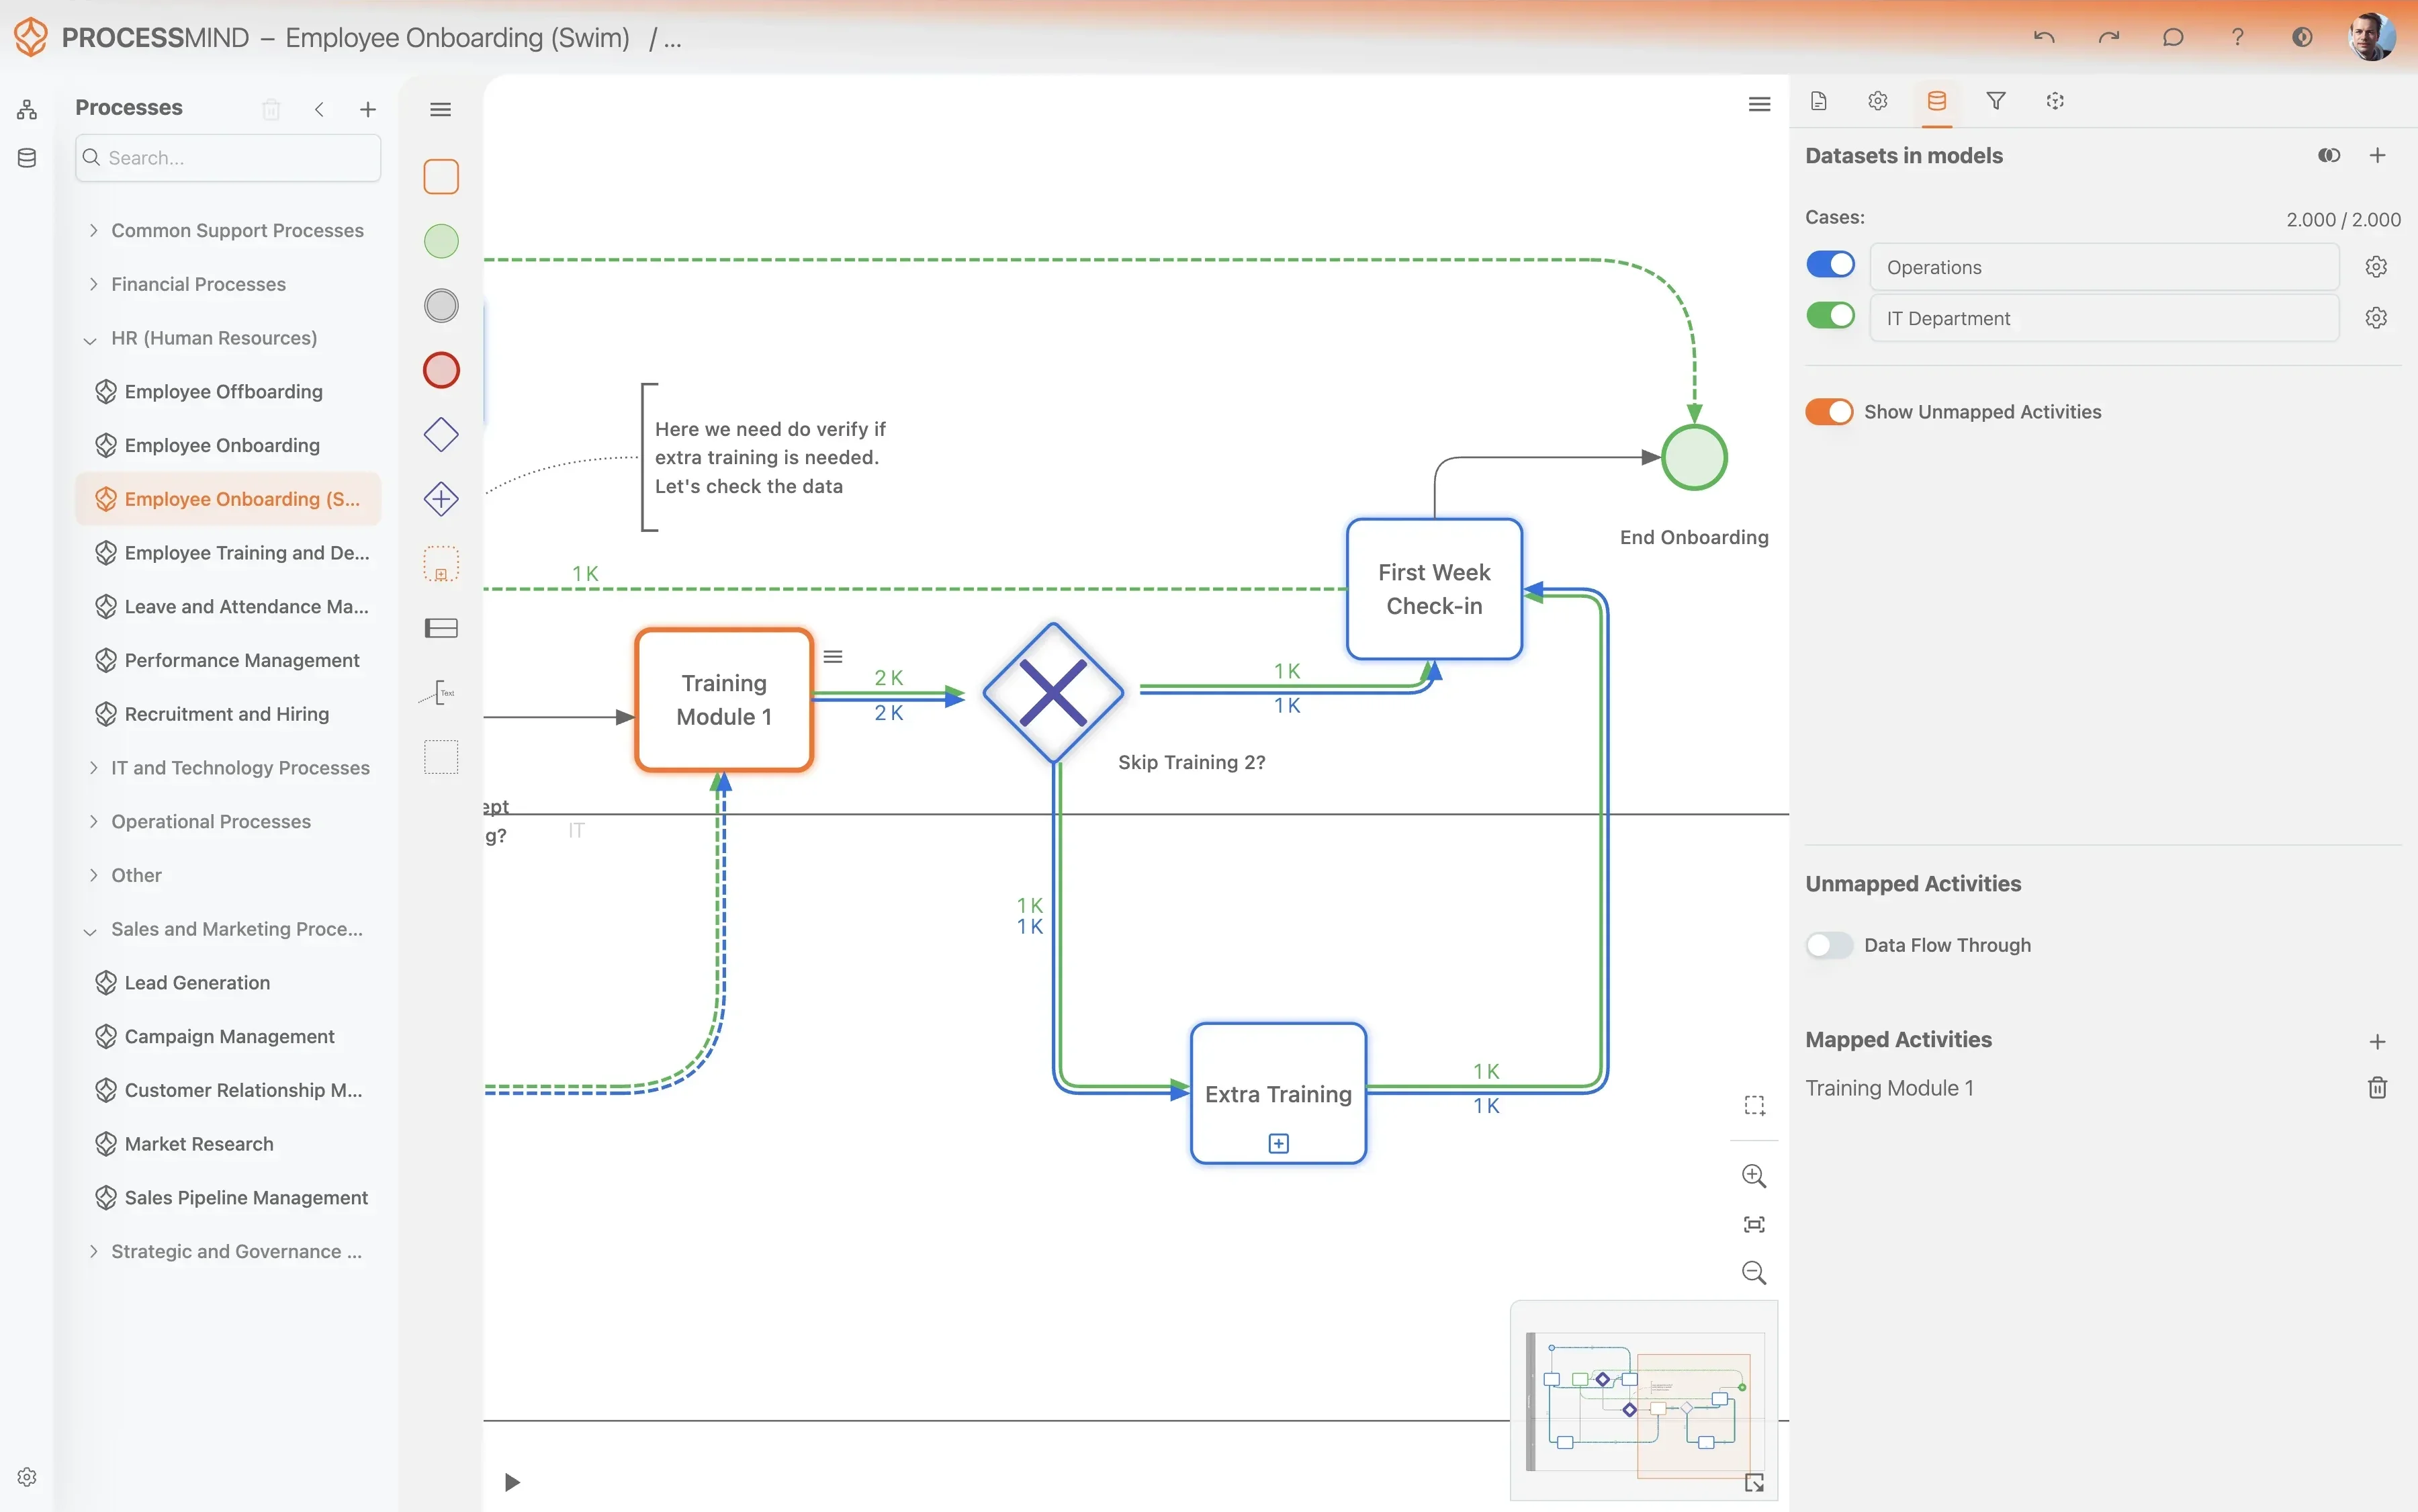
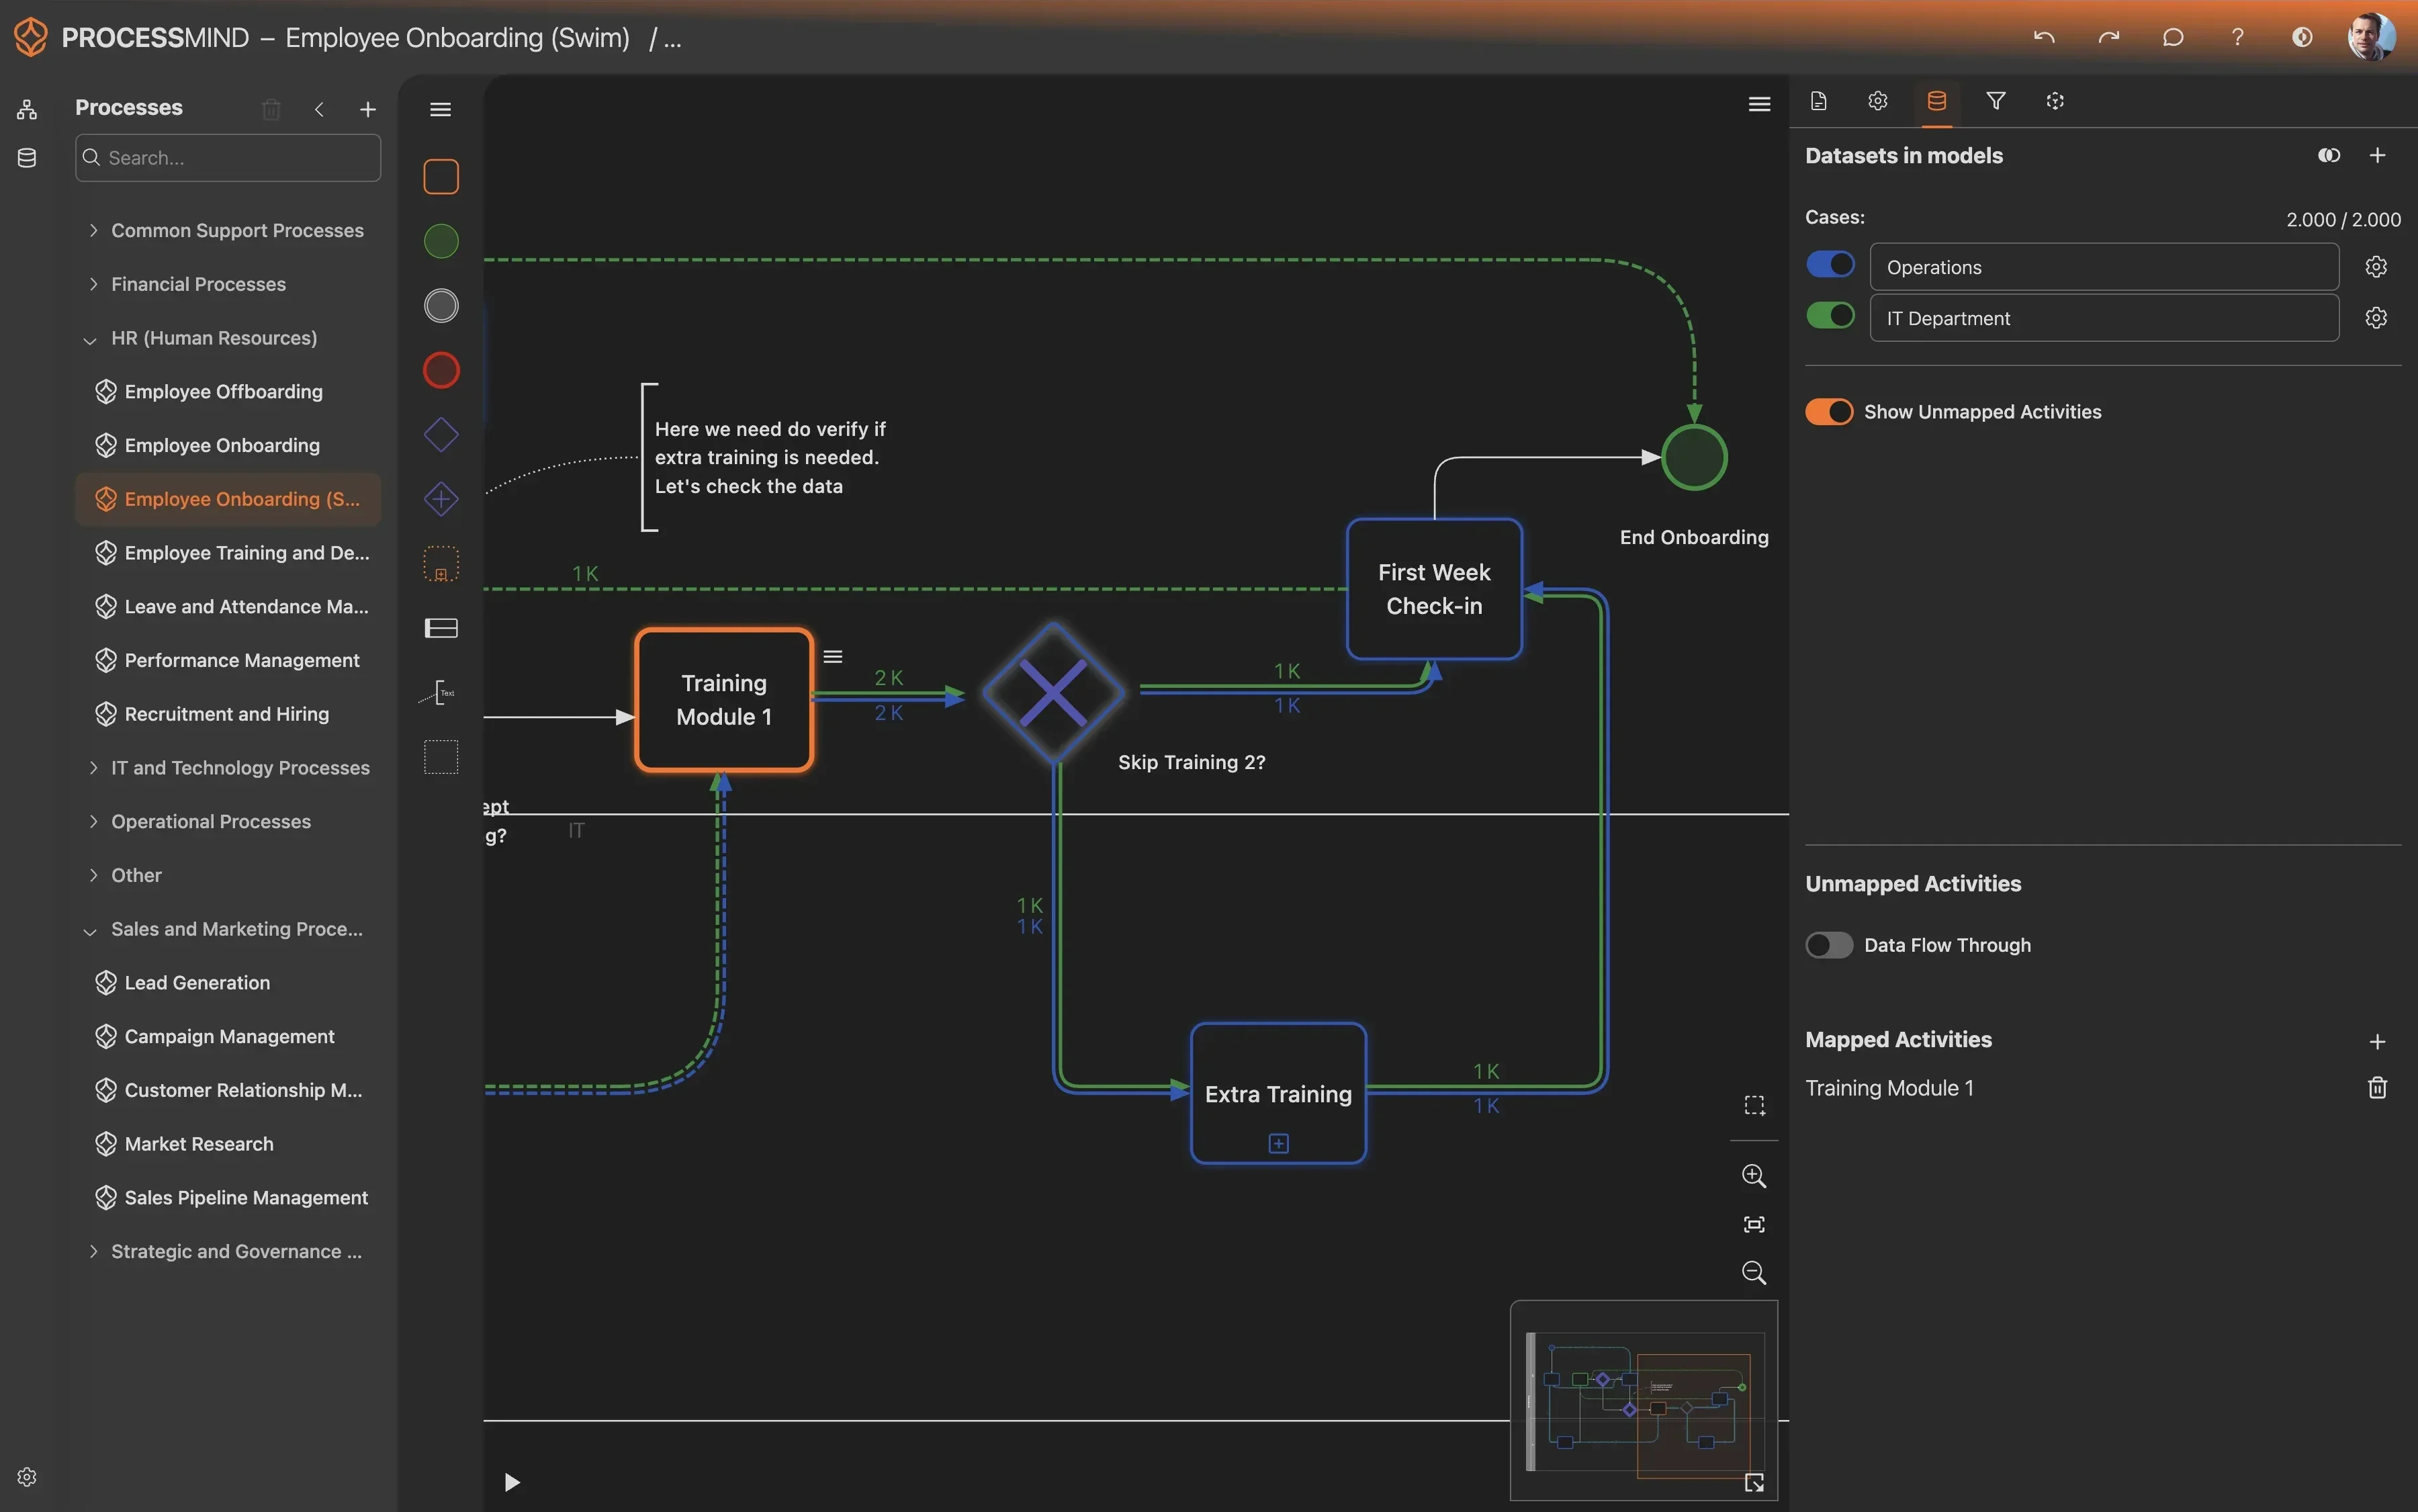
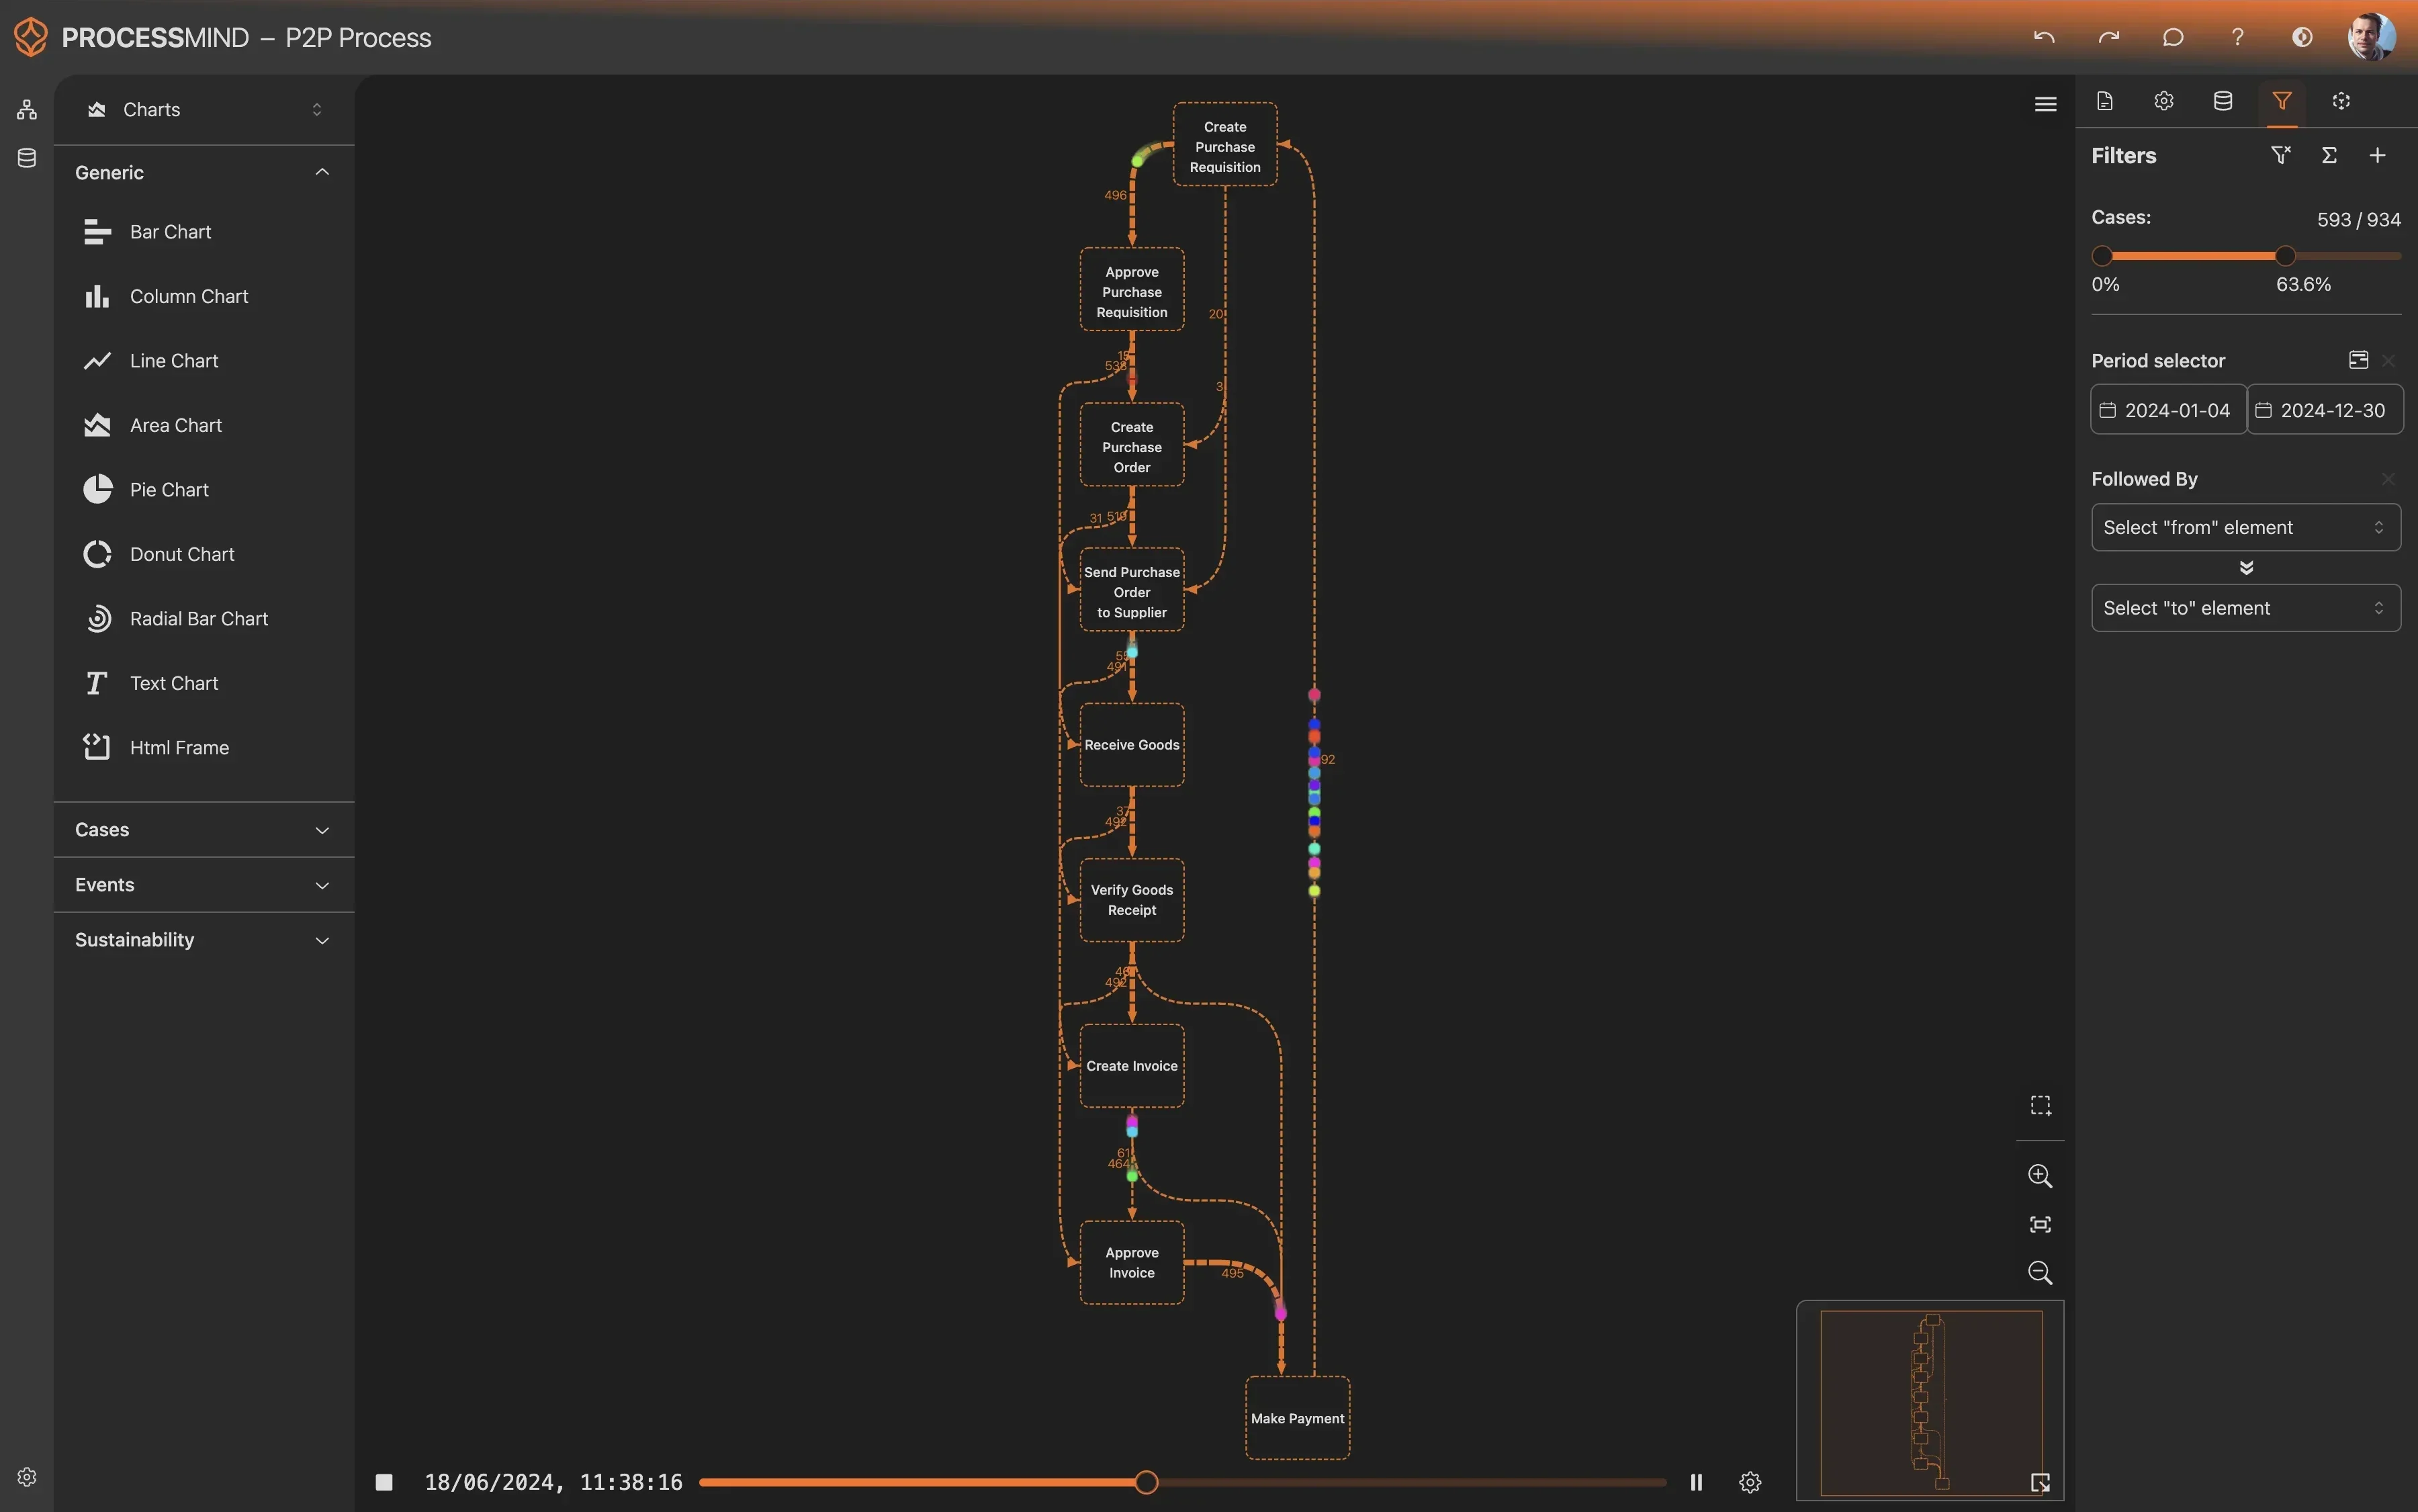
ProcessMind mostra come si svolgono realmente le attività, offrendo una visione oggettiva basata sui dati. Individua inefficienze e lacune di conformità che potrebbero non essere mai emerse.
  • Visualizzi il flusso del processo da un’estremità all’altra
  • Individui inefficienze nascoste e colli di bottiglia
  • Verifichi la conformità alle regole del processo
  • Ottimizzi l’allocazione delle risorse
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

RISULTATI TIPICI

Creare valore con il Process Mining per la gestione dei problemi

Questi risultati illustrano i miglioramenti concreti che le organizzazioni ottengono applicando il Process Mining ai flussi di lavoro di gestione dei problemi. Grazie a informazioni basate sui dati, i team possono individuare i colli di bottiglia, semplificare i processi di risoluzione e prevenire con maggiore efficacia il ripetersi dei problemi.

0 %
Individuazione più rapida delle cause profonde

Riduzione media dei tempi di indagine

Semplificare il percorso dall’avvio dell’indagine all’individuazione della causa profonda permette ai team tecnici di concentrarsi sulle soluzioni definitive anziché su diagnosi prolungate, riducendo le interruzioni dei servizi critici.

0 %
Meno rilavorazioni nei passaggi di consegne

Riduzione dei riassegnamenti delle registrazioni di problema

Individuare i colli di bottiglia nell’assegnazione iniziale permette di indirizzare subito le registrazioni di problema agli esperti più adatti, evitando sprechi di lavoro e ritardi tra i diversi gruppi di supporto.

0 %
Migliore rispetto degli SLA

Maggiore conformità per i problemi critici

La visibilità in tempo reale sulle registrazioni di problema bloccate aiuta la direzione a intervenire prima che vengano superati gli obiettivi degli accordi sui livelli di servizio, garantendo un’erogazione costante dei servizi all’azienda.

0 %
Meno rilavorazioni nella risoluzione

Riduzione delle riaperture dei problemi

Verificare le soluzioni prima della chiusura permette di accertare che i problemi alla base siano stati davvero risolti, evitando il costoso ciclo di nuove indagini dopo una presunta soluzione e migliorando la stabilità complessiva.

0 %
Distribuzione più rapida delle soluzioni temporanee

Pubblicazione più rapida delle soluzioni provvisorie

Pubblicare più rapidamente le soluzioni temporanee riduce sensibilmente l’impatto degli incidenti in corso sugli utenti finali e limita le interruzioni delle attività aziendali durante lo sviluppo della soluzione definitiva.

0 %
Meno incidenti ricorrenti

Riduzione dei ticket correlati al Service Desk

Individuare e risolvere efficacemente le cause profonde e pubblicare soluzioni definitive aiuta a evitare che nuovi incidenti sovraccarichino il Service Desk e riduce i costi complessivi del supporto.

I risultati variano in base alla complessità del processo, alla qualità dei dati e alla strategia di implementazione adottata. Queste cifre rappresentano miglioramenti tipici osservati in diverse implementazioni della gestione dei problemi.

Dati consigliati

Inizi dagli attributi e dalle attività più importanti, poi ampli l’analisi secondo necessità.
Non conosce ancora gli Event Log? Scopra come creare un Event Log per il Process Mining.

Attributi

Dati chiave da acquisire per l’analisi

Identificativo univoco di una segnalazione di problema, che rappresenta una singola istanza del processo di gestione dei problemi.

Perché è importante

È l’ID caso essenziale per raggruppare tutti gli eventi correlati e ricostruire l’intero percorso di ogni indagine su un problema.

Il nome di un evento, un’attività o una modifica di stato specifici verificatisi durante il ciclo di vita della gestione dei problemi.

Perché è importante

Questo attributo definisce le fasi del processo e consente di visualizzare e analizzare il flusso, compresi i percorsi più frequenti e le deviazioni.

La data e l’ora esatte in cui si è verificata una specifica attività.

Perché è importante

La marca temporale di ogni attività è fondamentale per ordinare gli eventi e calcolare tutte le metriche temporali, come i tempi di ciclo e la durata dei colli di bottiglia.

Il team tecnico o il reparto responsabile dell’indagine e della risoluzione del problema in un determinato momento.

Perché è importante

È fondamentale per analizzare le prestazioni dei team, individuare i colli di bottiglia causati dai passaggi di responsabilità e comprendere come si distribuisce il carico di lavoro tra i diversi team.

Il livello di priorità assegnato al problema, che determina l’urgenza dell’indagine e della risoluzione.

Perché è importante

Consente di segmentare l’analisi e confrontare la gestione dei problemi critici con quella dei casi ordinari; è inoltre essenziale per misurare il rispetto degli SLA.

La classificazione definitiva della causa alla base del problema.

Perché è importante

È fondamentale per l’analisi strategica, perché aiuta a individuare i problemi sistemici e le tendenze relative alle cause dei problemi nell’organizzazione.

Il servizio aziendale, l’applicazione o l’elemento di configurazione (CI) principale interessato dal problema.

Perché è importante

Fornisce un contesto aziendale collegando i problemi tecnici ai servizi interessati e consente di stabilire le priorità in base alla criticità per l’azienda.

Il numero totale di singole segnalazioni di incidente collegate al problema.

Perché è importante

Quantifica l’impatto aziendale di un problema, aiutando a stabilire le priorità delle indagini e a misurare l’efficacia della risoluzione.

La data e l’ora entro cui, in base all’accordo sul livello di servizio, si prevede di risolvere la segnalazione di problema.

Perché è importante

Definisce l’obiettivo di risoluzione e costituisce la base per misurare e rendicontare il rispetto degli SLA.

Indicatore che segnala se la risoluzione del problema ha superato la scadenza SLA assegnata.

Perché è importante

Indica chiaramente se l’SLA è stato rispettato, facilitando il filtraggio e l’analisi dei percorsi di processo che portano alle violazioni.

Il numero di volte in cui la segnalazione di problema è stata riassegnata tra diversi gruppi di supporto o singole persone.

Perché è importante

Aiuta a quantificare le inefficienze del processo monitorando i passaggi di responsabilità eccessivi, spesso riconducibili a un instradamento errato, lacune nelle conoscenze o responsabilità poco chiare.

Attività

Fasi del processo da monitorare e ottimizzare

Questa attività corrisponde alla creazione iniziale di una registrazione di problema. Segna l’avvio formale del processo di gestione dei problemi e fornisce la data e l’orario di riferimento per tutte le analisi successive.

Perché è importante

Questa attività è il punto di avvio principale di ogni istanza del processo. Analizzare il tempo che intercorre tra questo evento e gli altri è fondamentale per comprendere la durata complessiva del processo e i ritardi iniziali.

Questo evento segna il passaggio della registrazione di problema da uno stato nuovo o in attesa a uno stato di indagine attiva. Indica che un analista ha iniziato formalmente a diagnosticare il problema.

Perché è importante

Questa attività consente di misurare il tempo di risposta iniziale e la velocità di gestione degli arretrati. Il tempo che intercorre tra la creazione e l’avvio dell’indagine è un indicatore chiave della reattività del team.

Questo evento indica che una soluzione provvisoria è stata documentata e resa disponibile. Permette di ridurre l’impatto sugli utenti finali mentre viene sviluppata una soluzione definitiva.

Perché è importante

Il tempo necessario per fornire una soluzione temporanea è un indicatore chiave della capacità del team di ripristinare rapidamente il servizio. Questa attività consente di analizzare la rapidità e l’efficacia delle soluzioni provvisorie.

Questa attività segna il momento in cui la causa profonda del problema è stata diagnosticata e documentata. Indica il completamento della fase di indagine.

Perché è importante

È un passaggio fondamentale per misurare l’efficienza diagnostica. Il tempo che intercorre tra l’avvio dell’indagine e l’individuazione della causa profonda è un indicatore chiave delle prestazioni nell’analisi dei problemi.

Questo evento registra la creazione di una richiesta di modifica formale o il suo collegamento alla registrazione di problema. Segna il passaggio dalla gestione dei problemi alla gestione delle modifiche per implementare una soluzione definitiva.

Perché è importante

Questa attività è fondamentale per analizzare il ritardo tra la diagnosi del problema e l’avvio della soluzione. Aiuta a individuare i colli di bottiglia nel passaggio tra la gestione dei problemi e quella delle modifiche.

Questo evento indica che la soluzione tecnica definitiva, spesso gestita tramite una richiesta di modifica, è stata distribuita correttamente. Segna il completamento dell’intervento correttivo.

Perché è importante

Questa attività conclude la fase di implementazione della soluzione. Il tempo che intercorre tra l’avvio della modifica e questo momento misura l’efficienza del processo di gestione delle modifiche nella risoluzione dei problemi.

Questa è l’attività finale del ciclo di vita e indica che la registrazione di problema è stata chiusa a livello amministrativo e non sono previste altre azioni. Il caso è considerato completato e archiviato.

Perché è importante

Questa attività è il principale punto di conclusione della maggior parte delle istanze del processo. È essenziale per calcolare la durata complessiva del processo di gestione dei problemi.

Per ricevere raccomandazioni sui dati personalizzate, scelga il processo specifico.

Domande frequenti

Domande frequenti

Il Process Mining visualizza il percorso effettivo di ogni registrazione di problema, facendo emergere gli scostamenti dai flussi di lavoro standard e individuando i colli di bottiglia nascosti. Offre una visione del processo basata sui dati, che aiuta i team a migliorare l’efficienza e ridurre i tempi di risoluzione.

In genere serve un Event Log con un identificativo univoco del caso, una data e un orario per ogni attività e una descrizione dell’attività stessa. Attributi chiave come le modifiche di stato, i gruppi assegnati, la priorità e la categoria forniscono un contesto più ricco per un’analisi approfondita.

Spesso è possibile ottenere le prime informazioni nel giro di pochi giorni o settimane, una volta predisposta l’estrazione dei dati dal sistema di origine. La prima fase consiste nel collegarsi al sistema e mappare le principali modifiche del processo per creare un modello di base di riferimento.

Il Process Mining individua le fasi in cui le indagini si bloccano, quantificando la durata di ogni passaggio. Fa emergere la mancanza di risorse o di informazioni che prolunga la fase di indagine. Questo approccio basato sui dati sostituisce le impressioni aneddotiche con riscontri concreti sui punti in cui si verificano i ritardi.

Mappando ogni passaggio, il Process Mining individua le registrazioni che rimbalzano ripetutamente tra i gruppi di supporto senza essere risolte. Aiuta i responsabili a riconoscere le situazioni in cui le responsabilità dei gruppi non sono chiare o in cui alcuni team non dispongono delle risorse necessarie per gestire determinati tipi di problema. Queste informazioni consentono di riprogettare il processo e distribuire meglio le risorse.

Il Process Mining individua le cause profonde delle violazioni degli SLA mostrando il percorso esatto delle registrazioni che non hanno raggiunto gli obiettivi. È possibile confrontare le registrazioni conformi con quelle non conformi per verificare se alcuni gruppi di supporto o tipi di problema sono più soggetti a ritardi. Queste informazioni permettono di intervenire in modo mirato e assicurare che i problemi prioritari vengano gestiti entro i tempi previsti.

Analizzando il collegamento tra le registrazioni degli incidenti e quelle dei problemi, il Process Mining individua gli schemi in cui si ricorre ripetutamente a soluzioni temporanee anziché a soluzioni definitive. Questa visibilità aiuta a dare priorità agli interventi con il maggiore impatto, capaci di eliminare interi gruppi di ticket di supporto ricorrenti.

I report standard offrono istantanee e indicatori aggregati, ma spesso non mostrano il percorso effettivo di una registrazione di problema. Il Process Mining fa emergere i passaggi, i cicli e gli scostamenti specifici che si verificano tra un indicatore e l’altro. Mostra con precisione dove e perché il processo si blocca, affiancando alla reportistica standard una visione più approfondita e di lungo periodo, utile per migliorare davvero il processo.

Migliori la gestione dei problemi, inizi ora

Individui le inefficienze e risolva i problemi più rapidamente grazie a informazioni basate sui dati.

Inizi la prova gratuita

Non è richiesta la carta di credito. La configurazione richiede pochi minuti.