Verbeter je probleembeheer
Een 6-stappengids voor procesoptimalisatie in Freshservice
Verbeter je probleembeheer
Probleembeheer
Freshservice

Selecteer een proces

Kies een proces om verder te werken in de gekoppelde workspace.

259 Processen

Optimaliseer Probleembeheer in Freshservice met process mining

Ons platform brengt verborgen bottlenecks aan het licht en laat zien waar oorzaakanalyses vaak vastlopen. Door elke stap zichtbaar te maken, zie je precies waar vertraging ontstaat en welk effect afwijkende procesroutes hebben op de dienstverlening. Met die informatie kan je team workflows verbeteren en minder tijd kwijt zijn aan terugkerende incidenten.

Download onze vooraf ingestelde datatemplate en pak veelvoorkomende uitdagingen aan om je efficiëntie-doelen te bereiken. Volg ons verbeterplan in zes stappen en raadpleeg de gids voor de datatemplate om je bedrijfsvoering te verbeteren.

Gedetailleerde beschrijving tonen

De strategische waarde van goed Probleembeheer

Probleembeheer is vaak de stille motor achter goede IT-dienstverlening. Incidentbeheer draait om snelheid en herstel; Probleembeheer richt zich op kwaliteit en blijvende oplossingen. Teams kunnen in Freshservice eenvoudig tickets registreren en categoriseren. De uitdaging zit in de overdrachten tussen supportniveaus en in de stap van een tijdelijke workaround naar een definitieve oplossing. Verloopt dit proces traag of inefficiënt, dan krijgt je organisatie te maken met veel terugkerende problemen. Die kosten technische capaciteit en frustreren eindgebruikers.

Dit proces verbeteren betekent meer dan tickets sneller sluiten. Het gaat erom dat elke oorzaakanalyse leidt tot aantoonbaar minder verstoringen in de dienstverlening. Door te kijken naar hoe en waarom problemen ontstaan, kun je overstappen van brandjes blussen naar problemen voorkomen voordat ze uitval veroorzaken. Daarvoor moet je weten hoe informatie door Freshservice loopt en waar onderzoeken vaak stilvallen.

Van Freshservice-data naar een helder beeld

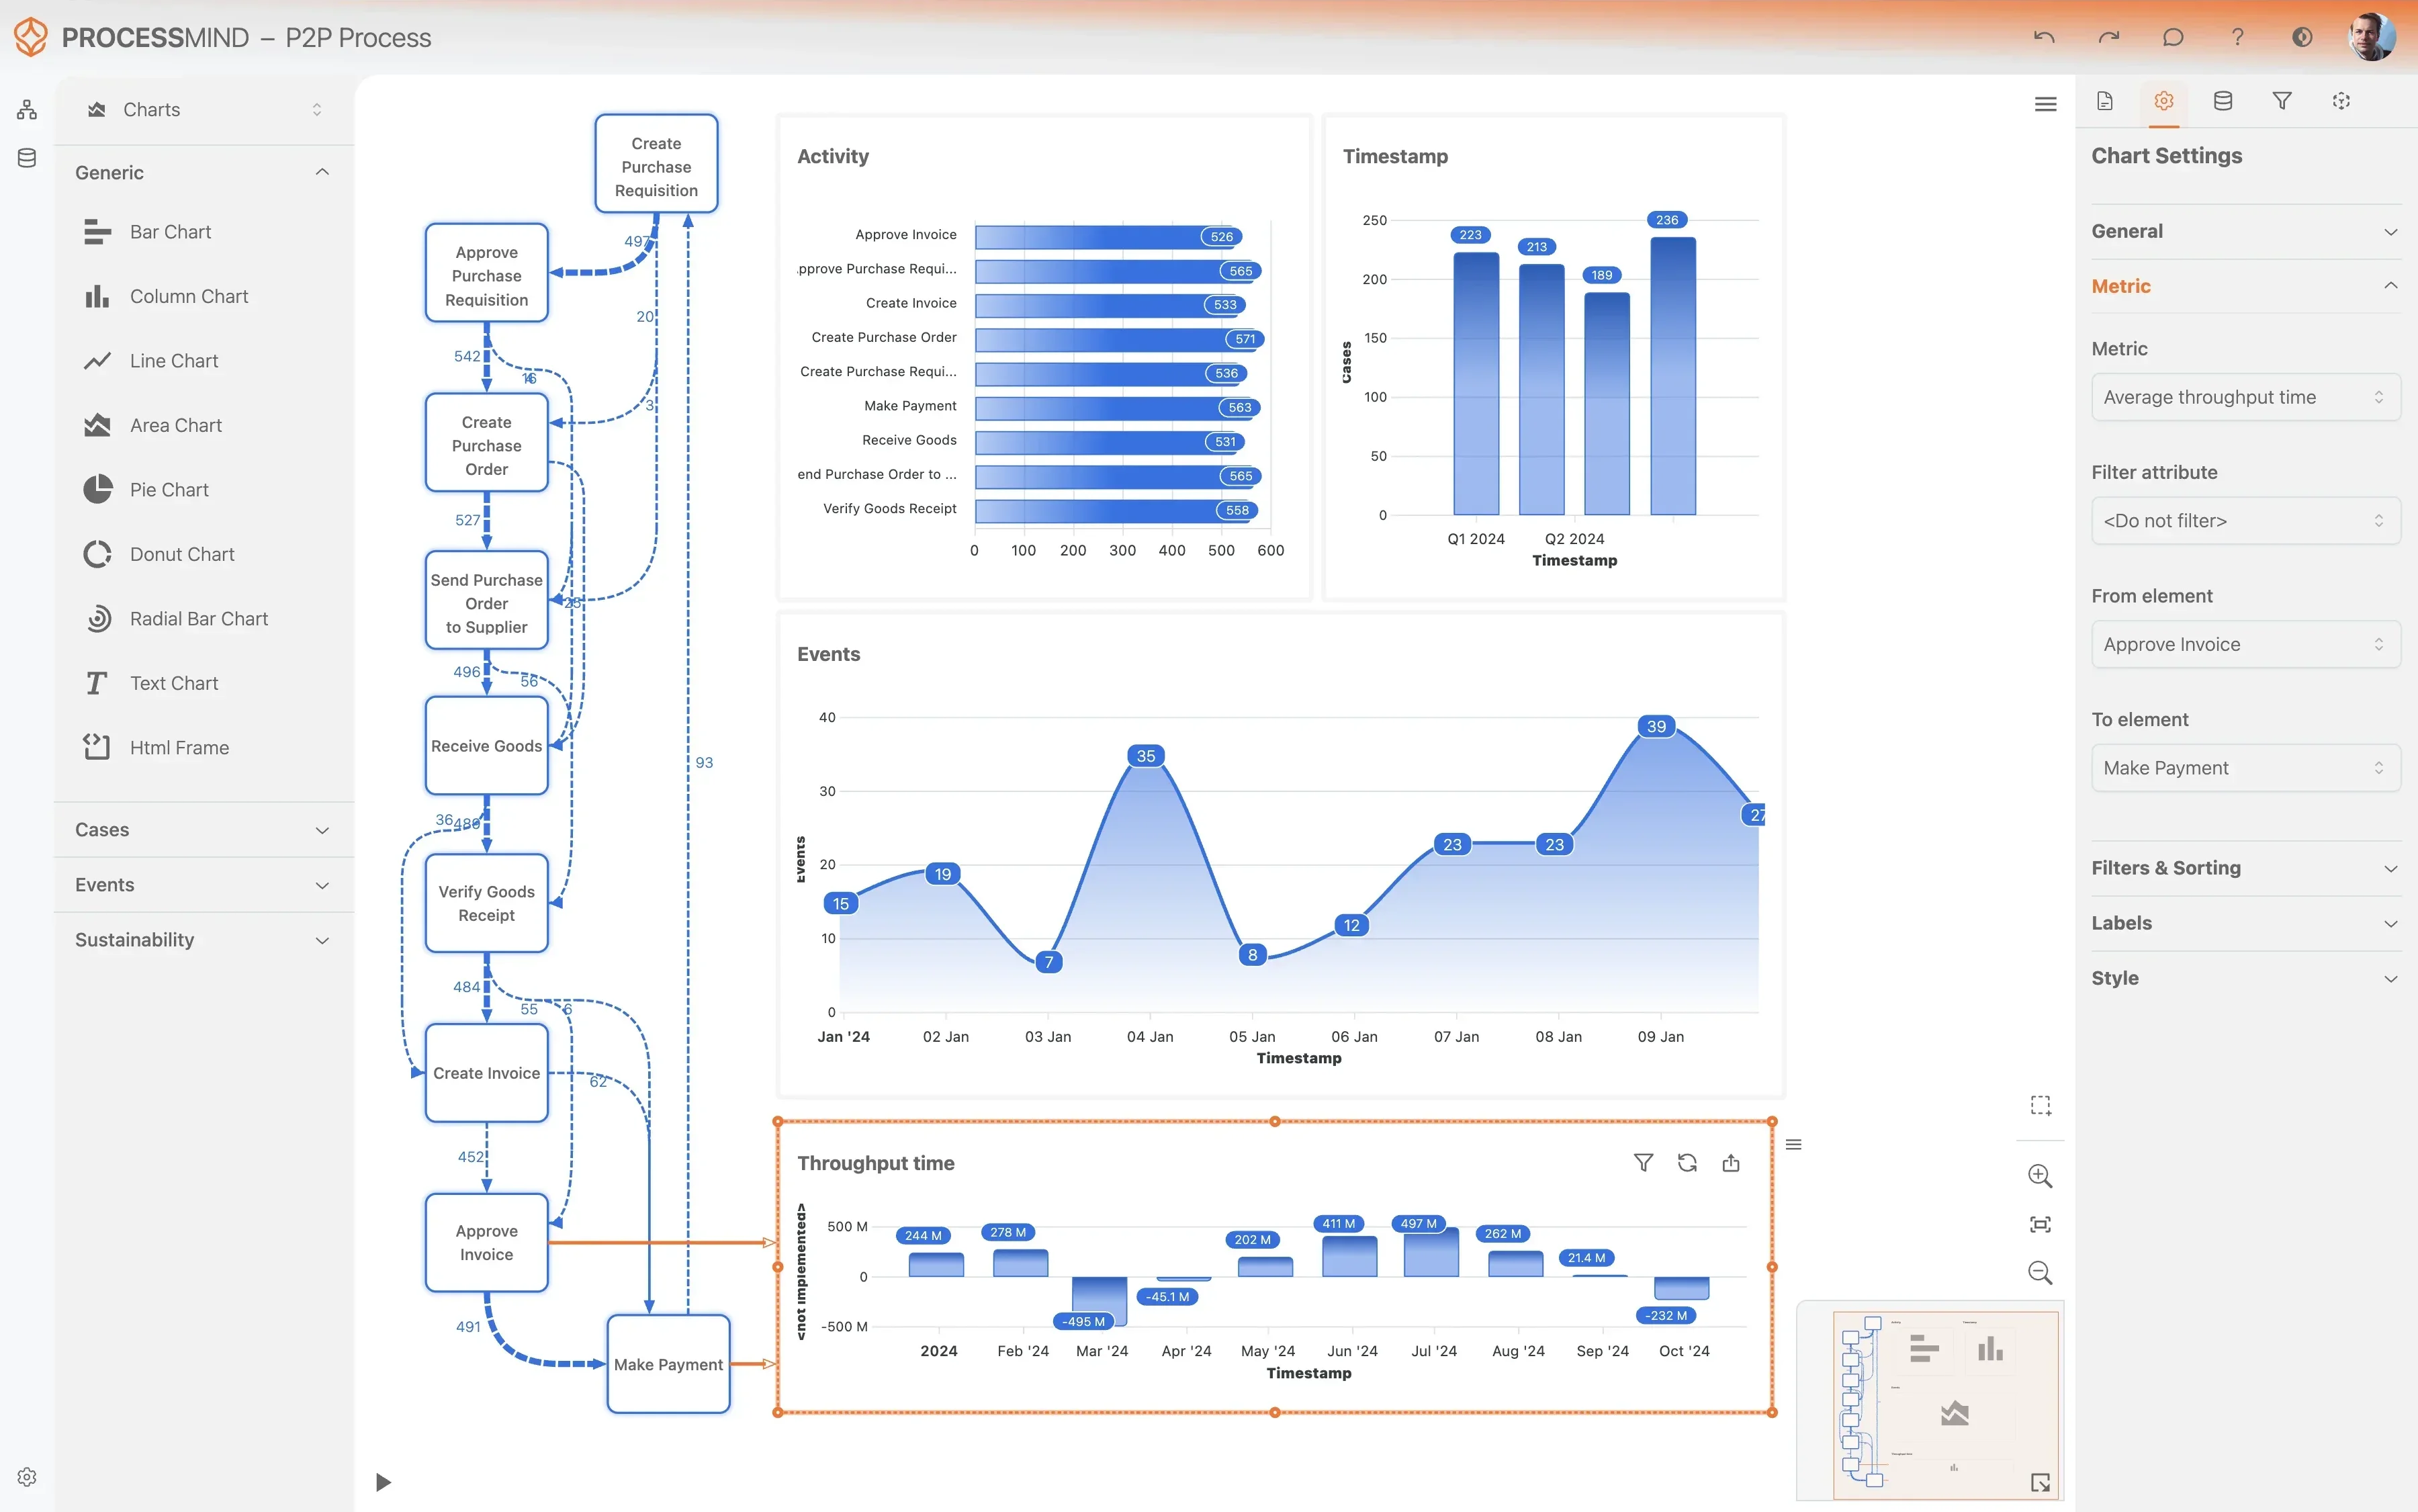
Process mining brengt in kaart welke stappen elk probleemrecord in Freshservice doorloopt. In plaats van alleen gemiddelden of eenvoudige staafdiagrammen te bekijken, zie je de routes die technische teams daadwerkelijk volgen. Je kunt precies zien waar een record dagenlang stilligt of heen en weer gaat tussen supportgroepen.

Zo maak je onderscheid tussen complexe onderzoeken die tijd kosten en eenvoudige administratieve vertragingen die je kunt aanpakken. Door de volgorde van activiteiten zichtbaar te maken, hoef je niet meer te gissen naar bottlenecks. Je kunt verbeteringen baseren op concrete gegevens. Misschien blijkt bijvoorbeeld dat de stap van Probleem vastgesteld naar Toegewezen aan supportgroep het langst duurt. Dat kan wijzen op de behoefte aan betere eerste triage of automatisering in Freshservice.

Knelpunten tijdens onderzoeken opsporen

Een veelvoorkomend verbeterpunt is de tijd tussen het vinden van een workaround en het starten van een volledig onderzoek. In veel organisaties neemt de druk om de oorzaak te vinden af zodra een tijdelijke oplossing het incident heeft verholpen. Process mining laat zien of je team blijft hangen in een patroon waarbij dezelfde workaround steeds opnieuw wordt toegepast, zonder dat er een blijvende oplossing komt.

Door overgangen in Freshservice te analyseren, zoals de tijd tussen Workaround gepubliceerd en Wijzigingsverzoek gestart, kun je middelen richten op belangrijke aanpassingen aan de architectuur in plaats van steeds opnieuw te repareren. Je kunt ook zien of bepaalde problemen vaak opnieuw worden geopend. Dat kan erop wijzen dat de oorzaak niet goed is vastgesteld of dat de verificatiestap is overgeslagen. Met deze inzichten kun je de compliance verbeteren en controleren of het proces volgens afspraak verloopt.

Sneller naar een blijvende oplossing

Om Probleembeheer te verbeteren, moet je ook kijken naar de samenwerking tussen teams. Wanneer een probleemrecord van een algemene supportgroep naar een gespecialiseerd engineeringteam gaat, raakt de context vaak verloren. Records kunnen meerdere keren worden teruggestuurd voor meer informatie, waardoor de totale doorlooptijd flink oploopt. Process mining helpt je zulke lussen te vinden en betere documentatieafspraken te maken voor het begin van een onderzoek.

Zo verloopt de overdracht beter en kunnen specialisten meteen met de juiste informatie aan de slag. Door ook de koppeling met Verandermanagement te volgen, zie je of voorgestelde oplossingen op tijd worden ingevoerd of in een achterstand van openstaande wijzigingen blijven liggen. Die vertraging beperken is belangrijk om verbeterinitiatieven op gang te houden.

Een stabielere IT-omgeving

Het uiteindelijke doel van beter Probleembeheer in Freshservice is een stabielere IT-dienstverlening. Als onderzoeken korter duren en blijvende oplossingen vaker slagen, dalen de totale kosten van de IT-bedrijfsvoering. Medewerkers besteden minder tijd aan terugkerende incidenten en houden meer tijd over voor vernieuwing en verbeteringen aan de infrastructuur.

Met process mining kies je voor een aanpak op basis van data. De sporen in Freshservice-logs laten zien hoe je IT-afdeling van reactief naar proactief kan werken en problemen kan voorkomen voordat ze gevolgen hebben voor de bedrijfsvoering. Dat verbetert niet alleen de interne efficiëntie, maar ook de betrouwbaarheid van de diensten waarop de organisatie dagelijks rekent.

Probleembeheer Oorzaakanalyse IT-servicemanagement Servicedeskmanager Incidenten verminderen Probleemcoördinator ITIL-compliance Ticketsysteem Ticketbeheer Bekende fout Terugkerende incidenten Workaround Incidenten voorkomen IT-helpdesk

Veelvoorkomende problemen en uitdagingen

Bekijk welke uitdagingen voor jou spelen

Probleemrecords blijven soms weken in de onderzoeksfase hangen zonder duidelijke voortgang. Daardoor groeit de achterstand en blijven onderliggende problemen onopgelost. Teams kunnen de oorzaak van terugkerende incidenten niet aanpakken, waardoor de servicedesk meer werk krijgt en de betrouwbaarheid van de dienstverlening voor zakelijke gebruikers afneemt.

Als een probleemrecord tussen meerdere technische teams heen en weer gaat, raakt de context vaak verloren en loopt de oplossing flinke vertraging op. Doordat niemand eigenaar is, gaat werk verloren, raken technische medewerkers gefrustreerd en worden serviceniveaudoelen voor de stabiliteit en prestaties van kritieke infrastructuur niet gehaald.

Als een workaround niet snel wordt gepubliceerd, blijven incidentmedewerkers met terugkerende problemen worstelen. Daardoor duurt het langer voordat eindgebruikers geholpen zijn. Duurt het te lang om een workaround te publiceren nadat een probleem is vastgesteld, dan heeft de organisatie onnodig last van uitval, terwijl er al een tijdelijke oplossing bekend is.

Ook nadat de oorzaak is vastgesteld, loopt de weg naar een blijvende oplossing vaak vast zodra een wijzigingsverzoek is ingediend. Doordat probleembeheer en wijzigingsbeheer niet goed op elkaar aansluiten, blijven bekende fouten bestaan terwijl ze opgelost hadden kunnen zijn. Zo blijft de IT-omgeving kwetsbaar voor terugkerende verstoringen en beveiligingsrisico's.

Als de evaluatie na de implementatie ontbreekt, kunnen IT-teams niet leren van grote incidenten en hun aanpak voor toekomstige problemen verbeteren. Worden evaluaties overgeslagen of afgeraffeld, dan legt de organisatie belangrijke inzichten niet vast. Daardoor worden dezelfde procesfouten herhaald bij volgende onderzoeken.

Teams besteden vaak veel tijd aan probleemrecords met lage prioriteit, terwijl problemen met grote impact onopgelost blijven. Zonder prioritering op basis van het werkelijke bedrijfsrisico worden gespecialiseerde technische middelen niet efficiënt ingezet en stabiliseren de belangrijkste diensten in Freshservice niet op tijd.

Het niet halen van serviceniveaudoelen voor problemen met hoge prioriteit kan grote financiële en reputatieschade veroorzaken voor IT-afdelingen. Als deadlines voor oorzaakanalyses of de invoering van blijvende oplossingen steeds worden gemist, loopt het proces vast of is er onvoldoende zicht op naderende deadlines.

Wordt een probleemrecord gesloten en later opnieuw geopend omdat incidenten terugkeren, dan is de oorzaak waarschijnlijk niet goed vastgesteld of was de oplossing niet afdoende. Dit herstelwerk verdubbelt de onderzoekskosten en ondermijnt het vertrouwen in Probleembeheer, terwijl het onderliggende probleem blijft bestaan.

Onjuiste of generieke categorieën voor oorzaken maken zinvolle trendanalyses en preventief onderhoud onmogelijk. Kiezen technische teams in Freshservice vage categorieën, dan kan de organisatie zwakke plekken in specifieke infrastructuur- of softwareonderdelen niet in de loop van de tijd opsporen.

Als incidenten niet goed aan een actief probleemrecord zijn gekoppeld, blijft de werkelijke impact buiten beeld bij het management. Teams doen dan dubbel onderzoek en het is moeilijker om de middelen voor een blijvende oplossing te onderbouwen, omdat het aantal incidenten lager lijkt dan het werkelijk is.

Veelvoorkomende doelen

Bepaal hoe succes eruitziet

Een kortere onderzoeksfase helpt toekomstige verstoringen van de dienstverlening voorkomen. Zolang oorzaakanalyses vertraging oplopen, blijft de organisatie kwetsbaar voor terugkerende incidenten die IT-middelen kosten en eindgebruikers frustreren. Door deze fase te versnellen, kunnen teams effectiever overstappen van brandjes blussen naar problemen voorkomen.

ProcessMind laat zien in welke fasen onderzoeken in Freshservice vastlopen, bijvoorbeeld tijdens het wachten op informatie van een externe leverancier of op interne documentatie. Door de tijd per status in beeld te brengen, kunnen teams haalbare normen vaststellen en bottlenecks wegnemen die een snelle diagnose in de weg staan. Zo kunnen onderzoeksdoorlooptijden mogelijk met 30 procent of meer dalen.

Regelmatige overdrachten van probleemrecords leiden vaak tot verlies van context en langere oplostijden. Door het aantal overdrachten te beperken, blijft het meest geschikte team van begin tot eind verantwoordelijk. Dat zorgt voor consistentere en betrouwbaardere technische resultaten en maakt duidelijker wie waarvoor verantwoordelijk is.

Ons process mining-platform brengt de route van probleemrecords door verschillende supportgroepen in kaart. Zo zie je omwegen en onnodige herindelingen. Managers kunnen de toewijzingsregels aanpassen, zodat problemen meteen bij de juiste experts terechtkomen. Daarmee daalt ook het gemiddelde aantal overdrachten per record.

Een workaround op tijd beschikbaar stellen is belangrijk om de dienstverlening te herstellen terwijl aan een blijvende oplossing wordt gewerkt. Zo beperk je de impact van actieve problemen op de bedrijfsvoering en verlaag je de druk op de servicedesk tijdens complexe onderzoeken. Een sneller proces voor workarounds verbetert de ervaring van eindgebruikers met terugkerende incidenten.

ProcessMind meet in Freshservice de tijd tussen het vaststellen van een probleem en het publiceren van een workaround. Door vertragingen in het publicatieproces op te sporen, kun je de beoordeling verbeteren en ervoor zorgen dat medewerkers aan de frontlinie workarounds sneller kunnen gebruiken. Zo neemt het aantal incidenten door bekende fouten af.

Een bekende oorzaak helpt weinig als de blijvende oplossing vastloopt in het wijzigingsproces. Door deze processen op elkaar af te stemmen, kunnen vastgestelde oplossingen sneller worden ingevoerd. Zo worden bekende fouten definitief verholpen en blijft de organisatie minder lang aan risico's blootgesteld.

We brengen de overdrachten tussen de modules Probleembeheer en Verandermanagement in Freshservice in beeld. Zo zie je waar voorgestelde oplossingen in goedkeuringswachtrijen blijven hangen. Probleemcoördinatoren en eigenaren van wijzigingen kunnen hun werk beter afstemmen en de uiteindelijke oplossing versnellen.

Voor problemen met hoge prioriteit moet je de serviceniveaudoelen strikt naleven om bedrijfskritieke diensten te beschermen. Betere compliance zorgt ervoor dat de ernstigste problemen snel de aandacht krijgen die nodig is om de bedrijfsvoering stabiel te houden. Zo kan de IT-afdeling haar afspraken met de rest van de organisatie nakomen.

ProcessMind analyseert historische prestatiegegevens en signaleert patronen die tot SLA-overschrijdingen leiden. Je ziet welke categorieën of prioriteitsniveaus hun doelen vaak niet halen. Zo kun je deadlines proactief bewaken en middelen beter verdelen, zodat kritieke doelen consequent worden gehaald.

Heropende probleemregistraties wijzen er vaak op dat de eerste oplossing niet volledig was of dat de oorzaak verkeerd is vastgesteld. Door dit aantal terug te dringen, wordt het probleembeheer betrouwbaarder en voorkom je dubbel werk aan problemen die al opgelost leken. Een probleem is pas echt verholpen als het na sluiting niet opnieuw opduikt.

Ons platform analyseert de digitale sporen van heropende cases om te bepalen of er bij de eerste poging activiteiten zijn overgeslagen. Zo kun je hogere kwaliteitsnormen hanteren en problemen pas sluiten als ze echt zijn opgelost. Dat kan het herstelwerk met wel 20 procent verminderen.

IT-teams besteden vaak onevenredig veel tijd aan problemen met weinig impact, terwijl kritieke problemen blijven liggen. Door de aandacht anders te verdelen, kunnen ervaren technici werken aan problemen die het meeste opleveren voor de stabiliteit van diensten. Zo haal je meer uit de specialistische kennis in het team.

ProcessMind brengt het aantal gerelateerde incidenten in verband met de tijd die aan probleemregistraties wordt besteed. Managers zien zo welke taken weinig opleveren en geautomatiseerd of lager geprioriteerd kunnen worden. Technische experts houden daardoor meer tijd over voor oorzaakanalyses die honderden toekomstige incidenten kunnen voorkomen.

Nauwkeurige categorisering vormt de basis voor goede trendanalyses en verbetering van diensten op de lange termijn. Als oorzaken slecht worden vastgelegd, is het bijna onmogelijk om structurele problemen in de IT-infrastructuur te herkennen. Consistente datakwaliteit leidt tot betere strategische beslissingen.

Onze process mining-oplossing controleert of gegevens consequent worden ingevoerd wanneer een probleem wordt afgesloten. Je ziet welke registraties een generieke of ontbrekende oorzaak hebben. Zo kun je gerichte training geven en de kwaliteit van rapportages op de lange termijn verbeteren, zodat nieuwe technologische trends eerder opvallen.

Door alle gerelateerde incidenten aan één probleemregistratie te koppelen, krijg je een duidelijk beeld van de totale impact en kun je herstelwerk beter prioriteren. Zo kun je alle getroffen gebruikers informeren zodra er een tijdelijke oplossing of definitieve oplossing beschikbaar is. Dat verbetert de communicatie en maakt de servicedesk efficiënter.

ProcessMind helpt je groepen vergelijkbare incidenten te vinden die in Freshservice niet aan een probleemregistratie zijn gekoppeld. Door deze hiaten zichtbaar te maken, kun je probleembeheer consequenter opstarten. Zo voorkom je pieken in het aantal incidenten en schat je de impact van problemen nauwkeuriger in.

Evaluaties na implementatie zijn belangrijk om te blijven leren en toekomstige procesproblemen te voorkomen. Als je deze evaluaties overslaat, mis je kansen om processen te verbeteren en kunnen dezelfde fouten zich opnieuw voordoen. Regelmatige evaluaties helpen een cultuur van continu verbeteren op te bouwen.

We controleren voor elke gesloten probleemregistratie of de evaluatieactiviteit heeft plaatsgevonden. Zo worden hiaten in de compliance zichtbaar. Managers kunnen de evaluatie verplicht stellen voor grote problemen, zodat elk belangrijk probleem bijdraagt aan de kennis binnen de organisatie.

Verbetertraject voor probleembeheer in 6 stappen

1

De template downloaden

Wat je moet doen

Download de speciale Excel-template die is afgestemd op de datastructuur van Freshservice Problem Management.

Waarom dit belangrijk is

Met een vooraf bepaalde structuur worden je gegevens correct aan de mining-engine gekoppeld, zodat de analyse klopt.

Verwacht resultaat

Een kant-en-klaar document voor datamapping

INZICHT IN PROBLEMEN

Krijg grip op de probleembeheerflow in Freshservice

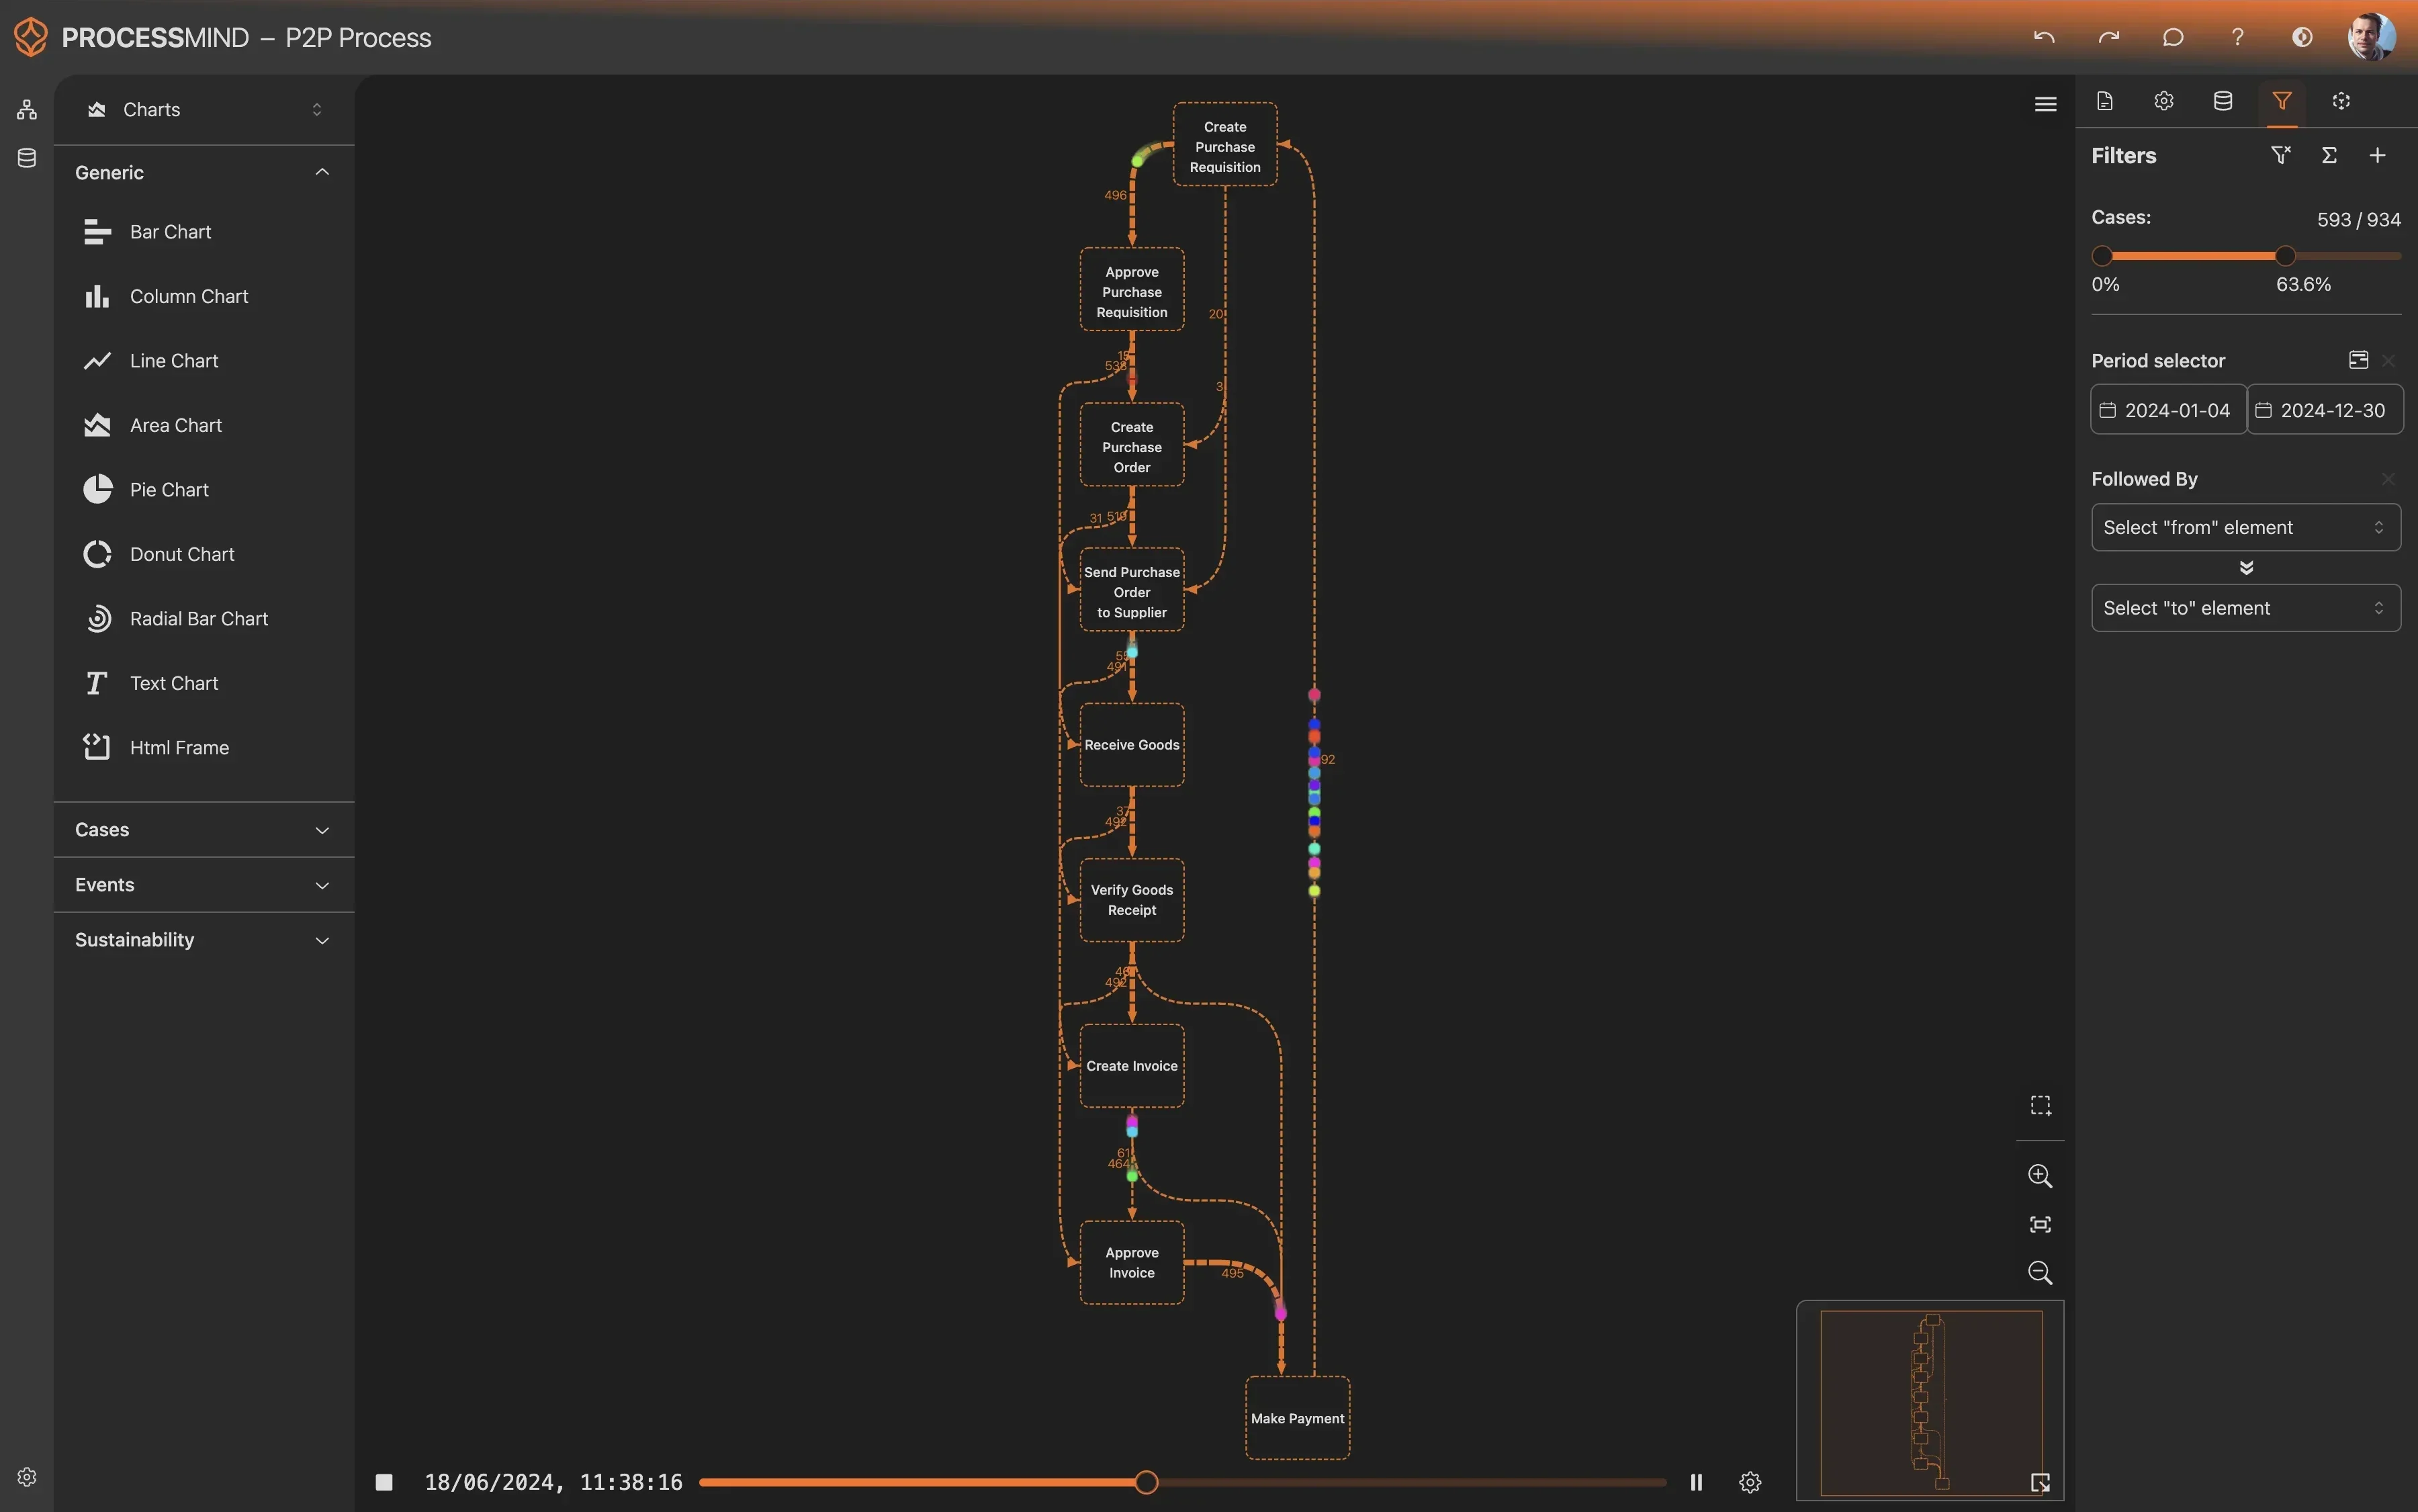
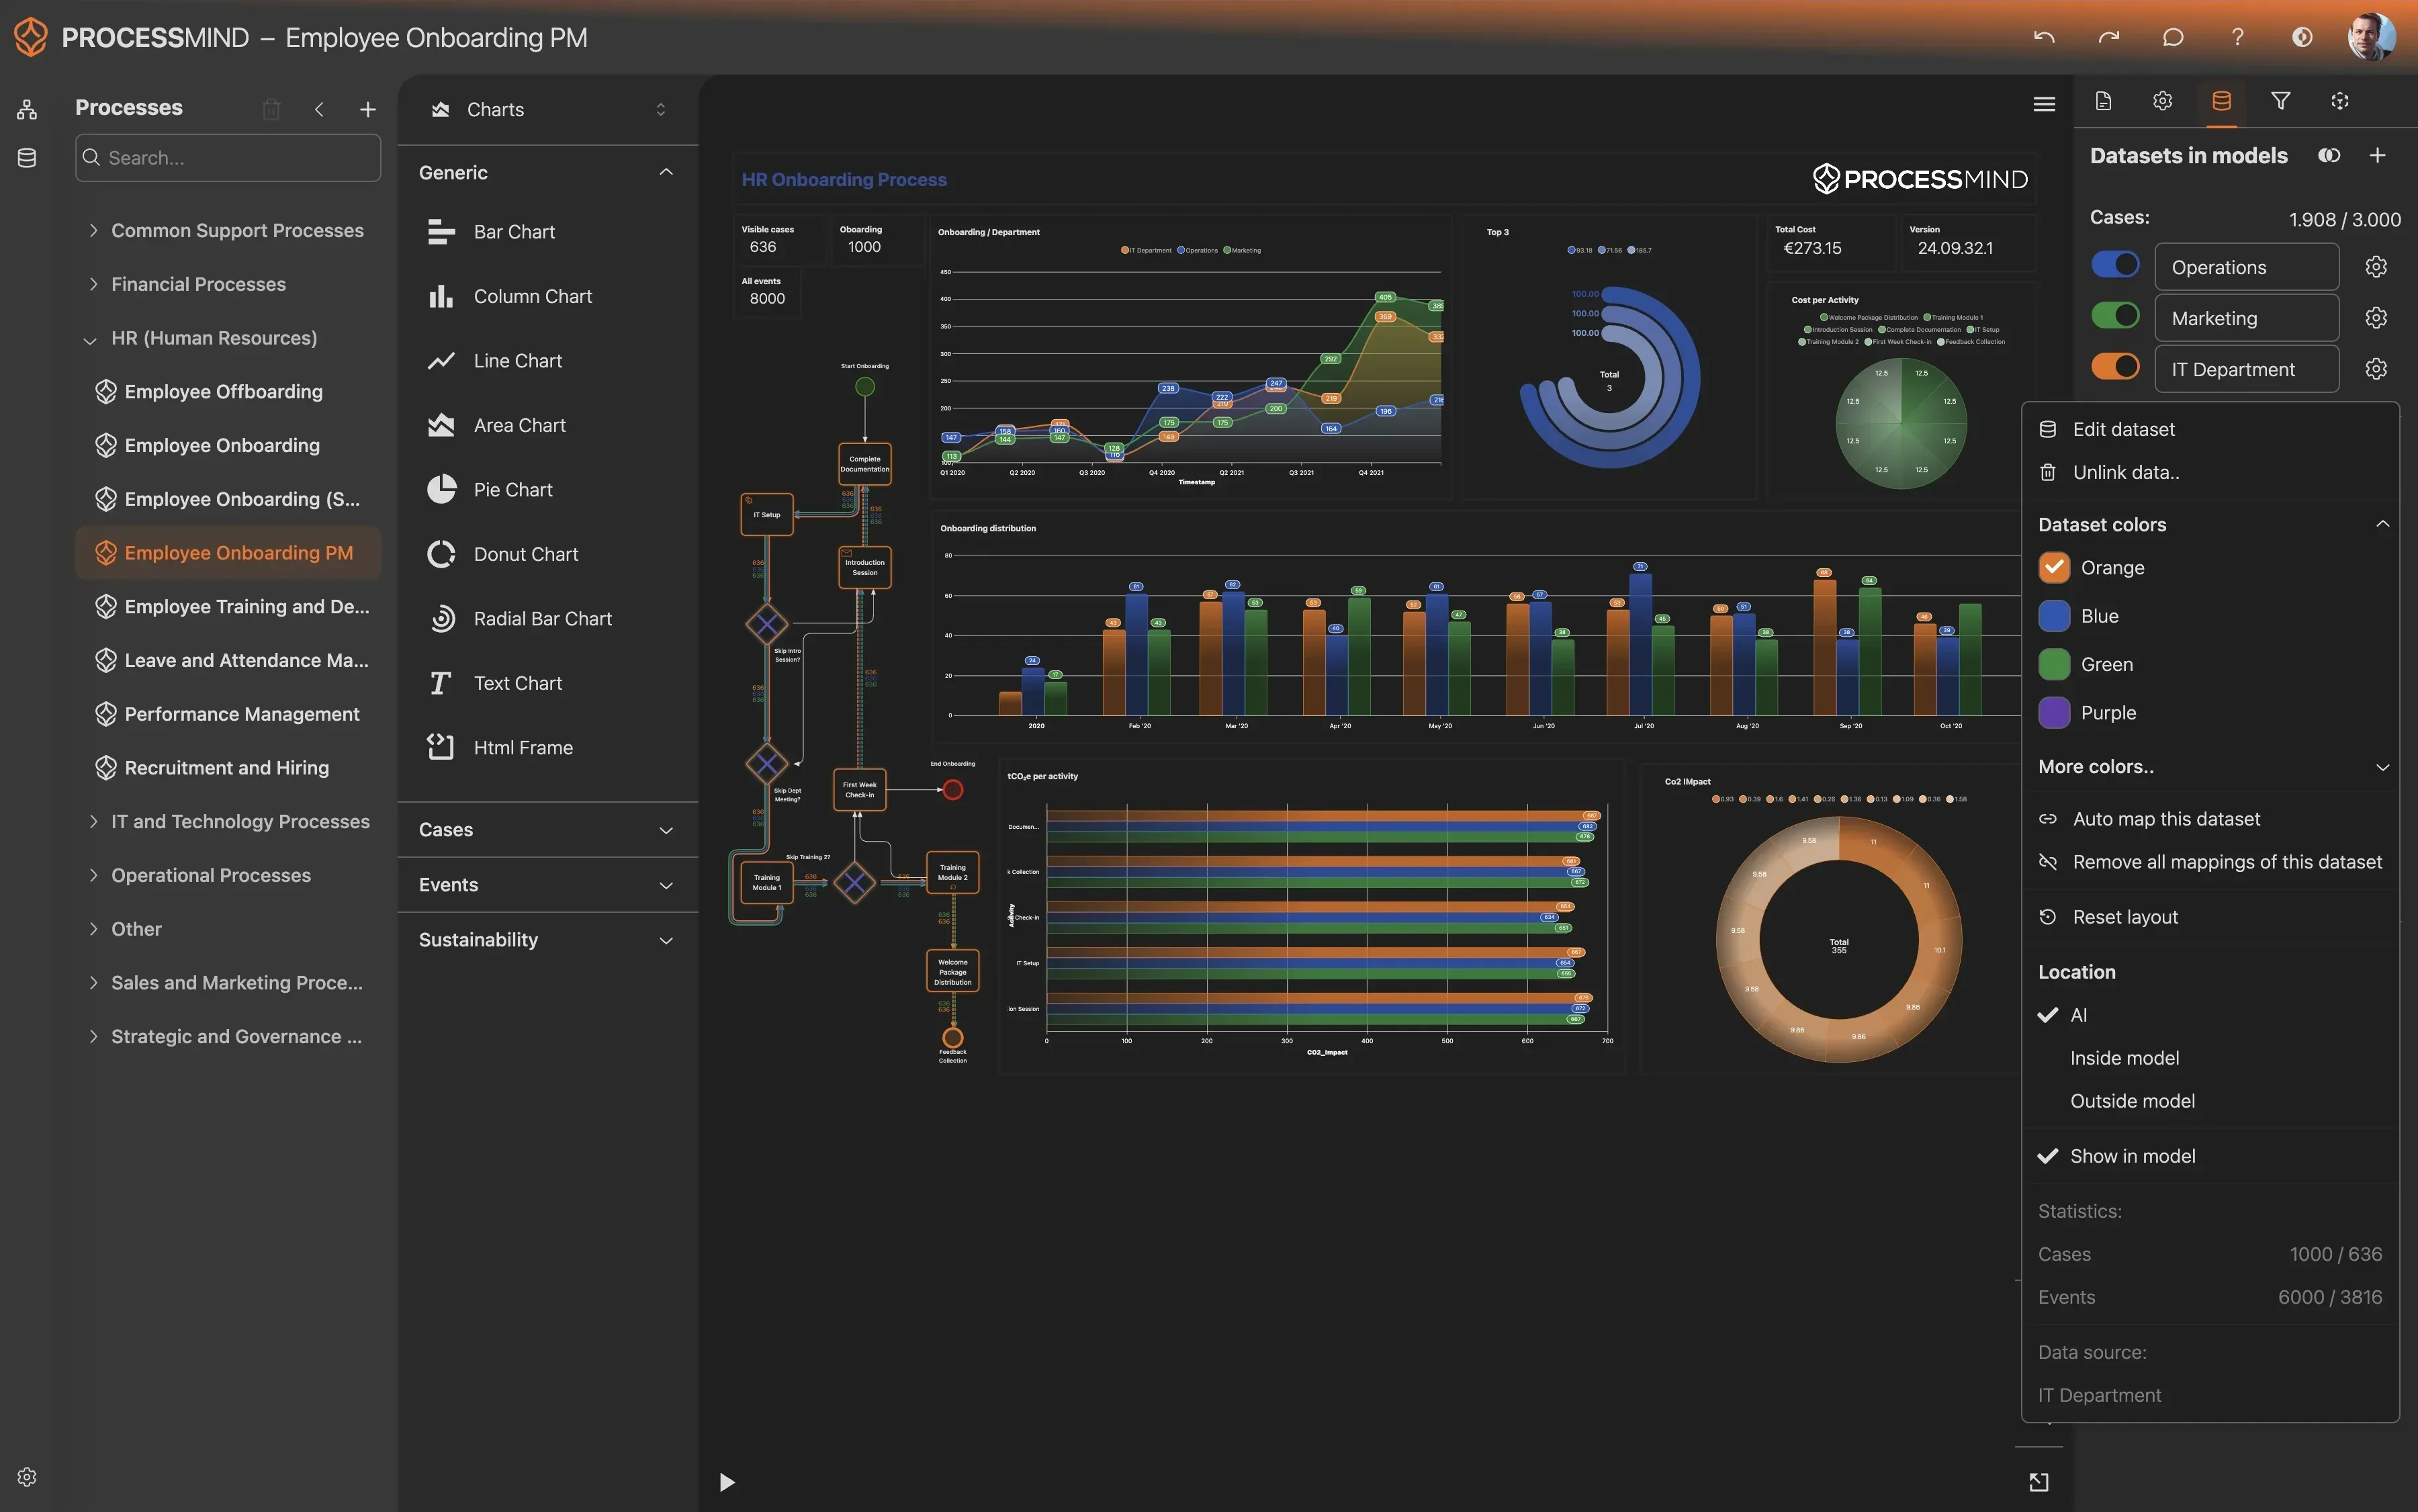
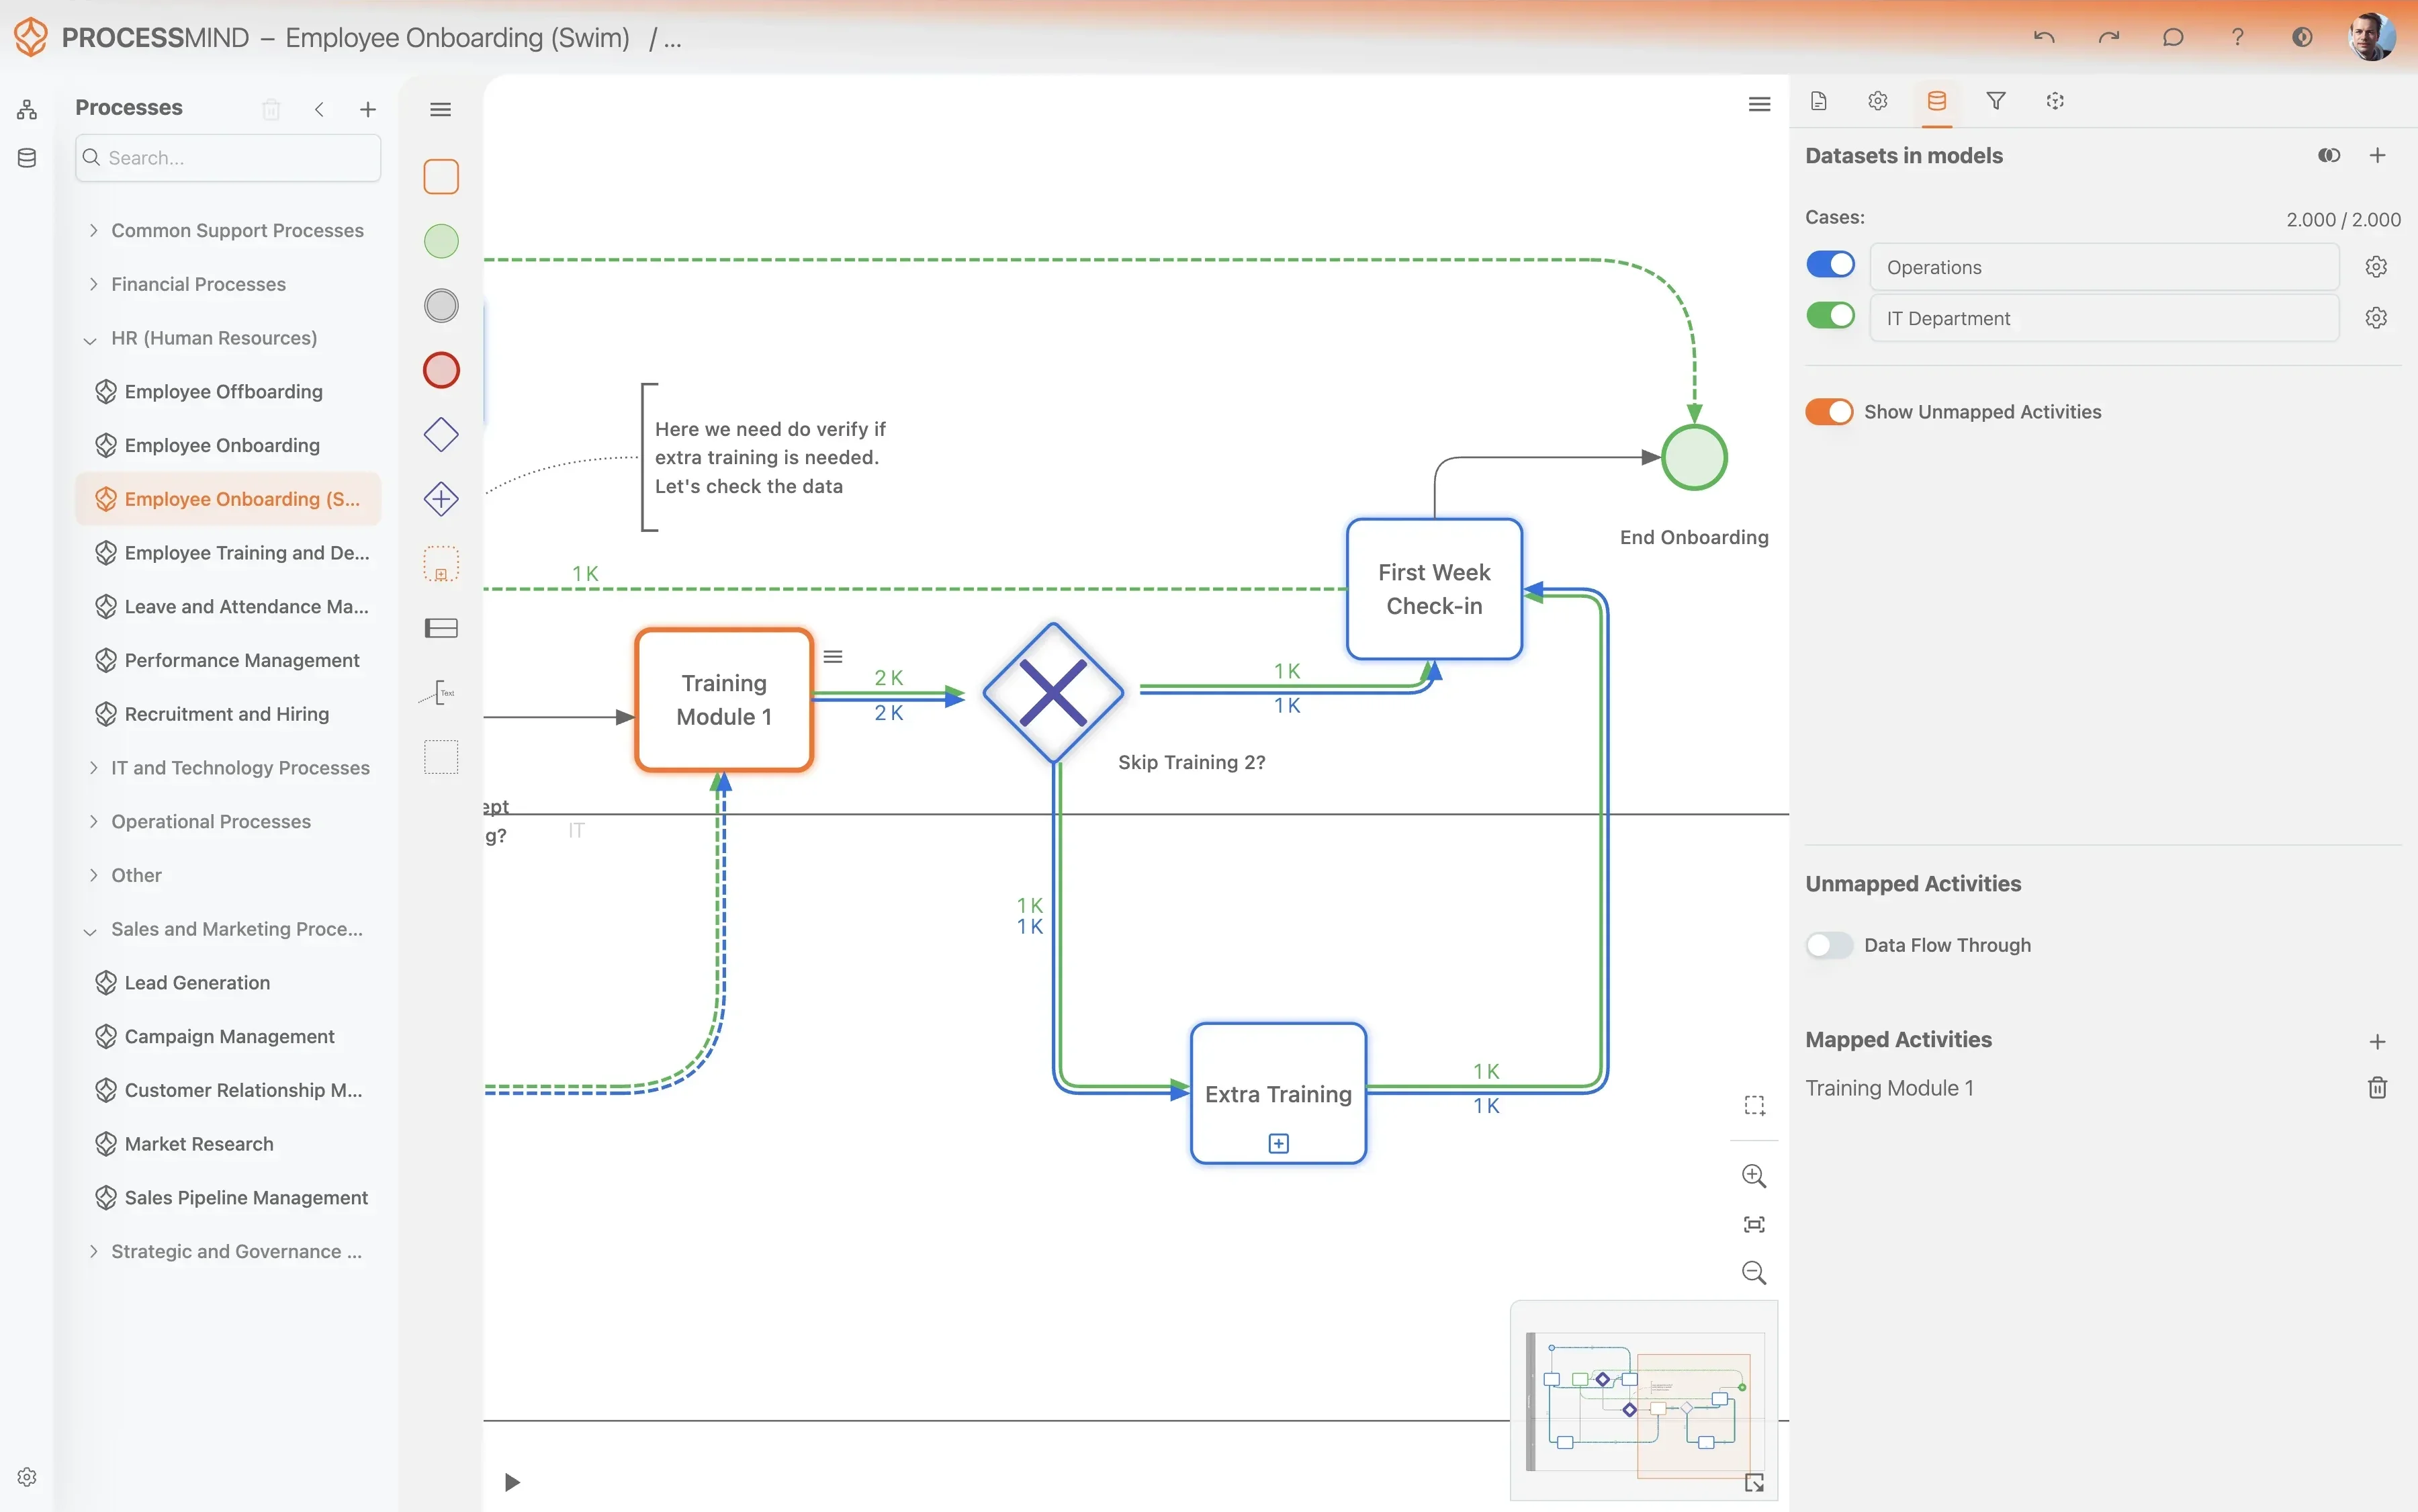
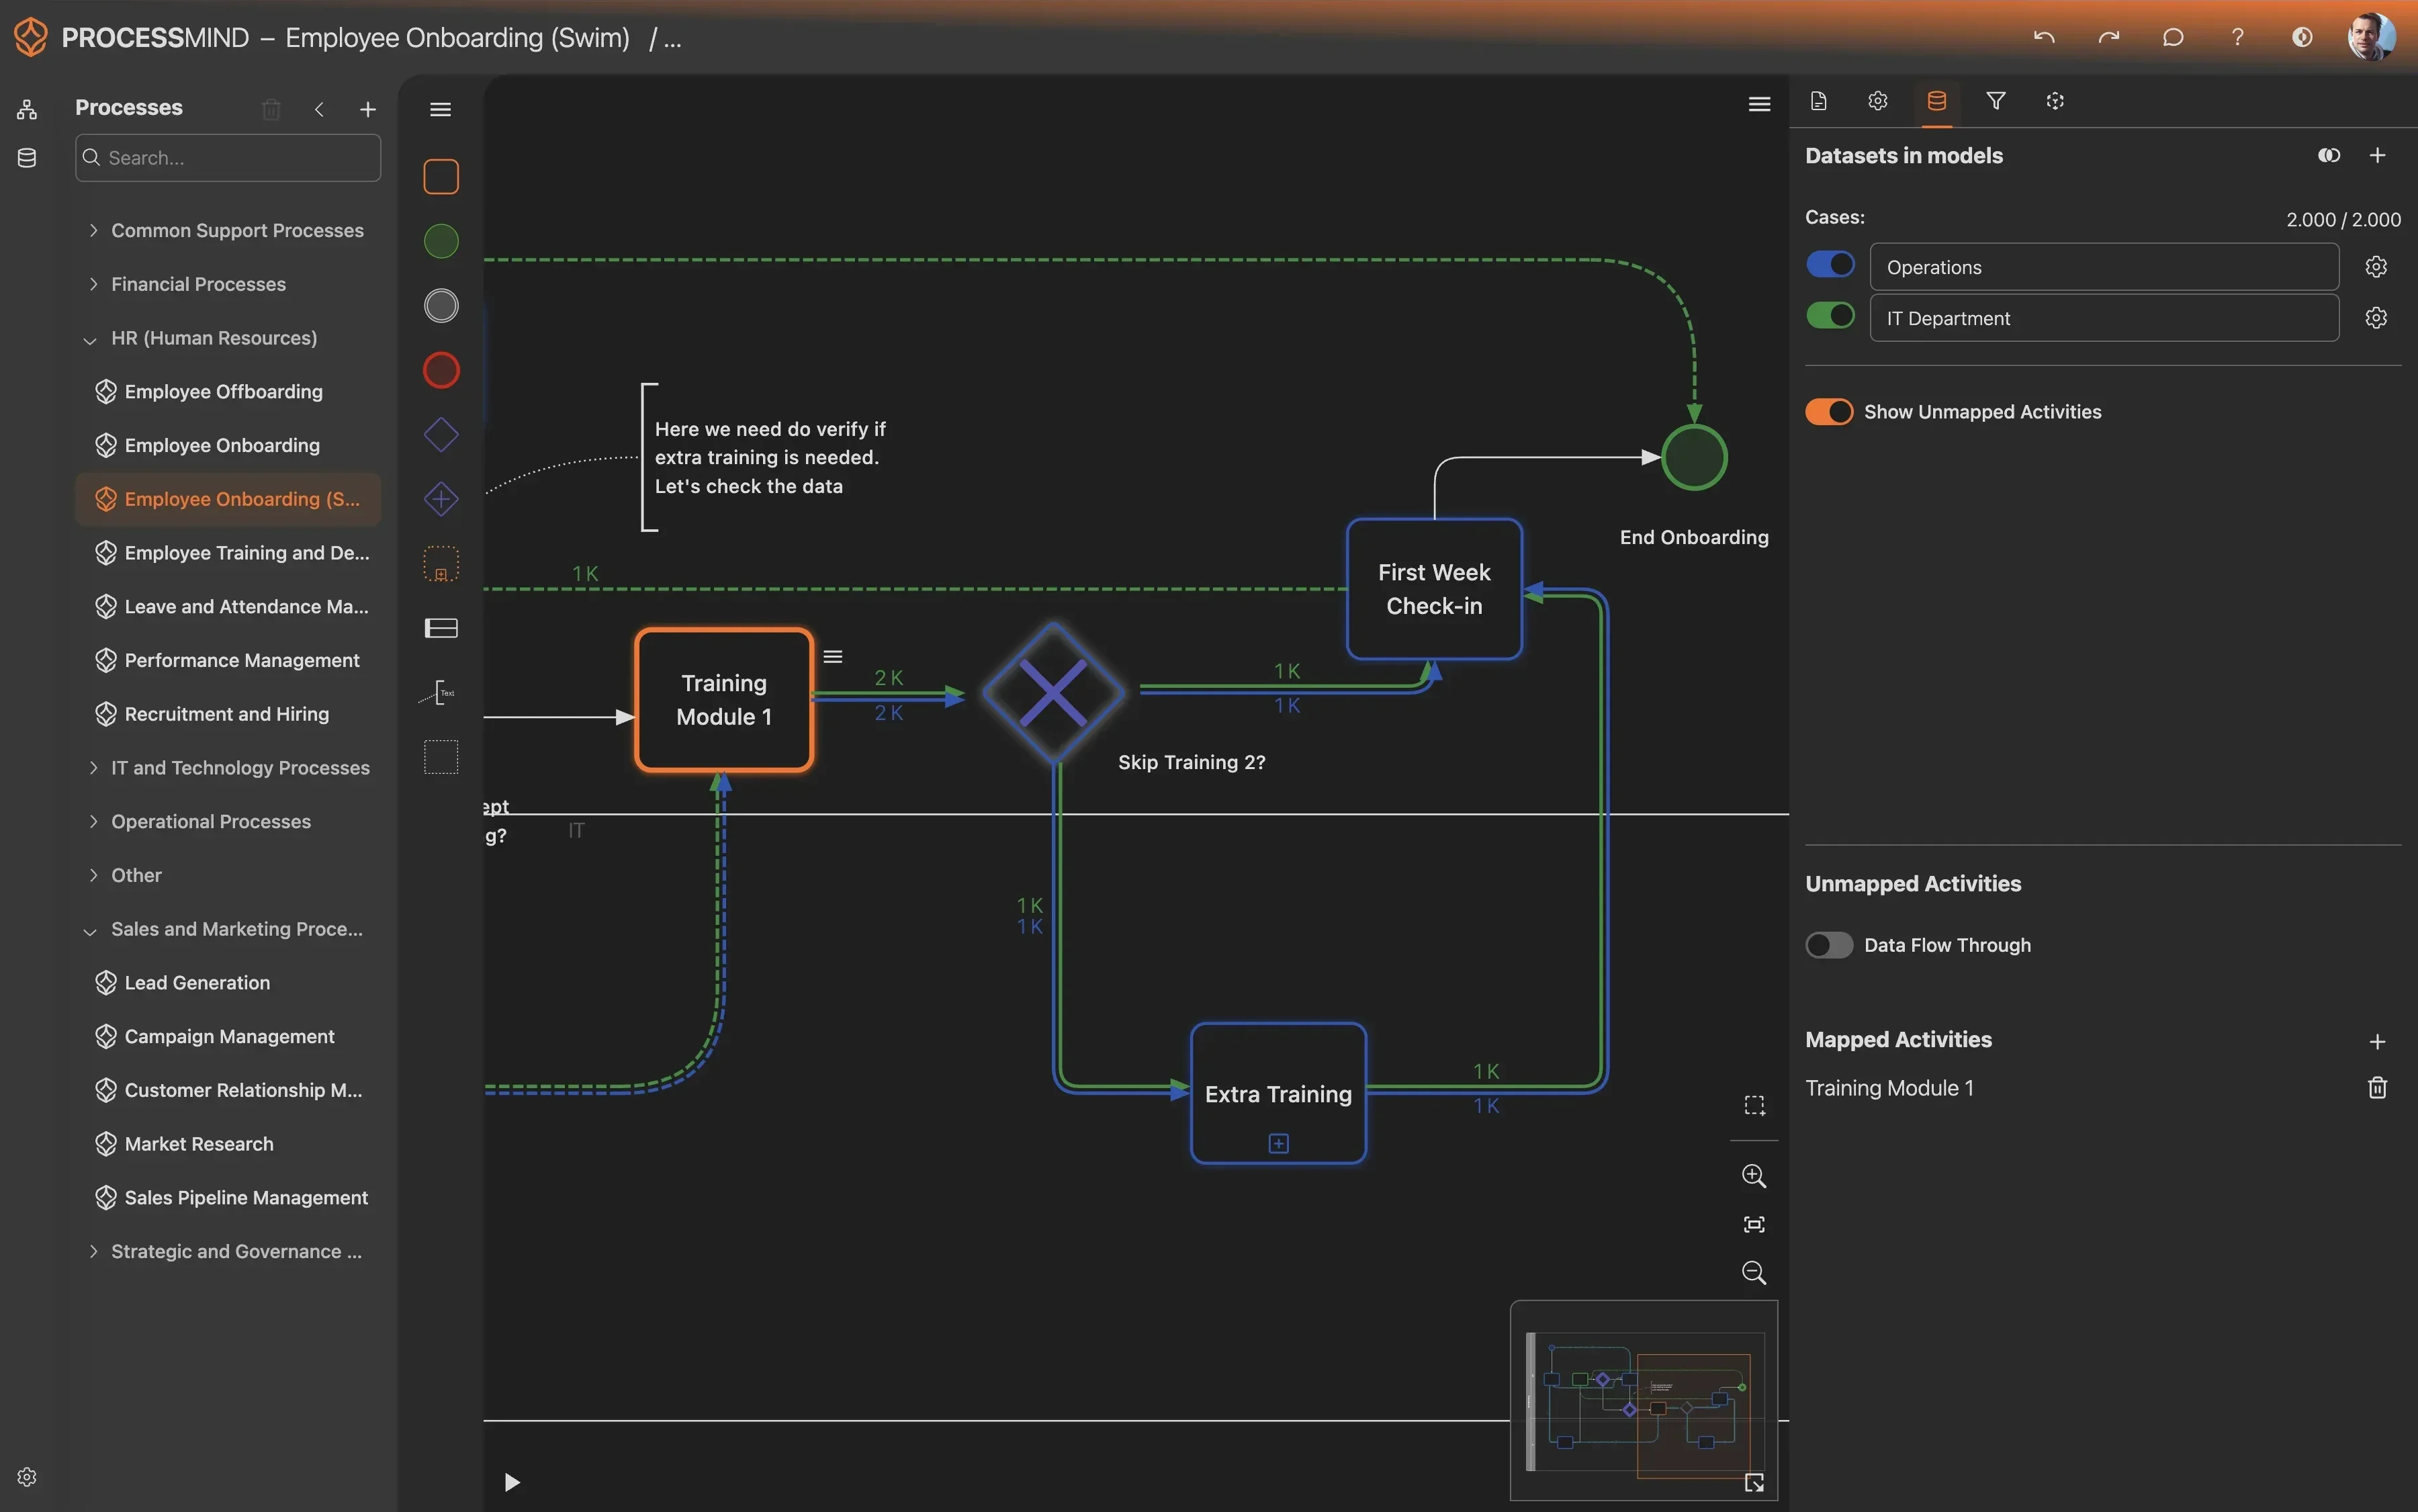
Krijg een volledig beeld van de levenscyclus van problemen en zie precies waar onderzoeken vastlopen. De visualisaties laten zien waar het proces hapert tussen het signaleren van een probleem en de definitieve oplossing.
  • Breng de volledige levenscyclus van oorzaakanalyses visueel in kaart
  • Bepaal welke processtappen de oplossing vertragen
  • Breng verborgen lussen in probleemonderzoek aan het licht
  • Meet het effect van tijdelijke oplossingen op de stabiliteit
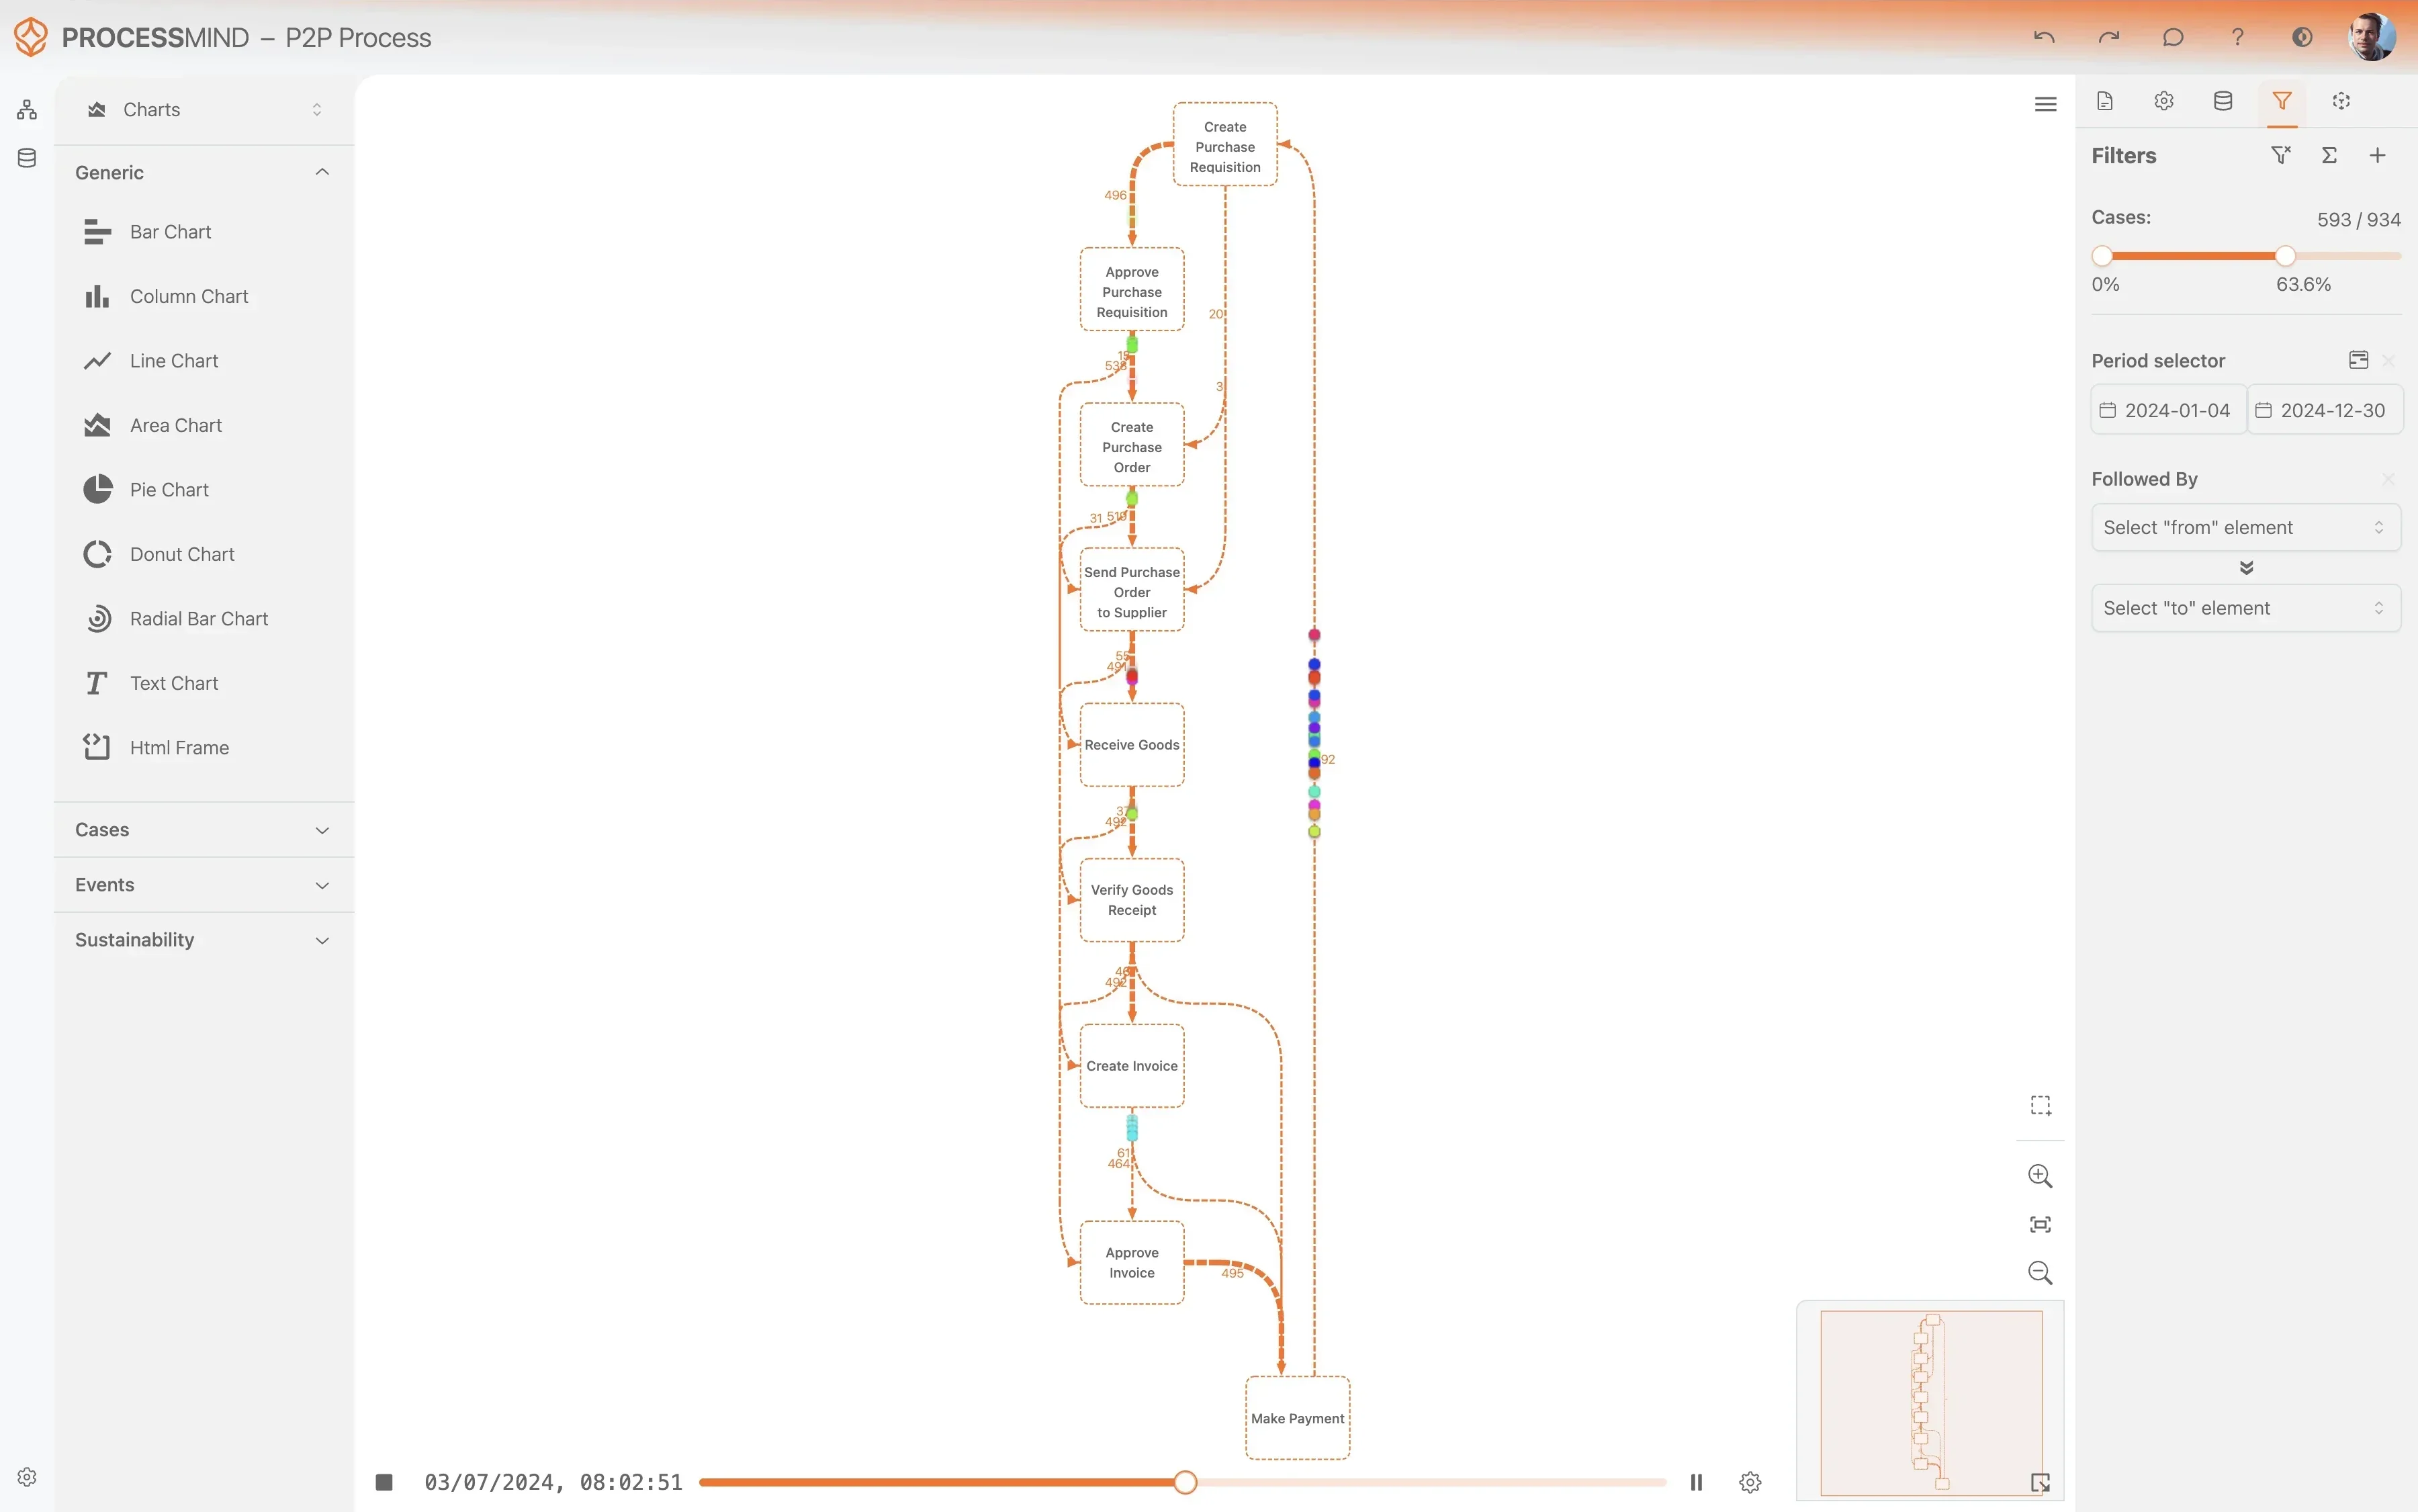
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

BEWEZEN RESULTATEN

Efficiënter probleembeheer

Organisaties die process mining toepassen op Freshservice-data vinden vaak belangrijke bottlenecks in de levenscyclus van probleemregistraties. Dat leidt tot snellere oorzaakanalyses en minder terugkerende incidenten.

0 %
Snellere oorzaakanalyse

Kortere doorlooptijd van de oorzaakanalyse

Door onderzoeksstappen efficiënter in te richten en bottlenecks in de diagnosefase te vinden, wordt de oorzaak van problemen veel sneller vastgesteld.

0 %
Minder overdrachten tussen teams

Minder herverdelingen tussen groepen

Door onnodige overdrachten tussen technische teams te voorkomen, kunnen de juiste experts eerder aan problemen werken. Dat verlaagt de totale arbeidskosten en vermindert vertragingen.

+ 0 %
Betere SLA-compliance

Kritieke problemen op tijd opgelost

Realtime monitoring van registraties met hoge prioriteit zorgt ervoor dat kritieke problemen binnen de afgesproken tijd worden aangepakt en de dienstverlening stabiel blijft.

0 %
Minder heropeningen

Minder herstelwerk aan registraties

Betere eerste onderzoeken en blijvende oplossingen voorkomen dat probleemregistraties opnieuw worden geopend. Zo weet je zeker dat problemen echt zijn opgelost.

+ 0 %
Meer evaluaties na implementatie afgerond

Meer evaluaties na het oplossen van problemen

Door evaluaties na implementatie consequent uit te voeren, leg je lessen vast en controleer je of blijvende oplossingen werken.

0 %
Tijdelijke oplossingen sneller beschikbaar

Doorlooptijd van tijdelijke oplossingen

Als effectieve tijdelijke oplossingen sneller worden gepubliceerd, blijft de impact op de bedrijfsvoering beperkt terwijl er nog aan een blijvende oplossing wordt gewerkt.

Resultaten verschillen per organisatie en hangen af van de volwassenheid van processen, de teamgrootte en de datakwaliteit in Freshservice. Deze cijfers geven de gemiddelde verbeteringen weer bij implementaties binnen grote organisaties.

Aanbevolen data

Begin met deze essentiële attributen en activiteiten om je proces te verbeteren.

Attributen

Belangrijke datapunten voor de analyse

De unieke alfanumerieke identificatiecode van de probleemregistratie (bijvoorbeeld PRB-10234).

Waarom dit belangrijk is

Dit is de belangrijkste sleutel om de procesgang te reconstrueren en is nodig om elke case uniek te identificeren.

De specifieke gebeurtenis of actie op de probleemregistratie.

Waarom dit belangrijk is

Dit beschrijft wat er tijdens de uitvoering van het proces gebeurt en is verplicht om een proceskaart te genereren.

De exacte datum en tijd waarop de activiteit plaatsvond.

Waarom dit belangrijk is

Dit bepaalt de tijdlijn van events, zodat de doorlooptijd kan worden berekend en het proces in de juiste volgorde kan worden gezet.

Het prioriteitsniveau dat aan het probleem is toegekend, bijvoorbeeld Laag, Gemiddeld, Hoog of Urgent.

Waarom dit belangrijk is

Nodig om analyses te filteren en prioriteit te geven aan problemen met grote impact.

De naam van de servicedeskmedewerker die momenteel aan het probleem is toegewezen.

Waarom dit belangrijk is

Belangrijk voor bronanalyse en analyse van de organisatie.

Het technische team of de groep die het probleem behandelt.

Waarom dit belangrijk is

Belangrijk om overdrachten te analyseren en knelpunten tussen afdelingen te vinden.

De huidige status van het probleem in de levenscyclus, bijvoorbeeld Open, Wijziging aangevraagd of Opgelost.

Waarom dit belangrijk is

Geeft de status van de case aan en wordt gebruikt om doorstroomstatistieken te berekenen.

De classificatie van de onderliggende oorzaak van het probleem.

Waarom dit belangrijk is

Belangrijk voor trendanalyses en het vinden van mogelijkheden voor proactieve verbetering.

Het aantal incidentrecords dat aan dit probleem is gekoppeld.

Waarom dit belangrijk is

Geeft aan hoe groot de impact van het probleem op de servicedesk is.

Een indicator die aangeeft of het probleemrecord de SLA-doelstelling heeft overschreden.

Waarom dit belangrijk is

Meet rechtstreeks de compliance en prestaties van het proces.

De afdeling van de gebruiker die het probleem heeft gemeld of er vooral door wordt getroffen.

Waarom dit belangrijk is

Geeft organisatorische context bij de impact van problemen.

Een indicator die aangeeft of het probleemrecord ooit van gesloten weer naar open is gezet.

Waarom dit belangrijk is

Belangrijke indicator voor onterecht als opgelost gemarkeerde problemen en herstelwerk.

Activiteiten

Processtappen om te volgen en te optimaliseren

De probleemregistratie wordt voor het eerst in het systeem aangemaakt. Dit event wordt expliciet vastgelegd in de Freshservice-auditlog wanneer een nieuw probleemticket wordt opgeslagen.

Waarom dit belangrijk is

Dit markeert het begin van de procesinstantie en vormt het startpunt voor de berekening van alle doorlooptijden.

De probleemregistratie wordt doorgestuurd naar een specifiek technisch team of een toewijzingsgroep. Dit wordt vastgelegd door wijzigingen in het veld 'Group' in de tickethistorie te volgen.

Waarom dit belangrijk is

Essentieel voor de heatmap van overdrachten tussen ondersteuningsgroepen. Door deze overdrachten te volgen, worden heen-en-weerbewegingen en onnodige overdrachten tussen teams zichtbaar.

Het moment waarop het tekstveld voor de oorzaak of de analyse wordt ingevuld. Dit wordt vastgelegd door de eerste wijziging van het veld 'Root Cause' vanuit een lege waarde te herkennen.

Waarom dit belangrijk is

De belangrijkste mijlpaal voor de analyse van de doorlooptijd van de oorzaakanalyse. Dit markeert de overgang van onderzoek naar het ontwerpen van een oplossing.

Er wordt een tijdelijke oplossing aan de probleemregistratie toegevoegd, vaak als notitie of veld 'Workaround'. Dit wordt gebruikt om de snelheid van publicatie van tijdelijke oplossingen te berekenen.

Waarom dit belangrijk is

Meet hoe snel het team de impact beperkt. Belangrijk voor de KPI voor de gemiddelde doorlooptijd van tijdelijke oplossingen.

Een wijzigingsregistratie wordt aan de probleemregistratie gekoppeld. Dit markeert het begin van de herstelfase en wordt vastgelegd via het systeemevent 'Association with Change'.

Waarom dit belangrijk is

Belangrijk voor de monitor van bottlenecks bij wijzigingsverzoeken. Meet de overdracht van probleembeheer naar verandermanagement.

Dit staat voor de uitvoering van de definitieve oplossing. In Freshservice wordt dit meestal afgeleid uit een statuswijziging naar 'Solved' of 'Resolved'.

Waarom dit belangrijk is

Berekent de vertraging bij de uitvoering van de blijvende oplossing en markeert het einde van het technische herstelwerk.

De laatste gebeurtenis in de levenscyclus. De registratie wordt vergrendeld en als inactief beschouwd. Dit wordt vastgelegd bij de statuswijziging naar 'Closed'.

Waarom dit belangrijk is

Markeert het definitieve einde van de procesinstantie en is nodig om de totale doorlooptijd te berekenen.

Veelgestelde vragen

Veelgestelde vragen

Process mining brengt elke stap in de levenscyclus van probleembeheer in beeld met bestaande event logs uit Freshservice. Je ziet bottlenecks, zoals lange onderzoeksfasen of veel overdrachten tussen groepen. Zo kunnen teams nagaan waar het proces afwijkt van de standaardworkflow.

Meestal heb je de ID van de probleemregistratie, timestamps van activiteiten en de wijzigingsgeschiedenis van velden uit Freshservice nodig. Ook belangrijke attributen zoals prioriteit, categorie en toegewezen groep worden geëxporteerd. Die geven context voor verdere analyse en filtering.

De eerste inzichten zijn meestal binnen enkele dagen beschikbaar nadat de historische data uit Freshservice is geëxporteerd. De doorlooptijd hangt af van de hoeveelheid data en de complexiteit van aangepaste velden. De meeste organisaties zien binnen twee weken patronen waarop ze actie kunnen ondernemen.

Nee. Process mining werkt meestal via een API-koppeling of data-export, niet via software-installatie. Je hoeft alleen toegang te geven tot de auditlogs en ticketgeschiedenis in je Freshservice-omgeving.

Ja. De analyse laat voor elke registratie precies zien hoeveel tijd de fase voor oorzaakanalyse in beslag neemt. Je kunt vervolgens inzoomen op een niveau dieper om te zien of bepaalde categorieën, prioriteitsniveaus of technische teams de grootste vertraging oplopen.

Door elke overgang in kaart te brengen, vindt de tool tickets die herhaaldelijk tussen groepen heen en weer gaan zonder dat ze worden opgelost. Managers zien zo wanneer het onduidelijk is wie verantwoordelijk is of wanneer technische teams niet over de middelen beschikken om bepaalde problemen op te lossen.

Ja. Het kan incidenttickets koppelen aan de bijbehorende probleemregistraties, zodat die relatie zichtbaar blijft. Zo kun je controleren of tijdelijke oplossingen worden doorgegeven aan de verantwoordelijken voor incidenten en of herstelstappen consequent worden toegepast op alle gerelateerde problemen.

De nadruk ligt vooral op historische analyses, maar veel platforms bieden regelmatige updates om lopende compliance te monitoren. Zo zie je of probleemregistraties de SLA-deadline naderen voordat die wordt overschreden.

Pak bottlenecks in probleembeheer vandaag nog aan

Verkort de doorlooptijd met 30 procent en maak IT-diensten stabieler

Start je gratis proefperiode

Geen creditcard nodig. Binnen 5 minuten ingesteld.