Verbeter probleembeheer
Je 6-stappengids voor het optimaliseren van probleembeheer.
Verbeter probleembeheer
Probleembeheer
Generiek

Selecteer een proces

Kies een proces om verder te werken in de gekoppelde workspace.

259 Processen

Verbeter probleembeheer met process mining

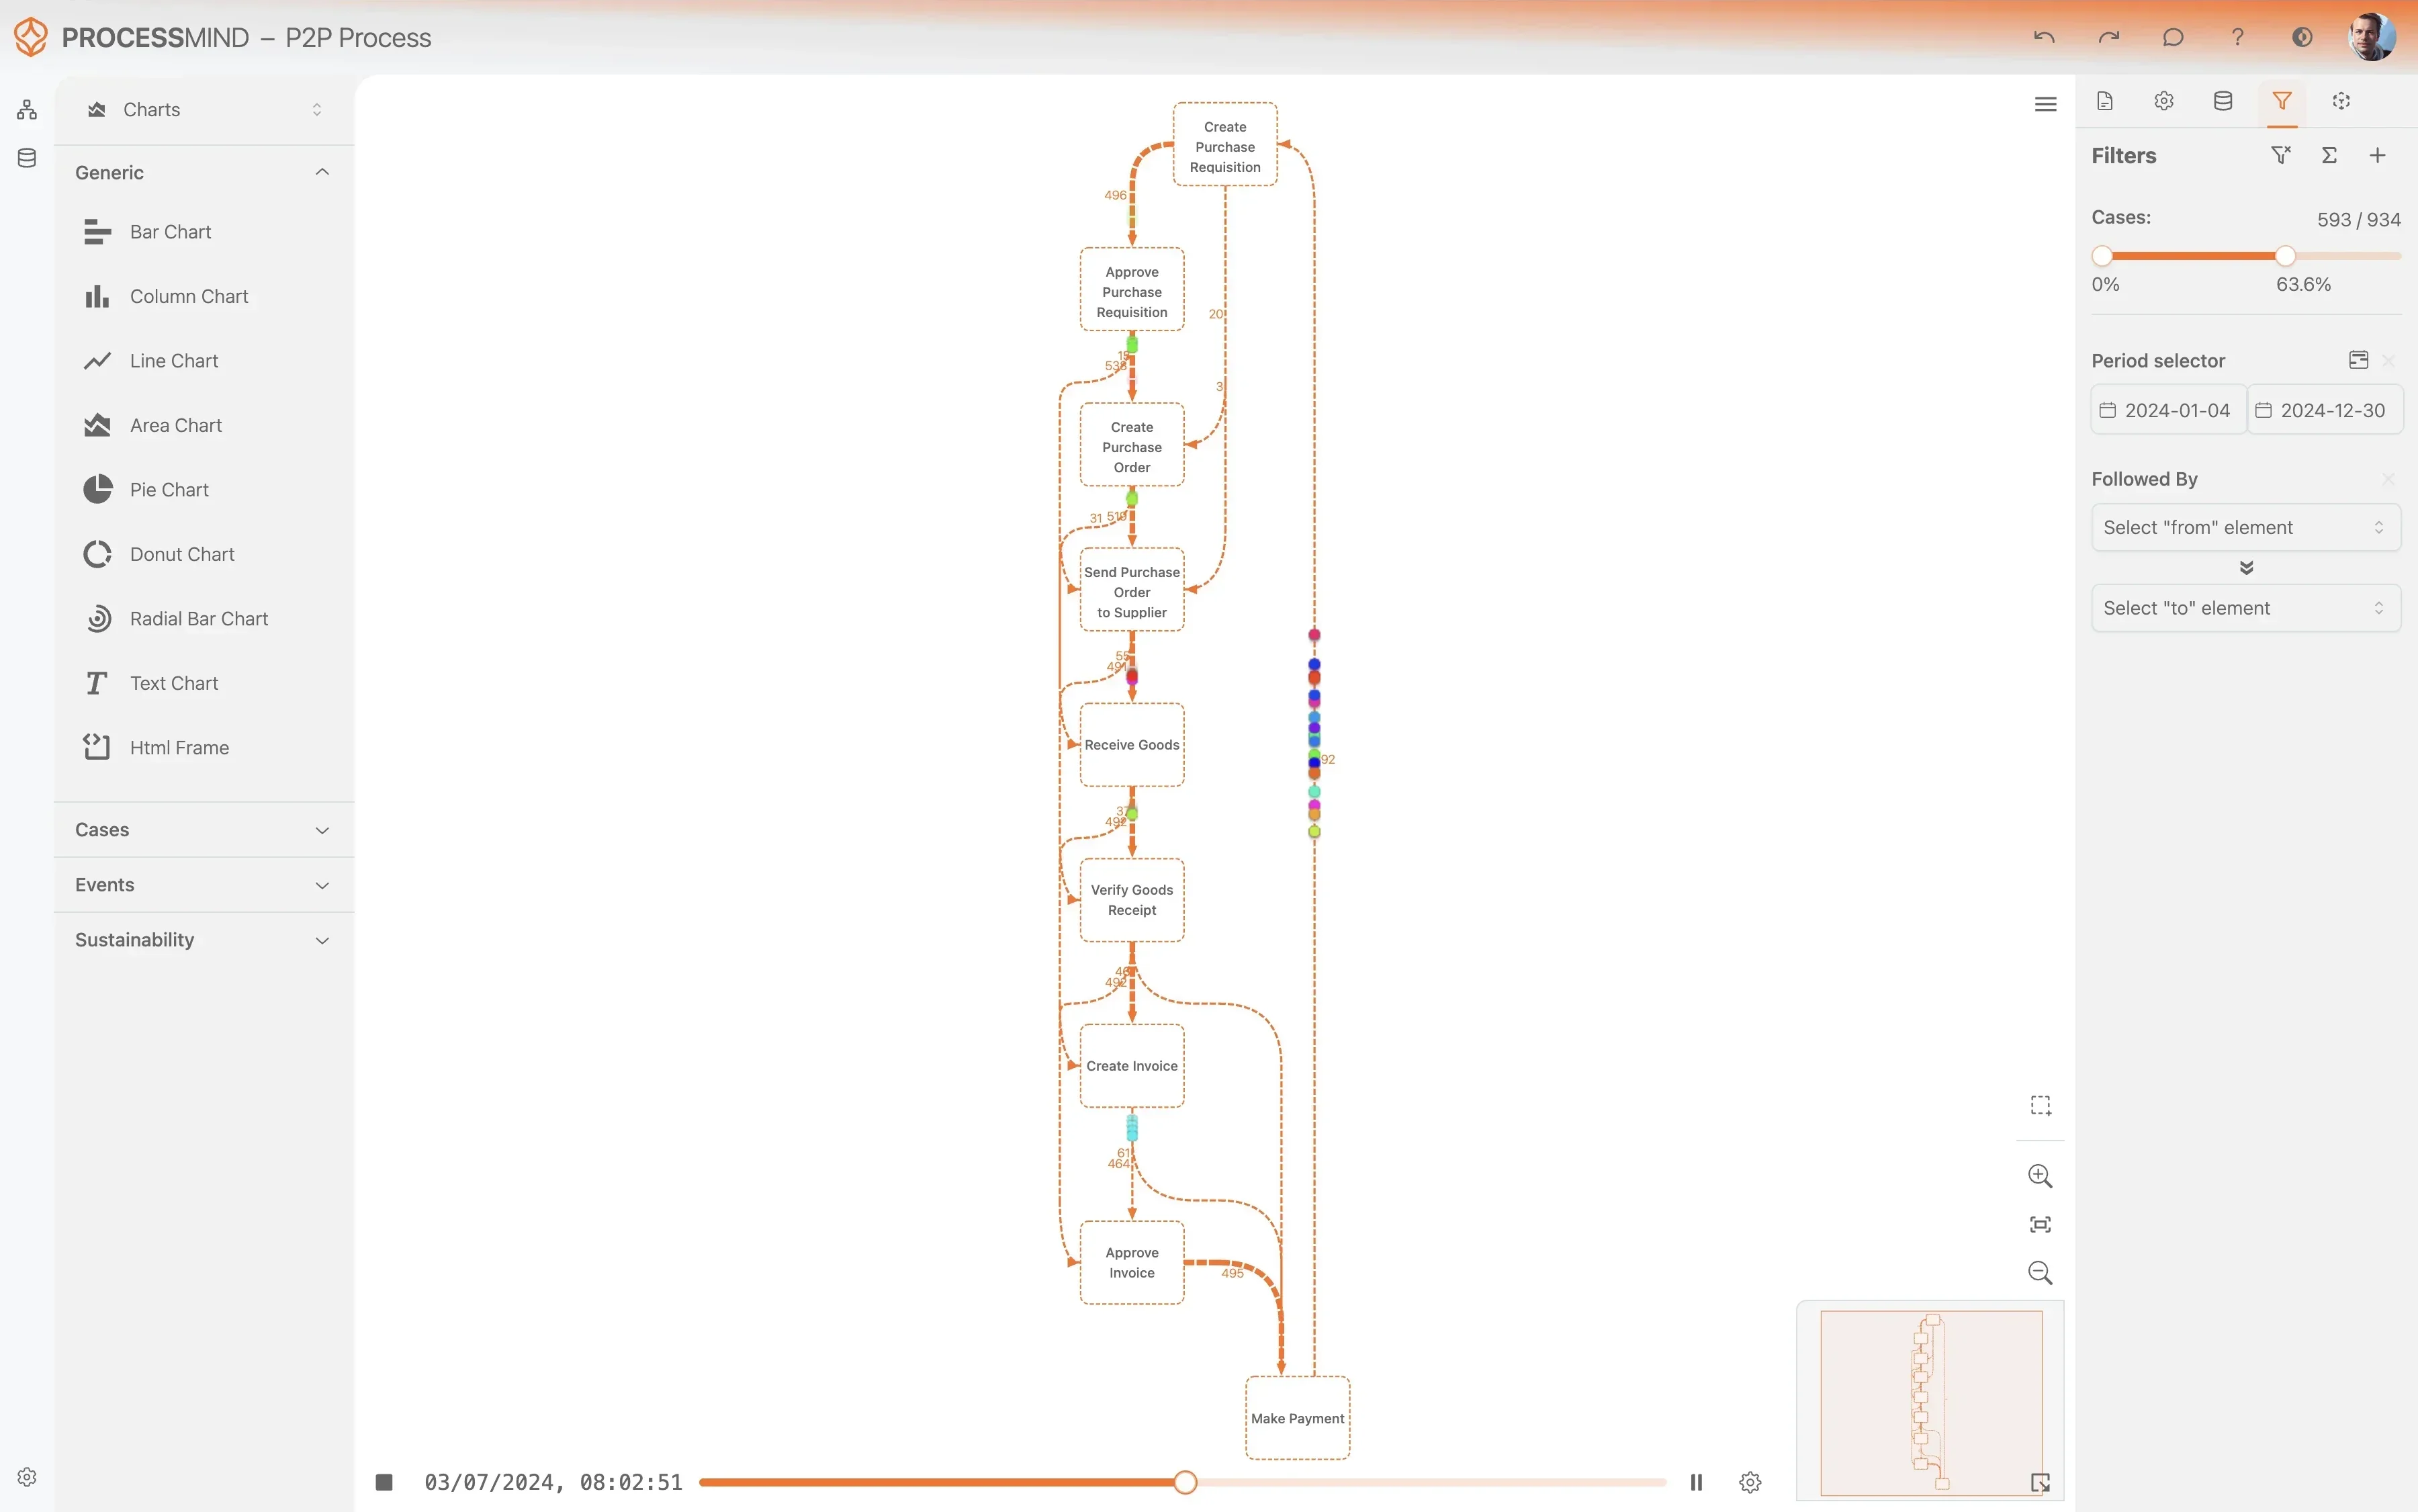
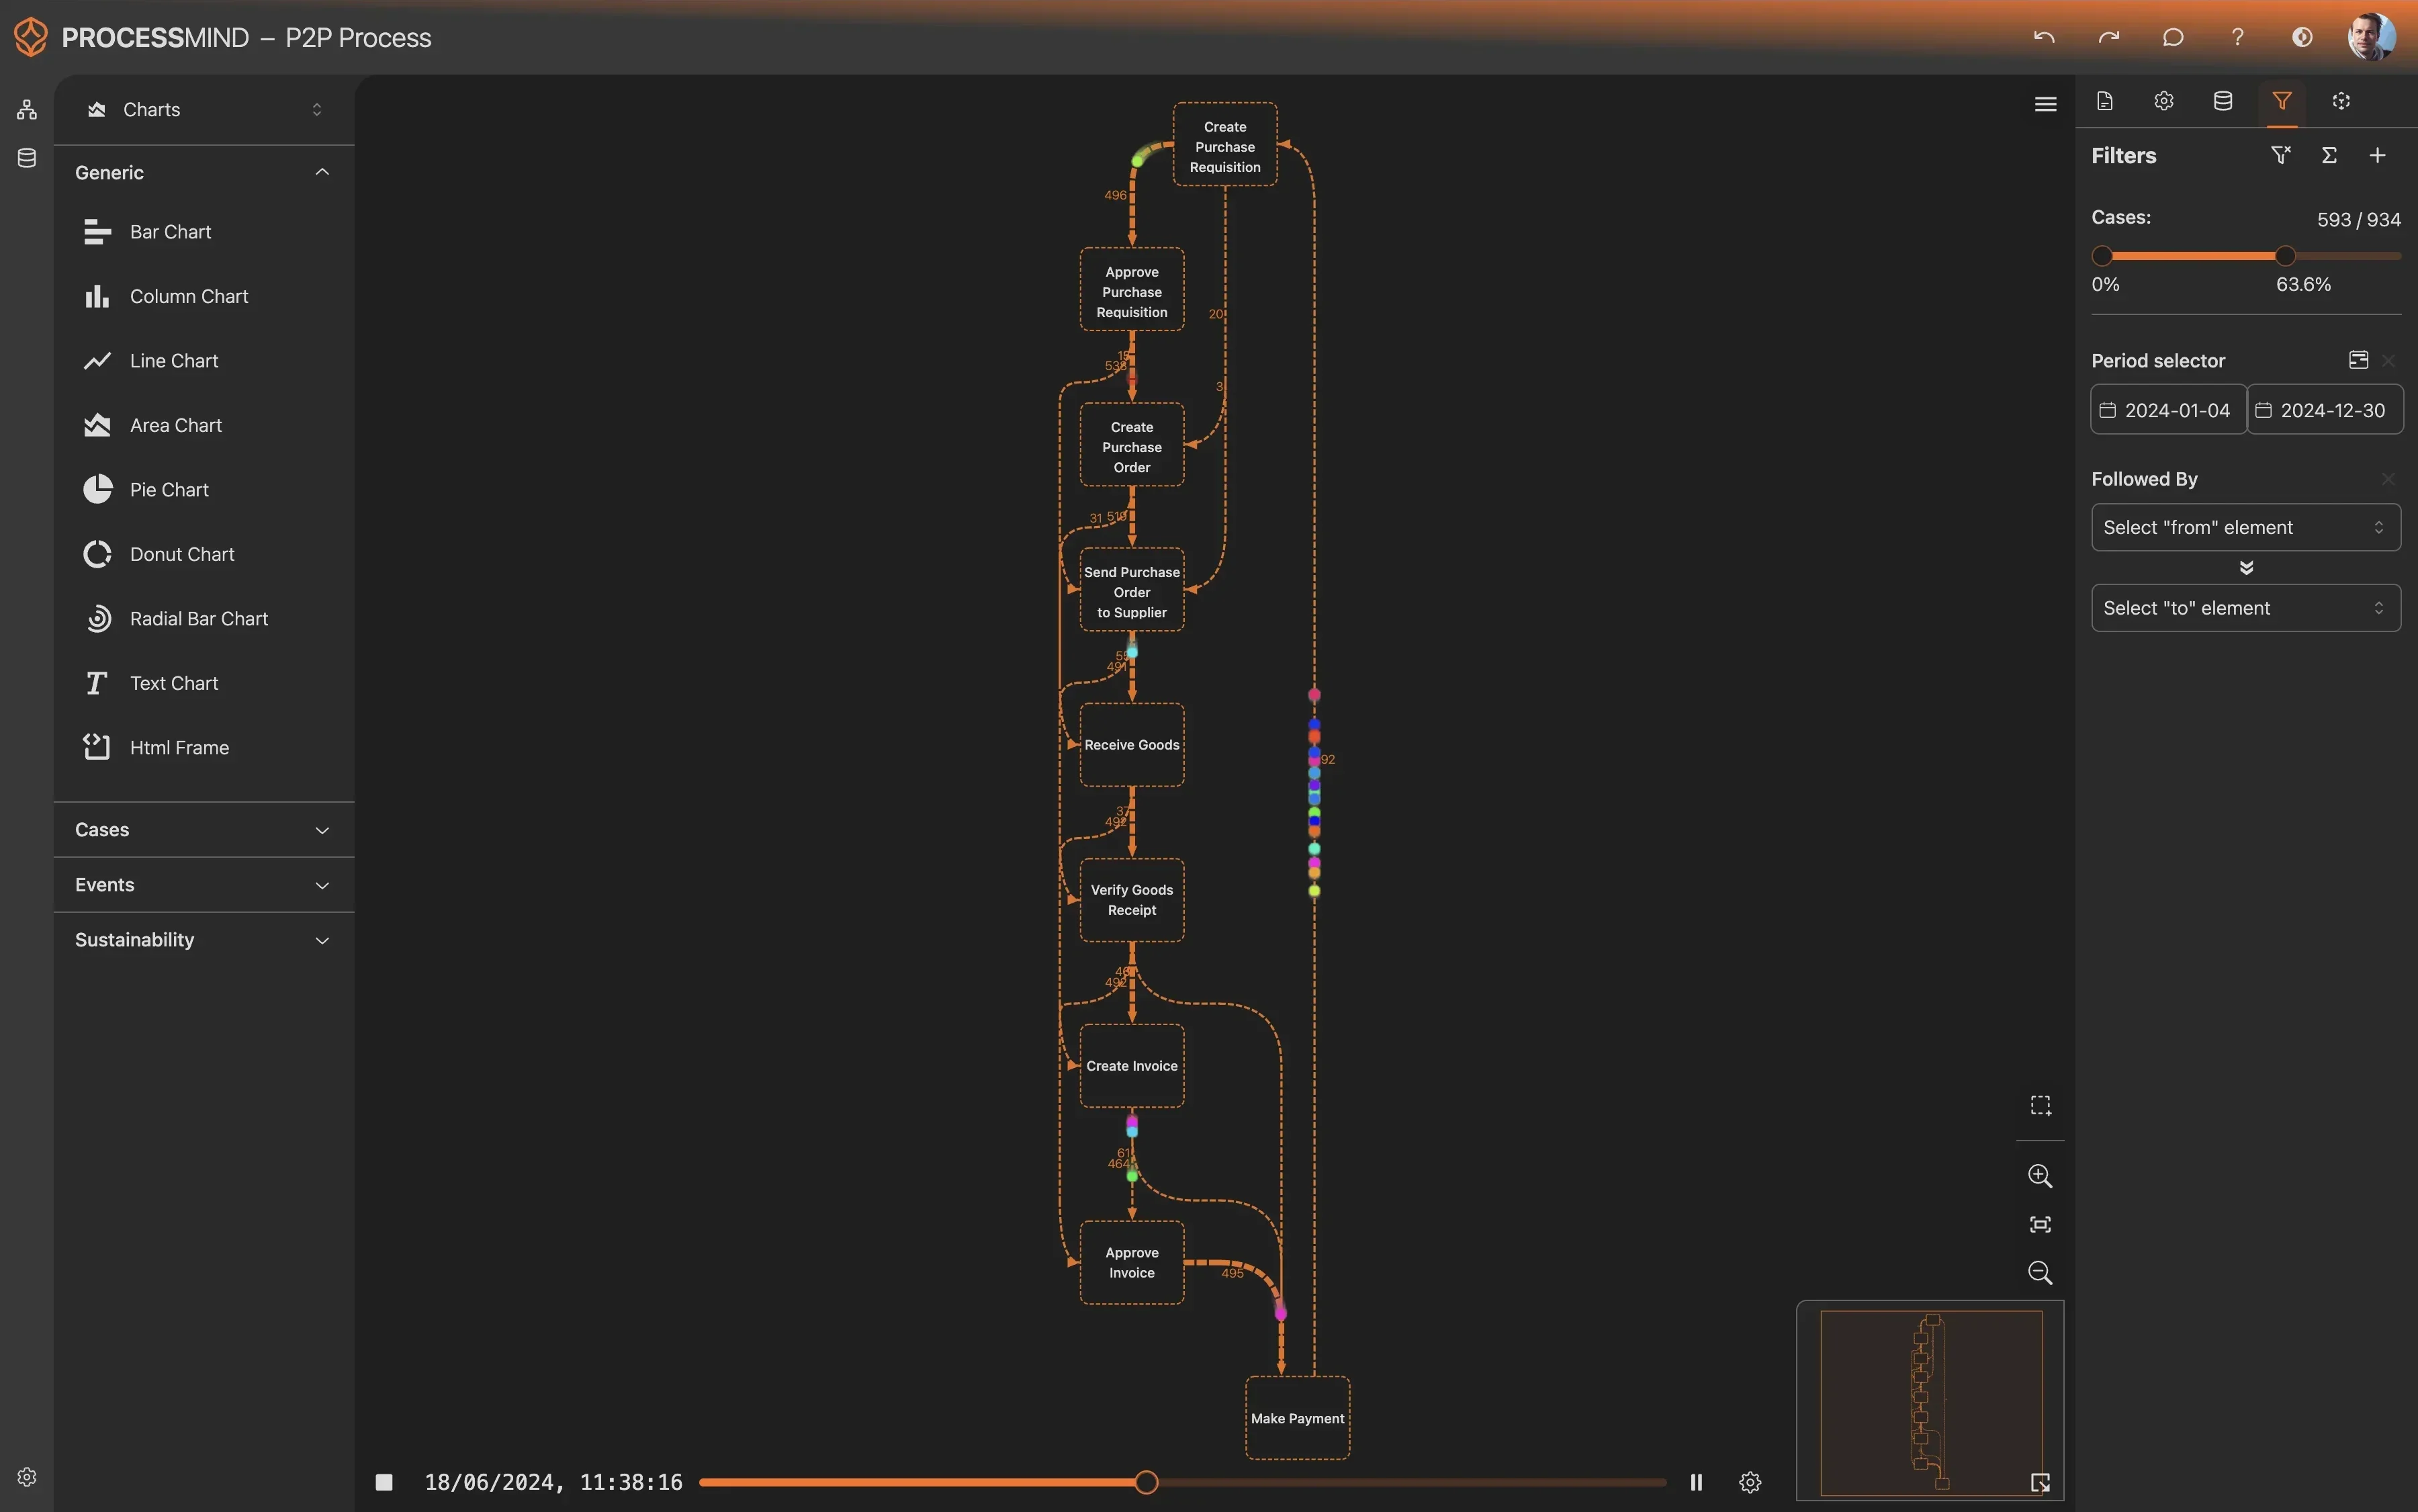
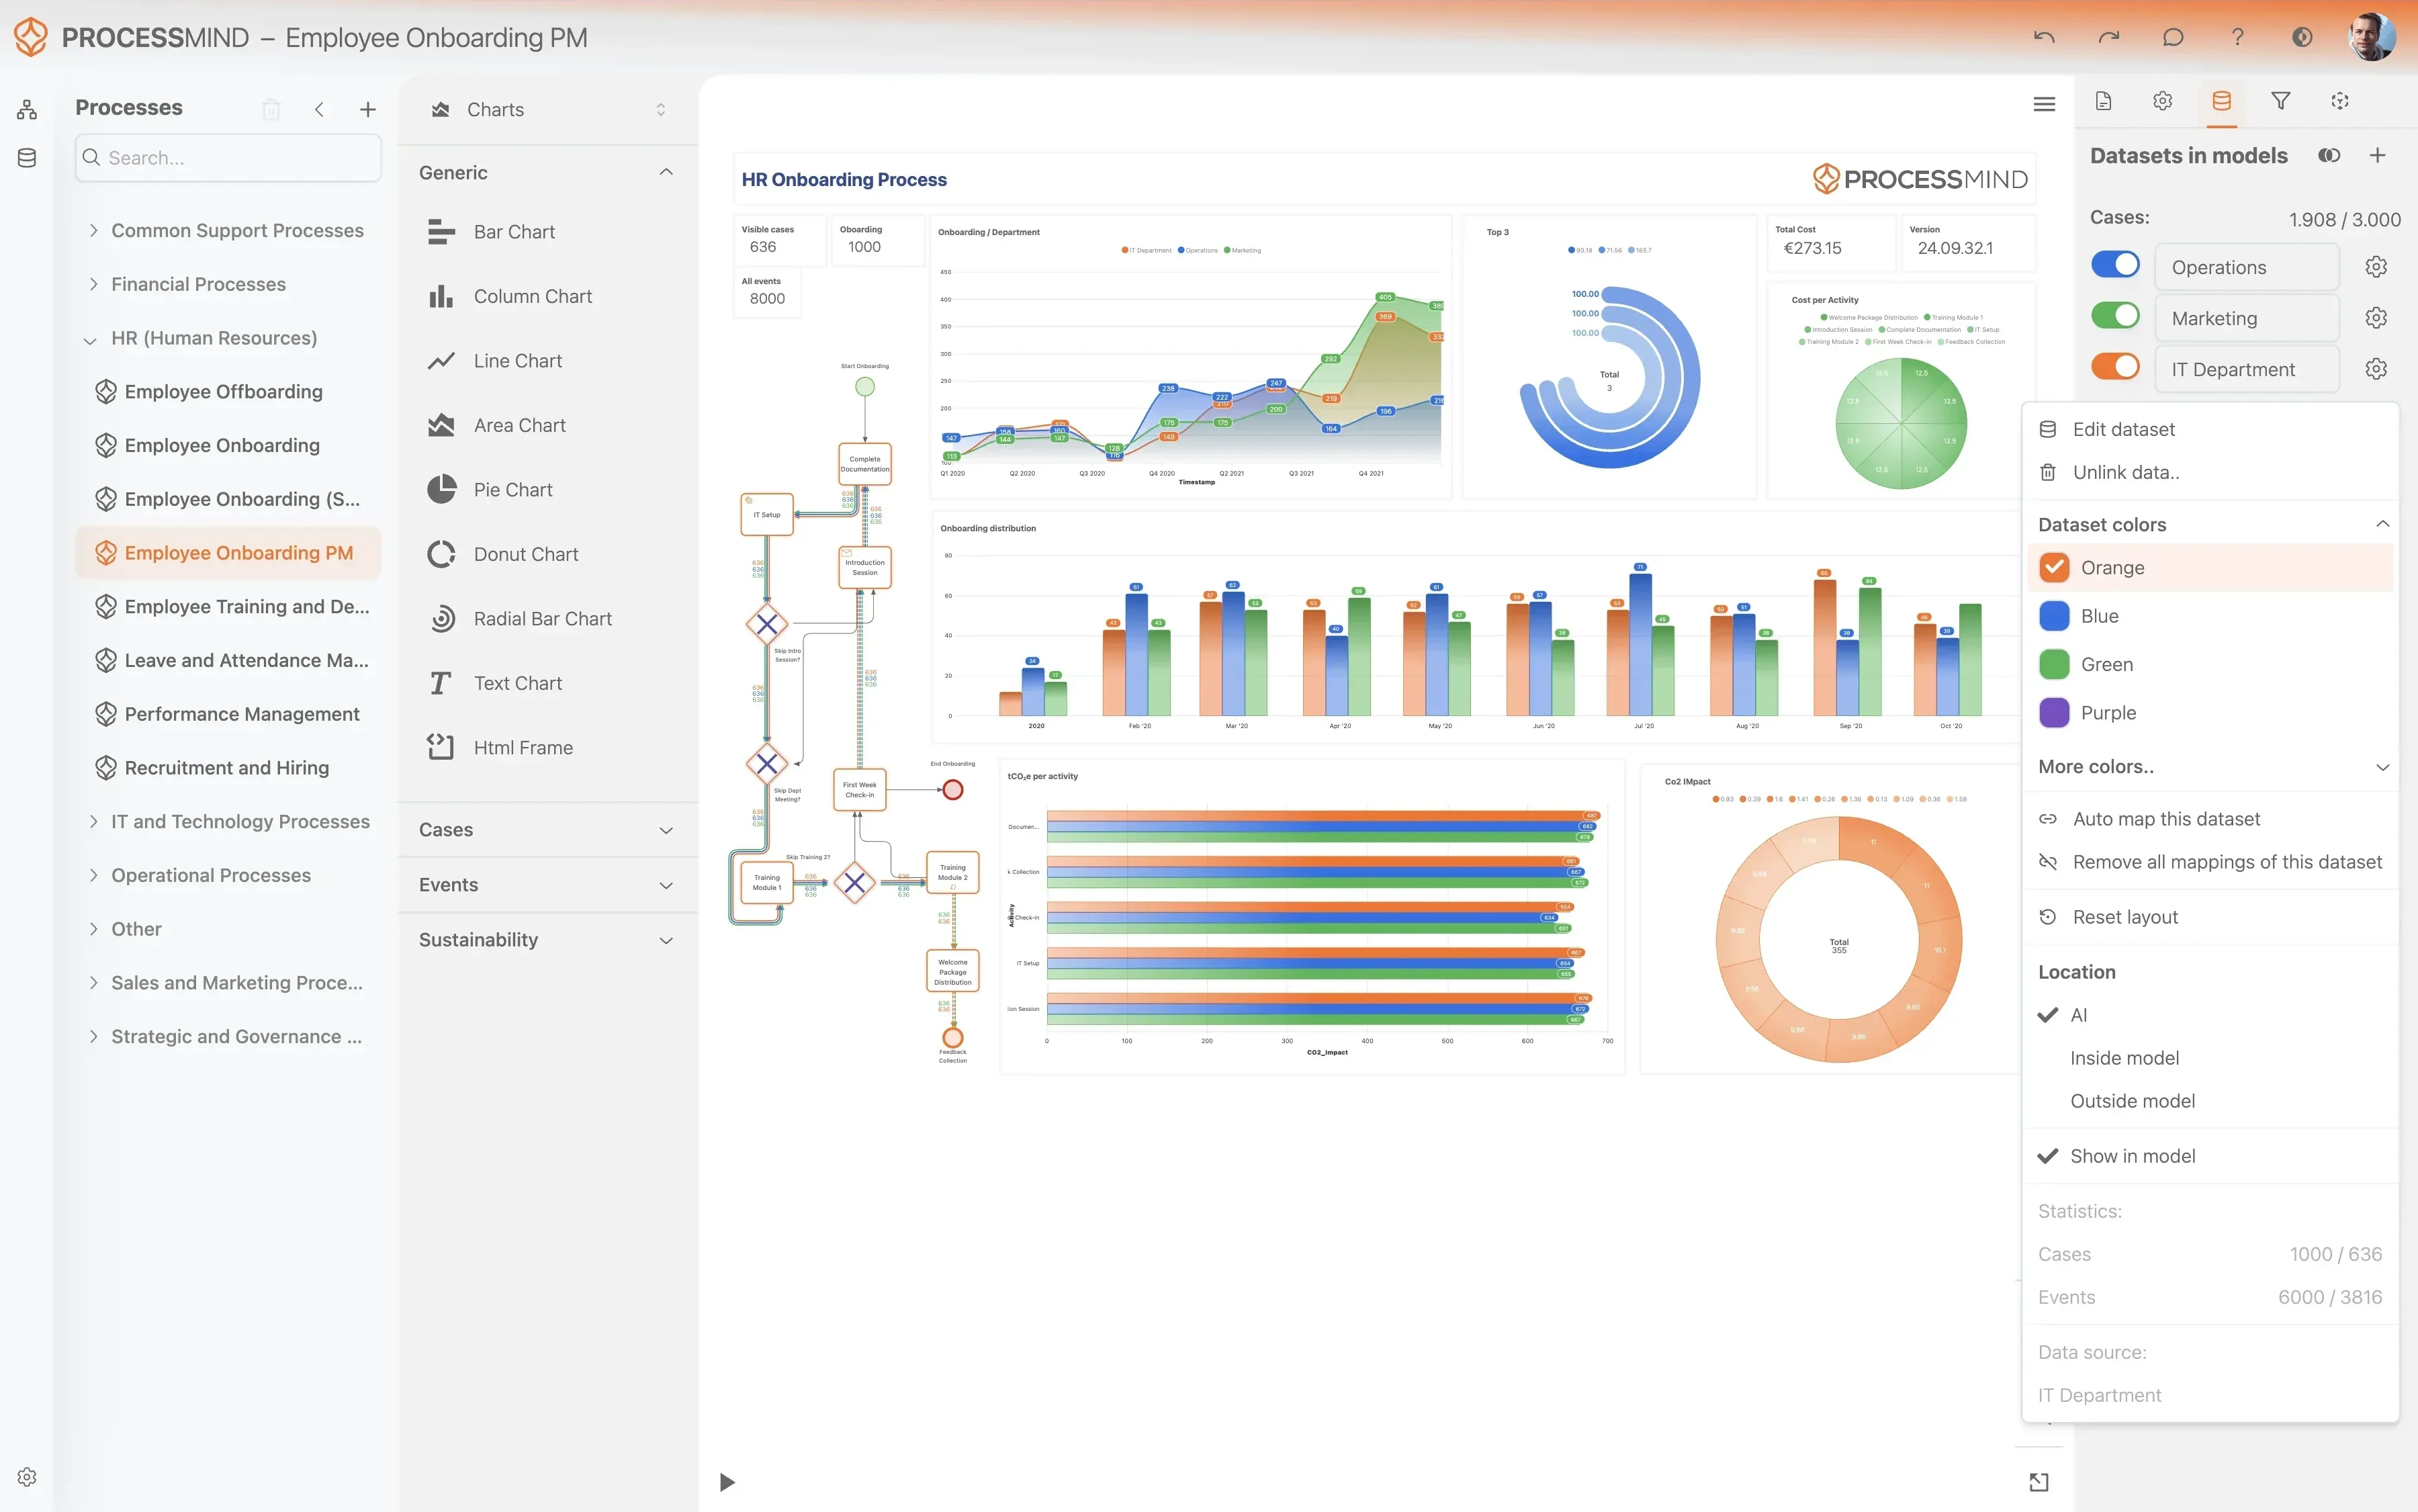
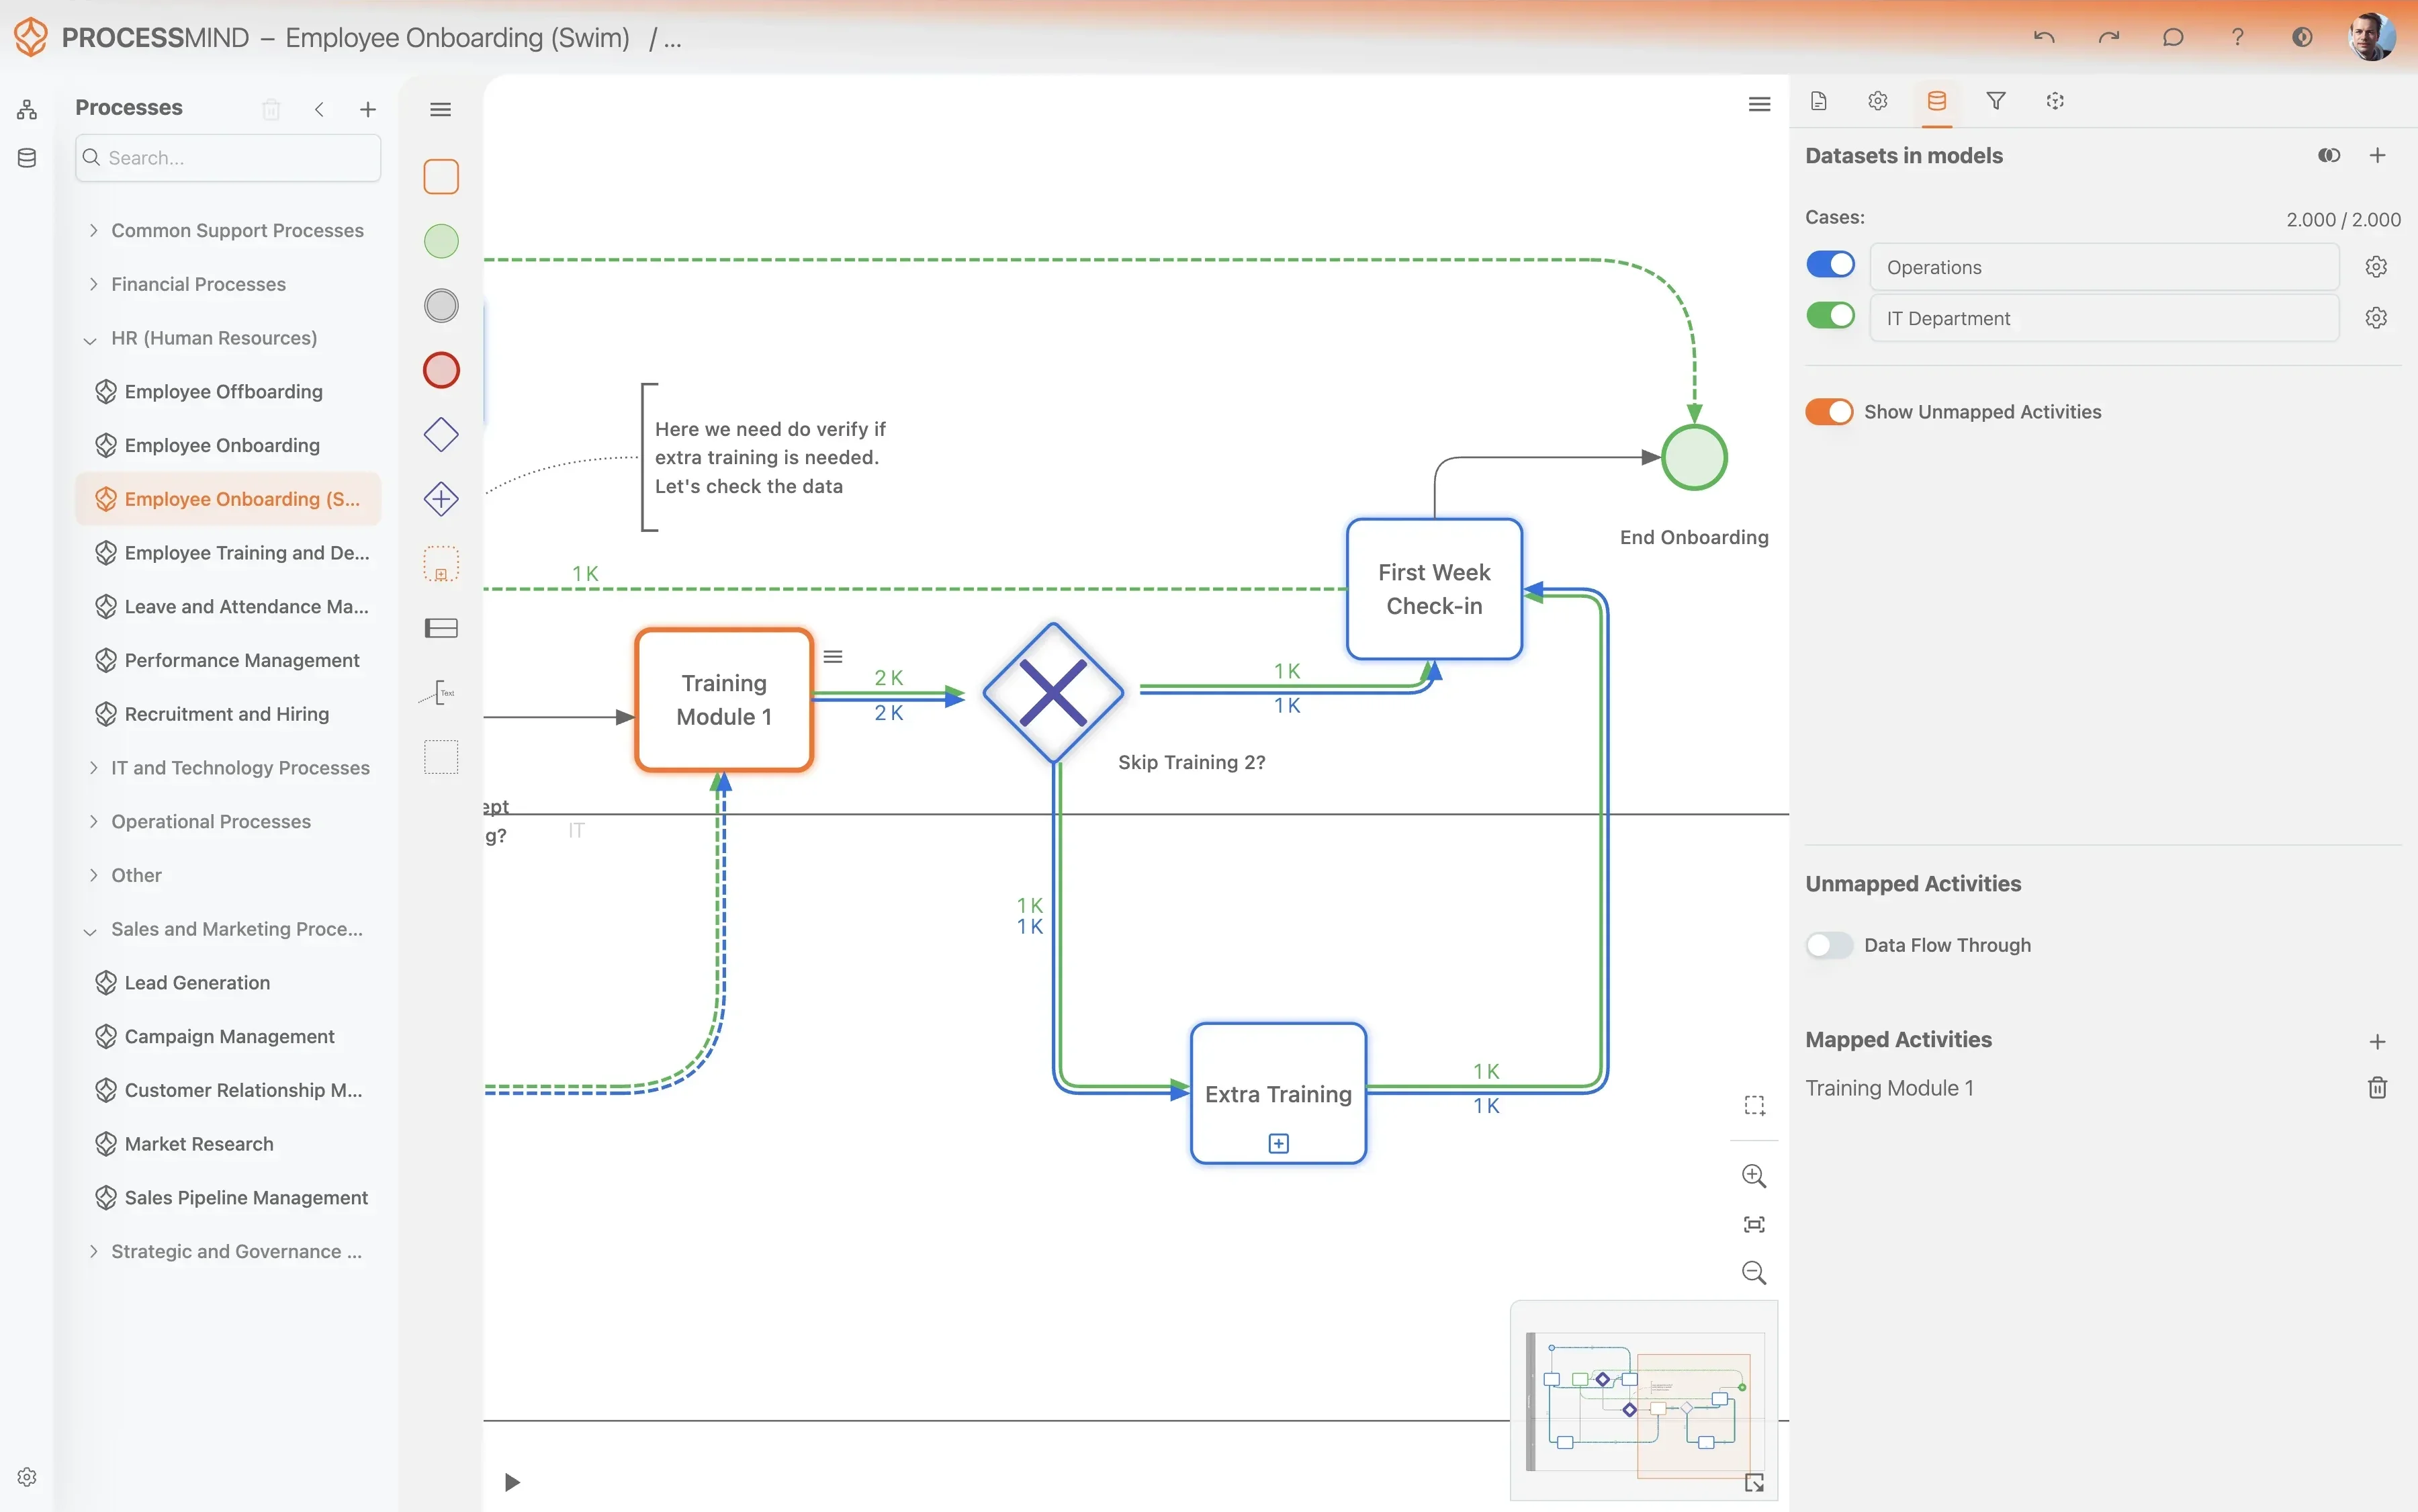
Met ProcessMind ontdek je inefficiënties in het probleembeheerproces. Breng bottlenecks, terugkerende taken en lange oplostijden in kaart die de servicekwaliteit beïnvloeden. Het platform laat zien waar processen afwijken en waar verbetering mogelijk is, zodat je verbeteringen op data kunt baseren. Krijg zicht op het hele traject van probleemoplossing, van signalering tot afsluiting, ongeacht het bronsysteem.

Download onze vooraf ingestelde datatemplate en pak veelvoorkomende uitdagingen aan om je efficiëntie-doelen te bereiken. Volg ons verbeterplan in zes stappen en raadpleeg de gids voor de datatemplate om je bedrijfsvoering te verbeteren.

Gedetailleerde beschrijving tonen

Goed probleembeheer is belangrijk voor een stabiele bedrijfsvoering en goede dienstverlening. Process mining voor probleembeheer laat zien hoe problemen binnen je organisatie daadwerkelijk worden gesignaleerd, onderzocht en opgelost. Je hoeft niet langer af te gaan op losse ervaringen: ontdek welke routes probleemregistraties volgen, van de eerste signalering tot de definitieve oplossing en controle. De analyse maakt zichtbaar waar bottlenecks de oplossing vertragen, waar processen afwijken van de afspraken en waar automatisering mogelijk is. ProcessMind haalt eventdata op uit je ERP-, ITSM- of andere bronsysteem en reconstrueert hoe het werk verloopt. Zo krijg je een objectief beeld van het proces voor probleembeheer, onafhankelijk van het gebruikte systeem.

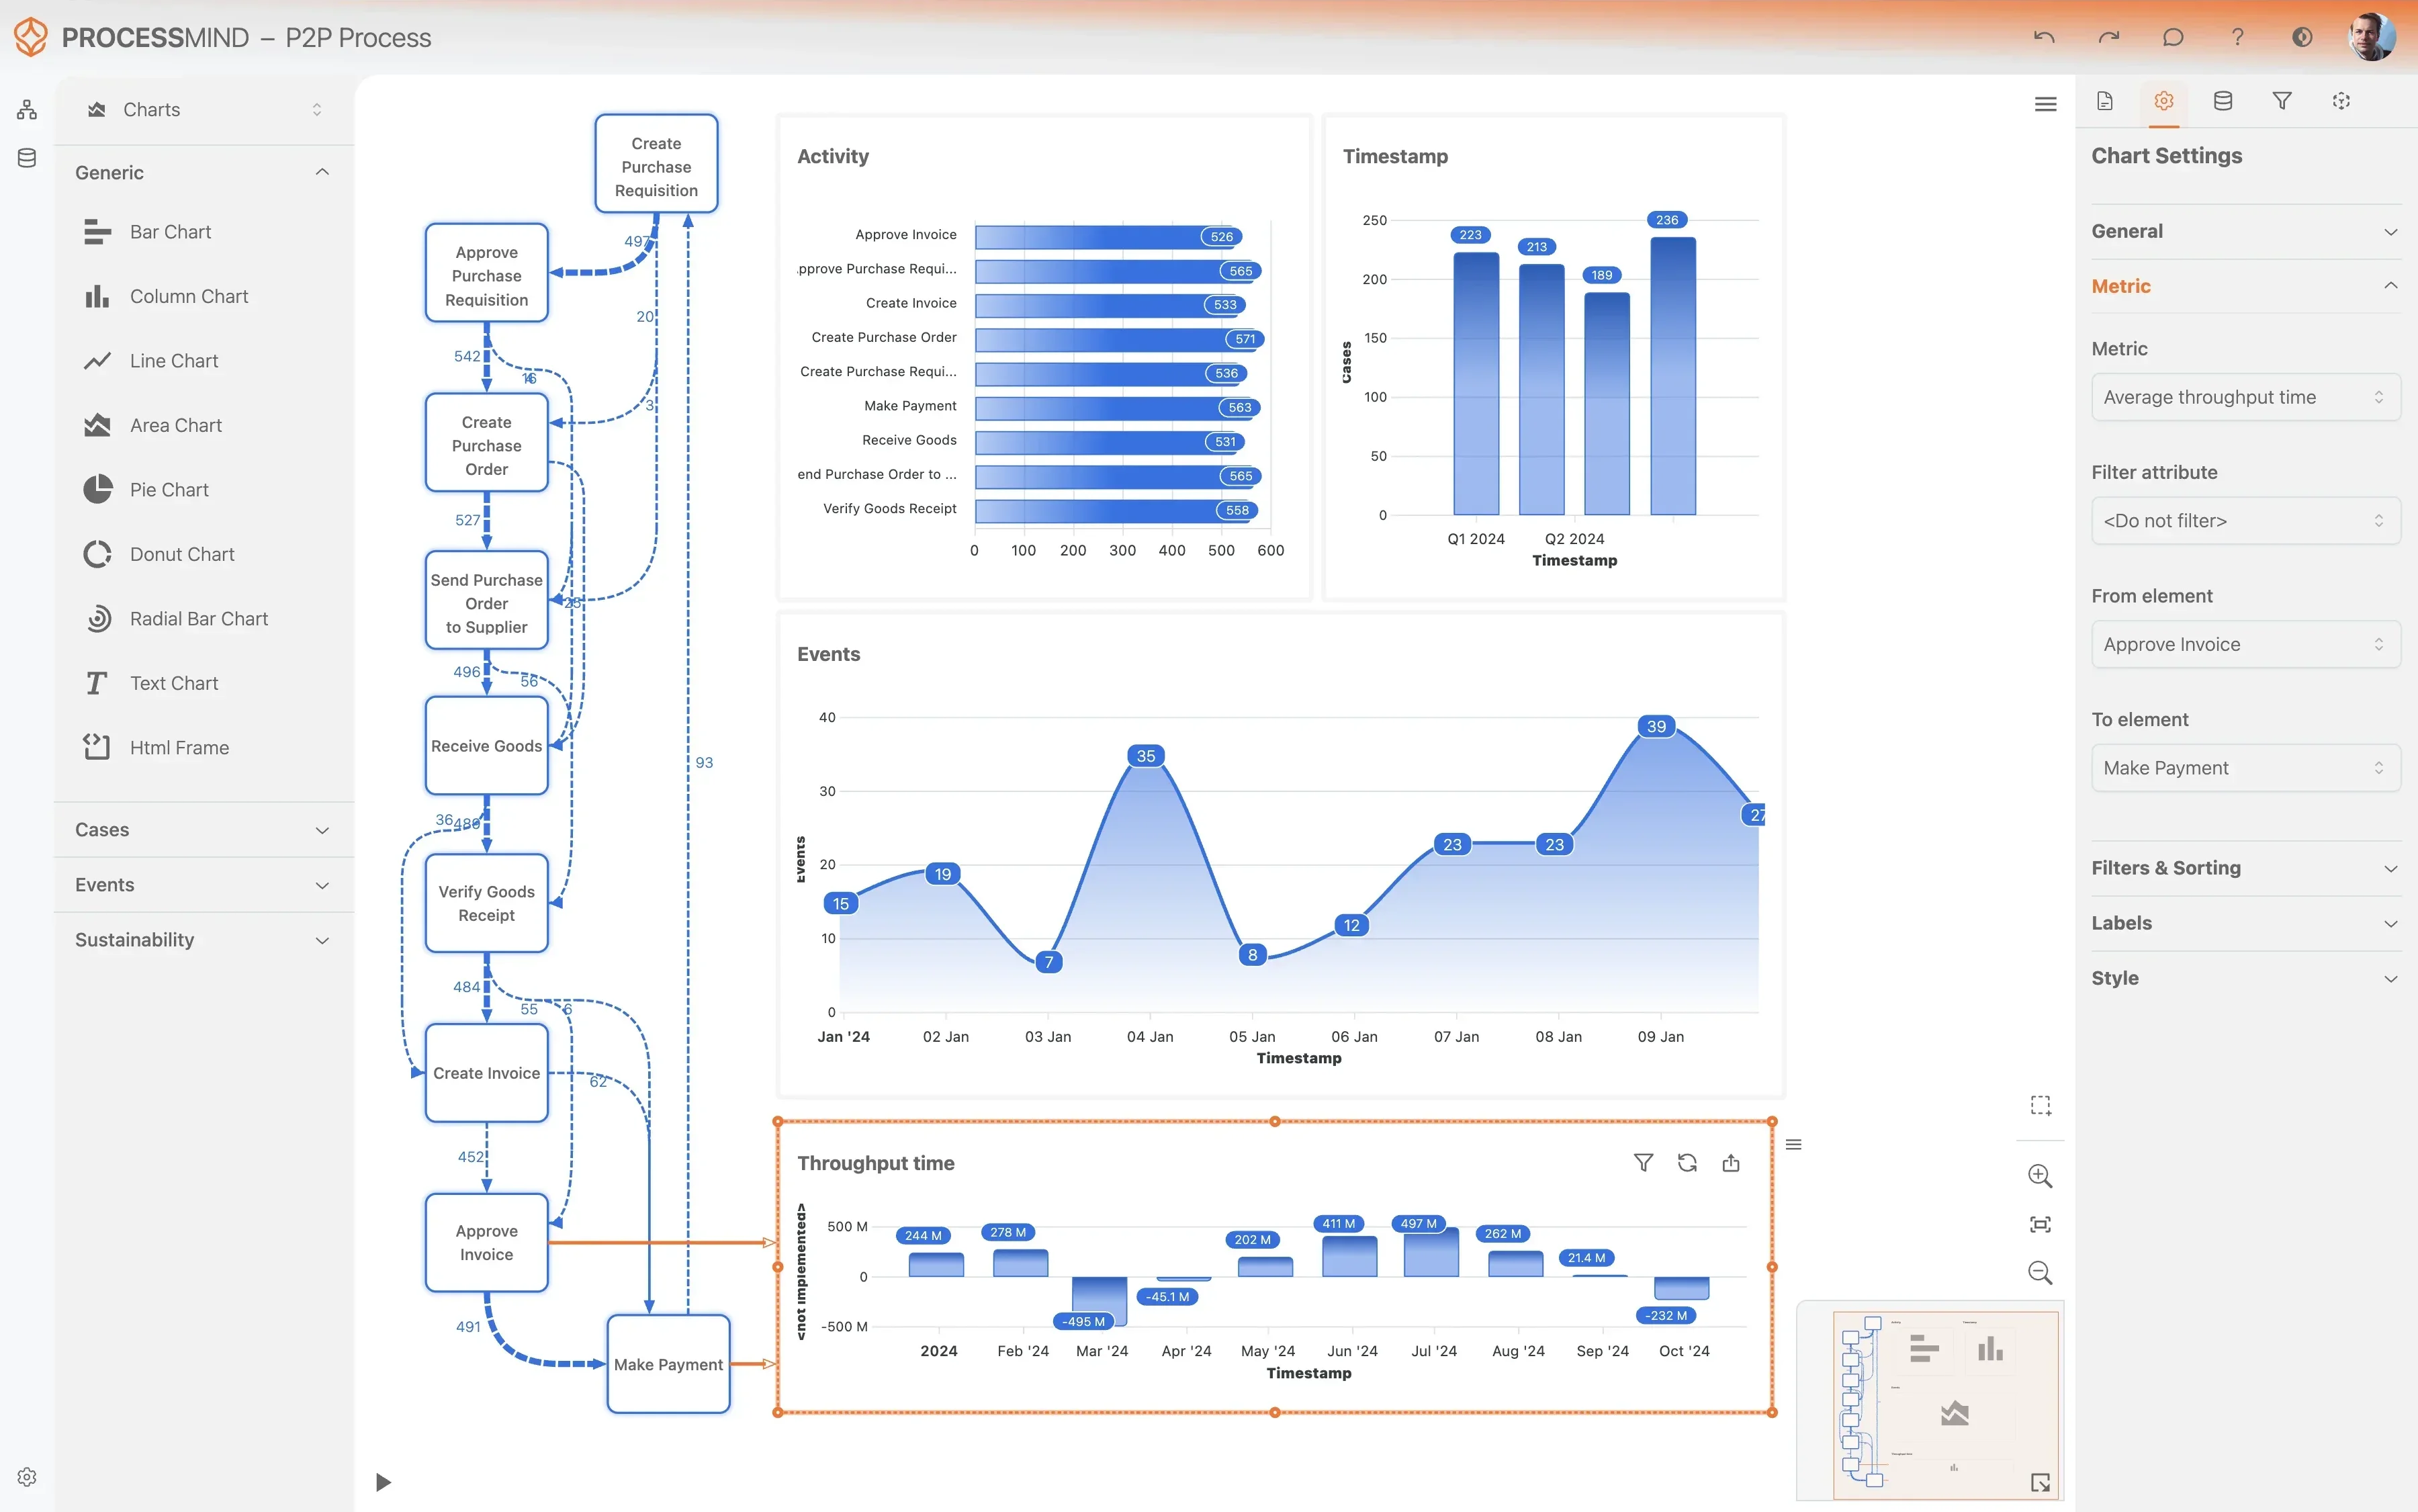
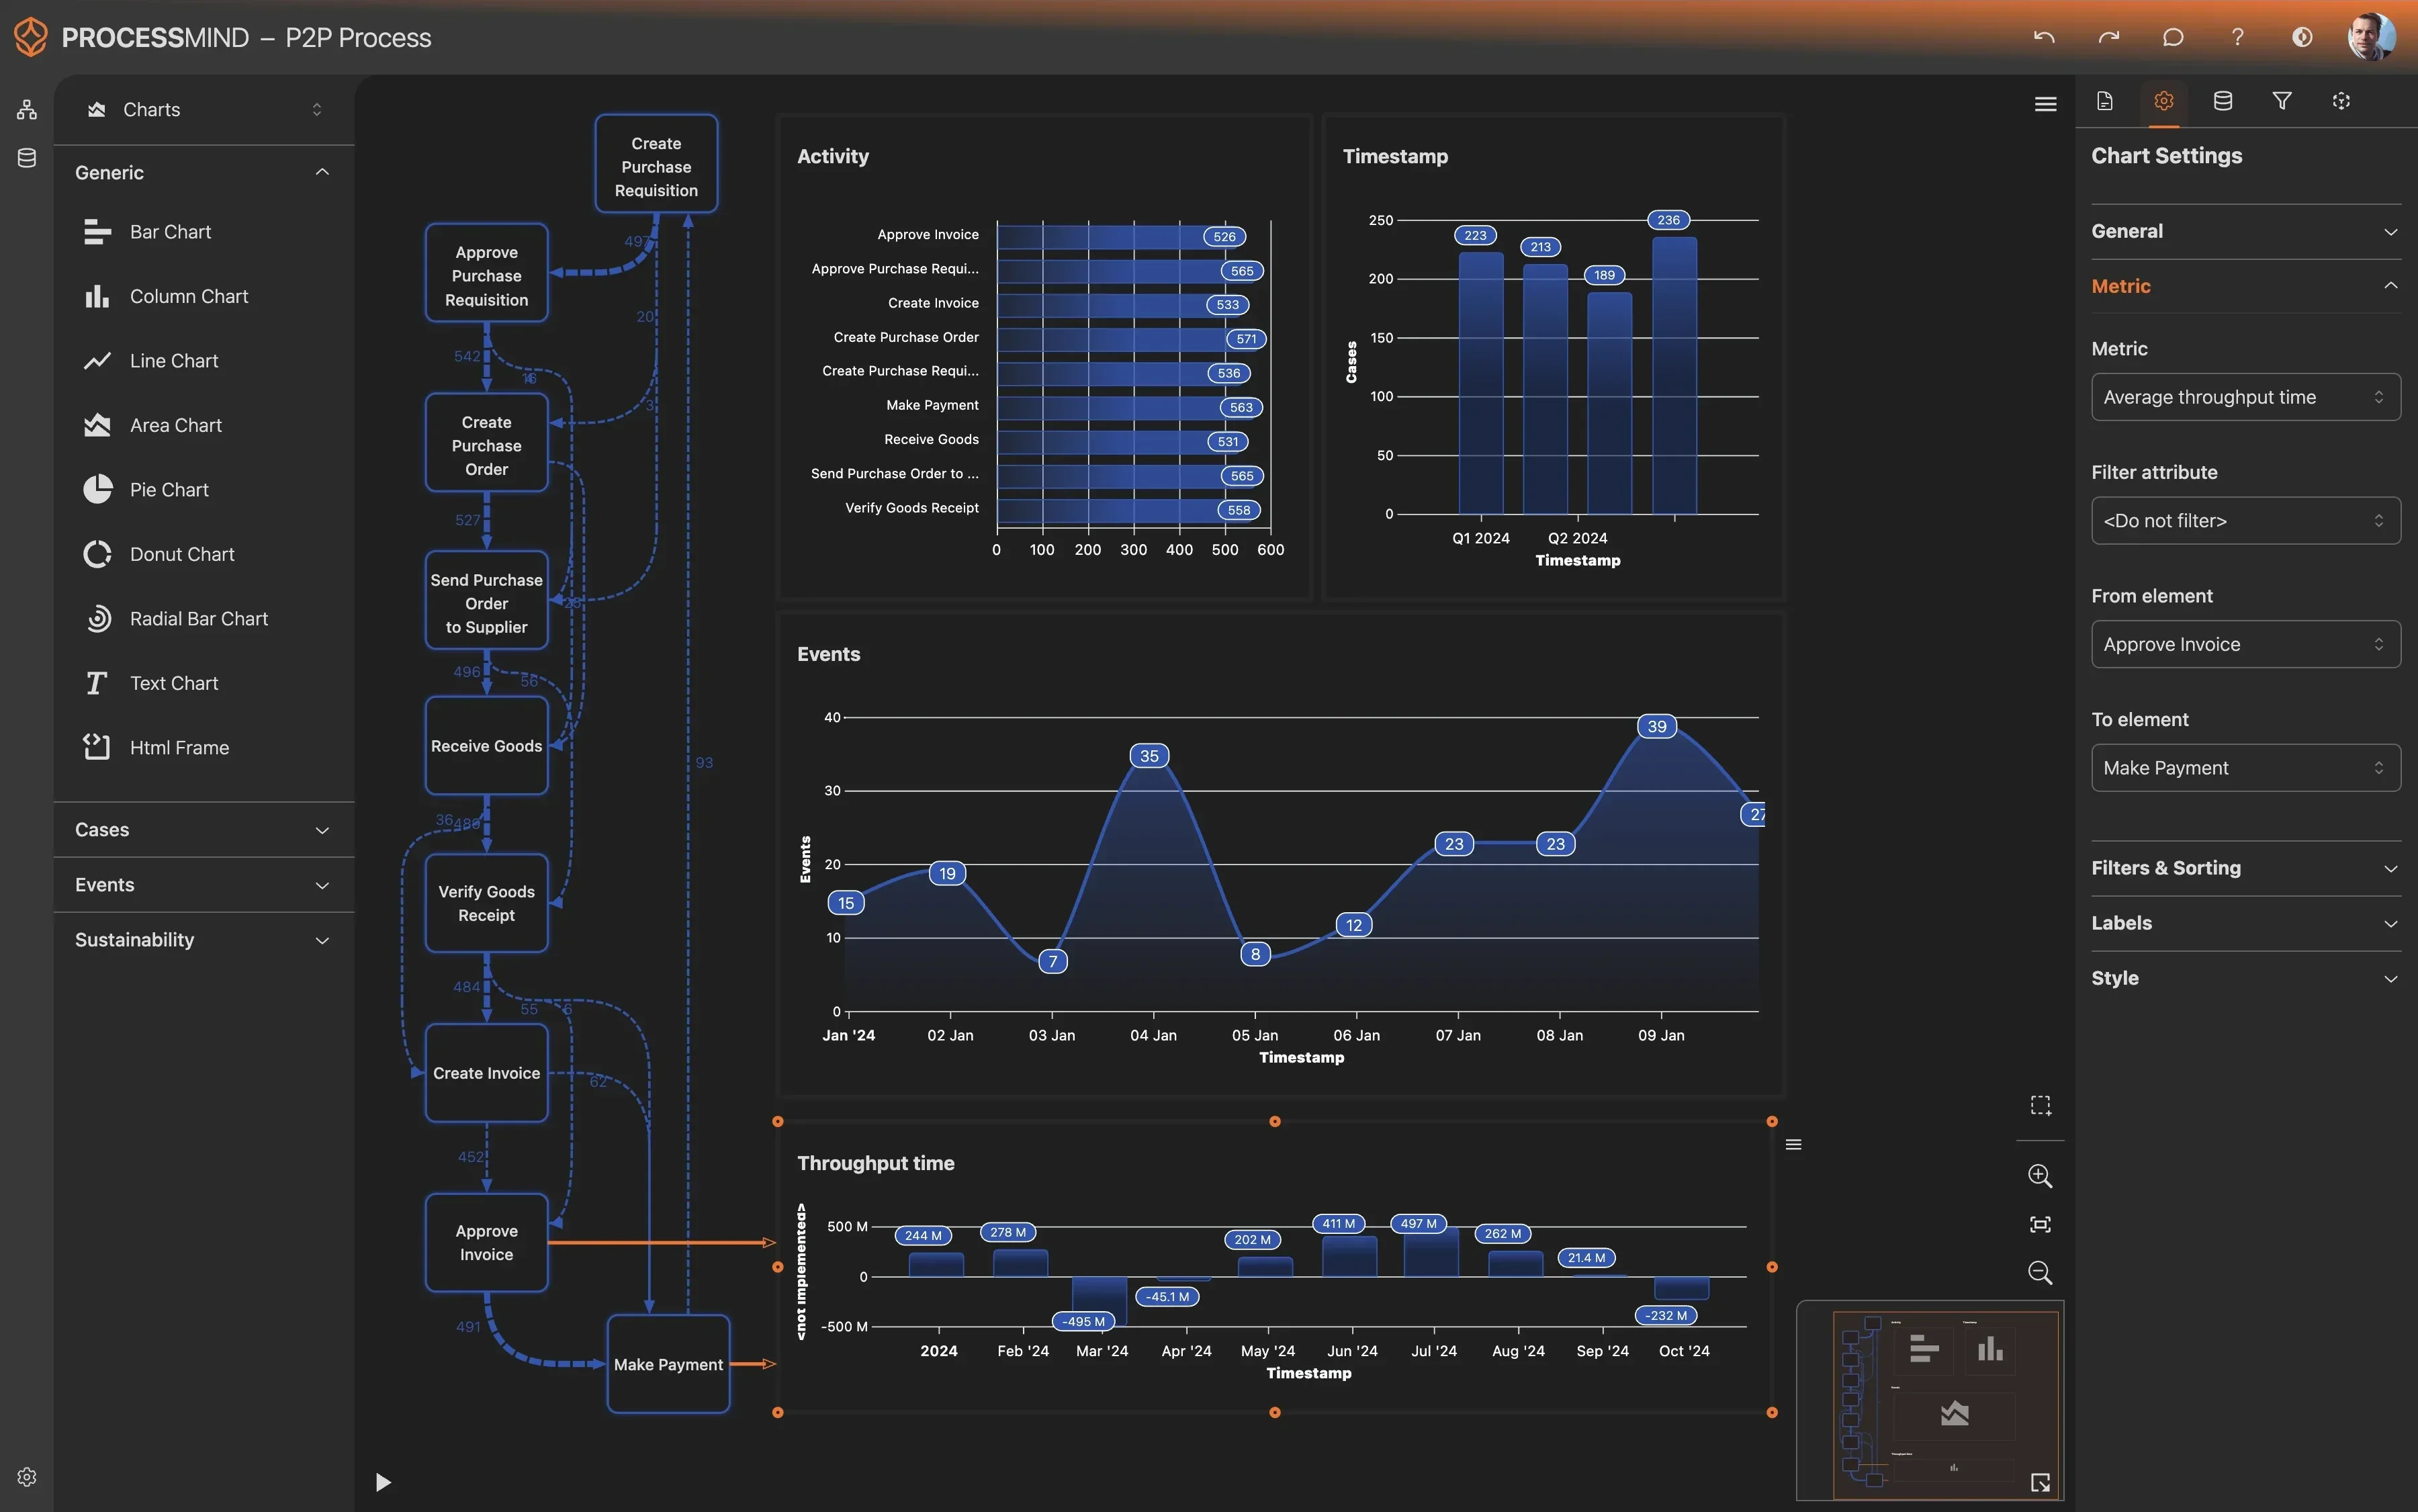
Probleembeheer kent vaak dezelfde uitdagingen, ongeacht het gebruikte systeem. Oorzaakanalyses duren lang, bekende problemen keren terug en overdrachten tussen teams verlopen niet efficiënt. Ook is er vaak weinig zicht op de werkelijke doorlooptijd van probleemoplossing. Organisaties weten niet altijd waarom sommige problemen langer duren, waar middelen verkeerd worden ingezet en of medewerkers de afgesproken werkwijzen volgen. ProcessMind maakt deze knelpunten zichtbaar met proceskaarten en prestatiemetingen op basis van je operationele data. Je ziet waar vertraging ontstaat, welke stappen niets toevoegen en welke variaties tot minder goede resultaten leiden. Met dat overzicht kun je processen verbeteren, de gemiddelde oplostijd (MTTR) verkorten, middelen beter inzetten en bijdragen aan stabiele dienstverlening in plaats van alleen op incidenten te reageren.

De analyse van probleembeheer met ProcessMind levert concrete verbeteringen op in efficiëntie, kosten en servicekwaliteit. Met een feitelijk beeld van het proces kun je onderbouwde keuzes maken, overbodige stappen schrappen en automatisering richten op de plekken met het meeste effect. Dat helpt terugkerende problemen en serviceonderbrekingen te verminderen en de klanttevredenheid te verhogen. Door hiaten in compliance vroeg te vinden en aan te pakken, beperk je risico’s en voldoe je beter aan interne beleidsregels en externe voorschriften. Je kunt beginnen met onze datatemplate, die uitlegt hoe je de benodigde event logs uit je systeem haalt. Zo kun je vlot aan de slag. ProcessMind helpt je probleembeheer te veranderen van een reactieve noodzaak in een proactief en efficiënt proces.

Probleembeheer Process Mining Servicemanagement ITSM Oorzaakanalyse Procesoptimalisatie Efficiëntie Compliance Ticketafhandeling Ticketbeheer Bekende fout Terugkerende incidenten Tijdelijke oplossing Incidentpreventie IT-servicedesk

Veelvoorkomende problemen en uitdagingen

Bekijk welke uitdagingen voor jou spelen

Probleemregistraties blijven soms wekenlang in de onderzoeksfase hangen zonder duidelijke voortgang. Daardoor groeit de achterstand en blijven onderliggende problemen bestaan. Teams kunnen de oorzaak van terugkerende incidenten niet aanpakken, waardoor de servicedesk meer werk krijgt en de betrouwbaarheid van de dienstverlening afneemt.

ProcessMind meet hoelang de onderzoeksfase duurt en laat precies zien waar het proces stilvalt. Je ziet welke registraties langer openstaan dan gebruikelijk, zodat probleemcoördinatoren kunnen ingrijpen en middelen anders kunnen verdelen voordat het onderzoek achterhaald raakt.

Als een probleemregistratie tussen meerdere technische teams heen en weer gaat, raakt context vaak verloren en loopt de oplossing flink vertraging op. Doordat niemand duidelijk eigenaar is, gaat werk verloren, raken technische medewerkers gefrustreerd en worden serviceniveaudoelen voor de stabiliteit van kritieke infrastructuur niet gehaald.

Onze analysetool brengt de volgorde van toewijzingsactiviteiten in kaart en maakt dit heen-en-weer zichtbaar. Je ziet welke supportgroepen registraties vaak doorsturen. Zo kun je gerichte training bieden of verantwoordelijkheden duidelijker afspreken en voorkomen dat teams het probleem blijven doorschuiven.

Als een tijdelijke oplossing niet snel wordt gepubliceerd, blijven incidentmedewerkers met terugkerende problemen worstelen. Daardoor duurt het langer voordat eindgebruikers geholpen zijn. Als er veel tijd zit tussen het signaleren van een probleem en het publiceren van een tijdelijke oplossing, ondervindt de bedrijfsvoering onnodige uitval terwijl er al een tijdelijke oplossing bekend is.

ProcessMind meet de tijd tussen het vaststellen van een tijdelijke oplossing en de activiteit Workaround Published. Zo zie je of tijdelijke oplossingen snel worden gedeeld. Dat beperkt de impact van lopende problemen terwijl technische teams aan de definitieve oplossing werken.

Ook nadat de hoofdoorzaak is vastgesteld, loopt de weg naar een permanente oplossing vaak vast voordat een wijzigingsverzoek wordt gestart. Door deze gebrekkige aansluiting tussen problem management en verandermanagement blijven bekende fouten bestaan, terwijl ze opgelost hadden kunnen worden. Zo blijft de IT-omgeving kwetsbaar voor terugkerende serviceonderbrekingen.

We analyseren de tijd tussen de activiteit ‘Hoofdoorzaak vastgesteld’ en de gebeurtenis ‘Wijzigingsverzoek gestart’. Zo wordt duidelijk waar de overgang van problem management naar verandermanagement stroef verloopt. Permanente oplossingen kunnen daardoor verder zonder onnodige administratieve vertraging.

Als de levenscyclus van problem management te traag verloopt, blijven dezelfde incidenten binnenkomen bij de servicedesk. Medewerkers besteden daardoor kostbare tijd aan terugkerend werk. Dat gaat ten koste van de efficiëntie, leidt teams af van strategische projecten en tast het vertrouwen aan in het vermogen van IT om een stabiele omgeving te onderhouden.

ProcessMind vergelijkt het aantal gerelateerde incidenten met de duur van de onderzoeks- en oplossingsfasen. Zo zie je hoe trage probleemoplossing het aantal incidenten verhoogt. Dat helpt je onderbouwen waarom permanente oplossingen sneller moeten worden doorgevoerd om de druk op de servicedesk te verlagen.

Teams slaan de evaluatie na implementatie vaak over om registraties snel af te sluiten en achterstanden weg te werken. Zonder deze belangrijke stap controleren organisaties niet of de oplossing naar behoren werkt en leggen ze geleerde lessen niet vast. Daardoor kunnen vergelijkbare problemen zich opnieuw voordoen en komt verbetering van de dienstverlening op lange termijn in het gedrang.

ProcessMind houdt voor elk afgesloten probleem bij of de evaluatie na implementatie is uitgevoerd. Afwijkingen van het standaardproces worden zichtbaar, zodat je kunt controleren of alle stappen zijn gevolgd en voldoet aan de eisen voor verbetering van de dienstverlening en compliance.

Kritieke problemen halen de afgesproken serviceniveaus vaak niet door verborgen inefficiënties tijdens het onderzoek en de oplossing. Als deadlines niet worden gehaald, komt de stabiliteit van IT-diensten in gevaar. Ook kan het vertrouwen van de organisatie afnemen wanneer kritieke infrastructuur langer dan afgesproken instabiel blijft.

ProcessMind vergelijkt de SLA-deadlines met de werkelijke timestamps uit het bronsysteem en laat zien welke activiteiten tot overschrijdingen leiden. Zo kun je de serviceniveaus realtime volgen en prioriteiten of workflows aanpassen voordat deadlines worden gemist.

Als technici de hoofdoorzaak van een probleem niet goed categoriseren, kun je langetermijntrends en structurele zwakke plekken in de infrastructuur niet herkennen. Door deze ontbrekende data kan het management geen goed onderbouwde beslissingen nemen over investeringen in infrastructuur of proceswijzigingen die de stabiliteit verbeteren.

ProcessMind vindt registraties waarin het attribuut voor de hoofdoorzaak ontbreekt of een generieke waarde heeft. Door deze hiaten in de datakwaliteit zichtbaar te maken, helpen we organisaties de data-integriteit te verbeteren en beter te begrijpen waardoor IT instabiel wordt.

Veelvoorkomende doelen

Bepaal hoe succes eruitziet

Een snellere oorzaakanalyse voorkomt terugkerende incidenten en beperkt de uitval van infrastructuur. Als de onderzoeksfase korter duurt, kunnen technische teams minder tijd besteden aan steeds dezelfde brandjes en meer aan permanente oplossingen. Zo wordt de dienstverlening betrouwbaarder en blijven kritieke kwetsbaarheden minder lang onopgelost.

Process mining brengt het volledige onderzoeksproces in je systeem in beeld en laat zien waar teams vastlopen. Door bottlenecks bij specifieke supportgroepen of technische domeinen aan te wijzen, geeft het platform concrete aanknopingspunten om de onderzoeksduur te verkorten. Je kunt het traject van probleemmelding tot vaststelling van de hoofdoorzaak volgen en zien of elk onderzoek op koers ligt.

Elke overdracht tussen supportgroepen verlengt de totale oplostijd en zorgt voor extra administratief werk. Met minder overdrachten komen problemen sneller bij de juiste experts terecht. Zo voorkom je dat registraties heen en weer worden gestuurd doordat niet duidelijk is wie verantwoordelijk is. Dat maakt het proces efficiënter en vergroot de verantwoordelijkheid.

Ons platform houdt de geschiedenis van de toewijzingsvelden bij voor elke probleemregistratie in het bronsysteem. Je ziet patronen waarbij registraties verkeerd worden doorgestuurd of vaak tussen teams heen en weer gaan. Pas de routeringsregels voor groepen aan en beperk onnodige hertoewijzingen, zodat het onderzoek tijdens overdrachten niet stilvalt.

Met een snelle workaround beperk je de impact van een actief probleem op eindgebruikers en de servicedesk. Supportmedewerkers kunnen incidenten dan oplossen voordat er een permanente oplossing is. Dat verlaagt het aantal openstaande tickets en verbetert de gebruikerstevredenheid terwijl aan een definitieve oplossing wordt gewerkt.

Process mining analyseert de tijd tussen het vaststellen van een probleem en het publiceren van een workaround in de database met bekende fouten. Zo zie je hoe je deze belangrijke stap kunt standaardiseren en documentatie over bekende fouten sneller beschikbaar kunt maken. Teams kunnen zo worden aangesproken op het tijdig communiceren van tijdelijke oplossingen.

Het belangrijkste resultaat voor een team dat aan problem management werkt, is een afname van terugkerende incidenten. Door hoofdoorzaken vast te stellen en op te lossen, verlaag je de totale eigendomskosten van IT-diensten en de dagelijkse druk op de servicedesk. Zo wordt ook voor de rest van de organisatie duidelijk wat het proces oplevert.

Ons platform vergelijkt het aantal incidenten met specifieke probleemregistraties om te beoordelen of permanente oplossingen op lange termijn werken. Zo controleer je of oplossingen de hoofdoorzaak wegnemen in plaats van alleen de symptomen te behandelen. Volg het succes van doorgevoerde wijzigingen en controleer of ze het aantal incidenten terugbrengen zoals verwacht.

Een soepele overgang van een probleemregistratie naar een wijzigingsverzoek is belangrijk om permanente oplossingen gecontroleerd door te voeren. Vertraging in deze overgang betekent dat vastgestelde kwetsbaarheden langer dan nodig in de productieomgeving blijven. Dat vergroot het risico en doet afbreuk aan het onderzoekswerk.

Process mining brengt de digitale sporen tussen problem management en verandermanagement in je systeem in kaart en maakt knelpunten in goedkeuringen en overdrachten zichtbaar. Zo verklein je de afstand tussen het vaststellen van de hoofdoorzaak en het starten van een oplossing. Voorgestelde oplossingen blijven daardoor minder lang steken in administratieve procedures of goedkeuringswachtrijen.

Het halen van serviceniveauafspraken voor problemen met hoge prioriteit is belangrijk voor de bedrijfscontinuïteit en operationele stabiliteit. Consequent voldoen aan de afspraken versterkt het vertrouwen van belanghebbenden en zorgt dat problemen met de grootste impact snel aandacht krijgen. Zo beperk je de totale duur van kritieke serviceonderbrekingen.

Process mining vergelijkt de werkelijke prestaties met de SLA-doelen aan de hand van timestamps gedurende de levenscyclus van een registratie. Je ziet in welke procesfasen of supportgroepen SLA-overschrijdingen het vaakst voorkomen. Zo krijgen teams vroegtijdig een waarschuwing, kunnen ze voor alle prioriteitsniveaus aan de afspraken voldoen en ingrijpen voordat een deadline wordt gemist.

Leren van problemen uit het verleden is belangrijk om de dienstverlening voortdurend te verbeteren en herhaling te voorkomen. Door elk groot probleem te evalueren, leg je lessen vast en deel je ze. Zo voorkom je vergelijkbare problemen en groeit de volwassenheid van de IT-organisatie in de loop van de tijd.

Ons platform controleert of de evaluatie na implementatie is uitgevoerd voordat een registratie wordt afgesloten. Je ziet waar deze stap vaak wordt overgeslagen of vertraagd. Zo kun je naleving van het afgesproken proces bewaken en zorgen dat waardevolle kennis over elk groot probleem wordt vastgelegd en gedeeld binnen de servicedesk.

Nauwkeurige data vormt de basis voor goed problem management en trendanalyse op lange termijn. Betere categorieën voor hoofdoorzaken helpen bij strategische beslissingen en gerichte investeringen in technologie of training. Zo pak je structurele problemen in de IT-infrastructuur aan en verbeter je de stabiliteit op lange termijn.

Process mining analyseert de velden voor hoofdoorzaak en categorie in duizenden registraties. Zo worden inconsistenties, wijzigingen van categorie en overmatig gebruik van generieke categorieën zoals ‘overig’ zichtbaar. Met deze informatie kunnen managers de invoerafspraken aanscherpen en rapportages betrouwbaarder maken. Daardoor herken je opkomende technologietrends makkelijker in de data uit het bronsysteem.

Verbetergids voor problem management in 6 stappen

1

Data koppelen en ontdekken

Wat je moet doen

Koppel een databron, zoals een ERP- of servicemanagementsysteem, om activiteitenlogboeken van probleemregistraties op te halen. Importeer alle benodigde gebeurtenisdata voor de analyse, waaronder timestamps en case-ID’s.

Waarom dit belangrijk is

Met deze eerste stap zorg je voor een volledige en nauwkeurige dataset. Die vormt de basis om het werkelijke verloop en de prestaties van het proces voor problem management te begrijpen.

Verwacht resultaat

Een volledige en nauwkeurige dataset met activiteiten voor problem management is klaar voor analyse.

DIT LEVERT HET OP

Ontdek vandaag wat er echt in je processen gebeurt

ProcessMind brengt de werkelijke procesgang van je bedrijfsvoering in beeld met een objectief overzicht op basis van data. Het maakt inefficiënties en complianceproblemen zichtbaar die anders onopgemerkt blijven.
  • Breng de volledige procesgang in beeld
  • Spoor verborgen inefficiënties en bottlenecks op
  • Controleer of processen aan de regels voldoen
  • Zet bronnen doelgericht in
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

GEBRUIKELIJKE RESULTATEN

Waarde halen uit process mining voor problem management

Deze resultaten laten zien welke concrete verbeteringen organisaties bereiken met process mining voor workflows rond problem management. Met inzichten op basis van data kunnen teams bottlenecks vinden, problemen sneller oplossen en herhaling beter voorkomen.

0 %
Hoofdoorzaken sneller vinden

Gemiddelde verkorting van de onderzoeksduur

Als het traject van de start van een onderzoek tot het vaststellen van de hoofdoorzaak korter wordt, kunnen technische teams zich richten op permanente oplossingen in plaats van langdurige diagnoses. Zo beperk je kritieke serviceonderbrekingen.

0 %
Minder herstelwerk door overdrachten

Minder hertoewijzingen van probleemregistraties

Door bottlenecks in de eerste routering te vinden, komen probleemregistraties meteen bij de juiste experts terecht. Zo voorkom je verspilde inspanning en vertraging bij meerdere supportgroepen.

0 %
Betere naleving van SLA’s

Betere compliance voor kritieke problemen

Realtime inzicht in probleemregistraties die vastlopen helpt het management in te grijpen voordat serviceniveaudoelen worden gemist. Zo blijft de dienstverlening aan de organisatie op peil.

0 %
Minder herstelwerk bij het oplossen

Minder heropende probleemregistraties

Door oplossingen vóór afsluiting te controleren, weet je zeker dat de onderliggende problemen echt zijn verholpen. Zo voorkom je de kostbare cyclus waarin onderzoeken na een vermeende oplossing opnieuw beginnen en verbeter je de algehele stabiliteit.

0 %
Workarounds sneller beschikbaar

Tijdelijke oplossingen sneller publiceren

Door tijdelijke workarounds sneller te publiceren, beperk je de impact van lopende incidenten op eindgebruikers. Zo blijft de verstoring voor de organisatie kleiner terwijl aan een langetermijnoplossing wordt gewerkt.

0 %
Minder terugkerende incidenten

Minder gerelateerde tickets bij de servicedesk

Door hoofdoorzaken efficiënt vast te stellen en op te lossen en permanente oplossingen te publiceren, voorkom je dat nieuwe incidenten de servicedesk overspoelen. Ook dalen de totale supportkosten.

De resultaten hangen af van de complexiteit van het proces, de datakwaliteit en de gekozen aanpak. Deze cijfers geven gebruikelijke verbeteringen weer die bij verschillende implementaties van problem management zijn waargenomen.

Aanbevolen data

Begin met de belangrijkste attributen en activiteiten. Breid de selectie daarna zo nodig uit.

Attributen

Belangrijke datapunten voor de analyse

De unieke identificatiecode van een probleemregistratie, die één uitvoering van het probleembeheerproces vertegenwoordigt.

Waarom dit belangrijk is

Dit is de essentiële Case-ID waarmee alle bijbehorende gebeurtenissen worden gegroepeerd. Zo kun je het volledige verloop van elk probleemonderzoek volgen.

De naam van een specifieke gebeurtenis, taak of statuswijziging tijdens de levenscyclus van probleembeheer.

Waarom dit belangrijk is

Dit attribuut beschrijft de processtappen en maakt het mogelijk de processtroom te visualiseren en analyseren, inclusief veelvoorkomende routes en afwijkingen.

De exacte datum en tijd waarop een activiteit plaatsvond.

Waarom dit belangrijk is

De timestamp van elke activiteit is belangrijk om gebeurtenissen te ordenen en tijdsgebonden metrieken te berekenen, zoals doorlooptijden en de duur van bottlenecks.

Het technische team of de afdeling die op een bepaald moment verantwoordelijk is voor het onderzoeken en oplossen van het probleem.

Waarom dit belangrijk is

Belangrijk voor het analyseren van teamprestaties, het opsporen van bottlenecks door overdrachten en het begrijpen van de werkverdeling tussen teams.

De toegewezen prioriteit van het probleem, die bepaalt hoe dringend het onderzoek en de oplossing zijn.

Waarom dit belangrijk is

Maakt het mogelijk om te vergelijken hoe kritieke problemen en routineproblemen worden afgehandeld. Ook essentieel om na te gaan of SLA’s worden nagekomen.

De uiteindelijke indeling van de onderliggende oorzaak van het probleem.

Waarom dit belangrijk is

Belangrijk voor strategische analyses: hiermee herken je structurele problemen en trends in de oorzaken van problemen binnen de organisatie.

De belangrijkste bedrijfsdienst, applicatie of configuratie-item (CI) waarop het probleem invloed heeft.

Waarom dit belangrijk is

Geeft bedrijfscontext door technische problemen te koppelen aan de diensten waarop ze invloed hebben. Zo kun je prioriteiten bepalen op basis van het belang voor de bedrijfsvoering.

Het totale aantal afzonderlijke incidentregistraties dat aan het probleem is gekoppeld.

Waarom dit belangrijk is

Maakt de bedrijfsimpact van een probleem meetbaar. Zo kun je onderzoeken prioriteren en de effectiviteit van de oplossing beoordelen.

De datum en tijd waarop de probleemregistratie volgens de serviceafspraak opgelost moet zijn.

Waarom dit belangrijk is

Bepaalt de doelstelling voor de oplostijd en vormt de basis voor het meten en rapporteren van SLA-compliance.

Een markering die aangeeft of de oplossing van het probleem later kwam dan de toegewezen SLA-deadline.

Waarom dit belangrijk is

Geeft duidelijk aan of de SLA is gehaald. Zo kun je eenvoudig de procesroutes filteren en analyseren die tot overschrijdingen leiden.

Het aantal keren dat de probleemregistratie opnieuw is toegewezen aan een andere supportgroep of medewerker.

Waarom dit belangrijk is

Maakt inefficiënties in het proces meetbaar door overmatige overdrachten bij te houden. Die wijzen vaak op verkeerde routering, kennislacunes of onduidelijke verantwoordelijkheden.

Activiteiten

Processtappen om te volgen en te optimaliseren

Dit is het moment waarop een probleemregistratie wordt aangemaakt. Het markeert de formele start van het proces voor problem management en vormt het uitgangspunt voor alle volgende analyses.

Waarom dit belangrijk is

Deze activiteit is het startpunt van elke procesinstantie. De tijd tussen deze gebeurtenis en andere gebeurtenissen analyseren is belangrijk om de totale procesduur en vertragingen aan het begin te begrijpen.

Deze gebeurtenis markeert de overgang van een nieuwe of wachtende probleemregistratie naar een actief onderzoek. Dit betekent dat een analist officieel is begonnen met het vaststellen van de oorzaak.

Waarom dit belangrijk is

Met deze activiteit meet je de eerste reactietijd en de snelheid waarmee de achterstand wordt verwerkt. De tijd tussen het aanmaken van de registratie en de start van het onderzoek geeft aan hoe snel het team reageert.

Deze gebeurtenis geeft aan dat een tijdelijke oplossing of workaround is vastgelegd en beschikbaar is gemaakt. Zo blijft de impact op eindgebruikers beperkt terwijl aan een permanente oplossing wordt gewerkt.

Waarom dit belangrijk is

De tijd die nodig is om een workaround beschikbaar te maken, is een belangrijke KPI voor het meten van hoe snel het team de service kan herstellen. Met deze activiteit analyseer je de snelheid en effectiviteit van tijdelijke oplossingen.

Deze activiteit markeert het moment waarop de onderliggende oorzaak van het probleem is vastgesteld en vastgelegd. Hiermee is de onderzoeksfase afgerond.

Waarom dit belangrijk is

Dit is een belangrijke mijlpaal om de efficiëntie van diagnoses te meten. De tijd tussen de start van het onderzoek en het vaststellen van de hoofdoorzaak is een belangrijke prestatie-indicator voor probleemanalyse.

Deze gebeurtenis legt vast dat een formeel wijzigingsverzoek is aangemaakt of aan de probleemregistratie is gekoppeld. Dit markeert de overdracht van problem management naar verandermanagement om een permanente oplossing door te voeren.

Waarom dit belangrijk is

Deze activiteit is belangrijk om de vertraging tussen de diagnose van een probleem en het starten van een oplossing te analyseren. Zo vind je bottlenecks op het snijvlak van problem management en verandermanagement.

Deze gebeurtenis geeft aan dat de permanente technische oplossing, vaak via een wijzigingsverzoek, succesvol is uitgerold. Hiermee is het herstelwerk afgerond.

Waarom dit belangrijk is

Met deze activiteit eindigt de fase waarin de oplossing wordt doorgevoerd. De tijd tussen het starten van de wijziging en dit moment geeft aan hoe efficiënt verandermanagement problemen oplost.

Dit is de laatste activiteit in de levenscyclus. De probleemregistratie wordt administratief afgesloten en er worden geen verdere acties verwacht. De case geldt als afgerond en wordt gearchiveerd.

Waarom dit belangrijk is

Dit is voor de meeste procesinstanties het eindpunt. Het is belangrijk om hiermee de totale doorlooptijd van het proces voor problem management te berekenen.

Voor aangepaste data-aanbevelingen, kies je specifieke proces.

Veelgestelde vragen

Veelgestelde vragen

Process mining brengt het werkelijke verloop van elke probleemregistratie in beeld. Zo worden afwijkingen van standaardworkflows en verborgen bottlenecks zichtbaar. Het geeft teams een datagedreven beeld van het proces, waarmee ze de efficiëntie kunnen verbeteren en problemen sneller kunnen oplossen.

Meestal heb je een event log nodig met een unieke case-ID, een timestamp voor elke activiteit en een omschrijving van de activiteit. Attributen zoals statuswijzigingen, toegewezen groepen, prioriteit en categorie geven meer context voor de analyse.

De eerste inzichten zijn vaak binnen enkele dagen tot een paar weken beschikbaar, zodra de data-extractie uit het bronsysteem is ingericht. In de eerste fase koppel je het systeem en breng je de belangrijkste proceswijzigingen in kaart om een basismodel te maken.

Process mining laat zien waar onderzoeken vastlopen door de duur van elke overgang te meten. Het wijst op ontbrekende capaciteit of informatie die de onderzoeksfase verlengt. Zo vervang je aannames door feitelijke data over waar vertraging ontstaat.

Door elke overgang in kaart te brengen, vindt process mining registraties die herhaaldelijk tussen supportgroepen heen en weer gaan zonder dat het probleem wordt opgelost. Zo herkennen managers onduidelijk eigenaarschap of situaties waarin teams niet over de middelen beschikken om bepaalde problemen af te handelen. Deze inzichten helpen bij het herontwerpen van processen en een betere verdeling van middelen.

Process mining laat het exacte verloop zien van registraties die de doelen niet hebben gehaald en helpt zo de oorzaken van SLA-overschrijdingen te vinden. Vergelijk registraties die wel en niet aan de afspraken voldoen om te zien of bepaalde supportgroepen of probleemtypen vaker vertraging oplopen. Zo kun je gericht ingrijpen en zorgen dat problemen met prioriteit binnen de afgesproken tijd worden afgehandeld.

Door de koppeling tussen incident- en probleemregistraties te analyseren, vindt process mining patronen waarbij problemen steeds met workarounds worden aangepakt in plaats van met permanente oplossingen. Zo kun je oplossingen met veel impact voorrang geven en hele reeksen terugkerende supporttickets voorkomen.

Standaardrapportages geven momentopnamen en samengevoegde metingen, maar laten vaak het werkelijke verloop van een probleemregistratie buiten beeld. Process mining toont de specifieke overgangen, lussen en afwijkingen tussen die metingen. Je ziet precies waar en waarom een proces vastloopt. Zo vullen de analyses standaardrapportages aan met een beeld van het procesverloop over tijd, waarmee je gericht kunt verbeteren.

Verbeter het probleembeheer, begin nu

Spoor inefficiënties op en los problemen sneller op met inzichten op basis van data.

Start je gratis proefperiode

Geen creditcard nodig. Binnen enkele minuten ingesteld.