Verbeter je probleembeheer
Volg deze gids in 6 stappen om je workflow te optimaliseren.
Verbeter je probleembeheer
Probleembeheer
Zendesk Support

Selecteer een proces

Kies een proces om verder te werken in de gekoppelde workspace.

259 Processen

Verbeter probleembeheer in Zendesk Support voor stabiele IT

Process mining brengt verborgen bottlenecks en structurele vertragingen aan het licht die bij handmatige controles vaak onopgemerkt blijven. Ons platform laat zien waar tickets vastlopen of herhaaldelijk tussen teams heen en weer gaan. Zo zie je waar het proces van probleemoplossing beter kan. Met dat overzicht kan je team zich richten op oplossingen met veel impact, in plaats van op administratief werk.

Download onze vooraf ingestelde datatemplate en pak veelvoorkomende uitdagingen aan om je efficiëntie-doelen te bereiken. Volg ons verbeterplan in zes stappen en raadpleeg de gids voor de datatemplate om je bedrijfsvoering te verbeteren.

Gedetailleerde beschrijving tonen

Waarom optimalisatie van Probleembeheer essentieel is voor IT-stabiliteit

Probleembeheer vormt de basis voor een stabiele IT-infrastructuur. Incidentbeheer richt zich op het zo snel mogelijk herstellen van de dienstverlening. Bij Probleembeheer draait het om het vinden en wegnemen van de onderliggende oorzaken van incidenten. In een Zendesk Support-omgeving blijven veel organisaties brandjes blussen. Dezelfde problemen keren week na week terug, omdat de oorzaak nooit goed is aangepakt. Dat kost veel geld: de operationele kosten lopen op, de beschikbaarheid van diensten neemt af en het supportteam raakt gefrustreerd omdat het steeds hetzelfde werk doet.

Dit proces optimaliseren gaat niet alleen om snelheid, maar ook om nauwkeurigheid en preventie. Door de workflow voor Probleembeheer te verbeteren, neemt het totale aantal binnenkomende incidenten na verloop van tijd af. Zo kunnen je meest ervaren technische medewerkers zich richten op projecten die waarde toevoegen, in plaats van steeds dezelfde problemen op te lossen. Zonder duidelijk zicht op de route die problemen door je systeem afleggen, is het bijna onmogelijk om te zien waar onderzoek vastloopt of waarom oplossingen op zich laten wachten.

Hoe process mining inzicht geeft in de levenscyclus in Zendesk

Process mining laat zien hoe problemen daadwerkelijk door Zendesk lopen, door de route van elk probleemrecord te reconstrueren op basis van de data. In plaats van alleen statische rapporten met gemiddelde oplostijden te bekijken, zie je de gebeurtenissen in de volgorde waarin ze echt plaatsvonden. Je kunt elke stap volgen, vanaf het moment dat een probleem wordt vastgesteld tot en met de evaluatie na implementatie. Zo zie je het verschil tussen het proces zoals het is vastgelegd en de manier waarop het werk in de praktijk verloopt.

Door het digitale spoor van technische teams te analyseren, laat process mining precies zien waar de voortgang stokt. Misschien ontdek je bijvoorbeeld dat probleemrecords vaak blijven liggen nadat een workaround is gevonden, omdat de urgentie om een permanente oplossing door te voeren dan wegvalt. Process mining brengt zulke verborgen patronen en bottlenecks aan het licht, zoals veel overdrachten tussen supportgroepen of lange wachttijden op goedkeuring van wijzigingsverzoeken. Met deze aanpak hoef je niet te gissen waar je het proces kunt verbeteren. Je richt je op de stappen waar de meeste winst te behalen valt.

Belangrijke verbeterpunten in het onderzoeksproces

Een veelvoorkomend verbeterpunt in Zendesk Support is de overdracht tussen Tier 2-support en gespecialiseerde engineeringteams. Process mining laat zien of die overdrachten soepel verlopen of dat problemen verdwijnen in wachtrijen zonder toegewezen eigenaar. Door te kijken naar de tijd in de fase Investigation Commenced, kun je nagaan of teams over de juiste middelen en informatie beschikken voor een goede oorzaakanalyse. Duurt het onderzoek steeds lang, dan is er mogelijk behoefte aan een betere koppeling met de kennisbank of meer gestandaardiseerde diagnoseprocedures.

Een ander belangrijk aandachtspunt is de tijd tussen een voorgestelde oplossing en de uitvoering van een permanente oplossing. Bij veel organisaties wordt een oplossing uitgewerkt, maar blijft die vervolgens in de backlog staan omdat het verandermanagementproces niet goed aansluit of te bureaucratisch is. Process mining laat precies zien hoe lang deze vertragingen duren. Je kunt ook nagaan hoe goed workarounds werken. Wordt een workaround gepubliceerd, maar blijven incidenten even vaak escaleren, dan is die oplossing misschien lastig te vinden of niet effectief. Dat vraagt om een andere aanpak.

De voordelen van een efficiënter oplossingsproces

Als je Probleembeheer goed optimaliseert, merkt de hele organisatie daar iets van. Een van de eerste resultaten is een meetbare verkorting van de doorlooptijd van oorzaakanalyses. Onderzoeken verlopen sneller, permanente oplossingen worden eerder ingevoerd en het aantal terugkerende incidenten neemt af. Dat draagt bij aan betere naleving van service level agreements en meer vertrouwen bij stakeholders in de organisatie.

Een beter ingericht proces verbetert niet alleen de snelheid, maar ook de kwaliteit van technische oplossingen. Door elk probleem grondig te controleren na de oplossing en na implementatie te evalueren, voorkom je dat er nieuwe problemen ontstaan. Zo ontstaat een cyclus van voortdurende verbetering: elk opgelost probleem maakt het systeem stabieler. Technische medewerkers raken bovendien minder snel overbelast, omdat ze minder tijd kwijt zijn aan terugkerende problemen en meer aan complexe, uitdagende oplossingen.

Aan de slag met datagedreven Probleembeheer

Wil je het proces voor Probleembeheer in Zendesk Support verbeteren, vertrouw dan niet alleen op ervaringen en anekdotes, maar kijk naar de procesdata. Breng eerst de huidige situatie in kaart en zoek naar verbeteringen die snel resultaat opleveren, zoals stappen met lange wachttijden of supportgroepen die structureel te veel werk hebben. Gebruik deze inzichten om haalbare doelen voor technische teams vast te stellen en de benodigde middelen voor complexere oorzaakanalyses te onderbouwen. Blijf de processtromen volgen wanneer je veranderingen doorvoert. Zo zie je of verbeteringen standhouden en of er nieuwe bottlenecks ontstaan. Je supportorganisatie omvormen tot een team dat problemen voorkomt in plaats van alleen oplost, kost tijd. Met goed zicht op de workflows in Zendesk is dat wel haalbaar.

Probleembeheer IT-servicemanagement Oorzaakanalyse Incidenten verminderen Servicedeskmanager Wijzigingsverzoeken beheren SLA-compliance Ticketafhandeling Ticketbeheer Bekende fout Terugkerende incidenten Tijdelijke oplossing Incidenten voorkomen IT-helpdesk

Veelvoorkomende problemen en uitdagingen

Bekijk welke uitdagingen voor jou spelen

Langdurige onderzoeksfasen zorgen er vaak voor dat kritieke problemen wekenlang onopgelost blijven. Zo stapelen technische schuld en terugkerende incidenten zich op. Als oorzaakanalyses te lang duren, blijft het supportteam vooral reageren op problemen. Dat tast de stabiliteit van IT-diensten aan en verhoogt de werkdruk voor medewerkers van Zendesk Support. Vertraging ontstaat vaak doordat het onderzoekspad onduidelijk is of teams tijdens het oplossen van problemen geen toegang hebben tot historische data.

Onze oplossing brengt de tijdlijn van Problem Identification tot Root Cause Identified in kaart en laat precies zien waar onderzoeken vastlopen. Door de processtroom tussen verschillende supportgroepen zichtbaar te maken, kun je bottlenecks in de inzet van medewerkers opsporen en overdrachten verbeteren, zodat permanente oplossingen sneller worden doorgevoerd. Zo kunnen technische teams zich richten op onderzoeken met veel impact, in plaats van tijd te verliezen aan administratieve vertragingen.

Als problemen niet bij de bron worden aangepakt, blijven dezelfde incidenten de servicedesk overspoelen. Dat kost tijd en middelen. Door deze cyclus van brandjes blussen komt het team niet toe aan verbeteringen en raken eindgebruikers gefrustreerd omdat ze steeds met dezelfde verstoringen te maken krijgen. Zonder duidelijk verband tussen incidenten en de oorzaken blijft de organisatie betalen voor dezelfde fouten.

We analyseren het verband tussen probleemrecords en het aantal incidenten in Zendesk Support. Zo zie je welke problemen de meeste verstoringen veroorzaken. Process mining laat zien of workarounds als permanente oplossing worden gebruikt, in plaats van het onderliggende probleem via een formeel wijzigingsverzoek aan te pakken. Zo kun je problemen prioriteren op basis van de daadwerkelijke afname van incidenten en de werkdruk bij de servicedesk.

Als technische teams tijdelijke oplossingen vinden maar die niet in de kennisbank publiceren, kunnen medewerkers aan de frontlinie gebruikers niet snel helpen. Door dit gebrek aan informatieoverdracht duren incidenten langer om op te lossen, terwijl het probleemrecord open blijft staan voor onderzoek. Waardevolle kennis blijft vaak steken in privénotities of e-mailwisselingen, in plaats van gedeeld te worden via Zendesk Support.

ProcessMind volgt de overgang van Workaround Identified naar Workaround Published, zodat kennisdeling een vast onderdeel van de workflow wordt. We signaleren cases waarin workarounds wel zijn gevonden, maar niet zijn vastgelegd. Zo kun je het kennisbeheer verbeteren en ervoor zorgen dat iedereen die incidenten oplost meteen toegang heeft tot bekende workarounds. Gebruikers hoeven dan minder lang op een oplossing te wachten.

Als oplostijden voor probleemrecords met hoge prioriteit niet worden gehaald, kan dat de bedrijfsvoering ernstig verstoren en de productiviteit verlagen. Zonder duidelijk zicht op de voortgang van deze records is het lastig om middelen goed in te zetten en afgesproken serviceniveaus te halen. Organisaties zien vaak niet in welke fase van de levenscyclus van een probleem de meeste SLA-overschrijdingen ontstaan.

Door het attribuut SLA Due Date te vergelijken met de realtime voortgang van het proces, signaleert ons platform records die het risico lopen de deadline te missen. Je ziet welke supportgroepen moeite hebben om kritieke problemen voortvarend op te lossen en kunt de werkverdeling in Zendesk Support aanpassen. Zo houd je zicht op de naleving van service level agreements en krijgen problemen met veel impact de aandacht die ze nodig hebben.

Probleemrecords gaan vaak heen en weer tussen supportgroepen zonder dat er echte voortgang wordt geboekt. Dat leidt tot onnodige vertraging. Onduidelijk eigenaarschap, ontbrekende informatie bij overdrachten of een gebrek aan verantwoordelijkheid tijdens het onderzoek zijn vaak de oorzaak. Door dit heen en weer loopt de totale leeftijd van het probleemrecord op, zonder dat een permanente oplossing dichterbij komt.

Onze process mining-tool maakt de stroom van problemen tussen Assigned Support Groups zichtbaar. Zo kun je rondgaande overdrachten en wachttijd opsporen. Dit inzicht helpt om eigenaarschap duidelijker af te bakenen en informatie bij overdrachten te verbeteren. Als je weet bij welke groepen problemen blijven hangen, kun je gerichte training geven of het proces in Zendesk Support aanpassen om de samenwerking tussen teams te verbeteren.

De oorzaak vinden is nog maar het halve werk. Veel organisaties hebben moeite om van een gevonden oplossing naar een uitgevoerde permanente oplossing te komen. Als wijzigingsverzoeken laat worden gestart of oplossingen niet worden doorgevoerd, blijft de omgeving kwetsbaar voor nieuwe incidenten, ook als de oorzaak bekend is. Die kloof tussen kennis en actie ontstaat vaak doordat probleembeheer en verandermanagement niet goed op elkaar aansluiten.

We volgen de levenscyclus van Proposed Solution Drafted tot Permanent Fix Applied om knelpunten bij de uitvoering op te sporen. Zo kun je meten hoe goed de aansluiting op verandermanagement werkt en nagaan of gevonden oplossingen op tijd worden doorgevoerd. Door te zien hoeveel tijd er op goedkeuring van wijzigingen wordt gewacht, kun je de workflow tussen technische analyse en praktische oplossing verbeteren.

Als de evaluatie na implementatie wordt overgeslagen, mist de organisatie kansen om van complexe problemen te leren en herhaling te voorkomen. Zonder een vaste terugkoppeling worden dezelfde inefficiënties waarschijnlijk opnieuw onderdeel van volgende onderzoeken. Doordat problemen niet formeel worden afgesloten, blijft voortdurende verbetering van de dienstverlening uit en stagneert de ontwikkeling van IT.

ProcessMind signaleert probleemrecords die rechtstreeks van Resolution Verified naar Closed gaan, zonder evaluatie. Zo zie je waar stappen ontbreken en kun je ervoor zorgen dat het team de volledige levenscyclus in Zendesk Support volgt en inzichten vastlegt voor voortdurende verbetering. Met deze datagedreven aanpak draagt elk groot probleem bij aan de kennis binnen de organisatie en aan betere preventieve maatregelen.

Als probleemrecords verkeerd zijn gecategoriseerd of specifieke attributen voor de oorzaak missen, is een bruikbare trendanalyse bijna onmogelijk. Door deze problemen met de datakwaliteit blijven de werkelijke oorzaken van IT-instabiliteit verborgen en kan het management geen goed onderbouwde beslissingen nemen over investeringen in de infrastructuur. Als Problem Category niet overeenkomt met de werkelijke oorzaak, berust de langetermijnplanning op verkeerde aannames.

We analyseren hoe attributen zoals Problem Category en Root Cause Category tijdens het proces in Zendesk Support worden gebruikt. Door te signaleren waar data ontbreekt of pas laat in de levenscyclus wordt gewijzigd, kun je de invoer verbeteren en nauwkeuriger inzicht krijgen in probleemdata. Zo zie je welke bedrijfsdiensten of configuratie-items de meeste investeringen en aandacht nodig hebben.

Teams vertrouwen soms eindeloos op tijdelijke workarounds om de complexiteit van een permanente oplossing te vermijden. Daarmee verhelpen ze misschien het directe symptoom, maar de onderliggende infrastructuur blijft instabiel en de onderhoudslast voor de IT-afdeling neemt op de lange termijn toe. Na verloop van tijd maken al die tijdelijke maatregelen de omgeving kwetsbaar, waardoor kleine wijzigingen grote verstoringen kunnen veroorzaken.

Ons platform signaleert probleemrecords die lang openstaan nadat een workaround is gepubliceerd, zonder dat er een wijzigingsverzoek is gestart. Zo zie je waar tijdelijke maatregelen moeten worden vervangen door een permanente oplossing en kun je de technische schuld beperken. Door bij te houden hoeveel tijd er sinds de publicatie van de workaround is verstreken, kun je het team aansporen om aan een stabielere oplossing voor de lange termijn te werken.

Veel probleemrecords worden geopend, maar nooit afgerond. Ze blijven maandenlang actief zonder updates. Deze records maken de wachtrij onoverzichtelijk, vertekenen prestatiecijfers en vormen onopgeloste risico’s voor de bedrijfsomgeving. Teams vergeten ze vaak wanneer ze verdergaan met urgentere incidenten. Uiteindelijk kan het onderliggende probleem opnieuw tot een crisis leiden.

We signaleren automatisch records met lange perioden zonder activiteit tussen stappen zoals Investigation Commenced en Proposed Solution Drafted. Zo kunnen managers de backlog controleren en onderzoeken die zijn vastgelopen weer op gang brengen, of records sluiten die niet meer relevant zijn in Zendesk Support. Door inactieve records op te ruimen, krijg je een veel nauwkeuriger beeld van de capaciteit en werkvoorraad voor Probleembeheer.

Veelvoorkomende doelen

Bepaal hoe succes eruitziet

Snel de oorzaak vinden is belangrijk, want zolang onderzoeken duren, blijven systemen kwetsbaar. Als je de tijd tot het vinden van de oorzaak verkort, beperk je mogelijke verstoringen van de bedrijfsvoering en blijft de dienstverlening in de hele organisatie beschikbaar. Met snellere onderzoeken kunnen IT-teams overstappen van reactief problemen oplossen naar proactief werken aan stabiliteit.

ProcessMind brengt de route van probleemidentificatie tot het vinden van de oorzaak in Zendesk Support in kaart. Het laat zien in welke stappen onderzoeken vastlopen, zodat managers technische experts anders kunnen inzetten en diagnoseprocedures kunnen verbeteren. Door deze bottlenecks aan te pakken, kunnen organisaties de duur van de onderzoeksfase met maximaal 30 procent verkorten.

Als incidenten vaak terugkeren, worden structurele problemen niet bij de bron opgelost. Door de oorzaak aan te pakken in plaats van alleen de symptomen, kunnen IT-teams de totale supportkosten verlagen en de tevredenheid van gebruikers verbeteren. Goed Probleembeheer leidt op termijn tot minder tickets in de wachtrij van Zendesk Support.

Met process mining kunnen teams probleemrecords vergelijken met patronen van veelvoorkomende incidenten. ProcessMind laat zien welke oplossingen herhaling voorkomen en welke de onderliggende oorzaak niet wegnemen. Zo kun je problemen aanpakken die de meeste incidenten veroorzaken en het aantal terugkerende tickets met 20 procent verlagen.

Een goede workaround biedt direct verlichting terwijl aan een permanente oplossing wordt gewerkt. Als workarounds snel worden vastgelegd en gepubliceerd, hebben eindgebruikers minder last van uitval en kunnen medewerkers van de servicedesk gerelateerde incidenten sneller oplossen. Met een vaste aanpak blijft technische kennis niet binnen één team hangen.

ProcessMind houdt in Zendesk Support bij hoeveel tijd er zit tussen het vinden van een workaround en de publicatie ervan in de kennisbank. Het signaleert tijdelijke oplossingen die wel bekend zijn, maar niet worden gedeeld. Zo wordt informatie beter verspreid. Dit inzicht helpt om workarounds vaker beschikbaar te maken en de gemiddelde tijd tot herstel van bekende problemen te verkorten.

Het is belangrijk om service level agreements voor problemen met hoge prioriteit na te leven, zodat de stabiliteit van bedrijfskritische diensten behouden blijft. Als je deze doelen consequent haalt, groeit het vertrouwen van stakeholders en krijgen de problemen met de grootste impact de aandacht die ze nodig hebben. Het niet halen van deze doelen kan leiden tot nieuwe storingen en productiviteitsverlies.

ProcessMind geeft realtime inzicht in de SLA-status van alle actieve probleemrecords. Het laat zien welke procesroutes tot gemiste deadlines leiden, zodat managers kunnen ingrijpen voordat een deadline wordt overschreden. Met deze inzichten kunnen organisaties alle kritieke problemen binnen de afgesproken termijn oplossen door vertragingen in het escalatieproces weg te nemen.

Voor problemen is vaak samenwerking nodig tussen meerdere gespecialiseerde technische teams. Goede overdrachten tussen groepen voorkomen informatieverlies en beperken de wachttijd die vaak bij complexe problemen ontstaat. Als overdrachten beter verlopen, doorloopt het hele proces de stappen sneller en neemt het aantal communicatiefouten af.

Het platform maakt overdrachtsmomenten tussen supportgroepen in Zendesk Support zichtbaar. Door de wachttijd bij elke overdracht te meten, helpt ProcessMind om silo’s op te sporen en de communicatie te verbeteren. Managers kunnen de afspraken voor overdrachten aanpassen, zodat probleemrecords minder lang op een wachtstatus blijven staan wanneer ze tussen groepen worden overgedragen.

Zodra de oorzaak is gevonden, moet de aandacht naar de uitvoering gaan. Door de tijd tussen het onderzoek en het starten van een wijzigingsverzoek te verkorten, kunnen systemen zo snel mogelijk weer stabiel worden. Administratieve obstakels of slechte afstemming tussen afdelingen veroorzaken vaak vertraging in deze fase.

ProcessMind analyseert hoeveel tijd er verstrijkt tussen het vaststellen van de oorzaak en het aanmaken van een wijzigingsverzoek of het doorvoeren van een oplossing. Zo worden administratieve obstakels zichtbaar die de overgang van diagnose naar oplossing vertragen. Door deze overdracht te verbeteren, kunnen organisaties de totale oplostijd van complexe IT-problemen verkorten.

Evaluaties na implementatie zijn belangrijk voor voortdurende procesverbetering en om als organisatie te leren. Door elk groot probleem formeel te evalueren, kunnen organisaties leren van eerdere fouten en voorkomen dat vergelijkbare problemen elders ontstaan. Zonder deze evaluaties worden dezelfde procesfouten waarschijnlijk steeds opnieuw gemaakt.

Process mining houdt bij hoe vaak evaluaties worden afgerond nadat een probleemrecord in Zendesk Support is gesloten. Het laat zien welke teams of categorieën deze stap vaak overslaan, zodat je de procesafspraken gericht kunt handhaven. Als evaluaties vaker worden uitgevoerd, draagt elk groot incident bij aan de kennis binnen de organisatie.

Een juiste categorisering is de basis voor bruikbare trendanalyses en planning van de inzet van medewerkers. Met nauwkeurige data kun je middelen richten op de gebieden die de kwaliteit van IT-diensten en de bedrijfsresultaten het meest beïnvloeden. Kloppen de categorieën niet, dan zijn managementrapportages onbetrouwbaar en zijn oorzaken moeilijker te vinden.

ProcessMind signaleert patronen waarbij de categorie tijdens de levenscyclus van een probleem wordt gewijzigd. Door te zien waar de eerste classificatie vaak niet klopt, kunnen managers de training en afspraken voor gegevensinvoer verbeteren. Betere datakwaliteit bij de bron leidt tot nauwkeurigere rapportages en betere strategische beslissingen over investeringen in IT-infrastructuur.

Als teams te veel op workarounds vertrouwen, ontstaat technische schuld en wordt de bedrijfsvoering op de lange termijn instabieler. Het uiteindelijke doel van Probleembeheer is tijdelijke oplossingen vervangen door permanente oplossingen die de onderliggende kwetsbaarheid wegnemen. Een belangrijke maatstaf voor succes is dat problemen niet eindeloos met een workaround worden afgedaan.

Het platform houdt bij hoeveel problemen langdurig in een workaroundstatus blijven staan. De data helpt onderbouwen hoeveel technische inspanning nodig is om permanente oplossingen door te voeren, in plaats van problemen steeds tijdelijk op te lossen. Zo neemt de onderhoudslast voor technische teams op de lange termijn af en wordt het systeem als geheel betrouwbaarder.

Open probleemrecords zonder activiteit wijzen op risico’s die niet worden aangepakt. Met een actuele backlog kan het IT-team zich richten op de prioriteiten van nu, in plaats van een steeds langere lijst met stilstaande records bij te houden. In zulke records kunnen onopgeloste problemen verborgen zitten die later tot grote storingen leiden.

ProcessMind signaleert inactieve probleemrecords in Zendesk Support op basis van de tijd sinds de laatste activiteit of statuswijziging. Managers kunnen meldingen instellen of records opnieuw laten toewijzen als ze binnen een bepaalde termijn niet verder komen. Zo blijft geen enkel probleemrecord vergeten en blijft de backlog beheersbaar.

Problemen met hoge prioriteit hebben de grootste impact op de bedrijfsvoering en omzet. Door deze problemen sneller en vaker op te lossen, bescherm je de belangrijkste diensten en bedrijfsmiddelen. Een hoog oplossingspercentage voor kritieke problemen is een belangrijke graadmeter voor goed Probleembeheer.

ProcessMind biedt een verdieping in de levenscyclus van probleemrecords met hoge prioriteit en vergelijkt die met standaardrecords. Je ziet of kritieke problemen met de juiste urgentie worden behandeld en waar procedurele obstakels zitten. Zo kunnen teams het belangrijkste werk voorrang geven en een groter deel van de kritieke problemen binnen de afgesproken termijn oplossen.

Onderzoek naar problemen kan veel middelen kosten en senior engineers uren werk bezorgen. Door het analyseproces te verbeteren, kunnen deze experts minder tijd besteden aan administratie en meer aan complexe technische problemen en innovatie. Lagere analysekosten maken Probleembeheer als geheel beter vol te houden.

ProcessMind brengt de benodigde arbeidsuren en doorlooptijd van verschillende soorten onderzoeken in kaart en laat zien welke oplossingsroutes het efficiëntst zijn. Met deze data kun je goede werkwijzen standaardiseren bij alle technische supportteams. Zo kunnen organisaties de gemiddelde kosten per opgeloste probleem verlagen en tegelijk de kwaliteit op peil houden.

Het 6-stappenplan voor Probleembeheer in Zendesk

1

Download de template

Wat je moet doen

Download de vooraf ingestelde Excel-template voor de datastructuur van Probleembeheer in Zendesk.

Waarom dit belangrijk is

Met een standaardindeling sluiten probleemrecords en ticketkoppelingen goed aan op de analyse-engine.

Verwacht resultaat

Een direct te gebruiken datatemplate voor het volgen van problemen in Zendesk.

JOUW ONTDEKKINGEN

Vind de oorzaken en los vertragingen in probleembeheer op

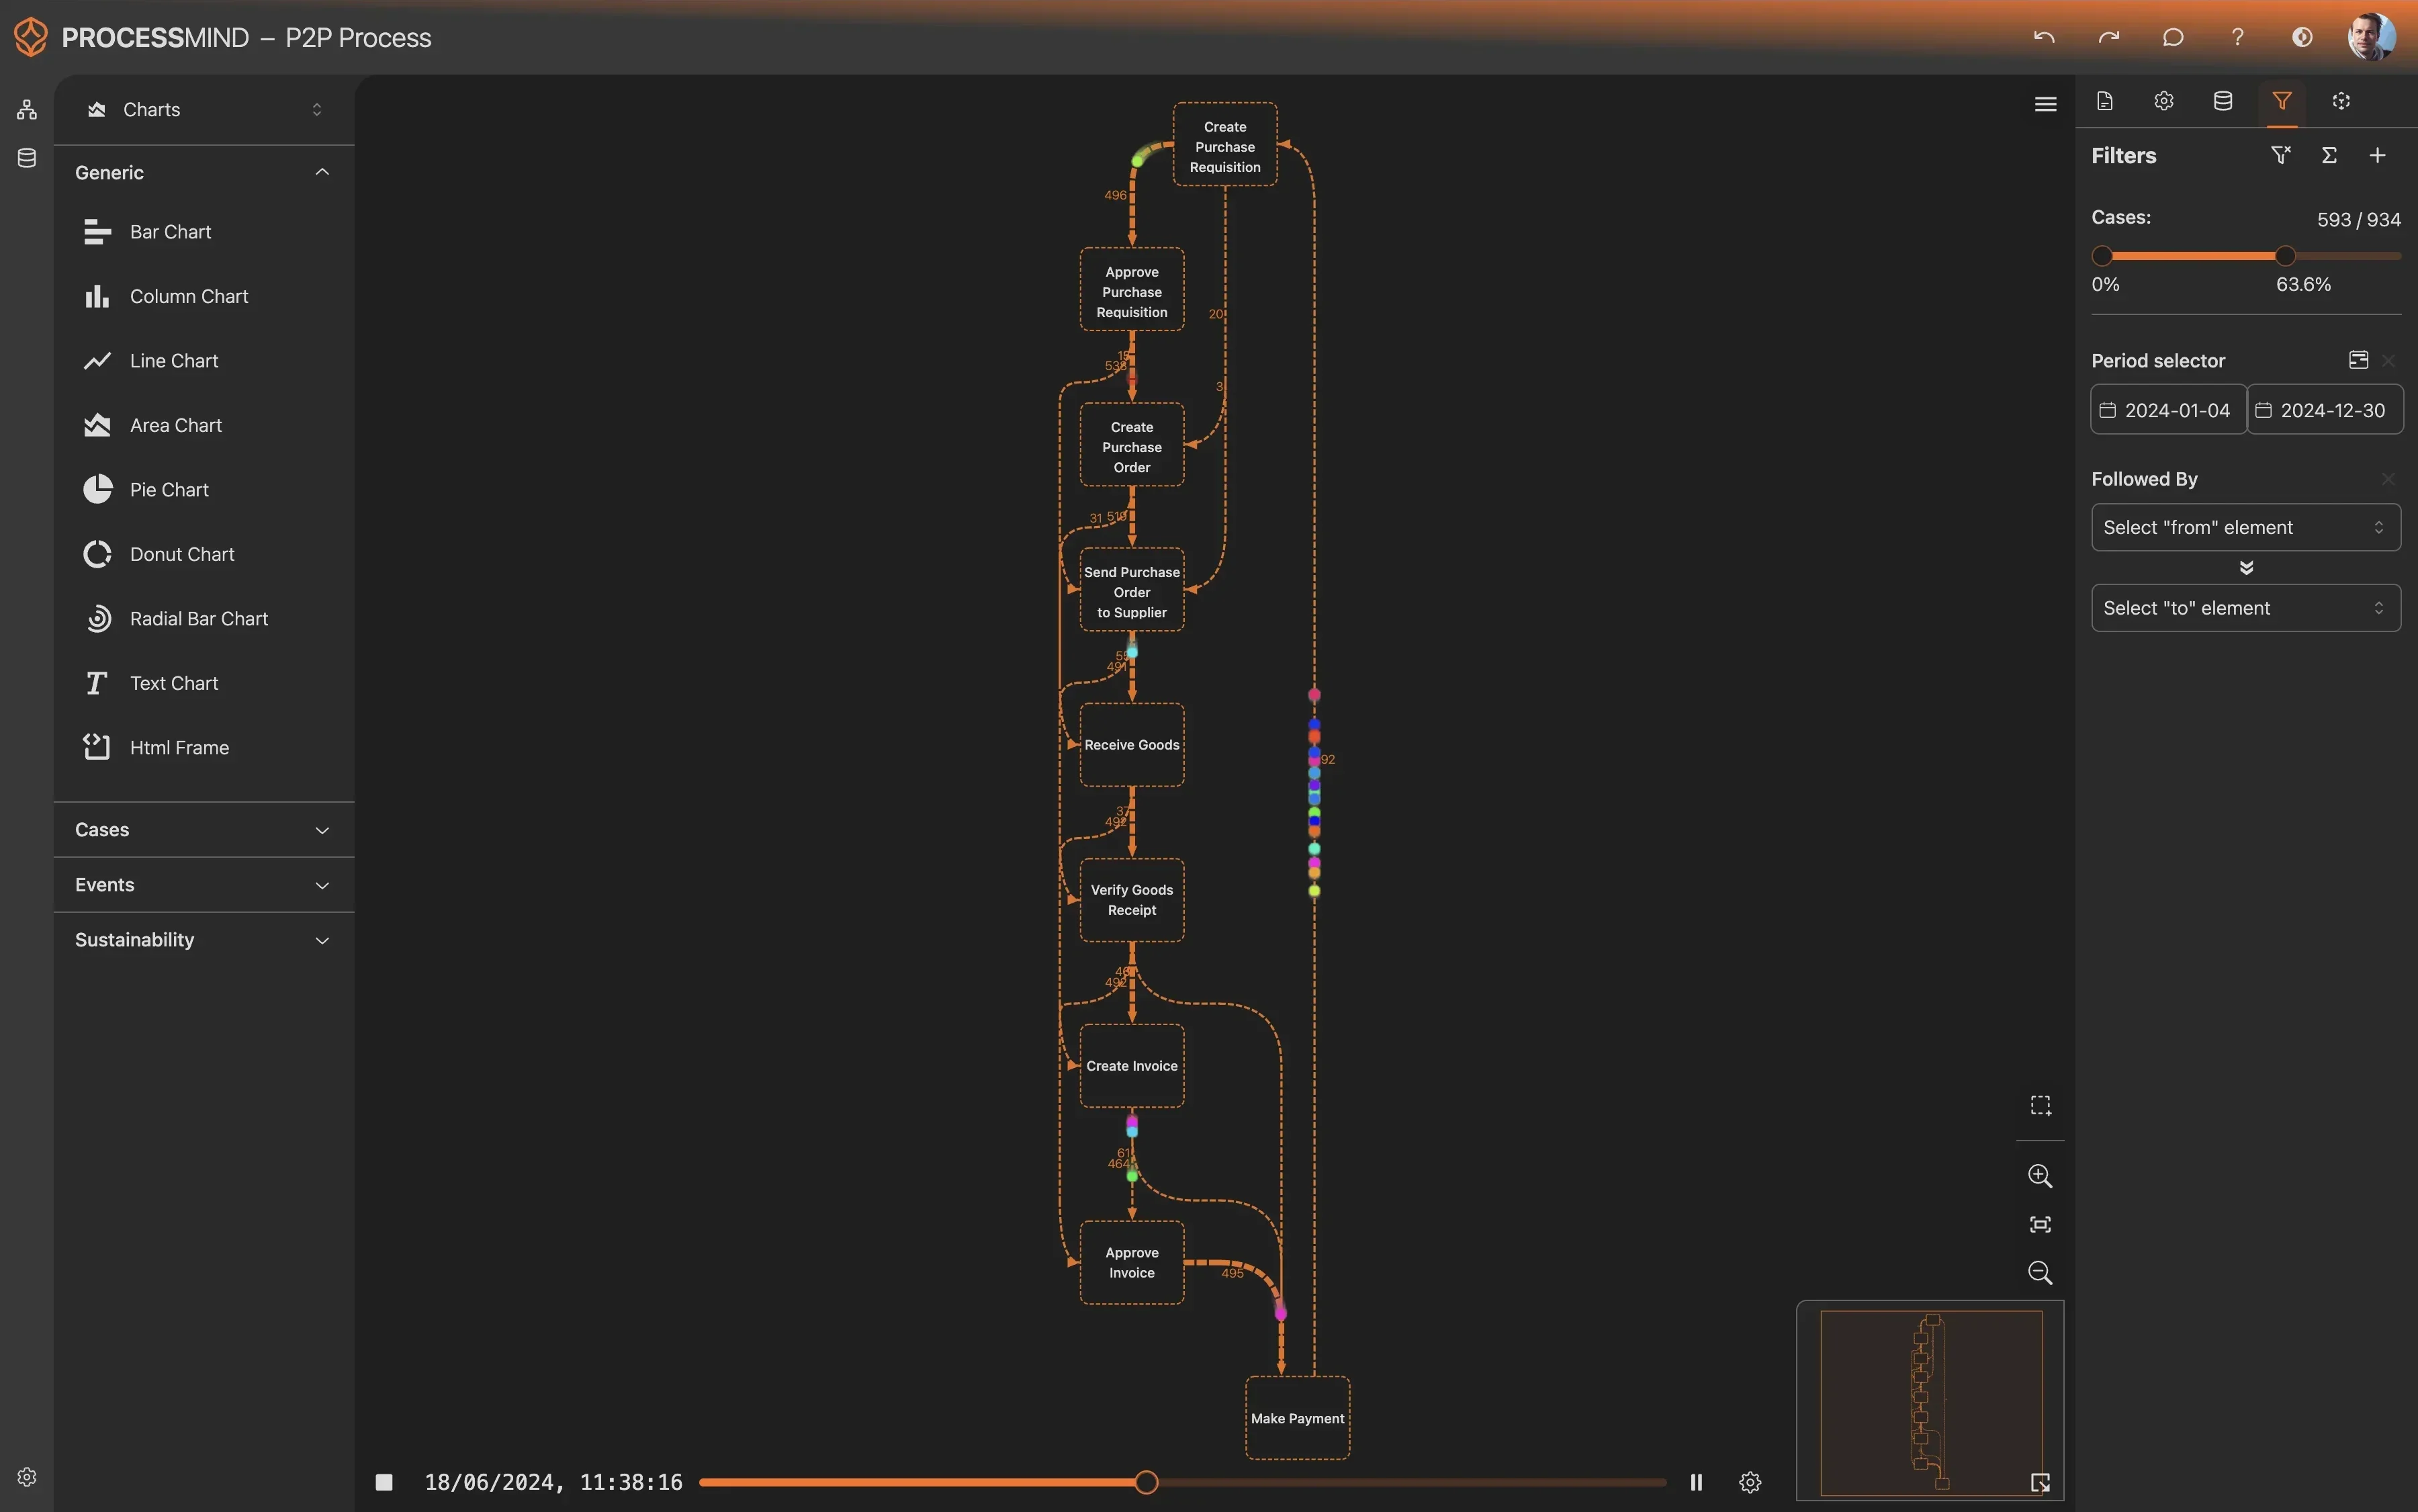
ProcessMind brengt je Zendesk-workflows in kaart en laat zien waar onderzoeken vastlopen en waarom oplossingen vertraging oplopen. Zo krijg je een helder beeld van de werkelijke doorlooptijd, vanaf het eerste ticket tot de definitieve oplossing.
  • Breng elke stap in het oplossingstraject in kaart
  • Spoor vertragingen in de oorzaakanalyse op
  • Vind bottlenecks bij het doorvoeren van oplossingen
  • Meet hoe consistent supportteams werken
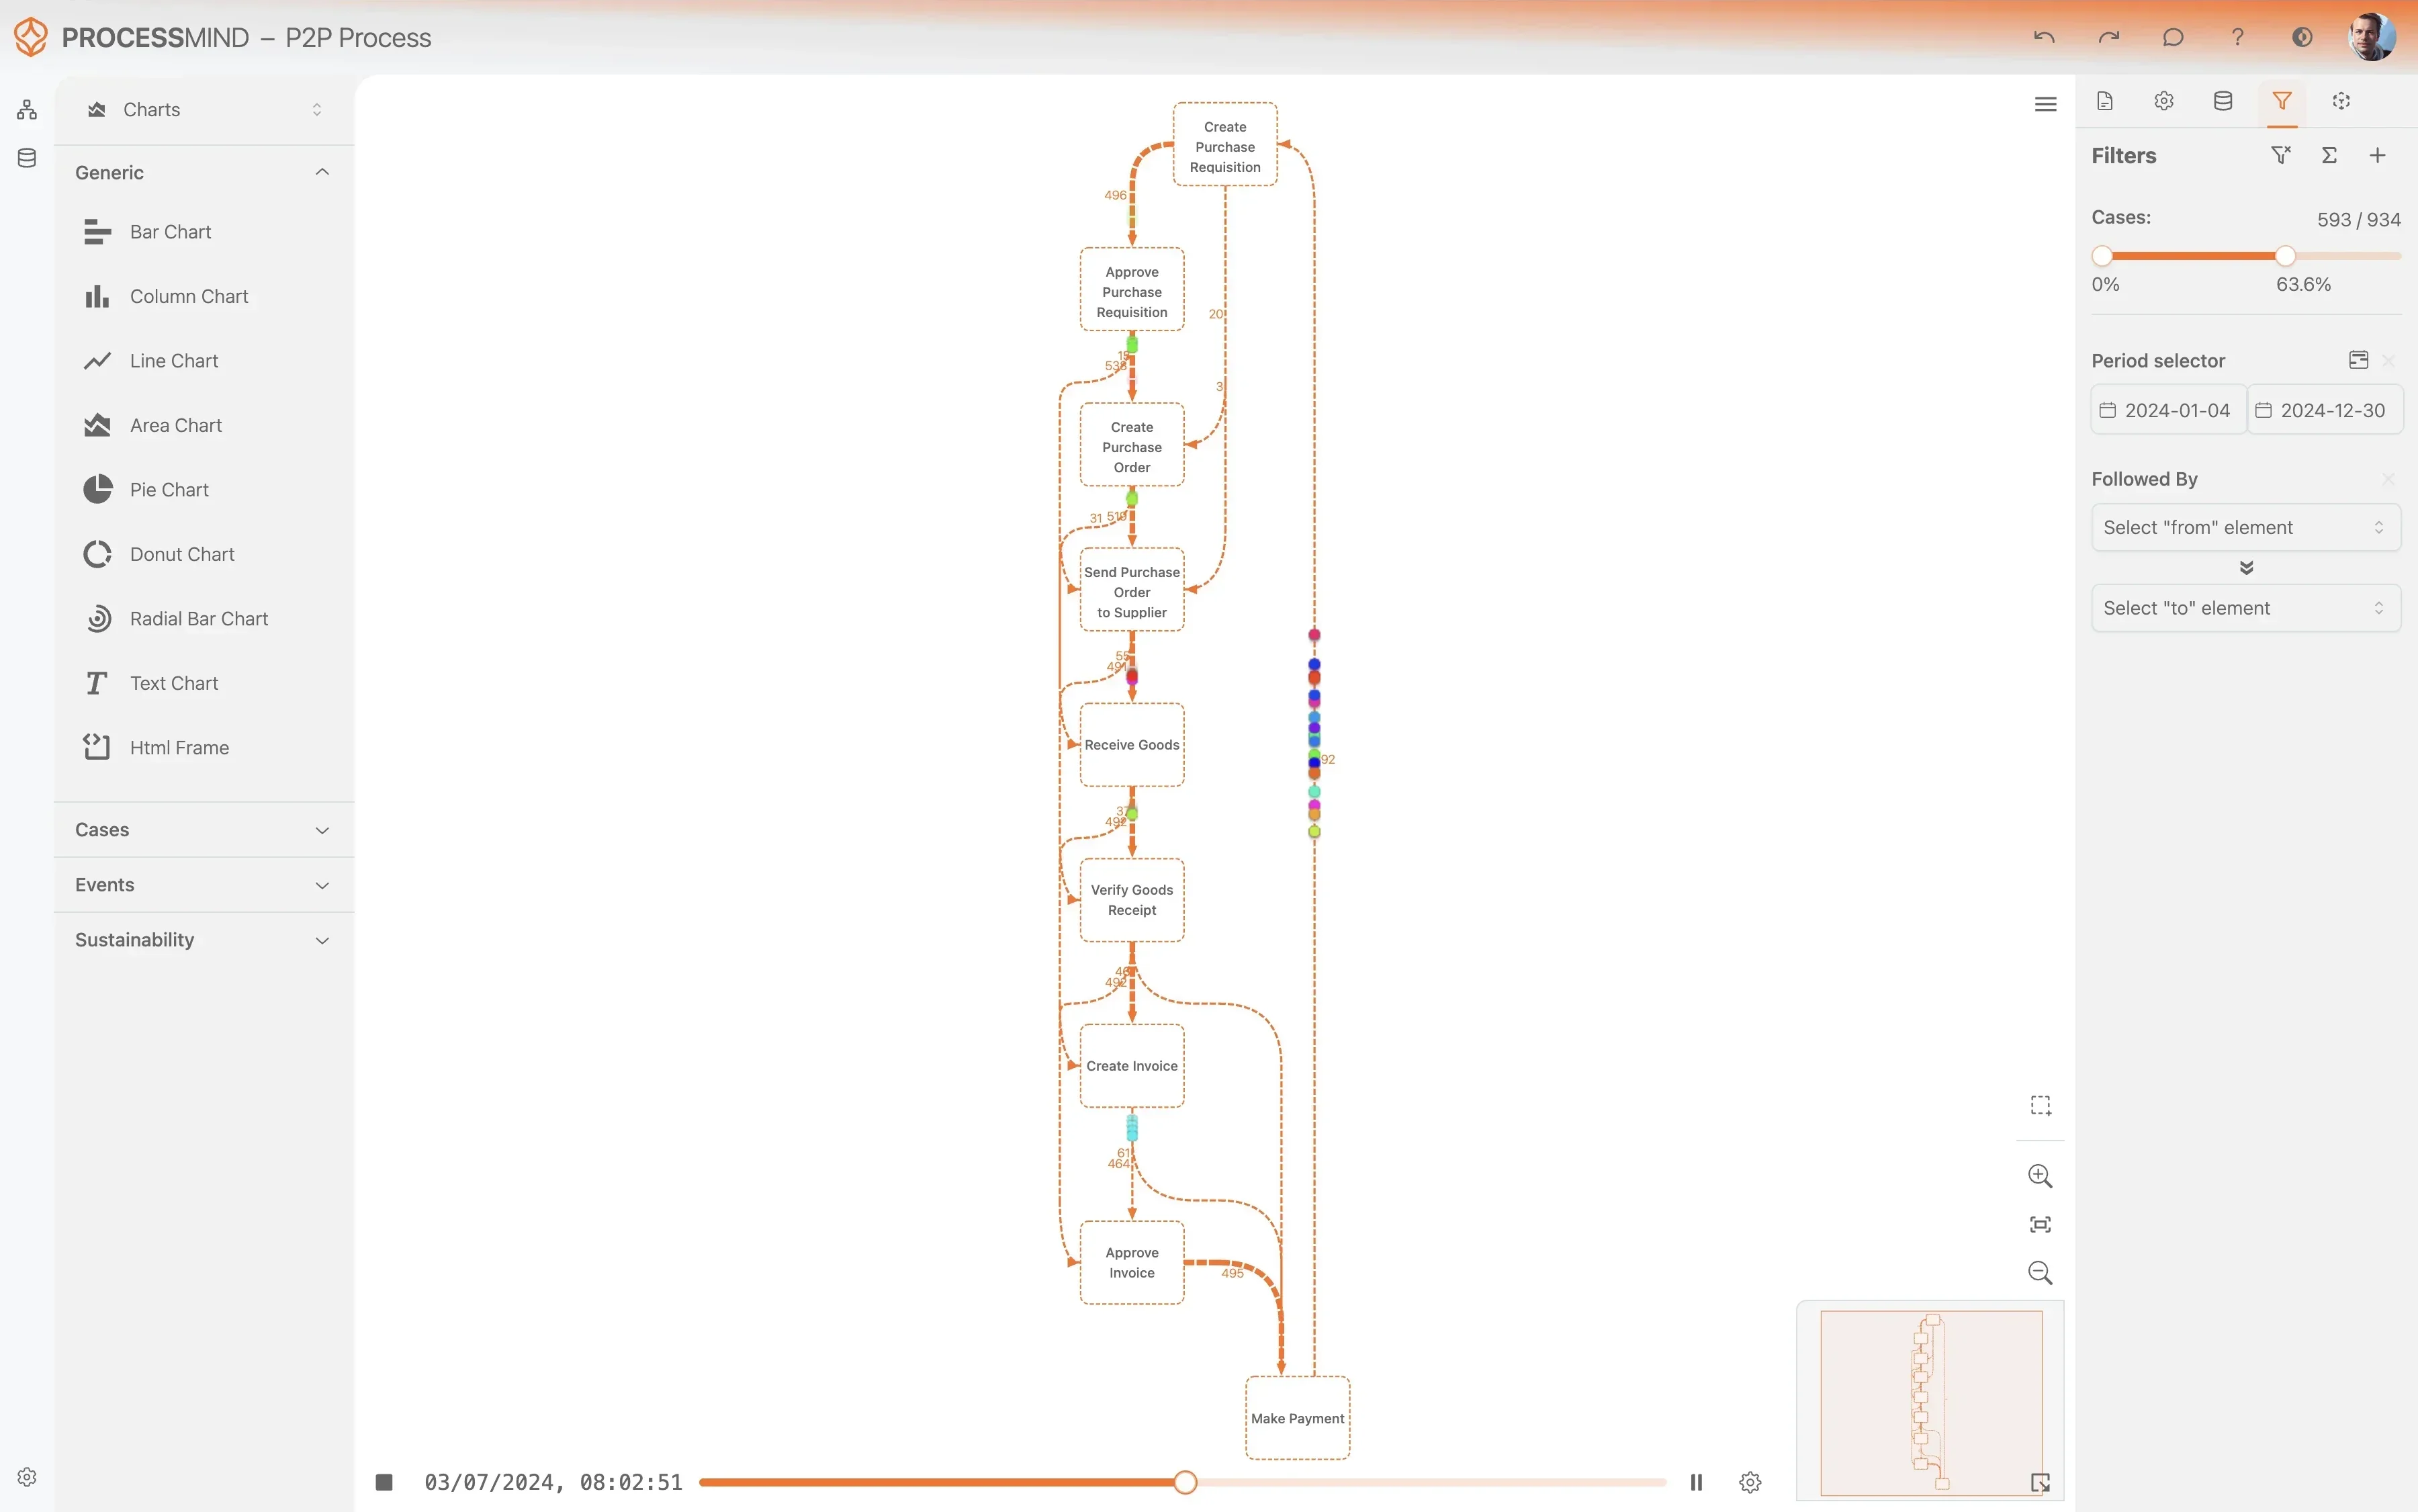
Discover your actual process flow
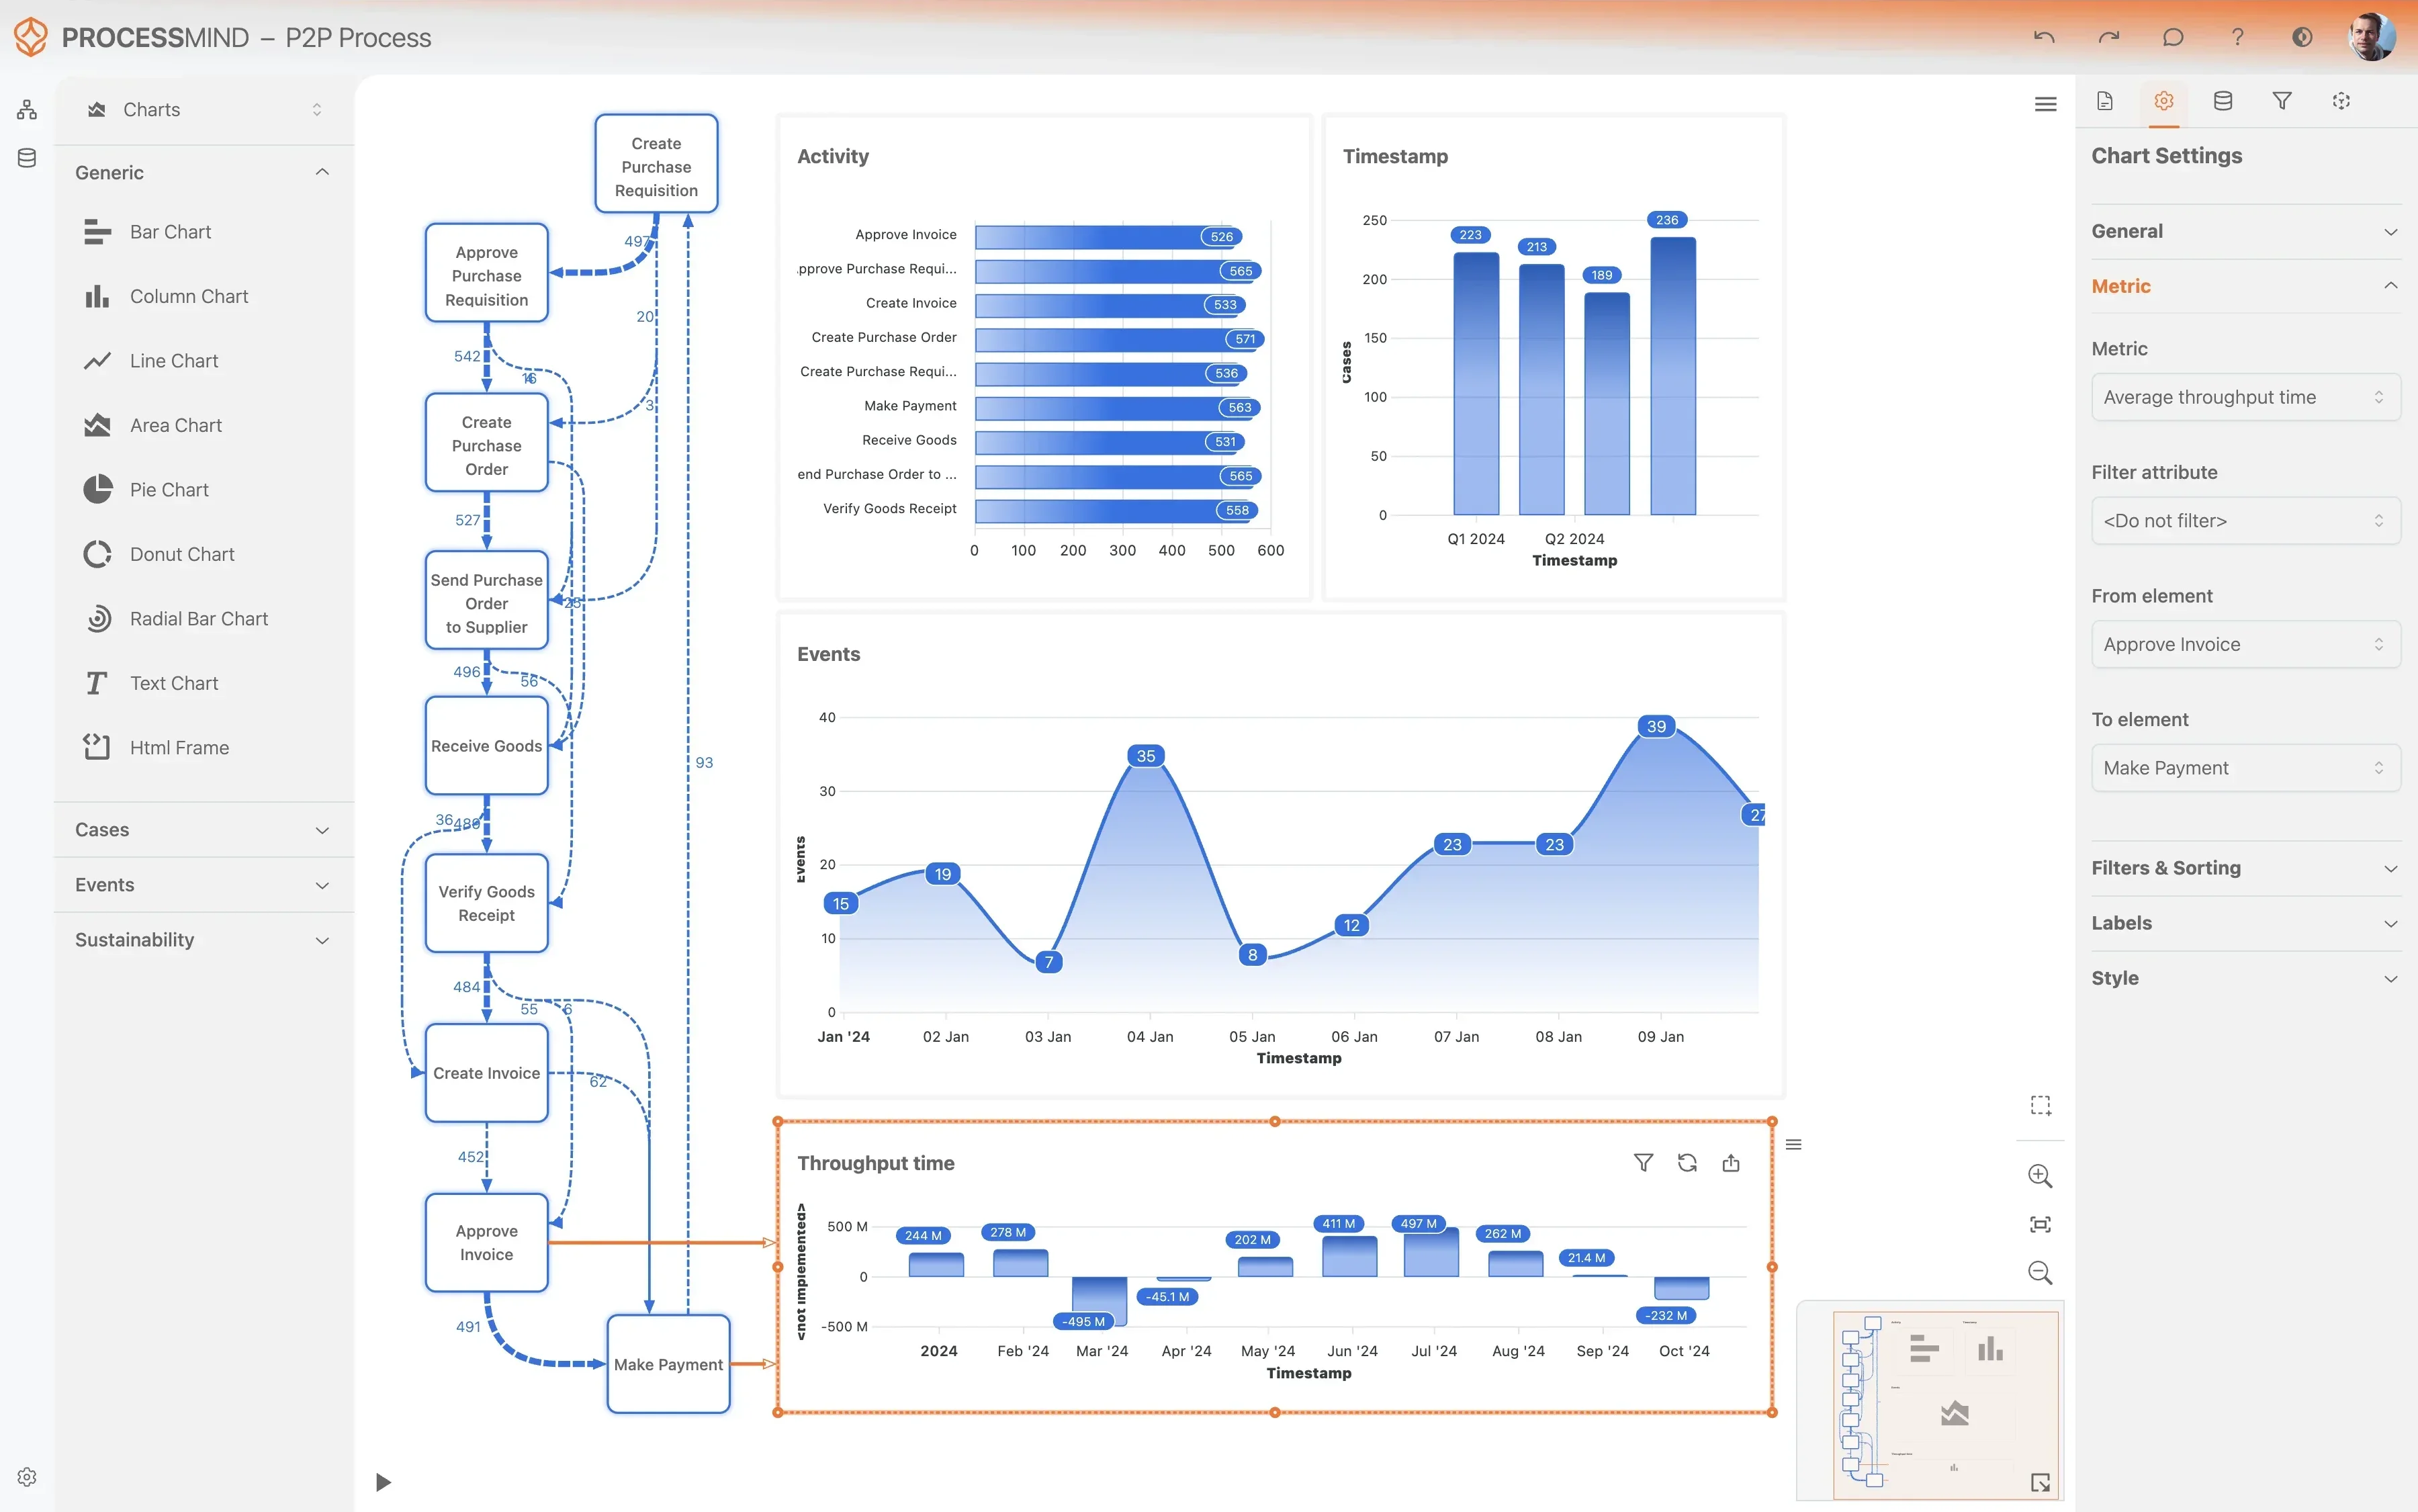
Identify bottlenecks and delays
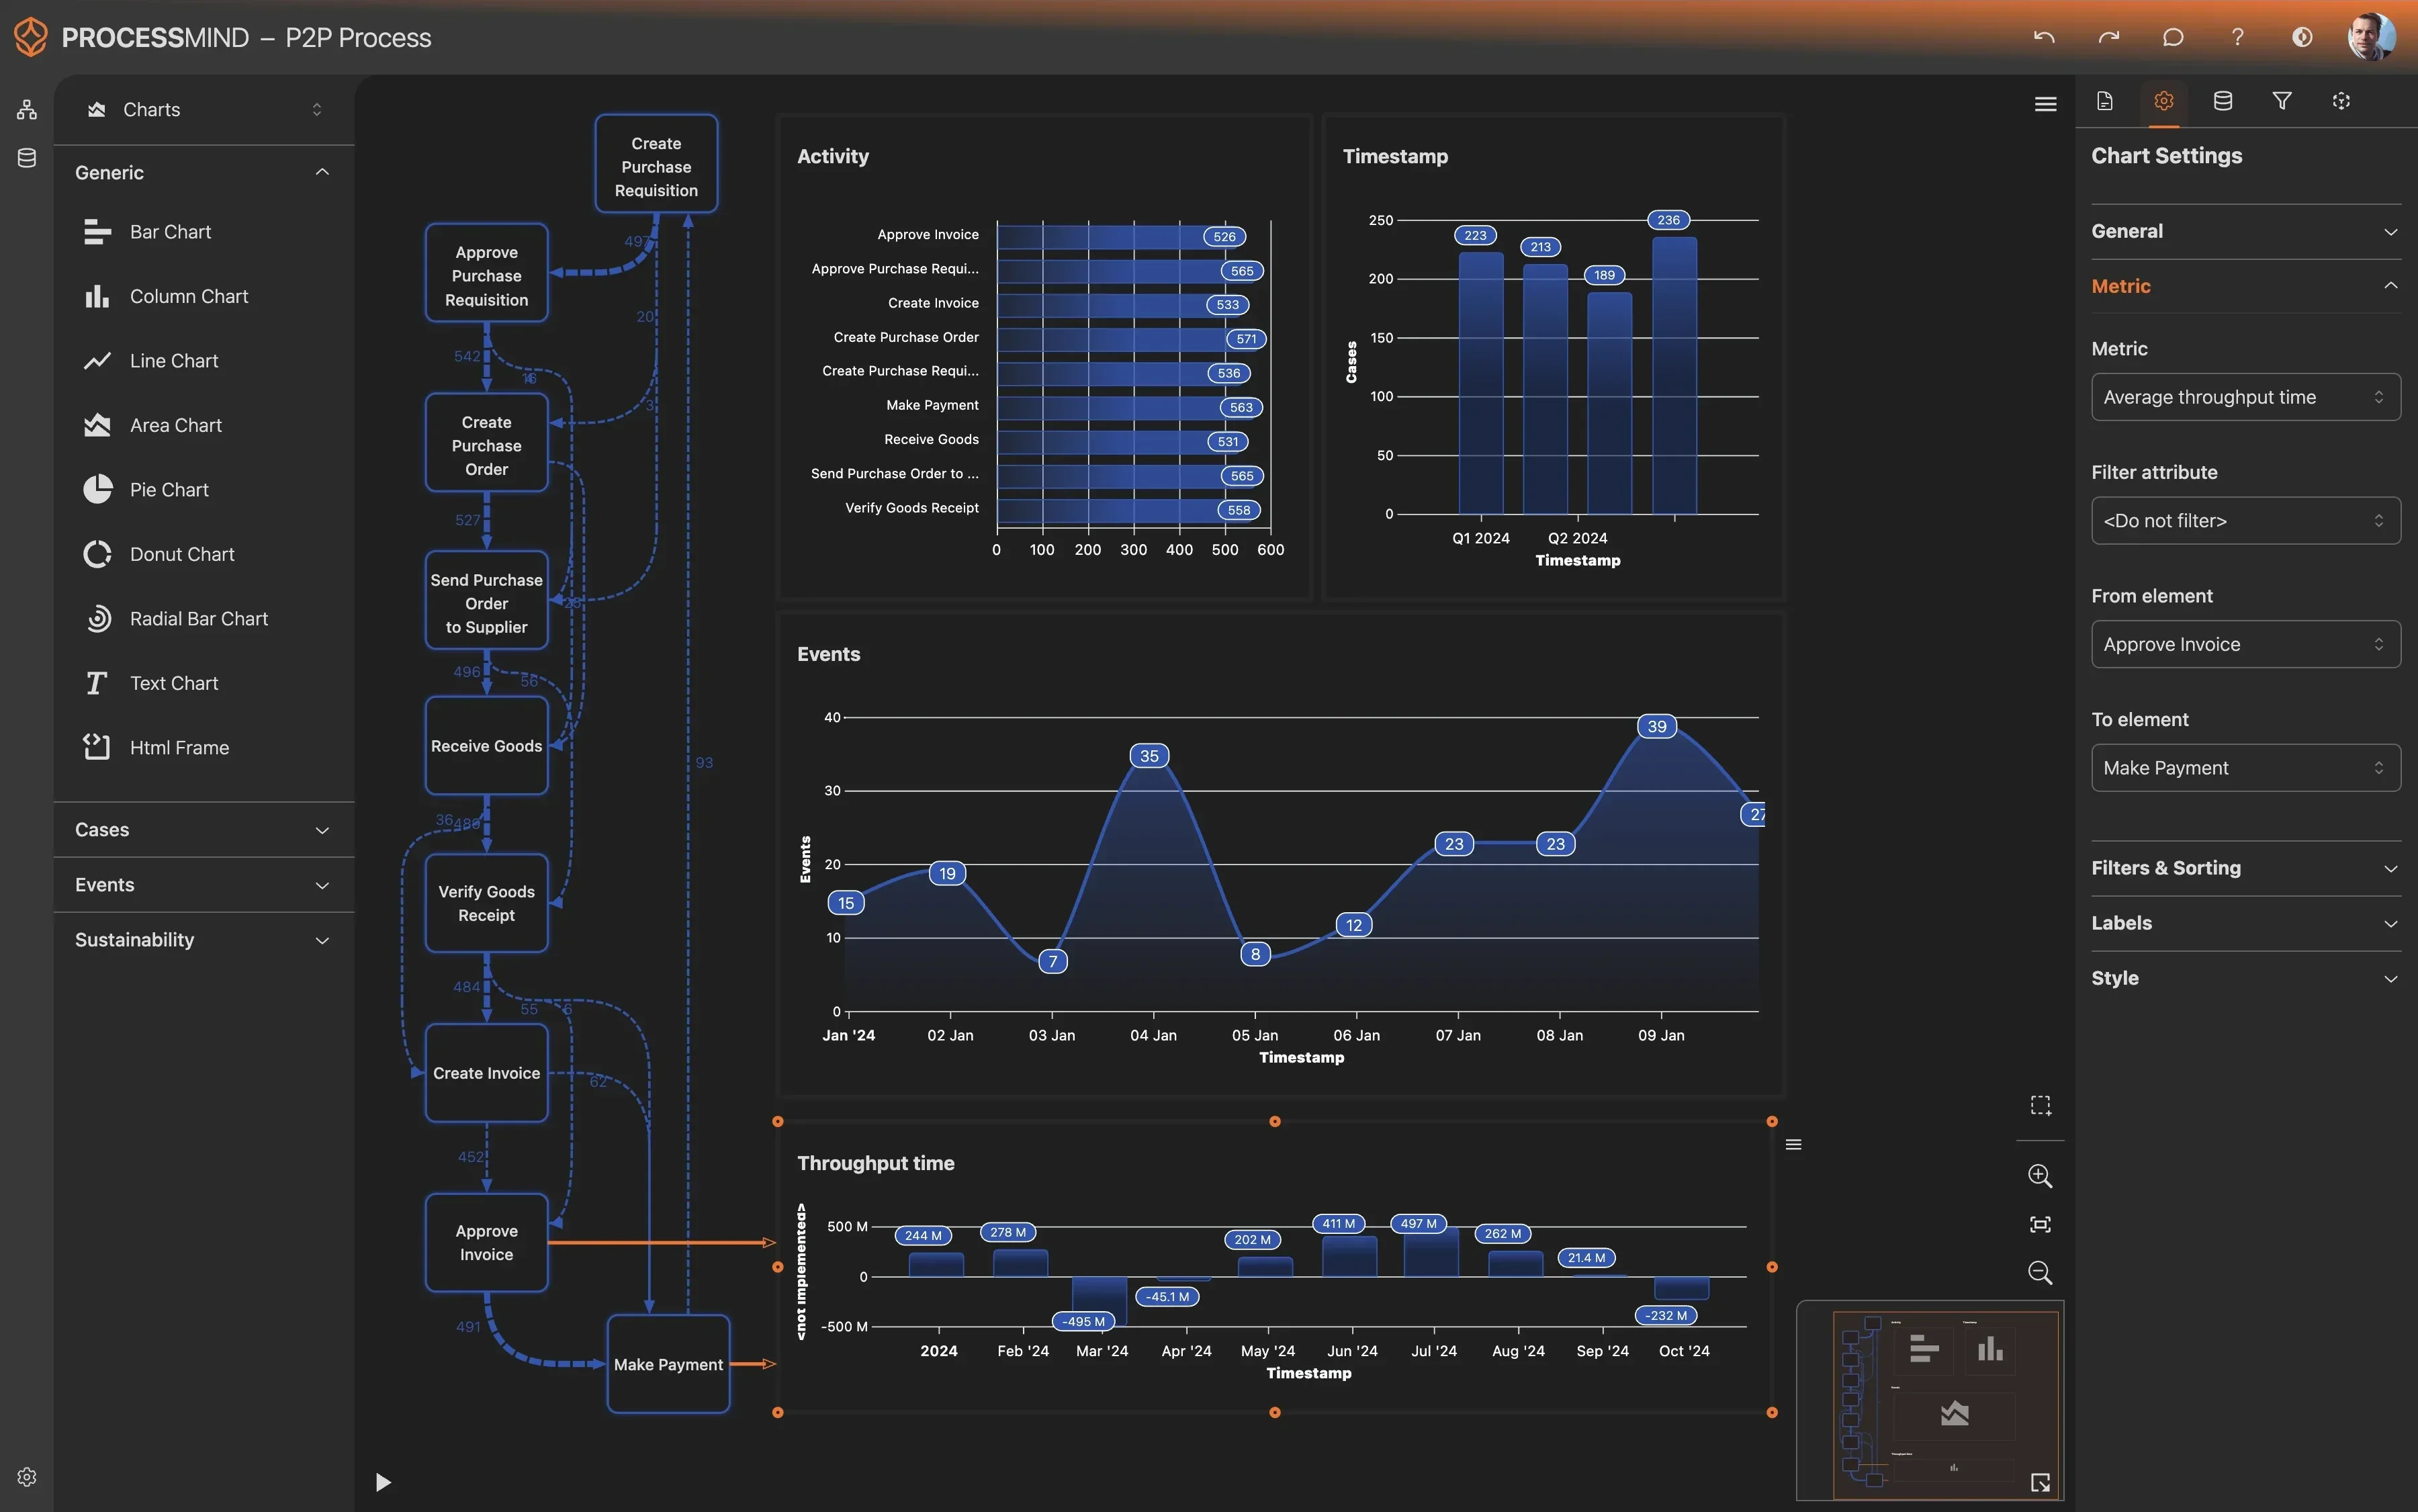
Analyze process variants
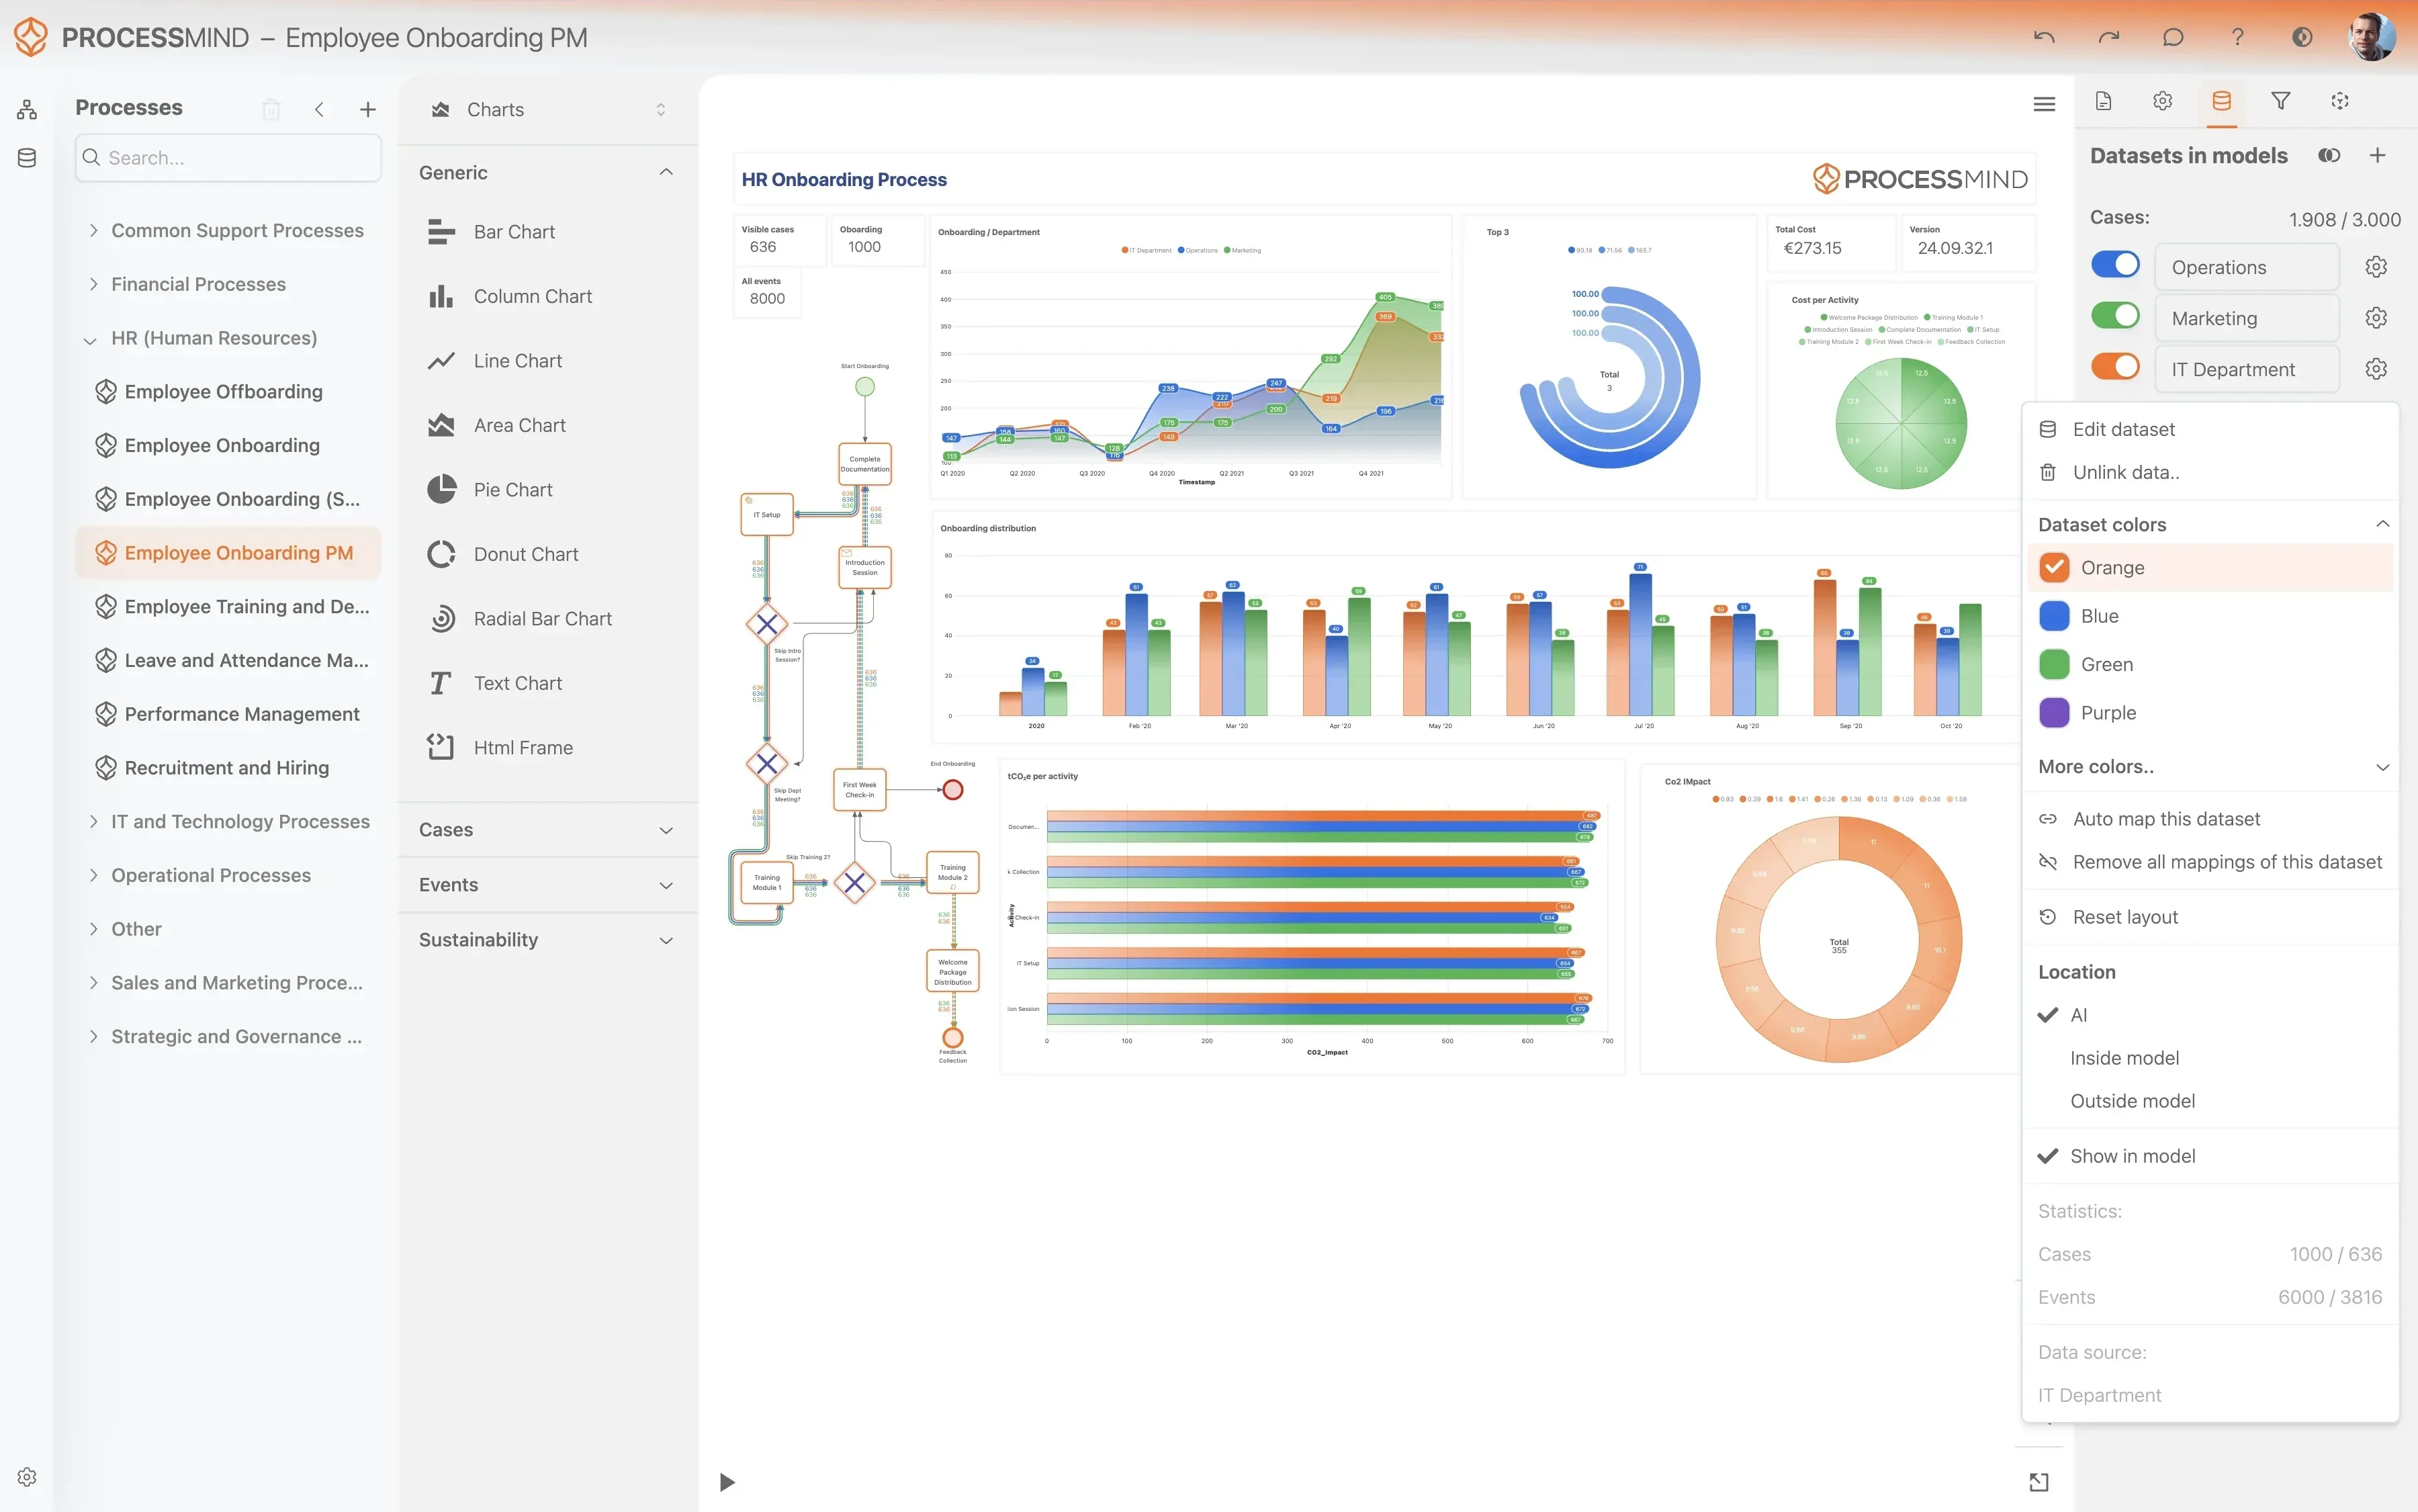
Design your optimized process

BEWEZEN RESULTATEN

De levenscyclus van probleembeheer optimaliseren

Door Zendesk Support-data met process mining te analyseren, vinden organisaties bottlenecks bij het oplossen van problemen en voorkomen ze terugkerende incidenten met gerichte oorzaakanalyses.

0 %
Snellere oorzaakanalyse

Kortere diagnosetijd

Door bottlenecks in de diagnose te vinden, kunnen teams sneller de oorzaak achterhalen en onderliggende problemen efficiënter oplossen.

0 %
Minder incidenten

Afname van gerelateerde incidenten

Een hoger percentage definitieve oplossingen leidt rechtstreeks tot minder vervolgincidenten en verlaagt de totale kosten van de supportafdeling aanzienlijk.

+ 0 %
Tijdelijke oplossingen beter vastleggen

Hoger percentage gedocumenteerde oplossingen

Als tijdelijke oplossingen consequent worden gepubliceerd, kunnen servicedeskmedewerkers de dienstverlening sneller herstellen terwijl aan een definitieve oplossing wordt gewerkt.

0 days
Efficiëntere overdrachten tussen groepen

Kortere wachttijden

Door overdrachten tussen afdelingen zichtbaar te maken, kunnen organisaties wachttijd voorkomen wanneer records tussen technische supportgroepen worden verplaatst.

0 %
Meer problemen in één keer opgelost

Minder heropende cases

Door te controleren of definitieve oplossingen werken, weet je of de oorzaken echt zijn aangepakt en voorkom je dat kritieke verstoringen terugkeren.

0 %
Minder stilstaande records

Inactieve probleemcases opschonen

Automatische bewaking van open records voorkomt dat onderzoeken worden vergeten. Zo blijft de achterstand gericht op actieve problemen met hoge prioriteit.

Resultaten verschillen per organisatie en zijn afhankelijk van de complexiteit van het proces en de datakwaliteit. Deze cijfers geven typische verbeteringen weer die bij verschillende Zendesk-implementaties zijn waargenomen.

Aanbevolen data

Begin met de belangrijkste attributen en activiteiten voor een helder procesmodel.

Attributen

Belangrijke datapunten voor de analyse

De urgentie van het probleemrecord.

Waarom dit belangrijk is

Dit is essentieel om cases op te delen en de SLA-naleving en prioritering van capaciteit te analyseren.

Het team of de afdeling waaraan het probleemrecord momenteel is toegewezen.

Waarom dit belangrijk is

Hiermee kun je de organisatie analyseren en bottlenecks tussen afdelingen vinden.

De agent die aan het probleem werkt.

Waarom dit belangrijk is

Hiermee kun je de inzet van capaciteit per persoon analyseren.

De huidige status van het probleemrecord in de levenscyclus.

Waarom dit belangrijk is

Hiermee kun je cases filteren op basis van hun afrondingsstatus.

Het aantal incidenttickets dat aan dit probleemrecord is gekoppeld.

Waarom dit belangrijk is

Dit geeft aan hoe groot de impact van het probleem op gebruikers is.

De datum en tijd waarop het probleem uiterlijk moet zijn opgelost.

Waarom dit belangrijk is

Dit is essentieel om compliance en contractuele prestaties te meten.

De classificatie van het probleem (bijvoorbeeld software, hardware of netwerk).

Waarom dit belangrijk is

Hiermee kun je segmenteren op technologie of bedrijfsdienst.

De vastgestelde onderliggende oorzaak van het probleem (bijvoorbeeld een codefout of configuratiefout).

Waarom dit belangrijk is

Hiermee kun je patronen in storingen analyseren en verbeteringen voor de lange termijn bepalen.

Activiteiten

Processtappen om te volgen en te optimaliseren

Het probleemticket wordt aangemaakt in Zendesk Support. Deze gebeurtenis legt de timestamp vast waarop het probleem voor het eerst in het systeem is geregistreerd. Meestal begint hiermee het proces.

Waarom dit belangrijk is

Dit bepaalt de starttijd van de volledige oplossingscyclus en vormt het uitgangspunt voor alle metingen van de doorlooptijd.

Het probleemrecord wordt toegewezen aan een specifiek technisch team of een specifieke afdeling. Dit wordt bijgehouden wanneer het veld Group ID van het ticket wordt bijgewerkt.

Waarom dit belangrijk is

Essentieel voor het dashboard voor analyse van overdrachten tussen supportgroepen, waarmee wachttijden tussen afdelingen worden gemeten.

Dit markeert de overgang van de passieve status 'New' naar een actieve werkstatus. Het geeft aan dat een agent het probleem heeft opgepakt en met de diagnose is begonnen.

Waarom dit belangrijk is

Wordt gebruikt voor de metriek voor verouderde probleemrecords en is het startpunt voor de KPI voor de gemiddelde duur van de oorzaakanalyse.

Een tijdelijke oplossing voor het probleem documenteren en delen. In Zendesk wordt dit vaak vastgelegd met een specifieke tag of een aangepast selectievakje dat aangeeft dat er een tijdelijke oplossing beschikbaar is.

Waarom dit belangrijk is

Ondersteunt het dashboard voor naleving van de publicatie van tijdelijke oplossingen. Zo krijgen gebruikers tijdens langdurige onderzoeken een tijdelijke oplossing.

Het moment waarop de onderliggende oorzaak van het probleem wordt vastgesteld. Dit wordt meestal vastgelegd wanneer een agent een aangepast tekstveld of keuzelijstveld 'Root Cause' invult.

Waarom dit belangrijk is

Een belangrijke mijlpaal voor het dashboard voor de snelheid van oorzaakanalyses en voor het meten van de efficiëntie van diagnoses.

Dit geeft aan dat de technische oplossing in de omgeving is uitgerold. Meestal wordt dit bijgehouden via een aangepaste statuswijziging of een specifieke tag voordat het ticket volledig is opgelost.

Waarom dit belangrijk is

Essentieel voor het dashboard voor de efficiëntie van de implementatie van fixes. Hiermee wordt de tijd tussen diagnose en uitrol gemeten.

Het probleem wordt formeel als opgelost gemarkeerd. In Zendesk gebeurt dit wanneer de standaardstatus van het systeem op 'Solved' wordt gezet. Dit geeft aan dat de oplossing is gecontroleerd en de case is afgerond.

Waarom dit belangrijk is

Het belangrijkste eindpunt voor de berekening van SLA-prestaties en -risico’s en het percentage nageleefde SLA’s voor problemen.

De laatste gebeurtenis in de levenscyclus: het ticket wordt vergrendeld en kan niet meer worden gewijzigd. In Zendesk gebeurt dit meestal automatisch, vier dagen nadat de status Solved is ingesteld.

Waarom dit belangrijk is

Dit markeert het definitieve einde van het record en wordt gebruikt voor gegevensbewaring en historische rapportages.

Veelgestelde vragen

Veelgestelde vragen

Process mining gebruikt de bestaande event logs van Zendesk om visueel in kaart te brengen hoe probleemrecords door het systeem lopen. Zo worden verborgen bottlenecks en afwijkingen van standaardprocedures zichtbaar en zie je precies waar onderzoeken vastlopen.

Om te beginnen hebben we meestal het ID van het probleemrecord nodig, een timestamp voor elke statuswijziging en de naam van de activiteit, zoals een status- of toewijzingswijziging. Extra velden, zoals prioriteit, categorie of toegewezen groep, zijn handig om verder te filteren en oorzaken te analyseren.

Door incidenten en probleemrecords met elkaar in verband te brengen, zie je welke problemen steeds opnieuw met een tijdelijke oplossing worden verholpen in plaats van definitief opgelost. Zo kun je fixes met veel impact prioriteren en hele reeksen terugkerende supporttickets voorkomen.

De meeste teams zien binnen enkele dagen na het koppelen van hun Zendesk-data de eerste procesmaps. Omdat het systeem historische logs gebruikt, hoef je niet te wachten tot er nieuwe data is verzameld om belangrijke bottlenecks of complianceproblemen te vinden.

Ja. De tool volgt hoe probleemrecords tussen supportgroepen en technische teams worden overgedragen. Zo zie je precies waar overdrachten misgaan of records te lang blijven liggen. Dat helpt je de beschikbare capaciteit beter te verdelen.

Nee. Process mining analyseert de auditlogs die Zendesk al op de achtergrond aanmaakt. Je hoeft geen workflows aan te passen, aangepaste velden toe te voegen of de werkwijze van agents te veranderen om betrouwbare resultaten te krijgen.

Het systeem vergelijkt de tijd in elke procesfase met de afgesproken serviceniveaus. Je ziet welke procesroutes vaak tot SLA-overschrijdingen leiden, bijvoorbeeld door vertraging tussen diagnose en herstel.

Door de volgorde van activiteiten te analyseren, kan de tool records signaleren die rechtstreeks naar een gesloten status gaan en verplichte stappen overslaan, zoals oorzaakanalyse of een evaluatie na de implementatie. Zo kan je team bij elk groot probleem de afgesproken kwaliteitsnormen volgen.

Verbeter probleembeheer voor snellere IT-oplossingen

Verkort de doorlooptijd van oplossingen met 30 procent en pak IT-bottlenecks aan.

Start je gratis proefperiode

Geen creditcard nodig. Binnen enkele minuten ingesteld.