Verbessern Sie Ihr Problemmanagement
Ihr Leitfaden zur Optimierung des Problemmanagements in 6 Schritten.
Verbessern Sie Ihr Problemmanagement
Problemmanagement
Beliebiges System

Prozess auswählen

Wählen Sie einen Prozess aus, um in Ihrem verbundenen Arbeitsbereich weiterzuarbeiten.

Verbessern Sie das Problemmanagement mit Process Mining

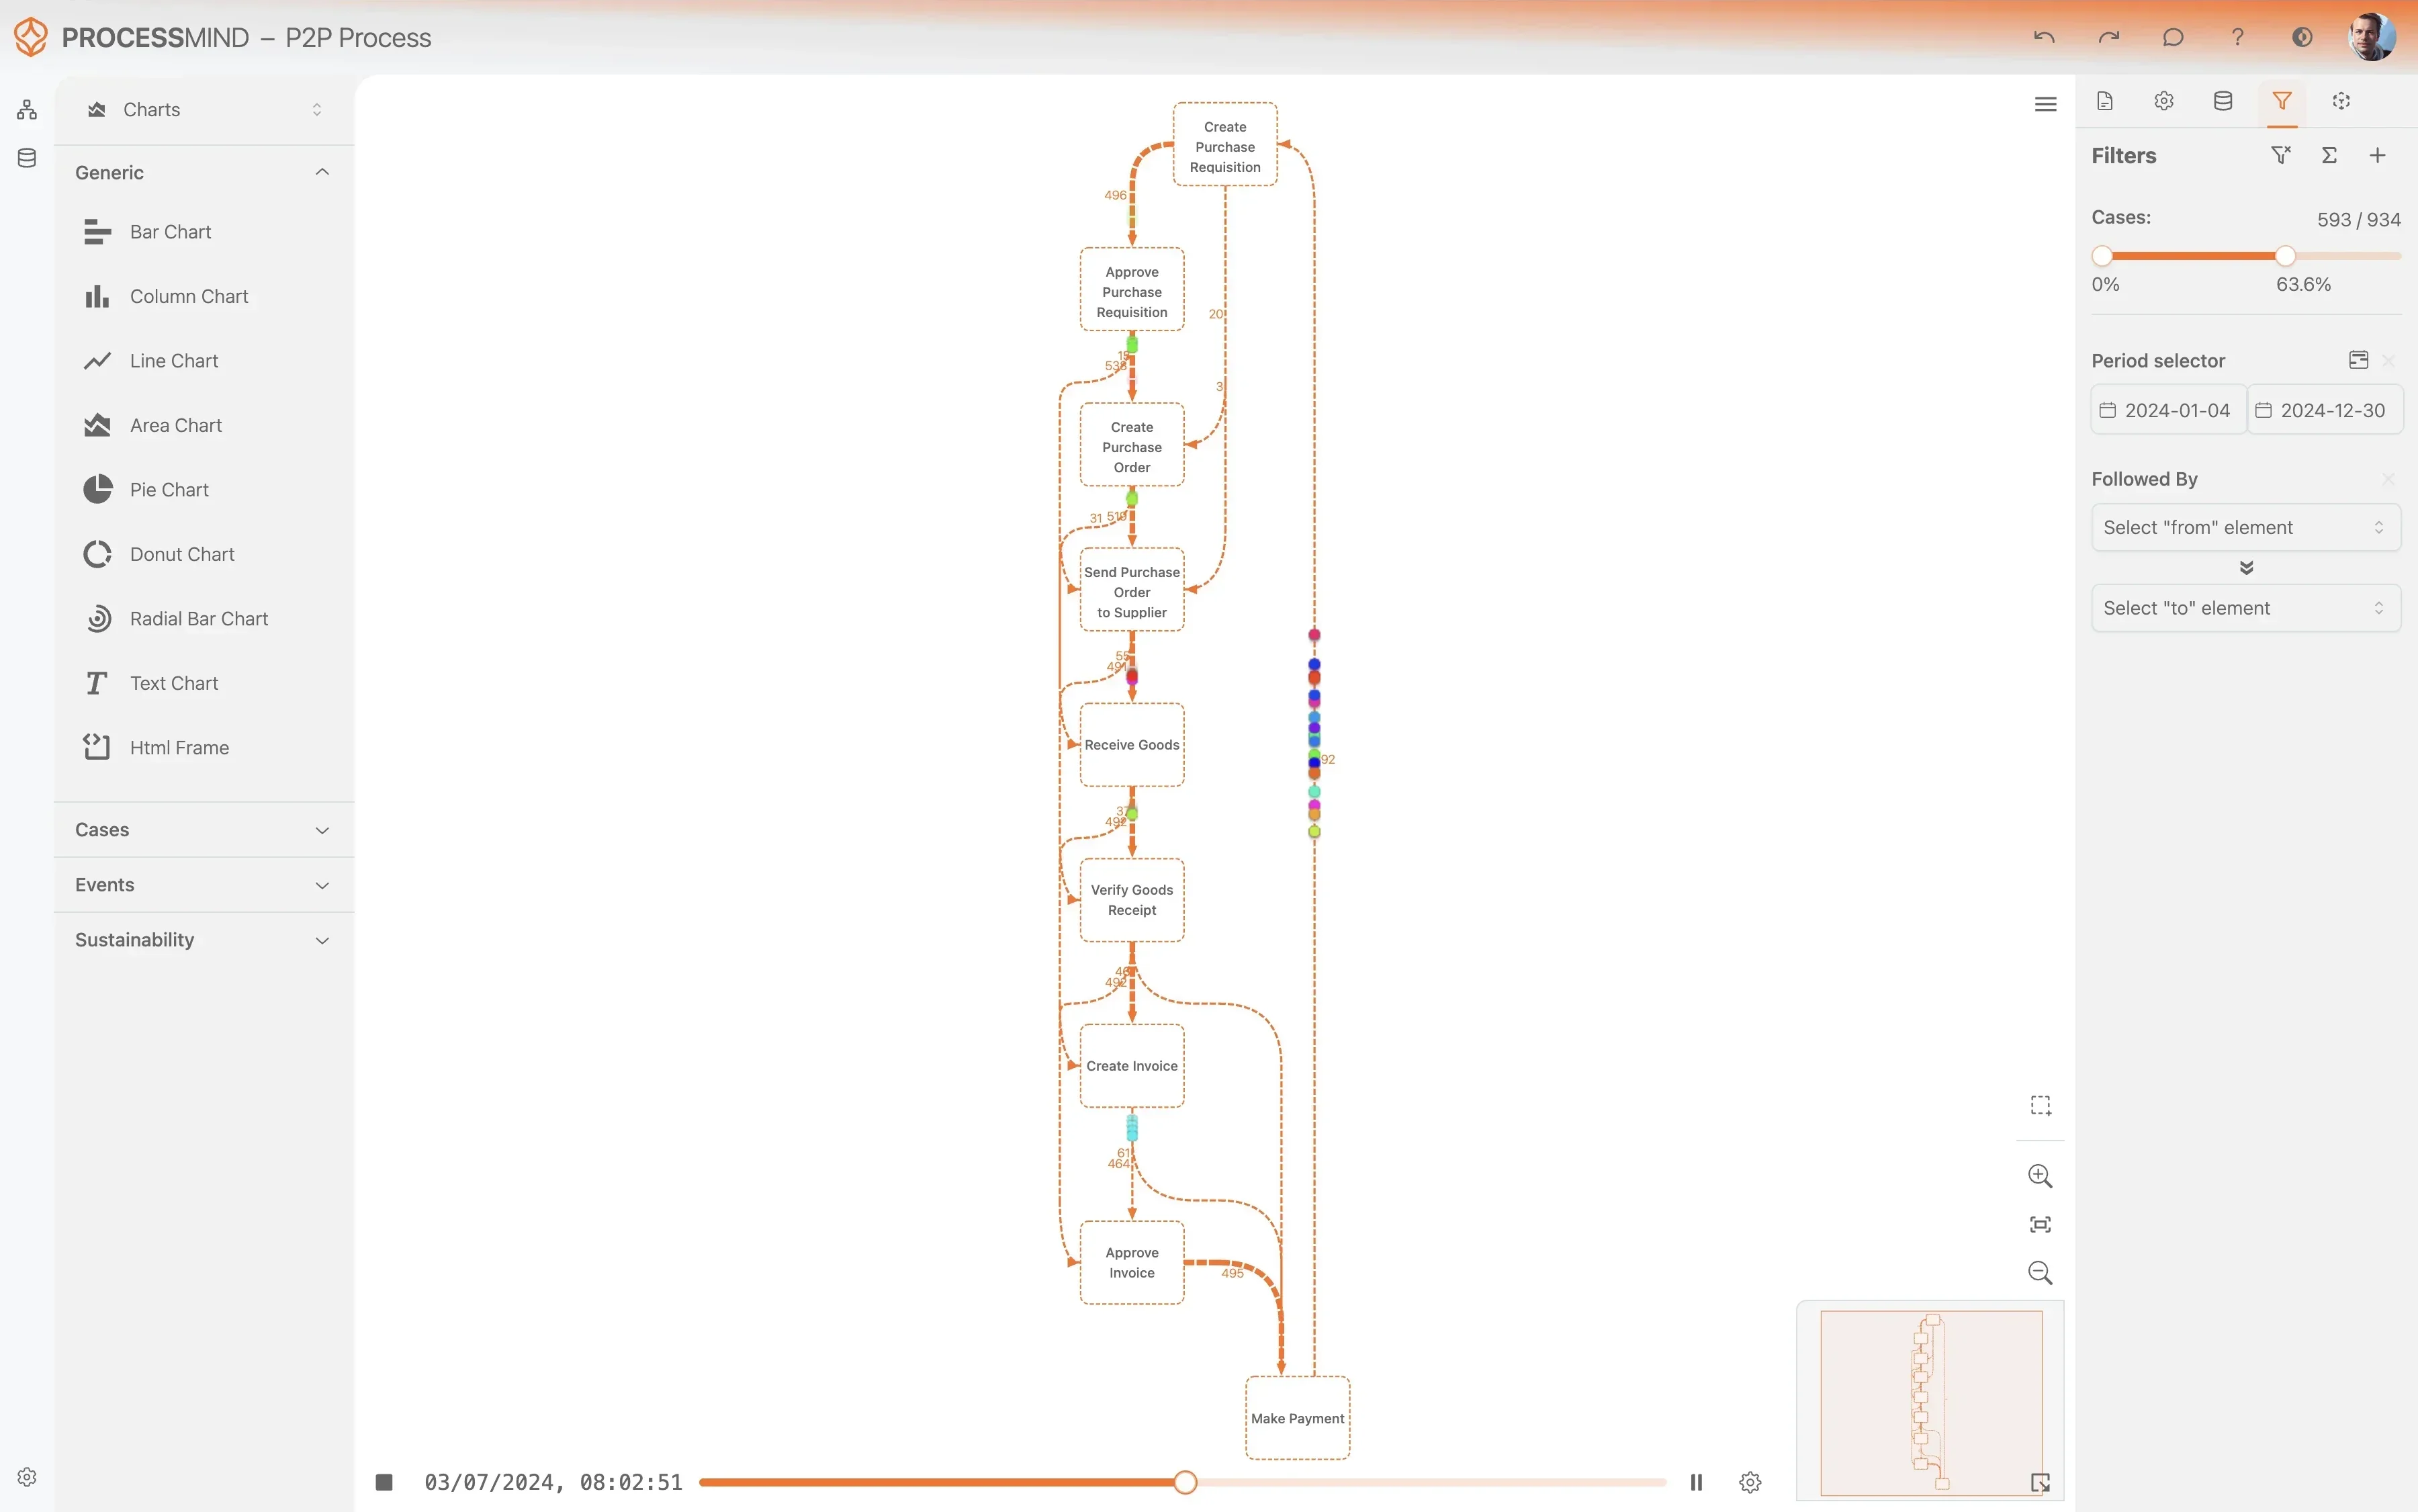
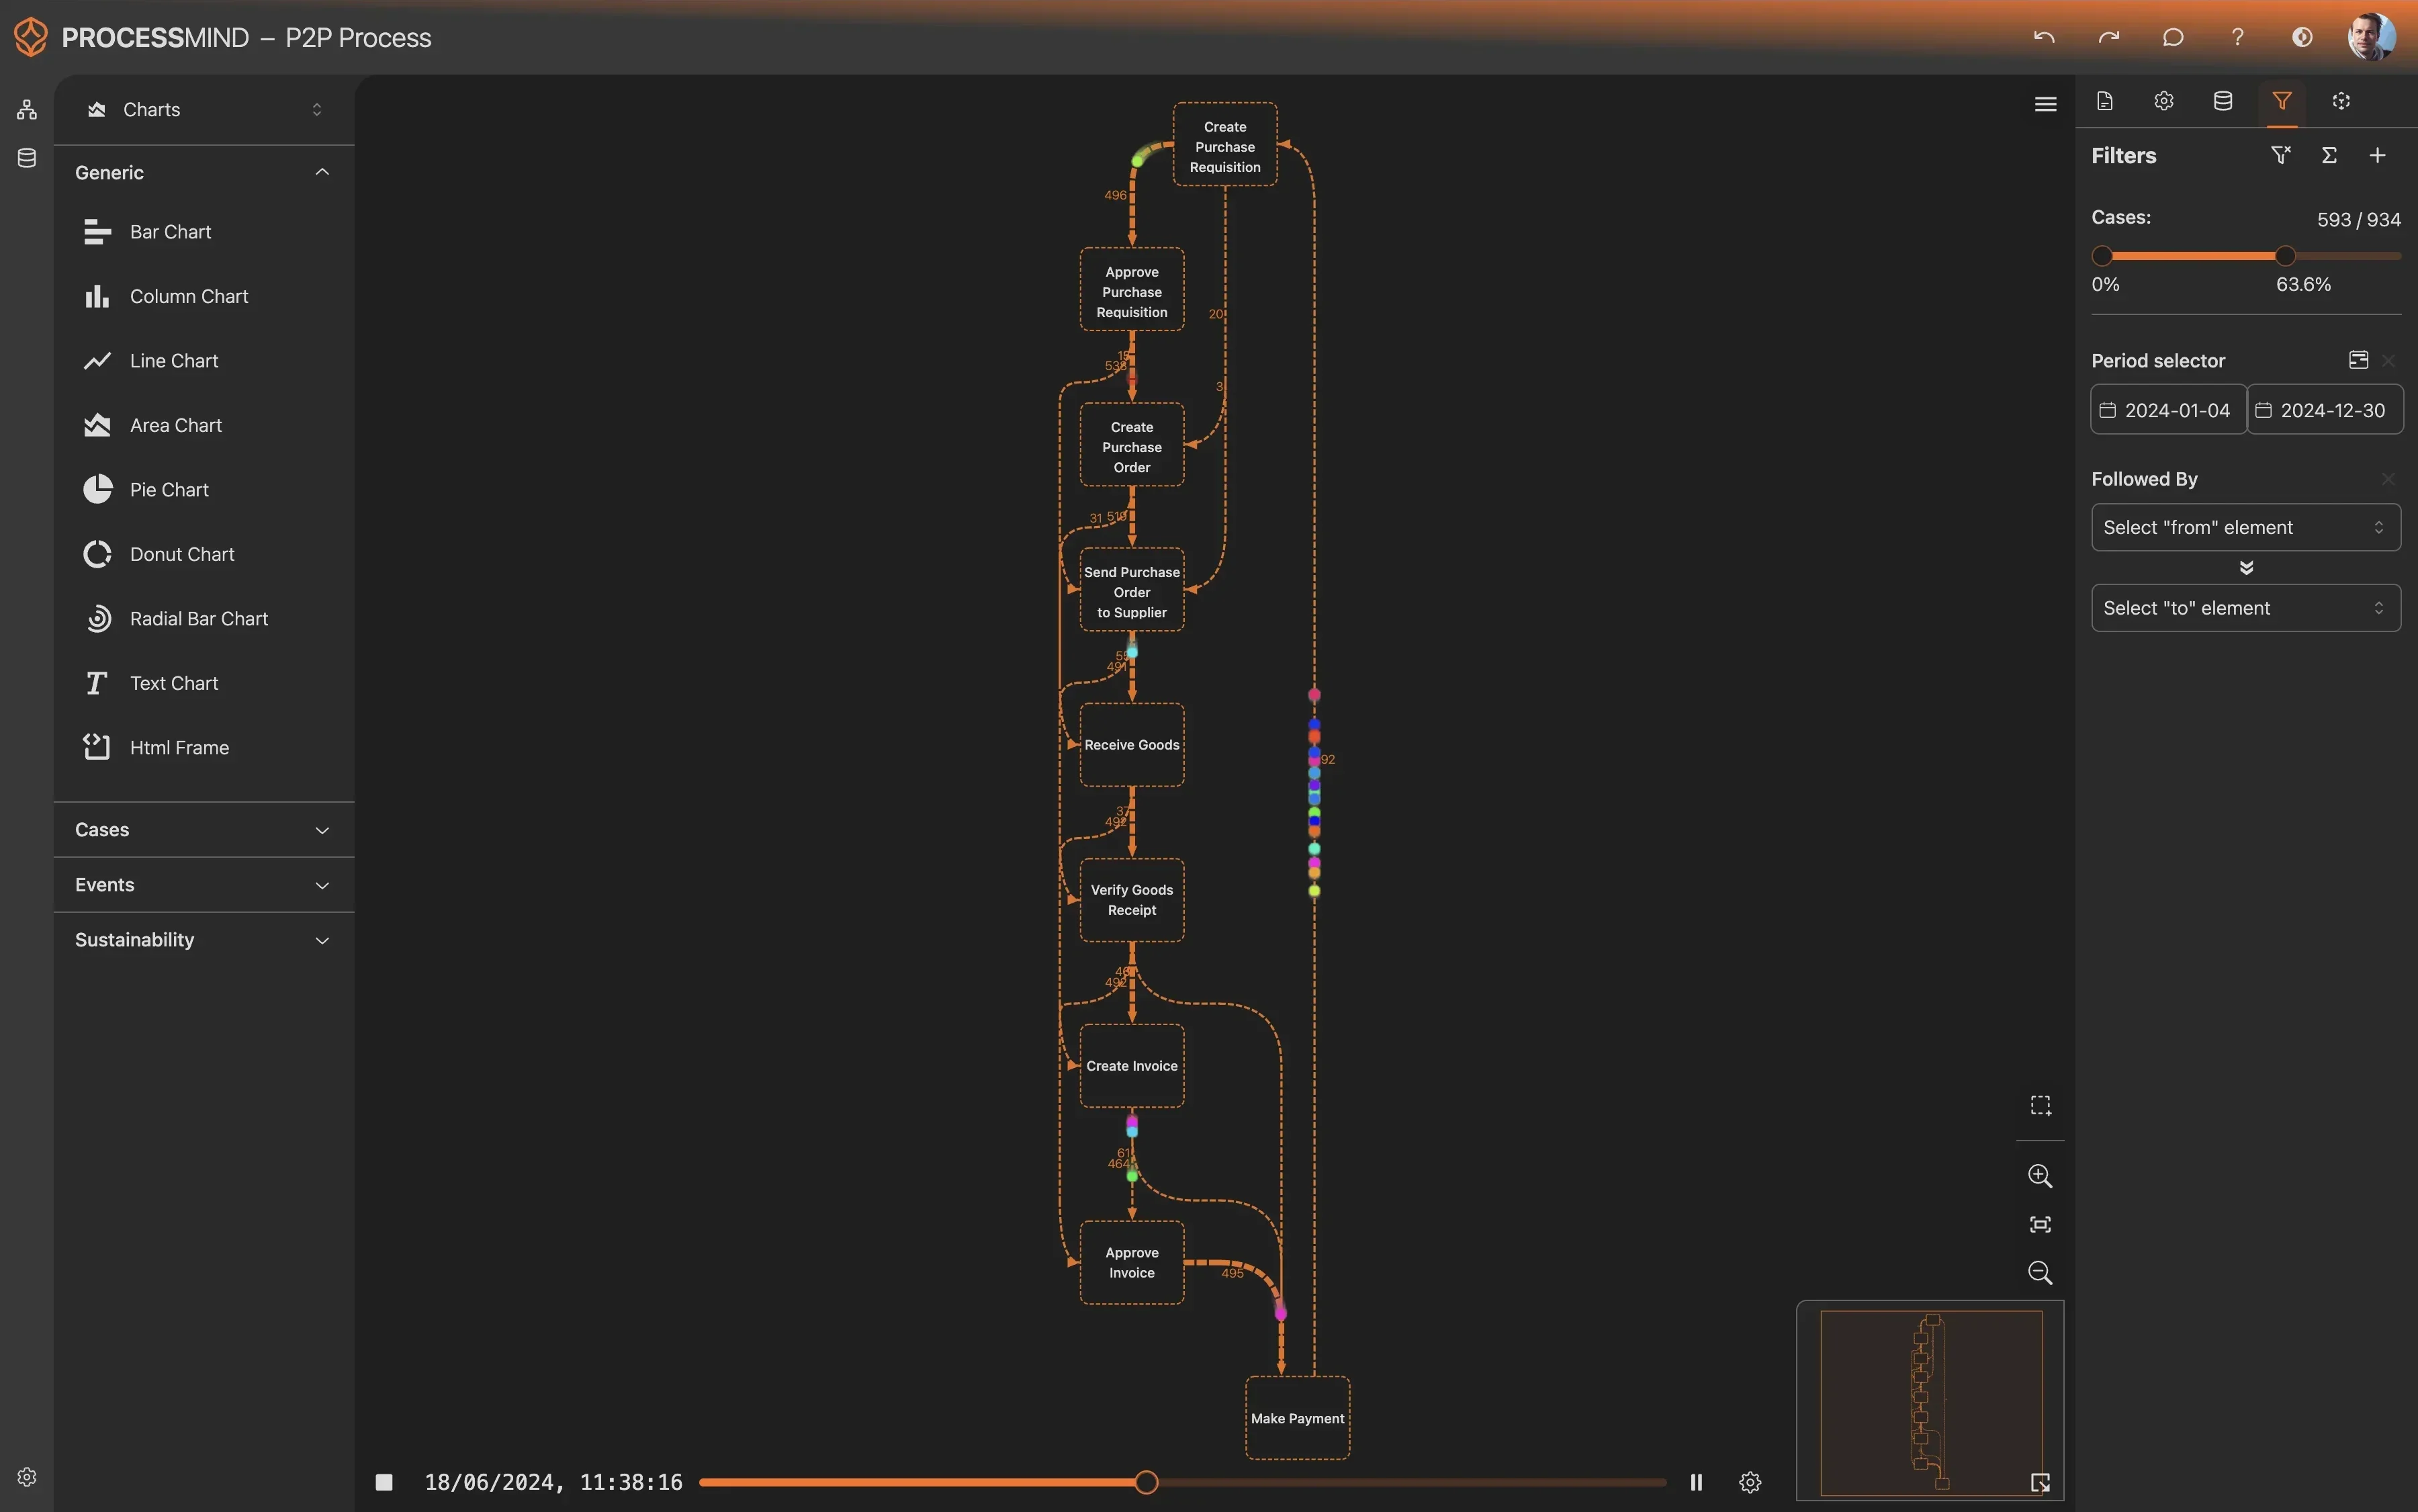
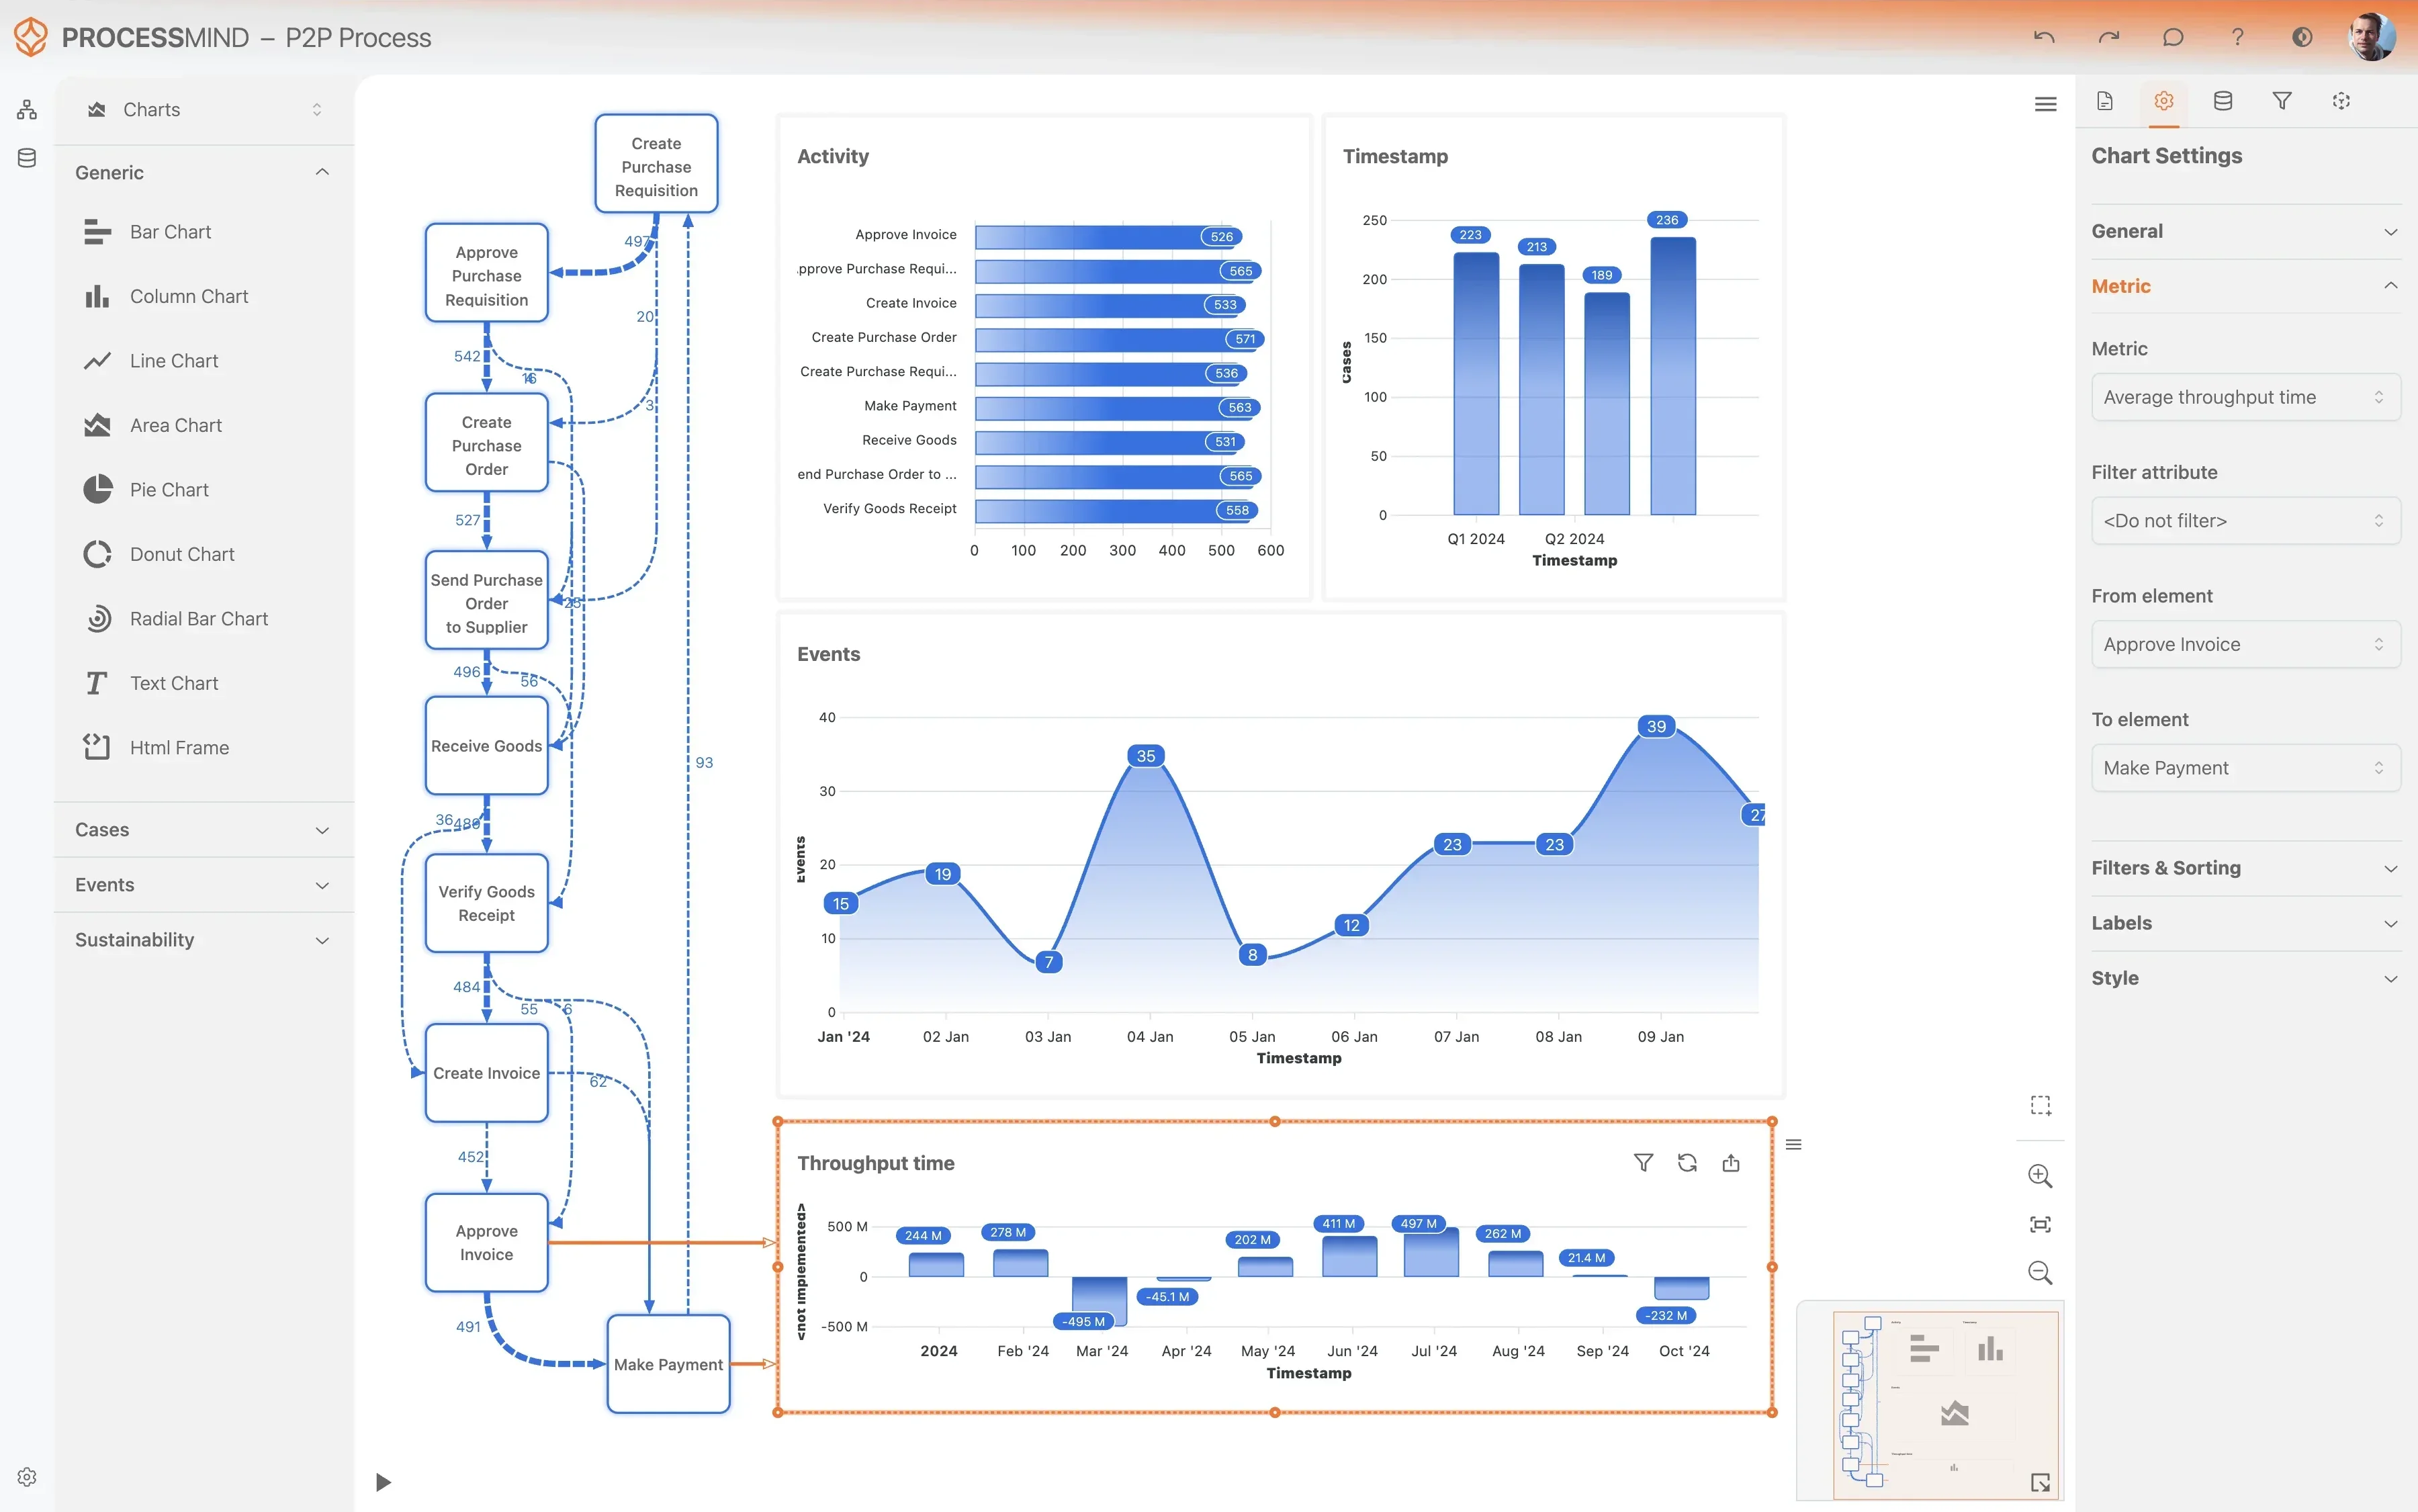
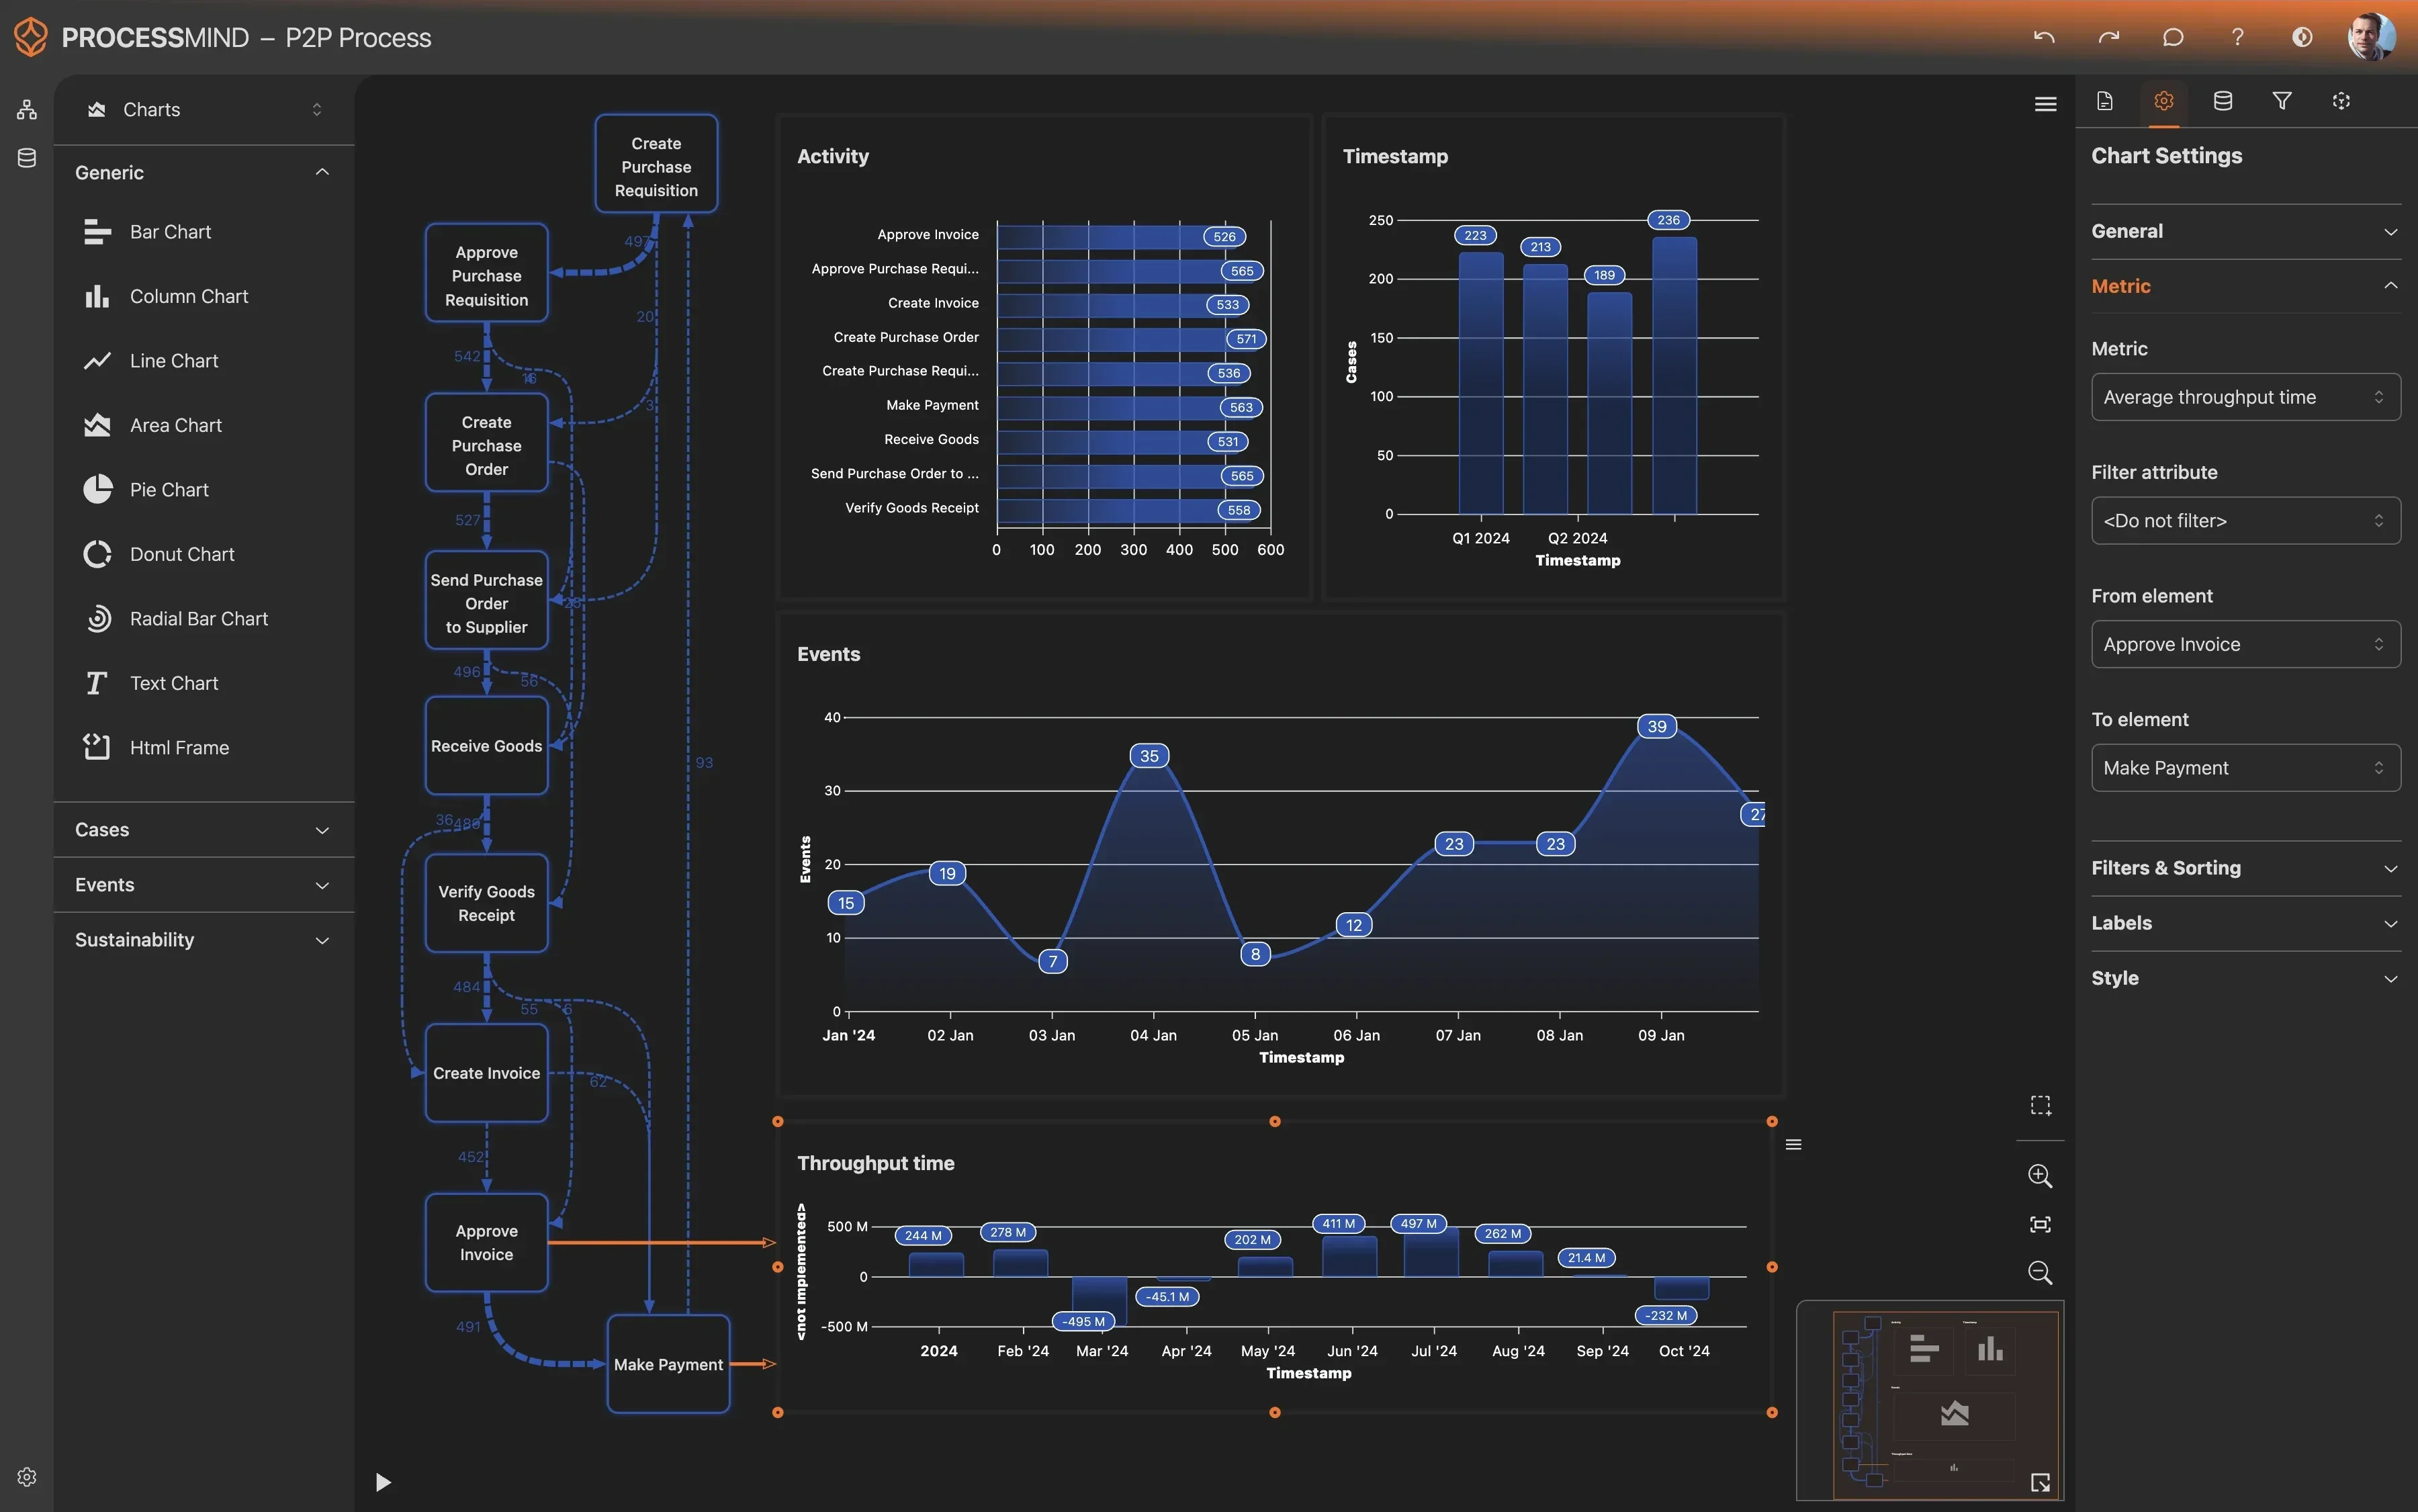
Mit ProcessMind erkennen Sie verborgene Ineffizienzen in Ihrem Problemmanagement. Finden Sie Engpässe, wiederkehrende Aufgaben und lange Lösungszeiten, die sich auf die Servicequalität auswirken. Unsere Plattform zeigt Prozessabweichungen und Verbesserungsmöglichkeiten klar auf und unterstützt so eine datengetriebene Optimierung. Verschaffen Sie sich einen umfassenden Überblick über den gesamten Lebenszyklus der Problemlösung, von der Erkennung bis zum Abschluss, unabhängig vom Quellsystem.

Laden Sie unser vorkonfiguriertes Daten-Template herunter und gehen Sie typische Herausforderungen an, um Ihre Effizienz-Ziele zu erreichen. Folgen Sie unserem Verbesserungsplan in sechs Schritten und lesen Sie den Leitfaden zum Daten-Template, um Ihre Abläufe zu verbessern.

Ausführliche Beschreibung anzeigen

Ein gut funktionierendes Problemmanagement ist entscheidend für stabile Abläufe und einen zuverlässigen Service. Process Mining im Problemmanagement zeigt durchgängig, wie Probleme in Ihrer Organisation tatsächlich erkannt, untersucht und gelöst werden. Statt sich auf Einzelfallberichte zu verlassen, sehen Sie, welche Wege Problemvorgänge von der ersten Erkennung bis zur endgültigen Lösung und Überprüfung nehmen. Die Analyse macht Engpässe sichtbar, die Lösungen verzögern, deckt Abweichungen von Compliance-Vorgaben auf und zeigt, wo sich Workflows automatisieren lassen. ProcessMind extrahiert Ereignisdaten aus Ihrem ERP-, ITSM- oder einem anderen Quellsystem und rekonstruiert damit die tatsächlichen Abläufe. So erhalten Sie eine objektive, datengetriebene Grundlage für die Analyse Ihres Problemmanagements, unabhängig vom eingesetzten System.

Im Problemmanagement treten unabhängig vom verwendeten System häufig ähnliche Herausforderungen auf: langwierige Ursachenanalysen, wiederkehrende bekannte Probleme, ineffiziente Übergaben zwischen Teams und fehlende Transparenz über die tatsächliche Durchlaufzeit bis zur Problemlösung. Oft ist unklar, warum manche Probleme länger ungelöst bleiben, wo Ressourcen falsch eingesetzt werden oder ob die festgelegten Standardverfahren in der Praxis eingehalten werden. ProcessMind setzt hier an und erstellt detaillierte Prozessübersichten und Leistungskennzahlen direkt aus Ihren Betriebsdaten. Sie erkennen genau, wo Verzögerungen entstehen, welche Schritte keinen Mehrwert schaffen und welche Abweichungen zu schlechteren Ergebnissen führen. Diese Transparenz hilft Ihnen, Abläufe zu verbessern, die mittlere Lösungszeit (MTTR) zu verkürzen, Ressourcen gezielter einzusetzen und die Stabilität Ihrer Services durch vorausschauendes Problemmanagement zu stärken, statt nur auf Incidents zu reagieren.

Die Analyse Ihres Problemmanagements mit ProcessMind liefert konkrete Ansatzpunkte für mehr Effizienz, geringere Kosten und eine bessere Servicequalität. Wenn Sie Ihren Prozess anhand tatsächlicher Daten verstehen, können Sie fundierte Entscheidungen treffen, Workflows optimieren, überflüssige Schritte vermeiden und Automatisierungsinitiativen mit großer Wirkung priorisieren. Das kann wiederkehrende Probleme und Serviceunterbrechungen verringern und die Kundenzufriedenheit steigern. Wenn Sie Lücken bei der Compliance frühzeitig erkennen und beheben, senken Sie Risiken und stellen die Einhaltung interner Richtlinien und externer Vorschriften sicher. Unsere Plattform lässt sich in Ihre vorhandenen Datenquellen integrieren. Beginnen Sie mit unserem umfassenden Datentemplate, das Sie durch die Extraktion der erforderlichen Event Logs aus Ihrem System führt und den Einstieg erleichtert. ProcessMind unterstützt Sie dabei, Ihr Problemmanagement von einer reaktiven Notwendigkeit zu einem vorausschauenden und effizienten Betrieb weiterzuentwickeln.

Problemmanagement Process Mining Service-Management ITSM Ursachenanalyse Prozessoptimierung Effizienz Compliance Ticketbearbeitung Ticketmanagement Bekannter Fehler Wiederkehrende Incidents Workaround Incident-Prävention IT-Helpdesk

Häufige Probleme und Herausforderungen

Ermitteln Sie, welche Herausforderungen Sie betreffen

Problemvorgänge bleiben oft wochenlang in der Untersuchungsphase, ohne dass klare Fortschritte erkennbar sind. Dadurch wächst der Rückstand, während die zugrunde liegenden Probleme ungelöst bleiben. Teams können die Ursachen wiederkehrender Incidents so nicht angehen. Das belastet den Service Desk zusätzlich und beeinträchtigt die Zuverlässigkeit des gesamten Service.

ProcessMind misst die Dauer der Untersuchungsphase und zeigt genau, an welcher Stelle der Prozess ins Stocken gerät. Die Plattform macht Vorgänge sichtbar, deren Bearbeitung länger dauert als üblich. So können Problemkoordinatoren eingreifen und Ressourcen neu zuweisen, bevor die Untersuchung überholt ist.

Wird ein Problemvorgang zwischen mehreren technischen Teams weitergereicht, geht häufig Kontext verloren und die Lösungsdauer verlängert sich deutlich. Fehlt eine klare Zuständigkeit, führt das zu unnötigem Aufwand, frustrierten Fachkräften und dazu, dass Service-Level-Ziele für die Stabilität kritischer Infrastruktur verfehlt werden.

Unsere Analyse bildet die Abfolge der Zuweisungsaktivitäten ab und macht solche Pingpong-Muster sichtbar. Sie sehen, welche Supportgruppen Vorgänge häufig weiterleiten. So können Sie gezielte Schulungen anbieten oder Zuständigkeiten klarer festlegen, um diesen Kreislauf zu durchbrechen.

Wird ein Workaround nicht zeitnah veröffentlicht, müssen Incident-Agents weiterhin mit wiederkehrenden Problemen umgehen. Dadurch verlängert sich die mittlere Lösungszeit für Endbenutzer. Liegt zwischen der Erkennung eines Problems und der Veröffentlichung eines Workarounds zu viel Zeit, entstehen unnötige Ausfallzeiten, obwohl bereits eine vorübergehende Lösung bekannt ist.

ProcessMind misst die Zeit zwischen der Erkennung eines Workarounds und der Aktivität „Workaround Published“. So sehen Sie, ob vorübergehende Lösungen schnell genug weitergegeben werden. Das begrenzt die Auswirkungen laufender Probleme, während sich technische Teams auf die endgültige Ursachenbehebung konzentrieren.

Auch wenn die Ursache bereits gefunden ist, kommt die dauerhafte Behebung oft nicht voran, bevor ein Änderungsantrag gestellt wird. Die fehlende Abstimmung zwischen Problem- und Änderungsmanagement führt dazu, dass bekannte Fehler bestehen bleiben, obwohl sie behoben werden könnten. Dadurch bleibt die IT-Umgebung anfällig für wiederkehrende Serviceunterbrechungen.

Wir analysieren die Zeit zwischen der Aktivität „Ursache identifiziert“ und dem Ereignis „Änderungsantrag eingeleitet“. So werden Reibungspunkte beim Übergang vom Problem- zum Änderungsmanagement sichtbar. Dauerhafte Lösungen können dadurch ohne unnötige administrative Verzögerungen umgesetzt werden.

Wenn der Problemmanagement-Lebenszyklus zu lange dauert, gehen dieselben Incidents immer wieder beim Service Desk ein. Mitarbeitende müssen wertvolle Ressourcen für wiederkehrende Aufgaben aufwenden. Das beeinträchtigt die Effizienz, lenkt Teams von strategischen Projekten ab und schwächt das Vertrauen der Benutzer in die Fähigkeit der IT, eine stabile Umgebung zu gewährleisten.

ProcessMind setzt die Anzahl der zugehörigen Incidents mit der Dauer der Untersuchungs- und Behebungsphasen in Beziehung. So wird sichtbar, wie eine langsame Problemlösung das Incident-Aufkommen erhöht. Diese Erkenntnisse helfen Ihnen, die Beschleunigung dauerhafter Lösungen wirtschaftlich zu begründen und den Service Desk insgesamt zu entlasten.

Teams überspringen häufig die Review-Phase nach der Implementierung, um Vorgänge schneller abzuschließen und Rückstände abzubauen. Ohne diesen wichtigen Schritt können Unternehmen nicht prüfen, ob die Lösung wie vorgesehen funktioniert hat, oder Erkenntnisse aus dem Vorgang festhalten. Dadurch steigt das Risiko ähnlicher Fehler in der Zukunft und die langfristige Verbesserung des Service wird erschwert.

ProcessMind verfolgt für jeden abgeschlossenen Problem-Datensatz, ob die Aktivität „Review nach der Implementierung“ durchgeführt wurde. Abweichungen vom Standardprozess werden sichtbar. So können Sie sicherstellen, dass alle Lösungsschritte eingehalten werden und langfristige Verbesserungen des Service sowie Compliance-Anforderungen unterstützt werden.

Kritische Probleme verfehlen häufig ihre Service-Level-Ziele, weil es in den Untersuchungs- und Behebungsphasen verborgene Ineffizienzen gibt. Werden Fristen versäumt, leidet die Stabilität der IT-Services. Bleibt kritische Infrastruktur länger als vereinbart instabil, kann zudem das Vertrauen in das Unternehmen sinken.

ProcessMind setzt SLA-Fälligkeitstermine mit den tatsächlichen Prozess-Timestamps aus Ihrem Quellsystem in Beziehung und identifiziert die Aktivitäten, die zu SLA-Verstößen führen. So können Sie Service-Level-Ziele in Echtzeit überwachen und Prioritäten oder Workflows anpassen, bevor Fristen verstreichen.

Wenn Techniker die Ursache eines Problems nicht korrekt kategorisieren, lassen sich langfristige Trends und systemische Schwachstellen der Infrastruktur kaum erkennen. Diese fehlenden Daten erschweren es dem Management, fundierte Entscheidungen über Investitionen in die Infrastruktur oder notwendige Prozessänderungen zur Verbesserung der Stabilität zu treffen.

ProcessMind findet Datensätze, bei denen das Attribut für die Ursachenkategorie fehlt oder einen generischen Wert enthält. Die sichtbaren Lücken in der Datenqualität helfen Unternehmen, die Datenintegrität zu verbessern und bessere Erkenntnisse über die tatsächlichen Ursachen von IT-Instabilität zu gewinnen.

Typische Ziele

Definieren Sie, woran Sie den Erfolg erkennen

Eine schnellere Ursachenanalyse verhindert wiederkehrende Incidents und verkürzt Ausfallzeiten der Infrastruktur. Wenn die Untersuchungsphase schneller abläuft, können sich technische Teams von der wiederholten Behebung akuter Störungen lösen und dauerhafte Lösungen umsetzen. Das verbessert die Zuverlässigkeit des Service und verkürzt die Zeit, in der kritische Schwachstellen unbehandelt bleiben.

Process Mining visualisiert den gesamten Untersuchungsablauf in Ihrem System und zeigt, an welchen Stellen Teams nicht weiterkommen. Die Plattform macht Engpässe in bestimmten Supportgruppen oder technischen Bereichen sichtbar und liefert konkrete Erkenntnisse, mit denen sich die Untersuchungsdauer verkürzen lässt. Sie können den Weg von der Problemerkennung bis zur Ursachenbestimmung verfolgen und prüfen, ob jede Untersuchung im Plan bleibt.

Jede Übergabe zwischen Supportgruppen verlängert die Gesamtdauer bis zur Lösung und verursacht zusätzlichen Verwaltungsaufwand. Weniger Übergaben sorgen dafür, dass sich die richtigen Fachleute sofort um das Problem kümmern. So vermeiden Sie das häufige Hin und Her bei unklarer Zuständigkeit und schaffen einen effizienteren Prozess mit klarerer Verantwortlichkeit.

Unsere Plattform verfolgt den Verlauf der Zuweisungsfelder für jeden Problem-Datensatz in Ihrem Quellsystem. Sie zeigt Muster auf, bei denen Datensätze falsch weitergeleitet oder häufig zwischen Teams hin- und hergeschoben werden. So können Sie die Weiterleitungsregeln für Gruppen verbessern und unnötige Neuzuweisungen vermeiden. Die Untersuchung kommt voran, ohne dass Übergaben den Fortschritt bremsen.

Ein schnell bereitgestellter Workaround begrenzt die Auswirkungen eines aktiven Problems auf Endbenutzer und den Service Desk. Supportmitarbeitende können Incidents damit lösen, bevor eine dauerhafte Lösung bereitsteht. So sinkt die Zahl offener Tickets deutlich und die Zufriedenheit der Benutzer steigt, während die dauerhafte Lösung entwickelt wird.

Process Mining analysiert die Zeit zwischen der Problemerkennung und der Veröffentlichung eines Workarounds in der Datenbank für bekannte Fehler. Diese Erkenntnisse helfen Ihnen, diesen wichtigen Schritt zu standardisieren und die Dokumentation bekannter Fehler schneller bereitzustellen. Die Transparenz erleichtert es, Teams für die zügige Kommunikation von Zwischenlösungen verantwortlich zu machen.

Der wichtigste Erfolgsmaßstab für jedes Problemmanagement-Team ist die Verringerung wiederkehrender Incidents. Wenn Sie Ursachen erkennen und beheben, sinken die Gesamtbetriebskosten der IT-Services und die tägliche Belastung des Service Desk. So lässt sich der konkrete Nutzen des Prozesses für das gesamte Unternehmen belegen.

Unsere Plattform setzt das Incident-Aufkommen mit bestimmten Problem-Datensätzen in Beziehung und bewertet so die langfristige Wirksamkeit dauerhafter Lösungen. Sie können prüfen, ob Lösungen die Ursache wie vorgesehen beseitigen, statt nur Symptome zu behandeln. Verfolgen Sie die Erfolgsquote umgesetzter Änderungen und stellen Sie fest, ob sie das Incident-Aufkommen wie erwartet senken.

Ein reibungsloser Übergang vom Problem-Datensatz zum Änderungsantrag ist entscheidend, um dauerhafte Lösungen kontrolliert umzusetzen. Verzögerungen dabei lassen erkannte Schwachstellen länger als nötig in der Produktionsumgebung bestehen. Das erhöht das Risiko und macht die Untersuchungsarbeit weniger wirksam.

Process Mining bildet die digitalen Spuren zwischen Problem- und Änderungsprozessen in Ihrem System ab und zeigt Reibungspunkte im Ablauf von Prüfung, Freigabe und Übergabe. So lässt sich die Lücke zwischen der Ursachenbestimmung und dem Start einer Behebung schließen. Vorgeschlagene Lösungen bleiben dadurch weniger lange in administrativen Warteschleifen oder Freigabeprozessen stecken.

Die Einhaltung von Service-Level-Vereinbarungen bei Problemen mit hoher Priorität ist entscheidend für die Geschäftskontinuität und die betriebliche Stabilität. Eine konsequente Einhaltung stärkt das Vertrauen der Fachbereiche und stellt sicher, dass besonders schwerwiegende Probleme die nötige Aufmerksamkeit erhalten. So verkürzt sich die Gesamtdauer kritischer Serviceausfälle.

Process Mining überwacht die tatsächliche Leistung im Vergleich zu den SLA-Zielen und analysiert dazu die Timestamps im gesamten Lebenszyklus eines Datensatzes. Die Plattform zeigt, in welchen Prozessphasen oder Supportgruppen SLA-Verstöße besonders wahrscheinlich sind, und liefert frühzeitig Warnhinweise. So können Ihre Teams die Vorgaben für alle Prioritätsstufen einhalten und eingreifen, bevor ein Verstoß eintritt.

Aus früheren Problemen zu lernen, ist entscheidend für die kontinuierliche Verbesserung des Service und dafür, künftige Fehler zu vermeiden. Werden alle größeren Probleme überprüft, lassen sich Erkenntnisse dokumentieren und weitergeben. So treten ähnliche Probleme seltener erneut auf und der Reifegrad der IT-Organisation steigt langfristig.

Unsere Plattform überwacht, ob vor dem Abschluss eines Datensatzes Aktivitäten für ein Review nach der Implementierung durchgeführt wurden. Sie zeigt, wo dieser Schritt häufig ausgelassen oder verzögert wird. So können Sie die Einhaltung Ihres definierten Prozesses sicherstellen und wertvolles Wissen zu jedem größeren Problem festhalten und im Service Desk weitergeben.

Korrekte Daten sind die Grundlage für wirksames Problemmanagement und langfristige Trendanalysen. Bessere Ursachenkategorien unterstützen fundierte strategische Entscheidungen und gezielte Investitionen in Technologie oder Schulungen, um systemische Probleme in der IT-Infrastruktur zu beheben und langfristige Stabilität zu erreichen.

Process Mining analysiert Ursachen- und Kategoriefelder in Tausenden von Datensätzen und findet Inkonsistenzen, nachträgliche Änderungen der Kategorie sowie eine übermäßige Verwendung generischer Kategorien wie „Sonstiges“. Diese Erkenntnisse helfen Führungskräften, Standards für die Dateneingabe zu verbessern und die Zuverlässigkeit von Berichten zu erhöhen. So lassen sich aufkommende Technologietrends leichter anhand der Daten aus Ihrem Quellsystem erkennen.

Leitfaden zur Verbesserung des Problemmanagements in 6 Schritten

1

Daten verbinden und entdecken

Was zu tun ist

Verbinden Sie Ihre Datenquelle, etwa Ihr ERP- oder Service-Management-System, um relevante Aktivitätsprotokolle zu Problem-Datensätzen zu extrahieren. Importieren Sie alle erforderlichen Ereignisdaten für die Analyse, einschließlich Timestamps und Case-IDs.

Warum das wichtig ist

Dieser grundlegende Schritt stellt sicher, dass Ihnen ein vollständiger und korrekter Datensatz vorliegt. Er bildet die Basis, um den tatsächlichen Ablauf und die Leistung Ihres Problemmanagementprozesses zu verstehen.

Erwartetes Ergebnis

Ein vollständiger und korrekter Datensatz zu den Aktivitäten im Problemmanagement steht für die Analyse bereit.

DAS ERWARTET SIE

Machen Sie verborgene Prozessprobleme sichtbar

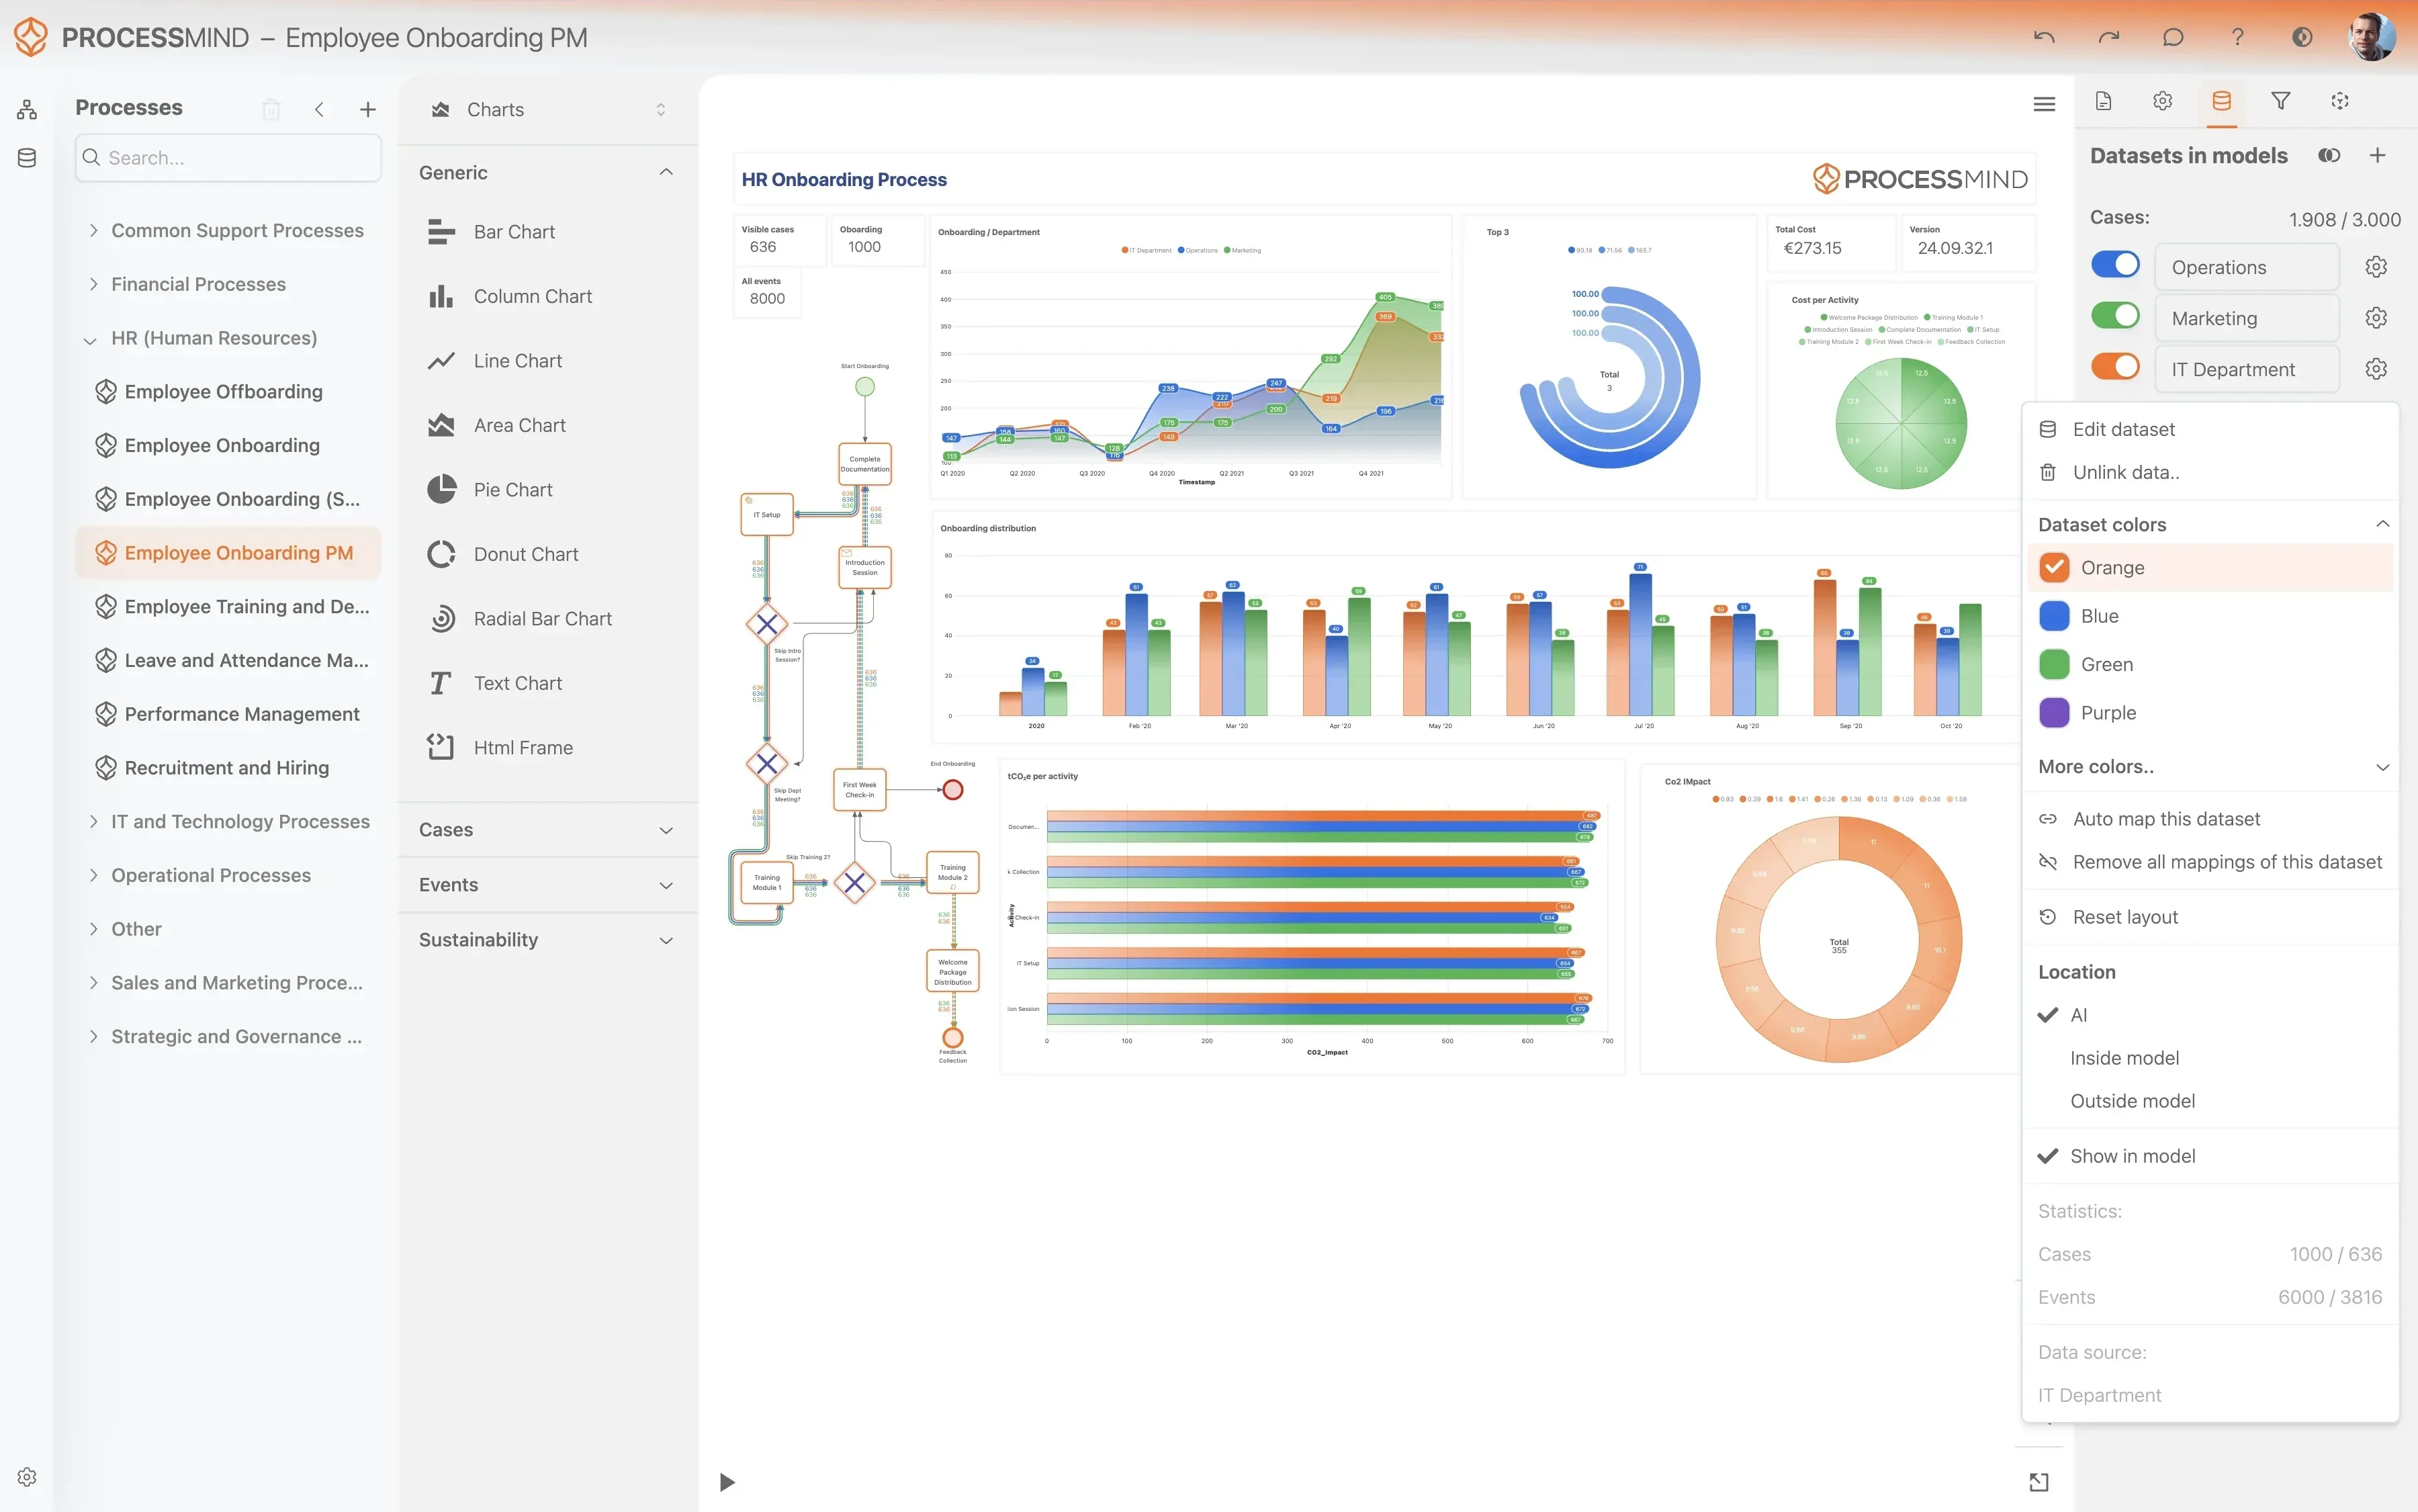
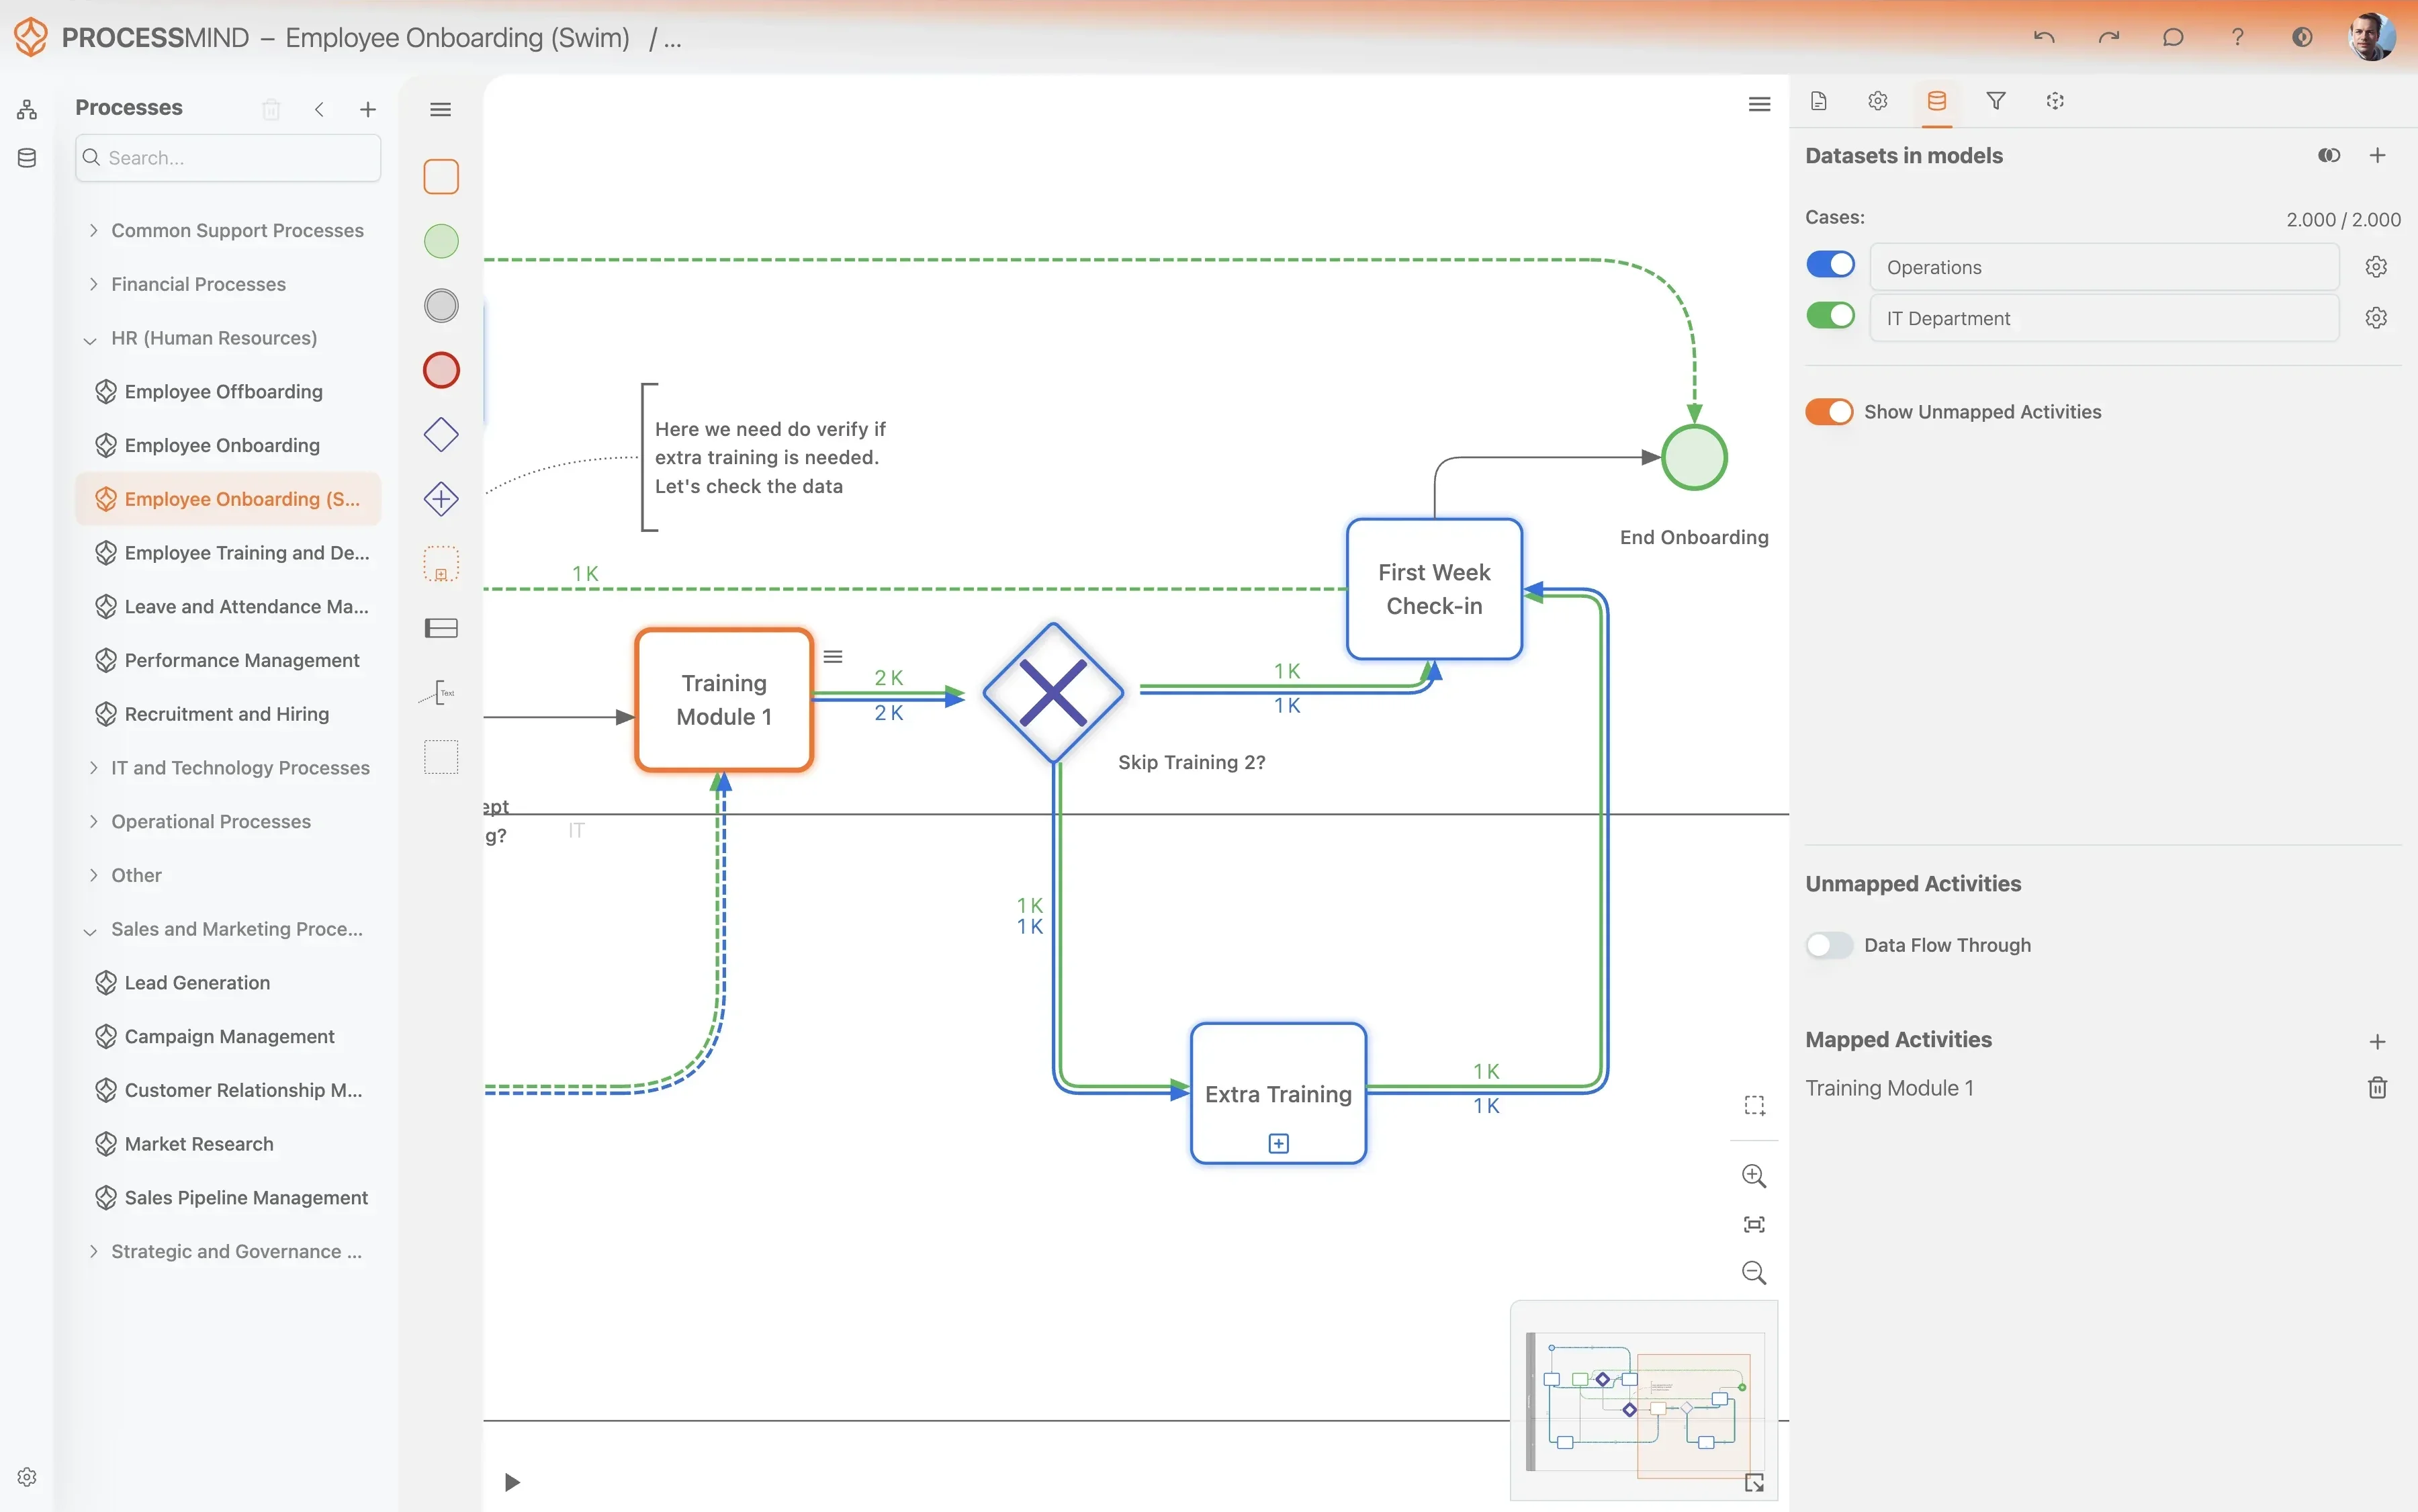
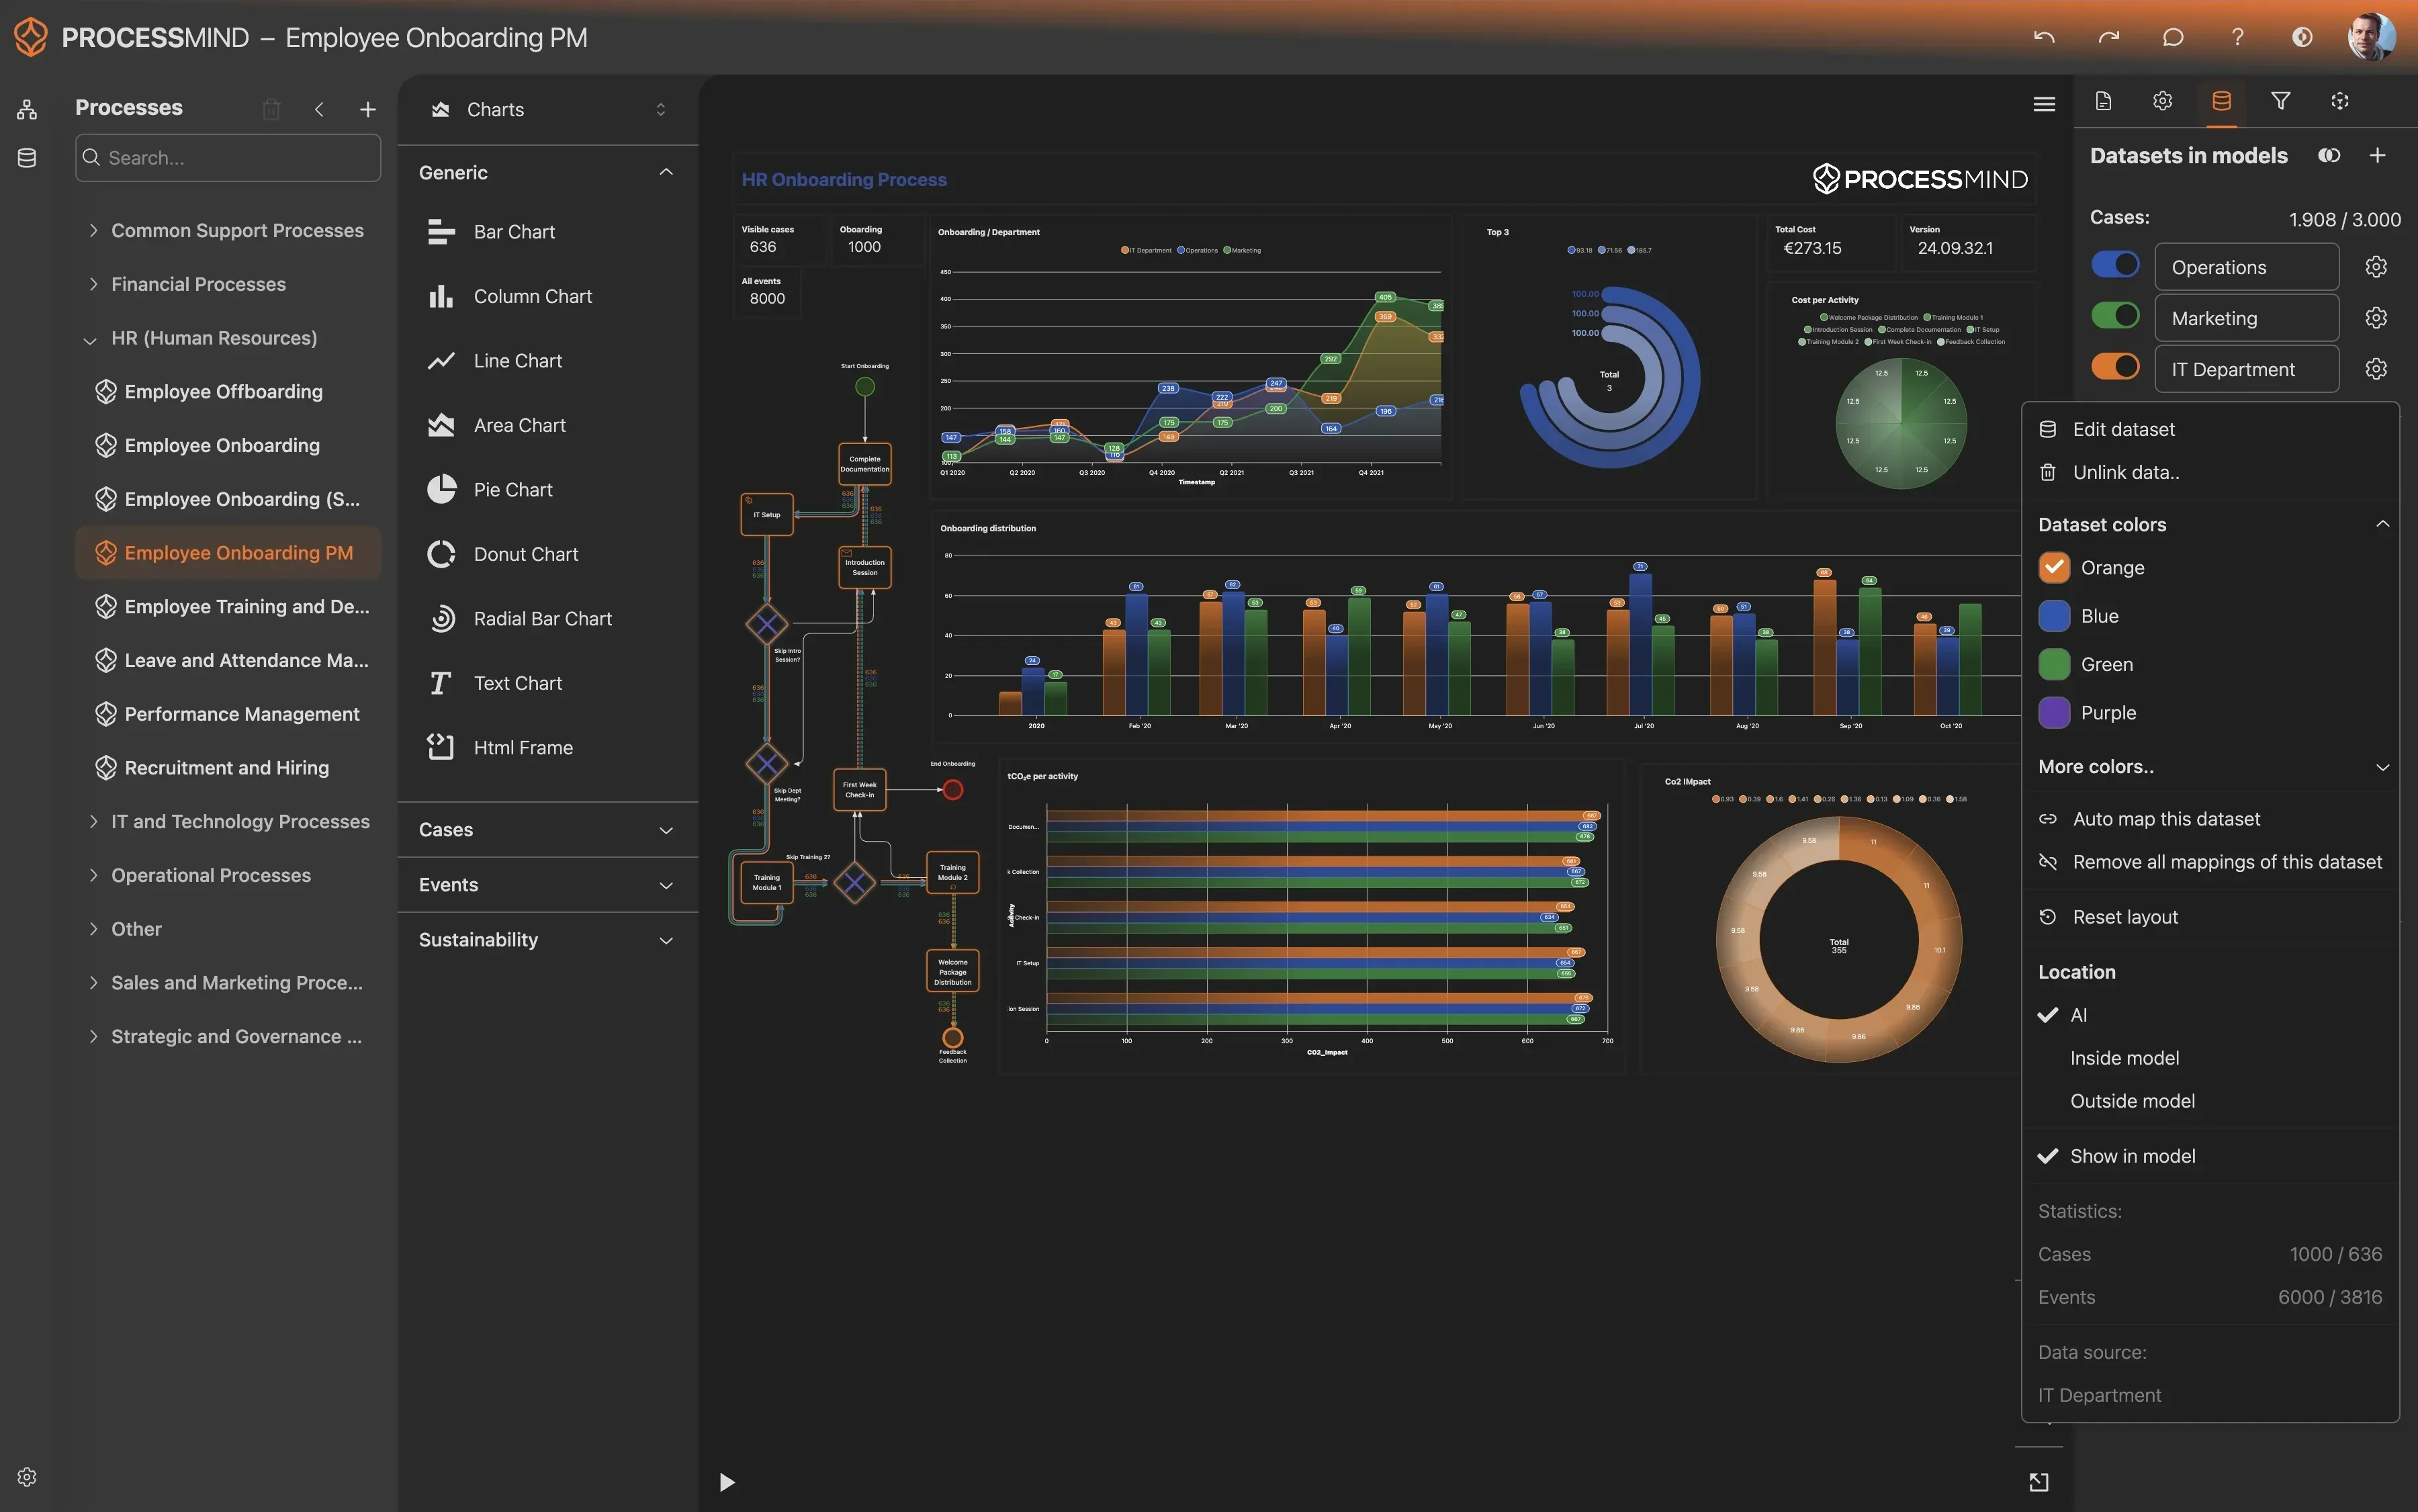
ProcessMind macht den tatsächlichen Ablauf Ihrer Prozesse sichtbar und liefert eine objektive, datengetriebene Sicht. Die Plattform zeigt Ineffizienzen und Compliance-Lücken auf, die Ihnen bisher möglicherweise nicht bekannt waren.
  • Visualisieren Sie den durchgängigen Prozessablauf
  • Erkennen Sie verborgene Ineffizienzen und Engpässe
  • Stellen Sie die Einhaltung von Prozessregeln sicher
  • Setzen Sie Ressourcen gezielt ein
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

TYPISCHE ERGEBNISSE

Mehr Nutzen durch Process Mining im Problemmanagement

Diese Ergebnisse zeigen die konkreten Verbesserungen, die Unternehmen durch Process Mining in ihren Problemmanagement-Workflows erzielen. Mit datengetriebenen Erkenntnissen können Teams Engpässe erkennen, die Problemlösung vereinfachen und wiederkehrende Probleme wirksamer verhindern.

0 %
Ursachen schneller erkennen

Durchschnittliche Verkürzung der Untersuchungsdauer

Wenn der Weg vom Untersuchungsbeginn bis zur Ursachenbestimmung kürzer wird, können sich technische Teams auf dauerhafte Lösungen statt auf langwierige Diagnosen konzentrieren. Das reduziert kritische Serviceunterbrechungen.

0 %
Weniger Nacharbeit bei Übergaben

Weniger Neuzuweisungen von Problem-Datensätzen

Wenn Engpässe bei der ersten Weiterleitung erkannt werden, erreichen Problem-Datensätze sofort die richtigen Fachleute. So vermeiden Sie unnötigen Aufwand und Verzögerungen in mehreren Supportgruppen.

0 %
SLA-Ziele besser einhalten

Höhere Konformität bei kritischen Problemen

Die Echtzeittransparenz bei festgefahrenen Problem-Datensätzen hilft dem Management, einzugreifen, bevor Service-Level-Ziele verfehlt werden. So lässt sich eine verlässliche Servicebereitstellung für das Unternehmen sicherstellen.

0 %
Weniger Nacharbeit bei der Problemlösung

Weniger erneut geöffnete Probleme

Wenn Lösungen vor dem Abschluss überprüft werden, lässt sich sicherstellen, dass die zugrunde liegenden Probleme tatsächlich behoben sind. So vermeiden Sie kostspielige neue Untersuchungen nach einer vermeintlichen Lösung und verbessern die Stabilität insgesamt.

0 %
Workarounds schneller bereitstellen

Temporäre Lösungen schneller veröffentlichen

Wenn temporäre Workarounds schneller veröffentlicht werden, sinken die Auswirkungen laufender Incidents auf Endbenutzer deutlich. Das begrenzt Betriebsunterbrechungen, während die langfristige Lösung entwickelt wird.

0 %
Weniger wiederkehrende Incidents

Weniger zugehörige Tickets beim Service Desk

Wenn Ursachen effizient erkannt und behoben sowie dauerhafte Lösungen veröffentlicht werden, verstopfen neue Incidents den Service Desk seltener und die Gesamtkosten des Supports sinken.

Die Ergebnisse hängen von der Prozesskomplexität, der Datenqualität und der konkreten Umsetzungsstrategie ab. Die Zahlen zeigen typische Verbesserungen, die bei verschiedenen Implementierungen im Problemmanagement beobachtet wurden.

Empfohlene Daten

Beginnen Sie mit den wichtigsten Attributen und Aktivitäten und ergänzen Sie weitere Daten nach Bedarf.
Neu bei Event Logs? Erfahren Sie, wie Sie ein Event Log für Process Mining erstellen.

Attribute

Wichtige Datenpunkte für die Analyse

Die eindeutige Kennung eines Problem-Datensatzes, der einen einzelnen Durchlauf des Problemmanagementprozesses darstellt.

Warum das wichtig ist

Dies ist die erforderliche Case-ID, mit der alle zugehörigen Ereignisse gruppiert werden. So lässt sich der gesamte Verlauf jeder Problemuntersuchung nachvollziehen.

Der Name eines bestimmten Ereignisses, einer Aufgabe oder einer Statusänderung im Lebenszyklus des Problemmanagements.

Warum das wichtig ist

Dieses Attribut legt die Prozessschritte fest und ermöglicht die Visualisierung und Analyse des Prozessablaufs, einschließlich typischer Pfade und Abweichungen.

Das genaue Datum und die Uhrzeit, zu denen eine bestimmte Aktivität stattgefunden hat.

Warum das wichtig ist

Der Timestamp jeder Aktivität ist entscheidend, um Ereignisse zu ordnen und zeitbasierte Kennzahlen wie Zykluszeiten und die Dauer von Engpässen zu berechnen.

Das technische Team oder die Abteilung, die zu einem bestimmten Zeitpunkt für die Untersuchung und Lösung des Problems zuständig ist.

Warum das wichtig ist

Wichtig für die Analyse der Teamleistung, das Ermitteln von Engpässen durch Übergaben und das Verständnis der Arbeitslastverteilung zwischen Teams.

Die zugewiesene Prioritätsstufe des Problems. Sie bestimmt, wie dringend die Untersuchung und Lösung sind.

Warum das wichtig ist

Ermöglicht den Vergleich der Bearbeitung kritischer und routinemäßiger Probleme und ist wichtig, um die SLA-Einhaltung zu messen.

Die abschließende Einordnung der zugrunde liegenden Ursache des Problems.

Warum das wichtig ist

Wichtig für strategische Analysen: Es hilft, systemische Probleme und Trends bei den Ursachen von Problemen in der Organisation zu erkennen.

Der wichtigste betroffene Geschäftsservice, die betroffene Anwendung oder das betroffene Konfigurationselement (CI).

Warum das wichtig ist

Stellt den geschäftlichen Kontext her, indem technische Probleme mit den betroffenen Services verknüpft werden. So lassen sich Maßnahmen nach ihrer geschäftlichen Bedeutung priorisieren.

Die Gesamtzahl der einzelnen Incident-Datensätze, die mit dem Problem verknüpft sind.

Warum das wichtig ist

Beziffert die geschäftlichen Auswirkungen eines Problems. Das hilft, Untersuchungen zu priorisieren und die Wirksamkeit der Lösung zu messen.

Das Zieldatum und die Zieluhrzeit, bis zu denen der Problem-Datensatz gemäß Service Level Agreement gelöst werden soll.

Warum das wichtig ist

Legt das Lösungsziel fest und bildet damit die Grundlage für die Messung und Berichterstattung zur SLA-Einhaltung.

Eine Kennzeichnung, die angibt, ob die Lösung des Problems nach dem zugewiesenen SLA-Fälligkeitstermin erfolgte.

Warum das wichtig ist

Zeigt eindeutig an, ob das SLA eingehalten wurde. So lassen sich Prozesspfade, die zu Verletzungen führen, einfach filtern und analysieren.

Wie oft der Problem-Datensatz zwischen verschiedenen Support-Gruppen oder einzelnen Benutzern neu zugewiesen wurde.

Warum das wichtig ist

Hilft, Ineffizienzen im Prozess anhand übermäßiger Übergaben zu beziffern. Diese weisen häufig auf falsche Zuweisungen, Wissenslücken oder unklare Zuständigkeiten hin.

Aktivitäten

Prozessschritte, die Sie verfolgen und optimieren sollten

Hier wird ein Problem-Datensatz erstmals angelegt. Damit beginnt der Problemmanagementprozess offiziell. Der Timestamp dient als Ausgangspunkt für alle weiteren Analysen.

Warum das wichtig ist

Diese Aktivität ist der Startpunkt jeder Prozessinstanz. Die Zeit zwischen diesem Ereignis und späteren Ereignissen ist entscheidend, um die Gesamtdauer des Prozesses und Verzögerungen zu Beginn zu verstehen.

Dieses Ereignis markiert den Übergang des Problem-Datensatzes von einem neuen oder ausstehenden Status in die aktive Untersuchung. Es zeigt an, dass ein Analyst offiziell mit der Diagnose des Problems begonnen hat.

Warum das wichtig ist

Anhand dieser Aktivität lassen sich die anfängliche Reaktionszeit und die Geschwindigkeit beim Abbau des Rückstands messen. Die Zeit zwischen der Erstellung und dem Beginn der Untersuchung ist ein wichtiger Indikator für die Reaktionsfähigkeit des Teams.

Dieses Ereignis zeigt an, dass eine temporäre Lösung oder ein Workaround dokumentiert und verfügbar gemacht wurde. So lassen sich die Auswirkungen auf Endbenutzer begrenzen, während eine dauerhafte Lösung entwickelt wird.

Warum das wichtig ist

Die Zeit bis zur Bereitstellung eines Workarounds ist eine wichtige Kennzahl dafür, wie schnell ein Team den Service wiederherstellen kann. Anhand dieser Aktivität lassen sich Geschwindigkeit und Wirksamkeit temporärer Lösungen analysieren.

Diese Aktivität markiert den Meilenstein, an dem die zugrunde liegende Ursache des Problems erfolgreich diagnostiziert und dokumentiert wurde. Damit ist die Untersuchungsphase abgeschlossen.

Warum das wichtig ist

Dieser Meilenstein ist entscheidend, um die Effizienz der Diagnose zu messen. Die Zeit vom Beginn der Untersuchung bis zur Ursachenbestimmung ist eine wichtige Leistungskennzahl für die Problemanalyse.

Dieses Ereignis erfasst, dass ein formeller Änderungsantrag erstellt oder mit dem Problem-Datensatz verknüpft wurde. Es markiert die Übergabe vom Problemmanagement an das Änderungsmanagement, damit eine dauerhafte Lösung umgesetzt werden kann.

Warum das wichtig ist

Diese Aktivität ist entscheidend, um die Verzögerung zwischen der Diagnose eines Problems und dem Start der Behebung zu analysieren. Sie hilft, Engpässe an der Schnittstelle zwischen Problem- und Änderungsmanagement zu erkennen.

Dieses Ereignis zeigt an, dass die dauerhafte technische Lösung, die häufig über einen Änderungsantrag verwaltet wird, erfolgreich bereitgestellt wurde. Damit sind die Behebungsarbeiten abgeschlossen.

Warum das wichtig ist

Mit dieser Aktivität endet die Umsetzungsphase der Lösung. Die Zeit vom Start der Änderung bis zu diesem Punkt zeigt, wie effizient das Änderungsmanagement Probleme behebt.

Dies ist die letzte Aktivität im Lebenszyklus. Sie zeigt an, dass der Problem-Datensatz administrativ geschlossen wurde und keine weiteren Maßnahmen erwartet werden. Der Case gilt als abgeschlossen und archiviert.

Warum das wichtig ist

Diese Aktivität ist bei den meisten Prozessinstanzen der Endpunkt. Sie ist entscheidend für die Berechnung der gesamten Dauer des Problemmanagementprozesses.

Für individuelle Datenempfehlungen wählen Sie Ihren konkreten Prozess aus.

Häufig gestellte Fragen

Häufig gestellte Fragen

Process Mining visualisiert den tatsächlichen Ablauf jedes Problem-Datensatzes. So werden Abweichungen von Standard-Workflows und verborgene Engpässe sichtbar. Die datengetriebene Sicht auf Ihren Prozess hilft Teams, die Effizienz zu steigern und die Lösungsdauer zu verkürzen.

In der Regel benötigen Sie ein Event Log mit einer eindeutigen Case-ID, einem Timestamp für jede Aktivität und einer Beschreibung der Aktivität. Wichtige Attribute wie Statusänderungen, zugewiesene Gruppen, Priorität und Kategorie liefern zusätzlichen Kontext für eine detailliertere Analyse.

Erste Erkenntnisse liegen häufig innerhalb weniger Tage bis Wochen vor, sobald der Datenexport aus Ihrem Quellsystem eingerichtet ist. In der ersten Phase wird die Verbindung zum System hergestellt und es werden die wichtigsten Prozessänderungen abgebildet, um ein Basismodell zu erstellen.

Process Mining zeigt anhand der Dauer einzelner Übergänge, in welchen Phasen Untersuchungen ins Stocken geraten. Die Analyse macht fehlende Ressourcen oder Informationen sichtbar, die die Untersuchung verlängern. So ersetzen Sie anekdotische Hinweise durch konkrete Daten dazu, wo Verzögerungen auftreten.

Process Mining bildet jeden Übergang ab und erkennt Problem-Datensätze, die wiederholt zwischen Supportgruppen wechseln, ohne gelöst zu werden. So können Führungskräfte unklare Zuständigkeiten oder fehlende Ressourcen in bestimmten Teams erkennen. Diese Erkenntnisse ermöglichen eine Neugestaltung des Prozesses und eine bessere Ressourcenverteilung.

Process Mining zeigt den genauen Ablauf von Datensätzen, bei denen SLA-Ziele verfehlt wurden, und macht so die Ursachen der Verstöße sichtbar. Vergleichen Sie Datensätze mit und ohne SLA-Verstoß, um festzustellen, ob bestimmte Supportgruppen oder Problemtypen häufiger von Verzögerungen betroffen sind. So können Sie gezielt eingreifen und sicherstellen, dass Probleme mit hoher Priorität innerhalb der vorgegebenen Fristen bearbeitet werden.

Durch die Analyse der Verknüpfungen zwischen Incident- und Problem-Datensätzen erkennt Process Mining Muster, bei denen Probleme wiederholt mit Workarounds statt mit dauerhaften Lösungen behandelt werden. Diese Transparenz hilft Ihnen, Lösungen mit großer Wirkung zu priorisieren, die ganze Gruppen wiederkehrender Support-Tickets beseitigen.

Standardberichte zeigen Momentaufnahmen und aggregierte Kennzahlen, bilden den tatsächlichen Verlauf eines Problem-Datensatzes jedoch oft nicht ab. Process Mining macht die konkreten Übergänge, Schleifen und Abweichungen zwischen diesen Kennzahlen sichtbar. Es zeigt genau, wo und warum ein Prozess ins Stocken gerät, und ergänzt Standardberichte um eine detaillierte Sicht auf den Prozessverlauf. So können Sie gezielt optimieren.

Verbessern Sie Ihr Problemmanagement, starten Sie jetzt

Erkennen Sie Ineffizienzen und lösen Sie Probleme schneller mit datengetriebenen Erkenntnissen.

Starten Sie Ihre kostenlose Testphase

Keine Kreditkarte erforderlich. Die Einrichtung dauert nur wenige Minuten.