Verbessern Sie Ihr Incident Management
Ihr Leitfaden in 6 Schritten zur Optimierung von Freshservice-Incidents
Verbessern Sie Ihr Incident Management
Incident Management
Freshservice

Prozess auswählen

Wählen Sie einen Prozess aus, um in Ihrem verbundenen Arbeitsbereich weiterzuarbeiten.

Optimieren Sie das Incident Management in Freshservice für eine schnellere Lösung von Vorfällen

Im Incident Management kommt es häufig zu langen Lösungszeiten und wiederkehrenden Problemen. Unsere Plattform zeigt Ihnen schnell, wo Verzögerungen entstehen und welche Ursachen dahinterstecken. So erkennen Sie verborgene Engpässe in Ihren Prozessen und können die Ursachen für Ineffizienzen gezielt untersuchen. Finden Sie heraus, wie sich Workflows wirksamer gestalten lassen, um die Servicebereitstellung und die Zufriedenheit der Benutzer zu verbessern.

Laden Sie unser vorkonfiguriertes Daten-Template herunter und gehen Sie typische Herausforderungen an, um Ihre Effizienz-Ziele zu erreichen. Folgen Sie unserem Verbesserungsplan in sechs Schritten und lesen Sie den Leitfaden zum Daten-Template, um Ihre Abläufe zu verbessern.

Ausführliche Beschreibung anzeigen

Warum die Optimierung des Incident Managements entscheidend ist

Ein wirksames Incident Management ist die Grundlage zuverlässiger IT-Services. Es wirkt sich direkt auf die Produktivität der Benutzer, die Betriebskosten und die Kundenzufriedenheit aus. In der schnelllebigen digitalen Arbeitswelt können Verzögerungen bei der Lösung von Vorfällen, ob geringfügig oder kritisch, erhebliche Geschäftsunterbrechungen verursachen. Längere Ausfallzeiten, wiederholte manuelle Arbeit und daraus entstehende Produktivitätsverluste sind typische Folgen ineffizienter Incident-Prozesse. Werden Vorfälle in Freshservice oder einem anderen System nicht effizient bearbeitet, steigen die Betriebskosten, SLA-Überschreitungen werden wahrscheinlicher und das Vertrauen der Benutzer nimmt ab. Wenn Sie den tatsächlichen Ablauf Ihres Incident-Management-Prozesses in Freshservice verstehen, können Sie diese Risiken verringern und zuverlässige Services sicherstellen.

Wie Process Mining die Lösung von Vorfällen in Freshservice verbessert

Process Mining bietet einen datenbasierten Einblick in Ihre bestehenden Incident-Management-Workflows in Freshservice. Es zeigt den tatsächlichen Soll-Ist-Verlauf statt eines theoretischen Idealprozesses. Durch die Analyse von Event Logs aus Freshservice rekonstruiert Process Mining den vollständigen Ablauf jedes Vorfalls, von der ersten Meldung bis zum endgültigen Abschluss. So erkennen Sie genau, wo Vorfälle ins Stocken geraten, unnötige Nacharbeit entsteht und welche Schritte Engpässe verursachen, die die Zykluszeit bis zur Lösung verlängern.

Sie können beispielsweise nachvollziehen, wie Vorfälle kategorisiert und priorisiert werden, wie oft sie tatsächlich zwischen Supportgruppen weitergeleitet werden und ob bestimmte Diagnoseschritte wiederholt werden, ohne Fortschritte zu erzielen. So lassen sich verborgene Ineffizienzen aufdecken, etwa häufige Neuzuweisungen, lange Wartezeiten auf eine Bestätigung durch Benutzer oder Abweichungen von Standardvorgehensweisen. Process Mining hilft Ihnen, wichtige Fragen zu beantworten: „Was verursacht die langen Lösungszeiten bei Vorfällen mit hoher Priorität in Freshservice?“ oder „Warum überschreiten Vorfälle bei bestimmten Services regelmäßig ihre SLA-Ziele?“ Diese detaillierten Erkenntnisse helfen Ihnen, Annahmen durch konkrete, empirische Belege aus Ihren Freshservice-Daten zu ersetzen und Verbesserungen gezielt anzugehen.

Wichtige Ansatzpunkte zur Verbesserung Ihres Incident-Management-Prozesses

Mit den Erkenntnissen aus dem Process Mining können Sie gezielt einzelne Bereiche Ihres Incident Managements in Freshservice optimieren. Typische Verbesserungsmöglichkeiten sind:

  • Kategorisierung und Priorisierung von Vorfällen vereinfachen: Ermitteln Sie, ob Vorfälle anfangs häufig falsch klassifiziert werden und deshalb neu kategorisiert werden müssen oder sich verzögern.
  • Unnötige Weiterleitungen und Eskalationen reduzieren: Finden Sie Vorfälle, die häufig zwischen Teams hin- und hergeleitet werden. Das kann auf Schulungsbedarf, unzureichenden Wissensaustausch oder ungeeignete Zuweisungsregeln hindeuten.
  • Diagnose- und Lösungsabläufe optimieren: Ermitteln Sie, welche Schritte zu lange dauern oder bei denen Mitarbeitende die Diagnose wiederholt neu beginnen. Das kann auf Lücken in Wissensdatenbanken oder standardisierten Vorgehensweisen hinweisen.
  • Nutzung der Wissensdatenbank verbessern: Erkennen Sie Vorfälle, bei denen Lösungen wiederholt
Incident Management Service Desk ITIL Servicewiederherstellung Einhaltung von SLAs Helpdesk Ursachenanalyse Lösung von Tickets Ticketbearbeitung Ticketverwaltung IT-Helpdesk Durchschnittliche Lösungszeit MTTR Lösung von Vorfällen IT-Support

Häufige Probleme und Herausforderungen

Ermitteln Sie, welche Herausforderungen Sie betreffen

Verzögerungen bei der Lösung von Vorfällen beeinträchtigen direkt die Produktivität der Benutzer und die Verfügbarkeit von Services. Das senkt die Zufriedenheit und kann zu geschäftlichen Verlusten führen. Häufige Ursachen sind ineffiziente Übergaben, langwierige Diagnosephasen oder Wartezeiten aufgrund externer Abhängigkeiten. Sie beeinträchtigen die Leistung Ihres Incident Managements erheblich.

ProcessMind bildet den tatsächlichen Ablauf des Incident Managements in Freshservice ab und zeigt genau, wo Vorfälle übermäßig viel Zeit in Anspruch nehmen, etwa zwischen Zuweisung und Diagnose oder während der Untersuchung. Die Analyse macht Engpässe und Abweichungen vom idealen Ablauf sichtbar und zeigt, wo Prozessanpassungen die Lösung beschleunigen können.

Regelmäßige Überschreitungen von Service Level Agreements (SLAs) schaden dem Vertrauen, können Vertragsstrafen nach sich ziehen und weisen auf systembedingte Ineffizienzen im Incident-Management-Prozess hin. Um die Servicequalität zu sichern und negative Auswirkungen auf Benutzererlebnis und Compliance zu vermeiden, müssen Sie verstehen, warum SLA-Ziele verfehlt werden.

Indem ProcessMind die Abläufe von Vorfällen mit ihrem SLA-Status verknüpft, zeigt die Plattform, welche Aktivitäten oder Ereignisfolgen in Freshservice regelmäßig zu Überschreitungen führen. Sie visualisiert Abweichungen von Standardvorgehensweisen, die dazu beitragen, dass Ziele verfehlt werden. So können Sie gezielte Verbesserungen zur besseren Einhaltung der Vorgaben umsetzen.

Vorfälle werden häufig zwischen Supportgruppen oder Mitarbeitenden hin- und hergeleitet. Das führt zu Verzögerungen und Nacharbeit. Unklare Übergabeverfahren oder fehlende Zuständigkeiten können die Lösungszeiten erheblich verlängern und Benutzer frustrieren. Dadurch steigen auch die Gesamtkosten des Incident Managements.

ProcessMind visualisiert alle Weiterleitungen und Neuzuweisungen in Freshservice und zeigt, wie häufig und wie lange Übergaben zwischen Supportgruppen und Mitarbeitenden dauern. Die Analyse deckt typische Pingpong-Abläufe und ineffiziente Weiterleitungsmuster auf, die eine schnelle Lösung verhindern. So erkennen Sie, wo sich die Workflow-Gestaltung verbessern lässt.

Falsch kategorisierte Vorfälle oder unpassende Prioritätsstufen können dazu führen, dass Vorfälle an die falschen Teams weitergeleitet oder nicht angemessen bearbeitet werden. Das verzögert die Lösung und kann die Auswirkungen verschärfen. In Ihrer Freshservice-Instanz führt dies zu verschwendeten Ressourcen und verfehlten Zielen.

Durch die Analyse der ursprünglichen Kategorisierung und späterer Änderungen an Kategorie oder Priorität deckt ProcessMind Muster fehlerhafter Klassifizierungen in Freshservice auf. Die Plattform zeigt, wo und warum Vorfälle häufig neu kategorisiert werden. Das kann auf den Bedarf an klareren Klassifizierungsrichtlinien oder Schulungen für Mitarbeitende hinweisen, damit Vorfälle von Anfang an korrekt eingeordnet und weitergeleitet werden.

Ohne wirksame Ursachenanalyse (Root Cause Analysis, RCA) lösen Unternehmen dieselben Probleme häufig wiederholt. Das erhöht die Zahl der Vorfälle und verursacht unnötigen Aufwand. Langfristige Stabilität und kontinuierliche Verbesserungen der Servicebereitstellung bleiben dadurch aus.

ProcessMind kann Vorfälle ermitteln, die ohne zugehörige Ursachenanalyse gelöst wurden, sowie häufig wiederkehrende Lösungscodes, zu denen in Freshservice kein entsprechendes Problem-Ticket vorliegt. Die Analyse zeigt, wie oft die RCA umgangen wird und wo sich das Problemmanagement besser in den Incident-Management-Workflow integrieren lässt.

Sind Eskalationswege unklar oder werden sie nicht konsequent eingehalten, können Vorfälle stecken bleiben oder willkürlich manuell eskaliert werden. Das führt zu uneinheitlicher Servicebereitstellung und längeren Lösungszeiten, besonders bei kritischen Problemen. Darunter leiden die Effizienz der Teams und das Vertrauen der Benutzer.

ProcessMind visualisiert die tatsächlichen Eskalationsmuster in Freshservice und macht nicht autorisierte oder ineffiziente Wege sichtbar, die von den festgelegten Verfahren abweichen. Die Plattform zeigt, wie, von wem und in welcher Phase Vorfälle eskaliert werden. So erkennen Sie Unstimmigkeiten und Engpässe, die sich durch Anpassungen des Eskalationsprozesses beseitigen lassen.

Workarounds sind wichtig, um Services schnell wiederherzustellen. Werden sie jedoch nicht effizient eingesetzt oder beheben sie das Problem nicht ausreichend, bleiben Vorfälle länger offen oder treten erneut auf. Das frustriert Benutzer und Supportteams und mindert die Wirksamkeit Ihrer Incident-Management-Strategie.

ProcessMind verfolgt die Aktivität 'Workaround Implemented' in Freshservice und zeigt, wie sie sich auf die anschließende Lösungszeit und wiedereröffnete Vorfälle auswirkt. Die Analyse macht sichtbar, ob Workarounds regelmäßig zu spät eingesetzt werden oder weitere Verzögerungen und erneute Vorfälle nach sich ziehen. So erkennen Sie Ineffizienzen im Umgang mit Workarounds.

Werden Vorfälle häufig zwischen Mitarbeitenden oder Gruppen neu zugewiesen oder nach der Lösung wiedereröffnet, deutet das auf Probleme bei der Diagnose, der Lösungsqualität oder der Kommunikation hin. Dadurch steigen die Betriebskosten und die Zufriedenheit der Benutzer sinkt deutlich.

ProcessMind verfolgt den gesamten Lebenszyklus eines Vorfalls in Freshservice und ermittelt die Anzahl der Neuzuweisungen und Wiedereröffnungen. Die Plattform zeigt, in welchen Phasen sie besonders häufig auftreten, und setzt sie mit bestimmten Mitarbeitenden oder Gruppen in Beziehung. So werden Qualitätsprobleme und Wissenslücken sichtbar, die Sie angehen können.

Deutliche Unterschiede darin, wie einzelne Agents oder Supportgruppen ähnliche Incidents bearbeiten, können zu schwankender Servicequalität, schwer planbaren Lösungszeiten und einer ungleichen Arbeitsverteilung führen. Diese Unterschiede zu erkennen, ist entscheidend, um die Leistung zu verbessern und Teams wirksam zu führen.

ProcessMind vergleicht in Freshservice die Lösungszeiten, die Einhaltung von Prozessschritten und den Einsatz von Workarounds verschiedener Agents oder Supportgruppen. Die Analyse zeigt bewährte Vorgehensweisen und Bereiche auf, in denen Schulungen oder eine konsequentere Einhaltung der Prozesse erforderlich sind, um die Leistung zu vereinheitlichen und die Effizienz insgesamt zu steigern.

Die letzten Schritte im Incident Management, etwa das Warten auf eine Bestätigung durch den Benutzer oder eine interne Überprüfung vor dem Schließen, können unerwartet zum Engpass werden. Dadurch dauert der Incident länger, obwohl die technische Lösung bereits umgesetzt ist. Das wirkt sich auf Berichte und Kennzahlen zur Wiederherstellung des Service aus.

ProcessMind analysiert in Freshservice gezielt die Zeit zwischen den Aktivitäten „Benachrichtigung an Benutzer gesendet“, „Bestätigung des Benutzers erhalten“, „Incident überprüft“ und „Incident geschlossen“. So wird sichtbar, ob sich diese letzten Schritte unnötig in die Länge ziehen und ob sich die Kommunikation vereinfachen oder Nachfassaktionen automatisieren lassen, damit Incidents schneller geschlossen werden.

Melden Benutzer Incidents regelmäßig über Kanäle, die sich nicht für eine schnelle Bearbeitung eignen, kann sich die erste Reaktionszeit verlängern und der manuelle Aufwand für Supportteams steigen. Um die Erfassung effizienter zu gestalten und Ressourcen passend einzusetzen, ist es wichtig zu wissen, welche Kanäle verwendet werden.

ProcessMind wertet in Freshservice das Attribut „Meldekanal“ zusammen mit den anschließenden Bearbeitungszeiten und der Effizienz der Lösung aus. So zeigt sich, welche Kanäle Verzögerungen verursachen oder zusätzliche Nacharbeit erfordern. Diese Erkenntnisse helfen, die Erfassung zu verbessern und Benutzer auf effizientere Meldewege hinzuweisen.

Typische Ziele

Definieren Sie, woran Sie den Erfolg erkennen

Kritische Incidents schneller zu lösen, ist entscheidend, um Betriebsunterbrechungen zu begrenzen und den laufenden Betrieb sicherzustellen. Eine zügige Lösung wirkt sich direkt auf die Zufriedenheit der Benutzer aus und hilft, finanzielle Vertragsstrafen bei Serviceausfällen in Freshservice zu vermeiden. Dafür muss die Zeit vom Eingang der Meldung bis zur vollständigen Wiederherstellung des Service verkürzt werden. ProcessMind identifiziert Engpässe und Prozessschritte ohne Mehrwert im Lösungsweg kritischer Incidents. Die Analyse zeigt, welche Aktivitäten oder Übergaben Verzögerungen verursachen. Anhand der tatsächlichen Prozessabläufe werden Abweichungen von effizienten Wegen sichtbar und Ansatzpunkte für Automatisierung oder eine andere Ressourcenverteilung aufgezeigt, um die Lösungszeiten deutlich zu verkürzen.

Service-Level-Agreement-Ziele (SLA-Ziele) konsequent einzuhalten, ist wichtig, um das Vertrauen der Kunden zu erhalten, Compliance sicherzustellen und Vertragsstrafen zu vermeiden. Ziel ist, in Freshservice die vereinbarten Reaktions- und Lösungszeiten für alle Incidents einzuhalten und die Servicequalität insgesamt zu verbessern. ProcessMind zeigt, bei welchen Incidents eine SLA-Verletzung droht und an welcher Stelle im Prozess Verzögerungen auftreten. Die Analyse deckt Ursachen für SLA-Verletzungen auf, etwa eine verspätete Erstzuweisung oder eine langwierige Diagnose. So können Sie gezielt gegensteuern, die Compliance sicherstellen und die Zuverlässigkeit des Service verbessern.

Unnötige oder verspätete Übergaben zwischen Teams oder Agents können die Lösungszeiten in Freshservice deutlich verlängern und die Effizienz mindern. Weniger Übergaben und kürzere Wartezeiten zwischen Prozessschritten sorgen für einen schnelleren und reibungsloseren Ablauf. ProcessMind bildet den gesamten Weg eines Incidents ab und macht jede Übergabe und Neuzuweisung sichtbar. Die Analyse deckt ineffiziente Übergabemuster und wiederholte Wechsel zwischen Gruppen auf. So erkennen Sie, wo sich Routing-Regeln verbessern, die Genauigkeit der Erstzuweisung erhöhen und die Zahl der Schritte bis zur Lösung verringern lässt.

Eine korrekte Kategorisierung von Incidents ist die Grundlage für ein effizientes Incident Management. Sie stellt sicher, dass Tickets an die zuständigen Teams weitergeleitet und zeitnah gelöst werden. Falsche Kategorien führen in Freshservice zu Fehlleitungen, Verzögerungen und unnötigem Ressourceneinsatz. Ziel ist es, die Genauigkeit der ersten Klassifizierung zu erhöhen. ProcessMind analysiert die Wege von Incidents aus verschiedenen Kategorien und zeigt, wo und warum sie falsch eingeordnet werden. Die Analyse macht auch die Folgen einer falschen Klassifizierung sichtbar, etwa längere Lösungszeiten. So können Unternehmen ihre Kategoriesysteme überarbeiten, Agents gezielter schulen oder automatische Klassifizierungswerkzeuge für eine bessere Weiterleitung einsetzen.

Wirksamere Ursachenanalysen (Root Cause Analysis, RCA) sind wichtig, um wiederkehrende Incidents zu verhindern, deren Zahl zu senken und die langfristige Stabilität von Systemen in Freshservice zu verbessern. Entscheidend ist, dass die ermittelten Ursachen tatsächlich die zugrunde liegenden Probleme beheben und zu nachhaltigen Lösungen führen. ProcessMind verknüpft Muster bei Incidents mit den Prozessen des Problem Managements und prüft, ob Incidents mit ähnlichen Symptomen nach einer RCA dauerhaft gelöst werden. Die Analyse zeigt auch Schwachstellen im RCA-Workflow auf, etwa wenn Probleme zu früh geschlossen werden oder wichtige Ursachen bei der Analyse regelmäßig unberücksichtigt bleiben. So lassen sich vorbeugende Maßnahmen verbessern.

Uneinheitliche oder fallweise geregelte Eskalationen können in Freshservice zu Verwirrung führen, unnötige Beteiligte einbeziehen und die Lösung kritischer Incidents verzögern. Ein standardisiertes Vorgehen stellt sicher, dass Incidents anhand klarer Kriterien und festgelegter Wege angemessen und vorhersehbar eskaliert werden. ProcessMind zeigt alle tatsächlich genutzten Eskalationswege und vergleicht sie mit den vorgesehenen oder dokumentierten Abläufen. Die Analyse deckt Abweichungen, Engpässe in der Eskalationsmatrix und häufige Auslöser ungeplanter Eskalationen auf. So können Sie klare, einheitliche und effiziente Eskalations-Workflows etablieren.

Workarounds sind wichtig, um den Service kurzfristig wiederherzustellen. Wie gut sie die Auswirkungen tatsächlich begrenzen und erneute Incidents verhindern, kann jedoch unterschiedlich sein. Ziel ist, sicherzustellen, dass Workarounds die Auswirkungen eines Incidents wirklich verringern und die endgültige Lösung in Freshservice weder verzögern noch erschweren. ProcessMind analysiert den Verlauf von Incidents mit Workarounds und setzt deren Einsatz in Beziehung zu den anschließenden Lösungszeiten, Wiedereröffnungen und verknüpften Problemen. So lässt sich beurteilen, welche Workarounds tatsächlich helfen und welche zusätzlichen Aufwand verursachen oder wirkungslos bleiben. Die Erkenntnisse unterstützen Sie dabei, Strategien für Übergangslösungen zu verbessern.

Unterschiedliche Leistungen der Agents im Incident Management können in Freshservice zu abweichenden Lösungszeiten, Servicequalität und Benutzerzufriedenheit führen. Ziel ist, bewährte Vorgehensweisen zu erkennen und weiterzugeben, damit Agents effizienter und wirksamer arbeiten. ProcessMind vergleicht die Prozessabläufe und Leistungskennzahlen verschiedener Agents oder Supportgruppen. Dabei werden besonders effiziente Workflows und Abweichungen sichtbar. Unternehmen können erfolgreiche Muster erkennen, gezielte Schulungen anbieten und einheitliche Workflows einführen, um die Leistung der Agents insgesamt zu verbessern.

Verzögerungen bei der Bestätigung oder Überprüfung einer Incident-Lösung durch Benutzer können die Ticketlaufzeit unnötig verlängern und sich auf Kennzahlen und Ressourceneinsatz in Freshservice auswirken. Ziel ist, die letzten Schritte bis zum Schließen des Incidents zu beschleunigen und die Interaktion mit Benutzern zu vereinfachen. ProcessMind zeigt, welche Phasen oder Auslöser zu langen Wartezeiten auf Rückmeldungen führen, etwa nach der Umsetzung einer Lösung. So erkennen Sie, wie sich Benachrichtigungen verbessern, Nachfassaktionen automatisieren oder Kommunikationsstrategien anpassen lassen, damit Benutzer die Lösung zeitnah bestätigen und Incidents schneller geschlossen werden.

Ineffiziente oder wenig genutzte Meldekanäle können in Freshservice Engpässe verursachen, Benutzer frustrieren und die erste Bearbeitung von Incidents verzögern. Bei der Optimierung geht es darum, Benutzern eine einfache Meldung zu ermöglichen und die Meldungen effizient weiterzuleiten, damit Incidents schneller gelöst werden. ProcessMind analysiert den Verlauf von Incidents, die über verschiedene Kanäle wie E-Mail, Portal oder Telefon eingehen. Die Analyse zeigt, über welche Kanäle Incidents schneller gelöst werden und wo zusätzliche Kategorisierung oder manuelle Schritte den Ablauf erschweren. So können Sie die Meldewege verbessern und eine reibungslose Meldung ermöglichen.

Hohe Betriebskosten im Incident Management belasten IT-Budgets. In Freshservice entstehen sie häufig durch ineffiziente Abläufe, übermäßige Nacharbeit und lange Lösungszeiten. Um Kosten zu senken, müssen Sie Ineffizienzen erkennen und beseitigen, die wertvolle Ressourcen binden. ProcessMind beziffert die Kostenfolgen verschiedener Prozessabweichungen, etwa häufiger Neuzuweisungen, unnötiger Eskalationen oder verlängerter Lösungszeiten. Die Analyse macht die finanziellen Auswirkungen ineffizienter Abläufe sichtbar. So können Unternehmen kostenintensive Aktivitäten gezielt reduzieren, Ressourcen besser einsetzen und ihr Budget effizienter nutzen.

Der Verbesserungsprozess in 6 Schritten für das Incident Management

1

Template herunterladen

Was zu tun ist

Greifen Sie auf das vorkonfigurierte Excel-Template für das Incident Management zu. Damit erfassen Sie alle erforderlichen Datenpunkte, um die Incident-Abläufe in Freshservice präzise abzubilden.

Warum das wichtig ist

Eine passende Datenstruktur von Anfang an ist entscheidend für eine genaue Analyse. Sie verhindert Nacharbeit und sorgt dafür, dass Ihre Erkenntnisse verlässlich sind.

Erwartetes Ergebnis

Ein sofort einsetzbares Daten-Template, passend für Ihren Incident-Management-Prozess strukturiert.

DAS ERWARTET SIE

Wichtige Erkenntnisse zum Incident Management gewinnen

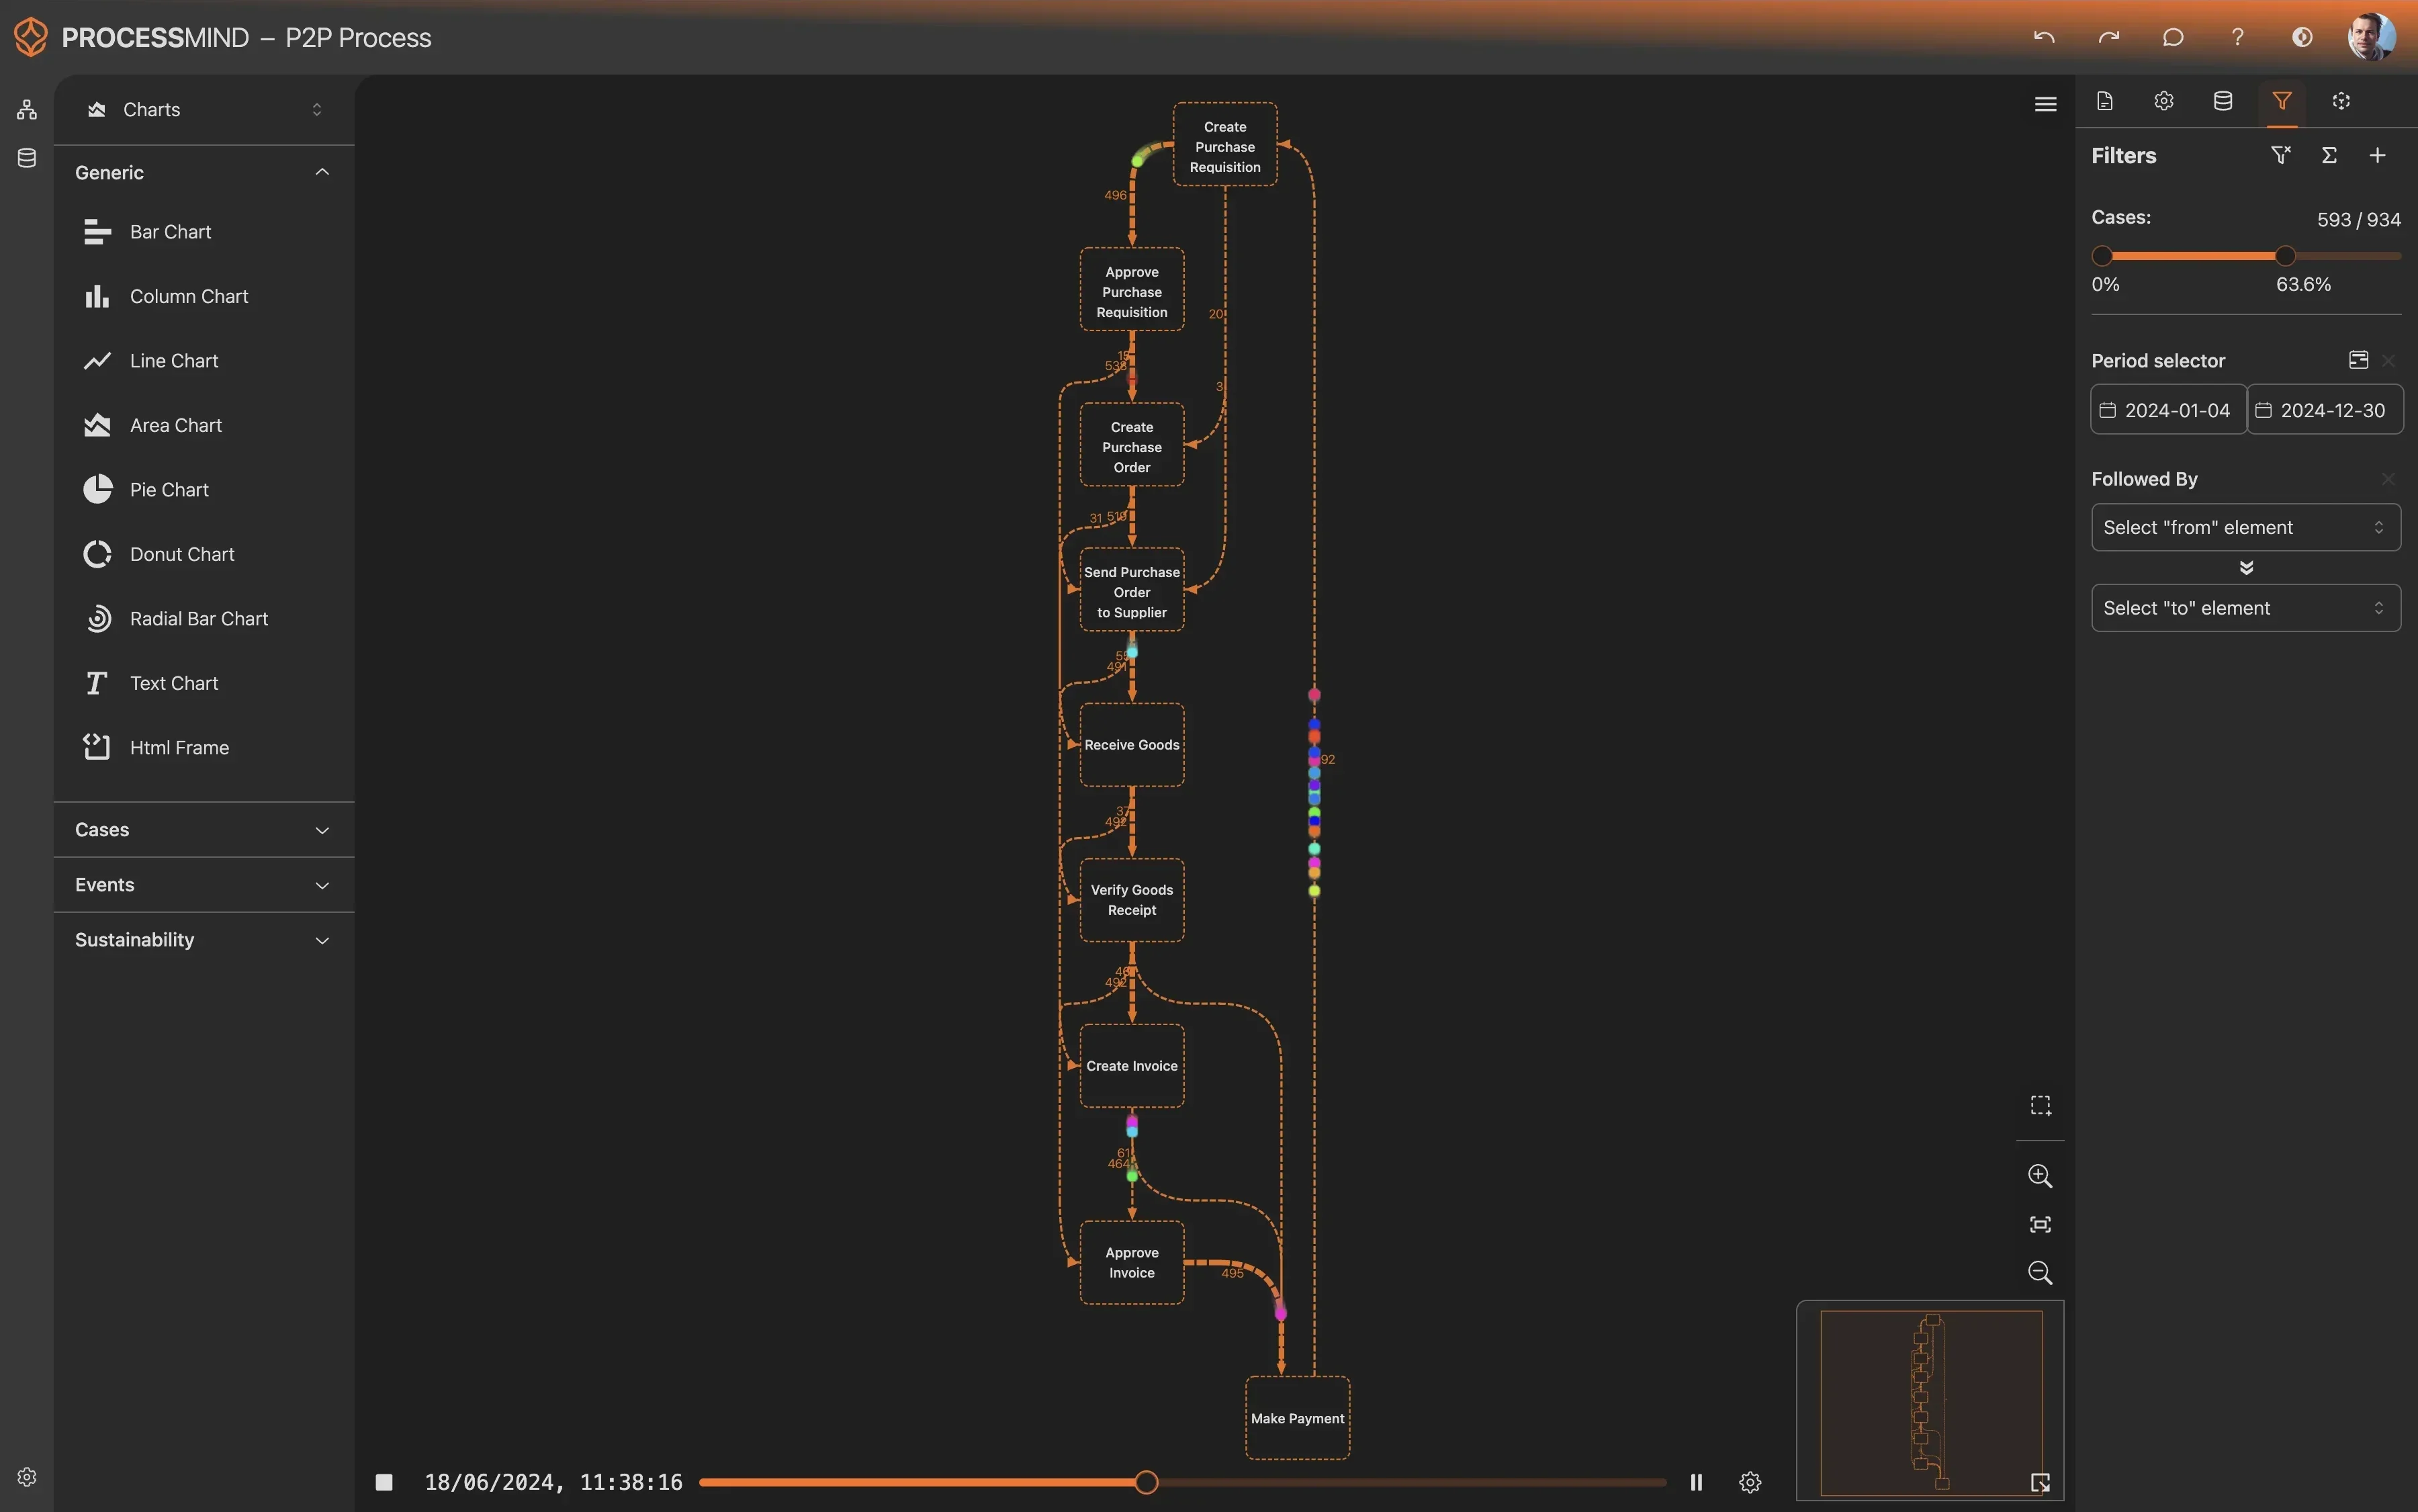
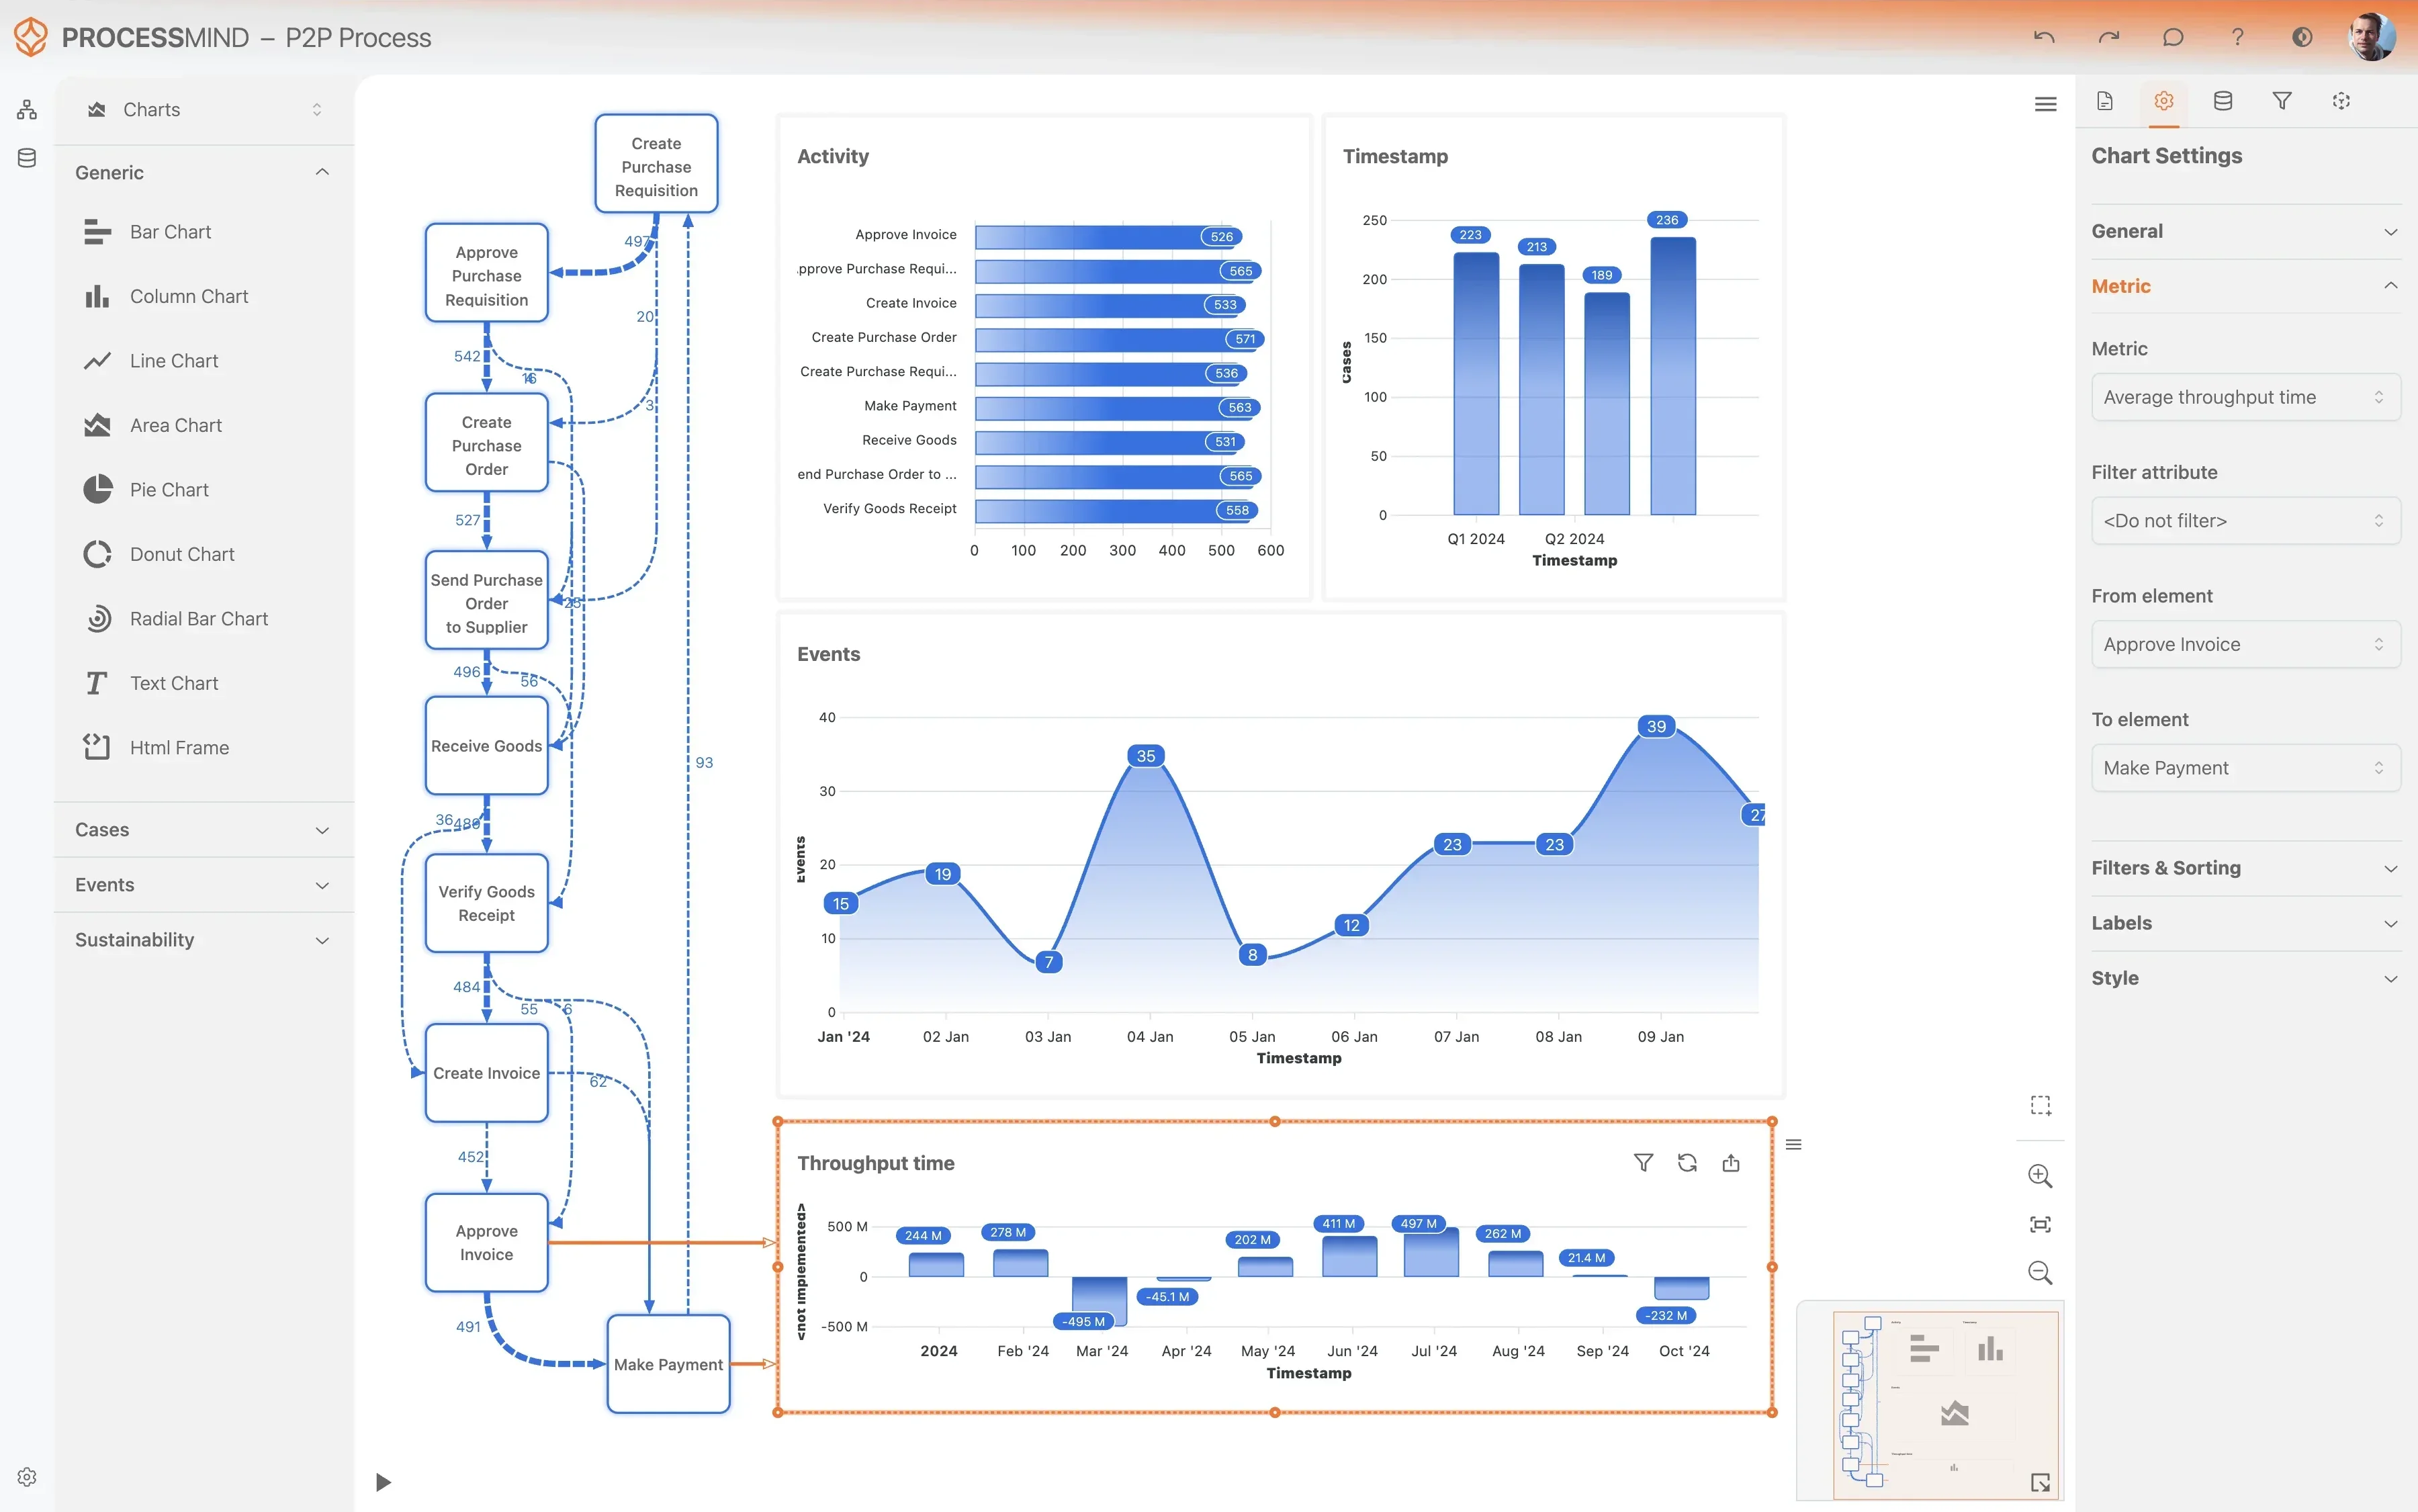
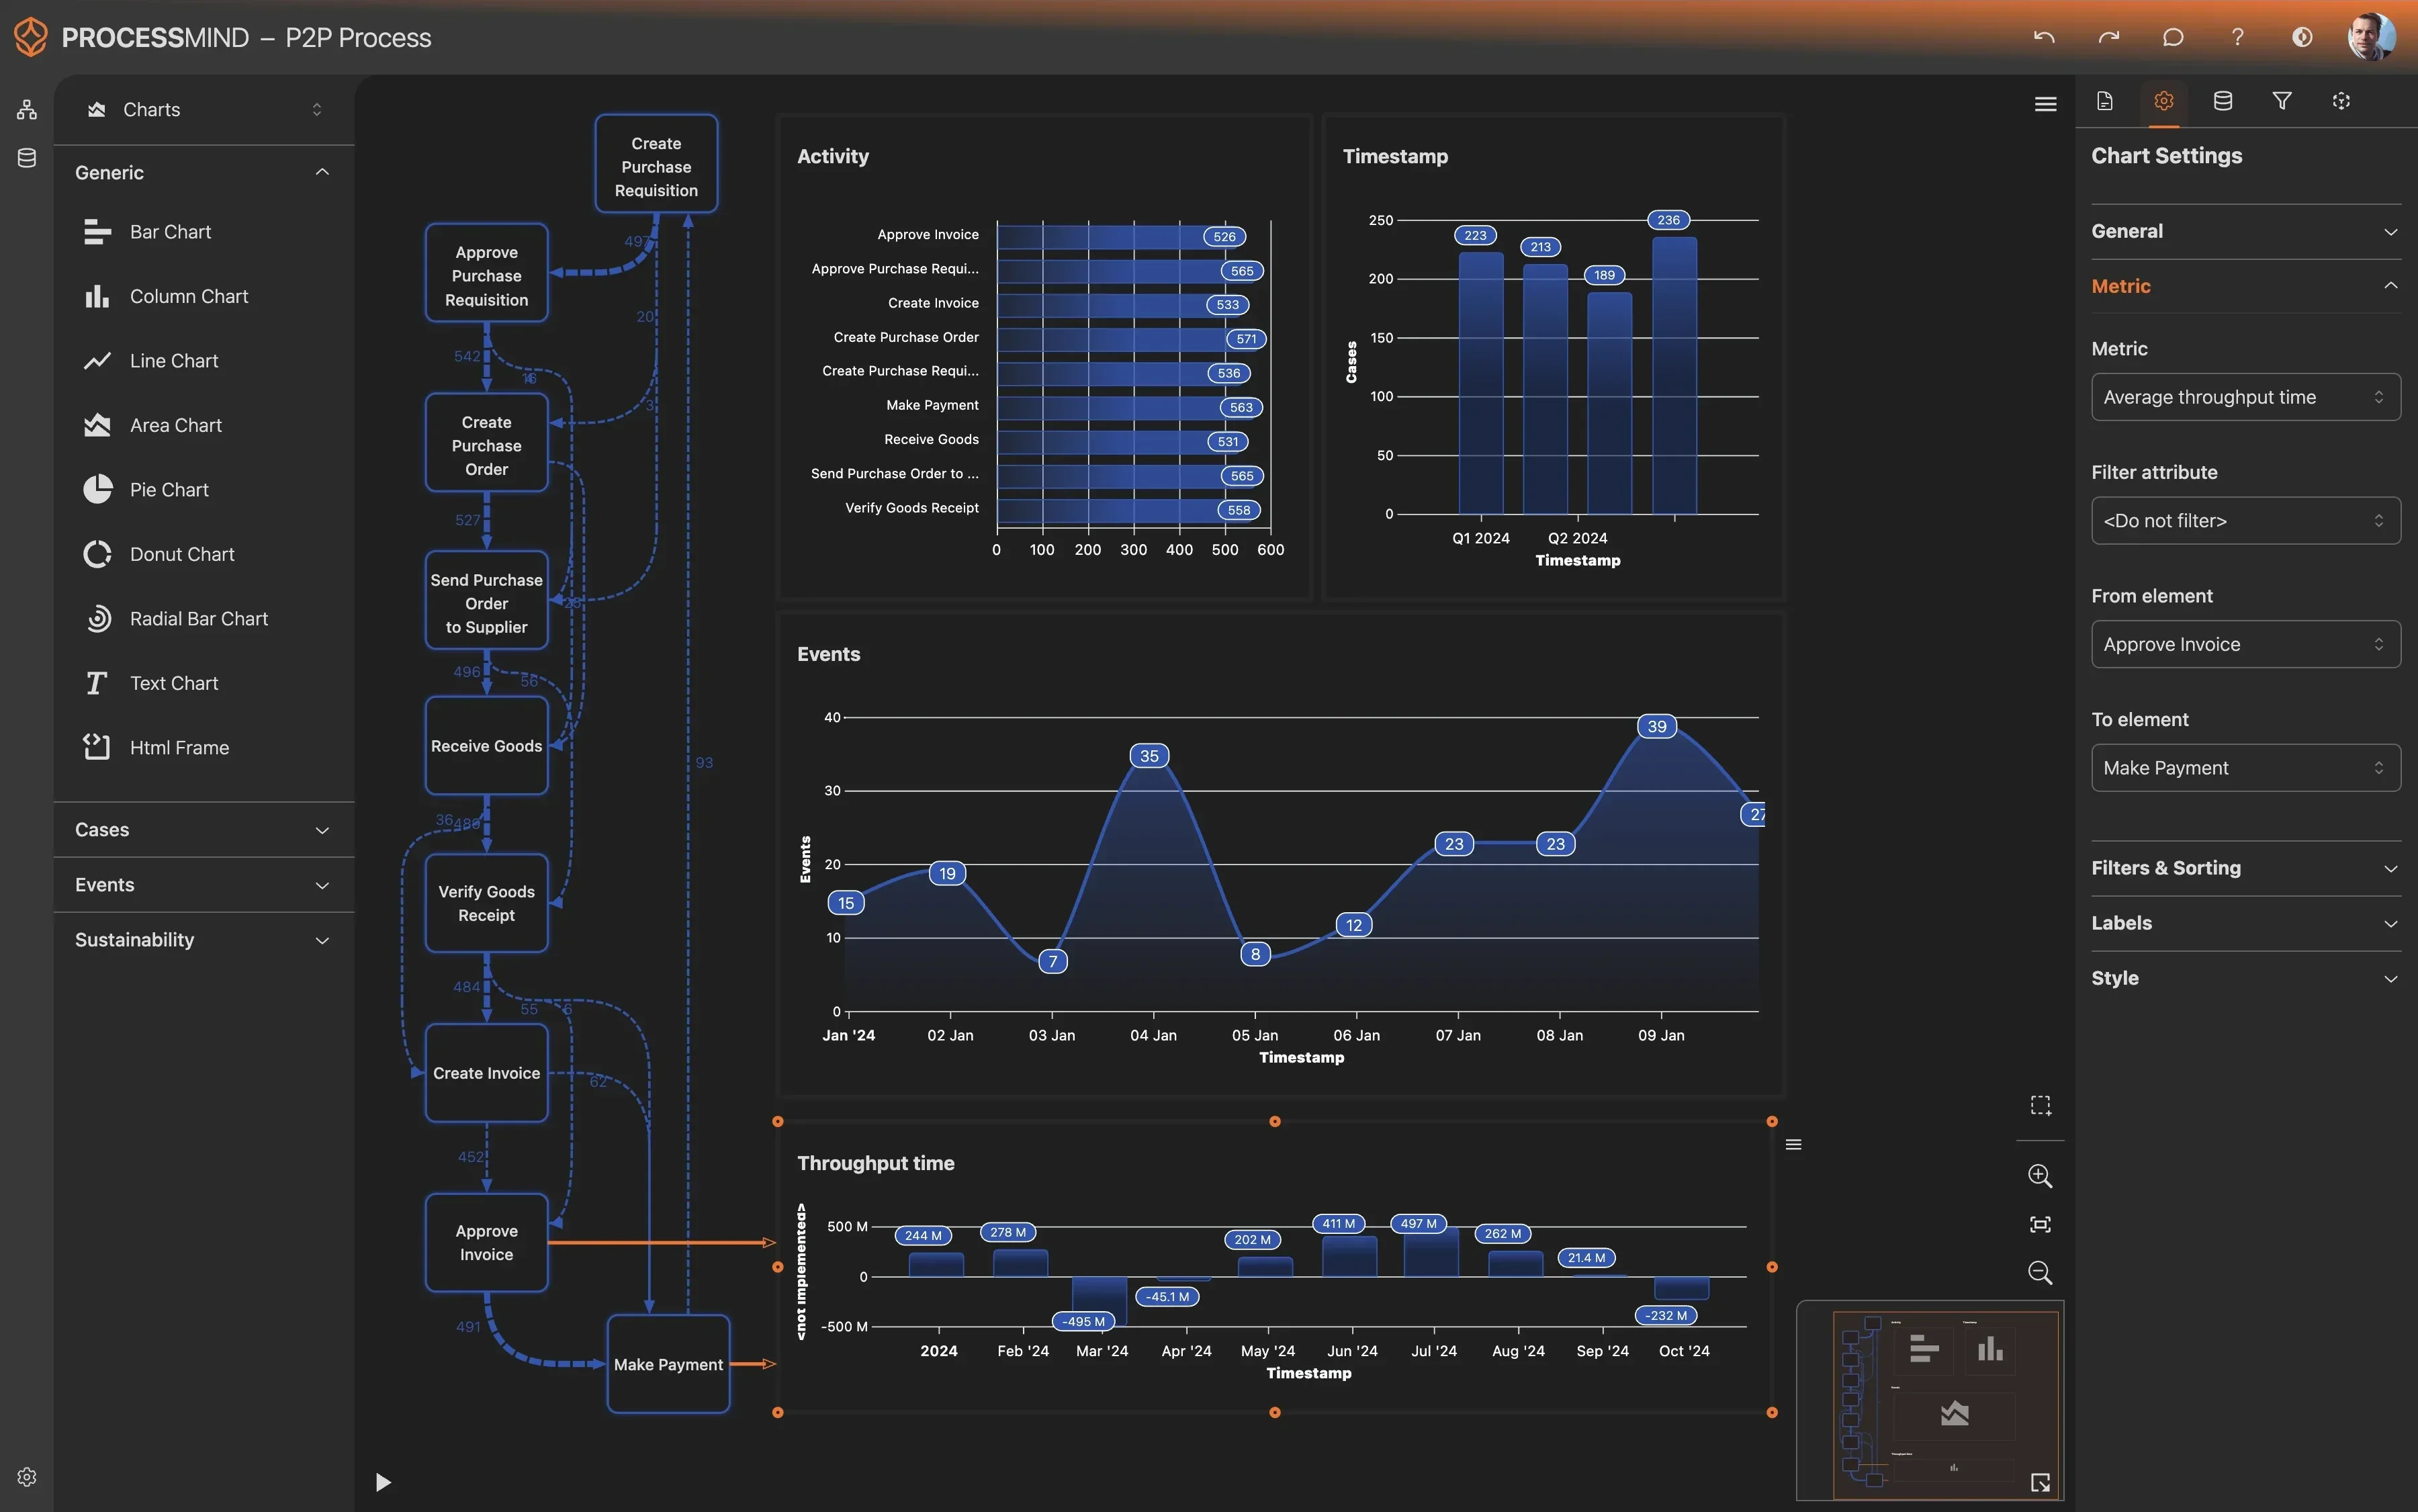
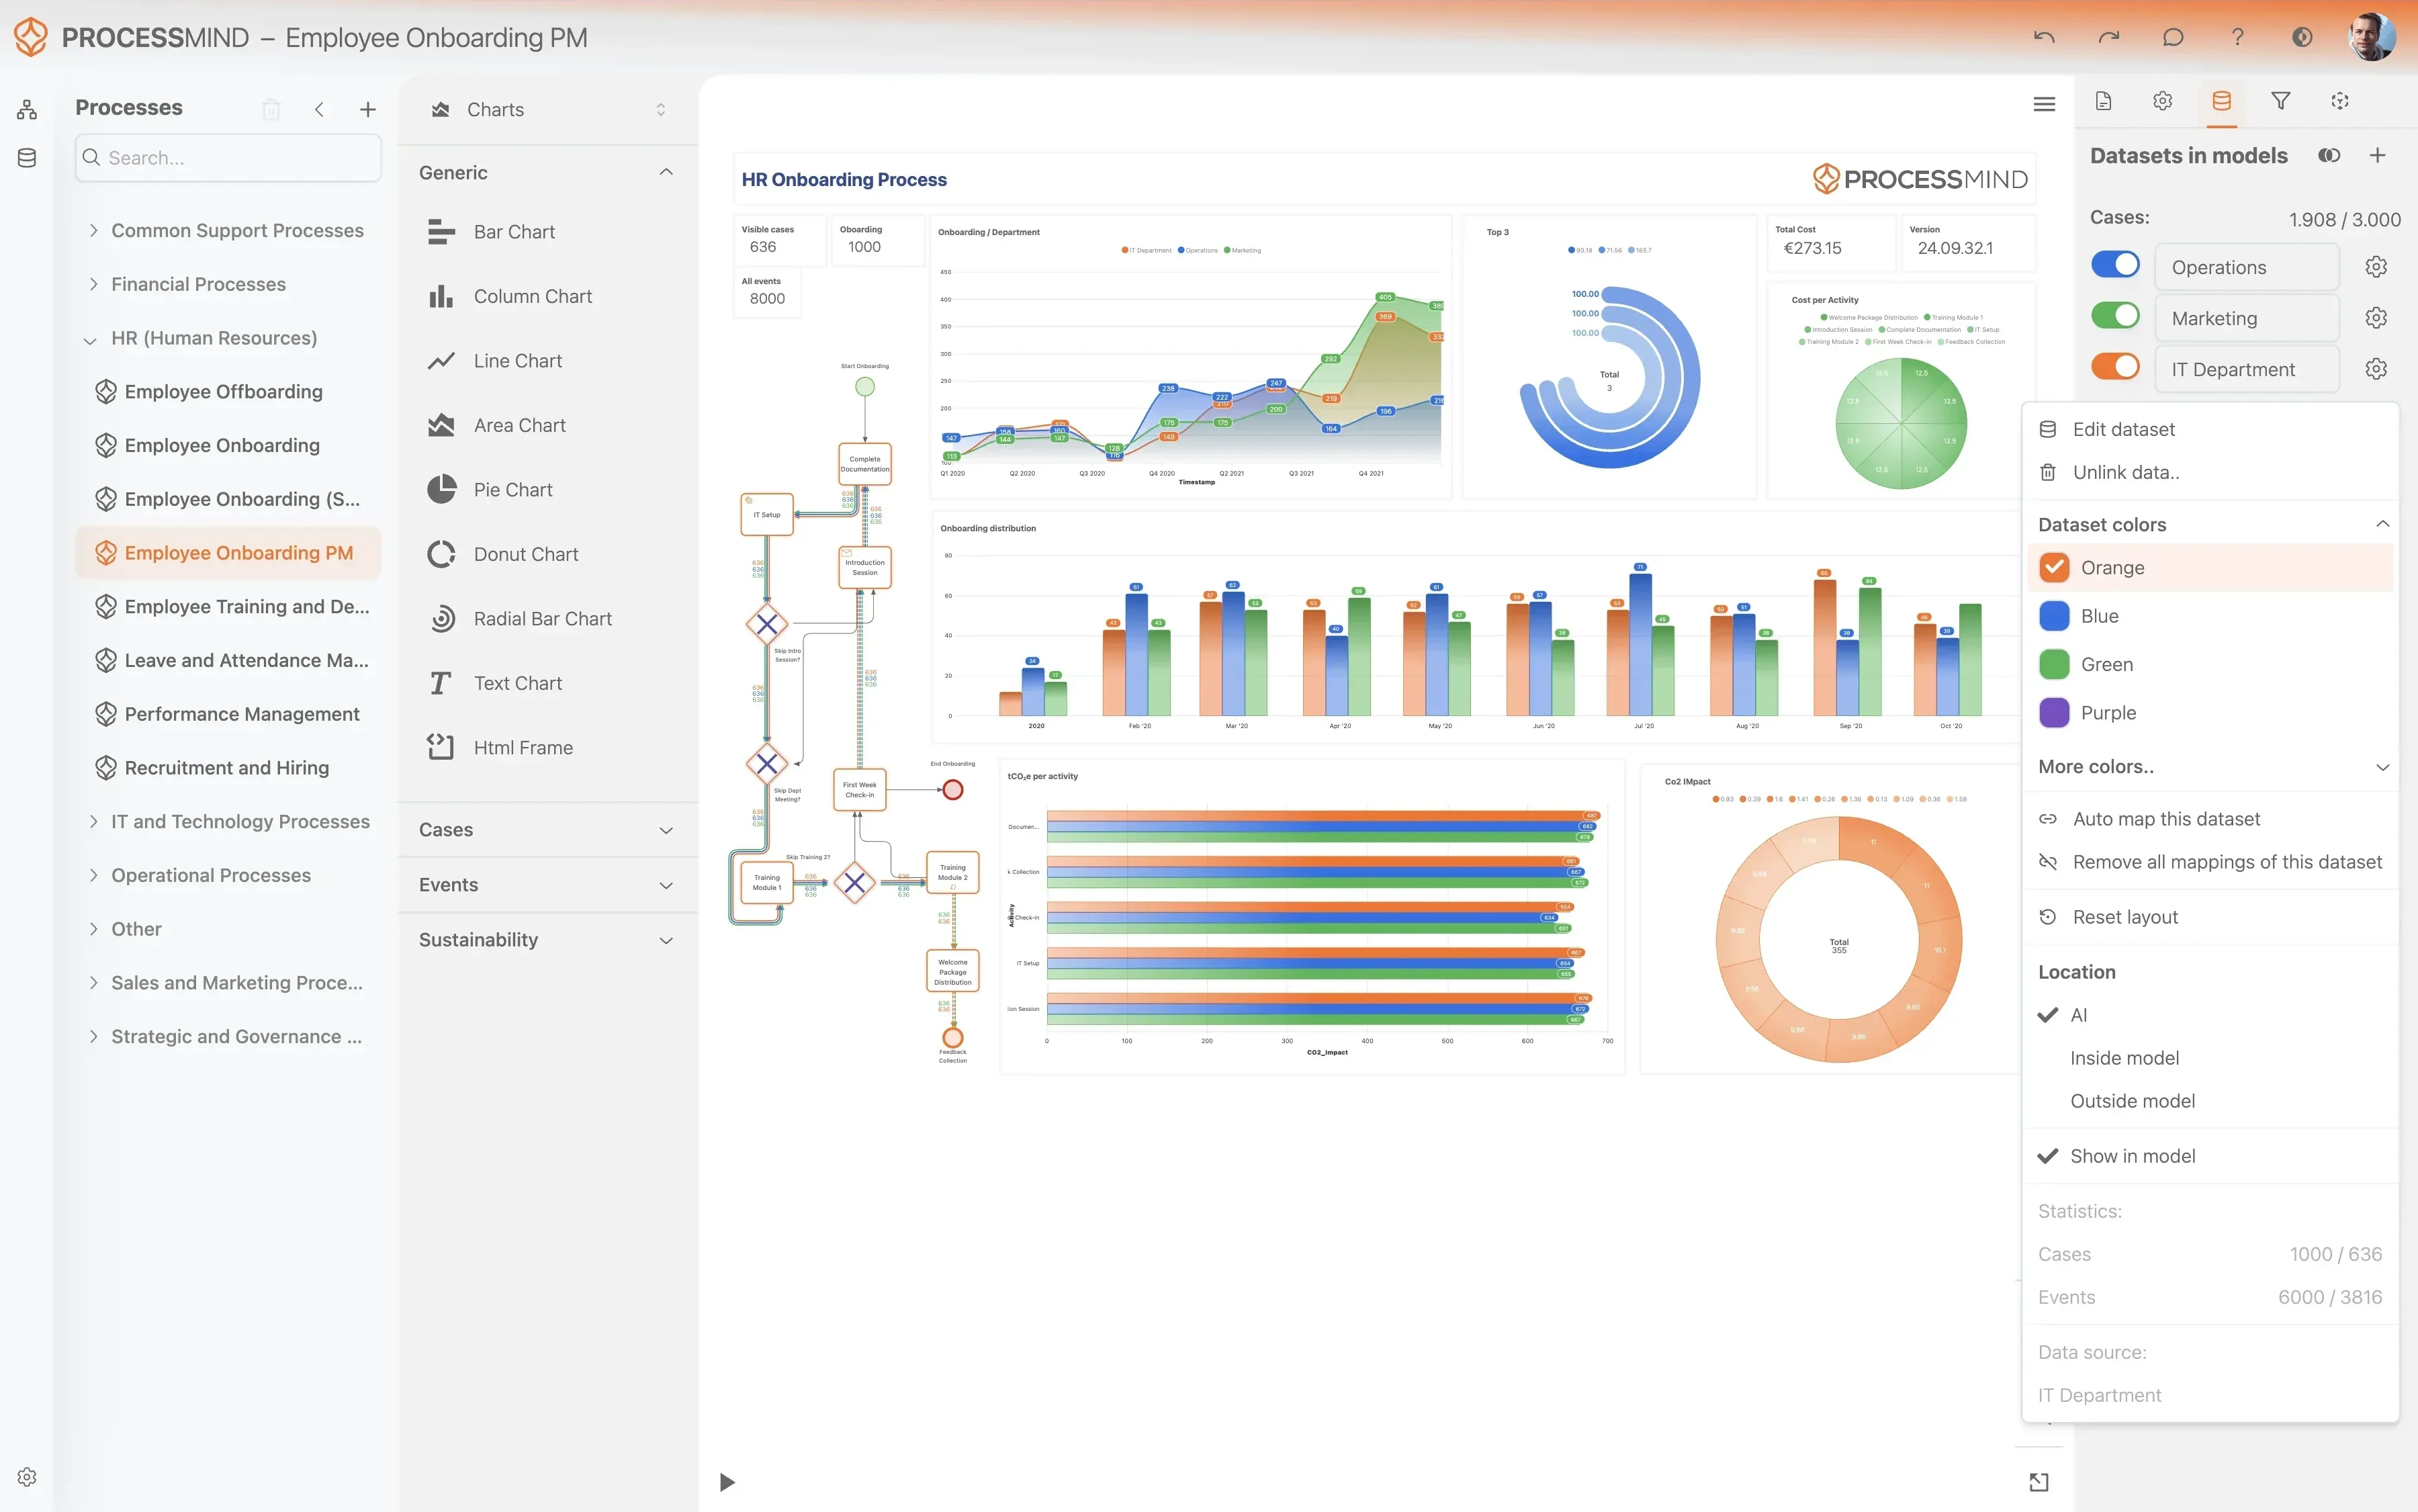
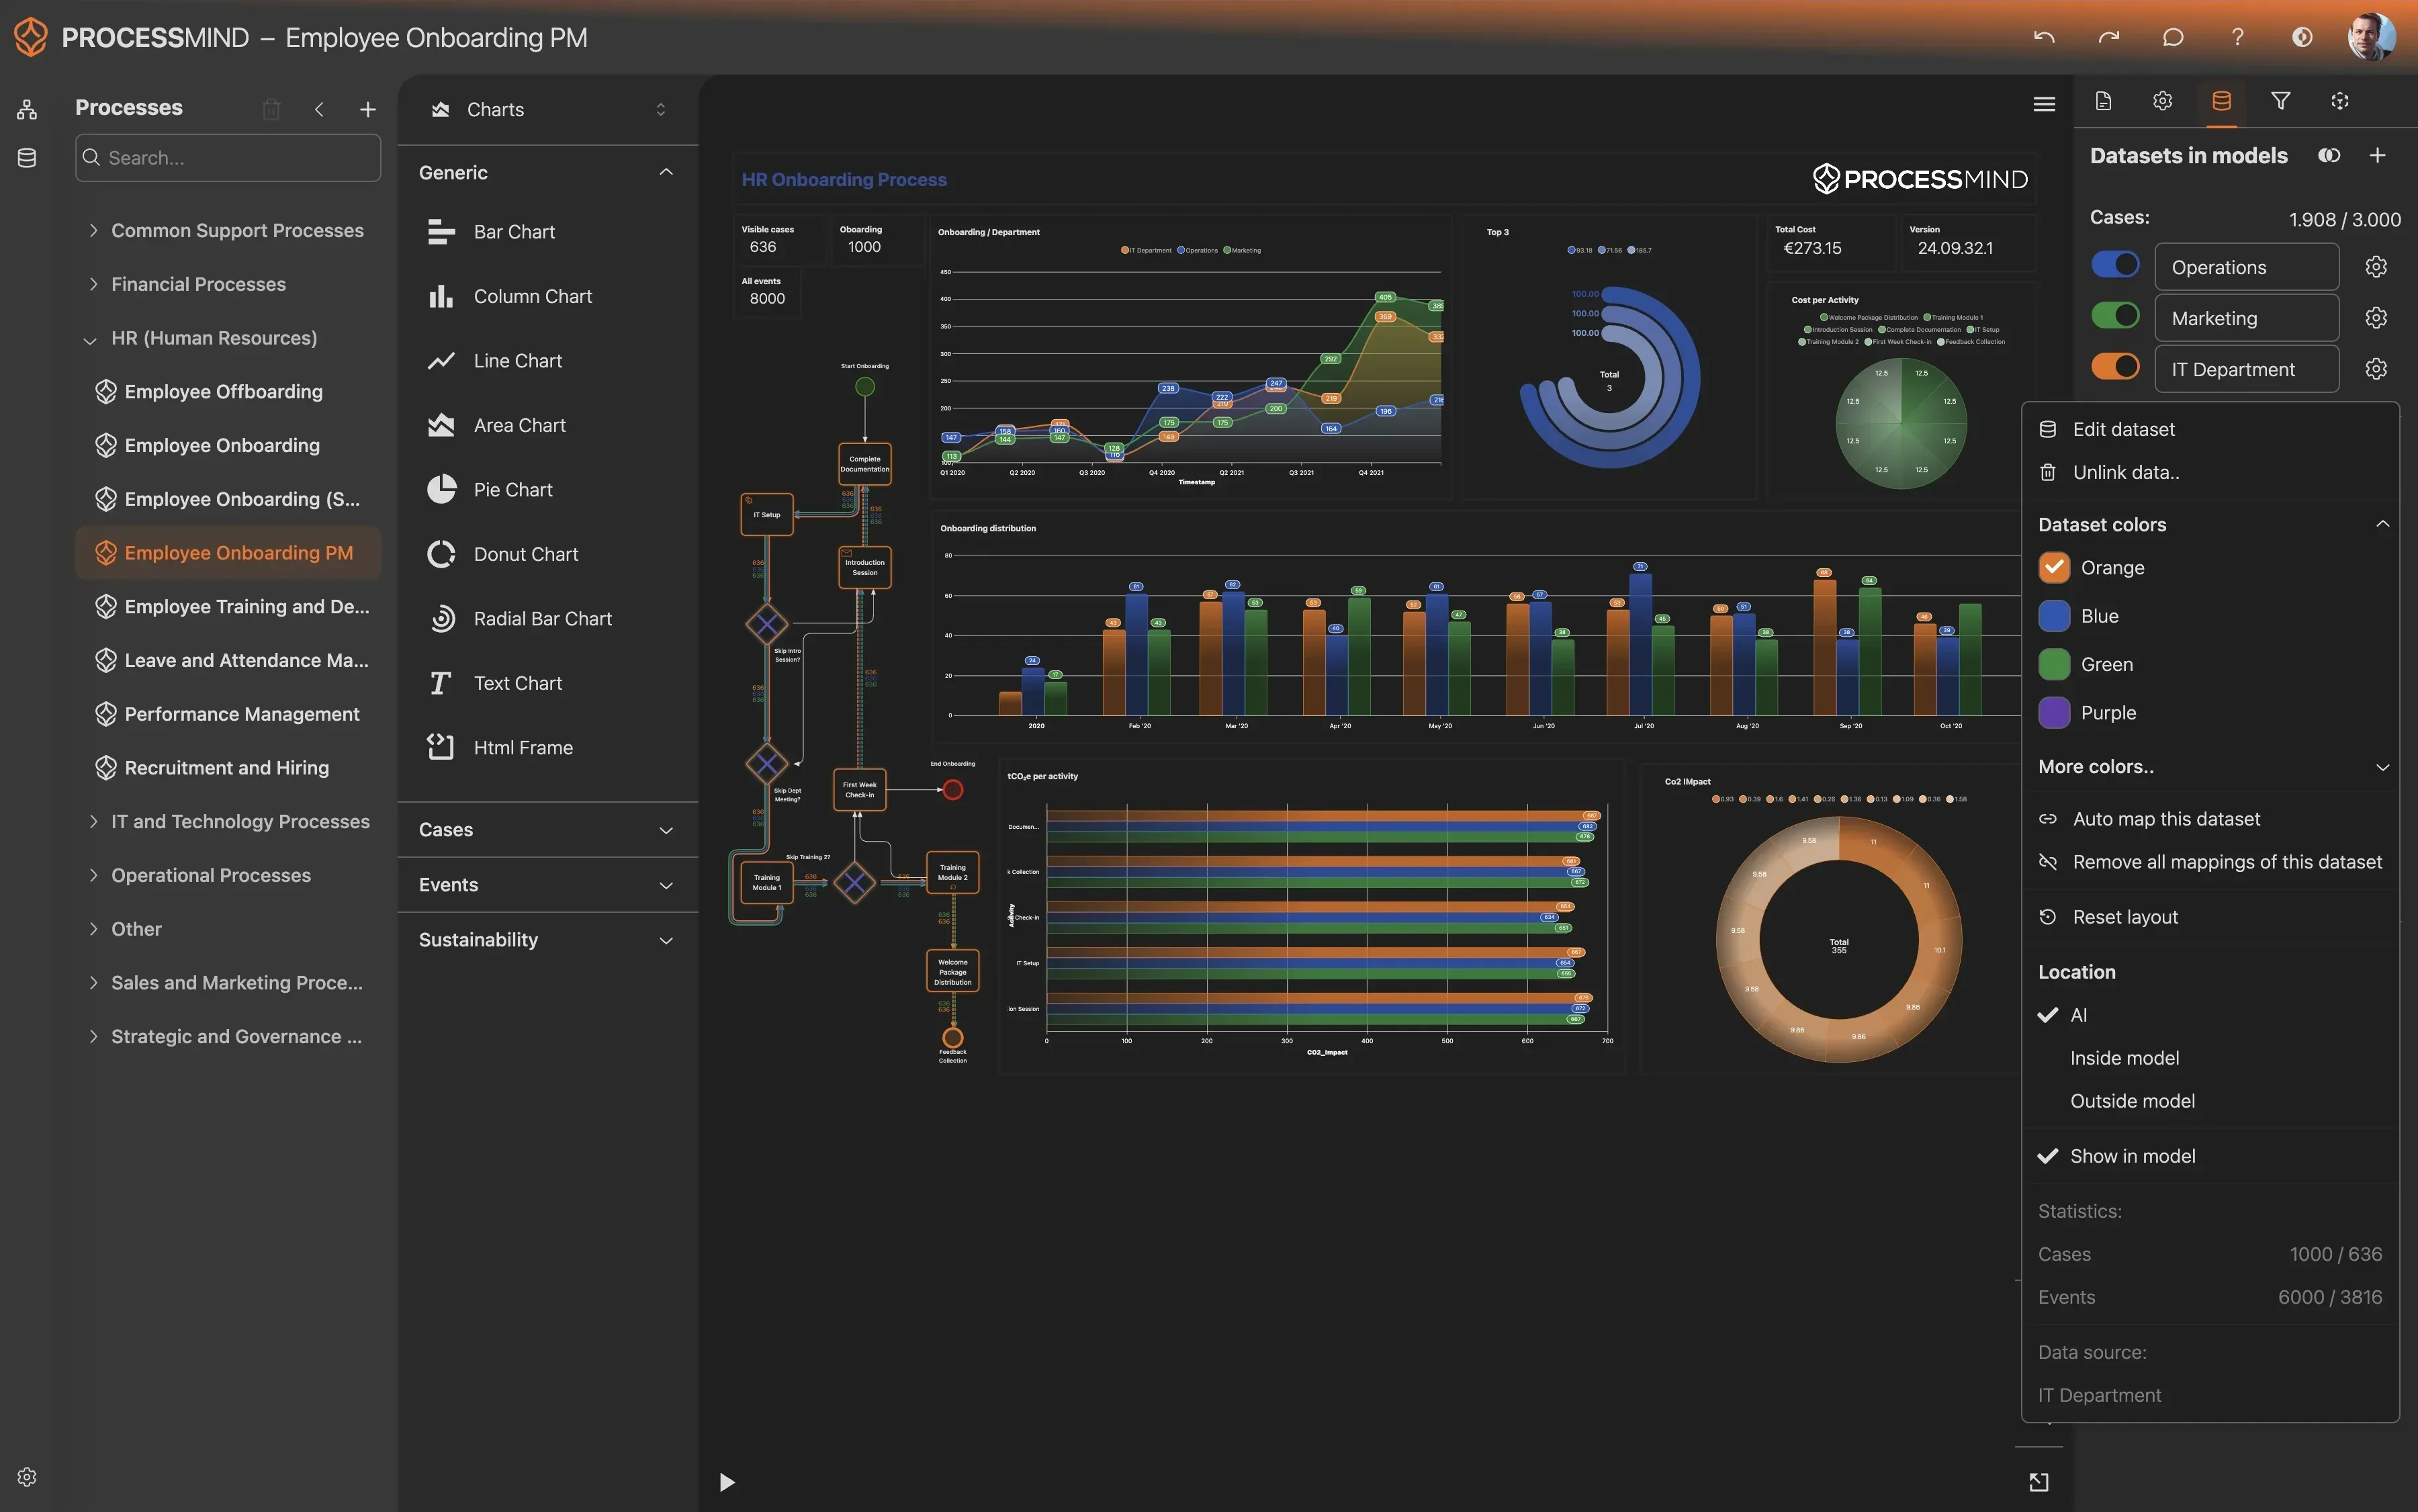
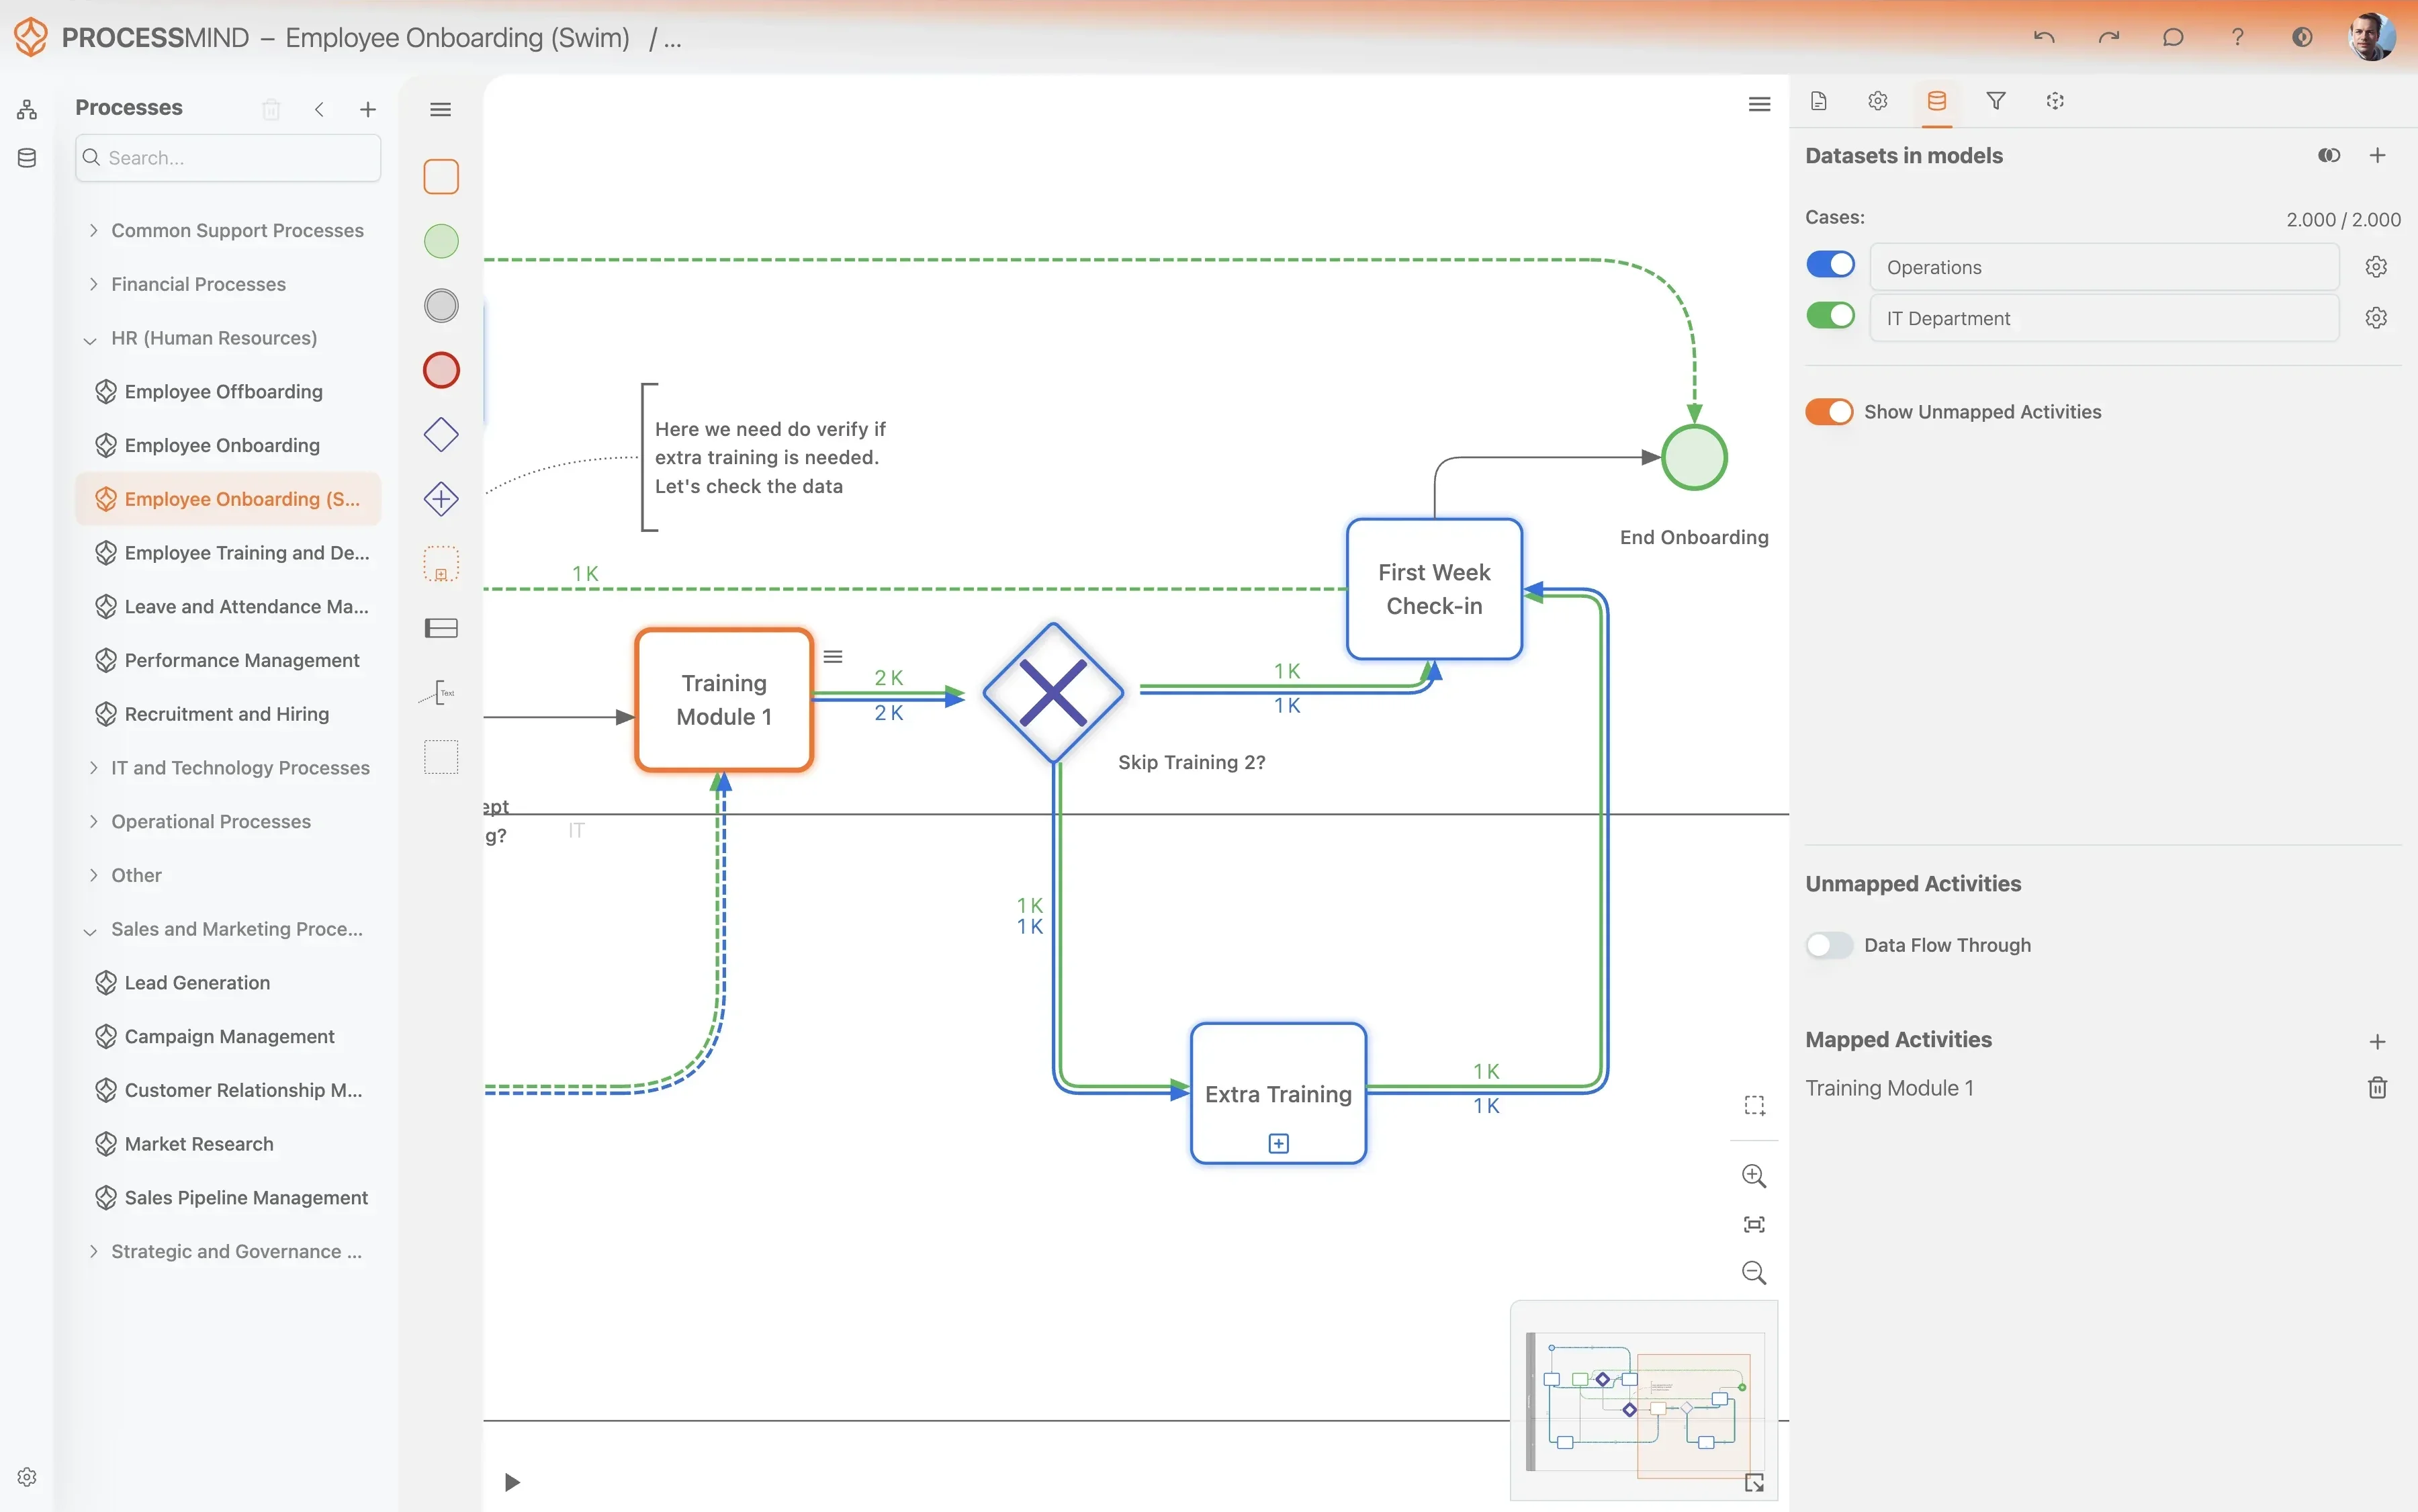
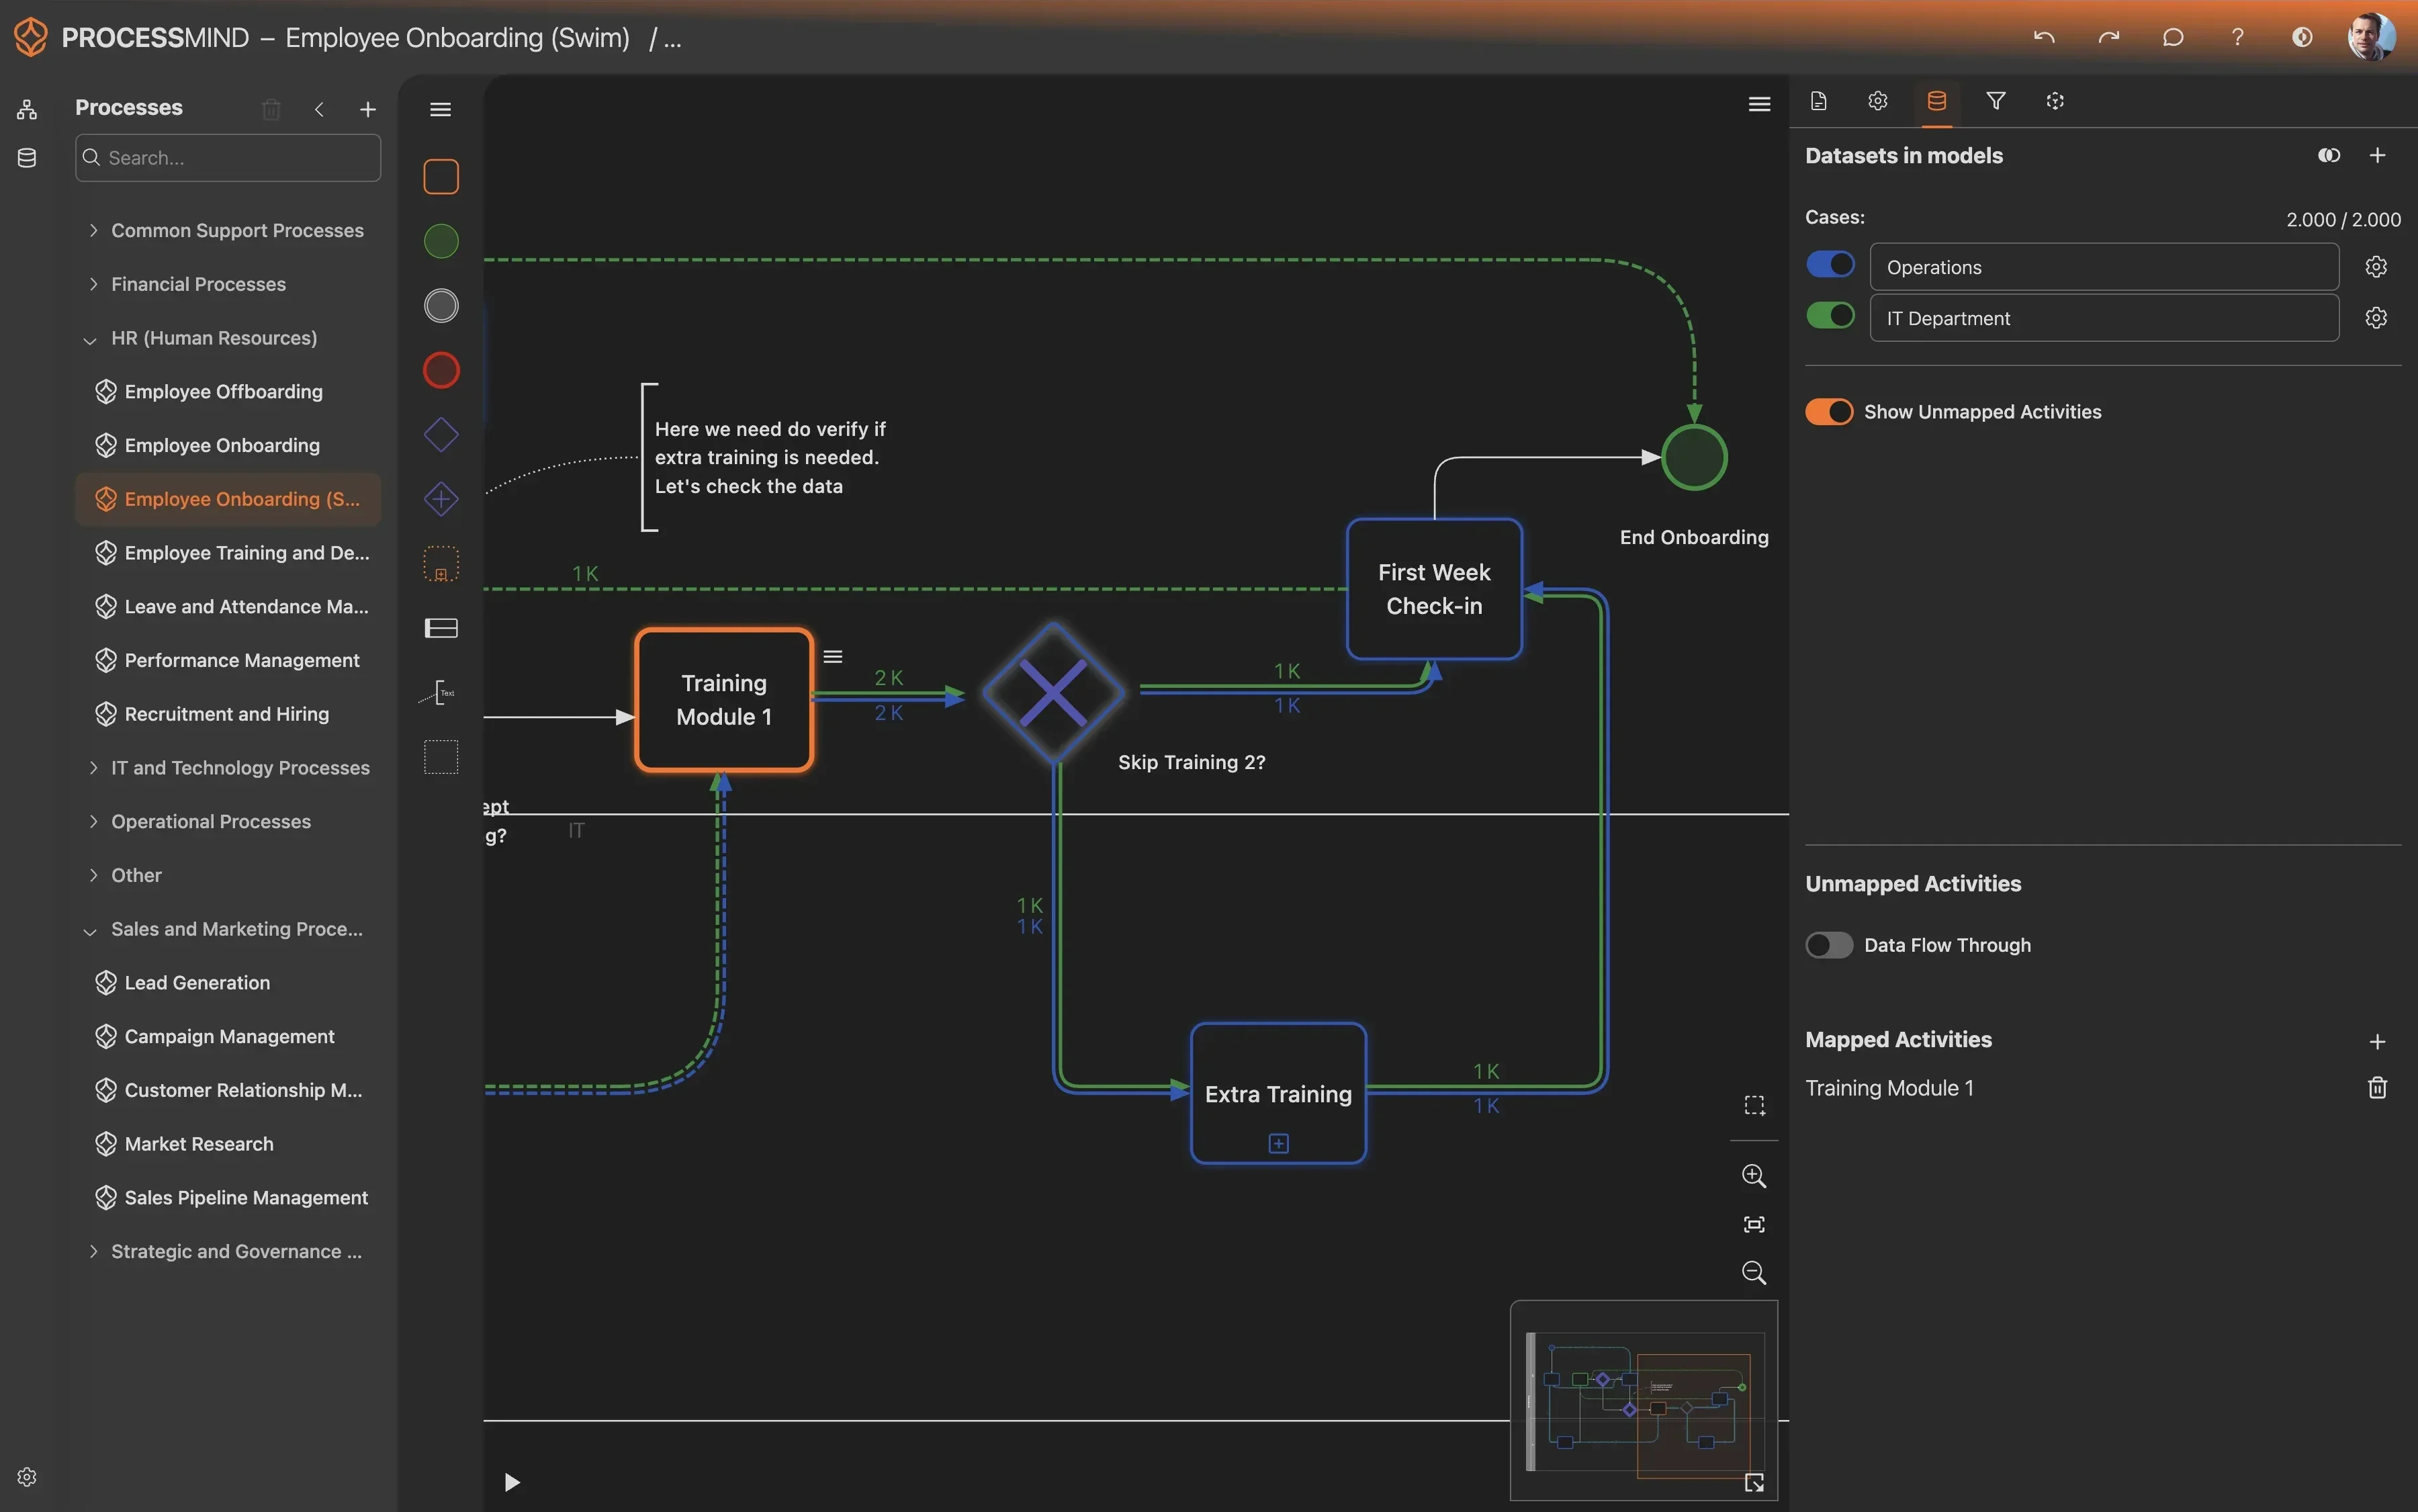
ProcessMind zeigt den vollständigen Ablauf Ihrer Freshservice-Incidents in interaktiven Visualisierungen. Ermitteln Sie genau, wo Verzögerungen auftreten, erkennen Sie problematische Übergaben und finden Sie Ansatzpunkte, um den Service schneller wiederherzustellen.
  • Incident-Workflows von Anfang bis Ende visualisieren
  • Engpässe in Freshservice erkennen
  • Ursachen für SLA-Verstöße aufdecken
  • Wege zu einer schnelleren Incident-Lösung entdecken
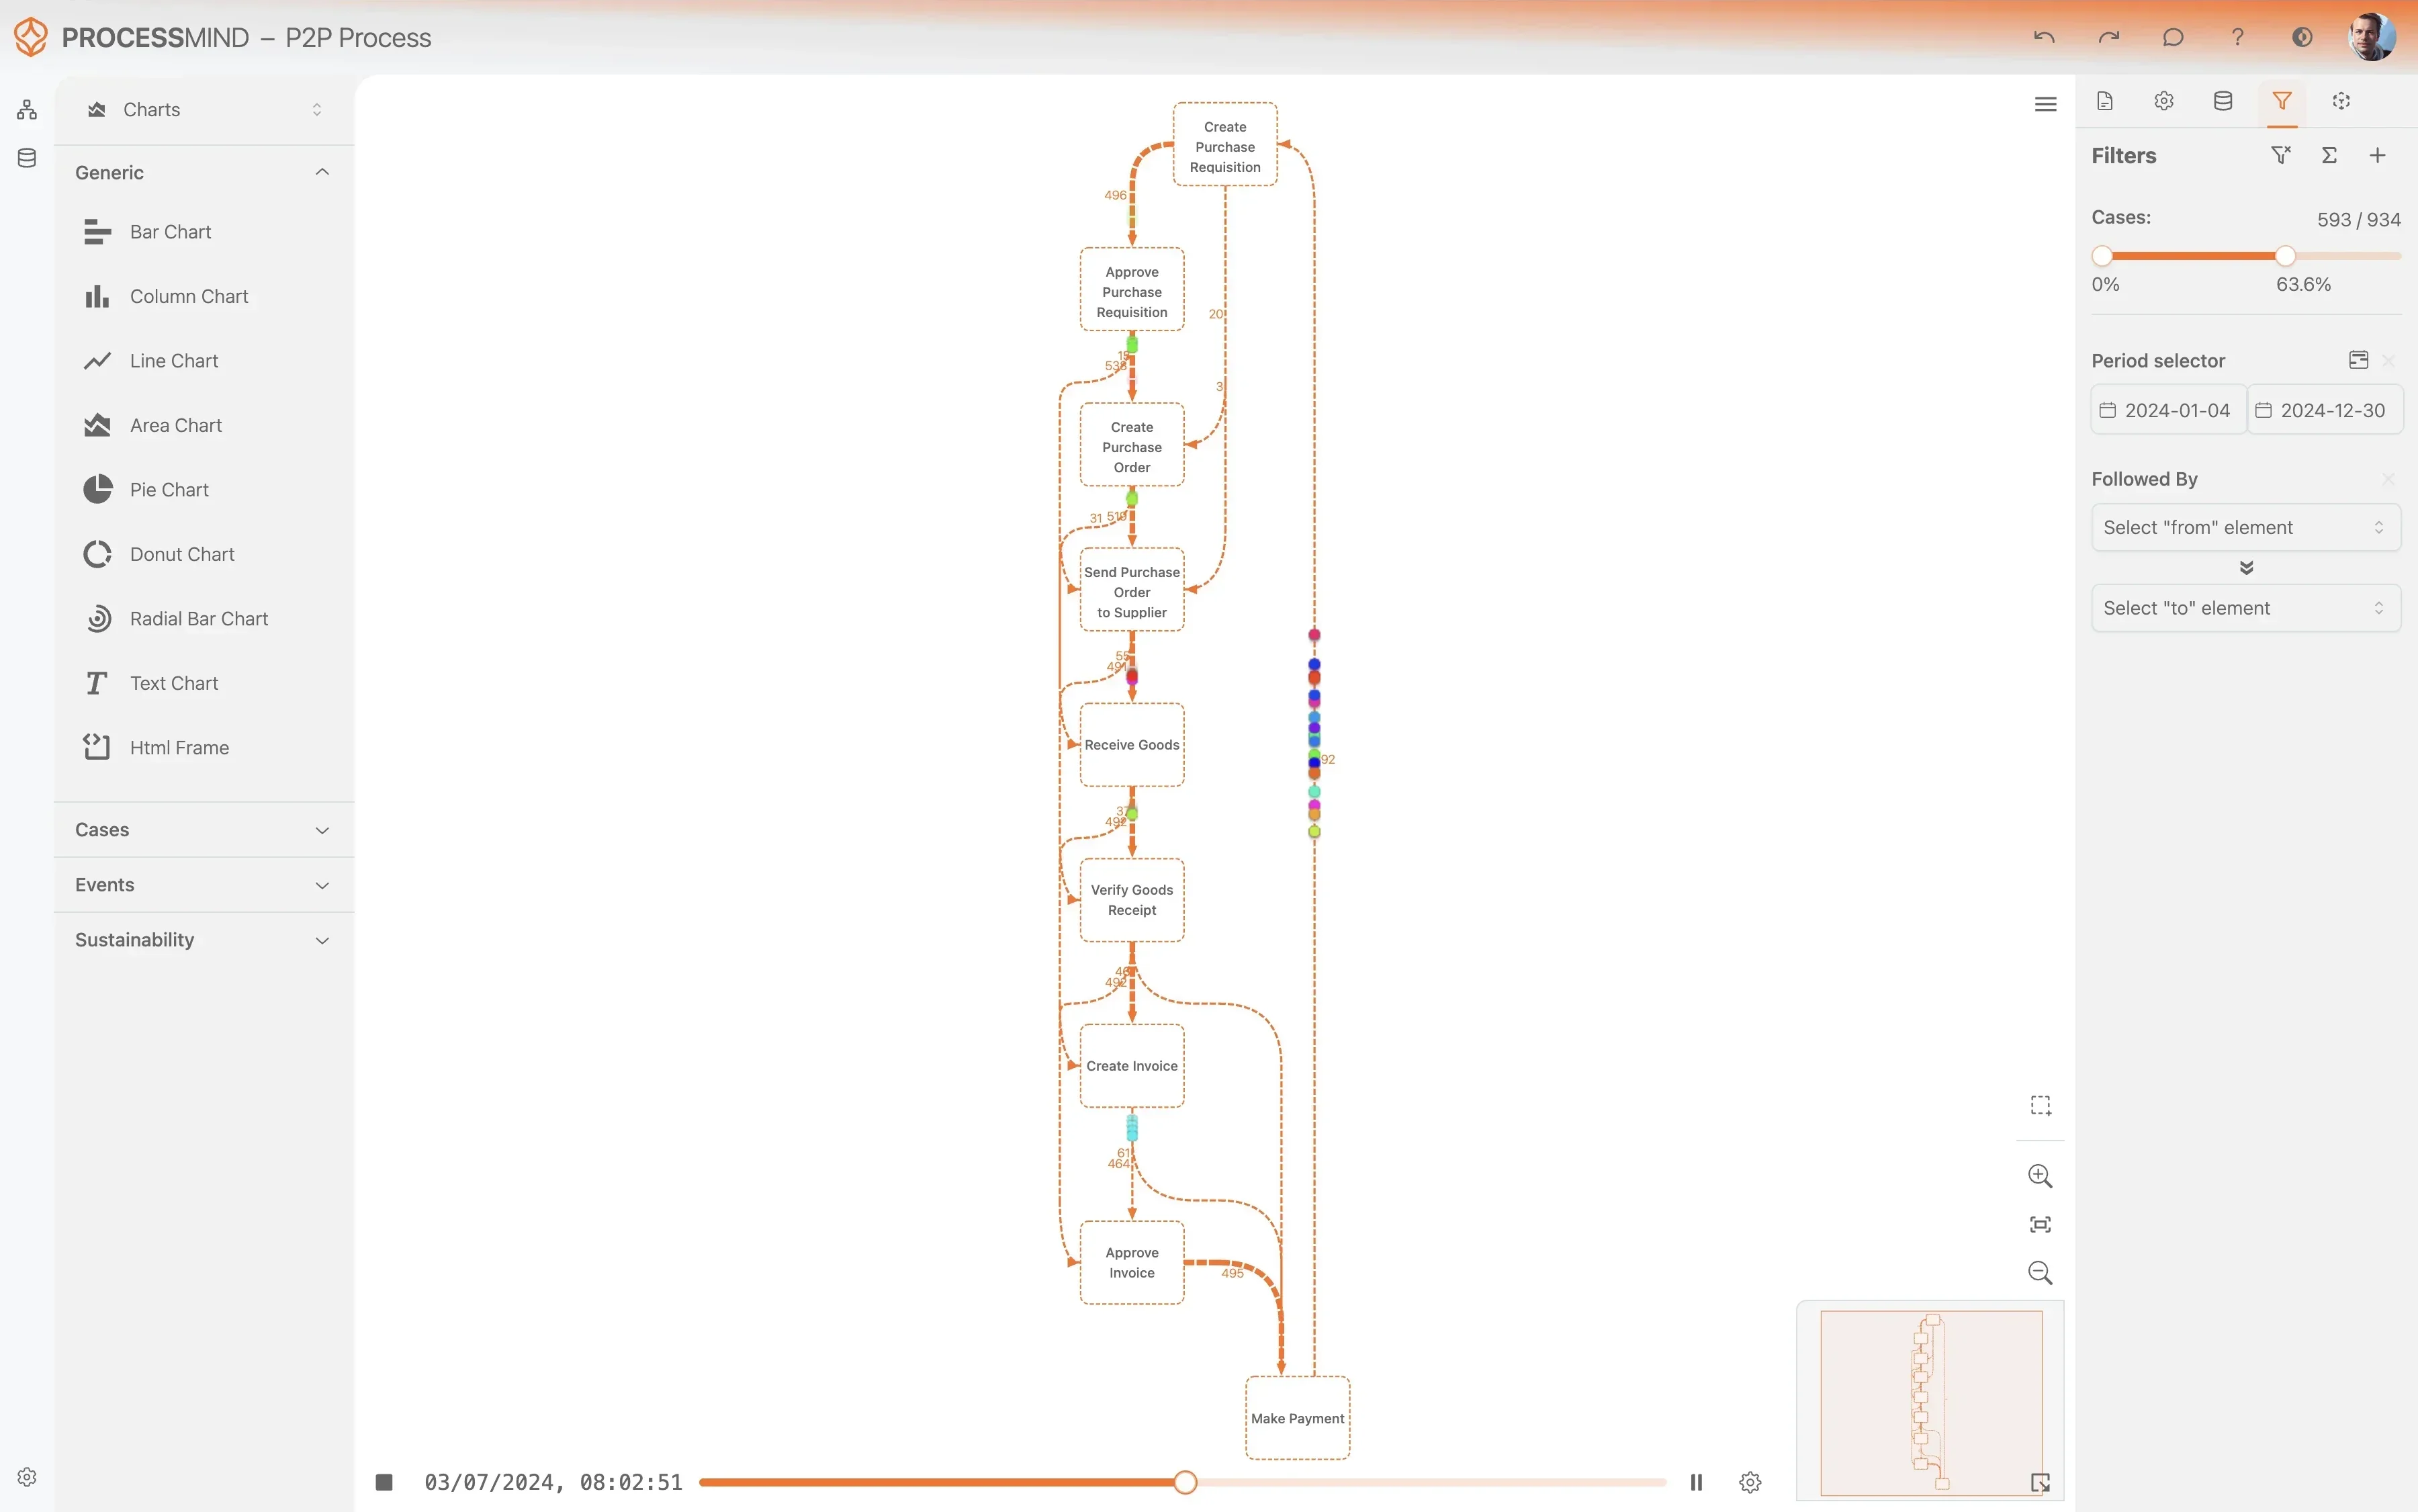
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

TYPISCHE ERGEBNISSE

Incident Management mit Process Mining verbessern

Process Mining macht Engpässe und Ineffizienzen in Ihren Freshservice-Daten zum Incident Management sichtbar und verändert so die Art, wie Sie Probleme lösen. Die folgenden Ergebnisse zeigen typische praktische Verbesserungen in Unternehmen.

0 %
Kritische Incidents schneller lösen

Durchschnittliche Zeit für Incidents mit hoher Priorität

Verkürzen Sie die durchschnittliche Lösungszeit kritischer Incidents, um Betriebsunterbrechungen und Serviceausfälle möglichst gering zu halten. Das steigert die Kundenzufriedenheit und verbessert die Systemverfügbarkeit.

0 %
SLA-Einhaltung verbessern

Höhere Einhaltung der Serviceziele

Halten Sie Service-Level-Agreements besser ein, indem Sie Engpässe erkennen und beseitigen, die zu verfehlten Fristen führen. Das stärkt das Vertrauen der Kunden und hilft, Vertragsstrafen zu vermeiden.

0 %
Übergaben bei Incidents reduzieren

Weniger Übergaben zwischen Teams oder Agents

Verringern Sie die Zahl der Übergaben eines Incidents zwischen Supportgruppen. Das beschleunigt die Lösung und senkt die Betriebskosten. Gleichzeitig arbeiten Agents effizienter und einheitlicher.

0 %
Kategorisierung verbessern

Weniger falsche Erstkategorisierungen

Kategorisieren Sie Incidents von Anfang an genauer, damit sie korrekt weitergeleitet werden und sich die Lösung nicht verzögert. Das verbessert die Erkenntnisse und den Ressourceneinsatz.

0 %
Wiedereröffnungsrate senken

Weniger Incidents, die nach der Lösung wiedereröffnet werden

Senken Sie den Anteil der Incidents, die nach dem ersten Schließen wiedereröffnet werden. Das zeigt, dass Lösungen bereits beim ersten Mal genauer und wirksamer sind. So steigt die Zufriedenheit der Benutzer und Agents müssen weniger nacharbeiten.

0 %
Managementkosten senken

Betriebsausgaben insgesamt reduzieren

Setzen Sie Ressourcen effizienter ein und verringern Sie unnötige manuelle Arbeit während des gesamten Incident-Management-Prozesses. So senken Sie die Kosten Ihres Unternehmens spürbar.

Die Ergebnisse hängen von der Komplexität der jeweiligen Prozesse, der Datenqualität und der bestehenden betrieblichen Effizienz ab. Die dargestellten Werte spiegeln häufig beobachtete Verbesserungen aus verschiedenen Implementierungen wider.

Empfohlene Daten

Beginnen Sie mit den wichtigsten Attributen und Aktivitäten und ergänzen Sie weitere, wenn Sie Fortschritte machen.
Neu bei Event Logs? Erfahren Sie, wie Sie ein Event Log für Process Mining erstellen.

Attribute

Wichtige Datenpunkte für die Analyse

Die eindeutige Kennung jedes Incident-Datensatzes. Sie dient als Primärschlüssel, um den gesamten Lebenszyklus des Incidents nachzuverfolgen.

Warum das wichtig ist

Die Kennung identifiziert jeden Incident eindeutig und ermöglicht es, seinen Lebenszyklus von der Erstellung bis zum Abschluss durchgängig nachzuverfolgen und zu analysieren.

Der Name oder die ID des Support-Mitarbeitenden, der derzeit für die Lösung des Incidents zuständig ist.

Warum das wichtig ist

Es ermöglicht die Analyse der Leistung und Arbeitslast der Mitarbeitenden sowie der Auswirkungen von Übergaben auf die Lösungszeiten.

Die Supportgruppe oder das Team, das derzeit für den Incident zuständig ist.

Warum das wichtig ist

Es zeigt, welches Team zuständig ist. Das ist wichtig, um Übergaben, Eskalationen und Verzögerungen zwischen Teams zu analysieren.

Die Prioritätsstufe des Incidents. Sie bestimmt, wie dringend die Reaktion und Lösung erfolgen müssen.

Warum das wichtig ist

Sie hilft, die Analyse auf besonders kritische Incidents auszurichten, und ist wichtig für die Bewertung der SLA-Leistung und die Ressourcenplanung.

Der Schweregrad des Incidents gibt dessen Auswirkungen auf das Geschäft an.

Warum das wichtig ist

Es misst die geschäftlichen Auswirkungen eines Incidents und ermöglicht Analysen, die sich auf die schwerwiegendsten Probleme konzentrieren.

Der aktuelle Status des Incidents in seinem Lebenszyklus, zum Beispiel Open, Pending, Resolved oder Closed.

Warum das wichtig ist

Es zeigt den Fortschritt des Incidents im Lebenszyklus und hilft, Phasen mit häufigen Verzögerungen zu erkennen.

Die Kategorie zur Klassifizierung des Incidents, zum Beispiel Hardware, Software oder Netzwerk.

Warum das wichtig ist

Es ermöglicht die Analyse von Incident-Trends und hilft festzustellen, ob eine falsche Kategorisierung die Lösung verzögert.

Der Timestamp, bis zu dem der Incident gemäß der SLA-Richtlinie gelöst werden soll.

Warum das wichtig ist

Es gibt die Frist für die Lösung an. Diese wird benötigt, um die SLA-Einhaltung zu berechnen und gefährdete Incidents zu erkennen.

Aktivitäten

Prozessschritte, die Sie verfolgen und optimieren sollten

Kennzeichnet die Erstellung eines neuen Incident-Datensatzes in Freshservice. Damit beginnt der Incident-Verlauf. In der Regel meldet ein Endbenutzer den Incident über ein Portal oder per E-Mail, oder ein Service-Desk-Agent erstellt stellvertretend ein Ticket. Dieses Ereignis wird mit einem Erstellungs-Timestamp protokolliert.

Warum das wichtig ist

Diese Aktivität ist das zentrale Start-Event des gesamten Prozesses. Die Zeit von diesem Ereignis bis zur Lösung zu analysieren, ist grundlegend, um die gesamte Zykluszeit und die SLA-Einhaltung zu messen.

Kennzeichnet die erste Zuweisung eines Incidents an eine Supportgruppe. Sie kann automatisch über Routing-Regeln oder manuell durch eine disponierende Person erfolgen. Erfasst wird die Aktivität anhand des ersten Eintrags des Felds „Gruppe“ im Audit-Log des Incidents.

Warum das wichtig ist

Die Zuweisungen zu verfolgen, ist wichtig, um die Zeit bis zur ersten Reaktion zu messen und Engpässe bei der Weiterleitung zu erkennen. So lässt sich analysieren, wie effizient Incidents an das zuständige Team gelangen.

Diese Aktivität tritt ein, wenn die Priorität eines Incidents festgelegt oder geändert wird. Die Priorität bestimmt die Dringlichkeit und die SLA-Ziele für die Lösung. Erfasst werden Änderungen am Feld „Priorität“ im Verlauf des Incidents.

Warum das wichtig ist

Eine falsche oder verspätete Priorisierung kann zu SLA-Verletzungen und einer ineffizienten Ressourcenverteilung führen. Die Analyse dieser Aktivität hilft sicherzustellen, dass kritische Incidents sofort bearbeitet werden.

Diese Aktivität kennzeichnet den offiziellen Beginn der aktiven Untersuchung und Bearbeitung des Incidents. Sie wird erfasst, wenn ein Agent den Status des Incidents auf „In Bearbeitung“ setzt. Diese übliche Statusänderung wird im Aktivitätsverlauf des Tickets protokolliert.

Warum das wichtig ist

Anhand dieses Meilensteins lassen sich Wartezeit und aktive Bearbeitungszeit unterscheiden. Wie lange ein Incident den Status „In Bearbeitung“ hat, ist wichtig, um den Aufwand für die Lösung zu verstehen.

Diese Aktivität tritt ein, wenn ein Agent die Lösung des Incidents in einer Lösungsnotiz dokumentiert. In Freshservice ist dies eine eigene Aktion, bevor der Status auf „Gelöst“ geändert wird. Die Aktion und ihr Inhalt werden ausdrücklich protokolliert.

Warum das wichtig ist

Damit wird die Ermittlung einer Lösung gekennzeichnet. Die Zeit zwischen diesem Ereignis und dem Status „Incident gelöst“ kann auf eine interne Prüfung oder zusätzlichen Dokumentationsaufwand hinweisen.

Kennzeichnet den Zeitpunkt, zu dem der Agent eine Korrektur umgesetzt hat und den Incident als gelöst betrachtet. Erfasst wird das Ereignis, wenn der Status des Incidents auf „Gelöst“ gesetzt wird. In Freshservice ist dies ein wichtiger Meilenstein, an dem die SLA-Zeitmessung endet.

Warum das wichtig ist

Dieser Meilenstein ist entscheidend, um die Zeit bis zur Lösung (TTR) zu messen. Der Zeitraum zwischen „Gelöst“ und „Geschlossen“ ist wichtig, um Verzögerungen bei der Bestätigung durch Benutzer und Regeln zum automatischen Schließen zu analysieren.

Bezeichnet den endgültigen, formalen Abschluss des Incident-Datensatzes. Dieser erfolgt in der Regel automatisch nach einer festgelegten Zeit im Status 'Resolved' oder wird manuell von einem Mitarbeitenden vorgenommen. Mit diesem Ereignis endet der Lebenszyklus des Incidents.

Warum das wichtig ist

Diese Aktivität markiert das definitive Ende des Prozesses. Die Gesamtzeit bis zu diesem Ereignis entspricht der Dauer des gesamten Incident-Lebenszyklus, einschließlich etwaiger Wartezeiten auf die Bestätigung durch den Benutzer.

Häufig gestellte Fragen

Häufig gestellte Fragen

Process Mining deckt Engpässe, Compliance-Verstöße und Ineffizienzen im gesamten Incident-Verlauf auf, von der Erstellung bis zur Lösung. Es bildet den tatsächlichen Prozessablauf ab und zeigt, wo sich etwa lange Lösungszeiten, häufige Neuzuweisungen oder Verzögerungen optimieren lassen. So wird klarer, wie Incidents tatsächlich bearbeitet werden. Abweichungen von den erwarteten Abläufen ermöglichen gezielte Verbesserungen und einen besseren Service.

In der Regel benötigen Sie Incident-Protokolle mit einer Case-ID, zum Beispiel einer Incident-ID, Aktivitätsbeschreibungen und Timestamps für jeden Prozessschritt. Zusätzliche Attribute wie Agent, Zuweisungsgruppe, Incident-Kategorie und Priorität können die Analyse deutlich erweitern. Vollständige und korrekte Daten sind entscheidend, um aussagekräftige Erkenntnisse zu gewinnen.

Sie können kritische Incidents schneller lösen, Service-Level-Agreements besser einhalten und Übergaben bei Incidents vereinfachen. Process Mining unterstützt außerdem eine genauere Kategorisierung, wirksamere Ursachenanalysen und standardisierte Eskalationen. Insgesamt lassen sich so die Kosten des Incident Managements senken und die Benutzererfahrung verbessern.

Ja. Process Mining verfolgt genau, welche Wege Incidents durchlaufen, und zeigt Aktivitäten oder Abläufe auf, die zu SLA-Verletzungen führen. Sichtbar werden etwa Verzögerungen durch mehrfache Neuzuweisungen, lange Wartezeiten oder nicht freigegebene Workarounds. So können Sie die Ursachen für verfehlte SLAs ermitteln und gezielte Verbesserungsmaßnahmen umsetzen.

Zunächst müssen Sie relevante Event-Log-Daten aus Ihrer Freshservice-Instanz ermitteln und extrahieren. Dazu gehören in der Regel Incident-IDs, die zugehörigen Timestamps der Aktivitäten und eindeutige Beschreibungen der einzelnen Schritte. Die extrahierten Daten müssen vollständig und von hoher Qualität sein, damit die Prozessanalyse genaue und aussagekräftige Ergebnisse liefert.

Nein. Process Mining hilft Unternehmen jeder Größe, ihre Prozesse unabhängig von deren Komplexität zu verbessern. Auch kleinere Teams gewinnen konkrete, umsetzbare Erkenntnisse über die Leistung ihres Incident Managements. So werden Möglichkeiten zur Effizienzsteigerung und zur besseren Einhaltung von Prozessen sichtbar, die sonst möglicherweise unentdeckt blieben.

Erste Erkenntnisse und Hinweise auf Prozessengpässe lassen sich oft innerhalb weniger Wochen gewinnen, sobald die Daten erfolgreich extrahiert und das Modell eingerichtet wurde. Eine detailliertere Analyse, die Umsetzung von Verbesserungen und die Messung ihrer Wirkung können einige Monate dauern. Wie lange es insgesamt dauert, hängt vor allem von der Komplexität Ihres Incident-Management-Prozesses und den verfügbaren Ressourcen ab.

Zusätzlich zu Ihren Freshservice-Daten benötigen Sie ein Process-Mining-Tool, entweder als Cloud-Lösung oder für den Betrieb vor Ort. Die meisten modernen Tools bieten eine benutzerfreundliche Oberfläche, sodass für die Bedienung in der Regel keine Programmierkenntnisse erforderlich sind. Für die Aufbereitung Ihrer Freshservice-Rohdaten können jedoch anfangs Datentransformationen oder Skripte nötig sein.

Durch die Analyse der individuellen Incident-Bearbeitung macht Process Mining Unterschiede bei der Leistung der Agents und der Einhaltung von Standardarbeitsanweisungen sichtbar. Die Analyse zeigt bewährte Vorgehensweisen besonders leistungsstarker Agents und Bereiche auf, in denen andere gezielte Schulungen oder klarere Prozessvorgaben benötigen. So können Sie gezielt coachen und einen einheitlichen Service sicherstellen.

Verhindern Sie SLA-Verstöße: Optimieren Sie Ihr Incident Management noch heute

Schließen Sie sich Unternehmen an, die ihre MTTR um 35 % senken und kostspielige SLA-Verstöße verhindern.

Starten Sie Ihre kostenlose Testphase

14 Tage kostenlos testen, keine Kreditkarte erforderlich.