Process-Mining-Event-Log erstellen: So geht’s
Erstellen Sie ein Process-Mining-Event-Log mit den passenden Spalten. Mit herunterladbarem Restaurantbeispiel und Anleitungen für Excel und SQL.

Für Process Mining brauchen Sie zunächst ein Event Log: eine Tabelle mit Aktivitäten und Timestamps, geordnet nach Case-ID. Dieser Leitfaden zeigt, wie Sie die Tabelle aus Systemdaten erstellen, anhand eines fiktiven Restaurant-Bestellprozesses. Sie können einzelne Zeilen in Excel anlegen oder die Aktivitäten mit einer SQL-Abfrage und UNION ALL zusammenführen. Vergleichen Sie Ihre Ergebnisse dabei mit dem fertigen Beispiel-Event-Log.
Ein Event Log zu erstellen, gilt oft als schwierige Aufgabe. Das muss es nicht sein, solange Sie nicht alles auf einmal erledigen wollen. Beginnen Sie heute mit einem Template oder einigen Zeilen in Excel. Sobald Sie wissen, was Sie benötigen, können Sie den Umfang erweitern.
Event Log für Process Mining: Diese drei Spalten benötigen Sie
Ein Event Log ist eine strukturierte Aufzeichnung der Vorgänge in einem Prozess. Jede Zeile steht für ein Ereignis, etwa eine aufgegebene Bestellung oder eine eingegangene Zahlung. Die Case-ID ordnet zusammengehörige Ereignisse zu, der Timestamp gibt den Zeitpunkt an. Damit kann ein Tool rekonstruieren, wie Cases den Prozess durchlaufen.
Eine Aktivität bezeichnet einen Typ, ein Ereignis einen konkreten Vorgang. Eine Aktivität ist eine Art Handlung, zum Beispiel „Bestellung versandt“. Ein Ereignis ist ein konkretes Vorkommnis: Bestellung 12345 wurde am 15. Januar um 14:30 Uhr versandt. Ihr Event Log erfasst Ereignisse, und jedes Ereignis enthält einen Aktivitätsnamen. Die Begriffe werden oft synonym verwendet. Bei der Datenaufbereitung ist der Unterschied jedoch wichtig: Die Aktivität beschreibt, was geschah. Das Ereignis hält fest, dass es diesem Case zu diesem Zeitpunkt widerfahren ist.
Ein einfaches Event Log für Process Mining benötigt drei Spalten:
| Spalte | Inhalt | Beispiel |
|---|---|---|
| Case-ID | Kennung, die Ereignisse desselben Cases gruppiert | 1001 |
| Timestamp | Zeitpunkt des Ereignisses | 2025-01-15 18:30:00 |
| Aktivität | Was geschehen ist | Order Placed |
Prüfen Sie anschließend die drei Felder, bevor Sie fortfahren:
| Prüfung | Was Sie bestätigen sollten |
|---|---|
| Case-ID | Zusammengehörige Ereignisse haben dieselbe ID, unterschiedliche Cases unterschiedliche IDs |
| Timestamp | Für jedes Ereignis sind ein verwendbares Datum und eine Uhrzeit vorhanden |
| Aktivität | Die Namen sind eindeutig und im gesamten Export einheitlich |
Diese drei Felder bilden die Grundlage. Fehlt eines davon oder ist es uneinheitlich, bildet die Prozessansicht die Arbeitsabläufe falsch ab. Alles Weitere ist optional: Ein Event Log, das Process-Mining-Tools für Geschäftsprozesse lesen können, besteht immer aus einer Tabelle mit Cases und Ereignissen. Die drei Spalten, die ein solches Event Log nutzbar machen, bleiben stets gleich. Informationen zu unterstützten Formaten und Vorbereitungsschritten finden Sie in der Dokumentation zu Process-Mining-Daten.
Ein durchgängiges Beispiel: das Bestellsystem von Pizza Palace
Damit die einzelnen Schritte konkret werden, verwenden wir das fiktive Restaurant Pizza Palace. Kunden bestellen online, Mitarbeitende bereiten das Essen zu und Lieferfahrer bringen es zu den Kunden. Das Beispiel enthält keine Kundendaten.
Angenommen, das System speichert Informationen in diesen Tabellen:
- orders: Bestell-ID, Kunde und Bestellzeitpunkt
- order_items: Pizzen, Beilagen und Getränke in jeder Bestellung
- kitchen_queue: Zeitpunkt, zu dem eine Bestellung in die Küche gelangt und sie wieder verlässt
- delivery_assignments: Zuweisung von Lieferfahrern und Lieferverfolgung
- payments: Datensätze zur Zahlungsabwicklung
Ziel ist ein Event Log, das jede Bestellung vom Eingang bis zur Lieferung abbildet. Die Bestell-ID dient als Case-ID. Jeder relevante Timestamp und jede Aktion wird zu einer Zeile. Laden Sie das Beispiel-Event-Log von Pizza Palace herunter und vergleichen Sie dessen Spalten mit Ihrem eigenen Export.
Legen Sie vor dem Export fest, welche Aktivitäten enthalten sein sollen. Bei Pizza Palace umfasst der Bestellablauf sechs Schritte:
- Bestellung aufgegeben: Der Kunde gibt die Bestellung auf.
- Zahlung eingegangen: Die Zahlung wird erfolgreich verarbeitet.
- Bestellung an die Küche übermittelt: Die Bestellung gelangt in die Zubereitungswarteschlange.
- Bestellung fertig: Die Küche kennzeichnet die Bestellung als abgeschlossen.
- Lieferfahrer zugewiesen: Ein Lieferfahrer wird zugewiesen.
- Lieferung abgeschlossen: Die Bestellung wird zugestellt.
Bestimmen Sie für jede Aktivität die Quelltabelle, das Timestamp-Feld und das Feld für die Case-ID. Prüfen Sie, ob die Case-ID das Ereignis der richtigen Bestellung zuordnet.
| Aktivität | Quelltabelle | Timestamp-Feld | Feld für die Case-ID |
|---|---|---|---|
| Bestellung aufgegeben | orders | created_at | id |
| Zahlung eingegangen | payments | payment_time | order_id |
| Bestellung an die Küche übermittelt | kitchen_queue | queue_entry_time | order_id |
| Bestellung fertig | kitchen_queue | completed_time | order_id |
| Lieferfahrer zugewiesen | delivery_assignments | assigned_at | order_id |
| Lieferung abgeschlossen | delivery_assignments | delivered_at | order_id |
Trennen Sie direkt erfasste von abgeleiteten Ereignissen. Ein direkt erfasstes Ereignis hat einen eigenen Datensatz und Timestamp im Quellsystem: „Bestellung aufgegeben“ stammt aus dem Timestamp in der Tabelle orders, „Zahlung eingegangen“ aus payments und „Lieferung abgeschlossen“ aus delivery_assignments. Solche Ereignisse lassen sich in der Regel einfach extrahieren, sofern der Timestamp dem Ereignis entspricht, das Sie analysieren möchten.
Ein abgeleitetes Ereignis hat keinen eigenen Datensatz. Deshalb leiten Sie den Zeitpunkt aus einem anderen Feld ab. „Lieferfahrer zugewiesen“ ist möglicherweise nur als Erstellungszeitpunkt der Lieferzuweisung erfasst. „Bestellung fertig“ könnte lediglich dem Zeitpunkt entsprechen, an dem sich der Status der Küchenwarteschlange in „abgeschlossen“ geändert hat. Abgeleitete Ereignisse können nützlich sein, doch dokumentieren Sie, wie Sie sie ermittelt haben. Eine Statusänderung oder der Erstellungszeitpunkt eines Datensatzes bedeutet möglicherweise nicht genau das, was der Aktivitätsname nahelegt. Klären Sie die Bedeutung des Feldes mit Personen, die das Quellsystem kennen, bevor Sie es als Timestamp eines Ereignisses verwenden.
Diese Zuordnung ist ein Plan, kein Beleg dafür, dass jedes Feld geeignet ist. Prüfen Sie, ob die Timestamps ausgefüllt sind und ob sich jede Tabelle mit der Bestell-ID verknüpfen lässt, ohne doppelte Zeilen zu erzeugen.
Attribute von Cases und Ereignissen
Attribute liefern zusätzlichen Kontext für Ihre Analyse. Es sind die Spalten neben Case-ID, Timestamp und Aktivität. Fügen Sie sie nur hinzu, wenn ihre Bedeutung klar ist und sie dem richtigen Case oder Ereignis zugeordnet werden können.
Case-Attribute beschreiben den gesamten Case und bleiben in der Regel bei allen zugehörigen Ereignissen gleich: Kundenname, Bestellwert, Lieferadresse oder Anzahl der bestellten Artikel. In einem flachen Event Log wiederholen Sie den Wert in jeder Zeile dieses Cases. So können Sie später Ereignisse anhand von Informationen auf Case-Ebene filtern oder vergleichen.
Ereignisattribute beschreiben ein einzelnes Ereignis: den Lieferfahrer bei einem Lieferereignis, die Zahlungsmethode bei einem Zahlungsereignis oder die Küchenstation bei einem Küchenereignis. Eine solche Spalte gilt nicht für jede Zeile. Lassen Sie sie dort leer, wo sie nicht zutrifft, und behalten Sie die Spalte in der Tabelle bei, damit alle Zeilen dieselbe Struktur haben.
Ihr fertiges Event Log sollte aus einer einzigen flachen Tabelle mit einem Ereignis pro Zeile bestehen. Hier sehen Sie das Event Log von Pizza Palace:
| Case-ID | Timestamp | Aktivität | Kunde | Bestellwert | Lieferfahrer | Zahlungsmethode |
|---|---|---|---|---|---|---|
| 1001 | 2025-01-15 18:30:00 | Bestellung aufgegeben | John Smith | 45.99 | ||
| 1001 | 2025-01-15 18:30:15 | Zahlung eingegangen | John Smith | 45.99 | Kreditkarte | |
| 1001 | 2025-01-15 18:31:00 | Bestellung an die Küche übermittelt | John Smith | 45.99 | ||
| 1001 | 2025-01-15 18:45:00 | Bestellung fertig | John Smith | 45.99 | ||
| 1001 | 2025-01-15 18:46:00 | Lieferfahrer zugewiesen | John Smith | 45.99 | Maria Garcia | |
| 1001 | 2025-01-15 19:05:00 | Lieferung abgeschlossen | John Smith | 45.99 | Maria Garcia | |
| 1002 | 2025-01-15 18:35:00 | Bestellung aufgegeben | Jane Doe | 28.50 | ||
| 1002 | 2025-01-15 18:35:20 | Zahlung eingegangen | Jane Doe | 28.50 | PayPal | |
| … | … | … | … | … | … | … |
Kunde und Bestellwert werden bei jedem Ereignis desselben Cases wiederholt. Das ist beabsichtigt: So bleibt das Event Log eine einfache Tabelle, die Process-Mining-Tools lesen können.
Methode 1: Erstellen in Excel
Excel eignet sich gut für einen kleinen Export oder eine erste Übung. Exportieren Sie jeden Ereignistyp, vereinheitlichen Sie die Spalten und führen Sie die Zeilen in einem Tabellenblatt zusammen. Die fünf Schritte unten dauern mit den Daten von Pizza Palace etwa eine Stunde.
Schritt 1: Exportieren Sie jeden Ereignistyp in ein eigenes Tabellenblatt. Erstellen Sie für jeden Aktivitätstyp ein Tabellenblatt. Zum Beispiel:
Tabellenblatt 1: Bestellung aufgegeben
| Case-ID | Timestamp | Aktivität | Kunde | Bestellwert |
|---|---|---|---|---|
| 1001 | 2025-01-15 18:30:00 | Bestellung aufgegeben | John Smith | 45.99 |
| 1002 | 2025-01-15 18:35:00 | Bestellung aufgegeben | Jane Doe | 28.50 |
Tabellenblatt 2: Zahlung eingegangen
| Case-ID | Timestamp | Aktivität | Kunde | Bestellwert | Zahlungsmethode |
|---|---|---|---|---|---|
| 1001 | 2025-01-15 18:30:15 | Zahlung eingegangen | John Smith | 45.99 | Kreditkarte |
| 1002 | 2025-01-15 18:35:20 | Zahlung eingegangen | Jane Doe | 28.50 | PayPal |
Erstellen Sie nach demselben Prinzip weitere Tabellenblätter für Ereignisse in der Küche und bei der Lieferung.
Schritt 2: Vereinheitlichen Sie die Spalten. Verwenden Sie auf jedem Tabellenblatt dieselben Spaltennamen in derselben Reihenfolge. Fügen Sie leere Spalten hinzu, wenn ein Attribut nicht zutrifft. Das Tabellenblatt „Bestellung aufgegeben“ kann beispielsweise alle Spalten enthalten:
| Case-ID | Timestamp | Aktivität | Kunde | Bestellwert | Lieferfahrer | Zahlungsmethode |
|---|---|---|---|---|---|---|
| 1001 | 2025-01-15 18:30:00 | Bestellung aufgegeben | John Smith | 45.99 |
Prüfen Sie, ob die Werte kompatible Formate haben. Achten Sie besonders darauf, dass Timestamps als Datum und Uhrzeit gespeichert sind und nicht als Text, der nur wie ein Timestamp aussieht.
Schritt 3: Führen Sie die Tabellenblätter zusammen. Erstellen Sie ein neues Tabellenblatt mit dem Namen Event Log. Kopieren Sie die Ereigniszeilen aus jedem Aktivitätsblatt hinein. Verwenden Sie dabei nur eine Kopfzeile und eine Zeile pro Ereignis.
Schritt 4: Sortieren Sie nach Case und Timestamp. Sortieren Sie die zusammengeführten Daten zuerst aufsteigend nach Case-ID und dann aufsteigend nach Timestamp. So lässt sich die Abfolge der einzelnen Cases leichter prüfen. Durch das Sortieren werden ungenaue Timestamps nicht korrigiert. Prüfen Sie daher Ereignisse mit identischen oder unerwarteten Zeitangaben, bevor Sie sich auf ihre Reihenfolge verlassen.
Schritt 5: Exportieren Sie die Daten als CSV. Speichern Sie das zusammengeführte Tabellenblatt als CSV-Datei für ein Event Log, die Ihr Tool lesen kann. Öffnen Sie die exportierte Datei einmal, um zu prüfen, ob Kopfzeilen, Trennzeichen, Datumsformat und leere Werte wie erwartet aussehen.
Excel-Tipps:
- Verwenden Sie SVERWEIS oder XVERWEIS, um Case-Attribute wie den Kundennamen aus dem Tabellenblatt „orders“ hinzuzufügen.
- Verwenden Sie ein einheitliches Datums- und Uhrzeitformat, zum Beispiel
YYYY-MM-DD HH:MM:SS. - Prüfen Sie vor dem Export, ob Zeilen doppelt vorkommen.
- Bewahren Sie eine unveränderte Kopie der ursprünglichen Exporte auf, damit Sie alle Korrekturen nachvollziehen können.
Methode 2: Erstellen mit SQL
SQL lohnt sich, wenn Ihre Daten in einer Datenbank liegen, der Export umfangreich ist oder Sie dieselbe Extraktion im nächsten Monat erneut ausführen müssen. Üblicherweise wird eine SELECT pro Aktivität erstellt und mit UNION ALL zusammengeführt.
So funktioniert UNION ALL. Damit werden die von mehreren SELECT-Anweisungen zurückgegebenen Zeilen zusammengeführt. Jede Anweisung muss dieselbe Anzahl von Spalten in derselben Reihenfolge und mit kompatiblen Datentypen zurückgeben. Verwenden Sie außerdem einheitliche Aliase, damit die Spalten im Ergebnis klare Namen haben.
Die Abfrage. Das folgende Beispiel verwendet die fiktiven Tabellen von Pizza Palace. Prüfen Sie vor der Anpassung Ihre eigenen Tabellennamen, Feldnamen, die Bedeutung der Timestamps und den SQL-Dialekt.
-- Event Log Extraction for Pizza Palace
-- This query combines multiple event types into a single event log
-- Each SELECT block represents one activity type

-- Event 1: Order Placed
-- Source: orders table
-- This captures when customers submit their orders
SELECT
    o.id AS case_id,                          -- The order ID is our case identifier
    o.created_at AS timestamp,                -- When the order was placed
    'Order Placed' AS activity,               -- The activity name (hardcoded)
    o.customer_name AS customer,              -- Case attribute: who ordered
    o.total_amount AS order_value,            -- Case attribute: order value
    NULL AS driver,                           -- Not applicable for this event
    NULL AS payment_method                    -- Not applicable for this event
FROM orders o
WHERE o.created_at >= '2025-01-01'            -- Filter to your desired date range

UNION ALL

-- Event 2: Payment Received
-- Source: payments table
-- This captures successful payment processing
SELECT
    p.order_id AS case_id,
    p.payment_time AS timestamp,
    'Payment Received' AS activity,
    o.customer_name AS customer,              -- Join to get case attributes
    o.total_amount AS order_value,
    NULL AS driver,
    p.payment_method AS payment_method        -- Event-specific attribute
FROM payments p
JOIN orders o ON p.order_id = o.id            -- Join to get order details
WHERE p.payment_time >= '2025-01-01'
  AND p.status = 'successful'                 -- Only include successful payments

UNION ALL

-- Event 3: Order Sent to Kitchen
-- Source: kitchen_queue table
-- This captures when the kitchen starts working on the order
SELECT
    k.order_id AS case_id,
    k.queue_entry_time AS timestamp,
    'Order Sent to Kitchen' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    NULL AS driver,
    NULL AS payment_method
FROM kitchen_queue k
JOIN orders o ON k.order_id = o.id
WHERE k.queue_entry_time >= '2025-01-01'

UNION ALL

-- Event 4: Order Ready
-- Source: kitchen_queue table (different timestamp field)
-- This is an inferred event based on when the kitchen marked it complete
SELECT
    k.order_id AS case_id,
    k.completed_time AS timestamp,            -- Different timestamp than entry
    'Order Ready' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    NULL AS driver,
    NULL AS payment_method
FROM kitchen_queue k
JOIN orders o ON k.order_id = o.id
WHERE k.completed_time >= '2025-01-01'
  AND k.completed_time IS NOT NULL            -- Only include completed orders

UNION ALL

-- Event 5: Assigned to Driver
-- Source: delivery_assignments table
-- This captures when a driver is assigned to deliver the order
SELECT
    d.order_id AS case_id,
    d.assigned_at AS timestamp,
    'Assigned to Driver' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    d.driver_name AS driver,                  -- Event-specific attribute
    NULL AS payment_method
FROM delivery_assignments d
JOIN orders o ON d.order_id = o.id
WHERE d.assigned_at >= '2025-01-01'

UNION ALL

-- Event 6: Delivery Completed
-- Source: delivery_assignments table (different timestamp field)
-- This captures when the order was delivered to the customer
SELECT
    d.order_id AS case_id,
    d.delivered_at AS timestamp,
    'Delivery Completed' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    d.driver_name AS driver,
    NULL AS payment_method
FROM delivery_assignments d
JOIN orders o ON d.order_id = o.id
WHERE d.delivered_at >= '2025-01-01'
  AND d.delivered_at IS NOT NULL              -- Only include completed deliveries

-- Final ordering: by case, then by time
-- This makes the event log easy to read and follow
ORDER BY case_id, timestamp;
Die Abfrage verwendet die Bestell-ID als Case-ID und gibt für jede Aktivität dieselben sieben Spalten zurück. Die Werte NULL sorgen für eine einheitliche Spaltenstruktur, wenn ein Attribut nicht zutrifft. Datumsfilter und die Bedingung für erfolgreiche Zahlungen dienen als Beispiele. Wählen Sie Filter, die zum untersuchten Prozess und Zeitraum passen.
Abfrage erweitern. So fügen Sie eine weitere Aktivität hinzu:
- Kopieren Sie einen
SELECT-Block als Ausgangspunkt. - Verwenden Sie die Quelltabelle, in der das Ereignis erfasst wird.
- Wählen Sie das Feld aus, das den Timestamp des Ereignisses abbildet.
- Legen Sie einen Aktivitätsnamen fest, der zu den übrigen Zeilen passt.
- Nehmen Sie die Case-ID und alle relevanten Attribute auf.
- Ergänzen Sie Filter, die zu Ihrer Analyse passen.
Wenn Ihr System die entsprechenden Tabellen und Felder enthält, können Sie beispielsweise einen Zustellversuch wie folgt hinzufügen:
UNION ALL

-- Event 7: Delivery Attempted
-- Add this to track failed delivery attempts
SELECT
    d.order_id AS case_id,
    d.attempt_time AS timestamp,
    'Delivery Attempted' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    d.driver_name AS driver,
    NULL AS payment_method
FROM delivery_attempts d
JOIN orders o ON d.order_id = o.id
WHERE d.attempt_time >= '2025-01-01'
Prüfungen vor der Analyse des Event Logs
Führen Sie diese Prüfungen durch, bevor Sie das Event Log analysieren. Zusammen decken sie die häufigsten Fehlerquellen in Event Logs für Process Mining ab, die zu irreführenden Ergebnissen führen: doppelte Ereignisse, fehlende Timestamps, instabile Case-IDs und Statusfelder, die fälschlich als Aktivitäten behandelt werden.
- Beginnen Sie mit den erforderlichen Spalten. Erstellen Sie ein kleines Event Log mit Case-ID, Timestamp und Aktivität, bevor Sie weitere Ereignisse oder Attribute hinzufügen.
- Verwenden Sie stabile Case-IDs. Jedes Ereignis desselben Cases sollte dieselbe Kennung haben. Verwenden Sie keinen Wert, der sich im Prozessverlauf ändert.
- Verwenden Sie einheitliche Aktivitätsnamen. Wählen Sie eine Bezeichnung wie „Bestellung aufgegeben“, statt sie mit „Bestellung erstellt“ und „Neue Bestellung“ zu vermischen.
- Prüfen Sie die Timestamps. Stellen Sie sicher, dass sie den Ereigniszeitpunkt abbilden, dieselbe Zeitzone verwenden und sich als Datum und Uhrzeit sortieren lassen.
- Prüfen Sie doppelte und fehlende Werte. Untersuchen Sie wiederholte Ereignisse sowie Zeilen ohne Case-ID, Timestamp oder Aktivität.
- Dokumentieren Sie Ihre Extraktion. Halten Sie Quelltabellen, Felder, Filter, Extraktionsdatum und Annahmen fest. So lässt sich das Event Log leichter aktualisieren und Fehler lassen sich einfacher beheben.
- Ergänzen Sie Attribute mit Bedacht. Nehmen Sie Felder auf, die bei der Beantwortung einer Frage helfen, und prüfen Sie, ob Verknüpfungen Ereigniszeilen vervielfachen.
Sieben häufige Datenprobleme, von doppelten Ereignissen bis zu fehlenden Case-IDs, werden in den FAQ am Ende dieser Seite beantwortet. ETL für Process Mining behandelt dieselben Arbeitsschritte für wiederkehrende Extraktionen.
Was Sie tun können, wenn Ihnen die Daten fehlen
Sie benötigen keinen vorgefertigten Konnektor, um ein Event Log vorzubereiten. Prüfen Sie zunächst, welche Daten Ihr System exportieren kann und ob die drei erforderlichen Felder enthalten sind.
- Bestimmen Sie den Prozess und die Case-ID, die Sie verfolgen möchten.
- Prüfen Sie, ob das System einen Ereignisverlauf, Audit-Datensätze oder mit Timestamps versehene Statusänderungen exportieren kann.
- Ordnen Sie die verfügbaren Felder mithilfe eines Daten-Templates den Spalten Case-ID, Timestamp und Aktivität zu.
- Wenn Sie keine fertige Ereignistabelle exportieren können, bitten Sie Ihr Datenteam um einen Datenbankexport oder einen Bericht mit einer Zeile pro Ereignis.
Ein Systemexport kann mehrere Tabellen enthalten oder für dasselbe Feld unterschiedliche Namen verwenden. Sie können die Daten in Excel oder SQL zusammenführen und umbenennen, sofern die Bedeutung jedes Feldes erhalten bleibt und sich bis zur Quelle zurückverfolgen lässt. Wo Sie Daten für Process Mining finden zeigt weitere Quellen mit verwendbaren Daten. Die Leitfäden zur Prozessverbesserung haben die Schritte 1 bis 3 für Ihr System bereits erledigt und enthalten ein Daten-Template für jeden Prozess.
Wenn Sie ein weiteres Beispiel-Event-Log für Process Mining suchen, um Formate zu vergleichen, enthält die Sammlung Beispiel-Event-Logs und Templates eine fertige Tabellenkalkulation. Auf der Seite zum Template-Event-Log finden Sie die erforderlichen und optionalen Spalten. Eine Anleitung zum ersten Datensatz bietet Laden Sie Ihren ersten Datensatz.
Laden Sie das erstellte Event Log
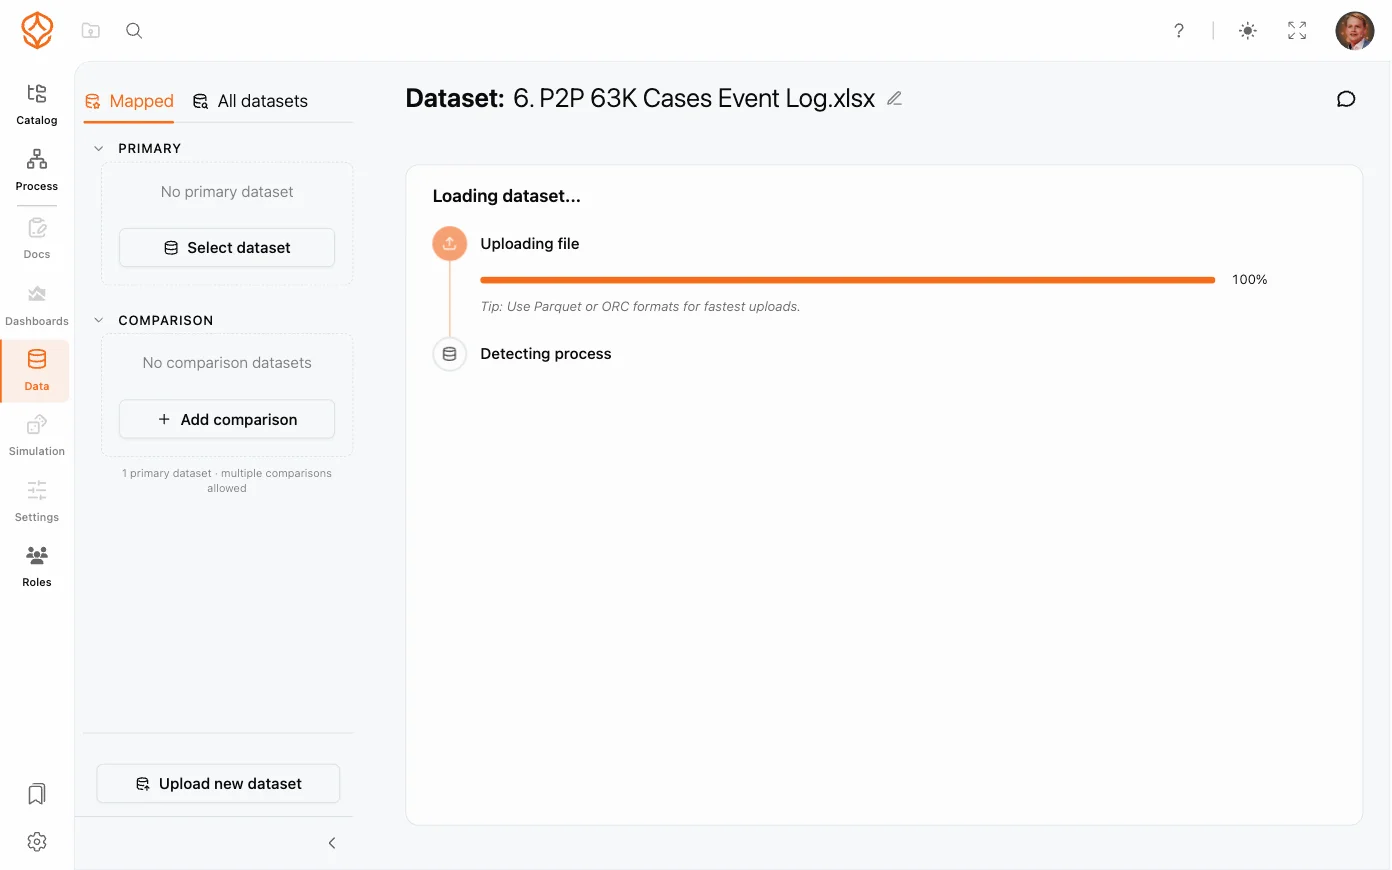
Sobald das Event Log fertig ist, laden Sie die Datei und ordnen Sie die drei erforderlichen Spalten zu. ProcessMind liest Excel-, CSV- und Datenbankexporte direkt ein.
- Laden Sie Ihre Datei hoch oder wählen Sie Ihren Datenbankexport aus.
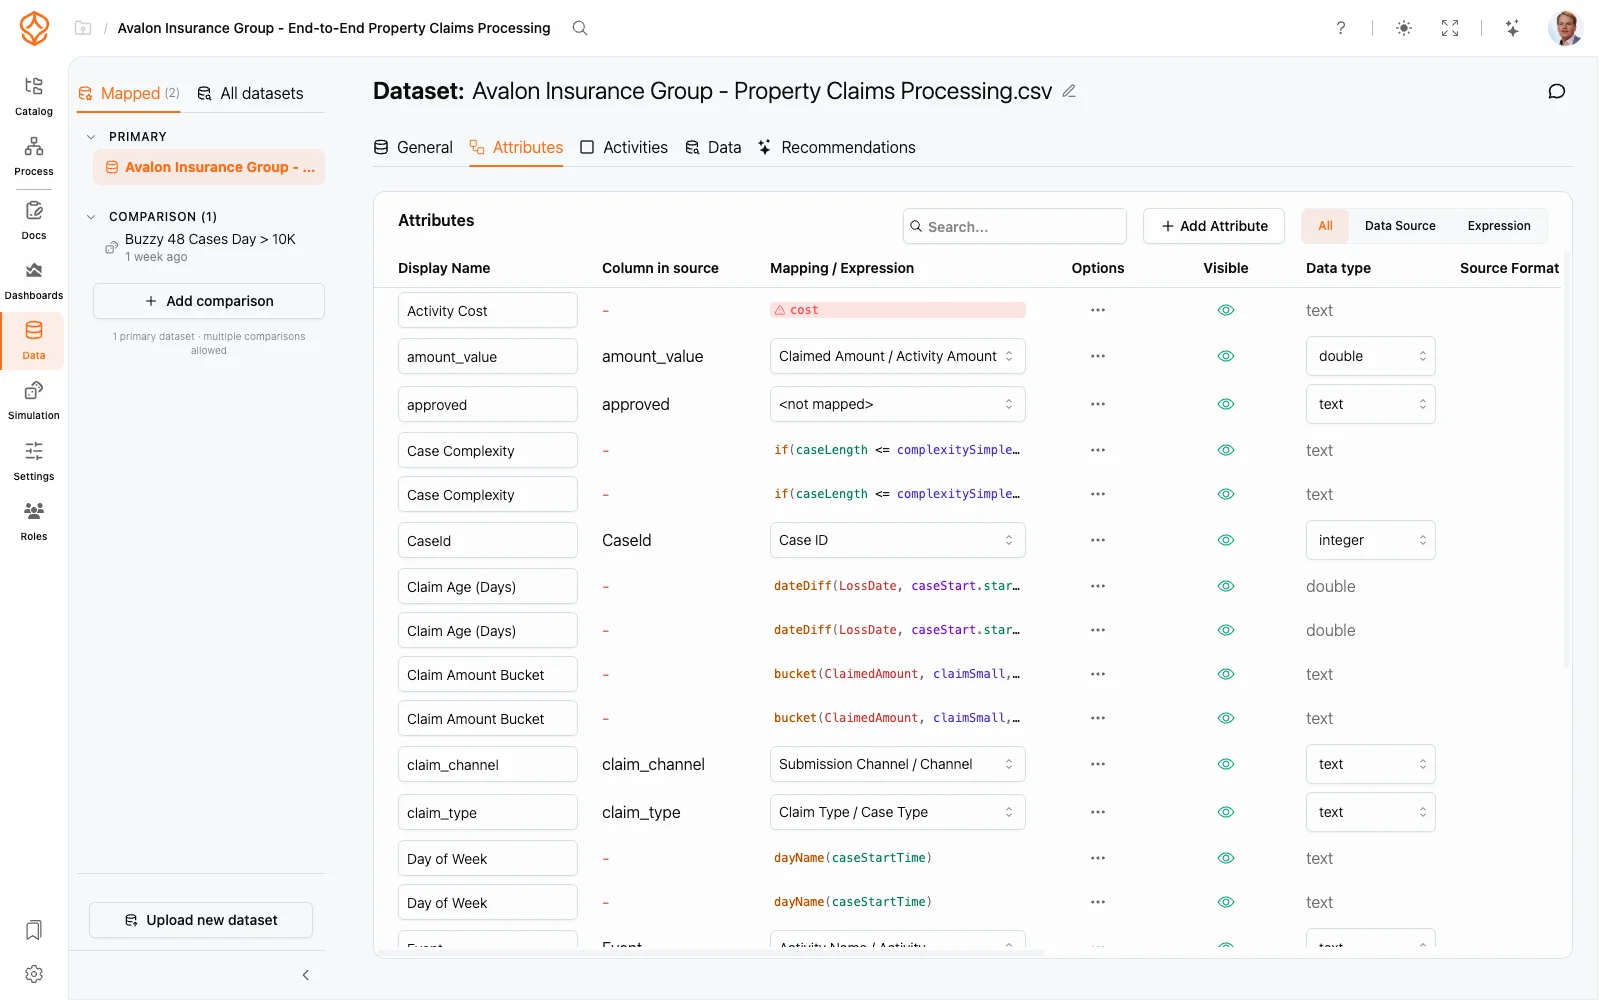
- Ordnen Sie die Spalten Case-ID, Timestamp und Aktivität zu.
- Prüfen Sie alle weiteren Attribute.
- Generieren Sie die Prozessansicht und prüfen Sie, ob die Cases und die Ereignisreihenfolge plausibel sind.
Eine Prozessansicht kann fehlende Aktivitäten, unerwartete Abläufe und Bereiche aufzeigen, die genauer untersucht werden sollten. Sie korrigiert weder die Quelldaten noch verändert sie die Arbeitsweise. Zeigt das erste Ergebnis ein Datenproblem, aktualisieren Sie den Export und laden Sie ihn erneut. Laden Sie Ihren ersten Datensatz führt ausführlich durch den Upload und die Zuordnung.
Where to Go From Here
Sie haben ein Event Log oder die drei nötigen Spalten dafür. Als Nächstes können Sie sehen, wie der Prozess tatsächlich abläuft.