Verbessern Sie Ihr Problemmanagement
Leitfaden zur Optimierung von Freshservice-Prozessen in 6 Schritten
Verbessern Sie Ihr Problemmanagement
Problem Management
Freshservice

Prozess auswählen

Wählen Sie einen Prozess aus, um in Ihrem verbundenen Arbeitsbereich weiterzuarbeiten.

259 Prozesse

Freshservice Problem Management mit Process Mining optimieren

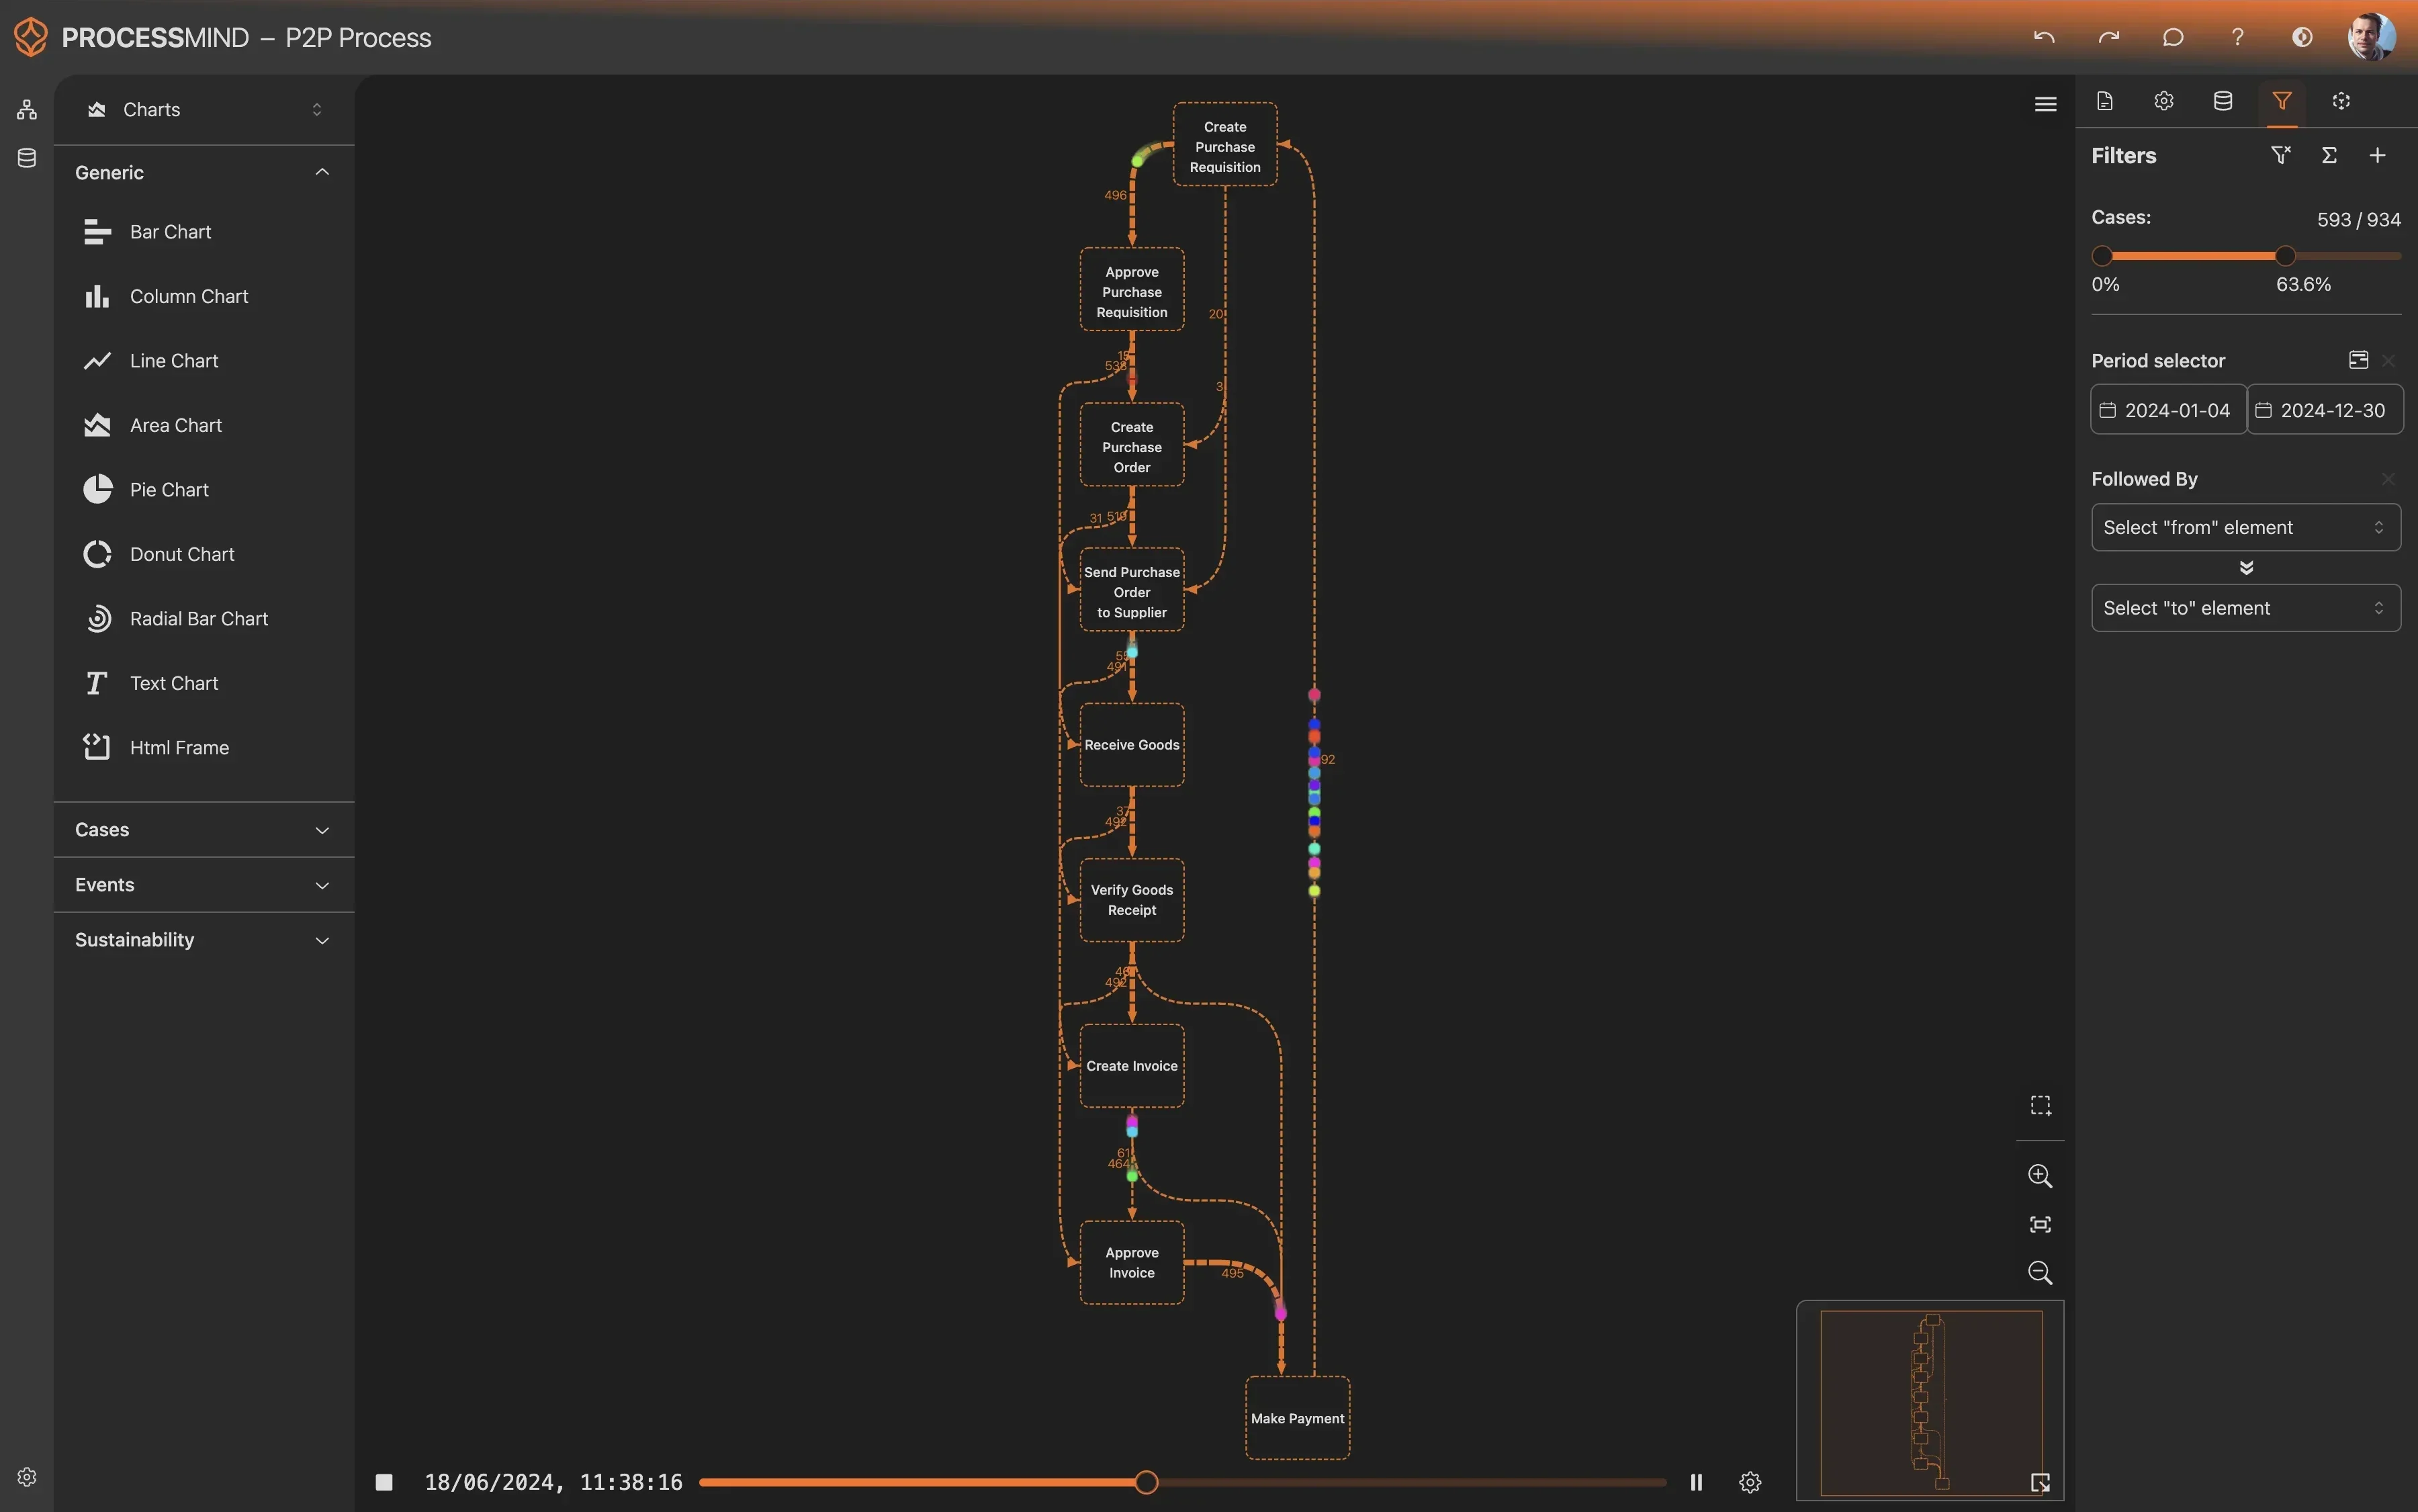
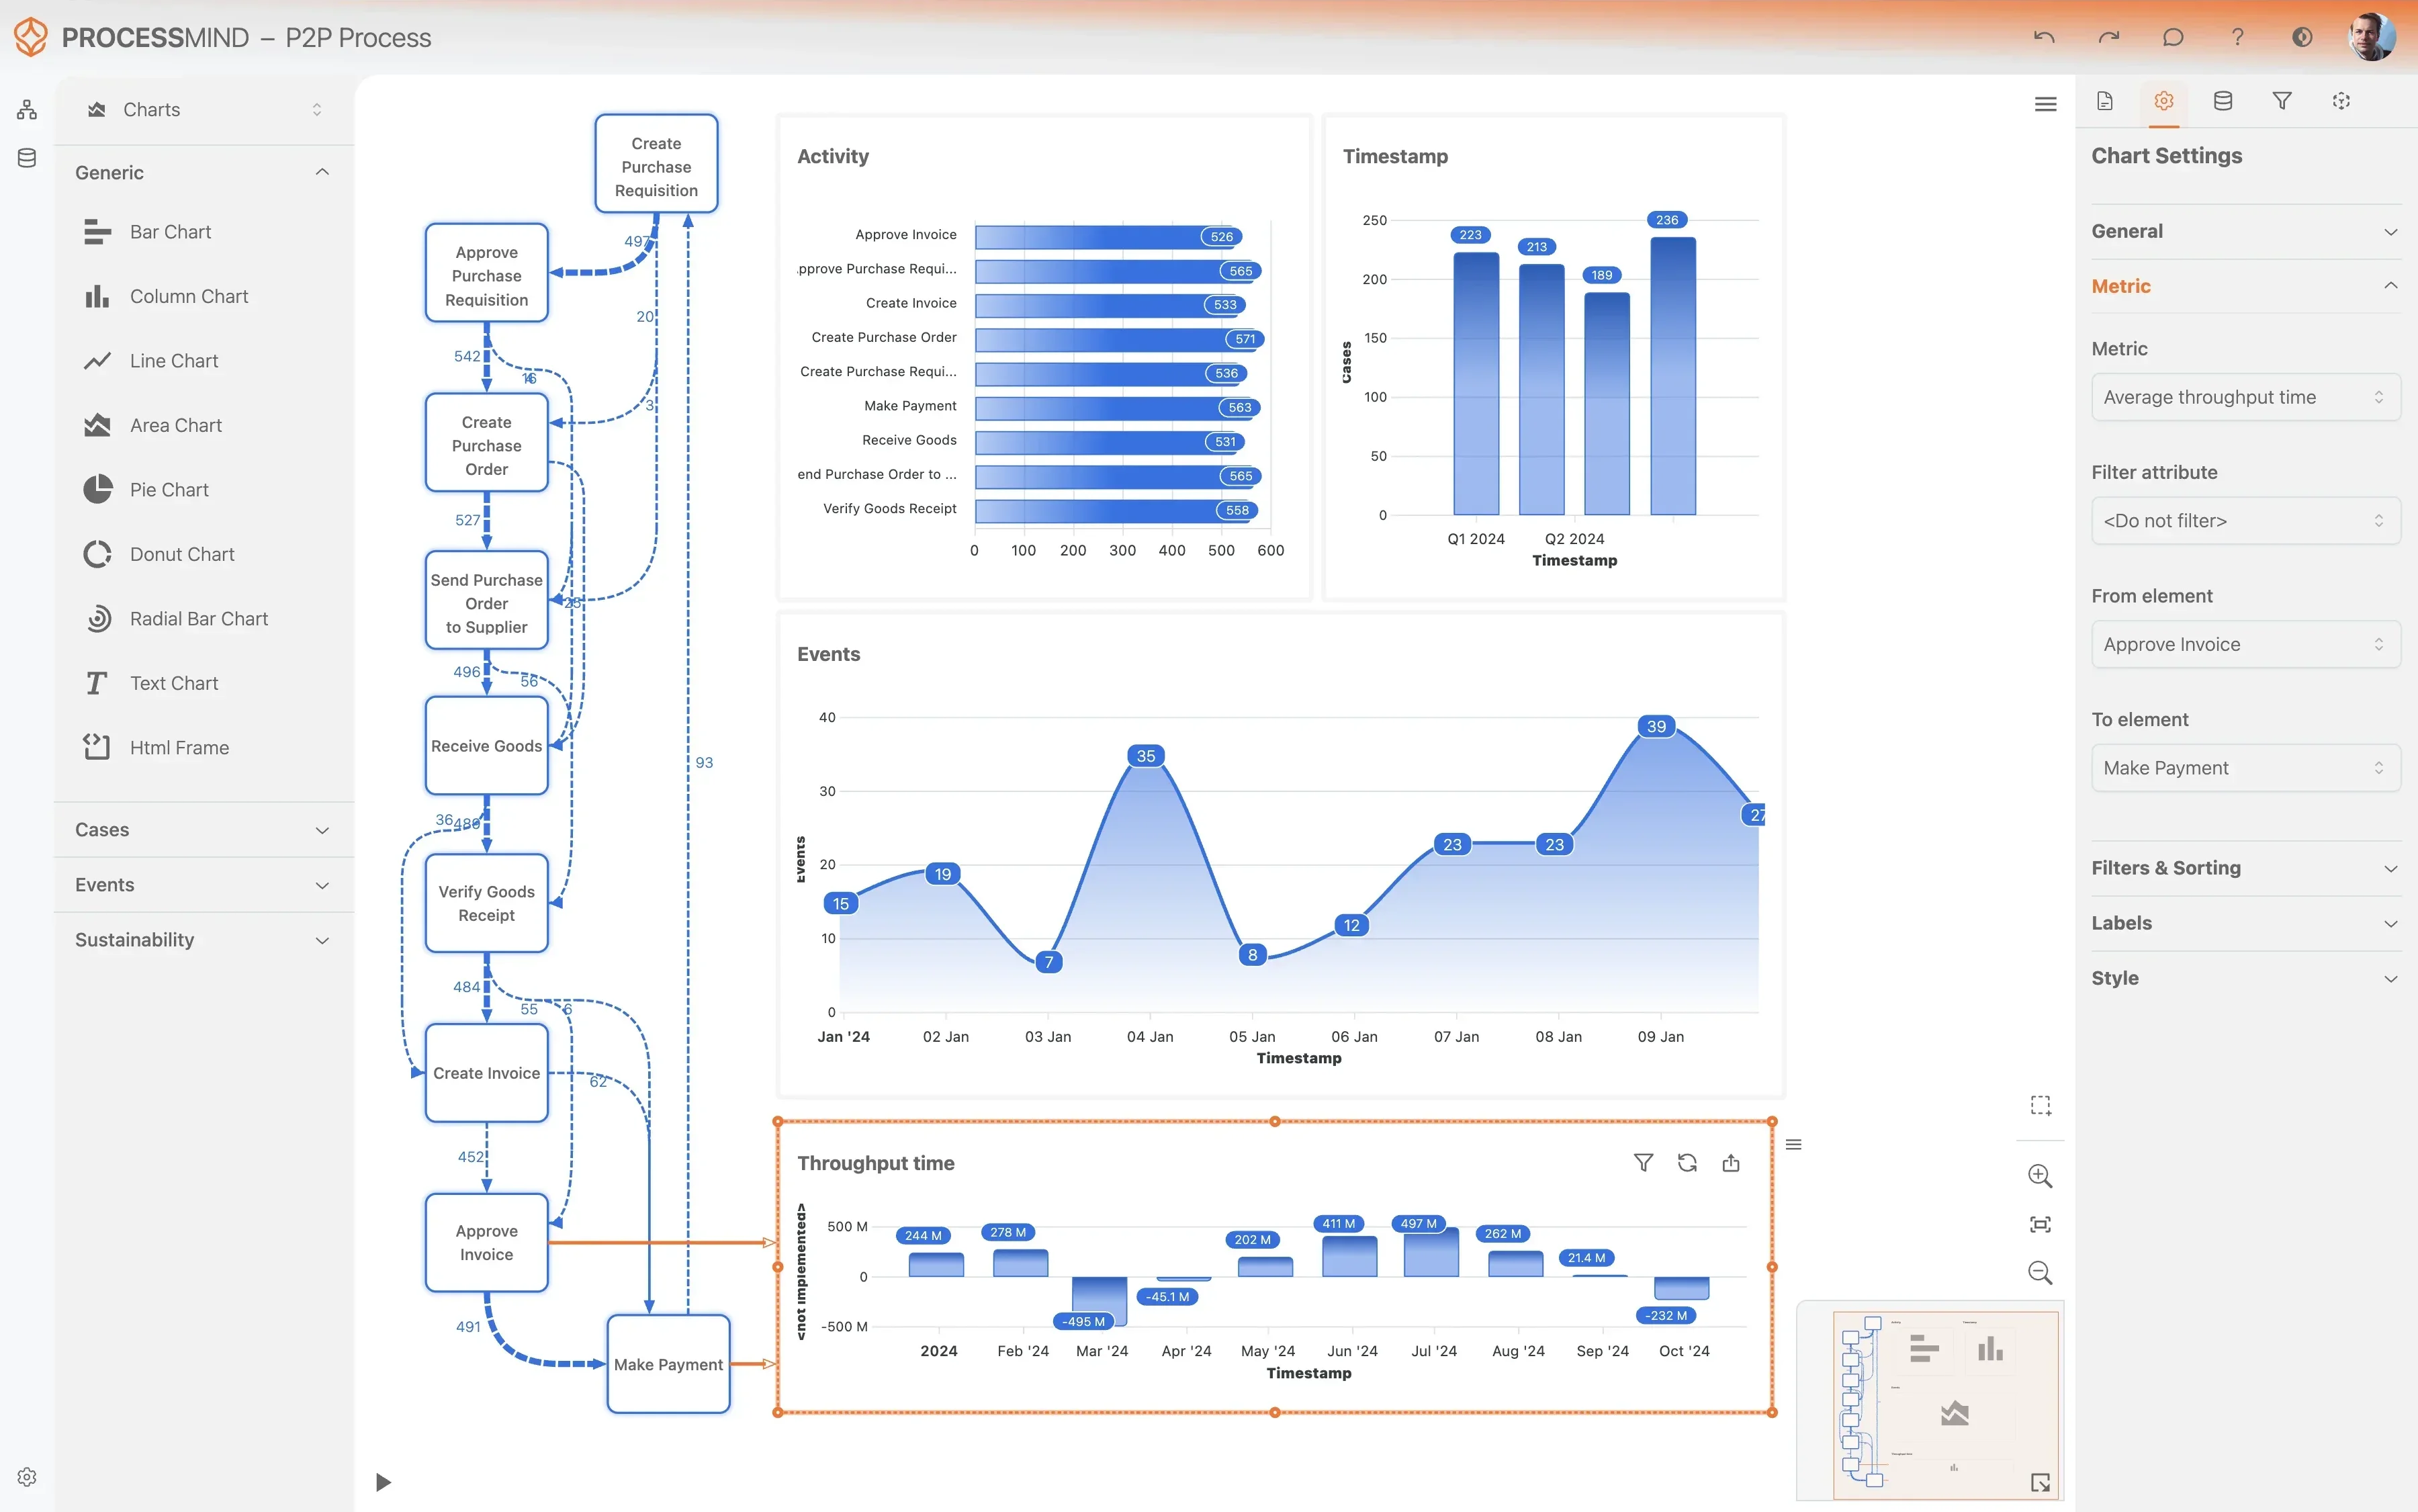
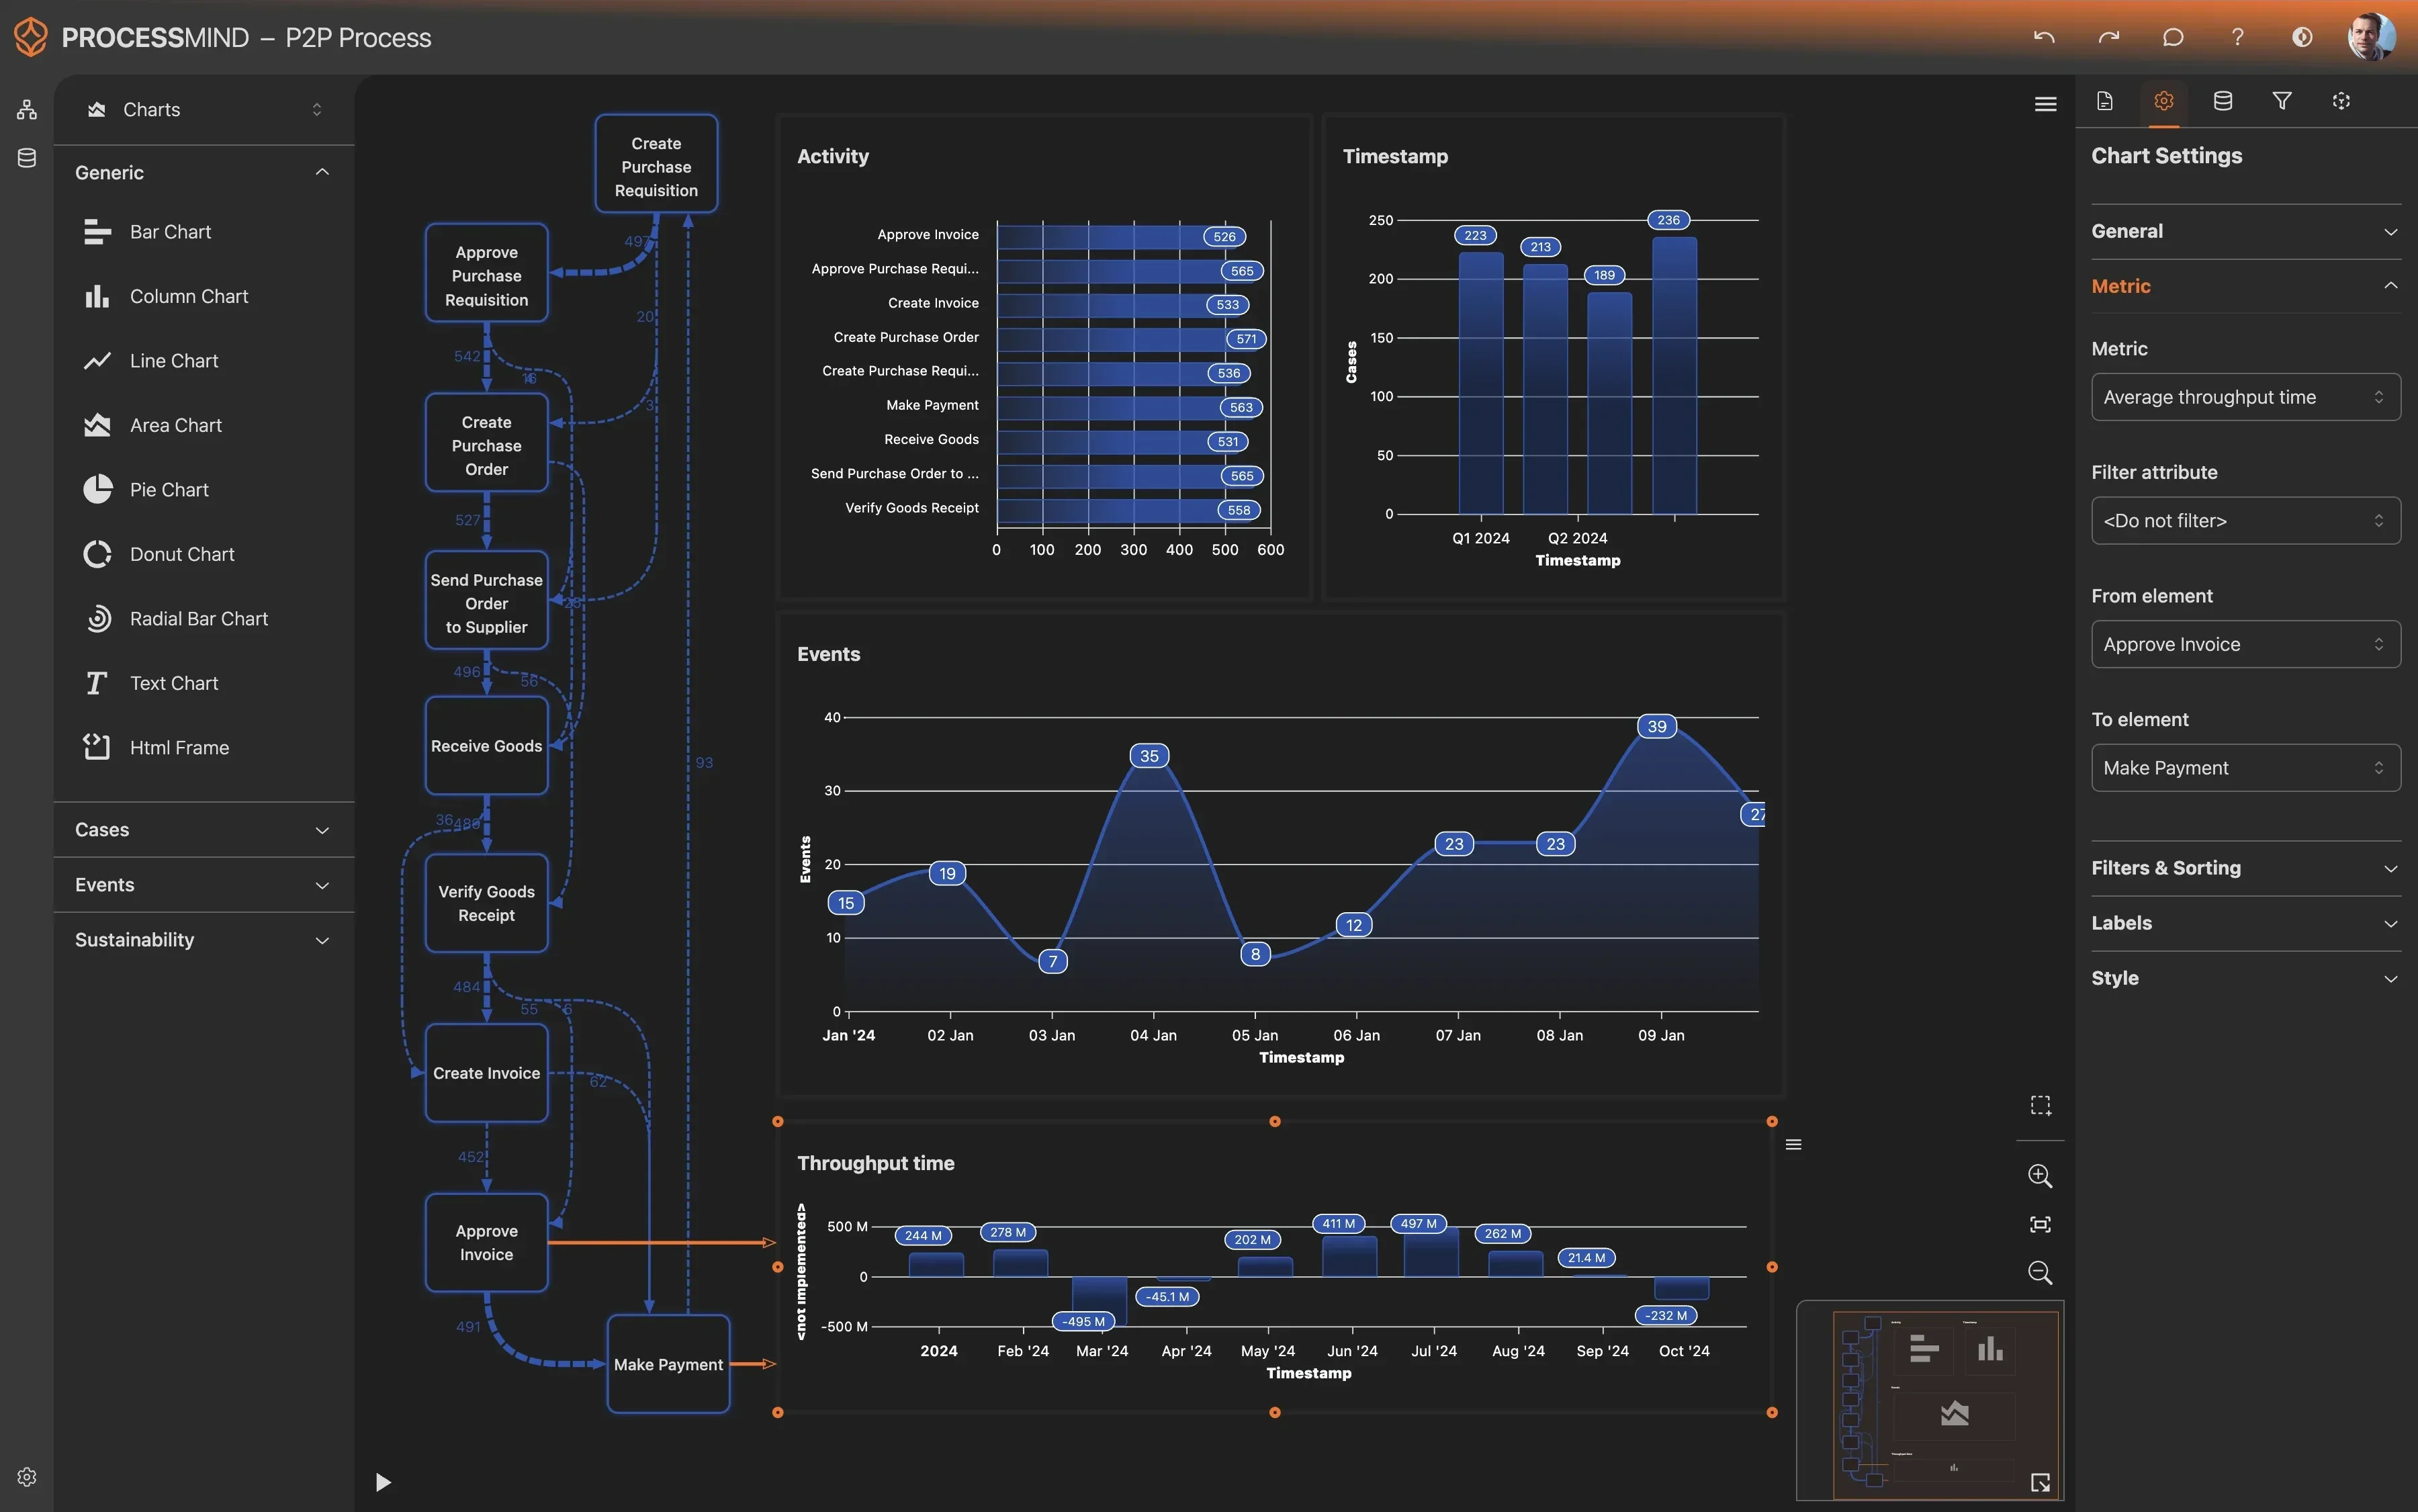
Unsere Plattform deckt verborgene Engpässe auf und zeigt, an welchen Stellen Untersuchungen der Ursachen häufig ins Stocken geraten. Die Visualisierung aller Prozessschritte macht deutlich, wo Verzögerungen auftreten und wie Abweichungen vom Standard Ihre Servicebereitstellung beeinträchtigen. So kann Ihr Team Workflows optimieren und den Aufwand für wiederkehrende Incidents verringern.

Laden Sie unser vorkonfiguriertes Daten-Template herunter und gehen Sie typische Herausforderungen an, um Ihre Effizienz-Ziele zu erreichen. Folgen Sie unserem Verbesserungsplan in sechs Schritten und lesen Sie den Leitfaden zum Daten-Template, um Ihre Abläufe zu verbessern.

Ausführliche Beschreibung anzeigen

Der strategische Wert eines optimierten Problem Managements

Problem Management ist ein wichtiger, oft wenig sichtbarer Bestandteil exzellenter IT-Services. Während Incident Management auf schnelle Wiederherstellung abzielt, steht beim Problem Management die dauerhafte Qualität der Lösung im Mittelpunkt. In Freshservice können Teams Tickets einfach erfassen und kategorisieren. Die eigentliche Herausforderung sind jedoch die komplexen Übergaben zwischen Supportstufen und der Wechsel von einem vorübergehenden Workaround zu einer dauerhaften Lösung. Läuft dieser Prozess langsam oder ineffizient ab, häufen sich wiederkehrende Probleme. Sie binden technische Ressourcen und frustrieren die Endbenutzer.

Bei der Optimierung geht es nicht nur darum, Tickets schneller zu schließen. Entscheidend ist, dass jede Ursachenanalyse messbar dazu beiträgt, Serviceunterbrechungen zu reduzieren. Wenn Sie untersuchen, wie und warum Probleme im Prozess entstehen, können Sie vom reaktiven Krisenmanagement zu einer vorausschauenden Strategie wechseln, die Ausfälle verhindert. Dafür müssen Sie verstehen, wie Informationen durch Freshservice fließen und an welchen Stellen Untersuchungen ins Stocken geraten.

Freshservice-Daten visuell auswerten

Process Mining rekonstruiert jeden einzelnen Schritt eines Problem-Datensatzes und eröffnet so einen neuen Blick auf Ihre Freshservice-Umgebung. Statt nur statische Durchschnittswerte oder einfache Balkendiagramme zu betrachten, sehen Sie die tatsächlichen Abläufe Ihrer technischen Teams. Sie erkennen genau, wo ein Datensatz tagelang unbearbeitet bleibt oder wiederholt zwischen Supportgruppen hin- und hergeschoben wird.

So können Sie zwischen komplexen Untersuchungen unterscheiden, die naturgemäß Zeit benötigen, und vermeidbaren administrativen Verzögerungen. Die Visualisierung der Aktivitätsabfolge liefert objektive Belege für gezielte Prozessverbesserungen. Vielleicht stellen Sie fest, dass der längste Abschnitt Ihres Zyklus zwischen „Problem erkannt“ und „Supportgruppe zugewiesen“ liegt. Das kann auf den Bedarf an einer besseren Ersteinschätzung oder an Automatisierung in Freshservice hindeuten.

Reibungspunkte im Untersuchungsprozess aufdecken

Häufig lässt sich die Zeit zwischen dem Finden eines Workarounds und dem Beginn der vollständigen Untersuchung verkürzen. Sobald ein vorübergehender Fix den unmittelbaren Druck mindert, verliert die Suche nach der Ursache in vielen Organisationen an Dringlichkeit. Process Mining zeigt, ob Ihr Team in einer Workaround-Schleife feststeckt und denselben vorübergehenden Fix wiederholt anwendet, statt auf eine dauerhafte Lösung hinzuarbeiten.

Analysieren Sie Übergänge in Freshservice, etwa die Zeit zwischen „Workaround veröffentlicht“ und „Change Request eingeleitet“. So können Sie sicherstellen, dass Ihre Ressourcen in wichtige Architekturänderungen statt in ständige Nachbesserungen fließen. Außerdem erkennen Sie, ob bestimmte Problemkategorien häufig wieder geöffnet werden. Das deutet oft darauf hin, dass die Ursache falsch ermittelt oder ein Prüfschritt ausgelassen wurde. Diese Erkenntnisse helfen Ihnen, die Compliance zu verbessern und die Einhaltung des vorgesehenen Prozesses sicherzustellen.

Dauerhafte Lösungen schneller erreichen

Zur Verbesserung des Problem Managements gehört auch, die Zusammenarbeit zwischen Teams zu betrachten. Wird ein Problem-Datensatz von einer allgemeinen Supportgruppe an ein spezialisiertes Engineering-Team übergeben, geht häufig Kontext verloren. Möglicherweise werden Datensätze wiederholt zurückgegeben, weil weitere Informationen fehlen. Das verlängert die gesamte Zykluszeit erheblich. Process Mining macht solche Schleifen sichtbar und hilft Ihnen, bessere Dokumentationsstandards für den Beginn einer Untersuchung festzulegen.

Dadurch werden Übergaben klarer und Spezialisten erhalten von Anfang an alle erforderlichen Daten für ihre Analyse. Wenn Sie außerdem die Integration mit Change Management beobachten, sehen Sie, ob vorgeschlagene Lösungen zeitnah umgesetzt werden oder in einem Rückstand offener Changes liegen. Kürzere Wartezeiten sind entscheidend, damit Ihre Maßnahmen zur Serviceverbesserung vorankommen.

Eine widerstandsfähigere IT-Umgebung schaffen

Mit der Optimierung des Problem Managements in Freshservice wollen Sie letztlich die Widerstandsfähigkeit Ihrer IT-Services stärken. Wenn Untersuchungen kürzer dauern und dauerhafte Lösungen häufiger greifen, sinken die Gesamtkosten des IT-Betriebs. Ihre Mitarbeitenden verbringen weniger Zeit mit wiederkehrenden Ausnahmezuständen und können sich stärker auf Innovation und die Verbesserung der Infrastruktur konzentrieren.

Mit Process Mining setzen Sie auf einen datengetriebenen Weg zu reiferen Prozessen. Die digitalen Spuren in Ihren Freshservice-Protokollen zeigen, wie Sie Ihre reaktive IT-Abteilung zu einem vorausschauenden Kompetenzzentrum weiterentwickeln können, das Probleme erkennt und verhindert, bevor sie das Geschäft beeinträchtigen. Das verbessert nicht nur die interne Effizienz, sondern auch die Zuverlässigkeit der Services, auf die Ihr Unternehmen täglich angewiesen ist.

Problem Management Ursachenanalyse IT-Service-Management Service-Desk-Manager Vorfallreduzierung Problemkoordinator ITIL-Konformität Ticketbearbeitung Ticketmanagement Bekannter Fehler Wiederkehrende Vorfälle Workaround Vorfallprävention IT-Helpdesk

Häufige Probleme und Herausforderungen

Ermitteln Sie, welche Herausforderungen Sie betreffen

Problem-Datensätze bleiben oft wochenlang ohne erkennbare Fortschritte in der Untersuchungsphase. Dadurch wächst der Rückstand, während die zugrunde liegenden Probleme ungelöst bleiben. Teams können so die Ursachen wiederkehrender Vorfälle nicht beheben. Das belastet den Service Desk zusätzlich und beeinträchtigt die Zuverlässigkeit der Services für die Fachbereiche.

Wird ein Problem-Datensatz zwischen mehreren technischen Teams hin- und hergeschoben, geht häufig Kontext verloren und die Lösung verzögert sich deutlich. Fehlende Zuständigkeit führt zu unnötigem Aufwand und frustrierten technischen Mitarbeitenden. Außerdem werden Service-Level-Ziele für die Stabilität und Leistung kritischer Infrastrukturen verfehlt.

Wird ein Workaround nicht zeitnah veröffentlicht, müssen Mitarbeitende im Incident Management weiterhin wiederkehrende Probleme bearbeiten. Dadurch steigt die durchschnittliche Lösungszeit für Endbenutzer. Liegt zwischen dem Erkennen eines Problems und der Veröffentlichung eines Workarounds zu viel Zeit, kommt es zu vermeidbaren Ausfällen, obwohl bereits eine vorübergehende Lösung bekannt ist.

Selbst nach Ermittlung der Ursache kann der Weg zu einer dauerhaften Lösung ins Stocken geraten, sobald ein Change Request eingeleitet wird. Die fehlende Abstimmung zwischen Problem- und Change-Management-Workflows lässt bekannte Fehler bestehen, obwohl sie behoben werden könnten. Dadurch bleibt die IT-Umgebung wiederkehrenden Serviceunterbrechungen und Sicherheitsrisiken ausgesetzt.

Werden Nachbesprechungen nach der Implementierung ausgelassen, können IT-Teams aus schwerwiegenden Vorfällen kaum lernen und ihre künftigen Reaktionsstrategien nicht verbessern. Finden diese Prüfungen gar nicht oder nur oberflächlich statt, gehen wichtige Erkenntnisse verloren. So wiederholen sich dieselben Prozessfehler bei späteren Untersuchungen.

Teams verbringen oft viel Zeit mit der Untersuchung von Problem-Datensätzen niedriger Priorität, während Probleme mit großer Auswirkung ungelöst bleiben. Werden Prioritäten nicht anhand des tatsächlichen Geschäftsrisikos gesetzt, kommen spezialisierte technische Ressourcen ineffizient zum Einsatz. Die wichtigsten Services im Freshservice-Umfeld lassen sich so nicht stabilisieren.

Werden Service-Level-Ziele bei Problemen mit hoher Priorität verfehlt, kann das für IT-Abteilungen schwerwiegende finanzielle und geschäftliche Folgen haben. Werden Fristen für Ursachenanalysen oder die Umsetzung dauerhafter Lösungen regelmäßig überschritten, deutet das auf Lücken im Prozessablauf oder fehlende Transparenz bei bevorstehenden Terminen hin.

Wird ein Problem-Datensatz geschlossen und wegen erneut auftretender Vorfälle später wieder geöffnet, wurde die Ursache möglicherweise nicht korrekt ermittelt oder die Lösung war unzureichend. Diese Nacharbeit verdoppelt den Untersuchungsaufwand und schwächt das Vertrauen in den Problem-Management-Prozess. Das zugrunde liegende Problem bleibt weiterhin bestehen.

Ungenaue oder allgemeine Kategorien für Ursachen verhindern aussagekräftige Trendanalysen und vorbeugende Wartung. Wählen technische Teams in Freshservice unpräzise Kategorien aus, kann die Organisation systematische Schwachstellen bestimmter Infrastruktur- oder Softwarekomponenten im Zeitverlauf nicht erkennen.

Werden Vorfälle nicht korrekt mit einem aktiven Problem-Datensatz verknüpft, bleibt das tatsächliche Ausmaß eines Problems für die Verantwortlichen unklar. Unterschiedliche Teams untersuchen denselben Sachverhalt mehrfach. Zudem lässt sich der Ressourcenbedarf für eine dauerhafte Lösung schwer begründen, weil das Vorfallaufkommen niedriger erscheint als es tatsächlich ist.

Typische Ziele

Definieren Sie, woran Sie den Erfolg erkennen

Eine kürzere Untersuchungsphase ist entscheidend, um künftige Serviceunterbrechungen zu verhindern. Verzögert sich die Ursachenanalyse, bleibt die Organisation wiederkehrenden Vorfällen ausgesetzt, die IT-Ressourcen binden und Endbenutzer frustrieren. Durch eine Beschleunigung dieser Phase können Teams wirksamer vom reaktiven Krisenmanagement zur Prävention übergehen.

ProcessMind zeigt genau, an welchen Stellen Untersuchungen in Freshservice ins Stocken geraten, etwa beim Warten auf externe Anbieter oder interne Dokumentation. Wenn Teams die Dauer einzelner Statusphasen sehen, können sie realistische Vergleichswerte festlegen und Engpässe beseitigen, die eine schnelle Diagnose verhindern. So lassen sich Untersuchungszyklen möglicherweise um 30 Prozent oder mehr verkürzen.

Häufige Übergaben von Problem-Datensätzen führen oft zu Kontextverlust und längeren Lösungszeiten. Weniger Übergaben helfen dem am besten qualifizierten Team, durchgehend die Verantwortung zu behalten. Das sorgt für konsistentere und zuverlässigere technische Ergebnisse und stärkt zugleich die Verantwortlichkeit innerhalb des technischen Supports.

Unsere Process-Mining-Plattform bildet den Ablauf von Problem-Datensätzen durch verschiedene Supportgruppen ab und macht Schleifen sowie übermäßige Neuzuweisungen sichtbar. Auf dieser Grundlage können Führungskräfte die Zuweisungsregeln verbessern, damit Probleme direkt bei den passenden Fachleuten landen. So sinkt die durchschnittliche Zahl der Bearbeitungsschritte pro Datensatz deutlich.

Zeitnah bereitgestellte Workarounds sind wichtig, um den Service wiederherzustellen, während eine dauerhafte Lösung entwickelt wird. Sie begrenzen die Auswirkungen aktiver Probleme auf das Geschäft und entlasten den Service Desk bei komplexen Untersuchungen. Ein schnellerer Workaround-Prozess verbessert unmittelbar die Situation der Endbenutzer, die von wiederkehrenden Vorfällen betroffen sind.

ProcessMind erfasst in Freshservice die Zeitspanne zwischen dem Erkennen eines Problems und der Veröffentlichung eines Workarounds. Wenn Sie Verzögerungen im Veröffentlichungsworkflow aufdecken, können Sie die Prüfung vereinfachen und Workarounds dem Frontline-Support deutlich schneller bereitstellen. Dadurch sinkt das Aufkommen von Vorfällen, die auf bekannte Fehler zurückgehen.

Eine bekannte Ursache hilft wenig, wenn die dauerhafte Lösung im Change-Management-Prozess stecken bleibt. Eine Abstimmung dieser beiden Prozesse sorgt dafür, dass ermittelte Lösungen zügig umgesetzt werden. So lassen sich bekannte Fehler dauerhaft beheben und die Zeitspanne, in der die Organisation Risiken ausgesetzt ist, verkürzen.

Wir machen die Übergaben zwischen den Modulen Problem Management und Change Management in Freshservice sichtbar. So erkennen Sie, wo vorgeschlagene Lösungen in Freigabewarteschlangen festhängen. Problemkoordinatoren und Change-Verantwortliche können ihre Arbeit besser abstimmen und die endgültige Lösung beschleunigen.

Bei Problemen mit hoher Priorität müssen die Service-Level-Ziele strikt eingehalten werden, damit geschäftskritische Services geschützt sind. Eine höhere Compliance stellt sicher, dass besonders schwerwiegende Probleme die nötige dringende Aufmerksamkeit erhalten und der Betrieb stabil bleibt. So kann die IT-Abteilung ihre Zusagen gegenüber dem gesamten Unternehmen erfüllen.

ProcessMind analysiert historische Leistungsdaten und macht Muster sichtbar, die zu SLA-Verstößen führen. Sie erkennen, welche Kategorien oder Prioritätsstufen ihre Ziele häufig verfehlen. So können Sie Fristen vorausschauend steuern und Ressourcen besser verteilen, damit kritische Ziele zuverlässig erreicht werden.

Wird ein Problem-Datensatz erneut geöffnet, deutet das häufig darauf hin, dass die ursprüngliche Lösung unvollständig war oder die Ursache falsch ermittelt wurde. Eine niedrigere Wiedereröffnungsrate macht das Problemmanagement zuverlässiger und verhindert unnötige Arbeit an vermeintlich gelösten Problemen. Ein als geschlossen markiertes Problem sollte tatsächlich behoben sein.

Unsere Plattform analysiert die digitalen Spuren erneut geöffneter Cases und ermittelt, ob bei der ersten Bearbeitung bestimmte Aktivitäten ausgelassen wurden. So können Sie höhere Qualitätsstandards durchsetzen und sicherstellen, dass ein Problem erst dann geschlossen wird, wenn es tatsächlich gelöst ist. Dadurch lässt sich der Nachbearbeitungsaufwand um bis zu 20 Prozent senken.

IT-Teams verbringen oft unverhältnismäßig viel Zeit mit Problemen geringer Auswirkung, während kritische Fälle unbearbeitet bleiben. Eine bessere Verteilung der Aufmerksamkeit sorgt dafür, dass erfahrene technische Mitarbeitende an den Problemen arbeiten, die den größten Beitrag zur Service-Stabilität leisten. So setzen Sie das Fachwissen Ihrer Spezialisten gezielter ein.

ProcessMind setzt das Volumen zusammenhängender Incidents mit dem Aufwand für Problem-Datensätze in Beziehung. So erkennen Führungskräfte Aufgaben mit geringem Nutzen, die automatisiert oder nachrangig behandelt werden können. Technische Experten gewinnen dadurch mehr Zeit für Ursachenanalysen mit großer Wirkung, die Hunderte künftiger Incidents verhindern können.

Eine korrekte Kategorisierung ist die Grundlage für aussagekräftige Trendanalysen und langfristige Verbesserungen des Service. Sind Ursachen unzureichend dokumentiert, lassen sich systemische Probleme in der IT-Infrastruktur kaum erkennen. Eine konsistente Datenqualität verbessert die strategische Entscheidungsfindung.

Unsere Process-Mining-Lösung prüft, ob Daten beim Abschluss des Problemlebenszyklus einheitlich erfasst werden. Sie können Datensätze mit allgemeinen oder fehlenden Angaben zur Ursache identifizieren, gezielte Schulungen veranlassen und die Qualität langfristiger Berichte verbessern. So lassen sich neue Technologietrends leichter erkennen.

Wenn alle zusammenhängenden Incidents einem Problem-Datensatz zugeordnet sind, wird die Gesamtauswirkung sichtbar und die Priorisierung der Lösungsarbeit fällt leichter. So können alle betroffenen Benutzer informiert werden, sobald eine Umgehungslösung oder ein Fix verfügbar ist. Das verbessert die Mitteilungen und die Effizienz des Service Desk.

ProcessMind hilft Ihnen, Gruppen ähnlicher Incidents in Freshservice zu entdecken, denen kein Problem-Datensatz zugeordnet ist. Wenn Sie diese Lücken sichtbar machen, können Sie das proaktive Problemmanagement konsequenter anstoßen. So beugen Sie Spitzen beim Incident-Aufkommen vor und bewerten die Auswirkungen von Problemen genauer.

Reviews nach der Implementierung sind wichtig, um kontinuierlich dazuzulernen und künftige Prozessfehler zu vermeiden. Werden diese Termine ausgelassen, bleiben Optimierungsmöglichkeiten ungenutzt und dieselben Fehler können sich in späteren Zyklen wiederholen. Regelmäßige Reviews fördern eine Kultur der kontinuierlichen Verbesserung.

Wir prüfen für jeden geschlossenen Problem-Datensatz, ob die Review-Aktivität stattgefunden hat, und machen Compliance-Lücken sichtbar. So können Führungskräfte die Review-Phase bei größeren Problemen als verbindlichen Schritt festlegen. Dadurch fließen die Erkenntnisse aus jedem bedeutenden Problem in die Wissensbasis des Unternehmens ein.

In 6 Schritten zu Verbesserungen im Problemmanagement

1

Template herunterladen

Was zu tun ist

Laden Sie das spezielle Excel-Template herunter, das für die Datenstruktur des Freshservice-Problemmanagements entwickelt wurde.

Warum das wichtig ist

Mit einer vordefinierten Struktur lassen sich Ihre Daten korrekt dem Analysemodul zuordnen und präzise auswerten.

Erwartetes Ergebnis

Ein sofort einsetzbares Dokument zur Datenzuordnung

IHRE ERKENNTNISSE ZU PROBLEMEN

Optimieren Sie den Ablauf Ihres Freshservice-Problemmanagements

Verschaffen Sie sich einen umfassenden Überblick über den gesamten Problemlebenszyklus und sehen Sie genau, wo Untersuchungen ins Stocken geraten. Unsere Visualisierungen zeigen, an welchen Stellen zwischen der Erkennung eines Problems und seiner endgültigen Lösung Reibungsverluste entstehen.
  • Visualisieren Sie den gesamten Lebenszyklus der Ursachenanalyse
  • Ermitteln Sie die konkreten Phasen, die zu Verzögerungen bei der Lösung führen
  • Decken Sie verborgene Schleifen bei der Untersuchung von Problemen auf
  • Messen Sie, wie sich Workarounds auf die Stabilität auswirken
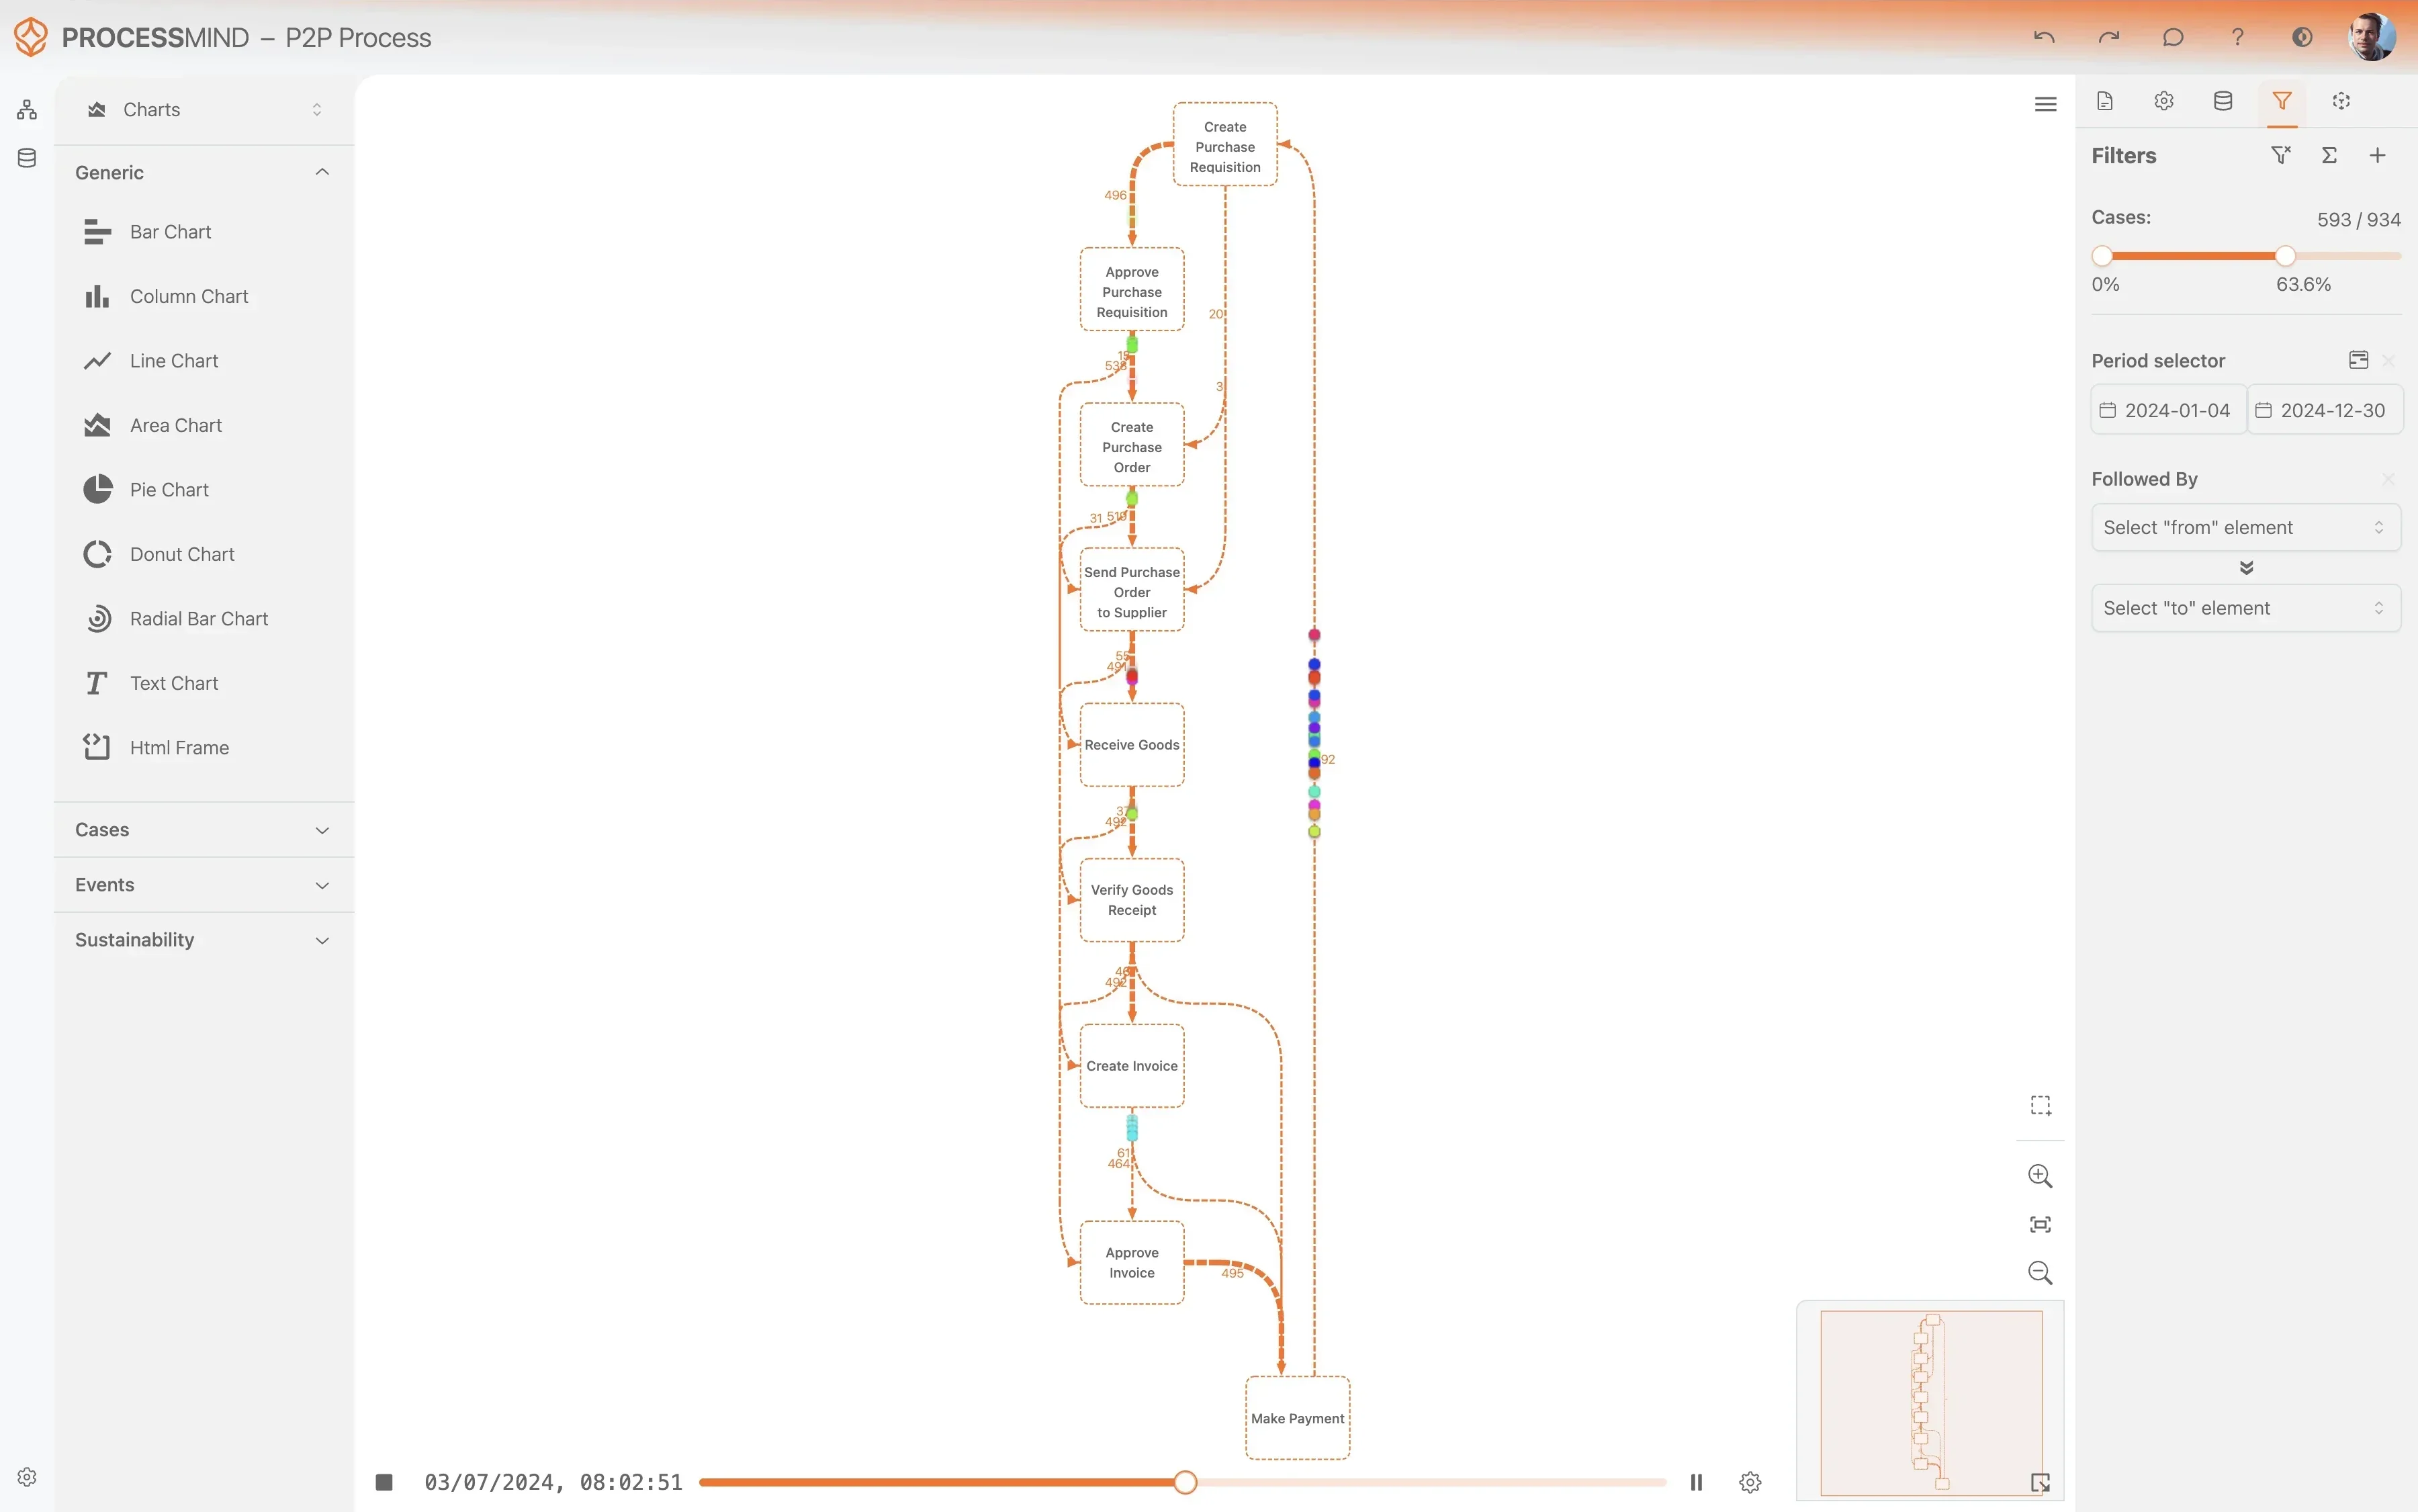
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

NACHGEWIESENE ERGEBNISSE

Effizienzgewinne im Problemmanagement

Unternehmen, die Process Mining auf Freshservice-Daten anwenden, erkennen häufig erhebliche Engpässe im Lebenszyklus von Problem-Datensätzen. Das ermöglicht schnellere Ursachenanalysen und verringert die Zahl wiederkehrender Incidents.

0 %
Ursachen schneller analysieren

Kürzere Zykluszeit der Ursachenanalyse

Wenn Untersuchungsschritte vereinfacht und Engpässe in der Diagnosephase erkannt werden, lässt sich die Ursache deutlich schneller ermitteln.

0 %
Weniger Teamübergaben

Weniger Neuzuweisungen zwischen Gruppen

Wenn unnötige Übergaben zwischen technischen Teams entfallen, können die passenden Experten früher an den Problemen arbeiten. Das senkt die Arbeitskosten und verkürzt Verzögerungen.

+ 0 %
Bessere SLA-Einhaltung

Kritische Probleme fristgerecht lösen

Die Echtzeitüberwachung von Datensätzen mit hoher Priorität stellt sicher, dass kritische Probleme innerhalb der vereinbarten Fristen bearbeitet werden und der Service stabil bleibt.

0 %
Weniger Wiedereröffnungen

Weniger Nachbearbeitung von Datensätzen

Bessere Erstuntersuchungen und dauerhafte Lösungen verhindern, dass Problem-Datensätze erneut geöffnet werden. So werden Probleme tatsächlich behoben.

+ 0 %
Mehr abgeschlossene PIRs

Mehr Reviews nach der Fehlerbehebung

Regelmäßige Reviews nach der Implementierung halten die gewonnenen Erkenntnisse fest und helfen sicherzustellen, dass dauerhafte Lösungen wirksam sind.

0 %
Umgehungslösungen schneller bereitstellen

Durchlaufzeit bis zur temporären Lösung

Werden wirksame Umgehungslösungen schneller veröffentlicht, sinkt die geschäftliche Auswirkung, während die langfristige Behebung noch läuft.

Die Ergebnisse hängen unter anderem vom Reifegrad der Prozesse, der Teamgröße und der Datenqualität in Freshservice ab. Die genannten Werte entsprechen durchschnittlichen Verbesserungen aus Implementierungen in großen Unternehmen.

Empfohlene Daten

Beginnen Sie mit diesen wichtigen Attributen und Aktivitäten, um Ihre Optimierung voranzubringen.
Neu bei Event Logs? Erfahren Sie, wie Sie ein Event Log für Process Mining erstellen.

Attribute

Wichtige Datenpunkte für die Analyse

Der eindeutige alphanumerische Bezeichner des Problem-Datensatzes (z. B. PRB-10234).

Warum das wichtig ist

Dieser grundlegende Schlüssel dient zur Rekonstruktion des Prozessablaufs und ist erforderlich, um jeden Case eindeutig zu identifizieren.

Das konkrete Ereignis oder die Aktion, die am Problem-Datensatz ausgeführt wurde.

Warum das wichtig ist

Definiert, was bei der Prozessausführung geschieht, und ist für die Erstellung der Prozessübersicht erforderlich.

Das genaue Datum und die Uhrzeit, zu denen die Aktivität stattgefunden hat.

Warum das wichtig ist

Legt die zeitliche Abfolge der Ereignisse fest und ermöglicht so die Berechnung der Zykluszeit und die Sortierung des Prozesses.

Die dem Problem zugewiesene Prioritätsstufe, zum Beispiel niedrig, mittel, hoch oder dringend.

Warum das wichtig ist

Unverzichtbar, um Analysen zu Problemen mit hoher Auswirkung zu filtern und zu priorisieren.

Der Name des Service-Desk-Agenten, der dem Problem derzeit zugewiesen ist.

Warum das wichtig ist

Wichtig für die Ressourcenanalyse und die Analyse der Organisationsstruktur.

Das technische Team oder die Gruppe, die mit der Bearbeitung des Problems betraut ist.

Warum das wichtig ist

Entscheidend für die Analyse von Übergaben und das Erkennen von Engpässen durch isolierte Teams.

Der aktuelle Lebenszyklusstatus des Problems, zum Beispiel offen, Änderung angefordert oder gelöst.

Warum das wichtig ist

Gibt den Status des Cases an und dient zur Berechnung von Prozessflusskennzahlen.

Die Klassifizierung der ermittelten Ursache des Problems.

Warum das wichtig ist

Unverzichtbar für die Trendanalyse und das Erkennen von Bereichen, die sich proaktiv verbessern lassen.

Die Anzahl der Incident-Datensätze, die mit diesem Problem verknüpft sind.

Warum das wichtig ist

Zeigt, wie stark sich das Problem auf den Helpdesk auswirkt.

Kennzeichnet, ob der Problem-Datensatz das vereinbarte Service-Level-Ziel verfehlt hat.

Warum das wichtig ist

Direktes Maß für Prozesseinhaltung und Leistung.

Die Abteilung des Benutzers, der das Problem gemeldet hat oder hauptsächlich davon betroffen ist.

Warum das wichtig ist

Liefert organisatorischen Kontext zu den Auswirkungen von Problemen.

Kennzeichnet, ob der Problem-Datensatz jemals von einem geschlossenen in einen offenen Status zurückgesetzt wurde.

Warum das wichtig ist

Wichtiger Indikator für fälschlich als gelöst markierte Probleme und Nacharbeit.

Aktivitäten

Prozessschritte, die Sie verfolgen und optimieren sollten

Der Problem-Datensatz wird erstmals im System angelegt. Dieses Ereignis wird im Freshservice-Audit-Protokoll ausdrücklich erfasst, wenn ein neues Problem-Ticket gespeichert wird.

Warum das wichtig ist

Markiert den Beginn der Prozessinstanz. Dieser Zeitpunkt dient als Ausgangspunkt für die Berechnung aller Durchlauf- und Zykluszeiten.

Der Problem-Datensatz wird an ein bestimmtes technisches Team oder eine Zuweisungsgruppe weitergeleitet. Erfasst werden Änderungen am Feld 'Group' im Ticketverlauf.

Warum das wichtig ist

Wichtig für die Heatmap zu Übergaben zwischen Supportgruppen. Die Nachverfolgung macht Pingpong-Effekte und übermäßige Übergaben zwischen Teams sichtbar.

Der Zeitpunkt, an dem das Textfeld zur Ursache oder der Analyseabschnitt ausgefüllt wird. Erfasst wird die erste Änderung des Felds 'Root Cause' von einem leeren Wert.

Warum das wichtig ist

Der wichtigste Meilenstein für die Analyse der Durchlaufzeit bis zur Ursachenanalyse. Er markiert den Übergang von der Untersuchung zum Entwurf einer Lösung.

Dem Problem-Datensatz wird eine temporäre Lösung hinzugefügt, häufig als Notiz oder Feld 'Workaround'. Dient zur Berechnung der Geschwindigkeit bei der Veröffentlichung von Umgehungslösungen.

Warum das wichtig ist

Misst, wie schnell das Team die Auswirkungen begrenzt. Wichtig für die KPI zur durchschnittlichen Durchlaufzeit bis zur Umgehungslösung.

Ein Change-Datensatz wird mit dem Problem-Datensatz verknüpft. Damit beginnt die Behebungsphase. Erfasst wird dies über das Systemereignis 'Association with Change'.

Warum das wichtig ist

Wichtig für die Überwachung von Engpässen bei Änderungsanforderungen. Misst die Übergabe vom Problemmanagement an das Änderungsmanagement.

Steht für die Umsetzung der endgültigen Lösung. In Freshservice wird dies üblicherweise daraus abgeleitet, dass der Status zu 'Solved' oder 'Resolved' wechselt.

Warum das wichtig ist

Berechnet die Verzögerung bis zur Umsetzung der dauerhaften Lösung. Markiert das Ende der technischen Behebung.

Das abschließende Ereignis im Lebenszyklus: Der Datensatz wird gesperrt und gilt als inaktiv. Erfasst wird der Statuswechsel zu 'Closed'.

Warum das wichtig ist

Legt das endgültige Ende der Prozessinstanz fest. Wird für die Berechnung der gesamten Zykluszeit benötigt.

Häufig gestellte Fragen

Häufig gestellte Fragen

Process Mining visualisiert anhand vorhandener Freshservice-Event-Logs jeden Schritt im Problemmanagement. Dabei werden Engpässe wie lange Untersuchungsphasen oder häufige Gruppenwechsel sichtbar. So erkennen Teams, an welchen Stellen der Prozess vom Standard-Workflow abweicht.

In der Regel benötigen Sie die ID des Problem-Datensatzes, die Zeitstempel der Aktivitäten und den Änderungsverlauf der Felder aus Freshservice. Wichtige Attribute wie Priorität, Kategorie und zugewiesene Gruppe werden ebenfalls exportiert. Sie liefern den Kontext für detaillierte Analysen und Filter.

Erste Erkenntnisse lassen sich meist innerhalb weniger Tage gewinnen, nachdem die historischen Daten aus Freshservice exportiert wurden. Wie lange es dauert, hängt vom Datenvolumen und der Komplexität Ihrer benutzerdefinierten Felder ab. Die meisten Unternehmen erkennen innerhalb von zwei Wochen konkrete Muster, aus denen sich Maßnahmen ableiten lassen.

Nein. Process Mining arbeitet in der Regel mit einer API-Integration oder Datenexporten und erfordert keine Softwareinstallation. Sie müssen lediglich Zugriff auf die Audit-Protokolle und den Ticketverlauf in Ihrer Freshservice-Umgebung bereitstellen.

Ja. Die Analyse zeigt für jeden Datensatz die genaue Dauer der Ursachenanalyse. Anschließend können Sie eine Ebene tiefer gehen und prüfen, ob bestimmte Kategorien, Prioritätsstufen oder technische Teams besonders lange Verzögerungen aufweisen.

Das Tool bildet jeden Übergang ab und identifiziert Tickets, die wiederholt zwischen Gruppen hin- und hergeschoben werden, ohne dass eine Lösung gefunden wird. So erkennen Führungskräfte, wenn die Zuständigkeit einer Gruppe unklar ist oder technischen Teams die Ressourcen für bestimmte Problemtypen fehlen.

Ja. Process Mining kann die Verknüpfung zwischen Incident-Tickets und den zugehörigen übergeordneten Problem-Datensätzen verfolgen und so für Transparenz sorgen. Damit lässt sich prüfen, ob Umgehungslösungen an die Verantwortlichen der Incidents weitergegeben und Lösungsschritte bei allen zusammenhängenden Problemen einheitlich angewendet werden.

Der Schwerpunkt liegt auf der Analyse historischer Daten. Viele Plattformen bieten jedoch häufige Aktualisierungen, mit denen sich die laufende SLA-Einhaltung überwachen lässt. So sehen Sie, ob aktuelle Problem-Datensätze kurz vor einem SLA-Verstoß stehen, bevor die Frist tatsächlich verstreicht.

Bauen Sie Engpässe im Problemmanagement noch heute ab

Verkürzen Sie Ihre Durchlaufzeit um 30 Prozent und stabilisieren Sie Ihre IT-Services

Starten Sie Ihre kostenlose Testphase

Keine Kreditkarte erforderlich. In 5 Minuten eingerichtet.