Verbeter incidentbeheer
Je gids in 6 stappen voor beter incidentbeheer in Jira.
Verbeter incidentbeheer
Incidentbeheer
Jira Service Management

Selecteer een proces

Kies een proces om verder te werken in de gekoppelde workspace.

259 Processen

Verbeter incidentbeheer in Jira Service Management en los incidenten sneller op

Om incidenten goed te beheren, moet je weten waar vertraging en inefficiëntie ontstaan. Met onze analyses zie je precies waar bottlenecks zitten, herken je patronen in herhaalwerk en houd je beter zicht op het naleven van SLA’s. Zo kun je het proces verbeteren, incidenten sneller oplossen en de tevredenheid verhogen.

Download onze vooraf ingestelde datatemplate en pak veelvoorkomende uitdagingen aan om je efficiëntie-doelen te bereiken. Volg ons verbeterplan in zes stappen en raadpleeg de gids voor de datatemplate om je bedrijfsvoering te verbeteren.

Gedetailleerde beschrijving tonen

Waarom incidentbeheer verbeteren belangrijk is

Goed incidentbeheer is de basis voor betrouwbare IT-diensten. Het heeft direct invloed op de tevredenheid van gebruikers, de continuïteit van de bedrijfsvoering en de kosten. In een omgeving waar alles snel verandert, is het belangrijk om incidenten snel te herkennen, op te lossen en te voorkomen. Toch hebben veel organisaties te maken met verborgen inefficiënties en bottlenecks in hun incidentbeheerprocessen, ook als ze systemen zoals Jira Service Management gebruiken. Dat kan leiden tot langere uitval, gemiste SLA-doelen, ontevreden gebruikers en hogere bedrijfskosten. Om verbeteringen op basis van data door te voeren en incidenten sneller op te lossen, moet je weten hoe incidenten in de praktijk door het proces gaan. Dat zie je niet in een theoretische proceskaart. Onzichtbaar herstelwerk, onnodige overdrachten en gemiste vertragingen kosten ongemerkt tijd. Een goede reden om incidentbeheer grondiger te analyseren.

Meer inzicht met process mining voor Jira Service Management

Met process mining zie je hoe incidentbeheer in Jira Service Management daadwerkelijk verloopt. In tegenstelling tot traditionele rapportages of dashboards reconstrueert process mining op basis van event logs het volledige verloop van elk incident, van de eerste melding tot de afsluiting. Je kunt de werkelijke processtroom bekijken, afwijkingen van de gewenste route opsporen en precies zien waar vertragingen ontstaan. Zo vind je activiteiten of overdrachtsmomenten die steeds voor bottlenecks zorgen, bijvoorbeeld langdurig onderzoek, herhaalde toewijzingen aan supportgroepen of vertraging bij de bevestiging door de gebruiker. Process mining geeft je een objectief beeld op basis van data. Zo hoef je niet af te gaan op aannames en kun je verbeteringen richten op de onderdelen die de meeste invloed hebben op incidentbeheer.

Belangrijke verbeterpunten bij incidentoplossing opsporen

Met process mining op incidentdata uit Jira Service Management ontdek je waar je kunt optimaliseren. Vergelijk de doorlooptijd van verschillende incidenttypen, ernstniveaus of getroffen services. Zo zie je welke incidenten het langst duren en waarom. Misschien blijkt dat incidenten die naar een gespecialiseerd team gaan vaak lang stilliggen, of dat de diagnose van incidenten met hoge prioriteit steeds langer duurt dan verwacht. Process mining brengt ook herstelwerk in beeld, bijvoorbeeld wanneer incidenten opnieuw worden geopend of toegewezen. Dat kan wijzen op problemen met de eerste diagnose, de kwaliteit van de oplossing of de communicatie met gebruikers. Met dit inzicht kun je oorzaken aanpakken, zoals onvoldoende training van medewerkers, onduidelijke escalatieroutes of omslachtige communicatieafspraken. Zo verkort je de totale doorlooptijd van incidentbeheer.

Meetbare resultaten en doorlopende verbetering

Met process mining voor incidentanalyse in Jira Service Management kun je meetbare verbeteringen realiseren. De gemiddelde tijd om incidenten op te lossen kan flink afnemen, waardoor belangrijke diensten minder lang uitvallen en gebruikers tevredener zijn. Een beter beeld van de naleving van processen helpt je om SLA-doelen consequent te halen of zelfs te overtreffen. Door bottlenecks en herstelwerk op te sporen en weg te nemen, kun je bronnen beter inzetten, kosten verlagen en supportteams meer tijd geven voor werk met een grotere impact. Door processen voortdurend te verbeteren, bouw je aan een efficiënte manier van werken en los je problemen eerder op. Zo kan incidentbeheer meegroeien met toekomstige behoeften en blijft de dienstverlening verbeteren. Je krijgt de inzichten die nodig zijn om workflows aan te passen en sneller betere service te leveren.

Aan de slag met het verbeteren van incidentbeheer

Verbeteren hoeft niet ingewikkeld te zijn. Met de juiste tools en een goed beeld van je incidentdata uit Jira Service Management kun je snel verborgen patronen in processen ontdekken. Met die analyse neem je beter onderbouwde beslissingen en verbeter je incidentbeheer. Dat leidt tot betrouwbaardere diensten en tevredener gebruikers. Begin vandaag met process mining op je incidentdata en ontdek hoe je efficiënter kunt werken en incidenten beter kunt afhandelen. Zo krijg je een helder beeld van de prestaties van incidentbeheer en zie je waar verbetering mogelijk is.

Incidentbeheer SLA-compliance Servicedesk IT-bedrijfsvoering Oorzaakanalyse Minder uitval Tickets oplossen Ticketafhandeling Ticketbeheer IT-helpdesk Gemiddelde tijd tot oplossing MTTR Serviceherstel Incidentoplossing IT-support

Veelvoorkomende problemen en uitdagingen

Bekijk welke uitdagingen voor jou spelen

Incidenten overschrijden regelmatig de afgesproken serviceniveaus. Dat leidt tot ontevreden gebruikers en kan boetes opleveren. Dit wijst op inefficiënties of bottlenecks in het oplossingsproces, die de servicekwaliteit en klanttevredenheid aantasten. ProcessMind laat precies zien waar incidenten te lang blijven liggen en welke activiteiten of overdrachten steeds tot SLA-overschrijdingen leiden. Door de werkelijke processtroom in Jira Service Management in beeld te brengen, ontdek je patronen die hieraan bijdragen.

Incidenten worden vaak tussen supportgroepen overgedragen of aan andere medewerkers toegewezen. Dat veroorzaakt vertraging en verlengt de doorlooptijd. Bij elke overdracht kunnen communicatieproblemen ontstaan en moeten medewerkers zich opnieuw in de situatie verdiepen. Dat kost tijd. ProcessMind brengt alle nieuwe toewijzingen en overdrachten in Jira Service Management in beeld. Je ziet welke afdelingen of medewerkers vaak in zulke rondes voorkomen. Zo spoor je verkeerde routering op en ontdek je waar je de eerste toewijzing kunt verbeteren of kennis beter kunt delen.

Tijdens de diagnose en het onderzoek wachten incidenten soms lang of duren deze fases onverklaarbaar lang. Daardoor duurt het oplossen langer, hebben getroffen gebruikers meer last van uitval en loopt de totale tijd tot oplossing op. ProcessMind laat zien hoe lang de activiteiten ‘Diagnose gestart’ en ‘Onderzoek uitgevoerd’ duren en waar en waarom vertragingen ontstaan. Zo spoor je wachtrijen, beperkte capaciteit of processtappen in Jira Service Management op die voor oponthoud zorgen.

Incidenten krijgen bij het aanmaken niet altijd dezelfde categorie of prioriteit. Daardoor krijgen kritieke problemen soms te weinig aandacht, terwijl kleine problemen juist te veel tijd kosten. Deze verkeerde inzet van bronnen belemmert een goede oplossing en het halen van SLA-doelen. ProcessMind vergelijkt de eerste categorie en prioriteit met het verdere oplossingsverloop en de naleving van SLA-doelen. Je ziet welke categorieën of prioriteiten in Jira Service Management onverwachte vertragingen of herhaalde wijzigingen in prioriteit opleveren. Dat kan betekenen dat er duidelijkere richtlijnen nodig zijn.

Incidenten gaan regelmatig terug naar eerder afgeronde stappen, zoals opnieuw onderzoek doen of een oplossing opnieuw toepassen. Dat herstelwerk verspilt bronnen, verlengt de doorlooptijd en frustreert zowel medewerkers als getroffen gebruikers. ProcessMind brengt het werkelijke verloop van incidenten in beeld. Zo herken je terugkerende patronen en zie je waar activiteiten zoals ‘Diagnose gestart’ of ‘Oplossing toegepast/getest’ voor hetzelfde incident in Jira Service Management worden herhaald.

Incidenten lopen vaak vast nadat ze naar gespecialiseerde teams zijn overgedragen. Zo ontstaan lange wachtrijen en duurt de oplossing langer. Dit kan wijzen op beperkte capaciteit of een inefficiënte overdracht naar specifieke expertgroepen. ProcessMind toont de gemiddelde wachttijd en doorvoer van incidenten nadat ze zijn ‘Overgedragen aan gespecialiseerd team’. Zo zie je welke gespecialiseerde teams in Jira Service Management bottlenecks vormen en de efficiëntie van het hele proces beïnvloeden.

Een tijdelijke oplossing wordt vaak laat of niet goed ingevoerd. Daardoor blijven gebruikers langer last houden van het incident terwijl er aan een definitieve oplossing wordt gewerkt. Zo verliest een tijdelijke oplossing haar waarde als noodmaatregel. ProcessMind analyseert de tijd tussen ‘Diagnose gestart’ en ‘Tijdelijke oplossing ingevoerd’ en bekijkt ook de daaropvolgende processtappen. Je ziet patronen waarbij tijdelijke oplossingen in het incidentbeheerproces van Jira Service Management vertraging oplopen of vaak worden gevolgd door nieuwe vertragingen.

Er zit soms veel tijd tussen het toepassen van een oplossing en de bevestiging door de gebruiker dat deze werkt. Daardoor kan de afsluiting van het incident vertraging oplopen. Dit beïnvloedt metingen zoals ‘Tijd tot oplossing’ en kan wijzen op communicatieproblemen of weinig betrokkenheid van gebruikers. ProcessMind meet de tijd tussen ‘Melding aan gebruiker verstuurd’ en ‘Bevestiging van gebruiker ontvangen’. Zo zie je bij welke incidenten of gebruikersgroepen de bevestiging steeds lang op zich laat wachten. Dit kan helpen om de communicatie of meldingen in Jira Service Management te verbeteren.

Het attribuut ‘Oorzaakcategorie’ ontbreekt vaak, is te algemeen of wordt niet gekoppeld aan preventieve acties. Daardoor keren incidenten terug. Zonder de oorzaak goed vast te stellen, blijft incidentbeheer reactief. ProcessMind laat zien bij welke incidenten het attribuut ‘Oorzaakcategorie’ vaak ontbreekt en waar vergelijkbare incidenten terugkeren. Door het verloop in Jira Service Management te analyseren, zie je of de oorzaakcategorie wordt gebruikt om preventieve maatregelen te nemen.

Soms worden incidenten afgesloten zonder goede controle. Daardoor kunnen problemen opnieuw ontstaan of raken gebruikers ontevreden. Als de belangrijke stap ‘Incident gecontroleerd’ wordt overgeslagen, kan dat de kwaliteit en duurzaamheid van oplossingen aantasten. ProcessMind laat zien bij welke cases de activiteit ‘Incident gecontroleerd’ vaak wordt overgeslagen of ongebruikelijk snel wordt uitgevoerd voordat het incident in Jira Service Management wordt afgesloten. Zo kun je de kwaliteitscontrole van het oplossingsproces verbeteren.

Incidenten van hetzelfde type of met dezelfde prioriteit volgen soms heel verschillende oplossingsroutes. Dat kan wijzen op het ontbreken van vaste procedures of gedeelde werkwijzen. Deze verschillen leiden tot wisselende servicekwaliteit en onvoorspelbare doorlooptijden. ProcessMind brengt alle gevonden procesvarianten voor incidentoplossing in beeld en laat veelvoorkomende afwijkingen van de gewenste route zien. Door deze routes in Jira Service Management te analyseren, ontdek je waar standaardisatie de efficiëntie en consistentie kan verbeteren.

Veelvoorkomende doelen

Bepaal hoe succes eruitziet

Als je de afgesproken serviceniveaus niet haalt, kan dat de tevredenheid van gebruikers en de reputatie van je organisatie schaden. Dit doel draait om incidenten consequent binnen de afgesproken tijd op te lossen, kritieke diensten snel te herstellen en het vertrouwen van gebruikers te behouden. Dat draagt bij aan betere servicekwaliteit en een betrouwbare bedrijfsvoering. ProcessMind geeft je een volledig beeld van incidentoplossingen in Jira Service Management. Je ziet welke processtappen en bottlenecks vertraging veroorzaken en tot SLA-overschrijdingen leiden. Ook wordt duidelijk waar incidenten vastlopen of onnodig worden overgedragen. Zo ontdek je routes die niet aan de afspraken voldoen en krijg je aanknopingspunten om workflows aan te passen. Daarmee kun je incidenten sneller oplossen en het aantal SLA-overschrijdingen mogelijk met 20 tot 30% verlagen.

Regelmatige overdrachten tussen teams of medewerkers zorgen voor vertraging, verlengen de oplostijd en frustreren zowel gebruikers als supportmedewerkers. Door deze overdrachten te beperken, komt een incident vanaf het begin bij het juiste team terecht. Dat verhoogt het percentage incidenten dat bij het eerste contact wordt opgelost en maakt het proces vlotter. Ook dalen de operationele kosten en verbetert de sfeer in het team. ProcessMind brengt de exacte routes van incidenten in Jira Service Management in kaart. Je ziet elke herverdeling en waar die het vaakst voorkomt. Zo worden de oorzaken van onnodige overdrachten zichtbaar en kunnen organisaties de routeringsregels voor teams aanpassen. Met aanpassingen op basis van data kan het aantal herverdelingen mogelijk met 15-25% dalen.

Als het lang duurt om de oorzaak van een incident of het onderliggende probleem vast te stellen, loopt ook de oplostijd op. Dat vergroot de uitval en de impact op de bedrijfsvoering. Een snellere diagnose helpt om de aard van het probleem eerder vast te stellen en sneller een oplossing te kiezen en toe te passen. Zo wordt de dienstverlening sneller hersteld en blijft de verstoring beperkt. Dit draagt bij aan een sneller herstel van de dienstverlening. ProcessMind brengt de diagnosefase van incidentbeheer in kaart en laat zien welke activiteiten, medewerkers of groepen het onderzoek in Jira Service Management vertragen. Je ziet veelvoorkomende activiteitenreeksen en afwijkingen. Daarmee kun je goede werkwijzen en opleidingsbehoeften herkennen. Door bestaande workflows te verbeteren, kan de diagnosecyclus mogelijk 10-20% korter worden.

Als incidenten niet op dezelfde manier worden geprioriteerd, kunnen kritieke incidenten over het hoofd worden gezien terwijl kleine problemen onevenredig veel aandacht krijgen. Dat leidt tot een verkeerde inzet van middelen en kan de bedrijfscontinuïteit schaden. Met een vaste prioritering worden incidenten consequent ingedeeld op basis van impact en urgentie. Zo sluiten de inspanningen aan op de bedrijfsprioriteiten en krijgen de ernstigste problemen als eerste aandacht. ProcessMind vergelijkt de werkelijke prioritering met het vastgestelde beleid door incidentkenmerken zoals ernst en impact in Jira Service Management te analyseren. Je ziet hoe verschillende beginprioriteiten leiden tot andere oplossingsroutes en doorlooptijden. Op basis daarvan kun je de indelings- en prioriteringsregels aanpassen, de consistentie met 30% verbeteren en middelen beter verdelen.

Als incidenten heen en weer gaan tussen statussen of teams, wijst dat op inefficiëntie, verspilde inspanning en langere oplostijden. Door deze lussen te voorkomen, verloopt het proces eenvoudiger en in een duidelijkere lijn. Medewerkers kunnen productiever werken en gebruikers zijn tevredener, omdat herhaalde handelingen en onnodige vertragingen uitblijven. ProcessMind brengt herstelwerk en herhaalde activiteiten in incidentprocessen in Jira Service Management expliciet in kaart en meet hoe vaak ze voorkomen. Je ziet waardoor deze lussen ontstaan. Dat helpt om het proces zo aan te passen dat ze niet terugkomen en onnodige stappen verdwijnen. Zo kan de totale doorlooptijd van incidenten met 10-15% afnemen.

Overdrachten naar specialistische teams zijn soms nodig bij complexe problemen, maar kunnen voor flinke vertraging zorgen als ze niet goed verlopen. Door deze overdrachten te verbeteren, komt een incident snel en met alle benodigde informatie bij het juiste team terecht. Zo voorkom je bottlenecks en worden complexe incidenten sneller opgelost. Dat maakt de ondersteuning op hogere niveaus efficiënter. ProcessMind analyseert de route van incidenten die naar specialistische teams worden overgedragen en laat zien waar in Jira Service Management vertraging ontstaat: vóór, tijdens of na de overdracht. Je ziet waar wachtrijen inefficiënt zijn of informatie ontbreekt. Daarmee kun je de escalatieprocedures en samenwerking gericht verbeteren en overdrachtsgerelateerde vertraging mogelijk met 20% terugdringen.

Een workaround snel invoeren beperkt de impact van grote incidenten. Zo kan een deel van de dienstverlening worden hersteld terwijl aan een permanente oplossing wordt gewerkt. Het doel is om de tijd tussen het vaststellen van een incident en het invoeren van een werkbare workaround te verkorten. Dat beperkt de verstoring van de bedrijfsvoering en verbetert de gebruikerservaring. ProcessMind brengt het deel van het proces rond het vinden en invoeren van workarounds in kaart. Zo worden vertragingen en ontbrekende stappen zichtbaar die deze fase in Jira Service Management verlengen. Door activiteitenreeksen en de inzet van medewerkers te analyseren, helpt ProcessMind de workflow te verbeteren. De invoeringstijd van workarounds kan zo met 15-25% dalen en de weerbaarheid verbeteren.

Als je na het toepassen van een oplossing lang op bevestiging van de gebruiker wacht, lopen de oplostijdcijfers kunstmatig op en wordt het incident later gesloten. Door deze wachttijd te verkorten, krijg je sneller feedback, kun je controleren of de oplossing werkt en het incident op tijd sluiten. De cijfers geven dan beter weer wanneer de dienstverlening daadwerkelijk is hersteld. ProcessMind laat zien hoeveel tijd en welke activiteiten er zitten tussen 'User Notification Sent' en 'User Confirmation Received' in Jira Service Management. Je kunt patronen herkennen en zien welke medewerkers of gebruikers voor vertraging zorgen. Zo kun je de communicatie verbeteren of herinneringen automatiseren. De bevestigingstijd kan daardoor met maximaal 30% dalen en incidenten kunnen sneller definitief worden gesloten.

Als een oorzaakanalyse (RCA) niet goed wordt uitgevoerd, keren incidenten en problemen terug in plaats van dat ze definitief worden opgelost. Dat leidt tot herhaalde verstoringen en verspilde inspanning. Een nauwkeurige RCA onderzoekt incidenten grondig om de werkelijke oorzaken te vinden. Zo voorkom je herhaling en verbeter je de stabiliteit van systemen en de betrouwbaarheid van de dienstverlening op de lange termijn. ProcessMind helpt de kwaliteit van het RCA-proces te beoordelen door incidenten te volgen die terugkeren of opnieuw moeten worden opgelost in Jira Service Management. Je kunt incidentcategorieën vergelijken met uiteindelijke oplossingscodes en oorzaken. Zo wordt duidelijk waar de RCA oppervlakkig blijft of ontbreekt. Door de kwaliteit van RCA te verbeteren, kan het aantal terugkerende incidenten met 10-20% dalen.

Een incident goed verifiëren bevestigt dat het probleem echt is opgelost en niet alleen tijdelijk is onderdrukt. Zo voorkom je dat incidenten te vroeg worden gesloten en later opnieuw worden geopend. Door de verificatiestappen te volgen, blijft de kwaliteitscontrole op peil en krijgen gebruikers meer vertrouwen in de oplossing. Dat draagt bij aan een betrouwbare dienstverlening. ProcessMind brengt de activiteit 'Incident Verified' in kaart en laat zien bij welke cases verificatiestappen worden overgeslagen of gehaast in Jira Service Management. Je ziet welke procesvarianten afwijken van de standaardprocedures. Zo kunnen organisaties de compliance verbeteren en de kwaliteit van oplossingen verhogen. Het aantal heropende incidenten na een oplossing kan met 15% dalen en het proces wordt betrouwbaarder.

Als incidenten onnodig vaak op verschillende manieren worden afgehandeld, ontbreekt het mogelijk aan standaardisatie. Dat kan leiden tot wisselende servicekwaliteit, fouten en inefficiëntie. Door onnodige variatie te beperken, ontstaan duidelijkere en voorspelbaardere routes naar een oplossing. Zo worden resultaten consistenter en verloopt de bedrijfsvoering efficiënter. ProcessMind brengt alle werkelijke routes van incidentprocessen in kaart en laat veelvoorkomende en zeldzame afwijkingen van de beoogde route in Jira Service Management zien. Je ziet hoe vaak elke variant voorkomt. Daarmee kunnen organisaties routes zonder toegevoegde waarde of routes die niet aan de regels voldoen herkennen en verwijderen. Zo wordt het proces gestandaardiseerd en zijn de uitkomsten beter voorspelbaar.

In 6 stappen incidentbeheer verbeteren

1

Download de template

Wat je moet doen

Download de vooraf gestructureerde Excel-template voor incidentbeheer. Met deze template verzamel je alle gegevens die nodig zijn voor een nauwkeurige analyse.

Waarom dit belangrijk is

Met de juiste datastructuur vanaf het begin voorkom je herstelwerk en kun je het incidentbeheer effectief analyseren.

Verwacht resultaat

Een direct te gebruiken datatemplate, afgestemd op incidentbeheer in Jira Service Management.

DIT LEVERT HET OP

Ontdek nu de belangrijkste bottlenecks in incidentbeheer

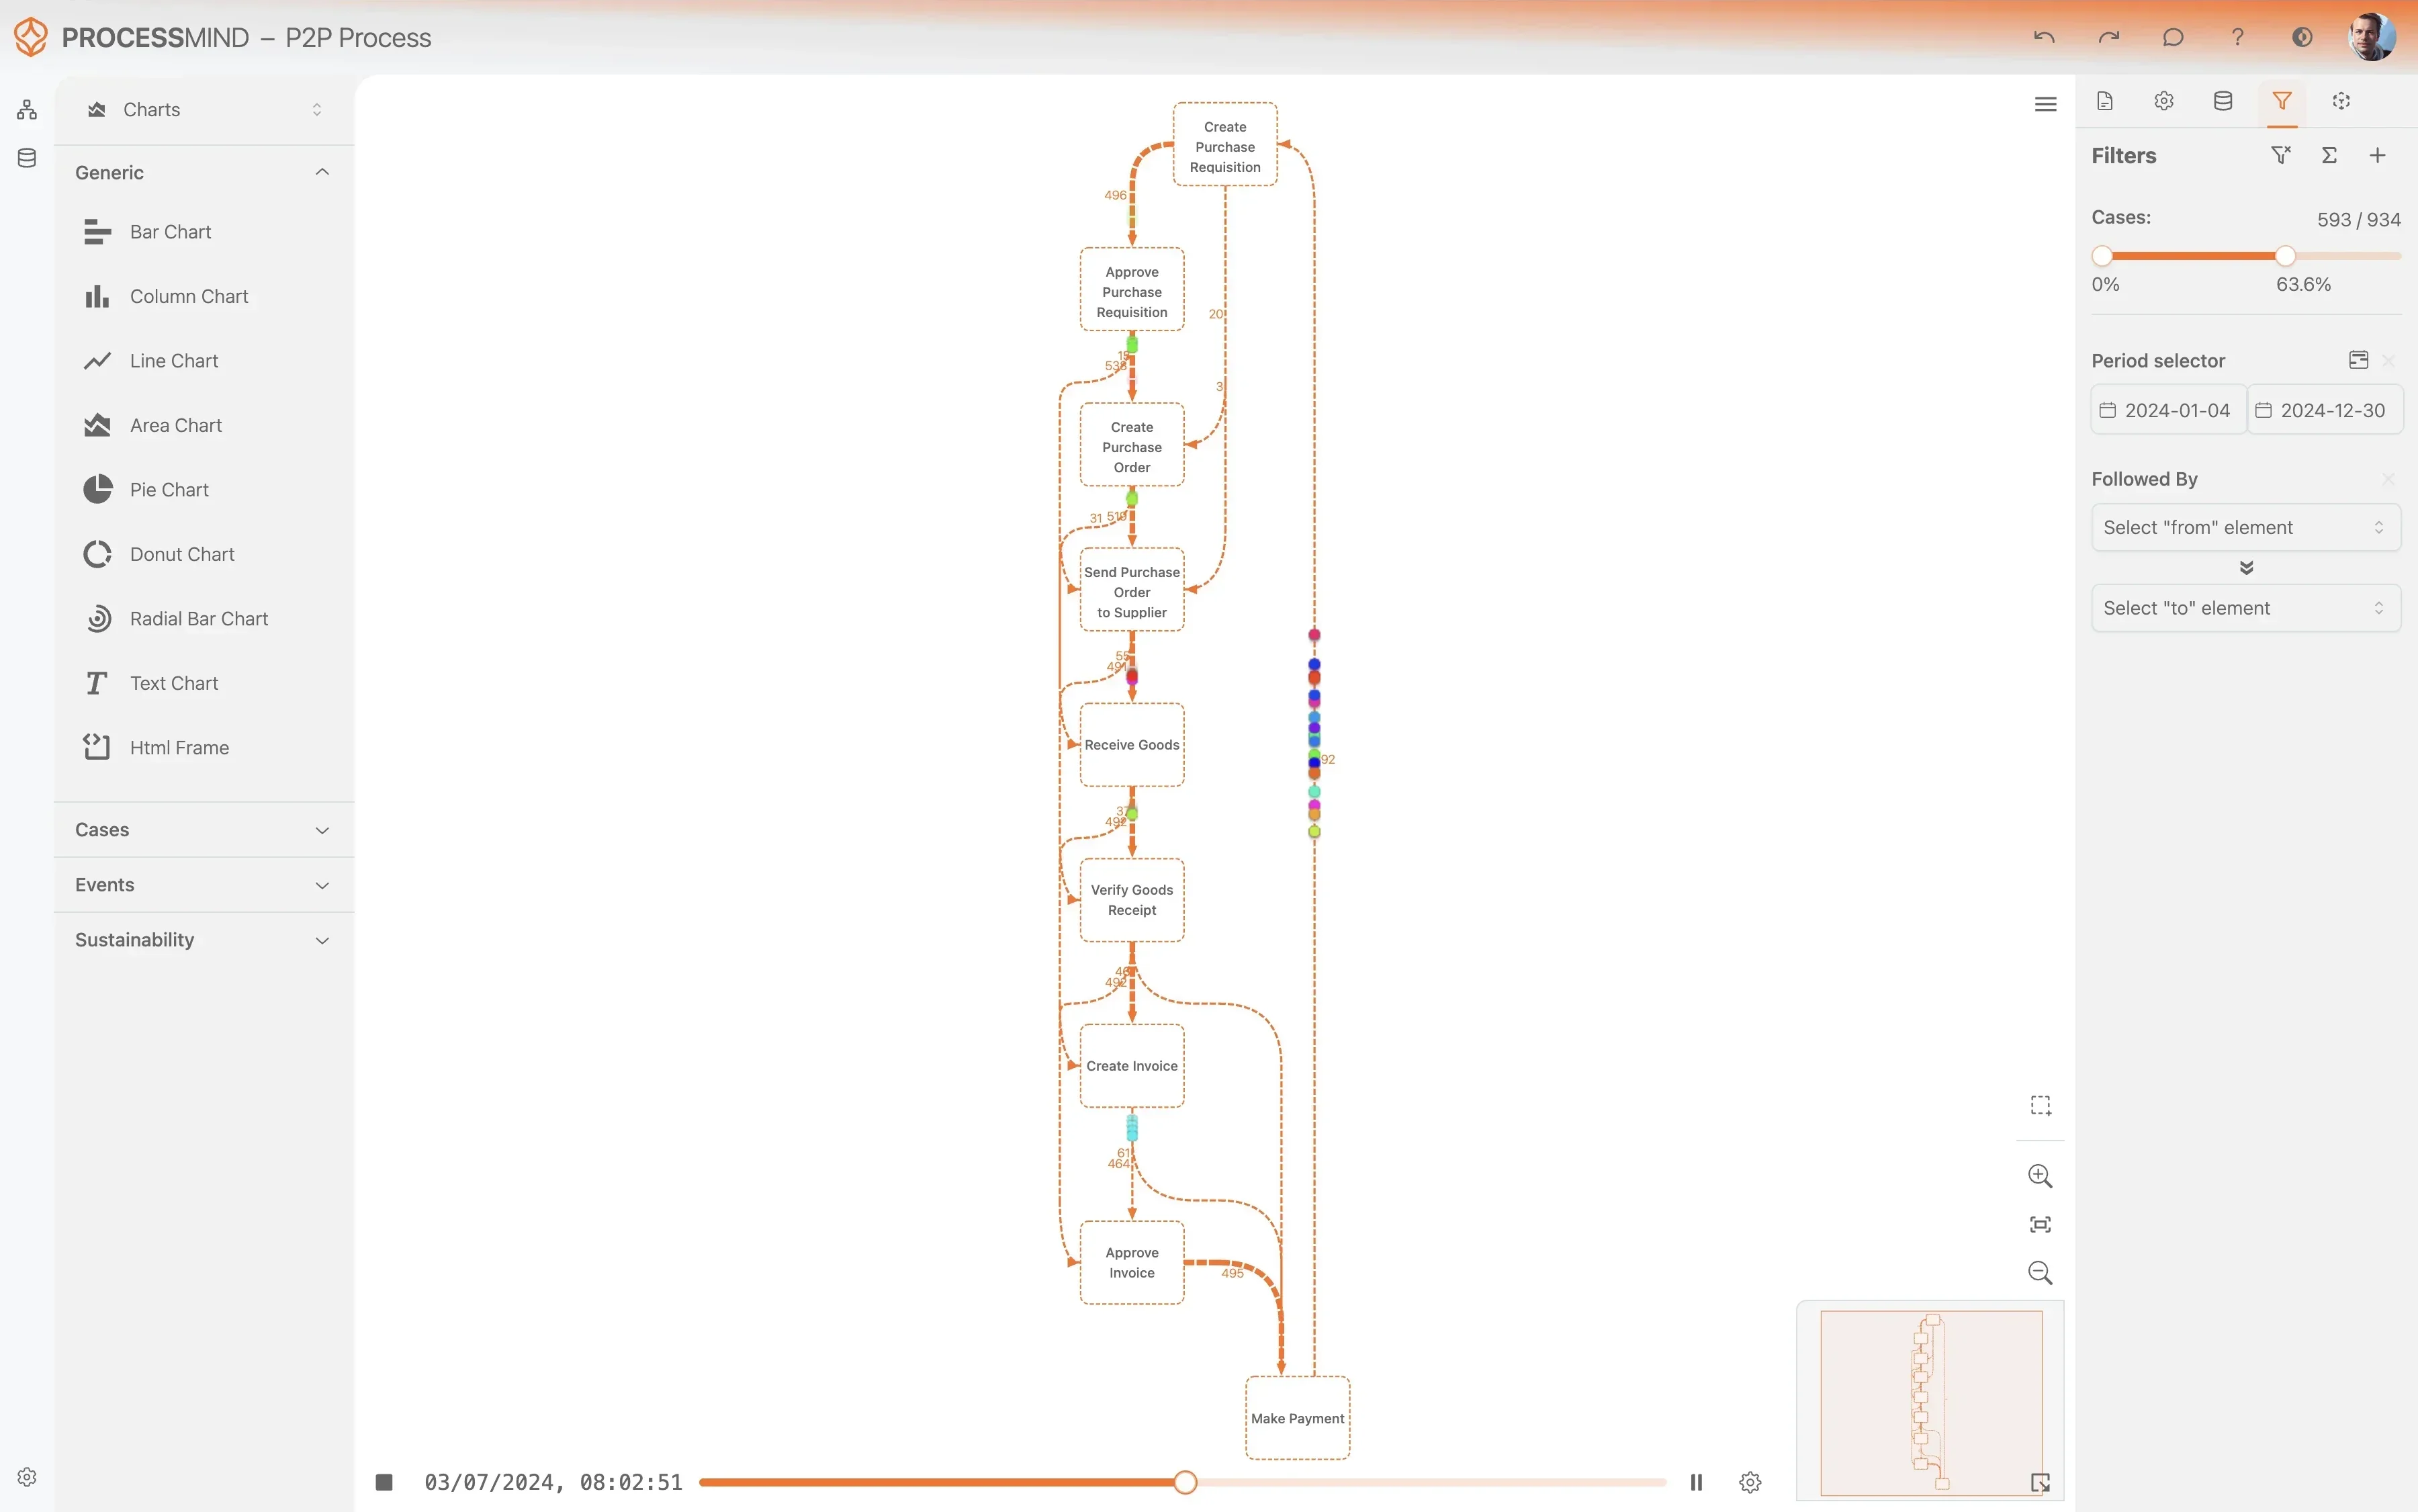
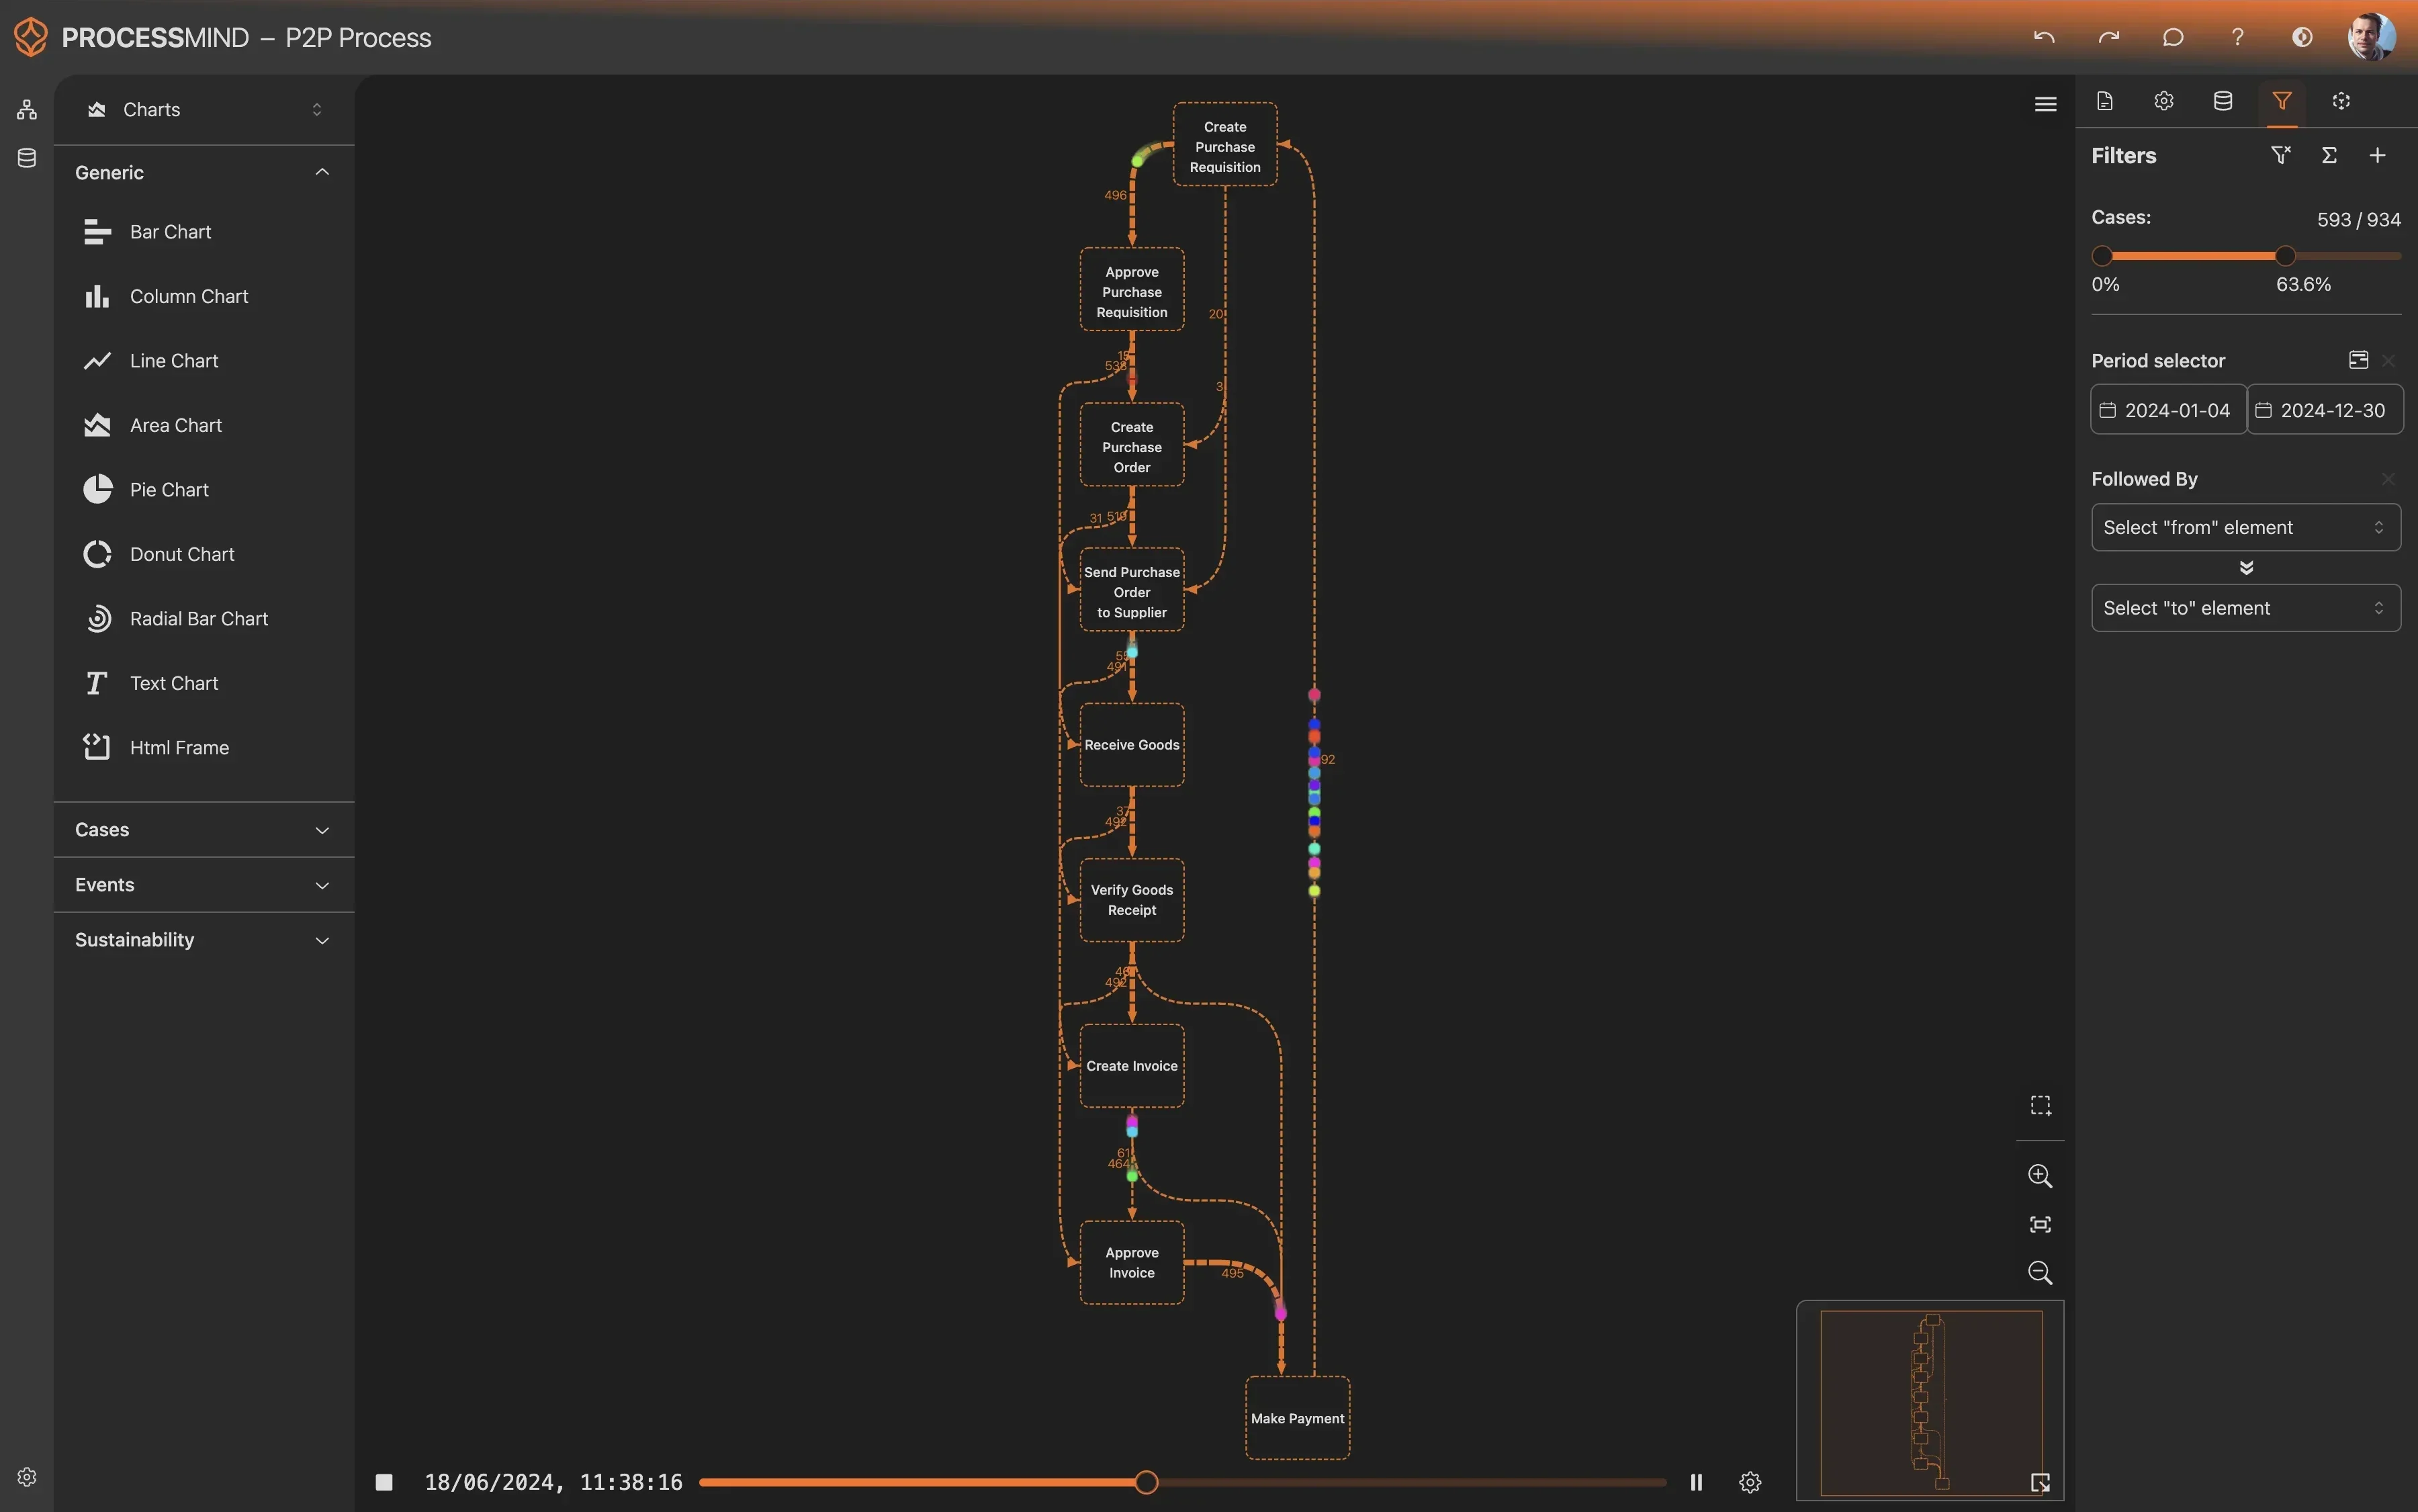
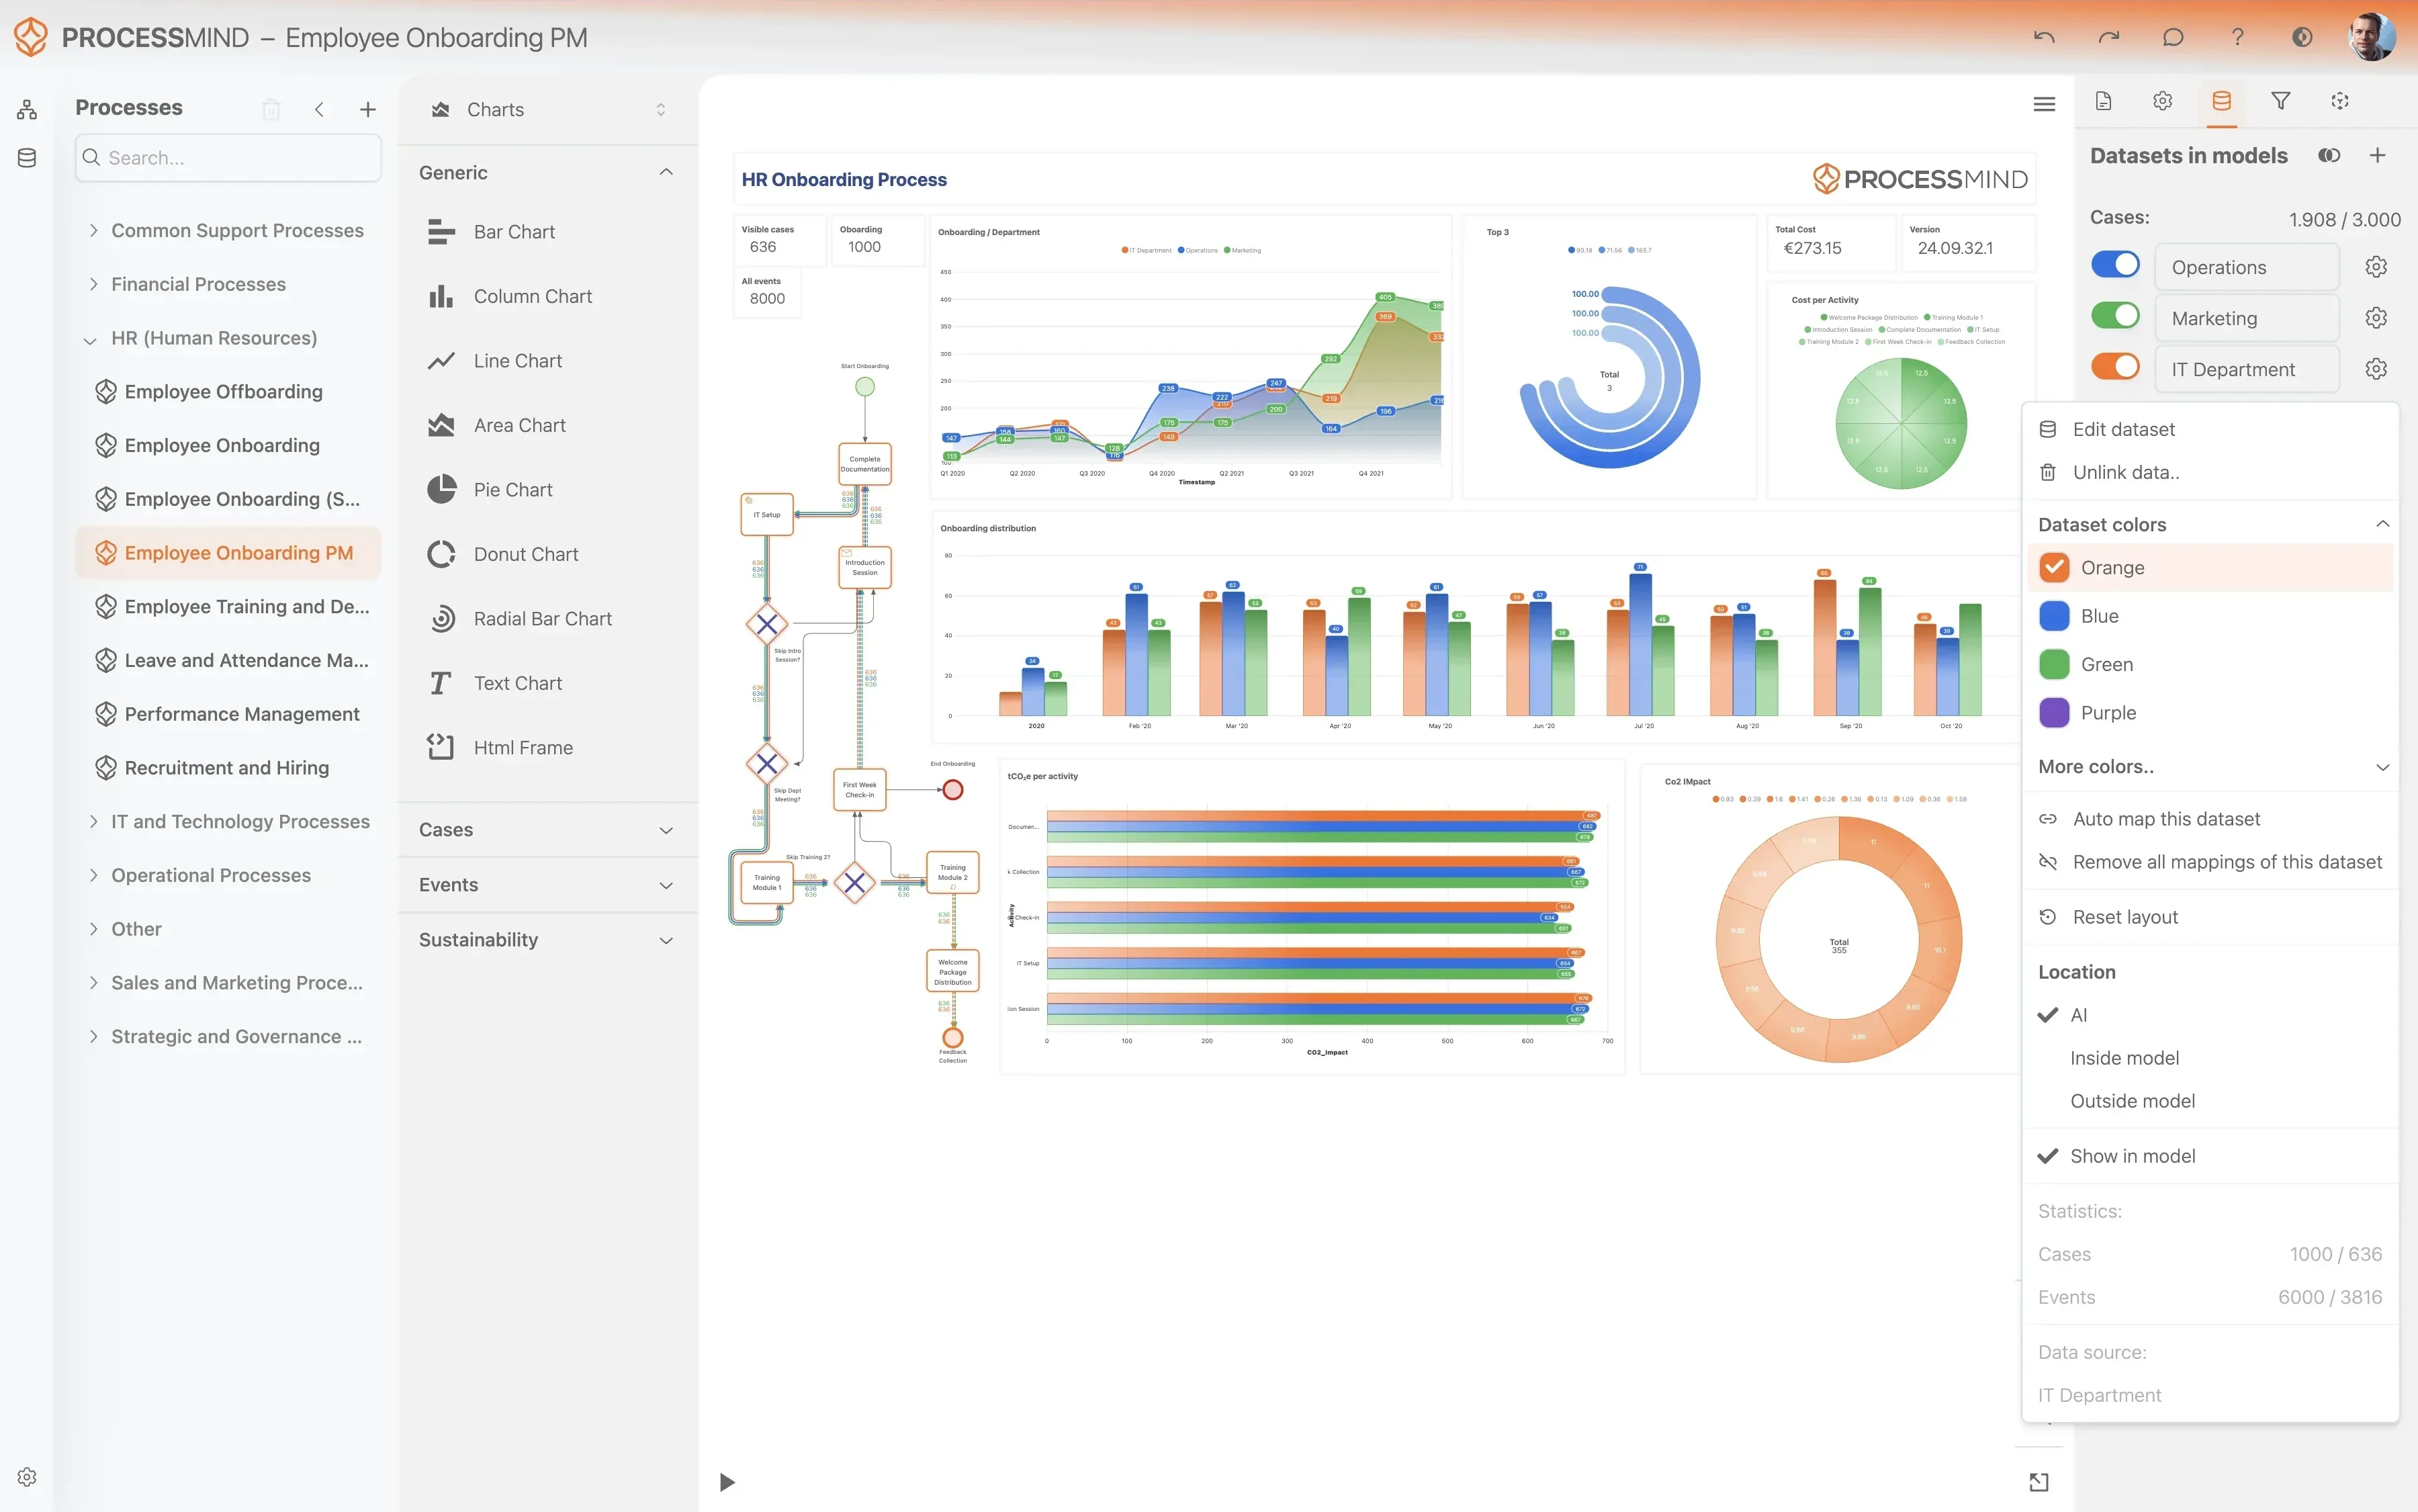
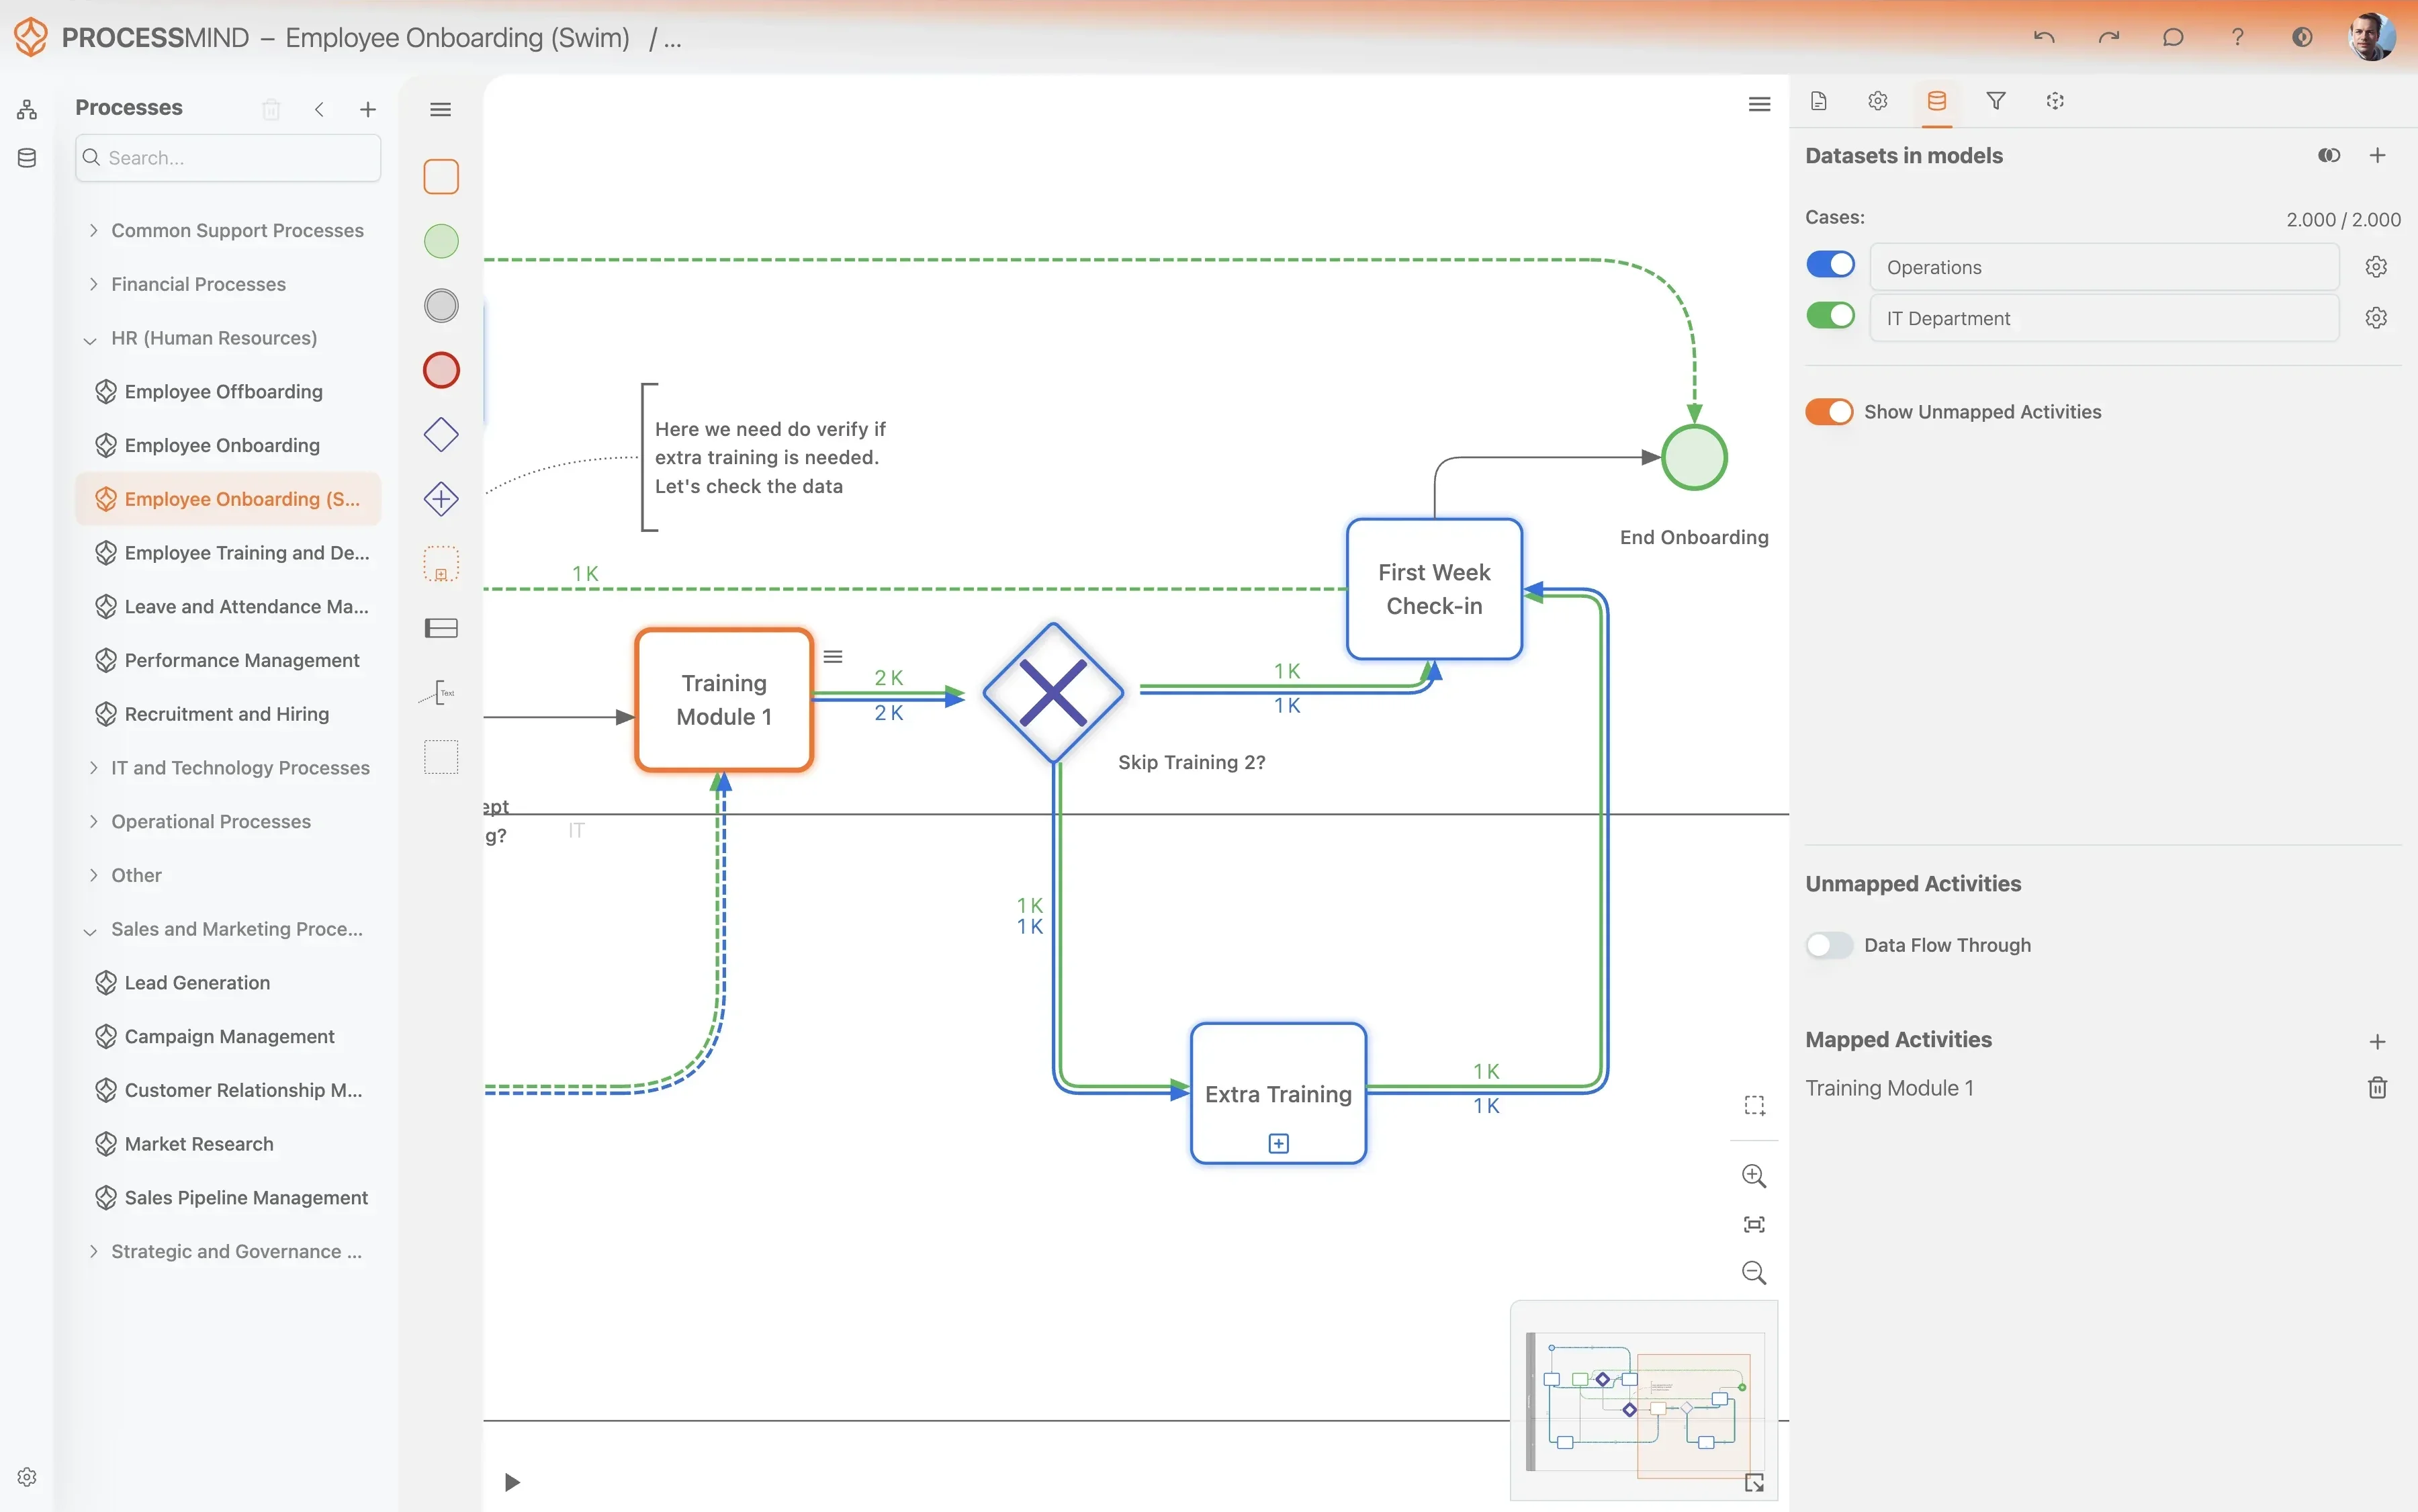
ProcessMind brengt het werkelijke verloop van incidentbeheer in beeld, met elke stap en interactie. Krijg helder zicht op vertragingen, het naleven van SLA’s en punten die verbetering vragen.
  • Breng het werkelijke verloop van incidentoplossingen in beeld
  • Spoor verborgen vertragingen en bottlenecks in workflows op
  • Houd bij of SLA’s worden nageleefd en voorkom overschrijdingen
  • Maak incidentbeheer efficiënter
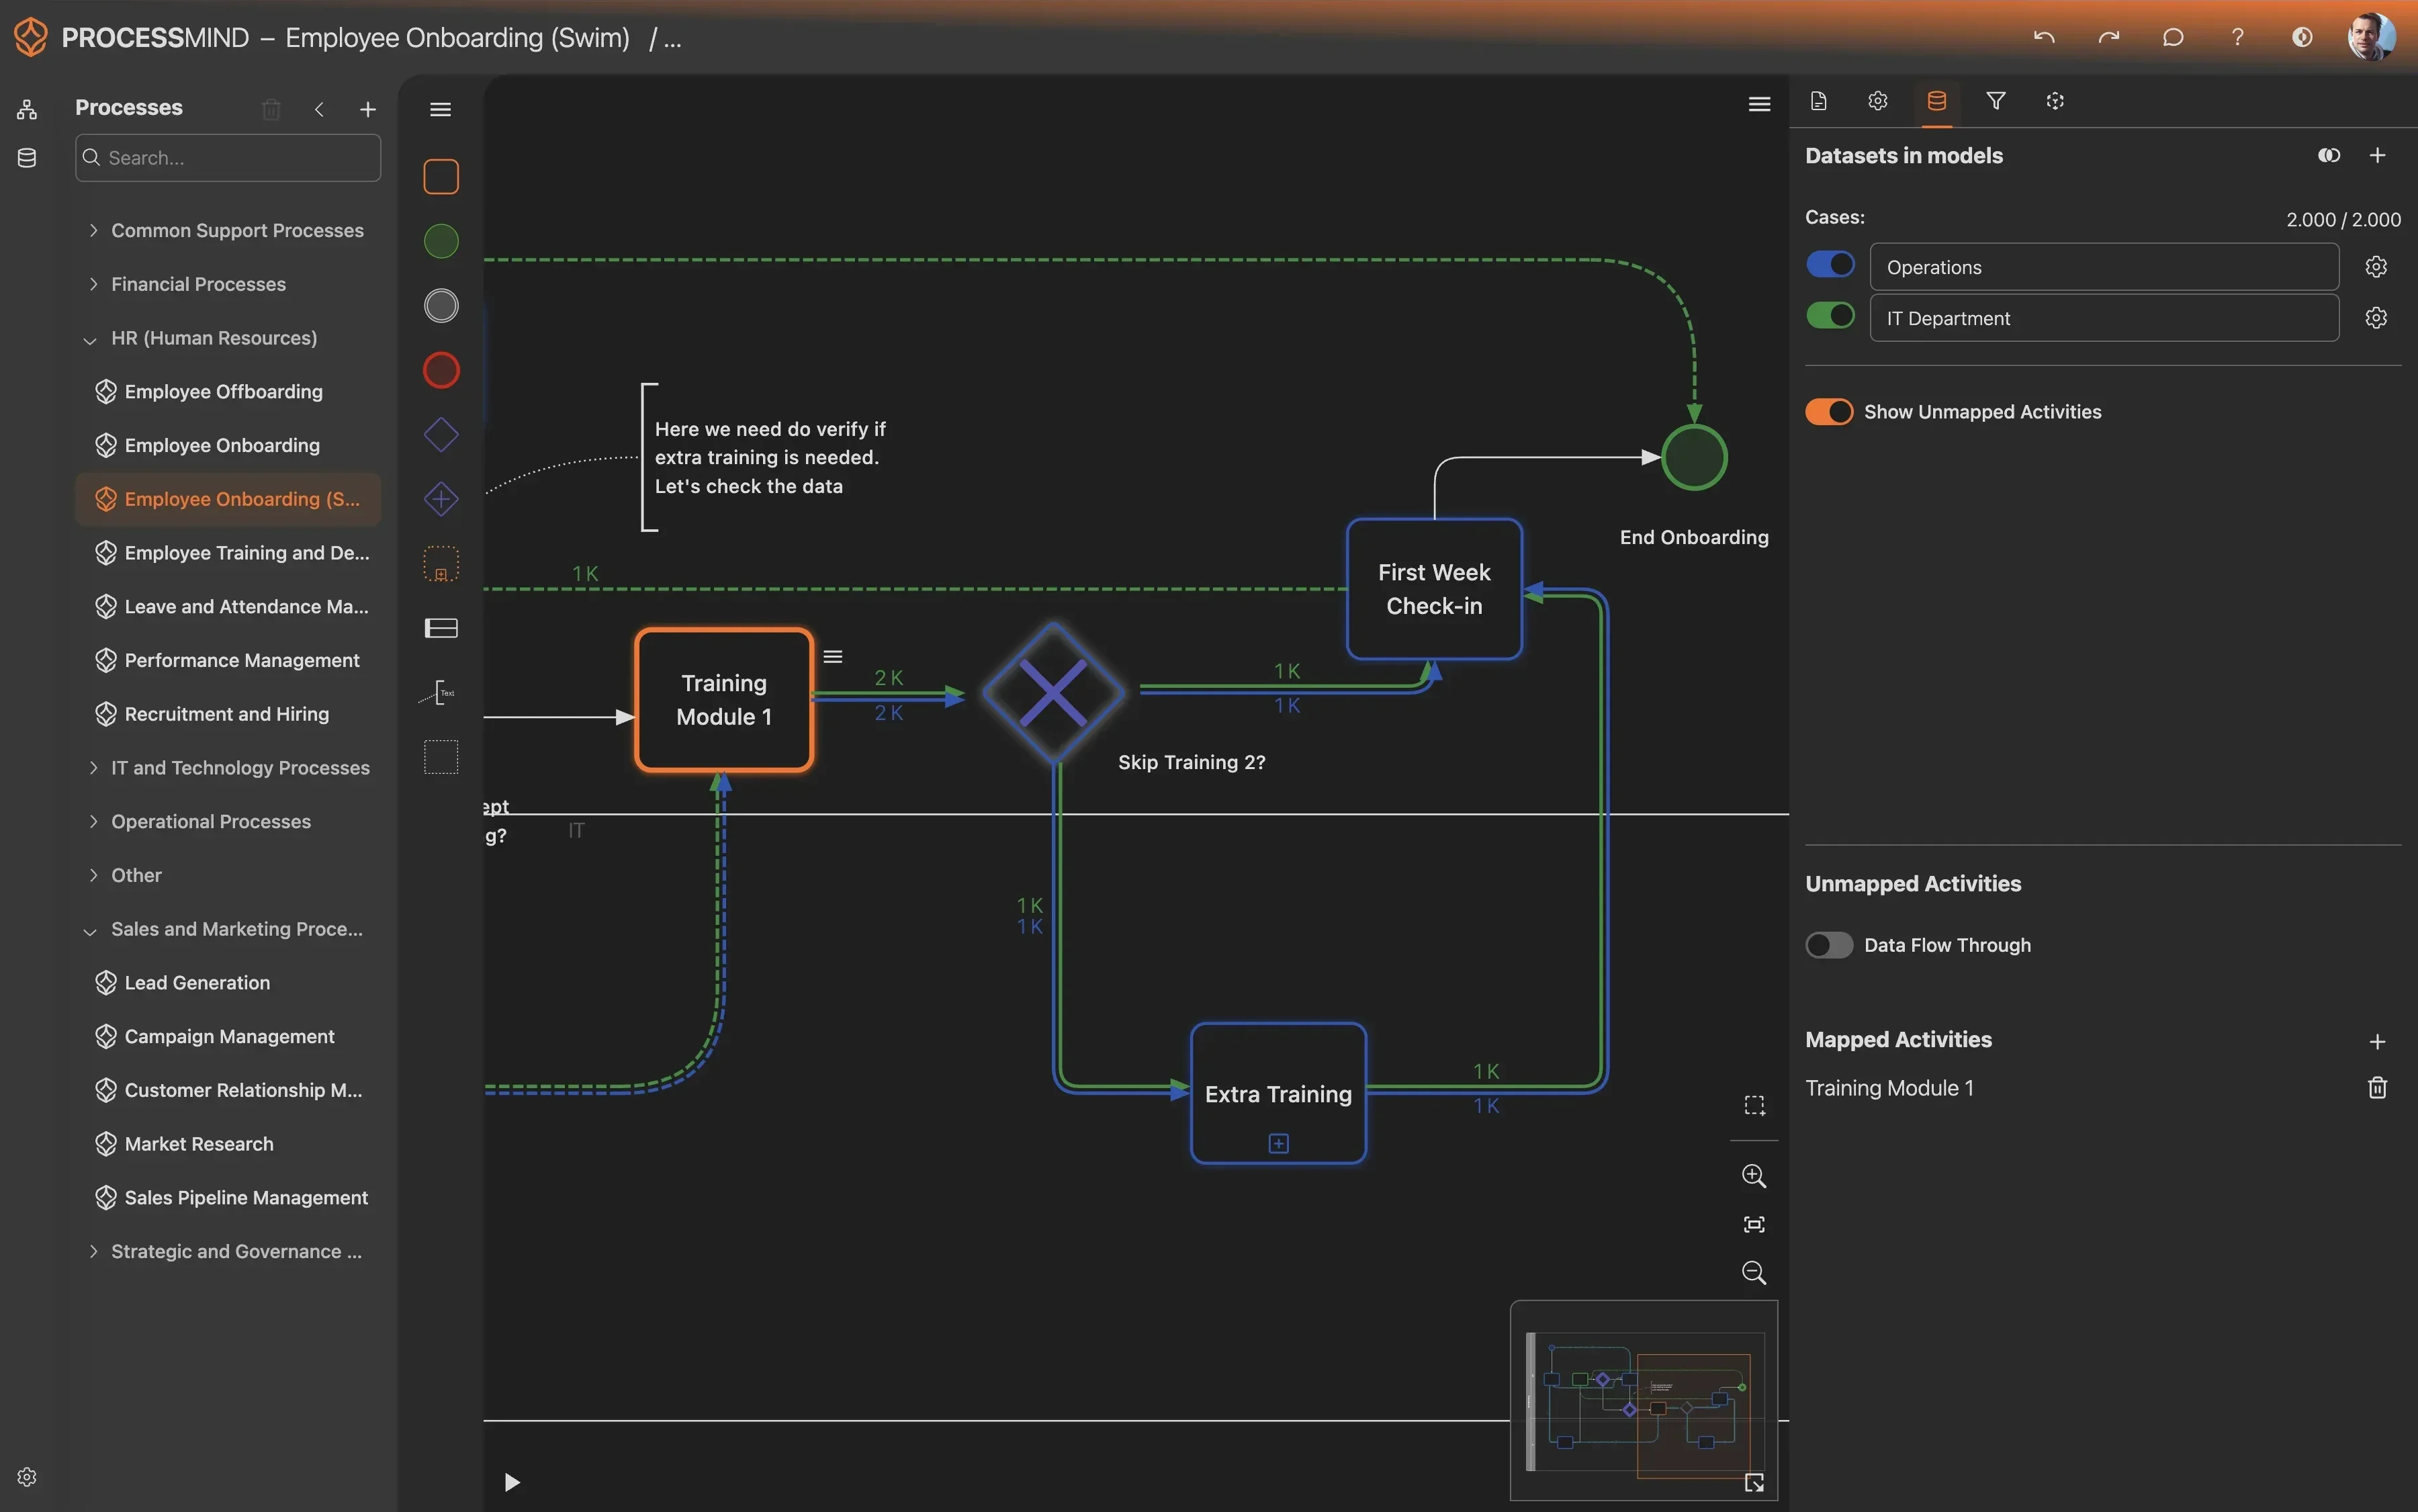
Discover your actual process flow
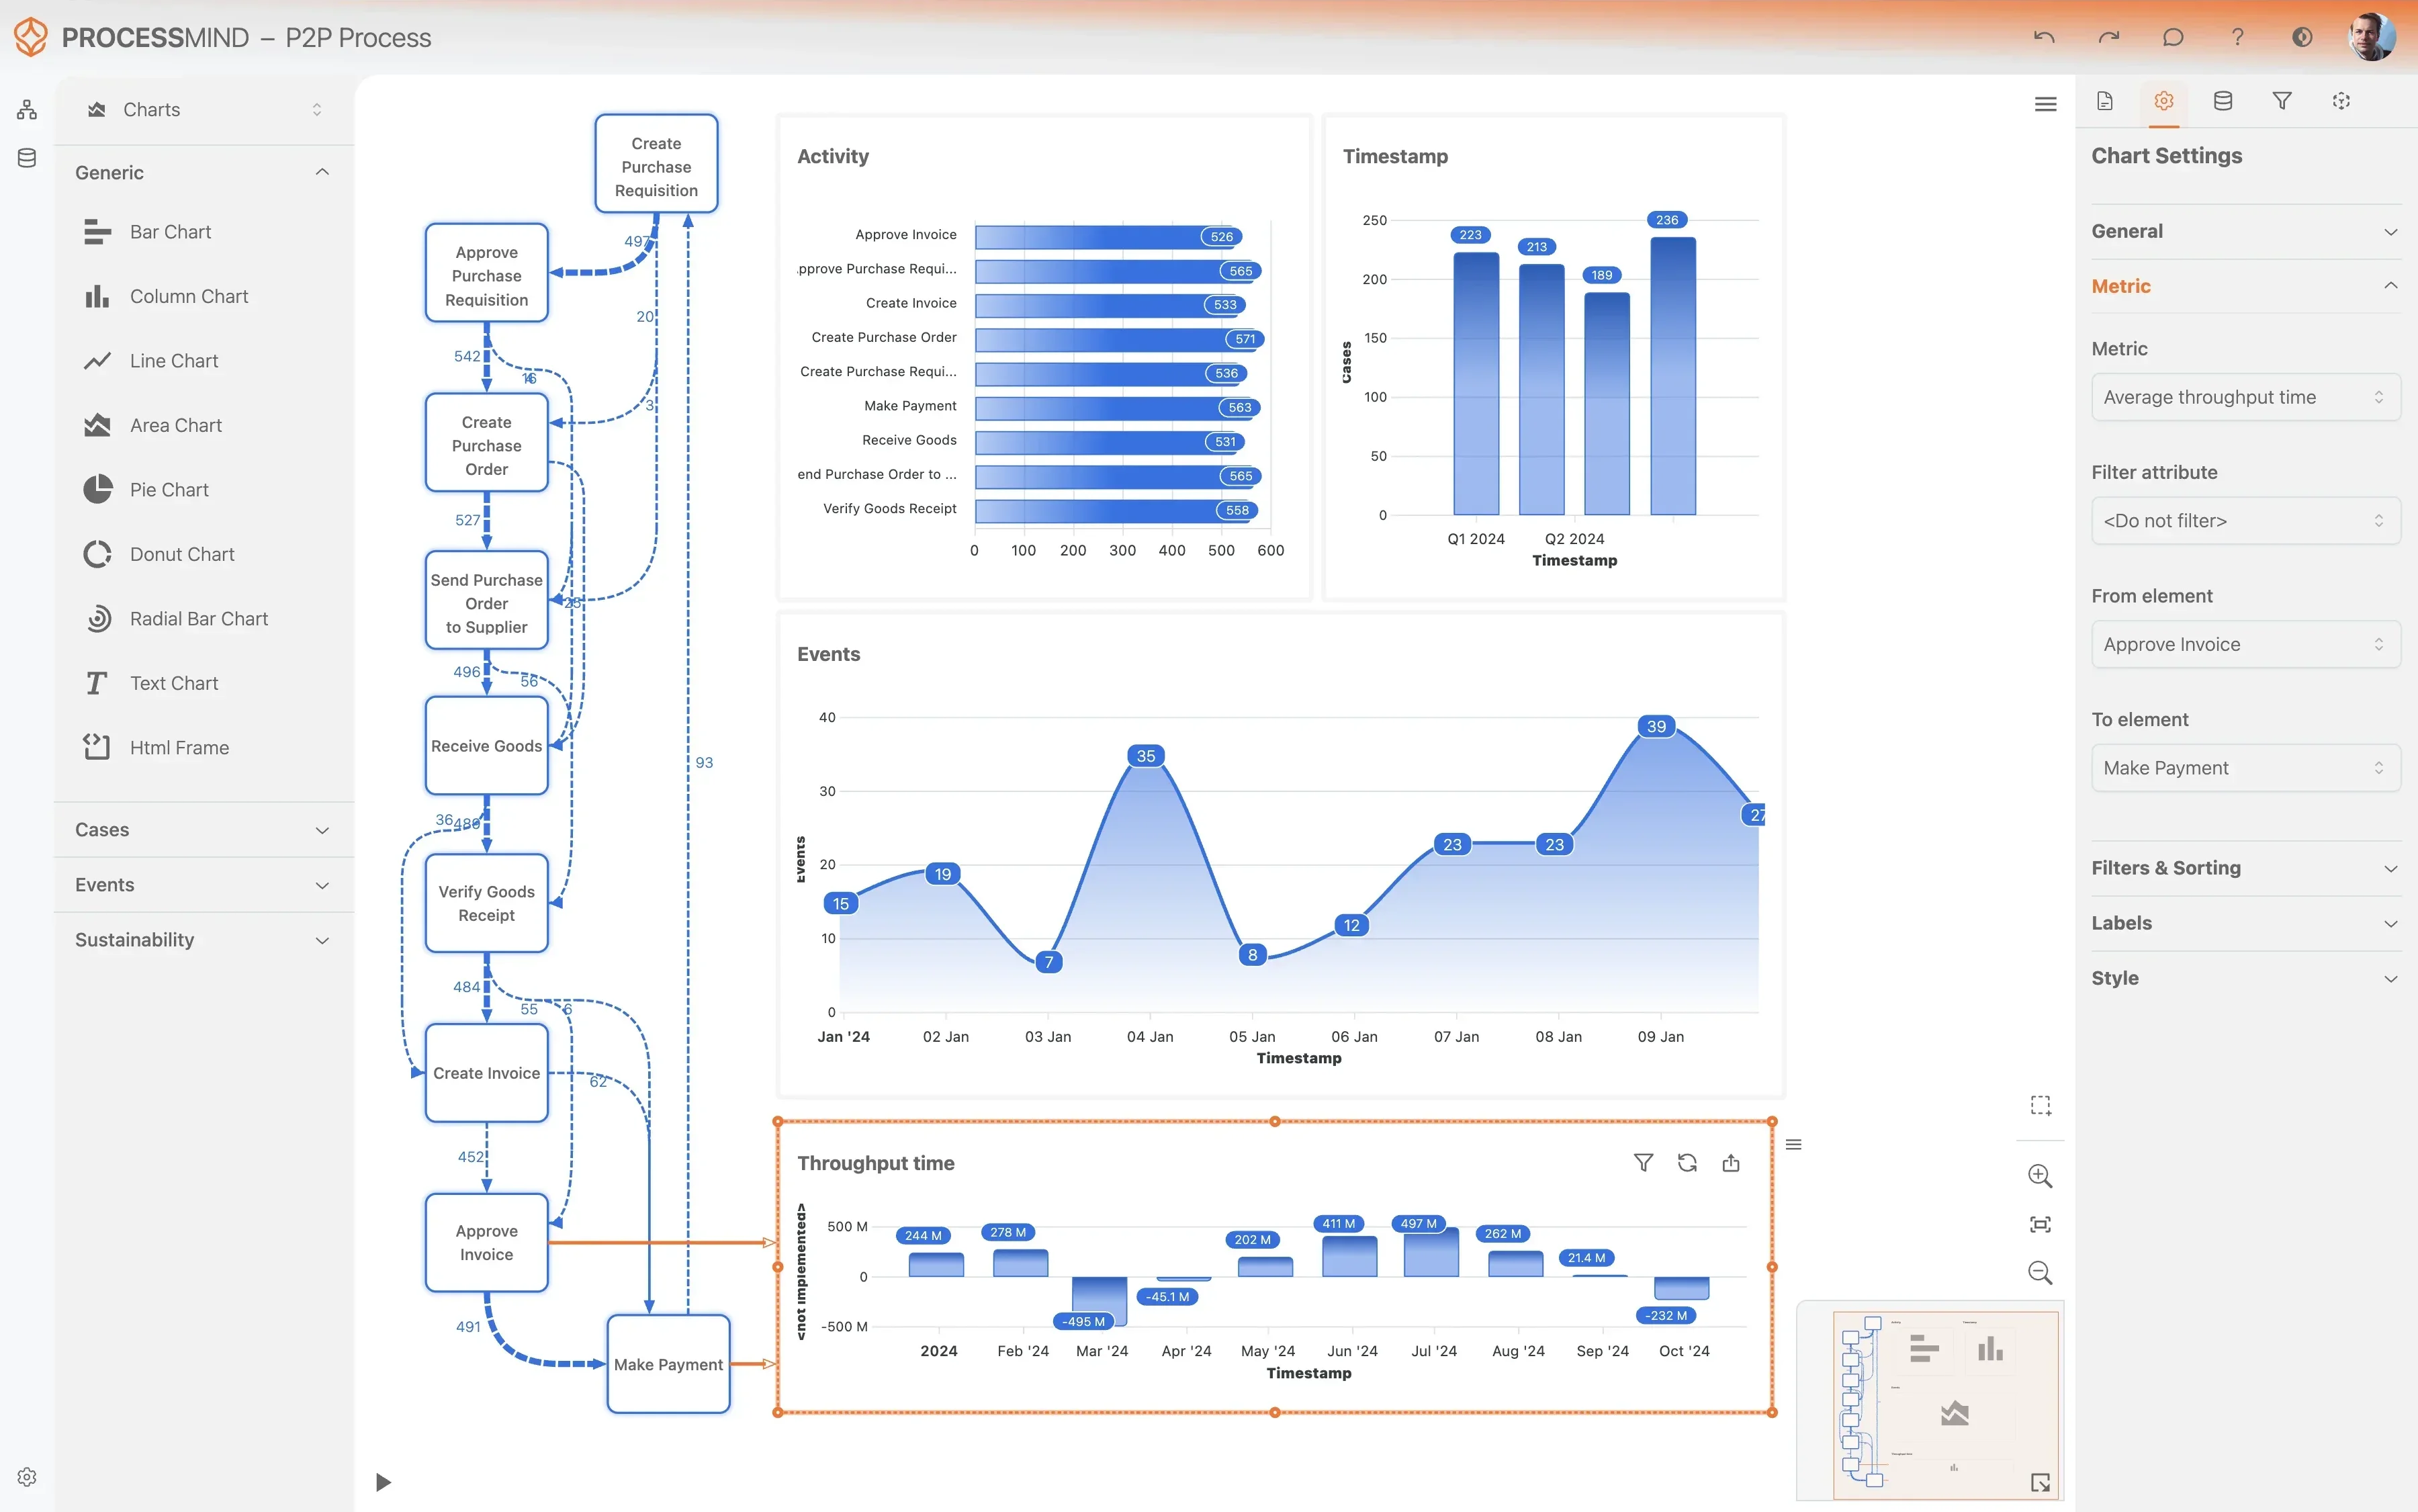
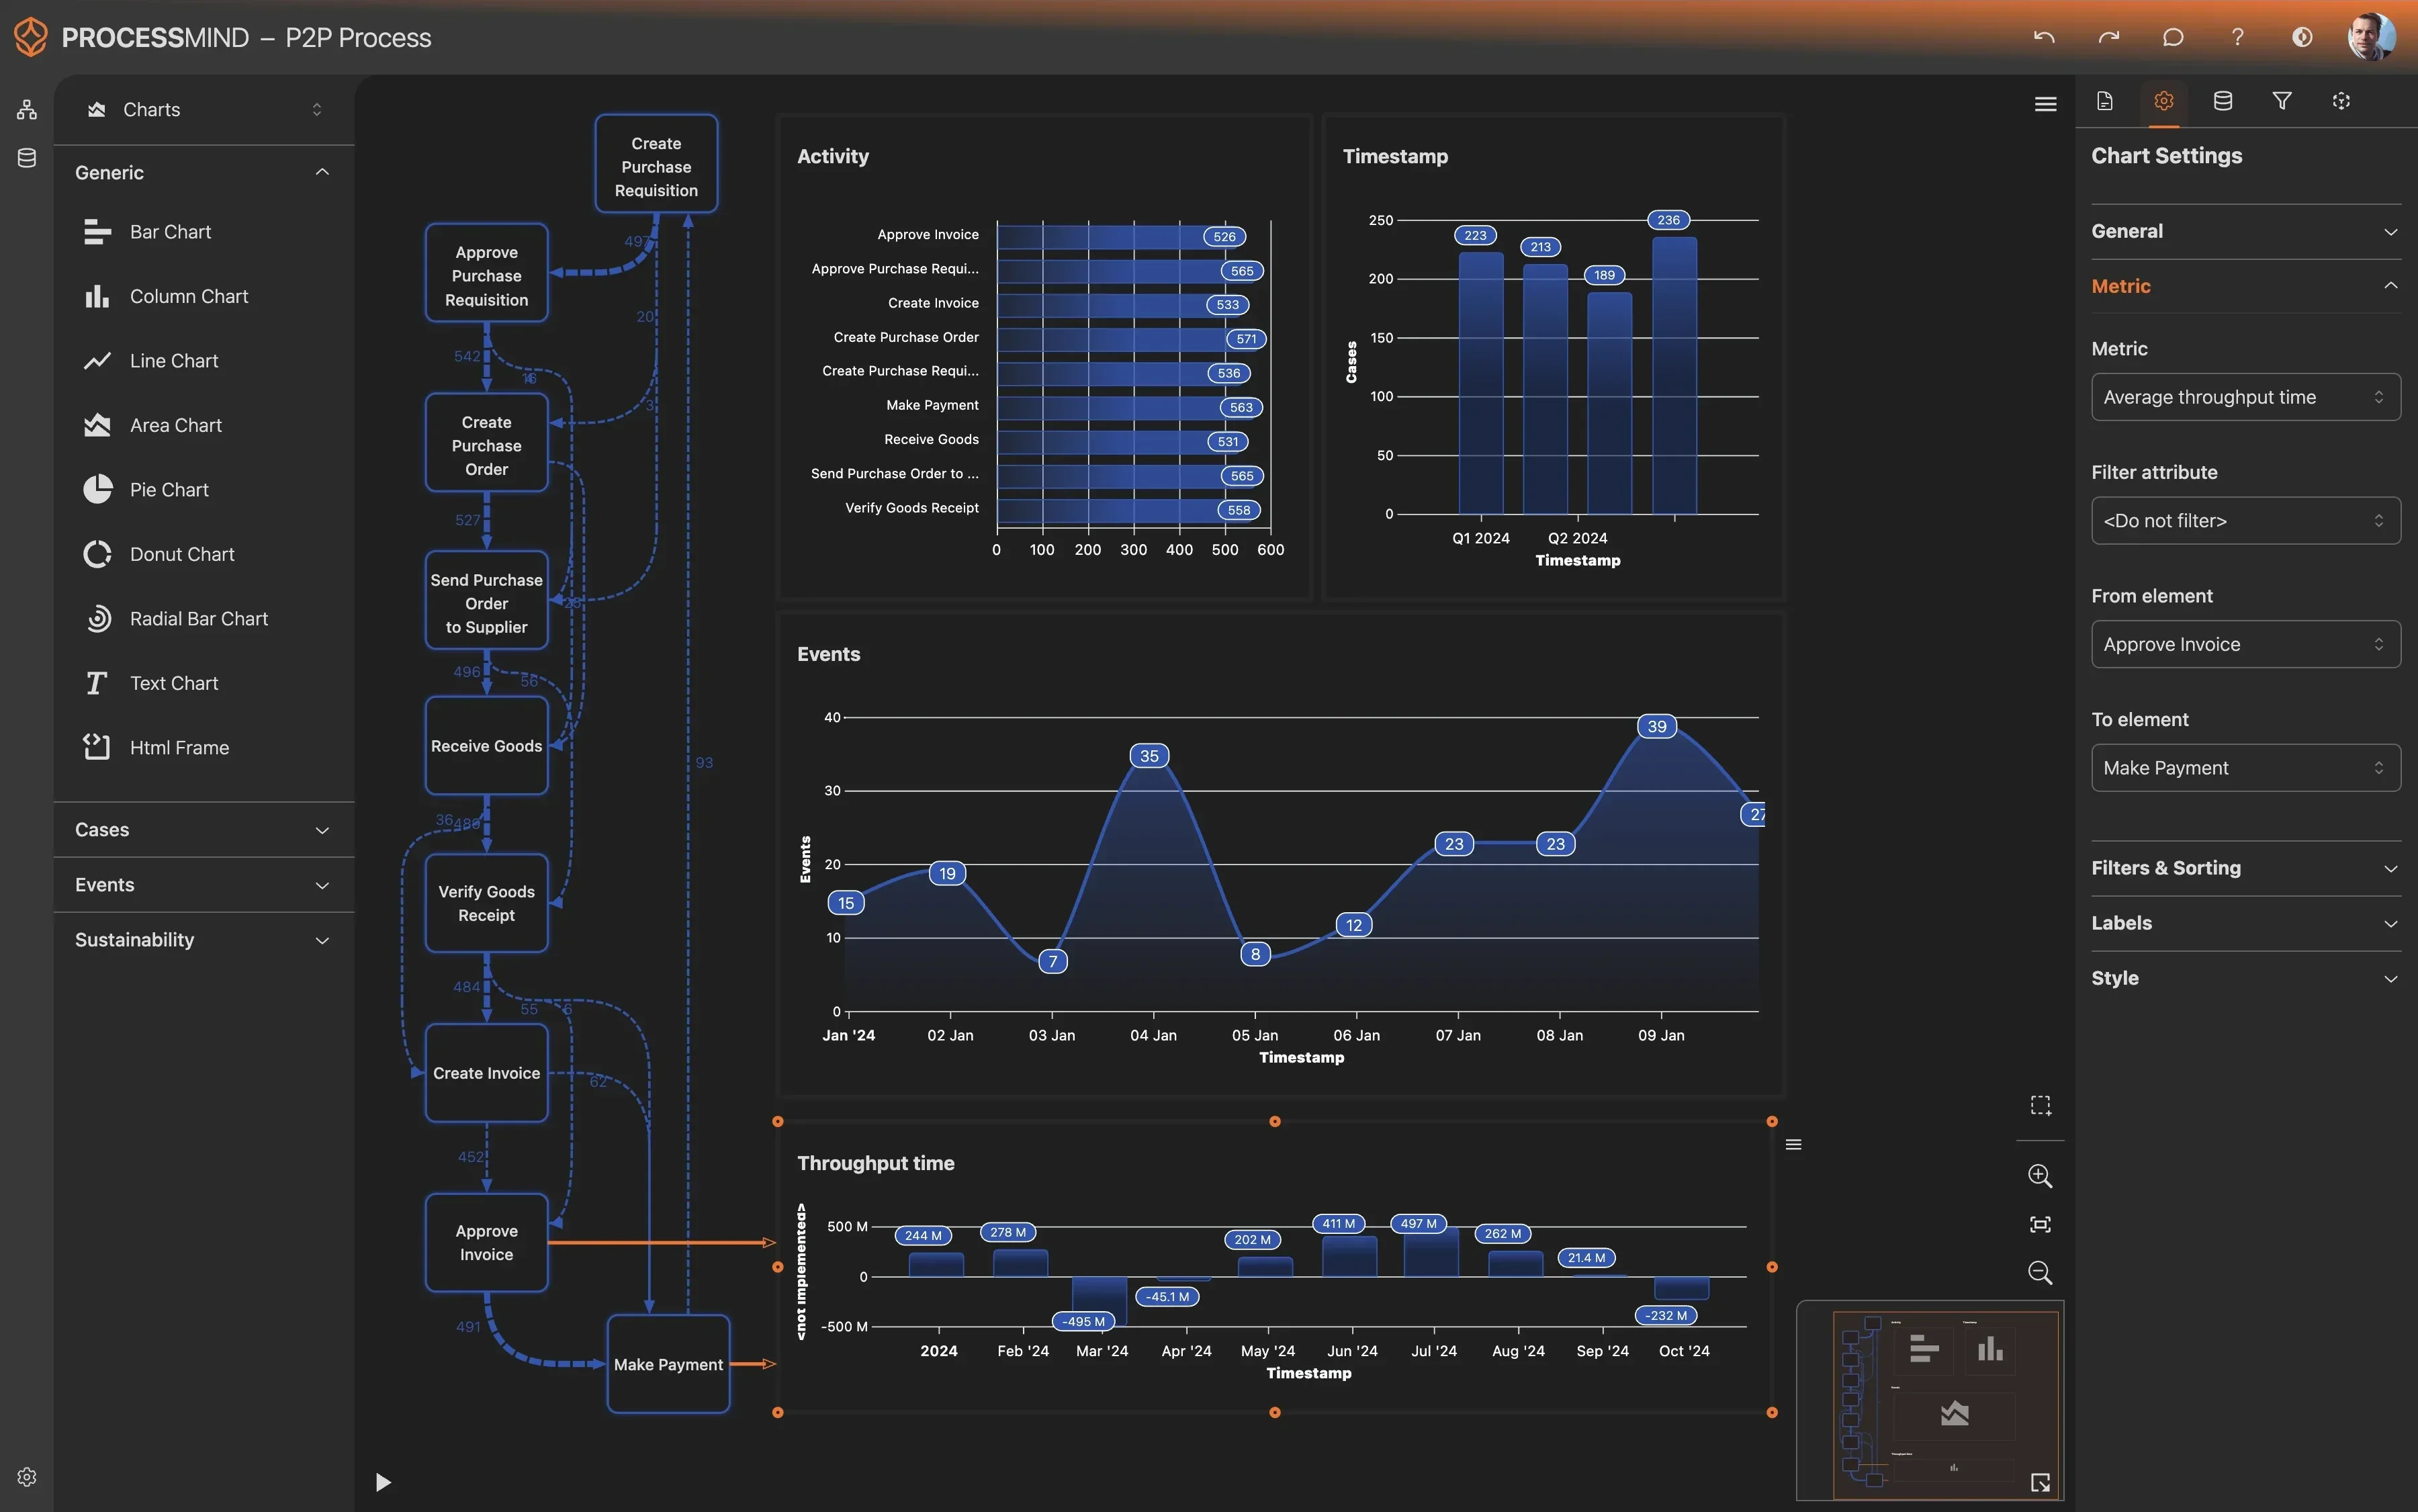
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

GEBRUIKELIJKE RESULTATEN

Wat process mining oplevert voor incidentbeheer

Deze resultaten laten zien hoe process mining de efficiëntie en effectiviteit van incidentbeheer kan verbeteren. Door bottlenecks in Jira Service Management te vinden en workflows aan te passen, kunnen incidenten beter worden opgelost.

0 % faster
Incidenten sneller oplossen

Gemiddelde verkorting van de totale doorlooptijd

Process mining helpt bottlenecks te vinden en weg te nemen. Daardoor neemt de totale tijd om incidenten op te lossen flink af en verbetert de dienstverlening.

0 % fewer
Minder SLA-overschrijdingen

Minder incidenten waarbij de doelstelling niet wordt gehaald

Door oorzaken van vertraging en afwijkingen van de regels te vinden, kunnen organisaties problemen proactief aanpakken. Zo voldoen meer incidenten aan de doelstellingen van de service level agreement.

0 % reduction
Minder overdrachten en herstelwerk

Efficiëntere procesroutes

Onnodige overdrachten en herhaalde stappen worden zichtbaar en kunnen verdwijnen. Zo verloopt het oplossen van incidenten eenvoudiger en directer en wordt de bedrijfsvoering efficiënter.

0 % fewer variants
Consistentere processen

Minder verschillende incidentroutes

Process mining laat alle varianten in de afhandeling van incidenten zien. Teams kunnen goede werkwijzen standaardiseren en het aantal afwijkende procesroutes terugbrengen. Zo worden de uitkomsten voorspelbaarder.

0 % improvement
Betere kwaliteit van oplossingen

Betere verificatie en oorzaakanalyse

Door belangrijke stappen, zoals incidentverificatie en oorzaakanalyse, consequent te volgen, ontstaan betere oplossingen en keren vergelijkbare problemen minder vaak terug.

De resultaten hangen af van de complexiteit van het proces, de datakwaliteit en de situatie binnen de organisatie. De cijfers geven gebruikelijke verbeteringen weer die bij verschillende implementaties van incidentbeheer zijn waargenomen.

Aanbevolen data

Begin met het importeren van de belangrijkste attributen en activiteiten. Breid de analyse daarna uit als dat nodig is.

Attributen

Belangrijke datapunten voor de analyse

De unieke identificatiecode van elk incidentticket in Jira Service Management.

Waarom dit belangrijk is

Deze ID koppelt alle bijbehorende gebeurtenissen aan één case en vormt daarmee de basis voor elke process mining-analyse.

De naam van de specifieke gebeurtenis of statuswijziging voor het incident.

Waarom dit belangrijk is

Activiteiten vormen de basis van de proceskaart en maken het mogelijk de levenscyclus van incidenten te visualiseren en analyseren.

De exacte datum en tijd waarop de activiteit plaatsvond.

Waarom dit belangrijk is

Timestamps zijn nodig om tijdsgebonden metrieken te berekenen, de procesduur te bepalen en bottlenecks in de prestaties te vinden.

De gebruiker die op dit moment aan het incident werkt.

Waarom dit belangrijk is

Helpt de werkbelasting per medewerker te volgen, bottlenecks bij specifieke medewerkers te vinden en te analyseren hoe overdrachten de oplostijd beïnvloeden.

Het team of de groep die verantwoordelijk is voor de afhandeling van het incident.

Waarom dit belangrijk is

Belangrijk voor het analyseren van teamprestaties, doorvoer en de werkverdeling tussen supportniveaus en gespecialiseerde groepen.

De huidige fase van het incident in de levenscyclus.

Waarom dit belangrijk is

Geeft rechtstreeks de voortgang van het incident weer en is de belangrijkste bron voor het bepalen van processtappen en wachttijden.

De prioriteit van het incident, die aangeeft hoe snel het moet worden opgelost.

Waarom dit belangrijk is

Belangrijk voor het analyseren van SLA-prestaties en om te controleren of capaciteit naar de incidenten met de grootste impact gaat.

De datum en tijd waarop het incident voor het eerst in het systeem is aangemaakt.

Waarom dit belangrijk is

Vormt het startpunt voor alle berekeningen van de end-to-end-doorlooptijd en voor SLA-metingen.

De datum en tijd waarop het incident als opgelost is gemarkeerd.

Waarom dit belangrijk is

Markeert het einde van het oplossingsproces en maakt het mogelijk de totale doorlooptijd en SLA-prestaties te berekenen.

Activiteiten

Processtappen om te volgen en te optimaliseren

Dit markeert het officiële begin van de levenscyclus van een incident: een incidentmelding wordt ingediend en in Jira wordt een nieuw probleem aangemaakt. Dit event wordt expliciet vastgelegd wanneer in het systeem een nieuw probleem van het type 'Incident' wordt geregistreerd.

Waarom dit belangrijk is

Dit is het belangrijkste startevent van het proces. De tijd tussen deze activiteit en de oplossing laat zien wat de totale doorlooptijd is en in hoeverre SLA-afspraken worden nagekomen.

Dit geeft aan dat een toegewezen medewerker actief is begonnen met het onderzoeken van het incident. Meestal wordt dit afgeleid wanneer de status van het incident verandert van 'Open' of 'New' naar 'In Progress'.

Waarom dit belangrijk is

Deze belangrijke mijlpaal markeert het begin van het actieve werk aan de oplossing. Door de tijd tot deze activiteit te meten, zie je vertragingen in de wachtrij en problemen met de beschikbaarheid van medewerkers.

Dit gebeurt wanneer een incident na de eerste toewijzing wordt overgedragen aan een andere medewerker of groep. Dit event wordt afgeleid van elke wijziging in het veld 'Assignee' of 'Assigned Group'.

Waarom dit belangrijk is

Het bijhouden van nieuwe toewijzingen is belangrijk om overdrachten te analyseren. Veel nieuwe toewijzingen wijzen vaak op inefficiënte processen, ontbrekende kennis of een verkeerde eerste routering. Daardoor kan de oplostijd oplopen.

Dit markeert het moment waarop het supportteam wacht op informatie of actie van de klant. Dit wordt afgeleid van een statuswijziging naar een aparte wachtstatus, zoals 'Waiting for customer'.

Waarom dit belangrijk is

Door deze wachttijd apart te meten, kun je de SLA nauwkeurig berekenen. Deze tijd telt vaak niet mee in de oplostijd. Ook wordt zo duidelijk hoe lang het duurt voordat klanten reageren.

Deze activiteit geeft aan dat een oplossing is gevonden en toegepast en dat het incident wacht op bevestiging of de laatste controle. Dit wordt afgeleid van de statuswijziging naar 'Resolved'.

Waarom dit belangrijk is

Dit is een belangrijke mijlpaal: het actieve werk van het supportteam is afgerond. Vaak stopt op dit moment ook de SLA-klok.

Deze activiteit bevestigt dat het incident is opgelost en de dienstverlening is hersteld. Vaak valt dit samen met de statuswijziging naar 'Resolved'.

Waarom dit belangrijk is

Dit is de belangrijkste mijlpaal voor een geslaagde afhandeling. De tijd tot dit moment is de meest gebruikte KPI: de oplostijd (TTR).

Dit staat voor de definitieve administratieve afsluiting van het incident nadat het is opgelost en gecontroleerd. Dit wordt afgeleid van de statuswijziging naar 'Closed'.

Waarom dit belangrijk is

Dit is het laatste event in het proces. De tijd tussen 'Resolved' en 'Closed' kan vertragingen in de administratieve afhandeling of het wachten op bevestiging van de gebruiker zichtbaar maken.

Veelgestelde vragen

Veelgestelde vragen

Met process mining zie je hoe incidenten daadwerkelijk door het proces lopen. Zo worden verborgen bottlenecks, lussen met herstelwerk en stappen die niet aan de regels voldoen zichtbaar. Je kunt achterhalen waarom SLA’s herhaaldelijk worden overschreden en waarom er te veel overdrachten zijn. Dat helpt je gerichte verbeteringen door te voeren en op basis van data beslissingen te nemen over het incidentproces.

Je hebt vooral een incident-ID nodig als case-ID, een activiteitsnaam voor elke stap, een timestamp van het moment waarop de activiteit plaatsvond en een bron of gebruiker die bij de activiteit hoort. Extra attributen, zoals prioriteit, categorie of toegewezen medewerker, kunnen de analyse aanvullen. Samen vormen deze gegevens het event log voor process mining.

Je kunt rekenen op minder overschrijdingen van incident-SLA’s en kortere diagnosetijden, naast minder onnodige overdrachten en lussen met herstelwerk. De inzichten helpen om de prioritering van incidenten te standaardiseren en overdrachten naar specialistische teams te verbeteren. Zo verloopt het oplossen van incidenten uiteindelijk efficiënter.

Je hebt toegang nodig tot de data in Jira Service Management, meestal via de API, rechtstreekse databasetoegang of exportfuncties. Ook heb je een geschikt process mining-platform nodig en basiskennis van data-engineering om data te extraheren en om te zetten. Veilige gegevensverwerking en naleving van privacyregels zijn eveneens belangrijk.

Process mining laat goed zien waar problemen in het proces ontstaan, bijvoorbeeld bij bottlenecks, afwijkingen of stappen die vertraging veroorzaken. De methode voert zelf geen traditionele oorzaakanalyse uit, maar levert je experts precies het bewijs en de context die ze nodig hebben om de onderliggende oorzaken te bepalen. Met deze aanpak op basis van bewijs verloopt RCA een stuk sneller.

Data-extractie gebeurt meestal via de REST API van Jira, rechtstreekse databasequery’s als Jira lokaal wordt gehost, of de ingebouwde exportfuncties voor relevante tabellen of aangepaste rapporten. Daarna wordt de ruwe data opgeschoond, omgezet en opgemaakt als event log: een gestandaardiseerde structuur voor process mining-tools. Deze voorbereiding is belangrijk voor een nauwkeurige analyse.

De eerste inzichten zijn vaak binnen enkele dagen of weken beschikbaar, afhankelijk van de beschikbaarheid en complexiteit van de data. Een grondigere analyse en het vinden van belangrijke verbeterkansen kosten meestal enkele weken. In die tijd pas je de datamodellen aan en verfijn je ze. Hoe snel dit gaat, hangt vooral af van de kwaliteit van de data en de samenwerking binnen het team.

Traditionele rapportages geven een momentopname of samengevoegde cijfers en laten zien wat er is gebeurd. Process mining reconstrueert de volledige route van elk incident, van begin tot eind. Je ziet de werkelijke volgorde van gebeurtenissen, verborgen procesvarianten en afwijkingen van de gewenste route. Zo wordt duidelijk hoe en waarom dingen zijn gebeurd. Het geeft een dynamisch beeld van de uitvoering van het proces op basis van data.

Ruwe data moet vaak eerst worden opgeschoond en omgezet voordat je process mining kunt toepassen. Process mining-tools zijn gemaakt voor data uit de praktijk. De eerste analyse brengt vaak ook problemen met de datakwaliteit aan het licht, zodat je die gericht kunt aanpakken. Meestal bereid je de data stapsgewijs voor en verfijn je die tot de resultaten goed zijn.

Verbeter incidentbeheer en los incidenten sneller op

Verlaag de MTTR met 35% en verhoog de tevredenheid van gebruikers met efficiëntere processen.

Start je gratis proefperiode

Geen creditcard nodig • In 5 minuten ingesteld