Dziennik zdarzeń w process mining: jak go przygotować
Przygotuj dziennik zdarzeń do process mining z odpowiednimi kolumnami. Pobierz przykład dla restauracji i poznaj instrukcje krok po kroku dla Excela i SQL.

Dziennik zdarzeń do process mining zaczyna się od jednej tabeli: aktywności ze znacznikami czasu pogrupowane według identyfikatora sprawy. W tym przewodniku pokazujemy, jak przygotować taką tabelę z danych systemowych na przykładzie fikcyjnego procesu realizacji zamówień w restauracji. Przedstawiamy dwie metody: kilka wierszy w Excelu albo jedno zapytanie SQL, które łączy aktywności za pomocą UNION ALL. W trakcie pracy można porównywać wyniki z gotowym przykładowym dziennikiem zdarzeń.
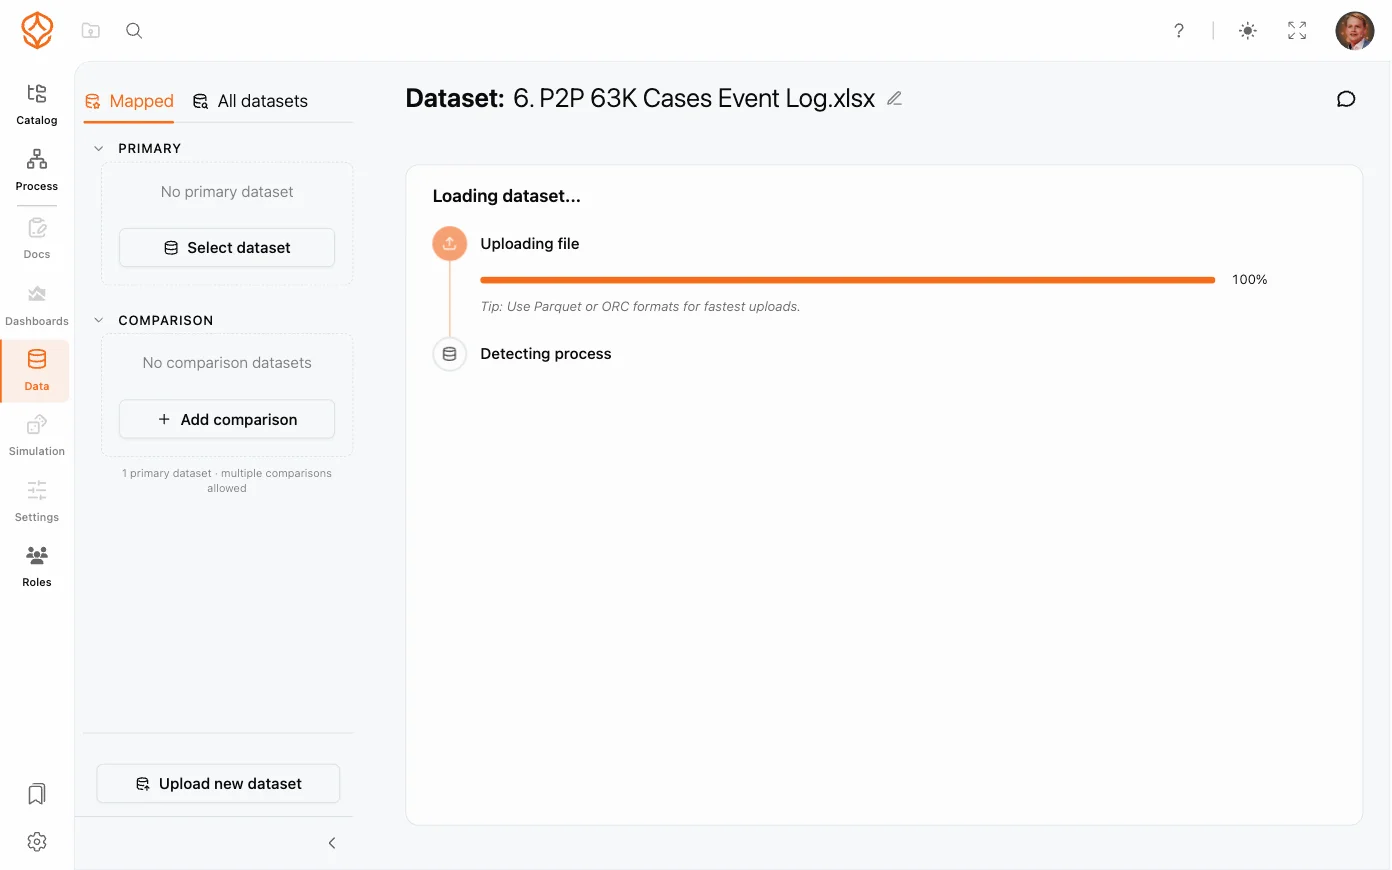
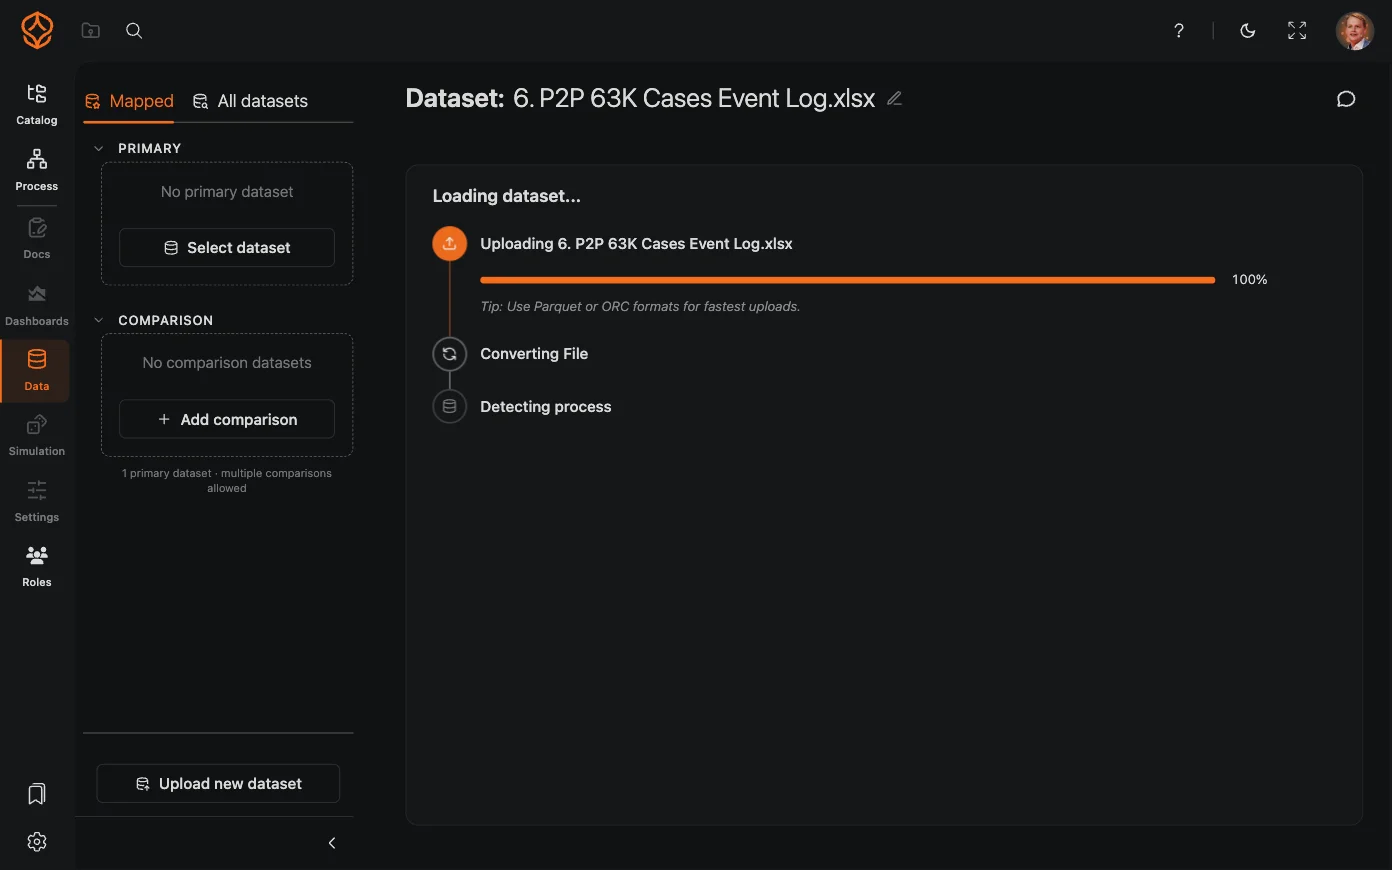
Przygotowywanie dziennika zdarzeń uchodzi za trudne zadanie. Wcale nie musi takie być, jeśli nie próbuje się zrobić wszystkiego naraz. Można zacząć już dziś od szablonu albo kilku wierszy w Excelu, a potem rozszerzyć rozwiązanie, gdy będzie wiadomo, czego potrzeba.
Dziennik zdarzeń do process mining: trzy potrzebne kolumny
Dziennik zdarzeń to uporządkowany zapis tego, co wydarzyło się w procesie. Każdy wiersz opisuje jedno zdarzenie, na przykład złożenie zamówienia lub otrzymanie płatności. Identyfikator sprawy łączy powiązane zdarzenia, a znacznik czasu określa, kiedy każde z nich wystąpiło. Dzięki temu narzędzie może odtworzyć przebieg spraw w procesie.
Aktywność to typ, a zdarzenie to konkretne wystąpienie. Aktywność oznacza rodzaj działania, na przykład „Wysłano zamówienie”. Zdarzenie to konkretne wystąpienie tego działania: zamówienie 12345 wysłano 15 stycznia o 14:30. Dziennik zapisuje zdarzenia, a każde z nich ma nazwę aktywności. Te pojęcia bywają używane zamiennie, ale ich rozróżnienie ma znaczenie podczas przygotowania danych. Aktywność określa, co się wydarzyło, a zdarzenie wskazuje, że stało się to w danej sprawie i w określonym czasie.
Podstawowy dziennik zdarzeń do process mining wymaga trzech kolumn:
| Kolumna | Zawartość | Przykład |
|---|---|---|
| Identyfikator sprawy | Identyfikator łączący zdarzenia należące do tej samej sprawy | 1001 |
| Znacznik czasu | Moment wystąpienia zdarzenia | 2025-01-15 18:30:00 |
| Aktywność | Opis tego, co się wydarzyło | Order Placed |
Przed dalszą pracą sprawdźcie te trzy pola:
| Pole | Co sprawdzić |
|---|---|
| Identyfikator sprawy | Powiązane zdarzenia mają ten sam identyfikator, a różne sprawy mają różne identyfikatory |
| Znacznik czasu | Każde zdarzenie ma prawidłową datę i godzinę |
| Aktywność | Nazwy są jasne i spójne w całym wyciągu |
Te trzy pola stanowią podstawę dziennika. Jeśli któregoś brakuje albo jest niespójne, widok procesu nieprawidłowo przedstawi kolejność pracy. Pozostałe pola są opcjonalne. Dziennik zdarzeń, który mogą odczytać narzędzia do process mining, to zawsze jedna tabela spraw i zdarzeń. Trzy kolumny potrzebne do wykorzystania dziennika zdarzeń w process mining pozostają niezmienne. Informacje o obsługiwanych formatach i przygotowaniu danych zawiera dokumentacja danych do process mining.
Przykład: system zamówień w restauracji Pizza Palace
Aby pokazać kolejne kroki na konkretnym przykładzie, posłużymy się fikcyjną restauracją Pizza Palace. Klienci składają zamówienia online, pracownicy przygotowują jedzenie, a kierowcy je dostarczają. Przykład nie zawiera danych klientów.
Załóżmy, że system przechowuje informacje w następujących tabelach:
- orders: identyfikator zamówienia, klient i czas złożenia zamówienia
- order_items: pizze, dodatki i napoje w każdym zamówieniu
- kitchen_queue: moment przyjęcia zamówienia do kuchni i jego opuszczenia
- delivery_assignments: przypisanie kierowcy i śledzenie dostawy
- payments: dane dotyczące obsługi płatności
Celem jest przygotowanie jednego dziennika zdarzeń, który obejmie każde zamówienie od złożenia po dostawę. Identyfikator zamówienia będzie identyfikatorem sprawy. Każdy istotny znacznik czasu i każda czynność staną się osobnym wierszem. Pobierzcie przykładowy dziennik zdarzeń Pizza Palace i porównajcie jego kolumny z własnym wyciągiem.
Przed wyodrębnieniem danych zdecydujcie, które aktywności uwzględnić. Proces realizacji zamówienia w Pizza Palace obejmuje sześć etapów:
- Order Placed: Klient składa zamówienie.
- Payment Received: Płatność zostaje pomyślnie przetworzona.
- Order Sent to Kitchen: Zamówienie trafia do kolejki przygotowania.
- Order Ready: Kuchnia oznacza zamówienie jako gotowe.
- Assigned to Driver: Do zamówienia zostaje przypisany kierowca.
- Delivery Completed: Zamówienie zostaje dostarczone.
Dla każdej aktywności wskażcie tabelę źródłową, pole znacznika czasu i pole identyfikatora sprawy. Sprawdźcie, czy identyfikator sprawy łączy zdarzenie z właściwym zamówieniem.
| Aktywność | Tabela źródłowa | Pole znacznika czasu | Pole identyfikatora sprawy |
|---|---|---|---|
| Order Placed | orders | created_at | id |
| Payment Received | payments | payment_time | order_id |
| Order Sent to Kitchen | kitchen_queue | queue_entry_time | order_id |
| Order Ready | kitchen_queue | completed_time | order_id |
| Assigned to Driver | delivery_assignments | assigned_at | order_id |
| Delivery Completed | delivery_assignments | delivered_at | order_id |
Rozdzielcie zdarzenia bezpośrednie od wywnioskowanych. Zdarzenie bezpośrednie ma jawny rekord i znacznik czasu w systemie źródłowym. Order Placed pochodzi ze znacznika czasu w wierszu orders, Payment Received z payments, a Delivery Completed z delivery_assignments. Zwykle można je łatwo wyodrębnić, o ile znacznik czasu odpowiada zdarzeniu, które ma być analizowane.
Zdarzenie wywnioskowane nie ma własnego rekordu, dlatego jego czas ustala się na podstawie innego pola. Assigned to Driver może być zapisane wyłącznie jako czas utworzenia przypisania dostawy, a Order Ready może odpowiadać chwili zmiany statusu kolejki kuchennej na „completed”. Zdarzenia wywnioskowane mogą być przydatne, ale sposób ich ustalenia trzeba udokumentować. Zmiana statusu lub czas utworzenia rekordu nie zawsze oznaczają dokładnie to, co sugeruje nazwa aktywności. Zanim znacznik czasu zostanie uznany za czas zdarzenia, warto sprawdzić znaczenie pola z osobami znającymi system źródłowy.
To mapowanie jest planem, a nie potwierdzeniem, że każde pole jest odpowiednie. Sprawdźcie, czy znaczniki czasu są uzupełnione i czy każdą tabelę można połączyć z identyfikatorem zamówienia bez tworzenia zduplikowanych wierszy.
Atrybuty spraw i zdarzeń
Atrybuty dodają kontekst do analizy. Są to kolumny poza identyfikatorem sprawy, znacznikiem czasu i aktywnością. Warto je uwzględnić tylko wtedy, gdy mają jasne znaczenie i można je powiązać z właściwą sprawą lub zdarzeniem.
Atrybuty spraw opisują całą sprawę i zwykle pozostają takie same dla wszystkich jej zdarzeń. Mogą to być nazwa klienta, łączna wartość zamówienia, adres dostawy czy liczba zamówionych produktów. W płaskim dzienniku zdarzeń wartość powtarza się w każdym wierszu danej sprawy. Dzięki temu można później filtrować zdarzenia lub porównywać je na podstawie informacji o sprawie.
Atrybuty zdarzeń opisują pojedyncze zdarzenie: kierowcę przypisanego do dostawy, metodę płatności przy płatności albo stanowisko kuchenne przy zdarzeniu w kuchni. Taka kolumna nie dotyczy każdego wiersza, więc w wierszach, których nie dotyczy, należy pozostawić ją pustą. Kolumna powinna pozostać w tabeli, aby wszystkie wiersze miały tę samą strukturę.
Gotowy dziennik zdarzeń powinien mieć postać jednej płaskiej tabeli, z jednym zdarzeniem w każdym wierszu. Oto dziennik Pizza Palace:
| Identyfikator sprawy | Znacznik czasu | Aktywność | Klient | Wartość zamówienia | Kierowca | Metoda płatności |
|---|---|---|---|---|---|---|
| 1001 | 2025-01-15 18:30:00 | Order Placed | John Smith | 45.99 | ||
| 1001 | 2025-01-15 18:30:15 | Payment Received | John Smith | 45.99 | Credit Card | |
| 1001 | 2025-01-15 18:31:00 | Order Sent to Kitchen | John Smith | 45.99 | ||
| 1001 | 2025-01-15 18:45:00 | Order Ready | John Smith | 45.99 | ||
| 1001 | 2025-01-15 18:46:00 | Assigned to Driver | John Smith | 45.99 | Maria Garcia | |
| 1001 | 2025-01-15 19:05:00 | Delivery Completed | John Smith | 45.99 | Maria Garcia | |
| 1002 | 2025-01-15 18:35:00 | Order Placed | Jane Doe | 28.50 | ||
| 1002 | 2025-01-15 18:35:20 | Payment Received | Jane Doe | 28.50 | PayPal | |
| … | … | … | … | … | … | … |
Dane klienta i wartość zamówienia powtarzają się przy każdym zdarzeniu w danej sprawie. To celowe. Dzięki temu dziennik ma prostą strukturę tabeli, którą narzędzia do process mining mogą odczytać.
Metoda 1: przygotowanie danych w Excelu
Excel sprawdza się przy niewielkim wyciągu danych lub pierwszym ćwiczeniu. Wyeksportujcie każdy typ zdarzenia, ujednolić kolumny i połączcie wiersze w jednym arkuszu. Przygotowanie danych Pizza Palace zajmuje około godziny, jeśli wykona się pięć poniższych kroków.
Krok 1: wyeksportujcie każdy typ zdarzenia do osobnego arkusza. Utwórzcie arkusz dla każdego typu aktywności. Na przykład:
Arkusz 1: Order Placed
| Identyfikator sprawy | Znacznik czasu | Aktywność | Klient | Wartość zamówienia |
|---|---|---|---|---|
| 1001 | 2025-01-15 18:30:00 | Order Placed | John Smith | 45.99 |
| 1002 | 2025-01-15 18:35:00 | Order Placed | Jane Doe | 28.50 |
Arkusz 2: Payment Received
| Identyfikator sprawy | Znacznik czasu | Aktywność | Klient | Wartość zamówienia | Metoda płatności |
|---|---|---|---|---|---|
| 1001 | 2025-01-15 18:30:15 | Payment Received | John Smith | 45.99 | Credit Card |
| 1002 | 2025-01-15 18:35:20 | Payment Received | Jane Doe | 28.50 | PayPal |
W ten sam sposób utwórzcie dodatkowe arkusze dla zdarzeń w kuchni i podczas dostawy.
Krok 2: ujednolićcie kolumny. Na każdym arkuszu użyjcie tych samych nazw kolumn w tej samej kolejności. Dodajcie puste kolumny dla atrybutów, które nie dotyczą danego zdarzenia. Na przykład arkusz Order Placed może zawierać pełny zestaw kolumn:
| Identyfikator sprawy | Znacznik czasu | Aktywność | Klient | Wartość zamówienia | Kierowca | Metoda płatności |
|---|---|---|---|---|---|---|
| 1001 | 2025-01-15 18:30:00 | Order Placed | John Smith | 45.99 |
Sprawdźcie, czy wartości mają zgodne formaty. Szczególnie ważne jest, aby znaczniki czasu były zapisane jako daty i godziny, a nie jako tekst, który tylko wygląda jak znacznik czasu.
Krok 3: połączcie arkusze. Utwórzcie nowy arkusz o nazwie Event Log i skopiujcie do niego wiersze zdarzeń z arkuszy aktywności. Zachowajcie jeden wiersz nagłówka i jedno zdarzenie w każdym wierszu.
Krok 4: posortuj dane według identyfikatora sprawy i znacznika czasu. Posortuj połączone dane rosnąco według identyfikatora sprawy, a następnie znacznika czasu. Dzięki temu łatwiej prześledzić kolejność zdarzeń w każdej sprawie. Sortowanie nie poprawia błędnych znaczników czasu, dlatego przed ustaleniem kolejności sprawdź zdarzenia z identycznymi lub nietypowymi godzinami.
Krok 5: wyeksportuj dane do CSV. Zapisz połączony arkusz jako dziennik zdarzeń do process mining w formacie CSV, który można wczytać do używanego narzędzia. Otwórz wyeksportowany plik i sprawdź, czy nagłówki, separatory, format dat oraz puste wartości wyglądają zgodnie z oczekiwaniami.
Wskazówki dotyczące Excela:
- Użyj funkcji VLOOKUP lub XLOOKUP, aby dodać atrybuty sprawy, na przykład nazwę klienta z arkusza zamówień.
- Stosuj jeden spójny format daty i godziny, na przykład
YYYY-MM-DD HH:MM:SS. - Przed eksportem sprawdź, czy nie ma zduplikowanych wierszy.
- Zachowaj niezmienioną kopię oryginalnych wyciągów, aby można było prześledzić wprowadzone poprawki.
Metoda 2: utwórz dziennik za pomocą SQL
SQL sprawdzi się, gdy dane znajdują się w bazie, wyciąg jest duży albo trzeba będzie powtórzyć tę samą ekstrakcję w kolejnym miesiącu. Zwykle tworzy się jeden SELECT dla każdej aktywności, a następnie łączy je za pomocą UNION ALL.
Jak działa UNION ALL. Łączy wiersze zwrócone przez kilka instrukcji SELECT. Każda instrukcja musi zwracać tę samą liczbę kolumn, w tej samej kolejności i z zgodnymi typami danych. Należy też stosować spójny zestaw aliasów, aby kolumny wynikowe miały czytelne nazwy.
Zapytanie. Poniższy przykład wykorzystuje fikcyjne tabele Pizza Palace. Przed dostosowaniem zapytania sprawdź nazwy tabel i pól, znaczenie znaczników czasu oraz dialekt SQL używany w Państwa systemie.
-- Event Log Extraction for Pizza Palace
-- This query combines multiple event types into a single event log
-- Each SELECT block represents one activity type

-- Event 1: Order Placed
-- Source: orders table
-- This captures when customers submit their orders
SELECT
    o.id AS case_id,                          -- The order ID is our case identifier
    o.created_at AS timestamp,                -- When the order was placed
    'Order Placed' AS activity,               -- The activity name (hardcoded)
    o.customer_name AS customer,              -- Case attribute: who ordered
    o.total_amount AS order_value,            -- Case attribute: order value
    NULL AS driver,                           -- Not applicable for this event
    NULL AS payment_method                    -- Not applicable for this event
FROM orders o
WHERE o.created_at >= '2025-01-01'            -- Filter to your desired date range

UNION ALL

-- Event 2: Payment Received
-- Source: payments table
-- This captures successful payment processing
SELECT
    p.order_id AS case_id,
    p.payment_time AS timestamp,
    'Payment Received' AS activity,
    o.customer_name AS customer,              -- Join to get case attributes
    o.total_amount AS order_value,
    NULL AS driver,
    p.payment_method AS payment_method        -- Event-specific attribute
FROM payments p
JOIN orders o ON p.order_id = o.id            -- Join to get order details
WHERE p.payment_time >= '2025-01-01'
  AND p.status = 'successful'                 -- Only include successful payments

UNION ALL

-- Event 3: Order Sent to Kitchen
-- Source: kitchen_queue table
-- This captures when the kitchen starts working on the order
SELECT
    k.order_id AS case_id,
    k.queue_entry_time AS timestamp,
    'Order Sent to Kitchen' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    NULL AS driver,
    NULL AS payment_method
FROM kitchen_queue k
JOIN orders o ON k.order_id = o.id
WHERE k.queue_entry_time >= '2025-01-01'

UNION ALL

-- Event 4: Order Ready
-- Source: kitchen_queue table (different timestamp field)
-- This is an inferred event based on when the kitchen marked it complete
SELECT
    k.order_id AS case_id,
    k.completed_time AS timestamp,            -- Different timestamp than entry
    'Order Ready' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    NULL AS driver,
    NULL AS payment_method
FROM kitchen_queue k
JOIN orders o ON k.order_id = o.id
WHERE k.completed_time >= '2025-01-01'
  AND k.completed_time IS NOT NULL            -- Only include completed orders

UNION ALL

-- Event 5: Assigned to Driver
-- Source: delivery_assignments table
-- This captures when a driver is assigned to deliver the order
SELECT
    d.order_id AS case_id,
    d.assigned_at AS timestamp,
    'Assigned to Driver' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    d.driver_name AS driver,                  -- Event-specific attribute
    NULL AS payment_method
FROM delivery_assignments d
JOIN orders o ON d.order_id = o.id
WHERE d.assigned_at >= '2025-01-01'

UNION ALL

-- Event 6: Delivery Completed
-- Source: delivery_assignments table (different timestamp field)
-- This captures when the order was delivered to the customer
SELECT
    d.order_id AS case_id,
    d.delivered_at AS timestamp,
    'Delivery Completed' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    d.driver_name AS driver,
    NULL AS payment_method
FROM delivery_assignments d
JOIN orders o ON d.order_id = o.id
WHERE d.delivered_at >= '2025-01-01'
  AND d.delivered_at IS NOT NULL              -- Only include completed deliveries

-- Final ordering: by case, then by time
-- This makes the event log easy to read and follow
ORDER BY case_id, timestamp;
Zapytanie wykorzystuje identyfikator zamówienia jako identyfikator sprawy i zwraca te same siedem kolumn dla każdej aktywności. Wartości NULL zapewniają spójną strukturę kolumn, gdy dany atrybut nie ma zastosowania. Filtr daty i warunek pomyślnej płatności to przykłady. Wybierz filtry odpowiednie dla analizowanego procesu i okresu.
Rozbudowa zapytania. Aby dodać kolejną aktywność:
- Skopiuj blok
SELECTi użyj go jako punktu wyjścia. - Wybierz tabelę źródłową, w której zapisywane jest zdarzenie.
- Wybierz pole zawierające znacznik czasu zdarzenia.
- Nadaj aktywności nazwę spójną z nazwami pozostałych wierszy.
- Uwzględnij identyfikator sprawy i potrzebne atrybuty.
- Dodaj filtry odpowiednie do analizy.
Na przykład próbę dostawy można dodać w ten sposób, jeśli w systemie znajdują się odpowiednia tabela i pola:
UNION ALL

-- Event 7: Delivery Attempted
-- Add this to track failed delivery attempts
SELECT
    d.order_id AS case_id,
    d.attempt_time AS timestamp,
    'Delivery Attempted' AS activity,
    o.customer_name AS customer,
    o.total_amount AS order_value,
    d.driver_name AS driver,
    NULL AS payment_method
FROM delivery_attempts d
JOIN orders o ON d.order_id = o.id
WHERE d.attempt_time >= '2025-01-01'
Kontrola dziennika przed analizą
Przed analizą dziennika wykonaj poniższe kontrole. Obejmują one najczęstsze problemy z danymi w dzienniku zdarzeń, które mogą prowadzić do mylących wyników process mining: duplikaty, brakujące znaczniki czasu, niestabilne identyfikatory spraw oraz pola statusu błędnie uznane za aktywności.
- Zacznij od wymaganych kolumn. Utwórz niewielki dziennik zawierający identyfikator sprawy, znacznik czasu i aktywność, zanim dodasz kolejne zdarzenia lub atrybuty.
- Stosuj stabilne identyfikatory spraw. Każde zdarzenie w ramach tej samej sprawy powinno mieć ten sam identyfikator. Nie używaj wartości, która zmienia się w trakcie procesu.
- Ujednolić nazwy aktywności. Wybierz jedną nazwę, na przykład „Złożenie zamówienia”, zamiast używać wymiennie określeń „Utworzenie zamówienia” i „Nowe zamówienie”.
- Sprawdź znaczniki czasu. Upewnij się, że wskazują moment wystąpienia zdarzenia, korzystają ze spójnej strefy czasowej i można je sortować jako daty oraz godziny.
- Sprawdź duplikaty i brakujące wartości. Zbadaj powtarzające się zdarzenia oraz wiersze bez identyfikatora sprawy, znacznika czasu lub aktywności.
- Udokumentuj sposób ekstrakcji. Zapisz tabele źródłowe, pola, filtry, datę ekstrakcji i przyjęte założenia. Ułatwi to aktualizowanie dziennika i rozwiązywanie problemów.
- Ostrożnie dodawaj atrybuty. Uwzględniaj pola przydatne do odpowiedzi na konkretne pytanie i sprawdź, czy łączenia tabel nie powielają wierszy zdarzeń.
Odpowiedzi na siedem częstych problemów z danymi, od zduplikowanych zdarzeń po brakujące identyfikatory spraw, znajdują się w sekcji FAQ na końcu strony. ETL w process mining opisuje, jak powtarzać te same czynności przy regularnej ekstrakcji danych.
Co zrobić, jeśli nie mają Państwo danych
Do przygotowania dziennika zdarzeń nie jest potrzebny gotowy konektor. Najpierw sprawdź, jakie dane można wyeksportować z systemu i czy eksport zawiera trzy wymagane pola.
- Określ proces i identyfikator sprawy, którą chcesz śledzić.
- Sprawdź, czy system pozwala wyeksportować historię zdarzeń, rejestry audytowe lub zmiany statusu ze znacznikami czasu.
- Użyj szablonu danych, aby przypisać dostępne pola do identyfikatora sprawy, znacznika czasu i aktywności.
- Jeśli nie można wyeksportować gotowej tabeli zdarzeń, poproś zespół ds. danych o wyciąg z bazy lub raport zawierający jeden wiersz na zdarzenie.
Eksport z systemu może zawierać kilka tabel albo różne nazwy tego samego pola. Dane można połączyć i zmienić ich nazwy w Excelu lub SQL, pod warunkiem że zachowają swoje znaczenie i będzie można prześledzić ich pochodzenie. Gdzie znaleźć dane do process mining opisuje inne miejsca, w których mogą znajdować się przydatne dane źródłowe. Z kolei przewodniki po ulepszaniu procesów zawierają już kroki od 1 do 3 dla danego systemu oraz szablon danych dla każdego procesu.
Jeśli chcą Państwo porównać formaty z innym przykładem dziennika zdarzeń do process mining, w zbiorze przykładowych plików dzienników i szablonów znajduje się gotowy arkusz. Na stronie szablon dziennika zdarzeń wymieniono wymagane i opcjonalne kolumny. Instrukcję dotyczącą pierwszego zbioru danych zawiera strona wczytaj pierwszy zbiór danych.
Wczytaj przygotowany dziennik
Gdy dziennik będzie gotowy, wczytaj plik i przypisz trzy wymagane kolumny. ProcessMind bezpośrednio odczytuje pliki Excel, CSV oraz wyciągi z baz danych.
- Prześlij plik lub wybierz wyciąg z bazy danych.
- Przypisz kolumny identyfikatora sprawy, znacznika czasu i aktywności.
- Sprawdź dodatkowe atrybuty.
- Wygeneruj widok procesu i sprawdź, czy sprawy oraz kolejność zdarzeń są prawidłowe.
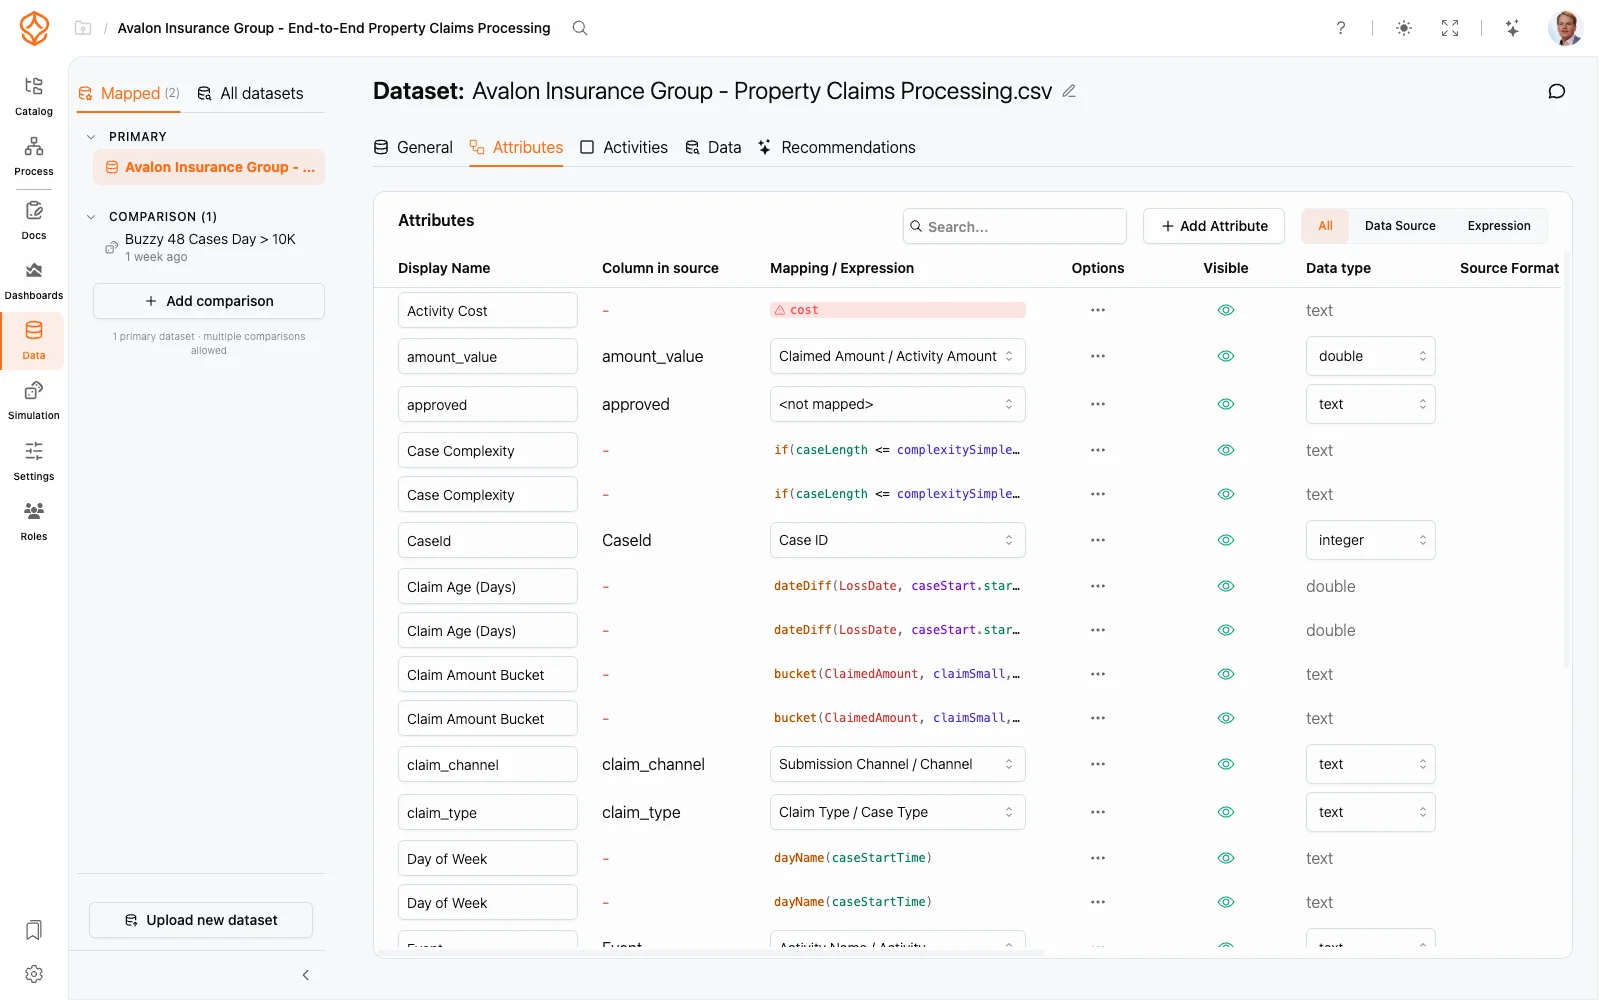
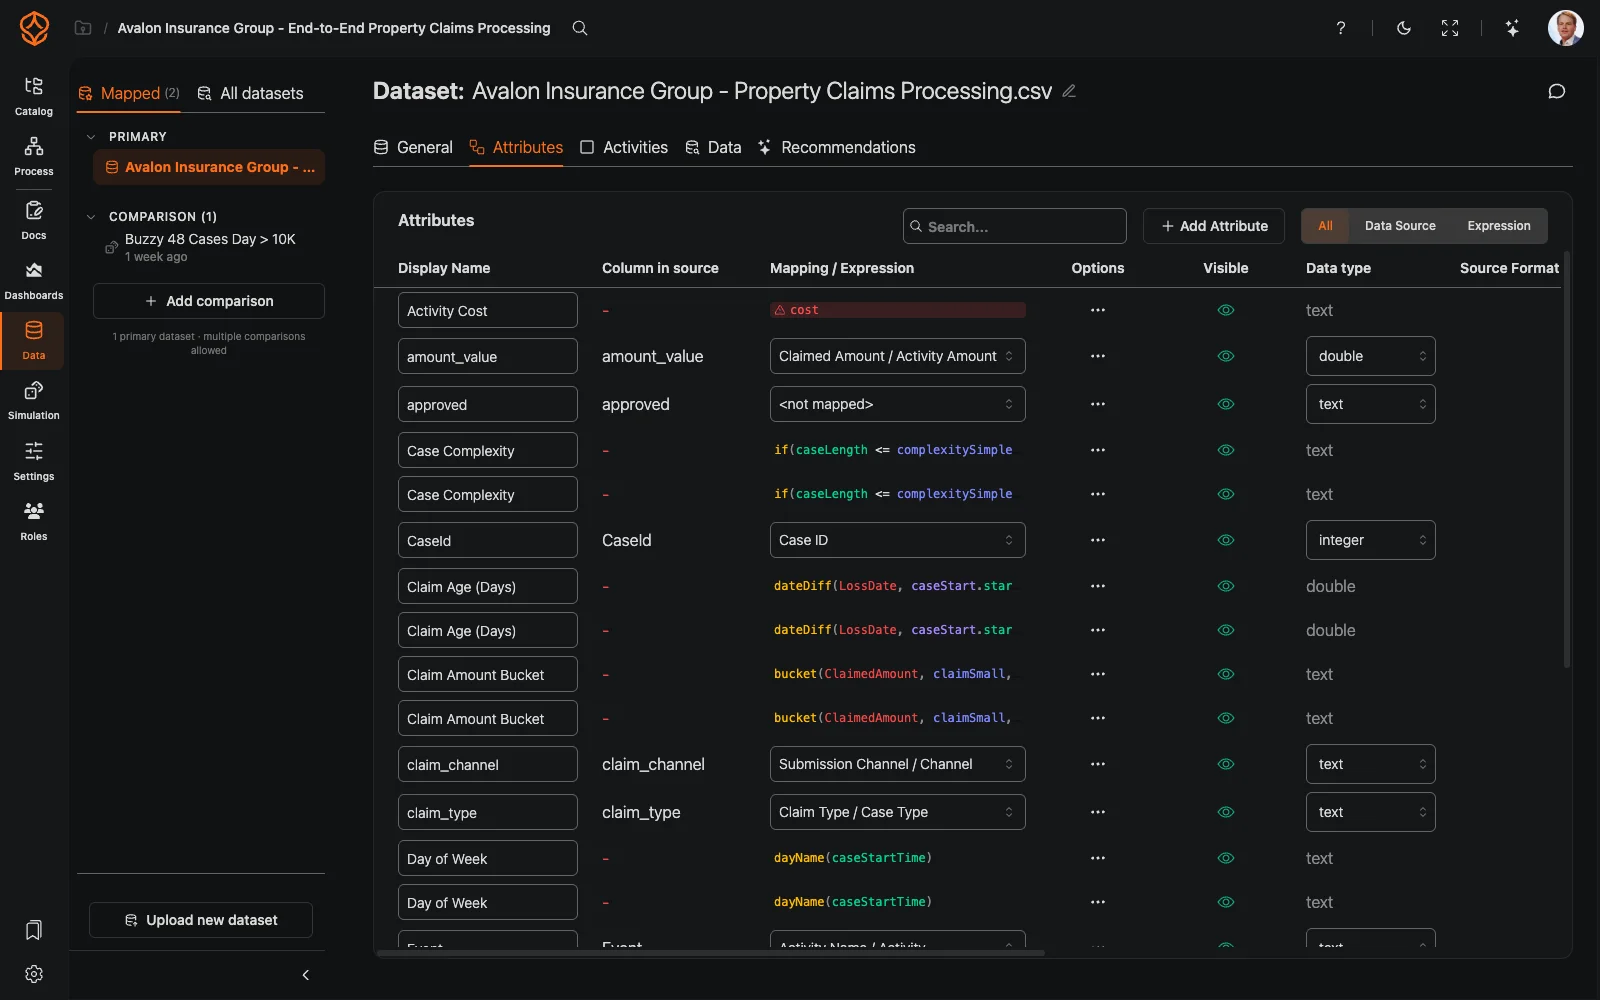
Widok procesu może pomóc wykryć brakujące aktywności, nieoczekiwane sekwencje i obszary wymagające zbadania. Nie poprawia danych źródłowych ani nie zmienia sposobu wykonywania pracy. Jeśli pierwszy wynik ujawni problem z danymi, zaktualizuj wyciąg i wczytaj go ponownie. Wczytaj pierwszy zbiór danych zawiera szczegółową instrukcję przesyłania pliku i przypisywania kolumn.
Where to Go From Here
Mają już Państwo dziennik zdarzeń albo trzy potrzebne do jego utworzenia kolumny. Kolejny krok to sprawdzenie, jak faktycznie przebiega proces.