Usprawnij zarządzanie problemami
6 kroków do optymalizacji procesów w Freshservice
Usprawnij zarządzanie problemami
Zarządzanie problemami
Freshservice

Wybierz proces

Wybierz proces, aby kontynuować pracę w połączonym obszarze roboczym.

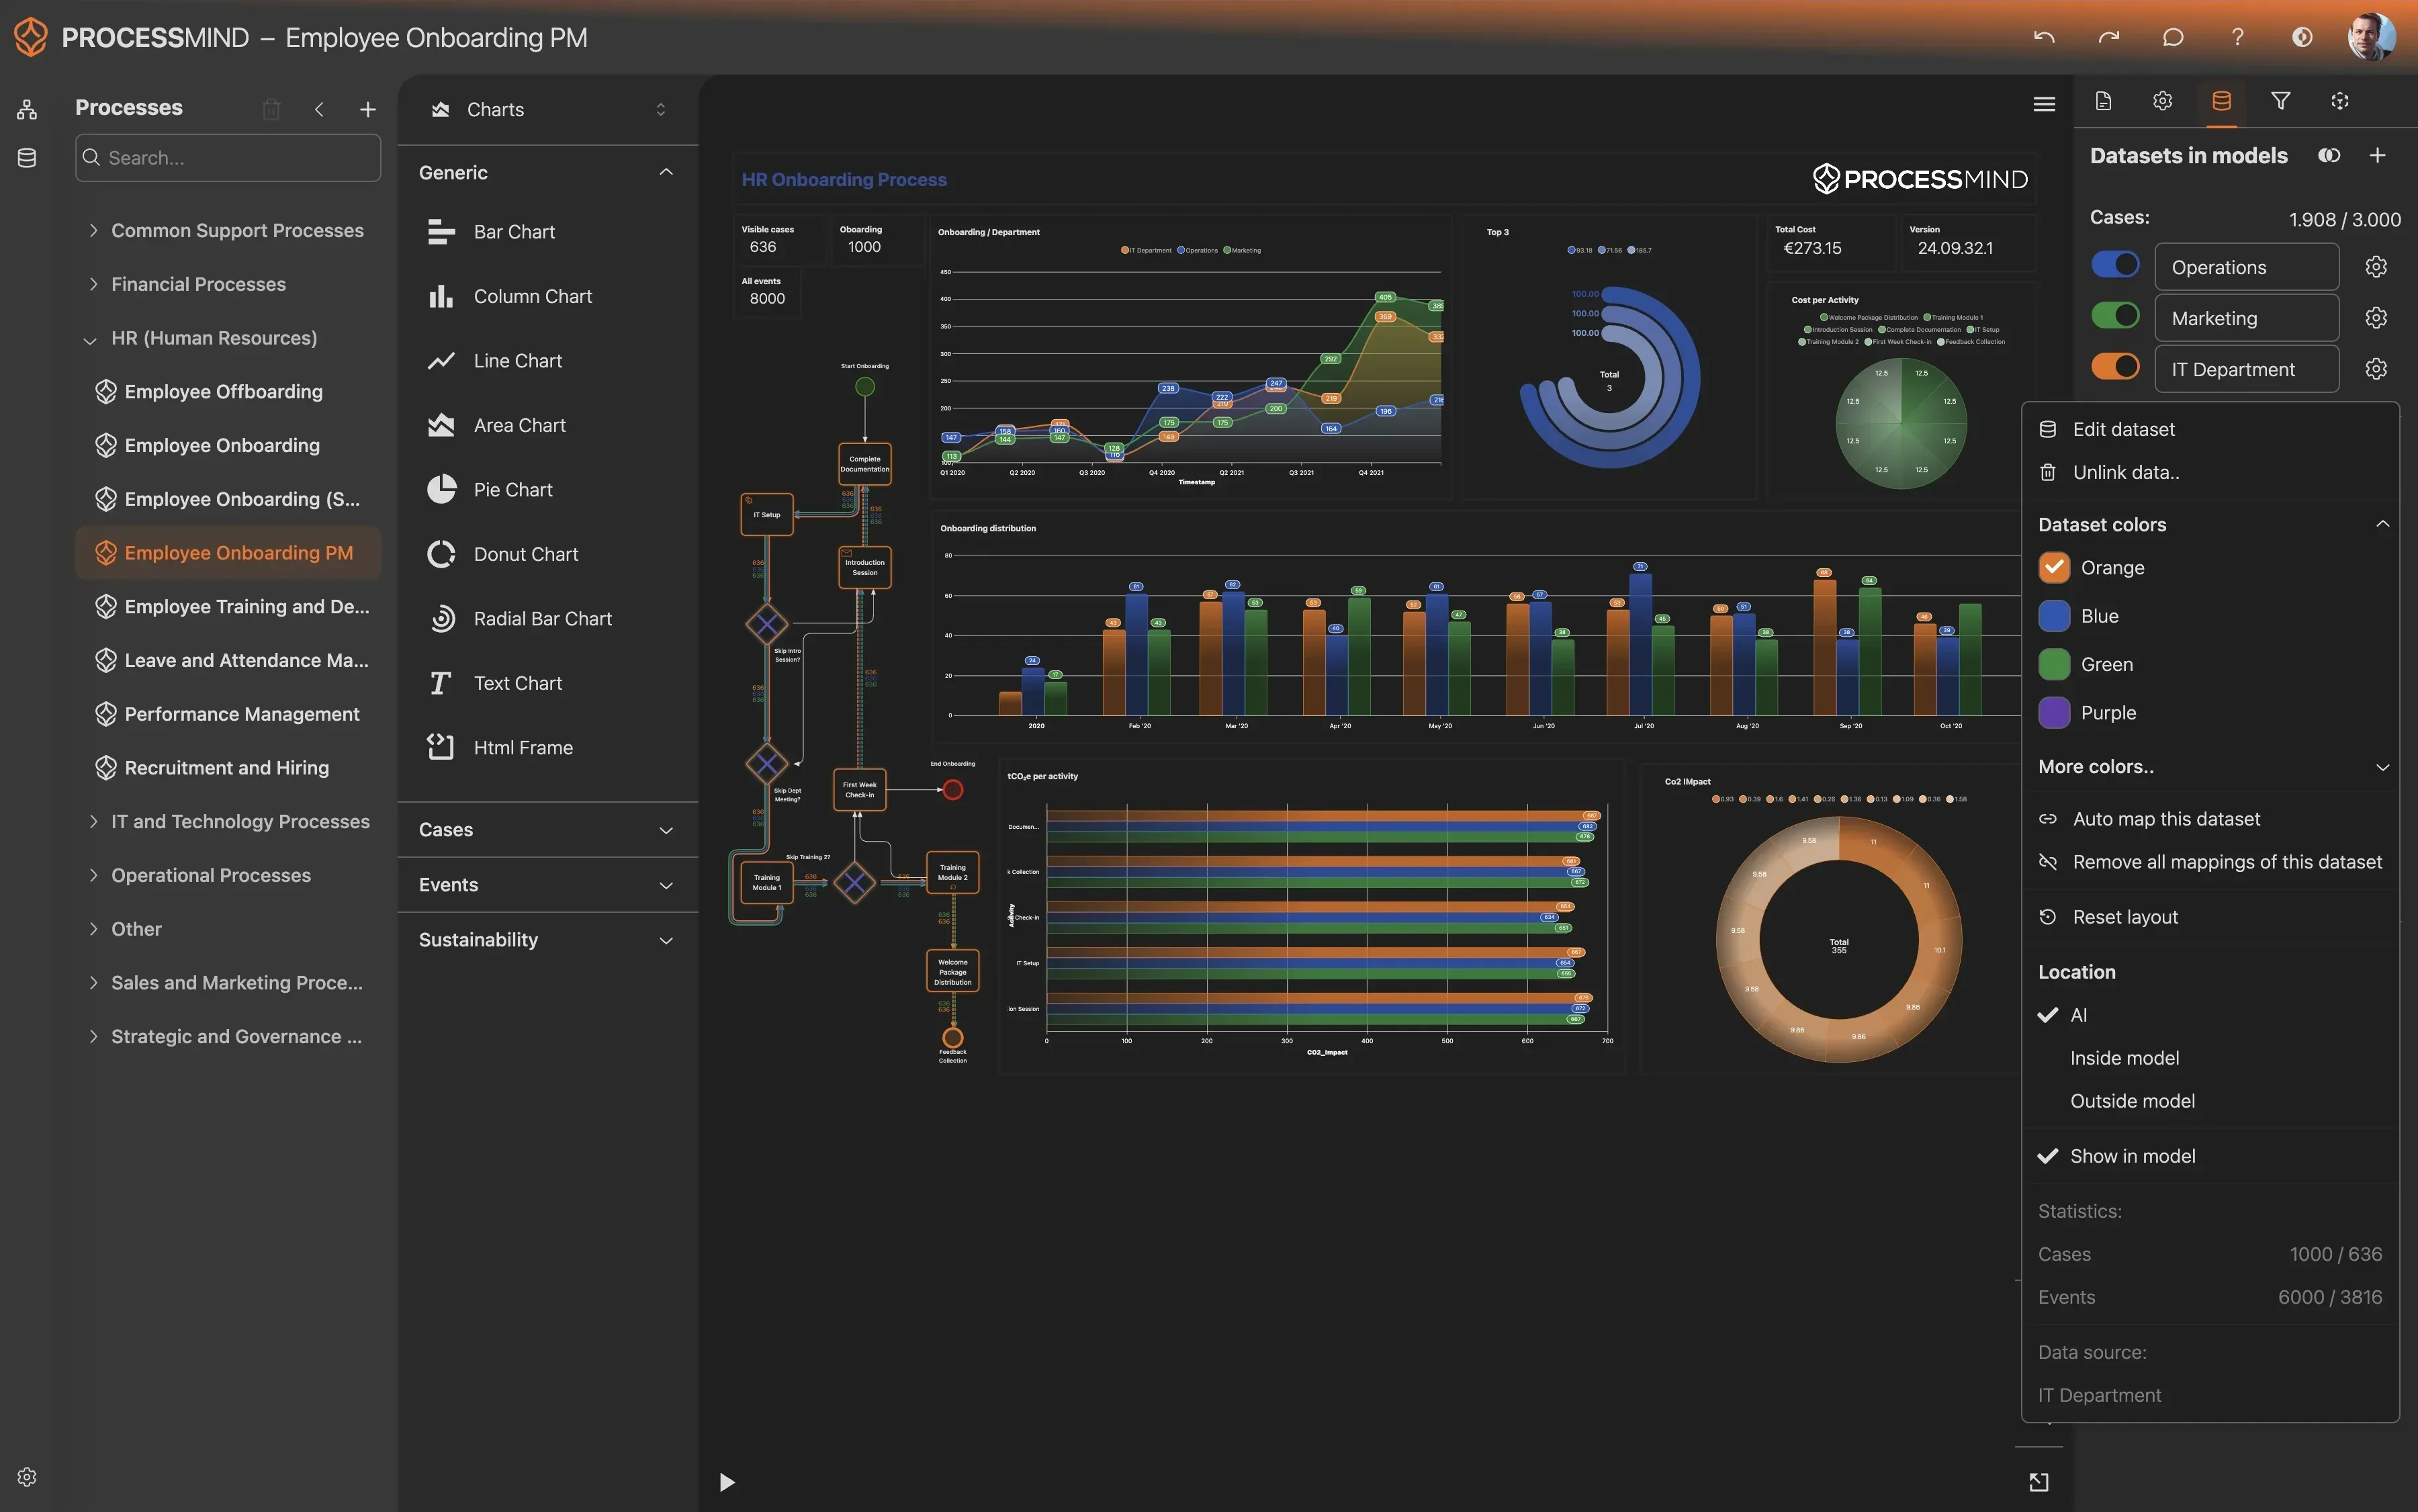
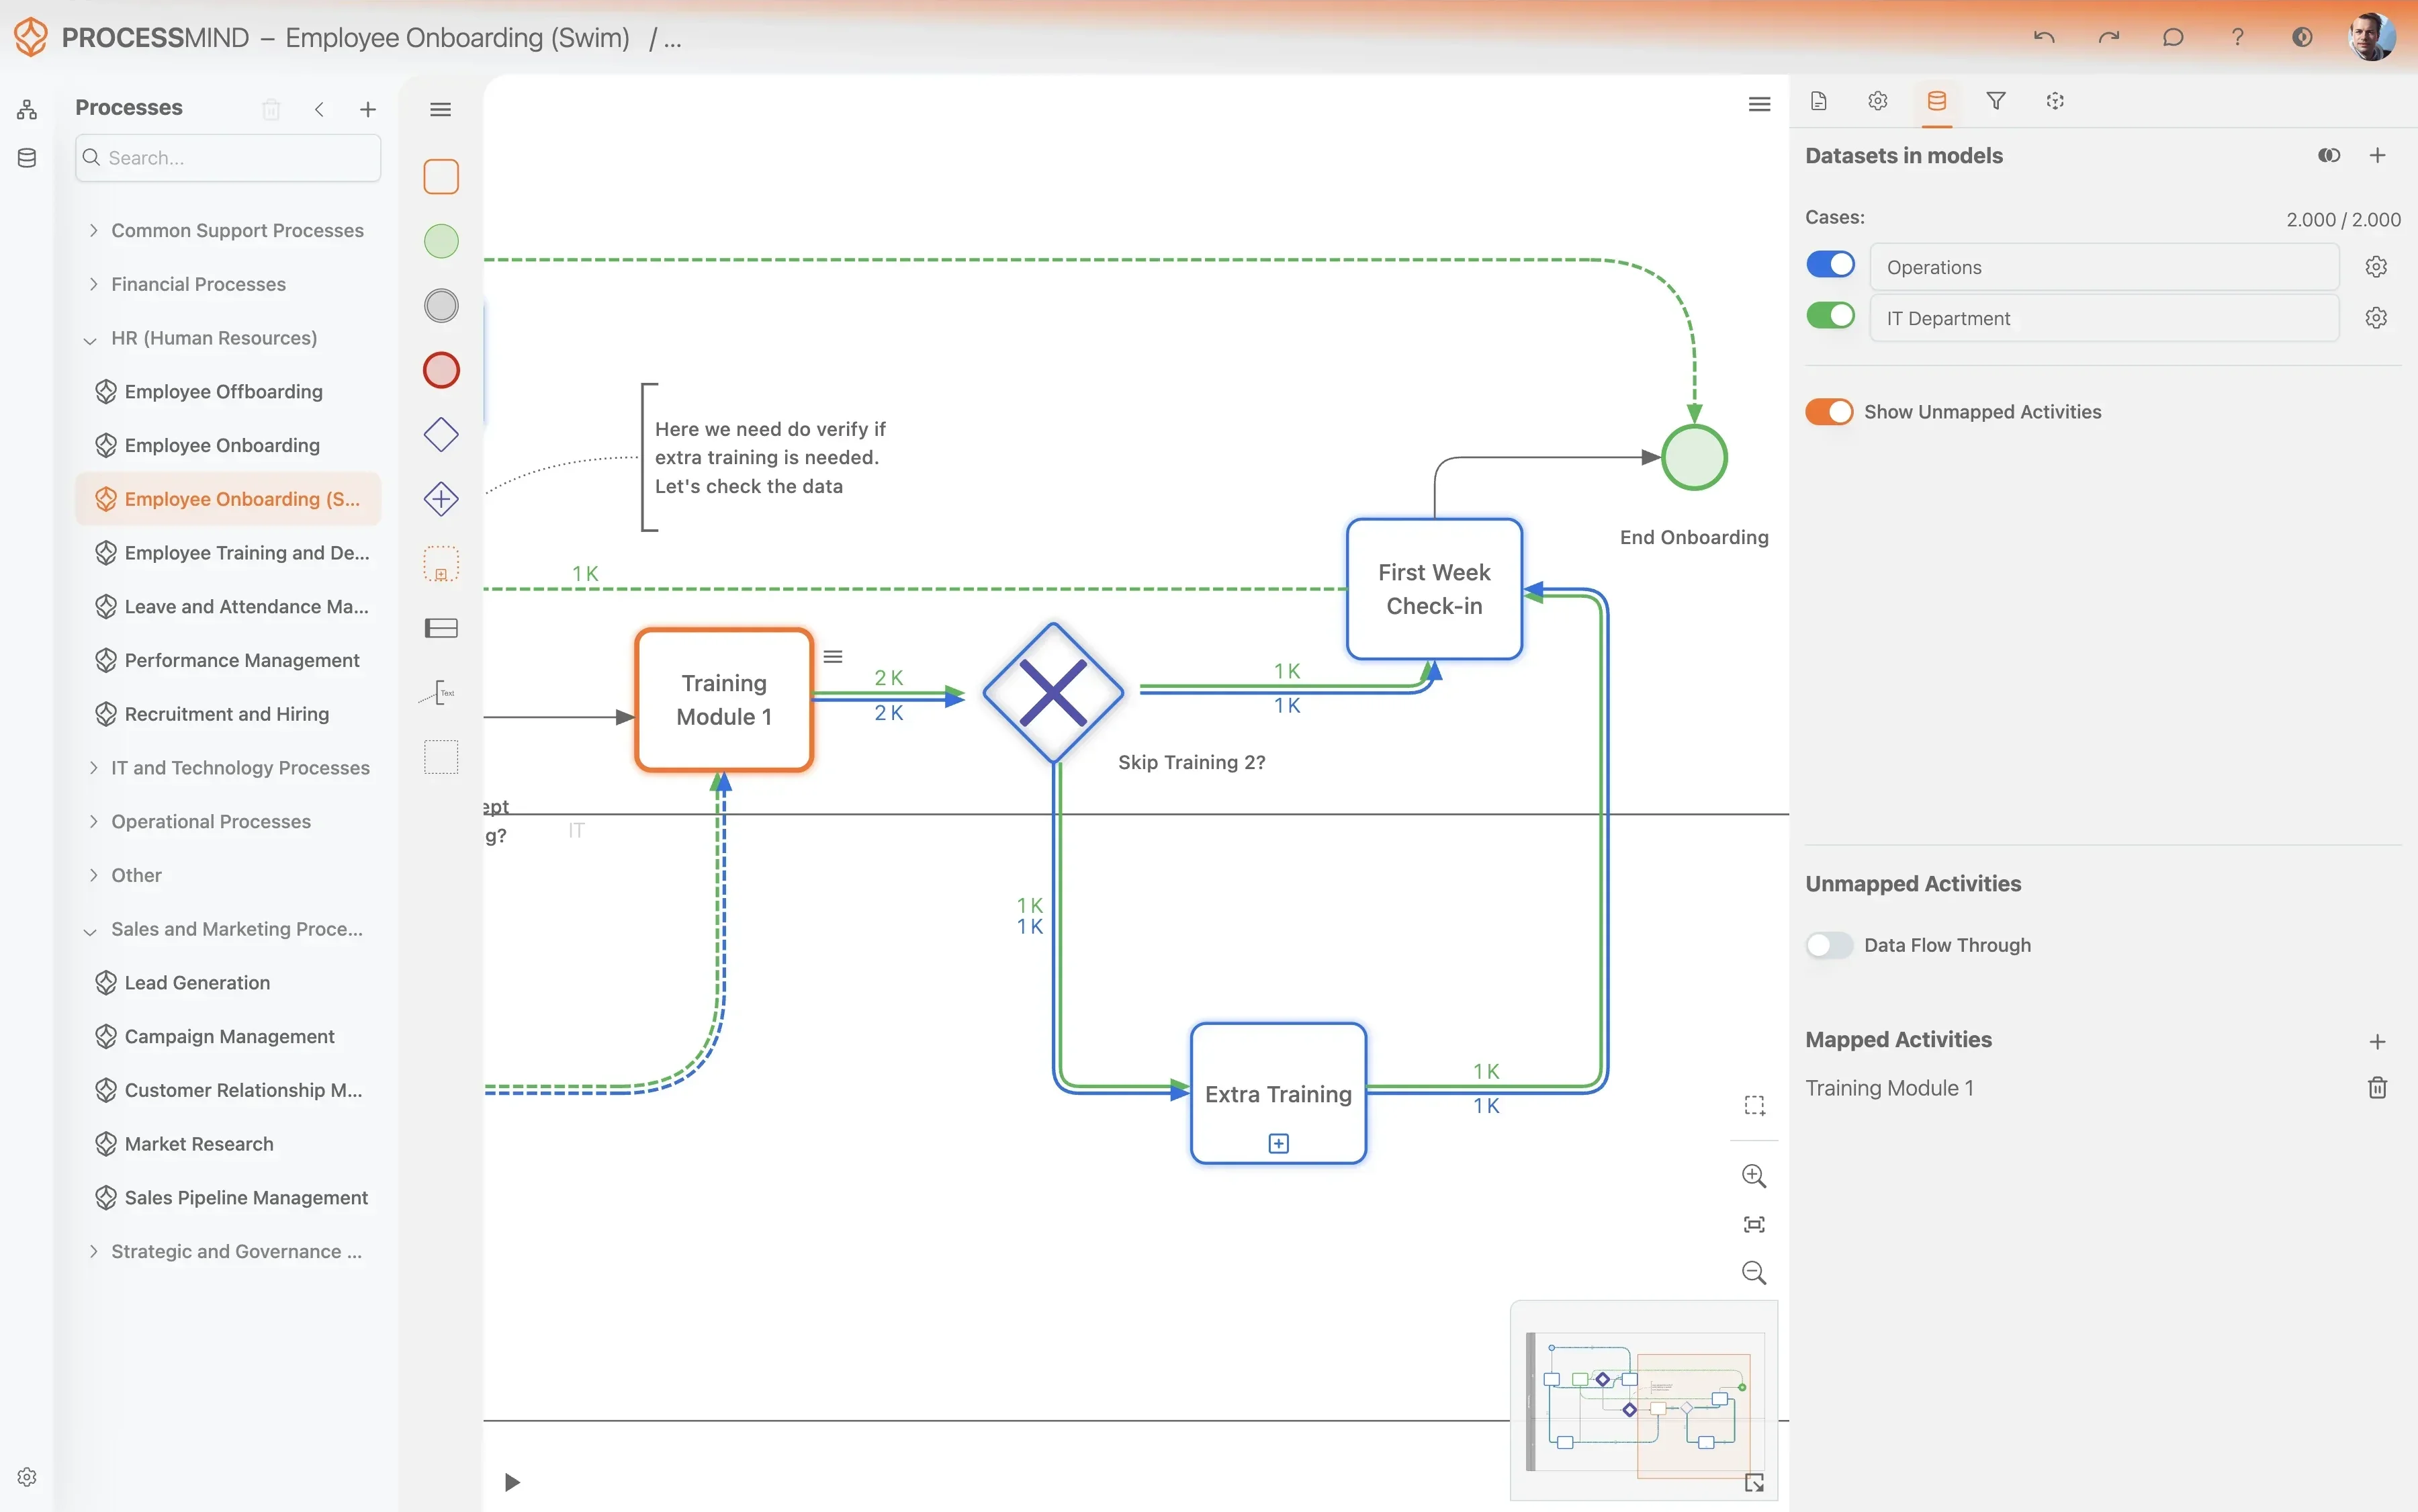
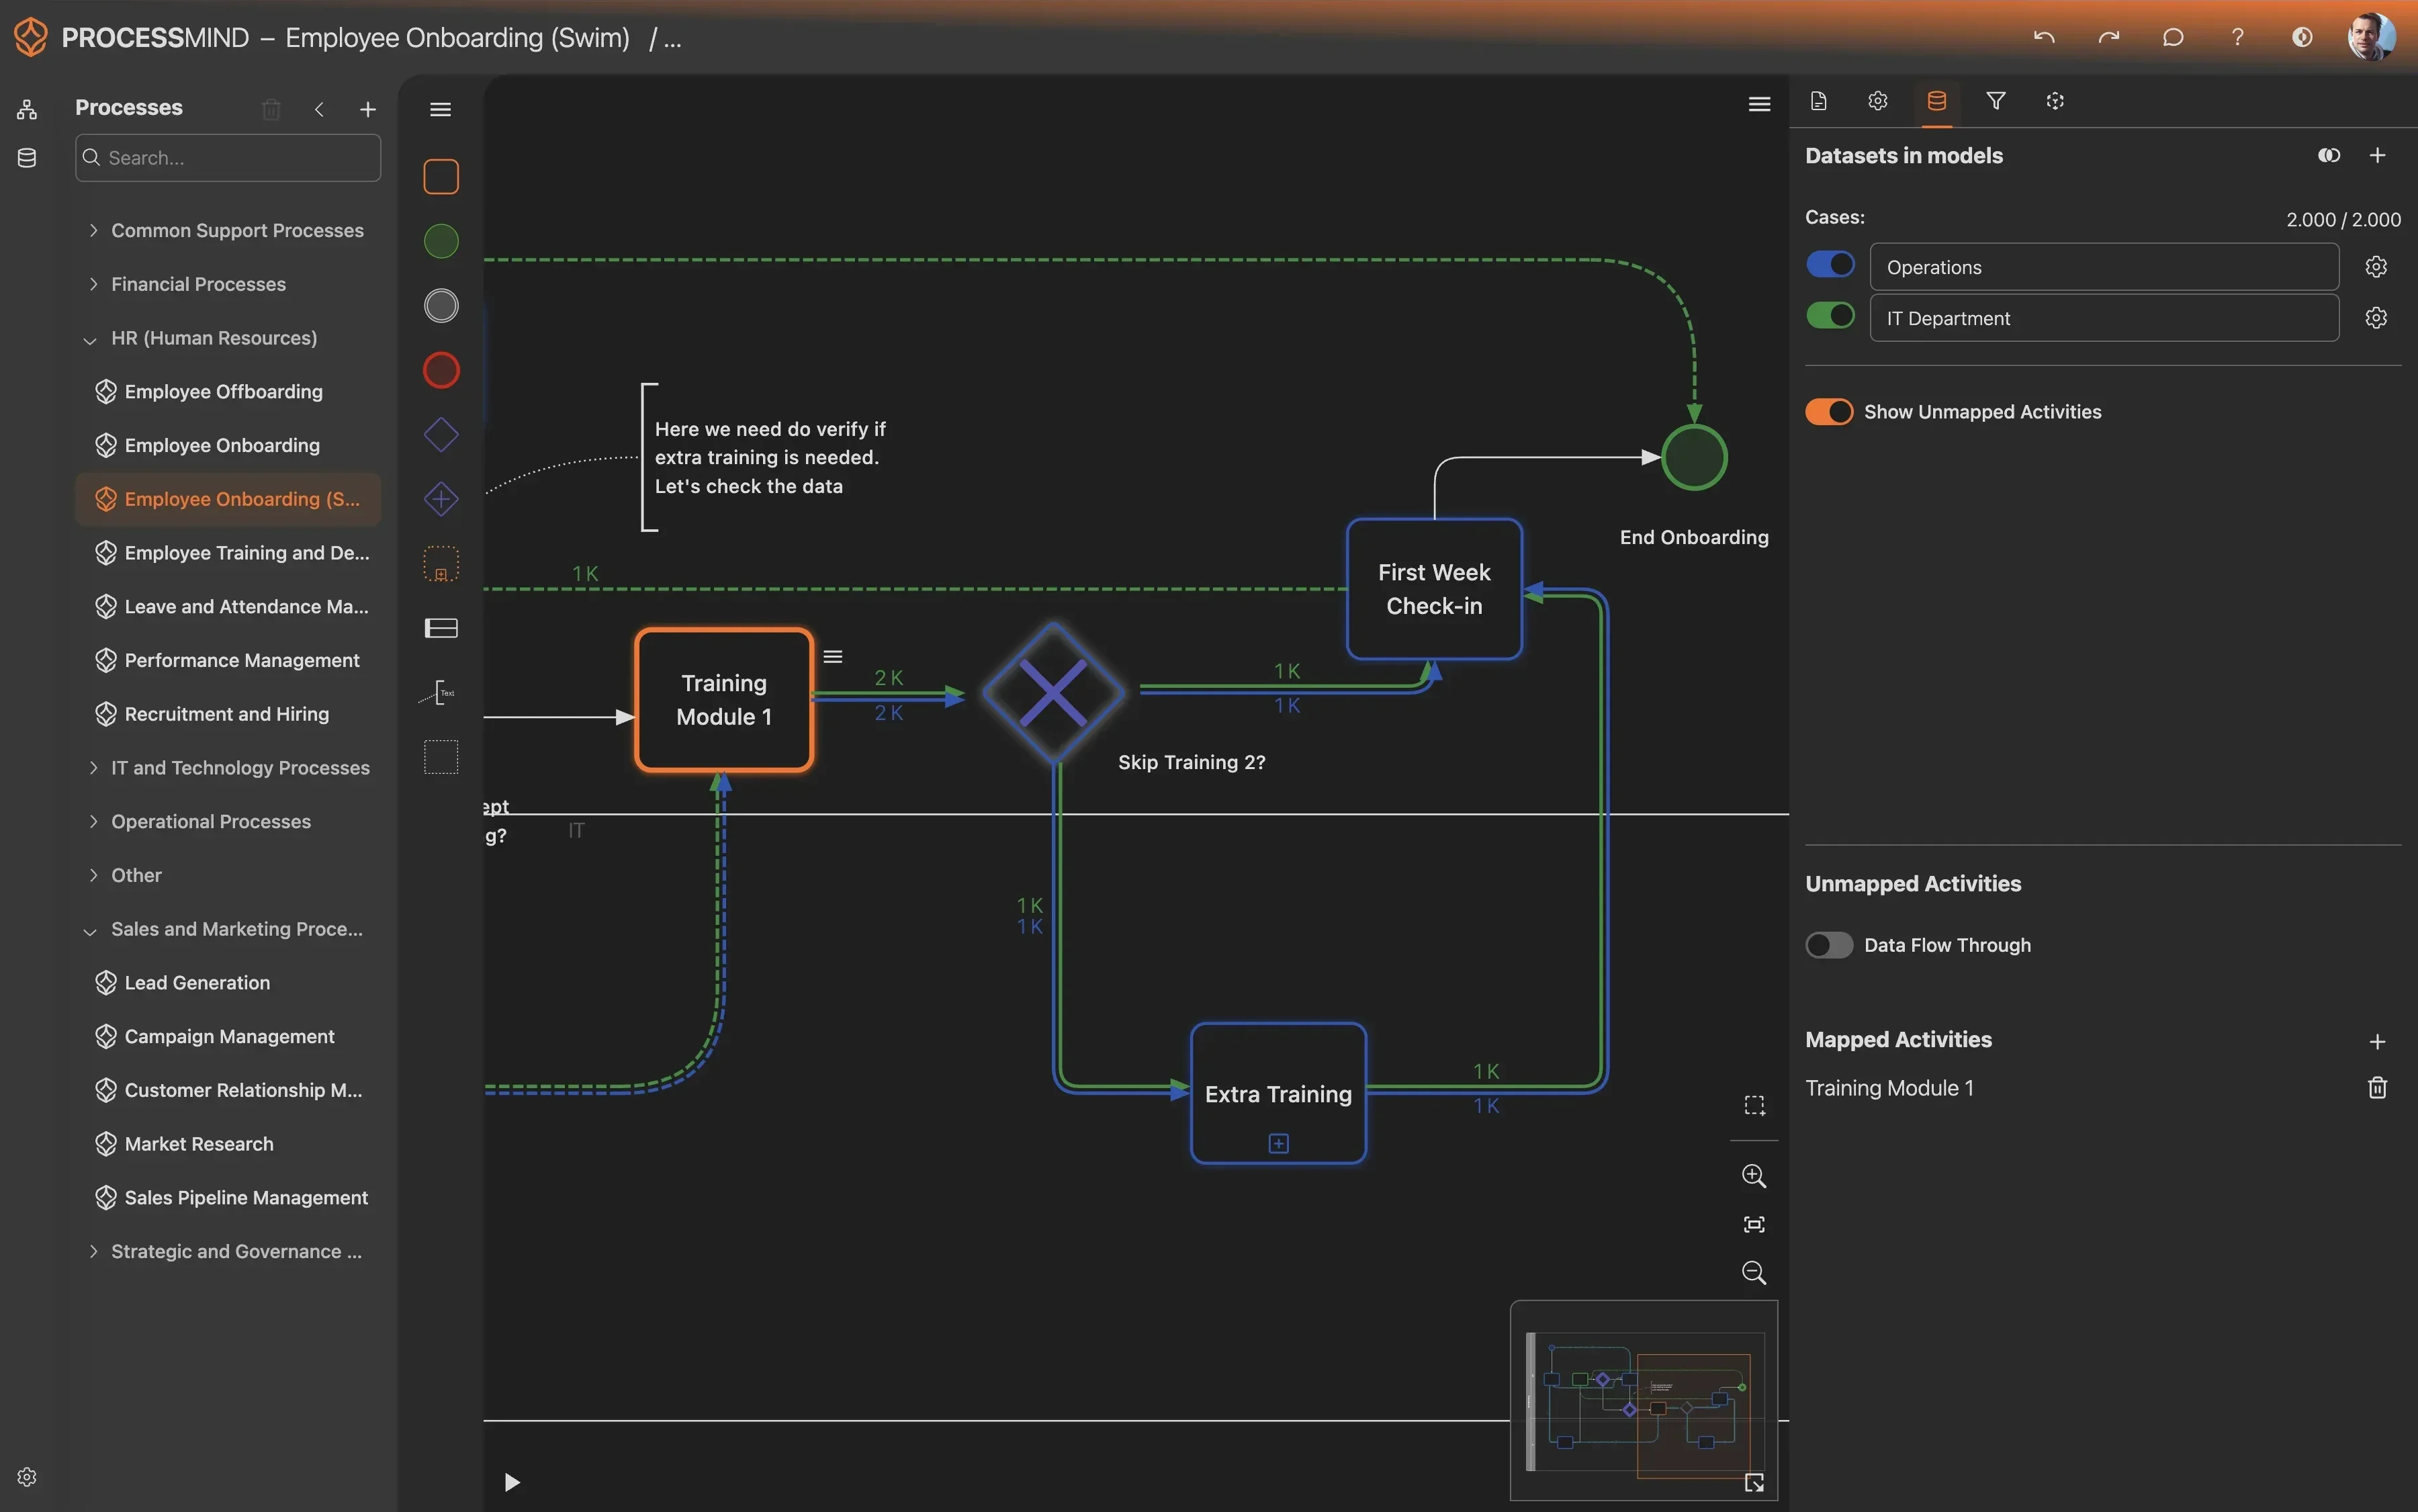
Usprawnij zarządzanie problemami w Freshservice dzięki process mining

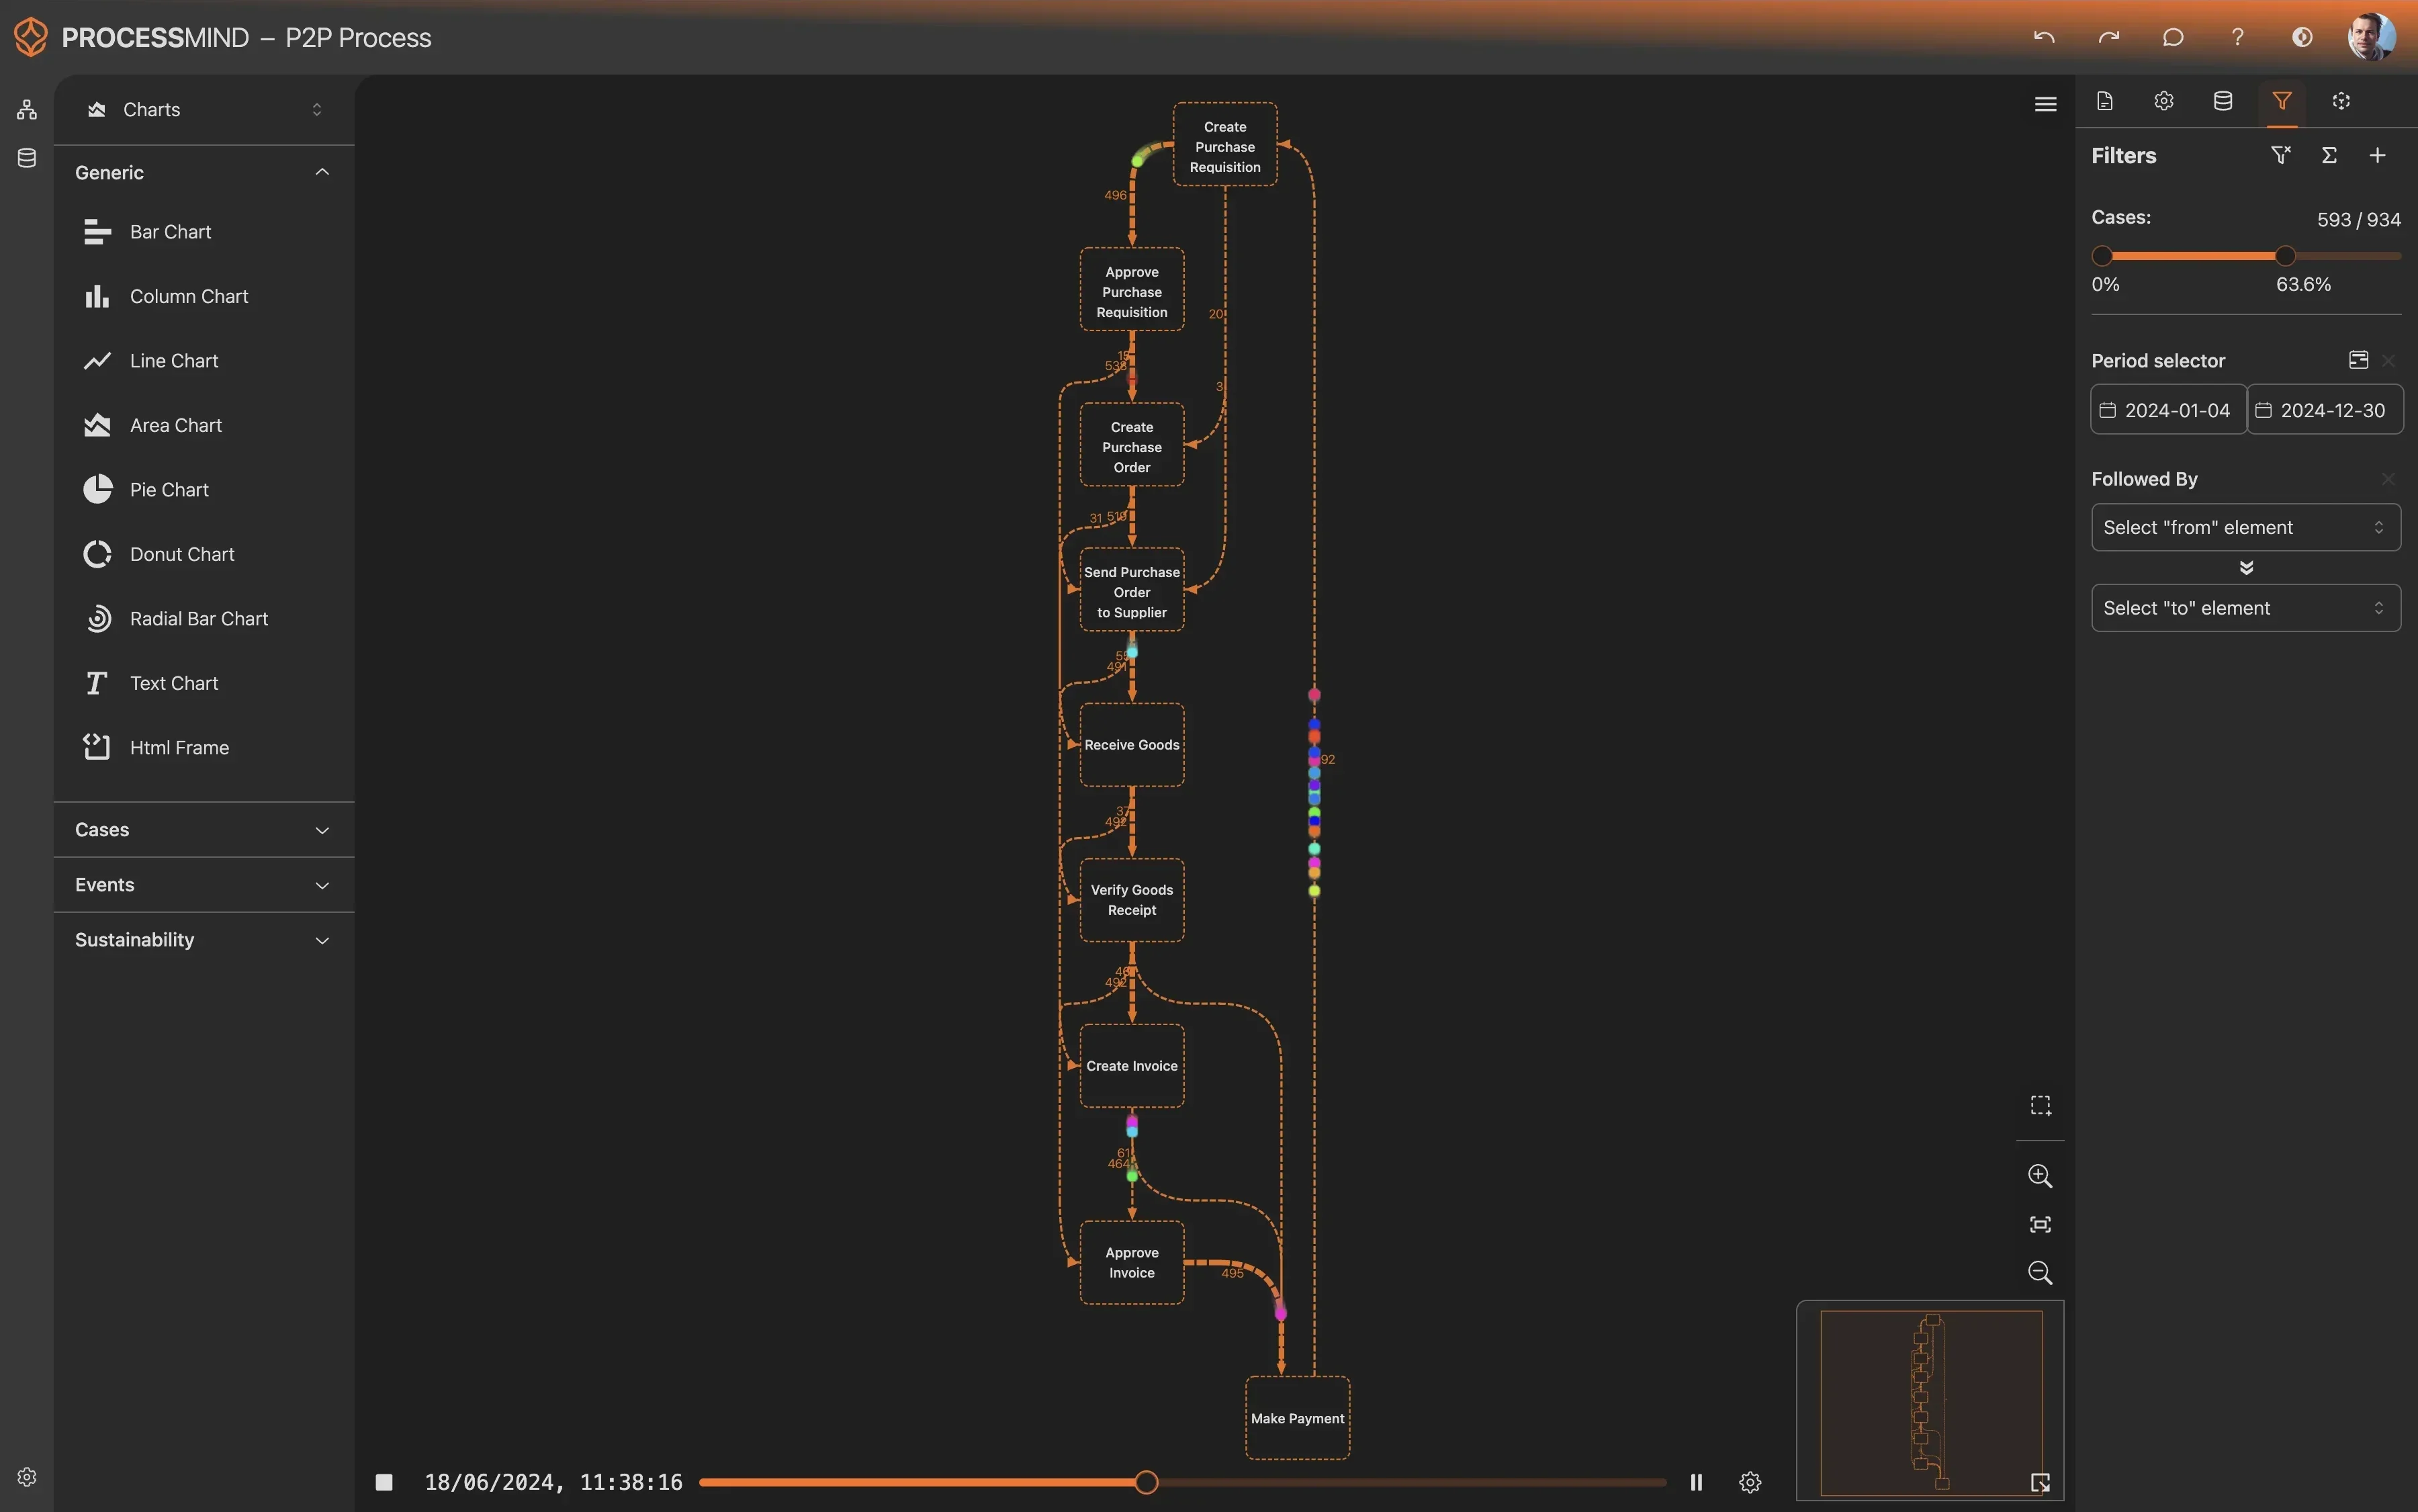
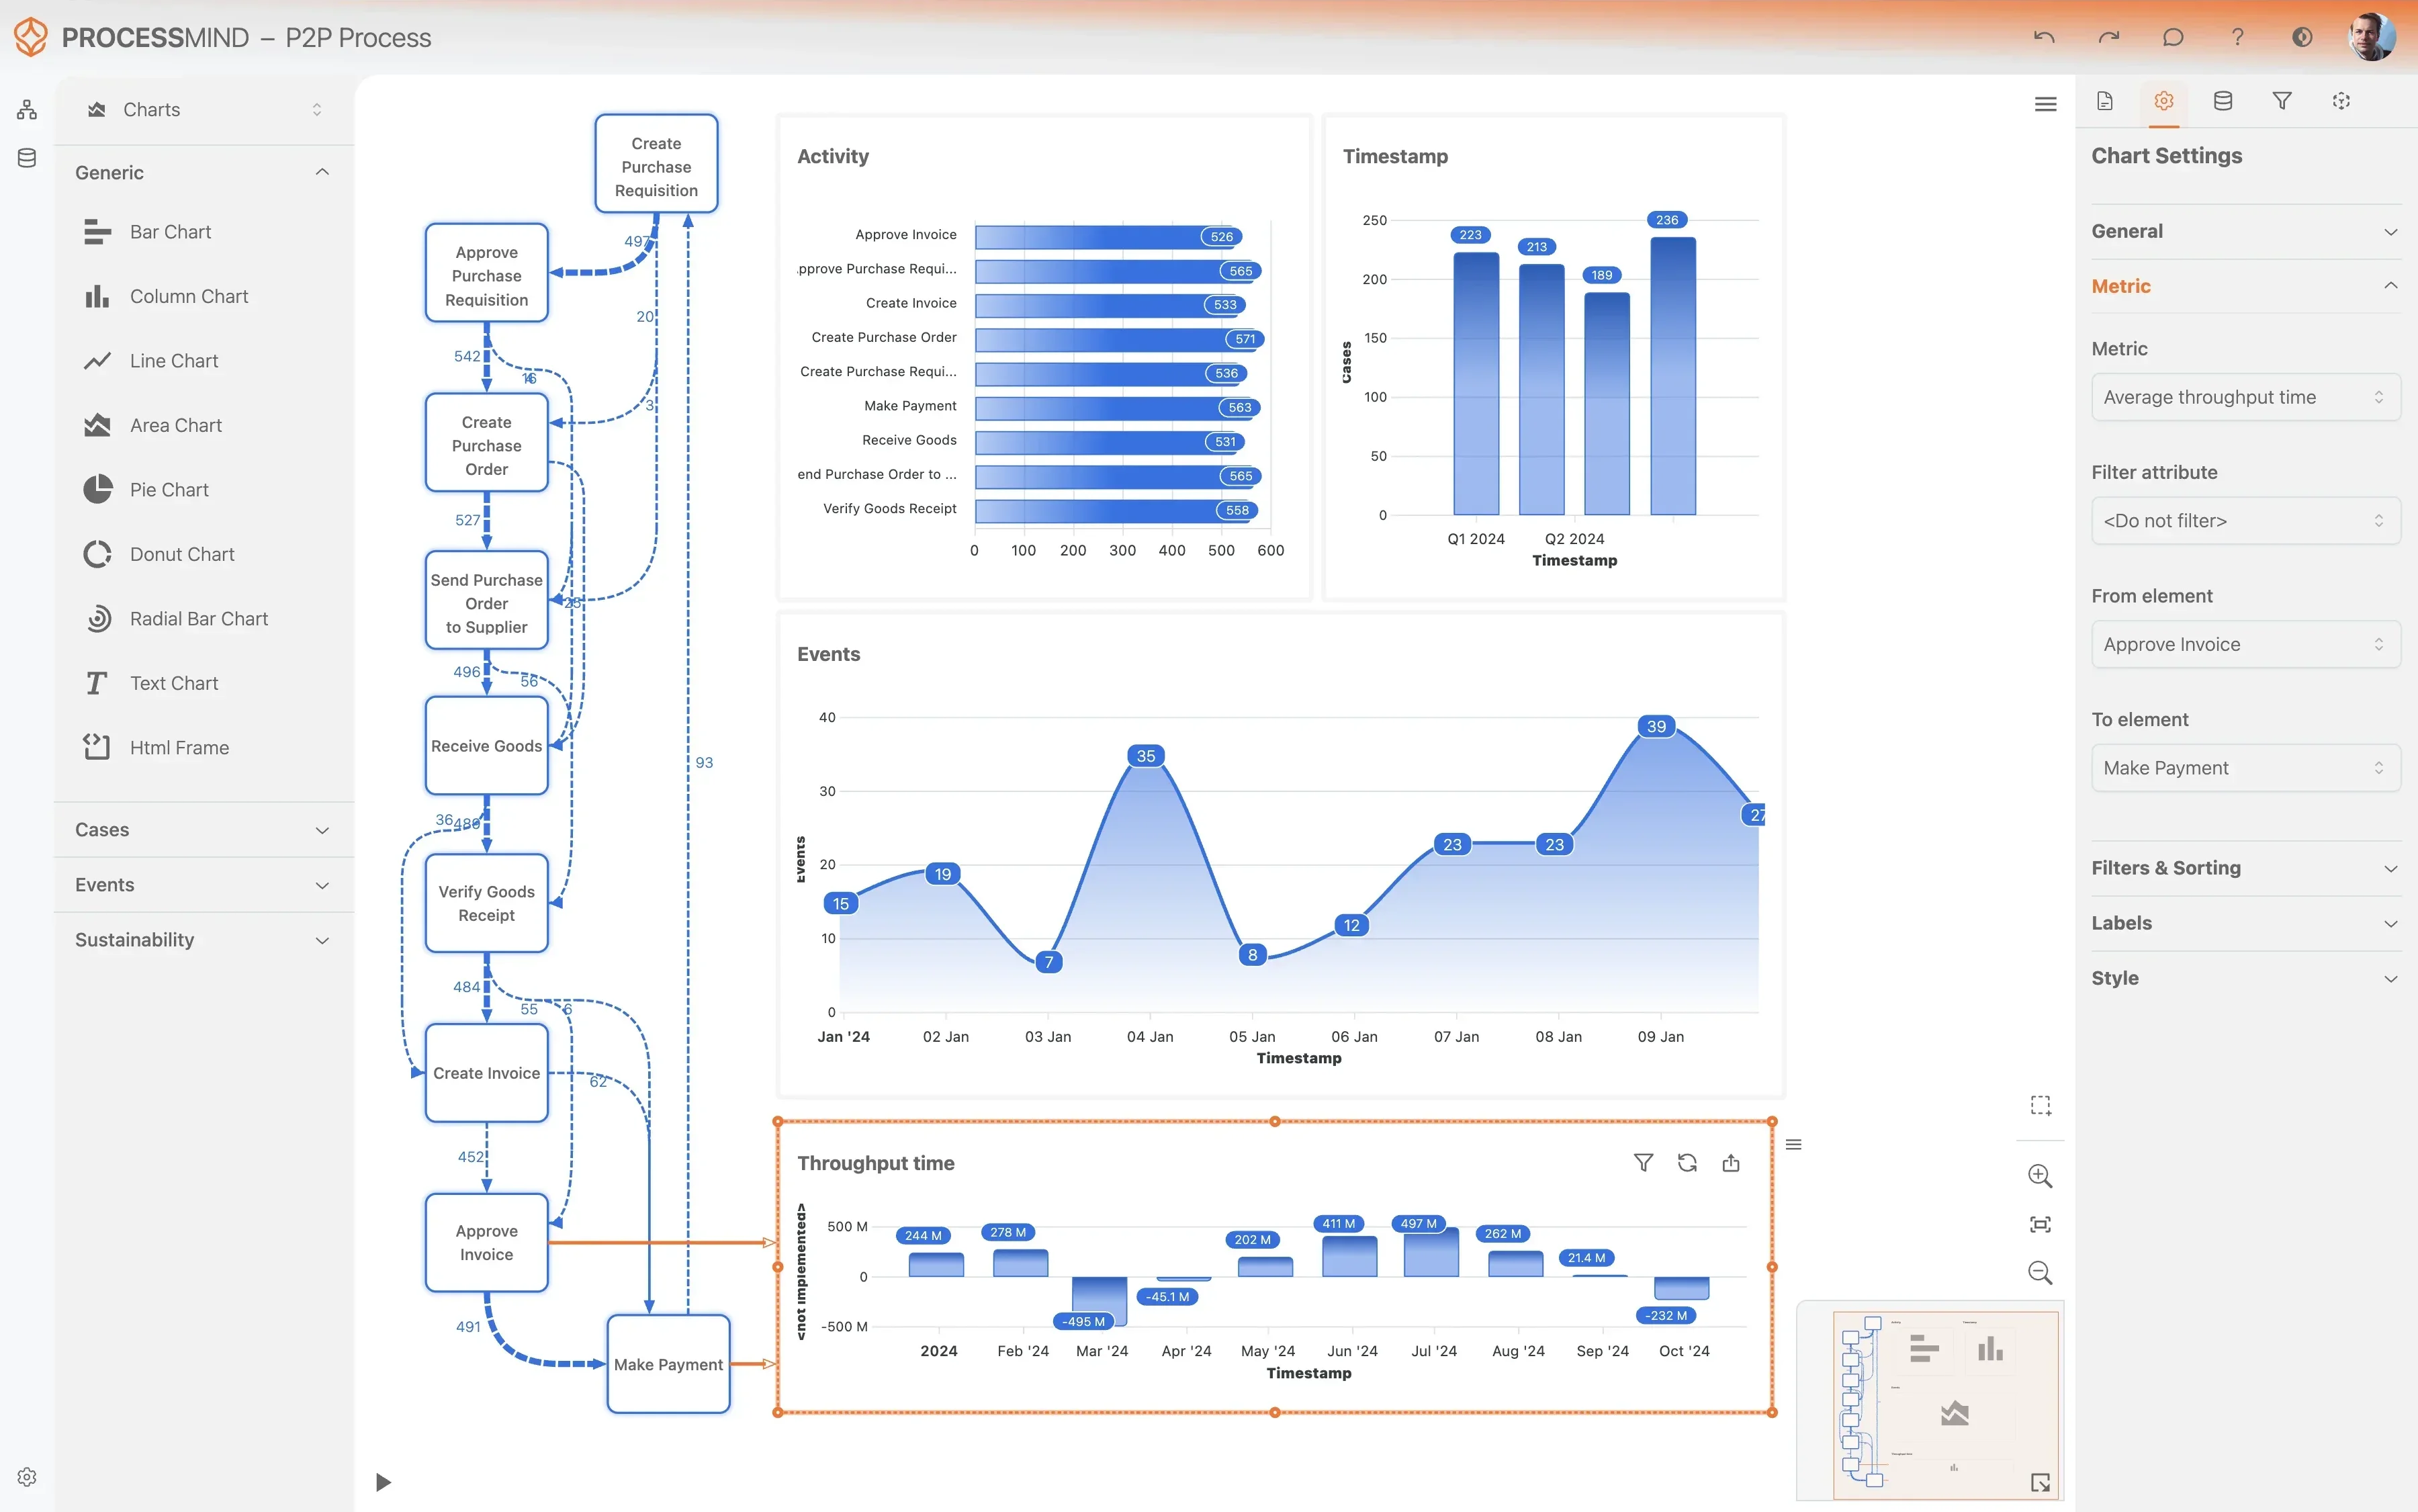
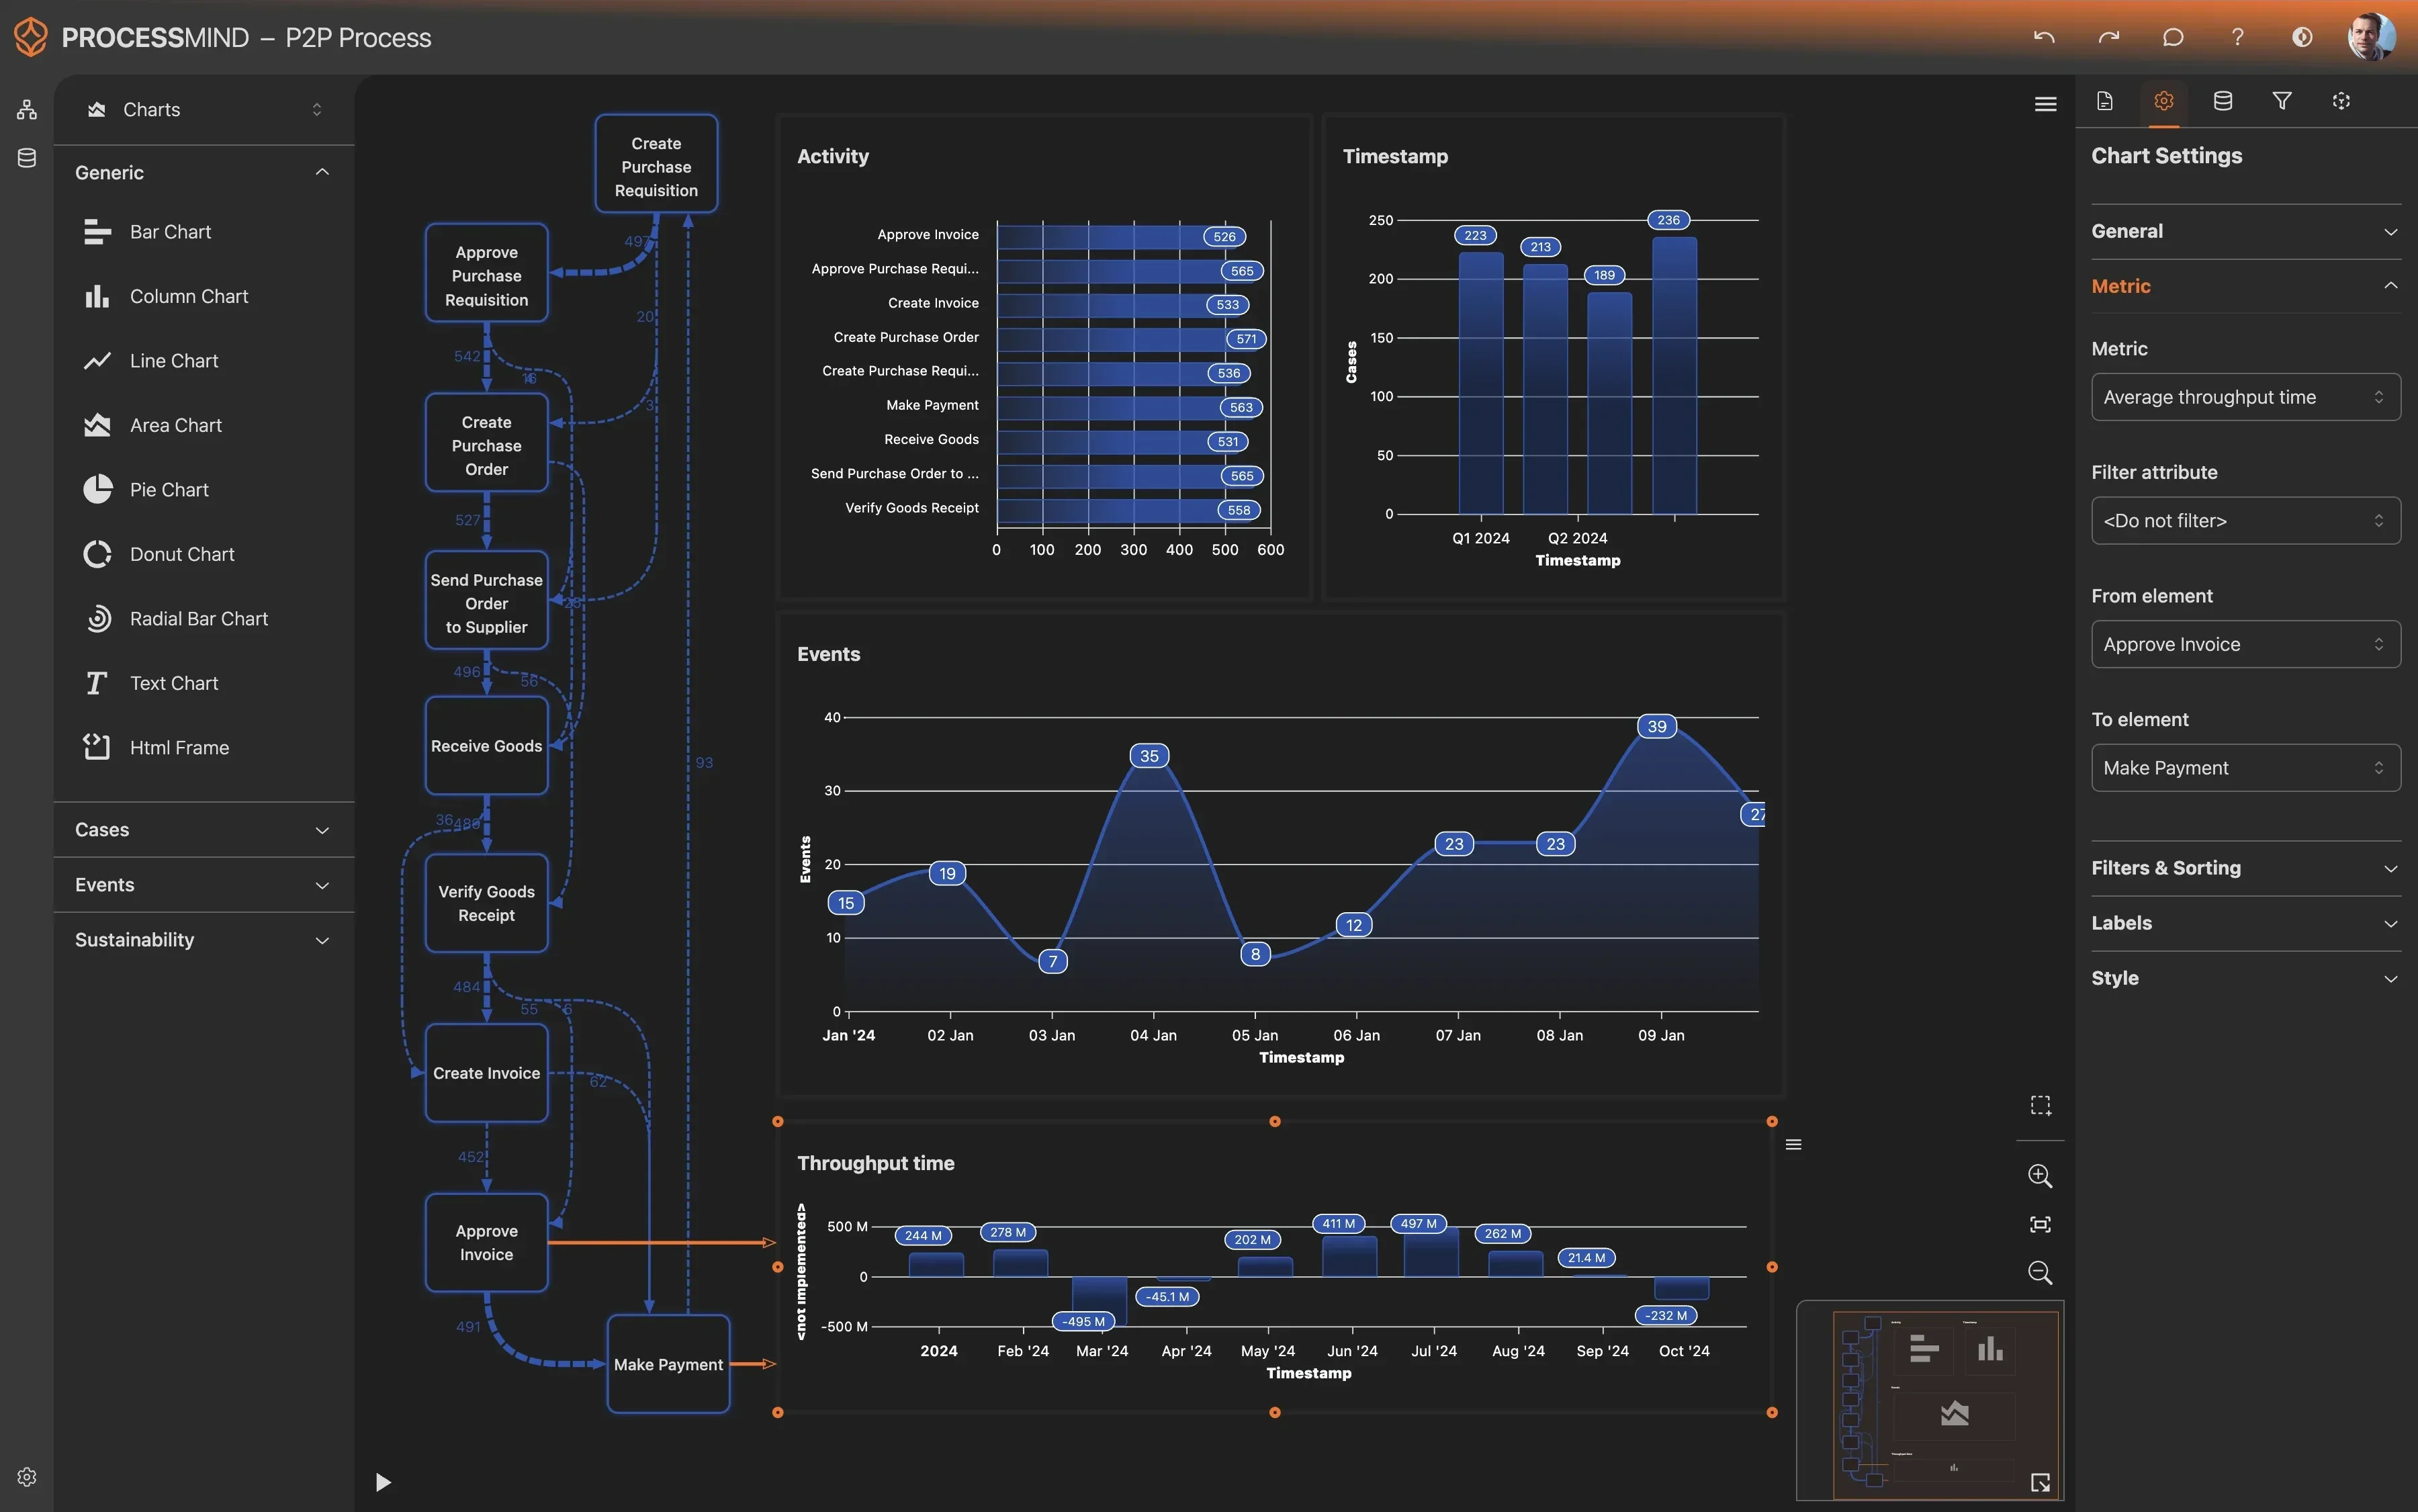
Nasza platforma ujawnia ukryte wąskie gardła i pokazuje, na jakich etapach najczęściej zatrzymują się analizy przyczyn źródłowych. Wizualizacja każdego kroku pozwala sprawdzić, gdzie powstają opóźnienia i jak niestandardowe ścieżki wpływają na świadczenie usług. Dzięki tym informacjom zespół może usprawnić workflow i skrócić czas obsługi powtarzających się incydentów.

Pobierz gotowy szablon danych i poznaj częste wyzwania, które utrudniają osiągnięcie celów efektywnościowych. Skorzystaj z planu doskonalenia w sześciu krokach oraz przewodnika po szablonie danych, aby usprawnić operacje.

Pokaż szczegółowy opis

Znaczenie sprawnego zarządzania problemami

Zarządzanie problemami wspiera wysoką jakość usług IT. Zarządzanie incydentami koncentruje się na szybkim przywróceniu działania, a zarządzanie problemami na trwałym rozwiązaniu przyczyn. W Freshservice zespoły mogą łatwo rejestrować i kategoryzować zgłoszenia. Trudność sprawiają jednak przekazania między poziomami wsparcia oraz przejście od tymczasowego obejścia do trwałej poprawki. Gdy proces przebiega powoli lub nieefektywnie, rośnie liczba powracających problemów, które obciążają zespoły techniczne i frustrują użytkowników końcowych.

Usprawnienie procesu nie polega wyłącznie na szybszym zamykaniu zgłoszeń. Chodzi o to, by analiza przyczyn źródłowych prowadziła do mierzalnego ograniczenia zakłóceń w działaniu usług. Analiza przebiegu i przyczyn problemów pomaga odejść od ciągłego reagowania na awarie na rzecz zapobiegania przestojom. Wymaga to zrozumienia, jak informacje przepływają przez Freshservice i na których etapach analiza najczęściej się zatrzymuje.

Dane Freshservice jako podstawa analizy

Process mining odtwarza przebieg każdego rekordu problemu w Freshservice. Zamiast statycznych średnich i prostych wykresów słupkowych można zobaczyć rzeczywiste ścieżki pracy zespołów technicznych. Łatwo wtedy ustalić, które sprawy pozostają bez działania przez kilka dni lub wielokrotnie trafiają między różnymi grupami wsparcia.

Taki obraz pozwala odróżnić złożone analizy, które wymagają czasu, od zbędnych opóźnień administracyjnych. Wizualizacja kolejności działań zastępuje przypuszczenia obiektywnymi danymi, które pomagają planować usprawnienia. Może się na przykład okazać, że najwięcej czasu upływa między zidentyfikowaniem problemu a przypisaniem go do grupy wsparcia. Wskazuje to na potrzebę lepszej wstępnej oceny lub automatyzacji w Freshservice.

Wykrywanie problemów w przebiegu analizy

Często warto przyjrzeć się czasowi, jaki upływa między znalezieniem obejścia a rozpoczęciem pełnej analizy. W wielu organizacjach po zastosowaniu tymczasowej poprawki spada presja na ustalenie przyczyny źródłowej. Process mining pokazuje, czy zespół utknął w pętli stosowania obejść, powtarzając tę samą tymczasową naprawę zamiast dążyć do trwałego rozwiązania.

Analiza przejść w Freshservice, na przykład czasu między opublikowaniem obejścia a rozpoczęciem wniosku o zmianę, pomaga kierować zasoby na istotne zmiany architektoniczne zamiast ciągłego łatania. Można też sprawdzić, czy problemy z określonych kategorii są często ponownie otwierane. Może to oznaczać, że błędnie ustalono przyczynę źródłową albo pominięto etap weryfikacji. Takie informacje pomagają poprawić zgodność z procedurami i sprawdzić, czy proces przebiega zgodnie z założeniami.

Szybsze trwałe rozwiązywanie problemów

Usprawnienie zarządzania problemami wymaga również analizy współpracy między zespołami. Gdy rekord problemu trafia z ogólnej grupy wsparcia do wyspecjalizowanego zespołu inżynierów, część kontekstu może zostać utracona. Powtarzające się prośby o dodatkowe informacje wydłużają cały proces. Process mining pomaga wykryć takie pętle i ustalić lepsze standardy dokumentowania spraw już na początku analizy.

Dzięki temu przekazanie sprawy przebiega sprawniej, a specjaliści od początku otrzymują potrzebne dane. Monitorowanie integracji z zarządzaniem zmianami pokazuje również, czy proponowane rozwiązania są wdrażane na czas, czy czekają w kolejce zmian. Skrócenie tych opóźnień pomaga utrzymać tempo usprawnień usług.

Większa odporność środowiska IT

Celem usprawnienia zarządzania problemami w Freshservice jest zwiększenie odporności usług IT. Skrócenie czasu analizy i częstsze wdrażanie trwałych poprawek bezpośrednio obniżają łączne koszty operacji IT. Pracownicy poświęcają mniej czasu na powracające awarie, a więcej na rozwój i ulepszanie infrastruktury.

Process mining pozwala oprzeć doskonalenie procesu na danych. Analiza śladów cyfrowych pozostawionych w dziennikach Freshservice pomaga przekształcić dział IT, który głównie reaguje na problemy, w zespół, który potrafi je przewidywać i im zapobiegać, zanim wpłyną na działalność firmy. Takie podejście poprawia efektywność wewnętrzną i niezawodność usług, od których firma zależy na co dzień.

Zarządzanie problemami Analiza przyczyn źródłowych Zarządzanie usługami IT Kierownik service desku Ograniczanie liczby incydentów Koordynator problemów Zgodność z ITIL Obsługa zgłoszeń Zarządzanie zgłoszeniami Znany błąd Powtarzające się incydenty Obejście problemu Zapobieganie incydentom Dział pomocy IT

Typowe problemy i wyzwania

Wskaż wyzwania, które Państwa dotyczą

Rekordy problemów często pozostają w fazie analizy przez wiele tygodni bez widocznych postępów. Powiększa się zaległość, a przyczyny problemów pozostają nierozwiązane. Zespoły nie mogą usunąć źródeł powtarzających się incydentów, co zwiększa obciążenie service desku i obniża niezawodność usług dla użytkowników biznesowych.

Gdy rekord problemu krąży między zespołami technicznymi, często ginie kontekst, a czas rozwiązania znacznie się wydłuża. Brak jasno określonej odpowiedzialności prowadzi do marnowania wysiłku, frustracji pracowników technicznych i problemów z realizacją celów dotyczących stabilności oraz wydajności infrastruktury krytycznej.

Opóźniona publikacja obejścia sprawia, że osoby obsługujące incydenty nadal zmagają się z powtarzającymi się problemami, a średni czas ich rozwiązania rośnie. Jeśli między wykryciem problemu a opublikowaniem obejścia upływa zbyt dużo czasu, firma niepotrzebnie doświadcza przestojów, mimo że znane jest tymczasowe rozwiązanie.

Nawet po ustaleniu przyczyny źródłowej wdrożenie trwałej poprawki może utknąć na etapie wniosku o zmianę. Brak powiązania workflow zarządzania problemami i zmianami sprawia, że znane błędy pozostają nierozwiązane. Środowisko IT jest wtedy narażone na kolejne zakłócenia usług i zagrożenia bezpieczeństwa.

Pominięcie przeglądu po wdrożeniu uniemożliwia zespołom IT wyciąganie wniosków z poważnych incydentów i ulepszanie sposobu reagowania. Jeśli przeglądy są pomijane lub przeprowadzane w pośpiechu, organizacja traci ważne informacje i powtarza te same błędy w kolejnych analizach problemów.

Zespoły często poświęcają dużo czasu na analizę problemów o niskim priorytecie, podczas gdy poważne sprawy pozostają nierozwiązane. Brak priorytetyzacji opartej na rzeczywistym ryzyku biznesowym prowadzi do nieefektywnego wykorzystania specjalistycznych zasobów technicznych i opóźnia stabilizację najważniejszych usług w Freshservice.

Niedotrzymanie celów dotyczących poziomu usług w przypadku problemów o wysokim priorytecie może mieć poważne konsekwencje finansowe i wizerunkowe dla działów IT. Regularne przekraczanie terminów analizy przyczyn źródłowych lub wdrożenia trwałych poprawek wskazuje na zakłócenia w przebiegu procesu albo brak informacji o zbliżających się terminach.

Jeśli zamknięty rekord problemu zostaje ponownie otwarty z powodu kolejnych incydentów, może to oznaczać, że nie ustalono prawidłowo przyczyny źródłowej albo poprawka była nieskuteczna. Ponowna praca podwaja koszt analizy i osłabia zaufanie do procesu zarządzania problemami, a źródło problemu nadal stanowi zagrożenie.

Nieprawidłowe lub zbyt ogólne kategorie przyczyn źródłowych uniemożliwiają rzetelną analizę trendów i planowanie działań zapobiegawczych. Jeśli zespoły techniczne wybierają w Freshservice nieprecyzyjne kategorie, organizacja traci możliwość wykrywania powtarzających się słabości konkretnych elementów infrastruktury lub oprogramowania.

Jeśli incydenty nie są prawidłowo powiązane z aktywnym rekordem problemu, kierownictwo nie widzi rzeczywistego wpływu problemu. Zespoły mogą powielać pracę analityczną, a uzasadnienie zasobów potrzebnych do wdrożenia trwałej poprawki staje się trudniejsze, ponieważ liczba incydentów wydaje się mniejsza niż w rzeczywistości.

Typowe cele

Określ, jak wygląda sukces

Szybsza analiza pomaga zapobiegać kolejnym zakłóceniom usług. Gdy ustalenie przyczyny źródłowej się opóźnia, organizacja pozostaje narażona na powtarzające się incydenty, które obciążają zasoby IT i frustrują użytkowników końcowych. Skrócenie tego etapu pomaga skuteczniej przejść od reagowania na awarie do zapobiegania im.

ProcessMind wskazuje etapy analizy w Freshservice, na których sprawy się zatrzymują, na przykład podczas oczekiwania na informacje od zewnętrznego dostawcy lub dokumentację wewnętrzną. Wizualizacja czasu spędzonego w każdym stanie pomaga ustalić realistyczne normy i usunąć wąskie gardła utrudniające szybką diagnozę. Może to skrócić cykl analizy o 30% lub więcej.

Częste przekazywanie rekordów problemów prowadzi do utraty kontekstu i wydłuża czas rozwiązania. Ograniczenie liczby takich przekazań pozwala utrzymać odpowiedzialność po stronie najlepiej przygotowanego zespołu od początku do końca, co sprzyja spójnym i niezawodnym rozwiązaniom. Poprawia też rozliczalność w strukturze wsparcia technicznego.

Nasza platforma process mining mapuje przepływ rekordów problemów między grupami wsparcia i wykrywa zapętlone ścieżki oraz nadmierne ponowne przypisania. Dzięki temu kierownicy mogą dopracować reguły przypisywania spraw, aby od razu trafiały do właściwych specjalistów, i znacznie ograniczyć średnią liczbę przekazań każdego rekordu.

Szybkie udostępnienie obejścia pozwala przywrócić działanie usługi w czasie opracowywania trwałej poprawki. Ogranicza wpływ aktywnych problemów na firmę i zmniejsza obciążenie service desku podczas złożonych analiz. Sprawniejszy proces przygotowywania obejść poprawia też doświadczenia użytkowników końcowych dotkniętych powtarzającymi się incydentami.

ProcessMind mierzy czas od wykrycia problemu do opublikowania obejścia w Freshservice. Wskazanie opóźnień w workflow publikacji pozwala usprawnić weryfikację i szybciej udostępniać obejścia pracownikom pierwszej linii wsparcia. Dzięki temu można ograniczyć liczbę incydentów związanych ze znanymi błędami.

Ustalona przyczyna źródłowa niewiele daje, jeśli trwałe rozwiązanie utknie w procesie zarządzania zmianami. Lepsze powiązanie tych procesów przyspiesza wdrażanie poprawek, pozwala trwale rozwiązać znane błędy i skraca okres ryzyka dla organizacji.

Wizualizujemy przekazania między modułami zarządzania problemami i zmianami w Freshservice. Dzięki temu można ustalić, na których etapach proponowane rozwiązania czekają na zatwierdzenie, a następnie lepiej skoordynować pracę koordynatorów problemów i właścicieli zmian, by szybciej wdrażać poprawki.

Problemy o wysokim priorytecie wymagają ścisłego przestrzegania celów SLA, aby chronić usługi krytyczne dla działalności firmy. Poprawa zgodności z SLA sprawia, że najpoważniejsze problemy otrzymują pilną uwagę, której wymagają, co pomaga utrzymać stabilność operacyjną. Dzięki temu dział IT może wywiązywać się ze zobowiązań wobec całej organizacji.

Analizując dane o wcześniejszej realizacji, ProcessMind wskazuje konkretne wzorce prowadzące do naruszeń SLA. Można sprawdzić, które kategorie lub poziomy priorytetu najczęściej nie mieszczą się w wyznaczonych terminach, a następnie lepiej zarządzać terminami i rozdzielać zasoby, by konsekwentnie dotrzymywać krytycznych celów.

Ponowne otwarcie zgłoszenia problemu często oznacza, że pierwotne rozwiązanie było niepełne albo błędnie ustalono przyczynę źródłową. Ograniczenie takich przypadków zwiększa niezawodność procesu zarządzania problemami i zapobiega ponownemu wykonywaniu pracy nad sprawami uznanymi za rozwiązane. Zamknięcie zgłoszenia powinno oznaczać, że źródło problemu zostało rzeczywiście usunięte.

Nasza platforma analizuje ślady cyfrowe ponownie otwieranych spraw, aby ustalić, czy podczas pierwszej próby rozwiązania pominięto konkretne działania. Dzięki temu można podnieść standardy jakości i zamykać zgłoszenia dopiero po faktycznym rozwiązaniu problemu, ograniczając ponowną pracę nawet o 20 procent.

Zespoły IT często poświęcają nieproporcjonalnie dużo czasu problemom o niewielkim wpływie, podczas gdy krytyczne sprawy czekają na rozwiązanie. Lepsze rozłożenie pracy pozwala starszym specjalistom technicznym zająć się problemami, których rozwiązanie przyniesie największe korzyści dla stabilności usług, i lepiej wykorzystać ich wiedzę.

ProcessMind zestawia liczbę powiązanych incydentów z nakładem pracy nad zgłoszeniami problemów. Dzięki temu menedżerowie mogą wskazać zadania o niewielkiej wartości, które można zautomatyzować lub odłożyć na później. Specjaliści zyskują wtedy czas na analizę przyczyn źródłowych problemów o dużym wpływie, co pomaga zapobiegać setkom przyszłych incydentów.

Dokładna klasyfikacja jest podstawą skutecznej analizy trendów i długofalowego doskonalenia usług. Jeśli przyczyny źródłowe są dokumentowane niedokładnie, trudno wykryć problemy systemowe w infrastrukturze IT. Spójne dane ułatwiają podejmowanie lepszych decyzji strategicznych.

Nasze rozwiązanie process mining monitoruje spójność danych wprowadzanych przy zamykaniu zgłoszeń problemów. Wskazując rekordy z ogólnikowymi lub brakującymi informacjami o przyczynie źródłowej, pomaga zaplanować ukierunkowane szkolenia i poprawić jakość raportowania w dłuższym okresie. Ułatwia to również dostrzeganie nowych trendów technologicznych.

Powiązanie wszystkich podobnych incydentów z jednym zgłoszeniem problemu pokazuje pełną skalę jego wpływu i ułatwia ustalanie priorytetów działań naprawczych. Dzięki temu można powiadomić wszystkich użytkowników, których dotyczy problem, gdy dostępne jest obejście lub poprawka. Usprawnia to komunikację i pracę service desku.

ProcessMind pomaga wykrywać grupy podobnych incydentów, które nie mają powiązanego zgłoszenia problemu w Freshservice. Wskazanie takich luk ułatwia regularne uruchamianie proaktywnego zarządzania problemami, zapobiega nagłym wzrostom liczby incydentów i poprawia ocenę ich wpływu.

Przeglądy po wdrożeniu pozwalają wyciągać wnioski i zapobiegać przyszłym błędom w procesie. Pomijanie tych spotkań oznacza utratę okazji do usprawnień i może prowadzić do powtarzania tych samych błędów w kolejnych cyklach. Regularne przeglądy wspierają kulturę ciągłego doskonalenia.

Sprawdzamy, czy dla każdego zamkniętego zgłoszenia problemu zarejestrowano przegląd, i wskazujemy braki w zgodności z procedurą. Dzięki temu menedżerowie mogą wymagać przeprowadzenia przeglądu w przypadku poważnych problemów. Każda istotna sprawa wnosi wtedy wartościowe wnioski do bazy wiedzy organizacji.

6 kroków do usprawnienia zarządzania problemami

1

Pobierz szablon

Co zrobić

Pobierz specjalny szablon Excel przygotowany z myślą o strukturze danych dotyczących zarządzania problemami w Freshservice.

Dlaczego to ważne

Wstępnie zdefiniowana struktura ułatwia prawidłowe przypisanie danych do silnika process mining i zapewnia dokładność analizy.

Oczekiwany rezultat

Gotowy dokument do mapowania danych

WNIOSKI DOTYCZĄCE PROBLEMÓW

Poznaj przebieg zarządzania problemami w Freshservice

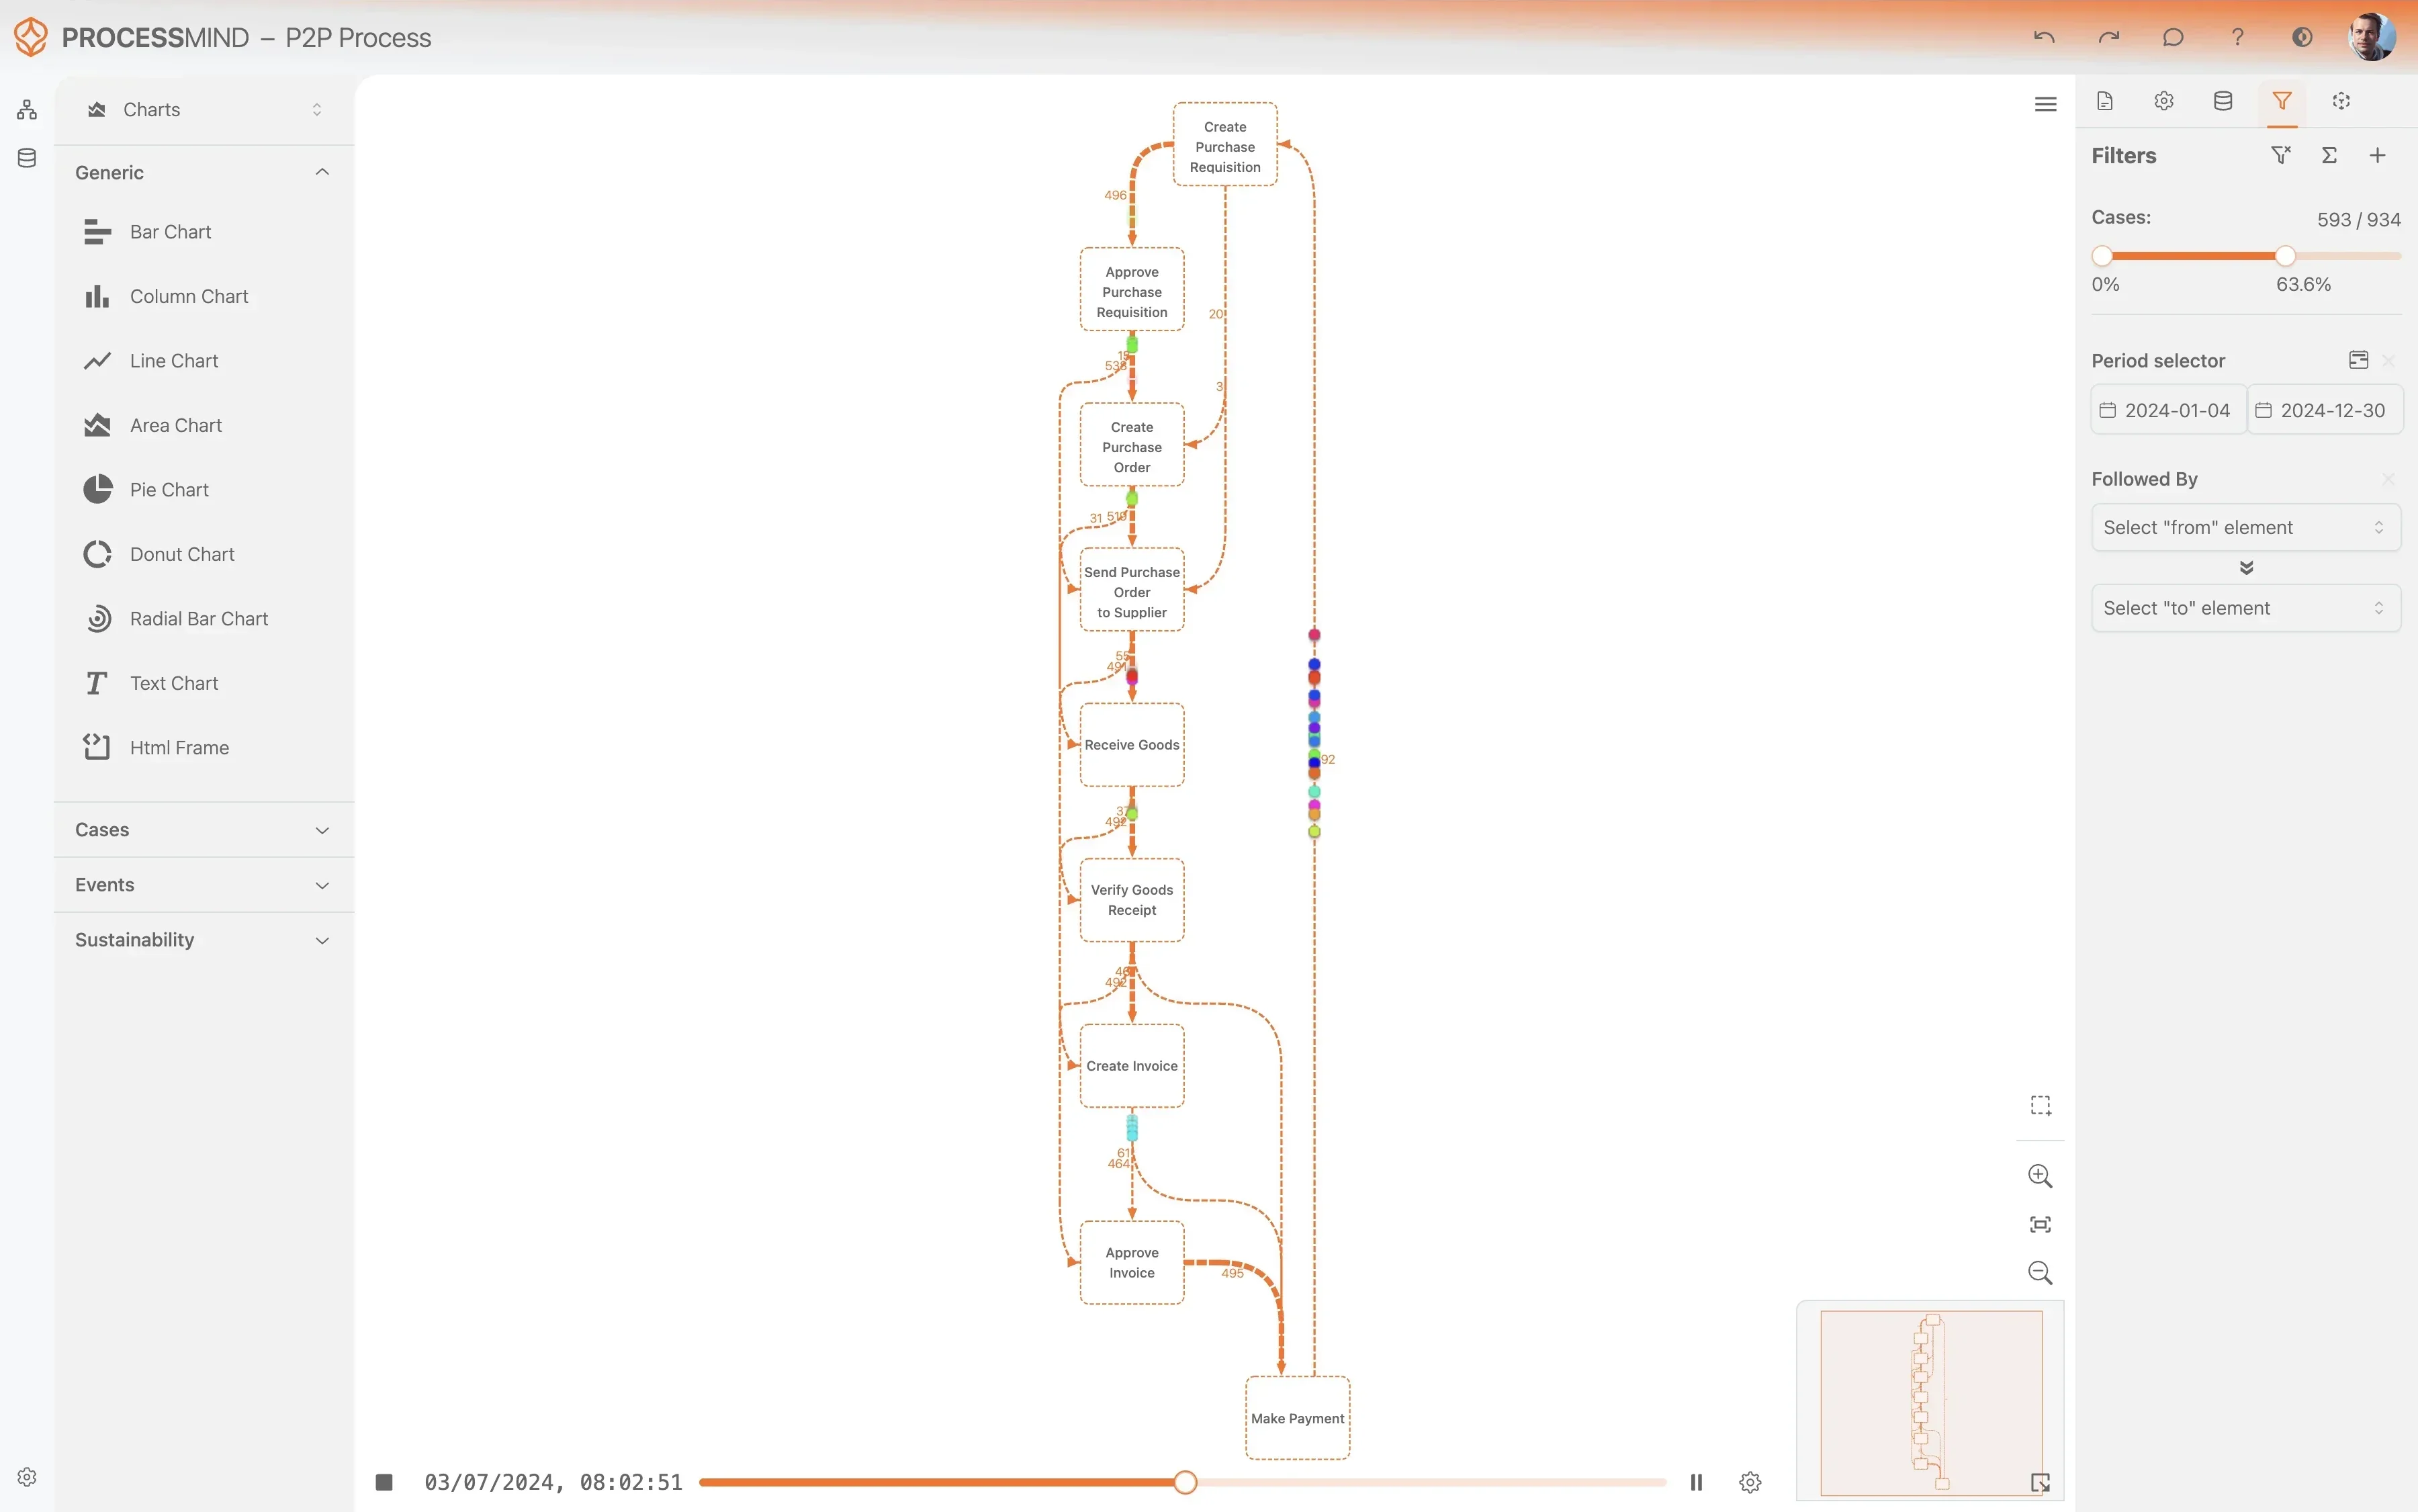
Uzyskaj pełny obraz cyklu życia problemu i sprawdź, na jakich etapach zatrzymują się analizy. Wizualizacje pokazują miejsca opóźnień między identyfikacją problemu a jego rozwiązaniem.
  • Wizualizuj cały cykl analizy przyczyn źródłowych (RCA)
  • Wskaż konkretne etapy opóźniające rozwiązanie problemu
  • Ujawnij powtarzające się pętle w analizie problemów
  • Zmierz wpływ obejść na stabilność usług
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

POTWIERDZONE WYNIKI

Większa efektywność zarządzania problemami

Organizacje analizujące dane Freshservice za pomocą process mining zazwyczaj wykrywają istotne wąskie gardła w cyklu życia zgłoszeń problemów. Pozwala to szybciej analizować przyczyny źródłowe i ograniczać liczbę powracających incydentów.

0 %
Szybsza analiza przyczyny źródłowej

Skrócenie czasu analizy przyczyny źródłowej

Usprawnienie etapów analizy i wykrycie wąskich gardeł w diagnostyce pozwala znacznie szybciej ustalić przyczynę źródłową.

0 %
Mniej przekazań między zespołami

Mniej zmian przypisanej grupy

Ograniczenie niepotrzebnego przekazywania spraw między zespołami technicznymi sprawia, że właściwi specjaliści szybciej zajmują się problemami, co zmniejsza koszty pracy i opóźnienia.

+ 0 %
Lepsza zgodność z SLA

Terminowe rozwiązywanie problemów krytycznych

Monitorowanie zgłoszeń o wysokim priorytecie pozwala rozwiązywać krytyczne problemy w uzgodnionych terminach i utrzymać stabilność usług.

0 %
Mniej ponownie otwieranych zgłoszeń

Mniej ponownej pracy nad zgłoszeniami

Lepsza jakość wstępnej analizy i trwałych poprawek zapobiega ponownemu otwieraniu zgłoszeń problemów i pomaga doprowadzić sprawy do faktycznego rozwiązania.

+ 0 %
Więcej ukończonych przeglądów PIR

Więcej przeglądów po wdrożeniu poprawki

Regularne przeprowadzanie przeglądów po wdrożeniu pozwala wyciągać wnioski i potwierdzać skuteczność trwałych poprawek.

0 %
Szybsze udostępnianie obejść

Czas przygotowania tymczasowych poprawek

Szybsze publikowanie skutecznych obejść ogranicza wpływ problemu na działalność firmy, gdy trwają prace nad jego trwałym rozwiązaniem.

Wyniki zależą od dojrzałości procesu, wielkości zespołu i jakości danych w Freshservice. Podane wartości odzwierciedlają średnią poprawę obserwowaną we wdrożeniach w dużych organizacjach.

Zalecane dane

Na początek wykorzystaj te podstawowe atrybuty i działania, aby rozpocząć optymalizację.
Pierwszy raz spotykają się Państwo z dziennikiem zdarzeń? Dowiedz się jak utworzyć dziennik zdarzeń na potrzeby process mining.

Atrybuty

Najważniejsze dane do zebrania na potrzeby analizy

Unikatowy identyfikator alfanumeryczny przypisany do zgłoszenia problemu, np. PRB-10234.

Dlaczego to ważne

To podstawowy klucz do odtworzenia przebiegu procesu. Jest niezbędny do jednoznacznego identyfikowania każdej sprawy.

Konkretne zdarzenie lub działanie wykonane w ramach zgłoszenia problemu.

Dlaczego to ważne

Określa, co wydarzyło się podczas realizacji procesu, i jest wymagane do wygenerowania mapy procesu.

Dokładna data i godzina wystąpienia działania.

Dlaczego to ważne

Wyznacza chronologię zdarzeń, umożliwiając obliczenie czasu cyklu i uporządkowanie procesu.

Poziom priorytetu przypisany do problemu, np. niski, średni, wysoki lub pilny.

Dlaczego to ważne

Ułatwia filtrowanie danych i nadawanie priorytetów analizie problemów o dużym wpływie.

Imię i nazwisko agenta service desk aktualnie przypisanego do problemu.

Dlaczego to ważne

Przydatny w analizie zasobów i analizie organizacyjnej.

Zespół techniczny lub grupa przypisana do obsługi problemu.

Dlaczego to ważne

Pomaga analizować przekazania spraw i wykrywać wąskie gardła wynikające z pracy w silosach.

Bieżący stan problemu w cyklu życia, np. otwarty, oczekuje na zmianę lub rozwiązany.

Dlaczego to ważne

Określa stan sprawy i służy do obliczania statystyk przepływu.

Klasyfikacja przyczyny źródłowej zidentyfikowanej dla problemu.

Dlaczego to ważne

Ułatwia analizę trendów i wskazywanie obszarów wymagających proaktywnego usprawnienia.

Liczba rekordów incydentów powiązanych z tym problemem.

Dlaczego to ważne

Wskazuje skalę wpływu problemu na pracę service desk.

Flaga wskazująca, czy rekord problemu nie spełnił wymagań SLA.

Dlaczego to ważne

Bezpośrednia miara zgodności procesu i jego wyników.

Dział użytkownika, który zgłosił problem lub którego problem dotyczy.

Dlaczego to ważne

Pokazuje, jak problemy wpływają na poszczególne części organizacji.

Flaga wskazująca, czy rekord problemu kiedykolwiek zmienił status z zamkniętego na otwarty.

Dlaczego to ważne

Podstawowy wskaźnik błędnego uznania problemu za rozwiązany i konieczności ponownej pracy.

Działania

Kroki procesu do monitorowania i optymalizacji

Utworzenie zgłoszenia problemu w systemie. To zdarzenie jest zapisywane w dzienniku audytu Freshservice podczas zapisywania nowego zgłoszenia problemu.

Dlaczego to ważne

Wyznacza początek instancji procesu. Stanowi punkt odniesienia przy obliczaniu czasu realizacji i czasu cyklu.

Przypisanie zgłoszenia problemu do konkretnego zespołu technicznego lub grupy. Zdarzenie wykrywa się, monitorując zmiany pola 'Group' w historii zgłoszenia.

Dlaczego to ważne

Niezbędne do utworzenia mapy cieplnej przekazań między grupami wsparcia. Analiza tych danych ujawnia efekt ping-ponga i nadmierną liczbę przekazań między zespołami.

Moment uzupełnienia pola tekstowego przyczyny źródłowej lub sekcji analizy. Wykrywany na podstawie pierwszej zmiany pola 'Root Cause' z pustej wartości.

Dlaczego to ważne

Główny punkt kontrolny w analizie czasu ustalania przyczyny źródłowej. Oznacza przejście od analizy do projektowania rozwiązania.

Dodanie tymczasowego rozwiązania do zgłoszenia problemu, zwykle w postaci notatki lub wartości pola 'Workaround'. Służy do obliczania szybkości publikowania obejść.

Dlaczego to ważne

Mierzy, jak szybko zespół ogranicza wpływ problemu. Niezbędne do obliczania KPI średniego czasu przygotowania obejścia.

Powiązanie zgłoszenia zmiany ze zgłoszeniem problemu, które oznacza początek etapu usuwania przyczyny. Wykrywane na podstawie zdarzenia systemowego 'Association with Change'.

Dlaczego to ważne

Niezbędne do monitorowania wąskich gardeł w obsłudze zgłoszeń zmian. Mierzy przekazanie sprawy z zarządzania problemami do zarządzania zmianami.

Oznacza wdrożenie ostatecznego rozwiązania. W Freshservice zwykle wnioskuje się o tym na podstawie zmiany statusu na 'Solved' lub 'Resolved'.

Dlaczego to ważne

Pozwala obliczyć opóźnienie we wdrożeniu trwałej poprawki. Oznacza koniec technicznych prac naprawczych.

Ostatnie zdarzenie cyklu życia, po którym zgłoszenie zostaje zablokowane i uznane za nieaktywne. Wykrywane na podstawie zmiany statusu na 'Closed'.

Dlaczego to ważne

Wyznacza bezwzględny koniec instancji procesu. Jest potrzebne do obliczenia całkowitego czasu cyklu.

FAQ

Często zadawane pytania

Process mining wykorzystuje istniejące dzienniki zdarzeń Freshservice do wizualizacji każdego etapu zarządzania problemami. Wskazuje wąskie gardła, takie jak długie etapy analizy czy częste przekazywanie spraw między grupami. Zespoły mogą dzięki temu ustalić, w których miejscach proces odbiega od standardowego workflow.

Zazwyczaj potrzebne są identyfikator zgłoszenia problemu, znaczniki czasu działań i historia zmian pól w Freshservice. Eksportuje się również ważne atrybuty, takie jak priorytet, kategoria i przypisana grupa, aby zapewnić kontekst do szczegółowej analizy i filtrowania.

Pierwsze wnioski można zwykle uzyskać w ciągu kilku dni od wyeksportowania danych historycznych z Freshservice. Czas zależy od ilości danych i złożoności pól niestandardowych, ale większość organizacji wykrywa wzorce, na podstawie których można podjąć działania, w mniej niż dwa tygodnie.

Nie. Process mining zazwyczaj korzysta z integracji API lub eksportu danych, a nie z instalacji oprogramowania. Wystarczy zapewnić dostęp do dzienników audytu i historii zgłoszeń przechowywanych w środowisku Freshservice.

Tak. Analiza pokazuje dokładny czas trwania etapu analizy przyczyny źródłowej dla każdego zgłoszenia. Można następnie przybliżyć poziom, aby sprawdzić, które kategorie, priorytety lub zespoły techniczne doświadczają największych opóźnień.

Odwzorowując każdą zmianę etapu, narzędzie wskazuje zgłoszenia, które wielokrotnie krążą między grupami bez rozwiązania. Menedżerowie mogą dzięki temu rozpoznać niejasny podział odpowiedzialności lub brak zasobów w zespołach technicznych do obsługi określonych typów problemów.

Może śledzić powiązania między zgłoszeniami incydentów a nadrzędnymi zgłoszeniami problemów, zapewniając ich widoczność. Ułatwia to sprawdzenie, czy obejścia są przekazywane osobom odpowiedzialnym za incydenty i czy działania naprawcze są stosowane spójnie we wszystkich powiązanych sprawach.

Głównym zastosowaniem jest analiza danych historycznych, ale wiele platform udostępnia częste aktualizacje, które pozwalają monitorować bieżącą zgodność z SLA. Dzięki temu można sprawdzić, czy aktywne zgłoszenia problemów zbliżają się do naruszenia SLA, zanim upłynie termin.

Usuń wąskie gardła w zarządzaniu problemami

Skróć czas obsługi o 30 procent i zwiększ stabilność usług IT

Rozpocznij okres próbny

Karta kredytowa nie jest wymagana. Konfiguracja zajmuje 5 minut.