Usprawnij zarządzanie problemami
6 kroków do optymalizacji zarządzania problemami.
Usprawnij zarządzanie problemami
Zarządzanie problemami
System ogólny

Wybierz proces

Wybierz proces, aby kontynuować pracę w połączonym obszarze roboczym.

Usprawnij zarządzanie problemami dzięki process mining

ProcessMind pomaga wykrywać ukryte nieefektywności w procesie zarządzania problemami. Można łatwo wskazać wąskie gardła, powtarzające się zadania i długi czas rozwiązywania, które wpływają na jakość usług. Platforma pokazuje odchylenia od procesu i obszary wymagające poprawy, ułatwiając podejmowanie decyzji na podstawie danych. Pozwala prześledzić cały cykl rozwiązywania problemu, od jego identyfikacji po zamknięcie, niezależnie od systemu źródłowego.

Pobierz gotowy szablon danych i poznaj częste wyzwania, które utrudniają osiągnięcie celów efektywnościowych. Skorzystaj z planu doskonalenia w sześciu krokach oraz przewodnika po szablonie danych, aby usprawnić operacje.

Pokaż szczegółowy opis

Sprawne zarządzanie problemami pomaga utrzymać stabilność operacyjną i zapewniać wysoką jakość usług. Process mining w zarządzaniu problemami pokazuje, jak w organizacji przebiega ich identyfikacja, analiza i rozwiązywanie. Zamiast opierać się na pojedynczych relacjach, można sprawdzić rzeczywiste ścieżki rekordów problemów: od wykrycia po rozwiązanie i weryfikację. Analiza ujawnia wąskie gardła opóźniające rozwiązanie, odstępstwa od wymaganych procedur oraz możliwości automatyzacji w całym workflow. Niezależnie od używanego systemu ERP, ITSM czy innego systemu źródłowego ProcessMind pobiera dane o zdarzeniach i odtwarza rzeczywisty przebieg operacji. Dzięki temu można obiektywnie analizować proces zarządzania problemami, niezależnie od systemu.

W zarządzaniu problemami często pojawiają się podobne trudności, niezależnie od używanego systemu. Analiza przyczyn źródłowych trwa zbyt długo, znane problemy powracają, przekazywanie spraw między zespołami jest nieefektywne, a rzeczywisty czas obsługi pozostaje niejasny. Organizacjom trudno ustalić, dlaczego rozwiązanie niektórych problemów zajmuje więcej czasu, gdzie zasoby są wykorzystywane nieefektywnie i czy ustalone procedury są stosowane w praktyce. ProcessMind pomaga analizować te kwestie za pomocą map procesów i miar wydajności opartych bezpośrednio na danych operacyjnych. Można dokładnie wskazać miejsca opóźnień, etapy, które nie wnoszą wartości, oraz różnice prowadzące do gorszych wyników. Taka wiedza ułatwia usprawnienie operacji, skrócenie średniego czasu rozwiązania (MTTR), lepsze wykorzystanie zasobów i zwiększenie wpływu zarządzania problemami na stabilność usług, zamiast ograniczać się do reagowania na incydenty.

Analiza procesu zarządzania problemami w ProcessMind przekłada się na większą efektywność, niższe koszty i lepszą jakość usług. Empiryczna wiedza o przebiegu procesu pomaga podejmować trafniejsze decyzje, usprawniać workflow, usuwać zbędne kroki i wybierać inicjatywy automatyzacyjne o największym wpływie. Może to ograniczyć liczbę powracających problemów i zakłóceń w świadczeniu usług, a w efekcie poprawić satysfakcję klientów. Wczesne wykrywanie i usuwanie luk w zgodności zmniejsza ryzyko oraz pomaga przestrzegać wewnętrznych zasad i zewnętrznych regulacji. Platforma integruje się z istniejącymi źródłami danych. Na początek można skorzystać z szablonu danych, który prowadzi przez ekstrakcję dzienników zdarzeń z systemu i ułatwia rozpoczęcie pracy. ProcessMind pomaga przekształcić zarządzanie problemami z reaktywnego obowiązku w proaktywny i sprawniej działający proces.

Zarządzanie problemami Process mining Zarządzanie usługami ITSM Analiza przyczyn źródłowych Optymalizacja procesów Efektywność Compliance Obsługa zgłoszeń Zarządzanie zgłoszeniami Znany błąd Powtarzające się incydenty Obejście problemu Zapobieganie incydentom Service desk IT

Typowe problemy i wyzwania

Wskaż wyzwania, które Państwa dotyczą

Rekordy problemów potrafią przez wiele tygodni pozostawać na etapie analizy bez widocznych postępów. Powoduje to narastanie zaległości i pozostawia nierozwiązane przyczyny problemów. Zespół nie może wtedy skutecznie przeciwdziałać powtarzającym się incydentom, co zwiększa obciążenie service desku i obniża niezawodność usług.

ProcessMind mierzy czas trwania analizy i pokazuje, na którym etapie proces się zatrzymuje. Wskazuje rekordy, których obsługa przekracza typowy czas rozwiązania, dzięki czemu koordynatorzy problemów mogą zareagować i przesunąć zasoby, zanim analiza straci aktualność.

Gdy rekord problemu trafia kolejno do kilku zespołów technicznych, często ginie kontekst, a czas rozwiązania znacznie się wydłuża. Brak jasno określonej odpowiedzialności prowadzi do niepotrzebnej pracy, frustracji pracowników technicznych i trudności w realizacji celów poziomu usług dotyczących stabilności infrastruktury.

Narzędzie analityczne odwzorowuje kolejność przypisań i ujawnia takie schematy przekazywania spraw. Można sprawdzić, które grupy wsparcia najczęściej przekierowują rekordy, a następnie lepiej przeszkolić zespoły lub precyzyjniej określić zakres ich odpowiedzialności.

Jeśli obejście problemu nie zostanie szybko opublikowane, agenci obsługujący incydenty nadal będą zmagać się z powtarzającymi się zgłoszeniami, co wydłuży średni czas rozwiązania dla użytkowników końcowych. Gdy między identyfikacją problemu a publikacją obejścia upływa zbyt dużo czasu, firma ponosi niepotrzebne straty z powodu przestojów, mimo że znane jest tymczasowe rozwiązanie.

ProcessMind mierzy czas od zidentyfikowania obejścia do działania Workaround Published. Dzięki temu można szybko udostępniać rozwiązania tymczasowe i ograniczać skutki trwających problemów, podczas gdy zespoły techniczne pracują nad usunięciem ich przyczyny.

Nawet po ustaleniu przyczyny źródłowej droga do trwałego rozwiązania często urywa się, zanim zostanie zainicjowany wniosek o zmianę. Brak ciągłości między workflow zarządzania problemami i zmianami sprawia, że znane błędy pozostają nierozwiązane, a środowisko IT jest narażone na kolejne zakłócenia usług.

Analizujemy czas od zarejestrowania aktywności „Ustalono przyczynę źródłową” do zdarzenia „Zainicjowano wniosek o zmianę”. Dzięki temu widać, co utrudnia przejście od zarządzania problemami do zarządzania zmianami i powoduje niepotrzebne opóźnienia administracyjne we wdrażaniu trwałych rozwiązań.

Gdy cykl zarządzania problemami trwa zbyt długo, te same incydenty nadal trafiają do service desk, a zespoły poświęcają zasoby na powtarzalne zadania. Spada wydajność, zespoły mają mniej czasu na projekty strategiczne, a użytkownicy tracą zaufanie do zdolności IT do zapewnienia stabilnego środowiska.

ProcessMind zestawia liczbę powiązanych incydentów z czasem trwania dochodzenia i usuwania problemu. Pokazuje, jak opóźnienia w rozwiązywaniu problemów zwiększają liczbę incydentów. Te dane pomagają uzasadnić biznesowo przyspieszenie wdrażania trwałych rozwiązań i ograniczenie obciążenia service desk.

Zespoły często pomijają przegląd po wdrożeniu, aby szybciej zamknąć zgłoszenia i zmniejszyć zaległości. Bez tego kroku organizacja nie sprawdza, czy rozwiązanie zadziałało zgodnie z założeniami, ani nie dokumentuje wniosków. Może to prowadzić do podobnych problemów w przyszłości i utrudniać długofalowe doskonalenie usług.

ProcessMind sprawdza, czy dla każdego zamkniętego rekordu problemu wykonano przegląd po wdrożeniu. Wskazuje odstępstwa od standardowego przebiegu procesu, pomagając dopilnować wykonania wszystkich etapów rozwiązania problemu oraz spełnienia wymagań dotyczących doskonalenia usług i zgodności.

Krytyczne problemy często nie są rozwiązywane w terminach określonych w SLA z powodu ukrytych nieefektywności na etapach dochodzenia i usuwania problemu. Niedotrzymanie terminów zagraża stabilności usług IT i może osłabić zaufanie biznesu, gdy krytyczna infrastruktura pozostaje niestabilna dłużej, niż uzgodniono.

ProcessMind porównuje terminy SLA z rzeczywistymi znacznikami czasu z systemu źródłowego i wskazuje aktywności prowadzące do przekroczeń. Można na bieżąco monitorować realizację celów SLA i zmieniać priorytety lub workflow, zanim upłyną terminy.

Jeśli technicy nieprawidłowo kategoryzują przyczyny źródłowe problemów, trudno wykryć długoterminowe trendy i systemowe słabości infrastruktury. Brak takich danych utrudnia podejmowanie świadomych decyzji o inwestycjach w infrastrukturę i zmianach procesów, które mogłyby poprawić stabilność.

ProcessMind wskazuje rekordy, w których brakuje kategorii przyczyny źródłowej lub przypisano ogólną wartość. Ujawnienie luk w jakości danych pomaga poprawić ich spójność i lepiej zrozumieć rzeczywiste przyczyny niestabilności IT.

Typowe cele

Określ, jak wygląda sukces

Szybsza analiza przyczyn źródłowych zapobiega powracającym incydentom i ogranicza przestoje infrastruktury. Przyspieszenie dochodzenia pozwala zespołom technicznym odejść od ciągłego gaszenia pożarów i skupić się na trwałych rozwiązaniach, które zwiększają niezawodność usług i skracają czas, przez jaki krytyczne podatności pozostają nierozwiązane.

Process mining pokazuje cały przebieg dochodzenia w systemie i pozwala ustalić, na jakich etapach praca się zatrzymuje. Wskazując wąskie gardła w konkretnych grupach wsparcia lub obszarach technicznych, platforma dostarcza danych, które pomagają skrócić dochodzenie. Można też monitorować drogę od zgłoszenia problemu do ustalenia jego przyczyny źródłowej i sprawdzać, czy każde dochodzenie przebiega zgodnie z planem.

Każde przekazanie sprawy między grupami wsparcia wydłuża czas rozwiązania problemu i zwiększa nakład pracy administracyjnej. Ograniczenie liczby przekazań pozwala od razu skierować sprawę do właściwych ekspertów i uniknąć przerzucania jej między zespołami, gdy odpowiedzialność za problem nie jest jasno określona. Usprawnia to proces i zwiększa rozliczalność.

Platforma śledzi historię pól przypisania w każdym rekordzie problemu w systemie źródłowym. Wskazuje przypadki błędnego kierowania zgłoszeń i częstego przekazywania ich między zespołami. Dzięki temu można usprawnić reguły kierowania do grup i ograniczyć niepotrzebne ponowne przypisania, aby dochodzenie nie traciło tempa przy przekazywaniu sprawy.

Szybkie udostępnienie obejścia ogranicza wpływ aktywnego problemu na użytkowników końcowych i service desk. Pracownicy wsparcia mogą rozwiązywać incydenty, zanim będzie gotowa trwała poprawka. Zmniejsza to liczbę otwartych zgłoszeń i poprawia zadowolenie użytkowników w czasie opracowywania docelowego rozwiązania.

Process mining analizuje czas od zidentyfikowania problemu do opublikowania obejścia w bazie znanych błędów. Te dane pomagają ujednolicić ten ważny etap i szybciej udostępniać dokumentację znanych błędów. Dzięki temu można rozliczać zespoły z terminowego przekazywania informacji o rozwiązaniach tymczasowych.

Najważniejszym miernikiem skuteczności zespołu zarządzania problemami jest spadek liczby powracających incydentów. Ustalanie i usuwanie przyczyn źródłowych obniża całkowity koszt utrzymania usług IT i zmniejsza codzienne obciążenie service desk. Pozwala też pokazać, jakie konkretne korzyści proces przynosi całej organizacji.

Platforma zestawia liczbę incydentów z konkretnymi rekordami problemów, aby ocenić długofalową skuteczność trwałych rozwiązań. Można sprawdzić, czy rozwiązania usuwają przyczyny źródłowe, zamiast jedynie łagodzić objawy. Można też śledzić skuteczność wdrożonych zmian i weryfikować, czy przynoszą oczekiwany spadek liczby incydentów.

Płynne przejście od rekordu problemu do wniosku o zmianę jest niezbędne, aby wdrażać trwałe rozwiązania w kontrolowany sposób. Opóźnienia oznaczają, że wykryte podatności pozostają w środowisku produkcyjnym dłużej, niż to konieczne. Zwiększa to ryzyko i niweczy część pracy włożonej w dochodzenie.

Mapując cyfrowy ślad między procesami zarządzania problemami i zmianami w systemie, process mining wskazuje utrudnienia na etapach zatwierdzania i przekazywania spraw. Pomaga usprawnić przejście od ustalenia przyczyny źródłowej do rozpoczęcia prac nad rozwiązaniem oraz skrócić czas, przez który propozycje zmian czekają w kolejkach administracyjnych i na zatwierdzenie.

Dotrzymywanie uzgodnionych poziomów usług w przypadku problemów o wysokim priorytecie pomaga zachować ciągłość działania i stabilność operacyjną. Stała zgodność z SLA buduje zaufanie interesariuszy biznesowych i zapewnia pilną obsługę problemów o największym wpływie, skracając czas krytycznych przerw w działaniu usług.

Process mining monitoruje rzeczywiste wyniki względem celów SLA, analizując znaczniki czasu z całego cyklu życia rekordu. Wskazuje etapy procesu i grupy wsparcia, w których najczęściej dochodzi do przekroczeń. Dzięki wczesnym ostrzeżeniom zespoły mogą dotrzymywać terminów SLA dla wszystkich priorytetów i reagować, zanim dojdzie do przekroczenia.

Wnioski z wcześniejszych problemów pomagają stale doskonalić usługi i zapobiegać podobnym błędom w przyszłości. Przegląd każdego poważnego problemu pozwala udokumentować i udostępnić wnioski, ograniczyć ryzyko powtórki i stopniowo podnosić dojrzałość organizacji IT.

Platforma sprawdza, czy przed zamknięciem rekordu wykonano przegląd po wdrożeniu. Wskazuje przypadki, w których ten etap jest często pomijany lub opóźniany. Dzięki temu można egzekwować zgodność z ustalonym procesem oraz zadbać o dokumentowanie i udostępnianie cennych wniosków z każdego poważnego problemu w service desk.

Dokładne dane są podstawą skutecznego zarządzania problemami i długoterminowej analizy trendów. Lepsza jakość kategorii przyczyn źródłowych ułatwia podejmowanie decyzji strategicznych i kierowanie inwestycji w technologię lub szkolenia tam, gdzie pomogą rozwiązać problemy systemowe w infrastrukturze IT i zapewnić jej długoterminową stabilność.

Process mining analizuje pola przyczyny źródłowej i kategorii w tysiącach rekordów, aby wykryć niespójności, zmiany kategorii i nadużywanie ogólnej kategorii „inne”. Te dane pomagają kierownikom doprecyzować standardy wprowadzania danych i poprawić wiarygodność raportów. Ułatwiają też wykrywanie nowych trendów technologicznych na podstawie danych z systemu źródłowego.

6 kroków do usprawnienia zarządzania problemami

1

Połącz źródło danych i zbierz dane

Co zrobić

Połącz źródło danych, na przykład system ERP lub system zarządzania usługami, aby pobrać dzienniki aktywności rekordów problemów. Zaimportuj wszystkie potrzebne dane o zdarzeniach, w tym znaczniki czasu i identyfikatory case, które będą potrzebne do analizy.

Dlaczego to ważne

Ten etap zapewnia kompletny i dokładny zbiór danych, który pozwala zrozumieć rzeczywisty przebieg i wyniki procesu zarządzania problemami.

Oczekiwany rezultat

Kompletny i dokładny zbiór danych o działaniach związanych z zarządzaniem problemami jest gotowy do analizy.

CO MOŻNA ZYSKAĆ

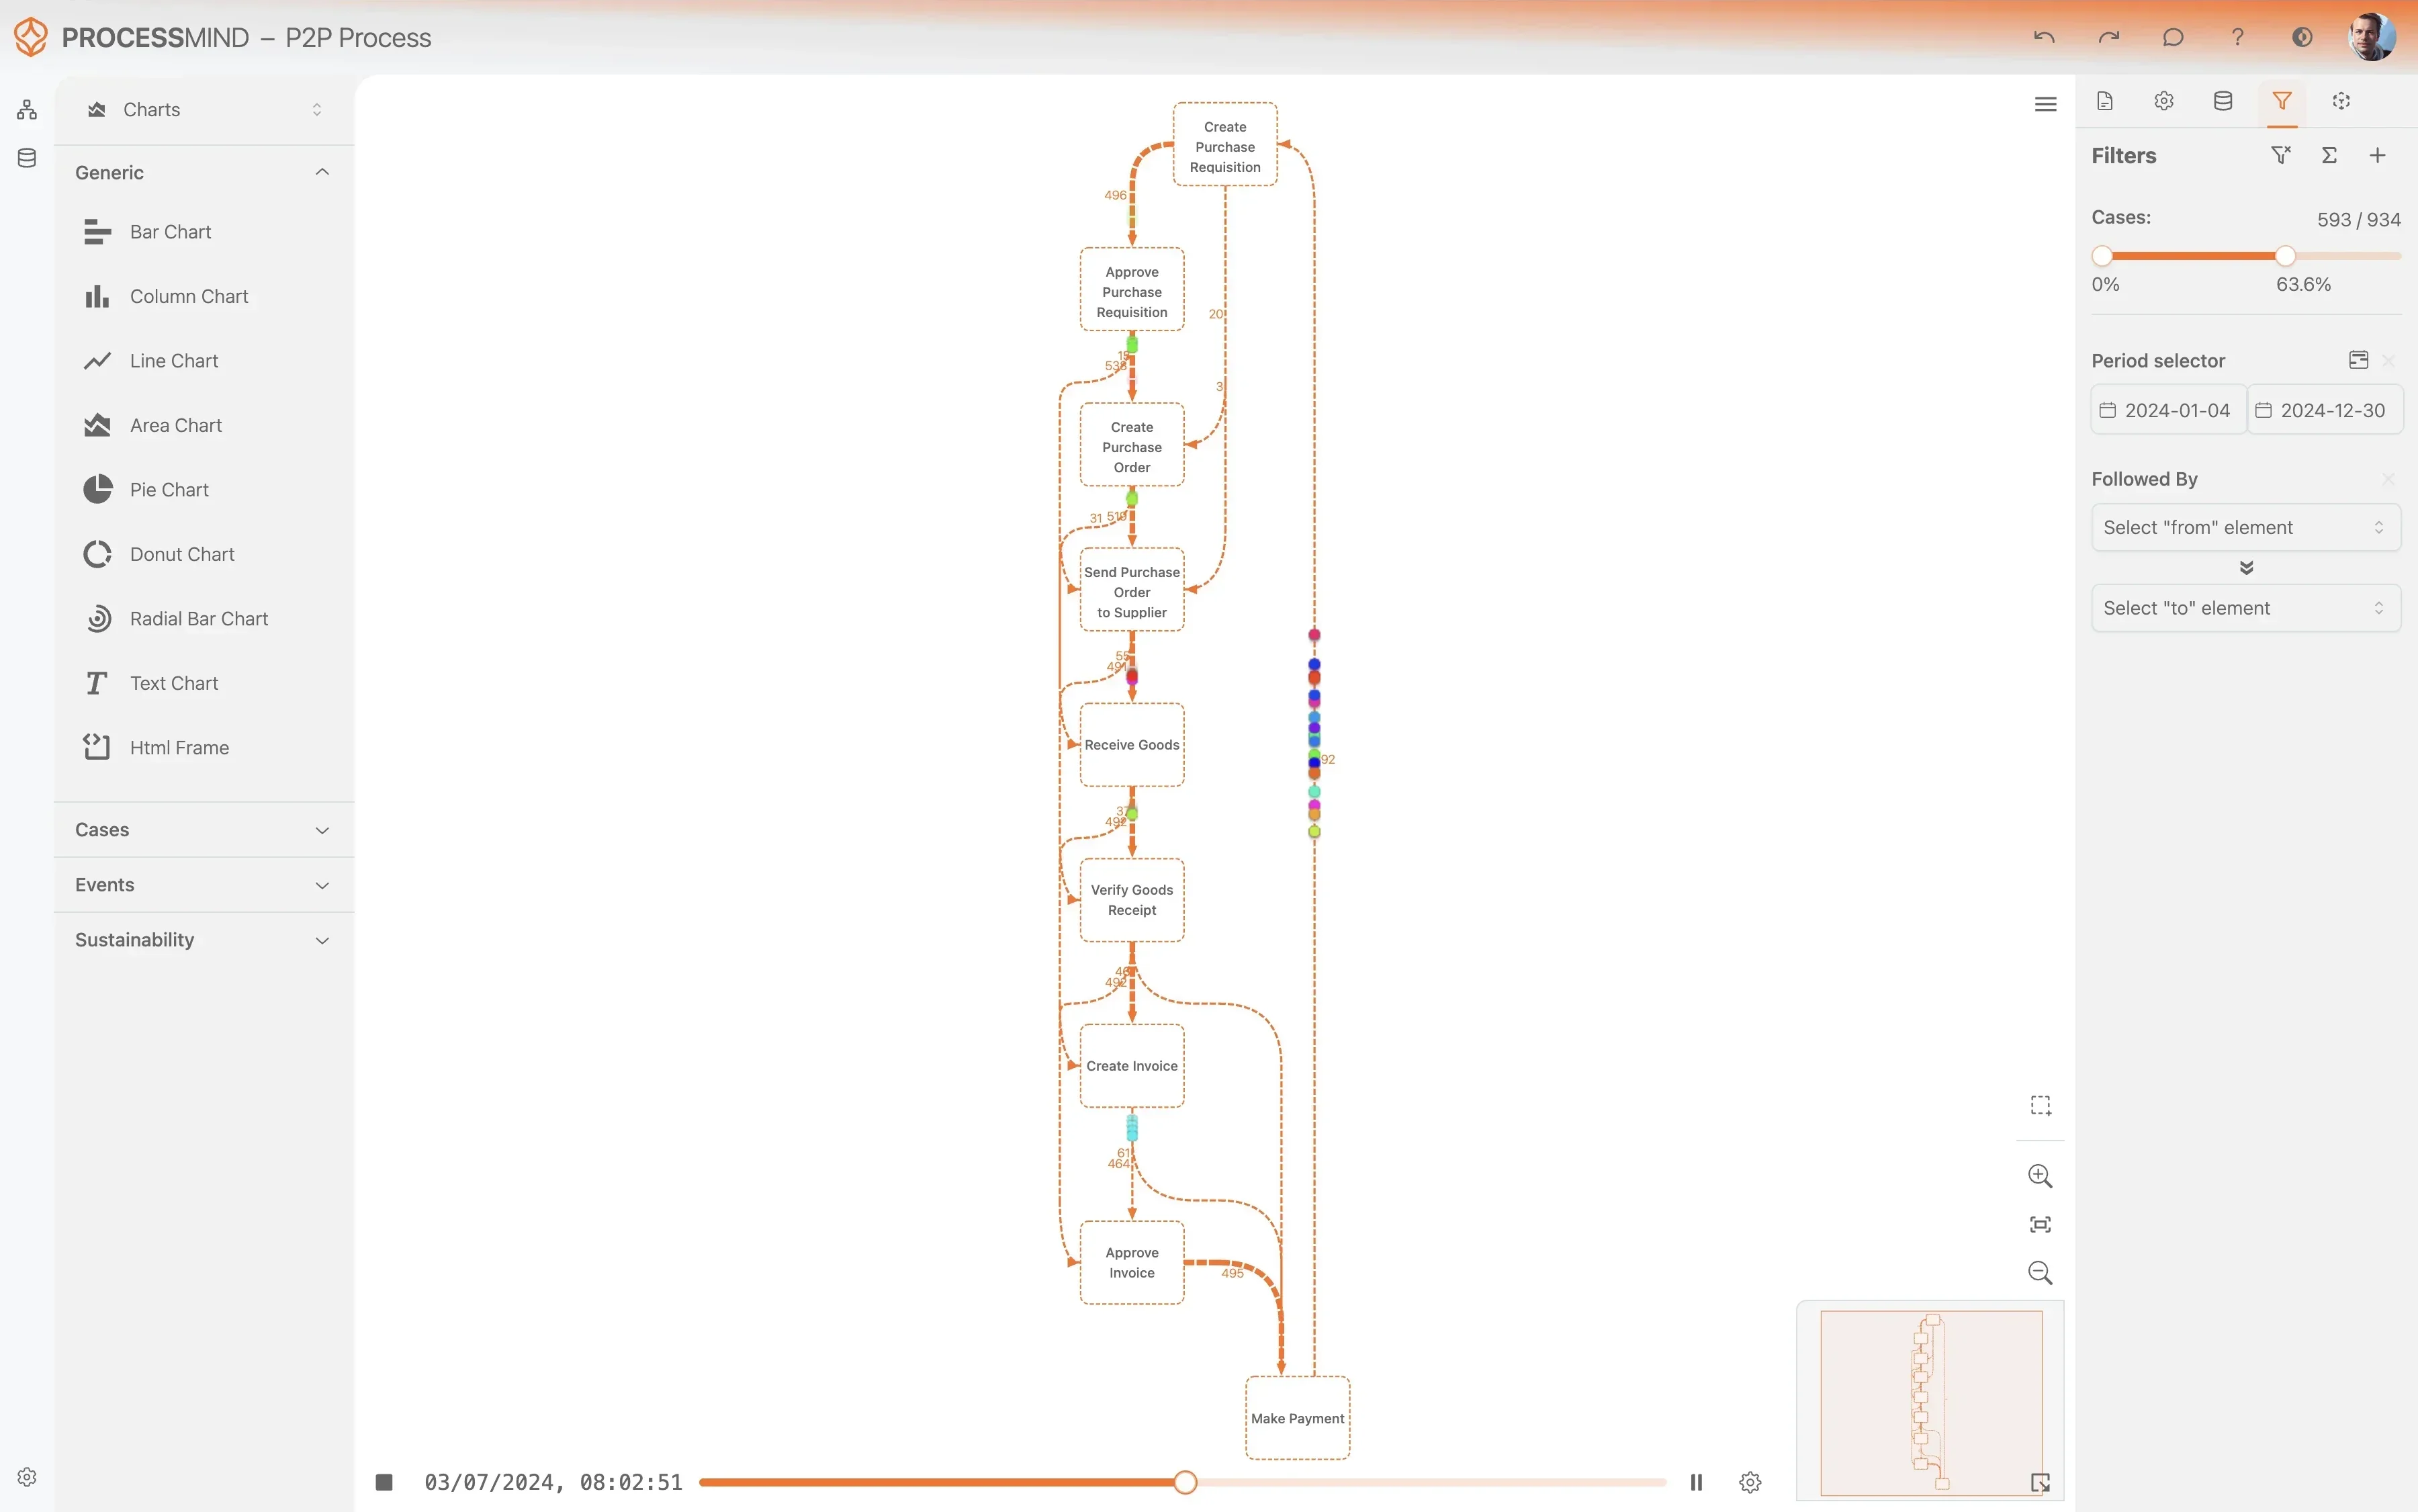
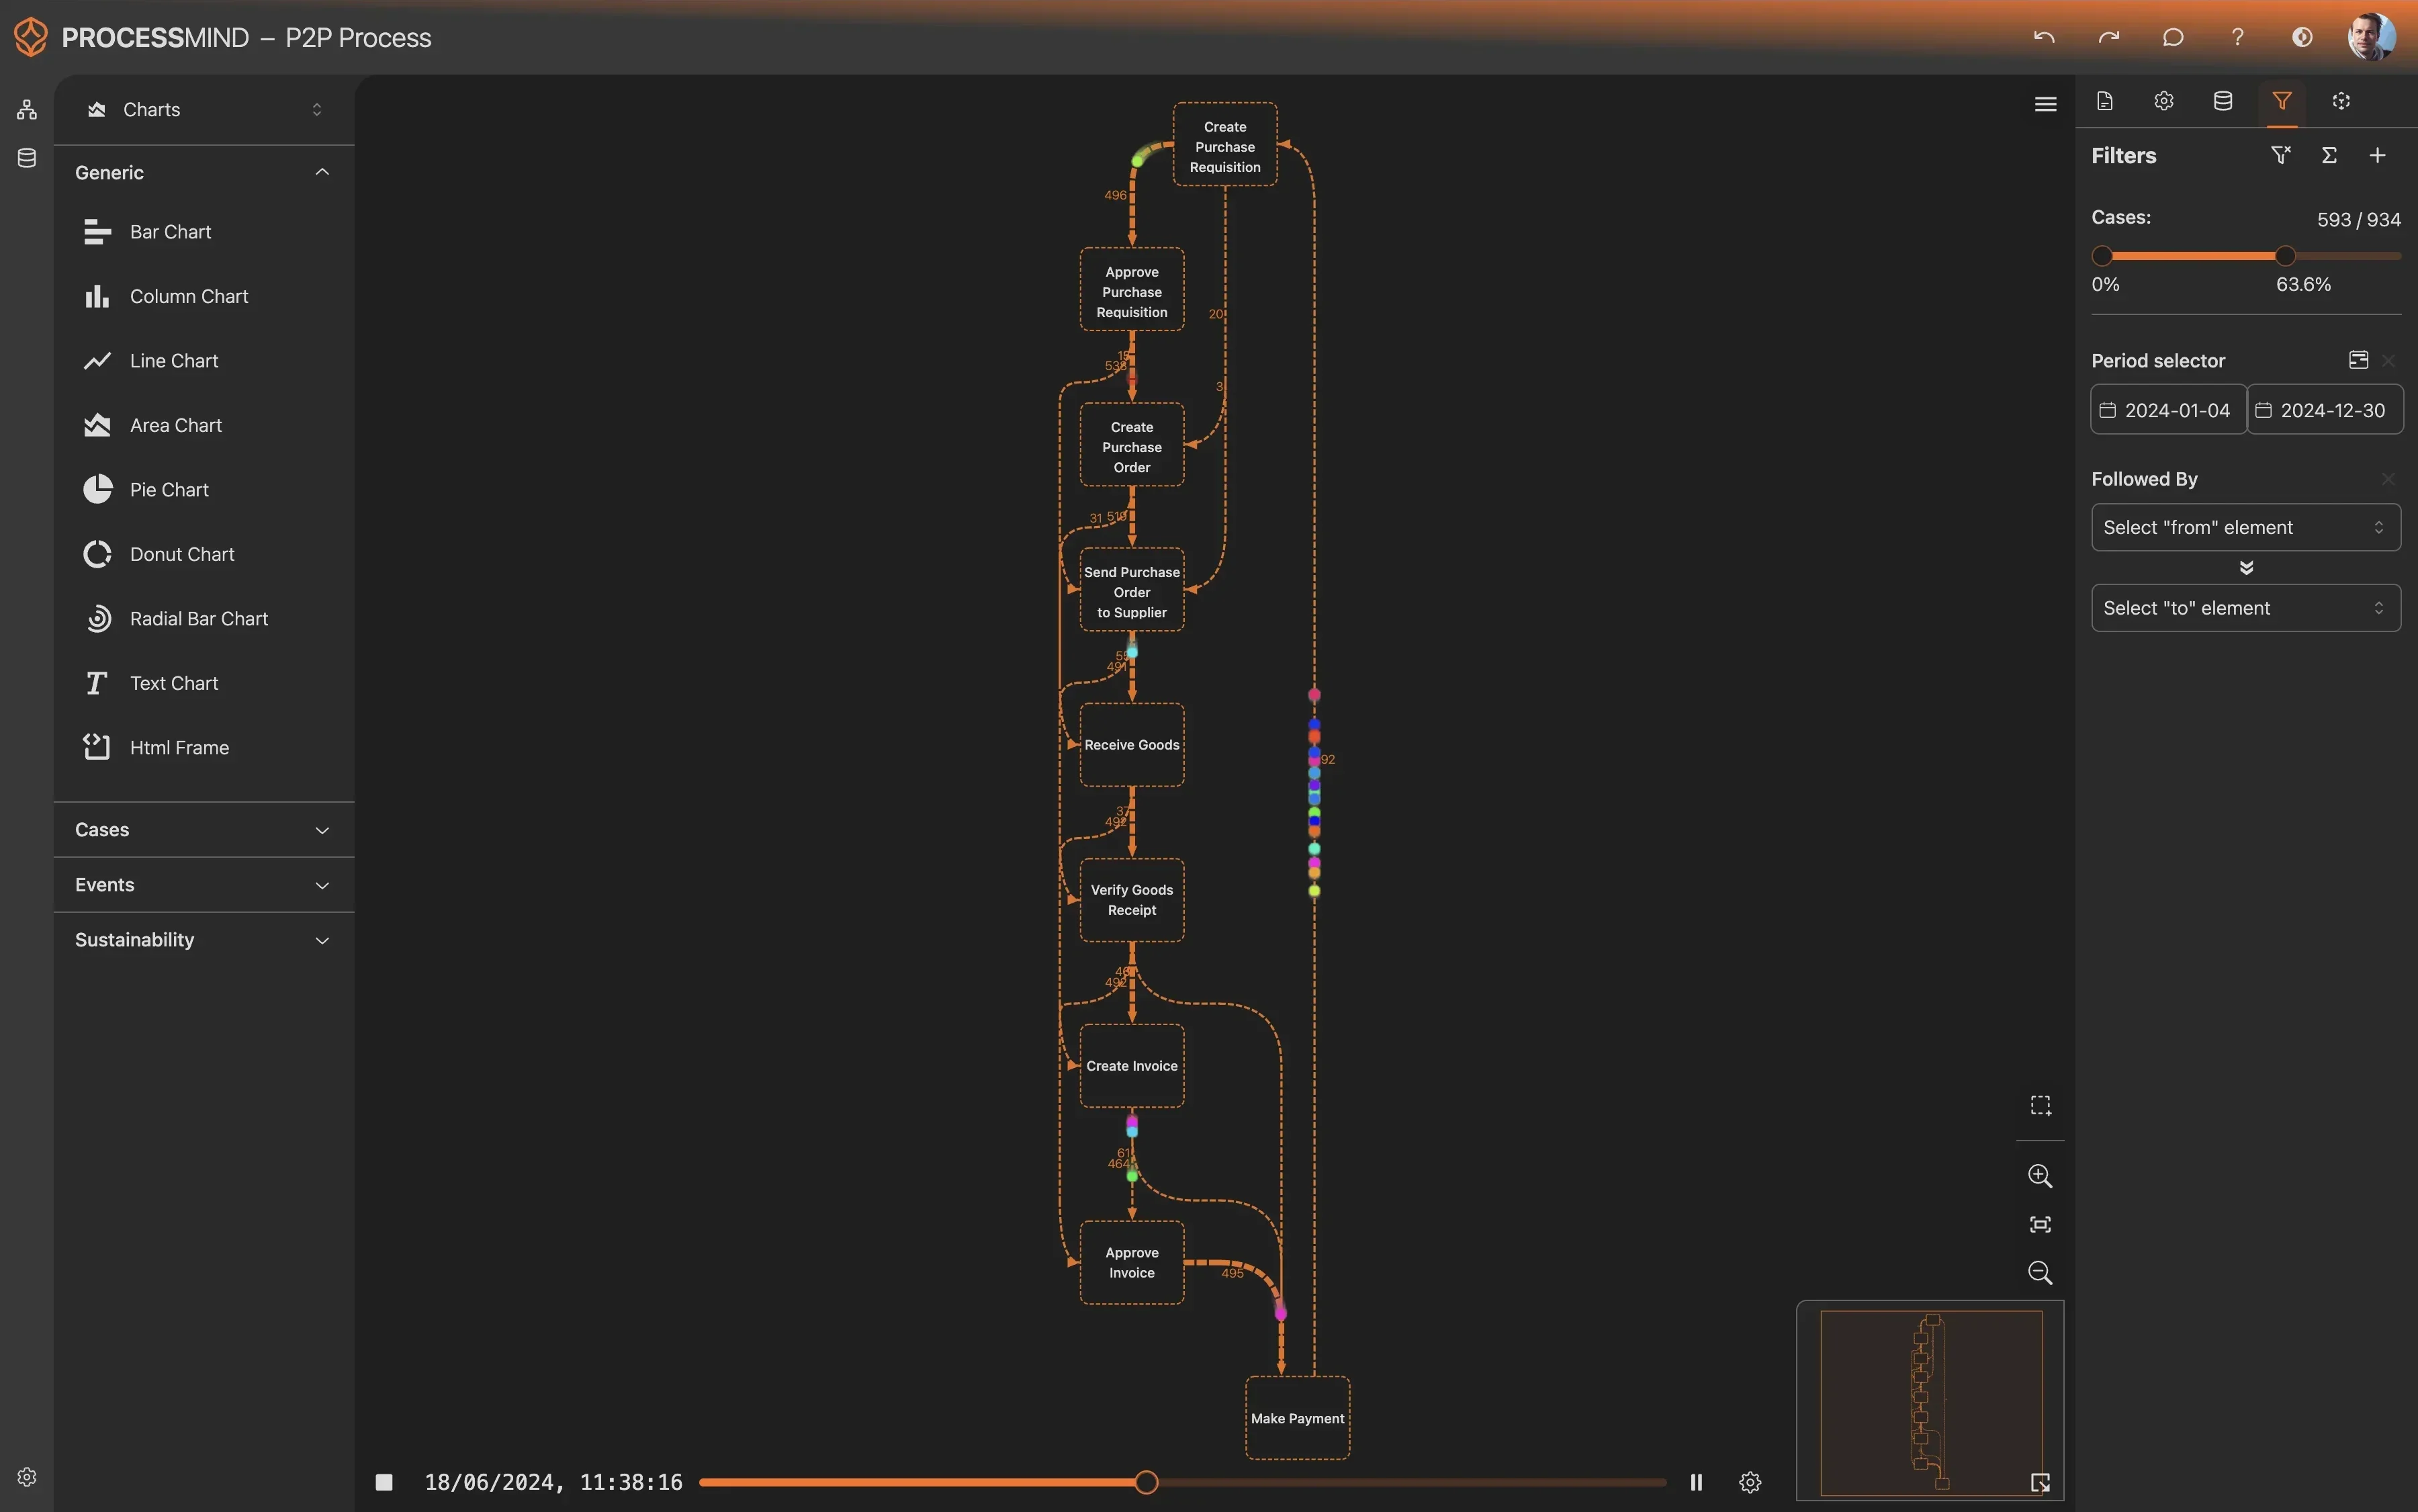
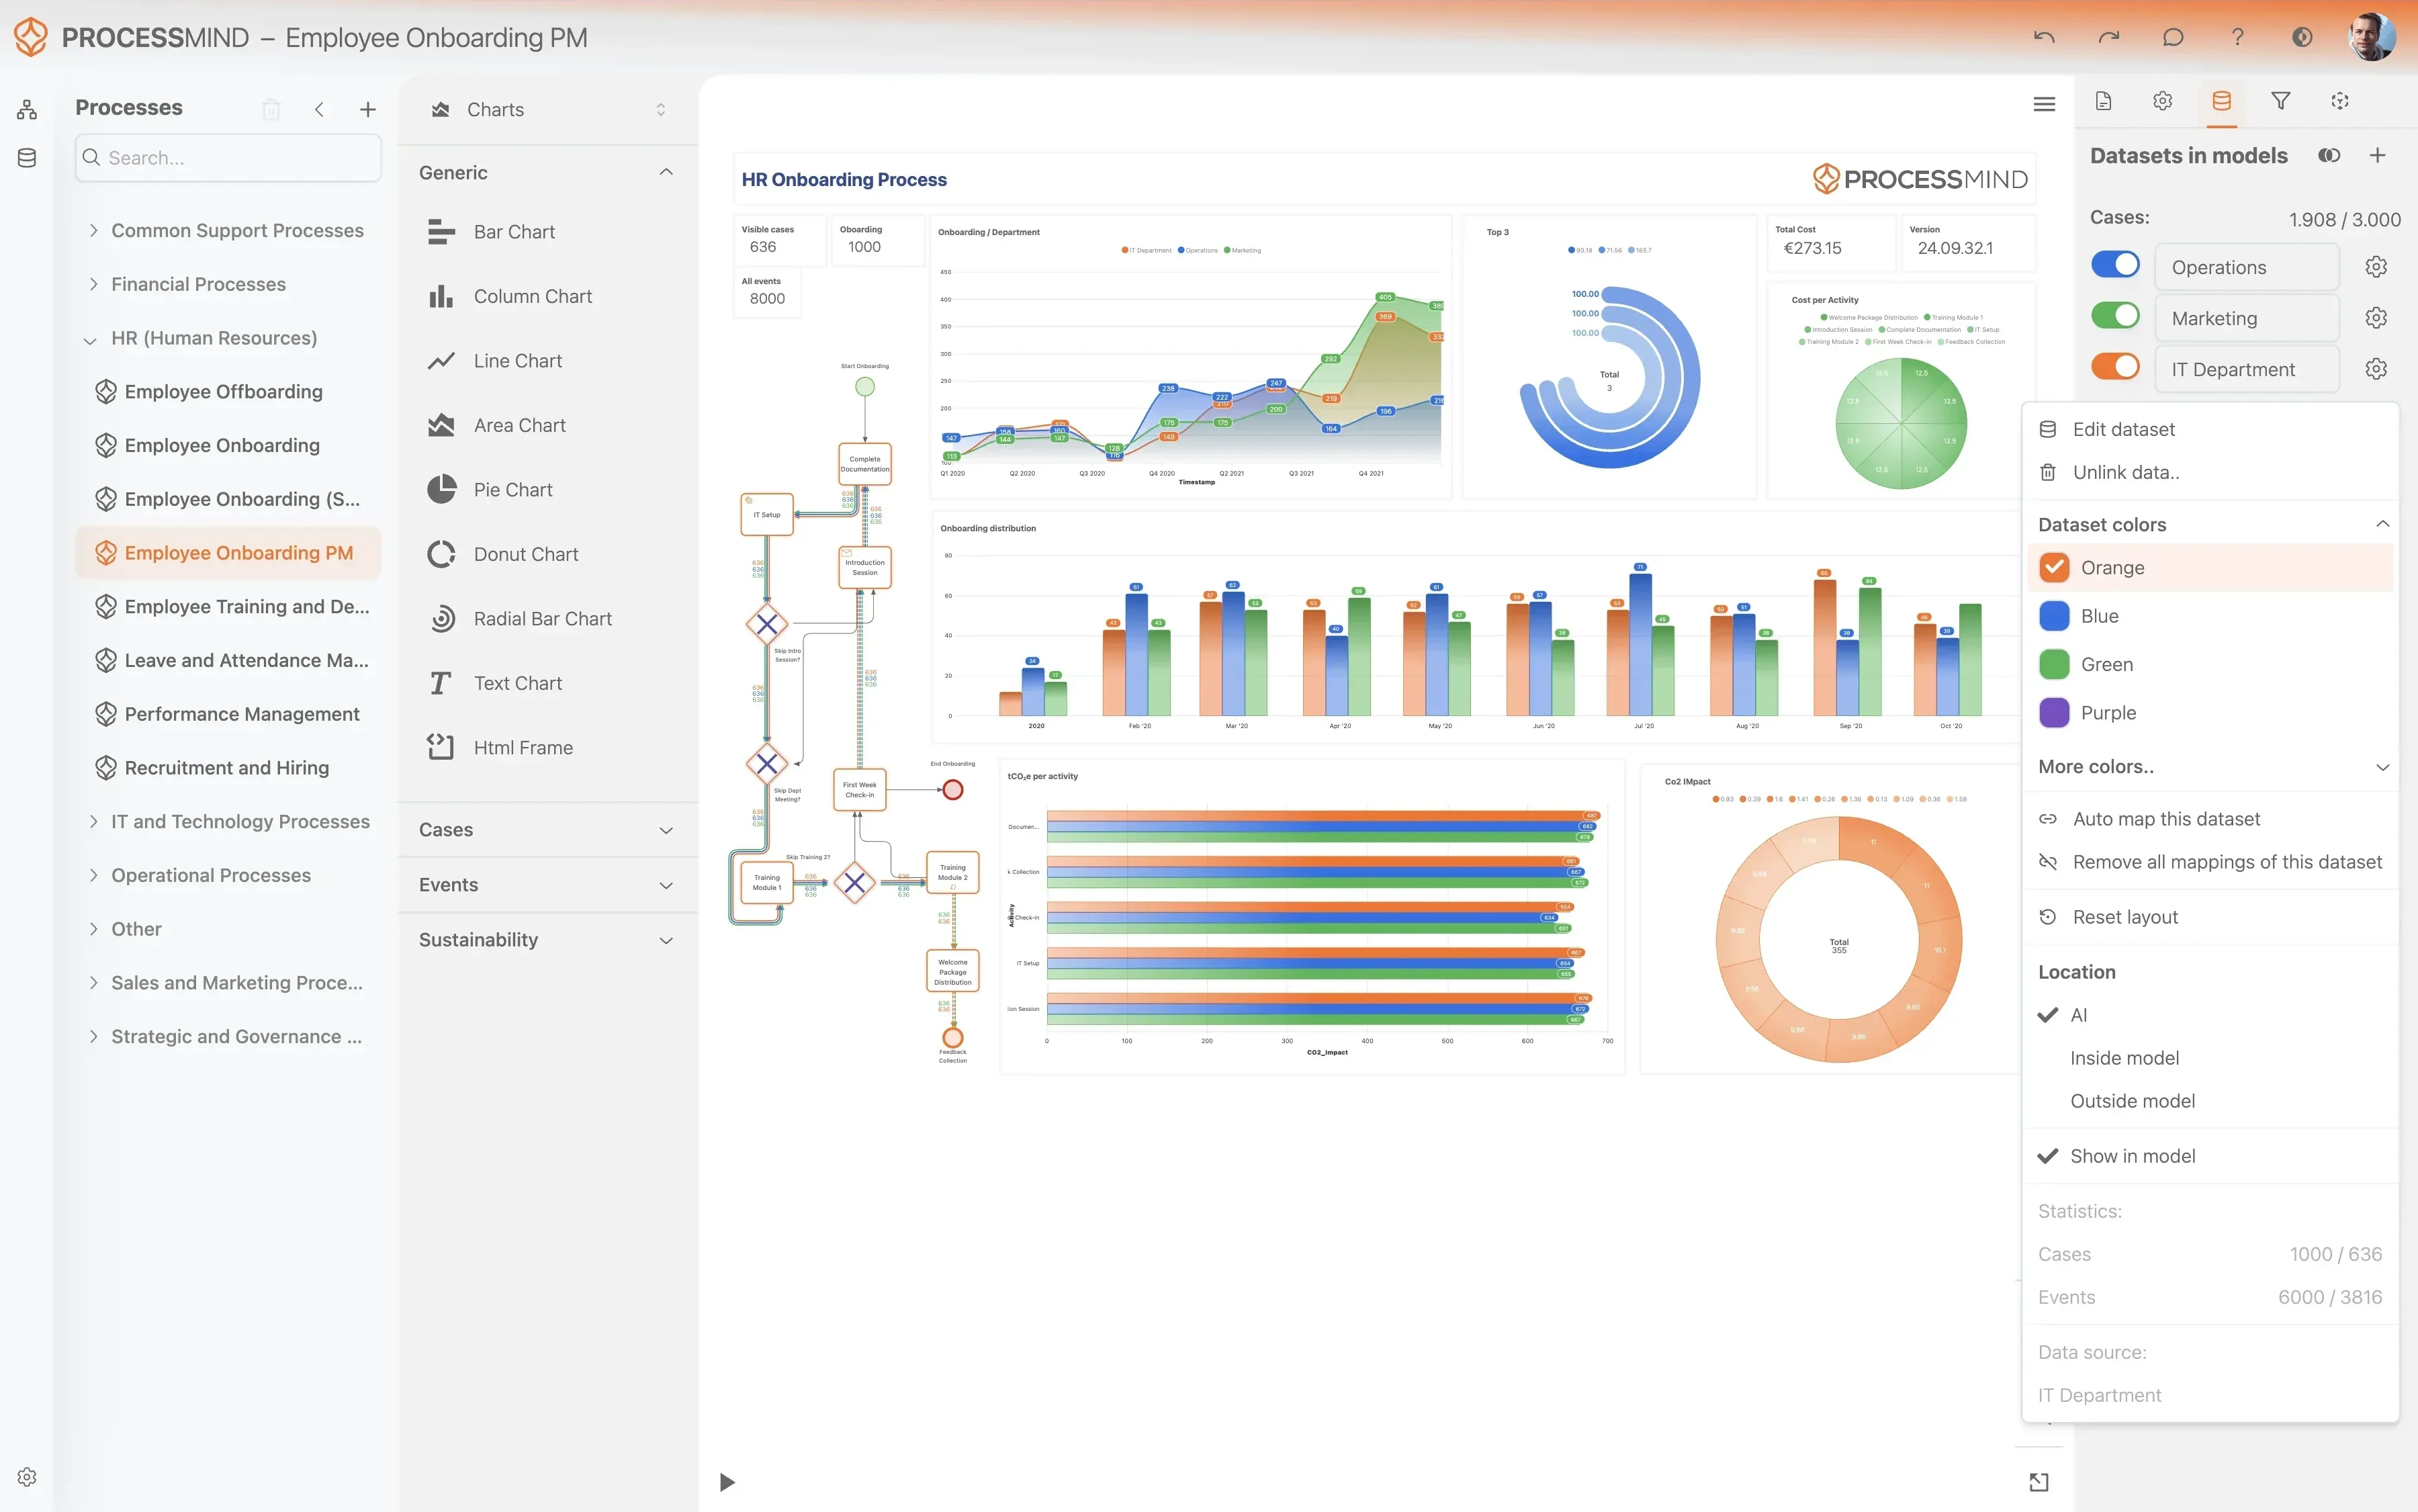
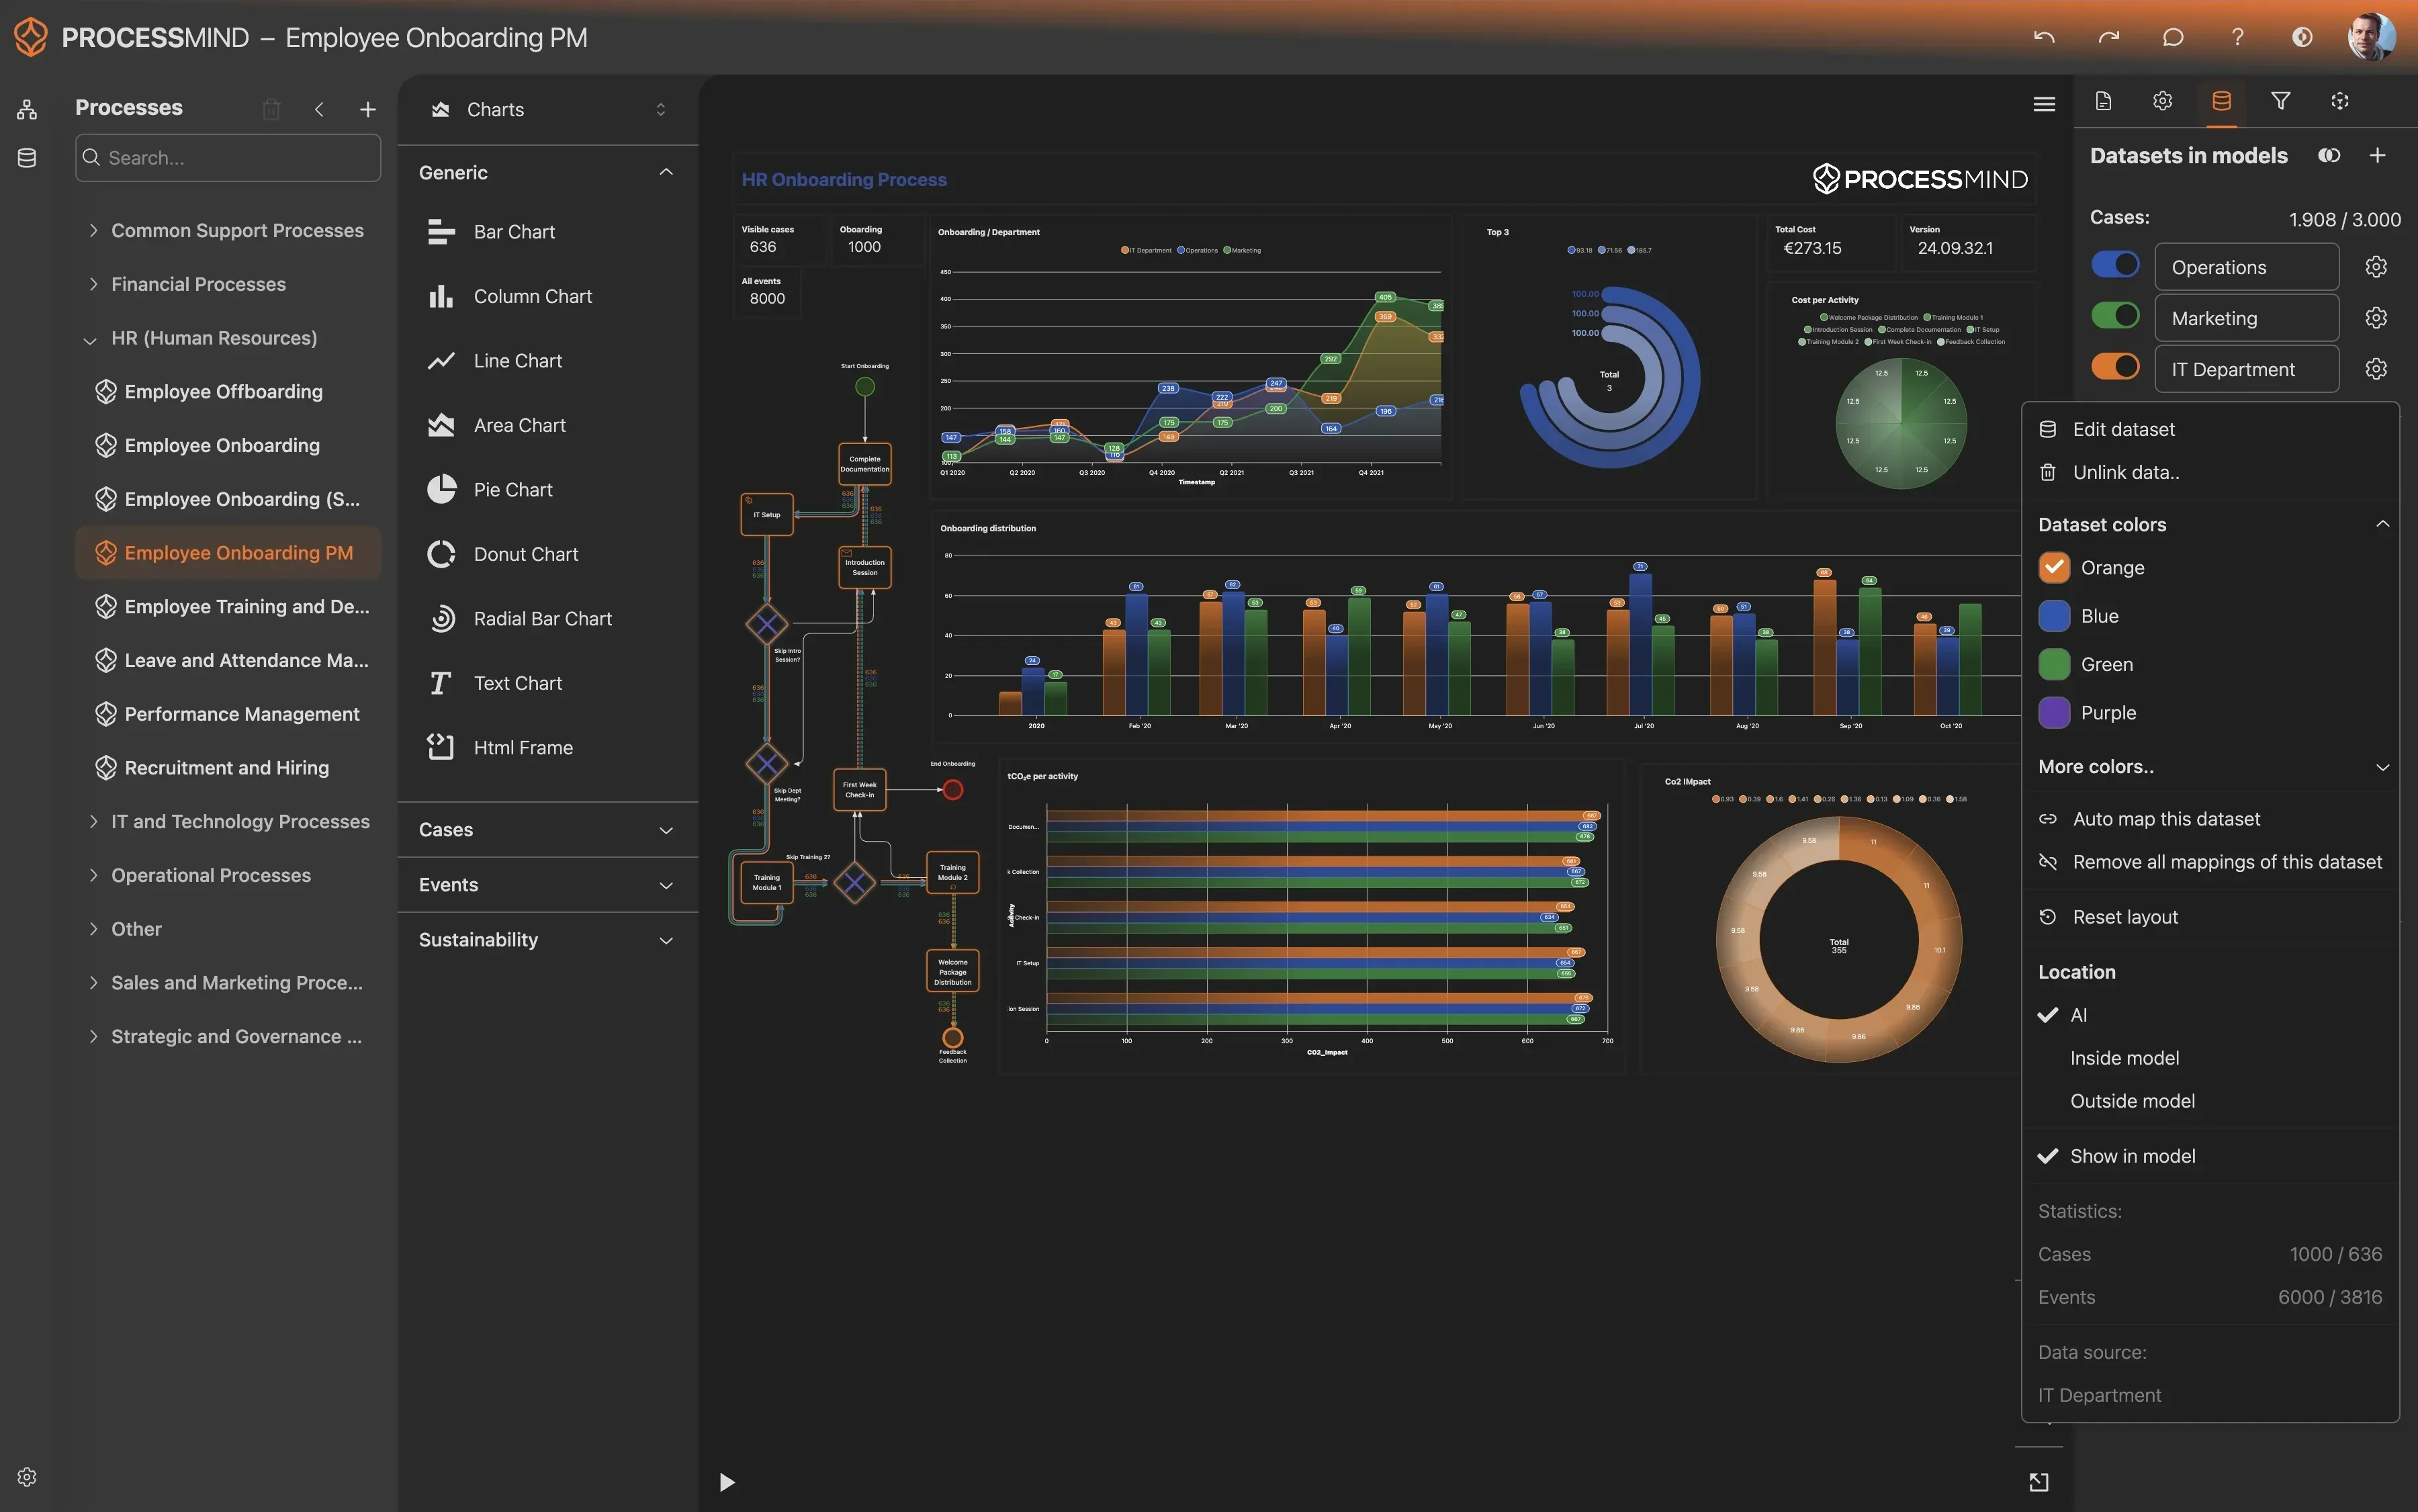
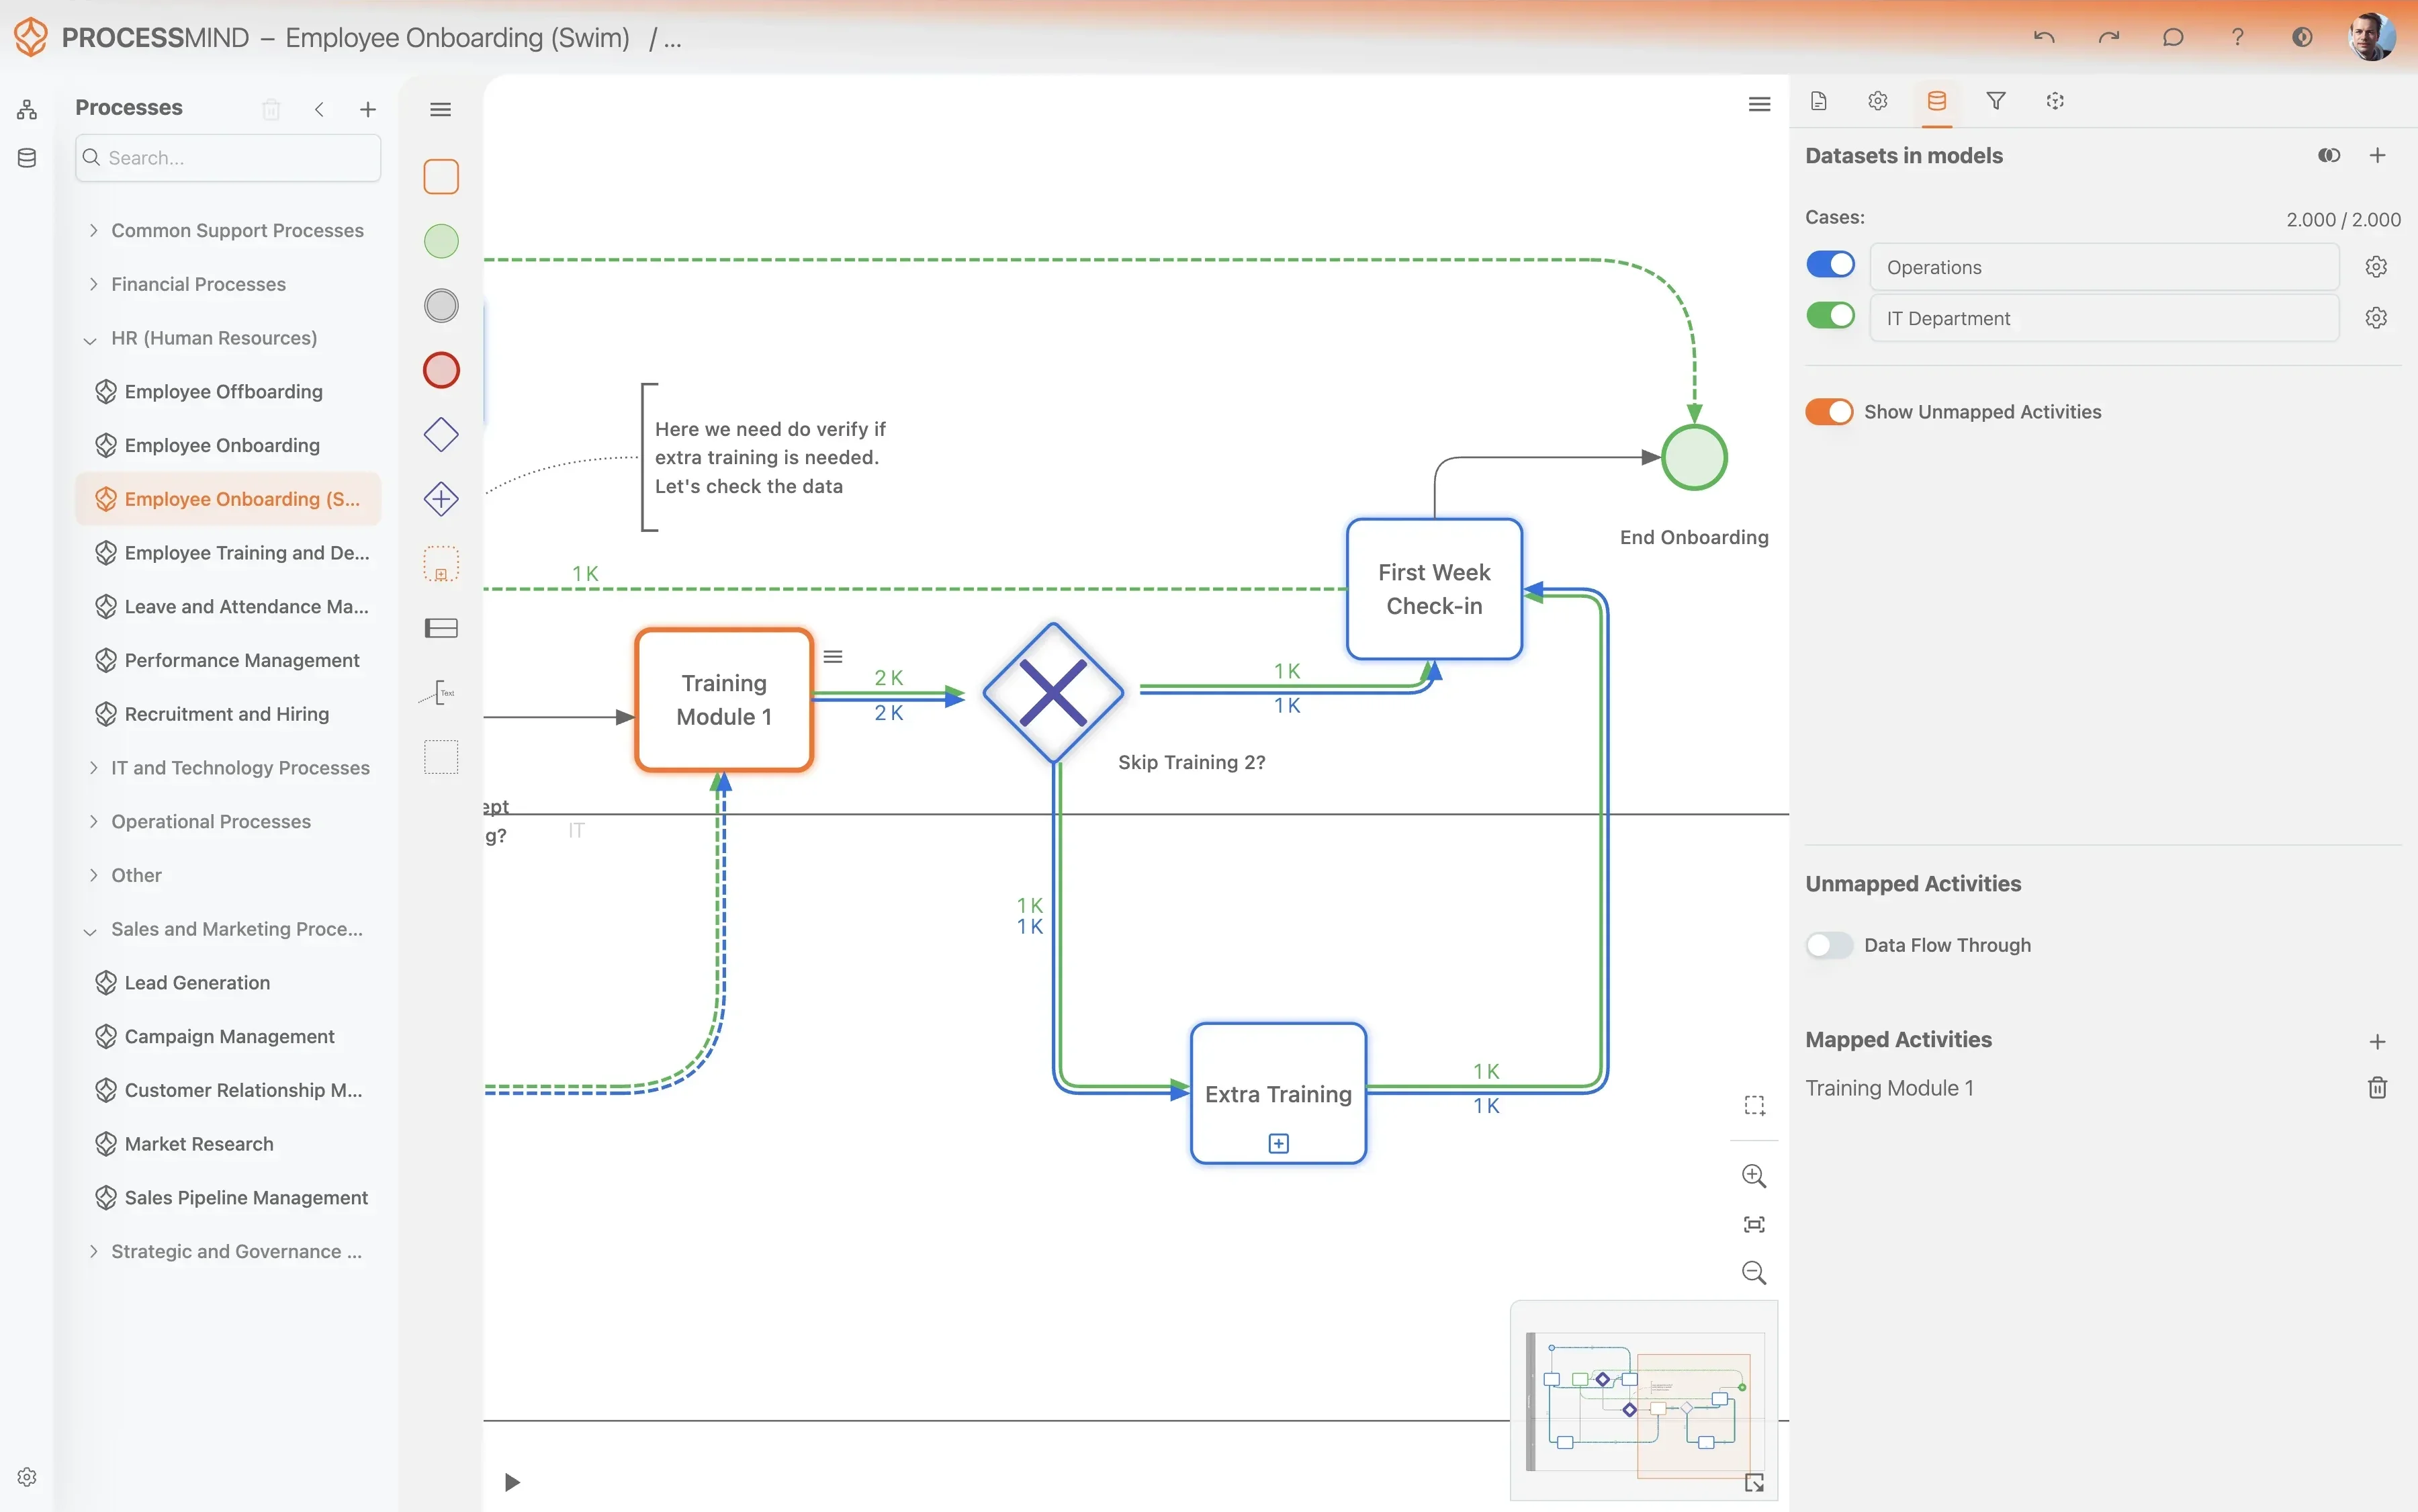
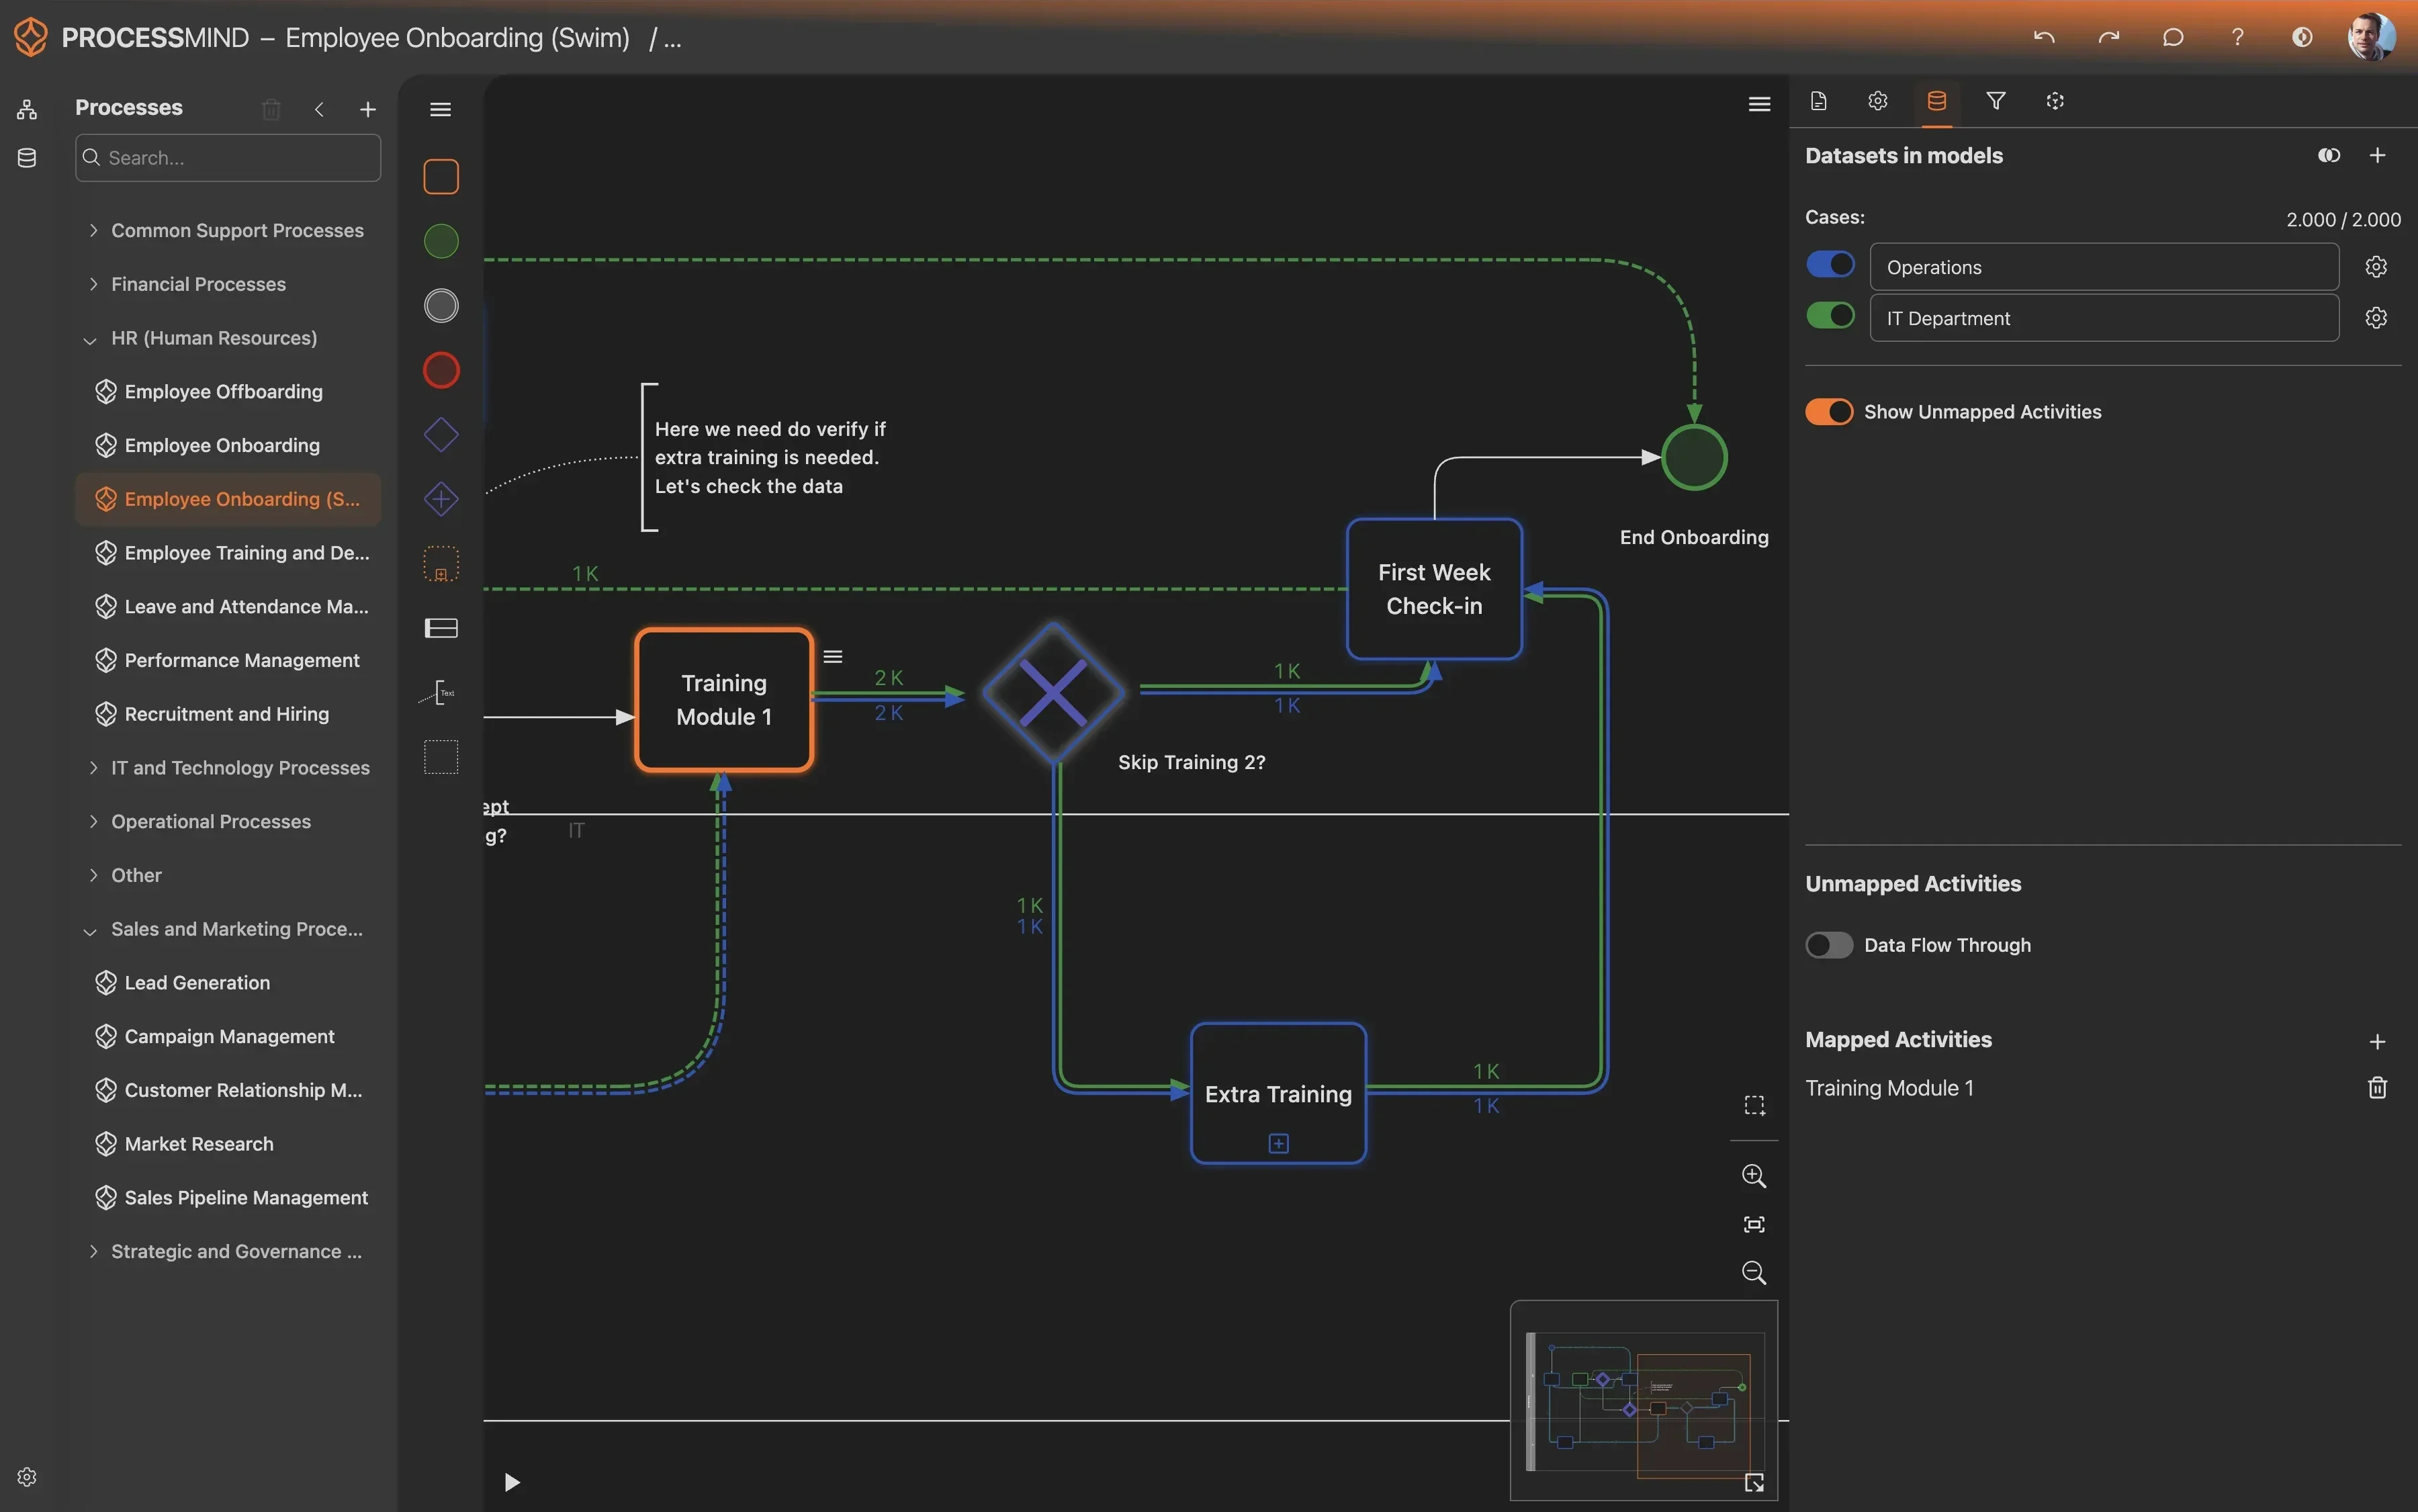
Zobacz, jak naprawdę przebiegają procesy

ProcessMind pokazuje rzeczywisty przebieg operacji na podstawie danych. Ujawnia nieefektywności i luki w zgodności, które mogą umykać w standardowych raportach.
  • Zobacz przebieg procesu od początku do końca
  • Wskaż ukryte nieefektywności i wąskie gardła
  • Sprawdź zgodność z regułami procesu
  • Efektywniej przydzielaj zasoby
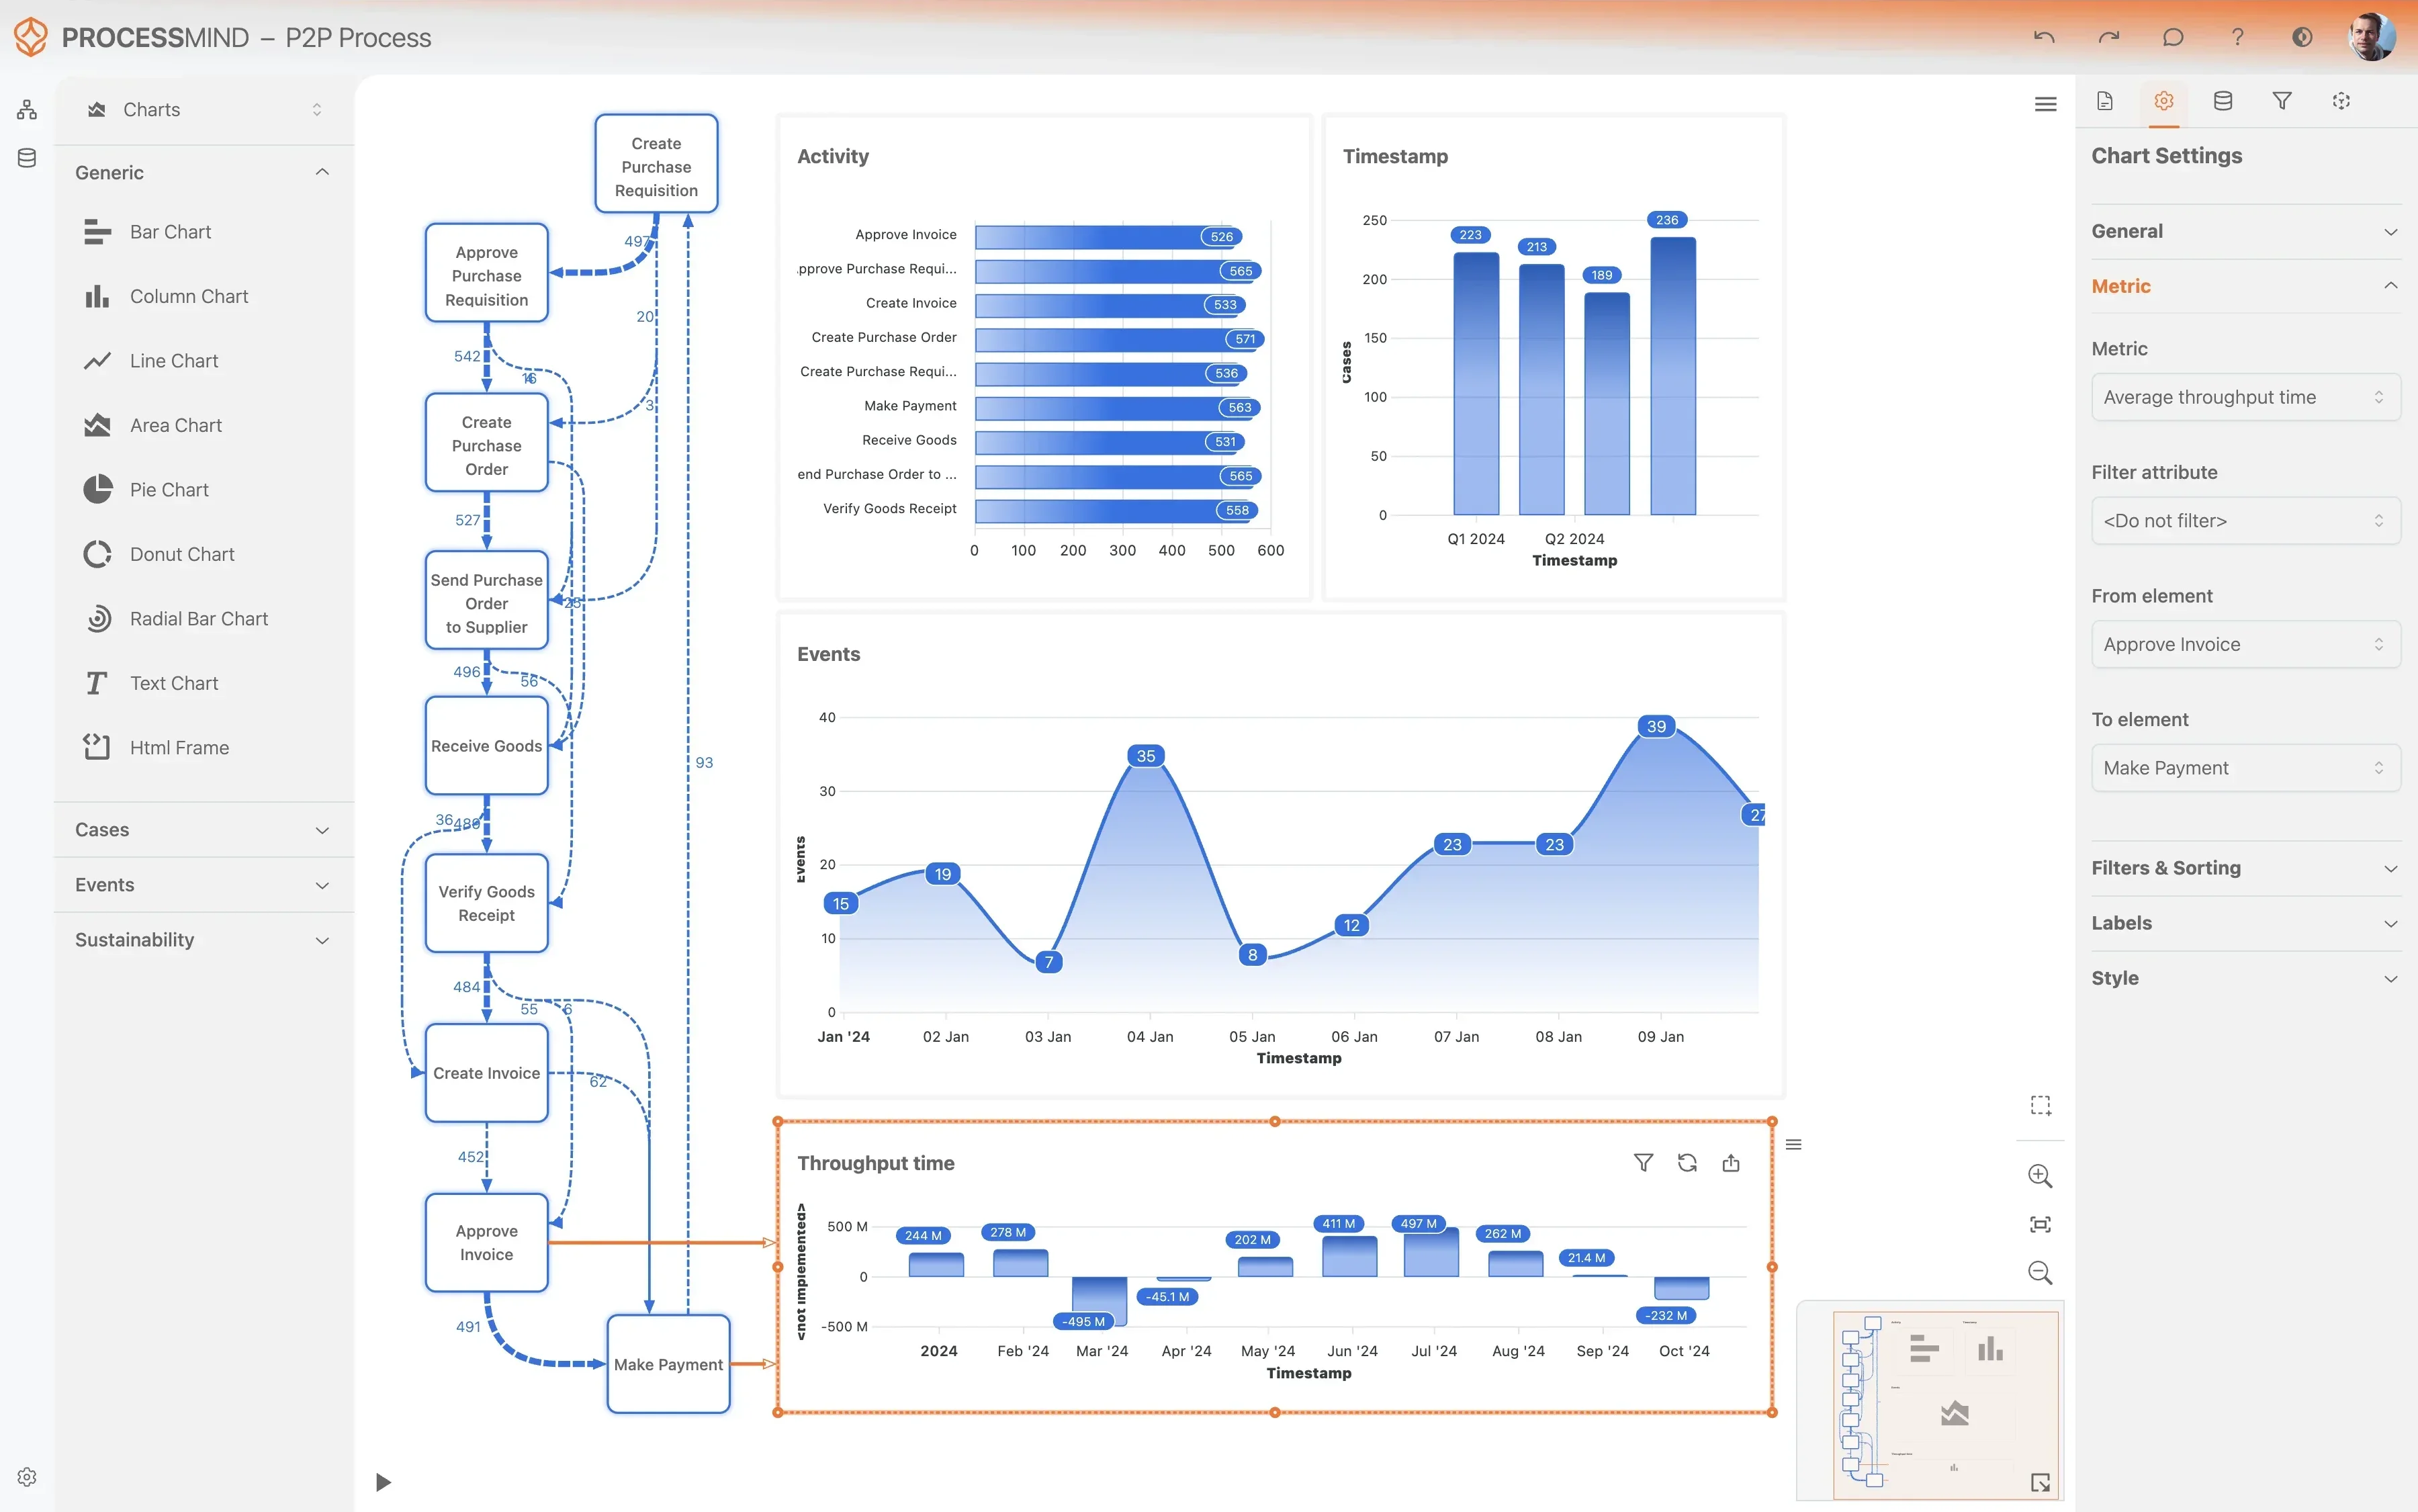
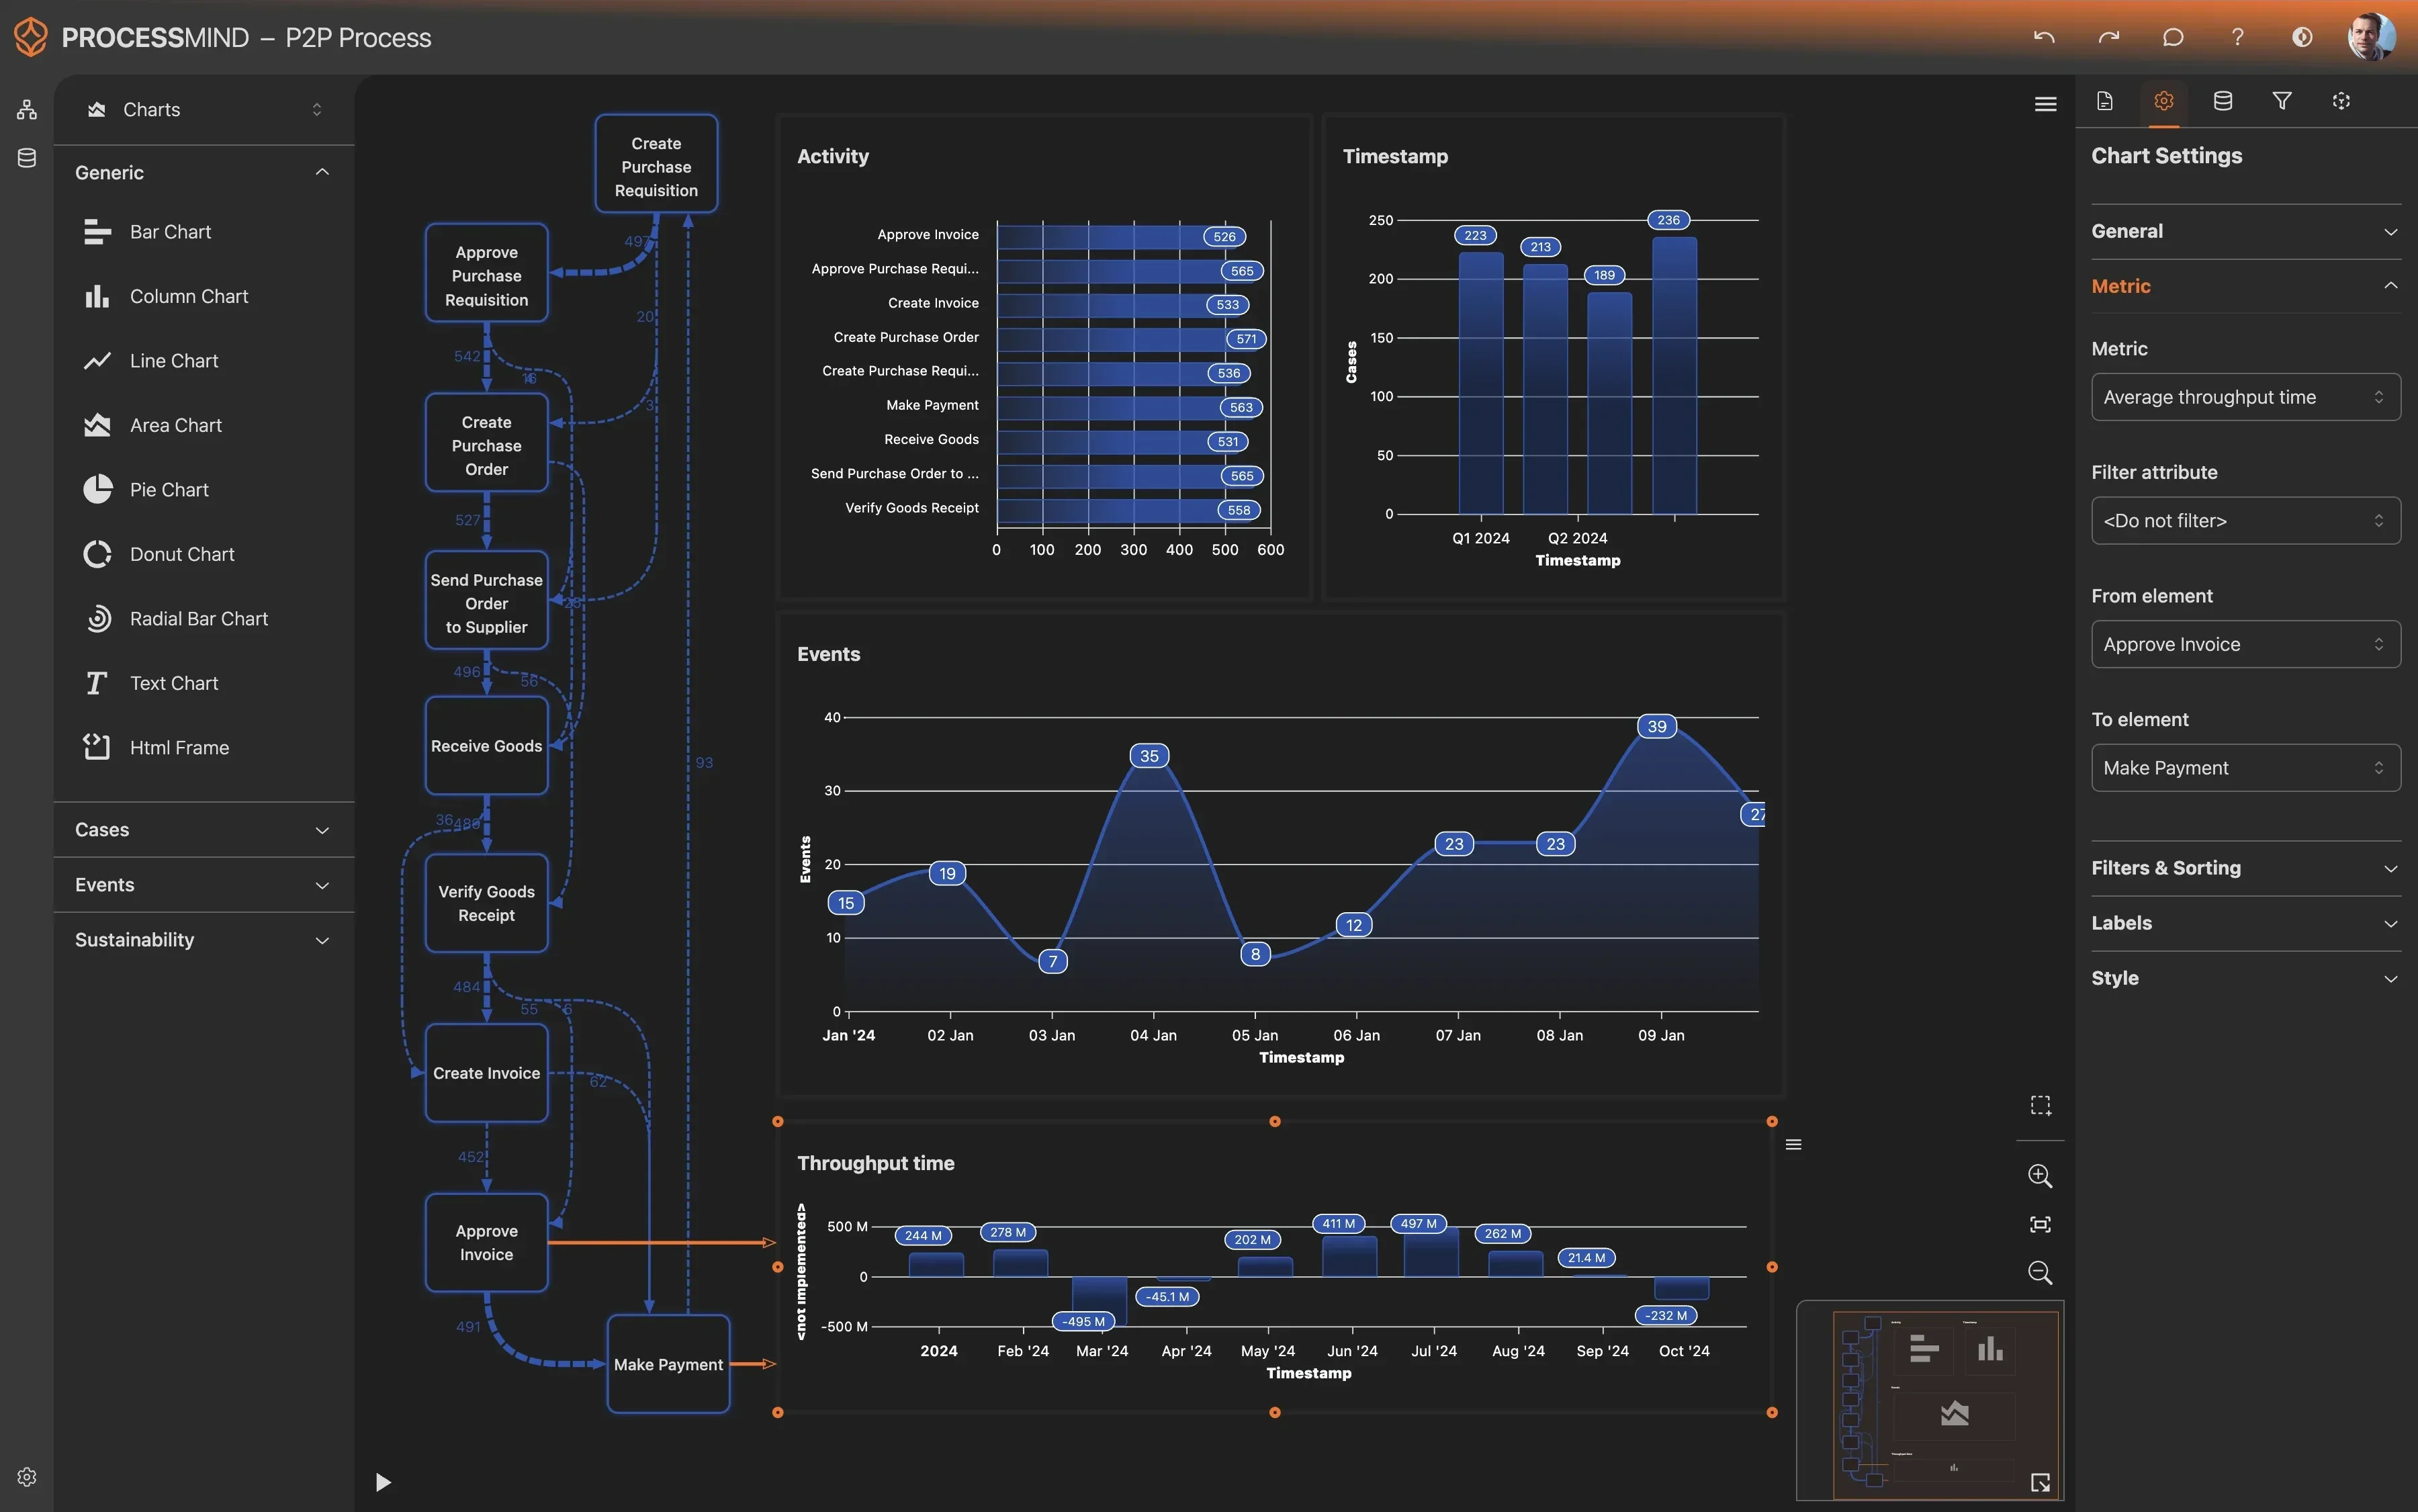
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

TYPOWE REZULTATY

Korzyści z process mining w zarządzaniu problemami

Te rezultaty pokazują wymierne usprawnienia, jakie organizacje osiągają dzięki zastosowaniu process mining w workflow zarządzania problemami. Analiza danych pomaga zespołom wykrywać wąskie gardła, usprawniać rozwiązywanie problemów i skuteczniej zapobiegać ich powracaniu.

0 %
Szybsze ustalanie przyczyn źródłowych

Średnie skrócenie czasu dochodzenia

Usprawnienie drogi od rozpoczęcia dochodzenia do ustalenia przyczyny źródłowej pozwala zespołom technicznym skupić się na trwałych rozwiązaniach zamiast na długotrwałej diagnostyce. Ogranicza to krytyczne przerwy w działaniu usług.

0 %
Mniej ponownej pracy przy przekazywaniu spraw

Spadek liczby ponownych przypisań rekordów problemów

Wykrycie wąskich gardeł na etapie wstępnego kierowania spraw pozwala od razu przekazywać rekordy problemów właściwym ekspertom. Ogranicza to zmarnowany wysiłek i opóźnienia w wielu grupach wsparcia.

0 %
Lepsza realizacja celów SLA

Większa zgodność z SLA w przypadku krytycznych problemów

Bieżący wgląd w rekordy problemów, których obsługa utknęła, pozwala kierownikom interweniować, zanim upłyną terminy SLA. Pomaga to zapewnić firmie stabilny poziom usług.

0 %
Mniej ponownej pracy przy rozwiązywaniu problemów

Niższy odsetek ponownie otwieranych problemów

Weryfikacja rozwiązania przed zamknięciem rekordu pozwala upewnić się, że problem został rzeczywiście usunięty. Zapobiega kosztownemu ponownemu rozpoczynaniu dochodzenia po nieskutecznej poprawce i zwiększa ogólną stabilność.

0 %
Szybsze udostępnianie obejść

Szybsza publikacja rozwiązań tymczasowych

Szybsza publikacja obejść znacznie ogranicza wpływ trwających incydentów na użytkowników końcowych. Zmniejsza zakłócenia w działalności firmy w czasie opracowywania trwałego rozwiązania.

0 %
Mniej powracających incydentów

Spadek liczby powiązanych zgłoszeń do service desk

Skuteczne ustalanie i usuwanie przyczyn źródłowych oraz publikowanie trwałych rozwiązań zapobiega napływowi nowych incydentów do service desk i obniża całkowity koszt wsparcia.

Wyniki zależą od złożoności procesu, jakości danych i przyjętego sposobu wdrożenia. Podane wartości przedstawiają typowe usprawnienia zaobserwowane w różnych wdrożeniach process mining w obszarze zarządzania problemami.

Zalecane dane

Najpierw uwzględnij najważniejsze atrybuty i czynności, a później w razie potrzeby rozszerz zakres.
Pierwszy raz spotykają się Państwo z dziennikiem zdarzeń? Dowiedz się jak utworzyć dziennik zdarzeń na potrzeby process mining.

Atrybuty

Najważniejsze dane do zebrania na potrzeby analizy

Unikalny identyfikator rekordu problemu, który reprezentuje pojedynczy przypadek procesu zarządzania problemami.

Dlaczego to ważne

To podstawowy identyfikator case, który grupuje powiązane zdarzenia i pozwala prześledzić cały przebieg analizy każdego problemu.

Nazwa konkretnego zdarzenia, zadania lub zmiany statusu, która wystąpiła w cyklu życia problemu.

Dlaczego to ważne

Ten atrybut określa kroki procesu i umożliwia wizualizację oraz analizę jego przebiegu, w tym typowych ścieżek i odstępstw.

Dokładna data i godzina wystąpienia danego działania.

Dlaczego to ważne

Znacznik czasu każdego działania jest niezbędny do uporządkowania zdarzeń i obliczania miar czasowych, takich jak czas realizacji i czas trwania wąskich gardeł.

Zespół techniczny lub dział odpowiedzialny za analizę i rozwiązanie problemu w danym momencie.

Dlaczego to ważne

Ułatwia analizę wyników zespołów, wykrywanie wąskich gardeł związanych z przekazywaniem spraw oraz ocenę rozkładu obciążenia między zespołami.

Przypisany problemowi poziom priorytetu, który określa pilność analizy i rozwiązania.

Dlaczego to ważne

Pozwala porównać sposób obsługi problemów krytycznych i rutynowych oraz mierzyć dotrzymywanie SLA.

Końcowa klasyfikacja podstawowej przyczyny problemu.

Dlaczego to ważne

Ułatwia analizę strategiczną, pomagając wykrywać problemy systemowe i trendy dotyczące przyczyn problemów w organizacji.

Główna usługa biznesowa, aplikacja lub element konfiguracji (CI), którego dotyczy problem.

Dlaczego to ważne

Zapewnia kontekst biznesowy, łącząc problemy techniczne z usługami, których dotyczą, i pozwala ustalać priorytety według znaczenia tych usług dla działalności.

Łączna liczba rekordów incydentów powiązanych z problemem.

Dlaczego to ważne

Określa wpływ problemu na działalność, pomagając ustalać priorytety analiz i oceniać skuteczność rozwiązania.

Docelowa data i godzina rozwiązania problemu określona w umowie o gwarantowanym poziomie świadczenia usług.

Dlaczego to ważne

Określa docelowy termin rozwiązania problemu i stanowi podstawę pomiaru oraz raportowania zgodności z SLA.

Flaga wskazująca, czy rozwiązanie problemu nastąpiło po wyznaczonym terminie SLA.

Dlaczego to ważne

Jasno wskazuje, czy dotrzymano SLA, i ułatwia filtrowanie oraz analizę ścieżek procesu prowadzących do naruszeń.

Liczba zmian przypisania rekordu problemu między grupami wsparcia lub poszczególnymi osobami.

Dlaczego to ważne

Pomaga mierzyć nieefektywność procesu przez śledzenie nadmiernej liczby przekazań, które często wskazują na błędne kierowanie spraw, braki wiedzy lub niejasny podział odpowiedzialności.

Działania

Kroki procesu do monitorowania i optymalizacji

Utworzenie rekordu problemu rozpoczyna proces zarządzania problemami i wyznacza początkowy znacznik czasu do dalszej analizy.

Dlaczego to ważne

Ta aktywność rozpoczyna każdą instancję procesu. Analiza czasu od tego zdarzenia do kolejnych etapów pomaga zrozumieć całkowity czas trwania procesu i opóźnienia na jego początku.

To zdarzenie oznacza przejście rekordu problemu ze stanu nowego lub oczekującego do aktywnego dochodzenia. Wskazuje, że analityk formalnie rozpoczął diagnozowanie problemu.

Dlaczego to ważne

Ta aktywność pozwala zmierzyć czas pierwszej reakcji i tempo obsługi zaległości. Czas od utworzenia rekordu do rozpoczęcia dochodzenia wskazuje, jak szybko reaguje zespół.

To zdarzenie oznacza udokumentowanie i udostępnienie rozwiązania tymczasowego lub obejścia. Pozwala ono ograniczyć wpływ problemu na użytkowników końcowych w czasie opracowywania trwałej poprawki.

Dlaczego to ważne

Czas udostępnienia obejścia to ważny KPI, który pokazuje, jak szybko zespół potrafi przywrócić usługę. Analiza tej aktywności pozwala ocenić szybkość i skuteczność rozwiązań tymczasowych.

Ta aktywność oznacza etap, na którym przyczyna źródłowa problemu została ustalona i udokumentowana. Kończy fazę dochodzenia.

Dlaczego to ważne

To ważny etap przy pomiarze skuteczności diagnostyki. Czas od rozpoczęcia dochodzenia do ustalenia przyczyny źródłowej jest istotnym wskaźnikiem efektywności analizy problemów.

To zdarzenie rejestruje utworzenie formalnego wniosku o zmianę lub powiązanie go z rekordem problemu. Oznacza przekazanie sprawy z procesu zarządzania problemami do procesu zarządzania zmianami w celu wdrożenia trwałego rozwiązania.

Dlaczego to ważne

Ta aktywność jest ważna przy analizie opóźnień między diagnozą problemu a rozpoczęciem prac nad rozwiązaniem. Pomaga wykryć wąskie gardła na styku zarządzania problemami i zmianami.

To zdarzenie oznacza pomyślne wdrożenie trwałego rozwiązania technicznego, często realizowanego w ramach wniosku o zmianę. Kończy prace naprawcze.

Dlaczego to ważne

Ta aktywność kończy etap wdrażania rozwiązania. Czas od zainicjowania zmiany do tego momentu pokazuje, jak sprawnie proces zarządzania zmianami rozwiązuje problemy.

To ostatnia aktywność w cyklu życia problemu. Oznacza administracyjne zamknięcie rekordu, po którym nie oczekuje się dalszych działań. Sprawa jest uznawana za zakończoną i zarchiwizowaną.

Dlaczego to ważne

Ta aktywność jest końcowym etapem większości instancji procesu. Jest niezbędna do obliczenia całkowitego czasu trwania procesu zarządzania problemami.

Aby otrzymać spersonalizowane rekomendacje dotyczące danych, wybierz konkretny proces.

FAQ

Często zadawane pytania

Process mining pokazuje rzeczywistą ścieżkę każdego rekordu problemu, ujawnia odstępstwa od standardowego workflow i wskazuje ukryte wąskie gardła. Dostarcza danych o przebiegu procesu, które pomagają zespołom zwiększyć wydajność i skrócić czas rozwiązywania problemów.

Zazwyczaj potrzebny jest dziennik zdarzeń zawierający unikalny identyfikator case, znacznik czasu każdej aktywności i jej opis. Dodatkowe informacje, takie jak zmiany statusu, przypisane grupy, priorytet i kategoria, zapewniają szerszy kontekst do analizy.

Pierwsze wnioski można często uzyskać w ciągu kilku dni lub tygodni od skonfigurowania pobierania danych z systemu źródłowego. Początkowy etap obejmuje połączenie z systemem i zmapowanie głównych zmian w procesie, aby przygotować model bazowy.

Process mining wskazuje etapy, na których dochodzenie się zatrzymuje, i mierzy czas trwania poszczególnych przejść. Ujawnia braki zasobów lub brakujące informacje, które wydłużają dochodzenie. Dzięki analizie danych można zastąpić przypuszczenia konkretnymi informacjami o miejscach, w których dochodzi do opóźnień.

Mapując każde przejście, process mining wskazuje rekordy, które wielokrotnie krążą między grupami wsparcia, nie prowadząc do rozwiązania. Pomaga to kierownikom wykryć niejasny podział odpowiedzialności lub sytuacje, w których zespołom brakuje zasobów do obsługi określonych typów problemów. Na tej podstawie można przeprojektować proces i lepiej przydzielać zasoby.

Process mining wskazuje przyczyny przekroczeń SLA, pokazując dokładny przebieg rekordów, dla których nie dotrzymano terminów. Można porównać rekordy obsłużone zgodnie z SLA z tymi, w których doszło do przekroczeń, i sprawdzić, czy opóźnienia częściej dotyczą określonych grup wsparcia lub typów problemów. Ułatwia to podjęcie ukierunkowanych działań, aby problemy o wysokim priorytecie były obsługiwane w wymaganym czasie.

Analizując powiązania między rekordami incydentów i problemów, process mining wykrywa sytuacje, w których problemy są wielokrotnie łagodzone za pomocą obejść zamiast trwałych rozwiązań. Dzięki temu można nadać priorytet rozwiązaniom o największym wpływie, które eliminują całe grupy powracających zgłoszeń do wsparcia.

Standardowe raporty przedstawiają migawki i zagregowane wskaźniki, ale często nie pokazują rzeczywistego przebiegu obsługi rekordu problemu. Process mining ujawnia konkretne przejścia, pętle i odstępstwa, które kryją się za tymi wskaźnikami. Pokazuje, gdzie i dlaczego proces się zatrzymuje, uzupełniając standardowe raporty o szerszy obraz zmian w czasie, potrzebny do skutecznej optymalizacji.

Usprawnij zarządzanie problemami już teraz

Wykryj nieefektywności i szybciej rozwiązuj problemy dzięki analizie danych.

Rozpocznij okres próbny

Karta kredytowa nie jest wymagana. Konfiguracja zajmuje kilka minut.