Usprawnij zarządzanie problemami
Skorzystaj z tego 6-etapowego przewodnika, aby usprawnić workflow.
Usprawnij zarządzanie problemami
Zarządzanie problemami
Zendesk Support

Wybierz proces

Wybierz proces, aby kontynuować pracę w połączonym obszarze roboczym.

Usprawnij zarządzanie problemami w Zendesk Support i zwiększ stabilność IT

Process mining ujawnia ukryte wąskie gardła i opóźnienia wynikające z organizacji procesu, które często umykają podczas ręcznych przeglądów. Platforma pokazuje, gdzie zgłoszenia utknęły lub wielokrotnie krążą między zespołami. Dzięki temu można usprawnić każdy etap rozwiązywania problemu. Taka widoczność pomaga zespołowi skupić się na poprawkach o największym wpływie, zamiast na obsłudze administracyjnej.

Pobierz gotowy szablon danych i poznaj częste wyzwania, które utrudniają osiągnięcie celów efektywnościowych. Skorzystaj z planu doskonalenia w sześciu krokach oraz przewodnika po szablonie danych, aby usprawnić operacje.

Pokaż szczegółowy opis

Dlaczego usprawnianie zarządzania problemami ma znaczenie dla stabilności IT

Zarządzanie problemami stanowi podstawę stabilnej infrastruktury IT. Zarządzanie incydentami koncentruje się na jak najszybszym przywróceniu usług, natomiast zarządzanie problemami służy znalezieniu i usunięciu przyczyn tych incydentów. W Zendesk Support wiele organizacji działa w trybie ciągłego reagowania na awarie. Te same problemy wracają tydzień po tygodniu, bo ich źródło nie zostało właściwie usunięte. To kosztuje: rosną wydatki operacyjne, spada dostępność usług, a zespół wsparcia ma poczucie, że stoi w miejscu.

Usprawnienie tego procesu to nie tylko kwestia szybkości, ale też trafnej diagnozy i zapobiegania problemom. Lepszy workflow zarządzania problemami pozwala z czasem ograniczyć liczbę zgłaszanych incydentów. Dzięki temu specjaliści techniczni mogą poświęcać mniej czasu na powtarzalne naprawy, a więcej na projekty przynoszące firmie wymierne korzyści. Bez jasnego obrazu przebiegu problemów trudno ustalić, na którym etapie dochodzenie traci tempo i dlaczego rozwiązania się opóźniają.

Jak process mining pokazuje przebieg problemów w Zendesk

Process mining odtwarza rzeczywisty przebieg każdego rekordu problemu na podstawie danych z Zendesk. Zamiast ograniczać się do statycznych raportów ze średnim czasem rozwiązania, można zobaczyć kolejność zdarzeń tak, jak faktycznie następowały. Analiza obejmuje każdy etap, od zgłoszenia problemu po przegląd po wdrożeniu. Taka przejrzystość pomaga porównać udokumentowany proces z tym, jak praca przebiega w praktyce.

Analiza cyfrowych śladów pracy zespołów technicznych pokazuje, gdzie proces traci tempo. Może się na przykład okazać, że rekordy problemów często zatrzymują się po znalezieniu obejścia, bo znika presja na wdrożenie trwałej poprawki. Process mining ujawnia też ukryte wzorce i wąskie gardła, takie jak nadmierna liczba przekazań między grupami wsparcia lub długie oczekiwanie na zatwierdzenie wniosku o zmianę. Dzięki analizie danych można skupić działania na etapach, które dają największe możliwości usprawnienia, zamiast opierać się na przypuszczeniach.

Gdzie usprawnić przebieg dochodzenia

Częstym obszarem do poprawy w Zendesk Support jest przekazywanie spraw między wsparciem drugiej linii a wyspecjalizowanymi zespołami inżynieryjnymi. Process mining pokazuje, czy przekazanie przebiega sprawnie, czy też problemy giną w kolejce bez przypisanego właściciela. Analiza czasu spędzonego na etapie Investigation Commenced pozwala ocenić, czy zespoły mają odpowiednie narzędzia i informacje do skutecznej analizy przyczyn źródłowych. Jeśli dochodzenie regularnie trwa długo, może to wskazywać na potrzebę lepszej integracji z bazą wiedzy lub ujednolicenia procedur diagnostycznych.

Warto też przyjrzeć się przerwie między zaproponowaniem rozwiązania a wdrożeniem trwałej poprawki. W wielu organizacjach rozwiązanie zostaje opracowane, ale trafia do kolejki zaległości, ponieważ proces zarządzania zmianami jest od niego odłączony lub nadmiernie sformalizowany. Process mining pokazuje dokładny czas tych opóźnień. Pozwala również ocenić skuteczność obejść. Jeśli po opublikowaniu obejścia liczba eskalowanych incydentów nie spada, może to oznaczać, że trudno je znaleźć albo nie działa. W takiej sytuacji warto szybko zmienić podejście.

Korzyści z usprawnienia procesu rozwiązywania problemów

Skuteczne usprawnienie zarządzania problemami przynosi korzyści całej organizacji. Jednym z pierwszych efektów jest mierzalne skrócenie czasu analizy przyczyn źródłowych. Szybsze dochodzenia pozwalają wcześniej wdrażać trwałe poprawki, co bezpośrednio przekłada się na mniejszą liczbę powracających incydentów. Łatwiej też dotrzymywać uzgodnionych poziomów usług i budować zaufanie interesariuszy biznesowych.

Usprawniony proces poprawia również jakość pracy technicznej. Dokładna weryfikacja rozwiązania i przegląd po wdrożeniu pomagają uniknąć wprowadzania nowych problemów do środowiska. Powstaje pętla informacji zwrotnej, która wspiera ciągłe doskonalenie: każdy rozwiązany problem zwiększa odporność systemu. Pracownicy techniczni są też mniej obciążeni powtarzalnymi zgłoszeniami i mogą poświęcić więcej czasu na złożone, rozwijające zadania.

Jak zacząć zarządzać problemami na podstawie danych

Aby usprawnić zarządzanie problemami w Zendesk Support, warto odejść od pojedynczych relacji i oprzeć się na danych o rzeczywistym przebiegu procesu. Najpierw należy zmapować obecny stan i wskazać łatwe do usunięcia problemy, takie jak długie okresy bezczynności lub stale przeciążone grupy wsparcia. Na tej podstawie można ustalić realistyczne cele dla zespołów technicznych i uzasadnić zasoby potrzebne do bardziej złożonych analiz przyczyn źródłowych. Po wprowadzeniu zmian warto nadal monitorować przebieg procesu, aby sprawdzić, czy efekty się utrzymują i nie pojawiają się nowe wąskie gardła. Przekształcenie organizacji wsparcia w zespół, który zapobiega problemom zamiast tylko na nie reagować, wymaga czasu. Przy dobrej widoczności workflow w Zendesk jest to jednak osiągalne.

Zarządzanie problemami Zarządzanie usługami IT Analiza przyczyn źródłowych Ograniczanie liczby incydentów Kierownik service desk Zarządzanie wnioskami o zmianę Zgodność z SLA Obsługa zgłoszeń Zarządzanie zgłoszeniami Znany błąd Powtarzające się incydenty Obejście problemu Zapobieganie incydentom Dział pomocy IT

Typowe problemy i wyzwania

Wskaż wyzwania, które Państwa dotyczą

Długie etapy dochodzenia sprawiają, że poważne problemy pozostają nierozwiązane przez wiele tygodni. Narasta dług techniczny, a incydenty powracają. Gdy analiza przyczyn źródłowych trwa zbyt długo, zespół wsparcia nadal działa reaktywnie, co osłabia stabilność usług IT i zwiększa obciążenie agentów Zendesk Support. Opóźnienia często wynikają z niejasnego przebiegu dochodzenia lub braku dostępu do danych historycznych podczas diagnozy.

Nasze rozwiązanie mapuje przebieg od Problem Identification do Root Cause Identified i wskazuje, na których etapach dochodzenia tracą tempo. Wizualizacja przepływu między grupami wsparcia pomaga wykryć wąskie gardła związane z zasobami i usprawnić przekazywanie spraw, aby szybciej wdrażać trwałe poprawki. Dzięki temu zespoły techniczne mogą skupić się na dochodzeniach o największym wpływie, zamiast tracić czas na opóźnienia administracyjne.

Jeśli problemy nie są usuwane u źródła, te same incydenty nadal trafiają do service desku, pochłaniając czas i zasoby. Ciągłe gaszenie pożarów utrudnia zespołowi pracę nad usprawnieniami, a użytkownicy są sfrustrowani powtarzającymi się zakłóceniami. Bez jasnego powiązania incydentów z ich przyczynami organizacja wciąż ponosi koszty tych samych błędów.

Analizujemy zależność między rekordami problemów a liczbą incydentów w Zendesk Support, aby wskazać problemy powodujące najwięcej zakłóceń. Process mining pokazuje, czy obejścia nie zastępują trwałego rozwiązania, które powinno zostać wdrożone w ramach formalnego wniosku o zmianę. Dzięki temu można ustalać priorytety na podstawie rzeczywistego wpływu rozwiązania problemu na liczbę incydentów i obciążenie service desku.

Jeśli zespoły techniczne znajdują tymczasowe rozwiązania, ale nie publikują ich w bazie wiedzy, pracownicy pierwszej linii nie mogą szybko pomóc użytkownikom. Brak informacji wydłuża rozwiązywanie incydentów, podczas gdy formalny rekord problemu pozostaje otwarty i w trakcie dochodzenia. Wiedza organizacyjna często ginie w prywatnych notatkach lub korespondencji e-mail zamiast trafiać do Zendesk Support, gdzie mogą z niej korzystać inni.

ProcessMind monitoruje przejście od Workaround Identified do Workaround Published, aby sprawdzić, czy dzielenie się wiedzą jest stałym elementem workflow. Wskazujemy przypadki, w których znaleziono obejście, ale go nie udokumentowano. Pozwala to usprawnić zarządzanie wiedzą i zapewnić, że każde znane obejście jest od razu dostępne dla osób obsługujących incydenty. Użytkownicy krócej czekają wtedy na rozwiązanie.

Niedotrzymanie terminów rozwiązania problemów o wysokim priorytecie może poważnie zakłócić działalność firmy i obniżyć produktywność. Bez jasnego obrazu postępu prac trudno skutecznie przydzielać zasoby i dotrzymywać uzgodnionych poziomów usług. Organizacje często nie wiedzą, który etap cyklu życia problemu najczęściej prowadzi do przekroczenia SLA.

Nasza platforma porównuje atrybut SLA Due Date z bieżącym postępem procesu i wskazuje rekordy zagrożone przekroczeniem terminu, zanim do niego dojdzie. W Zendesk Support można sprawdzić, które grupy wsparcia mają trudności z szybkim rozwiązywaniem poważnych problemów, i odpowiednio rozdzielić obciążenie. Takie monitorowanie pomaga dotrzymywać uzgodnionych poziomów usług i zapewnia, że problemy o dużym wpływie otrzymują należytą uwagę.

Rekordy problemów często krążą między grupami wsparcia bez widocznego postępu, co powoduje niepotrzebne opóźnienia. Przyczyną bywa niejasna odpowiedzialność, brak informacji przekazywanych między zespołami lub niedostateczna rozliczalność na etapie dochodzenia. Takie przekazywanie spraw wydłuża czas obsługi rekordu, nie przybliżając go do trwałego rozwiązania.

Nasze narzędzie process mining wizualizuje przepływ problemów między Assigned Support Groups, aby wykrywać powtarzające się przekazania i okresy bezczynności. Taki obraz pomaga wyraźniej określić zakres odpowiedzialności i poprawić jakość informacji przekazywanych między zespołami. Gdy wiadomo, w których grupach sprawy najczęściej utkną, można wprowadzić ukierunkowane szkolenia lub zmiany procesu w Zendesk Support, aby usprawnić współpracę.

Znalezienie przyczyny źródłowej to dopiero połowa pracy. Wiele organizacji ma trudności z przejściem od zaproponowanego rozwiązania do wdrożenia trwałej poprawki. Opóźnienia w składaniu wniosków o zmianę lub wdrażaniu poprawek narażają środowisko na kolejne incydenty, mimo że przyczyna jest już znana. Często wynika to z braku współpracy między zespołami zarządzającymi problemami i zmianami.

Śledzimy przebieg od Proposed Solution Drafted do Permanent Fix Applied, aby wskazać przeszkody na etapie wdrożenia. Pozwala to ocenić, jak dobrze zarządzanie zmianami współpracuje z obsługą problemów, i sprawdzić, czy zidentyfikowane poprawki są wdrażane bez zbędnej zwłoki. Analiza czasu oczekiwania na zatwierdzenie zmian pomaga usprawnić przejście od diagnozy technicznej do rozwiązania.

Pominięcie przeglądu po wdrożeniu pozbawia organizację możliwości wyciągania wniosków ze złożonych problemów i zapobiegania ich powrotom. Bez uporządkowanej pętli informacji zwrotnej te same nieefektywności mogą powtarzać się podczas kolejnych dochodzeń. Brak formalnego zamknięcia utrudnia ciągłe doskonalenie usług i hamuje rozwój dojrzałości IT.

ProcessMind wskazuje rekordy problemów, które przechodzą bezpośrednio od Resolution Verified do Closed, bez etapu przeglądu. Dzięki temu można sprawdzić, czy zespoły realizują pełny cykl życia problemu w Zendesk Support i zapisują wnioski potrzebne do dalszego doskonalenia. Analiza danych pomaga budować zasób wiedzy organizacyjnej i skuteczniejsze działania zapobiegawcze, tak aby każdy poważny problem przynosił użyteczne wnioski.

Jeśli rekordy problemów są błędnie kategoryzowane lub nie zawierają szczegółowych atrybutów dotyczących przyczyn źródłowych, rzetelna analiza trendów staje się niemal niemożliwa. Niska jakość danych ukrywa rzeczywiste przyczyny niestabilności IT i utrudnia podejmowanie świadomych decyzji o inwestycjach w infrastrukturę. Jeśli Problem Category nie odpowiada rzeczywistej przyczynie, długoterminowe planowanie opiera się na błędnych założeniach.

Analizujemy wykorzystanie atrybutów takich jak Problem Category i Root Cause Category na kolejnych etapach procesu w Zendesk Support. Wskazujemy, gdzie brakuje danych lub gdzie są one uzupełniane dopiero pod koniec cyklu życia problemu. Dzięki temu można poprawić standardy wprowadzania danych i uzyskać dokładniejszy obraz problemów. Ułatwia to ustalenie, które usługi biznesowe lub elementy konfiguracji wymagają największych nakładów i uwagi.

Zespoły czasem bezterminowo polegają na tymczasowych obejściach, aby uniknąć złożoności wdrożenia trwałej poprawki. Mogą one usunąć bieżący objaw, ale pozostawiają niestabilną infrastrukturę i zwiększają długoterminowe obciążenie działu IT. Z czasem nagromadzenie tymczasowych rozwiązań sprawia, że środowisko staje się podatne na awarie, a drobne zmiany mogą powodować poważne zakłócenia.

Nasza platforma wykrywa długo otwarte rekordy problemów, w których opublikowano obejście, ale nie złożono wniosku o zmianę. Dzięki temu można nadać priorytet przejściu od tymczasowego ograniczenia skutków do trwałego rozwiązania i zmniejszyć dług techniczny. Monitorowanie czasu, jaki upłynął od publikacji obejścia, pomaga skłonić zespół do wdrożenia stabilniejszego rozwiązania na dłuższą metę.

Wiele rekordów problemów zostaje otwartych, ale nigdy nie dociera do rozwiązania. Przez miesiące pozostają aktywne bez aktualizacji. Zaśmiecają kolejkę, zniekształcają wskaźniki efektywności i oznaczają nierozwiązane ryzyko dla firmy. Zespoły często o nich zapominają, gdy zajmują się pilniejszymi incydentami, a problem w końcu prowadzi do kolejnego kryzysu.

Automatycznie wskazujemy rekordy z długimi przerwami między działaniami, takimi jak Investigation Commenced i Proposed Solution Drafted. Dzięki temu menedżerowie mogą przejrzeć zaległości, wznowić dochodzenia, które utknęły, lub formalnie zamknąć rekordy, które nie są już istotne w Zendesk Support. Usunięcie nieaktywnych rekordów pozwala dokładniej ocenić rzeczywiste możliwości zespołu i jego obciążenie pracą.

Typowe cele

Określ, jak wygląda sukces

Szybkie ustalenie przyczyny ma znaczenie, ponieważ podczas długiego dochodzenia systemy pozostają narażone na kolejne problemy. Skrócenie czasu potrzebnego na znalezienie przyczyny źródłowej ogranicza ryzyko zakłóceń w działalności firmy i pomaga utrzymać ciągłość usług. Szybsze dochodzenia pozwalają zespołom IT przejść od reaktywnego diagnozowania do proaktywnego zwiększania stabilności.

ProcessMind mapuje przebieg od zgłoszenia problemu do ustalenia jego przyczyny źródłowej w Zendesk Support. Wskazuje etapy, na których dochodzenia tracą tempo, dzięki czemu menedżerowie mogą lepiej przydzielić specjalistów technicznych i uprościć diagnostykę. Identyfikacja tych wąskich gardeł pozwala skrócić etap dochodzenia nawet o 30%.

Częste powroty incydentów wskazują, że problemy systemowe nie są usuwane u źródła. Zajęcie się przyczyną, a nie tylko objawami, pozwala zespołom IT obniżyć całkowity koszt wsparcia i poprawić zadowolenie użytkowników. Skuteczne zarządzanie problemami z czasem przekłada się na mniejszą liczbę zgłoszeń w kolejce Zendesk Support.

Dzięki process mining zespoły mogą powiązać rekordy problemów z często powtarzającymi się incydentami. ProcessMind pokazuje, które rozwiązania zapobiegają nawrotom, a które nie usuwają przyczyny. Taka wiedza pozwala skupić się na problemach powodujących najwięcej incydentów i ograniczyć liczbę powracających zgłoszeń o 20%.

Skuteczne obejście pozwala szybko ograniczyć skutki problemu, gdy trwa opracowywanie trwałej poprawki. Szybkie udokumentowanie i opublikowanie obejścia skraca przestoje użytkowników i pomaga agentom service desku szybciej rozwiązywać powiązane incydenty. Ujednolicone podejście do obejść sprawia, że wiedza techniczna nie pozostaje wyłącznie w poszczególnych zespołach.

ProcessMind mierzy czas od znalezienia obejścia do jego publikacji w bazie wiedzy w Zendesk Support. Wskazuje znane, ale nieudostępnione rozwiązania tymczasowe, aby informacje mogły swobodnie przepływać między zespołami. Dzięki temu więcej obejść jest dostępnych, a średni czas przywrócenia usługi w przypadku znanych problemów się skraca.

Dotrzymywanie uzgodnionych poziomów usług przy problemach o wysokim priorytecie pomaga utrzymać stabilność usług istotnych dla działalności firmy. Regularne osiąganie tych celów buduje zaufanie interesariuszy i zapewnia, że najpoważniejsze problemy otrzymują należytą uwagę. Niedotrzymanie terminów może prowadzić do kolejnych awarii i spadku produktywności.

ProcessMind zapewnia bieżący wgląd w status SLA dla wszystkich aktywnych rekordów problemów. Wskazuje ścieżki procesu prowadzące do przekroczenia terminów, dzięki czemu menedżerowie mogą zareagować, zanim do niego dojdzie. Usunięcie przeszkód na ścieżce eskalacji pomaga organizacjom osiągnąć 100% zgodności z terminami rozwiązywania problemów krytycznych.

Rozwiązywanie problemów często wymaga współpracy kilku wyspecjalizowanych zespołów technicznych. Sprawne przekazywanie spraw ogranicza utratę informacji i skraca przestoje, które często towarzyszą rozwiązywaniu złożonych problemów. Lepsza organizacja przekazań przyspiesza cały cykl życia problemu i ogranicza błędy w komunikacji.

Platforma wizualizuje punkty przekazania spraw między grupami wsparcia w Zendesk Support. ProcessMind mierzy czas oczekiwania na każdym etapie, pomagając wykrywać silosy i usprawniać komunikację. Dzięki temu menedżerowie mogą poprawić zasady przekazywania spraw i skrócić czas, przez który rekord problemu pozostaje w stanie oczekiwania podczas zmiany grupy.

Po ustaleniu przyczyny źródłowej należy jak najszybciej przejść do wdrożenia rozwiązania. Skrócenie czasu między zakończeniem dochodzenia a złożeniem wniosku o zmianę pomaga szybciej przywrócić stabilność systemów. Opóźnienia na tym etapie często wynikają z przeszkód administracyjnych lub słabej koordynacji między działami.

ProcessMind analizuje czas od ustalenia przyczyny źródłowej do utworzenia wniosku o zmianę lub wdrożenia poprawki. Ujawnia przeszkody administracyjne, które utrudniają przejście od diagnozy do rozwiązania. Usprawnienie tego przekazania pozwala skrócić całkowity czas rozwiązywania złożonych problemów IT.

Przeglądy po wdrożeniu wspierają ciągłe doskonalenie procesów i uczenie się organizacji. Formalny przegląd każdego poważnego problemu pomaga wyciągać wnioski z wcześniejszych błędów i zapobiegać podobnym problemom w innych obszarach. Bez takich przeglądów te same błędy procesowe mogą powtarzać się bez końca.

Process mining mierzy odsetek przeglądów przeprowadzonych po zamknięciu rekordu problemu w Zendesk Support. Wskazuje zespoły lub kategorie, w których ten etap jest często pomijany, co pozwala lepiej egzekwować standardy procesu. Większa zgodność z wymogiem przeglądu sprawia, że każdy poważny incydent wzbogaca wiedzę organizacyjną.

Prawidłowa kategoryzacja stanowi podstawę rzetelnej analizy trendów i planowania zasobów. Dokładne dane pomagają kierować zasoby tam, gdzie mogą najbardziej poprawić jakość usług IT i wyniki firmy. Błędne kategorie sprawiają, że raporty zarządcze tracą wiarygodność, a znalezienie przyczyn źródłowych staje się trudniejsze.

ProcessMind wykrywa zmiany kategorii na kolejnych etapach cyklu życia problemu. Wskazanie miejsc, w których początkowa klasyfikacja często okazuje się błędna, pomaga menedżerom poprawić szkolenia i zasady wprowadzania danych. Lepsza jakość danych u źródła przekłada się na dokładniejsze raporty i trafniejsze decyzje dotyczące inwestycji w infrastrukturę IT.

Nadmierne poleganie na obejściach zwiększa dług techniczny i długoterminową niestabilność firmy. Celem zarządzania problemami jest zastępowanie tymczasowych rozwiązań trwałymi poprawkami, które całkowicie usuwają źródło podatności. Ważnym miernikiem skuteczności jest ograniczenie liczby problemów, które bezterminowo pozostają w stanie obejścia.

Platforma monitoruje problemy, w których obejście pozostaje w użyciu przez długi czas. Dostarcza danych uzasadniających nakład pracy technicznej potrzebny do wdrożenia trwałych poprawek zamiast dalszego reagowania na bieżące objawy. Takie działania zmniejszają długoterminowe obciążenie zespołów technicznych i zwiększają niezawodność systemów.

Otwarte rekordy problemów bez żadnej aktywności oznaczają zaniedbane ryzyko dla środowiska. Uporządkowana, aktualna kolejka pozwala zespołowi IT skupić się na bieżących priorytetach zamiast zarządzać stale rosnącą listą spraw bez postępu. Nieaktywne rekordy często kryją nierozwiązane problemy, które mogą doprowadzić do poważnych awarii.

ProcessMind wykrywa nieaktywne rekordy problemów na podstawie czasu od ostatniego działania lub zmiany statusu w Zendesk Support. Menedżerowie mogą skonfigurować alerty lub ponowne przypisanie rekordów, które nie posunęły się naprzód w określonym czasie. Takie monitorowanie pomaga zapobiegać zapominaniu o problemach i utrzymać zaległości na możliwym do opanowania poziomie.

Problemy o wysokim priorytecie mają największy wpływ na działalność firmy i jej przychody. Szybsze i częstsze rozwiązywanie takich problemów chroni najważniejsze usługi i zasoby biznesowe. Wysoki odsetek rozwiązanych problemów krytycznych świadczy o sprawnym zarządzaniu problemami.

ProcessMind pozwala szczegółowo analizować cykl życia rekordów o wysokim priorytecie i porównywać go z przebiegiem standardowych spraw. Pokazuje, czy problemy krytyczne są traktowane z należytą pilnością i gdzie proces napotyka przeszkody. Dzięki tym informacjom zespoły mogą ustalać priorytety pracy i zwiększać odsetek problemów krytycznych rozwiązanych w wyznaczonym czasie.

Analiza problemów może wymagać dużych nakładów pracy, często wielu godzin zaangażowania starszych inżynierów. Usprawnienie tego procesu pozwala specjalistom poświęcać mniej czasu na zadania administracyjne, a więcej na złożoną diagnostykę techniczną i rozwój. Niższy koszt analizy sprawia, że zarządzanie problemami jest bardziej efektywne kosztowo.

ProcessMind mierzy czas pracy i długość dochodzeń różnego rodzaju, aby wskazać najefektywniejsze ścieżki rozwiązywania problemów. Dane te pomagają ujednolicić dobre praktyki we wszystkich zespołach wsparcia technicznego. Organizacje mogą wykorzystać te informacje do obniżenia średniego kosztu rozwiązania problemu bez obniżania jakości.

6 kroków do zarządzania problemami w Zendesk

1

Pobierz szablon

Co zrobić

Pobierz gotowy szablon Excel przygotowany z myślą o strukturze danych dotyczących zarządzania problemami w Zendesk.

Dlaczego to ważne

Standardowy format zapewnia zgodność rekordów problemów i powiązanych zgłoszeń z mechanizmem analitycznym.

Oczekiwany rezultat

Gotowy szablon danych do śledzenia problemów w Zendesk.

CO MOŻNA ODKRYĆ

Znajdź przyczyny opóźnień w zarządzaniu problemami i usuń je

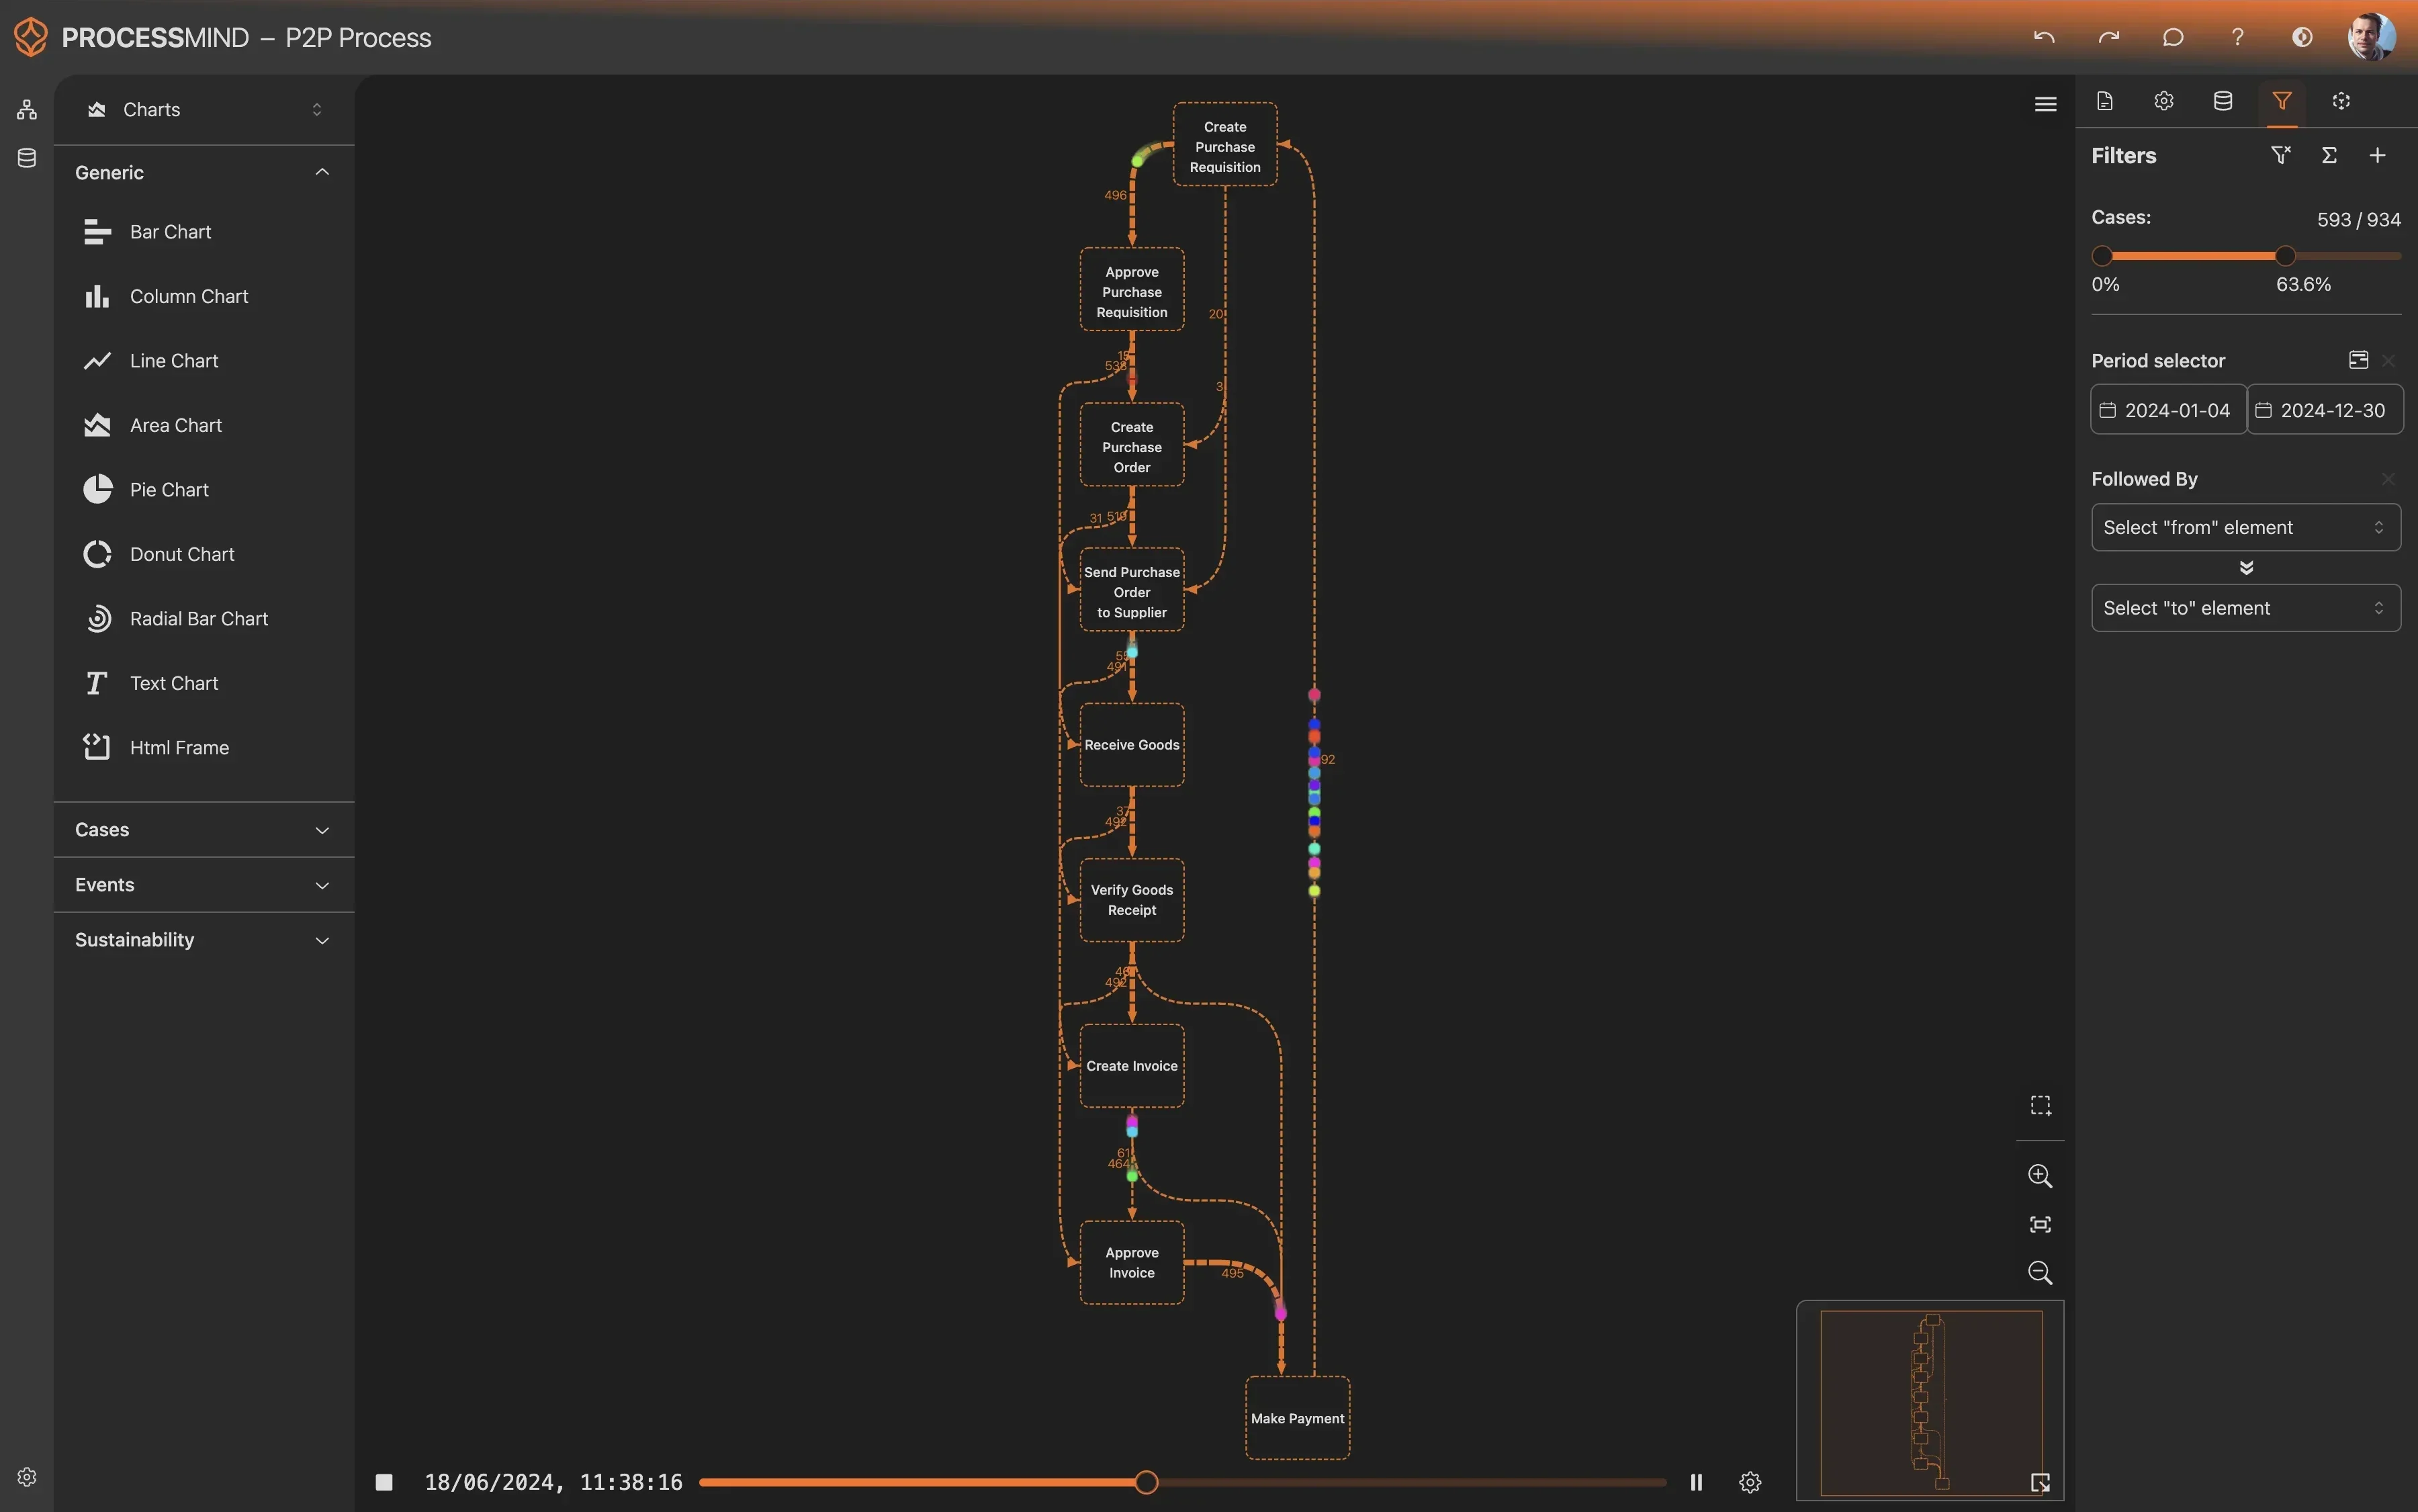
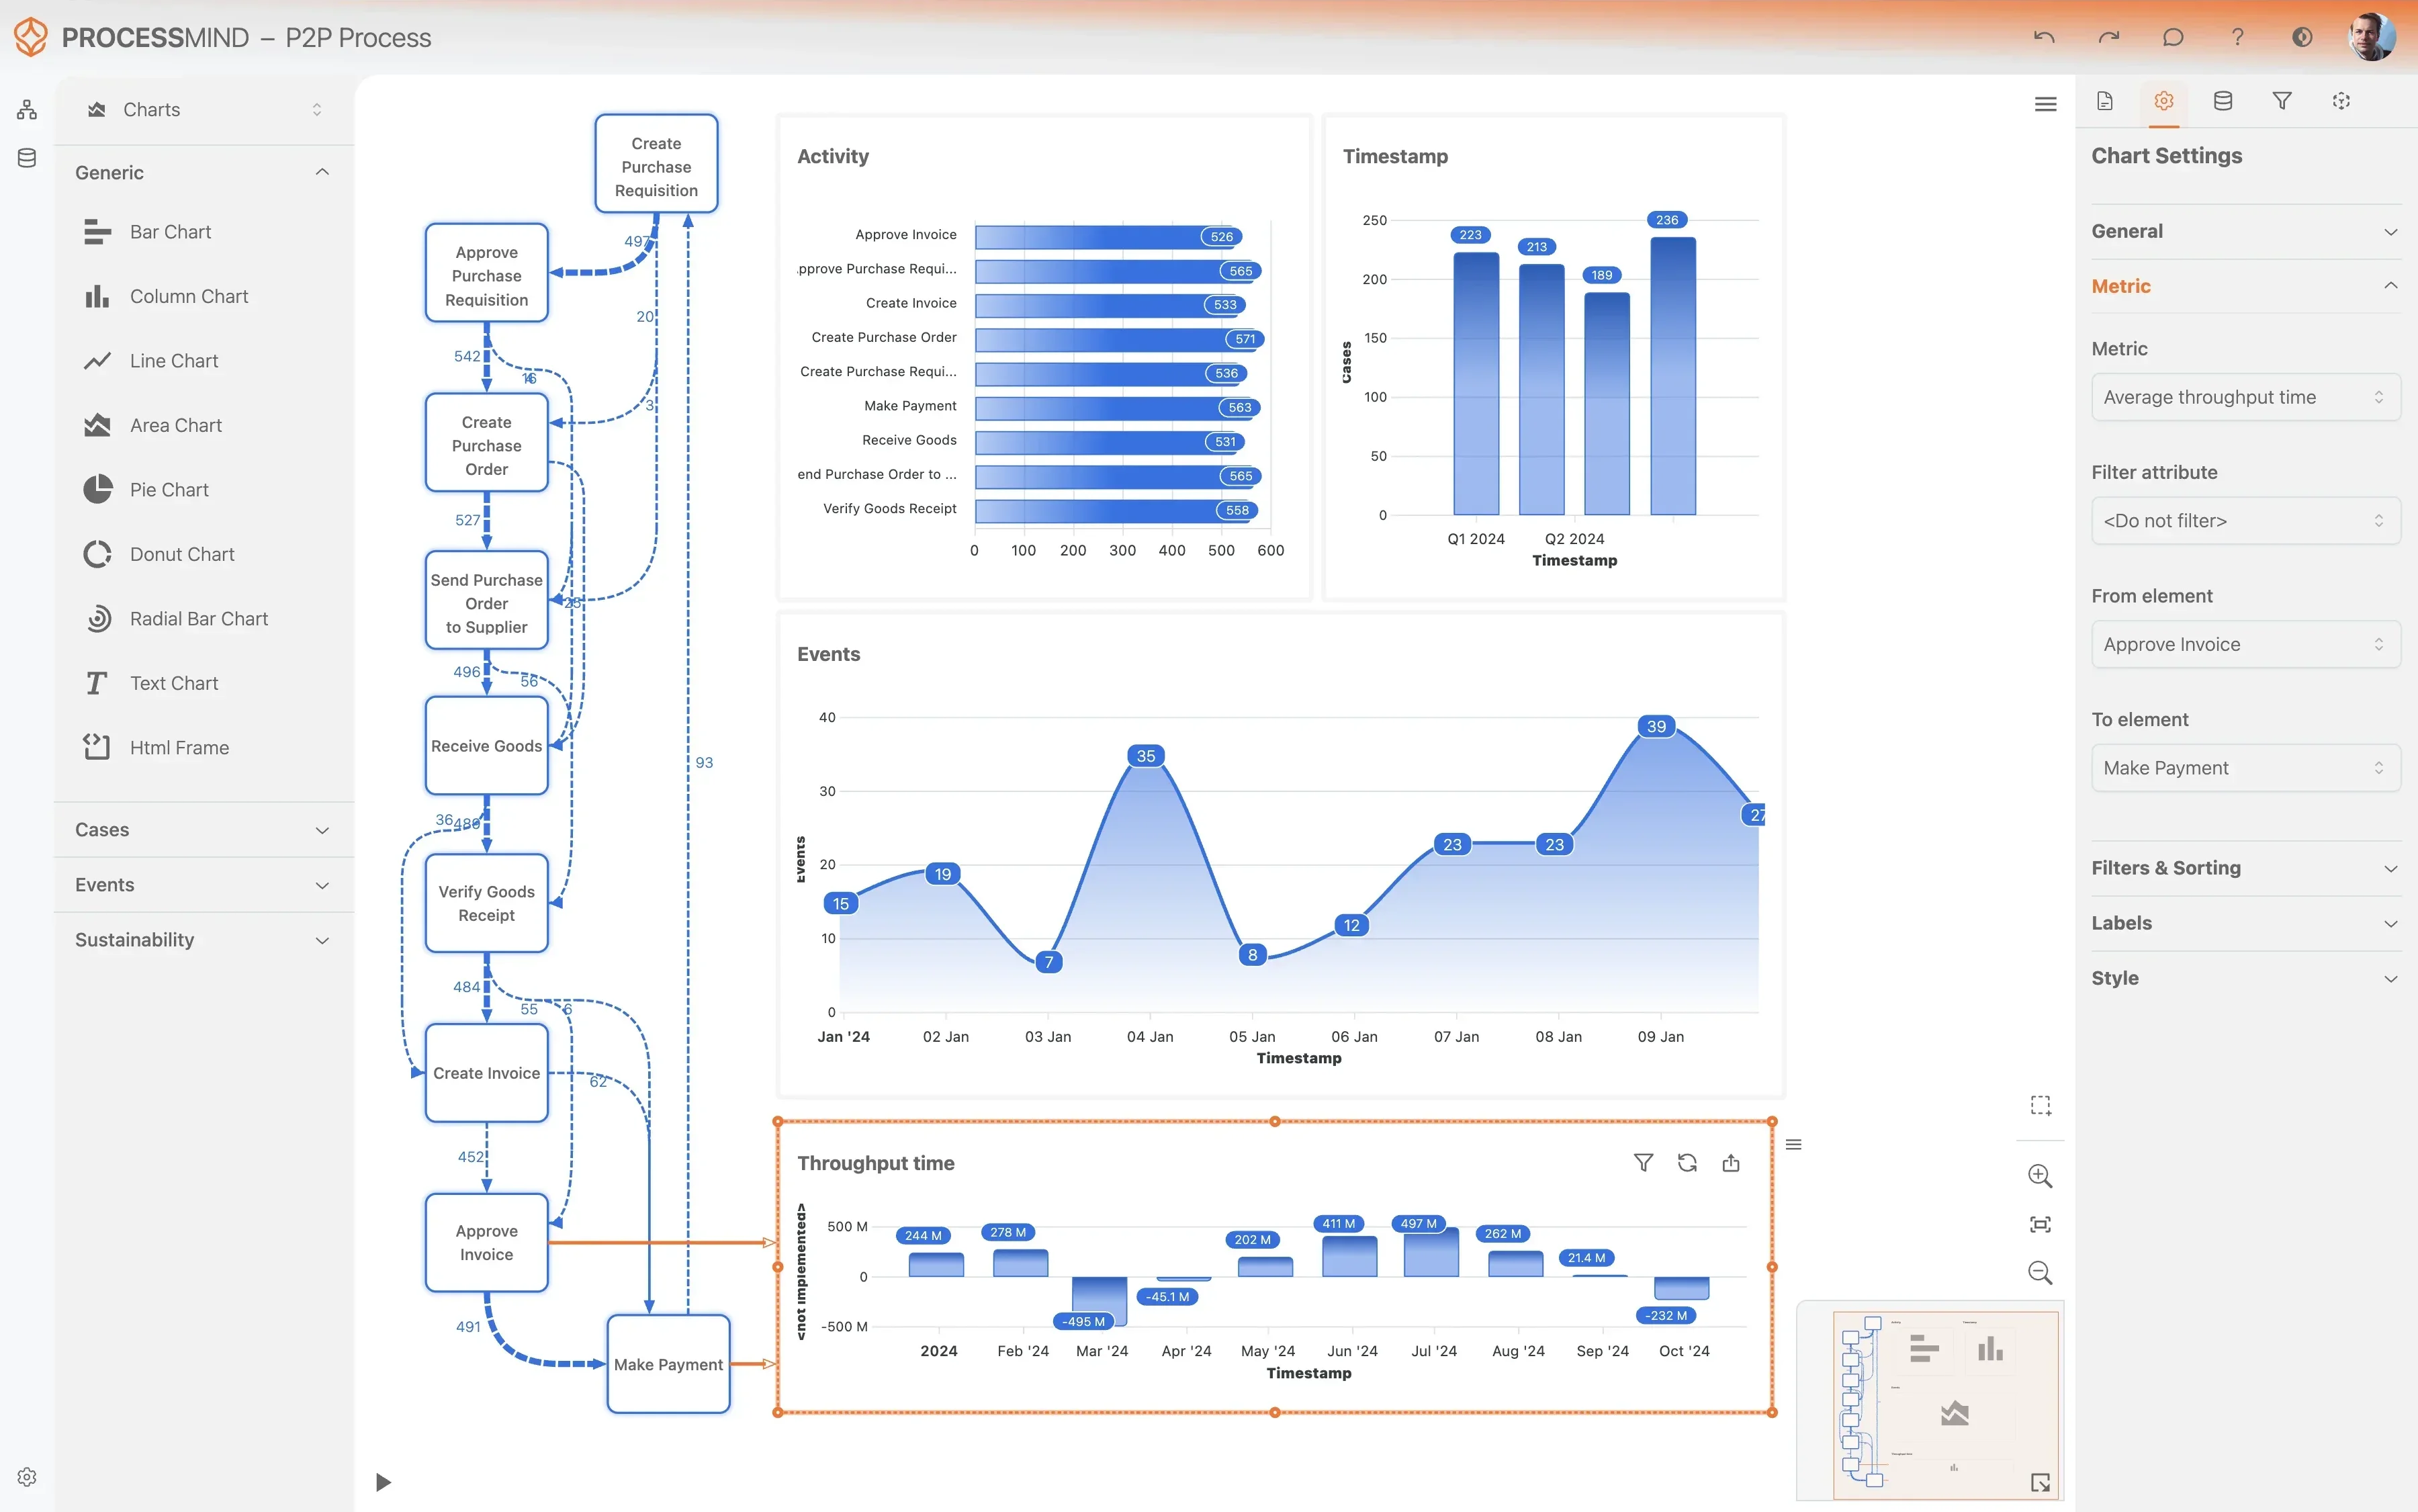
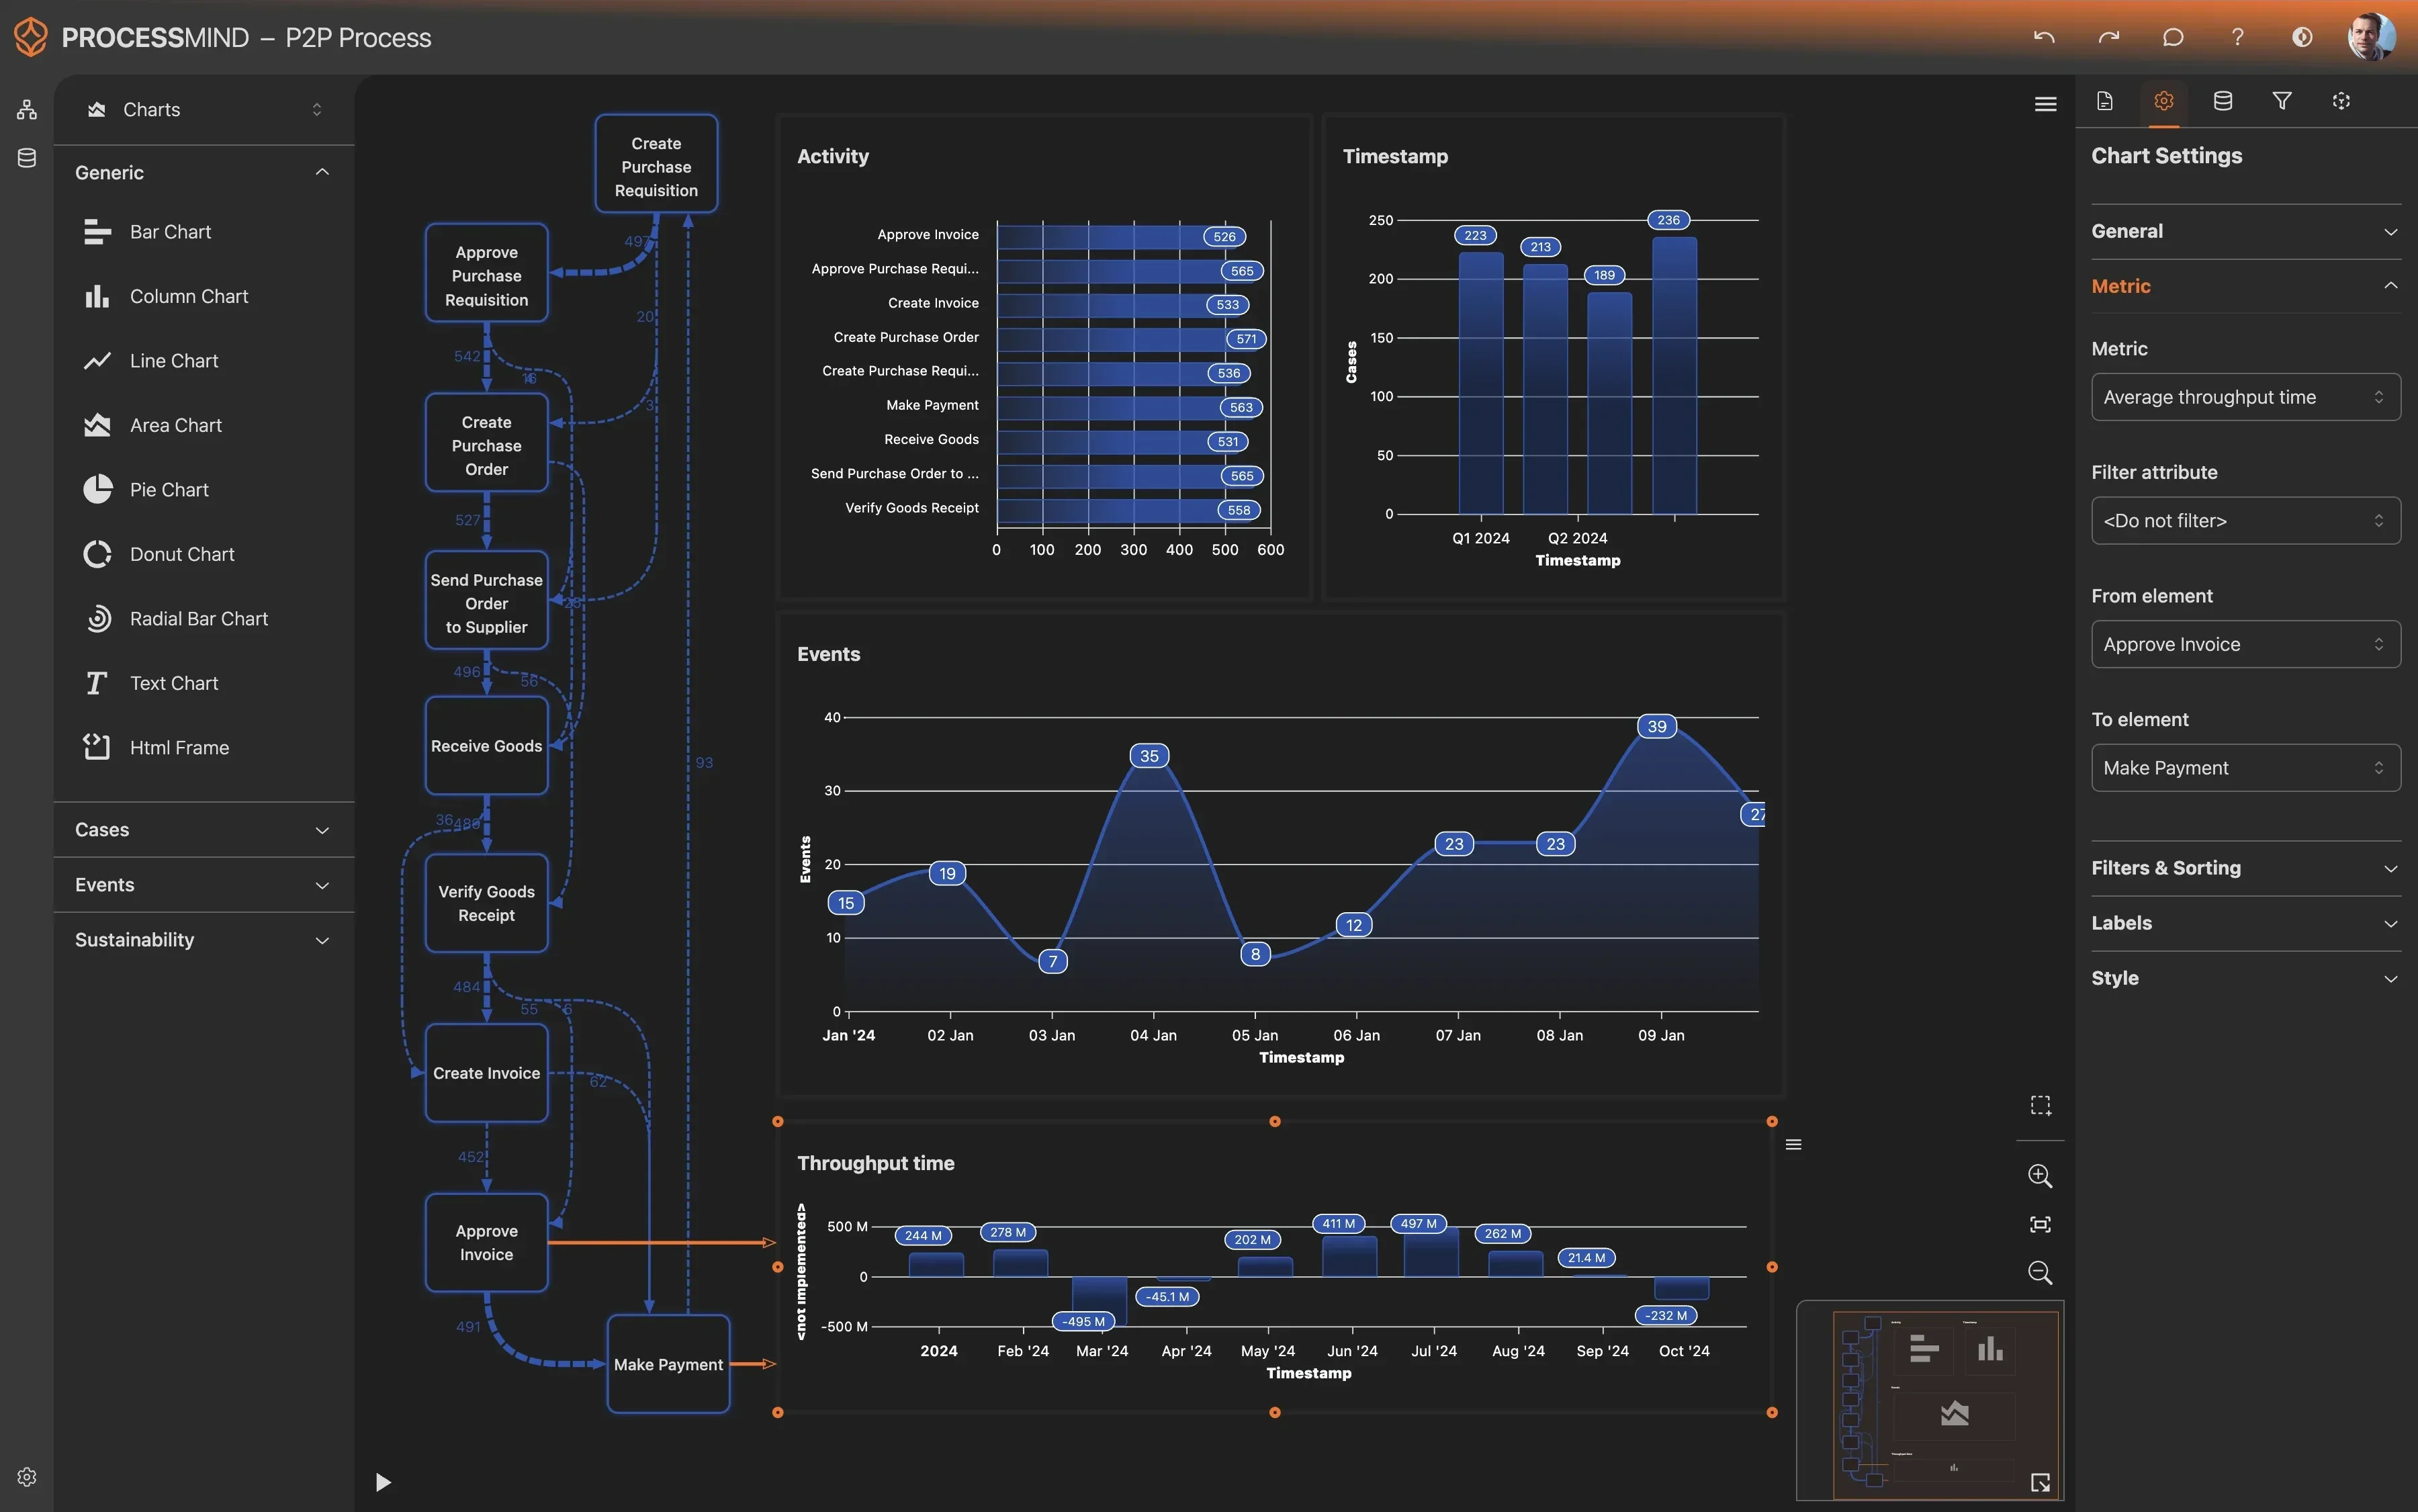
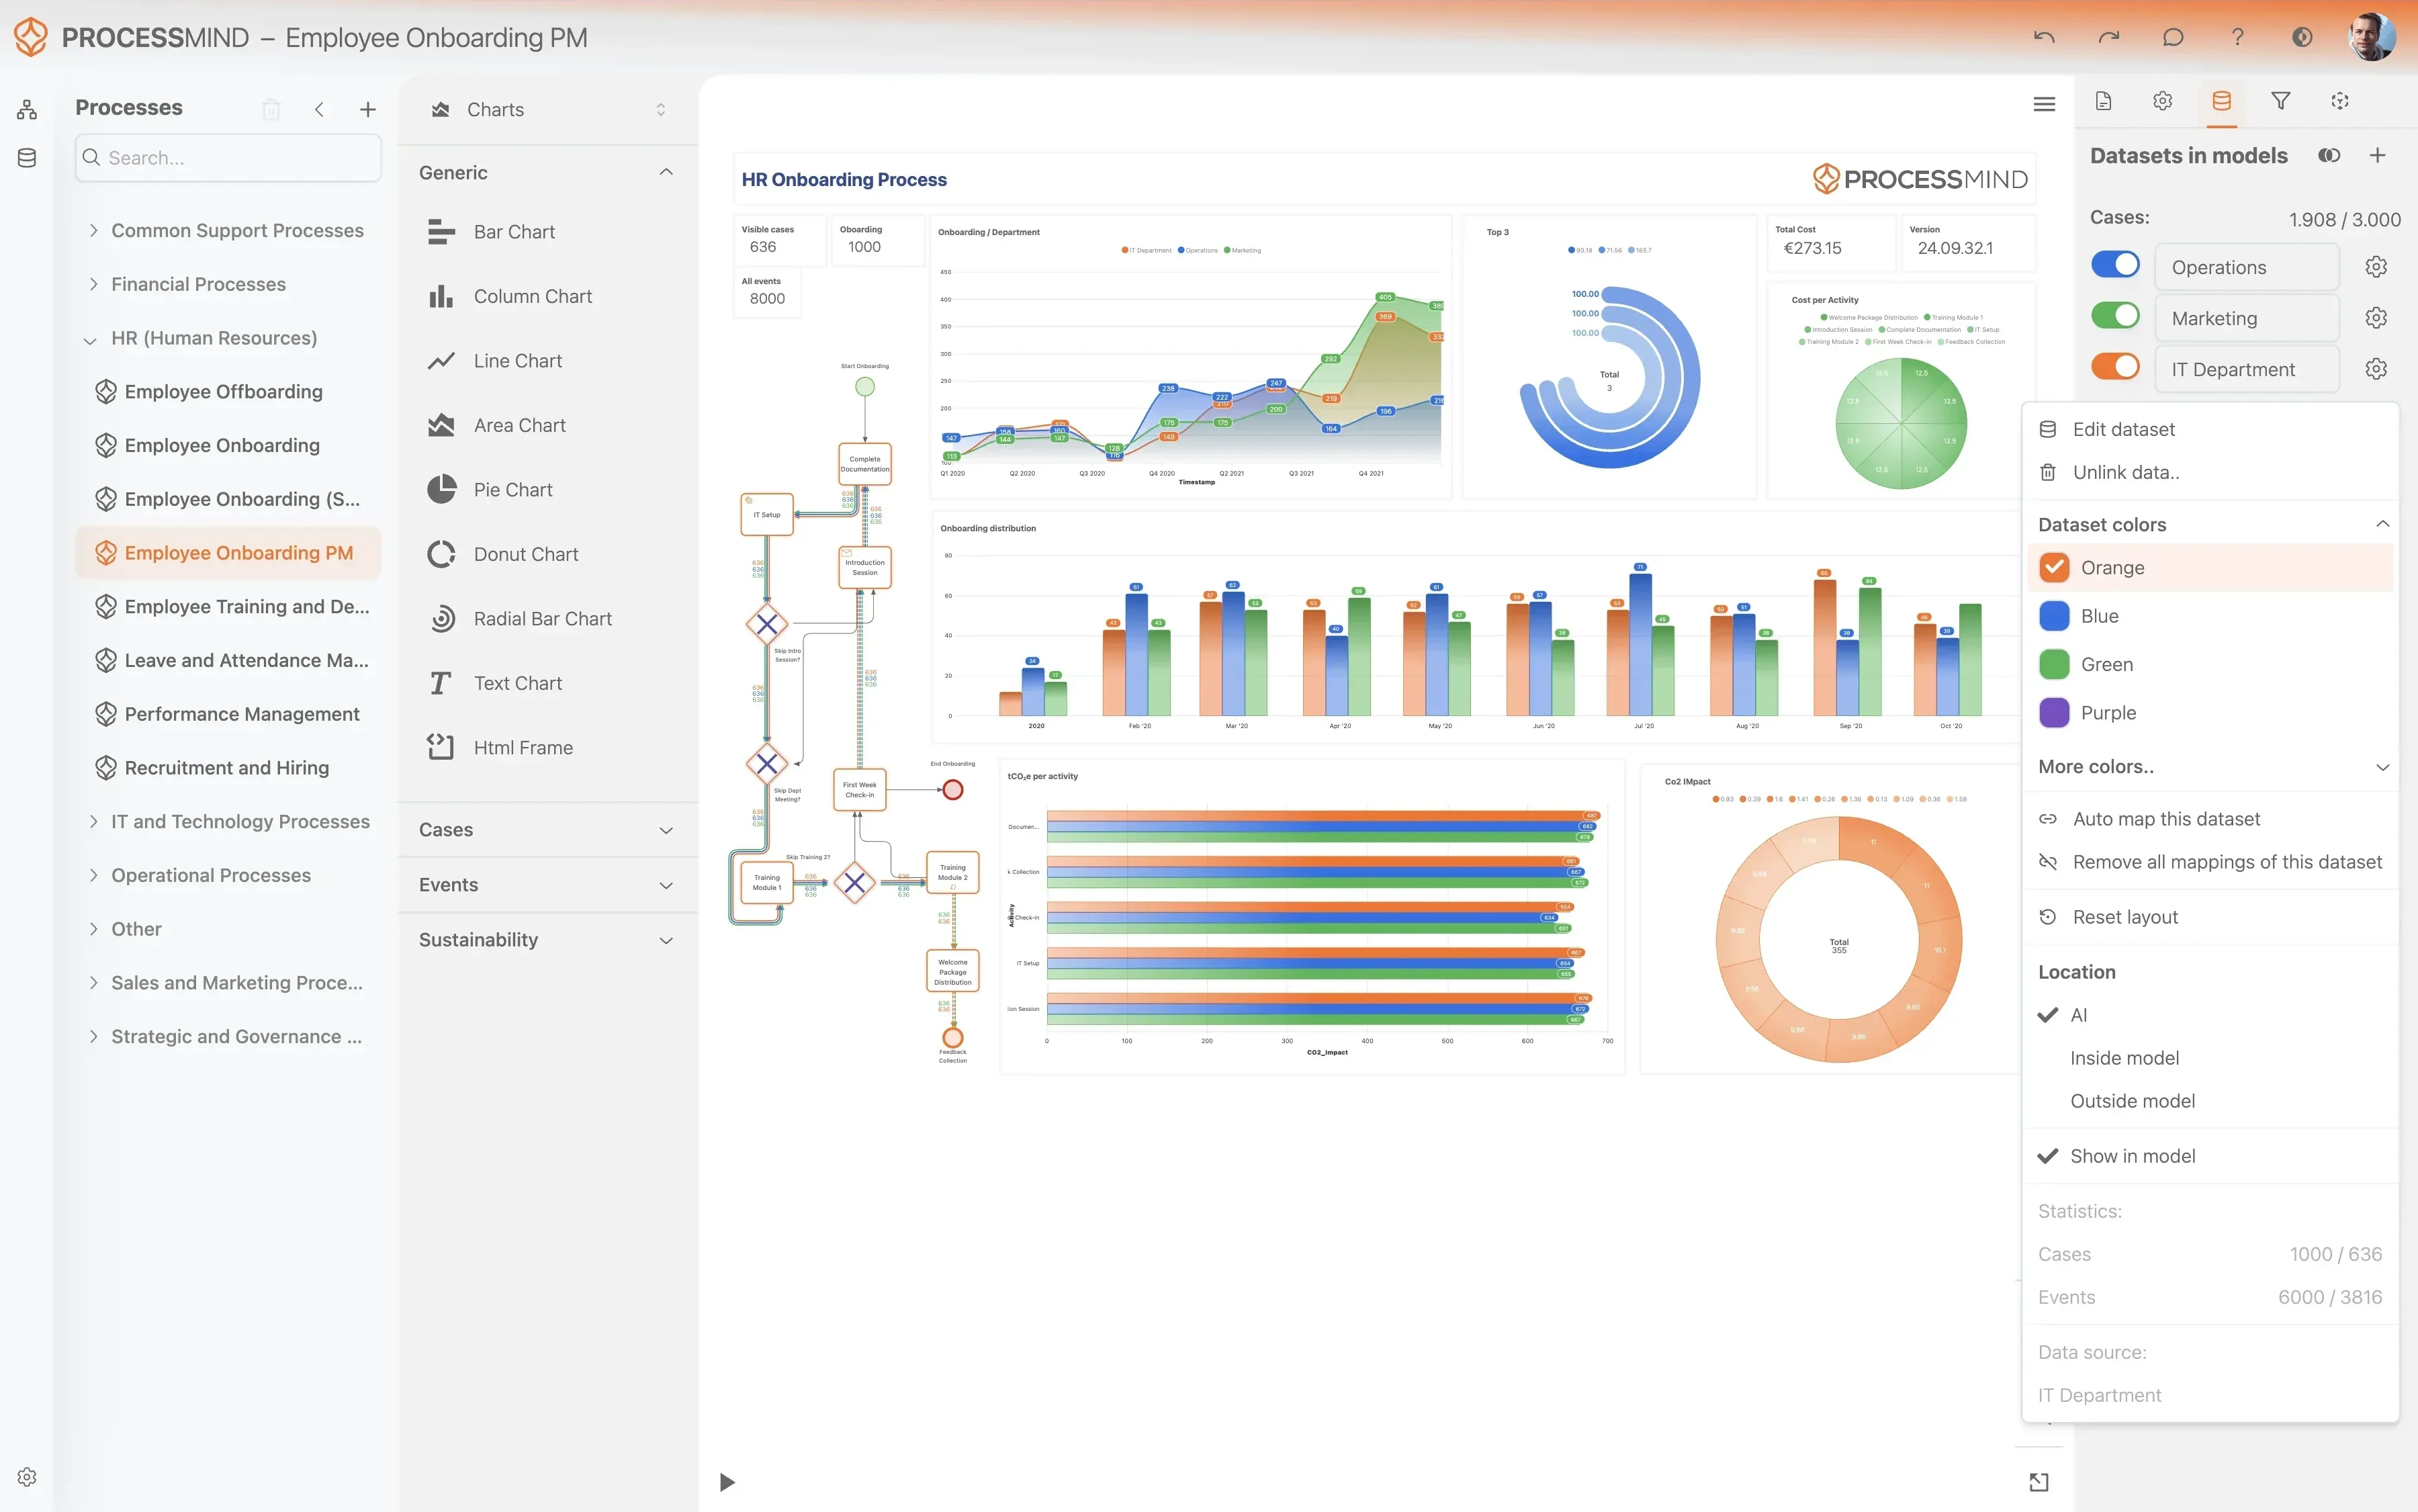
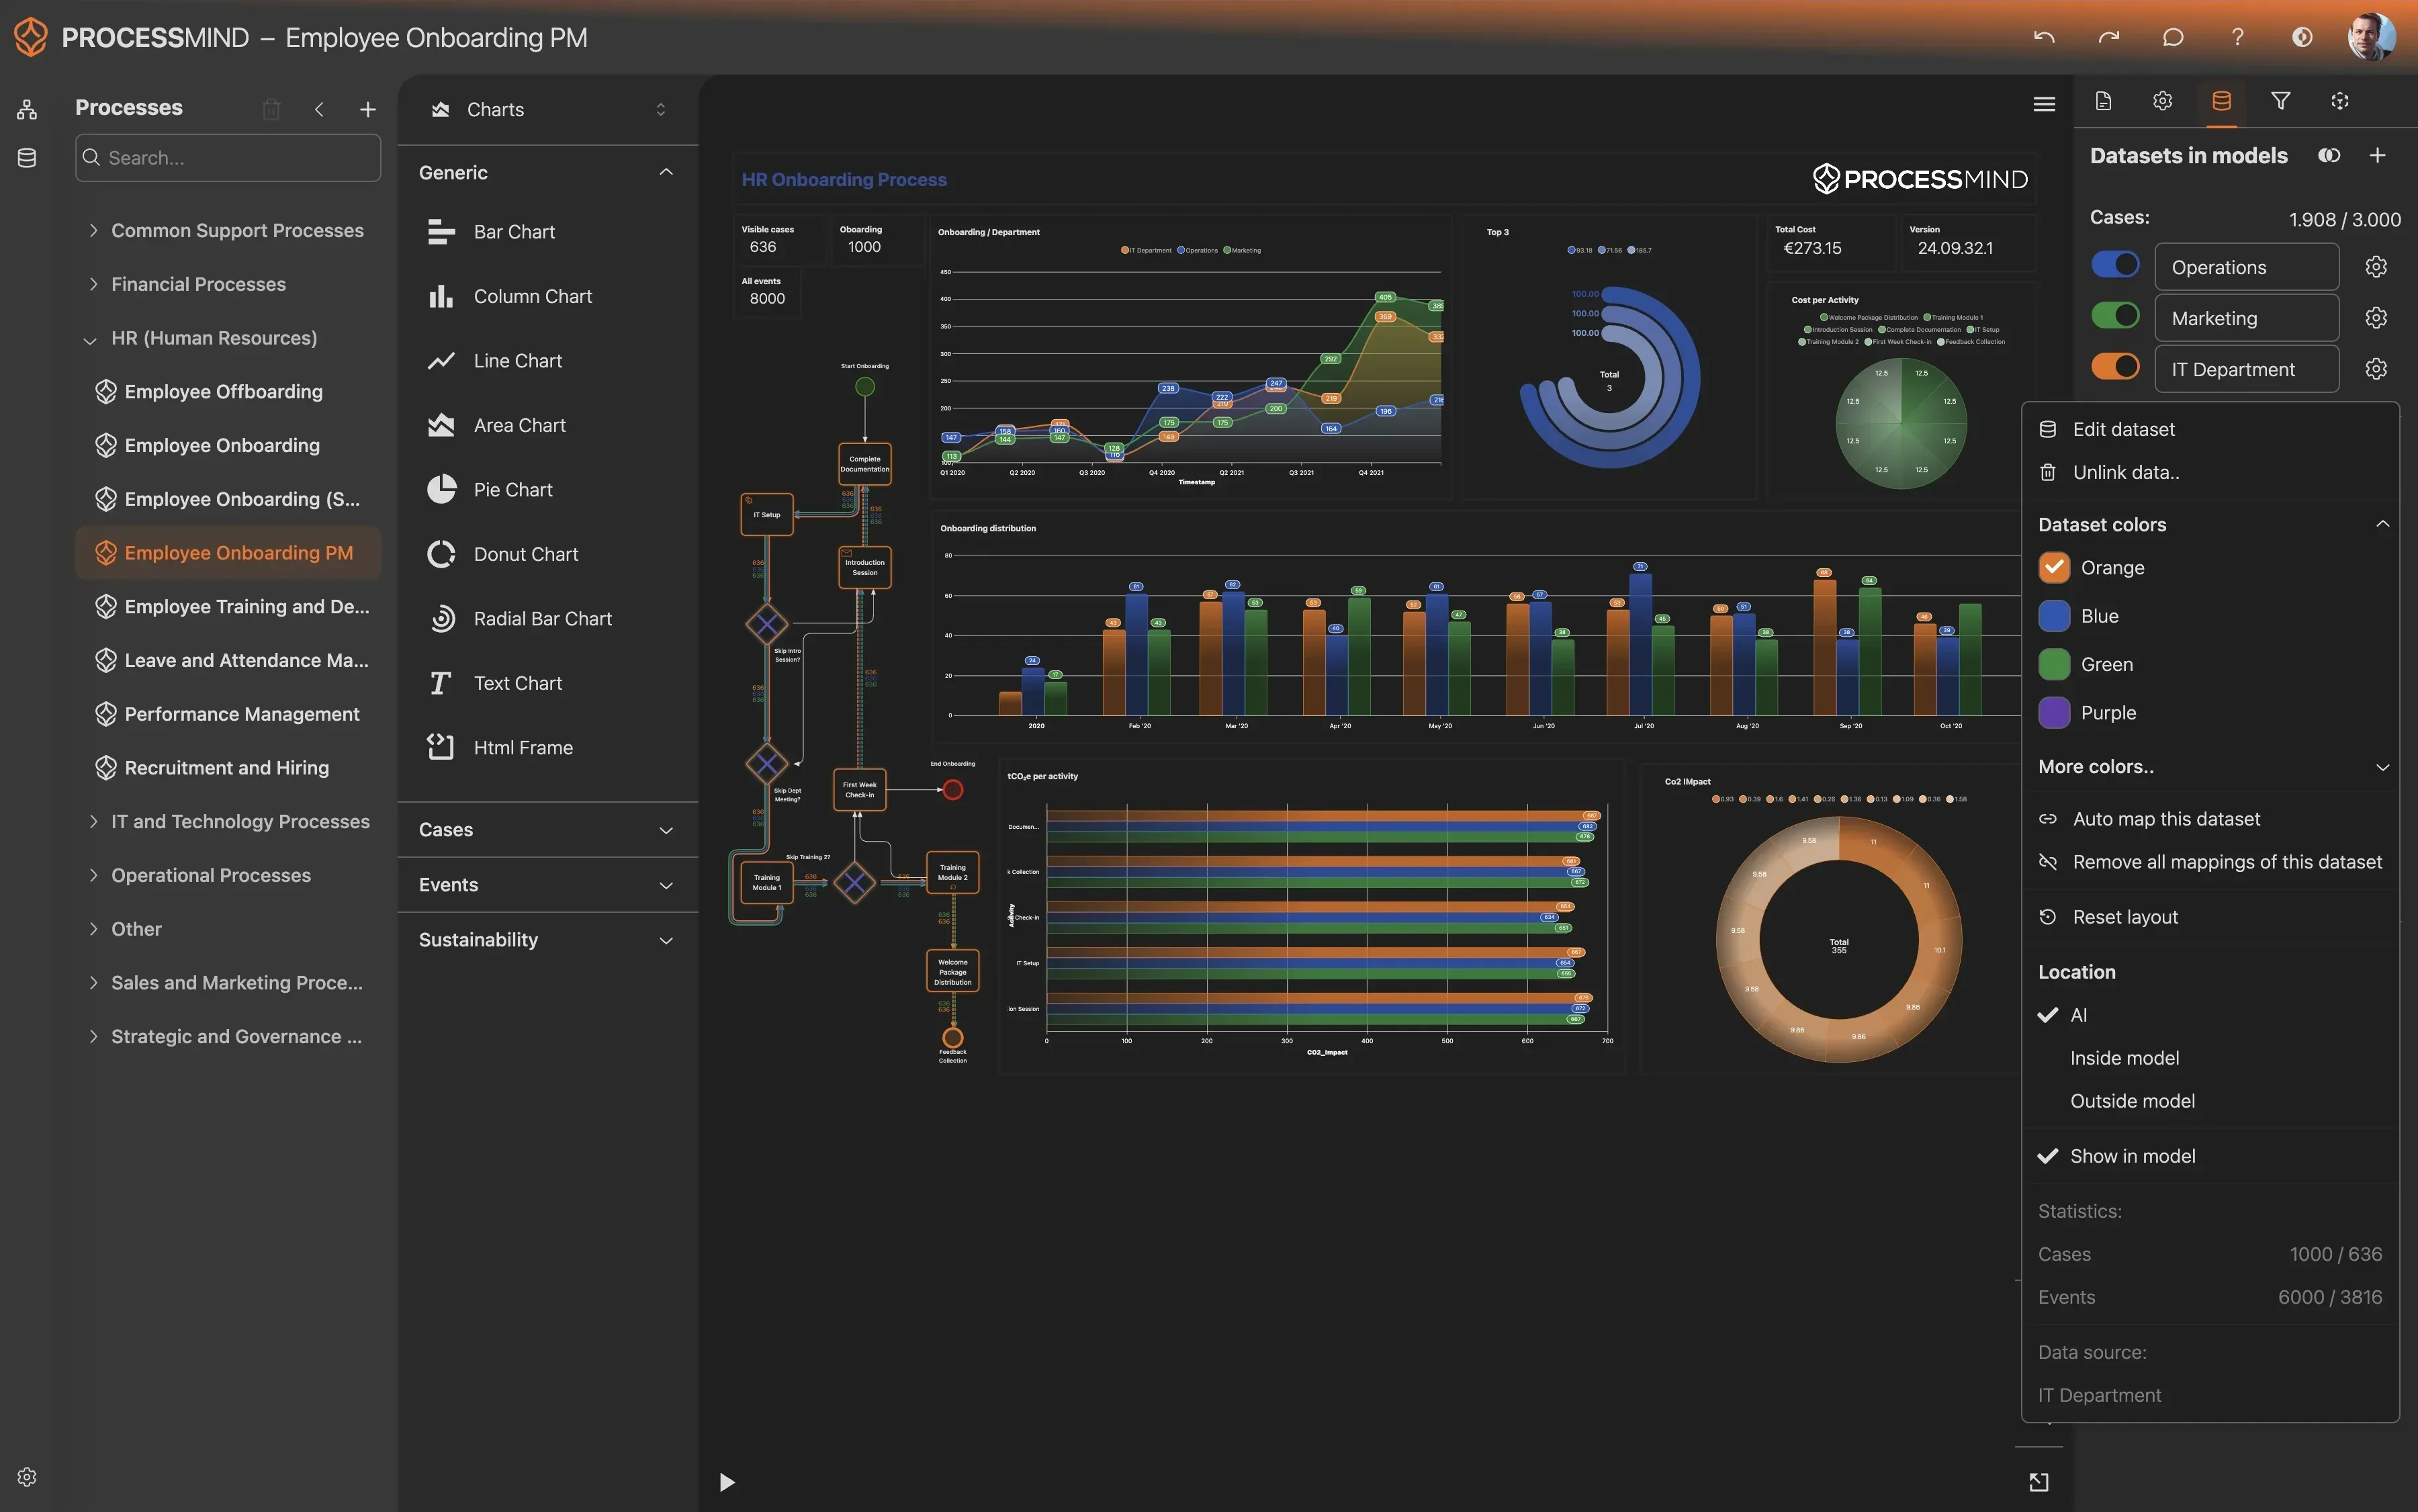
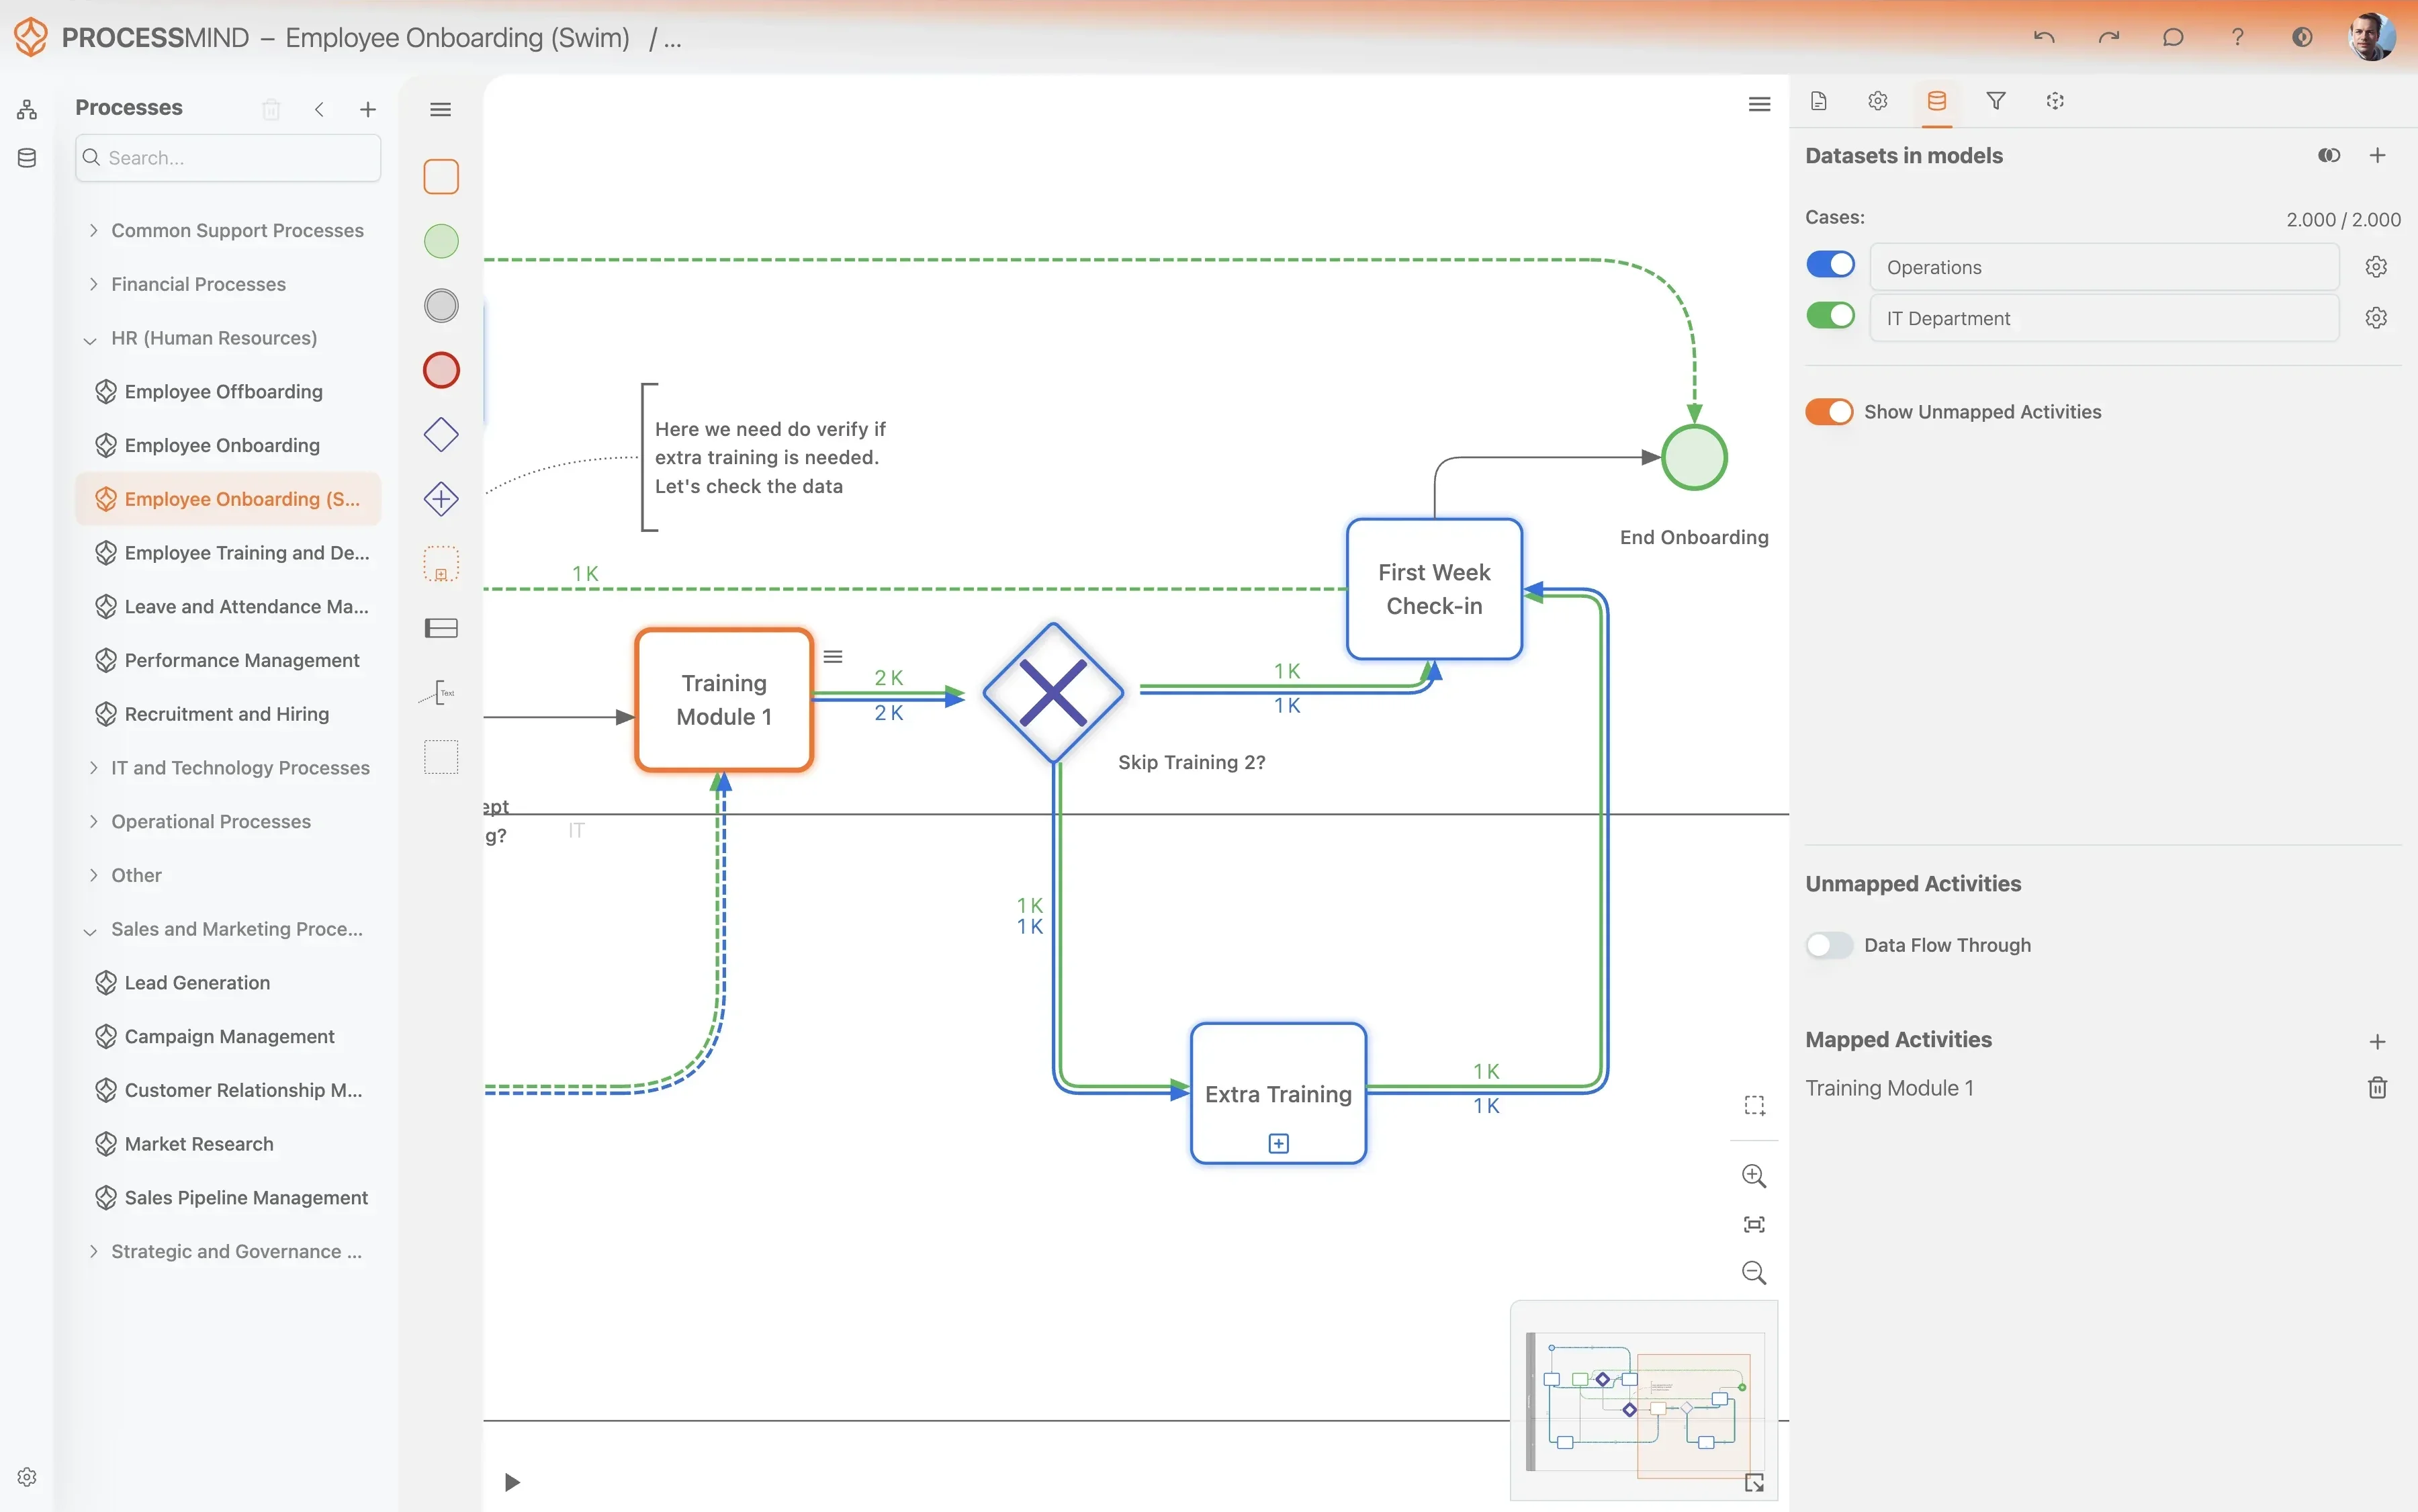
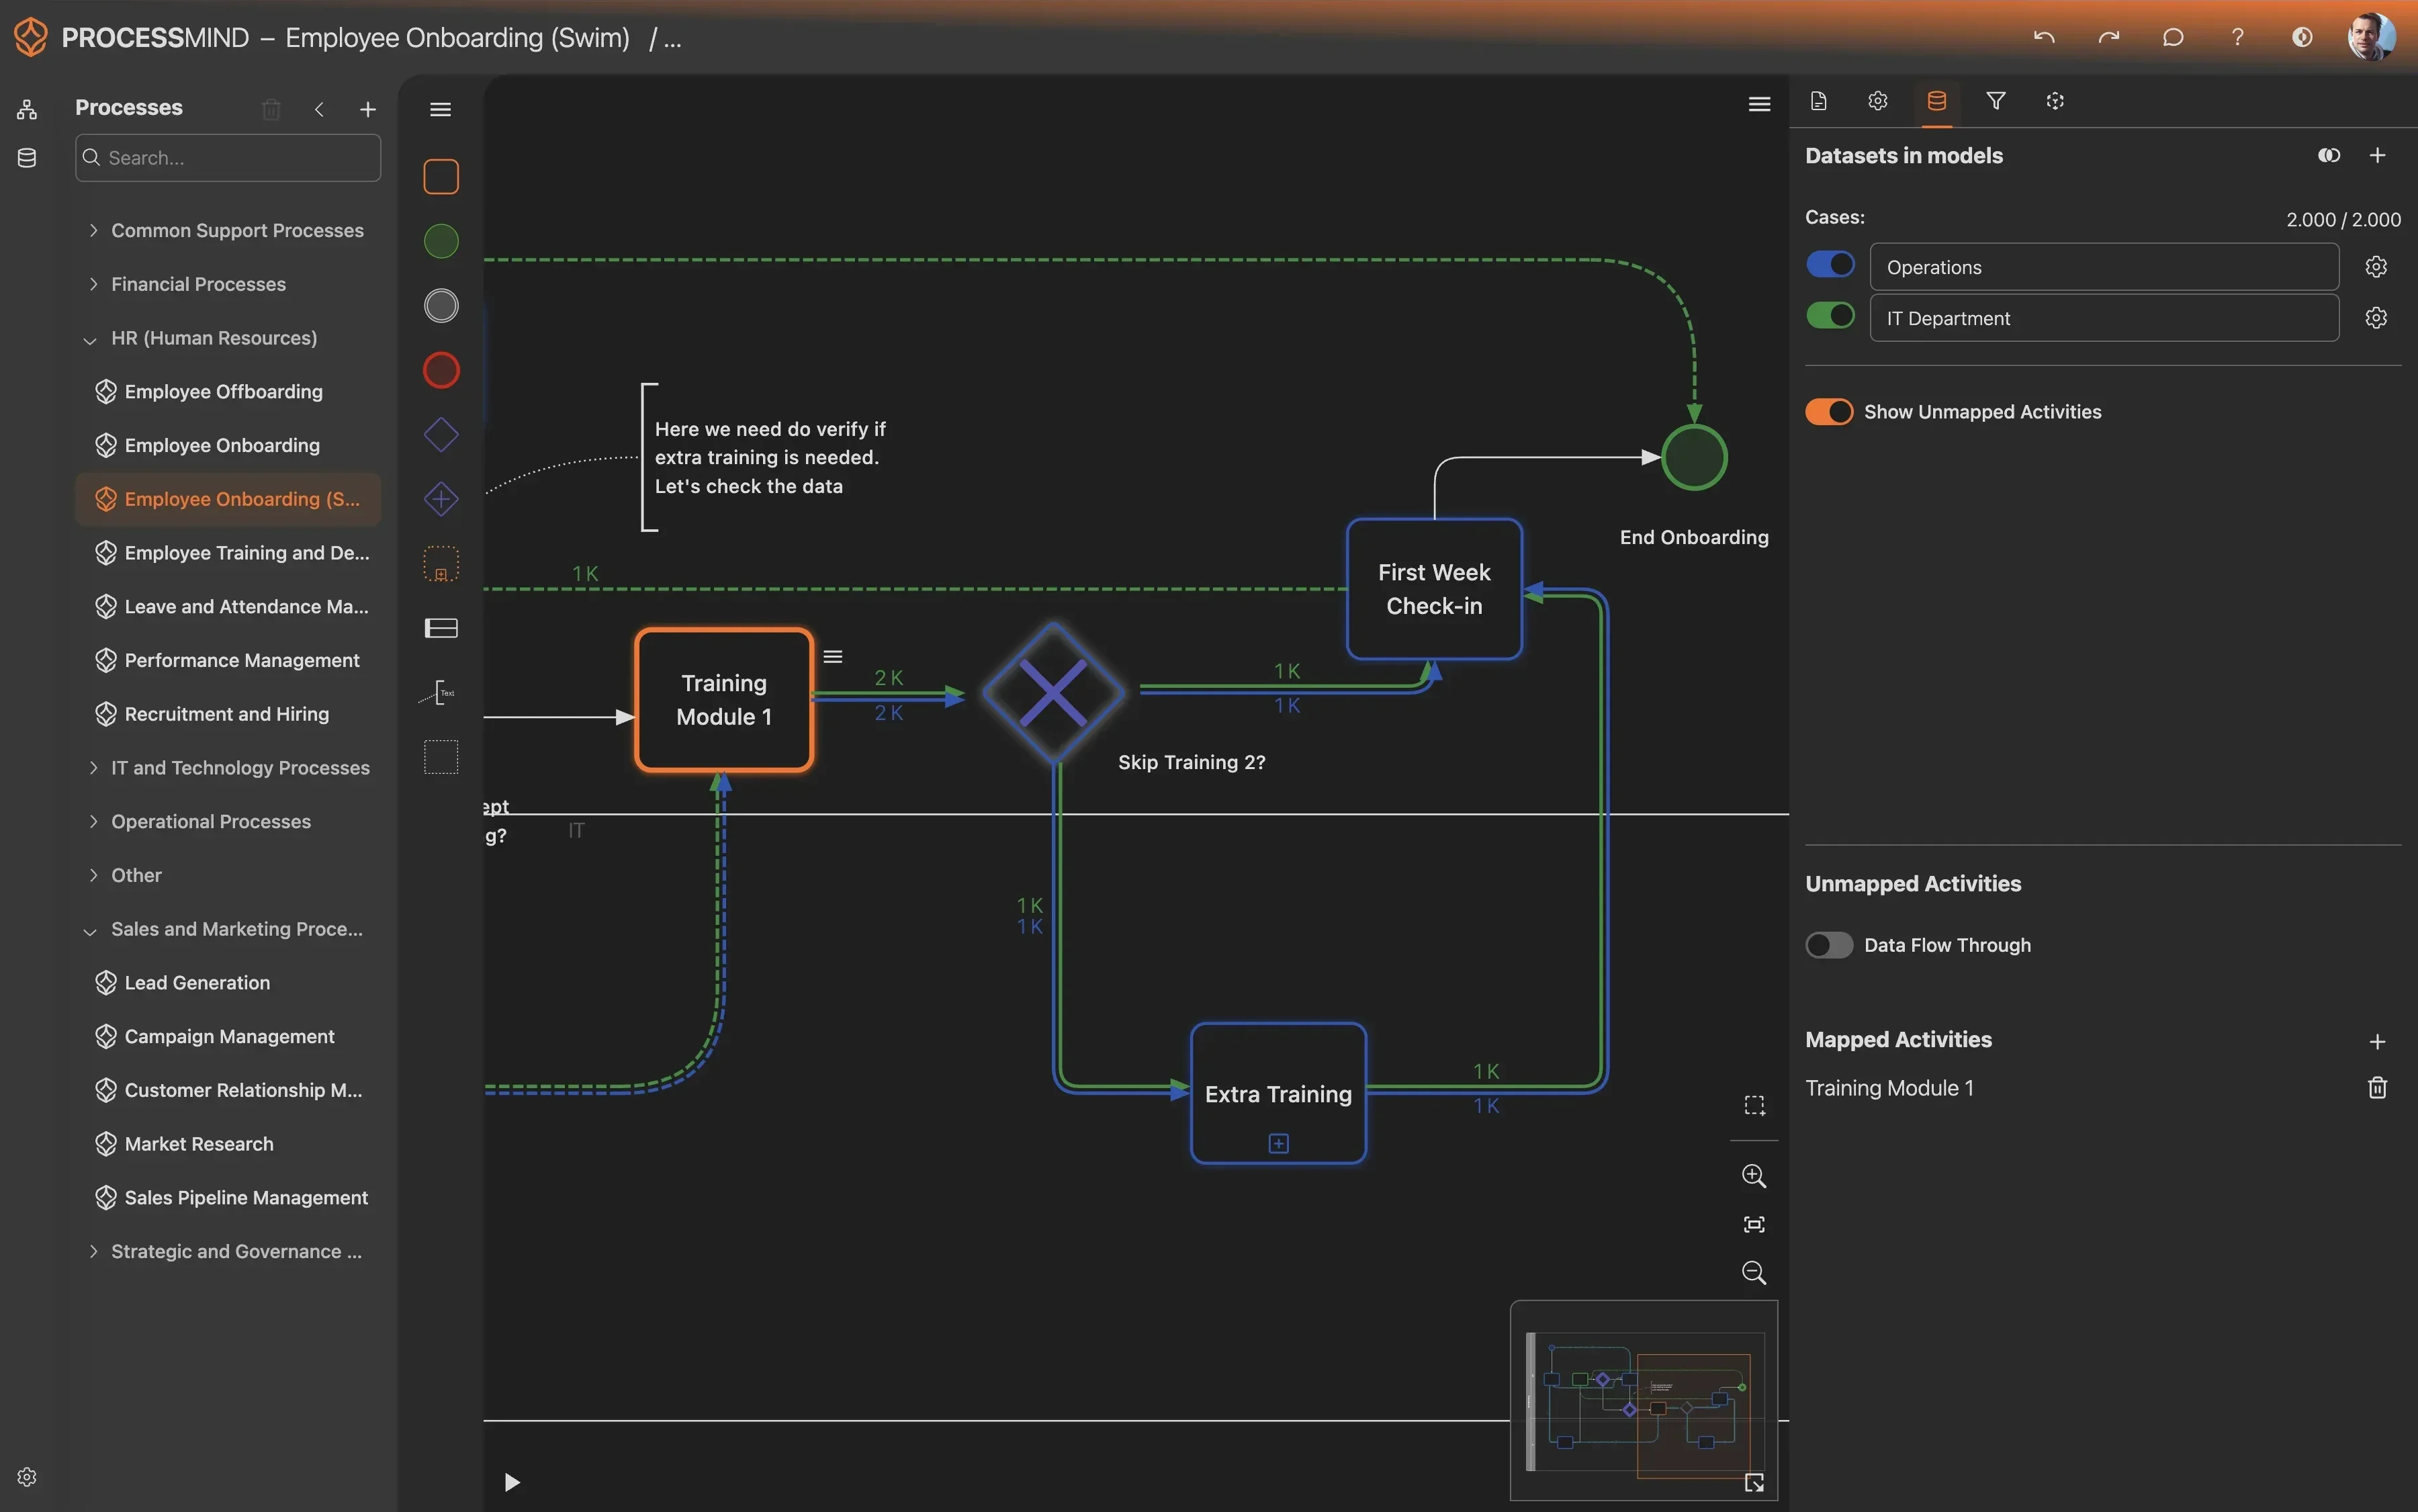
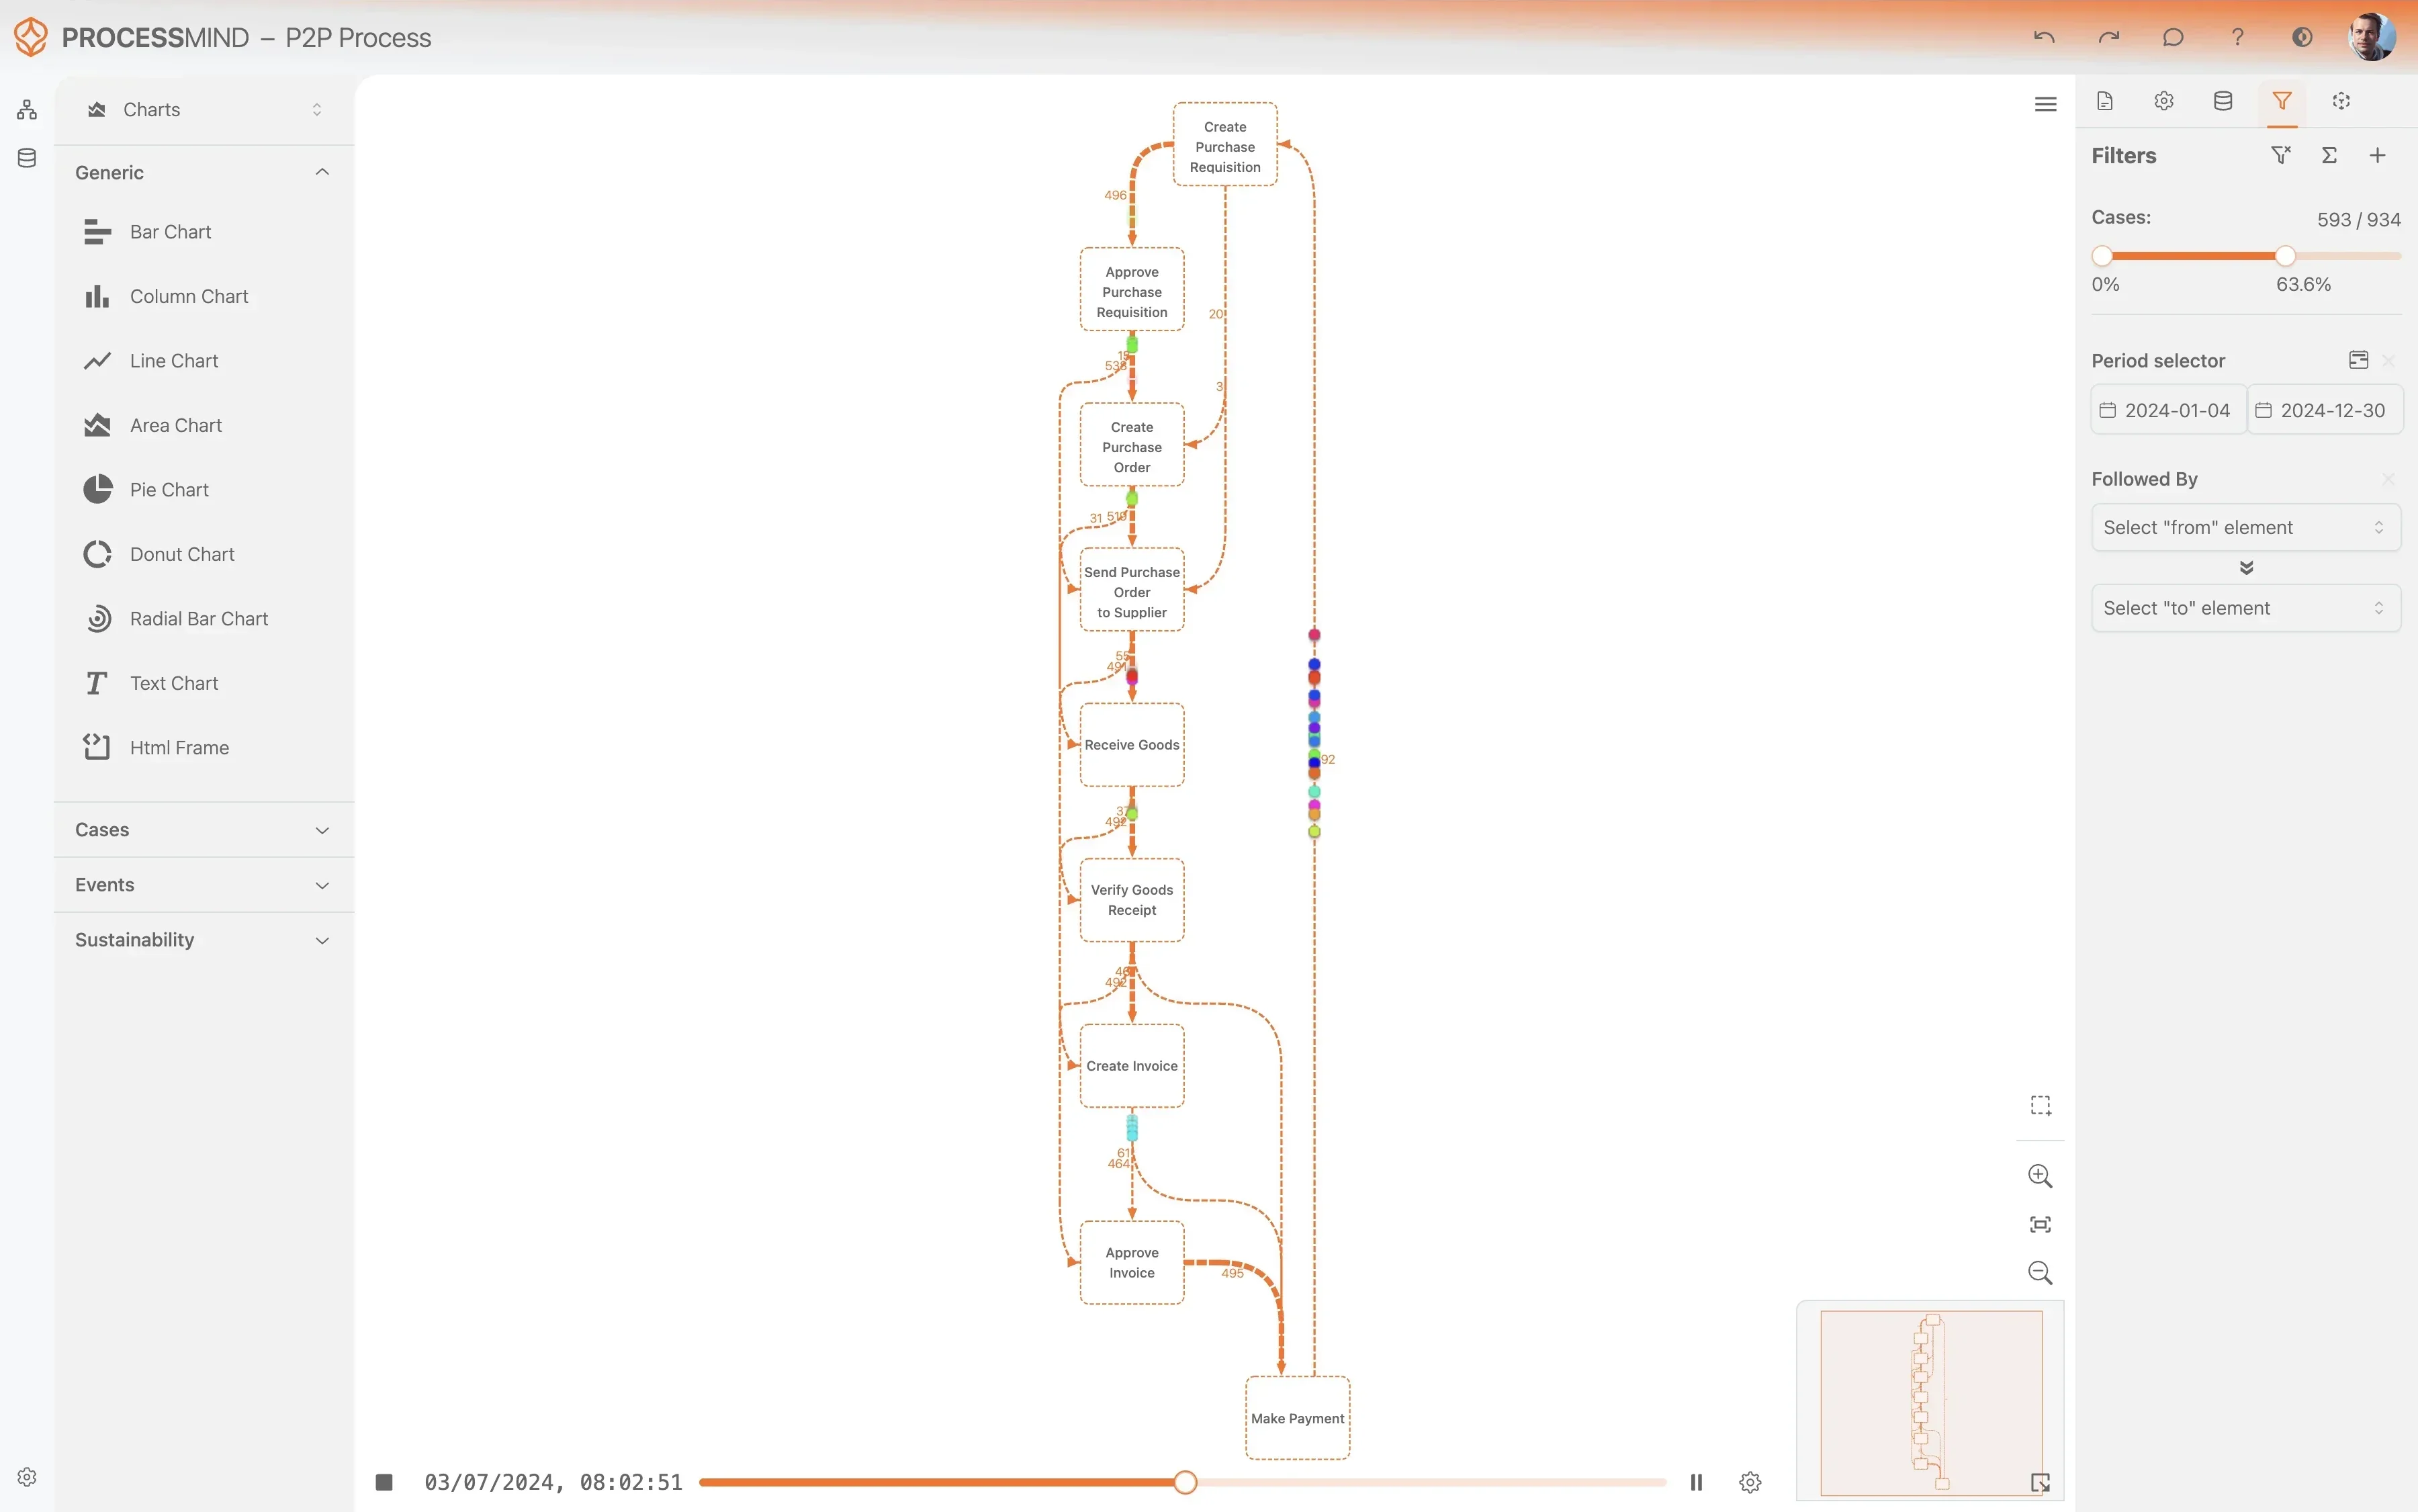
ProcessMind mapuje workflow w Zendesk, pokazując, na których etapach dochodzenia sprawy utknęły i co opóźnia wdrożenie poprawek. Zobaczą Państwo rzeczywisty przebieg rozwiązywania problemu, od utworzenia zgłoszenia po wdrożenie trwałego rozwiązania.
  • Mapuj każdy etap rozwiązywania problemu
  • Wskaż opóźnienia w analizie przyczyn źródłowych
  • Znajdź wąskie gardła we wdrażaniu poprawek
  • Porównaj spójność pracy zespołów wsparcia
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

POTWIERDZONE WYNIKI

Usprawnianie cyklu obsługi problemów

Analiza danych Zendesk Support za pomocą process mining pozwala wykrywać wąskie gardła w rozwiązywaniu problemów i ograniczać powtarzające się incydenty dzięki ukierunkowanej analizie przyczyn źródłowych.

0 %
Szybsza analiza przyczyn źródłowych

Krótszy czas diagnozy

Wykrycie wąskich gardeł w diagnostyce pozwala szybciej ustalać przyczyny źródłowe i sprawniej rozwiązywać problemy.

0 %
Mniej incydentów

Spadek liczby powiązanych incydentów

Większy odsetek trwałych napraw bezpośrednio ogranicza liczbę kolejnych incydentów, co znacząco obniża łączny koszt operacji wsparcia.

+ 0 %
Lepsze wykorzystanie obejść

Większy odsetek udokumentowanych obejść

Regularne publikowanie obejść pozwala agentom service desk szybciej przywracać działanie usług, gdy trwają prace nad trwałymi poprawkami.

0 days
Sprawniejsze przekazywanie spraw między grupami

Krótszy czas oczekiwania

Wizualizacja przekazywania spraw między działami pomaga ograniczyć przestoje, gdy rekordy trafiają do kolejnych grup wsparcia technicznego.

0 %
Więcej skutecznych napraw za pierwszym razem

Mniej ponownie otwieranych spraw

Weryfikacja skuteczności trwałych napraw pozwala upewnić się, że przyczyny źródłowe zostały usunięte, i zapobiega nawrotom poważnych zakłóceń w świadczeniu usług.

0 %
Mniej zalegających rekordów

Porządkowanie nieaktywnych spraw problemowych

Automatyczne monitorowanie otwartych rekordów pomaga dopilnować, by żadne dochodzenie nie zostało zapomniane, a lista zaległości obejmowała aktywne sprawy o wysokim priorytecie.

Wyniki zależą od złożoności procesu i jakości danych. Podane wartości odzwierciedlają typowe usprawnienia zaobserwowane w różnych wdrożeniach Zendesk.

Zalecane dane

Na początek wybierz najważniejsze atrybuty i czynności, aby utworzyć czytelną mapę procesu.
Pierwszy raz spotykają się Państwo z dziennikiem zdarzeń? Dowiedz się jak utworzyć dziennik zdarzeń na potrzeby process mining.

Atrybuty

Najważniejsze dane do zebrania na potrzeby analizy

Poziom pilności przypisany do rekordu problemu.

Dlaczego to ważne

Umożliwia podział case’ów na segmenty, aby analizować zgodność z SLA i priorytetyzację zasobów.

Zespół lub dział, do którego obecnie przypisano rekord problemu.

Dlaczego to ważne

Umożliwia analizę organizacyjną i wykrywanie wąskich gardeł między działami.

Agent przypisany do obsługi problemu.

Dlaczego to ważne

Umożliwia analizę zasobów na poziomie poszczególnych osób.

Bieżący stan rekordu problemu w jego cyklu życia.

Dlaczego to ważne

Umożliwia filtrowanie case’ów według stanu realizacji.

Liczba zgłoszeń incydentów powiązanych z tym rekordem problemu.

Dlaczego to ważne

Wskazuje skalę problemu i jego wpływ na użytkowników.

Docelowa data i godzina rozwiązania problemu.

Dlaczego to ważne

Niezbędny do pomiaru zgodności i realizacji zobowiązań umownych.

Klasyfikacja problemu, np. oprogramowanie, sprzęt lub sieć.

Dlaczego to ważne

Umożliwia podział danych według technologii lub usługi biznesowej.

Ustalona przyczyna problemu, np. błąd w kodzie lub błąd konfiguracji.

Dlaczego to ważne

Umożliwia analizę wzorców awarii i pomaga ukierunkować długoterminowe działania usprawniające.

Działania

Kroki procesu do monitorowania i optymalizacji

Utworzenie zgłoszenia problemu w Zendesk Support. To zdarzenie zapisuje znacznik czasu pierwszej rejestracji problemu w systemie i zwykle rozpoczyna instancję procesu.

Dlaczego to ważne

Wyznacza początek cyklu rozwiązania problemu od początku do końca i stanowi punkt odniesienia dla wszystkich późniejszych pomiarów czasu realizacji.

Przekazanie rekordu problemu do konkretnego zespołu technicznego lub działu. Zdarzenie jest rejestrowane po aktualizacji pola Group ID w zgłoszeniu.

Dlaczego to ważne

Niezbędne do pomiaru czasu oczekiwania między działami w dashboardzie Support Group Handover Analysis.

Oznacza przejście ze stanu „New” do aktywnej pracy nad problemem. Wskazuje, że agent przyjął zgłoszenie i rozpoczął diagnozę.

Dlaczego to ważne

Służy do obliczania wskaźników dotyczących nieaktualnych rekordów problemów i wyznacza początek pomiaru KPI Average Root Cause Analysis Duration.

Udokumentowanie i udostępnienie tymczasowego rozwiązania problemu. W Zendesk jest ono często rejestrowane za pomocą określonego tagu lub niestandardowego pola wyboru informującego o dostępności obejścia.

Dlaczego to ważne

Wspiera dashboard Workaround Publication Compliance i pomaga zapewnić użytkownikom tymczasowe rozwiązanie podczas długotrwałego dochodzenia.

Moment ustalenia podstawowej przyczyny problemu. Zwykle jest rejestrowany, gdy agent wypełni niestandardowe pole tekstowe „Root Cause” lub wybierze kategorię z listy.

Dlaczego to ważne

Ważny etap dla dashboardu Root Cause Investigation Velocity i pomiaru sprawności diagnozy.

Oznacza wdrożenie rozwiązania technicznego w środowisku. Zwykle jest rejestrowane jako zmiana statusu niestandardowego lub określony tag przed pełnym rozwiązaniem zgłoszenia.

Dlaczego to ważne

Niezbędne do pomiaru czasu od diagnozy do wdrożenia w dashboardzie Fix Implementation Efficiency.

Formalne oznaczenie problemu jako rozwiązany. W Zendesk następuje po ustawieniu standardowego statusu systemowego „Solved”, co oznacza, że poprawka została zweryfikowana, a sprawa zakończona.

Dlaczego to ważne

Główny punkt końcowy do obliczania wyników i ryzyka SLA oraz wskaźnika Problem SLA Adherence Rate.

Końcowe zdarzenie cyklu życia, po którym zgłoszenie zostaje zablokowane i nie można go już zmienić. W Zendesk następuje to zwykle automatycznie 4 dni po ustawieniu statusu „Solved”.

Dlaczego to ważne

Oznacza definitywny koniec cyklu życia rekordu i służy do zarządzania przechowywaniem danych oraz raportowania historycznego.

FAQ

Często zadawane pytania

Process mining wykorzystuje istniejące dzienniki zdarzeń z Zendesk, aby przedstawić na mapie rzeczywisty przebieg obsługi rekordów problemów. Wskazuje ukryte wąskie gardła i odstępstwa od standardowych procedur, dzięki czemu można dokładnie sprawdzić, na którym etapie dochodzenia się opóźniają.

Na początek potrzebne są zwykle identyfikator rekordu problemu, znacznik czasu każdej zmiany statusu oraz nazwa działania, na przykład zmiana statusu lub przypisania. Dodatkowe pola, takie jak priorytet, kategoria czy grupa przypisanego użytkownika, ułatwiają dokładniejsze filtrowanie i analizę przyczyn źródłowych.

Mapując powiązania między incydentami a rekordami problemów, można wykryć sytuacje, w których te same problemy są wielokrotnie łagodzone obejściami zamiast trwale rozwiązywane. Taki wgląd ułatwia ustalenie priorytetów dla poprawek o dużym wpływie, które eliminują całe grupy powtarzających się zgłoszeń do pomocy technicznej.

Większość zespołów otrzymuje pierwsze mapy procesów w ciągu kilku dni od połączenia danych z Zendesk. Ponieważ system analizuje dane historyczne, nie trzeba czekać na napływ nowych danych, aby wykryć istotne wąskie gardła lub problemy ze zgodnością.

Tak. Narzędzie śledzi przekazywanie rekordów problemów między grupami wsparcia i zespołami technicznymi. Pozwala dokładnie wskazać, gdzie przekazanie sprawy się opóźnia lub gdzie rekordy zbyt długo pozostają bez działania, co ułatwia lepsze przydzielanie zasobów.

Nie. Process mining analizuje dzienniki audytu, które Zendesk już zapisuje w tle. Nie trzeba zmieniać workflow, dodawać pól niestandardowych ani modyfikować sposobu pracy agentów, aby uzyskać dokładne wyniki.

System porównuje czas spędzony na każdym etapie procesu z określonymi celami dotyczącymi poziomu usług. Może wskazać ścieżki, które często prowadzą do naruszenia SLA, na przykład opóźnienia między diagnozą a naprawą.

Analizując kolejność działań, narzędzie może oznaczyć rekordy, które przechodzą bezpośrednio do statusu zamkniętego, z pominięciem wymaganych etapów, takich jak analiza przyczyn źródłowych czy przegląd po wdrożeniu. Dzięki temu zespół może przestrzegać wymaganych standardów jakości przy obsłudze każdego poważnego problemu.

Usprawnij zarządzanie problemami, aby szybciej usuwać awarie IT

Skróć cykle rozwiązywania problemów o 30% i usuń wąskie gardła w IT.

Rozpocznij bezpłatny okres próbny

Nie trzeba podawać danych karty. Konfiguracja zajmuje kilka minut.