Usprawnij zarządzanie problemami
6 kroków do usprawnienia BMC Helix ITSM
Usprawnij zarządzanie problemami
Zarządzanie problemami
BMC Helix ITSM

Wybierz proces

Wybierz proces, aby kontynuować pracę w połączonym obszarze roboczym.

Usprawnijcie zarządzanie problemami w BMC Helix ITSM

Nasza platforma wykrywa ukryte wąskie gardła i problemy w procesie, które obniżają efektywność obsługi. Można łatwo sprawdzić, na których etapach ręczne czynności lub przekazywanie spraw między zespołami powodują opóźnienia w analizie. Taka wiedza pomaga usprawnić workflow i usunąć przyczyny powtarzających się problemów operacyjnych.

Pobierz gotowy szablon danych i poznaj częste wyzwania, które utrudniają osiągnięcie celów efektywnościowych. Skorzystaj z planu doskonalenia w sześciu krokach oraz przewodnika po szablonie danych, aby usprawnić operacje.

Pokaż szczegółowy opis

Dlaczego warto usprawniać zarządzanie problemami

Sprawne zarządzanie problemami pomaga utrzymać stabilne środowisko IT. Zarządzanie incydentami koncentruje się na jak najszybszym przywróceniu usług, natomiast zarządzanie problemami ma na celu usunięcie przyczyn zakłóceń. Jeśli proces nie działa sprawnie, zespół IT wciąż reaguje na te same problemy. Rośnie koszt operacji, spada zadowolenie użytkowników, a pracownicy techniczni są niepotrzebnie obciążeni. Usprawnienie tego procesu w BMC Helix ITSM pozwala przejść od ciągłego reagowania do działań zapobiegawczych. W efekcie usługi biznesowe działają stabilniej, a organizacja jest mniej narażona na kosztowne przestoje.

Jak wykorzystać dane z BMC Helix ITSM

Standardowe raporty w BMC Helix ITSM pokazują zwykle statyczny obraz danych, na przykład liczbę otwartych problemów lub średni czas ich zamknięcia. Rzadko jednak wyjaśniają, dlaczego konkretne dochodzenie utknęło. Process mining odtwarza pełny przebieg każdego rekordu problemu na podstawie śladów cyfrowych z tabel takich jak PBM:Problem Investigation i PBM:Known Error. Pokazuje rzeczywistą kolejność zdarzeń oraz miejsca, w których zawodzą przekazania, przeciągają się zatwierdzenia lub pojawia się ponowna praca. Zamiast zgadywać, skąd bierze się długi czas obsługi, można sprawdzić, które ścieżki prowadzą do opóźnień i zaplanować usprawnienia na podstawie danych, a nie pojedynczych relacji.

Nieefektywności w analizie przyczyn źródłowych

Jednym z większych wyzwań w zarządzaniu problemami jest przejście od zarejestrowania problemu do rozpoczęcia dochodzenia. W wielu organizacjach rekord przez kilka dni pozostaje w stanie zarejestrowanym lub przypisanym, zanim specjalista rozpocznie pracę. Process mining pomaga wykryć te niewidoczne na pierwszy rzut oka wąskie gardła. Może się okazać, że niektóre grupy wsparcia są przeciążone albo że niejasne są kryteria przekazania problemu do analizy przyczyn źródłowych. Analiza przepływu między działaniami Investigation Commenced i Root Cause Identified pozwala sprawdzić, czy zespoły techniczne mają potrzebne informacje i czy nie poświęcają zbyt wiele czasu na administrację zamiast na diagnozę. Skrócenie tego etapu to najszybsza droga do poprawy stabilności IT.

Sprawniejsze wykorzystanie obejść i znanych błędów

Często pomijanym elementem procesu jest czas publikacji obejścia. Jeśli obejście zostanie znalezione, ale nie trafi do formularza PBM:Known Error, pracownicy Service Desk nadal mają trudności z obsługą powtarzających się incydentów. To oznacza stratę czasu w całej organizacji. Process mining pozwala zmierzyć czas między działaniami Workaround Identified i Workaround Published. Duża różnica może wskazywać na problemy z komunikacją, które bezpośrednio wpływają na liczbę incydentów. Usprawnienie tego fragmentu workflow pomaga szybko udostępniać tymczasowe rozwiązania, gdy trwa praca nad poprawką docelową. Specjaliści zyskują czas na dokładną analizę, a kolejka incydentów nie rośnie tak szybko.

Pomiar efektów i rozwój procesu

Celem optymalizacji procesu jest ograniczenie częstotliwości incydentów i ich wpływu na działalność firmy. Dzięki process mining można ustalić jasne punkty odniesienia dla całego cyklu zarządzania problemami. Można mierzyć skuteczność działań Change Request Initiated i sprawdzać, czy poprawki docelowe są wdrażane w uzgodnionych terminach SLA. Po wprowadzeniu zmian process mining zapewnia bieżącą informację zwrotną o ich efektach. Podejście oparte na danych sprzyja przejrzystości i odpowiedzialności, a zespoły mogą usprawniać workflow na podstawie faktów. Z czasem proces dojrzewa, liczba powracających problemów spada, a infrastruktura IT staje się bardziej odporna.

Jak zacząć usprawnianie procesu

Usprawnienie zarządzania problemami nie wymaga całkowitej przebudowy pakietu ITSM. Warto zacząć od poznania obecnego przebiegu procesu. Analizę danych z BMC Helix ITSM można rozpocząć od niewielkiego zakresu, na przykład jednej usługi o wysokim priorytecie lub często występującej kategorii problemów. W miarę wykrywania i usuwania wąskich gardeł spadek liczby incydentów zwolni zasoby zespołu, który będzie mógł zająć się kolejnymi, bardziej złożonymi usprawnieniami. Ten przewodnik i dołączone szablony pomogą rozpocząć pracę nad stabilniejszym, sprawniejszym i bardziej proaktywnym środowiskiem usług IT.

Zarządzanie problemami Analiza przyczyn źródłowych Zarządzanie usługami IT Service desk Operacje ITSM Ograniczanie liczby incydentów Koordynator ds. problemów System zgłoszeń Zarządzanie zgłoszeniami Znany błąd Powtarzające się incydenty Obejście problemu Zapobieganie incydentom Dział pomocy IT

Typowe problemy i wyzwania

Wskaż wyzwania, które Państwa dotyczą

Wiele rekordów problemów przez kilka dni pozostaje nieprzypisanych z powodu niejasnego zakresu odpowiedzialności lub braku powiadomień. Opóźnienie zwiększa ryzyko powrotu poważnych incydentów i obniża sprawność działu IT. Istotne problemy pozostają nierozwiązane, a czas upływa.

ProcessMind pokazuje, ile czasu mija od zarejestrowania rekordu do jego pierwszego przypisania w BMC Helix ITSM. Dzięki temu można wskazać grupy wsparcia lub kategorie problemów, w których najczęściej opóźnia się przejęcie odpowiedzialności, a następnie odpowiednio dostosować zasoby lub doprecyzować zasady przypisywania.

Dochodzenia dotyczące problemów często przechodzą do etapu investigation commenced, ale pozostają na nim bezterminowo, bez istotnych aktualizacji. Takie rekordy uniemożliwiają trwałe usunięcie przyczyn problemów i powiększają zaległości związane z długiem technologicznym, co z czasem prowadzi do kolejnych przerw w działaniu usług.

Analiza czasu trwania etapu dochodzenia pokazuje, gdzie proces się zatrzymuje. Rozwiązanie wskazuje rekordy w BMC Helix ITSM, których obsługa przekracza typowy czas. Koordynatorzy problemów mogą wtedy zareagować i przesunąć zasoby, zanim dochodzenie straci aktualność.

Jeśli znalezione obejście nie zostanie szybko opublikowane w systemie zarządzania wiedzą, pracownicy Service Desk nie mogą sprawnie rozwiązywać incydentów. Brak informacji o tymczasowych poprawkach wydłuża średni czas naprawy powiązanych incydentów i frustruje użytkowników, gdy trwa jeszcze opracowywanie trwałego rozwiązania.

ProcessMind mierzy czas między znalezieniem obejścia a działaniem Workaround Published. Dzięki temu można szybko udostępniać tymczasowe rozwiązania w BMC Helix ITSM, ograniczać wpływ bieżących problemów i pozwolić zespołom technicznym skupić się na usunięciu ich przyczyn.

Rekordy problemów często krążą między zespołami technicznymi, które próbują uniknąć odpowiedzialności lub różnie interpretują zakres techniczny. Takie przekazywanie w kółko znacznie wydłuża obsługę problemu i opóźnia rozpoczęcie analizy przyczyn źródłowych. Prowadzi też do straty czasu i przeciążenia zasobów.

Silnik analityczny mapuje kolejność działań związanych z przypisywaniem i ujawnia powtarzające się przekazania w BMC Helix ITSM. Można sprawdzić, które grupy wsparcia najczęściej przekierowują rekordy, a następnie uzupełnić szkolenia lub doprecyzować zakresy odpowiedzialności, by przerwać ten cykl.

Problemy o wysokim priorytecie często nie mieszczą się w uzgodnionych terminach SLA z powodu ukrytych nieefektywności na etapach dochodzenia i naprawy. Niedotrzymanie terminów zagraża stabilności usług IT i może osłabić zaufanie do działu IT, gdy krytyczna infrastruktura pozostaje niestabilna dłużej, niż uzgodniono.

ProcessMind zestawia terminy SLA z rzeczywistymi znacznikami czasu procesu i wskazuje działania prowadzące do naruszeń. Pozwala to monitorować terminy SLA w BMC Helix ITSM i zmieniać priorytety lub workflow, zanim upłynie termin i stabilność usług będzie zagrożona.

Po ustaleniu przyczyny źródłowej często długo czeka się na rozpoczęcie wniosku o zmianę, który umożliwi wdrożenie trwałej poprawki. W tym czasie organizacja pozostaje narażona na powracające incydenty, mimo że rozwiązanie techniczne jest już znane. Wdrożenie utknęło w formalnościach.

Analizujemy czas między działaniami Root Cause Identified i Change Request Initiated. Dzięki temu można wykryć przeszkody w przejściu od zarządzania problemami do zarządzania zmianami w BMC Helix ITSM i ograniczyć niepotrzebne opóźnienia administracyjne we wdrażaniu trwałych poprawek.

W okresach wzmożonej pracy zespoły często pomijają przegląd po wdrożeniu, aby szybciej zamknąć rekordy i zmniejszyć zaległości. Bez tego kroku organizacja nie sprawdza, czy poprawka zadziałała zgodnie z założeniami, ani nie zapisuje wniosków. W przyszłości mogą przez to wystąpić podobne problemy.

ProcessMind monitoruje, czy przed zamknięciem każdego rekordu problemu wykonano działanie post-implementation review conducted. Wskazuje odstępstwa od standardowego procesu w BMC Helix ITSM, pomagając dopilnować wszystkich etapów rozwiązania problemu i spełnić wymagania dotyczące zgodności.

Zdarza się, że rekord problemu zostaje zamknięty, zanim przedstawiciele biznesu lub zespołu technicznego potwierdzą skuteczność rozwiązania. Wkrótce potem problem może powrócić, co wymaga ponownego otwarcia rekordu lub utworzenia nowego. Utrudnia to raportowanie i obniża wiarygodność wskaźników.

Analiza porównuje działanie Resolution Verified ze zdarzeniem końcowym zamknięcia w BMC Helix ITSM. Wskazuje przypadki, w których pominięto lub przyspieszono weryfikację, pomagając zespołom kontrolować jakość i potwierdzić usunięcie przyczyny przed oficjalnym rozwiązaniem problemu.

Jeśli technicy nieprawidłowo przypisują kategorię przyczyny źródłowej, trudno wykrywać długoterminowe trendy i słabe punkty infrastruktury. Brak wiarygodnych danych utrudnia podejmowanie świadomych decyzji o inwestycjach w infrastrukturę i zmianach procesu, które poprawiłyby stabilność.

ProcessMind wskazuje rekordy, w których brakuje kategorii przyczyny źródłowej lub przypisano ogólną wartość. Ujawnienie tych braków w BMC Helix ITSM pomaga poprawić jakość danych i lepiej zrozumieć przyczyny niestabilności IT, a następnie skuteczniej im zapobiegać.

Wysoka liczba przypisanych problemów może przeciążyć wyspecjalizowane zespoły techniczne, powodując duże zaległości i opóźnienia w naprawach. Nierównomierne obciążenie tworzy pojedynczy punkt awarii, który zatrzymuje cały proces zarządzania problemami i naraża krytyczne usługi.

Analiza liczby aktywnych rekordów przypisanych do każdej grupy wsparcia pozwala wykryć wąskie gardła związane z zasobami. Na podstawie rzeczywistej przepustowości, a nie pojedynczych relacji, menedżerowie IT mogą lepiej rozłożyć obciążenie lub zwiększyć obsadę w krytycznych obszarach BMC Helix ITSM.

Gdy cykl zarządzania problemami trwa zbyt długo, te same incydenty nadal trafiają do Service Desk, a pracownicy poświęcają czas na powtarzalne zadania. Ogranicza to sprawność zespołu i odciąga go od projektów strategicznych oraz trudniejszych analiz.

ProcessMind zestawia liczbę powiązanych incydentów z czasem trwania dochodzenia i naprawy. Pokazuje, jak powolne rozwiązywanie problemów zwiększa liczbę incydentów w BMC Helix ITSM. Na tej podstawie można uzasadnić przyspieszenie wdrażania trwałych poprawek i ograniczyć obciążenie Service Desk.

Typowe cele

Określ, jak wygląda sukces

Szybkie przypisanie problemu pozwala od razu przekazać go właściwym specjalistom. Skrócenie czasu, przez który rekord pozostaje w stanie zarejestrowanym, umożliwia wcześniejsze rozpoczęcie dochodzenia i ogranicza ryzyko związane z trwającymi zakłóceniami IT. Przyspiesza też przywracanie usług.

ProcessMind mierzy czas między działaniami logged i assigned w BMC Helix ITSM. Wskazuje kategorie i poziomy priorytetu, w których przypisanie trwa dłużej niż przeciętnie. Menedżerowie mogą dzięki temu ustalić wartości docelowe i na bieżąco śledzić poprawę czasu reakcji.

Ustalenie przyczyny problemu to najbardziej pracochłonny etap procesu. Jego skrócenie przyspiesza opracowanie trwałych poprawek, ogranicza narastanie długu technologicznego i zmniejsza obciążenie zespołów technicznych, które w przeciwnym razie musiałyby obsługiwać powracające incydenty.

Platforma analizuje działanie Investigation Commenced, aby zmierzyć czas poświęcony na analizę przyczyn źródłowych. Ujawnia wąskie gardła, w których dochodzenia się zatrzymują, dzięki czemu koordynatorzy mogą zareagować i przesunąć zasoby do złożonych problemów, zanim zostaną przekroczone terminy SLA.

Szybkie udostępnienie obejścia pomaga przywrócić działanie usługi, gdy trwa opracowywanie trwałej poprawki. Sprawna publikacja informacji o znanych błędach ogranicza wpływ incydentów na operacje i poprawia komfort użytkowników. Pracownicy Service Desk mogą od razu stosować rozwiązania typowych problemów, co zwiększa dostępność usług.

Process mining pozwala zobaczyć czas między zarejestrowaniem problemu a działaniem Workaround Published. Dane pokazują, które grupy wsparcia najszybciej udostępniają rozwiązania tymczasowe. Ich sprawdzone workflow można następnie wykorzystać w całej organizacji IT.

Każde przekazanie rekordu problemu między grupami wsparcia oznacza stratę czasu i utratę kontekstu. Ograniczenie takich przekazań pozwala szybciej znaleźć rozwiązanie, zmniejsza frustrację pracowników technicznych i skraca obsługę rekordu, który trafia do właściwych specjalistów.

ProcessMind mapuje przepływ rekordów między grupami wsparcia w BMC Helix ITSM. Wskazuje powtarzające się pętle i częste zmiany przypisania, dzięki czemu można wykryć braki wiedzy lub usprawnić wstępną kwalifikację. Rekord może wtedy od razu trafić do właściwego zespołu.

Dotrzymywanie uzgodnionych poziomów usług w przypadku problemów o wysokim priorytecie pomaga zachować ciągłość działania firmy. Stała zgodność buduje zaufanie interesariuszy biznesowych i zapewnia pilną obsługę problemów o największym wpływie. Ogranicza też czas trwania krytycznych przerw w działaniu usług.

Platforma porównuje atrybut SLA due date z rzeczywistym czasem zakończenia każdego rekordu problemu. Wcześnie ostrzega o rekordach zbliżających się do terminu, pomagając koordynatorom ustalać priorytety i dotrzymywać uzgodnionych terminów w przypadku krytycznych usług.

Po ustaleniu przyczyny źródłowej przejście do formalnego wniosku o zmianę powinno przebiegać sprawnie. Szybsze przekazanie pozwala jak najszybciej wdrożyć trwałą poprawkę i usunąć zagrożenie dla środowiska IT. Skraca też czas oczekiwania na wdrożenie proponowanego rozwiązania.

Analizujemy kolejność zdarzeń od Root Cause Identified do Change Request Initiated. Dzięki temu można wykryć opóźnienia administracyjne i wąskie gardła w zatwierdzaniu. Zespoły mogą zautomatyzować tworzenie rekordów zmian i ograniczyć czas oczekiwania między ustaleniem przyczyny a rozpoczęciem naprawy.

Wyciąganie wniosków z wcześniejszych problemów jest niezbędne do ciągłego doskonalenia usług. Przegląd każdego poważnego problemu pozwala zapisać wnioski, zapobiegać podobnym zdarzeniom i stopniowo rozwijać dojrzałość organizacji IT dzięki lepszemu dzieleniu się wiedzą.

ProcessMind sprawdza, czy przed zamknięciem rekordu wykonano działanie post-implementation review conducted. Wskazuje, gdzie ten etap jest często pomijany, co pomaga zadbać o zgodność z procesem oraz zapisywanie i udostępnianie wiedzy w Service Desk.

Zamknięcie rekordu problemu bez sprawdzenia poprawki często prowadzi do powrotu tego samego problemu. Formalna weryfikacja pozwala potwierdzić, że przyczyna została usunięta. Ogranicza to liczbę przyszłych incydentów i pomaga utrzymać stabilność usług w całej firmie.

Analiza kolejności działań od Resolution Verified do Record Closed wskazuje przypadki przedwczesnego zamknięcia rekordu. Dane pomagają zespołom stawiać jakość na pierwszym miejscu i potwierdzać skuteczność każdej poprawki przed zakończeniem sprawy.

Dokładne dane są podstawą skutecznego zarządzania problemami. Lepsza jakość kategorii przyczyn źródłowych ułatwia analizę trendów i pozwala trafniej kierować inwestycje w technologię lub szkolenia, aby usuwać problemy systemowe w infrastrukturze IT i zapewnić jej długoterminową stabilność.

Platforma analizuje atrybut kategorii przyczyny źródłowej w tysiącach rekordów, aby wykryć niespójności i nadużywanie ogólnych kategorii. Dzięki tym informacjom menedżerowie mogą doprecyzować standardy wprowadzania danych i zwiększyć wiarygodność raportów w środowisku BMC Helix ITSM.

Równomierne rozłożenie pracy między zespołami technicznymi zapobiega powstawaniu wąskich gardeł. Właściwy przydział zasobów sprawia, że każdy problem, niezależnie od kategorii, otrzymuje odpowiednią uwagę i przechodzi przez kolejne etapy w przewidywalnym tempie.

ProcessMind pokazuje liczbę otwartych rekordów problemów obsługiwanych przez każdą przypisaną grupę wsparcia. Wskazuje zespoły z nieproporcjonalnie dużym obciążeniem lub dłuższym czasem obsługi, co ułatwia podejmowanie decyzji o zatrudnieniu, szkoleniach i równoważeniu obciążenia.

Głównym celem zarządzania problemami jest zapobieganie powtarzającym się incydentom. Ograniczenie ich liczby zmniejsza koszty wsparcia IT i zwiększa dostępność aplikacji ważnych dla firmy. Pracownicy IT mogą dzięki temu skupić się na rozwoju zamiast na utrzymaniu.

Łączymy rekordy problemów z liczbą powiązanych incydentów, aby zmierzyć rzeczywisty wpływ każdego problemu. Śledząc, jak szybko spada liczba incydentów po wdrożeniu trwałej poprawki, można ocenić zwrot z działań związanych z zarządzaniem problemami i wskazać poprawki, które przyniosły największe efekty.

Proaktywne zarządzanie problemami zapobiega zakłóceniom, zanim odczują je użytkownicy. Wczesne wykrywanie trendów pozwala usuwać podatności podczas zaplanowanych prac serwisowych, zamiast reagować w trybie awaryjnym. Dzięki temu środowisko IT działa stabilniej.

ProcessMind analizuje czas między skupiskami incydentów a utworzeniem rekordu problemu. Obserwacja tych wzorców pomaga wcześniej rozpoczynać dochodzenia i przesunąć uwagę zespołu z gaszenia pożarów na zapobieganie problemom. Ogranicza to ich wpływ na działalność firmy.

6 etapów usprawniania zarządzania problemami

1

Pobranie szablonu danych

Co zrobić

Pobierz standardowy szablon Excel z polami używanymi w BMC Helix Problem Management, w tym w formularzach Problem Investigation i Known Error.

Dlaczego to ważne

Gotowa struktura pozwala dopasować dane z cyklu obsługi problemu do modeli analitycznych i szybciej uzyskać wyniki analizy.

Oczekiwany rezultat

Gotowy szablon do mapowania danych ITSM.

WNIOSKI DOTYCZĄCE PROCESU

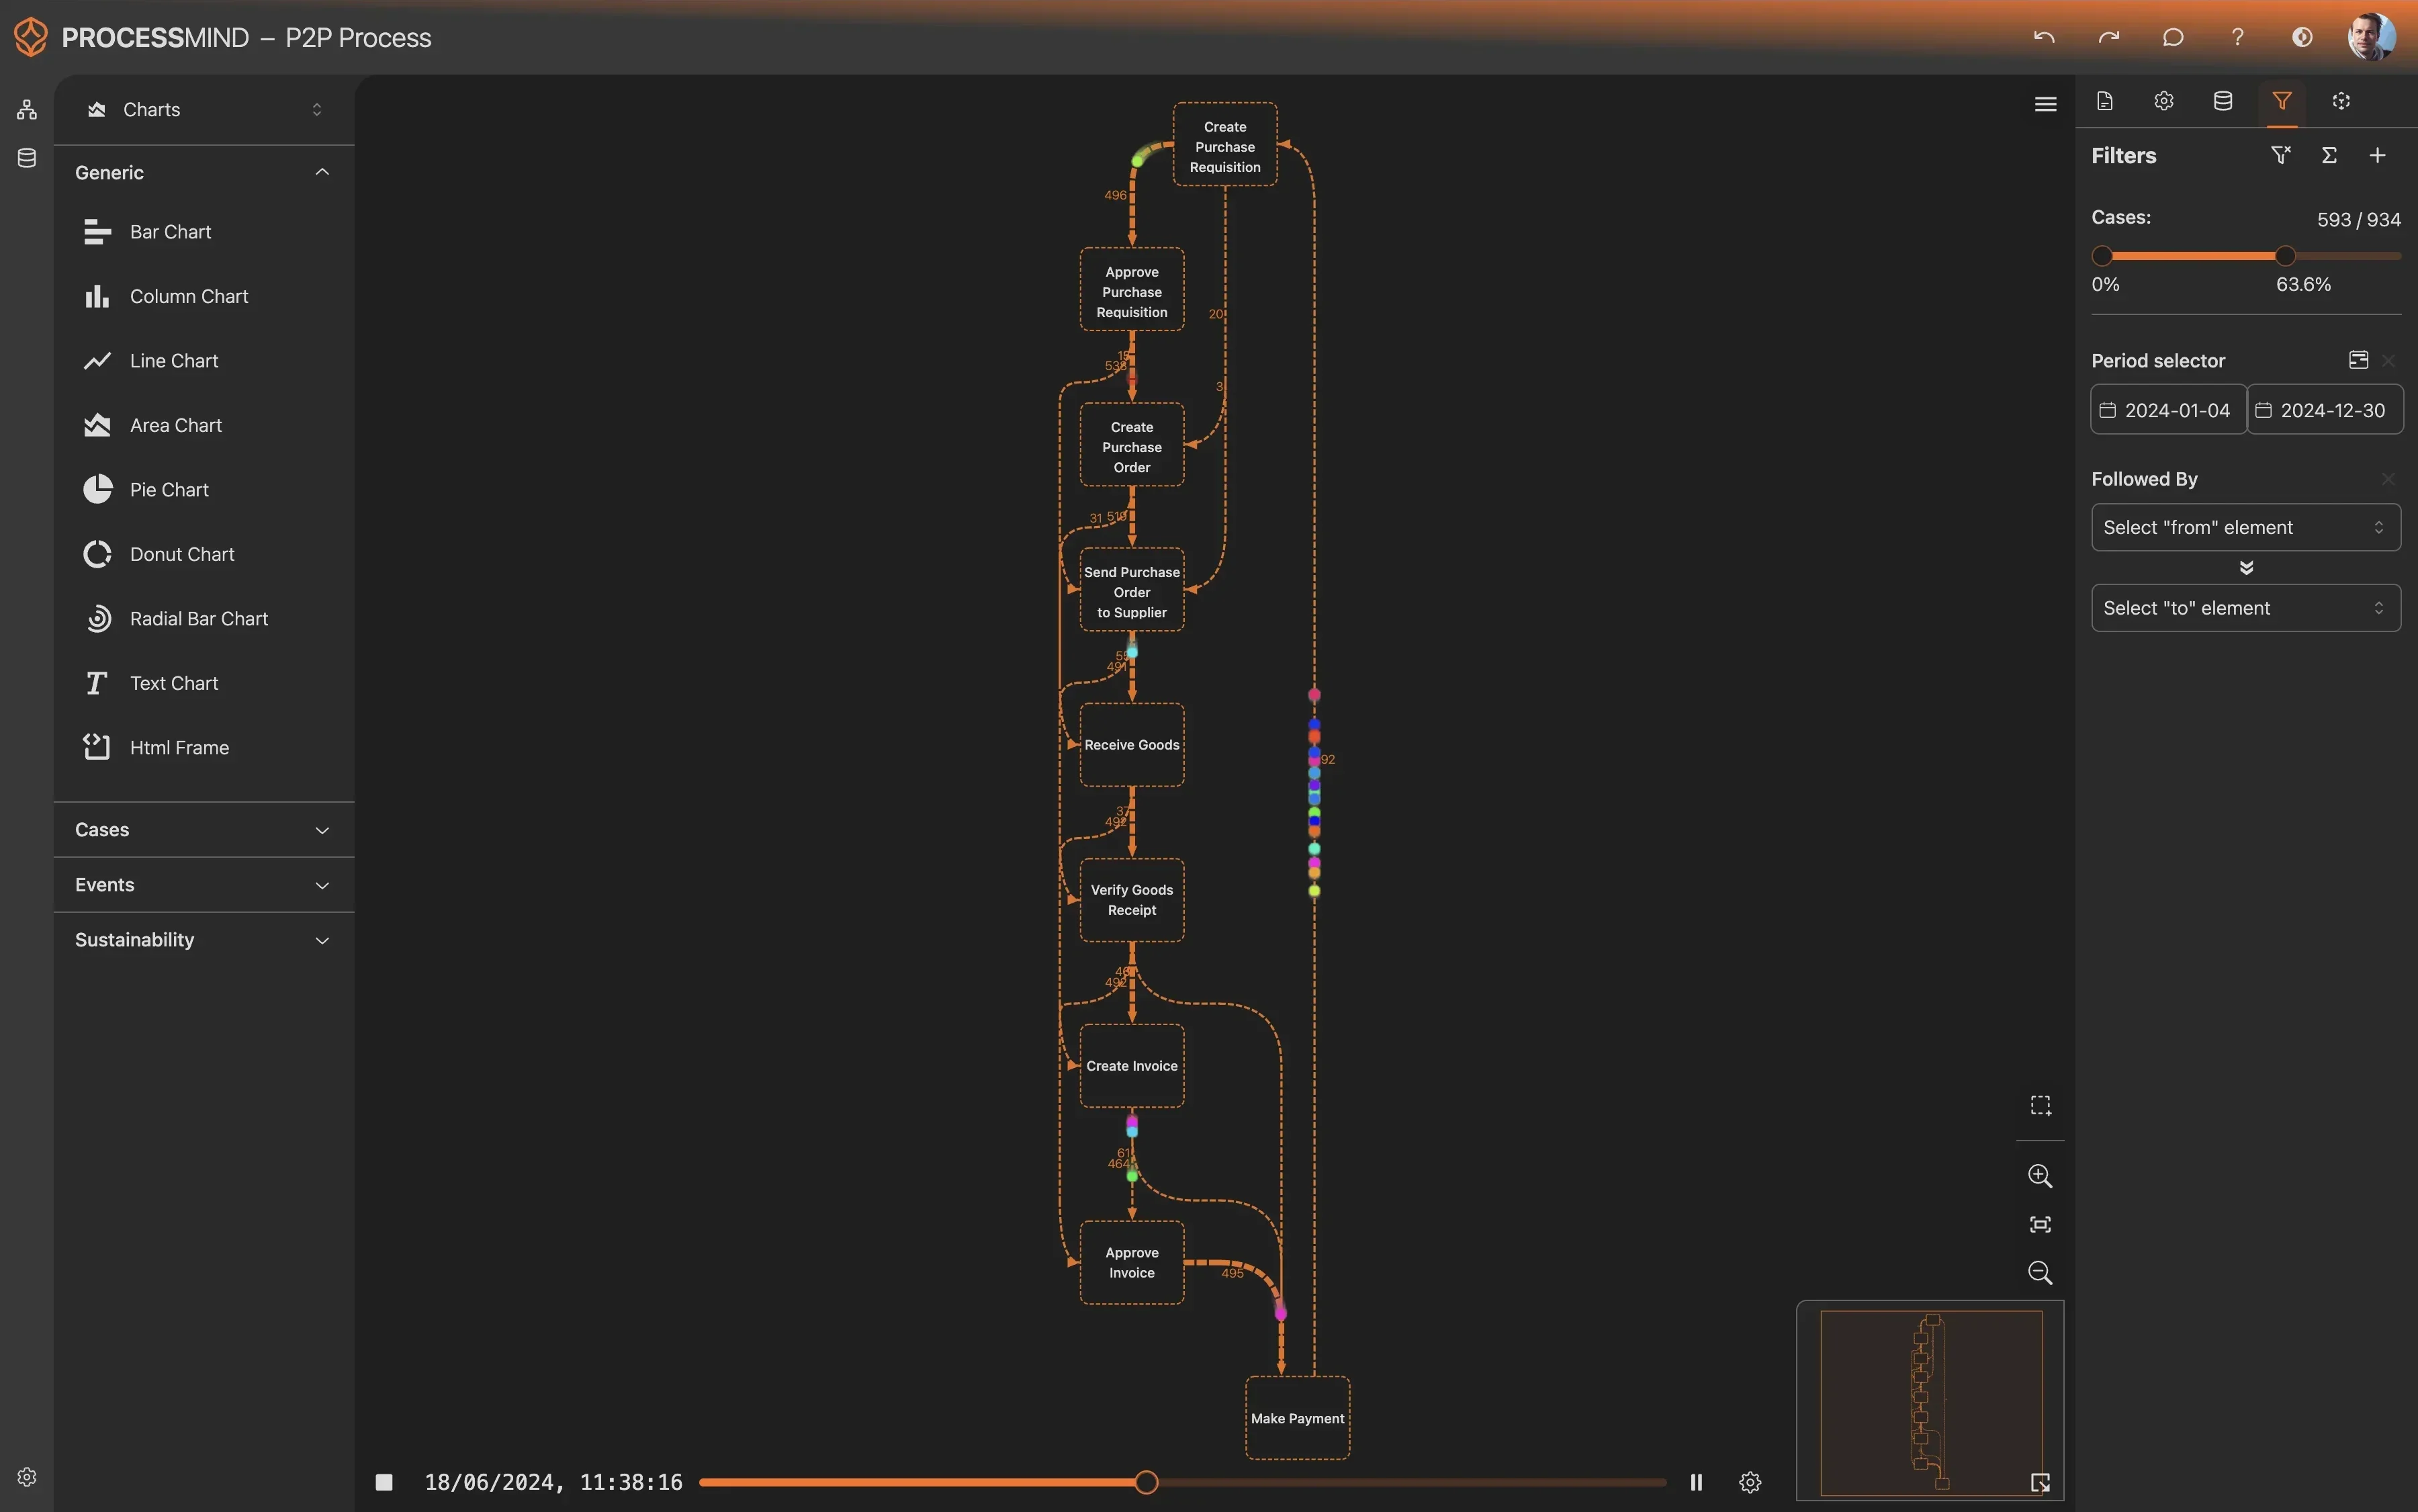
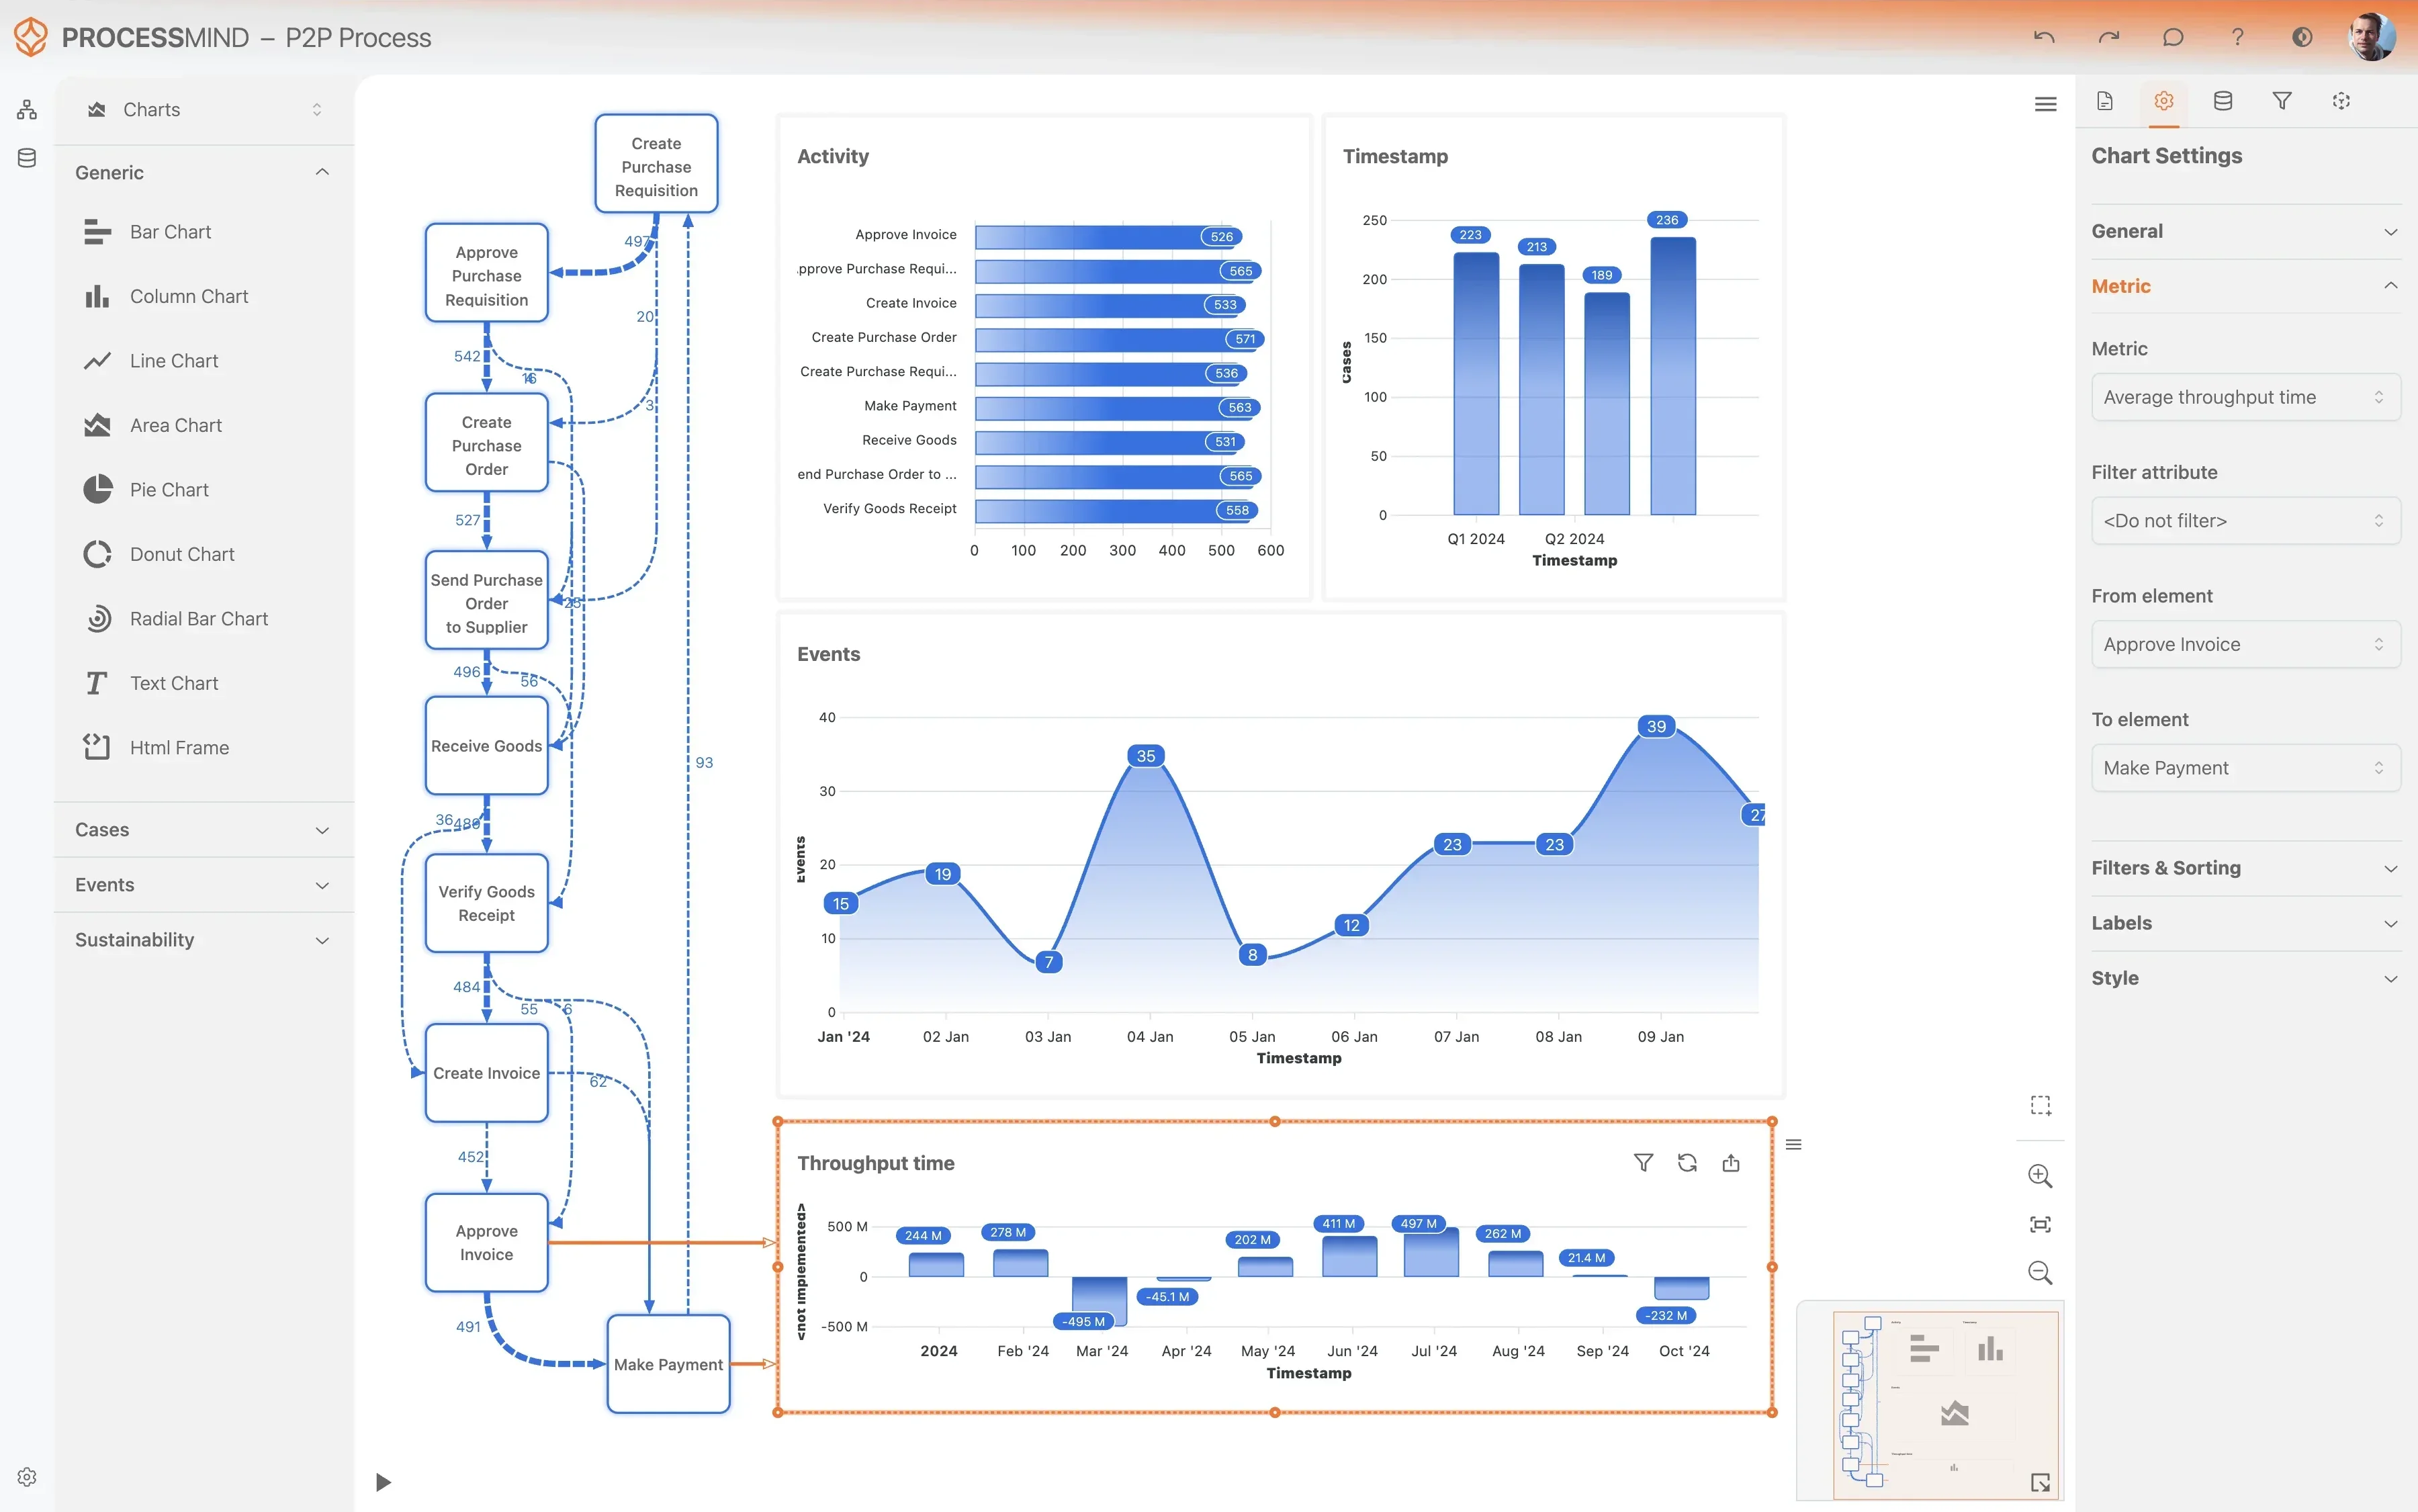
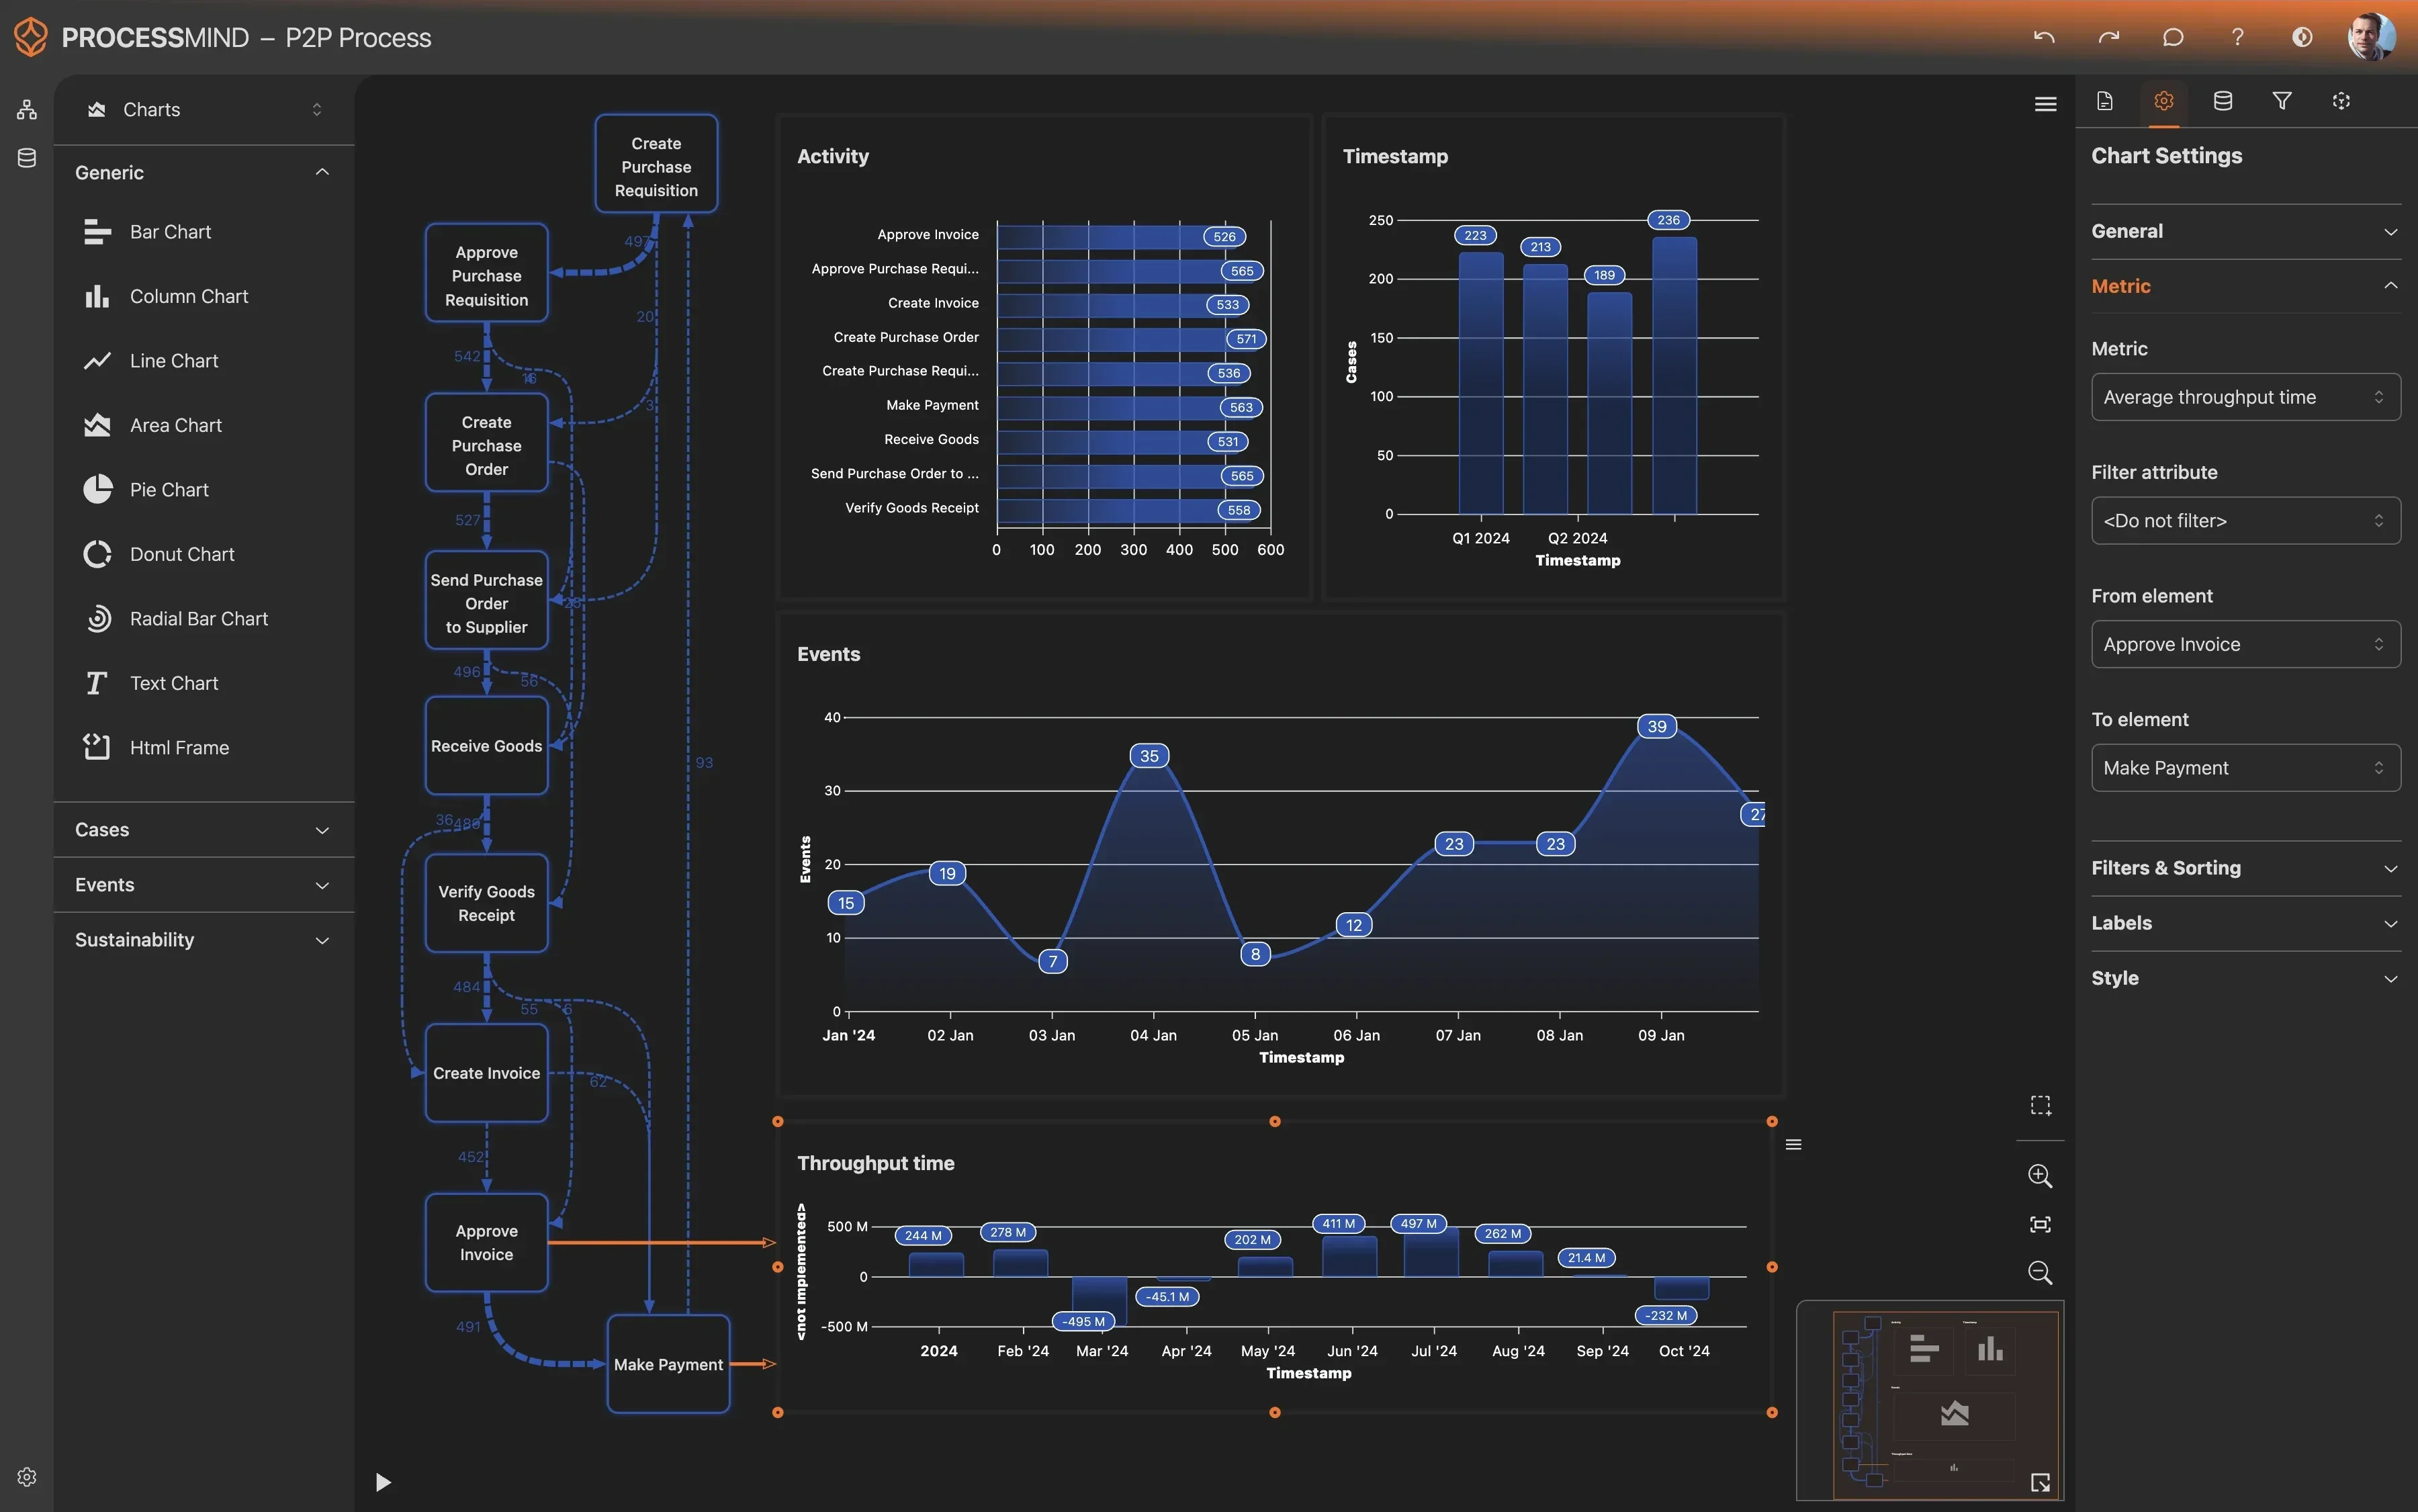
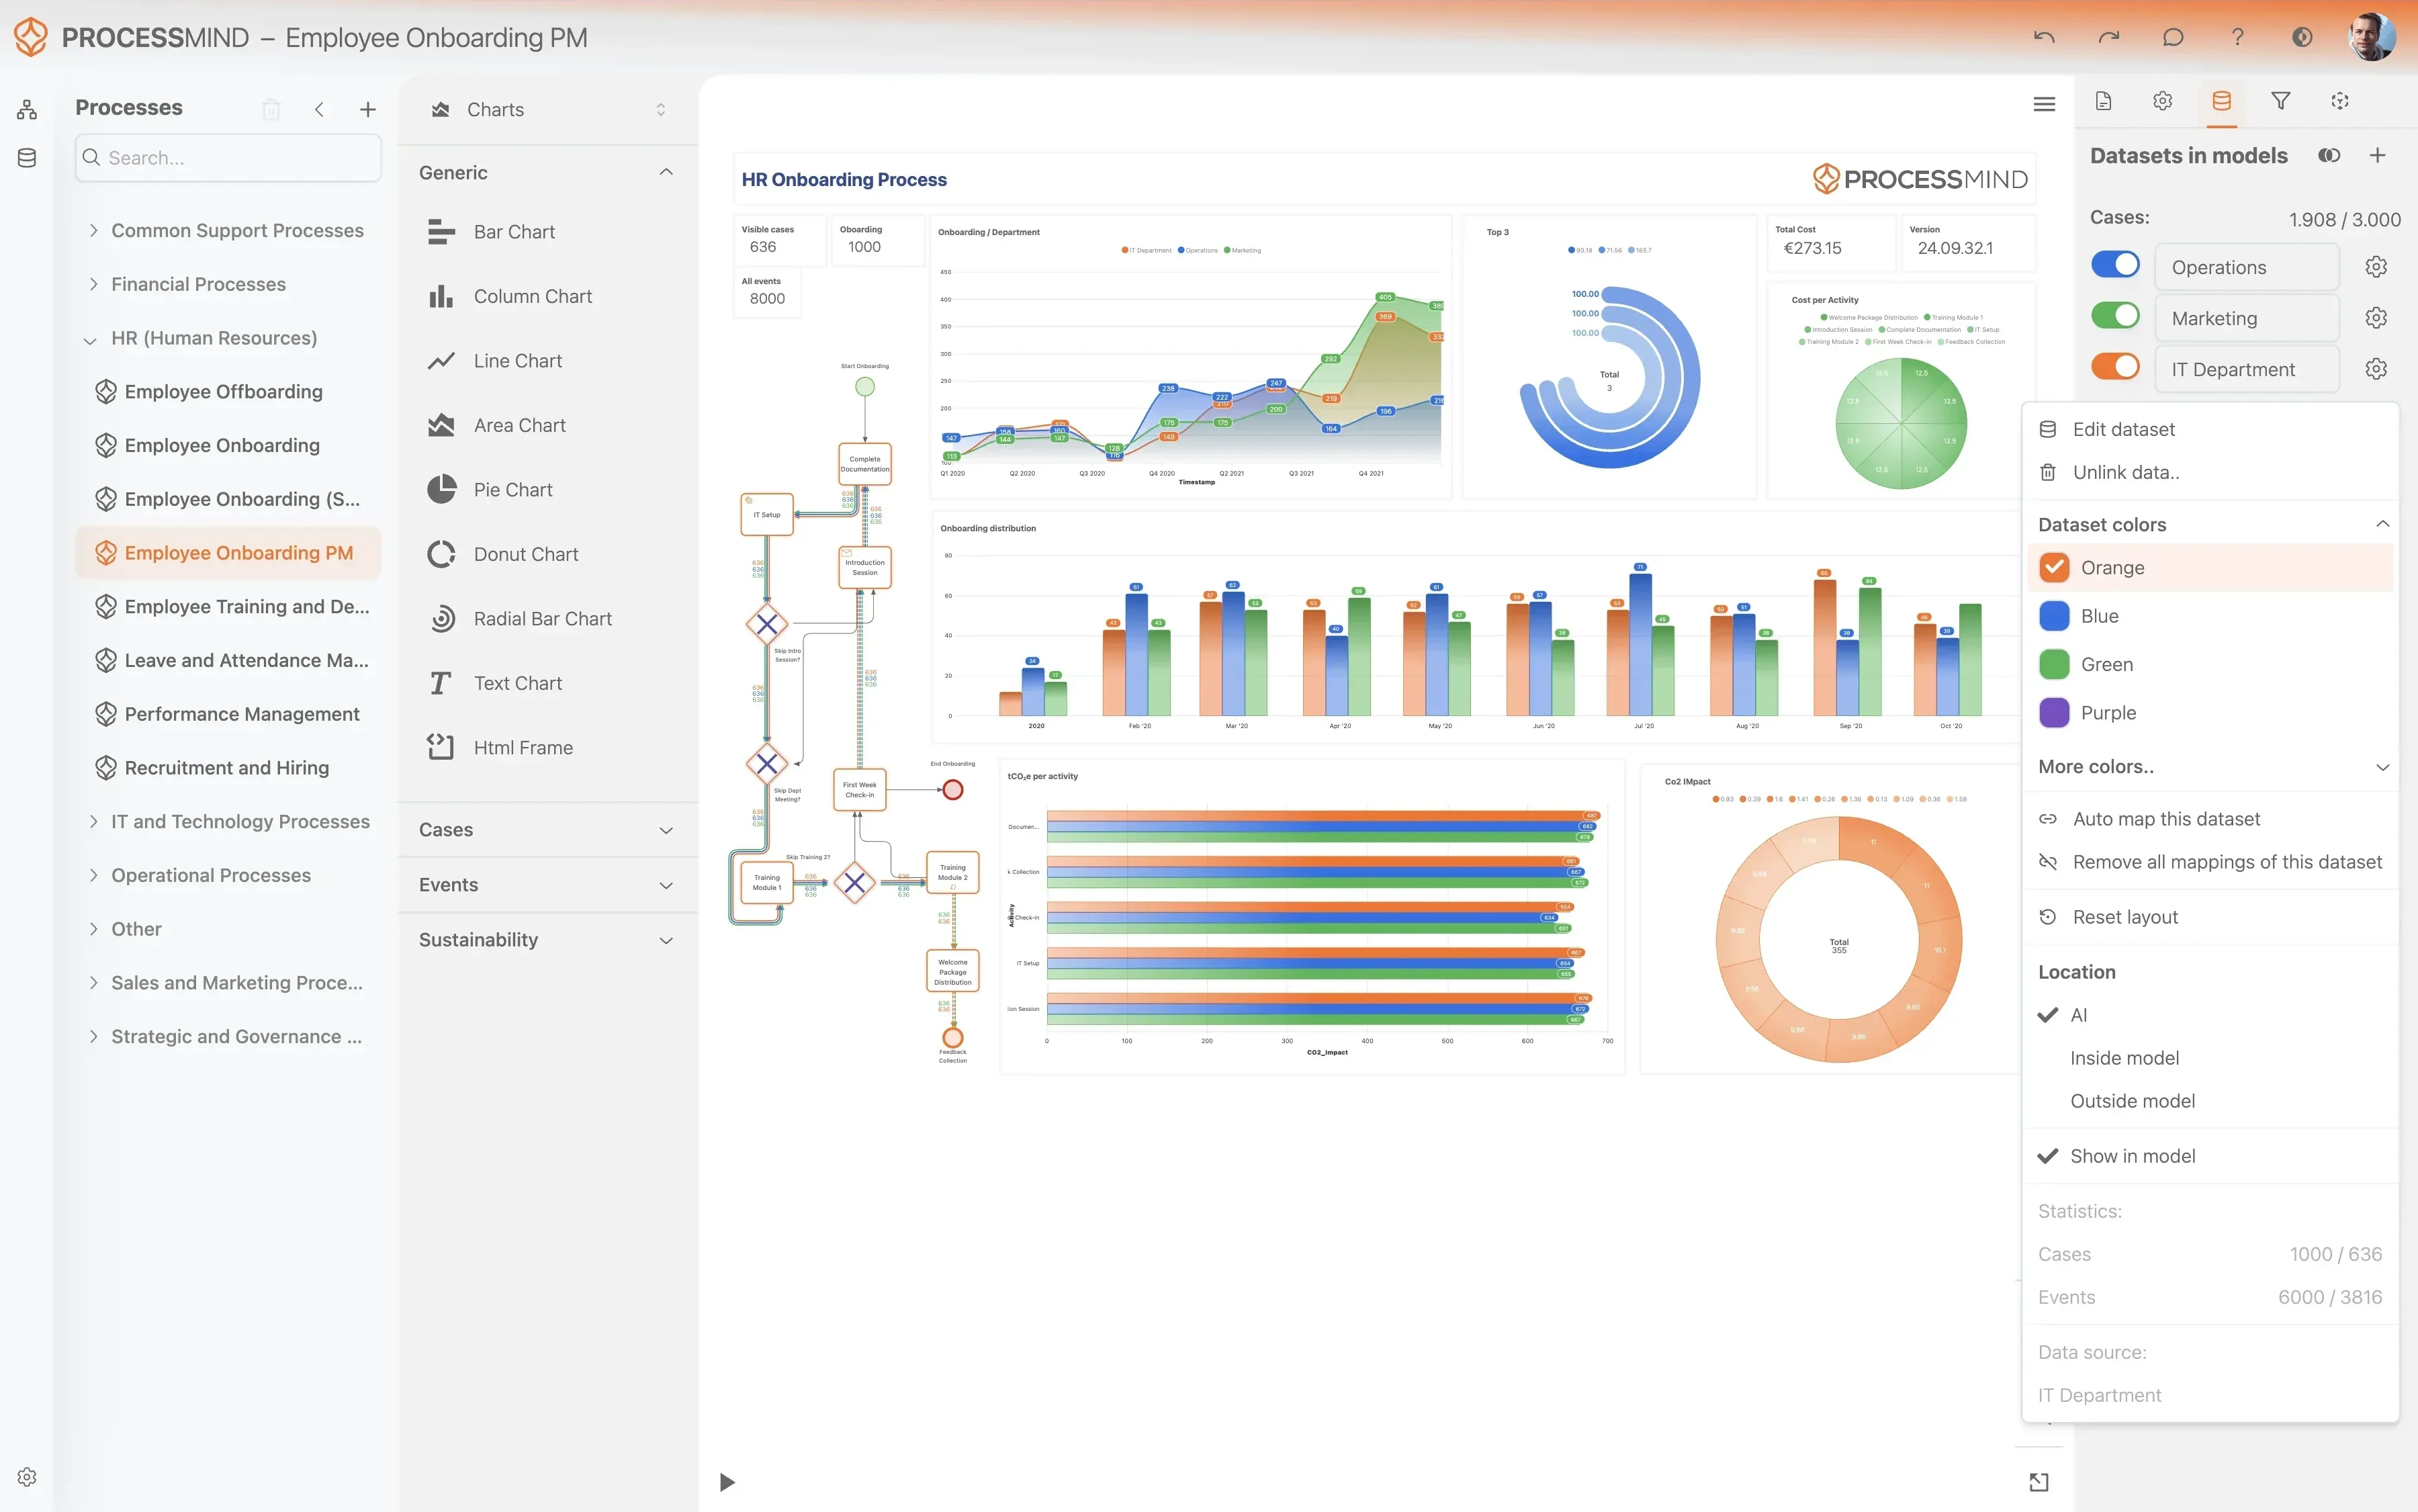
Wykryj rzeczywiste wąskie gardła w procesie obsługi problemów w Helix

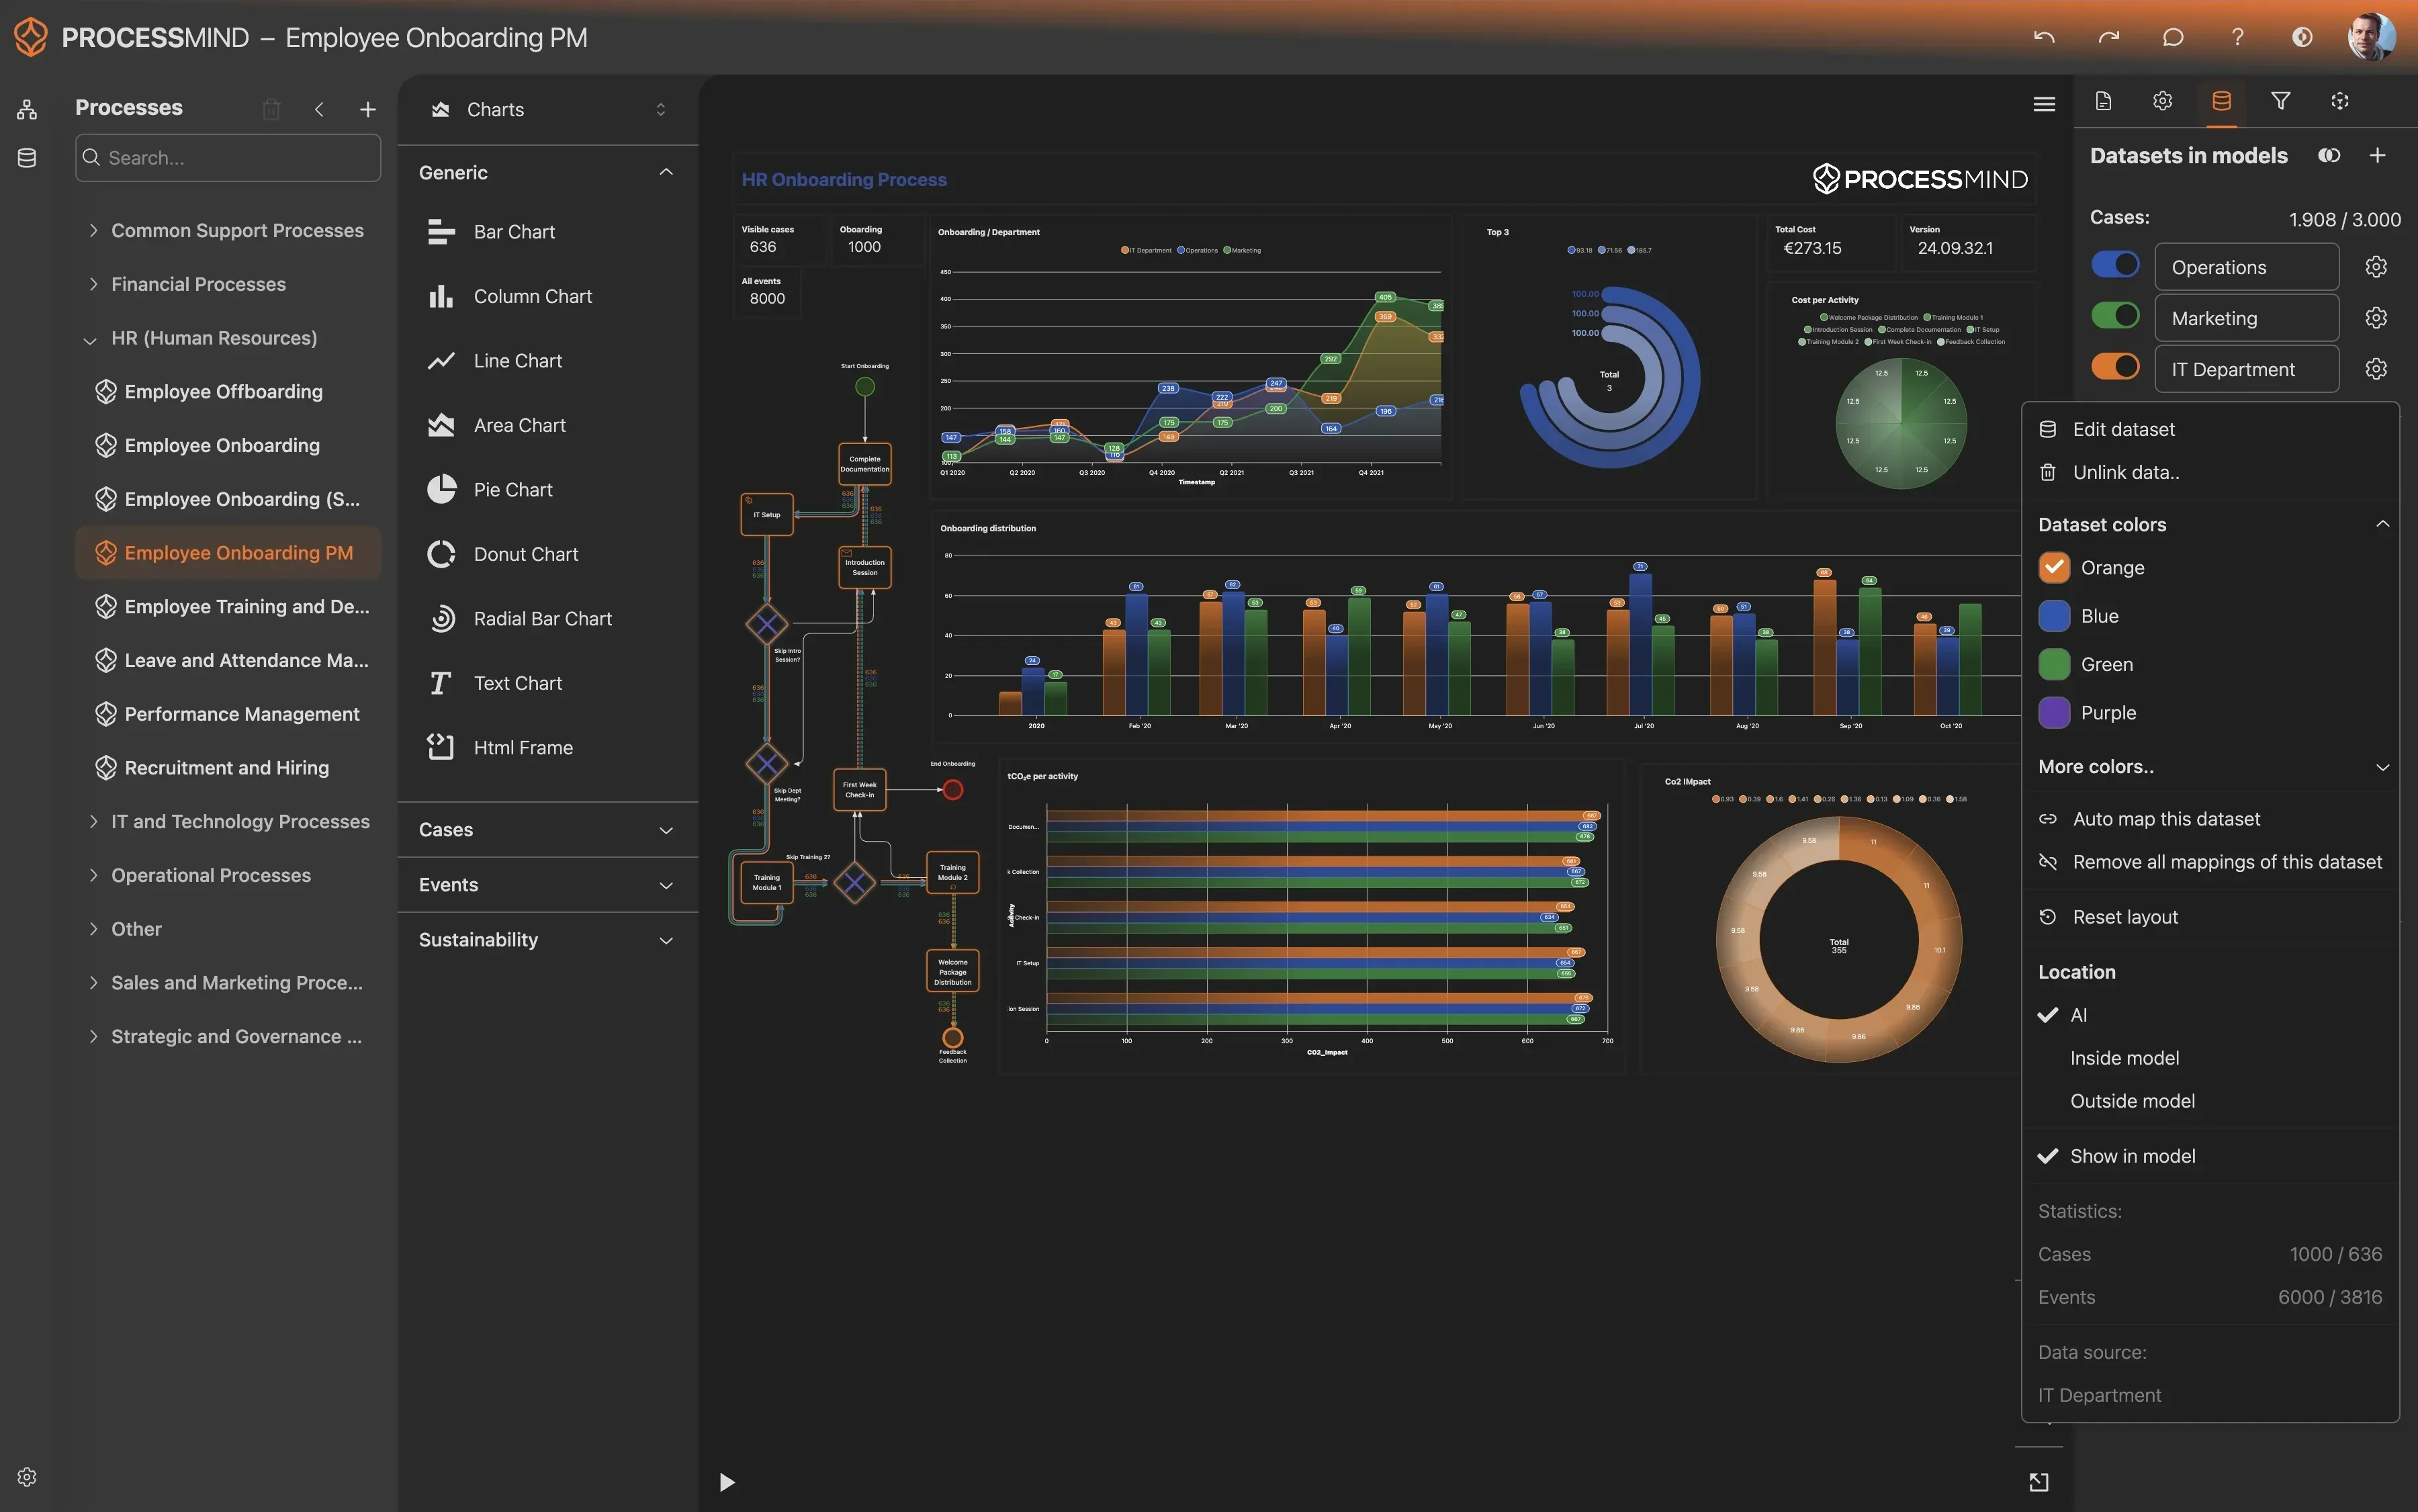
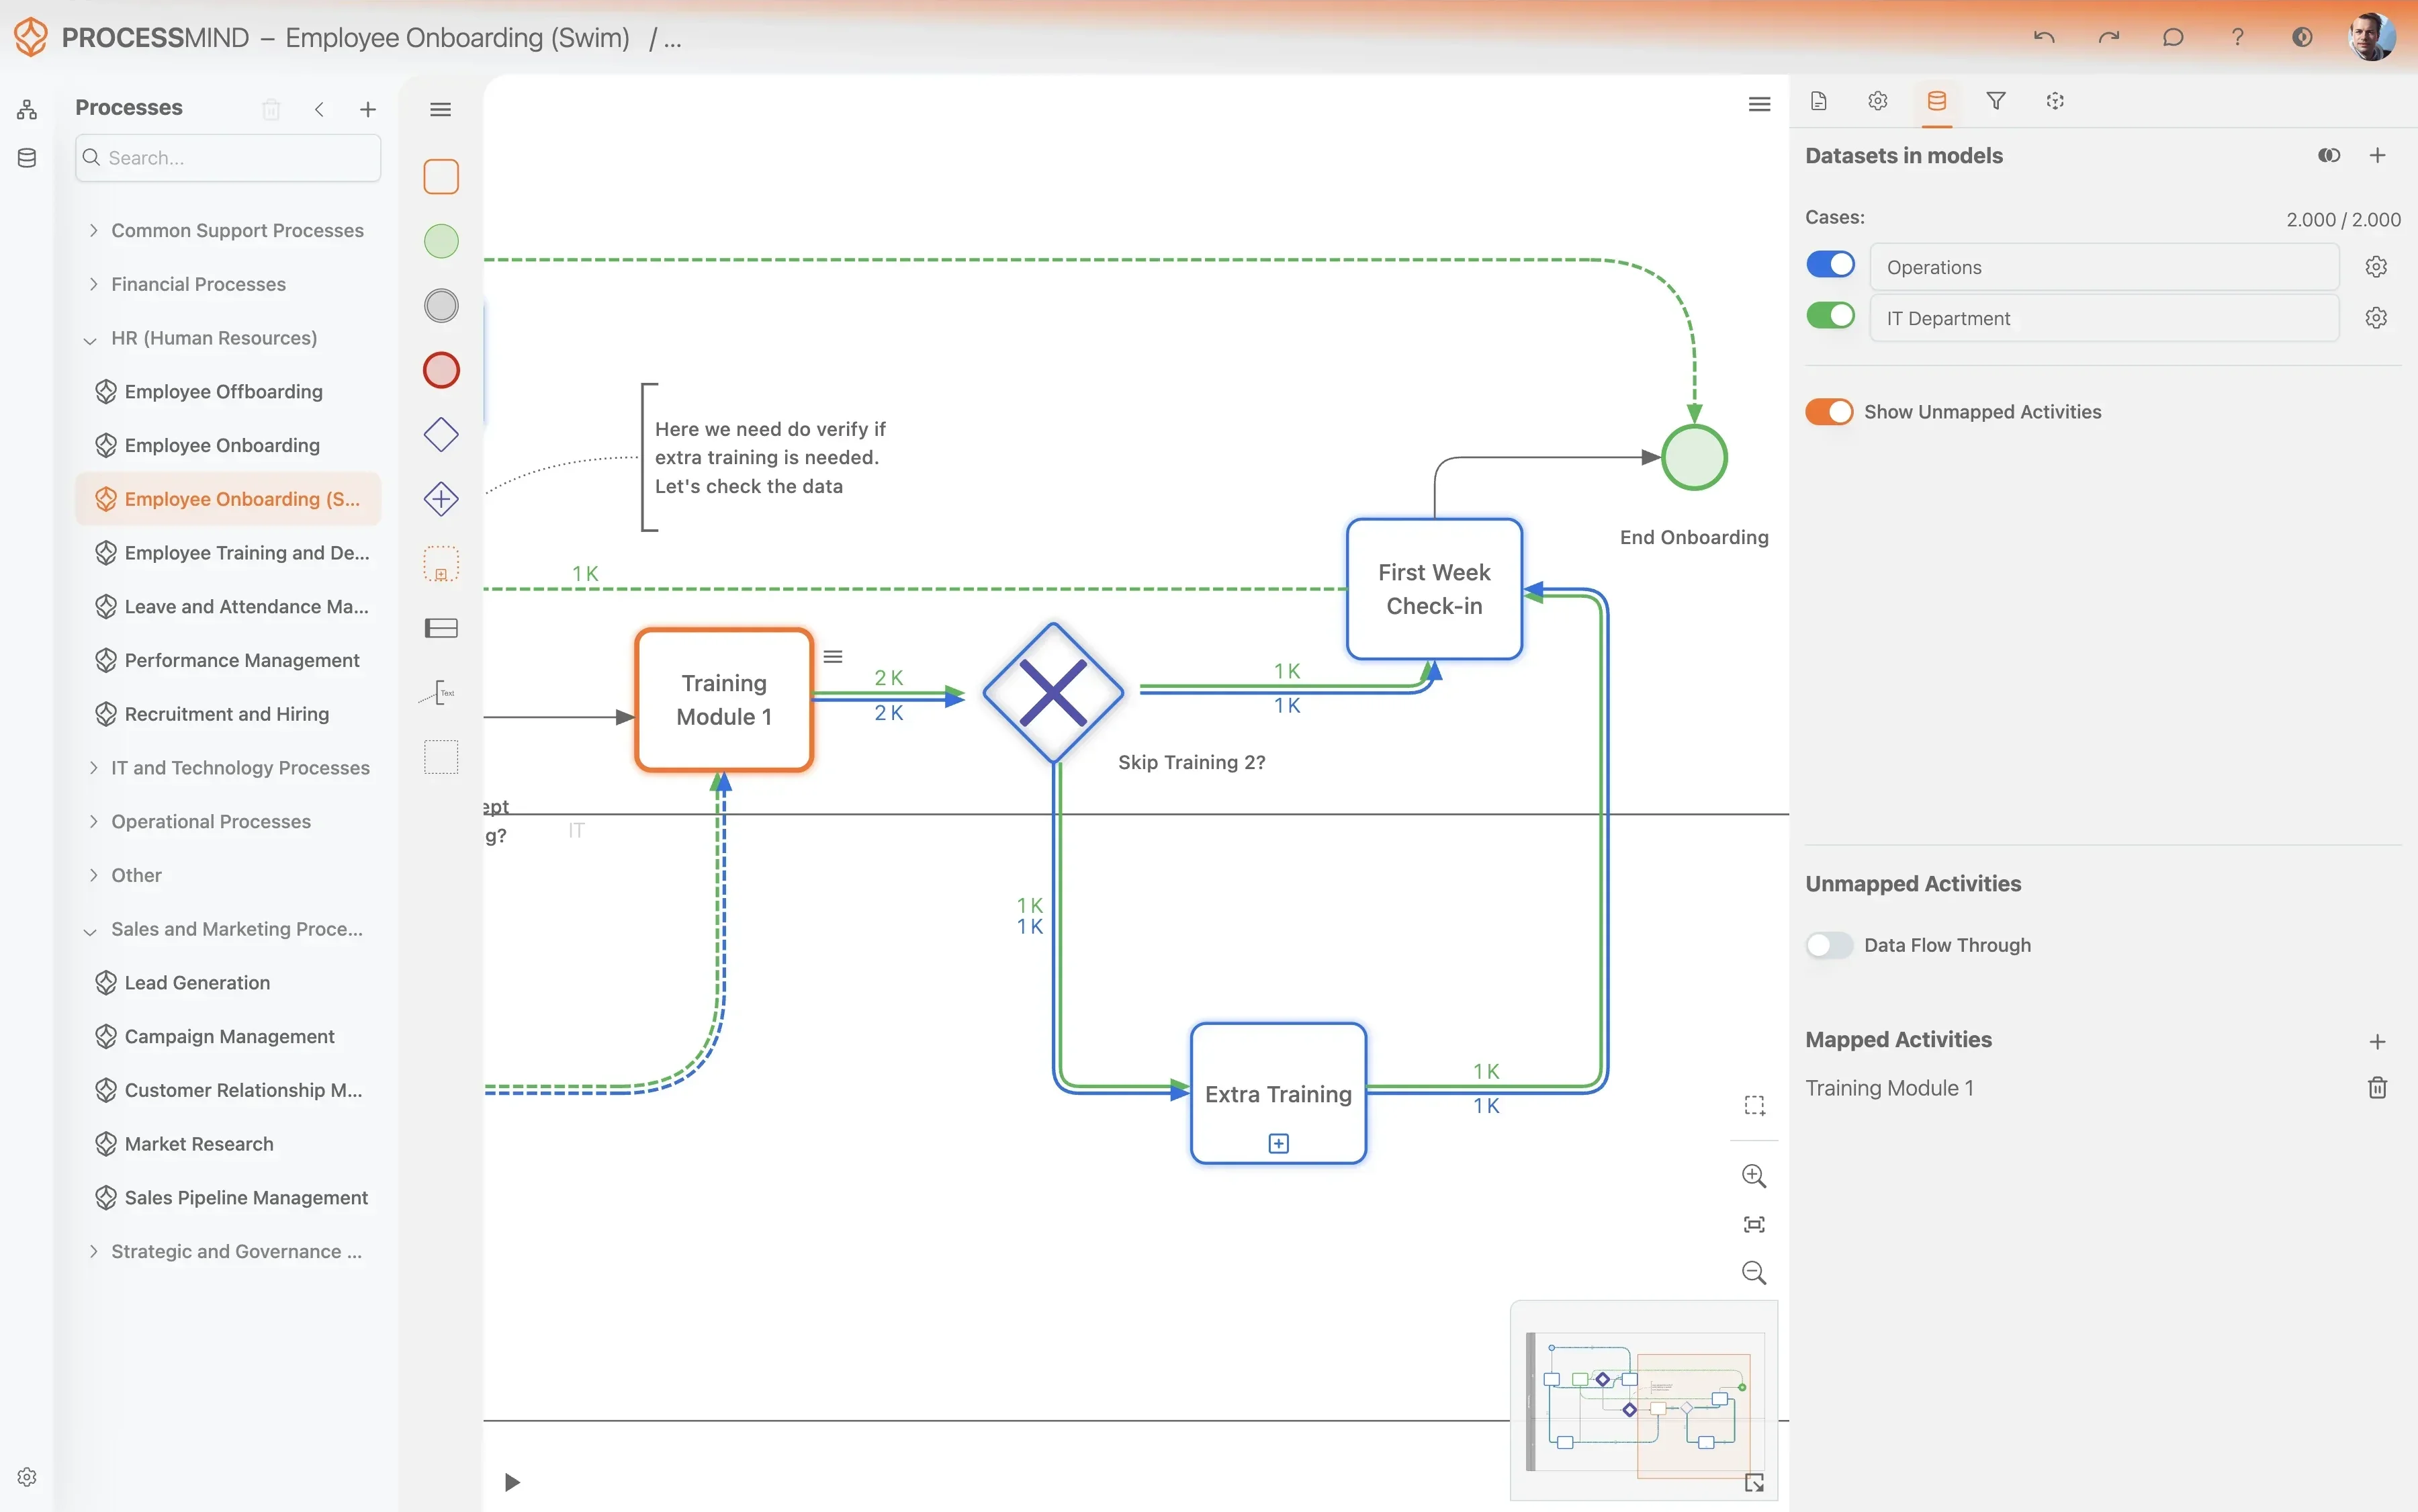
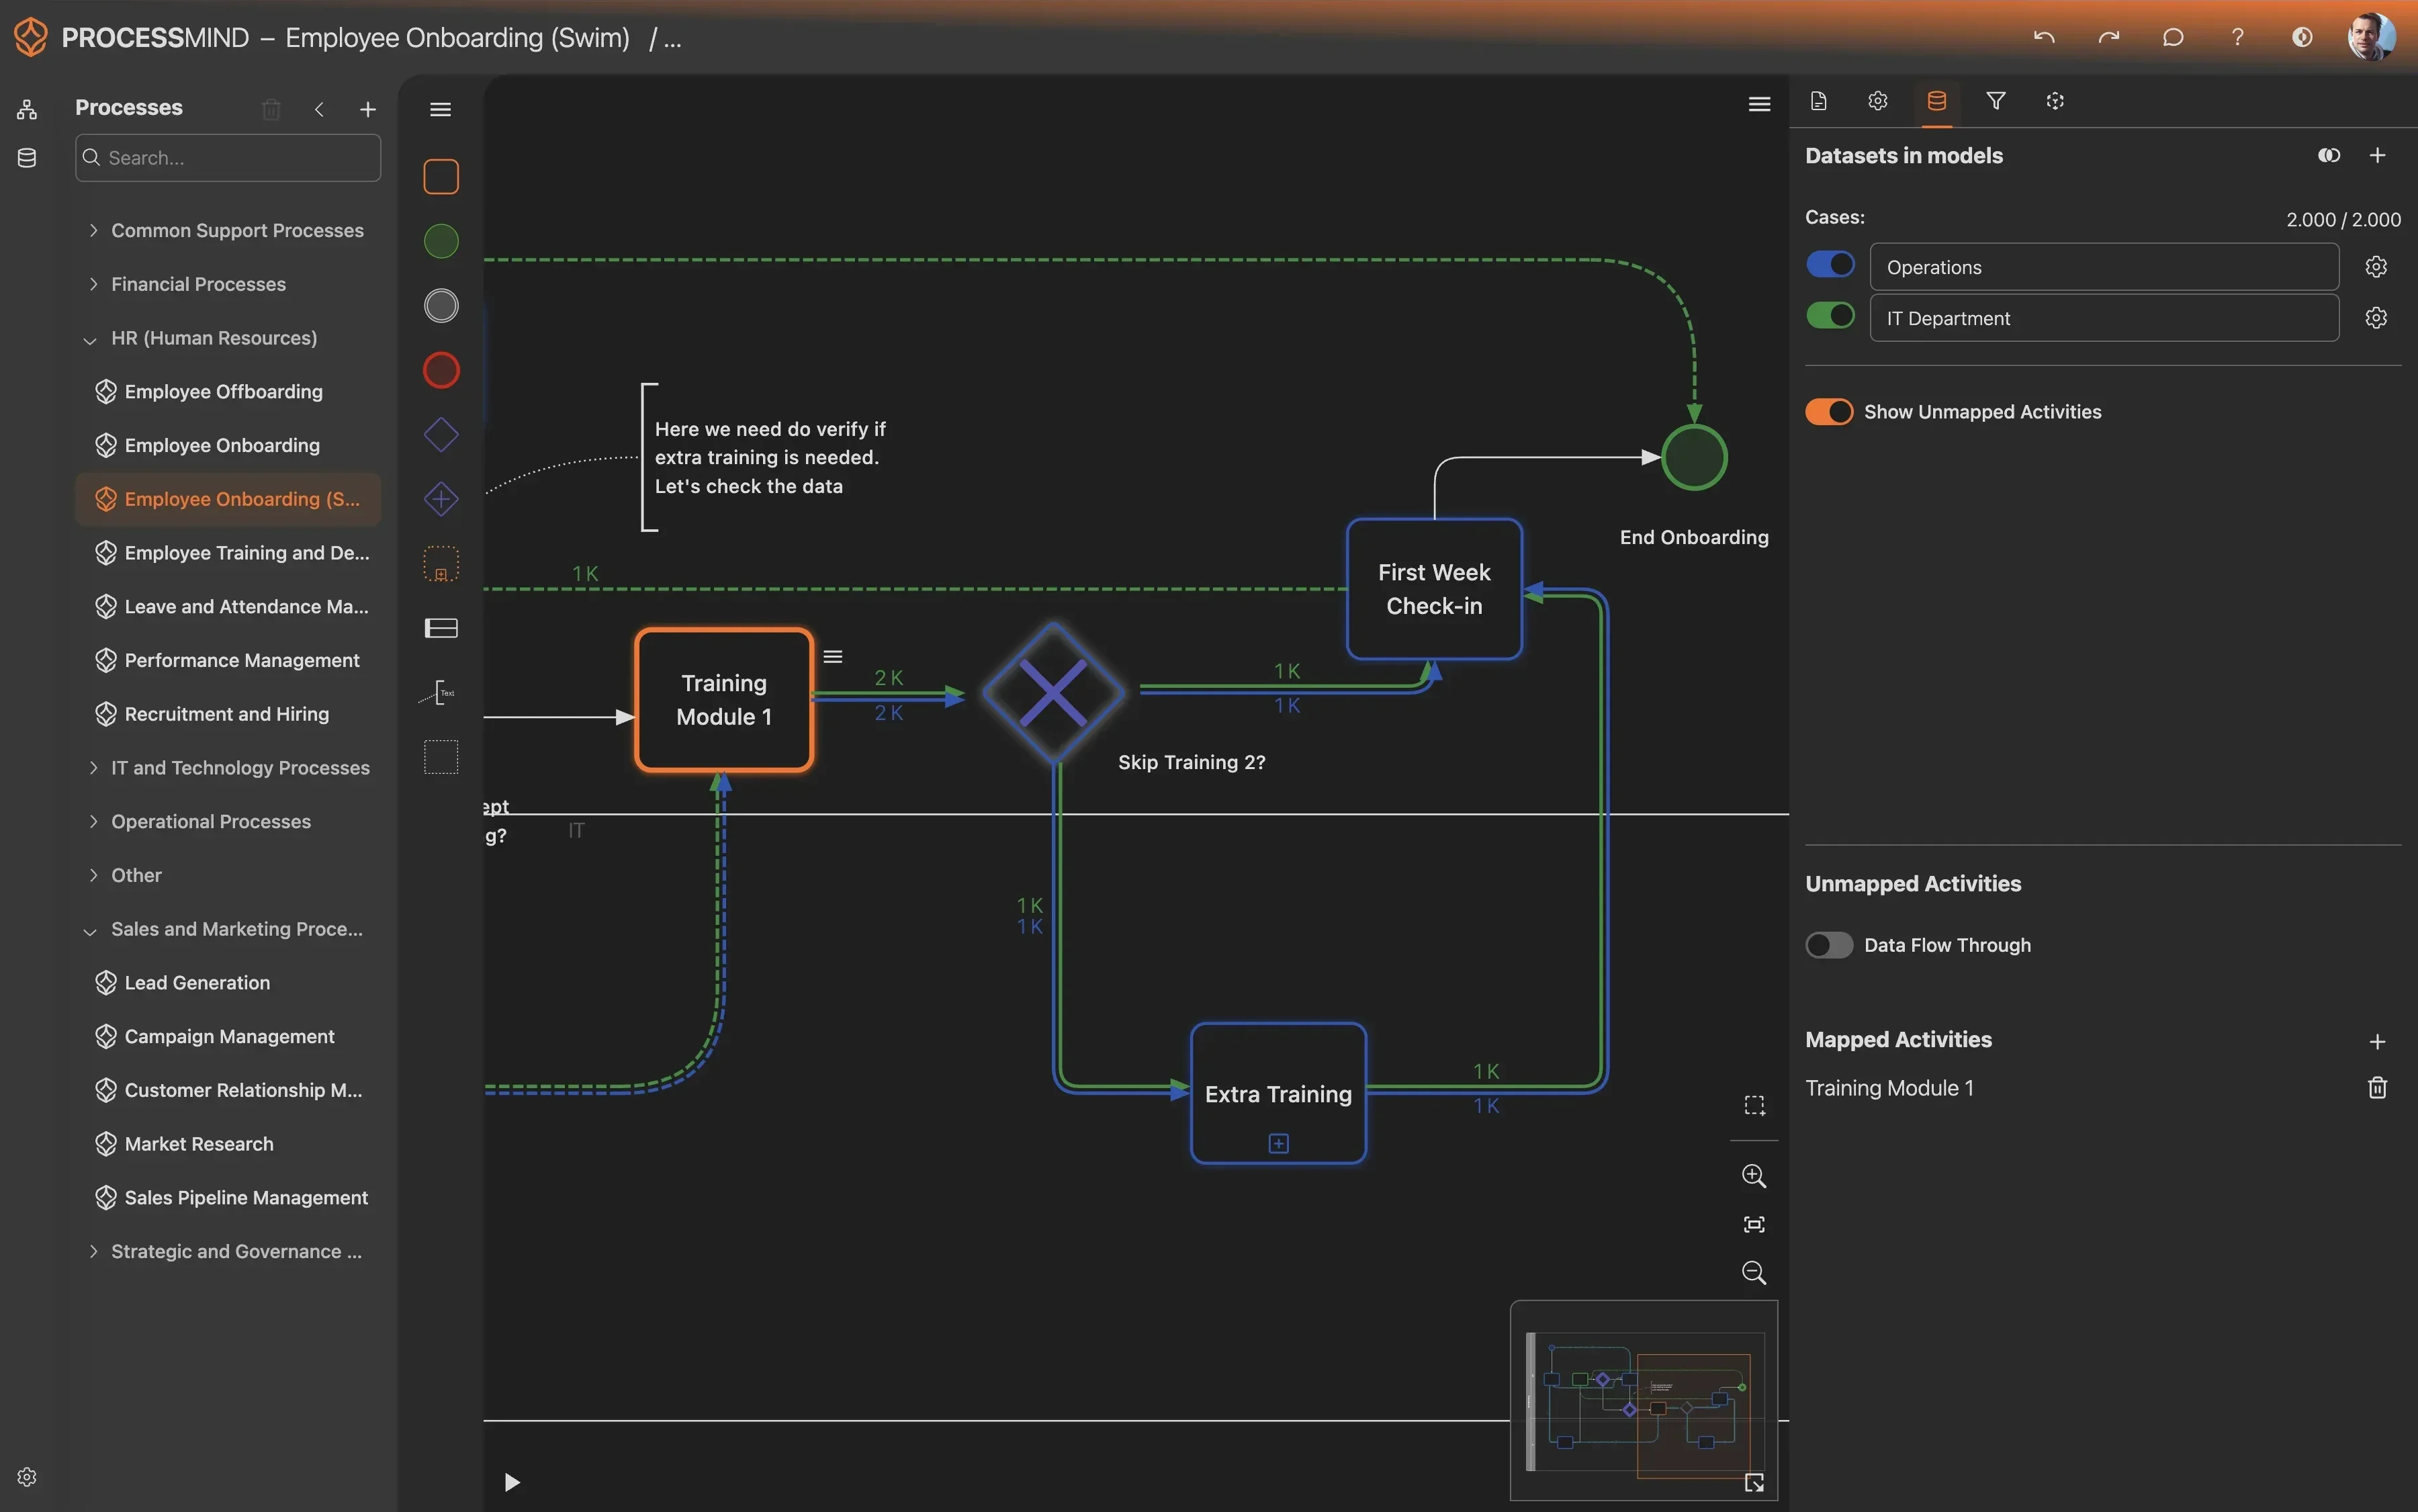
ProcessMind pokazuje dane z BMC Helix ITSM i wskazuje, na których etapach analiza problemów się zatrzymuje oraz co można zrobić, by szybciej trwale je rozwiązywać.
  • Przeanalizuj każdy etap cyklu badania problemu
  • Ustal dokładne przyczyny opóźnień w przypisywaniu spraw
  • Skróć czas dokumentowania obejść problemu
  • Zmierz wpływ poprawek na liczbę incydentów
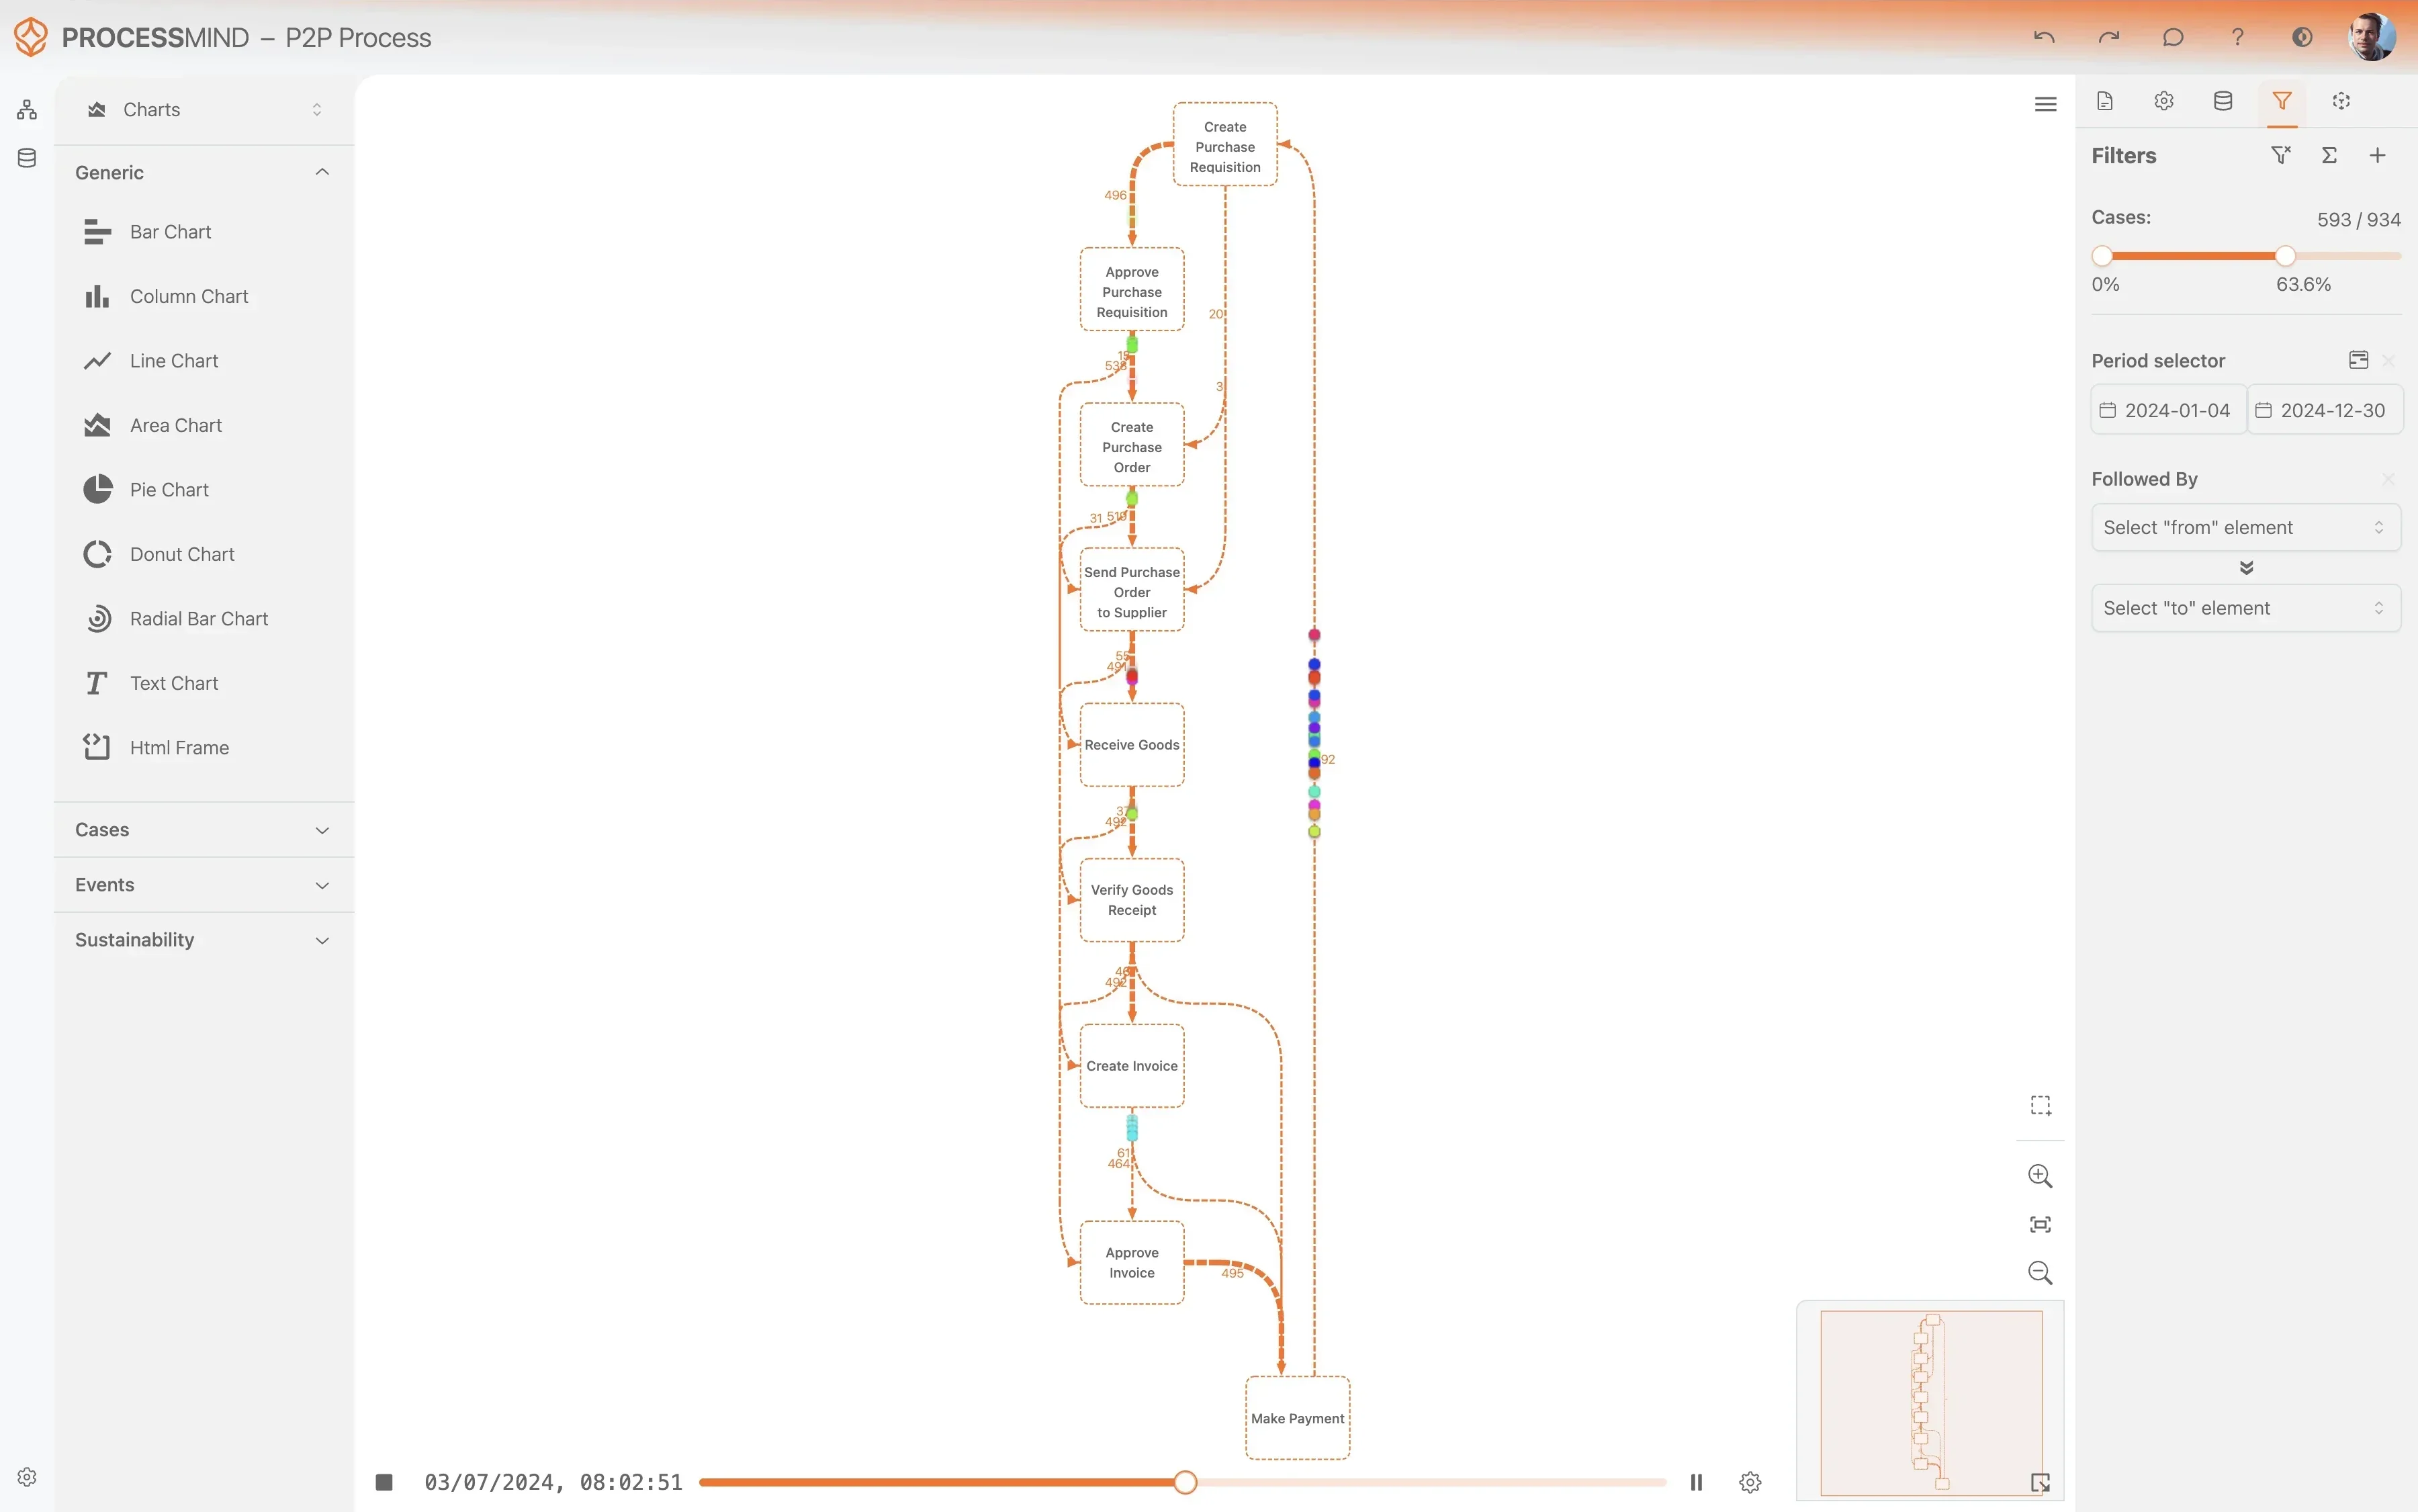
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

POTWIERDZONE WYNIKI

Mierzalny wpływ na rozwiązywanie problemów

Organizacje zyskują szczegółowy wgląd w rekordy problemów, co pomaga usprawnić analizę przyczyn źródłowych i ograniczyć liczbę powracających incydentów w całej firmie. Wyniki pokazują, jak można zwiększyć efektywność workflow BMC Helix ITSM, wykorzystując wnioski oparte na danych.

0 % reduction
Szybsze ustalanie przyczyn źródłowych

Krótszy czas analizy problemu

Usprawnienie drogi od rozpoczęcia analizy do ustalenia przyczyny źródłowej pozwala zespołom technicznym skupić się na trwałych rozwiązaniach zamiast przedłużającej się diagnostyki.

0 x fewer moves
Mniej przekazywania spraw między zespołami

Mniej zmian zespołu obsługującego zgłoszenie

Wykrycie wąskich gardeł na etapie wstępnego kierowania zgłoszeń pomaga od razu przekazywać problemy właściwym ekspertom i ogranicza niepotrzebną pracę wielu zespołów wsparcia.

+ 0 % improvement
Lepsza realizacja SLA

Wzrost odsetka zgodności z SLA

Bieżący wgląd w sprawy, które utknęły w obsłudze, pozwala kierownictwu zareagować, zanim zostaną przekroczone cele SLA. Pomaga to zapewnić firmie stabilny poziom usług.

0 % less rework
Mniej poprawek po rozwiązaniu problemu

Mniej ponownie otwieranych spraw problemowych

Weryfikacja rozwiązania przed zamknięciem sprawy pozwala upewnić się, że źródło problemu zostało usunięte. Zapobiega to kosztownemu ponownemu rozpoczynaniu analizy po wdrożeniu rozwiązania, które miało być trwałe.

0 hours saved
Szybsze udostępnianie obejść

Szybsza publikacja rozwiązań

Szybsze publikowanie tymczasowych obejść ogranicza wpływ trwających incydentów na użytkowników końcowych, gdy opracowywane jest rozwiązanie docelowe.

Rzeczywista poprawa wyników zależy od złożoności procesu i jakości danych. Podane wartości odzwierciedlają typowe rezultaty obserwowane w różnych środowiskach dużych organizacji.

Zalecane dane

Na początek warto uwzględnić te podstawowe atrybuty i działania, a następnie rozszerzyć analizę w razie potrzeby.
Pierwszy raz spotykają się Państwo z dziennikiem zdarzeń? Dowiedz się jak utworzyć dziennik zdarzeń na potrzeby process mining.

Atrybuty

Najważniejsze dane do zebrania na potrzeby analizy

Unikalny identyfikator sprawy dotyczącej analizy problemu.

Dlaczego to ważne

To podstawowy klucz potrzebny do utworzenia widoku procesu i śledzenia cyklu życia konkretnych problemów.

Konkretne zadanie lub zdarzenie polegające na zmianie statusu.

Dlaczego to ważne

Określa węzły na mapie procesu i umożliwia wizualizację workflow.

Znacznik czasu wskazujący, kiedy wystąpiła dana czynność.

Dlaczego to ważne

Umożliwia obliczanie wszystkich KPI opartych na czasie trwania oraz ustalanie kolejności zdarzeń.

Zespół techniczny aktualnie przypisany do analizy problemu.

Dlaczego to ważne

Umożliwia analizę organizacyjną i wykrywanie wąskich gardeł na poziomie zespołów.

Priorytet problemu obliczony na podstawie jego wpływu i pilności.

Dlaczego to ważne

Pozwala podzielić analizę według znaczenia problemu dla firmy i wspiera analizę SLA.

Osoba wyznaczona do koordynowania analizy problemu.

Dlaczego to ważne

Umożliwia analizę zasobów i równoważenie obciążenia pracą poszczególnych osób.

Klasyfikacja przyczyny źródłowej problemu.

Dlaczego to ważne

Umożliwia analizę trendów dotyczących problemów systemowych i wspiera proaktywne zarządzanie problemami.

Główna usługa biznesowa lub element konfiguracji, którego dotyczy problem.

Dlaczego to ważne

Łączy wyniki procesu z konkretnymi produktami lub usługami firmy.

Powód rozpoczęcia analizy problemu.

Dlaczego to ważne

Pozwala odróżnić pracę reaktywną od proaktywnej, co jest ważnym wskaźnikiem dojrzałości.

Docelowa data i godzina rozwiązania problemu.

Dlaczego to ważne

To punkt odniesienia przy obliczaniu wskaźników zgodności z SLA i terminowości.

Liczba incydentów powiązanych z tym rekordem problemu.

Dlaczego to ważne

Określa wpływ problemu na operacje i uciążliwość dla użytkowników.

Flaga informująca, czy rozwiązanie problemu zajęło więcej czasu, niż dopuszcza SLA.

Dlaczego to ważne

Ułatwia raportowanie zgodności z SLA i analizę niepowodzeń.

Działania

Kroki procesu do monitorowania i optymalizacji

Utworzenie rekordu analizy problemu w systemie. Zdarzenie jest rejestrowane w chwili zapisania nowego wpisu w formularzu PBM:Problem Investigation.

Dlaczego to ważne

Oznacza początek instancji procesu. Jest niezbędne do obliczania całkowitego czasu realizacji i wskaźników czasu pierwszej reakcji.

Przypisanie rekordu problemu do konkretnego zespołu technicznego. Zdarzenie można wykryć, monitorując zmiany pola „Assigned Group”.

Dlaczego to ważne

Niezbędne do mierzenia przekazań między zespołami, efektu „ping-pong” oraz KPI „Mean Time to Initial Assignment”.

Przejście rekordu problemu do aktywnej fazy analizy. Zdarzenie jest wnioskowane na podstawie zmiany pola Status na „Under Investigation”.

Dlaczego to ważne

Oznacza początek właściwej pracy nad problemem i umożliwia pomiar KPI „Investigation Cycle Time”.

Wprowadzenie lub aktualizacja tekstu w polu Workaround rekordu problemu. Zdarzenie oznacza udokumentowanie tymczasowego rozwiązania.

Dlaczego to ważne

Obsługuje KPI „Workaround Publication Lead Time” i wskazuje, że podjęto działania ograniczające wpływ incydentu.

Moment, w którym stan rekordu problemu wskazuje, że przyczyna jest znana. Zdarzenie jest wnioskowane na podstawie zmiany pola Status na „Root Cause Identified”.

Dlaczego to ważne

Ważny etap na dashboardzie „Root Cause Investigation Cycle Time”. Oznacza przejście od analizy do opracowywania rozwiązania.

Powiązanie wniosku Infrastructure Change Request z analizą problemu. Oznacza początek etapu wdrożenia.

Dlaczego to ważne

Niezbędne do pomiaru KPI „Root Cause to Change Lead Time” i wykrywania silosów między procesami Problem Management i Change Management.

Moment potwierdzenia, że trwałe rozwiązanie działa. Zdarzenie jest wnioskowane na podstawie zmiany pola Status na „Solution Implemented” lub „Completed”.

Dlaczego to ważne

Służy do obliczania wskaźnika „Problem SLA Adherence Rate”. Potwierdza zakończenie prac technicznych.

Ostateczne, administracyjne zamknięcie rekordu problemu. To zdarzenie kończy instancję procesu.

Dlaczego to ważne

Standardowe zdarzenie końcowe. Jest niezbędne do pełnej analizy czasu realizacji i obliczania wskaźnika „Incident Linkage Density”.

Zakończenie obsługi rekordu problemu przed jego rozwiązaniem. Zdarzenie jest rejestrowane, gdy status zmienia się na „Cancelled” lub „Rejected”.

Dlaczego to ważne

Pomaga wykryć niepotrzebną pracę lub uzasadnione duplikaty. Stanowi alternatywny punkt końcowy procesu.

FAQ

Często zadawane pytania

Process mining pokazuje wszystkie ścieżki, którymi przebiega rekord problemu, dzięki czemu widać rzeczywisty przebieg procesu, a nie tylko jego założony model. Analiza historycznych dzienników zdarzeń pozwala wykryć rekordy krążące między grupami wsparcia lub zatrzymane w oczekiwaniu. Taki obraz pomaga zespołom usunąć nieefektywności strukturalne i skupić się na analizie przyczyn źródłowych problemów o dużym wpływie.

Potrzebny jest podstawowy dziennik zdarzeń zawierający unikatowy identyfikator Problem Record ID, znacznik czasu oraz opis działania, na przykład Status Change lub Assigned Group. Dane te zwykle pochodzą z tabel PBM:Problem Investigation w bazie BMC Helix. Większość narzędzi process mining może łączyć się bezpośrednio z tymi tabelami lub importować pliki CSV, aby odwzorować przebieg procesu.

Wskazuje etapy, na których dochodzenia się zatrzymują, na przykład podczas oczekiwania na informacje od dostawcy lub odpowiedź innego działu. Pomiar czasu trwania poszczególnych przejść pomaga menedżerom wykryć braki zasobów lub dokumentacji, które spowalniają analizę. Podejście oparte na danych zastępuje pojedyncze relacje konkretnymi informacjami o miejscach, w których rzeczywiście występują opóźnienia.

Pierwsze wyniki można często uzyskać w ciągu dwóch do czterech tygodni od skonfigurowania eksportu danych z BMC Helix. Początkowy etap obejmuje połączenie z systemem i mapowanie głównych zmian statusu, aby utworzyć model bazowy. W kolejnych tygodniach można dopracować analizę i wskazać konkretne możliwości usprawnienia, na przykład ograniczenie ponownego przypisywania rekordów.

Process mining pomaga wykrywać problemy z jakością danych, takie jak brak znaczników czasu lub nieprawidłowa klasyfikacja. Niska jakość danych może ograniczyć zakres wniosków, ale wizualizacja często pokazuje, gdzie pracownicy pomijają lub błędnie rejestrują etapy procesu. Uzupełnienie tych braków może być jednym z pierwszych celów usprawnień, które zapewnią wiarygodność przyszłych raportów.

Process mining nie naprawia procesu, ale wskazuje przyczyny naruszeń SLA, pokazując dokładną ścieżkę rekordów, które nie spełniły wymagań. Można porównać rekordy zgodne z SLA i te, które go nie spełniły, aby sprawdzić, czy opóźnienia częściej dotyczą konkretnych grup wsparcia lub typów problemów. Ułatwia to zaplanowanie szkoleń lub zmian w podziale zasobów, tak aby problemy o wysokim priorytecie były obsługiwane w wymaganym czasie.

Śledzi przekazanie sprawy między modułami Problem Management i Change Management, aby sprawdzić, czy nie występują znaczące opóźnienia. Wizualizacja tego przejścia pokazuje, czy wnioski o zmianę są tworzone niezwłocznie po ustaleniu przyczyny źródłowej, czy też utknęły w obiegu administracyjnym. Dzięki temu można usprawnić cały cykl, od zgłoszenia problemu po wdrożenie trwałego rozwiązania.

Uzupełnia standardowe raporty o długoterminowy obraz procesu, zamiast pokazywać jedynie statyczny stan na dany moment. Tradycyjne raporty informują, ile problemów pozostaje otwartych, a process mining pokazuje, jak te problemy przechodziły przez system. Taki poziom szczegółowości jest potrzebny, aby rzeczywiście usprawniać procesy i wykrywać ukryte wąskie gardła, których standardowe dashboardy mogą nie ujawniać.

Usuń wąskie gardła w zarządzaniu problemami

Skróć czas cyklu o 30% i popraw stabilność usług.

Rozpocznij okres próbny

Karta kredytowa nie jest wymagana. Konfiguracja zajmuje kilka minut.