Je dataset configureren
Stapsgewijze uitleg voor het uploaden, mappen en instellen van je dataset voor een nauwkeurige process mining-analyse in ProcessMind.
Op het tabblad Attributen toont het scherm de volgende kolommen voor het mappen en configureren van attributen uit de geüploade dataset:
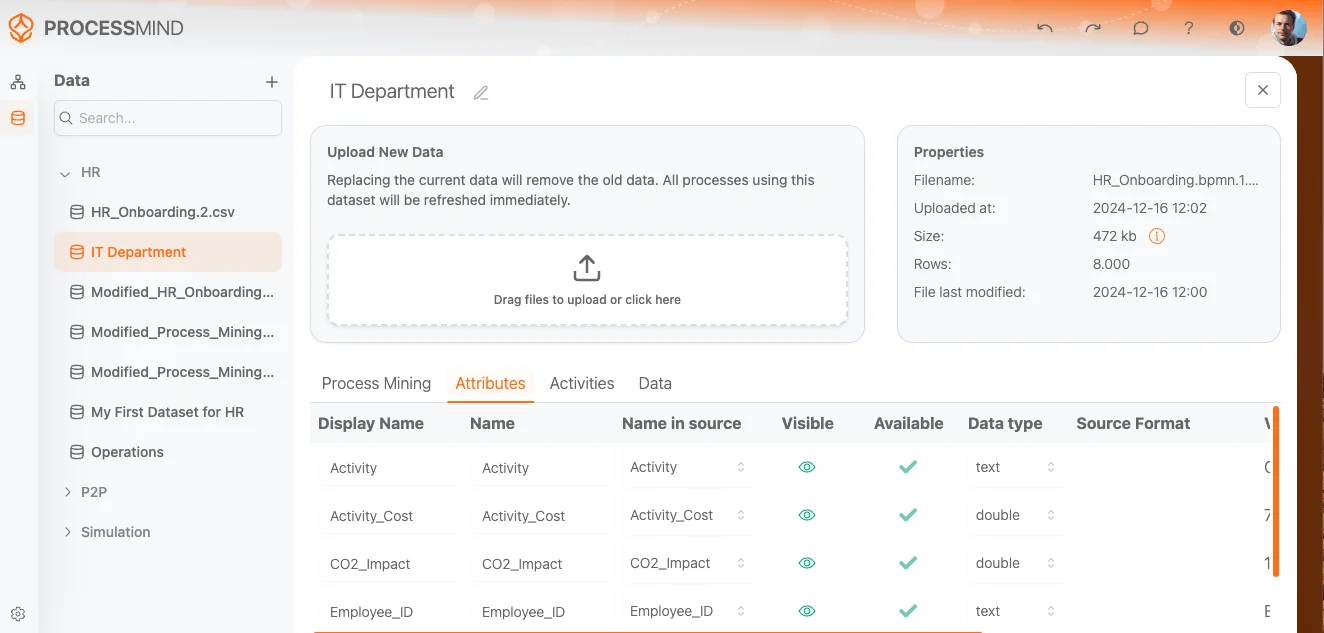
Geeft aan welk label elk attribuut krijgt in het process mining-gedeelte van de tool, bijvoorbeeld “ACTIVITY”, “Case ID” en “EVENTTIME”. Als je dit wijzigt, wordt ook de naam van het attribuut gewijzigd.
Toont de oorspronkelijke kolomnaam uit de geüploade dataset, bijvoorbeeld “ACTIVITY”, “Case ID” en “EVENTTIME”.
Toont hoe het attribuut is gemapt. Attributen kunnen verwijzen naar een kolom in de bron of worden berekend met een expressie, zie Berekende attributen.
Groene vinkjes geven aan dat het attribuut zichtbaar is en in de analyse wordt gebruikt. Je kunt de zichtbaarheid naar wens in- of uitschakelen.
Geeft het datatype van elke kolom aan. Elk datatype wordt gevalideerd om de data-integriteit te controleren en automatisch gedetecteerd, maar kan indien nodig worden gewijzigd.
Voor timestamps ondersteunt ProcessMind de meest voorkomende formaten. Deze worden automatisch gedetecteerd bij het uploaden van data, maar kunnen indien nodig worden gewijzigd.
Toont per attribuut een voorbeeld van de werkelijke data in de dataset:
We gebruiken cookies om je ervaring te verbeteren, content te personaliseren en verkeer te analyseren. Door op "Alles accepteren" te klikken, geef je toestemming voor ons gebruik van cookies.