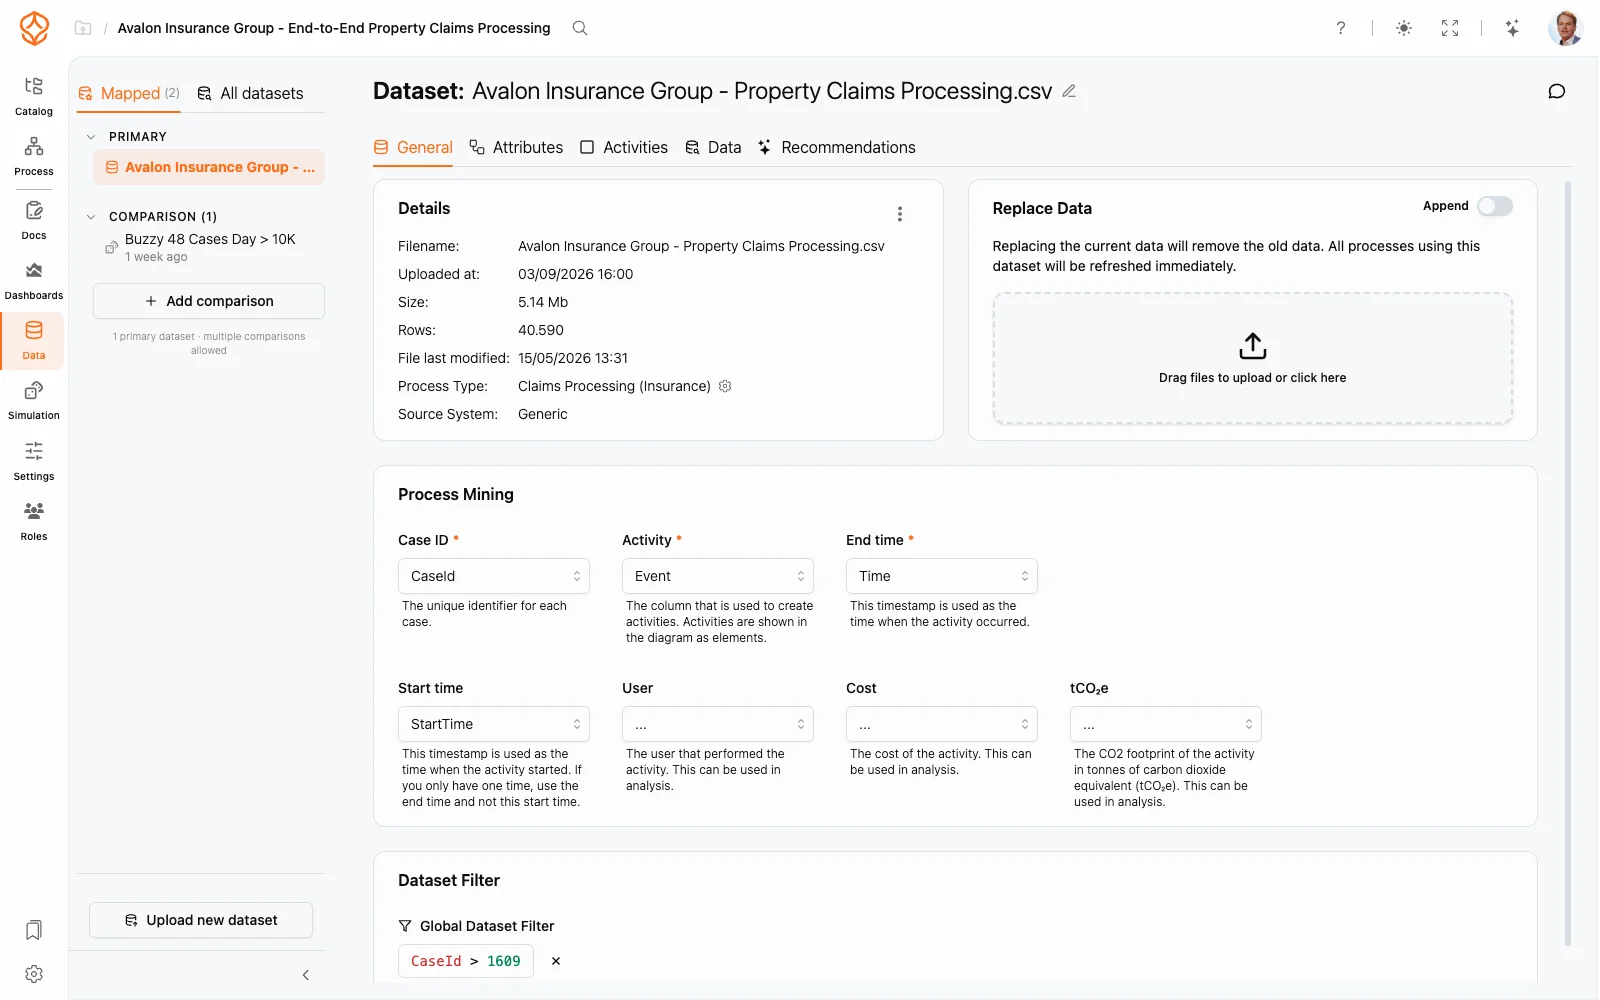
Je dataset configureren
Stapsgewijze uitleg voor het uploaden, toewijzen en instellen van je dataset voor een nauwkeurige process mining-analyse in ProcessMind.
Met incrementeel data laden (ook wel delta loading genoemd) kun je nieuwe rijen toevoegen aan een bestaande datatabel zonder de oorspronkelijke data te vervangen. Dit is handig als het event log in de loop van de tijd groeit en je de process mining-analyse actueel wilt houden zonder de volledige dataset opnieuw te uploaden.
Veelvoorkomende situaties zijn:
info
Deltabestanden moeten dezelfde kolomstructuur hebben als de oorspronkelijke upload (kolomnamen en volgorde). Extra kolommen in het deltabestand worden genegeerd. Ontbrekende kolommen krijgen de waarde null.
.gz), zolang het bestand binnenin hetzelfde formaat heeft als de oorspronkelijke upload.info
Bekijk de pagina Ondersteunde dataformaten voor een overzicht van alle ondersteunde bestandsformaten.
Gebruik de ProcessMind API om deltabestanden programmatisch te uploaden. Bekijk de pagina API-referentie: data voor alle details over de endpoints.
De workflow bestaat uit deze stappen:
Vraag een vooraf ondertekende upload-URL voor de delta op:
GET /v1/tenant/{tenantId}/datatables/{dataTableId}/uploads/presigned-url
    ?delta=true&filename=delta.csv&filesize=1024&filelastmodified=1704067200000
Upload het deltabestand met de vooraf ondertekende URL:
curl -X PUT --upload-file "delta.csv" \
    -H "Content-Type: text/csv" \
    "{PreSignedUploadUrl}"
Zodra de upload is voltooid, verwerkt ProcessMind de delta automatisch en voegt deze samen met de oorspronkelijke data. Je kunt GET /datatables/{dataTableId} blijven controleren tot hasDataLoaded de status true heeft, om te zien wanneer de verwerking klaar is.
Je kunt incrementeel data laden via het tabblad Algemeen van de dataset in ProcessMind:
ProcessMind uploadt het bestand als delta en verwerkt het samen met de bestaande data. Delta-uploads zijn expliciet: een gewone upload (vervangen) wordt nooit automatisch als delta herkend.
Na een of meer incrementele uploads bevat de uploadgeschiedenis van de datatabel een uploadParts-array met informatie over elk bestand:
{
	"uploadHistory": {
		"uploadParts": [
			{
				"key": "datatable/123/2.csv",
				"fileName": "orders-january.csv",
				"fileSize": 524288,
				"uploadedAt": "2024-01-15T10:00:00Z"
			},
			{
				"key": "datatable/123/3.csv",
				"fileName": "orders-february.csv",
				"fileSize": 419430,
				"uploadedAt": "2024-02-15T10:00:00Z"
			}
		]
	}
}warning
Incrementele uploads voegen data toe. Ze werken bestaande rijen niet bij en vervangen ze niet. Wil je data uit een eerdere upload corrigeren, upload dan de volledige dataset opnieuw.
ProcessMind dwingt geen strikt schema af voor de verschillende uploadonderdelen. Dat betekent het volgende:
Zorg voor het beste resultaat dat alle deltabestanden dezelfde kolomstructuur hebben als de oorspronkelijke upload.
info
Bij CSV- en JSONL-formaten worden alle waarden intern als tekst gelezen. Er ontstaat dus geen fout door een afwijkend gegevenstype. Bij Parquet- en ORC-formaten blijven de gegevenstypen uit het bestandsschema behouden. Als een kolom numerieke data verwacht en je ongeschikte waarden uploadt, kan de verdere analyse of simulatie in alle gevallen onverwachte resultaten opleveren.
We gebruiken cookies om je ervaring te verbeteren, content persoonlijker te maken en verkeer te analyseren. We meten paginaweergaven ook anoniem, zonder cookies. Als je toestemming geeft voor analytics, voegen we een identifier toe waarmee we je bezoeken aan elkaar kunnen koppelen. Door op "Alles accepteren" te klikken, geef je toestemming voor het gebruik van cookies.