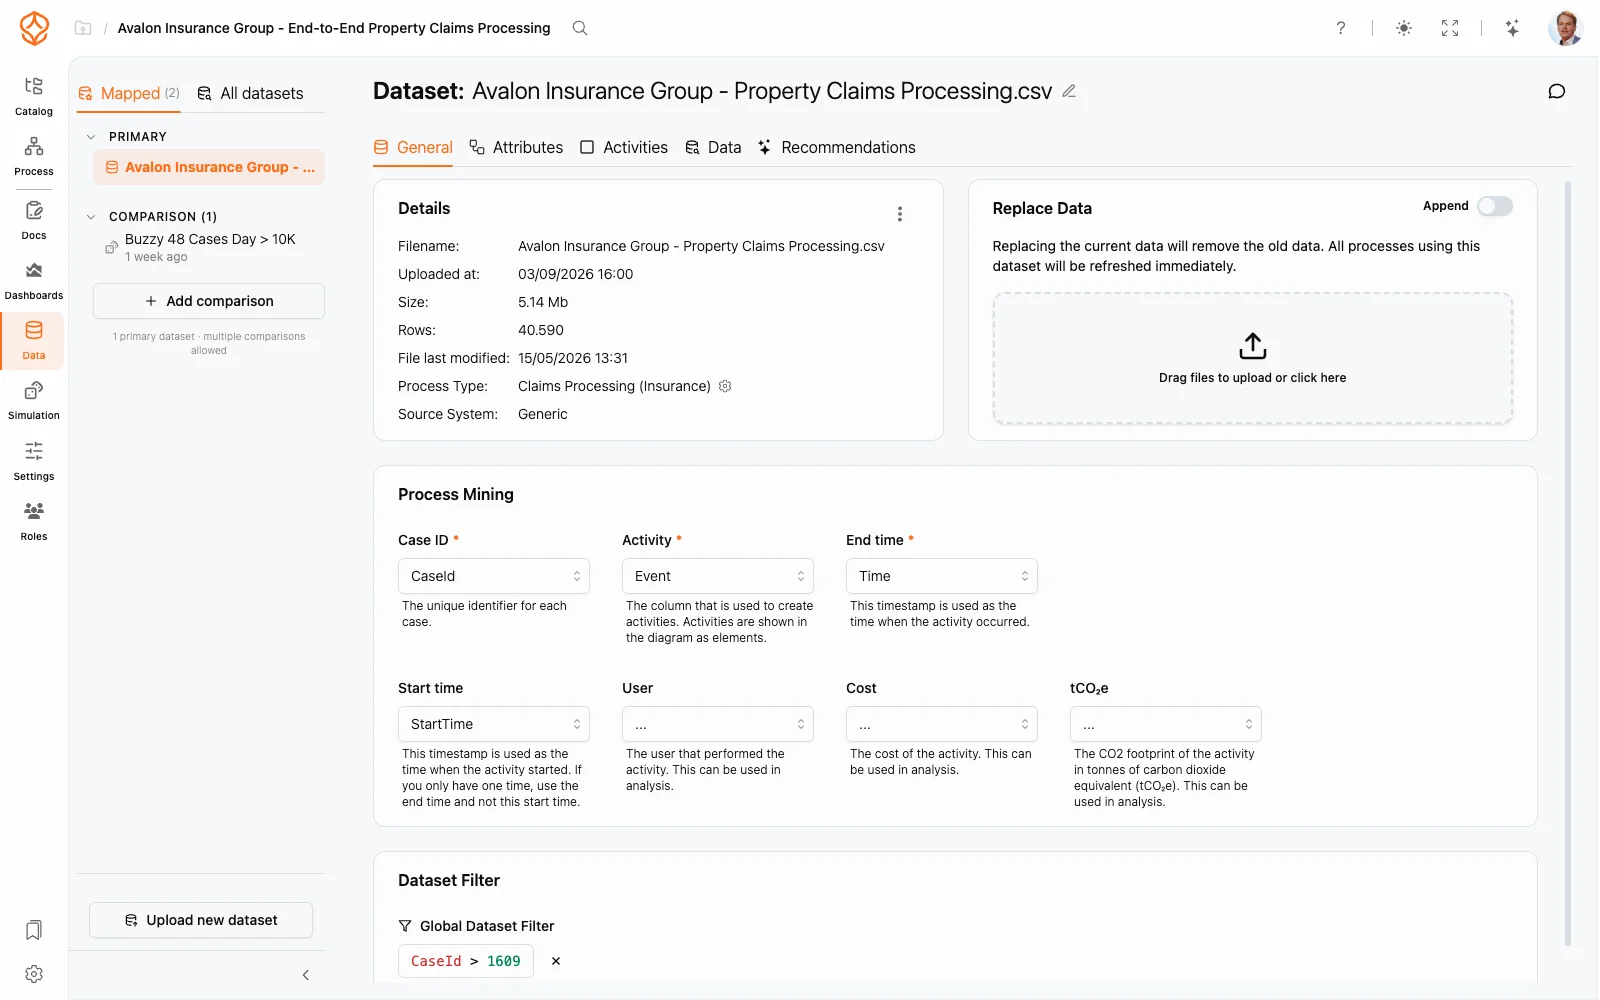
Primair en vergelijking
Je kunt een model aan meerdere datasets koppelen. Precies één daarvan is de primaire dataset; de overige zijn vergelijkingsdatasets. De primaire dataset vormt de basis voor je dashboards en KPI’s. Vergelijkingsdatasets worden in hun eigen kleur over hetzelfde model gelegd. Zo kun je zien hoe verschillende groepen, zoals periodes, regio’s of teams, het proces doorlopen.
Zo worden de rollen toegewezen
- De eerste dataset die je aan een model koppelt, wordt de primaire dataset.
- Datasets die je later toevoegt, worden standaard vergelijkingsdatasets.
- Als je een vergelijkingsdataset promoveert tot primaire dataset, wisselen de rollen in één stap: de vorige primaire dataset wordt een vergelijkingsdataset. Een model heeft nooit twee primaire datasets. Door een dataset te promoveren of te vervangen, blijft er altijd één primaire dataset. Alleen als je de primaire dataset verwijdert, is er tijdelijk geen primaire dataset totdat je een nieuwe selecteert.
- In de datasetzijbalk staat deze regel: 1 primaire dataset · meerdere vergelijkingen toegestaan.
Dashboards, KPI’s en de meeste analyses beginnen bij de primaire dataset. Als er geen primaire dataset is geselecteerd, staat er op het tabblad Datamapping van het model Geen primaire dataset geselecteerd en wordt je gevraagd er een toe te voegen.
Datasets beheren op de datapagina
Open Data en bekijk de datasetzijbalk:
- Op het tabblad Gekoppeld zijn datasets op rol gegroepeerd. Op het tabblad Alle datasets staan alle datasets in de workspace.
- **Onder Primair staat de huidige primaire dataset, of Dataset selecteren als er nog geen is gekozen. Via het menu ⋯ kun je Dataset vervangen of **Dataset verwijderen kiezen.- **Onder Vergelijking staan de vergelijkingsdatasets. Voeg er een toe met Vergelijking toevoegen. Verwijder er een met ✕ (**Uit vergelijking verwijderen ).- **Tijdens het selecteren geeft een banner aan wat je doet: Klik op een dataset om deze als primaire dataset in te stellen of Klik op een dataset om deze als vergelijking toe te voegen. Je kiest een dataset op het tabblad **Alle datasets .- Op datasetkaarten staan de pictogrammen Primaire dataset en Vergelijkingsdataset, zodat je de rol meteen ziet.
- Nieuwe dataset uploaden onderaan de zijbalk start een nieuwe upload.
Datasets beheren in een model
Open in een model het tabblad Datamapping in het rechterpaneel. De uitklapbare onderdelen Primaire dataset en Vergelijkingsdatasets tonen de mappings. Met Data toevoegen om te vergelijken voeg je een vergelijkingsdataset toe. Elke rij bevat:
- een aanpasbare weergavenaam,
- de schakelaar Data in model tonen, waarmee je bepaalt of de dataset in de procesgrafiek wordt weergegeven,
- een menu ⋯ met Dataset bewerken, Data uit model verwijderen, Deze dataset automatisch mappen en Datasetkleuren. Bij vergelijkingsdatasets vind je ook Instellen als primair, Omlaag verplaatsen en Omhoog verplaatsen om de volgorde van de overlays aan te passen. Met Datasets combineren kun je Datasets met dezelfde kleur samenvoegen of Houd datasets gescheiden kiezen.
Met Data uit model verwijderen ontkoppel je de dataset alleen van het model. De dataset zelf blijft in de workspace staan.
Wat vergelijkingen betekenen voor de analyse
- De procesgrafiek voegt de flows samen van alle datasets waarvoor Data in model tonen is ingeschakeld. Elke dataset krijgt een eigen kleur.
- De variantenlijst begint met de varianten uit de primaire dataset en voegt daar de varianten uit de vergelijkingsdatasets aan toe. Ontbreekt een variant in een vergelijkingsdataset, dan staat erbij: Niet aanwezig (0 cases, 0% dekking). Dat betekent dat de variant in die vergelijkingsdataset 0 cases en 0% dekking heeft.
- Lees bij Data vergelijken wat je kunt vergelijken en hoe je de verschillen interpreteert.
Gerelateerde onderwerpen
Frequently asked questions