Configurare il dataset
Guida alla schermata del dataset
Una volta caricato l’insieme di dati, ProcessMind apre la schermata Insieme di dati. Qui configura il modo in cui i dati vengono interpretati per il Process Mining: quali colonne contengono il caso, l’attività e le date e gli orari, che cosa contiene il file caricato e quali righe analizzare. La stessa schermata viene utilizzata per tutti i formati di file supportati.
Due guide correlate La aiutano a preparare e utilizzare i dati:
- Qualità dei dati: scopra come funzionano il badge di qualità e il pannello laterale della qualità.
- Raccomandazioni AI sui dati: utilizzi i suggerimenti della nostra AI per migliorare il dataset e la mappatura.
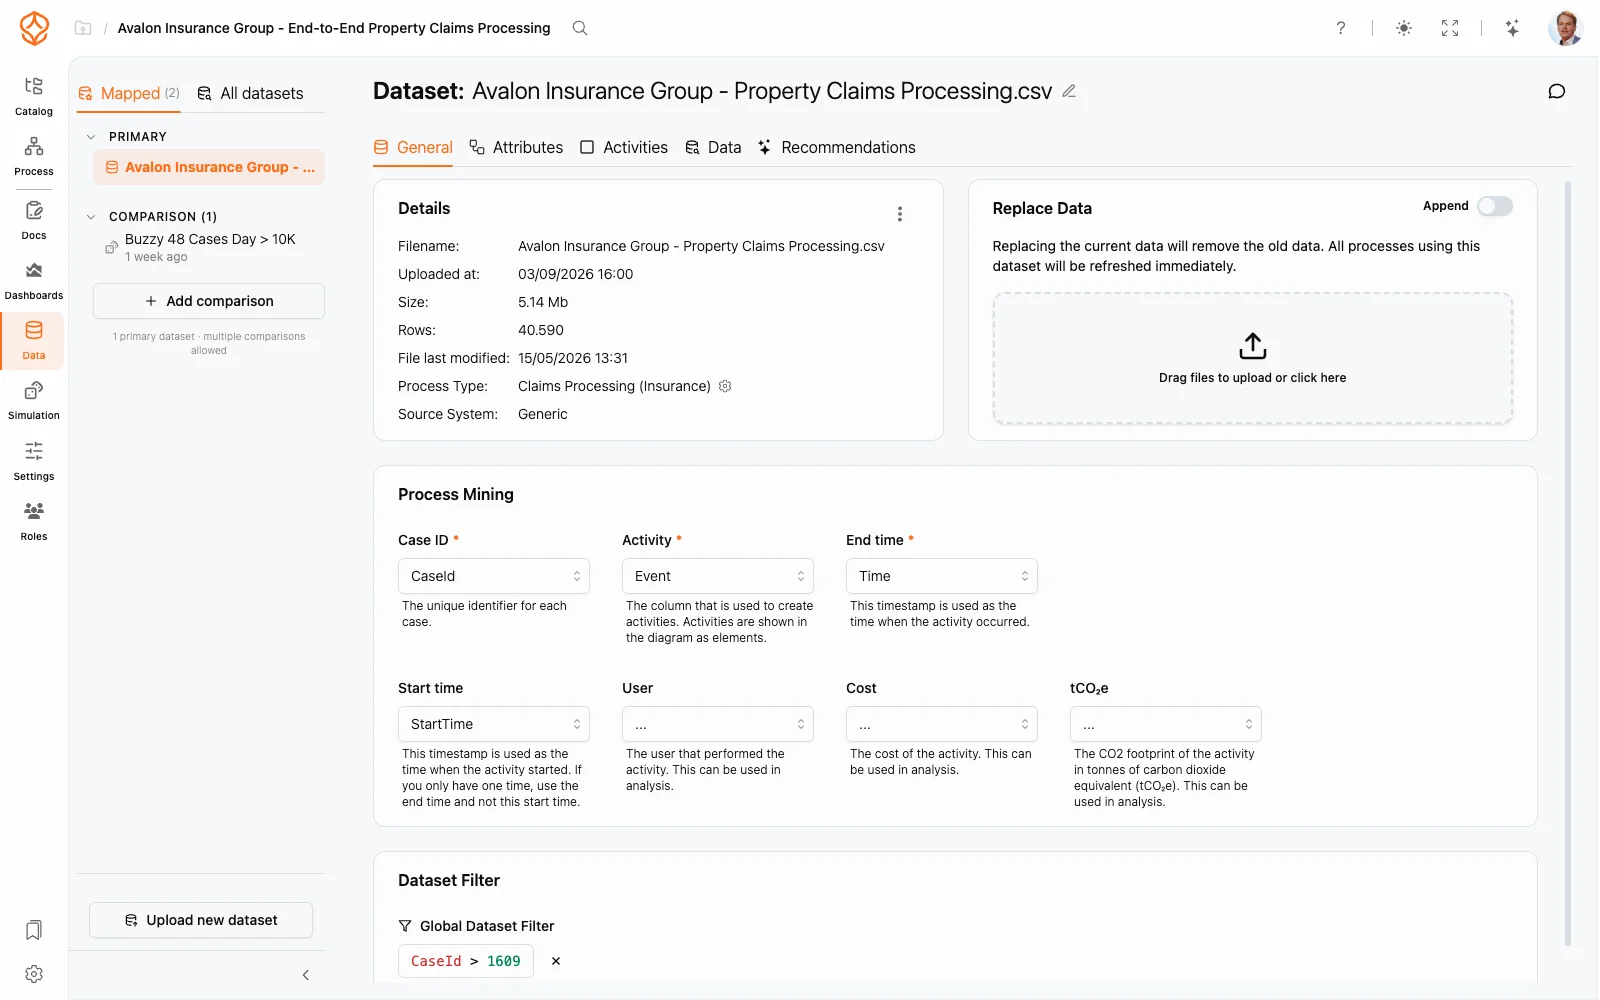
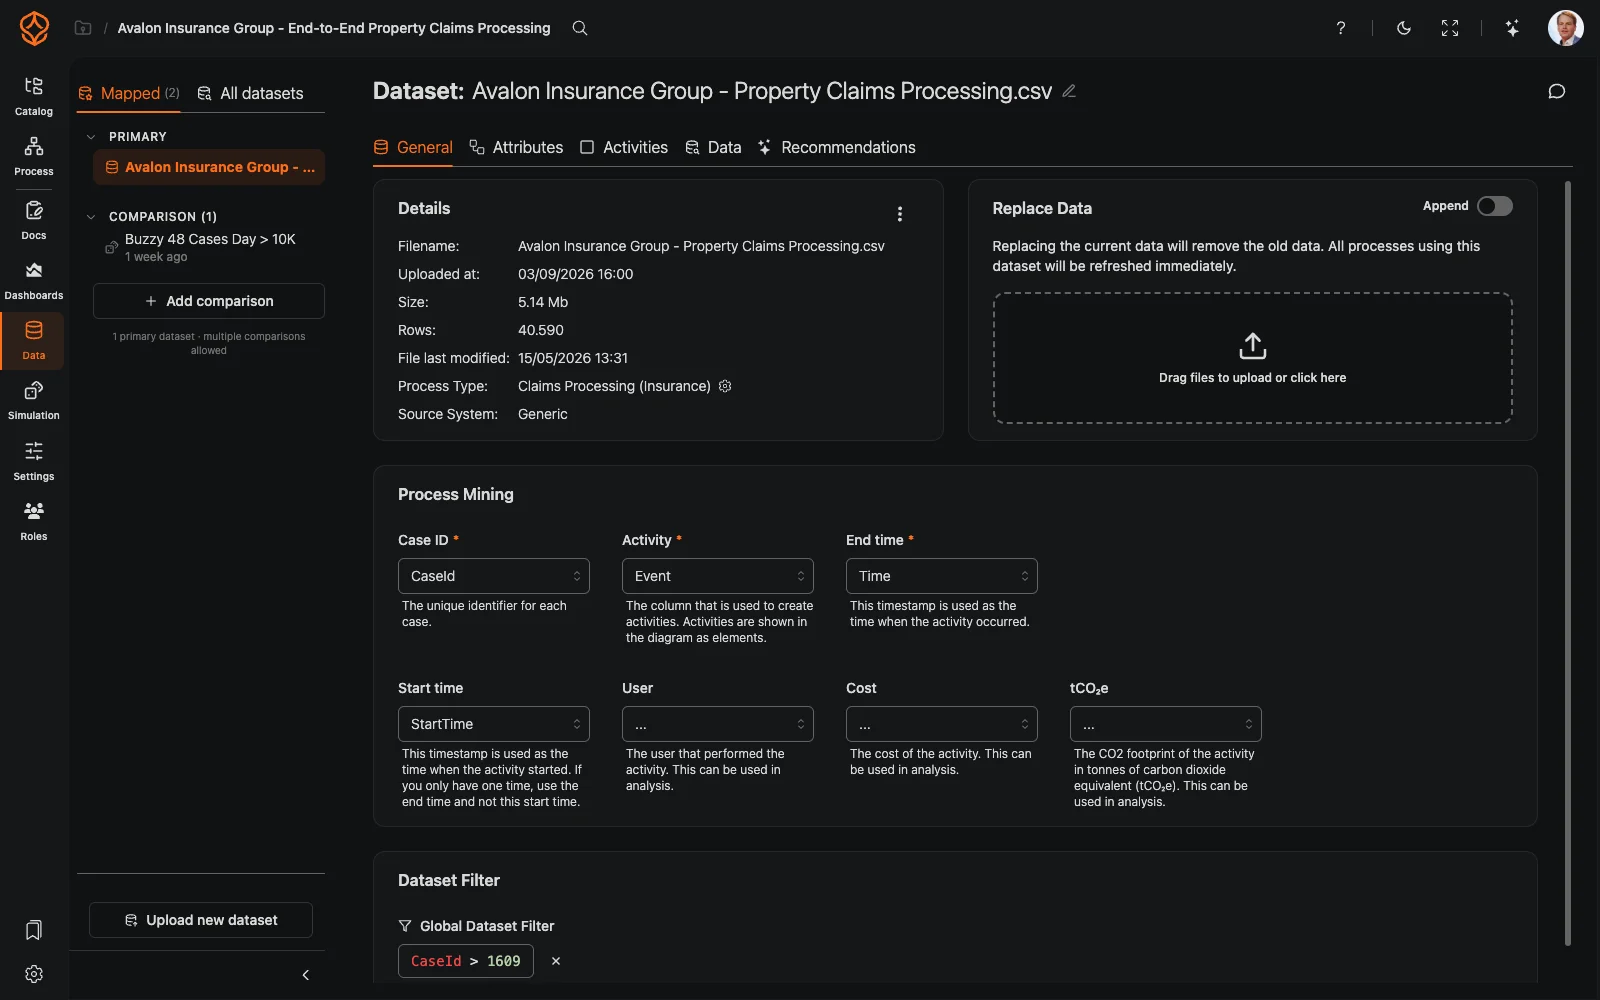
1. Nome del dataset
Nell’intestazione compare Dataset: seguito dal nome del dataset aperto. Faccia clic sul nome per modificarlo e scegliere una denominazione riconoscibile, ad esempio Customer Orders Data o Incident Reports. Nell’intestazione sono inoltre presenti il pulsante dei commenti e il badge di qualità del dataset.
2. Schede
Le schede sotto l’intestazione consentono di configurare il dataset:
- Generale: si apre per prima; consente di sostituire o aggiungere dati, controllare i dettagli del file, mappare le colonne del Process Mining e impostare un filtro per il dataset.
- Attributi: consente di rivedere le colonne individuate, rinominarle, associarvi un’espressione e nascondere quelle da escludere dall’analisi.
- Attività: offre gli stessi controlli per le attività ricavate dai dati.
- Dati: consente di consultare le righe così come vengono lette da ProcessMind, con funzioni di paginazione e ordinamento.
- Raccomandazioni Process Intelligence Process Intelligence Disponibile con una postazione Process Intelligence o superiore. Questa funzionalità è disponibile solo per le postazioni di questo piano o di un piano superiore. Confronti i piani : consente di ricevere suggerimenti della nostra AI per migliorare il dataset e la mappatura. Non è disponibile per i dataset di simulazione.
3. La scheda Generale
Avvisi sul dataset
Se un problema impedisce ancora l’analisi, sopra i pannelli compare un elenco in rosso che indica che cosa manca: ID del caso, Attività o Ora di fine nel pannello Process Mining; attività senza dati; attributi senza valori; oppure una discrepanza tra il file caricato di nuovo e il tipo di processo selezionato.
Sostituire o aggiungere dati
Il pannello a sinistra consente di caricare nuove righe:
- Sostituisci dati è l’opzione predefinita: trascini un file nell’area oppure faccia clic per selezionarlo. La sostituzione elimina le righe correnti e aggiorna tutti i processi che utilizzano il dataset.
- Aggiungi dati: attivi l’interruttore Aggiungi per aggiungere righe ai dati esistenti. La struttura del file aggiunto deve corrispondere a quella del dataset corrente.
Per i dataset di simulazione, questo pannello indica soltanto che il dataset è stato generato tramite una simulazione.
Dettagli
Il pannello a destra elenca le informazioni disponibili sul file:
- Nome file, Caricato il, Dimensioni, Righe e Ultima modifica del file.
- Tipo di processo e Sistema di origine: il processo aziendale e il sistema di origine individuati, utilizzati per la mappatura automatica delle colonne.
L’icona delle impostazioni accanto a Tipo di processo apre la finestra Impostazioni del tipo di processo, dove può selezionare un altro processo e sistema oppure fare clic su Rileva automaticamente processo e sistema e poi su Salva. La modifica di uno dei due valori può modificare tutte le mappature delle colonne.
Il menu (⋯) nell’intestazione del pannello include le opzioni Aggiungi al modello, Scarica, Mostra utilizzo per vedere quali processi utilizzano il dataset e Ottieni l’ID della tabella dati per recuperare gli ID della tabella dati e del tenant utilizzati nelle chiamate API.
Process Mining
Mappi le colonne necessarie per il Process Mining. I tre campi obbligatori sono:
- ID del caso: identificativo univoco di ogni caso.
- Attività: la colonna che diventa l’elenco delle attività del processo.
- Ora di fine: il timestamp che indica quando si è verificata l’attività.
I campi facoltativi aggiungono contesto all’analisi:
- Ora di inizio: indica quando è iniziata l’attività. Se i dati includono un solo timestamp, lo associ invece all’ora di fine.
- Utente: indica chi ha eseguito l’attività.
- Costo: il costo dell’attività.
- tCO₂e: l’impronta di carbonio dell’attività, espressa in tonnellate di CO₂ equivalente e utilizzata per metriche di sostenibilità come il grafico tCO₂e per attività nelle Dashboard (vedere Grafici dei processi).
Filtro globale del dataset
Il Filtro globale del dataset limita le righe analizzate da ProcessMind. Faccia clic su Aggiungi espressione del filtro… per creare un filtro sulle righe nell’editor delle espressioni; il filtro viene applicato ovunque sia utilizzato il dataset.
Passaggi finali
- Riveda le selezioni: prima di avviare l’analisi, verifichi che le colonne corrette siano associate a ID del caso, Attività e Ora di fine.
- Risolva gli avvisi: corregga gli eventuali avvisi ancora presenti nel dataset, quindi avvii il Process Mining sui dati configurati.
Una volta completata la configurazione, ProcessMind utilizza il dataset per l’individuazione dei processi, le Dashboard e la simulazione, senza richiedere ulteriori impostazioni.
Progettazione. Analisi. Miglioramento. Costruisca un’architettura dei processi integrata e mantenga il controllo.
Acceda subito, senza carta di credito né attese. Trasformi il modo in cui opera la Sua organizzazione in una progettazione dei processi chiara e interconnessa.
Definisca l’architettura dei processi, le responsabilità e i controlli, e allinei ruoli e compiti a ogni livello.
Inizi la prova gratuita e crei una base affidabile per governare, gestire e migliorare costantemente i processi della Sua organizzazione.