Caricamento incrementale dei dati
Che cos’è il caricamento incrementale dei dati?
Il caricamento incrementale dei dati, chiamato anche caricamento delta, consente di aggiungere nuove righe a una tabella di dati esistente senza sostituire i dati originali. È utile quando i dati dell’Event Log crescono nel tempo e desidera mantenere aggiornata l’analisi di Process Mining senza ricaricare l’intero dataset.
Gli scenari più comuni includono:
- Esportazioni giornaliere o settimanali: aggiunga nuove transazioni, ordini o casi non appena sono disponibili.
- Monitoraggio continuo dei processi: mantenga aggiornate le Dashboard aggiungendo regolarmente dati recenti.
- Event Log in crescita: aggiunga progressivamente nuovi eventi provenienti da sistemi ERP, strumenti CRM o altre fonti.
info
I file Delta devono avere la stessa struttura delle colonne (nomi e ordine delle colonne) del caricamento originale. Le colonne aggiuntive nel file Delta vengono ignorate. Le colonne mancanti producono valori null.
Requisiti
- La tabella di dati deve avere già un caricamento iniziale con dati caricati.
- Il file delta deve avere lo stesso formato del caricamento originale:
- i file CSV richiedono file delta CSV
- i file Parquet richiedono file delta Parquet
- i file ORC richiedono file delta ORC
- i file JSONL richiedono file delta JSONL
- i file Excel (XLSX/XLS/XLSB) e XES non sono supportati per i caricamenti delta: li converta prima in CSV.
- I nomi delle colonne nel file delta devono corrispondere a quelli del caricamento originale.
- I file delta possono essere compressi con gzip (
.gz), purché il formato interno corrisponda a quello del caricamento originale.
info
Per informazioni su tutti i formati di file supportati, consulti la pagina Formati di dati supportati.
Caricamento incrementale dei dati
Tramite API
Utilizzi l’API di ProcessMind per caricare programmaticamente i file delta. Per informazioni complete sugli endpoint, consulti la pagina Riferimento API: dati.
Il flusso di lavoro è il seguente:
-
Ottenga un URL di caricamento presigned per il delta:
GET /v1/tenant/{tenantId}/datatables/{dataTableId}/uploads/presignedurl ?delta=true&filename=delta.csv&filesize=1024&filelastmodified=1704067200000 -
Carichi il file delta utilizzando l’URL presigned:
curl -X PUT --upload-file "delta.csv" \
    -H "Content-Type: text/csv" \
    "{PreSignedUploadUrl}"
Al termine del caricamento, ProcessMind elabora automaticamente il delta e lo combina con i dati originali. Può eseguire il polling di GET /datatables/{dataTableId} finché hasDataLoaded non è true, per sapere quando l’elaborazione è terminata.
Tramite l’interfaccia utente
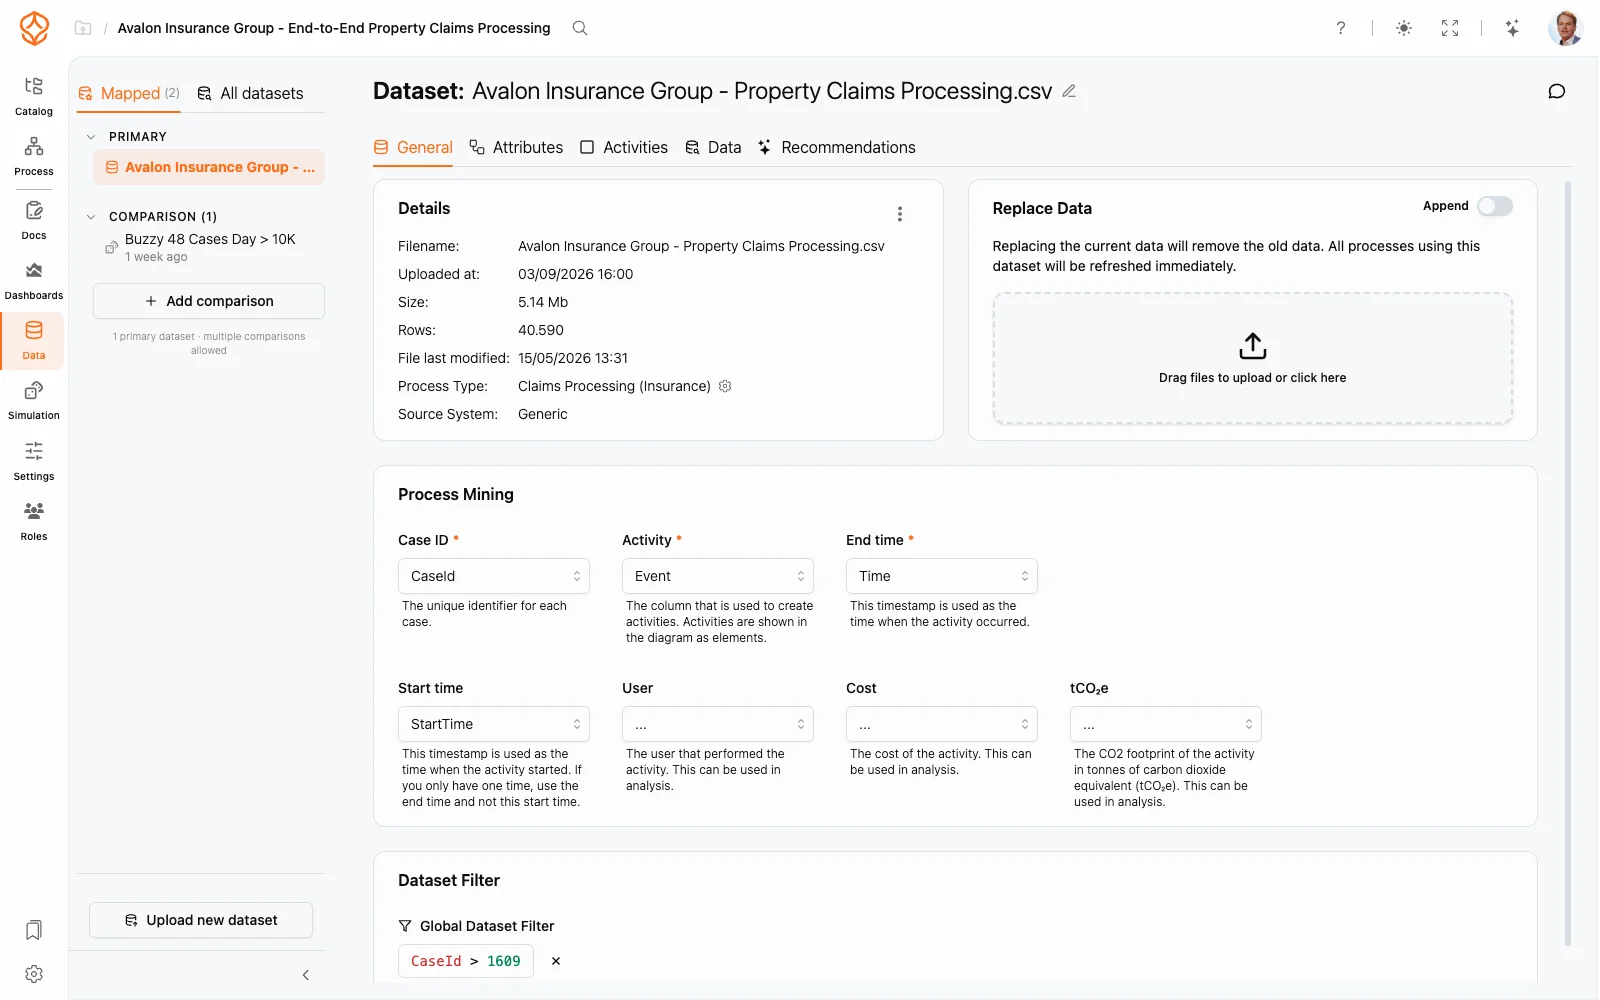
Il caricamento incrementale dei dati può essere avviato anche dalla scheda Generale del dataset nell’applicazione ProcessMind:
- Attivi l’interruttore Aggiungi per modificare l’area di caricamento da Sostituisci i dati a Aggiungi dati.
- Trascini il nuovo file nell’area Aggiungi dati oppure faccia clic per cercarlo e selezionarlo.
ProcessMind carica il file come delta e lo elabora insieme ai dati esistenti. I caricamenti delta sono espliciti: non vengono mai rilevati automaticamente a partire da un normale caricamento con sostituzione.
Visualizzazione delle parti del caricamento
Dopo uno o più caricamenti incrementali, la cronologia dei caricamenti della tabella di dati include un uploadPartsarray che tiene traccia di ogni file:
{
	"uploadHistory": {
		"uploadParts": [
			{
				"key": "datatable/123/2.csv",
				"fileName": "orders-january.csv",
				"fileSize": 524288,
				"uploadedAt": "2024-01-15T10:00:00Z"
			},
			{
				"key": "datatable/123/3.csv",
				"fileName": "orders-february.csv",
				"fileSize": 419430,
				"uploadedAt": "2024-02-15T10:00:00Z"
			}
		]
	}
}
Buone pratiche
- Utilizzi nomi coerenti per le colonne in tutti i file, per evitare problemi di allineamento dei dati.
- Carichi i file in ordine cronologico quando possibile, così la cronologia dei caricamenti riflette la sequenza temporale dei dati.
- Mantenga i file delta di dimensioni ragionevoli: carichi i dati in blocchi moderati, poiché un numero molto elevato di file piccoli può rallentare l’elaborazione.
- Monitori il numero di righe dopo ogni delta, per verificare che i dati siano stati caricati correttamente.
warning
I caricamenti incrementali aggiungono dati: non aggiornano né sostituiscono le righe esistenti. Se deve correggere dati presenti in un caricamento precedente, ricarichi l’intero dataset.
Comportamento in caso di mancata corrispondenza dello schema
ProcessMind non impone uno schema rigido tra le parti del caricamento. Ciò significa che:
- Le colonne aggiuntive nei file delta vengono ignorate durante l’elaborazione: vengono utilizzate solo le colonne presenti nello schema del caricamento originale.
- Le colonne mancanti generano valori null o vuoti per i relativi campi nelle righe delta.
- I nomi delle colonne diversi vengono trattati come colonne completamente differenti: le righe delta conterranno valori null per le colonne previste.
Per ottenere i risultati migliori, verifichi che tutti i file delta abbiano la stessa struttura delle colonne del caricamento originale.
info
Nei formati CSV e JSONL, tutti i valori vengono letti internamente come stringhe, quindi non si verifica alcun errore di mancata corrispondenza del tipo. Nei formati Parquet e ORC, i tipi di dati delle colonne vengono mantenuti secondo lo schema del file. In ogni caso, se una colonna prevede dati numerici e Lei carica valori incompatibili, l’analisi o le simulazioni successive potrebbero produrre risultati imprevisti.