Chargement incrémentiel des données
Qu’est-ce que le chargement incrémentiel des données ?
Le chargement incrémentiel des données, également appelé chargement delta, vous permet d’ajouter de nouvelles lignes à une table de données existante sans remplacer les données d’origine. Cette méthode est utile lorsque les données de votre journal d’événements augmentent au fil du temps et que vous souhaitez maintenir votre analyse de Process Mining à jour sans importer à nouveau l’ensemble du jeu de données.
Les scénarios courants sont les suivants :
- Exports quotidiens ou hebdomadaires : ajoutez les nouvelles transactions, commandes ou demandes dès qu’elles sont disponibles.
- Surveillance continue des processus : maintenez vos Dashboards à jour en ajoutant régulièrement les nouvelles données.
- Journaux d’événements qui s’enrichissent : ajoutez progressivement les nouveaux événements provenant de systèmes ERP, d’outils CRM ou d’autres sources.
info
Les fichiers Delta doivent avoir la même structure de colonnes (noms et ordre des colonnes) que le fichier importé à l’origine. Les colonnes supplémentaires du fichier Delta sont ignorées. Les colonnes manquantes produisent des valeurs nulles.
Conditions requises
- La table de données doit déjà contenir un premier import avec des données chargées.
- Le fichier delta doit être dans le même format que l’importation d’origine :
- les fichiers CSV nécessitent des fichiers delta CSV
- les fichiers Parquet nécessitent des fichiers delta Parquet
- les fichiers ORC nécessitent des fichiers delta ORC
- les fichiers JSONL nécessitent des fichiers delta JSONL
- les fichiers Excel (XLSX/XLS/XLSB) et XES ne sont pas pris en charge pour les imports delta : convertissez-les d’abord au format CSV.
- Les noms de colonnes du fichier delta doivent correspondre à ceux de l’importation d’origine.
- Les fichiers delta peuvent être compressés au format gzip (
.gz), à condition que leur format interne corresponde à celui de l’importation d’origine.
info
Pour obtenir des informations sur tous les formats de fichiers pris en charge, consultez la page Formats de données pris en charge.
Importer des données de manière incrémentielle
Via l’API
Utilisez l’API ProcessMind pour importer des fichiers delta par programmation. Consultez la page Référence de l’API : données pour obtenir tous les détails sur les points de terminaison.
Le flux de travail est le suivant :
-
Obtenez une URL d’importation présignée pour le delta :
GET /v1/tenant/{tenantId}/datatables/{dataTableId}/uploads/presignedurl ?delta=true&filename=delta.csv&filesize=1024&filelastmodified=1704067200000 -
Importez le fichier delta à l’aide de l’URL présignée :
curl -X PUT --upload-file "delta.csv" \
    -H "Content-Type: text/csv" \
    "{PreSignedUploadUrl}"
Une fois l’importation terminée, ProcessMind traite automatiquement le delta et le combine avec les données d’origine. Vous pouvez interroger GET /datatables/{dataTableId} jusqu’à ce que hasDataLoaded soit true pour savoir quand le traitement est terminé.
Via l’interface utilisateur
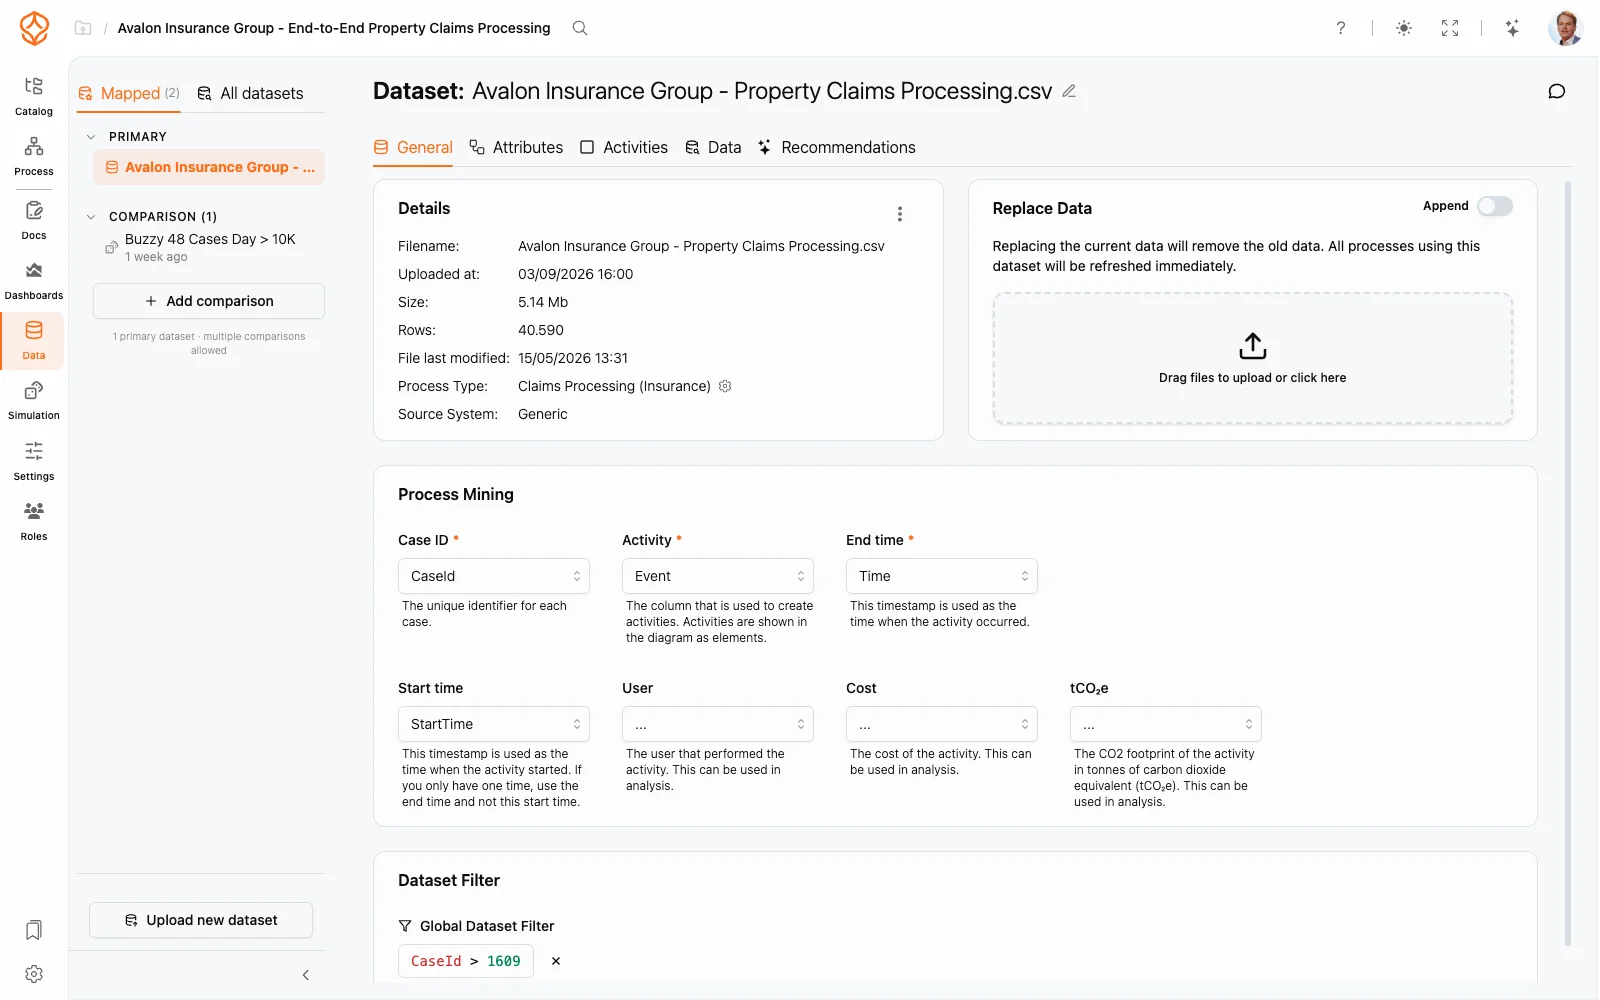
Le chargement incrémentiel des données peut également être lancé depuis l’onglet Général du jeu de données dans l’application ProcessMind :
- Activez le bouton Ajouter pour faire passer la zone d’importation de Remplacer les données à Ajouter des données.
- Déposez le nouveau fichier dans la zone Ajouter des données, ou cliquez dessus pour le rechercher et le sélectionner.
ProcessMind importe le fichier comme un delta et le traite avec les données existantes. Les imports delta sont explicites : ils ne sont jamais détectés automatiquement à partir d’un import normal, qui remplace les données.
Afficher les parties importées
Après un ou plusieurs imports incrémentiels, l’historique des importations de la table de données contient un uploadParts tableau qui suit chaque fichier :
{
	"uploadHistory": {
		"uploadParts": [
			{
				"key": "datatable/123/2.csv",
				"fileName": "orders-january.csv",
				"fileSize": 524288,
				"uploadedAt": "2024-01-15T10:00:00Z"
			},
			{
				"key": "datatable/123/3.csv",
				"fileName": "orders-february.csv",
				"fileSize": 419430,
				"uploadedAt": "2024-02-15T10:00:00Z"
			}
		]
	}
}
Bonnes pratiques
- Utilisez des noms de colonnes cohérents dans tous les fichiers afin d’éviter les problèmes d’alignement des données.
- Importez les fichiers dans l’ordre chronologique lorsque cela est possible, afin que l’historique des importations reflète la chronologie des données.
- Conservez une taille raisonnable pour les fichiers delta : importez les données par lots modérés ; un très grand nombre de petits fichiers peut ralentir le traitement.
- Surveillez le nombre de lignes après chaque delta pour vérifier que les données ont été correctement chargées.
warning
Les imports incrémentiels ajoutent des données : ils ne mettent pas à jour les lignes existantes et ne les remplacent pas. Si vous devez corriger des données d’un import précédent, importez à nouveau l’ensemble du jeu de données.
Comportement en cas de différence de schéma
ProcessMind n’impose pas de schéma strict entre les parties importées. Cela signifie que :
- Les colonnes supplémentaires des fichiers delta sont ignorées lors du traitement : seules les colonnes présentes dans le schéma de l’importation d’origine sont utilisées.
- Les colonnes manquantes produisent des valeurs nulles ou vides pour les champs correspondants des lignes delta.
- Les noms de colonnes différents sont considérés comme des colonnes entièrement distinctes : les lignes delta contiennent des valeurs nulles pour les colonnes attendues.
Pour obtenir les meilleurs résultats, vérifiez que tous les fichiers delta présentent la même structure de colonnes que l’importation d’origine.
info
Pour les formats CSV et JSONL, toutes les valeurs sont lues en interne comme des chaînes de caractères ; aucune erreur de type ne se produit donc. Pour les formats Parquet et ORC, les types de données des colonnes sont conservés à partir du schéma du fichier. Dans tous les cas, si une colonne attend des données numériques et que vous importez des valeurs incompatibles, l’analyse ou les simulations en aval peuvent produire des résultats inattendus.