增量加载数据
什么是增量加载数据?
增量数据加载(也称为增量加载)允许您追加新行到现有数据表中,而无需替换原始数据。当事件日志数据随时间增长时,这种方式非常有用。您无需重新上传整个数据集,即可让流程挖掘分析保持最新。
常见场景包括:
- 每日或每周导出数据:追加新交易、订单或案例数据。
- 持续监控流程:定期添加最新数据,让仪表板保持最新。
- 不断增长的事件日志:逐步添加来自ERP系统、CRM工具或其他来源的新事件。
info
增量文件必须与原始上传文件具有相同的列结构(列名和顺序)。增量文件中的额外列会被忽略。缺失的列将产生null值。
要求
- 数据表必须已有包含数据的初始上传文件。
- 增量文件必须与原始上传文件采用相同格式:
- CSV文件需要使用CSV增量文件
- Parquet文件需要使用Parquet增量文件
- ORC文件需要使用ORC增量文件
- JSONL文件需要使用JSONL增量文件
- 不支持Excel(XLSX/XLS/XLSB)和XES文件的增量上传,请先将其转换为CSV。
- 增量文件中的列名应与原始上传文件一致。
- 增量文件可以使用gzip压缩(
.gz),但内部格式必须与原始上传格式一致。
info
有关所有支持的文件格式,请参阅支持的数据格式页面。
上传增量数据
通过API
使用ProcessMind API以编程方式上传增量文件。有关完整的端点详情,请参阅API参考:数据页面。
工作流如下:
-
获取增量文件的预签名上传URL:
GET /v1/tenant/{tenantId}/datatables/{dataTableId}/uploads/presignedurl ?delta=true&filename=delta.csv&filesize=1024&filelastmodified=1704067200000 -
使用预签名URL上传增量文件:
curl -X PUT --upload-file "delta.csv" \
    -H "Content-Type: text/csv" \
    "{PreSignedUploadUrl}"
上传完成后,ProcessMind会自动处理增量文件,并将其与原始数据合并。您可以轮询GET /datatables/{dataTableId},直到hasDataLoaded为true,以确认处理完成。
通过界面
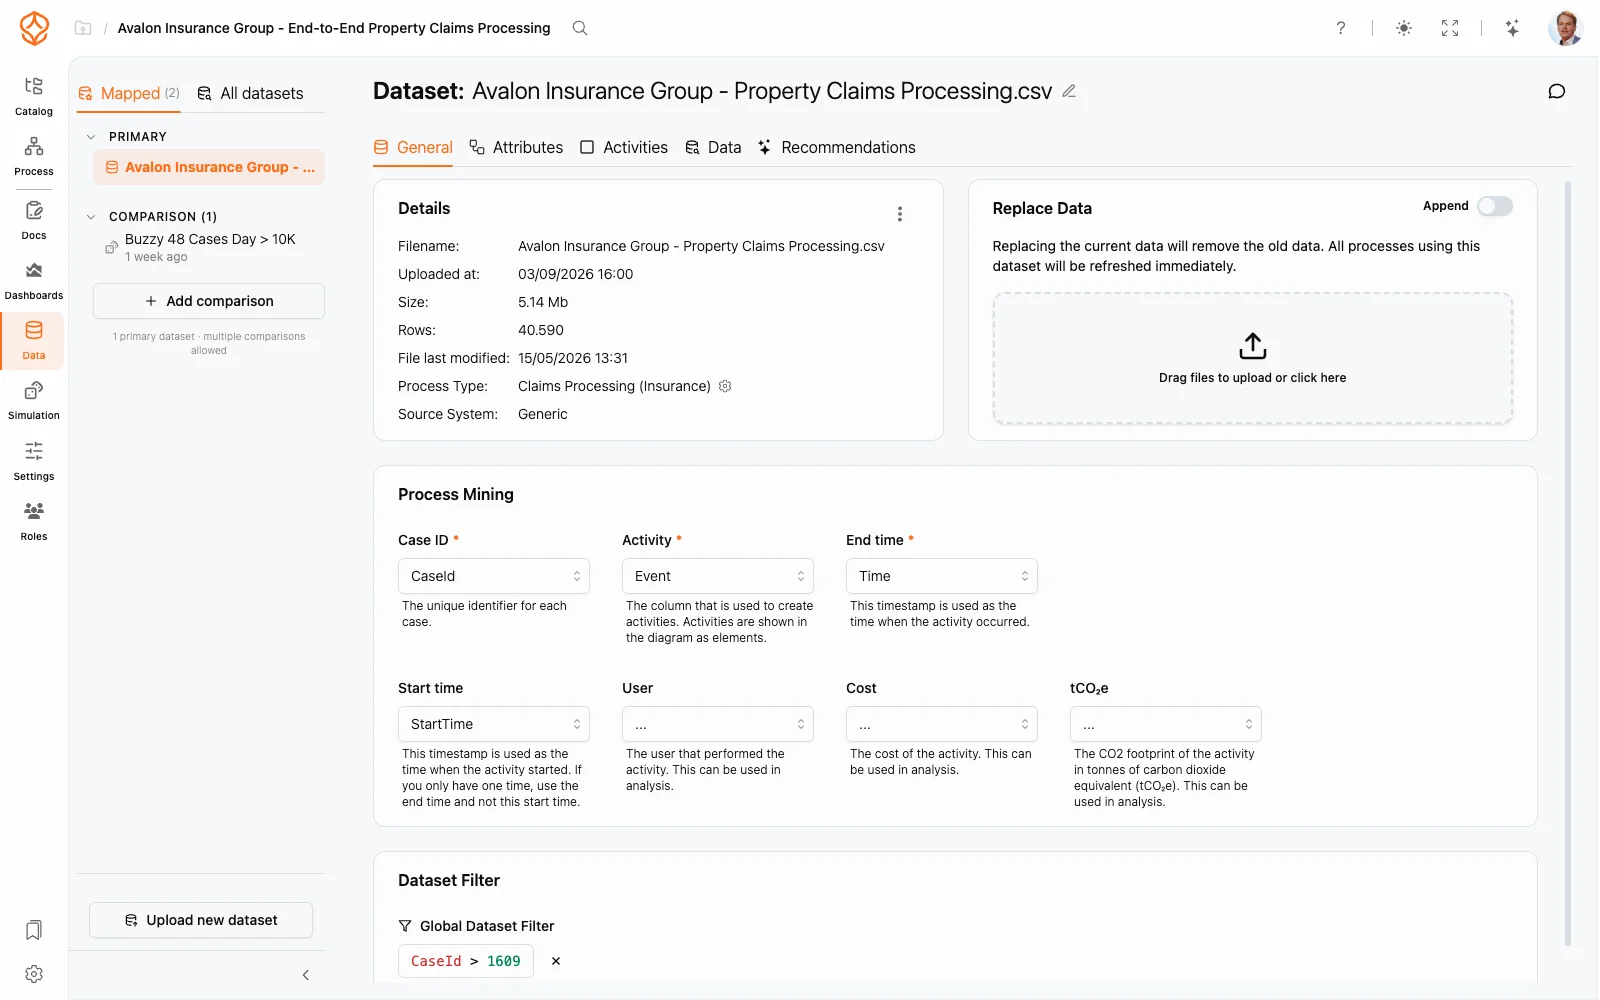
您也可以在ProcessMind应用中数据集的常规选项卡中触发增量数据加载:
- 将追加开关切换,使上传区域从替换数据变为追加数据。
- 将新文件拖入追加数据区域,或点击该区域浏览并选择文件。
ProcessMind会将文件作为增量文件上传,并与现有数据一起处理。增量上传需要明确指定,普通的替换上传不会被自动识别为增量上传。
查看上传部分
完成一次或多次增量上传后,数据表的上传历史会包含一个uploadParts数组,用于跟踪每个文件:
{
	"uploadHistory": {
		"uploadParts": [
			{
				"key": "datatable/123/2.csv",
				"fileName": "orders-january.csv",
				"fileSize": 524288,
				"uploadedAt": "2024-01-15T10:00:00Z"
			},
			{
				"key": "datatable/123/3.csv",
				"fileName": "orders-february.csv",
				"fileSize": 419430,
				"uploadedAt": "2024-02-15T10:00:00Z"
			}
		]
	}
}
最佳实践
- 统一列名:所有文件使用一致的列名,避免数据对齐问题。
- 按时间顺序上传:条件允许时按时间顺序上传,使上传历史反映数据时间线。
- 合理控制增量文件大小:分批上传适量数据;数量过多的小文件可能会降低处理速度。
- 监控行数:每次上传增量文件后检查行数,确认数据已正确加载。
warning
增量上传会追加数据,不会更新或替换现有行。如果需要更正之前上传的数据,请重新上传整个数据集。
架构不匹配时的处理方式
ProcessMind不会强制要求各上传部分使用严格一致的架构。这意味着:
- 额外列会在处理增量文件时被忽略:系统只使用原始上传架构中存在的列。
- 缺少的列会使增量行中对应字段的值为空或为null。
- 不同的列名会被视为完全不同的列:增量行中预期列的值将为null。
为获得最佳结果,请确保所有增量文件与原始上传文件具有相同的列结构。
info
对于CSV和JSONL格式,所有值在内部都会按字符串读取,因此不会出现类型不匹配错误。对于Parquet和ORC格式,列数据类型会根据文件架构保留。在所有情况下,如果某列要求数值数据,而您上传了不兼容的值,下游分析或模拟可能会产生意外结果。