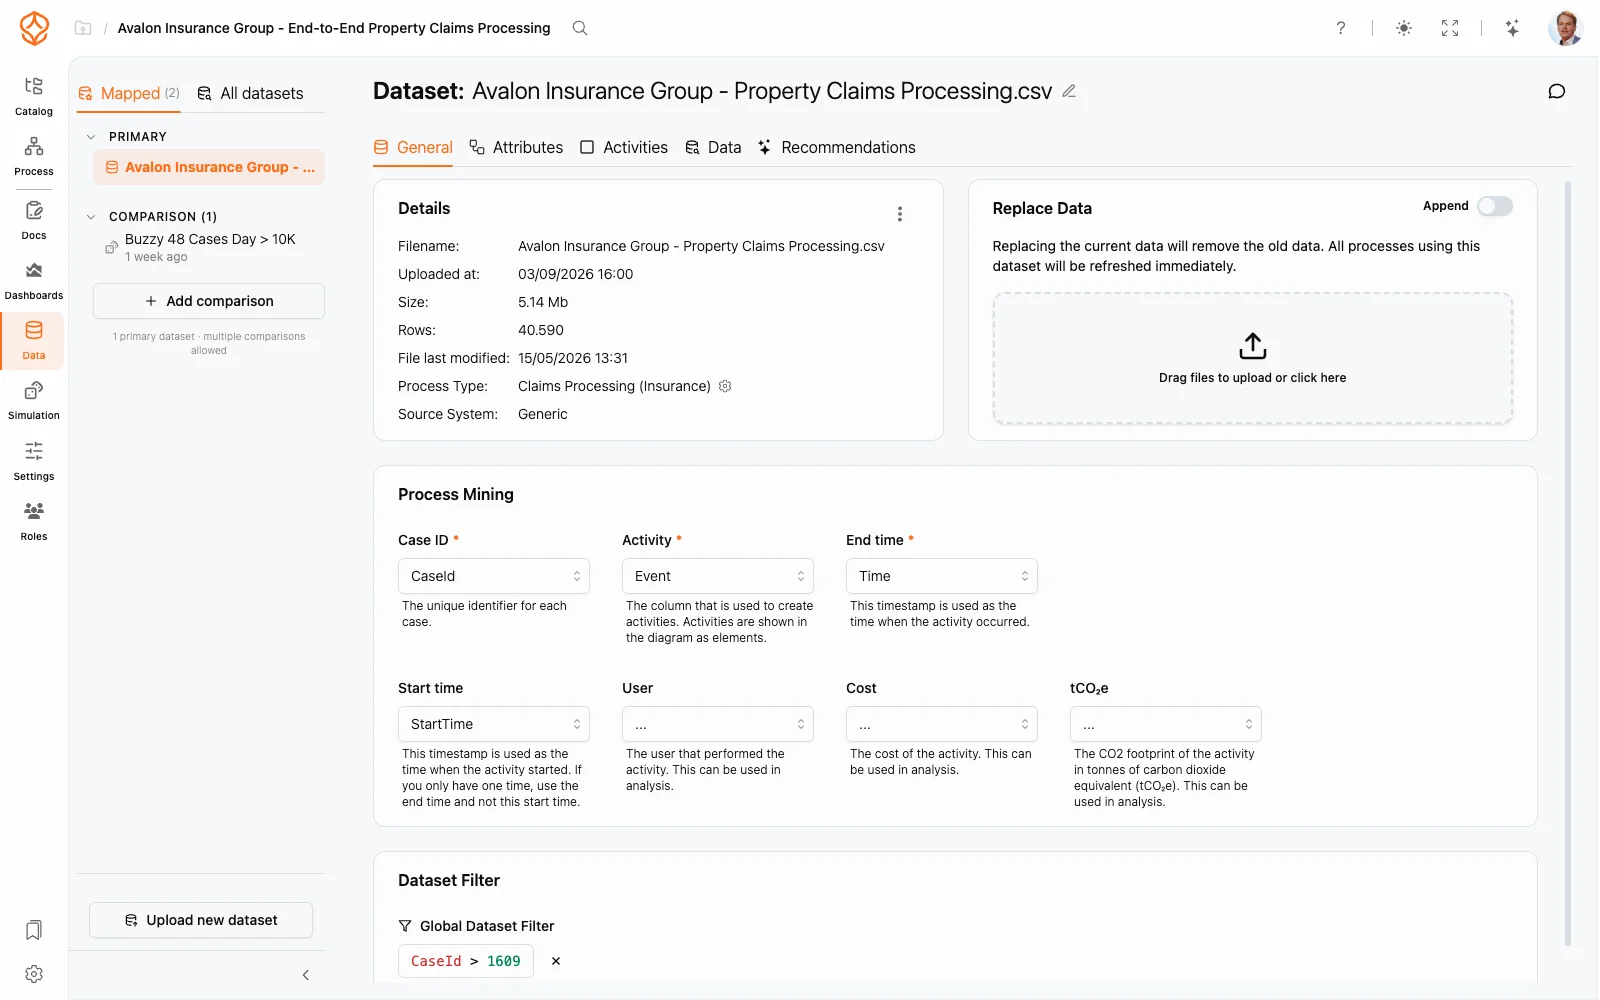
Konfigurace datasetu
Postup nahrání, mapování a nastavení datasetu pro přesnou analýzu process mining v ProcessMind.
Přírůstkové načítání dat, označované také jako delta loading, umožňuje přidávat nové řádky do existující datové tabulky, aniž by se původní data nahrazovala. Hodí se, když záznam událostí postupně roste a chcete mít analýzu process mining aktuální, aniž byste museli znovu nahrávat celý dataset.
Typické příklady použití:
info
Soubory delta musí mít stejnou strukturu sloupců jako původní nahraný soubor, tedy stejné názvy i pořadí sloupců. Sloupce navíc se ignorují. U chybějících sloupců se použijí hodnoty null.
.gz), pokud jejich vnitřní formát odpovídá formátu původního nahraného souboru.info
Přehled všech podporovaných formátů souborů najdete na stránce Podporované formáty dat.
Soubory delta můžete nahrávat programově pomocí ProcessMind API. Podrobnosti o všech koncových bodech najdete na stránce Referenční příručka API: data.
Postup je následující:
Získejte předem podepsanou URL pro nahrání souboru delta:
GET /v1/tenant/{tenantId}/datatables/{dataTableId}/uploads/presigned-url
    ?delta=true&filename=delta.csv&filesize=1024&filelastmodified=1704067200000
Nahrajte soubor delta pomocí předem podepsané URL:
curl -X PUT --upload-file "delta.csv" \
    -H "Content-Type: text/csv" \
    "{PreSignedUploadUrl}"
Po dokončení nahrávání ProcessMind soubor delta automaticky zpracuje a spojí ho s původními daty. Průběh můžete sledovat dotazováním na GET /datatables/{dataTableId}, dokud hasDataLoaded nebude mít stav true. Pak bude zpracování dokončeno.
Přírůstkové načítání dat můžete spustit také na kartě Obecné datové sady v aplikaci ProcessMind:
ProcessMind nahraje soubor jako delta a zpracuje ho společně s existujícími daty. Nahrání jako delta je nutné zvolit výslovně. Při běžném nahrání, které data nahrazuje, se delta automaticky nerozpozná.
Po jednom nebo více přírůstkových nahráních obsahuje historie nahrávání datové tabulky pole uploadParts, které eviduje jednotlivé soubory:
{
	"uploadHistory": {
		"uploadParts": [
			{
				"key": "datatable/123/2.csv",
				"fileName": "orders-january.csv",
				"fileSize": 524288,
				"uploadedAt": "2024-01-15T10:00:00Z"
			},
			{
				"key": "datatable/123/3.csv",
				"fileName": "orders-february.csv",
				"fileSize": 419430,
				"uploadedAt": "2024-02-15T10:00:00Z"
			}
		]
	}
}warning
Přírůstkové nahrání data pouze přidá. Stávající řádky neaktualizuje ani nenahrazuje. Pokud potřebujete opravit data z předchozího nahrání, nahrajte znovu celý dataset.
ProcessMind nevyžaduje, aby schéma jednotlivých částí nahraných dat přesně odpovídalo. To znamená:
Nejlepších výsledků dosáhnete, když budou mít všechny soubory delta stejnou strukturu sloupců jako původní nahraný soubor.
info
Ve formátech CSV a JSONL se všechny hodnoty interně načítají jako řetězce, takže nedochází k chybě kvůli neshodě datových typů. U formátů Parquet a ORC se datové typy sloupců přebírají ze schématu souboru. Pokud sloupec očekává číselná data a nahrajete hodnoty neodpovídajícího typu, může analýza nebo simulace následně přinést neočekávané výsledky.
Získejte přístup ihned, bez čekání a bez platební karty. Převádějte způsob práce ve své organizaci do přehledných a propojených návrhů procesů.
Vytvořte architekturu procesů, určete vlastníky a kontrolní mechanismy a slaďte role a odpovědnosti na všech úrovních.
Spusťte zkušební verzi a vytvořte spolehlivý základ pro řízení, správu a průběžné zlepšování procesů.
Soubory cookie používáme ke zlepšení vašeho používání webu, přizpůsobení obsahu a analýze návštěvnosti. Návštěvy stránek měříme anonymně i bez nich. Souhlas s analytickými cookies přidá identifikátor, který propojí vaše návštěvy. Kliknutím na „Přijmout vše“ souhlasíte s používáním souborů cookie.