การโหลดข้อมูลแบบเพิ่มทีละส่วน
การโหลดข้อมูลแบบเพิ่มทีละส่วนคืออะไร?
การโหลดข้อมูลแบบเพิ่มทีละส่วน (หรือ delta loading) ช่วยให้คุณเพิ่มแถวใหม่ลงในตารางข้อมูลเดิมได้ โดยไม่ต้องแทนที่ข้อมูลเดิม วิธีนี้เหมาะเมื่อข้อมูลในบันทึกเหตุการณ์เพิ่มขึ้นเรื่อยๆ และคุณต้องการให้การวิเคราะห์ process mining เป็นปัจจุบันโดยไม่ต้องอัปโหลดชุดข้อมูลทั้งหมดใหม่อีกครั้ง.
ตัวอย่างการใช้งานที่พบบ่อย:
- ส่งออกข้อมูลรายวันหรือรายสัปดาห์: เพิ่มธุรกรรม คำสั่งซื้อ หรือเคสใหม่เมื่อมีข้อมูล
- ติดตามกระบวนการอย่างต่อเนื่อง: เพิ่มข้อมูลใหม่เป็นประจำเพื่อให้แดชบอร์ดเป็นปัจจุบัน
- บันทึกเหตุการณ์ที่เพิ่มขึ้น: ทยอยเพิ่มเหตุการณ์ใหม่จากระบบ ERP, เครื่องมือ CRM หรือแหล่งข้อมูลอื่นๆ.
info
ไฟล์ delta ต้องมีโครงสร้างคอลัมน์เหมือนกันกับไฟล์ต้นฉบับ ทั้งชื่อและลำดับคอลัมน์ ระบบจะไม่สนใจคอลัมน์เพิ่มเติมในไฟล์ delta ส่วนคอลัมน์ที่ไม่มีในไฟล์จะมีค่าเป็น null
ข้อกำหนด
- ตารางข้อมูลต้องมีการอัปโหลดครั้งแรกและโหลดข้อมูลแล้ว
- ไฟล์ delta ต้องเป็นรูปแบบเดียวกันกับไฟล์ต้นฉบับ:
- ไฟล์ CSV ต้องใช้ไฟล์ delta แบบ CSV
- ไฟล์ Parquet ต้องใช้ไฟล์ delta แบบ Parquet
- ไฟล์ ORC ต้องใช้ไฟล์ delta แบบ ORC
- ไฟล์ JSONL ต้องใช้ไฟล์ delta แบบ JSONL
- ไม่รองรับการอัปโหลดไฟล์ delta สำหรับ Excel (XLSX/XLS/XLSB) และ XES ให้แปลงเป็น CSV ก่อน
- ชื่อคอลัมน์ในไฟล์ delta ควรตรงกับไฟล์ต้นฉบับ
- บีบอัดไฟล์ delta ด้วย gzip ได้ (
.gz) หากรูปแบบไฟล์ภายในตรงกับรูปแบบไฟล์ต้นฉบับ.
info
ดูรูปแบบไฟล์ที่รองรับทั้งหมดได้ที่หน้ารูปแบบข้อมูลที่รองรับ
อัปโหลดข้อมูลแบบเพิ่มทีละส่วน
ผ่าน API
ใช้ API ของ ProcessMind เพื่ออัปโหลดไฟล์ delta ด้วยโปรแกรม ดูรายละเอียด endpoint ทั้งหมดได้ที่หน้าเอกสารอ้างอิง API: ข้อมูล.
ขั้นตอนมีดังนี้:
-
รับ URL สำหรับอัปโหลด delta ที่ลงนามล่วงหน้า:
GET /v1/tenant/{tenantId}/datatables/{dataTableId}/uploads/presigned-url ?delta=true&filename=delta.csv&filesize=1024&filelastmodified=1704067200000 -
อัปโหลดไฟล์ deltaโดยใช้ URL ที่ลงนามล่วงหน้า:
curl -X PUT --upload-file "delta.csv" \
    -H "Content-Type: text/csv" \
    "{PreSignedUploadUrl}"
เมื่ออัปโหลดเสร็จ ProcessMind จะประมวลผล delta และรวมเข้ากับข้อมูลเดิมโดยอัตโนมัติ คุณสามารถตรวจสอบ GET /datatables/{dataTableId} จนกว่า hasDataLoaded จะเป็น true เพื่อดูว่าประมวลผลเสร็จแล้วหรือยัง.
ผ่าน UI
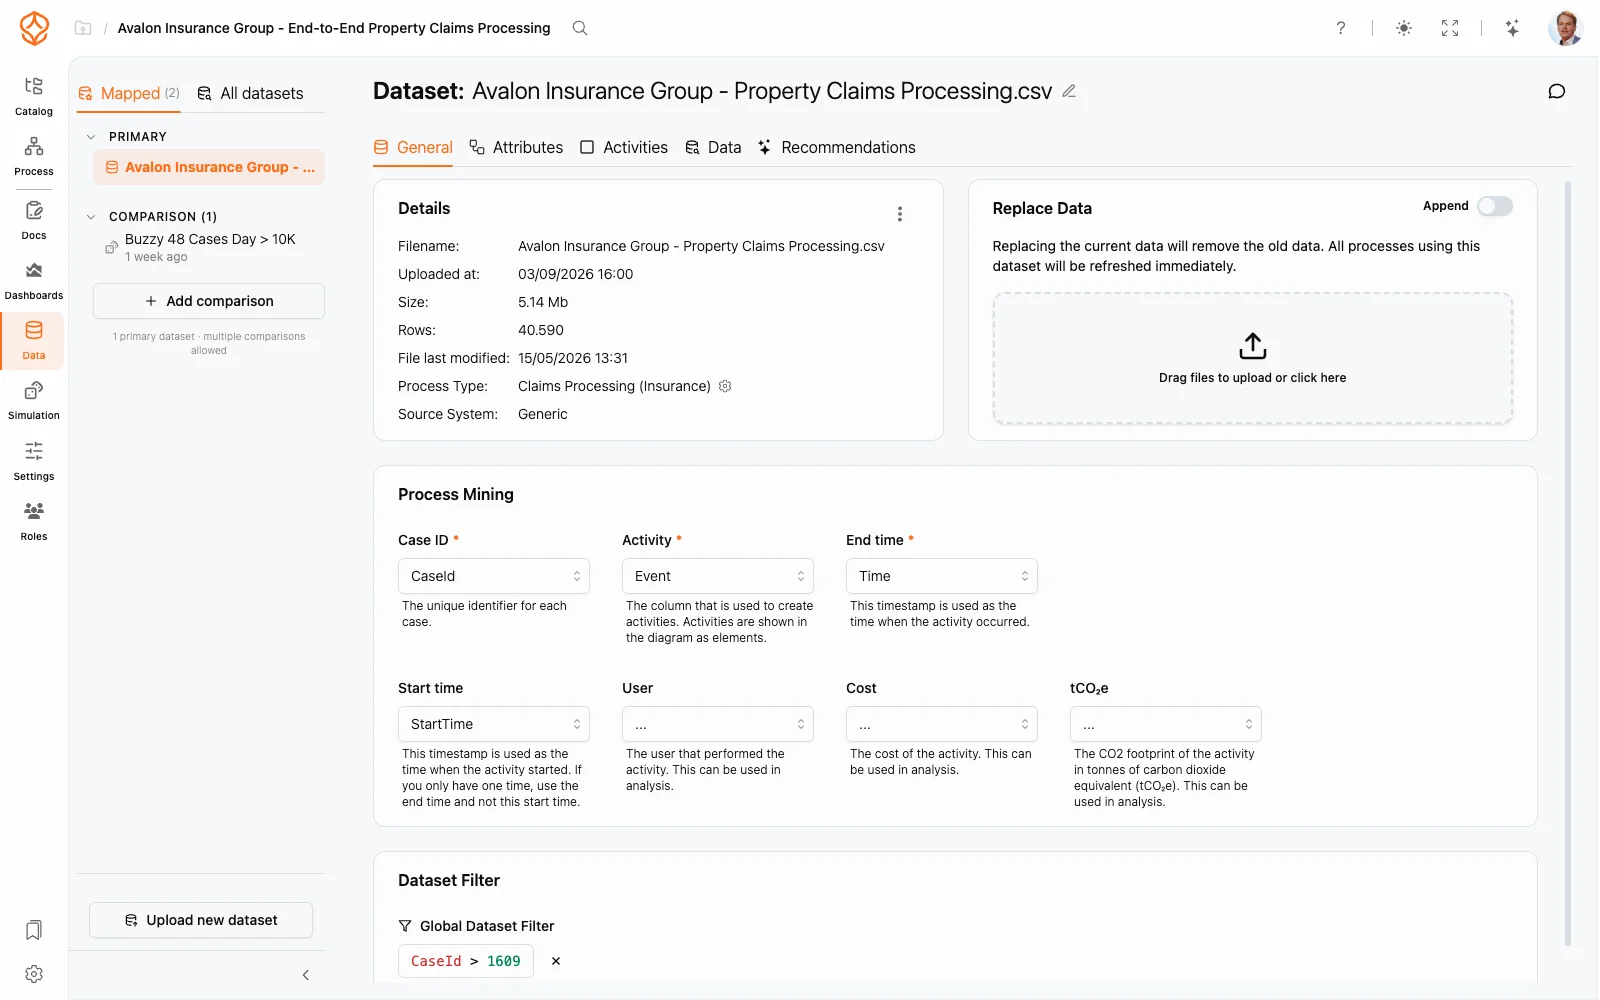
คุณเริ่มการโหลดข้อมูลแบบเพิ่มทีละส่วนได้จากแท็บ ทั่วไป ของชุดข้อมูลในแอป ProcessMind ด้วยเช่นกัน:
- เปิดสวิตช์ เพิ่มต่อท้าย เพื่อเปลี่ยนพื้นที่อัปโหลดจาก แทนที่ข้อมูล เป็น เพิ่มข้อมูล
- วางไฟล์ใหม่ในพื้นที่ เพิ่มข้อมูล (หรือคลิกเพื่อเลือกไฟล์).
ProcessMind จะอัปโหลดไฟล์เป็น delta และประมวลผลร่วมกับข้อมูลเดิม การอัปโหลด delta ต้องเลือกทำอย่างชัดเจน ระบบจะไม่ตรวจจับโดยอัตโนมัติจากการอัปโหลดปกติแบบแทนที่ข้อมูล.
ดูส่วนต่างๆ ของไฟล์ที่อัปโหลด
หลังจากอัปโหลดข้อมูลแบบเพิ่มทีละส่วนอย่างน้อยหนึ่งครั้ง ประวัติการอัปโหลดของตารางข้อมูลจะแสดงอาร์เรย์uploadPartsที่บันทึกรายละเอียดของแต่ละไฟล์:
{
	"uploadHistory": {
		"uploadParts": [
			{
				"key": "datatable/123/2.csv",
				"fileName": "orders-january.csv",
				"fileSize": 524288,
				"uploadedAt": "2024-01-15T10:00:00Z"
			},
			{
				"key": "datatable/123/3.csv",
				"fileName": "orders-february.csv",
				"fileSize": 419430,
				"uploadedAt": "2024-02-15T10:00:00Z"
			}
		]
	}
}
แนวทางปฏิบัติที่แนะนำ
- ใช้ชื่อคอลัมน์ให้ตรงกันในทุกไฟล์ เพื่อป้องกันปัญหาการจับคู่ข้อมูล
- อัปโหลดตามลำดับเวลาหากทำได้ เพื่อให้ประวัติการอัปโหลดแสดงลำดับเวลาของข้อมูล
- กำหนดขนาดไฟล์ delta ให้เหมาะสม: อัปโหลดข้อมูลเป็นชุดขนาดพอเหมาะ เพราะไฟล์ขนาดเล็กจำนวนมากอาจทำให้การประมวลผลช้าลง
- ตรวจสอบจำนวนแถวหลังอัปโหลด delta แต่ละครั้ง เพื่อยืนยันว่าโหลดข้อมูลถูกต้อง.
warning
การอัปโหลดแบบเพิ่มทีละส่วนจะเพิ่มข้อมูลใหม่เท่านั้น ไม่ได้แก้ไขหรือแทนที่แถวเดิม หากต้องการแก้ไขข้อมูลจากการอัปโหลดครั้งก่อน ให้อัปโหลดชุดข้อมูลทั้งหมดใหม่
เมื่อโครงสร้างข้อมูลไม่ตรงกัน
ProcessMind ไม่บังคับให้โครงสร้างข้อมูลของแต่ละส่วนที่อัปโหลดตรงกันทุกประการ ซึ่งหมายความว่า:
- คอลัมน์เพิ่มเติมในไฟล์ delta จะถูกละเว้นระหว่างการประมวลผล ระบบจะใช้เฉพาะคอลัมน์ที่มีอยู่ในโครงสร้างข้อมูลของไฟล์ต้นฉบับ
- คอลัมน์ที่ขาดหายไปจะมีค่า null หรือค่าว่างในฟิลด์นั้นของแถวใน delta
- ชื่อคอลัมน์ที่ต่างกันจะถือเป็นคนละคอลัมน์ แถวใน delta จึงมีค่า null ในคอลัมน์ที่ระบบคาดไว้.
เพื่อให้ได้ผลลัพธ์ที่ถูกต้อง ไฟล์ delta ทุกไฟล์ควรมีโครงสร้างคอลัมน์เหมือนกับไฟล์ต้นฉบับ.
info
สำหรับรูปแบบ CSV และ JSONL ระบบจะอ่านค่าทั้งหมดเป็นสตริงภายใน จึงไม่มีข้อผิดพลาดจากชนิดข้อมูลไม่ตรงกัน ส่วนรูปแบบ Parquet และ ORC จะคงชนิดข้อมูลของคอลัมน์ตามโครงสร้างไฟล์ ไม่ว่ากรณีใด หากคอลัมน์กำหนดให้เป็นข้อมูลตัวเลข แต่คุณอัปโหลดค่าที่ไม่เข้ากัน การวิเคราะห์หรือการจำลองกระบวนการในขั้นตอนถัดไปอาจให้ผลลัพธ์ที่ไม่คาดคิด
ออกแบบกระบวนการให้ดีขึ้น วางโครงสร้างที่เชื่อมโยงกัน และควบคุมได้.
เริ่มใช้งานได้ทันที ไม่ต้องใช้บัตรเครดิตและไม่ต้องรอ เปลี่ยนวิธีทำงานขององค์กรให้เป็นแบบจำลองกระบวนการที่ชัดเจนและเชื่อมโยงกัน.
สร้างสถาปัตยกรรมกระบวนการ กำหนดเจ้าของและการควบคุม พร้อมจัดบทบาทและความรับผิดชอบให้สอดคล้องกันในทุกระดับ.
เริ่มทดลองใช้ฟรี แล้วสร้างรากฐานที่เชื่อถือได้สำหรับกำกับดูแล จัดการ และปรับปรุงกระบวนการอย่างต่อเนื่อง.