プロセスマイニング
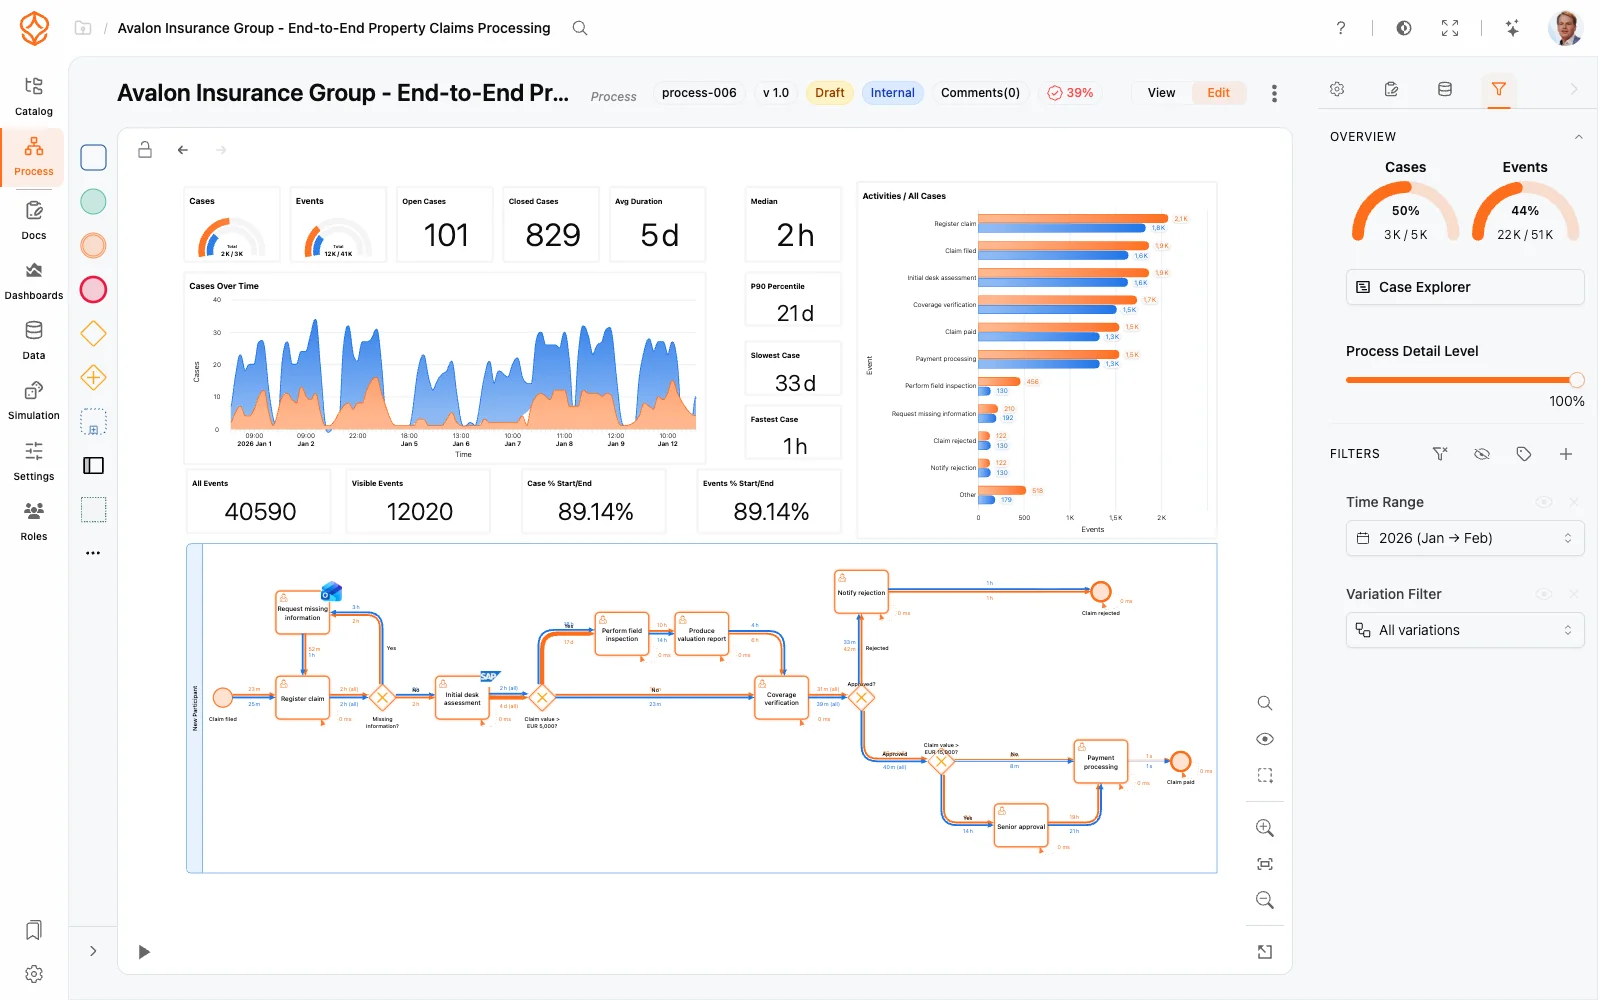
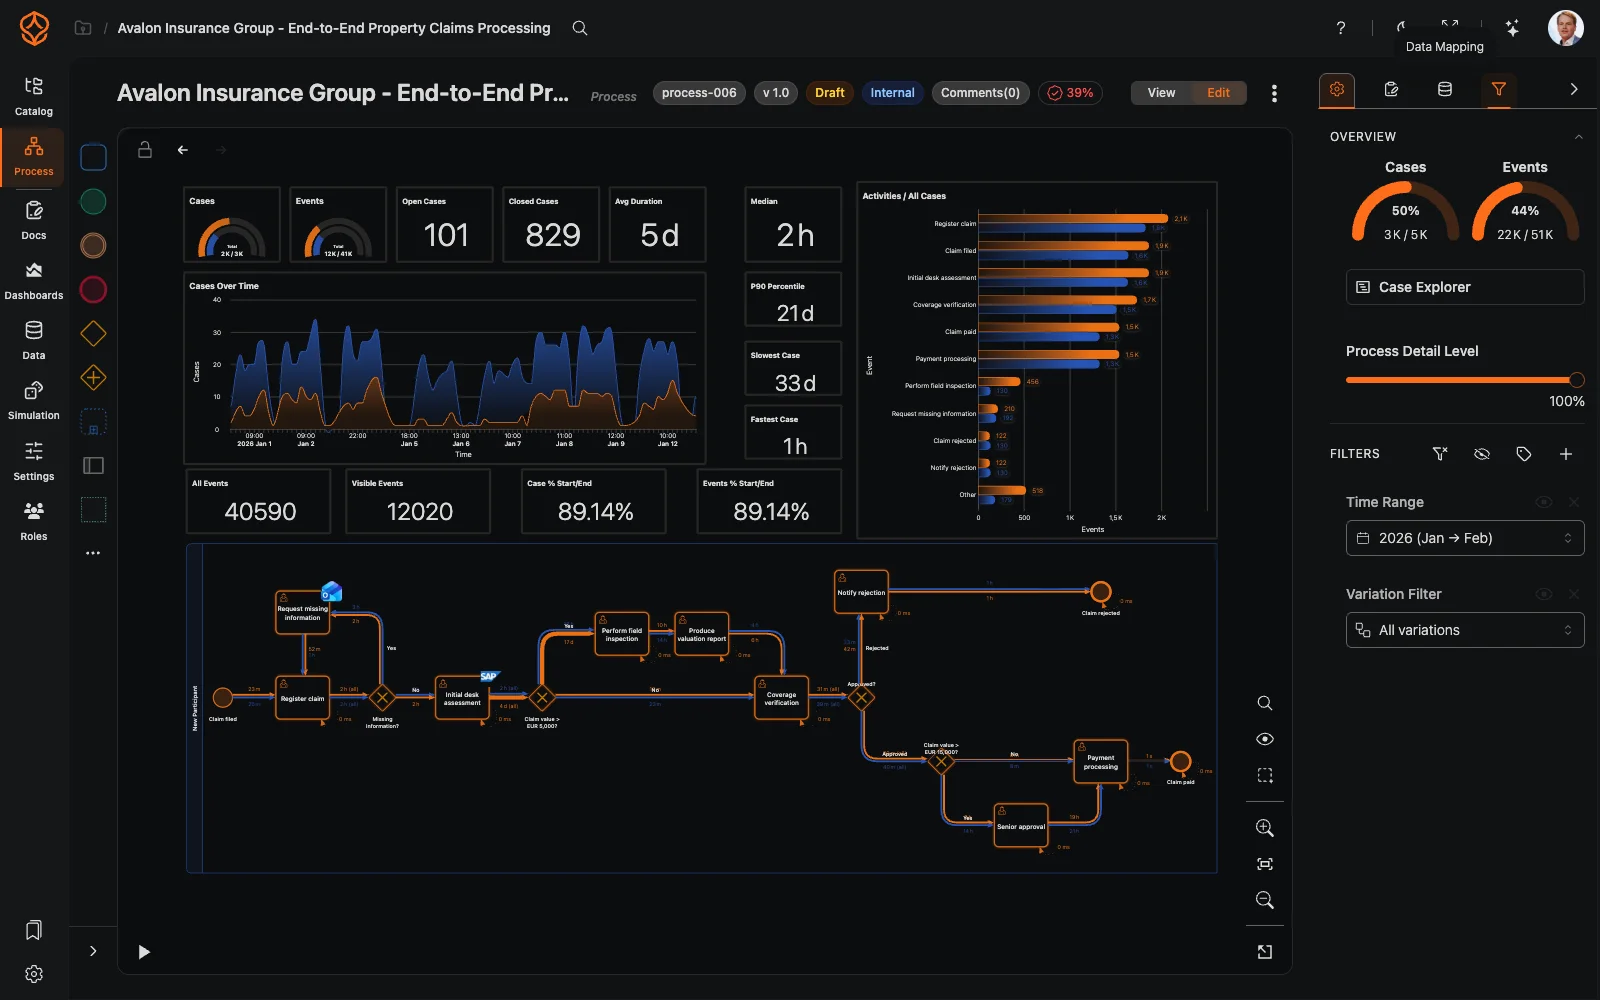
プロセスマイニングでは、システムが記録しているイベントログデータから実際の業務プロセスを再構築します。プロセスが想定どおりに見えるかではなく、モデルに反映されていないショートカット、手戻り、例外を含め、実際に起きていることをProcessMindが発見します。
マイニングの流れ
マイニングはイベントデータから始まり、インタラクティブなプロセスマップで終わります:
- データをアップロード:対応データ形式に従って、CSVまたはXLSXのイベントログをインポートします。
- 列をマッピング:データセットの設定で、ケースID、アクティビティ、タイムスタンプがどの列にあるかをProcessMindに指定します。
- プロセスをマイニング:データ内のアクティビティの順序から、ProcessMindがプロセスモデルを導き出します。
モデルをマイニング
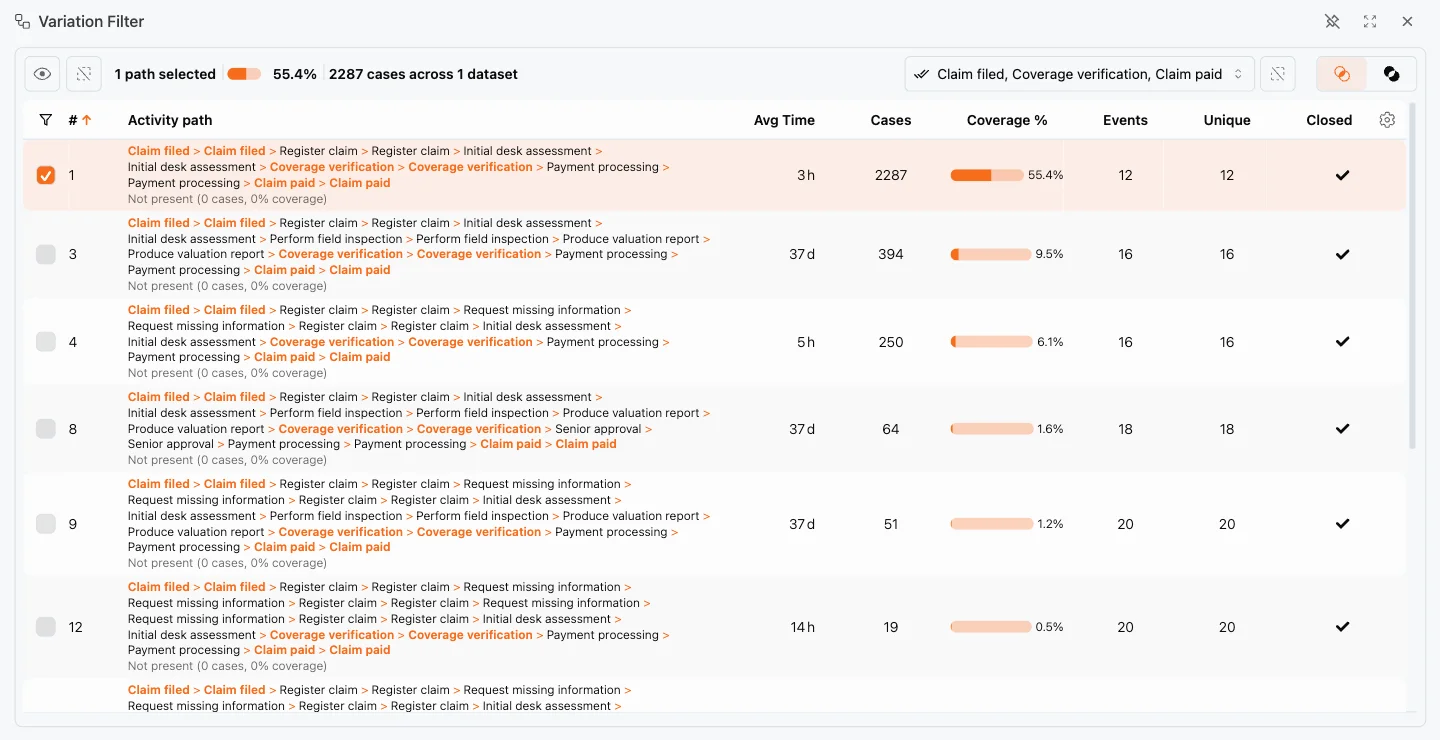
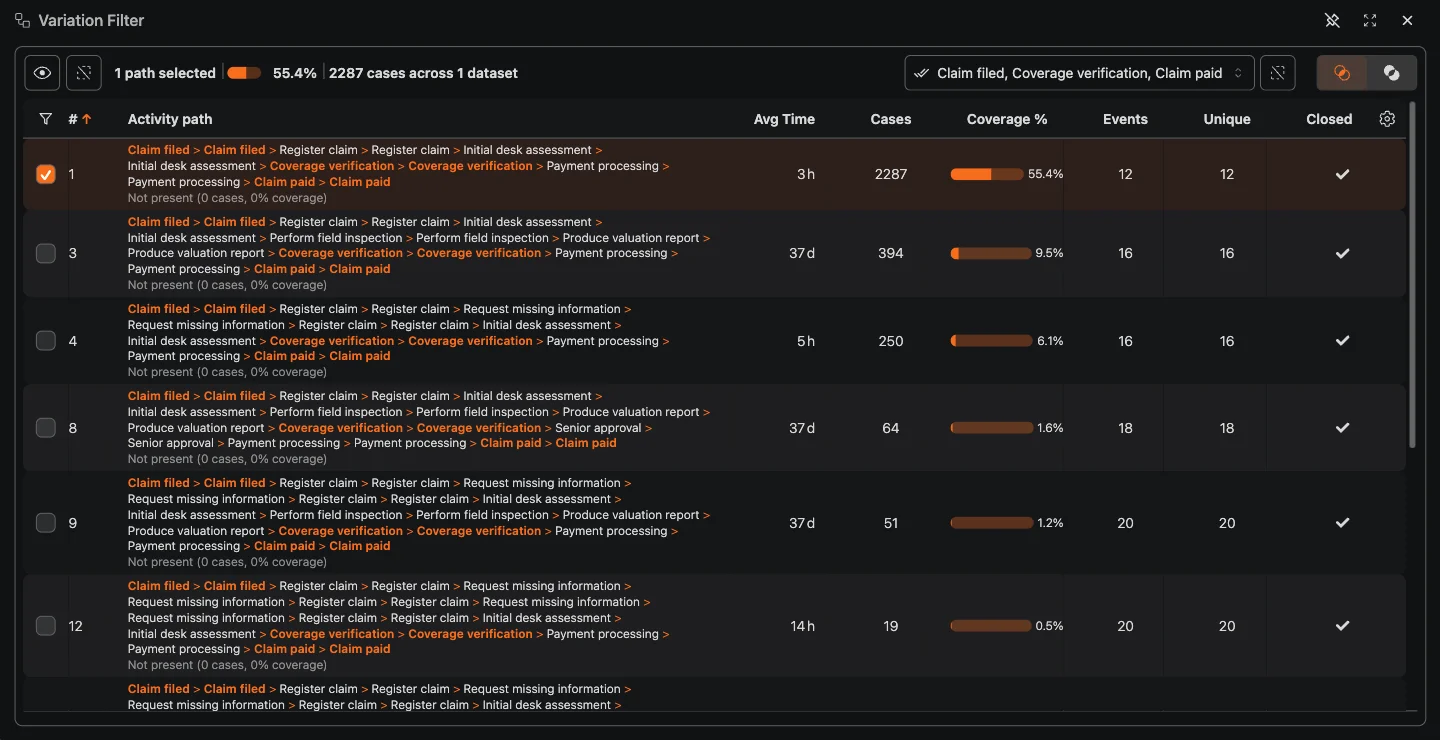
データセットをマッピングすると、ProcessMindは実際の作業フローを反映したモデルを作成します:
- アクティビティがプロセスの構成要素になります。
- 接続には、どのアクティビティの後にどのアクティビティが発生するかが頻度に応じて示されます。
- 頻度とパフォーマンスが各遷移について記録されるため、ケースがどこで時間を費やしているかを確認できます。
プロセスグラフで作成されたマップを確認し、ケースエクスプローラーで個別のケースを詳しく確認できます。
ディスカバリー結果の調整
マイニングしたモデルは、最終結果ではなく出発点です:
- 重要な部分に集中し、頻度の低い動作をフィルタリングします。
- 関連する作業をグループ化し、モデルを読みやすくするために上位レベルのアクティビティにまとめます。
- フローをアニメーション表示し、プロセスアニメーションで時間の経過に沿ってプロセスを確認します。
既存モデルのマイニング
キャンバス上にモデルとマッピング済みのフローデータがある場合、データの実際の動作に基づいてモデルを再構築できます:
プロセスページまたはカタログでモデルのプロセスメニュー(⋯)を開き、1. フローデータからモデルをマイニングを選択します。同じダイアログは、マッピングパネルのデータセットメニューからモデルを自動レイアウトを選択しても開けます。 イベントログに合ったマイナーを選択します。正確で従来型の結果には2. 直接後続マイナー**、簡潔なモデルにはシンプルマイナー、不完全または整理されていないデータにはAIマイナーを使用します。** 結果の厳密さを設定します。3. 排他的ゲートウェイポリシー**(なし、自動、または完全なXORゲートウェイ)と、並列ゲートウェイポリシー(なし、限定、または完全な並列ゲートウェイ)を指定します。** 4. モデルをマイニングをクリックすると、マッピング済みデータに基づいてキャンバスが再構築されます。
このダイアログでは、通常のレイアウトも設定できます。水平または垂直を選択して更新をクリックすると、マイニングを再実行せずに既存モデルを並べ替えられます。マイニングを実行するとモデル構造が置き換えられるため、現在の形状に戻す可能性がある場合は、先にバージョンを作成してください。
ディスカバリーからシミュレーションへ
マイニングしたモデルは実際の動作に基づいているため、予測の基盤として適しています。発見したプロセスをシミュレーションの入力として使用し、実施前に変更を検証してください。What-if分析でシナリオも確認できます。