データセットの設定
データセット画面の概要
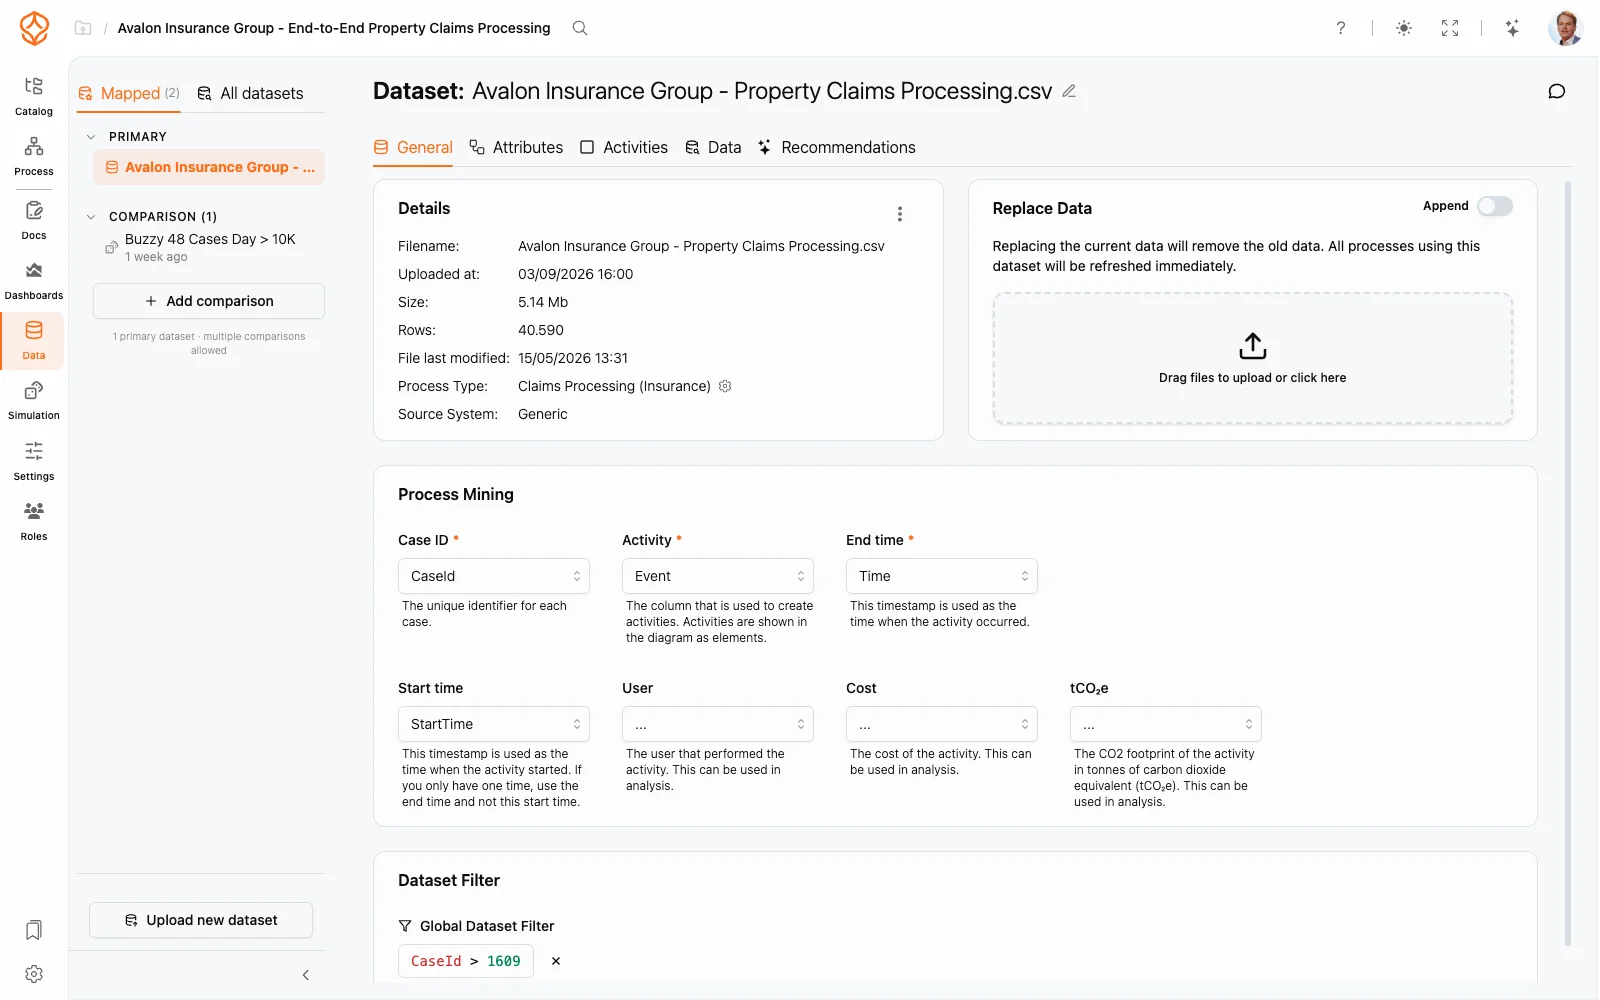
データセットが完全にアップロードされると、ProcessMindのデータセット画面が開きます。ここでは、プロセスマイニングでデータをどのように解釈するかを設定します。ケース、アクティビティ、タイムスタンプが入る列、アップロードしたファイルの内容、分析対象の行を指定します。同じ画面で、すべての対応ファイル形式を設定できます。
データの準備と利用には、次の2つの関連ガイドが役立ちます。
- データ品質:品質バッジとスライド表示される品質パネルを確認します。
- AIデータに関する提案:AIにデータセットとマッピングの改善を提案させます。
1. データセット名
ヘッダーには**データセット:**に続いて、開いているデータセットの名前が表示されます。名前をクリックして編集し、Customer Orders DataやIncident Reportsのように識別しやすい名前を付けます。ヘッダーにはコメントボタンとデータセットの品質バッジも表示されます。
2. タブ
ヘッダーの下では、タブを使ってデータセットを設定します。
- 一般:最初に開きます。データの置換または追加、ファイルの詳細確認、プロセスマイニング列のマッピング、データセットフィルターの設定を行います。
- 属性:検出された列の確認、名前の変更、式の追加、分析対象外にする列の非表示を行います。
- アクティビティ:データから作成されたアクティビティについて、同じ設定を行います。
- データ:ページングと並べ替えを使い、ProcessMindが読み取った行を確認します。
- 推奨事項 Process Intelligence Process Intelligence Process Intelligence席以上で利用できます。このプラン以上の席でのみ、この機能を利用できます。 プランを比較 :AIにデータセットとマッピングの改善案を提示させます。シミュレーションデータセットには表示されません。
3. 一般タブ
データセットの警告
分析を妨げる問題が残っている場合、パネルの上に赤い一覧が表示されます。ケースID、アクティビティ、終了時刻の不足、プロセスマイニングパネルのデータのないアクティビティ、値のない属性、再アップロードしたファイルと選択したプロセス種別の不一致など、対応が必要な箇所を示します。
データを置換します/データを追加
左側のパネルでは、新しい行をアップロードします。
- データを置換しますが既定の設定です。ファイルをボックスにドラッグ&ドロップするか、ボックスをクリックして参照します。置換すると現在の行が削除され、データセットを使用するすべてのプロセスが更新されます。
- データを追加:追加スイッチをオンにすると、既存のデータに行を追加できます。追加するファイルの構造は、現在のデータセットと一致している必要があります。
シミュレーションデータセットの場合、このパネルにはシミュレーションによってデータセットが生成されたことだけが表示されます。
詳細
右側のパネルには、ProcessMindがファイルについて把握している情報が表示されます。
- ファイル名、アップロード日時、サイズ、行、ファイルの最終更新日時。
- プロセス種別とソースシステム:検出された業務プロセスとソースシステムです。列の自動マッピングに使用されます。
プロセス種別の横にある設定アイコンをクリックすると、プロセス種別設定が開きます。ここで別のプロセスとシステムを選択するか、プロセスとシステムを自動検出をクリックし、その後保存をクリックします。いずれかを変更すると、すべての列マッピングが変わる場合があります。
パネルヘッダーのメニュー(⋯)には、モデルに追加、ダウンロード、データセットを使用しているプロセスを確認する使用状況を表示、API呼び出しで使用するデータテーブルIDとテナントIDを取得するデータテーブルIDを取得があります。
プロセスマイニング
プロセスマイニングに必要な列をマッピングします。必須フィールドは次の3つです。
- ケースID:各ケースを一意に識別するIDです。
- アクティビティ:プロセス内のアクティビティになる列です。
- 終了時刻:アクティビティが発生した時点として使用するタイムスタンプです。
任意のフィールドを追加すると、分析にコンテキストを加えられます。
- 開始時刻:アクティビティが開始した時刻です。データにタイムスタンプが1つしかない場合は、終了時刻としてマッピングします。
- ユーザー:アクティビティを実行したユーザーです。
- コスト:アクティビティのコストです。
- tCO₂e:アクティビティによるCO2排出量をCO2換算トンで示します。ダッシュボードのアクティビティあたりtCO₂eグラフなど、サステナビリティ指標に使用します(プロセスグラフを参照)。
グローバルデータセットフィルター
グローバルデータセットフィルターでは、ProcessMindが分析する行を絞り込みます。**フィルター式を追加…**をクリックし、式エディターで行フィルターを作成します。フィルターはデータセットを使用するすべての場所に適用されます。
最後の手順
- 選択内容を確認:分析する前に、正しい列がケースID、アクティビティ、終了時刻にマッピングされていることを確認します。
- 警告を解消:一覧に残っているデータセットの警告を修正し、設定済みのデータでプロセスマイニングを続けます。
これらを設定すると、ProcessMindは追加設定なしで、データセットを検出、ダッシュボード、シミュレーションに使用します。