インシデント管理を改善する

Freshserviceのインシデント管理を最適化する6つのステップ
インシデント管理を改善する
インシデント管理
Freshservice

プロセスを選択

接続済みのワークスペースで作業を続けるには、プロセスを選択してください。

Freshserviceのインシデント管理を最適化し、解決を迅速化

インシデント管理では、解決までの時間が長い、同じ問題が繰り返し発生するといった課題がよく見られます。ProcessMindを使うと、遅延が発生している場所とその原因をすばやく特定し、プロセスに潜むボトルネックを明らかにできます。非効率の根本原因を突き止め、ワークフローを効率化する方法を把握できます。これにより、サービスの提供を改善し、ユーザー満足度を高められます。

事前設定済みのデータテンプレートをダウンロードし、よくある課題に取り組んで、効率化の目標を達成しましょう。6段階の改善計画に沿って進め、データテンプレートガイドを参考に、業務を改善してください。

詳細を表示

インシデント管理の改善が重要な理由

効果的なインシデント管理は、信頼できるITサービスの基盤であり、ユーザーの生産性、運用コスト、顧客満足度に直接影響します。デジタル化が急速に進む現在、軽微なものから重大なものまで、インシデントの解決が遅れると、事業に大きな支障をきたす可能性があります。サービス停止の長期化、手作業の繰り返し、生産性の低下が連鎖的に発生するのは、インシデント対応プロセスが非効率な場合に起こり得る結果です。Freshserviceなどのシステムでインシデント対応が効率よく行われないと、組織は運用コストの増加やSLA違反のリスク、ユーザーからの信頼低下に直面します。Freshserviceのインシデント管理プロセスが実際にどのように進んでいるかを把握することは、こうしたリスクを抑え、サービスの信頼性を保つための第一歩です。

プロセスマイニングでFreshserviceのインシデント解決を改善

プロセスマイニングを使うと、Freshserviceのインシデント管理ワークフローをデータに基づいて分析し、理想上のプロセスではなく、実際の業務の流れを明らかにできます。Freshserviceのイベントログを分析し、インシデントの報告からクローズまでの経過を再構成します。これにより、インシデントが滞留する箇所、不要な手戻り、解決までのサイクルタイムを延ばすボトルネックを正確に特定できます。

たとえば、インシデントの分類や優先順位付けの実態を視覚的に追跡し、サポートグループ間の転送回数を確認したり、進展がないまま特定の診断手順が繰り返されていないかを把握したりできます。頻繁な再割り当て、ユーザー確認の長い待ち時間、標準手順からの逸脱など、見えにくい非効率を見つけるうえで役立ちます。プロセスマイニングを使えば、「Freshserviceで優先度の高いインシデントの解決時間に長い裾野が生じるのはなぜか」「特定のサービスに関するインシデントが、いつもSLA目標を超えるのはなぜか」といった問いに答えられます。Freshserviceのデータに基づく詳細な分析により、推測に頼らず、実際の根拠に基づいて改善に取り組めます。

インシデント管理プロセスの主な改善領域

プロセスマイニングで得られたインサイトをもとに、Freshserviceのインシデント管理で改善が必要な領域に取り組めます。よくある改善機会は次のとおりです。

  • インシデントの分類と優先順位付けの見直し:初期分類の誤りによって再分類や遅延が頻発していないかを特定します。
  • 不要な転送やエスカレーションの削減:チーム間を頻繁に行き来するインシデントを特定し、トレーニングや知識共有、割り当てルールの見直しが必要かを検討します。
  • 診断・解決ワークフローの最適化:時間がかかる手順や、担当者が診断を何度もやり直す箇所を見つけ、ナレッジベースや標準手順の不足を確認します。
  • ナレッジベースの利用状況の改善:解決策が繰り返し
インシデント管理 サービスデスク ITIL サービス復旧 SLA遵守 ヘルプデスク 根本原因分析 チケット解決 チケット管理 チケット管理 ITヘルプデスク 平均解決時間 MTTR インシデント解決 ITサポート

よくある問題と課題

影響している課題を特定

インシデントの解決が遅れると、ユーザーの生産性やサービスの可用性に直接影響し、ユーザー満足度の低下や事業損失につながる可能性があります。引き継ぎの非効率、診断の長期化、外部要因への依存による待ち時間などが原因となり、インシデント管理のパフォーマンスに大きく影響します。

ProcessMindはFreshserviceにおけるインシデント管理の実際の流れを可視化し、割り当てから診断までや調査中など、インシデントに過剰な時間がかかっている箇所を明らかにします。ボトルネックや標準的な経路からの逸脱を特定し、解決を早めるためにプロセスを見直すべき領域を示します。

サービスレベル契約(SLA)への違反が続くと、信頼の低下やペナルティにつながり、インシデント管理プロセスに構造的な非効率があることを示します。SLAを達成できない原因を把握することは、サービス品質を保ち、ユーザー体験やコンプライアンスへの悪影響を避けるうえで重要です。

ProcessMindはインシデントの経路とSLAのステータスを照合し、FreshserviceでSLA違反につながりやすいアクティビティやイベントの順序を明らかにします。目標未達につながる標準手順からの逸脱を可視化し、コンプライアンスの向上に向けた的を絞った改善を支援します。

インシデントがサポートグループや担当者の間を頻繁に行き来すると、遅延や手戻りが発生します。引き継ぎ手順が明確でない、または担当範囲が曖昧な場合、解決までの時間が長引き、ユーザーの不満やインシデント管理のコスト増加につながります。

ProcessMindはFreshservice内の転送や再割り当てを可視化し、サポートグループや担当者間での引き継ぎの頻度と所要時間を示します。迅速な解決を妨げる、いわゆる「たらい回し」や非効率な振り分けのパターンを特定し、ワークフロー設計を見直すべき箇所を明らかにします。

インシデントの分類や優先度が誤っていると、適切でないチームに割り当てられたり、必要な対応を受けられなかったりして、解決が遅れ、影響が拡大する可能性があります。Freshserviceインスタンス内でリソースが無駄になり、目標を達成できないことにもつながります。

ProcessMindはFreshserviceでの初期分類と、その後の再分類や優先度の変更を分析し、誤分類のパターンを明らかにします。インシデントの再分類が頻発する箇所とその理由を示し、初期分類の精度や振り分けを改善するために、分類基準の明確化や担当者のトレーニングが必要かを判断できます。

根本原因分析(RCA)が十分に行われないと、同じ問題への対応が繰り返され、インシデント件数や無駄な作業が増えるおそれがあります。その結果、サービスの長期的な安定や継続的な改善が難しくなります。

ProcessMindは、根本原因分析を伴わずに解決されたインシデントや、Freshserviceで解決コードが頻繁に繰り返されているにもかかわらず、対応する問題チケットがないケースを特定できます。RCAがどの程度省略されているかを明らかにし、インシデント管理ワークフローに問題管理をより効果的に組み込む機会を示します。

エスカレーションの経路が明確でない、または一貫して守られていないと、インシデントが滞留したり、場当たり的に手動でエスカレーションされたりします。その結果、サービス対応にばらつきが生じ、特に重大な問題では解決が長引く可能性があります。チームの効率やユーザーからの信頼にも影響します。

ProcessMindはFreshserviceで実際に行われているエスカレーションのパターンを可視化し、定められた手順から外れた未承認または非効率な経路を明らかにします。誰が、どの段階で、どのようにインシデントをエスカレーションしているかを示し、見直しによって効率化できる不整合やボトルネックを特定します。

サービスを迅速に復旧するには回避策の実施が重要ですが、適切に適用されない、または問題の影響を十分に抑えられない場合、インシデントが長期間オープンのままになったり、再発したりすることがあります。ユーザーやサポートチームの不満につながり、インシデント管理の効果も低下します。

ProcessMindはFreshserviceの「回避策の実施」アクティビティと、その後の解決時間や再オープンとの関係を追跡します。回避策の適用が遅れているケースや、適用後に遅延やインシデントの再発が頻繁に起きているケースを特定し、回避策のプロセスに潜む非効率を明らかにします。

担当者やグループ間で頻繁に再割り当てされるインシデントや、解決後に何度も再オープンされるインシデントは、診断、解決の品質、コミュニケーションに根本的な問題があることを示している可能性があります。運用コストが増加し、ユーザー満足度も大きく低下します。

ProcessMindはFreshserviceにおけるインシデントの全ライフサイクルを追跡し、再割り当てと再オープンの回数を定量化します。これらが頻発する段階を特定し、特定の担当者やグループとの関連を分析することで、対処が必要な品質上の問題や知識不足を明らかにします。

担当者やサポートグループによって、類似するインシデントへの対応に大きな差があると、サービス品質にばらつきが生じ、解決時間が予測しにくくなるほか、業務負荷の偏りにもつながります。こうした差を把握することは、パフォーマンスの改善やチーム管理に欠かせません。

ProcessMindでは、Freshservice上の担当者やサポートグループごとに、解決時間、プロセス手順の遵守状況、回避策の利用状況を比較できます。優れた対応方法や、パフォーマンスを標準化するためにトレーニングやプロセスの徹底が必要な領域を明らかにし、全体の効率向上に役立てられます。

インシデント管理の最終段階では、ユーザーの確認やクローズ前の社内検証を待つ間に、予想外のボトルネックが生じることがあります。技術的な解決後もインシデントのライフサイクルが長引き、サービス復旧に関する報告や指標に影響します。

ProcessMindは、Freshserviceの「ユーザーへの通知送信」「ユーザー確認の受領」「インシデントの検証」「インシデントのクローズ」の各アクティビティ間にかかる時間を分析します。最終段階に不必要な時間がかかっていないかを特定し、コミュニケーションの効率化やフォローアップの自動化によって、より早くクローズする方法を見つけられます。

ユーザーが迅速な処理に適さないチャネルからインシデントを報告し続けると、初動対応が遅れ、サポートチームの手作業が増える可能性があります。受付の効率化やリソース配分を改善するには、チャネルの利用状況を把握することが大切です。

ProcessMindは、Freshserviceの「報告チャネル」属性と、その後の処理時間や解決効率を照らし合わせ、遅延や手戻りが発生しやすいチャネルを明らかにします。受付プロセスの改善や、より効率的な報告方法へのユーザー誘導に役立ちます。

一般的な目標

成功の基準を定義

重大なインシデントの解決時間を短縮することは、業務への影響を抑え、サービスの継続性を保つうえで欠かせません。解決が早まればユーザー満足度が向上し、Freshserviceでのサービス停止に伴う金銭的なペナルティも回避しやすくなります。インシデントの報告からサービスの完全復旧までの時間を短縮することが目標です。ProcessMindは、重大なインシデントの解決経路にあるボトルネックや付加価値のない手順を特定し、遅延の原因となるアクティビティや引き継ぎを明らかにします。実際のプロセスフローを可視化して効率的な経路からの逸脱を示し、自動化やリソース再配分を検討すべき箇所を提示することで、解決時間の大幅な短縮を支援します。

サービスレベル契約(SLA)の目標を継続して達成することは、顧客の信頼を保ち、コンプライアンスを確保し、契約上のペナルティを避けるうえで重要です。Freshserviceのすべてのインシデントについて、合意した応答時間と解決時間を守り、サービス品質全体を高めることを目指します。ProcessMindは、SLA違反のリスクがあるインシデントと、プロセスのどこで遅延が発生しているかを具体的に示します。初期割り当ての遅れや診断の長期化など、SLA未達の根本原因を明らかにし、的を絞った対策によってコンプライアンスとサービスの信頼性を高められます。

Freshserviceでチームや担当者間の不要な引き継ぎや遅延が発生すると、解決時間が大幅に延び、効率が低下する可能性があります。引き継ぎの効率化では、転送回数を減らし、プロセスの各手順間の待ち時間を短縮して、インシデント対応をよりスムーズかつ迅速に進めます。ProcessMindは、インシデント対応の全過程を可視化し、すべての引き継ぎと再割り当てを示します。グループ間で対応が行き来する非効率なパターンを特定し、振り分けルールの見直し、初期割り当ての精度向上、解決までに必要な手順の削減につなげます。

インシデントを正確に分類することは、効率的なインシデント管理の基盤です。適切なチームにチケットを振り分け、迅速に解決できるようになります。Freshserviceで分類を誤ると、誤った振り分けや遅延、リソースの浪費につながります。初期分類の精度を高めることが目標です。ProcessMindは、さまざまなカテゴリから始まるインシデントの経路を分析し、分類ミスがどこで、なぜ起きるのかを特定します。解決時間の長期化など、誤分類が後続のプロセスに与える影響を明らかにし、組織が分類体系を見直したり、担当者向けのトレーニングを強化したり、自動分類ツールを導入したりする際に役立ちます。

根本原因分析(RCA)の効果を高めることは、インシデントの再発防止、件数の削減、Freshserviceにおけるシステムの長期的な安定性向上に役立ちます。特定した根本原因が実際の問題に対処し、持続的な解決につながっているかを確認します。ProcessMindは、インシデントのパターンと問題管理プロセスを関連付け、似た症状のインシデントがRCA後に恒久的に解決されているかを評価します。RCAワークフロー自体の非効率性も特定でき、問題を早期にクローズしていないか、分析で根本的な問題を見落としていないかを明らかにし、予防策の改善につなげます。

一貫性のない場当たり的なエスカレーションは、混乱を招き、不要な関係者を巻き込み、Freshserviceで重大なインシデントの解決を遅らせる可能性があります。エスカレーションを標準化すれば、定められた経路と基準に沿って、適切かつ予測可能に対応できます。ProcessMindは、インシデントが実際にたどったすべてのエスカレーション経路を明らかにし、想定または文書化された手順と比較します。手順からの逸脱、エスカレーション基準におけるボトルネック、予定外のエスカレーションを頻繁に引き起こす条件を特定し、明確で一貫性のある効率的なワークフローの整備を支援します。

回避策はサービスをすぐに復旧するうえで欠かせませんが、影響を本当に抑え、再発を防げるかどうかはさまざまです。Freshserviceで適用した回避策がインシデントの影響を実際に軽減し、最終的な解決を先送りしたり複雑にしたりしていないかを確認します。ProcessMindは、回避策を適用したインシデントのライフサイクルを分析し、その利用状況と、その後の解決時間、再オープン、関連する問題との関係を調べます。効果的な回避策と、複雑さを増す、または効果が見られない回避策を見分け、一時的な解決策の改善に役立てられます。

Freshserviceでインシデント管理を担当する人のパフォーマンスにばらつきがあると、組織全体で解決時間やサービス品質、ユーザー満足度に差が生じます。優れた対応方法を特定して共有し、担当者の効率と対応力を標準化することを目指します。ProcessMindは、担当者やサポートグループごとのプロセス経路とパフォーマンス指標を比較し、効率の高いワークフローや標準からの逸脱を明らかにします。うまくいっている対応パターンを特定し、対象を絞ったトレーニングを行い、一貫したワークフローを整備することで、担当者全体のパフォーマンス向上につなげられます。

ユーザーによる解決の確認や検証が遅れると、チケットのライフサイクルが不必要に長引き、Freshserviceの指標やリソース配分に影響します。ユーザーとのやり取りを効率化し、クローズまでの最終段階を迅速に進めることが目標です。ProcessMindは、解決策の適用後など、ユーザーからの回答を長時間待つ原因となる段階やきっかけを特定します。通知プロセスの見直し、フォローアップの自動化、コミュニケーション方法の改善によって、ユーザーの確認を促し、インシデントのクローズを早める方法を明らかにします。

インシデント報告チャネルが非効率だったり十分に使われていなかったりすると、Freshserviceでボトルネックが生じ、ユーザーの不満や初期処理の遅れにつながります。ユーザーが簡単にインシデントを報告でき、迅速な解決に向けて効率よく振り分けられるよう、チャネルを最適化します。ProcessMindは、メール、ポータル、電話など、報告チャネルごとのインシデント対応の流れを分析します。解決が早いチャネルや、追加の分類や手作業などの非効率が生じる箇所を特定し、報告しやすい環境の整備に役立てられます。

Freshserviceでインシデント管理の運用コストが高いと、IT予算を圧迫する可能性があります。非効率なプロセス、過剰な手戻り、長引く解決時間が原因となることも少なくありません。コスト削減には、貴重なリソースを消費する非効率を特定し、取り除く必要があります。ProcessMindは、頻繁な再割り当て、不要なエスカレーション、長引く解決時間など、さまざまなプロセス逸脱がコストに与える影響を数値化します。非効率がもたらす金銭的な影響を明らかにし、コスト増加につながる業務を特定して削減することで、リソース配分と予算の使い方を改善できます。

インシデント管理を改善する6つのステップ

1

テンプレートをダウンロード

実施内容

インシデント管理用に事前設定されたExcelテンプレートをご利用ください。Freshserviceのインシデント対応フローを正確にマッピングするために必要なデータを収集できます。

重要な理由

最初に適切なデータ構造を整えることは、正確な分析に欠かせません。手戻りを防ぎ、信頼できるインサイトにつながります。

期待される結果

インシデント管理プロセスに合わせて構成された、すぐに使えるデータテンプレート。

得られること

インシデント管理に関する重要なインサイトを発見

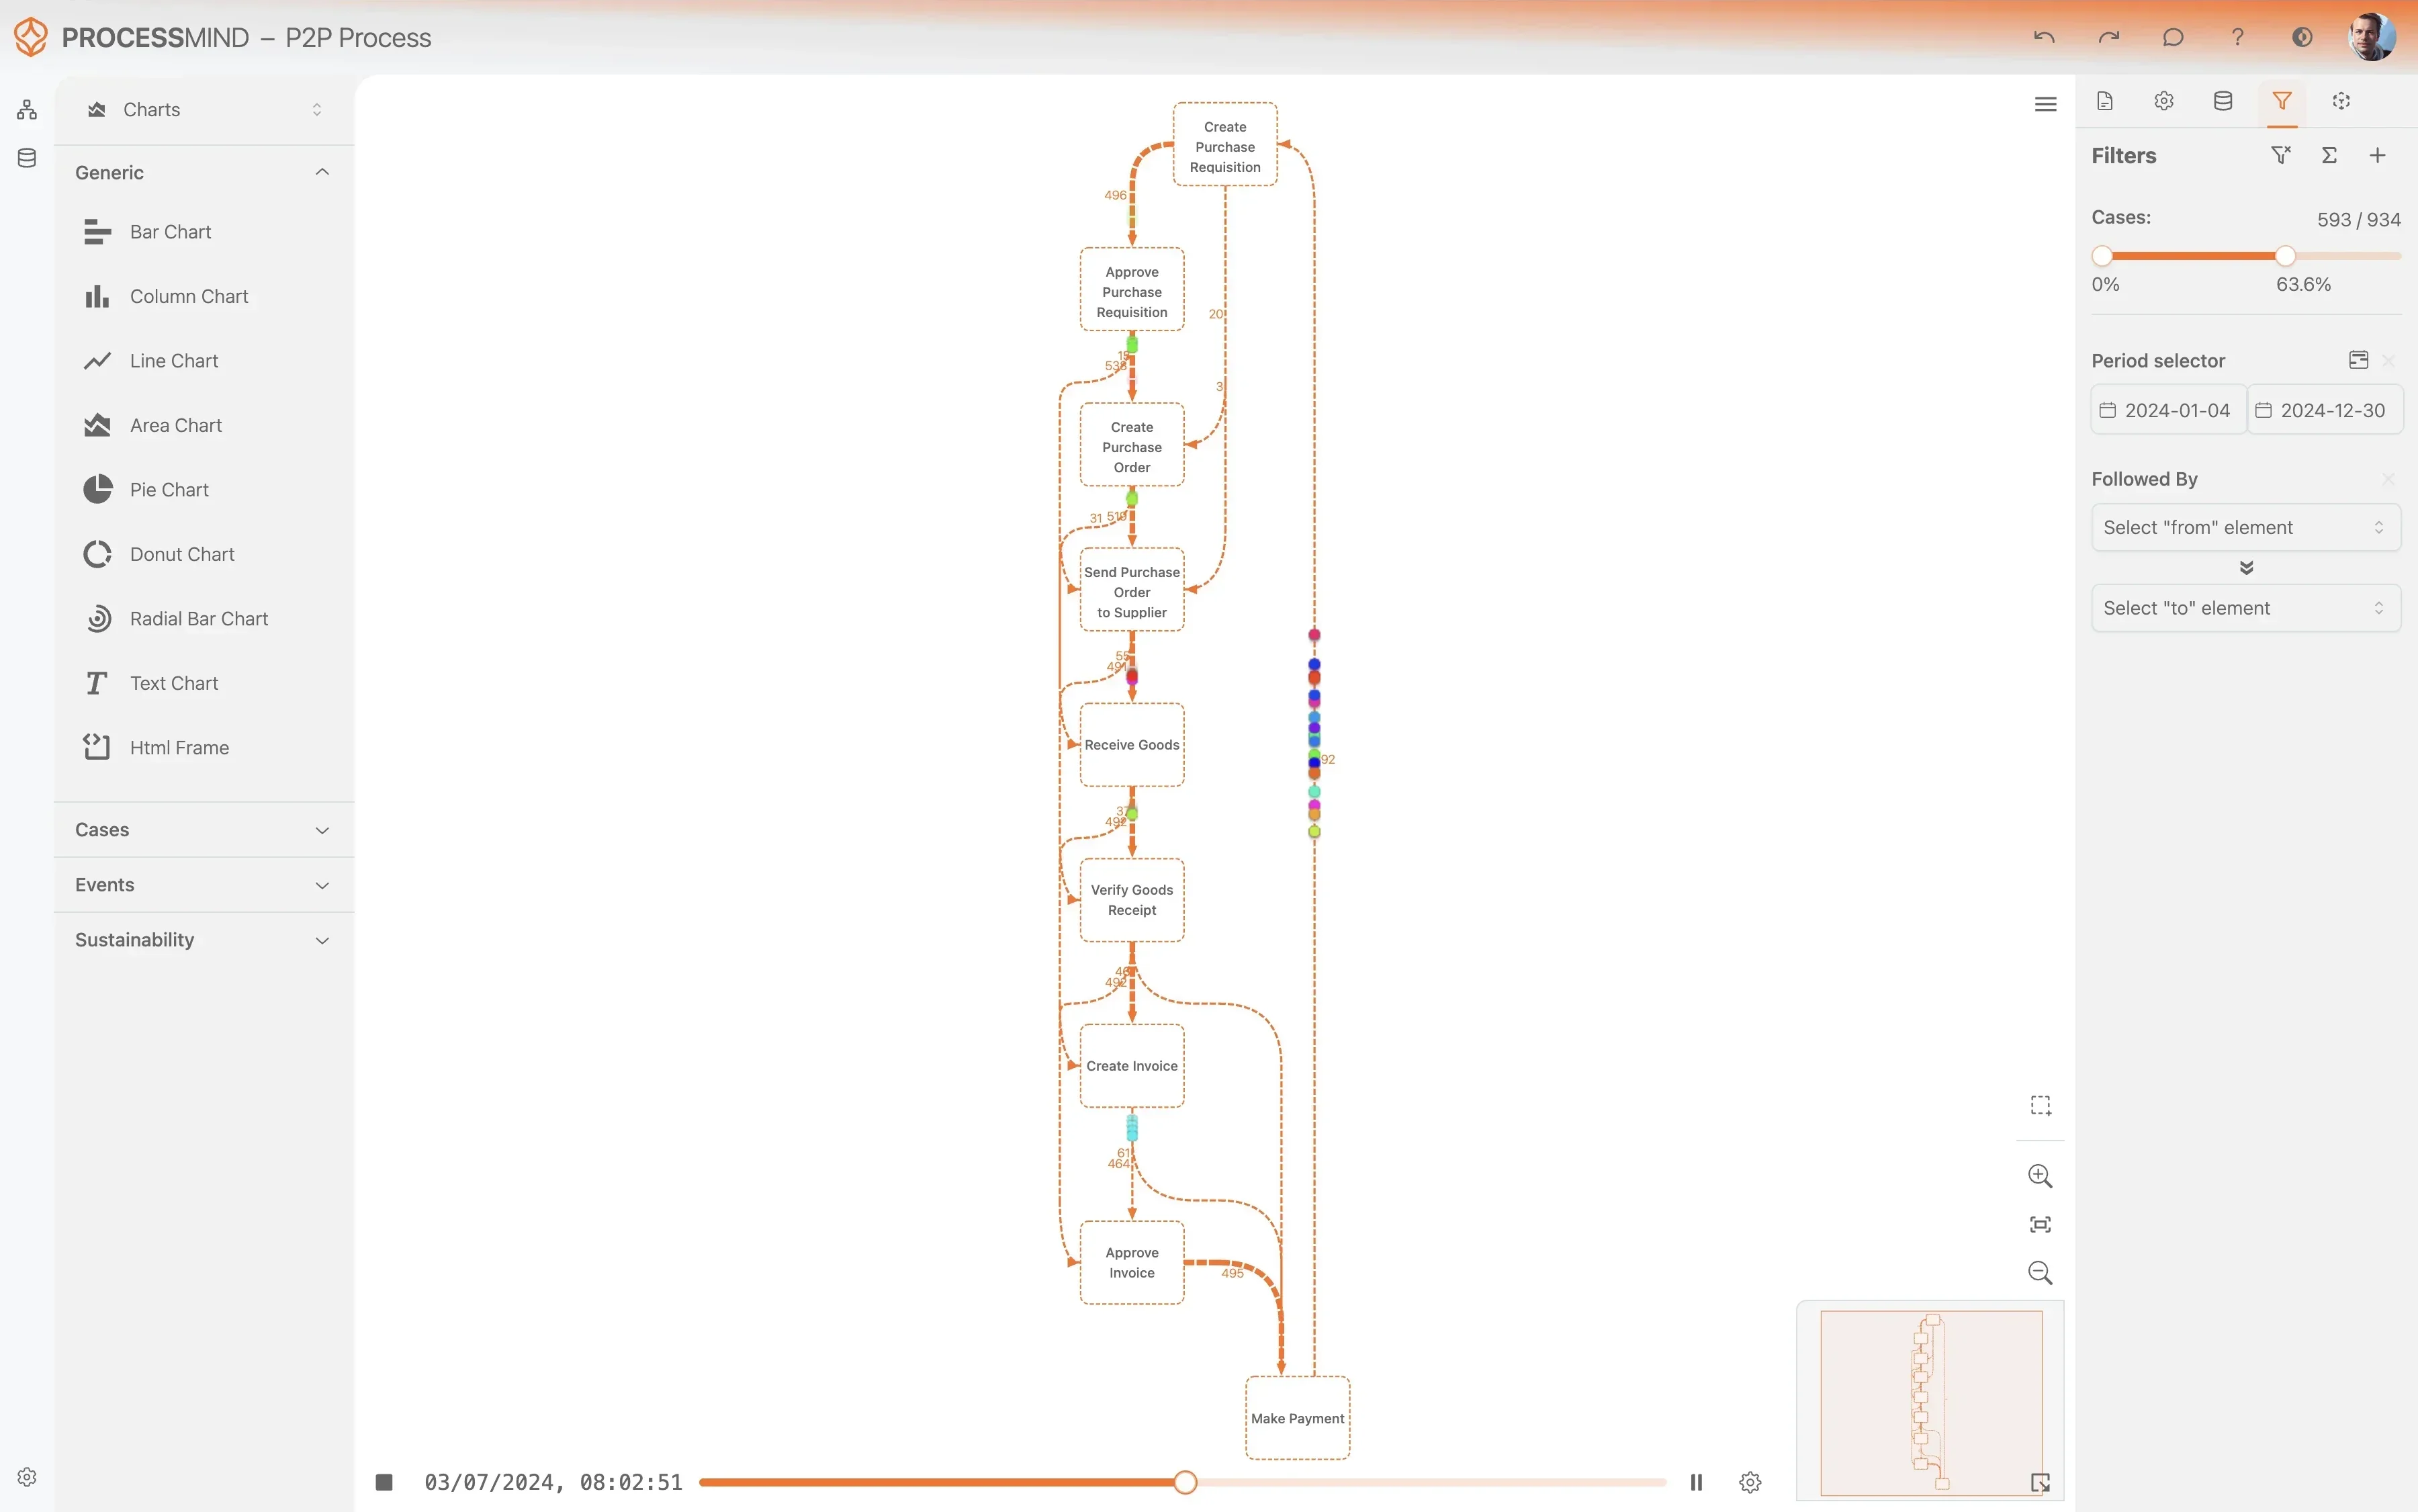
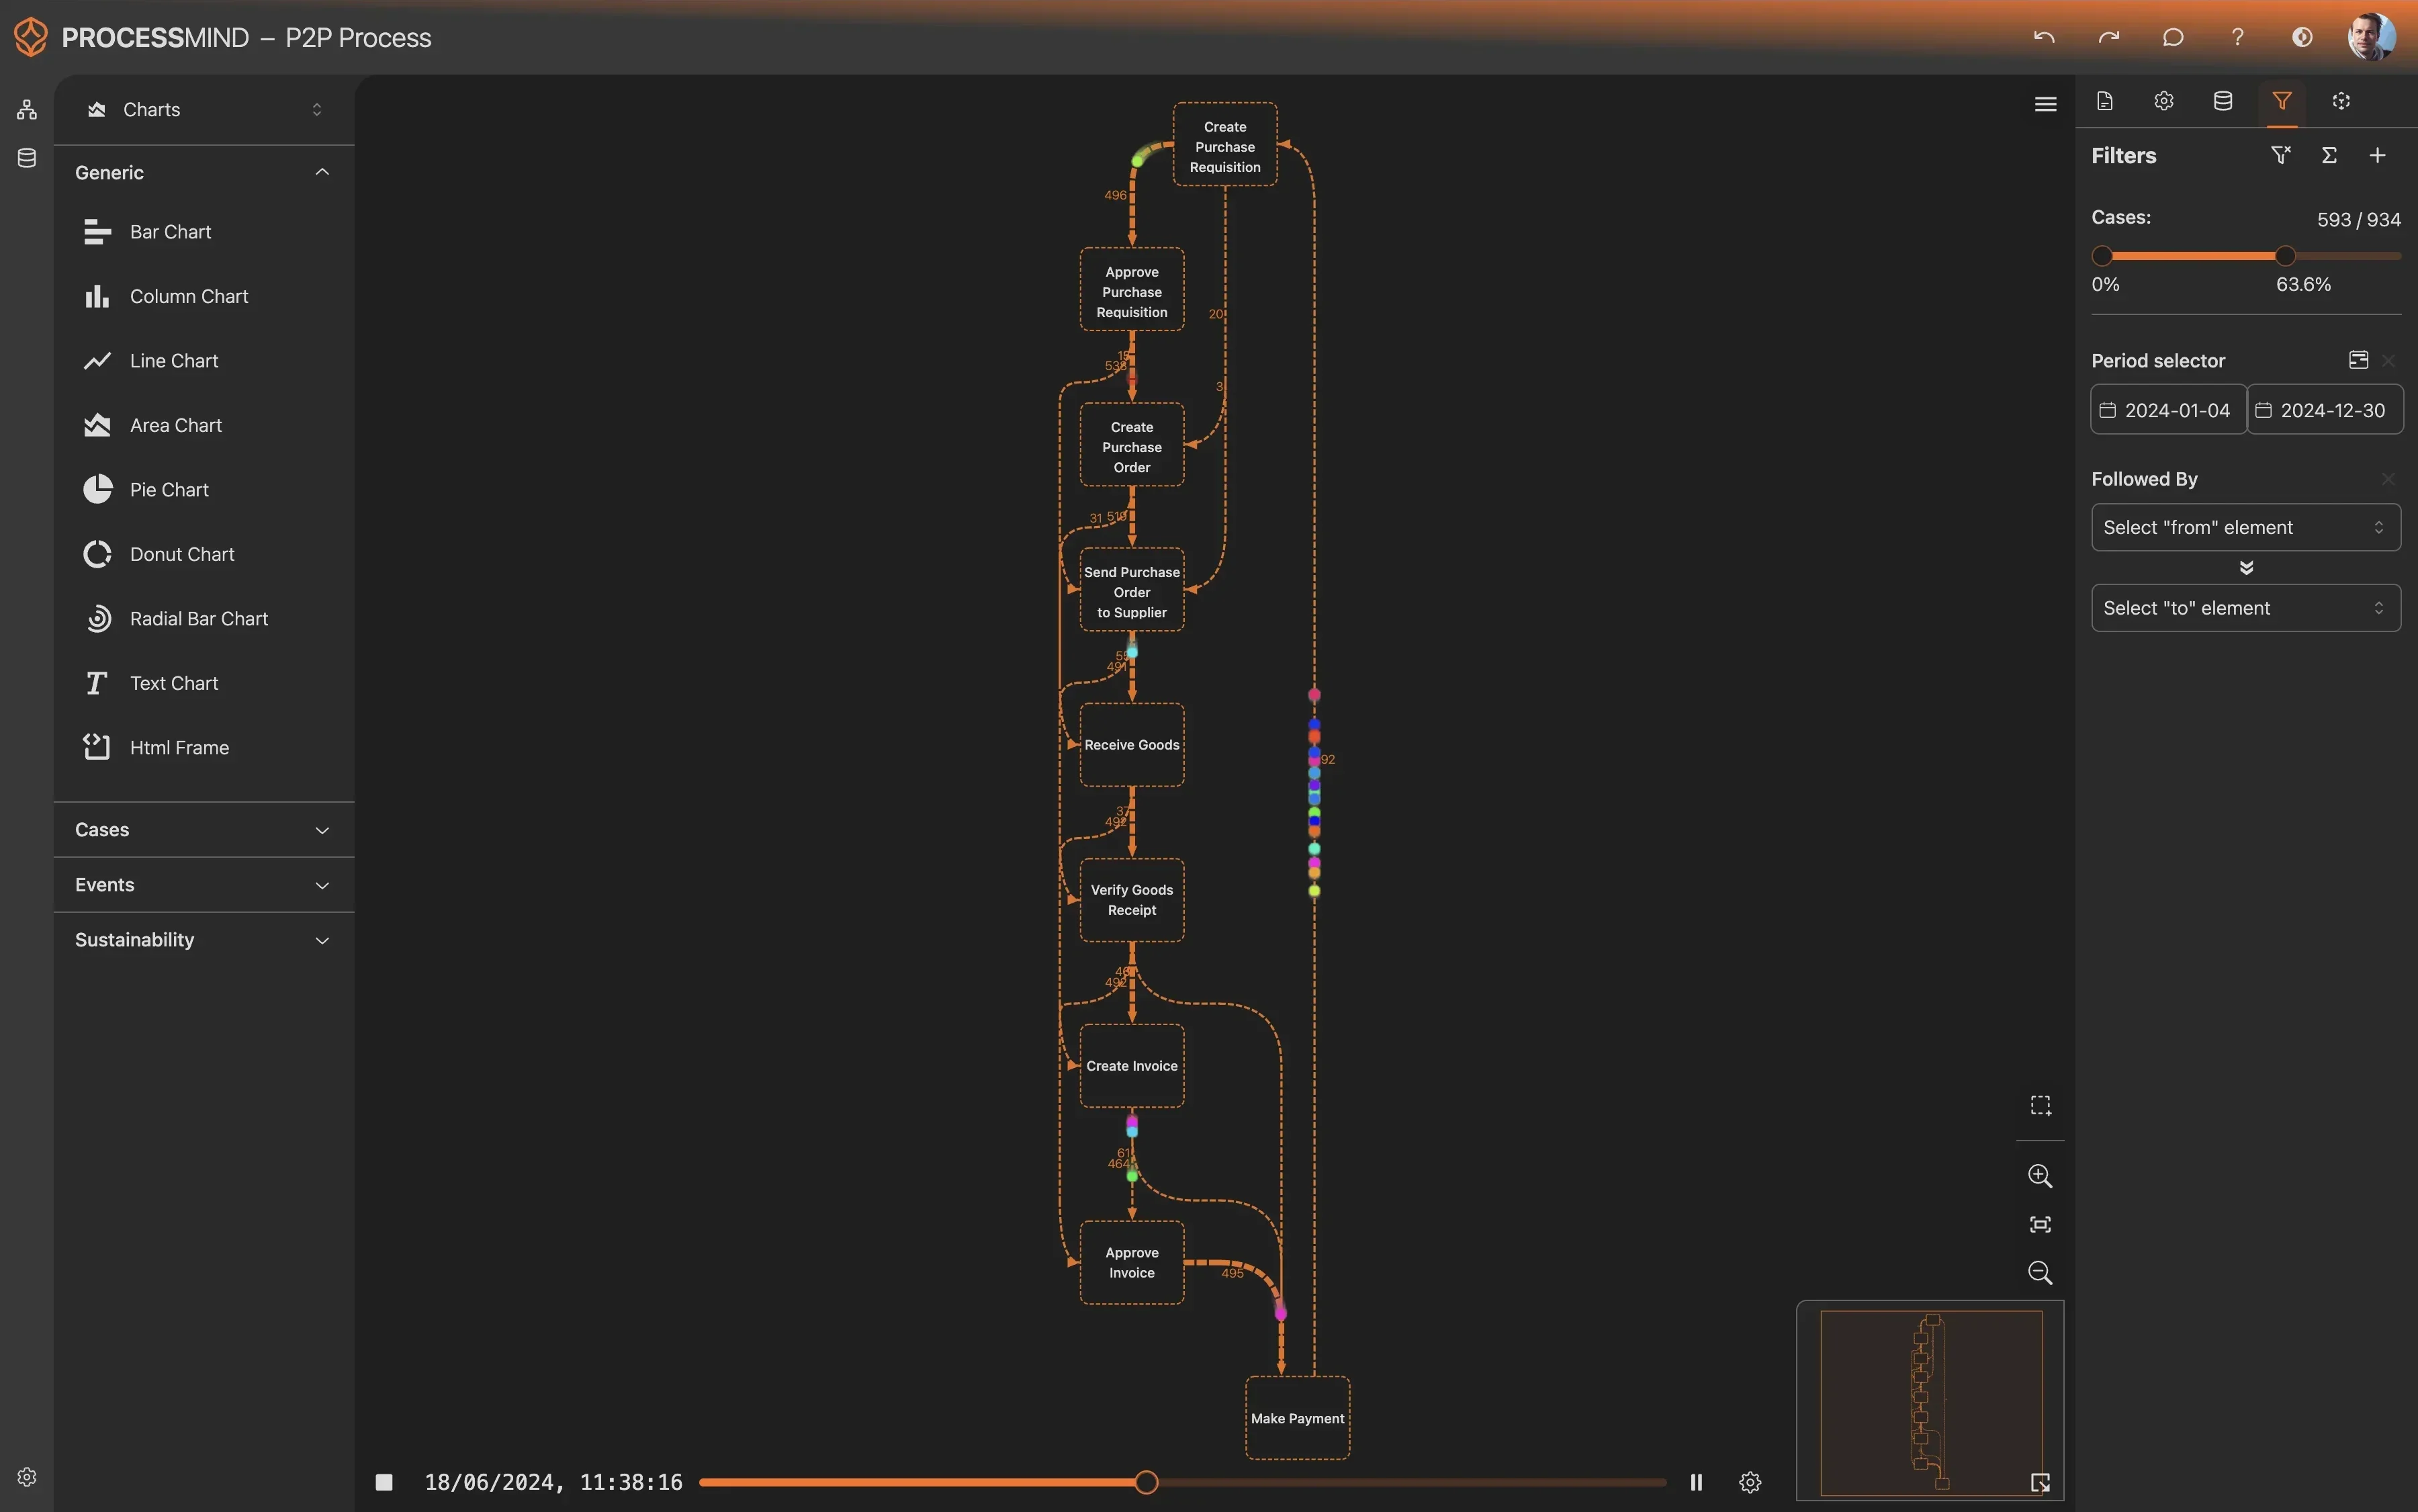
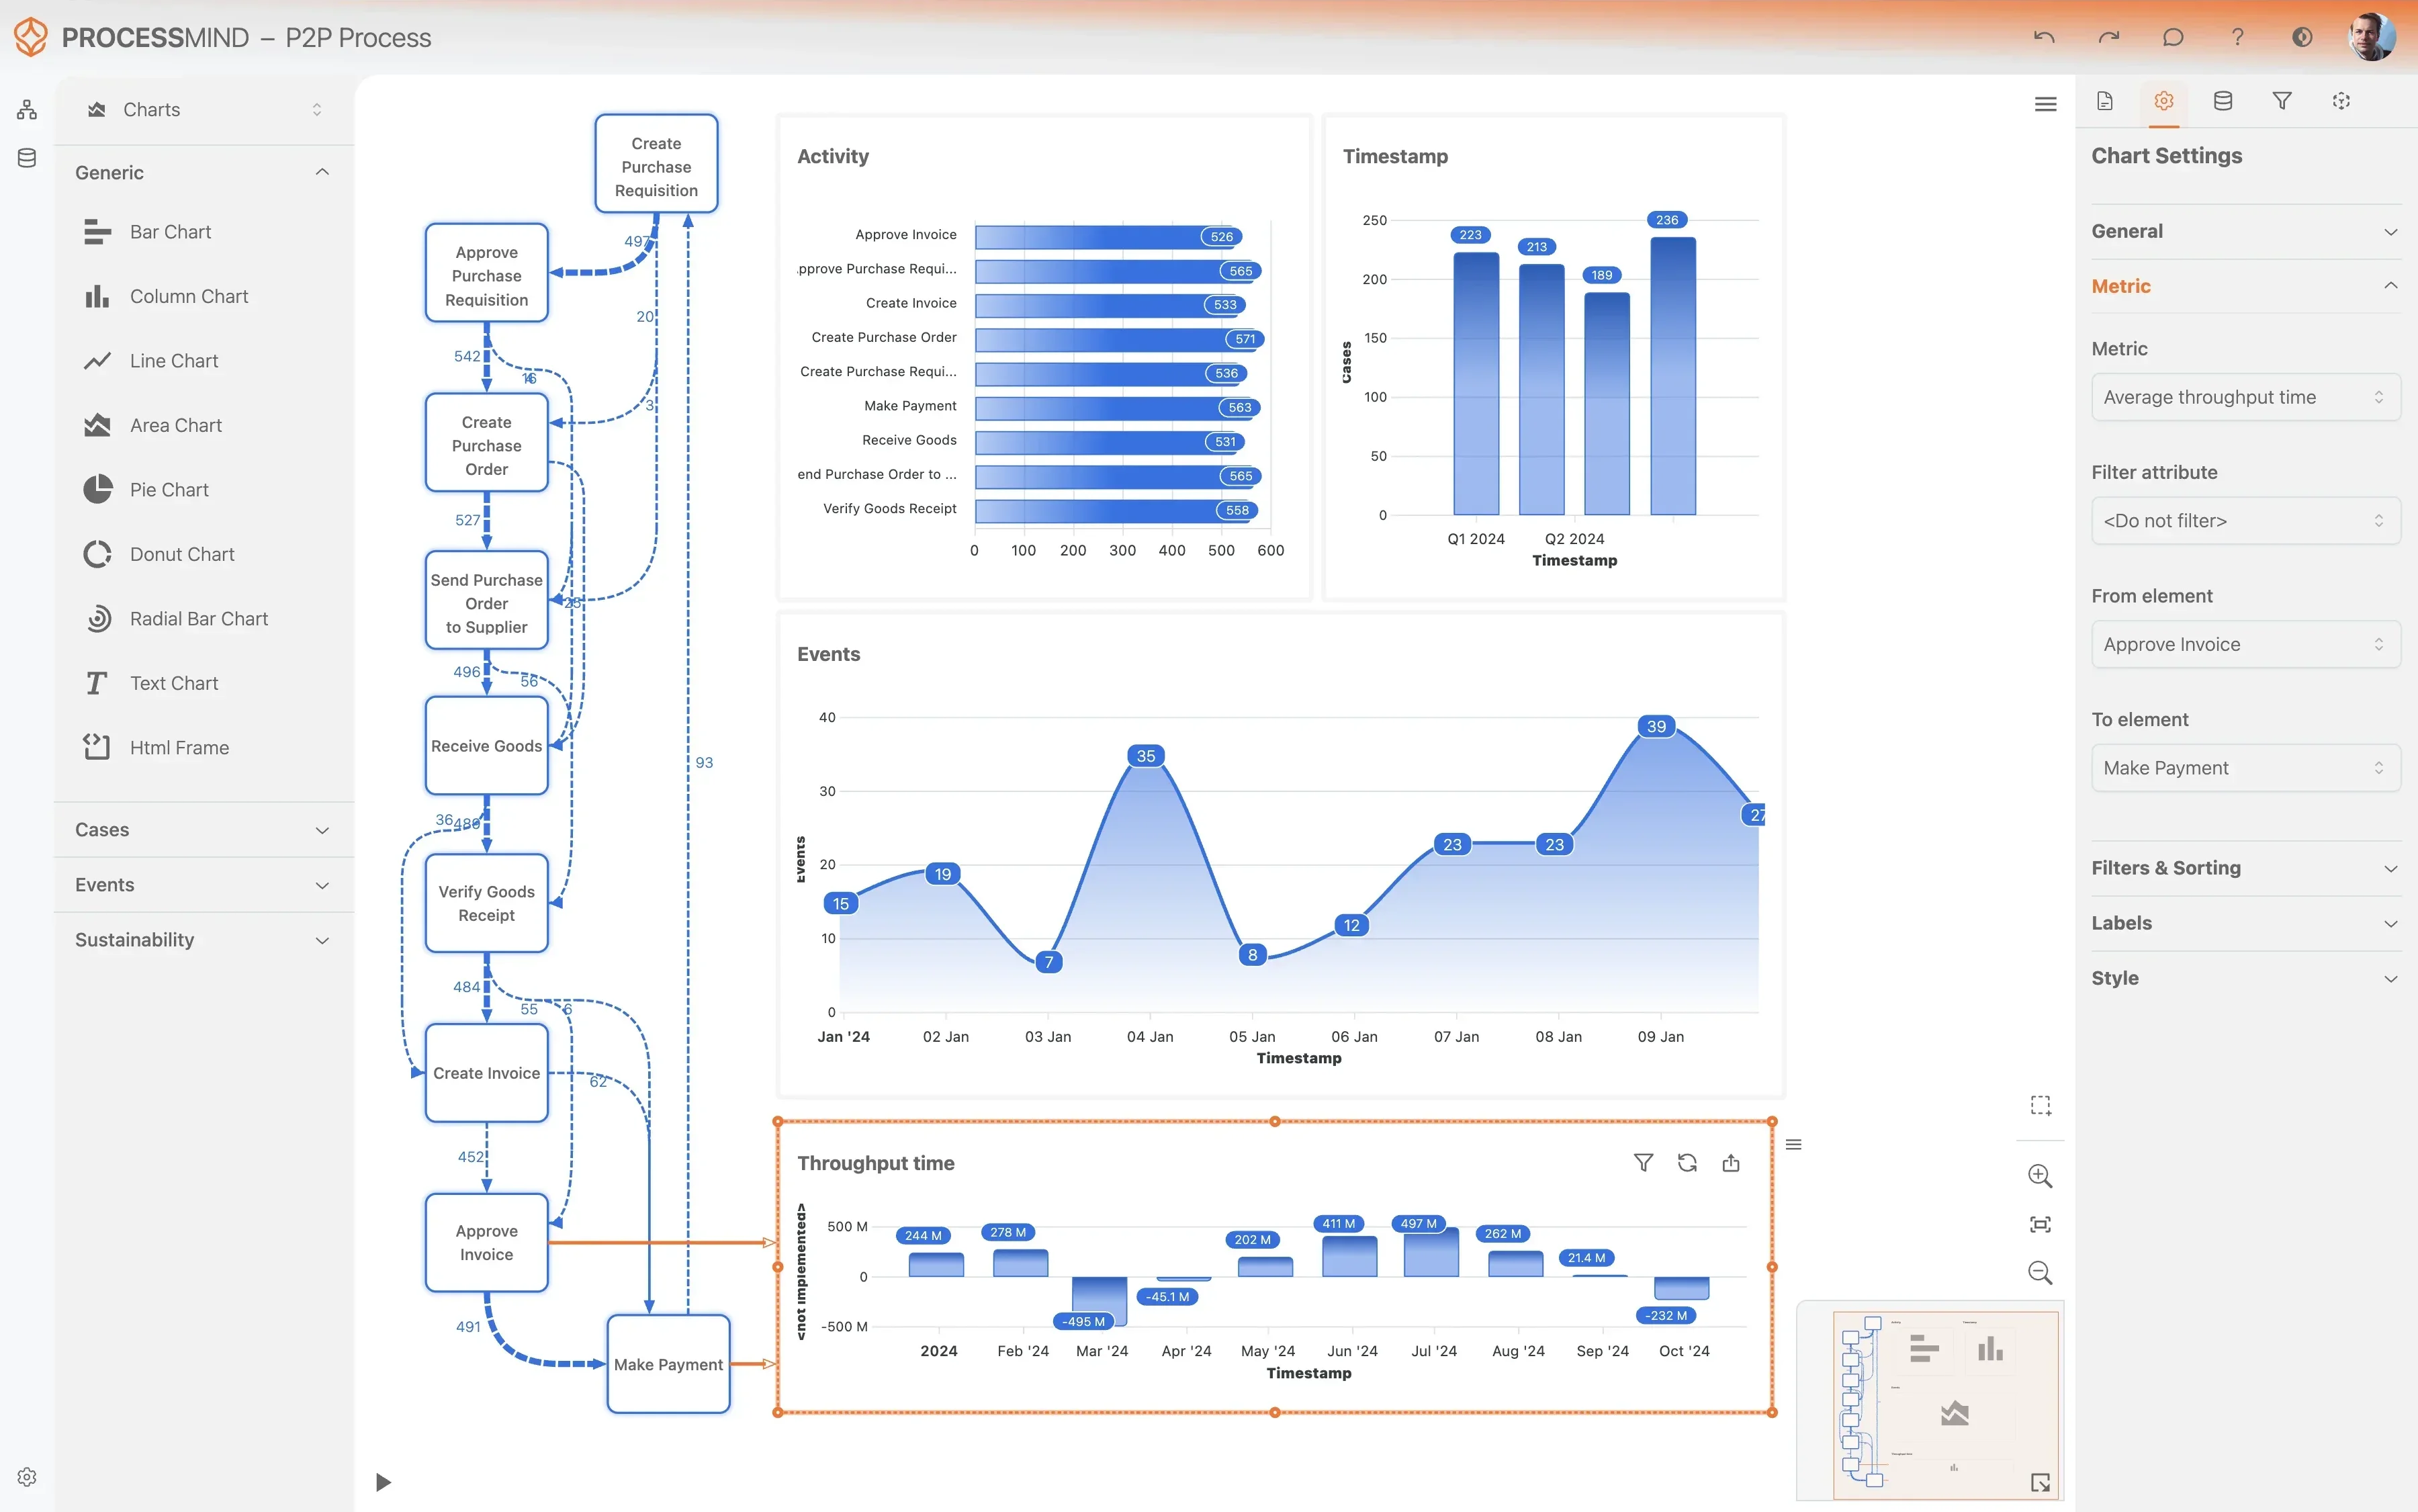
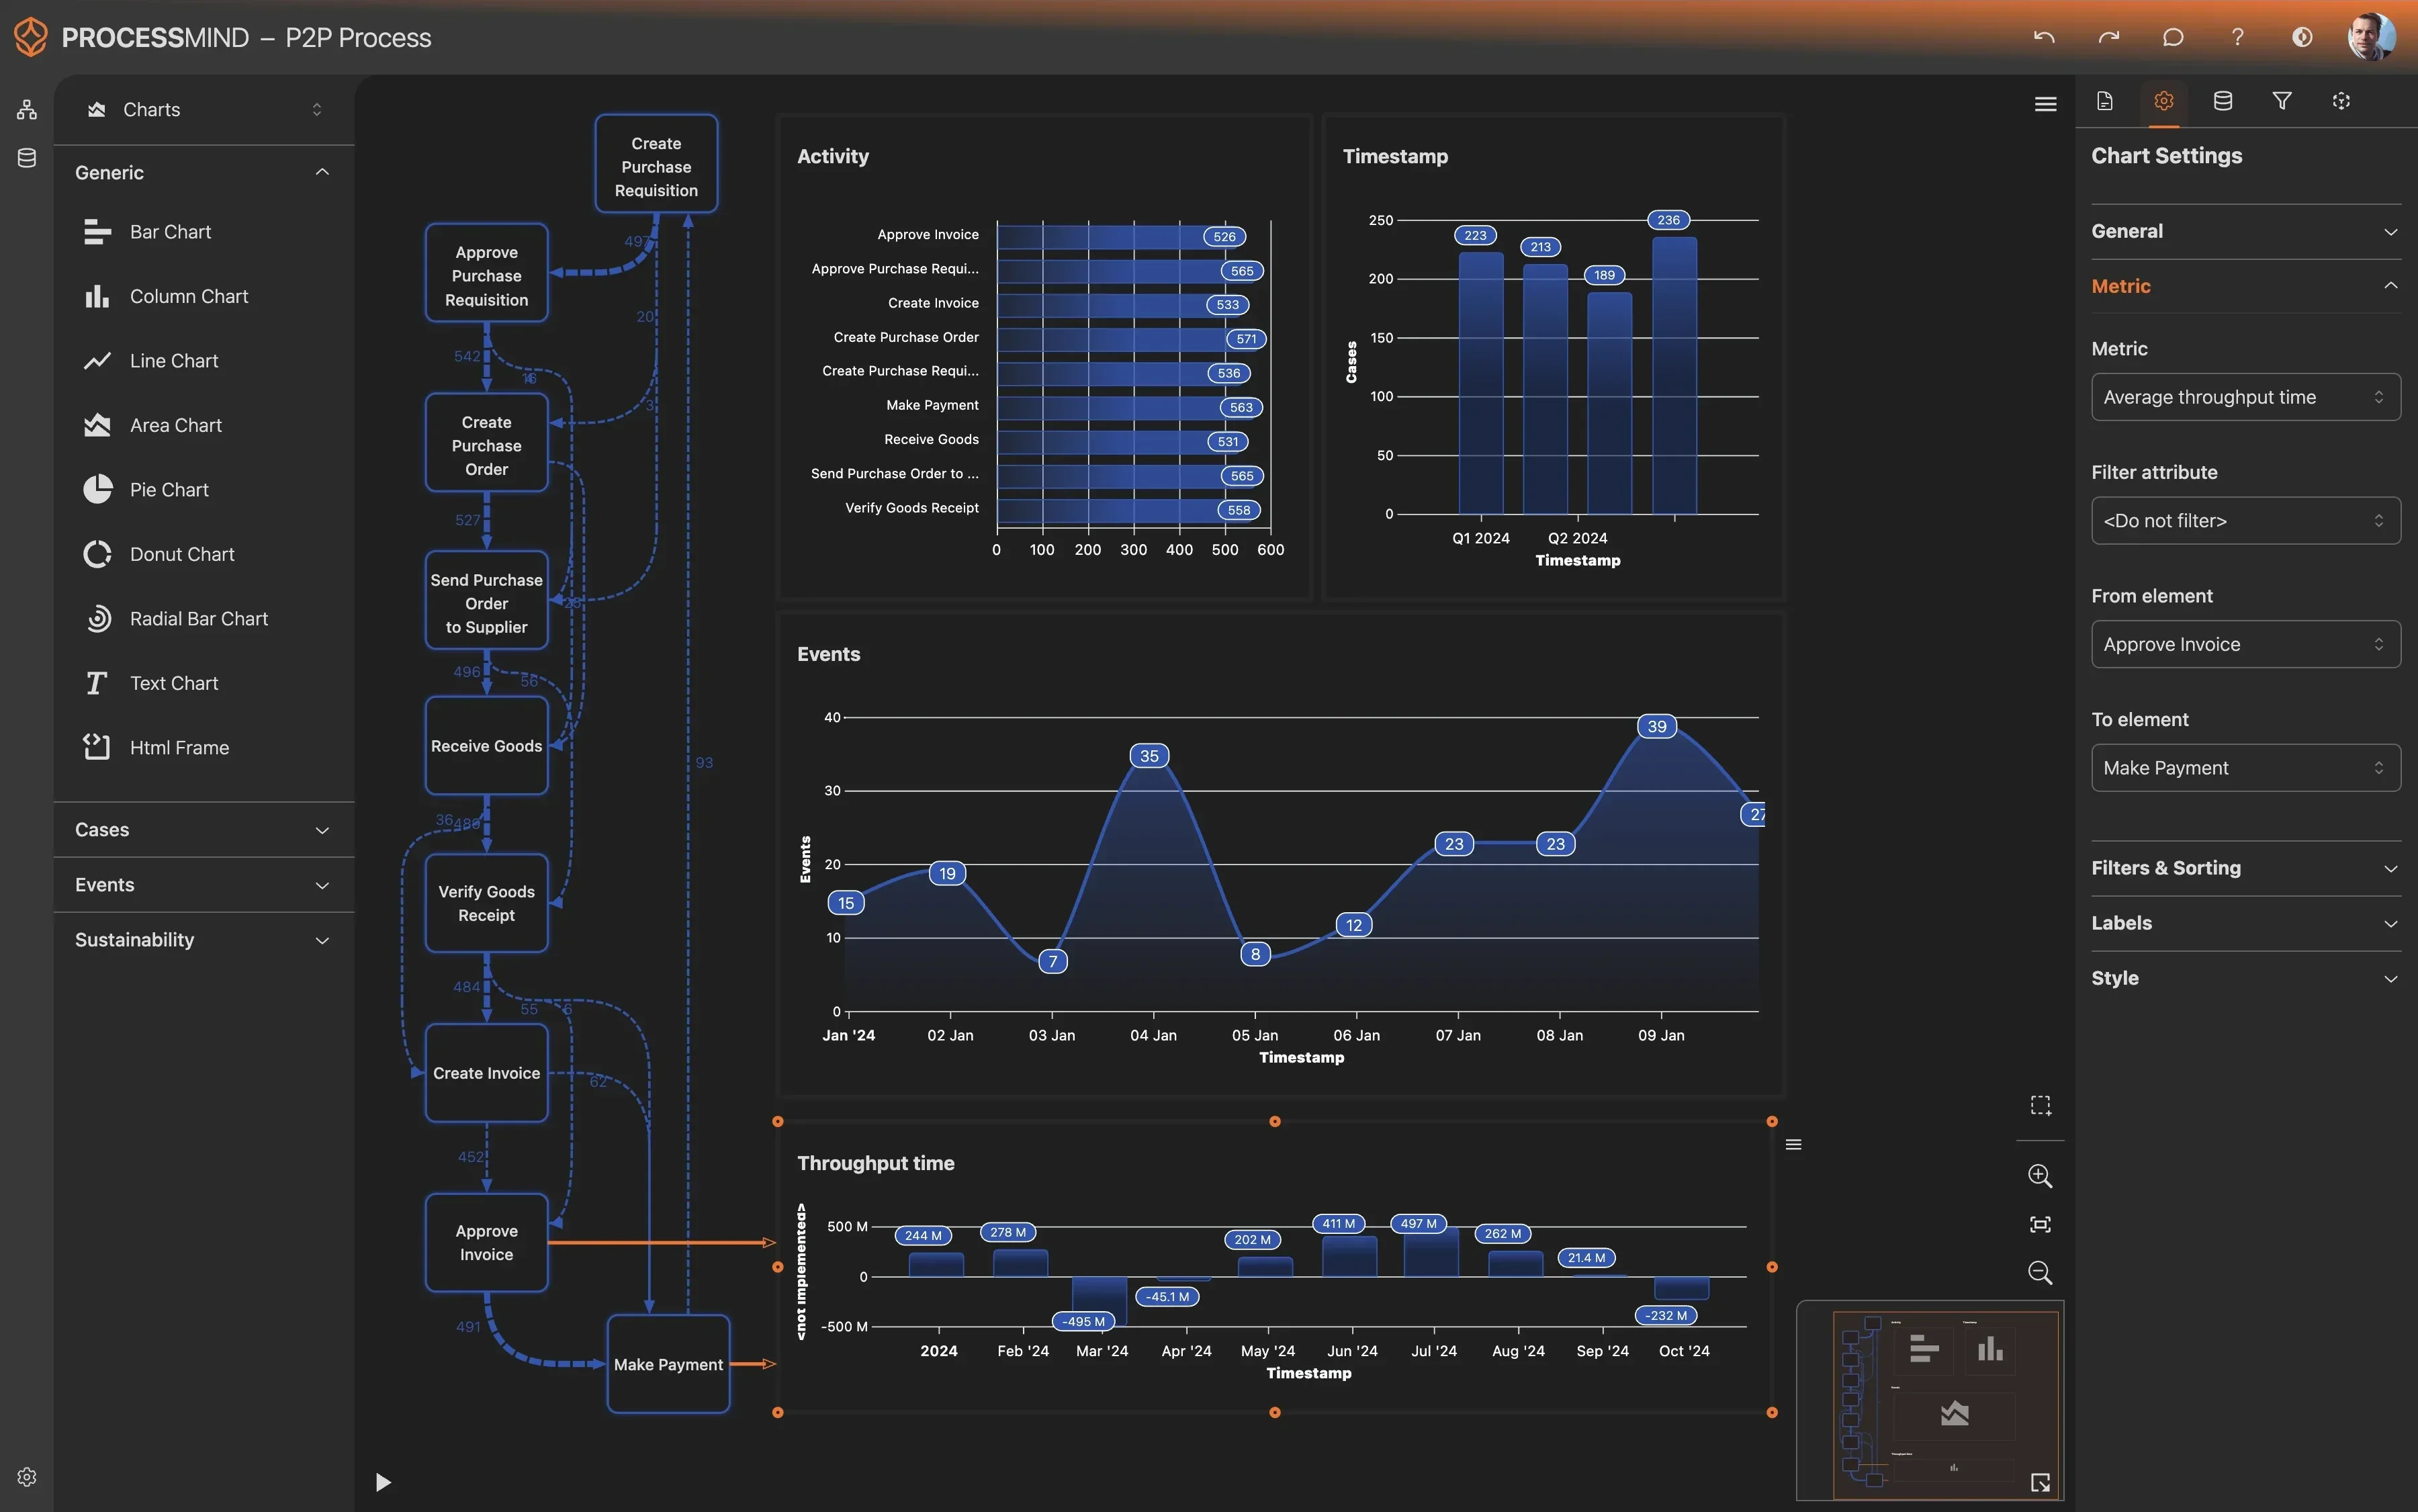
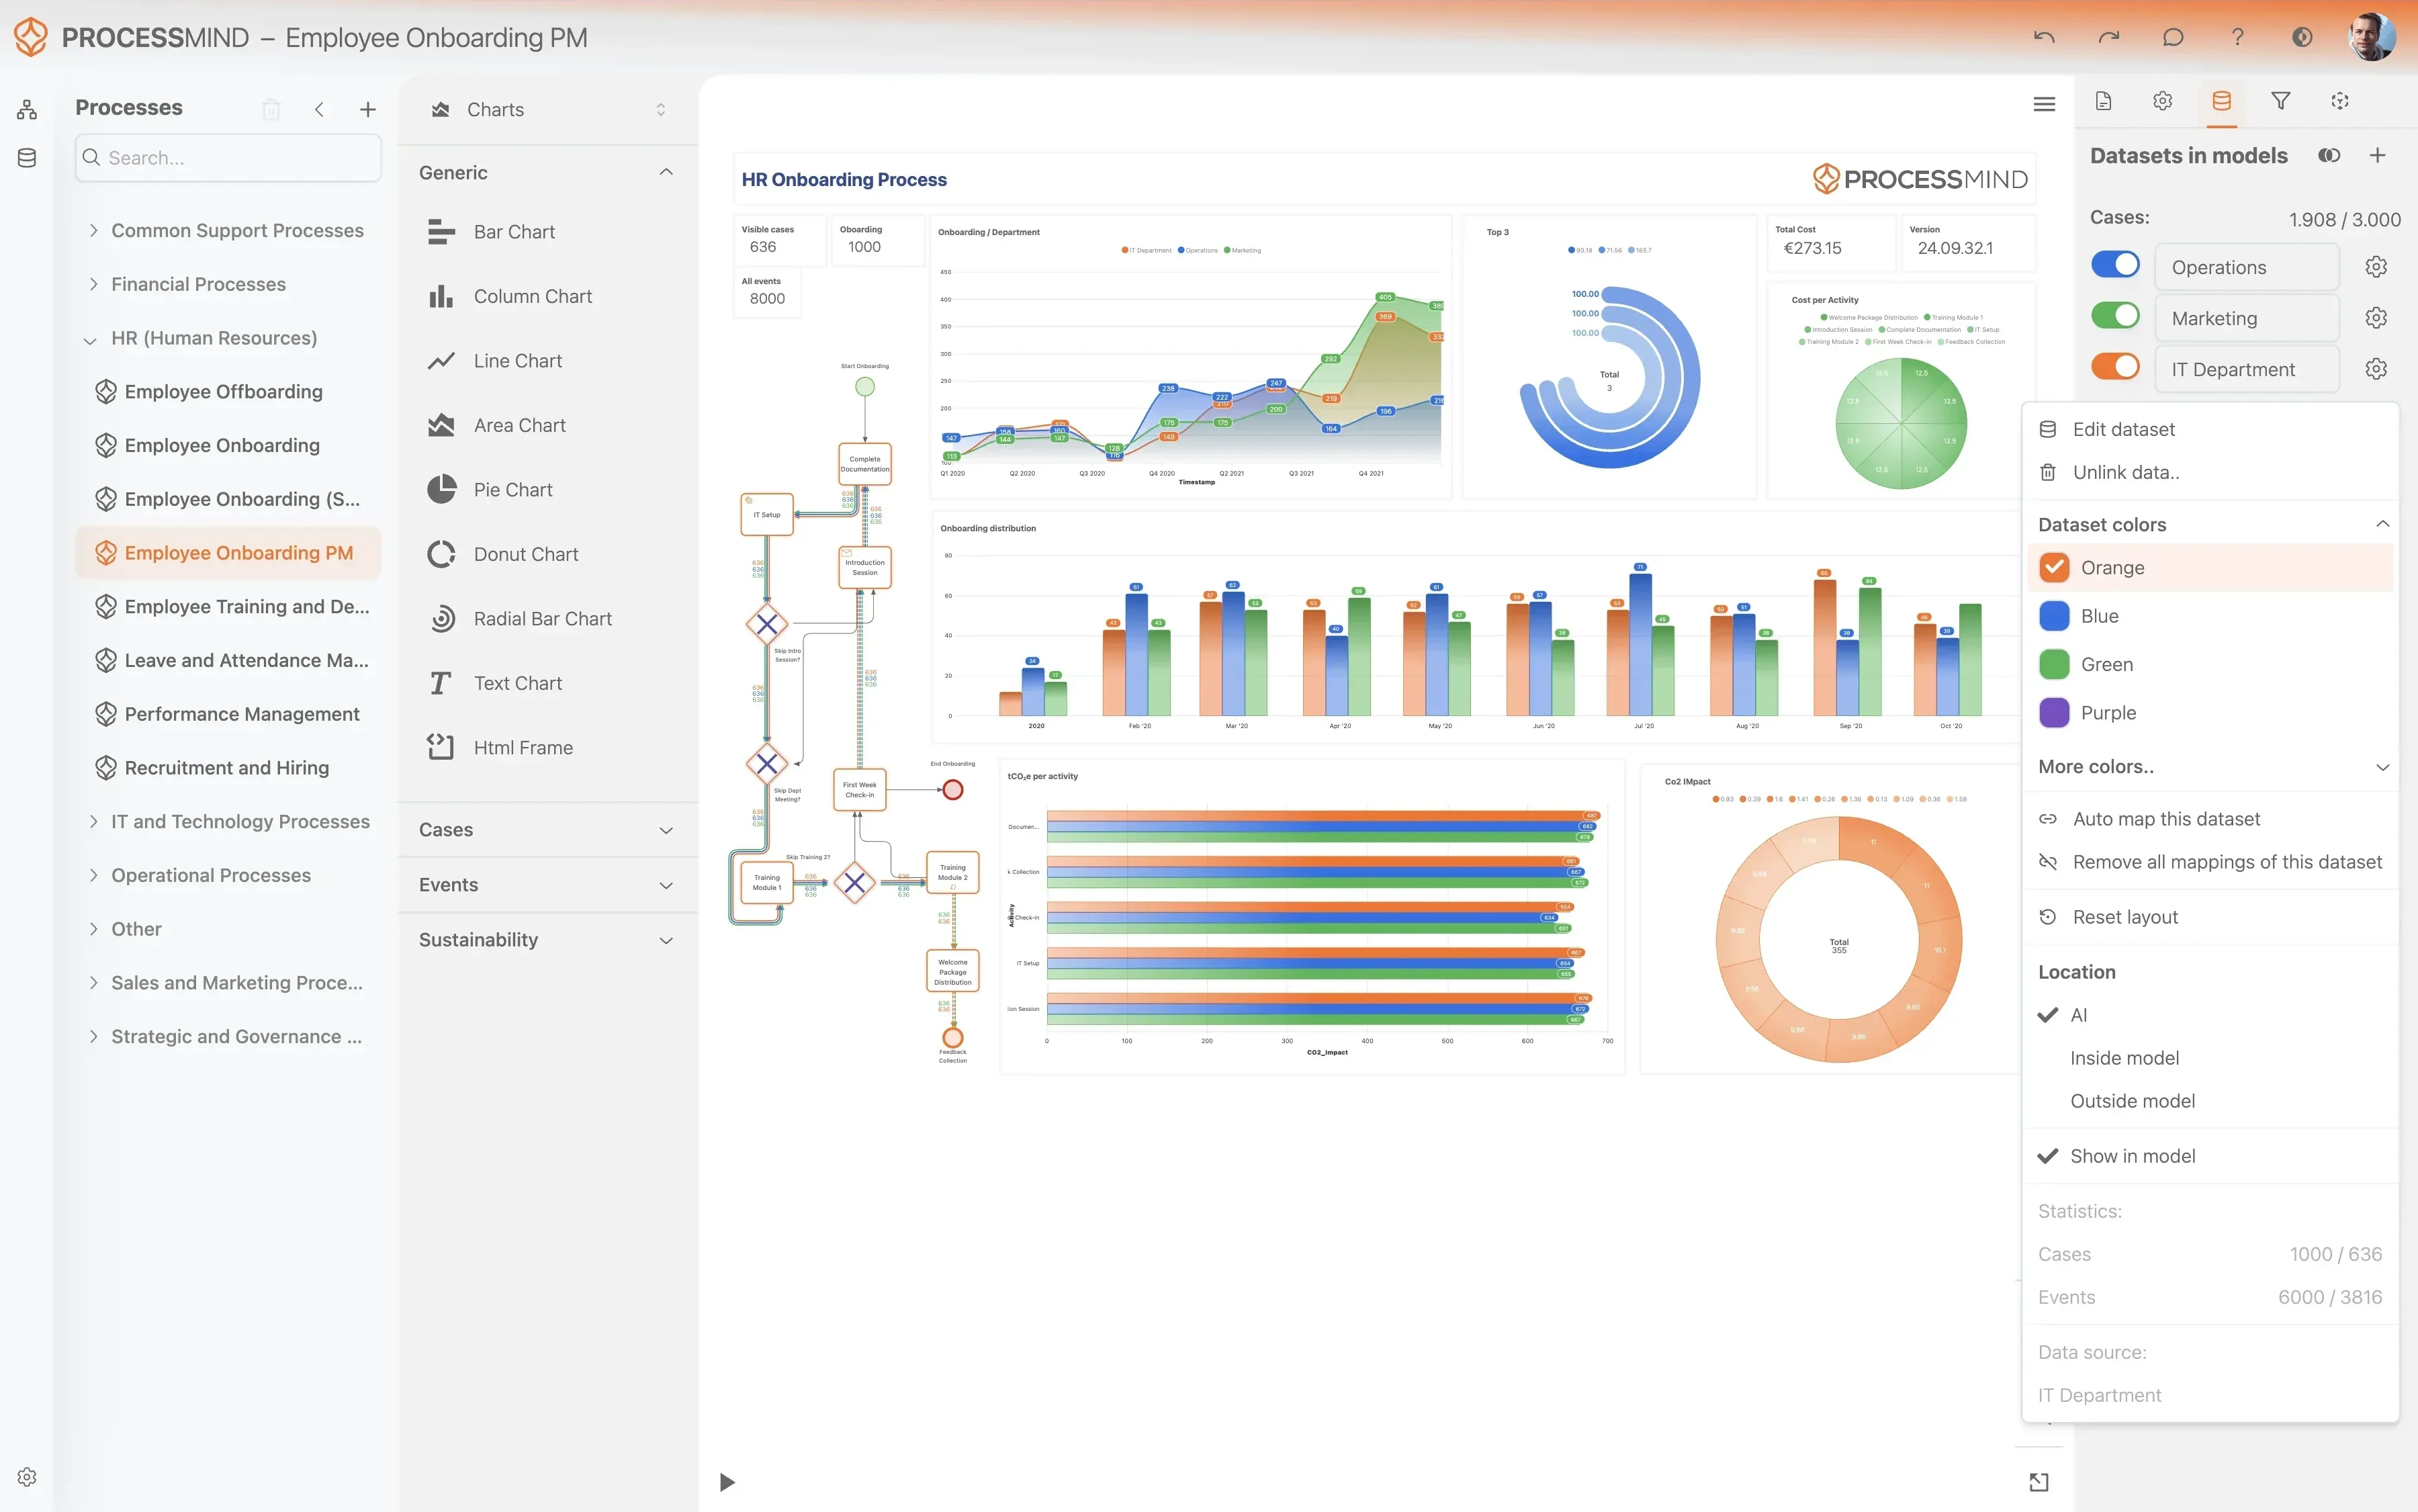
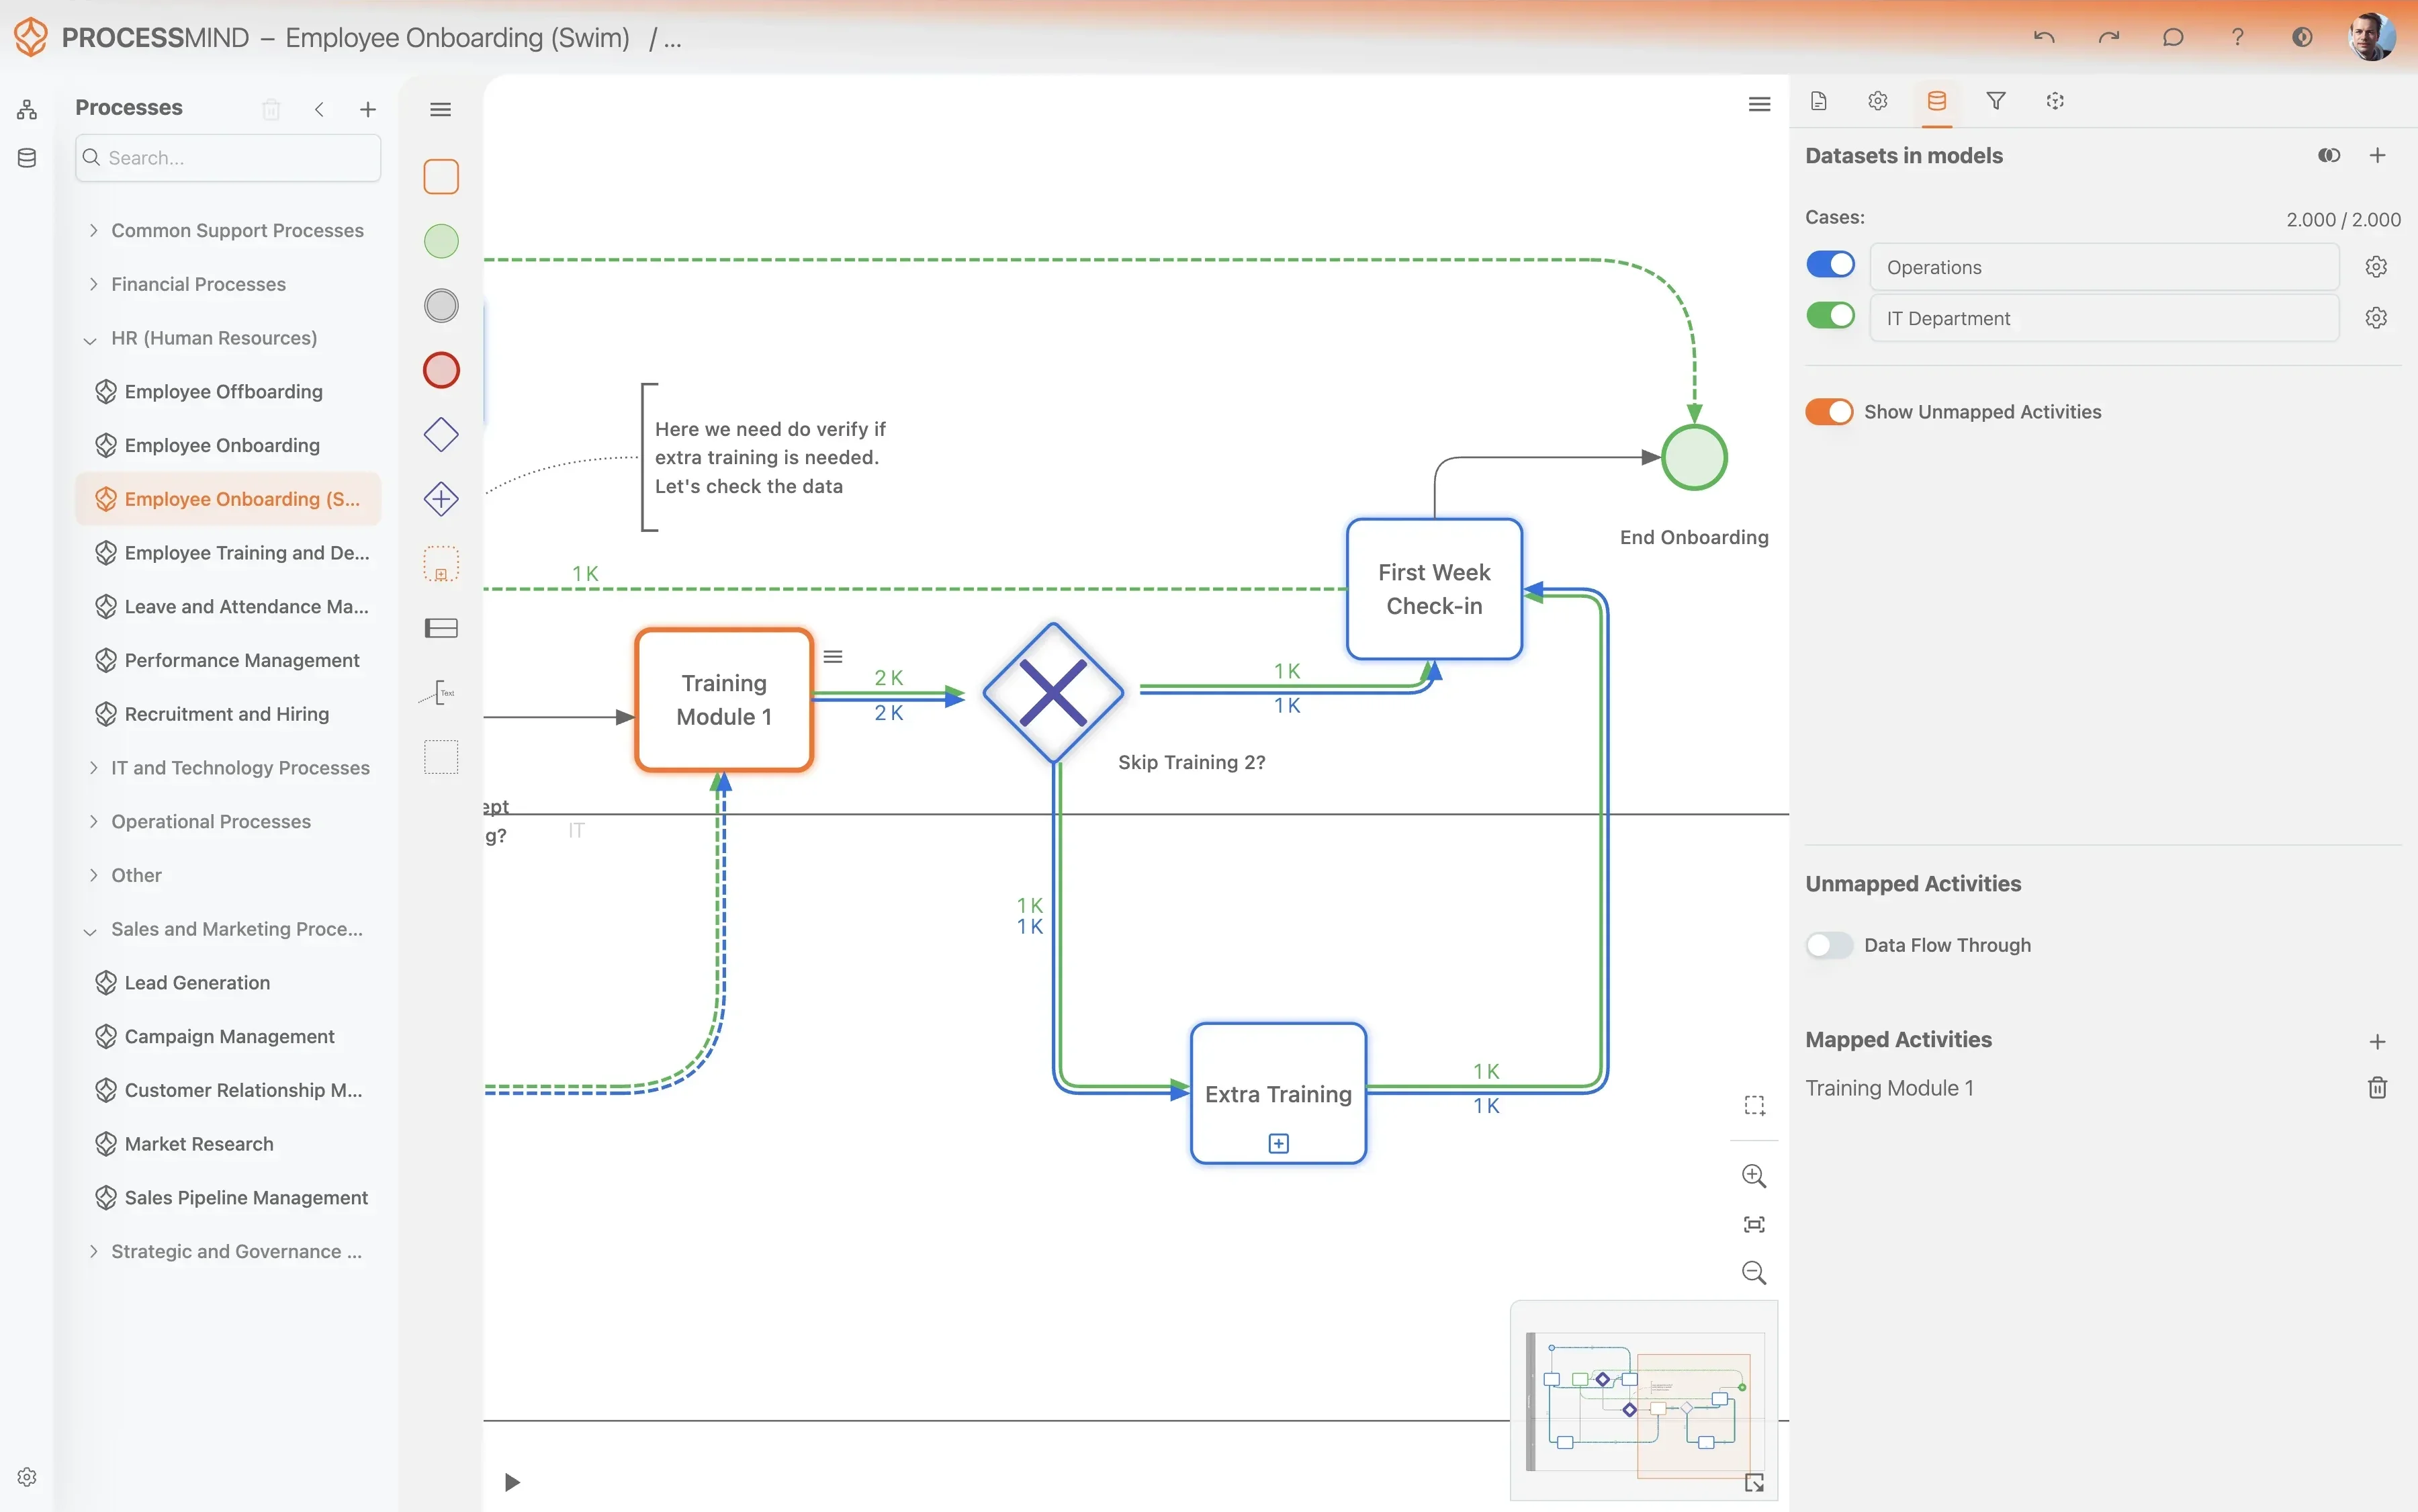
ProcessMindは、インタラクティブな可視化を通じて、Freshserviceのインシデントがたどる全体像を明らかにします。遅延の発生箇所を正確に特定し、問題のある引き継ぎを見つけ、サービスをより早く復旧するための改善機会を把握できます。
  • インシデント対応のワークフローを最初から最後まで可視化
  • Freshserviceでボトルネックとなっている箇所を特定
  • SLA違反の根本原因を特定
  • インシデントをより早く解決する方法を発見
Discover your actual process flow
Identify bottlenecks and delays
Analyze process variants
Design your optimized process

主な成果

プロセスマイニングでインシデント管理を改善

Freshserviceのインシデント管理データにプロセスマイニングを適用すると、ボトルネックや非効率が明らかになり、問題解決の進め方を見直せます。ここでは、組織が一般的に得られる具体的な改善例を紹介します。

0 %
重大なインシデントの解決を迅速化

優先度の高いインシデントの平均時間

重大なインシデントの平均解決時間を短縮し、業務やサービスへの影響を最小限に抑えます。顧客満足度とシステムの稼働時間の向上につながります。

0 %
SLA遵守率を向上

サービス目標の達成率の改善

期限未達の原因となるボトルネックを特定して取り除き、サービスレベル契約の遵守率を高めます。顧客の信頼向上とペナルティの回避につながります。

0 %
インシデントの引き継ぎを削減

チームや担当者間の転送回数を削減

サポートグループ間でインシデントを転送する回数を抑え、解決を早めるとともに運用コストを削減します。担当者の効率と対応の一貫性も高まります。

0 %
分類の精度を向上

初期分類の誤りを削減

インシデントの初期分類の精度を高め、最初から適切に振り分けることで、解決の遅れを減らします。より良いインサイトとリソース配分につながります。

0 %
再オープン率を低減

解決後に再オープンするインシデントを削減

最初のクローズ後に再オープンするインシデントの割合を減らし、初回の解決がより正確で確実であることを目指します。ユーザー満足度の向上と担当者の手戻り削減につながります。

0 %
管理コストを削減

運用支出全体を削減

インシデント管理のライフサイクル全体でリソースの使い方を最適化し、不要な手作業を減らします。組織の大幅なコスト削減に直結します。

結果は、組織ごとのプロセスの複雑さ、データ品質、既存の業務効率によって異なります。ここに示す数値は、さまざまな導入事例で見られた一般的な改善を表しています。

推奨データ

まず必要な属性とアクティビティから始め、分析を進めながら項目を追加してください。
イベントログを初めて作成する方はこちら: プロセスマイニング用イベントログの作成方法.

属性

分析に必要な主要データ項目

各インシデントの記録を一意に識別するIDです。インシデントのライフサイクル全体を追跡するための主キーとして機能します。

重要な理由

各インシデントを一意に識別し、作成から終了までのライフサイクルを最初から最後まで追跡・分析できます。

現在インシデントの解決を担当しているサポート担当者の名前またはIDです。

重要な理由

担当者のパフォーマンスや業務量の分布、担当者間の引き継ぎが解決時間に与える影響を分析できます。

現在インシデントを担当しているサポートグループまたはチームです。

重要な理由

担当チームを追跡できるため、引き継ぎやエスカレーション、チーム間の遅延を分析するうえで役立ちます。

インシデントの優先度です。応答と解決の緊急度を決定します。

重要な理由

重大なインシデントに焦点を当てた分析や、SLAパフォーマンスとリソース配分の評価に役立ちます。

インシデントの重大度です。業務への影響を示します。

重要な理由

インシデントが業務に与える影響を測定し、被害の大きい問題の抑制に焦点を当てた分析ができます。

インシデントのライフサイクルにおける現在のステータスです。「Open」「Pending」「Resolved」「Closed」などがあります。

重要な理由

インシデントのライフサイクル全体の進行状況を追跡し、遅延が起きやすい段階を特定できます。

インシデントを分類するカテゴリです。「ハードウェア」「ソフトウェア」「ネットワーク」などがあります。

重要な理由

インシデントの傾向を分析し、分類ミスが解決の遅延につながっているかを確認できます。

SLAポリシーに基づき、インシデントの解決が求められる期限のタイムスタンプです。

重要な理由

解決期限を示すため、SLAの遵守状況の算出や、期限超過のリスクがあるインシデントの特定に必要です。

アクティビティ

追跡・改善するプロセスのステップ

Freshserviceで新しいインシデント記録が作成されたことを示します。インシデントのライフサイクルの開始点で、通常はエンドユーザーがポータルやメールから報告するか、サービスデスクの担当者が代理でチケットを作成したときに発生します。このイベントには作成時刻が明示的に記録されます。

重要な理由

このアクティビティは、プロセス全体の主な開始イベントです。ここから解決までの時間を分析することは、全体のサイクルタイムとSLA遵守状況を測定するうえで基本となります。

インシデントをサポートグループに最初に割り当てたことを示します。振り分けルールによる自動割り当て、または担当者による手動割り当ての場合があります。インシデントの監査ログで「グループ」フィールドに最初に値が設定された記録を追跡して取得します。

重要な理由

割り当てを追跡すると、初回応答時間を測定し、振り分けプロセスのボトルネックを特定できます。インシデントが適切なチームにどれだけ効率よく振り分けられているかを分析するのに役立ちます。

インシデントの優先度が設定または更新されたときに発生します。優先度は、解決の緊急度とSLA目標を決定します。インシデント履歴の「優先度」フィールドの変更を監視して取得します。

重要な理由

優先度の設定が誤っていたり遅れたりすると、SLA違反や非効率なリソース配分につながる可能性があります。このアクティビティを分析することで、重大なインシデントにすぐ対応できているかを確認できます。

インシデントの調査と対応を正式に開始したことを示します。担当者がインシデントのステータスを「対応中」に変更したときに記録されます。チケットのアクティビティ履歴に記録される標準的なステータス変更です。

重要な理由

この節目により、待ち時間と実際の作業時間を区別できます。インシデントが「対応中」の状態にとどまる時間を分析すると、解決に必要な作業を把握できます。

担当者が解決メモを追加し、インシデントの解決策を文書化したときに発生します。Freshserviceでは、ステータスを「解決済み」に変更する前に行う個別の操作です。この操作と内容は明示的に記録されます。

重要な理由

解決策が特定されたことを示します。この時点から「インシデントを解決済みにする」までの時間は、社内レビューや文書化にかかる負荷を示す場合があります。

担当者が修正を実施し、インシデントを解決済みと判断した時点を示します。インシデントのステータスが「解決済み」に変更されたときに記録されます。Freshserviceでは、SLAの計測を停止する重要な節目です。

重要な理由

解決までの時間(TTR)を測定する重要な節目です。「解決済み」から「クローズ」までの期間を分析すると、ユーザー確認の遅れや自動クローズのルールを把握できます。

インシデントの記録を正式に終了したことを示します。通常は「Resolved」の状態が一定期間続いた後に自動で終了しますが、担当者が手動で終了することもできます。このイベントをもって、インシデントのライフサイクルが終了します。

重要な理由

このアクティビティは、プロセスの明確な終点です。このイベントまでの合計時間は、ユーザーの確認待ち期間を含む、インシデントのライフサイクル全体の所要時間を表します。

よくある質問

よくある質問

プロセスマイニングは、インシデントの作成から解決までのライフサイクルにおけるボトルネック、コンプライアンス違反、非効率を特定します。実際のプロセスフローを可視化し、解決時間の長期化、頻繁な再割り当て、待ち時間など、改善が必要な箇所を明らかにします。これにより、インシデントが実際にどのように管理されているかを把握できます。想定された経路からの逸脱を示すことで、対象を絞った改善と、より良いサービスの提供につなげられます。

通常は、インシデントIDなどのケース識別子、アクティビティの説明、各手順のタイムスタンプを含むインシデントログが必要です。担当者、割り当てグループ、インシデント分類、優先度などの属性を加えると、分析をさらに充実させられます。有意義なインサイトを得るには、データが完全で正確であることが大切です。

重大なインシデントの解決迅速化、サービスレベル契約の遵守向上、インシデントの引き継ぎ効率化が期待できます。また、インシデント分類の精度向上、根本原因分析の強化、エスカレーションの標準化にも役立ちます。最終的には、インシデント管理コストの削減とユーザー体験の向上につながります。

はい。プロセスマイニングでは、インシデントがたどった経路を詳しく追跡し、SLA違反につながるアクティビティや順序を明らかにできます。複数回の再割り当て、長い待ち時間、承認されていない回避策など、遅延が発生した箇所を示します。これにより、SLA未達の根本原因を特定し、改善に向けた対策を実施できます。

最初に、Freshserviceから関連するイベントログデータを特定して抽出します。通常は、インシデントID、各アクティビティのタイムスタンプ、手順ごとの明確なアクティビティの説明が含まれます。正確で有意義なプロセス分析を行うには、抽出したデータの品質と完全性を確保することが欠かせません。

いいえ。プロセスマイニングは、プロセスの複雑さにかかわらず、プロセスの最適化を目指すあらゆる規模の組織に役立ちます。小規模なチームでも、インシデント管理のパフォーマンスに関する具体的なインサイトを得られます。これまで見えにくかった効率化の余地や、プロセスの遵守状況を把握できます。

データの抽出とモデルの設定が完了すれば、数週間以内に初期インサイトを得て、プロセスのボトルネックを見つけられることがよくあります。詳細な分析や改善策の実施、その効果測定には数か月かかる場合があります。期間は、インシデント管理プロセスの複雑さや利用できるリソースによって異なります。

Freshserviceのデータに加えて、クラウド型またはオンプレミス型のプロセスマイニングツールが必要です。多くの最新ツールは使いやすいインターフェースを備えているため、通常、操作に特別なコーディングスキルは必要ありません。ただし、Freshserviceの生のデータを分析用に整えるため、初期段階でデータ変換やスクリプト作成が必要になる場合があります。

担当者ごとのインシデント対応パターンを分析することで、パフォーマンスや標準業務手順の遵守状況の違いを明らかにできます。パフォーマンスの高い担当者の優れた対応方法を特定し、ほかの担当者にトレーニングや明確なプロセスガイダンスが必要な領域を把握できます。これにより、対象を絞った指導と一貫したサービス提供が可能になります。

SLA違反を防ぐ:今日からインシデント管理を改善

MTTRを35%短縮し、コストのかかるSLA違反を防いでいる企業に続きましょう。

無料トライアルを開始しましょう。

14日間無料でお試しいただけます。クレジットカードは不要です。