データの増分読み込み
データの増分読み込みとは
増分読み込み(差分読み込みとも呼ばれます)を使うと、元のデータを置き換えずに、既存のデータテーブルへ新しい行を追加できます。イベントログのデータが時間とともに増える場合、データセット全体を再アップロードせずにプロセスマイニング分析を最新の状態に保てます。
よくある利用例:
- 日次または週次のデータエクスポート:新しいデータが用意できたら、取引、注文、ケースを追加します。
- 継続的なプロセス監視:定期的に新しいデータを追加し、ダッシュボードを最新の状態に保ちます。
- 増え続けるイベントログ:ERPシステム、CRMツール、その他のデータソースから新しいイベントを順次追加します。
info
差分ファイルは、元のアップロードと同じ列構成(列名と順序)にする必要があります。差分ファイルに余分な列があっても無視されます。列が不足している場合、その値はnullになります。
要件
- データテーブルにデータを読み込んだ初回アップロードが完了している必要があります。
- 差分ファイルは、元のアップロードと同じ形式である必要があります。
- CSVファイルにはCSV形式の差分ファイルが必要です。
- ParquetファイルにはParquet形式の差分ファイルが必要です。
- ORCファイルにはORC形式の差分ファイルが必要です。
- JSONLファイルにはJSONL形式の差分ファイルが必要です。
- Excel(XLSX/XLS/XLSB)とXESファイルは差分アップロードに対応していません。先にCSV形式に変換してください。
- 差分ファイルの列名は、元のアップロードと一致させてください。
- 差分ファイルはgzipで圧縮できます(
.gz)。ただし、圧縮ファイル内の形式は元のアップロードと同じにしてください。
info
対応するファイル形式の一覧は、対応データ形式のページを参照してください。
増分データのアップロード
APIを使う
ProcessMind APIを使うと、差分ファイルをプログラムからアップロードできます。エンドポイントの詳細は、APIリファレンス:データのページを参照してください。
手順は次のとおりです。
-
差分アップロード用の署名付きURLを取得する:
GET /v1/tenant/{tenantId}/datatables/{dataTableId}/uploads/presigned-url ?delta=true&filename=delta.csv&filesize=1024&filelastmodified=1704067200000 -
署名付きURLを使って差分ファイルをアップロードする:
curl -X PUT --upload-file "delta.csv" \
    -H "Content-Type: text/csv" \
    "{PreSignedUploadUrl}"
アップロードが完了すると、ProcessMindが差分データを自動で処理し、元のデータと結合します。処理の完了を確認するには、GET /datatables/{dataTableId}をポーリングし、hasDataLoadedがtrueになるまで確認してください。
UIから操作する
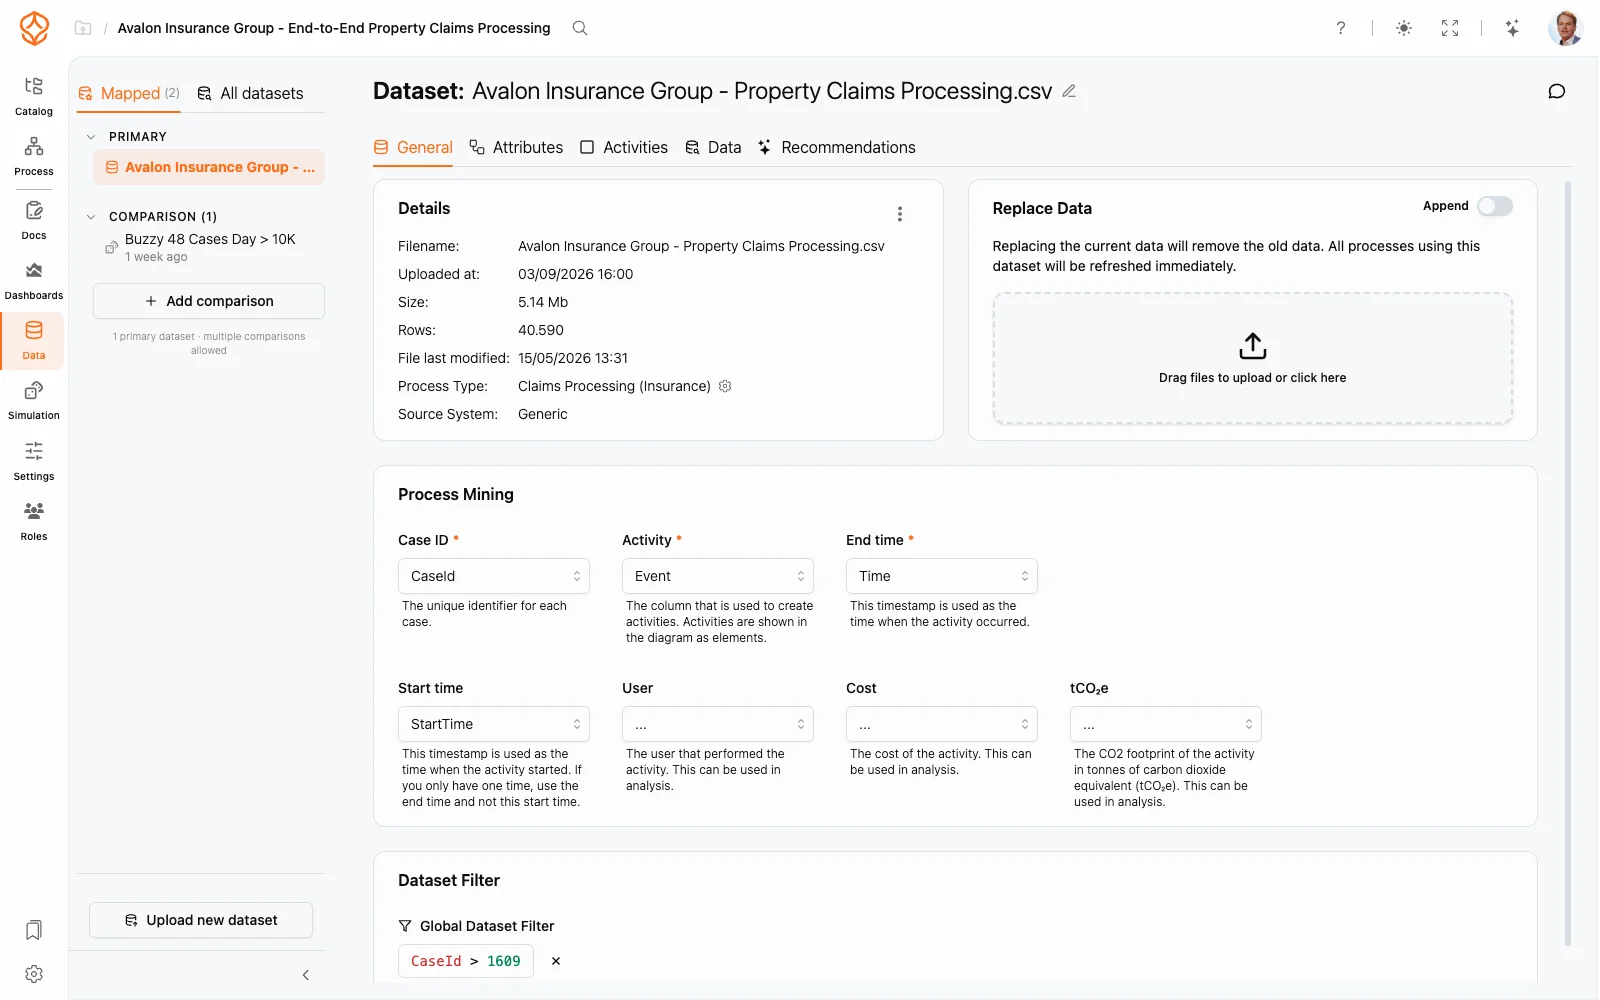
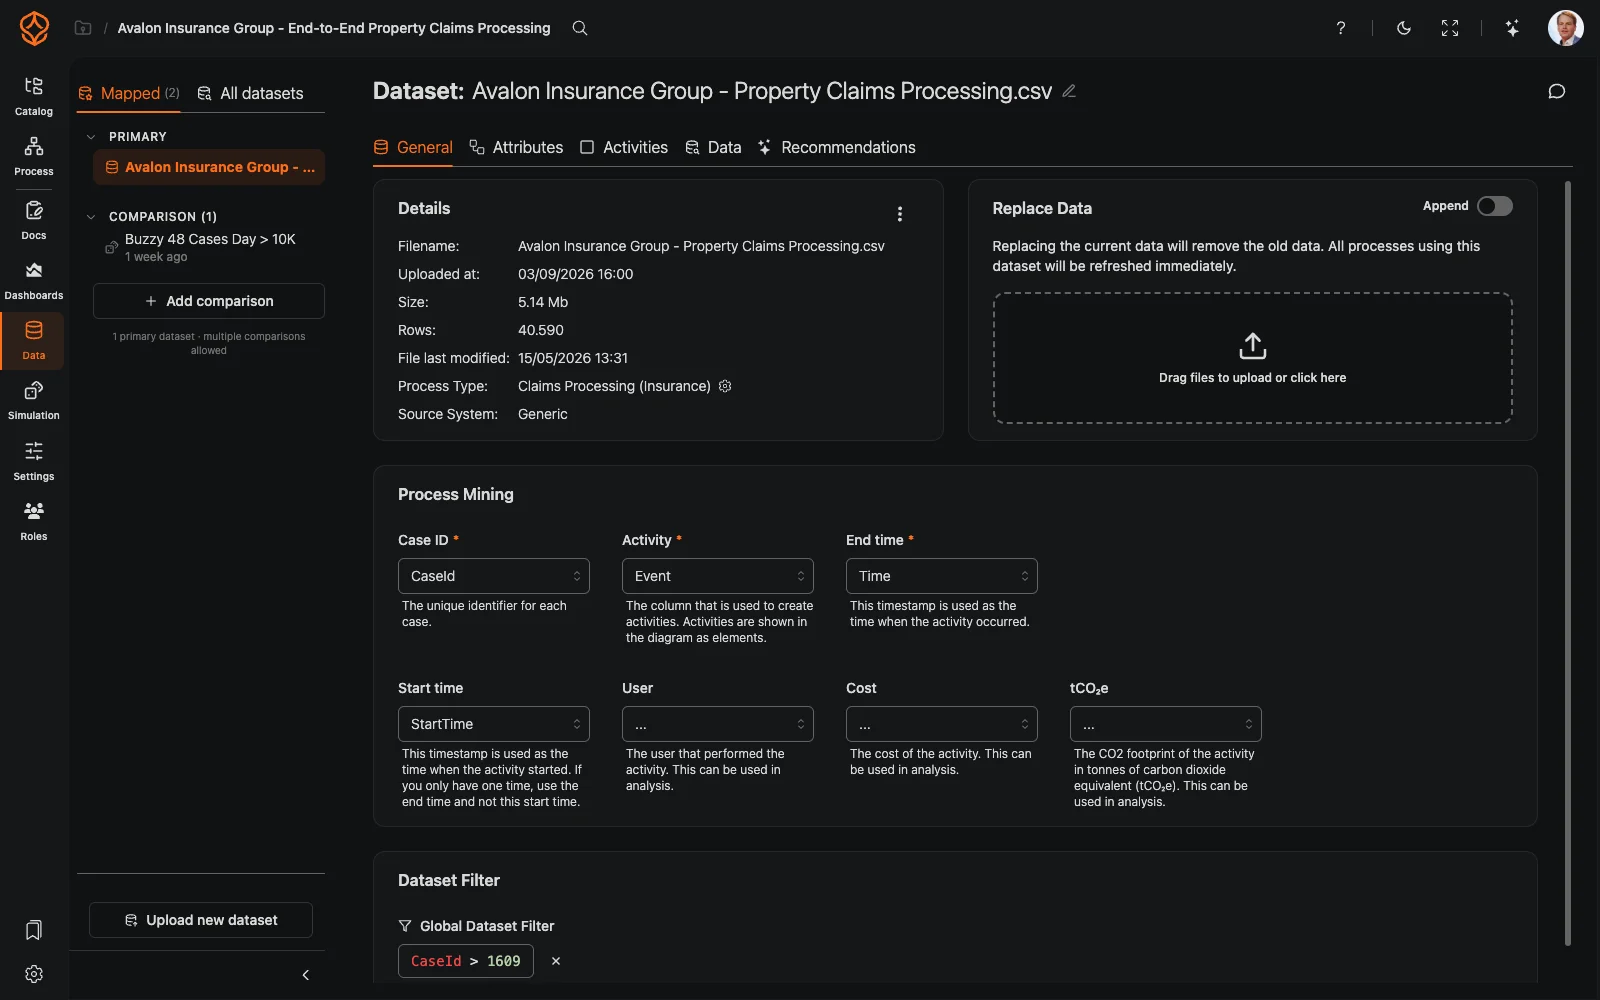
ProcessMindアプリケーションでは、データセットの一般タブからも増分読み込みを開始できます。
- 追加スイッチを切り替えると、アップロード領域がデータを置換しますからデータを追加に変わります。
- 新しいファイルをデータを追加領域にドロップします(またはクリックしてファイルを選択します)。
ProcessMindはファイルを差分データとしてアップロードし、既存のデータと合わせて処理します。差分アップロードは明示的に指定する必要があります。通常の(置換)アップロードから差分として自動判定されることはありません。
アップロードの各データを確認する
増分アップロードを1回以上行うと、データテーブルのアップロード履歴に、各ファイルを記録するuploadParts配列が含まれます。
{
	"uploadHistory": {
		"uploadParts": [
			{
				"key": "datatable/123/2.csv",
				"fileName": "orders-january.csv",
				"fileSize": 524288,
				"uploadedAt": "2024-01-15T10:00:00Z"
			},
			{
				"key": "datatable/123/3.csv",
				"fileName": "orders-february.csv",
				"fileSize": 419430,
				"uploadedAt": "2024-02-15T10:00:00Z"
			}
		]
	}
}
推奨される方法
- すべてのファイルで列名を統一すると、データの対応付けに関する問題を防げます。
- 可能な場合は時系列順にアップロードすると、アップロード履歴にデータの順序が反映されます。
- 差分ファイルのサイズを適切に保つ:適度な量に分けてアップロードしてください。小さなファイルを大量にアップロードすると、処理が遅くなることがあります。
- 各差分の読み込み後に行数を確認すると、データが正しく読み込まれたか確かめられます。
warning
増分アップロードではデータが追加されます。既存の行が更新または置換されることはありません。以前のアップロードのデータを修正する場合は、データセット全体を再アップロードしてください。
スキーマが一致しない場合の動作
ProcessMindはアップロードの各データ間で厳密なスキーマ検証を行いません。そのため、次のようになります。
- 余分な列:差分ファイルに含まれていても処理時に無視されます。元のアップロードのスキーマにある列だけが使用されます。
- 不足している列:差分データの該当フィールドはnullまたは空になります。
- 列名が異なる場合:別の列として扱われます。差分データでは、想定される列の値がnullになります。
正しく処理するには、すべての差分ファイルを元のアップロードと同じ列構成にしてください。
info
CSVとJSONLでは、すべての値が内部で文字列として読み込まれるため、型の不一致エラーは発生しません。ParquetとORCでは、ファイルのスキーマに定義された列のデータ型が保持されます。いずれの場合も、数値データを想定する列に互換性のない値をアップロードすると、その後の分析やシミュレーションで予期しない結果が生じる可能性があります。