增量数据加载
什么是增量数据加载?
增量数据加载(也称差量加载)允许您将新行追加到现有数据表,而不替换原有数据。当事件日志数据随时间增长时,您可以使用此功能更新流程挖掘分析,而无需重新上传整个数据集。
常见场景包括:
- 每日或每周导出数据:有新数据时,追加交易、订单或案例。
- 持续监控流程:定期添加新数据,让仪表板保持最新。
- 事件日志不断增长:逐步添加来自ERP系统、CRM工具或其他来源的新事件。
info
差量文件必须与原始上传文件具有相同的列结构(列名称和顺序)。差量文件中的额外列会被忽略;缺少的列将填入空值。
要求
- 数据表必须已通过初始上传加载数据。
- 差量文件必须与原始上传文件采用相同格式:
- CSV文件需要使用CSV差量文件。
- Parquet文件需要使用Parquet差量文件。
- ORC文件需要使用ORC差量文件。
- JSONL文件需要使用JSONL差量文件。
- 不支持通过差量上传Excel(XLSX/XLS/XLSB)和XES文件,请先将其转换为CSV。
- 差量文件中的列名称应与原始上传文件一致。
- 差量文件可以使用gzip压缩(
.gz),但内部格式必须与原始上传文件一致。
info
有关所有支持的文件格式,请参阅支持的数据格式页面。
上传增量数据
通过API上传
使用ProcessMind API以编程方式上传差量文件。有关接口详情,请参阅API参考:数据页面。
操作步骤如下:
-
获取差量文件的预签名上传URL:
GET /v1/tenant/{tenantId}/datatables/{dataTableId}/uploads/presigned-url ?delta=true&filename=delta.csv&filesize=1024&filelastmodified=1704067200000 -
使用预签名URL上传差量文件:
curl -X PUT --upload-file "delta.csv" \
    -H "Content-Type: text/csv" \
    "{PreSignedUploadUrl}"
上传完成后,ProcessMind会自动处理差量数据,并将其与原始数据合并。您可以轮询GET /datatables/{dataTableId},直到hasDataLoaded变为true,以确认处理已完成。
通过界面上传
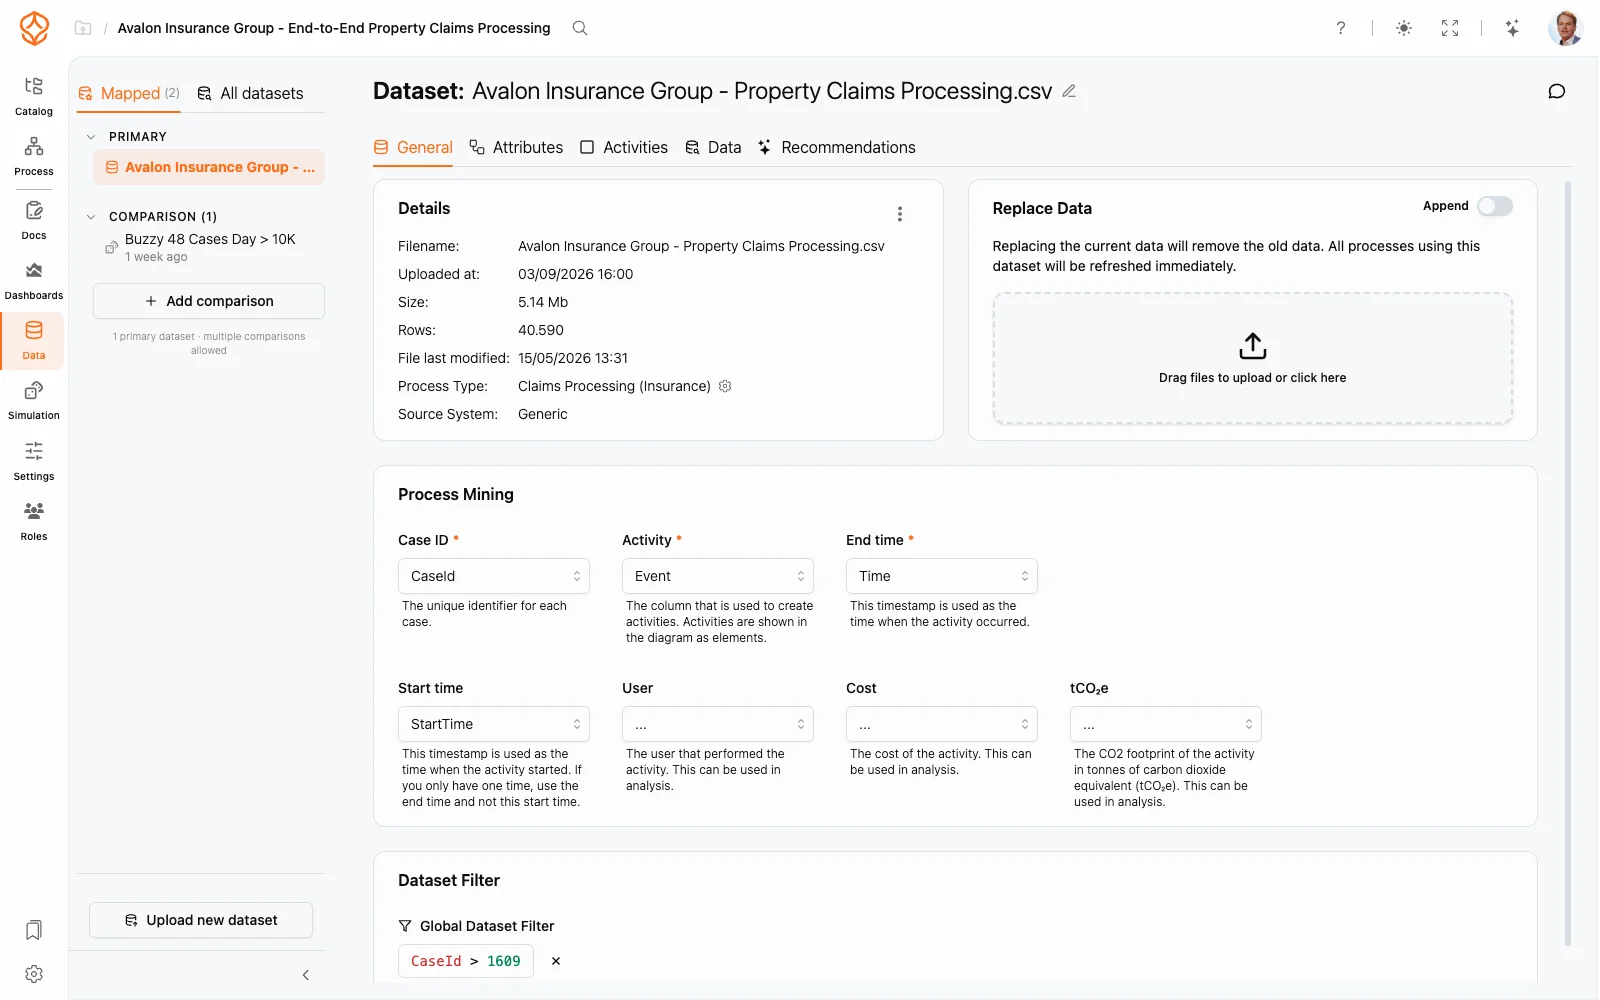
您也可以在ProcessMind应用中,通过数据集的常规选项卡启动增量数据加载:
- 切换追加开关,将上传区域从替换数据切换为追加数据。
- 将新文件拖入追加数据区域(或点击区域浏览并选择文件)。
ProcessMind会将文件作为差量数据上传,并与现有数据一起处理。差量上传需要明确选择,系统不会从普通的替换数据上传中自动识别差量文件。
查看上传分段
一次或多次增量上传后,数据表的上传历史记录中会包含uploadParts数组,用于记录每个文件:
{
	"uploadHistory": {
		"uploadParts": [
			{
				"key": "datatable/123/2.csv",
				"fileName": "orders-january.csv",
				"fileSize": 524288,
				"uploadedAt": "2024-01-15T10:00:00Z"
			},
			{
				"key": "datatable/123/3.csv",
				"fileName": "orders-february.csv",
				"fileSize": 419430,
				"uploadedAt": "2024-02-15T10:00:00Z"
			}
		]
	}
}
最佳实践
- 所有文件使用一致的列名称,避免数据对齐问题。
- 尽可能按时间顺序上传,使上传历史与数据时间线相符。
- 控制差量文件大小:分批上传适量数据;大量过小的文件可能拖慢处理速度。
- 每次上传差量数据后检查行数,确认数据已正确加载。
warning
增量上传只会追加数据,不会更新或替换现有行。如果需要修正之前上传的数据,请重新上传整个数据集。
架构不匹配时的处理方式
ProcessMind不会强制要求各上传分段使用严格一致的架构。这意味着:
- 额外列会在处理差量文件时被忽略:系统只使用原始上传架构中已有的列。
- 缺少的列在差量数据行中对应字段的值为空或为null。
- 不同的列名称会被视为完全不同的列:差量数据行中预期列的值将为null。
为获得最佳结果,请确保所有差量文件与原始上传文件具有相同的列结构。
info
对于CSV和JSONL格式,系统会在内部将所有值读取为字符串,因此不会出现类型不匹配错误。对于Parquet和ORC格式,系统会保留文件架构中的列数据类型。无论使用哪种格式,如果某列需要数值数据,但上传了不兼容的值,后续分析或模拟可能会产生意外结果。