Kinerja process mining: tolok ukur dan tips
Lihat pengaruh volume data, format file, dan bentuk kueri terhadap kinerja process mining, dengan tolok ukur bertanggal untuk 100K hingga 100M peristiwa.

Kinerja process mining tidak hanya bergantung pada jumlah peristiwa. Ukuran file, jumlah kasus, bentuk kueri, dan kecepatan jaringan turut menentukan waktu tunggu. Tolok ukur berikut mencakup dataset berisi 100K hingga 100M peristiwa. Pengujian dilakukan pada infrastruktur AWS produksi pada Maret 2026, menggunakan format file dan kondisi pengujian yang dijelaskan di sini.
Poin utama
- Untuk file besar atau koneksi lambat, waktu unggah dapat menjadi bagian terbesar dari waktu tunggu.
- File Parquet dan ORC jauh lebih kecil daripada CSV mentah sehingga waktu transfer lebih singkat.
- Waktu respons dashboard bergantung pada kueri. Statistik tetap cepat, sedangkan alur proses memerlukan waktu lebih lama seiring bertambahnya jumlah peristiwa.
- Pemuatan delta mentransfer peristiwa baru tanpa mengharuskan Anda mengunggah ulang seluruh dataset.
- Dataset yang terfokus dapat lebih cepat diunggah dan lebih mudah dianalisis.
Apa yang memengaruhi kinerja process mining?
Empat faktor memengaruhi kinerja: jumlah data, struktur log peristiwa, kueri yang dijalankan, serta lingkungan yang digunakan untuk mentransfer dan memproses data.
- Jumlah peristiwa dan kasus: Semakin banyak peristiwa, biasanya semakin banyak data yang perlu diunggah dan diproses. Jumlah kasus menentukan banyaknya instans proses yang tercakup dalam analisis.
- Bentuk kueri: Statistik ringkasan dan alur proses memerlukan perhitungan yang berbeda. Kueri untuk menghitung perpindahan antaraktivitas dapat memerlukan waktu lebih lama daripada kueri atas data yang sudah diagregasi.
- Jumlah aktivitas dan panjang kasus: Semakin banyak aktivitas yang berbeda dan semakin panjang kasus, semakin besar pekerjaan untuk menghitung alur dan variasi proses.
- Ukuran file dan kecepatan jaringan: Keduanya menentukan waktu unggah. File CSV dengan banyak kolom dan teks panjang dapat jauh lebih besar daripada file kolumnar ringkas yang berisi peristiwa sama.
Jumlah peristiwa saja tidak cukup untuk memperkirakan waktu pemrosesan dataset. Jadikan tolok ukur sebagai acuan, lalu uji log peristiwa dan kueri yang akan Anda gunakan. Itulah cara paling berguna untuk menganalisis kinerja process mining di lingkungan Anda.
Pipeline data: ke mana waktu Anda tersita?
Dataset melewati tiga tahap: unggah, prapemrosesan, dan penghitungan ulang saat Anda mengubah model proses.
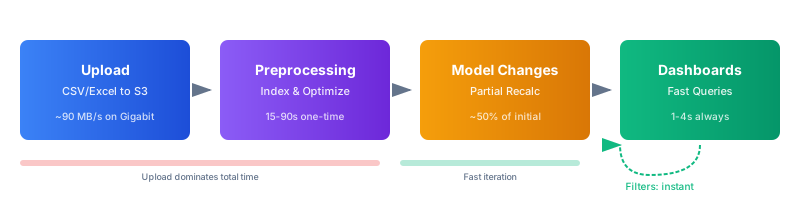
- Unggah: File Anda dikirim melalui internet ke infrastruktur cloud ProcessMind. Kecepatan jaringan dan ukuran file menentukan waktu transfer. Contohnya, file CSV berisi 50 juta peristiwa dengan ukuran 11 GB memerlukan sekitar 2 menit pada 1 Gbps, 18 menit pada 100 Mbps, atau lebih dari 3 jam pada 10 Mbps. Data yang sama dalam file Parquet 1,7 GB memerlukan sekitar 19 detik, 3 menit, atau 28 menit pada kecepatan tersebut.
- Prapemrosesan: Setelah diunggah, sistem mengubah data menjadi penyimpanan kolumnar yang dioptimalkan, mengindeks peristiwa, menghitung perpindahan aktivitas dan variasi proses, serta membuat statistik ringkasan. Dalam tolok ukur di bawah, tahap ini memerlukan 35 detik untuk 100K peristiwa dan hingga 2,5 menit untuk 100M peristiwa.
- Perubahan model: Saat Anda mengubah pemetaan aktivitas atau menambah maupun menghapus aktivitas, ProcessMind memperbarui perhitungan yang bergantung pada model. Dalam tolok ukur di bawah, tahap ini memerlukan sekitar 14 detik untuk 1M peristiwa dan 52 detik untuk 100M peristiwa. Perubahan filter langsung diterapkan.
Untuk dataset besar, mengurangi ukuran file sering kali menjadi cara paling efektif untuk mempersingkat waktu tunggu awal. Setelah prapemrosesan, kinerja kueri bergantung pada perhitungan yang diperlukan dashboard Anda.
Apa pengaruh jenis kueri terhadap kinerja?
Biaya pemrosesan setiap kueri berbeda. Karakteristik berikut membantu menjelaskan hal yang dapat Anda harapkan dan cara menyusun data.
- Jumlah aktivitas: Model dengan 10–20 aktivitas berbeda lebih mudah dianalisis dan ditampilkan. Jika jumlahnya lebih dari 50, perhitungan alur proses akan memakan waktu lebih lama dan hasilnya bisa lebih sulit dibaca. Kelompokkan langkah-langkah terkait jika pengelompokan tersebut benar-benar mencerminkan proses.
- Keragaman variasi: Proses yang sebagian besar kasusnya mengikuti beberapa jalur saja umumnya lebih cepat dianalisis dibandingkan proses yang setiap kasusnya mengikuti jalur berbeda. Variasi yang tinggi mungkin bermakna, tetapi dapat memperpanjang waktu kueri.
- Jumlah kolom: Kolom inti CaseId, Activity, dan Timestamp diperlukan untuk analisis proses. Atribut tambahan membantu pemfilteran dan pengelompokan, tetapi menambah jumlah data yang perlu dipindahkan dan dipindai.
- Panjang kasus: Kasus dengan 50 peristiwa membutuhkan lebih banyak pemrosesan daripada kasus dengan 5 peristiwa. Proses yang kasusnya mencakup ratusan peristiwa dapat membutuhkan waktu kueri lebih lama.
Waktu respons dashboard
Angka median ini berasal dari beberapa kali pengujian. Setiap komponen dashboard menjalankan kueri secara terpisah dan dimuat secara paralel.
| Dataset | Statistik | Alur proses | Variasi | Kategori | Browser data | Animasi |
|---|---|---|---|---|---|---|
| 100K | 0.6s | 1.5s | 1.1s | 1.5s | 1.2s | 1.4s |
| 1M | 0.6s | 1.6s | 1.4s | 1.9s | 1.5s | 2.0s |
| 5M | 0.6s | 2.5s | 1.8s | 2.4s | 1.3s | 2.1s |
| 10M | 0.6s | 3.4s | 2.2s | 2.5s | 1.6s | 2.4s |
| 20M | 0.6s | 3.9s | 2.7s | 3.3s | 1.9s | 3.6s |
| 50M | 0.6s | 5.1s | 4.2s | 5.7s | 1.6s | 2.7s |
| 100M | 0.6s | 7.2s | 3.5s | 4.7s | 1.6s | 5.0s |
Statistik tetap sekitar 0,6 detik pada semua ukuran yang diuji. Alur proses memerlukan waktu lebih lama seiring bertambahnya jumlah peristiwa karena menghitung perpindahan antaraktivitas. Kinerja variasi dan kategori meningkat secara bertahap, sedangkan Browser data tetap responsif berkat pemuatan halaman. Waktu animasi berubah sesuai jumlah kasus aktif yang ditampilkan.
Untuk 1M hingga 10M peristiwa, waktu respons yang diukur berkisar antara 0,6 hingga 3,4 detik, bergantung pada komponennya. Pada 50M peristiwa, Alur proses dan Kategori memerlukan sekitar 5–6 detik. Ini adalah hasil tolok ukur, bukan jaminan untuk setiap dataset atau lingkungan.
Data tolok ukur: bagaimana kondisi pengujiannya?
Tolok ukur ini dijalankan pada infrastruktur AWS produksi pada Maret 2026. Waktu unggah dan prapemrosesan merupakan rata-rata dari beberapa kali pengujian. Waktu respons dashboard merupakan nilai median dari beberapa pengujian. Pengujian mencakup lebih dari 50 jenis kueri untuk setiap ukuran dataset.
Jumlah peristiwa di bawah ini adalah jumlah sebenarnya dalam file pengujian. Ukuran file mengacu pada CSV yang belum dikompresi dengan skema log peristiwa umum: CaseId, Activity, Timestamp, dan 5–8 atribut bisnis. Ukuran file dan hasil Anda dapat berbeda, bergantung pada jumlah kolom, isi data, kondisi jaringan, jarak ke pusat data, dan beban saat ini.
Waktu unggah dan prapemrosesan
| Dataset | Jumlah peristiwa aktual | Ukuran file | Unggah (1 Gbps) | Unggah (100 Mbps) | Unggah (50 Mbps) | Unggah (10 Mbps) | Prapemrosesan |
|---|---|---|---|---|---|---|---|
| 100K | 125,260 | 22 MB | < 1s | 2s | 4s | 22s | 35s |
| 500K | 626,300 | 110 MB | 1s | 11s | 22s | 2 min | 45s |
| 1M | 1,253,424 | 221 MB | 3s | 22s | 44s | 4 min | 55s |
| 2M | 2,506,848 | 443 MB | 5s | 44s | 1.5 min | 7 min | 1 min |
| 5M | 4,996,877 | 1.1 GB | 13s | 2 min | 4 min | 18 min | 1.5 min |
| 10M | 12,511,867 | 2.2 GB | 25s | 4 min | 7 min | 37 min | 1.5 min |
| 20M | 25,023,734 | 4.4 GB | 50s | 7 min | 15 min | 1.2 hr | 2 min |
| 50M | 62,559,335 | 11.1 GB | 2 min | 18 min | 37 min | 3 hr | 2 min |
| 100M | 125,118,670 | 22.3 GB | 4 min | 37 min | 1.2 hr | 6 hr | 2.5 min |
Kecepatan transfer 1 Gbps yang diukur mencapai 88 MB/s ke AWS eu-central-1. Kecepatan lainnya merupakan perkiraan berdasarkan kecepatan transfer praktis: sekitar 5 MB/s pada 50 Mbps, 10 MB/s pada 100 Mbps, dan 1 MB/s pada 10 Mbps. Kecepatan aktual bergantung pada jaringan dan kondisi Anda.
Dalam pengujian ini, prapemrosesan memerlukan waktu 35 detik hingga 2,5 menit. Waktu unggah bertambah seiring ukuran file, sehingga menjadi bagian terbesar dari waktu tunggu untuk file besar.
Format file: Parquet dan ORC dibandingkan dengan CSV
ProcessMind mendukung CSV, Parquet, ORC, Excel, dan XES. Perbandingan ukuran file ini menggunakan jumlah peristiwa dan skema yang sama dengan tolok ukur di atas.
| Dataset | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| 1M peristiwa | 221 MB | 34 MB | 39 MB | 20 MB |
| 5M peristiwa | 1.1 GB | 151 MB | 197 MB | 107 MB |
| 10M peristiwa | 2.2 GB | 301 MB | 395 MB | 215 MB |
| 20M peristiwa | 4.4 GB | 603 MB | 791 MB | 430 MB |
| 50M peristiwa | 11.1 GB | 1.7 GB | 1.9 GB | 1.1 GB |
| 100M peristiwa | 22.3 GB | 3.4 GB | 3.7 GB | 2.2 GB |
Dalam pengujian ini, file Parquet sekitar 85% lebih kecil daripada CSV, sedangkan file ORC sekitar 82% lebih kecil. Keduanya merupakan format kolumnar dengan kompresi bawaan. Alat data seperti Spark, Databricks, dbt, dan BigQuery mungkin mendukung ekspor ke format ini.
Waktu prapemrosesan Parquet, ORC, dan CSV hampir sama. Pada jumlah peristiwa yang lebih besar, CSV.GZ memerlukan waktu lebih lama karena file gzip tidak dapat dipecah untuk dekompresi paralel.
| Dataset | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| 1M peristiwa | 55s | 55s | 55s | 55s |
| 5M peristiwa | 1.5 min | 1.5 min | 1.5 min | 1.5 min |
| 10M peristiwa | 1.5 min | 1.5 min | 1.5 min | 2 min |
| 20M peristiwa | 2 min | 2 min | 2 min | 2.5 min |
| 50M peristiwa | 2 min | 2 min | 2 min | 3 min |
| 100M peristiwa | 2.5 min | 2.5 min | 2.5 min | 4.5 min |
Total waktu mencakup unggah dan prapemrosesan. Contoh berikut menggunakan koneksi 100 Mbps.
| 10M peristiwa (100 Mbps) | Ukuran file | Unggah | Prapemrosesan | Total |
|---|---|---|---|---|
| Parquet | 301 MB | 30s | 1.5 min | ~2 min |
| ORC | 395 MB | 40s | 1.5 min | ~2.2 min |
| CSV | 2.2 GB | 4 min | 1.5 min | ~5.5 min |
| CSV.GZ | 215 MB | 21s | 2 min | ~2.5 min |
| 50M peristiwa (100 Mbps) | Ukuran file | Unggah | Prapemrosesan | Total |
|---|---|---|---|---|
| Parquet | 1.7 GB | 3 min | 2 min | ~5 min |
| ORC | 1.9 GB | 3.2 min | 2 min | ~5.2 min |
| CSV | 11.1 GB | 18 min | 2 min | ~20 min |
| CSV.GZ | 1.1 GB | 2 min | 3 min | ~5 min |
Untuk dataset besar, Parquet dan ORC mengurangi waktu transfer karena ukuran filenya lebih kecil. CSV tetap menjadi pilihan praktis untuk dataset kecil atau jika proses ekspor Anda tidak mendukung format kolumnar. CSV.GZ dapat mengurangi waktu transfer pada koneksi lambat, tetapi biaya dekompresinya bertambah seiring ukuran dataset.
Memilih format file
- Parquet: Pilihan awal yang baik untuk dataset besar jika pipeline data Anda mendukungnya. Format ini menghasilkan file terkecil dalam pengujian.
- ORC: Pilihan serupa, terutama jika pipeline data Anda menggunakan Hadoop atau Spark.
- CSV: Sederhana dan didukung secara luas. Praktis untuk dataset yang lebih kecil.
- CSV.GZ: Pertimbangkan format ini jika kecepatan unggah menjadi kendala utama. Uji waktu prapemrosesan dengan data Anda sendiri, terutama untuk jumlah peristiwa yang besar.
Pola kueri apa yang dapat memperlambat analisis?
Beberapa pola data dan dashboard memerlukan pemrosesan lebih banyak daripada yang lain. Gunakan pemeriksaan berikut untuk menemukan kemungkinan penyebab kueri lambat.
- Terlalu banyak aktivitas: Alur proses dengan lebih dari 50 aktivitas berbeda dapat memerlukan waktu lebih lama untuk dihitung dan sulit dipahami. Kelompokkan langkah terkait jika sesuai.
- Banyak variasi unik: Jika kasus mengikuti banyak jalur berbeda, perhitungan variasi memerlukan lebih banyak pemrosesan. Variasi tinggi juga dapat menunjukkan perilaku proses yang perlu diselidiki.
- Kasus yang panjang: Kasus dengan banyak peristiwa memerlukan pemrosesan lebih banyak daripada kasus pendek.
- Kolom yang tidak diperlukan: Atribut tambahan memperbesar file dan dapat menambah beban saat kueri dijalankan. Simpan kolom yang mendukung analisis Anda.
- Dashboard besar dan padat: Setiap grafik atau ubin menjalankan kuerinya sendiri. Pertahankan komponen yang menjawab pertanyaan dengan jelas dan pindahkan tampilan lain ke dashboard terpisah.
- Visualisasi yang berat: Pada dataset besar, grafik dengan banyak kategori dapat memerlukan waktu lebih lama untuk ditampilkan. Gunakan tampilan ringkasan jika Anda tidak memerlukan perincian.
- Animasi dengan banyak kasus aktif: Waktu animasi bergantung pada jumlah kasus yang ditampilkan. Kurangi kecepatannya atau nonaktifkan jejak dan efek jika Anda hanya perlu memeriksa alurnya.
Bagaimana memilih ukuran data yang tepat?
Mulailah dengan dataset terkecil yang dapat menjawab pertanyaan Anda. Dataset terfokus lebih cepat diunggah dan lebih mudah divalidasi. Tambahkan data jika Anda memerlukan cakupan lebih luas, peristiwa langka, atau tren jangka panjang.
Buat dan validasi model dengan dataset yang lebih kecil
Mulailah dengan sampel terbaru, konfigurasikan model, lalu periksa data sebelum menambah skalanya.
- Mulai dengan sampel. Misalnya, ambil 1M peristiwa dari periode tiga bulan terakhir. Dalam tolok ukur, unggah memerlukan 3 detik pada 1 Gbps atau 22 detik pada 100 Mbps, lalu prapemrosesan memerlukan 55 detik.
- Buat model. Konfigurasikan aktivitas, filter, dan tampilan. Perubahan model memerlukan sekitar 14–20 detik untuk dataset 1M hingga 10M peristiwa yang diuji.
- Validasi temuan. Pastikan nama aktivitas dan jalur proses masuk akal, lalu atasi masalah kualitas data.
- Tambahkan data jika perlu. Tambah jumlah peristiwa jika Anda perlu menyelidiki kasus langka atau membandingkan periode yang lebih panjang.
Tabel ini membandingkan waktu tunggu awal untuk jumlah peristiwa yang berbeda melalui koneksi 100 Mbps.
| Pendekatan | Unggah (100 Mbps) | Prapemrosesan | Total waktu tunggu | Kecepatan dashboard |
|---|---|---|---|---|
| Mulai dengan 1M peristiwa | 22s | 55s | ~1.5 min | 1–2s |
| Mulai dengan 5M peristiwa | 2 min | 1.5 min | ~3.5 min | 1–2.5s |
| Mulai dengan 50M peristiwa | 18 min | 2 min | ~20 min | 1–6s |
Jumlah peristiwa yang tepat bergantung pada pertanyaan Anda. Dataset yang lebih kecil mungkin cukup untuk menemukan pola proses umum, tetapi Anda mungkin memerlukan lebih banyak data untuk mempelajari peristiwa langka atau memenuhi kebutuhan cakupan seluruh populasi.
Bagi data menjadi segmen jika pertanyaannya spesifik
Jika Anda menyelidiki satu negara, departemen, atau lini produk, mulailah dari segmen tersebut, bukan dengan menggabungkan kelompok yang tidak terkait. Segmentasi dapat memperjelas perbandingan dan mengurangi jumlah data yang perlu diproses.
Sebagai contoh, tolok ukur ini menggambarkan dataset logistik Eropa dengan 42M peristiwa pengiriman di 8 negara:
- Semua negara: 42M peristiwa, 9.3 GB, perlu 16 menit untuk diunggah pada 100 Mbps dan 2 menit untuk prapemrosesan.
- Jerman: 8.5M peristiwa, 1.9 GB, perlu 3 menit untuk diunggah dan 1.5 menit untuk prapemrosesan.
- Belanda: 3.1M peristiwa, 690 MB, perlu 1 menit untuk diunggah dan 1 menit untuk prapemrosesan.
Anda dapat membandingkan segmen setelah memvalidasi masing-masing segmen. Dimensi yang berguna mencakup wilayah geografis, organisasi, produk, periode waktu, dan segmen pelanggan.
Saring kasus yang Anda perlukan
Jika Anda menyelidiki pengecualian, ekspor hanya kasus yang relevan untuk mengurangi ukuran dataset secara signifikan. Sebagai contoh, tolok ukur ini menggambarkan proses pengadaan hingga pembayaran dengan 1,2 juta pesanan pembelian dan 8,4M peristiwa. Menurut laporan, 96.000 pesanan atau 8% mengalami pengecualian seperti penolakan, pengembalian, faktur duplikat, atau persetujuan yang belum diberikan.
Untuk analisis tersebut, ekspor kasus pengecualian mengurangi dataset dari 8,4M menjadi 670K peristiwa. Ukuran file turun dari 1,9 GB menjadi 150 MB, sedangkan waktu unggah pada 100 Mbps turun dari 3 menit menjadi 15 detik. Dalam tolok ukur, ekspor data yang sama sebagai file Parquet 15 MB memerlukan waktu kurang dari 2 detik untuk diunggah.
Saring berdasarkan status, aktivitas, durasi kasus, periode waktu, atau unit bisnis jika kolom tersebut sesuai dengan pertanyaan yang sedang Anda selidiki.
Pilih hanya kolom yang diperlukan
Setiap kolom menambah ukuran file. Kolom teks panjang, pengenal yang berulang, kolom audit, dan metadata teknis mungkin tidak diperlukan untuk analisis Anda.
Tolok ukur ini menggambarkan ekspor SAP berisi 1,8M peristiwa pesanan pembelian dengan 45 kolom. Setelah dikurangi menjadi 12 kolom penting, ukuran file turun dari 2,1 GB menjadi 380 MB. Ekspor kolom tersebut sebagai Parquet menguranginya lagi menjadi 58 MB. Menurut laporan, waktu unggah pada 100 Mbps turun dari 3,5 menit menjadi 6 detik.
Simpan kolom yang mendukung analisis, termasuk CaseId, Activity, Timestamp, dan atribut bisnis yang relevan seperti status, jumlah, kategori, atau wilayah. Hapus informasi pribadi jika tidak diperlukan untuk analisis.
Kapan Anda perlu menggunakan dataset yang lebih besar?
Jumlah event yang lebih besar mungkin diperlukan jika pertanyaan Anda bergantung pada cakupan atau rentang waktu.
- Kejadian langka: Untuk menemukan pengecualian yang hanya terjadi sekali dalam 100.000 kasus, Anda perlu populasi yang cukup besar agar kejadian tersebut tercakup. Jika pengecualian terjadi pada 0,01% kasus dan Anda ingin mengkaji 50 kejadian, Anda memerlukan sekitar 500 ribu kasus.
- Varian berfrekuensi rendah: Varian yang terjadi pada 0,1% kasus mungkin tidak terlihat dalam sampel 1 juta event, tetapi dapat diukur dengan jelas dalam populasi 50 juta event.
- Kepatuhan dan audit: Beberapa persyaratan mengharuskan cakupan seluruh populasi, bukan sekadar sampel.
- Tren jangka panjang: Untuk membandingkan Q1 2024, Q1 2025, dan Q1 2026, Anda memerlukan data dari ketiga periode tersebut. Pemuatan delta menambahkan cakupan itu secara bertahap.
Untuk dataset di atas 50 juta event, hasil benchmark menyarankan penggunaan Parquet, mengunggah melalui API, dan memakai koneksi jaringan cepat jika tersedia. File CSV berisi 50 juta event dalam pengujian berukuran 11,1 GB, sedangkan versi Parquet berukuran 1,7 GB.
Kinerja selalu melibatkan kompromi: semakin banyak data dan semakin cepat pemrosesan, semakin besar biayanya. Pertanyaan utamanya bukan apa yang bisa dilakukan sebuah alat, melainkan apa yang dibutuhkan proses Anda. ProcessMind mampu menangani dataset yang besar, tetapi kami tetap menyarankan agar Anda tidak menggunakan dataset yang sangat besar jika tidak diperlukan. Dataset seperti itu sering menambah kerumitan dan mengalihkan perhatian dari perbaikan proses.
Bagaimana menjaga model dan antarmuka tetap responsif?
Volume data hanya salah satu faktor. Desain model proses dan dashboard juga memengaruhi kelancaran kerja Anda.
- Buat model tetap mudah dibaca: Pecah proses besar menjadi beberapa Subprocess yang modular. Kanvas dengan banyak elemen yang terlihat bisa lebih lama ditampilkan dan lebih sulit dinavigasi. Gunakan auto-layout setelah mengubah struktur.
- Pilih komponen dashboard dengan cermat: Setiap grafik dan ubin memerlukan perhitungan. Pertahankan tampilan yang menjawab pertanyaan Anda saat ini.
- Gunakan grafik yang sesuai dengan data: Pada dataset besar, visualisasi dengan banyak kategori mungkin memerlukan waktu lebih lama untuk dihitung. Gunakan ringkasan jika Anda tidak memerlukan perincian.
- Batasi filter sesuai kebutuhan: Filter dapat membantu mempersempit analisis. Hindari menggabungkan filter yang tidak membantu menjawab pertanyaan Anda.
- Sesuaikan pengaturan animasi: Beban animasi meningkat seiring jumlah kasus aktif. Kurangi kecepatannya atau matikan jejak dan efek jika Anda hanya perlu memeriksa alur. Lihat Process Animation.
- Hitung ulang hanya bagian yang berubah: Perubahan model memperbarui perhitungan yang bergantung pada model tanpa mengulang seluruh tahap prapemrosesan. Dalam benchmark, pembaruan memerlukan sekitar 14 detik untuk 1 juta event hingga 52 detik untuk 100 juta event.
Bagaimana pemuatan delta mengurangi waktu unggah?
Pemuatan delta memungkinkan Anda menambahkan event baru ke dataset yang sudah ada, tanpa mengunggah ulang seluruh dataset. Cara ini mengurangi jumlah data yang dikirim saat Anda memperbarui log peristiwa yang terus bertambah.
| Skenario | Unggah ulang penuh | Unggah delta | Waktu yang dihemat |
|---|---|---|---|
| 10 juta data awal + 500 ribu event baru (100 Mbps) | unggah 4 menit | unggah 5 detik | ~4 menit |
| 20 juta data awal + 2 juta event baru (100 Mbps) | unggah 7 menit | unggah 44 detik | ~6 menit |
| 50 juta data awal + 5 juta event baru (100 Mbps) | unggah 18 menit | unggah 2 menit | ~16 menit |
Setelah unggahan delta, prapemrosesan dijalankan kembali pada dataset gabungan. Dalam benchmark, proses ini memerlukan 1–2,5 menit. Penghematan waktu unggah berasal dari pengiriman event baru saja.
File delta harus menggunakan format file dan struktur kolom yang sama dengan unggahan awal. Baca panduan pemuatan data bertahap untuk mengetahui detailnya.
Kapan sebaiknya Anda mengunggah melalui API?
Untuk unggahan rutin atau file berukuran beberapa gigabita, unggahan melalui API mungkin lebih mudah dikelola daripada transfer lewat browser. Skrip atau alat baris perintah dapat digunakan dalam pipeline ETL, mendukung unggahan terjadwal, dan menampilkan progres transfer.
ProcessMind menyediakan URL bertanda tangan untuk mengunggah langsung ke penyimpanan cloud. Anda dapat menyalin URL unggahan dari menu pengaturan dataset di UI ProcessMind.
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquet
Lihat dokumentasi API untuk contoh Bash, JavaScript, dan Python, termasuk cara memperoleh URL bertanda tangan dan mengunggah file delta.
Kapan sebaiknya dataset dipisah?
Pisahkan dataset jika analisis tertentu hanya memerlukan sebagian data atau jika Anda perlu membandingkan kelompok secara terpisah. Anda dapat membagi data berdasarkan wilayah, departemen, lini produk, periode waktu, atau jenis kasus, lalu menganalisis setiap dataset secara terpisah.
Satukan data jika pertanyaan Anda bergantung pada perbandingan antarkelompok atau pelacakan proses secara menyeluruh. Sebelum memisahkan data, pastikan pemisahan tersebut tidak mengubah makna kasus atau menghilangkan event yang diperlukan untuk memahami alurnya. Misalnya, pemisahan berdasarkan waktu perlu memperhitungkan kasus yang dimulai pada satu periode dan selesai pada periode lain.
Uji kinerja dengan data Anda sendiri
Benchmark membantu Anda membuat perencanaan, tetapi tidak dapat memprediksi hasil untuk setiap log peristiwa, jaringan, atau kueri. Uji dataset yang akan Anda gunakan, lalu periksa waktu unggah, waktu prapemrosesan, dan waktu respons untuk tampilan dashboard yang penting bagi Anda.
Baca panduan persiapan data terlebih dahulu jika Anda perlu bantuan menyiapkan log peristiwa. Anda juga dapat membaca cara menganalisis proses dan cara memantau proses secara berkelanjutan.
Uji dengan volume data Anda sendiri
Muat log peristiwa yang ingin Anda analisis, lalu ukur kinerjanya dengan data Anda.