Prestaties van process mining: benchmarks en tips
Bekijk hoe datavolume, bestandsformaat en queryvorm de prestaties van process mining beïnvloeden. Met benchmarks uit 2026 voor 100.000 tot 100 miljoen events.
De prestaties van process mining hangen van meer af dan alleen het aantal events. Ook de bestandsgrootte, het aantal cases, de query en de netwerksnelheid bepalen hoelang je moet wachten. De benchmarks hieronder zijn gebaseerd op datasets met 100K tot 100M events. Ze zijn in maart 2026 uitgevoerd op AWS-infrastructuur voor productie, met de bestandsindelingen en testomstandigheden die hier worden beschreven.
Belangrijkste punten
- Bij grote bestanden of trage verbindingen kan het uploaden de meeste tijd kosten.
- Parquet- en ORC-bestanden zijn veel kleiner dan ruwe CSV-bestanden, waardoor de overdracht minder tijd kost.
- De reactietijd van dashboards hangt af van de query. Statistieken blijven snel beschikbaar, terwijl procesflows langer duren naarmate het aantal events groeit.
- Met delta loading draag je nieuwe events over zonder de volledige dataset opnieuw te uploaden.
- Een gerichte dataset is sneller te uploaden en eenvoudiger te analyseren.
Wat bepaalt de prestaties van process mining?
Vier factoren bepalen de prestaties: de hoeveelheid data, de structuur van het event log, de query en de omgeving waarin je de data overdraagt en verwerkt.
- Aantal events en cases: Meer events betekenen meestal meer data om te uploaden en te verwerken. Het aantal cases bepaalt hoeveel procesinstanties je analyse omvat.
- Queryvorm: Voor een samenvattend statistisch cijfer zijn andere berekeningen nodig dan voor een processtroom. Queries die overgangen tussen activiteiten berekenen, kunnen langer duren dan queries op vooraf geaggregeerde data.
- Aantal activiteiten en caselengte: Meer verschillende activiteiten en langere cases vragen meer rekenwerk voor het berekenen van stromen en varianten.
- Bestandsgrootte en netwerksnelheid: Deze bepalen de uploadtijd. Een breed CSV-bestand met lange tekstvelden kan veel groter zijn dan een compact kolomgeoriënteerd bestand met dezelfde events.
Alleen het aantal events is niet genoeg om te voorspellen hoe lang een dataset nodig heeft. Gebruik de benchmarks als richtlijn en test daarna het event log en de queries die je wilt gebruiken. Zo krijg je het bruikbaarste beeld van de prestaties van process mining in jouw omgeving.
De datapipeline: waar gaat de tijd naartoe?
Een dataset doorloopt drie fases: upload, voorbewerking en herberekening als je het procesmodel wijzigt.
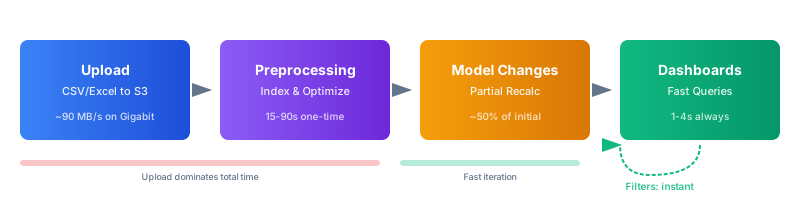
- Upload: Je bestand wordt via internet naar de cloudinfrastructuur van ProcessMind overgedragen. De netwerksnelheid en bestandsgrootte bepalen hoelang dat duurt. Een CSV-bestand met 50 miljoen events en een grootte van 11 GB duurt bijvoorbeeld ongeveer 2 minuten bij 1 Gbps, 18 minuten bij 100 Mbps of meer dan 3 uur bij 10 Mbps. Dezelfde data in een Parquet-bestand van 1,7 GB duurt bij die snelheden ongeveer 19 seconden, 3 minuten of 28 minuten.
- Voorbewerking: Na de upload zet het systeem de data om naar geoptimaliseerde kolomopslag, indexeert het events, berekent het overgangen tussen activiteiten en procesvarianten en maakt het samenvattende statistieken. In de benchmarks hieronder duurt dit 35 seconden voor 100K events en maximaal 2,5 minuut voor 100M events.
- Modelwijzigingen: Als je activiteitstoewijzingen wijzigt of activiteiten toevoegt of verwijdert, werkt ProcessMind de berekeningen bij die van het model afhangen. In de benchmarks hieronder duurt dit ongeveer 14 seconden voor 1M events en 52 seconden voor 100M events. Filterwijzigingen zijn meteen zichtbaar.
Bij grote datasets is het verkleinen van het bestand vaak de beste manier om de eerste wachttijd te verkorten. Na de voorbewerking hangt de querysnelheid af van wat je dashboard moet berekenen.
Hoe verschillen queryprestaties?
Niet elke query kost evenveel rekenwerk. Deze kenmerken helpen je te begrijpen wat je kunt verwachten en hoe je je data kunt indelen.
- Aantal activiteiten: Modellen met 10 tot 20 verschillende activiteiten zijn makkelijker te analyseren en weer te geven. Bij meer dan 50 activiteiten duurt het berekenen van processtromen langer en kan het lastiger worden om ze te lezen. Groepeer stappen die bij elkaar horen als dat het proces goed weergeeft.
- Variatie in varianten: Een proces waarin de meeste cases een beperkt aantal paden volgen, is doorgaans sneller te analyseren dan een proces waarin elke case een ander pad volgt. Veel variatie kan betekenisvol zijn, maar de query kan er langer door duren.
- Aantal kolommen: Voor procesanalyse zijn de basisvelden CaseId, Activity en Timestamp nodig. Extra attributen helpen bij filteren en categoriseren, maar vergroten de hoeveelheid data die moet worden overgedragen en doorzocht.
- Caselengte: Een case met 50 events vraagt meer rekenwerk dan een case met 5 events. Queries op processen met cases van honderden events kunnen langer duren.
Reactietijden van dashboards
Dit zijn medianen van meerdere benchmarktests. Elk dashboardonderdeel voert een eigen query uit en wordt parallel geladen.
| Dataset | Statistieken | Processtroom | Varianten | Categorieën | Databrowser | Animatie |
|---|---|---|---|---|---|---|
| 100K | 0.6s | 1.5s | 1.1s | 1.5s | 1.2s | 1.4s |
| 1M | 0.6s | 1.6s | 1.4s | 1.9s | 1.5s | 2.0s |
| 5M | 0.6s | 2.5s | 1.8s | 2.4s | 1.3s | 2.1s |
| 10M | 0.6s | 3.4s | 2.2s | 2.5s | 1.6s | 2.4s |
| 20M | 0.6s | 3.9s | 2.7s | 3.3s | 1.9s | 3.6s |
| 50M | 0.6s | 5.1s | 4.2s | 5.7s | 1.6s | 2.7s |
| 100M | 0.6s | 7.2s | 3.5s | 4.7s | 1.6s | 5.0s |
De statistieken bleven bij alle geteste groottes rond de 0,6 seconde. Processtroom duurde langer naarmate het aantal events toenam, omdat de query overgangen tussen activiteiten berekent. Varianten en categorieën schaalden redelijk mee, terwijl de Databrowser vlot bleef dankzij paginering. De animatietijd hing af van het aantal weergegeven actieve cases.
Bij 1M tot 10M events varieerden de gemeten reactietijden van 0,6 tot 3,4 seconden, afhankelijk van het onderdeel. Bij 50M events duurden Processtroom en Categorieën ongeveer 5 tot 6 seconden. Dit zijn benchmarkresultaten, geen garantie voor elke dataset of omgeving.
Benchmarkdata: onder welke omstandigheden zijn de tests uitgevoerd?
Deze benchmarks zijn in maart 2026 uitgevoerd op AWS-infrastructuur voor productie. De upload- en voorbewerkingstijden zijn gemiddelden van meerdere tests. De reactietijden van dashboards zijn medianen van meerdere tests. Per datasetgrootte zijn meer dan 50 querytypen getest.
De aantallen hieronder zijn de werkelijke aantallen events in de testbestanden. De bestandsgroottes gelden voor ongecomprimeerde CSV-bestanden met een gebruikelijk event logschema: CaseId, Activity, Timestamp en 5 tot 8 bedrijfsattributen. De bestandsgrootte en resultaten kunnen verschillen door het aantal kolommen, de inhoud, de netwerkomstandigheden, de afstand tot het datacenter en de actuele belasting.
Upload- en voorbewerkingstijden
| Dataset | Werkelijk aantal events | Bestandsgrootte | Upload (1 Gbps) | Upload (100 Mbps) | Upload (50 Mbps) | Upload (10 Mbps) | Voorbewerking |
|---|---|---|---|---|---|---|---|
| 100K | 125,260 | 22 MB | < 1s | 2s | 4s | 22s | 35s |
| 500K | 626,300 | 110 MB | 1s | 11s | 22s | 2 min | 45s |
| 1M | 1,253,424 | 221 MB | 3s | 22s | 44s | 4 min | 55s |
| 2M | 2,506,848 | 443 MB | 5s | 44s | 1.5 min | 7 min | 1 min |
| 5M | 4,996,877 | 1.1 GB | 13s | 2 min | 4 min | 18 min | 1.5 min |
| 10M | 12,511,867 | 2.2 GB | 25s | 4 min | 7 min | 37 min | 1.5 min |
| 20M | 25,023,734 | 4.4 GB | 50s | 7 min | 15 min | 1.2 hr | 2 min |
| 50M | 62,559,335 | 11.1 GB | 2 min | 18 min | 37 min | 3 hr | 2 min |
| 100M | 125,118,670 | 22.3 GB | 4 min | 37 min | 1.2 hr | 6 hr | 2.5 min |
De gemeten overdrachtssnelheid van 1 Gbps was 88 MB/s naar AWS eu-central-1. De andere snelheden zijn berekend op basis van praktische doorvoersnelheden: ongeveer 5 MB/s bij 50 Mbps, 10 MB/s bij 100 Mbps en 1 MB/s bij 10 Mbps. De werkelijke doorvoersnelheid hangt af van je netwerk en de omstandigheden.
In deze test duurde de voorbewerking 35 seconden tot 2,5 minuut. De uploadtijd nam toe met de bestandsgrootte en vormde bij grote bestanden het grootste deel van de wachttijd.
Bestandsindeling: Parquet en ORC vergeleken met CSV
ProcessMind ondersteunt CSV, Parquet, ORC, Excel en XES. Voor deze vergelijking van bestandsgroottes zijn dezelfde aantallen events en hetzelfde schema gebruikt als in de benchmark hierboven.
| Dataset | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| 1M events | 221 MB | 34 MB | 39 MB | 20 MB |
| 5M events | 1.1 GB | 151 MB | 197 MB | 107 MB |
| 10M events | 2.2 GB | 301 MB | 395 MB | 215 MB |
| 20M events | 4.4 GB | 603 MB | 791 MB | 430 MB |
| 50M events | 11.1 GB | 1.7 GB | 1.9 GB | 1.1 GB |
| 100M events | 22.3 GB | 3.4 GB | 3.7 GB | 2.2 GB |
In deze tests waren Parquet-bestanden ongeveer 85% kleiner dan CSV-bestanden en ORC-bestanden ongeveer 82% kleiner. Beide zijn kolomgeoriënteerde indelingen met ingebouwde compressie. Datatools zoals Spark, Databricks, dbt en BigQuery ondersteunen mogelijk export naar deze indelingen.
De voorbewerkingstijden waren vergelijkbaar voor Parquet, ORC en CSV. Bij grotere aantallen events duurde CSV.GZ langer, omdat gzip-bestanden niet kunnen worden opgesplitst voor parallelle decompressie.
| Dataset | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| 1M events | 55s | 55s | 55s | 55s |
| 5M events | 1.5 min | 1.5 min | 1.5 min | 1.5 min |
| 10M events | 1.5 min | 1.5 min | 1.5 min | 2 min |
| 20M events | 2 min | 2 min | 2 min | 2.5 min |
| 50M events | 2 min | 2 min | 2 min | 3 min |
| 100M events | 2.5 min | 2.5 min | 2.5 min | 4.5 min |
De totale tijd bestaat uit de upload en de voorbewerking. Deze voorbeelden gaan uit van een verbinding van 100 Mbps.
| 10M events (100 Mbps) | Bestandsgrootte | Upload | Voorbewerking | Totaal |
|---|---|---|---|---|
| Parquet | 301 MB | 30s | 1.5 min | ~2 min |
| ORC | 395 MB | 40s | 1.5 min | ~2.2 min |
| CSV | 2.2 GB | 4 min | 1.5 min | ~5.5 min |
| CSV.GZ | 215 MB | 21s | 2 min | ~2.5 min |
| 50M events (100 Mbps) | Bestandsgrootte | Upload | Voorbewerking | Totaal |
|---|---|---|---|---|
| Parquet | 1.7 GB | 3 min | 2 min | ~5 min |
| ORC | 1.9 GB | 3.2 min | 2 min | ~5.2 min |
| CSV | 11.1 GB | 18 min | 2 min | ~20 min |
| CSV.GZ | 1.1 GB | 2 min | 3 min | ~5 min |
Bij grote datasets verkorten Parquet en ORC de overdrachtstijd doordat de bestanden kleiner zijn. CSV blijft een eenvoudige keuze voor kleinere datasets of als je exportproces geen kolomgeoriënteerde indelingen ondersteunt. CSV.GZ kan de overdrachtstijd bij een trage verbinding verkorten, maar de decompressie kost meer tijd naarmate de dataset groter wordt.
Een bestandsindeling kiezen
- Parquet: Een goede standaardkeuze voor grote datasets als je datapipeline dit formaat ondersteunt. In deze tests leverde het de kleinste bestanden op.
- ORC: Een vergelijkbare optie, vooral als je datapipeline Hadoop of Spark gebruikt.
- CSV: Eenvoudig en breed ondersteund. Handig voor kleinere datasets.
- CSV.GZ: Een optie als uploadsnelheid de belangrijkste beperking is. Test de voorbewerkingstijd met je eigen data, vooral bij grotere aantallen events.
Welke querypatronen kunnen de analyse vertragen?
Sommige data- en dashboardpatronen vragen meer rekenwerk dan andere. Gebruik deze punten om mogelijke oorzaken van tragere queries op te sporen.
- Te veel activiteiten: Een processtroom met meer dan 50 verschillende activiteiten kan langer duren om te berekenen en lastig te interpreteren zijn. Groepeer stappen die bij elkaar horen als dat past.
- Veel unieke varianten: Als cases veel verschillende paden volgen, is er meer rekenwerk nodig om de varianten te berekenen. Veel variatie kan ook wijzen op procesgedrag dat nader onderzoek verdient.
- Lange cases: Cases met veel events vragen meer verwerking dan korte cases.
- Onnodige kolommen: Extra attributen vergroten het bestand en kunnen extra werk opleveren bij queries. Behoud alleen de velden die je voor je analyse nodig hebt.
- Grote, volle dashboards: Elke grafiek of tegel voert een eigen query uit. Behoud de onderdelen die een duidelijke vraag beantwoorden en zet andere weergaven op een apart dashboard.
- Zware visualisaties: Bij grote datasets kunnen grafieken met veel categorieën langer nodig hebben om weer te geven. Gebruik een samenvatting als je geen gedetailleerde uitsplitsing nodig hebt.
- Animatie met veel actieve cases: De animatietijd hangt af van het aantal weergegeven cases. Verlaag de snelheid of schakel staartlijnen en effecten uit als je alleen de processtroom wilt bekijken.
Hoe kies je de juiste datagrootte?
Begin met de kleinste dataset waarmee je je vraag kunt beantwoorden. Een gerichte dataset is sneller te uploaden en makkelijker te controleren. Breid de dataset uit als je een groter deel van het proces, zeldzame events of trends over een langere periode wilt onderzoeken.
Stel je model in en controleer het met een kleinere dataset
Begin met een recente steekproef, stel je model in en controleer de data voordat je opschaalt.
- Begin met een steekproef. Haal bijvoorbeeld 1M events uit een recente periode van drie maanden. In de benchmark duurde de upload 3 seconden bij 1 Gbps of 22 seconden bij 100 Mbps, gevolgd door 55 seconden voorbewerking.
- Bouw je model op. Stel activiteiten, filters en weergaven in. Modelwijzigingen duurden ongeveer 14 tot 20 seconden voor de geteste datasets van 1M tot 10M events.
- Controleer de bevindingen. Ga na of de activiteitennamen en procespaden kloppen en los problemen met de datakwaliteit op.
- Voeg indien nodig meer data toe. Verhoog het aantal events als je zeldzame cases wilt onderzoeken of langere perioden wilt vergelijken.
De tabel vergelijkt de eerste wachttijd bij verschillende aantallen events en een verbinding van 100 Mbps.
| Aanpak | Upload (100 Mbps) | Voorbewerking | Totale wachttijd | Dashboardsnelheid |
|---|---|---|---|---|
| Begin met 1M events | 22s | 55s | ~1.5 min | 1–2s |
| Begin met 5M events | 2 min | 1.5 min | ~3.5 min | 1–2.5s |
| Begin met 50M events | 18 min | 2 min | ~20 min | 1–6s |
Het juiste aantal events hangt af van je vraag. Een kleinere dataset is misschien voldoende voor veelvoorkomende procespatronen. Voor onderzoek naar zeldzame events of als je alle gevallen moet meenemen, heb je mogelijk meer data nodig.
Splits de data op als je een gerichte vraag hebt
Onderzoek je één land, afdeling of productlijn, begin dan met die groep in plaats van niet-gerelateerde groepen samen te voegen. Door data op te splitsen kun je vergelijkingen duidelijker maken en de hoeveelheid te verwerken data beperken.
De benchmark beschrijft bijvoorbeeld een Europese logistieke dataset met 42M verzendevents uit 8 landen:
- Alle landen: 42M events, 9,3 GB, 16 minuten uploadtijd bij 100 Mbps en 2 minuten voorbewerking.
- Duitsland: 8,5M events, 1,9 GB, 3 minuten uploadtijd en 1,5 minuut voorbewerking.
- Nederland: 3,1M events, 690 MB, 1 minuut uploadtijd en 1 minuut voorbewerking.
Je kunt de groepen vergelijken nadat je elke groep hebt gecontroleerd. Handige dimensies zijn onder meer geografie, organisatie, product, periode en klantsegment.
Filter op de cases die je nodig hebt
Onderzoek je uitzonderingen, dan kun je de dataset flink verkleinen door alleen relevante cases te exporteren. De benchmark beschrijft bijvoorbeeld een purchase-to-pay-proces met 1,2 miljoen inkooporders en 8,4M events. Volgens de benchmark waren er uitzonderingen bij 96.000 orders, oftewel 8%. Voorbeelden zijn afwijzingen, retouren, dubbele facturen en ontbrekende goedkeuringen.
Voor die analyse verkleint de export van de uitzonderingscases de dataset van 8,4M naar 670K events. De gerapporteerde bestandsgrootte daalt van 1,9 GB naar 150 MB. Bij 100 Mbps daalt de uploadtijd van 3 minuten naar 15 seconden. In de benchmark duurt het minder dan 2 seconden om dezelfde data als een Parquet-bestand van 15 MB te uploaden.
Filter op status, activiteit, caselengte, periode of bedrijfseenheid als die velden aansluiten op de vraag die je onderzoekt.
Selecteer alleen de kolommen die je nodig hebt
Elke kolom draagt bij aan de bestandsgrootte. Lange tekstvelden, dubbele identificatiegegevens, auditvelden en technische metadata zijn mogelijk niet nodig voor je analyse.
De benchmark beschrijft een SAP-export met 1,8M inkooporderevents en 45 kolommen. Door dit terug te brengen tot 12 essentiële kolommen daalde de bestandsgrootte van 2,1 GB naar 380 MB. Exporteren van die kolommen als Parquet verkleinde het bestand verder tot 58 MB. De gerapporteerde uploadtijd bij 100 Mbps daalde van 3,5 minuten naar 6 seconden.
Houd de velden die je nodig hebt voor je analyse, zoals CaseId, Activity, Timestamp en relevante bedrijfsattributen zoals status, bedrag, categorie of regio. Verwijder persoonsgegevens als je ze niet nodig hebt voor de analyse.
Wanneer heb je een grotere dataset nodig?
Een groter aantal events kan nodig zijn als je vraag afhangt van de dekking of de periode die je onderzoekt.
- Zeldzame events: Om uitzonderingen te vinden die één keer per 100.000 cases voorkomen, heb je een populatie nodig die groot genoeg is om ze te bevatten. Komt een uitzondering in 0,01% van de gevallen voor en wil je er 50 onderzoeken, dan heb je ongeveer 500.000 cases nodig.
- Varianten die weinig voorkomen: Varianten die in 0,1% van de gevallen voorkomen, zijn mogelijk niet zichtbaar in een steekproef van 1 miljoen events, maar wel goed meetbaar in een populatie van 50 miljoen events.
- Compliance en audits: Sommige vereisten vragen om dekking van de volledige populatie in plaats van een steekproef.
- Trends op lange termijn: Om Q1 2024 met Q1 2025 en Q1 2026 te vergelijken, heb je data uit alle drie de perioden nodig. Met delta loading bouw je die dekking stap voor stap op.
Voor datasets met meer dan 50 miljoen events adviseert de benchmark Parquet, uploaden via de API en waar mogelijk een snelle netwerkverbinding. Het CSV-bestand met 50 miljoen events uit de test was 11,1 GB, tegenover 1,7 GB voor Parquet.
Prestaties vragen altijd om een afweging: meer data en hogere snelheid kosten meer. De vraag is niet wat een tool aankan, maar wat je proces nodig heeft. ProcessMind kan grote datasets verwerken, maar we raden zeer grote datasets toch vaak af. Die zijn meestal niet nodig en zorgen voor extra complexiteit die afleidt van de verbetering zelf.
Hoe houd je het model en de interface snel?
De hoeveelheid data is maar een deel van het verhaal. Ook het procesmodel en het ontwerp van het dashboard bepalen hoe vlot je kunt werken.
- Houd het model leesbaar: Deel grote processen op in modulaire Subprocesses. Een canvas met veel zichtbare elementen kan langer nodig hebben om te laden en is lastiger te navigeren. Gebruik auto-layout na structurele wijzigingen.
- Kies dashboardonderdelen zorgvuldig: Elke grafiek en tegel vraagt om een berekening. Houd alleen de weergaven die antwoord geven op je huidige vragen.
- Kies grafieken die passen bij de data: Bij grote datasets kan een visualisatie met veel categorieën langer nodig hebben om te berekenen. Gebruik een samenvatting als je geen gedetailleerde uitsplitsing nodig hebt.
- Beperk filters tot wat je wilt weten: Met filters kun je een analyse afbakenen. Combineer geen filters die niets toevoegen aan de vraag die je onderzoekt.
- Pas de animatie-instellingen aan: De animatie vraagt meer rekenkracht naarmate er meer actieve cases zijn. Verlaag de snelheid of schakel staarten en effecten uit als je alleen de flow wilt bekijken. Lees meer over Procesanimatie.
- Bereken alleen opnieuw wat is gewijzigd: Wijzigingen in het model werken door in de berekeningen die ervan afhankelijk zijn, zonder dat de volledige voorbewerking opnieuw hoeft. In de benchmark duurde dit ongeveer 14 seconden voor 1 miljoen events en 52 seconden voor 100 miljoen events.
Hoe verkort delta loading de uploadtijd?
Met delta loading voeg je nieuwe events toe aan een bestaande dataset, in plaats van de volledige dataset opnieuw te uploaden. Zo wordt er minder data overgedragen wanneer je een groeiend event log ververst.
| Scenario | Volledige upload opnieuw | Delta-upload | Tijdwinst |
|---|---|---|---|
| 10 miljoen bestaande + 500.000 nieuwe events (100 Mbps) | 4 min. uploaden | 5 sec. uploaden | ~4 min. |
| 20 miljoen bestaande + 2 miljoen nieuwe events (100 Mbps) | 7 min. uploaden | 44 sec. uploaden | ~6 min. |
| 50 miljoen bestaande + 5 miljoen nieuwe events (100 Mbps) | 18 min. uploaden | 2 min. uploaden | ~16 min. |
Na een delta-upload wordt de gecombineerde dataset opnieuw voorbewerkt. In de benchmark duurde dat 1 tot 2,5 minuten. De tijdwinst bij het uploaden komt doordat alleen de nieuwe events worden overgedragen.
Een delt bestand moet hetzelfde bestandsformaat en dezelfde kolomstructuur hebben als de oorspronkelijke upload. Lees de gids voor incrementeel laden van data voor meer informatie.
Wanneer kun je het best uploaden via de API?
Bij terugkerende uploads of bestanden van meerdere gigabytes is uploaden via de API vaak eenvoudiger te beheren dan via de browser. Een script of opdrachtregelprogramma past in een ETL-pipeline, ondersteunt geplande uploads en toont de voortgang van de overdracht.
ProcessMind biedt vooraf ondertekende URL’s voor rechtstreekse uploads naar cloudopslag. Je kunt de upload-URL kopiëren via het instellingenmenu van de dataset in de ProcessMind-interface.
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquet
Bekijk de API-documentatie voor voorbeelden in Bash, JavaScript en Python. Daar lees je ook hoe je vooraf ondertekende URL’s ophaalt en delt bestanden uploadt.
Wanneer kun je een dataset het best opsplitsen?
Splits een dataset op als een specifieke analyse maar een deel van de data nodig heeft, of als je groepen afzonderlijk wilt vergelijken. Je kunt segmenteren op regio, afdeling, productlijn, periode of casetype en elke dataset daarna apart analyseren.
Houd de data bij elkaar als je groepen wilt vergelijken of het volledige proces over die groepen heen wilt volgen. Controleer vóór het opsplitsen of de indeling de betekenis van de case verandert of events weglaat die nodig zijn om het verloop te begrijpen. Bij een indeling op periode moet je bijvoorbeeld rekening houden met cases die in de ene periode beginnen en in een andere eindigen.
Test de prestaties met je eigen data
Benchmarks helpen je bij de planning, maar voorspellen niet hoe elk event log, netwerk of elke query presteert. Test de dataset die je wilt gebruiken en controleer daarna de uploadtijd, voorbewerkingstijd en reactietijden van de dashboardweergaven die voor jou belangrijk zijn.
Lees eerst de richtlijnen voor datavoorbereiding als je hulp nodig hebt bij het samenstellen van je event log. Bekijk ook hoe je je proces analyseert en hoe je je proces continu monitort.