Rendimiento del Process Mining: referencias y consejos
Descubra cómo influyen el volumen de datos, el formato de archivo y las consultas en el rendimiento del Process Mining, con pruebas fechadas de 100.000 a 100 millones de eventos.

El rendimiento del Process Mining depende de algo más que la cantidad de eventos. El tamaño del archivo, la cantidad de casos, la estructura de las consultas y la velocidad de la red también influyen en el tiempo de espera. Las pruebas comparativas que se muestran a continuación abarcan conjuntos de datos de 100K a 100M de eventos. Se realizaron en infraestructura de producción de AWS en marzo de 2026, con los formatos de archivo y las condiciones de prueba que se describen aquí.
Conclusiones principales
- La carga puede representar la mayor parte del tiempo de espera cuando los archivos son grandes o la conexión es lenta.
- Los archivos Parquet y ORC ocupan mucho menos que los CSV sin procesar, lo que reduce el tiempo de transferencia.
- Los tiempos de respuesta del Dashboard dependen de la consulta. Las estadísticas se obtienen rápidamente, mientras que los flujos de proceso tardan más a medida que aumenta la cantidad de eventos.
- La carga delta transfiere los eventos nuevos sin que tenga que volver a cargar todo el conjunto de datos.
- Un conjunto de datos más acotado puede cargarse más rápido y ser más fácil de analizar.
¿Qué determina el rendimiento del process mining?
El rendimiento depende de cuatro factores: el volumen de datos, la estructura del registro de eventos, la consulta que se ejecuta y el entorno utilizado para transferir y procesar los datos.
- Número de eventos y de casos: Por lo general, cuantos más eventos hay, más datos se deben cargar y procesar. El número de casos determina cuántas instancias del proceso abarca el análisis.
- Tipo de consulta: Una estadística resumida y un flujo de proceso requieren cálculos distintos. Las consultas que calculan transiciones entre actividades pueden tardar más que las que trabajan con datos previamente agregados.
- Número de actividades y duración de los casos: Cuantas más actividades distintas haya y más largos sean los casos, más trabajo se necesita para calcular los flujos y las variantes.
- Tamaño del archivo y velocidad de la red: Estos factores determinan el tiempo de carga. Un archivo CSV ancho con campos de texto extensos puede ocupar mucho más que un archivo columnar compacto con los mismos eventos.
El número de eventos por sí solo no permite predecir cuánto tardará un conjunto de datos. Use las pruebas de rendimiento como referencia y, después, pruebe el registro de eventos y las consultas que piensa utilizar. Es la forma más útil de analizar el rendimiento del process mining en su entorno.
El flujo de datos: ¿en qué se invierte el tiempo?
Un conjunto de datos pasa por tres etapas: carga, preprocesamiento y recálculo cuando se modifica el modelo de proceso.
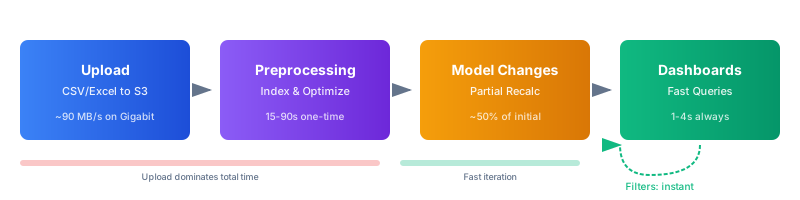
- Carga: El archivo se transfiere por internet a la infraestructura en la nube de ProcessMind. El rendimiento de la red y el tamaño del archivo determinan el tiempo de transferencia. Por ejemplo, un archivo CSV de 11 GB con 50 millones de eventos tarda unos 2 minutos a 1 Gbps, 18 minutos a 100 Mbps o más de 3 horas a 10 Mbps. Con los mismos datos en un archivo Parquet de 1,7 GB, tarda unos 19 segundos, 3 minutos o 28 minutos, respectivamente.
- Preprocesamiento: Después de la carga, el sistema convierte los datos a un formato columnar optimizado, indexa los eventos, calcula las transiciones entre actividades y las variantes del proceso, y genera estadísticas resumidas. En las pruebas de rendimiento que aparecen a continuación, esta etapa tarda 35 segundos para 100.000 eventos y hasta 2,5 minutos para 100 millones.
- Cambios en el modelo: Cuando modifica las asignaciones de actividades o añade o elimina actividades, ProcessMind actualiza los cálculos que dependen del modelo. En las pruebas de rendimiento que aparecen a continuación, esto tarda unos 14 segundos para 1 millón de eventos y 52 segundos para 100 millones. Los cambios en los filtros se aplican al instante.
En conjuntos de datos grandes, reducir el tamaño del archivo suele ser la forma más eficaz de acortar la espera inicial. Una vez completado el preprocesamiento, el rendimiento de las consultas depende de los cálculos que necesita su Dashboard.
¿Cómo varía el rendimiento de las consultas?
El coste varía según la consulta. Estas características ayudan a entender qué puede esperar y cómo estructurar los datos.
- Número de actividades: Los modelos con entre 10 y 20 actividades distintas son más fáciles de analizar y mostrar. Con más de 50 actividades, los flujos de proceso tardan más en calcularse y pueden ser más difíciles de leer. Agrupe los pasos relacionados cuando esto represente fielmente el proceso.
- Diversidad de variantes: Por lo general, un proceso en el que la mayoría de los casos sigue unas pocas rutas se analiza más rápido que uno en el que cada caso sigue una ruta diferente. Una gran variación puede ser significativa, pero también puede aumentar el tiempo de consulta.
- Número de columnas: Los campos básicos CaseId, Activity y Timestamp son necesarios para analizar el proceso. Los atributos adicionales permiten filtrar y categorizar, pero aumentan el volumen de datos que se debe transferir y examinar.
- Duración de los casos: Un caso con 50 eventos requiere más trabajo que uno con 5. Las consultas pueden tardar más en procesos cuyos casos abarcan cientos de eventos.
Tiempos de respuesta del Dashboard
Estas medianas se calcularon a partir de varias pruebas de rendimiento. Cada componente del Dashboard ejecuta su consulta de forma independiente y se carga en paralelo.
| Conjunto de datos | Estadísticas | Flujo del proceso | Variantes | Categorías | Explorador de datos | Animación |
|---|---|---|---|---|---|---|
| 100K | 0,6 s | 1,5 s | 1,1 s | 1,5 s | 1,2 s | 1,4 s |
| 1M | 0,6 s | 1,6 s | 1,4 s | 1,9 s | 1,5 s | 2,0 s |
| 5M | 0,6 s | 2,5 s | 1,8 s | 2,4 s | 1,3 s | 2,1 s |
| 10M | 0,6 s | 3,4 s | 2,2 s | 2,5 s | 1,6 s | 2,4 s |
| 20M | 0,6 s | 3,9 s | 2,7 s | 3,3 s | 1,9 s | 3,6 s |
| 50M | 0,6 s | 5,1 s | 4,2 s | 5,7 s | 1,6 s | 2,7 s |
| 100M | 0,6 s | 7,2 s | 3,5 s | 4,7 s | 1,6 s | 5,0 s |
Las estadísticas se mantuvieron en torno a 0,6 segundos en todos los tamaños probados. El flujo del proceso tardó más a medida que aumentaba el número de eventos, porque calcula las transiciones entre actividades. Las variantes y las categorías escalaron de forma moderada, mientras que el Explorador de datos mantuvo su rapidez gracias a la paginación. El tiempo de animación varió según el número de casos activos mostrados.
Con entre 1 y 10 millones de eventos, los tiempos de respuesta medidos oscilaron entre 0,6 y 3,4 segundos, según el componente. Con 50 millones de eventos, el flujo del proceso y las categorías tardaron unos 5 o 6 segundos. Estos son resultados de pruebas de rendimiento, no una garantía para todos los conjuntos de datos o entornos.
Datos de las pruebas de rendimiento: ¿en qué condiciones se realizaron?
Estas pruebas de rendimiento se realizaron en marzo de 2026 en la infraestructura de AWS de producción. Los tiempos de carga y preprocesamiento son promedios de varias pruebas. Los tiempos de respuesta del Dashboard son medianas de varias pruebas. Se probaron más de 50 tipos de consultas para cada tamaño de conjunto de datos.
El número de eventos que aparece a continuación corresponde al recuento real de los archivos de prueba. Los tamaños indicados corresponden a archivos CSV sin comprimir con un esquema habitual de registro de eventos: CaseId, Activity, Timestamp y entre 5 y 8 atributos de negocio. El tamaño de sus archivos y los resultados pueden variar según el número de columnas, el contenido, las condiciones de la red, la distancia al centro de datos y la carga del sistema en ese momento.
Tiempos de carga y preprocesamiento
| Conjunto de datos | Eventos reales | Tamaño del archivo | Carga (1 Gbps) | Carga (100 Mbps) | Carga (50 Mbps) | Carga (10 Mbps) | Preprocesamiento |
|---|---|---|---|---|---|---|---|
| 100K | 125.260 | 22 MB | < 1 s | 2 s | 4 s | 22 s | 35 s |
| 500K | 626.300 | 110 MB | 1 s | 11 s | 22 s | 2 min | 45 s |
| 1M | 1.253.424 | 221 MB | 3 s | 22 s | 44 s | 4 min | 55 s |
| 2M | 2.506.848 | 443 MB | 5 s | 44 s | 1,5 min | 7 min | 1 min |
| 5M | 4.996.877 | 1,1 GB | 13 s | 2 min | 4 min | 18 min | 1,5 min |
| 10M | 12.511.867 | 2,2 GB | 25 s | 4 min | 7 min | 37 min | 1,5 min |
| 20M | 25.023.734 | 4,4 GB | 50 s | 7 min | 15 min | 1,2 h | 2 min |
| 50M | 62.559.335 | 11,1 GB | 2 min | 18 min | 37 min | 3 h | 2 min |
| 100M | 125.118.670 | 22,3 GB | 4 min | 37 min | 1,2 h | 6 h | 2,5 min |
La velocidad de transferencia medida a 1 Gbps fue de 88 MB/s hacia AWS eu-central-1. Las demás velocidades son estimaciones basadas en rendimientos prácticos: unos 5 MB/s a 50 Mbps, 10 MB/s a 100 Mbps y 1 MB/s a 10 Mbps. El rendimiento real depende de la red y de las condiciones de conexión.
En esta prueba, el preprocesamiento tardó entre 35 segundos y 2,5 minutos. El tiempo de carga aumentó con el tamaño del archivo y fue la parte más larga de la espera para los archivos grandes.
Formato de archivo: Parquet y ORC frente a CSV
ProcessMind admite CSV, Parquet, ORC, Excel y XES. Esta comparación de tamaños de archivo utiliza el mismo número de eventos y el mismo esquema que la prueba de rendimiento anterior.
| Conjunto de datos | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| 1M de eventos | 221 MB | 34 MB | 39 MB | 20 MB |
| 5M de eventos | 1,1 GB | 151 MB | 197 MB | 107 MB |
| 10M de eventos | 2,2 GB | 301 MB | 395 MB | 215 MB |
| 20M de eventos | 4,4 GB | 603 MB | 791 MB | 430 MB |
| 50M de eventos | 11,1 GB | 1,7 GB | 1,9 GB | 1,1 GB |
| 100M de eventos | 22,3 GB | 3,4 GB | 3,7 GB | 2,2 GB |
En estas pruebas, los archivos Parquet ocuparon alrededor de un 85 % menos que los CSV, y los archivos ORC, cerca de un 82 % menos. Ambos son formatos columnares con compresión integrada. Algunas herramientas de datos, como Spark, Databricks, dbt y BigQuery, pueden permitir exportar a estos formatos.
Los tiempos de preprocesamiento fueron similares para Parquet, ORC y CSV. Con un gran número de eventos, CSV.GZ tardó más porque los archivos gzip no se pueden dividir para descomprimirlos en paralelo.
| Conjunto de datos | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| 1M de eventos | 55 s | 55 s | 55 s | 55 s |
| 5M de eventos | 1,5 min | 1,5 min | 1,5 min | 1,5 min |
| 10M de eventos | 1,5 min | 1,5 min | 1,5 min | 2 min |
| 20M de eventos | 2 min | 2 min | 2 min | 2,5 min |
| 50M de eventos | 2 min | 2 min | 2 min | 3 min |
| 100M de eventos | 2,5 min | 2,5 min | 2,5 min | 4,5 min |
El tiempo total suma la carga y el preprocesamiento. Estos ejemplos corresponden a una conexión de 100 Mbps.
| 10M de eventos (100 Mbps) | Tamaño del archivo | Carga | Preprocesamiento | Total |
|---|---|---|---|---|
| Parquet | 301 MB | 30 s | 1,5 min | ~2 min |
| ORC | 395 MB | 40 s | 1,5 min | ~2,2 min |
| CSV | 2,2 GB | 4 min | 1,5 min | ~5,5 min |
| CSV.GZ | 215 MB | 21 s | 2 min | ~2,5 min |
| 50M de eventos (100 Mbps) | Tamaño del archivo | Carga | Preprocesamiento | Total |
|---|---|---|---|---|
| Parquet | 1,7 GB | 3 min | 2 min | ~5 min |
| ORC | 1,9 GB | 3,2 min | 2 min | ~5,2 min |
| CSV | 11,1 GB | 18 min | 2 min | ~20 min |
| CSV.GZ | 1,1 GB | 2 min | 3 min | ~5 min |
En conjuntos de datos grandes, Parquet y ORC reducen el tiempo de transferencia porque sus archivos ocupan menos. CSV sigue siendo una opción sencilla para conjuntos de datos pequeños o cuando el proceso de exportación no admite formatos columnares. CSV.GZ puede reducir el tiempo de transferencia con una conexión lenta, pero el coste de descompresión aumenta con el tamaño del conjunto de datos.
Cómo elegir un formato de archivo
- Parquet: Una buena opción predeterminada para conjuntos de datos grandes, si su flujo de datos lo admite. En estas pruebas, generó los archivos más pequeños.
- ORC: Una alternativa similar, especialmente si su flujo de datos utiliza Hadoop o Spark.
- CSV: Sencillo y ampliamente compatible. Puede ser práctico para conjuntos de datos pequeños.
- CSV.GZ: Considérelo cuando la velocidad de carga sea el principal obstáculo. Pruebe el tiempo de preprocesamiento con sus propios datos, sobre todo si contienen muchos eventos.
¿Qué tipos de consultas pueden ralentizar el análisis?
Algunos tipos de datos y configuraciones del Dashboard requieren más trabajo que otros. Estas comprobaciones ayudan a identificar posibles causas de consultas más lentas.
- Demasiadas actividades: Un flujo de proceso con más de 50 actividades distintas puede tardar más en calcularse y ser difícil de interpretar. Agrupe los pasos relacionados cuando corresponda.
- Muchas variantes distintas: Cuando los casos siguen muchas rutas diferentes, calcular las variantes requiere más trabajo. Una gran variación también puede revelar comportamientos del proceso que conviene investigar.
- Casos largos: Los casos con muchos eventos requieren más procesamiento que los casos cortos.
- Columnas innecesarias: Los atributos adicionales aumentan el tamaño del archivo y pueden añadir trabajo al ejecutar consultas. Conserve los campos que necesita para el análisis.
- Dashboards grandes y recargados: Cada gráfico o mosaico ejecuta su propia consulta. Conserve los componentes que respondan a una pregunta concreta y coloque las demás vistas en otro Dashboard.
- Visualizaciones costosas: En conjuntos de datos grandes, los gráficos con muchas categorías pueden tardar más en mostrarse. Use una vista resumida cuando no necesite un desglose detallado.
- Animación con muchos casos activos: El tiempo de animación depende del número de casos mostrados. Reduzca la velocidad o desactive las estelas y los efectos si solo necesita examinar el flujo.
¿Cómo elegir el tamaño adecuado para los datos?
Empiece con el conjunto de datos más pequeño que permita responder a su pregunta. Un conjunto acotado se carga más rápido y es más fácil de validar. Amplíelo cuando necesite abarcar más casos, encontrar eventos poco frecuentes o analizar tendencias a largo plazo.
Desarrolle y valide el modelo con un conjunto de datos más pequeño
Empiece con una muestra reciente, configure el modelo y revise los datos antes de ampliarlos.
- Empiece con una muestra. Por ejemplo, extraiga 1 millón de eventos de un periodo reciente de tres meses. En la prueba de rendimiento, la carga tardó 3 segundos a 1 Gbps o 22 segundos a 100 Mbps; después, el preprocesamiento tardó 55 segundos.
- Cree el modelo. Configure las actividades, los filtros y las vistas. En los conjuntos de datos probados, con entre 1 y 10 millones de eventos, los cambios en el modelo tardaron unos 14–20 segundos.
- Valide los resultados. Compruebe que los nombres de las actividades y las rutas del proceso tengan sentido, y resuelva los problemas de calidad de los datos.
- Añada más datos si hace falta. Aumente el número de eventos cuando necesite investigar casos poco frecuentes o comparar periodos más largos.
La tabla compara la espera inicial para distintos números de eventos con una conexión de 100 Mbps.
| Enfoque | Carga (100 Mbps) | Preprocesamiento | Espera total | Velocidad del Dashboard |
|---|---|---|---|---|
| Empezar con 1M de eventos | 22 s | 55 s | ~1,5 min | 1–2 s |
| Empezar con 5M de eventos | 2 min | 1,5 min | ~3,5 min | 1–2,5 s |
| Empezar con 50M de eventos | 18 min | 2 min | ~20 min | 1–6 s |
El número adecuado de eventos depende de la pregunta. Un conjunto de datos más pequeño puede bastar para detectar patrones habituales del proceso, pero quizá necesite más datos para estudiar eventos poco frecuentes o cumplir un requisito de cobertura completa de la población.
Segmente los datos cuando la pregunta sea específica
Si investiga un país, departamento o línea de productos, empiece por ese segmento en lugar de combinar grupos que no guardan relación. La segmentación puede facilitar las comparaciones y reducir el volumen de datos que debe procesar.
Por ejemplo, la prueba de rendimiento describe un conjunto de datos de logística europea con 42 millones de eventos de envío en 8 países:
- Todos los países: 42 millones de eventos, 9,3 GB, 16 minutos de carga a 100 Mbps y 2 minutos de preprocesamiento.
- Alemania: 8,5 millones de eventos, 1,9 GB, 3 minutos de carga y 1,5 minutos de preprocesamiento.
- Países Bajos: 3,1 millones de eventos, 690 MB, 1 minuto de carga y 1 minuto de preprocesamiento.
Puede comparar los segmentos una vez que haya validado cada uno. Entre las dimensiones útiles se incluyen la zona geográfica, la organización, el producto, el periodo y el segmento de clientes.
Filtre los casos que necesita
Si investiga excepciones, exportar solo los casos pertinentes puede reducir considerablemente el conjunto de datos. Por ejemplo, la prueba de rendimiento describe un proceso de compra a pago con 1,2 millones de órdenes de compra y 8,4 millones de eventos. Según los datos, 96.000 órdenes, es decir, el 8 %, presentaron excepciones como rechazos, devoluciones, facturas duplicadas o aprobaciones pendientes.
Para ese análisis, exportar los casos con excepciones reduce el conjunto de datos de 8,4 millones a 670.000 eventos. El tamaño del archivo indicado baja de 1,9 GB a 150 MB, y el tiempo de carga a 100 Mbps pasa de 3 minutos a 15 segundos. En la prueba de rendimiento, exportar los mismos datos como archivo Parquet de 15 MB tarda menos de 2 segundos.
Filtre por estado, actividad, duración del caso, periodo o unidad de negocio cuando esos campos correspondan a la pregunta que está investigando.
Seleccione solo las columnas que necesita
Cada columna aumenta el tamaño del archivo. Los campos de texto extensos, los identificadores redundantes, los campos de auditoría y los metadatos técnicos quizá no sean útiles para el análisis.
La prueba de rendimiento describe una exportación de SAP con 1,8 millones de eventos de órdenes de compra y 45 columnas. Al reducirla a 12 columnas esenciales, el tamaño del archivo pasó de 2,1 GB a 380 MB. Al exportar esas columnas como Parquet, se redujo aún más, hasta 58 MB. El tiempo de carga indicado a 100 Mbps bajó de 3,5 minutos a 6 segundos.
Conserve los campos que necesita para el análisis, como CaseId, Activity, Timestamp y los atributos de negocio pertinentes, por ejemplo, estado, importe, categoría o región. Elimine la información personal cuando no sea necesaria para el análisis.
¿Cuándo conviene usar un conjunto de datos más grande?
Puede necesitar más eventos si su pregunta depende de la cobertura o del periodo analizado.
- Eventos poco frecuentes: Para encontrar excepciones que se producen una vez cada 100.000 casos, necesita una población lo bastante grande como para incluirlas. Si una excepción ocurre en el 0,01 % de los casos y quiere estudiar 50, necesita unos 500.000 casos.
- Variantes poco frecuentes: Las variantes que se producen en el 0,1 % de los casos pueden pasar inadvertidas en una muestra de 1 millón de eventos y ser claramente medibles en una población de 50 millones.
- Cumplimiento y auditoría: Algunos requisitos exigen cubrir toda la población en lugar de trabajar con una muestra.
- Tendencias a largo plazo: Para comparar el primer trimestre de 2024 con el primer trimestre de 2025 y el de 2026, necesita datos de los tres periodos. La carga incremental permite incorporar esos datos de forma progresiva.
Para conjuntos de datos con más de 50 millones de eventos, la prueba de rendimiento recomienda usar Parquet, cargar los datos mediante la API y aprovechar una conexión de red rápida cuando esté disponible. En la prueba, el archivo CSV con 50 millones de eventos ocupaba 11,1 GB, frente a 1,7 GB en Parquet.
El rendimiento siempre implica un equilibrio: más datos y más velocidad cuestan más. La pregunta clave no es qué puede hacer una herramienta, sino qué necesita su proceso. ProcessMind admite conjuntos de datos muy grandes, aunque recomendamos evitar los de tamaño desmesurado, porque a menudo no hacen falta y añaden una complejidad que puede desviar la atención de la mejora del proceso.
¿Cómo mantener el modelo y la interfaz ágiles?
El volumen de datos es solo una parte. El modelo de proceso y el diseño del Dashboard también influyen en la agilidad del trabajo.
- Mantenga el modelo legible: Divida los procesos grandes en Subprocesses modulares. Un lienzo con muchos elementos visibles puede tardar más en mostrarse y ser más difícil de recorrer. Use auto-layout después de realizar cambios estructurales.
- Elija con cuidado los componentes del Dashboard: Cada gráfico y mosaico requiere un cálculo. Conserve las vistas que respondan a sus preguntas actuales.
- Elija gráficos adecuados para los datos: En conjuntos de datos grandes, una visualización con muchas categorías puede tardar más en calcularse. Use un resumen cuando no necesite un desglose detallado.
- Limite los filtros a lo necesario: Los filtros pueden ayudar a acotar el análisis. Evite combinar filtros que no contribuyan a responder la pregunta.
- Ajuste la configuración de la animación: El coste de la animación aumenta con el número de casos activos. Reduzca la velocidad o desactive las estelas y los efectos si solo necesita examinar el flujo. Consulte Animación del proceso.
- Recalcule solo lo que haya cambiado: Los cambios en el modelo actualizan los cálculos que dependen de él, sin repetir todo el preprocesamiento. En la prueba de rendimiento, los cambios tardaron entre unos 14 segundos para 1 millón de eventos y 52 segundos para 100 millones.
¿Cómo reduce la carga incremental el tiempo de carga?
La carga incremental permite añadir eventos nuevos a un conjunto de datos existente, en lugar de volver a cargarlo por completo. Así se reduce el volumen de datos transferidos al actualizar un registro de eventos que sigue creciendo.
| Escenario | Volver a cargar todo | Carga incremental | Tiempo ahorrado |
|---|---|---|---|
| 10M de eventos iniciales + 500K nuevos (100 Mbps) | 4 min de carga | 5 s de carga | ~4 min |
| 20M de eventos iniciales + 2M nuevos (100 Mbps) | 7 min de carga | 44 s de carga | ~6 min |
| 50M de eventos iniciales + 5M nuevos (100 Mbps) | 18 min de carga | 2 min de carga | ~16 min |
Después de una carga incremental, se vuelve a ejecutar el preprocesamiento en el conjunto de datos combinado. En la prueba de rendimiento, tardó entre 1 y 2,5 minutos. El ahorro de tiempo en la carga se debe a que solo se transfieren los eventos nuevos.
El archivo incremental debe tener el mismo formato y la misma estructura de columnas que la carga original. Consulte la guía de carga incremental de datos para obtener más información.
¿Cuándo conviene cargar los datos mediante una API?
Si realiza cargas periódicas o trabaja con archivos de varios gigabytes, puede ser más fácil gestionar la carga mediante una API que desde el navegador. Un script o una herramienta de línea de comandos puede integrarse en un flujo ETL, permitir cargas programadas y mostrar el progreso de la transferencia.
ProcessMind proporciona URL prefirmadas para cargar directamente en el almacenamiento en la nube. Puede copiar la URL de carga desde el menú de configuración del conjunto de datos en la interfaz de ProcessMind.
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquet
Consulte la documentación de la API para ver ejemplos en Bash, JavaScript y Python, incluido cómo obtener URL prefirmadas y cargar archivos incrementales.
¿Cuándo conviene dividir un conjunto de datos?
Divida un conjunto de datos cuando un análisis concreto solo necesite una parte de los datos o cuando haya que comparar grupos por separado. Puede segmentarlo por zona geográfica, departamento, línea de productos, periodo o tipo de caso y analizar cada conjunto por separado.
Mantenga los datos juntos cuando la pregunta requiera comparar grupos o seguir el proceso completo entre ellos. Antes de dividirlos, compruebe si la división cambia el significado del caso o elimina eventos necesarios para entender su recorrido. Por ejemplo, una división por periodos debe tener en cuenta los casos que empiezan en uno y terminan en otro.
Pruebe el rendimiento con sus propios datos
Las pruebas de rendimiento ayudan a planificar, pero no permiten predecir los resultados de todos los registros de eventos, redes o consultas. Pruebe el conjunto de datos que piensa utilizar y compruebe el tiempo de carga, el de preprocesamiento y los tiempos de respuesta de las vistas del Dashboard que más le interesan.
Consulte primero las recomendaciones para preparar los datos si necesita ayuda para estructurar el registro de eventos. También puede revisar cómo analizar su proceso y cómo supervisar su proceso de forma continua.
Pruébelo con su propio volumen de datos
Cargue el Registro de eventos que espera analizar y mida el rendimiento con sus datos.