Process-Mining-Performance: Benchmarks und Tipps
Wie Datenvolumen, Dateiformat und Abfrageform die Process-Mining-Leistung beeinflussen: Benchmarks von März 2026 mit 100.000 bis 100 Millionen Ereignissen.

Die Leistung von Process Mining hängt von mehr ab als der Anzahl der Ereignisse. Dateigröße, Case-Anzahl, Abfrage und Netzwerkdurchsatz beeinflussen, wie lange Sie warten müssen. Die folgenden Benchmarks umfassen Datensätze mit 100K bis 100M Ereignissen. Sie wurden im März 2026 auf produktiver AWS-Infrastruktur durchgeführt. Die verwendeten Dateiformate und Testbedingungen sind hier beschrieben.
Wichtigste Erkenntnisse
- Bei großen Dateien oder langsamen Verbindungen kann der Upload den größten Teil der Wartezeit ausmachen.
- Parquet- und ORC-Dateien sind deutlich kleiner als Rohdaten im CSV-Format und lassen sich daher schneller übertragen.
- Wie schnell ein Dashboard reagiert, hängt von der Abfrage ab. Statistiken werden schnell angezeigt, während Prozessflüsse mit steigender Ereigniszahl länger brauchen.
- Beim Delta-Loading werden neue Ereignisse übertragen, ohne dass Sie den gesamten Datensatz erneut hochladen müssen.
- Ein gezielt zusammengestellter Datensatz lässt sich schneller hochladen und einfacher analysieren.
Wovon hängt die Performance beim Process Mining ab?
Vier Faktoren bestimmen die Performance: die Datenmenge, die Struktur des Event Logs, die ausgeführte Abfrage und die Umgebung, in der die Daten übertragen und verarbeitet werden.
- Anzahl der Ereignisse und Cases: Mehr Ereignisse bedeuten in der Regel mehr Daten, die hochgeladen und verarbeitet werden müssen. Die Anzahl der Cases bestimmt, wie viele Prozessinstanzen Ihre Analyse umfasst.
- Art der Abfrage: Für eine zusammenfassende Statistik sind andere Berechnungen nötig als für einen Prozessablauf. Abfragen, die Übergänge zwischen Aktivitäten berechnen, können länger dauern als Abfragen auf voraggregierten Daten.
- Anzahl der Aktivitäten und Länge der Cases: Je mehr unterschiedliche Aktivitäten und je länger die Cases sind, desto mehr Aufwand erfordert die Berechnung von Abläufen und Varianten.
- Dateigröße und Netzwerkgeschwindigkeit: Diese Faktoren bestimmen die Upload-Zeit. Eine umfangreiche CSV-Datei mit langen Textfeldern kann deutlich größer sein als eine kompakte Spaltendatei mit denselben Ereignissen.
Die Anzahl der Ereignisse allein sagt nicht voraus, wie lange die Verarbeitung eines Datensatzes dauert. Nutzen Sie die Benchmarks als Richtwerte und testen Sie anschließend das Event Log und die Abfragen, die Sie einsetzen möchten. So erhalten Sie die aussagekräftigsten Ergebnisse zur Process-Mining-Performance in Ihrer Umgebung.
Die Datenpipeline: Wo geht die Zeit hin?
Ein Datensatz durchläuft drei Phasen: Upload, Vorverarbeitung und Neuberechnung, wenn Sie das Prozessmodell ändern.
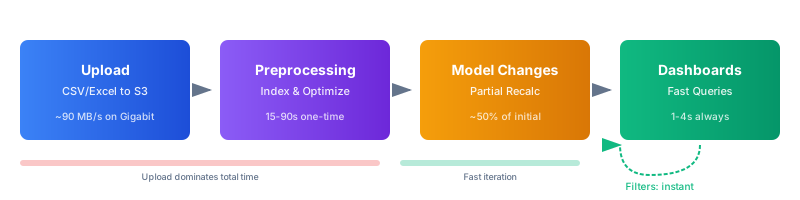
- Upload: Ihre Datei wird über das Internet in die Cloud-Infrastruktur von ProcessMind übertragen. Netzwerkdurchsatz und Dateigröße bestimmen die Übertragungszeit. Eine CSV-Datei mit 50 Millionen Ereignissen und 11 GB benötigt bei 1 Gbit/s etwa 2 Minuten, bei 100 Mbit/s 18 Minuten und bei 10 Mbit/s mehr als 3 Stunden. Dieselben Daten in einer 1,7 GB großen Parquet-Datei benötigen bei diesen Geschwindigkeiten etwa 19 Sekunden, 3 Minuten beziehungsweise 28 Minuten.
- Vorverarbeitung: Nach dem Upload wandelt das System die Daten in einen optimierten Spaltenspeicher um, indexiert die Ereignisse, berechnet Aktivitätsübergänge und Prozessvarianten und erstellt zusammenfassende Statistiken. In den folgenden Benchmarks dauert dies bei 100.000 Ereignissen 35 Sekunden und bei 100 Millionen Ereignissen bis zu 2,5 Minuten.
- Modelländerungen: Wenn Sie Aktivitätszuordnungen ändern oder Aktivitäten hinzufügen beziehungsweise entfernen, aktualisiert ProcessMind die modellabhängigen Berechnungen. In den folgenden Benchmarks dauert dies bei 1 Million Ereignissen etwa 14 Sekunden und bei 100 Millionen Ereignissen 52 Sekunden. Filteränderungen werden sofort übernommen.
Bei großen Datensätzen lässt sich die anfängliche Wartezeit meist am wirksamsten verkürzen, indem Sie die Dateigröße reduzieren. Nach der Vorverarbeitung hängt die Abfragegeschwindigkeit davon ab, was Ihr Dashboard berechnen muss.
Wie unterscheidet sich die Abfragegeschwindigkeit?
Abfragen verursachen unterschiedlich viel Rechenaufwand. Die folgenden Merkmale helfen Ihnen einzuschätzen, was Sie erwarten können und wie Sie Ihre Daten strukturieren sollten.
- Anzahl der Aktivitäten: Modelle mit 10 bis 20 unterschiedlichen Aktivitäten lassen sich leichter analysieren und darstellen. Bei mehr als 50 Aktivitäten dauert die Berechnung von Prozessabläufen länger, und sie können schwerer lesbar werden. Gruppieren Sie zusammengehörige Schritte, wenn dies den Prozess korrekt abbildet.
- Vielfalt der Varianten: Ein Prozess, in dem die meisten Cases wenigen Pfaden folgen, lässt sich in der Regel schneller analysieren als ein Prozess mit einem eigenen Pfad für jeden Case. Eine hohe Vielfalt kann aufschlussreich sein, aber auch die Abfragezeit verlängern.
- Anzahl der Spalten: Für die Prozessanalyse sind die Kernfelder CaseId, Activity und Timestamp erforderlich. Zusätzliche Attribute ermöglichen Filterung und Kategorisierung, vergrößern aber die zu übertragende und zu durchsuchende Datenmenge.
- Länge der Cases: Ein Case mit 50 Ereignissen erfordert mehr Aufwand als einer mit 5. Bei Prozessen mit Cases, die Hunderte von Ereignissen umfassen, können Abfragen länger dauern.
Reaktionszeiten des Dashboards
Die angegebenen Medianwerte stammen aus mehreren Benchmark-Läufen. Jede Dashboard-Komponente führt ihre Abfragen unabhängig aus und wird parallel geladen.
| Datensatz | Statistiken | Prozessablauf | Varianten | Kategorien | Datenbrowser | Animation |
|---|---|---|---|---|---|---|
| 100K | 0.6s | 1.5s | 1.1s | 1.5s | 1.2s | 1.4s |
| 1M | 0.6s | 1.6s | 1.4s | 1.9s | 1.5s | 2.0s |
| 5M | 0.6s | 2.5s | 1.8s | 2.4s | 1.3s | 2.1s |
| 10M | 0.6s | 3.4s | 2.2s | 2.5s | 1.6s | 2.4s |
| 20M | 0.6s | 3.9s | 2.7s | 3.3s | 1.9s | 3.6s |
| 50M | 0.6s | 5.1s | 4.2s | 5.7s | 1.6s | 2.7s |
| 100M | 0.6s | 7.2s | 3.5s | 4.7s | 1.6s | 5.0s |
Die Statistiken lagen bei allen getesteten Datensatzgrößen bei etwa 0,6 Sekunden. Die Berechnung des Prozessablaufs dauerte mit steigender Ereigniszahl länger, da dabei Übergänge zwischen Aktivitäten berechnet werden. Varianten und Kategorien skalierten moderat, während der Datenbrowser dank Paginierung reaktionsschnell blieb. Die Animationsdauer hing von der Anzahl der angezeigten aktiven Cases ab.
Bei 1 bis 10 Millionen Ereignissen lagen die gemessenen Reaktionszeiten je nach Komponente zwischen 0,6 und 3,4 Sekunden. Bei 50 Millionen Ereignissen benötigten Prozessablauf und Kategorien etwa 5 bis 6 Sekunden. Dies sind Benchmark-Ergebnisse und keine Garantie für jeden Datensatz oder jede Umgebung.
Benchmark-Daten: Unter welchen Bedingungen wurde getestet?
Diese Benchmarks wurden im März 2026 auf der AWS-Produktionsinfrastruktur durchgeführt. Die Upload- und Vorverarbeitungszeiten sind Durchschnittswerte aus mehreren Testläufen. Bei den Reaktionszeiten des Dashboards handelt es sich um Medianwerte aus mehreren Läufen. Pro Datensatzgröße wurden mehr als 50 Abfragetypen getestet.
Die folgenden Ereigniszahlen entsprechen den tatsächlichen Werten in den Testdateien. Die Dateigrößen beziehen sich auf unkomprimierte CSV-Dateien mit einem typischen Event-Log-Schema: CaseId, Activity, Timestamp und 5 bis 8 Geschäftsattribute. Dateigröße und Ergebnisse hängen von der Anzahl der Spalten, den Inhalten, den Netzwerkbedingungen, der Entfernung zum Rechenzentrum und der aktuellen Auslastung ab.
Upload- und Vorverarbeitungszeiten
| Datensatz | Tatsächliche Ereignisse | Dateigröße | Upload (1 Gbit/s) | Upload (100 Mbit/s) | Upload (50 Mbit/s) | Upload (10 Mbit/s) | Vorverarbeitung |
|---|---|---|---|---|---|---|---|
| 100K | 125,260 | 22 MB | < 1s | 2s | 4s | 22s | 35s |
| 500K | 626,300 | 110 MB | 1s | 11s | 22s | 2 min | 45s |
| 1M | 1,253,424 | 221 MB | 3s | 22s | 44s | 4 min | 55s |
| 2M | 2,506,848 | 443 MB | 5s | 44s | 1.5 min | 7 min | 1 min |
| 5M | 4,996,877 | 1.1 GB | 13s | 2 min | 4 min | 18 min | 1.5 min |
| 10M | 12,511,867 | 2.2 GB | 25s | 4 min | 7 min | 37 min | 1.5 min |
| 20M | 25,023,734 | 4.4 GB | 50s | 7 min | 15 min | 1.2 hr | 2 min |
| 50M | 62,559,335 | 11.1 GB | 2 min | 18 min | 37 min | 3 hr | 2 min |
| 100M | 125,118,670 | 22.3 GB | 4 min | 37 min | 1.2 hr | 6 hr | 2.5 min |
Die gemessene Übertragungsrate von 1 Gbit/s entsprach 88 MB/s zu AWS eu-central-1. Die anderen Geschwindigkeiten sind anhand praxisnaher Durchsatzwerte hochgerechnet: etwa 5 MB/s bei 50 Mbit/s, 10 MB/s bei 100 Mbit/s und 1 MB/s bei 10 Mbit/s. Der tatsächliche Durchsatz hängt von Ihrem Netzwerk und den jeweiligen Bedingungen ab.
In diesem Test dauerte die Vorverarbeitung zwischen 35 Sekunden und 2,5 Minuten. Mit der Dateigröße stieg auch die Upload-Zeit. Bei großen Dateien machte sie den größten Teil der Wartezeit aus.
Dateiformate: Parquet und ORC im Vergleich zu CSV
ProcessMind unterstützt CSV, Parquet, ORC, Excel und XES. Für diesen Vergleich der Dateigrößen wurden dieselben Ereigniszahlen und dasselbe Schema wie im vorherigen Benchmark verwendet.
| Datensatz | CSV | Parquet | ORC | CSV.GZ |
|---|---|---|---|---|
| 1M Ereignisse | 221 MB | 34 MB | 39 MB | 20 MB |
| 5M Ereignisse | 1.1 GB | 151 MB | 197 MB | 107 MB |
| 10M Ereignisse | 2.2 GB | 301 MB | 395 MB | 215 MB |
| 20M Ereignisse | 4.4 GB | 603 MB | 791 MB | 430 MB |
| 50M Ereignisse | 11.1 GB | 1.7 GB | 1.9 GB | 1.1 GB |
| 100M Ereignisse | 22.3 GB | 3.4 GB | 3.7 GB | 2.2 GB |
In diesen Tests waren Parquet-Dateien etwa 85 % kleiner als CSV-Dateien, ORC-Dateien etwa 82 %. Beide Spaltenformate verfügen über eine integrierte Komprimierung. Datentools wie Spark, Databricks, dbt und BigQuery unterstützen möglicherweise den Export in diese Formate.
Die Vorverarbeitungszeiten waren bei Parquet, ORC und CSV ähnlich. Bei größeren Ereignismengen dauerte die Verarbeitung von CSV.GZ länger, da sich gzip-Dateien nicht für die parallele Dekomprimierung aufteilen lassen.
| Datensatz | Parquet | ORC | CSV | CSV.GZ |
|---|---|---|---|---|
| 1M Ereignisse | 55s | 55s | 55s | 55s |
| 5M Ereignisse | 1.5 min | 1.5 min | 1.5 min | 1.5 min |
| 10M Ereignisse | 1.5 min | 1.5 min | 1.5 min | 2 min |
| 20M Ereignisse | 2 min | 2 min | 2 min | 2.5 min |
| 50M Ereignisse | 2 min | 2 min | 2 min | 3 min |
| 100M Ereignisse | 2.5 min | 2.5 min | 2.5 min | 4.5 min |
Die Gesamtzeit umfasst Upload und Vorverarbeitung. Für diese Beispiele wurde eine Verbindung mit 100 Mbit/s angenommen.
| 10M Ereignisse (100 Mbit/s) | Dateigröße | Upload | Vorverarbeitung | Gesamt |
|---|---|---|---|---|
| Parquet | 301 MB | 30s | 1.5 min | ~2 min |
| ORC | 395 MB | 40s | 1.5 min | ~2.2 min |
| CSV | 2.2 GB | 4 min | 1.5 min | ~5.5 min |
| CSV.GZ | 215 MB | 21s | 2 min | ~2.5 min |
| 50M Ereignisse (100 Mbit/s) | Dateigröße | Upload | Vorverarbeitung | Gesamt |
|---|---|---|---|---|
| Parquet | 1.7 GB | 3 min | 2 min | ~5 min |
| ORC | 1.9 GB | 3.2 min | 2 min | ~5.2 min |
| CSV | 11.1 GB | 18 min | 2 min | ~20 min |
| CSV.GZ | 1.1 GB | 2 min | 3 min | ~5 min |
Bei großen Datensätzen verkürzen Parquet und ORC die Übertragungszeit, weil ihre Dateien kleiner sind. CSV ist weiterhin eine unkomplizierte Option für kleinere Datensätze oder wenn Ihr Export keine Spaltenformate unterstützt. CSV.GZ kann bei langsamer Verbindung die Übertragungszeit reduzieren. Der Aufwand für die Dekomprimierung steigt jedoch mit der Datensatzgröße.
Dateiformat auswählen
- Parquet: Eine gute Standardwahl für große Datensätze, sofern Ihre Datenpipeline das Format unterstützt. In diesen Tests entstanden damit die kleinsten Dateien.
- ORC: Eine vergleichbare Option, insbesondere wenn Ihre Datenpipeline Hadoop oder Spark verwendet.
- CSV: Einfach und weit verbreitet. Für kleinere Datensätze kann dieses Format praktisch sein.
- CSV.GZ: Eine Option, wenn die Upload-Geschwindigkeit der entscheidende Faktor ist. Testen Sie die Vorverarbeitungszeit mit Ihren eigenen Daten, insbesondere bei großen Ereignismengen.
Welche Abfragemuster können die Analyse verlangsamen?
Manche Datenstrukturen und Dashboard-Konfigurationen erfordern mehr Rechenaufwand als andere. Mit diesen Prüfpunkten können Sie mögliche Ursachen für langsamere Abfragen ermitteln.
- Zu viele Aktivitäten: Die Berechnung eines Prozessablaufs mit mehr als 50 unterschiedlichen Aktivitäten kann länger dauern und das Ergebnis schwerer verständlich machen. Gruppieren Sie zusammengehörige Schritte, wenn es sinnvoll ist.
- Viele unterschiedliche Varianten: Folgen die Cases vielen verschiedenen Pfaden, ist für die Variantenberechnung mehr Aufwand nötig. Eine hohe Vielfalt kann auch auf Prozessverhalten hinweisen, das sich näher zu untersuchen lohnt.
- Lange Cases: Cases mit vielen Ereignissen erfordern mehr Verarbeitung als kurze Cases.
- Nicht benötigte Spalten: Zusätzliche Attribute vergrößern die Datei und können Abfragen aufwendiger machen. Beschränken Sie sich auf die Felder, die Ihre Analyse benötigt.
- Umfangreiche, überladene Dashboards: Jedes Chart und jede Kachel führt eine eigene Abfrage aus. Behalten Sie die Komponenten, die eine konkrete Frage beantworten, und verschieben Sie andere Ansichten auf ein separates Dashboard.
- Aufwendige Visualisierungen: Bei großen Datensätzen kann die Darstellung von Charts mit vielen Kategorien länger dauern. Verwenden Sie eine zusammenfassende Ansicht, wenn Sie keine detaillierte Aufschlüsselung benötigen.
- Animation mit vielen aktiven Cases: Die Animationsdauer hängt von der Anzahl der angezeigten Cases ab. Verringern Sie die Geschwindigkeit oder deaktivieren Sie Spuren und Effekte, wenn Sie nur den Ablauf prüfen möchten.
Wie wählen Sie die passende Datensatzgröße?
Beginnen Sie mit dem kleinsten Datensatz, der Ihre Frage beantworten kann. Ein gezielt zusammengestellter Datensatz lässt sich schneller hochladen und leichter validieren. Erweitern Sie ihn, wenn Sie eine breitere Abdeckung, seltene Ereignisse oder längerfristige Trends untersuchen möchten.
Mit einem kleineren Datensatz entwickeln und validieren
Beginnen Sie mit einer aktuellen Stichprobe, konfigurieren Sie Ihr Modell und prüfen Sie die Daten, bevor Sie den Umfang vergrößern.
- Beginnen Sie mit einer Stichprobe. Extrahieren Sie beispielsweise 1 Million Ereignisse aus einem aktuellen Zeitraum von drei Monaten. Im Benchmark dauerte der Upload bei 1 Gbit/s 3 Sekunden und bei 100 Mbit/s 22 Sekunden. Die Vorverarbeitung nahm anschließend 55 Sekunden in Anspruch.
- Erstellen Sie Ihr Modell. Konfigurieren Sie Aktivitäten, Filter und Ansichten. Bei den getesteten Datensätzen mit 1 bis 10 Millionen Ereignissen dauerten Modelländerungen etwa 14 bis 20 Sekunden.
- Validieren Sie die Ergebnisse. Prüfen Sie, ob Aktivitätsnamen und Prozesspfade plausibel sind, und beheben Sie Probleme mit der Datenqualität.
- Erweitern Sie den Datensatz bei Bedarf. Erhöhen Sie die Ereigniszahl, wenn Sie seltene Cases untersuchen oder längere Zeiträume vergleichen möchten.
Die Tabelle vergleicht die anfängliche Wartezeit bei unterschiedlichen Ereigniszahlen und einer Verbindung mit 100 Mbit/s.
| Vorgehen | Upload (100 Mbit/s) | Vorverarbeitung | Gesamte Wartezeit | Dashboard-Geschwindigkeit |
|---|---|---|---|---|
| Mit 1M Ereignissen beginnen | 22s | 55s | ~1.5 min | 1–2s |
| Mit 5M Ereignissen beginnen | 2 min | 1.5 min | ~3.5 min | 1–2.5s |
| Mit 50M Ereignissen beginnen | 18 min | 2 min | ~20 min | 1–6s |
Die passende Ereigniszahl hängt von Ihrer Fragestellung ab. Für häufige Prozessmuster kann ein kleinerer Datensatz ausreichen. Für die Untersuchung seltener Ereignisse oder eine vollständige Abdeckung der Grundgesamtheit benötigen Sie möglicherweise mehr Daten.
Daten segmentieren, wenn die Fragestellung klar eingegrenzt ist
Wenn Sie ein bestimmtes Land, eine Abteilung oder eine Produktlinie untersuchen, beginnen Sie mit diesem Segment, statt nicht zusammengehörige Gruppen zu kombinieren. Durch die Segmentierung werden Vergleiche oft klarer und die zu verarbeitende Datenmenge kleiner.
Im Benchmark wird beispielsweise ein europäischer Logistikdatensatz mit 42 Millionen Versandereignissen aus 8 Ländern beschrieben:
- Alle Länder: 42 Millionen Ereignisse, 9,3 GB, 16 Minuten Upload bei 100 Mbit/s und 2 Minuten Vorverarbeitung.
- Deutschland: 8,5 Millionen Ereignisse, 1,9 GB, 3 Minuten Upload und 1,5 Minuten Vorverarbeitung.
- Niederlande: 3,1 Millionen Ereignisse, 690 MB, 1 Minute Upload und 1 Minute Vorverarbeitung.
Nachdem Sie jedes Segment validiert haben, können Sie die Segmente miteinander vergleichen. Sinnvolle Dimensionen sind unter anderem Geografie, Organisation, Produkt, Zeitraum und Kundensegment.
Nach den benötigten Cases filtern
Wenn Sie Ausnahmen untersuchen, kann der Export ausschließlich relevanter Cases den Datensatz deutlich verkleinern. Im Benchmark wird beispielsweise ein Purchase-to-Pay-Prozess mit 1,2 Millionen Bestellungen und 8,4 Millionen Ereignissen beschrieben. Demnach wiesen 96.000 Bestellungen, also 8 %, Ausnahmen auf, etwa Ablehnungen, Rücksendungen, doppelte Rechnungen oder fehlende Freigaben.
Für diese Analyse reduziert der Export der Ausnahme-Cases den Datensatz von 8,4 Millionen auf 670.000 Ereignisse. Die angegebene Dateigröße sinkt von 1,9 GB auf 150 MB, die Upload-Zeit bei 100 Mbit/s von 3 Minuten auf 15 Sekunden. Im Benchmark dauert der Upload derselben Daten als 15 MB große Parquet-Datei weniger als 2 Sekunden.
Filtern Sie nach Status, Aktivität, Case-Dauer, Zeitraum oder Geschäftseinheit, sofern diese Felder zu Ihrer Fragestellung passen.
Nur die benötigten Spalten auswählen
Jede Spalte trägt zur Dateigröße bei. Lange Textfelder, redundante Kennungen, Audit-Felder und technische Metadaten sind für Ihre Analyse möglicherweise nicht erforderlich.
Im Benchmark wird ein SAP-Export mit 1,8 Millionen Bestellereignissen und 45 Spalten beschrieben. Durch die Reduzierung auf 12 wesentliche Spalten sank die Dateigröße von 2,1 GB auf 380 MB. Der Export dieser Spalten als Parquet verringerte sie weiter auf 58 MB. Die angegebene Upload-Zeit bei 100 Mbit/s sank von 3,5 Minuten auf 6 Sekunden.
Behalten Sie die Felder, die Ihre Analyse unterstützen, darunter CaseId, Activity, Timestamp und relevante Geschäftsattribute wie Status, Betrag, Kategorie oder Region. Entfernen Sie personenbezogene Daten, wenn Sie sie für die Analyse nicht benötigen.
Wann sollten Sie einen größeren Datensatz verwenden?
Eine höhere Ereigniszahl kann erforderlich sein, wenn Ihre Fragestellung eine umfassende Abdeckung oder einen längeren Zeitraum voraussetzt.
- Seltene Ereignisse: Um Ausnahmen zu finden, die nur in einem von 100.000 Cases auftreten, muss die Grundgesamtheit groß genug sein. Tritt eine Ausnahme in 0,01 % der Fälle auf und möchten Sie 50 solcher Fälle untersuchen, benötigen Sie etwa 500.000 Cases.
- Seltene Varianten: Varianten, die in 0,1 % der Fälle auftreten, sind in einer Stichprobe mit 1 Million Ereignissen möglicherweise nicht sichtbar, lassen sich in einer Grundgesamtheit mit 50 Millionen Ereignissen jedoch klar messen.
- Compliance und Audit: Manche Anforderungen setzen eine vollständige Abdeckung der Grundgesamtheit statt einer Stichprobe voraus.
- Langfristige Trends: Für einen Vergleich von Q1 2024 mit Q1 2025 und Q1 2026 benötigen Sie Daten aus allen drei Zeiträumen. Mit Delta-Uploads lässt sich diese Abdeckung schrittweise aufbauen.
Für Datensätze mit mehr als 50 Millionen Ereignissen empfiehlt der Benchmark Parquet, den Upload über die API und, sofern verfügbar, eine schnelle Netzwerkverbindung. Die CSV-Datei mit 50 Millionen Ereignissen im Test war 11,1 GB groß, die Parquet-Datei dagegen 1,7 GB.
Bei der Performance gibt es immer einen Zielkonflikt: Mehr Daten und höhere Geschwindigkeit kosten mehr. Entscheidend ist nicht, was ein Tool leisten kann, sondern was Ihr Prozess erfordert. ProcessMind lässt sich weit skalieren. Trotzdem raten wir von sehr großen Datensätzen ab, wenn sie nicht nötig sind und so viel zusätzliche Komplexität schaffen, dass die eigentliche Verbesserung aus dem Blick gerät.
Wie bleiben Modell und Benutzeroberfläche reaktionsschnell?
Das Datenvolumen ist nur ein Teil des Gesamtbilds. Auch das Prozessmodell und die Gestaltung des Dashboards beeinflussen, wie schnell Sie arbeiten können.
- Halten Sie das Modell übersichtlich: Teilen Sie große Prozesse in modulare Subprocesses auf. Eine Zeichenfläche mit vielen sichtbaren Elementen kann langsamer geladen und schwieriger navigiert werden. Verwenden Sie nach strukturellen Änderungen auto-layout.
- Wählen Sie Dashboard-Komponenten gezielt aus: Jedes Chart und jede Kachel erfordert eine Berechnung. Behalten Sie die Ansichten, die Ihre aktuellen Fragen beantworten.
- Verwenden Sie passende Charts: Bei großen Datensätzen kann die Berechnung einer Visualisierung mit vielen Kategorien länger dauern. Verwenden Sie eine zusammenfassende Ansicht, wenn Sie keine detaillierte Aufschlüsselung benötigen.
- Beschränken Sie Filter auf die Fragestellung: Filter können helfen, eine Analyse einzugrenzen. Kombinieren Sie keine Filter, die für die zu beantwortende Frage unerheblich sind.
- Passen Sie die Animationseinstellungen an: Der Rechenaufwand für die Animation steigt mit der Anzahl aktiver Cases. Verringern Sie die Geschwindigkeit oder deaktivieren Sie Spuren und Effekte, wenn Sie nur den Ablauf prüfen möchten. Weitere Informationen finden Sie unter Prozessanimation.
- Berechnen Sie nur Geändertes neu: Modelländerungen aktualisieren modellabhängige Berechnungen, ohne die gesamte Vorverarbeitung zu wiederholen. Im Benchmark dauerten Änderungen bei 1 Million Ereignissen etwa 14 Sekunden und bei 100 Millionen Ereignissen 52 Sekunden.
Wie verkürzt ein Delta-Upload die Upload-Zeit?
Mit einem Delta-Upload können Sie neue Ereignisse an einen bestehenden Datensatz anhängen, statt den gesamten Datensatz erneut hochzuladen. So wird bei der Aktualisierung eines wachsenden Event Logs weniger Datenvolumen übertragen.
| Szenario | Vollständiger erneuter Upload | Delta-Upload | Zeitersparnis |
|---|---|---|---|
| 10M Basis + 500K neue Ereignisse (100 Mbit/s) | 4 min Upload | 5s Upload | ~4 min |
| 20M Basis + 2M neue Ereignisse (100 Mbit/s) | 7 min Upload | 44s Upload | ~6 min |
| 50M Basis + 5M neue Ereignisse (100 Mbit/s) | 18 min Upload | 2 min Upload | ~16 min |
Nach einem Delta-Upload wird der zusammengeführte Datensatz erneut vorverarbeitet. Im Benchmark dauerte dies 1 bis 2,5 Minuten. Die Zeitersparnis beim Upload entsteht dadurch, dass nur die neuen Ereignisse übertragen werden.
Eine Delta-Datei muss dasselbe Dateiformat und dieselbe Spaltenstruktur wie der ursprüngliche Upload haben. Weitere Informationen finden Sie in der Anleitung zum inkrementellen Laden von Daten.
Wann sollten Sie einen Upload über die API verwenden?
Bei wiederkehrenden Uploads oder Dateien mit mehreren Gigabyte lässt sich ein Upload über die API oft einfacher verwalten als eine Übertragung über den Browser. Ein Skript oder Befehlszeilentool kann in eine ETL-Pipeline integriert werden, geplante Uploads unterstützen und den Übertragungsfortschritt anzeigen.
ProcessMind stellt vorab signierte URLs für direkte Uploads in den Cloud-Speicher bereit. Die Upload-URL können Sie im Einstellungsmenü des Datensatzes in der ProcessMind-Benutzeroberfläche kopieren.
# Upload a Parquet file directly using a presigned URL
curl -X PUT "$PRESIGNED_URL" --upload-file data.parquet
In der API-Dokumentation finden Sie Beispiele für Bash, JavaScript und Python, darunter auch Anleitungen zum Abrufen vorab signierter URLs und zum Upload von Delta-Dateien.
Wann sollten Sie einen Datensatz aufteilen?
Teilen Sie einen Datensatz auf, wenn eine bestimmte Analyse nur einen Teil der Daten benötigt oder wenn getrennte Gruppen unabhängig voneinander verglichen werden sollen. Sie können nach Geografie, Abteilung, Produktlinie, Zeitraum oder Case-Typ segmentieren und anschließend jeden Datensatz einzeln analysieren.
Lassen Sie die Daten zusammen, wenn Ihre Fragestellung den Vergleich von Gruppen oder die Nachverfolgung des gesamten Prozesses über diese Gruppen hinweg erfordert. Prüfen Sie vor einer Aufteilung, ob sich dadurch die Bedeutung eines Cases verändert oder Ereignisse fehlen, die für das Verständnis seines Pfads erforderlich sind. Bei einer zeitlichen Aufteilung müssen Sie beispielsweise Cases berücksichtigen, die in einem Zeitraum beginnen und im nächsten enden.
Testen Sie die Performance mit Ihren eigenen Daten
Benchmarks helfen bei der Planung, können aber keine Ergebnisse für jedes Event Log, jedes Netzwerk und jede Abfrage vorhersagen. Testen Sie den Datensatz, den Sie voraussichtlich verwenden werden, und prüfen Sie anschließend Upload-Zeit, Vorverarbeitungszeit und Reaktionszeiten der für Sie wichtigen Dashboard-Ansichten.
Lesen Sie zuerst die Hinweise zur Datenaufbereitung, wenn Sie Unterstützung bei der Strukturierung Ihres Event Logs benötigen. Sehen Sie sich auch an, wie Sie Ihren Prozess analysieren und wie Sie Ihren Prozess kontinuierlich überwachen.
Testen Sie mit Ihrem eigenen Datenvolumen
Laden Sie das Event Log hoch, das Sie analysieren möchten, und messen Sie die Leistung mit Ihren Daten.